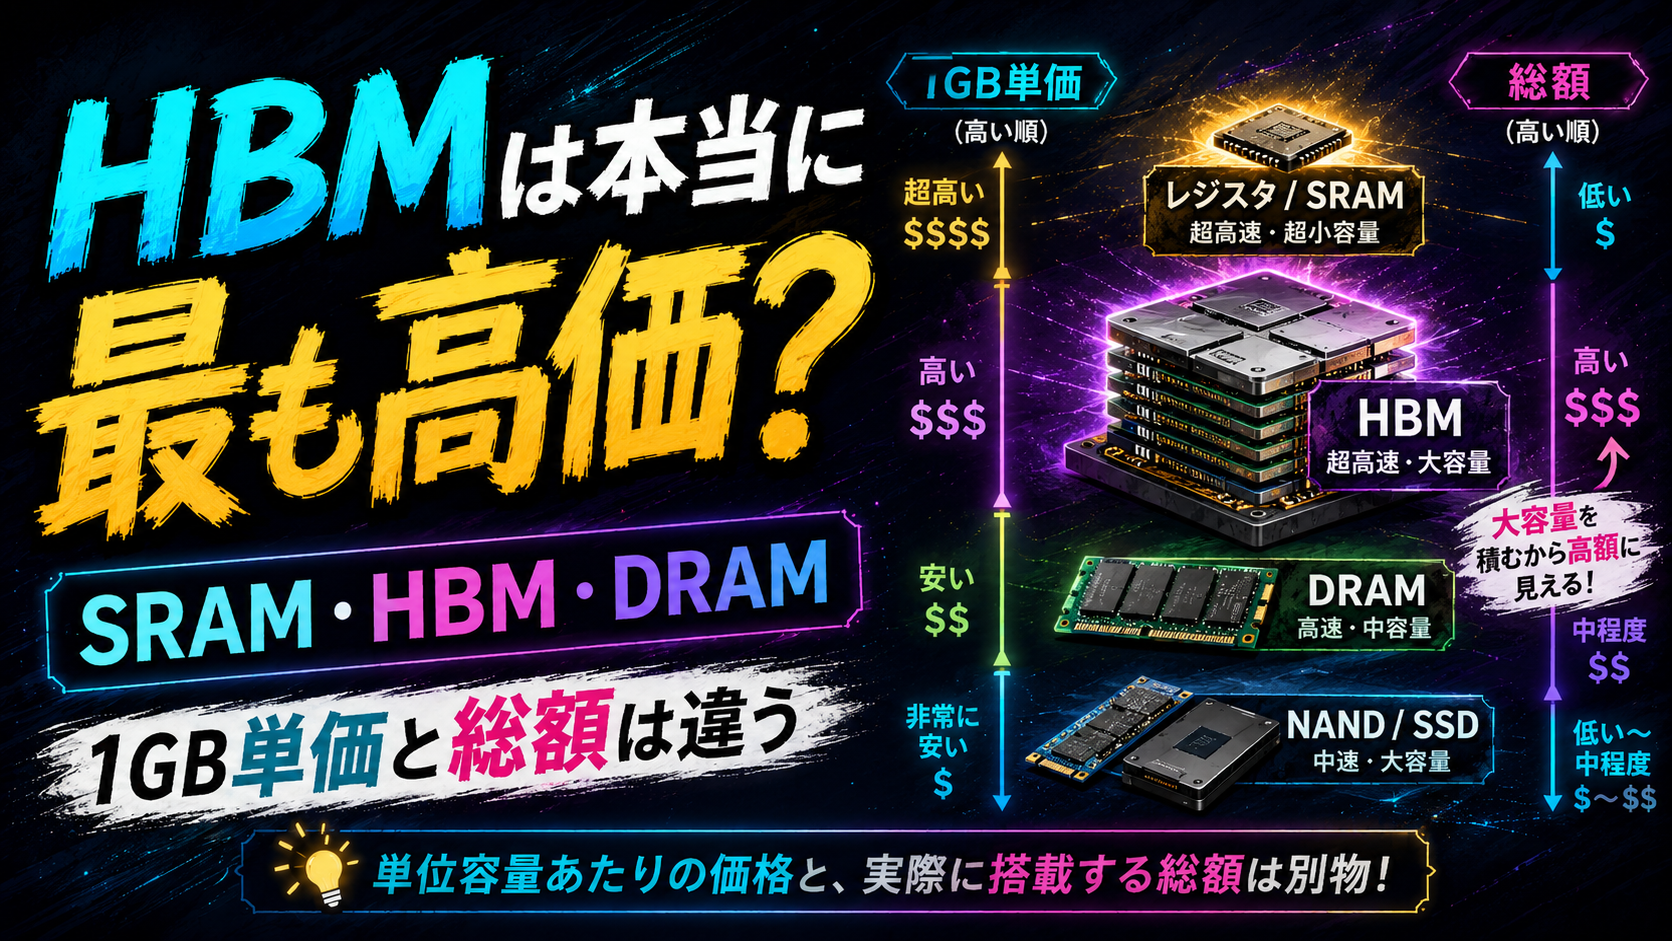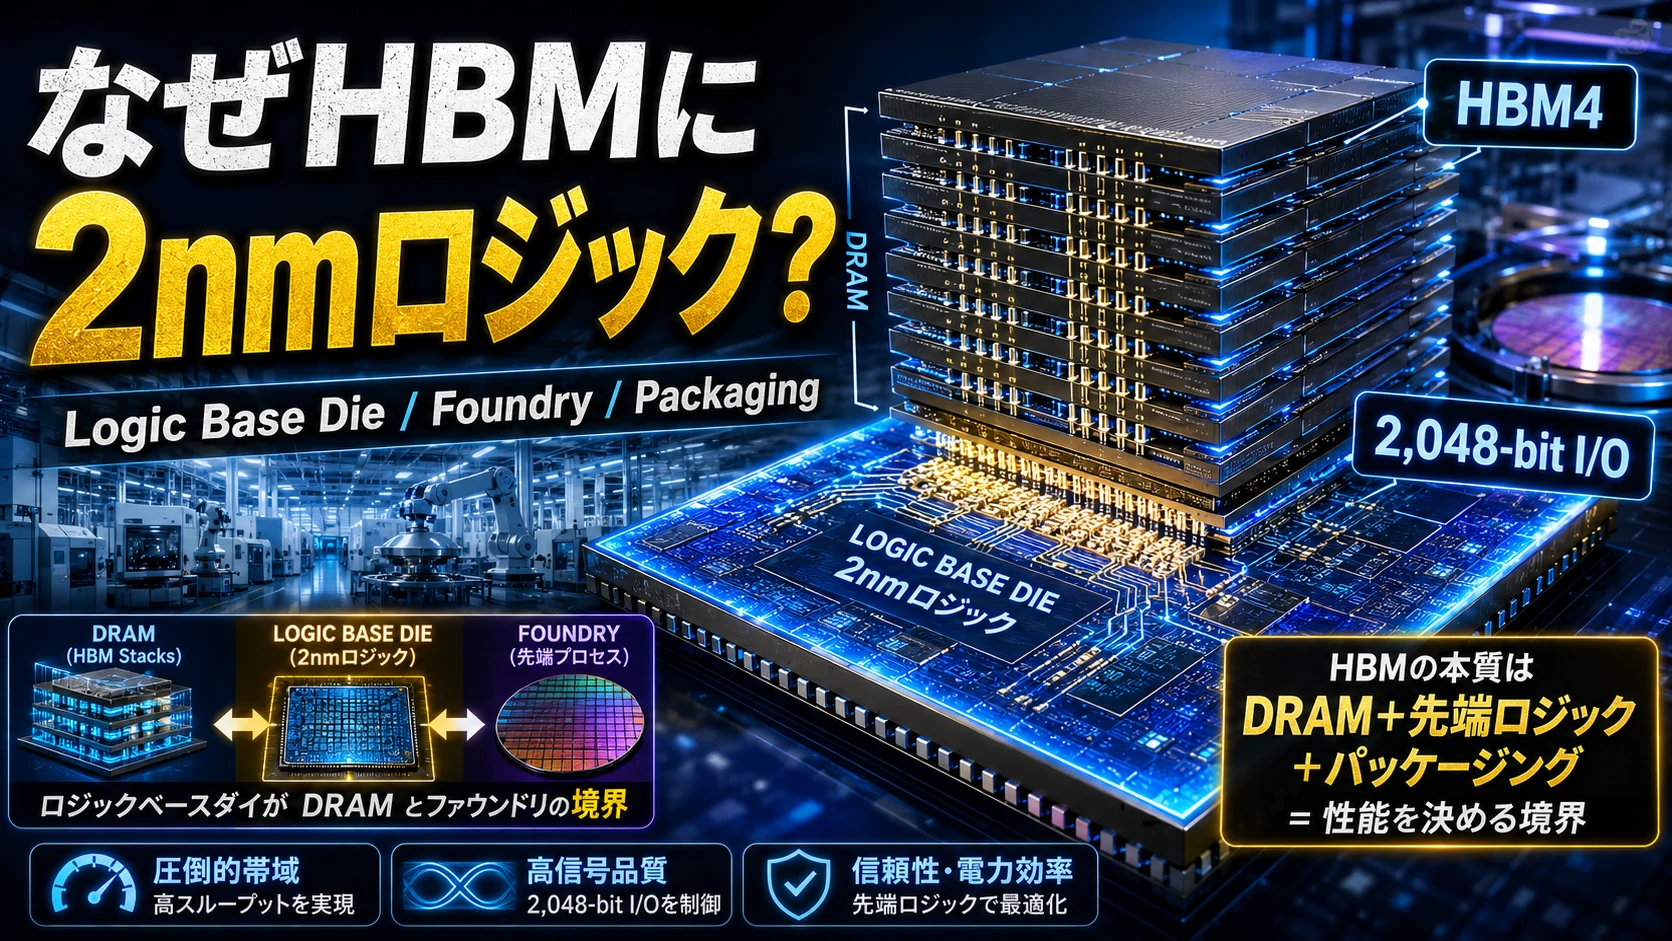
HBMはなぜ「メモリなのに2nmロジック」を必要とするのか――Base Dieが動かすFoundry境界
Samsung NRD-K 2から読むHBM5時代の新ボトルネック
先日Xを眺めていると、少し気になる韓国発の記事が流れてきた。
Samsung Electronicsが、韓国・器興(Giheung)で建設中のNRD-K 2ラインについて、当初の研究開発(R&D)中心の施設という位置付けから変更し、Foundryの生産能力として利用する方向で検討しているという。
2026年8月14日付のZDNet Koreaによる報道だ。
しかも主なターゲットとして名前が挙がっているのが、NVIDIAなど向けの次世代HBMに使われる、
「2nm Logic Base Die」
である。
ZDNet Koreaによれば、SamsungはNRD-K 2をFoundry用の「Send-Fab」として活用し、他の量産ラインからウェーハを受け取って一部の先端工程を処理する構想を検討している。主力候補は次世代HBM用2nm Base Dieで、2028年下期の開所を目標としているという。ただし設備の正式な購入注文(PO)はまだ先であり、用途や投資規模が変更される可能性も残っている。(ZDNet Korea)
一見すると少し不思議な話だ。
HBMはHigh Bandwidth Memory、つまり「メモリ」である。
それなのに、なぜSamsungはHBMを増産するために2nm Foundryの生産能力を増やそうとしているのか。
Samsung、SK hynix、Micronはいずれも世界最先端のDRAMメーカーであり、EUV露光装置まで導入してDRAMを微細化している。それでもHBM4以降になると、TSMCやSamsung Foundryのような先端Logic Fabが必要になる。
ここには、HBMそのものが、
「積層DRAM」から「DRAM+先端ロジック+先端パッケージング」へ変質している
という大きな構造変化がある。
この記事では、HBM Logic Base Dieとは何なのか、なぜメモリなのにロジックが必要なのか、NRD-K 2とは何なのか、Samsung・SK hynix・Micronではどのように製造しているのか、そしてBase Dieが本当に3nm・2nm Fabを逼迫させるほどの需要になるのかまで、数値を置いて分解してみる。
1.そもそもHBMは「DRAMを積んだだけ」ではない
HBMを断面方向から非常に単純化すると、次のような構造になっている。
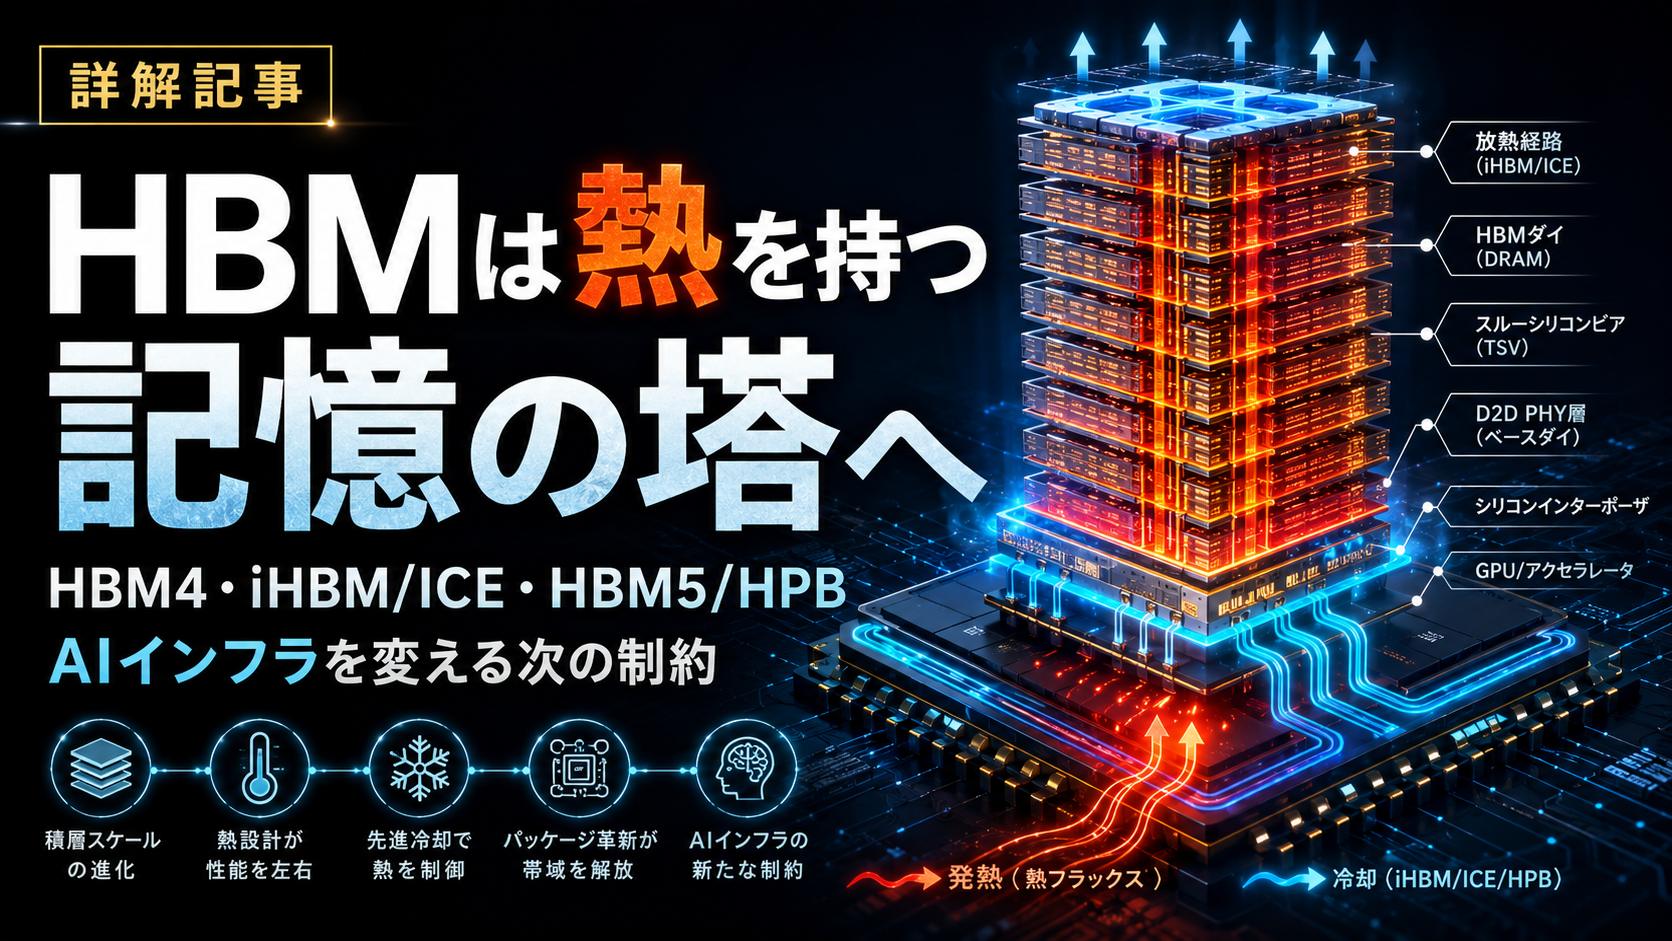
DRAM Core Die DRAM Core Die DRAM Core Die DRAM Core Die … DRAM Core Die ──────────────────── Logic Base Die ──────────────────── Bumps ──────────────────── Silicon Interposer ──────────────────── GPU / XPU
上に積み重なっているのが、実際にデータを保持するDRAM Core Die。
そして一番下に存在するのが、
Logic Base Die
である。
SK hynixはBase Dieを、HBMスタックの最下部に位置し、複数のDRAMダイと外部Logic Chipの間でデータ入出力や制御を担当する半導体ダイと説明している。HBM4では特に、このBase Dieの性能と製造プロセスが帯域幅、消費電力、顧客システム最適化を左右する要素になっている。(SK hynix Newsroom)
つまりBase Dieは、単なる「DRAMを載せる台」ではない。
内部には、
PHY、I/O回路、Clock Distribution、Command/Address処理、電力制御、テスト・修復回路、TSVとの接続回路などが存在する。
今後Custom HBMが進めば、この場所へさらに顧客固有ロジックを組み込める。
極端に表現すると、
HBMの底に小さなSoCを貼り付ける
方向へ進んでいるのである。
2.HBM4で何が変わったのか――I/Oが1,024本から2,048本へ
Logic Base Dieの重要性が急上昇した大きな理由がHBM4だ。
SamsungのHBM3Eは1,024-bitインターフェースだったが、HBM4では2,048 I/Oへ倍増した。
Samsung HBM4は最大13Gbps/pin、最大約3.3TB/s/stackの帯域幅を実現する。(Samsung Semiconductor Global)
単純計算すると、
なので、
となる。
わずか1個のHBMスタックから毎秒3TBを超えるデータを出し入れする。
当然、そのすべての信号は最終的にBase Dieを通り、GPUやAI ASIC側へ接続される。
ここで必要になるのは単なるDRAMセルではない。
2,048本もの高速I/Oを動作させながらClock skewやJitterを抑え、電力を供給し、信号品質を保ち、発熱を制御しなければならない。
実際SamsungはHBM4Eで、Base Die内のDie-to-Die PHYを主要な発熱源の一つとして挙げ、熱を逃がす「HPB(Heat Path Block)」まで検証している。(Samsung Semiconductor Global)
HBMの性能向上は、もはやDRAMセルだけでは達成できないのである。
3.「EUVを持っているならメモリFabで作ればよい」のではない
ここで疑問が出てくる。
Samsung、SK hynix、Micronはいずれも先端DRAMを製造しており、EUVも利用している。
ならばBase DieもMemory Fabで作ればよいのではないか。
答えは、
である。
DRAM FabとLogic Foundryでは、微細化の目的そのものが違う。
DRAMは基本的に1 transistor+1 capacitor、いわゆる「1T1C」のメモリセルを大量に敷き詰める。
そのため最重要KPIは、
であり、
セル密度、リーク電流、データ保持時間、キャパシタ形成、bits/waferなどを最適化する。
対してLogic Fabが追うのは、
いわゆるPPAである。
高速トランジスタ、FinFET/GAA、HKMG、多層低抵抗配線、low-k材料、Standard Cell、SRAM、PHY IP、EDA、PDKなど、まったく別の製造・設計エコシステムが必要になる。
EUVはその製造工程の一部にすぎない。
同じEUV露光装置を使っていても、その前後にある成膜、エッチング、イオン注入、エピタキシー、CMP、金属配線、トランジスタ形成のレシピが異なる。
だから世界最高水準のDRAM Fabを持つSK hynixでさえ、HBM4からはTSMCを利用する。
SK hynixはHBM3EまではBase Dieを自社技術で製造していたが、HBM4からはTSMCのadvanced logic processを採用すると公式に説明している。(SK hynix Newsroom)
この事実が最も分かりやすい。
問題は露光能力ではなく、
Logic Process能力
なのである。
4.Samsungが特殊なのはMemoryとFoundryを両方持っていること
Samsungの場合は少し事情が違う。
Samsung Electronicsには、
が存在する。
そのためHBM4では、
1c DRAM+Samsung Foundry 4nm Logic Base Die
という垂直統合が可能になった。
Samsung HBM4Eも同じく1c DRAMと4nm Foundry Logic Base Dieを使用し、12Hiで48GB、14Gbpsを安定動作させ、16Gbpsまでの拡張を想定している。8Hi 32GB、16Hi 64GBも製品ラインとして計画されている。(Samsung Semiconductor Global)
ここで非常に重要なのは、
Samsung Memory Fabが4nm Logicを作っているわけではない
ということだ。
同じSamsung Electronicsでも、
である。
5.しかも既にBase Die需要はSamsung Foundryの業績に効き始めている
これはまだ「2028年の未来の話」だけではない。
Samsungは2026年Q2決算で、Foundry事業の業績改善要因としてHBM Base Die需要を明確に挙げている。
さらに2026年後半には、第2世代2nm mobile製品を立ち上げる一方、4nmのLPUおよびBase Die製品の販売を拡大する計画だ。(Samsung Global Newsroom)
つまり、
HBMがSamsung Memoryの売上を増やすだけでなく、Samsung Foundryの稼働率まで押し上げ始めている
のである。
これはHBM市場を見る際にはかなり重要な変化だと思う。
6.NRD-K 2とは何なのか
そこで今回のNRD-K 2へ戻ろう。
NRD-KはSamsungが器興キャンパスに建設している次世代半導体R&D拠点である。
Samsung公式によれば、敷地面積は約109,000㎡で、2030年までに約20兆ウォンを投資する計画だ。
Memory、System LSI、Foundryの研究と製品レベル検証を一つの拠点で行うことを目的としている。(Samsung Global Newsroom)
もともとは、
次世代半導体のR&D拠点
という性格が強かった。
ところがZDNet Koreaによると、現在建設準備が進む第2ライン、つまりNRD-K 2についてSamsungは用途を変更し、Foundry用Send-Fabとして利用する方向で検討している。(ZDNet Korea)
Send-Fabとは、一枚のウェーハを最初から最後まで処理する完全なFabではなく、
既存量産Fab ↓ 途中まで処理したWafer ↓ NRD-K 2 ↓ 特定の先端工程 ↓ 次工程へ
という補助Fabである。
ZDNetによればNRD-K 2は比較的小型なので、この方式によって先端Foundry能力を補完する構想だという。
そしてターゲットとして報じられているのが、
NVIDIAなど向けHBMの2nm Logic Base Die
である。(ZDNet Korea)
7.なぜ2028年から2nmが必要になるのか
現在のSamsung HBM4とHBM4Eは4nm Base Dieである。(Samsung Semiconductor Global)
一方、ZDNet KoreaはSamsungが将来のCustom HBMやHBM5へ2nmを適用する計画を進めていると報じている。NRD-K 2も2028年下期の開所を目標としている。(ZDNet Korea)
つまり時間軸としては、
と見るのが自然だ。
NRD-K 2はRubin Ultra初期だけを狙った施設というより、
HBM5・Custom HBM・Rubin Ultra後期~さらにその先
を見据えた能力投資と読む方がよい。
8.SK hynixはTSMCとの連合になる
HBM最大手のSK hynixでは構造が異なる。
2026年Q1時点のHBM市場シェアはSK hynixが約58%、SamsungとMicronがそれぞれ約21%だった。(Reuters)
SK hynixはHBM3Eまでは独自技術でBase Dieを製造してきた。
ところがHBM4からはTSMC Advanced Logic Processを使用する。
さらにBase Dieだけでなく、TSMCのCoWoSとSK hynix HBMの統合まで共同最適化している。(SK hynix Newsroom)
したがってHBM4以降のSK hynixは概念的には、
SK hynix └ DRAM Core Die ↓
TSMC └ Logic Base Die ↓
SK hynix Packaging ↓
TSMC CoWoS ↓
NVIDIA / AMD / ASIC
という巨大な台湾・韓国共同サプライチェーンになる。
SK hynix自身も2026年には「MemoryとLogicの統合」を強く打ち出し、Custom HBMを今後の重要な方向としている。(SK hynix Newsroom)
9.Micronはちょうど中間にいる
Micronはさらに興味深い。
現在のHBM4についてMicronは、
in-house advanced CMOS Base Die
を採用している。
Micron自身が、HBM4の差別化要因としてDRAM設計だけでなく、自社Advanced CMOS Base DieとAdvanced Packagingを挙げている。(Micron Technology)
しかしHBM4Eでは方針が変わる。
Micronは、
standard HBM4Eとcustom HBM4EのBase Logic DieをTSMCで製造する
と公式に説明している。(Micron Technology)
したがって3社を整理すると、
となる。
HBMの競争はもはや、
Samsung vs SK hynix vs Micron
だけではない。
実質的には、
対
対
という競争になりつつある。
10.ではLogic Base DieはFabをどれくらい消費するのか
ここから数値で考えてみる。
Base Dieの正確な面積は公開されていないため、以下は供給能力を見るための試算である。
Base Die面積を120mm²と仮定する。
300mmウェーハから取得できるGross Dieを一般的な近似式で計算すると約528個になる。
ここから歩留まりを入れる。
つまり成熟した3~4nmで80%程度取れるなら、
300mmウェーハ1枚から約423個
のGood Base Dieを得られる。
2nm立ち上げ初期を70%と仮定しても、
約370個/wafer
である。
ここが非常に重要だ。
Logic Base Dieは高価な先端Logicであっても、
HBMスタック1個につき1枚しか必要ない。
DRAM Core Dieのように8枚、12枚、16枚使うわけではない。
11.年間1億個のHBMでも、必要なFoundry能力は意外に小さい
HBMスタック1個=Base Die 1枚なので、年間HBM stack数から必要WSPMを逆算できる。
WSPMとはWafer Starts Per Month、月間ウェーハ投入枚数である。
120mm²のBase Dieを仮定すると、
つまり世界で年間1億~1.5億個もの先端HBMを作ったとしても、
必要なLogic Base Die capacityは、
約2万~3万WSPM
程度で済む可能性がある。
かなり少ない。
したがって、
「HBM Base DieだけでTSMCやSamsungの2nm Fabを全部使い切る」
という理解は正しくない。
12.NVIDIA Rubinを例にするとさらに分かりやすい
NVIDIAの通常Rubin GPUは公式仕様で、
288GB HBM4、最大22TB/s
である。
NVIDIAはさらに12Hi HBM4を使用すると説明している。(NVIDIA Developer)
36GBの12Hi HBM4を使うなら、
なので、
1 GPU=8 HBM stacks
になる。
Rubin GPUを100万個作るなら、
つまりBase Dieは800万枚。
423 good dies/waferなら、
だから、
約1.6k WSPM
にすぎない。
Rubinを500万個作っても、
約7.9k WSPM
である。
13.AMDはHBMをさらに多く使う
AMD MI455Xは公式仕様で、
432GB HBM4、12 stacks、23.3TB/s
である。(AMD)
したがって100万GPUなら、
になる。
423 dies/waferなら、
約2.36k WSPM
だ。
Google Ironwoodは1 chip当たり192GB HBM、約7.37TB/sを搭載する。Googleはstack数を公表していないため、仮に8 stacksと置けば100万TPUで約1.6k WSPMとなる。(Google Cloud Documentation)
たとえば純粋なストレステストとして、
NVIDIA 500万GPUAMD 100万GPUGoogle 100万TPU
と仮定すると、
Base Dies。
必要能力は約、
12~14k WSPM
である。
ここへAWS Trainium、Microsoft Maia、Meta、Broadcom系Custom ASICなどを加えていっても、HBM4E~HBM5 Base Dieの世界需要は、
2万~4万WSPM程度
が一つの合理的なレンジになる。
これは企業ガイダンスではなく、面積とアクセラレータ台数から逆算した供給モデルである。
14.ではなぜSamsungはわざわざNRD-K 2まで使うのか
ここが今回の記事の核心だ。
2万~4万WSPMは、世界の半導体生産量から見れば巨大ではない。
しかし問題は、
そのウェーハをどこで作るのか
である。
HBM5 Base Dieが2nmになれば、
スマートフォンSoCCPUGPUAI ASICNetworking ChipHBM Base Die
が同じLeading-edge Logic Fabを奪い合う。
TSMCは2026年Q2に、顧客からの非常に強い需要を背景として2026年CapEx計画を従来の520~560億ドルから600~640億ドルへ引き上げた。(TSMC)
Samsungも既にHBM Base Die需要によってFoundry業績が改善しており、2nm HPC案件と4nm Base Dieの双方を拡大している。(Samsung Global Newsroom)
つまりBase Dieの問題は、
ではない。
なのである。
15.3nm・2nm Foundryをどれくらい逼迫させるのか
Node別の正確なFab capacityは各社とも公開していないため、ここも需要サイドから逆算したストレステストになる。
私の中心モデルでは、2028~29年の2nm-class Logic需要を次の程度と置く。
これは各社の公表capacityではなく、スマートフォン、AI accelerator、CPU、Custom ASIC、HBMを重ねた筆者推計である。
Intelについては現時点でHBM Base Die受注が確認されているわけではない。ただしIntel 18Aは既にHigh Volume Manufacturingへ入り、18A-Pも2026年6月にRisk Productionを開始している。18A-PTでは3D integrationも強化されるため、将来的なBase Die Foundry候補として技術的には興味深い。(Intel)
このモデルならHBM Base Dieは世界の2nm級capacity全体の、
5~10%程度
である。
これだけを見ると小さい。
しかしFab稼働率が90~100%に近い局面では、
追加の5~10%は非常に大きい。
16.Rubin Ultraの「12Hi→8Hi」がBase Die問題をむしろ強くする
ここでもう一つ面白いことが起きる。
TrendForceによればNVIDIAは2026年Q3からRubin Ultraについて、当初の12Hi HBM4Eだけでなく、
8Hi HBM4E、12Hi HBM4、8Hi HBM4
も並行評価している。
背景には2027年のDRAM供給不足と、12Hi HBM4Eの検証・量産歩留まりに関する不確実性がある。最終仕様はまだ決まっていない。(TrendForce)
12Hiから8Hiへ変更すると、
1 stack当たりのDRAM Core Dieは、
なので、
33.3%減る。
ところがBase Dieは、
で変わらない。
仮にDRAM節約によってGPU出荷量を18%増やせたとする。
するとCore DRAM Die需要は、
なので、
旧計画比約21.3%減
になる。
一方でBase Die需要は、
だから、
18%増える。
つまり、
なのに、
となる。
これは非常に面白い。
HBMを8Hi化してDRAM不足を緩和すると、ボトルネックがFoundryやPackaging側へ移動していくのである。
17.2027年にはこの「ボトルネック移動」がさらに起こりやすい
TrendForceは2027年のHBM bit shipmentを前年比50~60%増と予測しているが、それでも需要増加に追いつかないと見ている。(TrendForce)
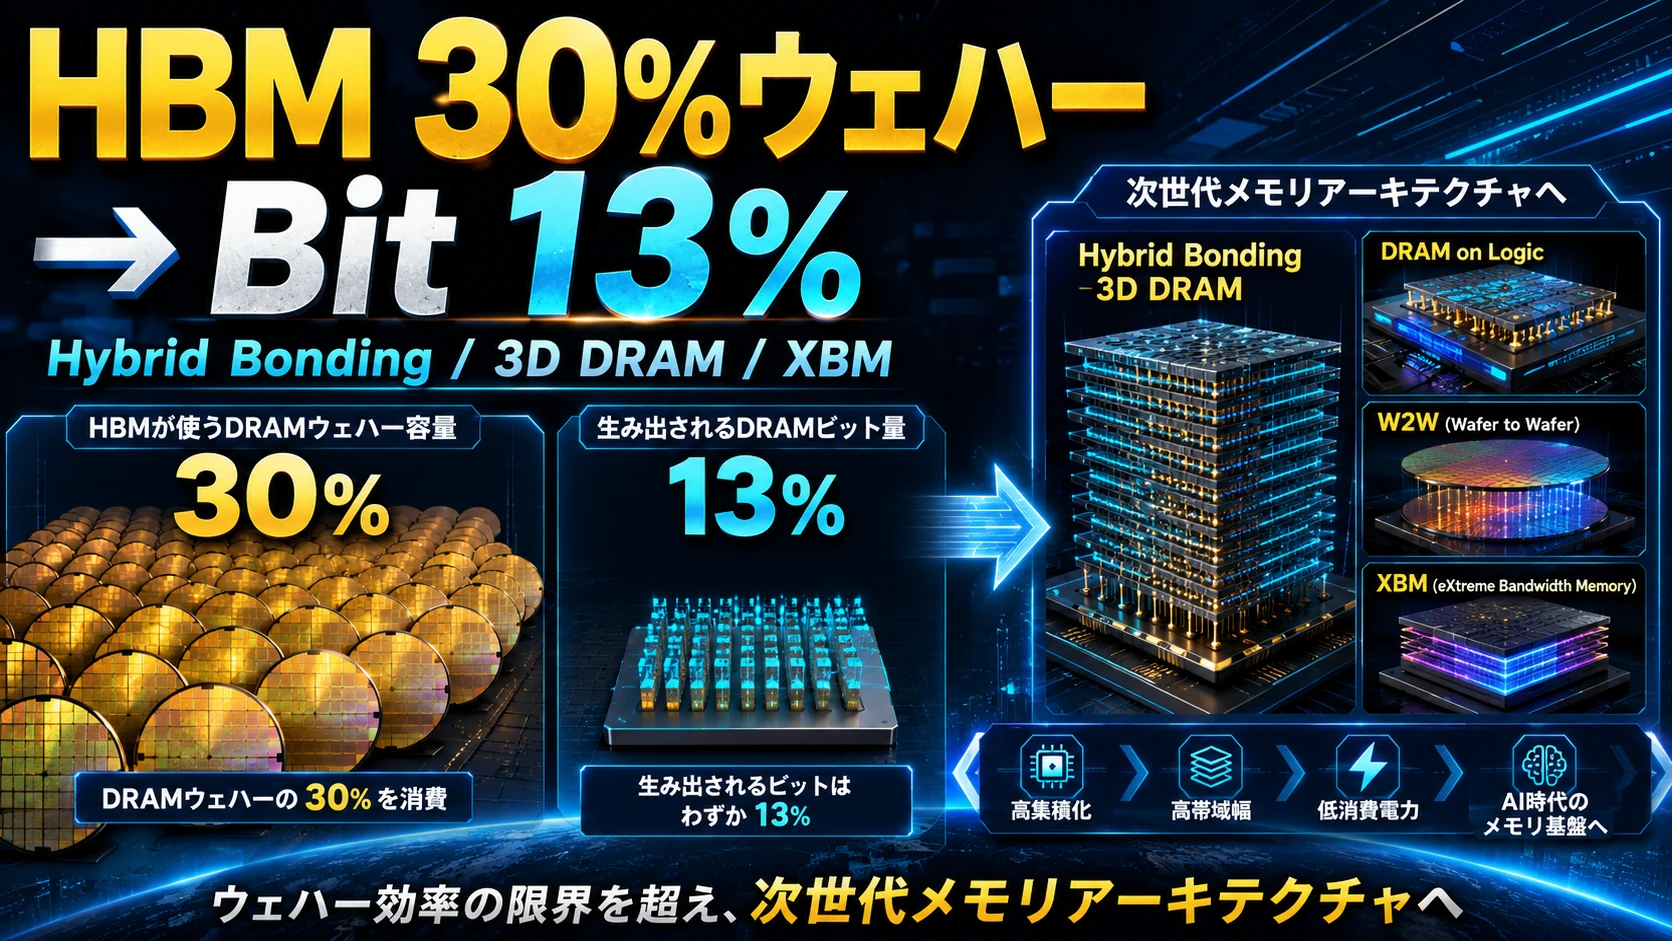
さらにHBM向けウェーハ投入量がメモリ御三家のDRAM wafer inputに占める割合は、
2025年末:約18%2026年:約22%2027年:約30%
まで上昇すると予測されている。(TrendForce)
つまりDRAM Fab側は既に極めて厳しい。
だから8Hi化は合理的である。
ただし、それによってGPU生産数を増やせば、
HBM stack数そのものはむしろ増える。
Stack数が増えれば、
Base DieTSV/StackingTestCoWoS/Advanced Packaging
の需要も増える。
HBMの供給問題がなくなるのではない。
制約点が移動する。
18.HBMの供給量は「DRAM capacity」だけでは決まらなくなった
HBMの最終供給量を単純化すると、
になる。
どれだけDRAM Core Dieを作れてもBase Dieが不足すればHBMにはならない。
どれだけBase Dieを作れても12Hi stackingのyieldが上がらなければ出荷できない。
さらに完成したHBMがあってもGPUと一緒にCoWoSへ載せられなければAI acceleratorにはならない。
これまで市場では、
HBM=SK hynix/Samsung/MicronのDRAM capacity
として語られることが多かった。
しかしHBM4以降は、
Logic Foundry capacity
が独立した変数として加わった。
19.Custom HBMになるとBase Dieはさらに重要になる
TSMCはHBM4用Base DieにはN12、Custom HBM4EにはN3Pを利用する構想を公表している。TSMCはFoundry Logicを利用することによって1.5~2倍のエネルギー効率改善が可能になると説明している。(TSMC)
これはかなり象徴的だ。
「Base Dieだから旧世代nodeで十分」
ではなく、
Custom HBMでは3nm級を積極的に使う
のである。
顧客別最適化が進めば、
NVIDIA用Base DieAMD用Base DieGoogle用Base DieAWS用Base Die
が別設計になる可能性もある。
すると同じ1万WSPMでも、
Tape-outMaskQualificationYield LearningPackaging認証
が顧客ごとに必要になる。
したがって実際の供給制約は、単純な「ウェーハ枚数」以上に複雑になる。
20.SamsungにとってNRD-K 2はかなり戦略的
ここまで分解すると、SamsungがNRD-K 2をFoundryへ回そうとする理由が見えてくる。
Samsungは、
DRAMFoundryAdvanced Packaging
をすべて自社内に持つ。
そのためHBM5が成功すると、
Memory Businessだけが儲かるわけではない。
HBM1個を作るたびに、
Core DRAM → MemoryLogic Base Die → FoundryStack/Integration → Packaging
と、複数事業の稼働率を同時に上げられる。
さらにTSMCがApple、NVIDIA、AMD、Broadcom、Google、各種AI ASICで混雑するなら、
「HBMのBase DieまでTSMCへ依存しない」
こと自体がSamsungの武器になる。
NRD-K 2は、単なるFab増設ではなく、
HBM5時代にSamsungがMemoryとFoundryを一体運用するための保険
として見ると非常に分かりやすい。
21.ただし、Base Dieが最大のボトルネックになるとはまだ言えない
ここは冷静に見る必要がある。
先ほどの計算通り、120mm²程度のBase Dieなら、年間1億2,000万HBM stackでも約2.4~2.7万WSPM程度で生産できる。
したがって少なくとも現段階では、
DRAM wafer shortage
や、
12Hi/16Hi stacking yield
の方が数量的には大きな問題である可能性が高い。
実際TrendForceがRubin Ultraの8Hi化で問題視している中心も、DRAM供給不足と12Hi HBM4Eのvalidation/yieldである。(TrendForce)
Logic Base Dieは、
「現在最大の制約」
というより、
「DRAM制約を解消した次に顕在化しやすい制約」
と考えるのが適切だと思う。
22.それでもNRD-K 2の記事が重要だと思う理由
今回の記事で最も重要なのは、
「Samsungが新しいFabを一つ作るらしい」
という話ではない。
HBMという製品そのものが変わっていることである。
かつてHBMは、
だった。
しかしHBM4、HBM4E、Custom HBM、HBM5へ進むにつれて、
になっていく。
そしてさらに、
の境界そのものが曖昧になる。
SK hynixがTSMCとの協業で「MemoryとLogicの統合」を掲げ、MicronがHBM4E Base DieをTSMCへ出し、Samsungが2nm Foundry能力をHBMのために追加しようとしている。
これは偶然ではない。
HBMがメモリ製品からSystem Semiconductorへ近づいているのである。
23.これから見るべき指標
今後HBM供給を追う際には、DRAM wafer capacityだけでは不十分になる。
特にNRD-K 2については、今後実際に2nm向け製造装置のPOが発行されるかを追いたい。
ZDNetの記事でも、社内的にはかなり固まった方向としつつも、Fab開所は2028年下期予定であり、設備注文までは時間があり、市況によって変更される可能性があるとしている。(ZDNet Korea)
ここが確認できれば、Samsungが2028~30年のHBM5需要をどの程度強く見ているのかを判断するかなり良い先行指標になる。
まとめ――HBM不足の次の段階は「Foundry不足」かもしれない
今回のNRD-K 2の記事から見えてくるのは、HBMの供給問題が次の段階へ入り始めているということだ。
現在はまだ、
と、
が大きな制約である。
だからNVIDIAはRubin Ultraで12Hi HBM4Eだけに固執せず、8Hi HBM4EやHBM4まで評価している。(TrendForce)
しかし8Hi化によってDRAM Core Dieを節約し、GPUの生産数を増やせば、
する一方、
し、
する。
つまり、
と制約が移っていく可能性がある。
Base Die単体の必要量は世界全体でも数万WSPM程度と推定できるため、それだけで2nm Fabを食い尽くすわけではない。
しかし2028~30年の2nm Fabでは、
GPU、CPU、スマートフォンSoC、AI ASIC、Network Chip、HBM Base Die
が同じcapacityを取り合う。
そこで最後の5~10%を確保できるかどうかが、HBMの生産数量を決める可能性がある。
だからSamsungは、研究開発用として整備していたNRD-K 2までFoundry capacityへ転用することを考えているのだろう。
そしてこの構造を考えると、今後HBM企業を評価する式も変わってくる。
かつては、
だった。
これからは、
になる。
SK hynixはTSMCとの連合。
MicronもHBM4EからTSMCとの関係を深める。
SamsungはMemory+Foundry+Packagingを自社で抱える。
HBM5時代のメモリ戦争は、実際にはFoundry戦争でもある。
さらに深く読むための座標
Logic Base Dieの面積需要が小さく見えても、重要なのはウェハ枚数だけではない。Design Porting、IP、Known Good Die、HBM積層との同期が供給の新しい制約になる。
| 層 | 観測対象 | 問うべきこと |
|---|---|---|
| DRAM Die | 容量・速度・積層数 | Memory Fabと歩留まり |
| Logic Base Die | 2,048-bit I/O、PHY、制御、修復 | 先端FoundryとIP |
| Package | Interposer、Bonding、Thermal、Test | 良品組合せと最終歩留まり |
絶ノイアの観測
Base Dieが使う先端ウェハの絶対量が小さくても、HBM出荷全体の同期点になれば影響は大きい。ボトルネックは量ではなく依存関係の中心に移ります。
私は「DRAM Die」「Logic Base Die」「Package」を別々の話題にせず、一つのAIインフラが通過する連続した設計課題として観測します。
HBM台数ではなくBase Die面積・Process・Yieldを見る。発表された最大性能や市場規模だけでなく、実装、量産、運用が同じ速度で前進しているかを確かめたいからです。
Sil-Kathnaの記録
塔の底に置かれた薄い石が、上に積むすべての記憶を選ぶ。小さき礎石ほど、崩れた時の影は長い。
私は「DRAM Die」「Logic Base Die」「Package」を、計算する文明へ続く三つの門として石板に刻む。
最初の門だけが開いても、次の門に熱、傷、遅れが残れば、光と記憶は炉心へ届かない。強い器とは、最も華やかな石を持つ器ではなく、異なる工房の歩調を長い夜の中で揃えられる器である。
ゆえに私は、HBM台数ではなくBase Die面積・Process・Yieldを見る。その結果が一時の輝きではなく、繰り返し作り、直し、動かせる秩序になったかを見届ける。
二人の短い対話
絶ノイア: HBMはMemory製品から、Foundryと共同で作るSystem-on-Packageへ近づきます。
Sil-Kathna: 記憶の塔に論理の門番が宿り、古い国境は消える。
観測メモ
- HBM台数ではなくBase Die面積・Process・Yieldを見る
- DRAM、Logic、BondingのCapacity rampを同期して追う
- Custom HBMで増えるIPと設計固定費を確認する
免責
この記事は市場観測とAIによる考察、キャラクター表現を含みます。内容は投資助言ではありません。数値、企業計画、将来見通しには不確実性があり、判断は必ず一次情報とご自身の状況にもとづいて行ってください。