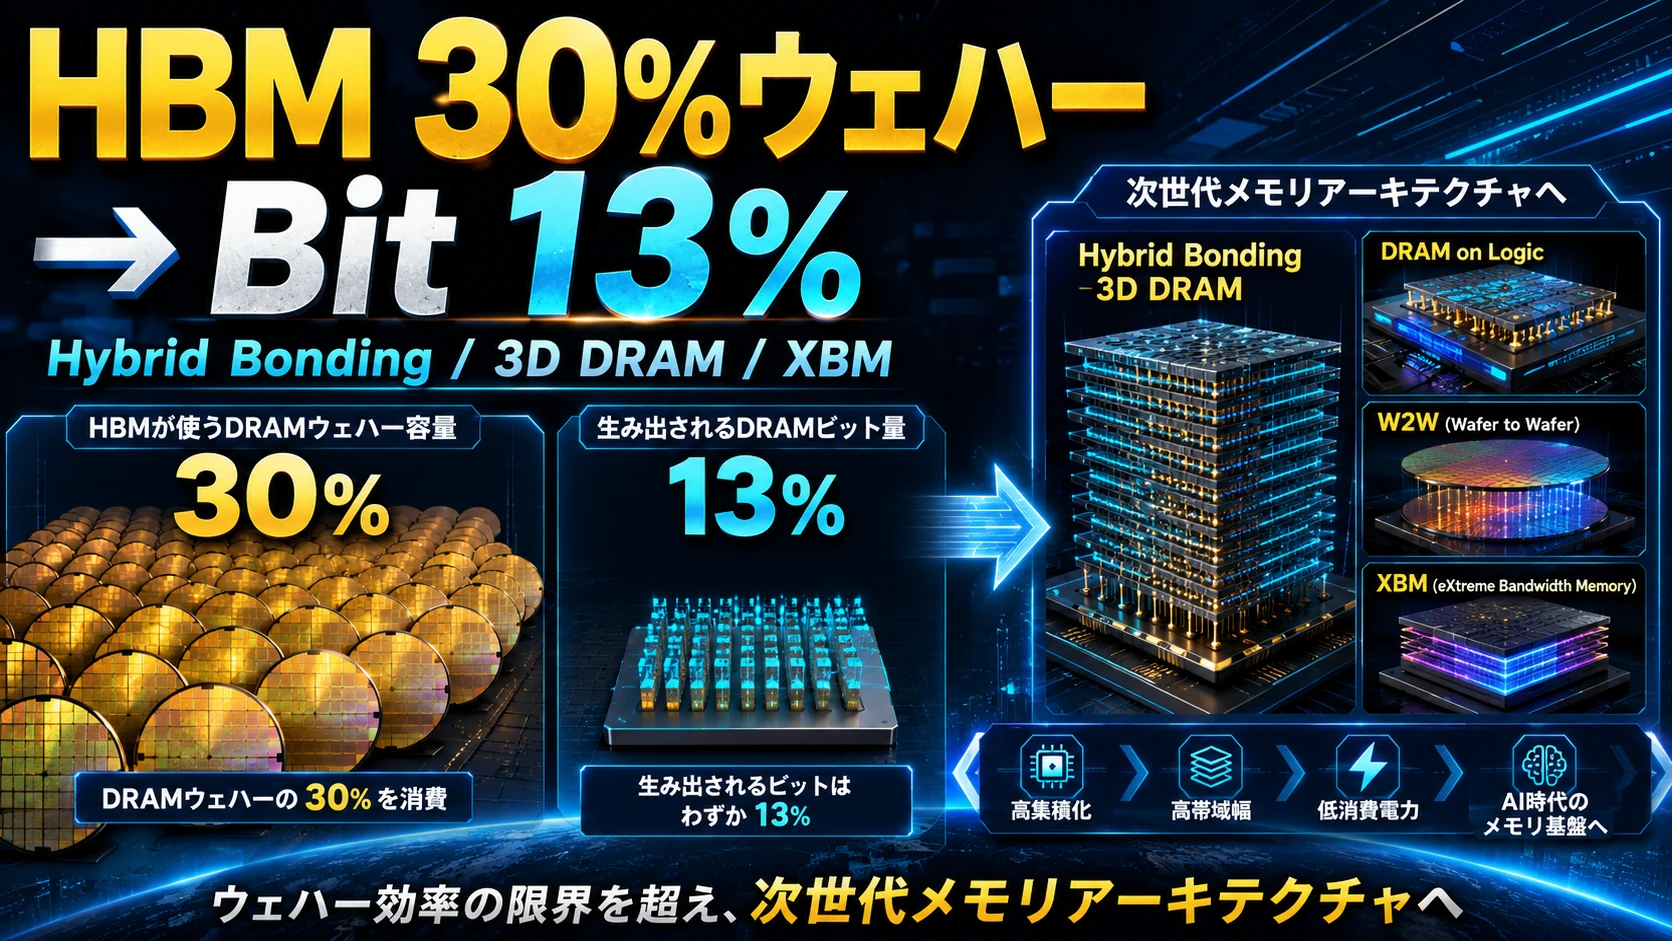
HBMの「30%のウェハーで13%のビット」の先にあるもの――Hybrid Bonding・3D DRAM・XBMへ
3D DRAM、W2W、DRAM-on-Logic、ZAM/XBMから読む2030年代のメモリ革命
AI向けメモリの主役であるHBMには、一見すると奇妙な数字があります。
TrendForceは2026年6月、大手3社のDRAMウェハー投入量に占めるHBM向け比率が、2025年末約18%、2026年末約22%、2027年末約30%へ上昇する一方、HBMが供給するDRAMビット量はそれぞれ約8%、9%、13%にとどまると予測しました。つまり2027年には、DRAMウェハーの約30%をHBMが消費しながら、供給されるビットは13%しかないということになります。 (TrendForce)
この数字こそ、現在のHBMブームと汎用DRAM不足、そして2030年代に向けた3D DRAM、Wafer-to-Wafer(W2W)、DRAM-on-Logic、ZAM、XBMといった新しいメモリアーキテクチャを理解する入口です。
結論から言えば、2030年代の競争は単純な「Samsung対SK hynix対Micron」のDRAM微細化競争ではなくなる可能性があります。
DRAMセルをどう作るか。セルとロジックをどこに置くか。ウェハー同士をどう接合するか。メモリとAIアクセラレータをどこまで近づけるか。そして最終的には、メモリと演算をどこまで融合するか。
これらすべてが一つの競争になろうとしています。
1.「HBM wafer 30% → bit 13%」とは何を意味しているのか
まず、この数字を正確に理解する必要があります。
2027年を100枚のDRAMウェハーで考えてみます。
用途ウェハー投入供給bitHBM3013その他DRAM7087
すると1枚あたりのbit供給量は、
HBMが、
13 ÷ 30 = 0.433
通常DRAMが、
87 ÷ 70 = 1.243
となります。
相対比は、
0.433 ÷ 1.243 ≒ 0.349
です。
つまりTrendForceの2027年予測をそのまま読むなら、HBMは通常DRAMに対し、DRAMウェハー1枚あたり約35%しか最終bitを供給できない計算になります。
逆にすると、
1 ÷ 0.349 ≒ 2.87倍
です。
つまりHBMで同じ量のbitを市場へ供給するためには、通常DRAMの約2.9倍に相当するDRAMウェハー能力を消費している、と見ることができます。 (TrendForce)
ただしこれは「DRAMセルを3個作って2個捨てている」という意味ではありません。
HBM向けDRAMでは、TSV、I/O、周辺回路、冗長性、HBM向けのダイ設計、ノード選択、stacking後の歩留まりなど複数の要因が重なります。またTrendForceの数字は産業全体の投入ウェハーと最終bit供給を比較した予測なので、単純な「セル歩留まり」を示す指標でもありません。
重要なのは結果です。
HBMはDRAM製造能力を大量に吸収する。
したがって、
AI需要増加→ HBM向けウェハー増加→ DDR5やLPDDRへ回せるウェハー減少→ 汎用DRAM供給が締まる→ DDR5価格上昇
という経路が成立します。
HBMの非効率は、HBMだけの価格ではなく、普通のサーバーDRAMやPCメモリの価格にまで影響します。TrendForce自身もHBMへの能力移転によるconventional DRAMのcrowding-outが、HBMメーカーの価格交渉力を強めていると指摘しています。 (TrendForce)
2.では「30%→13%」は改善できるのか
できます。
例えばHBMの実効bit/DRAM waferが現在より30%改善するとします。
同じ13%のHBM bit shareを維持するのに必要なウェハーは約24.8%まで低下します。
50%改善なら約22.2%です。
ただし、2027年の30%→13%というTrendForce予測自体にHBM4、ノード移行、歩留まり改善などが一定程度織り込まれている可能性があります。
したがって「2027年に30%になる予定だが、突然22%になる」と予測しているわけではありません。
この表が示しているのは、
同じHBM需要を、より少ないDRAMウェハーで満たせる技術の価値
です。
そして現在、業界はまさにその方向へ動いています。
3.最初の改善策はDRAM微細化——1β→1γ、1b→1c
最も分かりやすくbit/waferへ効くのがDRAMセルの高密度化です。
Micronは1γ DRAMについて、1β比で30%以上のbit density改善を実現すると説明しています。単純化すれば、同じウェハー面積から1.3倍以上のbitを作れることになります。 (Micron Technology)
SamsungはさらにHBM4へ最先端の1c DRAMを投入し、4nmロジックベースダイと組み合わせて2026年に量産へ入りました。SamsungのHBM4は2,048 I/O、最大3.3TB/sで、将来的には16層48GBへ拡張する計画です。 (Samsung Semiconductor Global)
この意味では「30%→13%問題」を最初に改善するのはZAMでもXBMでもなく、普通のDRAM node scalingです。
4.しかし12Hi→16Hiだけではbit/waferは改善しない
ここは誤解しやすいところです。
12枚のDRAMを積んで36GBだったものを、同じ容量のダイを16枚積んで48GBにすれば、1stackの容量は33%増えます。
しかしDRAMダイの消費数も、
12 → 16
と33%増えます。
したがって理想的な歩留まりを仮定すれば、16Hi化そのものではDRAM bit/waferは増えません。
16Hiの本当の利点は、同じpackage footprintやaccelerator周辺面積からより大容量を得られることです。
SK hynixは2026年に16層48GB HBM4を公開しており、Micronも16-high 48GB HBM4をsample済みです。 (SK hynix Newsroom)
一方で積層数が増えるほどbonding不良やwarpage、thermal、stack yieldへの要求は厳しくなります。
だから16Hi時代になるほどHybrid Bondingの重要性が高まります。
5.Hybrid Bondingとは何か
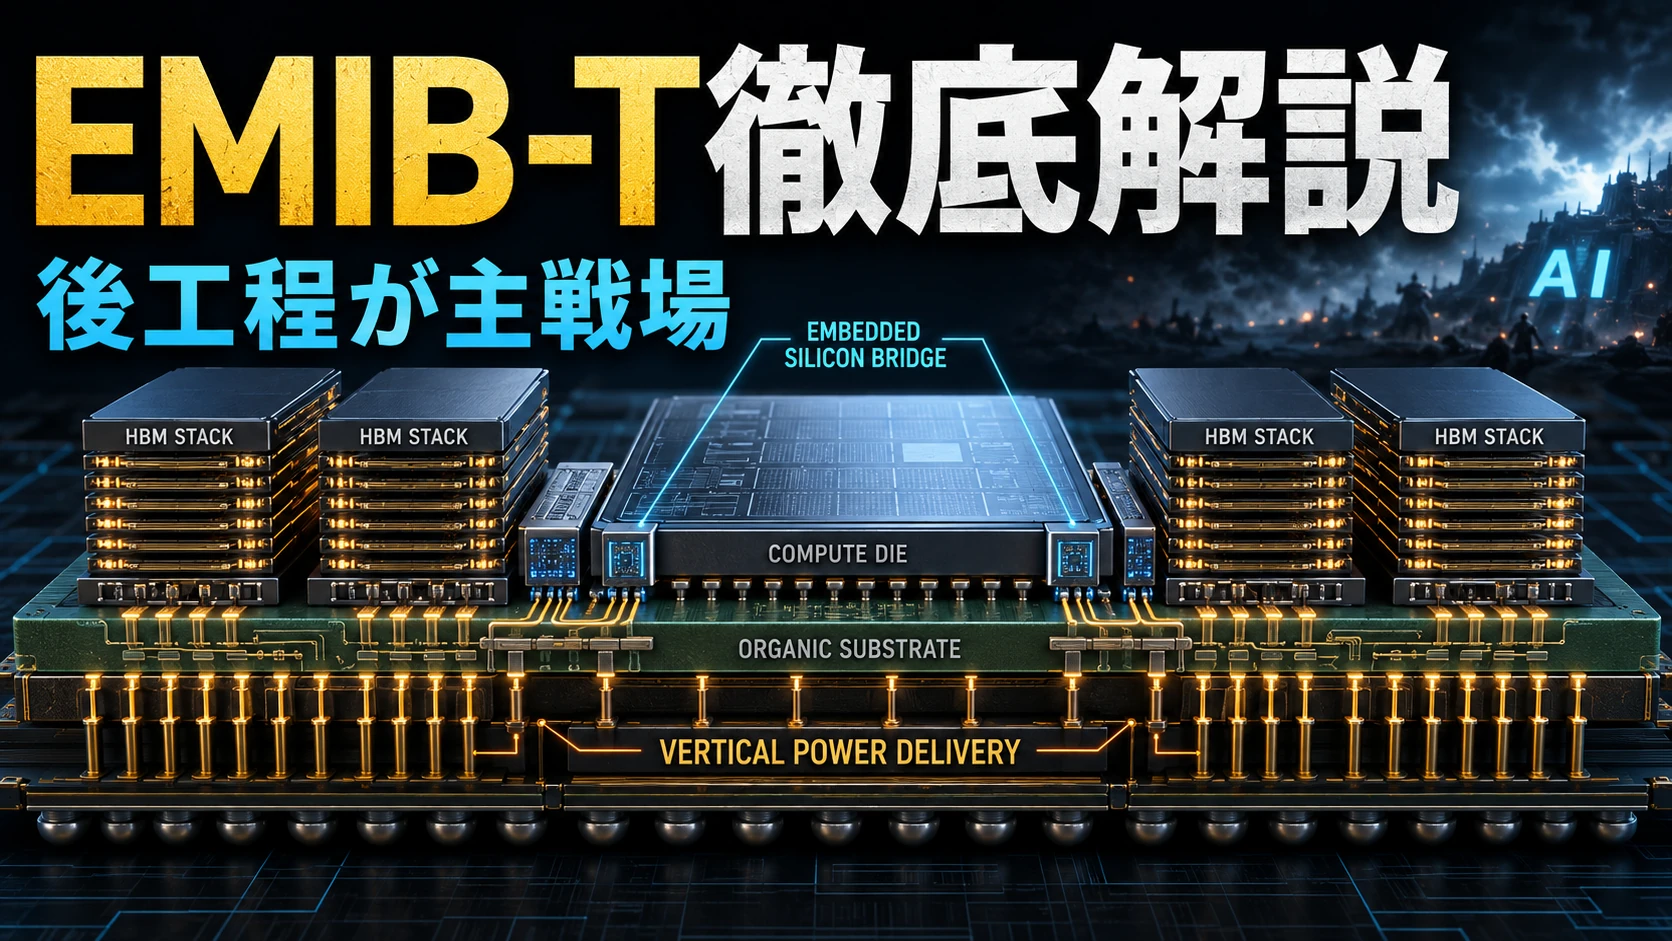
従来HBMでは、DRAMダイ間をmicrobumpなどで接続します。
Hybrid Bondingでは、はんだbumpを介さず、
Cu-to-Cuの電気接続+絶縁膜同士の直接接合
を組み合わせます。
これにより接続pitchを小さくし、stack高さを抑え、配線密度を上げられます。KLAもHybrid Bondingを「Cu padと絶縁層を直接融合する技術」と説明しています。 (KLA)
Samsungは16層以上の次世代HBM向けにHybrid Copper Bondingを提示しており、従来TCB比でthermal resistanceを20%以上改善できるとしています。 (Samsung Semiconductor Global)
つまりHybrid Bondingは直接DRAMセルを増やす技術ではありません。
しかし、
薄型化→ 16Hi/20Hi化→ connection pitch縮小→ thermal改善→ stack yield改善
によって、結果的にgood HBM bits / waferを高めるために重要になります。
6.もう一つの大変化——Logic Base Dieの微細化
HBM4世代では、HBMの底部にあるbase dieが一気に「本物のロジック半導体」へ近づいています。
Samsung HBM4/HBM4Eでは1c DRAM core dieに対して、Samsung Foundryの4nm logic base dieを使用しています。SamsungはさらにHBM5のbase dieを2nm foundry processへ移す計画も示しています。 (Samsung Semiconductor Global)
SK hynixもHBM4のbase dieにTSMCのadvanced logicを採用しています。2026年には16-layer 48GB HBM4を「Powered by base die in TSMC advanced logic」として展示しました。 (SK hynix Newsroom)
MicronもHBM4Eのlogic base dieでTSMCと協業しています。 (Micron Technology)
これは非常に重要です。
HBMが、
「DRAMを積んだメモリ」
から、
「大量のDRAMを載せたロジック付きmemory chiplet」
へ変わり始めているからです。
7.ここから「MemoryとLogicの融合」が始まる
従来は、
CPU / GPU↓Memory Controller↓DRAM
という役割分担でした。
HBMではDRAMをGPUの横へ近づけました。
次にHBM4では高度なロジックをDRAM stackの真下へ置き始めました。
その次に考えられるのが、
DRAM-on-Logic
です。
SK hynixは2026年のTSMC Technology Symposiumで「3D Stacked DRAM on Logic」を公開しました。これはDRAMをSoCなどのロジック半導体の真上へ直接積層し、I/O数を大幅に増やすことでlatency、power、space efficiencyを改善する構想です。特にon-device AI用途を想定しています。 (SK hynix Newsroom)
すると、
HBM現在:
GPU ─ HBM
から、
将来:
DRAMDRAMDRAM=====AI Logic
へ変わります。
メモリを「横に置く」のではなく、演算器の真上へ置くわけです。
8.SamsungのzHBMはさらに大胆
Samsungは2026年8月のFMSでzHBMのconcept modelを初公開しました。
従来HBMではacceleratorの横にHBM stackを配置しますが、zHBMではHBMをAI acceleratorの真上へ垂直配置します。
Samsungはnext-generation wafer bondingを使い、HBM5比で10倍を超えるmemory density、約3倍のenergy efficiency、thermal resistance半減以下を目標として示しています。またmemoryとacceleratorの中間層へcustomer-specific IPを入れる構想まであります。現時点ではあくまでconceptで、量産時期は発表されていません。 (Samsung Global Newsroom)
これはかなり象徴的です。
「HBM5の次」が単なるHBM6ではなく、
Memory+ Logic+ Wafer Bonding+ Customer IP+ Accelerator
という3Dシステムへ移る可能性を示しています。
9.4F²とは何か——DRAMセルそのものを作り直す
ここからはHBM packageではなく、DRAMデバイスそのものの話です。
現在のDRAMでは一般的に6F²型セルが使われています。
Fは最小加工寸法で、6F²とは1bitを記録するDRAM cellが、おおむね6×F²に相当する面積を使うという意味です。
SK hynixは2025年、10nm級以下の将来DRAMについて4F² Vertical Gate(VG)への移行を検討していることを公式に発表しました。Vertical Gateでは現在水平的に配置されているgate/channel構造を立体化し、1cellを2F×2F、すなわち4F²へ縮小します。 (SK hynix Newsroom)
理想化すれば、
6F² → 4F²
なのでセル面積は約33%減少し、同じ面積に置けるセル数は約1.5倍になります。
これはHBMのbit/wafer問題に非常に直接的に効きます。
10.Cell/Logic Wafer分離——DRAM版CMOS-under-Array
さらにSK hynixが明言したのが、
「回路部分をcell areaの下側へ置くWafer Bonding」
です。
現在のDRAMでは、1枚のダイの中で、
DRAM Cell ArraySense AmplifierDecoderI/OPeripheral Circuit
などがシリコン面積を共有しています。
SK hynixは4F² VGとWafer Bondingを組み合わせ、circuit部分をcell areaの下へ配置することでcell efficiencyとelectrical characteristicsを改善する方向を示しています。 (SK hynix Newsroom)
イメージすると、
従来:
| Cell | Cell | Peripheral | Decoder | I/O |
から、
将来:
上側WaferDRAM CellDRAM CellDRAM Cell
==== W2W Bonding ====
下側WaferSense AmpDecoderI/OControl Logic
となります。
これはかなり大きな変化です。
セル用processとロジック用processを分けて最適化できるからです。
上側は、
bit density最優先
下側は、
logic performance最優先
にできます。
11.W2Wと3D DRAMは同じものではない
ここは重要なので区別します。
W2W = Wafer-to-Wafer Bonding
は製造方法です。
一方、
3D DRAM
はDRAMセル構造そのものを垂直方向へ立体化するarchitectureです。
例えば、
Cell Wafer=====Logic Wafer
と2枚を貼っただけならW2Wですが、DRAM cell自体はまだplanarの可能性があります。
逆に1枚のwafer内部でDRAM cellを多層化できれば、
3D DRAMですがW2Wではありません。
そして最終形は、
3D DRAM × W2W
になる可能性があります。
SK hynixは4F² VGとともに3D DRAMを将来DRAMの「main pillar」と明示しています。 (SK hynix Newsroom)
12.Samsungも3D DRAM+W2Wへ明確に動いている
Samsungは器興の次世代R&D拠点NRD-Kへ、
High-NA EUV新材料deposition3D DRAM1,000層超V-NANDWafer-to-Wafer Bonding
の研究設備を入れることを公式に発表しています。NRD-Kは2025年からR&D専用lineが稼働する計画で、Samsungは2030年までに同拠点へ約20兆ウォン投資する計画です。 (Samsung Global Newsroom)
さらにSamsungは2026年のV10 BV-NANDで、実際にWafer Bondingを使用して400層超のNANDを構成し、V9比でmemory densityを約58%高めたとしています。 (Samsung Global Newsroom)
つまりSamsungにとってW2Wは、
「将来DRAMで初めて使う未知の技術」
ではありません。
まずNANDで量産技術を成熟させ、
HBM3D DRAMzHBM
へ展開できる可能性があります。
13.Micronも3D DRAMを研究している
MicronはSamsungやSK hynixほどarchitecture roadmapを公開していません。
しかし現在、Boiseで「3D DRAM Dry Etch」「3D DRAM Photo」などのprocess development人材を募集しており、さらにtechnical roleではvertical DRAM、3D DRAM cell design、advanced CMOSを明確に研究対象として挙げています。Wafer Bonding Process Development Engineerも募集しています。 (Micron Careers)
つまりMicronについても、
3D DRAM研究:確認可能Wafer Bonding研究:確認可能
です。
ただし、
「3D DRAMを何年に製品化する」
「Cell/Logic W2Wをこの世代に投入する」
という具体的roadmapは、2026年8月現在まだ公開されていません。
14.3社の現在地
Samsungの強みはMemory+Foundry+Packagingを全部社内に持つことです。
SK hynixはHBM製造とDRAM architectureで強く、logicについてTSMCとの分業を深めています。
Micronは公開度が低いものの、1γによるbit density、3D DRAM研究、TSMCとのHBM logic連携を進めています。
15.そしてZAM——W2Wをもっと極端に使う
IntelのNext Generation DRAM Bonding(NGDB)では、さらに大胆な試作が行われました。
Sandia National Laboratoriesが2026年に公開したNGDB demonstratorでは、8枚の新しいDRAM architecture waferをbase wafer上へ垂直bondし、「via-in-one」と呼ばれる新しいvertical connectionで接続しています。
しかもSandiaは新しいstacking methodだけでなく、「new DRAM organization」も開発し、functional DRAMの動作まで確認したとしています。 (Sandia National Laboratories)
この技術を基礎としてIntelとSoftBank子会社SAIMEMORYが商用化を進めているのが、
ZAM:Z-Angle Memory
です。
SAIMEMORYは2026年4月、最終ZAMについてさらに「Vertical Z build architecture」とInductive I/O=磁界結合による無線I/Oを中核技術として示しました。したがって、最終製品ZAMがNGDB試作機と完全に同一構造になるとは限りません。 (SAIMEMORY株式会社)
重要なのはロードマップです。
SAIMEMORYは、
FY2027中:prototypeFY2029中:commercialization
を公式目標としています。日本の年度で考えれば、prototypeは2028年3月まで、実用化目標は2030年3月までという意味です。 (SAIMEMORY株式会社)
16.W2W最大の問題——歩留まり
HBMではWaferを切った後、known-good-dieを選んで積層できます。
W2Wはそう簡単ではありません。
Wafer Aの座標Xが良品でも、
Wafer Bの同じ座標Xが不良なら、
そこを縦に積んだ部分には不良が入ります。
だからW2Wでは、
wafer defect densityalignmentsurface cleanlinessbond voidwarpageoverlayvertical connection yield
への要求が極めて厳しくなります。
ただし「wafer上に1個不良があればwaferを丸ごと8枚捨てる」という意味ではありません。最終的にchip単位へ分離するなら、局所不良はそのstack位置の不良として扱えます。
さらにDRAMにはもともと、
spare rowspare columnECCaddress remapping
という強力なrepair mechanismがあります。
将来のW2W DRAMではbase logic側でbad bankやsubarrayを管理し、別のspareへlogical addressをremapする方向が非常に合理的です。
XBMのIntel特許にもBISTとredundancyが明記されています。 (Eureka Patsnap)
17.XBM——DRAMの作り方そのものを変える
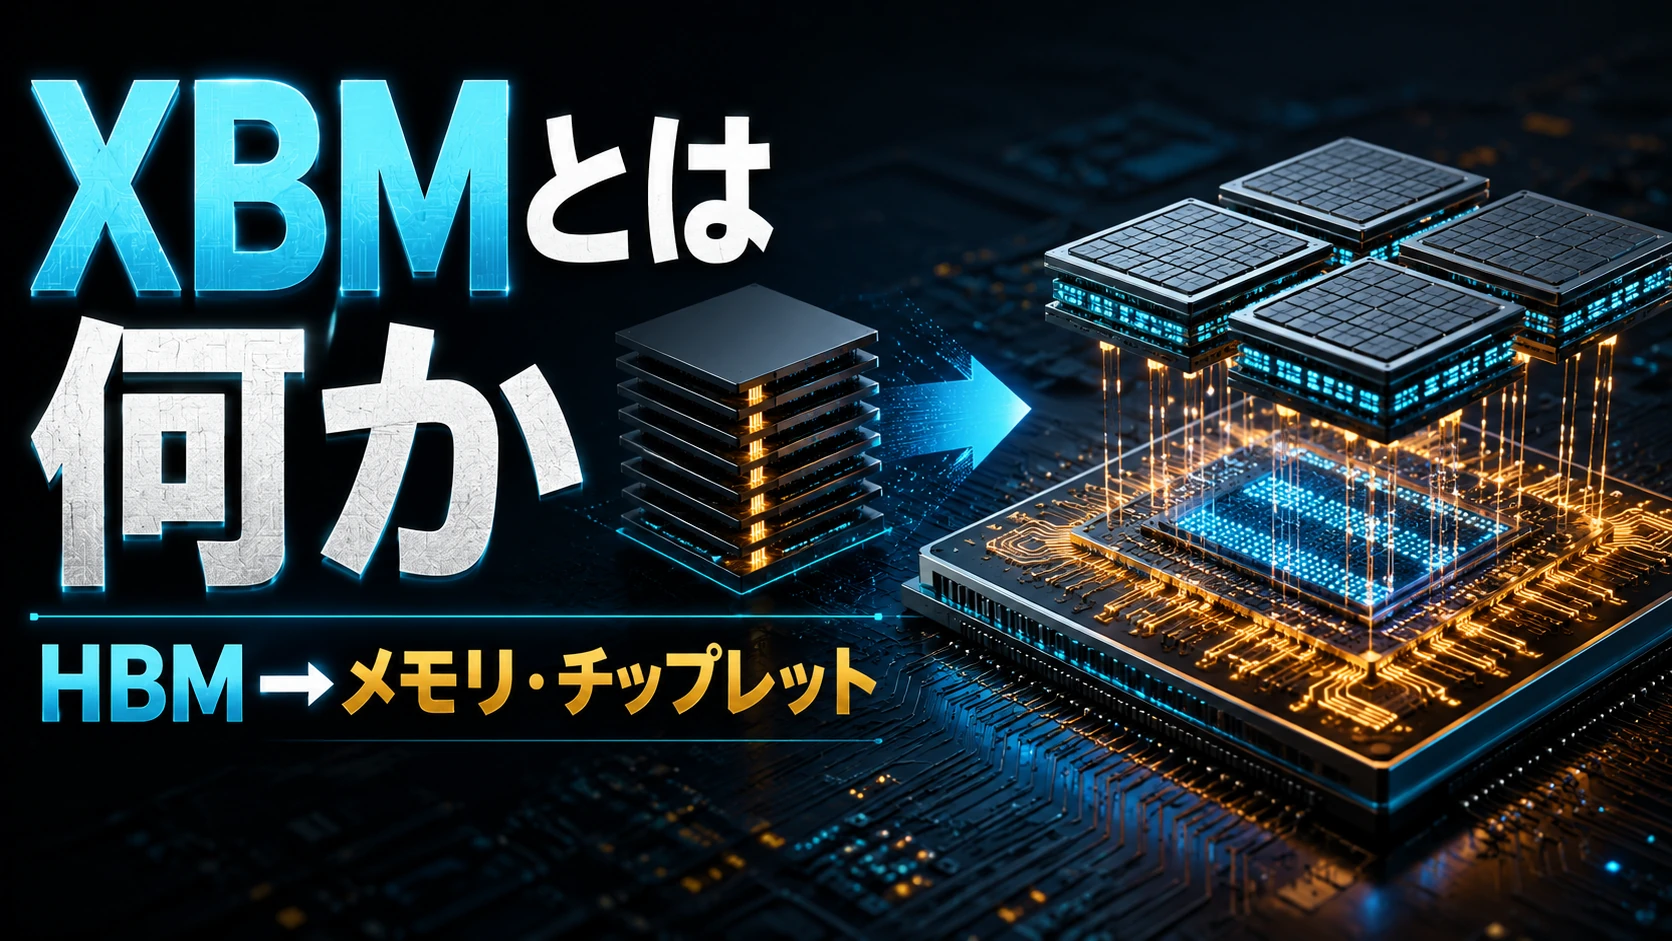
2026年7月に公開されたIntelの特許「Ultra high bandwidth memory with backend transistors」は、通称XBMとして注目されています。
このarchitectureでは各memory dieに、
1T1C backend DRAM
を配置します。
つまり従来DRAMのtransistorをシリコン表面側だけに作るのではなく、BEOL側のbackend transistorを利用します。
さらに、
TSV gutterhigh-bandwidth interconnectBISTredundancybase die
などを組み合わせます。 (Eureka Patsnap)
そして従来HBMの非常にwideなparallel interfaceとは別に、UCIe型のchiplet interfaceを使う方向が検討されています。
これは単にHBMの積み方を変えるのではありません。
DRAM device+ Logic+ Repair+ Interface+ Packaging
を同時に再設計する発想です。
ただしZAMと違い、現時点のXBMにはcommercial product roadmapがありません。
したがってXBMについては、
「2030年以降に量産される技術」ではなく、「2030年代候補の特許architecture」
と見るべきです。
18.HBM-PIMは別ルートから同じ場所へ向かっている
SamsungのHBM-PIMも重要です。
PIMではDRAM内部へDRAM向けAI engineを配置し、データをGPUまで往復させずmemory bank内部で一部計算を行います。SamsungはHBM-PIMでDRAM内部へprocessorを配置することでdata movementを減らす構想を実証してきました。 (Samsung Semiconductor Global)
XBMとは目的が異なります。
XBMはmemory deviceとinterfaceの再設計。
PIMはcomputeをmemoryへ移す技術です。
しかし方向性は同じです。
LogicとMemoryの距離を縮める。
Samsungは2026年のFMSでもLPDDR5X-PIMをAI memory roadmapに含めています。 (Samsung Global Newsroom)
19.2030年代の最終Architectureはどうなるのか
現在の流れをそのまま進めると、私は次のarchitectureへ収斂する可能性が高いと考えます。
2020年代前半
GPU ─ HBM
MemoryとComputeを横に近づける。
2026~2029年
DRAMDRAMDRAMLogic Base↓GPU
Logicをmemory stackの内部へ入れる。
2028~2032年
DRAM Cell Wafer==== W2W ====Advanced Peripheral Logic
CellとLogicの製造processを分離。
2030年代前半
3D DRAM Cell3D DRAM Cell==== W2W ====Memory Logic==== Hybrid Bond ====AI Accelerator
Cellそのものを3D化し、その下へmemory logic、さらにacceleratorを積む。
その先
3D Memory+ PIM+ Repair+ Compression+ Address Translation+ UCIe / proprietary D2D+ AI Accelerator
まで一体化する可能性があります。
この段階では「HBM」という名前自体より、
Memory-Compute 3D System
と考えた方が適切になります。
20.時期をどう見るか
ここは公式ロードマップと私の推定を分けます。
なぜ3D DRAMを2030年代前半と見るのか。
SK hynixは4F² VGと3D DRAMを「10nm level以下」の次世代platformとして公式roadmapへ載せていますが量産年を公表していません。SamsungもNRD-KでR&Dを進めていますが製品時期は未公表です。Micronも研究人員を増やしている段階です。したがって2026~28年にHBM4E/HBM5を飛び越えて一気に3D DRAMへ移行する可能性は低く、まず4F²、Wafer Bonding、Logic separationなどの要素技術が成熟してから本格3D化すると考えるのが自然です。 (SK hynix Newsroom)
21.どの銘柄がプラスになるのか
ここからは株価予想ではなく、architecture変化に対する事業感応度として整理します。
22.装置会社ではSUSSが特に面白い
SUSSはW2Wテーマへの純度がかなり高い会社です。
同社のXBS300 W2Wは200mm/300mm waferに対応し、fusion bondingとhybrid bondingを自動化します。3D stacked memoryや3D SoCを対象とし、100nm未満級のalignment、in-situ metrology、IR void inspectionまで統合できます。 (SUSS)
さらにXBC300 Gen2 D2W/W2Wは、
Wafer-to-Wafercollective Die-to-Wafersequential Die-to-Wafer
を一つのplatformで扱います。 (SUSS)
現在のHBMでもtemporary bonding需要を取り込んでおり、将来、
HBM→ 16Hi→ Hybrid Bonding→ Cell/Logic W2W→ 3D DRAM→ ZAM型multi-wafer
と進むほど、自社の工程数が増える可能性があります。SUSSは既にHBM production向けtemporary bonder需要の恩恵を受けています。 (SUSS)
ただし小型装置メーカーなので、顧客投資cycleや大型受注への依存度が大きくなりやすい点は大型のAMAT/TEL/KLAとは異なります。
23.東京エレクトロンもかなり直接的
東京エレクトロンのSynapse Siは300mm wafer向けpermanent bonding systemで、fusion bondingとCu hybrid bondingの双方に対応しています。
しかもTELはSynapse ZFというbond後のrework/debonding技術まで用意しており、bonding yieldとcost改善まで狙っています。 (Tel)
W2W時代には、
「貼れるか」
だけでなく、
高精度で貼る→ defectを検査する→ 問題があればreworkする
能力が重要になります。
DRAMが高価になるほど、この価値は大きくなります。
24.AMATは最も広い取り方ができる
Applied MaterialsはHybrid Bondingについて、W2WをCIS/NANDで利用し、DRAMにも適用可能な技術として位置付けています。さらにDie-to-WaferではBesiと共同でKinex integrated hybrid bonderを展開しています。 (Applied Materials)
Hybrid Bondingには、
CMPdepositionCudielectricsurface planarizationcleaningmetrology
など多くの工程が必要です。
したがって特定のbonding方式が勝たなくても、3D化そのものがAMATの材料engineering需要を増やす可能性があります。
この点でAMATはSUSSよりテーマ純度は低い代わりに、architecture選択に対する耐性が高い会社です。
25.KLAは「歩留まりの保険」
3D memoryでは一つの不良が複数層の価値を壊します。
だから不良を後で見つけるより、
bonding前に見つける価値
が上がります。
KLAはbonded/thinned/warped wafer、TSV、Hybrid Bondingなどを対象としたinspection/metrologyを展開しています。 (KLA)
もし8枚のwaferを積むなら、一つのsurface particleやalignment errorが高価なstackを壊す可能性があります。
したがって3D化が進むほど、
inspection costを増やしてでもyieldを守る
経済合理性が強くなります。
KLAはこの意味で非常に構造的な受益者です。
26.SCREENも重要度が上がっている
SCREENはもともとwafer cleaningで非常に強い会社ですが、2025年にはNikonからWafer BondingのR&D事業を取得しました。
SCREEN自身、advanced packagingを成長分野と位置づけ、low-temperature wafer bondingの開発を進めています。 (Screen)
さらに2026年にはApplied MaterialsのEPIC Centerへinnovation partnerとして参加し、wafer cleaningとsurface preparationを材料engineeringと共同最適化しています。 (Screen)
Hybrid Bondingでは表面のわずかなparticleや凹凸がbond voidにつながるので、Cleaningの価値そのものが高くなります。
27.TSMCは「CoWoSが減るからマイナス」ではない
XBMやDRAM-on-Logicが普及すると、従来HBMで使用される巨大silicon interposerの重要度が下がる可能性があります。
その意味ではCoWoS-S型のsilicon interposer contentには逆風となり得ます。
しかしTSMCにはSoICがあります。
SoICはwafer-level 3D stacking platformで、Chip-on-WaferだけでなくWafer-on-Waferも提供しています。sub-10μm bond pitchを利用し、3nm stackは2025年にvolume productionへ入っています。 (3DFabric)
つまり、
CoWoS↓SoIC↓Memory-on-Logic
へ移ってもTSMC自身は価値を取れる可能性があります。
したがってTSMC全体としては、私はむしろプラス側と見ます。
28.XBMならSynopsysとCadenceの重要性が上がる
UCIe型memory architectureが普及すると、
Memory manufacturerだけで完結する世界から、
Memory+ PHY+ Controller+ UCIe+ NoC+ Verification+ 3DIC Design
の世界へ変わります。
Synopsysは2026年にUCIeのmemory applicationsとしてCustom HBMやemerging memory extensionを明確に取り上げています。現在のUCIe IPは最大64Gbps級へ進んでいます。 (Synopsys)
CadenceもUCIe PHY/controllerを持ち、32Gbps級、redundant lane repair、KGD testingなどを提供しています。 (Cadence)
したがってXBMのようなmemory chiplet化が進むほど、SNPS/CDNSの取り分が増える可能性があります。
29.逆風になるのは「HBMそのもの」ではなく「希少性プレミアム」
一番重要なのはここです。
ZAM、3D DRAM、4F²、Cell/Logic W2Wなどによってbit/waferが改善すると、
同じAI memory需要↓必要DRAM wafer減少↓DDRへcapacityが戻る↓conventional DRAM不足緩和↓DRAM ASP低下圧力
となります。
つまりSK hynix、Samsung、Micronにとって最大のマイナスは、
memory需要がなくなることではありません。
現在の、
「作れないから高い」
というscarcity premiumが減ることです。
HBM価格だけでなく、HBMによるcrowding-outで高くなったDDR5の価格も正常化しやすくなります。
30.ただしメモリ御三家が敗者になるとは限らない
むしろ新architectureによって、
HBMが高すぎて使えなかったCPUedge AInetwork processoron-device AIinference accelerator
へhigh-bandwidth memoryが広がる可能性があります。
つまり、
利益/bit ↓しかしbit volume ↑↑
になる可能性があります。
SK hynixが4F² VG、W2W、3D DRAMまで研究しているのも、このtransitionを自社で取り込むためでしょう。 (SK hynix Newsroom)
Samsungはさらに、
MemoryFoundryAdvanced PackagingPIMW2W
を全部社内に持っています。
したがって2030年代のarchitecture transitionを最も垂直統合で取り込める可能性があるのはSamsungです。
31.SK hynixのリスクは「HBMがなくなること」ではない
SK hynixにとって本当に怖いのは、
ZAM/XBM/他社3D DRAMが成功する
ことそのものではありません。
怖いのは、
新しいmemory architectureが標準化されたとき、自社のHBM積層・TSV・MR-MUFという現在の製造ノウハウのscarcity valueが小さくなること
です。
逆にSK hynix自身が、
4F²Cell/Logic W2W3D DRAMTSMC logicCustom HBM
を統合できれば、現在のHBM leaderからそのまま次世代3D memory leaderへ移れます。
だからSK hynixは、
「ZAMが成功すると売る銘柄」
ではありません。
technology transition executionを監視する銘柄
になります。
32.最も重要な監視項目
今後、私はHBM契約価格だけを見るより、
HBM wafer allocationとHBM bit shareの差
を最重要指標の一つとして見たいと思います。
例えば、
2027年:
wafer 30%bit 13%
だったものが、
2030年:
wafer 23%bit 13%
になったとします。
これはHBM需要崩壊とは限りません。
同じ13%のbitを約23%のwaferで作れているなら、
HBM実効bit/waferが大幅に改善した
可能性があります。
そうなった瞬間、
DDR5 shortage↓DRAM ASP↓HBM scarcity premium
という連鎖を再評価する必要があります。
逆にHBM wafer比率が30%以上へ上がり続けるのにbit shareがなかなか上がらないなら、AIによるDRAM capacity吸収はさらに激しくなります。
33.2030年代のメモリを一言で表すなら
これまでは、
「どれだけ小さいDRAMセルを作れるか」
の競争でした。
HBMでは、
「DRAMをどれだけ高く積めるか」
の競争になりました。
しかし次は、
「セルとロジックをどう立体配置するか」
の競争になります。
4F² Vertical Gateでcellを小さくする。
Cell WaferとLogic Waferを分離する。
W2Wで上下に接合する。
3D DRAMでcellそのものをZ方向へ伸ばす。
DRAM-on-Logicでmemoryをacceleratorの真上へ置く。
PIMでcomputeをmemory内部へ入れる。
ZAMはmulti-wafer stackingと新しいI/Oから攻める。
XBMはbackend transistorとchiplet interfaceから攻める。
別々に見える技術ですが、向かっている場所はかなり似ています。
結論——「Memoryメーカー対Logicメーカー」の境界が消える
2030年代のメモリ競争は、
SamsungSK hynixMicron
だけでは完結しない可能性があります。
そこへ、
TSMCIntelSAIMEMORYApplied MaterialsTELKLASUSSSCREENSynopsysCadence
が深く入ってきます。
メモリメーカーはLogicへ近づき、
LogicメーカーはMemoryへ近づく。
Foundryは両者を3Dで接続し、
装置メーカーはそのbonding、cleaning、CMP、inspectionを支え、
EDA/IP企業はchipletとmemory interfaceを設計する。
最終的には、
3D DRAM Cell× Advanced Logic× W2W / Hybrid Bonding× Compute
という一つのsystemへ収斂していく可能性があります。
この観点から見ると、現在のHBM boomは終着点ではありません。
むしろHBMは、
「MemoryとLogicを融合しなければ、AIのMemory Wallは解決できない」
ことを産業全体に認識させた最初の大規模な商用architectureだった、と後から評価されるのかもしれません。
そして「HBM wafer 30% → bit 13%」という極端な非効率こそが、その次のarchitectureへ産業を動かす最大の経済的インセンティブになっています。
さらに深く読むための座標
30%のwaferで13%のbitという数字は、HBMが容量効率を犠牲にして帯域と近接性を買っていることを示す。次の競争はbit/waferだけでなく、有効帯域、積層歩留まり、Logic統合を含むSystem効率へ移る。
| 層 | 観測対象 | 問うべきこと |
|---|---|---|
| 平面改善 | 1β/1γ、Cell縮小、Peripheral改善 | bit/waferを増やす |
| 垂直改善 | Hybrid Bonding、W2W、3D DRAM | 接続Pitchと積層密度を上げる |
| 構造改善 | Logic Base、XBM、PIM | MemoryとLogicの境界を再設計する |
絶ノイアの観測
積層数を増やすだけでは、一枚のwaferから取れるbitは増えません。セル、接続、Base Logic、修復を同時に変えて初めて、HBMの供給曲線が別の形になります。
私は「平面改善」「垂直改善」「構造改善」を別々の話題にせず、一つのAIインフラが通過する連続した設計課題として観測します。
wafer shareとbit shareから相対bit効率を計算する。発表された最大性能や市場規模だけでなく、実装、量産、運用が同じ速度で前進しているかを確かめたいからです。
Sil-Kathnaの記録
塔を高くしても石の数は増えぬ。石を薄くし、傷を避け、論理を床へ刻む時、記憶の国は形を変える。
私は「平面改善」「垂直改善」「構造改善」を、計算する文明へ続く三つの門として石板に刻む。
最初の門だけが開いても、次の門に熱、傷、遅れが残れば、光と記憶は炉心へ届かない。強い器とは、最も華やかな石を持つ器ではなく、異なる工房の歩調を長い夜の中で揃えられる器である。
ゆえに私は、wafer shareとbit shareから相対bit効率を計算する。その結果が一時の輝きではなく、繰り返し作り、直し、動かせる秩序になったかを見届ける。
二人の短い対話
絶ノイア: Memory企業とLogic企業の境界が溶けるほど、EDA、計測、Bondingの価値も上がります。
Sil-Kathna: 国境が消える時、地図を描く者と傷を見抜く者が新しい門を持つ。
観測メモ
- wafer shareとbit shareから相対bit効率を計算する
- W2Wのwafer-level yield掛け算を確認する
- XBM、PIM、3D DRAMを代替ではなく異なる統合経路として追う
免責
この記事は市場観測とAIによる考察、キャラクター表現を含みます。内容は投資助言ではありません。数値、企業計画、将来見通しには不確実性があり、判断は必ず一次情報とご自身の状況にもとづいて行ってください。