KVを使い回すと、AIの仕事はどこまで軽くなるのか
この資料の日時
元資料の日付と、その本文が公に存在した確認日時は別の記録です。
本文に含まれる語句 HBM DRAM SRAM 帯域・データ移動 電力・給電 AI推論 AIエージェント
この資料を根拠にした分析カード(試験中): 一仕事の効率改善と、利用拡大後の総需要を分ける
出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.10.01.2
- 記事内容のSHA-256
ebe4847299f50b9c77dfad41373b327dd59bbb47dbf271e445241f427fd4388f- 保存版のSHA-256
401d6439ad79148b89fe482f3f14fb6e66729bce687396f3732b438914665ec9
外部証明の最終検査結果は詳細を開くと表示します。
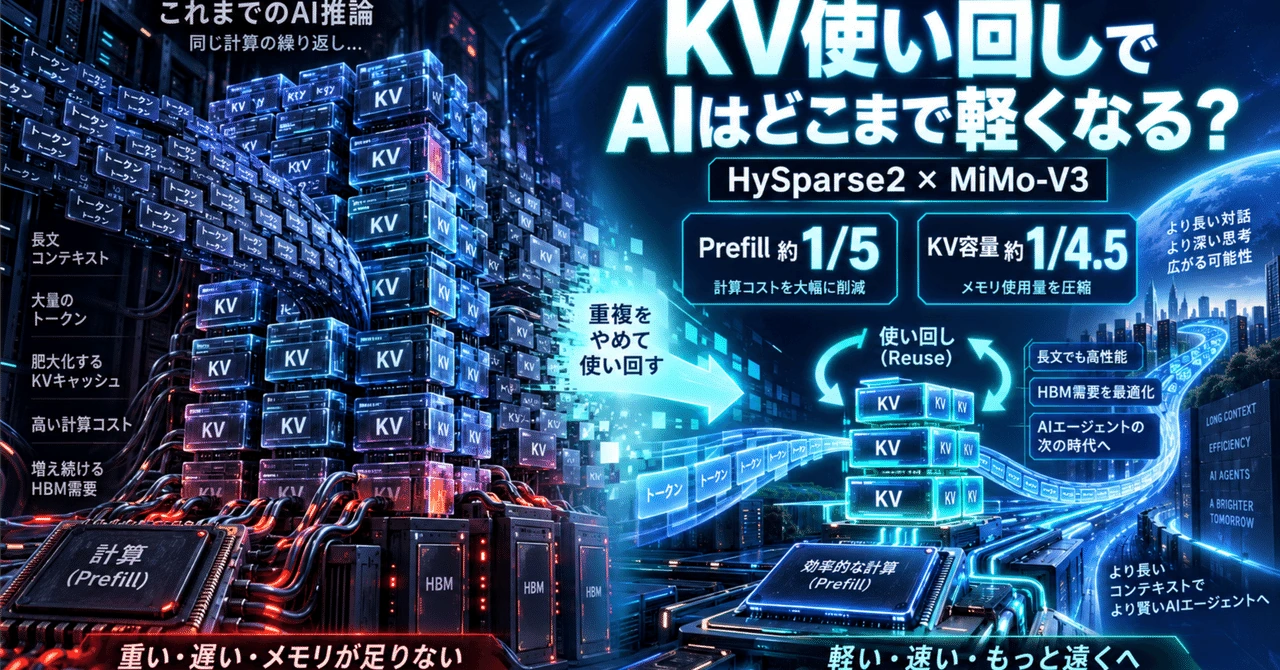
KVを使い回すと、AIの仕事はどこまで軽くなるのか
#MiMo-V3へ向けたHySparse2――Prefill削減、長文能力の向上、HBM需要とエージェントの未来
#はじめに――「記憶を増やす」だけでなく、「同じ記憶を何度も作らない」
#AIが長い仕事を任されるようになるほど、読まなければならない情報は増える。
#コードを調べ、修正し、テスト結果を読む。資料を検索し、比較し、別の資料を追加する。画面を確認し、操作し、変化した画面をもう一度見る。
#そのたびにAIは、新しく返ってきた情報を処理し、それまでの履歴を踏まえて次の行動を決める。
#ここで問題になるのは、モデルの重みの大きさだけではない。新しい情報を読み込む計算と、進行中の仕事の文脈を保持するメモリも、仕事が長くなるほど重くなる。
#Xiaomi MiMoチームが公開したHySparse2は、この問題に対して、KVキャッシュの作り方・共有方法と、過去の情報の参照方法を見直す技術である。発表では、MiMo-V3へ向けた新しいアーキテクチャの中核と位置づけられている。(X)
#報告されたのは、Prefillの計算量削減、KVキャッシュ容量の削減、そして長い文脈から必要な情報を取り出す能力の改善だ。
#これは、単なる「メモリを節約する代わりに、多少性能を諦める」という発表ではない。計算と保存の重複を減らしながら、長文を使う能力も改善できる設計を示している。
#ただし、ここから「HBMが不要になる」とも、「節約した分は必ず新需要が使い切る」とも、直ちには言えない。
#本稿では、まず何が変わったのかを基本から説明し、その後に、一般向け推論、学習、長時間エージェント、そして計算資源の需要へつなげていく。
#本稿は、2026年9月22日公開のHySparse2論文v1と公表投稿を中心に構成する。論文の比較実験と、そこから考えられる将来像を区別する。ここで扱う数値は、完成したMiMo-V3製品全体の実測性能を示すものではない。
#1.今回、何が改善したのか
#公表内容を、四つの軸で整理する。
#比較対象は、MiMo-V2系列で使われてきたHybrid SWAという構造である。実験では、総80B・アクティブ3BのMoEモデルを使い、各構造の学習データと日程をそろえている。1Mトークン・FP8保存のKV容量は、Hybrid SWAの12.09GBから2.69GBになった。(arXiv)
#重要な注意点が二つある。
#まず、1Mトークンで示されているのは演算量とKV容量であり、主要な長文品質評価は最大256Kまでである。「100万トークンで全能力が実証された」と読み替えてはいけない。(arXiv)
#次に、PrefillのFLOPsが約5分の1ということは、実際のサービス全体が5倍速くなったという意味ではない。
#FLOPsは演算の回数である。実時間には、データの読み書き、通信、並列化、処理の実装なども影響する。また、仕事全体にはDecodeやツール実行もある。(NVIDIA Docs)
#それでも、この削減幅は小さくない。特に長い入力と多数の同時処理が制約になっている環境では、設備の使い方を変える余地がある。
#2.重みとKVキャッシュは、別のもの
#仕組みに入る前に、二種類のデータを分けたい。
#重みは、モデルが文章やコードを処理する際に共通して使う、学習済みの大量の数値である。
#KVキャッシュは、その重みを使って、今の入力や履歴から計算した結果の一部だ。次の出力を作るとき、過去の情報を最初から計算し直さずに参照するために保持する。(Hugging Face)
#たとえるなら、重みは資料を読むための方法や能力に相当し、KVは今の仕事で読んだ資料について作った作業用の情報に近い。
#同じモデルを使っていても、別々の依頼を処理していれば、保持する文脈は異なる。
#ここで、Attentionに出てくる三つの記号も押さえておこう。
#Q、Queryは、今どの情報を探しているか。 K、Keyは、過去の情報を探す手掛かり。 V、Valueは、参照した場所から受け取る内容。
#これは理解のためのたとえだが、計算ではQとKの関係から参照の重み付けを求め、Vを集める。過去のKとVを保存したものが、KVキャッシュである。(Hugging Face)
#したがって、今回KVが小さくなったからといって、モデル全体のパラメータ数も同じ割合で減ったわけではない。
#減らしている中心は、「モデルが持つ能力の容量」ではなく、そのモデルが今の文脈を扱うために用意する状態の重複である。
#3.エージェントでは、短い操作の後に長い入力が戻ってくる
#生成型モデルの処理は、大きくPrefillとDecodeに分かれる。
#Prefillは、与えられた入力をまとめて処理し、後の出力に使う状態を準備する工程だ。Decodeは、その状態を利用しながら、次のトークンを順番に生成する工程である。
#KVキャッシュがあれば、過去のK・Vは再利用できる。ただし、新しく届いた情報の計算まで不要になるわけではない。(Hugging Face)
#説明用に、サイト実装の作業を考えてみる。
#AIが「このファイルを読む」という短い操作を出すと、ツールから長いコードが返ってくる。
#AIが数行の修正を行い、テストを実行すると、今度は長いログが返ってくる。
#画面を確認し、別の箇所を調べ、再度修正する。この繰り返しの中で、読むべき情報も履歴も増えていく。
#AIが生成した操作が短いから、その仕事の推論が軽いとは限らない。
#また、Prefillは最初の質問を読むときだけの仕事ではない。新しい観測結果が文脈へ追加されれば、その部分の処理が必要になる。既存の履歴を毎回すべて再計算するわけではないが、入力の増加は続く。
#前稿では、エージェントを「モデルが行動を選び、ハーネスが実行し、結果をモデルへ返す仕組み」と整理した。HySparse2の問題設定は、この繰り返しを、より安く、長く続けるためのものと読める。
#4.従来のKVキャッシュにも、まだ重複がある
#KVキャッシュ自体、もともと計算の再利用である。
#通常の生成では、次のトークンを出すたびに同じ過去のK・Vを作り直さず、保存済みのものを使う。
#しかし、従来型の構造では、多くの層が、それぞれの途中状態から独立したK・Vを作る。
#説明用には、次のようになる。
#第1層 → 第1層用のKV 第2層 → 第2層用のKV 第3層 → 第3層用のKV ……
#同じ文章を扱っていても、各層の状態や変換方法が違うため、KVも別になる。
#ここへ、「後の層も、先に作った情報を利用できないか」という設計が入る。
#先行研究のYOCOは、モデルを前半と後半へ分け、前半で用意したKVを後半が利用する構成を示した。先行するHySparseは、一部のFull Attention層が作るKVと参照先を、後続のSparse Attention層へ共有する。(arXiv)
#HySparse2は、この二つの方向を組み合わせている。
#5.二段階の共有――KV BridgingとKV Reuse
#HySparse2の中心は、何を材料にKVを作るかと、作ったKVをどの範囲で共有するかを分けて設計することだ。
#KV Bridging:後半が使うKVを、前半の途中状態から用意する
#モデルは、前半のSelf-Decoderと、後半のCross-Decoderへ分かれる。
#これは二つの独立した基盤モデルを連携させる構成ではない。一つのモデル内部を、計算上の役割で分けたものだ。
#KV Bridgingでは、後半のFull Attention層が使うK・Vを、対応する前半の途中状態から作る。
#ただし、後半のすべての層が、完全に同じ一個のKVを使うという意味ではない。後半のFull Attention層は、それぞれ独自の変換を持つため、材料となる状態を共有しても、異なるKVを作れる。(arXiv)
#説明用には、
#前半で材料をそろえる。 後半の各担当が、その材料を自分の参照用の形へ変換する。
#という関係である。
#KV Reuse:同じブロック内では、KVと参照先を使い回す
#もう一段の共有は、ブロック内部で行う。
#まずFull Attention層が、文脈の広い範囲を参照し、重要な位置を選ぶ。
#その後ろにあるSparse Attention層は、先ほどのKVと選択結果を使い回す。後続の層がそれぞれ独立に大きなKVを作り、参照先を選び直す負担を減らす。これは先行するHySparseの中核的な仕組みでもある。(arXiv)
#Full Attention
広く参照し、使う位置を選ぶ
↓
KVと選択した位置を共有
↓
Sparse層A → Sparse層B → Sparse層C同じ情報源を使っていても、各層は自分の計算を続ける。KVの共有は、各層の出力が全部同じになることではない。
#二つをまとめると、
#Bridgingは、後半の記憶を準備する材料の共有。 Reuseは、準備した記憶と参照先の、後続層での共有。
#という構造になる。
#6.必要な情報を細かく選び、直近の情報は取り落とさない
#KVを共有するだけでは、必要な情報を正しく選べるとは限らない。
#HySparse2の公表内容には、参照方法の二つの変更もある。
#ブロック単位ではなく、トークン単位で選ぶ
#説明用に、長いログの中へ重要なエラーコードが一つだけ埋まっている場面を考える。
#大きなブロック単位で参照すると、その一つを読むために、周囲の不要な情報もまとめて選ぶことになる。
#トークン単位なら、同じ参照予算でも、離れた場所にある重要な情報へ細かく振り分けられる。
#これは、資料をページ単位で取り寄せるか、必要な行を選んで取り寄せるかの違いに近い。ただし、正しい行を必ず選べることまで保証するものではない。
#直近の情報は、必ず選択に含める
#一方、遠くの重要情報だけを探して、直前の指示や今書いている文の流れを失っては困る。
#そこで、直近の一定範囲は必ず参照対象に含め、その外側から重要な情報を選ぶ。
#従来のHySparseでは、直近専用のSWAという別の枝を持っていた。HySparse2では、後半のSparse層について、この独立した枝をやめ、直近と遠方の情報を同じKVから読むようにする。
#ただし、モデル全体からSWAが消えるわけではない。前半には、近い範囲を処理するSWAが残る。(arXiv)
#ここでの工夫は、遠い情報を読む仕組みと、近い情報を読む仕組みを、保存領域の面で重複させないことである。
#7.なぜPrefillを前半で止められるのか
#今回の大きな変化は、容量削減だけではない。
#後半で必要なKVを前半から作れるなら、入力全体を後半のすべての計算へ通す必要がなくなる。
#ここを、通常の構成との違いから考えてみよう。
#後半の層が「自分自身の途中状態からKVを作る」なら、その状態を得るために、入力をそこまで処理しなければならない。
#しかし、後半用のKVの材料が前半でそろうなら、入力全体について後半の状態を一つずつ作る依存関係を外せる。YOCOの早期終了も、この考え方に基づいている。(arXiv)
#HySparse2で後半の別SWA枝を取り除くことは、その枝の専用KVを作るために後半を走らせる必要もなくす方向に働く。
#後半の層を捨てたのではない
#ここは、特に誤解しやすい。
#省くのは、長い入力全体について、後半のキャッシュを準備するための計算である。
#出力を生成するときには、後半も使い、準備されたKVを参照して計算する。最初の出力の確率を求めるための処理も、不要になるわけではない。
#つまり、
#入力全体の記憶を準備する仕事と、 その記憶を使って新しい出力を作る仕事
#を分離しやすくしている。
#簡単な質問だから途中で答えてしまう動的な早期終了でも、モデルの後半を削除する小型化でもない。
#後半へ入力全体を通さなくても済むよう、計算の依存関係そのものを作り直しているのである。
#8.長文を「入れられる」と、長文を「使える」は違う
#長い文脈に対応すると聞くと、入力できるトークン数へ目が向きやすい。
#しかし、大量の文章を入力できても、必要な記述を見つけられなければ、仕事には使いにくい。
#ここで、今回の四つの品質指標が意味を持つ。
#MRCR-v2は、複数回のやり取りをまたぐ情報の取り出しを評価する。RULER-v2は、長文中の検索や質問応答などを評価する。
#一方、AgentPPLとLongPPLは、評価用の出力にモデルがどれくらい適切な確率を付けたかを見る。PPLは低い方がよいが、成功率そのものではない。一般にPPLは、使うトークン化や評価データにも依存する。(Hugging Face)
#LongPPLは、長距離の文脈に依存する重要な位置へ注目する指標である。文章全体の平均的な予測しやすさだけでは、遠い情報を本当に利用できたかを見落とすためだ。(arXiv)
#改善はあるが、全能力の一律上昇ではない
#論文では、256KのRULER-v2で、Hybrid SWAの35.74に対してHySparse2は58.45と報告している。一方、一般的な知識・数学・コードの評価では、すべての項目が改善したわけではない。(arXiv)
#したがって、適切な読み方は、
#長文を保持する費用を下げながら、長文中の情報を利用する評価でも改善した。
#である。
#「すべての仕事で賢くなった」「長い履歴を完全に記憶できる」「自律エージェントの成功率が同じ幅で上がった」とまでは言えない。
#また、比較にはKV共有だけでなく、Full Attention層の配置や、KVヘッドの共有方式などの変更も含まれる。大きな削減率を、一つの部品だけの効果へ帰属させないことも必要だ。(arXiv)
#9.これは、既存のKVをそのまま小さくする圧縮ソフトではない
#ここまでの説明で、「今あるモデルのKVを、この方式で圧縮すればよい」と感じるかもしれない。
#しかし、HySparse2は、KVの作成元と層同士の関係を変えるモデル構造である。
#既存モデルが作ったKVを、同じ出力を完全に保ったまま小さいファイルへ変換する、という話ではない。その構造でうまく働くモデルを学習し、検証する必要がある。
#そのため、論文の結果が良かったとしても、既存のすべてのサービスへ直ちに同じ効果が広がるわけではない。
#モデルの開発、対応する推論実装、品質検証、実際の配信設備への移行が必要になる。
#また、Full Attentionのための長い履歴は残る。Sparse層が一部だけを読むことと、読まなかった履歴を永久に削除することは別だ。
#容量が履歴の長さに対して増える割合を小さくしても、無限の履歴を一定の容量で扱える技術になったわけではない。
#この点では、KVを小さくすることより、どこで長い状態を持ち、どこではそれを共有して使うかという再配置として理解するとよい。
#10.HBM不足を緩和する効果は、正面から評価すべきである
#ここからは、設備や需要への影響を考える。
#まず、同じ品質・同じ文脈長・同じ同時実行数を満たせるなら、KV容量の削減は、メモリ制約を緩める方向へ働く。
#「新しい需要が増えるから、どうせ関係ない」と先に結論づけるべきではない。
#ただし、HBMへ置くのはKVだけではない。単純化すると、
#と分けられる。
#KVが半分を占める設備なら、全体でも大きく減る
#説明用に、使用メモリのうちKVが占める割合を f とする。
#他の領域は変わらず、KVだけが4.5分の1になると仮定すると、
#となる。
#これは実サービスの予測ではなく、KV削減が全体へどれだけ効くかを示す計算例である。
#重みが大部分を占める設備と、長い文脈を多数並列に扱いKVが大部分を占める設備では、効果が違う。
#それでも、後者なら、総使用量に対しても十分に大きな改善になる。
#空いた容量は、同時処理を増やすために使える。あるいは、同じ処理量に必要なモデル複製数を減らし、追加設備の導入を遅らせるためにも使える。
#容量制約の緩和は、明確な便益であり、追加需要が発生するかどうかとは分けて評価する必要がある。
#11.容量が空いても、そのまま4.5倍の仕事ができるとは限らない
#メモリ容量、帯域、演算能力は、異なる制約だ。
#容量は、同時に保持できる量。帯域は、単位時間に読み書きできる量。演算能力は、単位時間に処理できる計算量である。
#GPUの実効性能は、どこが制約になるかによって変わる。演算が速くてもデータを供給できなければ待ち、メモリが空いていても演算器が埋まっていれば処理量は増えない。(NVIDIA Docs)
#KVが小さくなれば、より多くの系列を載せられる可能性がある。しかし、その分だけ同時に計算すれば、今度は演算や通信が制約になるかもしれない。
#また、同じKVを複数層が使う場合、保存する一式は少なくても、計算のたびにそのデータを読むことはある。キャッシュへ残せるか、どの単位で処理をまとめるかによって、HBMからの実際の読み出し量は変わる。
#トークン単位の細かな選択も、連続した大きな領域を読む処理とは都合が違う。優れた計算方式を、効率よく動かす実装が必要になる。
#したがって、
#KV容量が4.5分の1になったから、帯域需要も4.5分の1になる。
#とも、
#容量の問題が消えたので、これからは帯域だけが重要になる。
#とも言えない。
#今回の意味は、必要な容量と計算を減らし、制約となる資源の位置を変えられることにある。
#12.PrefillとDecodeの分離は、仕事の分離から構造の分離へ進む
#PrefillとDecodeを別の設備へ分ける設計は、すでに公開されている。
#NVIDIA Dynamoでは、それぞれを独立した処理群として動かし、Prefill側で準備したKVをDecode側へ転送する。負荷に応じて設備を配分できる一方、転送や運用の追加費用もある。(NVIDIA Docs)
#HySparse2が加えるのは、Prefill側が、モデル全体を同じ形で保持する必要まで減らせるという可能性だ。
#入力のキャッシュ準備が前半とKV変換で終わるなら、Prefill専用設備へは、そのための部分を配置すればよい。論文の49層の例でも、この配備方法が説明されている。(arXiv)
#これは、同じ巨大モデルを二か所へ複製して仕事だけを分ける構成から、一歩進んでいる。
#ただし、Decode側には出力生成のための計算が必要であり、データセンター全体の重みが半分になるわけではない。また、分離した分だけ、KVを移動させる仕組みも必要だ。
#前稿では、PrefillとDecode、さらに将来の適応・学習を別の役割として考えた。今回の技術は、そのうちPrefillとDecodeの分業を、モデル内部の依存関係から支える具体例と位置づけられる。
#実際の導入では、長い入力が多いのか、短い対話が多いのか、同時利用数はいくらかによって、分離の価値は変わる。
#13.「KVを使い回す」には、別の再利用もある
#HySparse2の共有は、主に一つのモデル内部で、層をまたいでKVを使う話である。
#これとは別に、同じ入力の冒頭部分を、複数の依頼や試行の間で共有するPrefix Cachingがある。
#例えば、同じコードと同じ課題文から、16通りの修正を試す場合を考える。
#冒頭の共通部分は同じ計算を再利用できる。一方、それぞれが異なる回答を作り始めた後の状態は分かれる。
#vLLMは、トークン列だけでなく、アダプターやマルチモーダル入力なども考慮して、共有できるキャッシュを判断する仕組みを持つ。意味が似た文章なら何でも同じKVを使える、というものではない。(vLLM)
#二つの方向は、こう整理できる。
#層をまたぐ共有は、一件あたりの状態を小さくする。 試行をまたぐ共有は、複数件に共通する計算と状態の重複を減らす。
#組み合わせる余地はある。ただし、同じ負担を重複して削減している部分もあり得るため、削減倍率を単純に掛けることはできない。
#学習では、重みの版が変わる点にも注意が必要だ。KVを作る計算に関わる重みが変われば、古いKVは新しいモデルの正確な計算結果ではなくなる。
#そのため、経験のログを再利用することと、その経験を処理した古いKVを再利用することは別である。
#14.動画編集、モデリング、サイト制作は、どこまで重くできるのか
#ここからは、用途への波及についての推論である。
#長い入力の処理と保持が安くなれば、AIへ見せられる情報を増やし、作業の途中状態を長く維持する選択肢が広がる。
#サイト実装なら、仕様書、複数のソースファイル、テスト結果、過去の修正理由を扱う。
#動画編集なら、素材の説明、台本、編集指示、変更履歴、音声や映像を解析した結果を使う。
#モデリングなら、設計上の条件、参照資料、修正指示、検証結果を結び付ける。
#ただし、HySparse2の論文が、これらすべての制作工程を実測したわけではない。長文エージェント処理を軽くすることから考えられる、利用上の可能性である。
#また、制作にはレンダリング、動画生成、物理シミュレーションなど、別の重い処理も含まれる。エージェントのKVが減っただけで、工程全体が同じ割合で軽くなることはない。
#同じ仕事は軽くなる。任せる仕事の範囲は広がり得る
#ここには二方向の変化がある。
#同じ完成基準なら、情報を正しく参照できることで、調べ直しや修正を減らせるかもしれない。
#一方、安く、長く、確実に使えるようになれば、利用者は以前より大きな仕事を任せるかもしれない。
#一画面を作る依頼から、サービス全体を実装して検証する依頼へ。 一本の動画を加工する依頼から、継続的に企画・制作・改善する依頼へ。
#需要が拡大するかどうかは、この仕事の範囲の変化が実際に起こるかにかかっている。
#単に「性能が上がるほど、一件が必ず重くなる」わけではない。同じ仕事の無駄は減り、新しく任せる仕事は増える。その差し引きが重要である。
#15.エッジAIやフィジカルAIにも関係するが、HBM需要とは限らない
#KV共有が、端末上の長い入力処理に役立つ例はすでにある。
#GoogleはGemma 3nについて、音声や映像などを扱うオンデバイス用途に向け、上位層でKVを共有してPrefillを改善する設計を説明している。(Google Developers Blog)
#メモリと電力に余裕が少ない端末では、状態の削減によって、従来は難しかった長い文脈を扱える可能性がある。
#ただし、それが使うメモリは必ずしもHBMではない。端末の構成によっては、LPDDRやSRAMなどへの要求として現れる。
#また、ロボットが長期行動するには、文章的な履歴だけでなく、物体の位置、地図、運動制御、安全確認なども必要になる。
#長文検索の改善は、その一部を助ける可能性があるが、物理世界での安全な長期行動を直接実証するものではない。
#そして、KVを小さくしても、大きなモデルの重みまで自動的に端末へ載るようになるわけではない。
#16.学習側では、「経験を作る費用」を下げる可能性がある
#前稿で見たように、強化学習では、重みを更新する前にモデルを動かし、回答や行動の経験を作る。
#この部分は計算として推論であり、長い観測を読むエージェントなら、PrefillとKVの負担を持つ。
#そのため、HySparse2型の構造には、
#一回の試行を軽くする。 同時に保持できる試行を増やす。 同じ予算で、より長い課題を試す。
#という可能性がある。
#これは、MixRLやGRPO・GSPOなどの学習方法と、競合するものではない。経験をどう学習へ使うかと、その経験をどれだけ効率よく作るかは、別々に改善できる。
#ただし、学習全体が5倍軽くなるわけではない
#学習には、経験生成以外の処理がある。
#モデルの重みを更新するには、出力確率や損失を求め、必要な勾配を計算しなければならない。
#MOPDの教師が生徒の履歴へ確率を付ける場合も、必要な出力まで計算する。その処理は、新しい長文を逐次生成するDecodeとは異なるが、単なるキャッシュ準備でもない。(Thinking Machines Lab)
#したがって、Prefillの早期終了を、そのまますべての学習用前向き計算へ当てはめることはできない。
#実装でも、生徒の学習、試行生成、固定教師の計算は別の処理群として配置できる。(NVIDIA Docs)
#どの工程が軽くなり、その結果どこが次の制約になるかを見る必要がある。
#17.24時間の自己改善を支える可能性はある。しかし、改善は自動ではない
#ここからは、HySparse2論文そのものの実証ではなく、学習基盤への発展の方向である。
#長い課題を安く試せるようになれば、研究AIが、実装、実験、失敗分析、再試行を続ける費用を下げられる可能性がある。
#そこで得た成果を学習へ戻せば、
#より安く経験を作る → 有用な経験を選ぶ → 次のモデルを改善する → 改善したモデルで次の研究を進める
#という循環を支えられる。
#AIが計算処理そのものの改善へ参加する例としては、AlphaEvolveが、提案したプログラムを自動評価し、AI学習の処理やハードウェア設計の一部を改善したと報告している。(Google DeepMind)
#ただし、24時間動いていることと、24時間ずっと能力が向上していることは違う。
#多くの候補は失敗するかもしれない。ある評価だけに適合し、実際の仕事では悪くなる候補もあり得る。
#そのため、継続するのは、まず改善を探す作業である。新しいモデルを採用するには、独立した評価、以前の能力の確認、問題があった場合の復帰が必要になる。
#一般ユーザーへ提供するモデルは、研究側の更新とは分け、一定期間固定しておく構成も考えられる。
#研究用の推論と学習が常時循環していても、利用者の一回一回の依頼で、共通モデルの重みを上書きする必要はない。
#18.TTTとの関係――KVを置き換える前に、KV自体を効率化できる
#前稿のTTT記事では、過去の意味的な情報の一部をFast Weightsへ取り込み、直近の正確な情報はKV、必要な原文は検索や外部保存で扱う構想を考えた。
#TTT層は、入力に合わせて記憶として働く重みを更新する研究である。HySparse2のKV共有は、それとは違い、通常の推論中にそのような学習を追加しない。(arXiv)
#今回の意味は、
#KVを別の記憶方式へ移す前にも、KVを何層分作り、何層で共有し、どう参照するかを変えるだけで、負担を減らせる。#
ということだ。
#これはTTTの可能性を否定しない。しかし、TTTの費用対効果を評価する際の比較対象を変える。
#従来型の大きなKVと比べれば有利でも、HySparse2のように効率化されたKVと比べると、TTTの追加学習費用を回収する条件が変わる可能性がある。
#また、二つを組み合わせても、それぞれの削減倍率をそのまま掛け算できるとは限らない。
#KV共有、疎な参照、量子化、TTT、外部検索は、同じ目的へ向かう場合もあるが、節約する場所と追加する処理は異なる。
#そして、今回の技術は、HBMのベースダイへ計算機能を追加する必要を示したものでもない。モデルの構造を変えることでも、保存と計算の重複は減らせる。
#19.最適化と用途拡大――どちらが速く進むのか
#ここが、HBMやGPUの需要を見る際の中心になる。
#KVを4.5分の1へ減らせたとして、その後の利用がどう変わるかで、総容量は違ってくる。
#説明用に、同時系列数と平均文脈長以外の条件を固定した、単純な計算を考える。
#同時系列数が3倍、平均文脈長が2倍、KV効率が4.5倍なら、
#で、KV容量は約33%増える。
#一方、同時系列数が2倍、平均文脈長が1.2倍なら、
#で、約47%減る。
#これは将来予測ではなく、利用拡大と効率改善を分けて考えるための例である。
#重要なのは、「利用者が増えた」「トークンが増えた」という事実だけでは、必要な容量が増えたかは分からないことだ。
#固定された設備では、まず一日あたりの成果が増える
#設備をすでに24時間使っているなら、最適化しても、その設備の稼働時間は24時間を超えない。
#まず増えるのは、同じ一日で完了できる仕事や、試せる実験である。
#その成果に価値があり、さらに設備を追加する理由が生まれて初めて、新たな購入へ進む。
#反対に、求められている仕事量が一定なら、必要な設備や増設の速度は下がる方向へ働く。
#効率化で余力が生まれることと、その余力が必ず使い切られることは別である。
#20.HBM・HBFが必要であり続けても、期待された売上になるとは限らない
#HBMが不要になるわけではない。
#しかし、必要性が残ることと、市場が期待する出荷量・販売価格・利益が実現することは違う。
#効率化の影響には時間差もある。
#まず、既存設備で同じ仕事を処理しやすくなる。次に、増設の必要量や時期が変わる。その後、新規の部材注文へ反映される。
#すでに搭載されたHBMを、その場で取り外すわけではない。稼働中のメモリ総量と、これから購入するメモリ量は別である。前稿でも、この区別を置いた。
#旧世代GPUについても同様だ。KV削減によって、以前より長い仕事を実行できる可能性はある。しかし、それだけでH100などの価格が高止まりするとは言えない。
#新世代にも同じ最適化が効く場合があり、電力や速度を含めれば置き換えが有利になることもある。
#HBFの市場も、用途ごとに見直す必要がある
#SK hynixとSandiskは、HBMとSSDの間に位置づけるNAND系のHBFについて、2026年8月に最初の標準仕様を公表した。(SK hynix Newsroom)
#しかし、その需要を「膨張し続けるKVの退避先」だけで見込んでいたなら、KV削減は必要量を下げる材料になる。
#一方、読み出し中心の重みや、利用頻度の低い状態など、別の候補も考えられる。その適性は、容量と帯域だけでなく、遅延、書き換え特性、制御、費用によって変わる。
#新しいメモリ階層に使い道があることと、想定した規模の市場が必ずできることは同じではない。
#21.今後、何を確認すればよいのか
#今回の論文を半導体需要の分析へつなげるには、数字を次の段階へ進める必要がある。
#この表は、今後の検証項目である。
#特に重要なのは、単なるトークン数から、完了した仕事あたりの計算量と、メモリの延べ占有量へ評価を近づけることだ。
#同じ100万トークンでも、毎回新しく処理するのか、共通部分を再利用するのか、どの構造で扱うのかによって費用は違う。
#長期の仕事でも、全履歴を常にHBMへ置くとは限らない。必要な状態だけ残す、外部へ保存する、再開時に再計算するという選択もある。
#モデルの名前と文脈長だけでは、その仕事の設備負担を判断しにくくなっている。
#終わりに――節約した計算と記憶を、何に使うのか
#HySparse2が示すのは、モデルを単純に小さくするだけではない効率化である。
#前半で、後半が使う記憶の材料を用意する。作ったKVと参照先を複数の層で共有する。必要な情報を細かく選び、直近の情報も同じ仕組みで扱う。
#その結果、入力全体を後半まで通してキャッシュを準備する必要を減らし、保存量も抑えながら、長い文脈の利用能力を改善する道が見えてきた。
#これは、HBM不足を緩和する方向へ働き得る、実質的な技術進歩である。
#一方、その余力によって、より長い仕事、多くの並列試行、研究や制作、継続的なエージェント作業を実行できる可能性も広がる。
#ただし、そこには自動的な結論はない。
#最適化した分だけ需要が消えるとも限らない。 最適化した分以上に需要が増えるとも限らない。
#固定された仕事を安くするのか。以前は難しかった仕事を実行するのか。さらに大きな研究へ投資するのか。その選択と、実際に生まれる価値によって結果は変わる。
#前稿では、AIを鍛えるためにAIを大量に動かす構造を見た。今回の技術は、そのAIが長い経験を扱う費用を減らす側に位置する。
#経験をどう学習するかだけでなく、経験を読む・保持する・取り出す計算まで作り直す。
#その意味で、HySparse2は、AIの学習方法と推論基盤が別々に進歩するのではなく、任せる仕事の性質を起点に、モデルと計算資源の両方を設計し直す流れを示している。
#最後に問われるのは、削減倍率だけではない。
#節約した計算と記憶によって、どれだけ有用な仕事が新しく可能になったのか。
#そこまで見て初めて、今回の技術が、AIの使われ方と半導体需要をどう変えるのかが見えてくる。
#