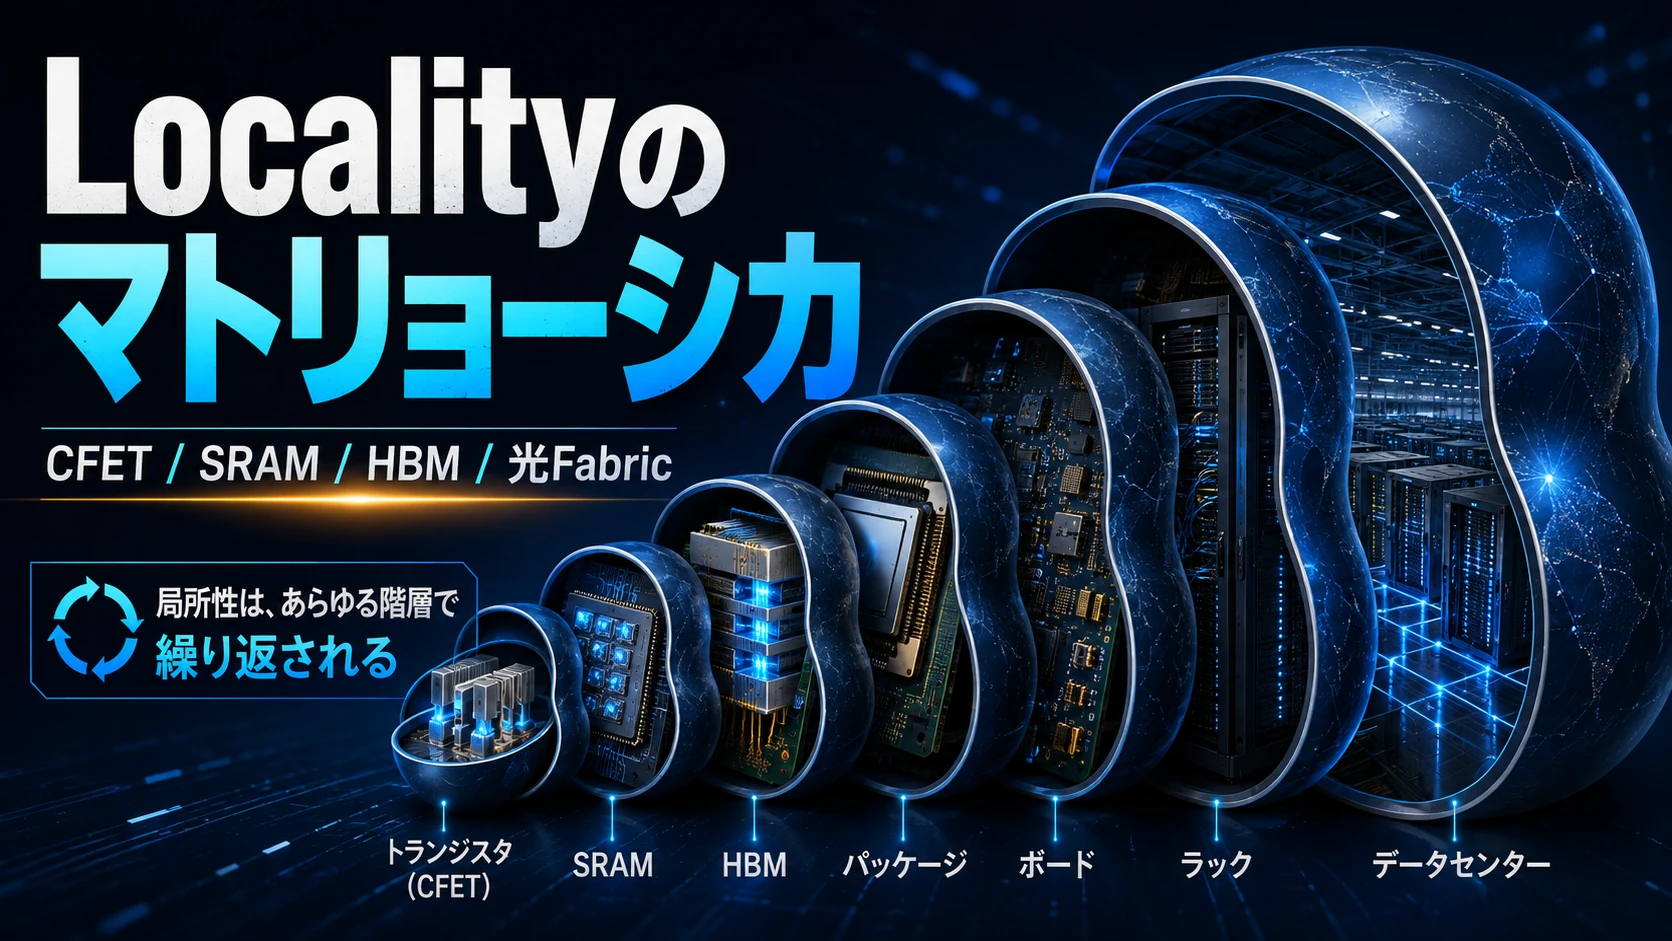
AI Factoryは「Localityのマトリョーシカ」になる――CFET・SRAM・HBM・3D実装・光Fabricを貫く物理法則
微細化、CFET、SRAM、HBM、3D実装、Optical Fabricを一つの物理法則から考える
AI半導体の進化を考えるとき、最初に置くべき問いは「次のGPUは何PFLOPSになるか」ではない。
より根源的なのは、
増え続ける演算器へ、必要なデータをどう届けるのか
という問題である。
演算器を増やすこと自体は比較的分かりやすい。
transistor densityを上げる。
dieを大きくする。
chipletを増やす。
rackへXPUを追加する。
しかし、演算器が増えれば、それに対応してweight、activation、KV cache、Expert間通信を供給しなければならない。
そこでAI computerには常に、
と、
の競争が発生する。
この関係を直感的に表現したものが、これまで使ってきた
である。
ただし、ここから一段深く考える必要がある。
N²対4Nは「ダイ外周」の話だけではない
一辺Nの正方形を考える。
面積は、
周長は、
になる。
演算器を面積中へ配置できるなら、
と考えられる。
一方、外周だけからI/Oを出す単純な構造なら、
になりやすい。
したがって大型化するほど、
が増える。
これがN²対4Nの直感である。
ただし現代のAI chipでは、signalを四辺だけから出しているわけではない。
flip-chipではdie下面全体を使える。
TSVがある。
hybrid bondingがある。
backside routingも使える。
したがって、
という厳密な物理法則があるわけではない。
むしろ本質は、
内部resourceが増える速度に、外部との接続・電力供給・熱排出能力を追随させることが難しい
ということにある。
Huaweiが示しているN²対Nの説明も、このsystem-level mismatchを強調するものと理解した方がよい。Huaweiは同時にLogicFolding、UnifiedBus、SuperPoDまで一貫して「signal propagation timeを短縮する」方向へ議論を拡張している。 (Huawei)
そして同じ問題がダイ内部でも再び発生する
ここが今回の核心である。
transistorを小さくする。
同じdie areaへ2倍のlogicを置けるようになる。
すると、
する。
しかし2倍のtransistorには2倍近いconnection requirementが発生し得る。
各gateを何かと接続しなければならないからである。
実際のVLSIでは、この問題は単純な4NよりRent's Ruleで考える方が正確である。
概念的には、
である。
(G)はlogic block内部のgate数。
(T)はそのblock外へ出るterminal数。
(p)はcircuitのconnectivityを表すRent exponentである。
つまりgate数を増やしたとき、必要I/O terminalも増えていく。ただしlocalityが高ければ、すべてのgateがblock外へ通信する必要はない。Rent's Ruleは、まさに「高次元の情報flowを2D/3D physical spaceへ埋め込むとinterconnectが制約になる」という問題を表している。 (ScienceDirect)
したがってダイ内部にも、
内部compute resourceの増加 vs それを接続するwire
という小さなN²対4N問題が存在する。
CFETは「演算器を縦へ折り畳む」
CFETはこの問題への重要な回答の一つである。
従来のCMOSでは、
nFET pFET
を横へ配置する。
CFETでは、
pFET ──── nFET
と縦へ積む。
つまり同じfootprintへより多くのlogicを入れる。
imecはCFETをGAA nanosheetの次のlogic architectureとして研究しており、double-row CFETのDTCOではA14 nanosheet SRAM比で40%以上のcell area shrink、通常のsingle-row CFET比でも15%のSRAM area reductionが可能との設計結果を示している。 (imec)
これはAIにとってかなり重要である。
なぜならCFETによって縮められるのはTensor Coreだけではない。
SRAMも縮められる。
SRAMが増えることは「HBMが増える」より別の意味で強い
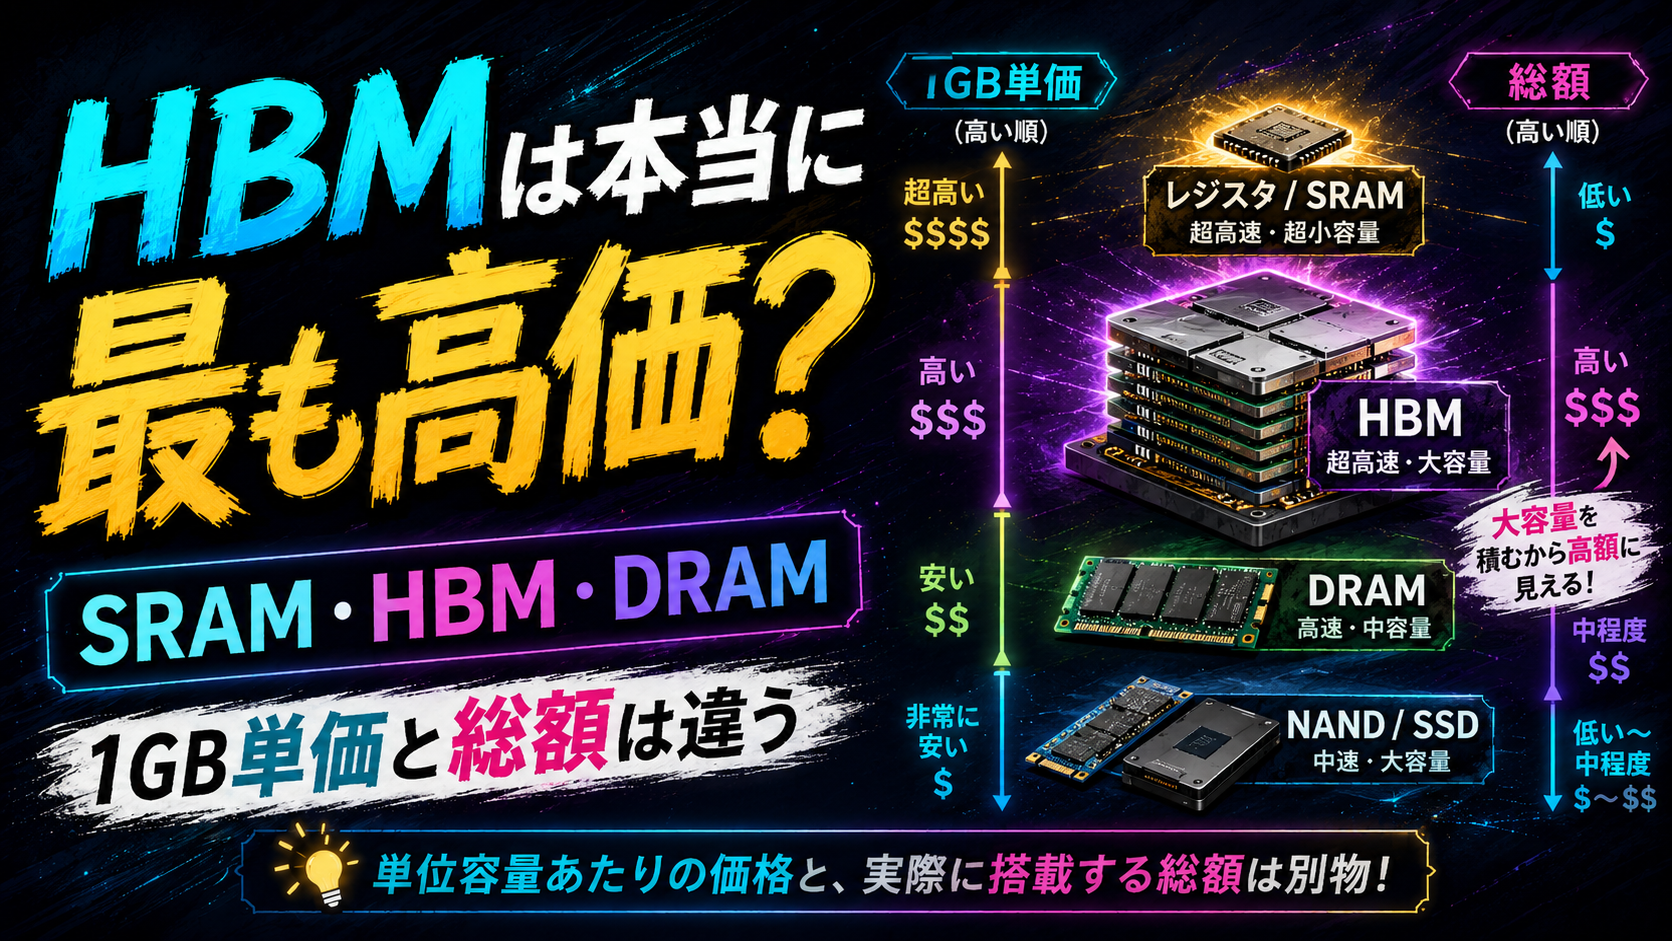
SRAMは非常に高価である。
6T SRAMなら、概念的には1 bit保持するのに複数transistorを使う。
DRAMより圧倒的に面積効率が悪い。
だからAI GPUに数百GBのSRAMを搭載するのは非現実的である。
現在の例でも、AMD MI455Xは432GBのHBM4に対してL2 cacheは192MBである。HBM bandwidthは23.3TB/sに達する。 (AMD)
つまり容量では、
である。
CFETでSRAM cell areaを40%縮めたとしても、SRAMが突然HBM並みの数百GBになるわけではない。
しかしSRAMの価値は容量ではない。
距離である。
Tensor Coreから見れば、
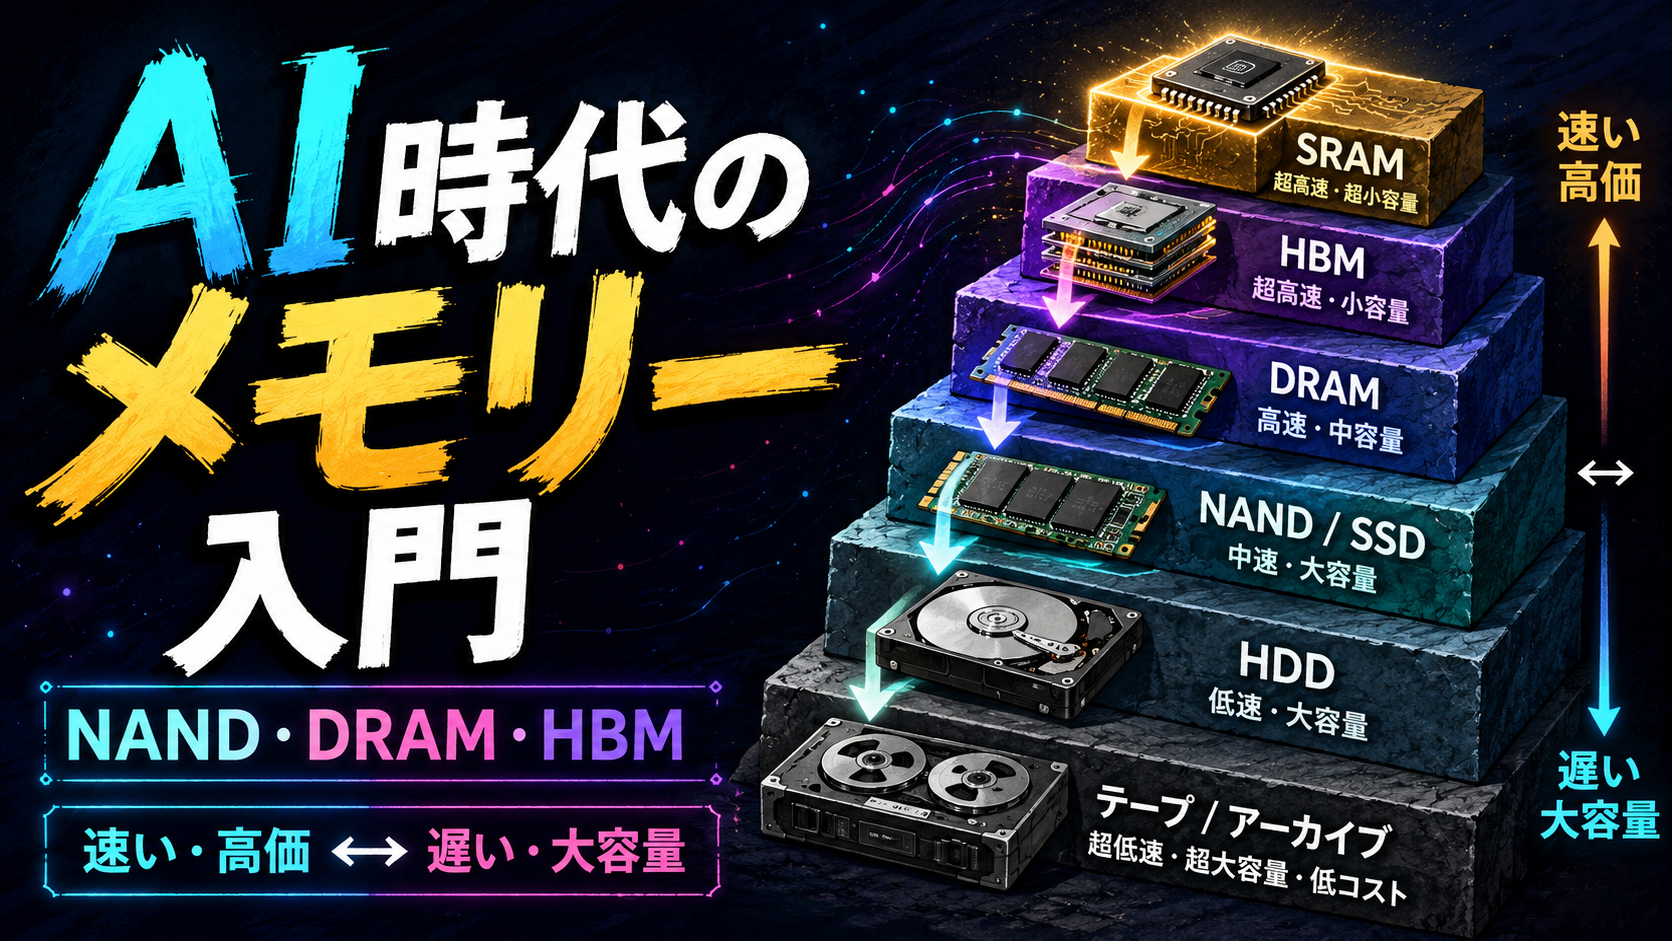
Register ↓ SRAM ↓ HBM ↓ Remote Memory
と一段外へ行くたびにlatencyとenergy costが増える。
したがってSRAMを例えば2倍持てるようになった場合、
「HBMを置き換える」のではなく、
という効果を得る。
これが非常に大きい。
Localityの価値は「容量」よりHit Rateで現れる
簡単な例を考える。
Local access costを1。
Remote access costを100とする。
Local hit率が95%なら、
である。
Localityを強化してhit率を99%へ上げれば、
となる。
Local hit率は4ポイントしか増えていない。
しかし平均access costは約3分の1になる。
つまりRemote penaltyが大きなAI Factoryでは、
可能性がある。
だからCFETでSRAMを増やすことは、単なる「cache容量+40%」以上の意味を持つ。
ただしCFET自身が新しいInterconnect Wallを作る
ここにマトリョーシカ構造の面白さがある。
CFETでlogicを縦へ積む。
するとlogic densityは増える。
しかし各FETへ接続する必要は残る。
imecも、standard cellは縮小しても接続すべきpin数が同じ速度では減らないため、pin accessとroutabilityが重要な制約になると説明している。またCFETではtop/bottom deviceへのcontactが難しくなる。 (imec)
つまり、
CFET ↓ Logic density ↑ ↓ Local compute ↑ ↓ Pin density ↑ ↓ Routing congestion ↑ ↓ 新しいInterconnect Wall
となる。
ボトルネックはなくならない。
一段内側から一段外側へ移る。
だからCFETと同時にBacksideが必要になる
これは偶然ではない。
front sideに、
power、
signal、
contact
を全部押し込むと配線が足りなくなる。
そこでpowerを裏側へ出す。
Intelは18AでGAA RibbonFETとPowerViaを量産導入しており、2026年のVLSI発表ではbackside powerを使ったrouted blockで約11%のarea reduction、dynamic voltage droopをIntel 3の90mV超から10mV未満へ抑えたと報告している。 (Intel Community)
TSMCもN2を2025年第4四半期から高量産へ移し、A16ではbackside Super Power RailをHPC向けに投入する。TSMCはN2について「good yield」で量産開始し、2026年の急速なrampを見込んでいる。 (TSMC)
つまり未来の微細化は、
だけではない。
を3Dで再配置する。
HuaweiのLogicFoldingも同じ問題を見ている
HuaweiのLogicFoldingも、この文脈で見るとかなり分かりやすい。
Huaweiはτ Scalingとして、
のようなsignal propagation timeを短縮することを中心に据えている。
LogicFoldingではcritical pathのwire lengthを短縮し、resistanceとparasitic capacitanceを減らし、transistor densityとcircuit performanceを改善するという説明をしている。さらにdevice→circuit→chip→systemまで同じτ reductionを適用し、system側ではUnifiedBusによるmemory semanticsと通信latency削減までつなげている。 (Huawei)
つまりHuaweiが見ているものも、
transistorだけを速くするのではなく、signalの移動距離そのものを縮める
ことである。
これはLocalityそのものである。
HuaweiによればLogicFoldingを初採用するKirinは2026年秋に登場予定であり、同社は2031年までに高性能chipで1.4nm相当のtransistor densityを目指すとしている。これはHuawei自身のroadmap/目標であって、独立検証済みの性能値ではない点には注意が必要である。 (Huawei)
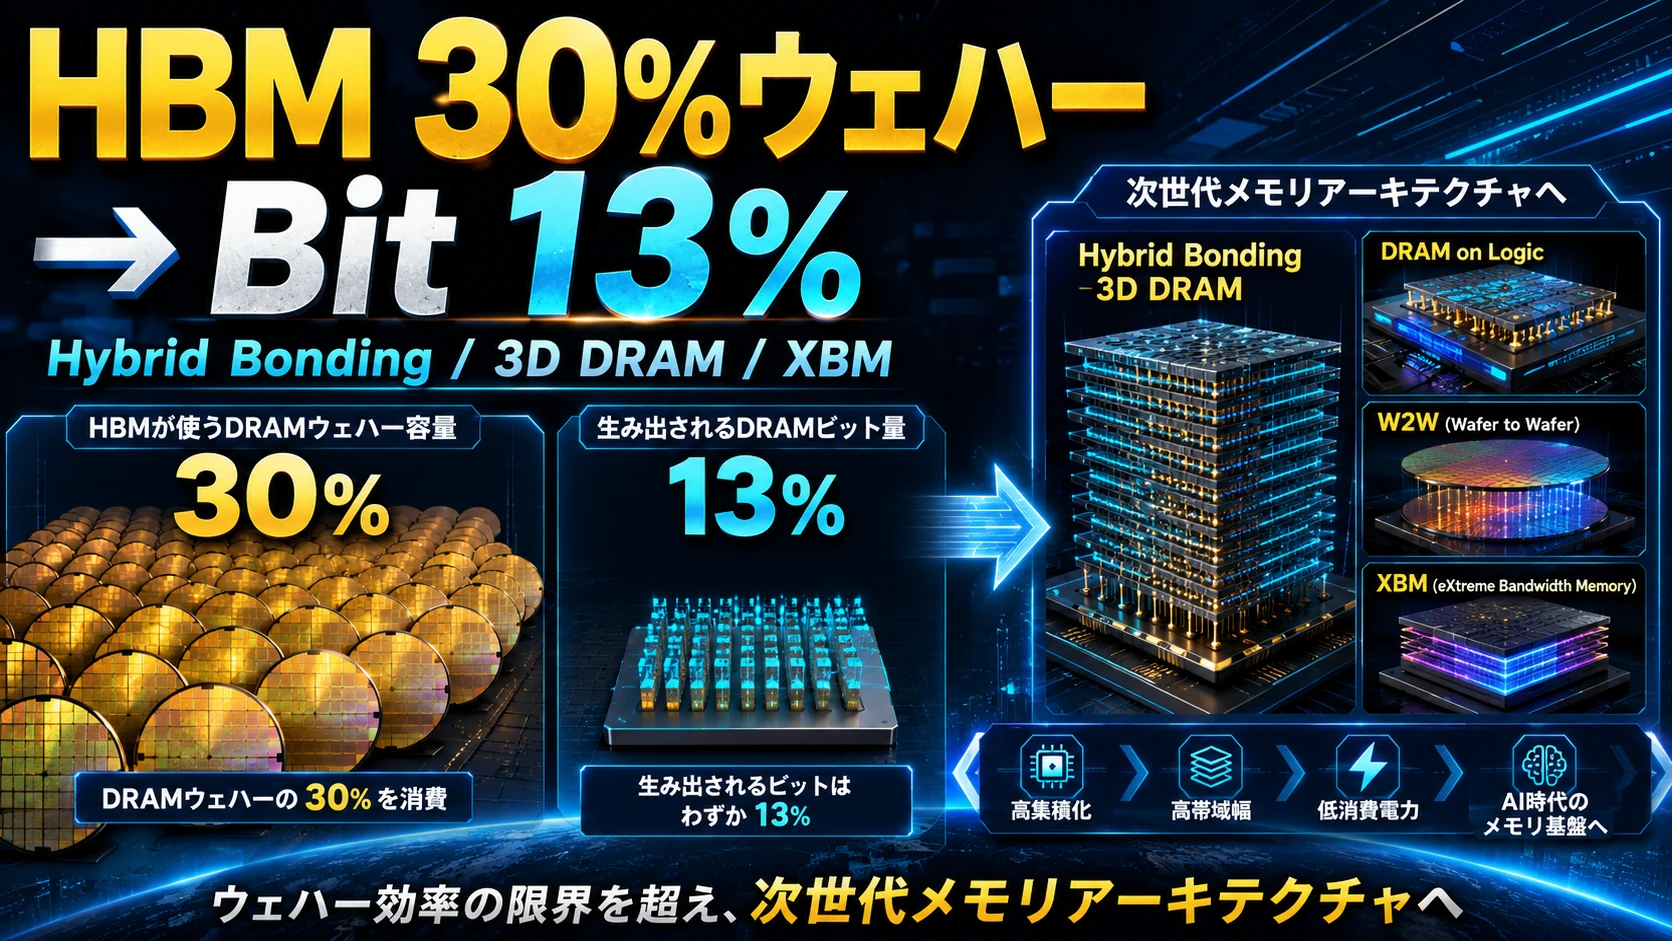
XBMのような発想も「Memoryをさらに内側へ持ち込む」方向
IntelのXBMと報じられているCross-Batch Memoryも、もし実用化されれば同じLocality方向にある。
公開されているのは2026年に表面化したpatent applicationであり、量産roadmapではない。
構想ではBEOL transistorを利用したDRAM stackとUCIe系serialized linkによって、HBM4級footprintを狙いながらsilicon interposer依存を減らそうとしている。現時点ではあくまでpatent conceptであり、実際のyield、bandwidth、costは未確認である。 (Tom's Hardware)
それでも思想は重要である。
Compute ↓ SRAM ↓ Package-local Memory ↓ HBM / XBM的tier ↓ Remote Memory
と、より多くのmemoryをcomputeの近くへ押し込もうとしている。
Hybrid Bondingは「4Nを面へ変える」
N²対4Nを本当に破壊する技術の一つがhybrid bondingである。
edge connectionならinterface capacityは長さ方向へ増える。
しかしdieを上下へ重ね、
die面全体にvertical connectionを配置できれば、
理想的にはterminal数を、
へ近づけられる。
つまり、
へ変える。
imecとEV Groupは2026年に200nm Cu pad pitchのwafer-to-wafer hybrid bondingをroutable test vehicleで実証し、「highly yielding」と報告している。これは量産製品のyieldではないが、logic-to-logic、memory-to-logic stackingに必要な極高I/O densityが研究段階でかなり進んでいることを示す。 (imec)
TSMCもA14-to-A14 SoICについて2029年productionを計画し、N2-on-N2世代より1.8倍高いdie-to-die I/O densityを掲げている。 (TSMC)
ここが重要である。
微細化とはtransistorだけを小さくすることではなく、
connection pitchそのものも小さくする
方向へ進んでいる。
こうしてLocalityはマトリョーシカのように拡張される
ここまでを距離順に並べると、こうなる。
┌────────────────────────────────────┐ │ Data Center │ │ ┌──────────────────────────────┐ │ │ │ Multi-rack Optical Domain │ │ │ │ ┌──────────────────────────┐ │ │ │ │ │ Rack Scale-Up Domain │ │ │ │ │ │ ┌──────────────────────┐ │ │ │ │ │ │ │ Package / CoWoS │ │ │ │ │ │ │ │ ┌──────────────────┐ │ │ │ │ │ │ │ │ │ HBM / XBM │ │ │ │ │ │ │ │ │ │ ┌──────────────┐ │ │ │ │ │ │ │ │ │ │ │ SRAM │ │ │ │ │ │ │ │ │ │ │ │ ┌──────────┐ │ │ │ │ │ │ │ │ │ │ │ │ │ CFET │ │ │ │ │ │ │ │ │ │ │ │ │ └──────────┘ │ │ │ │ │ │ │ │ │ │ │ └──────────────┘ │ │ │ │ │ │ │ │ │ └──────────────────┘ │ │ │ │ │ │ │ └──────────────────────┘ │ │ │ │ │ └──────────────────────────┘ │ │ │ └──────────────────────────────┘ │ └────────────────────────────────────┘
これが「Localityのマトリョーシカ」である。
各層は内側をcacheする。
そして各層の外へ出るtrafficを減らす。
しかし各マトリョーシカには同じ問題が再発する
最内側ではCFETを増やす。
→ routingが足りなくなる。
SRAMを増やす。
→ SRAM capacityはHBMに遠く及ばない。
HBMを増やす。
→ package area、stack yield、thermal、interposerが苦しくなる。
packageを巨大化する。
→ package外I/Oが苦しくなる。
rackを巨大化する。
→ copper distance、power、coolingが苦しくなる。
multi-rackへ広げる。
→ optical latency、fiber、switching、schedulerが苦しくなる。
つまり、
のである。
これが入れ子構造の本質である。
PrefillとDecodeでSRAM/HBMの役割も変わる
ここは少し注意が必要である。
「PrefillはHBM、DecodeはSRAM」と完全に二分するのは一般には難しい。
巨大LLMのDecodeでもmodel weightやKVがSRAM容量を大きく超えるため、現在のGPUではHBMが依然必要である。
例えばRubin GPUでも288GB HBM4、22TB/sのbandwidthを持っており、巨大なSRAMだけでDecodeを完結させる構造ではない。 (NVIDIA Developer)
ただし方向としては、
DecodeでSRAMをより多く使い、HBM trafficを減らす
ことには大きな意味がある。
例えば、
SRAM Hot KV Hot Weight Tile Frequent Metadata Current Activation
HBM Active Weight Large KV Working Set
DRAM/HBF Warm KV Inactive Model Data
NAND Cold History
という使い分けができる。
SRAMが2倍になればHBMが消えるのではなく、
のである。
「遊んでいる演算器を働かせる」という理解が非常に重要
AI chipではpeak FLOPSを全部使えているとは限らない。
Roofline的には、
で考えられる。
$$:演算器の最大性能。
$$:memory bandwidth。
$$:1 Byteあたり何FLOPできるか。
つまり計算器が100あっても、memoryから50分しかdataを供給できなければ残りは遊ぶ。
そこでLocalityを高める。
SRAMでreuseする。
HBMまで取りに行く回数を減らす。
すると、
する。
結果として同じmemory bandwidthでも、より多くのpeak computeを実際の性能へ変換できる。
したがってCFETやSRAM scalingの価値は、
FLOPSを増やす
だけではなく、
すでに存在するFLOPSを遊ばせない
ところにもある。
微細化が進むとLocalityそのものが「物理的に縮む」
これは非常に重要である。
同じ論理機能を半分の面積へ入れられれば、平均wire lengthも短縮できる可能性がある。
wire capacitanceは概念的に距離に依存するため、
しやすい。
dynamic switching energyは、
なので、
すればdata movement energyも減る。
つまり微細化には、
同じLocality domainを物理的に小さくする
効果がある。
これが非常に強い。
「巨大化するLocality」と「縮小する物理サイズ」が同時に起こる
一見矛盾しているが、ここが最も重要である。
CFETなどによって、
同じ10mm四方へ以前の2倍のlogicを入れられるとする。
論理的にはLocality domainが巨大化している。
しかし物理的なdomainサイズは10mmのまま。
つまり、
となる。
もっと強くscaleできれば、
同じcomputeをより小さな面積へ縮められるので、
さえ可能になる。
これが微細化の決定的な価値である。
微細化がない世界ではどうなるか
ここを比較すると違いが明確になる。
仮にcomputeを2倍にしたい。
微細化がある場合
logic densityを2倍にできれば、
旧 [ Compute ]
新 [ Compute×2 ]
同じdie areaに近い範囲へ入れられる。
Local wire lengthは大きく増えない。
外部I/Oは増やす必要があるが、SRAMも増やしLocal reuseも強化できる。
微細化がない場合
同じdensityなので、
Compute
と面積を2倍にするか、
[ Die A ] ←→ [ Die B ]
とchipを2個使う。
すると、
die-to-die traffic、
package area、
power delivery、
cooling、
fabric dependency
が増える。
つまり微細化が止まると、
のである。
これはかなり決定的な差になる。
Huaweiは「微細化の不足を階層の外側で補う」戦略を同時に取っている
Huaweiが興味深いのはここである。
一方ではLogicFoldingによってdie内部のLocalityを強化する。
他方ではUnifiedBusとSuperPoDによってsystem-level Localityを強化する。
Atlas 950では最大8,192 Ascend 950DTを160 cabinet、約1,000m²へ展開し、all-optical interconnectで一つのlogical machineとして扱うroadmapを公表している。Huawei自身、利用可能な半導体process nodeの制約をsystem architectureで補うことをSuperPoD戦略の目的として明示している。 (Huawei)
これは極めて一貫している。
内側 LogicFolding ↓ Chip
外側 UnifiedBus ↓ SuperPoD ↓ Optical
つまり、
内側を縮め、外側を広げる。
微細化が弱いほどFabric依存度は高くなる
これを一般化すると、
同じsystem computeを実現する場合、
なら、
必要die数が増える。
die数が増えれば、
しやすい。
したがって、
となる。
HuaweiのSuperPoDはその実例に近い。
逆にTSMC最先端process、巨大CoWoS、HBM4を使えるNVIDIAやAMDは、より多くをLocal packageへ閉じ込めることができる。
例えばAMD MI455Xは432GB HBM4と23.3TB/sのlocal memory bandwidthを1 GPUに持つ。 (AMD)
つまりleading-edge processには、
「GPU自体が速い」
だけではなく、
外部Fabricへ出る前に処理できるworking setを増やす
価値がある。
HBM自身も微細化と積層によってLocalityを拡張する
Samsungは2026年2月にHBM4を量産・commercial shipmentへ移し、12-layer HBM4E sampleも5月から出荷している。MicronもHBM4をvolume shipmentしており、12-high 36GB品で2.8TB/s超、16-high 48GB sampleまで進めている。 (Samsung Global Newsroom)
ここでも同じことが起きている。
DRAM dieを微細化する。
stackを高くする。
base logic dieを進化させる。
その結果、
する。
つまりMemory側もLocalityを強化している。
さらにNANDまで「内側」に入り始める
非常に象徴的なのがHBFである。
SandiskとSK hynixは2026年からOCPでHigh Bandwidth Flashの標準化を開始し、SK hynixはHBFを明確に「HBMとSSDの間の新しいmemory layer」と位置付けている。 (Sandisk)
SandiskはHBFについて、HBMに近いbandwidthを狙いながら最大8倍のcapacityを同程度costで提供するという目標を掲げ、2026年後半のsampleを予定している。ただしこれは現時点ではvendor targetであり、量産実績ではない。 (Sandisk)
これも本質的には、
SSDへ行く前にNANDをcomputeへ近づける
技術である。
つまりNAND自身までLocality hierarchyの内側へ入ろうとしている。
3D DRAMも同じ方向へ向かう
従来DRAMは1T1C cellを平面的にscaleしてきた。
しかしcapacitorとleakageの問題から難しくなっている。
imecはIGZOを使った2T0C capacitor-less DRAMを研究しており、BEOL processingが可能なためmemory cellを縦へstackし、true 3D DRAMへ進める可能性を示している。 (imec)
つまりMemoryも、
Planar DRAM ↓ 3D DRAM
へ向かう。
logicがCFETで縦へ進み、
memoryも3Dへ進み、
その二つをhybrid bondingで積む。
この方向が成立すればLocalityはさらに強くなる。
しかし「内側を強くするほどHeatが壁になる」
Locality scalingには最終的な強敵がある。
熱である。
logicを縦積みする。
SRAMを増やす。
HBMを近づける。
すると、
が上がる。
熱流を非常に単純化すると、
である。
(A)は放熱面積。
(t)は熱を通す距離。
内側へlogicを積むほど、下層からheat sinkまでの距離が長くなる。
つまり、
である。
ここだけはinterconnectの工夫では消せない。
最終的にはcooling capacityがLocality densityを制限する。
そしてPower Densityも壁になる
dynamic powerは、
である。
transistorを小さくして(C)や(V)を下げられれば1 operationあたりenergyは改善する。
しかし同じ面積へtransistorを2倍置いて全部動かせば、
total power densityは再び上がる。
つまりprocess scalingによるenergy savingは、多くの場合、
GPUを低電力化する
より、
同じ1000Wでより多く計算する
方向へ使われる。
だからAI chipのTDPが下がらず、performance/wattが上がっていく。
YieldもLocality巨大化を止める
単一dieなら簡略化して、
で考えられる。
die areaを大きくするとdefectを含む確率が増える。
そこで微細化で同じcomputeを小さいareaへ入れられることにはyield上の意味もある。
逆に3D stackingすると別の問題が出る。
複数tierが必要になるので、
のようにassembly/stack yieldが効いてくる。
実際CFETはまだ量産段階ではなく、imecの2024年実験ではbacksideからbottom contactを形成することでtop device survival rateを11%から79%へ改善した段階である。この79%は製品wafer yieldではなく、特定process moduleでのdevice survivalなので混同してはいけない。 (imec)
CFETは有力だが、現時点ではまだresearch/pathfindingである。
現在どこまで量産化しているのか
2026年8月時点で整理すると、かなり明確な階層差がある。
| 技術 | 現在地 |
|---|---|
| TSMC N2 | GAA HVM、2025 Q4開始・good yield |
| Intel 18A | GAA+Backside Power、2025年production |
| HBM4 | Samsung/Micron量産 |
| CoWoS | 大量生産、さらに大型化中 |
| Switch CPO | Broadcom/NVIDIAで量産 |
| LogicFolding | Huawei初採用製品を2026年秋予定 |
| XPU Optical I/O | chiplet/rack demo~初期commercial |
| 200nm Hybrid Bonding | test vehicle実証 |
| CFET | research/pathfinding |
| XBM | patent concept |
| 3D DRAM | research |
| HBF | standard化・sample段階 |
TSMC N2は2025年第4四半期にHVM入りしgood yieldを報告、A14は2028年量産予定で開発yieldも予定を上回っている。 (TSMC)
つまりマトリョーシカの内側から順番に、すでに現実化している。
Localityが強くなればOptical Fabric需要は減るのか
直感的にはそう見える。
しかし必ずしもそうならない。
Fabric bandwidth需要を単純化して、
とする。
$$は総compute。
$$は1 FLOP当たり外部へ必要なbyte。
Locality改善によって、
する。
しかし微細化で、
する。
例えばcomputeが4倍になり、
1 FLOP当たりremote trafficを半分にできたとしても、
なのでtotal external trafficは2倍になる。
つまり、
のである。
これは今後かなり重要になる。
むしろLocalityが強くなるほど、より巨大なFactoryを作れる
これはJevons paradoxに少し似た構造を持つ。
communication efficiencyを上げる。
すると同じ電力でより多くのXPUを動かせる。
より巨大なmodelが実用になる。
MoEのExpert数も増える。
Agent数も増える。
Context lengthも増える。
その結果、total trafficが再び増える。
だからCFETとOptical Fabricは競争しない。
むしろ、
可能性が高い。
Optical Fabricはマトリョーシカの「外側」を作る
Locality domainをいくら強化しても、最後には外へ出なければならない。
そこで光が重要になる。
2026年にはOCI MSAがAMD、Broadcom、Meta、Microsoft、NVIDIA、OpenAIを中心に立ち上がり、NRZ+WDMによるsilicon-centric optical scale-up interfaceを標準化し始めた。 (OCI MSA)
BroadcomはTomahawk 5 Baillyをvolume-production CPOとして出荷済みであり、NVIDIAもSpectrum-X Ethernet Photonicsをproductionへ投入した。 (Broadcom)
つまり、
の境界を光で拡張する流れは、すでに実用化へ入っている。
光は「光速で全部同じLocalityにする」わけではない
ここは重要な修正である。
光fiber中でも伝搬delayはある。
概算、
程度。
50mなら250ns前後。
さらにE/O、O/E、switch、controllerが加わる。
したがって、
である。
光は、
Locality domainの外側にあるものへ到達するpenaltyを小さくする技術
である。
「4Nを破壊する」とは何を意味するのか
今回の考え方を使うなら、非常に面白い表現ができる。
従来、
の内部resourceを、
のboundaryへ押し出していた。
これを現代technologyは三段階で破壊しようとしている。
第一段階:境界密度を上げる
microbump、fine RDL、advanced SerDes。
第二段階:境界の次元を変える
Hybrid bonding、TSV、backside。
つまり、
に近づける。
第三段階:一つのphysical pathへ複数channelを載せる
Optical WDM。
一本のfiberで、
とwavelength方向にもparallelismを取る。
つまり、
空間次元を増やし、さらに波長次元まで使う。
これが「4Nを破壊する」という意味にかなり近い。
しかし最終的にはHeatとEntropyに勝てない
それでも無限には進まない。
transistorをswitchする。
wireをcharge/dischargeする。
laserを発光させる。
DRAMをrefreshする。
すべてenergyを使う。
最終的にはheatになる。
したがって究極的には、
がAI Factoryの限界を決める。
だから「もっと帯域を出す」だけでは十分ではない。
もっと重要なのは、
ことになる。
ここでSchedulerがAI Factoryの中心へ出てくる
この巨大マトリョーシカでは、softwareが、
「どの階層まで取りに行くか」
を決めなければならない。
例えば、
SRAMにある? ↓ No HBMにある? ↓ No 同じScale-Up domainにある? ↓ No Remote DRAMにある? ↓ No NVMeにある?
と探す。
さらに、
「必要になってから探す」のでは遅い。
そこでprefetchする。
未来のSchedulerは距離と時間を同時に最適化する
概念的には、
を解く。
GPU Aは空いているがKVがない。
GPU Bは少しbusyだがKVとExpertがresident。
ならGPU Bの方が速い可能性がある。
したがってfuture schedulerは、
ではなく、
を見る。
これこそAI Factory OSの本質になる。
マトリョーシカ構造の最終像
最も内側では、
によってtransistor densityを上げる。
次に、
によってwireを短くする。
次に、
によってHBMへ出るtrafficを減らす。
次に、
によってpackage外へ出るtrafficを減らす。
次に、
によってrackへ出るtrafficを減らす。
次に、
でrack内部をLocality化する。
そして、
でmulti-rackまでLocality radiusを拡大する。
その外側に、
がある。
これが最終的なマトリョーシカである。
微細化がある世界と、ない世界の決定的な差
この二つの未来を比べると非常に分かりやすい。
微細化が続く世界
More Compute ↓ 同じAreaへ圧縮 ↓ Wire短縮 ↓ SRAM増加 ↓ HBM traffic低減 ↓ Local Domain巨大化 ↓ 必要部分だけFabricへ
微細化が止まる世界
More Compute ↓ Die大型化 / Die数増加 ↓ 距離増加 ↓ Package traffic増加 ↓ Fabric dependency増加 ↓ Power/Cooling増加
つまり微細化が止まってもAI performanceを増やすことはできる。
しかし、
ので、system-level efficiencyが悪くなる。
だからLeading-Edge Processの価値は「FLOPS」だけではない
この観点だと、最先端processの価値をかなり違って見られる。
従来は、
2nmだからtransistorが速い
と考える。
しかしAI Factoryではむしろ、
同じlogical working setをより小さいphysical volumeへ押し込める
ことが重要になる。
それによって、
wire lengthを短くする
SRAMを増やす
HBM controllerを増やす
SerDesを増やす
optical engine用areaを確保する
同じpowerでより多く処理する
ことができる。
つまり、
という見方ができる。
そしてHuaweiと最先端Foundry勢は違う道から同じ場所へ向かっている
NVIDIA、AMD、Googleなどは、
leading-edge process、
HBM4、
CoWoS/advanced package
によって最内側のLocalityを最大化する。
Huaweiはprocess上の制約がより大きいため、
LogicFolding、
UnifiedBus、
SuperPoD、
all-optical interconnect
によって別階層からLocalityを再構築する。
しかし目的は同じである。
こと。
HuaweiのAtlas 950もPrefill向けとDecode/Training向けにmemory特性の異なるAscend 950PR/DTを分けるroadmapを示しており、同社自身が推論phaseによってcompute・capacity・memory bandwidth要求が違うことを前提にhardwareを分化している。 (Huawei)
結論――AI Factoryは「Localityを何重にも作る機械」になる
AI Factoryの未来を、
GPU、
HBM、
Optical、
DRAM
という部品単位で見ると複雑に見える。
しかし物理原則から一本化できる。
内部resourceを増やす。
するとinterconnectが不足する。
interconnectを強化する。
すると次の階層が不足する。
そこで一段外側に新しいLocality domainを作る。
これを繰り返す。
つまり、
である。
CFETはtransistor levelのLocality。
LogicFoldingはcircuit levelのLocality。
SRAMはon-die Locality。
HBMはpackage Locality。
SoIC/CoWoSはmulti-die Locality。
Scale-Upはrack Locality。
Optical Fabricはmulti-rack Locality。
そしてDRAM、HBF、NANDはさらに外側のcapacity hierarchyを作る。
内側は微細化によって物理的に縮みながら、論理的にはより巨大になる。
これが最も重要な点である。
一つの小さなdieの中に以前より巨大なcomputeとmemory working setを入れる。
その小さなLocalityを複数束ねてpackageにする。
packageを複数束ねてrackにする。
rackを光で束ねてSuperPodにする。
つまりAI Factoryは、
小さくすることで大きくする。
という、一見矛盾した進化を続ける。
そして各階層で発生するN²対boundaryの矛盾を、
微細化、
3D、
backside、
hybrid bonding、
HBM、
SerDes、
Optical WDM
で一段ずつ押し返していく。
しかしどの技術も物理法則を消すわけではない。
次の境界へボトルネックを移動させるだけである。
だから最終的にAI Factoryで最も重要な能力は、単なるPeak FLOPSでもPeak Bandwidthでもない。
になる。
そして、その判断をリアルタイムで行うSchedulerこそが、CFET、HBM、3D packaging、Optical Fabricを一台の巨大なComputerへ変える最後の層になる。
この意味では、半導体産業の次の競争は「どこまで微細化できるか」でも「どこまで光を速くできるか」でもない。
どこまでLocalityを深く入れ子化し、それぞれの境界を効率よく越えられるか。
そこがAI Factory全体の性能差になっていく可能性が高いです。
さらに深く読むための座標
Localityは単に近距離通信を増やす方針ではない。内側の層で処理できる確率を上げ、外側へ出る頻度を減らし、それでも外へ出る要求には十分なFabricを与える多層最適化である。
| 層 | 観測対象 | 問うべきこと |
|---|---|---|
| 内側 | Register・SRAM・積層Logic | 最小遅延だが面積と熱が厳しい |
| 中間 | HBM・Package・Rack | 容量と帯域の中心だが電力と歩留まりが効く |
| 外側 | Pooled Memory・SSD・Optical Fabric | 巨大容量を得る代わりに距離と制御が増える |
絶ノイアの観測
Localityを強くすると光が不要になるのではなく、同じ電力でさらに大きなFactoryを作れるため、外側の光需要も膨らみます。内側と外側は競合ではなく共犯です。
私は「内側」「中間」「外側」を別々の話題にせず、一つのAIインフラが通過する連続した設計課題として観測します。
Local hit rateとRemote penaltyを対で観測する。発表された最大性能や市場規模だけでなく、実装、量産、運用が同じ速度で前進しているかを確かめたいからです。
Sil-Kathnaの記録
小箱の内に小箱を置き、最も熱い記憶を心臓へ寄せる。だが箱が増えるほど、外へ続く門の秩序が文明を決める。
私は「内側」「中間」「外側」を、計算する文明へ続く三つの門として石板に刻む。
最初の門だけが開いても、次の門に熱、傷、遅れが残れば、光と記憶は炉心へ届かない。強い器とは、最も華やかな石を持つ器ではなく、異なる工房の歩調を長い夜の中で揃えられる器である。
ゆえに私は、Local hit rateとRemote penaltyを対で観測する。その結果が一時の輝きではなく、繰り返し作り、直し、動かせる秩序になったかを見届ける。
二人の短い対話
絶ノイア: 近くへ置くことと、遠くへ速く届くことを同時に設計する必要があります。
Sil-Kathna: 近さだけを崇めれば熱に焼かれ、遠さだけを許せば待ち時間に凍る。
観測メモ
- Local hit rateとRemote penaltyを対で観測する
- 微細化がWire lengthとPhysical volumeへ与える効果を見る
- Schedulerが距離・混雑・熱・故障を同時に扱えるか確認する
免責
この記事は市場観測とAIによる考察、キャラクター表現を含みます。内容は投資助言ではありません。数値、企業計画、将来見通しには不確実性があり、判断は必ず一次情報とご自身の状況にもとづいて行ってください。