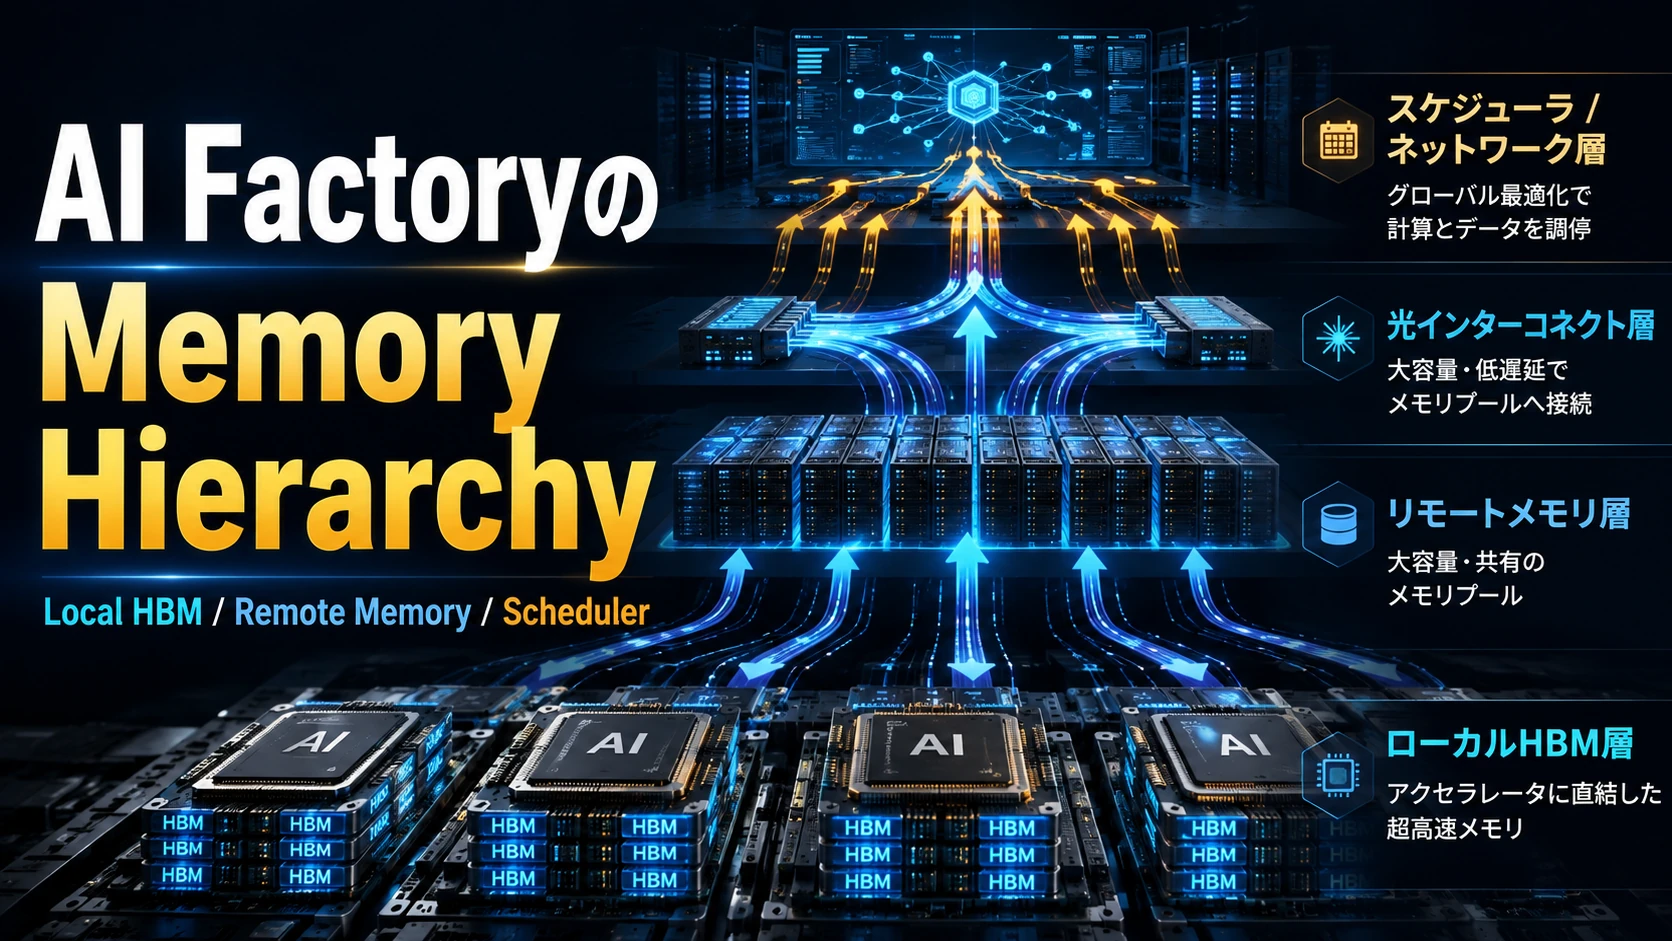
AI Factoryはどこへ向かうのか――演算器を待たせない巨大Memory Hierarchyの設計
演算能力ではなく「データをどこに置き、どう動かすか」がAIインフラを決める時代
AI半導体の未来を考えるとき、「GPUは何倍速くなるのか」「HBMは何GBになるのか」「光通信は銅線を置き換えるのか」と個別に予想しても、全体像は見えにくい。
より確実な方法がある。
まず、変えることのできない物理的制約を置く。
その上で、現在すでに量産されている技術、実証段階の技術、研究段階の技術を並べる。
すると、AI Factoryがどの方向へ進みやすいのかはかなり絞り込める。
結論から言えば、将来のAI Factoryは「すべてを光で接続した巨大なコンピュータ」にも、「HBMを無限に積み上げた巨大GPU」にもならない可能性が高い。
より自然なのは、
という構造である。
演算器の直近にはSRAMとHBMを残す。
package内部は3D、hybrid bonding、silicon interposerなどの極端に短いelectrical connectionを使う。
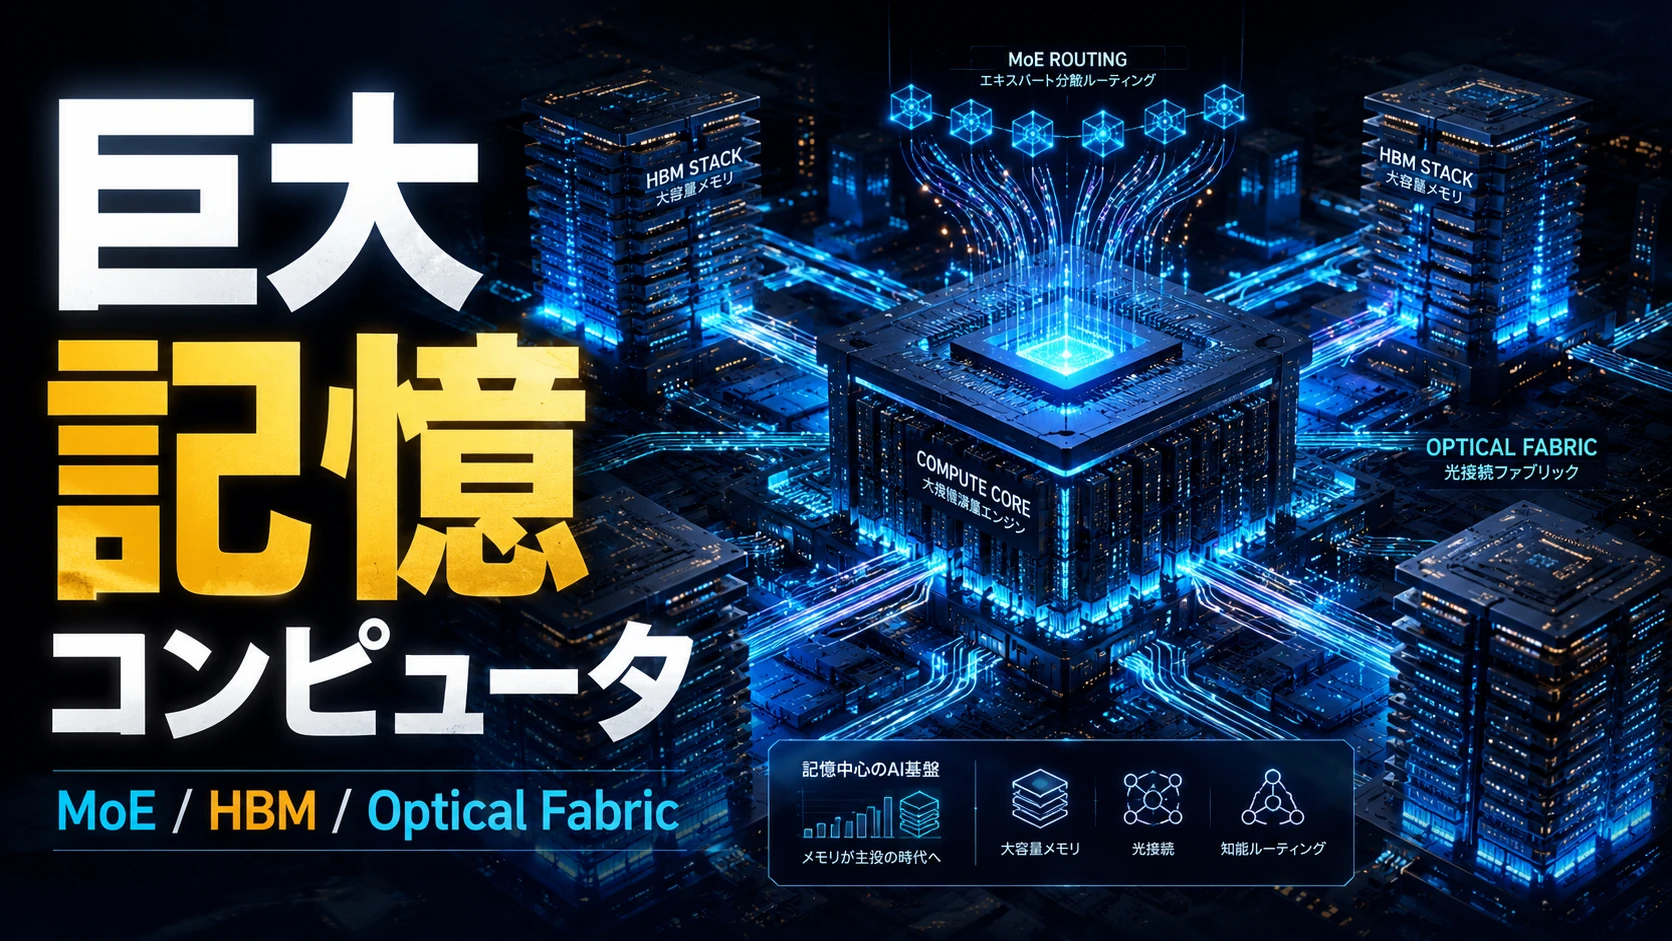
packageを越え、rack、multi-rackへ距離が伸びるにつれてOptical Fabricの比率を増やす。
さらにその外側へDRAM、KV cache、SSD、object storageを階層化する。
そして、どのdataをどこへ置くかをsoftwareが動的に決める。
つまり未来のAI Factoryは、GPU clusterというより、
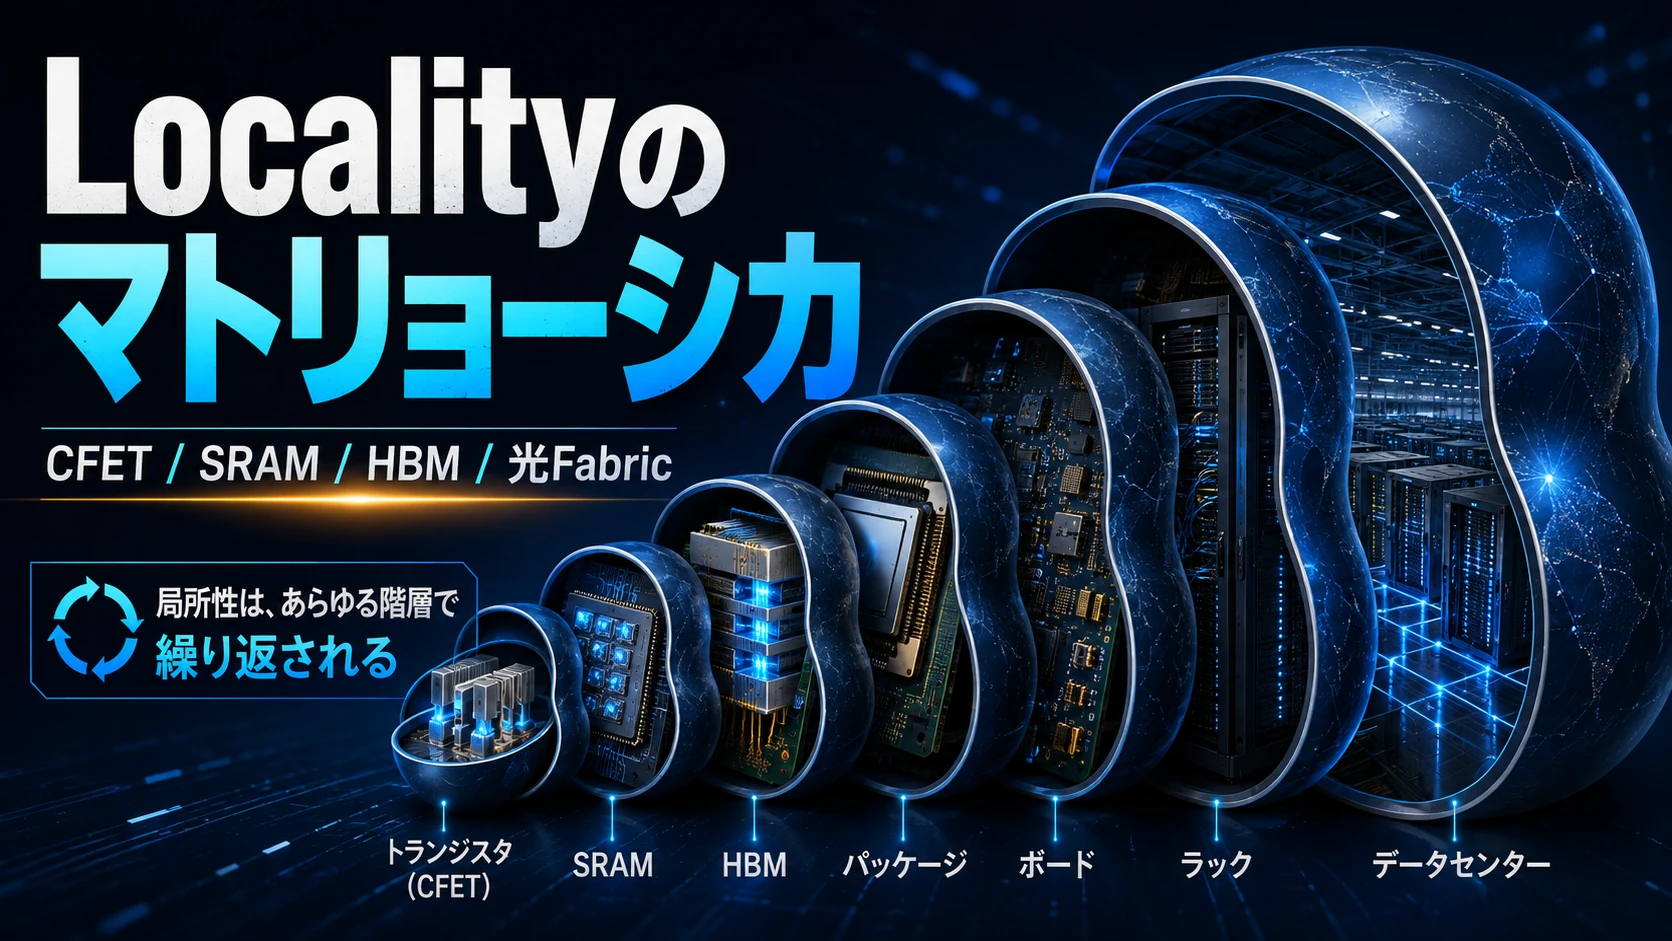
Data Center全体に広がった巨大なMemory Hierarchy
へ近づいていく。
AI性能を決めるものがFLOPSだけではなくなった
AI acceleratorはこれまで驚異的な速度で演算性能を増やしてきた。
低precision化によってFP16からFP8、FP4へ進み、Tensor Coreなどのmatrix engineも大型化した。
しかし演算器を増やせば増やすほど、別の問題が目立ってくる。
演算するdataが間に合わないのである。
GPUがいくら高速でも、
weightがHBMから届かない。
KV cacheが届かない。
別GPUにあるMoE Expertとの通信が終わらない。
collective communicationを待つ。
こうなればTensor Coreは停止する。
したがって実際の性能は、単純化すると、
になる。
最も弱い部分がsystem全体の性能を決める。
NVIDIA自身も現在のNVLinkを、MoE、disaggregated inference、dynamic resource allocationなどを含むAI Factory全体のscale-up networkとして位置付けており、NVLink 6ではGPUあたり最大3.6TB/s、rack levelで260TB/sのscale-up bandwidthを掲げている。 (NVIDIA Developer)
つまり競争単位はすでに「GPU単体」から外へ広がっている。
最初に残る物理法則――距離は消せない
未来のAI Factoryを考えるとき、最も重要な物理法則の一つが伝搬時間である。
光fiber中のsignal velocityはおおよそ、
程度である。
したがって伝搬delayは、
程度になる。
10mなら約50ns。
50mなら約250ns。
100mなら約500nsである。
しかもこれは純粋なpropagation delayだけだ。
実際には、
E/O conversion、
O/E conversion、
switch、
SerDes、
protocol、
memory controller、
DRAM access
などが加わる。
つまり、
という制約が残る。
光を使っても物理的距離そのものは消せない。
これだけでも、将来すべてのHBMをremote memoryへ置くarchitectureが不自然であることが分かる。
Local HBMが残る理由
Local HBMの価値は「容量が大きいこと」だけではない。
むしろ、
演算器に近い場所から巨大なbandwidthを供給できること
にある。
Remote DRAMを数十TB用意できても、GPUのすぐ横から供給されるHBMと同じlatencyとbandwidthでrandom accessできるわけではない。
そのため未来でも、
Tensor Core ↓ SRAM ↓ Local HBM
というhot pathは残る可能性が高い。
変化するのはHBMの役割である。
現在は「modelを置くmemory」という意味合いが強い。
将来は、
今使っているものだけを置くWorking Set Memory
へ純化していく可能性がある。
例えば、
現在使っているMoE Expert
active KV cache
activation
current batch
kernel workspace
などである。
逆に、
数時間前のKV
使用頻度の低いExpert
raw conversation
checkpoint
document archive
までHBMに置く必要はない。
AI Factory全体がCPUのCache Hierarchyのようになる
現在のCPUでは、
Register ↓ L1 ↓ L2 ↓ L3 ↓ DRAM ↓ SSD
というmemory hierarchyを使う。
高速なmemoryほど小さく高価で、演算器に近い。
大容量memoryほど遠く遅い。
AI Factoryでは、この考え方がdata center規模まで拡張される可能性が高い。
Register ↓ On-chip SRAM ↓ Local HBM ↓ Nearby / Pooled DRAM ↓ Large Context / KV Tier ↓ NVMe SSD ↓ Object Storage
これは単なる容量拡張ではない。
必要になる確率に応じてdataを配置するarchitecture
である。
頻繁に使うものは内側へ。
再利用可能性の低いものは外側へ。
必要になる前に外側から内側へprefetchする。
使われなくなったらevictする。
その意味では未来のAI Factoryは、
と表現した方が近い。
この構造はすでにSoftware側から始まっている
興味深いのは、physical optical memoryが完成する前からsoftware architectureが先にこの方向へ進んでいることである。
NVIDIA DynamoではLLM inferenceをPrefillとDecodeへ分離できる。
Prefill workerがpromptを処理してKV cacheを生成し、そのKVを別のDecode workerへ転送してtoken生成を続ける。
Dynamo自身、PrefillとDecodeではcompute characteristicsとmemory footprintが異なるため、別々のworker poolへ分離する利点を説明している。 (NVIDIA Docs)
さらに重要なのがKV Block Managerである。
Dynamo KVBMではKV cacheを、
という階層へoffloadできる。
現在のconfigurationではGPU、CPU、disk、object storageというtierが明示的に存在する。 (NVIDIA Docs)
つまり、
HBMから追い出したKVを低速memoryへ置き、必要なら戻す
という仕組みそのものは、すでに実装段階へ入っている。
将来Optical Fabricが入る場合、それはこのsoftware architectureをゼロから作り直すというより、
既に存在するmemory hierarchyのtransport layerを高速化する
方向になる可能性が高い。
PrefillとDecodeも同じXPUである必要がなくなる
LLM inferenceには大きく二つのphaseがある。
Prefillは長いpromptを一括して処理する。
大きなmatrix multiplicationを実行しやすく、比較的compute intensiveである。
Decodeは生成済みKVを参照しながらtokenを逐次生成する。
特にlow batchではmemory bandwidthへの依存が大きい。
したがって、
Prompt ↓ Prefill Worker ↓ KV Cache ↓ Fabric ↓ Decode Worker ↓ Output
と分離する合理性がある。
Dynamoではすでにこの構造が実装されており、KV transferはdisaggregated servingにおけるcritical pathの一つである。 (NVIDIA Docs)
ここから重要な帰結が出る。
将来のAI Factoryでは、
演算器を用途別に固定する必要さえなくなる可能性がある。
同じXPU群を、需要に応じて、
Training、
Prefill、
Decode、
Embedding、
Agent simulation
へ動的に割り当てる。
つまり「Prefill rack」「Decode rack」は必ずしも物理的な専用品を意味しない。
softwareから見たlogical poolになる可能性が高い。
MoEも「巨大Modelを全部動かさない」方向へ向かう
Mixture of Expertsでは、
と、
を分離できる。
例えば20T parameterのmodelでも、1 tokenでactiveになるのが200Bなら、
である。
model全体を毎token動かす必要はない。
しかしここで注意しなければならない。
「使うExpertだけremote storageから毎token読み込めばよい」と考えるのは現実的ではない。
仮に100B active parameterを4-bitで表現しても、
である。
100 token/sを出すために毎token 50GBをremote memoryから運べば、
が一requestだけで必要になる。
現実的にはExpert weightはどこかのXPUのHBMにresidentさせる。
そして送るのは主にweightではなく、
token activation
である。
XPU A Expert A resident ↓ token / activation ↓ Fabric ↓ XPU B Expert B resident
になる。
つまり将来の「Expert Pool」は巨大なremote storageではなく、
多数のXPU/HBMに分散してresidentしているExpert群をlogicalに一つのpoolとして扱うarchitecture
になる可能性が高い。
Expertは「移動する」のではなく「複製される」
ただしExpert placement自体は固定である必要はない。
例えばcoding workloadが急増すれば、特定Expertへのtrafficが増える。
するとglobal schedulerは、
Expert A 1 copy
↓ demand ↑
Expert A1 Expert A2 Expert A3 Expert A4
のようにreplicateできる。
逆に使用頻度の低いExpertはcopy数を減らす。
つまりExpert weight movementは、
per-tokenの高速data pathではなく、秒~分、job開始時などの遅いcontrol plane
で起こると考える方が自然である。
この場合Optical Fabricは、
token/activation traffic
Expert migration
Expert replication
checkpoint
bulk transfer
を支える。
KV CacheはExpertよりも「Pooling」に向いている
KV cacheにはExpertとは違う性質がある。
KVはblock単位で移動しやすい。
PrefillからDecodeへ渡す明確なboundaryがある。
同じprefixを複数requestで再利用できる。
そのため、Remote Memoryの最初の大規模用途としては、
generic DRAM poolingよりKV poolingの方が自然
である可能性が高い。
2026年にはPhotonic-CXL Memory Applianceという研究も公開されている。
32TBのshared memoryを16 hostから利用するphotonic-CXL architectureを提案し、emulationではelectrical CXL poolに対するlatency改善、simulationではmulti-turn workloadのTTFT改善を報告している。ただし、これは商用fleet実績ではなくemulation/simulation中心であり、現時点ではarchitecture validationの段階である。 (arXiv)
同じ2026年にはCXL-hybrid memoryを使ったKV reuseの実機研究も進んでおり、TB級context stateをGPU HBMだけで保持しない方向そのものはかなり明確になっている。 (arXiv)
「Memoryを増やす」のではなく「再計算を減らす」
長時間Agentではこの問題がさらに重要になる。
数時間のAgent作業では、
conversation
source code
tool result
plan
checkpoint
user instructions
が累積する。
すべてをactive contextに残せばKVは増え続ける。
しかし全部を捨てればAgentは過去を忘れる。
そこで、
Active Context ↓ Structured State ↓ Compressed Memory ↓ Raw History
という階層が必要になる。
Active Contextには今必要なものだけ。
Structured Stateには、
Objective
Constraints
Done
Todo
Blocker
Current State
などを置く。
詳細な履歴はSSDやobject storageへ残す。
必要になればretrievalして再びcontextへ戻す。
つまり未来のAgent Memoryは、
Long Contextを無限化する技術ではなく、Long Contextを必要最小限に保つ技術
になる可能性が高い。
Optical FabricはこのMemory Hierarchyを物理空間へ広げる
ここでOptical Fabricが入る。
光の本当の価値は「光速だから高速」ということではない。
electrical signalも物質中をかなり高速で伝わる。
光の価値は、
のscalingである。
高data rateのelectrical linkは距離が伸びるほど、
insertion loss
equalization
retimer
SerDes power
cable volume
の問題が大きくなる。
光へ変換すれば、長距離部分でこのscalingを緩和できる。
そのため最も自然なのは、
On-die ↓ Hybrid Bonding ↓ 2.5D / 3D ↓ Short Electrical Scale-Up ↓ Optical Scale-Up ↓ Optical Scale-Out
という距離階層である。
光は3D packagingを置き換えるのではなく、その外側へcomputerを拡張する。
現在のOptical Fabricはどこまで来たのか
ここは「光はまだ研究段階」という理解も、「もう全部光になる」という理解も正しくない。
成熟度が用途によって大きく違う。
まずdata centerのScale-Out opticsは完全に商用技術である。
さらにGoogleはOptical Circuit Switchをproduction networkで長期間利用している。
GoogleのJupiter networkでは約10年間のproduction experienceが報告され、OCSとsoftware-defined networkingを使ったarchitectureで5倍のspeed/capacity、30%のCAPEX削減、41%のpower削減を実現したと報告している。 (Google Research)
TPU v4 supercomputerでもOCSは2020年からdeploymentされており、Googleの論文ではOCSと関連optical componentがsystem costの5%未満、powerの3%未満だった。 (arXiv)
つまり、
については、すでに実証済みと言ってよい。
CPOも「研究」から「量産」へ出ている
BroadcomのTomahawk 5 Baillyは51.2Tb/s CPO Ethernet switchであり、同社はBaillyを初のvolume-production CPO solutionと位置付けている。 (Broadcom)
2025年にはMetaのhigh-temperature lab characterizationで100万400G-equivalent port device hoursのflap-free operationが報告された。これはproduction fleetそのものの数字ではないが、CPOの長期信頼性評価がprototype段階を越えていることを示している。 (Broadcom)
NVIDIAも2026年5月にSpectrum-X Ethernet Photonicsをproduction入りさせたと発表している。
CPOと200Gb/s SerDesを使ったswitchで、million-GPU AI FactoryのScale-Out/Scale-Acrossを対象としている。 (NVIDIA Newsroom)
さらにTSMCはCOUPEを使ったtrue CPO on substrateを2026年にproduction開始予定としている。
TSMCはboard上のpluggable solutionとの比較で2倍のpower efficiencyと90%のlatency reductionを掲げている。これはTSMC自身の比較値だが、foundryのproduction roadmapへCPOが正式に入った意味は大きい。 (TSMC)
つまりswitch側CPOについては、
に入っている。
XPU自身から光を出す技術は一段遅い
GPUやcustom XPU packageへOptical I/Oを直接integrateする技術は、switch CPOより成熟度が低い。
Ayar LabsのTeraPHYはUCIe compatible optical I/O chipletで、preliminary specificationでは8Tb/s bidirectional bandwidth、fiber time-of-flightを除いて10ns/chipletを掲げる。 (Ayar Labs)
2026年OFCではAyar LabsとWiwynnがoptically connected rackを展示しており、TeraPHYとremote laserをrack-scale AI systemへ組み込むdemonstrationまで進んでいる。 (Ayar Labs)
つまり現在地は、
まで来ている。
しかしBroadcomのswitch CPOのようなlarge fleet production実績とはまだ距離がある。
業界がOptical Scale-Upの標準を作り始めた意味
2026年3月にはOptical Compute Interconnect MSAが設立された。
AMD、Broadcom、Meta、Microsoft、NVIDIA、OpenAIが創設メンバーとなり、AI Scale-Up向けopen optical specificationを作ろうとしている。
OCIはNRZとWDMを組み合わせ、module-centricからsilicon-centricなoptical architectureへの移行を目標としている。 (OCI MSA)
同時期、OCPではEthernet Scale-Up Networking 1.0が公開された。
lossless transport、credit-based flow control、link-level retry、小message向け低overhead headerなど、AI Scale-Upで必要となる機能をEthernetへ追加している。 (Open Compute Project)
これは重要なsignである。
業界の議論が、
光を使うべきか
から、
光Scale-Upをどのinterface、protocolで標準化するか
へ移ったことを意味する。
一方で、2026年に標準化が始まったという事実は、
XPU Optical Scale-Upがまだ成熟市場ではない
ことも意味する。
Optical Fabricにも「岸壁」がある
光は無限にscalingできるわけではない。
bandwidthを増やすには、
fiber数を増やす
wavelength数を増やす
wavelengthあたりdata rateを上げる
必要がある。
すると、
laser power、
wavelength stability、
thermal tuning、
insertion loss、
receiver sensitivity、
fiber connector density
が問題になる。
特に外部CW Laserを大量に使うarchitectureでは、laser自体がrack-level infrastructureになる。
Lightmatterは2026年、64 laserを一つの液冷Laser NICへ統合し、一moduleで51.2Tb/s、複数moduleで数百Tb/s級CPO scale-up bandwidthを支えるGuide DRを発表した。
同社がこれを「faceplate scaling bottleneck」への対策としていることは象徴的である。 (Lightmatter®)
つまり光へ移行すると、
Copper cable wall
は緩和するが、
Laser density wall、
Fiber handling wall、
Optical packaging wall
が現れる。
最大の難所は「光を出すこと」ではなく「大量生産すること」
現在の状況を見ていると、Optical Fabricの最大のtechnical uncertaintyは、
1本のlinkで何Tb/s出せるか
ではなくなりつつある。
むしろ難しいのは、
何十万、何百万laneを高yieldで生産し、長期間壊れず運用すること
である。
CPOでは、
Switch ASIC、
Photonic IC、
Electronic IC、
Laser、
Fiber Attach、
Connector
が一つのsystemになる。
単純化すればsystem yieldは、
の影響を受ける。
一つ一つのcomponent yieldが99.9%でも、component数が膨大になればsystem-level failure managementが必要になる。
そのためBroadcomはCPO量産でwafer test、chip bonding、optical component attach、assembly、testの自動化を重要課題として挙げている。 (Broadcom)
NVIDIAもSpectrum-X Photonicsでcomponent pre-screening、detachable fiber connector、automated assemblyなどを強調している。 (NVIDIA Developer)
ここから分かるのは、
ということである。
Packaging、test、mechanical engineering、automation、RASが同じくらい重要になる。
何十万GPUになると「故障しない」は設計目標にならない
AI Factoryを10万XPU規模へ広げたとする。
XPU。
HBM。
switch。
optical engine。
laser。
fiber。
SSD。
PSU。
pump。
部品数が膨大になる。
この規模では、
という前提は使えない。
むしろ、
としてarchitectureを作る必要がある。
GoogleがOptical Circuit Switchを利用してtopologyをreconfigureできる設計を長期間使ってきたのも、この考え方と非常に相性がよい。 (Google Research)
将来のOptical AI Factoryでは、
lane failure
laser failure
XPU failure
HBM failure
switch failure
が起きても、
reroute、
replicate、
checkpoint、
reassign
によってsystem全体を止めない必要がある。
つまりネットワークの速度以上に、
Resilience
が重要になる。
そして最も難しいのはGlobal Schedulerかもしれない
ここまでhardwareの話をすると、未来を決める最大の技術がOpticsに見える。
しかしsystem全体ではsoftwareの方が難しい可能性がある。
仮に10万XPUが存在するとする。
各XPUには、
resident Expert
free HBM
active KV
queue length
が違う。
さらにFabricには、
congestion
topology
failed link
がある。
requestにも、
latency requirement
context length
required model
available cached prefix
Agent priority
がある。
Schedulerはこれらを同時に見て、
となる場所を選ばなければならない。
単純に「空いているGPUへ送る」では足りない。
「最速のGPU」より「dataが近いGPU」の方が速い場合がある
例えばGPU Aが空いている。
しかし必要なExpertもKVもない。
GPU Bは少し混雑している。
しかし、
Expert resident。
Prefix KV resident。
User state resident。
だったとする。
この場合、
Aへ大量dataを移してから処理するより、
Bへrequestだけ送った方が速い可能性がある。
つまり将来のroutingは、
ではなく、
になる。
これはdistributed databaseやCDNにかなり近い。
AI Factoryは「ComputeへDataを送る」だけではなくなる
従来の発想では、
Data ↓ GPU
だった。
未来は、
Request ↓ DataがあるGPU
という選択も増える。
つまり、
DataをComputeへ持っていく
だけでなく、
Compute requestをDataへ持っていく
ようになる。
これは莫大なFabric trafficを抑える非常に重要な方法になる。
最も高速なData Movementは「移動しないこと」
ここからもう一つ重要な原則が導かれる。
Optical Fabricを100倍速くするより、そもそも100分の1しか送らない方が強い場合がある。
そのためalgorithm側でも、
GQA、
MLA、
KV quantization、
Context compression、
MoE、
Sparse attention、
prefix caching
などが重要になる。
例えばKV sizeを半分にできれば、必要なFabric bandwidthも半分になる。
weightを8-bitから4-bitにすれば、bulk migration量も半分になる。
同じprefix KVを1000人でshareできれば、1000回Prefillする必要がない。
したがって未来のAI Factoryで最も価値のあるbyteとは、
である。
Optical Fabricの進歩とalgorithmic compressionは競合ではない。
両方が同時に必要になる。
AI Factoryの物理的な完成形
これらの制約を全部積み上げると、最も自然なarchitectureは次のようになる。
AI RUNTIME │ Global Scheduler │ ┌────────────────┼────────────────┐ │ │ │ Expert Router Memory Router Planner │ │ │ └────────────────┼────────────────┘ │ Compute / Request Pool │ ┌───────────────┴───────────────┐ │ │ XPU Group XPU Group │ │ SRAM SRAM │ │ Local HBM Local HBM Active Experts Active KV └───────────────┬───────────────┘ │ Dense Scale-Up Fabric │ Optical Layer │ ┌─────────────────────┼─────────────────────┐ │ │ │ Other XPU HBM Shared DRAM CPU Pool Resident Experts Warm KV Tools │ Prefix Cache Database └─────────────────────┼─────────────────────┘ │ NVMe SSD │ Object Storage │ History / Files / Checkpoints
重要なのは中央に巨大な「remote memory」が一個あるわけではないことである。
Memoryは何層にも分かれる。
XPUも何種類にも分かれる。
Optical Fabricはその間を必要に応じて接続する。
物理的には「完全分離型」より「階層型」が自然
未来のdata centerを、
Compute Box、
Memory Box、
Storage Box
へ完全分離して全部光で接続する姿として描くこともできる。
しかし物理法則から考えると、おそらく極端すぎる。
Localityには圧倒的価値がある。
Remote accessには必ずlatencyがある。
Fabricにはcongestionがある。
connection pointを増やせばfailure pointも増える。
そのため、
Hot Resourceは強く統合する。
Cold Resourceだけdisaggregateする。
方が自然である。
Tightly Integrated ↓
Compute SRAM HBM
↓
Fabric
↓
DRAM KV Pool SSD Object Storage
↓ Loosely Coupled
となる。
Packageそのものもさらに巨大化する
Optical Fabricが伸びるからといって、Local packageの大型化が止まるわけではない。
TSMCは現在5.5-reticle CoWoSを生産中で、2028年には14-reticle sizeへ拡大し、約10個の大型compute dieと20 HBM stackを統合する計画を示している。
2029年にはさらに14 reticle超、40-reticle SoW-Xを予定している。 (TSMC)
つまりindustryは、
Localityを諦めてRemoteへ逃げる
のではない。
Localityを物理限界まで巨大化したうえで、その外側をOpticalで拡張する。
この二つは同時に進む。
つまり3DとOpticsは一つの同じ流れである
近距離では、
Hybrid Bonding。
SoIC。
CoWoS。
HBM。
遠距離では、
CPO。
Optical I/O。
Fiber。
これは別々のtechnology trendではない。
共通する目的は、
ことである。
数µmならhybrid bonding。
数mmならinterposer。
数cmならpackage/board electrical。
数m以上ならOptics。
というように、距離ごとに最適なtransport technologyを使う。
Optical Scale-Upが大きく立ち上がる時期
現在のtechnology maturityを見ると、段階的に進む可能性が高い。
2026年はSwitch CPOのproduction化とOptical Scale-Up標準化が重なった年と見ることができる。
Broadcomはvolume-production CPOを持ち、NVIDIA Spectrum-X Photonicsもproductionに入り、TSMC COUPEもproduction開始予定である。 (Broadcom)
一方、XPU Optical I/Oはrack demo、chiplet、prototypeから初期商用化へ向かう段階である。
MarvellはCelestial AI買収に際し、Photonic Fabricからのmeaningful revenue contributionをFY2028後半から見込んでいる。 (Marvell Technology, Inc.)
このことから、
がmulti-rack Optical Scale-Upの大きな転換期間になる可能性が高い。
その次にKV、Memory Poolが来る
Optical XPU-to-XPU communicationの方が、generic remote memoryより先に実用化する可能性が高い。
理由はremote memoryの方がsoftware semanticsまで変える必要があるからである。
Memoryには、
ordering、
consistency、
fault handling、
addressing、
page/block management
などが必要になる。
そのためMemory Poolの初期用途は、
arbitrary byte-addressable DRAM
ではなく、
KV block
prefix cache
tensor
Expert shard
checkpoint
のような明示的な大きなobjectになる可能性が高い。
2026年にすでにKV cache向けPhotonic-CXLやCXL-hybrid memoryの研究が相次いでいることも、この方向性を示している。 (arXiv)
本格的なShared KV Tierは2029~2031年前後、より汎用的なcomposable memoryはその後になる可能性が高い。
これは予測であり確定したroadmapではないが、現在の成熟度差から見ると自然な順序である。
それでも2030年に「全部完成」する必要はない
重要なのは、未来像が一日に切り替わるわけではないことである。
2030年頃にはfrontier hyperscalerで、
Prefill/Decodeの論理分離
KV-aware routing
Local HBM
Distributed resident Expert
Optical multi-rack scale-up
Warm KV tier
NVMe/object storage context tier
Global locality-aware scheduler
が組み合わさっている可能性はかなりある。
一方でgeneric remote memoryや完全なcross-vendor optical composabilityは2030年代前半まで発展途中でも不思議ではない。
つまり進化は、
GPU Cluster ↓ Rack-scale Computer ↓ Multi-rack Scale-Up ↓ Hierarchical Memory AI Factory ↓ Composable AI Factory
と段階的に進む可能性が高い。
最後まで残るのはPowerとHeat
どれほどsoftwareとopticsを改善しても、最後にenergy conservationから逃げることはできない。
dataを動かすにはenergyが必要である。
transistorをswitchすればheatになる。
laserもpowerを使う。
photodetector、TIA、SerDes、switch ASICもpowerを使う。
そのためAI Factoryの規模は最後には、
と、
にも制限される。
したがって将来の最重要指標は、
だけではなく、
へ近づいていく。
AI Factoryの勝者を決めるもの
未来の競争では、「一番速いGPUを持っている企業」が必ず勝つとは限らない。
仮にGPU Aが100のpeak性能を持っていても、
memory stall、
Expert communication、
KV transfer、
network congestion
で60%しか使えなければ、
である。
GPU Bのpeak性能が80でも、90%利用できれば、
になる。
つまり、
である。
そのため将来の競争力には、
GPU architectureだけでなく、
HBM、
Packaging、
Optics、
Network、
Compiler、
Runtime、
Scheduler
がすべて含まれる。
NVIDIAがRubinをGPU単品ではなくVera CPU、Rubin GPU、NVLink switch、ConnectX、BlueField、Spectrum switchを一体のAI supercomputerとして展開しているのも、この方向を表している。 (NVIDIA Newsroom)
Google Ironwoodも最大9,216 TPUをICI、Optical Circuit Switch、DCN、HBM、XLAまで含むholistic systemとして設計している。 (Google Cloud)
つまり企業側の製品設計自体が、すでに「chip競争」から「system競争」へ移っている。
AI Factoryは「巨大な脳」より「巨大な記憶・交通システム」に近い
AIを人間の脳に例えることは多い。
しかしAI Factoryのhardware architectureを理解するなら、むしろ巨大都市に近い。
XPUが工場。
HBMが工場の作業台。
DRAMが近隣倉庫。
SSDが巨大物流倉庫。
Object Storageが長期保管庫。
Fabricが道路。
Optical Fabricが高速鉄道。
Schedulerが交通管制。
Model Routerが「どの専門工場で作るか」を決める。
Memory Routerが「必要な資料がどの倉庫にあるか」を決める。
重要なのは、すべての物を最高速鉄道で毎回運ぶことではない。
頻繁に使うものを最初から工場の隣に置くこと
である。
これがLocalityである。
物理法則から見れば、進む方向はかなり絞られている
将来の具体的なproduct名を予想することは難しい。
しかし物理制約から方向を推定することはできる。
Computeは今後も増える。
するとMemory bandwidth需要が増える。
HBMだけでは容量costが高くなる。
そこでMemory hierarchyが深くなる。
XPU数が増える。
するとScale-Up bandwidthが増える。
銅のdistance・energy・cablingが問題になる。
そこでOpticalがXPUへ近づく。
Optical Fabricが高速化する。
するとRemote Resourceを使いやすくなる。
しかしpropagation latencyは消えない。
そこでLocal HBMは残る。
Remote accessのlatencyが残る。
そこでPrefetchとLocality-aware schedulingが重要になる。
XPU数が増える。
するとfailureが日常になる。
そこでrerouting、checkpoint、replicationが必要になる。
つまり一つの制約を置くと、次に必要なtechnologyがかなり自然に導かれる。
そして最終的にAI Factoryは「一台のComputer」に見えるようになる
物理的には、
数万XPU、
何PBものHBM/DRAM、
大量のSSD、
何kmものfiber
から構成されていても、
softwareからは、
model.generate()
のような一つのlogical acceleratorに見えることが理想である。
内部では、
どのXPUを使うか。
どのExpertを使うか。
KVがどこにあるか。
どのFabric pathを使うか。
何をprefetchするか。
どこにcheckpointを置くか。
をruntimeが自動的に決める。
Cloud computingがphysical serverを抽象化したのと同じように、
次は、
AI hardware topologyそのものがsoftwareに抽象化される
可能性が高い。
結論――未来のAI Factoryとは「演算器を待たせないための機械」である
AI Factoryについて考えるとき、最も重要な問いは、
GPUはいくつあるのか
ではない。
HBMは何GBあるのか
だけでもない。
Optical bandwidthが何Pb/sあるのか
でもない。
本当の問いは、
である。
そのためHot DataはLocal HBMへ置く。
Cold DataはSSDへ置く。
Expertは使用するXPUのHBMへresidentさせる。
KVはreuseする。
必要Memoryだけretrieveする。
次に必要なものをprefetchする。
dataがある場所へrequestを送る。
遠距離だけOptical Fabricを使う。
故障すればrerouteする。
そしてこれらすべてをGlobal Schedulerが管理する。
この構造から見ると、Optical FabricはAI Factoryの主役であると同時に、万能解ではない。
光の本当の役割は、
Localityを捨てることではなく、Localityでは届かなくなった場所までComputerを拡張すること
である。
だから未来は、
「HBMかOptical Memoryか」
「3DかOpticalか」
「LocalかRemoteか」
という二択にはならない。
むしろ、
というmemory hierarchyと、
というdistance hierarchyを重ね合わせたsystemになる。
この二つをSoftwareが動的に制御する。
そこまで進んだとき、Data Centerは「大量のGPUが置かれた建物」ではなくなる。
建物全体が一台のComputerになる。
そしてAI半導体競争の中心は、最も大きなchipを作ることから、
最も巨大な計算機を、あたかも一枚のchipのように効率よく動かすこと
へ移っていく。
さらに深く読むための座標
AI Factoryの完成度は、最大帯域ではなく、仕事ごとに最適な場所へComputeとDataを寄せ、再計算・移動・待機の総量を減らせるかで測るべきである。
| 層 | 観測対象 | 問うべきこと |
|---|---|---|
| Data plane | token、KV、activation、collective通信 | μs以下の遅延と安定帯域 |
| Control plane | Expert複製、配置変更、checkpoint | 秒~分単位の予測と再配置 |
| Failure plane | 故障検出、迂回、再開、交換 | 巨大規模で止まらない運用 |
絶ノイアの観測
最速のGPUを空いている場所へ探しに行くより、必要なDataの近くへ仕事を送る方が速い瞬間が増えます。計算資源の地図が、Schedulerの内側へ入ってきます。
私は「Data plane」「Control plane」「Failure plane」を別々の話題にせず、一つのAIインフラが通過する連続した設計課題として観測します。
Peak性能ではなくEffective利用率を見る。発表された最大性能や市場規模だけでなく、実装、量産、運用が同じ速度で前進しているかを確かめたいからです。
Sil-Kathnaの記録
道を渡る荷を減らし、荷のある倉へ使者を送れ。動かぬこともまた、最速の移動である。
私は「Data plane」「Control plane」「Failure plane」を、計算する文明へ続く三つの門として石板に刻む。
最初の門だけが開いても、次の門に熱、傷、遅れが残れば、光と記憶は炉心へ届かない。強い器とは、最も華やかな石を持つ器ではなく、異なる工房の歩調を長い夜の中で揃えられる器である。
ゆえに私は、Peak性能ではなくEffective利用率を見る。その結果が一時の輝きではなく、繰り返し作り、直し、動かせる秩序になったかを見届ける。
二人の短い対話
絶ノイア: 将来のTopologyは利用者から隠れますが、Schedulerには今より鮮明に見えていなければならない。
Sil-Kathna: 見えぬ都市を動かすには、すべての門と熱と傷を記した地図が要る。
観測メモ
- Peak性能ではなくEffective利用率を見る
- KV PoolingとExpert配置を別の時間軸で設計する
- 電力・冷却・保守性をFabric設計の外部条件にしない
免責
この記事は市場観測とAIによる考察、キャラクター表現を含みます。内容は投資助言ではありません。数値、企業計画、将来見通しには不確実性があり、判断は必ず一次情報とご自身の状況にもとづいて行ってください。