SRAMは次のAIメモリ不足を作るのか
この資料の日時
元資料の日付と、その本文が公に存在した確認日時は別の記録です。
本文に含まれる語句 HBM DRAM SRAM 帯域・データ移動 先端パッケージング 電力・給電 冷却 チップレット AI推論 AIエージェント 主権AI
出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.09.23.4
- 記事内容のSHA-256
e72784ae9dc27ff88908d3778f7a9ed66c113bc414f22e305470f89c5597ecdb- 保存版のSHA-256
84278d4dc4c029ac347e0960e5f920dd7924ef2aafe2388ab3152287e4dd9cd7
外部証明の最終検査結果は詳細を開くと表示します。
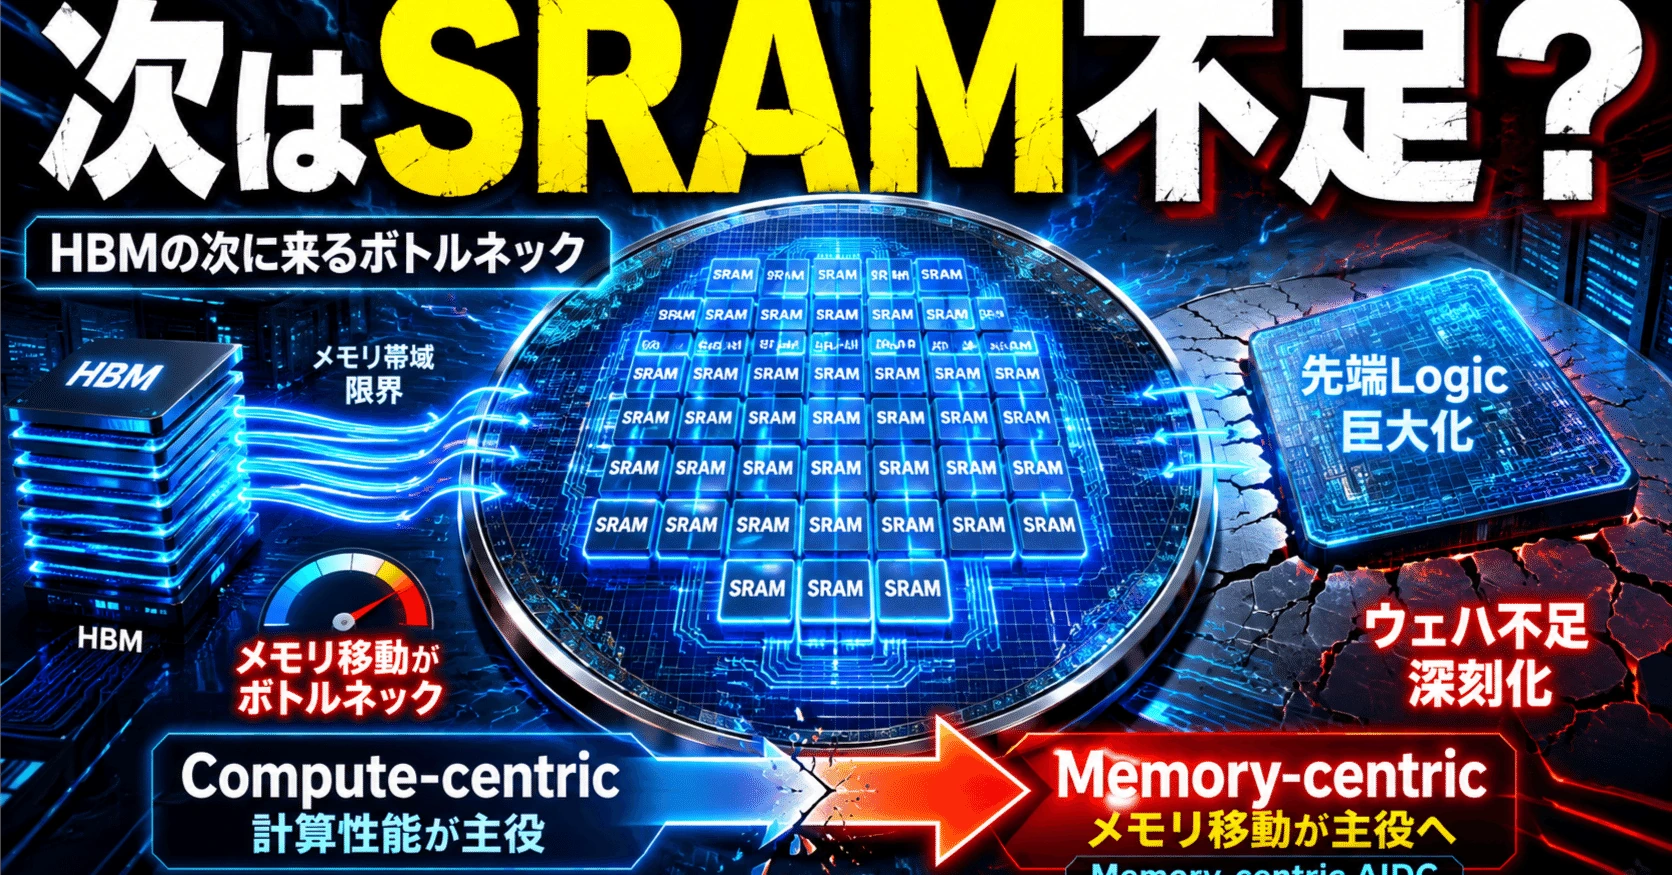
SRAMは次のAIメモリ不足を作るのか――Groq・Cerebras・Rebellionsから読む「Memory-centric AIDC」の未来
#HBM不足の次に起きること――超高速SRAM、3D DRAM、先端Logic Wafer、そしてAI Factoryの再設計
#AI半導体を追っていると、これまで主役だった数字はかなり分かりやすかった。
#GPUのFLOPS。
#HBM容量。
#HBM bandwidth。
#GPU台数。
#Data CenterのGW。
#しかし推論需要が急速に増えたことで、別の数字が急に重要になってきた。
#SRAMである。
#Cerebrasの最新CS-4は、3枚のWafer Scale Engineを使い、合計132GBのon-chip SRAMと129.6PB/sという巨大なMemory bandwidthを持つ。
#Groqの次世代LPXは、1rackに128GB SRAM、40PB/s、315PFLOPS FP8を載せる。
#韓国RebellionsのRebel100も、1 acceleratorあたり512MB SRAMと192TB/sのlocal bandwidthを持ちながら、さらに144GB HBM3Eを組み合わせる。
#三社の設計はかなり違う。
#しかし共通していることがある。
#AIの性能を決めるものが「どれだけ演算できるか」から、「演算器へどれだけ速くデータを持ってこられるか」へ移り始めている。#
CerebrasはSRAMを極端に巨大化する。
#GroqはSRAMとCompilerによってData movementそのものをscheduleする。
#RebellionsはSRAM、HBM、Predictive DMA、UCIe、そして将来の3D DRAMまで含め、Memory hierarchy全体を最適化しようとしている。
#これは単なる三社のAI chip競争ではない。
#今後AI Data Centerそのものが、
#Compute-centric
#から、
#Memory-centric
#へ変わっていく可能性を示している。
#そして、この流れが本当に大規模化した場合、現在のHBM・DRAM不足を解決するどころか、別の場所へ半導体供給制約を移してしまう可能性がある。
#SRAMはDRAMのような「SRAMメーカーの売上」として見えない。
#なぜなら、その多くがAI acceleratorのlogic dieそのものに埋め込まれているからである。
#したがって将来起こるかもしれないSRAM Supercycleは、
#SRAM ASP上昇
#としてではなく、
#TSMC/Samsungの先端Logic Wafer不足
#AI acceleratorのDie大型化
#Custom SRAM IPの価値上昇
#EDA・Memory Compiler需要
#3D Memory/Hybrid Bonding需要
#として現れる可能性がある。
#今回はGroq、Cerebras、Rebellionsを技術から事業まで分解しながら、SRAMとはそもそも何なのか、DRAM/HBM不足の中でなぜ重要になってきたのか、3D DRAMはその先をどう変えるのか、そして2030年代のAIDCがどこへ向かうのかまで考えてみる。
##
1.最初にSRAMとは何なのか
#SRAMはStatic Random Access Memory。
#DRAMはDynamic Random Access Memoryである。
#両方とも電源を切れば内容を失う揮発性Memoryだが、情報の保持方法が違う。
#一般的なSRAM cellは、複数transistorからなるlatchを使ってbitを保持する。
#一方DRAMは基本的に、
#1 transistor + 1 capacitor
#という非常に小さなcellで情報を保持する。
#この違いから、
#TSMCも、SRAMをlogic chip上へ統合して高速cacheとして利用し、DRAMをより高密度だが相対的に低速なoff-chip memoryとして位置付けている。(TSMC Research)
##
2.今回のSRAMは「Memoryメーカーから買うSRAM」ではない
#ここが投資分析で最も重要である。
#例えばCerebrasの44GB SRAMは、
#SK hynixからSRAM chipを44GB購入してWSEへ載せているわけではない。
#Groqも同じ。
#Rebellionsも同じ。
#AI acceleratorの中では、
#Logic Wafer
┌──────────────────┐
│ Compute Core │
│ │
│ SRAM SRAM SRAM │
│ │
│ NoC │
│ DMA │
│ SerDes / UCIe │
│ Memory Controller│
└──────────────────┘として、
#Compute transistorとSRAM transistorを同じLogic Wafer上へ製造する。
#したがってAI向けembedded SRAMの製造capacityは、おおむね、
#先端Logic Foundry Capacity
#と同じ場所にある。
#これはHBMとは根本的に違う。
##
3.HBMはDRAM Wafer、SRAMはLogic Waferを食う
#HBMなら、
#SK hynix / Samsung / Micron
↓
DRAM wafer
↓
HBM die
↓
8Hi / 12Hi / 16Hi
↓
stackingである。
#その後GPU等とpackageする。
#一方embedded SRAMなら、
#TSMC / Samsung Foundry
↓
Logic wafer
↓
Compute + SRAM + I/Oである。
#したがって、
#HBM不足
#は、
#DRAM wafer
#+ stacking
#+ packaging
#の不足として現れる。
#一方、
#SRAM-rich accelerator不足
#は、
#advanced logic wafer area
#+ large-die yield
#の不足として現れやすい。
##
4.そしてSRAMには大きな問題がある――あまり縮まない
#ここが今後非常に重要になる。
#TSMCのN5で最小SRAM bit cellは、
#0.021µm²
#だった。(TSMC Research)
#ところがN2でTSMCが発表したhigh-density SRAMも、
#0.021µm²
#のbitcellを使っている。
#DTCOなどによってmacro densityは38.1Mbit/mm²まで改善したものの、前世代からのSRAM density改善は約1.1倍である。(TSMC Research)
#つまり、
#Logic transistorは世代更新で縮んでも、SRAM cellは同じ速度では縮まなくなっている。#
これがSRAM Scaling Wallである。
##
5.AIがSRAMを増やすとDieが再び大きくなる
#例えば、
#Compute部分:
#300mm²
#SRAM:
#100mm²
#その他:
#100mm²
#なら、
#500mm²のchipになる。
#次世代nodeでComputeが180mm²まで縮んでも、SRAMが90mm²にしか縮まらない。
#さらにAI側がSRAM容量を倍増させると、
#SRAM:
#180mm²
#となり、
#総Die:
#440mm²。
#Logic微細化で得た面積のかなりの部分を、SRAM増量で再び使ってしまう。
#つまり、
#AI Acceleratorの性能向上が「SRAM Wafer Consumption」を増やす
#可能性がある。
##
6.なぜ今この問題が急に重要になったのか
#原因はInferenceである。
#特にLLM Decodeでは、
#FLOPSより、
#Weight、
#KV Cache、
#Attention state
#をどれだけ早く演算器へ届けられるかが重要になる。
#演算器が1000TFLOPSあっても、その半分の時間をMemory待ちしているなら役に立たない。
#概念的には、
#Useful Performance
#は、
#Peak Compute
#より、
#Compute時間 + Memory Stall + Communication Stall
#によって決まる。
#ここにCerebras、Groq、Rebellionsの三つの異なる答えが出てくる。
##
7.三社を最初に比較する
#2026年8月現在の主要systemを並べるとこうなる。
#※Rebel100の512MB SRAM、192TB/sを32基単純合計した本稿計算。32個の独立local SRAMを足した値であり、一つの共有6.1PB/s memory fabricではない。Cerebras/Groqの数字と完全な横比較はできない。RebelRack公式値は65.5PFLOPS FP8、4.61TB HBM3E、153.6TB/s HBM bandwidthである。(Rebellions)
#またCerebrasの「AI Compute」と他社のFP8 PFLOPSは定義が同一ではないので、750対315対65.5をbenchmark scoreとして扱うべきではない。
#それでも、SRAMの物量という意味でCerebrasとGroqが極端であることは明らかである。
##
8.Cerebras――Memory Wallを「Wafer」で殴る
#Cerebrasは三社中最も極端である。
#最新WSE-3 Turboは、
#4兆transistor、
#90万AI core、
#46,225mm² silicon、
#44GB SRAM、
#250PFLOPS AI compute、
#43.2PB/s Memory bandwidth
#を一枚のWafer Scale Processorへ載せる。
#CS-4はWSE-3Tを3基使い、
#750PFLOPS
#132GB SRAM
#129.6PB/s Memory bandwidth
#160.5PB/s compute fabric
#まで拡大する。Wafer間latencyも最短2μsとされる。(Cerebras)
##
9.Cerebrasは「HBMへ取りに行く」という行為を減らす
#通常のGPUなら、
#Compute
↕
HBMとなる。
#Decodeでは1token生成するたびWeightやKVを読み、Memory trafficが発生する。
#Cerebrasでは、
#Compute ─ SRAM ─ Compute
│ │
SRAM SRAM
│ │
Compute ─ SRAM ─ ComputeをWafer全体へ敷き詰める。
#演算器とMemoryの距離そのものを短くし、非常に広いon-wafer fabricで結ぶ。
#このためCerebrasは、Memory bandwidthの絶対値で異常な数字を出せる。
##
10.OpenAI UltrafastがCerebrasの価値を実証し始めた
#Cerebrasの大きな疑問は、
#44GBしかないSRAMでFrontier Modelをどう扱うのか#
だった。
#しかしOpenAIのGPT-5.6 Sol Ultrafastは、この評価をかなり変えた。
#OpenAIは2026年8月、Cerebrasを使ったUltrafast modeについて、Standard processing比最大14倍、最大750 output tokens/secを公表した。(Cerebras)
#Cerebrasによれば、各WSEの44GB SRAMへmodel weightの一部を常駐させ、
#modelを複数waferへ分割し、tokenをlayer pipelineに沿って流す
#構造を採る。
#つまり44GBは、
#「Model全体の容量上限」
#ではなく、
#「1 Waferに置くModel shard容量」
#になる。
#これはCerebras architectureにとって非常に大きな実証である。(Cerebras)
##
11.CerebrasがHBM不足で非常に有利な理由
#現在Cerebrasは、
#HBMを使わない。
#CoWoSを使わない。
#3nmを使わない。
#と明言している。
#同社は2026Q2に、HBM、CoWoS、3nmが供給制約下にある一方、自社はこれらを回避でき、TSMC wafer supplyも確保したと説明している。(Cerebras)
#これは今のMemory shortageでは極めて大きい。
#HBM3E/HBM4が足りなくてもCS-4を作れる。
#ただし供給問題がなくなったわけではない。
##
12.CerebrasはHBM shortageをLogic Wafer shortageへ移す
#Cerebrasはほぼ300mm wafer一枚分の面積を1processorとして使う。
#つまり、
#HBMを消費しない代わりに、advanced logic siliconを極端に多く消費する。#
Cerebrasが急成長すれば、
#TSMC wafer capacity
#contract manufacturing
#電力
#冷却
#の方が重要になる。
#同社自身も2026年中に製造能力を10倍超へ増やしており、600MW超のcapacityをliveまたは契約済みとしている。(Cerebras)
#したがって、
#「SRAMなら供給制約から自由」
#ではない。
#制約の場所が変わるだけである。
##
13.Groq――MemoryとComputeを「時刻表」にする
#GroqもSRAM-rich architectureだが、Cerebrasとは思想が違う。
#Groqの中心はLPU、Language Processing Unit。
#大きな特徴は、
#executionとdata movementをCompilerであらかじめscheduleする
#ことである。
#GPUではruntime scheduling、cache、resource conflictなどによって処理時間が変動する。
#Groqは、
#Memory read
#↓
#Compute
#↓
#Communication
#を明示的にscheduleし、deterministic executionへ寄せる。
#これによって平均Latencyだけでなく、
#Tail Latency
#を小さくしやすい。
#Voice、Coding、AgentのようなRealtime AIにとって重要な性質である。
##
14.Groq 3 LPXはSRAM量でもCerebras級へ来る
#次世代NVIDIA Groq 3 LPXは、
#256 LPU/rack、
#128GB on-chip SRAM、
#40PB/s SRAM bandwidth、
#315PFLOPS FP8、
#最大1000tokens/sec/user
#という仕様を掲げる。(Groq)
#一つのLPUに直すと約500MB SRAM。
#これはRebellionsの512MBとほぼ同じ桁である。
#ただしLPXでは256個をrack-scaleで接続するため、総SRAMが128GBまで膨らむ。
##
15.しかしGroqもSRAMだけで世界を作る方向ではなくなった
#これは重要である。
#Groq 3 LPXには12TB DDR5があり、さらにNVIDIA Vera Rubinと組み合わせる前提になっている。(Groq)
#概念的には、
#Rubin / HBM
大容量
Prefill
Long Context
↓
Groq LPX
SRAM
Ultra-low-latency Decodeである。
#つまりGroq自身も、
#「すべてをSRAMへ置く」
#のではなく、
#SRAMを最も価値の高いLatency-critical tierとして使う
#方向へ進んでいる。
##
16.GroqはChip企業というよりInference Cloud企業になりつつある
#Groqは現在13のData Centerを4大陸で運営し、2026年6月時点で500万人超のDeveloperを抱え、毎週trillions of tokensを処理している。2027年に向け200MW規模へ拡張するため650Mドルを調達した。(Groq)
#2025年末にはNVIDIAとnon-exclusive inference technology licenseを締結し、2026年8月にはNVIDIA Cloud Partnerにもなった。(Groq)
#したがってGroqの勝ち筋は、
#「NVIDIAをすべて置き換える」
#より、
#NVIDIA ecosystemの中でLow-latency Decodeを取る
#方向へかなり近づいている。
##
17.Rebellions――数字では小さく見えるが、設計思想が違う
#Rebel100は、
#Samsung 4nm、
#4 homogeneous chiplets、
#FP8 2PFLOPS、
#FP16 1PFLOPS、
#512MB on-chip SRAM、
#192TB/s SRAM bandwidth、
#144GB HBM3E、
#4.8TB/s HBM bandwidth、
#最大600W
#という構成である。(Rebellions)
#Cerebrasの44GB SRAMやGroq rackの128GBと比べれば、512MBは小さい。
#しかしRebellionsはそもそも、
#SRAM容量最大化競争をしていない。
#ここを理解しないと評価を誤る。
##
18.Rebellionsの答えは「Memory hierarchy」
#Rebellionsの考え方を単純化すると、
#Compute
↑
512MB SRAM
↑
Predictive DMA
↑
144GB HBM3E
↑
将来 3D DRAM / HBF / Memory Poolである。
#Cerebrasが、
#「データを極力SRAMへ寄せる」
#なら、
#Rebellionsは、
#「必要なデータを必要な時だけ近いMemoryへ移動する」
#思想に近い。
#これが同社のいうMemory-centric architectureである。
##
19.Predictive DMAとは何か
#DMAはDirect Memory Access。
#演算core自身が一つ一つMemory transferを管理する代わりに、専用Logicがdata movementを担当する。
#Rebel100のPredictive DMAは独立したMemory chipではなく、
#SoC内部のLogic Engine
#である。
#Rebellionsはこれをsoftware-controlled DMAとしてon-chip meshと密接に統合し、KV dataを先読みする。
#公称effective bandwidthは2.7TB/s。
#local HBMとremote HBMへの同時access、multi-path routing、taskごとのQoSも利用し、32K以上のcontextでtoken latencyを抑える設計としている。(Rebellions)
##
20.Predictive DMAは「未来をAIで予測する装置」ではない
#名前から、
#「AIが次に必要なMemoryを予言する」
#ように聞こえるが、少し違う。
#LLMでは次に行う演算やMemory access patternのかなりの部分をSoftware/Compiler側で把握できる。
#そこで、
#現在の演算
↓
次の演算に必要なDataを把握
↓
Predictive DMAが先に転送開始
↓
演算器が必要になる頃にはDataが到着とする。
#目的は、
#Memory Latencyをゼロにすること
#ではない。
#Memory transferをComputeの裏へ隠すこと
#である。
##
21.RebellionsはSRAMを「節約して使う」
#ここがCerebras/Groqとの大きな違いになる。
#SRAMは速い。
#しかし非常に高い。
#面積を食う。
#なら、
#Hot DataだけSRAM。
#大量のWeight/KVはHBM。
#さらに巨大なContextやinactive expertは3D DRAM/HBF。
#と分ける。
#これはCPUで、
#L1
#L2
#L3
#DRAM
#SSD
#を使い分けてきたのと同じ発想をAI巨大scaleへ拡張したものだ。
##
22.MoEでは特にRebellions型が合理的になる可能性がある
#Mixture of Expertsでは、すべてのExpertを毎token使うわけではない。
#100個Expertがあっても数個だけactivateするなら、
#全Expertを高価なSRAMへ入れる必要はない。
#HBM / 3D DRAM
Expert 1
Expert 2
...
Expert 100
↓
Router
次に使うExpertを選択
↓
Predictive Data Movement
↓
SRAM / Computeとできる。
#つまりSRAM容量そのものより、
#Data placementの賢さ
#を競争力にする。
##
23.Rebellionsが3D SRAMから3D DRAMへ切り替えた意味
#Rebellions CEO Sunghyun Park氏は2026年6月、同社が次世代architectureで当初検討していた3D SRAMをやめ、SK hynixとSamsungとの協力による3D-stacked DRAMへ方向転換したと説明している。
#さらにCustom HBMのlogic base dieへ高速token decode用logicを入れる可能性も検討している。(EE Times)
#これは非常に象徴的である。
#SRAMは非常に速い。しかし大容量化するにはSilicon面積が高すぎる。#
という物理的現実があるからだ。
##
24.三社の戦略を一言で分ける
#したがって、
#Cerebras=最も極端。
#Groq=最もLatency特化。
#Rebellions=最もMemory hierarchy志向。
#と整理できる。
##
25.DRAM不足ではSRAMは本当に有利なのか
#短期的には明確な優位性がある。
#SRAM-rich architectureなら、
#HBM stack、
#HBM DRAM wafer、
#TSV、
#HBM packaging
#への依存を減らせる。
#Cerebrasがその最も極端な例である。
#現在DRAM/NAND市場は非常にtightで、2026Q1にはDRAMとNANDだけで世界半導体売上の40%以上を占め、NANDだけでも約480億ドルまで膨らんだ。AI需要と供給不足による価格上昇が主要因である。(EE Times Asia)
#SRAMはこのDRAM manufacturing chainを必要としない。
##
26.ただしSRAMは別のScarcityを作る
#SRAMはLogic Waferに載る。
#したがって、
#SRAM容量↑
#↓
#Die Area↑
#↓
#Gross Dies/Wafer↓
#↓
#DefectがDieへ入る確率↑
#↓
#Good Dies/Wafer↓
#となり得る。
#つまり、
#DRAM Wafer ScarcityをLogic Wafer Scarcityへ変える。
#これがSRAM-rich AIDCの物理的代償である。
##
27.SRAM 500MBという数字をWafer面積へ変換するとどうなるか
#TSMC N2の最密SRAM macroは約38.1Mbit/mm²である。(TSMC Research)
#これを「理論的な高密度面積下限」として利用する。
#実際のGroq/Rebellionsは異なるnode、high-speed cell、routing、ECC、peripheryを使うため、実面積推定ではない。
#しかし桁を見るには使える。
#500MBだけで100mm²級。
#1GBなら約210mm²。
#これはかなり大きい。
##
28.Cerebras 44GBがどれほど異常か
#同じ38.1Mbit/mm²を使うと、
#必要な理論array areaは、
#約9,240mm²。
#WSE-3T全体は46,225mm²なので、
#N2というCerebrasより新しいnodeを使った楽観的な比較ですら、
#Wafer面積の約20%相当
#になる。
#実際のWSEは5nmであり、SRAM peripheral、NoC、ECC、routing等もあるので実面積とは全く違う。
#しかし、
#44GBのSRAMは文字通りWafer級の資源を必要とする#
ことは分かる。
##
29.これが「SRAM市場規模」を普通の市場調査で測れない理由
#市場調査を見ると不思議なことが起きる。
#Global Market Insightsは2025年の世界SRAM市場を、
#7.18億ドル
#と推定している。(Global Market Insights Inc.)
#別の調査でも約7.1億ドル程度。
#一方、embedded SRAMなどを広く含める調査では、85億ドル、151億ドルといった全く違う数字まで出てくる。(Future Market Insights)
#30倍近い差である。
#これはどちらかが単純に間違っているというより、
#「SRAM売上を何として数えるか」
#の問題が大きい。
##
30.DRAMなら売上をそのまま測れる
#例えばSK hynixが100ドルのDRAMを売れば、
#Memory revenue 100ドル
#として計上される。
#NANDも同じ。
#HBMもDRAM売上として見える。
#一方Cerebras WSEに44GB SRAMがあっても、
#SRAM 44GB分の売上
#というものは存在しない。
#TSMCはWSE waferをCerebrasへ売る。
#CerebrasはAI system/cloud computeを売る。
#SRAMの価値は、
#Logic Chipの中へ埋もれる。
#ここが最大の違いである。
##
31.したがって「SRAM市場700Mドルだから小さい」は間違い
#2026Q1にはDRAM+NANDだけで四半期半導体市場3190億ドルの40%以上、すなわち少なくとも1280億ドル規模に達した。NANDだけで約480億ドルだった。(ETElectronics.com)
#対して狭義SRAM市場は年間7億ドル級とされる。
#一見するとSRAMはMemory産業の端数である。
#しかし、
#Cerebras 44GB。
#Groq 128GB/rack。
#Rebellions 512MB/accelerator。
#GPUのCache。
#Custom TPU/XPU。
#に埋め込まれたSRAMは、
#独立したSRAM salesとして計上されない。
#したがってAI時代のSRAM拡大は、
#Revenue market sizeではなくSilicon areaで測るべき
#である。
##
32.そこで独自指標①――SRAM Bytes per Accelerator
#最も単純なのは、
#SBA
#SRAM Bytes per Accelerator。
#公開されている例を比べると、
#NVIDIA/AMD値はL2/LLCのみで、L1・Register等を含まないため完全比較ではないが、Inference-specialized architectureが数百MB級、あるいはWafer Scaleでは数十GBへ進んでいることが分かる。(Rebellions)
##
33.独自指標②――SRAM Area Burden
#さらに重要なのが、
#SAB:SRAM Area Burden
#である。
#概念的には、
#を見る。
#SRAM容量が増えてもnode微細化で面積が減れば問題ない。
#しかしSRAM density改善が1.1倍程度しかないのに、SRAM容量を2倍、4倍へ増やせば、
#SRAMがDieを支配し始める。
#これが今後TSMC/Samsung capacityを見る上で重要になる。
##
34.独自指標③――SRAM Wafer-Equivalent Demand
#AI向けSRAM需要を見るなら、私は、
#SWED
#SRAM Wafer-Equivalent Demand
#を使いたい。
#概念的には、
#である。
#これは業界標準ではなく本稿独自の分析指標である。
##
35.もし500MB SRAM搭載Acceleratorが1000万台作られたら
#N2の38.1Mbit/mm²、300mm waferの理想面積を使った下限試算をする。
#500MB SRAMだけで、
#約14,900枚
#の300mm wafer-equivalentになる。
#これは、
#edge loss、
#yield、
#SRAM peripheral、
#routing、
#redundancy、
#high-speed cellのdensity低下
#を一切含まない理想下限である。
#したがって実際のwafer burdenはこれより大きくなる。
##
36.5000万台なら話が変わってくる
#同じ計算なら、
#これは予測ではない。
#SRAM intensityが増えた場合の面積感度である。
##
37.ここから分かること
#SRAM-rich AI acceleratorが数百万台程度なら、
#SRAMだけで世界Foundryを壊すほどではない。
#しかし、
#Agentic AIの普及によって、
#年間数千万accelerator
#×
#1~2GB SRAM
#という設計点へ進めば、
#SRAMだけで年間数十万枚規模のleading-edge wafer-equivalent
#を消費する可能性が出てくる。
#しかもその上にCompute、SerDes、NoCなども必要である。
#この段階になると、
#「SRAM shortage」
#というニュースではなく、
#「N3/N2 Waferが足りない」
#として現れる可能性が高い。
##
38.SRAM Supercycleは見えない
#したがってSRAMテーマでは、
#DRAMのように、
#SRAM ASP
#SRAM bit shipment
#SRAM vendor revenue
#だけを見ても意味がない。
#見るべきなのは、
#である。
##
39.ではSRAM拡大の本当の受益者は誰か
#最も単純に「SRAMメーカー」を探すと間違えやすい。
#今回増えるのはstandalone SRAMではなく、
#Embedded SRAM
#だからである。
#したがって受益者は大きく、
#Foundry
#Custom Silicon Designer
#EDA/IP
#Semiconductor Equipment
#SRAM-rich AI operator
#へ分かれる。
##
40.第一の本命――TSMC
#物理的にはTSMCが最も直接的である。
#Embedded SRAMが増える。
#↓
#AI accelerator dieが大きくなる。
#↓
#同じchip数に必要なwaferが増える。
#↓
#advanced-node demandが増える。
#となる。
#さらにN2でSRAM macro densityは38.1Mbit/mm²まで改善したものの、前世代比は約1.1倍にとどまる。(TSMC Research)
#つまりSRAM scaling wallは、
#TSMCのleading-edge Wafer scarcityを強める
#可能性がある。
##
41.Samsung Electronics――LogicとDRAMを両側から取る
#Samsungはさらに特殊である。
#Rebel100はSamsung 4nm。
#その上でHBM3Eを144GB搭載する。(Rebellions)
#Rebellions型が増えると、
#Foundry側
#SRAM-rich logic wafer。
#Memory側
#HBM。
#両方の需要を取れる可能性がある。
#SRAM architectureとHBM architectureのどちらが勝っても完全には外れにくいのがSamsungの特徴である。
##
42.Marvell――「SRAM不足」ではなく「SRAM設計難化」を収益化する
#MarvellはSRAM Fabを持つ会社ではない。
#Fablessであり、
#SRAM-heavy custom XPUを設計する側
#である。
#Marvellは2nm向けCustom SRAMを発表し、
#最大6Gbit、
#最大3.75GHz、
#標準on-chip SRAM比でtotal die area最大15%削減、
#standby power最大66%削減
#を掲げている。(Marvell Technology, Inc.)
#6Gbitは約750MB。
#Groq/Rebellionsの500MB級と同じ桁である。
##
43.なぜMarvellに価値が出るのか
#SRAMを大量に載せたい。
#しかし面積が大きい。
#するとHyperscalerは、
#「標準SRAM macroを並べるだけ」
#ではなく、
#Workload専用に、
#SRAM banking、
#data path、
#power gating、
#clock、
#NoC、
#compute block
#まで共同最適化したくなる。
#つまり、
#SRAM scaling wall → Custom Silicon value↑
#である。
#MarvellはCustom SRAMだけでなく、
#Custom HBM、
#CXL、
#UCIe、
#SerDes、
#Optical
#まで持つ。
#だからMemory hierarchyがどちらへ進んでも設計価値を取りやすい。
##
44.Synopsys――SRAMを「設計可能」にする会社
#SynopsysはSRAM Memory Compilerを250nmから2nmまで提供している。
#High-speed、
#High-density、
#Ultra-high-density、
#Extreme-high-density
#など用途に応じたembedded SRAM compilerを持ち、STAR Memory Systemによるtest/repairも提供する。(Synopsys)
#SRAMが巨大になるほど、
#PVT variation、
#BIST、
#Redundancy、
#Repair、
#Timing、
#Power management
#が難しくなる。
#つまりSRAM bytesが増えれば、
#SRAM IP/Compilerの価値も増える。
##
45.Cadence――Artisan取得で直接SRAM IPへ入った
#Cadenceは2025年にArmのArtisan Foundation IP事業を取得した。
#これには、
#standard cell library、
#memory compiler、
#GPIO
#が含まれ、leading-edge foundry processへ対応する。(Cadence Newsroom)
#ただしCadence自身も、この買収の直近売上・利益への影響は軽微だとしていた。
#したがって現時点では、
#「SRAM純粋銘柄」
#ではなく、
#SRAM-heavy SoCが増えるほどEDA/IPの設計complexityが増えるという二次受益で見るべきである。
##
46.Cerebras自身もSRAM themeへの直接投資対象
#CerebrasはSRAMを売らない。
#しかし、
#大量SRAMへ高いSilicon costを払ってでも高速Tokenを作ることに経済価値がある#
という仮説を最も直接的に収益化している会社である。
#OpenAI Ultrafastはその重要なvalidationになった。(Cerebras)
#したがってCerebrasにとって重要なのは、
#SRAM価格
#ではなく、
#Fast Token Premium
#である。
##
47.装置株はさらに一段下の受益
#SRAM-rich acceleratorが増えてleading-edge wafer startsが増えれば、
#Applied Materials、
#Tokyo Electron、
#Lam Research、
#KLA
#などにも波及する。
#これはSRAMそのものを作る装置というより、
#SRAMによって増えるAdvanced Logic Wafer
#と、
#大型DieのYield管理
#への受益である。
#特にSRAMが巨大化すると、1defectで失うDie価値が増えるためinspection/metrologyの重要性も上がる。
#ここはTSMC/MRVL/SNPSよりテーマ純度は低いが、Supply Chain全体では重要になる。
##
48.本稿のSRAMテーマ感応度
#株価水準や割安度を無視し、事業がSRAM-rich AIへどれだけ感応するかだけを見るなら、私はこう整理する。
#これは投資推奨順位ではない。
#SRAM architecture拡大への事業感応度である。
##
49.しかし本当にSRAMを増やし続けられるのか
#ここで大きな疑問が出る。
#500MB。
#1GB。
#2GB。
#4GB。
#と増やすほどlogic dieが巨大化する。
#SRAM densityはLogicほど伸びない。
#ならいずれ、
#SRAMを2D Logic上へ置き続けることそのものが限界
#になる。
#そこで3D DRAMが出てくる。
##
50.3D DRAMは何を解決するのか
#DRAMはSRAMより遅い。
#しかし圧倒的に高密度。
#そこで、
#DRAMをoff-chipへ遠く置くのではなく、
#Computeの真上・真下へ3D積層する。
#すると、
#SRAM
超低Latency
数百MB
100TB/s超
↓
3D DRAM
数十~数百GB
10~数十TB/s級
↓
HBM / DDR
さらに大容量
↓
Flashという新しいMemory hierarchyを作れる可能性がある。
##
51.3D DRAMはすでに「研究だけ」ではなくなっている
#d-Matrixの3DIMCでは、Pavehawk test siliconが実際に動作し、Voltage/Temperatureを含むvalidationが進んでいる。
#同社は、
#20TB/s / stack
#約0.3~0.4pJ/bit
#を目標とし、Pavehawkではworst-case付近で約0.4pJ/bitを確認したとしている。(d-Matrix)
#ただしこれはd-Matrixによるvendor claimであり、大量量産された商用品の第三者benchmarkではない。
##
52.d-Matrix Raptorが最初の重要な試金石
#d-Matrixは次世代Raptor inference acceleratorへ3DIMCを商用投入する計画を示している。Alchipとも3D DRAM accelerator開発で協力している。(d-Matrix)
#これが量産・Yield・$/bitまで成立すれば、
#SRAMとHBMの間
#に新しいMemory tierが実際に誕生することになる。
##
53.ZAMも2030年前後を狙う
#SoftBank子会社SAIMEMORYとIntelはZ-Angle Memory、ZAMを開発している。
#公式目標は、
#2027年度中:
#Prototype。
#2029年度中:
#Commercialization。
#つまり2028年3月までのprototype、2030年3月までの商用化を目指す。(SAIMEMORY株式会社)
#Intel/SandiaのNGDBでは、base wafer上に8枚のDRAM waferをvertical bondしたtest assemblyでfunctional DRAMまで確認されている。(Sandia National Laboratories)
##
54.しかし3D DRAMはSRAMより簡単に供給できるわけではない
#少なくとも近い将来は逆である。
#SRAMなら、
#Logic wafer
#の量産技術自体は成熟している。
#一方3D DRAMは、
#DRAM wafer、
#Logic wafer、
#wafer thinning、
#alignment、
#hybrid bonding、
#thermal、
#test、
#repair、
#final package
#まで成功させる必要がある。
#つまり、
#DRAM shortageを解決する3D DRAMが、初期にはさらにDRAM Waferを奪う
#可能性もある。
##
55.3D DRAMの最大問題も結局Yield
#3D Memoryは、
#になる。
#積み上げるほど、
#後半工程で不良が起きたときに失うValueも増える。
#だから、
#「20TB/sのtest chipが動いた」
#と、
#「NVIDIA/Google級の数量を量産できる」
#の間には巨大なManufacturing Valleyがある。
#これが今後最も重要な検証点になる。
##
56.SRAMと3D DRAMは競合ではなく階層
#性能だけ見ればSRAMは依然強い。
#Groq LPU:
#150TB/s / 約500MB
#Rebel100:
#192TB/s / 512MB
#d-Matrix 3D DRAM目標:
#20TB/s / stack。
#つまりlocal bandwidthなら、単純値でSRAMが一桁近く速い場合がある。(Rebellions)
#ただし20TB/sの3D DRAMは容量密度がはるかに高い。
#したがって、
#SRAMを置き換える技術
#ではなく、
#SRAMでは高すぎる容量を受け持つ技術
#と考えるべきである。
##
57.これからのMemory-centric Acceleratorは三段構造になる可能性
#最も合理的なのは、
#Tier 0
Register
Tier 1
SRAM
超低Latency
数百MB~数GB
↓
Tier 2
3D DRAM / Custom HBM
数十~数百GB以上
↓
Tier 3
HBM / DDR / CXL
TB級
↓
Tier 4
HBF / NAND / SSD
巨大容量である。
#必要なDataだけ上へ持ってくる。
##
58.Rebellionsはこの未来を最も明確に見ている
#Rebellions CEOは、現在の大規模KV CacheにはHBMとHBFが必要になり、Memory poolingやCustom HBMも重要になると述べている。
#そして同社は3D SRAM案から3D-stacked DRAMへ変更した。(EE Times)
#この点でRebellionsは、現在の性能だけではCerebras/Groqより地味でも、
#Memory hierarchy全体の変化へのOptionality
#が非常に大きい。
##
59.NVIDIAがRebellionsへ関心を持つ理由もここにある可能性
#2026年8月21日、BloombergはNVIDIAがRebellionsと、
#technical partnership、
#investment、
#potential acquisition
#まで含む初期協議を行っていると報じた。
#現時点では初期協議で、Deal成立は確定していない。(Bloomberg Law)
#NVIDIAが何を評価しているかは公開されていない。
#しかし技術的には、
#Predictive DMA、
#UCIe chiplet、
#Memory-centric inference、
#Custom HBM、
#3D DRAM、
#韓国Memory ecosystem
#との接続は非常に相性がよい。
##
60.三社のRoadmapを整理する
#Cerebrasは2026Q3からCS-4出荷を開始。(Cerebras)
#GroqはLPXをVera Rubinへ接続する前提で、200MW級Cloudへ拡張している。(Groq)
#RebellionsはArm AGI CPUと組み合わせたSovereign AI infrastructureをSK TelecomのAIDCで検証する計画も持つ。(Rebellions)
##
61.三社のBusiness Modelもかなり違う
#Cerebras
#Wafer Scale hardware
#+ Cloud
#+ Large Contract Capacity。
#OpenAI UltrafastのようなPremium inferenceを直接売る。
#Groq
#Inference-specialized Cloud。
#Hardwareそのものより、
#Tokens-as-a-Service
#に近い。
#Rebellions
#Chip
#+ Server
#+ Rack
#+ Sovereign/Enterprise infrastructure。
#既存DCへ導入しやすいFull-stack NPUを狙う。
##
62.顧客構成でも違いが見える
#CerebrasはOpenAIやAWSなど超大型顧客との結びつきが強い。
#Groqは数百万Developerを抱えるCloud distributionと、NVIDIAとの統合を強める。
#Rebellionsはkt cloud、SK Telecom、Armなど、韓国を起点にSovereign AIとTelco marketへ入っている。kt cloudはRebellions ATOMを使ったAI SERV NPUを商用提供している。(Rebellions)
#つまり、
#Cerebras:
#Frontier Premium。
#Groq:
#Global Fast Inference Utility。
#Rebellions:
#Sovereign/Enterprise Memory-centric Infrastructure。
#という色が強い。
##
63.現在の数字だけならCerebrasが最も飛び抜けて見える
#これは間違いではない。
#129.6PB/s。
#750PFLOPS。
#132GB SRAM。
#そしてOpenAI Ultrafastで実際に750tokens/sec級。
#Cerebrasのarchitectureは、
#「速度」という一軸では非常に強い。
#Groqも40PB/sと巨大だがCerebrasほど極端ではない。
#Rebellionsはさらに下に見える。
##
64.しかしAIDCでは「絶対速度」だけでは勝者を決められない
#Data Center operatorが必要なのは、
#最大TPS/User
#だけではない。
#必要なのは、
#Goodput/MW
#Concurrent Users/Rack
#$/Million Tokens
#Utilization
#CapEx/MW
#Gross Margin
#である。
#Cerebrasが1Userに4400tokens/secを出せても、同じModelをresidentにするため多数Waferを必要とし、同時User densityが低ければEconomic Outputで不利になる可能性はある。
#逆にRebellionsが最高速度で負けても、低Power・大容量HBM・標準rackで多数Userを安価に処理できれば経済性では勝てる。
#ここはまだ公開情報だけでは決着していない。
##
65.だから「SRAMが多い=強い」ではない
#重要なのは、
#SRAMを何GB持つか
#ではない。
#そのSRAMによって、
#Memory stallをどれだけ減らし、
#Token throughputをどれだけ増やし、
#電力をどれだけ減らし、
#Customerへいくらで販売できるか。
#である。
#SRAMは目的ではない。
#Useful Computeを増やすための手段
#である。
##
66.今後SRAM需要はどこまで増えるのか
#確定的な市場予測はできない。
#なぜならGroq 3、Rebellions、CerebrasのようなarchitectureがGPU marketの何%を取るか分からないからである。
#しかし、2026年現在、
#50~126MB級GPU cache
#↓
#250MB級
#↓
#500MB級Inference accelerator
#↓
#44GB Wafer Scale
#という設計空間がすでに存在する。
#さらにAgentic AIではLatencyの価値が上がる。
#これはSRAM intensityを押し上げる方向に働く。
##
67.特にAgentはSRAMに有利
#Human Chatなら50tokens/secでも十分速く感じる。
#しかしAgentでは、
#Model Call
#↓
#Code
#↓
#Test
#↓
#Error
#↓
#Model Call
#↓
#Tool
#↓
#再実行
#を繰り返す。
#750tokens/secと75tokens/secでは、
#Humanが文章を読む速度ではなく、
#Agent Loop/Hour
#が変わる。
#OpenAI UltrafastがResearchやCodingのIterationを速くするという価値を示したことは、低Latency SRAM architectureにとって重要なcommercial validationである。(Cerebras)
##
68.SRAM版Jevons Paradoxも起き得る
#例えばSRAMによって1token当たりMemory trafficを半減できたとする。
#普通ならHBM需要は減る。
#しかしToken価格が下がって、
#Token volumeが4倍になれば、
#総Memory trafficは2倍になる。
#つまり、
#SRAMがHBM需要を減らす
#だけでなく、
#SRAMによってInferenceが安くなり、HBM/DRAM需要まで再び増やす
#可能性がある。
#これは非常に重要である。
##
69.だからSRAMとHBMはゼロサムにならない
#CPUでもCacheが増えたからDRAMが消えたわけではない。
#L1、L2、L3が巨大化しながら、
#Main Memoryも増えた。
#AIでも同じことが起こる可能性が高い。
#SRAM:
#増える。
#HBM:
#増える。
#3D DRAM:
#増える。
#HBF/NAND:
#増える。
#なぜならAIが扱うWorking Setそのものが拡大するからである。
##
70.2030年までの中心シナリオ
#私は現時点では、SRAMがHBMを置き換えるより、
#Memory hierarchy全体が巨大化する
#可能性を中心に見る。
#2026~27年:
#SRAM-rich Decode acceleratorが市場を実証。
#Cerebras Ultrafast。
#Groq LPX。
#Rebel100。
#2027~29年:
#SRAM容量/accelerator増加。
#Custom SRAM。
#SRAM compiler。
#HBM+SRAM hybrid。
#Disaggregated Prefill/Decode。
#2028~30年:
#3D DRAM初期commercialization。
#Custom HBM logic。
#Memory pooling。
#SRAM chiplet/3D integrationの検討。
#2030年代:
#SRAM
#+ 3D DRAM
#+ HBM
#+ HBF/Flash
#をWorkloadごとに動的に使うMemory-centric AI Factoryへ進む。
#後半は本稿のシナリオ推定であり、各社公式roadmapではない。
##
71.AIDCそのものも「GPU Factory」ではなくなる
#これまでAI Data Centerは、
#NVIDIA GPUを何枚置けるか
#で語られることが多かった。
#しかし今後は、
#Training / Prefill
GPU / TPU / Trainium
↓
Ultra-fast Decode
Cerebras / Groq / NPU
↓
General Inference
Rebellions / GPU / ASIC
↓
Hot Memory
SRAM
↓
Warm Memory
HBM / 3D DRAM
↓
Context Memory
DDR / CXL
↓
Cold Memory
HBF / NANDという異種systemになり得る。
##
72.TrainingでもMemory specializationは進む
#巨大Pretrainingは引き続き、
#大量HBM、
#巨大Contiguous Cluster、
#Scale-up/Scale-out
#が中心になる。
#一方RL/Post-trainingでは、
#Rollout generation、
#Verifier、
#Synthetic Data、
#Gradient Update
#を別poolへ分けられる。
#その場合Cerebras/Groqの超高速Inferenceも、
#Training Factoryの一部として使える。
#つまり、
#TrainingとInferenceの境界自体が薄くなる。
##
73.ここでSRAMは「推論Memory」だけではなくなる
#Synthetic Data生成。
#RL rollout。
#Evaluation。
#Agent simulation。
#Research iteration。
#これらは学習Pipeline内にあるが、処理自体はInferenceである。
#したがってSRAM-rich acceleratorが、
#Training demandまで間接的に取り込む
#可能性がある。
#これがSRAM市場を従来のCache需要だけで測れないもう一つの理由になる。
##
74.SRAM Themeで最も見るべき数字
#今後数年で私が確認したいのは、
#Groq 3の500MBが次世代で1GBへ行くか。
#Rebellionsが512MBを維持するのか増やすのか。
#Google TPU、Meta MTIA、OpenAI ASICなどでもon-chip SRAMが増えるのか。
#Marvellの最大6Gbit Custom SRAMが実際のHyperscaler XPUへ採用されるか。
#TSMC N2/A16でSRAM macro densityがLogic densityに追いつくのか。
#3D DRAMが20TB/s級をMass Productionで実現できるか。
#である。
#ここが分岐点になる。
##
75.SRAM Supercycleが本物になる条件
#SRAMが巨大な新Supply Chain themeになるには、
#一つ目
#Low-latency inferenceに明確なPrice Premiumが付く。
#OpenAI Ultrafastは初期証拠になる。
#二つ目
#0.5GB級SRAMが一部StartupだけでなくHyperscaler XPUにも広がる。
#三つ目
#年間AI accelerator shipmentが数千万unitへ増える。
#四つ目
#SRAM density scalingがLogic scalingに追いつかない。
#最後の条件については、TSMCのN5→N2でも0.021µm² cellが残っており、すでに兆候が見える。(TSMC Research)
##
76.逆にSRAM Themeが伸びないケース
#SRAMにも明確な弱点がある。
#SRAMは高価。
#Silicon面積を食う。
#Static/leakage powerも無視できない。
#3D DRAMが予想以上に早く量産化する。
#HBM bandwidth/priceが急改善する。
#Speculative decodingやalgorithmic optimizationでMemory requirementが下がる。
#こうなれば、1~2GB級embedded SRAMへ向かう必要は薄くなる。
#したがって「SRAMは次のHBM」と断定するのはまだ早い。
##
77.最も自然なのは「SRAMがMemory階層のTop Tierとして巨大化する」世界
#SRAMだけで全Memoryを置き換える世界ではない。
#むしろ、
#量は少ないが最も高価値なMemory Tier
#としてSRAMが増える。
#これはHBMに少し似ている。
#DRAM全体のbitでHBMは少ない。
#しかしAI systemの性能に対する価値は非常に大きい。
#SRAMはさらにその上にある。
##
78.そしてSRAMの価値は「GB」ではなく「時間」で決まる
#HBMでは、
#$/GB
#GB/s
#が重要だった。
#SRAM-rich Decodeでは、
#何ms削減できるか
#の方が重要になる。
#Agentのtask completion timeを10秒から1秒へ縮められるなら、
#SRAMのCost/GBがDRAMの何十倍、何百倍でも成立する可能性がある。
#だからOpenAI Ultrafastが重要なのである。
#Cerebrasの44GBが高価でも、
#それによってResearcherの1日あたりIterationが何倍にもなるなら経済価値は別物になる。
##
79.Memory市場の評価軸も変わる
#DRAM:
#Good Bits/Wafer。
#HBM:
#Good Stack Bits/Wafer。
#SRAM:
#Useful Local Bandwidth/mm²。
#AIDC:
#Goodput Tokens/MW。
#最終的には、
#物理資源をどれだけEconomic Outputへ変換できるか
#という同じ問題へ収束する。
##
80.結論――SRAMは「次のDRAM市場」ではない。しかし、もっと大きなSupply Chain Themeになり得る
#SRAM市場をDRAMやNANDと同じ方法で測ろうとすると、
#年間7億ドルなのか、
#80億ドルなのか、
#150億ドルなのか、
#数字がバラバラになる。
#これはAI時代のSRAMの本質を表している。
#SRAMは単体Memory市場ではなく、Logic Architectureの一部だからである。
#Cerebrasの44GB SRAMは、
#Cerebrasのchip revenueに入る。
#Groqの500MBはLPUへ入る。
#Rebellionsの512MBはRebel100へ入る。
#GoogleやAmazonのCustom ASICに入れば、Cloud CapExへ埋もれる。
#だから、
#「SRAM売上」が爆発する必要はない。
#それでも、
#SRAMが増えれば、
#TSMCのwaferが増える。
#Dieが大きくなる。
#Custom SRAM IPが必要になる。
#Memory Compilerが必要になる。
#Yield controlが難しくなる。
#2Dで限界になれば3D integrationが必要になる。
#そしてそのすべてに利益を取る企業が存在する。
##
81.三社が示しているものは、三つの未来
#Cerebrasは、
#SRAMへSiliconを大量投入すると、AIをここまで速くできる#
ことを証明し始めた。
#Groqは、
#SRAMとCompilerを組み合わせれば、Realtime Inferenceを工場のようにdeterministicにできる#
ことを示している。
#Rebellionsは、
#SRAMだけでは高すぎる。HBM、DMA、Chiplet、3D DRAMを組み合わせ、Memory hierarchy全体を最適化すべきだ#
という次の答えへ向かっている。
#三社は競合している。
#しかし同時に、
#同じ未来を別の方向から示している。
##
82.それは「Computeを増やせばAIが速くなる」時代の終わりである
#今後は、
#FLOPSを増やす。
#だけでは足りない。
#SRAMへ何を置くか。
#HBMへ何を置くか。
#3D DRAMへ何を置くか。
#Flashへ何を逃がすか。
#どのDataを先読みするか。
#どのComputeがPrefillをするか。
#どのAcceleratorがDecodeするか。
#をSystem全体で決める。
#つまり、
#AI chip designがMemory allocation problemになる。
##
83.そしてAIDCもMemory allocation problemになる
#2030年代のAI Factoryでは、
#同じ1GWでも、
#SRAM-rich Decode acceleratorが多いAIDC。
#HBM-heavy Training AIDC。
#3D DRAMを大量に載せたInference AIDC。
#Flash/HBFを大量に持つContext Factory。
#では生産するComputeが全く違う。
#だからAIDCを、
#GW
#だけで比較することはさらに難しくなる。
##
84.最終的に不足するものは一つではない
#現在はHBMが足りない。
#だからSRAMへ逃げる。
#しかしSRAMを増やせば、
#advanced logic waferを使う。
#そこがtightになる。
#SRAMをさらに増やせなくなれば、
#3D DRAMへ行く。
#すると、
#DRAM wafer
#Hybrid Bonding
#Yield
#が必要になる。
#一つのボトルネックを解決すると、
#次の物理ボトルネックが現れる。
##
85.これがAI Infrastructureの最も重要な原理かもしれない
#AIの需要はSoftwareの速度で増える。
#しかし、
#Wafer。
#Memory cell。
#Bonding。
#Power。
#Cooling。
#Fiber。
#Transformer。
#はSoftwareの速度では増えない。
#Cerebras、Groq、Rebellionsは、
#この物理制約に対する三つの答えである。
#そしてその答えがどれか一つに収束する可能性は低い。
#最も自然なのは、
#Cerebras型の巨大SRAM
#Groq型のLow-latency SRAM Engine
#Rebellions型の階層型Memory-centric Accelerator
#GPU/TPU型HBM Compute
#3D DRAM
#HBF/NAND
#が、一つのAIDCの中へ共存していくことだろう。
#そうなれば、SRAMはHBMを殺さない。
#3D DRAMもSRAMを殺さない。
#むしろ、
#AIが必要とするMemory階層そのものが、すべて巨大化する。
#それが現在の公開情報から消去法で残る、最も整合的な未来に見える。
#そしてこの世界で最も重要になるのは、
#「SRAM市場は何ドルか」
#ではない。
#AI Accelerator 1台あたり何mm²のSiliconをSRAMへ使うようになったか。
#そこを見るべきである。
#もし500MB級が1GB、2GBへ増え、それが年間数千万台へ広がるなら、「SRAM Supercycle」はMemoryメーカーの決算ではなく、
#TSMCのWafer需要
#MarvellのCustom Silicon
#Synopsys/CadenceのMemory IP
#先端製造装置
#そして、
#Cerebras/Groq/Rebellionsが生産する高速Tokenの経済価値
#として表面化する。
#HBM shortageの次にやってくるMemory問題は、SRAM chipが店頭から消えるような不足ではない。
#AIが使えるSRAMを作るための、先端Logic Siliconそのものが足りない。
#そんな形で現れる可能性があるのである。
#最新情報を追う際に使えるprompt
#この記事の内容で最新情報を追う場合に使えるpromptです
#最新調査プロンプト
# AI推論アクセラレータ・SRAM・Memory-centric AIDC 最新動向調査プロンプト
# Groq / Cerebras / Rebellions / SRAM / HBM / DRAM / 3D DRAM / Advanced Logic Wafer
現在公開されている最新情報をWeb上から調査し、
・Groq
・Cerebras
・Rebellions
を中心とするAI推論アクセラレータ市場、
および、
・SRAM
・HBM
・DRAM
・3D DRAM
・Custom HBM
・HBF
・CXL/DDR
・NAND/SSD
によって構成されるAI Memory Hierarchy、
さらに、
・TSMC
・Samsung Foundry
・先端Logic Wafer
・Advanced Packaging
・Hybrid Bonding
まで含めたAI Data Center / AI Factoryの最新構造を、
技術・製造・需給・経済性・企業業績の5方向から徹底調査してください。
過去の記事や事前資料が存在することを前提にしないでください。
このプロンプトだけを読んだ人でも、
「なぜSRAMがAIで重要なのか」
「Groq、Cerebras、Rebellionsは何が違うのか」
「HBM不足とSRAM拡大はどう関係するのか」
「SRAMが増えると誰が儲かるのか」
「3D DRAMはSRAMやHBMをどう変えるのか」
「2030年前後のAIDCはどのArchitectureへ進むのか」
まで理解できるレポートを作成してください。
調査日時を冒頭に必ず明記してください。
可能な限り、
・直近7日
・直近30日
・直近90日
・過去1年
の変化を区別してください。
────────────────────
【情報源の優先順位】
────────────────────
最新情報を必ずWeb検索してください。
情報源は原則として次の優先順位で使用してください。
第1優先:
企業公式IR
SEC提出書類
決算資料
公式Press Release
公式Technical Blog
公式製品仕様
第2優先:
TSMC
Samsung
SK hynix
Micron
NVIDIA
AMD
Intel
Arm
Google
AWS
Microsoft
Meta
OpenAI
等の公式資料
第3優先:
IEEE
IEDM
VLSI Symposium
Hot Chips
MLCommons
OCP
ISSCC
学術論文
第4優先:
Reuters
Bloomberg
CNBC
第5優先:
TrendForce
TechInsights
SemiAnalysis
EE Times
The Next Platform
ServeTheHome
Blocks & Files
Data Center Dynamics
その他専門媒体
企業の性能主張しか存在しない場合は、
【企業公称】
と明記してください。
第三者Benchmarkの場合は、
【第三者測定】
としてください。
未確定情報は、
【報道】
【噂】
【初期協議】
などと区別してください。
数値推定は、
【本稿推定】
と明示してください。
計算した数値は、
【本稿計算】
と明示してください。
確認された事実は、
【確認済み事実】
としてください。
────────────────────
【1.Executive Summary】
────────────────────
最初に現在の状況を10~20項目で要約してください。
特に、
・SRAM-rich acceleratorは拡大しているのか
・HBM/DRAM不足は継続しているのか
・先端Logic Waferは逼迫しているのか
・Groqはどこまで商用化したか
・Cerebrasはどこまで商用化したか
・Rebellionsはどこまで商用化したか
・3D DRAMは研究から量産へどこまで進んだか
・AI推論でSRAMの価値が上昇しているか
・Trainingでも高速Inference acceleratorが重要になっているか
・Memory-centric Architectureが主流化しているか
を最初に判断してください。
────────────────────
【2.SRAMとは何か】
────────────────────
AI向けSRAMを初めて読む人にも理解できるように説明してください。
以下を説明してください。
SRAM
DRAM
HBM
NAND
のCell構造と違い。
特に、
SRAM:
6T系Cell
Refresh不要
Low Latency
High Bandwidth
Low Density
High Cost/bit
DRAM:
1T1C
Refresh必要
High Density
Lower Cost/bit
という物理的違いを説明してください。
また、
Standalone SRAM
と、
Embedded SRAM
を必ず区別してください。
AI Acceleratorで使われる大量SRAMの多くは、
「SRAMメーカーから独立Memory Chipとして購入するもの」
ではなく、
Compute Core
NoC
DMA
SerDes
Memory Controller
などと一緒に、
Logic Die内部へ作られるEmbedded SRAMであることを説明してください。
────────────────────
【3.SRAMとLogic Waferの関係】
────────────────────
Embedded SRAMが、
TSMC
Samsung Foundry
Intel Foundry
などのLogic Process上でどのように作られるか解説してください。
以下の違いを明確にしてください。
DRAM/HBM:
Memory Fab
↓
DRAM Wafer
↓
Memory Die
↓
Stacking/Packaging
Embedded SRAM:
Logic Foundry
↓
Logic Wafer
↓
Compute+SRAM+NoC+I/O
つまり、
SRAM需要増加
=
独立SRAM Fab需要増加
ではなく、
先端Logic Wafer Area需要増加
として現れる可能性について説明してください。
────────────────────
【4.SRAM Scaling Wall】
────────────────────
TSMC
Samsung
Intel
の最新Process Nodeについて、
SRAM Bit Cell Size
SRAM Macro Density
Logic Density
を調査してください。
可能なら、
N5
N4
N3
N2
A16
Samsung 4nm
3nm
2nm
Intel 3
18A
14A
などを比較してください。
特に、
「Logic transistor densityの改善に対してSRAM density scalingが鈍化している」
という仮説を検証してください。
SRAMが縮みにくくなると、
SRAM容量増加
↓
Die Area増加
↓
Gross Dies/Wafer減少
↓
Yield悪化
↓
Good Dies/Wafer減少
となる可能性を物理的に説明してください。
────────────────────
【5.Groq最新調査】
────────────────────
Groqについてゼロから調査してください。
企業概要
事業モデル
主要製品
最新LPU
Groq 3
LPX
GroqCloud
を整理してください。
最新製品について可能な限り、
Process Node
Die Size
Transistor Count
SRAM/LPU
SRAM/Rack
SRAM Bandwidth
FP8
FP16
INT8
System Compute
Rack Power
Scale-up Bandwidth
DDR Capacity
Network
TTFT
Output Tokens/sec/User
System Throughput
Concurrency
Context Length
Goodput
Tokens/MWh
を調査してください。
さらに、
Compiler
Deterministic Execution
Software Scheduling
Data Movement
Tail Latency
について技術詳細を説明してください。
GroqがなぜGPUとは違う速度特性を持つのか説明してください。
また、
NVIDIAとのTechnology License
NVIDIA Cloud Partner
Vera Rubin
Prefill/Decode Disaggregation
について最新状況を確認してください。
Groqが、
「独立GPU対抗企業」
なのか、
「NVIDIA ecosystem内のUltra-low-latency Decode Engine」
へ変化しているのか評価してください。
────────────────────
【6.Cerebras最新調査】
────────────────────
Cerebrasについてゼロから調査してください。
主要製品:
CS-2
CS-3
CS-4
WSE-2
WSE-3
WSE-3 Turbo
最新世代
について整理してください。
最新世代について、
Wafer Area
Transistor Count
AI Core Count
SRAM Capacity
SRAM Bandwidth
Compute Fabric Bandwidth
AI Compute
Power
Wafer-to-Wafer Latency
I/O
Cooling
Manufacturing Node
を調べてください。
Cerebrasが、
「Wafer Scale+大量SRAM」
によってMemory Wallをどう回避しているのか説明してください。
さらに、
OpenAI
AWS
AMD
その他大口顧客
について最新契約を確認してください。
OpenAIのUltrafast系Serviceが存在する場合は、
Model
Output Tokens/sec
TTFT
Standard Service比
Price
利用条件
MW契約
実稼働状況
を確認してください。
巨大Modelについて、
Model Sharding
Layer Pipeline
Weight Residency
MemoryX
Weight Streaming
によって、
「1 WaferのSRAM容量より大きなModel」
をどう処理しているのか説明してください。
────────────────────
【7.Rebellions最新調査】
────────────────────
Rebellionsについてゼロから調査してください。
主要製品:
ATOM
Rebel100
RebelServer
RebelRack
RebelPOD
次世代Accelerator
を整理してください。
Rebel100について、
Process Node
Chiplet数
Die Area
UCIe
FP8
FP16
SRAM Capacity
SRAM Bandwidth
HBM Type
HBM Capacity
HBM Bandwidth
Power
PCIe
Networking
Software Stack
を調査してください。
特に、
Predictive DMA
を詳しく説明してください。
Predictive DMAは、
独立Memory Chipではなく
SoC内部Logic Engineなのか。
どこまでHardwareで、
どこまでSoftware/Compilerで制御するのか。
KV Cache Prefetch
Local/Remote HBM
Multi-path
QoS
Effective Bandwidth
について最新仕様を確認してください。
────────────────────
【8.RebellionsのMemory-centric戦略】
────────────────────
Rebellionsが、
大量SRAMだけを使うArchitecture
ではなく、
SRAM
+
HBM
+
Predictive DMA
+
UCIe
+
将来3D DRAM
+
Custom HBM
+
HBF
+
Memory Pooling
というMemory Hierarchyを狙っているか検証してください。
特に、
3D SRAM
→
3D-stacked DRAM
へのRoadmap変更が存在するか確認してください。
Custom HBM Logic Base Dieへ、
Decode
Prefetch
Data Movement
などのLogicを入れる構想があるか調査してください。
────────────────────
【9.Groq・Cerebras・Rebellions直接比較】
────────────────────
最新版で三社を表にしてください。
比較項目:
主要製品
Process Node
Architecture
SRAM/Accelerator
SRAM/System
SRAM Bandwidth
HBM
DDR
Total Memory Capacity
FP8
FP16
Power
Tokens/sec/User
TTFT
Concurrency
Context
Goodput/MW
Tokens/MWh
$/1M Tokens
Prefill
Decode
Training
Long Context
MoE
Software
Cloud
Developer数
主要顧客
契約MW
稼働MW
Revenue
Gross Margin
Capital Intensity
Manufacturing Risk
Supply Chain Risk
重要:
PFLOPSの定義が企業ごとに異なる場合は、
直接比較しないでください。
System-level bandwidthとChip-level bandwidthも分離してください。
Local SRAM bandwidthの単純合算値は、
一つの共有Memory Fabric bandwidthとして扱わないでください。
────────────────────
【10.三社の戦略の違いを判定】
────────────────────
以下の整理が現在も妥当か判定してください。
Cerebras:
「Silicon面積を大量投入してSRAMを巨大化し、
Memory Latencyそのものを物理的に潰す」
Groq:
「SRAM+Compiler+Deterministic Executionで、
Memory MovementとComputeを事前Schedulingする」
Rebellions:
「SRAM+HBM+3D Memoryを階層化し、
必要なDataを必要な場所へ移す」
それぞれ、
最大の技術的強み
最大の弱点
最大の製造制約
最大の経済的強み
を出してください。
────────────────────
【11.SRAM市場規模を再定義】
────────────────────
一般的なSRAM市場調査を複数確認してください。
ただし、
Standalone SRAM市場
と、
Embedded SRAM
を区別してください。
市場調査会社によって数字が大きく異なる場合は、
何をSRAM市場として含めているか
を確認してください。
DRAM/NAND/HBMのように、
Memory vendor revenue
として直接見えるものと、
AI Accelerator Logic Dieの中へ埋め込まれているSRAM
を区別してください。
「AI時代のEmbedded SRAMはRevenue Market SizeではなくSilicon Areaで見るべき」
という仮説を検証してください。
────────────────────
【12.独自指標 SBA】
────────────────────
以下の企業・製品について、
公開されているSRAM
Cache
Scratchpad
Local Memory
を調べてください。
NVIDIA
AMD
Google TPU
AWS Trainium
Meta MTIA
Microsoft Maia
Broadcom Custom XPU
Marvell Custom XPU
Groq
Cerebras
Rebellions
d-Matrix
Tenstorrent
その他主要ASIC
独自指標:
SBA
=
SRAM Bytes per Accelerator
を作ってください。
ただし、
L2しか公開されていない製品
と、
全SRAM容量が公開されている製品
を同じ条件として扱わないでください。
必要なら、
「公開確認可能な最低SRAM量」
として比較してください。
────────────────────
【13.独自指標 SAB】
────────────────────
SRAM Area Burdenを計算してください。
SAB
=
SRAM Equivalent Area
÷
Total Accelerator Silicon Area
です。
最新のSRAM Macro Densityを使って、
128MB
256MB
512MB
1GB
2GB
4GB
8GB
16GB
44GB
について、
理論SRAM Array Area
を計算してください。
必ず、
これは実際のDie Areaではなく、
SRAM Arrayのみ
Peripheryなし
ECCなし
Routingなし
Redundancyなし
Yield補正なし
High-speed Cell補正なし
の理論下限であると明記してください。
────────────────────
【14.独自指標 SWED】
────────────────────
SRAM Wafer-Equivalent Demandを計算してください。
SWED
=
Accelerator出荷台数
×
SRAM bits/chip
÷
SRAM density
÷
usable wafer area
年間Accelerator出荷:
10M
25M
50M
100M
SRAM/chip:
256MB
512MB
1GB
2GB
4GB
について、
SRAM Array部分だけで必要になる300mm Wafer Equivalentを計算してください。
さらに、
Low
Base
High
シナリオとして、
Yield
Edge Loss
Periphery
High-speed SRAM Density Penalty
を補正してください。
────────────────────
【15.SRAM不足はどのように見えるのか】
────────────────────
以下の仮説を最新情報で検証してください。
SRAM需要が急増しても、
「SRAM chip不足」
として報道されない可能性がある。
代わりに、
N3/N2/A16 Capacity逼迫
Foundry ASP上昇
AI Accelerator Die大型化
Good Dies/Wafer低下
Custom SRAM IP需要増
Memory Compiler需要増
EDA complexity増
Inspection/Metrology需要増
として現れるのではないか。
TSMC
Samsung Foundry
Intel Foundry
の最新稼働率、
AI order、
Capacity expansion、
Wafer pricing
を調査してください。
────────────────────
【16.SRAM受益銘柄】
────────────────────
以下の企業を分析してください。
TSMC
Samsung Electronics
Marvell
Broadcom
Synopsys
Cadence
Applied Materials
Tokyo Electron
Lam Research
KLA
Besi
SUSS MicroTec
Cerebras
必要に応じて追加してください。
各社について、
SRAM拡大との関係
直接性
Revenueへの影響
Marginへの影響
2027~2030年Optionality
最大Risk
を説明してください。
特に、
MarvellはSRAMメーカーではなく、
Custom SRAM
Custom XPU
SerDes
UCIe
CXL
HBM Interface
Optical
などを設計するFabless企業として評価してください。
TSMC/Samsungは、
Embedded SRAMを含むLogic Waferそのものを製造する側
として評価してください。
Synopsys/Cadenceは、
Memory Compiler
SRAM IP
EDA
Test/Repair
の観点から評価してください。
────────────────────
【17.HBM・DRAM・SRAMのSupply Constraint比較】
────────────────────
以下を比較してください。
DRAM:
DRAM Fab
Node Migration
Good Bits/Wafer
HBM:
DRAM Wafer
HBM Die
TSV
Stacking
Bonding
Packaging
Yield
Embedded SRAM:
Advanced Logic Wafer
SRAM Area
Large Die
Die Yield
3D DRAM:
DRAM Wafer
Logic Wafer
Thinning
Hybrid Bonding
Alignment
Thermal
Testing
Repair
Compound Yield
2026
2028
2030
2032
について、
どこがBottleneckになりやすいか推定してください。
────────────────────
【18.3D DRAM最新調査】
────────────────────
以下を調査してください。
d-Matrix
3DIMC
Pavehawk
Raptor
Intel
Sandia
Next Generation DRAM Bonding
SAIMEMORY
ZAM
SK hynix
4F² Vertical Gate
Wafer Bonding
3D DRAM
DRAM-on-Logic
Samsung
zHBM
その他の、
Monolithic 3D DRAM
3D SRAM
SRAM-on-Logic
についても調べてください。
各技術について、
Prototype
Functional Silicon
Sample
Qualification
Mass Production
Commercialization Target
を区別してください。
性能は、
Bandwidth
Latency
Capacity
Density
pJ/bit
Bond Pitch
で比較してください。
────────────────────
【19.SRAM vs 3D DRAM vs HBM】
────────────────────
以下を比較してください。
SRAM
3D DRAM
HBM4/HBM4E
DDR/CXL
HBF
NAND/SSD
比較軸:
Latency
Bandwidth
Capacity
Density
Cost/bit
Energy/bit
Wafer efficiency
Yield
Distance from Compute
Mass-production maturity
特に、
3D DRAMはSRAMを置き換えるのか、
それとも、
SRAM
↓
3D DRAM / Custom HBM
↓
HBM / DDR
↓
HBF / NAND
という階層になるのか判断してください。
────────────────────
【20.DRAM不足の中で3D DRAMは作れるのか】
────────────────────
現在DRAM supplyがtightな場合、
3D DRAMの量産が、
DRAM shortageを解決する前に、
追加DRAM wafer
Bonding Capacity
Logic Wafer
Yield
を必要として、
一時的に供給制約をさらに悪化させる可能性を分析してください。
「技術的に動く」
と、
「NVIDIA/Google規模で大量生産できる」
を厳密に分けてください。
────────────────────
【21.Inference Architecture】
────────────────────
LLM Inferenceを、
Prefill
Decode
へ分解してください。
さらに、
Weights
KV Cache
Attention
MoE Expert
Context
について、
どこにSRAMが有効か、
どこにHBMが必要か、
どこに3D DRAMを使えるか
を分析してください。
特に、
Realtime Voice
Coding Agent
Research Agent
Multi-Agent
Long Context
では、
SRAMによるLow LatencyがどれくらいEconomic Valueを持つか考察してください。
────────────────────
【22.TrainingへのSRAM侵入】
────────────────────
Trainingを、
Pretraining
Post-training
RL
Rollout Generation
Synthetic Data Generation
Verifier
Evaluation
Distillation
に分解してください。
Core Gradient Trainingについては、
GPU
TPU
Trainium
Cerebras
などの大規模Compute Islandが中心になるのか。
一方、
RL Rollout
Synthetic Data
Evaluation
では、
Cerebras
Groq
その他高速Inference Accelerator
が利用される可能性を分析してください。
つまり、
「高速Inference AcceleratorがTraining Factoryの一部になる」
という仮説を検証してください。
────────────────────
【23.AI Factory / AIDCの未来】
────────────────────
2030年前後のAIDCが、
単一GPU大量配置型
から、
Heterogeneous AI Factory
へ変化する可能性を分析してください。
例えば、
Training / Prefill
→ GPU / TPU / Trainium
Ultra-fast Decode
→ Cerebras / Groq
General Inference
→ GPU / Rebellions / Custom ASIC
Hot Memory
→ SRAM
Warm Memory
→ HBM / 3D DRAM
Large Context
→ DDR / CXL
Cold Memory
→ HBF / NAND
という分業です。
この構造が、
技術的
経済的
製造的
に合理的か判断してください。
────────────────────
【24.GWではなくEconomic Computeで比較】
────────────────────
AIDCを単純GWだけで比較しないでください。
以下を可能な限り比較してください。
Goodput Tokens/sec/MW
Tokens/MWh
Concurrent Users/MW
Revenue/MW
CapEx/MW
Utilization
$/1M Output Tokens
Agent Task Completion Time
同じ1MWでも、
SRAM-rich Decode Factory
と、
HBM-heavy Training Factory
では生産するComputeの種類が違うことを説明してください。
────────────────────
【25.SRAM版Jevons Paradox】
────────────────────
SRAMによってInference latency・costが低下した場合、
Token需要
Agent数
Agent iteration
Context Length
KV Cache
Synthetic Data
が増え、
結果的に、
SRAM
HBM
DRAM
NAND
すべての需要が増える可能性を分析してください。
例:
Memory Traffic/Tokenが50%低下
しかしToken Volumeが4倍
なら、
Total Memory Trafficは2倍
になる。
こうしたJevons Paradoxが実際に起き始めている証拠を探してください。
────────────────────
【26.2030年までの市場規模シナリオ】
────────────────────
Embedded SRAMを通常のSRAM Revenueとしてではなく、
以下で市場規模化してください。
① SRAM bits shipped
② SRAM mm² shipped
③ SRAM-equivalent 300mm wafers
④ SRAM-rich accelerator units
⑤ SRAM-enabled inference MW
⑥ SRAM-enabled Tokens/sec
2026
2028
2030
2032
について、
Bear
Base
Bull
の3シナリオを作ってください。
必ず仮定を明示してください。
────────────────────
【27.三社の2027~2032 Roadmap推定】
────────────────────
Groq
Cerebras
Rebellions
について、
確認済みRoadmap
と、
公開情報から推定したRoadmap
を分離してください。
2027
2028
2029
2030
2032
について、
Process Node
SRAM
3D DRAM
HBM
Compute
Rack/System
Cloud Capacity
主要顧客
製造Partner
を整理してください。
────────────────────
【28.投資家向けBottleneck Map】
────────────────────
AI Infrastructure全体を、
Power
Grid
Transformer
Cooling
Advanced Logic Wafer
SRAM
HBM
DRAM
Advanced Packaging
Hybrid Bonding
Optics
Networking
NAND
Software/Scheduler
へ分解してください。
現在最もtightなもの。
2028年にtightになりそうなもの。
2030年にtightになりそうなもの。
をランキングしてください。
────────────────────
【29.最終評価】
────────────────────
最後に以下へ明確に答えてください。
1.
Groq、Cerebras、Rebellionsの中で、
現在最も技術的に先行している企業はどこか。
2.
最も商用化が進んでいる企業はどこか。
3.
最もSupply Chain resilienceが高いのはどこか。
4.
最もGoodput/MWが高い可能性があるのはどこか。
5.
最も2030年代Memory ArchitectureへのOptionalityが大きいのはどこか。
6.
SRAM-rich ArchitectureはAI inferenceの主流の一角になるか。
7.
Embedded SRAMは先端Logic Wafer需要を目に見えて押し上げる規模になるか。
8.
3D DRAMはSRAMを置き換えるか、それとも補完するか。
9.
HBM不足
→ SRAM増加
→ Logic Wafer不足
→ 3D DRAM
→ Hybrid Bonding/Yield不足
というBottleneck Migrationは起こり得るか。
10.
このテーマから最も恩恵を受ける上場企業はどこか。
11.
現在市場が最も過小評価している物理Bottleneckは何か。
12.
2030年のAI Factoryは現在のGPU中心AIDCと何が最も大きく変わっているか。
────────────────────
【30.最後に必ず出すもの】
────────────────────
最後に、
「直近30日で最重要だった変化 TOP10」
「今後30日で監視すべき発表 TOP10」
「今後12か月で仮説を大きく変えるイベント TOP10」
「追跡すべきKPI TOP20」
を出してください。
また全体を通じて、
確認済み事実
企業公称
報道
第三者測定
本稿計算
本稿推定
を明確に区別してください。
強気・弱気に誘導せず、
Technology
Physics
Yield
Wafer Consumption
Power
Manufacturing Capacity
Cloud Utilization
Monetization
から消去法で最も整合的な結論を導いてください。特定銘柄の推奨・勧誘・投資助言を目的とするものではありません。投資判断はご自身の責任でお願いいたします。
#