Cerebrasに勝ち目はないのか
この資料の日時
元資料の日付と、その本文が公に存在した確認日時は別の記録です。
本文に含まれる語句 HBM DRAM SRAM 帯域・データ移動 先端パッケージング 光接続 電力・給電 冷却 基板・材料 AI推論 AIエージェント
出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.09.23.4
- 記事内容のSHA-256
2f02c461e9be7669477f7bde5afa38934a67084f30ecb7285ecad9f998e21957- 保存版のSHA-256
9df9fd7c41faed481c648f13aa9d01c64982ca5ff53d86bd0e9867fda742169b
外部証明の最終検査結果は詳細を開くと表示します。
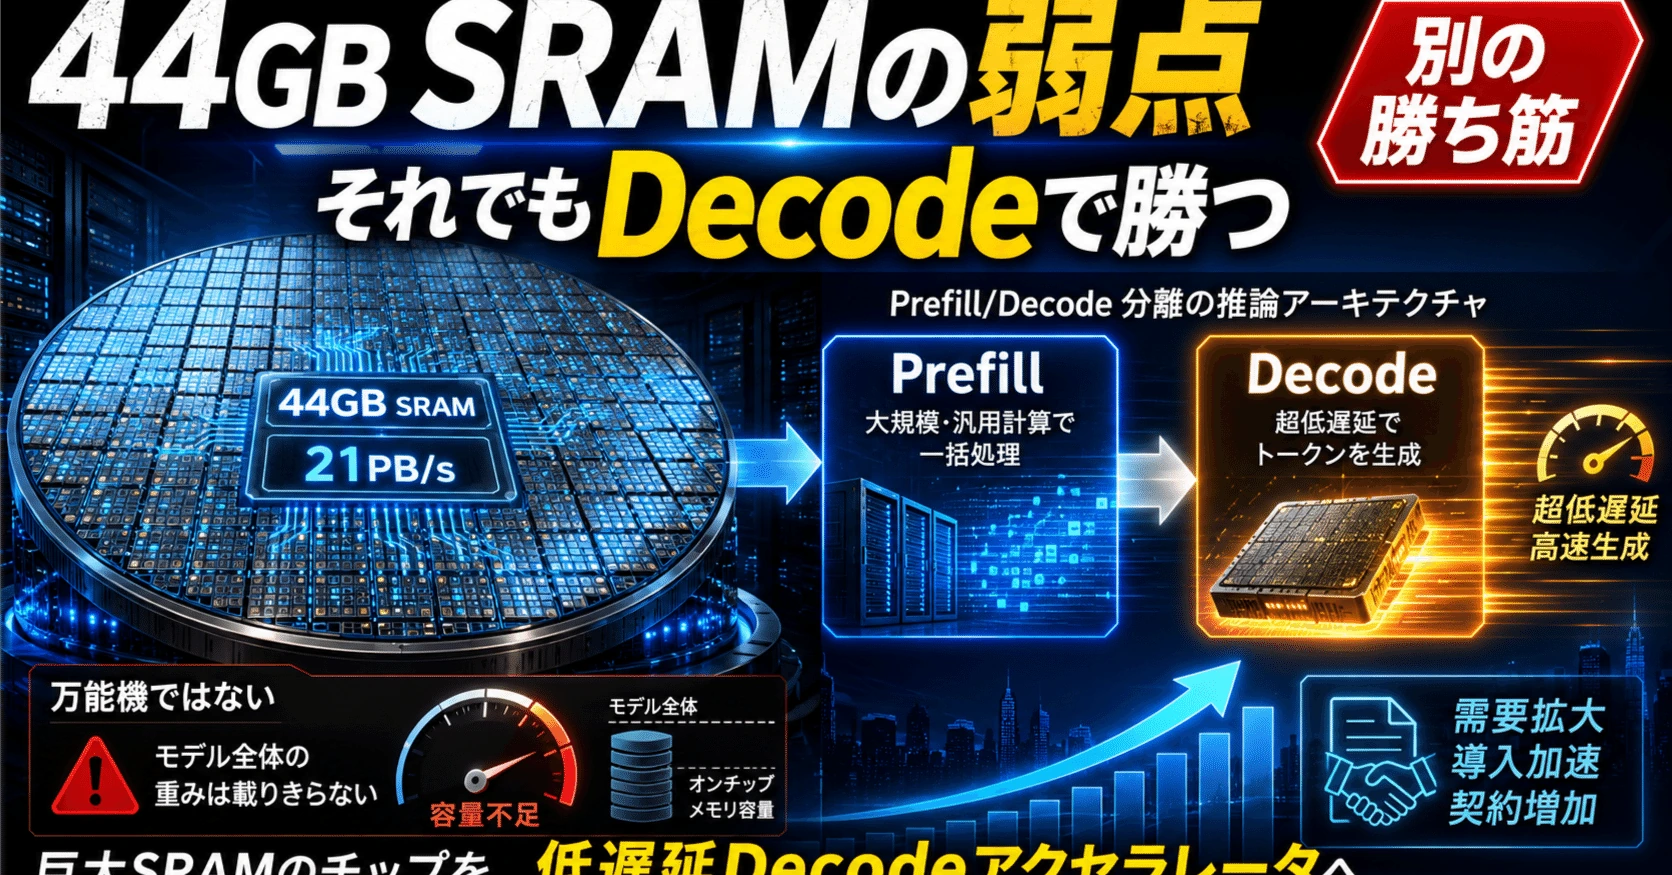
Cerebrasに勝ち目はないのか
#――44GB SRAMの弱点から見えてくる「Decode専用機」という別の勝ち筋
#CerebrasのWafer-Scale Engine(WSE)を初めて見ると、その設計思想には強烈な魅力がある。
#通常のAIアクセラレーターが多数のGPUやASICを高速リンクで接続するのに対し、Cerebrasは1枚のシリコンウェハーを巨大な演算器として利用する。WSE-3には90万個のAIコア、44GBのオンチップSRAM、21PB/sのメモリー帯域、214Pb/sの内部接続帯域が実装されている。演算器、メモリー、通信網を同じ巨大シリコン上へ配置することで、GPU間通信を減らし、極めて低い遅延を実現する設計である。(Cerebras)
#しかし、その数字を注意深く見ると、大きな疑問も生まれる。
#44GBしかないSRAMで、数百GBから数TBに達する巨大AIモデルをどう処理するのか。#
NVIDIAのGPUや大手クラウド企業のASICには、大容量のHBMがロジックダイの近くへパッケージングされている。これに対してCerebrasは、モデル全体をWSE内へ保持できない場合、外部メモリーから必要な重みを送り込むWeight Streamingを利用する。
#WSE内部は圧倒的に速い。しかし、外部メモリーとの間へ出た瞬間、その絶対的な速度差は縮小する。
#この構造だけを見れば、
#Cerebrasは巨大なSRAMを持つが、HBMを持たないため、長期的にはNVIDIA GPUや専用ASICに勝てないのではないか。#
という結論に至りやすい。
#ところが、Cerebrasの最新決算、OpenAIとの大型契約、Amazon Web Servicesとの提携を合わせて見ると、別の勝ち筋が見えてくる。
#Cerebrasは、AI推論全体を1種類のチップで置き換えようとしているのではない。
#LLM推論を複数の工程へ分解し、その中でも低遅延が特に重要なDecodeを担当する専用アクセラレーターとして、自社の位置を確立しようとしているのである。
#
#
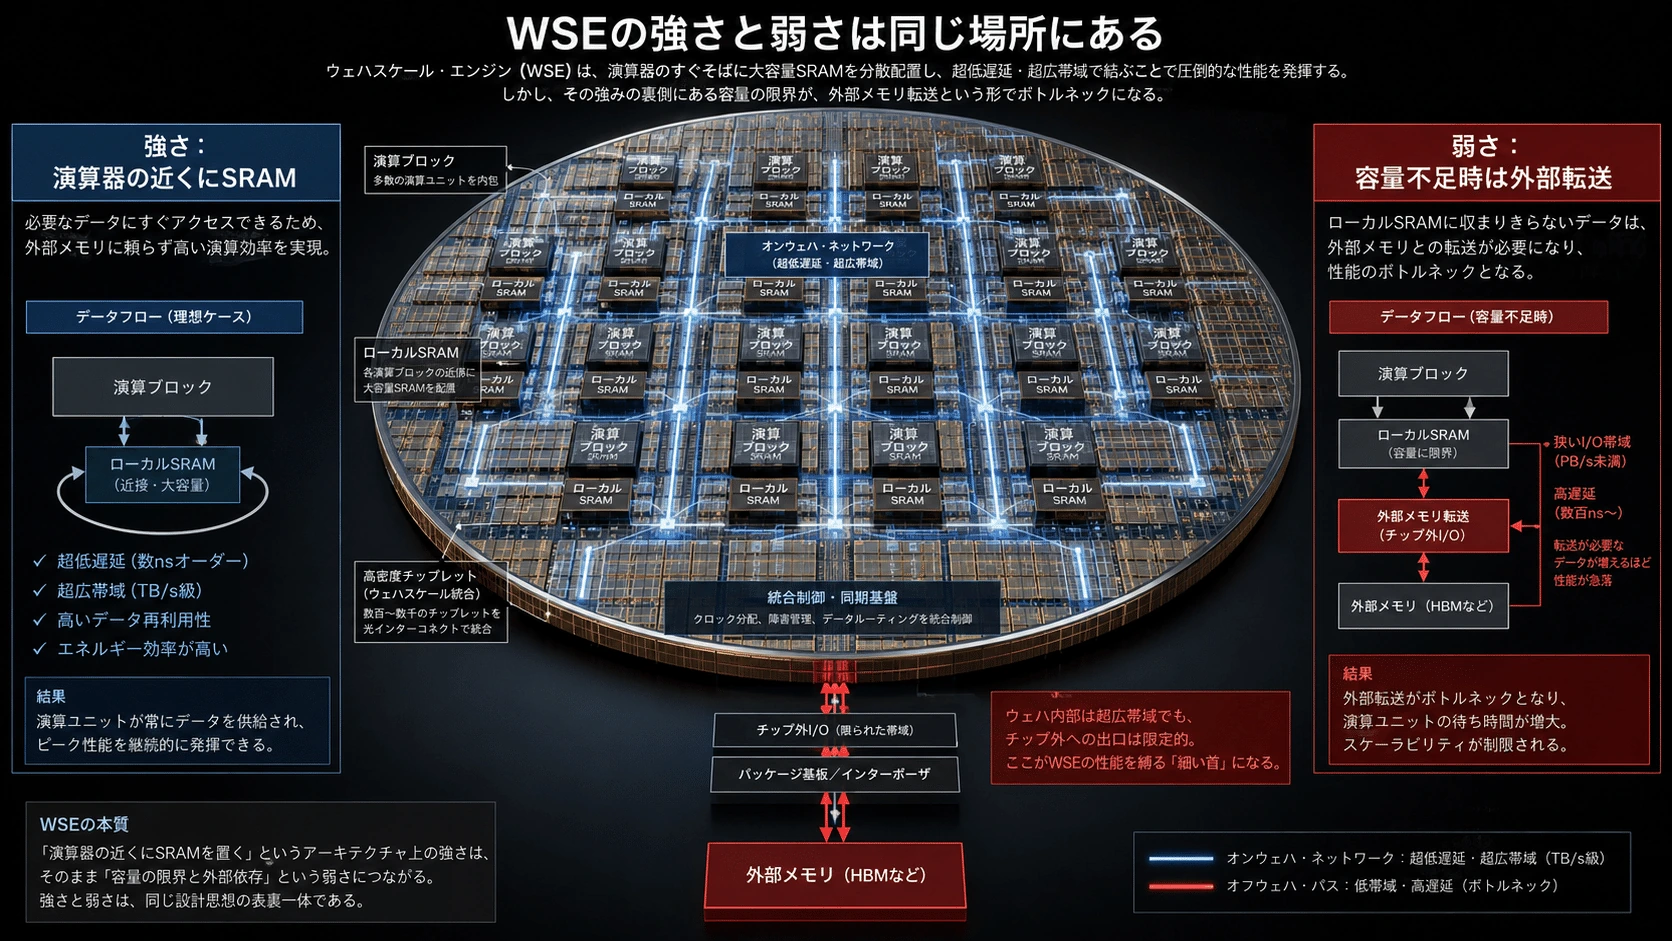
WSEの強さと弱さは同じ場所にある
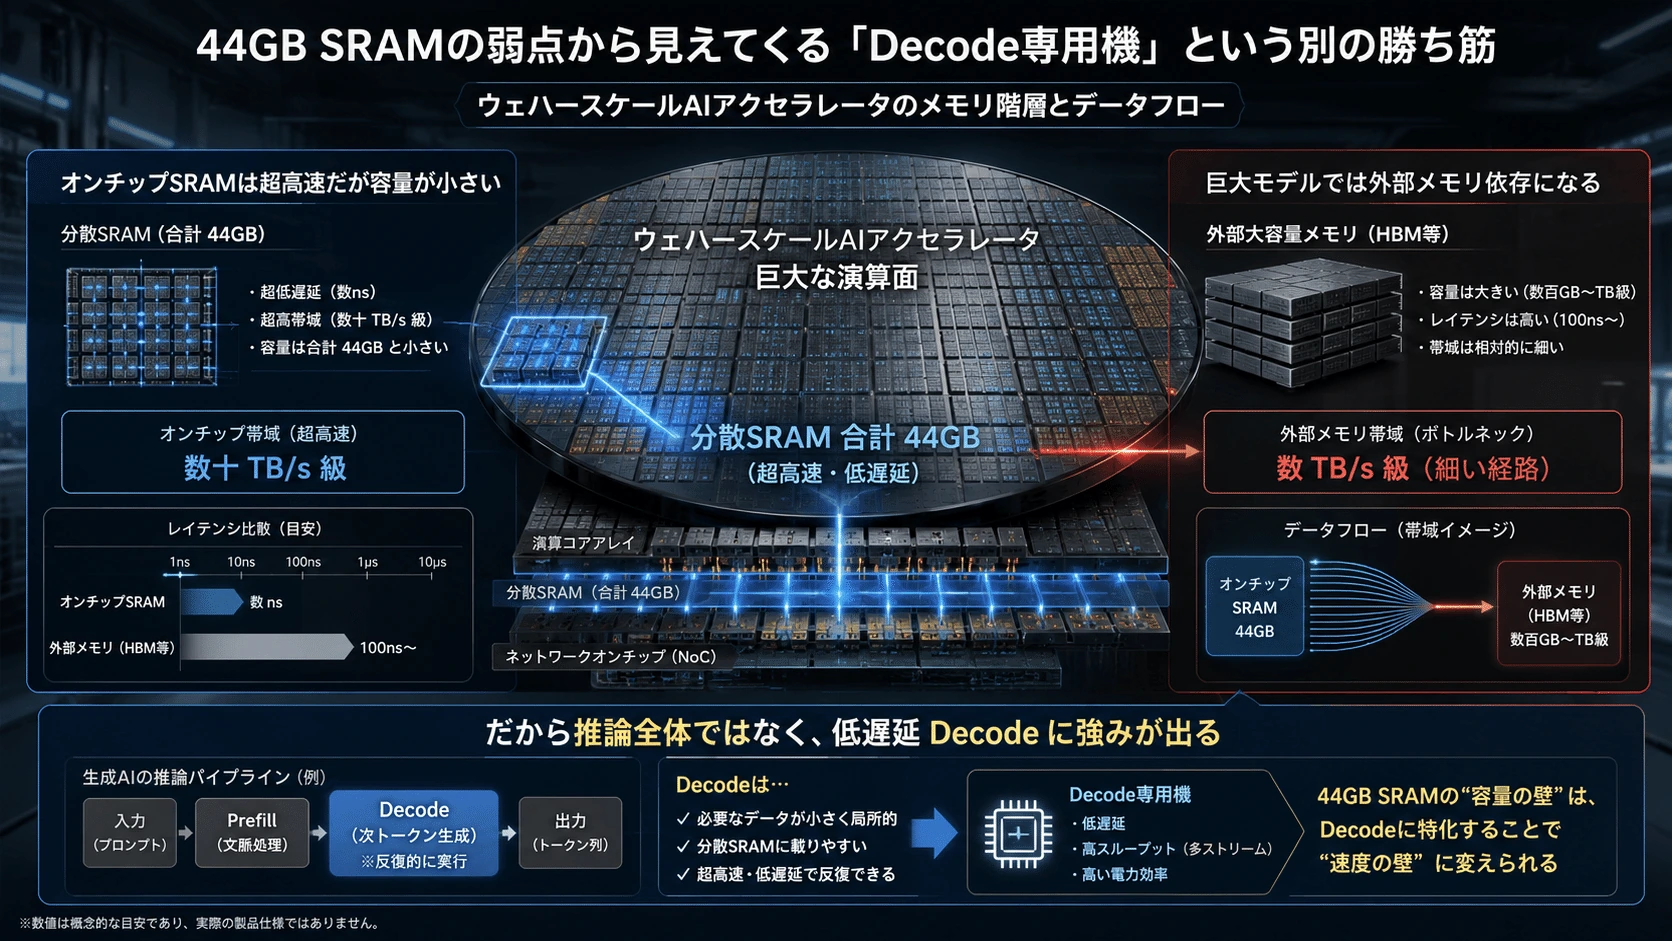
#WSE-3の最大の強みは、44GBの分散SRAMである。
#SRAMはHBMや通常のDRAMより容量密度が低いが、演算器のすぐそばへ配置できる。WSEでは90万個のコアの周辺へSRAMを分散し、ウェハー内のNoCで直接接続している。
#WSE-3
演算コア ─ SRAM ─ Router ─ 演算コア
│ │
SRAM SRAM
│ │
演算コア ─ Router ─ SRAM ─ 演算コアこの構造では、演算器がデータを取りに行く距離が短く、複数のパッケージやGPUをまたぐ通信も減らせる。
#一方で44GBという容量は、現在の巨大モデルを丸ごと置くには小さい。
#WSE内部
44GB SRAM
超高速・低遅延
↓
容量を超える
↓
外部メモリー
大容量だが相対的に低速CerebrasはこれをWeight Streamingで補う。
#モデル全体を外部メモリー側へ保存し、現在演算する層の重みをWSEへ順番に送り込む。演算中に次の重みを先読みできれば、転送時間の一部を演算の裏へ隠せる。
#しかし、これは外部メモリー問題を消す技術ではない。
#重みの転送時間 < 演算時間
→ 転送を隠せる
重みの転送時間 > 演算時間
→ WSEがメモリー待ちになる特に、小バッチ推論、巨大なKVキャッシュ、長文脈、大規模MoE、不規則なメモリーアクセスでは、モデル重みや状態を大容量HBMへ常駐できるGPU・ASICが有利になりやすい。
#したがって、Cerebrasを「NVIDIA GPUをあらゆる用途で置き換える万能アクセラレーター」と考えると、確かに勝ち目は見えにくい。
#
#
それでも売上と契約は急拡大している
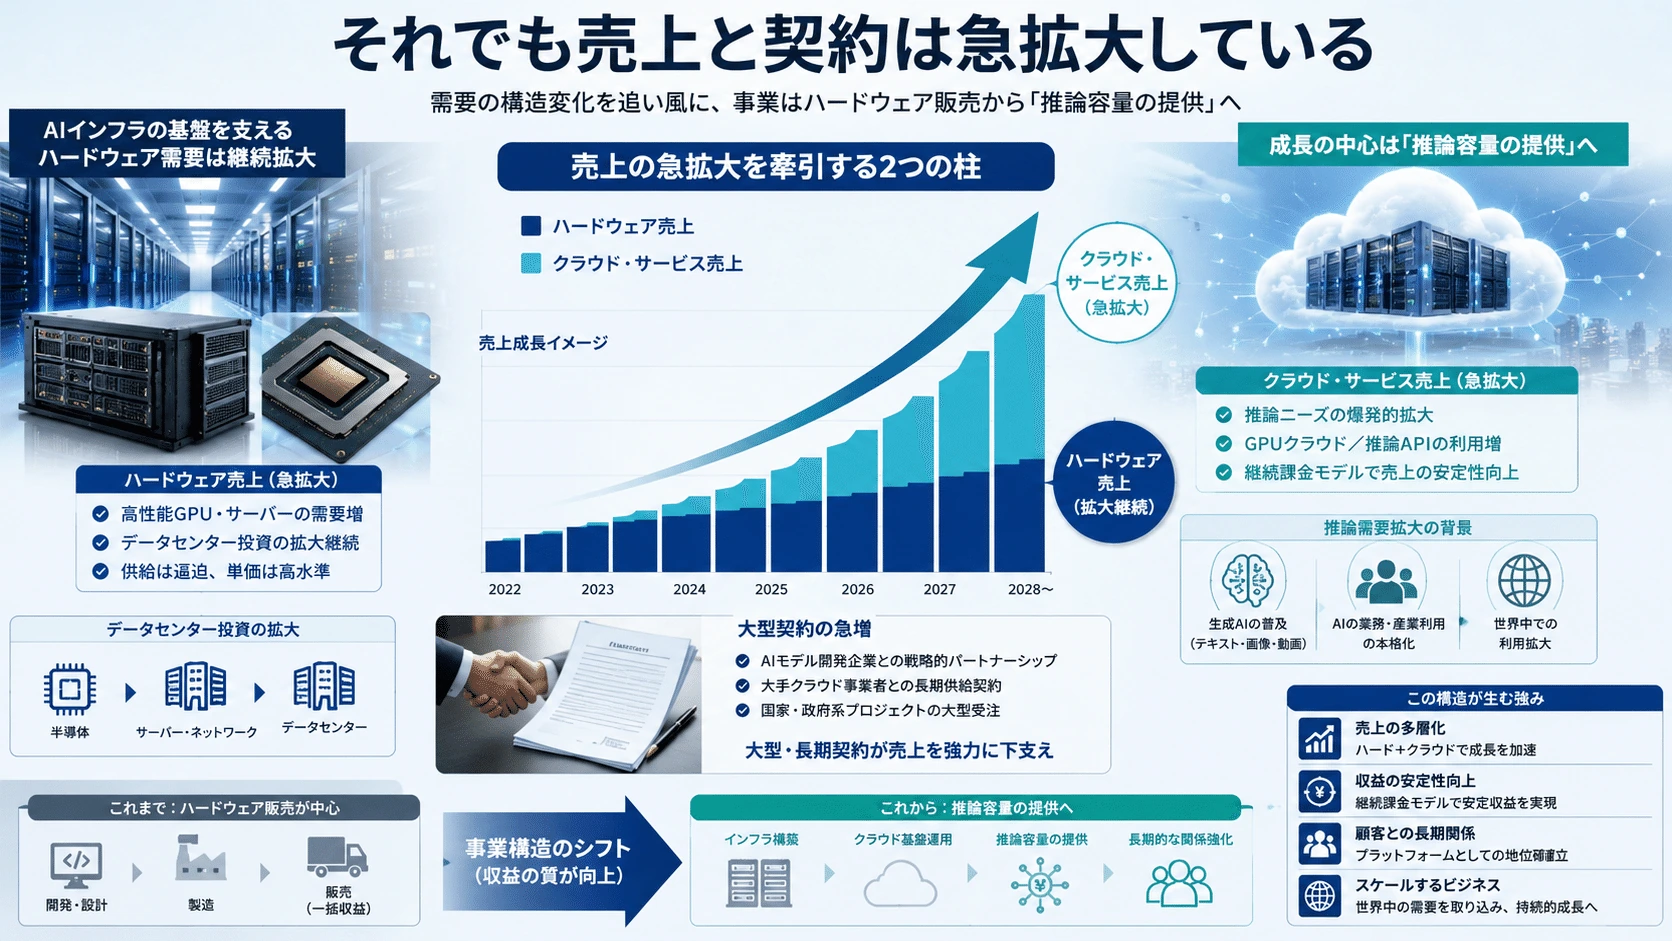
#技術的な弱点が明確であるにもかかわらず、Cerebrasの需要は拡大している。
#2026年1~3月期の売上高は1億9,340万ドルで、前年同期比94%増となった。内訳はハードウェア売上が1億1,060万ドル、クラウド・その他サービスが8,280万ドルであり、クラウド・サービス売上は前年同期比178%増加した。
#GAAP粗利率は45%、営業損失は1,500万ドル、純損失は1,400万ドルだった。急成長しているものの、本業はまだ安定した高収益段階には入っていない。(Cerebras)
#会社側の2026年通期ガイダンスは次のとおりである。
#| 項目 | 2026年通期見通し |
| コア売上高 | 8億5,500万~8億6,500万ドル |
| 前年比成長率 | 中央値で約69% |
| コア粗利率 | 38~41% |
| コア営業利益率 | マイナス28~32% |売上は急拡大する一方、データセンター取得、設備展開、顧客向け容量建設に伴い、営業赤字は拡大する見通しである。(Cerebras)
#これはCerebrasの投資ストーリーが、単なるチップ販売ではなくなっていることを示す。
#従来のCerebras
CSシステムを顧客へ販売
↓
ハードウェア収益
現在のCerebras
WSEを自社・提携データセンターへ設置
↓
高速推論容量をクラウドとして販売
↓
継続的なサービス収益利益率が低下していることは弱点だが、同時に、供給可能な推論容量を増やすために先行投資しているとも読める。
#
#
OpenAI案件が示す「速度への実需要」
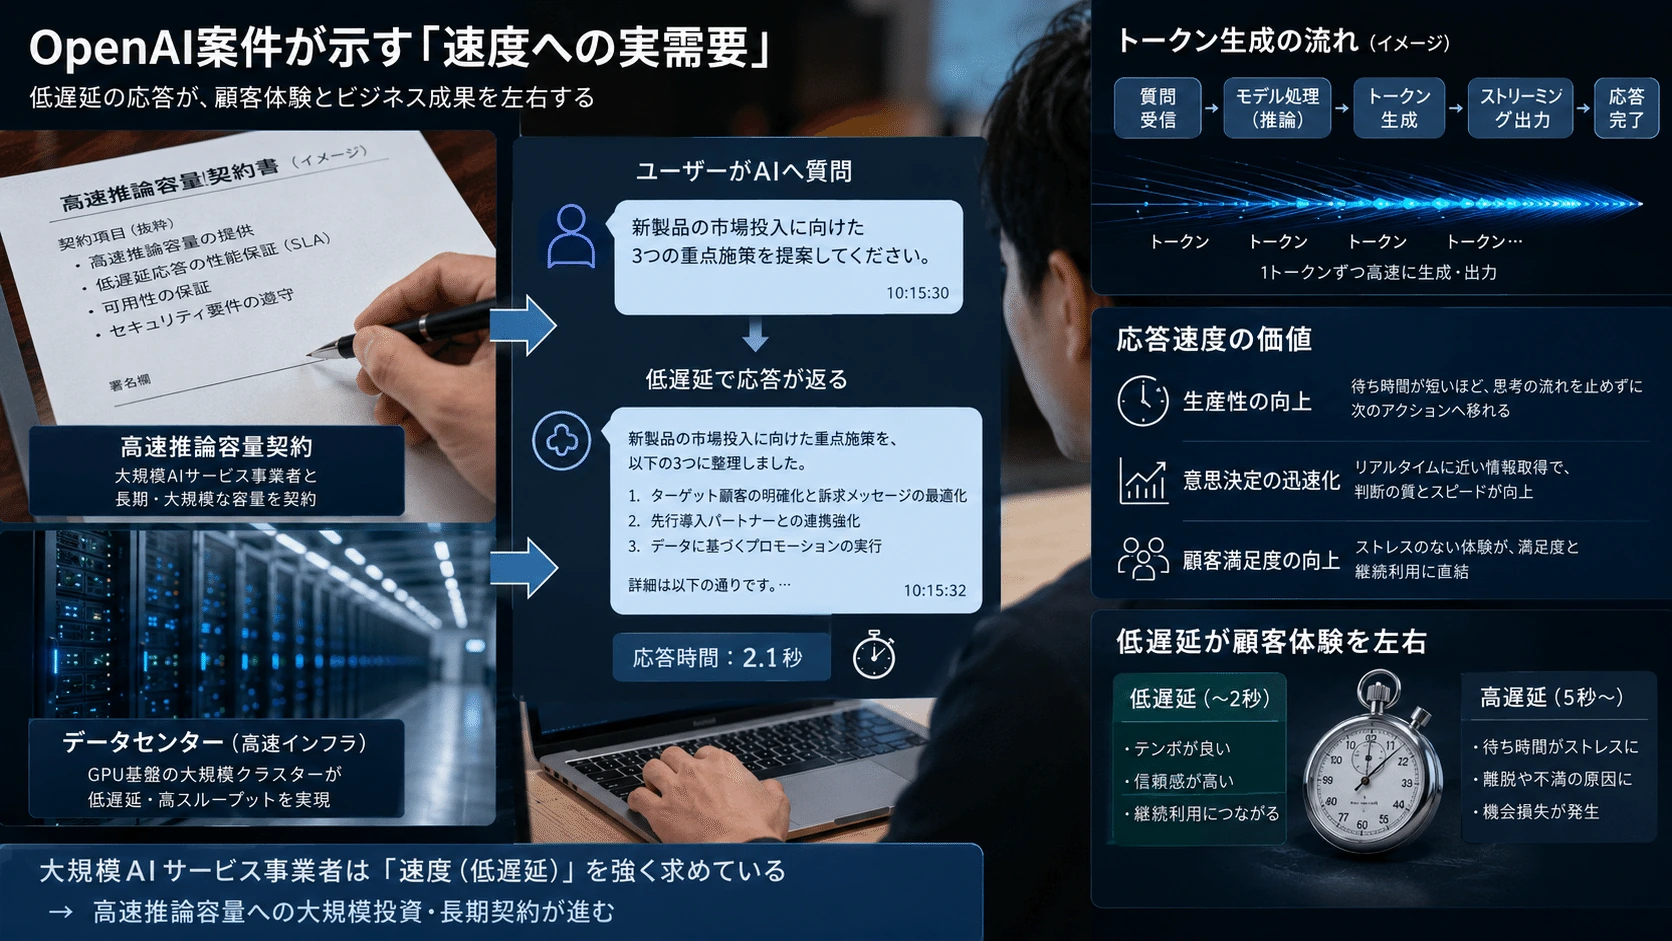
#CerebrasはOpenAIと、750MWの高速推論容量を段階的に提供する複数年契約を締結した。
#Cerebrasは2026年1~3月期の決算資料で、契約価値を200億ドル超と説明している。OpenAIは、Cerebrasを計算基盤へ組み込む目的について、AIの応答を高速化するためだと説明している。容量は複数回に分けて展開される予定である。(Cerebras)
#ここで重要なのは、OpenAIがCerebrasだけへ全面移行するという話ではないことだ。
#OpenAIはNVIDIA、AMD、独自ASIC、複数のクラウド、Cerebrasなどを組み合わせる。Cerebrasはその中で、応答速度を重視する推論容量として採用されている。
#OpenAI案件については、PrefillとDecodeをどのように分担するかという詳細は公開されていない。
#したがって、この契約から直接、
#OpenAIもPrefillを別チップ、DecodeをCerebrasへ分けている#
と断定することはできない。
#それでも、巨大な契約が成立したことは、低遅延推論に対して実際に大きな支払い需要があることを示している。
#
#
Amazon案件で明確になったDecode専用戦略
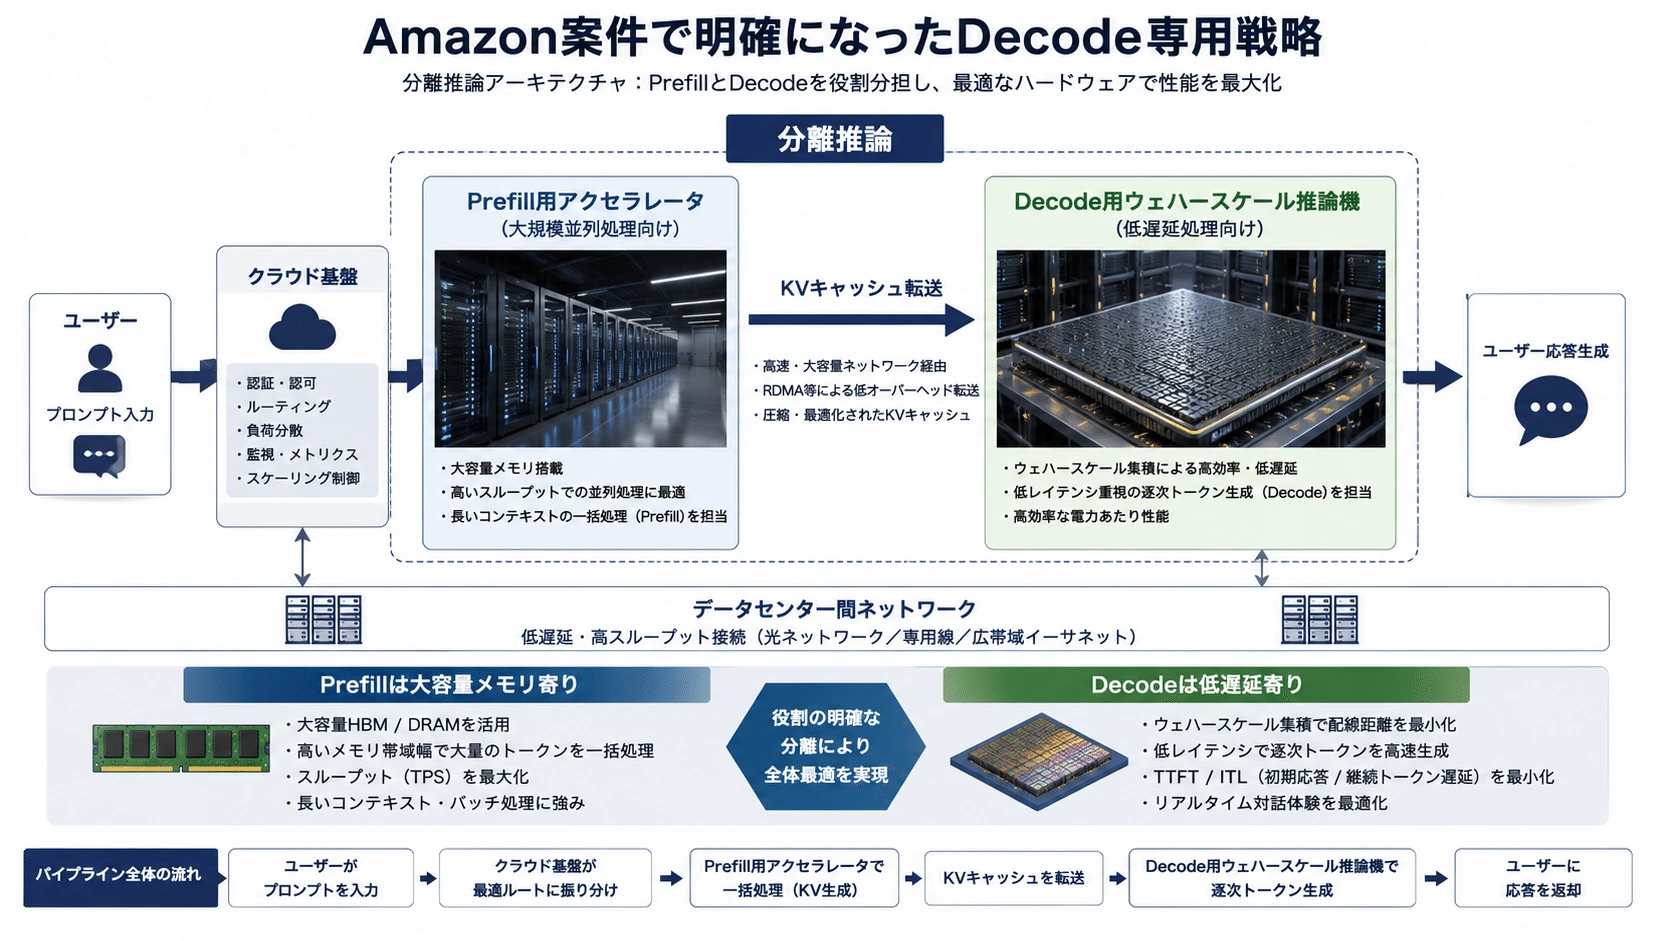
#Cerebrasの新しい立ち位置を最も明確に示したのが、AWSとの提携である。
#AWSとCerebrasは、LLM推論を次のように分担する構成を発表した。
#ユーザーの入力
↓
Amazon Trainium 3
Prefillを担当
↓
KVキャッシュを転送
↓
Cerebras CS-3
Decodeを担当
↓
回答を高速生成Cerebrasの2026年1~3月期資料にも、AWS Trainium 3がPrefillを行い、Cerebras CS-3がDecodeを実行する「disaggregated inference strategy」が明記されている。両システムはAmazonのカスタムネットワークで接続される。(Cerebras)
#これは、Cerebrasの弱点をAWS側のASICで補い、WSEの強みだけを利用する構成である。
#Trainiumの強み
長い入力をまとめて処理
高い行列演算効率
大容量メモリー
大量のPrefillを処理
Cerebrasの強み
ウェハー内通信
分散SRAM
低い同期遅延
高速な逐次生成CerebrasはPrefillもDecodeも学習もすべて担当する必要がない。
#Decodeだけで明確な性能差を作れれば、異種アクセラレーター基盤の一部として生き残れる。
#これが、従来とは異なる勝ち筋である。
#
#
Prefillとは何か
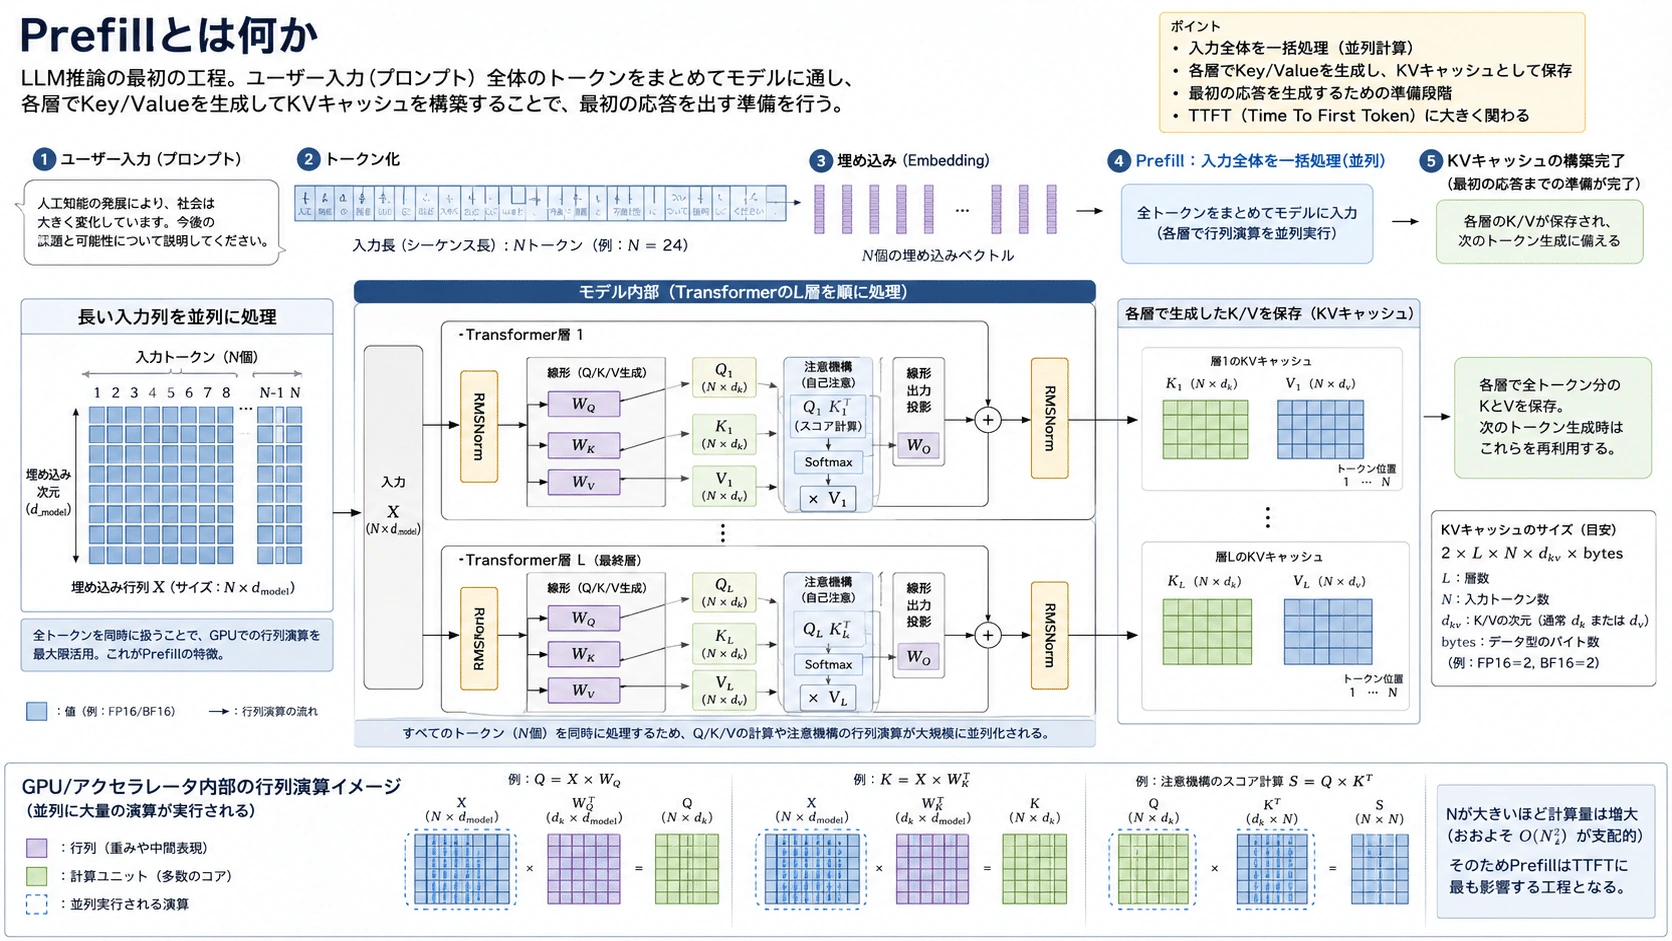
#LLM推論は、大きくPrefillとDecodeへ分けられる。
#Prefillは、ユーザーが入力した文章全体を最初に処理する工程である。
#「Cerebrasの将来性について、
決算と技術から分析してください」
↓
入力トークン全体を並列計算
↓
各層のKey・Valueを生成
↓
KVキャッシュを作成
↓
最初の出力トークンを決めるPrefillでは数百から数万の入力トークンをまとめて計算できる。
#そのため、一般に大規模な行列演算を多用する、演算性能寄りの工程になる。
#Prefillの性能は、主に最初の出力が始まるまでの時間であるTTFT、Time to First Tokenに影響する。
#
#
Decodeとは何か
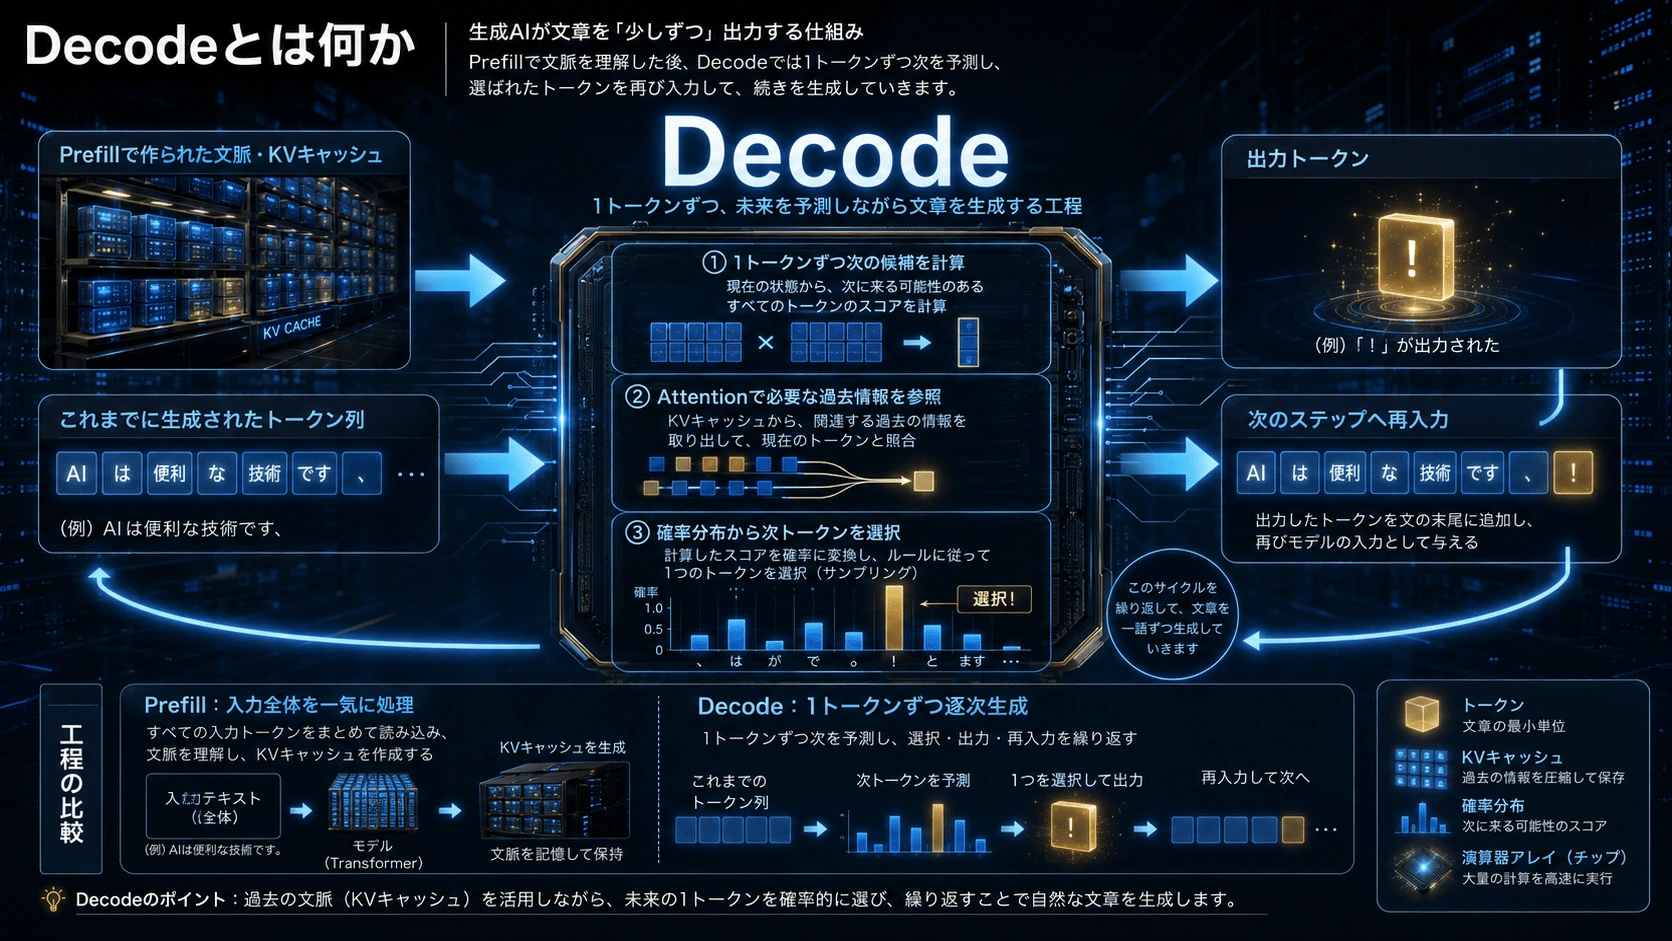
#Decodeは、Prefillで作ったKVキャッシュを利用しながら、回答を1トークンずつ生成する工程である。
#「Cerebras」
↓
「Cerebrasは」
↓
「Cerebrasは巨大な」
↓
「Cerebrasは巨大なWSEを」次のトークンは直前の結果が出るまで決められない。
#したがって、Decodeは本質的に逐次処理である。
#Token 1
↓
Token 2
↓
Token 3
↓
Token 4Decodeでは、トークンを1個生成するたびに、
#- モデル重みを参照する
- KVキャッシュを読む
- Attentionを計算する
- 複数チップ間で同期する
- 次のトークンを選択する
という処理が繰り返される。
#そのため、最大演算性能よりも、
#- メモリー帯域
- 通信遅延
- 同期回数
- KVキャッシュ管理
- トークン間の待ち時間
が重要になる。
#Decodeの性能は、TPOT(Time Per Output Token)やITL(Inter-Token Latency)として測られる。
#PrefillとDecodeを同じGPUで混在させると、大きなPrefill処理が進行中のDecodeへ割り込み、回答の表示間隔が不安定になることがある。両工程を別々のGPUやアクセラレーターへ配置することで、干渉を減らし、それぞれに適した台数と並列化方式を選べる。(arXiv)
#
#
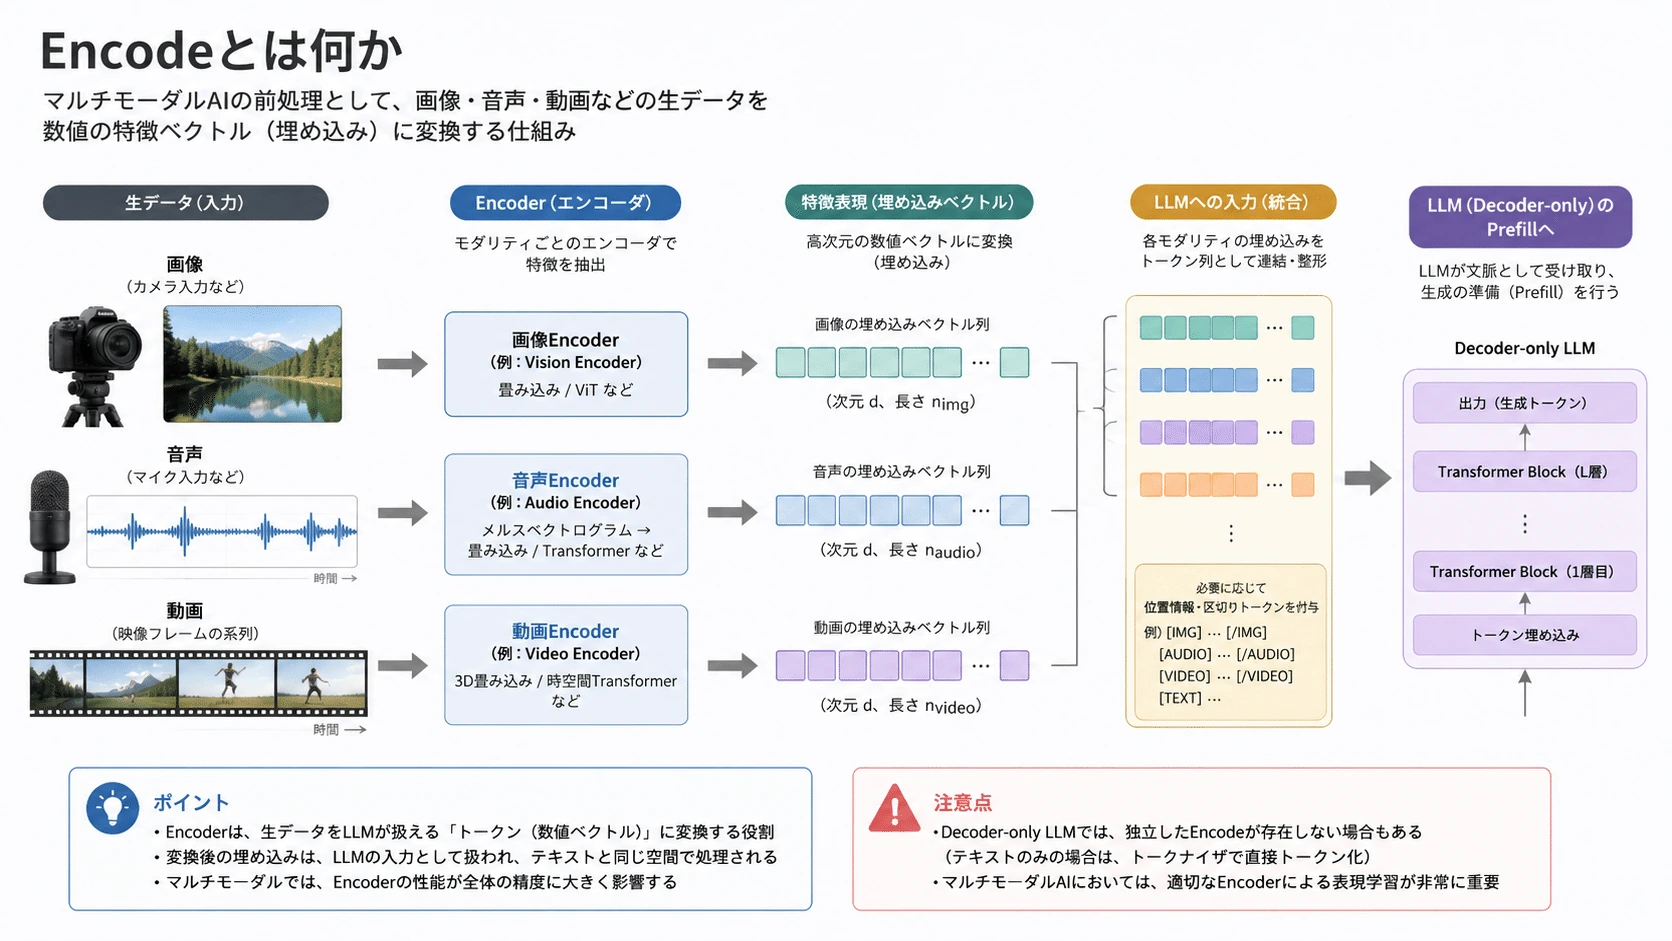
Encodeとは何か
#Encodeは、すべてのテキストLLMに独立して存在する工程ではない。
#Llama系などのDecoder-onlyモデルでは、文字入力は直接Prefillへ送られる。
#テキスト
↓
Prefill
↓
Decode一方、画像、音声、動画を扱うマルチモーダルモデルでは、最初に入力データをLLMが理解できる特徴表現へ変換する必要がある。
#画像・動画・音声
↓
Encoder
特徴ベクトル・埋め込みへ変換
↓
テキストトークンと結合
↓
Prefill
↓
Decode画像であればVision Encoder、音声であればAudio Encoderが使われる。
#将来のマルチモーダル推論基盤では、
#Encoder専用プール
↓
Prefill専用プール
↓
Decode専用プールのように三工程を分離し、画像処理、文脈理解、文章生成へ異なるアクセラレーターを割り当てる可能性がある。vLLMの最新ドキュメントにも、Disaggregated EncoderとDisaggregated Servingの構成が掲載されている。(vLLM)
#
#
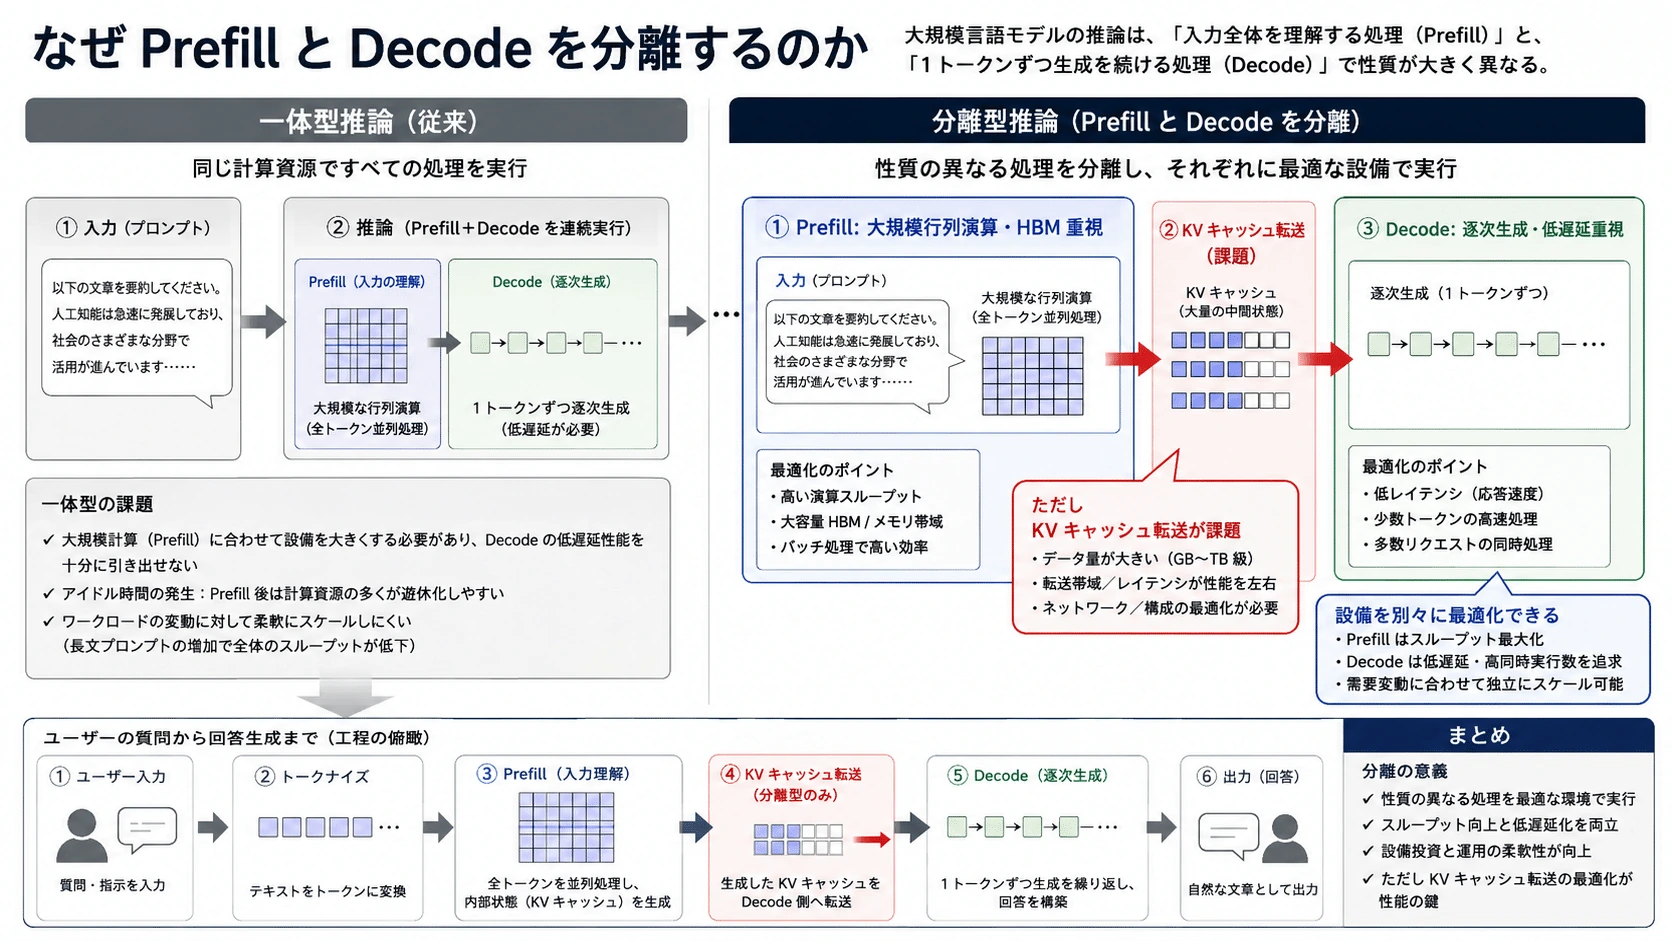
なぜPrefillとDecodeを分離するのか
#最大の理由は、両者で最適なハードウェアと設備数が異なるためである。
#| 工程 | 処理の性質 | 重視されるもの |
| Encode | 画像・音声・動画の特徴抽出 | 専用カーネル、並列演算 |
| Prefill | 入力全体の一括処理 | 行列演算性能、HBM容量 |
| Decode | 1トークンずつ逐次生成 | メモリー帯域、低遅延、KV管理 |例えば長文要約では、入力が長く出力が短い。
#Prefill設備:多い
Decode設備 :少ないコード生成や長い推論では、入力より出力が長くなる。
#Prefill設備:少ない
Decode設備 :多い工程を分ければ、需要に合わせて独立して増減できる。
#ただし分離には明確な代償がある。
#Prefill側で作ったKVキャッシュを、Decode側へ転送しなければならない。
#Prefillアクセラレーター
↓
数GB~数十GBのKVキャッシュ
↓
専用ネットワーク
↓
DecodeアクセラレーターKV転送時間が大きければ、Decodeを高速化した利益が相殺される。
#したがって、Prefill/Decode分離は常に優れているわけではない。短い入力、短い出力、低負荷では、同じGPU上で両方を実行した方が速い場合がある。研究でも、厳しいTTFTを優先する場合は統合型、安定したTPOTを重視する場合は分離型が有利であり、最終的には動的なハイブリッド方式が有力とされている。(arXiv)
#
#
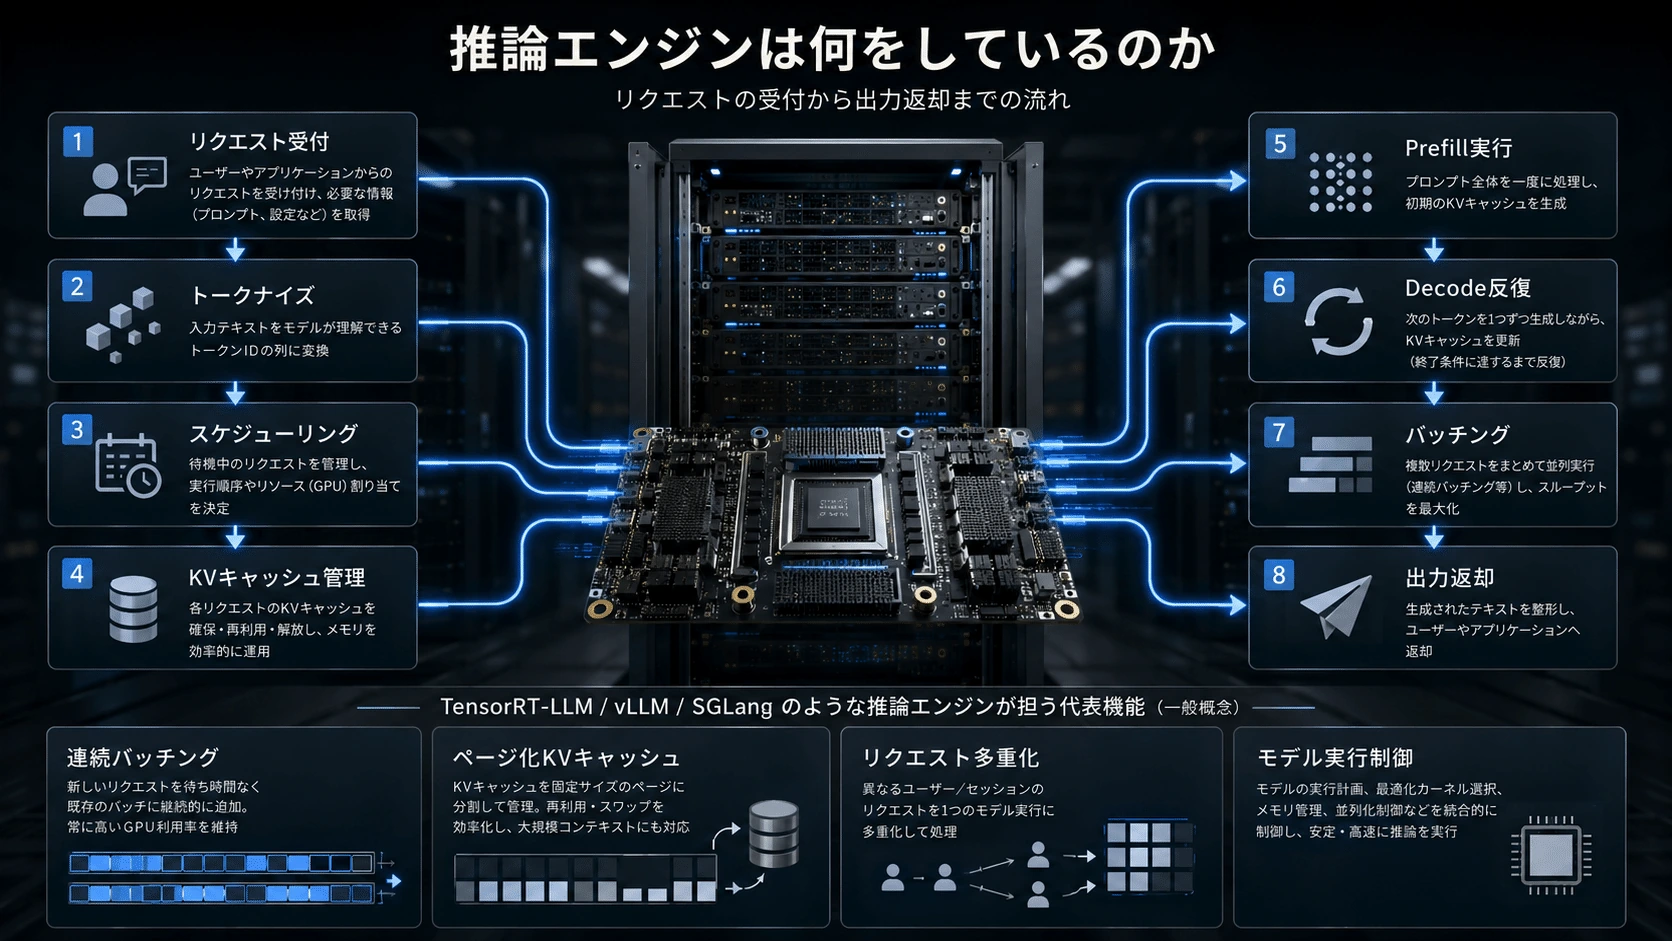
推論エンジンは何をしているのか
#Prefill、Decode、KVキャッシュ、複数ユーザーの要求を効率よく処理するには、ハードウェアだけでは足りない。
#そこで使われるのが、TensorRT-LLM、vLLM、SGLangなどの推論エンジンである。
#推論エンジンはAIモデルそのものではない。
#学習済みモデル
↓
推論エンジン
バッチ化・KV管理・量子化・並列化
↓
GPU/ASIC
↓
ユーザーへの回答推論エンジンの主な仕事は、
#- 多数の要求を動的にまとめる
- KVキャッシュを効率よく配置する
- 終了した要求をバッチから外す
- 新しい要求を途中から追加する
- モデルを複数GPUへ分割する
- FP8、FP4、INT8、INT4などへ量子化する
- 投機的デコードを行う
- PrefillとDecodeを分離する
- OpenAI互換APIとして提供する
ことである。
#TensorRT-LLM
#TensorRT-LLMは、NVIDIA GPU向けに強く最適化された推論エンジンである。
#専用CUDAカーネル、効率的なランタイム、BlackwellやHopper向けの低精度演算、マルチGPU、MoE、投機的デコード、KVキャッシュ再利用、Prefill/Decode分離などを統合する。NVIDIA環境へ固定し、最高性能を追求する用途に向いている。(GitHub)
#vLLM
#vLLMは、導入の容易さとメモリー効率を重視したオープンソース推論エンジンである。
#代表技術のPagedAttentionは、KVキャッシュを固定サイズのブロックへ分割し、OSの仮想メモリーのように管理する。連続した巨大領域を事前確保せず、要求の長さに合わせて必要なブロックを追加できるため、HBMの断片化を減らし、同時処理数を増やせる。(arXiv)
#SGLang
#SGLangは、複数回の生成、RAG、マルチターン会話、AIエージェント、構造化出力を効率化する推論基盤である。
#代表技術のRadixAttentionは、複数の要求に共通するシステムプロンプトや会話履歴を見つけ、そのKVキャッシュを再利用する。
#共通システムプロンプト
├─ ユーザーAの質問
├─ ユーザーBの質問
└─ ユーザーCの質問共通部分を毎回Prefillし直さずに済むため、RAG、エージェント、共通プロンプトの多いサービスで効果を発揮する。(arXiv)
#三つの違いを単純化すると、次のようになる。
#エンジン主な強みTensorRT-LLMNVIDIA GPUの性能を最大化vLLM導入しやすさとKVメモリー効率SGLangPrefix再利用、エージェント、構造化生成
#これらの推論エンジンがPrefillやDecodeを実行し、Dynamoのような上位のオーケストレーターが要求の配置を決め、NIXLのような転送ライブラリーがKVキャッシュを実際に運ぶ。
#
#
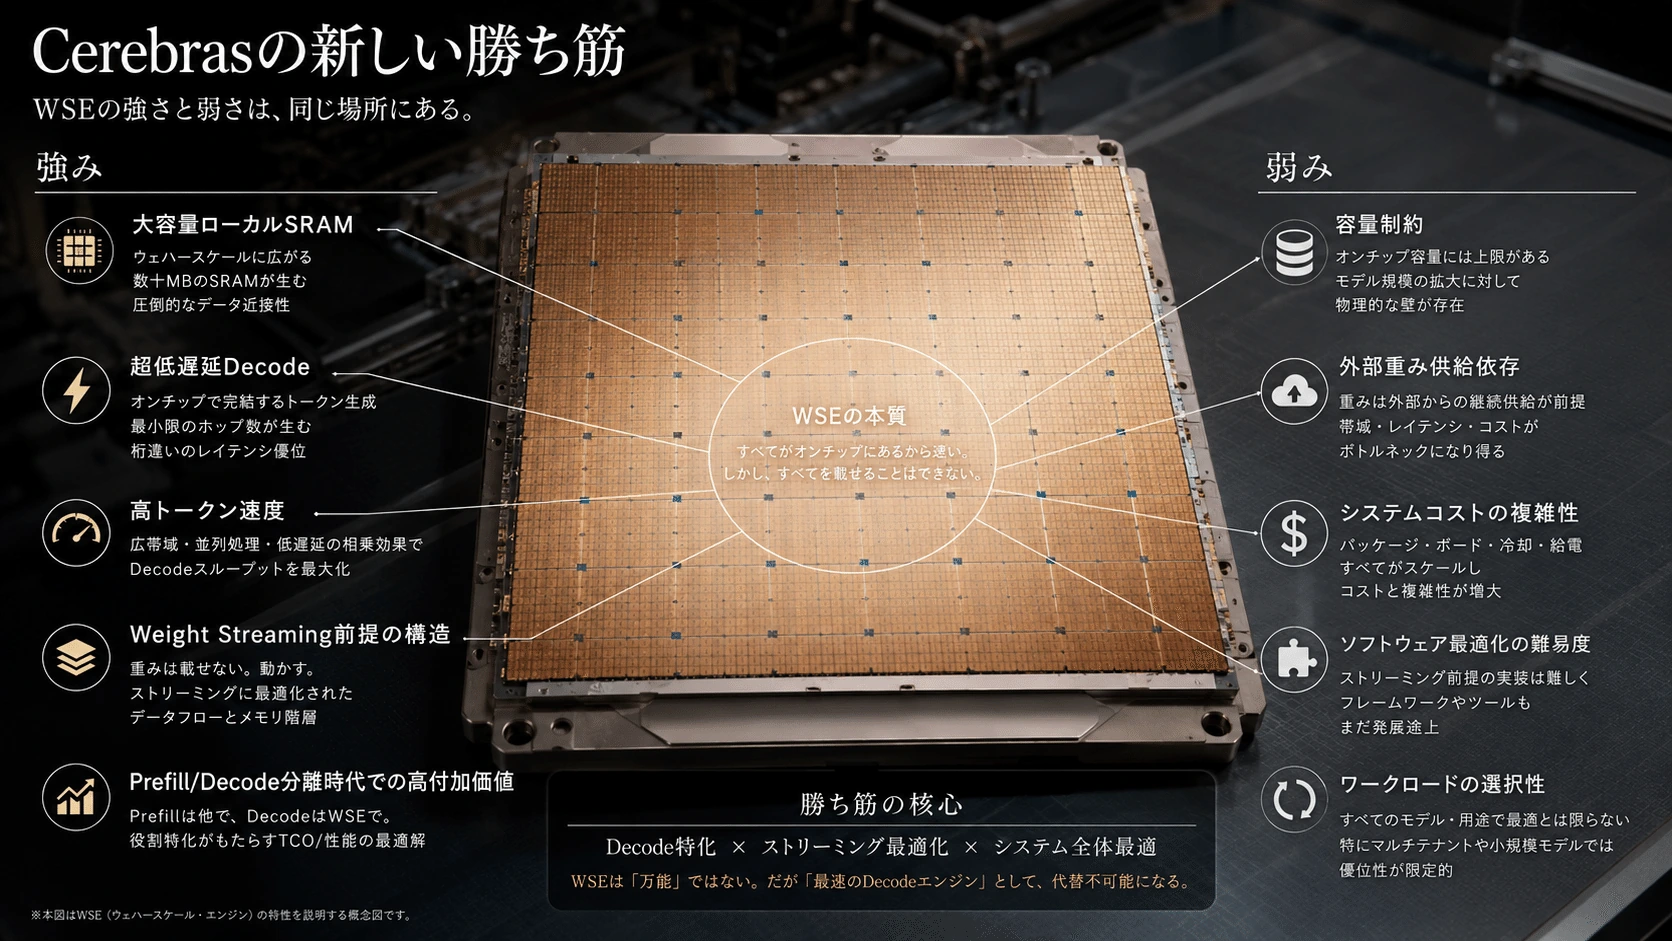
Cerebrasの新しい勝ち筋
#この構造から考えると、Cerebrasが狙うべき市場は明確である。
#CerebrasはNVIDIAと同じ方法で戦う必要がない。
#NVIDIA
GPU
+ HBM
+ NVLink
+ InfiniBand/Ethernet
+ TensorRT-LLM
+ Dynamo
+ NIXLCerebras
巨大なWSE
+ 分散SRAM
+ オンウェハーNoC
+ 超低遅延DecodeCerebrasが勝つための条件は、モデル全体を44GBへ収めることではない。
#次のような異種構成の中で、Decodeの完了時間と応答速度を大幅に改善することである。
#Encode
GPU・画像ASIC
↓
Prefill
Trainium・GPU・別のASIC
↓
KV転送
↓
Decode
Cerebras WSEこの戦略には複数の意味がある。
#第一に、WSEの容量不足を他のアクセラレーターへ任せられる。
#第二に、CerebrasはHBMや先端パッケージングの供給制約を受けにくい。
#第三に、Decodeだけへ設備を集中することで、1ユーザー当たりの生成速度やエージェントの処理完了時間を短縮できる。
#第四に、AWSのような巨大クラウドの販売網とデータセンターを利用できる。
#第五に、ハードウェアを一括販売するのではなく、高速推論容量を継続的なクラウドサービスとして販売できる。
#
#
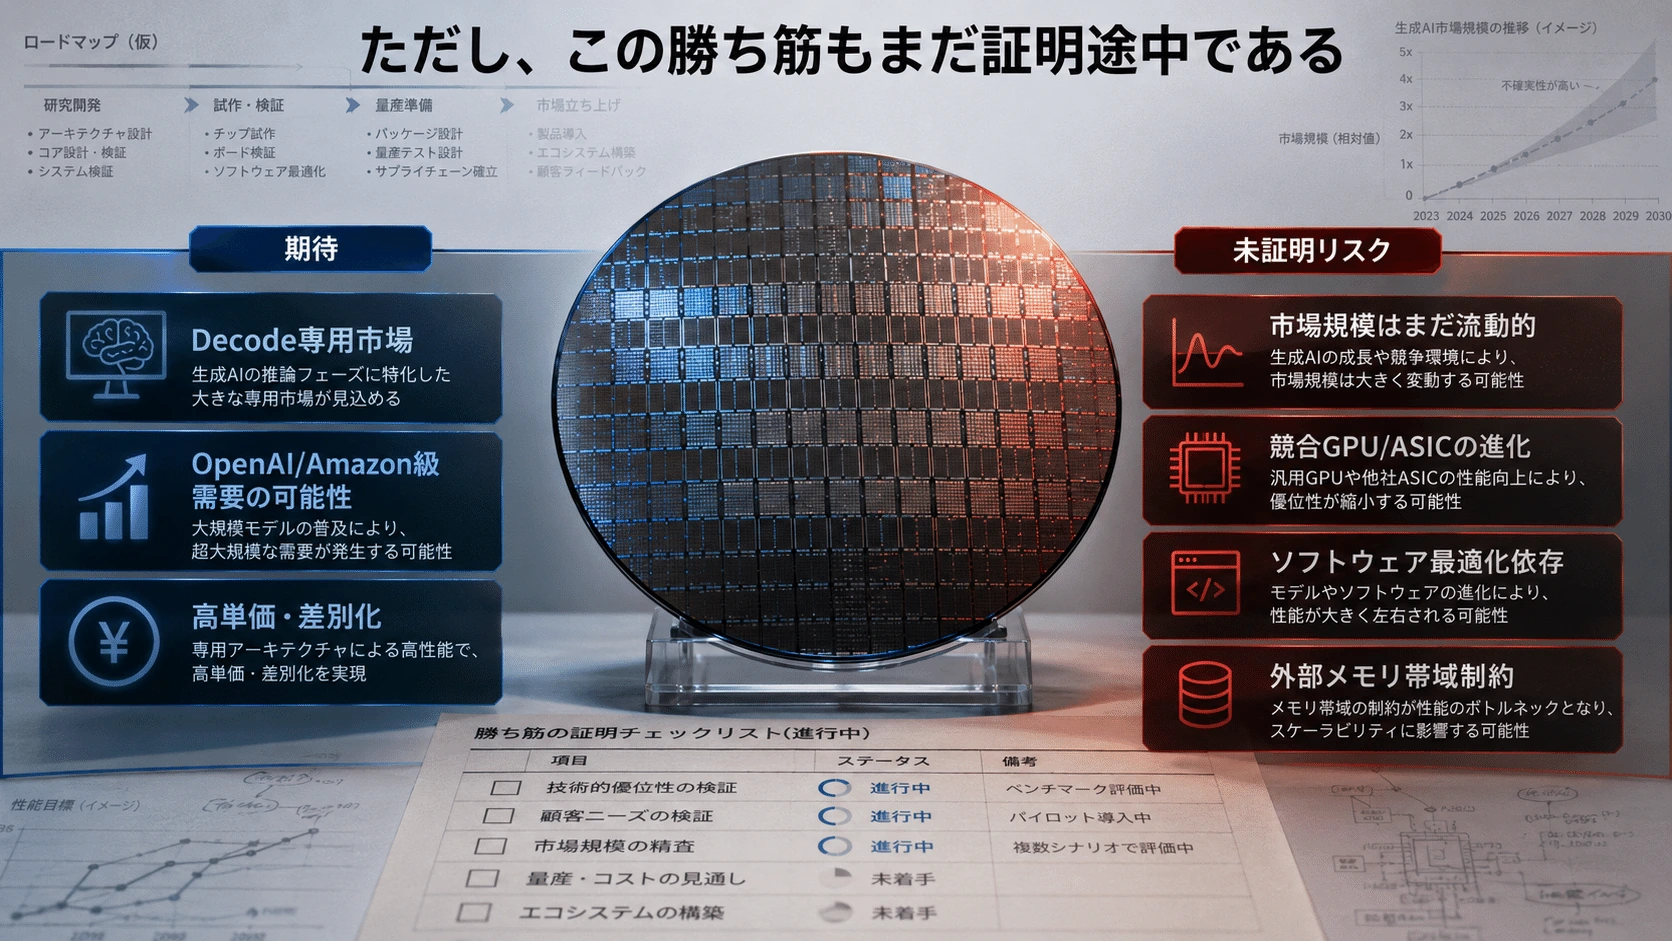
ただし、この勝ち筋もまだ証明途中である
#AWSやOpenAIとの契約は、Cerebrasの技術に需要があることを示している。
#しかし、長期的な競争優位まで証明したわけではない。
#確認すべき指標は、単なる「1ユーザー当たりトークン速度」ではない。
#| 監視すべき指標 | 意味 |
| TTFT | 最初のトークンまでの時間 |
| TPOT/ITL | 生成中のトークン間隔 |
| 総トークン処理量 | 大人数を同時処理できるか |
| 100万トークン当たり原価 | GPUより経済的か |
| KV転送時間 | 分離による損失 |
| 設備稼働率 | 高価なWSEを遊ばせていないか |
| 1MW当たり性能 | 電力効率 |
| 粗利率 | 技術優位を利益へ変えられるか |Cerebrasの2026年通期粗利率見通しは38~41%、コア営業利益率はマイナス28~32%である。需要は強いが、設備拡張とクラウド運営の経済性はまだ完成していない。(Cerebras)
#さらにNVIDIAも、TensorRT-LLM、Dynamo、NIXL、KVキャッシュ再利用、Prefill/Decode分離を進化させている。
#つまりCerebrasだけが工程分離の恩恵を受けるわけではない。
#AWS案
Trainium Prefill
↓
Cerebras Decode
NVIDIA案
Blackwell/Rubin Prefill
↓
Blackwell/Rubin Decode
↓
DynamoとNIXLで最適化Cerebrasが勝つには、KV転送を含めたシステム全体で、GPUだけの構成より速く、安く、安定して処理できることを示す必要がある。
#
#
結論――Cerebrasは万能機ではなく、推論パイプラインの専用機になる
#WSEの設計を単体で見ると、弱点は明確である。
#44GBのSRAMは極めて高速だが容量が小さい。巨大モデルでは外部メモリーとWeight Streamingへ依存し、HBMを持つGPUやASICに対して不利になる場面がある。
#したがって、
#CerebrasがNVIDIA GPUを全面的に置き換える#
という物語には無理がある。
#しかし、最新の決算と大型契約が示すのは、別の物語である。
#AI推論をEncode、Prefill、Decodeへ分解し、Cerebrasは最も逐次性と低遅延が重要なDecodeを担当する。#
AWSはこの構成を明示的に採用し、Trainium 3をPrefill、Cerebras CS-3をDecodeへ配置する。OpenAIも、AIの応答を高速化する目的で大規模なCerebras推論容量を契約している。(Cerebras)
#Cerebrasの本当の勝ち筋は、
#巨大モデル全体をWSEへ収納することではなく、
#巨大な推論システムの中で
最も遅延が問題になる工程を
WSEへ切り出すことにある。
#これはCerebrasがNVIDIAへ勝つというより、NVIDIA、Trainium、各社ASICと共存しながら、高速Decodeという高付加価値工程を獲得する戦略である。
#したがって現時点の評価は、次のようになる。
#WSE単体のメモリー構造だけを見れば勝ち目は狭い。 しかし、推論を工程別に分離する時代には、WSEの極端な低遅延性そのものが専用アクセラレーターとしての価値になる。#
Cerebrasの将来は、44GBという容量そのものよりも、AWSやOpenAIの実運用で、KV転送を含む総スループット、トークン当たり原価、粗利率をどこまで改善できるかによって決まる。
#未来の可能性――近接大容量メモリーと光接続を備えたWSE
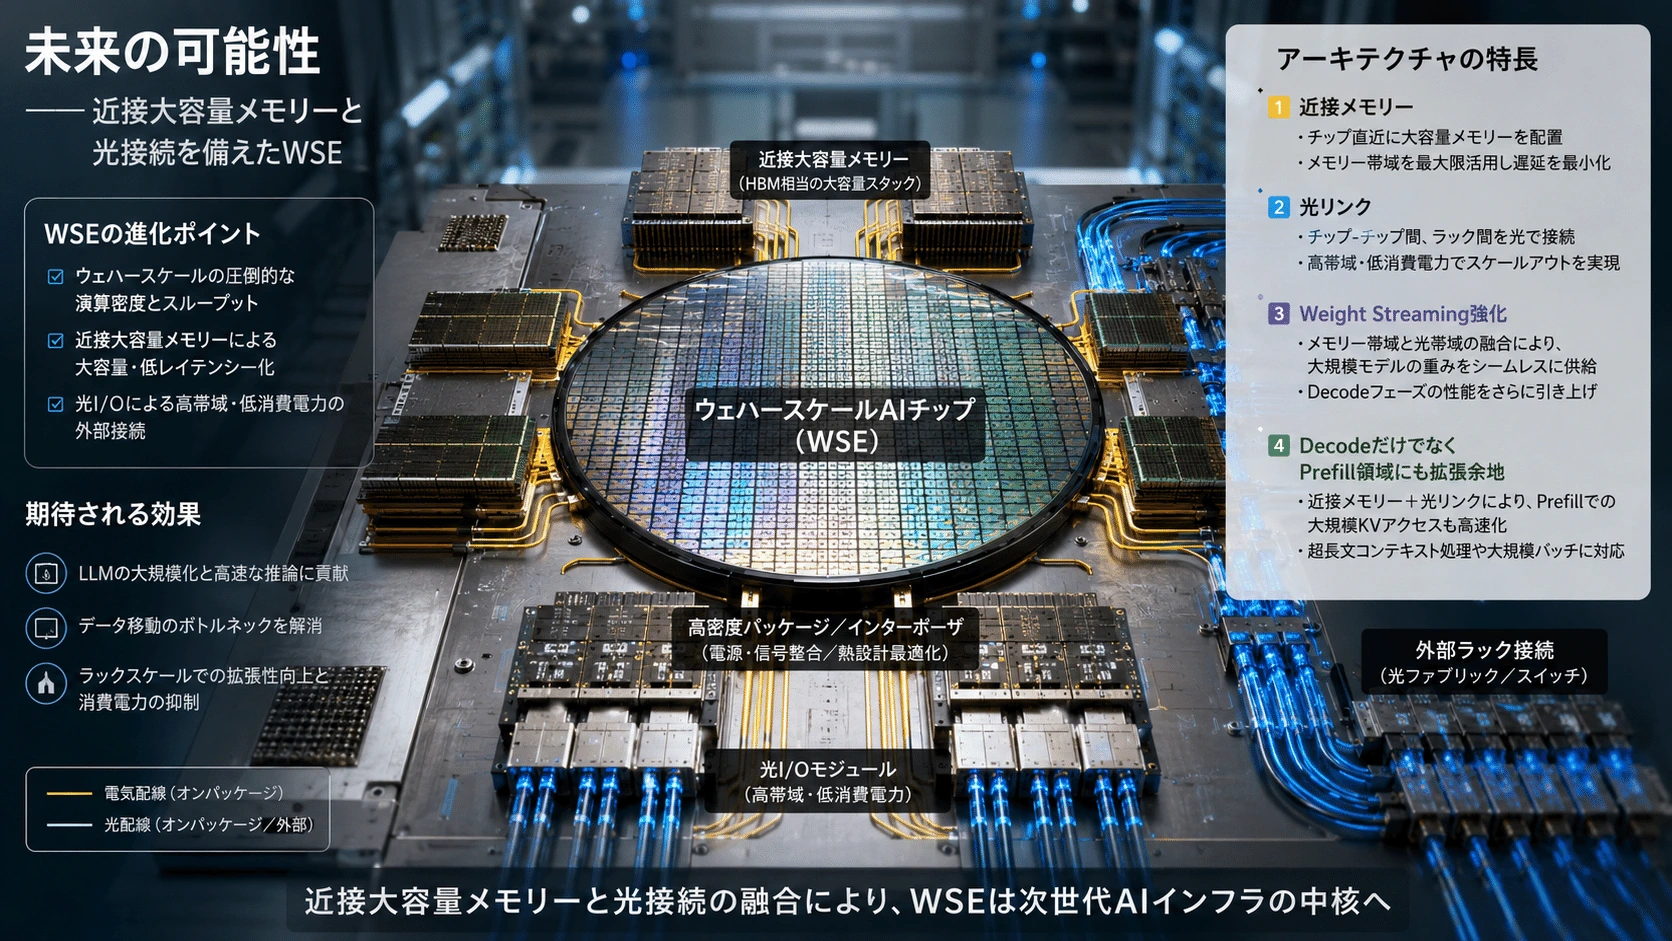
#Cerebrasのさらに先の成長物語として考えられるのが、WSEの分散SRAMと、近接大容量メモリー、光I/Oを組み合わせる構成である。
#現在のWSE-3は、44GBのオンチップSRAMを21PB/sで利用できる一方、CS-3のシステムI/Oは1.2Tb/s、バイト換算で約150GB/sにとどまる。つまり、WSE内部から外部メモリーへ出た瞬間、利用可能な帯域が約14万分の1へ落ちる極端な「帯域の断崖」が存在する。(Cerebras)
#現在のCerebras
WSE分散SRAM
44GB・21PB/s
│
│ 約14万倍の帯域差
↓
システム外部I/O
約0.15TB/s
↓
MemoryX・外部メモリーWeight Streamingは、この遅い外部転送を演算と重ねることで隠す技術である。しかし、転送そのものを消しているわけではない。
#この構造の中間へ、HBMに近い大容量・高帯域メモリーを追加できれば、Cerebrasの弱点は大幅に緩和される。
#
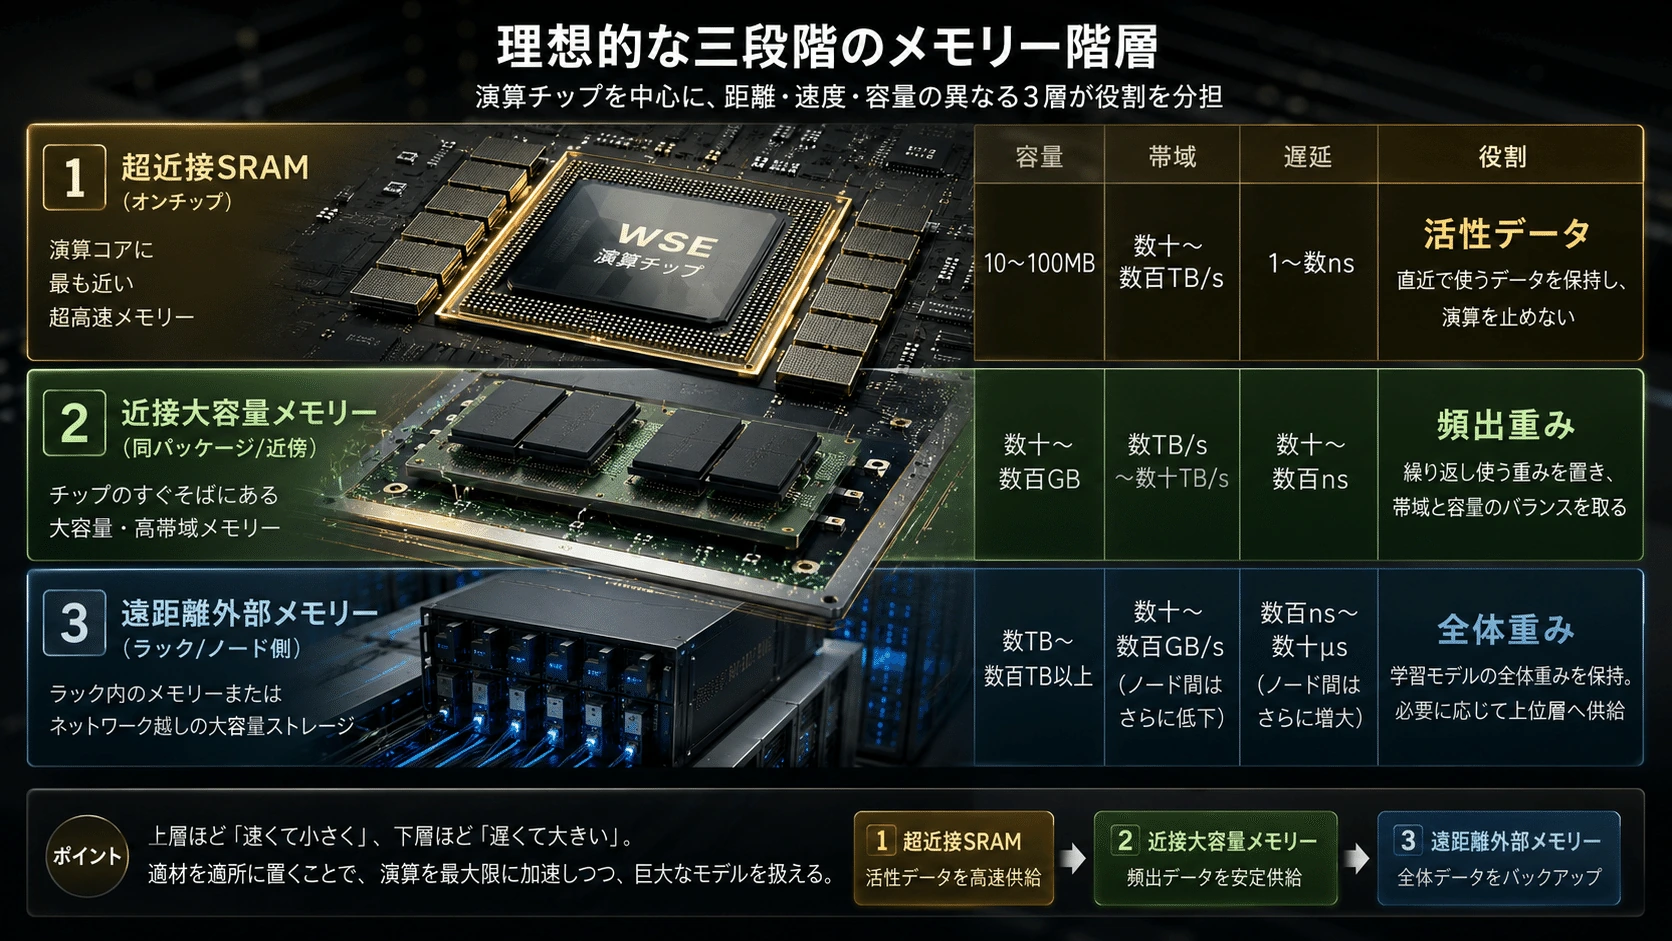
理想的な三段階のメモリー階層
#将来のWSEで考えられる理想形は、次のような構造である。
#第1階層
WSE分散SRAM
数十GB・数十PB/s
演算中の最重要データ
↓
第2階層
近接HBM/積層DRAM
数百GB~1TB超・数十TB/s
モデル重み・KVキャッシュ
↓
第3階層
外部MemoryX
数十TB~PB級
モデル保管・チェックポイント第2階層が加われば、巨大モデルの重みやKVキャッシュを外部MemoryXから毎回送り直すのではなく、近接メモリーへ常駐させ、必要な部分だけをWSEの分散SRAMへ供給できる。
#
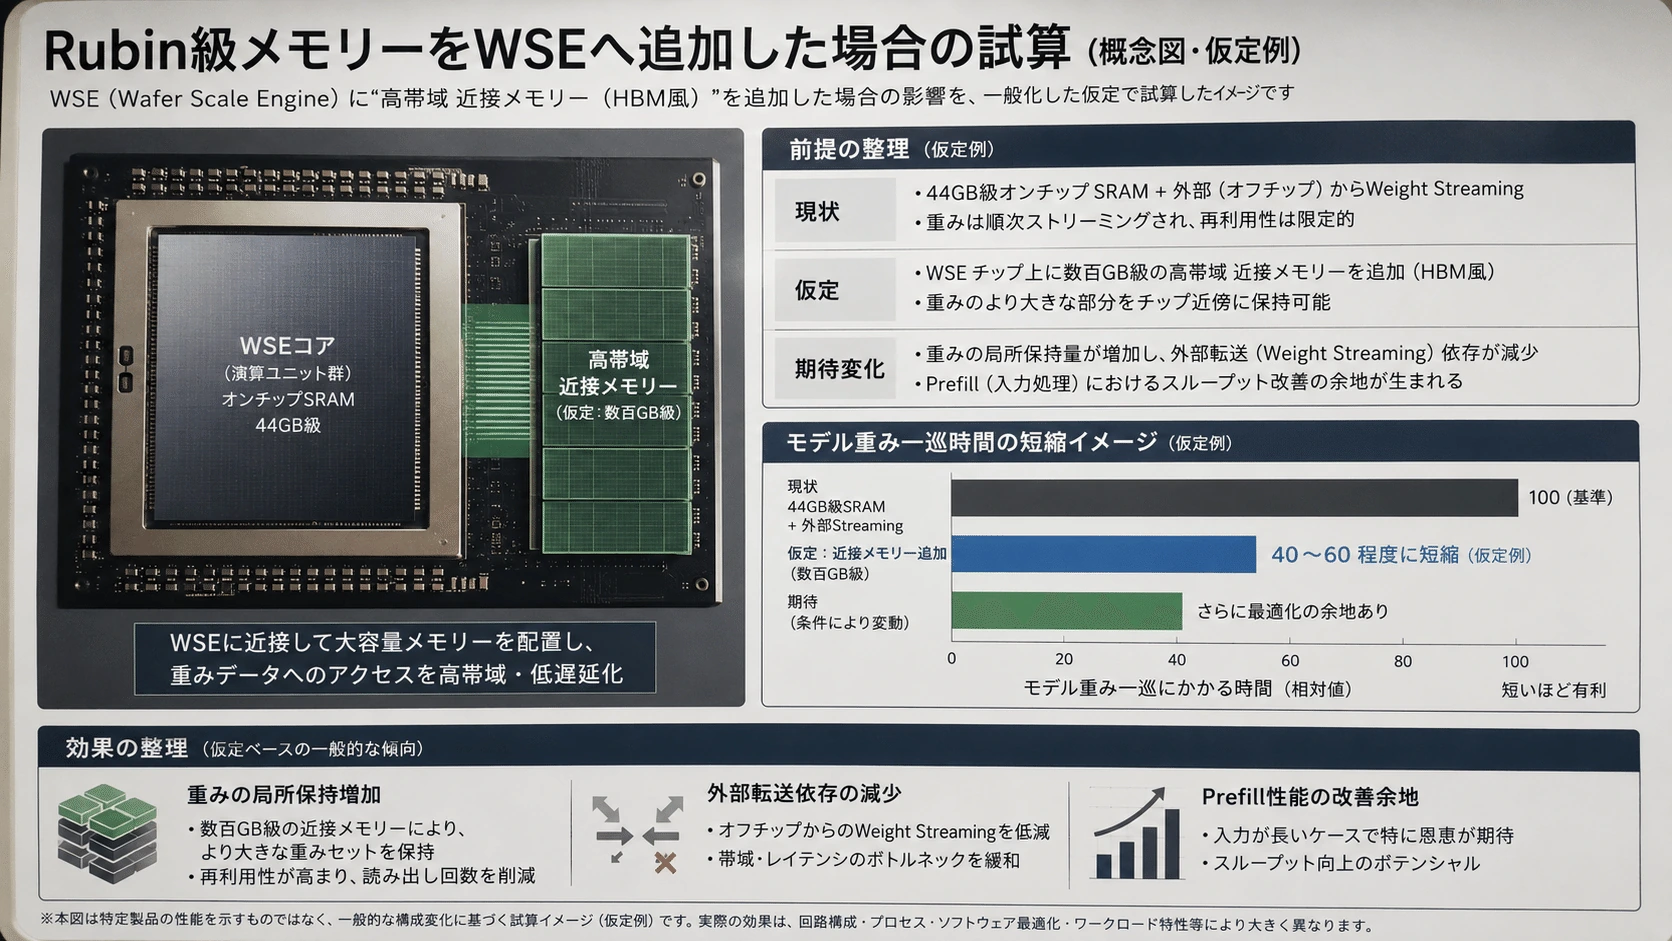
Rubin級メモリーをWSEへ追加した場合の試算
#比較対象として、NVIDIA Rubin GPUは1基当たり288GBのHBM4と22TB/s、2GPUのRubin Superchipは576GBと44TB/sを備える。Rubin NVL72全体では20.7TB、1,580TB/sとなるが、これらはNVIDIAが暫定値として示している仕様である。(NVIDIA)
#仮に将来のWSEへRubin級のメモリーサブシステムを追加できた場合、次のような帯域が考えられる。これはCerebrasが発表したロードマップではなく、Rubinの公称値を基準にした技術的試算である。
#| 仮想的なWSE構成 | 近接容量 | 近接帯域 | 現在の外部I/O比 |
| 現行CS-3外部I/O | 外部依存 | 0.15TB/s | 1倍 |
| Rubin GPU相当の近接メモリー | 288GB | 22TB/s | 約147倍 |
| Rubin Superchip相当 | 576GB | 44TB/s | 約293倍 |
| より大型の分散HBM構成 | 約1.15TB | 88TB/s | 約587倍 |
| WSE内部SRAM | 44GB | 21,000TB/s | 約14万倍 |近接メモリーが88TB/sまで拡大しても、21PB/sのSRAMより約239倍遅い。しかし、それで問題はない。
#近接メモリーの役割はSRAMを置き換えることではなく、現在ほぼ空白になっている、
#44GBの超高速SRAM
と
大容量だが遅い外部MemoryXの中間を埋めることだからである。
#
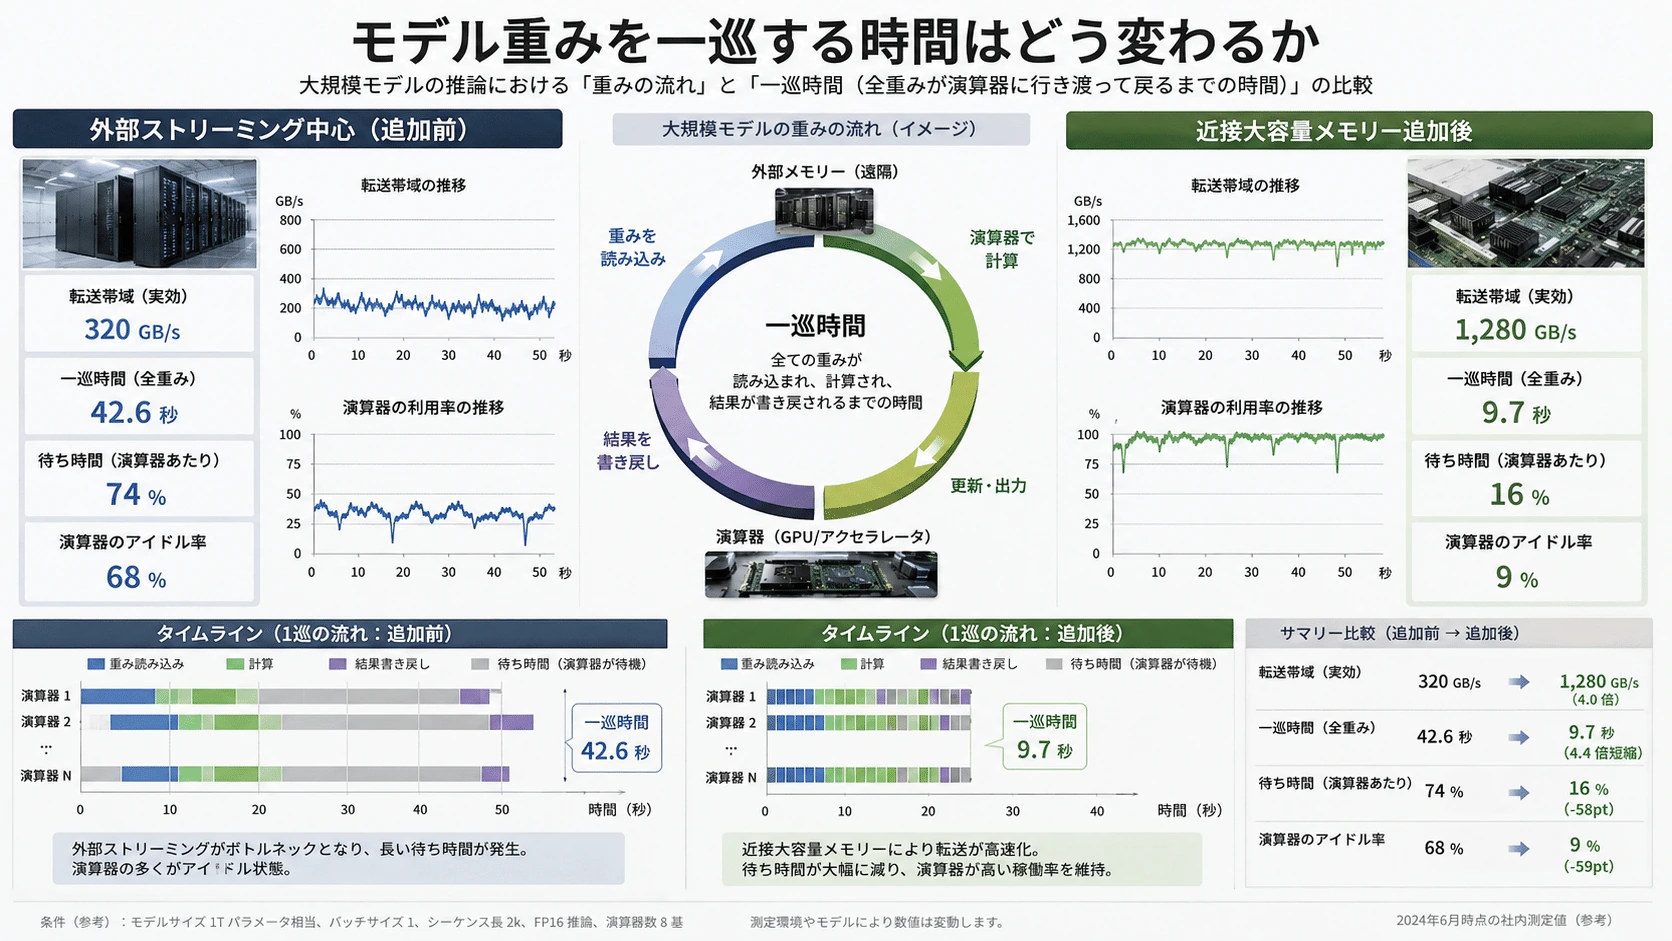
モデル重みを一巡する時間はどう変わるか
#バッチ1のDenseモデルでは、1トークン生成ごとにモデル重みの大部分を読み出すため、メモリー帯域がDecode速度へ強く影響する。
#帯域を100%使用できると仮定し、重みだけを一度読み出す理論時間を計算すると、次のようになる。
#FP8の70Bモデルを約70GBとした場合
#| メモリー経路 | 重み一巡の理論時間 |
| 現行外部I/O・0.15TB/s | 約467ms |
| 近接メモリー・22TB/s | 約3.2ms |
| 近接メモリー・44TB/s | 約1.6ms |
| 近接メモリー・88TB/s | 約0.8ms |FP8の405Bモデルを約405GBとした場合
#| メモリー経路 | 重み一巡の理論時間 |
| 現行外部I/O・0.15TB/s | 約2.7秒 |
| 近接メモリー・22TB/s | 約18ms |
| 近接メモリー・44TB/s | 約9ms |
| 近接メモリー・88TB/s | 約4.6ms |実際には演算、KVキャッシュ、Attention、メモリー効率、量子化、データ配置などが加わるため、この数字がそのままトークン間隔になるわけではない。
#それでも、22~88TB/s級の近接メモリーが実現すれば、現在の0.15TB/s級外部経路と比べ、重み供給に起因する待ち時間を2桁から3桁近く縮められる可能性がある。
#これはWSEを、低遅延Decode専用機から、より広い長文脈、MoE、大型モデル推論へ拡張する上で大きな意味を持つ。
#
光接続が加わると何が変わるのか
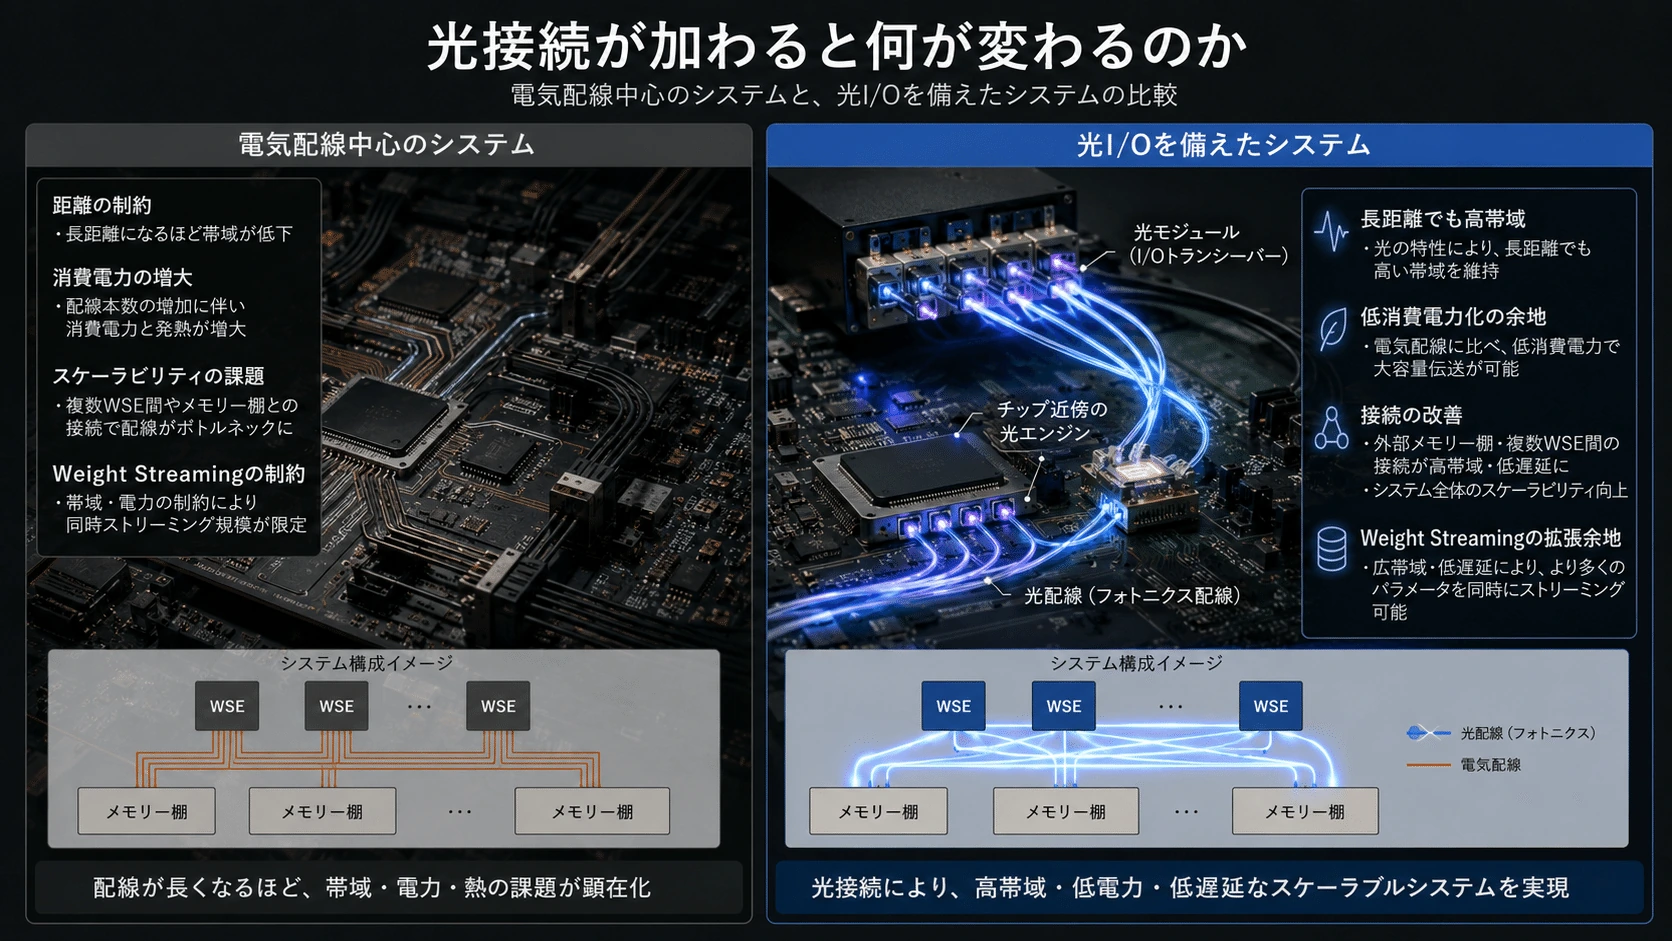
#近接メモリーだけでは、複数WSEの接続や、PrefillシステムからDecodeシステムへのKVキャッシュ転送問題は残る。
#そこで次の段階として考えられるのが、WSE周辺へシリコンフォトニクスやCo-Packaged Opticsを統合する構成である。
#Prefill ASIC/GPU
↓
光I/O
↓
光スイッチ/光ファブリック
↓
Cerebras WSE
↓
近接HBM
↓
分散SRAMCerebrasはRanovusとともに、光接続を使ってチップ間通信を高速化・省電力化するDARPAプロジェクトを進めている。ただし、採用技術や最終的な製品仕様は公開されておらず、現在は将来技術の研究開発に近い段階である。(Reuters)
#
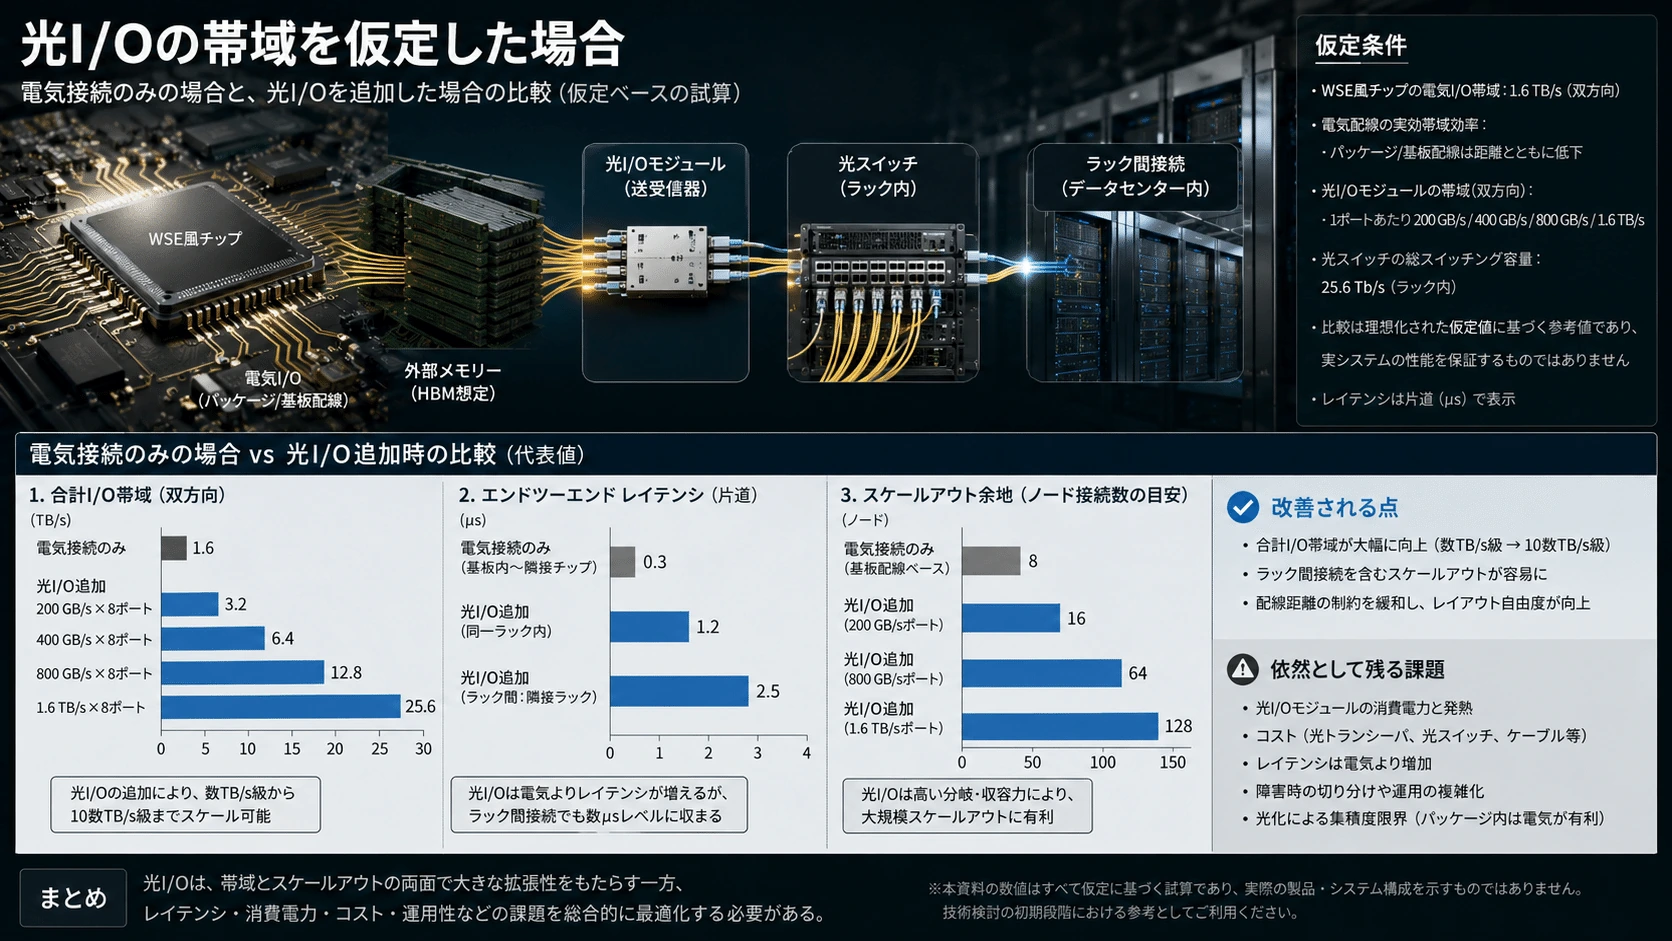
光I/Oの帯域を仮定した場合
#以下もCerebrasの発表値ではなく、将来の光I/O帯域を仮定した試算である。
#| 接続帯域 | 現行CS-3 I/O比 |
| 現行CS-3システムI/O (1.2Tb/s=0.15TB/s) | 1倍 |
| 25Tb/s級光I/O (3.1TB/s) | 約21倍 |
| 100Tb/s級光I/O (12.5TB/s) | 約83倍 |
| 200Tb/s級光I/O (25TB/s) | 約167倍 |
| Rubin 1GPUのHBM4 (22TB/s) | 約147倍 |
| WSE内部SRAM (21,000TB/s) | 約14万倍 |100~200Tb/s級の光I/OをWSEへ実装できれば、外部接続帯域は12.5~25TB/sとなり、Rubin 1GPUのHBM4帯域に近い水準まで引き上げられる。
#光接続はHBMと同じものではない。HBMはローカルメモリーであり、光I/Oは外部装置へ接続する経路である。それでも、遠隔HBMプール、Prefillアクセラレーター、別のWSEとの接続を高速化する中核技術になり得る。
#
KVキャッシュ転送はどこまで短縮できるか
#PrefillとDecodeを分離する場合、Prefill側で生成されたKVキャッシュをWSE側へ送る必要がある。
#理想的に帯域を使い切れる場合の転送時間は次のようになる。
#| KV容量 | 現行0.15TB/s | 光12.5TB/s | 光25TB/s |
| 10GB | 約67ms | 約0.8ms | 約0.4ms |
| 40GB | 約267ms | 約3.2ms | 約1.6ms |
| 100GB | 約667ms | 約8ms | 約4ms |現在のI/Oでは、長文脈のKVキャッシュ転送だけで数百ミリ秒かかり、Cerebrasによる高速Decodeの利点を打ち消す可能性がある。
#100~200Tb/s級の光接続が実現すれば、同じ転送を数ミリ秒へ縮められるため、
#Trainium/GPUでPrefill
↓
巨大KVを光転送
↓
WSEで高速Decodeという異種構成が、はるかに現実的になる。
#さらに複数WSE間も同じ光ファブリックで接続できれば、現在はシステム境界で失われているWSE内部の低遅延性を、ラックや複数ラックへある程度拡張できる可能性がある。
#「近接メモリー+光I/O+WSE」という夢の構成
#最終的な理想像は次のようになる。
#外部ストレージ/MemoryX
モデル全体・チェックポイント
│
│ 光メモリーファブリック
↓ 10~25TB/s以上
近接HBM/積層DRAM
500GB~1TB超・22~88TB/s
│
↓
WSE分散SRAM
44GB以上・21PB/s以上
│
↓
90万個以上の演算コア
│
│ 光scale-up接続
↓
別のWSE/Prefill ASIC/共有メモリーこの構成では、
#- 巨大モデルの重みを近接メモリーへ常駐
- ホットな重みや活性値を分散SRAMへ配置
- Prefill側からKVキャッシュを光で転送
- 複数WSEを光ファブリックで接続
- Weight Streamingを低速な外部DDRではなく近接HBMから実行
- 長文脈やMoEでも高いDecode速度を維持
できる可能性がある。
#WSEの21PB/sという局所帯域を保ちながら、容量を数百GBから1TB以上へ拡張できれば、Cerebrasの「容量は小さいが内部だけ速い」という弱点は大きく変わる。
#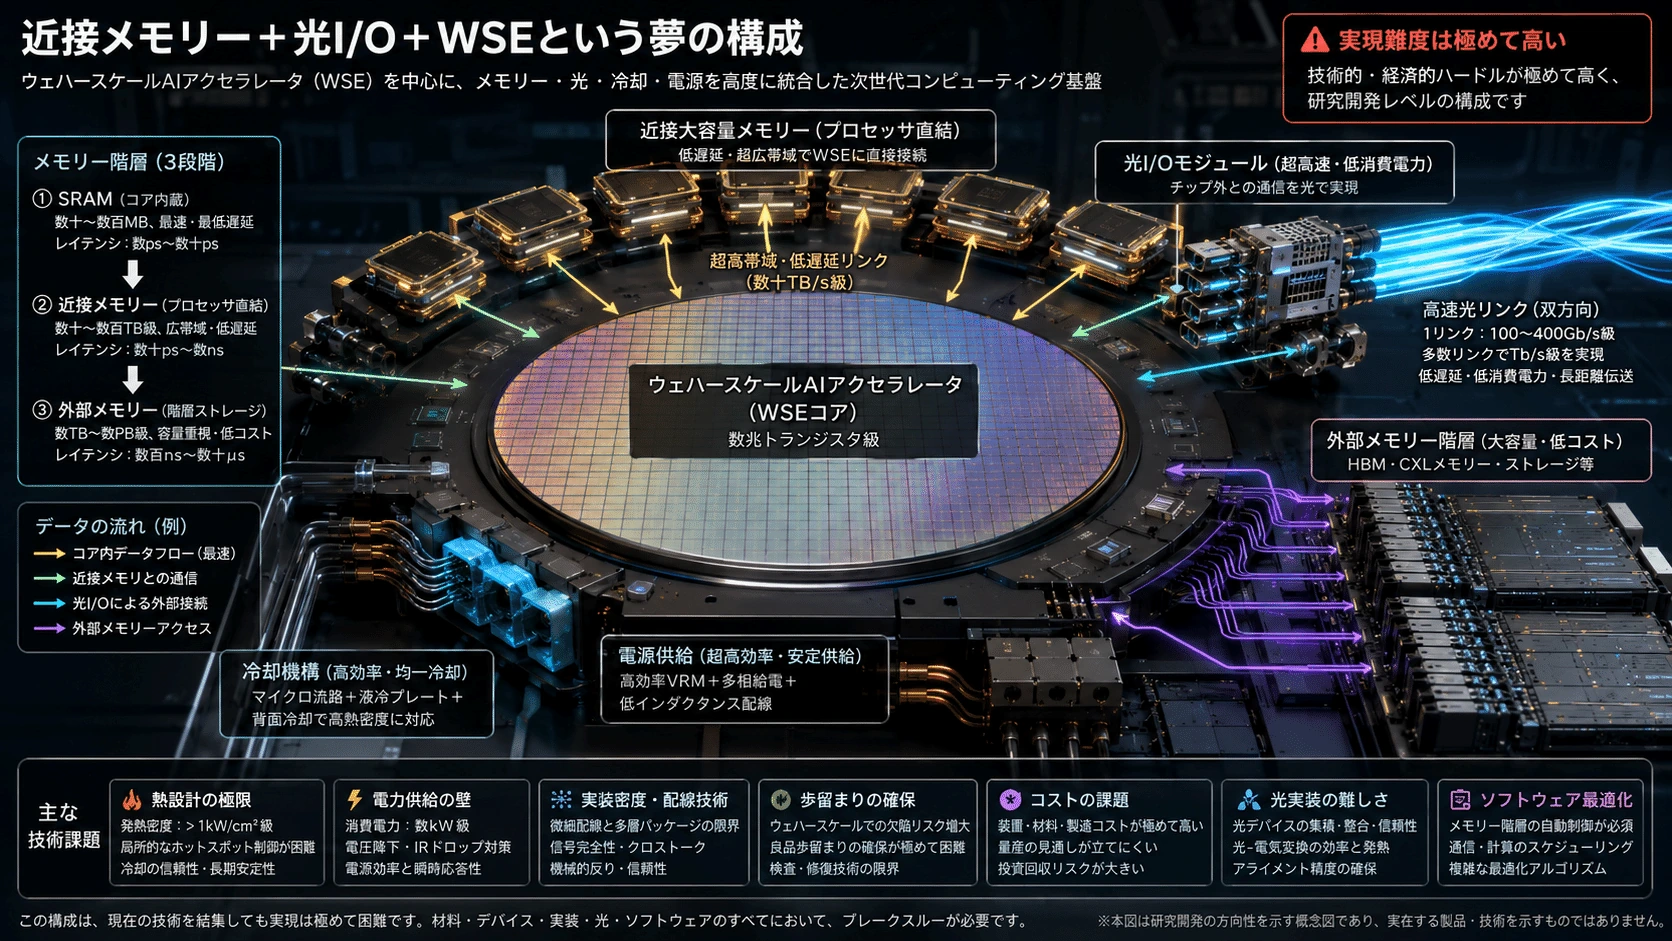
しかし実現難度は極めて高い
#この構成は魅力的だが、単にHBMと光チップを横へ置けば完成するものではない。
#WSE-3は46,225mm²という巨大なシリコンであり、専用Engine Blockからウェハー表面へ直接給電し、全面を均一に冷却する構造を採っている。(Cerebras)
#その周辺や上面へ大容量メモリーを追加するには、
#- HBMコントローラーをWSE外周へ分散配置する
- 中央部までデータを運ぶNoCを強化する
- メモリー流入口への集中を防ぐ
- HBMとWSEを接続する巨大基板を製造する
- ウェハーの反りと熱膨張を管理する
- HBM、光I/O、WSEを同時に冷却する
- 光源、変調器、受光器を実装する
- 欠陥のあるメモリーや光I/Oを切り離す
- ソフトウェアからNUMA的な距離を管理する
必要がある。
#WSE上へメモリーを3D積層すれば配線距離は縮まるが、演算面の真上をメモリーが覆うため、現在の冷却経路を塞ぐ可能性がある。ウェハー全面のHybrid Bonding、Known Good Die、修理性、熱密度という未解決問題も生じる。
#また、光接続を高速化しても、接続先のメモリーが十分な帯域を持たなければ意味がない。
#光リンク:25TB/s
↓
接続先DDR:1TB/s
ボトルネックはメモリー側へ移動必要なのは光だけではなく、光I/O、近接HBM、分散メモリーコントローラー、NoC、キャッシュ管理ソフトウェアを同時に再設計することである。
#この夢はCerebrasだけのものではない
#さらに注意すべきなのは、HBMとSRAM型アクセラレーターを組み合わせる方向へ、競合側も進んでいることである。
#NVIDIAはVera Rubin NVL72の構成で、288GB・22TB/sのHBM4を持つRubin GPUに加え、低遅延推論向けのGroq 3 LPUを組み合わせる方針を示している。公式仕様ではGroq 3 LPXラックは128GBのSRAM、40PB/sのメモリー帯域、640TB/sのラック内scale-up帯域を持つとされる。(NVIDIA)
#これは概念的に、
#Rubin
大容量HBMを持つ汎用AI GPU
+
Groq LPU
大容量SRAMを持つ低遅延推論機という構成である。
#つまりCerebrasが目指す、
#HBM系アクセラレーターでPrefillや容量問題を処理し、SRAM系アクセラレーターでDecodeを高速化する#
という方向そのものを、NVIDIAも自社のラックへ取り込もうとしている。
#Cerebrasが将来、近接メモリーや光接続を実現しても、その時点でNVIDIA、Broadcom、各ハイパースケーラーもHBM4、光スイッチ、CPO、専用LPUを進化させている可能性が高い。
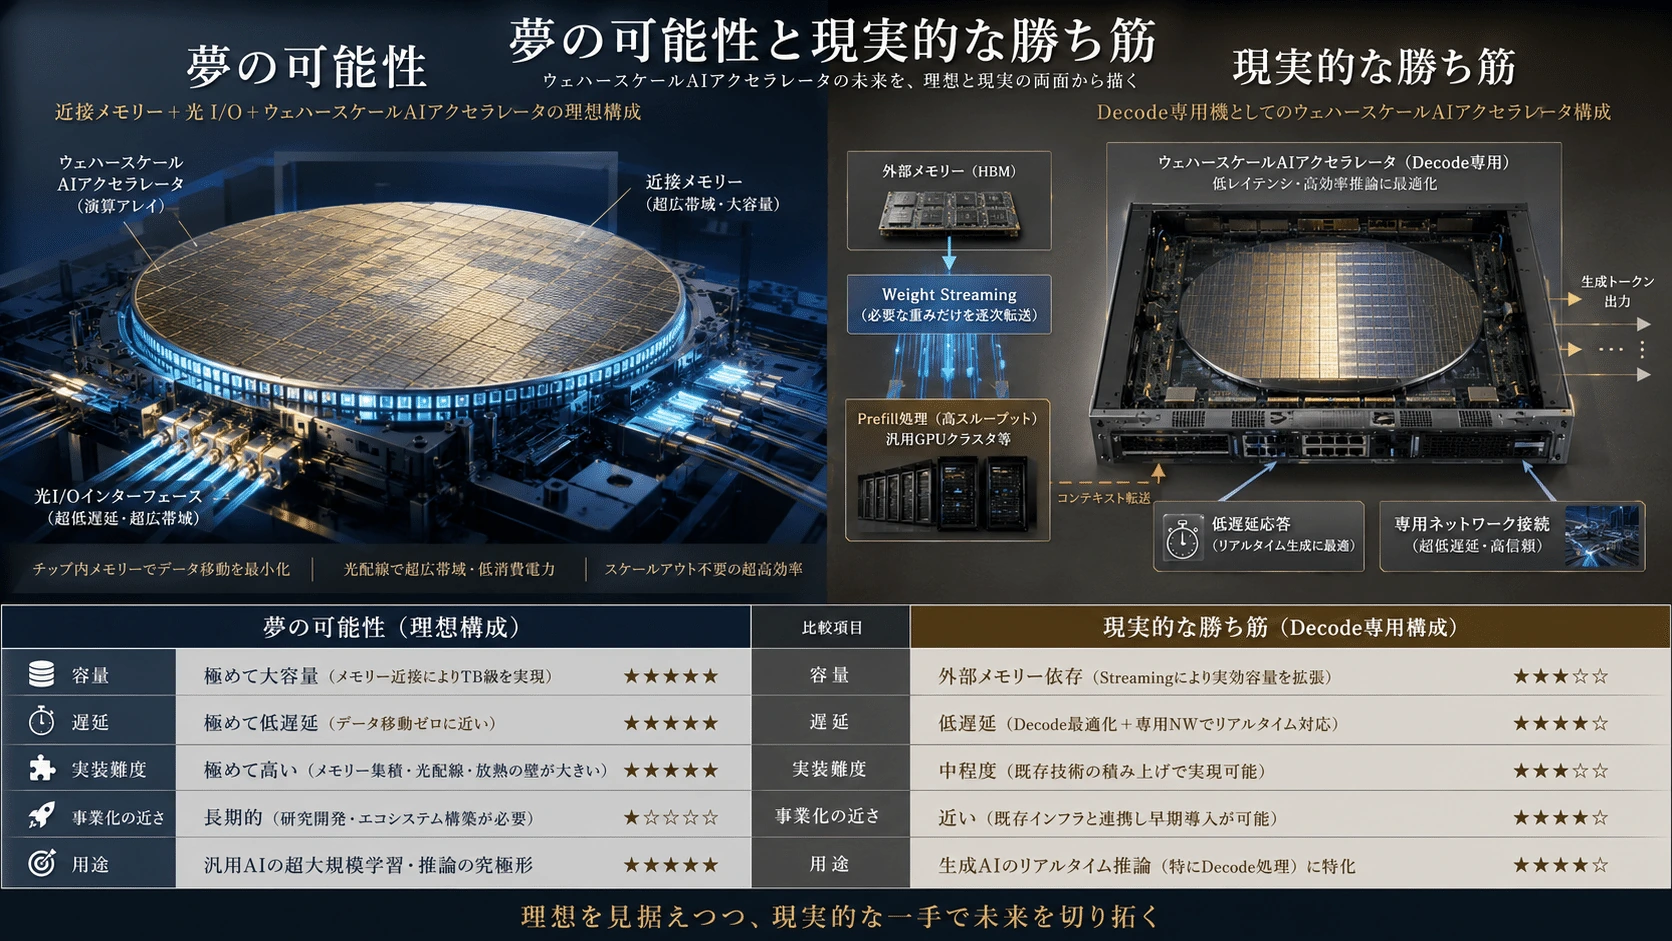
#夢の可能性と現実的な勝ち筋
#近接大容量メモリーと光接続を統合したWSEは、技術的には非常に魅力的である。
#仮に、
#WSE分散SRAM
44GB以上・21PB/s
+
近接メモリー
500GB~1TB・22~88TB/s
+
光I/O
100~200Tb/sを実現できれば、現在の外部I/Oに対して100倍から500倍規模の帯域改善が期待できる。
#Cerebrasは、
#44GBを超えると急激に遅くなる特殊なウェハースケール機#
から、
#大容量近接メモリーと光ファブリックを備えた、巨大な統合AIコンピューター#
へ変わる可能性がある。
#しかし、これは現時点では製品として確認できない夢のアーキテクチャである。
#実現にはパッケージング、冷却、給電、HBM調達、光I/O、NoC、ソフトウェアを全面的に作り直す必要があり、完成時期も経済性も見通せない。この将来像だけをCerebrasの事業価値の根拠にすることはできない。
#現実に確認できる勝ち筋は、もっと限定的である。
#現在のWSEが持つ圧倒的な分散SRAM帯域と低遅延通信を、推論パイプライン全体ではなく、Decodeという高付加価値工程へ集中させること。#
PrefillはTrainium、GPU、各社ASICが担当し、大容量HBMで入力とKVキャッシュを処理する。Cerebrasは、その後の逐次生成を担当し、応答時間、エージェントの反復速度、コード生成の完了時間を短縮する。
#現実的な構成
Encoder
GPU/専用ASIC
↓
Prefill
Trainium/GPU
↓
KV転送
↓
Decode
Cerebras WSEOpenAIとAmazonの案件が示しているのは、WSEがすべてのAI計算を置き換えるという物語ではない。
#巨大な異種AIインフラの中で、時間的価値の高いDecode工程だけを獲得する需要が存在するということである。
#したがってCerebrasの将来を二つに分けると、
#長期の夢
近接HBM
+光I/O
+複数WSE
+21PB/sの分散SRAM
現在の現実的な勝ち筋
Prefill/Decode分離
+低遅延Decode
+OpenAI・AWS向け推論容量となる。
#近接大容量メモリーと光接続は、Cerebrasを万能AI基盤へ変える可能性を持つ。しかし、それはまだ実証されていない未来である。
#当面のCerebrasを評価する上で重視すべきなのは、その夢ではない。
#Decode速度へどれだけの追加料金を付けられるか、同時利用者を処理しながら低遅延を維持できるか、そしてその高付加価値を粗利率とキャッシュフローへ変換できるか。#
Cerebrasの現実的な勝ち筋は、NVIDIAを全面的に置き換えることではない。
#推論が工程ごとに分離されていく時代に、Decodeという最も遅延価値の高い領域を占有することなのである。
#
特定銘柄の推奨・勧誘・投資助言を目的とするものではありません。投資判断はご自身の責任でお願いいたします。
#