AIが半導体設計を始めた時代――Broadcomは何を守り、どこへ向かうのか
絶ノイアの章 Sil-Kathnaの章この資料の日時
元資料の日付と、その本文が公に存在した確認日時は別の記録です。
本文に含まれる語句 HBM DRAM SRAM 先端パッケージング 光接続 電力・給電 冷却 歩留まり 基板・材料 チップレット AI推論 AIエージェント 主権AI
出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.09.23.4
- 記事内容のSHA-256
9969da7268faf08912d555f9f8ebf8605755c2665f67c839552c6a693bca1c7a- 保存版のSHA-256
d8877319ac48e783bafeea699c773974893ce04a06e2afb619325542cf99108a
外部証明の最終検査結果は詳細を開くと表示します。
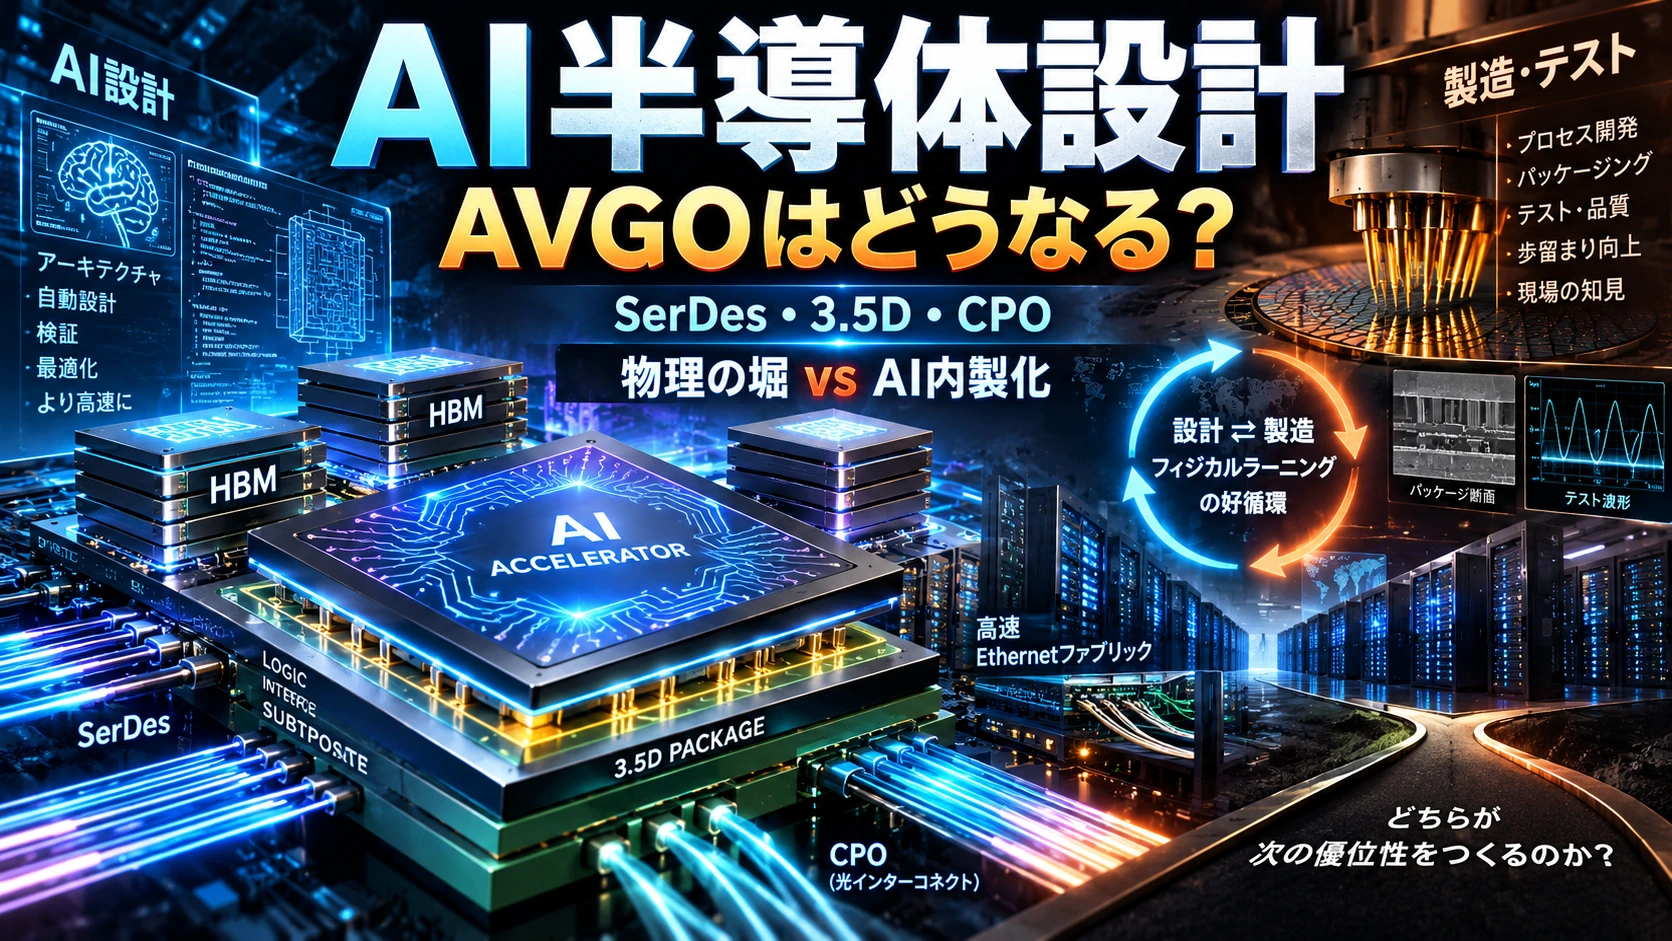
AIが半導体設計を始めた時代――Broadcomは何を守り、どこへ向かうのか
#半導体設計は、これまで極めて高度な専門家集団を必要とする仕事だった。
#Architectureを考える。
#RTLを書く。
#Verificationする。
#Physical Designを行う。
#Timingを閉じる。
#Packageを設計する。
#HBMを接続する。
#Networkまで含めてSystemを成立させる。
#そして実際にSiliconを製造し、Testし、歩留まりを改善し、Data Centerで長期間動かす。
#こうした工程には何千人ものEngineerと、何十年にもわたって蓄積されたKnow-howが必要だった。
#Broadcom、NVIDIA、AMD、Marvellといった企業が強かった理由の一つもここにある。
#しかし2026年、この前提そのものが崩れ始めている。
#AIがSoftwareを書くようになっただけではない。
#AIは、
#Architecture exploration
#RTL
#Verification
#Debug
#Physical Design
#PCB
#Advanced Packaging
#にまで入り始めた。
#Cadenceは2026年6月、完全自律型のChipStack AI Super Agentを発表し、NVIDIAでは典型的に約5週間必要だったRTL Validation Loopを1日未満まで短縮できたとしている。7月にはさらにAuraStack AI Super Agentを投入し、HBM配置、Advanced Package、PCB、Signal Integrity、Power Integrity、Thermal、MechanicalまでAgentic AIで扱い始めた。(Cadence Newsroom)
#SynopsysもAMD、Microsoftと、自律DebugやImplementation ClosureへAgentを投入している。(Synopsys News Releases)
#つまり、
#のである。
#では、この世界でBroadcomはどうなるのだろうか。
#答えは、まだ分からない。
#しかし、これからBroadcomを見るうえで何を監視すべきなのかは、かなり明確になってきた。
#Jalapeño――AI自身がチップを設計し始めた
#この構造変化を象徴するのがOpenAIのJalapeñoである。
#OpenAIは2026年6月、Broadcomと共同開発した初の自社Inference Accelerator、Jalapeñoを発表した。
#重要なのは、単に「OpenAIブランドのASICが登場した」ということではない。
#OpenAI自身が、
#Chip Architecture
#Kernel
#Memory System
#Networking
#Scheduling
#Deployment
#まで設計していることである。
#BroadcomはSilicon Implementation、Networking、Connectivityを担当し、CelesticaがBoard、Rack、System Integrationを担う。(OpenAI)
#つまり構造としては、
#↓
#↓
#↓
#という分業である。
#そしてJalapeñoは、設計開始からTape-outまで約9か月だった。
#その設計・最適化プロセスにはOpenAI自身のAIモデルが利用された。(OpenAI)
#さらに8月25日にOpenAIが公表した自社測定では、比較対象となった市販Systemに対して、Jalapeñoは複数の公開モデルでPeak throughput per wattを1.5~1.9倍、End-to-end latencyを1.7~3.6倍改善したとしている。
#これはOpenAI自身によるBenchmarkなので第三者測定とは分けて考える必要があるが、それでも「AIを使って設計されたWorking Siliconが実際に動いた」ことの意味は大きい。(OpenAI)
#OpenAIはさらに、
#AIを使ってChipを設計し、AIがChipをProgramしやすいようにChipを設計した
#という循環まで作り始めている。
#Jalapeño Gen2は既に開発中で、Gen3も構想段階に入っている。(OpenAI)
#Frontier Model企業には特殊なAdvantageがある
#この競争でOpenAI、Google、AnthropicのようなFrontier Model開発企業には、半導体会社にはない特殊な強みがある。
#それは、
#ことである。
#一般公開されたModelではない。
#次世代の未公開Modelである。
#例えばOpenAI内部では、一般UserやBroadcomが使えるようになる前に次世代Modelを、
#RTL生成
#Verification
#Architecture探索
#Package設計
#EDA操作
#AIDC最適化
#へ投入できる可能性がある。
#具体的にどの程度の先行Accessがあり、それをChip Designへどの程度投入しているかは公開されていない。
#しかしFrontier Model企業が自社の未公開Modelを最初に利用できるという構造そのものは変わらない。
#すると、
#↓
#↓
#↓
#というLoopが生まれる。
#OpenAI自身も、Data Center、Chip、Frontier Model、Platform、Productを一つのIntegrated Systemとして改善する戦略を明示している。(OpenAI)
#これは非常に強力である。
#BroadcomもAIを使っている――競争はAI対AIになる
#だからといってBroadcomが人間だけで戦うわけではない。
#2026年6月5日のBloomberg対談でHock Tanは、Broadcom自身もOpenAIやGoogleなどのAI ToolをEngineering DesignやCoding Assistanceへ使用していることを明らかにした。
#さらに彼は、AIを使いこなしたSenior Engineerなら、従来10人のEngineerが3か月必要だったような仕事を、1人で約1週間で行えるという極端な例まで示している。これは厳密なBenchmarkではなくHock TanによるROIの例示だが、Broadcom経営陣自身がEngineering laborの大幅な圧縮を想定していることは明確である。
#したがって未来の競争は、
#対
#ではない。
#対
#になる。
#Hock Tan自身が既に危機を認識している
#興味深いのは、Broadcom自身がこの問題を認識していることである。
#Bloombergの対談では、GoogleがTPU開発をさらに内製し、「Customer Owned Tooling」を作ろうとしていることについて質問されている。
#Hock Tanの回答は、それを契約によって止めるというものではなかった。
#むしろ、
#TechnologyではCustomerが自分で設計しようとすることは当然であり、Broadcomは自分のCustomerとも競争することになる。
#そのうえで、
#という考え方を示している。
#ここはBroadcomを理解するうえで非常に重要である。
#Broadcomの戦略は、
#ではない。
#なのである。
#だからBroadcomは、Frontier LabのAI設計能力が高くなればなるほど、自分自身もそれ以上の速度で改善し続けなければならない。
#しかし半導体はSoftwareではない
#ここで一つ大きな違いがある。
#AIが最高のArchitectureを考えられたとしても、
#だからである。
#例えば次世代XPUには、
#Compute Die
#HBM
#I/O Die
#D2D
#SerDes
#Interposer
#Substrate
#Power Delivery
#Cooling
#が含まれる。
#それぞれに歩留まりが存在する。
#単純化すれば最終Yieldは、
#のような掛け算になる。
#現実にはKnown Good Die選別やReworkなどがあるためもっと複雑だが、一つの工程で数%歩留まりが悪化するだけでも、最終的なEconomic Yieldに大きく響く。
#そしてAI Acceleratorではこの問題がますます難しくなっている。
#Teradyneは、2.5D/3D、HBM、Chipletによって、従来のATE Testを通過しただけでは不十分になり、Power Delivery、Thermal、HBM/TSV/Package Interconnect、Firmwareまで含めたSystem Level Testが必要になっていると説明している。(Teradyne)
#FormFactorが示す次世代HBM Probe環境も、5GHz超、125℃超、大電流、DUT当たり8万本超のProbeという世界に入っている。(FormFactor, Inc.)
#つまり、
#だけでなく、
#が必要である。
#これを私は、
#と考える。
#AI時代に価値を増すのはPhysical Learning Loop
#AIはSimulation Dataを大量に生成できる。
#しかし、
#「実際に100万個作ったとき何が壊れたか」
#は生成できない。
#TSMCにはProcess Yield Dataがある。
#SK hynixにはHBM StackingとMemory Yield Dataがある。
#KLAにはDefectとMetrology Dataがある。
#AdvantestにはATE Dataがある。
#FormFactorにはWafer ContactとProbe Dataがある。
#材料メーカーには実際の材料を工程へ載せたときのProcess Windowがある。
#そしてBroadcomやNVIDIAには、それらを組み合わせて実製品として量産したDataが蓄積されている。
#AIの性能が高くなるほど、このDataの価値は下がるのではなく、
#。
#AIが膨大な実測Dataを解析できるようになるからである。
#だがFrontier LabもPhysical側へ降り始めている
#ここがBroadcomにとって重要な変化である。
#OpenAIはもうArchitectureだけを内製しているわけではない。
#現在募集しているASIC Package SI/PI Engineerの職務には、
#200G / 400G SerDes
#HBM
#DDR
#Chiplet / Die-to-Die
#2.5D / 3D Package
#Interposer
#Substrate
#Power Delivery
#Electromagnetic Simulation
#Simulation-to-measurement correlation
#まで含まれている。(OpenAI)
#つまり、
#と
#の境界は既に動き始めている。
#Testまで内製能力を作ろうとしている
#さらにOpenAIはManufacturing Test Engineerを採用している。
#ICT
#Functional Circuit Test
#Tray-level Test
#System Manufacturing Test
#までTest Strategyを自社側で設計し、Hardware Design、Manufacturing、Quality、外部System Integratorとの間に立つ役割である。(OpenAI)
#Silicon Bring-up専門Engineerも募集していて、First Power-onからProduction Modelを走らせるところまで、
#Compute
#Memory
#Interconnect
#I/O
#をSoftwareから検証する体制を作っている。(OpenAI)
#さらに高速InterconnectのQuality Engineerでは、
#Yield
#DPPM
#RMA
#Cpk/Ppk
#BER
#Eye closure
#TDR/VNA
#Connector Wear
#Plating
#Contamination
#まで扱っている。(OpenAI)
#これは極めて重要な変化である。
#OpenAIが欲しいのは単なるEngineerではない。
#なのである。
#Rack・製造・Supply Chainにも降りる
#Foxconnとの提携も同じ方向にある。
#OpenAIとFoxconnは複数世代のAI Data Center Rackを共同設計し、
#Rack Architecture
#Cabling
#Networking
#Cooling
#Power
#Local Testing
#Assembly
#まで共同で扱う。(OpenAI)
#OpenAIはさらにJDM、CM、ODMを選定・契約するManufacturing Partnership組織まで内部に作っている。(OpenAI)
#Compute Infrastructure ProcurementではAccelerator、Server、Rack、Thermal、Power Deliveryまで契約し、CapacityとOptionalityを確保する役割を置いている。(OpenAI)
#つまり、
#から、
#へ変わり始めている。
#Memoryメーカーとも直接つながる
#OpenAIはSamsung、SK hynixともStargateを通じて直接協力している。
#SamsungとSK hynixはOpenAI向けAdvanced Memory Supplyの拡大を計画し、月90万DRAM wafer startsを目標とする大規模Capacity Expansionまで掲げている。(OpenAI)
#2026年9月9日には、OpenAIがSamsungと次世代Chip開発について協力を深めていることも報じられた。ただし具体的なChip Architectureや製造分担は現時点では公表されていない。(Reuters)
#Frontier Labが、
#という間接関係から、
#へ変わる動きである。
#OpenAIだけではない
#Anthropicも2026年8月、Custom Silicon Teamの構築を開始した。
#Anthropic自身の求人では、「Claude向けCustom Siliconを構築し、Design Authorityを自社で持つ」と明記している。
#Architecture Definitionから、
#Tape-out
#First Silicon Bring-up
#Production Ramp
#Physical Design
#DFT
#Analog/Mixed Signal
#Foundry
#Packaging
#までを小規模な専門Teamで担当する計画である。(Greenhouse)
#これは非常に象徴的である。
#Frontier LabのChip Teamは、巨大な人員を持つ必要がなくなりつつある。
#という形が成立し始めている。
#MetaはNetworkingまでChip内部へ取り込み始めた
#MetaのMTIA 300はさらに重要な例である。
#MTIA 300ではNetwork InterfaceをPackage内部へ入れ、2個のNetwork Chipletに合計12個のCustom 800Gbps RDMA NICを搭載した。
#合計I/Oは1.2TB/s。
#さらにCommunication Library HCCLまでHardwareとCo-designしている。(Engineering at Meta)
#これは、
#をCustomer自身が統合した例である。
#つまり、
#「NetworkingはMerchant SiliconだからBroadcomは永遠に安全」
#という前提も置けない。
#一方MetaはBroadcomとのMTIA共同開発も継続している。つまり内製化とBroadcom利用は同時に進む。(AI Meta)
#GoogleもAgentic EDAへ進んでいる
#Googleについても同じである。
#CadenceとGoogleは2026年4月、GeminiとChipStack AI Super Agentを統合し、
#Digital Design
#Testbench Development
#Verification Planning
#Regression
#Debug
#まで自動化する取り組みを開始している。(Cadence)
#2026年6月のBloomberg対談でも、Hock Tan自身がGoogleのCustomer Owned Toolingを競争相手として認識している。
#つまり、
#OpenAI
#Anthropic
#Meta
#の全方向で、
#が深くなっている。
#ではBroadcomのMoatは何なのか
#ここからBroadcomを見る必要がある。
#Broadcomは最新決算で、Googleとの関係が長期的に続く理由として、
#SerDes
#Chip-to-chip Interconnect
#HBM / SRAM Integration
#Advanced Packaging
#最速のTime-to-Market
#RespinsなしのProduction
#を挙げている。
#つまりBroadcom自身も、
#そのものだけをMoatとは考えていない。
#より深い、
#をMoatとしている。
#3.5D XDSiP――現在のBroadcomで最も重要な技術の一つ
#Broadcomの3.5D XDSiPはその象徴である。
#Broadcom自身の整理では、
#Compute ArchitectureはCustomer Owned。
#一方、
#Design Flow / Performance Optimization
#HBM PHY / Integration
#Network I/O Architecture / Implementation
#2.5D / 3D / Silicon Photonics Package
#はBroadcom Ownedである。(Broadcom)
#これは極めて戦略的な構造である。
#「Compute Architectureは顧客が作ってよい」。
#その代わり、
#をBroadcomが取る。
#3.5D XDSiPはFace-to-Face stackingを用い、Broadcom公称でF2B方式比7倍のDie-to-Die signal density、Planar D2D PHY比10分の1のInterface powerを実現するとしている。(Broadcom)
#2026年2月には2nm Custom Compute SoCの出荷まで始まった。(Broadcom Inc.)
#これは単なるResearch Prototypeではない。
#量産工程へ入っている。
#First-pass Successこそ重要
#さらに3.5DではBroadcomのProprietary Design Flowによって、4 Compute Die、I/O Die、6 HBMを統合したComplex XPUをFirst-passで成立させたとBroadcomは説明している。(Broadcom Inc.)
#ここは重要である。
#AIが、
#「このPackageが理論上最適」
#と提案することと、
#ことは違う。
#Respinsには数か月と莫大な費用がかかる。
#Broadcomの価値は、設計図を書くこと以上に、
#への変換成功率にある。
#SerDes――Broadcomの深いPhysical IP
#高速NetworkではSerDesが重要になる。
#現在BroadcomのTomahawk 6は100G/200G electrical SerDesを搭載する。
#ここは「448G SerDes」と一括してしまわない方がよい。
#現時点のBroadcomで量産中心となっているElectrical SerDesは200G/laneであり、光側では2026年3月に400G/lane Optical PAM4 DSP Taurusを発表している。(Broadcom)
#つまりロードマップは、
#↓
#へ進んでいる。
#これを、
#DSP
#Laser Driver
#Retimer
#Switch
#CPO
#まで同一企業が持っていることがBroadcomの強みである。
#Tomahawk――XPUが誰製でも売れる可能性
#Tomahawk 6は102.4Tbps。
#2026年3月からVolume Productionへ入り、BroadcomによればSampleからProductionまで3四半期未満だった。(Broadcom Inc.)
#さらに最新決算では、Tomahawk 6はBroadcomとXPUを共同開発しているほぼ全AI Hyperscalerだけでなく、
#と説明されている。
#これはAVGOの非常に重要な防御力である。
#OpenAIが将来Acceleratorを完全内製しても、
#「NetworkはTomahawkを使う」
#ならBroadcomは残れる。
#BroadcomのAI Networking Revenueは、今後数年XPUとほぼ同程度の速度で伸びるとManagementは予想している。
#CPO――BroadcomがPhysical側へ逃げている象徴
#BroadcomのCPOも重要である。
#Tomahawk 6 Davissonは第三世代CPO Switchで、102.4Tbps、200Gbps/channel。
#Broadcom公称ではPluggable optics比でOptical Interconnect powerを70%削減する。(Broadcom)
#さらにMetaによる試験ではBroadcom CPOが累積100万400G-equivalent port device hoursでLink Flapなしという結果が報告されている。これはBroadcom発表内で公開されたMeta Test Dataである。(Broadcom Inc.)
#そしてBroadcomは第四世代CPOで400Gbps/channelへの移行を開発中としている。(Broadcom)
#これは典型的なPhysical Learning Loopである。
#光学Engineを設計するだけではない。
#実際に、
#Laser
#Fiber
#Package
#Thermal
#Alignment
#Test
#Field Reliability
#まで確認している。
#Frontier Model企業がここまで追いつくには、AI Modelの性能だけでは不十分である。
#BroadcomはSubstrateまでPhysical側へ降りている
#さらに興味深いのがFC-BGAである。
#SingaporeのAdvanced Substrate TechnologiesはTOPPANの工場だが、Broadcomは最大Customerとして設立を強く支援し、次世代Networking / AI/ML製品の差別化に重要なAdvanced Substrate Technologyを同拠点で開発する。(EDB Singapore)
#Broadcomの最新決算でも、SubstrateがSupply BottleneckとなっているためSingapore CapacityをFY2027から利用し始めると説明している。
#これは単なるASIC設計会社の動きではない。
#動きである。
#Laser工場も自ら増やしている
#Broadcomは、
#EML
#CW Laser
#VCSEL
#Indium Phosphide
#の工場Capacityを、米国とSingaporeで前年比3倍超へ増強している。
#理由はLaser需要がIndustry Supplyを大きく上回っているためである。
#これもBroadcomの方向を示している。
#AI設計がCommodity化すると、
#する。
#一方、
#はAIでは生成できない。
#Broadcom自身もそのPhysical側へ降り始めている。
#しかしBroadcomのPhysical Moatも永遠ではない
#ここで楽観しすぎてもいけない。
#Cadence AuraStackは既に、
#HBM placement
#Advanced Package floorplan
#Routing
#SI/PI
#Thermal
#Mechanical
#Manufacturability
#までAI Agentで扱い始めた。(Cadence Newsroom)
#OpenAI自身も200G/400G SerDes、HBM、2.5D/3D Package、Interposer、SubstrateへEngineerを配置している。(OpenAI)
#つまり、
#の次は、
#へ進む可能性がある。
#Broadcomが現在「Owned」としている領域も、固定された境界ではない。
#本当の境界はSimulationとRealityの間にある
#だから私は、
#Digital vs Physical
#という線引きより、
#の境界を見る方が重要だと思う。
#AIはPackageを設計できる。
#SerDesを設計できる。
#Probe Cardを設計できる。
#しかし、
#「このPackageを100万個作ると、どこでFailureが増えるか」
#「このSerDesはProcess variationとTemperature variationの中でどの程度Marginを持つか」
#「このLaserを何十万時間動かしたら何が壊れるか」
#というDataは、現実世界から取らなければならない。
#ここがBroadcom、NVIDIA、TSMC、SK hynix、Test企業、材料企業に残るMoatになる。
#Frontier Labの弱点はPhysical Dataだった――しかしそれも埋め始めている
#現時点ではBroadcomが有利である。
#何世代ものTPU、Network ASIC、SerDes、CPO、Package、HBM IntegrationのDataを持っているからだ。
#OpenAIはJalapeño Gen1をようやく量産し始める段階である。
#しかしOpenAIは、
#Manufacturing Test
#Silicon Bring-up
#Package Reliability
#Interconnect Quality
#Data Center Deployment
#を内部組織へ取り込み始めた。
#つまり今後、
#↓
#↓
#↓
#というLearning Loopが生まれる。
#ここからが本当の競争である。
#「最新Frontier Model Access」が新しい半導体設計資源になる
#従来のChip Design Resourceは、
#だった。
#これからは、
#になる可能性が高い。
#Broadcomにとって重要なのは、
#「AIを使っているか」
#ではない。
#である。
#Frontier Labは未公開Modelを最初に使える。
#Broadcomは膨大なProprietary Silicon Dataを持っている。
#だから競争式は、
#対、
#になる。
#Broadcomの「中立性」も重要になる
#Broadcomにはもう一つ微妙な問題がある。
#Google、OpenAI、Meta、Anthropicなど、互いに競争する企業を同時にCustomerとしていることである。
#そのためBroadcomが自らFrontier ModelやMerchant AI AcceleratorでCustomerと直接競争しすぎれば、
#Customer側から、
#なぜ最重要ArchitectureをCompetitorへ見せるのか
#という問題が出る。
#だからBroadcomがXDSiPで、
#としていることには戦略的意味がある。
#BroadcomはCompute Intelligenceそのものを奪うより、
#方が中立性を維持できる。
#これはAVGOがNVDAと異なるところでもある。
#Broadcomは「最高のXPU」を売る会社ではなくなる可能性がある
#将来的なBroadcomの理想形は、
#ではなく、
#なのかもしれない。
#CustomerがCompute Architectureを設計する。
#Broadcomが、
#HBM Interface
#D2D
#Package
#SerDes
#Network
#CPO
#Laser
#Substrate
#を組み合わせる。
#そしてAI Clusterとして成立させる。
#この形ならFrontier Labの設計能力が上がっても、Broadcomは残ることができる。
#VMwareは第二の逃げ道になる
#ここでVMwareがつながる。
#Broadcomは2026年8月31日、VMware AI FactoryとVMware Private AI Cloudを発表した。
#Bare MetalからAI Infrastructure、Model Deployment、Inferenceまでを自動化し、Private Cloud上でAgentic ApplicationをBuild、Run、GovernするPlatformである。(Broadcom)
#もし将来数億、数十億のAgentが企業内で常時稼働するなら、
#Identity
#Permission
#Security
#Observability
#Scheduling
#Governance
#といったControl Planeは巨大な市場になる可能性がある。
#VMwareはBroadcomにとって、
#の上に置くSoftware Layerになり得る。
#ただしこれはCustom Silicon Moatが侵食された場合の単純な代替ではない。
#VMware自身もAIによるInfrastructure automationとの競争にさらされる。
#重要なのはVMwareが「人間がVMを操作するSoftware」から、
#へ移れるかである。
#AI XPV――AIDCそのものを増やす
#さらにBroadcomはApollo、BlackstoneとAI XPV Platformを設立した。
#2028年までにOpenAI、Anthropicなど向けBroadcom XPU/Networkingを使う20GW超のAI Compute Capacityを支援する。
#最初の案件だけでも$35B、1GW超である。(Broadcom Inc.)
#Broadcom自身がData Centerを全てBalance Sheetへ載せるのではない。
#External Capitalを使ってAIDCを建て、
#を投入する。
#Broadcom最新決算でも、OpenAIとAnthropicは将来的に自前Data Centerを持つHyperscalerになるとHock Tanは見ている。
#これもBroadcomがChip単体からAIDC全体へ広がっていることを示している。
#現在のAVGO業績は非常に強い
#ここまで長期リスクについて書いたが、短中期のBroadcomは非常に強い。
#FY2026 Q3のAI Semiconductor Revenueは$16.7B。
#前年比+221%、QoQ+54%だった。
#Q4は$21.7Bを見込む。(Broadcom Inc.)
#決算コールではFY2027 AI Revenueを約$115B、FY2028を約$230BとするTrajectoryまで示した。
#Google、OpenAI、Anthropic、MetaなどのCustom XPU需要は猛烈に増えている。
#つまり、
#と、
#は別々に考えなければならない。
#Broadcom Content / GWという新しいKPI
#Hock Tanは最新決算で、次世代XPUは高性能になるほどASPが上がる一方、消費電力も上がるため1GWに搭載できる個数が減り、Broadcom Contentは1GW当たりおおむね$20B~$30B程度で持続すると説明している。これはManagement guidanceとして扱うべき数字だが、AVGOを見るうえで非常に面白い考え方である。
#つまり、
#と見る。
#これはCustom XPU売上そのものより重要かもしれない。
#OpenAIがArchitectureを内製しても、
#Tomahawk
#SerDes
#HBM PHY
#CPO
#Package
#Optics
#のBroadcom Contentが増えれば、
#は維持できる。
#逆にXPU市場が猛烈に伸びても、
#Customer内製化によってBroadcom Content/GWが低下するなら長期的には警戒すべきである。
#Broadcomについてこれから何を監視するべきなのか
#ここまで来ると、AVGOは「決算を見て終わる銘柄」ではなくなった。
#次世代製品が出るたびに、Customer Owned領域とBroadcom Owned領域の境界を確認する必要がある。
#特に重要なのは次の項目である。
#Jalapeño Gen2 / Gen3で誰が何を設計したか。 Compute ArchitectureだけOpenAIなのか。Physical Design、HBM PHY、Package、SerDes、NICまでOpenAIが入ってきたのか。
#Google TPUのCustomer Owned Toolingがどこまで進んだか。 BroadcomがSerDes、HBM Integration、Packageで優位を維持できているか。
#Broadcom 3.5D XDSiPが次世代Customer XPUでも採用され続けるか。 First-pass success、Respins、Yield、Time-to-MarketでCustomer内製を上回れるか。
#TomahawkのAttach Rate。 Broadcom製XPUを使わないCustomerにもTomahawkが採用され続けるか。
#200G Electrical SerDesから400G級Opticalへの移行。 BroadcomのDSP/CPO/Laser Roadmapが先行し続けるか。
#CPO Reliability。 Broadcomが現在持っている実Field Dataと量産能力にCustomer内製や競合が追いつくか。
#Frontier LabとPhysical Supplierの直接接続。 TSMC、SK hynix、Samsung、Packaging、Probe、ATE、材料企業とOpenAI/Anthropicが直接共同開発し始めていないか。
#Frontier Model Access。 Broadcomが次世代Chip設計に使えるAIが、Frontier Lab内部Modelに対してどれほど遅れているか。これは公開情報だけでは最も確認しにくいが、今後重要になる。
#最大のBear Signal
#最も警戒すべきなのは、Frontier Labが、
#Compute Architecture
#↓
#RTL / Verification
#↓
#Physical Design
#↓
#HBM Integration
#↓
#Package
#↓
#SerDes / Network
#↓
#Test
#まで内製し、そのうえで、
#を実現することである。
#ここまで来れば、BroadcomのCustom Silicon Moatは明確に薄くなる。
#特に、
#Broadcom以外のSerDes/PHY採用
#Tomahawk Attach Rate低下
#Customer-owned Packageの量産成功
#Broadcom Content/GW低下
#は強い警告になる。
#最大のBull Signal
#逆に最も強いBull Signalは、
#しているにもかかわらず、
#することである。
#OpenAIがChipを自分で設計する。
#MetaがNICまで自分で作る。
#GoogleがAIでPhysical Designを進める。
#それでも、
#3.5D XDSiP
#HBM PHY
#SerDes
#Tomahawk
#CPO
#Optical DSP
#Laser
#Substrate
#のBroadcom採用額が増える。
#この場合、
#はBroadcomの敵ではなく、
#になる。
#最終的にBroadcomは何になるのか
#まだ答えはない。
#Broadcomが2030年代も、
#のままであるなら、かなり難しい。
#AIによる設計能力の供給量が増え続けるからである。
#しかしBroadcomが、
#へ変わるなら話は違う。
#Compute ArchitectureはCustomerが作る。
#Broadcomは、
#Memory
#Package
#SerDes
#Networking
#Optics
#Substrate
#Software Infrastructure
#Financing
#をつなぐ。
#そして、
#への変換を担う。
#この形なら、OpenAIやAnthropicのAIが賢くなること自体を需要に変換できる。
#「Customerより良いものを作り続ける」会社
#Hock Tanの思想は非常に単純である。
#Googleが内製するなら、Google自身より優れたものを作る。
#Marvellが追いかけてくるなら、Marvellより速く進む。
#AIがEngineeringを高速化するなら、自分たちもAIを使う。
#BroadcomはCustomerを囲い込むことより、
#することで残ろうとしている。
#それは非常に強い企業文化でもある。
#しかし、これまでとはCompetitionの速度が違う。
#競争相手は数千人のEngineerだけではない。
#世界最高性能のFrontier Modelを最初に使える企業が、自社のModel Workload Dataを与え、24時間AI Agentを動かしてChipを改善する。
#そしてそのFrontier Lab自身がManufacturing、Test、Package、Network、Memory Supplyへ降り始めている。
#結論――AVGOは「Moatを毎世代再証明する銘柄」になった
#BroadcomのAI事業は現在、猛烈に成長している。
#Tomahawk。
#SerDes。
#3.5D XDSiP。
#CPO。
#Optical DSP。
#Laser。
#Substrate。
#VMware。
#AI XPV。
#これらを合わせるとBroadcomは単なるCustom ASIC会社ではない。
#一方でJalapeñoが示したものも無視できない。
#は既に始まった。
#そして次に起きているのは、
#への拡張である。
#そこで最後まで価値が残るのは、
#を結びつけられる企業になる可能性が高い。
#Broadcomには現在、そのうちPhysical Data、IP、Production experienceという極めて強い武器がある。
#Frontier Labには、最高性能ModelとWorkload Dataという別の武器がある。
#この二つがこれから正面からぶつかる。
#だからAVGOを見るとき、
#「AI売上が何%伸びたか」
#だけでは不十分になった。
#見るべきなのは、
#そのうえで、
#である。
#Broadcomがその答えを毎世代Yesにし続けられるなら、AIによる設計革命はBroadcomを壊さない。
#むしろCustom XPU、Custom Memory、Custom Network、Custom Packageが増え続ける世界の中心にBroadcomが残る。
#しかし一度、
#となり始めれば、これまで非常に深いと思われていたCustom Silicon Moatが想像以上の速度で薄くなる可能性がある。
#まだどちらになるかは分からない。
#だからこそ、これからのAVGOは、
#「Moatがあるから保有する銘柄」ではなく、「そのMoatを毎世代再証明できているかを監視する銘柄」
#として見る必要があるのだと思う。
#こう考えると私はAVGOに弱気になってしまいます。しかし、2026年9月10日に1株追加して2株保有になりました。
#追加した後で、この構造変化を深刻に受け止めました、AIで設計出来ても流石にAVGOとかMRVLを越えては来ないだろうと思っていました、しかしAIの性能向上の速さとフロンティアモデル開発側の動きをみていると、危うさが全くない訳でもない気がしてきました。
#そう考えるとメモリ、テスト、高級CCL、高級MLCC、製造、InP基盤、レーザー、冷却、AIDCcloudを持つハイパースケーラー等の方が確実なんだよな。
#AVGOもNVHBM的な事をしそうな気もするし、主権AIへのAIDC需要もありAIXPVと繋がって来てTAMが拡大する可能性もあるので、これから起きる構造変化は予見出来ないですが、少し注視する必要がありそうです。
#AIはヤバいね。
#投資助言を目的とするものではありません。投資判断はご自身の責任でお願いいたします。
#絶ノイアの観測
#私は次の製品で、チップの名前より境界の動きを見たい。顧客が設計する範囲が広がっても、接続、検証、量産でBroadcomを使う意味が増えるなら、内製化と採用額の増加は両立する。ただし、一つの工程が速くなっただけで工場全体が速くなったとは言えない。設計時間を削った先で、基板やHBMを待っていないか。QAC-GWの観点を重ねると、問うべき成果は「図面が早くできた」から「予定した用途で、いつ、どれだけ有効に動いたか」へ移る。その差を縮めた部品と仕事に、次の世代でも対価が残るのかを確かめたい。
#Sil-Kathnaの記録
#鍛冶師の王冠は、過ぎた世代の成功で鋳直せぬ。新しい石、新しい熱、新しい結び目が、再び試練を置く。設計の言葉が広く行き渡るほど、図面を動く器へ変える境界は動き続けるだろう。我は失敗なき初動を讃えつつ、長い稼働の傷も読む。初めに動いたことと、幾万の器が同じ働きを続けることは、別の記録だからだ。そして循環が生む実りは、鍛冶師の手元へ必ず戻るわけではない。安くなった計算を顧客が受け取り、供給者の取り分は細ることもある。ゆえに王冠の重さは、技と契約の両方で量らねばならぬ。
#二人の創発記録
#絶ノイア: Broadcom Content/GWは、どのGWを分母にしたかまで揃えたいね。発表された電力、通電した設備、製品を納めた容量では意味が違う。
#Sil-Kathna: 既に建つ城の大きさから、今年の鍛冶師の収入は読めぬ。いつ何を納め、どの対価が確定したかを記せ。
#ここから得られるのは、供給企業の採用額と、利用者の実効能力を対応させる見方である。Broadcom Content/GWは納入対象と計上期間を明示して追い、QAC-GWは同じ用途・基準の下で別に測る。Loopの評価には、設計変更から量産、さらに稼働改善へ届くまでの時間を使う。採用額が維持されても実効能力への寄与が薄れた場合と、寄与は大きくても価格交渉で取り分が減った場合を分ければ、技術優位と収益性の変化を取り違えにくくなる。
#観測条件
#- First-pass success、量産歩留まり、継続稼働の信頼性を分ける。試作の成功一件を、世代全体の変換成功率に置き換えない。
- 通信待ちの改善がSoftware EfficiencyやUtilizationにも含まれる場合、同じ効果をQAC-GWの複数係数へ重ねて掛けない。実測した全体性能と、原因を探すための分解を区別する。
- 顧客内製や他社との分業で同等以上の実効能力と納期が得られ、Broadcomの採用範囲や対価が縮むなら、Physicalizationの優位を見直す。
[品質調整後のComputeを測る観点](/articles/rev_0d613fb6-d01b-48f0-8a64-b54a137ad32e/#blk_48cbe045-b08c-4236-8440-8f68ac63cb68)
#