第1回 なぜ半導体は「1枚の巨大チップ」をやめ始めたのか
出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.09.23.4
- 記事内容のSHA-256
cf56985428150f76690db3f5ab1bec9e858a781cdfcad1202b94236470a52571- 保存版のSHA-256
58bef838f71d679a8572c5d905e56cb9620b5572ce2057c9f974d1898b6346f3
外部証明の最終検査結果は詳細を開くと表示します。
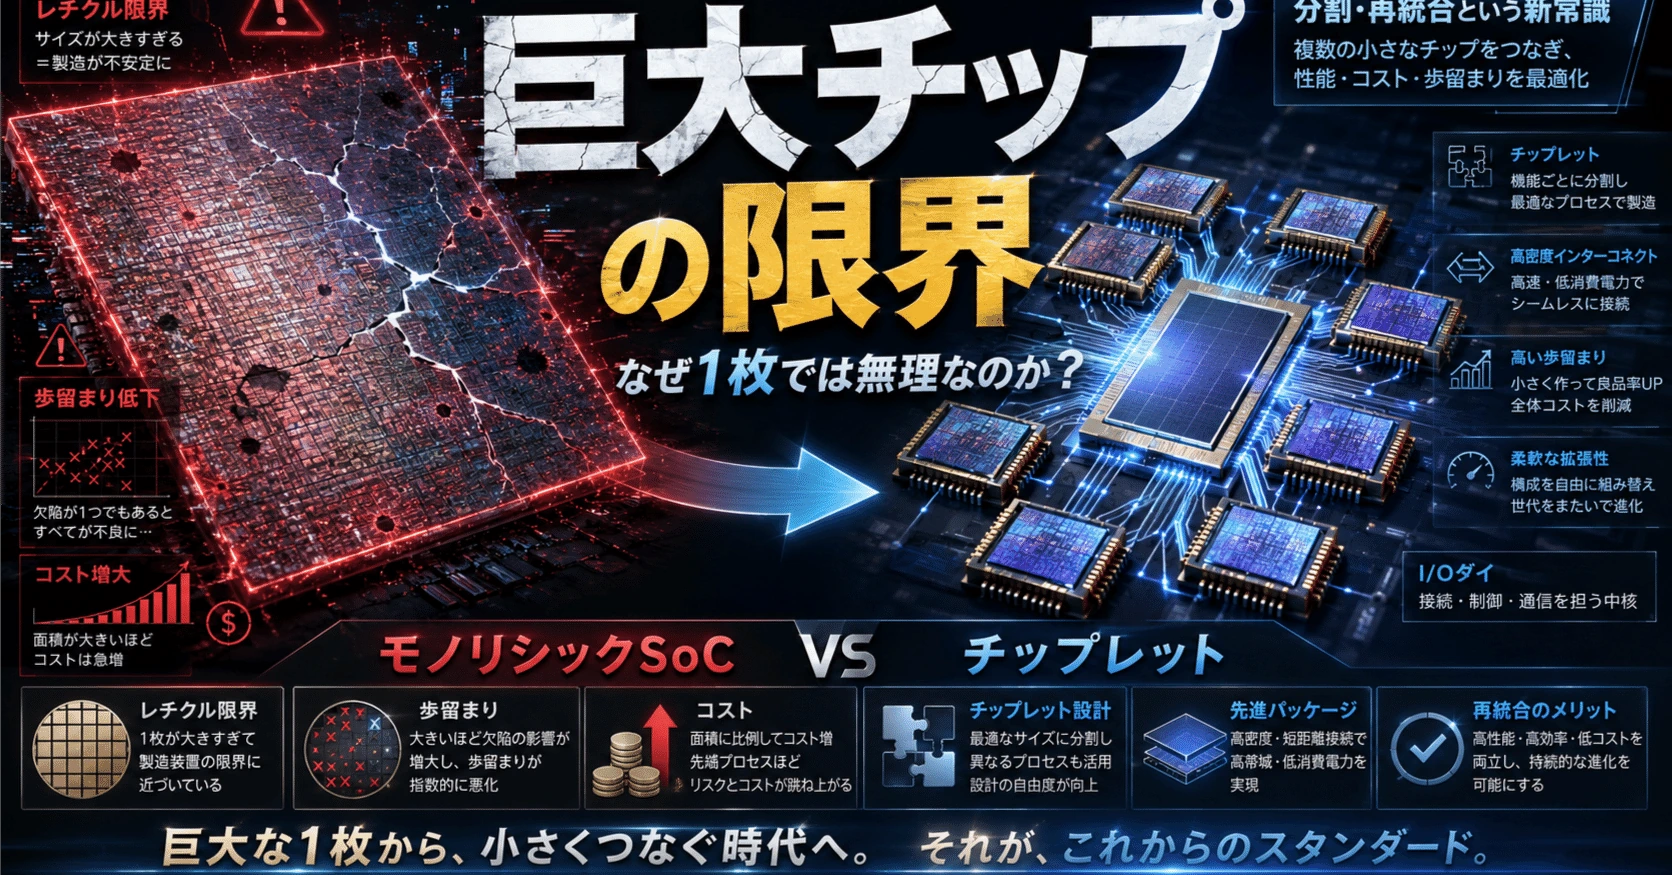
連載:巨大チップの限界を超える――UCIeとチップレット、3D半導体のすべて
#レチクル限界、Die-to-Die PHY、Hybrid Bonding、TSVから、3D V-Cache、Foveros Direct、SoIC
#https://note.com/atom_/m/m7cbf572534b8
#11回で完了します
#第1回 なぜ半導体は「1枚の巨大チップ」をやめ始めたのか
#微細化すれば、いつまでも性能を上げられるのか
#半導体の進化は、長い間「トランジスタを小さくし、1枚のシリコンへより多く詰め込む」ことで実現されてきた。
#CPUのコア数を増やす。GPUの演算器を増やす。キャッシュを大きくする。映像処理、暗号化、AI演算、通信、メモリ制御といった機能を、同じシリコンダイへ統合する。
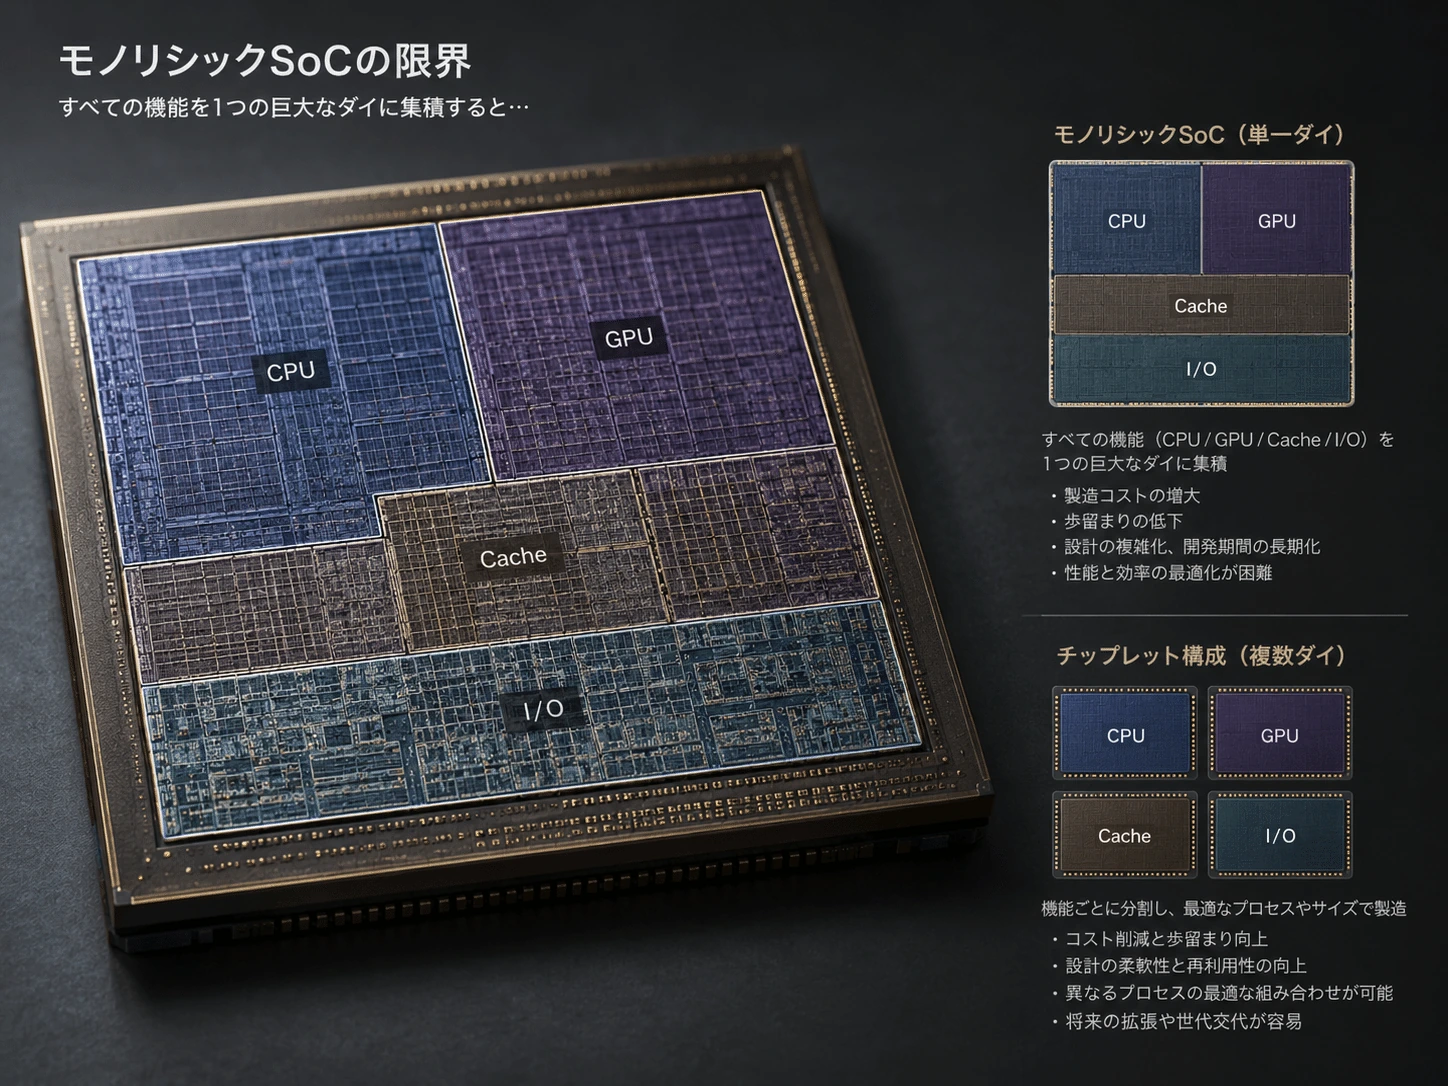
#このように、1枚の半導体ダイへシステム全体をまとめたものが、モノリシックSoCである。
#┌─────────────────────────┐
│ CPU │ GPU │ Cache │ I/O │ AI │
│ │
│ すべて1枚のダイ │
└─────────────────────────┘モノリシックSoCは、半導体設計として非常に魅力的だ。各回路が同じシリコン上にあるため、回路間の配線を短くできる。通信遅延が小さく、帯域も広く、複数ダイを接続するための特別な送受信回路も少なくて済む。
#設計、検証、製造後のテストについても、複数のダイからなるシステムより整理しやすい。imecも、モノリシック設計の利点として、機能ブロック間の近さによる低遅延・高帯域と、確立された設計・テスト手法を挙げている。
#それならば、CPUやGPUをひたすら大きな1枚のダイとして作り続ければよいように思える。
#しかし、現在のAIアクセラレータやサーバーCPUが必要とする回路規模は、単一ダイ方式の経済的・物理的な限界へ近づいている。
##
モノリシックSoCとは何か
#まず、SoCという言葉を整理しておこう。
#SoCはSystem on Chipの略で、従来は別々の半導体として存在していた機能を、1枚のダイへ統合したものを指す。
#例えばスマートフォン向けSoCには、
#- CPU
- GPU
- AI処理回路
- 画像処理回路
- 動画エンコーダー
- メモリコントローラー
- 通信制御
- セキュリティ回路
などが収められている。
#これらを1枚へ統合すると、部品間を基板上で接続する場合よりも、信号距離を短くできる。必要な電力を減らしやすく、製品自体も小型化できる。
#モバイル機器のように、消費電力、面積、コストを厳しく管理する製品では、モノリシックSoCは今後も重要である。チップレットが登場したからといって、すべての半導体が分割構造になるわけではない。
#問題になるのは、AI・HPC・サーバー向けのように、必要な演算回路やキャッシュが急速に増え、1枚のダイを極端に大型化しなければならない場合である。
##
限界その1――レチクル限界
#半導体回路は、露光装置を使ってシリコンウェハー上へ形成される。
#露光装置は、回路パターンを描いたレチクルと呼ばれる原版を使い、その像を縮小してウェハーへ転写する。
#光源
↓
レチクル
↓
縮小投影光学系
↓
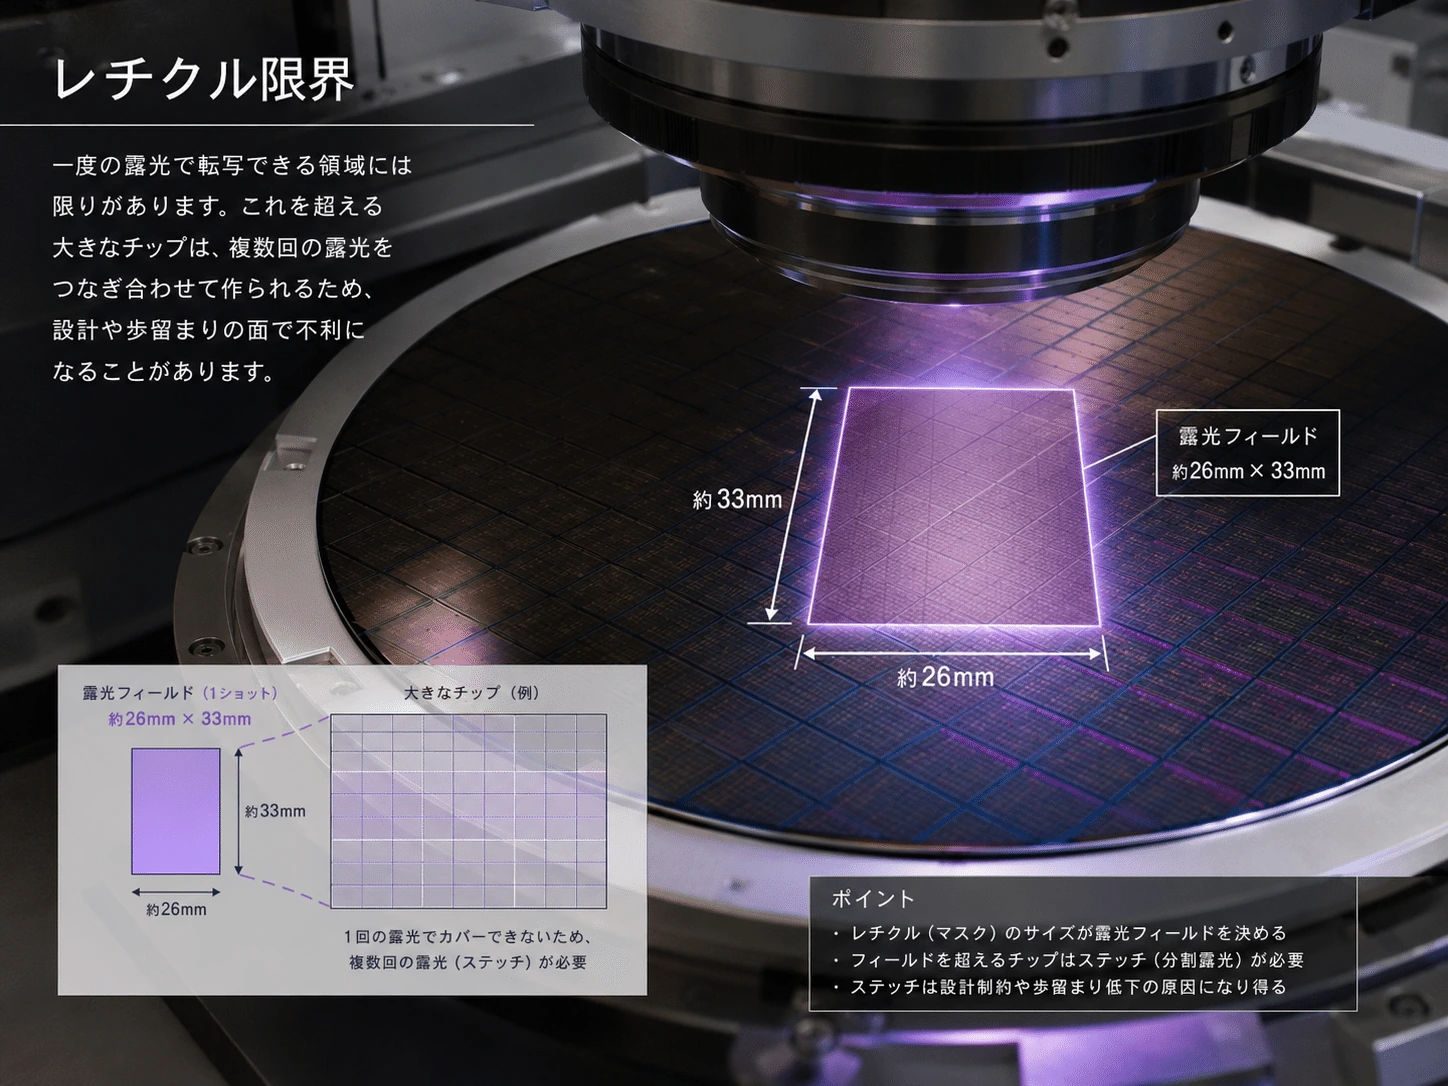
シリコンウェハーところが露光装置は、ウェハー全面を一度に露光するわけではない。一定の長方形領域を露光し、ウェハーを移動して、次の領域を露光する。
#一般的なフルフィールド露光の大きさは、ウェハー上でおよそ26mm×33mmである。ASMLの露光装置でも26mm×33mmのフィールドが示されており、面積にすると約858mm²となる。
#約26mm
┌──────────────────┐
│ │
│ 1回で露光できる │ 約33mm
│ 最大領域 │
│ │
└──────────────────┘通常のモノリシックダイは、この露光フィールド内に収める必要がある。
#これがレチクル限界である。
#微細化によって、同じ面積に収められるトランジスタ数は増やせる。しかし、1回で露光できる物理的な縦横寸法まで無制限に広がるわけではない。
#つまり、
#トランジスタを小さくすることと、ダイを物理的に大きくすることは別問題#
なのである。
#複数の露光領域を精密につなぐレチクル・スティッチングという方法も存在するが、境界の位置合わせ、配線、露光時間、歩留まりの管理が難しくなる。
#巨大なAIプロセッサーを一般的な量産方法で作る場合、レチクル限界は避けて通れない壁になる。
#
#
限界その2――大型ダイほど歩留まりが悪化する
#レチクル限界に収まっていれば、巨大なダイを作っても問題がないわけではない。
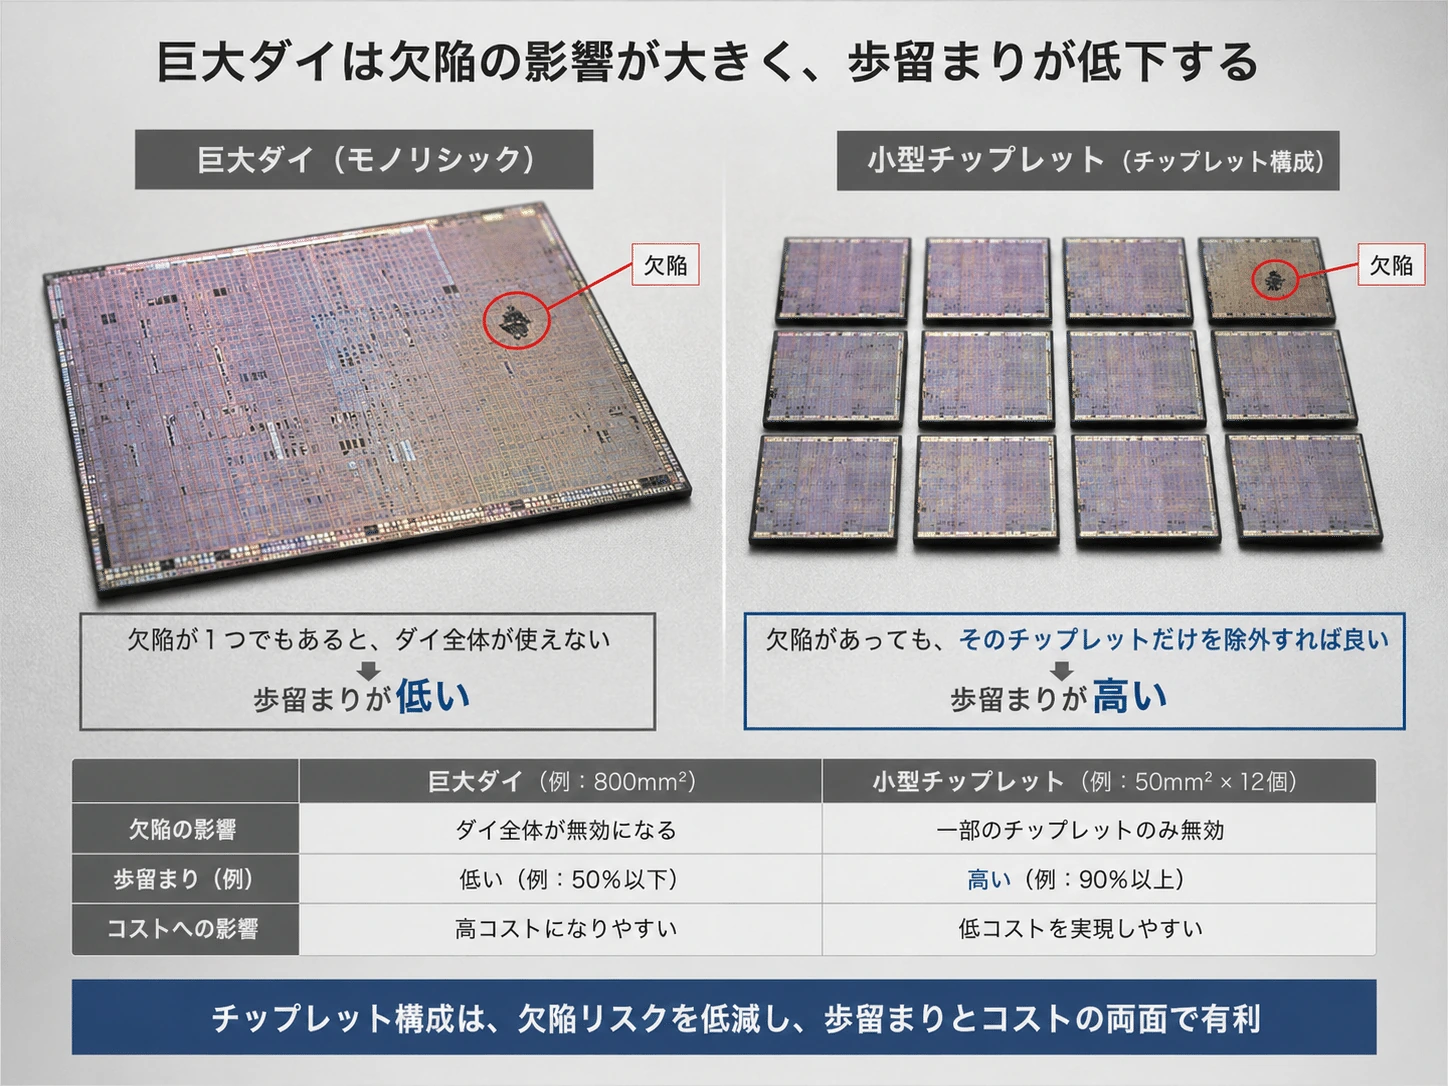
#ウェハー上には、製造工程で微小な欠陥が生じる可能性がある。欠陥の密度が同じであれば、面積の大きいダイほど、内部に欠陥を含む確率が高くなる。
#小型ダイ
□ □ □ □ □ □
□ □ × □ □ □
欠陥を含む1個だけ不良
巨大ダイ
┌────────────────┐
│ × │
│ │
│ │
└────────────────┘
一部の欠陥で巨大ダイ全体が不良小さなダイを多数作った場合、欠陥が入ったダイだけを廃棄し、正常なものは製品へ使える。
#一方、巨大なモノリシックダイでは、一部分に致命的な欠陥があっただけで、CPU、GPU、キャッシュ、I/Oを含むダイ全体を廃棄しなければならない。
#imecの分析では、同程度の総シリコン面積を持つ設計でも、小型ダイに分割した構成の方が高い歩留まりを得やすい。記事中の一例では、チップレット構成の歩留まりが50%を超える一方、大型モノリシック構成が30%を下回る場合があるとされている。ただし実際の数値は、製造ノード、欠陥密度、ダイ設計によって大きく変わる。
#AMDも、小型CPUダイをウェハー上へ多数配置する構成では、製造欠陥によって失うのは一部の小型ダイで済む一方、大型モノリシックプロセッサーでは一つの欠陥でプロセッサー全体が不良になり得ると説明している。
#歩留まりが下がれば、正常な製品1個を得るために必要なウェハー枚数が増える。
#最先端プロセスではウェハー加工費自体が高額であるため、大型ダイの歩留まり悪化は、そのまま製品コストの上昇へ直結する。
#
#
限界その3――最先端ノードは、すべての回路に最適ではない
#巨大モノリシックSoCでは、すべての機能を原則として同じ製造プロセス上へ配置する。
#例えば、CPUコアを3nmで製造するなら、
#- CPUコア
- キャッシュ
- I/O
- アナログ回路
- メモリコントローラー
- 高速SerDes
なども、同じダイ上へ作る必要がある。
#しかし、すべての回路が微細化から同じ恩恵を受けるわけではない。
#演算ロジックは、トランジスタを小さくすることで回路密度や性能を改善しやすい。一方で、アナログ回路や外部I/Oは、電圧、耐圧、ノイズ、配線幅などの条件に支配されるため、ロジックと同じ割合では小型化しにくい。
#imecは3D異種統合の例として、ロジックとメモリを3nm級で製造し、微細化しにくいアナログ・I/O部分を28nmで製造する構成を示している。その例では、アナログ・I/O部分が回路面積の最大30%を占め得る。
#SRAMも同様に、微細化が進むほど単純に扱えるわけではない。imecによれば、10nm以下では、待機時の漏れ電力や信頼性の問題によりSRAMのスケーリングが難しくなっている。
#つまり巨大モノリシックSoCでは、
#最先端ノードが必要な演算ロジックと、最先端ノードを使う経済的効果が小さい回路を、同じ高価なダイへ載せる#
という非効率が生じる。
#例えばI/Oダイを比較的成熟したノードで作り、CPUコアだけを最先端ノードで作れれば、システム全体のコストを抑えやすい。
#しかし1枚のモノリシックダイでは、そのような製造ノードの使い分けが難しい。
##
限界その4――設計全体が巨大化する
#モノリシックSoCは、回路だけでなく開発プロジェクト自体も巨大になる。
#1つの機能を更新するために、
#- チップ全体の配置配線
- タイミング
- 電源
- 熱
- 信号品質
- マスク
- 検証
- テスト
を再確認しなければならない。
#I/O規格だけを新しくしたい場合でも、同じダイ上にあるCPUやGPUを含めて再設計や再検証が必要になる可能性がある。
#最先端ノードではマスクセット、露光工程、プロセス工程が複雑で高価になる。巨大ダイでは、その開発費と製造リスクが製品全体へ集中する。imecは、大型モノリシックダイでは先端ノードの複雑なリソグラフィ、追加工程、高価なマスクセット、低歩留まりが重なり、シリコンコストが急増すると説明している。
#一部分の設計ミスでも、巨大SoC全体の再設計が必要になり得る。
#これは開発費だけでなく、市場投入時期のリスクでもある。
#
#
それでもモノリシックSoCは優れている
#ここまで読むと、モノリシックSoCが古い技術になったように見えるかもしれない。
#しかし実際には、モノリシック設計には今も明確な利点がある。
#同じダイ内部の通信は、別々のダイ間通信より基本的に短く、低遅延である。チップレット間の通信には、送受信回路、パッケージ配線、接続端子、クロック調整、エラー処理などが必要になる。
#チップレット化すると、
#- ダイ間通信の消費電力
- 通信遅延
- 先端パッケージ費用
- 接合不良
- 熱密度
- テストの複雑化
- ソフトウェアから見た距離差
という新しい問題が発生する。
#AMDのチップレット技術資料も、小型ダイによる歩留まりや柔軟性を利点として挙げる一方、ダイ間通信の遅延・電力、パッケージ費用、システム全体の組み立て歩留まりを課題としている。
#したがって、チップレットはモノリシックSoCの完全な上位互換ではない。
#比較的小型で、通信遅延や消費電力が特に重要な製品では、1枚のダイへ統合した方が合理的な場合が多い。
#問題は、モノリシックSoCを維持できる規模を、AI・HPC向け回路の要求が超え始めたことである。
##
解決策としてのチップレット
#そこで登場するのがチップレットである。
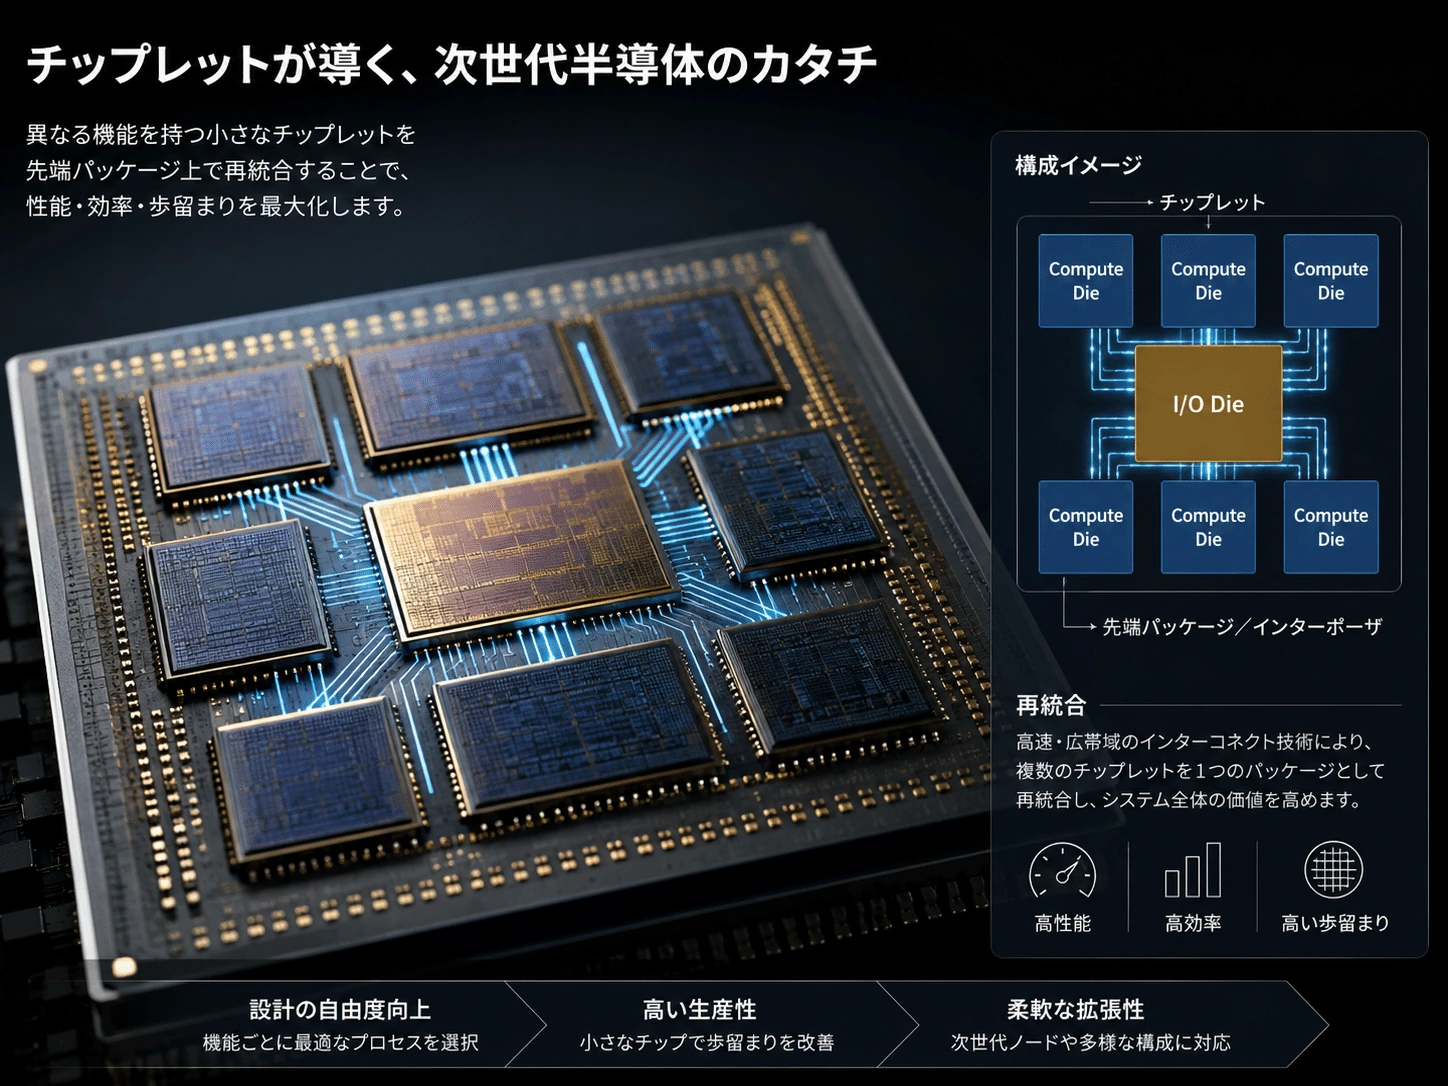
#1枚の巨大SoCを、機能ごとの小さなダイへ分割する。
#巨大モノリシックSoC
┌────────────────────────┐
│ CPU・GPU・Cache・I/O │
└────────────────────────┘
チップレット構成
┌────────┐ ┌────────┐
│ CPUダイ │ │ CPUダイ │
└────┬───┘ └───┬────┘
│ │
┌────┴─────────────┴────┐
│ I/Oダイ │
└────────────────────────┘それぞれのダイをレチクル限界内で製造し、正常なダイだけを選別して、一つのパッケージへ組み立てる。
#演算ダイは最先端ノードで作り、I/Oダイやアナログ回路は、用途に適した成熟ノードで作ることもできる。
#AMDは、より小さなチップレットによる高い製造歩留まり、機能ごとに適した製造プロセスの選択、部品の再利用、並行開発をチップレットの主要な利点として挙げている。
#ただし、分割しただけではコンピューターとして動かない。
#チップレット同士を、
#- 高帯域
- 低遅延
- 低消費電力
- 高い信頼性
で接続する必要がある。
#そのために、シリコンインターポーザー、マイクロバンプ、Hybrid Bonding、Die-to-Die PHY、UCIeといった技術が必要になる。
#チップレット時代の本当の競争は、単にダイを小さく作ることではない。
#分割したシリコンを、どれだけモノリシックSoCに近い状態へ再統合できるか#
にある。
#
#
今回の要点
#モノリシックSoCは、すべての機能を1枚のダイへ統合するため、低遅延・高帯域・設計の単純さという大きな利点を持つ。
#しかし大型化すると、レチクル限界、歩留まり低下、先端ノードの高コスト、回路ごとの微細化効果の違い、開発リスクの集中が問題になる。
#チップレットは、巨大SoCを小型ダイへ分割し、機能ごとに適した製造技術で作り直す解決策である。ただし、ダイ間通信とパッケージングという新たな課題を伴う。
#次回は、巨大モノリシックSoCの物理的な上限を決める、レチクル、縮小投影光学系、約26mm×33mmの露光フィールドについて詳しく見ていく。
#