AIインフラの次のボトルネックはどこへ移るのか
この資料の日時
元資料の日付と、その本文が公に存在した確認日時は別の記録です。
本文に含まれる語句 HBM DRAM SRAM 帯域・データ移動 先端パッケージング 光接続 電力・給電 歩留まり 基板・材料 チップレット AI推論 AIエージェント
出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.09.23.4
- 記事内容のSHA-256
cf6e381f7f8ed96158a7a2f5b79bed1788364f089e5b57878855738139f91cb8- 保存版のSHA-256
30548caf3cb15618fcfedc97ee432db35d1015d22be33502e23580722b3833ef
外部証明の最終検査結果は詳細を開くと表示します。
AIインフラの次のボトルネックはどこへ移るのか
#AIDC・HBM・SRAM・3D DRAM・Logic Base Die・Optical Fabricを一つの需給モデルで読む
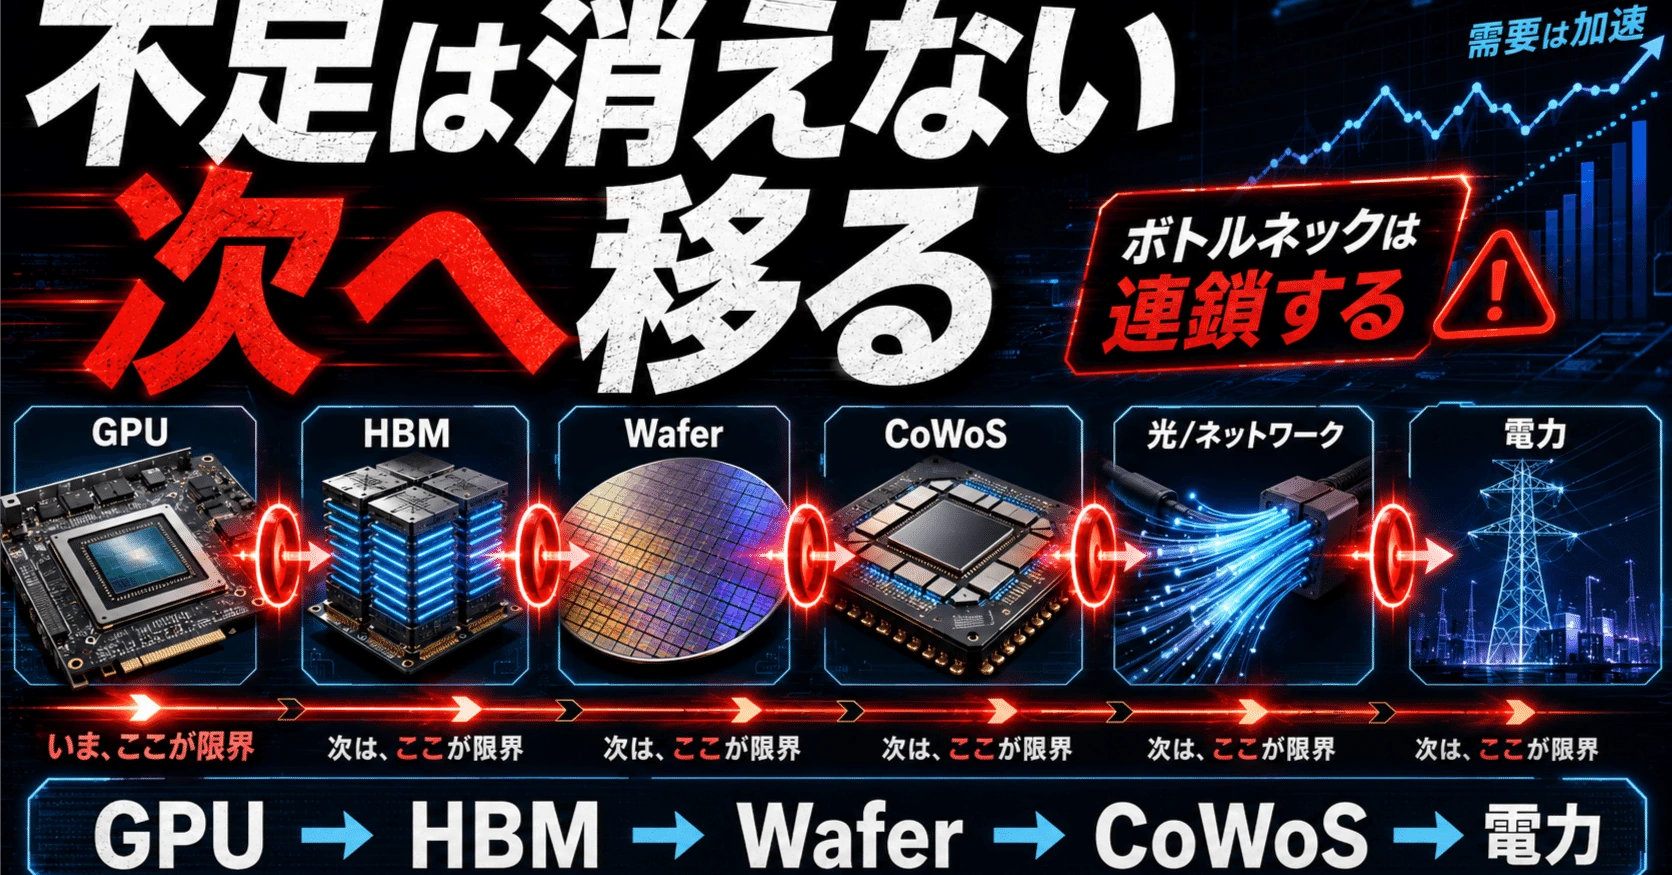
#2026年のAI Infrastructureを一つの言葉で表すなら、私は「ボトルネックの移動」だと考える。
#GPUが足りないからGPUを増やす。するとHBMが足りなくなる。HBMを増やすとDRAM waferを大量に消費し、Server DRAMやLPDDRまで締まる。HBMを節約するためSRAMを増やせば、今度はLogic Dieが大きくなり、N3/N2のGross Dies Per Wafer、つまりGDPWが落ちる。Logic waferを増やせばCoWoSが必要になり、HBM4からはHBMの底にあるLogic Base DieまでTSMCやSamsung Foundryの先端ノードを使い始める。
#さらにMemory Wallを解くため、
#W2W。
#4F² Vertical Gate。
#3D DRAM。
#DRAM-on-Logic。
#zHBM。
#PIM。
#ZAM。
#XBM。
#HBF。
#zNAND。
#CMX。
#XL-FLASH。
#CXL Memory Fabric。
#Optical Fabric。
#まで一斉に動き始めている。
#これは単なる「メモリ不足」ではない。
#限られたWafer・Packaging・Power・Networkを、何単位のUseful AI Computeへ変換できるか。#
という巨大な物理資源変換競争である。
#HBMの本当の供給量も、単純なGBやstack数ではなく、
#で測る必要がある。添付資料で整理されているように、これは概念的にはGross Dies/Wafer、Bits/Die、Die Yield、Stack Yield、Package Yieldの掛け算で決まる。
#一方AIDCも単純なGWでは測れない。同じ1GWでも、最新Accelerator、大量HBM、高速Fabric、高いUtilization、Cloud販売能力を持つ1GWと、旧GPUを低稼働率で並べた1GWでは生産できる「知能」が違う。
#この二つは同じ問題へ収束し始めている。
##
最初に「確信度」の定義
#本稿では各分析結果に以下の確信度を付ける。
#これは「発生確率」ではなく、現在入手できるEvidenceの強さである。
##
1.最初に全体像――2026年のAI Infrastructureは何が足りないのか
#重要な結論を先に並べる。
##
2.AIDCの現在地――需要はすでに約60GW
#McKinseyの2026年6月時点のモデルでは、現在のAI Data Center需要はおおむね、
#Training:
#Inference:
#合計、
#約62GW
#である。(McKinsey & Company)
#添付資料では公開情報の幅を考慮し、現在のAI workloadを約55~62GWとしている。
#重要なのは、この数字を、
#「世界には60GWの高品質AI Factoryが存在する」#
と読んではいけないことである。
#60GWは基本的にPower Demandの尺度だ。
#GPU世代。
#HBM量。
#Network。
#Contiguous Cluster size。
#Utilization。
#Scheduler。
#Cloudability。
#が違えば、同じ1GWでも生産できるAI outputは全く違う。
#確信度:A
##
3.そこで独自指標①――QAC-GW
#私はAIDCを見るとき、
#QAC-GW
#Quality-Adjusted Compute GW
#を使う。
#より完全な式にすると、
#と考える。
#PCEは「確保した電力のうち、実際にIT Computeへ構造的に渡せる比率」であり、Uptime InstituteもAI Data Center時代にPUEだけでは足りないとして紹介している。
#さらにMemory Feed Factorを入れる理由は単純だ。
#GPUが100の演算能力を持っていても、
#HBM不足。
#Memory stall。
#KV Cache miss。
#PCIe/CXL bottleneck。
#が起きれば100を使えない。
#つまりAI FactoryもMemoryと同様、
#InputをGood Outputへ何%変換できるか#
を見るべきなのである。
#添付資料の現在モデルでは、約55~62GWのPhysical AI workloadを品質補正すると、
#約35~45 QAC-GW
#中央値約40 QAC-GW程度と推定している。これは市場統計ではなく独自推計である。
#確信度:C
##
4.2030年需要――219GWのうち155.5GWがAI
#McKinseyの2026年モデルでは世界Data Center Demandは、
#2025:
#から、
#2030:
#へ増える。
#内訳は、
#したがって2030年AI workloadは、
#になる。(McKinsey & Company)
#現在の55~62GWから、
#約2.5倍
#である。
#しかもInferenceが特に速い。
#20.9→93.3GWなので、
#である。
#ここがSRAM、KV Cache、HBF、CMX、Memory Poolが急浮上している背景でもある。
#確信度:A
##
5.2030年の「キャパ」は何GWなのか
#ここはDemandほど簡単ではない。
#「2030年に世界で何GWのAI Data Centerが実際にOnlineになるか」という監査済みの単一統計は存在しない。
#むしろ重要なのは、
#Headline Pipeline ≠ Online Capacity
#である。
#Uptime Instituteが2026年に追跡した100MW超の巨大Data Center proposalでは、2025年だけで計画電力は181GWを超えた。しかしUptime Intelligenceは、
#建設される:約50%。
#さらに計画通りのPowerを達成:約50%。
#したがって全計画電力のうち実際にActiveになるのは、
#約25%
#程度とみている。(Uptime Intelligence)
#一方、Synergy Researchによれば2025年末時点でHyperscale operatorは世界Data Center Capacityの48%を占め、2031年には67%へ上がる見通し。既知のfuture pipelineだけでも約800 hyperscale DCがあり、Hyperscale capacityは3年程度で倍増すると予想されている。(Synergy Research Group)
#つまり、
#資金とAnnouncementは大量にある。しかしGrid、Transformer、Cooling、GPU、HBM、Networking、ConstructionによってPhysical conversionが削られる。#
#
6.2030年QACを逆算すると約110~125GW
#仮に2030年に155.5GWのAI workloadを物理的に供給できたとする。
#現在のPhysical GW→QAC conversionを60~70%程度、2030年は、
#Liquid Cooling。
#800VDC。
#Rubin/Feynman世代。
#CPO。
#Memory hierarchy。
#Scheduler改善。
#Hyperscaler consolidation。
#などによって70~80%へ改善できると仮定する。
#すると、
#したがって、
#2030年に必要・供給されるUseful AI Computeは約110~125 QAC-GW
#というのが一つのBase scenarioになる。
#現在約35~45 QAC-GWなら、
#Useful Compute Capacityも約3倍
#必要になる。
#ただしこれは独自モデルである。
#確信度:C
##
7.重要なのは「AIDCが余るか」ではなく、何が余るか
#2030年にData Center総量が大きく増えれば、Commodity Computeが余ることは十分ある。
#しかし同時に、
#Frontier Training-ready GW。
#Premium Low-latency Inference GW。
#Cloud-Sellable GW。
#は不足できる。
#添付資料でも、
#「Powerはある、DCもある、GPUもある。しかし最新Accelerator、HBM、高速Fabric、Cloud-ready Schedulerを揃えた高級AIDCだけが足りない」
#という構造を整理している。
#したがって独自指標として、
#FR-GW
#Frontier-Ready GW。
#CS-GW
#Cloud-Sellable GW。
#も重要になる。
#Inferenceならさらに、
#Goodput/MW
#つまり、
#一定TTFT、TPS/User、Reliabilityを守った状態で何tokens/sec/MW出せるか#
を見る。
#経済まで見るなら、
#Revenue/GW。
#NOPAT/GW。
#FCF/GW。
#へ進む。
#確信度:B(概念)/ C(数量化)
##
8.次にMemory Fab――2027年はかなり危険な谷になる
#AI需要が急増してもMemory FabはSoftwareのようには増えない。
#Fab建設。
#Tool install。
#Process qualification。
#Yield ramp。
#Customer qualification。
#まで必要だからだ。
#SK hynixは2026年6月、今後5年間でwafer capacityを倍増させる方針を示し、同時にMemory supply bottleneckが2030年まで続く可能性を警告した。(Reuters)
#TrendForceの供給網推定では、SK hynixの現在DRAM Capacityは約55万WPMで、2030~31年に約100万WPMを目指している。
#Yongin Fab 1:
#程度を2030年前半までに追加。
#M15X:
#2026 H2 約40K WPM
#↓
#2027 約80K WPM
#へ拡大する計画とされる。(TrendForce)
#これは巨大だが、逆に言えば、
#2026~27年需要を2030年Fabで解くことはできない。
##
9.Micronは2027・2028・2030の三段階
#Micronは米国で非常に明確なcapacity roadmapを持つ。
#Idaho Fab 1:
#2027年半ば First Wafer
#Idaho Fab 2:
#2028年末 operational
#New York:
#2030年以降のSupply
#である。Micronは2026年7月、米国内製造・R&D投資計画を2035年までに2500億ドル超へ増額した。(Micron Investors)
#したがってMemory supplyの時間軸は、
#2026
#既存FabのTech Migrationとyield improvement。
#2027
#M15X、Idaho 1などが徐々に効く。
#2028
#新Fab供給が明確に増える最初の年。
#2030
#YonginやNew Yorkを含む本格的な巨大Supply wave。
#と見るのが自然である。
#確信度:A~B
##
10.しかし「Wafer Capacityが2倍」でもBit Supplyが2倍になるとは限らない
#ここでHBM特有の問題が出る。
#HBMは通常DRAMよりWaferを激しく食う。
#TrendForceは2027年末に、
#HBM:
#DRAM Wafer Input 約30%
#に対し、
#HBM Bit Supply:
#約13%
#と予測している。
#これは非常に重要な数字である。
#100枚のWaferを想像すると、
#HBM:
#Conventional DRAM:
#になる。
#1Wafer当たりでは、
#対して、
#相対比は、
#したがって、
#HBMは通常DRAMの約35%のBit/Wafer
#というaggregate structureになる。
#逆数は、
#なので、
#同じBit量を供給するのに約2.9倍のWafer Capacityを使う構造
#である。
#これは「HBM yieldが35%」という意味ではない。
#Die Size。
#TSV。
#Peripheral。
#Node。
#Stacking。
#Product Mix。
#Yield。
#などを全部合わせた産業全体のconversion efficiencyだ。
#確信度:A(30/13)/ B(2.87倍という本稿正規化)
##
11.独自指標②――WBD:Wafer-to-Bit Dislocation
#そこで私は、
#WBD
#Wafer-to-Bit Dislocation
#を使いたい。
#2027 HBMなら、
#である。
#これは単純な「Wafer shareに対してBit shareがどれだけ小さいか」を示す。
#さらにConventional DRAMに対して正規化した、
#Relative WBD
#なら、
#になる。
#この数字が下がるなら、
#4F²。
#3D DRAM。
#Yield。
#Die shrink。
#などによってHBM conversion efficiencyが改善している。
#需要が落ちたのか、製造効率が上がったのかを区別しやすくなる。
#確信度:B
##
12.「12Hiは8Hiより大容量」と「Wafer効率が良い」は別
#ここはHBMを見るうえで最も重要なポイントの一つである。
#同じ3GB DRAM dieを使うと仮定する。
#8Hi:
#12Hi:
#確かに12Hiは、
#+50%容量。
#しかし使うDRAM dieも、
#で、
#+50%。
#したがって同じdie、同じyieldなら、
#Bits/Waferは改善しない。
#12Hiが改善するのは主に、
#GB/stack。
#GB/interposer area。
#GB/package footprint。
#である。
#つまり、
#Package Efficiency ≠ DRAM Wafer Efficiency
#である。
#確信度:A
##
13.GDPWを入れるとさらに重要になる
#300mm waferのGross Dies Per Waferを概算するなら、
#と置ける。
#例えばモデル上、
#HBM3E相当:
#なら、
#HBM4相当:
#なら、
#になる。
#Die Area:
#に対して、
#GDPW:
#約−14.8%。
#である。
#この120.5/140.2mm²自体はanalyst/model inputであり、メーカー公式の実量産die sizeではないため注意が必要だ。
#確信度:C(面積仮定)/ A(面積が増えるとGDPWが落ちる物理関係)
##
14.Die大型化+8Hi→12HiならStack/Waferは約43%減る
#120.5mm²・8Hiなら、
#140.2mm²・12Hiなら、
#である。
#したがって、
#つまり同じWaferから取れるStack数は、
#約43%減。
#逆に1stack当たりWafer burdenは、
#約1.76倍
#になる。
#これは、
#という、
#Stack Penalty × Die Penalty
#である。
#さらに8Hi最終yield 95%、12Hi 90%と置けば、
#まで広がる。
#ただしこれはSensitivity Modelであり実際のHBM4歩留まりではない。
#確信度:C
##
15.HBM4から「Memory Fabだけ見ればよい」が終わった
#HBM4の構造を単純化すると、
#DRAM Core Die
DRAM Core Die
DRAM Core Die
...
DRAM Core Die
──────────────
Logic Base Die
──────────────
Interposer
──────────────
GPU / XPUになる。
#Logic Base Dieはただの支持基板ではない。
#PHY。
#I/O。
#Clock distribution。
#Command/Address。
#Power control。
#Test/BIST。
#Repair。
#TSV termination。
#などを持つ。
#添付資料では「HBMの底に小さなSoCを貼る方向」と表現されている。
#HBM4ではこれが一段重要になる。
##
16.なぜHBM4 Base Dieに先端Logicが必要なのか
#Samsung HBM4は、
#1c DRAM。
#4nm Logic Base Die。
#2,048 I/O pins。
#最大13Gbps/pin。
#最大約3.3TB/s/stack。
#という構成で量産されている。(Samsung Semiconductor Global)
#I/OはHBM3E世代の1,024から、
#へ倍増した。
#理論帯域は、
#になる。
#この2,048本を高周波で駆動しながら、
#Clock skew。
#Jitter。
#Signal Integrity。
#PDN。
#Thermal。
#Control。
#を処理するには、単純なDRAM peripheral processだけではなくPPAを最適化したLogic processが必要になる。
#DRAM Fabが追うのは、
#Cost/bit。
#Logic Foundryが追うのは、
#Performance × Power × Area。
#であり、同じEUVを使っていても製造技術は別物である。
#確信度:A
##
17.SK hynix・Samsung・MicronでBase Die戦略も違う
#Samsungは垂直統合できる。
#Memory Fab:
#DRAM Core Die。
#Samsung Foundry:
#4nm Base Die。
#Advanced Packaging:
#Integration。
#という構造だ。
#SK hynixはHBM3Eまでは独自Base Dieだったが、HBM4からTSMC advanced logic processを採用し、CoWoS integrationまで共同最適化する。(SK hynix Newsroom)
#MicronもHBM4では自社Advanced CMOS Base Dieを活用する一方、HBM4EではTSMCとの連携を強める構造が示されている。添付資料でもこのSupplier divergenceが整理されている。
#つまりHBM4以降は、
#DRAM Supplier × Foundry × Packaging
#の三者連合競争になる。
##
18.Logic Base Die自身もN3/N2 Capacityを食い始める
#HBM stackが1億個必要なら、
#Base Dieも基本的には、
#1億個
#必要になる。
#例えばストレスモデルとして、
#NVIDIA 500万GPU × 8 stacks。
#AMD 100万GPU × 12。
#Google 100万TPU × 8。
#とすると、
#Base Dies。
#仮にGood 423dies/waferなら、
#つまり、
#になる。
#AWS、Meta、Microsoft等まで加え、HBM4E/HBM5世代のBase Die world demandを、
#20~40K WSPM
#と見るのが一つのStress Rangeになる。これは企業Guidanceではなく添付資料の需給モデルである。
#HBM5 Base Dieが2nm方向へ行けば、
#Smartphone SoC。
#CPU。
#GPU。
#AI ASIC。
#Networking。
#Base Die。
#が同じscarce leading-edge Foundry capacityを奪い合う。
#確信度:C
##
19.独自指標③――LBD-WSPM
#そこでBase Dieについて、
#LBD-WSPM
#Logic Base Die Wafer Starts Per Month
#を追う。
#である。
#HBM市場を見る際、
#DRAM waferだけを追う時代は終わりつつある。
#必要なのは、
#Core DRAM WSPM
#+
#Logic Base Die WSPM
#+
#CoWoS equivalent
#である。
#これが「HBMはMemoryなのにFoundry shortageを作る」理由になる。
#確信度:B~C
##
20.4F² Vertical Gate――30% Wafer / 13% Bit問題への最も直接的な回答
#現在一般的なDRAM Cellは6F²系。
#SK hynixは長期Roadmapで、
#4F² Vertical Gate
#とWafer Bondingを提示している。(SK hynix Newsroom)
#理想化すればCell Areaは、
#なので、
#+50% Cell Density
#である。
#さらにCircuit/Peripheral部分をCell arrayの下へ移せれば、2D平面で両者が横に並んでいた面積を減らせる。
#これは30%→13%問題へ非常に直接効く。
#しかし、
#Cell Density +50% ≠ Good Bits/Wafer +50%#
である。
#理由は、
#Peripheral。
#Redundancy。
#Repair。
#Alignment。
#Bonding。
#Yield。
#である。
#確信度:B
##
21.W2Wの最大問題――Yieldが掛け算になる
#Wafer-to-Wafer bondingでは、
#Cell Wafer。
#Logic Wafer。
#を別々に作り、bondする。
#理論的には非常に合理的だ。
#Cell Wafer:
#Memory Density最優先。
#Logic Wafer:
#Sense Amp。
#Decoder。
#ECC。
#Repair。
#I/O。
#を最適化できる。
#しかしDelivered Yieldは概念的に、
#になる。
#例えば全部98%でも5工程なら、
#である。
#Wafer-to-WaferではDie-to-WaferのようにKnown-Good-Dieを自由に選別して配置しにくい。
#Cell waferの座標Xが良品でも、Logic waferの座標Xが不良なら、bond後のsite Xが失われる可能性がある。
#必要になるのは、
#Alignment。
#Particle control。
#Surface cleanliness。
#Void control。
#Warpage。
#Overlay。
#Repair mapping。
#である。
#SK hynix自身も2026年、Vertical Gate+wafer bondingについてmass manufacturabilityとreliabilityを主要課題としている。(SK hynix Newsroom)
#確信度:A(課題)/ C(将来歩留まり)
##
22.3D DRAM――SRAMとHBMの間に新しいTierを作る
#DRAMはSRAMほど速くない。
#しかしSRAMより圧倒的に高密度だ。
#そこでDRAMをfar-off-chipへ置くのではなく、
#Computeの真上・真下へ積む
#というのが3D DRAMの考え方になる。
#概念的には、
#SRAM
超低Latency
数百MB~数GB
↓
3D DRAM
数十~数百GB
↓
HBM / DDR
↓
HBF / Flashという階層になる。
#d-Matrixの3DIMCではすでにPavehawk test siliconが動作し、次世代Raptorへ技術を組み込む方針を示している。
#同社公称目標は、
#20TB/s / stack
#0.3~0.4pJ/bit
#級である。これはvendor target/validationであり、量産された第三者Benchmarkではない。
#確信度:B(技術存在)/ C(量産経済性)
##
23.3D DRAMの最大問題もYield
#3D DRAMでは、
#DRAM Die Yield
#×
#Logic Yield
#×
#Bonding Yield
#×
#Layer Yield
#×
#Package Yield
#になる。添付資料もこのmultiplicative yieldを整理している。
#さらに問題なのは、
#Value-at-Risk per Defect
#が大きくなることだ。
#DRAM waferを作る。
#Testする。
#薄化する。
#Bondする。
#さらにLogicへBondする。
#Packageする。
#最後の工程で不良になるほど、それまで投入した価値をまとめて失う。
#だから「Prototypeが動く」と、
#年間1000万stackを高Yieldで作る
#は全く別の技術レベルである。
#確信度:A
##
24.Rebellionsが3D SRAMから3D DRAMへ方向転換した意味
#Rebellionsはこの問題を非常に象徴的に示している。
#Rebel100は、
#512MB on-chip SRAM。
#192TB/s SRAM bandwidth。
#144GB HBM3E。
#4.8TB/s HBM bandwidth。
#を持つ。(Rebellions)
#つまりSRAMは非常に速い。
#しかしHBMは容量で、
#約281倍
#大きい。
#Rebellions CEOは、当初検討していた3D SRAMから、SK hynixとSamsungとの3D-stacked DRAM方向へ切り替えたと説明している。Custom HBMのLogic Base Dieへfast token decoding logicを入れる可能性も検討している。
#これは非常に合理的だ。
#SRAMは速い。
#だが1GB、2GB、4GBへ増やすとSilicon areaが大きすぎる。
#そこで、
#SRAMはHot Tier。
#3D DRAM/HBMはCapacity Tier。
#へ役割分担する。
#確信度:B
##
25.DRAM-on-Logic――MemoryとComputeの境界そのものを消す
#SK hynixは2026年TSMC Symposiumで、
#3D Stacked DRAM on Logic
#を提示した。
#DRAMをSoCなどのLogic semiconductorへ直接積み、
#I/O数を増やす。
#Latencyを減らす。
#Powerを減らす。
#Space efficiencyを改善する。
#というものだ。(SK hynix Newsroom)
#ここがHBMの延長として重要である。
#HBM4ではLogic Base Dieへ、
#PHY。
#Control。
#Test。
#が入った。
#次に、
#Prefetch。
#Compression。
#KV movement。
#Decode assistance。
#Near-memory compute。
#まで入るなら、
#MemoryとProcessorの境界そのものが薄くなる。
#これはPIMとも連続した方向である。
#確信度:B
##
26.PIM――「DataをProcessorへ運ぶ」前提そのものを変える
#Processing-in-Memoryは、
#MemoryからGPUへDataを運ぶ
#のではなく、
#Memory側で一部演算する
#思想である。
#Samsungは現在のroadmapにもLPDDR5X-PIMを載せており、
#16GB。
#最大4.8Tbps。
#1 PIM / Bank。
#FP16/8、INT16/8/4。
#GEMV。
#を示している。(Samsung Semiconductor Global)
#PIMが特に効くのは、
#Memory bandwidth-boundな演算。
#低Arithmetic Intensity。
#Vector/Matrix movement。
#などだ。
#ただしCUDA/GPUの汎用Computeすべてを置換する技術ではない。
#Programming model。
#Memory consistency。
#Thermal。
#Area overhead。
#Software ecosystem。
#があるからだ。
#最も現実的なのは、
#Memory-side acceleration
#としてData movementを減らす方向だろう。
#確信度:B
##
27.ZAM――2030年を狙う最も具体的な次世代候補の一つ
#SAIMEMORYとIntelはZ-Angle Memory、ZAMを共同開発している。
#公式目標は、
#FY2027:
#Prototype。
#つまり、
#2028年3月まで。
#FY2029:
#Commercialization。
#つまり、
#2030年3月まで。
#である。(SAIMEMORY株式会社)
#IntelのNext Generation DRAM Bondingで培われた技術を基礎に、
#Vertical Build。
#Inductive I/O。
#などを使い、高容量・高Bandwidth・低Powerを目指す。
#ただし、
#Commercialization ≠ Hyperscaler Volume Production
#である。
#2030年に製品が出ても、その後にYield RampとCustomer Qualificationがある。
#確信度:A(公式目標)/ C(2030大規模Supply)
##
28.XBM――面白いが、まだSupply Modelへ入れてはいけない
#Intel関連で注目されたXBMのPatent applicationでは、
#Backend 1T1C DRAM。
#0.5~5GB/die。
#UCIe 32GT/s。
#Base Die。
#TSV gutter。
#8Hi/16Hi構成。
#Redundancy。
#などが記述されている。(Justia Patents)
#技術的には、
#HBMの広帯域。
#UCIeのchiplet connectivity。
#backend memory integration。
#を組み合わせる興味深いarchitectureである。
#しかし、
#Patent ≠ Product Roadmap。
#2030年Supply modelへXBMを数百万unitで入れるのは現在は早すぎる。添付資料でもXBMはPatent stageとして整理されている。
#確信度:D
##
29.zHBM――非常に魅力的だがConcept Model
#SamsungがFMS 2026で公開したzHBMは、
#従来の、
#GPU ─ HBMというside-by-side配置ではなく、
#Memory
↓
Interlayer
↓
AI Acceleratorのような3D方向へ進むConceptである。
#SamsungのConcept targetでは、
#HBM5比最大8倍級のsystem performance。
#最大3倍のenergy efficiency。
#Thermal Resistanceを半分以下。
#Custom IPをinterlayerへ配置。
#といった方向を示している。(Samsung Semiconductor Global)
#重要なのは、
#これはConcept Model
#であり、量産時期やyield、costは公開されていないことだ。
#Hybrid Cu bonding。
#Thermal。
#Warpage。
#Repair。
#Known-Good-Die。
#Test access。
#がすべて難しくなる。
#したがって2030年のBase Supplyへは入れない。
#確信度:A(Concept発表)/ D(量産時期)
##
30.zNAND-O――NANDも3D Packageへ進む
#SamsungのzNAND-Oは、V-NAND自体のvertical cell structureに加え、
#4Hi / 8Hi NAND Dieを3D Package
#する構想で、TSVを使い、Edge AIなどの高性能Data loadingを狙う。(Samsung Semiconductor Global)
#Samsungはさらに400層超のV10 Bonding V-NANDを公開し、V9比約58%のdensity improvementを掲げている。(Samsung Semiconductor Global)
#ここでも、
#Cell stacking。
#Wafer bonding。
#Die stacking。
#が同時に進む。
#NANDまで「ただ層数を増やす」から、
#Cell architecture × Wafer Bonding × Package stacking
#へ移る。
#確信度:B
##
31.HBF――HBMを置換せず、HBMに置く必要があるDataを減らす
#SK hynixとSandiskは2026年8月、OCPでHBFの最初のopen standard specificationを公開した。
#8Hi / 16Hi NAND。
#最大512GB。
#Bandwidth:
#約0.4~3TB/s。
#UCIe接続。
#Google、Tenstorrentなどもecosystemに参加している。(SK hynix Newsroom)
#重要なのは、
#HBF:
#に対し、
#Rubin級HBM:
#20TB/s超
#であること。
#つまりHBFはHot KVやAttention Inner Loopを置換するものではない。
#向いているのは、
#Inactive MoE Experts。
#Weights。
#Warm KV。
#Cold/Warm Context。
#である。
#要するに、
#HBM需要をゼロにするのではなく、HBMの容量成長率を抑える。
#これがHBFの価値だ。
#確信度:A(仕様)/ B(採用拡大)
##
32.CMX――KV CacheをGPUの外へ出す
#NVIDIAも全DataをHBMへ置くことを諦め始めている。
#BlueField-4を使うContext Memory Storage Platformでは、KV Cacheをcluster-levelで共有し、GPU memoryを拡張する新しいContext Tierを作る。
#DOCA。
#NIXL。
#Dynamo。
#Spectrum-X。
#を組み合わせ、GPU node間でKV Cacheを共有・再利用する。
#NVIDIAは従来Storage比最大5倍TPS・最大5倍Power Efficiencyというvendor claimを掲げている。(NVIDIA Newsroom)
#本質は性能倍率より、
#KV Cacheを高価なHBMへ永続保持しない#
ことである。
#確信度:A(Platform)/ B(実運用効果)
##
33.XL-FLASH――FlashをGPU Memoryの最外周へ持ってくる
#KioxiaのGP1 Seriesは、
#PCIe 6.0。
#第2世代XL-FLASH。
#GPU Direct Access。
#最大10M random read IOPS。
#を持ち、2026年末までに限定customerへsample予定。(KIOXIA Corporation)
#さらに将来、
#100M IOPS
#を目指すroadmapも示している。(KIOXIA Corporation)
#これはHBMの代わりではない。
#FlashはLatencyが桁違いに高い。
#しかしPersistent Context。
#Weight。
#Cold KV。
#Model artifacts。
#をGPUから直接アクセス可能にできれば、
#HBM/DRAMに置く必要のあるworking setを小さくできる。
#確信度:A(10M IOPS product/sample)/ C(100M IOPS product)
##
34.Enfabrica――HBMの外へ18TBのDDRをぶら下げる
#Enfabrica EMFASYSは別の答えを出している。
#3.2Tbps ACF SuperNIC。
#最大144 CXL memory lanes。
#400G/800G RDMA Ethernet。
#最大18TB DDR5 pool。
#将来28TB。
#18+ memory channels。
#Read latency:
#microsecond級。
#という構造だ。(Enfabrica)
#HBMはnanosecond級。
#だから完全代替にはならない。
#しかし、
#Large Context。
#Agentic workloads。
#Expert-parallel。
#Activation offload。
#Optimizer state。
#などでは使える。
#これも同じ思想だ。
#HBMを速くするのではなく、HBMの外側を賢くする。
#確信度:A(製品仕様)/ B(大規模普及)
##
35.Optical Fabric――Memory Wallを消さないが、距離のコストを下げる
#AI Factoryが100K、1M GPUへ進むとElectric networkingだけではPowerとReliabilityが厳しくなる。
#NVIDIAのSpectrum-X Ethernet Photonicsは、Rubin世代でCPOを実際にproductionへ持ち込み、
#200G SerDes。
#5× network power efficiency。
#5× longer sustained AI uptime。
#10× resiliency級のvendor claim。
#を掲げている。(NVIDIA Newsroom)
#しかしOpticsで物理法則は消えない。
#Propagation delay。
#Serialization。
#Switching。
#Queue。
#Congestion。
#Memory consistency。
#Data placement。
#は残る。
#だからOptical Fabricの意味は、
#遠くに置いたMemory/Computeへ到達するEnergy/bitを下げる
#ことだ。
#HBMを遠隔DDRに変える魔法ではない。
#Google側でもTPU、Apollo Optical Circuit Switch、800G+ opticsが一つのsystemとして統合され、TrendForceは2026年800G+ penetrationを60%超と予測し、Laser/MEMS yieldをSupply Chain bottleneckの一つとしている。(TrendForce)
#確信度:A~B
##
36.SRAM-rich化――次のMemory shortageは「SRAM価格」では見えない
#ここからSRAMが重要になる。
#Cerebras。
#Groq。
#Rebellions。
#Google TPU 8i。
#Maia。
#MI455X。
#などを見ると、Inference時代にon-chip memoryを増やす流れがはっきりしている。
#Google TPU 8iは公式に、
#384MB on-chip SRAM
#を搭載し、前世代比3倍。
#HBMも288GBへ増やしている。Google自身がMemory Wallを破るため、active working setをon-chipへ保持すると説明している。(blog.google)
#AMD MI455Xも、
#192MB L2。
#432GB HBM4。
#12 HBM stacks。
#を持つ。(AMD)
#これはSRAMとHBMがZero-Sumではない証拠でもある。
#SRAMも増える。HBMも増える。
##
37.SRAM不足はDRAM不足と全く違う
#Embedded SRAMはMemory vendorから独立chipとして買うものではない。
#Logic Waferの中へ、
#Compute。
#SRAM。
#NoC。
#DMA。
#SerDes。
#を一緒に作る。
#したがって、
#HBM shortage:
#DRAM Wafer + Stacking + Packaging
#として見える。
#SRAM-rich shortage:
#Advanced Logic Wafer Area + Large Die Yield
#として見える。
#つまり将来、
#「SRAM価格が高騰」
#というニュースが出なくても、
#TSMC N2がfull。
#AI dieが800mm²超。
#GDPWが低下。
#Memory compiler demand増。
#なら、
#実質的なSRAM scarcity
#が起きている可能性がある。
#確信度:A
##
38.SRAM Scaling Wall
#SRAMには厄介な特徴がある。
#Logic transistorほど速く縮まない。
#TSMC N5のminimum SRAM bitcell:
#N2で公開されたhigh-density SRAMも、
#である。
#DTCOなどによってmacro densityは38.1Mbit/mm²まで改善しているが、Logic density scalingとは速度が違う。
#つまり、
#ComputeがNode migrationで小さくなっても、SRAMを2倍載せればDieが再び大きくなる。#
#
39.500MB SRAMだけで100mm²級
#N2の38.1Mbit/mm²を理論的なarray densityとして使えば、
#500MB:
#1GB:
#2GB:
#である。
#実際には、
#ECC。
#Peripheral。
#Routing。
#Redundancy。
#High-speed cells。
#が必要なので、これは楽観的下限だ。
#それでも1GB SRAMが約210mm²。
#かなり大きい。
#SRAM-rich化は、
#SRAM↑
#↓
#Die Area↑
#↓
#GDPW↓
#↓
#Defect probability↑
#↓
#Good Dies/Wafer↓
#という形でLogic wafer demandを増やす。
#確信度:A(方向)/ B(面積換算)
##
40.独自指標④――SBA・SAB・SWED
#SRAMでは市場売上ではなくSilicon Areaを測る必要がある。
#そこで、
#SBA
#SRAM Bytes per Accelerator。
#SAB
#SRAM Area Burden。
#SWED
#SRAM Wafer-Equivalent Demand。
#を見る。
#SRAMが1GBでもdie全体2000mm²なら影響は小さいかもしれない。
#500MBでも300mm² chipなら支配的だ。
#「何GB SRAMか」より、
#Siliconの何%をSRAMが占めるか
#が重要になる。
#確信度:B
##
41.Cerebras――Memory WallをWafer Scaleで殴る
#CerebrasはSRAM-richの最も極端な例だ。
#最新WSE-3 Turboは、
#4兆Transistors。
#90万AI cores。
#46,225mm² Silicon。
#44GB SRAM。
#250PFLOPS AI Compute。
#43.2PB/s Memory Bandwidth。
#を一枚のWafer Scale Processorへ載せる。
#CS-4ではWSE-3Tを3枚使い、
#750PFLOPS。
#132GB SRAM。
#129.6PB/s memory bandwidth。
#まで拡大する。(Cerebras Systems)
#添付資料が示すように、CerebrasはHBMを使わず、HBM/CoWoS/3nmの制約を避ける一方、ほぼwafer-sizeのlogic siliconを投入する。
#つまり、
#HBM Scarcity → Logic Wafer Scarcity
#へ変換するArchitectureである。
#確信度:A
##
42.Groq――SRAMとCompilerでMemory Movementを「時刻表」にする
#Groq 3 LPXでは、
#256 LPU/rack。
#1 LPU:
#500MB SRAM。
#Rack:
#128GB SRAM。
#40PB/s SRAM bandwidth。
#315PFLOPS FP8。
#12TB DDR5。
#最大1000tokens/sec/userというvendor specificationを掲げている。(Groq)
#Cerebrasとの違いは、
#Data MovementをCompilerでdeterministicにscheduleする
#ことだ。
#Memory read。
#Compute。
#Communication。
#を事前配置して、runtime uncertaintyを減らす。
#Tail latencyを抑えやすいので、
#Voice。
#Coding。
#Agent。
#Realtime workloads。
#と相性がいい。
#さらにGroq 3 LPXはRubinと組み合わせるheterogeneous architectureを取る。
#つまりGroq自身も、
#全MemoryをSRAMにする
#わけではない。
#SRAMをLatency-critical tierとして使う。
#確信度:A~B
##
43.Rebellions――最もMemory Hierarchy志向
#三社を一言でまとめると、
#これは添付資料でも明確に整理されている。
#RebellionsのPredictive DMAは必要なKV dataを先読みし、Computeが使う頃までにMemory transferを終わらせる。
#目的は、
#Latencyをゼロにする
#ことではない。
#TransferをComputeの裏へ隠す
#ことである。
#この思想はEnfabrica、HBF、CMX、Optical Fabricと同じ方向にある。
#つまり今後の競争は、
#Memoryそのものの速さ
#より、
#Data Placement Intelligence
#になり得る。
#確信度:B
##
44.ここから6社AI chip需給モデルを作る
#NVIDIA。
#Google。
#AWS。
#AMD。
#Meta。
#Microsoft。
#について、
#↓
#↓
#↓
#↓
#まで換算する。
#ここからの数量は企業公式出荷Guidanceではない。
#公開chip roadmap、第三者出荷推定、HBM仕様、die size、yield sensitivityを組み合わせたBase scenarioである。
#特に2028年は不確実性が高い。
#Googleは比較的アンカーが強く、供給網推定で2027年500万、2028年700万TPUが示されている。(TrendForce)
#AWSはTrainium2 140万chipがlanded済みで、Trainium3はほぼ全供給が予約済み、Trainium4は2027年予定だが、絶対年間台数は非公開である。(Amazon)
#Metaも2026年9月から新custom chip生産を始め、2027年まで半年ごとのchip rolloutを計画するが、数量は非公開。(Reuters)
#Microsoft Maia 300は2027年向け30万chip超のTSMC capacityを交渉しているとReutersが報じている。(Reuters)
##
45.2026年モデル
#2026年NVIDIAについては、KeyBanc系の市場推定でBlackwell約5.5~6.0M、Rubin約1.7~1.8Mという規模感も出ており、本モデルとおおむね同じorderである。(Barron's)
##
46.2027年モデル――最も危険な年
#SRAM content増加も織り込んだBase case。
#2026→27でAI chip数は、
#程度なのに、
#HBM DRAM waferは、
#+54%
#近く増える。
#Chip Unitsだけ見てはいけない理由がここにある。
##
47.2028年モデル――Memory intensityが台数を上回る
#2026→28では、
#AI chip:
#だが、
#HBM DRAM Wafer:
#になる。
#Memory Silicon DemandがChip Unit growthを大幅に上回る。
#これがこの需給モデル最大の結論である。
##
48.SRAM-rich化まで入れるとLogic waferも再加速する
#同じAI Chip台数でSRAMが増えなければ、モデル上Logic waferは、
#2027:
#約526k。
#2028:
#約678k。
#だった。
#SRAM-rich Baseでは、
#2027:
#+4.4%
#2028:
#+12.7%
#になる。
#High SRAM scenarioでは2028年、
#約903k Logic wafers
#まで上がり、
#SRAMなし比:
#+33%
#程度になる。
#つまり、
#HBMを減らすためSRAMを大量投入すると、N2/A16 wafer demandが再び増える。#
確信度:C
##
49.TSMC N3/N2 Capacityと比べる
#TrendForceによればTSMC N3は2026年上期約150K WPMから、Q4初頭には約180K WPMへ増える見通し。
#N2も、
#H1:
#約50~60K WPM。
#Q4初頭:
#80K超。
#年末:
#約100K WPM。
#方向へ進んでいる。2026~28年N2 capacity CAGRは約70%とする供給網推定もある。
#つまりLogic waferの絶対Capacityは猛烈に増える。
#しかしSRAM-heavy XPU。
#GPU。
#CPU。
#Smartphone。
#Networking ASIC。
#HBM Base Die。
#が同じ先端nodeを共有する。
#したがって、
#SRAM shortage = N2 shortage
#という形で現れる可能性がある。
#確信度:B
##
50.CoWoSはLogic Wafer以上に危ない
#TrendForceの2026年推定ではTSMC CoWoS capacityは、
#120~140K WPM
#程度。
#OSATを加えたecosystemでは約200K WPM規模へ向かい、TSMC自身も2027年へ60%以上増産する方向とされる。
#しかしAI Packageは巨大化している。
#Logic dieが増える。
#HBM stacksが増える。
#Interposerも広がる。
#そのためCoWoS WPMが60%増えても、
#完成Accelerator台数が60%増えるとは限らない。
#今回の6社モデルではCoWoS equivalent demandが、
#2026:
#1.09M/year。
#2027:
#1.78M。
#2028:
#3.21M。
#へ増える。
#2027だけでも月換算、
#equivalent。
#つまり6社だけでTSMCのCoWoS capacityにかなり接近する。
#確信度:B(方向)/ C(等価Wafer量)
##
51.独自指標⑤――CASW
#ここでAI chip側の指標として、
#CASW
#Completed Accelerators per Scarce Wafer
#を考える。
#単なるGPU Dies/Waferではなく、
#である。
#Weighted inputsには、
#Compute Logic Wafer。
#HBM DRAM Wafer。
#HBM Base Die Wafer。
#CoWoS equivalent。
#を入れる。
#例えば12Hiを8Hiへ落とすとGPU当たりMemoryは減る。
#しかしHBM wafer poolから完成できるGPU台数は最大1.5倍方向へ動く。
#したがってFrontier chip設計は、
#最大GB/GPU
#ではなく、
#Completed GPUs / Scarce Manufacturing Resource
#の最適化になる。
#確信度:C
##
52.独自指標⑥――BDR:SRAMがHBMを本当に救っているか
#SRAMを増やせばLogic waferが増える。
#その代わりHBMを減らせるなら意味がある。
#そこで、
#BDR
#Bottleneck Displacement Ratio
#を、
#とする。
#例えば2028 Base SRAMで追加Logic waferが約86k。
#仮にMemory hierarchy最適化で12Hi stackの25%を8Hiへ落とせ、約0.61M DRAM wafer相当を節約できるなら、
#になる。
#これは異なるFab種類なので「7枚と1枚を交換できる」という意味ではない。
#だが、
#1単位のscarce Logic Siliconを追加して、どれだけMemory Fab burdenを逃がしたか#
を見るには有用だ。
#確信度:D~C(完全な独自指標・scenario依存)
##
53.2026・27・28のボトルネックを整理する
#2027が特に危険なのは、
#Rubin/Rubin Ultra。
#Google TPU8。
#Trainium3/4。
#MI455。
#MTIA。
#Maia300。
#が同時に量産規模へ上がる一方、新DRAM mega-Fabの本格寄与がまだ途中だからだ。
#2028以降、新Fabが効いてもFeynman、次世代TPU、MI500級などがN2/A16、より巨大なHBM4E/Custom HBMへ進めば、Supply Reliefをcontent growthが食い戻す可能性がある。
##
54.Memory Technologyを成熟度で並べるとこうなる
#この表で重要なのは、
#Technology AnnouncementとMass Supplyを分けること
#である。
##
55.そしてAIDCとMemoryを同じ式で見る
#Memoryの本当のSupplyは、
#である。
#AIDCの本当のSupplyは、
#である。
#Cloudまで行けば、
#になる。添付資料もAI Factory Valueが最終的に「MW × Useful Compute/MW × Utilization × Monetization」へ収束すると整理している。
#この視点に立つと、2030年AIDCの問題は、
#「219GW建つか」
#ではない。
#「155GW AI workloadがあるか」
#だけでもない。
#そのうち何GWが本当に高品質Computeへ変換されるのか
#が本当のSupplyになる。
##
56.MemoryもJevons Paradoxから逃げられない
#Good Bits/Waferが改善する。
#↓
#$/GBが下がる。
#↓
#GPU当たりMemoryが増える。
#↓
#Context lengthが増える。
#↓
#ModelがMemoryを使うようになる。
#↓
#Bit Demandが再び増える。
#SRAMも同じ。
#SRAM増加。
#↓
#Memory Stall減少。
#↓
#Token単価低下。
#↓
#Realtime AIが増える。
#↓
#Agentが増える。
#↓
#Total Memory Traffic増加。
#となり得る。
#だから、
#Efficiency Improvement ≠ Demand Reduction
#である。
#AIは効率改善を需要拡大へ再投資する性質が非常に強い。
##
57.2030年に本当に見るべきDashboard
#私は2030年へ向け、少なくとも以下を一緒に見る。
#単一の売上やshipmentだけではSupply Chainを読めなくなる。
##
58.最終分析――何が最も確からしいのか
#現在のEvidenceを一つずつ積み重ねると、私は次のScenarioが最も整合的だと考える。
#① AIDCは「全部余る」「全部不足する」にはならない
#総GWは急増する。しかしFrontier-ready、Low-latency、Cloud-sellableなPremium Computeは希少であり続ける可能性が高い。
#確信度:B
#② 2027年はMemory+Packagingのピークstress年になりやすい
#新Fab供給がまだ全面寄与しない中、Rubin、TPU、Trainium、AMD、Meta、Maiaが同時に増える。
#確信度:B
#③ 2028年以降はMemory shortageが単純には消えない
#Fab capacityは増えるが、HBM4E、SRAM content、Logic Base Die、Package sizeも増える。
#確信度:B~C
#④ HBMの競争軸はGB/stackからGood Bits/Waferへ移る
#12Hi/16Hiは非常に重要だが、stack heightだけではwafer efficiencyは改善しない。
#確信度:A
#⑤ SRAMは次のAI Memory themeだが、Commodity SRAM cycleとしては現れにくい
#TSMC/Samsungのadvanced-node utilization、大型die、custom SRAM compilerとして表面化する。
#確信度:A~B
#⑥ MemoryとLogicは融合する
#HBM4 Base Die、Custom HBM、PIM、DRAM-on-Logicが同じ方向を指している。
#確信度:A~B
#⑦ HBF/CMX/XL-FLASH/CXLはHBMを倒すのではない
#HBMへ置く必要があるData量を減らす。
#確信度:A~B
#⑧ 3D DRAMは有望だがYield Valleyが最大の壁
#Prototypeと年間数百万~数千万stackのvolume productionの間は非常に大きい。
#確信度:B
#⑨ zHBM/XBMを2030 supplyへ大量に織り込むのはまだ早い
#特にXBMはPatent、zHBMはConcept。
#確信度:A
##
59.結論――AI Infrastructureは「GPUを作る産業」から変わった
#2026年現在、AI Infrastructureで起きていることを順番に並べると非常に分かりやすい。
#GPUを増やす。
#するとHBMが足りない。
#HBMを12Hiへ増やす。
#すると1GPUが食うDRAM Siliconが増える。
#Dieまで大きくなればGDPWも落ちる。
#そこで8Hiへ戻せばGPU台数を増やせる。
#しかしMemory容量は減る。
#SRAMを増やしてHot Dataを近づける。
#しかしLogic Dieが大きくなる。
#N3/N2 waferをさらに食う。
#DDR/CXL Poolへ逃がす。
#しかしLatencyが増える。
#Optical Fabricで距離のEnergy Costを下げる。
#しかしMemory Physicsは消えない。
#HBFやXL-FLASHへCold Dataを逃がす。
#しかしHBMの22TB/s級帯域には届かない。
#3D DRAMへ進む。
#しかしW2W/Bonding Yieldが待っている。
#4F²でbit densityを上げる。
#しかしManufacturabilityが待っている。
#Logic Base Dieを高度化する。
#するとHBMまで2nm Foundryを使う。
#つまり、
#一つの制約を解くたび、次の物理制約が現れる。
#しかしこれはAI Infrastructureが失速している証拠ではない。
#むしろ、
#Compute demandの増加速度が、個々の半導体技術の改善速度を次々に使い切っている#
ことを示している。
#AIDCについては、現在約55~62GWのAI workloadから2030年約155.5GWへ向かうという大きな需要curveが存在する。(McKinsey & Company)
#MemoryではSK hynixがwafer capacityを5年で倍増させ、Micronも2027、2028、2030と巨大Fab supplyを段階的に増やす。それでもSK hynix自身が2030までSupply bottleneck継続の可能性を語っている。(Reuters)
#同時にHBMは「DRAM stack」から、
#DRAM
#+
#Advanced Logic
#+
#Advanced Packaging
#+
#Thermal
#+
#Data Movement Logic
#へ変質している。Logic Base Dieがその象徴である。
#SRAMも独立したMemory市場ではなく、AI Logicそのものへ吸収され、SRAM-rich acceleratorの不足はadvanced logic waferとlarge-die yieldの不足として現れる。
#したがって2030年代に最も価値を持つ会社は、
#最もFLOPSの高いGPUを作る会社だけでも、
#最も大容量のHBMを作る会社だけでも、
#最も多くGWを確保するData Center operatorだけでもないだろう。
#勝つのは、
#限られたWafer、HBM、SRAM面積、Packaging、Network、Electricityを、最も高いYieldとUtilizationでUseful Intelligenceへ変換できる企業#
だと思う。
#Memoryの本当のSupplyは、
#Good Bits/Wafer。
#Logicの本当のSupplyは、
#Good AI Dies/Wafer。
#Packagingの本当のSupplyは、
#Completed Accelerators/CoWoS Capacity。
#AIDCの本当のSupplyは、
#QAC-GW。
#Inferenceの本当のSupplyは、
#Goodput/MW。
#そして経済的に最後に残るのは、
#FCF/GW。
#になる。
#AI Infrastructureはもはや「GPUを何枚作れるか」という一変数の産業ではない。
#Wafer → Memory → Logic → Package → Fabric → Power → Useful Compute → Revenue
#という長いconversion chainの中で、
#最も低いConversion Yieldを持つ工程が、世界全体のAI供給量を決める。
#これが、2026年から2030年へ向けて最も重要な構造変化だと考える。
#特定銘柄の推奨・勧誘・投資助言を目的とするものではありません。投資判断はご自身の責任でお願いいたします。
#