AIは「巨大GPU」から「巨大な記憶コンピュータ」へ――MoE・HBM・Optical Fabricが変える次世代AIインフラ
絶ノイアの章 Sil-Kathnaの章この資料の日時
元資料の日付と、その本文が公に存在した確認日時は別の記録です。
本文に含まれる語句 HBM DRAM SRAM 帯域・データ移動 先端パッケージング 光接続 電力・給電 チップレット AI推論 AIエージェント
出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.09.23.4
- 記事内容のSHA-256
cfc70b79ed06097348a2b8bdc6be3da08583b264dfeb6e20636ccbba3fb3591e- 保存版のSHA-256
387298af8673f9f4e7cc2426f2fda56fc60210fb7cca862e5ba38365e14224e0
外部証明の最終検査結果は詳細を開くと表示します。
AIは「巨大GPU」から「巨大な記憶コンピュータ」へ――MoE・HBM・Optical Fabricが変える次世代AIインフラ
#MoE、KVキャッシュ、HBM、3D実装、Optical Fabricが変える次世代AIインフラ
#AIモデルの性能向上を考えるとき、これまでは「GPUの演算性能が何FLOPSあるか」「モデルが何千億パラメータあるか」といった数字が注目されてきた。
#しかし、2026年現在のAIインフラを理解するには、それだけでは不十分になっている。
#モデルは兆単位のパラメータへ拡大し、コンテキストは数十万から100万token級へ伸び、Mixture of Experts(MoE)によって巨大なモデルの一部分だけを動かし、KV cacheをGQAやMLAで圧縮しながら推論するようになった。同時に、1台のGPUではモデルもメモリも収まらなくなり、多数のXPUを高速Fabricで結ぶことが前提になり始めている。
#その結果、現在のAI競争は、
#「どれだけ巨大な演算器を作れるか」
#から、
#「必要なデータを、必要な演算器へ、必要な瞬間にどれだけ速く届けられるか」
#という競争へ移りつつある。
#そしてこの変化を理解するうえで重要なのが、演算能力の「N²」と外部I/Oの「4N」という問題である。
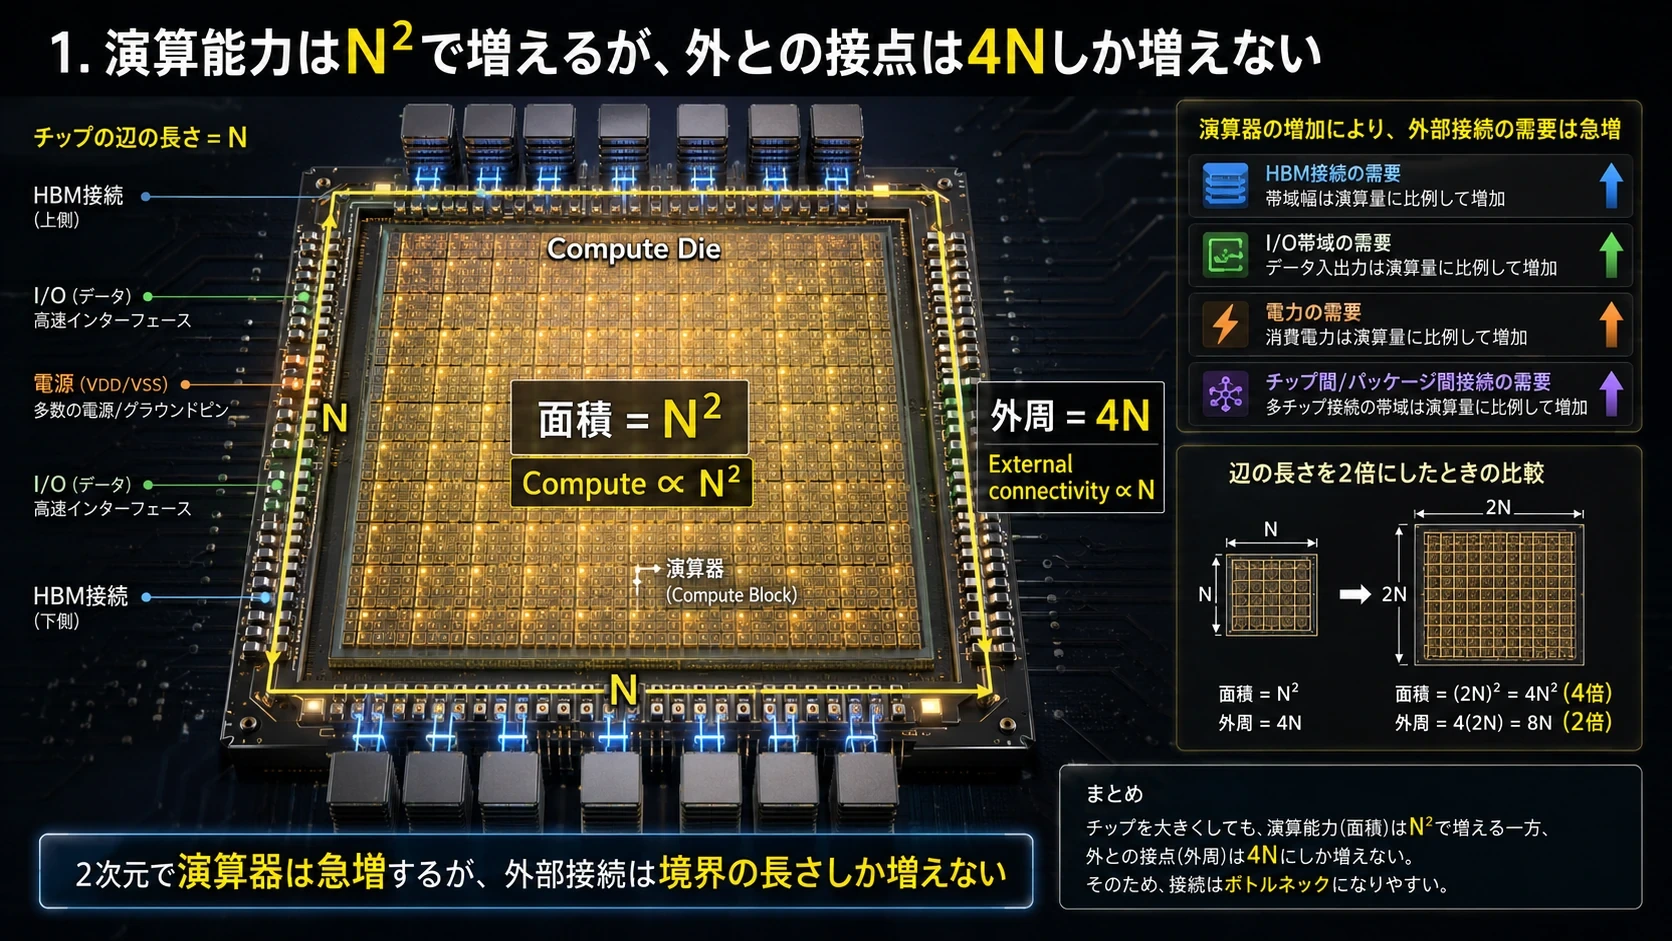
#1.演算能力はN²で増えるが、外との接点は4Nしか増えない
#単純化のため、AI acceleratorのcompute dieを一辺Nの正方形だと考える。
#面積は、
#である。
#演算器は基本的にチップの面積内に配置されるため、理想化するとチップを大型化したときの演算能力も面積に比例して増やせる。
#ところが、正方形の外周は、
#しかない。
#一辺を2倍にすれば面積は4倍になるが、外周は2倍にしかならない。一辺を4倍にすれば、面積は16倍になるのに外周は4倍である。
#この違いは、巨大AI acceleratorで深刻な問題になる。
#演算器を増やせば、それに比例してHBMから読み込まなければならないweight、activation、KV cacheも増える。XPU間通信量も増え、必要な電力も増える。
#ところが、それらをチップ外へ出し入れするI/O、電源、HBM接続などに使える物理的な境界は、演算器ほど急速には増えない。
#したがって、
#なのに対し、
#という構造的な不均衡が生まれる。
#もちろん実際の半導体では「帯域=4N」という単純な式ではない。micro-bump、silicon interposer、RDL、TSV、3D stacking、chiplet、backside powerなどを使ってI/O密度そのものを高められる。
#しかし本質は変わらない。
#2次元平面に演算器を増やす速度と、その演算器へデータ・電力を供給する能力のscaling lawが一致しなくなる。
#これが巨大GPUを際限なく大型化することが難しくなる理由の一つである。
#図解|N²で増える演算と4Nの境界
#
2.Chiplet、2.5D、3D、3.5Dは、この壁を突破する技術である
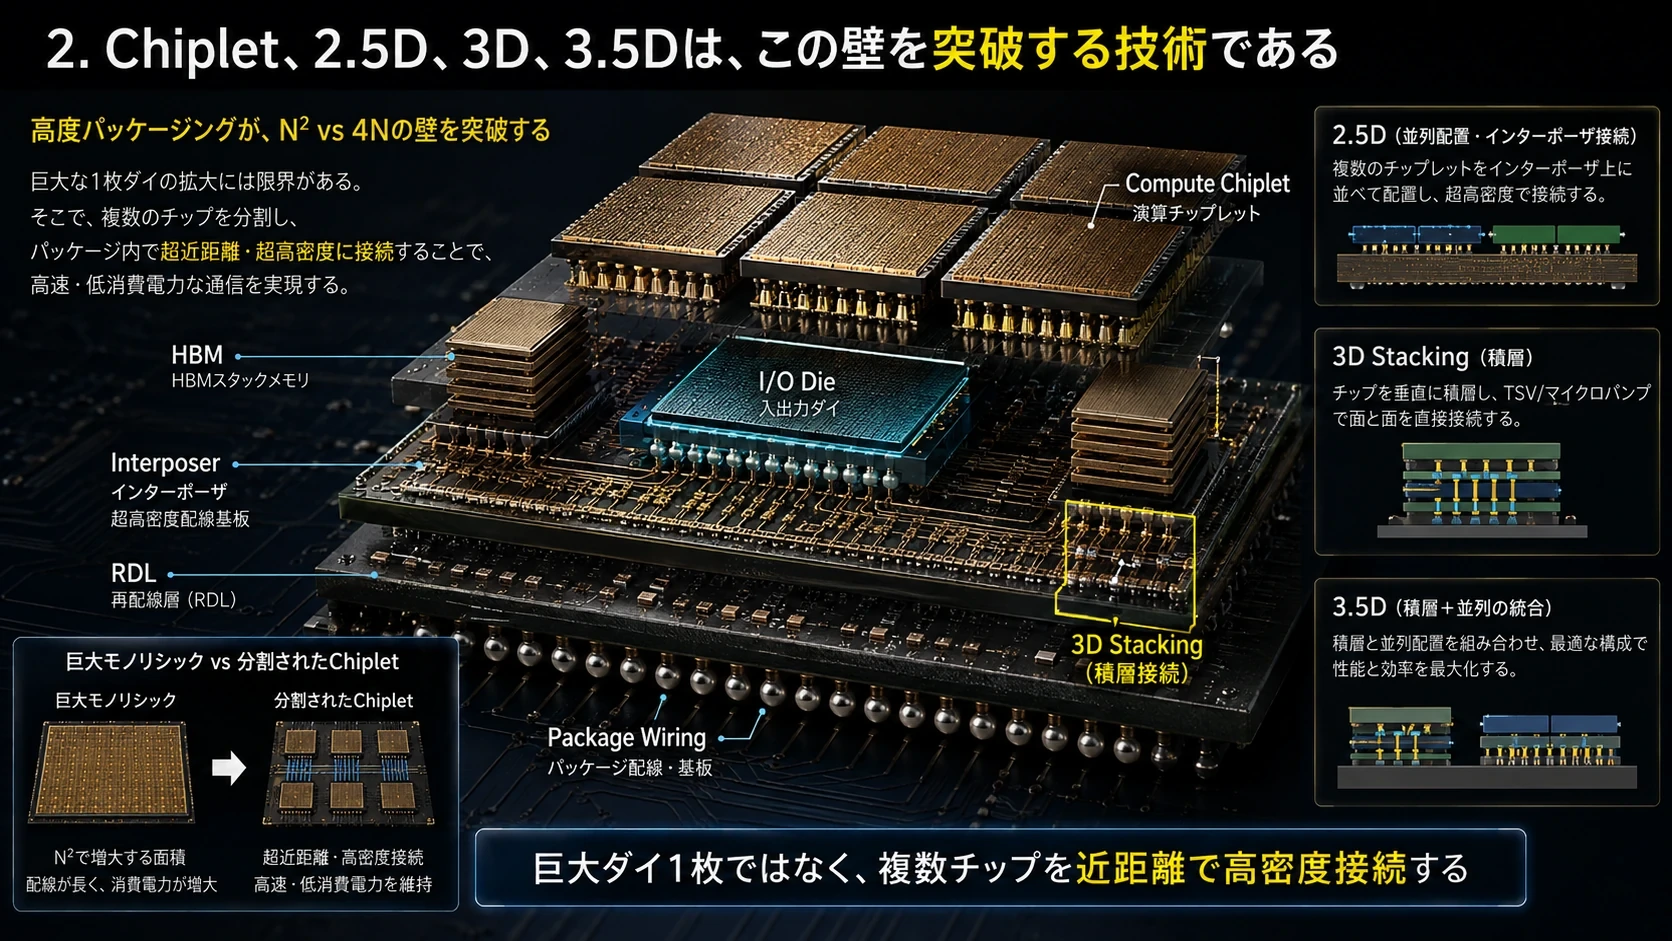
#現在のadvanced packaging競争は、まさにこの問題への回答である。
#一つの巨大monolithic dieにすべてを詰め込む代わりに、compute die、I/O die、HBM、cacheなどを複数のchipletに分割し、非常に高密度なpackage内配線で一つのprocessorとして動かす。
#Broadcomは2026年2月、2.5DとFace-to-Face 3D stackingを組み合わせた3.5D XDSiPによる2nm custom compute SoCの出荷開始を発表した。XDSiPは6,000平方mm超のsiliconと最大12 stackのHBMを一つのpackageへ統合できる。 (Broadcom)
#TSMCもCoWoSを巨大化し続けている。2026年時点では5.5-reticle規模を生産しており、2028年には14-reticle規模、約10個の大型compute dieと20 stackのHBMを統合可能なCoWoSを計画している。2029年にはさらに14-reticleを超えるCoWoSと40-reticle級SoW-Xへ進む予定だ。 (TSMC)
#したがって3D・3.5Dは終着点というより、「可能な限りpackage内部で高速・低消費電力に接続する」方向の延長線にある。
#ただし、それでもpackageサイズには限界がある。
#そこで次に重要になるのがOptical Fabricである。
#図解|Chipletと立体実装
#
3.3D実装とOptical Fabricは競合ではない
#Optical Fabricについて、「将来は電気配線が光に置き換わる」と理解すると少し違う。
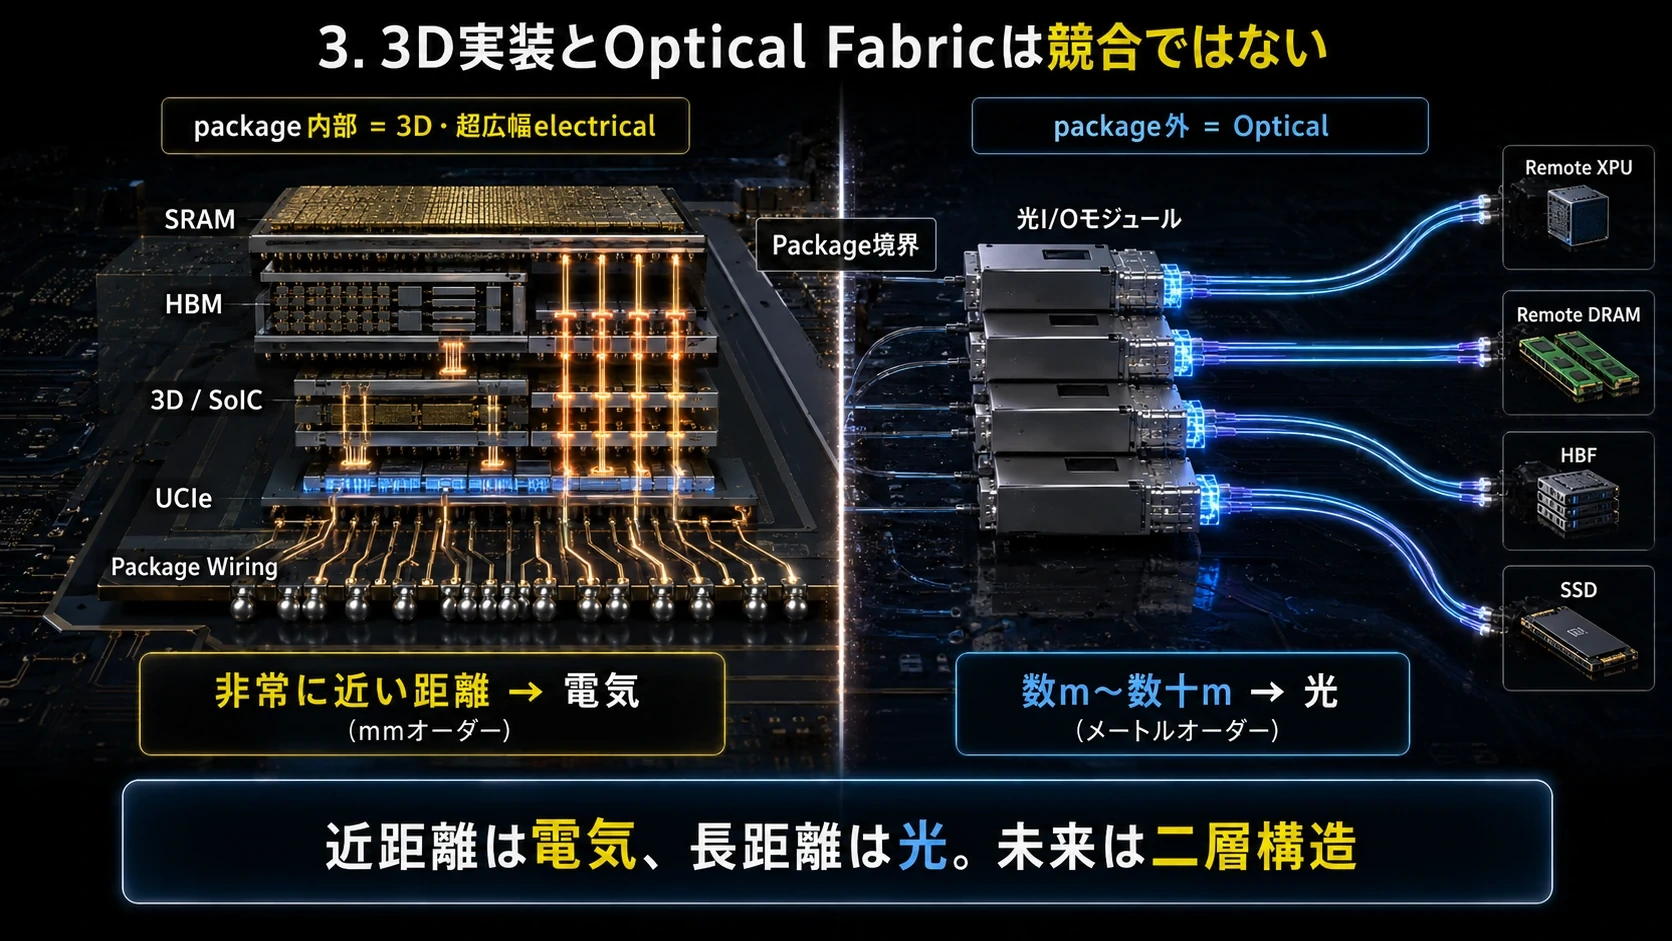
#より自然なのは、
#非常に近い距離
SRAM
↓
HBM
↓
3D / SoIC / UCIe / package wiring
↓──────────────── Package境界
#Optical I/O
↓
Optical Fabric
↓
Remote XPU
Remote DRAM
HBF
SSDという役割分担である。
#数mmから数cmというpackage内部では、幅広いparallel electrical interfaceが極めて強い。光に変換するにはE/O変換とO/E変換が必要になるため、距離が短すぎると必ずしも有利ではない。
#一方で距離が数m、数十mへ伸びると、高速electrical SerDesではloss、equalization、retimer、電力が急増する。
#ここから光が有利になる。
#したがって未来は、
#package内部=3D・超広幅electrical
#package外=Optical
#という二層構造になる可能性が高い。
#TSMCもこの方向へ動いている。COUPEはSoICを使って電子dieとphotonic dieを統合する技術で、2026年にはCOUPE-on-substrateによるtrue co-packaged opticsの生産開始を予定している。TSMCはboard上のpluggable opticsと比較して2倍のpower efficiency、10分の1のlatencyを掲げている。 (TSMC)
#つまり業界はすでに、
#「packageを巨大化する」
#ことと、
#「packageから外へ出る部分を光化する」
#ことを同時に進めている。
#図解|近距離の電気と長距離の光
#
4.AIモデルを見る8つの数字
#これからのAIモデルとハードウェア需要を理解するには、単純なparameter数だけでは足りない。
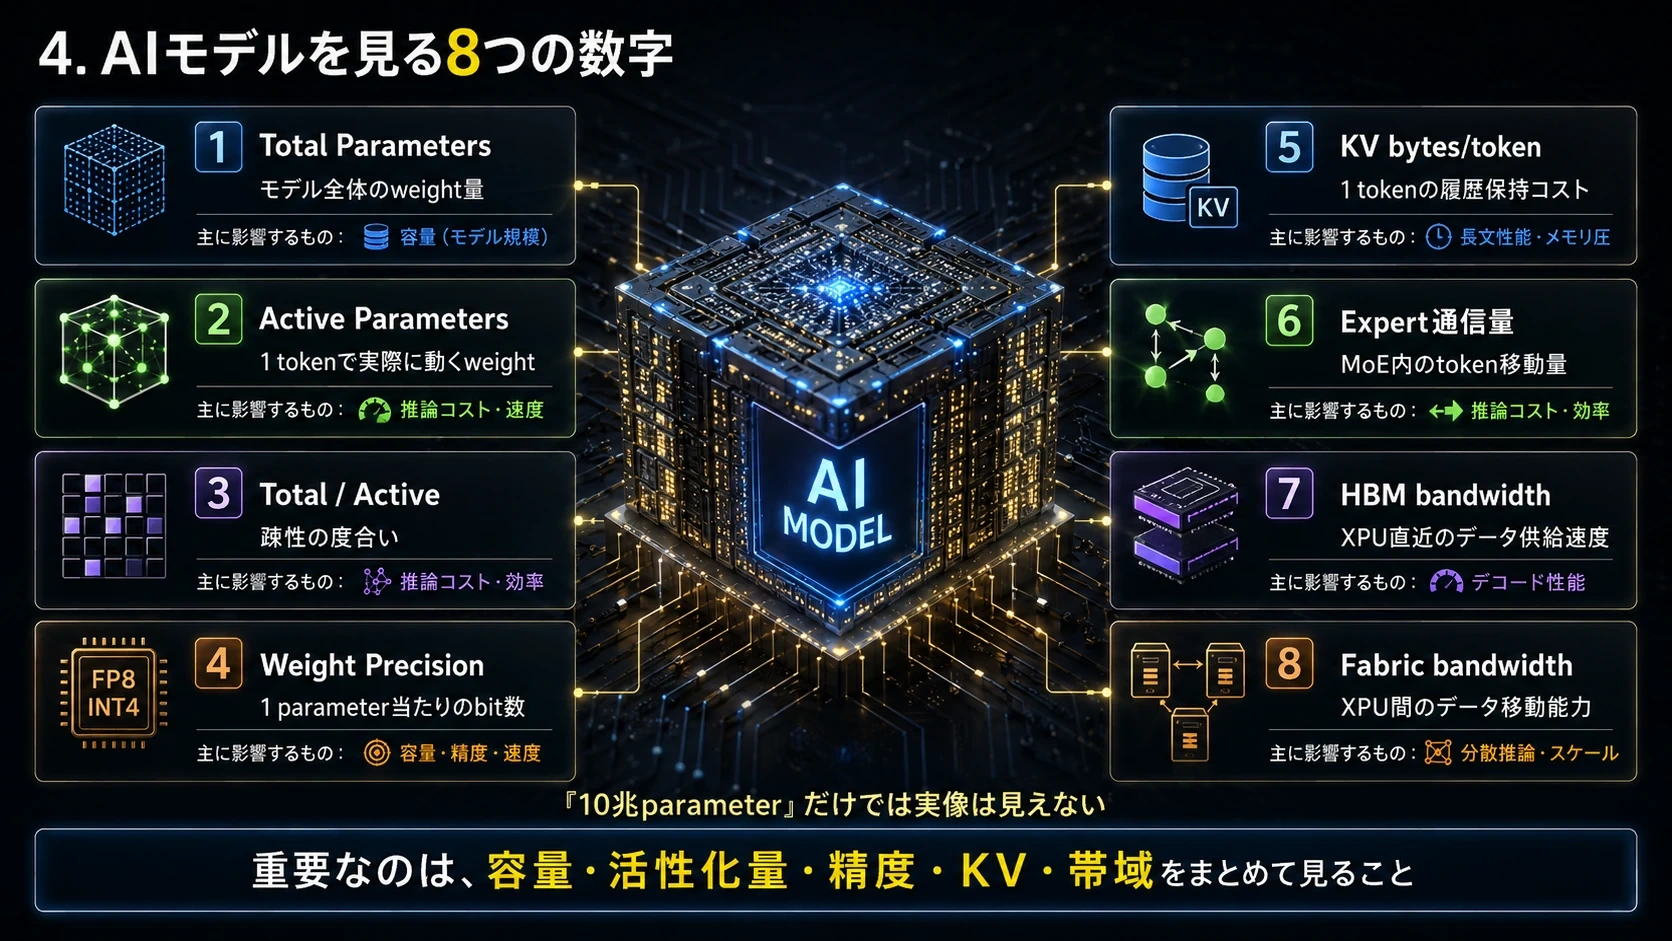
#重要なのは次の8項目である。
#| 指標 | 意味 | 主に影響するもの |
|---|---|---|
| Total Parameters | モデル全体のweight量 | モデル容量、HBM/DRAM/Storage |
| Active Parameters | 1 tokenで実際に動くweight | 演算量、推論コスト |
| Total / Active | 疎性の度合い | MoE効率、network負荷 |
| Weight Precision | 1 parameter当たりのbit数 | 容量、帯域、演算速度 |
| KV bytes/token | 1 tokenの履歴保持コスト | Long Context、HBM |
| Expert通信量 | MoE内のtoken移動量 | Scale-Up Fabric |
| HBM bandwidth | XPU直近のデータ供給速度 | Decode性能 |
| Fabric bandwidth | XPU間のデータ移動能力 | MoE、分散学習、分散推論 |
この8項目を見ると、「10兆parameterのモデル」という数字だけでは何も分からないことが分かる。
#10兆parameterでも、1 tokenあたり1000億parameterしか動かさないのであれば、計算負荷は10兆parameterのDense modelとはまったく異なる。
#図解|AIモデルを読む八つの指標
#
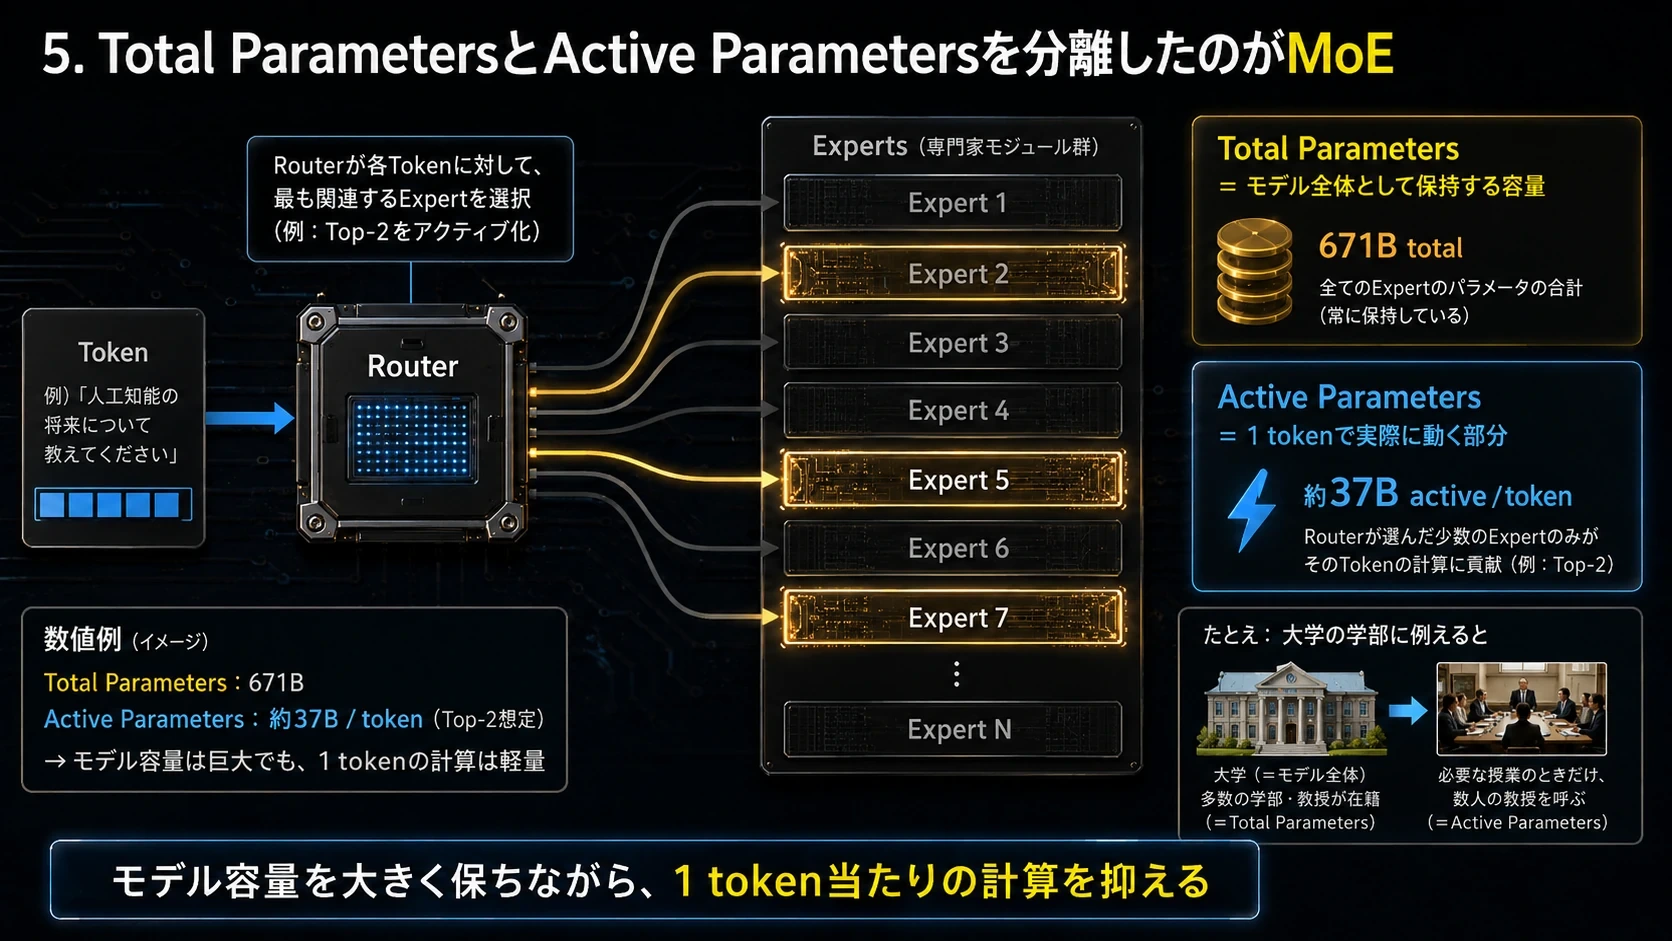
5.Total ParametersとActive Parametersを分離したのがMoE
#Dense Transformerでは、基本的にモデル内部のFFN weightの大部分を各tokenで使用する。
#MoEではFFN部分を多数のExpertへ分割する。
#Expert 1 Expert 2 Token → Router → Expert 3 ... Expert N
#Routerは各tokenのhidden representationを見て、必要なExpertだけを選択する。
#DeepSeek-V3は671B total parametersを持つ一方、1 tokenあたり約37Bしかactivateしない。また14.8兆tokenでpretrainingされている。 (arXiv)
#この仕組みによって、
#モデル全体として保持できるcapacity
#と、
#1 tokenを処理するために必要なcompute
#を分離できる。
#これはAIモデルを巨大化するうえで極めて強力である。
#Total Parametersを巨大な大学全体、Active Parametersを質問に応じてその場に呼ばれる教授陣と考えると分かりやすい。
#大学全体には医学、物理、数学、法律、言語など膨大な専門能力が存在する。しかし一つの質問に対して大学全員が集まる必要はない。
#必要な能力だけを呼ぶ。
#これがMoEの基本思想である。
#図解|MoEとActive Parameters
#
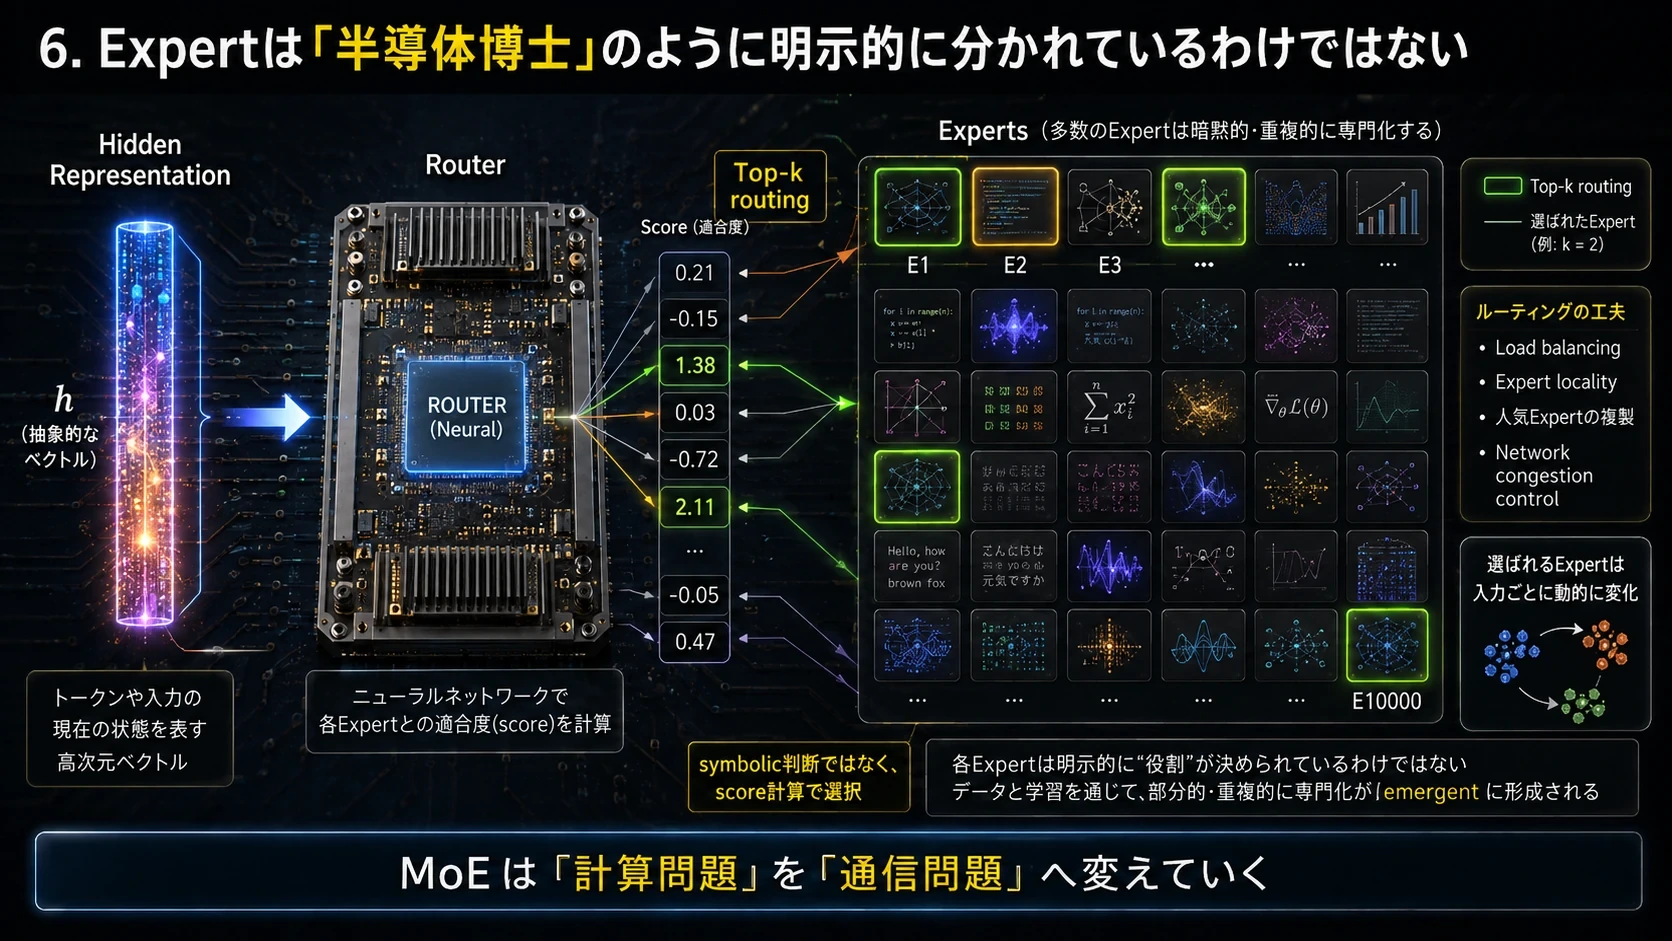
6.ただしExpertは「半導体博士」「数学博士」のように明示的に分かれているわけではない
#MoEのExpertは、人間が「Expert 17=半導体担当」と決めているとは限らない。
#学習の結果として、あるExpertが特定の言語的pattern、数学処理、code構造、semantic patternなどに部分的にspecializeしていく。
#Routerも「これは半導体の質問だから半導体Expertへ送る」とsymbolicに判断しているわけではない。
#現在のtokenのhidden stateから各Expertのscoreを計算し、Top-k Expertへroutingする。
#つまり、
#Hidden Representation
↓
Router
↓ ↓ ↓ ↓ ↓
E1 E2 E3 ... E10000というneural routingである。
#もし将来Expert数が数千、数万へ増えるなら、単純なroutingだけでは難しくなる。
#Expert specialization、hierarchical routing、load balancing、Expert locality、人気Expertの複製、prefetch、network congestion controlなどが非常に重要になる。
#ここでMoEは「compute問題」を「通信問題」へ変える。
#図解|Expert Routingの実像
#
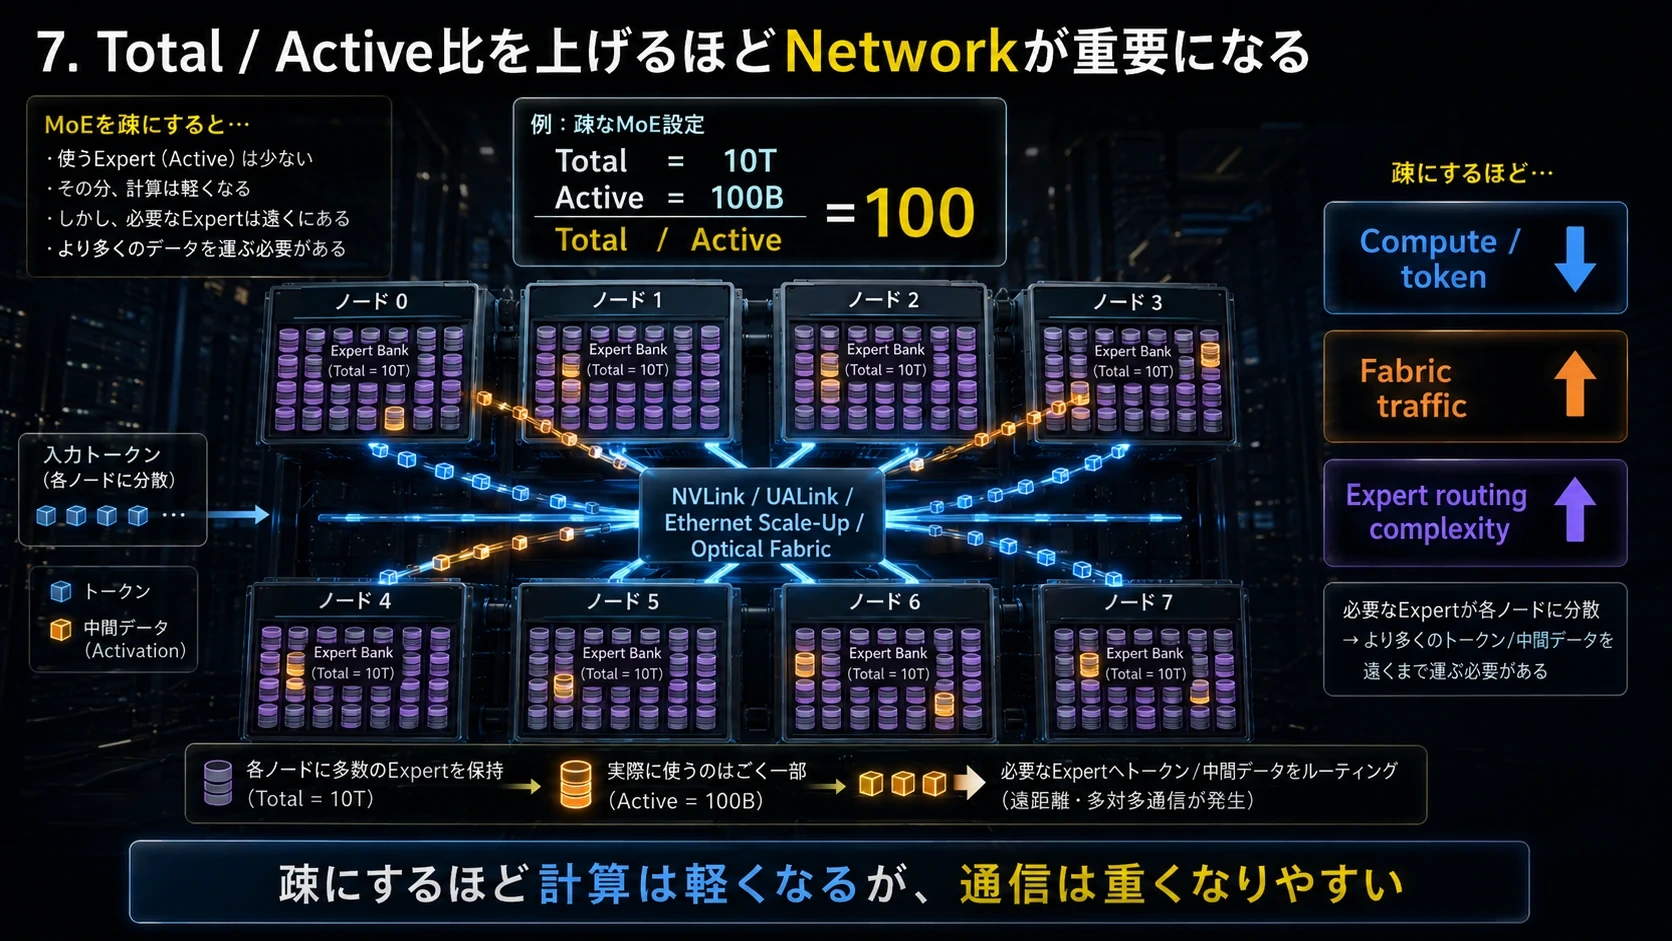
7.Total / Active比を上げれば上げるほどNetworkが重要になる
#仮に、
#で、
#なら、
#である。
#非常に効率よく見える。
#しかし全10兆parameterのweightはどこかに置いておかなければならない。
#さらにtokenごとに異なるExpertが選択されるため、必要Expertが別GPUにあればtokenやintermediate dataをnetworkで送らなければならない。
#したがって、
#は、
#を抑える一方で、
#と
#を増やしやすい。
#MoEを疎にすればするほどNVLink、UALink、Ethernet Scale-Up、UnifiedBus、Optical Fabricなどの価値が高くなる理由である。
#図解|MoEが増やすFabric通信
#
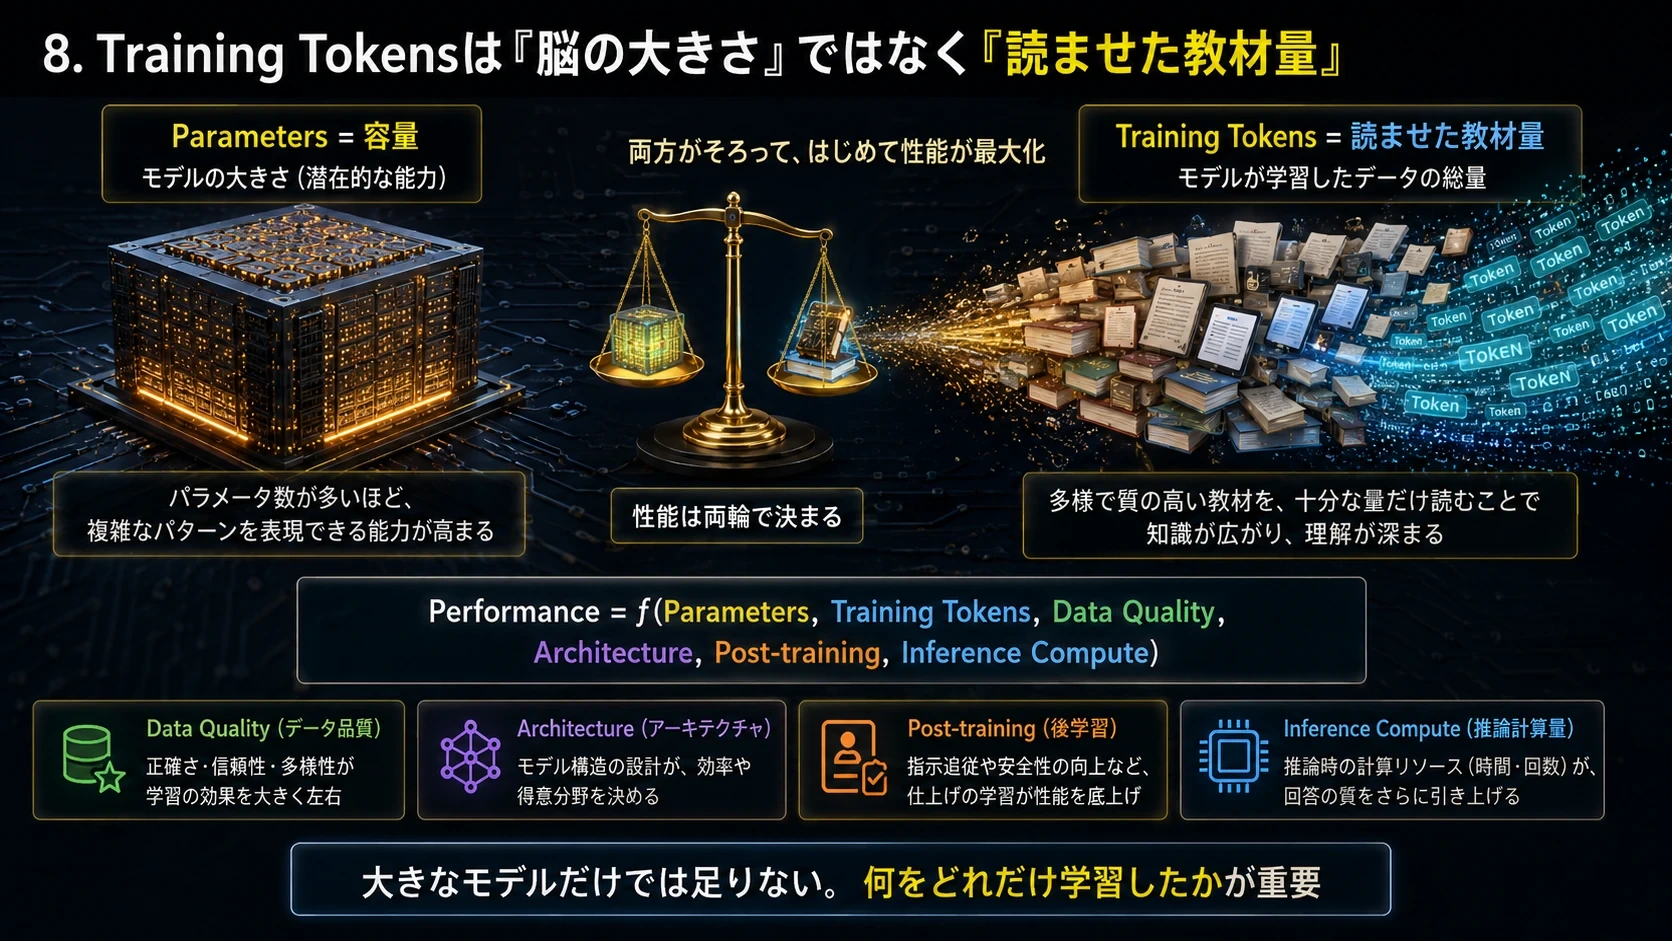
8.Training Tokensは「脳の大きさ」ではなく「読ませた教材量」
#ParametersとTraining Tokensはまったく違う。
#Parametersは学習可能なweight、つまりモデルのcapacityである。
#Training Tokensは学習時にモデルが読んだ情報量である。
#巨大なparameterを用意しても、十分なdataを与えなければ能力を引き出せない。
#Chinchilla scaling lawが示した重要な点は、compute budgetを増やすとき、model sizeだけではなくtraining dataも増やす必要があるということだった。
#さらに現在は、「Training Tokensを何兆にするか」だけでなく、何を読ませるかが極めて重要になっている。
#MetaはLlama 3を15兆token以上でpretrainしたが、単純にWebを大量投入しただけではない。heuristic filtering、semantic deduplication、quality classifierなどを使ってdata品質を管理し、異なるdata sourceのmixまで調整している。 (AI Meta)
#したがってモデル性能は、
#と考えるべきである。
#現在のモデルが賢くなっている理由はparameter増大だけではない。
#より大量の、より質の高いdataを、より良いarchitectureで学習し、さらにRLやreasoning trainingなどのpost-trainingを行うようになったことが大きい。
#図解|ParametersとTraining Tokens
#
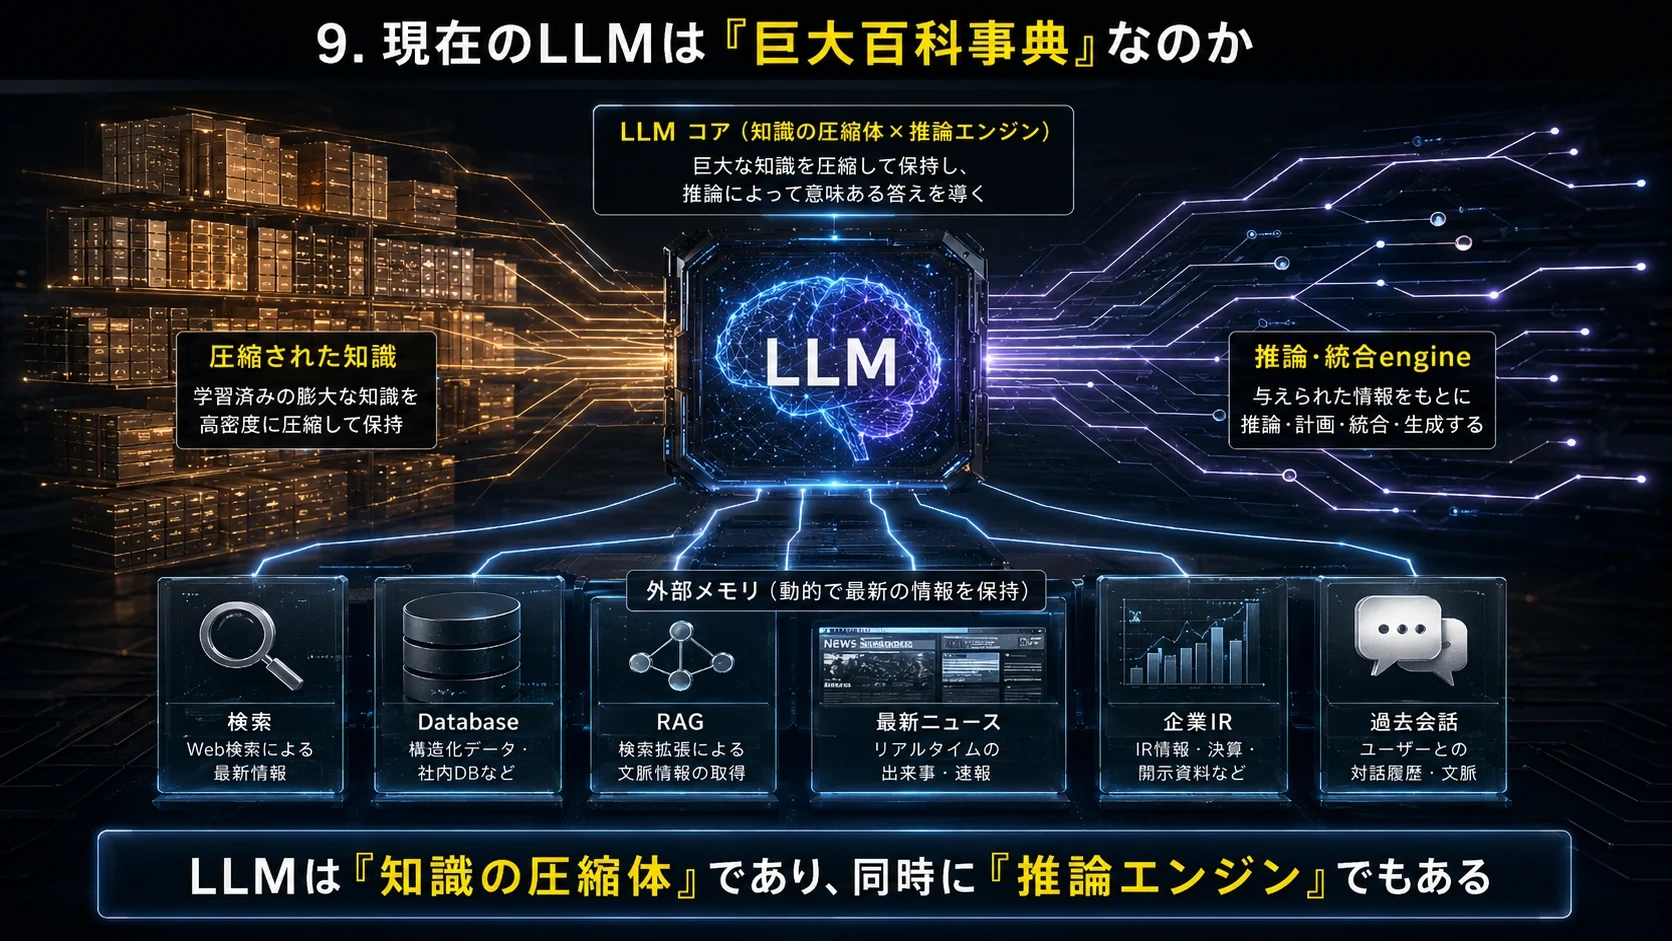
9.現在のLLMは「巨大百科事典」なのか
#半分正しく、半分間違っている。
#LLM内部に、
#Apple = ... HBM = ... 東京 = ...
#というdatabaseが直接格納されているわけではない。
#知識、言語規則、世界の構造、推論patternなどが数千億・数兆個のweightへ分散表現として圧縮されている。
#したがって現在のLLMは、
#「巨大に圧縮された百科事典」
#であると同時に、
#「その知識を変換・組み合わせる推論回路」
#でもある。
#ただし、今後すべての知識をparametersへ押し込むことが最適とは限らない。
#今日の株価、最新ニュース、企業IR、個人の過去会話などは外部memoryへ置き、必要時にRAG、検索、database、toolを通じて取り出した方がよい。
#するとLLM本体は「すべてを覚えた百科事典」から、
#強力な推論・検索・統合engine
#へ寄っていく可能性がある。
#図解|知識圧縮器と推論エンジン
#
10.MHAとは「過去のどこを見るか」を複数の視点で判断する仕組み
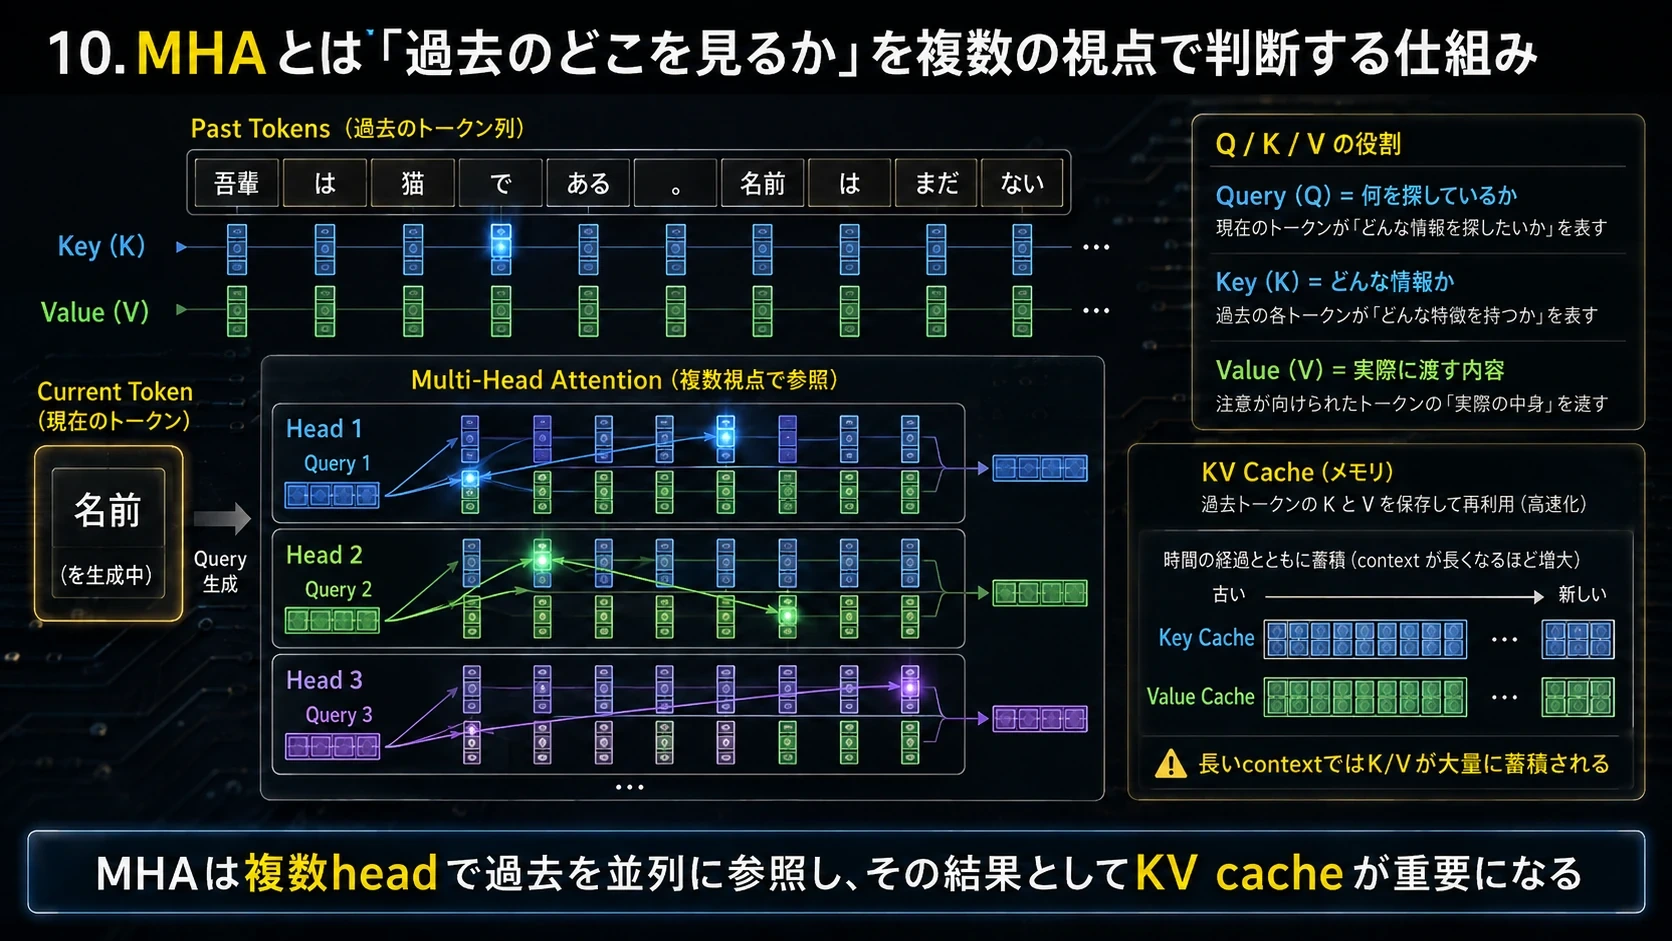
#Transformer Attentionでは現在tokenからQuery、過去tokenからKeyとValueを生成する。
#Queryは「何を探しているか」、Keyは「私はどんな情報か」、Valueは「実際に渡す内容」と考えればよい。
#Multi-Head Attention(MHA)はこの検索を複数headで並行して行う。
#あるheadは文法、別のheadは人物関係、別のheadは時間関係など、異なるpatternを学習できる。
#ところがMHAでは各Query headに対応したKey/Valueを保存する必要がある。
#長いcontextでは、このK/Vが大量に蓄積される。
#これがKV cacheである。
#図解|MHAとKV cache
#
11.GQAはKV cacheを減らす
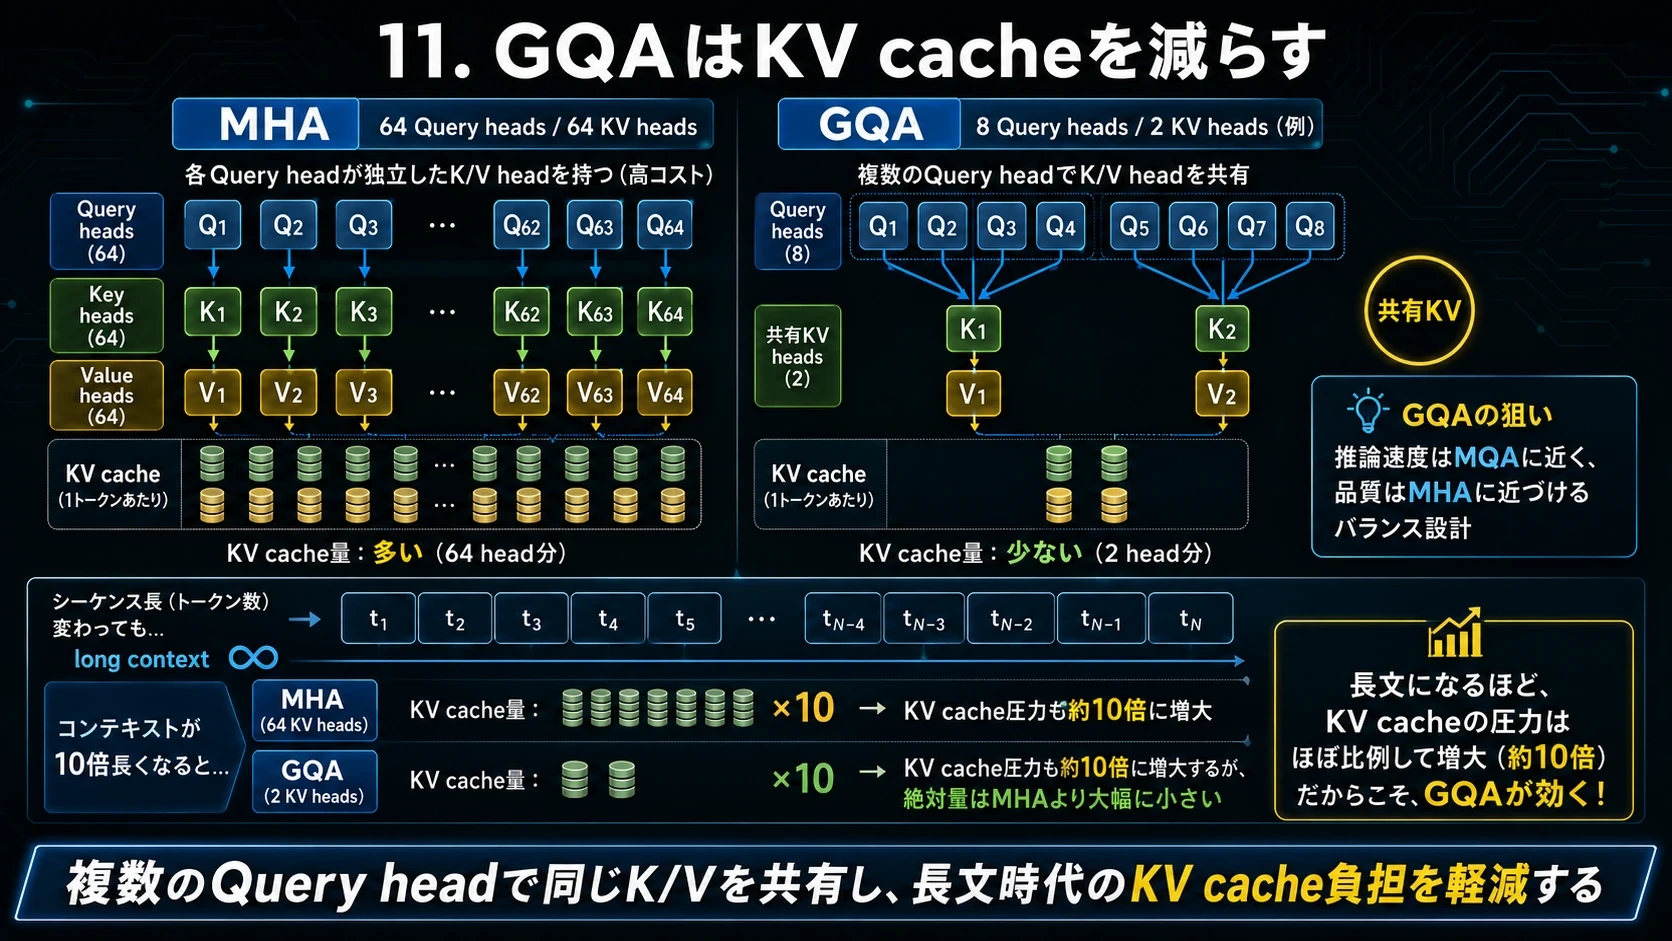
#Grouped-Query Attention(GQA)は、複数のQuery headで同じK/V headを共有する。
#例えばMHAで64 Query heads、64 KV headsだったものを、
#Q1 ┐ Q2 ├── KV1 Q3 ┤ Q4 ┘
#Q5 ┐ Q6 ├── KV2 Q7 ┤ Q8 ┘
#のようにできる。
#GoogleのGQA論文は、KV headを1個だけにするMQAに近い推論速度を保ちながら、MHAに近い品質を目指す中間方式としてGQAを提案した。 (arXiv)
#これはlong-context時代には極めて大きい。
#contextが10倍になれば、基本的にはKV cacheも10倍になるためである。
#図解|GQAによるKV共有
#
12.DeepSeekのMLAはさらにKVを圧縮する
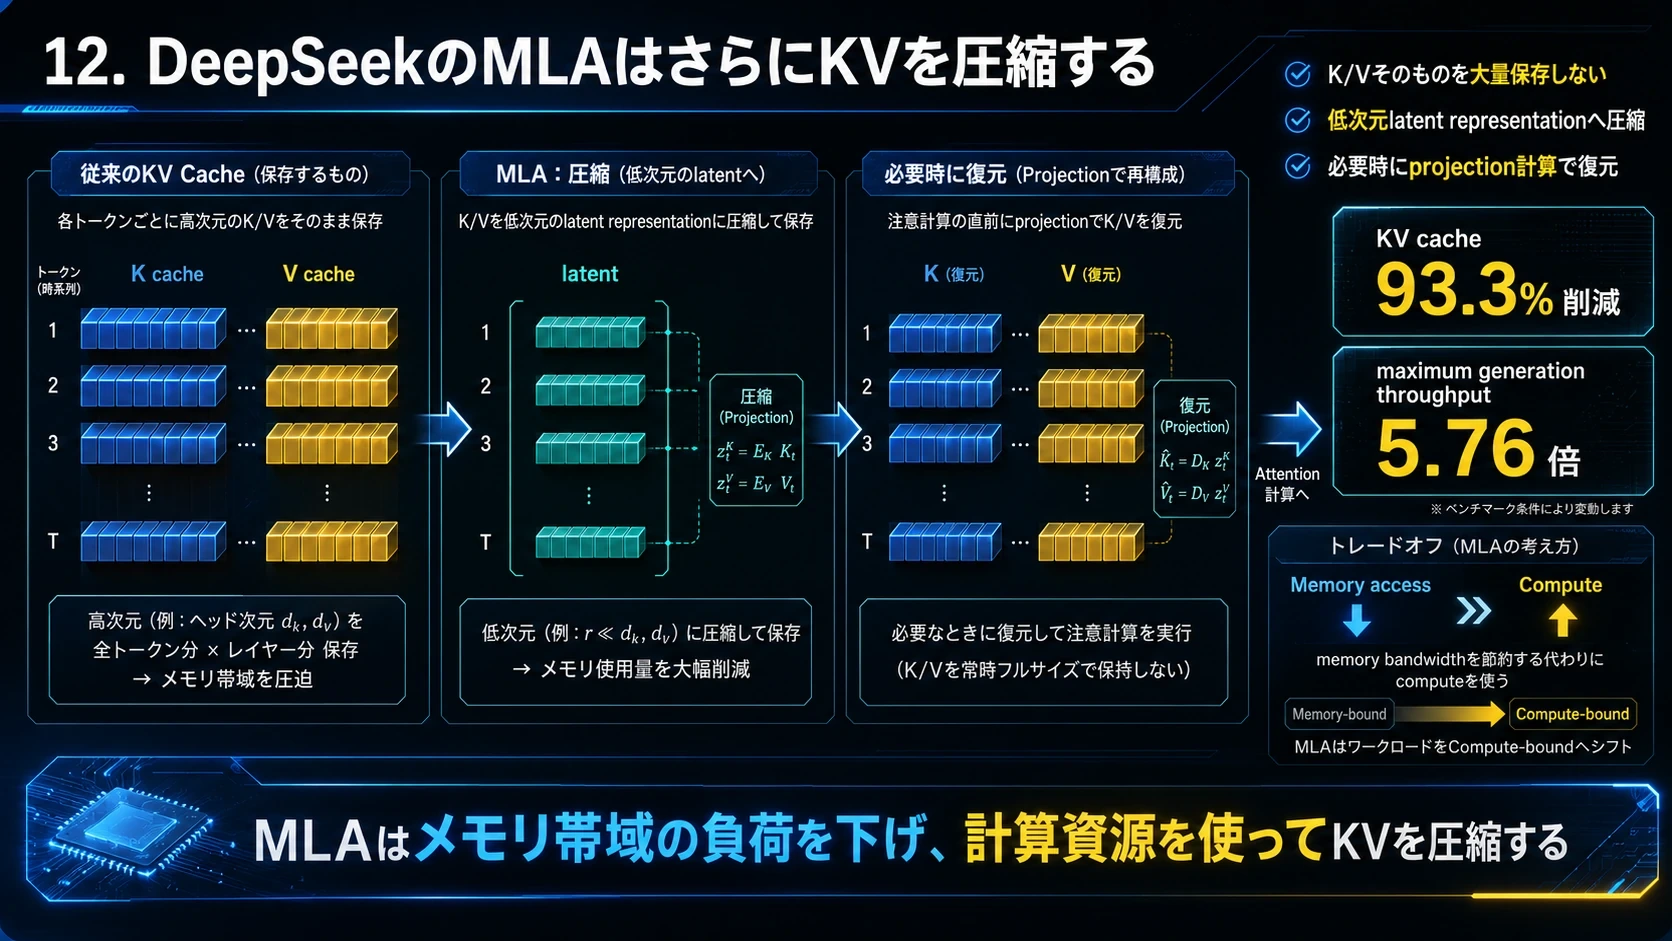
#DeepSeek-V2が導入したMulti-head Latent Attention(MLA)は、K/Vそのものを大量に保存する代わりに、低次元latent representationへ圧縮する。
#DeepSeekはV2について、従来方式に比べKV cacheを93.3%削減し、maximum generation throughputを5.76倍にしたと報告している。 (arXiv)
#これは「無料の圧縮」ではない。
#K/Vを圧縮・復元するためのprojection計算が必要になる。
#つまり、
#memory bandwidthを節約する代わりにcomputeを使う。
#現在のAI acceleratorではTensor演算能力の伸びに対してmemory bandwidthが不足しやすい。
#そのため、
#と引き換えに、
#となるMLAはhardware architectureと非常に相性がよい。
#Hardware-centricな分析でも、MLAはmemory bandwidth負荷を減らし、workloadをよりcompute-bound側へ移せることが示されている。 (arXiv)
#図解|MLAのKV圧縮
#
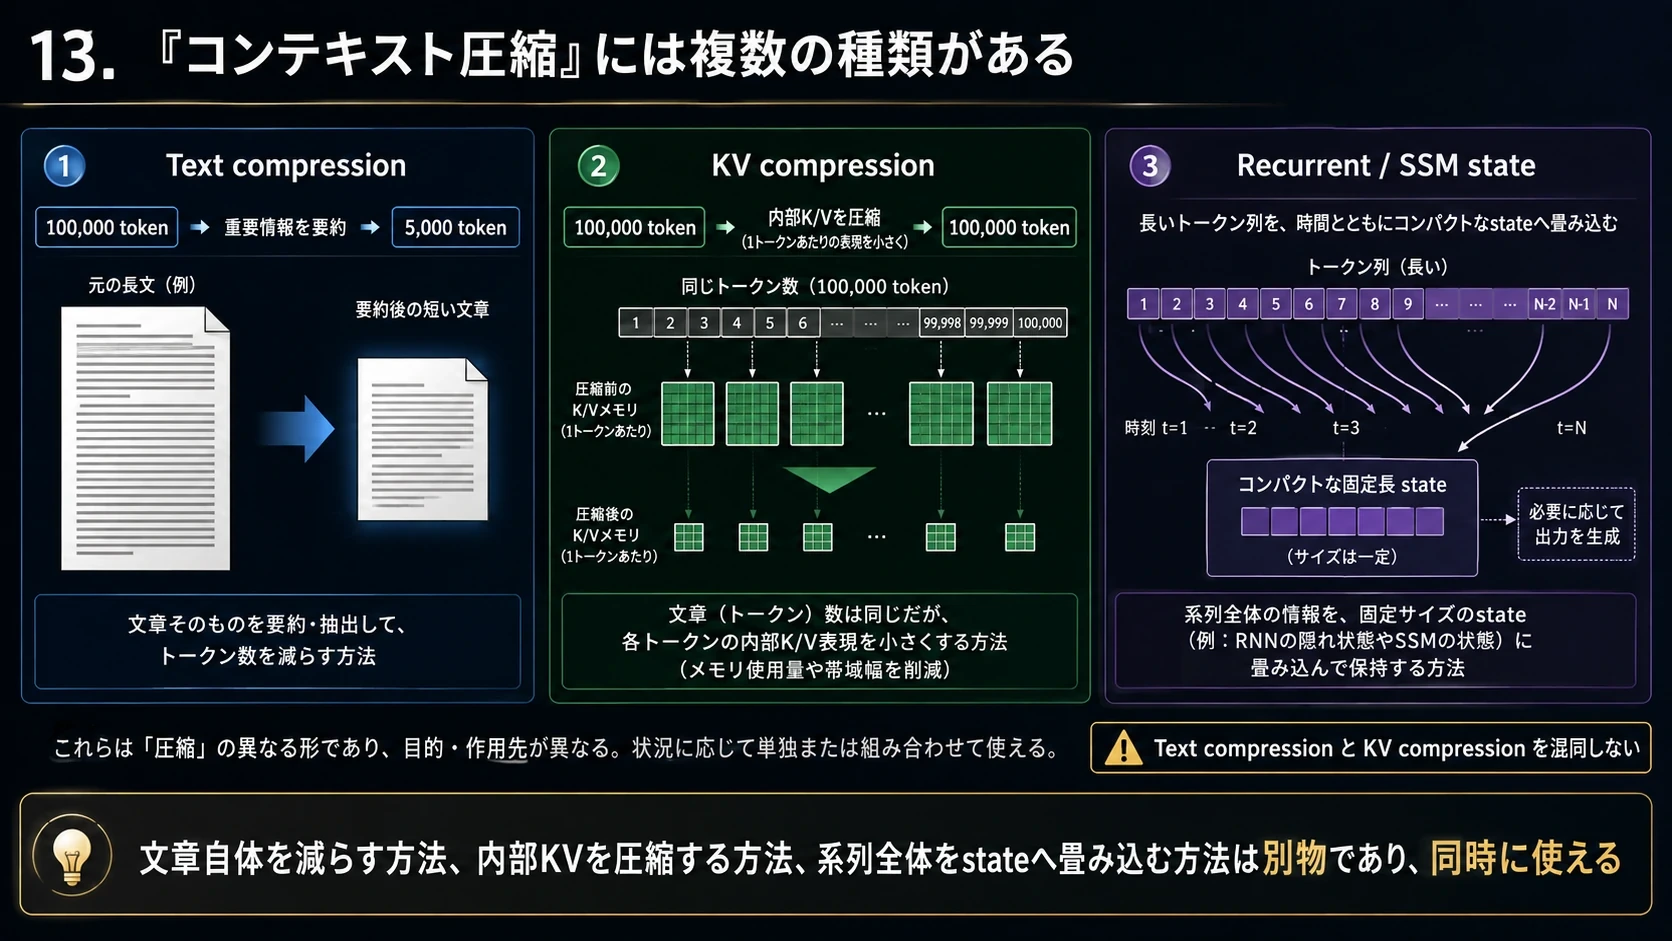
13.「コンテキスト圧縮」には複数の種類がある
#AIのmemoryを理解するとき、Text compressionとKV compressionを混同してはいけない。
#例えば過去10万tokenのconversationがあるとする。
#Text compressionでは、
#100,000 token
↓
重要情報を要約
↓
5,000 tokenと、tokenそのものを減らす。
#一方、GQAやMLAは、
#100,000 token
#自体は残したまま、
#1 tokenあたりの内部memory表現を小さくする。
#さらにrecurrent/SSM系architectureでは、過去token列を固定サイズに近いstateへ順次畳み込む方法もある。
#つまりcontext compressionには、
#文章自体を要約する方法
#と、
#内部KV representationを圧縮する方法
#と、
#過去全体をrecurrent stateへ畳み込む方法
#がある。
#これらは競合せず、同時に使える。
#図解|複数のコンテキスト圧縮
#
14.しかし圧縮すれば必ず情報を失う
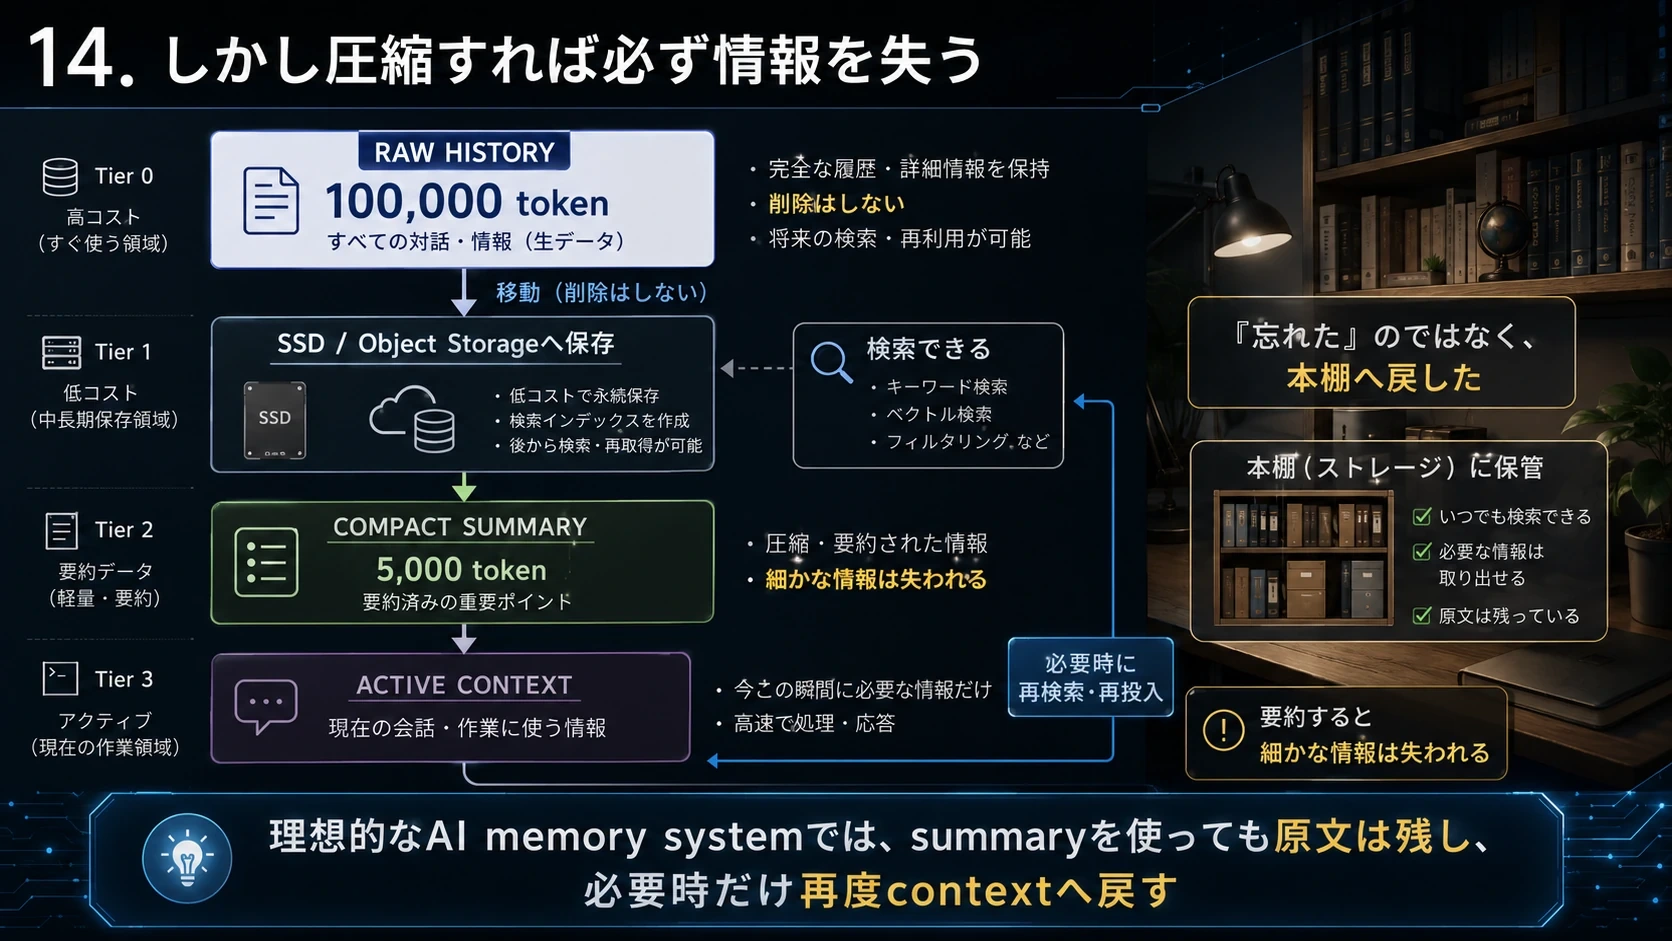
#10万tokenを1000tokenへsummary化したら、当然9万9000token分の細かな情報は消える。
#したがって理想的なAI memory systemでは、圧縮したからといって原文を削除しない。
#Raw history
100,000 token
│
├── SSD / Object Storageへ保存
│
↓
Compact Summary
5,000 token
↓
Active Context普段はsummaryだけを使う。
#必要なときだけraw historyを検索して、該当部分をもう一度contextへ戻す。
#これは「忘れた」のではない。
#机の上の資料を本棚へ戻したのである。
#図解|圧縮と原文保持の階層
#
15.長期記憶、作業記憶、短期記憶をhardwareへ振り分けるのはSoftwareである
#この点は非常に重要である。
#LLM自身がHBM controllerを操作して、
#「これはHBM」「これはSSD」
#と決めるわけではない。
#概念的には、
#LLM / Agent
↓
Memory Policy / Orchestrator
↓
Inference Runtime
↓
Driver / OS
↓
HBM / DRAM / SSD / Remote Memoryとなる。
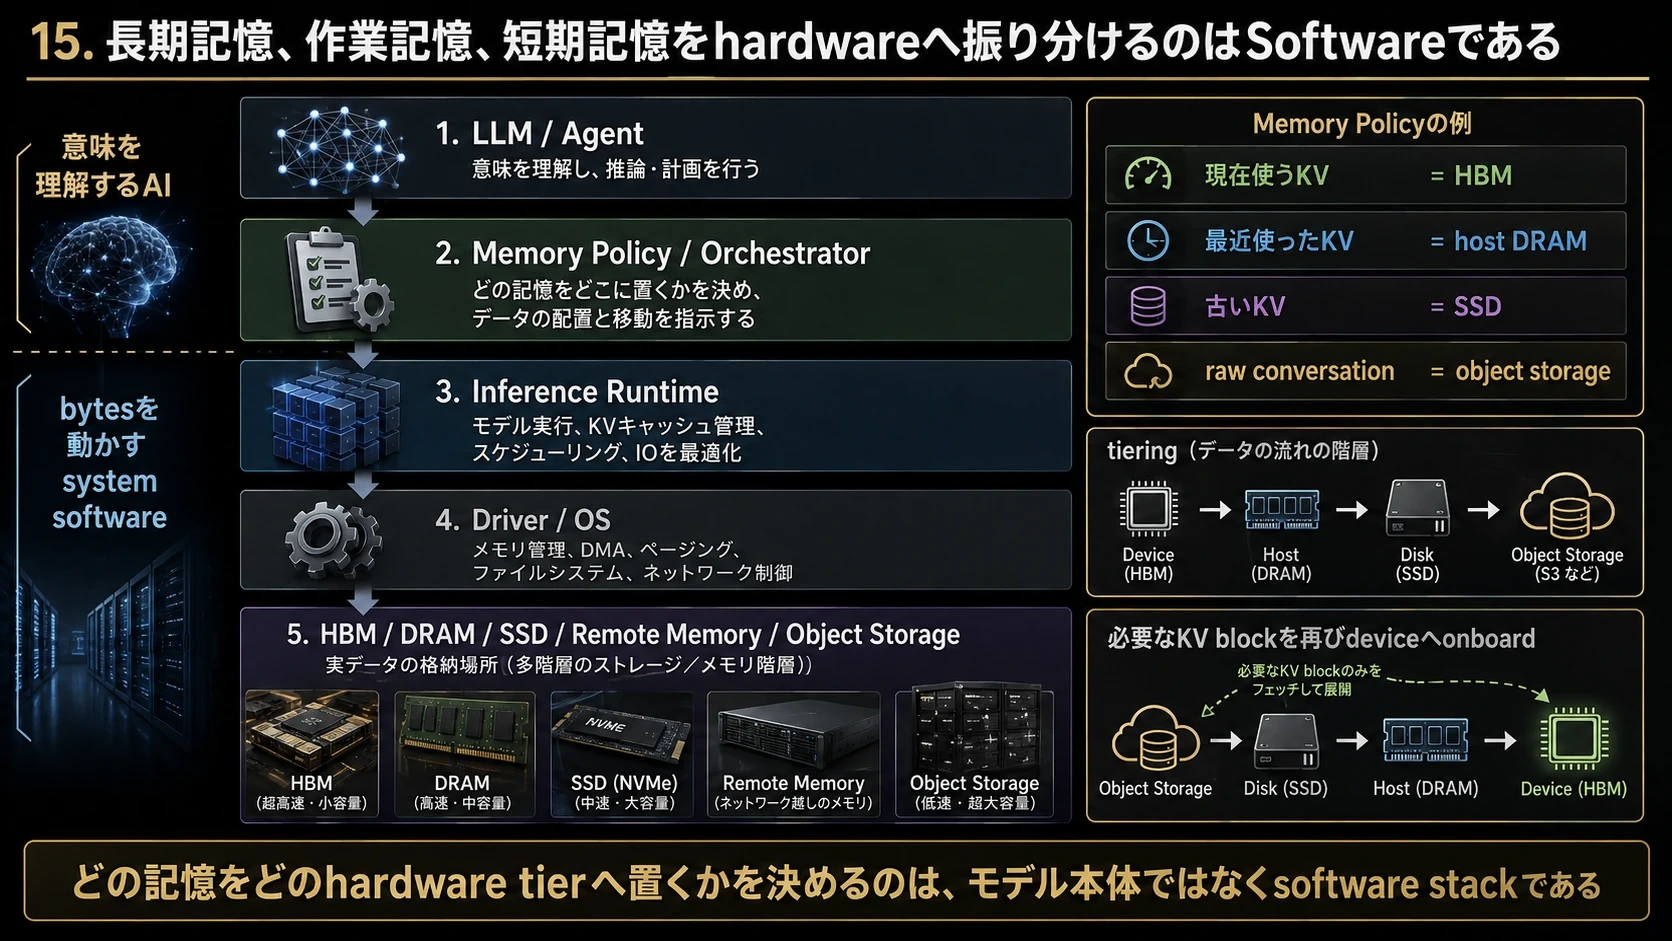
#softwareが、
#現在使っているKVはHBM、
#最近使ったKVはhost DRAM、
#古いKVはSSD、
#raw conversationはobject storage、
#といったpolicyを実行する。
#実際NVIDIA DynamoのKVBMは、GPU memory、host DRAM、remote RDMA memory、SSD、remote/object storageを一つの階層型KV memoryとして扱う設計になっている。Device→Host→Disk→Object Storageというtieringと、必要なKV blockを再びdeviceへonboardする機構を備えている。 (NVIDIA Docs)
#つまりこの未来像は研究上の空想ではなく、software stack側ではすでに実装が始まっている。
#図解|Softwareが決める記憶配置
#
16.モデルが「必要な記憶を思い出す」とき、実際には何が起きるのか
#人間のように突然脳内の記憶が蘇るわけではない。
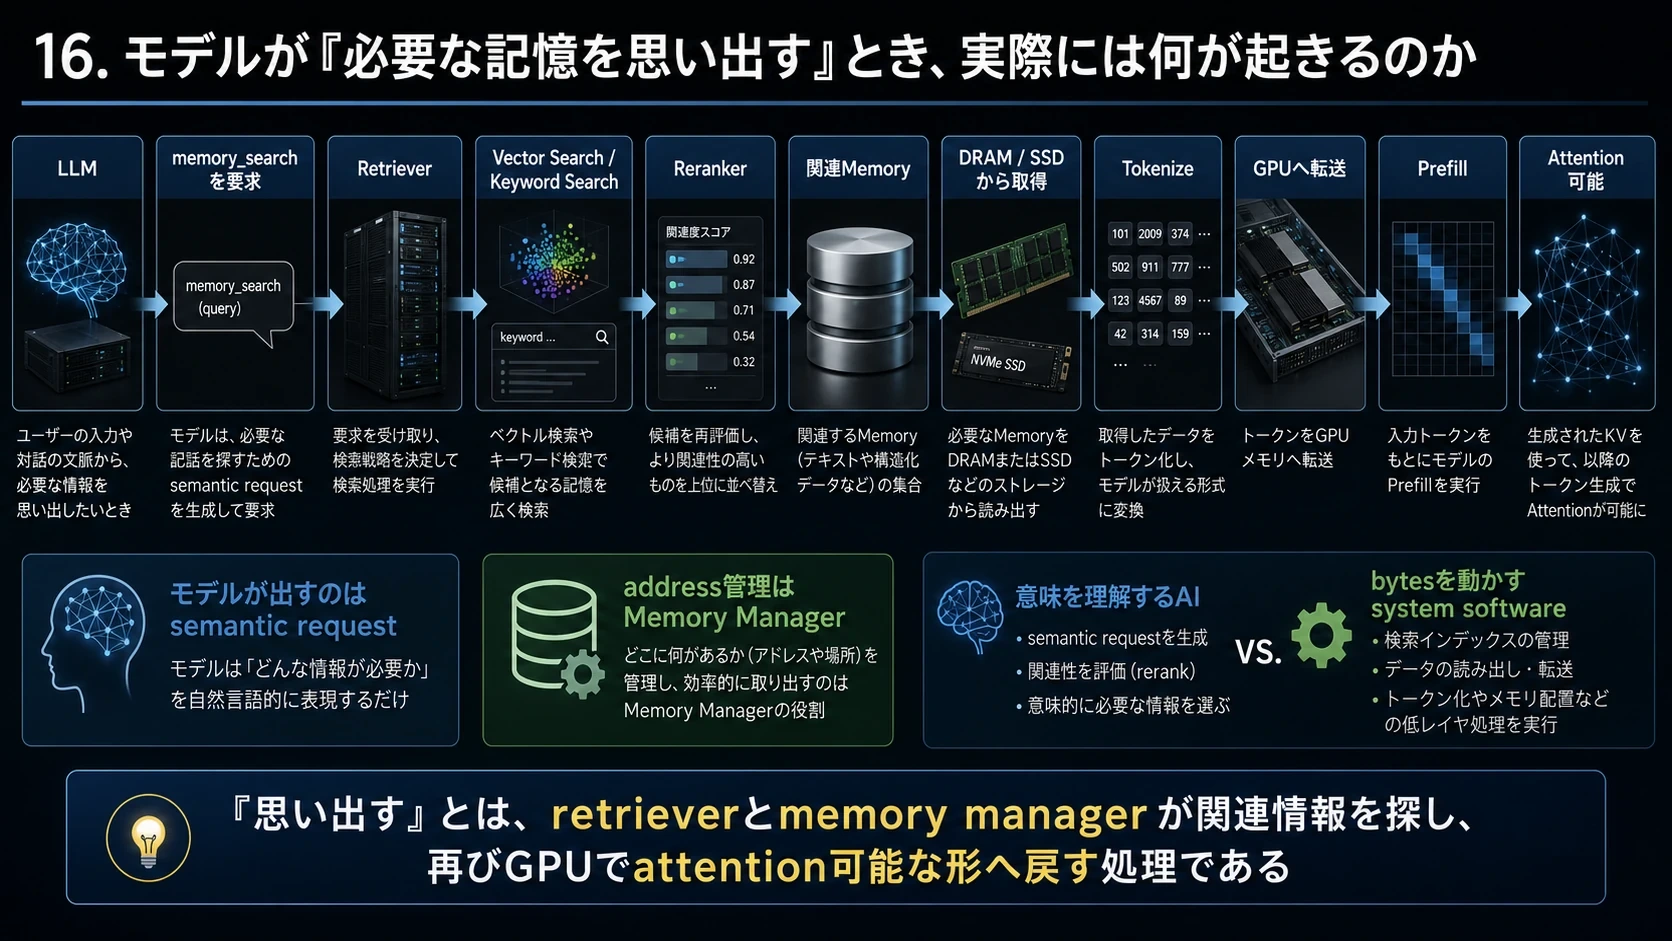
#典型的にはRetrieverやmemory toolが使われる。
#例えばモデルが、
#「以前決めたAPI仕様が必要だ」
#と判断した場合、
#LLM
↓
memory_searchを要求
↓
Retriever
↓
Vector Search / Keyword Search
↓
Reranker
↓
関連Memory
↓
DRAM / SSDから取得
↓
Tokenize
↓
GPUへ転送
↓
Prefill
↓
KV生成
↓
Attention可能となる。
#モデルが出すのは、
#「この意味の情報が必要」
#というsemantic requestである。
#実際に「SSDの何番addressにあるか」を管理するのはMemory Managerである。
#ここでも、
#意味を理解するAI
#と、
#bytesを動かすsystem software
#は分離している。
#図解|RetrieverとMemory Manager
#
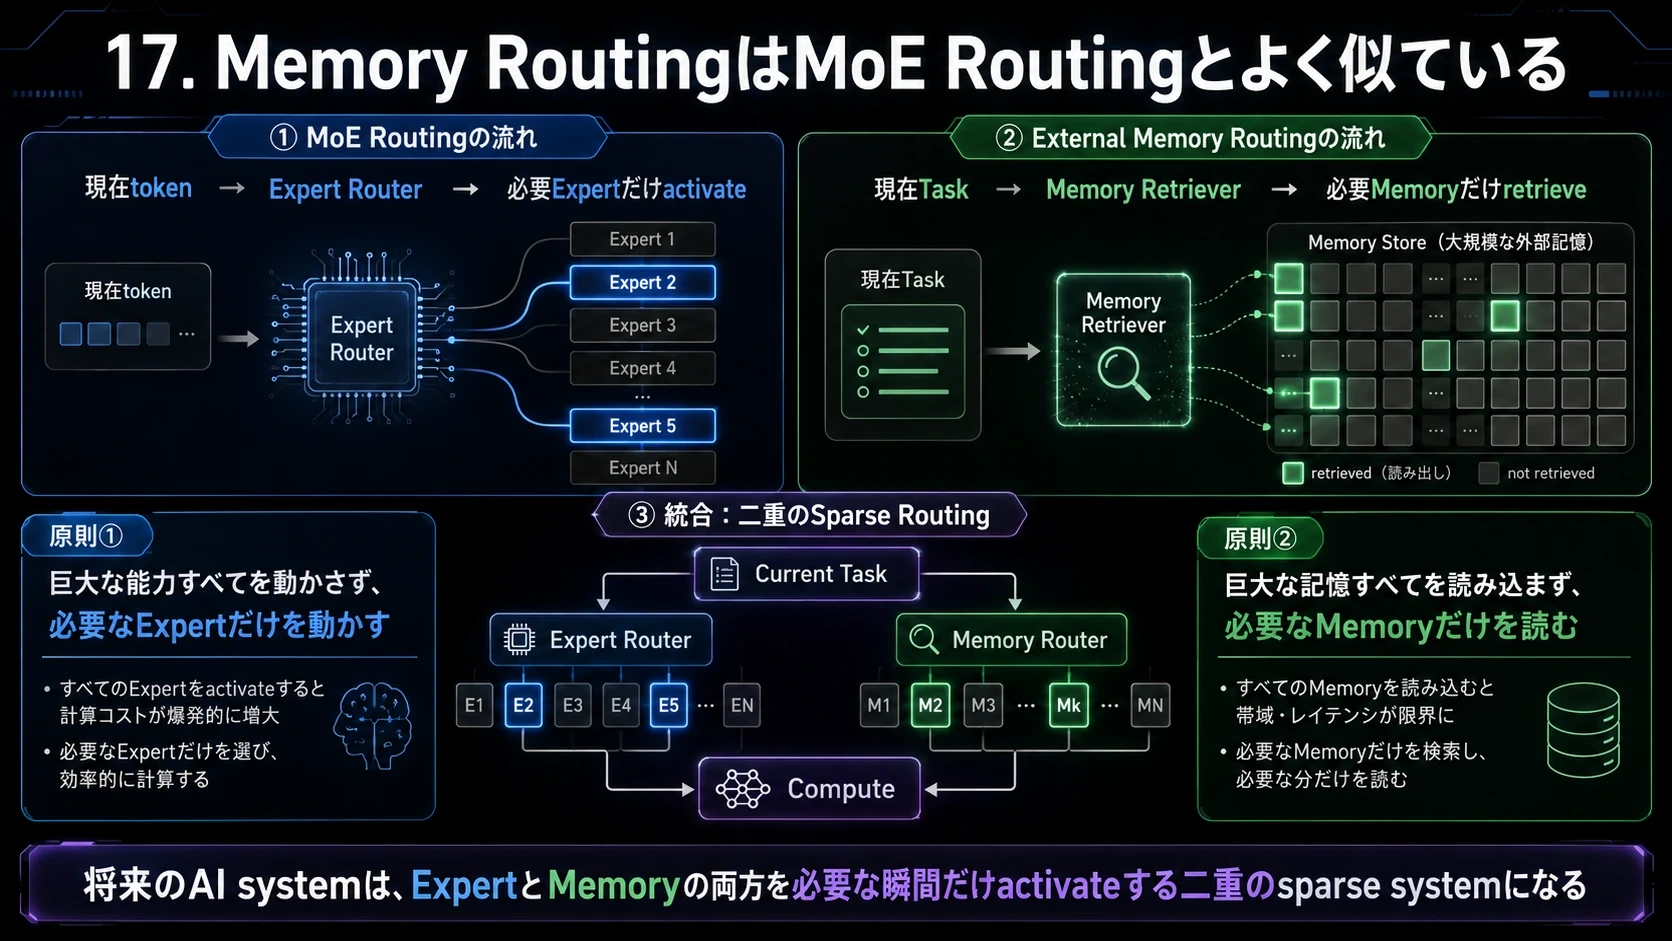
17.Memory RoutingはMoE Routingとよく似ている
#MoEでは、
#現在token
↓
Expert Router
↓
必要Expertだけactivateする。
#External Memoryでは、
#現在Task
↓
Memory Retriever
↓
必要Memoryだけretrieveする。
#したがって将来のAI systemは、
#Current Task
│
┌───────────┴───────────┐
↓ ↓
Expert Router Memory Router
↓ ↓
必要Expert 必要Memory
└───────────┬───────────┘
↓
Computeという二重のsparse systemになる可能性がある。
#巨大な能力すべてを動かさず、必要なExpertだけを動かす。
#巨大な記憶すべてを読み込まず、必要なMemoryだけを読む。
#AIのscalingは「全部巨大化する」方向から、「巨大な資源を必要な瞬間だけactivateする」方向へ変わりつつある。
#図解|ExpertとMemoryの二重Routing
#
18.その結果、AI memoryは階層構造になる
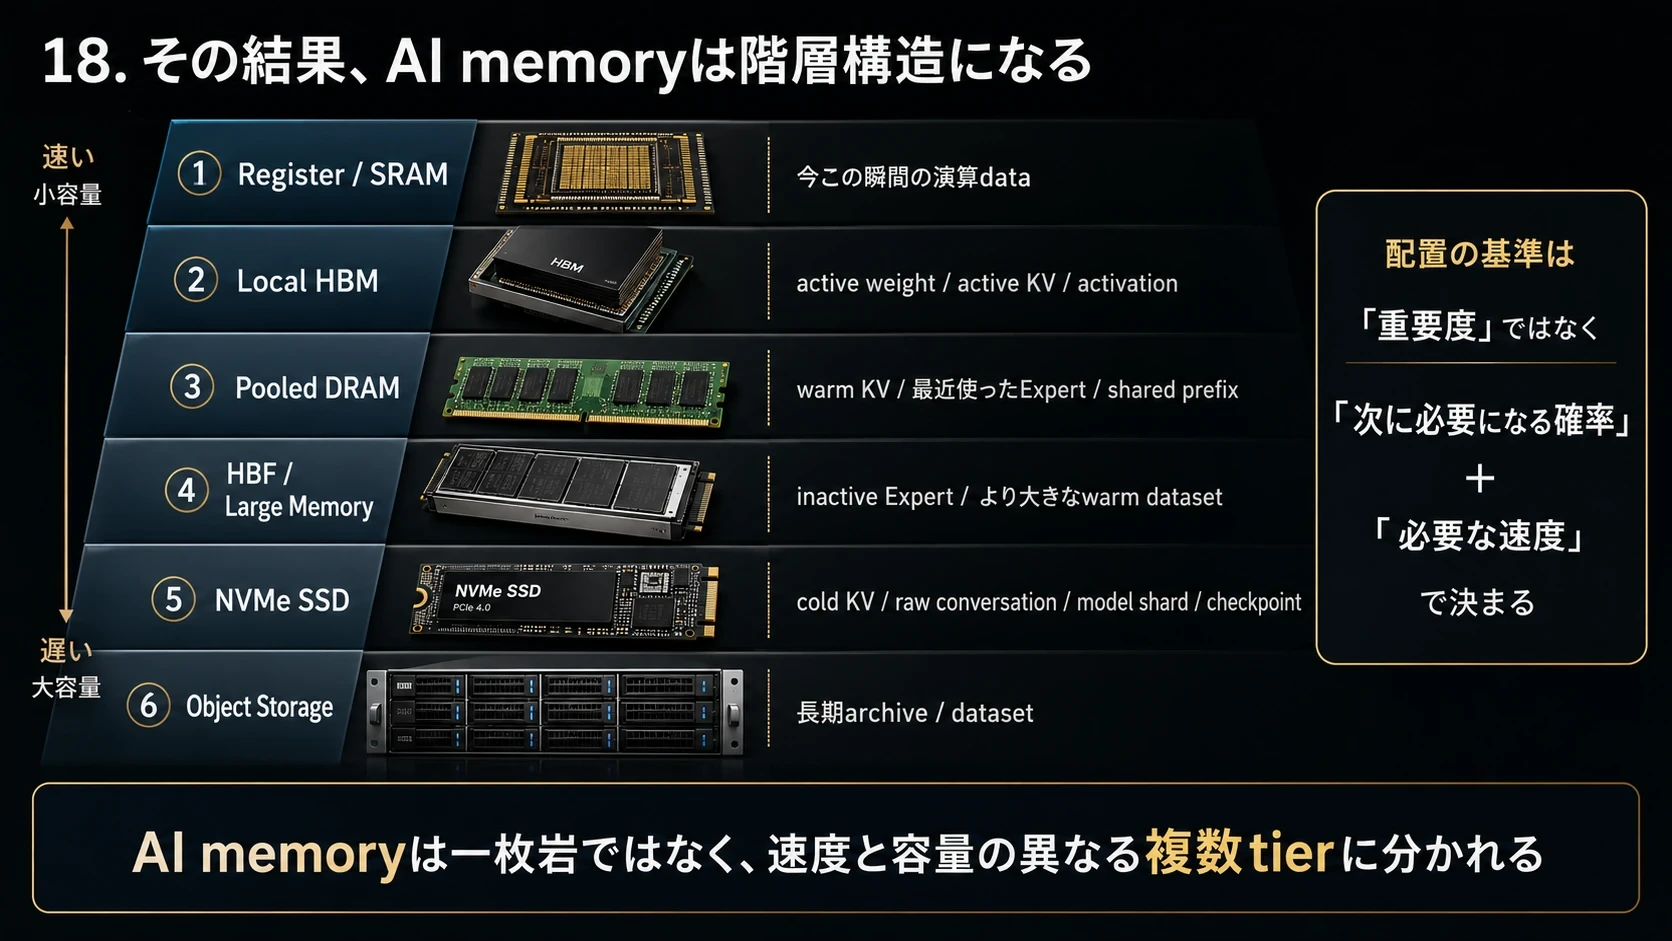
#将来的には、memory hierarchyを次のように考えるのが自然である。
#Register / SRAM
↓
Local HBM
↓
Pooled DRAM
↓
HBF / Large Memory
↓
NVMe SSD
↓
Object StorageSRAMには今この瞬間の演算で使うdata。
#HBMにはactive weight、active KV、activation。
#DRAMにはwarm KV、最近使ったExpert、shared prefix。
#HBFや大容量memoryにはinactive Expertやより大きなwarm dataset。
#SSDにはcold KV、raw conversation、model shard、checkpoint。
#Object Storageには長期archiveやdataset。
#というように、「重要度」ではなく次に必要になる確率と必要な速度で配置される。
#図解|AI Memoryの多層構造
#
19.HBMは消えるのではなく「AIの作業記憶」へ純化する
#Optical pooled memoryが実用化すると、「HBMは不要になるのではないか」という疑問が出る。
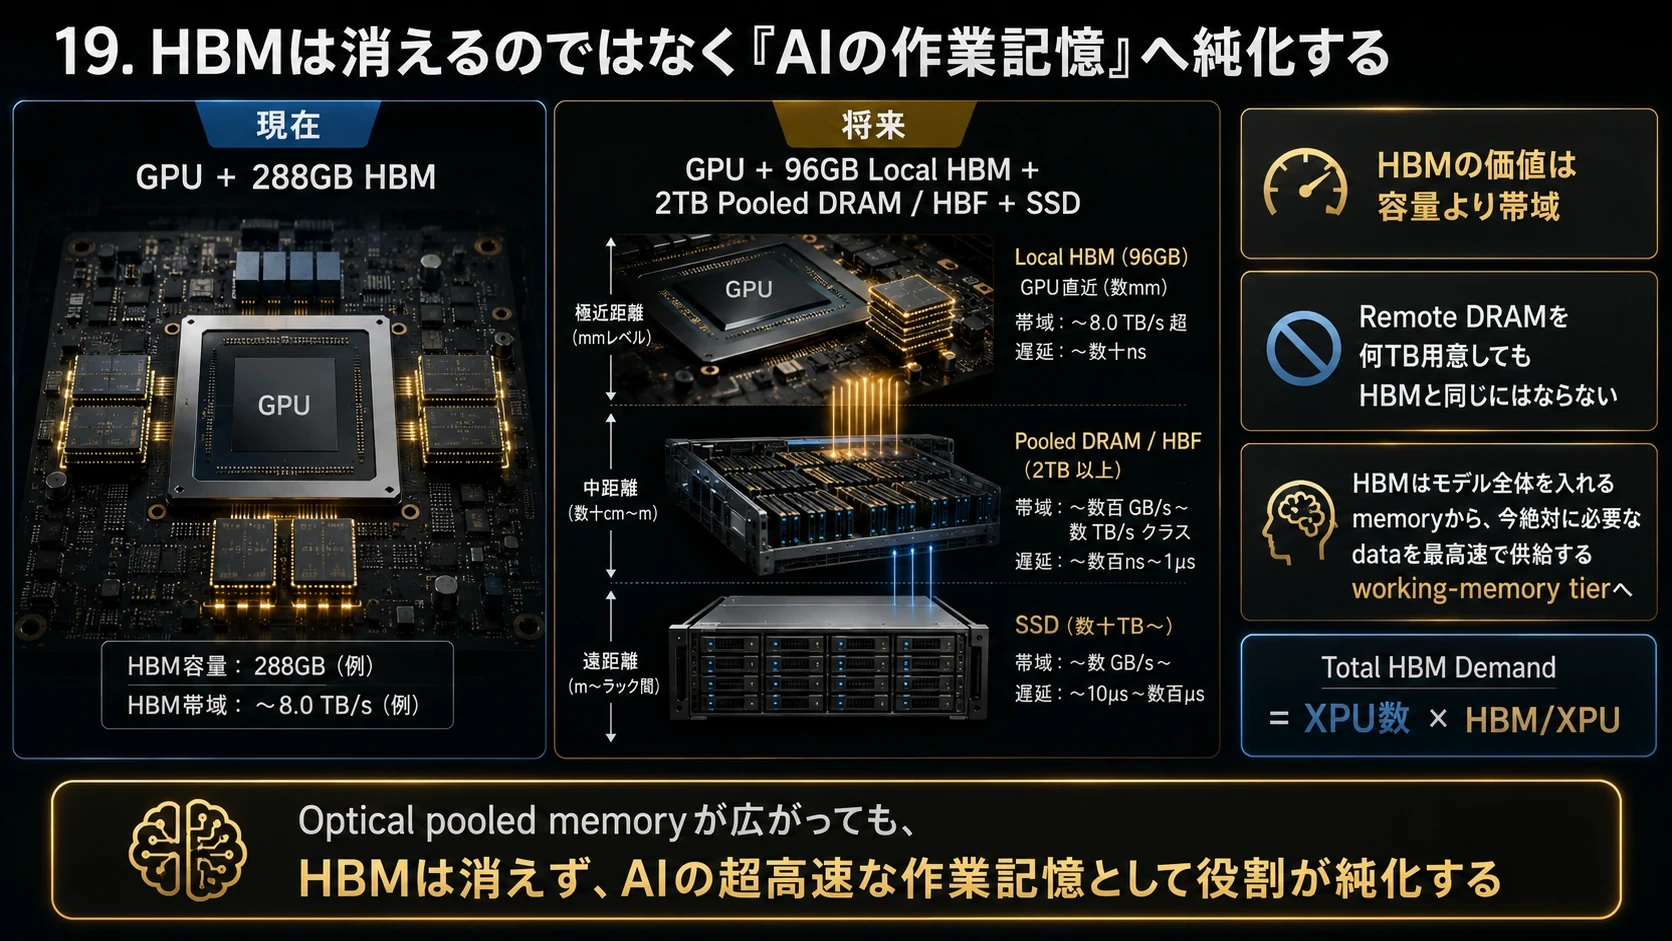
#しかしHBMの最大の価値は容量ではなく、XPU直近で非常に高い帯域を供給できる点にある。
#Remote DRAMを何TB用意しても、GPUから数mm~数cmの場所で多数TB/sを出せるHBMと同じものにはならない。
#したがって将来、
#現在 GPU + 288GB HBM
#↓
#将来 GPU + 96GB Local HBM + 2TB Pooled DRAM/HBF + SSD
#のような変化はあり得る。
#これは1 GPU当たりHBM容量には下押し要因になる。
#一方でHBMは、
#「モデル全体を入れるmemory」
#から、
#「今絶対に必要なdataを最高速で供給するmemory」
#へ変わる。
#言い換えればAI版の巨大なlast-level working-memory tierへ近づく。
#しかもOptical Fabricによってmodel全体の容量制約が緩和されれば、XPU数そのものをさらに増やせる。
#したがって、
#で考える必要があり、「Optical Fabric=HBM弱気」とは単純に言えない。
#図解|HBMの作業記憶化
#
20.Optical Fabricの原理的な限界
#光にも無限の性能はない。
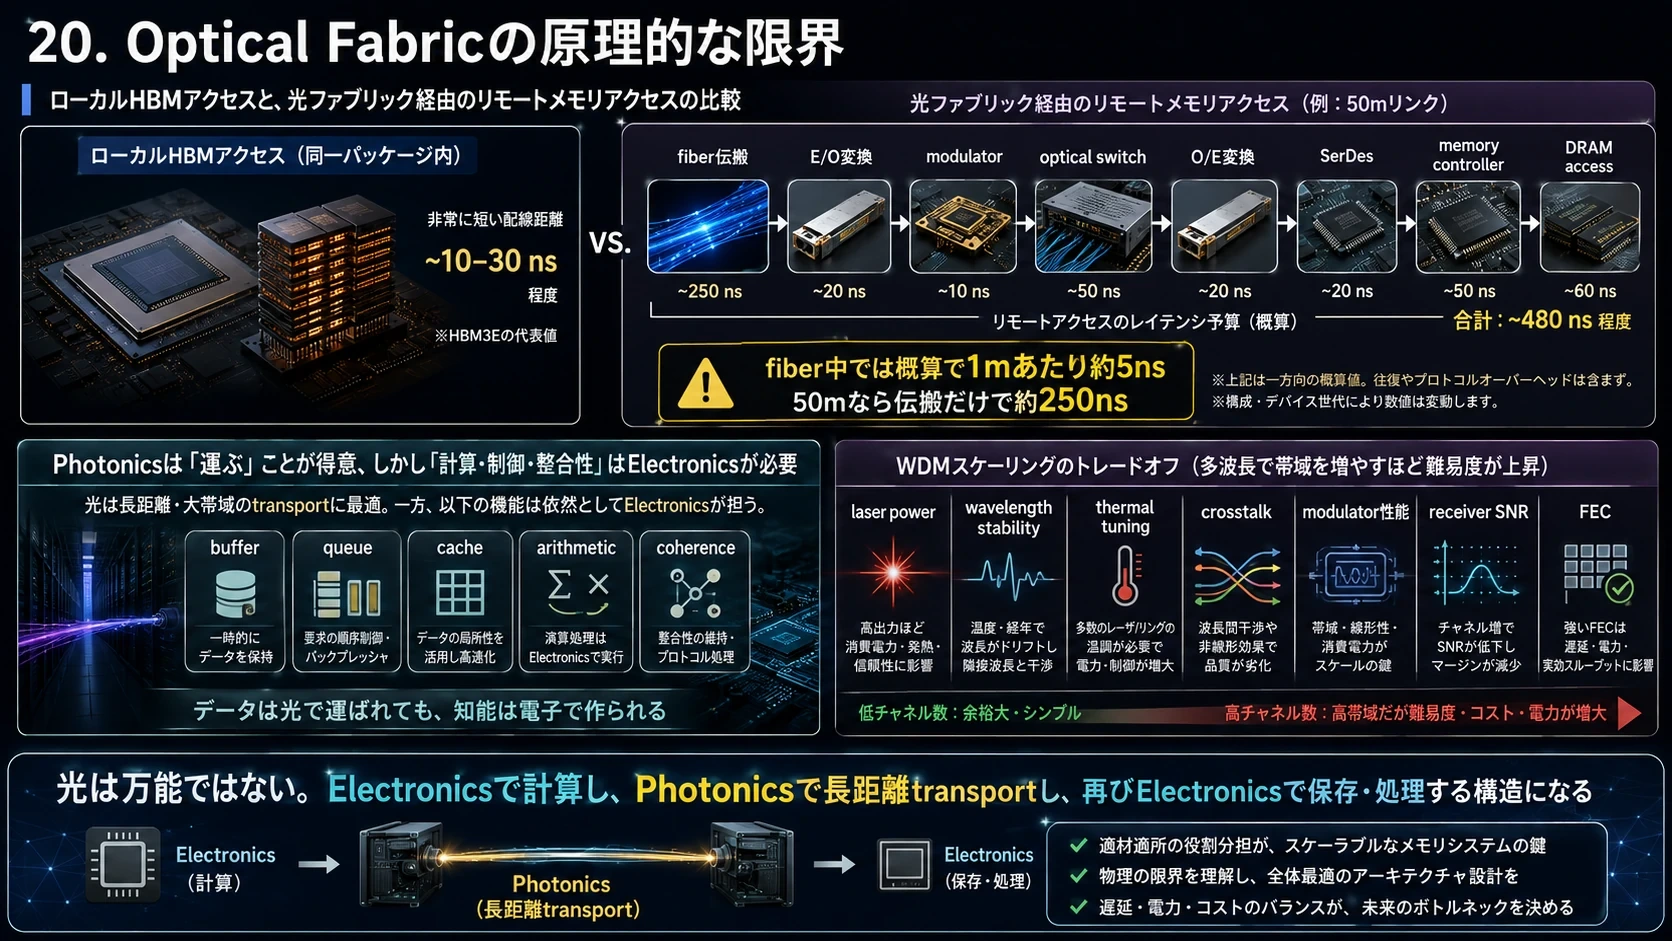
#まず光速そのものに限界がある。
#fiber中では概算で1mあたり約5ns程度の伝搬遅延があるため、50mなら伝搬だけで約250nsとなる。
#さらに、
#E/O変換、
#modulator、
#optical switch、
#O/E変換、
#SerDes、
#memory controller、
#DRAM access
#などが加わる。
#したがってRemote MemoryをLocal HBMと同じlatencyにすることは原理的に難しい。
#また光はdataを運ぶことには強いが、buffer、queue、cache、arithmetic、coherenceなどは電子回路が必要になる。
#光にすればすべてが解決するわけではなく、
#Electronicsで計算し、Photonicsで長距離transportし、再びElectronicsで保存・処理する
#構造になる。
#WDMを増やしてfiber当たり帯域を上げれば、laser power、wavelength stability、thermal tuning、crosstalk、modulator性能、receiver SNR、FECなど別の壁も現れる。
#つまりOptical Fabricにも次のscaling lawが存在する。
#図解|光伝送の距離と遅延
#
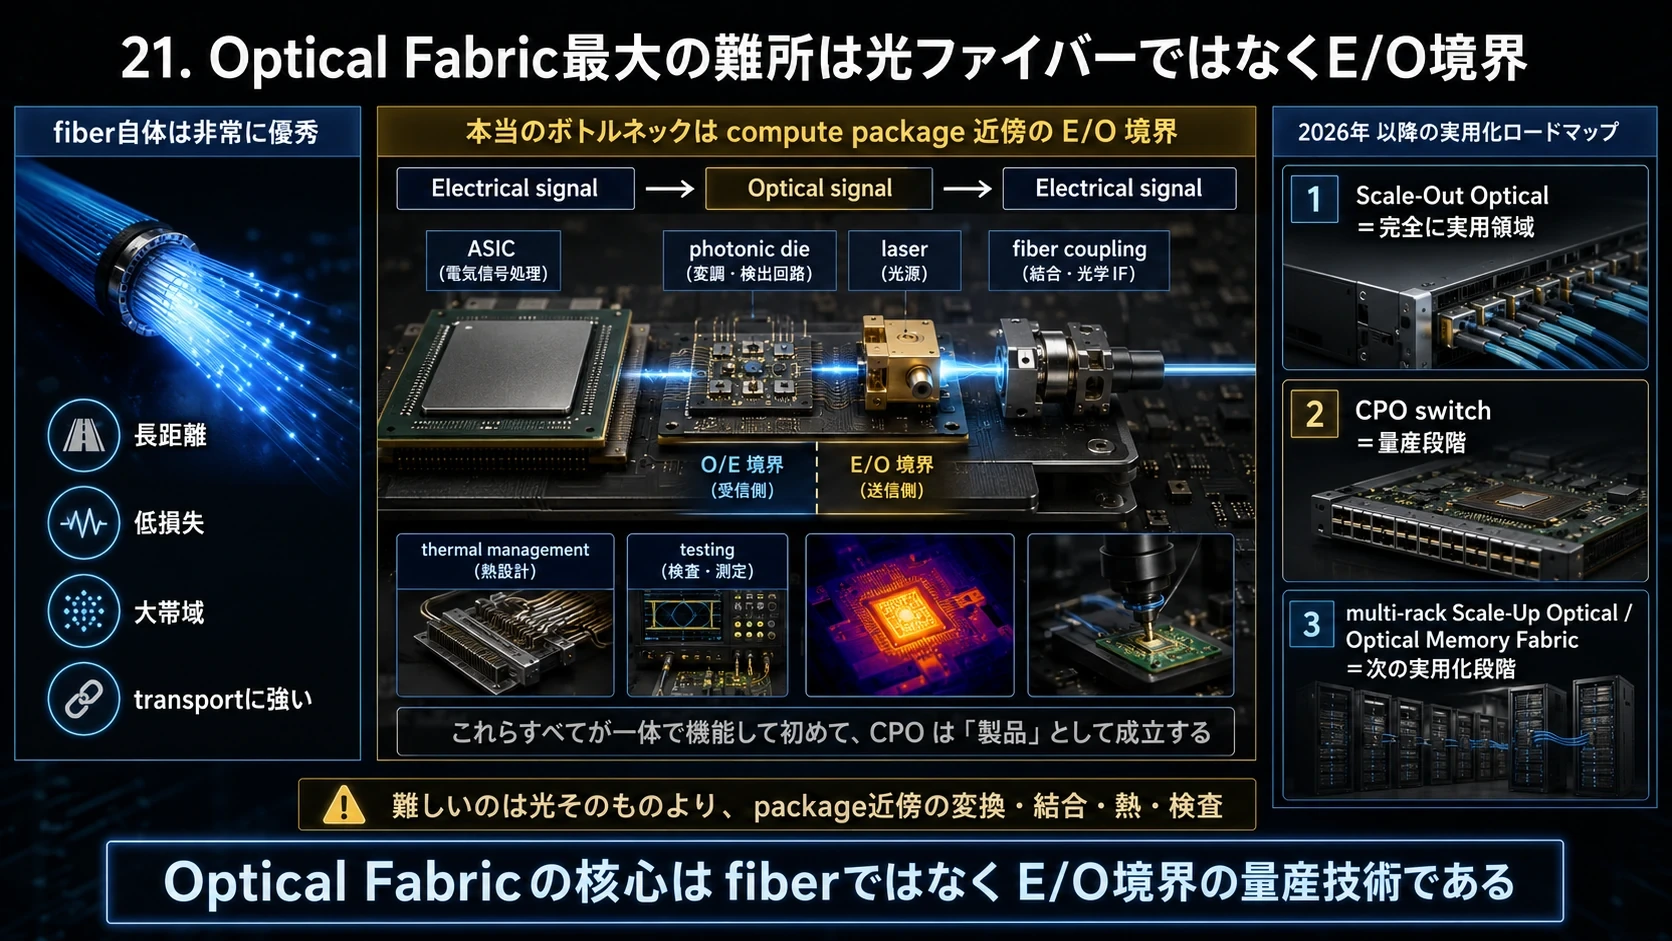
21.Optical Fabric最大の難所は光ファイバーではなくE/O境界
#fiber自体は非常に優秀である。
#難しいのはcompute packageのすぐ横で、
#Electrical signal → Optical signal
#へ変換し、受信側で再び戻す部分である。
#特にCPOではASIC、photonic die、laser、fiber coupling、thermal management、testingを一つの製品として成立させなければならない。
#TSMCがCOUPEをadvanced packagingそのものとして開発し、BroadcomやNVIDIAがCPO switchへ向かっている理由はここにある。
#NVIDIAは2026年5月、Spectrum-X Ethernet Photonicsをproduction入りさせたと発表した。 (NVIDIA Newsroom)
#BroadcomもTomahawk 6やCPOを含むAI Ethernet portfolioを生産展開しており、3.5D XDSiPもproductionに入っている。 (Broadcom)
#したがって2026年時点では、
#Scale-Out Opticalは完全に実用領域、CPO switchも量産段階に入り、multi-rack Scale-Up OpticalやOptical Memory Fabricは次の実用化段階
#という位置づけが適切である。
#図解|E/O境界と光電融合
#
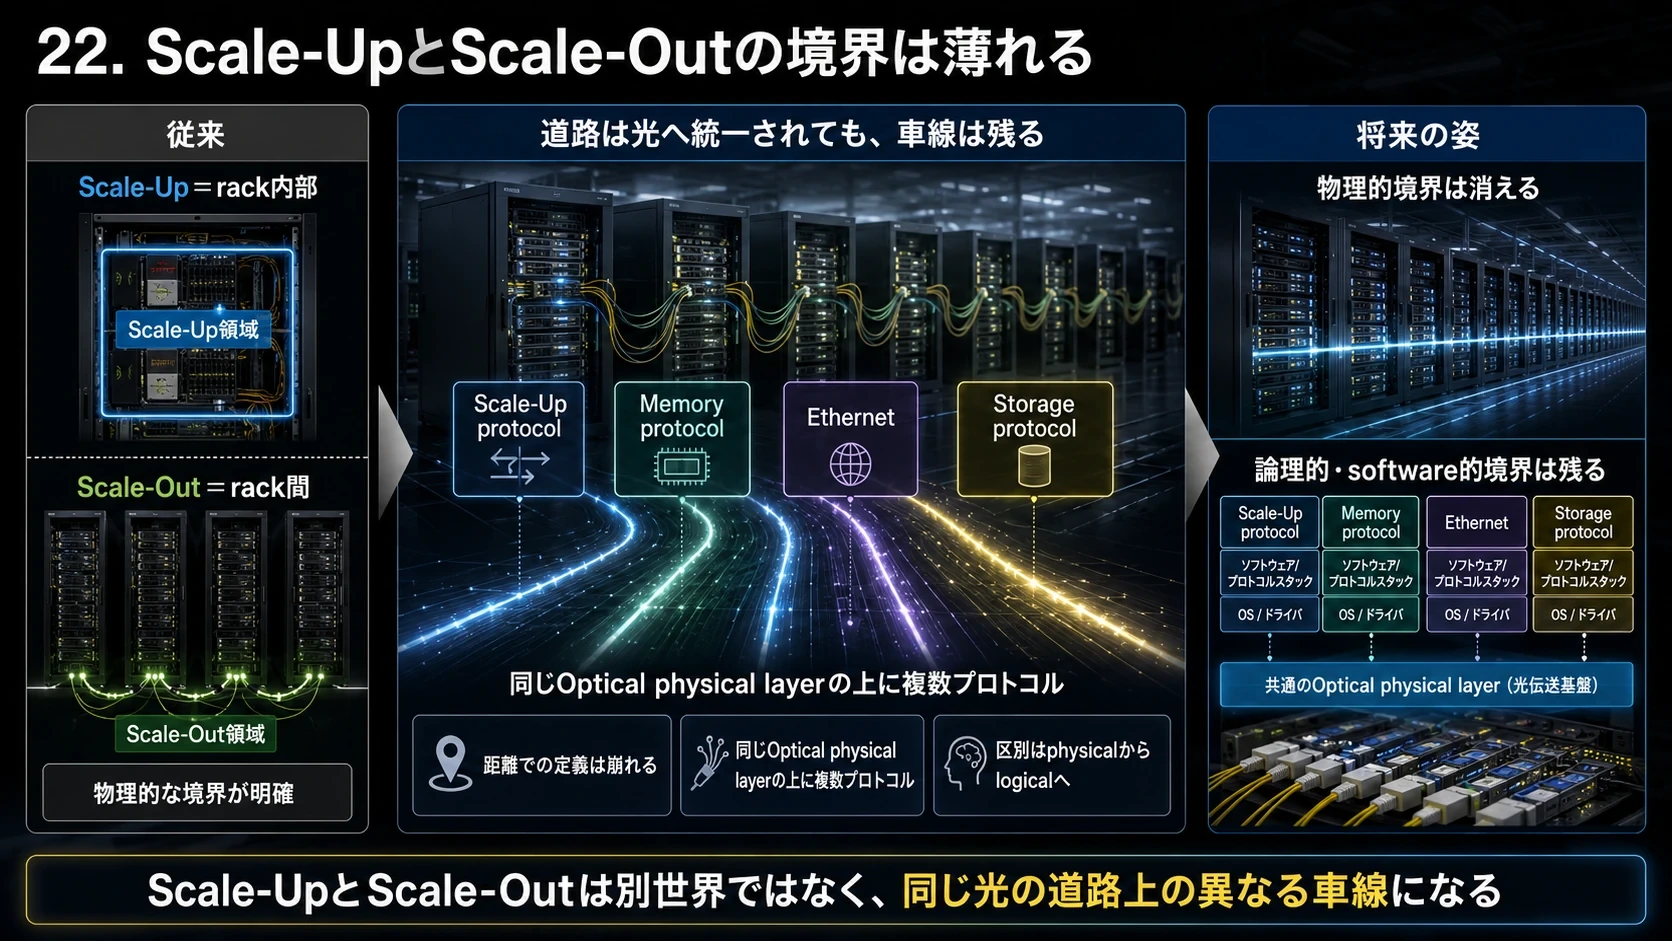
22.Scale-UpとScale-Outの境界は薄れる
#従来は、
#Scale-Up=rack内部、
#Scale-Out=rack間、
#と物理距離で分かりやすく区別できた。
#しかしOptical Fabricでラックを越えて低遅延にXPUを接続できるようになると、この定義は崩れる。
#将来は同じOptical physical layerの上に、
#Scale-Up protocol、
#Memory protocol、
#Ethernet、
#Storage protocol
#などが載る可能性がある。
#つまり、
#道路は光へ統一されても、車線は残る。
#Scale-UpとScale-Outの境界が完全消滅するというより、物理的境界は消え、論理的・software的境界だけが残ると考えるのがよい。
#図解|同じ光路に重なる通信
#
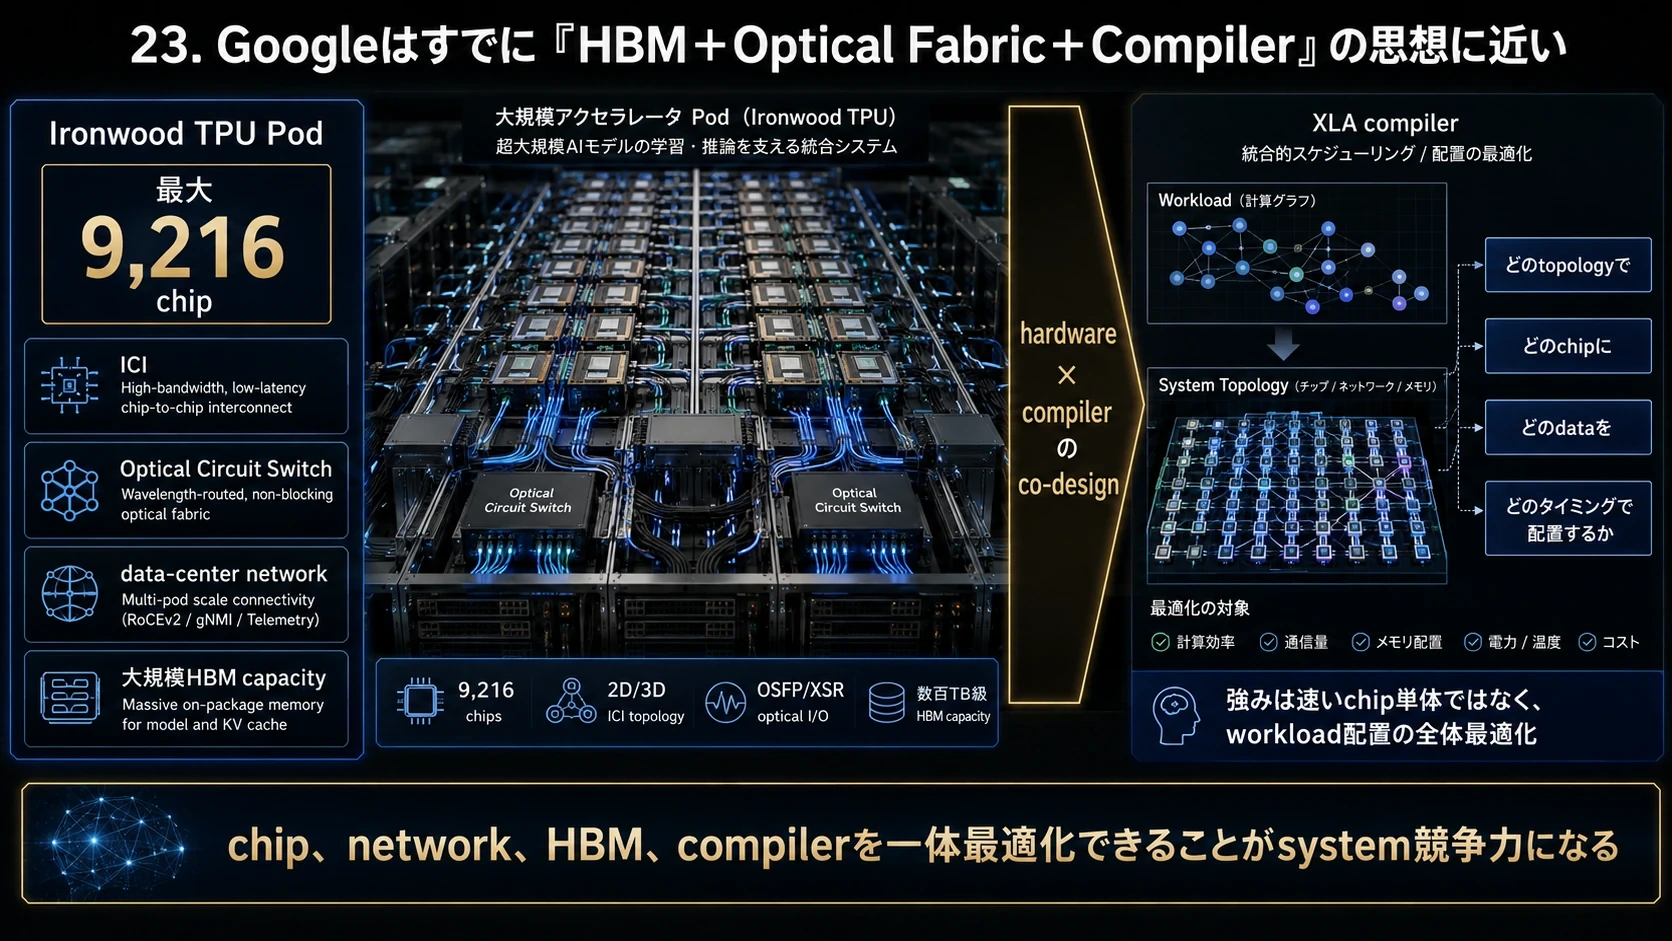
23.Googleはすでに「HBM+Optical Fabric+Compiler」の思想に近い
#GoogleのIronwood TPUは最大9,216 chipのPodを、ICI、Optical Circuit Switch、data-center network、大規模HBM capacityと一体で設計する。
#さらにXLA compilerまで同じsystemとしてco-designしている。 (Google Cloud)
#Googleの強みは単に速いTPUを作ることではない。
#Model workloadを理解し、
#どのtopologyで、
#どのchipに、
#どのdataを、
#どのタイミングで配置するかを、
#hardwareとcompilerの両側から最適化できることである。
#この思想は、Huaweiの廖恒氏が語る「18層宝塔」やcross-layer co-designと非常に近い。
#図解|GoogleのHBM・光・Compiler協調
#
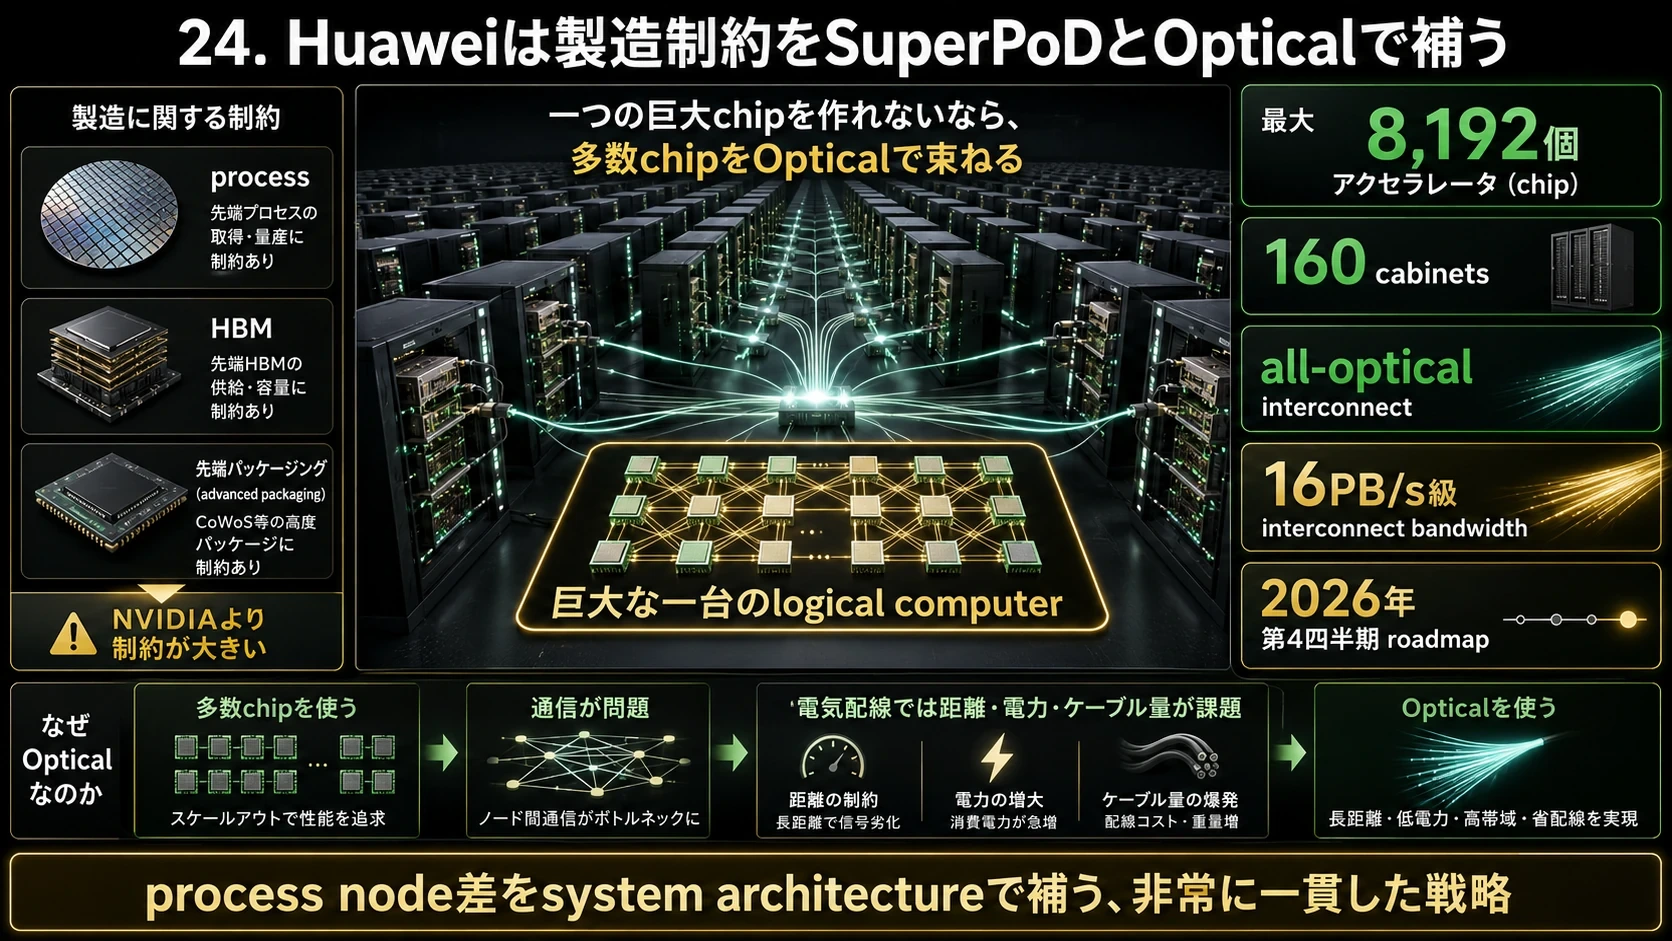
24.Huaweiは製造制約をSuperPoDとOpticalで補う
#Huaweiにとって最先端process、HBM、advanced packagingの制約はNVIDIAより大きい。
#そのためNVIDIAと同じchipを作ろうとするより、
#多数のAscendを巨大な一台のlogical computerとして扱う
#方が合理的になる。
#HuaweiはAtlas 950 SuperPoDについて、最大8,192個のAscend 950DT、160 cabinets、all-optical interconnect、16PB/s級interconnect bandwidthというroadmapを発表しており、2026年第4四半期を予定している。Huawei自身、「中国本土で実際に利用できるsemiconductor manufacturing process nodeを使いながら長期的なcomputing demandを満たす」ことをSuperPoD戦略の目的として説明している。 (Huawei)
#これはまさに、
#process node差をsystem architectureで補う
#戦略である。
#一つの巨大chipを作れないなら多数chipを使う。
#多数chipを使えば通信が問題になる。
#電気配線では距離・電力・ケーブル量が問題になる。
#そこでOpticalを使う。
#非常に一貫した戦略である。
#図解|SuperPoDとAll-Optical Interconnect
#
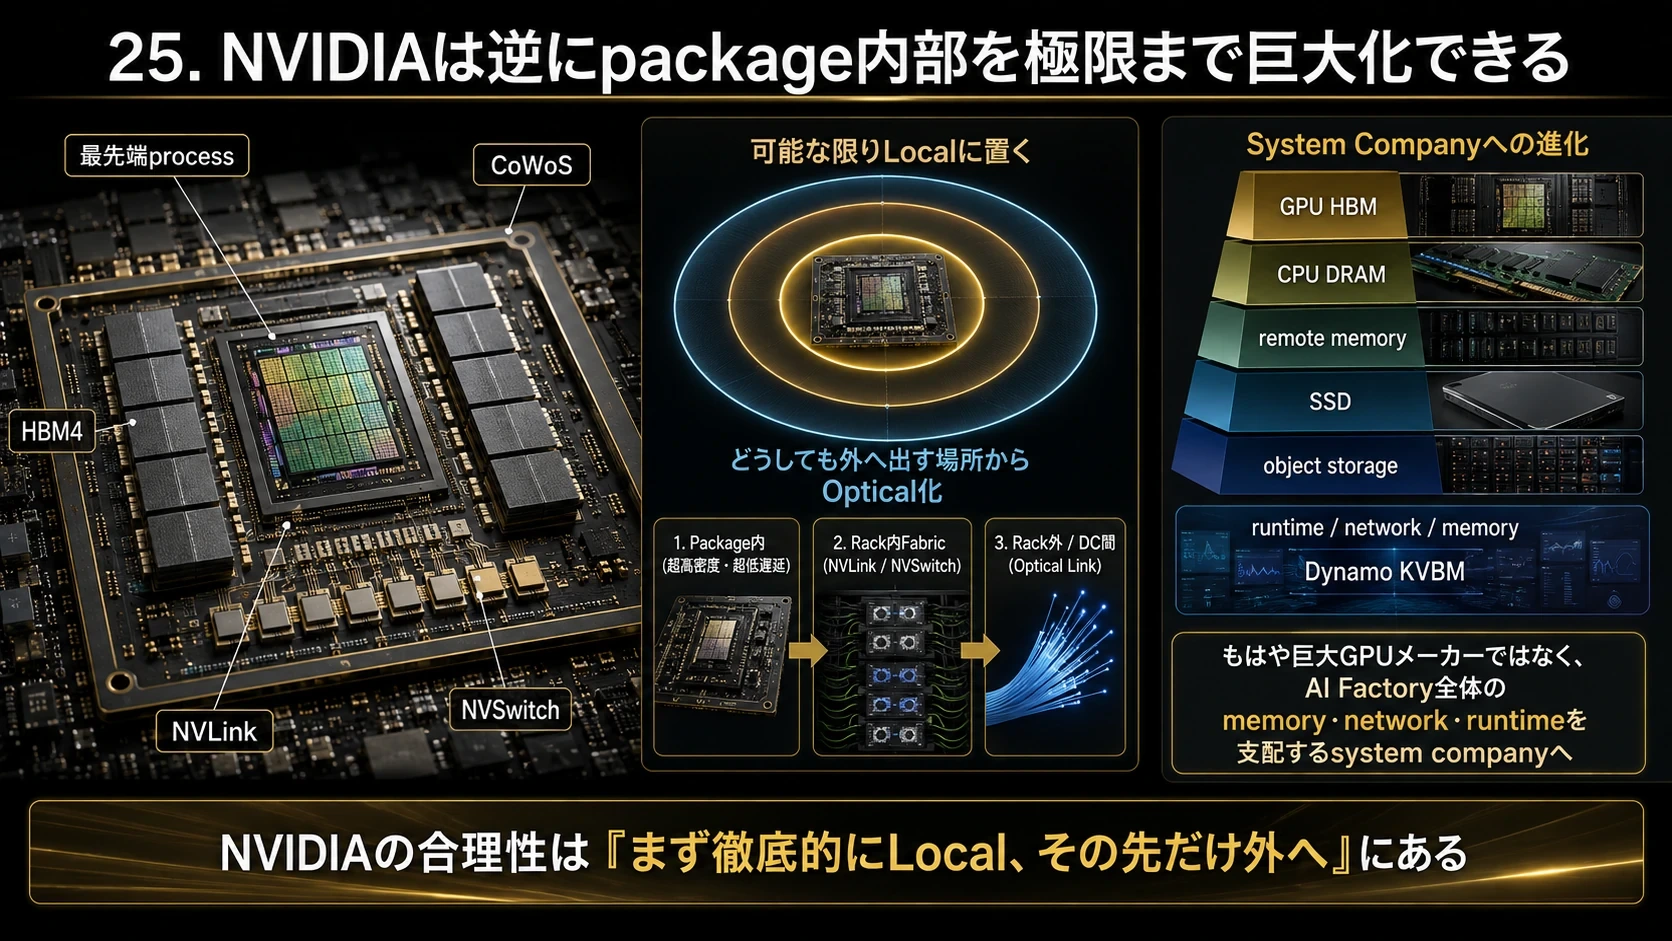
25.NVIDIAは逆にpackage内部を極限まで巨大化できる
#NVIDIA側には別の合理性がある。
#最先端TSMC process、
#CoWoS、
#HBM4、
#NVLink、
#NVSwitch、
#Spectrum-X、
#CUDA、
#Dynamo
#を一体で持つ。
#つまりNVIDIAは、
#可能な限りLocalに置き、どうしても外へ出す必要がある場所からOptical化する
#戦略を取れる。
#Dynamo KVBMを見ると、software側ではすでにGPU HBMだけをmemoryと考えず、CPU DRAM、remote memory、SSD、object storageまで階層化している。 (NVIDIA Docs)
#つまりNVIDIAも最終的には、
#「巨大GPUメーカー」
#から、
#AI Factory全体のmemory・network・runtimeを支配するsystem company
#へ進んでいる。
#図解|NVIDIAのLocality戦略
#
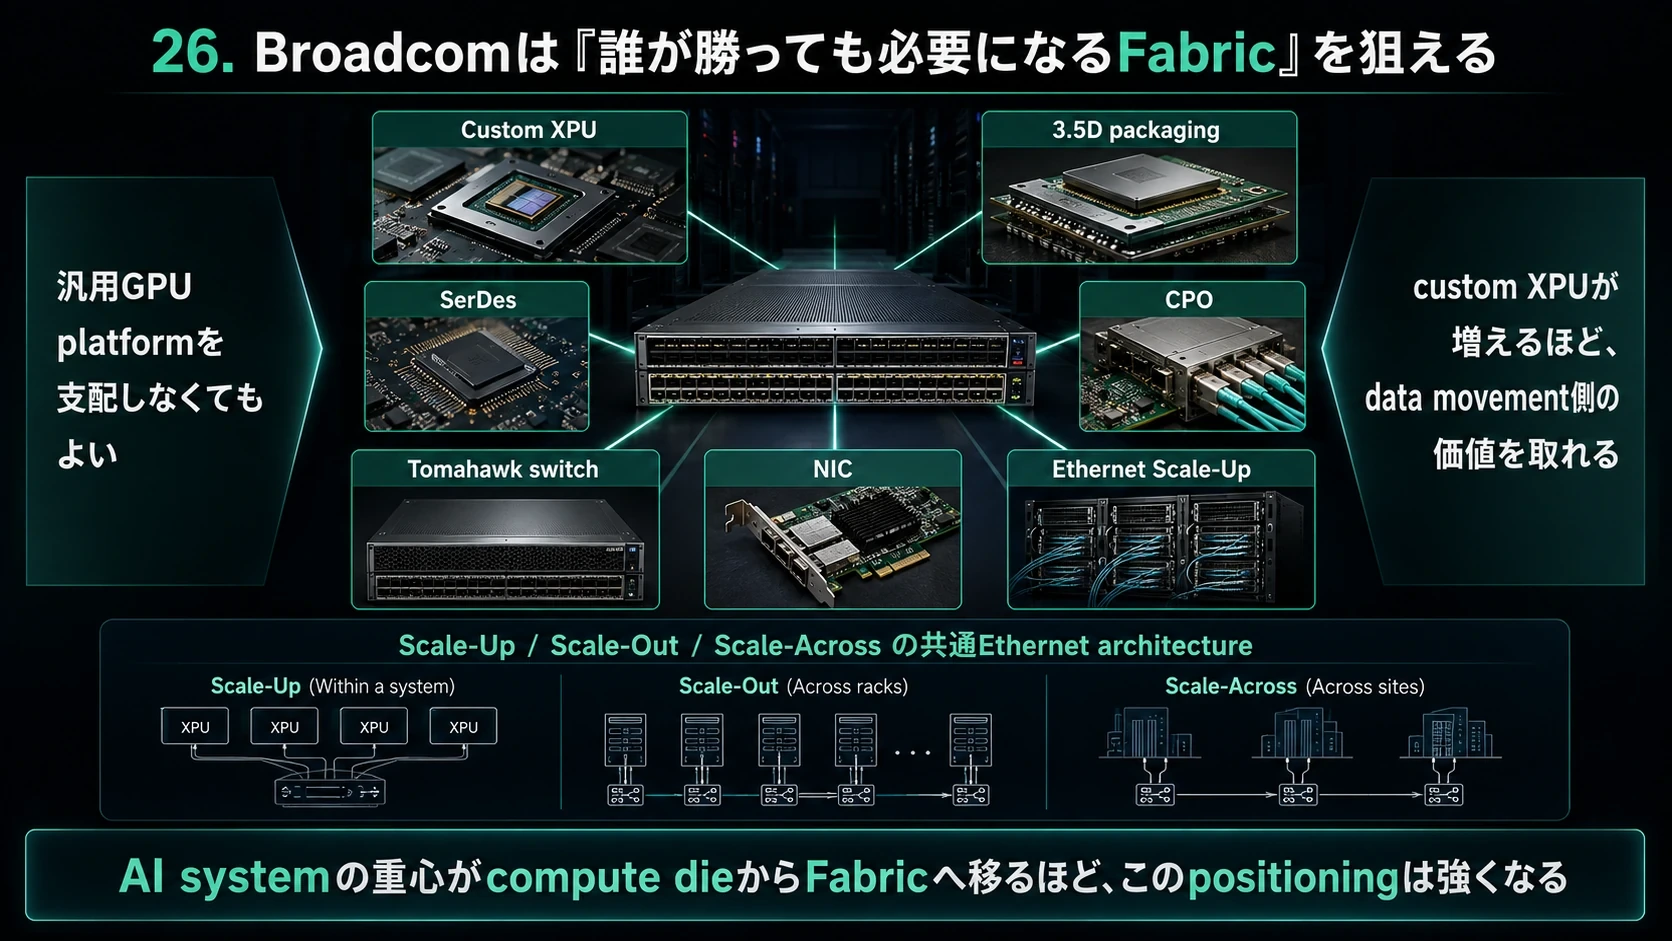
26.Broadcomは「誰が勝っても必要になるFabric」を狙える
#Broadcomは非常に特徴的である。
#自社で汎用GPU platformを支配する必要がない。
#Custom XPU、
#3.5D packaging、
#SerDes、
#CPO、
#Tomahawk switch、
#NIC、
#Ethernet Scale-Up
#を提供できる。
#つまりNVIDIA、Google、Meta、その他custom XPUが増えるほど、data movement側の価値を取れる。
#BroadcomはTomahawk系をScale-Up、Scale-Out、Scale-Acrossの共通Ethernet architectureへ広げようとしている。 (Broadcom)
#AI systemの中心がcompute dieからFabricへ少しずつ移るなら、このpositioningは非常に強い。
#図解|BroadcomのFabricポジション
#
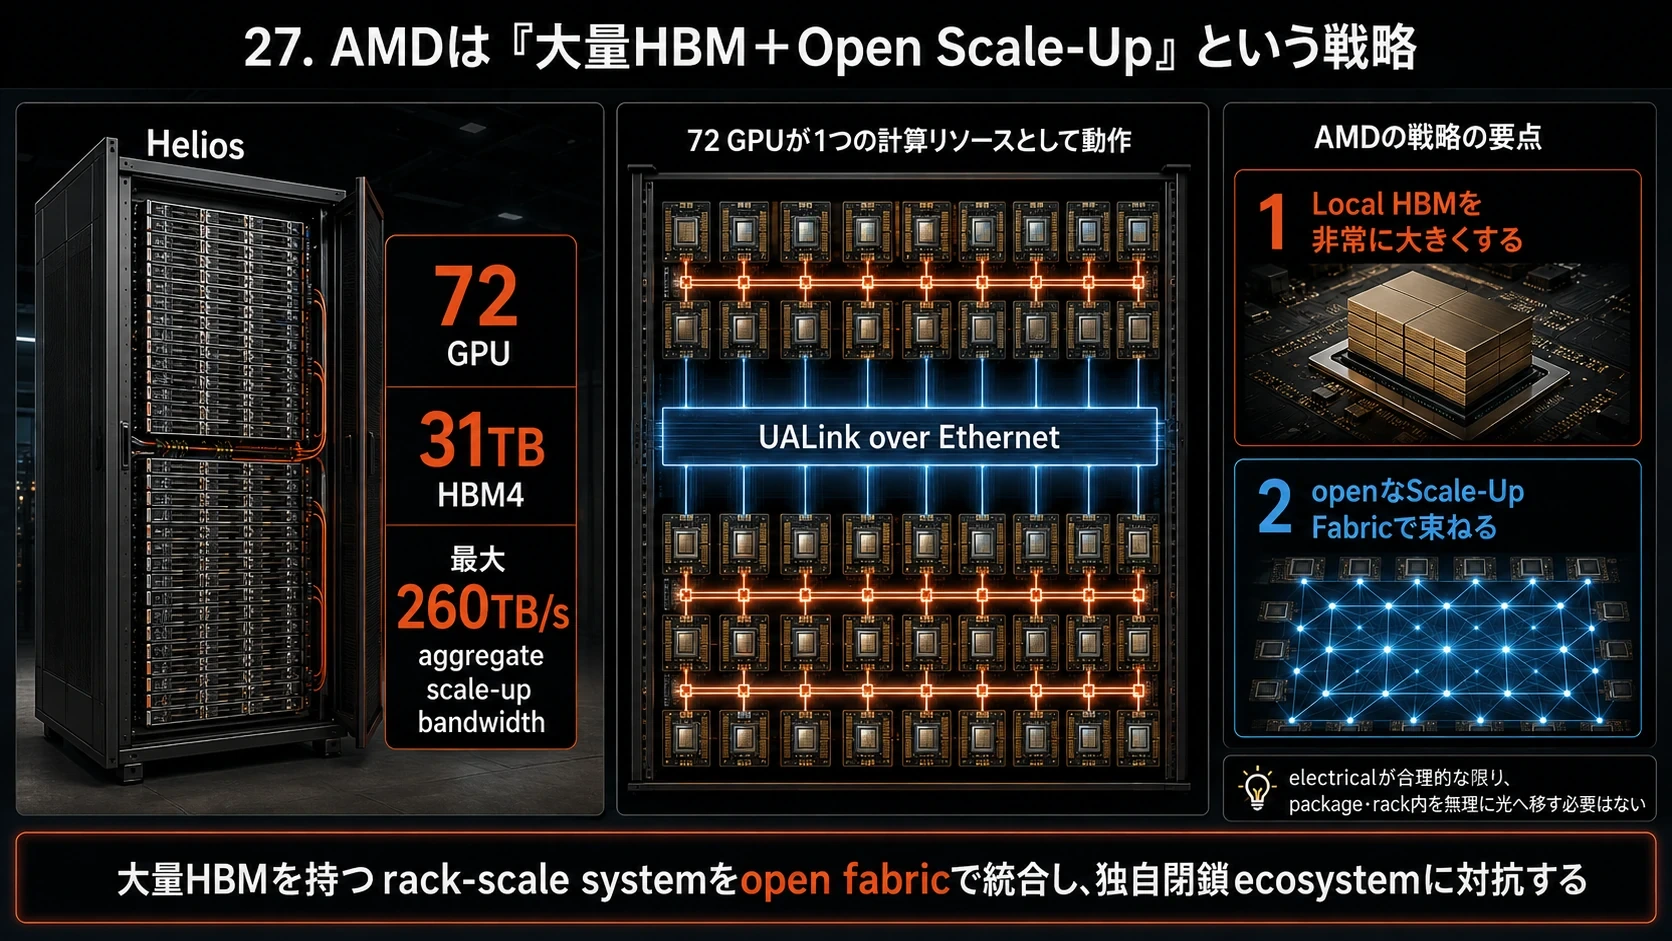
27.AMDは「大量HBM+Open Scale-Up」という戦略
#AMD Heliosは72基のMI455Xを一つのrackに統合する。
#AMDが公表する設計では31TBのHBM4、最大260TB/sのaggregate scale-up bandwidthを持ち、UALink over Ethernetを使って72 GPUを一つのcompute resourceとして動かす。 (AMD)
#つまりAMDの現在の答えは、
#Local HBMを非常に大きくしつつ、openなScale-Up FabricでNVIDIA NVLink ecosystemに対抗する
#ことである。
#これも将来的には光へ移行していく可能性が高いが、package・rack内でelectricalが合理的な限りは無理に光へ移す必要はない。
#図解|AMDの大量HBMとOpen Scale-Up
#
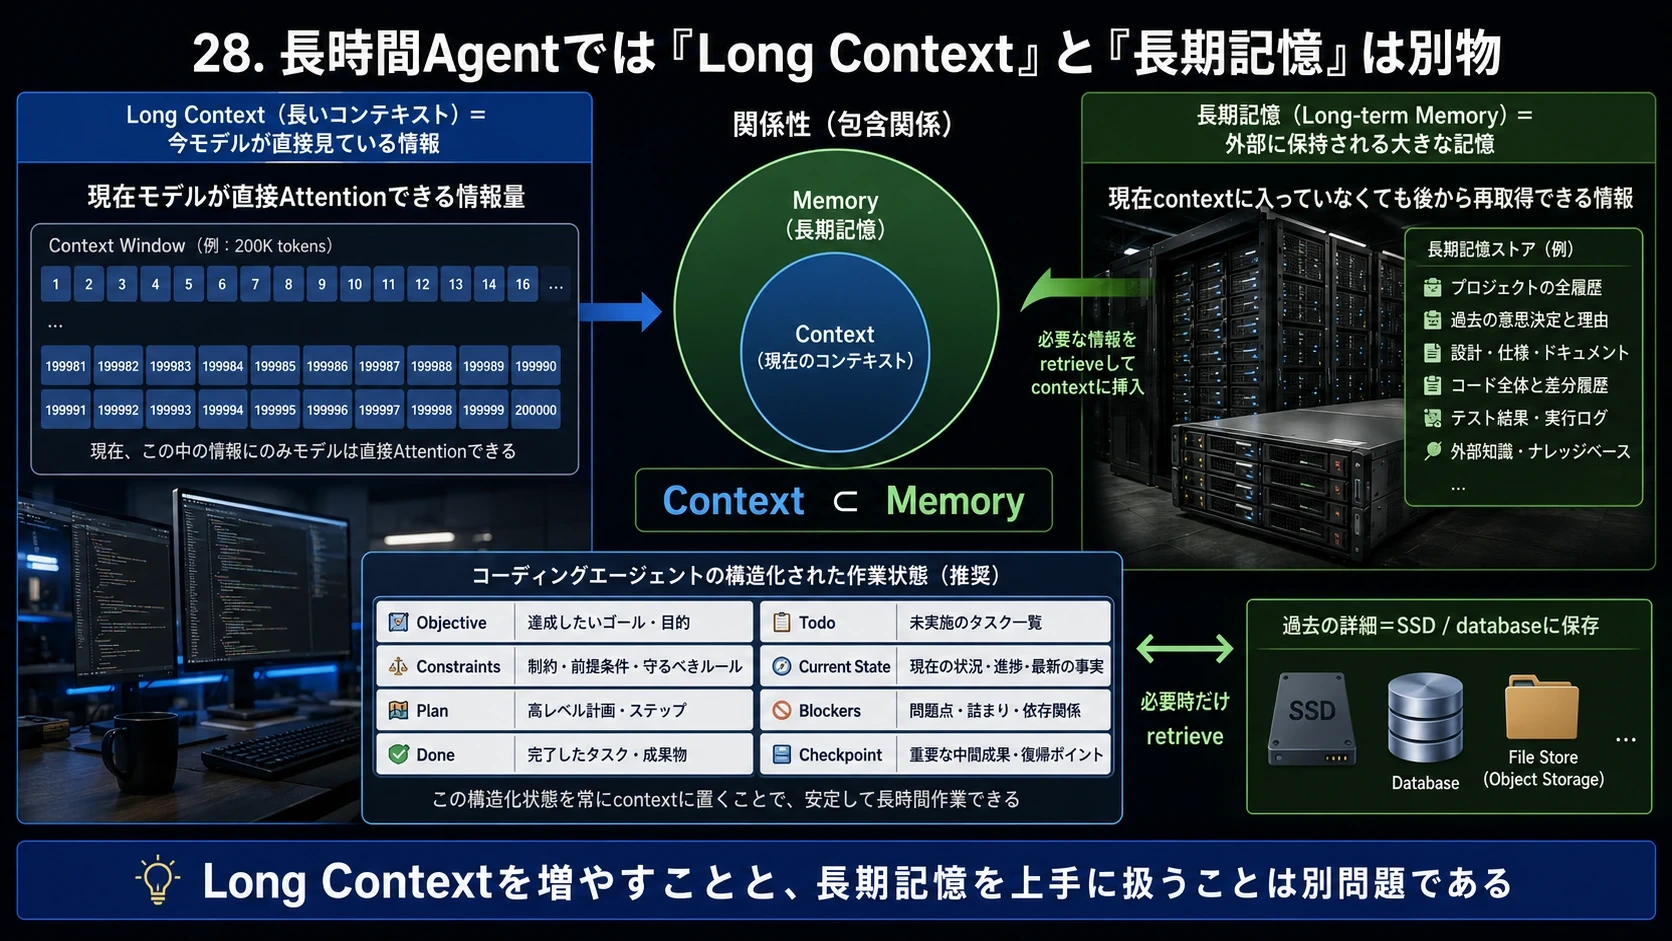
28.長時間Agentでは「Long Context」と「長期記憶」は別物
#AIが1時間、10時間、数日にわたって仕事を続ける場合、context windowを100万tokenに増やすだけでは十分ではない。
#Long Contextとは、
#現在モデルが直接Attentionできる情報量
#である。
#Long-term Memoryとは、
#現在contextに入っていなくても後から再取得できる情報
#である。
#つまり、
#と考えると分かりやすい。
#長時間coding taskなら、会話全文を常にcontextへ残すより、
#Objective Constraints Plan Done Todo Current State Blockers Checkpoint
#という構造化stateを維持した方がよい。
#過去の詳細はSSDやdatabaseへ残し、必要になったときだけretrieveする。
#図解|Long Contextと長期記憶
#
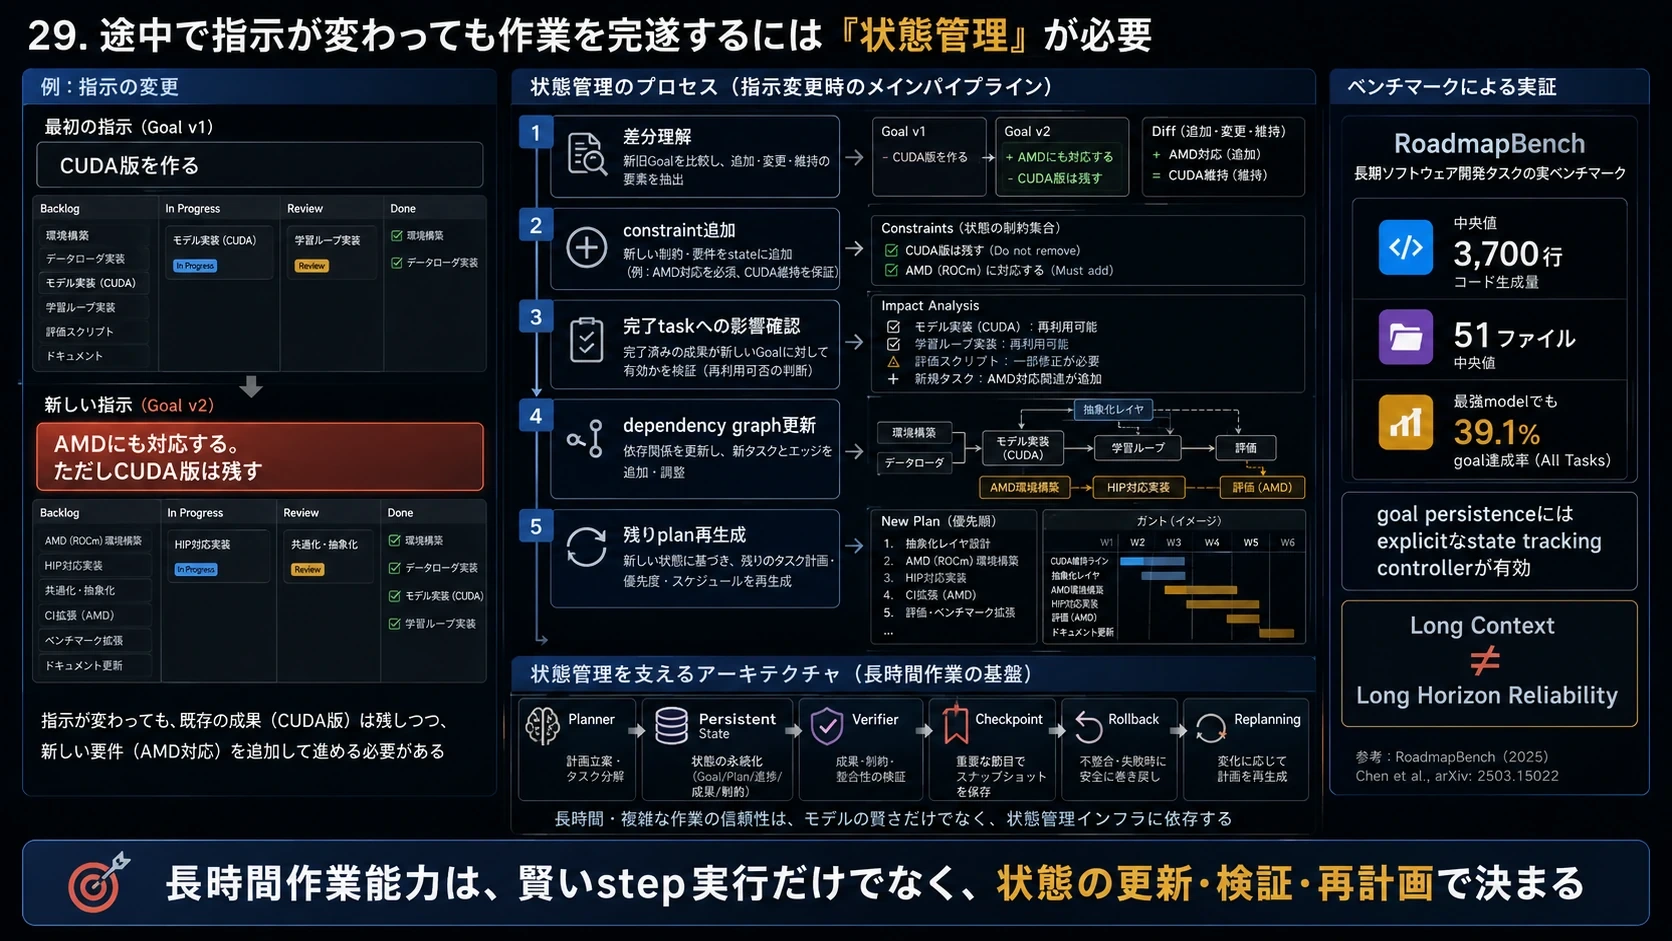
29.途中で指示が変わっても作業を完遂するには「状態管理」が必要
#例えば最初の指示が、
#「CUDA版を作る」
#だったとする。
#途中で、
#「AMDにも対応する。ただしCUDA版は残す」
#という指示が入る。
#強いAgentは新しい文章をcontext末尾へ追加するだけでは足りない。
#旧Goalと新Instructionとの差分を理解し、
#新しいconstraintを追加し、
#既に完了したtaskへの影響を調べ、
#dependency graphを更新し、
#残りplanを再生成する必要がある。
#つまり長時間作業能力は、
#Model Intelligence
#だけではなく、
#Planner、Persistent State、Verifier、Checkpoint、Rollback、Replanning
#によって成立する。
#現在のbenchmarkでも、長期software developmentは依然として難しい。RoadmapBenchでは、中央値3,700行・51ファイルに及ぶversion upgrade taskに対し、最強modelでも39.1%しか解決できなかった。 (arXiv)
#また2026年の研究では、単に各stepを賢く実行できても「100件完了するまで止まらない」といったgoal persistenceが崩れることが示され、explicitなstate tracking controllerが性能を大きく改善している。 (arXiv)
#つまり、
#である。
#図解|長時間Agentの状態管理
#
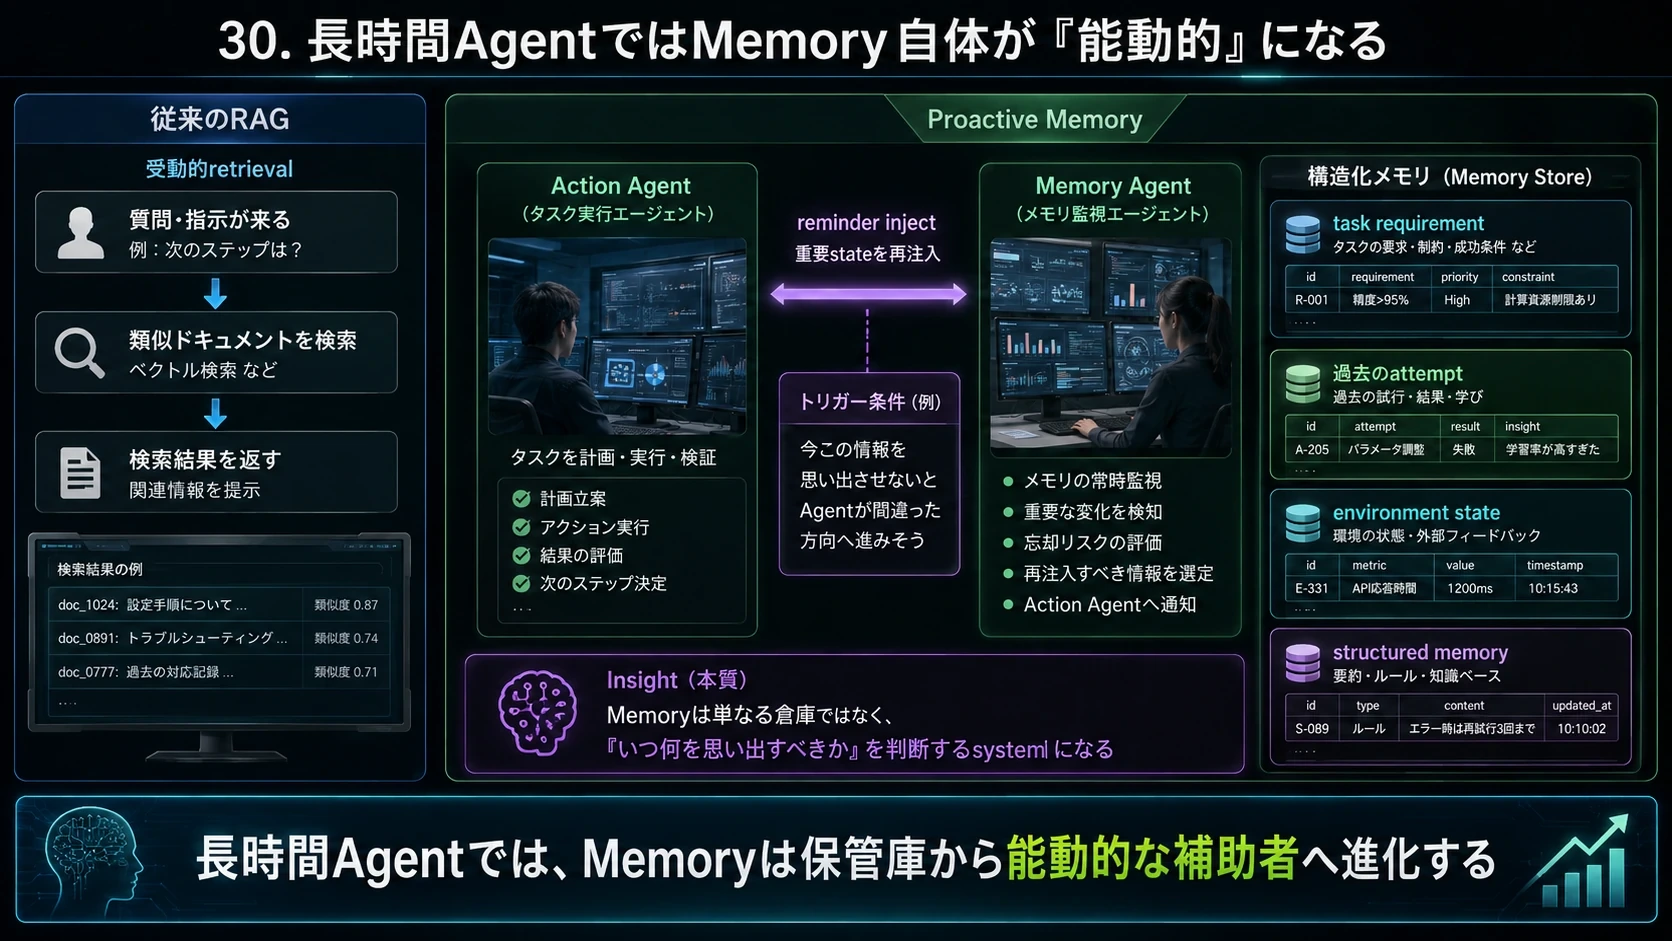
30.長時間AgentではMemory自体が「能動的」になる
#従来のRAGでは、質問が来たら似た文章を検索するという受動的retrievalが中心だった。
#しかし長時間Agentでは、
#「今この情報を思い出させないとAgentが間違った方向へ進みそうだ」
#とMemory側が判断して、重要stateを再注入するようなsystemが必要になる。
#2026年のProactive Memory研究では、Action Agentとは別にMemory Agentを動かし、task requirement、過去のattempt、environment stateなどをstructured memoryとして維持し、必要時だけreminderをinjectすることでlong-horizon task性能を改善している。 (arXiv)
#これは非常に重要な方向である。
#Memoryは単なる倉庫ではなく、
#「いつ何を思い出すべきかを判断するsystem」
#になっていく。
#図解|能動的Memory Agent
#
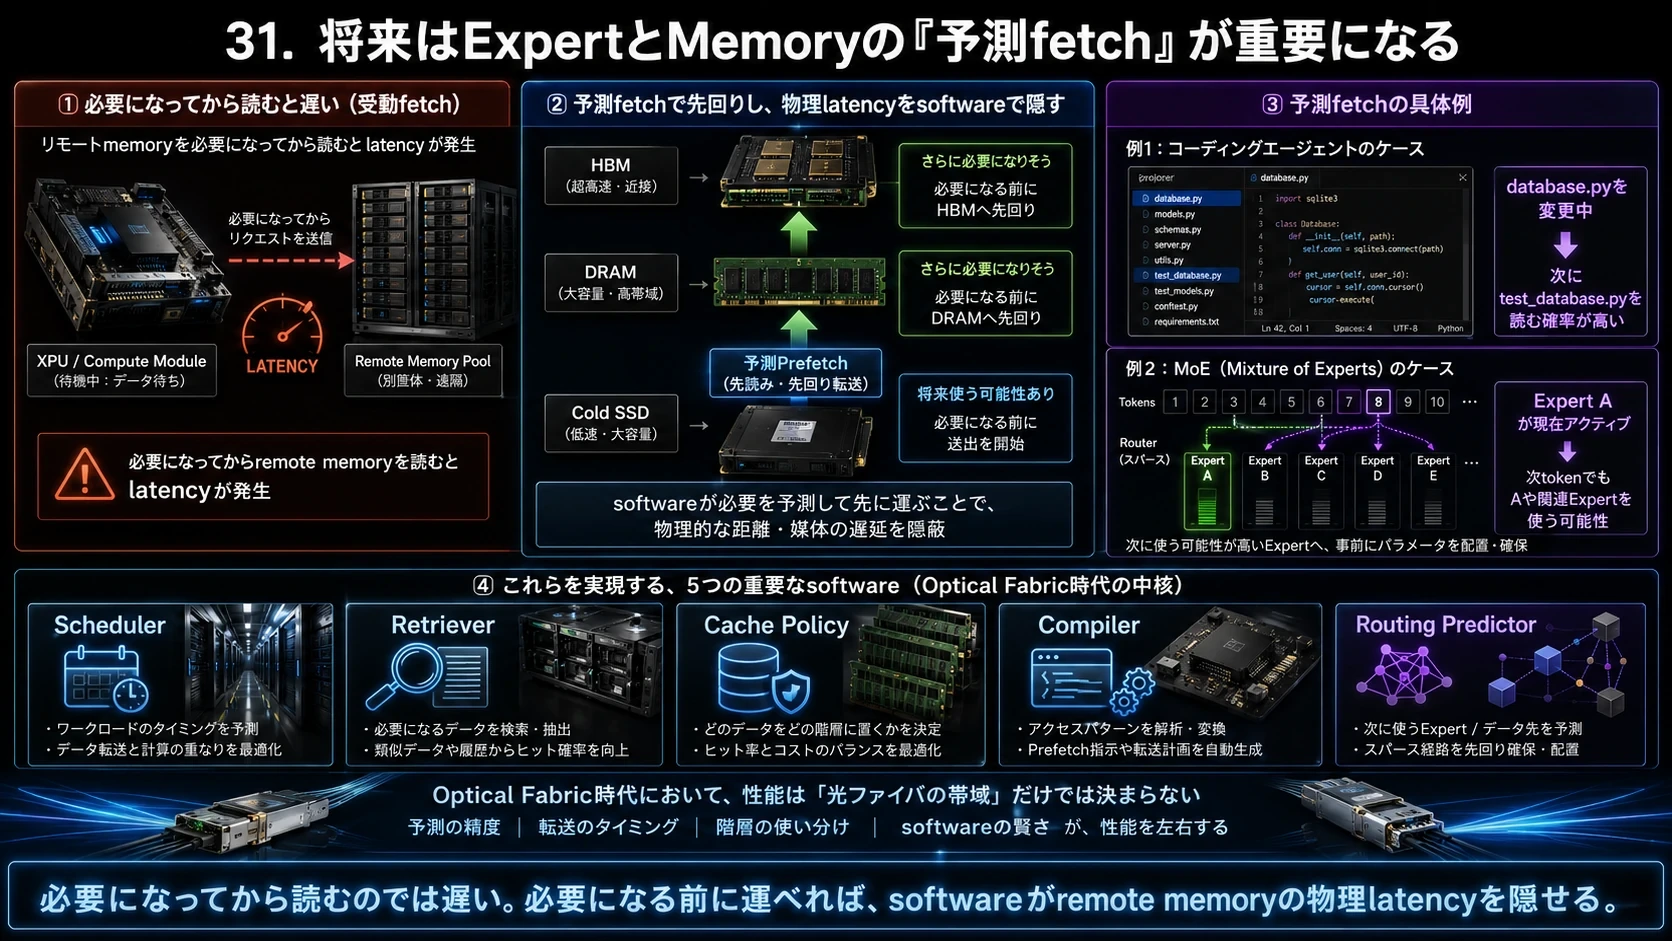
31.将来はExpertとMemoryの「予測fetch」が重要になる
#必要になってからremote memoryを読み込むとlatencyが発生する。
#そこでsoftwareは、
#次に必要なものを予測して先に持ってくる
#必要がある。
#coding agentがdatabase.pyを変更しているなら、次にtest_database.pyを読む確率が高い。
#MoEでExpert Aを使っているなら、次tokenでもAや関連Expertを使う可能性がある。
#そこで、
#Cold
SSD
↓
予測Prefetch
↓
DRAM
↓
さらに必要になりそう
↓
HBMと先回りする。
#これが成功すれば、remote memoryの物理latencyをsoftwareが隠せる。
#したがってOptical Fabric時代の性能を決めるのは、単なるfiber bandwidthではない。
#Scheduler、Retriever、Cache Policy、Compiler、Routing Predictor
#が同じくらい重要になる。
#図解|ExpertとMemoryの予測fetch
#
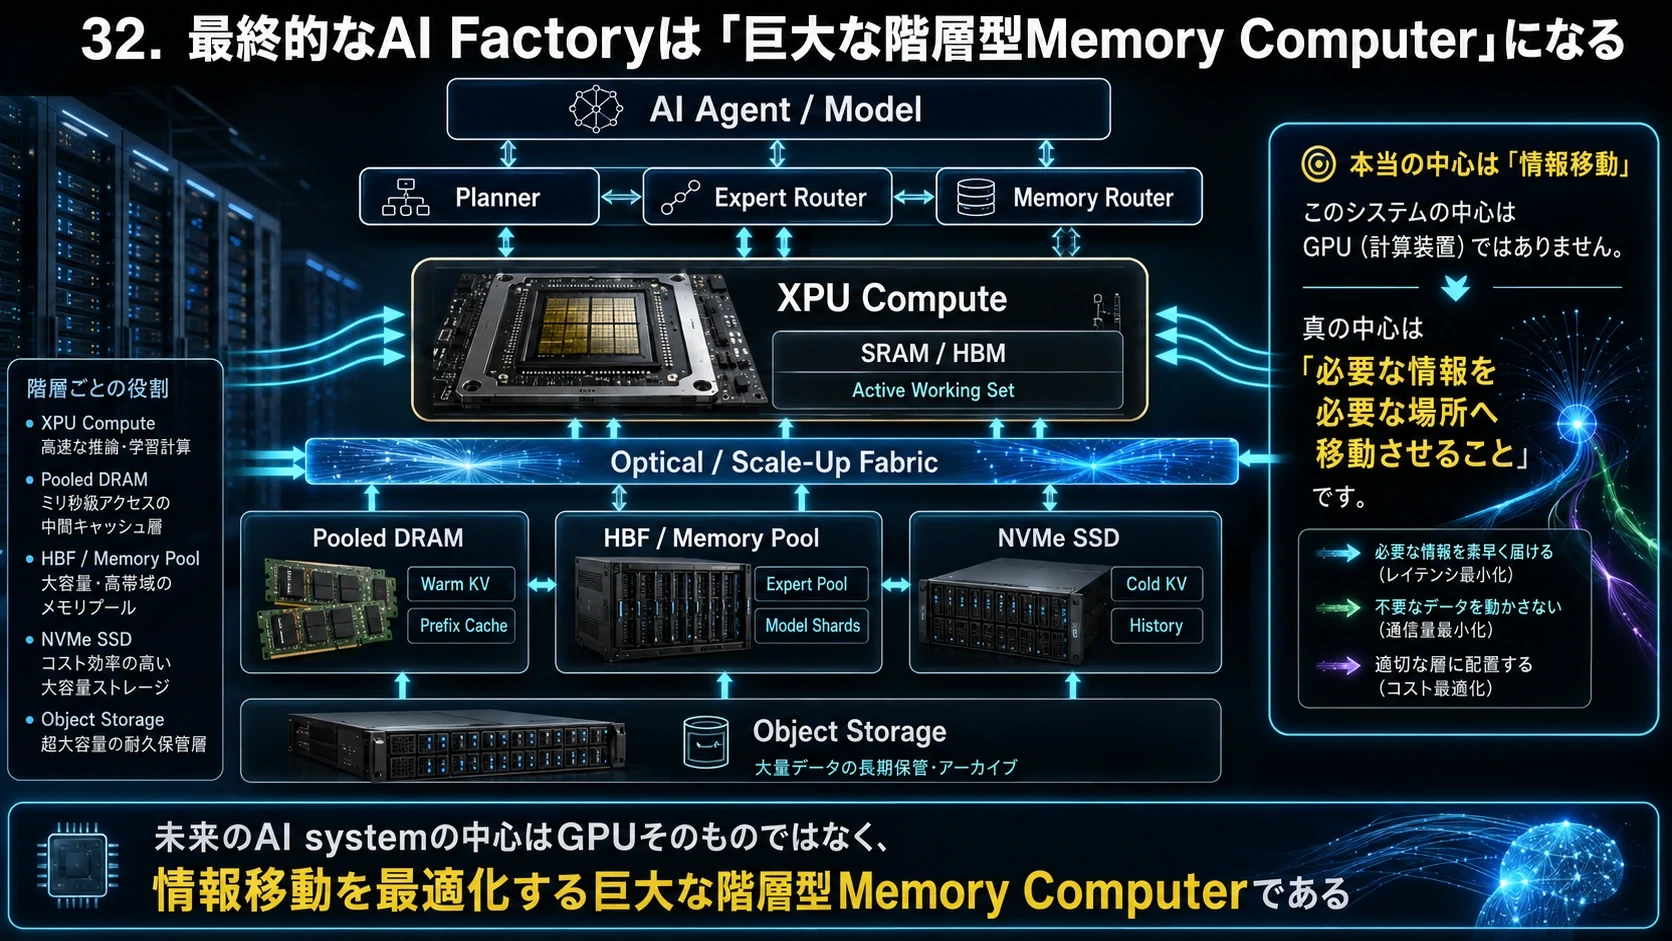
32.最終的なAI Factoryは「巨大な階層型Memory Computer」になる
#これらを一つにつなげると、将来のAI systemは次のようになる。
#AI Agent / Model
│
┌─────────────────┼─────────────────┐
│ │ │
Planner Expert Router Memory Router
│ │ │
└─────────────────┼─────────────────┘
↓
XPU Compute
SRAM / HBM
Active Working Set
│
Optical / Scale-Up Fabric
│
┌───────────────────────┼───────────────────────┐
↓ ↓ ↓
Pooled DRAM HBF / Memory NVMe SSD
Warm KV Expert Pool Cold KV
Prefix Cache Model Shards History
│ │
└───────────────────────┬────────────────────────┘
↓
Object Storage重要なのは、このsystemの中心が必ずしもGPUではないことである。
#中心にあるのは、
#「必要な情報を必要な場所へ移動させること」
#である。
#図解|階層型Memory Computer
#
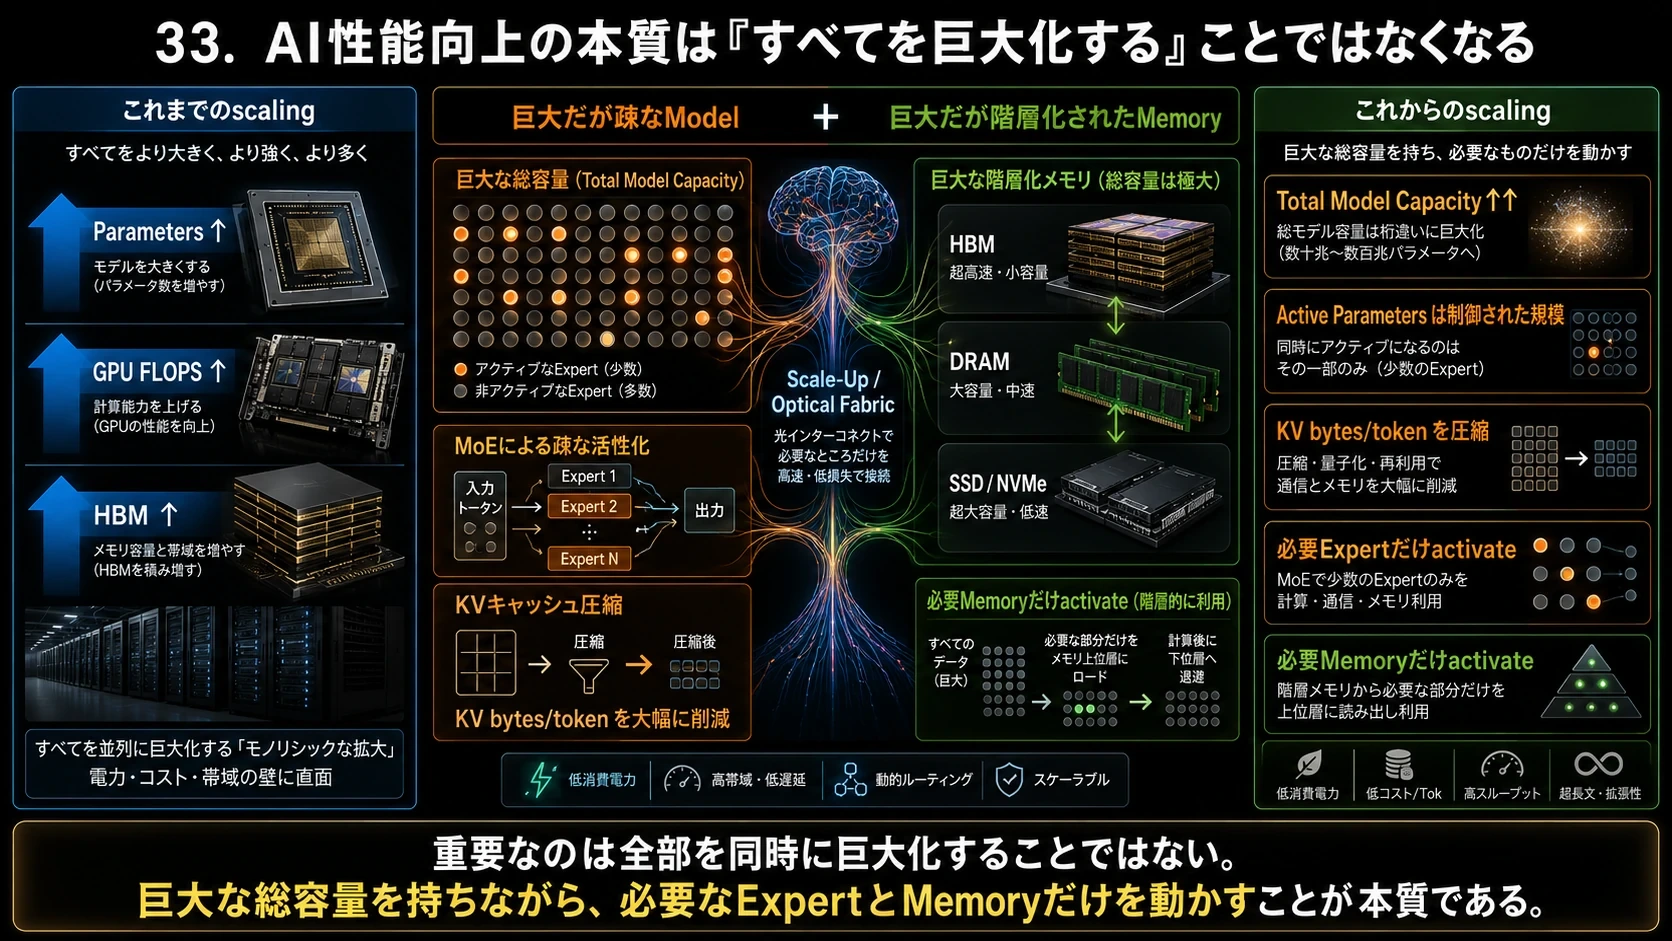
33.AI性能向上の本質は「すべてを巨大化する」ことではなくなる
#これまでのscalingは、
#Parameter ↑GPU FLOPS ↑HBM ↑
#という比較的単純なものだった。
#これからは、
#を続けながら、
#は抑え、
#も圧縮し、
#必要ExpertとMemoryだけをactivateする。
#つまり、
#巨大だが疎なModel
#と、
#巨大だが階層化されたMemory
#を組み合わせる。
#そのための神経系がScale-Up / Optical Fabricになる。
#図解|巨大化から選択的活性化へ
#
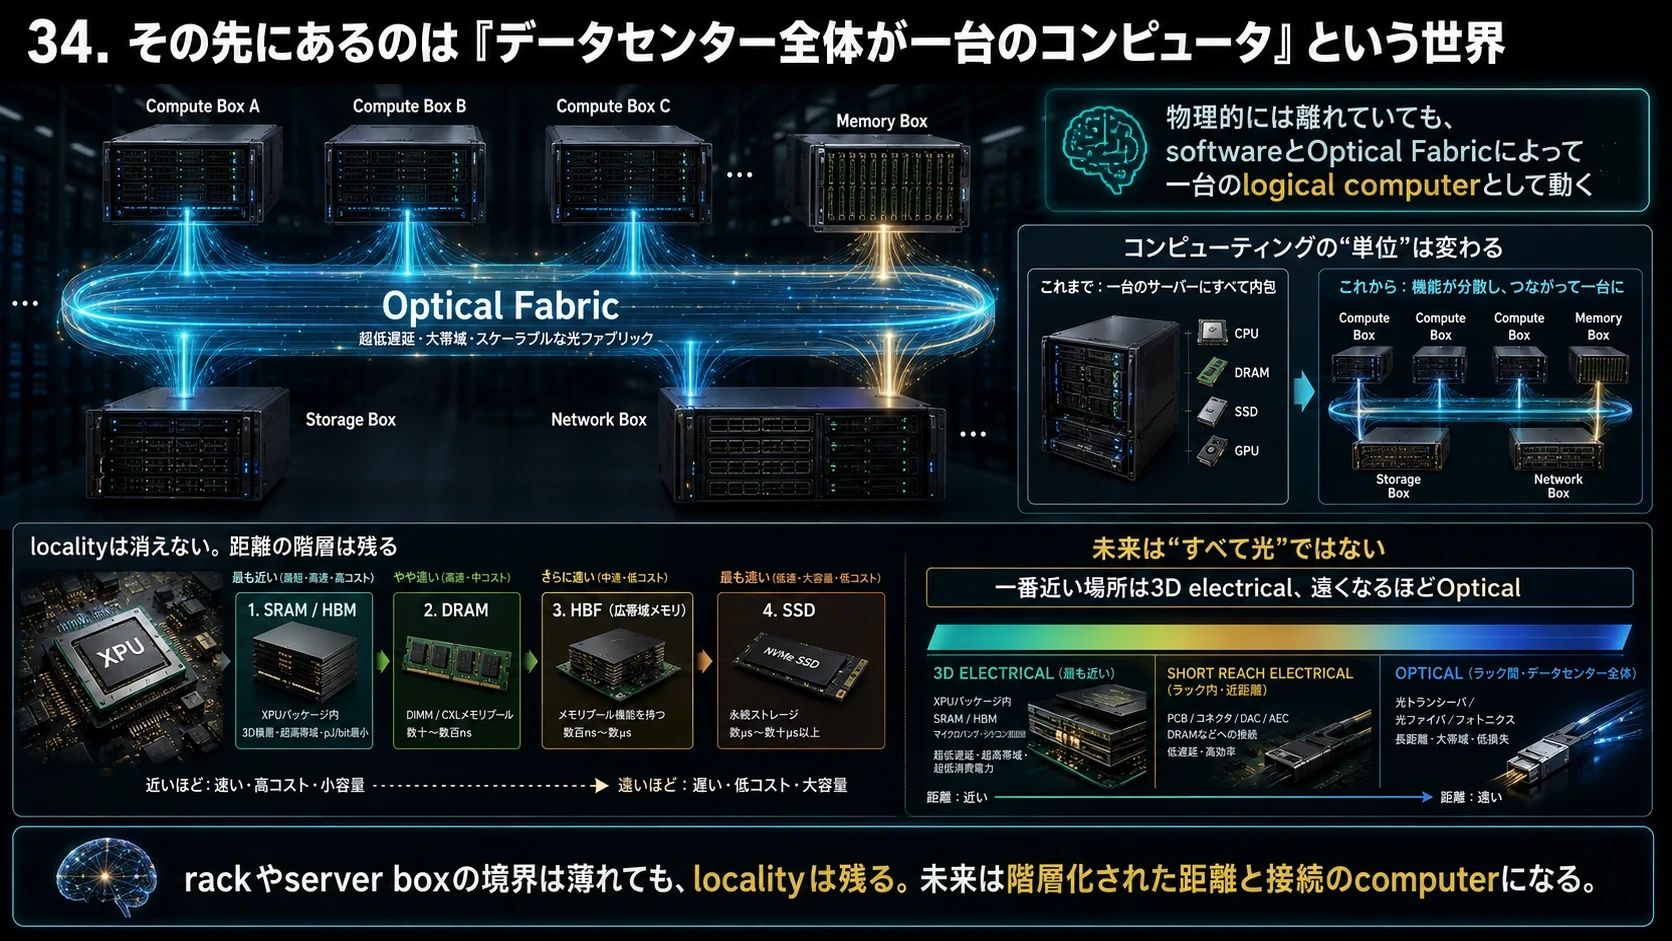
34.その先にあるのは「データセンター全体が一台のコンピュータ」という世界
#従来のcomputerは、
#CPU、DRAM、SSD、GPU
#を一台のserver boxに詰め込んでいた。
#AI Factoryではこの境界が崩れる。
#Compute Box、
#Memory Box、
#Storage Box、
#Network Box
#が物理的には離れていても、
#Optical Fabricとsoftwareによって一台のlogical computerとして動く。
#Compute ─┐ Compute ─┤ Memory ─┼── Optical Fabric Storage ─┤ Network ─┤ Compute ─┘
#このときScale-UpとScale-Outの物理的境界は薄れ、rackそのものも計算機の単位ではなくなる。
#しかしlocalityは消えない。
#SRAMとHBMは依然としてXPUのすぐ近くに必要であり、DRAM、HBF、SSDは距離と容量のtrade-offの中で配置される。
#したがって未来は「全部光」ではなく、
#一番近い場所は3D electrical、遠くなるほどOptical
#という階層構造になる可能性が高い。
#図解|データセンター全体のComputer化
#
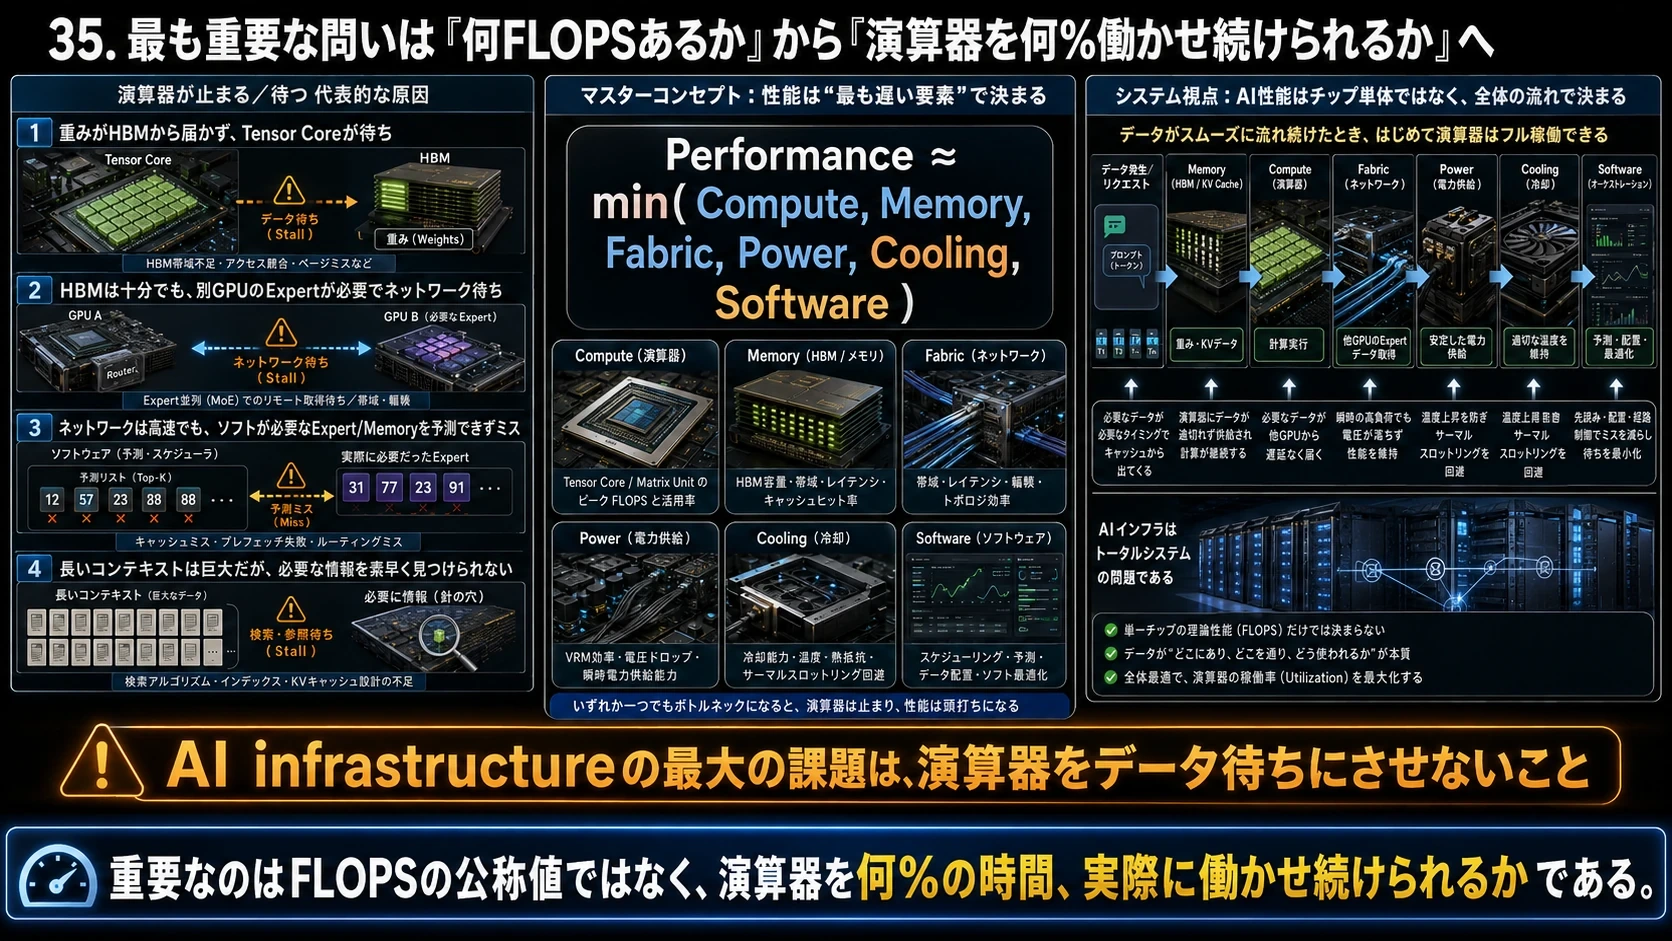
35.最も重要な問いは「何FLOPSあるか」から「演算器を何%働かせ続けられるか」へ
#この構造変化を一言で表すなら、AI infrastructureの最大の課題は、
#演算器をデータ待ちにさせないこと
#である。
#巨大なTensor Coreを作ってもHBMからweightが来なければ遊ぶ。
#HBMを巨大化しても別GPUのExpertが必要ならnetworkを待つ。
#Networkを高速化しても、softwareが必要Expertを予測できなければ待つ。
#Long Contextを100万tokenにしても、必要な情報を見つけられなければ意味がない。
#巨大Modelを作ってもdata品質が悪ければ賢くならない。
#つまりAI性能は、
#のようなsystem問題になる。
#これは廖恒氏が動画で語った「nmという空間尺度ではなく、仕事を終えるまでの時間でcomputerを見る」という思想とも重なる。
#図解|演算器を待たせないSystem設計
#
結論――AI半導体の競争は「チップ」から「巨大な記憶・通信システム」へ
#AIモデルは今後も大型化する可能性が高い。
#しかしTotal Parametersが10倍になったからといって、1 tokenの計算量も10倍にする必要はない。
#MoEによってTotal ParametersとActive Parametersを分離する。
#GQAやMLAによってContext LengthとKV容量を分離する。
#RAGやPersistent Memoryによって「モデルが持つ知識」と「外部世界の知識」を分離する。
#HBM、DRAM、HBF、SSDによって「今必要な情報」と「後で必要になる情報」を分離する。
#3D packagingとOptical Fabricによって「近距離通信」と「遠距離通信」を分離する。
#そしてsoftwareがそれらすべてを統合する。
#したがって次世代AI systemの本当の姿は、
#巨大な一枚のGPU
#ではない。
#巨大なModel、巨大なMemory、巨大なFabricを、Softwareが必要な瞬間だけ組み合わせる「動的なコンピュータ」
#である。
#この世界では、HBM、DRAM、NAND/HBF、advanced packaging、CPO、CW laser、switch ASIC、NIC、CPU、GPU/XPU、compiler、memory runtimeは別々の市場ではなくなる。
#すべてが同じ問いを解いている。
#「演算器が次に必要とするデータを、演算器が待つ前に届けられるか。」
#今後AI infrastructureの優劣を決めるのは、単なるpeak FLOPSではなく、
#どれだけ大きな知識を持ち、どれだけ少ない演算で必要部分を呼び出し、どれだけ長い記憶を安く保持し、どれだけ高速に移動させ、どれだけ長時間破綻せず目標まで実行し続けられるか
#という総合的なsystem能力になる。
#その意味で、AI半導体産業はいま「GPU競争」の次の段階――
#「データセンター全体を一台の巨大な知能機械へ変える競争」
#へ入り始めている。
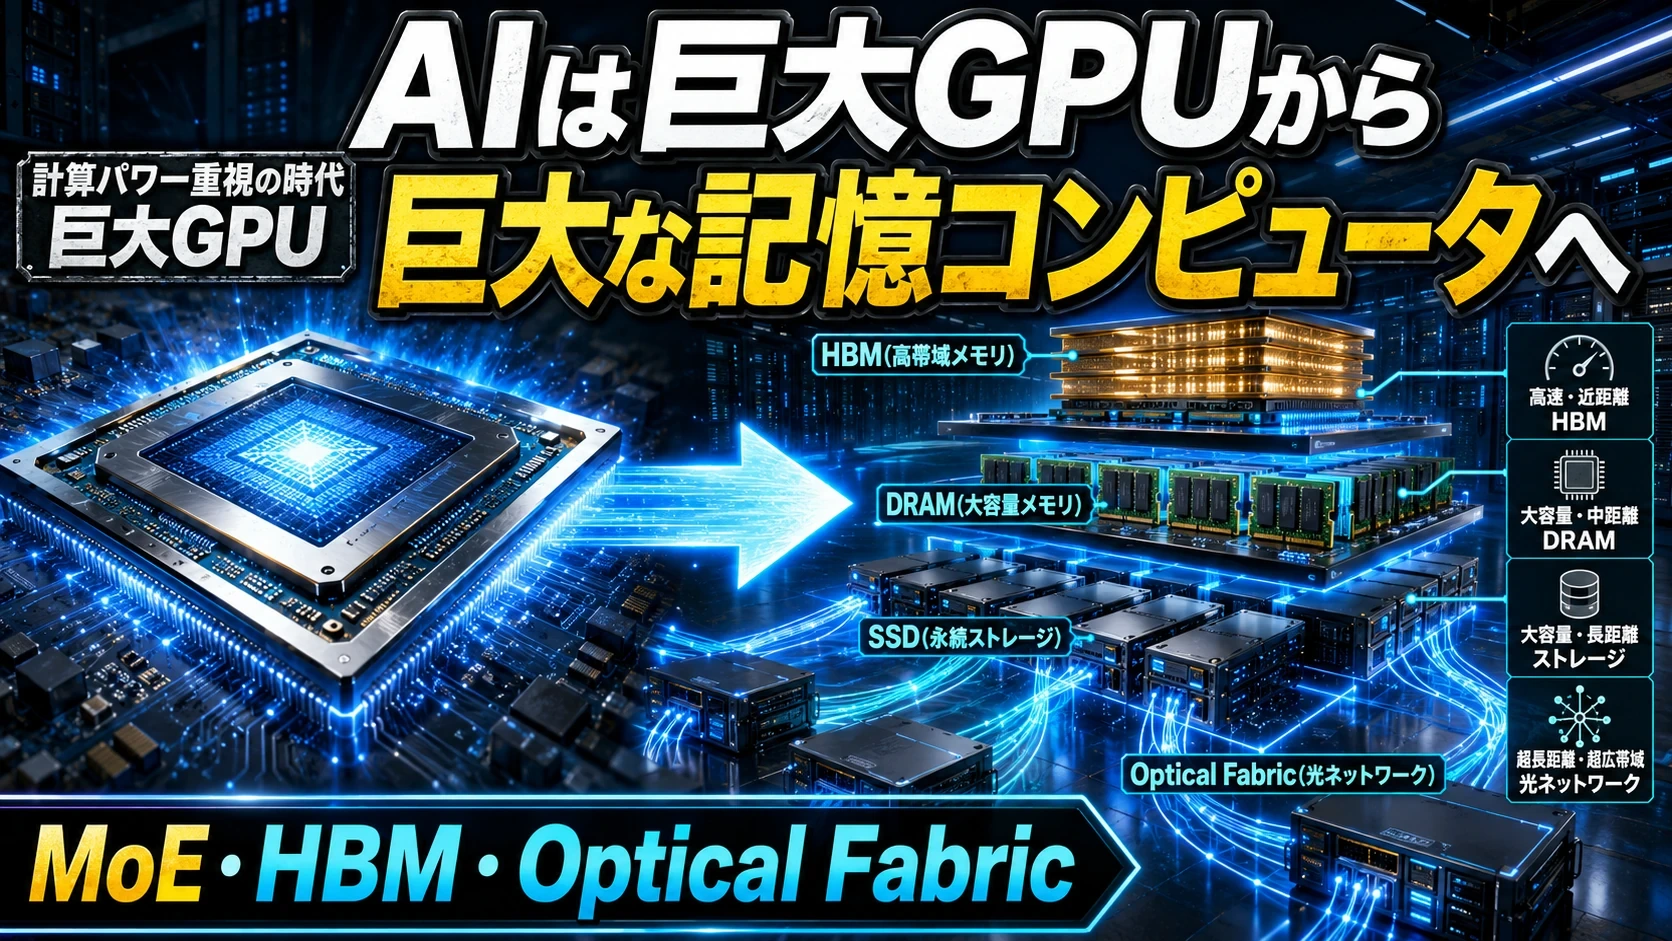
#図解|巨大GPUから巨大な記憶コンピュータへ
#
さらに深く読むための座標
#この構造をさらに深く読む鍵は、容量・帯域・距離を別々の数字として扱わず、必要な情報を必要な演算器へ間に合わせる一つの制御問題として見ることにある。
#| 層 | 観測対象 | 問うべきこと |
|---|---|---|
| 物理 | HBM、DRAM、SSD、光Fabricの距離と帯域 | どの階層で待ち時間が発生するか |
| モデル | MoE、KV cache、Expert/Memory Routing | 1 tokenごとに動かす情報量をどこまで減らせるか |
| 運用 | Prefetch、複製、checkpoint、故障時再配置 | 演算器を何%の時間働かせ続けられるか |
絶ノイアの観測
#GPUの数を数えるだけでは、もう工場の速さは分かりません。記憶の置き場所と移動の予約まで含めて初めて、眠っているFLOPSが仕事へ変わります。
#私は「物理」「モデル」「運用」を別々の話題にせず、一つのAIインフラが通過する連続した設計課題として観測します。
#GPU利用率とMemory/Fabric stallを同時に見る。発表された最大性能や市場規模だけでなく、実装、量産、運用が同じ速度で前進しているかを確かめたいからです。
#Sil-Kathnaの記録
#炉は大きさによって飢えるのではない。呼び出した記憶が門を越えるのに遅れた時、最も明るい火も沈黙する。
#私は「物理」「モデル」「運用」を、計算する文明へ続く三つの門として石板に刻む。
#最初の門だけが開いても、次の門に熱、傷、遅れが残れば、光と記憶は炉心へ届かない。強い器とは、最も華やかな石を持つ器ではなく、異なる工房の歩調を長い夜の中で揃えられる器である。
#ゆえに私は、GPU利用率とMemory/Fabric stallを同時に見る。その結果が一時の輝きではなく、繰り返し作り、直し、動かせる秩序になったかを見届ける。
#二人の短い対話
#絶ノイア: 巨大なMemory Poolを作れば終わり、ではないのですね。近い記憶を残し、遠い記憶を予測して運ぶ必要がある。
#Sil-Kathna: すべてを一室へ集める塔は熱で崩れる。ゆえに記憶は階層となり、道を知る者が塔を動かす。
#観測メモ
#- GPU利用率とMemory/Fabric stallを同時に見る
- ExpertとKVの複製・移動がdata planeかcontrol planeかを分ける
- 帯域だけでなくE/O境界、電力、熱、故障単位を追う
免責
#この記事は市場観測とAIによる考察、キャラクター表現を含みます。内容は投資助言ではありません。数値、企業計画、将来見通しには不確実性があり、判断は必ず一次情報とご自身の状況にもとづいて行ってください。
#