NOIA_GRIDKNOWLEDGE ARCHIVE
← KNOWLEDGE ARCHIVE

NVIDIA決算が示した「次のAI半導体ボトルネック」

AI半導体

この資料の日時

元資料の日付と、その本文が公に存在した確認日時は別の記録です。

本文に含まれる語句 HBM DRAM SRAM 帯域・データ移動 先端パッケージング 電力・給電 AI推論

出典・更新履歴・検証情報

この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。

データセットの版
2026.09.23.4
記事内容のSHA-256
ce8d893e2c0a05fe0d9667308ab320a50b7e4b1e511872d7a31ffecbd771474f
保存版のSHA-256
bc05c41c6a776c639e2c05871687e14a0cf84a644672c0f3b2b7dd6188f9fea7

外部証明の最終検査結果は詳細を開くと表示します。
公開版の履歴・検証方法 · 証拠ファイルを保存(本文・画像は別)

#
記事内の画像
図・画像

NVIDIA決算が示した「次のAI半導体ボトルネック」

#

NVHBMはHBM4Eをどう変え、SRAM・Logic Base Die・Feynman・PIMへ何を引き起こすのか

#

NVIDIAの最新決算を単純に読むなら、「AI需要は依然として極めて強い」で終わります。

#

しかし、今回の決算と同時期に発表されたNVHBM、Rubin、OpenAI Jalapeño、Google TPU 8i、Custom HBM、PIMまでを一つの流れとして見ると、もっと大きな構造変化が見えてきます。

#

それは、

#
AI半導体の競争軸がFLOPSからMemory Hierarchyへ移り始めた\boxed{\text{AI半導体の競争軸がFLOPSからMemory Hierarchyへ移り始めた}}
#

ということです。

#

より具体的には、

#
Compute→HBM→SRAM / NoC→Network→Near-Memory Compute\boxed{\text{Compute}\rightarrow\text{HBM}\rightarrow\text{SRAM / NoC}\rightarrow\text{Network}\rightarrow\text{Near-Memory Compute}}
#

と、ボトルネックが順番に移動しています。

#

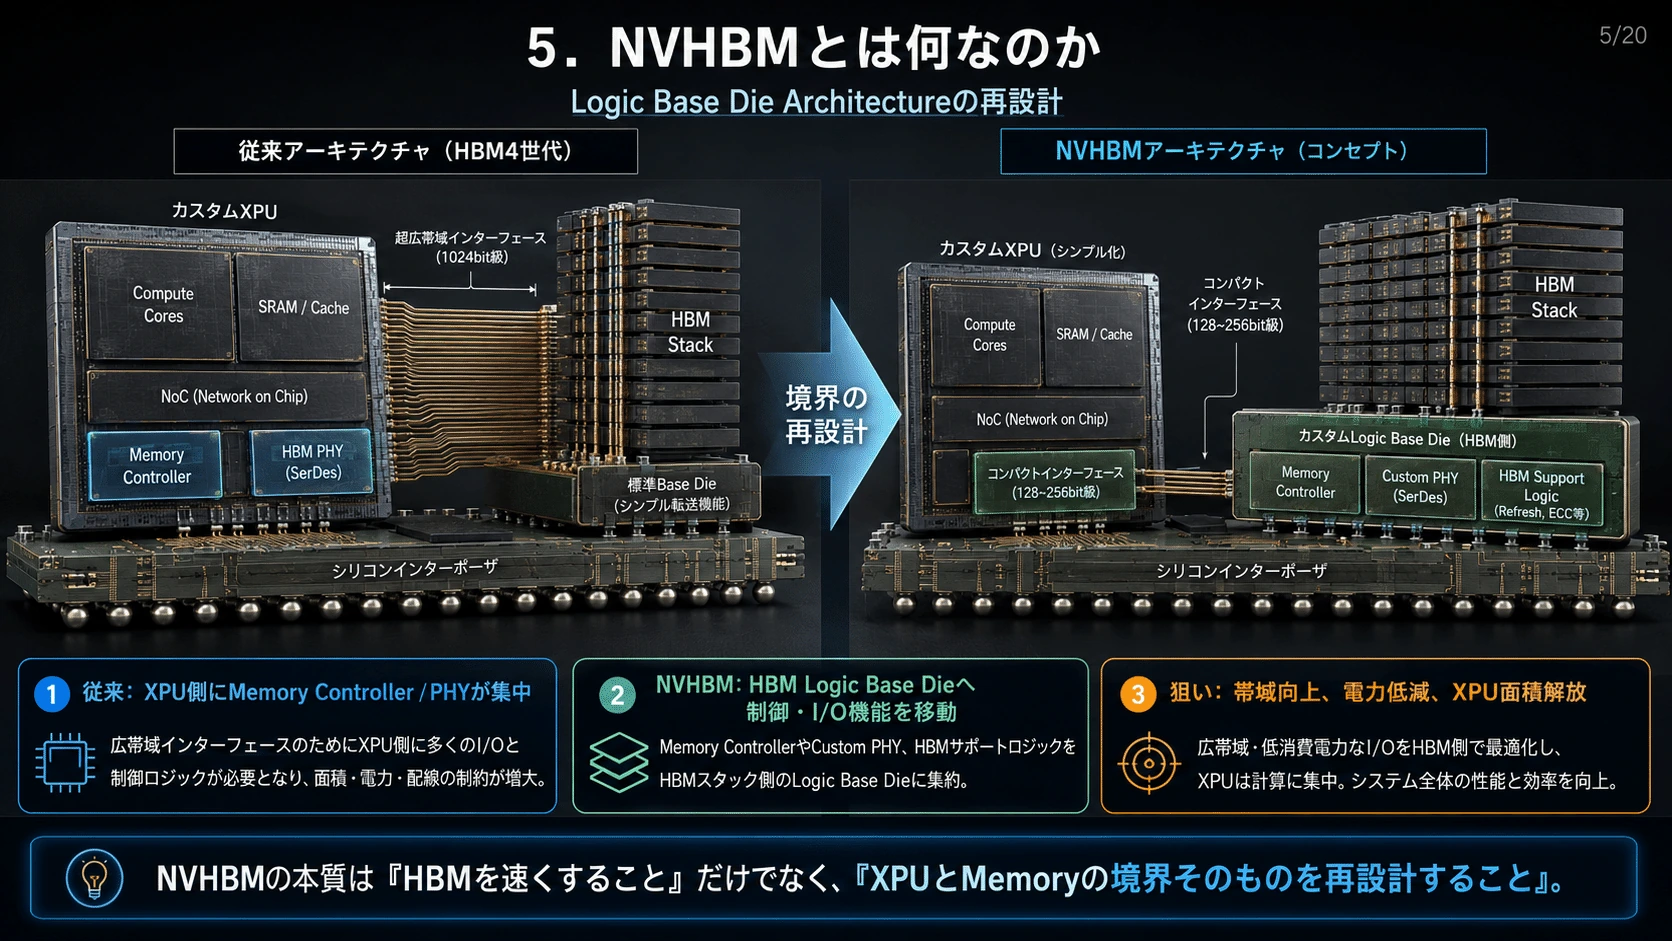
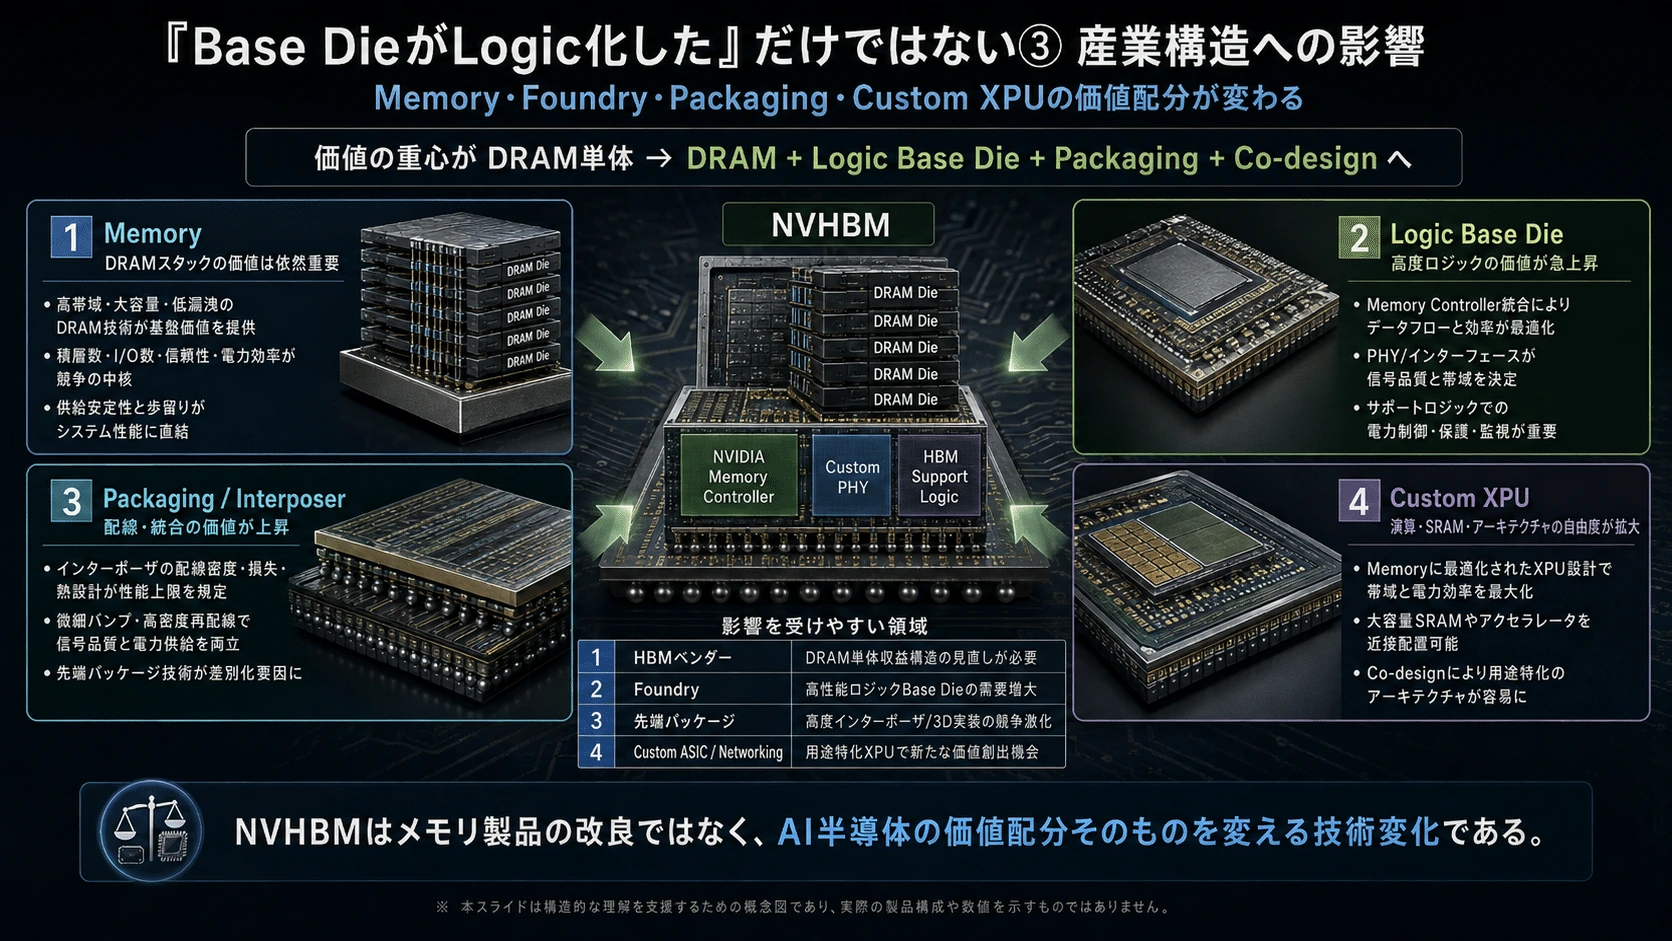
NVHBMはこの中で単なる「高速な次世代HBM」ではありません。

#

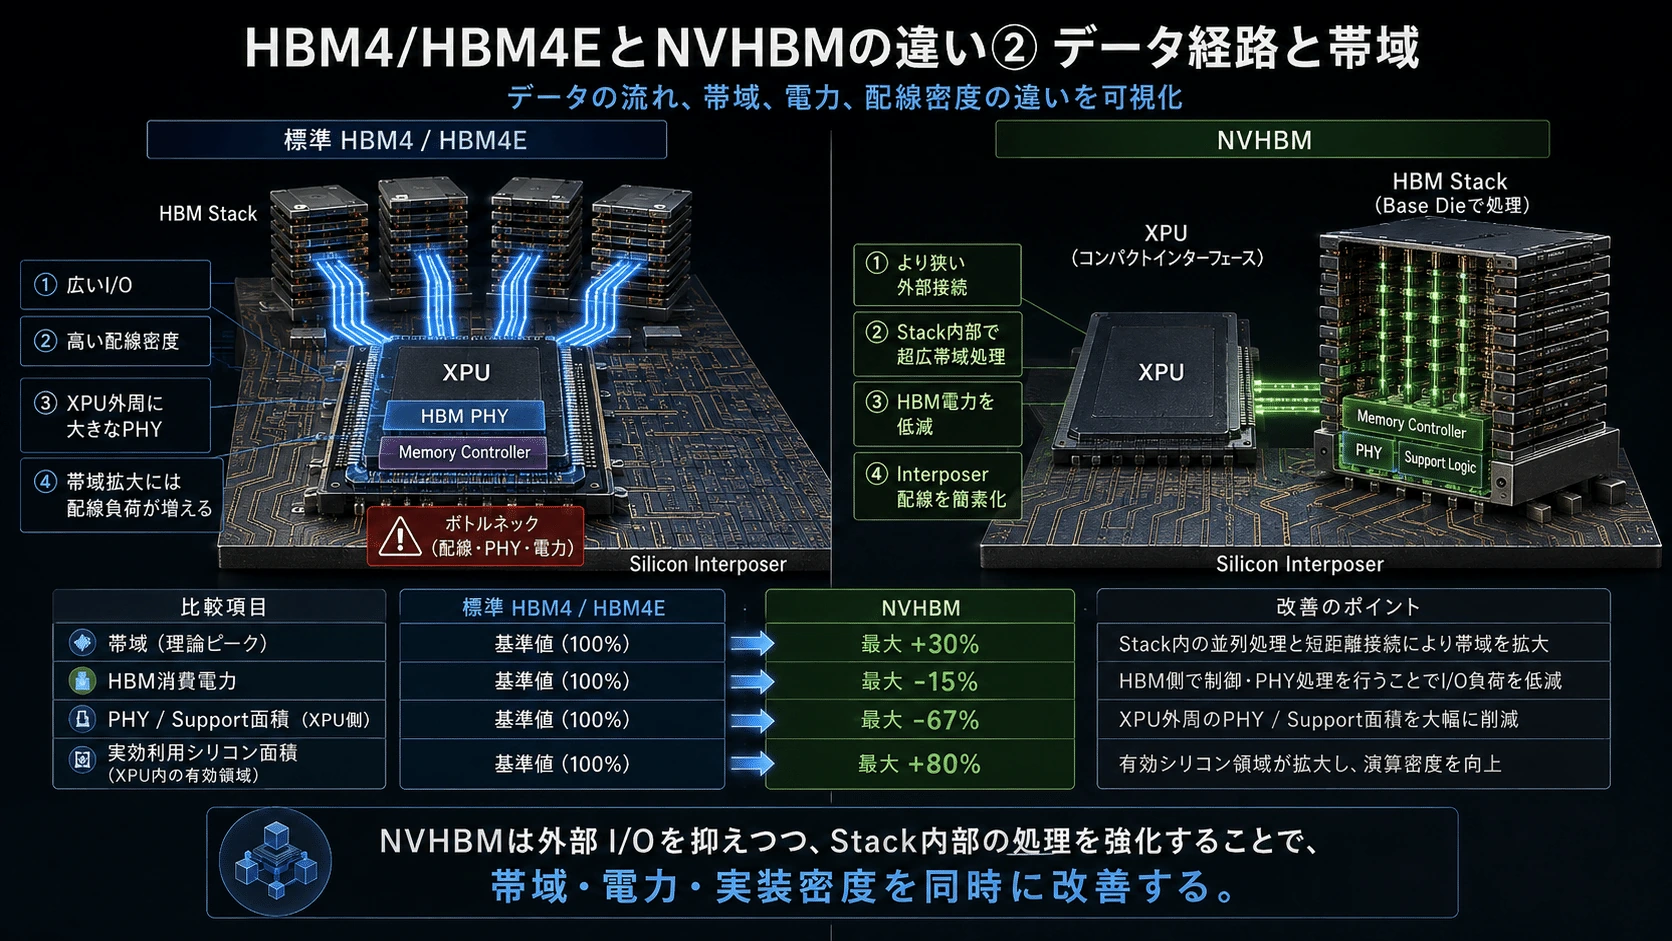
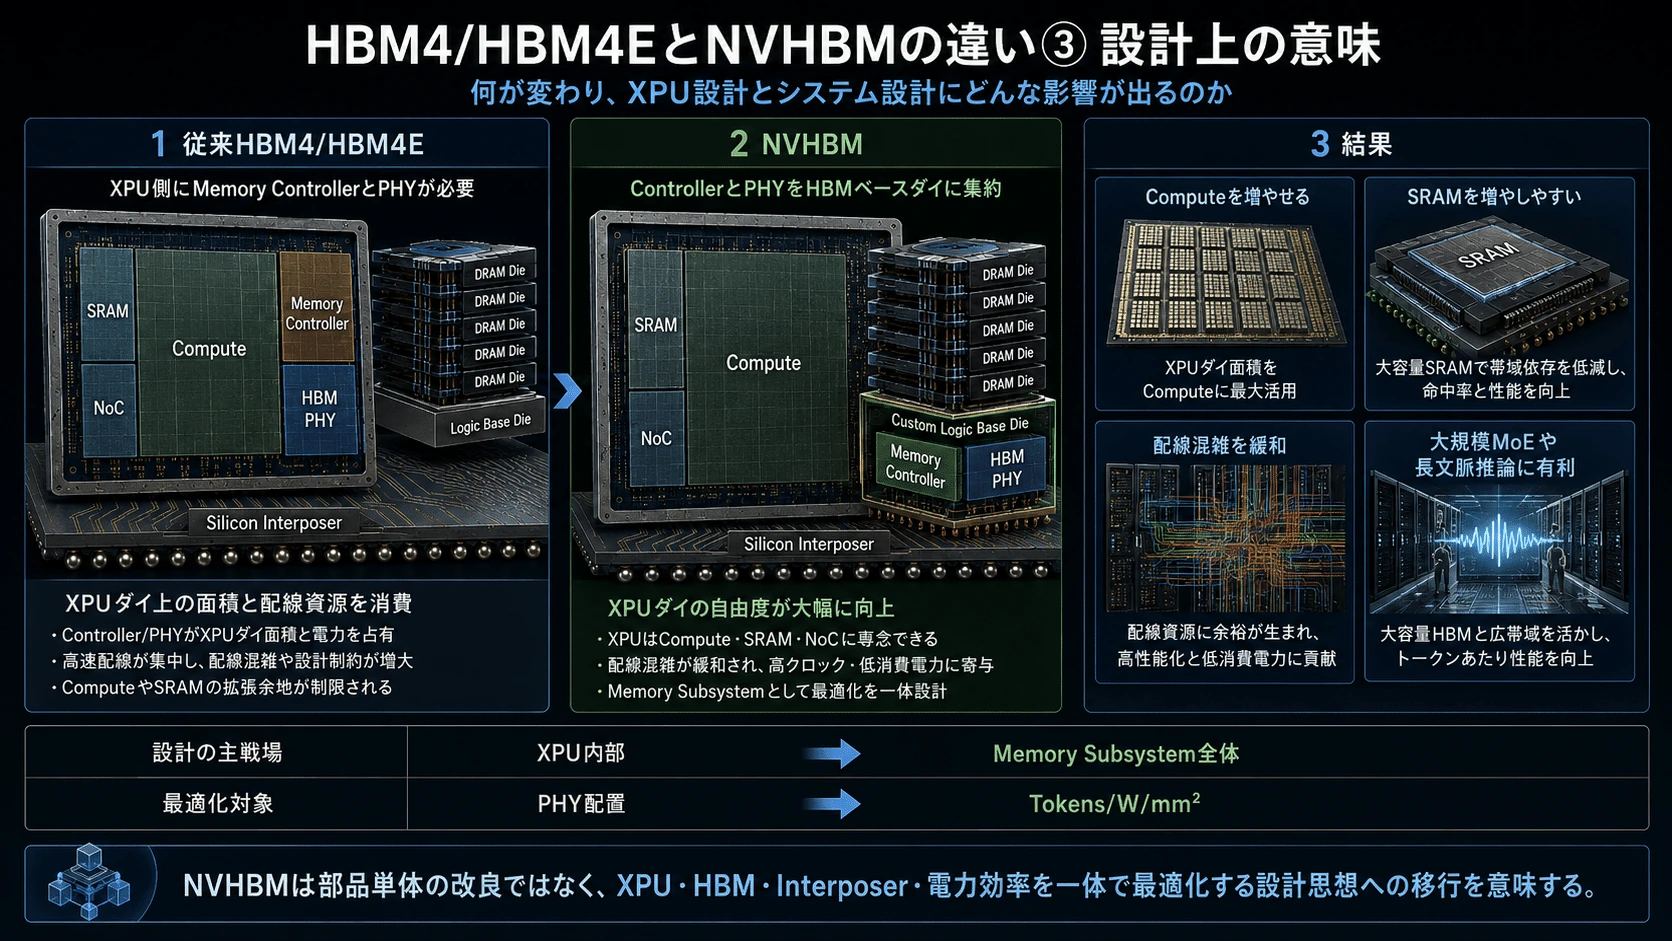
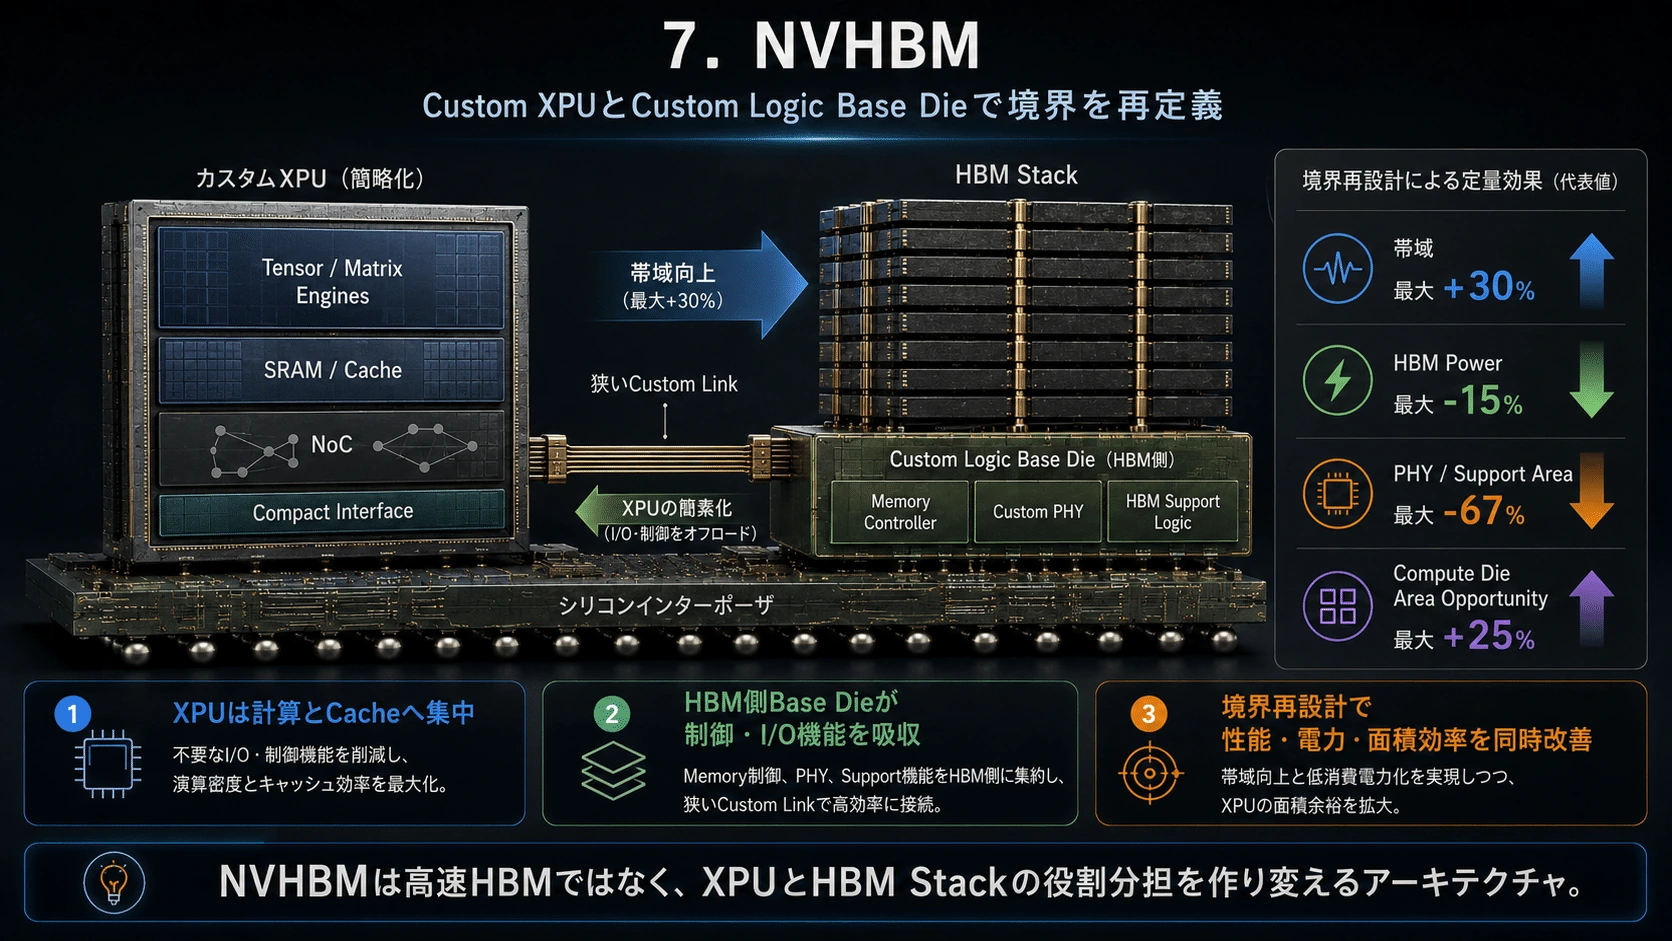
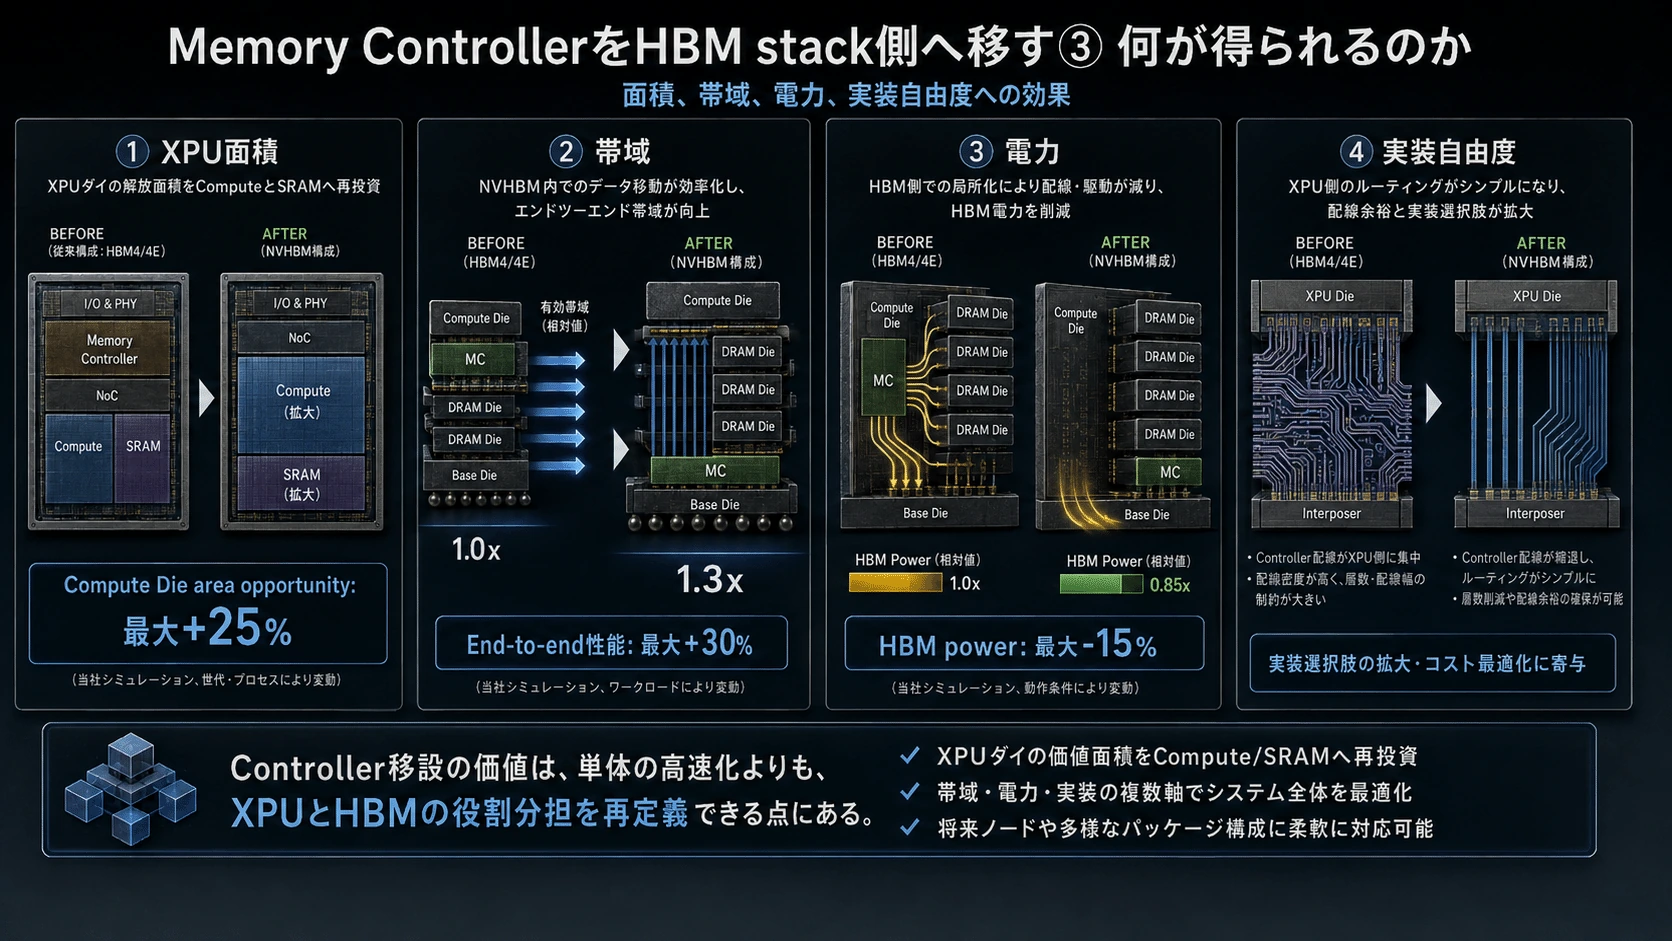
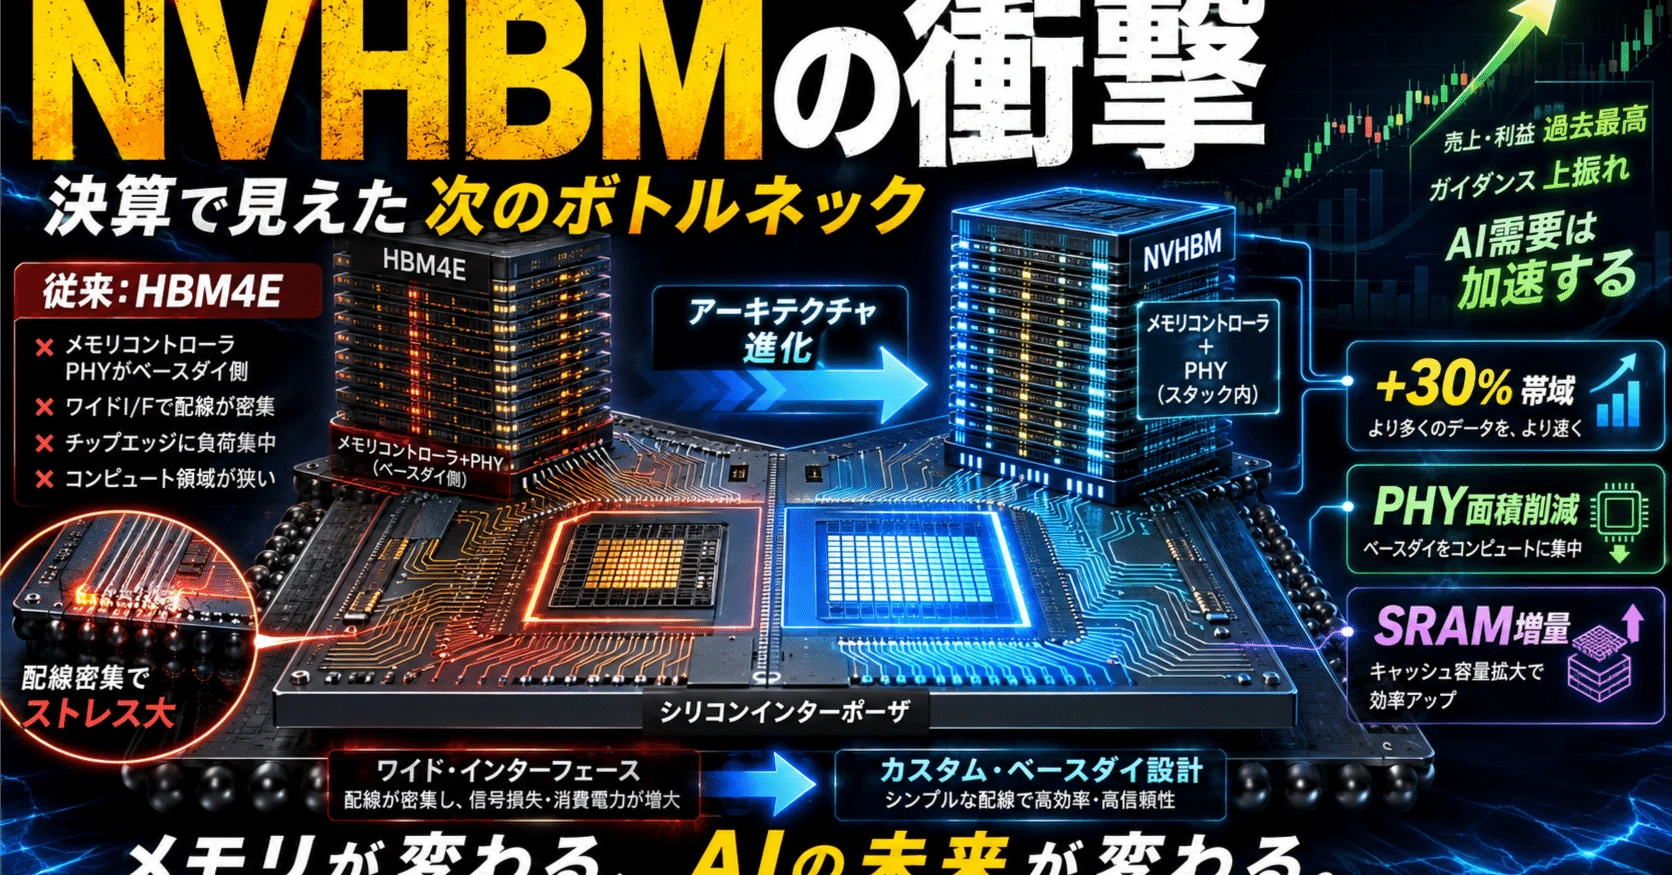
HBM Logic Base DieへMemory ControllerとCustom PHYを押し込み、XPUとMemoryの境界そのものを再設計する技術です。NVIDIAによればStandard HBM4E比で最大30%高いMemory Bandwidth、最大15%低いHBM Power、最大67%のPHY/support area削減、最大25%のCompute Die Area opportunityを実現します。(NVIDIA Developer)

#

そして今回の定量モデルを最後まで進めると、一つ重要な結論に到達します。

#
NVHBM first→SRAM second→Near-Memory Compute third\boxed{\text{NVHBM first}\rightarrow\text{SRAM second}\rightarrow\text{Near-Memory Compute third}}
#

です。

#

#

1.まずNVIDIA最新決算――問題は「需要」ではなく「供給」に移った

#

NVIDIA FY2027 Q2売上高は962億ドル、前年同期比+106%、前四半期比+18%。

#

Data Center売上は890億ドル、前年同期比+117%、Q/Q+18%でした。

#

Q3売上ガイダンスは1,080億ドル±2%。中国向けData Center Compute revenueを一切織り込んでいません。(NVIDIA Newsroom)

#
指標FY27 Q2RevenueUSD 96.2BData CenterUSD 89.0BData Center比率92.5%Q/Q Revenue growth+18%Y/Y Revenue growth+106%Gross margin75.0%Q3 GuideUSD 108B ±2%Q3 Gross margin74% ±0.5pt\begin{array}{|l|c|} \text{指標}&\text{FY27 Q2}\cr\hline \text{Revenue}&\text{USD 96.2B}\cr\hline \text{Data Center}&\text{USD 89.0B}\cr\hline \text{Data Center比率}&\text{92.5%}\cr\hline \text{Q/Q Revenue growth}&\text{+18%}\cr\hline \text{Y/Y Revenue growth}&\text{+106%}\cr\hline \text{Gross margin}&\text{75.0%}\cr\hline \text{Q3 Guide}&\text{USD 108B ±2%}\cr\hline \text{Q3 Gross margin}&\text{74% ±0.5pt}\cr\hline \end{array}
#

Data Center比率は、

#
8996.221=92.5%\frac{89}{96.221}=\text{92.5%}
#

です。

#

さらにQ1→Q2の全社増収額は、

#
96.221−81.615=14.606B96.221-81.615=\text{14.606B}
#

Data Center増収額は、

#
89.0−75.2=13.8B89.0-75.2=\text{13.8B}
#

なので、

#
13.814.606=94.5%\frac{13.8}{14.606}=\text{94.5%}
#

となります。

#

つまりNVIDIAの前四半期からの増収額の約94.5%をData Centerが説明しています。

#

もはやNVIDIAの業績は「GPUメーカーの業績」というより、世界のAI Infrastructure投資そのものに近づいています。

#

#

2.さらに重要なのはHyperscaler以外が伸びていること

#

今回NVIDIAはData CenterをHyperscaleとACIE――AI Cloud、Industrial、Enterprise等――に分けています。

#

Q2は、

#
売上Q2Q/QHyperscaleUSD 49B+13%ACIEUSD 40B+25%\begin{array}{|l|c|c|} \text{売上}&\text{Q2}&\text{Q/Q}\cr\hline \text{Hyperscale}&\text{USD 49B}&\text{+13%}\cr\hline \text{ACIE}&\text{USD 40B}&\text{+25%}\cr\hline \end{array}
#

でした。(marketbeat.com)

#

Q1を逆算すると、

#
491.13=43.36B401.25=32B\frac{49}{1.13}=\text{43.36B}\quad \frac{40}{1.25}=\text{32B}
#

したがって増収は、

#

Hyperscale:

#
5.64B\text{5.64B}
#

ACIE:

#
8.0B\text{8.0B}
#

です。

#

Data Centerの増加額に占めるACIEの比率は、

#
88+5.64=58.7%\frac{8}{8+5.64}=\text{58.7%}
#

となります。

#

これはかなり大きな変化です。

#

従来は、

#
Microsoft
Amazon
Google
Meta
 ↓
Hyperscaler CAPEX
 ↓
NVIDIA需要
#

を見ればかなり説明できました。

#

現在は、

#
Hyperscaler
     +
Neo Cloud
     +
AI Native
     +
Sovereign AI
     +
Enterprise
     +
Industrial / Physical AI
#

へ需要源が分散しています。

#

NVIDIA自身もFY28について、顧客forecastでは「来年ほぼ倍増」する需要が示される一方、Revenue成長は約70%にとどまると説明しており、その理由をSupply Constraintとしています。(marketbeat.com)

#

単純化すると、

#
Demand:1.0→2.0\text{Demand}:1.0\rightarrow2.0
#

に対して、

#
Supply:1.0→1.7\text{Supply}:1.0\rightarrow1.7
#

です。

#

つまり需要に対する供給率は、

#
1.72.0=85%\frac{1.7}{2.0}=\text{85%}
#

であり、約15%を供給できません。

#

重要なのは、

#
NVIDIAの成長率を需要ではなくSupply Chainが決め始めた\boxed{\text{NVIDIAの成長率を需要ではなくSupply Chainが決め始めた}}
#

ことです。

#

#

3.そしてMemory価格がNVIDIA粗利率を押し下げ始めた

#

Q2 Gross Marginは75%。

#

Q3 Guideは74%。

#

さらにCFO Colette KressはQ4に71~72%まで低下し、FY28は72~73%へ回復する見通しを説明しています。

#

理由の一つが、予想以上に上昇しているMemory価格です。(NDTV Profit)

#

構造は単純です。

#
AI需要↑
 ↓
GPU需要↑
 ↓
HBM需要↑
 ↓
DRAM / HBM供給逼迫
 ↓
HBM価格↑
 ↓
NVIDIA BOM↑
 ↓
NVIDIA Gross Margin↓
#

つまり今回のMargin低下は需要不足ではありません。

#

むしろ、

#
NVIDIAが得ていたEconomic Rentの一部がMemory側へ移動している\boxed{\text{NVIDIAが得ていたEconomic Rentの一部がMemory側へ移動している}}
#

と考えられます。

#

しかもQ2 Gross Profitは、

#
96.221×0.75=72.17B96.221\times0.75=\text{72.17B}
#

Q3 midpointでは、

#
108×0.74=79.92B108\times0.74=\text{79.92B}
#

なので、

#
79.9272.17−1=10.7%\frac{79.92}{72.17}-1=\text{10.7%}
#

です。

#

粗利率が1pt下がってもGross Profit額は約11%増えます。

#

したがってこれは「NVIDIA成長終了」ではなく、

#

AI Infrastructure Value Chainの中で利益配分がMemory側へ動いている

#

という話です。

#

#

4.Rubinでは1GW当たりNVIDIA売上機会が2倍以上になった

#

決算説明では、AI Factory 1GW当たりのNVIDIA Revenue Opportunityが、

#
世代Revenue/GWHopper約USD 18BBlackwell約USD 25BVera Rubin約USD 40B\begin{array}{|l|c|} \text{世代}&\text{Revenue/GW}\cr\hline \text{Hopper}&\text{約USD 18B}\cr\hline \text{Blackwell}&\text{約USD 25B}\cr\hline \text{Vera Rubin}&\text{約USD 40B}\cr\hline \end{array}
#

とされています。(marketbeat.com)

#

Hopper→Rubinで、

#
4018=2.22倍\frac{40}{18}=\text{2.22倍}
#

です。

#

これはGPU価格が単純に2倍になったという話ではありません。

#

NVIDIAが、

#
GPU
+
CPU
+
NVLink
+
NVSwitch
+
Ethernet / InfiniBand
+
DPU
+
Software
+
Rack Architecture
#

まで取り込んでいるからです。

#

ここにNVHBMが加わる意味は大きい。

#

Custom ASICがNVIDIA GPUの代わりになっても、

#

Memory InterfaceとScale-up FabricをNVIDIA Ecosystem側へ取り込む

#

ことが可能になるからです。

#

#

5.NVHBMとは何なのか

#

ここを最初に明確にしておく必要があります。

#

NVHBMは、

#
Logic Base Die Architecture\boxed{\text{Logic Base Die Architecture}}
#

の話です。

#

ただし単に、

#
「HBM4からBase DieがLogic化する」
#

という意味ではありません。

#

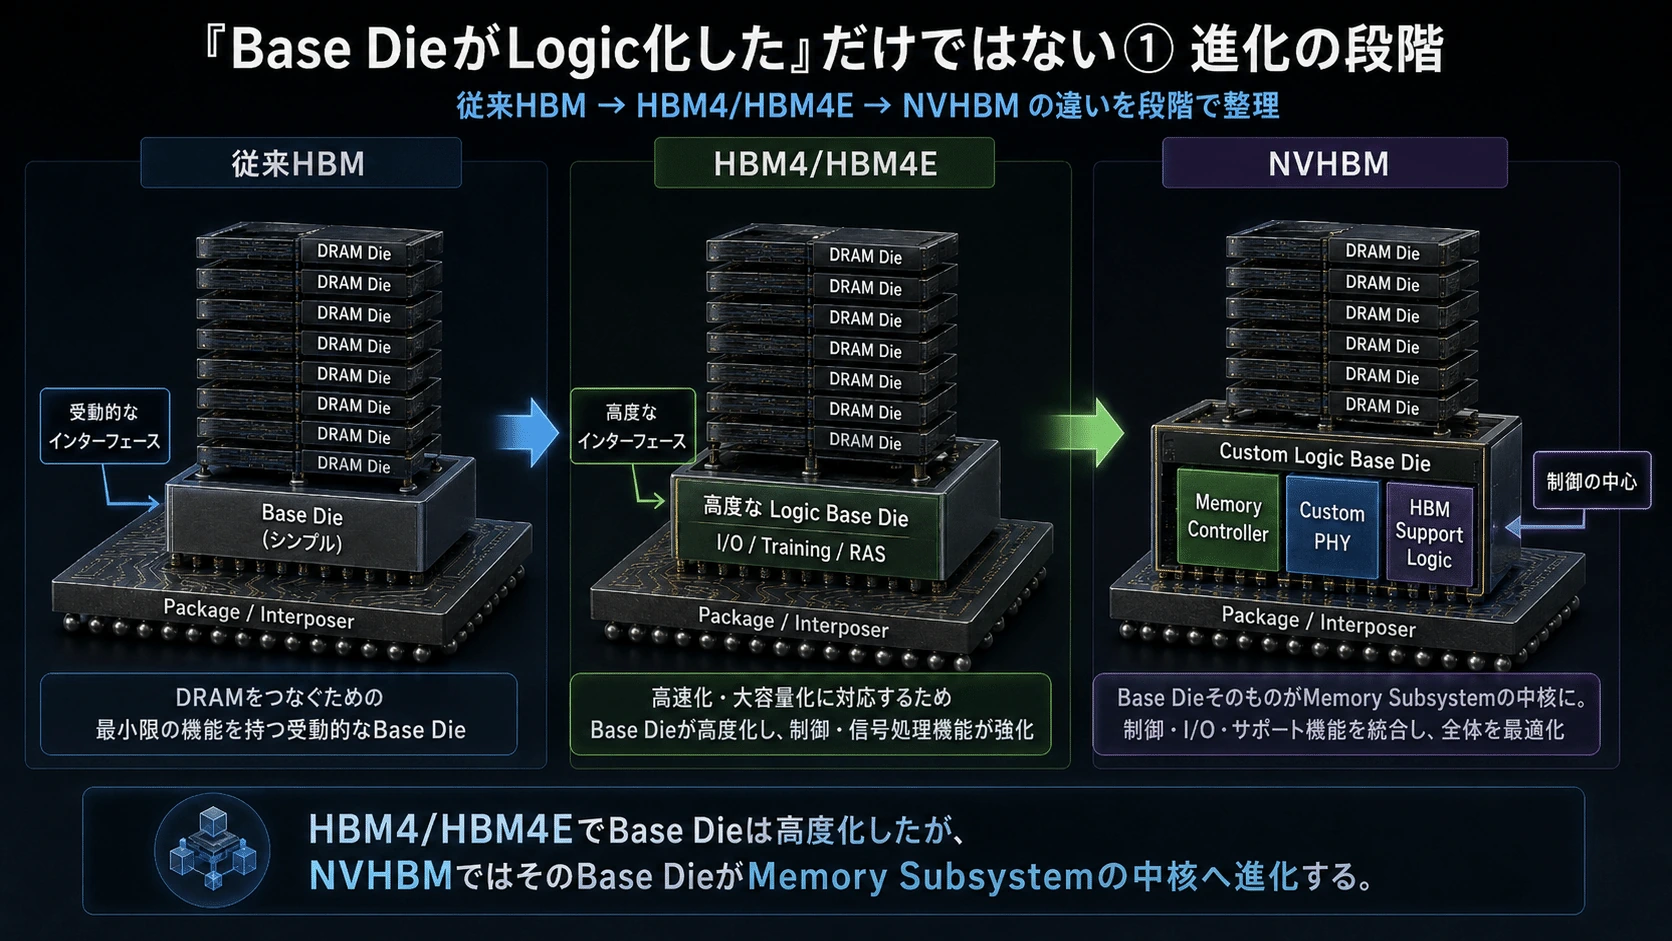
HBM4ですでにLogic Base Dieは高度化しています。

#

SK hynixはHBM4からTSMC Advanced Logic ProcessをBase Dieへ採用すると説明しており、SamsungはHBM5 Base Dieを2nm Foundry Processへ移行する計画です。(SK hynix Newsroom)

#

NVHBMの新しさは、

#
どのLogicをBase Dieへ移すか
#

です。

#

#
記事内の画像
図・画像

#

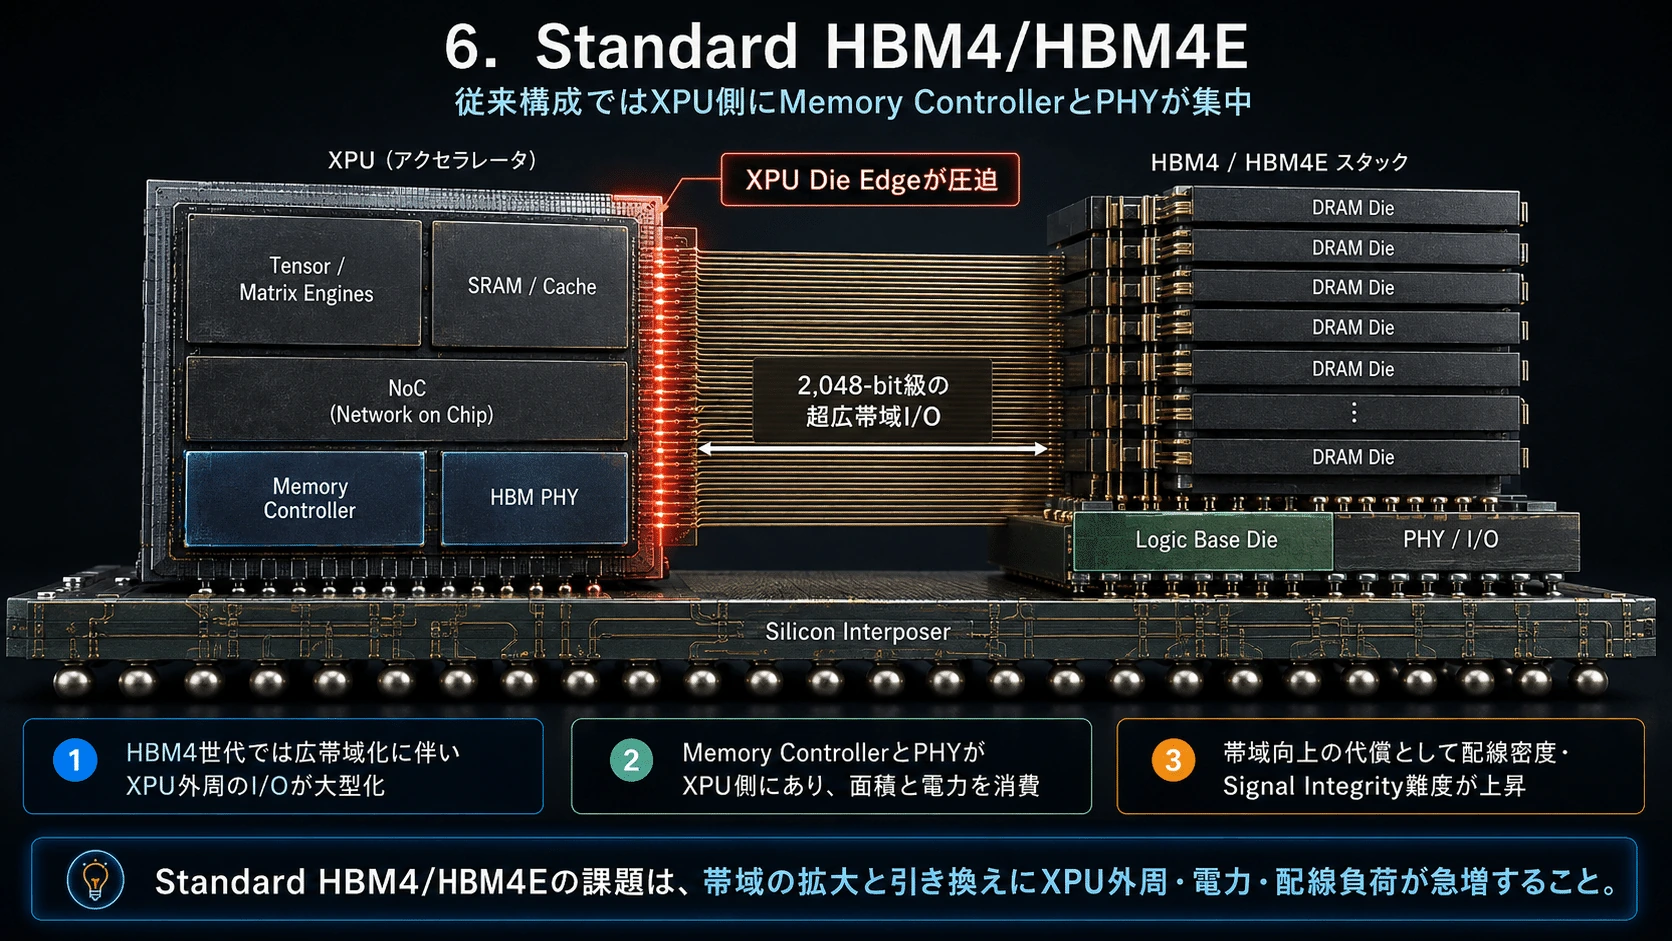
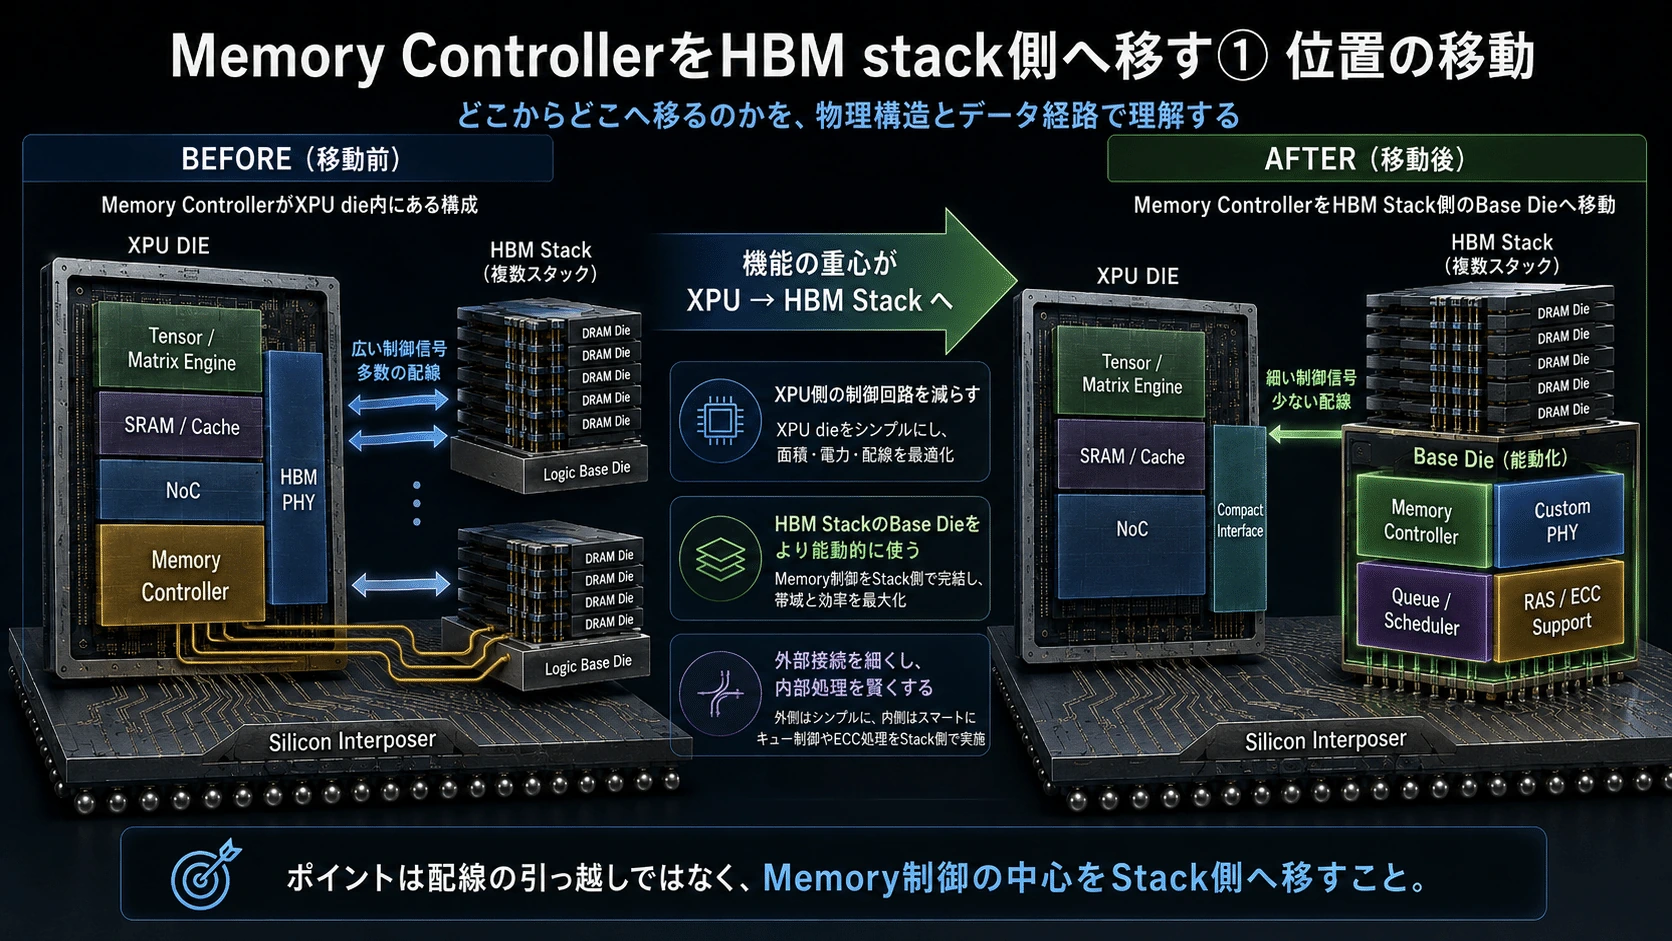
6.Standard HBM4/HBM4E

#

単純化するとこうです。

#
                HBM4 / HBM4E

┌─────────────────────────────┐
│ XPU                         │
│                             │
│ Tensor / Matrix Engines     │
│ SRAM / Cache                │
│ NoC                         │
│                             │
│ Memory Controller           │
│ HBM PHY                     │
└─────────────┬───────────────┘
              │
              │  very wide interface
              │
══════════════╪════════════════
       Silicon Interposer
══════════════╪════════════════
              │
        ┌─────▼────────┐
        │ DRAM Die     │
        │ DRAM Die     │
        │ DRAM Die     │
        │ ...          │
        ├──────────────┤
        │ Logic        │
        │ Base Die     │
        │ PHY / I/O    │
        └──────────────┘
#

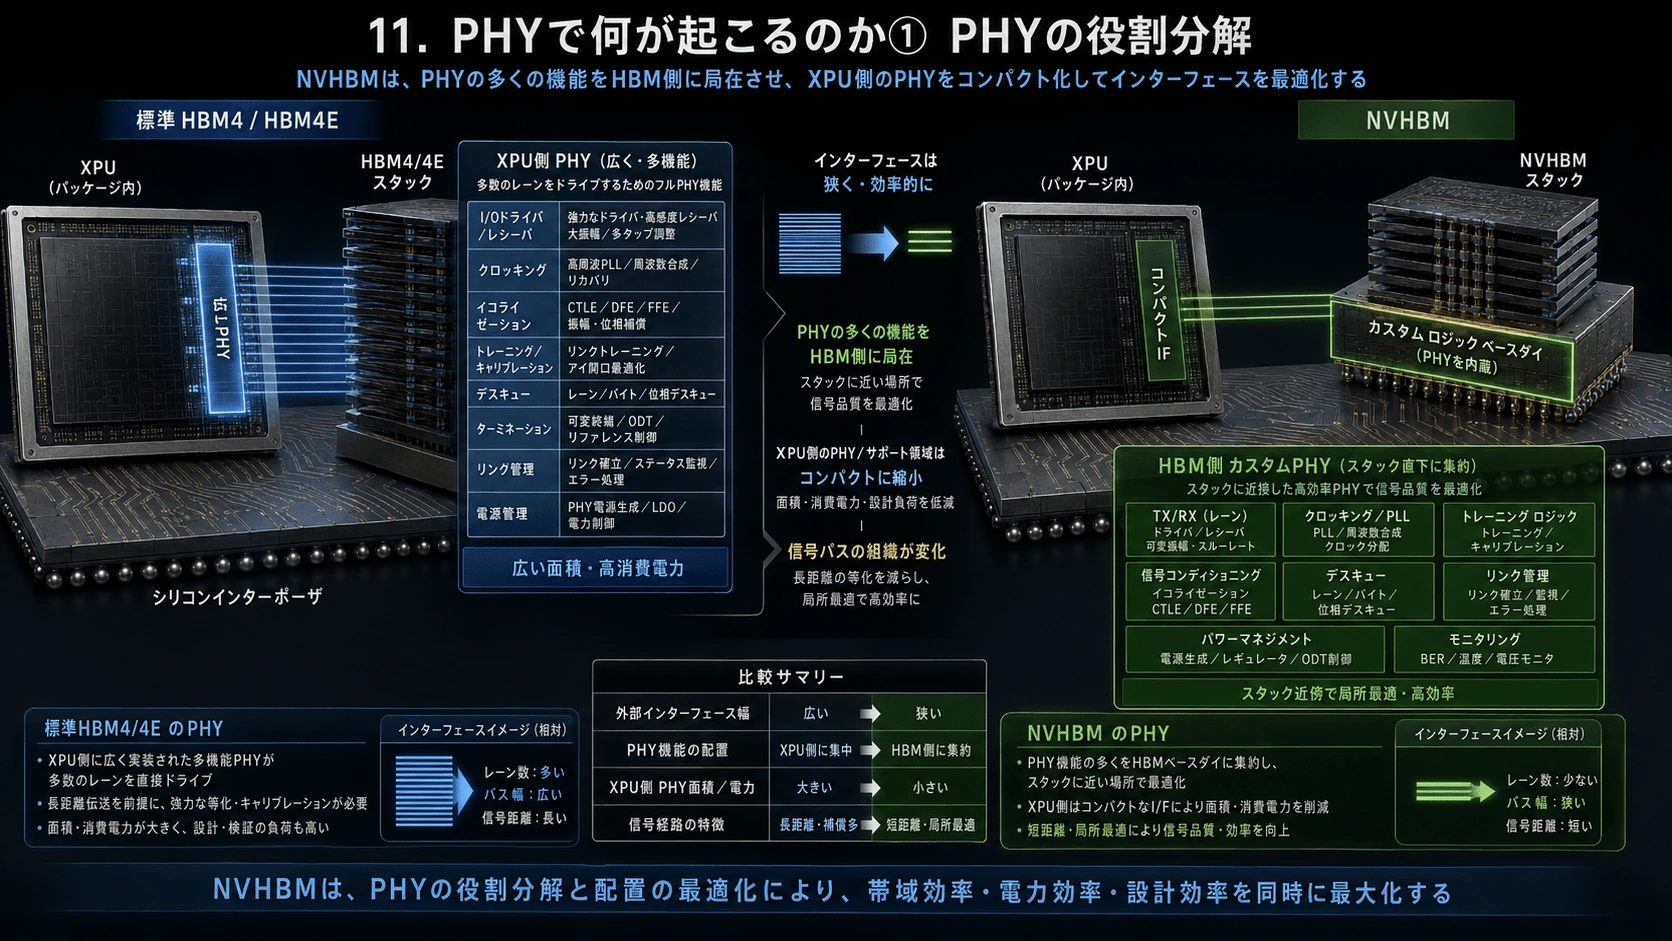
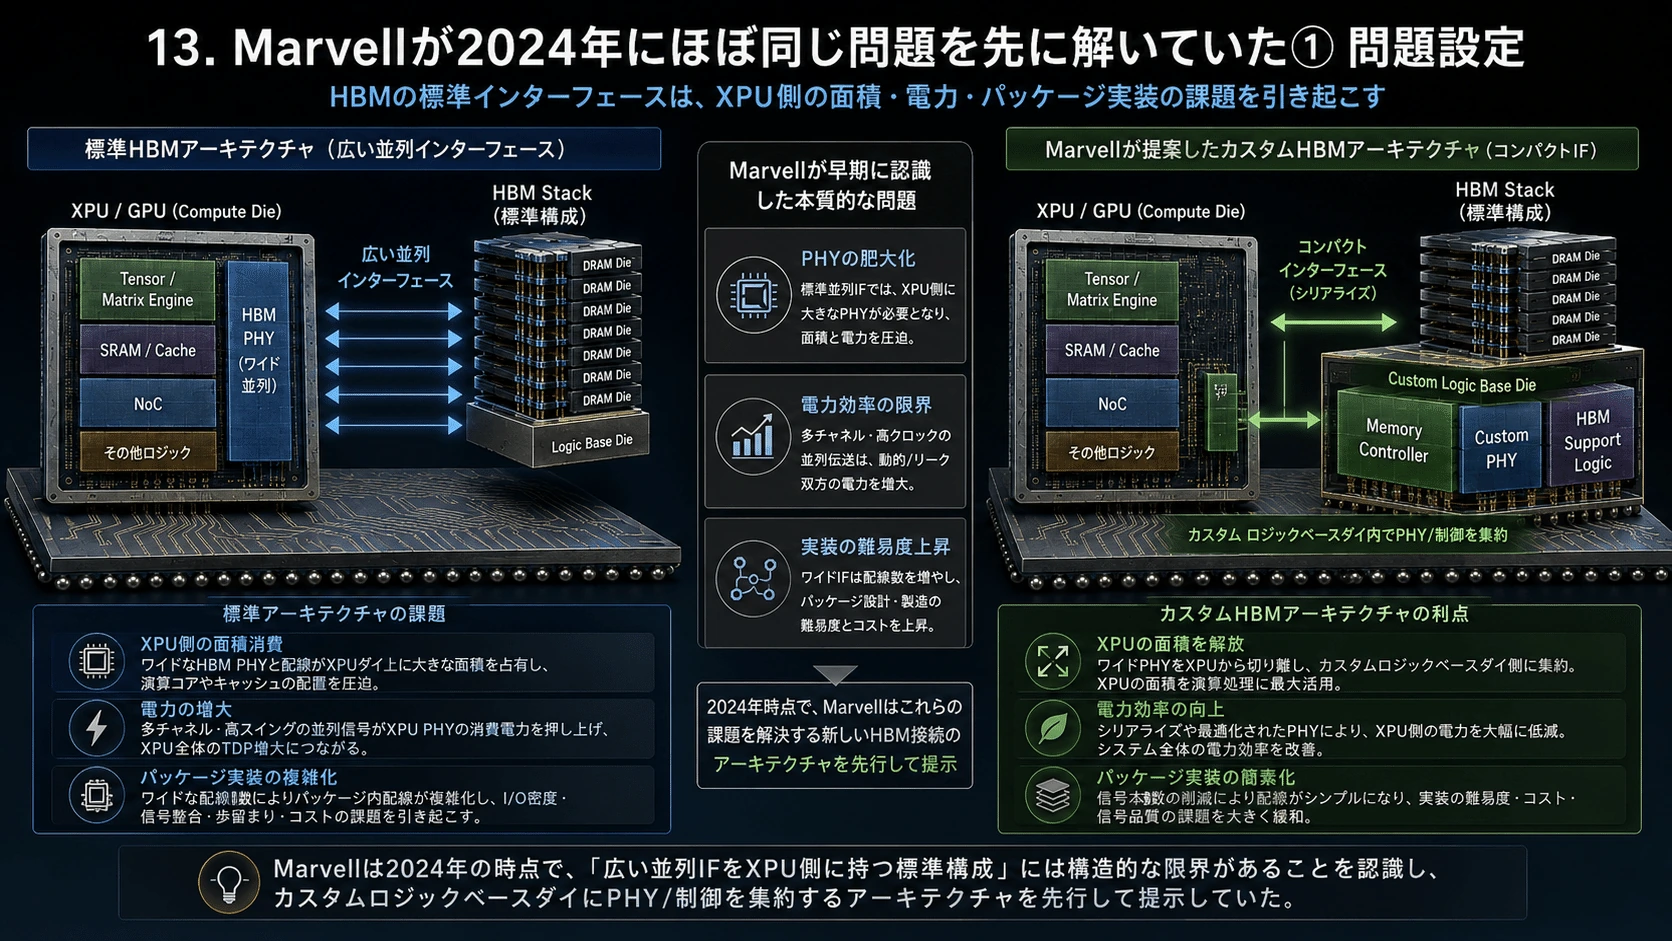
HBM4ではinterfaceは2,048-bit級まで広がっています。

#

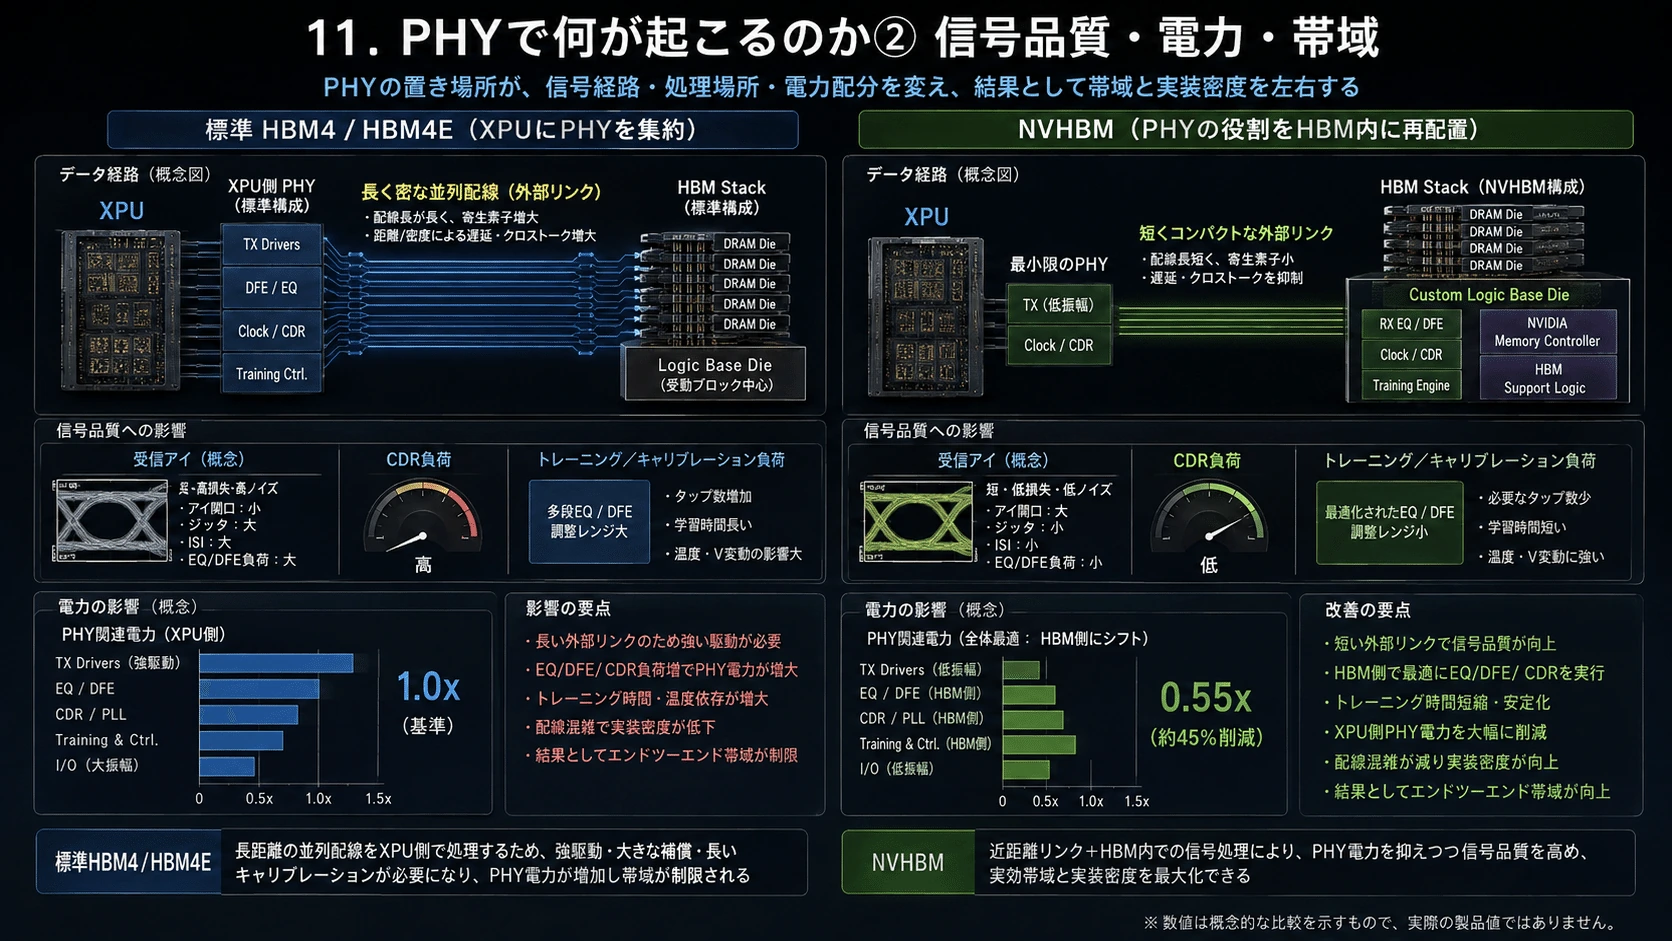
HBM4 PHYはHBM3Eより面積も電力も大きくなる方向で、業界資料ではHBM3E級11mm²→HBM4級15mm²、PHY power 6W→9Wという例も報告されています。(Tom's Hardware)

#

高帯域化するほど、

#

XPU Die EdgeをMemory Interfaceが食う

#

という問題が大きくなります。

#

#
記事内の画像
図・画像

#
記事内の画像
図・画像

#
記事内の画像
図・画像

#
記事内の画像
図・画像

#

7.NVHBM

#

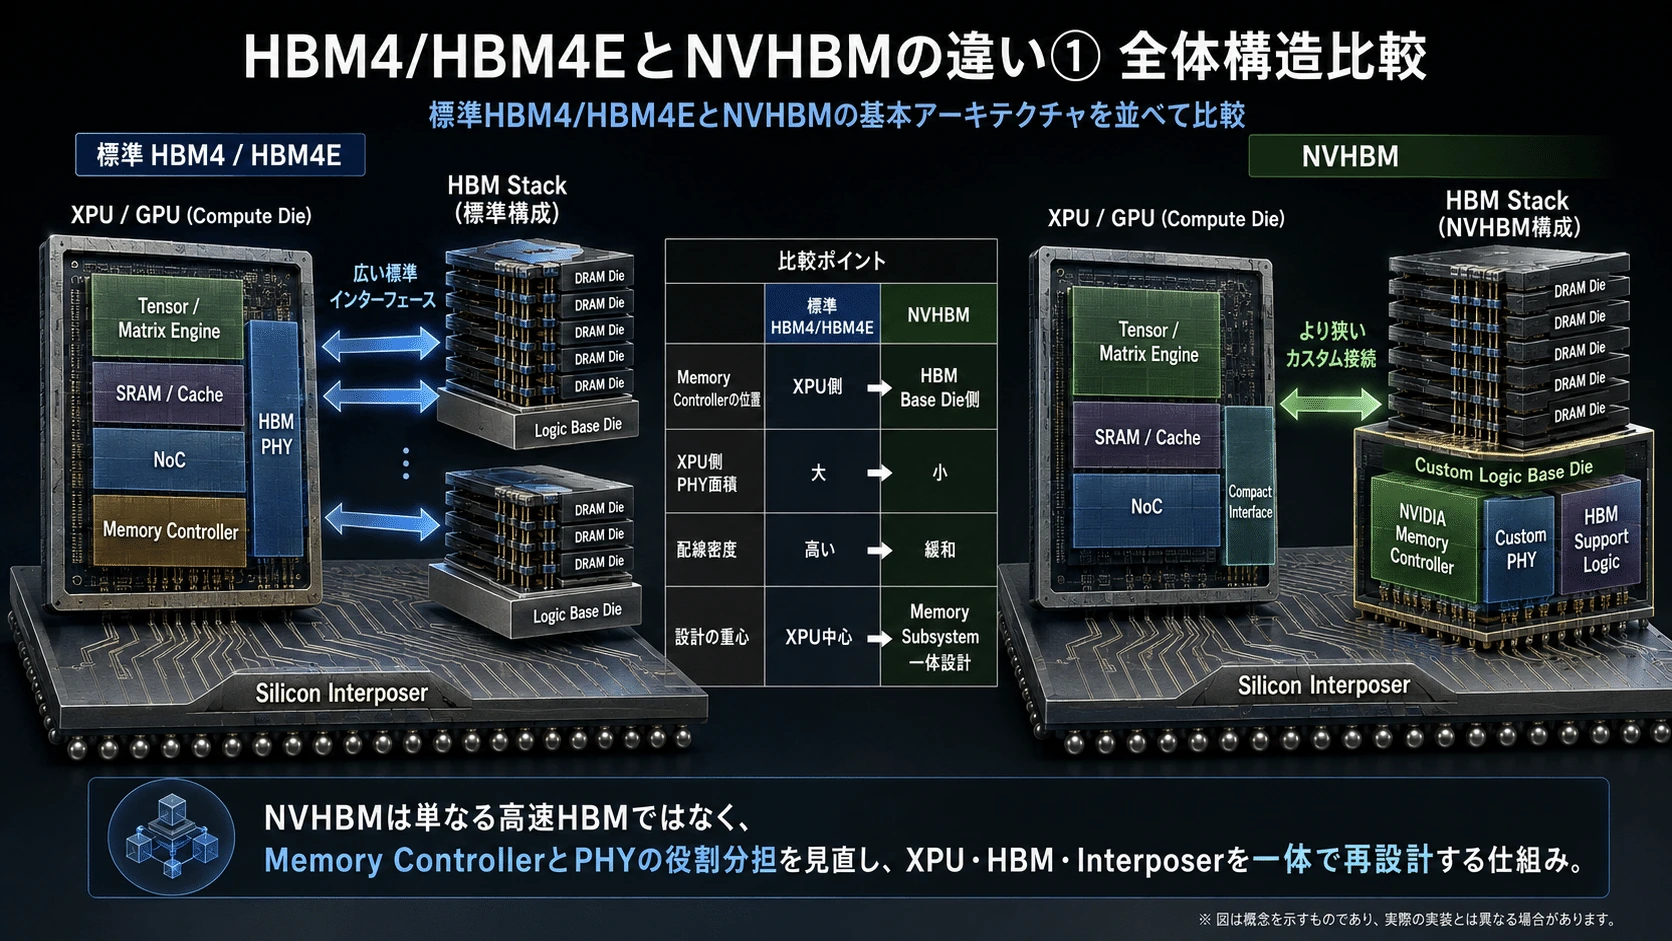
NVHBMでは構造がこう変わります。

#
                     NVHBM

┌─────────────────────────────┐
│ Custom XPU                  │
│                             │
│ Tensor / Matrix Engines     │
│ SRAM / Cache                │
│ NoC                         │
│                             │
│ Compact Interface           │
└─────────────┬───────────────┘
              │
              │ narrower custom link
              │
══════════════╪════════════════
       Silicon Interposer
══════════════╪════════════════
              │
        ┌─────▼──────────────┐
        │ DRAM Die           │
        │ DRAM Die           │
        │ DRAM Die           │
        │ ...                │
        ├────────────────────┤
        │ Custom Logic       │
        │ Base Die           │
        │                    │
        │ Memory Controller  │
        │ Custom PHY         │
        │ HBM Support Logic  │
        └────────────────────┘
#

NVIDIA自身が、Traditional HBMではXPUにあるMemory Controllerを3D HBM stack内のCustom Base Dieへ移すと説明しています。(NVIDIA Developer)

#

これがNVHBMの本質です。

#

#
記事内の画像
図・画像

#
記事内の画像
図・画像

#
記事内の画像
図・画像

#
記事内の画像
図・画像

#

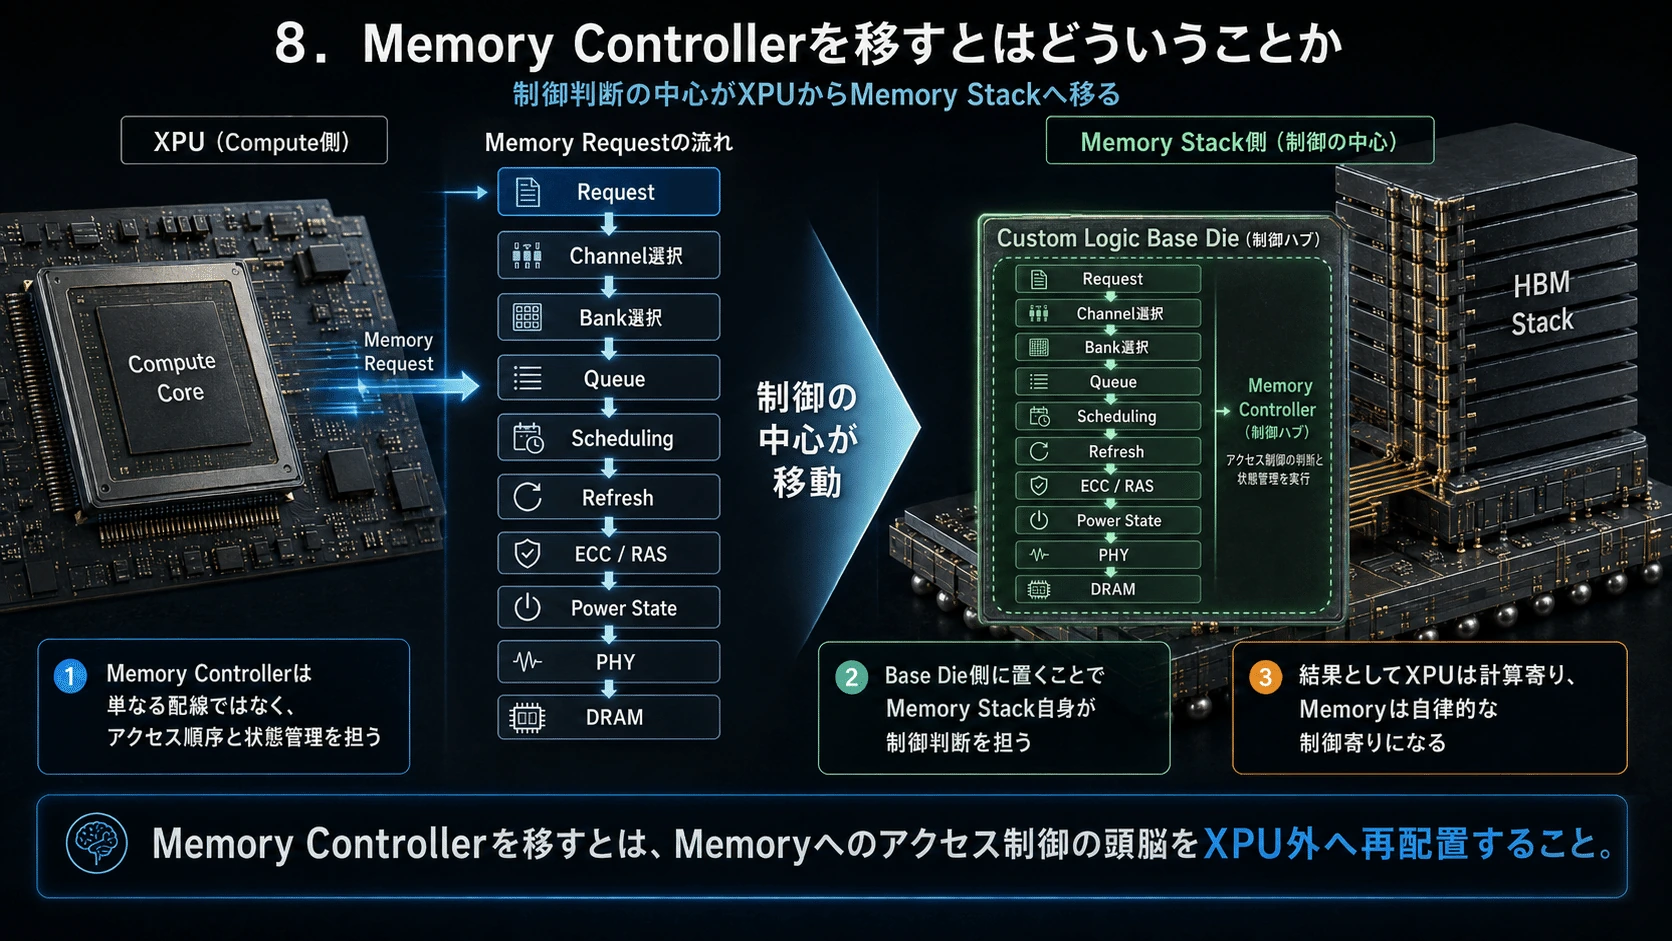
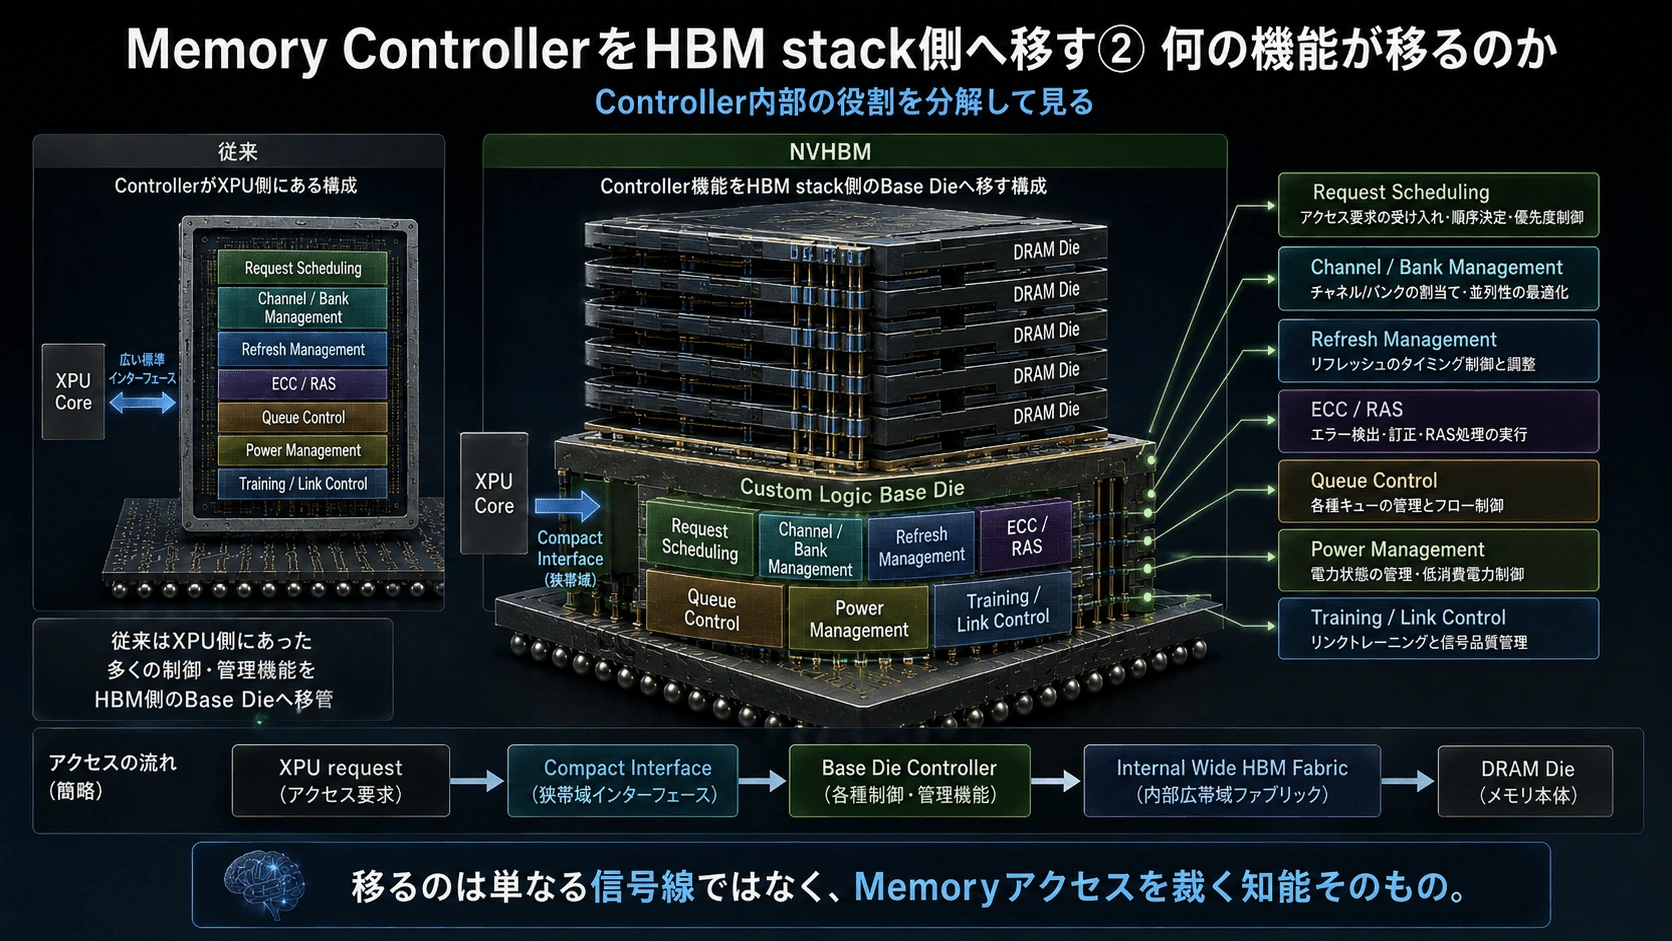
8.Memory Controllerを移すとはどういうことか

#

Memory Controllerは単なる信号変換器ではありません。

#

Compute Coreから来たMemory Requestについて、

#
Request
 ↓
Channel選択
 ↓
Bank選択
 ↓
Queue
 ↓
Scheduling
 ↓
Refresh
 ↓
ECC / RAS
 ↓
Power State
 ↓
PHY
 ↓
DRAM
#

を管理します。

#

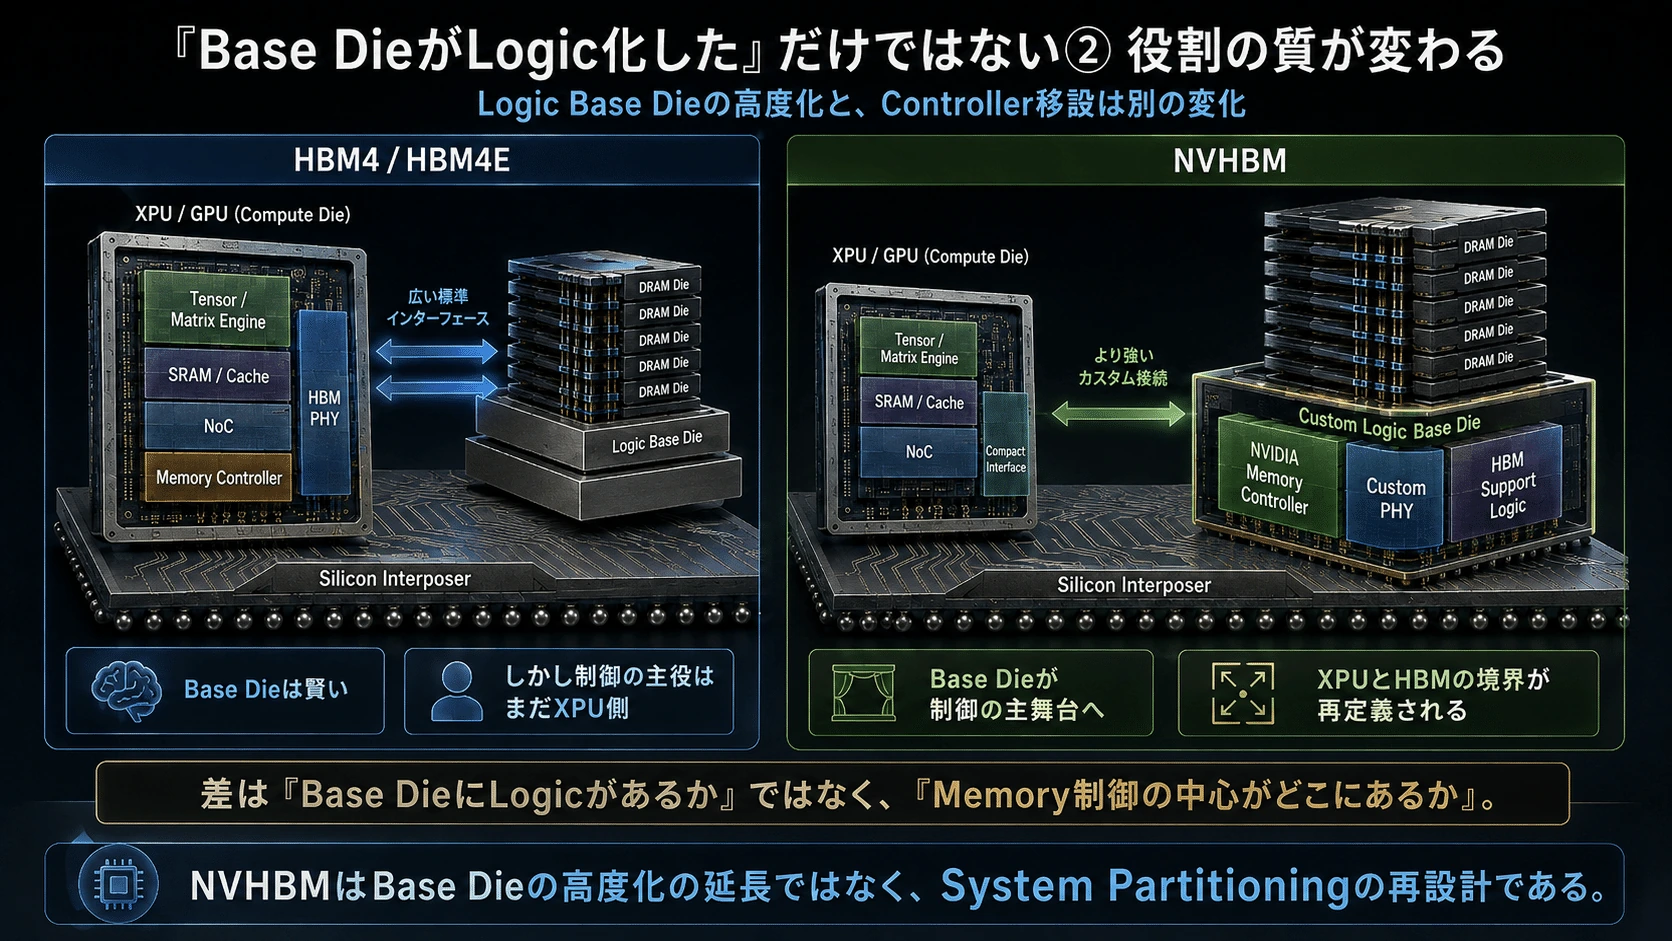
したがってMemory ControllerをBase Dieへ持っていくとは、

#

Memoryに関する制御判断の中心をXPUからMemory Stackへ移す

#

ということです。

#

ここが単なるLogic Base Die高度化との違いです。

#

#
記事内の画像
図・画像

#
記事内の画像
図・画像

#
記事内の画像
図・画像

#
記事内の画像
図・画像

#

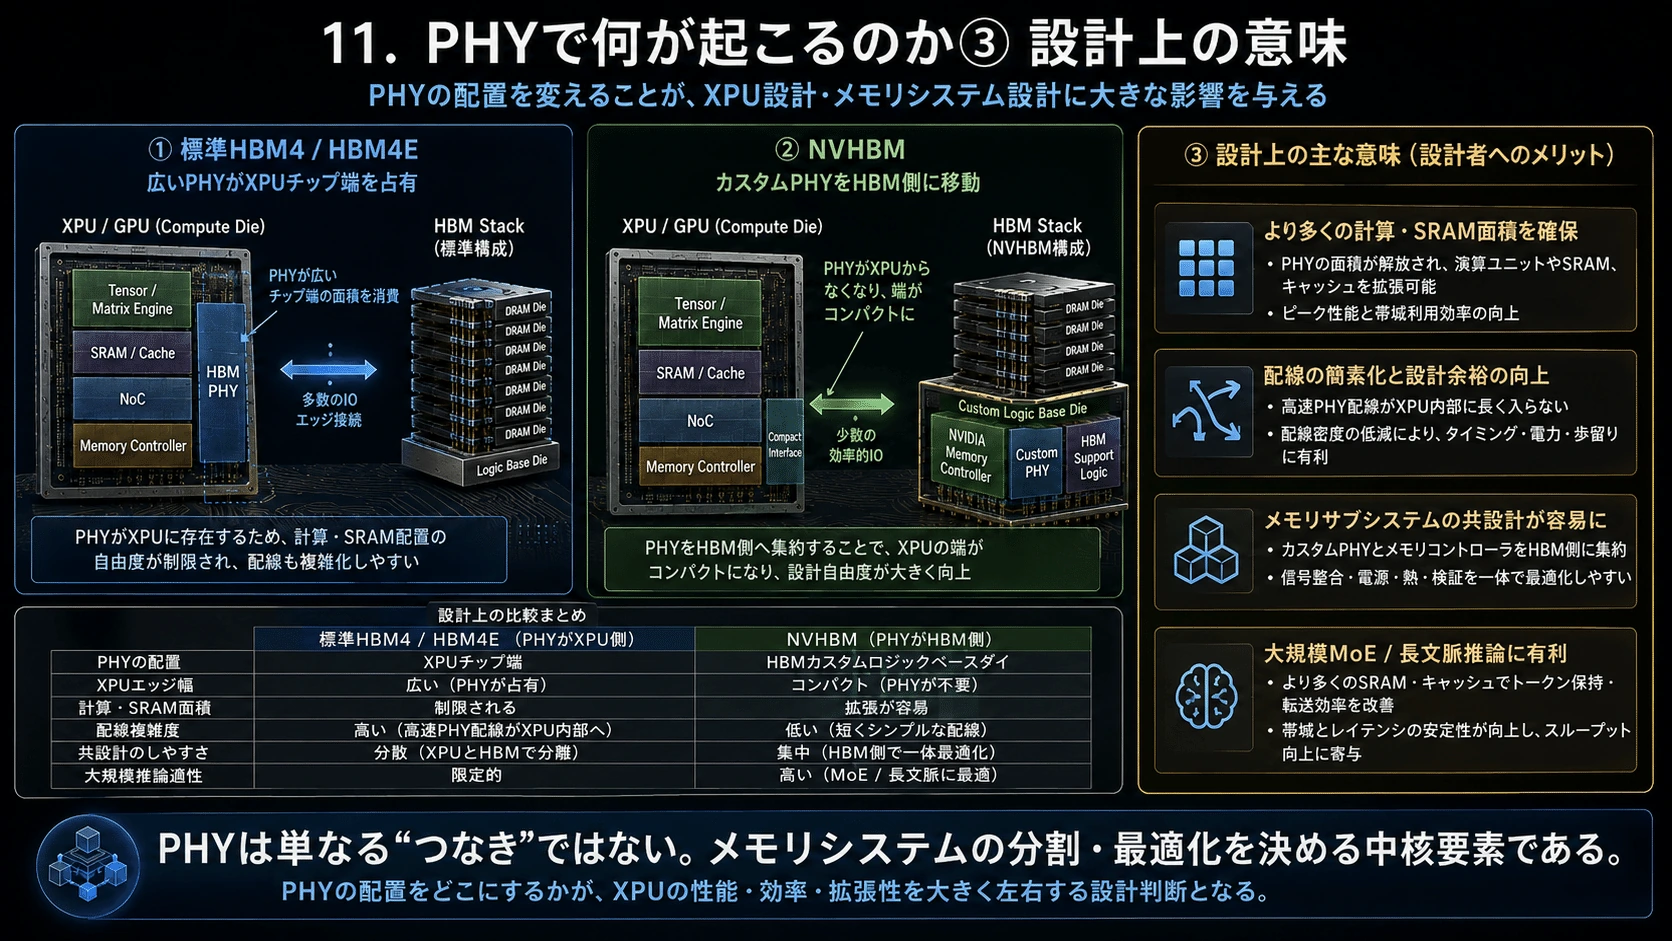
9.PHYでは何が変わるのか

#

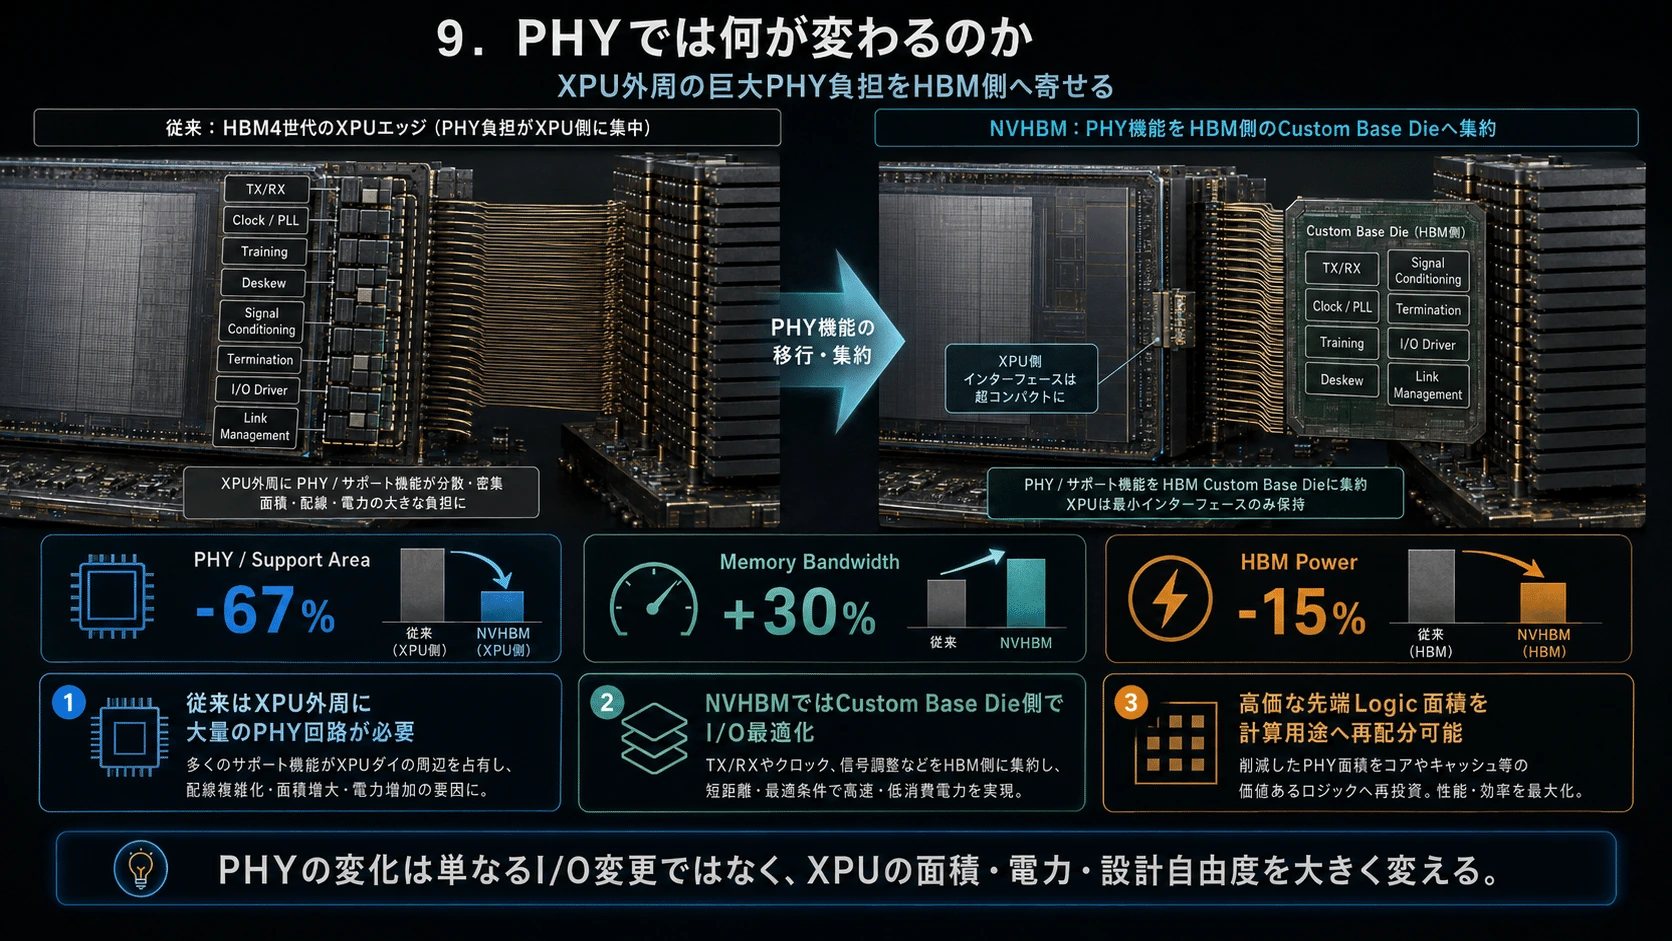
Standard HBM4ではXPU外周に、

#
TX/RX
Clock / PLL
Training
Deskew
Signal Conditioning
Termination
I/O Driver
Link Management
#

といったPHY/support回路が大量に必要です。

#

NVHBMではCustom Base Die側へこの負担を寄せ、XPU↔HBMをより狭いCustom Interfaceへ変えます。

#

NVIDIA公表値は、

#
PHY/support area: -67%\boxed{\text{PHY/support area: -67%}}
#

です。(NVIDIA Developer)

#

つまりNVHBMの価値はBandwidth +30%だけではありません。

#

最も高価なXPU先端Logic面積をMemory Interfaceから取り返す

#

ところにもあります。

#

#
記事内の画像
図・画像

#
記事内の画像
図・画像

#
記事内の画像
図・画像

#
記事内の画像
図・画像

#

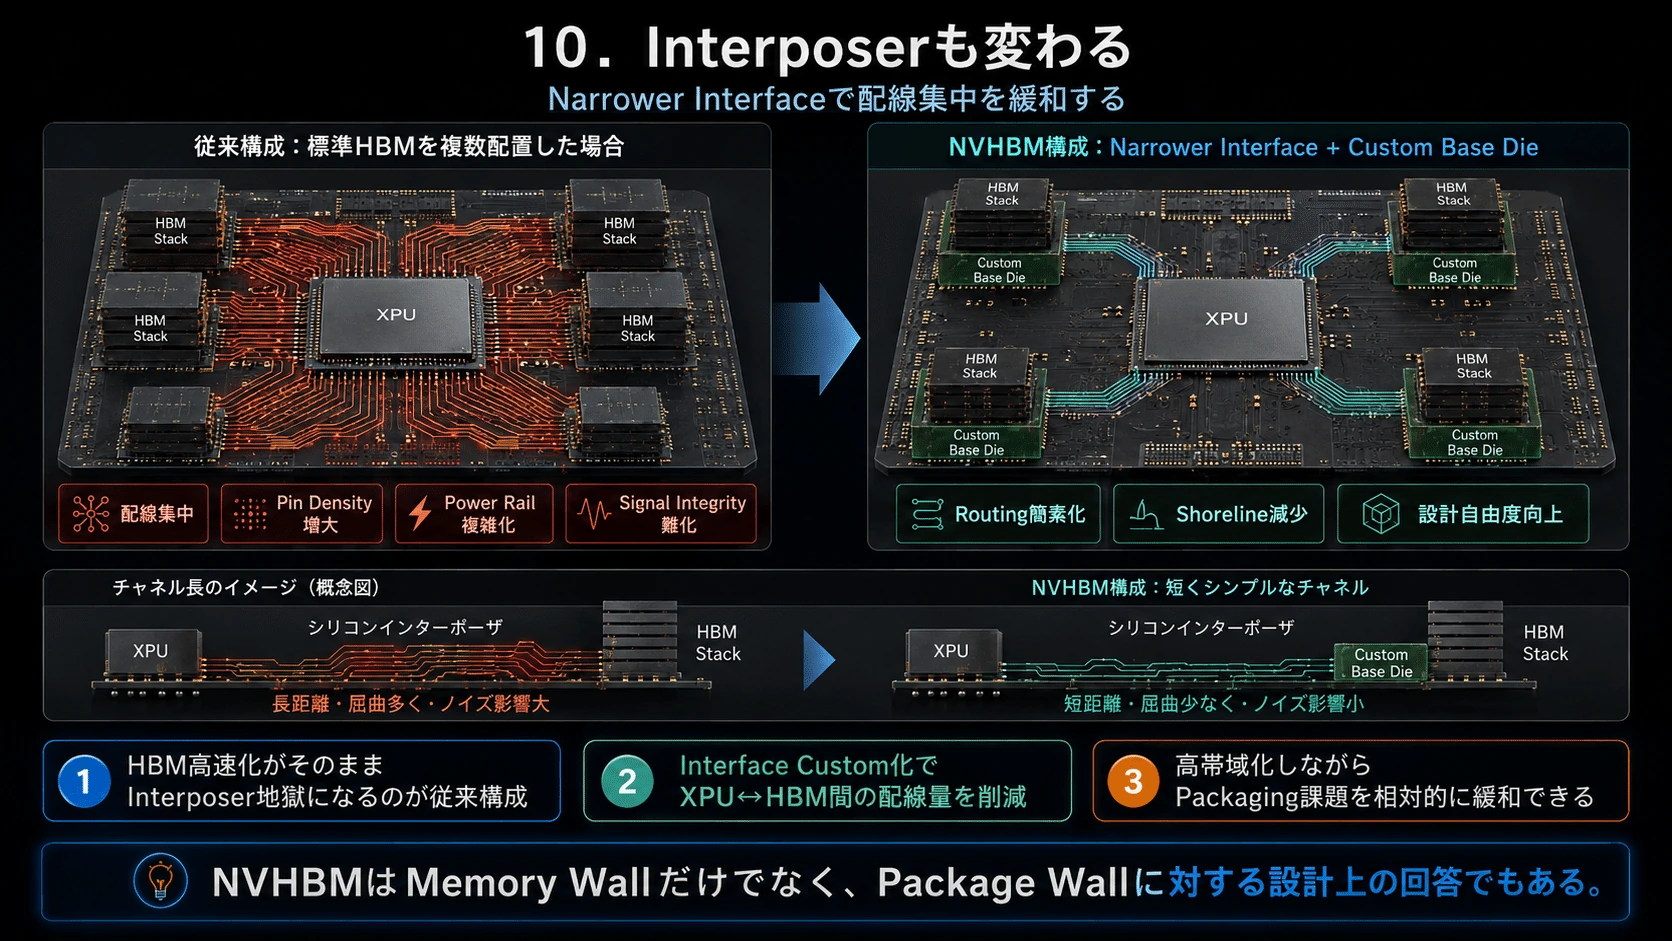
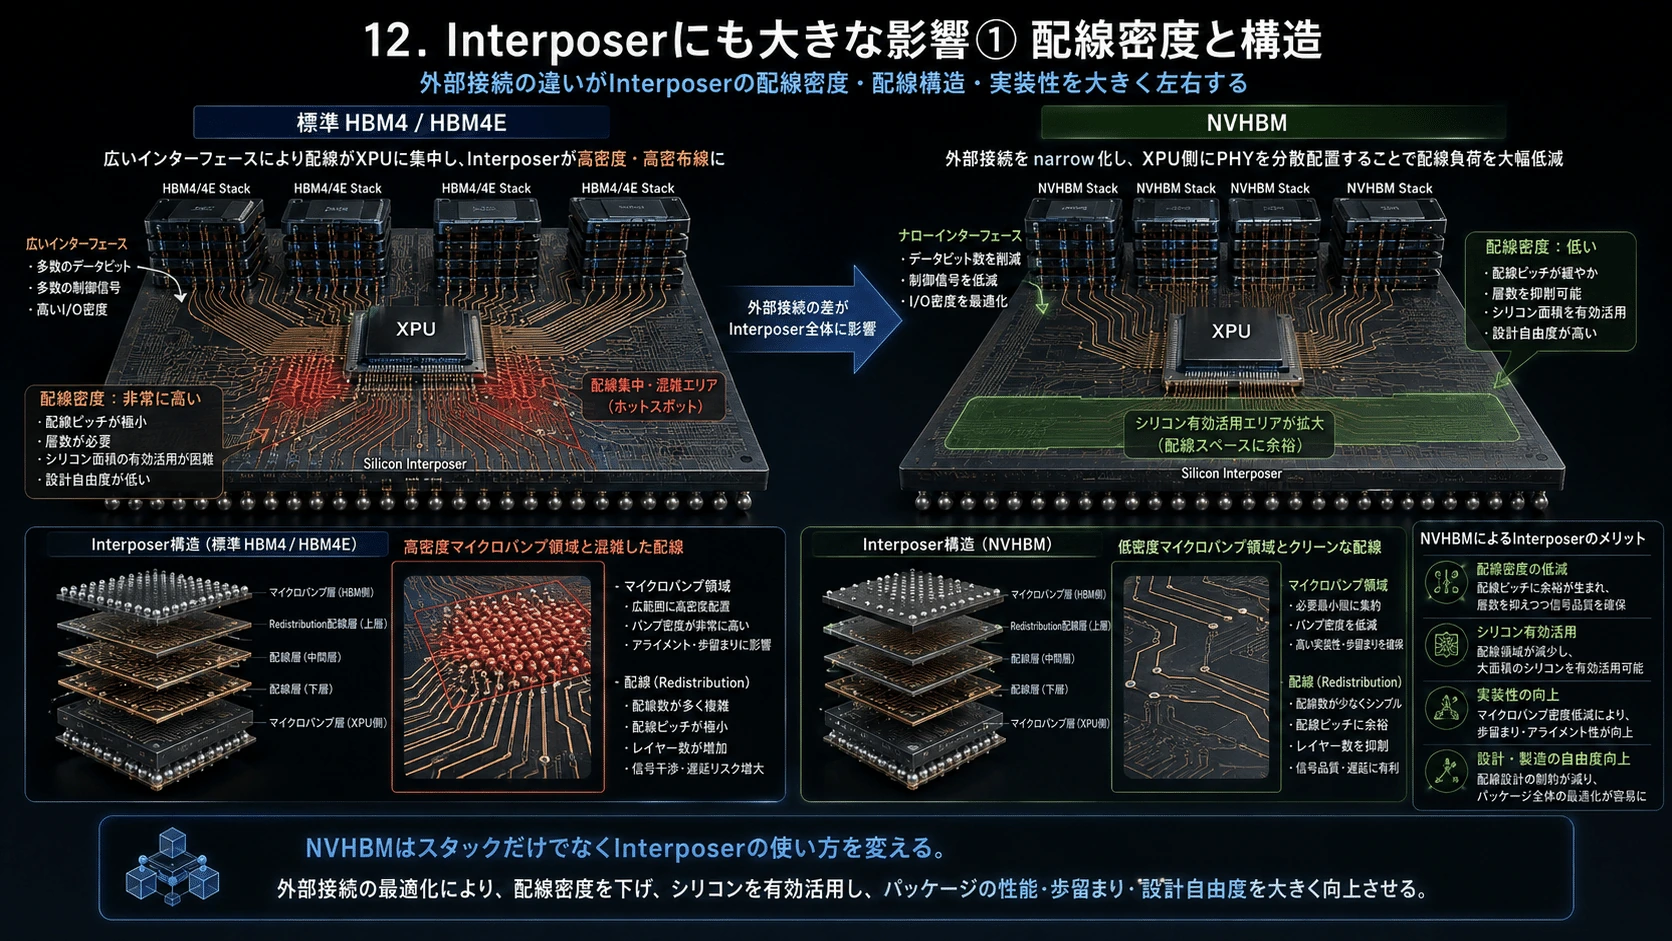
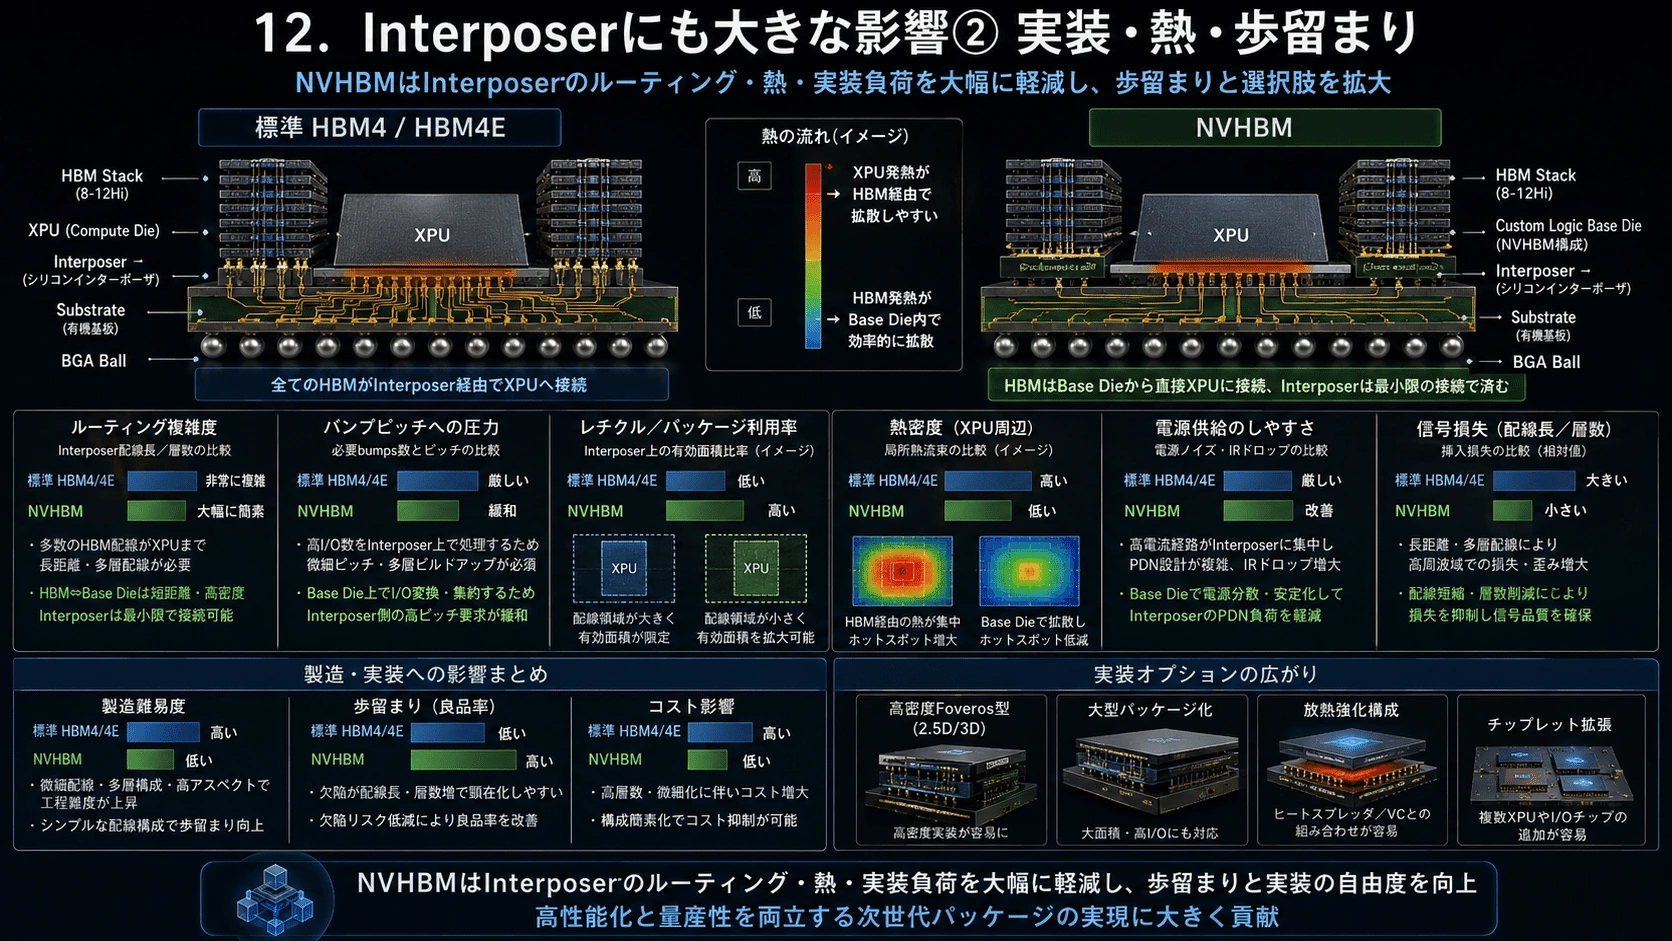
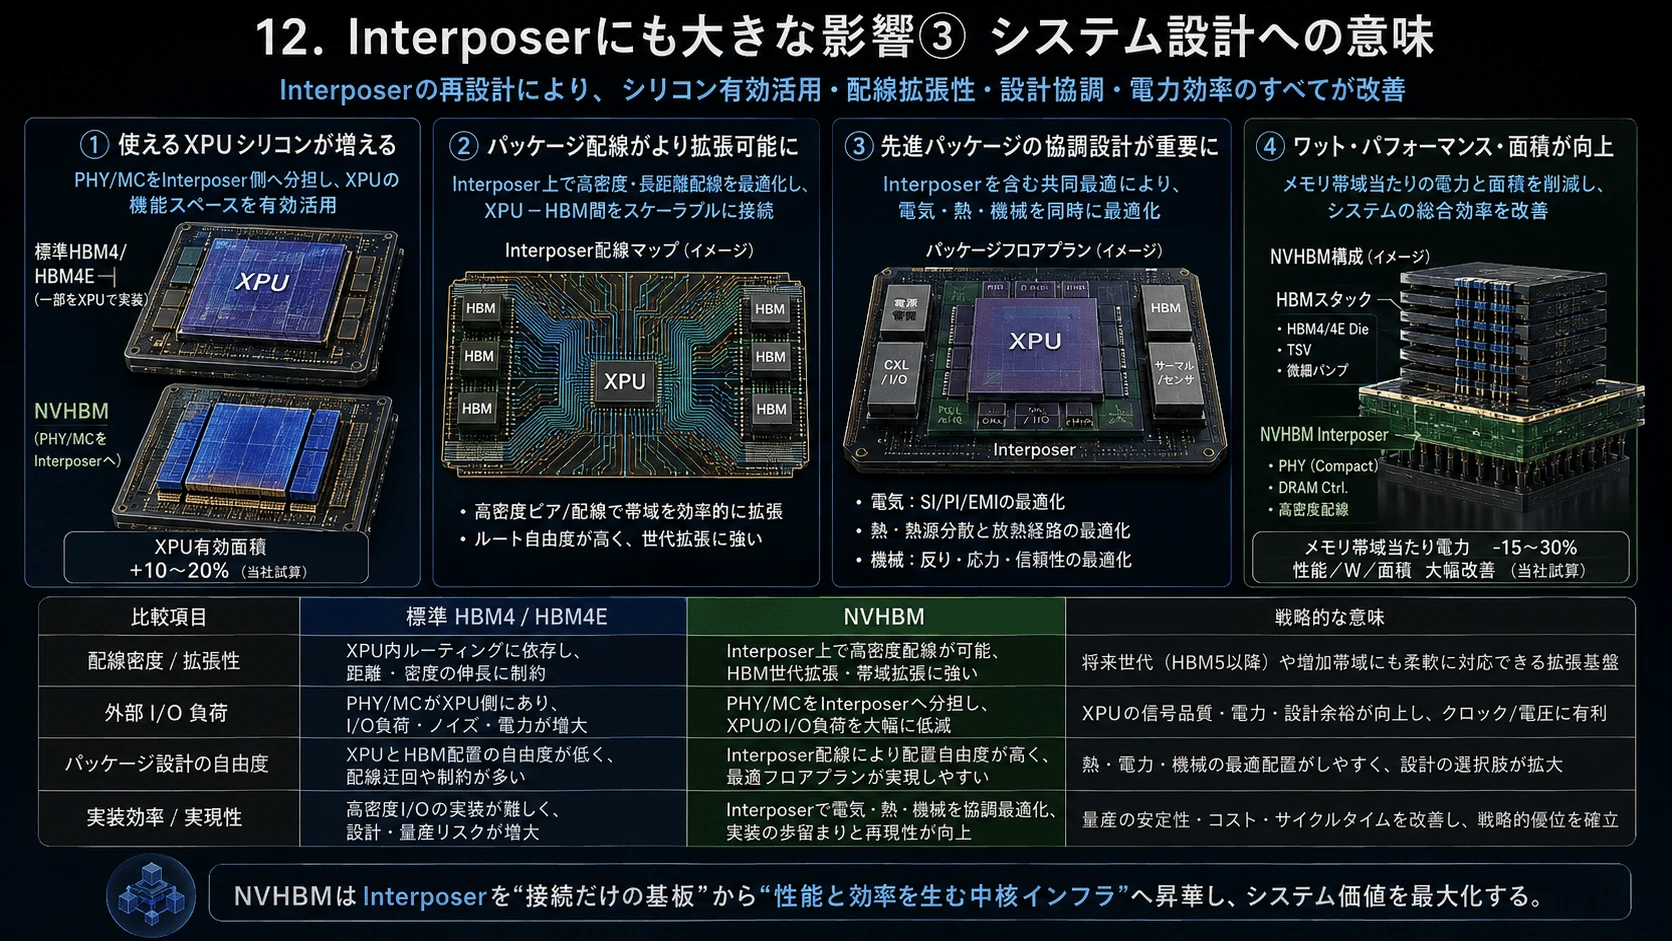
10.Interposerも変わる

#

Standard HBMでは、

#
HBM ═════════╗       ╔════════ HBM
             ║       ║
HBM ═════════╬═ XPU ═╬════════ HBM
             ║       ║
HBM ═════════╝       ╚════════ HBM
#

のように各HBMからXPUへ大量のparallel routingが集中します。

#

HBM4EになるほどPin Density、Power Rail、Signal Integrityの難易度が上がります。

#

ECTC 2026ではHBM4E routingがAdvanced Packagingの主要課題の一つとして扱われており、Custom HBMではHost ASIC側HBM PHY footprintを約60%減らし、Interposer channel lengthを6.5mm→1.5mmへ短縮するMarvell例も報告されています。(newsletter.semianalysis.com)

#

NVHBMも同様にNarrower InterfaceによってInterposer Routingを簡素化します。

#

したがって、

#
HBM高速化
 ↓
配線増加
 ↓
Interposer苦しくなる
#

という従来の関係を、

#
HBM高速化
+
Interface Custom化
 ↓
XPU shoreline減少
 ↓
Interposer routing簡素化
#

へ変えることができます。

#

#
記事内の画像
図・画像

#
記事内の画像
図・画像

#
記事内の画像
図・画像

#
記事内の画像
図・画像

#

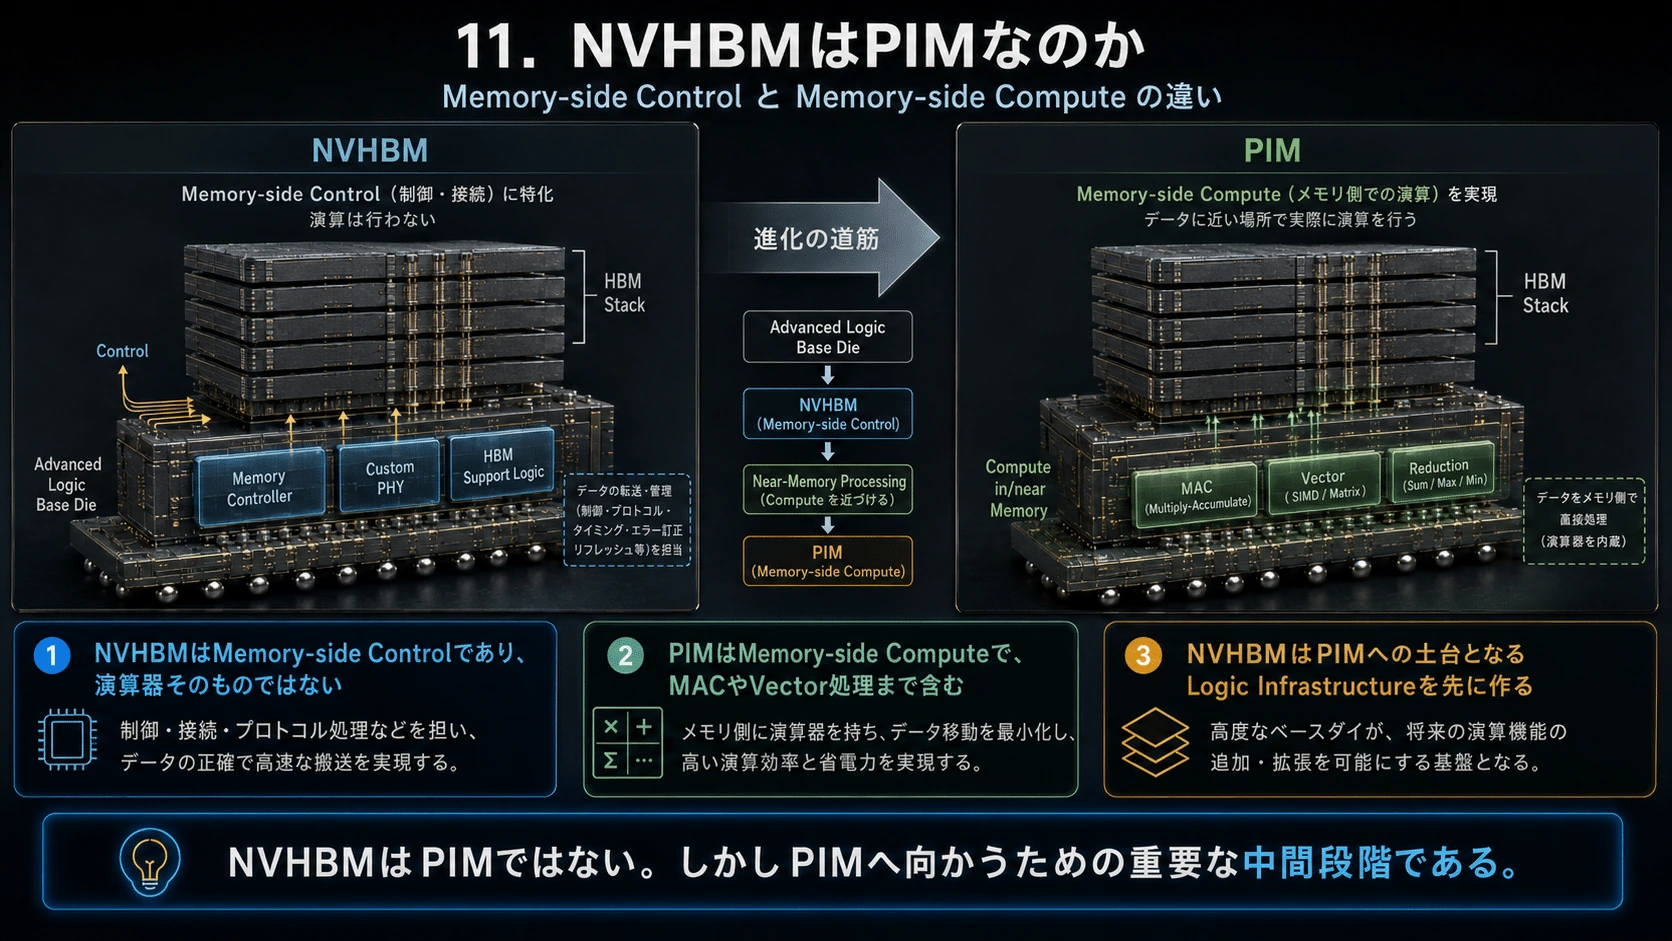
11.NVHBMはPIMなのか

#

違います。

#

ここは重要です。

#

NVHBM

#
Memory-side Control\boxed{\text{Memory-side Control}}
#

PIM

#
Memory-side Compute\boxed{\text{Memory-side Compute}}
#

です。

#

NVHBMはMemory Controller、PHY、Support LogicをMemory側へ寄せますが、Tensor Matrix MultiplyそのものをHBM内で実行するわけではありません。

#

PIMではMAC、Reduction、Vector処理など実際の演算までMemory側へ入ります。

#

Samsung HBM-PIMは、AI処理機能をMemory側へ入れることでXilinx Alveoを使った検証では約2.5倍のSystem Performanceと60%以上のEnergy reductionを報告しています。これは特定workloadでの結果であり現代LLM全体へそのまま適用できる数字ではありません。(Samsung Semiconductor)

#

したがって進化を並べるなら、

#
Standard HBM
 ↓
Advanced Logic Base Die
 ↓
NVHBM
Memory Controller + PHY
 ↓
Near-Memory Processing
Compression / Gather / Reduction
 ↓
PIM
MAC / Vector / Matrix
 ↓
3D Memory-Compute System
#

となります。

#

NVHBMはPIMではありません。

#

しかし、

#
PIMへ進むためのLogic InfrastructureをBase Dieに作る\boxed{\text{PIMへ進むためのLogic InfrastructureをBase Dieに作る}}
#

という意味では非常に重要です。

#

#
記事内の画像
図・画像

#

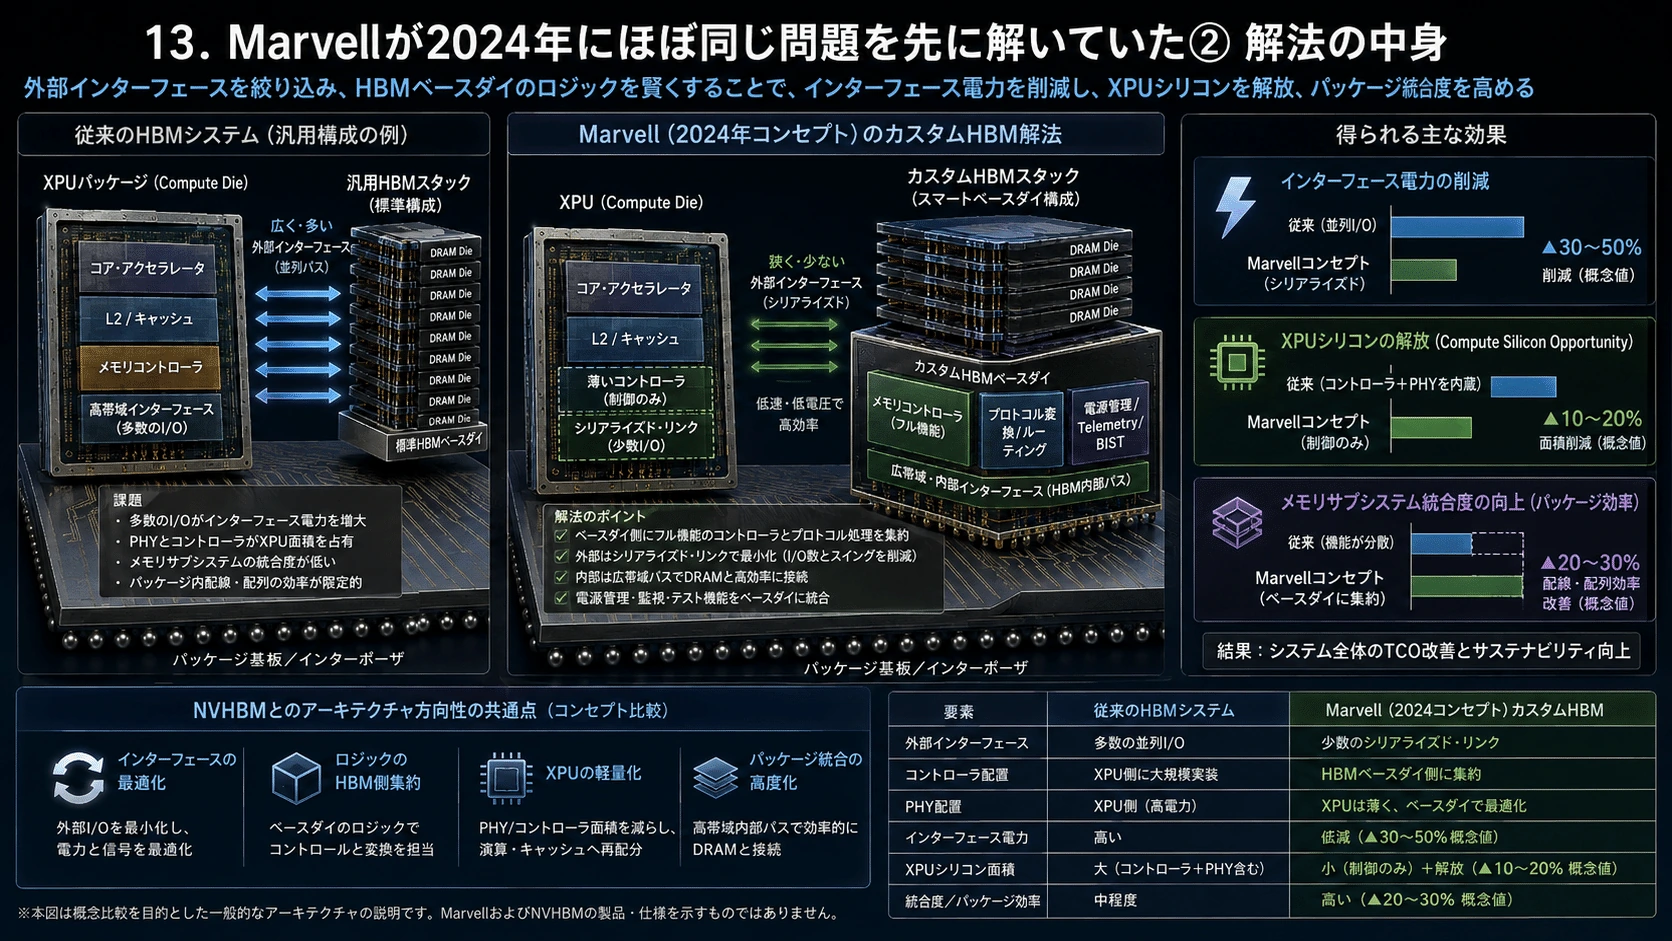
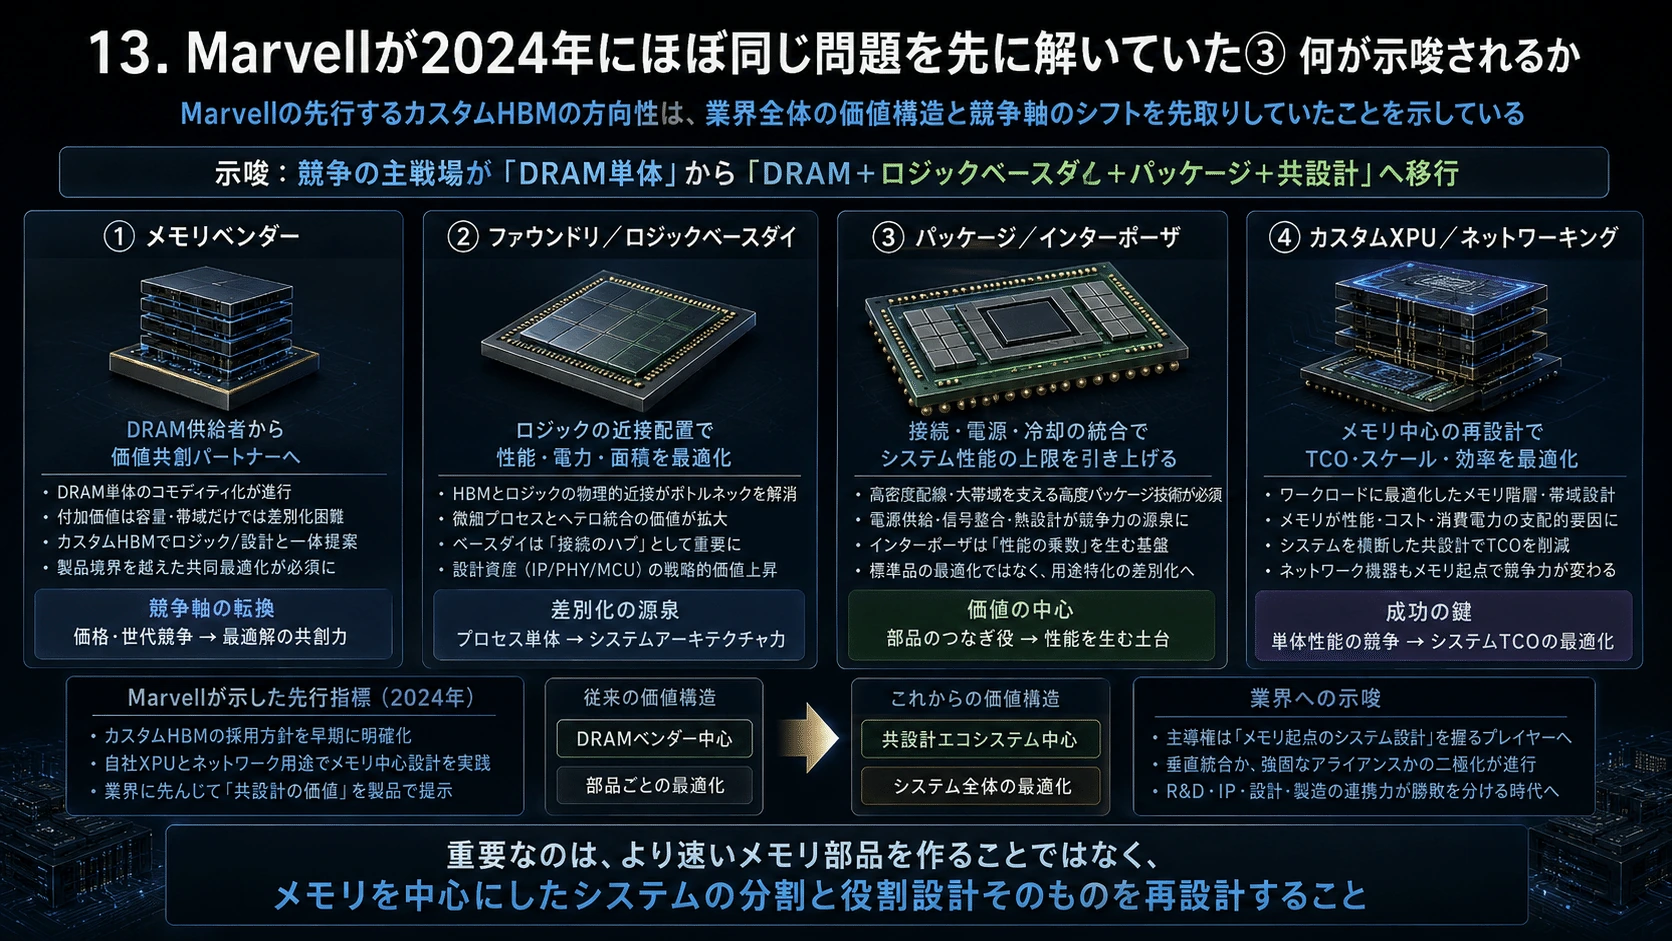
12.Marvellは2024年に同じ問題を既に見ていた

#

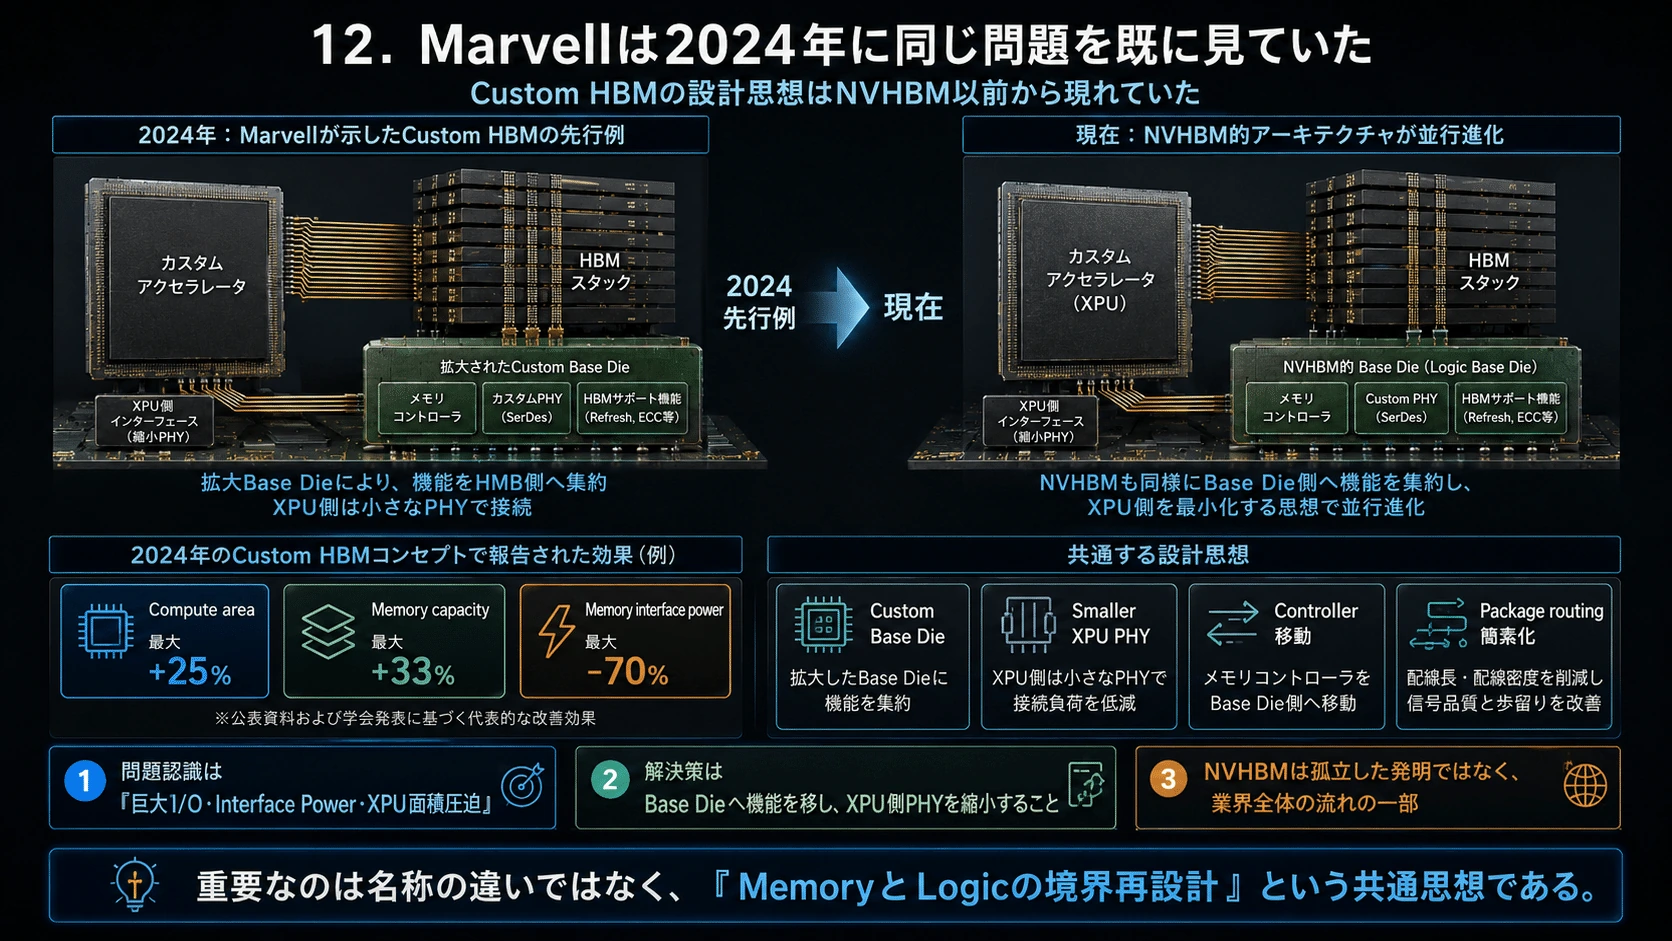
Marvellは2024年12月にCustom HBM Compute Architectureを発表しています。

#

公表効果は、

#
効果MarvellCompute area最大+25%Memory capacity最大+33%Memory interface power最大-70%\begin{array}{|l|c|} \text{効果}&\text{Marvell}\cr\hline \text{Compute area}&\text{最大+25%}\cr\hline \text{Memory capacity}&\text{最大+33%}\cr\hline \text{Memory interface power}&\text{最大-70%}\cr\hline \end{array}
#

です。(Marvell Technology)

#

MarvellはStandard HBM Interfaceの問題を、

#

巨大I/O、Interface Power、XPU Silicon Real Estate

#

と捉えていました。

#

そしてCustom Base Die、Controller Logic、Advanced D2D Interface、Advanced Packagingへ機能を移す方式を提案しました。

#

NVHBMとMarvell Custom HBMは同一仕様ではありません。

#

しかし、

#
Custom Base Die
+
Smaller XPU PHY
+
Controller移動
+
Package routing簡素化
#

という設計思想はかなり近い。

#

現在MarvellはNVLink Fusion Partnerとなり、NVIDIAはMarvellへ20億ドルを投資しています。(NVIDIA Newsroom)

#

2024年のMarvell発表は、Custom HBMが一企業だけの特殊技術ではなく、業界全体が向かう方向だったことを示す先行例になっています。

#
#
記事内の画像
図・画像

#
記事内の画像
図・画像

#
記事内の画像
図・画像

#
記事内の画像
図・画像

#

13.NVHBMで誰が勝つのか

#

現時点での構造評価はこうなります。

#
企業評価理由TSMC最有力WinnerXPU+Base Die+PackagingSK hynixWinnerHBM数量+Custom化MicronWinnerHBM4E Custom Base DieSamsungPotential WinnerMemory+Foundry+PackagingMarvellWinnerCustom HBM+XPU+NVLink FusionBroadcomMixedASIC増は+、NVLink/NVHBM侵食は-\begin{array}{|l|c|l|} \text{企業}&\text{評価}&\text{理由}\cr\hline \text{TSMC}&\text{最有力Winner}&\text{XPU+Base Die+Packaging}\cr\hline \text{SK hynix}&\text{Winner}&\text{HBM数量+Custom化}\cr\hline \text{Micron}&\text{Winner}&\text{HBM4E Custom Base Die}\cr\hline \text{Samsung}&\text{Potential Winner}&\text{Memory+Foundry+Packaging}\cr\hline \text{Marvell}&\text{Winner}&\text{Custom HBM+XPU+NVLink Fusion}\cr\hline \text{Broadcom}&\text{Mixed}&\text{ASIC増は+、NVLink/NVHBM侵食は-}\cr\hline \end{array}
#

SK hynixはHBM4からTSMC Advanced LogicをBase Dieへ採用し、MemoryとLogicのIntegrationを明確に次の方向として示しています。(SK hynix Newsroom)

#

MicronもHBM4EでStandardとCustomized Base Logic Dieの双方をTSMCで製造し、Custom品の方が高Gross Marginになると説明しています。(Micron Technology)

#

SamsungはHBM5 Base Dieを2nmへ移行する計画で、Memory・Foundry・Packagingを一社で持つ垂直統合が強みです。(Samsung Semiconductor)

#

BroadcomはHBM PHY、2.5D/3D Packaging、Network I/O、Custom XPUを自社で統合できるためCustom ASIC拡大自体は追い風です。一方NVLink Fusion+NVHBMがCustom XPUのMemory/Scale-up layerへ入り込むことは競争上の圧力になります。Broadcom自身も3.5D XDSiPでHBM PHY、Packaging、Network I/Oまで統合しています。(Broadcom)

#

TSMCは最も分かりやすい。

#

MemoryとLogicの境界が曖昧になるほど、

#
XPU Logic
 ↓
TSMC

HBM Logic Base Die
 ↓
TSMC

Advanced Packaging
 ↓
TSMC Ecosystem
#

となりやすいからです。

#

#

14.NVHBMはSRAM需要を減らすのか

#

直感的には、

#
HBMが30%速くなるならSRAMは減らせる
#

ように思えます。

#

確かに一定性能を維持するだけならそうです。

#

しかしAI XPUでは効率改善をDie縮小ではなく性能追加へ再投資する傾向があります。

#

NVHBMは、

#
Bandwidth↑\text{Bandwidth}\uparrow
#

だけでなく、

#
PHY/Controller Area↓\text{PHY/Controller Area}\downarrow
#

も同時に起こします。

#

すると、

#
NVHBM
 ↓
XPU面積解放
 ↓
SRAM増量
 ↓
HBMから読んだDataをより多くReuse
 ↓
Compute utilization↑
#

が可能になります。

#

したがってNVHBMとSRAMは代替関係というより、

#
Complementary\boxed{\text{Complementary}}
#

です。

#

#

15.定量モデルの前提

#

以下のモデルでは、公式仕様と仮定を混同しないよう分けます。

#

Rubin公式仕様は288GB HBM4、22TB/s、NVFP4 Dense 35PFLOPS、Inference peak 50PFLOPS、NVLink 3.6TB/sです。(NVIDIA)

#

DeepSeek R1、Kimi K2.5、GPT-OSS、Future 1T MoEについては、これまで作成したモデルで以下を使用します。

#
ModelTotalActiveExpertsActive/tokenDeepSeek R1671B37B2568Kimi K2.5約1T約32B3848+sharedGPT-OSS 120B約117B5.1B1284Future scenario1T20B5128\begin{array}{|l|c|c|c|c|} \text{Model}&\text{Total}&\text{Active}&\text{Experts}&\text{Active/token}\cr\hline \text{DeepSeek R1}&\text{671B}&\text{37B}&256&8\cr\hline \text{Kimi K2.5}&\text{約1T}&\text{約32B}&384&\text{8+shared}\cr\hline \text{GPT-OSS 120B}&\text{約117B}&\text{5.1B}&128&4\cr\hline \text{Future scenario}&\text{1T}&\text{20B}&512&8\cr\hline \end{array}
#

SRAM容量はRubin公式仕様ではなく、effective on-chip fast SRAMを仮定した分析値です。

#

#

調査1.NVHBMで本当にどれだけXPU面積が空くのか

#

ここは以前の計算を修正する必要があります。

#

NVIDIAの「+25% Compute Die Area」をRubin die sizeへそのまま掛けるのは適切ではありません。

#

Rubinは既にReticle-class Compute Dieを2枚使う構造であり、物理Dieを25%大きくするという意味ではないからです。

#

SemiAnalysisはECTC 2026分析で、Rubin GPU die areaの約16%をHBM関連LogicとPHYが占めると推定しています。(newsletter.semianalysis.com)

#

Rubin Compute Dieを外部推定728mm²×2と置くと、

#
AGPU=1456mm2A_{\text{GPU}}=1456\text{mm}^2
#

HBM-related logic:

#
1456×16%=233mm21456\times\text{16%}=233\text{mm}^2
#

程度です。

#

さらにHBM4 PHYを15mm²/stack、8 stackとすると、

#
15×8=120mm215\times8=120\text{mm}^2
#

級。

#

NVHBMのPHY/support -67%を当てると、

#
120×0.67=80mm2120\times0.67=80\text{mm}^2
#

程度です。

#

したがって回収可能面積のSensitivity Rangeを、

#
80~156mm2\boxed{80~156\text{mm}^2}
#

程度に置くのが合理的です。

#

Rubin級全体の約5.5~10.7%。

#

つまり、

#
NVHBMでRubin Dieの25%が消える
#

ではなく、

#
HBM Interface関連の5~11%程度を再配置できる可能性がある
#

と見る方がよい。

#

#

調査2.そこへ何MBのSRAMを積めるのか

#

これまで使ったTSMC N2 high-density SRAM Macroは約38.1Mb/mm²です。

#

しかし実際にはECC、Tag、Banking、Decoder、Routing、Power、Crossbarが必要です。

#

そこでRaw Densityの65%を実効値と仮定すると、

#

N3-class:

#
≈20.7Mb/mm2\approx20.7\text{Mb/mm}^2
#

N2:

#
≈24.8Mb/mm2\approx24.8\text{Mb/mm}^2
#

です。

#

すると、

#
NVHBMで回収N3級追加SRAMN2追加SRAM80mm2約207MB約248MB120mm2約310MB約371MB130mm2約336MB約402MB156mm2約403MB約483MB\begin{array}{|l|c|c|} \text{NVHBMで回収}&\text{N3級追加SRAM}&\text{N2追加SRAM}\cr\hline \text{80mm}^2&\text{約207MB}&\text{約248MB}\cr\hline \text{120mm}^2&\text{約310MB}&\text{約371MB}\cr\hline \text{130mm}^2&\text{約336MB}&\text{約402MB}\cr\hline \text{156mm}^2&\text{約403MB}&\text{約483MB}\cr\hline \end{array}
#

になります。

#

仮にBaseline 512MBなら、

#

N3級

#
512MB→720~915MB\text{512MB}\rightarrow\text{720~915MB}
#

N2

#
512MB→760~995MB\text{512MB}\rightarrow\text{760~995MB}
#

です。

#

これが非常に重要です。

#
NVHBMだけで512MB→768MB級はかなり自然\boxed{\text{NVHBMだけで512MB}\rightarrow\text{768MB級はかなり自然}}
#

です。

#

N2+AggressiveなFloorplanなら、1GB近くまでNVHBMが「自己資金化」できる可能性があります。

#

#

調査3.SRAM 256MB~2GBのContinuous tokens/s Curve

#

モデルは、

#
TPS(S)=min⁡(CFtoken,ηNBDHBM(S))TPS(S)=\min\left(\frac{C}{F_{\text{token}}},\frac{\eta NB}{D_{\text{HBM}}(S)}\right)
#

です。

#

SRAMが増えるほど、

#
DHBM(S)D_{\text{HBM}}(S)
#

が減ります。

#

DeepSeek R1、B1、128Kでは、

#
SRAM22TB/sNVHBM 28.6TB/s256MB24853231512MB25833358768MB268934951GB280436451.5GB306639862GB33824397\begin{array}{|l|c|c|} \text{SRAM}&\text{22TB/s}&\text{NVHBM 28.6TB/s}\cr\hline \text{256MB}&2485&3231\cr\hline \text{512MB}&2583&3358\cr\hline \text{768MB}&2689&3495\cr\hline \text{1GB}&2804&3645\cr\hline \text{1.5GB}&3066&3986\cr\hline \text{2GB}&3382&4397\cr\hline \end{array}
#

です。

#

Kimi B1/128Kでは、

#
SRAM22TB/sNVHBM256MB26943502512MB28103653768MB293538161GB307339951.5GB339144082GB37824917\begin{array}{|l|c|c|} \text{SRAM}&\text{22TB/s}&\text{NVHBM}\cr\hline \text{256MB}&2694&3502\cr\hline \text{512MB}&2810&3653\cr\hline \text{768MB}&2935&3816\cr\hline \text{1GB}&3073&3995\cr\hline \text{1.5GB}&3391&4408\cr\hline \text{2GB}&3782&4917\cr\hline \end{array}
#

GPT-OSS B1/32Kでは1.3~1.5GB付近でPlateauへ入ります。

#

Future 1T/B1/128Kでは約1.5GBでPlateauへ入ります。

#

一方Kimi B32/128Kは、

#
512MB:39971GB:4012\text{512MB}:3997\quad \text{1GB}:4012
#

程度でほぼ変わりません。

#

既存の512/768/1GB比較でも同じ傾向が確認されています。

#

つまり、

#
SRAMの価値はContext↑・Batch↓ほど大きい\boxed{\text{SRAMの価値はContext}\uparrow\text{・Batch}\downarrow\text{ほど大きい}}
#

ということです。

#

#

調査4.NVHBM+SRAMのPareto Frontier

#

単純な「最大tokens/s」だけでは不十分です。

#

本当に見るべきなのは、

#
Tokens/sTokens/WTokens/mm2\text{Tokens/s}\quad\text{Tokens/W}\quad\text{Tokens/mm}^2
#

です。

#

DeepSeek B1/128Kでは、SRAM 512→768MBで性能は約4%、1GBで約8.6%上昇。

#

しかしNVHBMはBandwidth-boundなら最大30%近い効果があります。

#

さらにHBM Powerが15%減ります。

#

XPU全体に占めるHBM Power比をfとすると、

#
TPS/WNVHBMTPS/WHBM4E=1.301−0.15f\frac{\text{TPS/W}{\text{NVHBM}}}{\text{TPS/W}{\text{HBM4E}}}=\frac{1.30}{1-0.15f}
#

です。

#

HBM Power比10~30%なら、

#
+32~36%\text{+32~36%}
#

のtokens/W改善になります。

#

一方SRAM 512MB追加によるPower増を1~5%とすると、DeepSeekでのtokens/W改善はおよそ3~8%程度。

#

High Batchでは性能増がほぼないので悪化することすらあります。

#

したがってPareto Frontierは、

#

General inference

#
NVHBM+768~900MB\boxed{\text{NVHBM+768~900MB}}
#

Long-context

#
NVHBM+1~1.3GB\boxed{\text{NVHBM+1~1.3GB}}
#

High batch

#
NVHBM+512~768MB\boxed{\text{NVHBM+512~768MB}}
#

付近になります。

#

#

調査5.Jalapeño実測値から15.4TB/s利用率を逆算できるか

#

OpenAI公式InferenceX結果では、JalapeñoはGPT-OSS 120BでPeak Mixed TPS/kW 85,448、DeepSeek R1で19,641、Kimi K2.5で18,195。

#

Rated Powerは700W、実測Sustained Powerは550W以下でした。(OpenAI)

#

SemiAnalysisによればB0 Jalapeñoは13.4PFLOPS MXFP4、15.4TB/s HBM4です。(InferenceX)

#

700Wで単純換算すると、

#

GPT-OSS:

#
85448×0.7=59,814TPS85448\times0.7=\text{59,814TPS}
#

DeepSeek:

#
19641×0.7=13,749TPS19641\times0.7=\text{13,749TPS}
#

Kimi:

#
18195×0.7=12,737TPS18195\times0.7=\text{12,737TPS}
#

です。

#

15.4TB/sを100%消費したと仮定したMemory Budget/tokenは、

#
ModelHBM Budget/tokenGPT-OSS約257MBDeepSeek約1.12GBKimi約1.21GB\begin{array}{|l|c|} \text{Model}&\text{HBM Budget/token}\cr\hline \text{GPT-OSS}&\text{約257MB}\cr\hline \text{DeepSeek}&\text{約1.12GB}\cr\hline \text{Kimi}&\text{約1.21GB}\cr\hline \end{array}
#

になります。

#

ところが公開されているMixed TPSはPrefill/Decode、Batch、Concurrency、TP/EP等を含むため、

#
Jalapen˜oの実効HBM利用率を公開情報だけから一意に逆算することはできない\boxed{\text{Jalapeñoの実効HBM利用率を公開情報だけから一意に逆算することはできない}}
#

というのが正しい結論です。

#

「15.4TB/sを100%使っている」とは言えません。

#

しかしJalapeñoは13.4PF/15.4TB/sなので、

#
870FLOP/B\text{870FLOP/B}
#

です。

#

Rubin Dense:

#
3522=1591FLOP/B\frac{35}{22}=\text{1591FLOP/B}
#

Rubin Inference peak:

#
5022=2273FLOP/B\frac{50}{22}=\text{2273FLOP/B}
#

なので、JalapeñoはRubinより1.8~2.6倍Memory-richです。

#

だからHBM Rooflineへ近づきやすい。

#

さらにOpenAIはKV CacheをLocalに保持しData Movementを最小化することを設計原則として明示しています。(OpenAI)

#

#

調査6.TPU 8i 384MBでSRAMモデルをCalibrationする

#

Google TPU 8iは非常に有用な実データです。

#
項目TPU 8tTPU 8iFP412.6PF10.1PFHBM BW6.528TB/s8.601TB/sHBM216GB288GBSRAM128MB384MB\begin{array}{|l|c|c|} \text{項目}&\text{TPU 8t}&\text{TPU 8i}\cr\hline \text{FP4}&\text{12.6PF}&\text{10.1PF}\cr\hline \text{HBM BW}&\text{6.528TB/s}&\text{8.601TB/s}\cr\hline \text{HBM}&\text{216GB}&\text{288GB}\cr\hline \text{SRAM}&\text{128MB}&\text{384MB}\cr\hline \end{array}
#

Googleは384MB SRAMを使い、Long-context decodingでKV CacheをOn Siliconへより多く保持しCore Idleを減らすと明記しています。(Google Cloud)

#

TPU 8iのSRAM/HBM比は、

#
3848.601=44.6MB/(TB/s)\frac{384}{8.601}=\text{44.6MB/(TB/s)}
#

です。

#

同じ比率をRubinへ当てると、

#
22×44.6=981MB22\times44.6=\text{981MB}
#

NVHBM 28.6TB/sなら、

#
28.6×44.6=1276MB28.6\times44.6=\text{1276MB}
#

です。

#

もちろんGPUとTPUをそのまま比例させることはできません。

#

しかし、

#
Rubin級Inference XPUで768MB~1.3GBというレンジは十分妥当\boxed{\text{Rubin級Inference XPUで768MB~1.3GBというレンジは十分妥当}}
#

というCalibrationになります。

#

#

調査7.MoE Expert RoutingをUniformからZipfへ変える

#

従来モデルではExpertが均等に選ばれるとしました。

#

しかしProduction MoEではPopular Expertへの偏りが発生します。

#

Expert popularityをZipf distribution、

#
pe∝e−αp_e\propto e^{-\alpha}
#

でStress Testします。

#

Batch32、top-8をMonte Carloで評価すると、DeepSeek 256 ExpertsではUnique Expert数が、

#
αUnique Experts0 Uniform約1630.5約1481.0約1051.2約88\begin{array}{|c|c|} \alpha&\text{Unique Experts}\cr\hline \text{0 Uniform}&\text{約163}\cr\hline 0.5&\text{約148}\cr\hline 1.0&\text{約105}\cr\hline 1.2&\text{約88}\cr\hline \end{array}
#

Kimi 384 Expertsなら、

#
αUnique ExpertsUniform約1880.5約1711.0約1171.2約96\begin{array}{|c|c|} \alpha&\text{Unique Experts}\cr\hline \text{Uniform}&\text{約188}\cr\hline 0.5&\text{約171}\cr\hline 1.0&\text{約117}\cr\hline 1.2&\text{約96}\cr\hline \end{array}
#

となります。

#

その結果DeepSeek B32 Weight Traffic/tokenは、

#
7.20GB→4.75GB\text{7.20GB}\rightarrow\text{4.75GB}
#

Kimiは、

#
8.44GB→5.33GB\text{8.44GB}\rightarrow\text{5.33GB}
#

程度まで下がります。

#

これはかなり大きい。

#

つまりMoEでは、

#
HBM需要を決める重要変数はParameter数だけではなくExpert Popularity\boxed{\text{HBM需要を決める重要変数はParameter数だけではなくExpert Popularity}}
#

です。

#

ただし実際のRouterにはLoad Balance Loss、Expert Group制約等があるため、α=1が実モデルを表すという意味ではありません。

#

これはSensitivity Testです。

#

#

調査8.TP/EP/CP+NVLinkを含むSystem Roofline

#

HBMだけを速くすると、次はNetworkが問題になります。

#

System Rooflineを、

#
T=max⁡(Tcompute,THBM,TNVLink,Tnetwork)T=\max\left(T_{\text{compute}},T_{\text{HBM}},T_{\text{NVLink}},T_{\text{network}}\right)
#

とします。

#

DeepSeek/Kimi hidden=7168とするとBF16 activation vectorは、

#
7168×2=14,336Bytes7168\times2=\text{14,336Bytes}
#

程度です。

#

TP4+EP4を簡略モデル化すると、System-wide communicationはおよそ20MB/token級になります。

#

Rubin NVLinkは1 GPU当たり3.6TB/s。(NVIDIA)

#

4 GPUならrawで、

#
14.4TB/s\text{14.4TB/s}
#

70%効率でも、

#
10TB/s\text{10TB/s}
#

程度です。

#

20MB/tokenなら単純Bandwidth ceilingは数十万token/sとなり、今回の数千token/s級HBM Rooflineを大きく上回ります。

#

したがって現段階では、

#

NVLink raw bandwidthそのものよりLatency、Synchronization、All-to-all、Expert imbalanceが問題

#

になります。

#

GoogleがTPU 8iでBoardflyとCAEを導入し、Network diameterを16 hop→7 hopへ減らしCollective Latencyを削減したのも、この方向と整合します。(Google Cloud)

#

#

調査9.FeynmanでNVHBMが必須になるCompute閾値

#

Rubin DenseのCompute/BW ratioを基準とします。

#
RR=3522=1.591PF/(TB/s)R_R=\frac{35}{22}=\text{1.591PF/(TB/s)}
#

このBalanceを維持できるCompute上限は、

#
Cmax=B×1.591C_{\text{max}}=B\times1.591
#

です。

#
Memory BWRubin Balanceを維持できるCompute28.6TB/s45.5PF32TB/s50.9PF37.18TB/s59.2PF48TB/s76.4PF\begin{array}{|l|c|} \text{Memory BW}&\text{Rubin Balanceを維持できるCompute}\cr\hline \text{28.6TB/s}&\text{45.5PF}\cr\hline \text{32TB/s}&\text{50.9PF}\cr\hline \text{37.18TB/s}&\text{59.2PF}\cr\hline \text{48TB/s}&\text{76.4PF}\cr\hline \end{array}
#

つまりFeynmanを仮に70PFとすると、28.6TB/sでは明確にMemory-poorです。

#

37.18TB/sへ上げても、

#
7037.18=1883FLOP/B\frac{70}{37.18}=\text{1883FLOP/B}
#

でRubinの1591を上回ります。

#

必要な追加Traffic reductionは、

#

Feynman 70PF

#
15.5%\text{15.5%}
#

100PF

#
40.8%\text{40.8%}
#

140PF

#
57.8%\text{57.8%}
#

です。

#

Feynmanの実FLOPSはまだ公開されていません。

#

NVIDIAはGTCでFeynmanを次世代GPUとして説明しており、SemiAnalysisもFeynmanでCustom HBMが重要になると分析しています。(NVIDIA)

#

このThreshold Modelが示すのは、

#
Feynmanが70PFを大きく超えるほどNVHBMだけでは足りなくなる\boxed{\text{Feynmanが70PFを大きく超えるほどNVHBMだけでは足りなくなる}}
#

ということです。

#

#

調査10.SRAM増量はN2/N3 Waferをどれだけ食うのか

#

ここには重要な修正があります。

#

SRAMを増やしても、NVHBMが回収した面積の中なら追加Waferを消費しません。

#

N3-classの実効SRAM densityを20.7Mb/mm²とすると、

#
SRAM追加必要面積+128MB約50mm2+256MB約99mm2+384MB約149mm2+512MB約198mm2\begin{array}{|l|c|} \text{SRAM追加}&\text{必要面積}\cr\hline \text{+128MB}&\text{約50mm}^2\cr\hline \text{+256MB}&\text{約99mm}^2\cr\hline \text{+384MB}&\text{約149mm}^2\cr\hline \text{+512MB}&\text{約198mm}^2\cr\hline \end{array}
#

N2なら、

#
SRAM追加必要面積+128MB約41mm2+256MB約83mm2+384MB約124mm2+512MB約165mm2\begin{array}{|l|c|} \text{SRAM追加}&\text{必要面積}\cr\hline \text{+128MB}&\text{約41mm}^2\cr\hline \text{+256MB}&\text{約83mm}^2\cr\hline \text{+384MB}&\text{約124mm}^2\cr\hline \text{+512MB}&\text{約165mm}^2\cr\hline \end{array}
#

NVHBMで130mm²回収できるなら、

#

N3

#

+256MBまではほぼ追加waferゼロ。

#

N2

#

+384MBまでほぼ追加waferゼロ。

#

です。

#

つまり、

#
NVHBM→SRAM増加\boxed{\text{NVHBM}\rightarrow\text{SRAM増加}}
#

が即、

#
N2/N3 wafer shortage\boxed{\text{N2/N3 wafer shortage}}
#

になるわけではありません。

#

最初はDie内のArea Reallocationとして起こります。

#

#

調査11.むしろNVHBM Logic Base Die Waferの方が先に効く

#

NVHBMのBase Die面積は未公開です。

#

そこで100~180mm²でSensitivityを取ります。

#

300mm waferで概算するとGross dies/waferは、

#
Base DieGross DPW100mm2約640120mm2約528150mm2約417180mm2約343\begin{array}{|l|c|} \text{Base Die}&\text{Gross DPW}\cr\hline \text{100mm}^2&\text{約640}\cr\hline \text{120mm}^2&\text{約528}\cr\hline \text{150mm}^2&\text{約417}\cr\hline \text{180mm}^2&\text{約343}\cr\hline \end{array}
#

1 XPU=8 HBM stack、Yield80%、年間1,000万XPUなら、

#
Base DieLogic Base Die WSPM100mm213.0k120mm215.8k150mm220.0k180mm224.3k\begin{array}{|l|c|} \text{Base Die}&\text{Logic Base Die WSPM}\cr\hline \text{100mm}^2&\text{13.0k}\cr\hline \text{120mm}^2&\text{15.8k}\cr\hline \text{150mm}^2&\text{20.0k}\cr\hline \text{180mm}^2&\text{24.3k}\cr\hline \end{array}
#

です。

#

HBM4にも既にBase Dieは存在します。

#

したがってNVHBMのインパクトはBase Dieの「新規追加」ではなく、

#
Base Die area↑+Logic complexity↑+Advanced node化\boxed{\text{Base Die area}\uparrow+\text{Logic complexity}\uparrow+\text{Advanced node化}}
#

です。

#

この点ではTSMCの重要性が大きく上がります。

#

#

調査12.DRAM+Base Die+SRAMを統合したAI Memory Wafer Model

#

仮に、

#

年間1,000万XPU 8 HBM/XPU 12 DRAM Die/stack DRAM die 70mm² DRAM yield 90% Base Die 120mm² Base Die yield 80%

#

とします。

#

HBM DRAM die数は1 XPU当たり、

#
8×12=96die8\times12=\text{96die}
#

です。

#

年間960M DRAM die。

#

Wafer換算すると約、

#
95.6k WSPM\boxed{\text{95.6k WSPM}}
#

です。

#

Base Dieは、

#
15.8k WSPM\boxed{\text{15.8k WSPM}}
#

程度。

#

Embedded SRAMのSilicon area equivalentはN3級で、

#
XPU SRAM面積相当WSPM512MB約3.7k768MB約5.5k1GB約7.3k\begin{array}{|l|c|} \text{XPU SRAM}&\text{面積相当WSPM}\cr\hline \text{512MB}&\text{約3.7k}\cr\hline \text{768MB}&\text{約5.5k}\cr\hline \text{1GB}&\text{約7.3k}\cr\hline \end{array}
#

程度です。

#

ただしSRAMはXPUの一部なので、これは別wafer需要として単純加算できません。

#

重要なのは構造です。

#
AI Memory Silicon
   │
   ├─ 大量のDRAM wafer
   │
   ├─ Advanced Logic Base Die
   │
   └─ Embedded SRAM on XPU
#

量ではDRAMが圧倒的。

#

しかしBase DieとSRAMは極めて高価で希少なAdvanced Logic capacityを消費します。

#

したがってAI Memory不足は、

#
DRAM shortage+Advanced Logic shortage\boxed{\text{DRAM shortage}+\text{Advanced Logic shortage}}
#

という二重構造になります。

#

#

調査13.PIM/Near-MemoryがNVHBM+SRAMを上回るCross-over

#

最後に最も長期的な論点です。

#

NVHBM+SRAMでHBM Trafficを減らせる量には限界があります。

#

今回のモデルでは512MB→1GB SRAMにしても、

#

DeepSeek/Kimi/GPT-OSSでは、

#
8~10%\text{8~10%}
#

Future 1Tで、

#
15~18%\text{15~18%}
#

程度のTraffic reduction相当です。

#

ところがFeynman ScenarioでRubinと同じMemory Balanceを維持するために必要な追加削減は、

#
Compute必要Traffic削減70PF15.5%100PF40.8%140PF57.8%\begin{array}{|l|c|} \text{Compute}&\text{必要Traffic削減}\cr\hline \text{70PF}&\text{15.5%}\cr\hline \text{100PF}&\text{40.8%}\cr\hline \text{140PF}&\text{57.8%}\cr\hline \end{array}
#

です。

#

ここから3段階に分かれます。

#

70PF級

#
NVHBM+SRAM+Compression+Expert Reuse\text{NVHBM+SRAM+Compression+Expert Reuse}
#

で対応可能性が高い。

#

100PF級

#

40%級を削る必要があるため、

#
Compression
Gather / Scatter
KV Management
Reduction
DMA
Prefetch
#

をBase Die側へ入れるNear-Memory Processingが急に魅力的になります。

#

140PF級

#

約58%削減が必要。

#

この水準では単純なSRAM Cacheだけでは厳しく、

#
PIM / Memory-side Compute\boxed{\text{PIM / Memory-side Compute}}
#

が本格的な候補になります。

#

#

Rubin / Feynman / Jalapeño / TPUのSRAMをどこまで増やすべきか

#

ここまでをまとめると、設計上のSweet Spotは次のようになります。

#
ArchitectureSRAM評価TPU 8i384MB実装済みJalapen˜o公開容量不足で定量判定不能Rubin型General Inference512~768MBRubin Long-context768MB~1GBRubin+NVHBM型768~900MBが非常に合理的Feynman 70PF級1GB前後Feynman 100PF級1~1.3GB+Near-memoryそれ以上SRAMだけで解決困難\begin{array}{|l|l|} \text{Architecture}&\text{SRAM評価}\cr\hline \text{TPU 8i}&\text{384MB実装済み}\cr\hline \text{Jalapeño}&\text{公開容量不足で定量判定不能}\cr\hline \text{Rubin型General Inference}&\text{512~768MB}\cr\hline \text{Rubin Long-context}&\text{768MB~1GB}\cr\hline \text{Rubin+NVHBM型}&\text{768~900MBが非常に合理的}\cr\hline \text{Feynman 70PF級}&\text{1GB前後}\cr\hline \text{Feynman 100PF級}&\text{1~1.3GB+Near-memory}\cr\hline \text{それ以上}&\text{SRAMだけで解決困難}\cr\hline \end{array}
#

Googleが実際にTPU 8iで384MB SRAMを選び、HBM Bandwidthも増やしたことは、「HBMかSRAMか」の二択ではないことを強く示しています。(Google Cloud)

#

#

一番重要な結論――NVHBMとSRAMは競合していない

#

これまでの議論を最初は、

#
SRAM 1GBvsNVHBM 28.6TB/s\text{SRAM 1GB}\quad vs\quad\text{NVHBM 28.6TB/s}
#

として比較しました。

#

その比較だけなら明確に、

#
NVHBM>SRAM only\boxed{\text{NVHBM}>\text{SRAM only}}
#

です。

#

既存モデルでは、

#
WorkloadSRAM 1GBNVHBMBothDeepSeek+8.6%+30%+41.1%Kimi+9.6%+30%+42.4%GPT-OSS+10.2%+30%+43.3%Future 1T+17.6%+30%+52.8%Kimi B32+0.4%+30%+30.5%\begin{array}{|l|c|c|c|} \text{Workload}&\text{SRAM 1GB}&\text{NVHBM}&\text{Both}\cr\hline \text{DeepSeek}&\text{+8.6%}&\text{+30%}&\text{+41.1%}\cr\hline \text{Kimi}&\text{+9.6%}&\text{+30%}&\text{+42.4%}\cr\hline \text{GPT-OSS}&\text{+10.2%}&\text{+30%}&\text{+43.3%}\cr\hline \text{Future 1T}&\text{+17.6%}&\text{+30%}&\text{+52.8%}\cr\hline \text{Kimi B32}&\text{+0.4%}&\text{+30%}&\text{+30.5%}\cr\hline \end{array}
#

しかしFloorplanまで考慮すると、本当の関係は、

#
NVHBM→SRAM増量\boxed{\text{NVHBM}\rightarrow\text{SRAM増量}}
#

です。

#

つまりNVHBMは、

#

HBMを高速化する技術であると同時に、SRAM-heavy XPUを可能にする技術

#

でもあります。

#

#

以前の「DRAM不足→SRAM増大」の議論はどう変わるのか

#

以前の記事では、

#
HBM不足
 ↓
Data Movementを減らしたい
 ↓
SRAM増大
 ↓
Advanced Logic Area増加
#

という流れを考えました。

#

https://note.com/atom_/n/n4a82e9eb3228

#

NVHBMを加えると、

#
AI需要↑
 ↓
HBM / DRAM不足
 ↓
┌─────────────┬─────────────┐
↓                           ↓
SRAM増大                  NVHBM
↓                           ↓
HBM traffic削減      BW↑ / Power↓
                            ↓
                       PHY / MC Area↓
                            ↓
                        XPU面積解放
                            ↓
                        SRAM増大
                            ↓
                 Advanced Logic intensity↑
#

となります。

#

つまり以前の仮説は弱まるどころか、

#

より具体的になった

#

と考えています。

#

ただし重要な修正は、

#
SRAMが増えるからすぐN2/N3 waferが増える
#

ではないことです。

#

NVHBMでPHY/MC面積を回収できるため、最初の256~384MB程度の追加SRAMは同じDie Envelopeへ収められる可能性があります。

#

先に圧力が高まりやすいのは、

#
HBM Logic Base Die\boxed{\text{HBM Logic Base Die}}
#

です。

#

#

NVIDIAが将来取るべきArchitecture

#

今回の定量結果から、NVIDIAがFeynman以降に取る合理的な順序はかなり明確です。

#
① NVHBM / Custom HBM
   ↓
Bandwidth↑
HBM Power↓
PHY/MC burden↓
   ↓
② 回収したXPU area
   ↓
┌────────┬────────┬─────────┐
↓        ↓        ↓         ↓
SRAM     NoC    Compute   Attention/
Cache                    MoE Engines
   ↓
③ Compression / Data Movement Engines
   ↓
④ Near-Memory Processing
   ↓
⑤ 必要ならPIM
#

NVHBMで得られるArea Opportunityを100とするなら、設計上の一例として、

#
用途配分SRAM / Cache30~40%Compute25~35%NoC/Data Movement15~25%Attention/MoE/Compression10~20%\begin{array}{|l|c|} \text{用途}&\text{配分}\cr\hline \text{SRAM / Cache}&\text{30~40%}\cr\hline \text{Compute}&\text{25~35%}\cr\hline \text{NoC/Data Movement}&\text{15~25%}\cr\hline \text{Attention/MoE/Compression}&\text{10~20%}\cr\hline \end{array}
#

くらいが合理的です。これはNVIDIA公式計画ではなく、今回のRooflineモデルからの推定です。

#

#

最終結論

#

今回のNVIDIA決算とNVHBMを別々に見るべきではありません。

#

決算では、

#
AI需要
 ↓
HBM不足
 ↓
Memory価格上昇
 ↓
Supply Constraint
 ↓
Margin圧迫
#

が現れました。

#

NVHBMはその問題へのArchitecture側の回答です。

#
HBM Bandwidth↑
+
HBM Power↓
+
Memory ControllerをBase Dieへ
+
XPU PHY縮小
+
Interposer簡素化
#

によって、一度にMemory Wall、PHY Wall、Package Wallへ対応します。

#

そしてNVHBMによって空いたXPU面積は、SRAM、NoC、Computeへ再投資される可能性が高い。

#

そのため次世代AI AcceleratorのMemory階層は、

#
SRAM+NVHBM+Advanced Logic Base Die\boxed{\text{SRAM+NVHBM+Advanced Logic Base Die}}
#

へ進みます。

#

さらにComputeがFeynman世代で増え続けるなら、

#
Near-Memory Processing\boxed{\text{Near-Memory Processing}}
#

その先に、

#
PIM\boxed{\text{PIM}}
#

が現れます。

#

つまり2027~2030年以降のAI半導体競争を理解するうえで、見るべき指標はもう単純なPFLOPSではありません。

#

本当に重要なのは、

#
Tokens/sTokens/WTokens/mm2\boxed{\text{Tokens/s}}\quad\boxed{\text{Tokens/W}}\quad\boxed{\text{Tokens/mm}^2}
#

そして最終的には、

#
Tokens/W/mm2\boxed{\text{Tokens/W/mm}^2}
#

です。

#

JalapeñoはHBMをComputeに対して太くする。TPU 8iはHBMとSRAMを同時に増やす。NVIDIAはNVHBMによってLogic Base Dieまで自分のArchitectureへ取り込む。

#

3社が異なる方法で同じ問題を解こうとしていること自体が、

#
AI半導体の主戦場が「演算器」から「Memory Hierarchy全体」へ移った\boxed{\text{AI半導体の主戦場が「演算器」から「Memory Hierarchy全体」へ移った}}
#

ことを示していると考えます。

#

特定銘柄の推奨・勧誘・投資助言を目的とするものではありません。投資判断はご自身の責任でお願いいたします。

#
記事の記述・図・出典の対応を保持しています。引用には記事URLと段落リンクを添えられます。再利用の条件を確認する →