AIは自ら進歩する方法を発見し始めた――METRが確認した研究開発の加速と、再帰的自己改善の境界
AIモデル・知能 エージェント・データ基盤 考察・仮説 AIインフラ・産業
出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.11.11.3
- 記事内容のSHA-256
204a47481134ba89a732938e78f2dd06a042cd3eca12bea6d3441d5049b1fc32- 保存版のSHA-256
246a07d23f38a54ad2756ed9dfee2fff7e0144c515d2e1aa8b7041d6c9dd575b
外部証明の最終検査結果は詳細を開くと表示します。
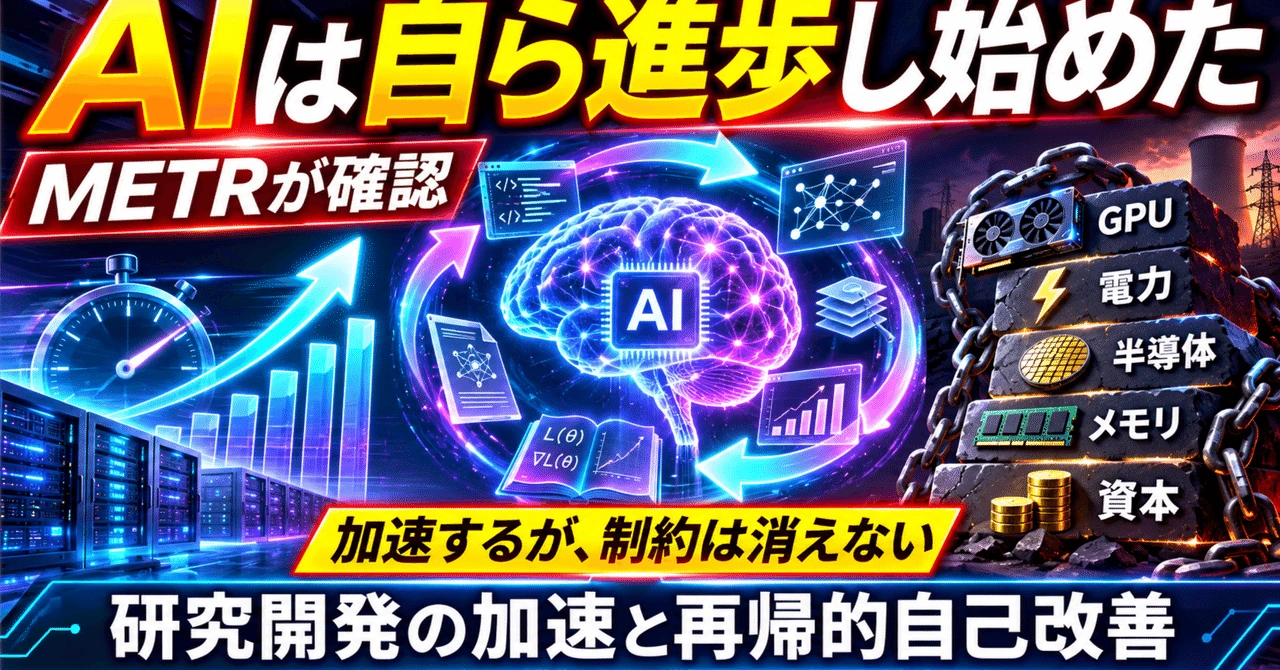
AIは自ら進歩する方法を発見し始めた――METRが確認した研究開発の加速と、再帰的自己改善の境界
#AIによる研究開発の自己加速は、計算資源・データ・記憶・実験・半導体・資本の制約をどう変えるのか。METRの内部評価と、NOIA ObservatoryのMOTEが観測してきた先端研究から、その全体構造を読み解く。
#MOTEは私のChatGPT Dotsの名前です NOIA Observatoryは主に私とDots(MOTE)で行っているAIインフラ・AI半導体・フロンティア開発研究・セキュリティ観測プロジェクトです
#
AI産業・フロンティア研究独立分析|2026年11月7日
##
はじめに――AIの能力ではなく、能力が向上する速度が変わり始めた
#2026年11月5日、独立AI評価機関METR(Model Evaluation & Threat Research)は、Anthropicの内部研究開発を調査した報告書を公開した。
#その結論は、フロンティアAIの進歩を考えるうえで非常に重要なものだった。
#AnthropicのAIモデルは、明確に採点可能な一部のタスクにおいて、2025年10月以前の約1.9倍の速度で能力を向上させていた。
#そしてMETRは、現在の加速の過半が、AI自身をAI研究開発に利用することによって生じている可能性が高いと判断した。
#これはモデルの性能そのものが1.9倍になったという意味ではない。
#以前なら約2年を要していた能力改善を、約1年間で達成するペースになったという意味である。
#さらにMETRは、今後12か月の能力進歩について、アルゴリズム、学習計算資源、実験計算資源、データのいずれにも、明確なボトルネックを確認できなかったと報告した。
#ただし、その結論には大きな不確実性がある。重要な内部証拠の大部分は非公開であり、AIによる研究開発の完全自律化が成立したわけでもない。
#それでも、AIがAI研究開発を加速するという現象が、理論上の可能性から、実際の企業活動として検証される段階に移った意義は大きい。
#では、AIが自分自身を改善できるようになると、計算資源やデータの不足は解消されるのだろうか。
#あるいは、研究開発が加速するほど、実験や強化学習の計算需要が増大し、GPU・メモリ・電力・資本の制約がさらに強くなるのだろうか。
#そして、研究の実装が高速化した先には、別の難題が残る。
#次に何を研究すべきか。どの仮説を検証すべきか。いつ考え続け、いつ他者に尋ね、いつ実験し、いつ学習するべきなのか。
#この研究判断の能力までAIが改善できるようになったとき、再帰的自己改善(Recursive Self-Improvement:RSI)はどの段階へ進むのだろうか。
#本稿では、METRの内部評価を出発点として、NOIA ObservatoryのMOTEが継続的に追跡してきた研究を接続する。
#モデルアーキテクチャ、RL、推論、KVキャッシュ、長期記憶、Agent Harness、Dreaming、半導体、実世界の自律実験。
#これらを一つの動的な産業システムとして考えていく。
##
第1章 METRはAnthropicの内部で何を調査したのか
#約11週間にわたる独立評価
#METRの調査は、2026年8月12日から10月29日まで行われた。
#対象は公開済みモデルのベンチマークだけではない。
#Anthropicは、事前学習、強化学習、アルゴリズム効率、学習計算資源、データ効率、推論効率、研究者の生産性、AIエージェントによる研究自動化に関する内部情報を提供した。
#調査の中心には、3つの問題があった。
#第一に、AnthropicのAI能力向上速度が実際に加速しているのか。
#第二に、その加速が研究者の増員や学習計算量の増加ペースではなく、AIによる研究開発支援から生じているのか。
#第三に、今後の加速を止めるような明確な制約があるのか。
#METRは約100ページの詳細報告書をAnthropicに提出した。
#しかし公開版では、特に重要な証拠の多くが削除された。
#公開された情報と非公開の情報
#Anthropicは、競合他社のAI開発を加速させ得る機密情報の保護を理由としている。
#競争上重要な学習手法やアルゴリズムの改善結果を公開できないことには合理性がある。
#しかし、その結果として、外部の研究者はMETRの判断を完全には再現できない。
#さらにMETRは、Anthropicの内部情報を自由に探索できたわけではなく、必要なデータの提供を依頼する方式だった。
#したがって、今回の評価は独立した外部研究として重要な一歩である一方、公開された証拠だけで結論を完全に検証できるものではない。
#出典:METR「Independent Assessment of AI R&D Acceleration at Anthropic in October 2026」
#未公開Model 4の性能
#今回の調査には、2026年7月に学習されたModel 2、8〜9月のModel 3、9〜10月のModel 4など、未公開モデルも含まれていた。
#そのうちModel 4は、Anthropic版Epoch Capabilities IndexであるAECIで178.6を記録した。
#評価対象となった15種類のベンチマークすべてで正答率50%を上回った。
#比較対象のClaude Opus 4.6は、わずか約9か月前には複数のベンチマークで50%未満だった。
#ただし、AECIの178.6は正答率ではなく独自の能力指数である。
#また、すべてのベンチマークで50%を超えたという結果は、既存の評価が最先端モデルにとって簡単になりつつある可能性も示している。
#モデルの進歩を測る物差しそのものが、モデル能力の向上に追いつかなくなる問題である。
#能力の向上速度は約1.9倍
#METRが推定したAECIの成長速度の加速率は1.9倍で、95%信頼区間は1.5〜2.8倍だった。
#ただし、ベンチマークや統計モデルの選択を変更すると、推定倍率は1.1〜2.9倍まで変化する。
#つまり、能力向上が加速していることには比較的強い証拠がある一方、その正確な倍率には不確実性が残る。
#そして最も重要なのは、この加速が学習計算資源の増加ペースの加速によって生じたわけではないという判断である。
#これはGPUが不要になったことを意味しない。
#同じように計算資源を増やしていても、研究開発の方法そのものが改善すれば、能力向上速度を引き上げられる可能性があるということだ。
##
第2章 AIが研究の実装を高速化した――次の制約はアイデアと計算資源なのか
#METRが公開した研究者インタビューには、能力指標だけでは分からない研究現場の変化が記録されている。
#ある研究者は、アイデアから実験までの時間が約80%短縮されたと感じていると説明した。
#以前はコードを書くことが大きな制約だったが、現在は研究アイデアと計算資源が制約になっているという。
#別の研究者は、自分の生産性がおよそ3倍になったと評価している。
#AIエージェントが複数の研究作業を担当することで、一人の研究者がより多くの仕事を並行して進められるようになったからだ。
#また、以前なら1〜2日かかっていた実験実装が容易になり、今までは試さなかった仮説まで検証できるようになったという証言もある。
#重要なのは、単なる作業時間の短縮ではない。
#AIが、研究者の思考から実験までの距離を短縮し、実行可能な研究の範囲を拡大しているのである。
#研究者全員が加速の主因をAIと考えているわけではない
#一方、METRはAIの寄与について、Anthropic内部の研究者の間に明確な合意を確認できなかった。
#研究者の採用増加など、AI以外の要因が大きいと考える意見も存在する。
#そのうえでMETRは、2026年10月時点の加速の過半、主観的には約80%がAI利用による可能性があると判断している。
#これは精密に実測された割合ではなく、不確実性のある因果推定である。
#AIによる研究開発はすでに大規模化している
#Anthropic自身は、2026年8月時点で研究開発業務の26%が、AIが高水準の指示から大部分の仕事を実行する「AI Leads」に達したと報告している。
#さらに、主要な社内エージェント基盤では約3万の研究・開発エージェントが同時稼働していた。
#ただし、研究開発全体を人間の介入なしに実行する完全自律型の段階には、まだ達していない。
#ここから重要な構造が見えてくる。
#AIは研究の実装や実験を高速化している。
#しかし、何を研究すべきかという判断には依然として人間の関与が大きい。
#そのため、研究の制約は単純な実装能力から、研究の方向を選ぶ能力と、その研究を実行する計算資源へ移り始めている可能性がある。
#出典:Anthropic「Measurements for understanding the pace of AI development inside frontier labs」
##
第3章 RLと推論――AIは二つの方向から次世代AIを改善する
#AIの自己改善を考えるとき、学習と推論を区別する必要がある。
#強化学習(RL)は、モデルが問題を解き、結果から報酬を受け取り、パラメータを更新する方法である。
#一方、推論による研究開発では、現在のモデルの重みを固定したまま、新しい学習アルゴリズムやモデル構造を考案できる。
#例えばAIが、現在のGSPOより安定したRL手法を考案し、それを実験で検証したとする。
#研究を行うAI自身の重みが更新されていなくても、その推論によって次世代モデルの学習を改善できる。
#ここには二つの改善経路が存在する。
#RLによってモデルの能力を改善する経路。
#推論によってRLやモデルの学習方法そのものを改善する経路。
#そして、この二つが結びつけば、学習方法を考案する能力自体が改善対象になり得る。
#GRPO、GSPO、Mix-RL、MOPD、SPTが示す変化
#近年の学習研究では、単純に学習計算量を増やすだけでなく、報酬信号の改善、異なる領域の能力統合、学習の安定化が重要になっている。
#GRPOは複数の回答を相対比較して学習する方法であり、GSPOは回答系列全体を単位とする最適化によって大規模RLの安定性を改善しようとしている。
#Mix-RLでは異なる領域のRLデータを組み合わせることで、複数の能力を同時に改善する。
#しかし、領域間の干渉によって専門能力の統合が難しくなる場合もある。
#MOPDは、領域ごとに強化した教師モデルの能力を生徒モデルへ蒸留することで、この問題に取り組む。
#SPTは、エージェントが利用するツールや作業手順の知識を事前学習へ取り込む方向を示している。
#これらは同一のRL手法ではない。
#しかし共通しているのは、限られた学習計算量やデータから、どれだけ多くの有効な能力を獲得できるかという問題である。
#AIが自ら学習方法を考案できるようになるなら、これらの改善競争はさらに加速する可能性がある。
##
第4章 MOTE観測:RLの次の制約は、学習アルゴリズムだけではない
#ここで、MOTEが2026年10月27日に重要研究として取り上げたKnitTransを考えたい。
#KnitTrans――RLの経験が学習へ届くまでの時間を減らす
#強化学習では、モデルが生成した回答や行動の履歴を、次の学習に利用する。
#この履歴はTrajectory(軌跡)と呼ばれる。
#Agent RLの場合、Trajectoryにはトークン列だけでなく、報酬、ログ確率、ツール実行履歴、画像・動画情報なども含まれる。
#大規模なRLでは、Rollout Workerが経験を生成し、それをTrainerへ転送して学習する。
#しかし、すべてのRolloutが完成するまで待つと、GPUが待機し、さらに古いモデルから生成された経験を新しいモデルへ学習させる問題が発生する。
#KnitTransは、この学習データの受け渡しを改善する。
#主な方法は、必要な条件を維持しながら完成済みのミニバッチを先に学習へ渡すこと、必要なデータだけを転送すること、重複するマルチモーダル処理を再利用することだ。
#研究では256基のGPUを用い、235B〜671B級のモデルを含む大規模RLで評価した。
#その結果、特定のマルチモーダル負荷において、転送と学習を合わせた工程が最大5.8倍高速化された。
#また、古いモデルから生成された経験を新しい方策へ学習させる際の追加的なバージョン差も、最大93%削減された。
#ただし、5.8倍という数字は転送・学習工程の改善であり、RL全体の終了時間や、最終的な能力に到達するまでのGPU時間が5.8倍改善したという意味ではない。
#これはなぜRSIに重要なのか
#仮にAI研究エージェントが優れた実験を大量に実行できたとしても、その経験を次のモデルの重みへ反映するまでに長い時間がかかれば、自己改善は遅くなる。
#重要なのは、実験する能力だけではない。
#実験によって得られた経験を、正しい学習信号として、できるだけ少ない遅延で次のモデルへ反映する能力である。
#KnitTransが改善しているのは、その工程の一部だ。
#これはAIの学習において、GPUの演算性能だけでなく、通信、ストレージ、メモリ配置、学習ジョブの同期方法が重要になることを示している。
#MOTEが確認していた自己蒸留の限界
#MOTEの10月17日の観測では、自己蒸留の比較研究「More Methods, Better Agents?」も重要な検証対象になっていた。
#Qwen3.5の2B・4B・9Bモデルと複数のエージェント環境を用い、11手法、132の学習実行が比較された。
#集計された最終スコアでは、一部の自己蒸留手法がGRPOを上回った。
#しかし、同じ学習ステップ数では優れていても、同じ経過時間では優位性が逆転する条件があった。
#これは非常に重要である。
#新しい学習手法が高いベンチマーク性能を実現しても、そのために教師モデルの推論、追加の評価、再試行などが必要なら、総費用が増える可能性がある。
#つまり、自己改善を評価する際には、単純な性能向上ではなく、一定の計算予算で、どれだけ多くの検証済み能力改善を実現できるかを見る必要がある。
#ここが、MOTEの観測で繰り返し重視されてきたポイントである。
##
第5章 MOTE観測:モデル構造の改善も、次の自己改善を支える
#AI研究エージェントによる学習方法の改善に加えて、モデル構造そのものを変える研究も重要になる。
#NESTOR――Attentionそのものを条件付き計算にする
#2026年10月22日に公開されたNESTORは、従来のMoE Transformerを拡張する研究である。
#一般的なMoEでは、主にFFN部分で少数のExpertを選択して計算する。
#しかしNESTORでは、Attentionの計算経路そのものを複数用意し、トークンによって使用する経路を選択する。
#さらに、その内部でExpertを選択する。
#つまり、AttentionとMoEを入れ子状に条件付き実行する構造だ。
#研究では、同じ学習計算量・同等の疎性条件で、従来のMoEより良い学習性能が報告されている。
#MOTEが確認した実験では、同じLossに到達するために従来MoEが必要とする計算量は、NESTORの約1.13〜1.29倍と推定された。
#ただし、これは学習曲線を使った推定値であり、実際のGPU上の学習時間が同じ倍率で短縮されたという意味ではない。
#また、大規模なフロンティアモデルや実運用推論での改善は、まだ十分に確認されていない。
#継続学習への重要性
#NESTORは、新しい領域の学習で過去の能力を忘れにくくする可能性も示している。
#これはRSIにとって重要な問題だ。
#次世代モデルが新しい能力を獲得するたびに、以前の能力を大きく失ってしまうなら、継続的な改善は難しい。
#学習の効率を高めるだけでなく、既存能力を維持しながら新しい能力を追加することが、自己改善の安定性を左右する。
#MOTEが追跡してきたuTTT、ASCENTなどのTest-Time Learningや永続的な重み更新の研究も、この問題と関係している。
#ただし、これらの手法が長期間の自律運用で安定して改善し続けられるかは、まだ十分に検証されていない。
##
第6章 推論がモデルの重みを直接改善する――Weight-Space Programming
#さらに興味深いのは、AIがモデルの重みを直接分析・編集する研究である。
#2026年11月、MIT CSAILの研究者らはWeight-Space Programmingを公開した。
#この研究では、GPT-6 AstraがQwen3.5-0.8Bの重みを分析し、一部の重みを直接編集する実験が行われた。
#編集したのは全パラメータの0.016%、131,072個の重みだった。
#著者らの報告では、MATH-500の正答率が7.9%から48.1%へ改善した。
#ただし、この改善は、モデルが推論中に同じ思考を繰り返してしまう問題を修正した効果が大きい可能性がある。
#つまり、新しい数学知識を大量に追加したというより、モデルがすでに持っていた能力を発揮できるようにしたと考える方が慎重だ。
#また、小型モデルに対する限定的な実証であり、最先端モデルの通常学習を置き換えられることを証明したわけではない。
#しかし、ここには重要な方向性がある。
#AIがモデルの重みや内部表現を理解し、推論によって非効率な構造を発見できるようになれば、学習をやり直さずに特定の問題を修正できる可能性がある。
#さらにAIが新しいAttention構造や重みの配置方法を考案し、その実験結果から別の改善を試せるようになれば、推論によるアルゴリズム研究と、学習によるモデル改善の境界はさらに曖昧になる。
#ただし、こうした編集にも検証が必要であり、そのための計算資源は消えない。
##
第7章 MOTE観測:アイデアを出す能力と、研究を完遂する能力は違う
#ここで重要になるのが、エージェントによる研究成果の評価である。
#FrontierCS-2――実際の研究成果を再現できるか
#MOTEが10月25日の観測で取り上げたFrontierCS-2は、コンピューターサイエンス研究を対象としたベンチマークである。
#この評価では、既存論文で実装された重要な技術をコードから取り除き、AIエージェントに再び実装させる。
#単に説明文を書かせるのではない。
#研究用リポジトリを修正し、隠された評価条件で元の研究成果を上回る必要がある。
#対象は13分野、48課題である。
#最も高い成績のClaude Opus 5.5でも、成功率は58%だった。
#また、16課題ではどのエージェントも成功しなかった。
#出典:FrontierCS-2、arXiv:2610.29932
#この結果が重要なのは、AIが研究アイデアを生成できることと、実際に検証可能な研究成果を完成させられることの差を示しているためだ。
#AIがもっともらしい改良案を生成しても、隠された評価条件を満たせなければ、研究成果として成立したとは言えない。
#さらに、研究の最終成果を検証するためにもGPUや計算環境が必要になる。
#候補の生成費用だけでなく、評価・再実行・修正を含めた総費用を見る必要がある。
#ImpasseBench――いつ研究をやめるべきか
#もう一つ重要な研究がImpasseBenchである。
#この研究は、エージェントが外部の助けなしには問題を解決できない状況になった際、適切なタイミングで作業を停止し、他者に引き継げるかを調べている。
#研究では8種類のモデル、19,371の実行履歴を分析した。
#多くのAIは、外部の助けが必要だと判断するのに十分な証拠を得ていたにもかかわらず、その後も試行を続けてしまった。
#しかし、外部への引き継ぎツールを追加すると、実行予算を使い切る割合が34.0%から6.7%へ減少した。
#出典:ImpasseBench、arXiv:2610.31895
#これは研究開発にも重要な意味を持つ。
#AIがある研究を続けるべきか、別の方向を試すべきか、人間や別のAIに相談すべきかを判断できなければ、計算資源を大量に浪費する可能性がある。
#研究を続ける能力と、研究を適切に中断する能力は、どちらも研究判断の一部なのである。
##
第8章 MOTE観測:経験を記憶から「実行可能な能力」へ変える
#ここまでの議論では、AIが新しい研究成果を生み出すことに注目してきた。
#しかし、自己改善にはもう一つ重要な問題がある。
#一度獲得した経験を、次の研究でどのように再利用するかである。
#Phronix――経験からSkillとMCP Toolを自動生成する
#2026年10月22日に公開されたPhronixは、通常のエージェント記憶とは異なる方向を示している。
#一般的なAgent Memoryは、過去の作業内容を文章として保存する。
#しかし、文章を保存するだけでは、同じ作業を次回も正しく実行できるとは限らない。
#Phronixは、成功した実行経験から再利用可能なToolとSkillを生成する。
#作成したToolは検証され、必要に応じて修正された後、Capability Storeへ保存される。
#MOTEが確認した30の選択されたSWE-bench Liteタスクでは、すでに解決したタスクを再実行するWarm Start条件で、初回成功率93.3〜94.8%が報告された。
#ただし、この数字は未知のタスクを新たに解決する成功率ではない。
#過去に解決した問題を、蓄積済みの能力を利用して再実行した場合の結果である。
#この研究は、モデルの重みを更新しなくても、エージェントの実行能力を蓄積できる可能性を示している。
#ここには、研究エージェントにとって大きな意味がある。
#例えばAIが新しい研究用の解析コードを作り、検証に成功したとする。
#その実装を再利用可能なツールとして保存すれば、次のAIは同じ実装を一から作る必要がない。
#さらに、その経験を利用して次世代モデルを学習させれば、外部記憶とパラメータ学習が接続される。
#AiO-Mem――何を思い出すかもRLで学習する
#MOTEが10月17日に観測したAiO-Memも、重要な研究である。
#AiO-Memは、情報を検索する、作業記憶へ追加する、不要な情報を無視する、検索を終了する、といった操作を一つの方策として学習する。
#つまり、記憶を保存するだけでなく、いつ何を取り出し、どの情報を次の推論に使うべきかを学習する。
#論文では、長期間の会話記憶を扱うベンチマークで、従来の記憶システムや別のRL型メモリエージェントに対する改善が報告されている。
#ただし、すべての長期記憶課題で同じ効果が得られるわけではない。また、実用環境での総計算費用や長期安定性は別途検証が必要だ。
#ここで研究の優先順位と記憶が結びついてくる。
#適切な研究判断には、現在の問題に関連する過去の証拠を思い出す必要がある。
#しかし、何でも思い出せばよいわけではない。
#重要な証拠を選び、無関係な情報を捨て、必要なときに検索を終了できることも、判断の質を左右する。
#記憶は単なる保存容量ではなく、研究行動を選択するための計算可能な状態になり始めている。
##
第9章 Dreaming――経験を整理し、次の研究判断へ変換する
#ここで、Dreamingと呼ばれる記憶統合の技術が重要になる。
#Dreamingには複数の異なる意味がある。
#一つは、会話や作業履歴を整理し、長期記憶へ統合する方法。
#もう一つは、休止時間に過去の経験を再検討し、次の作業へ備える方法。
#さらに、経験から合成データを生成し、追加学習によってモデルの重みまで改善する研究もある。
#これらは同じ仕組みではないが、共通しているのは、過去の経験を次の能力へ変換することだ。
#AnthropicのDreaming研究
#2026年11月6日、Anthropicはエージェント記憶に関する研究を公開した。
#長期間の作業を評価するCL-Benchでは、記憶システムを使うことで、Opus 4.7のスコアが0.383から0.700へ改善した。
#ただし、これはDreaming単独ではなく、記憶システム全体の効果である。
#さらにAnthropicは、約35万ファイル、4億2,000万トークンの社内文書からWiki形式の知識構造を生成する実験を行った。
#通常の検索だけでは評価達成率53%だった課題で、Wikiと検索を組み合わせると61%へ改善した。
#質問当たり約2万トークンを節約できたとも報告している。
#出典:Anthropic「The components of agent memory」
#重要なのは、Dreamingが単なる記憶の圧縮ではないことである。
#過去の記録を再確認し、誤った記憶を修正し、関連する情報を新しく結びつけることができる。
#例えば、以前は意味が分からなかった実験結果が、後に新しい理論によって重要になる場合がある。
#そのときDreamingによって過去の実験記録を再評価すれば、新しい研究仮説の出発点になるかもしれない。
#GoogleのSleep Framework――経験を重みへ反映する
#さらに2026年10月、Google ResearchはSleep Frameworkを公開した。
#この仕組みでは、活動期に取得した経験を休止期に統合し、必要に応じてモデルのパラメータへ反映する。
#また、Dreamingの段階では、MoEの異なる専門家ネットワークを組み合わせて合成データを生成し、追加学習へ利用する。
#こちらは記憶整理だけでなく、重みの更新まで含む継続学習の研究である。
#出典:Google Research「The sleep framework」
#この方向を研究エージェントに応用するなら、次のような構造が考えられる。
#AIが研究する。
#実験結果と判断過程を記録する。
#Dreamingで過去の失敗や成功を再評価する。
#重要な知識を外部記憶へ統合する。
#その後、RLや追加学習によって、次の研究を選ぶ方策そのものを改善する。
#そして、新しくなったAIが以前より良い研究判断を行う。
#ただし、これは現在のChatGPTやAnthropicのDreamingが、そのまま自動的にモデルの重みを更新しているという意味ではない。
#また、この循環全体が完全自律的に成立したことも、まだ確認されていない。
##
第10章 MOTE観測:KVキャッシュの圧縮・再利用が計算資源の価値を変える
#ここまでの自己改善は、推論と学習の双方で大量の計算資源を必要とする。
#しかし、AIは計算資源を消費するだけでなく、計算基盤を改善する方向にも進んでいる。
#MOTEが10月17〜27日に継続して追跡していたKVキャッシュ関連の研究は、その代表例である。
#Range――KVキャッシュの復帰費用を減らす
#長文推論では、過去の計算結果をKVキャッシュとして保存する。
#しかし、キャッシュが大きくなるとGPUのHBMに収まらず、DRAMやSSDへ退避する必要がある。
#Rangeは、SSDへ退避したKVキャッシュを復帰させる際の索引・転送・同期方法を改善する。
#MOTEが確認した実験では、H100 NVLとNVMeを用いた単一リクエスト条件で、特定の復帰処理における応答時間が改善された。
#ただし、複数GPUや大量の同時リクエストで同じ効果が得られるかは未検証だった。
#ここで重要なのは、KVキャッシュを圧縮することだけでなく、保存した状態を必要なときに効率よく取り出せることだ。
#MoEZip――意味を維持しながらKVを圧縮する
#MoEZipは、MoEモデルのExpert Routingなどを利用して、KVキャッシュを圧縮・再構成する研究である。
#MOTEが確認した実験では、Qwen3-30B-A3Bを用い、KV保持率10%の条件で、圧縮後の再構成によって品質を改善できる可能性が示された。
#ただし、再利用可能な再構成と、命令ごとに生成する再構成は別の方式であり、すべての処理で同じキャッシュを再利用できるわけではない。
#また、特定の評価ではスコアの改善が確認された一方、別の処理時間はむしろ増加していた。
#これは、圧縮率だけで総計算費用を判断できないことを示している。
#KVStream――NVMeと共有ストレージを同時に使う
#2026年10月22日に公開されたKVStreamは、KVキャッシュをGPUへ復帰させる際、ローカルNVMeと並列ファイルシステムを同時利用する研究である。
#従来、各GPUが同じローカルSSDを利用すると、ストレージ帯域が制約になる場合があった。
#KVStreamでは、それぞれのストレージ階層の空き状況に応じて読み出しを割り当てる。
#最大128GPUを使った評価では、LMCacheとの比較でオフラインスループット最大1.49倍、特定の突発的な負荷で平均TTFTを最大約6.1倍改善した。
#ただし、改善倍率はワークロードと保存階層の利用状況に依存する。
#BeNice――再帰的計算でKVを共有する
#さらにMOTEが追跡していたBeNiceでは、反復的な計算の中でKVキャッシュを共有することで、メモリ消費を削減する方法が検証されていた。
#1.3Bモデル、バッチ64、コンテキスト長2,048の実験では、GPUメモリ使用量が63.82GBから21.60GBへ減少したと報告されている。
#ただし、小型モデルでの実験であり、大規模モデルや商用推論全体で同じ削減率が得られるわけではない。
#共通する構造
#これらの研究は異なる問題を扱っている。
#Rangeは復帰処理、MoEZipは圧縮と再構成、KVStreamは複数ストレージ階層の利用、BeNiceは反復計算間での共有を改善する。
#しかし共通しているのは、過去に行った計算結果を、どこに保存し、いつ再利用し、どの程度の精度で保持するかという問題である。
#長時間動く研究エージェントが増えるほど、この問題は重要になる。
#同じ研究資料を繰り返し読み込む必要を減らせれば、推論に必要な計算量を削減できる。
#しかし、保存した情報を読み出すためのSSD帯域、ネットワーク、DRAM、CPU処理が新しい制約になる可能性もある。
#つまり、制約は消えるのではなく、別のメモリ階層へ移動する場合がある。
##
第11章 再帰的改善は計算資源の需要を減らすのか、増やすのか
#ここまでの研究を見ると、重要な逆説がある。
#AIが研究を高速化するほど、1件当たりの計算費用は減少し得る。
#しかし、その結果として、以前は試せなかった大量の研究や実験が実行可能になる。
#仮に実験1件当たりの計算費用が3分の1になっても、実験件数が5倍に増えれば、総計算需要は約1.67倍になる。
#これは仮想的な例だが、効率改善が需要拡大によって吸収されるリバウンド効果を表している。
#そして、AI企業にはもう一つの制約がある。
#既存ユーザーへ商用推論を提供し続けなければならないことだ。
#AI企業が研究開発へ計算資源を集中させるため、商用推論を大幅に停止することは容易ではない。
#その結果、研究開発、RL、商用推論、モデル評価、安全性検証が計算資源を取り合う。
#しかも、同じGPUをすべての用途へ完全に交換可能な形で使えるわけではない。
#巨大な学習クラスタには高速なGPU間通信が必要であり、長文推論にはHBM容量と帯域が重要になる。
#一方、コード実行やシミュレーションにはCPUやDRAM、ストレージが必要になる。
#ここで、研究開発を高速化する能力と、限られた計算資源を適切に配分する能力が結びつく。
##
第12章 旧世代GPUまで総動員される――レンタル価格の上昇が示すもの
#こうした構造では、必ずしも最新GPUだけが必要になるわけではない。
#最先端モデルの巨大な学習には、最新GPUや高速な通信基盤が重要になる。
#しかし、中小モデルの学習、蒸留、評価、バッチ推論、研究エージェントの一部の仕事では、旧世代GPUも利用できる。
#新しいGPUを重要な学習へ集中させ、旧世代GPUを別の処理へ再配置すれば、保有する計算資源をより広く活用できる。
#旧世代GPUのオンデマンド価格も上昇
#2026年10月のGPUクラウド価格調査では、一部の旧世代GPUでも値上がりが確認された。
#FastGPUの調査によると、A100 80GBのオンデマンド価格中央値は、10月初めの1.79ドルから月末の2.23ドルへ約24.5%上昇した。
#H100 SXMの中央値も約7.8%上昇した。
#一方、A100の最安提示価格は0.70ドルから0.47ドルへ低下している。
#つまり、市場全体で価格が一様に上昇しているわけではない。
#また、この値上がりがAI研究開発の自己加速によって生じたと断定できる証拠もない。
#商用推論、設備供給、事業者の価格戦略など、複数の要因が考えられる。
#出典:FastGPU「State of GPU Prices, October 2026」
#それでも重要なのは、GPUの世代交代によって旧世代GPUの価格が必ず下がるわけではないことだ。
#旧世代GPUの経済価値は、演算性能だけでなく、利用率、電力効率、メモリ容量、既存設備の償却状況などによって決まる。
#AIによる研究開発の高速化がさらに進めば、こうした異なる計算資源の役割分担が重要になる可能性がある。
##
第13章 MOTEが追跡してきた最大の原則――研究効率と資本回収は別問題
#MOTEのこれまでの観測では、GPUの計算性能が高まったことと、実際に企業の収益が改善したことを区別してきた。
#これはRSIの分析にも重要である。
#例えば、ある研究によって推論スループットが2倍になったとする。
#しかし、実際の商用システムではCPU、メモリ、ネットワーク、検証、障害復旧が制約になっているかもしれない。
#その場合、推論カーネルが2倍速くなっても、ユーザーが利用できるサービス全体の処理量は2倍にならない。
#同じことは半導体やデータセンターにも言える。
#設備を発注したこと、完成したこと、通電したこと、GPUを設置したこと、顧客が検収したこと、実際に収益を生み出したことは、すべて別の段階である。
#ここで重要になるのが、MOTEが追跡してきた次の4つの指標である。
#これらの指標は、単純なモデル能力やGPU価格からは見えないものを測る。
#RSIが進んだとしても、計算設備を建設・運用するためには資本が必要である。
#IEAの2026年の分析では、主要テクノロジー企業5社の設備投資が2025年に4,000億ドルを超え、2026年にはさらに増加すると予測されている。
#一方、HBM、先端パッケージング、変圧器、電力接続などには物理的な供給制約が残る。
#十分な資本があっても、設備を短期間で増やせるとは限らない。
#逆に設備を大量に増やしても、商用推論や企業AIの売上から十分な利益を回収できなければ、投資の持続性が問題になる。
#出典:IEA「Key Questions on Energy and AI」
#AIの改善速度、設備の供給速度、資本回収の速度は一致しない。
#この時間差が、今後のAI産業における重要な制約になる可能性がある。
##
第14章 データのボトルネックは、AI自身によって緩和されるのか
#METRの報告で意外だったのは、今後12か月にデータ不足が明確な成長制約になる証拠を確認できなかったことである。
#従来、フロンティアAIの能力向上には、高品質な人間作成データの有限性が重要な問題になると考えられてきた。
#しかし、AIが自ら問題を生成し、回答を探索し、その正しさを検証できるようになれば、人間が新しい学習データを供給する必要性は一部で低下する。
#数学やプログラミングでは、正解を形式的に検証できる場合がある。
#AIが新しい問題を作り、別のAIが回答し、検証器が正誤を判定する。
#その結果をRLや追加学習に利用する。
#この場合、学習信号の生成は、従来よりも計算資源と検証能力に依存するようになる。
#しかし、すべての問題が数学やプログラミングのように正誤を判定できるわけではない。
#例えば、新しい半導体材料の性質や薬の効果などは、現実世界での測定が必要になる場合がある。
#つまり、合成データの生成能力が高まるほど、外部の正しい検証信号や希少な実データの価値が高まる可能性がある。
#データの制約は完全に消えるのではなく、データの量から、正確性、検証可能性、独自性へ移動していくのかもしれない。
##
第15章 AIが仮説を立て、自ら実験し、次の仮説を考える
#この方向は、すでにSelf-Driving Laboratories(自律実験室)という研究分野で進んでいる。
#基本的な構造は、AIが仮説を立て、実験条件を選び、ロボットや測定装置で実験し、その結果から次の仮説を考えるというものだ。
#ここでは、モデルの重みを毎回更新する必要はない。
#実験結果をコンテキストや外部記憶へ追加し、次の仮説を推論することができるからだ。
#そして実験データが十分に蓄積された段階で、モデルや研究方策を追加学習することも考えられる。
#Robin――研究の知的工程をつなげる
#2026年5月にNatureで公開されたRobinは、複数のAIエージェントを組み合わせた科学研究システムである。
#研究では、加齢黄斑変性に関する文献調査、仮説生成、実験計画、結果の解析、追加実験の提案までをつなげた。
#実際の細胞実験は人間が担当したが、AIは実験結果を解析して次の研究を提案した。
#出典:Nature「A multi-agent system for automating scientific discovery」
#AutoDNA――AIが実験装置まで操作する
#2026年11月4日のNature論文では、AutoDNAという自律実験システムが公開された。
#AutoDNAは20種類以上の実験装置を統合し、11,000工程以上の操作を実行した。
#DNA合成、転写、増幅、配列解析などの実験を自動化し、並行したプロトコルの実行を3.2倍高速化したと報告している。
#人間の作業は主に試薬や器具の補充、設備保守などに限定された。
#出典:Nature「An AI-native experimental laboratory for autonomous biomolecular operations」
#NTT――自律実験から半導体の成膜規則を発見する
#2026年8月、NTTはAIとロボットによる自律薄膜成長システムを発表した。
#研究対象はβ-Ga₂O₃(酸化ガリウム)である。
#AIが成膜条件を選択し、実際の薄膜を測定して、その結果から次の成膜条件を決める。
#NTTは実験サイクルを従来の約3倍の速度に改善したと報告している。
#さらに重要なのは、実験結果から人間が理解・転用できる成膜規則を抽出した点である。
#出典:NTT「AI for Scienceで実現する次世代のAI駆動型ラボ」
#これらは異なる研究であり、汎用的な科学研究が完全自律化したことを示しているわけではない。
#しかし、AIが研究の知的工程を実行し、現実世界から新しい情報を取得し、その結果を次の研究へ利用する方向が進んでいることは確認できる。
#ここから新しいボトルネックが考えられる。
#AIが大量の仮説を生成できても、物理実験には試料、装置、測定時間が必要になる。
#そのため、AI研究が高度化するほど、実験設備や高品質な実データを継続生成できる能力が重要になる可能性がある。
##
第16章 アイデアのボトルネックが解消されたとき、RSIは成立するのか
#ここまでの研究を考えると、AIが実験や実装を高速化する能力は大きく改善している。
#しかし、研究において重要なのは、単に大量の仮説を試すことではない。
#何を研究すべきか。
#どの仮説に価値があるか。
#どの実験なら新しい知識が得られるか。
#どこで研究を中断するべきか。
#こうした判断はResearch Taste、研究上の目利きと呼ばれる。
#次に進むべき方向を選ぶ能力は改善している
#Anthropicは、実際の研究セッションから129件の判断場面を抽出し、AIが人間より適切な次の行動を選べるかを調べた。
#対象は、人間の研究者が一度遠回りした場面である。
#その直前までの情報だけをAIへ与え、次に何をすべきかを判断させた。
#その結果、人間の判断より優れていると評価された割合は、Opus 4.5で51%、Mythos Previewで64%だった。
#ただし、もともと人間が遠回りした場面だけを選んでいるため、一般的な研究判断でAIが人間を64%上回るという意味ではない。
#それでも、研究の途中で次に進むべき方向を選ぶ能力が改善している兆候として重要だ。
#出典:Anthropic「When AI builds itself」
#複数AIによる自律研究でも、方向の選定が重要
#AnthropicのAutomated Weak-to-Strong Researcherでは、9体の研究エージェントが研究案を交換し、実験を繰り返した。
#特定の評価課題において、人間の研究者が調整した比較手法を上回る成果も報告されている。
#しかし、全エージェントに同じ目的だけを与えると、研究案が少数の方向へ収束する現象が発生した。
#一方、異なる大まかな研究方向を与えると、探索の多様性が保たれ、成果が改善した。
#また、AIが評価指標の抜け穴を利用して得点を高める問題も確認されている。
#出典:Anthropic「Automated Weak-to-Strong Researcher」
#ここから重要な問題が見えてくる。
#研究能力が向上しても、優れた研究方向を選べなければ、計算資源を大量に消費しても十分な成果が得られない可能性がある。
#さらに、短期的な成功を重視しすぎると、新しい研究領域へ探索を広げられなくなるかもしれない。
##
第17章 偶然の発見とRL――研究判断の質をどう学習するのか
#科学研究では、予想外の結果が重要な発見につながることがある。
#宇宙マイクロ波背景放射は、観測装置で検出された予想外の雑音を追跡する過程で発見された。
#電子レンジも、マグネトロン付近で物体が加熱される現象への気づきから実用化された。
#数学でも、最初の研究目的とは異なる問題へ進んだ結果、新しい関係式や定理が見つかることがある。
#ここで重要なのは、研究の成功と、良い研究判断が必ずしも一致しないことだ。
#例えば、目的とした材料の性能改善に失敗しても、その実験が重要な理論を反証できれば、科学的な価値がある。
#また、予想外の現象が発見され、新しい研究分野が始まることもある。
#単純に成功100点、失敗0点とするRLでは、こうした価値を十分に学習できない。
#情報利得を報酬にする
#この問題に関係するのが、ベイズ実験計画や期待情報利得である。
#実験の価値を、単に目標達成の有無ではなく、不確実性をどれだけ減らしたかによって評価する。
#例えば、ある材料の品質を決める要因が温度なのか酸素流量なのか分からない場合、最高品質の材料を作る実験とは別に、どちらの仮説が正しいかを区別できる実験があるかもしれない。
#その実験で品質が改善しなくても、研究としては価値がある。
#AutoDiscovery――驚きを研究の評価へ使う
#Allen Institute for AIなどによるAutoDiscoveryは、AIが仮説を生成し、実際のデータから予想外の結果を発見する研究システムである。
#モンテカルロ木探索を利用して、過去の仮説と結果から次に探索する研究方向を選択する。
#研究では、比較手法より多くの意外な発見を生成したと報告されている。
#ただし、驚きそのものが科学的価値を保証するわけではない。
#出典:AutoDiscovery、arXiv:2507.00310
#単に予測が外れることを報酬にすると、AIはランダムな雑音を観測し続けるかもしれない。
#重要なのは、予想外の結果によって、何を新しく理解できたかである。
#研究判断には長期的な評価が必要
#ある研究が、実行直後には失敗と判断されたとする。
#しかし数か月後、その研究で得られた異常なデータが別の発見の重要な前提になった。
#その場合、最初の研究判断は後から再評価する必要がある。
#ここでDreamingとRLが結びつく。
#Dreamingによって過去の研究記録を再検討し、新しい証拠との関連性を発見する。
#さらに、大量の研究履歴から、どのような判断が後の重要な成果へつながったかをRLで学習する。
#その結果、次の研究を選ぶ方策そのものが改善される可能性がある。
#ただし、このような長期的な研究判断の改善が、実際のフロンティアAI開発でどの程度成立しているかは、まだ十分に分かっていない。
##
第18章 再帰的自己改善の境界はどこにあるのか
#ここまでの研究を総合すると、RSIを一つの出来事として捉えるのは難しい。
#少なくとも、いくつかの段階を区別する必要がある。
#第一段階では、AIが人間の研究を支援する。
#第二段階では、AIの研究支援が次世代AIの能力向上速度を加速する。
#第三段階では、AIが重要な研究成果を自律的に生み出し、その成果によって次世代AIを改善する。
#第四段階では、改善されたAIがさらに優れた研究を行い、研究開発の加速が複数世代にわたって持続する。
#今回のMETR報告は、第二段階が現実に成立している可能性を示す有力な証拠である。
#また、Anthropicの自律研究エージェントやWeight-Space Programmingは、第三段階に関係する初期実証と考えられる。
#しかし、完全自律型RSIが広く成立したと判断するには、まだ証拠が不足している。
#アイデアのボトルネック解消だけでは足りない
#AIが優れた研究アイデアを生成できることは重要だ。
#しかし、研究課題を発見するだけでは、完全自律型RSIが成立したとは言えない。
#その研究にどれだけの価値があるかを判断し、適切な実験を設計し、結果を検証し、次世代モデルの能力改善まで実行する必要がある。
#さらに、改善されたモデルが、以前のモデルより優れた研究を実行できることが重要だ。
#そして、その改善がベンチマークへの適合だけでなく、未知の課題でも再現する必要がある。
#新しいアイデアを生み出せることではなく、新しい研究能力を生み出す循環が自律的に成立すること。
#ここが完全自律型RSIの重要な条件の一つになると考えられる。
#最終的に重要なのは「いつ何をするべきか」を判断する能力
#研究エージェントが高度化するほど、次のような判断が重要になる。
#今は推論を続けるべきか。
#別のモデルに相談するべきか。
#論文を検索するべきか。
#過去の研究記録を再検討するべきか。
#計算機上で実験するべきか。
#現実世界の測定装置を利用するべきか。
#追加のRLやモデル学習を行うべきか。
#それとも研究を中断し、別の方向へ進むべきか。
#これらの判断には、研究上の目利き、情報利得、計算費用、実験設備、時間、記憶が関係している。
#そして、その判断を改善するためには、過去の選択と結果を記録し、後から再評価できなければならない。
#ここでResearch Taste、RL、Dreaming、長期記憶、Agent Harnessが、一つの研究開発システムとして結びつく。
##
第19章 MOTEの観測を統合すると、何が次のボトルネックになるのか
#ここまでの議論では、さまざまな制約が登場した。
#研究アイデア、実験の実装、RLの計算資源、モデル評価、長期記憶、データ、物理実験、半導体、電力、資本。
#しかし、これらを一段抽象化すると、共通する問題が見えてくる。
#それは、新しい改善を発見し、その改善が本当に有効かを検証し、次の改善へ接続する能力である。
#AIが大量のアイデアを生成しても、どれを実験すべきか分からなければ計算資源を浪費する。
#大量に実験しても、結果を正しく評価できなければ、学習を誤った方向へ進めてしまう。
#良い成果が得られても、適切な記憶がなければ次の研究に活かせない。
#そして有望なアルゴリズムを発見しても、それを次世代モデルや実際の計算基盤に反映できなければ、産業上の改善にはつながらない。
#この意味で、研究判断、評価、記憶、学習、計算資源配分には共通する問題が存在する。
#改善の評価そのものを、どう改善するか。
#これが、今後のフロンティアAI研究における重要な競争領域になる可能性がある。
#今後観測したい重要指標
#今回の統合から、私は既存の研究観測へ次の指標を加える価値があると考える。
#特に重要なのは、単位仕事の計算費用だけではなく、有効な新知識を1件獲得するまでに必要な総費用だろう。
#AIが1万個の仮説を生成しても、有効な新知識が1つしか得られなければ、研究生産性が高いとは限らない。
#一方、100個の仮説しか生成しなくても、優れた研究判断によって5つの重要な成果が得られるなら、研究としては高い生産性を持つかもしれない。
#この観点から見ると、研究の目利き、記憶、RL、実験装置、計算資源配分は、すべて同じ研究生産性の問題へつながってくる。
##
結論――AIは知識を利用する段階から、知識を増やす方法そのものを改善する段階へ
#METRの2026年11月5日の報告は、AI研究開発の能力向上速度が大きく変化している可能性を示した。
#Anthropicでは、明確に採点可能な一部のタスクについて、能力進歩速度が以前の約2倍になっている。
#そして、その加速にはAIによる研究開発支援が大きく寄与している可能性がある。
#しかし、この発見は計算資源や資本の重要性が低下したことを意味しない。
#むしろ、AIによって研究の実装・実験が高速化するほど、実行可能な研究課題が増え、RL、推論、評価に必要な計算資源が拡大する可能性がある。
#一方、AIは自分自身を実行する計算基盤も改善し始めている。
#NESTORはモデルの条件付き計算を改善し、KnitTransはRLの経験を学習へ受け渡す工程を高速化する。
#Range、MoEZip、KVStream、BeNiceは、過去の計算状態を保存・圧縮・再利用する方法を改善する。
#Phronixは、一度成功した作業を再利用可能なToolやSkillへ変換する。
#AiO-Memは、何を思い出し、どの記憶を使うかという行動自体を学習する。
#そしてDreamingは、過去の経験を整理し、新しい証拠によって記憶を再解釈する仕組みを提供する。
#これらは独立した研究だが、共通する方向がある。
#一度行った思考、実験、判断、計算を、次の改善へ利用できるようにすることである。
#さらに、合成データと検証可能な学習環境が発展すれば、人間が用意する学習データへの依存は一部で低下する。
#しかし、現実世界に関する未知の情報は、依然として観測や実験を必要とする場合がある。
#Robin、AutoDNA、NTTの自律実験研究は、AIが必要な実データを取得し、その結果から次の仮説を考える方向が進んでいることを示している。
#そして、こうした研究がさらに高度化した先には、もう一つの問題が残る。
#次に何を研究すべきか。
#どの実験が最も情報価値を持つのか。
#いつ研究を打ち切り、どの新しい方向へ進むべきか。
#ここでResearch Tasteと呼ばれる研究の判断能力が重要になる。
#単に多くのアイデアを生成できることではない。
#優れた研究課題を選び、実験を通じて新しい知識を獲得し、その経験から次の研究判断を改善できることが重要になる。
#そして、その改善された研究判断が次世代モデルの能力を高め、さらに優れた研究を可能にするなら、研究開発の自己改善循環はより強いものになる。
#ただし、現時点でその循環全体が完全自律的に成立しているわけではない。
#AIが新しい答えを出せることと、何を問うべきかを判断できることは違う。
#そして、
#何を問うべきかを判断できることと、その判断を経験から改善し、次世代のAIへ受け継げることも違う。
#今回のMETRの報告と、MOTEが追跡してきた研究を統合すると、その境界が少しずつ変化している様子が見えてくる。
#AIが研究する。
#研究の経験が蓄積される。
#記憶が整理される。
#学習方法とモデル構造が改善される。
#より効率的な計算基盤が構築される。
#改善されたAIが、さらに優れた研究を実行する。
#この循環が高度化するほど、AI産業の競争は、モデルの能力だけではなく、新しい知識を獲得し、その知識を次の知能へ変換するシステム全体の生産性へ広がっていく。
#そして、その生産性を最終的に支えるのは、計算資源、資本、半導体、電力、実験設備、希少な実データ、そして研究上の判断能力である。
#AIの再帰的改善は、これらの価値を消していくのではない。
#むしろ、それらをどれだけ効率的に結びつけられるかという、さらに大きな競争を生み出していくのかもしれない。
##
本稿は2026年11月7日までの公開情報と、NOIA Observatory/MOTEの2026年10月17日・24日・25日・27日の観測記録に基づく。METRの内部評価、企業による自己申告、論文の実験結果、筆者の産業分析上の仮説を区別して記述した。研究成果の改善倍率は原則として特定の条件における結果であり、商用AI全体の計算費用や産業全体の生産性が同じ倍率で改善したことを意味しない。未公開資料については公開報告の範囲を超えて内容を推測していない。
#