TTTが「記憶」を再設計する
この資料の日時
元資料の日付と、その本文が公に存在した確認日時は別の記録です。
本文に含まれる語句 HBM DRAM SRAM 帯域・データ移動 先端パッケージング 光接続 電力・給電 歩留まり 基板・材料 チップレット AI推論 AIエージェント
出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.09.23.4
- 記事内容のSHA-256
a4992d2dd0b04b2a9aaed56f4dddb7a1f755a9881170a8d6342127d5931562d5- 保存版のSHA-256
957fe269c0fb8426a08e0b669f17021eb78671f98eb38b1b6aa1608d3557828a
外部証明の最終検査結果は詳細を開くと表示します。
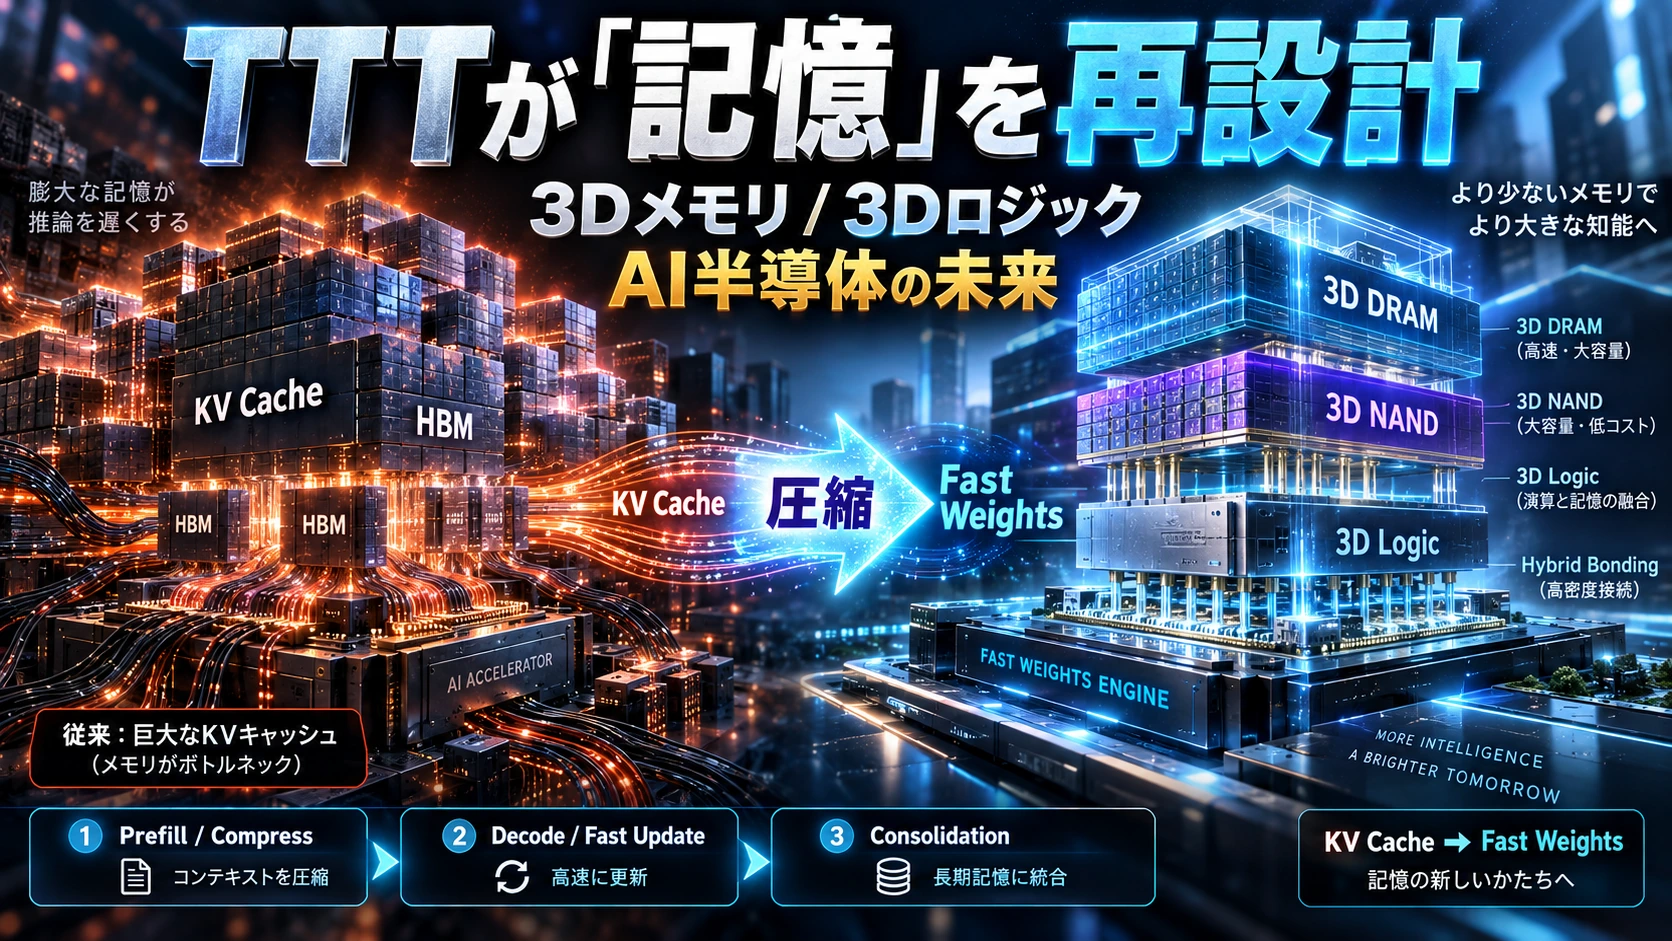
TTTが「記憶」を再設計する
#Prefill・Decode・Consolidation分業と、3Dメモリ/3Dロジックが変える2035年のAI半導体
#AI半導体の競争を、単純な「GPUのFLOPS」と「HBM容量」の競争だけで捉えることが難しくなり始めています。
#2026年現在、すでに大規模LLM推論ではPrefillとDecodeを異なるアクセラレータへ分離する設計が商用化され始めました。NVIDIA DynamoはPrefillとDecodeを別worker poolとして独立に拡張できる設計を採用し、AWSはTrainiumをPrefill、Cerebras WSEをDecodeに割り当てる構成を発表しています。AMDとCerebrasもHeliosを高throughput側、WSEをultra-low-latency Decode側へ配置する分業を打ち出しました。(NVIDIA Docs)
#ここへTest-Time Training、TTTが入ると、さらに大きな変化が起こり得ます。
#従来は、
#Prefill → Decode
#だった推論が、
#Prefill / Compress → Decode / Fast Update → Consolidation
#へ分かれていく可能性があるのです。
#そして、この計算処理の分業に合わせるように、
#SRAMHBM3D DRAMHBF / zNAND3D NANDHBM Logic Base Die3D Logic
#まで、それぞれの仕事が分かれていく。
#本稿では、この構造変化をTTTの基本から説明し、最後に2026~2030年、2030~2035年のメモリ、ロジック、先端パッケージ、Hybrid Bonding、テスト、光接続まで同じモデルに載せて計算してみます。
#1.そもそもTTTとは何か
#現在のLLMは基本的に、
#という構造です。
#ユーザーが何百万token話しても、通常はモデル本体のparameter W は変化しません。
#モデルが会話中の過去を覚えているように見えるのは、主としてKV Cacheや外部memoryによって情報を保持しているからです。
#TTTはここを変えます。
#と、推論中に一部のparameterを更新する。
#この更新対象をFast Weightsと呼ぶことがあります。
#ICLR 2026のIn-Place Test-Time Trainingでは、既存LLMのMLP最終projection matrixの一部をfast weightsとして扱い、推論時にchunk単位で更新しています。4Bモデルで128K contextまで検証され、静的な「train then deploy」からcontinual learningへ移る方向を示しています。(ICLR Proceedings)
#またICLR 2026の「Test-Time Training Done Right」は、fast weightsを過去tokenを保存するtemporary memoryとして捉えています。(ICLR Proceedings)
#重要なのは、TTTは必ずしも、
#「巨大モデル全体を毎token再学習する」
#技術ではないということです。
#現実的には、
#Base Modelは固定Fast Weightsのみ更新
#という構造が中心になります。
#2.なぜKV Cacheが問題になるのか
#まず現在のTransformer推論を理解する必要があります。
#入力が来ると最初にPrefillを行います。
#例えば128K tokenを入力すると、
#を各layerで計算し、そのK/Vを保存します。
#その後Decodeでは新しいtokenを1つ生成するたびに、過去のK/Vを参照します。
#NVIDIAも現在のdisaggregated inferenceを、
#Prefill engineがKV Cacheを生成
#KVをDecode engineへ転送
#Decode engineがtoken生成
#という構造として説明しています。Prefillはcompute-intensive、Decodeはmemory-boundであり、両者を分離することで異なるresource allocationを行えます。(NVIDIA Docs)
#3.KV Cacheを実際に計算する
#70B級GQAモデルを簡略化して、
#80 layers
#8 KV heads
#head dimension 128
#BF16 = 2 byte
#とします。
#1 tokenあたりKVは、
#約320KiBです。
#128K tokenなら、
#約40GiB。
#つまり、
#です。
#Batch 32なら、
#となります。
#モデル本体とは別に、KVだけで1.25TiBです。
#これがDecodeでHBM容量を猛烈に消費する理由です。
#NVIDIAもDecode workerでは、最大batch数やtoken数を増やすほどKV blockが増え、利用可能HBMを圧迫すると説明しています。(NVIDIA Docs)
#4.CloudがBatchを増やしたい理由
#Decodeは1 tokenずつ生成するため、そのままでは大きなGPUを効率よく使えません。
#そこで、
#User AUser BUser C……User 32
#をまとめて計算します。
#モデルweight W は全員で共有できます。
#一方、
#は共有できません。
#したがってBatchを増やすほど、
#Weight reuse効率は上がるが、KV容量は線形に増える
#という問題が発生します。
#現在のCloud AIの経済性は、この巨大Batchと巨大HBM容量に大きく依存しています。
#5.TTTは「メモリを計算へ変換する」
#TTTが面白いのはここです。
#従来、
#として保存していた過去情報の一部を、
#としてparameter stateへ圧縮できる可能性があります。
#ただし、ここは誤解してはいけません。
#現在のTTT研究が「任意の40GiB KVを完全に2GBへ可逆圧縮できる」と実証したわけではありません。
#Fast Weightsは意味情報を圧縮したparametric memoryであり、rareな数字、UUID、固有名詞などを完全保存するのは難しい。
#したがって実際には、
#最近の正確なcontext → KV古いsemantic context → Fast Weightsrare exact facts → Retrieval全文 → NAND
#というhybridになる可能性が高いでしょう。
#6.それでも容量効果は非常に大きい
#説明用に1B parameterのFast Weight stateを考えます。
#BF16なら、
#です。
#先ほどの128K KVは約40GiB。
#すると、
#で、おおむね20分の1です。
#Batch 32なら、
#通常KV:
#Fast State:
#です。
#もし性能を維持したままこの規模の圧縮ができるなら、HBM容量制約は根本的に変わります。
#7.ただし「圧縮」には計算資源が要る
#メモリを減らす代わりに、TTTではparameter updateを実行します。
#更新対象parameterを S として、非常に粗いengineering estimateとしてForward+Backwardを、
#と置きます。
#1B Fast Weightなら、
#です。
#70B Base ModelのForwardを、
#とすれば、
#追加計算は、
#程度です。
#理論FLOPsだけを見ると、かなり安い。
#8.しかし現在のGPUではTTTが非常に非効率になる
#問題は利用率です。
#従来のTTTは16~64 tokenごとのsmall online minibatchでupdateする方式が多く、ICLR 2026の「Test-Time Training Done Right」は、こうしたTTT layerが現在のGPU上でFLOPs utilization 5%未満になるケースがあると報告しています。(ICLR Proceedings)
#つまり理論計算量が4%増えるだけでも、hardwareが効率よく使えなければ実時間は数十%~数倍に伸びる可能性があります。
#そこで同論文はupdate chunkを2K~1M token規模へ大きくし、大型GEMMへ変換する方向を取っています。
#ここが非常に重要です。
#TTTが成功するかどうかはアルゴリズムだけでなく、
#に依存します。
#9.KVとFast Weightsの損益分岐を計算する
#先ほどの例を使います。
#128K context:
#KV ≈ 43GB(10進換算)
#Fast State:
#2GB
#差は約41GB。
#HBM bandwidthを5TB/sとすると、1 Decode stepで41GB読む時間は、
#約8.2ms。
#一方、128K tokenを1B Fast Weightへ学習する追加計算は、
#です。
#1PFLOPS acceleratorを70%実効で使えれば、
#です。
#すると損益分岐は、
#つまり約140 output tokenです。
#140 token以上生成するなら、単純bandwidth計算では圧縮コストを回収できます。
#ところがTTT update engineが5%しか使えないと、
#約15.7秒。
#損益分岐は、
#になります。
#これこそが、TTT専用architectureが必要になる理由です。
#10.Prefill / Compress・Decode / Fast Update・Consolidation
#TTTが本格化すると、私はAI inferenceが実用上3つへ分かれる可能性が高いと考えています。
#Context Engine
#Prefill + Compress
#大量tokenをまとめて処理する。
#長いPrompt
#Retrieval結果
#multimodal input
#Fast Weight生成
#Context distillation
#ここでは大型GEMMが使えるため、
#GPUTPUCustom ASICHBM
#が強い。
#PrefillとCompressは性質がかなり近いため、初期には同一poolで処理する可能性が高いでしょう。
#Generation / Learning Engine
#Decode + Fast Update
#ここでは、
#1 tokenずつDecode
#recent KV
#Fast Weight read/write
#small gradient
#low-latency update
#を行います。
#これは巨大Tensor Coreより、
#大容量SRAM高bandwidth SRAMSmart HBM細粒度compute
#が重要になります。
#Cerebras WSE-3は44GBのon-chip SRAMと21PB/sのSRAM bandwidthを持っています。AWSはTrainiumでPrefillし、WSEでDecodeする構造をすでに発表しています。(Cerebras)
#TTTがsmall frequent update型になれば、
#へ進化する余地があります。
#Consolidation Engine
#Fast Updateは、
#「今覚える」
#ための処理です。
#Consolidationは、
#「それを長期的に残すべきか検証し、Slow Weightsへ統合する」
#処理です。
#大量の経験をReplayし、
#deduplication
#validation
#large batch Forward
#Backward
#weight merge
#LoRA merge
#checkpoint
#rollback testing
#を行います。
#したがってこれは再び、
#GPU / TPU / Training ASIC+大量HBM
#が得意です。
#Decodeのような10ms latencyは必要ありません。
#夜間、安い電力時間、遠隔AIDCでまとめて処理することもできます。
#11.現在のPrefill/Decode分離は、その前兆に見える
#2026年時点ですでに、
#AWS Trainium → PrefillCerebras → Decode
#という実システムが登場しています。(Cerebras)
#AMD/Cerebrasも、
#AMD Helios → 高throughputCerebras WSE → ultra-low latency
#へ分けています。(Cerebras)
#NVIDIA Dynamoも独立worker poolです。(NVIDIA Docs)
#つまり将来、
#と分かれることは、現在のarchitectureからそれほど遠い飛躍ではありません。
#12.そしてメモリ側も同じように分業する
#この三つに最適なmemoryは違います。
#したがって未来のAI memory hierarchyは、
#になります。
#13.3D NANDはすでに次の段階へ入っている
#SamsungはFMS 2026で400層超のV10 BV-NANDを公開し、wafer bonding architectureによってV9比約58%のmemory density向上を示しています。(Samsung Semiconductor Global)
#さらにzNAND-Oでは4層・8層のNAND dieを3D package化し、
#latency 3µs未満
#bandwidth 200~400GB/s
#を狙っています。(Samsung Semiconductor Global)
#これは単なるSSDではありません。
#将来、
#inactive expertslarge read-heavy model weightsold Fast WeightsKV snapshots
#を置くnear-memory storage層になります。
#14.HBFはHBMとSSDの間へ入る
#SK hynixとSandiskは2026年8月、HBFの最初のOCP標準仕様を公開しました。
#最大512GB、bandwidthは約0.4~3.0TB/s、UCIe接続です。(SK hynix Newsroom)
#これは、
#HBMほど高価ではないSSDよりはるかに高速
#という中間層です。
#TTT時代には、
#active Fast Weight → SRAM/HBMconsolidated dormant skill → HBFraw experience → NAND
#という階層が成立しやすい。
#15.3D DRAMは2030年より「2032~35年」が本番
#東京エレクトロンのDRAM roadmapでは、4F² Vertical Channel Transistorから3D DRAMへ移る時期が2030年代前半に置かれており、3D構造のHVMは2032年前後から本格化する形です。(Tel)
#したがって2030年時点では、
#「3D DRAMが大量供給されてDRAM不足を解消した」
#と置くべきではありません。
#2030~32:
#pilot / early HVM
#2033~35:
#本格量産
#程度が中心ケースです。
#16.3D SRAMと3D Logic
#さらに上の階層ではSRAMとlogicが近づきます。
#HuaweiのLogicFoldingは2026年Kirinで、1.5µm hybrid-bond pitchを用いて上下のactive logic tierへ回路を分割しました。
#Huaweiの測定では、
#transistor density 155 → 238MTr/mm²
#約55%向上
#representative core wire length 約30%短縮
#SRAM frequency 40%以上向上
#とされています。Huawei自身のpreprint測定なので第三者検証は必要ですが、実際にKirin 9050 Proへ商用投入されています。(ChinaRxiv)
#HuaweiのroadmapではLogicFoldingをAscend AI acceleratorへ2030年前後から展開する方向も示されています。(TrendForce)
#つまり、
#3D Logicは2030年以降、AIDCへ入ってくる可能性が十分ある。
#17.HBM Logic Base Dieも「小さなアクセラレータ」になる
#HBM4ではすでに変化が始まっています。
#Samsung HBM4は4nm Logic Base Dieを採用して量産されています。(Samsung Global Newsroom)
#Samsung Foundryはcustom HBMについて、memory controllerだけでなくacceleratorやCPU機能もbase dieへ統合可能と説明しています。(Samsung Semiconductor Global)
#SK hynixもcHBMのStream DQ Architectureでpre-processingをbase dieへoffloadし、最大inference throughputを約7倍改善できると説明しています。(SK hynix Newsroom)
#つまり、
#になり始めています。
#18.2030年代は「何Hi積むか」だけの競争ではなくなる
#現在HBMは、
#8Hi12Hi16Hi20Hi
#方向へ進んでいます。
#しかし積層数が増えるほど、
#thin die
#bonding
#warpage
#thermal
#test
#aggregate yield
#が難しくなります。
#しかもHBMはすでにDRAM waferを大量消費します。
#TrendForceは2027年に、HBMが上位3社のDRAM wafer inputの約30%を使う一方、DRAM bit supplyに占めるHBMは約13%と予測しています。(TrendForce)
#つまりHBM 1bitは通常DRAMよりはるかに高いwafer resourceを必要とします。
#このため、
#Hiをさらに上げる
#だけでなく、
#KVをFast Weight化して必要容量を減らすSRAMを増やすLogic Base Dieを賢くするHBFへcold stateを逃がす
#という方向が合理的になります。
#19.2026→2030→2035のDRAM需要を再計算する
#ここからは本稿独自の中心シナリオです。
#2026を約45.8EBの年間DRAM需要として正規化し、
#Agentic AI
#HBM
#server DRAM
#PC
#Smartphone
#Automotive
#Physical AI
#MEC
#TTT
#を加えます。
#結果は、
#です。
#必要CAGRは、
#2026→30:
#2030→35:
#です。
#20.TTTはHBMを減らすのに、総HBM需要は減らない可能性
#2035 baselineでAIDC HBMを42.3EBとします。
#本稿の中心TTTケースでは、
#KV compression:
#3D SRAM offload:
#Fast Update / Gradient state:
#AI低価格化・Agent増加のJevons効果:
#です。
#ネットでは、
#となります。
#つまり、
#1 taskあたりHBM容量は大幅に減っても、世界全体のHBM bit需要はむしろ増える
#という結果です。
#21.むしろServer DRAMが大きく増える
#TTT/Agentで増えるのは、
#inactive adapters
#warm KV
#replay data
#personal state
#VM state
#Consolidation staging
#です。
#これらはHBMほどhotではないが、NANDほどcoldでもない。
#したがってServer DRAM/CXLが大きく伸びます。
#2035中心ケースでは約80EB。
#これはHBM44.8EBより大きい。
#2030年代のmemory投資では、
#HBMだけを見ると全体を見失う
#可能性があります。
#22.DRAMの製造能力は足りるか
#本稿では2030のDRAM fab能力を約3.65M 300mm wafers/month、2035を5.5M WPMの中心ケースと置きます。
#2030の通常node改善後の生産性を約25.7EB / 1M WPMとすると、
#需要98.2EBに対して約4.5%不足。
#まだ増産で対応可能な範囲です。
#23.2035は3D DRAMの歩留まり次第
#2035を5.5M WPMとし、通常node改善後を29.4EB/MWPMとします。
#3D DRAMによるindustry-wideのyield-adjusted bit productivityを変えると、
#です。
#つまり3D DRAMが非常にうまく立ち上がれば、5.5M WPMでもほぼ足ります。
#歩留まりが伸びなければ、巨大DRAM fabをさらに複数建設する必要があります。
#2030年代の核心指標は、
#より、
#になるでしょう。
#24.NAND需要
#本稿の中心ケースでは、
#2026:
#2030:
#2035:
#程度まで増えると置きます。
#必要CAGRは、
#2026→30:約22.4%
#2030→35:約17.6%
#です。
#NANDはlayer増加によってbit/waferをDRAMより増やしやすいため、通常QLC/TLCは比較的供給対応しやすい。
#実際TrendForceも2027年後半から通常NAND全体の需給は緩む可能性を見ています。(TrendForce)
#しかしSLC NANDは逆で、AI edge、自動車、networking需要により2026年後半に契約価格+120~170%が予測されています。(TrendForce)
#したがって、
#Bulk NANDは余るHot NAND / HBF / zNANDは不足
#という二重市場になる可能性があります。
#25.ロジック製造能力も再計算する
#ここからが2030年代に新しく加わる制約です。
#本稿のleading-edge logic wafer需要モデルでは、
#2026:
#約0.247M WPM
#2030:
#約0.444M WPM
#2035:
#約1.055M WPM
#です。
#2026→30 CAGR:
#約15.8%
#2030→35:
#約18.9%
#となります。
#3D logicを使わないbaselineに対し、
#2030では約+8%
#2035では約+25%
#程度の追加leading-edge wafer需要を想定しています。
#26.HBM Logic Base Dieが意外に大きい
#2035に、
#90M accelerator/year12 HBM stacks/accelerator80mm²-class Logic Base Die
#という中心ケースなら、
#Logic Base Dieだけで約176K WPM相当まで行き得ます。
#つまりleading-edge logic demand約1.055M WPMの、
#がHBM Base Dieです。
#もしHi競争が頭打ちして16Hi→8Hiとなり、同じ容量のためstack数が倍になれば、
#方向になります。
#TTTで必要HBM容量を30%削っても約249K WPM。
#つまり、
#DRAM dieは減るLogic Base Dieは増える
#という構造まであり得ます。
#27.Advanced Packagingはさらに速く増える
#2026のAI accelerator package処理量を1とします。
#本稿の中心ケースでは、
#2030:
#2035:
#までadvanced packaging area workloadが増える可能性があります。
#TSMC自身も2028年に14-reticle CoWoSで約10個の大型compute dieと20 HBM stacksを統合し、2029年には14 reticle超へ拡大するroadmapを示しています。(TSMC)
#つまり「GPU台数」以上に、
#が増えます。
#28.Hybrid Bondingは製造業の新しいボトルネックになる
#2030年代には、
#HBM3D DRAMLogicFolding3D SRAMCPO
#が同時にHybrid Bondingを使い始めます。
#中心ケースでD2W bonding workloadを装置throughput換算すると、
#2030:
#約82台のBesi-class tool-equivalent
#2035:
#約564台。
#maintenance marginとCPO/CPU/その他3D integrationを含めると、
#程度。
#Stress caseでは1,300~1,600台equivalentまで行き得ます。
#一方3D DRAMのW2W bondingは中心ケース2035で約151台のEVG-class throughput-equivalent、余裕を含めれば200~250台級です。
#これは実際にBesi/EVGがその台数を出すという予測ではなく、現在の装置throughputに換算したmanufacturing workloadです。
#29.材料需要も「微細化」から「接合」へ広がる
#この場合増えるのは、
#高純度Cu
#Cu hybrid-bond pad
#CMP slurry
#wafer clean chemistry
#dielectric
#temporary bonding/debond material
#thermal interface material
#advanced substrate
#glass / T-glass
#optical coupling material
#InP substrate
#SiPh wafer
#です。
#2035中心ケースでprocess workloadを2026=1と置けば、本稿では、
#程度の処理量増加を中心ケースに置きます。
#ここでの30~45倍は「Cu使用重量が45倍」という意味ではなく、hybrid-bond interface処理workloadの指数です。
#30.Testが非常に重要になる
#HBMを単純die数で見ると、
#2026:
#約1.8B DRAM dies
#2030:
#約3.8B
#2035:
#約10.8B
#という規模まで行き得ます。
#さらに、
#I/O数Hi数Logic Base DieHybrid BondCPO
#が複雑になります。
#したがってKnown-Good-Die testing、pre-bond test、post-bond testの重要性が急増します。
#2035には、HBM test workloadが2026比15~25倍まで増えるシナリオも十分考えられます。
#3D化では「歩留まり問題をtestによって早期発見する能力」そのものが製造能力になります。
#31.Physical AIがこの需要へさらに加わる
#Local AIはスマホ・PCだけではありません。
#2030年代には、
#自動車
#humanoid
#industrial robot
#autonomous mobile robot
#drone
#smart factory
#AI-RAN
#MEC
#もmemoryを消費します。
#しかもPhysical AIはCloudへ逃がしにくい。
#Emergency brakingやmotor controlは通信が切れたから止めるわけにはいきません。
#したがって、
#という特徴があります。
#2035中心ケースではAutomotive+Physical AI+MECだけで約24EBのDRAM需要を置いています。
#ここにLocal TTTが入れば、
#個体fast stateregional/fleet stateglobal state
#をそれぞれ持つため、同じskillが三階層に複製される可能性があります。
#32.最後の問題が「これをどう繋ぐか」
#Computeを分業すれば、
#PrefillDecodeUpdateConsolidation
#の間でstateを移動しなければなりません。
#現在NVIDIA Dynamoでも、Prefill→DecodeのKV transferにはRDMAが重要で、RDMAなしでは40倍のperformance degradationが生じ得るとしています。(NVIDIA Docs)
#TTTで40GB KVを2GB Fast Stateへ圧縮できるなら、Prefill→Decode転送量は20分の1方向へ縮小できます。
#これはComputeとMemoryだけでなく、Network architectureまで変える可能性があります。
#33.銅はなくならない
#NVIDIAは2026年にも明確に、
#「Copperが使える場所ではCopperを使う」
#という方針を示しています。
#理由は、
#安い
#reliabilityが高い
#optical conversion電力が不要
#だからです。
#一方、rackを越えると距離の問題でopticalが必要になると説明しています。(NVIDIA)
#UALink 200G 1.0も現在はcopperが基本で、repeaterなしでは数m程度を想定しています。(UALink Consortium)
#したがって当面は、
#です。
#34.しかしScale-UpもOpticalへ広がる
#NVIDIA NVLink 6はGPU当たり3.6TB/s、NVL72全体で260TB/sの帯域を持ちます。(NVIDIA)
#今後Scale-Up domainを複数rackへ広げると、Copperだけでは距離・SerDes powerが厳しくなります。
#NVIDIA自身、copper NVL72に加えてopticalでNVL576へ広げる構想を公開しています。(NVIDIA)
#UALinkも1,024 acceleratorsまでを対象とし、200G/laneを定義しています。(UALink Consortium)
#つまり2030年前後には、
#Rack内=Copper
#という境界は残りながら、
#複数rackのScale-Up=Optical
#が大きく伸びる可能性があります。
#35.CPOは2026年ですでに量産へ入った
#NVIDIA Spectrum-X Ethernet Photonicsは2026年にproductionへ入りました。(NVIDIA Newsroom)
#Broadcom Bailly CPOもvolume manufacturingへ入っています。TrendForceによればBroadcomの51.2T Baillyは従来pluggable比で最大70%のpower削減を掲げています。(TrendForce)
#TSMC COUPEも2026年からCPO production開始を予定し、pluggableとの比較で2倍のpower efficiency、10分の1のlatencyを掲げています。(TSMC)
#つまり光は2030年代の話ではなく、すでに量産移行が始まっています。
#36.Optical TAMはどこまで行くか
#2026年のAI向けoptical transceiver市場は約260億ドルとTrendForceは予測しています。(TrendForce)
#2030年についてTrendForceは、
#CPO/NPO:390億ドル超Pluggable:ほぼ260億ドル
#を予測しています。(TrendForce)
#単純合計すると、
#です。
#LightCountingはより強気で、条件が揃えば2030年のAI cluster optical interconnect市場が年間1,000億ドルへ到達する可能性さえ指摘しています。(LightCounting)
#本稿では、
#と置きます。
#*2035は本稿独自推計。
#2026→30のbase CAGRは、
#です。
#37.PluggableはCPOに全部置換されない
#2030にCPO/NPOが390億ドルを超えても、Pluggableも約260億ドル残るとTrendForceは見ています。(TrendForce)
#理由は、
#serviceability
#multi-vendor flexibility
#replacement
#cost
#yield
#reach
#です。
#したがって未来は、
#PluggableLPONPOCPOOptical I/O
#が共存します。
#38.Silicon PhotonicsとInPは競合ではなく補完
#SiPhは、
#modulator
#waveguide
#multiplexer
#photodetector integration
#に向きます。
#しかしSilicon自体は効率のよいlaserを作りにくい。
#そこでInPのCW-DFB laserを外部光源として使います。
#TrendForceは2026年時点でInP substrate供給がtightであり、CSP各社がlaser、photodetector、InP capacityを戦略資産として確保していると報告しています。(TrendForce)
#2026年のEML+CW-DFB laser生産能力は合計約5,070万個/月、年間換算約6.08億個まで増強される見通しです。(TrendForce)
#39.EML・CW-DFB・SiPhの役割
#EML
#laser+electro-absorption modulator。
#高信号品質で、特に800G以上や2km超の用途に強い。
#TrendForceではLumentum、Broadcom、Mitsubishi ElectricがEML市場の約72%を占めるとしています。(TrendForce)
#CW-DFB
#CPO/SiPhへ連続光を供給するexternal laser。
#CPOが増えるほど重要になります。
#Silicon Photonics
#laser以外の光回路を大規模CMOS processへ統合できる。
#CPO/NPOの中心platformです。
#40.2030 Optical Value Poolを分解してみる
#ここは各categoryが重複するので、合計してはいけません。
#最終module/system市場を650億ドルとした場合の、本稿のsupply-chain value pool推計です。
#これは独立した市場を単純加算したものではなく、同じoptical module内部に含まれるvalue layerです。
#2035 base TAMを1,200億ドルまで伸ばすと、
#SiPh value pool:
#InP laser/device:
#InP substrate/epi:
#程度まで拡大する可能性があります。
#特にCPO化するとEMLの比率は相対的に下がり、CW-DFB external laser+SiPh側へ価値が移る可能性があります。
#41.Optical I/Oまで行くとPackage境界そのものが消える
#Ayar Labs TeraPHYは8Tbps bi-directionalのoptical I/O chipletを掲げ、mmからkmまでのpackage-to-package接続を狙っています。(Ayar Labs)
#Lightmatterも6.4Tbps/方向のNPO/OBO optical engineを2026年に発表しています。(Lightmatter®)
#つまり将来、
#GPU↓ electricalCPO switch
#だけではなく、
#Compute Die│Optical I/O Chiplet│──────── Fiber ────────│Decode / Memory Die
#まで可能になります。
#これはPrefill/CompressとDecode/Fast Updateを別rackへ分けるTTT architectureと非常に相性がいい。
#42.ただしFast Updateだけは遠くへ置きにくい
#例えば2GB Fast Stateを100GB/s networkで送ると、
#です。
#64 tokenごとにupdateするなら、network overheadが大きすぎる。
#したがって、
#Fast UpdateはDecodeの隣
#に置く必要があります。
#一方Consolidationは数分~数時間単位なので遠隔AIDCでもよい。
#したがって物理配置は、
#Prefill / CompressGPU / ASIC / HBM││ Optical▼Decode + Fast UpdateSRAM-heavy││ Async transfer▼ConsolidationTraining ASIC / HBM
#が合理的です。
#43.2030~35年に何が「減る」のか
#今回の構造変化では、すべてが増えるわけではありません。
#減る可能性があるのは、
#1 taskあたりKV/HBM capacity
#長距離electrical SerDes
#光への移行で減少。
#High-Hi HBMの絶対必要性
#TTT+SRAM+HBFが効けば16/20Hi一辺倒ではなくなる。
#Decode用巨大Batchへの依存
#SRAM-heavy low-latency acceleratorが普及すれば一部低下。
#DSP-heavy pluggableのシェア
#LPO/NPO/CPOへ移行。
#44.逆に大きく増えるもの
#SRAM
#TTT Fast WeightとDecode state。
#HBM write bandwidth
#Read中心からRead-Modify-Writeへ。
#Server DRAM
#Agent stateとConsolidation staging。
#NAND
#Raw history、Replay、checkpoint。
#Logic Base Die
#HBMがactive memoryになる。
#Hybrid Bonding
#Memory/Logic/Optics全部で使用。
#Test
#KGD、pre/post bond。
#Advanced Packaging
#異種accelerator分業によりchiplet数増加。
#Optics
#複数rackでのScale-Upまで光化。
#45.2026~30と2030~35では、ボトルネックそのものが変わる
#2026~2030
#主な不足は、
#HBM / DRAM waferCoWoS / EMIBadvanced logicoptical transceiver
#です。
#ここではまだ従来型のAI infrastructure shortageの延長です。
#2030~2035
#不足対象が、
#3D DRAM yieldHBM Logic Base Die3D SRAMHybrid BondingCMP / CleaningAdvanced PackagingKGD TestCPO packagingInP laserSiPhOptical coupling
#へ分散します。
#つまり、
#へ変化する可能性があります。
#46.最終的には「計算」と「記憶」の境界が曖昧になる
#現在のコンピューターは、
#と明確に分かれています。
#しかしTTTと3D化を組み合わせると、
#Compute Logic────────────3D SRAMFast Weights────────────HBM LogicKV / Compression / PIM────────────3D DRAMActive State────────────HBF / zNANDWarm State────────────3D NANDExperience
#となります。
#Samsungが2026年に示したzHBMも、HBMをAI acceleratorの上へ直接3D stackし、Hybrid Copper Bondingを使ってlogicとmemoryの距離そのものを縮める構想です。SamsungはconceptとしてHBM5比最大8倍のinterface performance、10倍超のmemory density、3倍のenergy efficiencyを掲げています。(Samsung Global Newsroom)
#これが量産可能になるかどうかは別として、向かっている方向は明確です。
#47.AI architectureは「何を記憶し、何を再計算するか」の競争になる
#従来は、
#全部HBMに入れる
#ことが最も速かった。
#しかしHBMは高価で、電力もwafer resourceも大量に消費します。
#そこで将来は、
#exactでhot → SRAM/KVsemanticでhot → Fast Weightswarm → DRAM/HBFcold → NAND必要になったら再計算
#という構造になる。
#つまり、
#ようになります。
#ただし総Memory需要が減るとは限らない。
#安くなったAIをより多く使うからです。
#終わりに――「HBMを何Hi積むか」の次に来る競争
#2020年代前半のAI半導体は、
#という比較的単純な競争でした。
#ところが2030年代へ向かうと、
#へcomputeが分業し、それぞれに、
#が割り当てられる可能性があります。
#さらにそれを、
#が接続する。
#この世界では、HBMを16Hiから20Hiへ伸ばせたかどうかだけでAI半導体の性能を判断することはできません。
#見るべき指標は、
#KV / Fast Weight比率SRAM / Compute比率HBM GB / useful tokenHBM bandwidth / ComputeLogic Base Dieの機能3D DRAM yield-adjusted bits/waferHybrid Bond pitchとyieldKGD/Test throughputCopper/Optical境界CPO/NPO penetration
#へ変わっていきます。
#TTTが本当に長期記憶として成立するかはまだ研究段階です。
#しかし、PrefillとDecodeがすでに異なるhardwareへ分かれ始め、HBMはlogicを持ち始め、SRAM-heavy Decode acceleratorが実際にCloudへ入り、HBFという新しいmemory tierが標準化され、3D DRAM・3D Logic・CPOが同時にロードマップへ現れ始めている。
#これらを別々の現象として見るより、
#「計算と記憶を、最も効率のよい場所へ再配置する大規模なarchitecture転換」
#として見る方が、2030年代の半導体産業を理解しやすいのではないかと思います。
#そしてその場合、次のAIインフラ不足は単純なHBM不足ではありません。
#ロジック、メモリ、ストレージ、光を三次元で接続し、それを高歩留まりで量産できる能力そのものが、次の希少資源になる可能性があります。
#投資助言を目的とするものではありません。投資判断はご自身の責任でお願いいたします。
#