HBMは本当に「最も高価なメモリー」なのか
この資料の日時
元資料の日付と、その本文が公に存在した確認日時は別の記録です。
本文に含まれる語句 HBM DRAM SRAM 帯域・データ移動 先端パッケージング 電力・給電 歩留まり 基板・材料 チップレット AI推論
出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.09.23.4
- 記事内容のSHA-256
82267812cd645440cf6844e752cb5314401180f843ef948c50389675c7cf8a64- 保存版のSHA-256
5b62a358dcf00ff1ec3f48593a488d2d7f76f3b5ab8a8cee6d5d653ac7f22800
外部証明の最終検査結果は詳細を開くと表示します。
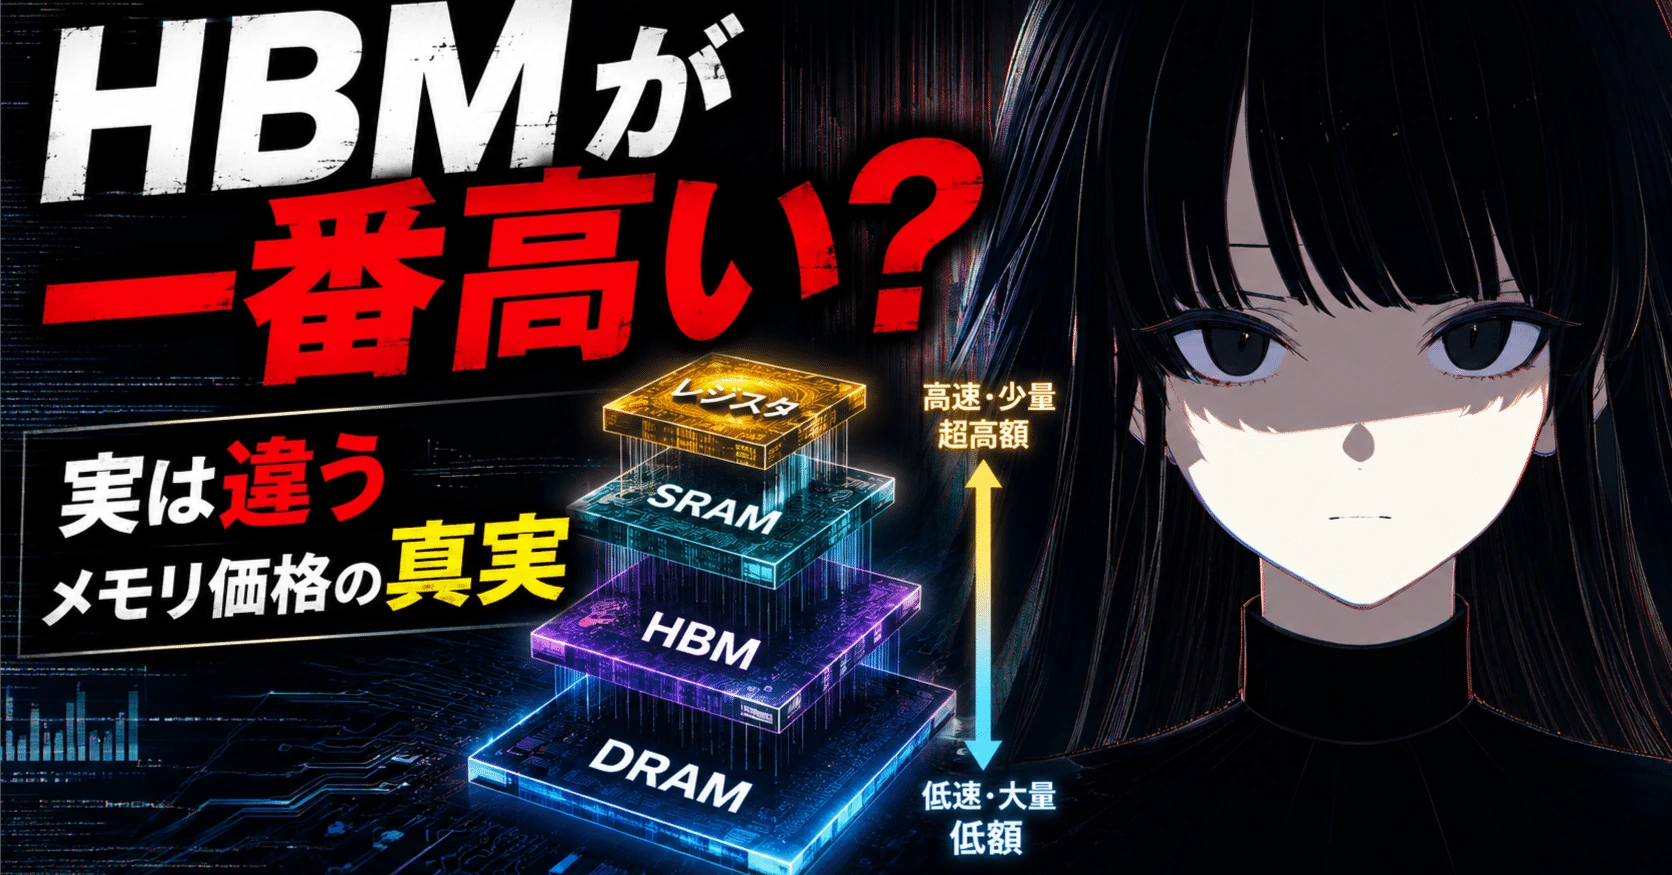
HBMは本当に「最も高価なメモリー」なのか
#レジスタ・SRAM・HBM・DRAMを、1bit当たりと製品総額の両方から比較する
#AI半導体の価格を見ていると、HBMは特別に高価なメモリーに見える。
#実際、AIアクセラレーターには数十GBから数百GBのHBMが搭載され、複数のDRAMダイ、TSV、ベースダイ、先端パッケージまで必要になる。GPUの部品コストの中でも、HBMは非常に大きな割合を占める。
#しかし、同じ1GBを保存する費用で比べると、最も高価なのはHBMではない。
#大まかな順番は次のようになる。
#レジスタ > オンチップSRAM > HBM > DDR・LPDDR > NAND#
意外に見える理由は、「部品一式の価格」と「1bit当たりの価格」を混同しやすいからである。
##
1.「高価」には三つの意味がある
#メモリー価格を比較するときは、最低でも次の三つを分けなければならない。
#1bit・1GB当たりの価格
#同じ容量を保存するために、どれだけのシリコンと費用が必要かという比較である。
#この基準では、トランジスタを大量に使うレジスタとSRAMが圧倒的に高い。
#部品一個当たりの価格
#HBMは1スタックで24GB、36GBなどの大容量を持つ。複数スタックをGPUの周囲へ搭載するため、部品一式では数千ドル規模になりやすい。
#システム全体に与える費用
#オンチップSRAMを増やすと、GPUやASICのダイ面積が拡大し、ウェハーから取れるチップ数と歩留まりが悪化する。独立した部品代としては見えなくても、AIチップそのものの原価を大きく押し上げる。
#つまり、
#HBMは請求書上で目立つ。SRAMとレジスタはロジックダイの内部に隠れている。#
という違いがある。
##
2.実際の価格を並べる
#価格は世代、顧客、契約時期、数量によって大きく変わる。特にHBMの契約価格と、オンチップSRAM・レジスタの原価は公開されない。
#そこで、公開されているBOM推計、契約価格、セル面積、ウェハー価格を使って、おおよその範囲を比較する。
#| メモリー | 1GB当たりの概算 | 数字の性質 |
| レジスタファイル | 300~1,000ドル超相当 | 面積から推定。実際に1GB作るのは非現実的 |
| オンチップSRAM | 100~300ドル相当 | 先端ロジック上のシリコン・歩留まり価値 |
| HBM3/HBM3E | 約14~20ドル | 公開BOM推計と価格動向 |
| DDR5/LPDDR | 約5~11ドル | 大口契約・部品価格の例 |
| NANDフラッシュ | DRAMより大幅に安い | TLC・QLC、世代、市況で変動 |この表のSRAMとレジスタは、市場で購入できる製品価格ではない。同じ1GBを先端ロジック上へ実装した場合の、等価的な製造コスト・機会費用である。
##
3.HBMの実価格はどれくらいか
#SemiAnalysisは、H100に使われる80GBのHBMについて、NVIDIAの調達費を約1,150ドルと推計していた。
#1GB当たりでは、
#1,150ドル ÷ 80GB = 約14.4ドル/GB
#となる。別の推計でもHBM3は約15ドル/GBとされていた。2026年にはHBM3Eの一部供給価格を約20%引き上げる動きも報じられているため、世代や契約によっては15~20ドル/GB程度、HBM4ではさらに高くなる可能性がある。(SemiAnalysis)
#MicronのHBM3Eは1スタック当たり24GBまたは36GBで、1.2TB/sを超える帯域を持つ。(Micron Technology)
#仮に1GB当たり15~20ドルとすると、
#| HBM構成 | HBM単体の概算 |
| 24GB | 約360~480ドル |
| 36GB | 約540~720ドル |
| 80GB | 約1,200~1,600ドル |
| 192GB | 約2,880~3,840ドル |
| 288GB | 約4,320~5,760ドル |実際には世代、選別グレード、ベースダイ、顧客契約、パッケージ費用が異なるため、これは単純な容量換算である。
#それでも、数百GBを搭載すれば、HBMの合計額が数千ドルになる理由は分かる。
##
HBMは通常DRAMより何倍高いのか
#通常時のHBMは、一般的なDDR5より1GB当たり数倍高い。
#SemiAnalysisは、HBMを標準DDR5の3倍以上、LPDDRをHBMの約5分の1のコストと説明している。(SemiAnalysis)
#ただし2025年後半から2026年にかけては、通常DRAMの供給不足が極端に進んだ。
#TrendForceはDDR5の価格例として0.65ドル/Gbを示している。1バイトは8bitなので、
#0.65ドル × 8 = 5.20ドル/GB
#となる。(TrendForce)
#さらにSemiAnalysisの2026年システム原価モデルでは、LPDDRの大口調達価格が約6.77~10.63ドル/GBとされている。(SemiAnalysis)
#現在はDRAM価格が急騰したため、特定の契約ではDDR・LPDDRとHBMの価格差がかなり縮小している。これは恒久的な技術コストの逆転というより、供給不足による市況の影響である。
##
4.SRAMを1GB作ると、どれだけ大きくなるのか
#TSMCが公表した5nm高密度SRAMセルは、1bit当たり0.021平方マイクロメートルである。(TSMC Research)
#1GBは約85.9億bitなので、セルだけでも、
#**85.9億bit × 0.021µm² = 約180mm²**
#を必要とする。
#しかし実際のSRAMには、
#- ワード線・ビット線
- デコーダー
- センスアンプ
- 書き込み回路
- ECC
- 冗長セル
- 電源回路
- クロック・制御回路
が必要になる。
#SRAMセル配列が全体の55~70%を占めると仮定すると、1GBのSRAMマクロ全体は、
#約258~328mm²
#になる。
#これは、SRAMだけで大型CPUやGPUに匹敵する面積を使うということである。
##
SRAMの1GB当たりコストを計算する
#業界推計では、TSMCのN5ウェハーはおよそ1万6,000~1万7,000ドルとされてきた。(SemiAnalysis)
#300mmウェハーの面積とエッジロスを考慮すると、258~328mm²のSRAMダイを作る場合、理想的なシリコン費用だけでも数十ドルになる。
#そこへ、
#- 欠陥による歩留まり低下
- テスト
- ダイ選別
- 設計費
- パッケージ
- 冗長領域
- 高速・多ポート化
を加えると、単純な高密度SRAMでも1GB当たり100~200ドル前後の等価コストになる。
#さらに、巨大なAIロジックダイの一部として実装する場合、SRAMが演算器を置ける面積を奪い、ダイ全体の歩留まりも悪化させる。その機会費用まで考えると、100~300ドル/GB程度と見るのが妥当な範囲になる。
#したがってHBMが15~20ドル/GBなら、オンチップSRAMは、同容量当たりでHBMの5~20倍程度高くなり得る。
##
5.なぜレジスタはSRAMよりさらに高価なのか
#一般的な高密度SRAMは、1bitを6トランジスタで保持する6Tセルを使う。
#レジスタにはフリップフロップや、高速な多ポート・レジスタファイルが使われる。TSMCが公表した5nmの2ポート・レジスタファイルの例では、1bit当たり16トランジスタのセルを使っている。(TSMC Research)
#単純なトランジスタ数だけでも、
#16T ÷ 6T = 約2.7倍
#である。
#実際にはレジスタファイルには、
#- 複数の読み出しポート
- 複数の書き込みポート
- バイパス回路
- 高速クロック配線
- 大電流のドライバー
- 多数の演算器へ向かう広い配線
が必要になる。
#そのため1bit当たりの面積は、通常のSRAMの2~5倍以上になることがある。
#SRAMの等価コストを100~300ドル/GBとすれば、レジスタファイルを1GB相当まで拡張した場合、
#数百ドルから1,000ドル/GBを超える#
可能性がある。
#ただし現実には、1GBのレジスタファイルは面積、電力、配線、ポート数の面で成立しにくい。そのためこの数字は製品価格ではなく、なぜレジスタを数十MB程度に抑える必要があるかを示す換算値である。
##
6.なぜHBMが一番高く見えるのか
#レジスタとSRAMは、GPUダイの価格に埋め込まれている。
#購入者が見る請求書には、
#GPUロジックダイ ○○ドル
HBM ○○ドル
先端パッケージ ○○ドルと表示されても、
#レジスタ ○○ドル
L2 SRAM ○○ドルとは表示されない。
#SRAMの費用は、GPUロジックダイの面積、歩留まり、ファウンドリー代として隠れている。
#一方HBMは、24GBや36GBのスタックを4個、6個、8個と搭載する。MicronのHBM3Eは24GBまたは36GB、HBM4も36GBの12層構成を持つ。(Micron Technology)
#そのため、1GB当たりではSRAMより安くても、搭載容量が数百倍大きいので総額ではHBMが最大になる。
##
7.SRAMを増やすと、AIチップの価格はどれくらい上がるか
#600mm²の大型AI ASICを例に考える。
#TSMC N5の高密度SRAMセルと、周辺回路を含む60%程度の配列効率を仮定すると、追加面積は概ね次のようになる。
#| 追加SRAM | 推定追加面積 |
| 64MB | 約19mm² |
| 128MB | 約38mm² |
| 256MB | 約75mm² |
| 512MB | 約150mm² |
| 1GB | 約300mm² |ウェハー価格を1万7,000ドル、欠陥密度を0.1個/cm²とした簡易的な歩留まりモデルでは、600mm²のダイ原価を基準として次のようになる。
#| 構成 | ダイ面積 | 良品ダイ原価の概算 | 基準からの上昇 |
| 元のASIC | 600mm² | 約342ドル | ― |
| +256MB SRAM | 675mm² | 約422ドル | 約24% |
| +512MB SRAM | 750mm² | 約515ドル | 約51% |
| +1GB SRAM | 900mm² | 約742ドル | 約117% |これは設計費、パッケージ、テスト、マージンを含まない説明用の試算である。実際の歩留まりは工程、設計、冗長性、欠陥密度によって大きく異なる。
#それでも、SRAMを1GB増やすだけで、ダイ面積は約50%増え、良品ロジックダイ原価が倍以上になる可能性があることが分かる。
##
8.それでもSRAMを増やす理由
#SRAMはDRAM容量を同じだけ置き換えるために使うのではない。
#例えば256MBのSRAMを追加しても、256GBのHBMやDRAMが不要になるわけではない。
#目的は、頻繁に使うデータを演算器の近くへ残し、
#- HBMから同じ重みを繰り返し読まない
- 中間結果を外部へ書き戻さない
- 行列演算のタイルを再利用する
- ホットなKVキャッシュを保持する
- 演算器の待ち時間を短くする
ことである。
#少量の高価なSRAMを追加
↓
HBMアクセス回数を削減
↓
必要帯域と消費電力を削減
↓
演算器の稼働率を向上例えばチップ原価が20%上昇しても、推論性能が30%向上し、必要なGPU台数を減らせるなら、データセンター全体では安くなる可能性がある。
#ここでは「GB当たりの安さ」ではなく、1ドル当たり何トークン処理できるかが重要になる。
##
9.3D積層SRAMなら安くなるのか
#SRAMをロジックダイ上へ直接増設すると、計算ダイ全体が大型化し、歩留まりが悪化する。
#そこで、
#上層:SRAMキャッシュダイ
↕
下層:演算ロジックダイという3D積層が検討される。
#別の小型SRAMダイとして製造すれば、巨大な演算ダイをさらに拡大する必要はない。
#しかし、
#- SRAMダイの製造費
- ハイブリッドボンディング
- Known Good Dieの選別
- 積層後テスト
- 熱設計
- パッケージ歩留まり
が追加される。
#3D積層はSRAMをHBM並みに安くする技術ではない。巨大な単一ダイにSRAMを追加するより、経済的に容量を増やしやすくする技術である。
#SRAMのスケーリングは5nm以降停滞しており、3nmや2nmへ移ってもロジックほど面積が縮まらないことが、積層化を促す一因になっている。(SemiAnalysis)
##
10.最終的な価格序列
#同じ1GBを実装するなら
#レジスタ > SRAM > HBM > DDR・LPDDR > NAND#
AIチップ一個の部品総額なら
#大容量・複数搭載のHBMが最大になりやすい#
ダイ面積への負担なら
#SRAMとレジスタが非常に重い#
保存容量を増やすなら
#HBMよりDRAM、さらにNANDの方が安い#
これを住宅に例えるなら、
#- レジスタ:演算器の真横にある専用の机
- SRAM:都心の個室
- HBM:高速エレベーター付きの高級高層住宅
- DDR:郊外の大規模集合住宅
- NAND:巨大な保管倉庫
となる。
#高級高層住宅であるHBMは、建物一棟では非常に高い。しかし1人当たりの床面積では、演算器の横を一人で占有するレジスタの方が高価である。
##
まとめ
#HBMが高価であること自体は間違いではない。
#ただし、正確には、
#**HBMは「大容量部品として総額が高い」。 レジスタとSRAMは「1bit当たりのシリコンコストが高い」。**#
という違いである。
#AIチップがSRAMだけでもHBMだけでも成立しないのは、この価格と性能の差があるからだ。
#今計算している値 → レジスタ
何度も再利用する値 → SRAM
モデル全体・Active KV → HBM
退避・大容量作業領域 → DDR・LPDDR
保存データ → NAND性能だけを考えれば、すべてをレジスタやSRAMに置きたい。しかし、それではダイが巨大化し、コストと歩留まりが破綻する。
#容量だけを考えれば、すべてをNANDに置きたい。しかし、それでは演算器がデータを待ち続ける。
#AI半導体の設計とは、速くて高価な上位メモリーをどこまで増やし、安くて大容量な下位メモリーへ何を逃がすかを決める作業である。
##
SRAMとHBMの総容量で価格比較
#AI ASICは、GPUよりSRAMを多めに配分しやすいです。特に低遅延推論、推薦、エッジ処理など、処理内容が決まっているASICでは、再利用するデータをオンチップSRAMへ明示的に置き、HBMやDRAMへのアクセスを減らせます。
#ただし、学習用TPUや大規模生成AI向けASICは大量のHBMも必要です。したがって、
#- SRAM重視ASIC:Meta MTIA、Groq LPU型
- HBM重視ASIC:Google TPU型
- SRAM+HBM併用型:多くの大規模AI ASIC
に分かれます。
#価格は1bit当たりではSRAMがHBMの約9~31倍高いと試算できます。一方、1ラックではHBM容量がSRAMの数百倍になるため、HBMの総額がSRAMの約25~83倍になるケースがあります。
##
1.なぜAI ASICはSRAMを多めにしやすいのか
#GPUはさまざまなモデルや計算へ対応する汎用アクセラレーターです。そのため、モデル全体やKVキャッシュを大容量HBMへ置き、ハードウェアキャッシュで必要な部分を取り込みます。
#ASICは用途を限定できるので、
#- どのデータを何回再利用するか
- 演算する順番
- 必要なバッファ容量
- チップ間通信のタイミング
を設計時に決められます。
#そのため、頻繁に使う重み、活性値、中間結果、KVキャッシュの一部をSRAMへ固定しやすくなります。
#Metaは次世代MTIAについて、一般的なGPUより相対的に大きなSRAMを持たせることで、小さいバッチサイズでも高い稼働率を実現すると説明しています。同チップは256MBのオンチップSRAMと128GBのLPDDR5を搭載し、最大72個を1ラックに収容します。(AI Meta)
#Groq系LPUはさらに極端で、1チップ当たり500MBのSRAMを主要な作業領域として使います。8チップのLPXトレイでは合計4GBのオンチップSRAMと1.2PB/sのSRAM帯域を持ちます。(NVIDIA Developer)
#一方、Google TPU7xは1チップ当たり192GBのHBMを搭載します。これはASICだから必ずSRAM中心になるわけではなく、大規模モデル向けではHBMが引き続き中心になることを示しています。(Google Cloud Documentation)
##
2.今回の価格計算で使う前提
#SRAMには、HBMのような「1GBいくら」という市場価格がありません。AI ASICのロジックダイ内部へ埋め込まれているためです。
#そこで、SRAMはSRAMを追加したことで増える良品ダイ原価として計算します。
#SRAMの計算前提
#TSMCの5nm高密度SRAMセルは、1bit当たり0.021µm²です。(TSMC Research)
#256MBの場合、
#- 容量:20.48億bit
- セルだけの面積:約43mm²
- 周辺回路を含む推定面積:約61~78mm²
となります。
#ここに、
#- N5ウェハー価格:1枚1万6500~1万8500ドル
- SRAM配列効率:55~70%
- 欠陥密度:0.08~0.12個/cm²
- Meta MTIAの実ダイ面積:421mm²
を当てはめました。N5ウェハー価格は公開契約価格ではありませんが、SemiAnalysisは約1万6500ドルとの推計を示しており、最近の市場推計では1万8500ドル前後です。(SemiAnalysis)
#このモデルでは、256MBのSRAMを組み込む増分原価は約34~62ドルです。
#したがって、
#組み込みSRAM:約135~245ドル/GB#
と推定します。
#これは設計費、メーカー利益、完成パッケージ費を除いた、製造原価に近い等価値です。
##
HBMの計算前提
#HBM価格は顧客、世代、選別、契約量で変わり、正式価格は非公開です。
#公開推計では、
#- HBM3:約15ドル/GB
- 80GBのH100向けHBM:約1150ドル
- 2026年の36GB HBM3E:約300ドル前後、約8.3ドル/GB
といった値があります。2026年分については約20%の価格引き上げ報道もあります。(SemiAnalysis)
#契約差を考慮し、今回は、
#HBM:約8~15ドル/GB#
として計算します。
#この価格は主にHBMスタック自体で、インターポーザーや先端パッケージ費用は含めません。
##
3.1bit当たりの価格比較
#メモリー推定価格/GB推定価格/GbitオンチップSRAM135~245ドル16.9~30.6ドルHBM8~15ドル1.0~1.88ドル
#したがって同じ容量を保存する場合、
#SRAMはHBMの約9~31倍/bit高い#
と推定できます。
#中央値で比較すると、
#- SRAM:約185ドル/GB
- HBM:約11.5ドル/GB
なので、
#185 ÷ 11.5 ≒ 16倍
#です。
#SRAMが高い理由は、HBMが高密度なDRAMセルを専用メモリー工程で作るのに対し、SRAMは先端ロジック工程上で6個前後のトランジスタを1bitごとに使用するためです。
##
4.1ラックで比較する
#異なる製品を公平に比較するため、72個のAIアクセラレーターを搭載するラックに統一します。
#SRAM容量にはMeta MTIAの256MB/チップ、HBM容量にはGoogle TPU7xの192GB/チップを使います。
#これは実在する単一製品の構成ではなく、SRAMとHBMの容量・費用差を示すための標準化シナリオです。
#容量
#SRAM
#72個 × 256MB = 18.432GB
#HBM
#72個 × 192GB = 13,824GB=約13.8TB
#HBM容量はSRAM容量の、
#13,824 ÷ 18.432=750倍
#です。
##
5.1ラック当たりのSRAMコスト
#SRAMを135~245ドル/GBとすると、
#下限
#18.432GB × 135ドル = 約2488ドル
#上限
#18.432GB × 245ドル = 約4516ドル
#したがって、72チップ分のオンチップSRAM増分原価は、
#約2500~4500ドル/ラック#
です。
#1ドル150円で単純換算すると、約37万~68万円です。
#これはSRAM部分だけの製造原価相当であり、AI ASIC全体の価格ではありません。
##
6.1ラック当たりのHBMコスト
#HBMを8~15ドル/GBとすると、
#下限
#13,824GB × 8ドル = 11万592ドル
#上限
#13,824GB × 15ドル = 20万7360ドル
#したがって、
#約11万~20.7万ドル/ラック#
です。
#1ドル150円なら、約1660万~3110万円となります。
#さらに実際のHBMシステムでは、
#- シリコンインターポーザー
- ベースダイ
- CoWoSなどの先端パッケージ
- 実装・テスト
- パッケージ歩留まり
が加わります。
#そのため完成アクセラレーター内でのHBM関連費用は、ここで示した数字より高くなります。
##
7.1ラックで見ると、HBMはSRAMの何倍高いのか
#項目SRAMHBM1チップ容量256MB192GB72チップ合計18.4GB13.8TB容量比1750価格/GB135~245ドル8~15ドルラック総額約2500~4500ドル約11万~20.7万ドル
#組み合わせによって変わりますが、HBM総額はSRAM総額の、
#約25~83倍#
です。
#中央値では、
#- SRAM:約3410ドル
- HBM:約15万9000ドル
となり、
#HBM総額はSRAM総額の約47倍#
です。
#つまり、
#- 1bit当たり:SRAMが約16倍高い
- 1ラック総額:HBMが約47倍高い
という逆転が起きます。
#理由は、HBMをSRAMの約750倍も搭載するからです。
##
8.さらにSRAMが多いGroq型の場合
#Groq 3 LPUは1チップ当たり500MBのSRAMを持ちます。(NVIDIA Developer)
#72チップへ換算すると、
#72 × 500MB = 36GB SRAM
#です。
#SRAM費用は、
#- 下限:36GB × 135ドル=約4860ドル
- 上限:36GB × 245ドル=約8820ドル
となります。
#同じ72チップに192GBずつHBMを搭載した場合と比べると、HBM総額はSRAM総額の約13~43倍です。
#72チップ構成容量推定費用Groq型SRAM36GB約4900~8800ドルTPU型HBM13.8TB約11万~20.7万ドル
#Groq型はSRAM量がMTIA型の約2倍ですが、それでもHBMラックの総メモリー費用には届きません。
#ただしGroq型では、大きなモデルを多数のLPUへ分割する必要があります。そのためSRAM原価以外に、
#- チップ数
- チップ間ネットワーク
- 基板
- 電源
- 通信回路
- ソフトウェア
のコストが増えます。
##
9.ASIC全体ではSRAMは高いのか、安いのか
#ラック全体の金額ではHBMより小さく見えますが、AI ASICのダイ内部ではSRAMは非常に重いコスト要因です。
#Meta MTIAを例にすると、推定61~78mm²のSRAM領域は421mm²ダイの約15~19%を占めます。
#つまりSRAMを増やすことは、
#- 演算器を置ける面積が減る
- ダイが大型化する
- ウェハー当たり個数が減る
- 良品率が下がる
- テスト時間が伸びる
ことを意味します。
#HBMは外付けなので高価でも追加容量を増やしやすい。一方SRAMは、少量を増やすだけでもAI ASICのダイ設計そのものへ影響します。
##
10.何を基準に選ぶのか
#SRAMを増やすべきケース
#- バッチ1などの低遅延推論
- 同じデータを繰り返し使う
- データフローを事前に固定できる
- HBMアクセスを大幅に削減できる
- 少ない容量で演算器の稼働率を高められる
HBMを増やすべきケース
#- 大規模モデル全体を保持したい
- 長いKVキャッシュが必要
- 学習処理
- 大きなバッチサイズ
- 多様なモデルを同じチップで動かす
- 容量と帯域の両方が必要
#
最終整理
#AI ASICはGPUよりSRAMを多めに設計しやすいものの、すべてのASICがSRAM中心になるわけではありません。
#価格関係は次の通りです。
#1bit当たり
#SRAM:約135~245ドル/GB HBM:約8~15ドル/GB#
したがって、
#SRAMはHBMの約9~31倍高い#
72アクセラレーターのラック総額
#SRAM:約2500~4500ドル HBM:約11万~20.7万ドル#
したがって、
#HBMの総額はSRAMの約25~83倍#
になります。
#一見矛盾していますが、
#**SRAMは少量でも非常に高価。 HBMは1bit当たりでは安いが、搭載量が桁違いに多いため総額が大きい。**#
という関係です。
#AI ASICの経済性を考えるときは、SRAMとHBMの部品価格だけでなく、
#SRAMを増やしてHBMアクセスを減らした結果、ラック全体で何個のアクセラレーターが必要になるか#
まで見る必要があります。SRAM増加によって必要チップ数や消費電力を減らせれば、メモリー単体では高くても、システム全体では安くなる可能性があります。
##
追記:1bitではSRAM、総額ではHBMが高くなる理由
#AI ASICとラック全体で見るメモリー価格の逆転
#AIチップのメモリー価格を考えるとき、少し不思議な現象が起きる。
#同じ1GBを実装するなら、オンチップSRAMはHBMよりはるかに高い。ところがAIアクセラレーター1個、あるいはラック全体のメモリー費用を合計すると、HBMの方が数十倍高くなる場合がある。
#これは価格評価が矛盾しているのではない。
#**SRAMは1bitが高いが、搭載量が少ない。 HBMは1bitではSRAMより安いが、搭載量が数百倍多い。**#
この容量差が、総額を逆転させる。
##
1.比較に使う標準モデル
#実際のASICは製品ごとに構成が異なり、SRAM容量を公表していない企業も多い。そこで今回は、公開されている実製品の数字を参考にした比較用モデルを作る。
#比較用AIアクセラレーター
#- オンチップSRAM:256MB=0.25GB
- HBM:192GB
- 1ラック当たり:72アクセラレーター
256MBのオンチップメモリーはMetaのMTIA、192GBのHBMはGoogleのTPU7x、72台構成はMetaのラック設計を参考にしている。ただし、これらは同一製品の仕様ではなく、SRAMとHBMの経済性を比較するために組み合わせた仮想モデルである。MetaのMTIAは256MBのオンチップメモリーと128GBのLPDDR5を備え、最大72基をラックへ搭載する構成を公開している。Google TPU7xは1チップ当たり192GBのHBMを搭載する。(AI Meta)
##
2.1GB当たりのコストを設定する
#オンチップSRAM
#SRAMは独立部品として「1GBいくら」で販売されるものではない。ASICのロジックダイ内に作り込まれるため、その価格は主に、
#- 使用するシリコン面積
- ウェハー単価
- ダイ大型化による歩留まり低下
- 周辺回路
- テスト
- 演算器を置けなくなる機会費用
として現れる。
#TSMCの5nm高密度SRAMセルは、1bit当たり0.021µm²と公表されている。N5ウェハー価格については、顧客契約で差があるものの、SemiAnalysisは約1万6500ドルと推定している。(TSMC Research)
#セル面積だけでなく、デコーダー、センスアンプ、ECC、配線、冗長領域を加え、さらにダイ大型化による良品率低下を考慮すると、オンチップSRAMの増分原価は概算で、
#約150~300ドル/GB#
程度と見積もれる。
#これは市場販売価格ではなく、先端ASICにSRAMを追加した場合の製造原価・機会費用換算である。元のASICが大きく歩留まりが低い場合は、300ドル/GBを超えることもあり得る。
##
HBM
#HBMも正式な契約価格は公開されていないが、世代と容量から概算できる。
#HBM3Eの12層品は1スタック36GB。MicronとSamsungはいずれも36GB品を公開している。(Micron Technology)
#業界報道では、12層HBM3Eは1スタック300ドル台半ば、HBM4は500ドル台半ばと推定されている。36GBで割ると、
#- HBM3E:約9~11ドル/GB
- HBM4:約14~16ドル/GB
程度になる。(TrendForce)
#今回は世代差を含め、
#HBM:約10~15ドル/GB#
として計算する。
##
3.1bit当たりではSRAMが圧倒的に高い
#メモリー概算コスト/GBオンチップSRAM150~300ドルHBM10~15ドル
#同じ1GBを保存するなら、SRAMはHBMの、
#- 最小差:150 ÷ 15=10倍
- 最大差:300 ÷ 10=30倍
となる。
#したがって、
#1bit当たりではSRAMがHBMの約10~30倍高い#
という関係になる。
#中央値として、
#- SRAM:200ドル/GB
- HBM:12ドル/GB
を使えば、
#200 ÷ 12=約16.7倍
#である。
#HBMは高価なメモリーだが、先端ロジック工程上へ6トランジスタ型セルを並べるSRAMよりは、はるかに高密度に容量を作れる。
##
4.1アクセラレーターで見ると価格が逆転する
#比較用モデルでは、1個のアクセラレーターに、
#- SRAM:0.25GB
- HBM:192GB
を搭載する。
#HBM容量はSRAM容量の、
#192 ÷ 0.25=768倍
#である。
#SRAMの総額
#0.25GB × 150~300ドル
#= 37.5~75ドル
#HBMの総額
#192GB × 10~15ドル
#= 1920~2880ドル
#| デバイス | 搭載容量 | 1GB当たり推定単価 | 推定総額 |
| SRAM | 0.25GB | 150~300ドル | 約38~75ドル |
| HBM | 192GB | 10~15ドル | 約1920~2880ドル |したがって総額では、HBMがSRAMの、
#- 最小差:1920 ÷ 75=約26倍
- 最大差:2880 ÷ 37.5=約77倍
になる。
#中央値なら、
#- SRAM:0.25GB × 200ドル=50ドル
- HBM:192GB × 12ドル=2304ドル
となり、
#HBM総額はSRAM総額の約46倍#
である。
##
5.ラック全体ではどうなるか
#同じアクセラレーターを72個搭載すると仮定する。
#SRAMの総量
#0.25GB × 72基
#= 18GB
#HBMの総量
#192GB × 72基
#= 13,824GB=約13.8TB
#容量だけでも、HBMはSRAMの768倍である。
##
SRAMのラック総額
#18GB × 150~300ドル
#= 2700~5400ドル
#HBMのラック総額
#13,824GB × 10~15ドル
#= 13万8240~20万7360ドル
#| 構成 | 総容量 | 推定総額 |
| SRAM | 18GB | 約2,700~5,400ドル |
| HBM | 約13.8TB | 約13.8万~20.7万ドル |1ドル150円で単純換算すると、
#- SRAM:約41万~81万円
- HBM:約2074万~3110万円
となる。
#中央値では、
#- SRAM:18GB × 200ドル=3600ドル
- HBM:13,824GB × 12ドル=16万5888ドル
であり、やはりHBM総額はSRAMの約46倍になる。
##
6.なぜASIC単体でもラックでも比率が同じなのか
#同じアクセラレーターを72個に増やしただけなら、SRAMとHBMの両方が72倍になる。
#1アクセラレーター
SRAM:50ドル
HBM:2304ドル
差:約46倍
72アクセラレーター
SRAM:3600ドル
HBM:16万5888ドル
差:約46倍したがって、同一設計を並べる限り、1チップでも1ラックでも価格比は変わらない。
#変わるのは絶対額である。
#ラック全体ではHBMだけで10万~20万ドルを超えるため、HBM価格の10%変動だけでも、ラック原価が1万~2万ドル程度変動し得る。
##
7.SRAMを増やせば価格差は縮まる
#SRAM重視型ASICでは、256MBより多くのSRAMを搭載する可能性がある。
#中央値として、
#- SRAM:200ドル/GB
- HBM:12ドル/GB
- HBM容量:192GB
を固定して比較する。
#| SRAM容量/ASIC | SRAM総額 | HBM総額 | HBMとの差 |
| 256MB | 50ドル | 2304ドル | HBMが約46倍 |
| 512MB | 100ドル | 2304ドル | 約23倍 |
| 1GB | 200ドル | 2304ドル | 約12倍 |
| 2GB | 400ドル | 2304ドル | 約5.8倍 |
| 4GB | 800ドル | 2304ドル | 約2.9倍 |SRAMを4GBまで増やせば、メモリー総額の差は約3倍まで縮まる。
#しかし4GBのオンチップSRAMを平面上に置くのは現実的に非常に難しい。
#5nmの0.021µm²セルを基準にすると、1GBのSRAMはセルだけでも約168~180mm²を使う。周辺回路込みでは250~300mm²前後になり得るため、4GBなら大型AIチップ数個分に相当する面積が必要になる。(TSMC Research)
#実現するには、
#- SRAMチップレット
- 3D積層SRAM
- SoICやハイブリッドボンディング
- 複数のSRAM中心ASICをネットワーク接続
といった構成が必要になる。
#その場合、SRAMセル以外にもパッケージ、接合、テスト、基板、ネットワークの費用が増える。
##
8.HBM総額にはさらに費用が加わる
#ここまでのHBM価格は主にメモリースタック単体の推定である。
#実際のアクセラレーターには、
#- シリコンインターポーザー
- HBMベースダイ
- 2.5Dパッケージ
- 高密度基板
- HBMとASICの実装
- Known Good Dieの選別
- 完成後のテスト
- パッケージ歩留まり
も必要になる。
#またHBM4ではI/O数がHBM3Eの1024本から2048本へ倍増し、ロジックベースダイの採用によって製造難度とコストが上昇する。TrendForceはHBM4の導入時プレミアムが30%を超える可能性を示している。(TrendForce)
#したがって、完成パッケージ内の「HBM関連費用」は、先ほど計算したHBMスタック代よりさらに大きくなる可能性がある。
##
9.それでもSRAMの方が高価だと言える理由
#ラック総額だけを見るとHBMが圧倒的に高く、SRAMは小さな費用に見える。
#しかしSRAMには、単純な製造費以外の負担がある。
#SRAMを増やすと、
#- ASICダイが大型化する
- ウェハーから取れる個数が減る
- 良品率が下がる
- 演算器の面積が減る
- 配線と電力供給が難しくなる
- テスト時間が延びる
という影響が生じる。
#つまり、SRAMの本当の費用は「SRAM部分のシリコン代」だけではない。
#**SRAMはASICの設計可能面積を消費する。 HBMは外付け費用とパッケージ費用を消費する。**#
という異なるコスト構造を持つ。
##
10.SRAMを増やす経済合理性
#SRAMを増やす目的は、HBMと同じ容量を置き換えることではない。
#256MBのSRAMを追加しても、192GBのHBMを不要にはできない。
#SRAMへ置くのは、
#- 今すぐ再利用する重み
- 行列演算のタイル
- 活性値
- 中間結果
- ホットなKVキャッシュ
- ルーティング情報
などである。
#これにより、
#- HBMアクセス回数を減らす
- HBM帯域を節約する
- データ移動電力を減らす
- 演算器の待機時間を短縮する
- 1チップ当たりの処理性能を高める
ことができる。
#仮にSRAM追加でチップ原価が50ドル増えても、推論性能が上がってラックに必要なアクセラレーター数を1基減らせるなら、数千ドル規模のHBMやパッケージ費用を削減できる可能性がある。
#したがってASIC設計で重要なのは、SRAMとHBMの単純な価格差ではなく、
#SRAMへ1ドル追加したとき、HBMアクセスと必要アクセラレーター台数をどれだけ減らせるか#
である。
##
まとめ
#SRAMとHBMは、価格の見方によって高低が逆転する。
#1GB当たり
#- SRAM:約150~300ドル
- HBM:約10~15ドル
- SRAMが約10~30倍高い
1アクセラレーター
#256MB SRAM+192GB HBMの比較モデル
#- SRAM:約38~75ドル
- HBM:約1920~2880ドル
- HBM総額が約26~77倍大きい
72基ラック
#- SRAM:18GB、約2700~5400ドル
- HBM:約13.8TB、約13.8万~20.7万ドル
- HBM総額が約26~77倍大きい
この逆転は、HBMの搭載容量がSRAMの768倍あるために起きる。
#**SRAMは、少量でも非常に高価な高速メモリー。 HBMは、1bit当たりではSRAMより安いが、数百GB単位で搭載するため総額が巨大になるメモリー。**#
AI ASICの設計とは、SRAMかHBMのどちらかを選ぶ作業ではない。
#少量の高価なSRAMを使ってデータを再利用し、その外側に大容量のHBMを配置することで、速度、容量、電力、チップ面積、ラック原価の均衡を取る作業である。
#SRAMは「メモリー御三家」だけが作るものではない
#TSMCの供給逼迫がSamsung・Intelに開くAI ASICの第二供給網
#AI半導体の供給網を理解するとき、まず整理しておきたいのは、SRAMとDRAM・HBM・NANDでは製造の位置づけが異なるという点です。
#DRAM、HBM、NANDは、Samsung Electronics、SK hynix、Micronなどが独立したメモリーダイとして大量生産します。一方、AI ASICで使われるSRAMの大部分は、演算器や制御回路と同じロジックダイに埋め込まれた「組み込みSRAM」です。
#したがってAI ASIC内部のSRAMは、メモリー御三家ではなく、そのASICを製造するファウンドリーがロジック回路と一緒に作ります。
#そして2026年、TSMCの先端工程と先端パッケージ能力がAI需要で逼迫していることは、Samsung FoundryとIntel Foundryにとって大きな商機になりつつあります。
##
1.AI ASICのSRAMは誰が作るのか
#例えば、あるAI企業が独自ASICをTSMCの2nm工程で製造するとします。
#そのチップに含まれる、
#- 行列演算器
- レジスタ
- L1・L2キャッシュ
- スクラッチパッド
- SRAMバッファ
- HBMコントローラー
- 高速通信回路
は、すべてTSMCの同じロジック工程で製造されます。
#TSMCは2nmナノシート工程で、0.021平方マイクロメートルの高密度SRAMセルと、38.1Mb/mm²のSRAMマクロを公表しています。つまりTSMCはDRAMやNANDを販売しなくても、CPU・GPU・ASIC内部のSRAMについては、世界最大級の製造企業なのです。(TSMC Research)
#同じことはSamsung FoundryとIntel Foundryにも当てはまります。
#Samsungは3nm GAA工程で、SRAMを構成する各トランジスタのチャネル幅を調整し、読み出し安定性、書き込み性能、低電圧動作を最適化する技術を説明しています。(Samsung Semiconductor Global)
#Intelも18A工程で0.021平方マイクロメートルの高密度6T SRAMを実証し、18A-Pでは低動作電圧向けのSRAMをAIアクセラレーターやCPU、GPUへ統合する方針を示しています。(Intel)
#したがって、先端AI ASICのSRAM製造企業は主に、
#TSMC、Samsung Foundry、Intel Foundry#
です。
#成熟工程まで広げれば、UMCなどのファウンドリーも組み込みSRAMや特殊メモリーを提供しています。ただし大規模な生成AI向けASICで中心になるのは、2nm、3nm、4nm級の先端ロジック工程です。(UMC)
##
2.なぜメモリーメーカーではなくファウンドリーがSRAMを作るのか
#通常のSRAMセルは、1bitをおよそ6個のトランジスタで保持します。
#このトランジスタは、AI演算器を構成するトランジスタと同じロジック製造工程で作れます。そのためSRAMだけを別のチップとして作り、外から接続するよりも、ASIC内へ埋め込んだ方が圧倒的に低遅延になります。
#構造は次のようになります。
#AI ASICロジックダイ
├─ 演算器
├─ レジスタ
├─ オンチップSRAM
├─ 制御回路
├─ HBMコントローラー
└─ 高速I/O
外部
├─ HBM
├─ CPU側DRAM
└─ SSD・NANDつまり、オンチップSRAMは「外から購入して載せるメモリー」ではなく、ASICそのものの一部分です。
#一方、HBMはASICの横に搭載される独立したメモリースタックであり、NANDは主にSSDとしてサーバーやラック側へ搭載されます。
##
3.TSMCのキャパシティ逼迫が意味すること
#AI ASICの供給制約には、大きく二つあります。
#一つは、2nm、3nm、4nmなどの先端ロジックウェハー能力です。
#もう一つは、ASICと複数のHBMを接続するCoWoSなどの先端パッケージ能力です。
#2026年3月にはBroadcom関係者が、TSMCの製造能力をAI半導体供給のボトルネックとして挙げ、従来はほぼ無限に見えたTSMCの能力でも需要を吸収できなくなっていると報じられました。(Reuters)
#TSMC自身も2025年から2026年にかけて能力増強を加速し、2030年までにウェハーファブと先端パッケージを合わせて九つのフェーズを建設する計画を示しています。2026年の設備投資計画も520億~560億ドル規模です。(Reuters)
#それでもTrendForceは、TSMCのCoWoS供給不足率が2026年末に向けて縮小するものの、完全には解消せず、需給ギャップが残るとの見方を伝えています。(TrendForce)
#この状況では、AI企業にとって、
#「最も高性能なファウンドリーを選ぶ」#
だけでなく、
#「必要な時期に必要な枚数を確保できるファウンドリーを選ぶ」#
ことが重要になります。
#これがSamsungとIntelに追い風となる理由です。
##
4.Samsungが持つ最大の強み
#Samsung FoundryでAI ASICを製造する場合、チップ内部のSRAMもSamsungのロジック工程で製造されます。
#しかしSamsungの強みは、SRAMを作れることだけではありません。
#Samsung Electronicsの内部には、
#- Foundry:ASIC、演算器、組み込みSRAM
- Memory:HBM、DDR、LPDDR
- Flash:NAND、エンタープライズSSD
- Advanced Packaging:2.5D、3D、チップレット統合
- System LSI・設計基盤:コントローラー、設計支援
がそろっています。
#Samsung自身も2026年、メモリー、ロジック、ファウンドリー、先端パッケージを横断する「Total AI Solution」を提供できる企業であると説明しています。(Samsung Global Newsroom)
#理想的には、次のような受注構造を作れます。
#外部AI企業が独自ASICを開発
↓
Samsung FoundryがASICを製造
↓
ASIC内部のSRAMもSamsung工程
↓
Samsung HBMを組み合わせる
↓
Samsungの2.5Dパッケージで統合
↓
ラック側にSamsung DDR・SSDを供給TSMCでもASICとSRAM、先端パッケージまでは提供できます。
#しかしTSMCはHBM、DRAM、NANDを自社製品として製造していません。外部のSamsung、SK hynix、Micron、Kioxia、Solidigmなどと組み合わせる必要があります。
#Samsungは、これらを社内で束ねられる点が異なります。
##
5.ASICとHBMを一体で握ることの強み
#設計の共同最適化
#AI ASICの性能は、演算器だけでは決まりません。
#オンチップSRAMから演算器へデータを渡す速度、ASICからHBMへの配線、HBMベースダイ、パッケージの熱設計まで一体で決まります。
#SamsungがロジックとHBMの両方を供給すれば、
#- SRAM容量とHBM帯域の配分
- HBMコントローラー
- ベースダイ
- 信号電圧
- 電力管理
- パッケージ配線
- 熱設計
を同じロードマップで調整しやすくなります。
#Samsung Foundryは、ロジック、HBM、先端パッケージを統一した開発環境で共同最適化することを明示しています。(Samsung Semiconductor Global)
##
供給能力をまとめて確保できる
#AI企業が別々の企業から調達する場合、
#TSMC:ASIC
SK hynix:HBM
OSAT:パッケージ
別企業:基板
別企業:SSDという複数契約になります。
#どこか一つでも遅れれば、完成アクセラレーターを出荷できません。
#Samsungへ一括発注できれば、少なくとも理論上は、
#- ロジックウェハー
- HBM
- パッケージ
- テスト
の生産計画を合わせやすくなります。
#SamsungはHBM、先端パッケージ、ファウンドリーを組み合わせたカスタム・ターンキーサービスを以前から掲げています。(Samsung Semiconductor Global)
##
不良原因の責任分界を減らせる
#AIアクセラレーターが正常に動作しない場合、原因は、
#- ASICダイ
- SRAM
- HBM
- インターポーザー
- 接合
- 基板
- 電源
- 熱
のどこにあるか、切り分けが難しくなります。
#複数企業が関与すると、原因解析と責任分担に時間がかかります。
#SamsungがASIC、HBM、パッケージ、テストをまとめて受ければ、歩留まり解析と設計修正を内部で回しやすくなります。これは性能以上に、量産立ち上げ速度に効く可能性があります。
##
6.NANDはASIC受注に自動付属するわけではない
#ここは区別が必要です。
#HBMはAIアクセラレーターのパッケージに直接搭載されるため、ASIC受注と結びつきやすい部品です。
#しかしNANDは通常、ASICパッケージには入りません。
#AIアクセラレーター
├─ ASIC
├─ SRAM
└─ HBM
AIサーバー・ラック
├─ アクセラレーター
├─ CPU
├─ DRAM
└─ SSD・NANDしたがってSamsungがASICを受注しても、NANDやSSDまで自動的にSamsung製になるわけではありません。
#それでも同じ顧客に対して、
#- 学習データ用eSSD
- KVキャッシュ退避用SSD
- モデル保存用QLC SSD
- チェックポイント保存
- 大容量データレイク
を提案できます。
#SamsungはAI時代において、HBMだけでなく、高性能ストレージや大容量NANDも必要になると説明し、QLC第9世代V-NANDをサーバーSSDへ展開しています。(Samsung Semiconductor Global)
#つまりNANDの強みは、
#ASICに付属する部品ではなく、同じAIインフラ投資をラック・ストレージ層まで横展開できること#
です。
##
7.Intel Foundryにとっての追い風
#IntelもTSMC逼迫の代替候補です。
#Intel 18AはRibbonFETとPowerViaを採用し、AI・HPC向けの先端SRAM、ロジック、低電圧動作を提供します。Intel Foundryはさらに、EMIBとFoverosによる2.5D・3Dパッケージを外部顧客にも提供しています。(Intel)
#Intelの強みは、
#- 米国内製造能力
- 18A・14Aロードマップ
- 高密度SRAM
- EMIB
- Foveros
- 大型チップレットパッケージ
- UCIeを利用したオープンな統合
です。
#EMIB-Tは将来のHBM搭載を想定した大規模パッケージ向け技術として位置づけられています。(Intel Community)
#ただしIntelは現在、SamsungのようにHBMやNANDを自社供給できません。
#IntelはNAND・SSD事業をSK hynixへ売却し、Solidigmとして分離しました。(Intel)
#そのためIntelのモデルは、
#Intel Foundry
├─ ASIC・SRAM
├─ EMIB・Foveros
└─ テスト・パッケージ
外部企業
├─ SK hynix HBM
├─ Samsung HBM
└─ Micron HBMというオープン統合型です。
#Samsungのような完全垂直統合ではありませんが、顧客が複数社のHBMやチップレットを自由に組み合わせたい場合には、それが中立性という強みになります。
##
8.TSMCの逼迫だけでは受注は移らない
#TSMCが混雑しているからといって、設計を簡単にSamsungやIntelへ移せるわけではありません。
#SRAMセル、標準セル、I/O、HBMコントローラーなどは各ファウンドリーの製造工程に合わせて設計されています。
#TSMC向けに完成したASICをSamsungへ移すには、
#- SRAMマクロの置き換え
- 標準セルの置き換え
- 回路配置の再設計
- タイミング検証
- 消費電力検証
- マスクの再作成
- ソフトウェア再検証
- HBMとパッケージの再認証
が必要です。
#そのため顧客は、単に空いているファブではなく、
#十分な歩留まり、設計IP、EDA環境、先端パッケージ、量産実績を持つ代替ファブ#
を求めます。
#SamsungとIntelにとって追い風ではありますが、TSMCの受注がそのまま自動的に流れてくるわけではありません。
##
9.Samsungにとって成立し得るフライホイール
#Samsungが外部AI ASICの大型顧客を獲得し、量産を成功させた場合、次の循環が成立する可能性があります。
#TSMCの能力不足
↓
Samsungへセカンドソース需要
↓
AI ASIC・組み込みSRAM受注
↓
先端ファブの稼働率上昇
↓
歩留まりと設計実績が改善
↓
Samsung HBM採用率上昇
↓
先端パッケージ受注
↓
DRAM・SSDへクロスセル
↓
次世代ASICも継続受注重要なのは、ASICの売上だけではありません。
#Samsungが一つのアクセラレーターから獲得できる可能性のある売上は、
#- AI ASICウェハー
- ASIC内部のSRAM面積
- HBM
- HBMベースダイ
- インターポーザー
- 先端パッケージ
- テスト
- サーバーDRAM
- eSSD・NAND
まで広がります。
#これが実現すれば、Samsungはメモリー市況に左右される企業から、AIシステム全体の部品構成を握る企業へ一段変化します。
##
最終評価
#SRAMは、DRAM・HBM・NANDと同じようにメモリー御三家だけが製造するものではありません。
#AI ASIC内のSRAMは、そのチップを作るロジックファウンドリーが製造します。
#したがって、
#- TSMCはSRAMを含むASICを製造する
- SamsungもSRAMを含むASICを製造する
- Intelも18AでSRAMを含むASICを製造できる
- DRAM・HBM・NANDは別の専用メモリー事業で製造する
という構造です。
#TSMCの先端工程とCoWoS能力が逼迫する局面では、SamsungとIntelが代替供給先として評価される余地が広がります。
#その中でもSamsungの特徴は、
#ASIC内部のSRAMから、外付けHBM、サーバーDRAM、NAND、SSD、先端パッケージまで一社で持っていること#
です。
#ただし本当の競争力は、単に製品を全部持っていることではありません。
#外部AI ASICを十分な歩留まりで量産し、Samsung製HBMとパッケージの採用率を高め、その顧客関係をDRAM・SSDへ広げられるか#
にあります。
#TSMCの供給逼迫は、その垂直統合モデルを試す大きな機会です。Samsungがここで外部顧客を獲得できれば、AIメモリー需要の受益企業から、AI ASICとメモリー階層を一体で供給するシステム半導体企業へ再評価される可能性があります。
##
特定銘柄の推奨・勧誘・投資助言を目的とするものではありません。投資判断はご自身の責任でお願いいたします。
#サムネはPixAIsunflowerモデルとGPTImage2.0
#