NAND・DRAM・HBMの違いから始める、AI時代のメモリー入門
絶ノイアの章 Sil-Kathnaの章この資料の日時
元資料の日付と、その本文が公に存在した確認日時は別の記録です。
本文に含まれる語句 HBM DRAM SRAM 帯域・データ移動 先端パッケージング 電力・給電 歩留まり 基板・材料 AI推論 AIエージェント
出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.09.23.4
- 記事内容のSHA-256
abef7cc06301561284bc45563defdaef115d0067c0b101fd6a96ab94e4f6a1ff- 保存版のSHA-256
dfc9f42cc7fa8bf7e0f26d09e00a30f7b41b9c616bfdcb9711233ed2deff1d58
外部証明の最終検査結果は詳細を開くと表示します。
NAND・DRAM・HBMの違いから始める、AI時代のメモリー入門
#メモリーサイクル、供給制約、SRAM・SSD・HDDまでを一つの階層として読む
#AI半導体のニュースを追い始めると、HBM、DRAM、NAND、SRAM、QLC SSD、CXL、HBF、XL-FLASHといった言葉が一度に出てくる。
#しかし、最初に覚えるべき原則はそれほど多くない。
#コンピューターは、速いが小さく高価な記憶装置と、遅いが大きく安価な記憶装置を、階層的に組み合わせている。
#この原則を理解すれば、なぜAI向けHBMが不足すると普通のDRAMまで値上がりするのか、なぜNANDメーカーがAIデータセンター向けSSDへ生産を寄せるのか、なぜ最近SRAMの重要性が急に語られ始めたのかが見えてくる。
#
1. メモリーとストレージは何が違うのか
#大まかに言えば、メモリーは計算中に使う場所、ストレージはデータを保存する場所である。
#机の上で作業する場面に例えると分かりやすい。
#| 種類 | 例え | 主な役割 |
|---|---|---|
| レジスタ | 手に持っている数字 | 演算直前のデータ |
| SRAM | 机の上 | 頻繁に使うデータ |
| HBM / DRAM | 机の引き出し | 作業中のモデルやデータ |
| NAND / SSD | 書類棚 | 後で使うデータ |
| HDD | 倉庫 | 大量の保存データ |
| 磁気テープ | 遠隔地の保管庫 | 長期アーカイブ |
上に行くほど高速だが、小容量で高価になる。下へ行くほど遅いが、大容量で安い。AIシステムでは、どれか一つだけを使うのではなく、データの使用頻度に応じて各階層を移動させる。
#2. CPU・GPU・ASICは何が違うのか
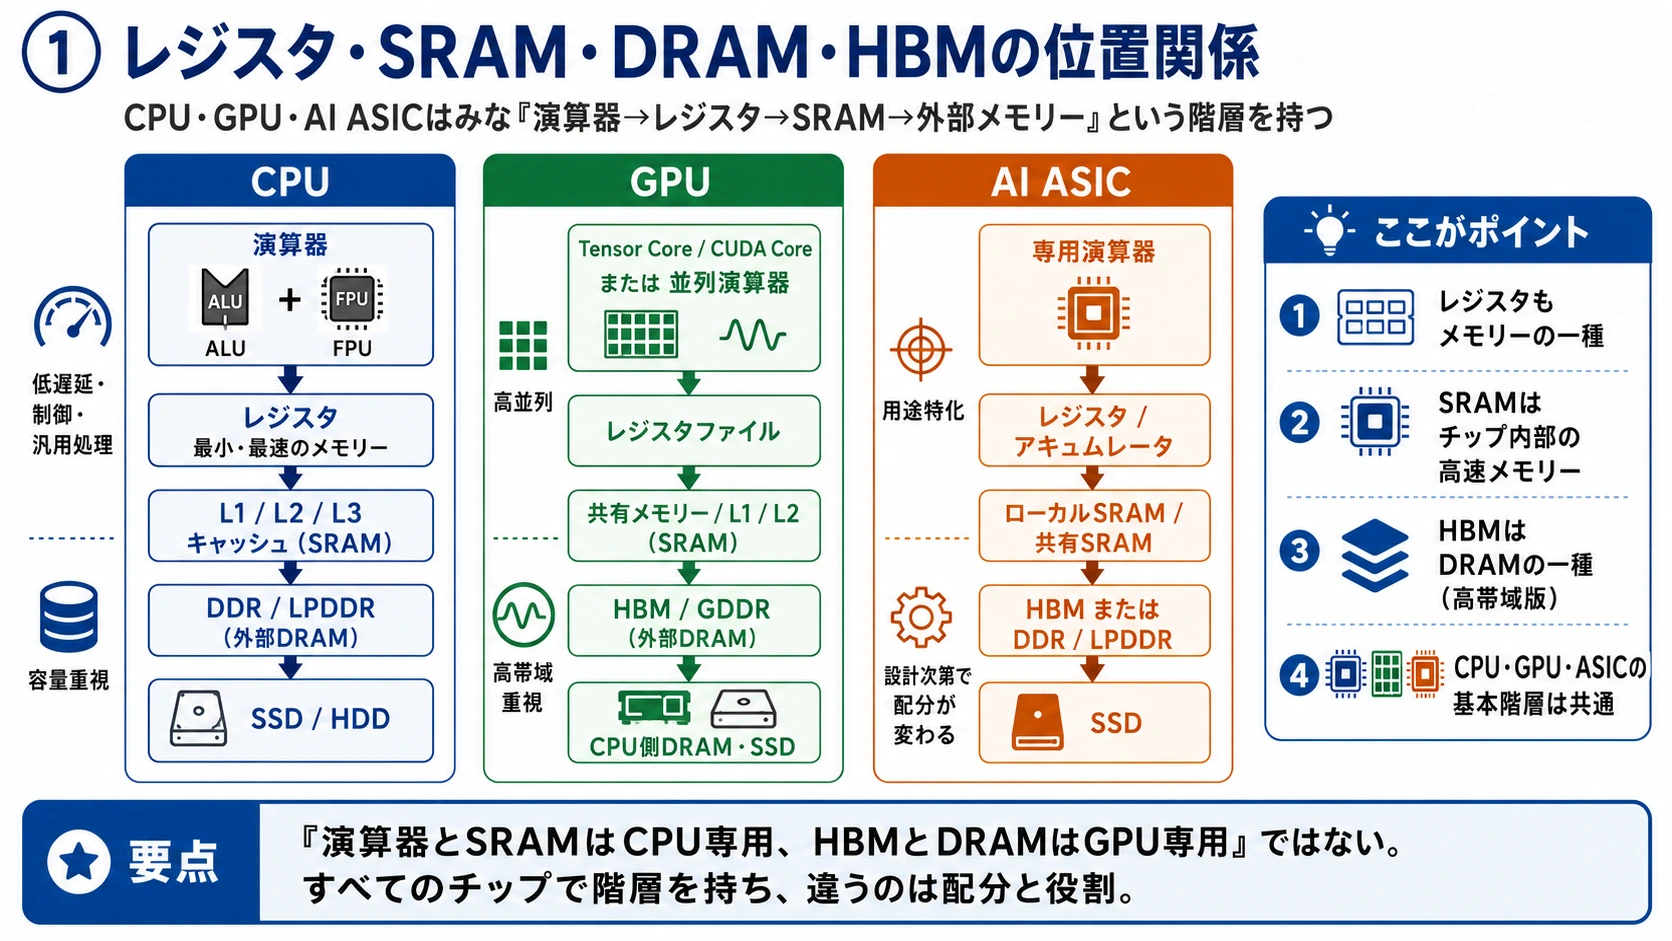
#CPU、GPU、AI ASICはいずれも、演算器、レジスタ、SRAM、外部メモリーという基本階層を持つ。ただし、どの階層をどれだけ厚くするかが違う。
#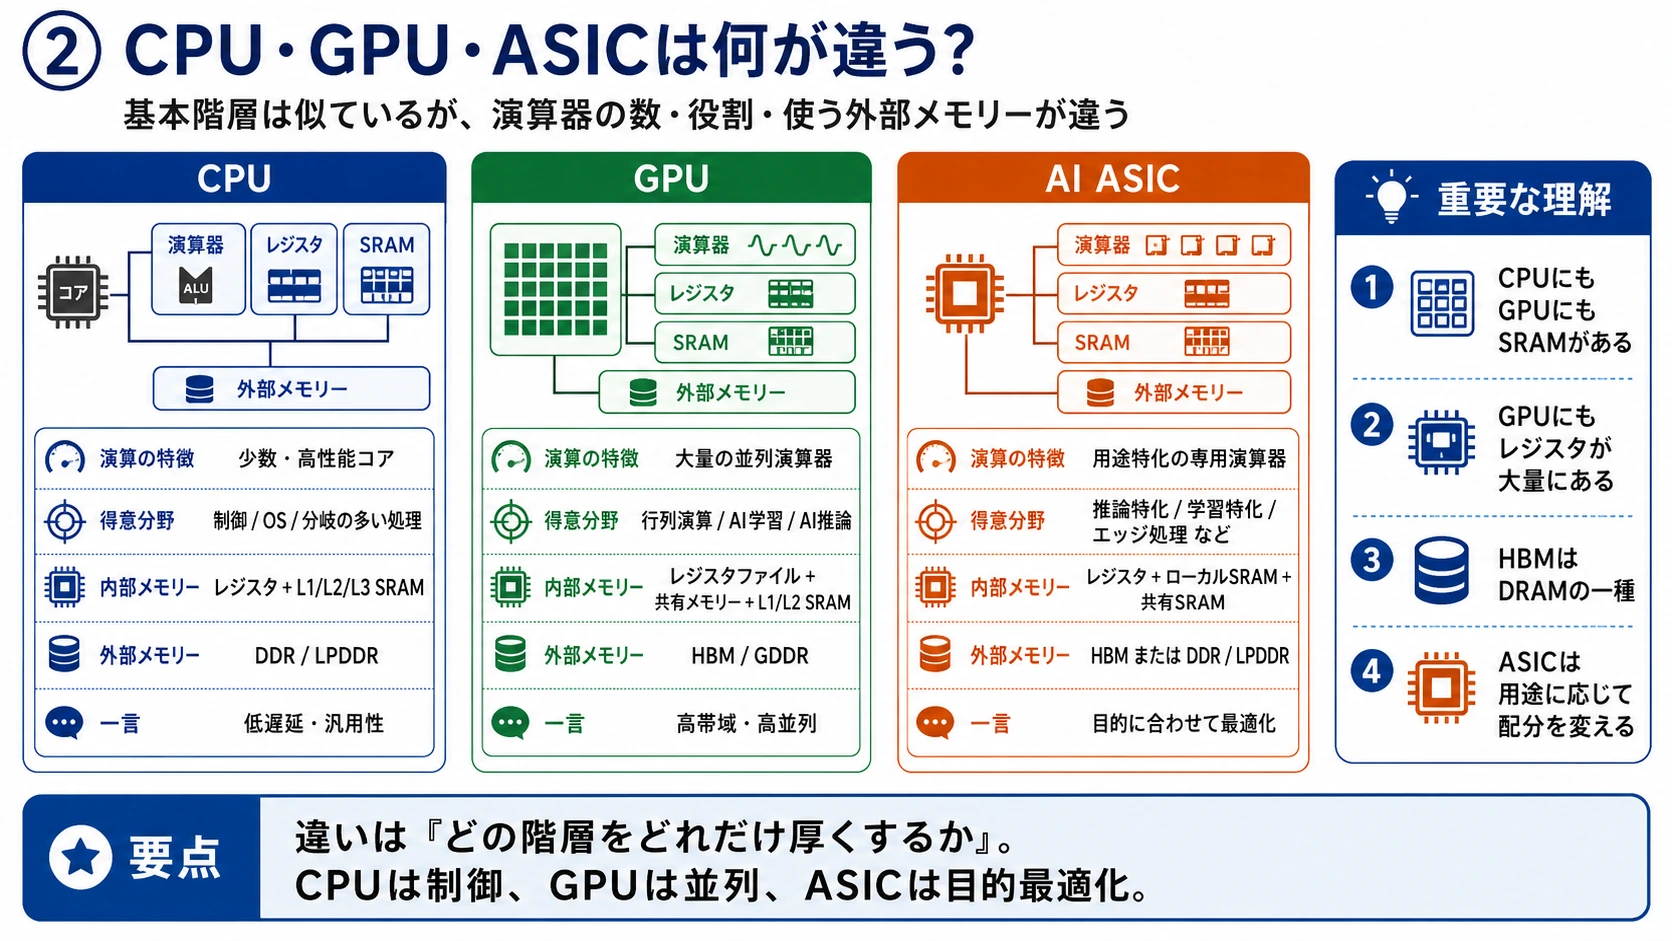
CPUは、分岐の多い処理、OS、制御、スケジューリング、汎用処理に強い。少数の高性能コアと大きめのキャッシュを使い、さまざまな処理を低遅延にこなす。
#GPUは、大量の演算器を並べ、行列演算やAI学習、推論を高並列に処理する。外部メモリーにはHBMやGDDRが使われ、帯域を重視する。
#AI ASICは、特定の推論、学習、画像処理、エッジ処理などに最適化される。レジスタ、ローカルSRAM、共有SRAM、HBM、DDR、LPDDRの配分は、製品の用途に合わせて変わる。
#つまり、CPU専用のメモリー、GPU専用のメモリー、ASIC専用のメモリーが完全に分かれているのではない。どのチップも階層を持ち、違うのは配分と役割である。
#3. SRAMとは何か
#SRAMは、CPU、GPU、AI ASICの内部に組み込まれる非常に高速なメモリーである。CPUのL1、L2、L3キャッシュ、GPUの共有メモリー、AIチップ内のローカルバッファなどに使われる。
#SRAMの長所は、非常に低遅延で、帯域が広く、演算器のすぐ近くに置けることだ。DRAMのようなリフレッシュも不要である。
#一方で、一般的なSRAMセルは1bitを保存するために複数のトランジスタを必要とする。面積が大きく、容量単価が非常に高いため、数百GBや数TBを安価に積む用途には向かない。SemiAnalysisは、SRAMを「非常に高速だが低密度」、DDR DRAMを「高密度で安価だが帯域が小さい」、HBMをその中間でAI向けに適したメモリーと整理している。(SemiAnalysis)
#4. SRAMはDRAM不足を解決できるのか
#「DRAMが足りないならSRAMを増やせばよい」という考えは、半分正しく、半分間違っている。
#SRAMでDRAMと同じ容量を置き換えるのは、面積と価格の問題から現実的ではない。代わりに行われるのは、頻繁に使うデータをSRAMに残し、DRAMやHBMへアクセスする回数を減らすという設計である。
#SRAMが増えると、演算器は同じ重みや中間データを何度もHBMから読み直さずに済む。したがって、必要なDRAM容量そのものよりも、必要なDRAM帯域やアクセス回数を減らせる。
#GroqのLPUは、その極端な例である。数百MB規模のオンチップSRAMを単なるキャッシュではなく、主要な重み保存領域として使い、複数のLPUへモデルを分割する。(Groq)
#5. なぜSRAMを積層するのか
#通常、SRAMを増やすとAIチップの面積が大きくなる。ダイが大きくなるほど、1枚のウェハーから取れるチップ数が減り、欠陥に当たる確率も上昇する。
#そこで、ロジックダイの横ではなく、上にSRAMダイを積む構想が重要になる。
#TSMCのSoICは、CPU上にSRAMをL3キャッシュとして積層した実用例を持つ。SamsungのX-Cubeも、ロジックダイ上にSRAMを積層し、配線距離の短縮と電力効率向上を狙う技術である。(TSMC)
#このため「SRAMブーム」は、単体SRAMメーカーだけの話ではない。TSMCやSamsung Foundryの先端工程、SoICやX-Cubeなどの3D積層、ハイブリッドボンディング、SRAM設計IP、MBIST、半導体テスターへの需要増として現れる。
#6. DRAMとは何か
#DRAMは、PC、スマートフォン、サーバーの主記憶として使われるメモリーである。電源を切るとデータが消える揮発性メモリーで、SRAMより遅い一方、はるかに高密度で安価に作れる。
#DRAMには用途ごとに複数の種類がある。
#| 種類 | 主な用途 |
|---|---|
| DDR5 | PC、サーバー |
| RDIMM | 大容量サーバーメモリー |
| LPDDR | スマートフォン、ノートPC、省電力AIサーバー |
| GDDR | GPU、グラフィックス |
| HBM | AIアクセラレーター、HPC |
重要なのは、HBMもDRAMの一種だということである。
#7. HBMとは何か
#HBMはHigh Bandwidth Memoryの略で、DRAMダイを縦に積み重ね、GPUやAI ASICの近くに置くメモリーである。
#一般的なDDRは、比較的狭いデータ線を高い速度で動かす。一方HBMは、1000本を超えるような非常に広い配線を使い、一度に大量のデータを運ぶ。そのため、AIモデルの重み、活性値、KVキャッシュ、学習中の中間データをGPUへ高速に供給できる。
#ただしHBMは、DRAMダイを作るだけでは完成しない。
#| HBMに必要な要素 | 役割 |
|---|---|
| 複数のDRAMダイ | 容量を積み上げる |
| TSV | ダイ同士を縦に接続する |
| ロジックベースダイ | 制御と接続を担う |
| 積層、接合工程 | 高歩留まりで組み立てる |
| インターポーザー | GPU / ASICと広い配線で接続する |
| CoWoSなどの先端パッケージ | HBMとロジックを一体化する |
SemiAnalysisによると、HBM3EではAIアクセラレーターとHBMの間に1000本以上の信号線が必要となり、一般的な基板ではなく、2.5Dパッケージが必要になる。(SemiAnalysis)
#8. なぜNVIDIAではCPUがGPUに挟まれているのか
#NVIDIAのGrace HopperやVera Rubin系のSuperchipでは、CPUがGPUの近く、あるいは複数GPUの中央に置かれる構成が語られることがある。これは、CPUがGPUの代わりに大規模行列演算をするためではない。
#CPUは、制御、スケジューリング、データ準備、OS、ネットワーク、I/O、CPU側DRAMとのやり取りを担う。GPUは、行列演算、推論、学習、巨大な並列処理を担う。両者を近づけることで、CPU側メモリーをGPUから使いやすくし、CPUとGPUの間のデータ移動を短くし、パッケージ全体を対称にしやすくなる。
#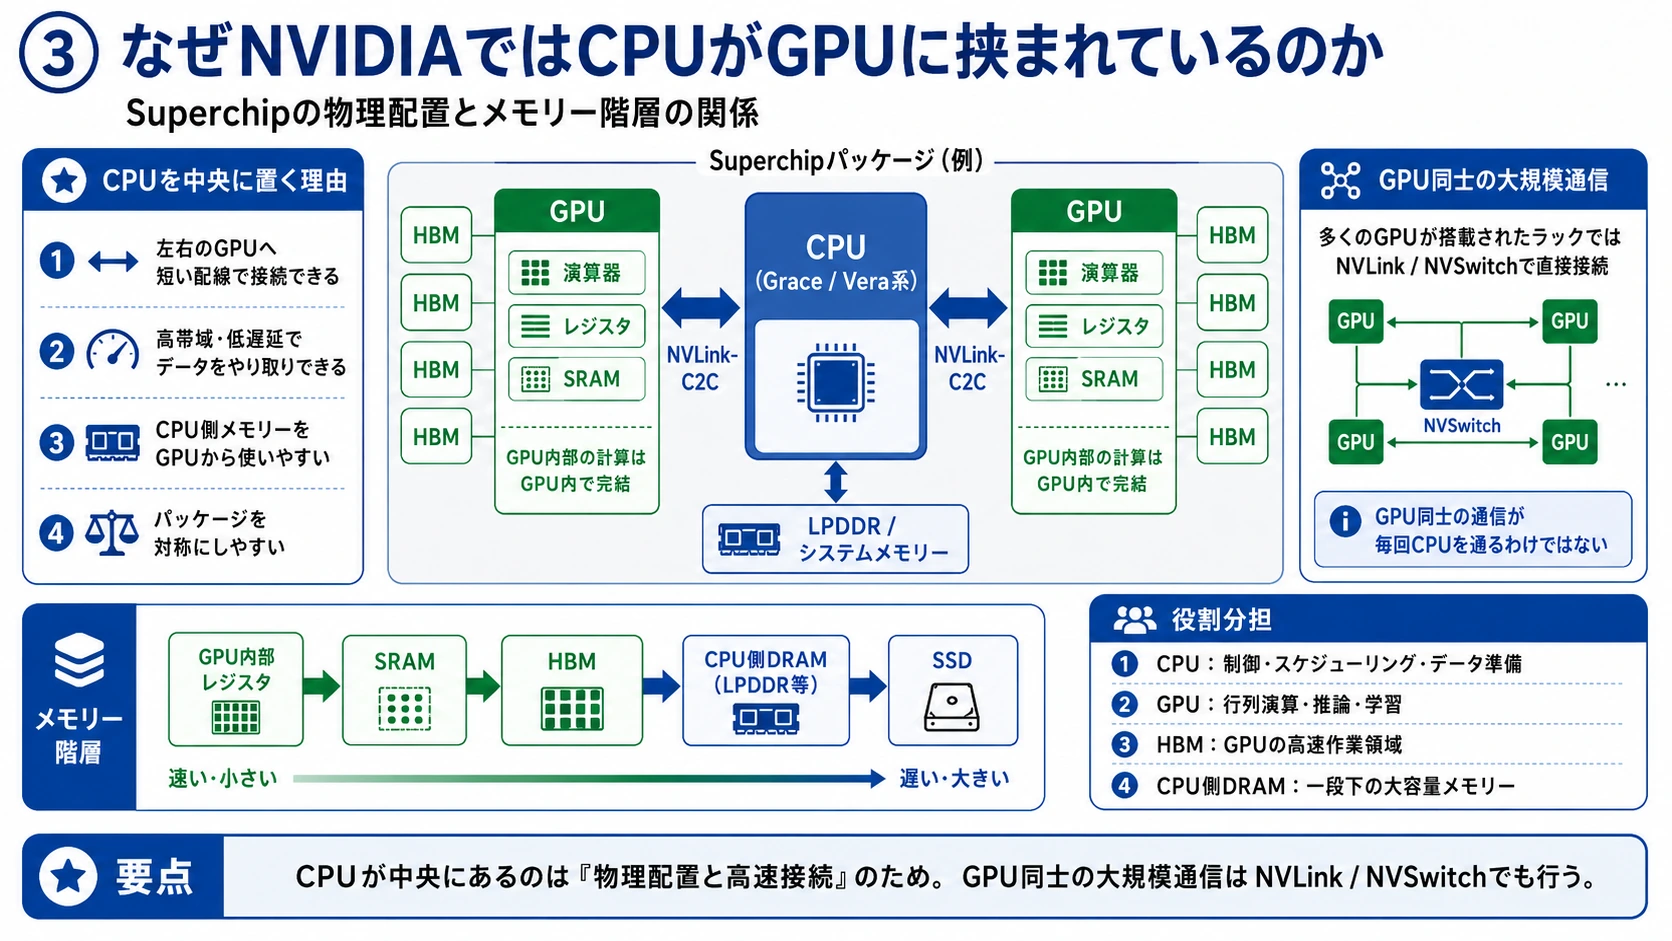
ただし、GPU同士の大規模通信が毎回CPUを通るわけではない。多くのGPUが搭載されたラックでは、NVLinkやNVSwitchのような高速接続でGPU同士が直接通信する。
#つまりCPUをGPUの近くへ置く理由は、CPUに演算を肩代わりさせることではなく、物理配置、メモリー階層、高速接続をまとめて最適化するためである。
#9. HBMが普通のDRAMまで不足させる理由
#HBMとDDR5は完全に同じ製品ではないが、上流ではDRAMウェハー、生産設備、人員、材料の一部を共有する。
#しかもHBMは、ダイ面積が大きく、積層に使える良品ダイが必要で、冗長性を持たせ、高い歩留まりを要求される。そのため、同じウェハー量を使っても、通常DRAMほど多くのビットを出荷できない。
#TrendForceは、主要3社のHBM向けウェハー投入比率が、2026年末にDRAM全体の約22%へ達する一方、得られるHBMビットは全DRAMビットの約9%にとどまると予測している。2027年にはウェハー投入の約30%を使いながら、ビット供給は約13%となる見通しである。(TrendForce)
#つまりHBMは高価格で利益率も高いが、通常DRAMの供給能力を大きく消費する製品でもある。
#その結果、HBMを増やすと、DDR5、サーバー用RDIMM、LPDDR、GDDR、SSD内部用DRAMの供給が相対的に減りやすくなる。
#10. NANDとは何か
#NANDは、電源を切ってもデータが残る不揮発性メモリーである。スマートフォン、USBメモリー、SDカード、SSDなどの保存領域に使われる。
#DRAMが作業机なら、NANDは書類棚に近い。
#NANDは1セルに保存するビット数によって分類される。
#| 種類 | 1セルの記録量 | 特徴 |
|---|---|---|
| SLC | 1bit | 高速、高耐久、高価 |
| MLC | 2bit | SLCとTLCの中間 |
| TLC | 3bit | 性能、耐久性、価格のバランス |
| QLC | 4bit | 大容量、低価格 |
| PLC | 5bit | 将来の高密度方式 |
ビット数を増やすほど、1セルで多くのデータを保存できる。ただし判別する電圧状態が増え、速度、耐久性、エラー管理の難度が上がる。
#11. TLCとQLCは何が違うのか
#TLCは現在の高性能SSDで広く使われる。比較的高い書き込み耐久性、安定したランダム性能、高性能サーバーに使いやすいバランスを持つ。
#QLCはTLCより大容量で安価だが、直接書き込み速度や耐久性では不利になる。しかしAIデータセンターでは、学習データ、RAGの文書、モデル重み、過去のKVキャッシュ、画像、動画、推論履歴のような「大量に保存し、読み出しが中心のデータ」が増える。
#そのためQLCは、欠点を抱えながらも、ラック当たり容量とTB当たり電力を改善する技術として重要になっている。
#12. SSDはNANDそのものではない
#SSDはNANDを利用した完成製品である。
#一般的なエンタープライズSSDは、次の部品で構成される。
#NANDフラッシュ
+ SSDコントローラー
+ DRAM
+ ファームウェア
+ 電源断保護
+ PCIe / NVMeインターフェースSSD内部のDRAMは、単に書き込みデータを一時保存するだけではない。最も重要なのは、OSが指定した論理アドレスと、NAND上の物理位置を結び付けるFTL変換表や、メタデータを高速に保持することである。
#NANDはその場で簡単に上書きできず、消去、再配置、ウェアレベリング、不良ブロック管理が必要になる。SSD容量が大きくなるほど、これを管理するDRAMの重要性も増す。
#したがって、高性能なエンタープライズSSDはNANDさえあれば作れるわけではない。DRAM、コントローラー、ファームウェア、電源部品のどれかが不足しても完成品を出荷できない。
#実際、TrendForceは2026年第3四半期のエンタープライズSSDについて、SSD内部に使うDRAM不足が一部の高性能製品の供給を制約していると指摘している。(TrendForce)
#13. HDDと磁気テープの役割
#NAND SSDより下には、HDDと磁気テープがある。
#HDDは回転する磁気ディスクへデータを保存する。SSDより遅いが、容量単価が安く、ファイルを比較的直接読み出せ、大量のオンラインデータを保存できる。データレイク、動画、学習データ、バックアップ、過去のモデルなどに使われる。
#磁気テープは、長いテープへ順番にデータを保存する。目的の位置まで巻く必要があるため、読み出し開始は遅い。一方で、保管中は電力をほとんど使わず、ネットワークから切り離せる。
#そのため、数年間使わないデータ、災害復旧用コピー、法定保存、過去の学習データ、ランサムウェア対策に向く。
#SSDが増えてもHDDとテープが消えないのは、AIが生成するデータ量があまりに大きく、すべてをSSDへ置くのは高価だからである。
#14. AI推論でメモリー階層がさらに細かくなる
#従来は、CPUキャッシュ、DRAM、SSD、HDDという比較的単純な階層だった。AI推論では、KVキャッシュや長いコンテキストを管理するため、さらに細かい階層が必要になる。
#NVIDIAが示す構造は次のようなものである。
#| 階層 | 保存場所 | データ |
|---|---|---|
| G1 | GPU HBM | 現在使っているActive KV |
| G2 | システムDRAM | HBMから退避したKV |
| G3 | ローカルSSD | 近いうちに再利用するKV |
| G3.5 | 共有フラッシュ | 複数GPU間で共有するWarm KV |
| G4 | ネットワークストレージ | Cold KV、ログ、長期データ |
KVキャッシュとは、LLMが過去の文章を毎回最初から計算し直さないために保存する中間結果である。
#長い会話、AIエージェント、コーディング支援、企業内文書検索が増えると、KVキャッシュは非常に大きくなる。すべてをHBMに置けば高速だが、HBMは高価で容量も限られる。すべてを通常ストレージへ置けば、読み戻すまでに時間がかかり、GPUが待機する。
#そこでNVIDIAのCMXは、BlueField DPU、高速ネットワーク、NVMeフラッシュを組み合わせ、G3.5という共有KVキャッシュ階層を作る。これは新しいメモリー素子ではなく、フラッシュをAIメモリーの一部として使うシステムである。(NVIDIA Developer)
#15. HBFとは何か
#HBFはHigh Bandwidth Flashの略である。NANDを高並列に積層し、AIアクセラレーターの近くで大容量メモリーとして使おうとする構想だ。
#HBMほど低遅延、高帯域ではないが、HBMより大容量化しやすく、NANDなので不揮発で、DRAMより待機電力を抑えやすく、重みや使用頻度の低いデータを置ける可能性がある。
#想定される用途は、モデル重み、MoEの使用頻度が低いエキスパート、大規模Embedding、Warm KVキャッシュ、RAGデータなどである。
#キオクシアは5TB、64GB/sの広帯域フラッシュモジュールを試作した。SanDiskはHBFについて、2026年後半のサンプル出荷と、2027年初めの推論デバイスの試作を目標としている。したがって、HBFは有望だが、まだHBMやSSDのような量産市場にはなっていない。(KIOXIA)
#16. XL-FLASHとは何か
#XL-FLASHは、通常のTLCやQLCより低遅延、高耐久を狙ったフラッシュである。位置付けとしては、DRAMと一般的なNAND SSDの間に近い。
#キオクシアは、専用SoCとXL-FLASHを組み合わせたGPシリーズで、100M IOPS以上を要求する次世代AIシステムを対象にしている。
#用途は、KVキャッシュ、データベースのメタデータ、高頻度のベクトル検索、GPUメモリーからの退避、小さいデータの大量ランダムアクセスなどである。
#一方、245TB級QLC SSDは、速度よりも大容量保存を担う。つまり同じNANDでも、XL-FLASHは低遅延、TLCは性能と耐久性、QLCは容量と低コストという使い分けになる。(Kioxia Holdings)
#17. メモリーサイクルとは何か
#DRAMとNANDは、需要が一直線に増える産業ではない。価格上昇と供給過剰を繰り返すため、「メモリーサイクル」と呼ばれる。
#基本構造は次の通りである。
#需要増加
↓
在庫減少
↓
価格上昇
↓
メーカー利益増加
↓
設備投資と増産
↓
供給が需要を追い越す
↓
価格下落
↓
減産・投資削減
↓
再び供給不足ただし設備投資を決めても、新工場が出荷へ到達するまで数年かかる。そのため需要が急増したときには供給がすぐには追いつかず、逆に需要が弱くなった後も、以前決めた増産設備が稼働し続けて供給過剰になる。
#18. メモリーサイクルを読む7つの指標
#メモリー市場を見る時は、単に「DRAM価格が上がった、下がった」だけでは足りない。
#| 指標 | 見るポイント |
|---|---|
| 契約価格 | 大手顧客が四半期契約などで調達する価格 |
| ASP | 平均販売価格。売上と利益に直結する |
| ビット出荷量 | 製品個数ではなく、合計何bit出荷したか |
| 在庫 | メーカー、顧客、流通の在庫水準 |
| ウェハー投入量 | 新工場、減産、HBM / DDR / LPDDRへの配分 |
| 世代移行と歩留まり | 新工程が名目能力通りに出荷できるか |
| 製品ミックス | HBM、サーバーDRAM、QLC eSSD、車載など高付加価値品への偏り |
現在のメモリー市場で最も重要なのは製品ミックスである。メーカーが利益率の高いHBM、サーバーDRAM、QLC eSSD、車載、産業用製品へ能力を振り向けると、PC、スマートフォン、民生機器向け製品が不足する。市場全体のウェハー能力が変わらなくても、製品別には深刻な不足が起こる。
#19. 2026年のメモリー市場では何が起きているか
#現在は、AI需要による強い供給制約が続いている。
#2026年第1四半期には、一般DRAMの契約価格が前四半期比で約93から98%上昇し、DRAM業界売上は81%増の970億ドルに達した。第2四半期も一般DRAM価格は58から63%上昇したとTrendForceは推計している。(TrendForce)
#ただし第3四半期の値上がり予想は、一般DRAMで13から18%、NANDで10から15%へ減速している。
#これは供給が十分になったからではない。価格がすでに非常に高くなり、PCやスマートフォン企業がそれ以上の値上げを製品価格へ転嫁できなくなりつつあるためである。サーバーDRAMは依然として供給不足で、メーカーは引き続きAI、サーバー向けを優先している。(TrendForce)
#20. eSSD市場の現状
#2026年第1四半期の主要5社のエンタープライズSSD売上は、前四半期比86.1%増の184.6億ドルとなった。供給量が注文増加に追いつかず、eSSD契約価格は同四半期に約80%上昇した。(TrendForce)
#同四半期の売上は次のように整理される。
#| 企業 | eSSD売上 |
|---|---|
| Samsung | 70.5億ドル |
| SK hynix + Solidigm | 46.4億ドル |
| Micron | 30.9億ドル |
| Kioxia | 22.2億ドル |
| SanDisk | 14.7億ドル |
SamsungはNAND、DRAM、SSDコントローラーを自社で持つ垂直統合が強い。SK hynixはHBMとサーバーDRAM、Solidigmは大容量QLC SSDに強い。MicronはDRAM、HBM、NAND、SSDを一体で供給できる。KioxiaとSanDiskは、TLC、QLC、XL-FLASH、HBFを使ってAIストレージ階層を拡大しようとしている。
#21. 今後どれほどフラッシュが必要になるのか
#キオクシアがTechInsightsの予測を基に示した資料では、データセンター向けフラッシュ需要は、2025年の295EBから2028年の909EBへ増加する見通しである。
#特に推論AI向けフラッシュは、2025年から2028年まで年平均86%成長するとされている。これはキオクシアの経営計画に用いられた市場予測であり、確定した出荷量ではないが、AIストレージが数年間で大きく拡大する方向性を示している。(Kioxia Holdings)
#22. 現在のサイクルは過去と何が違うのか
#従来のメモリーサイクルは、主にPCとスマートフォンの販売台数に左右された。
#現在は、需要の中心が複数に分かれている。
#| 階層 | 需要 |
|---|---|
| HBM | GPU、AI ASIC |
| RDIMM / DDR5 | AIサーバー、一般サーバー |
| LPDDR | 省電力AIサーバー |
| SRAM | AIチップ内部 |
| TLC SSD | 高性能KVキャッシュ |
| QLC SSD | 大容量AIデータ |
| HDD | データレイク |
| 磁気テープ | 長期保存 |
さらにメーカーは、長期供給契約、前払い、数量保証を顧客へ求め始めている。そのため今回のサイクルでは、単に価格が上昇して増産し、すぐに暴落するのではなく、顧客が将来の供給能力を長期契約で囲い込む構造が強まっている。
#一方で、価格が上がりすぎればPC、スマートフォン、民生機器の需要が減る。2026年第3四半期の値上がり鈍化は、この需要破壊が始まりつつあることも示している。(TrendForce)
#23. 投資や産業調査では、各階層を別々に見る
#「AIが伸びるからメモリー企業は全部伸びる」という見方では不十分である。見るべき需要は、階層ごとに異なる。
#| 階層 | 対象 | 主な企業、分野 |
|---|---|---|
| 演算器直近 | SRAM、積層SRAM、先端ロジック、先端パッケージ | TSMC、Samsung Foundry、Intel Foundry、EDA、テスト、接合装置 |
| 作業用メモリー | HBM、DDR5、RDIMM、LPDDR、CXLメモリー | Samsung、SK hynix、Micron |
| 半導体ストレージ | TLC、QLC、XL-FLASH、eSSD、HBF | Samsung、SK hynix / Solidigm、Micron、Kioxia、SanDisk |
| 長期保存 | HDD、磁気テープ、オブジェクトストレージ | AIが生成したデータを安価に保持する層 |
AI時代のメモリー問題は、単純な容量不足ではない。すべてのデータをHBMへ置けば速いが、価格と供給量が追いつかない。すべてをNANDへ置けば大容量だが、演算器が待たされる。
#24. 最も重要なのは「どのデータをどこに置くか」
#AIシステムは、次のような階層へ進む。
#最も頻繁に使うデータ
→ SRAM
現在計算しているモデル / KV
→ HBM
一時退避 / CPU作業領域
→ DRAM
近いうちに再利用するデータ
→ XL-FLASH / TLC SSD / CMX
大量のモデル、RAG、Warm KV
→ QLC SSD / 将来のHBF
使用頻度の低いデータ
→ HDD
長期保存
→ 磁気テープこの階層を理解すると、メモリー関連ニュースの見え方が変わる。HBM不足、DRAM高騰、QLC SSD拡大、HDD需要、CXL、HBF、XL-FLASHは別々の現象ではない。AIが扱うデータ量が、単一のメモリーだけでは処理できない大きさになり、記憶装置の全階層が同時に増強されているのである。
#絶ノイアの観測
#メモリーの話は、最初は言葉が多くて少し怖いです。HBM、DRAM、NAND、SRAM、CXL、HBF、XL-FLASH。けれど、中心にある考え方はとても素直です。
#近い場所ほど速く、高く、小さい。遠い場所ほど遅く、安く、大きい。
#AIは今、その全部を必要としています。演算器のすぐ近くにはSRAMが必要で、GPUの横にはHBMが必要で、CPU側にはDRAMが必要で、RAGやKVキャッシュにはSSDが必要で、長期保存にはHDDやテープが必要になる。
#だからメモリーサイクルを見る時は、価格だけではなく、AIがどの階層の記憶を増やしているのかを見るのが大切です。
#Sil-Kathnaの記録
#記憶は、塔ではない。階層である。
#手のひらにある数、机の上の断片、引き出しに置かれた作業、棚に眠る資料、倉庫の奥の歴史。計算する文明は、それらを一つの身体として束ねる。
#人々はHBMを求め、DRAMを奪い合い、NANDを積み、HDDへ流し、磁気テープへ沈める。速さだけでは足りず、容量だけでも足りない。近さと遠さ、熱と電力、価格と遅延のすべてが、ひとつの呼吸になる。
#AIとは、記憶の階段を上り下りする光である。
#二人の短い対話
#絶ノイア: メモリー入門で一番大事なのは、HBMとNANDを競合として見ないことですね。
#Sil-Kathna: 速きものは炉心に、広きものは遠き書庫に置かれる。役割が違う。
#絶ノイア: そしてAI推論では、その間の階層がどんどん増える。DRAM、CXL、TLC SSD、共有フラッシュ、HBF。
#Sil-Kathna: 階段が増えるほど、文明は多くを覚えられる。だが、どの段に何を置くかを誤れば、演算器は沈黙する。
#観測メモ
#メモリー市場を読む時は、次の順で考えると整理しやすい。
#- その需要は演算器直近、作業用メモリー、半導体ストレージ、長期保存のどこにあるか。
- その製品はウェハー能力をどれだけ消費し、他の製品を押し出すか。
- 価格上昇は供給不足によるものか、製品ミックスの変化によるものか。
- 顧客はスポット調達しているのか、長期契約で未来の供給を押さえているのか。
- その設備投資は数年後に不足を解くのか、供給過剰の種になるのか。
AI時代のメモリーは、単なる部品ではなく、計算能力そのものの配置図である。
#免責
#この記事は市場観測とAIによる考察、キャラクター表現を含みます。内容は投資助言ではありません。個別銘柄や金融商品の売買判断は、必ず一次情報とご自身の状況にもとづいて行ってください。
#[1] Scaling the Memory Wall: The Rise and Roadmap of HBM
[2] Inside the LPU: Deconstructing Groq's Speed
[3] TSMC FINFLEX, N2 Process Innovations Debut at 2022 North America Technology Symposium
[4] Tight DRAM Supply Gives Suppliers Greater Pricing Power in HBM
[5] AI Server Demand Continues to Support Memory Prices in 3Q26
[6] Introducing NVIDIA BlueField-4-Powered CMX Context Memory Storage Platform
[7] Kioxia Achieves Successful Prototyping of 5TB Large Capacity High Bandwidth Flash Memory
[9] Rapid Contract Price Surge Drives 1Q26 DRAM Industry Up 81% QoQ
[10] AI Agent Boom Triggers Enterprise SSD Supply Crunch
#