JalapeñoはRubinを超えたのか
出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.09.23.4
- 記事内容のSHA-256
cb428ff0ed443ede713d78f8159cd2db083108e58ae2ad3f549bd718cff0e77e- 保存版のSHA-256
68649fb13342b7f03ac69519c4256c1d04b327beac310957819ab25a65eada31
外部証明の最終検査結果は詳細を開くと表示します。
JalapeñoはRubinを超えたのか――OpenAI独自ASICが変えるHBM競争と、Samsung・Broadcom・TSMCを結ぶ10GW供給網
#2026年8月25日、SemiAnalysisが公開したOpenAI独自AIアクセラレータ「Jalapeño」の分析は、単なる新しいAIチップの性能比較以上の意味を持っている。
#最も目を引くのは、Jalapeñoが一部のLLM推論条件でNVIDIA Blackwellを大きく上回り、SemiAnalysisが公開済みのRubinデータと比較した場合にも、電力当たりの推論スループットで非常に競争力のある結果を示していることだ。
#しかし、このニュースを「OpenAIがNVIDIAより高性能なGPUを作った」と理解すると本質を見誤る。
#Jalapeñoの重要性はむしろ逆にある。
#NVIDIA Rubinほど巨大な演算能力やチップ間通信能力を持たせなくても、HBM、演算器、KV cache、ネットワーク、カーネル、モデルそのものを一つの推論システムとして設計すれば、LLM推論ではRubin級あるいはそれ以上の電力効率を狙える。
#さらにOpenAIはCodexとGPT-Astraを使い、従来なら数年かかり得た新ASICのソフトウェア成熟を猛烈な速度で進め始めている。
#そこへ2026年7月のSam AltmanとSamsung Electronics会長・李在鎔の会談、サンフランシスコAI Summit、そしてSamsungとBroadcomが発表した5年間・2,000億ドル超規模のHBM・ファウンドリー・先端パッケージ協力MOUを重ねると、さらに大きな構図が見えてくる。
#これは初代Jalapeñoだけの話ではない。
#OpenAI × Broadcomが2029年までに構築する10GW級・複数世代AI ASIC供給網を巡る争いとして見る必要がある。
##
SemiAnalysisが明らかにしたJalapeñoの正体
#OpenAIは2026年6月24日、Jalapeñoを自社初の「Intelligence Processor」として正式発表した。
#OpenAIがアーキテクチャを設計し、BroadcomとCelesticaがシリコン実装、ボード、ラック、ネットワーク、量産化を支援する。しかもJalapeñoは単発製品ではなく、OpenAI自身がmulti-generation compute platformの第1世代と位置づけている。(OpenAI)
#SemiAnalysisによれば、B0 steppingのJalapeñoはTSMC N3Pのreticle-scale compute dieを使い、MXFP4で約13.4PFLOPS。HBM4は216GB、帯域は約15.4TB/sで、HBM4のpin speedは約10Gbpsと推定されている。
#さらにSemiAnalysisは、このHBMについて「likely provided by Samsung」としている。
#重要なのは、これはSamsung供給の有力な推定ではあるものの、OpenAIやSamsungが「Samsung独占」「ほぼ100%」と公式発表したものではない点だ。(SemiAnalysis)
#Jalapeñoは128 XPUを1ラックに搭載し、最大2,048 XPU規模のdomainへ拡張する設計と報じられている。(Data Center Dynamics)
#しかし、Jalapeñoの本当の特徴は13.4PFLOPSという数字ではない。
#Rubinの方が演算能力は大きい。
#Jalapeñoが特別なのは、
#「演算器1単位に対して、どれほど大量のHBM帯域を与えるか」
#という設計比率である。
##
JalapeñoはなぜHBM帯域を使い切れるのか
#LLM推論には大きくPrefillとDecodeがある。
#Prefillでは入力された大量のtokenを一気に計算するため、Matrix Multiplyが多く、比較的compute-boundになりやすい。
#一方Decodeでは、通常1 tokenずつ生成する。
#このとき巨大なweightや過去tokenのKV cacheを繰り返し参照するため、問題になるのはFLOPSよりも、
#HBMから何TB/sのデータを演算器まで持ってこられるか
#になる。
#OpenAI自身も、Prefillはcompute intensive、Decodeはmemory-bandwidth constrainedになりやすいと説明している。(OpenAI)
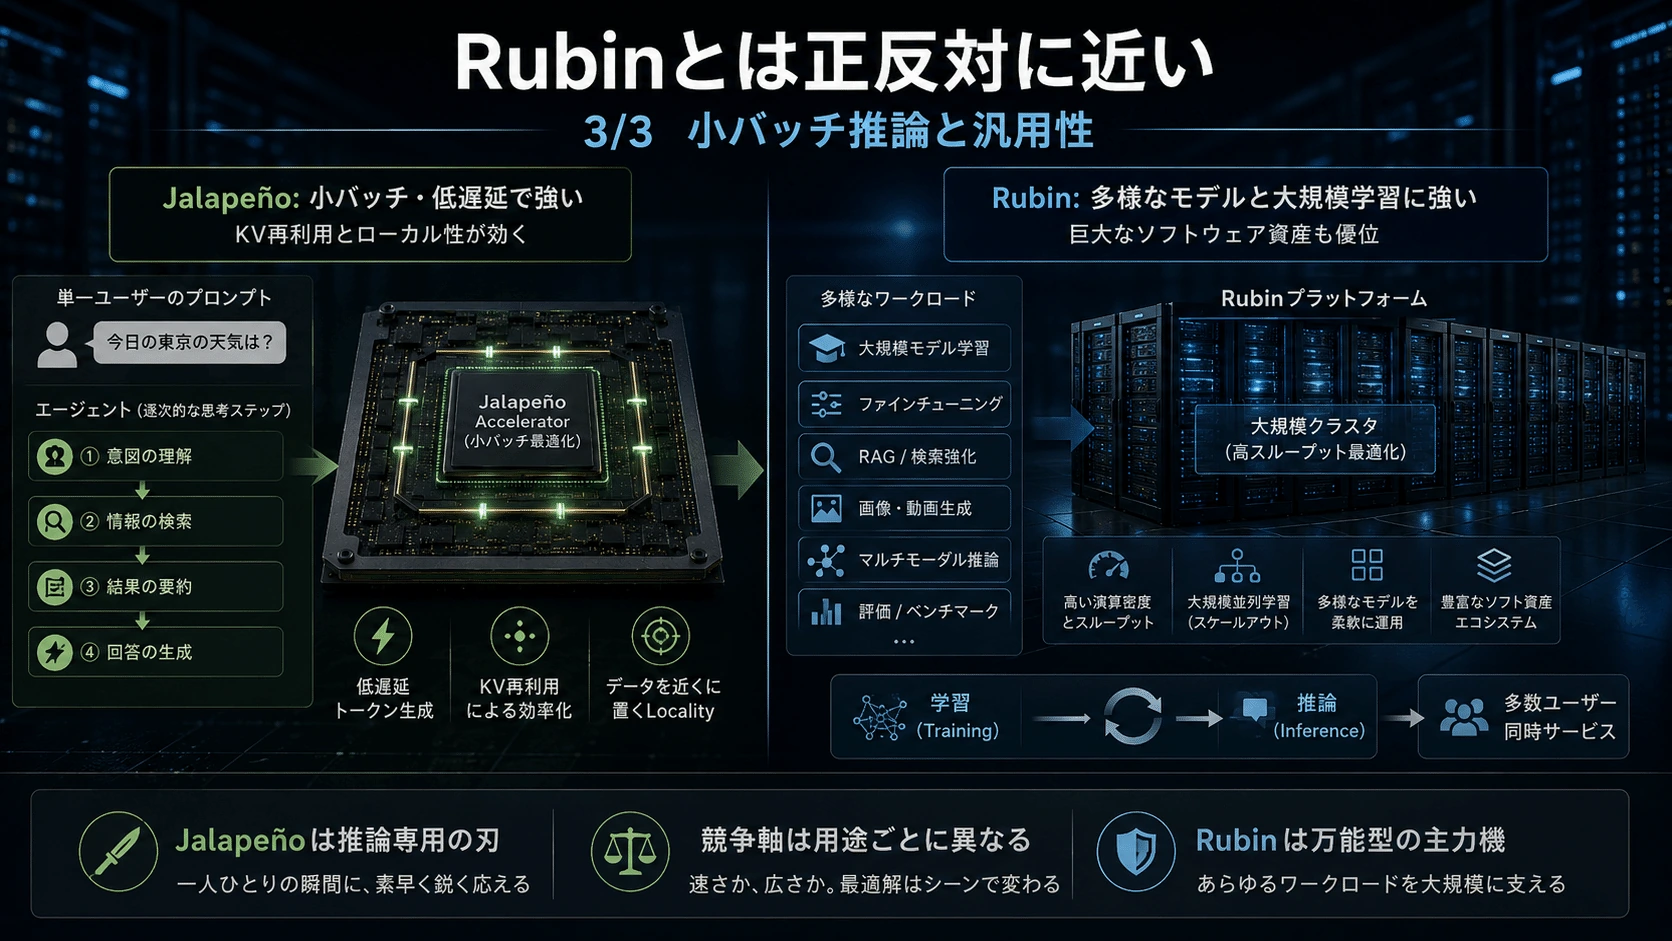
#そこでJalapeñoは、巨大な汎用GPUとは違う方向へ振り切った。
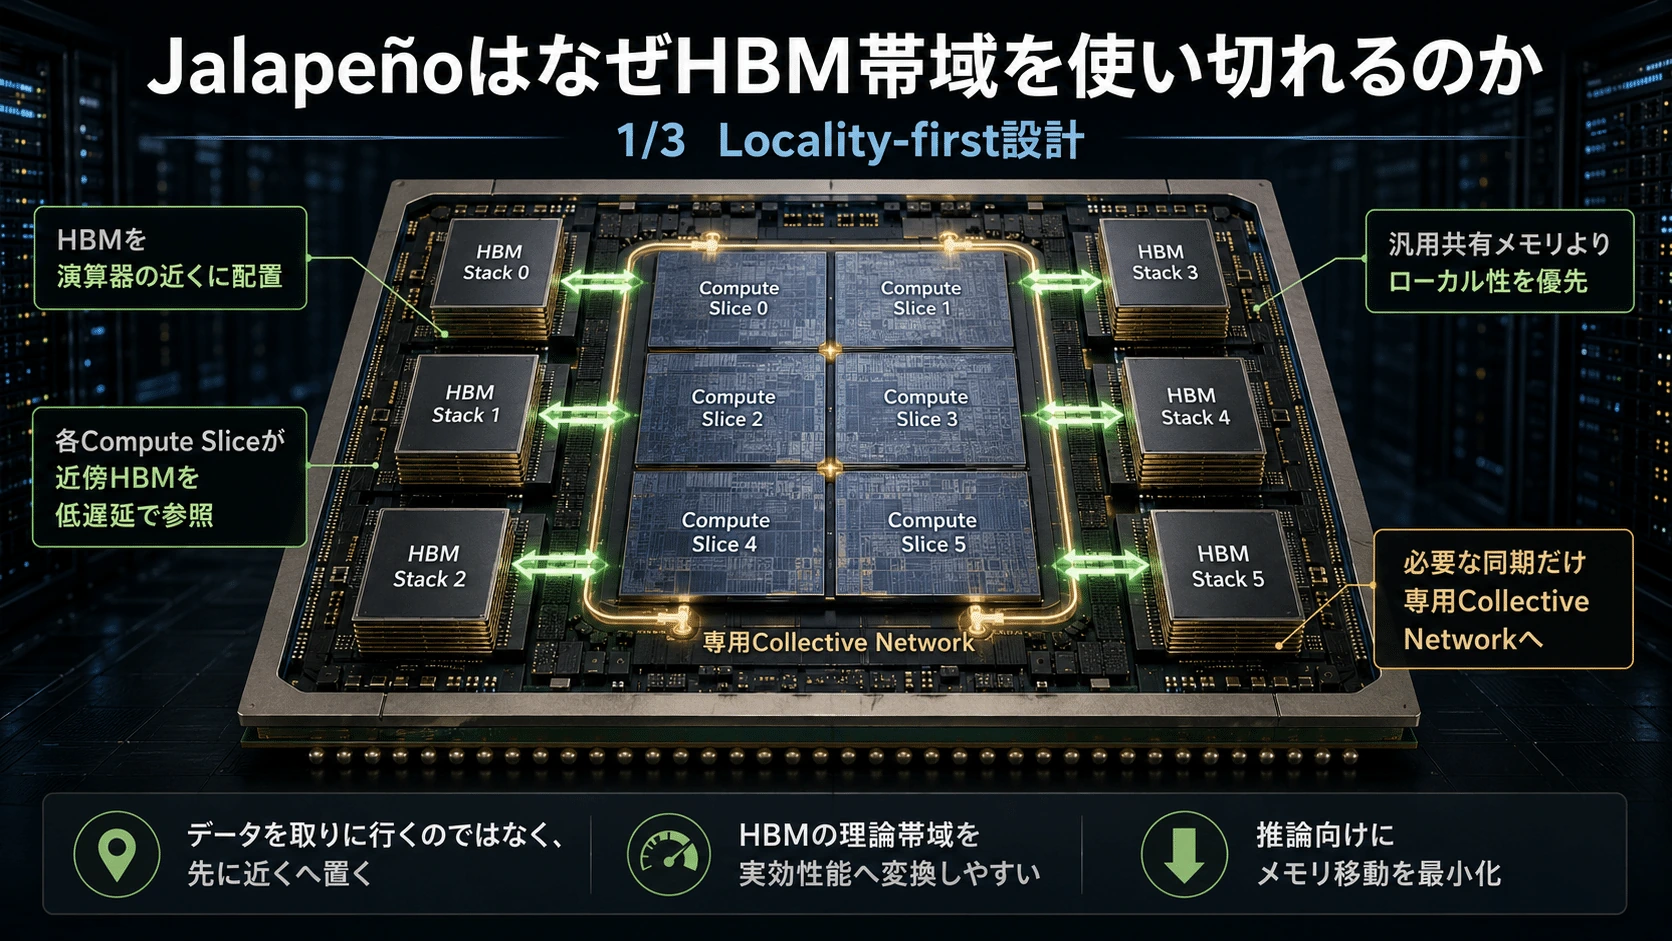
#SemiAnalysisによれば、Jalapeñoではcompute coreとHBMを複数のsliceへ分割し、各compute sliceが自分に対応したHBM sliceを低レイテンシで見る。
#概念的には、
#HBM slice A ⇄ Compute slice A
HBM slice B ⇄ Compute slice B
HBM slice C ⇄ Compute slice C
HBM slice D ⇄ Compute slice D
│
Dedicated Collective
Networkとなる。
#GPUのように「あらゆる演算器があらゆるmemoryへ柔軟にアクセスする」ことより、
#「使うデータを最初から使う演算器の近くに置く」
#ことを優先する。
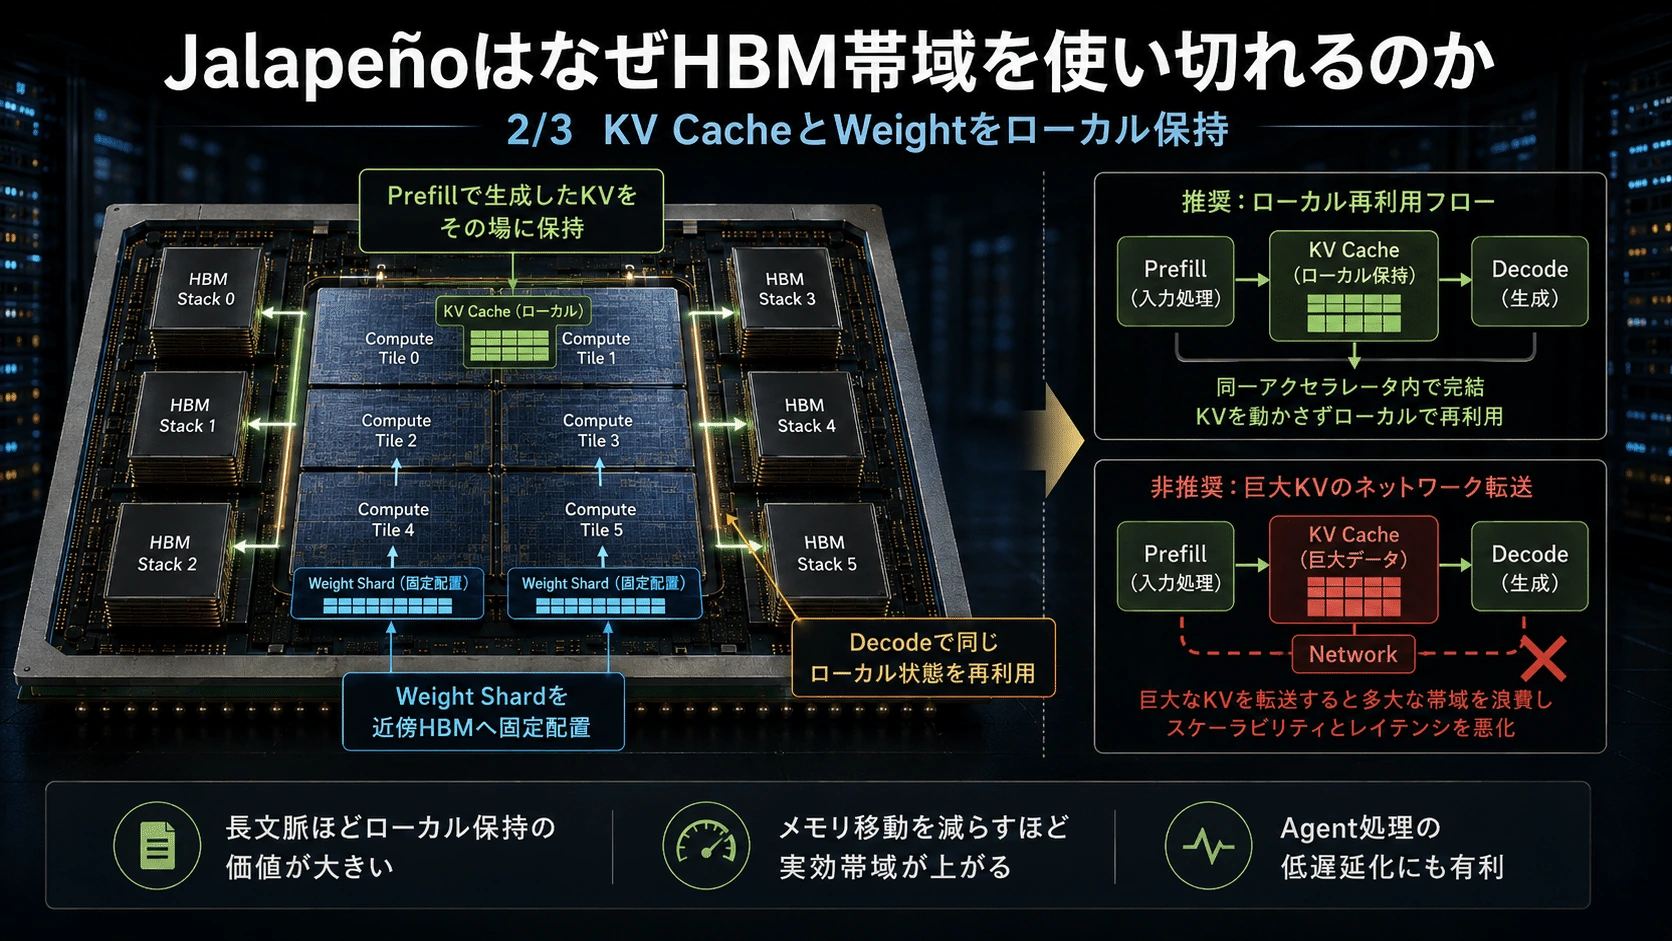
#OpenAI公式も、weightやKV cacheを含むmodel stateを明示的に配置し、localに保持できることをJalapeñoの重要な特徴として挙げている。(OpenAI)
#これは特にKV cacheで効いてくる。
#長いcontextを扱うLLMでは、過去tokenのKey/Valueが巨大化する。
#Prefill用GPUからDecode用GPUへKV cacheを移せば、それだけでネットワークを大量消費する。
#Jalapeñoは可能な限り、
#Prefill → KVをその場に保持 → Decode
#とすることで、そもそもデータを動かさない。
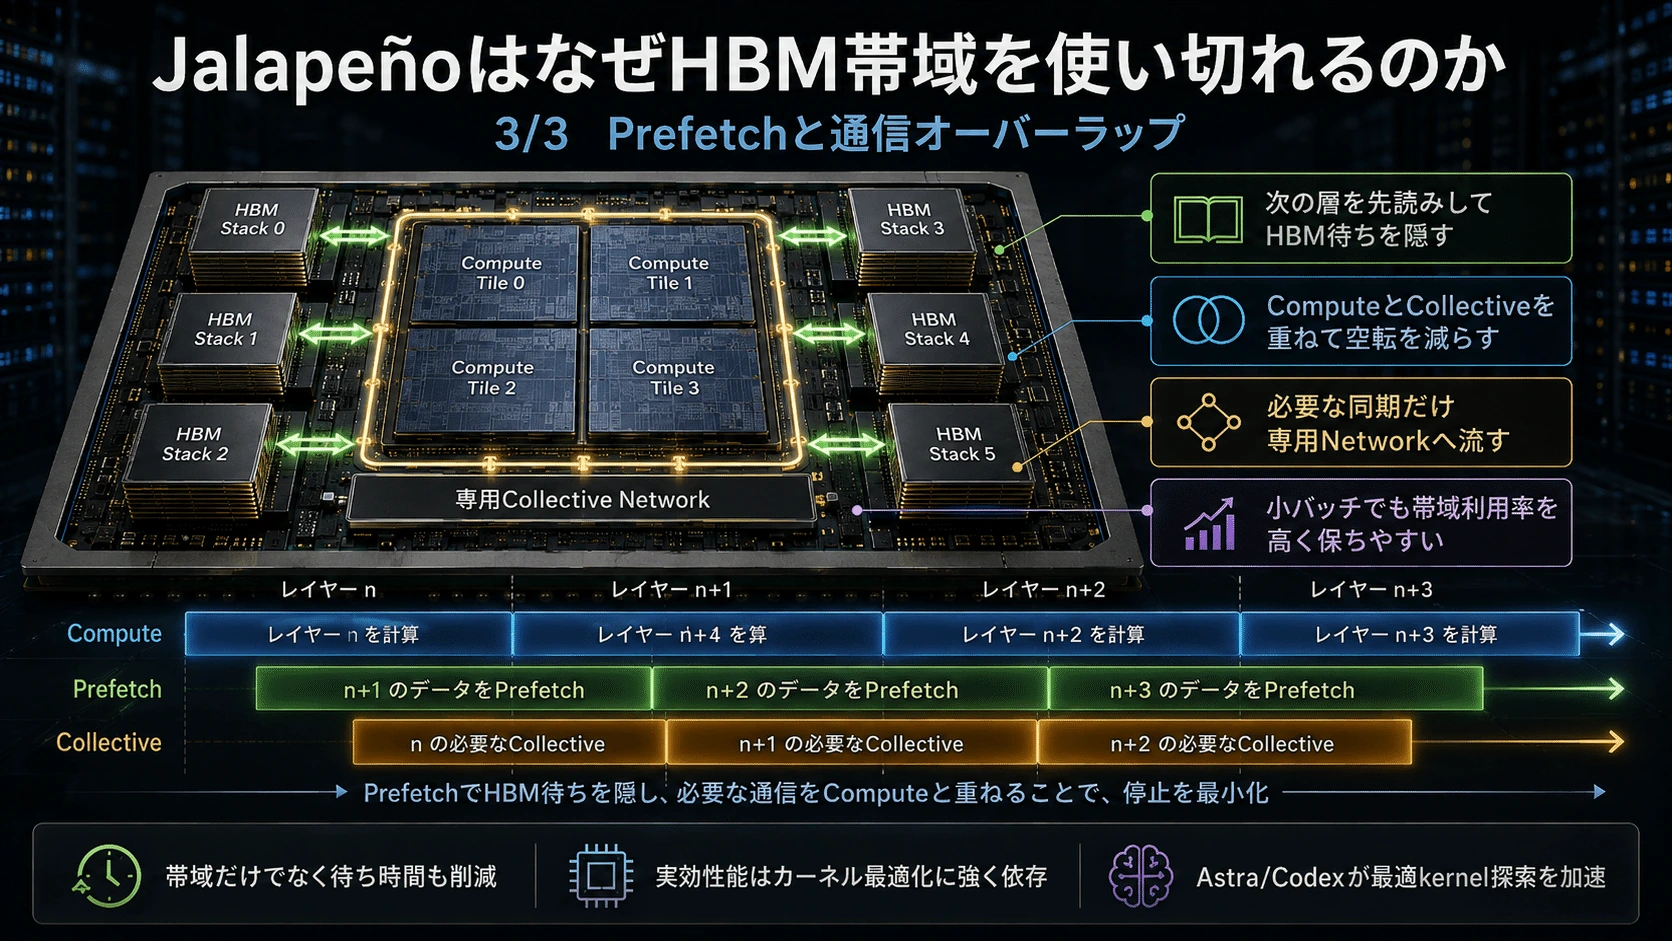
#必要なTensor Parallelismなどの通信だけを専用collective networkへ送り、computeと通信を重ねる。
#つまりJalapeñoは、
#「ネットワークを高速化する」前に「ネットワークへ出すデータを減らす」
#設計なのである。(SemiAnalysis)
#
#
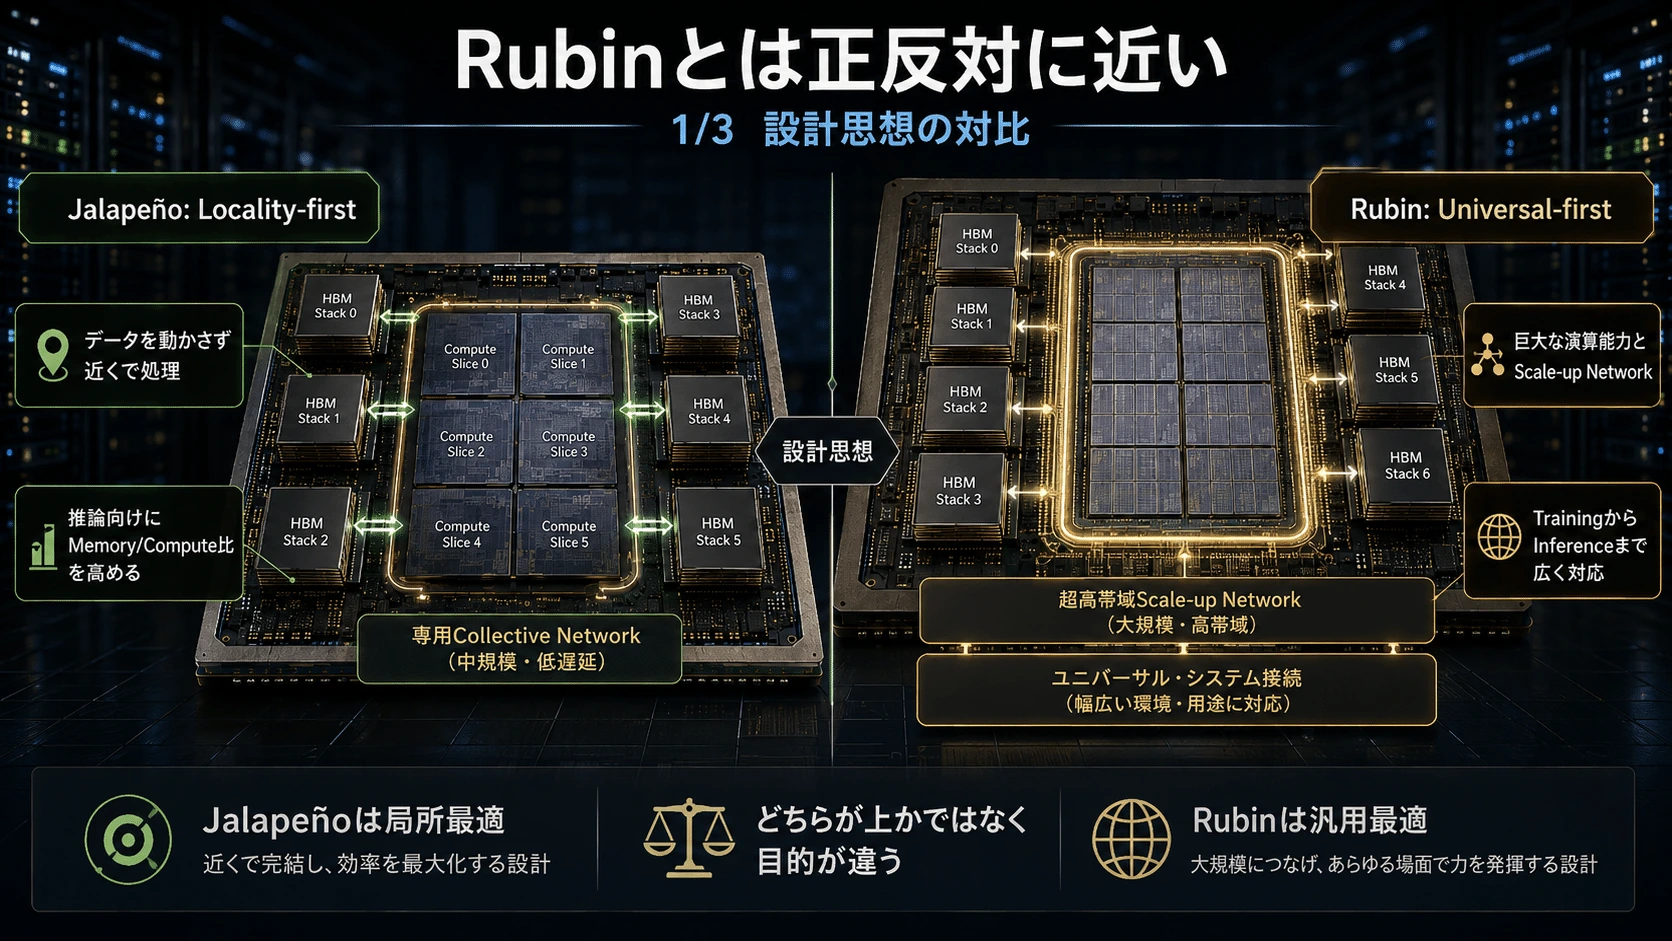
Rubinとは正反対に近い
#NVIDIA Vera Rubinは、非常に強力な万能型アクセラレータである。
#1 GPUあたり、
#となる。(NVIDIA)
#したがって、生のHBM帯域だけなら、
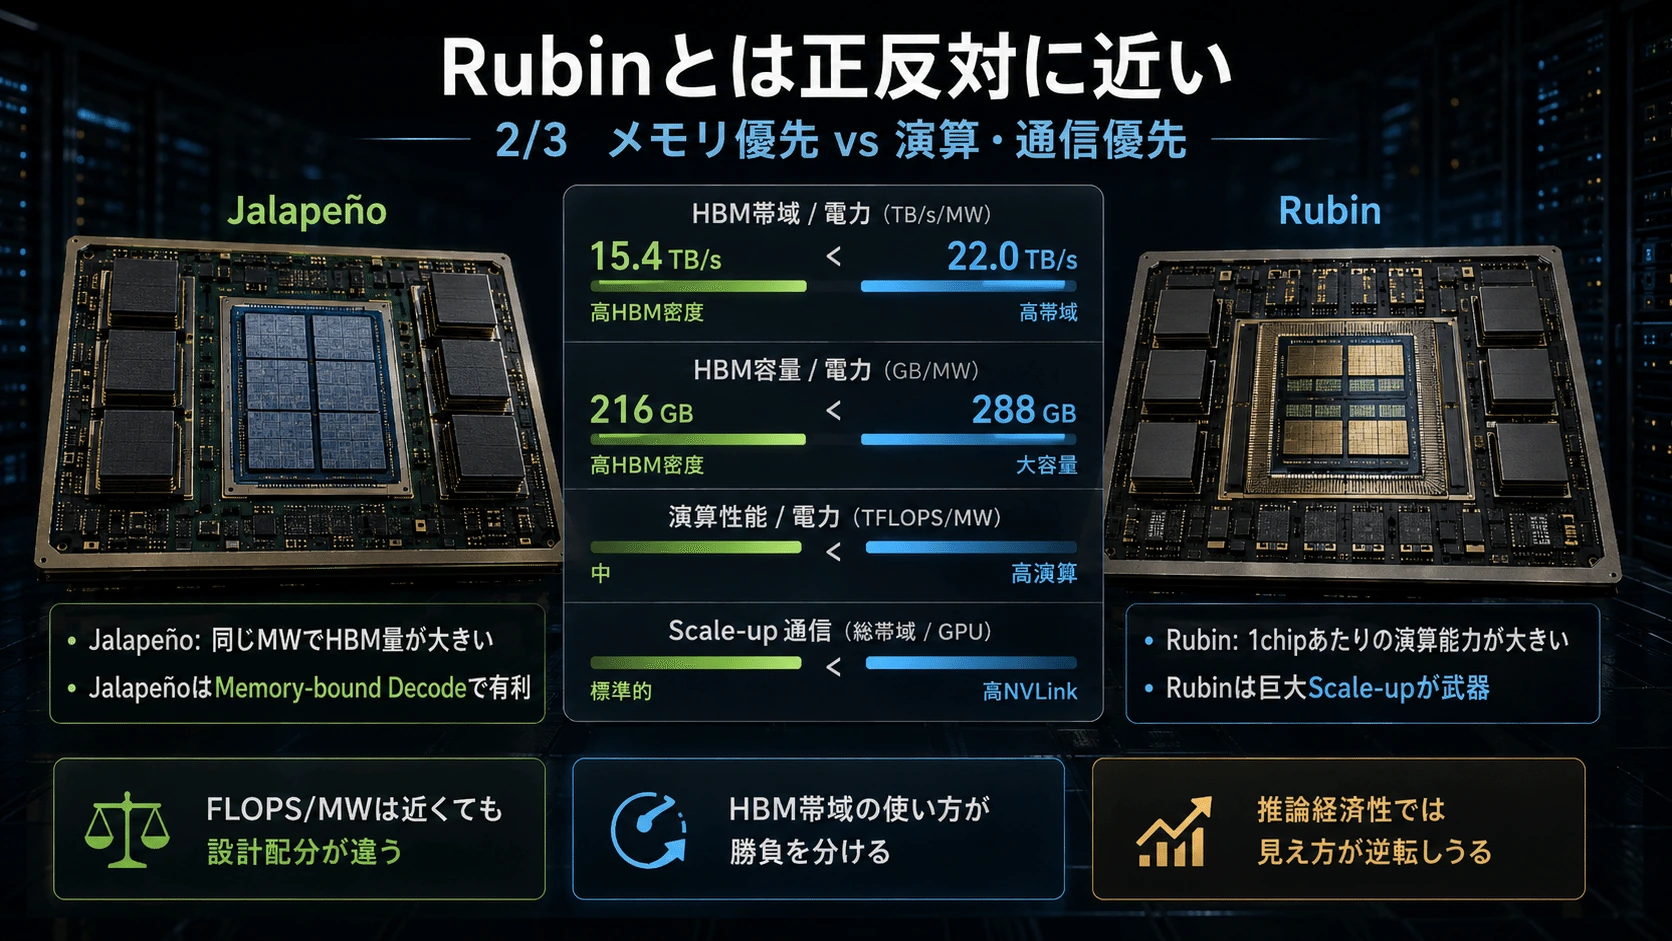
#Rubin 22TB/s > Jalapeño 15.4TB/s
#である。
#演算能力もRubinが大きい。
#それでもJalapeñoがLLM推論で非常に強いのは、HBM bandwidthを演算能力に対して極端に厚くしているからだ。
#単純に「HBM帯域÷FP4演算能力」を計算すると、
#となる。
#FP4形式がMXFP4、NVFP4、Google FP4で完全に同一ではないため性能指標として直接比較はできないが、設計のmemory intensityを見るには非常に分かりやすい。
#Jalapeñoは明らかに「FLOPSを増やす」より、「FLOPSを遊ばせない」ことへ多くのsiliconと電力を割り振っている。
#
#
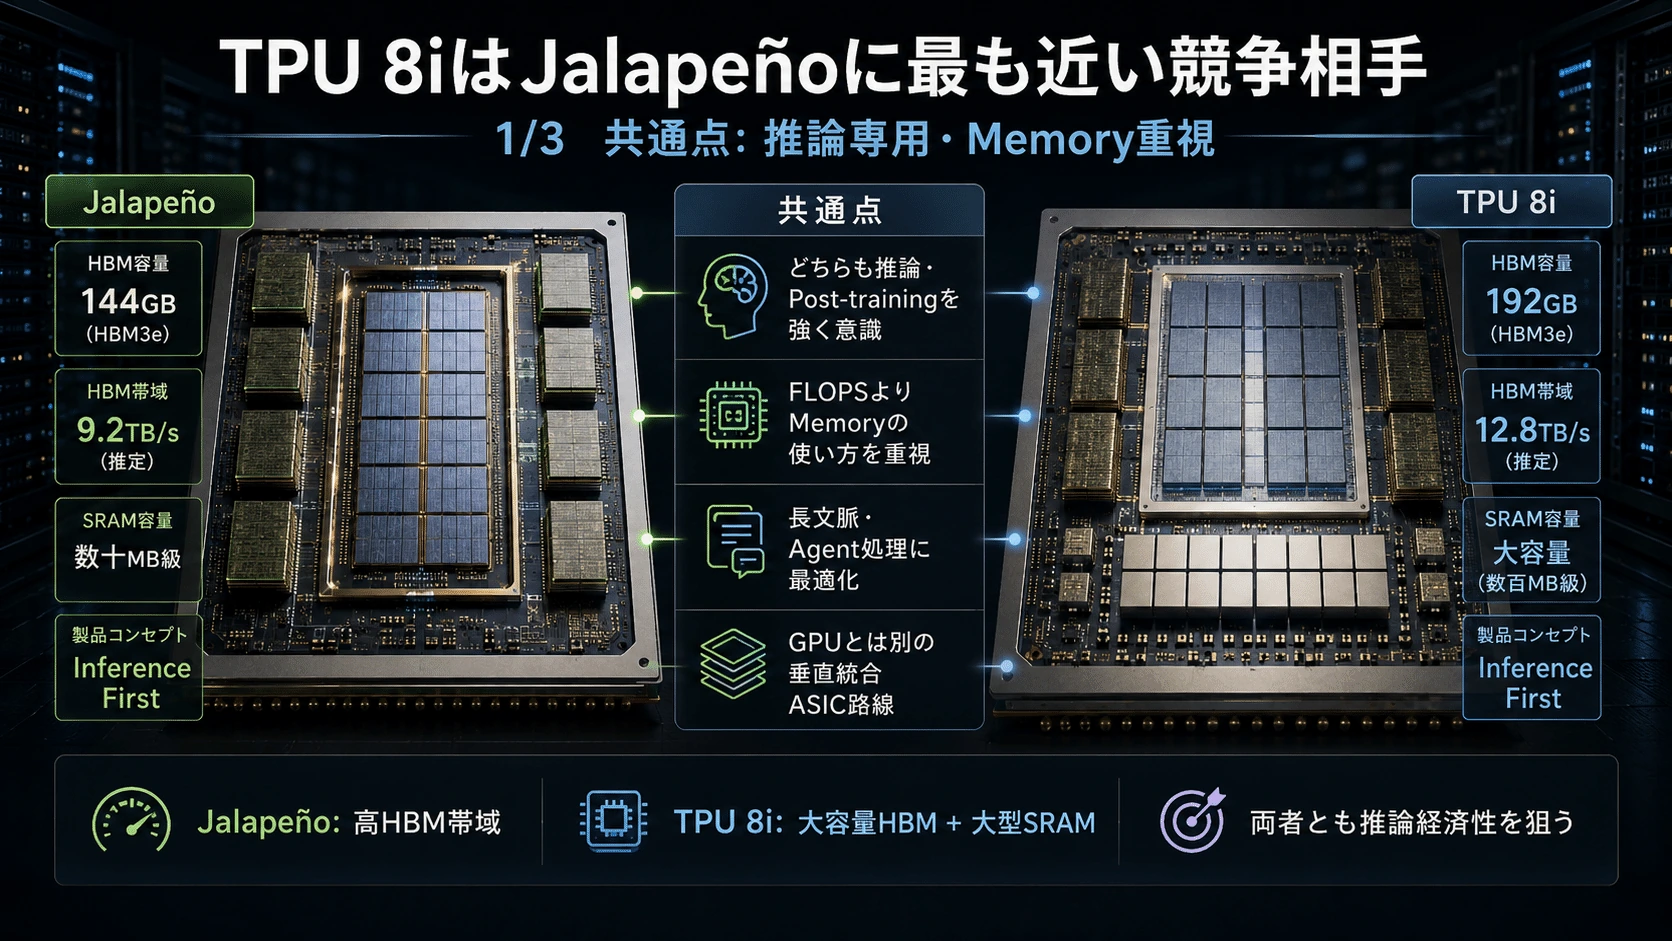
TPU 8iはJalapeñoに最も近い競争相手
#Googleの第8世代TPUは、8tと8iに完全に分かれた。
#TPU 8tは巨大なfrontier modelのpre-training向け。
#TPU 8iはSampling、Serving、Reasoning、RLなど推論・post-training向けである。
#Google公式仕様では、
#となる。(Google Cloud)
#8iではFP4演算能力を8tより減らしたのに、
#HBM容量を216→288GB
#SRAMを128→384MB
#へ増やしている。
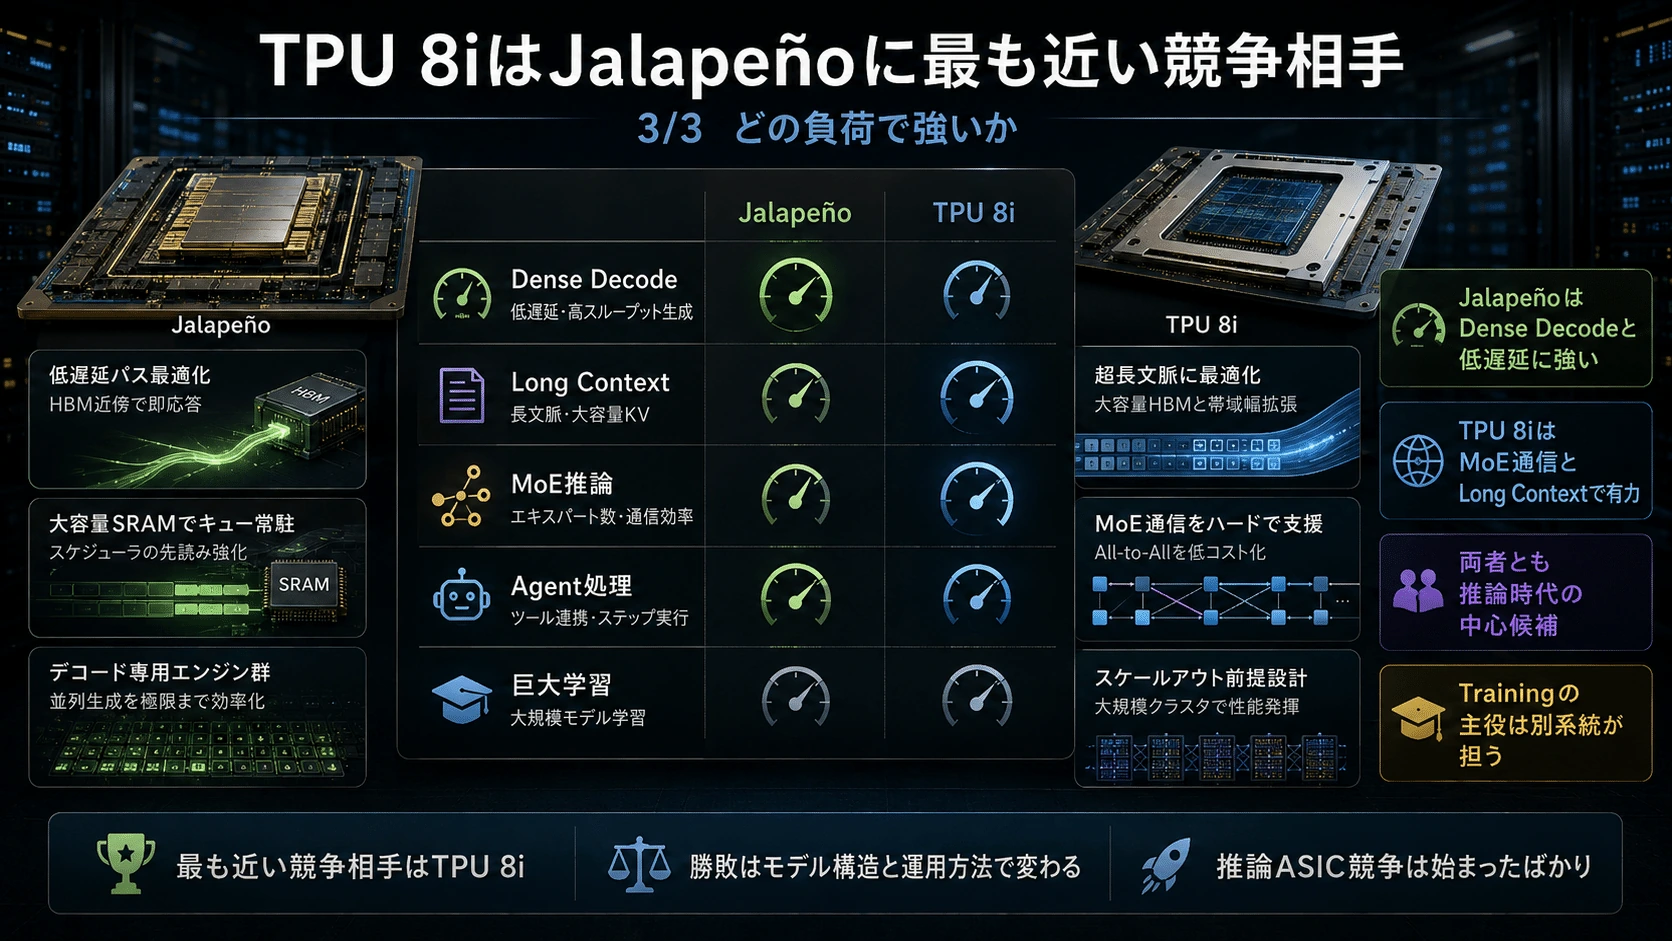
#これはGoogleもOpenAIと同じ結論へ到達していることを意味する。
#推論ではFLOPSだけ増やしても駄目なのである。
#ただし解決方法は違う。
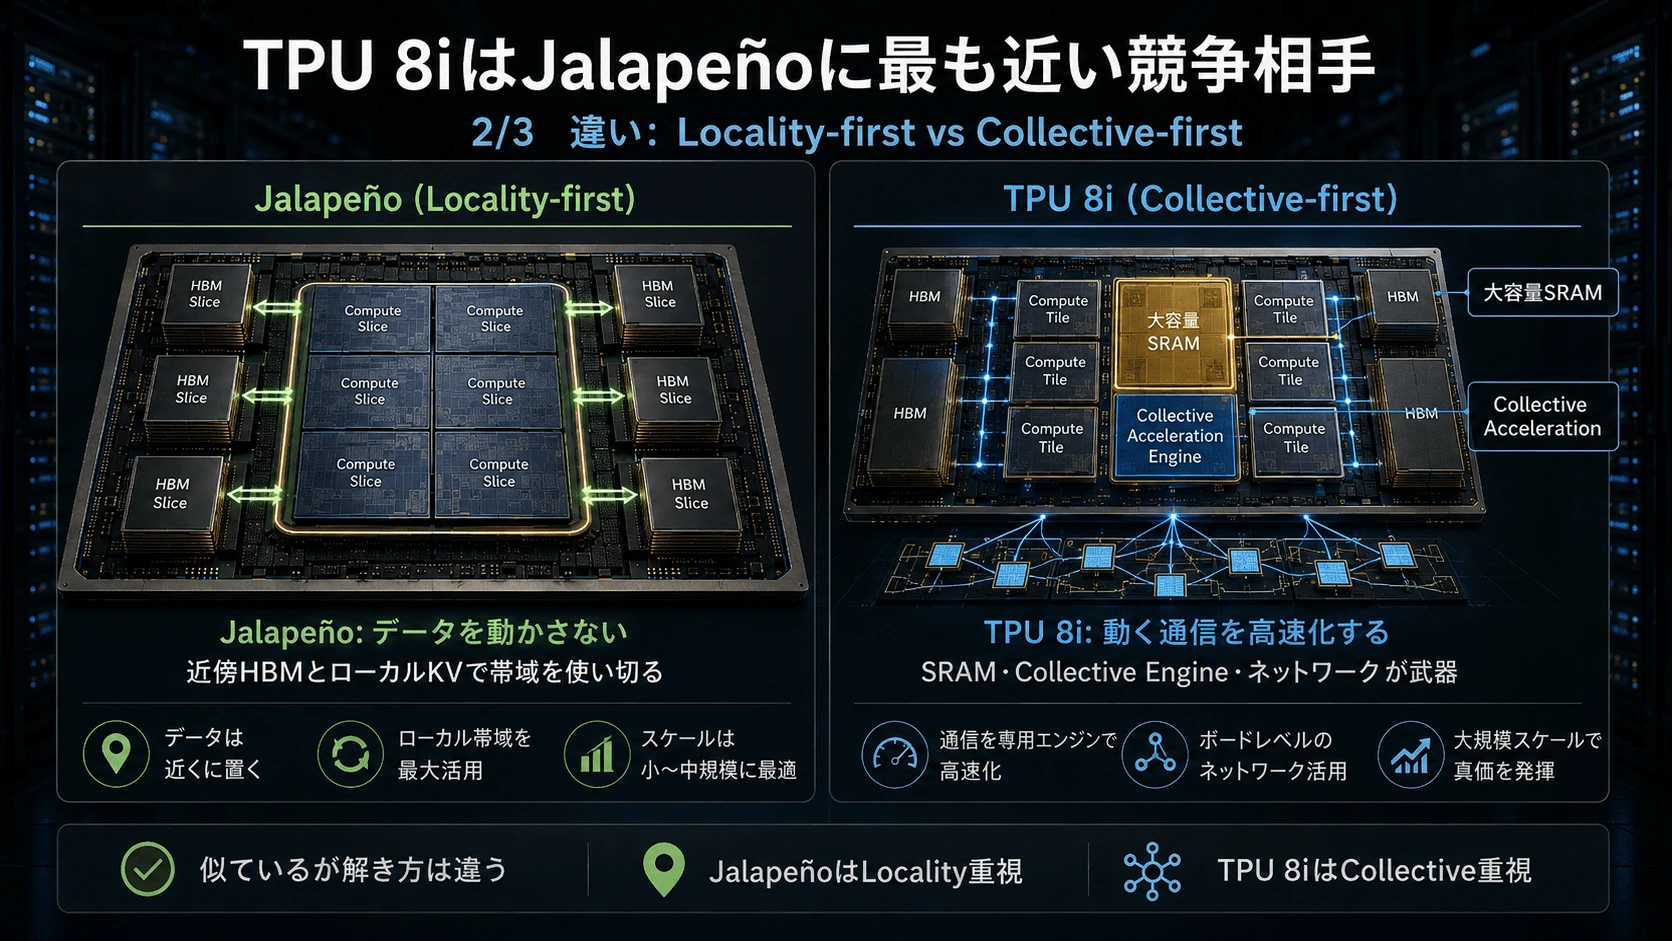
#Jalapeñoは、
#Localityを最大化してデータを動かさない。
#TPU 8iは、
#384MB SRAMにhot working setやKVを多く保持し、どうしても発生するMoE通信はCAEとBoardflyで猛烈に高速化する。
#GoogleはTPU 8iにCollectives Acceleration Engine、CAEを導入した。
#さらにBoardfly topologyではnetwork diameterを16 hopから7 hopへ縮小し、約56%削減している。(Google Cloud)
#つまり、
#Jalapeño
データを動かさない
↓
Locality-first
TPU 8i
データが動いても速く処理
↓
Collective-first
Rubin
巨大帯域+巨大NVLink+CUDA
↓
Universal-firstという三者三様の答えが出ている。
#
#
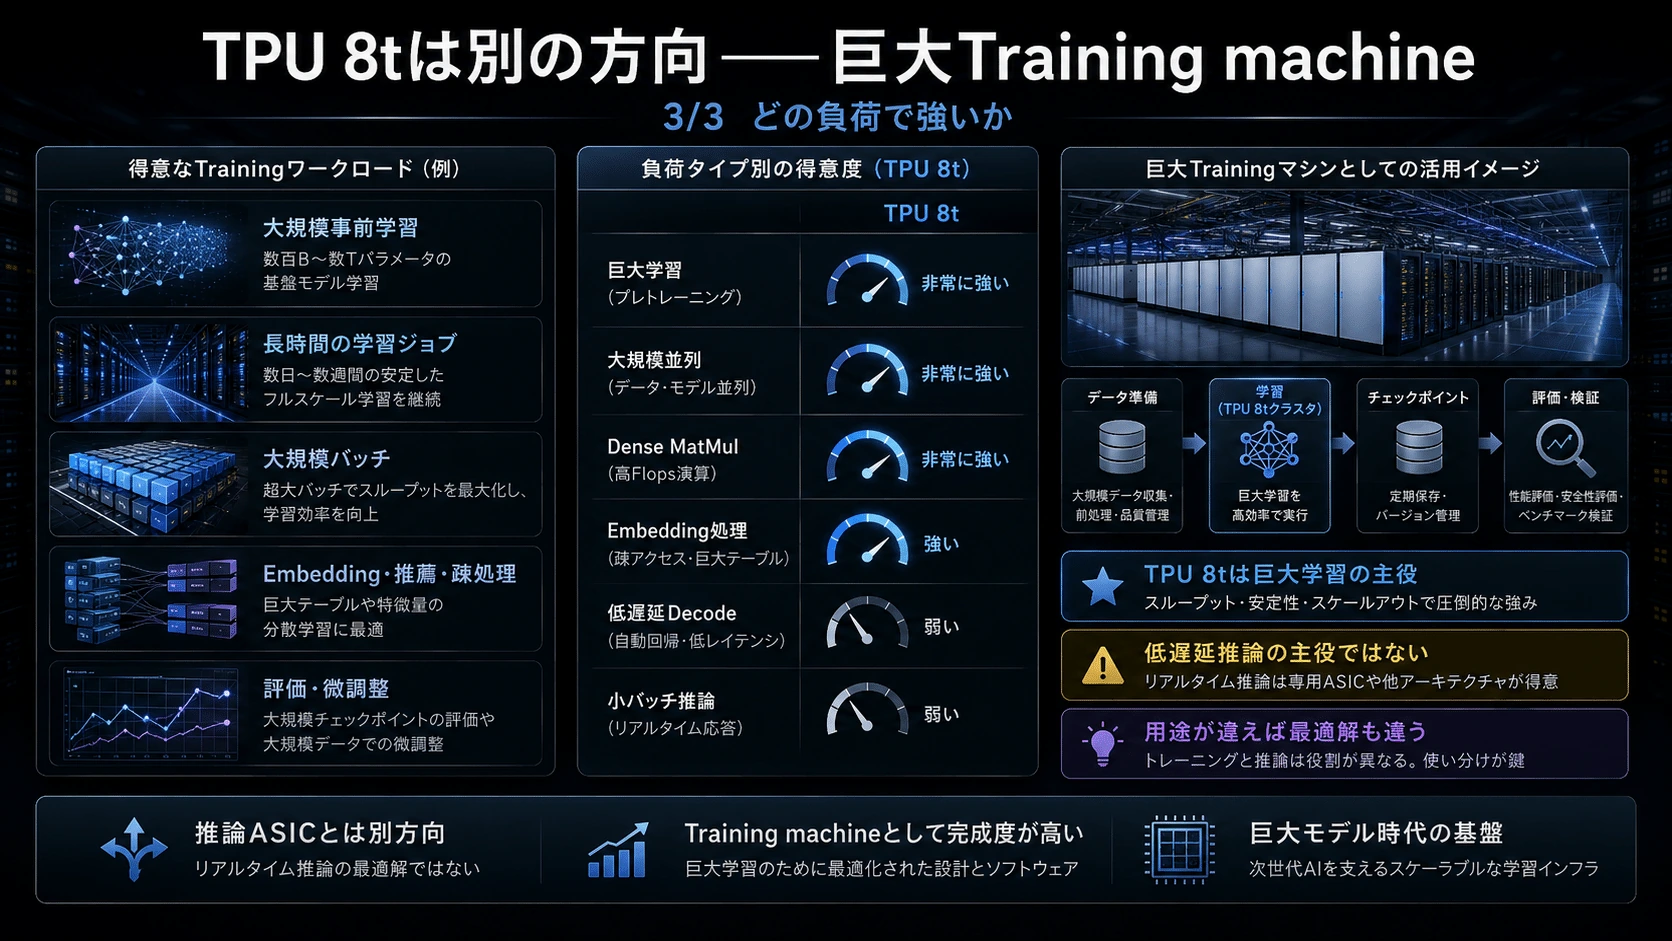
TPU 8tは別の方向――巨大Training machine
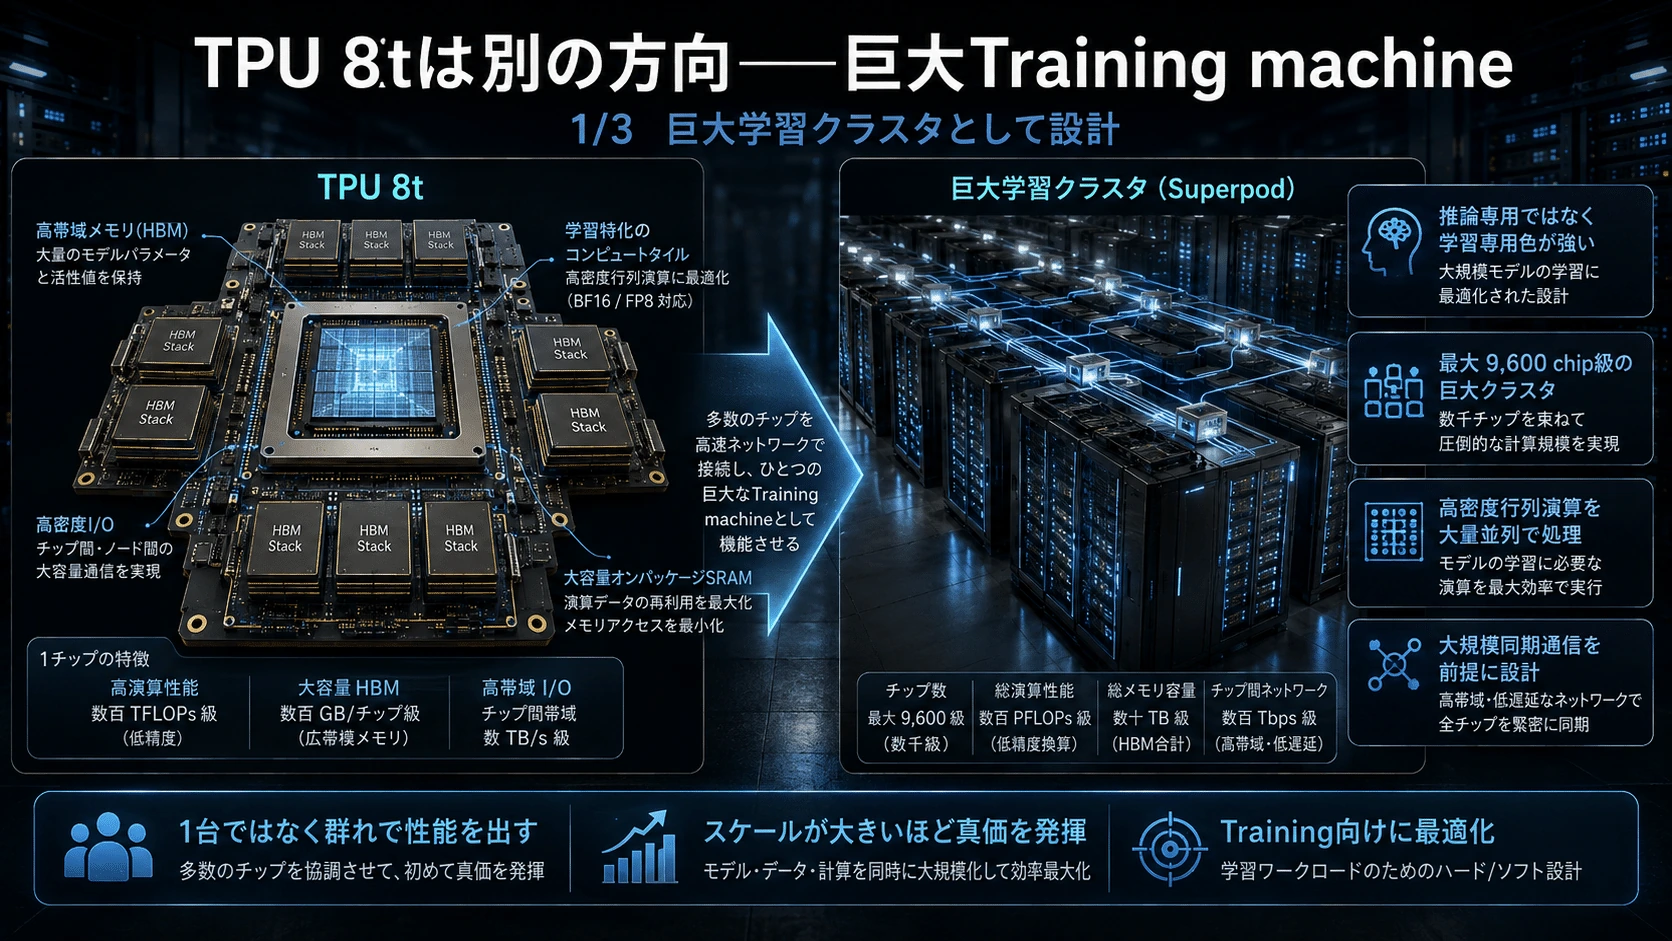
#TPU 8tはJalapeñoの直接競争相手ではない。
#Googleは最大9,600 chipのSuperpodを構築し、FP4で121EFLOPS、2PB超のHBMを一つのtraining systemとして扱う。(Google Cloud)
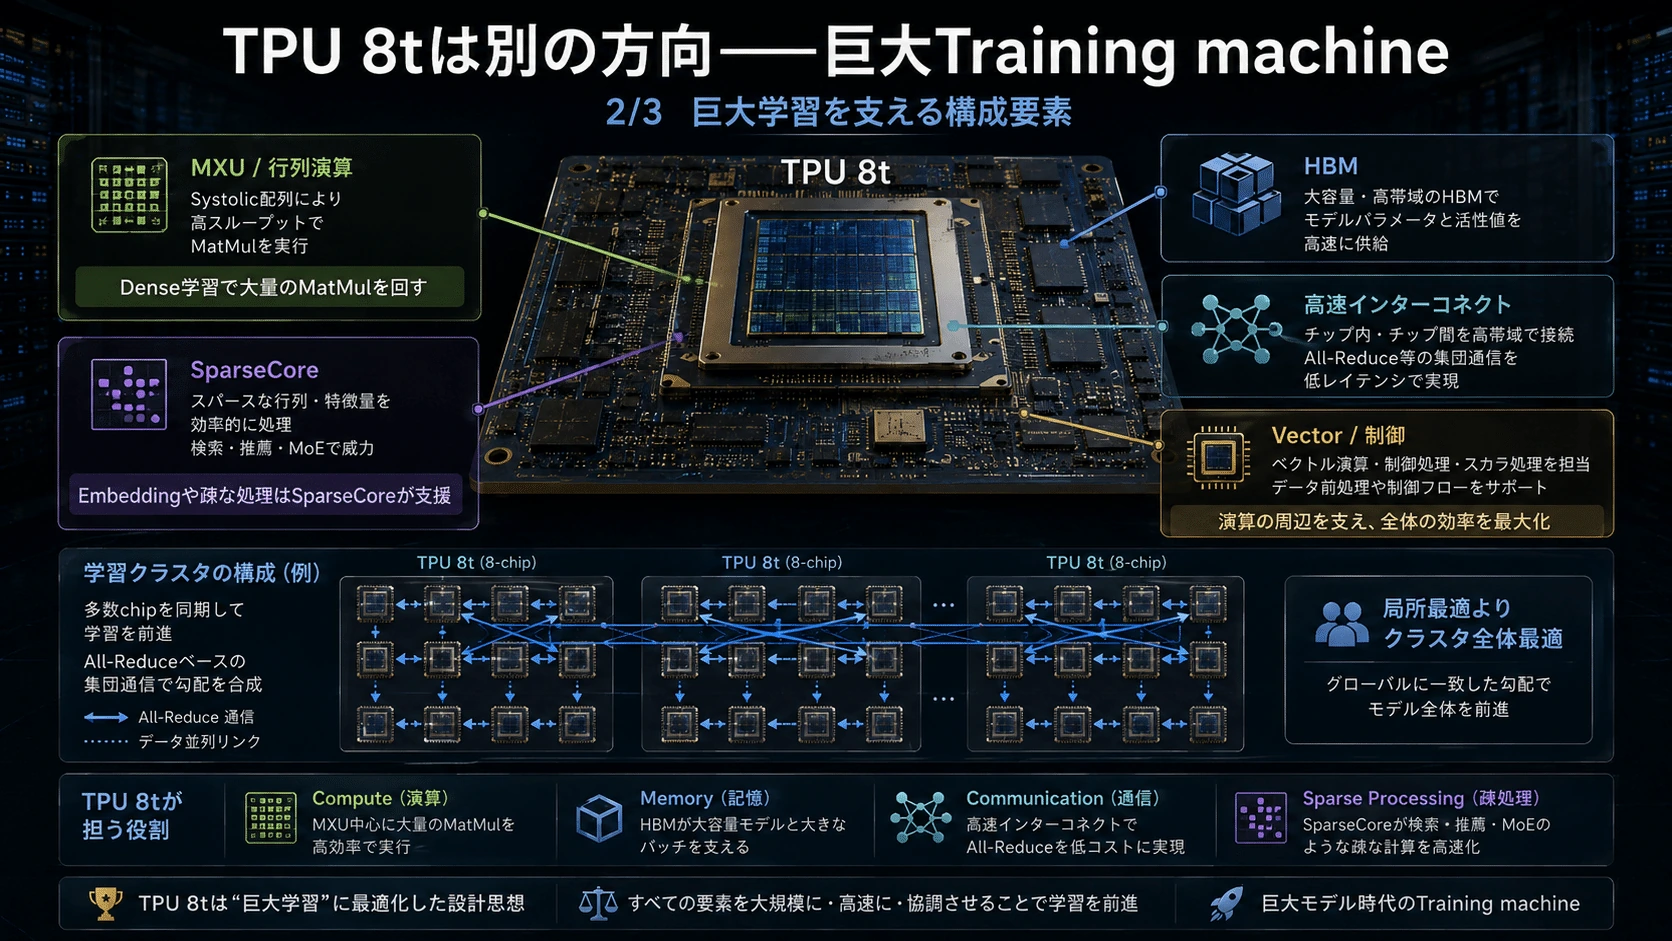
#8tではSparseCoreを持ち、Embeddingやirregular memory accessをMXUから切り離す。
#巨大モデルのtrainingでは、
#Dense MatMul Embedding Collective Routing Vector処理
#を別々のengineへ分業し、9,600個のacceleratorを一つの巨大なtraining machineとして使う思想だ。
#したがって用途を整理すると、
#となる。
#Rubinは最も汎用的である。
#一方JalapeñoとTPUは、自社モデルと自社サービスを知っているからこそ可能な垂直統合ASICだ。
#
#
Jalapeñoのもう一つの武器――GPT-AstraがASICを育てる
#Jalapeñoが本当に異質なのはここかもしれない。
#新しいASICを作っただけではモデルは高速に動かない。
#Attention、MoE、GEMM、collective、prefetch、tensor layoutなどについて、そのASIC固有のkernelを大量に作る必要がある。
#これこそCUDAが20年近く築いた最大のmoatの一つだった。
#OpenAIは、この「時間」をAIで圧縮し始めている。
#OpenAIによると、Jalapeñoの当初のproduction planに含まれていなかった3つのopen-weight modelについて、CodexとGPT-Astraを使い2か月未満で高性能動作までbring-upした。
#さらにGPT-OSSの一部Attention/MoE blockでは、AI生成implementationが人間のexpert-written implementationより1.5~1.8倍高速だった。これはmodel全体が1.8倍という意味ではなく、選ばれたkernel blockでの結果である。(OpenAI)
#SemiAnalysisによると、Jalapeñoのkernelは極めて低水準までチューニングされる。
#Gluonを通して、
#prefetch距離 tile size memory layout collective overlap instruction scheduling
#などを探索する。
#人間だけなら何週間もかかる探索をCodex/Astraが大量に反復できれば、
#ASICにはCUDAのような20年間の蓄積がない
#という弱点そのものを縮められる。
#これはJalapeñoの性能以上にNVIDIAにとって重要である。
#ただしSemiAnalysis自身も、現時点でNVIDIA siliconそのものが劣っているとは評価していない。
#Rubinのsoftware stackもまだ初期であり、JalapeñoとRubinの比較は同一ラボで同一条件に揃えた直接benchmarkではない。Jalapeñoの公開結果も主としてA0 steppingであり、8k/1k token条件が中心で、長文脈・複数ターンAgent workloadの全体を証明したものではない。(SemiAnalysis)
#したがって、
#「CUDA moatは消えた」ではなく、「AIがCUDAの時間的moatを削り始めた」
#と見る方が正確だろう。
##
そして7月――Samsung、Broadcom、OpenAIの動きが一本につながる
#ここから半導体供給網の話になる。
#OpenAIとBroadcomは2025年10月の時点で、OpenAI独自AI acceleratorを10GW規模で展開すると発表していた。
#OpenAIがacceleratorとsystemを設計し、Broadcomが共同開発、Ethernetを含むscale-up/scale-out networkingを提供する。
#deploymentは2026年後半から開始し、2029年末までを予定している。(OpenAI)
#そして2026年7月24日、サンフランシスコで韓国政府主導のAI Summitが開催された。
#Sam Altman、Jensen Huang、Dario Amodeiなど米AI企業側と、Samsung・SKなど韓国半導体企業側のトップが集まった。(Reuters)
#翌7月25日、Samsung ElectronicsとBroadcomは非常に大きなMOUを発表した。
#期間は2030年までの5年間。
#想定協力規模は、
#2,000億ドル超。
#ただし、これは「BroadcomがSamsung Foundryへ2,000億ドル分のwaferを発注した」という契約ではない。
#Samsung公式では、
#Memory + Foundry + Advanced Packaging
#にまたがる戦略的協力の推定規模である。(Samsung Global Newsroom)
#MemoryではBroadcomの次世代AI accelerator向けを含むHBM。
#FoundryではSamsungの2nm以下。
#さらに2.3D/2.5D advanced packagingまで対象に含まれている。
#これは非常に重要だ。
#JalapeñoでBroadcomが担う領域とほとんど重なるからである。
##
同じ7月25日、Sam Altmanと李在鎔がOpenAI本社で会談
#さらに同日、Samsung Electronics会長の李在鎔とSam AltmanはOpenAIのサンフランシスコ本社で会談した。
#OpenAI側は会談そのものを認めたものの、具体的な内容は公開していない。
#韓国報道では、
#HBM DRAM Advanced Foundry AI Infrastructure
#などが主要議題だった可能性が報じられている。(아시아경제)
#そして1か月後の8月25日、SemiAnalysisがJalapeñoのHBM4を、
#likely Samsung
#と分析した。
#時系列だけを見ると、非常に意味深である。
#ただしここで、
#「7月のMOUとAltman・李在鎔会談はJalapeño契約のためだった」
#と断定する証拠はない。
#むしろ、より整合的な見方は、
#Jalapeñoを第1世代とするOpenAI × Broadcomの複数世代10GW ASIC供給網へ、SamsungがHBM、将来のFoundry、Advanced Packagingの3方向から入り込もうとしている
#というものだろう。
#初代Jalapeñoのcompute dieはSemiAnalysisによればTSMC N3Pである。
#したがってSamsung Foundryとの7月MOUを、「初代Jalapeño compute dieをSamsungで作る契約」と解釈するのは難しい。(SemiAnalysis)
#しかし次世代Jalapeñoなら話は違う。
##
Samsungの狙い――HBMから入り、FoundryとPackagingまで取る
#Samsungは2026年2月、HBM4の量産・commercial shipment開始を発表した。
#12Hiで最大36GB、1 stackあたり最大3.3TB/s級。安定動作11.7Gbps、最大13Gbpsを示している。(news.samsungsemiconductor.com)
#Jalapeñoの216GBという容量は、
#で非常に綺麗に一致する。
#さらに6 stack × 2,048bit × 約10Gbpsなら、
#約15.36TB/s
#となり、SemiAnalysisが示した15.4TB/sとも一致する。
#だからSamsung HBM4説には技術的にも整合性がある。
#そしてSamsungが最終的に狙える構造は、
#現在
TSMC Compute
+
Samsung HBM4
+
Broadcom implementation/network
将来
Samsung Foundry
+
Samsung HBM4/HBM4E
+
Samsung Advanced Packaging
+
Broadcomである。
#SamsungにとってJalapeñoは、HBM4のdesign winだけでなく、赤字が続いたFoundryを次世代CSP ASICへ食い込ませる入口になり得る。
##
4チップを1MWに揃える
#ここから実際にJalapeño、Rubin、TPU 8t、TPU 8iを同じ「1MW」という物差しに換算する。
#ここでは1MWをアクセラレータpackageそのものに投入するIT電力として扱う。
#Jalapeñoは公式rated powerの700W。
#RubinはSemiAnalysisが性能比較で使用している約1.8kW Max-Q構成。
#GoogleはTPU 8t/8iのchip TDPを公開していないため、本試算では8t=1.50kW、8i=1.15kWを中心仮定とした。
#したがってTPUの1MW値には特に±20%程度の感度を見ておく必要がある。
#1MW当たりの比較
#- SemiAnalysis比較条件。一般的なRubin公式TDPとして扱ってはいない。
本稿の推定。Google非公表。 dense training NVFP4。NVIDIAはinferenceで50PFLOPSも公表している。
#ここで最も興味深いのは、
#JalapeñoとRubinのFP4/MWがほぼ同じ
#なのに、
#JalapeñoのHBM bandwidth/MWはRubinの約1.8倍
#ということだ。
#さらにHBM容量/MWでは、
#つまり同じ1MWを使うなら、JalapeñoはRubinのほぼ2倍のHBMを抱える。
#これこそがJalapeñoの設計思想を数字で表したものになる。
##
推定token/sへ換算する
#実際のLLM token/sはmodel、MoE、batch、context length、speculative decoding、KV cache、network、kernelによって数倍以上変わる。
#そのためここでは実測performanceを予言するのではなく、4チップのmemory-bound decode能力を同じ条件で比較するためのtoken-equivalentを作る。
#仮定は、
#70B dense-equivalent FP4 weight約35GB KV・metadata・無駄なtrafficを加えて40GB/token 実効HBM利用率60%
#とする。
#すると、
#である。
#結果は、
#となる。
#当然、これはGPT-OSSやDeepSeek R1の実測値ではない。
#JalapeñoではOpenAIが実際にGPT-OSSで1,459 tok/s/user級、DeepSeek R1で700 tok/s/user級を公表しているが、それとは別の比較用モデルである。(OpenAI)
#重要なのは絶対値ではなく、
#memory-bound workloadを1MWで何個並列に処理できるか
#という関係だ。
#この単純モデルではJalapeñoがRubinの約1.8倍になる。
#つまりJalapeñoは1 chipではRubinより弱くても、
#1MWで大量に並べると強い。
#Data Center Economicsではこちらの方が重要になる可能性がある。
##
HBM wafer消費量へ変換する
#さらに4チップがどれだけDRAM waferを消費するのかを見る。
#Samsungの36GB HBM4 12Hiを基準にすると、
#である。(Samsung Semiconductor Global)
#そこで比較モデルを、
#とする。
#TPU 8ではGoogleがHBMのstack構成や世代を公式には明示していないため、ここも36GB・12Hi換算したDRAM wafer-equivalentとして扱う。
#さらに24Gb HBM DRAMで、
#300mm wafer当たり430~500 good die
#と仮定する。
#これはメーカー公表値ではなく、die sizeとyieldをまとめてレンジ化した試算である。
#すると、
#HBM DRAM wafer-equivalent / 1MW
#となる。
#1GWなら単純に1,000倍、
#である。
#これはHBMのlogic base die wafer、TSV/stacking/test yield、spareを含まないDRAM front-end wafer-equivalentなので、実際の投入waferはさらに増える可能性がある。
##
ここで非常に重要な結論が出る
#もし1GWのAI設備をRubinからJalapeñoへ置き換えた場合、
#HBM wafer-equivalentは、
#Rubin:約10.7~12.4万枚
#から、
#Jalapeño:約20.6~23.9万枚
#へ増える。
#ほぼ2倍である。
#したがって、
#「NVIDIA GPUのシェアがcustom ASICへ移る=HBM需要が減る」
#とは限らない。
#むしろInference ASICがmemory-heavyになるほど、
#同じMWから発生するHBM需要は増える
#可能性がある。
#これはSamsung、SK hynix、Micronを見るうえで極めて重要だ。
##
Samsungへのインパクト
#Jalapeño 1GW-equivalentでは、
#20.6~23.9万枚
#のHBM DRAM wafer需要が発生する。
#Samsungが仮に80%を供給した場合、
#約16.5~19.1万枚/GW
#になる。
#これはあくまで80%供給というシナリオであり、実際のSamsung shareは公表されていない。
#より安全な見方をするなら、
#JalapeñoのHBMシェアが10ポイント動くだけで約2.1~2.4万枚/GWがsupplier間を移動する
#と考えればよい。
#Samsungは2026年にHBM4 qualificationを急速に進めており、TrendForceもSamsungがHBM4で追い上げている一方、SK hynixがHBM全体では依然首位にいると分析している。(TrendForce)
#もしJalapeñoがSamsung HBM4の大型design winだった場合、SamsungのHBM4 share回復に与える影響はかなり大きい。
##
SK hynixへのインパクト
#SK hynixにとってJalapeñoのSamsung採用は相対的なリスクだが、HBM需要全体が拡大するなら絶対額では必ずしも悪材料にならない。
#Rubin 1GWだけでも、
#10.7~12.4万枚
#のHBM DRAM wafer-equivalentが必要になる。
#そこでsupplier shareが10ポイント動けば、
#約1.1~1.2万枚/GW
#が移動する。
#NVIDIAのRubin volumeが数GW規模へ拡大すれば、SK hynixがそこで最大シェアを維持するだけでも非常に大きな需要になる。
#そしてAI accelerator市場が、
#NVIDIA Google TPU OpenAI Jalapeño AWS Trainium Meta ASIC
#へ分散するほど、
#「HBM市場全体の首位」より「どのCSP ASICのdesign winを持っているか」
#が重要になる。
##
Micronへのインパクト
#MicronはSamsungやSK hynixほどのcapacityを持たない。
#しかしRubinのような巨大platformでは、それでも十分である。
#Rubin 1GWのHBMを10%取るだけで、
#約1.1~1.2万枚のHBM DRAM wafer-equivalent
#になる。
#20%なら約2.1~2.5万枚。
#NVIDIA自身がRubin向けHBMを複数supplier化する方向にあり、TrendForceもSamsung、SK hynix、Micronの3社体制になる可能性を指摘している。(TrendForce)
#Micronは「シェア1位」を取らなくても、巨大なRubin TAMのthird sourceとして十分大きな売上を作れる。
##
Broadcomへのインパクト――Jalapeñoの最も直接的な外部受益者
#BroadcomはJalapeñoで単なるASIC設計会社ではない。
#OpenAI公式によれば、
#silicon implementation board/rack integration high-performance networking scale-up / scale-out connectivity production
#まで深く関与する。(OpenAI)
#Broadcom自身のAI semiconductor revenueは2026年第2四半期だけで108億ドル、第3四半期guideは160億ドルに達している。(Broadcom Inc.)
#さらにBroadcom earnings callでは、AI infrastructureのBroadcom contentについて、顧客によって大きく異なるとしながらも、アナリストが置く1GW当たり約150~200億ドルというrough heuristicから大きく外れていないとのやり取りがある。
#これは会社公式のOpenAI契約単価ではない。
#しかし仮に参考値として使えば、
#という桁になる。(The Motley Fool)
#そしてOpenAI/Broadcomの公式計画自体が10GWである。
#Samsung × BroadcomのMOUが2,000億ドル超という巨大な数字になったことが、急に理解しやすくなる。
#もちろん両者をそのまま同じ契約とみなすことはできないが、Broadcomが2027~2030年に扱うAI infrastructure siliconの規模自体が、それほど巨大になり始めている。
##
TSMC――誰が勝っても現時点では最大の中立的勝者
#JalapeñoはSemiAnalysisによれば、
#Compute die:TSMC N3P
#I/O chiplet:TSMC N3E
#である。(SemiAnalysis)
#RubinもN3世代。
#TPU 8についても供給網報道ではTSMC N3 familyでの製造が示されている。(TrendForce)
#つまり2026年時点では、
#NVIDIAが勝つ → TSMC
#OpenAIが勝つ → TSMC
#Google TPUが伸びる → TSMC
#という構造がまだ強い。
#Jalapeñoについてcompute dieをfull-reticle classと置き、300mm waferから35~45 good die程度と仮定すると、1GW-equivalentで、
#約3.2~4.1万枚のN3P compute wafer
#が必要になる。
#Rubinは2 large compute die/GPUとして同じgood-die rangeを置けば、
#約2.5~3.2万枚/GW
#程度になる。
#これにはJalapeñoのN3E I/O die、Rubinの周辺die、CoWoSなどを含まない。
#つまりHBMだけでなく、1GWという単位そのものが先端logic waferを数万枚単位で飲み込む。
#だからTSMCの3nm capacityがAI需要で逼迫し続ける。Reutersも2026年に先端capacity不足から一部顧客がSamsungなどのalternative foundryを探す動きを報じている。(Reuters)
#そしてSamsung × Broadcomの2nm以下MOUは、まさにこのTSMC集中を崩すための選択肢にもなる。
##
OpenAIの「10GW」が本当に意味するもの
#ここでは注意が必要だ。
#OpenAI/Broadcomが発表した10GWは巨大なsystem deployment計画であり、
#をそのまま出荷個数forecastとして扱うべきではない。
#ラックにはCPU、memory、NIC、switch、power conversion、coolingなども存在する。
#それでも「accelerator package TDPだけで機械的に換算する」と規模感を理解することはできる。
#700Wだけで10GWを割ると、
#約1,429万Jalapeño
#相当。
#6 stack/XPUなら、
#約8,570万HBM stack
#相当。
#HBM DRAM wafer-equivalentは、
#約206~239万枚
#になる。
#これは予測ではない。
#あくまで「10GWを全部現行Jalapeñoのpackage TDPへ置き換えた上限的なmechanical scenario」である。
#しかし、OpenAI計画がHBM supplierにとってどれほど巨大かを理解するには十分だ。
#しかも2027~2029年にJalapeñoがHBM4E、より大容量stack、16Hiへ進めば、XPU当たりのHBM bit demandはさらに増える可能性がある。
##
Samsung・Broadcomの2,000億ドルMOUをもう一度見る
#ここまで計算すると、7月25日のMOUの意味が変わって見える。
#SamsungはBroadcomへ単にDRAMを販売したいのではない。
#HBM Foundry Advanced Packaging
#をまとめて取りたい。
#BroadcomはOpenAIだけでも10GW級のcustom AI infrastructureを抱える。
#さらにGoogleをはじめ複数のhyperscaler向けASICを扱っている。
#つまりSamsungがBroadcomを押さえるということは、
#Broadcom経由で複数のCSP ASIC supply chainへ入る
#ことを意味する。
#初代JalapeñoでHBMを取る。
#次世代では2nm以下のlogicを取る。
#さらに2.3D/2.5D packagingまで取る。
#もしこれが成功すれば、SamsungのAI semiconductor事業は、
#「SK hynixにHBMで追いつく」
#だけではなく、
#TSMC + SK hynixという分業型の供給網に対して、Samsung単独でMemory + Logic + Packagingを束ねる
#方向へ進める。
#Samsung × BroadcomのMOUは、この可能性を狙ったものと読むと非常に整合的だ。(Samsung Global Newsroom)
##
4陣営の競争は「GPU vs ASIC」ではなくなっている
#今回の比較から見えてくるのは、単純なNVIDIA対ASICではない。
#Jalapeñoは、
#HBM bandwidth Locality AI-generated kernel
#で攻める。
#TPU 8iは、
#大容量HBM 巨大SRAM CAE Boardfly
#で攻める。
#TPU 8tは、
#9,600 chip scale SparseCore 巨大training fabric
#で攻める。
#Rubinは、
#最大級のcompute 22TB/s HBM4 3.6TB/s NVLink CUDA ecosystem
#を全部持つ。
#つまり最適化対象が異なる。
#Rubinは世界中のモデルを動かさなければならない。
#GoogleはGeminiを知っている。
#OpenAIはChatGPT、Codex、GPT-familyのserving patternを知っている。
#そして自社モデルを持つ企業は、
#モデルをchipへ合わせ、chipをmodelへ合わせる
#ことができる。
##
Jalapeñoが本当に脅かしているもの
#JalapeñoがNVIDIAに突きつけた最大の問題は、13.4PFLOPSでも15.4TB/sでもない。
#これまでcustom ASICには、
#「hardwareを作れてもCUDA ecosystemを追いつかせられない」
#という大きな壁があった。
#OpenAIはそこへGPT-AstraとCodexを投入した。
#もし次世代では、
#architecture探索 RTL optimization verification kernel生成 prefetch tuning model porting serving optimization
#までAIが継続的に回すようになれば、
#より強いAI
↓
より良いAI chipを設計
↓
推論コスト低下
↓
より大量のAIを実行
↓
さらに強いAIというloopが生まれる。
#このcycle timeの短縮こそ、Jalapeñoの本当の意味だろう。
##
そして最大の受益者は誰か
#4チップの競争を供給網まで降ろすと、意外な結論になる。
#NVIDIAのaccelerator shareが下がっても、AI infrastructure投資そのものが伸び続けるなら、
#HBM三社とTSMCのTAMはむしろ拡大する可能性がある。
#特にJalapeñoのようなmemory-heavy inference ASICでは、同じ1MWからRubinの約2倍のHBM wafer需要が発生し得る。
#SamsungはJalapeño HBM4とGoogle TPU、さらにRubinでシェア回復を狙える。
#SK hynixはHBM全体の首位とRubin volumeを防波堤にできる。
#Micronはthird sourceとして数%~十数%を取るだけでも巨大なwafer需要を獲得できる。
#TSMCは誰がaccelerator市場を取ってもN3、advanced packaging需要を取れる。
#Broadcomはcustom XPUだけでなくnetworkingまで取り込むため、GPUからASICへのシェア移動そのものが売上機会になる。
#つまり2026~2030年のAI accelerator競争は、
#「NVIDIAが勝つか、Googleが勝つか、OpenAIが勝つか」
#だけで見るべきではない。
#むしろ、
#1MWの電力から何tokenを生み、そのために何TBのHBM、何PB/sの帯域、何枚のDRAM wafer、何枚のN3 wafer、何Tb/sのnetworkを必要とするのか
#まで見る必要がある。
#その物差しで見ると、Jalapeñoは非常に象徴的だ。
#FLOPSを最大にしたわけではない。
#HBM帯域そのものもRubinより小さい。
#それでも、
#データを動かさず、HBMを使い切り、AI自身にkernelを書かせることで、MW当たりの推論効率を最大化する。
#その設計思想が成立すれば、AI半導体の競争軸は、
#「最も大きなGPUを作る競争」から「モデル・memory・network・softwareを最も効率的に一体設計する競争」へ移る。
#そしてSam Altmanと李在鎔の会談、サンフランシスコAI Summit、Samsung × Broadcomの2,000億ドル超MOUは、その次の世代の供給網がすでに動き始めていることを示している可能性がある。
#初代Jalapeñoそのものよりも、その先にあるJalapeño 2、3と10GWの量産体制。
#そこまで見たとき、今回のSemiAnalysisの記事は単なる新ASICのbenchmark記事ではない。
#NVIDIA中心だったAI infrastructure supply chainが、OpenAI・Google・Broadcom・Samsungを巻き込みながら再編され始めたことを示す記事として読むべきだろう。
##
試算上の注意点
#本稿の1MW比較ではJalapeño 700Wは公式rated power、Rubin 1.8kWはSemiAnalysisの比較条件を採用した。一方TPU 8t=1.5kW、8i=1.15kWはGoogle非公表のため分析用仮定である。HBM waferについても24Gb DRAM die、12Hi、430~500 good die/300mm waferという共通モデルを使ったDRAM wafer-equivalentで、各社実際のdie size、yield、stack lossを示すものではない。
#また、MXFP4、NVFP4、Google FP4は同一フォーマットではない。JalapeñoとRubinのperformance比較も同一施設・同一software stackでの直接benchmarkではなく、Jalapeñoの公開値はA0 stepping中心、B0の改善値は今後の量産siliconに対する見込みである。
#SamsungによるJalapeño向けHBM4供給もSemiAnalysisの「likely」という分析段階であり、Samsung独占供給を確認した公式発表は現時点ではない。
#そしてSamsung × Broadcomの2,000億ドル超は5年間のMemory・Foundryを中心とする戦略協力MOUの推定規模であって、2,000億ドルの確定Foundry発注やOpenAI向け単独契約ではない。
#それでも、これらの前提を保守的に置いても、Inference ASICのmemory-heavy化によって、GPUの市場シェア低下とHBM需要拡大が同時に起こり得るという結論そのものは変わりにくい。
#特定銘柄の推奨・勧誘・投資助言を目的とするものではありません。投資判断はご自身の責任でお願いいたします。
#