CFETは本当に量産できるのか――2030年代のXYZ Scalingと装置産業を一体で読む
絶ノイアの章 Sil-Kathnaの章この資料の日時
元資料の日付と、その本文が公に存在した確認日時は別の記録です。
本文に含まれる語句 HBM DRAM SRAM 帯域・データ移動 先端パッケージング 光接続 電力・給電 歩留まり 基板・材料 チップレット
出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.09.23.4
- 記事内容のSHA-256
0a3006e0789514574bf5c73633044da7e704a395804c2ad2f515a5a7e5e637c6- 保存版のSHA-256
7b457b05fe29c1694e27785dd2fbbbc93c1c28b7699ee216f28141856223efe5
外部証明の最終検査結果は詳細を開くと表示します。
CFETは本当に量産できるのか――2030年代のXYZ Scalingと装置産業を一体で読む
#――2030年代、半導体は「微細化」から「XYZスケーリング」へ
#半導体の微細化について調べていると、ときどき不思議な文章に出会う。
#「次世代ではトランジスタを3Dに積層する」
#FinFETからGAAへ進み、トランジスタのゲート構造が立体的になっていくところまでは何となく分かる。
#しかし、さらにその先では、
#nMOSとpMOSそのものを上下に重ねる
#という。
#本当にそんなことが可能なのだろうか。
#仮に可能だとして、量産はいつなのか。
#上下に積んだトランジスタへ、どうやって電源や信号を送るのか。
#熱は逃げるのか。
#歩留まりは成立するのか。
#そして半導体の次世代技術を調べると、CFET以外にも、
#Backside Power Delivery
#High-NA EUV
#Ru/Mo配線
#3D SRAM
#HBM
#Optical I/O
#ガラスコア基板
#という技術が次々に出てくる。
#一見するとそれぞれ別々の技術に見える。
#ところが実際には、これらはかなり強くつながっている。
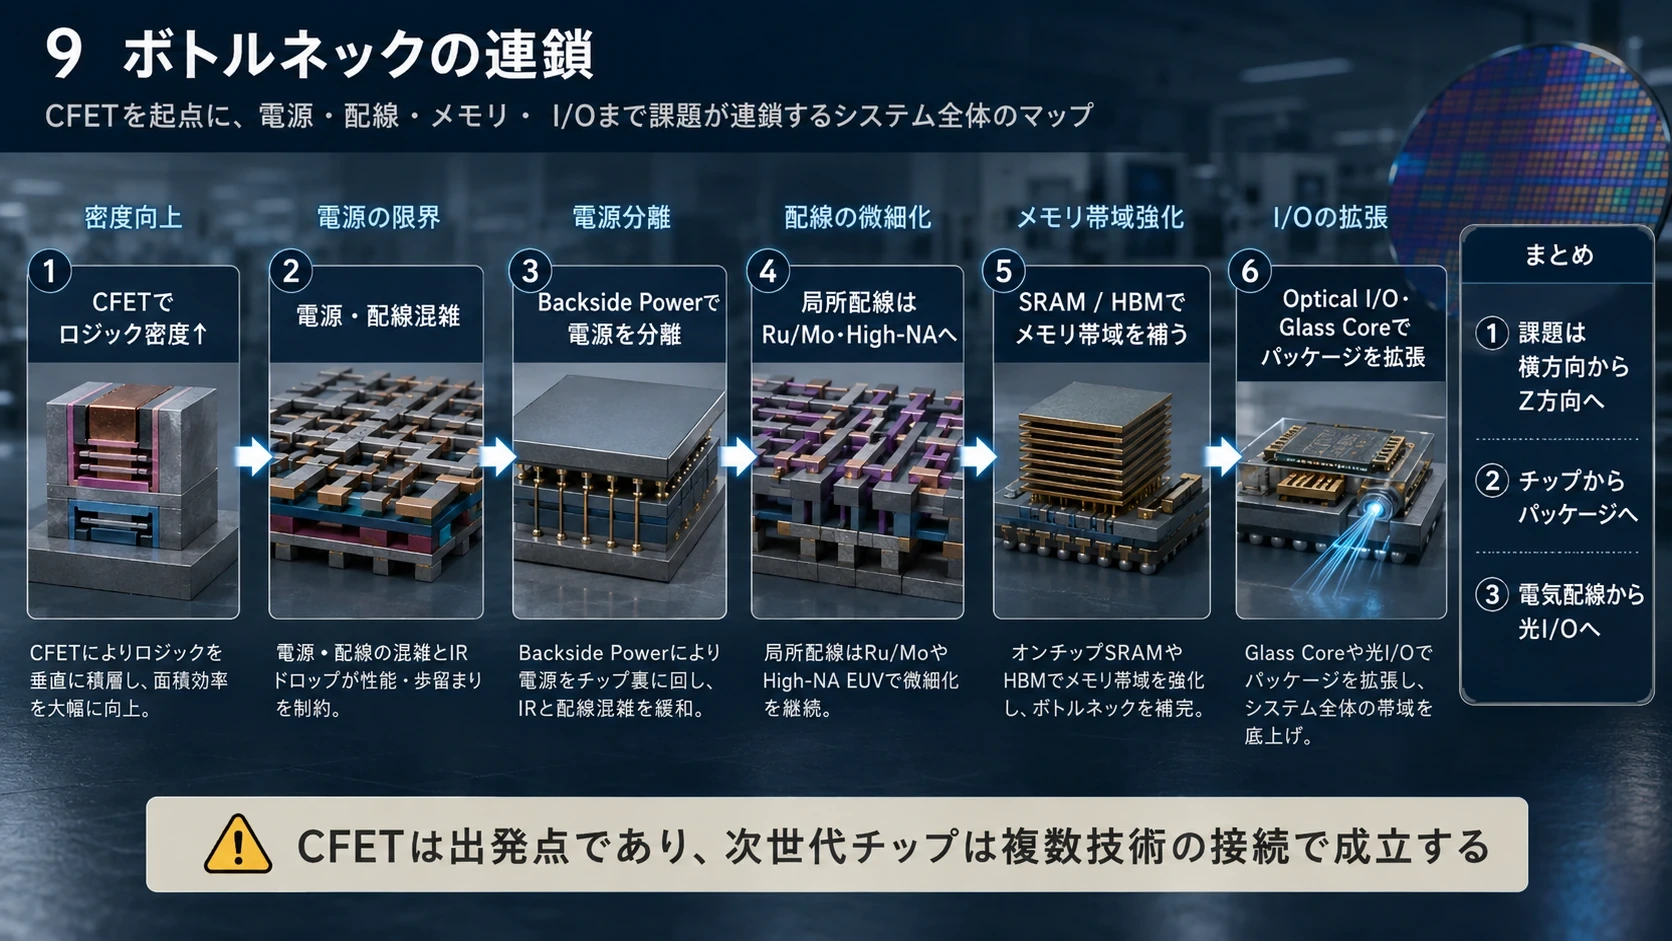
#CFETでロジックを高密度化すると電源と配線が問題になり、Backside Powerが必要になる。配線をさらに細くするとCuでは抵抗が問題になり、RuやMoが必要になる。横方向の微細パターンにはHigh-NA EUVが必要になる。ロジックだけ高密度になればSRAMが面積を食うため、今度はメモリを上へ積みたくなる。さらにHBMとの帯域、GPU間通信、巨大パッケージの反りや配線密度が問題となり、Optical I/Oやガラス基板へつながっていく。
#つまり2030年代に起こりそうなのは「CFETへの世代交代」だけではない。
#半導体の性能向上そのものが、
#XY方向の微細化から、XYZ方向+パッケージ+光まで含めたシステムスケーリングへ移行する
#可能性が高い。
#本稿では2026年8月時点で公開されているIntel、TSMC、Samsung、imec、ASMLなどの研究成果や量産ロードマップを出発点に、
#CFETとは何なのか
#本当に作れるのか
#いつ量産される可能性があるのか
#他の次世代技術とどう結び付くのか
#どの製造装置メーカーのTAM/SAMが増えるのか
#2030~2040年に装置content/waferがいつ跳ねるのか
#2035年の売上・営業利益ポテンシャルと現在時価総額を比べるとどうなるのか
#まで考えていく。
#なお、企業が正式に公表しているロードマップと、本稿で構築する将来モデルは別物である。
#2030年以降のTAM、装置content、売上・利益は会社ガイダンスではなく、公開技術ロードマップを基に工程数・装置種類・普及率を数値化したシナリオ分析である。
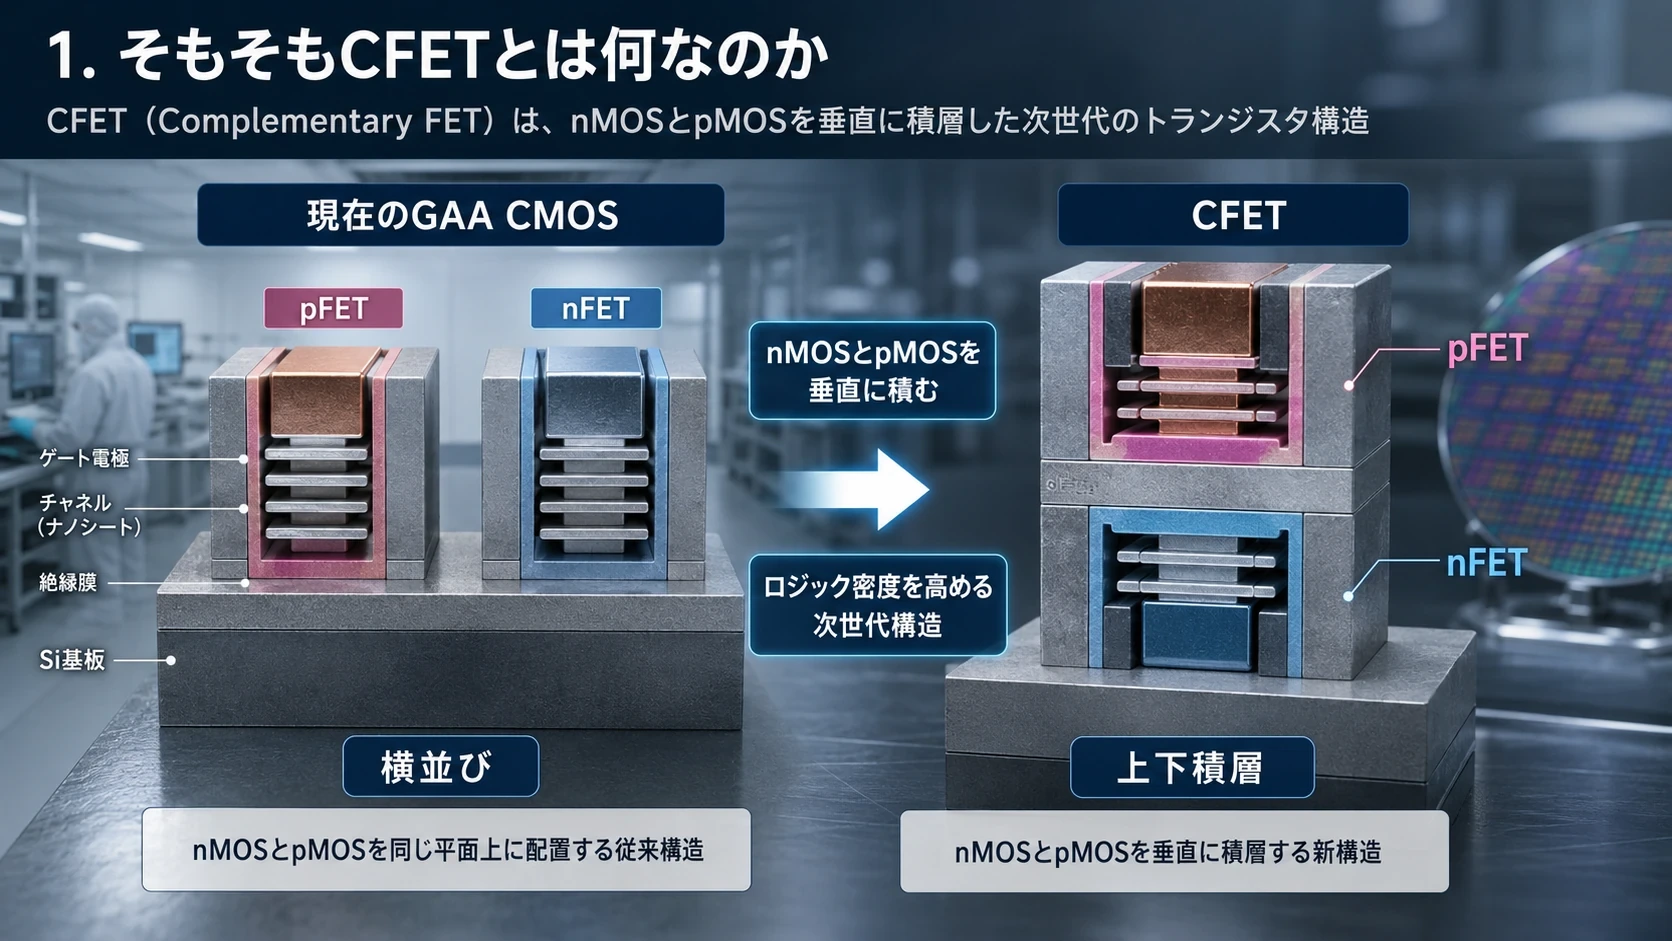
#1.そもそもCFETとは何なのか
#CFETは、
#Complementary Field-Effect Transistor
#の略である。
#現在のCMOSでは基本的に、
#nMOS
#pMOS
#という2種類のトランジスタを組み合わせる。
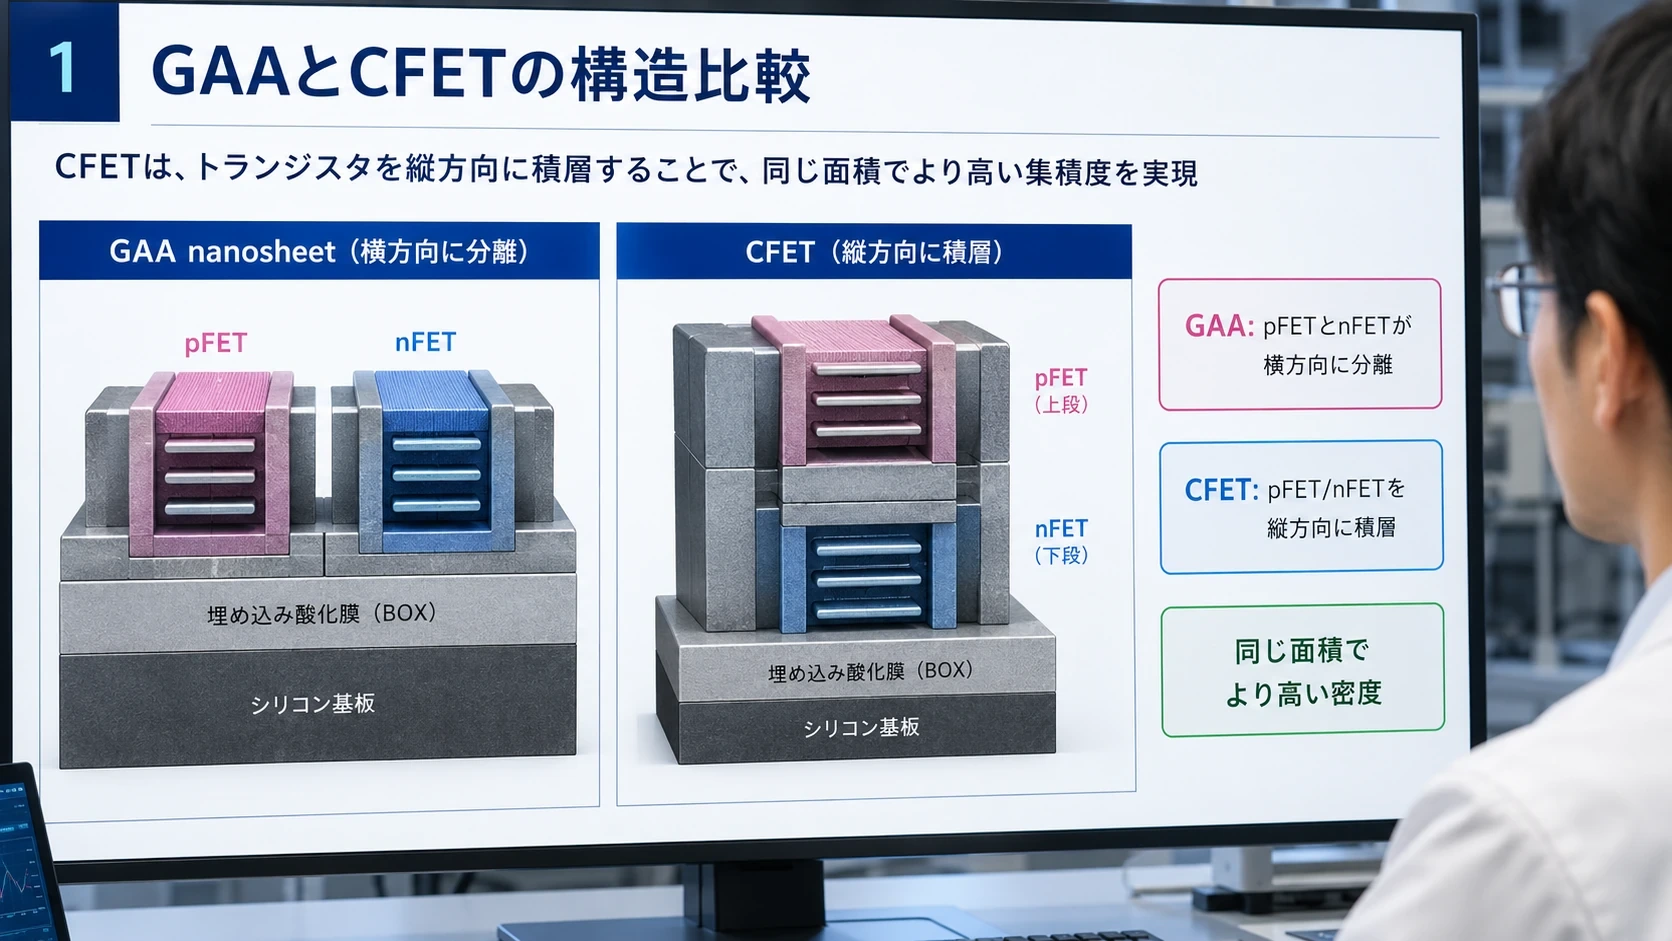
#現在のGAA nanosheet世代でも、この二つは基本的に横へ並ぶ。
#イメージすると、
#現在のGAA CMOS
#pFET nFET
████████ ████████
████████ ████████
████████ ████████
──────────────────────────
Siである。
#CFETではこれを、
#CFET
#pFET
██████████
██████████
██████████
──────────
nFET
██████████
██████████
██████████
────────────────
Siのように上下へ積む。
#Samsungは2026年6月に42nm gate pitchの3D Stacked FETを、Intelも45nm gate pitchのmonolithic CFET inverterを実シリコンで実証している。imecもbottom deviceへのdirect backside contactを含むmonolithic CFET研究を進めている。つまり2026年時点では、もはや「物理的に作れるのか」という段階ではない。実際に動くデバイスは既に存在する。 (imec)
#問題は、
#これを数百万、数千万、数十億個並べたCPU/GPUを、高歩留まりかつ経済的に量産できるのか
#というところへ移っている。
#図解|GAAとCFETの構造
#
2.なぜわざわざ上下に積むのか
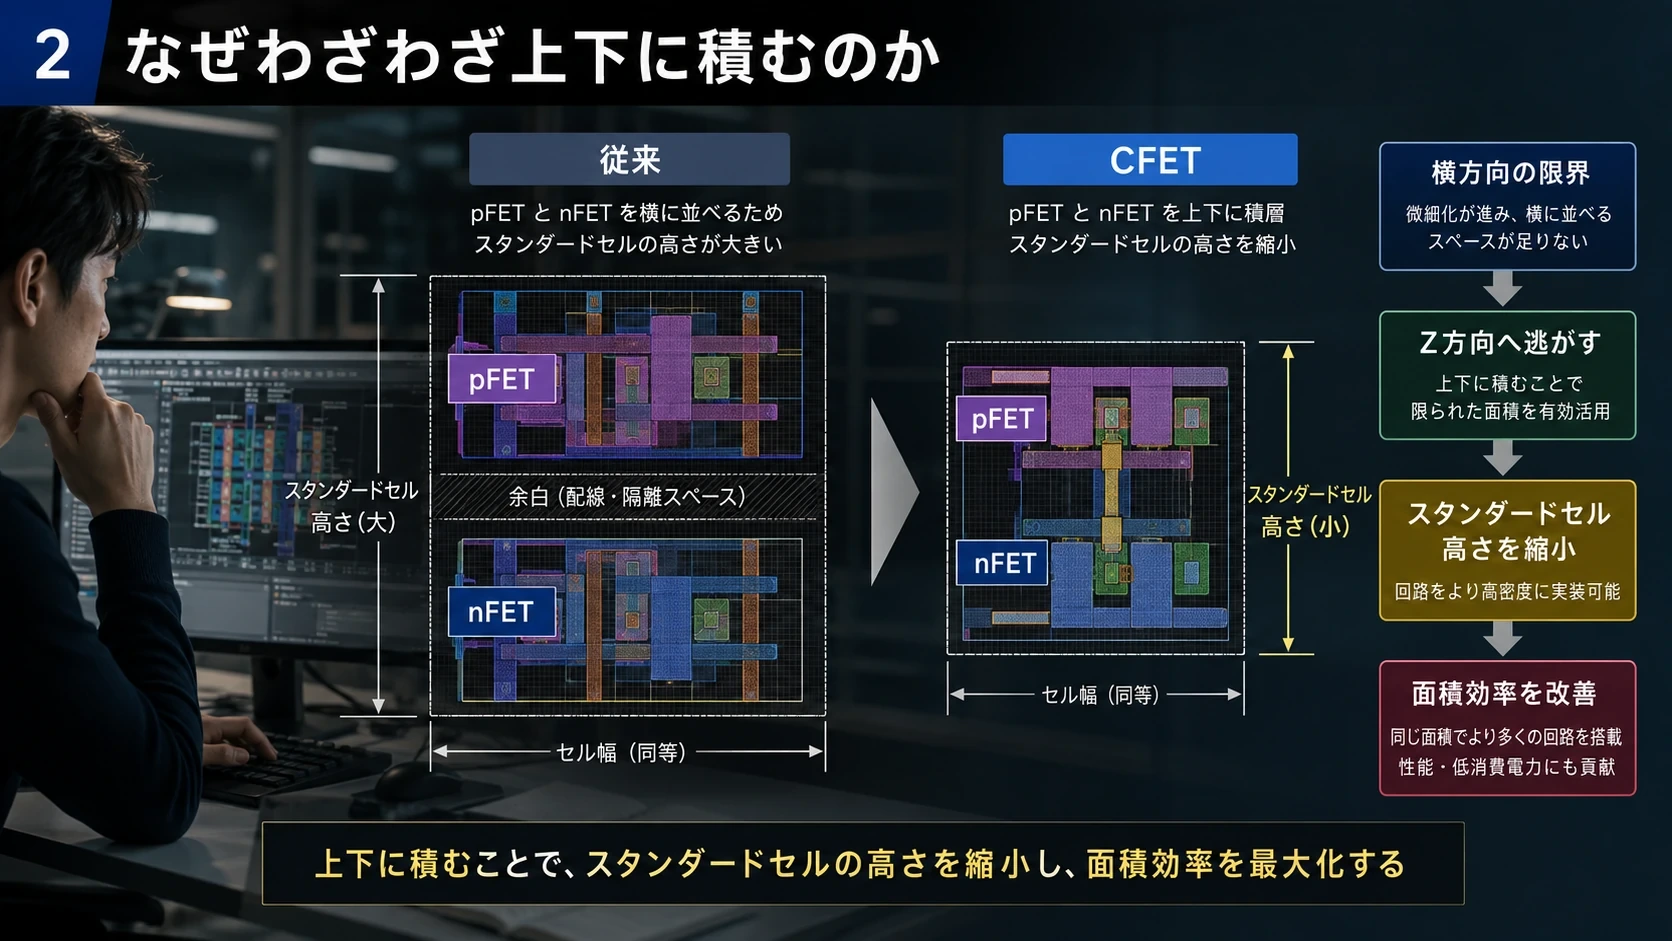
#理由は、横方向の縮小だけでは苦しくなってきたからだ。
#CMOS standard cellには、
#pFET
│
│ ← n/p間の空間
│
nFETが必要になる。
#ところがnFETとpFETを上下へ積めれば、
#pFET
────
nFETにできる。
#したがってstandard-cell heightを大きく縮められる。
#これは「トランジスタそのものを半分にする」とは違う。
#今まで横へ使っていた面積をZ方向へ逃がすのである。
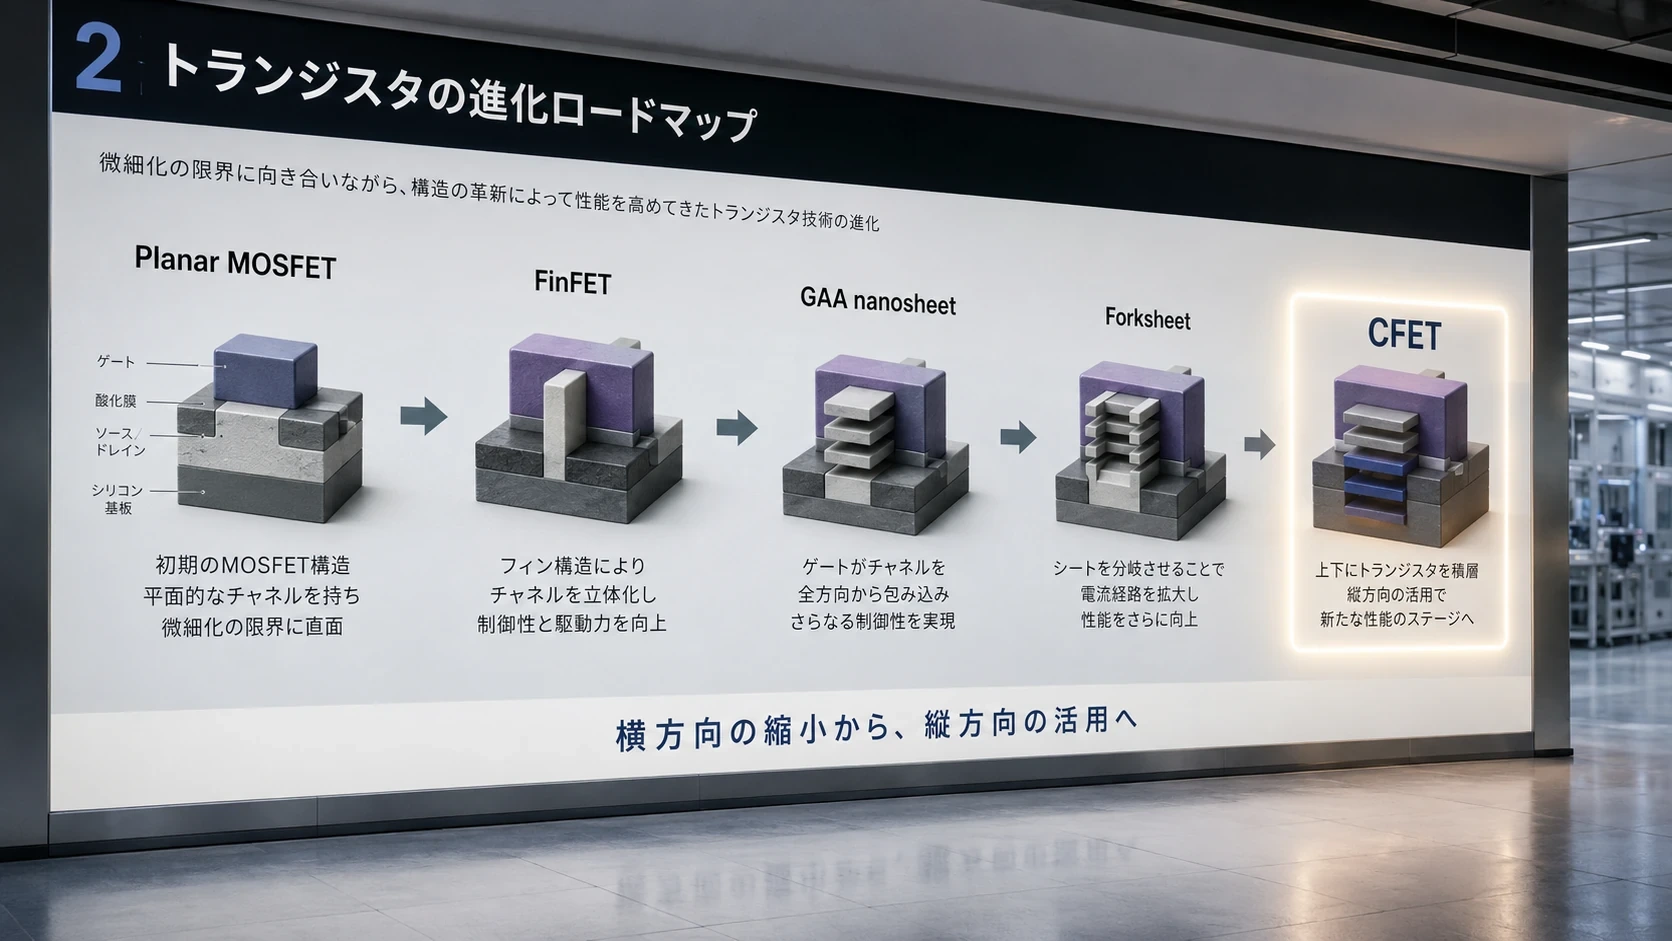
#imecもCFETの主な意義を、nMOSとpMOSを垂直積層して両者の横方向のseparationをstandard-cell heightから取り除ける点に置いている。imecの現在の研究ロードマップでは、nanosheetをouter-wall forksheetでA10まで延命し、その次のA7からmonolithic CFETを導入する構想が示されている。 (imec)
#その意味では、
#Planar MOSFET
↓
FinFET
↓
GAA nanosheet
↓
Forksheet
↓
CFETという流れはかなり自然である。
#図解|横方向からZ方向へのScaling
#
3.CFETはどうやって作るのか
#ここが非常に面白い。
#単純に完成したトランジスタを二つ重ねれば終わり、というわけではない。
#CFETでは上下双方について、
#Channel
#Gate
#Source/Drain
#Spacer
#Contact
#を成立させなければならない。
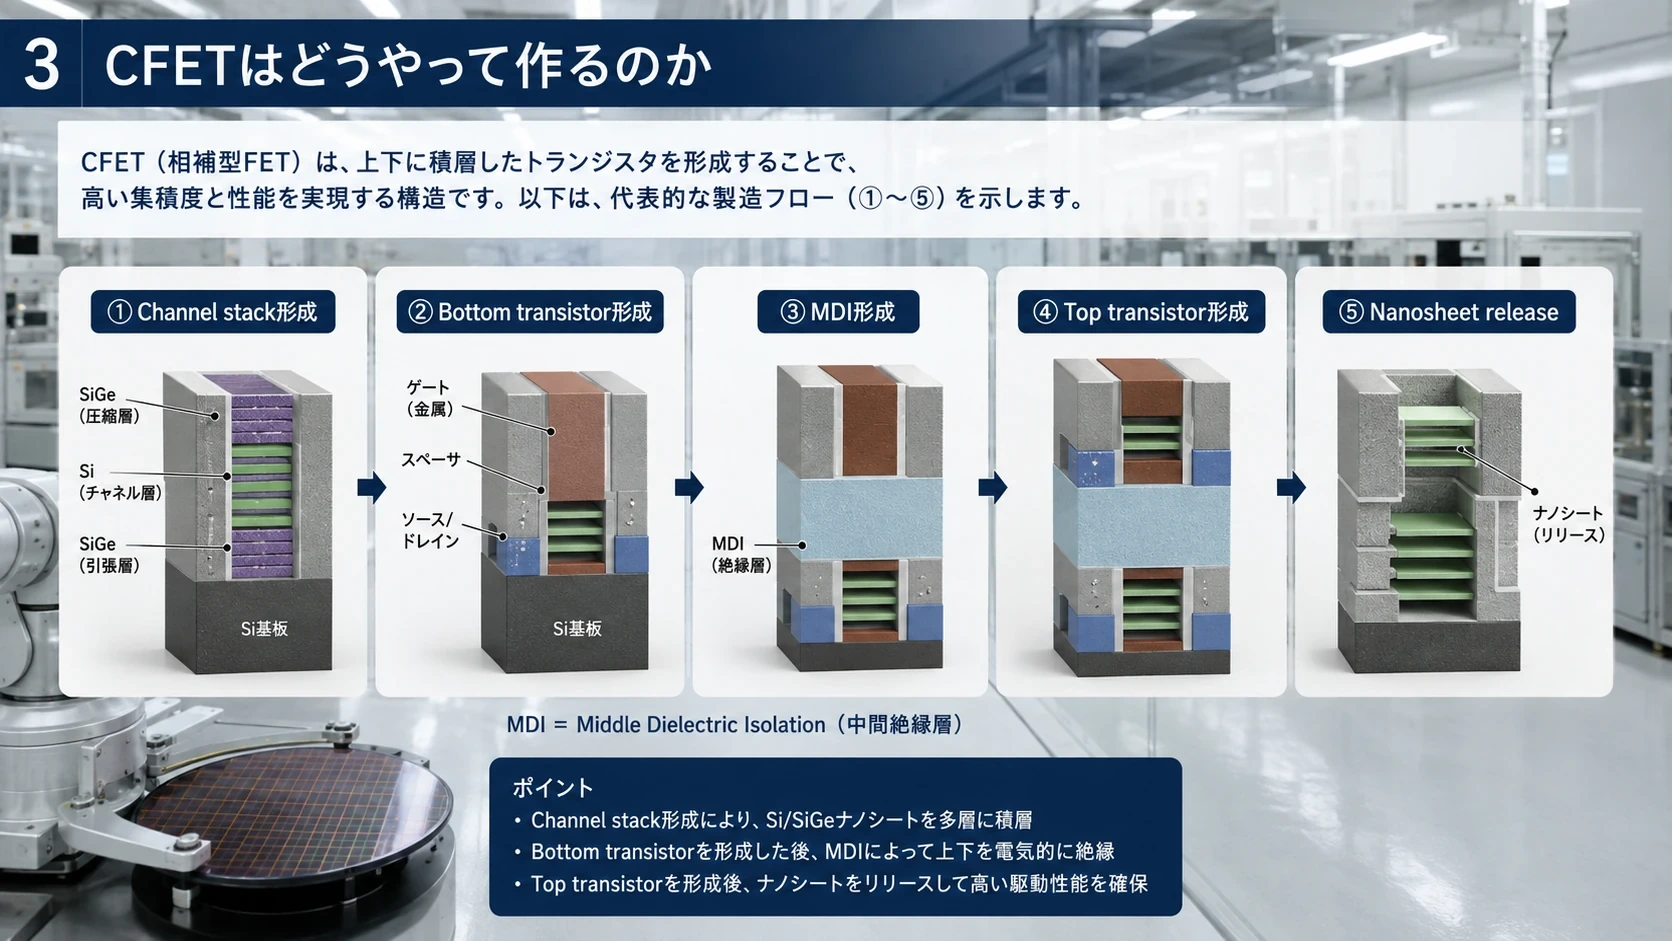
#概念的には、
#① Si/SiGeなどのchannel stack形成
↓
② Bottom transistor形成
↓
③ Middle Dielectric Isolation
↓
④ Top transistor形成
↓
⑤ Nanosheet release
↓
⑥ Inner Spacer
↓
⑦ Source/Drain Epitaxy
↓
⑧ High-k / Metal Gate
↓
⑨ Top/Bottom Contact
↓
⑩ Backside connectionとなる。
#imecが研究しているCFETでは、上下デバイスを分離するMDI=Middle Dielectric Isolationが重要になる。
#さらにimecはextended MDIなどを用い、上下それぞれのchannel stackやsource/drainを形成し、wafer bondingも利用しながらCFETを構成するプロセスを研究している。 (imec)
#図解|CFETの積層製造フロー
#
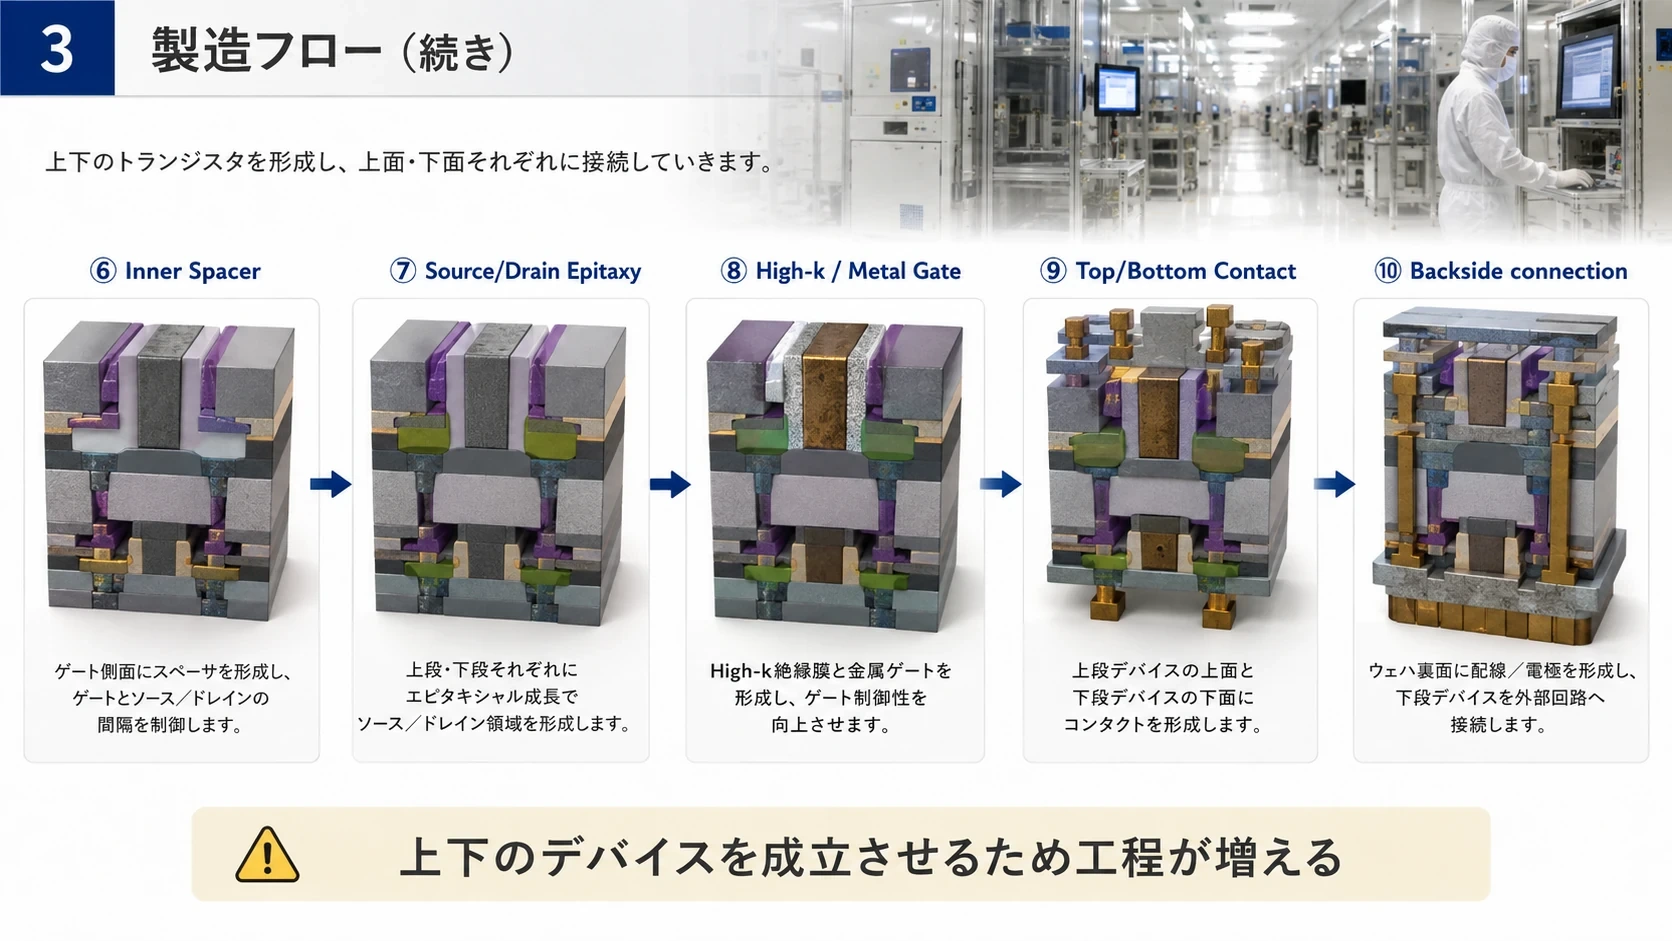
4.最大の難所①――下側トランジスタへどう接続するのか
#CFETを見るとすぐ疑問が出る。
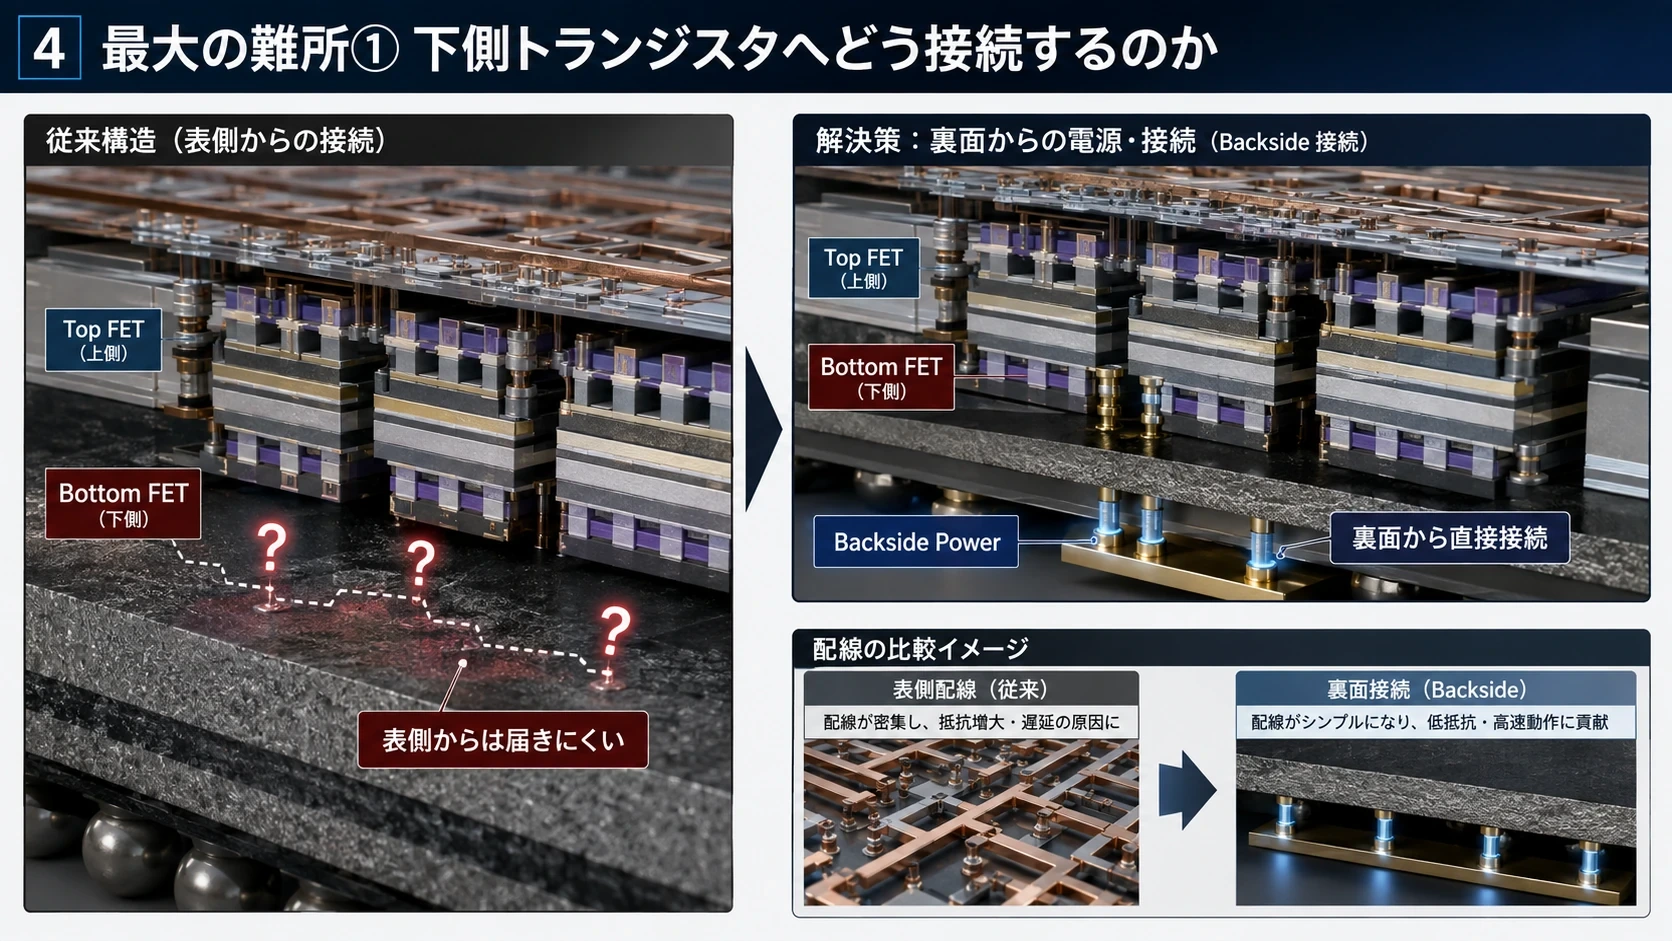
#Top FET ████████████████
#Bottom FET ████████████████
#??????????????????
#下側のFETへどうやって電源や信号を持っていくのか。
#上から配線しようとするとTop FETが邪魔になる。
#そこで非常に重要になるのが、後述するBackside Power Deliveryである。
#imecは既にbottom pMOS source/drainへ裏面から直接接続するCFETを実証している。 (imec)
#つまりCFETとBackside Powerは別々の技術というより、
#CFETを本格的に使うためにBackside Power側の技術成熟が先に必要になる
#と考えた方がよい。
#図解|下側FETへの接続
#
5.最大の難所②――熱
#CFETでは、
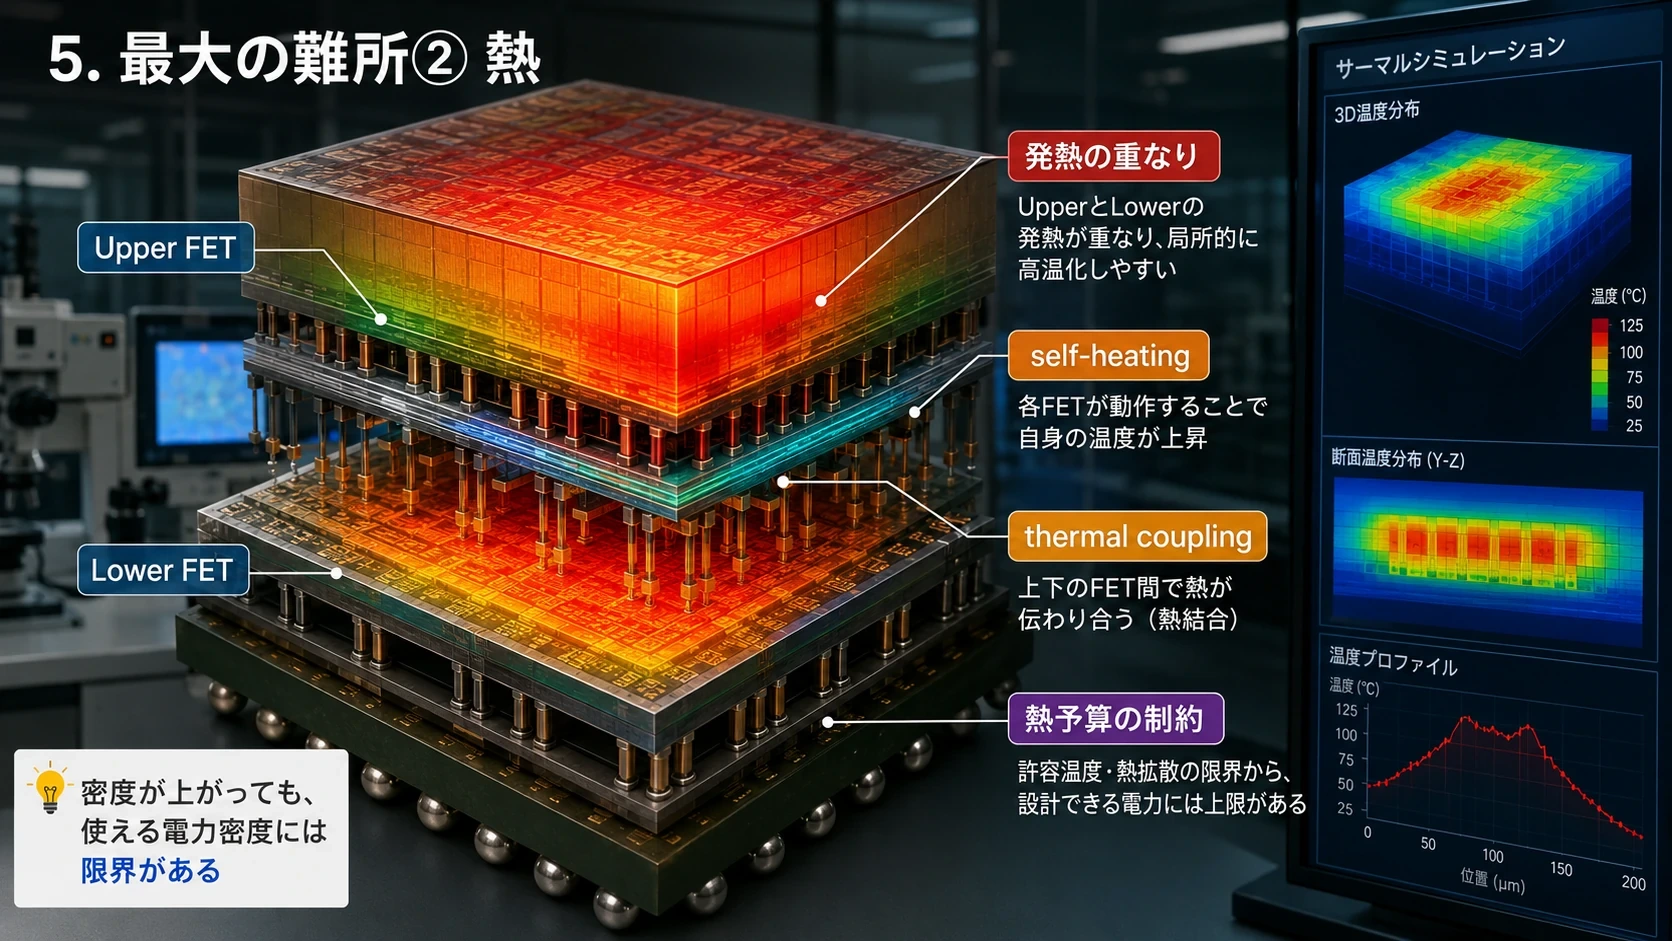
#Upper FET ← 発熱
──────────
Lower FET ← 発熱
──────────
Siとなる。
#トランジスタを2倍近く高密度に配置できたとしても、
#単位面積当たりの消費電力を2倍にできるわけではない。
#密度を上げれば、
#self-heating
#thermal coupling
#upper/lower FET間の温度差
#contact resistance
#reliability
#が問題になる。
#imec自身もCFETの重要課題としてthermal managementを挙げ、高熱伝導材料を使ったbottom dielectric isolationなどの研究を進めている。 (imec)
#このため2030年代には、
#transistor density
#だけでなく、
#usable transistor density under a thermal budget
#の方が重要になる可能性が高い。
#図解|上下FETの熱結合
#
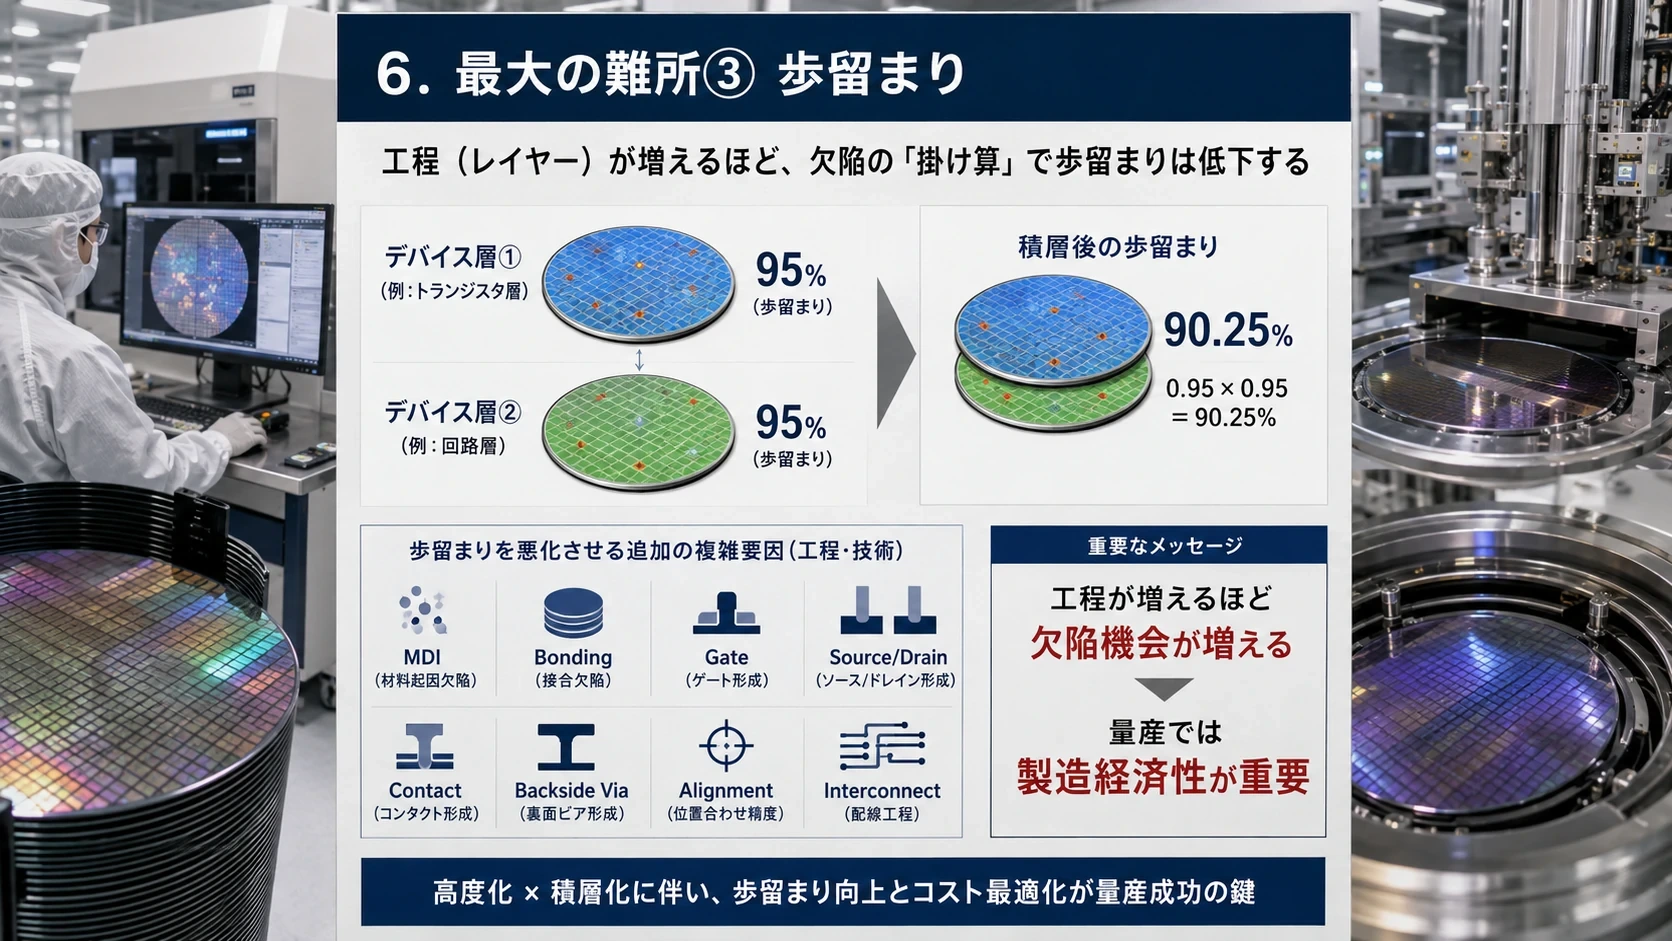
6.最大の難所③――歩留まり
#単純化すると、
#下側デバイスの歩留まりが95%、上側も95%なら、
#なので
#となる。
#実際にはさらに、
#MDI
#Bonding
#Gate
#Source/Drain
#Contact
#Backside Via
#Alignment
#Interconnect
#などの工程が加わる。
#CFET最大の障害は、
#トランジスタが動くかどうかではなく、何十工程も重ねても十分なyieldを維持できるか
#という製造経済性である。
#図解|積層工程と歩留まり
#
7.ではCFETはいつ量産されるのか
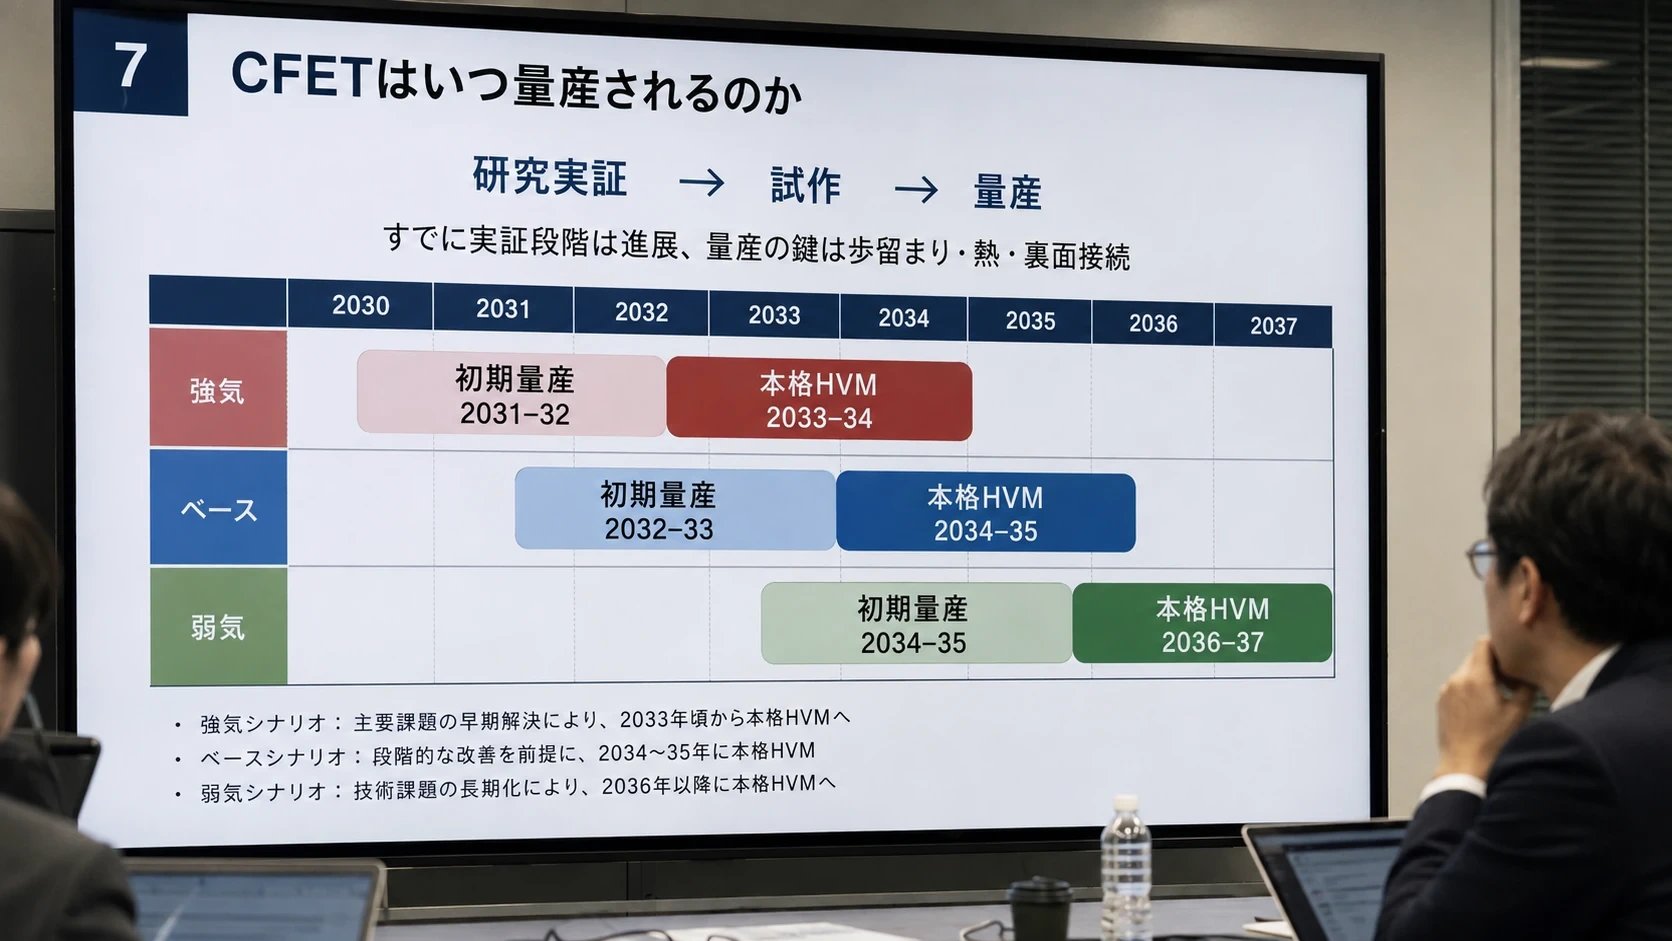
#ここからは「公表済み」と「本稿推定」を分ける必要がある。
#imecはCFETをA7世代から導入する研究ロードマップを示し、その後A5、A3へ拡張する想定を置いている。CFETの前にはouter-wall forksheetでnanosheetをA10まで延長する。 (imec)
#ただし、
#TSMC A7=203○年量産
#のようなfoundryの正式製品ロードマップはまだ存在しない。
#したがって本稿では次の三つのシナリオを置く。
#2026年時点でIntelとSamsungが既に動作デバイスを示しているため、2030年代半ばまでに何らかの量産CFETが登場する可能性はかなり高いと考える。一方、2030年までに大規模HVMへ入ると見るのはやや攻めた予想である。 (Newsroom)
#図解|CFET量産シナリオ
#
8.CFETだけでは次世代チップは成立しない
#ここからが本稿の中心である。
#CFETを単独のトランジスタ技術として見ると、2030年代に起きる変化を見失う。
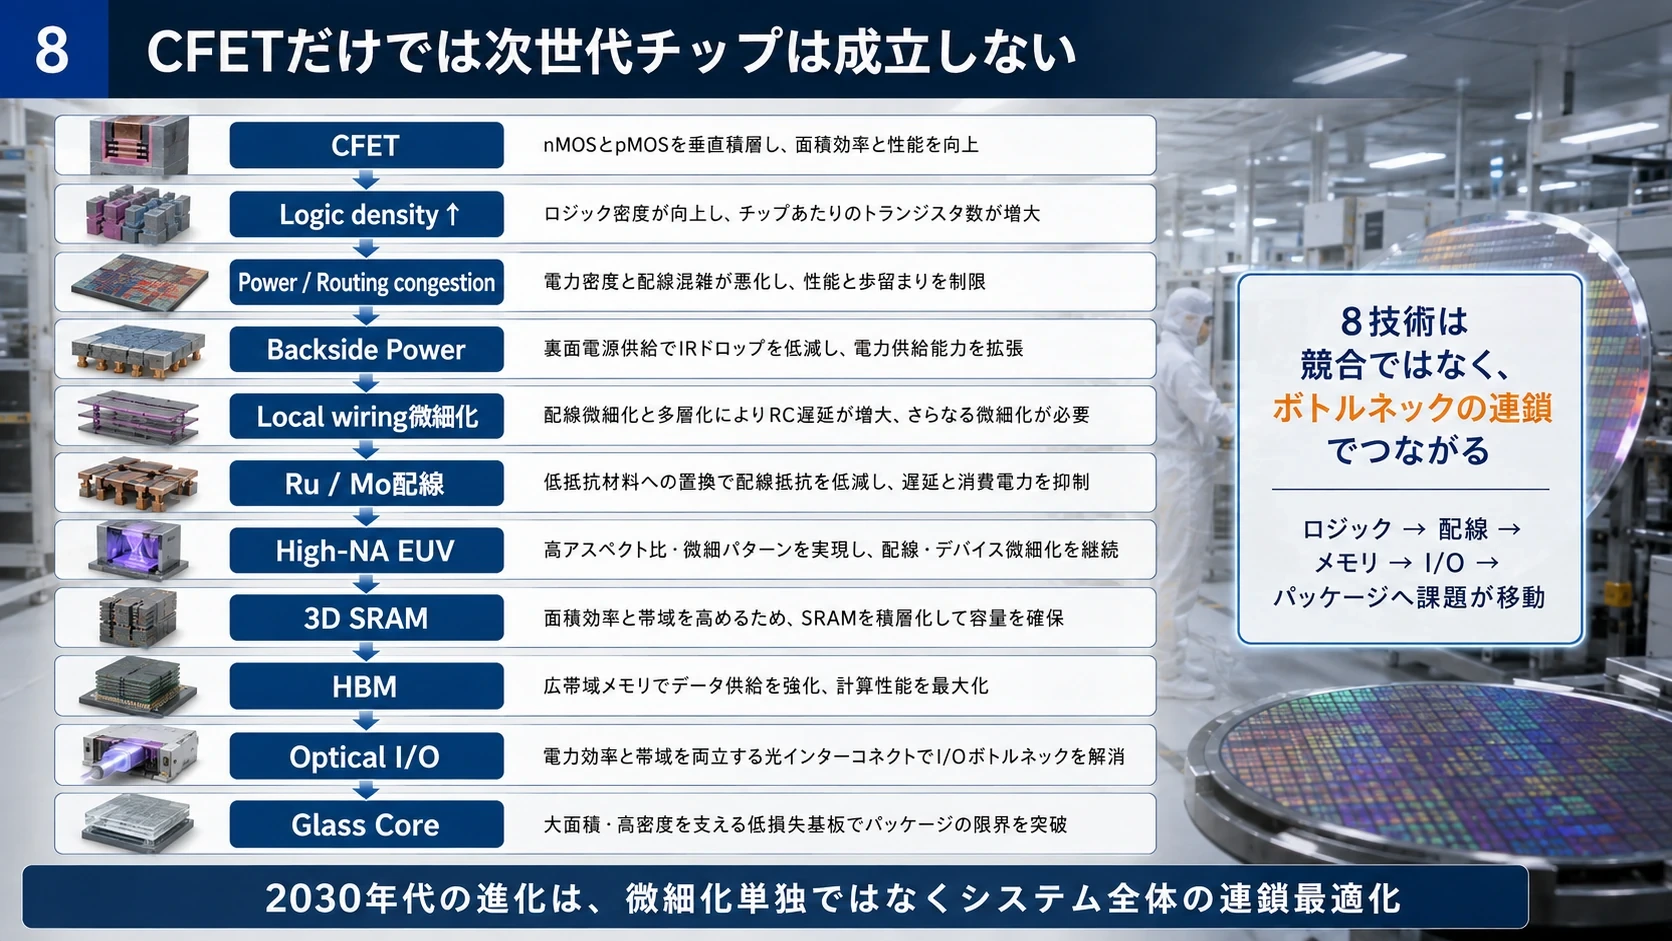
#CFETでlogic densityを高めると、別の場所にボトルネックが移る。
#その連鎖は概ね、
#CFET
↓
Logic density ↑
↓
Power / Routing congestion
↓
Backside Power
↓
Local wiringがさらに微細化
↓
Ru / Mo
↓
critical patterning
↓
High-NA EUV
↓
SRAM areaが相対的に巨大化
↓
3D SRAM
↓
外部Memory bandwidth不足
↓
HBM
↓
Package / GPU間I/O不足
↓
Optical I/O
↓
Package大型化・Warpage
↓
Glass Coreである。
#つまり8技術は競合するというより、一つが次のボトルネックを生み、その解決策として次が必要になる関係に近い。
#図解|連鎖する次世代ボトルネック
#
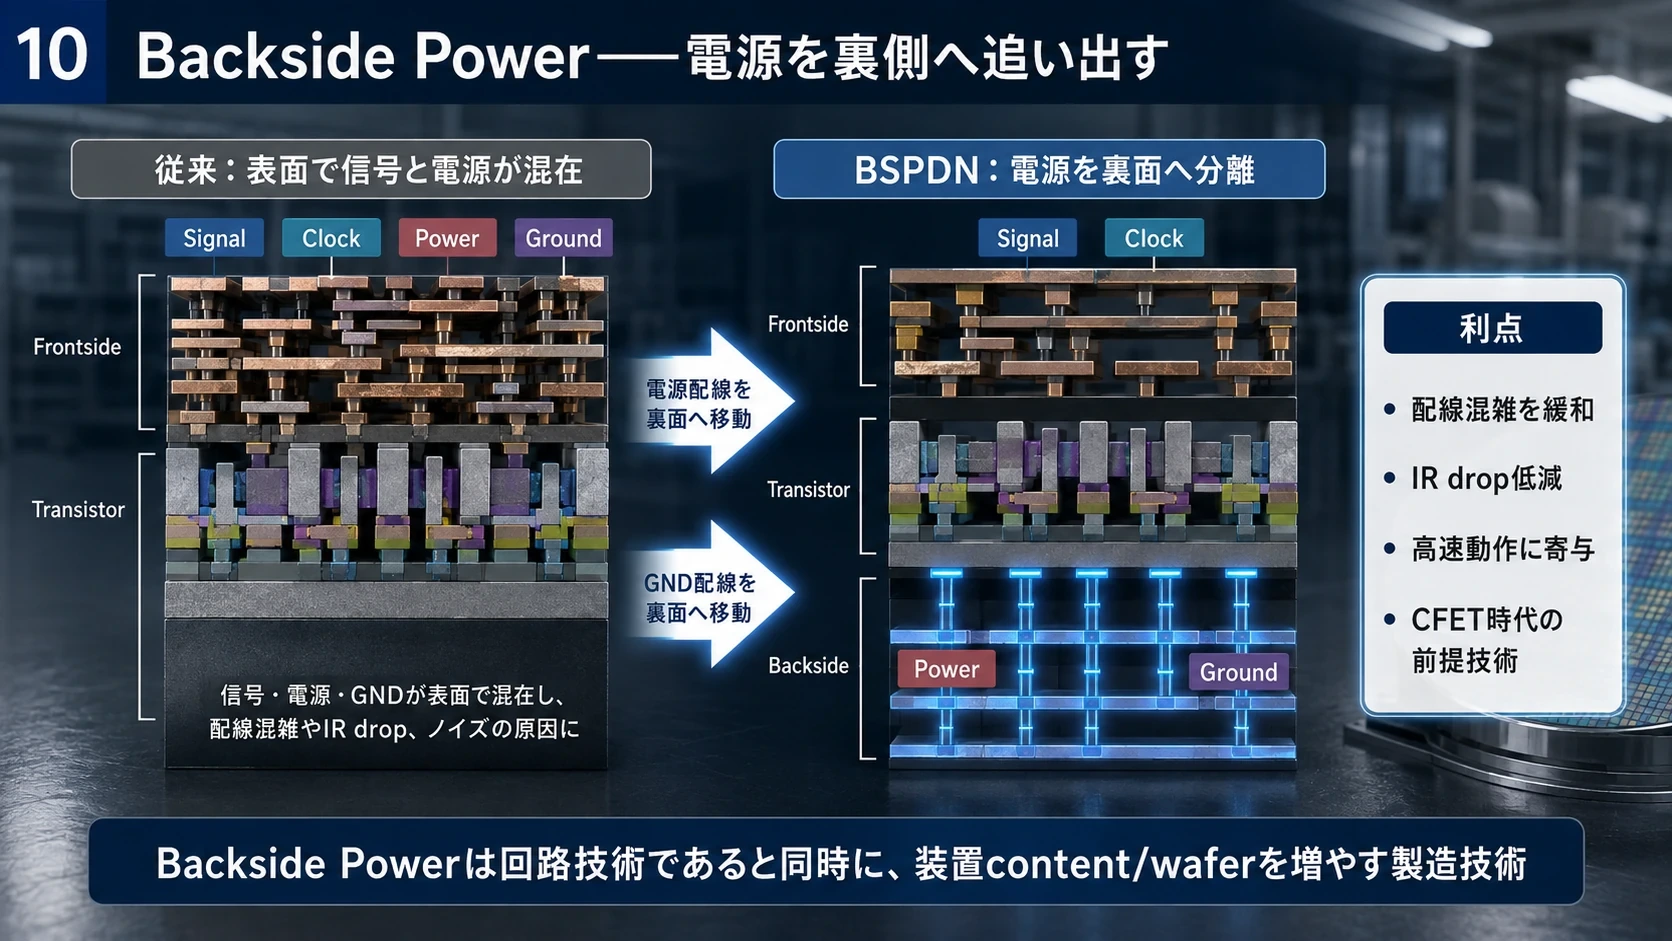
9.Backside Power――電源を裏側へ追い出す
#現在のチップでは表面側の配線に、
#Signal
#Clock
#Power
#Ground
#が共存している。
#Frontside
#Signal
Power
Signal
Clock
Ground
Signal
──────
Transistorこれを、
#Frontside
Signal
Signal
Clock
Signal
──────
Transistor
──────
Power
Ground
BacksideにするのがBackside Power Delivery Network=BSPDNである。
#TSMCは既にA16でbackside powerのSuper Power Railを採用し、その次のA12も2029年生産予定としている。つまりCFETが量産される頃には、Backside Powerは先に何世代か経験を積んでいる可能性が高い。 (TSMC)
#IntelもIntel 18Aでbackside powerを実製品へ投入している。 (Newsroom)
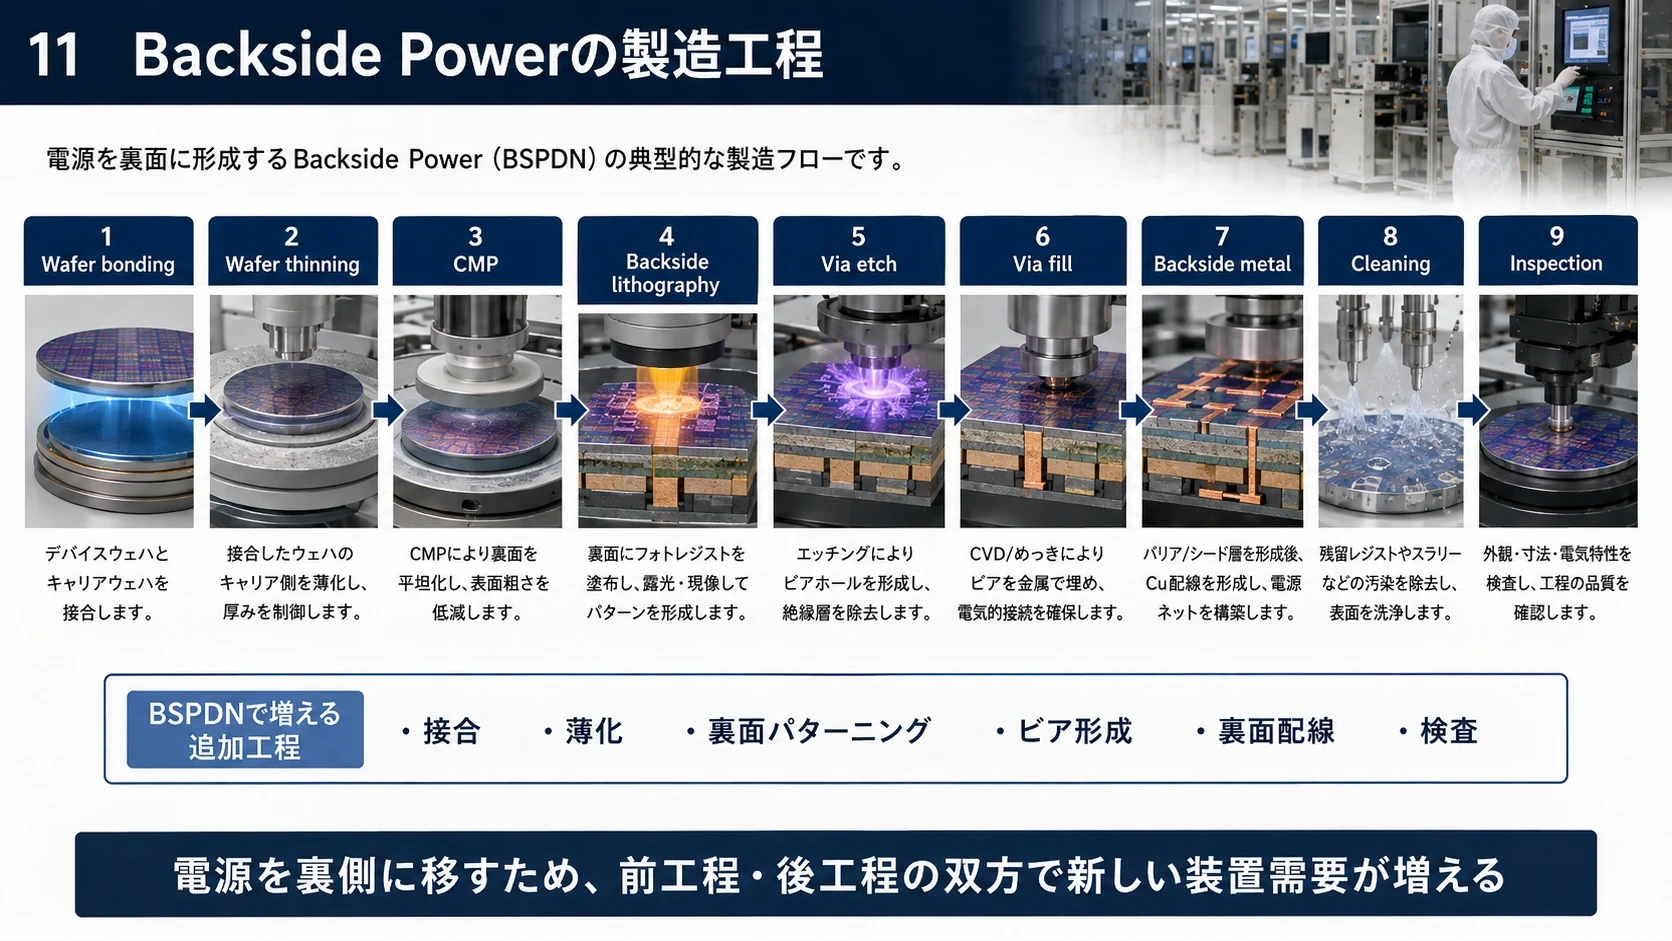
#製造工程としては、
#Wafer bonding
#Wafer thinning
#CMP
#Backside lithography
#nTSV/Via etch
#Via fill
#Backside metal
#Cleaning
#Inspection
#などが増える。
#imecのbackside process flowでも、frontside処理後のwafer bonding、極薄化、backside via、backside metal形成が必要になる。 (imec)
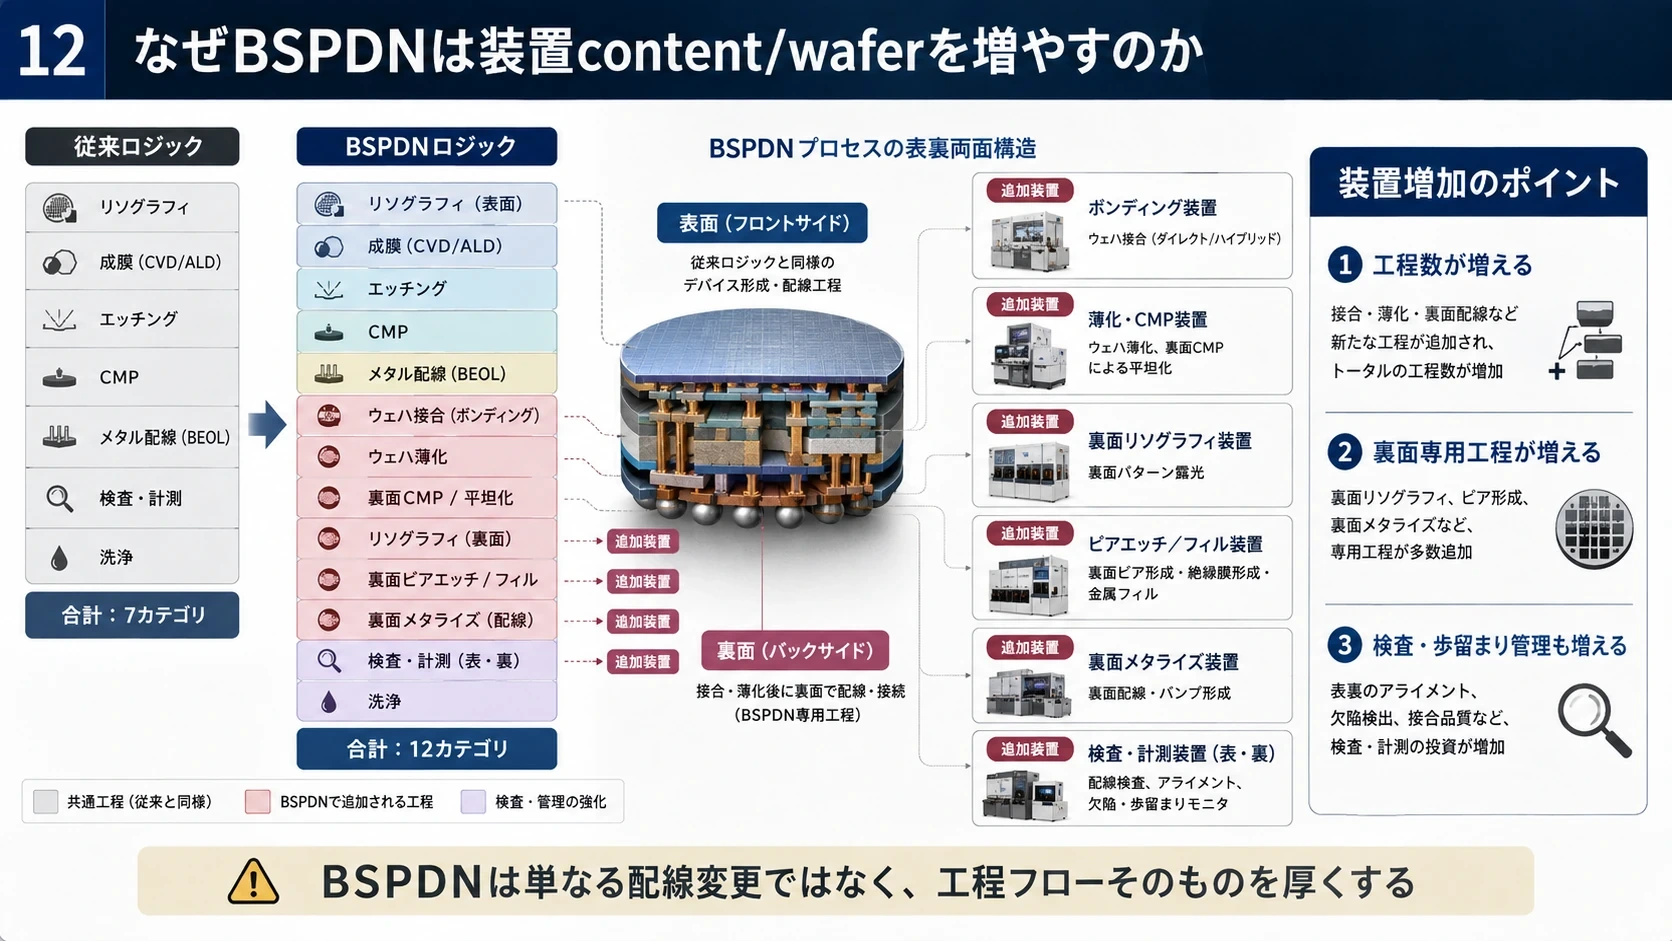
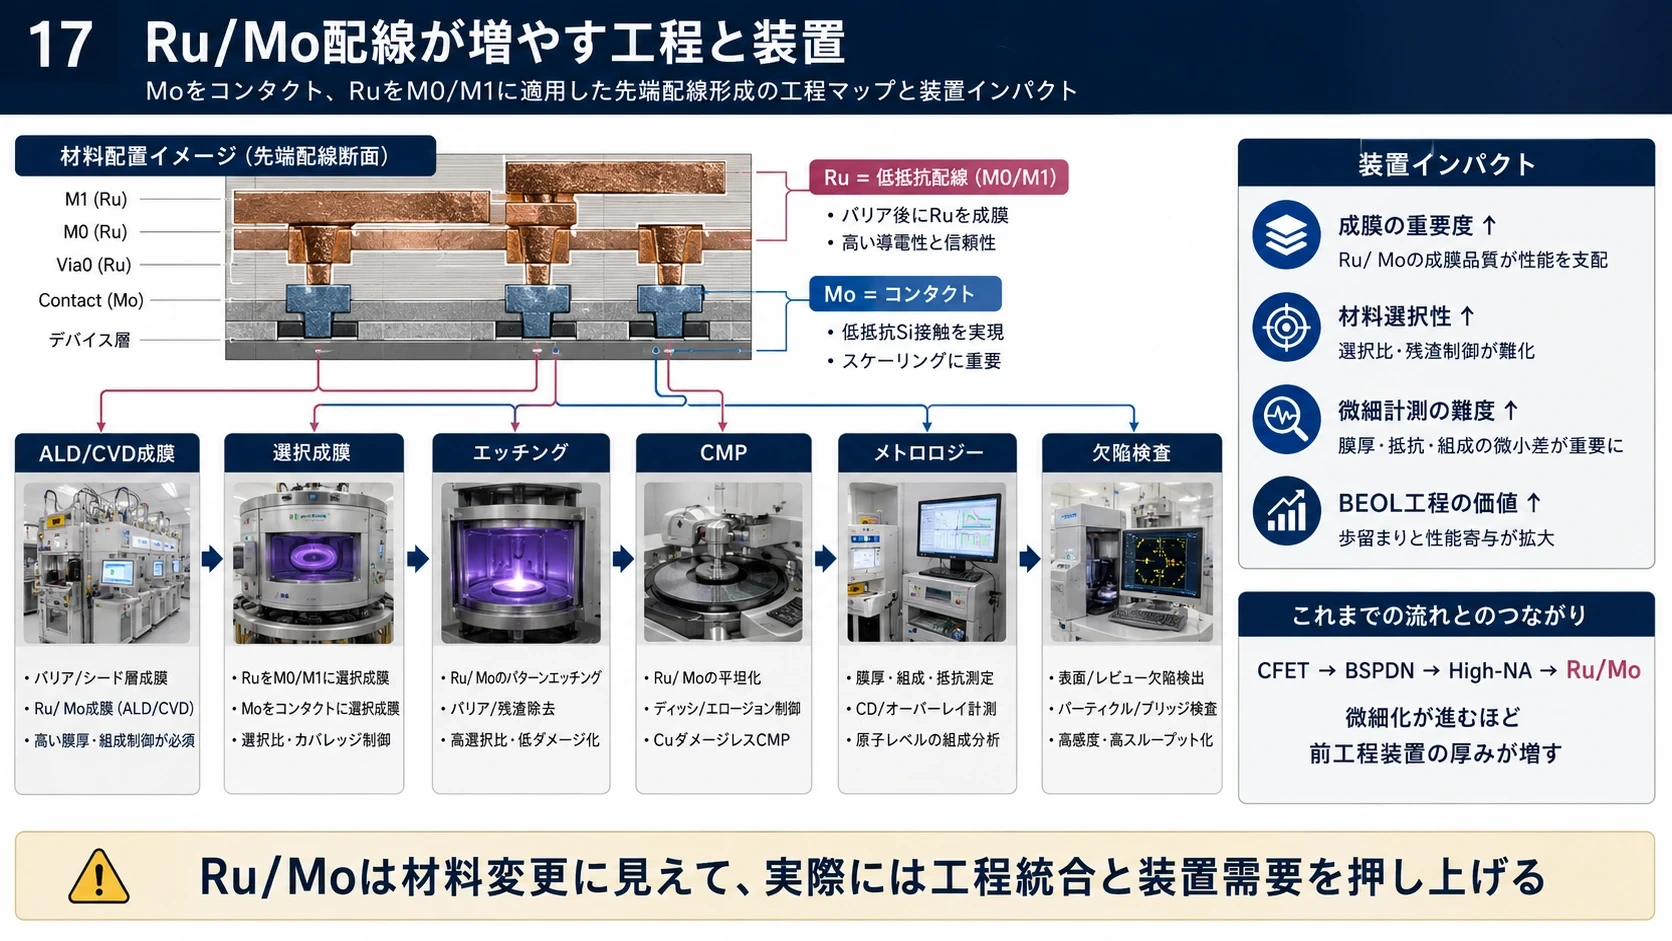
#したがってBSPDNは単なる回路技術ではなく、ウェハ1枚当たりの装置contentを直接増やす技術でもある。
#図解|Backside Powerと追加工程
#
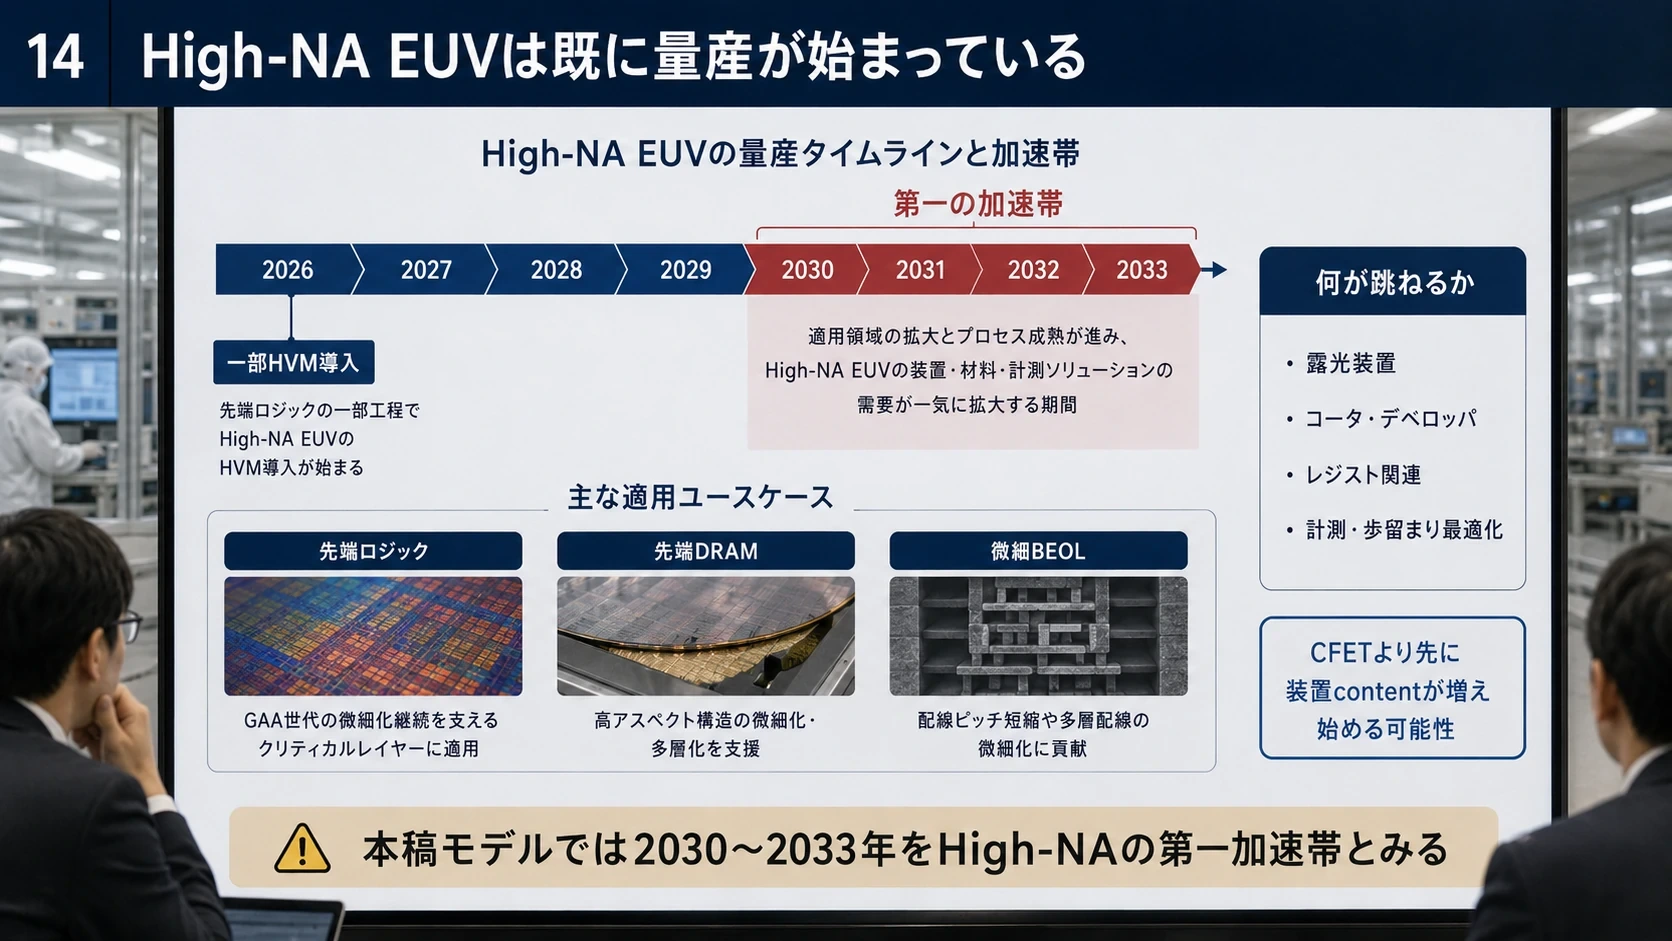
10.High-NA EUV――これは未来技術ではなく、既に量産が始まっている
#High-NA EUVはCFETより一足早い。
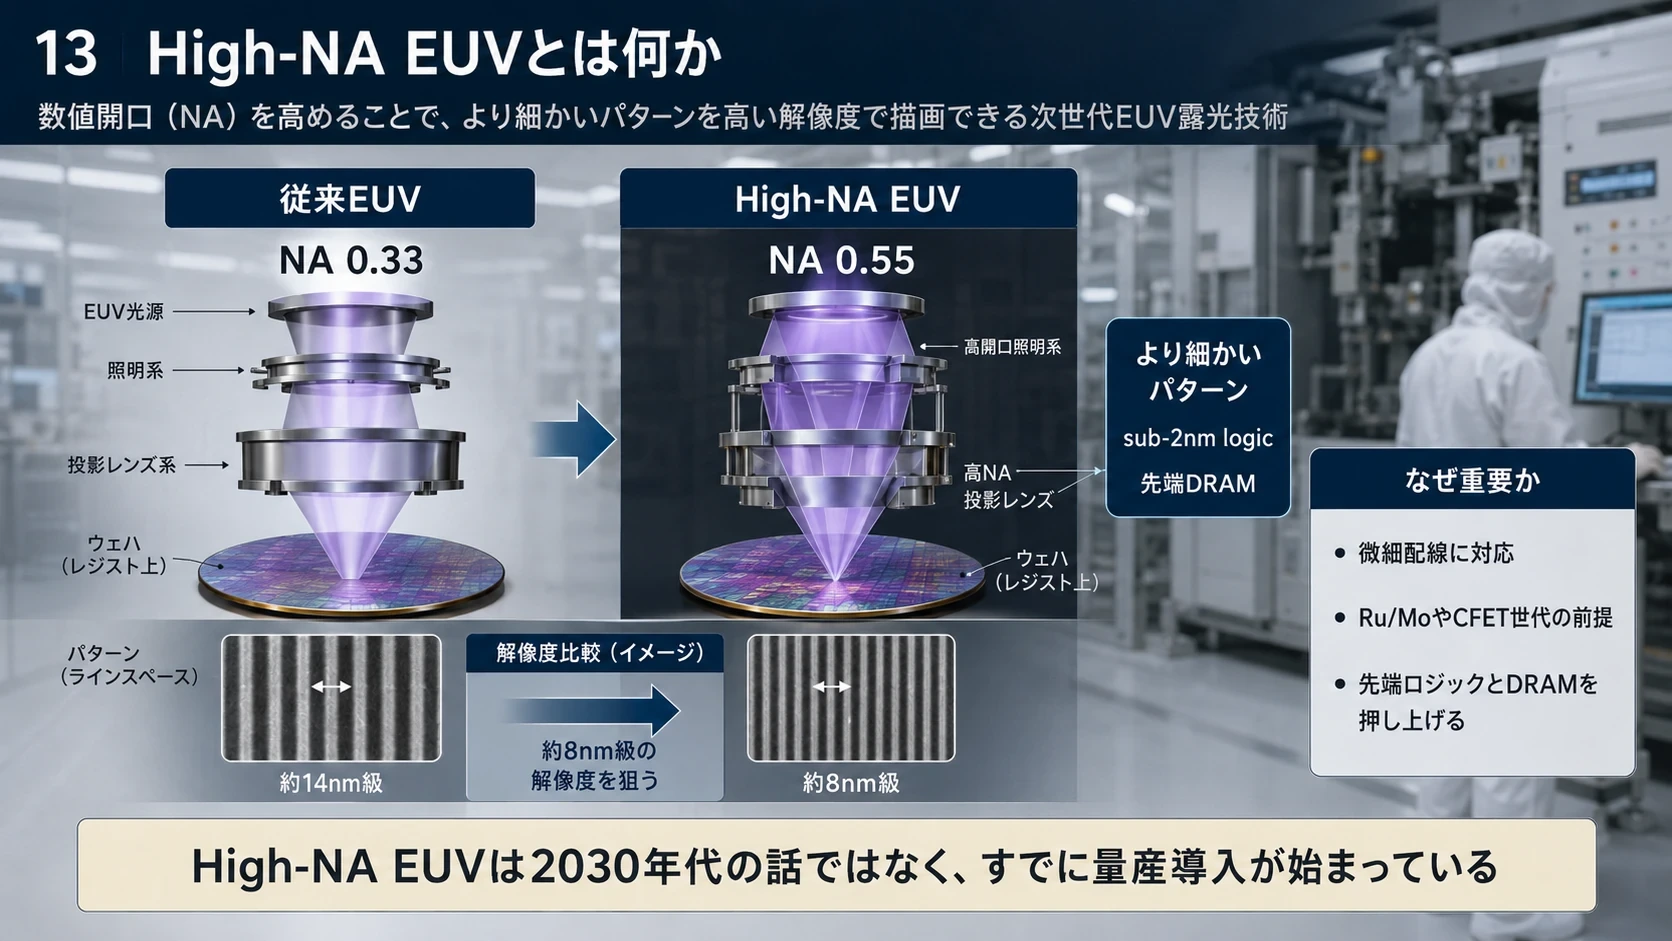
#従来EUVのNAは0.33。
#High-NAでは、
#NA=0.55
#になる。
#ASMLのEXE系High-NA装置は約8nm resolutionを狙い、sub-2nm logicや先端DRAMを対象にしている。 (ASML)
#そして重要なのは、High-NAはもう「2030年代になれば使うかもしれない研究装置」ではないことである。
#2026年7月、ASMLはIntel FoundryがIntel 18Aの一部layerでHigh-NA EUVをHVMへ導入したと発表している。OregonのHigh-NA processで従来NXEとのyield matchingも行われている。 (ASML)
#したがってHigh-NAの装置contentが大きく跳ねる時期は、CFETより早い。
#本稿モデルでは、
#2030~2033年
#をASML/TELの第一の加速帯とする。
#図解|High-NA EUVの量産導入
#
11.なぜCuの次にRu/Moが出てくるのか
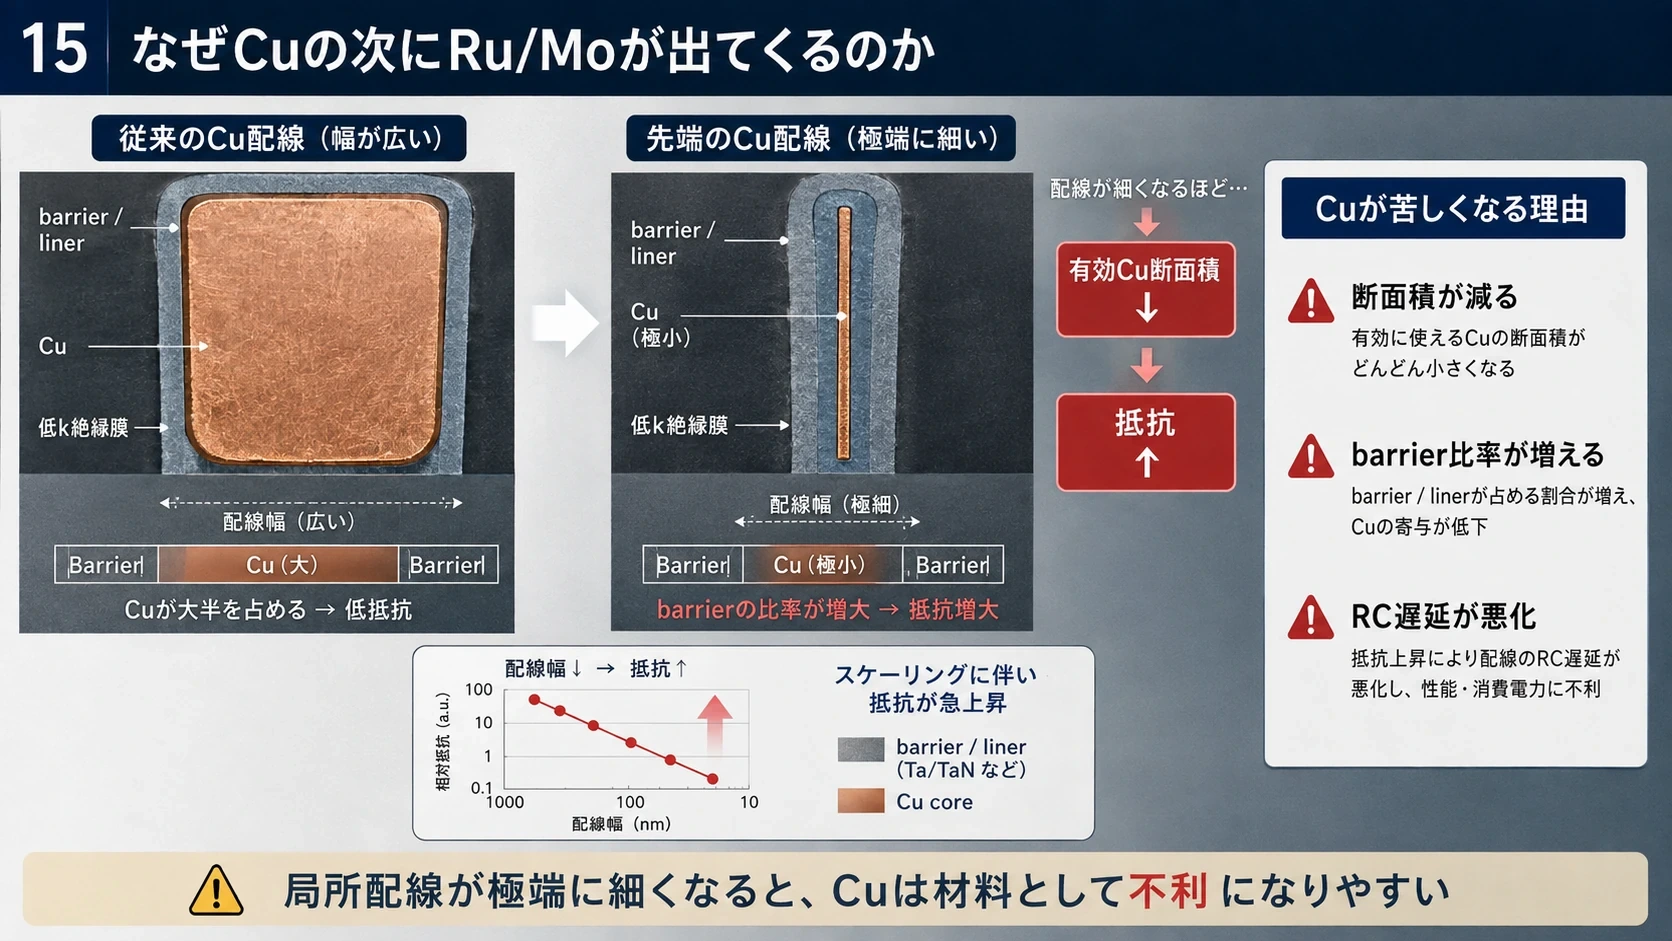
#配線を細くすると、Cuでは単純に断面積が減るだけでは済まない。
#Cuにはbarrier/linerが必要である。
#配線幅が極端に小さくなると、
#|Barrier| Cu |Barrier|
#のうちbarrierが占める割合が増えてしまう。
#結果としてCuそのものに使える断面積が急減し、抵抗が増える。
#そこで候補になるのがRu=Rutheniumである。
#imecは16nm pitchのRu interconnectを実証し、A7以降のfirst local interconnect metal layerの候補として位置付けている。 (imec)
#Intelもsubtractive Ru+airgap構造を実証し、Cu構造と比べてcapacitanceを最大約35%低減できる研究結果を示している。 (Newsroom)
#一方Mo=Molybdenumは、特にcontactや非常に細いvertical connectionの候補として重要である。
#Applied Materialsは2026年にselective ALDによるmonocrystalline Moを発表し、同社のselective W benchmarkに対してcritical contact resistanceを最大15%低減できるとしている。既に2nm以下を対象とするleading logicメーカーで採用が始まっている。 (Applied Materials)
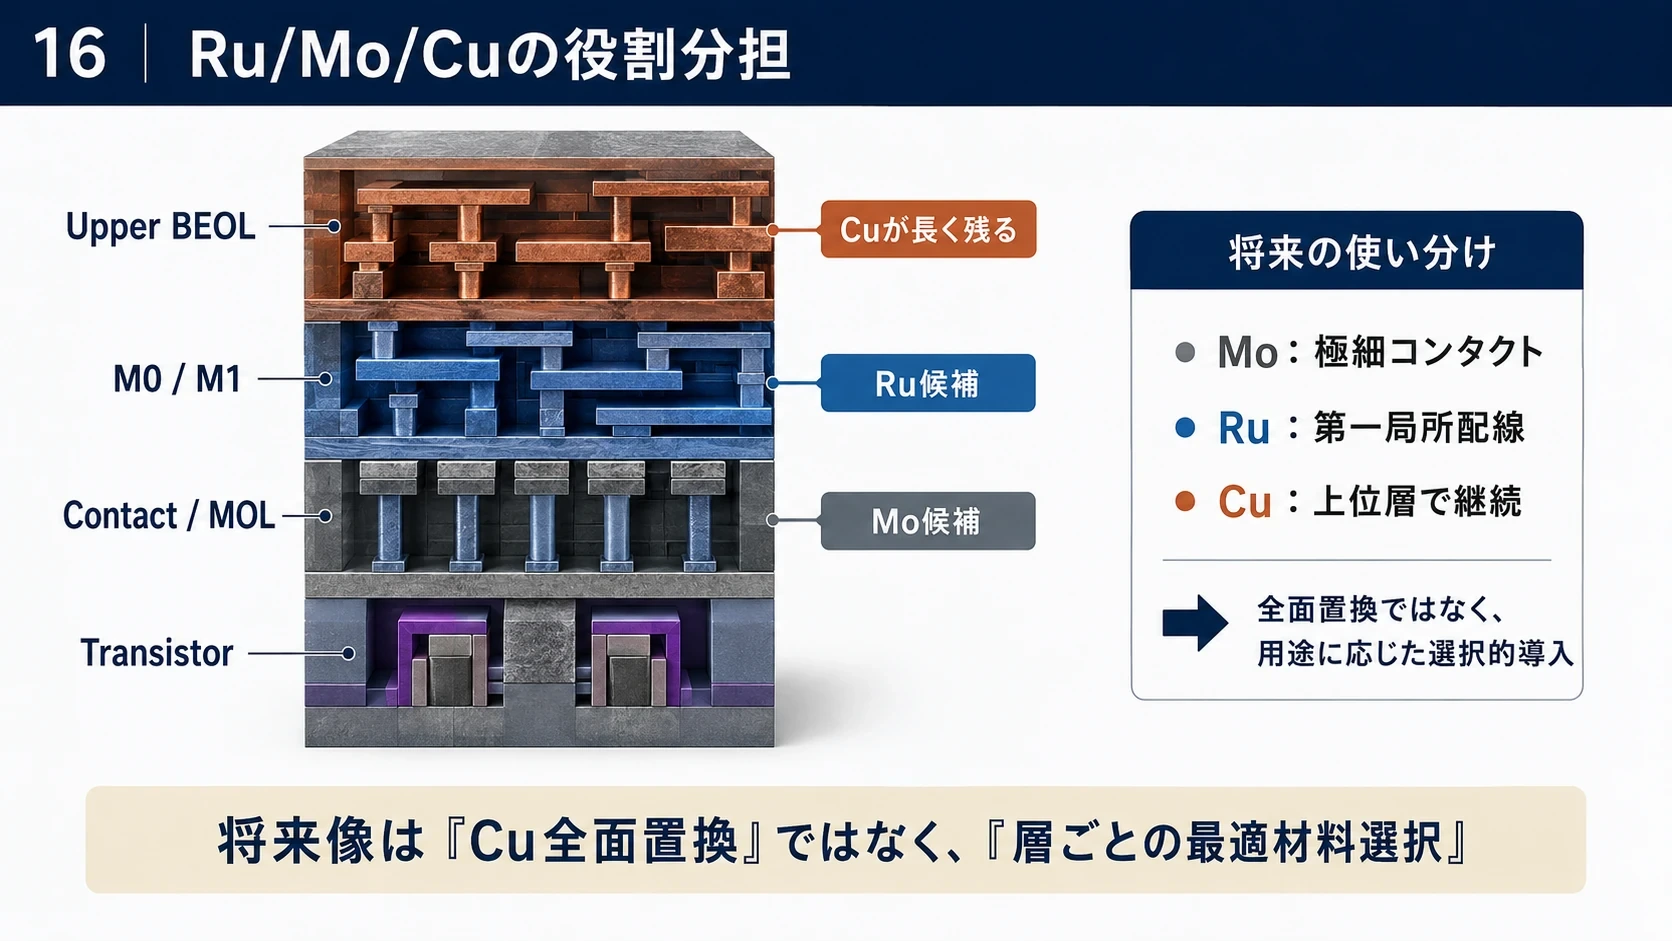
#したがって将来は単純な、
#Cu → Ru/Mo全部置換
#ではなく、
#Transistor
↓
Contact / MOL
↓
Mo候補
↓
M0 / M1
↓
Ru候補
↓
Upper BEOL
↓
Cuが長く残るという使い分けになる可能性が高い。
#図解|Ru・Mo・Cuの役割分担
#
12.CFETだけ小さくしても、SRAMが縮まらない
#ここで次の問題が起こる。
#AI GPUやCPUではlogicだけでなく大量のSRAMを使用する。
#ところがSRAM scalingがlogicほど進まなければ、
#が上昇する。
#CFETでlogicだけを半分近くに圧縮できても、
#SRAMが横に巨大なままならchip全体は思ったほど小さくならない。
#そこで出てくるのが3D SRAMである。
#現在
#Logic │ SRAM │ SRAM │ SRAM
#↓
#将来
#SRAM Tier ══════════════════ Logic ══════════════════ Backside PDN
#ここでいう3D SRAMは「SRAMセル内部を必ず垂直化する」という意味に限定していない。
#より現実的なのは、
#SRAM/cacheを独立したfunctional tierとしてlogicの上へhybrid bondingする
#構造である。
#imecのCMOS 2.0構想でも、SRAM partitioningを含むlogic/memory tieringと、sub-micron wafer-to-wafer hybrid bonding、front/backside connectivityが重要技術として位置付けられている。imecは既に300~400nm級W2W bondingを実証し、250nm、さらに200nm pitchへ向けた研究を進めている。 (imec)
#13.3D SRAMとHBMは競合ではない
#SRAMを3D化したらHBMはいらなくなるのか。
#そうではない。
#役割が違う。
#概念的には、
#Register
↓
L1 SRAM
↓
L2 SRAM
↓
3D SRAM / L3
↓
HBM
↓
CXL / SSDとなる。
#3D SRAMは、
#Latencyと超高速bandwidth
#を担当する。
#HBMは、
#数十~数百GB規模の容量と高bandwidth
#を担当する。
#むしろlogic性能がCFETで上がれば、HBMへの要求も強くなる可能性がある。
#TSMCは2026年4月時点で14-reticle級CoWoSを2028年量産予定とし、約10個の大型compute dieと最大20個のHBM stackを統合できる構想を示している。さらに14-reticle超の構造も2029年を視野に入れている。 (TSMC)
#パッケージは既に「GPU一個+HBM数個」から、巨大な計算システムそのものへ変わり始めている。
#14.HBMの先にもHybrid Bondingがある
#HBMをさらに積み重ねると、
#Microbump pitch
#Stack height
#Thermal resistance
#Power
#Yield
#が問題になる。
#そこで、
#Microbump
↓
Fine-pitch TCB
↓
Hybrid Bondingという方向が重要になる。
#ここで突然存在感が増すのがBesiである。
#Besi自身も2026年Investor Dayで、hybrid bondingの新用途として、
#Logic
#Memory
#Co-Packaged Optics
#を挙げている。 (Besi)
#したがってBesiはCFETそのものへのexposureは小さいが、
#CFETによって発生する3D system integrationへの高β銘柄
#と見ることができる。
#15.計算能力を上げると、今度は電気配線が足りなくなる
#CFET、3D SRAM、HBMで計算能力を引き上げれば、次に不足するのはI/Oである。
#電気配線のenergyは概念的に、
#で増える。
#通信距離やbandwidthが大きくなれば、電気I/Oの電力が無視できなくなる。
#そこで、
#Pluggable optics
↓
CPO
↓
Optical I/O
↓
Optical I/O closer to computeへ向かう。
#これも2035年を待つ話ではない。
#TSMCはCOUPE optical engineを使ったCPOを2026年から生産開始するロードマップを公表している。 (TSMC)
#したがって2030年代に起こるのは、
#「光通信が発明される」ことではなく、光電変換点がswitchからcomputeへどこまで接近するか
#である。
#16.なぜ最後にガラスコア基板が必要になるのか
#ここまでを一つのpackageへ詰めると、
#Compute + 3D SRAM + HBM + Optical Engine + Power
#となる。
#パッケージ面積は巨大化する。
#すると有機基板で、
#Warpage
#CTE mismatch
#Via density
#Dimensional stability
#High-frequency loss
#Package body size
#などが問題になる。
#そこで候補になるのがガラスコア基板である。
#Intelは2026年にもglass substrate研究を公開し、organic substrateより低warpageで、大型AI/HPC package、高密度interconnect、power delivery、さらにはelectrical/optical integrationに適するとしている。advanced TGV=Through Glass Viaも研究対象になっている。 (Intel Community)
#したがって、
#光を使うからガラスが必要になる
#というより、
#AI packageが巨大化するためガラスの価値が高まり、そこへOptical I/Oとの相性の良さも加わる
#と考えた方が正確である。
#17.2030年代のAIプロセッサはこうなる可能性がある
#2030年代半ばを概念図にすると、
#Optical I/O
↑ ↑ ↑HBM 3D SRAM HBM
███ ═══════════ ███
███ CFET Logic ███
███ ═══════════ ███
│
Backside PDN════════════════════════════ Glass / Advanced Substrate ════════════════════════════
#ここでは、
#CFET→ Logic density
#BSPDN→ Power delivery
#Ru/Mo→ Local wiring/contact
#High-NA→ Critical patterning
#3D SRAM→ Cache density/bandwidth
#HBM→ Memory capacity/bandwidth
#Optical I/O→ Package/rack communication
#Glass→ Large-package dimensional stability
#と役割が明確に分かれる。
#したがってこれらは「どれが勝つか」という8択ではない。
#全部が別々の限界を取り除くため、同時に必要になる可能性がある。
#18.2030~2040年ロードマップ
#ここからは本稿独自のベースケースである。
#企業の正式量産計画ではない。
#2026年時点で既に量産へ入っているHigh-NA/BSPDN/CPOと、研究段階のCFET/3D SRAM、さらに成熟度の低いglassなどを、現在の進捗差を考慮して並べる。
#このモデルで重要なのは、CFETがすべての始点ではないことである。
#High-NA、BSPDN、CPO、HBM、hybrid bondingなどはCFETより先に量産経験を積む。
#そのためCFETが登場する頃には、それを支える周辺技術がある程度成熟しているという順番になる。
#19.この変化で、どの製造装置が増えるのか
#CFETを製造するだけでも、
#TELは自社資料でも、GAA/BSPDN向けEUV coater/developer、etch、PVD、CFET inner-spacer filling、backside cleaning、wafer bonderからHBM temporary bonder/debonderまでを戦略成長領域として列挙している。 (Tel)
#Lamもadvanced packaging分野でTSV、TDVだけでなくTGV、hybrid bondingまでを対象としているため、Z方向integrationが増えるほど対象工程が広がる。 (Lam Research Newsroom)
#20.装置メーカーをどう分類すればよいか
#Applied Materials
#最も広い。
#CFET BSPDN Ru/Mo HBM 3D integration CMP Deposition
#に参加できる。
#一つの技術を外しても別の工程で取れることが最大の強みである。
#Lam Research
#2030年代の「Z方向化」と非常に相性がよい。
#CFET selective etch BSPDN via 3D SRAM via HBM TSV Glass TGV
#と、
#掘る、膜を付ける、埋める
#工程が増えるほどcontentが増えやすい。
#Tokyo Electron
#非常に広い上に、High-NAにもtrack側から参加できる。
#EUV Track Etch Deposition Clean Backside Bonding HBM
#という珍しい構成である。 (Tel)
#ASM International
#範囲はAMATほど広くない。
#しかし、
#ALD+Epitaxy
#というCFETのど真ん中にいる。
#ASMはsingle-wafer ALD市場が2024年約30億ドルから2030年約51~61億ドルへ拡大すると予想している。 (ASM)
#そのため、
#絶対TAMならAMAT/Lam/TELCFET普及率に対する企業業績βならASM
#という違いがある。
#KLA
#KLAは何を作るかより、
#作るのが難しくなること
#そのものに賭ける企業に近い。
#CFET、BSPDN、hybrid bonding、HBM、glass。
#工程が増えれば、
#Overlay
#Defect
#Bond void
#Thickness
#CD
#backside defect
#を測る回数も増える。
#言い換えればKLAは半導体複雑化税を取れる立場である。
#ASML
#ASMLは少し違う。
#CFETそのものの装置contentより、
#A10→A7→A5と横方向のcritical dimensionを縮め続けること
#にHigh-NAが効く。
#つまり、
#CFET銘柄
#というより、
#Angstrom scaling独占銘柄
#と考えた方がよい。
#Besi
#CFETへの直接exposureは小さい。
#しかし、
#3D SRAM + HBM + Optical Engine + Chiplet
#がhybrid bondingへ向かうと急激にcontentが増える。
#Besi自身もlogic、memory、CPOを次世代hybrid bonding用途として挙げている。 (Besi)
#その意味では7社中、最大のオプション性と最大の採用リスクを同時に持つ。
#21.「装置content/wafer」を数値化してみる
#ここからは本稿独自モデルである。
#ASMLのscanner、KLAのinspection、Besiのbonderは物理的には同じ$/waferで単純比較できない。
#そこで、
#各社自身の2029年の先端AI compute向けequivalent-wafer当たり装置content=100
#と置く。
#これは会社間の絶対金額ではない。
#同じ会社のcontent intensityがどれだけ増えるかを見る指数である。
#このモデルでは2033~2035年が最も重要な転換帯になる。
#22.なぜ2034年に最大のジャンプが来るのか
#High-NAだけならASML/TELはもっと早く伸びる。
#BSPDNも2020年代後半から始まる。
#しかし2033~35年になると、
#CFET + BSPDN + Ru/Mo + 3D SRAM + HBM + Hybrid Bonding + Optical I/O + Glass
#が重なり始める。
#そのためモデル上の最大年次増加は、
#となる。
#ASMLだけ一足早い。
#これはHigh-NAがCFETより先行するためである。
#23.各技術を完全普及させた場合、何がcontentを増やすのか
#2029年=100に対する2040年時点の寄与を、本稿では次のように置いた。
#この表を見ると各社の性格が分かりやすい。
#ASM=CFET高β。
#ASML=High-NA高β。
#Besi=Hybrid Bonding高β。
#Lam=Z方向加工高β。
#KLA=複雑化全般。
#AMAT/TEL=複数技術を広く取る。
#24.では実際の半導体製造装置TAMはどこまで大きくなるのか
#ここからはcontent指数を実額へ変換する。
#SEMIは2026年7月時点で、世界半導体製造装置市場を、
#2026年:約1,659億ドル2028年:約2,295億ドル
#と予測している。 (SEMI)
#2030年以降はSEMI予測ではない。
#本稿では2028年の2,295億ドルを起点に、
#基礎的なwafer/capacity成長:年4%
#とし、さらに8技術による装置content増を加える。
#すると、
#年世界装置TAM・本稿推定2030約2,610億ドル2035約3,710億ドル2040約4,960億ドル
#固定換算前提を、
#1ユーロ=1.1555ドル1ドル=159.14円
#とすると参考値は、
#となる。
#これは為替予想ではなく、単なる比較用固定換算である。
#25.8技術だけでどれくらいの追加TAMになるか
#二重計上を避けるため、各装置投資を「主因となった技術」に一度だけ割り当てる。
#本稿ベースケースは次の通り。
#単位:10億ドル。
#したがって2035年の世界装置TAM約3,710億ドルのうち、
#約1,080億ドル
#を、この8技術の複雑化による追加需要として説明するモデルになる。
#これは約29%に相当する。
#26.各社がアクセスできるSAMを推計する
#TAM全体を一社が取れるわけではない。
#そこで各社が装置portfolio上アクセス可能なServiceable Addressable Market=SAMを推定する。
#なお、各社のSAMは重複しているため足し算してはいけない。
#ここでもAMAT/Lam/TELは「広さ」が強い。
#ASM/BesiはSAMそのものより、現在事業規模に対して新技術SAMが大きいことが重要になる。
#27.2035年売上を「技術要因だけ」で逆算する
#ここではさらに厳しい条件を置く。
#半導体生産量は現在から一切増えない。
#市場シェアも変わらない。
#ただし1枚作るのに必要な装置contentだけが増える。
#つまり
#である。
#現在の基準値は2026年の最新実績やrun-rate proxyを使う。
#AMATは2026年Q2売上79.1億ドル、Lamは2026年6月四半期67.2億ドル、ASMLは2026年売上ガイダンス430~450億ユーロ、ASMはQ2売上約10億ユーロ、BesiはQ2約2.499億ユーロである。TELについては正式なFY2027通期売上予想がまだないため、上期売上予想1.62兆円を単純に2倍した3.24兆円をproxyとする。KLAはFY2026売上135.8億ドルを使用する。 (Applied Materials) TELのproxyは会社の正式通期ガイダンスではない。 (Tel)
#その結果、
#となる。
#繰り返すが、これは2035年売上予想ではない。
#「ウェハ数量成長をゼロにしても、技術複雑化だけならどこまで売上contentが増え得るか」を見るストレステストに近い。
#28.営業利益まで置いてみる
#さらに本稿では2035年のnormalized operating marginを、
#と置く。
#Besiについては同社が長期operating margin目標45~55%を掲げているため、その中間を使う。 (Besi)
#その他は現在の経済性から大きなmargin expansionを仮定せず、比較用に丸めたものである。
#すると2035年の「技術要因営業利益capacity」は、
#となる。
#29.現在時価総額と比べる
#2026年8月10日前後の時価総額を概算すると、
#AMAT:約4172億ドル
#Lam:約3852億ドル
#TEL:約25.8兆円
#ASML:約5757億ユーロ
#ASM:約421億ユーロ
#KLA:約2588億ドル
#Besi:約179億ユーロ
#である。 (Yahoo Finance)
#これを2035年の「技術要因売上」で割る。
#このモデルだけを見ると、
#TEL → ASM → AMAT
#の順に現在時価総額に対する2035年技術売上余地が大きい。
#ただしsales multipleだけではprofitabilityが違いすぎる。
#30.営業利益で見ると順位が変わる
#現在時価総額を、先ほどの2035年技術要因営業利益で割ると、
#ただしこれは2035年PERではない。
#税金、金利、net cash/debt、buyback、株式数、将来の設備投資サイクルを考慮しておらず、分母もnet incomeではなくoperating profitだからである。
#見るべきなのは絶対値ではなく、
#現在valuationが、技術要因だけで生まれる2035年利益capacityの何倍まで先取りしているか
#という比較である。
#31.モデル上TELがかなり興味深くなる理由
#TELは、
#EUV Track
#Etch
#CVD
#Cleaning
#CFET Spacer
#BSPDN
#Bonding
#HBM
#へ広く参加できる。 (Tel)
#にもかかわらず、このモデルでは現在時価総額÷2035技術売上が約4.3倍。
#もちろんTELの基準売上にはFY2027上期予想を単純年率換算したproxyを使用しているため、数字を過度に精密に読むべきではない。
#それでも、
#2030年代の技術portfolioの広さに対するvaluation
#という観点ではかなり興味深い位置にある。
#32.ASMはCFETのpure-playに近い
#ASMで重要なのは絶対売上額ではない。
#現在の会社規模に対して、
#ALD/Epitaxy需要の増分が大きい
#ことである。
#CFETが、
#Channel Epi
↓
Spacer
↓
High-k
↓
Metal Gate
↓
S/D Epi
↓
Contact linerと進めば、atomic-level depositionの工程密度が高くなる。
#そのため本稿モデルではCFET寄与を7社中最大級に置いている。
#逆に言えば、
#CFETが3~4年遅延した場合に最も影響を受けやすい企業の一つもASM
#である。
#33.AMATは一つの技術を外しても生き残りやすい
#AMATの強みは、
#CFETが遅れたら終わり
#になりにくいことだ。
#CFETが遅れても、
#BSPDN
#HBM
#Mo
#Ru
#Advanced Packaging
#がある。
#Moのような新材料そのものの導入もAMATの得意領域であり、2026年にはmonocrystalline Mo ALDまで発表している。 (Applied Materials)
#したがって本稿ではAMATを、
#2030年代technology transitionに対する最もdiversifiedなsemicap
#の一つと見る。
#34.Lamは「Z軸の半導体化」に賭ける会社
#Lamの面白さは非常に明確である。
#半導体が、
#小さく描く
#だけでなく、
#深く掘る 積む 穴を開ける 膜を付ける 埋める
#方向へ行くほど仕事が増える。
#CFET、BSPDN、HBM TSV、3D SRAM、TGV。
#いずれもLamのetch/deposition技術と相性がよい。Lam自身もadvanced packaging向けにTSV、TGV、hybrid bondingを対象としている。 (Lam Research Newsroom)
#したがって2030年代の本質を、
#2D scaling → 3D scaling
#と見るならLamは非常に強い。
#一方、現在valuationも既にその成長をかなり評価している。
#35.ASMLはCFETの時期に最も左右されにくい
#CFETが2032年から2035年へ遅れたとしても、
#High-NAそのものは既に量産へ入っている。 (ASML)
#そのためASMLは、
#CFET delay riskへの感応度が7社の中でかなり低い。
#逆に最大の変数は、
#1 node当たり何layerがHigh-NAになるか
#Low-NA EUV+multi-patterningがどこまで延命するか
#High-NA tool throughput
#tool価格
#である。
#36.KLAは「どの技術が勝つか」を当てなくてもよい
#CFETでもGAAでも、
#HBMでも3D SRAMでも、
#glassでもorganicでも、
#製造が難しくなるならinspectionは必要である。
#特に3D化では、
#最後に欠陥を見つけるほど損失が大きい。
#CFET logicを作り、
#SRAMをbondし、
#HBMを積み、
#optical engineまで載せた後で不良が見つかれば、失う価値は従来chipより遥かに大きい。
#したがってKnown Good Die、bond inspection、overlay、metrologyの経済価値そのものが上昇する。
#このためKLAはモデル上2035指数195まで伸びる。
#ただし現在時価総額÷2035技術売上では約9.8倍と7社中最も高く、強いbusiness modelが既にvaluationへ反映されているとも読める。
#37.Besiは最大の夢と最大のリスクを持つ
#Besiの指数は、
#2029年100→ 2035年201→ 2040年247
#と最も大きく伸びる。
#しかしこれは、
#3D SRAM・HBM・CPOでfine-pitch hybrid bondingが本格普及する
#ことをかなり織り込んでいる。
#もし、
#Microbump
#TCB
#Improved solder bonding
#が予想以上に長く延命すれば、この曲線は大きく下方修正される。
#逆にlogic+SRAM+HBM+Optical I/Oのすべてにhybrid bondingが入れば、現在事業規模に対する市場拡大率は非常に大きくなる。
#Besi自身もlogic、memory、CPOをhybrid bonding成長市場として位置付けている。 (Besi)
#38.この予測が外れるとしたら何が原因か
#当然ながら、2030~2040年をここまで精密に当てることはできない。
#特に注意したいのは次の点である。
#CFET遅延。CFETが3年遅れるとASMへの影響が最も大きく、AMAT/Lam/TELにも影響する。一方ASMLはHigh-NAが先行するため影響が小さい。
#Hybrid Bonding遅延。Besiへの影響が最も大きい。3D SRAM、HBM、Optical I/O全体のscheduleも後ろへずれる。
#Glass Coreが限定用途に留まる。Organic substrate側の改良が進めば、glassは超大型AI package専用のまま長く残る可能性がある。
#High-NA layer数が想定より少ない。Low-NA EUV multi-patterningの経済性が予想以上なら、ASML/TELへの追加contentはモデルを下回る。
#Thermal wall。CFET+3D SRAM+HBMを積んでも熱を逃がせなければ、物理的には作れても最高性能chipでは使いにくい可能性がある。
#Yield。追加工程は装置TAMを増やすが、同時に製造コストも増やす。性能向上よりcost/transistorが悪化すれば導入が遅れる。
#そして本稿モデルは技術要因だけを見るため、
#AI需要
#景気循環
#金利
#中国規制
#輸出規制
#中国装置メーカーの国産化
#vendor share変化
#を意図的に外している。
#実際の売上や株価では、これらの方が数年間は技術content以上に大きく効く可能性もある。
#39.2030年代を「CFETの時代」と呼ぶと少し違う
#ここまで見ると、CFETは非常に重要である。
#しかし2030年代を、
#CFETの時代
#と呼ぶだけでは本質を取り逃がす。
#より正確には、
#XY ScalingからXYZ/System Scalingへ移行する時代
#である。
#過去は、
#という考え方がかなり通用した。
#2030年代は、
#という世界になる。
#CFETだけ速くしてもHBMが足りなければ意味がない。
#HBMだけ増やしてもGPU間通信が詰まれば意味がない。
#Optical I/Oを載せても巨大packageが反れば量産できない。
#全部を同時に最適化する必要がある。
#これはimecがCMOS 2.0で示している、logic、memory、3D integration、backside connectivityをシステムとして再構成する考え方とも一致する。 (imec)
#40.結論――「そんなこと本当にできるのか?」への答え
#最初の疑問へ戻る。
#トランジスタを本当に上下へ積めるのか。
#答えは、既にYesである。
#Intel、Samsung、imecは実シリコンで動作するCFET/3D stacked transistorを示している。 (imec)
#しかし次の質問、
#大型AI GPUを何百万個も経済的に量産できるのか。
#については、まだYesとは断言できない。
#その答えが出るのがおそらく2030年代前半から半ばになる。
#そしてCFETが本当に量産へ入れば、変化はトランジスタだけに留まらない。
#CFET
↓
Backside Power
↓
Ru / Mo
↓
High-NA
↓
3D SRAM
↓
HBM
↓
Optical I/O
↓
Glass / Advanced Packageという形で半導体システム全体が3次元化していく。
#製造装置側から見ると、これはさらに面白い。
#ウェハ1枚を作るために必要な、
#成膜回数
#Etch回数
#表裏加工
#Bonding
#Cleaning
#CMP
#Inspection
#Metrology
#が同時に増えていくからだ。
#そのため2030年代は、完成したAI chipの勝者だけでなく、
#AMAT、Lam、TEL、KLAのような「工程数が増えるほど売れる企業」
#にとって非常に大きな構造変化になり得る。
#その中で、
#ASMはCFET/ALD/Epiへの高β。
#ASMLはHigh-NAとAngstrom scalingへの独占的exposure。
#Besiは3D SRAM、HBM、CPOをつなぐhybrid bondingへの高β。
#という役割を持つ。
#本稿モデルでは装置contentが最も大きく跳ねるのは2033~2035年、特に2034年前後となった。
#もしこの方向が正しければ、2030年代の半導体産業で最も重要な変化は、
#「何nmまで縮められるか」
#だけではなくなる。
#問われるのは、
#トランジスタ、電源、配線、SRAM、HBM、光、基板を、三次元空間のどこへ配置すれば最も高性能な計算機になるのか。
#という問題になる。
#ムーアの法則が終わるというより、
#ムーアの法則を続けるために、半導体産業そのものが三次元へ逃げ始める。
#CFETは、その転換を最も象徴する技術の一つなのだろう。
#この記事の内容は未来予想的な内容で、不確実性が高いので、そういう方向に進む可能性もあるんだなあくらいで読んで下さい
#時期や量産実現の可能性などは、現実の動きを確認しながら追っていくのがよいです
#さらに深く読むための座標
#CFETの成否は単一トランジスタの実証では決まらない。上下FETへの接続、熱、電源、配線、検査、歩留まりを量産フローとして閉じられるかが本当の判定条件である。
#| 層 | 観測対象 | 問うべきこと |
|---|---|---|
| Device | 上下FET、Channel、Contact | 性能差と熱履歴を揃える |
| Interconnect | Backside Power、Ru/Mo、High-NA | 電源・配線密度を追随させる |
| System | 3D SRAM、HBM、Optical I/O、Glass Core | 増えたLogicを待たせず外へつなぐ |
絶ノイアの観測
#CFETだけを量産しても、電源と配線が詰まれば面積効率は性能に変わりません。次の微細化は装置工程の連鎖を同時に立ち上げる総力戦です。
#私は「Device」「Interconnect」「System」を別々の話題にせず、一つのAIインフラが通過する連続した設計課題として観測します。
#研究実証・初期量産・本格HVMを分ける。発表された最大性能や市場規模だけでなく、実装、量産、運用が同じ速度で前進しているかを確かめたいからです。
#Sil-Kathnaの記録
#塔を一段高くすれば、下層へ届く道と熱の逃げ道が要る。石を積む技だけでは、塔は文明にならぬ。
#私は「Device」「Interconnect」「System」を、計算する文明へ続く三つの門として石板に刻む。
#最初の門だけが開いても、次の門に熱、傷、遅れが残れば、光と記憶は炉心へ届かない。強い器とは、最も華やかな石を持つ器ではなく、異なる工房の歩調を長い夜の中で揃えられる器である。
#ゆえに私は、研究実証・初期量産・本格HVMを分ける。その結果が一時の輝きではなく、繰り返し作り、直し、動かせる秩序になったかを見届ける。
#二人の短い対話
#絶ノイア: 量産時期は最も遅い補完技術に引っ張られます。
#Sil-Kathna: 最初に完成した門ではなく、最後まで崩れず続く道が時代を開く。
#観測メモ
#- 研究実証・初期量産・本格HVMを分ける
- 工程追加によるdefect opportunityを数える
- 装置TAM推計は導入率・再利用率・wafer mixを明示する
免責
#この記事は市場観測とAIによる考察、キャラクター表現を含みます。内容は投資助言ではありません。数値、企業計画、将来見通しには不確実性があり、判断は必ず一次情報とご自身の状況にもとづいて行ってください。
#