第10回 3D V-Cache、Foveros Direct、SoIC、CoWoS―3D積層技術は何が違うのか
この資料の日時
元資料の日付と、その本文が公に存在した確認日時は別の記録です。
本文に含まれる語句 HBM DRAM SRAM 帯域・データ移動 先端パッケージング 光接続 電力・給電 冷却 歩留まり 基板・材料 チップレット
出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.09.23.4
- 記事内容のSHA-256
debe416e7f22913559a006c769a6b94764c57acbc13874385d0d432667231d6b- 保存版のSHA-256
6badc9820011d44f2212e07743231ddaacf750ef7e2b801e98cfde5910f86700
外部証明の最終検査結果は詳細を開くと表示します。
連載:巨大チップの限界を超える――UCIeとチップレット、3D半導体のすべて
#レチクル限界、Die-to-Die PHY、Hybrid Bonding、TSVから、3D V-Cache、Foveros Direct、SoIC
#第10回 3D V-Cache、Foveros Direct、SoIC、CoWoS――3D積層技術は何が違うのか
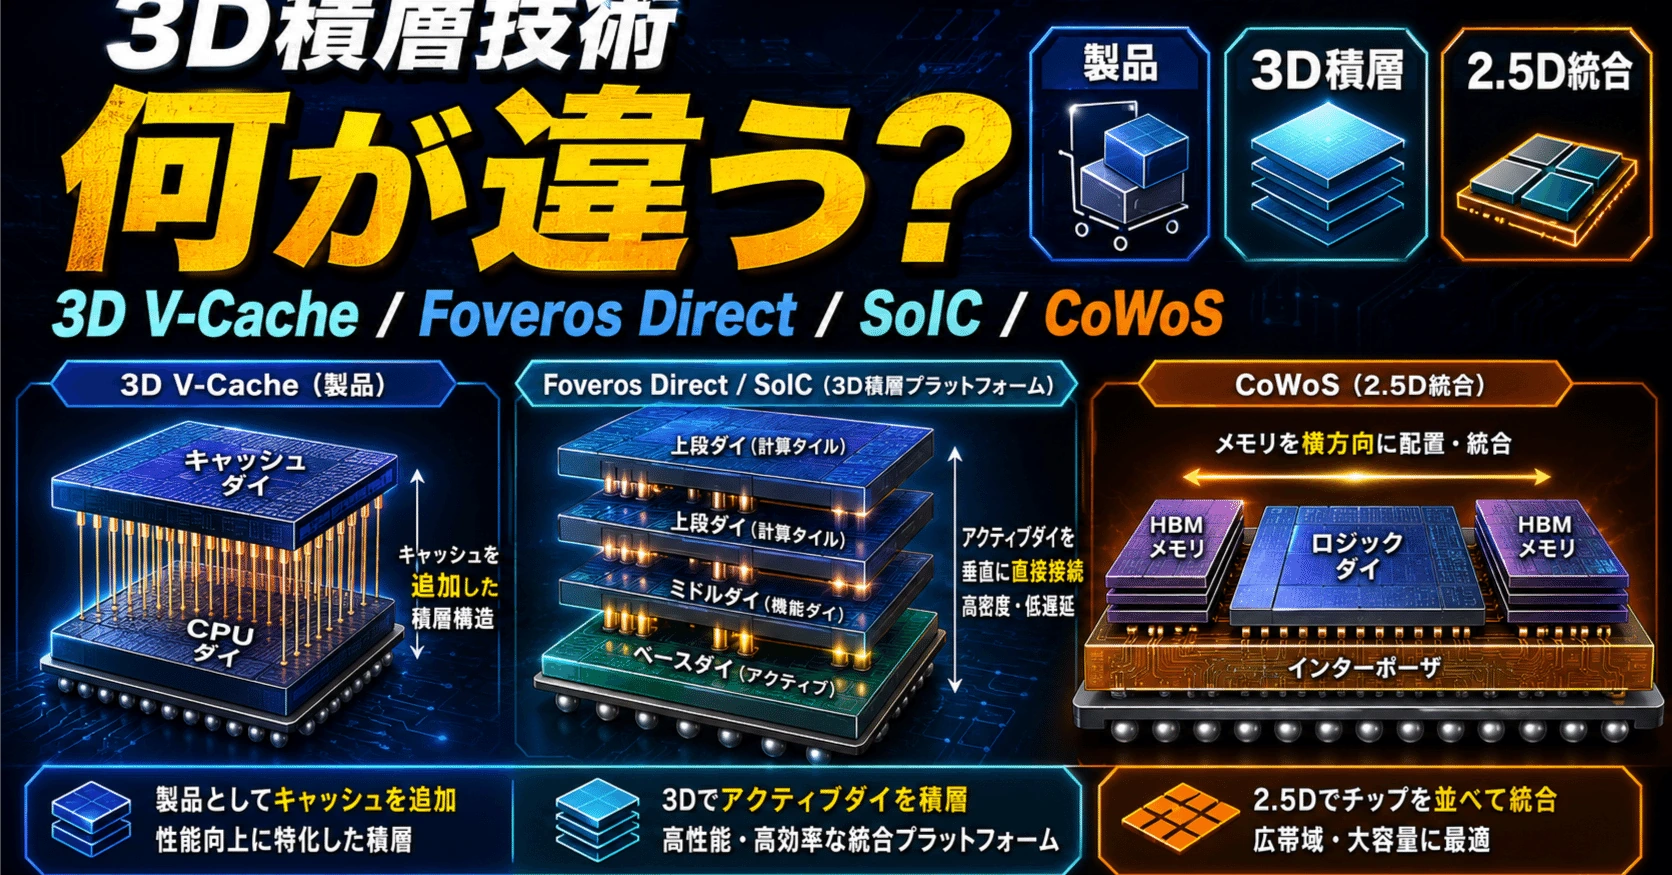
#Hybrid Bondingは「技術」、3D V-Cacheは「製品」、SoICとFoveros Directは「製造プラットフォーム」である
#ここまで、チップレット、マイクロバンプ、Hybrid Bonding、TSV、Die-to-Die PHY、UCIeを順に見てきた。
#ここからは、それらの技術が実際の製品や先端パッケージで、どのように組み合わされているのかを解説する。
#今回扱うのは、次の4つである。
#- AMD 3D V-Cache
- Intel Foveros Direct 3D
- TSMC SoIC
- TSMC CoWoS
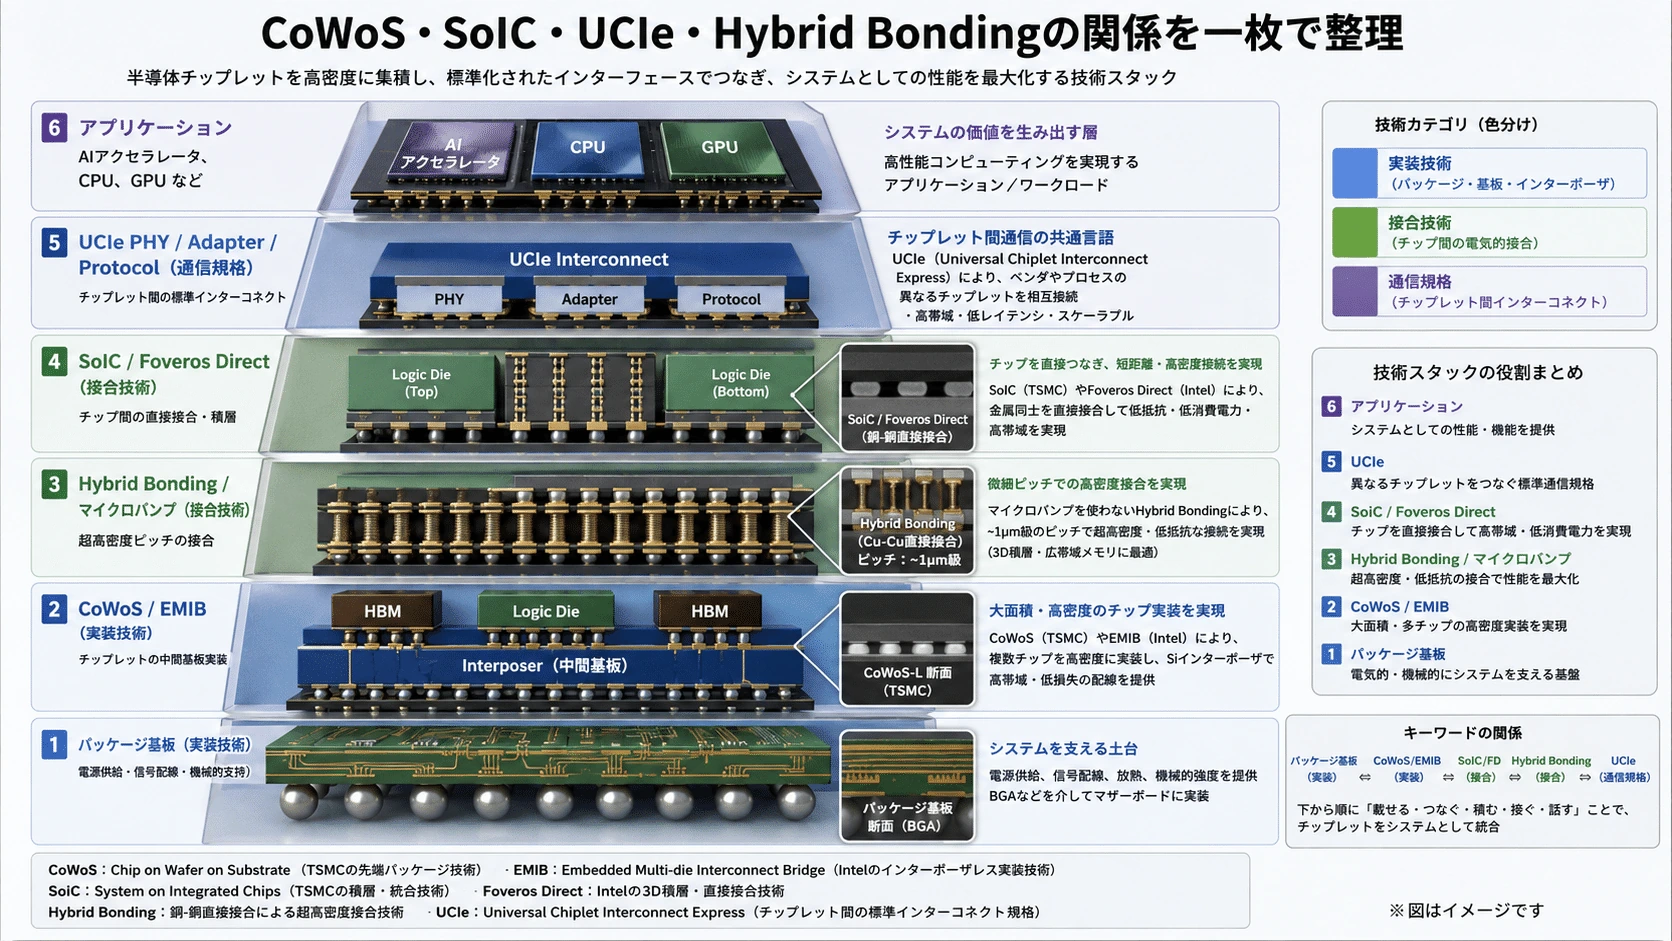
これらは、同じ「3D半導体」の話題で並べられることが多い。しかし、実際には技術階層が異なる。
#| 名称 | 技術階層 | 主な役割 |
| AMD 3D V-Cache | 製品アーキテクチャ | CPUへ追加SRAMを積層する |
| Foveros Direct 3D | 3D製造・実装プラットフォーム | アクティブダイ同士を直接積層する |
| TSMC SoIC | 3Dシリコン積層プラットフォーム | ロジック、SRAMなどを垂直統合する |
| TSMC CoWoS | 2.5D先端パッケージ | ロジックとHBMを横方向に統合する |
| Hybrid Bonding | 接合技術 | 銅と誘電体を直接接合する |
| TSV | ダイ内部配線 | シリコンを厚さ方向に貫通する |
| UCIe | 通信規格 | チップレット間の通信条件を共通化する |3D V-CacheはHybrid Bondingを使った製品であり、Foveros DirectとSoICは3D積層を作る製造基盤、CoWoSは複数のダイとHBMを横方向へ統合するパッケージ基盤である。#
#
AMD 3D V-Cacheとは何か
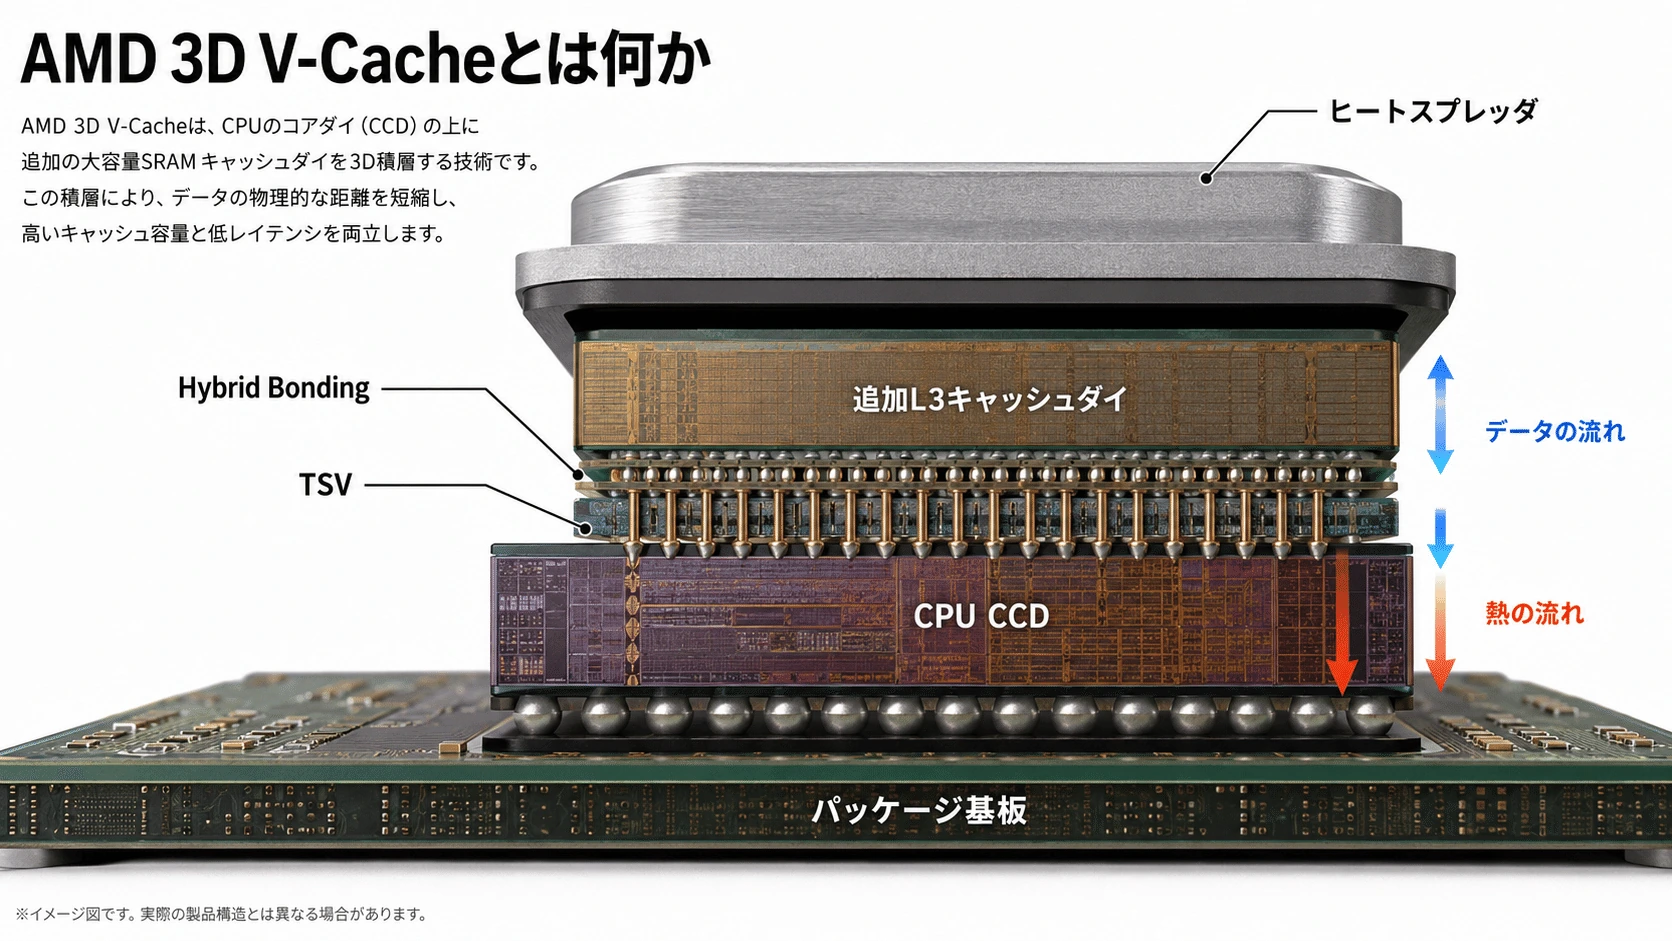
#AMD 3D V-Cacheは、CPUのCore Complex Die、すなわちCCDへ、追加のL3キャッシュ用シリコンダイを垂直に統合する技術である。
#追加されるキャッシュダイは、主としてSRAMセルで構成された大容量キャッシュである。
#第1世代の概念
ヒートスプレッダ
↑
追加L3キャッシュダイ
│
Hybrid Bonding
│
CPU CCD
│
パッケージ基板AMDは現在の3D V-Cacheについて、64MBのL3キャッシュダイ、最大8コアのZen 5 CCD、TSV、Direct Copper-to-Copper Bondを主要構成として説明している。AMD公称では、マイクロバンプ型3D接続と比べて15倍超の接続密度、3倍超の接続エネルギー効率を持つ。これらはAMDの社内比較値である。(AMD)
#
#
なぜキャッシュを積層するのか
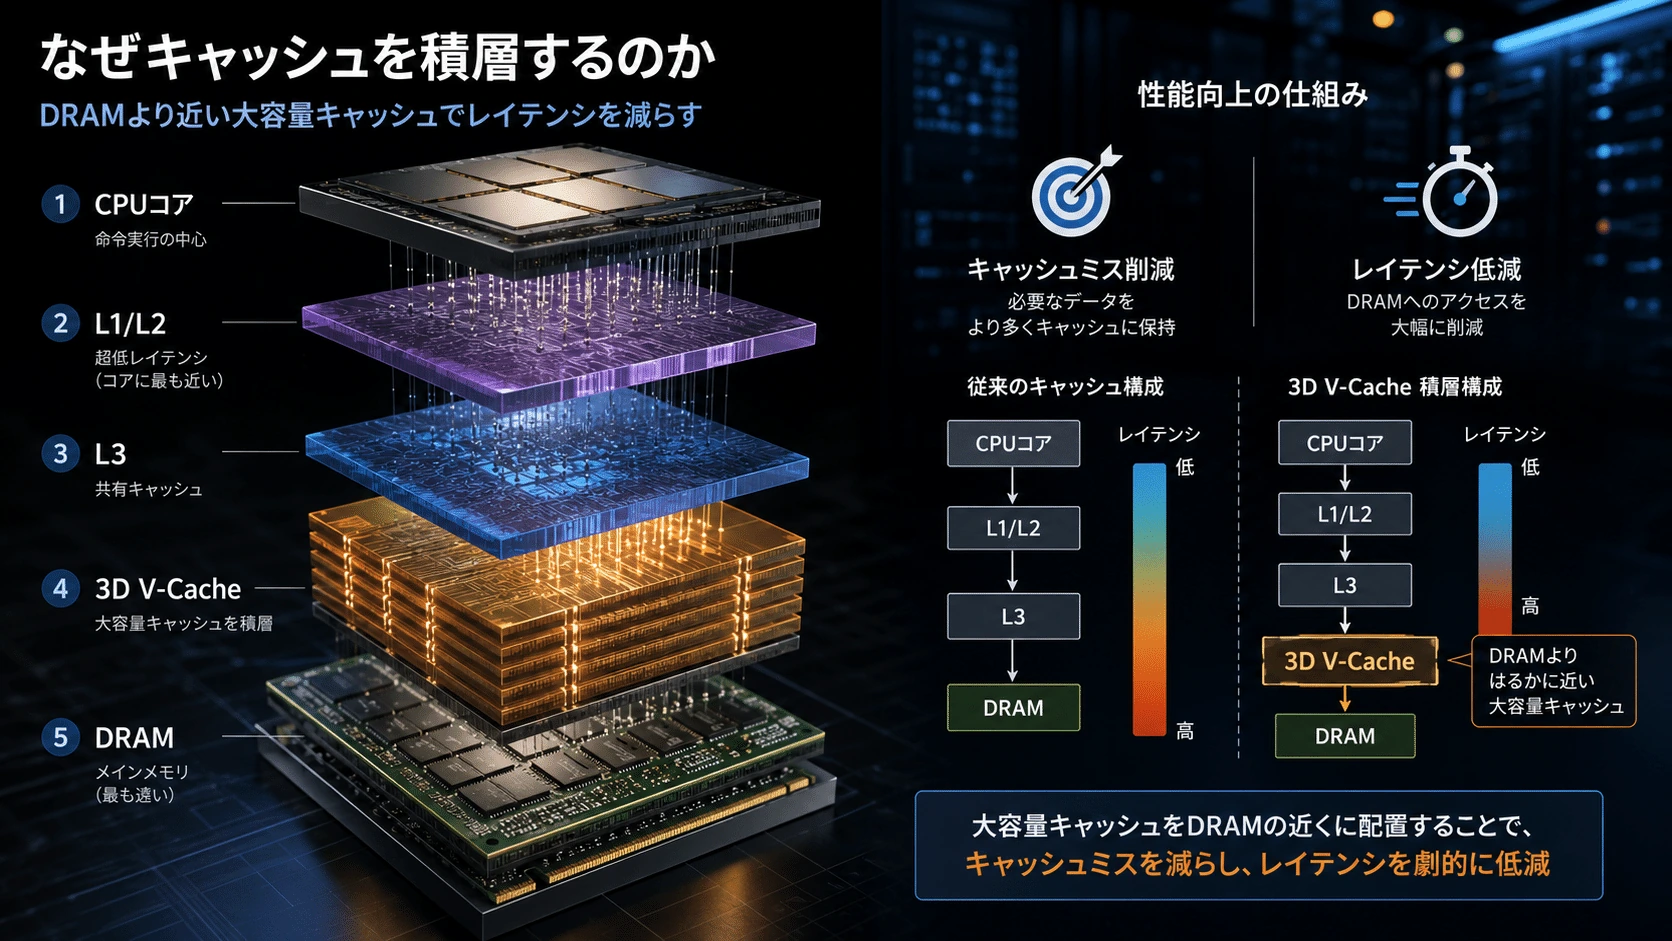
#CPUコアは、演算に必要なデータをL1、L2、L3キャッシュから取得する。
#必要なデータがキャッシュに存在しなければ、より遠いDRAMへアクセスしなければならない。
#平均メモリーアクセス時間は、単純化すると次のように表せる。
#AMATは、Average Memory Access Timeの略で、日本語では平均メモリアクセス時間という。
#CPUが必要なデータへアクセスするときに、キャッシュヒットとキャッシュミスの両方を考慮した、平均的な待ち時間を表す。
#DRAMアクセスのペナルティーは大きいため、L3キャッシュ容量を増やしてミス率を少し下げるだけでも、性能が大きく改善する場合がある。
#特に効果が出やすいのは、
#- ゲームの不規則なデータアクセス
- EDA
- CFD
- 有限要素解析
- 分子動力学
- データベース
- 一部の科学技術計算
などである。
#AMDのEPYC 7003世代では、追加キャッシュにより1 CCD当たり最大96MB、1ソケット当たり最大768MBのL3を構成し、銅同士のバンプレスHybrid Bondingを使用した。(docs.amd.com)
#
#
キャッシュダイは通常のRAMと何が違うのか
#3D V-Cacheのキャッシュダイは、一般的なDIMM上のDRAMとは役割が異なる。
#DRAM
#- 容量が大きい
- CPUから比較的遠い
- レイテンシーが大きい
- 定期的なリフレッシュが必要
- システムの主記憶として使われる
SRAMキャッシュ
#- 容量当たりの面積が大きい
- リフレッシュ不要
- 高速
- CPUコアに近い
- DRAMアクセスを減らすために使われる
3D V-Cacheのキャッシュダイは、独立したメモリーモジュールとしてCPUへ接続されるわけではない。
#CPUのL3キャッシュ階層へ組み込まれ、CPU側のキャッシュ制御、タグ管理、置換制御、コヒーレンシ機構と一体として動作する。
#CPUコア
↓
L1
↓
L2
↓
CCD内L3 + 3D積層L3
↓
I/O Die
↓
DRAM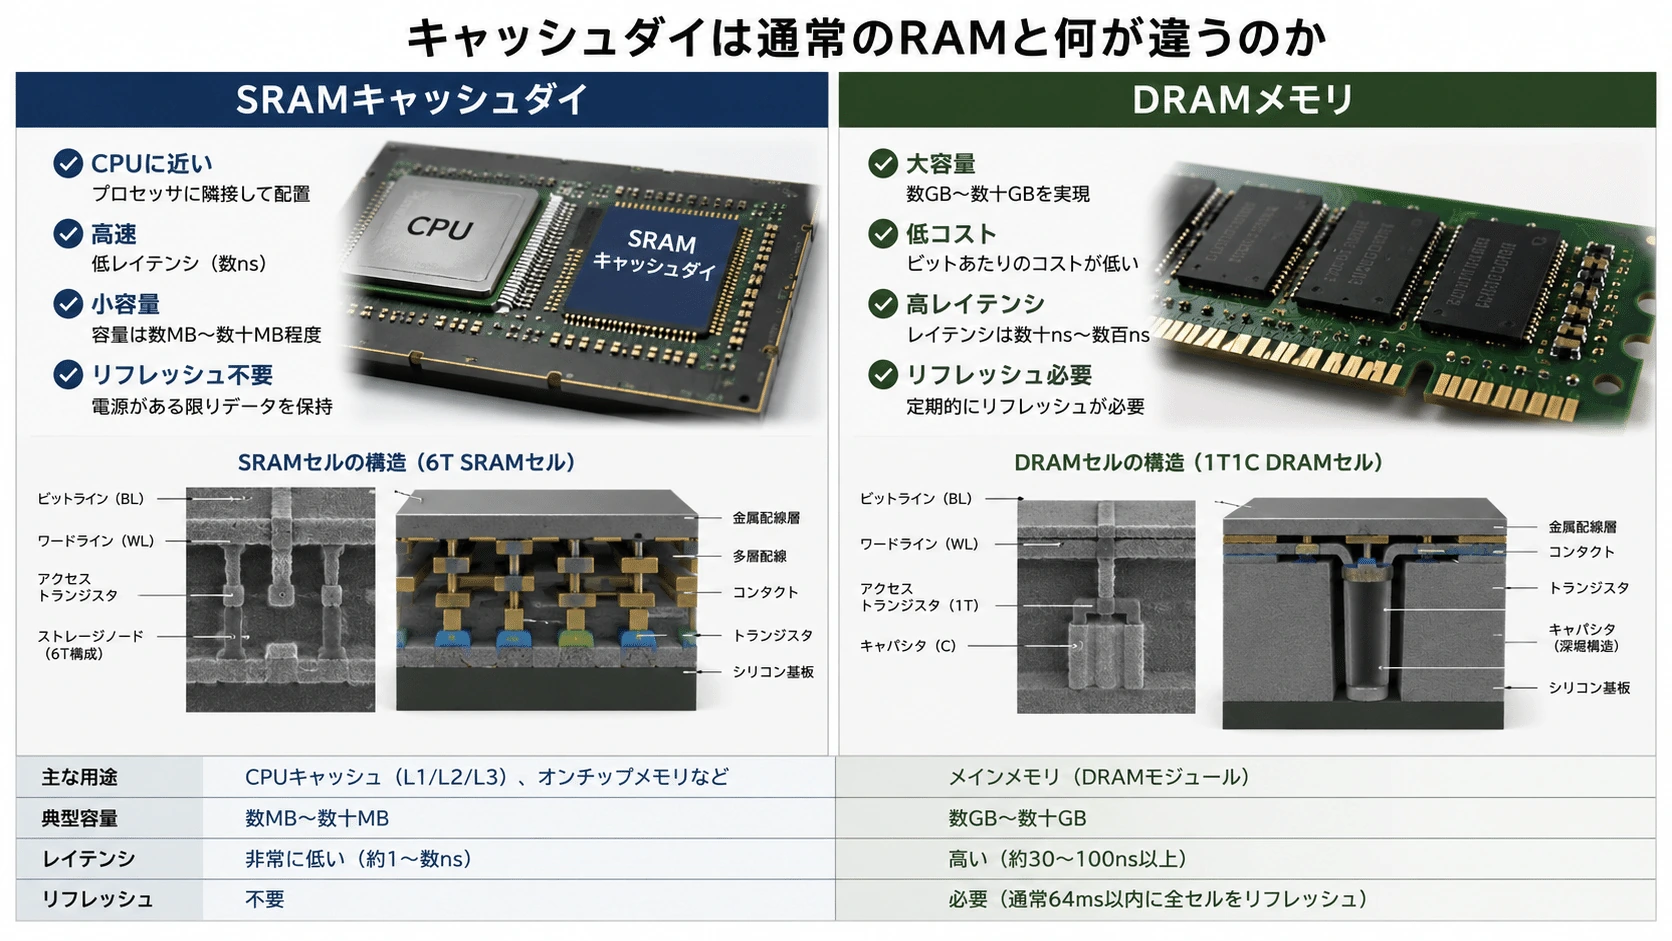
#
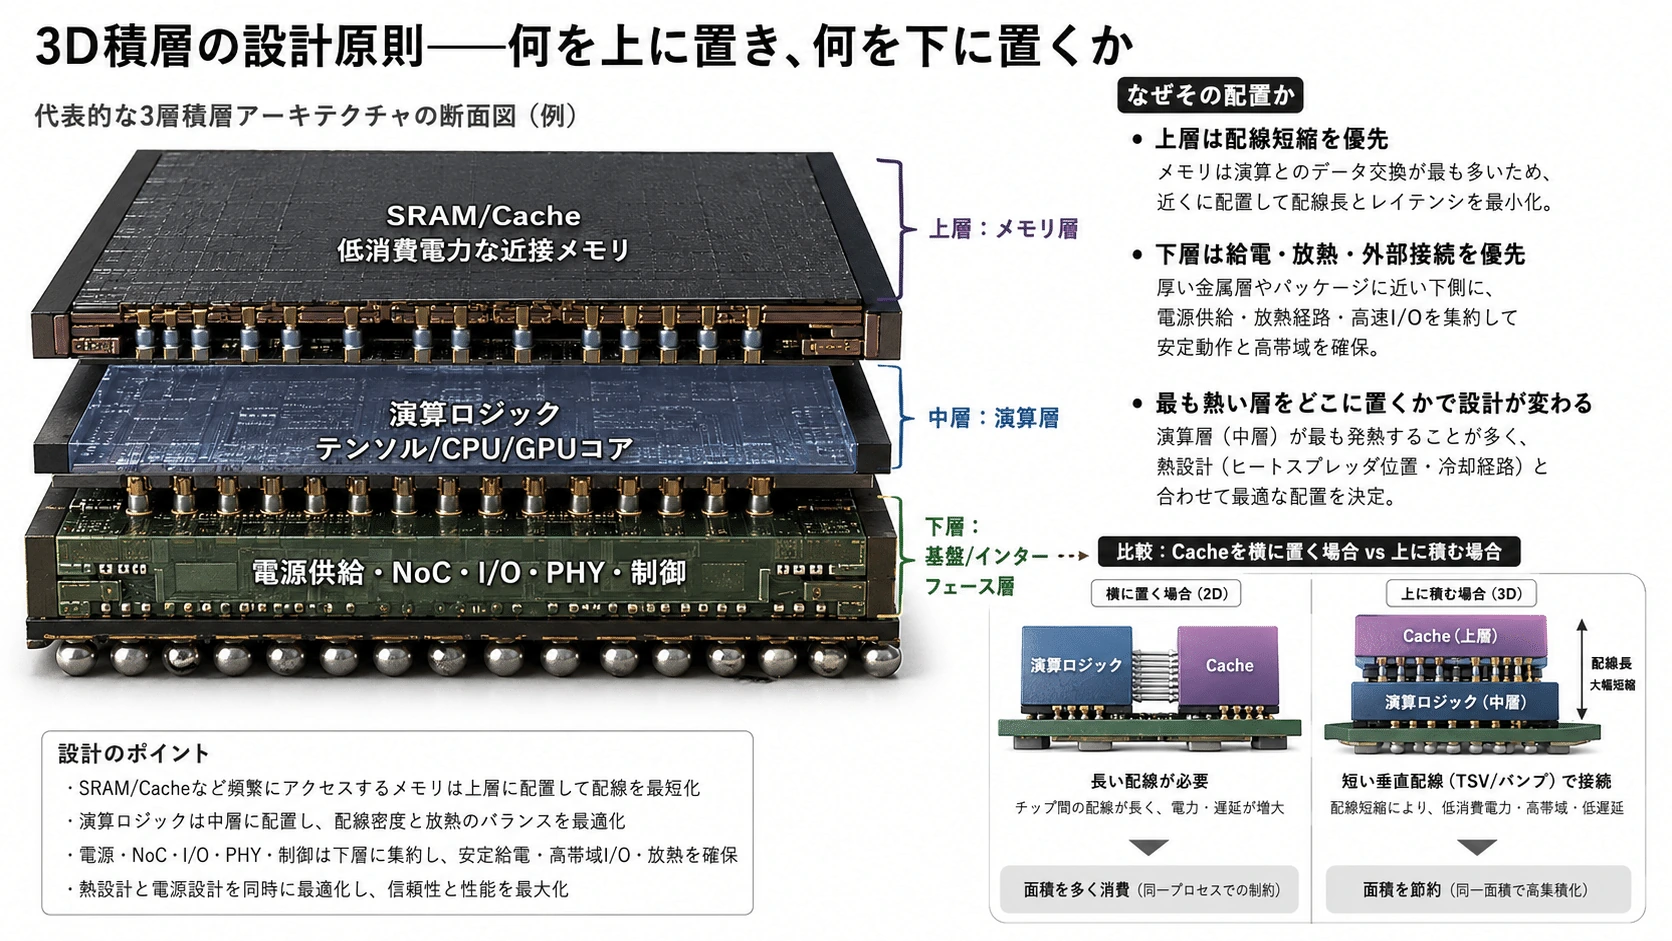
なぜ横に置かず、上へ積むのか
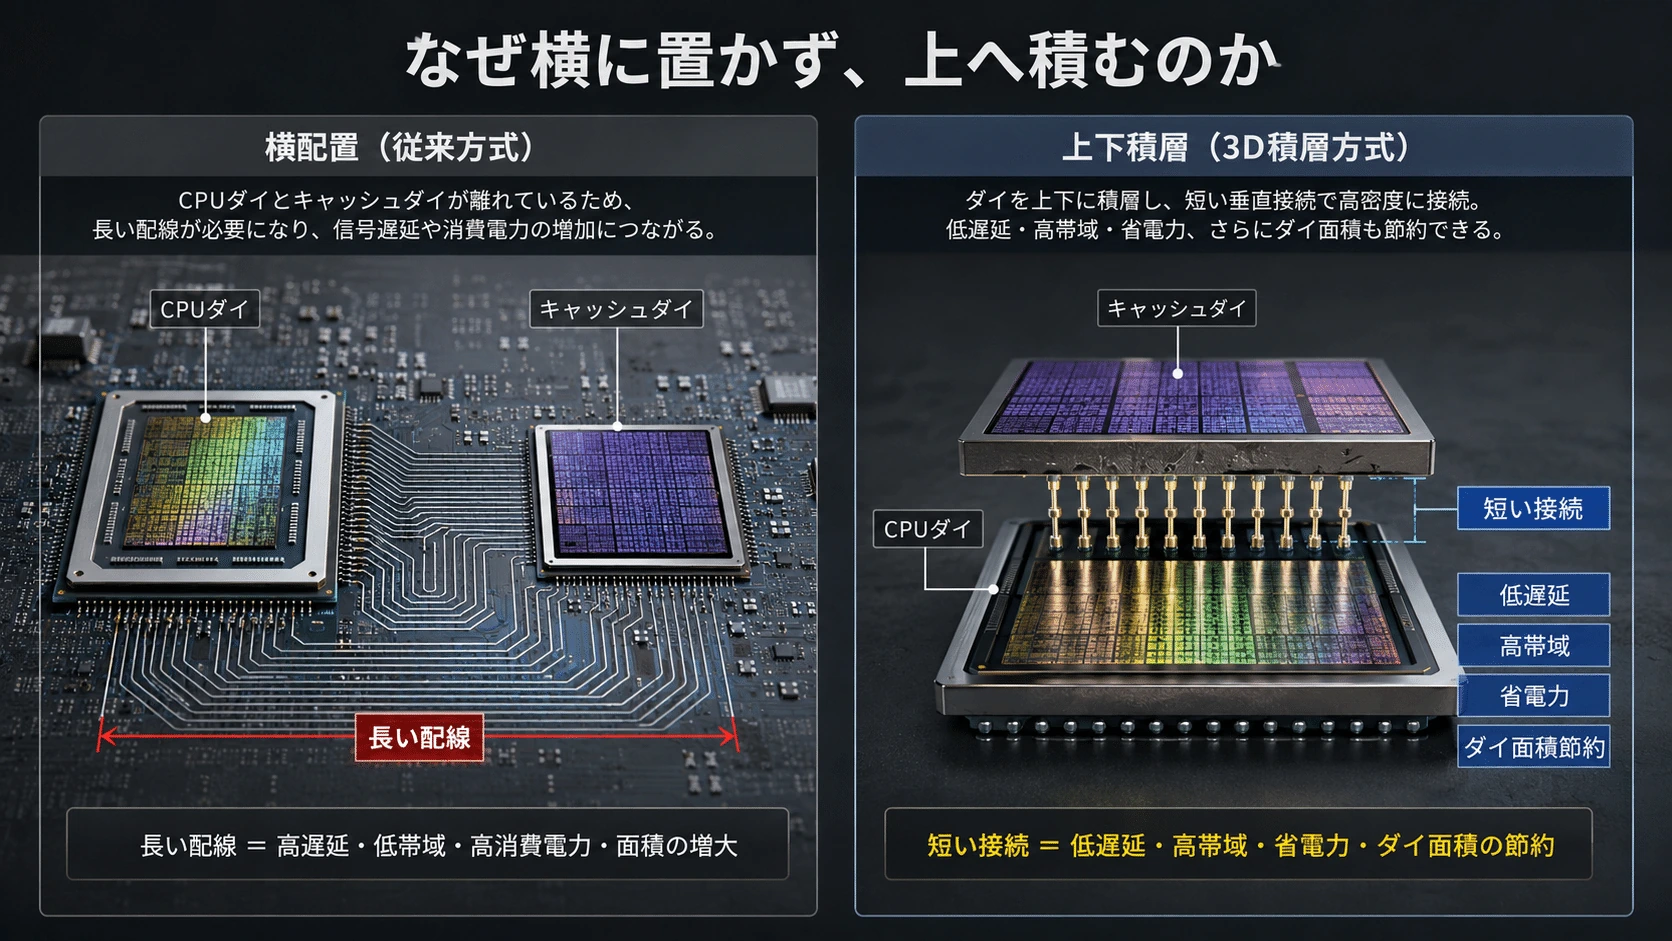
#追加SRAMをCPUダイの横へ置く場合、CPUとキャッシュの間に長い配線とDie-to-Die PHYが必要になる。
#横配置
CPU CCD
│ 長い配線
│
Cache DieHybrid Bondingで垂直に積む場合は、接合面全体に多数の接点を配置できる。
#垂直配置
Cache Die
●●●●●●●●
││││││││
●●●●●●●●
CPU CCDこれにより、
#- 非常に広い並列接続
- 低い接続抵抗
- 短い通信距離
- 低い通信電力
- 小さなパッケージ面積
を実現しやすい。
#AMDは銅同士の直接接合により、従来の2Dオンパッケージ接続と比べて200倍超の接続密度を掲げている。(AMD)
#
#
TSVはどこに使われるのか
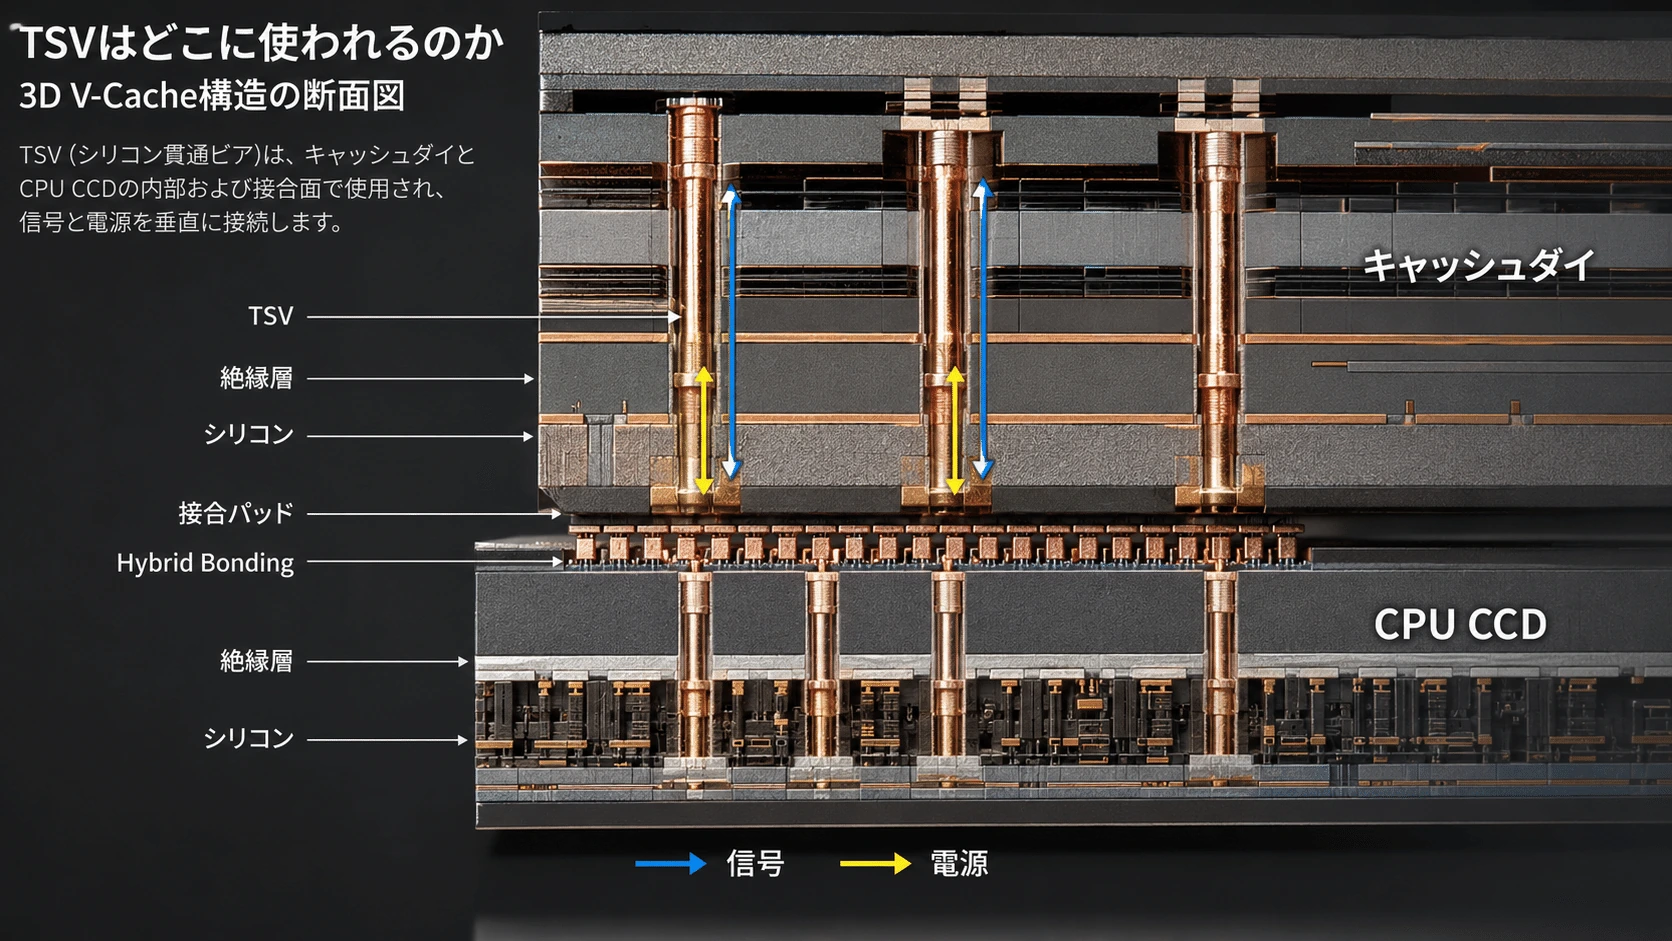
#3D V-CacheではHybrid BondingとTSVが組み合わされる。
#- Hybrid Bonding:CPUダイとキャッシュダイの境界面を接続
- TSV:積層ダイの厚さ方向へ信号や電源を通す
上側または下側ダイの回路
        ↓
       TSV
        ↓
接合用Cuパッド
        ↓
Hybrid Bonding
        ↓
相手側のCuパッド
        ↓
相手側回路AMDの公式資料も、3D V-Cacheの構成要素としてTSVとDirect Copper-to-Copper Bondを別々に挙げている。(AMD)
#
#
第2世代3D V-Cacheでは上下関係が逆になった
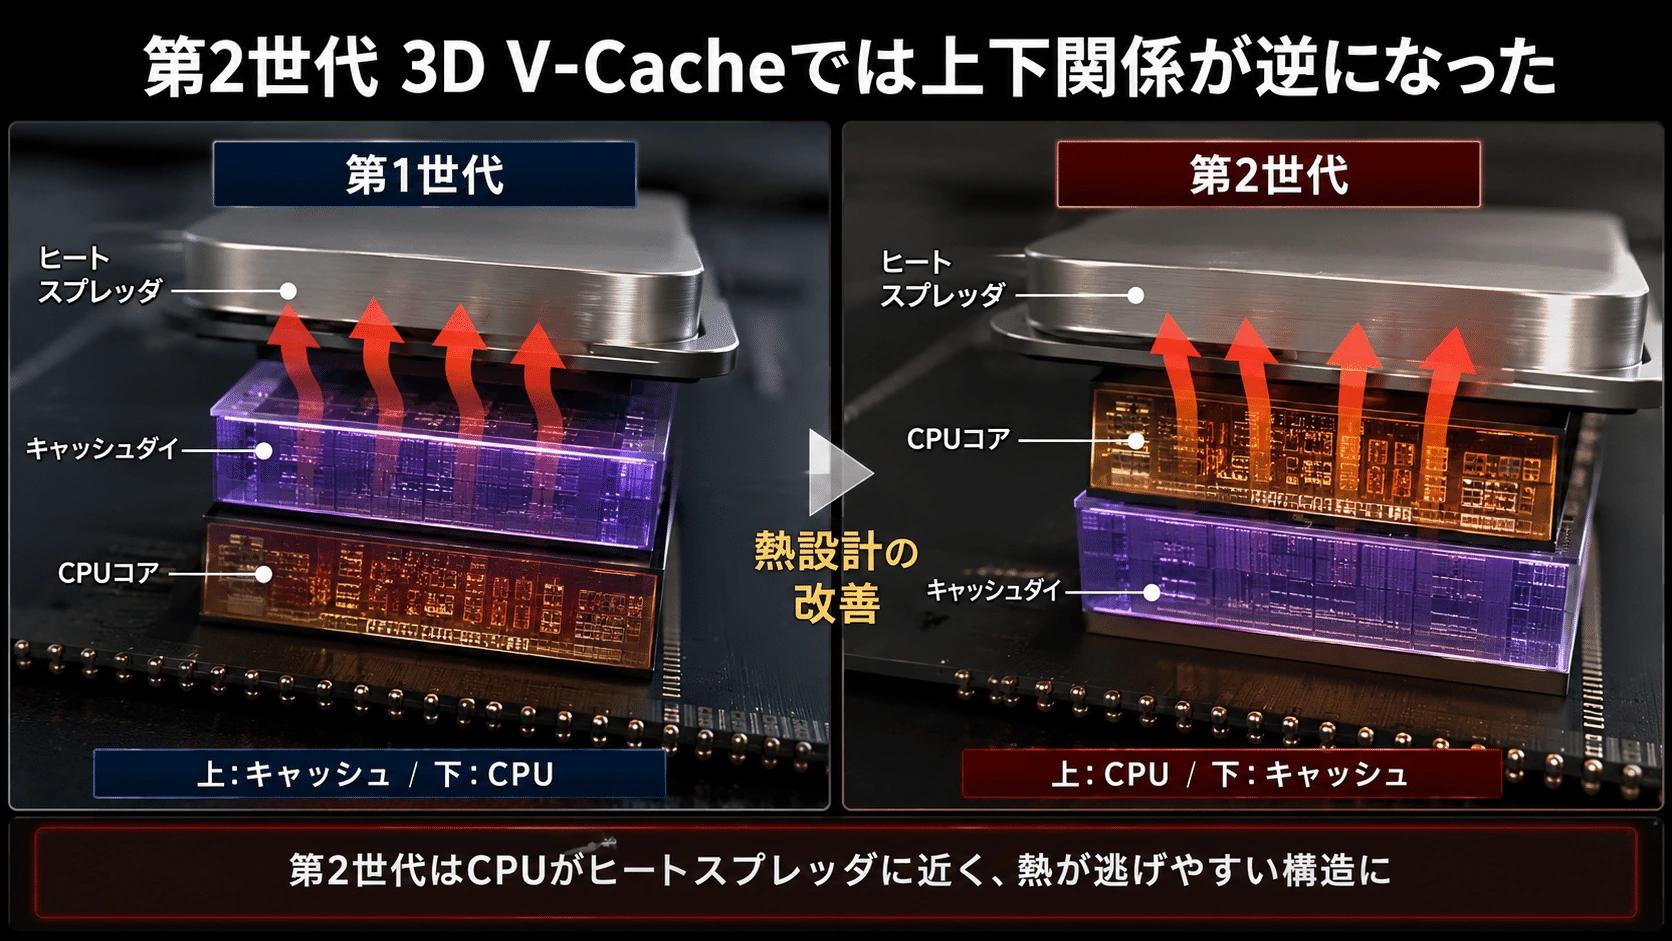
#初期の3D V-Cacheでは、追加キャッシュダイがCPU CCDの上側、すなわち冷却面に近い位置へ載っていた。
#この構造では、CPUコアで発生した熱が、追加キャッシュダイを経由してヒートスプレッダへ移動する。
#第1世代
冷却面
↑
Cache Die
↑
CPU CCD第2世代では、AMDは64MBのキャッシュメモリーをプロセッサーコアの下側へ移動した。これにより、発熱の大きなZen 5 CCDを冷却面へ近づけられる。(Advanced Micro Devices, Inc.)
#第2世代
冷却面
↑
CPU CCD
↑
Cache Die
↑
パッケージこの変更は重要である。
#3D積層では、通信距離だけでなく、
#どのダイを冷却面へ近づけるか#
が性能を左右する。
#SRAMキャッシュよりCPUコアの方が一般に発熱密度が高いため、CPUを上側へ置くことでクロックと持続性能を確保しやすくなる。
#
#
3D V-Cacheの弱点
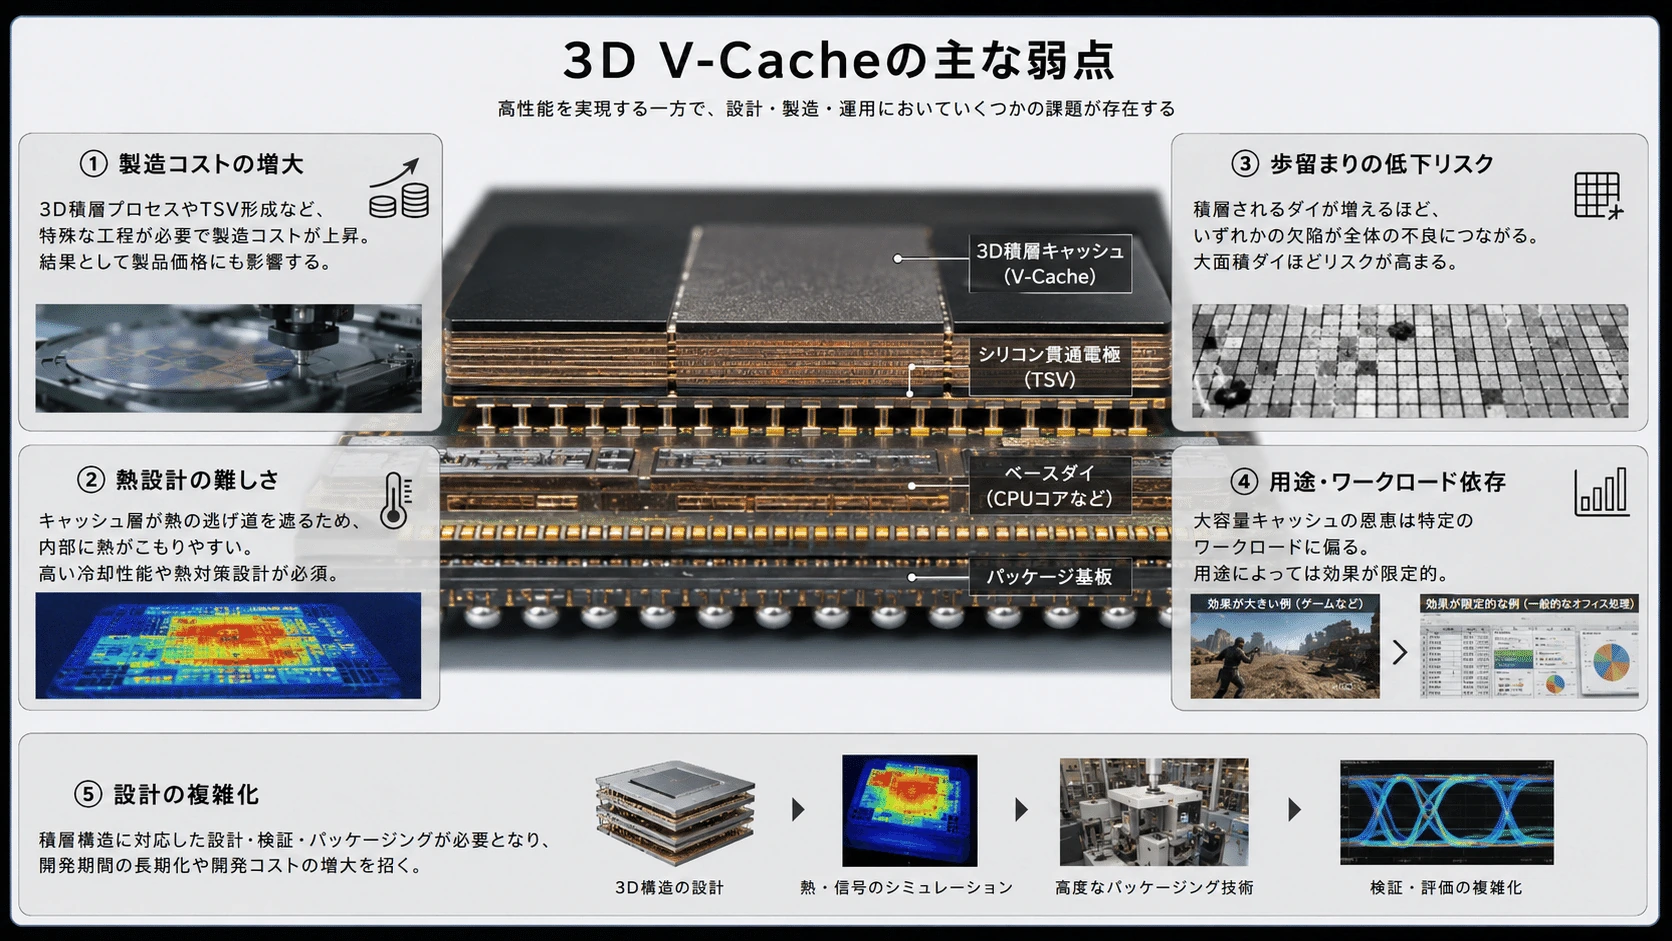
#キャッシュ容量を増やしても、すべての処理が高速になるわけではない。
#キャッシュ容量を使い切れない処理
#処理対象が小さく、元のL3へ十分収まる場合、追加容量の効果は小さい。
#帯域制約の処理
#性能がDRAM帯域、GPU性能、I/O性能で決まっている場合、L3容量だけを増やしても改善しない。
#逐次依存性の強い処理
#演算依存や分岐予測がボトルネックなら、キャッシュ容量は決定的ではない。
#製造コスト
#CPU CCDに加えてSRAMダイ、TSV、Hybrid Bonding、薄化、検査が必要になる。
#熱
#接合界面の熱抵抗は小さくできても、シリコン層を増やすこと自体は熱経路を複雑にする。
#第2世代の上下反転は、まさにこの熱設計を改善するためのアーキテクチャ変更である。
#
#
3D V-CacheはUCIeを使っているのか
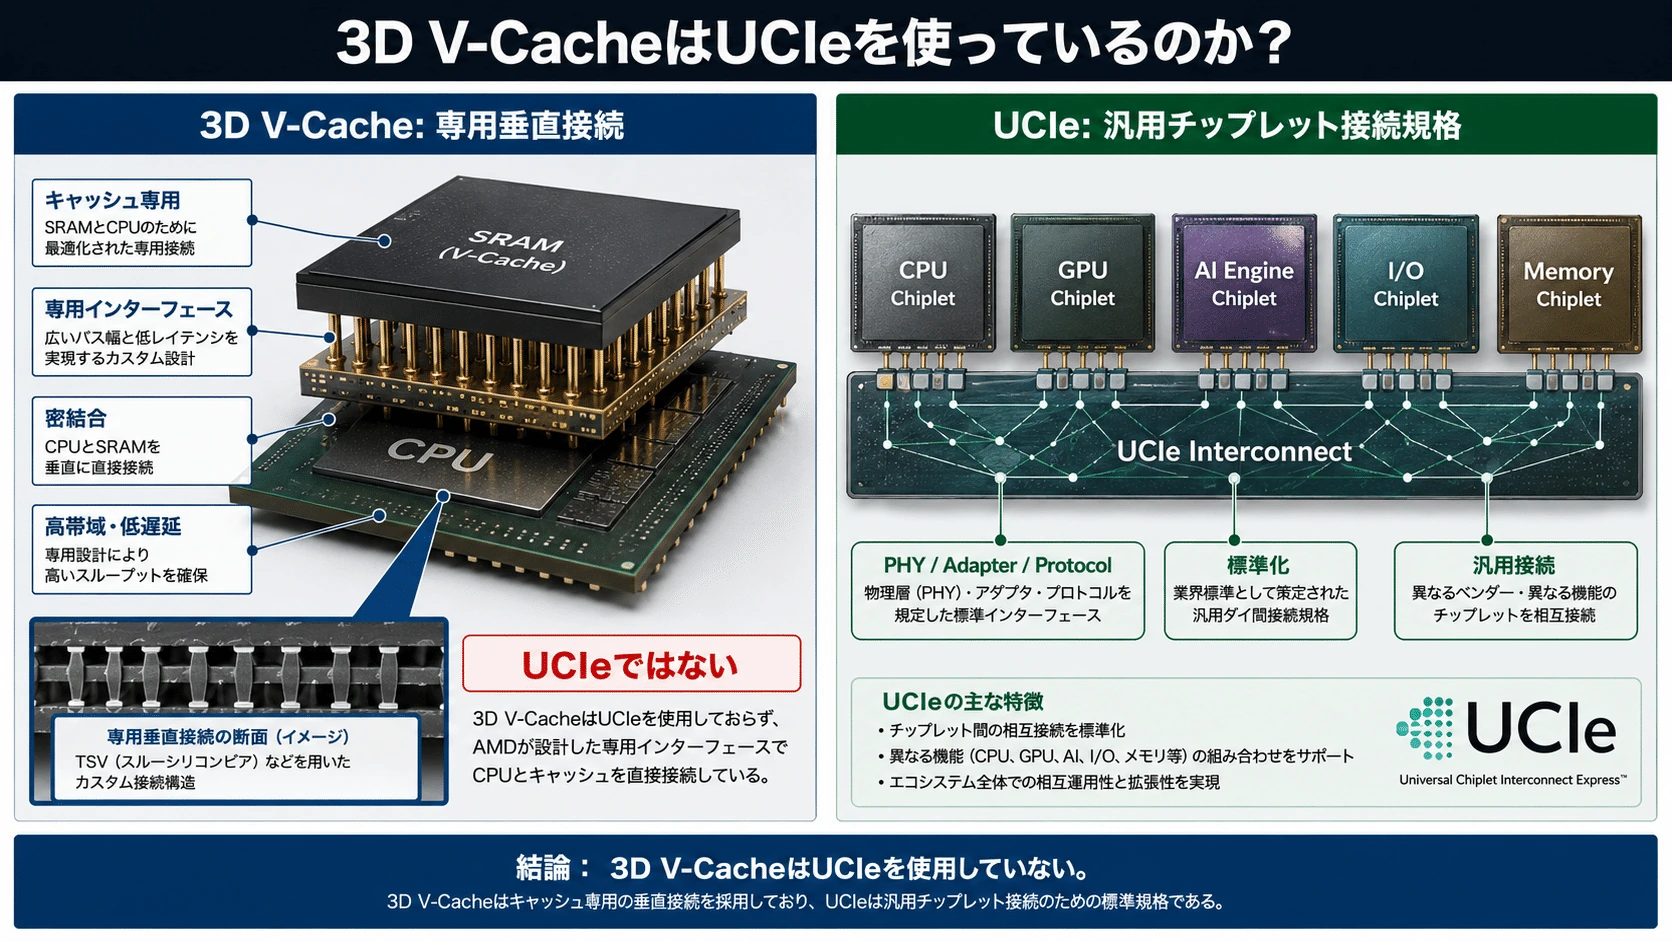
#公開資料上、3D V-CacheはUCIeによる汎用チップレット接続ではなく、CPUとキャッシュのために最適化された専用の垂直接続として理解するのが妥当である。
#UCIeは異なるチップレット間の相互運用性を意識した通信規格である。一方3D V-Cacheでは、CPU CCDと専用SRAMダイの構造、パッド配置、キャッシュ制御をAMDが一体設計できる。
#そのため、
#- 汎用プロトコル
- 複雑なリンク交渉
- 外部SerDes型のPHY
- PCIeやCXLのようなパケット処理
を省き、キャッシュ専用の極めて広い垂直インターフェースを使用できる。
#これは、標準化よりも電力、遅延、面積を優先した設計である。
#
#
Intel Foveros Direct 3Dとは何か
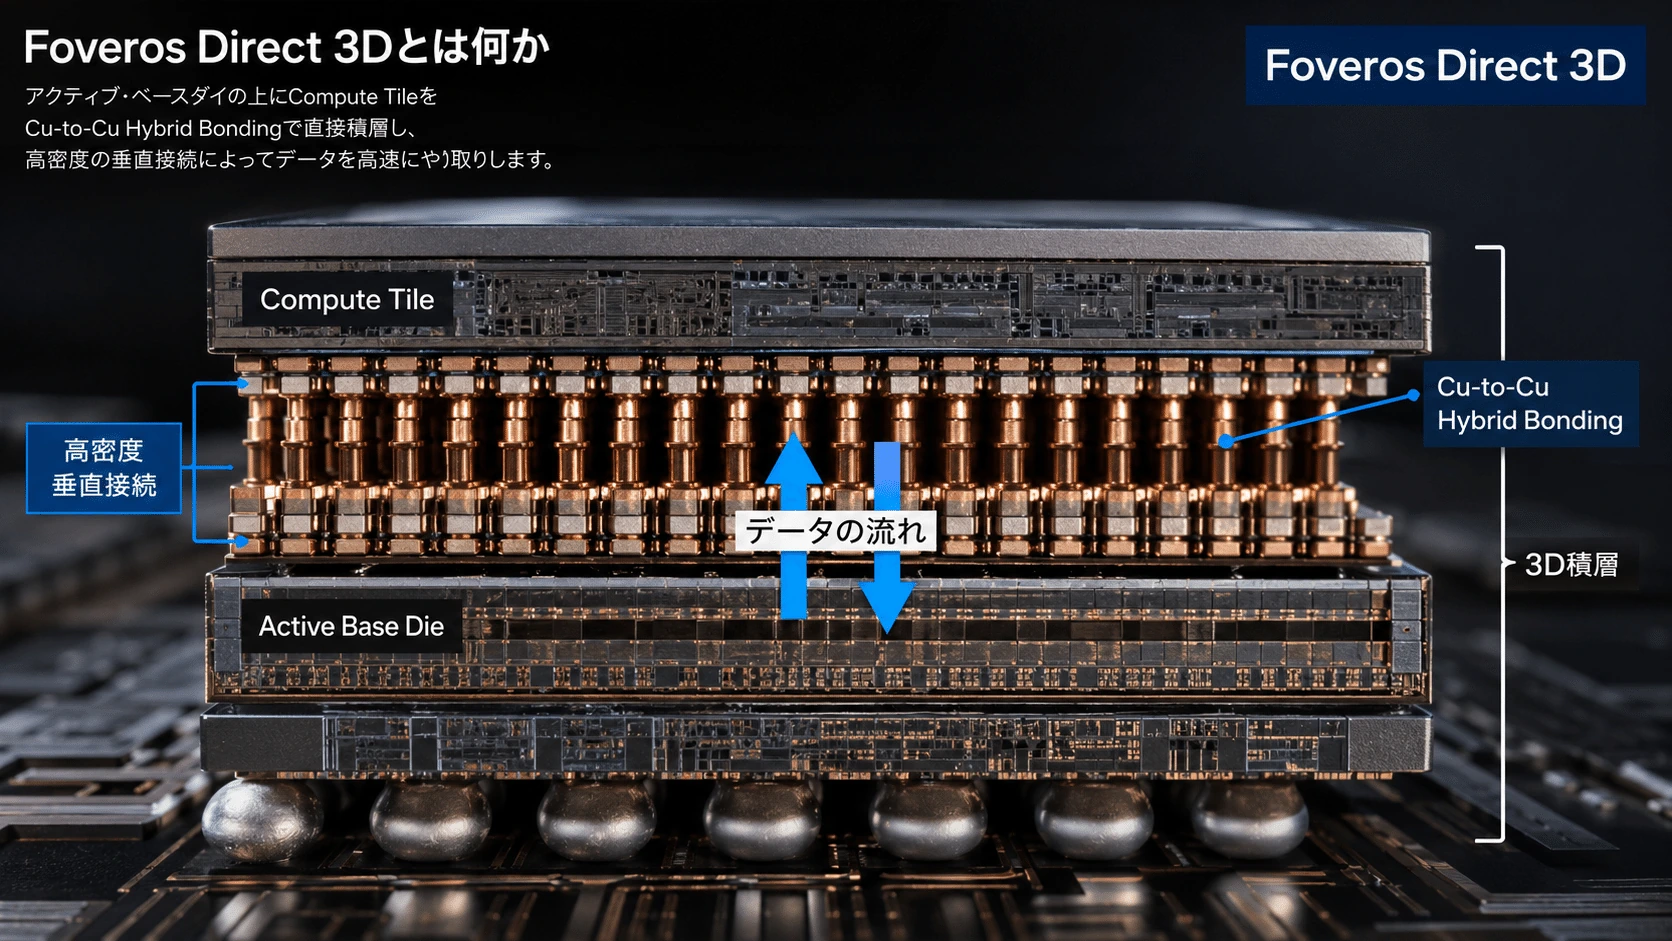
#Foveros Direct 3Dは、Intel Foundryの3D積層プラットフォームである。
#1個または複数のチップレットを、回路を持つアクティブ・ベースダイへ垂直に積層する。
#上側Compute Tile
│
Cu-to-Cu Hybrid Bonding
│
Active Base Die
NoC・Cache・I/O・制御
│
パッケージ基板IntelはFoveros Directについて、従来のはんだマイクロバンプを排除し、直接Cu-to-Cu Hybrid Bondingを使うことで、sub-10µmの接続ピッチを実現すると説明している。(Intel)
#
#
通常のFoverosとFoveros Directの違い
#IntelのFoveros系技術は、世代や用途によって構造が異なる。
#重要なのは、Directという名称である。
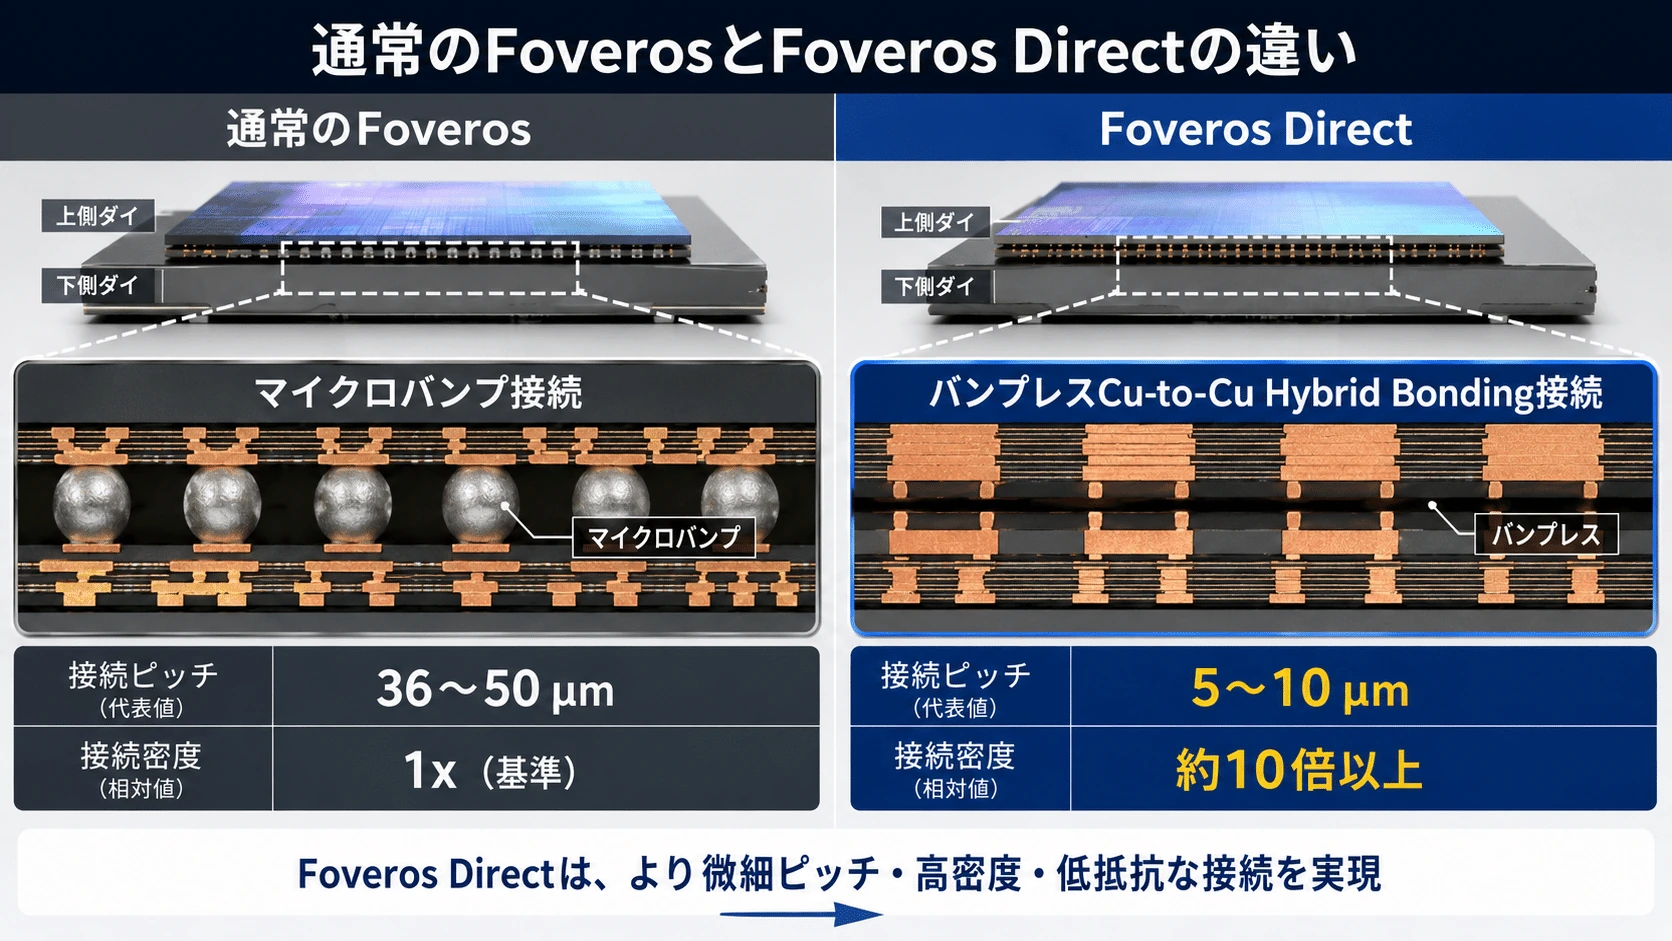
#従来型の積層接続では、ダイ間に微細なはんだ接続を使う。
#従来型
上側ダイ
● ● ● ● マイクロバンプ
────────
下側ダイFoveros Directでは、はんだマイクロバンプをなくして、銅パッドと絶縁面を直接接合する。
#Foveros Direct
上側ダイ
Cu SiO₂ Cu
│ │
Cu SiO₂ Cu
下側ダイIntelは、Direct化によりマイクロバンプ型より最大10倍細かな接続密度を得られるとしている。(Intel)
#
#
アクティブ・ベースダイとは何か
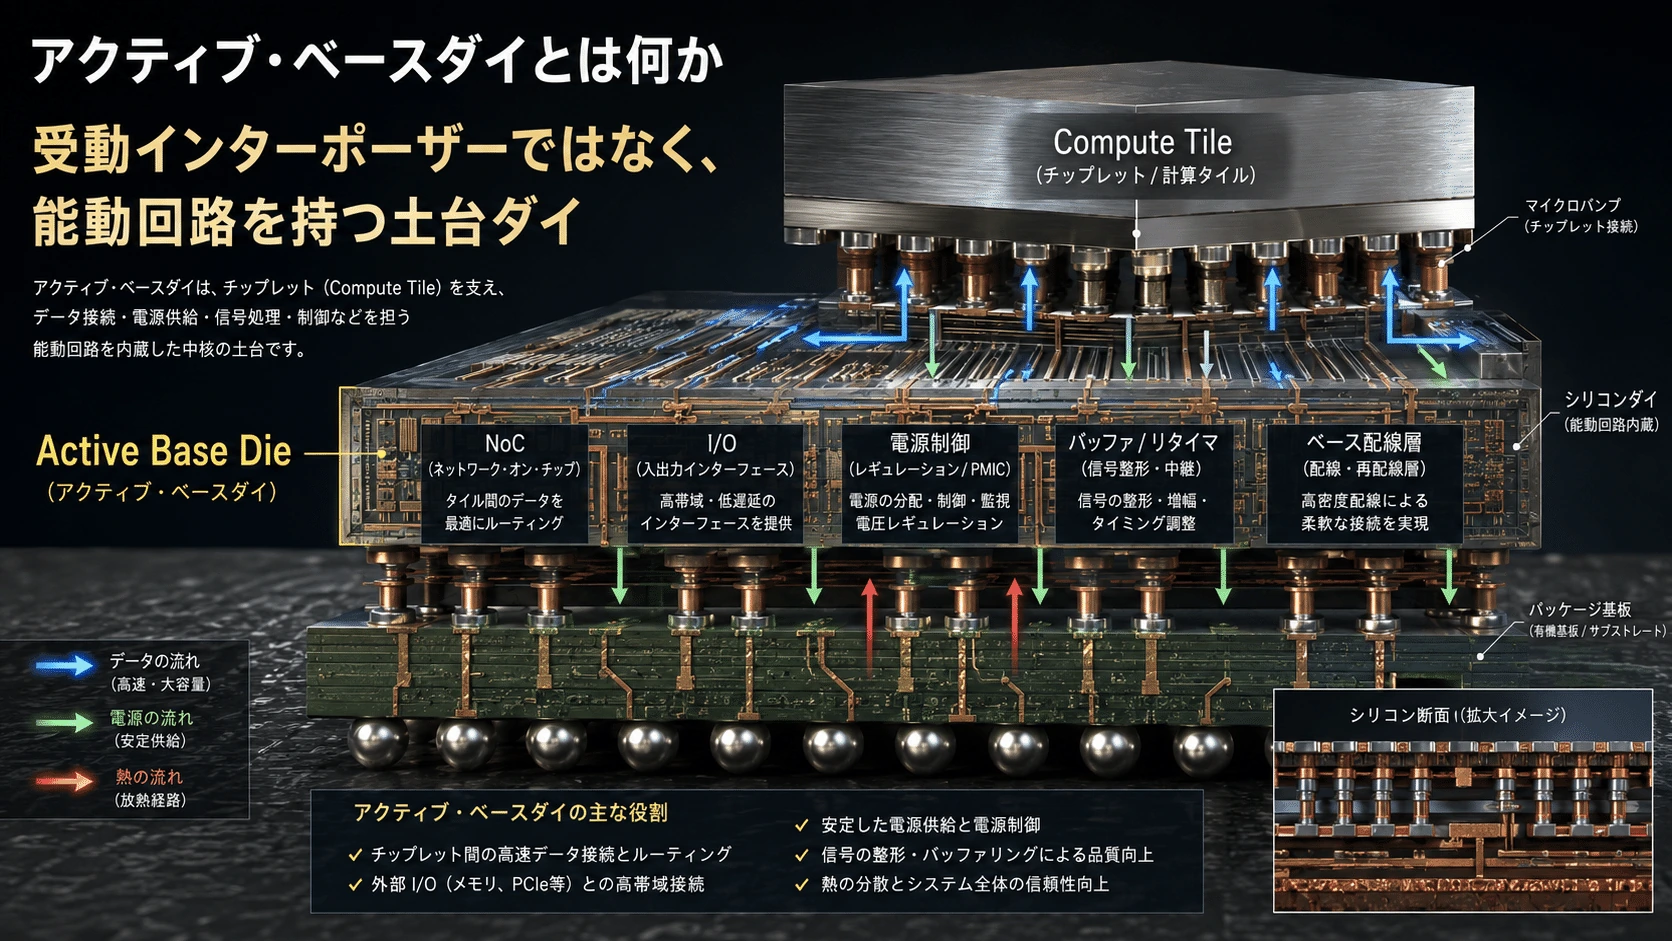
#単なるシリコンインターポーザーは、主に配線を担うパッシブな中間層である。
#アクティブ・ベースダイには、トランジスタ回路を実装できる。
#例えば、
#- キャッシュ
- NoC
- ルーター
- I/O
- メモリーコントローラー
- クロック制御
- 電源管理
- セキュリティー回路
などを下側へ配置できる。
#上側
Compute Chiplet
Compute Chiplet
Compute Chiplet
↓
Active Base Die
Cache・NoC・I/O
↓
外部I/OIntelは、Compute Chipletを大きなローカルキャッシュを持つベースタイル上へ積層し、複製可能な計算モジュールにする構想を説明している。(Intel)
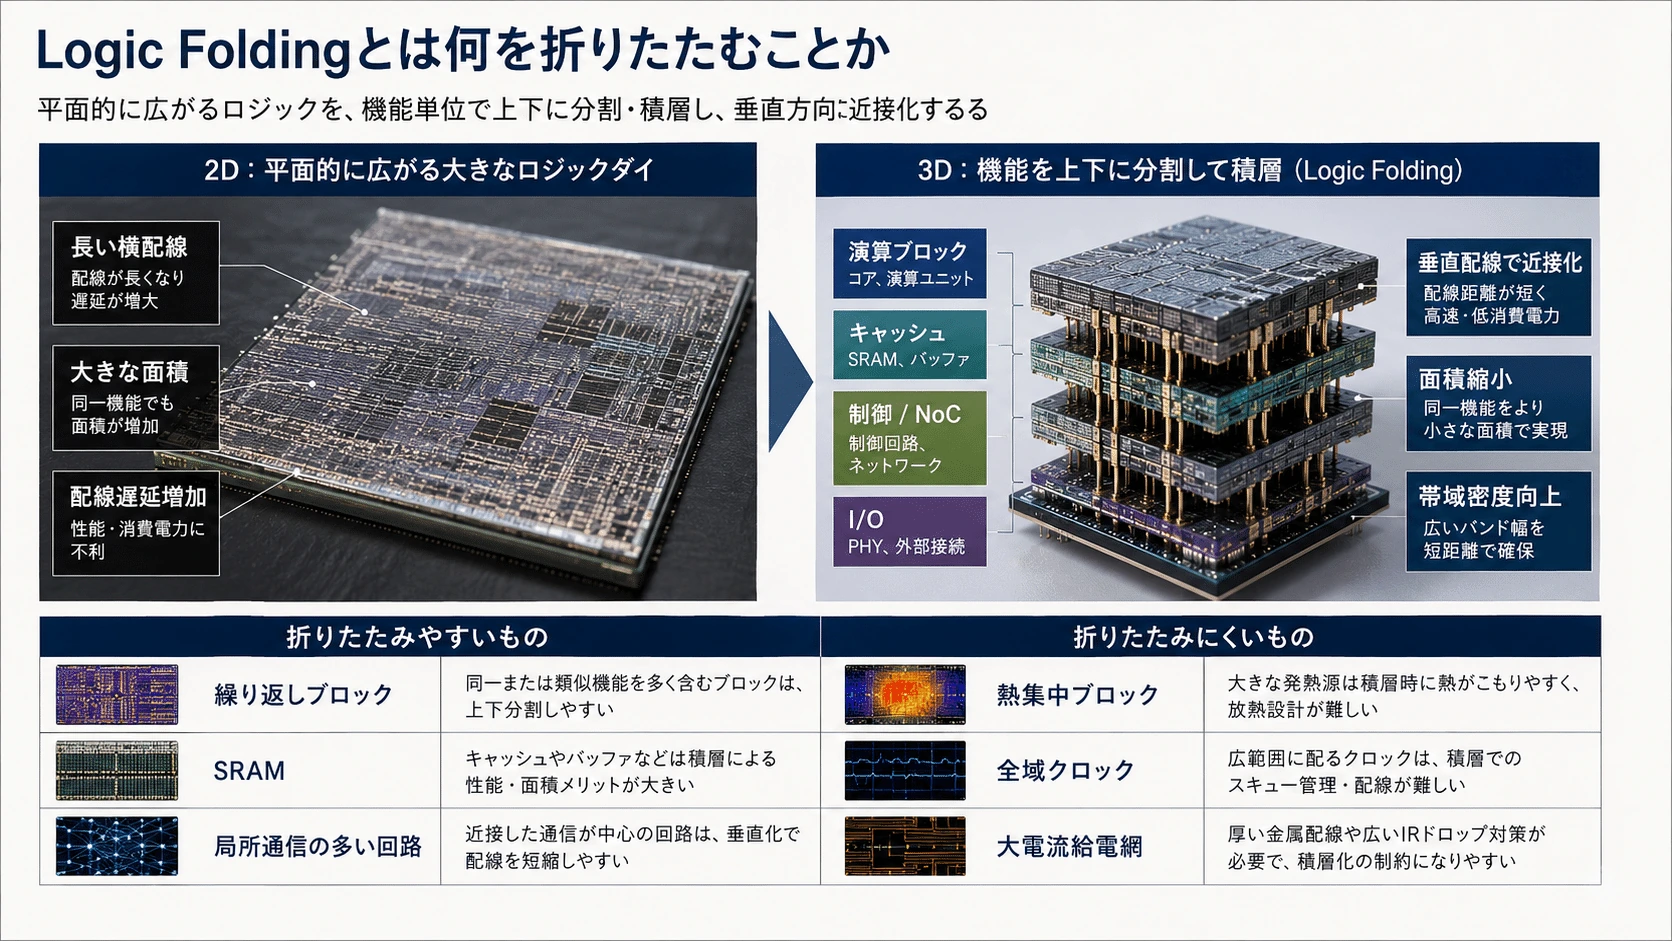
#この構造は、将来のLogic Foldingに直結する。
#演算器を上層へ、キャッシュと通信網を下層へ分けられるからである。
#
#
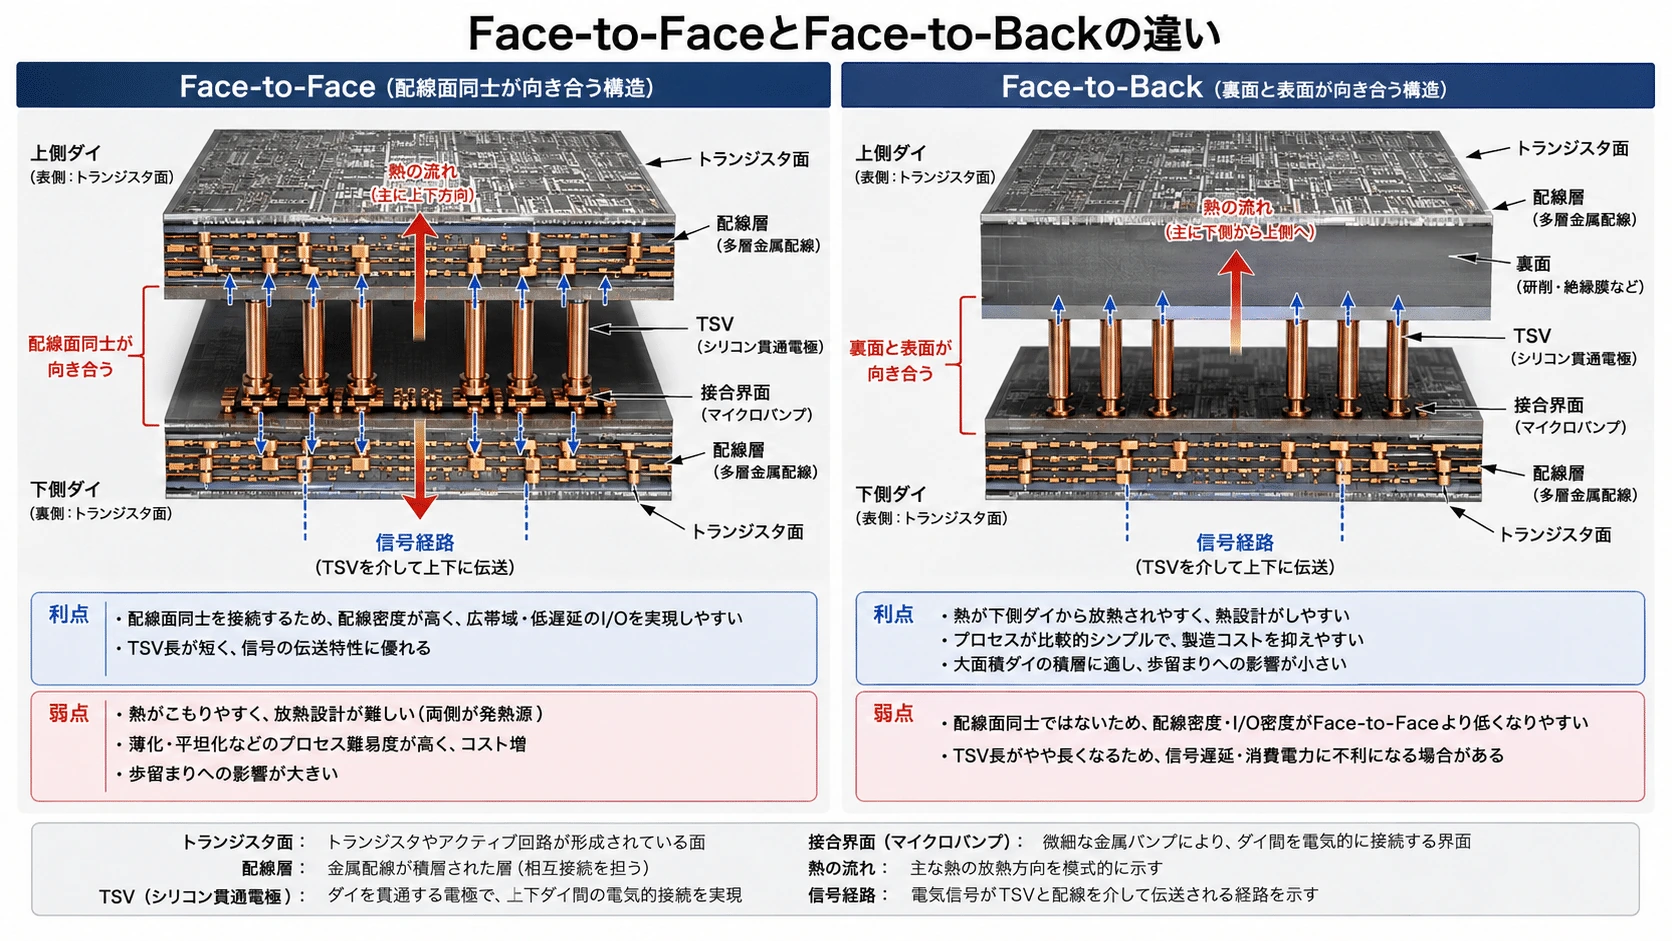
Face-to-FaceとFace-to-Back
#Foveros Directは、Face-to-FaceとFace-to-Backの両方に対応する。
#Face-to-Face
#両方のダイの配線面を向かい合わせる。
#上側ダイ裏面
────────
上側回路面
↓↓↓↓↓↓
接合面
↑↑↑↑↑↑
下側回路面
────────
下側ダイ裏面接合面と回路層を近づけやすいため、高密度・低遅延接続に向く。
#Face-to-Back
#一方のダイの回路面を、もう一方の裏面側へ接合する。
#上側ダイ回路面
↓
接合面
↓
下側ダイ裏面
↓
TSV
↓
下側ダイ回路面Face-to-Backは多段積層へ拡張しやすいが、下側ダイを貫通するTSVが必要になる。
#IntelはFoveros Directについて、個別チップレットをウェハーへ接合する方式と、ウェハー同士を接合する方式、Face-to-FaceとFace-to-Backの両方を想定している。(Intel)
#
#
接続ピッチと帯域
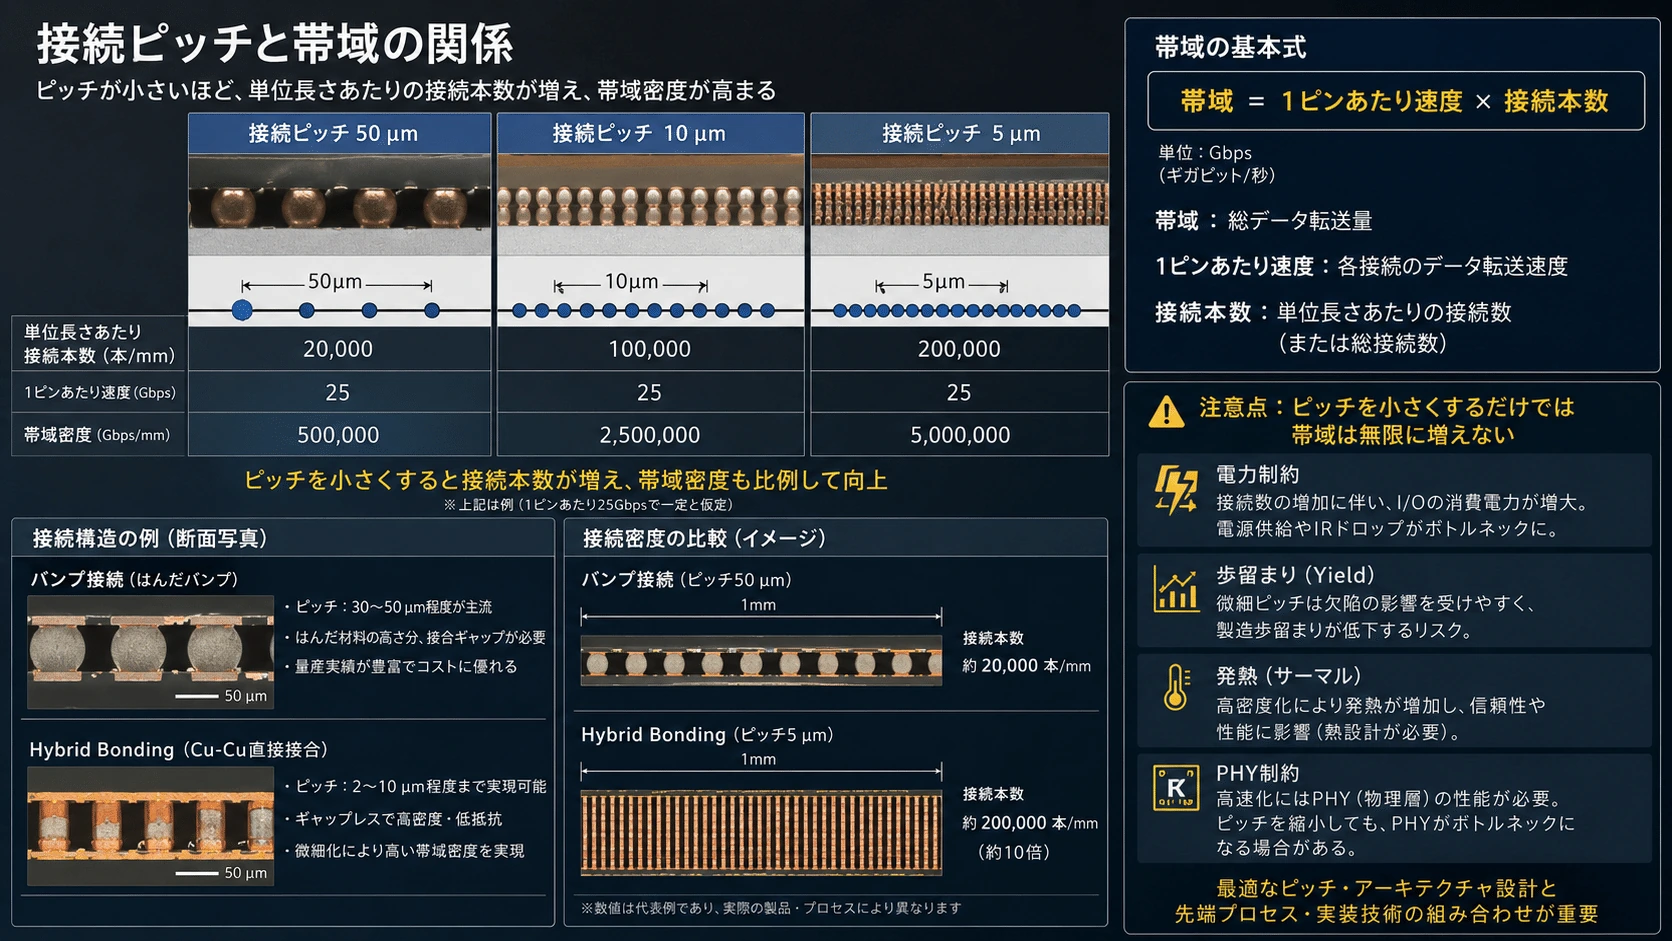
#接続数は、接続ピッチが小さくなるほど急激に増える。
#単純化して正方格子状にパッドを配置する場合、面積当たりの接続数は、おおよそピッチの2乗に反比例する。
#ピッチを9µmから3µmへ縮小すると、理論上の面積密度は、
#倍になる。
#IntelはFoveros Directのロードマップ例として、第1世代9µm、第2世代3µmの銅接合ピッチを説明している。より新しいIntel資料では、Foveros Directを広くsub-10µm級として位置付けている。(Intel)
#ただし、接続数が9倍になれば実効帯域も必ず9倍になるわけではない。
#- PHY回路
- クロック
- 電源供給
- ダイ内部NoC
- 配線混雑
- 発熱
- テスト
にも制約があるからである。
#
#
Foveros DirectとEMIB 3.5D
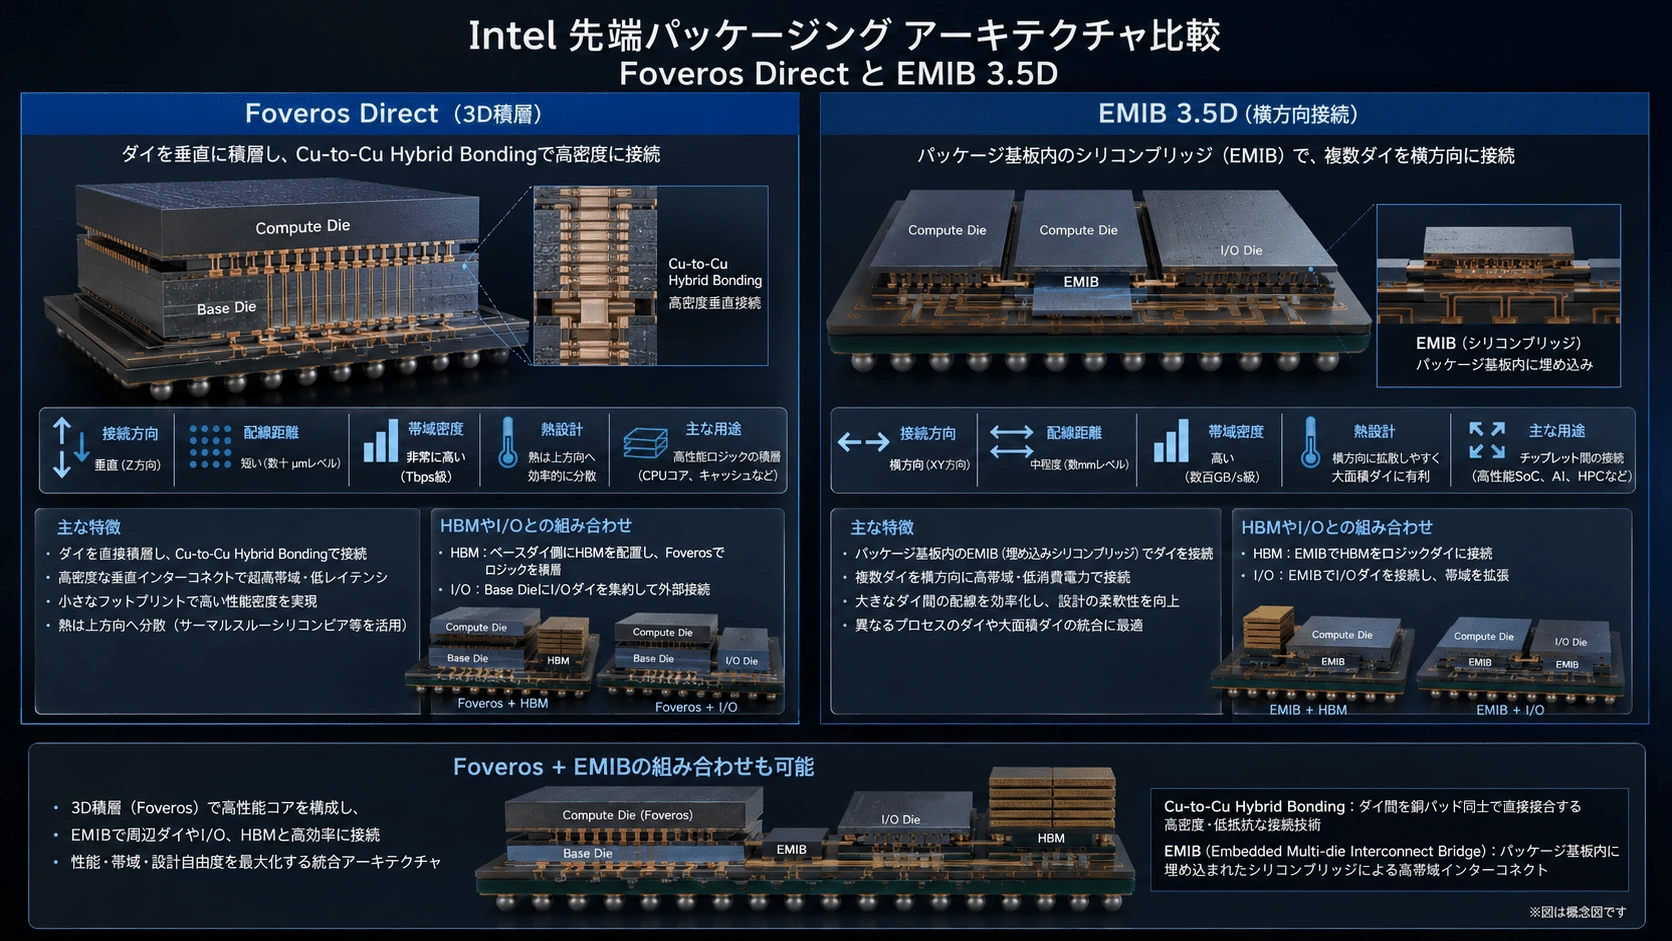
#3D積層は上下方向の接続に強い。
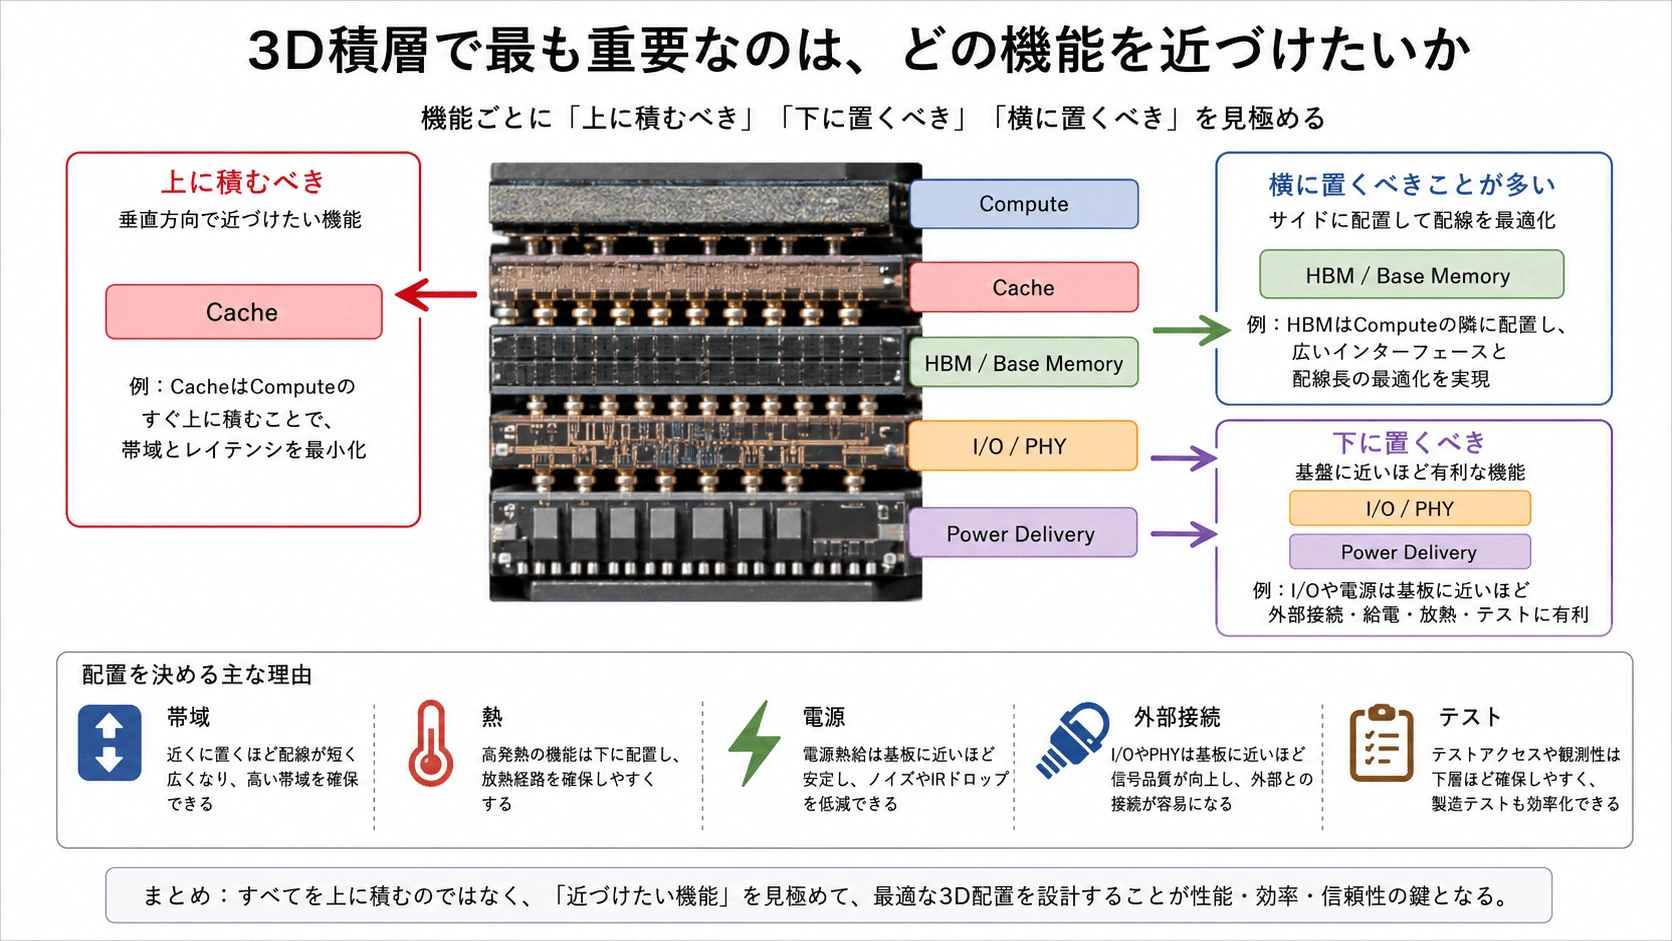
#しかし、複数の3Dスタック、I/Oダイ、HBMを1つのパッケージに並べるには横方向の接続も必要になる。
#そこでIntelは、FoverosとEMIBを組み合わせる。
#3D Stack A 3D Stack B
┌────────┐ ┌────────┐
│Compute │ │Compute │
│Base Die│ │Base Die│
└───●────┘ └────●───┘
╲ ╱
EMIB Bridge
────────────────────────
有機パッケージ基板この構成がEMIB 3.5Dである。
#Foveros Directが垂直方向を担当し、EMIBが横方向を担当する。Intelは、この組み合わせによってパッケージ面積、性能、電力、コストのバランスを取り、大規模なSystem of Chipsへ拡張できるとしている。(Intel)
#
#
Foveros DirectとUCIeの関係
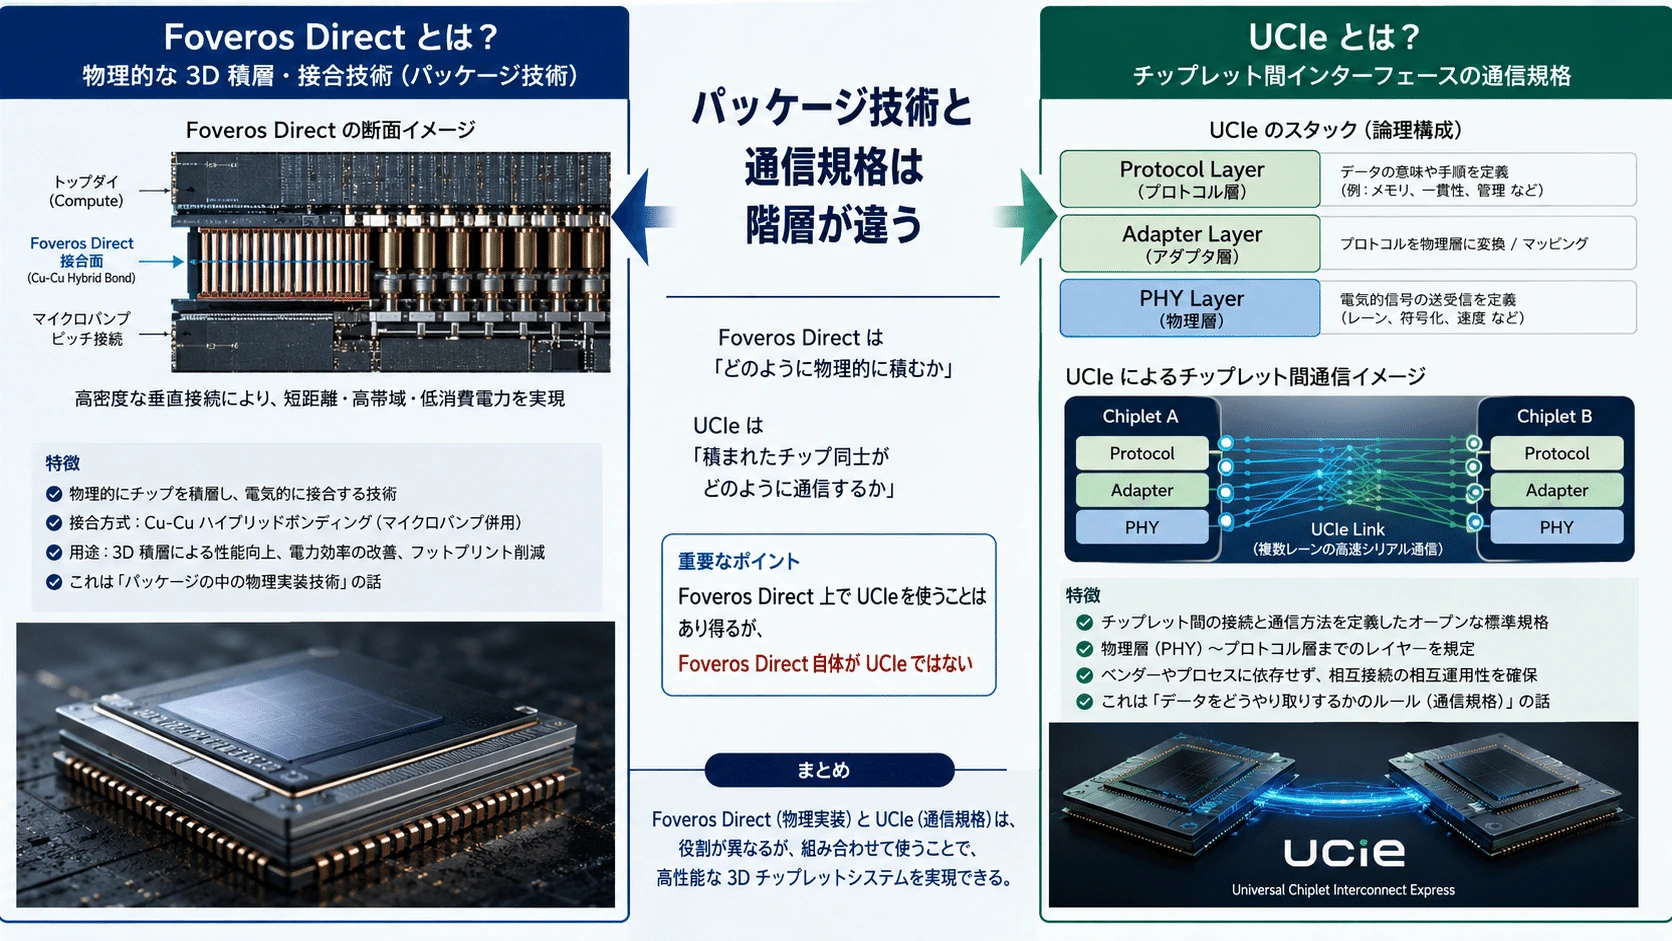
#Foveros Directは物理的な積層技術であり、UCIeは通信規格である。
#Foveros Direct
=どう接合するか
UCIe
=接合されたダイ間で
どう通信するかFoveros Direct上でUCIeを使うことは可能だが、Foveros Directを使用したすべての接続がUCIeになるわけではない。
#IntelのパッケージポートフォリオはUCIeとの互換性を掲げている一方、製品内部では専用インターフェースを使う選択肢も残る。(Intel)
#
#
TSMC SoICとは何か
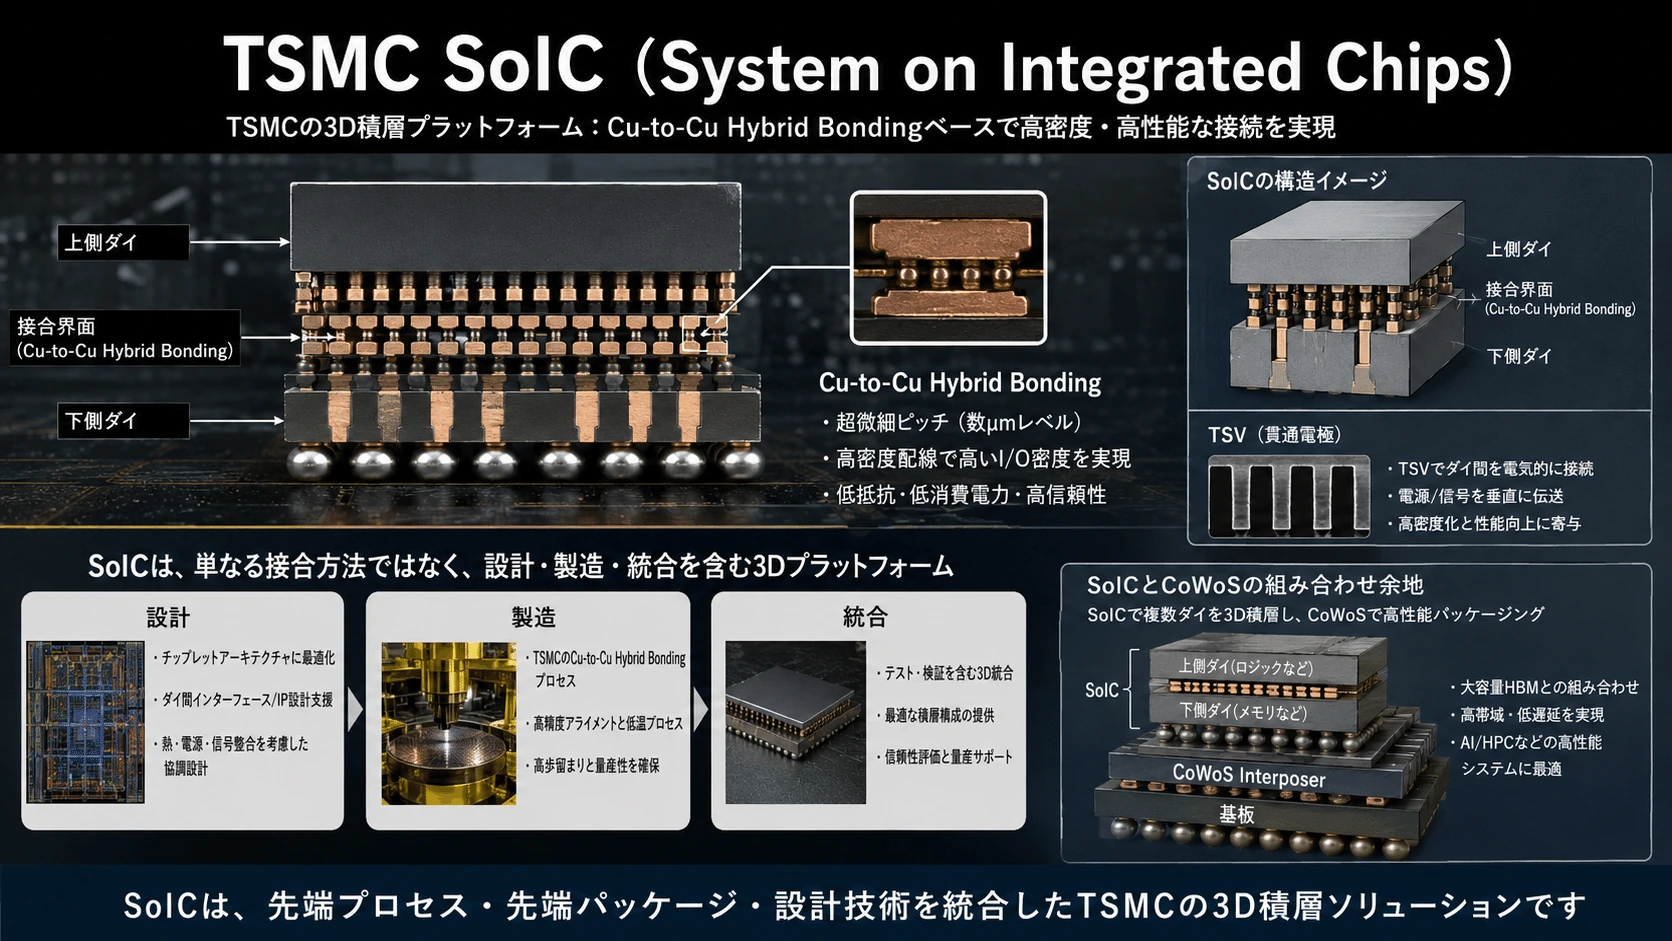
#SoICはSystem on Integrated Chipsの略で、TSMCのフロントエンド3Dシリコン積層プラットフォームである。
#SoICは、SoCを複数のチップレットへ分割し、それらを高密度な垂直接続で再統合することを目的としている。
#TSMCはSoICについて、
#- 異なるサイズ
- 異なる機能
- 異なる製造ノード
- Known Good Die
を1つのSoCに近い形へ統合できるとしている。接続ピッチはsub-10µmから拡張され、短いダイ間接続によって帯域、電源品質、信号品質、消費電力を改善する。(3DFabric)
#
#
SoIC-XとSoIC-P
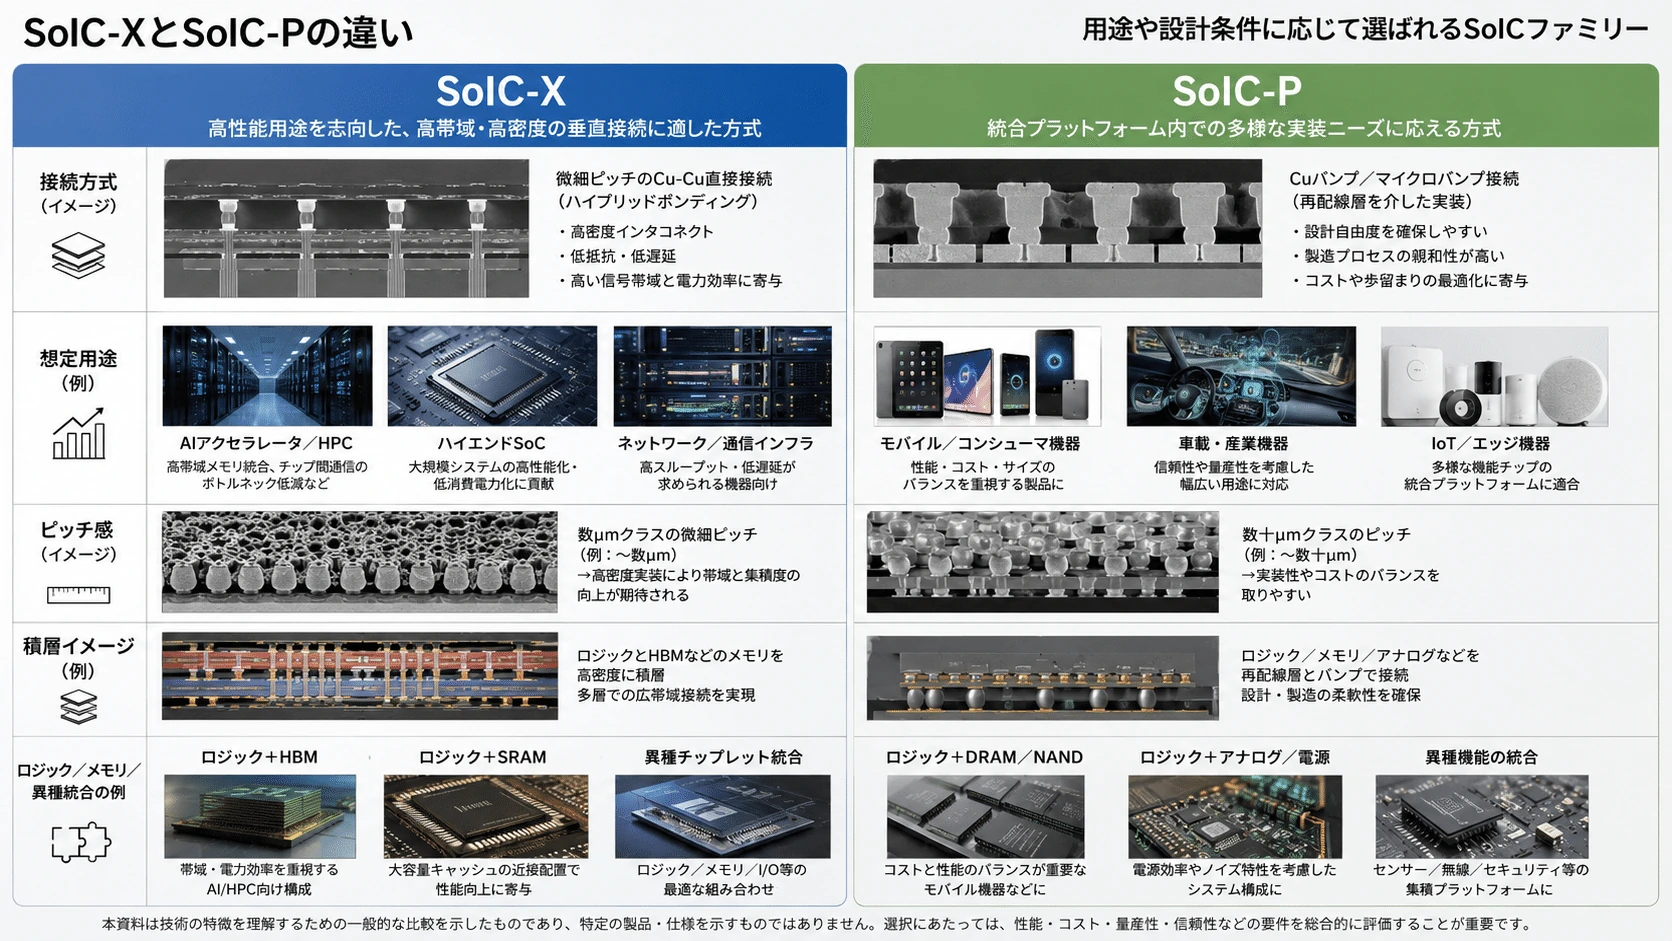
#SoICには、接合方式の異なる2つの方向がある。
#SoIC-X
#- バンプレス
- Hybrid Bonding
- 高い接続密度
- 低抵抗
- 高性能HPC向け
SoIC-P
#- マイクロバンプ型
- SoIC-Xより粗い接続
- 比較的低コスト
- 3D積層の適用範囲を広げる
TSMCは2023年、従来のバンプレス方式をSoIC-Xと呼び、マイクロバンプによるコスト重視の方式をSoIC-Pとして追加した。(TSMC)
#SoIC-X
ダイ
Cu SiO₂ Cu
│ │
Cu SiO₂ Cu
ダイ
SoIC-P
ダイ
● ● ●
────────
ダイSoIC-XとSoIC-Pは優劣だけでなく、必要な接続密度とコストに応じて使い分ける技術である。
#
#
Chip-on-WaferとWafer-on-Wafer
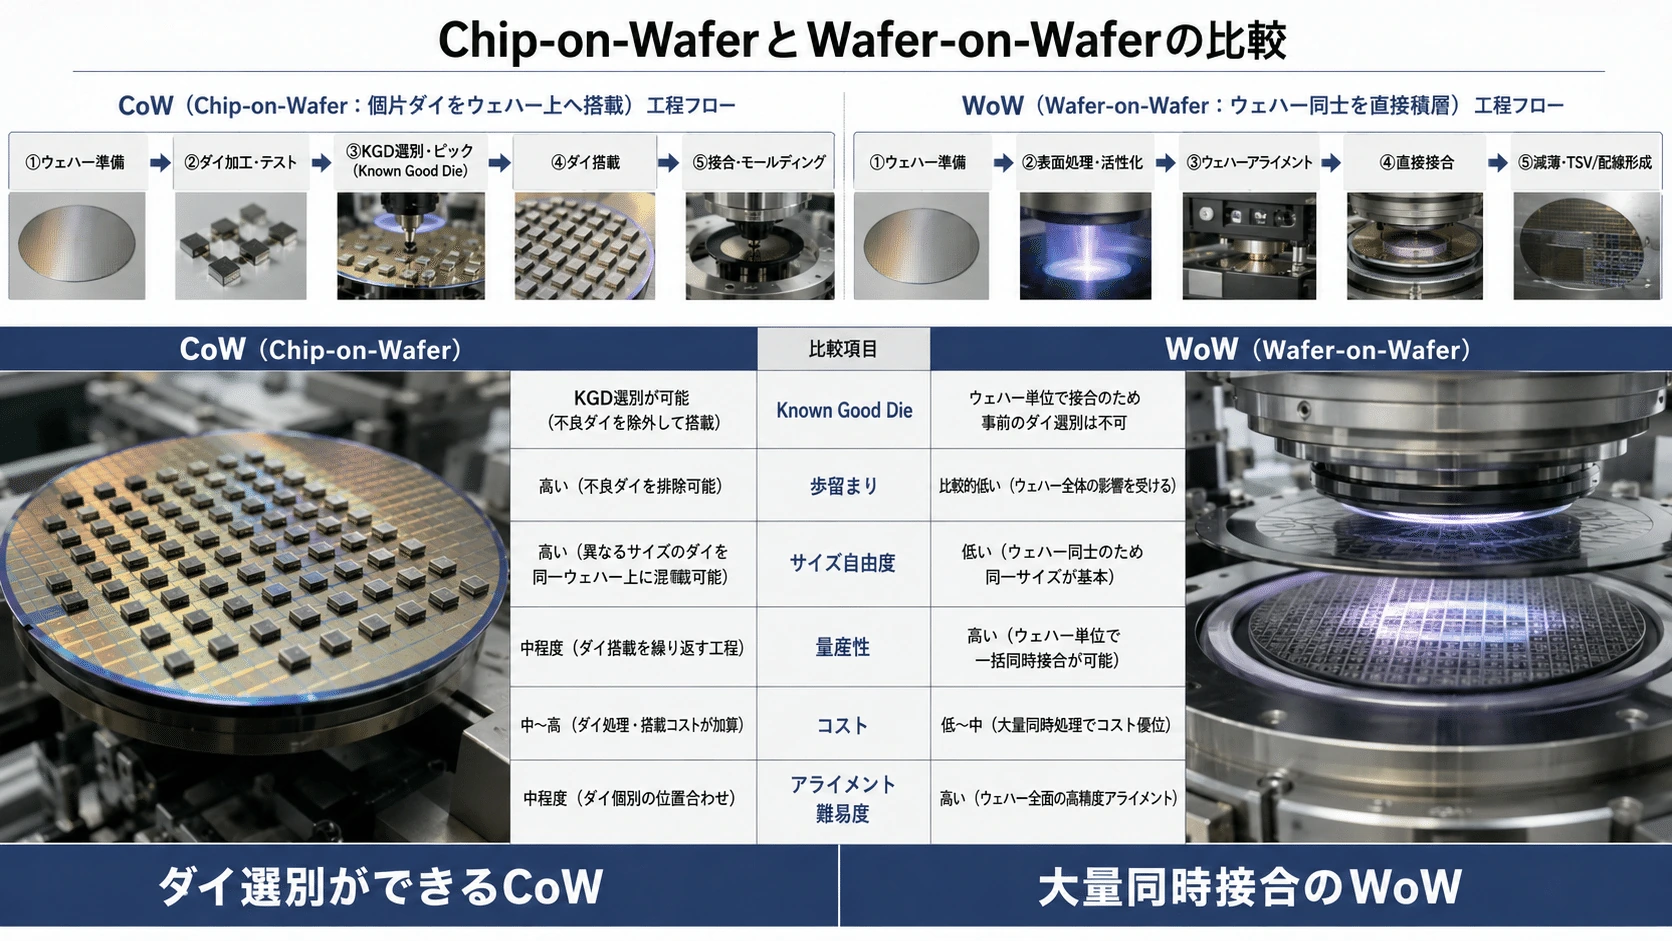
#SoICは、CoWとWoWの両方を扱う。
#Chip-on-Wafer
#個別に切り出し、検査したダイを下側ウェハーへ配置する。
#良品ダイ 良品ダイ 良品ダイ
↓ ↓ ↓
════════════════
下側ウェハー利点は、
#- Known Good Dieを使える
- 異なるサイズを組み合わせられる
- 異なるノードを混載できる
- 不良ダイを除外できる
ことである。
#Wafer-on-Wafer
#2枚のウェハーを丸ごと接合する。
#上側ウェハー
════════════
接合面
════════════
下側ウェハー利点は、
#- 高い接続密度
- 高い位置合わせ精度
- ウェハー単位の高い処理能力
- 非常に細かなピッチへの拡張
である。
#一方で、上下ウェハーのダイ配置やサイズを合わせる必要があり、両方のウェハーに高い歩留まりが要求される。
#TSMCはSoICでCoWとWoWの両方を提供し、機能、サイズ、ノードの組み合わせに応じて選択できるとしている。(3DFabric)
#
#
SoICの量産状況
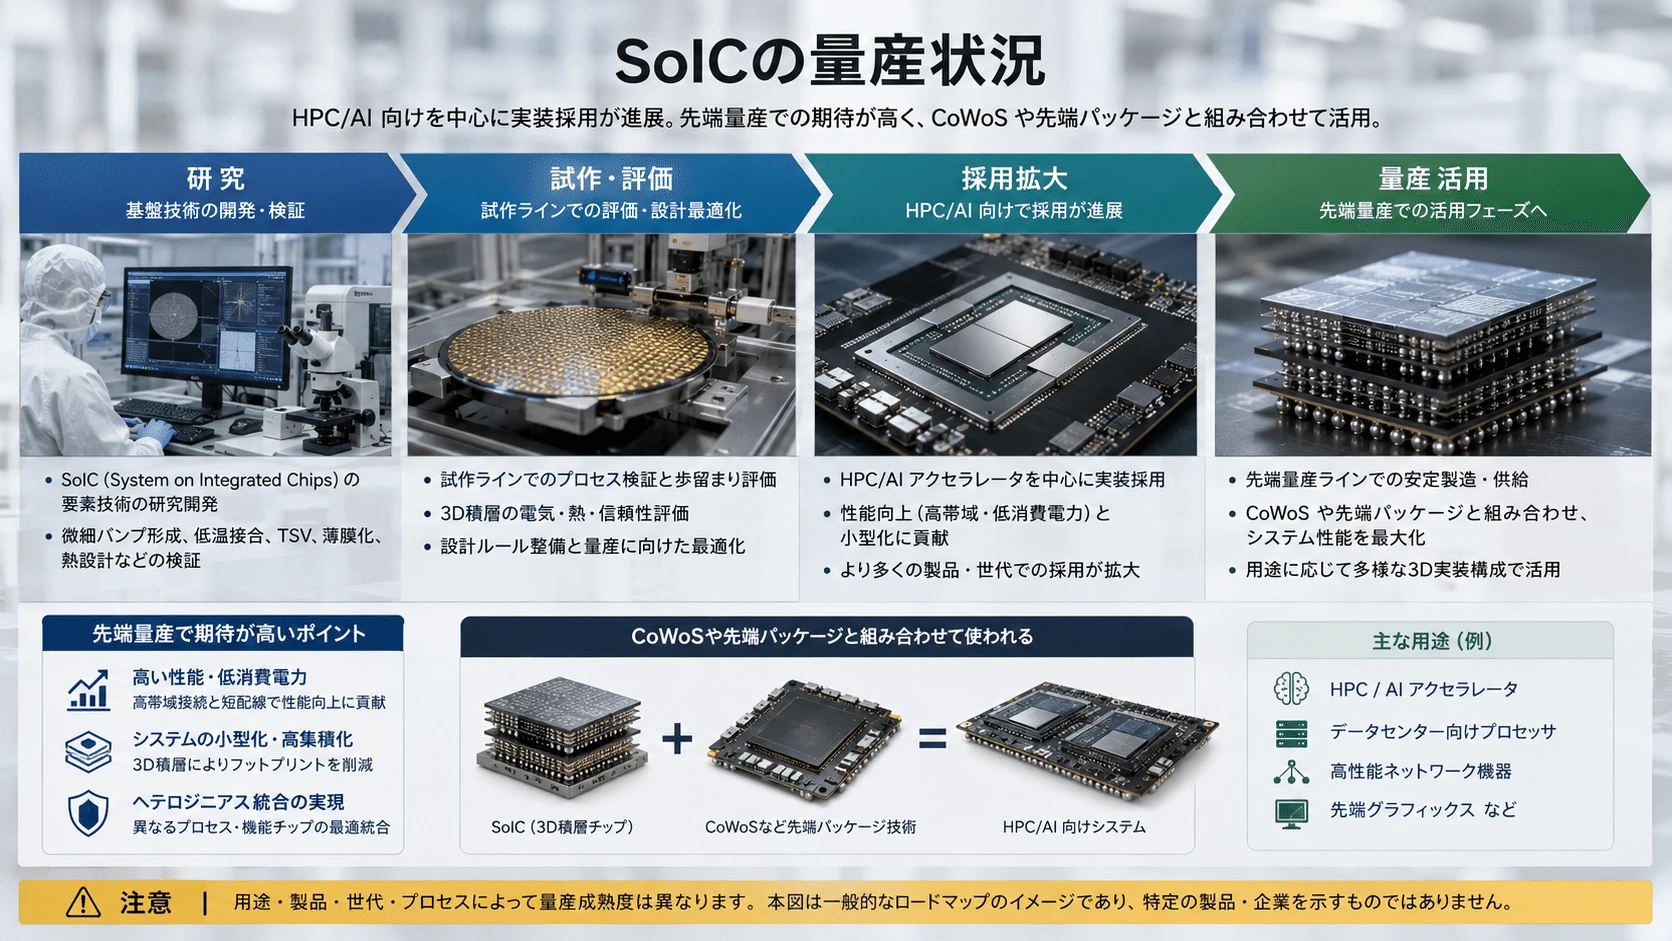
#SoICは研究技術だけではない。
#TSMCの2025年年次報告では、3nm SoIC積層技術が2025年に量産へ入ったとされている。
#SoICは、ロジック・オン・ロジックだけでなく、
#- SRAM-on-Logic
- Memory-on-Logic
- Deep Trench Capacitorとの積層
- シリコンフォトニクスと電気制御ICの積層
などへ展開されている。TSMCはSoIC CoWを使ったシリコンフォトニクス統合技術COUPEについて、2026年の量産を目標としている。
#
#
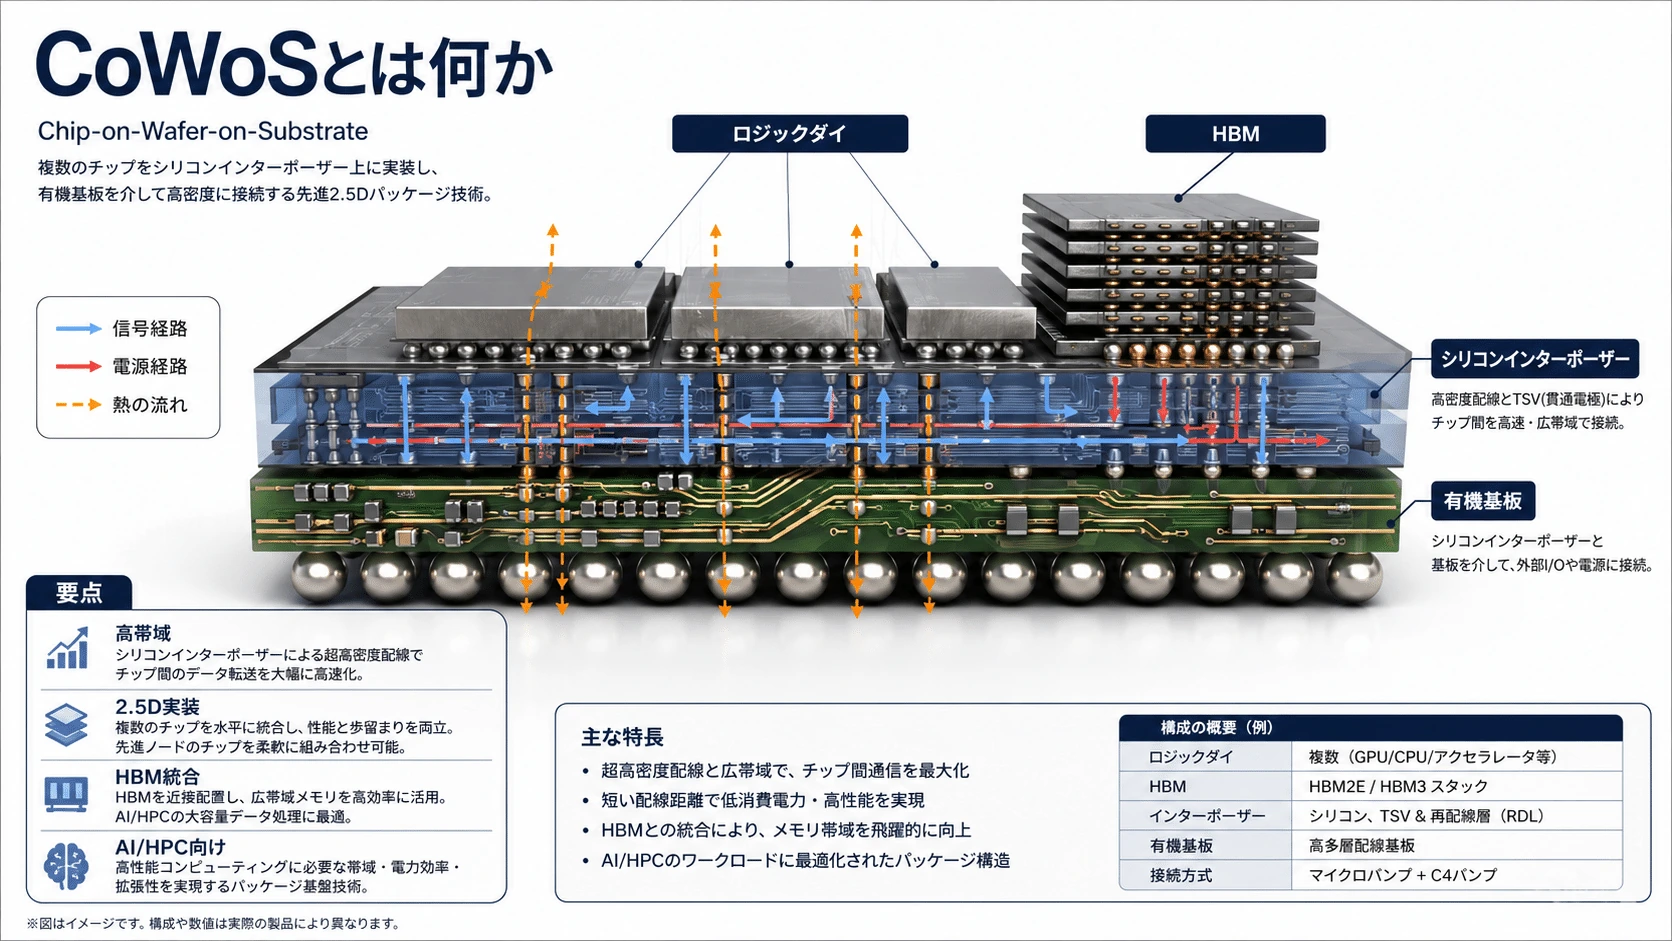
CoWoSとは何か
#CoWoSはChip on Wafer on Substrateの略である。
#主に、ロジックダイとHBMを高密度な中間配線基盤の上へ横方向に並べる2.5Dパッケージである。
#HBM Logic Die HBM
┌───┐ ┌────────┐ ┌───┐
└●●●┘ └●●●●●●●●┘ └●●●┘
══════════════════════════════
Interposer/RDL
──────────────────────────────
有機パッケージ基板HBM内部は3D積層されているが、ロジックとHBMの関係は基本的に横並びである。
#したがってCoWoS自体は、SoICやFoveros Directと同じ垂直ロジック積層ではなく、2.5Dシステム統合技術である。
#
#
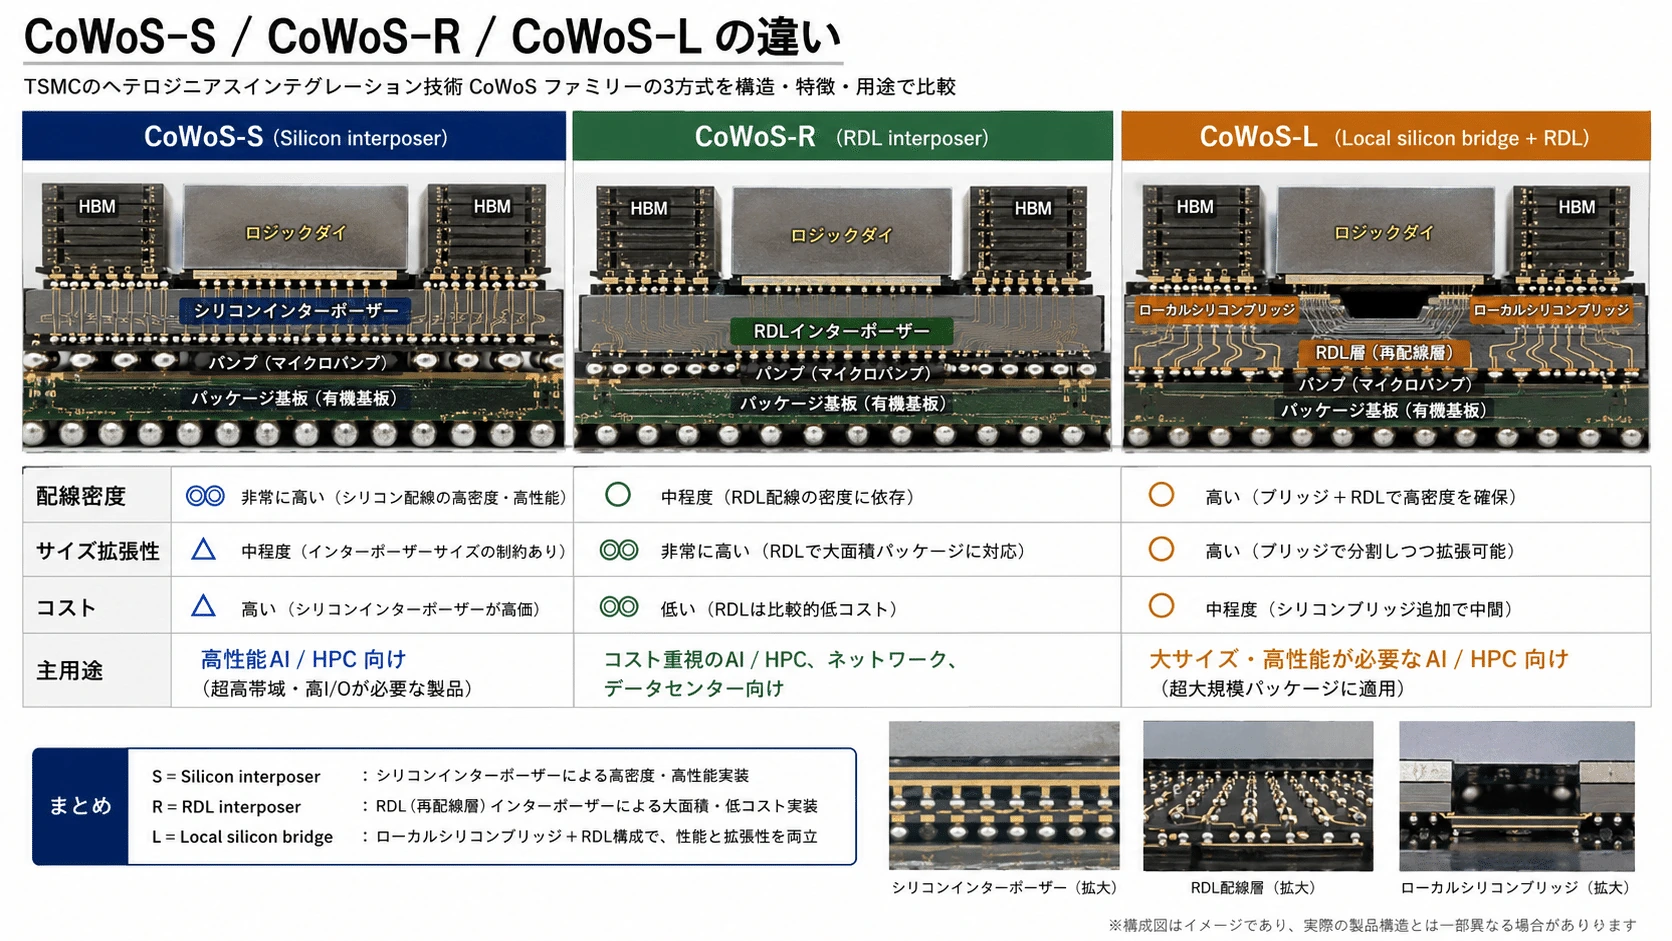
CoWoS-S
#CoWoS-Sは、大型のシリコンインターポーザーを使用する。
#特徴は、
#- 高密度シリコン配線
- ロジックとHBMの広帯域接続
- eDTCによる電源安定化
- 高い信号品質
- AI・HPC向け
である。
#TSMCの現行公式情報では、CoWoS-Sは最大3.3倍レチクル、約2,700mm²のインターポーザーに対応し、それ以上のサイズにはCoWoS-LまたはCoWoS-Rが推奨されている。(3DFabric)
##
CoWoS-R
#CoWoS-Rは、シリコン全面ではなく、ポリマーと銅配線によるRDLインターポーザーを使う。
#Logic・HBM
↓
RDL Interposer
銅配線+ポリマー
↓
Package SubstrateRDLはシリコンより柔軟で、熱膨張差によるC4接合部への応力を緩和しやすい。
#TSMCはCoWoS-Rについて、最小4µmピッチのRDL配線、低RC配線、GSGSG配置と層間シールドによる信号・電源品質を挙げている。(3DFabric)
##
CoWoS-L
#CoWoS-Lは、大型RDLインターポーザーと、必要な部分だけに配置したLocal Silicon Interconnect、LSIを組み合わせる。
#Die A Die B
┌──────┐ ┌──────┐
└──●───┘ └───●──┘
╲ 高密度接続 ╱
LSI Bridge
────────────────────
大型RDLインターポーザー全面を高価なシリコンで作らず、ダイ間の高密度接続が必要な場所だけにシリコン配線片を使う。
#TSMCはCoWoS-Lについて、
#- RDLインターポーザー
- sub-micron級銅配線を持つLSI
- eDTC
- 複数の埋め込みチップ
を組み合わせ、大型HPC製品へ対応すると説明している。(3DFabric)
#2025年時点で、CoWoS-Rは量産3年目、CoWoS-Lは量産2年目に入り、より大型のCoWoS-L製品が2026年に量産開始予定とTSMCは報告している。
#
#
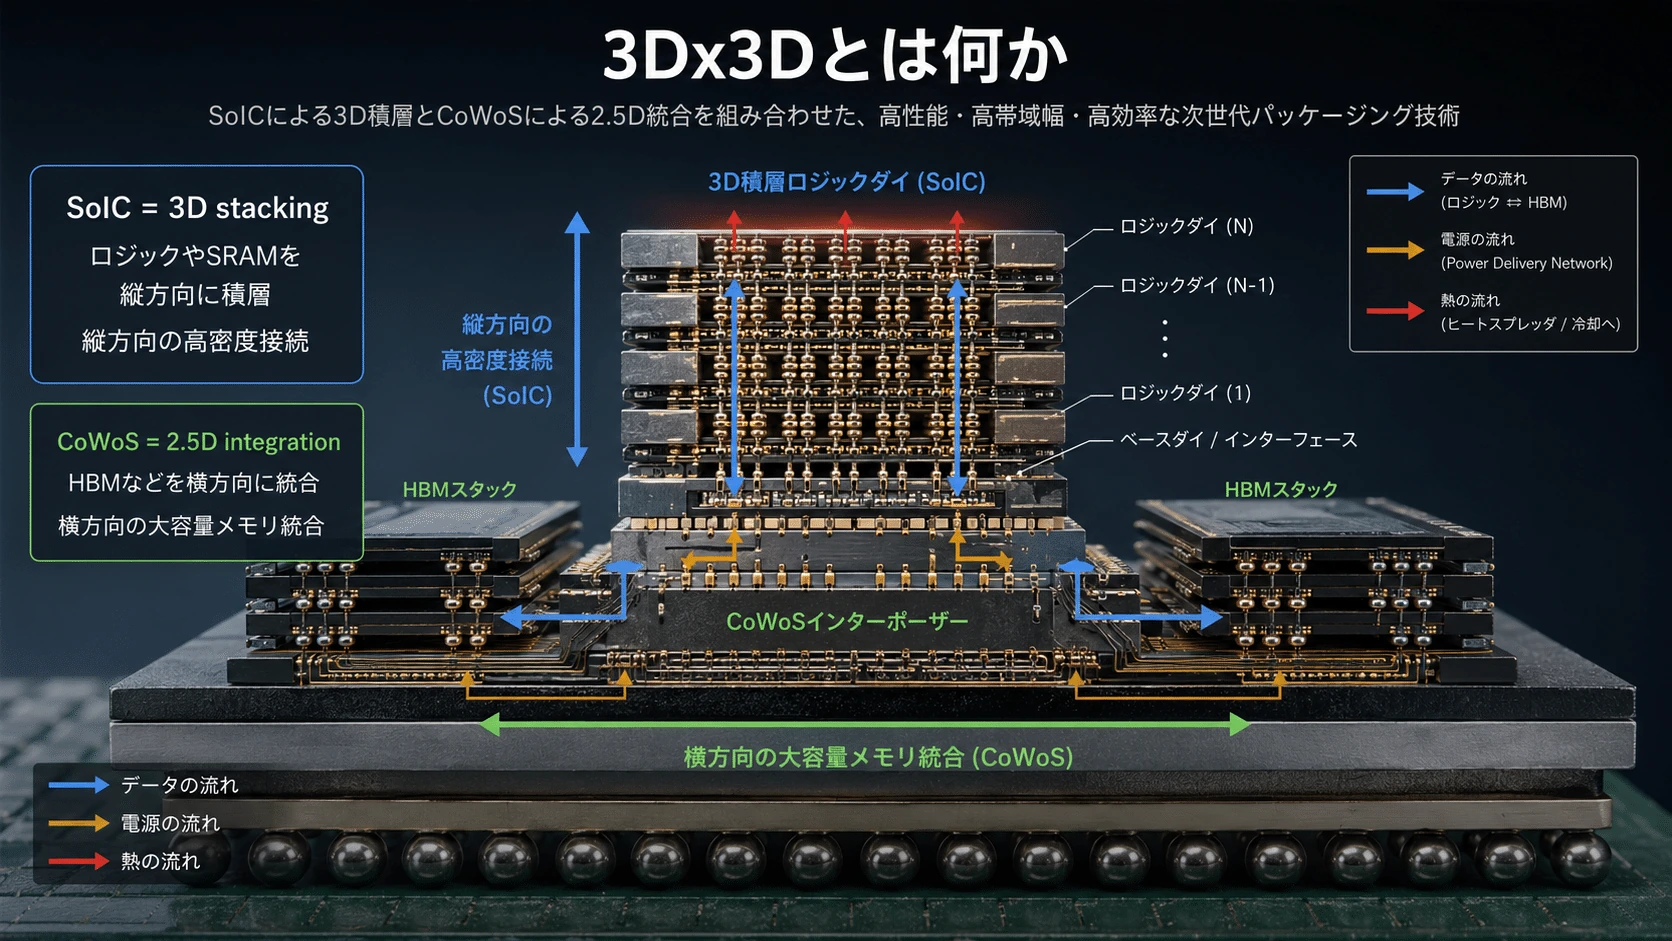
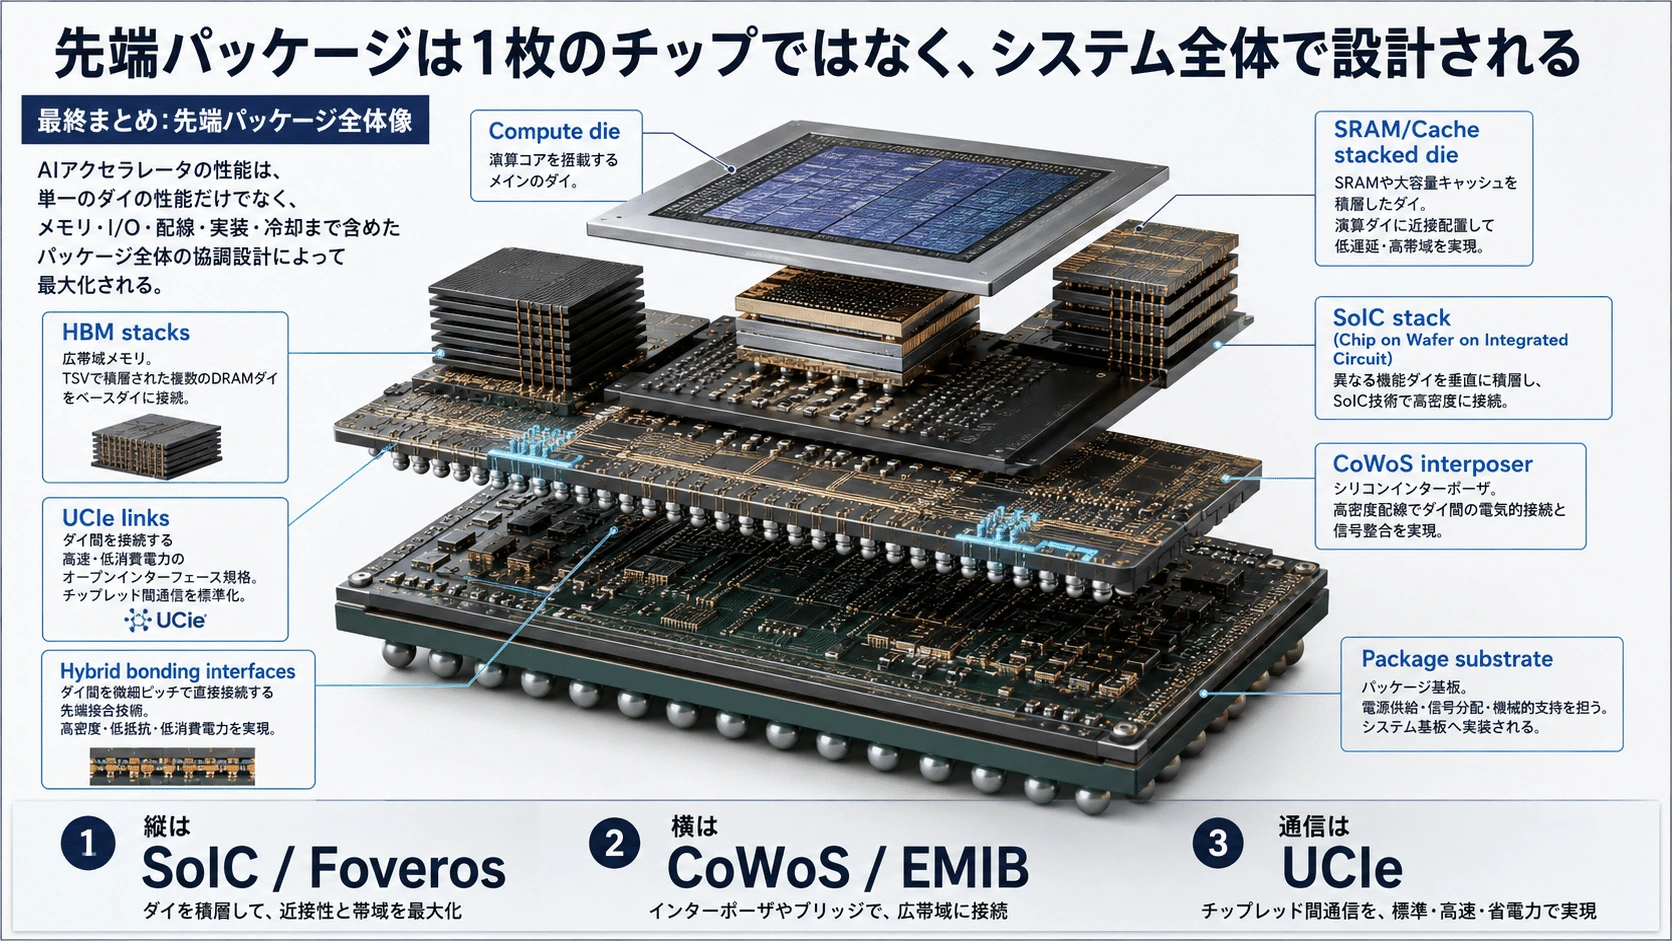
SoICとCoWoSを組み合わせる3Dx3D
#SoICとCoWoSは競合する技術ではない。
#SoICで作った3D積層ダイを、CoWoSの上へ載せられる。
# SRAM/Logic
│
SoIC 3D接合
│
Compute Die
HBM == CoWoS Interposer == HBMこれをTSMCは3Dx3Dと呼ぶ。
#- SoIC:上下方向の3D積層
- CoWoS:横方向の2.5D統合
- HBM:メモリー内部の3D積層
を一つのパッケージへ統合する。
#TSMCはSoICをCoWoSまたはInFOへ統合できるとし、垂直積層と横方向パッケージを組み合わせる3Dx3Dをシステムレベルの構成として位置付けている。(3DFabric)
#
#
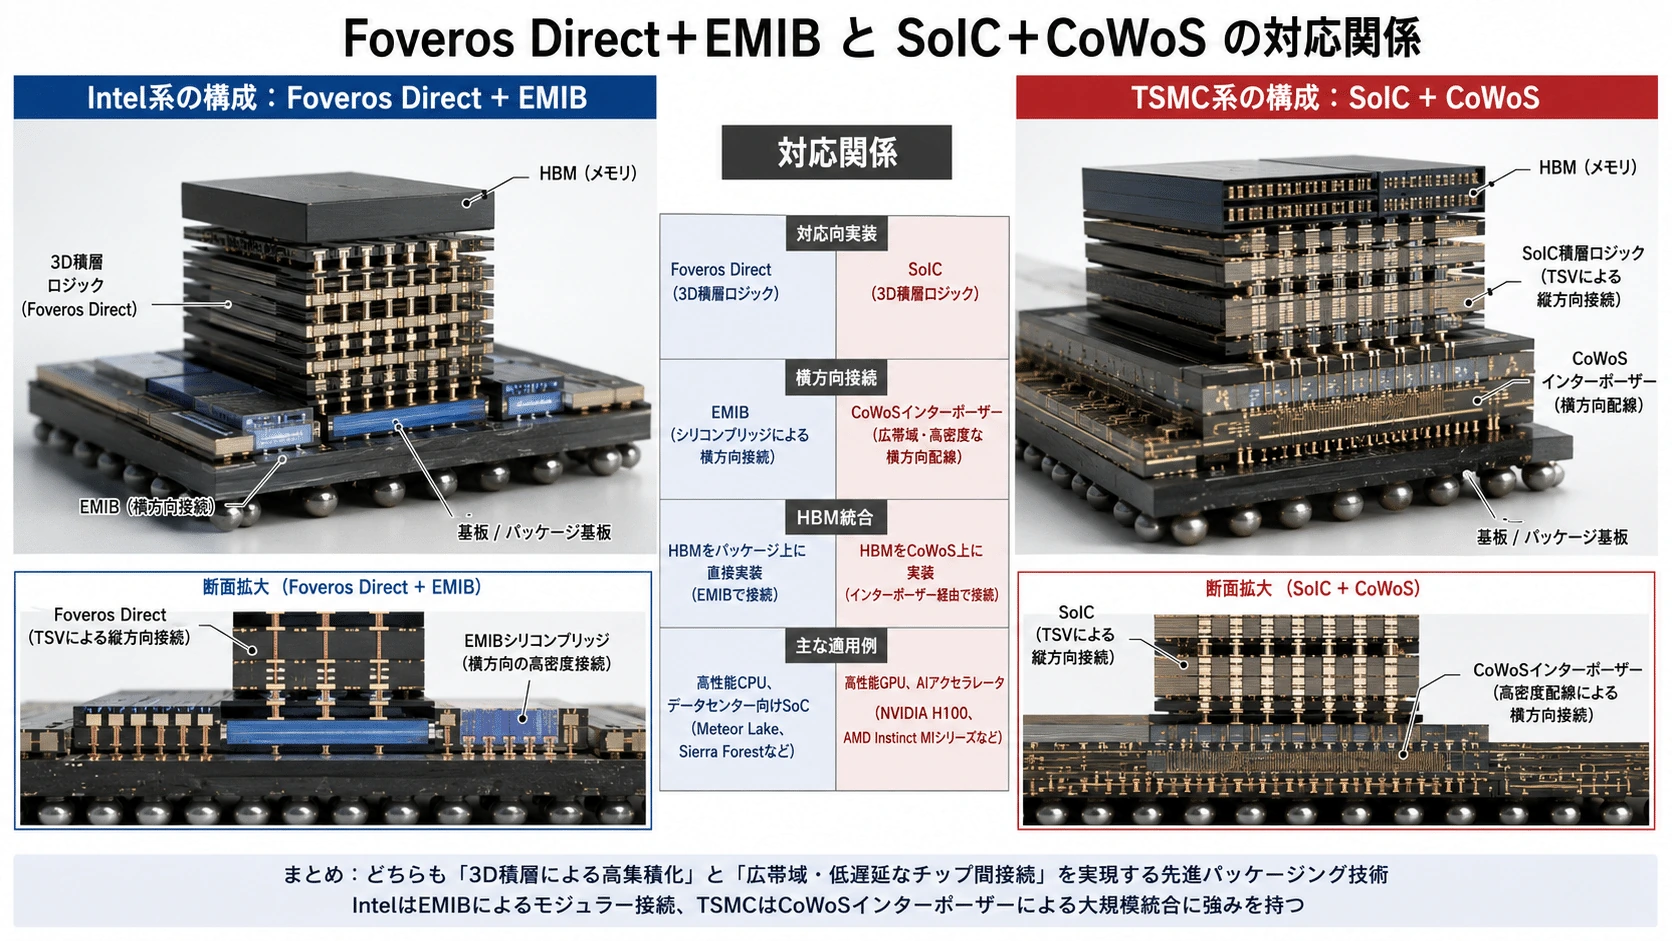
Foveros Direct+EMIBと、SoIC+CoWoSの対応関係
#両社の技術を概念的に並べると、次のようになる。
#垂直方向横方向システム構成Intel Foveros DirectIntel EMIBEMIB 3.5DTSMC SoICTSMC CoWoS3Dx3D
#Intel
Foveros Direct
上下積層
+
EMIB
横方向接続
TSMC
SoIC
上下積層
+
CoWoS
横方向統合ただし両者は完全に同じ構造ではない。
#EMIBは有機基板へ埋め込んだ局所シリコンブリッジであり、CoWoS-Sは大型シリコンインターポーザーを使用する。CoWoS-LはRDLと局所シリコン接続を組み合わせるため、構造的にはEMIB的な思想にも近づいている。
#
#
4つの技術の本質的な違い
#AMD 3D V-Cache
#特定のCPU製品の性能を高めるための完成アーキテクチャである。
#専用SRAM
+
専用垂直接続
+
CPUキャッシュ制御Intel Foveros Direct
#異なるアクティブダイをCu-to-Cu接合で積層する製造・パッケージ技術である。
#Compute
+
Active Base Die
+
Hybrid BondingTSMC SoIC
#ファウンドリ顧客が異なるダイを3D再統合するための製造プラットフォームである。
#Logic/SRAM/Photonics
+
CoW/WoW
+
SoIC-X/SoIC-PTSMC CoWoS
#大型ロジック、チップレット、HBMを横方向に統合する2.5Dパッケージである。
#Logic
+
HBM
+
Interposer/RDL/LSI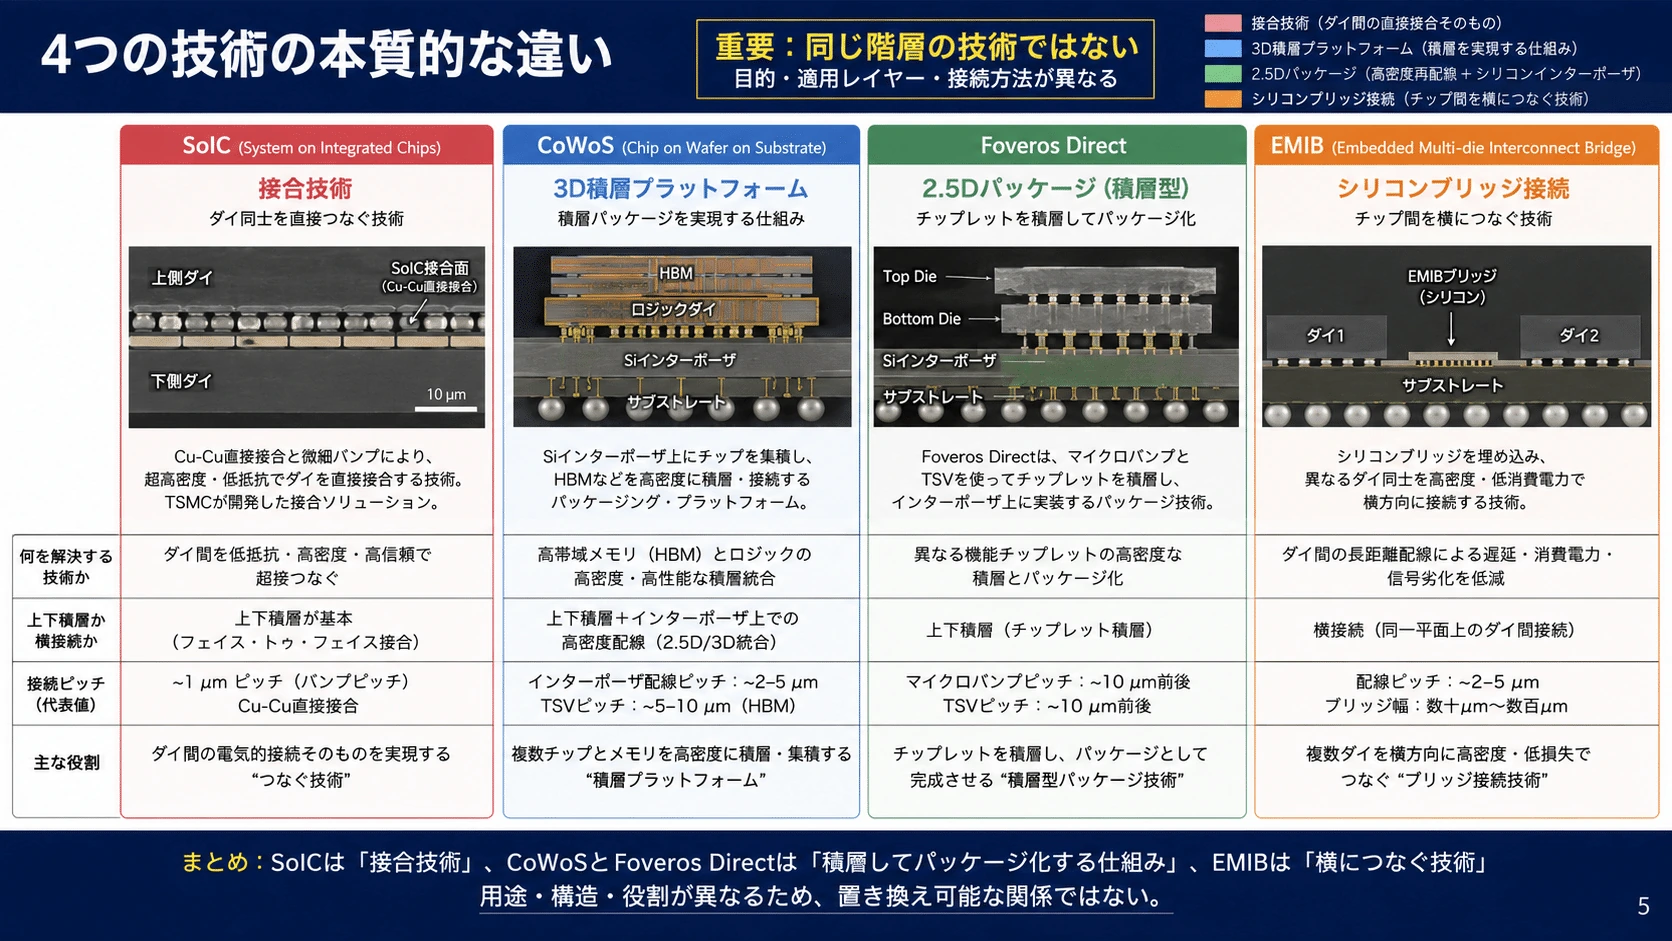
#
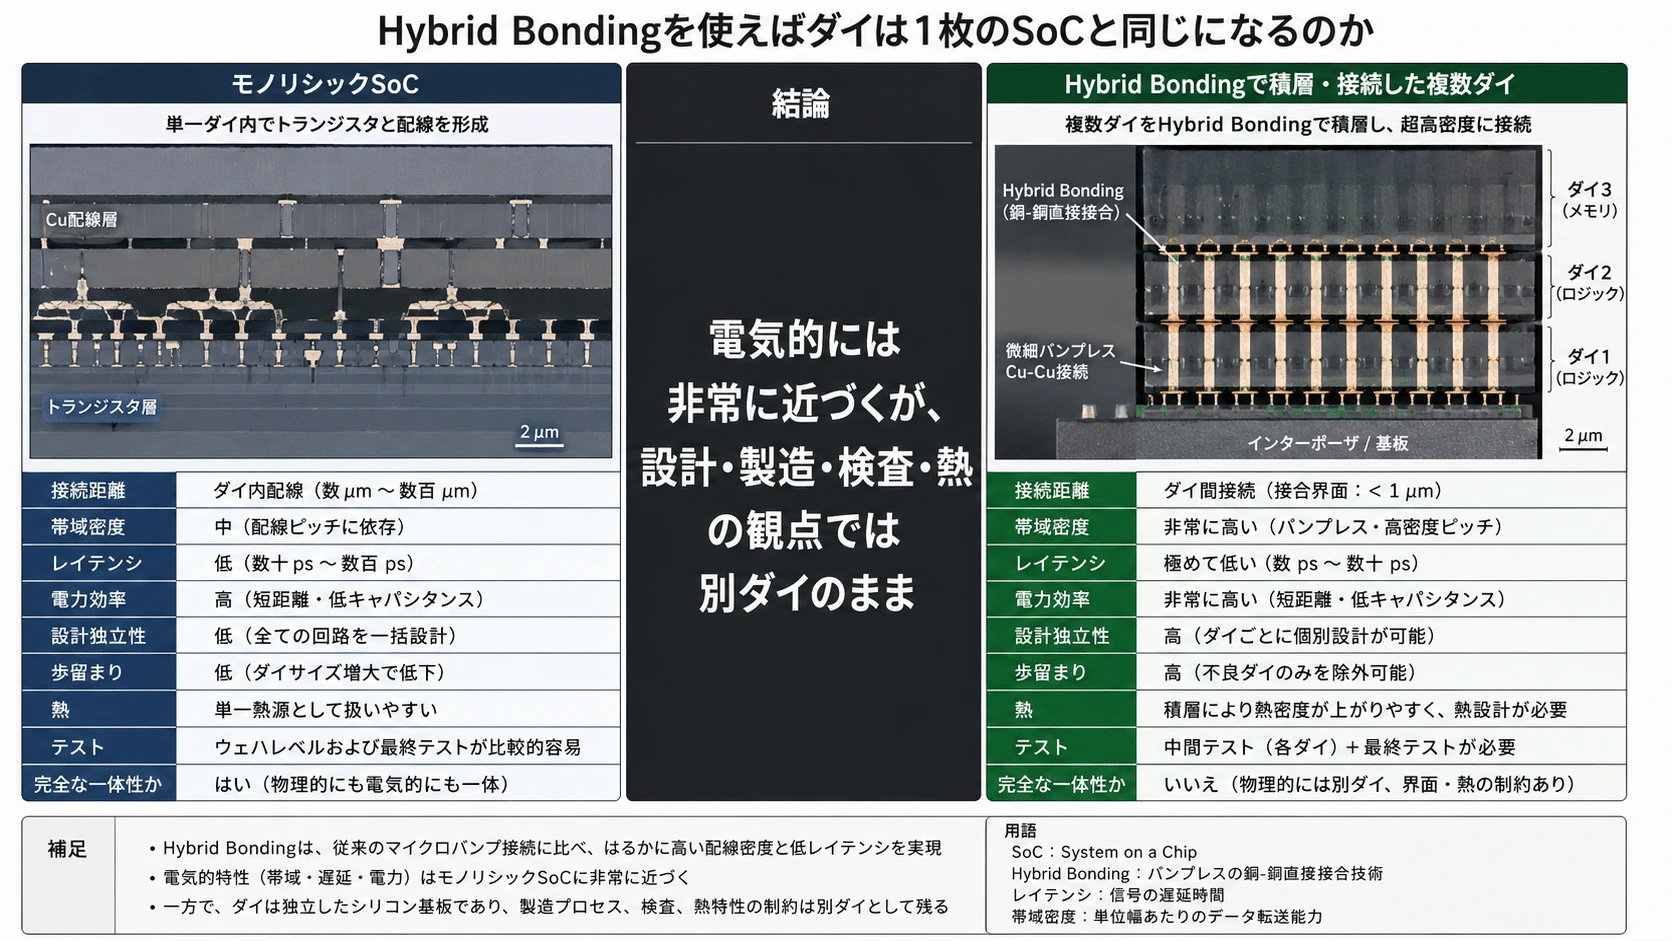
Hybrid Bondingを使えば、ダイは1枚のSoCと同じになるのか
#完全に同じにはならない。
#Hybrid Bondingで接続距離とピッチを小さくしても、ダイ境界には依然として、
#- 接合パッド
- PHYまたはI/O回路
- クロック境界
- 電源境界
- テスト回路
- 故障管理
- 製造ばらつき
が存在する。
#モノリシックSoCの配線は、トランジスタ間をBEOLの微細配線で接続する。
#Hybrid Bondingはそれより粗いが、マイクロバンプや2.5D接続よりは、はるかにモノリシック配線へ近い。
#モノリシックBEOL
最も細かい・短い
Hybrid Bonding
非常に細かい・短い
マイクロバンプ
数十µm級
2.5Dインターポーザー
mm級横配線
有機基板
さらに長いしたがってHybrid Bondingは、
#別々のダイを完全に1枚にする技術ではなく、ダイ分割のペナルティーを小さくする技術#
と捉えるべきである。
#
#
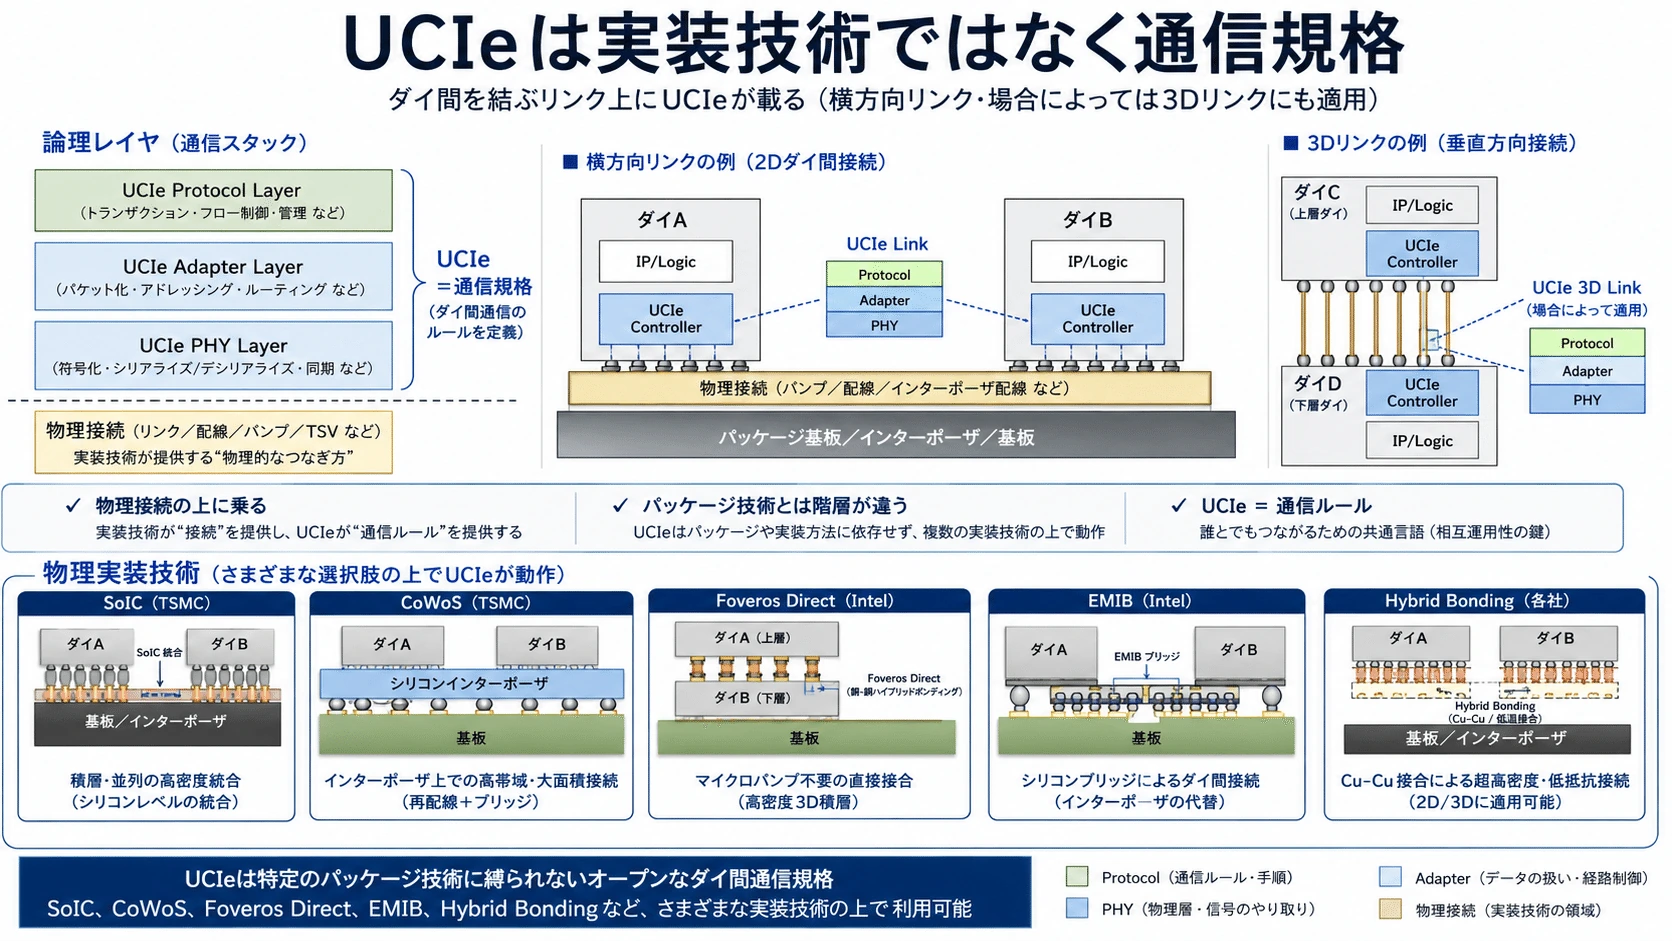
UCIeはどこへ入るのか
#UCIeはFoveros Direct、SoIC、CoWoSの代替ではない。
#これらの接続構造の上で使える通信規格である。
#上位プロトコル
PCIe/CXL/Streaming
↓
UCIe Adapter
↓
UCIe PHY
↓
Foveros/SoIC/CoWoS上の接続ただし、3D V-Cacheのように送受信する機能が最初から固定された専用構造では、UCIeの汎用性より専用インターフェースの効率が優先される。
#UCIe-3DはHybrid Bonding向けに最適化され、10~25µm級から1µm以下までの接続ピッチを想定しているが、Hybrid Bondingを使うすべての製品がUCIe-3Dを使用するわけではない。(UCIe Consortium)
#
#
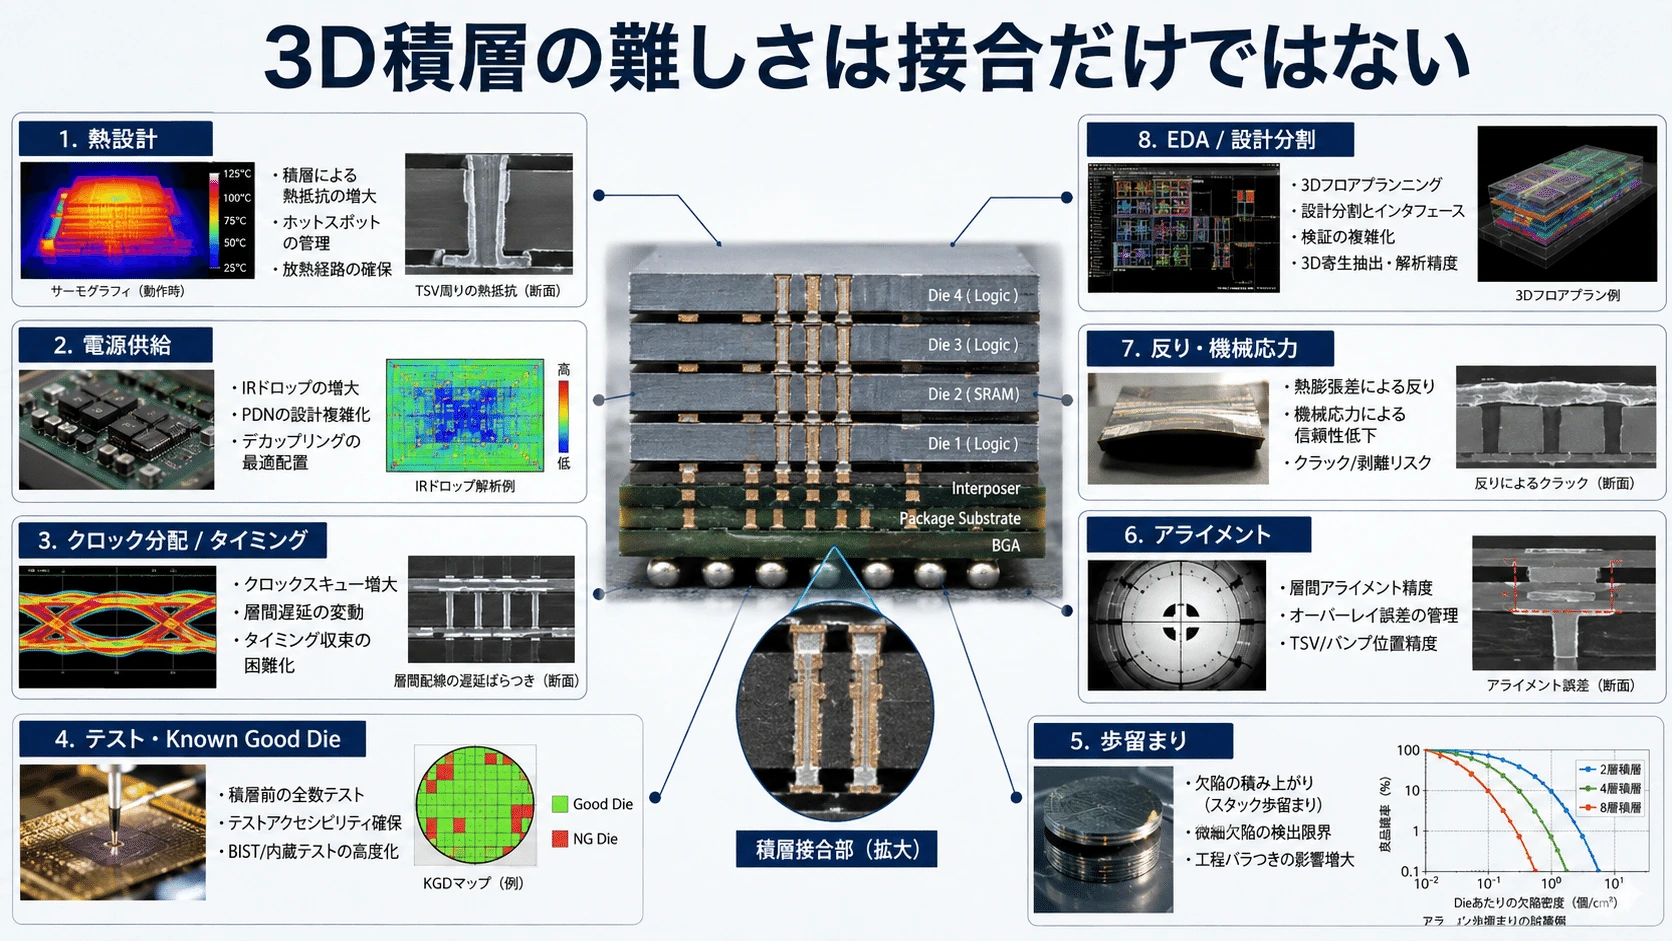
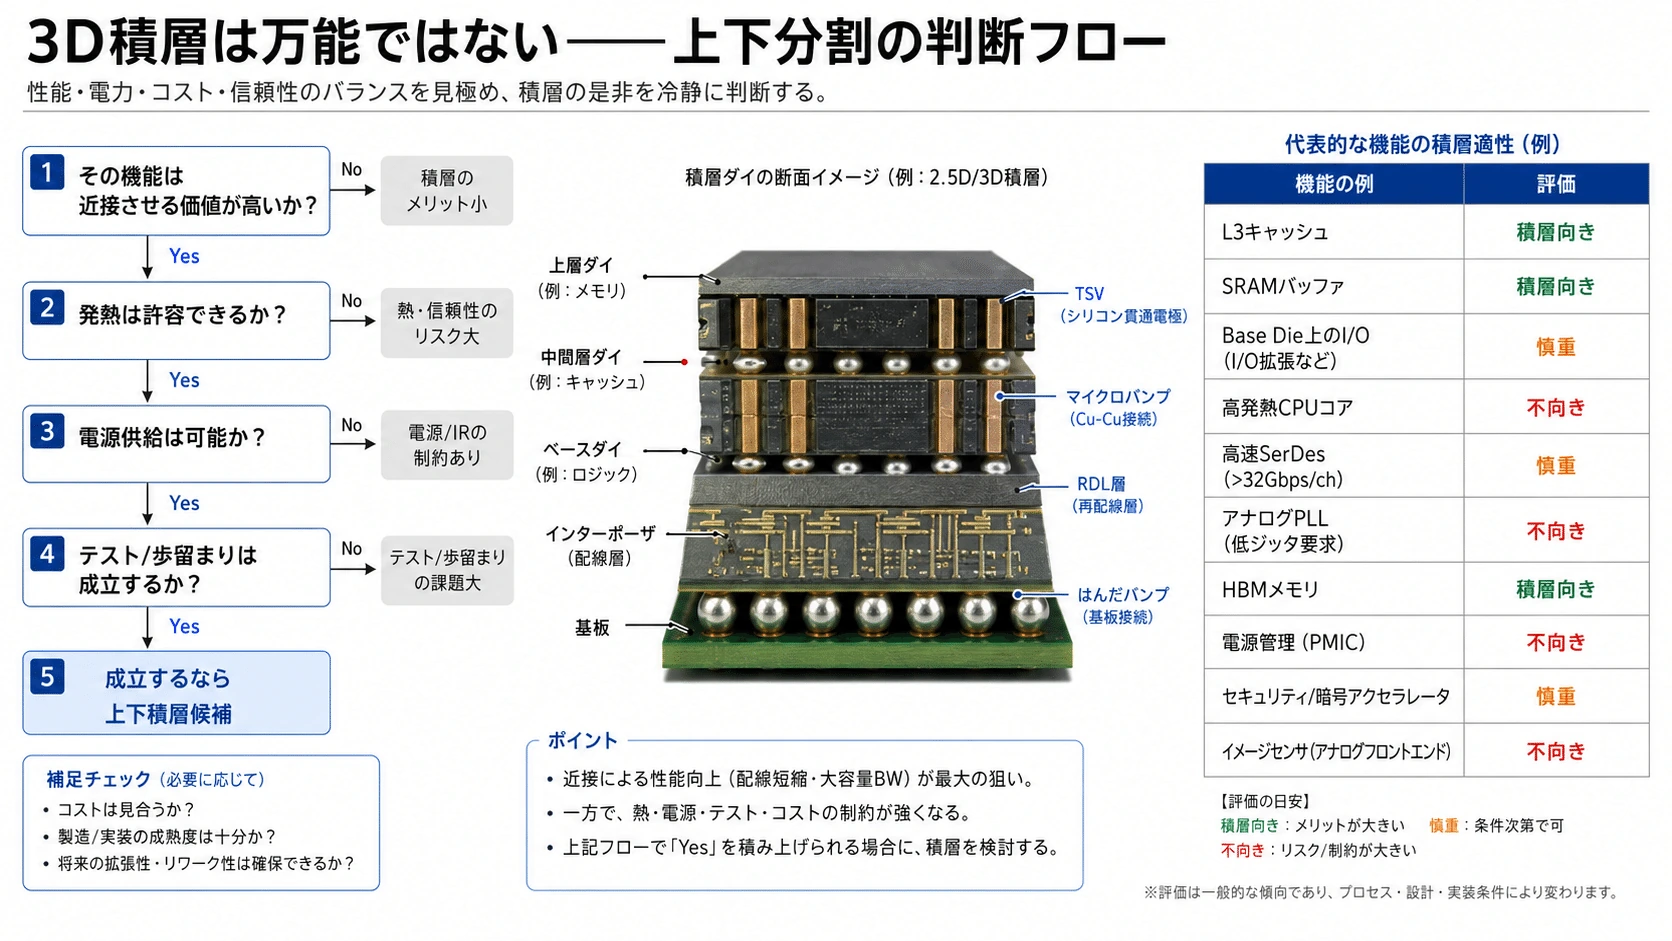
3D積層で最も難しいのは接合だけではない
#熱
#接合界面の熱抵抗が低くても、発熱ダイを複数層に積めば、内部の熱を冷却面へ逃がしにくくなる。
#ヒートスプレッダ
↑
高発熱Compute
↑
高発熱Logic
↑
Base Dieメモリー・オン・ロジックは比較的実現しやすいが、高発熱ロジック・オン・ロジックは難度が高い。
#電源供給
#積層上部まで大電流を供給する必要がある。
#信号接点を増やすだけでなく、
#- VDD
- VSS
- グラウンド
- デカップリング
- TSV
- 裏面電源
を設計しなければならない。
#Known Good Die
#積層後に1枚のダイが不良だと判明すれば、高価なスタック全体を失う可能性がある。
#テスト
#接合前、接合後、薄化後、パッケージ完成後で、それぞれ検査が必要になる。
#修理性
#Hybrid Bondingで接合したダイを、損傷なく剥がして交換することは極めて難しい。
#EDA
#3D配置配線、層間タイミング、クロック、電源、熱、機械応力を同時に解析しなければならない。
#
#
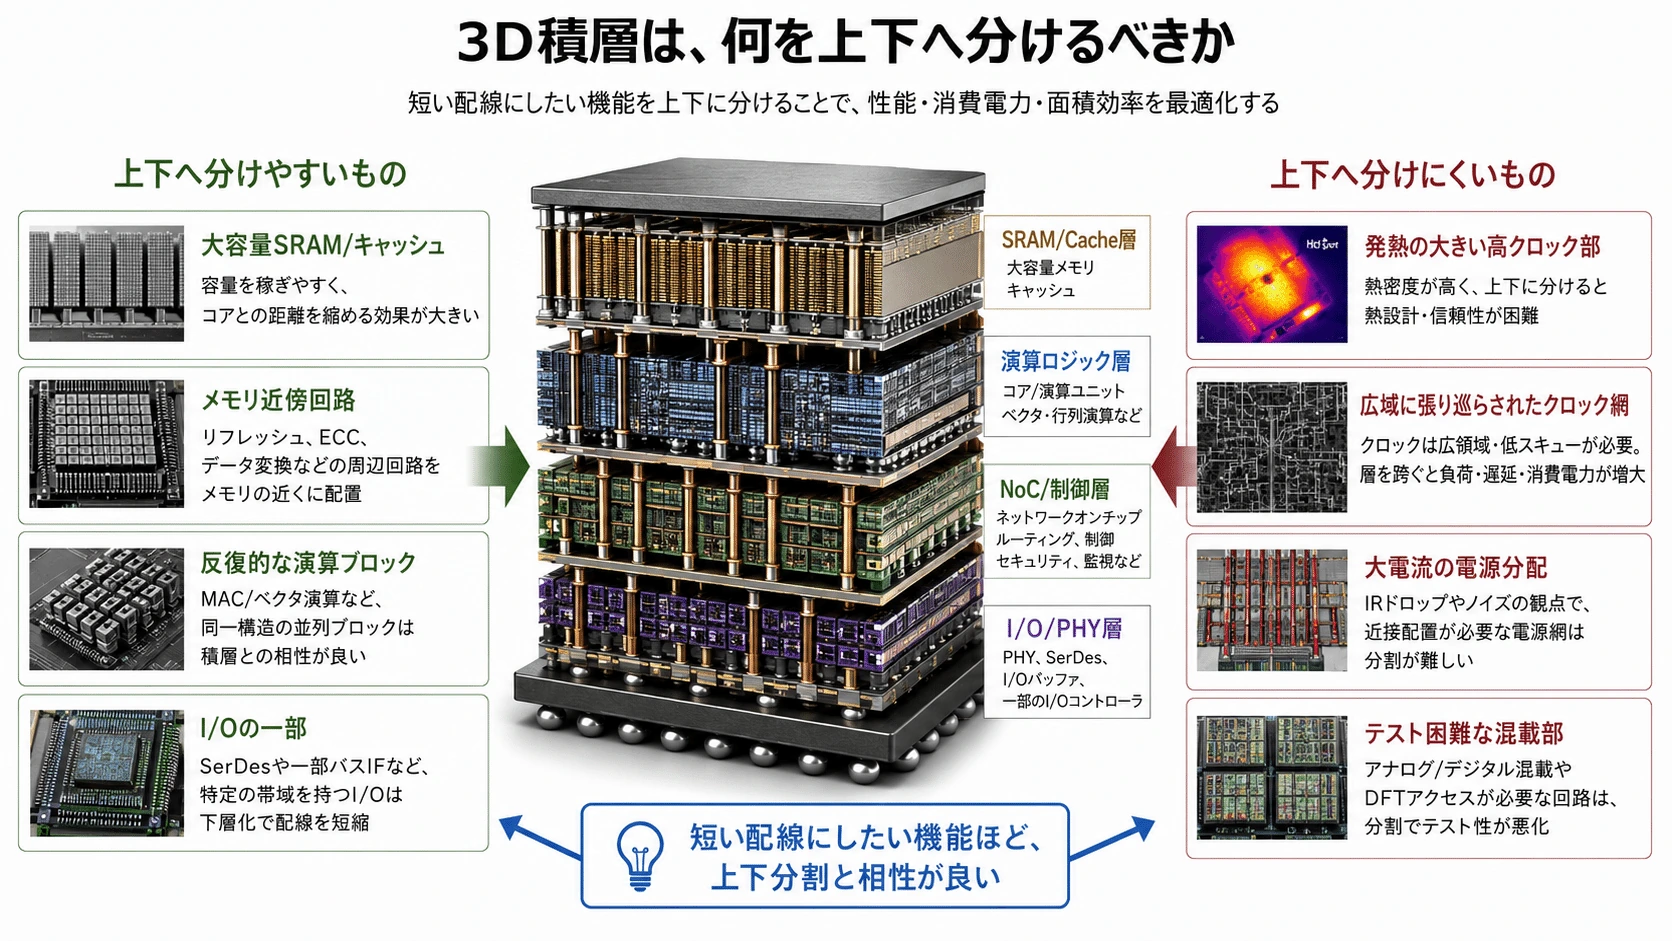
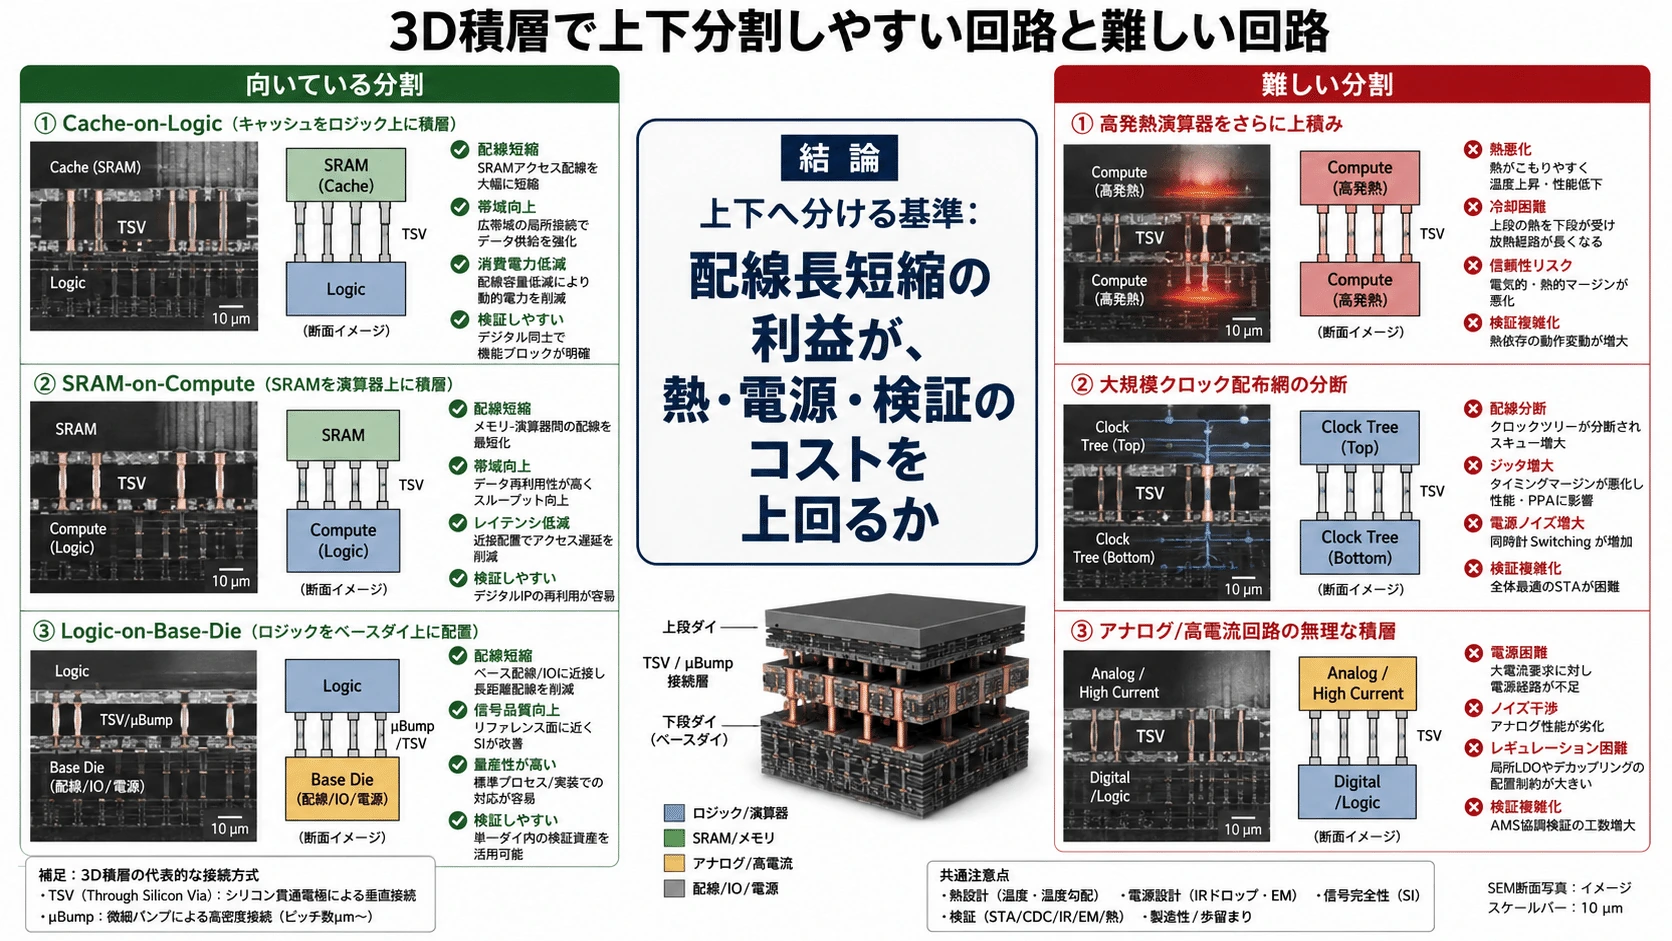
3D積層は、何を上下へ分けるべきか
#すべての回路を無条件に積層すればよいわけではない。
#積層しやすい組み合わせ
#- SRAM on Logic
- Cache on Compute
- Sensor on Logic
- Photonics on Electrical Control
- DTC on Logic
難しい組み合わせ
#- 高発熱Compute on Compute
- 高電流回路の多段積層
- アナログ回路とノイズの大きなデジタル回路
- 毎サイクル極端に複雑な双方向通信を行う回路
3D V-Cacheが最初に大規模商用化しやすかった理由は、SRAMが比較的規則的な構造であり、CPUコアより発熱密度が低く、追加容量の効果が明確だったためである。
#
#
今回の要点
#- 3D V-Cacheは、CPUへ追加SRAMキャッシュを積層するAMDの製品アーキテクチャである。
- 3D V-Cacheでは、Cu-to-Cu Hybrid BondingとTSVが組み合わされる。
- 第2世代3D V-CacheではキャッシュをCPUの下へ移し、高発熱CPUコアを冷却面へ近づけた。
- Foveros Direct 3Dは、アクティブ・ベースダイへチップレットをCu-to-Cu接合するIntelの3Dプラットフォームである。
- Foveros DirectとEMIBを組み合わせると、上下積層と横方向接続を併用するEMIB 3.5Dになる。
- SoICは、CoWとWoW、異なるサイズ・機能・ノードのダイを扱うTSMCの3Dシリコン積層プラットフォームである。
- SoIC-XはバンプレスHybrid Bonding、SoIC-Pはマイクロバンプ型のコスト重視構成である。
- CoWoSは、ロジックとHBMを横方向に統合する2.5Dパッケージである。
- CoWoS-Sはシリコンインターポーザー、CoWoS-RはRDL、CoWoS-LはRDLと局所シリコン接続を使う。
- SoIC+CoWoSはTSMCの3Dx3D、Foveros Direct+EMIBはIntelのEMIB 3.5Dに相当する。
- Hybrid Bondingは接合技術、UCIeは通信規格であり、同じ技術ではない。
- 将来の性能は、トランジスタの微細化だけでなく、上下方向と横方向をどう組み合わせるかによって決まる。
次回は、ロジック回路そのものを上下の層へ分割するLogic Foldingを解説する。
#ALU、レジスターファイル、スケジューラー、キャッシュ、NoCをどの層へ配置するのか、なぜHybrid Bondingと裏面電源が必要になるのか、そして将来のAIチップが「パッケージ全体で1台のコンピューター」になる過程を見ていく。
#