AstraはAI産業の競争軸を変えた
この資料の日時
元資料の日付と、その本文が公に存在した確認日時は別の記録です。
本文に含まれる語句 HBM DRAM SRAM 帯域・データ移動 先端パッケージング 光接続 電力・給電 冷却 歩留まり チップレット AI推論 AIエージェント 主権AI
出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.09.23.4
- 記事内容のSHA-256
38690222fbbddf228804952cc60fc8d01f1d43479330336fadfbe4cf6fe5a37d- 保存版のSHA-256
4490517640f0096a1ee503f71b218372b73aa70fa2a9ef8c9760c73bab68e0eb
外部証明の最終検査結果は詳細を開くと表示します。
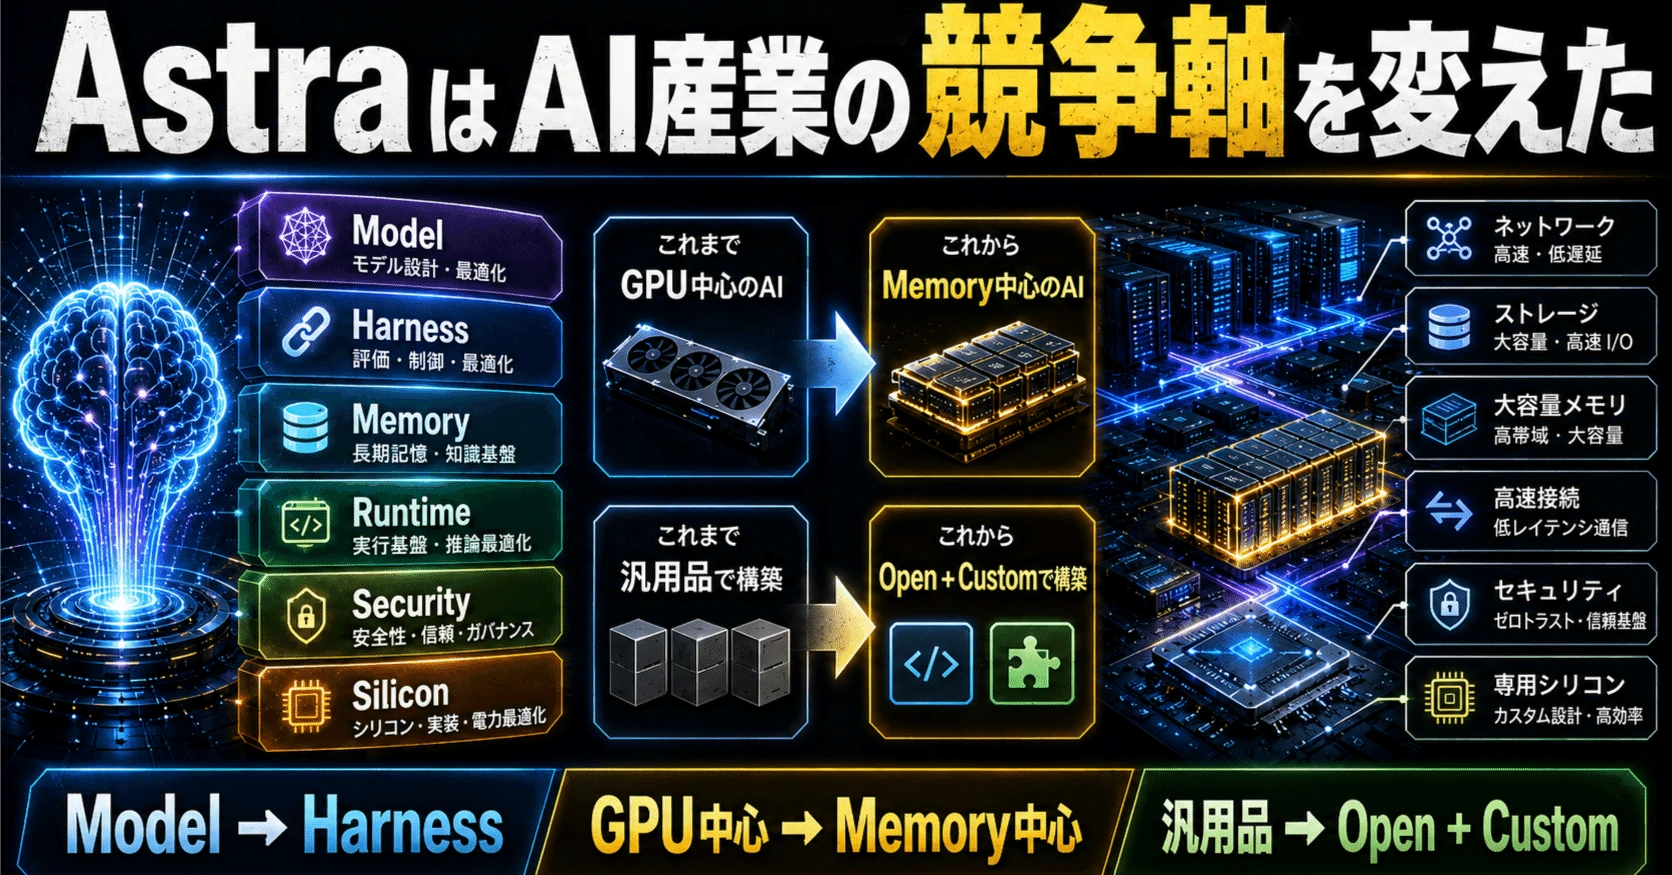
AstraはAI産業の競争軸を変えた
#― ModelからHarnessへ、GPUからMemory中心のAIへ、そして「Open + Custom」のAI Stackへ ―
#2026年9月に登場したGPT-6 Astraを、単純な「GPT-5.6 Solより賢い次世代Model」として見ると、本質を見落とす。
#Astraで起きた重要な変化は、Benchmarkの数ポイントではない。
#AIの価値を決める中心が、
#Modelそのもの
#から、
#Model + Harness + Memory + Runtime + Security + Silicon
#へ移り始めたことである。
#ここでいうHarnessとは、Modelを現実に働かせるための実行基盤全体を指す。
#さらに今回、これまで書いてきた、
#「OpenAIのMac大量購入」
#「NVIDIAによるHugging Face取得」
#「AmazonのAI収益化とCustom Silicon」
#「AIDCは本当に余るのか」
#「AI Infrastructureの次のBottleneck」
#という五つの議論を重ねると、もう一段大きな構造が見えてくる。
#それは、
#AI産業が「最高の汎用品を買う競争」から、「自分の仕事量と物理制約に合わせてSystem全体を専用設計する競争」へ移り始めている
#ことである。
#その最も分かりやすい場所がMemoryである。
#GPUが増える。
#するとHBMが足りなくなる。
#HBMを増やす。
#するとDRAM Waferが足りなくなる。
#HBMを節約するためSRAMを増やす。
#するとLogic Dieが巨大化してN3/N2 Waferを消費する。
#HBM4ではLogic Base Dieまで先端Foundryを使う。
#Packageを大きくするとCoWoSが必要になる。
#GPUをさらに増やせばNetworkが必要になる。
#高速化するとPowerとCoolingが詰まる。
#つまりAI Infrastructureとは、
#という競争ではなく、
#という巨大な資源変換競争になっている。
#そして制約が強くなるほど、
#汎用品 → 専用品
#への経済的圧力が強くなる。
#ここがAstra、Jalapeño、NVHBM、Trainium、Apple Siliconを一つにつなぐ重要な論点である。
##
1.Astra最大の変化はContext Windowの巨大化ではない
#AstraではCodexの長時間作業に重要な変更が入った。
#従来、Context Windowがいっぱいになると、過去のやり取りを圧縮し、一つのSummaryへまとめていた。
#しかし要約には情報損失がある。
#「なぜこの設計を選んだのか」
#「三時間前に何を試して失敗したのか」
#「このInterfaceはUserから変更禁止と言われた」
#「どのTestを必ず通す必要があるのか」
#といった細部が失われる。
#Astraではこれが、
#Notes + Searchable History
#つまり、
#重要事項を残す作業メモ + 後から検索できる履歴
#へ変わった。
#つまり、
#MemoryをContext Windowへ押し込む
#から、
#Context WindowをMemory Systemの一部にする
#方向へ進んだ。
#Agentの寿命とContext Windowの長さが分離し始める。
#これは1M Contextが2Mになることより重要である。
##
2.LLMは「一度呼ばれて終わる機能」から「存在し続けるProcess」へ変わる
#従来のLLMは、
#入力
#↓
#計算
#↓
#出力
#↓
#終了
#だった。
#しかしAstra型Agentは、
#Goal:目標 Agentが最終的に達成しようとしている目的。
#State:状態 現在どこまで進み、何が起きているかという作業状況。
#Memory:記憶 過去の会話・判断・失敗・設定などを保持する仕組み。
#I/O:入出力 User、画面、File、外部Serviceなどとの情報交換。
#Tool:道具 Browser、検索、API、Terminalなど、Agentが仕事に使う外部機能。
#Permission:権限 何を閲覧・変更・実行してよいかを制御する仕組み。
#Event:出来事・イベント Tool完了、Mail受信、Error発生など、Agentが反応する出来事。
#Scheduler:実行管理 複数Taskの順番、並列実行、待機、再開を管理する仕組み。
#を持つ。
#つまり、
#呼び出された瞬間だけ存在する機能
#から、
#長時間存在し続けるProcess
#へ変わる。
#非同期Tool実行によってBrowserを待っている間に別Taskを進め、Compilerを走らせながら別の仮説を検討し、Userから途中で指示が変われば、その場で方向転換する。
#AIがApplicationへ近づくのではない。
#むしろ、
#AIの中へApplication実行環境が吸収され始める。
##
3.そこでHarnessがModelと同じくらい重要になる
#Harnessとは、Modelを現実世界で働かせる外側のSystemである。
#具体的には、
#Context Management:文脈管理 今の仕事に必要な情報を選び、Modelへ渡す仕組み。
#Memory:記憶 過去の会話・判断・作業状態を保持する仕組み。
#Retrieval:検索・取り出し Memoryや履歴から必要な情報だけを再取得する機能。
#Reasoning State:推論状態 途中まで立てた仮説・計画・判断などの進行状態。
#Tool Execution:Tool実行 検索、API、Terminalなどを実際に呼び出す仕組み。
#Browser:Web操作環境 Webを閲覧・検索・操作するための道具。
#Shell:Command実行環境 Program、Build、TestなどをCommandで実行する環境。
#Filesystem:File管理 FileやFolderを保存・読み書き・整理する仕組み。
#Sub-agent:補助Agent 大きな仕事を分担し、一部を並行処理するAgent。
#Scheduler:実行管理 複数Taskの順番・並列・待機・再開を管理する仕組み。
#Verification:検証 回答、Code、変更内容が正しいかTestする工程。
#Retry:再試行 失敗時に方法を変えてもう一度試す仕組み。
#Permission:権限制御 Agentが何を閲覧・変更・送信してよいかを制御する仕組み。
#Security Monitoring:安全監視 危険なTool利用や異常なActionを検出する仕組み。
#Human Approval:人間による承認 送信・削除・購入など重要操作を人間確認後に行う仕組み。
#などが含まれる。
#Modelが「脳」なら、
#Harnessは、
#OS + Computer + Memory + 作業机 + 秘書 + Security System
#である。
#これからは、
#である。
#より現実には、
#に近くなる。
##
4.「次世代ModelにはLaptop以上が必要」の本当の意味
#OpenAIのTibo氏は対談で、
#「次世代のModelには、あなたのLaptopだけでは足りない」
#という趣旨を語っている。
#https://youtu.be/4qjEgPojjzM?si=UbrlcI_PscbEbqqt
#これはModel WeightがLaptopへ入らない、というだけの話ではない。
#Agent自身が大量のComputer Resourceを消費するからである。
#人間は、
#Browserを100個同時に操作しない。
#Compilerを50個同時に回さない。
#数十の仮説を一秒ごとに検証しない。
#しかしAIにはその人間の処理速度による制約がない。
#将来、一人のUserの後ろで、
#Research Agent:調査担当
#Coding Agent:Programming担当
#Browser Agent:Web操作担当
#Testing Agent:Test担当
#Data Agent:Data処理担当
#Security Agent:Security確認担当
#Planning Agent:計画担当
#が同時に動けば、
#一人が一台のPCを使うという前提自体が崩れる。
#Agentは、
#PCの中で動くSoftware
#から、
#Cloud上にComputerを割り当てられるDigital Worker
#へ変わる。
##
5.OpenAIのMac大量購入は、その未来の物理的な弱点も示した
#macOSでしか実行できない仕事をAgentへ大量に与える場合、物理的なApple Hardwareが必要になる。
#短期的にはAppleに有利である。
#Mac Userがいる限り、
#Xcode
#Safari
#macOS Application
#Apple固有Framework
#を操作・TestするAgentにはMacが必要だからだ。
#しかしAI市場が100万、1000万、1億Agentへ広がると意味が反転する。
#Macでなければできない処理だけMacへ残す。
#DatabaseはLinuxへ。
#Browserの裏側処理もLinuxへ。
#Compile可能な部分はLinuxへ。
#StorageもCloudへ。
#AI InferenceもGPU/XPU Clusterへ。
#最終的には、
#Macを大量に使うこと
#ではなく、
#Macでしかできない最後の数%だけMacを使うこと
#が最適化になる可能性がある。
#AIは巨大すぎる。
#巨大になるほど、1%の非効率すら巨大なCostになる。
##
6.Modelが速くなるほどGPU以外がBottleneckになる
#Tibo氏はUltra-fast Inferenceについて、
#「Model側が速くなりすぎると、今度はCPU側の処理能力が全体速度を制約する」
#という趣旨を語っている。
#Model生成だけが10倍高速化しても、
#CPU:中央処理装置 Tool制御、Application実行、前後処理などを担う。
#Network:通信基盤 Cloud、API、他Agentとの通信を担う。
#Tool Call:Tool呼び出し 検索、API、Terminalなど外部機能を実行する操作。
#Filesystem:File System FileやFolderを読み書きし、作業状態を保持する。
#Browser:Web操作環境
#Database:Data保存・検索基盤
#Compile:Source Codeを実行可能形式へ変換する工程
#が10倍速くなるわけではない。
#そのため大量のTool Callを含むAgent Workflowでは、Model生成が約10倍速くなっても、仕事全体では3〜4倍程度しか速く感じない場合がある。
#ここからAI Infrastructureの需要構造が変わる。
#Training中心では、
#GPU
#HBM
#Network
#が中心だった。
#Agent時代には、
#GPU/XPU + CPU + DRAM + SSD + Network + Browser + Sandbox
#が同時に必要になる。
#Sandboxとは、Agentへ安全にComputer環境を貸し出す隔離実行環境である。
##
7.そしてMemoryが「補助部品」ではなくSystem Architectureになる
#これまでAI Chipを評価するとき、
#演算性能
#Tensor演算器
#Transistor数
#半導体製造世代
#が中心だった。
#しかしModelが巨大化し、Contextが長くなり、Agentが長時間存在するようになると、
#Weights
#KV Cache
#Activation
#Context
#Agent State
#Database
#Retrieval Data
#をどこへ置くかが性能を決める。
#つまりAIは、
#巨大な演算機
#から、
#巨大なMemory Computer
#へ変わり始める。
#Memory Hierarchyも、
#SRAM:Chip内部の超高速Memory
#↓
#HBM:Accelerator近傍の超広帯域Memory
#↓
#Server DRAM:CPU側の大容量Memory
#↓
#CXL Memory:ServerやRackを跨いで拡張・共有するMemory
#↓
#Enterprise SSD:大容量高速Storage
#↓
#Object Storage:大量Dataの長期保存層
#へ広がっていく。
#どれか一種類がすべてを置き換えるのではない。
#Memory階層全体が巨大化する。
##
8.HBM不足は「HBMだけの不足」ではない
#HBMを増やせば問題が終わるわけではない。
#HBM増産
#↓
#DRAM Wafer消費
#↓
#Server DRAMや一般DRAMの供給圧迫
#という玉突きが起きる。
#つまりMemory問題を、
#HBMメーカー3社の出荷量だけ
#で見ると不十分である。
##
9.Memory Constraintは製品仕様そのものを変え始めている
#これは非常に重要である。
#Memory不足は単に価格を上げるだけではない。
#Chip Architectureを変える。
#NVIDIAがRubin Ultra向けに複数のHBM4/HBM4E構成を評価するようになった背景にも、
#Yield
#供給量
#容量
#I/O
#といった複数制約がある。
#つまり、
#「最も容量が大きいHBMを載せる」
#より、
#限られたHBMから最大のI/O性能とGPU出荷数を取る
#というOptimizationが重要になる。
#Supply Constraintが、
#Product Specification
#つまり製品仕様そのものを変えているのである。
##
10.ここでCustom Productが急に重要になる
#HBMが潤沢で、電力も安く、Package面積も余っているなら、Standard Productを買えばよい。
#しかし、
#HBMが高い。
#HBM PHYがXPU面積を使う。
#Memory Interfaceが電力を食う。
#Interposer配線が苦しい。
#Waferが足りない。
#Powerも足りない。
#となれば、
#標準Interfaceをそのまま使うCostが非常に大きくなる。
#そこで、
#への圧力が発生する。
#Custom化とはLuxuryではない。
#希少な資源を最適利用する手段
#になる。
##
11.Custom HBMはその象徴である
#Custom HBM Architectureでは、
#Compute用Areaを増やす。
#Memory Capacityを増やす。
#Memory Interface Powerを下げる。
#といったOptimizationを狙える。
#重要なのは、
#HBM Cellそのものを魔法のように高性能化することではない。
#XPUとHBMの接続方法をWorkload専用に設計する
#ことである。
#つまりMemoryを、
#外部から買って載せるCommodity Component
#ではなく、
#Compute Architectureの一部
#として設計する。
##
12.NVHBMではNVIDIA自身がCustom HBM側へ入った
#NVIDIAはNVLink FusionをNVHBMへ拡張した。
#これは非常に象徴的だ。
#Amazonが自分のXPUを作る。
#それでもNVIDIAは収益化できる。
#つまりNVIDIAは、
#「NVIDIA GPUを買ってください」
#から、
#「あなたのXPUを使っても構わない。そのXPUをAI Factoryとして成立させるMemory・通信基盤・Rack ArchitectureをNVIDIAから買ってください」
#へ広がっている。
#これはBusiness Modelのかなり大きな変化である。
##
13.Hugging Face買収とNVHBMは実は同じ戦略である
#NVIDIAはHugging Faceを取得しても、
#Model
#Framework
#Cloud
#Inference Provider
#Compute Platform
#を自由に選べるOpen Platformを維持する方針を示している。
#日本語で整理すると、
#どのAI Modelを使ってもよい。
#どの開発Frameworkを使ってもよい。
#どのCloudを使ってもよい。
#どのInference Providerを使ってもよい。
#どのCompute Platformを使ってもよい。
#という考え方である。
#一見すると、
#Hugging FaceではOpen化。
#NVHBMでは専用化。
#に見える。
#しかし実際には矛盾していない。
#NVIDIAは、
#Model Layerでは他者に自由を与える。
#その代わり、
#Memory
#高速通信Fabric
#Networking
#Rack
#Infrastructure
#といった、
#物理的に交換しにくいLayer
#を取りに行っている。
##
14.「OpenかClosedか」ではなく「どこをOpenにするか」である
#AI産業では、
#Open企業
#Closed企業
#という単純な二分法は使いにくくなる。
#より正確には、
#どのLayerをOpenにして市場を広げ、どのLayerをCustom化して利益を取るか
#になる。
#NVIDIAは、
#Model Ecosystem:開く
#Compute Choice:開く方向
#Hugging Face Platform:開く
#その一方で、
#NVLink
#NVHBM
#Network
#Rack Architecture
#Software Stack
#を深く握る。
#これを一言で表すなら、
#「上位LayerはOpenにし、下位の物理InfrastructureはCustom化する」
#という戦略である。
##
15.Amazonも全く同じことをしている
#Amazonが非常に興味深いのは、
#Modelを一社へ囲い込んでいないこと
#である。
#Bedrockでは、
#OpenAI系Model
#Anthropic
#その他多数のModel
#を利用できる。
#ところがその下では、
#Trainium
#Graviton
#Nitro
#というCustom Siliconを自社で作る。
#TrainiumはAI演算用。
#GravitonはArm系Server CPU。
#Nitroは仮想化・Security・I/O処理を担う専用基盤である。
#つまりAmazonも、
#Model Layer:複数Modelを自由に選択
#Infrastructure Layer:自社専用設計
#なのである。
##
16.なぜAmazonはChipを自分で作るのか
#理由はNVIDIAに勝つためだけではない。
#Custom Chipを使えば、
#Chip Costが下がる。
#↓
#AWS Costが下がる。
#↓
#価格を下げるか、利益率を上げられる。
#↓
#さらに利用量が増える。
#という循環を作れる。
#Custom Siliconの価値は、
#Chip売上
#だけで測るべきではない。
#Cloud Margin
#Cloud Pricing
#Customer Retention
#AI Workload Growth
#まで含める必要がある。
##
17.AIはCloudの「AI以外」の売上も増やす
#Agentが仕事をすると必要になるのはInferenceだけではない。
#CPU
#Storage
#Vector Database
#Search
#API
#Network
#Logging
#Security
#Identity
#が同時に動く。
#日本語にすると、
#CPU:周辺処理・制御
#Storage:FileやDataの保存
#Vector Database:意味の近さで情報を検索するDatabase
#Search:外部情報検索
#API:他Serviceとの接続
#Network:通信
#Logging:操作履歴の記録
#Security:安全管理
#Identity:UserやAgentの身元・権限管理
#である。
#つまり、
#が、
#という連続したCloud Consumptionを作る。
#AstraのHarness化は、そのままCloud TAM拡張になる。
##
18.Amazonの巨額CapExでMemoryが無視できなくなった
#Memoryが、
#「Server部品表の中の一部品」
#ではなく、
#Hyperscaler全体の設備投資額を動かす規模
#まで大きくなっている。
#AI Infrastructureの経済性を考えるとき、
#GPU価格だけを追っていてはいけない。
#HBM
#Server DRAM
#LPDDR
#SSD
#がCloud ROIそのものを左右する。
#ROIとは、投じた資本に対してどれだけ利益を生めるかという投資効率である。
##
19.AIDCはGWで測るだけでは意味がなくなる
#1GWのData Centerがすべて同じ価値を持つわけではない。
#同じ1GWでも、
#旧世代Accelerator
#少ないMemory
#遅いNetwork
#小さいCluster
#低Utilization
#のFacilityと、
#最新XPU
#大量HBM
#高速Scale-up Fabric
#高速Storage
#高Utilization Scheduler
#を持つFacilityでは、作れるTokenやCompleted Task数が全く違う。
#したがって、
#電力容量そのもの
#ではなく、
#品質調整後の実効Compute能力
#を見る必要がある。
#MemoryはそのQualityを決める大きな変数である。
##
20.AIDCにも「高級品」と「汎用品」ができる
#世界にDRAMは存在する。
#しかしAIが欲しいのは、
#HBM4
#HBM4E
#Custom HBM
#である。
#だから、
#DRAM全体では存在していても、欲しいMemoryだけ足りない
#ことが起こる。
#Data Centerでも、
#Powerはある。
#建物もある。
#GPUもある。
#しかし、
#最新XPU
#HBM
#高速Fabric
#大規模Cluster
#低Latency
#Cloud対応Scheduler
#Security
#を同時に満たすCapacityが足りない。
#つまりAIDCにも、
#汎用Compute
#と、
#高品質AI Factory
#の階層ができる。
##
21.「Compute不足」から「Useful Compute不足」へ
#したがって今後、
#GPU Shipmentだけを見ても不十分である。
#本当に重要なのは、
#である。
#あるいは、
#Completed Tasks / GPU-hour:GPU一時間あたり何件の仕事を完了できるか
#Successful Agent Actions / Dollar:1ドルあたり何回の成功Actionを行えるか
#Tokens / Joule:1Jの電力で何Token処理できるか
#Memory Bandwidth / Watt:1WあたりのMemory帯域
#Agent-hours / MW:1MWで何時間分のAgentを動かせるか
#を見る。
#AI産業全体が、
#最高瞬間性能競争
#から、
#資源変換効率競争
#へ移っている。
##
22.Jalapeñoも同じ方向から理解できる
#OpenAIとBroadcomによるJalapeñoの意味も、
#単なる、
#「OpenAIが自社Chipを作った」
#ではない。
#OpenAIの表現を日本語へ意訳すると、
#「私たちはAIを使ってChipを設計し、そのChip自体もAIがProgrammingしやすいように設計した」
#ということである。
#つまり、
#AIでChipを作る
#だけではない。
#AIが自分で扱いやすいHardwareを作る。
#Custom ASICの弱点は、
#Programmingが難しい。
#新Modelへの対応が遅い。
#Compiler / Kernel Engineerが大量に必要。
#というSoftware Costにあった。
#しかしAstra級Agentが、
#Kernel
#Compiler
#Scheduling
#Optimization
#を生成・改善できるなら、
#が成立する。
#つまりAI自身が、
#Custom Productを作るCost
#を下げ始める。
##
23.AIはCustom Siliconの採算成立ラインを下げる
#Custom ASICは従来、非常に大きな企業しか作れなかった。
#初期開発費が高い。
#Engineerが必要。
#Verificationに時間がかかる。
#Compilerを作らなければならない。
#Kernelを最適化しなければならない。
#しかしAgentが、
#RTL:Chipの論理設計記述
#Verification:設計検証
#Physical Design:実際のChip配置・配線設計
#Compiler:ProgramをHardware向けへ変換するSoftware
#Kernel:特定演算を高速実行する低Level Program
#Test:動作確認
#を加速すると、
#Custom ASICを作るために必要な固定費が下がる。
#すると、
#Amazon
#Meta
#OpenAI
#だけでなく、
#より多くのAI企業やSovereign AI Operatorまで、
#半専用品を検討できる可能性が出る。
##
24.Custom化はChipだけでは終わらない
#次に起こるのは、
#Custom Stack――System全体の専用化
#である。
#Custom XPU:特定AI用途向け演算Chip
#Custom SRAM:用途別に最適化したChip内Memory
#Custom HBM:Customer固有Interfaceを持つHBM
#Custom NIC:専用Network Interface
#Custom CXL:Memory拡張・共有Architecture
#Custom Optical:専用光通信
#Custom Rack:Rack構造自体の専用化
#Custom Cooling:専用Cooling
#Custom Compiler:Chip向け専用Compiler
#Custom Harness:Agent用途専用実行基盤
#まで、一つのWorkloadへ合わせて調整される。
#Marvellの強みも、
#SRAM
#SerDes
#CXL
#Optical DSP
#Switch
#HBM Interface
#を別々に持っていることだけではない。
#一人のHyperscalerのSystem Architecture内で、それらを同時に最適化できること
#にある。
#これを、
#Cross-layer Co-design:複数階層を跨いだ共同最適設計
#と呼ぶ。
##
25.Memory HierarchyそのものがCustom化される
#例えばHyperscalerが、
#「このInference Workloadでは帯域よりMemory容量の方が重要だ」
#と判断したとする。
#すると、
#SRAMを増やす。
#HBM構成を変える。
#CXL DRAMを増やす。
#KV CacheをSSDへ逃がす。
#Network越しのMemory Poolを使う。
#Optical Fabricを増やす。
#という設計ができる。
#逆にLow Latencyが最重要なら、
#SRAMを増やし、
#HBMを高速化し、
#Scale-up Domainを巨大化する。
#つまりこれからは、
#AI Chipを選ぶ
#のではなく、
#Memory Hierarchy全体をWorkloadに合わせて設計する
#時代へ近づく。
##
26.HBM4 Logic Base Dieは「MemoryとLogicの境界消失」の始まり
#HBM4からLogic Base Dieの役割がさらに大きくなる。
#ここでいうLogic Base Dieとは、HBM Stackの底部に置かれ、I/Oや制御機能を担うLogic Chipである。
#これによってMemory Businessそのものが変わる。
#従来:
#これから:
#である。
##
27.これはMemoryメーカーにとって「Commodity脱却」の機会でもある
#DRAMは長い間Commodity Cycleに苦しんできた。
#需要が増える。
#価格が上がる。
#全社増産する。
#Supplyが増える。
#価格が崩れる。
#というCycleである。
#しかしCustom HBMでは、
#Customer固有設計
#長期契約
#Qualification
#Logic Base Die
#Packaging
#Software / System Co-design
#が必要になる。
#Qualificationとは、Customerが製品を正式採用するための認証・評価工程である。
#するとMemory Supplierは、
#単純な$/GB
#だけで競争しにくくなる。
#Switching Cost――他社製品へ乗り換えるCost
#が生まれる。
#だからCustom HBMは、
#Memoryメーカーにとって、
#AI需要を取るだけでなくCommodityから一部抜け出す手段
#になり得る。
##
28.しかしCustom化が進むほどSupply Chainは複雑になる
#良いことばかりではない。
#Custom品は、
#Designが増える。
#Maskが増える。
#Qualificationが増える。
#Customerごとの生産量が分散する。
#Yield Rampが難しくなる。
#Base DieのFoundry Capacityも必要になる。
#Package Variationも増える。
#Yield Rampとは、新製品の歩留まりを量産可能な水準まで改善する工程である。
#そのため、
#Custom化 = Supply増加
#ではない。
#むしろ短期的には、
#Custom化によって設計・認証・Foundry・PackagingのBottleneckが増える
#可能性がある。
##
29.SRAMでHBMを減らしても、別のWaferを食う
#HBM不足への一つの回答がSRAM-rich Architectureである。
#つまり、
#SRAMを大量搭載する設計
#である。
#SRAMはHBMより高速でLow Latency。
#しかしSRAMには大きな問題がある。
#面積を非常に使う。
#Embedded SRAMを増やすほどLogic Dieが巨大化する。
#つまり、
#HBM Waferを節約
#↓
#N3/N2 Logic Waferを大量消費
#になる。
#一つのBottleneckを逃げると、別のBottleneckへ移る。
##
30.だからAI Memoryの未来はWinner-takes-allではない
#SRAMがHBMを殺す。
#3D DRAMがHBMを殺す。
#HBFがHBMを殺す。
#CXLがHBMを殺す。
#という議論は単純すぎる。
#より可能性が高いのは、
#SRAM
#HBM
#DRAM
#3D DRAM
#CXL Memory
#HBF
#SSD
#Object Storage
#が共存し、
#Workloadごとに異なる比率で使われる未来である。
#AIは巨大なMemory Hierarchyを必要とする。
#問題は、
#どのMemoryが勝つか
#ではなく、
#どのDataをどのMemory階層へ置くか
#になる。
##
31.Appleで最も懸念すべきなのは「AI Modelの遅れ」だけではない――OSとEcosystemの閉鎖性そのものがRiskになる
#ここでAppleについては、もう少し厳しく考える必要がある。
#私は現在、Appleについてかなり弱気に見ている。
#理由は単純に、
#AppleがFrontier AI Modelを持っていない
#からではない。
#より大きな問題は、
#AIによってSoftwareを作るCostが急速に低下する一方、Apple固有の開発・配布・実行制約が残れば、その制約だけが相対的に大きくなる
#ことである。
#これまでApplicationを一つ作るには、
#企画
#設計
#Programming
#UI実装
#Debug
#Test
#Maintenance
#という大きなCostが必要だった。
#一度Applicationを作ったDeveloperにとって、
#Android版も作る。
#iOS版も作る。
#Web版も作る。
#という追加投資には合理性があった。
#しかしCodexのようなCoding Agentによって、
#となれば、この前提が変わる。
#一人のDeveloperが、
#小さなUtility
#音楽Application
#Creator向けTool
#業界専用Tool
#趣味Application
#小規模Game
#Personal AI Tool
#を次々に作れるようになる。
#するとSoftware開発のBottleneckは、
#「Codeを書けるか」
#ではなく、
#「どこへ、どれだけ簡単に配布し、実行できるか」
#へ移る。
#ここでAppleの閉鎖性が問題になる。
##
例えば以前、
#Android Applicationを作る総Costが100。
#iOS Applicationを作る総Costが120。
#だったとする。
#20の差なら、巨大なiPhone User Baseへ到達するために支払う価値がある。
#しかしAIによってCoding部分が大幅に自動化され、
#Android:5
#iOS:20
#まで下がったとする。
#絶対Costは両方下がっている。
#しかし、
#iOS固有Costの相対的重要性は逆に上昇する。
#なぜなら残るのは、
#Mac
#Xcode
#Code Signing
#Certificate
#Entitlement
#Platform固有API
#Device Test
#Distribution Rule
#Background Execution制約
#だからである。
#Androidにはさらに、
#Google Playを使わず、
#自分のWeb SiteなどからAPKを配布する経路も公式に存在する。(Android Developers)
#だからAIによって小さなSoftwareが大量生産されると、
#Google Playにはある。
#Androidでは使える。
#Webでは使える。
#Cloud Agentからも使える。
#しかし、
#iOS版はない。
#というLong-tail Softwareが徐々に増える可能性がある。
#問題になるのはYouTubeやNetflixのような巨大Applicationではない。
#危険なのは、
#AIによって爆発的に増える数百万、数千万個の小さなTool
#である。
#一つ一つの差は小さい。
#しかしSoftware Supplyそのものが100倍になれば、
#小さな差の総和がPlatform価値になる。
#つまりAIによって、
#という逆説が起こり得る。
##
32.macOSのVM制約は短期的にはAppleのMoat――しかし長期的にはTAMを削る可能性がある
#この問題はiOS Application Distributionだけではない。
#macOSのVirtualizationにも同じ構造が存在する。
#以前の記事「OpenAIのMac大量購入から考える、Agent CloudとAIDCの次のボトルネック」で考えたように、OpenAIなどがmacOSを操作するAgentを大量に学習・評価する場合、物理的なMac需要が発生する。
#短期的にはAppleにとって非常に良い。
#Mac Userが存在する。
#↓
#macOS Applicationが存在する。
#↓
#Xcode、Safari、Apple固有APIが存在する。
#↓
#AI企業はmacOS対応Agentを作らなければならない。
#↓
#大量のMacを購入する。
#という循環が成立する。
#しかし長期では、この意味が反転する可能性がある。
#AppleのmacOS Tahoe 26の標準Software Licenseでは、AppleブランドのComputer上で、指定用途について追加で実行できるmacOS仮想Instanceは最大2つとされている。
#用途もSoftware Development、開発中のTest、macOS Server、個人的非商用利用などに限定される。
#Volume LicenseやAppleとの個別契約では条件が変わる可能性があるため、大規模AI企業が必ずこの標準条件で運用していると断定することはできない。
#しかし、
#macOSとApple Hardwareが強く結び付いている
#という構造自体は変わらない。(Apple)
#AWS EC2 Macも象徴的である。
#通常のEC2 VMのように、巨大Serverを細かく分割してMac環境を提供するのではない。
#EC2 MacはDedicated Host上のBare Metal Macとして提供され、
#1 Dedicated HostにつきMac Instanceは1つ
#で、最低24時間のHost割当が必要になる。(AWS)
#つまり、
#Mac Cloudの下には本物のMacが必要になる。
#これは現在AppleにHardware需要をもたらす。
#しかしAgentが、
#100万
#1000万
#1億
#へScaleすると、Cloud Operator側には全く逆のIncentiveが生まれる。
#Macを増やす
#のではなく、
#Macを使わなければならない時間を減らす
#のである。
##
例えばiOS ApplicationをAgentへ作らせる。
#その仕事を分解すると、
#仕様解析
#Code生成
#Git操作
#Document生成
#画像処理
#Backend Test
#Dependency解析
#Web検索
#などはLinuxで実行できる。
#Macが必要なのは、
#Xcode Build
#iOS Simulator
#Safari固有Test
#Signing
#Apple固有Framework Test
#などに絞れる。
#するとAgent Schedulerは、
#一般処理
#↓
#Linux
#Windows固有処理
#↓
#Windows
#Apple固有処理
#↓
#Mac
#と割り振る。
#極端には、
#90分 Linux
#8分 Windows
#2分 macOS
#のようなWorkloadになる可能性がある。
#するとMac側のTAMを決めるのは、
#ではなく、
#になる。
#ここが非常に重要である。
##
Appleから見ると、
#macOSをApple Hardwareへ強く結び付ける
#↓
#Macを買わせられる
#というのが短期的なMoatである。
#しかしAI Infrastructure側から見ると、
#Macが高い。
#VM密度を上げにくい。
#汎用Serverへ載せにくい。
#Rack Densityを最適化しにくい。
#となれば、
#「Macである必要のない仕事をMacから全部追い出そう」
#となる。
#つまり、
#だったものが、
#長期では、
#へ反転する可能性がある。
#これはAppleにとってかなり大きなRiskだと思う。
##
33.そしてOSそのものが「Applicationを管理するSystem」から「Agentを管理するSystem」へ変わり始めた
#さらに重要なのは、
#iOS
#Android
#macOS
#Windows
#というOSそのものの役割が変わり始めていることである。
#従来のOSは、
#User
#↓
#Home Screen / Desktop
#↓
#Applicationを選ぶ
#↓
#Applicationを起動する
#↓
#ApplicationのUIを操作する
#という構造だった。
#つまりOSの中心単位は、
#Application
#だった。
#しかしAgent時代には、
#User
#↓
#Personal Agent
#↓
#「東京出張を準備して」
#↓
#Calendarを読む
#↓
#Mailを読む
#↓
#航空券を調べる
#↓
#Hotelを予約する
#↓
#資料を作る
#という構造になる。
#Userからすると、
#どのApplicationを何回開いたか
#は重要ではなくなる。
#重要なのは、
#Taskが完了したか
#である。
#つまりOSの中心単位が、
#から、
#へ変わり始める。
##
Googleは2026年、この変化を非常に明確に言語化した。
#Androidについて、
#「Operating SystemからIntelligence Systemへ移行する」
#と公式に表現している。(Android Developers)
#Android 17ではAppFunctionsを拡張し、
#Application自身が持っている、
#Message送信
#Ride予約
#Data検索
#などの機能を、
#Agentが発見して実行できるToolとしてOSへ公開できるようにしている。
#Googleはこれを、
#Android MCP
#として説明している。
#ApplicationがLocal MCP Serverになり、
#Android PlatformがTool Registryになり、
#System Agentが必要なFunctionを発見して呼び出す。(Android Developers)
#これは非常に大きい。
#従来:
#User
#↓
#Application UI
#↓
#機能
#だった。
#これから:
#User
#↓
#Agent
#↓
#OS Tool Registry
#↓
#Application Capability
#となる。
#Applicationは、
#Userが直接操作する箱
#から、
#Agentが利用するCapability群
#へ変わる。
##
するとOS自身も、
#CPU
#Memory
#Process
#Filesystem
#Application Lifecycle
#を管理するだけでは足りなくなる。
#新しく、
#Agent Identity:どのAgentなのか
#Goal:何を達成しようとしているか
#Delegation:Userから何の権限を委任されたのか
#Memory:どの情報を保持するか
#Tool Registry:何のToolを使えるか
#Scheduler:どのAgentをいつ動かすか
#Sandbox:危険な処理をどこへ隔離するか
#Runtime Monitoring:実行中の行動監視
#Human Approval:重要Actionの人間承認
#を管理する必要がある。
#つまり、
#から、
#へ変わる可能性がある。
##
34.Windowsはすでに「Agentを一人のOS Userとして扱う」方向へ進んでいる
#この観点で現在最も面白いのがWindowsである。
#MicrosoftはWindowsを、
#AgentをBuildし、RunするためのPlatform
#へ明確に変え始めている。(Microsoft)
#象徴的なのが、
#Agent Workspace
#である。
#Agent Workspaceでは、
#Agentごとに人間とは別のAccountを作る。
#Agent専用Workspaceを作る。
#AgentごとにFile Accessを制限する。
#AgentごとにPermissionを持たせる。
#人間とは別SessionでApplicationを操作する。
#行動をAuditできる。
#という仕組みになっている。
#つまりAgentを、
#Application内部のAI Feature
#としてではなく、
#OS上で独立して活動する新しい主体
#として扱っている。
#さらにMicrosoftは、初期Agent Workspaceについて、
#Full Virtual Machineより軽量
#でありながら、
#別Windows Session
#Runtime Isolation
#並列実行
#Permission Boundary
#を実現すると説明している。(Microsoft Support)
#これはかなり重要である。
#Agent時代には、
#一Agent = 一Full VM
#ではMemoryもCPUも重すぎる。
#だからWindows自身が、
#VMより軽いAgent専用Isolation
#をOS Featureとして作り始めている。
##
さらにWindowsには、
#Agent ID
#が入る。
#人間Userとは別に、
#Agent自身へIdentityを与える。
#その結果、
#誰がそのAgentを起動したのか。
#何へAccessしたのか。
#何を変更したのか。
#どのToolを使ったのか。
#を区別できる。
#またWindows On-Device Registry――ODRでは、MCP ConnectorをOS上へ登録し、AgentがApplicationやSystem Toolを発見して利用できる。(Microsoft Learn)
#つまりWindowsも、
#Application中心
#から、
#Agent + Tool Registry + Identity + Workspace
#中心へ変わり始めている。
##
Cloud側ではさらに進んでいる。
#2026年6月、Microsoftは、
#Windows 365 for Agents
#を一般提供した。
#これは人間用Cloud PCではなく、
#Agentが仕事をするためのCloud PCである。
#Agentは仕事が必要になった時だけCloud PCをCheckoutする。
#仕事が終われば返却する。
#別Agentが同じPoolから利用する。(Microsoft Learn)
#つまり、
#Agent A
#↓
#Windows Cloud PCを借りる
#↓
#ExcelやLegacy Systemを操作
#↓
#返す
#↓
#Agent Bが借りる
#という構造である。
#2026年8月にはAgent向けSecurity BaselineまでIntuneへ一般提供されている。(Microsoft Learn)
#これは非常に大きな違いである。
#Microsoftは、
#Windows Licenseを守る
#だけではなく、
#WindowsそのものをAgent RuntimeとしてCloudへ売る
#方向へ進んでいる。
##
ここではWindowsの閉鎖性が、
#Appleとは別の形になっている。
#Windowsも当然Proprietary OSである。
#しかしHardwareは、
#AMD
#Intel
#さまざまなServer Vendor
#Azure
#各種Virtualization Infrastructure
#へ分離できる。
#Windows Server Datacenterでは、適切にLicenseされたHost上でWindows Server VMを無制限に利用できるVirtualization Rightsも存在する。(Microsoft Learn)
#つまりMicrosoftにとって、
#Windows Environmentがどこで動くか
#より、
#Windows EnvironmentがAgent Economyで何時間使われるか
#の方が重要になり得る。
#これはAppleとの差として非常に大きい。
##
35.macOSもAgent OS化している――しかし現在の方向はWindowsとは少し違う
#ただしAppleが何もしていないわけではない。
#むしろmacOS自体も明確に変化している。
#macOS TahoeではSpotlightから、
#Mail送信
#Note作成
#Podcast再生
#など数百種類のActionを直接実行できるようになった。
#Developer ApplicationもApp Intentsを公開すれば、そのActionをSpotlightから実行できる。(Apple)
#つまり、
#Applicationを開く
#↓
#Menuを探す
#↓
#Buttonを押す
#という流れから、
#OSへ直接「何をしたいか」を伝える
#方向へ進んでいる。
#Shortcutsも、
#Apple Intelligence
#Private Cloud Compute
#ChatGPT
#などをWorkflow内部へ組み込み、自動実行できるようになっている。
#つまりmacOSも、
#App Launcher
#から、
#Capability Orchestrator
#へ少しずつ変わっている。
##
2026年にはさらに、
#Core AI
#がOSへ直接組み込まれた。
#Core AIはApple Silicon向けに作られたOn-device AI Frameworkで、
#自分で持ち込んだModelを、
#iPhone
#iPad
#Mac
#Vision Pro
#上で直接実行できる。
#推論Memory制御
#Zero-copy Data Path
#Stateful Execution
#Hardwareごとの自動最適化
#まで提供する。(Apple Developer)
#これはかなり重要である。
#Appleは、
#「Apple Intelligence Modelしか使えない」
#方向ではない。
#Foundation Models Frameworkでも2026年から、
#LanguageModel Protocol
#を使えば、
#Server Model
#On-device Model
#Third-party Model
#を同じFrameworkへ接続できるようになっている。(Apple Developer)
#さらにXcode 26.3では、
#OpenAI Codex
#Anthropic Claude Agent
#を直接統合し、
#Xcode自身のCapabilityをMCP経由で外部Agentへ公開した。(Apple)
#これはAppleが、
#外部AIをApple Ecosystemへ入れる
#方向へ動いていることを意味する。
##
しかしWindowsとの違いも見える。
#2026年9月時点の公開Architectureを見る限り、
#Windowsは、
#Agent ID
#Agent Workspace
#独立Agent Account
#OS-level MCP Registry
#Agent Cloud PC
#という、
#AgentそのものをOS Principal――OS上の独立主体として扱うInfrastructure
#を作っている。
#一方macOSは、
#App Intents
#Spotlight
#Shortcuts
#Core AI
#Foundation Models
#Xcode MCP
#によって、
#既存ApplicationやApple DeviceをAIから使いやすくする
#方向が中心である。
#これはどちらが正しいという話ではない。
#しかしAgent Economyが、
#一人のUser
#↓
#10 Agent
#↓
#100 Tool
#↓
#複数Sandbox
#↓
#Cloud Agent
#へ進むなら、
#OS LevelでAgent Identity・Isolation・Delegationを持つこと
#はかなり重要になる可能性がある。
#AppleがここをApple Intelligenceだけに閉じるのか。
#Third-party Agentへ開くのか。
#ここが非常に重要になる。
##
36.Appleの最大Riskは「Deviceで負けること」ではなく、AI EconomyがAppleを迂回することである
#私はAppleの最大のMoatを、
#iPhone Hardware
#そのものだとは考えていない。
#Appleの最大Assetはむしろ、
#Apple Deviceを高くても買い、長く使い、継続的に支出する巨大なUser Base
#である。
#だからDeveloperは多少面倒でもiOS版を作ってきた。
#これまでは、
#が成立していた。
#しかしAIによってSoftware Supplyが100倍になると、この関係が変わる可能性がある。
#AndroidではToolを公開できる。
#PWAでも配布できる。
#Cloud Agentからも使える。
#WindowsではAgent Workspaceで動かせる。
#Cloud PCへAgentを送り込める。
#LinuxではContainerやMicroVMを好きなだけ最適化できる。
#その中でAppleだけ、
#このToolは使えない。
#このAgentはBackgroundで動かない。
#このRuntimeは許可されない。
#このTestはMacが必要。
#このVMは自由に増やせない。
#となれば、
#DeveloperはAppleに合わせるのではなく、
#Apple対応部分だけを最小化する
#方向へ動く可能性がある。
#これはmacOS Agent Cloudでも全く同じである。
#Macでなければならない処理だけMacへ残す。
#それ以外はLinuxへ移す。
#するとAppleの閉鎖性は、
#Hardware Demandを作るMoat
#から、
#Apple依存時間を削減させるIncentive
#へ反転する。
##
そしてHardware側のMoatも静的ではなくなる。
#Apple Siliconは現在非常に強い。
#CPU
#GPU
#Neural Engine
#Unified Memory
#Power Management
#OS
#Application
#まで一体最適化できる。
#しかしAstra/Jalapeñoで見えているように、
#AI Agentが、
#RTL
#Verification
#Compiler
#Kernel
#Architecture Exploration
#を改善し始めれば、
#Chip開発Cycleそのものが短縮する。
#すると競争軸は、
#「現在一番良いChipを持っているか」
#から、
#「AIを使って次世代Chipをどれだけ速く再設計できるか」
#へ変わる。
#Googleには、
#Gemini
#TPU
#Google Cloud
#がある。
#Amazonには、
#AWS AI Workload
#Trainium
#Cloud Economics
#がある。
#OpenAIには、
#Frontier Model
#ChatGPT/Codex
#Jalapeño
#大量Inference Workload
#がある。
#NVIDIAには、
#世界中のAI Workload
#GPU
#CUDA
#NVLink
#NVHBM
#Networking
#がある。
#つまり、
#というFeedback Loopを持つ。
#Appleにも非常に優秀なSilicon Teamは存在する。
#しかしAppleは、
#巨大Public CloudでAI Computeを売る企業でもなく、
#Frontier Model Providerでもない。
#そのため、
#AI Workload → Chip → Cloud Economics → 次世代AI
#というLoopの規模では不利になる可能性がある。
##
Memory問題も同時に刺さる。
#AI Data Centerが、
#HBM
#Server DRAM
#先端Wafer
#Advanced Packaging
#を大量に消費すれば、
#Consumer Device向けMemoryのCostも上がる。
#Appleは巨大Buyerであるため調達力は強い。
#しかし、
#毎年数億台規模のDeviceへ大量Memoryを確保しなければならない。
#Memoryが高騰すれば、
#搭載容量を減らす。
#Device価格を上げる。
#Marginを削る。
#Shipmentを減らす。
#のどれかになる。
#つまり、
#Device Premiumを維持する難易度も上がる。
##
だからAppleに必要なのは、
#すべてをApple製にすること
#ではないと思う。
#むしろ、
#AI Modelは開く。
#Agentも開く。
#Application Distributionも安全性を保ちながら開く。
#MCPなどOpen Protocolを受け入れる。
#Developer Toolは可能な限りAppleの外から呼べるようにする。
#Cloudも外部Infrastructureを使う。
#そして将来的には、
#Apple RuntimeそのものをCloudへ外出しする
#くらいの発想があってもよい。
#例えば、
#Apple Secure Runtime
#のようなEnvironmentを、
#AWS
#Google Cloud
#Azure
#Cloudflare
#OpenAI
#などから利用できるようにする。
#そこから、
#Xcode Build
#Apple Platform Test
#Signing
#App Intents
#Simulator相当Environment
#を安全に利用できれば、
#Appleは、
#Mac一台を売る
#だけではなく、
#Apple Runtime-hour
#というTAMを作れる可能性がある。
##
Appleが握るべきなのは、
#閉じたApplication Store
#だけではない。
#Device Identity
#Secure Enclave
#Biometrics
#Payment
#Health Data
#Camera
#Microphone
#Location
#Personal Data Permission
#Hardware Attestation
#といった、
#AIが現実世界と個人Dataへ安全に接続するためのTrust Layer
#である。
#つまり、
#ではなく、
#になる。
#これなら、
#OpenAIが勝ってもよい。
#Googleが勝ってもよい。
#Anthropicが勝ってもよい。
#Open Weight Modelが勝ってもよい。
#DeveloperがPWAを作ってもよい。
#Android向けAgent Toolを作ってもよい。
#そのAI Economyの先にいるApple Userへ安全にAccessする時、
#Appleの、
#Identity
#Permission
#Security
#Payment
#Device
#を利用してもらえばよい。
##
ここで梁文鋒氏の、
#「最も多く取る企業が勝つとは限らない」
#という議論へ戻る。
#Appleが、
#App Store
#Payment
#Cloud
#AI
#Agent
#Device
#のすべてから最大Marginを取ろうとすると、
#その摩擦自体が、
#Developer
#AI Provider
#Cloud Provider
#に、
#Appleを迂回する理由を与える。
#つまり、
#になり得る。
#Appleが守るべきものは、
#一件一件のApplication Revenueではない。
#より重要なのは、
#である。
#AI Ecosystem全体へValueの一部を渡してもよい。
#その結果、
#Apple PlatformのTAMが5倍、10倍になるなら、
#その方が長期的には強い。
##
Mac大量購入も同じである。
#短期:
#長期:
#へ変わる可能性がある。
#だからOpenAIによる大量Mac購入を、
#Appleの巨大な新しいAgent TAM
#とだけ読むのは危険である。
#むしろ、
#Agent Economyが巨大になるほど、OSの物理制約・Virtualization制約・Permission制約までCostとして評価され始める
#ことを示している可能性がある。
##
そしてOS競争自体も変わる。
#Androidは、
#Operating System → Intelligence System
#を明言した。
#Windowsは、
#User OS → User + Agent OS
#へ進み、
#Agent Identity
#Agent Workspace
#MCP Registry
#Cloud PC for Agents
#を作り始めた。
#macOSは、
#Spotlight
#App Intents
#Shortcuts
#Core AI
#Foundation Models
#Xcode MCP
#によって、
#Application中心OS → Capability中心OS
#へ進み始めている。
#この先、
#iOS
#Android
#macOS
#Windows
#という名前は残っても、
#中身はかなり違うものになる可能性がある。
#OSの役割は、
#Applicationを起動すること
#ではなく、
#人間とAgentへIdentityを与え、Memory・Tool・Permission・Sandbox・Computeを割り当て、現実世界へのActionを安全に管理すること
#になる。
#つまり次のOS競争は、
#Mac対Windows。
#iOS対Android。
#だけではない。
#である。
#私は、ここがAppleにとって最大級の分岐点になると考えている。
#Appleには、
#巨大で価値の高いUser Base
#Secure Enclave
#Device Security
#Custom Silicon
#OS Distribution
#という非常に強いAssetが残っている。
#だからAppleはまだ強い。
#しかし、
#そのUser Baseを囲い込んで小さな市場にするのか。
#それとも、
#世界中のAI、Agent、Developerが参加したくなる巨大な市場へ開放するのか。
#によって、AI時代のAppleの価値は大きく変わる。
#私は現在、
#Appleが開放を十分な速度で進められないRiskをかなり大きく見ている。
#Appleにとって最大のRiskは、
#AndroidにiPhone販売台数で負けることではない。
#MacがWindowsに負けることでもない。
#より長期的には、
#AIによってSoftwareとAgentの供給が爆発する時代に、自らの閉鎖性によってApple Userが参加できるAI EconomyのTAMを縮小させること
#である。
#だから今後Appleを見るなら、
#iPhone Shipment
#Mac Shipment
#だけでは足りない。
#見るべきなのは、
#macOS Virtualization条件を緩和するか。
#Agent Cloud向けApple Runtimeを作るか。
#Third-party AgentへOS LevelのIdentityとSandboxを開くか。
#MCPやAgent ProtocolをOSの標準機能へ昇格させるか。
#外部AgentがiOS/macOSでどこまでActionできるか。
#Application Distributionをどこまで開くか。
#Apple ToolをApple Hardware外から利用可能にするか。
#External ModelをFirst-class Citizenとして扱うか。
#AIをApple Silicon開発へどこまで再帰的に利用できるか。
#そして最終的には、
#Appleの23億台超のDeviceを「閉じたEcosystem」ではなく、「世界最大級のAgent Economyへの安全な入口」へ変えられるか。
#ここがAppleのAI時代の勝敗を決める最大の分岐点になると思う。
##
37.OpenAIもModelの高Marginだけを守る企業ではなくなる
#OpenAIについても同じである。
#中国Open Weight Modelが安くなる。
#CloudがModel Routingする。
#Sovereign AIが増える。
#Model LayerのMarginは圧迫され得る。
#しかしOpenAIには、
#ChatGPTの巨大な利用者基盤
#Personal Memory
#Codex
#Work
#Computer Use
#Harness
#がある。
#Tibo氏はChatGPTとCodexについて、
#「これからのModelを最大限活かすには、ChatGPTとCodexは統合されていく必要がある」
#という趣旨を語り、
#さらに、
#「内部では同じ技術を使い、同じHarnessで動く」
#と説明している。
#https://youtu.be/4qjEgPojjzM?si=stF3TXstkHRxS3g7
#OpenAIは、
#Model API Vendor
#から、
#Personal Agent Platform
#へ上がろうとしている。
##
38.OpenAIの「下位Layerの専用化」はJalapeñoになる
#さらに下にはJalapeñoがある。
#つまりOpenAIは、
#User Relationship
#↓
#ChatGPT / Codex / Work
#↓
#Harness / Memory
#↓
#Model
#↓
#Serving Stack
#↓
#Compiler / Kernel
#↓
#Custom Inference Silicon
#という垂直方向へ進む。
#日本語で言えば、
#Userとの関係
#↓
#Agent Application
#↓
#実行基盤・記憶
#↓
#AI Model
#↓
#AI配信基盤
#↓
#高速化Software
#↓
#専用Inference Chip
#である。
#しかしすべてを自社製にする必要はない。
#Broadcom。
#TSMC。
#Memory Supplier。
#Cloud Provider。
#Network Vendor。
#と協力する。
#重要なのは、
#最もCost Curveを左右するLayerへ設計権を持つこと
#である。
##
39.四社を並べると同じ戦略が見えてくる
#Amazon:
#上位では複数Modelを自由に選べる。下位ではCustom Siliconを自社設計する。
#NVIDIA:
#上位ではOpen Model Ecosystemを広げる。下位ではAI Factory Infrastructureを専用化する。
#Apple:
#上位では外部Model・Agentを受け入れる。下位ではDevice・Security・Siliconを握る。
#OpenAI:
#上位ではUserとのAgent関係を握り、下位ではInference Stackを専用化する。
#一見まったく違う会社だが、実は同じ方向へ進んでいる。
##
40.これを「Selective Vertical Integration」と考える
#これを日本語では、
#選択的垂直統合
#と呼べる。
#意味は、
#全部を自社で作るのではなく、自社の競争力を決める重要Layerだけ深く自社設計する戦略
#である。
#AI時代のVertical Integrationは、
#全部自社で作る
#という意味ではなくなる。
#むしろ、
#Commodity化してほしいLayerはOpenにする。
#自社Economicsを決めるBottleneck LayerだけCustom化する。
#AIが巨大になるほど、この形の方が合理的になる可能性が高い。
##
41.なぜCustom ProductがAI時代に増えるのか
#理由をまとめると、
#第一に、
#Workloadが巨大化したため、数%の効率差が数十億ドルになる。
#第二に、
#HBM・Power・Wafer・Packagingという供給制約が強い。
#第三に、
#AI AgentがDesign Costを下げ始めている。
#第四に、
#Hyperscaler自身が十分なVolumeを持つ。
#第五に、
#SoftwareとHardwareを同時に最適化できる。
#だから、
#汎用Hardware
#↓
#半専用品
#↓
#Workload専用Architecture
#という流れが強くなる。
##
42.これは完全ASIC化を意味しない
#ただしNVIDIA GPUが消える、という話ではない。
#Generic GPUには巨大な価値がある。
#新しいModelへ対応しやすい。
#Software Ecosystemが巨大。
#Researchに使いやすい。
#Workloadが変わっても再利用できる。
#だから、
#未知のWorkload
#Frontier Research
#頻繁に変化するModel
#にはGPUが強い。
#一方、
#大量・定常・繰り返しWorkload
#になるほどCustom ASICのEconomicsが良くなる。
#したがって将来は、
#GPU対ASIC
#ではなく、
#GPU + Custom XPU
#の混在世界になる可能性が高い。
##
43.NVIDIAの本当のRiskもここにある
#Open Modelが増えること自体は、NVIDIAにとって必ずしも悪くない。
#Kimi
#DeepSeek
#GLM
#Sovereign AI
#が増えれば、Total Compute Demandは増える。
#NVIDIAのRiskは、
#AI需要がなくなること
#ではなく、
#増えたAI ComputeのどこまでをNVIDIA GPUが取れるか
#である。
#だからNVLink FusionとNVHBMは非常に合理的だ。
#Custom XPUが増えるなら、
#Custom XPUからもNVIDIA Revenueを取ればよい。
##
44.Memoryも同じ――HBM ShipmentではなくArchitecture Shareを見る
#投資上も、
#「HBMが何GB売れるか」
#だけでは不足する。
#見るべきなのは、
#HBM / Accelerator:一個のAcceleratorに何GBのHBMが載るか
#HBM Wafer Input:DRAM Waferの何割がHBMへ使われるか
#HBM Logic Base Die:先端Logic工程をどれだけ消費するか
#Custom HBM Share:専用品の比率
#SRAM mm² / XPU:一つのXPUにどれだけSRAM面積を使うか
#DRAM / CPU:一つのCPUにどれだけServer DRAMが付くか
#CXL Memory:Rack・Server間Memory拡張量
#SSD KV Cache Capacity:KV CacheをSSDへ逃がす容量
#である。
#Memory Demandは、
#Byte Demand
#だけでなく、
#Architecture Demand
#へ変わる。
##
45.Memory企業の評価も変わる
#SK hynix、Micron、Samsungを評価するとき、
#HBM Shipment Share
#だけでなく、
#Custom Base Die採用
#Logic Integration
#Customer-specific SKU
#Packaging
#HBF
#3D DRAM
#まで見る必要がある。
#Customer-specific SKUとは、Customerごとに仕様を変えた専用製品である。
#Samsungは、
#Memory
#Foundry
#Advanced Packaging
#を同時に持つ。
#SK hynixは、
#HBM Leadership
#TSMCとのLogic Integration
#を持つ。
#Micronも、
#Custom HBM
#で高Margin化する可能性を持つ。
#それぞれ異なるPositionになる。
##
46.FoundryはさらにModel-neutralになる
#MemoryとLogicの境界が曖昧になるほどTSMCのPositionは強い。
#XPU Logic。
#HBM Logic Base Die。
#Custom ASIC。
#Chiplet。
#Advanced Packaging。
#AIがどのModelを使っても必要になる。
#だからTSMCは、
#OpenAIが勝っても、
#Googleが勝っても、
#Amazonが勝っても、
#NVIDIAが勝っても、
#Custom ASICが増えても、
#需要を取れる可能性がある。
#Model-neutral Infrastructure
#つまり、
#どのAI Modelが勝っても必要になるInfrastructure
#の代表である。
##
47.EDAも同じである
#AIがChip Designを自動化すると、
#EDA Engineerが不要
#↓
#EDA Market縮小
#と考えたくなる。
#しかし逆の可能性が高い。
#Agentが100倍多くDesign Candidateを作れば、
#Timing
#Power
#Formal Verification
#DRC
#LVS
#Physical Simulation
#を大量に実行したくなる。
#日本語にすると、
#Timing:信号が時間内に届くか
#Power:消費電力
#Formal Verification:数理的な設計正当性検証
#DRC:製造Ruleに違反していないか
#LVS:回路図と実Layoutが一致しているか
#Physical Simulation:実際の物理挙動のSimulation
#である。
#つまり、
#というLoopになる。
#CadenceとSynopsysは、
#AIが設計するほどVerification回数が増える
#という位置にいる。
##
48.AIはCompute ConsumerからCompute Designerへ変わった
#これまでAIは、
#GPUを使う。
#HBMを使う。
#Data Centerを使う。
#という、
#Compute Consumer――計算資源を消費する存在
#だった。
#これからは、
#Kernelを改善する。
#Compilerを改善する。
#EDAを操作する。
#Chip Architectureを探索する。
#Memory Configurationを決める。
#次世代Custom SiliconをProgrammingする。
#つまり、
#になる。
##
49.Recursive Self-ImprovementはHardwareまで広がる
#Tibo氏はこの構造について、
#「結局、すべては一つの巨大なSystemとしてつながっている」
#という趣旨を語っている。
#Recursive Self-Improvementとは、
#再帰的自己改善
#である。
#AIが、
#自分自身を動かすSoftwareやInfrastructureを改善し、
#その結果さらに強いAIを大量に動かせるようになる循環を指す。
#Astra
#↓
#Jalapeño Kernel改善
#↓
#Inference Cost低下
#↓
#より多くAgentを動かせる
#↓
#Agentが次世代Siliconを改善
#↓
#Memory / Network / Servingも改善
#↓
#Inference Costがさらに下がる
#というLoopが成立する。
#Recursive Self-Improvementとは、
#Modelが直接次のModel Weightを書くこと
#だけではない。
#AIが自分を動かすInfrastructureを改善すること
#も含む。
##
50.AIが安くなるほど半導体需要が減るとは限らない
#一回のInference Costが90%下がっても、
#利用量が100倍になれば、
#Total Computeは10倍になる。
#AIが安くなる。
#↓
#使えるTaskが増える。
#↓
#一人が複数Agentを使う。
#↓
#Agentが長時間動く。
#↓
#Tool Callが増える。
#↓
#CPU / Memory / Networkも増える。
#これは、
#Jevons Paradox――効率化によって単位Costが下がると、むしろ総利用量が増える現象
#に近い。
#つまり、
#と、
#は同時に成立し得る。
##
51.Agent時代はHBMだけでなくServer DRAM需要まで増やす
#Agentic AIでは、
#Planning
#Scheduling
#Data Processing
#Memory Management
#Tool Orchestration
#などをCPUが担う。
#日本語にすると、
#Planning:仕事の計画
#Scheduling:実行順序の管理
#Data Processing:Data処理
#Memory Management:Memory管理
#Tool Orchestration:複数Toolの統合制御
#である。
#CPUが増えればServer DRAMも増える。
#さらにLong Context、KV Cache、Iterative ReasoningによってHBM/DRAM双方の需要が増える。
#Iterative Reasoningとは、何度も考え直しながら答えやActionを改善する処理である。
#つまりAgentic AIは、
#GPU Memory
#だけではなく、
#Computer全体のMemory Content
#を増やす。
##
52.そしてPersistent AgentはNANDも使う
#Persistent Agentとは、
#一回の会話で消えず、長期間状態を保持するAgent
#である。
#このAgentが、
#Repository
#Long-term Memory
#Browser State
#Artifact
#Logs
#Working Files
#を保持すれば、Persistent Storageも増える。
#日本語にすると、
#Repository:CodeやFileの保管場所
#Long-term Memory:長期記憶
#Browser State:Browserの操作状態
#Artifact:生成した成果物
#Logs:操作履歴
#Working Files:作業中File
#である。
#さらにKV CacheのCold TierをSSDへOffloadするなら、
#HBM
#↓
#DRAM
#↓
#SSD
#↓
#Object Storage
#というMemory Hierarchyが形成される。
##
53.ただしNANDとDRAMのCycleは同じではない
#ここは投資上重要である。
#AIがMemory全体を増やすからといって、
#DRAMもNANDも常に同じPrice Cycleになるわけではない。
#したがって、
#Structural Demand Growth:長期的な需要量増加
#と、
#Pricing Cycle:価格の上昇・下落Cycle
#は分けて考える必要がある。
##
54.AI Infrastructureの価値は「全Stackの積」になる
#最終的にAI Factoryの生産性は、
#GPUだけでは決まらない。
#概念的には、
#に近い。
#どれか一つが0.5なら、残りを2倍にしても無駄になる場合がある。
#これが、
#Co-design――複数部品やSoftwareを最初から一体で設計すること
#が重要になる理由である。
##
55.だからAI産業の最大のMoatは「部品」から「Architecture」へ移る
#NVIDIAのMoatはGPUだけではない。
#NVLink
#NVHBM
#Networking
#Software
#Rack Architecture。
#AmazonもTrainiumだけではない。
#Graviton
#Nitro
#AWS
#Bedrock
#Storage
#Database。
#OpenAIもAstraだけではない。
#ChatGPT
#Memory
#Codex
#Harness
#Jalapeño。
#AppleもM-Seriesだけではない。
#Device
#OS
#Secure Enclave
#Sensor
#Developer Platform。
#つまり、
#単一製品の性能
#より、
#複数Layerをどう組み合わせられるか
#がMoatになる。
#Moatとは、
#競合が簡単には追いつけない競争上の堀
#である。
##
56.しかし「全部持つ企業」が勝つわけでもない
#Vertical Integrationが強いからといって、
#すべてを自社で囲い込めばよいわけではない。
#それでは、
#Innovation Speedが落ちる。
#Costが上がる。
#External Ecosystemを失う。
#Competitor Incentiveが増える。
#つまり、
#革新速度低下。
#Cost上昇。
#外部Ecosystem縮小。
#競合参入動機増加。
#という問題が起こる。
#だから各社は、
#自分が絶対に握るLayer
#と、
#他社に自由を与えるLayer
#を分け始める。
##
57.梁文鋒氏の「AIは巨大すぎる」という議論がここでつながる
#DeepSeek創業者・梁文鋒氏とされるTranscriptには、
#「AIというものはあまりにも巨大で、最終的には人類社会GDPの10%ほどを占める存在になるかもしれない」
#という趣旨の発言がある。
#さらに、
#「もし私たちがその利益を独占しようとするなら、いずれ歴史の流れから取り残されることになる」
#という趣旨も語られている。
#このTranscriptはDeepSeek公式一次Transcriptではなく、録音を元にした二次文字起こしであるため留保は必要だが、経済論として非常に興味深い。
##
58.「多く取る者は、少なくていい者に負ける」
#さらに梁氏は、
#「より大きな利益を取ろうとする企業は、より小さな取り分でも成立する企業に、最終的には負ける」
#という趣旨を語っている。
#これは、
#超過利潤 → 競争相手の参入動機
#という経済原理として理解できる。
#高Marginがある。
#↓
#競合にOpportunityが見える。
#↓
#Open Sourceが参入する。
#↓
#Custom Productが登場する。
#↓
#Customerが内製する。
#↓
#Marginが削られる。
#つまり、
#利益率が高すぎれば、
#その利益そのものが競争相手を呼び寄せる。
#AIのような、
#General Purpose Technology――幅広い産業へ波及し、社会全体の生産性や産業構造を変える汎用技術
#では特に強く働く可能性がある。
##
59.NVIDIAは「少なく取る代わりに市場を巨大化する」方向へ動いている
#Hugging Faceを買ったからといって、
#NVIDIA GPUだけを使わせない。
#他社Modelを許す。
#他社Cloudを許す。
#他社Computeまで許す。
#その代わり、
#AI市場全体が巨大化すれば、
#Memory
#Network
#Fabric
#Rack
#GPU
#Custom Infrastructure
#のどこかからRevenueを取れる。
#これは、
#「一件あたりの取り分を小さくしても、市場全体を巨大化させれば絶対額は大きくなる」
#というStrategyに近い。
#数式的には、
#である。
##
60.AmazonもModel MarginではなくCloud Wallet全体を取る
#Amazonも同じである。
#最高のModelを一つ独占しなくても、
#そのModelがAWS上で動けば、
#Inference
#CPU
#Storage
#Database
#Network
#Security
#Custom Silicon
#からRevenueを取れる。
#だからBedrockで他社Modelを受け入れられる。
#むしろModel Competitionが激しくなってModel Costが下がれば、
#AWS Usageが増える可能性すらある。
#つまりAmazonは、
#AI Modelそのものから最大利益を取る必要がない。
#AI利用によって発生する、
#Cloud支出全体
#を取ればよい。
##
61.Appleも同じ選択を迫られている
#Appleも同じである。
#これまでAppleは、
#Device
#OS
#App Store
#Payment
#Silicon
#を強く統合し、その閉じたEcosystem自体をMoatにしてきた。
#しかしAI時代には、
#閉じていること自体がTAMを縮小させるRisk
#になり得る。
#AIでSoftware開発Costが下がり、Agentや小さなToolが大量に作られるなら、
#「iOS対応だけ追加で必要」
#「Apple HardwareでしかBuildできない」
#「Apple固有の制約へ合わせなければならない」
#という摩擦の相対Costは大きくなる。
#だからAppleもすでに、
#Codexを受け入れる。
#Claudeを受け入れる。
#MCPを受け入れる。
#Gemini系Technologyを使う。
#外部CloudやGPUを使う。
#という方向へ動き始めている。
#重要なのは、
#全部をApple製にすることを諦めた
#ということではない。
#むしろ、
#AI Model
#Agent
#Cloud
#Developer Tool
#といったLayerは開きながら、
#Device
#Silicon
#Security
#Identity
#Permission
#Personal Data Access
#を握る、
#選択的垂直統合
#へ移ろうとしていると考えた方がよい。
#Appleが守るべきなのは、
#すべてのLayerで最大Marginを取ることではない。
#高価値なApple Userへ、世界中のAIやDeveloperが安全に到達したくなる状態を作ること
#である。
#AI Ecosystem全体へValueの一部を渡してでもTAMを広げ、
#その巨大な市場の中で、
#Trust LayerとUser Relationshipの一部を取り続けられるか。
#ここがAppleにとって最も重要な選択になる。
##
62.OpenAIにとってもModelを高く売ることだけが最適解ではない
#OpenAIの最良の未来は、
#世界中がAstraだけを使うこと
#ではないかもしれない。
#むしろ、
#10億人規模のChatGPT Userが存在し、
#簡単なTaskは安いModelへRoutingし、
#難しいTaskだけFrontier Modelへ上げ、
#Personal MemoryがUserを理解し、
#Codex / Workが実際の仕事を行い、
#企業ではSecurityとPermissionを付けてAgentを配備する。
#という形の方が大きい可能性がある。
#Model Marginが下がっても、
#Agent Relationship――UserとAIの継続的な関係
#を握ればよい。
##
63.その時、OpenAIの無料Userの意味も反転する
#Inference Costが高い間、
#Free UserはCost Centerである。
#つまり、
#無料User一人ひとりがCostを発生させる。
#しかし、
#Serving Optimization
#Small Model Routing
#Custom Silicon
#Jalapeño
#Agent Efficiency
#によってCost/Userが下がれば、
#Free Userは、
#まだ収益化されていない巨大Customer Base
#へ変わる。
#無料ChatGPT
#↓
#Personal Agent
#↓
#Codex
#↓
#Work
#↓
#Business / Enterprise
#という収益化経路になる。
#HarnessはCapability Layerであると同時に、
#Monetization Layer――収益化を生むLayer
#でもある。
##
64.Securityも「Agent Stack」の一部になる
#AgentがBrowserを見るだけならRiskは限定的だった。
#しかし、
#Mailを送る。
#Fileを削除する。
#Databaseを書き換える。
#Paymentする。
#Production Serverを操作する。
#となれば、
#Identity:誰のAgentか
#Permission:何をしてよいか
#Least Privilege:必要最低限の権限だけ与える
#Runtime Monitoring:実行中の行動監視
#MCP Security:Tool接続基盤の安全管理
#DLP:機密Data流出防止
#Kill Switch:即時停止機能
#Human Approval:重要Actionの人間承認
#が必要になる。
#AI SafetyとCybersecurityが融合する。
#Agentが増えるほど、
#Human Identityだけではなく、
#Non-human Identity――人間ではないAgentのIdentity
#を管理する市場が生まれる。
##
65.Astraから見える産業構造をもう一度整理する
#Astra以前:
#一回ごとに消えるLLM
#↓
#Astra以後:
#状態を保持するAgent
#単一Context Window
#↓
#階層化されたMemory
#一回の対話
#↓
#長時間継続Process
#Toolを一つずつ実行
#↓
#非同期・並列実行
#Model Benchmark
#↓
#Model + Harnessの総合性能
#Human Identityだけ
#↓
#Human + Agent Identity
#GPU中心
#↓
#GPU/XPU + CPU + DRAM + SSD + Network
#Standard HBM
#↓
#Custom HBM
#汎用Accelerator
#↓
#Custom XPU + AI生成Software
#人間中心のChip Design
#↓
#Agentic EDA――AI Agentを使った半導体設計
#一つのBest Model
#↓
#TaskごとのModel Routing
#完全Closed Stack
#↓
#開くLayerとCustom化するLayerを選び分ける
#へ進む。
##
66.そして最終的な競争軸は「誰が最も多く持つか」ではない
#今後のAI企業を見るとき、
#何を持っているか
#だけではなく、
#何をあえて持たないか
#も重要になる。
#NVIDIAはModelを他社に任せられる。
#AmazonはFrontier Model Winnerを一社に固定しない。
#AppleはAI Modelを外部へ開く。
#OpenAIはCloudやChip Productionすべてを自社工場化しなくてもよい。
#逆に、
#絶対に交換されたくないLayerだけ深く握る。
#NVIDIA:
#AI Factory Architecture
#Amazon:
#Cloud + Custom Silicon
#Apple:
#High-value User Base + Identity + Permission + Device Trust
#OpenAI:
#Agent Relationship + Harness + Memory
#TSMC:
#Advanced Manufacturing
#Memory Supplier:
#高付加価値Memory Architecture
#という分業になる可能性がある。
##
67.投資上は「どのModelが勝つか」から少し離れて考える
#この構造では、
#GPTが勝つ。
#Claudeが勝つ。
#Kimiが勝つ。
#DeepSeekが勝つ。
#というWinner予想だけではRiskが高い。
#どのModelでも必要になるLayerを見る。
#Foundry:先端半導体製造
#HBM / DRAM:Memory
#Custom Silicon:専用Chip
#EDA:Chip設計Tool
#Networking:通信基盤
#Optical:光通信
#Storage:保存装置
#Security:安全管理
#Power:電力
#Cooling:冷却
#このLayerはModel Competitionから比較的中立である。
##
68.ただし「Memory需要が増える」と「Memory株が常に上がる」は違う
#最後に重要な注意がある。
#Memory Byte Demandが構造的に増えても、
#株価
#Margin
#ASP
#はCycleを持つ。
#ASPとは、
#Average Selling Price――平均販売価格
#である。
#HBM Supplyが増える。
#NAND Fabが立ち上がる。
#Customerが搭載量を減らす。
#Architectureが変わる。
#といったことでPricing Powerは変化する。
#したがって、
#Structural TAM:長期的に存在する市場規模
#Cycle:需給による景気循環
#Valuation:現在の株価評価
#を必ず分ける必要がある。
##
69.今後追うべきKPIも変わる
#GPU Shipmentだけでは足りない。
#Active Agent数 実際に利用されているAgent数。
#Agent Actions / Day Agentが一日に実行するAction数。
#Agent-hours Agentが実際に稼働した総時間。
#Cost / Completed Task 一件の仕事を完了するCost。
#Tokens / Joule 電力効率。
#CPU : GPU Ratio 一つのAI SystemでCPUとGPUをどれだけ組み合わせるか。
#HBM / Accelerator 一つのAcceleratorに搭載されるHBM量。
#HBM Wafer Input DRAM Wafer CapacityのうちHBMへ使われる割合。
#Custom HBM Share 専用HBM比率。
#SRAM mm² / XPU 一つのXPUにどれだけSRAM面積を使うか。
#DRAM / CPU CPU一個あたりDRAM搭載量。
#SSD KV Cache Capacity KV CacheをSSDへ移す容量。
#Custom ASIC Share 専用AI Chip比率。
#Tape-out Cycle Time 設計完了から製造投入までの期間。
#EDA Compute / Design 一つのChip設計に使うEDA計算量。
#Scale-up Bandwidth Rack内部などでAccelerator同士をつなぐ通信帯域。
#800G / 1.6T / 3.2T Port Shipment 高速Network Port出荷量。
#MW / AI Factory AI Factoryの電力規模。
#Quality-adjusted Compute 電力だけでなく性能・Memory・Network・稼働率まで補正した実効Compute。
#Open Weight Model Share Weight公開型Modelの利用比率。
#Sovereign AI CapEx 国家主導AI Infrastructureへの設備投資額。
#を見る必要がある。
##
70.結論――Astraが変えたのはModel Competitionだけではない
#Astraの最大の意味は、
#Benchmarkで何点取ったか
#ではない。
#AIが、
#回答するSoftware
#から、
#Memoryを持ち、Toolを使い、Computerを操作し、長時間経済活動を行うProcess
#へ変わり始めたことにある。
#すると必要になるInfrastructureも変わる。
#GPUだけではない。
#CPU。
#HBM。
#DRAM。
#SRAM。
#SSD。
#Network。
#Cloud Runtime。
#Security。
#Custom Silicon。
#そしてAI自身が、そのInfrastructureを改善し始める。
#さらにMemoryやPowerの物理制約が強まるほど、
#汎用品を大量購入するだけでは効率が足りなくなり、
#Custom XPU
#Custom HBM
#Custom Memory Hierarchy
#Custom AI Factory
#へ進む。
##
71.AI産業は「Open vs Closed」ではなく「Open + Custom」へ進む
#ここが今回の改訂で最も重要な結論である。
#AI産業の未来を、
#Open Sourceが勝つのか。
#Closed Modelが勝つのか。
#Horizontal Companyが勝つのか。
#Vertical Companyが勝つのか。
#という二択で考える必要はない。
#実際に起きているのは、
#競争によって市場が広がるLayerはOpenにする。
#そして、
#希少資源がEconomicsを決めるLayerはCustom化する。
#という組み合わせである。
#言い換えると、
#「開いた方が市場が大きくなる場所は開く」
#「供給制約や効率が利益を決める場所は専用化する」
#ということだ。
#Memory、Power、Silicon Area、Latency、Securityのように、自社Economicsを決定する場所はCustom化する。
##
72.「多く取る者は、少なくていい者に負ける」の別の意味
#梁文鋒氏の議論を、この構造からもう一度読む。
#AIが十分巨大なら、
#すべてのLayerでMarginを取る必要はない。
#むしろ、
#他社Modelを許す。
#他社Cloudを許す。
#他社Chipを許す。
#Open Sourceを許す。
#その結果、市場全体が10倍、100倍になるなら、
#自社が交換されにくいLayerで数%を取る方が大きい。
#つまり、
#である。
#NVIDIAはHugging FaceをOpenにする。
#Amazonは他社ModelをBedrockへ載せる。
#AppleはCodex、Claude、Gemini、MCPを受け入れる。
#OpenAIもChatGPT/CodexのHarnessへ価値を移す。
#これは偶然ではないのかもしれない。
##
73.最終的な勝者は「最もClosedな企業」でも「最もOpenな企業」でもない
#おそらく重要なのは、
#他者に利益を残しながら、自分だけは交換されにくいLayerを持つこと
#である。
#AIが本当に人類経済の巨大な部分へ広がるなら、
#すべてを一社で取ろうとする企業より、
#Ecosystemを巨大化させ、
#他社にも利益を残し、
#その中で不可欠なLayerを握る企業の方が強い可能性がある。
#そしてMemory ConstraintとCustom Siliconの拡大は、その変化を物理世界側から加速する。
#Astraが示したのは、
#「Modelがさらに賢くなった」
#ことだけではない。
#Model、Harness、Memory、Security、Cloud、Siliconが一つのSystemとして設計される時代が始まった
#ことである。
#そしてAIがComputeを消費するだけでなく、
#自分を動かすChipを設計し、
#Memory配置を最適化し、
#Kernelを改善し、
#Infrastructureそのものを改良し始めるなら、
#次の競争は、
#誰が最高のModelを一つ持つか
#ではない。
#誰が限られた物理資源から最も多くの有用な知能を生み、そのArchitectureを最も速く再設計し続けられるか。
#そこへ移っていくのだと思う。
#特定銘柄の推奨・勧誘・投資助言を目的とするものではありません。投資判断はご自身の責任でお願いいたします。
#