Rubin / Rubin Ultra / Blackwell / Groq の技術比較と、AI手法の進化が要求する次世代アクセラレータ設計考察
この資料の日時
元資料の日付と、その本文が公に存在した確認日時は別の記録です。
本文に含まれる語句 HBM SRAM 帯域・データ移動 先端パッケージング 光接続 電力・給電 冷却 歩留まり 基板・材料 チップレット AI推論 AIエージェント
出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.09.23.4
- 記事内容のSHA-256
217278d313cffe280ddf88cb0f18e06e8a92ef1180e27e5fb23a3c7c7a6e23de- 保存版のSHA-256
8ca0ac222e33c0602607f064a697200cefc0e2d9b19032406870e1aadc47432f
外部証明の最終検査結果は詳細を開くと表示します。
Rubin / Rubin Ultra / Blackwell / Groq の技術比較と、AI手法の進化が要求する次世代アクセラレータ設計
#エグゼクティブサマリー
#本調査の結論は、「推論(特にデコード)と“エージェント化が、GPU中心設計のボトルネックをメモリ階層+通信+ジッタ(ばらつき)へ押し上げ、Rubin世代ではHBM4・NVLink6・KVコンテキスト拡張(CMX/ICMS/類似層)・LPU併用という“異種混載”が前提になりつつある」という点に集約されます。根拠となる公開情報として、BlackwellはTSMC 4NP上の2ダイ(デュアル・レチクル)GPUで、NVL72ラックやHGX/DGX構成を強化しました(例:Blackwell GPUは2ダイを単一GPUとして統合、2ダイ間は10TB/sのC2C)。
#一方Rubinは、HBMをHBM3eからHBM4へ更新し、1GPUあたり288GB HBM4・22TB/s、ラックスケールのNVLinkを第6世代に引き上げ、1GPUあたり3.6TB/sのNVLink6を公表しています。また、Rubin NVL72の公式ページでは、Blackwell比でMoE学習に必要なGPU数を1/4、高対話・深い推論の推論コストを1/10($/百万トークン)とする“経済性”指標を前面に置き、推論が「大量トークン×長文脈×低レイテンシ」の領域へ移ったことを明確にしています。
#Rubin Ultraは2027年をターゲットとし、報道・ロードマップ資料では「4チップレット+HBM4eで最大1TB級」が語られていますが、プロセスノードや実メモリ帯域などは公式には未公表で、第三者報道にもばらつきがあります(例:2nm級を狙うという報道と、3nm級継続という観測が併存)。
#Groq(LPU系)は「GPUが苦手になりやすいデコードの逐次性・小バッチ・テイルレイテンシ」に焦点を当て、大容量オンチップSRAMを主記憶として使うSRAM-first設計とコンパイラ主導の静的スケジューリング(決定論的実行)でジッタを抑えます。さらにの公式情報として、Vera Rubinと組み合わせる「NVIDIA Groq 3 LPX」では、1LPUあたり500MB SRAM・150TB/s、ラックで256 LPU=128GB SRAM・40PB/sを掲げ、GPU(HBM)とLPU(SRAM)で推論パスを分割する異種推論を推進しています。
#市場面では、AIインフラ支出の継続拡大が複数の調査機関から示され、たとえばは2026年の世界AI支出を約2.52兆ドルと予測しています。同時に、HBMや先端パッケージ能力が供給制約になりやすく、RubinについてもHBM4確保が出荷計画に影響し得るというアナリスト報道があります。
#比較:技術・アーキテクチャ・チップ構造・メモリサブシステム・プロセスノード
#加速器単体の比較(チップ構造・メモリ・通信)
#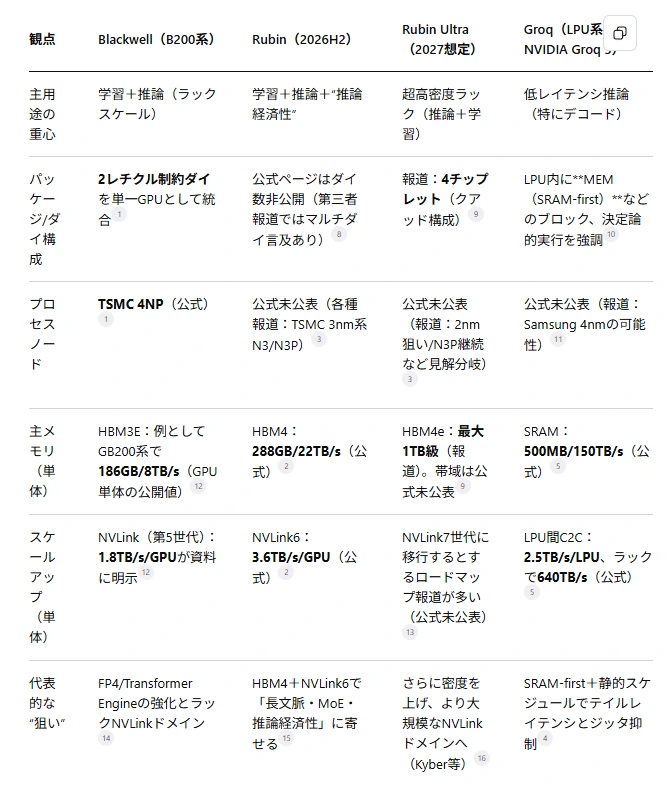
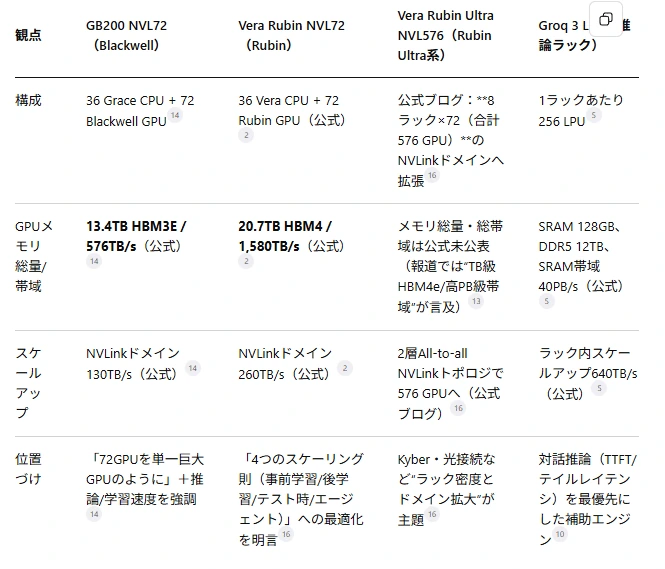
上表の公式の核は、BlackwellのTSMC 4NP+2ダイ統合、Rubinの288GB HBM4・22TB/s、そしてGroq 3(LPX/LPU)の500MB SRAM・150TB/sです。Rubin Ultraは2027のシステム計画(NVL576やKyber)自体は公式ブログで語られる一方、チップの製造プロセスや実帯域は公表が限定され、第三者推定の領域が残ります。
#システム構成の比較(ラック/ドメインのメモリ・帯域・スケール)
#
HBMの世代差と Rubinが22TB/sに到達する理由の検証
#HBM4は、HBM3eに比べてI/O幅が増え(一般に1024→2048ピン/ビット幅の拡張が語られる)、スタックあたりの帯域が大きく上がるのが中核です。Rubinの公式技術ブログも「HBM4はHBM3eに対してインターフェース幅を倍増」と述べ、世代間で帯域がほぼ3倍になる点を示しています。またMicron Technologyは、Rubin向けHBM4として12層36GB・ピン速度11Gb/s超・帯域2.8TB/s超の量産開始を発表しており、Rubin側の「22TB/s」主張と整合します(2.8TB/s×8スタック=22.4TB/s)。同様にSamsung ElectronicsもHBM4で2048ピン・最大13Gbps・スタックあたり3.3TB/s級を示しています。
#このため、Rubinの「288GB HBM4・22TB/s」は、(a) 36GB級HBM4スタックを8個搭載して容量288GBを作り、(b) 1スタックあたり約2.75TB/s(=22/8)級の動作点を採る、という構成で説明可能です(ただしスタック数そのものはNVIDIAが直接明示していないため推定)。
#性能比較:学習と推論の実測・公表値・推定の整理
#公式/標準ベンチに基づく “Blackwell世代の差分”
#Blackwellは、公式のGB200 NVL72ページやデータシートで、H100比30倍のリアルタイム兆パラメータ級推論、学習4倍などの主張を掲げています(いずれも「Projected」表記と条件明記あり)。条件の重要点として、推論比較はTTL(token-to-token)=50ms、FTL(first token latency)=5s、入力32,768/出力1,024などが明示されており、比較は対話推論を強く意識した設定です。
#B200データシート内の例(GPT-MoE-1.8T)では、出力トークン/秒/GPUとしてHGX H100が3.5、HGX B200が58、GB200 NVL72が116というグラフ値が掲載され、相対として15x/30xを提示しています。 ここはワークロード固定・実装固定の比較値として有用ですが、(a) モデル、(b) 並列化方式、(c) ネットワーク、(d) ソフト最適化で大きく動くため、報告値の解釈は「何が支配ボトルネックか(メモリ/通信/演算)」とともに行う必要があります。
#Rubinの性能は FLOPS より「経済性指標」で語られる
#Rubinは、公式のNVL72ページと技術ブログで、単体性能(例:Rubin GPUでNVFP4推論50PFLOPS、学習35PFLOPS)を示しつつも、より前面にコスト/トークンやMoE学習の必要GPU数といった経済性指標を置いています。これは、推論が「長文脈+対話+多段推論(agentic)」の比率を増やし、GPUのピークFLOPSよりも「実効帯域」「通信」「ジッタ」が支配的になりがちな現実を反映したメッセージです(Rubin技術ブログでもachieved memory performanceが支配的と述べる)。
#RubinのNVLink6は、全結合(all-to-all)を前提にMoEルーティングやcollectiveをさばく設計を強調し、NVLink6内にSHARP(in-network compute)を統合し、all-reduce通信量を最大50%削減し得る、としています(モデル・NCCL設定などに依存)。これも、MoEや大規模学習の通信支配フェーズに寄せたハード/ファブリック側の機能追加と言えます。
#Groq:推論の「TTFT/デコード速度」を定量化しやすい
#Groq系は、公開ベンチの第三者計測(API提供者比較など)で、TTFT(time to first token)と出力速度(tokens/s)が比較されやすい領域にあります。例としてArtificialAnalysisのLlama 3.3 Instruct 70B比較では、Groqの出力速度が308.4 tokens/s、TTFTが0.77sという値が提示されています(同ページはproviders比較で、TTFTと出力tokens/sを指標化)。 TTFTの定義自体はMLCommonsの説明(Client benchmark)でも整理されており、「最初のトークンが返るまでの待ち時間」を独立に測ることが“対話品質”の指標になる、としています。
#一方で、Groqの本質的なトレードオフは「SRAM容量が限られるため、巨大モデルは多数チップで分割し、通信と編成が重要になる」点です。NVIDIAのGroq 3 LPX技術ブログも「オンチップ容量は有限なので、より大きなモデルは多LPUでスケールさせる」と述べ、LPXは“デコードの中でもFFN/MoEなど”を担当し、GPUはprefillやattentionを担当する形を提示しています。
#帯域・スループット・レイテンシのチャート(Mermaid)
#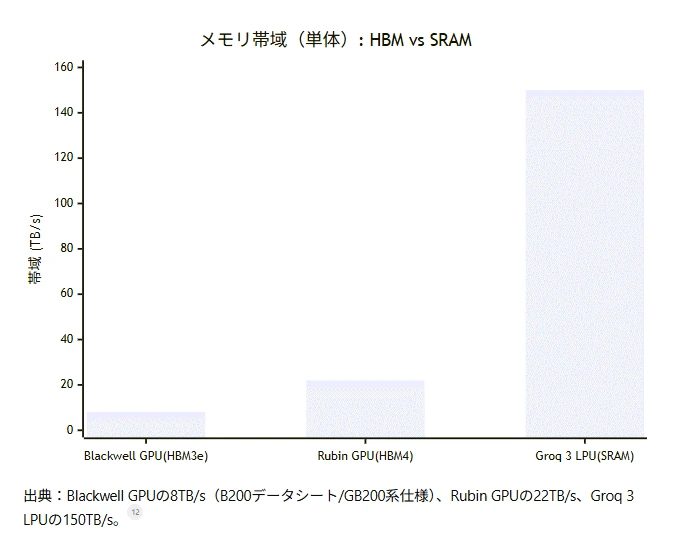
出典:Blackwell GPUの8TB/s(B200データシート/GB200系仕様)、Rubin GPUの22TB/s、Groq 3 LPUの150TB/s。
#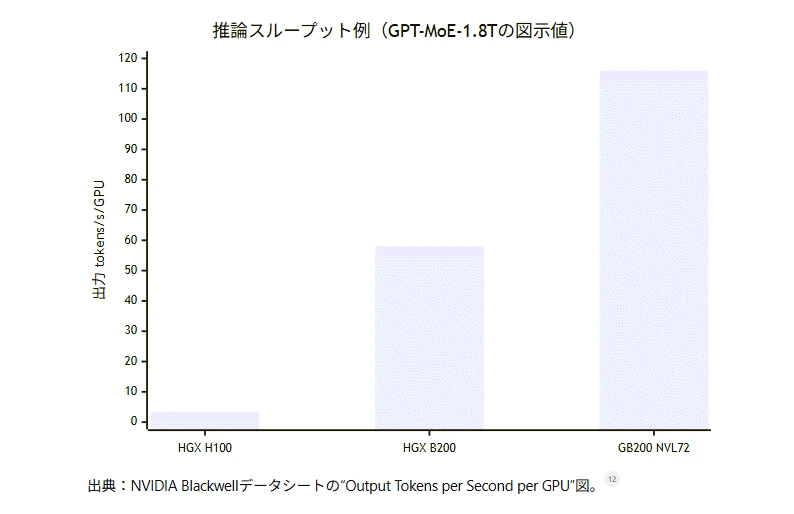
出典:NVIDIA BlackwellデータシートのOutput Tokens per Second per GPU図。
#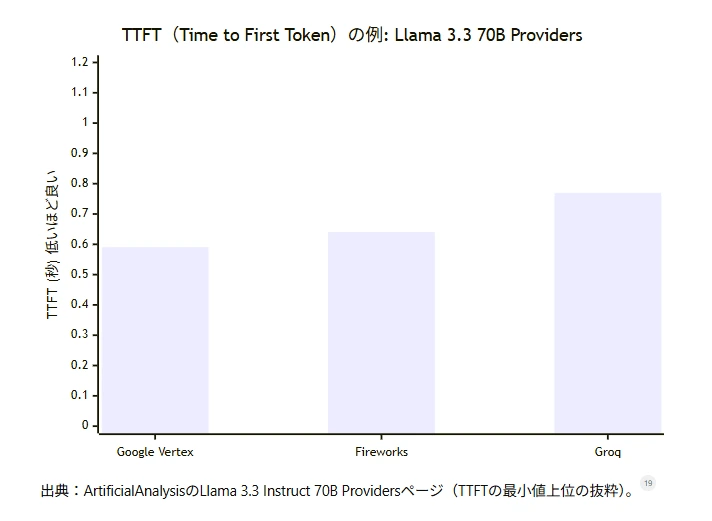
出典:ArtificialAnalysisのLlama 3.3 Instruct 70B Providersページ(TTFTの最小値上位の抜粋)。
#新しいAI手法の採用が変える計算・メモリ・通信パターン
#ここでは、手法の採用が「HBM容量」「HBM帯域」「オンチップSRAM」「スケールアップ/スケールアウト通信」「レイテンシ(特にTTFT/TPOT)」「演算密度」に与える影響を、一次文献中心に整理します。
#大規模事前学習:高演算密度だが、レンジが広がりメモリ&通信が支配しやすい
#Transformer系LMの性能がモデル・データ・計算量のスケーリングに従うという見立ては、スケーリング則の研究で体系化されました。OpenAIらのスケーリング則は、損失がモデルサイズやデータ量、計算量に対してべき則的に改善することを示しています。またDeepMindのChinchilla研究は「計算予算が一定なら、モデルサイズとトークン数を同程度に増やすのが計算最適になり得る」ことを実験から示し、学習だけでなく下流の微調整や推論の計算量にも波及すると論じています。
#ハードウェア観点では、事前学習は依然としてGEMMが中心で“ピークFLOPSが効きやすい”一方、(a) 長系列化、(b) 並列化の複雑化、(c) MoE併用、(d) 通信のcollective支配フェーズにより、HBM帯域とスケールアップ帯域がボトルネックになりやすくなります。Rubinの技術ブログが「通信支配AI」「MoE routingやcollectivesがNVLink6設計の中心」と明言するのは、この潮流と合致します。
#アライメントのSFT:総計算は減るが、メモリ要件は“事前学習の縮小版”で残る
#SFT(教師あり微調整)は、事前学習に比べると総トークン数は小さくなりがちですが、バッチ/系列長/最適化手法によっては活性化メモリが支配し、チェックポイント頻度や評価のためにI/Oが支配するケースも増えます(特にマルチモーダルや長文脈)。Rubinプラットフォームがpost-training(後学習)も対象として強調するのは、コア顧客のワークロードが事前学習から後学習+推論運用へ比率移動していることを示唆します。
#RLHF / 推論のためのRL:推論トークンが激増し、CPU・ストレージ・低レイテンシが前面に出る
#OpenAIのInstructGPT論文は、SFT→報酬モデル→PPO(RL)という典型的なRLHF流れを提示し、ヒト嗜好に沿う出力を得る枠組みを示しました。その後、DPO(Direct Preference Optimization)は報酬モデルを内在化した最適化問題として直接最適化する方向を提示し、RLHFの一部を単純化する流れの代表です。
#重要なのは、RLHF/RL系は「環境ロールアウト=大量推論」を伴い、(a) 低TTFT、(b) 低TPOT(time per output token)、(c) 高スループットの両立が難しくなる点です。Rubin PODがVera CPUラックで多数のRL/agent sandboxを高密度に回すことを語り、推論コンテキスト(KV cache)を“ストレージ層”にオフロードするCMX/ICMSのような仕組みを打ち出しているのは、まさに「推論がCPU・ネットワーク・ストレージを巻き込む」方向への対応です。
#MoE:演算量は下がる一方、メモリ容量とall-to-all通信が支配ボトルネック化
#MoEは「全パラメータの一部だけをトークンごとにアクティブ化」することで、計算量を抑えつつ総パラメータ(知識容量)を増やせる設計として広く採用が進みました。代表例としてSwitch Transformerは大規模MoEの実装とスケーリングの方向性を示しています。
#MoEのハードウェア影響は二面性があります。計算は“実効的に疎”になりますが、(a) 専門家重みの常駐が必要でHBM容量が効きやすい、(b) ルーティングでトークンのシャッフル=all-to-all通信が頻発し、NVLink/スイッチの“実効帯域”と遅延が支配します。Rubin NVL72の公式ページが「MoE学習をBlackwellより少ないGPU数で」と語り、NVLink6のall-to-allやin-network compute(SHARP)を強調するのは、この“通信支配”を公式に認めた形です。
#エージェント型の反復探索:トークンとKVが増え、レイテンシが累積する
#ReActは「推論(思考)と行動(ツール/環境操作)を交互に行う」枠組みを示し、エージェントの基本形になりました。citeturn0search19 またTree of Thoughtsは、複数の思考経路を探索・自己評価して進む“探索型推論”を提案し、テスト時スケーリングの代表になっています。
#これらは、単一リクエストが「(1) prefill → (2) decode → (3) ツール → (4) 追加文脈 → (5) decode…」を繰り返し、レイテンシがステップ数に比例して累積しやすいのが特徴です。NVIDIAのGroq 3 LPX技術ブログが「エージェントループではレイテンシが複利的に効く」「TTFT、tokens/s per user、tail latencyが重要」と述べるのは、まさにこのためです。
#さらに長文脈化が進むと、推論はKV cache(過去トークンのKey/Value)に支配されます。PagedAttention/vLLMはKV cacheをOSのページングに似せて管理し、断片化を抑え、同一レイテンシでスループットを2~4倍改善し得ることを報告しています。これはハード側から見ると「HBM容量と帯域をKVのためにどれだけ効率よく使えるか」が重要になることを意味します。
#FlashAttentionは、attention計算でHBM↔オンチップSRAMのI/Oを削減する“IO-awareな設計で、HBMアクセスを減らし長文脈を現実化することを示しました。これも「オンチップSRAMがアルゴリズムの性能上限を決める」代表例です。
#将来GPU/チップアーキテクチャへの提言
#以下は、上記のワークロード変化(長文脈・MoE・RL/エージェント・テスト時スケーリング)を前提に、「何を変えると“良いトークン/秒・良い$ / token・良いTTFT/テイル”が同時に伸びるか」を、設計項目ごとに整理した提言です。Rubinプラットフォームがすでに示している方向(HBM4、NVLink6、CMX/ICMS、LPU併用、光)を一般化して次世代へという視点で述べます。
#メモリ階層:HBMの拡張だけでは足りないため「KVを前提にした多層メモリ」へ
#第一に、HBM容量・帯域は今後も最重要です。RubinがHBM4で帯域2.8倍級(8→22TB/s)を公表したように、長文脈・MoE・推論経済性では帯域が直撃します。ただし、KV cacheは「容量も帯域も食う上に動的で断片化しやすい」という性質を持つため、HBM拡張だけでは十分でありません。PagedAttentionのようなソフト管理が効く一方、アーキ側でもKVに最適化した階層を持つ方が効きます。
#提言としては、(a) GPU内にKV向けの大容量SRAM(あるいはSRAMバンク群)を設け、FlashAttention型のタイル処理と共鳴させる、(b) GPUメモリの外側に推論コンテキスト層を置く(NVIDIAのCMX/ICMSの思想を一般化)、(c) 可能ならCXL等でメモリプールを扱い、prefill/agenticで膨らむKVを安価な階層へ逃がす、という3層化です。
#Rubin PODが「KV cacheを高帯域ストレージ層へオフロードし、トークン/秒を最大5倍」と述べるのは、まさにKVが第一級データ型になったことの表明です。
#スケールアップ/インターコネクト:MoEとエージェントは“全結合+低ジッタ”を要求する
#MoEはall-to-allが支配であり、NVLink6が「72GPU全結合、均一レイテンシ、in-network compute」を強調するのは必然です。Rubin Ultra系はさらにドメインを拡張し、公式ブログでは576GPUドメインや、Kyberで1ラックあたりGPU数を倍増する方向が語られます。
#提言は次の通りです。第一に、ラック内はできる限り“単一ホップに近い全結合”を維持し、collectiveのメタデータ制御やSHARPのようなネットワーク内演算を拡張する(MoE/TPに効く)。第二に、ラック間を光(直結/コパッケージ)で拡張し、銅配線の密度と電力を破綻させない(Spectrum-6のCPO等はその方向)。
#スパース対応:推論では構造化スパースより適応圧縮/量子化+ソフト協調が本命になりやすい
#Rubinでは「適応圧縮(adaptive compression)」をTransformer Engineの重要機能として掲げ、NVFP4性能を押し上げるとしています。一方で、第三者報道では「LLM推論において構造化スパースは効果が限定的だった」反省に触れ、Rubinの性能主張はスパースより圧縮・形式(FP4)側に寄せる、という説明があります。
#提言としては、(a) 量子化・圧縮を“ハード命令+コンパイラ+ランタイム”で共同設計し、(b) MoEや推論の精度要求に合わせて“層別に精度を変える/圧縮率を変える”ことを高速に行い、(c) 推論中に発生するKVやactivationsの圧縮/転送も含めて最適化することです。これはGroq側のTruePointや静的スケジュールの思想とも接続し得ます。
#チップレット vs モノリシック:前者が主流だが、プロセス・歩留まり・パッケージ制約を設計点として扱う
#Blackwellが2ダイ統合を公式に提示し、Rubin Ultraでも4チップレットが語られるように、最先端GPUはチップレット/マルチダイが前提になっています。ここでの提言は「計算ダイは最先端ノード、I/Oや一部機能は成熟ノード」などの異種ノード混在を早期から許容し、パッケージ制約(HBM実装数、基板、CoWoS能力)をボトルネックではなく入力条件として最適化することです。
#TSMCは2nm(N2)でnanosheet構造などを掲げ、密度・電力効率の向上を訴求していますが、同時に先端ノードは供給制約やコスト増を伴います。したがって2nm化は万能ではなく、同一消費電力枠での(a)HBMあたりの有効帯域、(b)NVLinkあたりの有効帯域、(c)SRAM/キャッシュ面積の確保、のどれが最もトークン/秒/ワットに効くかを世代ごとに見極める必要があります(RubinはHBM4+NVLink6側に大きく振っている)。
#NVRAM/ストレージ:エージェント時代は「一時的コンテキスト」が最大のストレージ消費源になり得る
#エージェントはマルチターンでKV cacheを増やし、再利用(prefix caching等)も増える一方、コンテキストは“半一時データ”として膨張します。Rubin PODはこれを「推論コンテキストを共有データ型として扱う」方向で設計し、BlueField-4や専用ストレージ層を組み合わせています。
#提言としては、(a) DPU/SmartNICでKV cacheのI/Oと暗号化/隔離をオフロード、(b) NVMe/次世代NVRAMをKV向けレイテンシ最適(小IO・高QPS・RDMA直結)にチューニング、(c) GPU側はKVの階層化APIを標準化し、vLLMのようなページング管理と接続する、が現実的です。
#市場分析:需要見通し、売上予測、採用シナリオ
#需要の前提:AI支出とAIインフラ支出は「減速より拡大」がメインシナリオ
#International Data CorporationはAIインフラ支出が長期で拡大する見通しを示し(例:2029年にAIインフラ支出が7,580億ドルに到達し、加速サーバが大部分を占める、というIDCの予測)、ハイパースケールの設備投資継続を示唆します。一方NVIDIAは2026年2月の通期決算でもデータセンター売上が急伸していることを公表しており(FY2026 Q4売上$68.1B、データセンター$62.3B、通期売上$215.9Bなど)、需要の強さを裏付けます。
#さらに、同社CEOはBlackwellとRubinを中心に「2027年末までにAIプロセッサで1兆ドル規模の売上(または受注・事業)を見込む」と報じられています(Reuters、Bloomberg、Morningsta等)。/
#採用シナリオ:Rubinは2026H2の供給開始が公式線、初期顧客はクラウド/ネオクラウド中心
#Rubinプラットフォームの公式発表では、Rubinはfull productionであり、パートナーからの提供が2026年後半とされています。また投資家向けの同発表文では、2026年にAWS/Google Cloud/Microsoft/OCIなどが初期導入する、とされています。具体例としてBusiness Wireの配信では、NebiusがH2 2026にRubin NVL72の提供を計画している旨が報じられています。
#Rubin Ultraは2027年が中心線で、公式ブログの範囲では「NVL576(576 GPUドメイン)」「Kyberで1ラックあたりGPU数を倍にしNVL1152へ」など、データセンター設計(電力・冷却・光)を含めた長期計画が必要というメッセージが強いです。
#リスク要因:HBM4/先端パッケージ/地政学と「カスタムAIチップ」の加速
#供給面の最大リスクはHBM(特にHBM4)と先端パッケージ能力です。Rubin向けHBM4はMicron Technologyなどが量産開始を公表している一方で、HBM確保がRubinの供給計画に影響し得るというアナリスト報道もあります。また、先端プロセス(2nm等)についても予約逼迫が報じられ、供給が技術ではなくキャパシティで決まる局面が増えています。
#競争面では、クラウド各社がカスタムAIチップを拡大していることが象徴的です。たとえばReutersは、BroadcomがGoogleと長期でカスタムAIチップを共同開発する契約を報じており、GPU一択からGPU+カスタムASICへ資本配分が分散するシナリオを示唆します。
#同時に、中国市場では輸出規制も絡み、国内AIチップの比率が上がっているというIDCデータに基づく報道もあり、地域差が拡大しています。
#Groq(LPU)の位置づけ:推論単価と対話品質の別軸を作る
#Groq 3 LPXは「推論市場(特にエージェント)の価値軸=低TTFT・低テイル・高tokens/s per user」を前面に出し、Rubinとの組み合わせで推論パレート境界を押し広げる戦略です。 一方で、SRAM容量の小ささは根本制約なので、巨大モデルは多数LPUへ分割し、スケールアップ通信設計が価値の大部分になります。
#また、NVIDIAがGroqの技術・人材を取り込む形の契約があったという報道もあり(契約形態は複数記事で表現が異なるため要注意)、いずれにせよ低レイテンシ推論アクセラレータがGPUロードマップの一部に組み込まれた点は重要です。
#前提・データソース・未公表項目の推定手法
#本レポートで優先したソース階層
#一次情報は、(a) NVIDIA公式プロダクトページ/技術ブログ/データシート、(b) HBMベンダ公式(Micron/Samsung)、(c) 標準ベンチ(MLPerf/MLCommons)、(d) 一次論文(InstructGPT/Chinchilla/FlashAttention/PagedAttention/ToT等)、(e) 大手報道・調査(Reuters/Bloomberg/Morningstar/Gartner/IDC)
#未公表仕様の表記ルール
#- NVIDIAが公式に数値を示していない項目は「未公表」と明記しました。
- 第三者報道がある場合は「報道ではA/Bがあり不確実」と併記しました(例:Rubin Ultraのプロセスノード)。
- 推定値は、式と入力(仮定)を必ず書き、推定だと明示しました。
推定例:RubinのHBMスタック数(推定)
#Rubin GPUは公式に288GB HBM4。 MicronはRubin向けHBM4として**36GB(12層)の量産開始を公表。 推定:288GB ÷ 36GB/stack = 8 stacks。 このとき、Rubinの公表帯域22TB/sなら 22 ÷ 8 = 2.75TB/s/stackで、Micronが示す2.8TB/s超/stackと近い。 よって「36GB級×8スタック」が最も整合する、というのが推定ロジックです(ただしNVIDIAはスタック数を明示していないため確定ではありません)。
#推定例:Rubin UltraのHBM4e帯域(範囲推定)
#Rubin Ultraについては、報道・ロードマップ資料で「HBM4e」「16S」「1TB級」が語られますが、NVIDIA公式ページでの帯域値は未公表です。 推定の置き方は2通りあります。
#- 容量側から:16Sで1TBなら、1スタックあたり64GBが必要(16×64GB=1024GB)。これはHBM4世代で“1スタック容量が増える”道筋(16層化など)と整合し得ますが、どの容量構成を採るかは未公表です。
- 帯域側から:HBM4は2048ビット幅で“スタックあたり2TB/s級〜3TB/s級がベンダ資料で語られ、HBM4eはさらにデータレートを上げる(一般に“E”は拡張版)という前提で、スタックあたり帯域が増える可能性があります。ただしJEDEC準拠の確定値は本調査範囲ではRubin Ultra向けに特定できないため、最終的には未公表扱いとし、設備計画では「スタック数×(2~4TB/s級の複数シナリオ)」で感度分析するのが妥当です。
推定例:プロセスノード(2nm等)
#Blackwellの4NPは公式明記です。一方Rubin/Rubin Ultraは公式未公表で、第三者記事で「3nm級」「2nm狙い」「N3P継続」などが併存します。 従って本レポートでは、プロセスは*世代クラス(4nm級/3nm級/2nm級)でレンジ把握し、性能推定は「ノード微細化によるFLOPS増」よりも、HBM帯域・NVLink帯域・実効利用率(ジッタ/並列化効率)の寄与を優先して評価する方針としました(Rubinの公式主張もメモリ性能が支配的という語りを含む)。
#どうしてGPUのピークFLOPSよりも「実効帯域」「通信」「ジッタ」が支配的になるのか?
#GPUは「計算器そのもの」は非常に速いのに、実際の処理ではその計算器へデータを十分な速さと安定性で届けられないことが多いので、ピークFLOPSよりも「実効帯域」「通信」「ジッタ」が支配的になりやすいです。NVIDIAの資料でも、GPU性能の律速要因は大きく memory bandwidth・math bandwidth・latency の3つだと整理されています。さらに、ある処理が計算律速かメモリ律速かは、処理の arithmetic intensity(1バイト当たり何回演算するか) と、GPU側の ops:byte 比 の比較で決まる、と説明されています。 (NVIDIA Docs)
#まず用語の違いです。
#FLOPS は、Floating Point Operations Per Second の略で、1秒あたりに何回の浮動小数点演算ができるかを表します。単位は FLOP/s、TFLOPS なら毎秒 10^12 回の演算です。Nsight Compute の roofline でも、縦軸は FLOPS です。つまり FLOPS は「計算機の馬力」を表す数字です。 (NVIDIA)
#帯域(bandwidth) は、1秒あたりにどれだけのデータを運べるかです。単位は B/s, GB/s, TB/s です。H100 SXM の例では、GPUメモリ帯域は 3.35 TB/s、GPU間の NVLink は 900 GB/s、PCIe Gen5 は 128 GB/s です。つまり同じ H100 でも、GPU内部の計算能力、GPUメモリ、GPU間接続、CPU-GPU接続は、それぞれ全く別の「太さ」を持つ経路です。 (NVIDIA)
#実効帯域(effective bandwidth) は、仕様書上の理論最大帯域ではなく、実際のカーネルがどれだけ有効にデータを読んで書けたかを表す値です。CUDA Best Practices Guide では、
#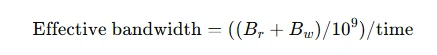
と定義されています。ここで (B_r) は読んだバイト数、(B_w) は書いたバイト数です。さらに NVIDIA は、requested/effective bandwidth と actual throughput を区別しており、その差を見ることで、非効率なアクセスや無駄な転送がどれだけあるかを推定できると説明しています。 (NVIDIA Docs)
#通信(communication) は、主に GPU↔GPU や GPU↔CPU や ノード↔ノード のデータ受け渡しです。NCCL は all-reduce, all-gather, broadcast などの集団通信を担い、NVIDIA自身が「高帯域・低遅延」を目標に最適化していると説明しています。裏を返すと、分散学習やマルチGPU推論では、この通信が性能の中心課題になりやすいということです。 (NVIDIA Developer)
#ジッタ(jitter) は、遅延のばらつきです。AWS は jitter を「送受信の時間遅れの変動」と説明しています。平均遅延が同じでも、毎回の到着時間が揺れると、同期処理やリアルタイム処理では性能が悪化します。つまりジッタは「遅いこと」そのものではなく、速かったり遅かったりが揺れることです。 (Amazon Web Services, Inc.)
#では、なぜピークFLOPSよりこれらが支配的になるのか。 一番大きい理由は、現代GPUの計算能力の伸び方が、データ移動の伸び方より速いからです。H100 SXM は FP16/BF16 Tensor Core で 1,979 TFLOPS、FP8 では 3,958 TFLOPS ですが、メモリ帯域は 3.35 TB/s です。これを単純に割ると、H100 が FP16 ピークを出すにはおおむね 約591 FLOP/byte、FP8 ピークなら 約1181 FLOP/byte 相当の計算密度が必要になります。FP32 でも 約20 FLOP/byte です。つまり、1バイト読んで数回しか計算しないような処理は、計算器がどれだけ速くても、データ供給が先に限界に当たりやすいです。 (NVIDIA)
#この考え方を NVIDIA は arithmetic intensity で整理しています。処理の arithmetic intensity が GPU の ops:byte 比より低ければ、その処理は memory-limited です。実際、NVIDIA の性能ガイドでは、ReLU、pooling、layer normalization、バッチ1の線形層など、多くの処理が低 arithmetic intensity でメモリ律速になりやすいとしています。つまり「GPUの演算器は空いているのに、データ待ちで進まない」状態が普通に起きます。 (NVIDIA Docs)
#さらに、実効帯域は理論帯域よりかなり低くなりうるのも重要です。CUDA Best Practices Guide では、V100 上の行列計算の例で、最適化前は 12.8 GB/s しか出ていなかったものが、coalescing や shared memory の使い方や bank conflict 解消で 199.4 GB/s まで改善しています。これは「ハードの仕様が悪い」のではなく、アクセスの仕方が悪いと、理論上太いはずの帯域を全然使えないことを示しています。 (NVIDIA Docs)
#ここで、ピークFLOPSと実効帯域の違いを感覚的に言うとこうです。 FLOPSは「工場の機械が1秒で何個加工できるか」。 帯域は「その機械に材料を運び込めるベルトコンベアの太さ」。 実効帯域は「実際の現場で、材料詰まりや並べ方の悪さも含めて、どれだけ材料が機械に届いているか」です。 機械が超高速でも、材料が届かないなら機械は遊びます。これが memory-bound です。 (NVIDIA Docs)
#通信 が支配的になるのは、1枚のGPUの中だけで完結しない処理が増えるからです。たとえば分散学習では勾配の all-reduce、モデル並列や MoE では GPU 間の活性値やトークンのやり取り、推論サーバでも KV キャッシュや中間結果の受け渡しが発生します。しかも H100 SXM でも、NVLink は GPUメモリ帯域の約 3.7分の1、PCIe Gen5 は約 26分の1 しかありません。つまりローカルHBMで読めば速いのに、別GPUやCPUから持ってくると急に細い道に入ります。そこで通信が律速になります。 (NVIDIA)
#ジッタ が支配的になるのは、特に同期型処理やリアルタイム推論で、平均より「遅い側の揺れ」が効くからです。たとえば 8 GPU で all-reduce する場合、7枚が速く終わっても、1枚だけ一瞬遅れれば全員が待ちます。オンライン推論でも、平均応答時間より p95/p99 が悪いと体感品質が落ちます。AWS も jitter は latency の変動だと説明しており、NCCL でも低遅延アルゴリズムや、逆に帯域優先のリング設定など、帯域と遅延をトレードオフする設計があることがわかります。つまり大規模システムでは「平均性能」より「待たされるばらつき」が全体を支配しやすいです。 (Amazon Web Services, Inc.)
#整理すると、各数値はこういう意味です。
#- FLOPS: 演算の速さ。単位は FLOP/s。GPUの計算器の理論的な上限。 (NVIDIA)
- 帯域: データ移動の速さ。単位は B/s, GB/s, TB/s。メモリ帯域やNVLink帯域など。 (NVIDIA)
- 実効帯域: 実際の処理が有効利用できた帯域。読書きバイト数を実測時間で割ったもの。 (NVIDIA Docs)
- 通信レイテンシ: 1回のやり取りにかかる時間。単位は ns, μs, ms。小さいメッセージや同期では特に重要。 (NVIDIA Developer)
- ジッタ: レイテンシの揺れ。平均が同じでもばらつきが大きいと、同期やリアルタイムで悪化。 (Amazon Web Services, Inc.)
最後にひとことで言うと、 ピークFLOPSは「理想状態での演算上限」、実効帯域・通信・ジッタは「現実の詰まり方」を表す数字です。 実務で性能を決めるのは、しばしば後者です。特に AI では、要素演算・正規化・小バッチ・分散同期・GPU間転送のように、計算よりデータ移動や待ち合わせの比重が高い処理が多いため、FLOPSだけ見ても実性能は読めません。NVIDIA も roofline で、GPU性能は「ピーク計算性能」と「メモリ帯域」と「Arithmetic Intensity」を一緒に見ないと現実的に評価できないと説明しています。 (NVIDIA Docs)
#学習ではなぜ通信が重く、推論ではなぜジッタとKVキャッシュが効くのか?
#「学習」と「推論」で、どこでFLOPSより実効帯域・通信・ジッタが効いてくるのかを図解っぽく並べます。基礎の見方は、NVIDIAのいう 「memory bandwidth / math bandwidth / latency」 と、処理側の arithmetic intensity(1バイトあたり何回演算するか) の比較です。ReLU、LayerNorm、小バッチの線形層のような処理は arithmetic intensity が低く、メモリ律速になりやすい例として挙げられています。 (NVIDIA Docs)
#まず全体像
#理想の見え方
[GPUの演算器] ===== すごく速い =====> 計算完了
現実の見え方
[HBM/キャッシュ] --データ供給-->
[GPUの演算器] --計算-->
[GPU間通信] --同期-->
[次の処理]
↑
ここが詰まると
演算器は空くつまり、FLOPSは中央の「計算箱」の最大馬力ですが、現実にはその前後にある メモリ供給・GPU間通信・待ち合わせ が詰まるので、そこが支配的になります。NVIDIAも、処理時間は「メモリアクセス時間」と「演算時間」の長いほうで決まり、前者はアクセスしたバイト数÷メモリ帯域、後者は演算回数÷演算帯域で見られると説明しています。 (NVIDIA Docs)
#\1. 単体GPUで起きること
#ケースA: 計算律速
データ読む -> 計算たくさん -> 書く
少し すごく長い 少し
結果:
[FLOPSが効く]
演算器をもっと速くすると効くケースB: メモリ律速
データ読む -> 計算ちょっと -> 書く
長い 短い 長い
結果:
[帯域が効く]
演算器をもっと速くしてもあまり効かないこの境目を決めるのが arithmetic intensity です。処理の arithmetic intensity が GPU の ops:byte 比より低いと、計算器は速くてもデータ供給が足りず、memory-limited になります。NVIDIAの例では、V100上で ReLU は 0.25 FLOPS/B、LayerNorm は 10 FLOPS/B未満、小バッチ1の線形層は 1 FLOPS/B で、いずれもメモリ律速寄りです。 (NVIDIA Docs)
#\2. 「理論帯域」ではなく「実効帯域」が大事な理由
#理論上
HBMは太い道路
でも実際は
・バラバラな読み方
・無駄な転送
・ストライドアクセス
・bank conflict
で、細い道路としてしか使えていないCUDA Best Practices Guide では、effective bandwidth = ((read bytes + write bytes)/10^9) / time で実効帯域を測るよう勧めています。そして、理論帯域より実効帯域が大きく低いなら、設計や実装の問題が主な改善点だと説明しています。実例として、V100である行列処理が 12.8 GB/s → 140.2 GB/s → 199.4 GB/s まで改善しており、shared memory の使い方や bank conflict の解消だけで帯域利用が大きく変わります。 (NVIDIA Docs)
#言い換えると、
#ピークFLOPS = エンジンの最大馬力
理論帯域 = 道路の最大車線数
実効帯域 = 実際に流れている車の量です。現場で効くのは、最後の 「実際に流れている量」 です。 (NVIDIA Docs)
#\3. 学習で通信が支配的になる図
#GPU0: 順伝播 -> 逆伝播 -> 勾配
GPU1: 順伝播 -> 逆伝播 -> 勾配
GPU2: 順伝播 -> 逆伝播 -> 勾配
GPU3: 順伝播 -> 逆伝播 -> 勾配
↓ ここで全員の勾配を集約
[all-reduce / all-gather]
↓ そろったら次のstepへ分散学習では、各GPUがローカルで計算したあと、all-reduce などの集団通信 で勾配をそろえる必要があります。NCCL 自体が、peak bandwidth と minimal latency を狙って ring や tree を最適化するライブラリとして説明されているので、裏を返せば学習のスケーリングでは 通信帯域と通信遅延 がボトルネックになりやすい、ということです。NCCL の技術解説でも、ring は帯域利用が強く、tree は対数的レイテンシで中程度メッセージサイズに強いと説明されています。 (NVIDIA Developer)
#H100の公称値で見ても、SXM版の GPUメモリ帯域は 3.35 TB/s、一方で NVLink は 900 GB/s、PCIe Gen5 は 128 GB/s です。つまり、同じGPUでも GPU内部HBM > GPU間NVLink > CPU-GPUのPCIe の順で道が細くなります。GPU内で完結する計算より、GPU外へ出る通信のほうが先に詰まりやすい理由はここです。 (NVIDIA)
#図にするとこうです。
#学習1 step
[HBMから読む]
↓
[Tensor Coreで計算]
↓
[勾配を作る]
↓
[他GPUと通信して平均化] ← ここで待つ
↓
[次のstep]
GPUが8枚でも、
最後の1枚・最後の通信が遅いと
全員が待つなので学習では、FLOPSだけでなく 通信量を減らす・通信を重ねる・同期回数を減らす ことが非常に重要になります。 (NVIDIA Developer)
#\4. 推論で帯域とジッタが支配的になる図
#LLM推論は大きく prefill と decode に分けて考えると見えやすいです。NVIDIA NIM のベンチ資料でも、長い入力列は TTFT を増やし、長い出力列は generation 側のメモリ要求を増やして ITL を悪化させる と説明されています。さらに、出力が長くなると KV cache が成長し、各新トークンでの attention 計算コストも入力+出力長に対して線形に増え、この計算は一般に compute-bound ではない とされています。 (NVIDIA Docs)
#4-1. Prefill
#長いプロンプトを一気に読む段階
[入力トークン列]
↓
[まとめて計算]
↓
[KV cacheを作る]
↓
[最初の1トークン]prefill は「最初の返答まで」の重さに効きます。入力が長いほど、KV cache の形成と前段のメモリ要求が増え、TTFT が伸びやすくなります。 (NVIDIA Docs)
#4-2. Decode
#1トークンずつ返す段階
前のKV cacheを読む
↓
今回の1トークンを計算
↓
新しいK/Vをcacheへ追記
↓
次の1トークンへ
↓
またKV cacheを読むTensorRT では、LLM推論で KV cache を使うための IKVCacheUpdateLayer があり、cache テンソルの形
図で強調するとこうです。
#推論のdecode
token 1:
cache読む -> 少し計算 -> cache書く
token 2:
もっと大きいcache読む -> 少し計算 -> cache書く
token 3:
さらに大きいcache読む -> 少し計算 -> cache書くなので、「毎回の計算は小さいのに、読むべき履歴はだんだん増える」 という構造になりやすく、ここで帯域が効いてきます。NVIDIAのベンチ資料でも、長い出力では KV cache のメモリコストが成長し、安定した inter-token latency は効率のよいメモリ管理や帯域利用を示す、とされています。 (NVIDIA Docs)
#\5. 推論で「ジッタ」が嫌われる図
#理想
20ms -> 20ms -> 20ms -> 20ms -> 20ms
ジッタあり
12ms -> 18ms -> 45ms -> 17ms -> 38msAWSの定義では、jitter は latency の時間的な変動 です。推論サーバでは、この揺れがそのまま TTFT のばらつき や ITL のばらつき に見えてきます。平均が同じでも、途中で 45ms が混ざると体感はかなり悪化します。NVIDIA TensorRT でも、小さい処理は enqueue-bound になりやすく、CPU/driver のカーネル起動時間が 約5~15マイクロ秒/カーネル かかるため、GPU計算そのものより起動や同期の揺れがボトルネックになる場合があると説明しています。 (Amazon Web Services, Inc.)
#つまり推論では、
#FLOPS不足:
ずっと遅い
ジッタ問題:
ときどき急に遅い
しかもその遅れがキュー全体に波及するという違いがあります。特に小バッチ・小さいカーネル・分岐や同期を含む処理では、計算量よりも launch overhead / queueing / syncの揺れ が目立ちます。TensorRT でも、batch size を増やすと throughput が改善しやすい一方、最大バッチを超えると待ち行列で TTFT が増え、システム throughput はそのあたりで飽和しやすいと説明されています。 (NVIDIA Docs)
#\6. 学習と推論を一枚で重ねると
#学習
[HBM] -> [計算] -> [勾配] -> [GPU間all-reduce] -> [次step]
↑
通信・同期が重い
推論
[prefillでKV作成] -> [decodeでKVを毎回読む/足す] -> [1 token出力]
↑
帯域・容量・ジッタが重いなので、同じ「GPU性能を見る」でも注目点は少し違います。
#学習で見たいもの
- FLOPS利用率
- HBM帯域利用率
- all-reduce時間
- 通信待ち時間
- スケーリング効率
推論で見たいもの
- TTFT
- ITL
- TPS
- queueing
- KV cache使用量
- latencyのばらつきNVIDIA NIM のベンチ資料でも、TTFT、ITL、TPS を分けて見ること、concurrency が max batch size を超えると待ち行列で TTFT が悪化し、throughput はその近辺で飽和しやすいことが説明されています。 (NVIDIA Docs)
#最後に一言でまとめると
#FLOPS = 「計算機の馬力」
実効帯域 = 「実際に材料が届く速さ」
通信 = 「他のGPUと受け渡しする速さ」
ジッタ = 「その速さがどれだけ揺れるか」AIでは、特に 低 arithmetic intensity の処理、分散同期、LLMのKV cache を伴う decode、小さいカーネルの連打 が多いため、ピークFLOPSだけでは実性能をほぼ説明しきれない、というのが本質です。 (NVIDIA Docs)
#はい。今回は 「1トークン出すたびに、なぜ次のトークンが少しずつ重くなりやすいのか」 を、会話例つきで図解っぽく説明します。 NVIDIA は ITL を ((e2e\ latency - TTFT)/(total\ output\ tokens - 1)) と定義していて、これは**最初の1トークンを除いた、デコード中の“1トークンあたりの待ち時間”**です。また NVIDIA は、出力が長くなるほど KV キャッシュが増え、各新トークンでの attention 計算コストは「これまでの入力+出力長」に対して線形に増えると説明しています。さらにこの部分は 一般に compute-bound ではない、つまりFLOPSよりメモリ側が効きやすいとされています。 (NVIDIA Docs)
#まず、KVキャッシュそのものを一言でいうと、**過去トークンの Key / Value を「あとで参照するために溜めておく場所」**です。TensorRT の説明では、KV cache は
まずは超ざっくり図
#会話履歴が短いとき
[過去トークン 8個] -> 次の1トークンを計算
会話履歴が長いとき
[過去トークン 800個] -> 次の1トークンを計算違いは単純で、次の1トークンを出すたびに「参照すべき過去」が増えていくことです。NVIDIA のベンチ資料でも、長い出力列は generation 段階で 帯域と容量の両方 のメモリ要求を増やし、その結果 ITL を押し上げると説明されています。 (NVIDIA Docs)
##
会話例で見る
#たとえば、ユーザーがこう聞いたとします。
#ユーザー:
N町の将来性がある仕事を3つ教えて説明のために、これをすごく雑にトークン化して、
#[N町][の][将来性][が][ある][仕事][を][3つ][教えて]の 9トークン だったとします。 実際のトークン分割はモデルや tokenizer によって違いますが、ここでは「過去が増えるほど参照量が増える」ことを見るための簡略例です。KV cache は、こうした処理済みトークンの履歴を保持して、後続トークンの attention で再利用するためにあります。TensorRT はこの再利用を GPU 計算削減のための仕組みとして説明しています。 (NVIDIA Docs)
#\0. prefill の直後
#まず入力プロンプトを読んで、KV cache を作ります。
#入力を読む(prefill)
[N町][の][将来性][が][ある][仕事][を][3つ][教えて]
KV cache:
[1][2][3][4][5][6][7][8][9]この段階は主に TTFT 側に効きます。NVIDIA は、長い入力列(ISL)は prefill のメモリ要求を増やし、TTFT を増やすと説明しています。 (NVIDIA Docs)
##
1トークン目を出す
#モデルが最初の出力トークンとして、たとえば
#[まず]を出したとします。
#このとき内部ではざっくりこうです。
#参照する履歴:
[N町][の][将来性][が][ある][仕事][を][3つ][教えて]
9個ぶんの過去を見る
出力:
[まず]
出力後のKV cache:
[1][2][3][4][5][6][7][8][9][10]ここで大事なのは、1トークン出したあと、その新トークン自身の K/V もキャッシュに追加されることです。TensorRT の IKVCacheUpdateLayer も、既存 cache に対して新しい K/V を sequential に書き込む仕組みになっています。 (NVIDIA Docs)
##
2トークン目を出す
#次に
#[、]を出すとします。
#参照する履歴:
[N町][の][将来性][が][ある][仕事][を][3つ][教えて][まず]
10個ぶんの過去を見る
出力:
[、]
出力後のKV cache:
[1][2][3][4][5][6][7][8][9][10][11]つまり、2トークン目は1トークン目より、少しだけ長い履歴を読まないといけません。NVIDIA は、各新トークンでの attention 計算コストは、それまでの入力+出力長に線形に増えると明記しています。 (NVIDIA Docs)
##
3トークン目、4トークン目……
#たとえば返答がこう伸びるとします。
#[まず][、][スポーツ興業][と][Embodied AI実装][です]すると各段階はこうなります。
#1トークン目:
過去 9個を参照 -> [まず] を出す -> cache 10個
2トークン目:
過去10個を参照 -> [、] を出す -> cache 11個
3トークン目:
過去11個を参照 -> [スポーツ興業] を出す -> cache 12個
4トークン目:
過去12個を参照 -> [と] を出す -> cache 13個
5トークン目:
過去13個を参照 -> [Embodied AI実装] を出す -> cache 14個
6トークン目:
過去14個を参照 -> [です] を出す -> cache 15個この「読む履歴が 9 → 10 → 11 → 12 … と伸びる」のが、長文生成で ITL が悪くなりやすい中心理由です。NVIDIA は、長い出力列(OSL)が generation の 帯域・容量要求 を増やし、ITL を増やすとしています。 (NVIDIA Docs)
##
図で見るとこう
#decodeの各ステップ
step 1:
[過去9] -> 1 token計算 -> cache 10
step 2:
[過去10] -> 1 token計算 -> cache 11
step 3:
[過去11] -> 1 token計算 -> cache 12
step 4:
[過去12] -> 1 token計算 -> cache 13ここでのポイントは「毎回1トークンしか出していないのに、毎回読むべき履歴は増えていく」ことです。だから decode は、派手な行列演算の“馬力勝負”というより、大きくなり続ける過去を何度も読み返すメモリ帯域勝負になりやすいです。NVIDIA も、この部分は一般に compute-bound ではないと書いています。 (NVIDIA Docs)
##
なぜ ITL が悪化するのかを、時間の感覚で書くと
#たとえば単純化して、各ステップの待ち時間がこうだとします。
#1トークン目の後: 18ms
2トークン目の後: 19ms
3トークン目の後: 21ms
4トークン目の後: 24ms
5トークン目の後: 28ms
6トークン目の後: 33msすると体感としては、
#最初はスラスラ
↓
少しずつ重くなる
↓
長文になるほど1文字ごとの間が伸びやすいという見え方になります。ITL はまさにこのデコード区間の平均的な1トークン待ちを見る指標です。NVIDIA は、安定した ITL は efficient memory management、better memory bandwidth、efficient attention computation を示すと説明しています。逆に言うと、ITL が崩れるときはメモリ管理や帯域の問題が疑わしい、ということです。 (NVIDIA Docs)
##
さらに重くなる場面 1: 長い会話
#マルチターン会話では、履歴そのものが長くなります。
#1往復目:
履歴 300 token
2往復目:
履歴 900 token
3往復目:
履歴 1800 tokenすると、3往復目の返答生成では、最初からかなり大きい履歴を読みながら decode することになります。vLLM は、マルチラウンド会話では過去チャット履歴の KV cache を再利用できるので、将来のラウンドで latency を下げられると説明しています。ただしこれは主に prefill の再計算を省く効果であり、decode の時間そのものは減らさないとも明記しています。 (docs.vllm.ai)
#ここは重要で、
#prefix caching が助けるもの:
- すでに読んだ履歴の再prefill
prefix caching があまり助けないもの:
- 今まさに長く生成している最中の decodeです。つまり、会話履歴の再利用はTTFTには効きやすいが、長文回答でじわじわ悪くなる ITL そのものは別問題です。 (docs.vllm.ai)
##
さらに重くなる場面 2: 複数人を同時にさばく
#同時に複数リクエストを処理すると、GPU は複数シーケンスの KV cache を抱えます。NVIDIA は、concurrency が高いほどシステム全体の TPS は増える一方、レイテンシは悪化しやすいと説明しています。出力が長いケースでは、各リクエストの KV cache が膨らみ、帯域と容量の取り合いが起きやすくなります。 (NVIDIA Docs)
#図にすると、
#ユーザーA: cache 2000 token
ユーザーB: cache 1500 token
ユーザーC: cache 900 token
ユーザーD: cache 2400 token
全員ぶんのcacheを抱えながら
次の1 tokenずつを回すとなります。だからサーバ推論では、長文・高同時接続・大きいコンテキスト が重なると ITL が崩れやすいです。NVIDIA は、ITL や TPS を見るときに concurrency と sequence length を分けて評価するよう勧めています。 (NVIDIA Docs)
##
じゃあ、なぜ PagedAttention や FP8 KV cache が出てくるのか
#vLLM は、KV cache を 固定トークン数ごとの block に分けて管理する PagedAttention 系の設計を説明しています。ブロック化する狙いは、KV cache を扱いやすくし、メモリの無駄や断片化を抑えることです。さらに vLLM は、FP8 KV cache でメモリ使用量を大きく減らし、より多くのトークンをメモリに置けるようにして throughput や長文対応を改善できると説明しています。 (docs.vllm.ai)
#感覚的にはこうです。
#何もしない:
KV cache がどんどん太っていく
↓
メモリ容量・帯域が苦しい
↓
ITLが悪化しやすい
改善策:
- cacheを上手く分割管理する
- cacheを圧縮する
- 共有prefixは再利用するただし根本の構造、つまり「出力が1トークン増えるたびに、次回はより長い履歴を読む」という事実そのものは変わりません。だから最適化は「消す」より「緩和する」方向です。 (NVIDIA Docs)
##
すごく短くまとめると
#1. 入力を読むと、KV cache ができる
2. 1トークン出す
3. その1トークンの K/V も cache に追加される
4. 次のトークンでは、前回より長い cache を読む
5. これを繰り返す
6. だから長文ほど ITL は悪化しやすいNVIDIA の説明をそのまま噛み砕くと、長い出力ほど KV cache が増え、各新トークンの attention コストは入力+出力長に線形に伸びるので、generation のメモリ帯域・容量要求が強くなり、ITL が上がりやすい、ということです。 (NVIDIA Docs)
#はい。これらは全部、**LLM推論の「どこに時間とメモリが使われているか」**を説明するための用語です。 まず一言で並べると、
#- prefill = 入力文を一気に読んで KV cache を作る前半戦
- ITL = 出力中の 1トークンごとの待ち時間
- PagedAttention = 増え続ける KV cache をうまく管理する仕組み
- FP8 KV cache = その KV cache を 軽くする圧縮手法
- compute-bound = 処理が 計算器の速さ に縛られている状態
です。NVIDIA は prefill を「入力プロンプトを処理して KV cache を生成する最初の段階」と定義し、ITL を「連続するトークン間の平均時間」と定義しています。vLLM は PagedAttention を、attention の key/value メモリを効率よく扱う仕組みとして挙げています。FP8 KV cache は vLLM で、KV cache を FP8 化してメモリ使用量を減らす機能として説明されています。compute-bound は NVIDIA の性能ガイドで、十分な並列性があり、arithmetic intensity が GPU の ops:byte 比より高いときの「計算律速」の状態として整理されています。 (NVIDIA Docs)
#\1. prefill とは何か
#prefill は、LLM推論の前半です。 ユーザーの入力文をまとめて読み、attention に必要な KV cache を作る段階です。NVIDIA Dynamo の用語集では、prefill phase は「入力プロンプトを処理して KV cache を生成する最初の段階」とされています。NVIDIA NIM の指標説明でも、TTFT には通常 queueing・prefill・network latency が含まれ、長いプロンプトほど TTFT が大きくなると説明されています。 (NVIDIA Docs)
#図解っぽく言うとこうです。
#入力:
「N町の将来性ある仕事を3つ教えて」
prefill:
[入力を全部読む]
↓
[内部表現を作る]
↓
[KV cacheを作る]
↓
最初の1トークンを出せる状態になるつまり prefill は、返答を始める前の下ごしらえです。 長い文章を読ませるほど、この前半戦が重くなります。NVIDIA は、入力長が長いほど prefill 段階のメモリ要求が増え、TTFT が伸びると説明しています。 (NVIDIA Docs)
#\2. ITL とは何か
#ITL は Inter-Token Latency の略で、連続する出力トークンの間の平均待ち時間です。NVIDIA NIM では、ITL は average time between consecutive tokens、別名 TPOT と定義されています。さらに GenAI-Perf では
として扱われています。 (NVIDIA Docs)
#図にするとこうです。
#ユーザーから見た応答
最初の1文字が出るまで: TTFT
その後
token1 -> token2 の間: ITL
token2 -> token3 の間: ITL
token3 -> token4 の間: ITL感覚的には、
#- TTFT = 「返答が始まるまでの待ち」
- ITL = 「返答が始まった後の、文字送りの間隔」
です。 だから、チャットが「最初は遅いが出始めると滑らか」なのか、「最初は速いが途中からモタつく」のかを分けて見るときに、TTFT と ITL を分けて考えます。NVIDIA も TTFT と ITL を別指標として扱っています。 (NVIDIA Docs)
#\3. PagedAttention とは何か
#PagedAttention は、増え続ける KV cache をブロック単位で効率よく管理する考え方です。NVIDIA Dynamo の用語集では、vLLM由来の「KV cache を requests を blocks に分けて効率よく管理する memory management technique」と説明されています。vLLM のトップページでも、PagedAttention は key/value memory の efficient management に関わる仕組みとして紹介されています。 (NVIDIA Docs)
#なぜ必要かというと、LLM は出力を1トークンずつ伸ばすたびに KV cache も増えていくからです。
#普通に考えると
[大きい連続メモリを丸ごと確保]
→ 会話ごとに長さがバラバラ
→ 無駄や断片化が起きやすい
PagedAttentionの発想
[小さい block に分けて持つ]
→ 必要な block をつなげて使う
→ 管理しやすいかなり雑に言うと、 「1本の巨大ノートを毎回作る」のではなく、「小さいメモ帳を必要なだけ継ぎ足していく」感じです。 vLLM の設計資料では、この仕組みは paged KV caches と整合するように作られているとされています。ただし vLLM のその設計文書自体は、現在のコードをそのまま説明するものではなく historical document だという注意書きもあります。なので概念理解には有用ですが、実装詳細の唯一の正解として読むものではありません。 (vLLM)
#\4. FP8 KV cache とは何か
#FP8 KV cache は、KV cache を 8ビット浮動小数点で保存して軽くする仕組みです。vLLM は、KV cache を FP8 に量子化するとメモリ使用量を大きく減らせて、より多くのトークンをメモリに置けるようになり、throughput 改善や長い context window のサポートにつながると説明しています。 (vLLM)
#図にするとこうです。
#通常のKV cache
[重い]
[重い]
[重い]
[重い]
FP8 KV cache
[軽い]
[軽い]
[軽い]
[軽い]もちろん万能ではなく、量子化なので精度とのトレードオフがあります。vLLM の FP8 KV cache 文書では、量子化スケールの決め方として、デフォルト値、ランダムトークンによる推定、データセットを使った校正などが説明されています。つまり「ただ小さくすればよい」ではなく、どの程度の精度劣化でどれだけメモリを浮かせるかの設計が必要です。 (vLLM)
#要するに FP8 KV cache は、
#- KV cache がメモリを圧迫する
- だから軽くしたい
- 軽くすると長文や高同時接続に強くなりやすい
という流れの対策です。 (vLLM)
#\5. compute-bound とは何か
#compute-bound は、処理のボトルネックが 計算器そのものの速さ にある状態です。NVIDIA の性能ガイドでは、十分な並列性があるとき、algorithm arithmetic intensity が GPU の ops:byte ratio より高ければ math が律速、低ければ memory が律速だと整理されています。つまり compute-bound は、ざっくり言えば 「データ移動より計算のほうが先に限界に当たっている状態」 です。 (NVIDIA Docs)
#図解っぽく言うと、
#compute-bound
データ供給: 間に合っている
計算器: 忙しい
→ もっと速いGPUやもっと良いカーネルで効く
memory-bound
データ供給: 間に合わない
計算器: 待っている
→ FLOPSを増やしても効きにくいvLLM の最適化説明では、prefill は compute-bound、decode は memory-bound と対比されています。chunked prefill は、この両者をうまく混ぜて GPU 利用率とレイテンシを改善するための仕組みだと説明されています。 (vLLM)
#\6. これらの用語のつながり
#ここが一番大事です。
#ユーザー入力
↓
[prefill]
- 入力を全部読む
- KV cacheを作る
- 長い入力だとTTFTが重くなる
↓
[decode]
- 1トークンずつ出す
- そのたびにKV cacheを読む/足す
- ここでITLが効く
↓
KV cacheが重いと困る
↓
PagedAttentionで管理をうまくする
FP8 KV cacheで軽くするさらに性能面では、
#prefill = compute-bound寄り
decode = memory-bound寄りという見方がよく使われます。これは vLLM が公式ドキュメントでそのように整理しています。NVIDIA も、長い入力は prefill のメモリ要求を増やして TTFT を押し上げ、長い出力は generation のメモリ要求を増やして ITL を押し上げると説明しています。 (vLLM)
#\7. すごく短く言い換えると
#- prefill
入力文を読んで、返答の準備をする段階。最初の返答の遅さに効く。 (NVIDIA Docs)
- ITL
返答が始まった後の、1トークンごとの間隔。文字送りの滑らかさに効く。 (NVIDIA Docs)
- PagedAttention
増える KV cache を、ブロック化して無駄を抑えながら扱う仕組み。 (NVIDIA Docs)
- FP8 KV cache
KV cache を 軽量化して、より多く置けるようにする手法。長文や高負荷に効きやすい。 (vLLM)
- compute-bound
処理が 計算器の速さ に縛られている状態。prefill 側で出やすい見方。 (NVIDIA Docs)
#「TTFT・ITL・TPS の違い」 か、「prefill は compute-bound、decode は memory-bound になりやすい理由」 を図解っぽく解説
#ユーザーが見る1回の応答
リクエスト送信
|
|------ TTFT ------| 最初の1トークンが出る
|
|-ITL-|-ITL-|-ITL-| 後続トークンが続く
|
応答完了
全体としてどれだけ吐けたか
= TPSNVIDIA は、TTFT を「リクエスト送信から最初のトークン受信までの時間」、ITL を「連続するトークン間の平均時間」、TPS を「システム全体が1秒あたりに出した総トークン数」と定義しています。さらに TTFT には通常、キュー待ち・prefill・ネットワーク遅延 が含まれ、ITL は decode 部分だけを見るために 最初の1トークンを除いて計算されます。 (NVIDIA Docs)
#それぞれを感覚で言い換えると、
#- TTFT = 「返事が始まるまでの待ち」
- ITL = 「返事が始まってからの文字送りの間隔」
- TPS = 「サーバ全体のさばける量」
ユーザー1人視点の TPS は出力長が十分長いと 1 / ITL に近づくと説明されています。 (NVIDIA Docs)
#図にすると、重視するものはこう変わります。
#チャット体感を良くしたい
→ TTFT と ITL が重要
サーバ全体でたくさん処理したい
→ TPS が重要つまり、TTFT/ITL はレイテンシ指標、TPS は処理量指標です。高TPSでも TTFT や ITL が悪ければ、ユーザーは「出足が遅い」「途中がカクつく」と感じます。逆に TTFT と ITL が良くても、同時接続が増えると総TPSが足りず、全体の待ち行列が悪化します。NVIDIA も、同時リクエスト数が増えると総TPSは飽和点まで増え、その先は低下しうると説明しています。 (NVIDIA Docs)
#ここから、なぜ prefill は compute-bound、decode は memory-bound になりやすいか につなげます。
#LLM推論の中身
[Prefill]
入力をまとめて読む
→ KV cache を作る
→ 最初の1トークンを出せる状態へ
[Decode]
1トークン出す
→ KV cache に足す
→ 次の1トークン
→ またKV cacheを読むvLLM は、chunked prefill の説明で prefill を compute-bound、decode を memory-bound と明示的に対比しています。さらに、decode を優先して prefill を小分けに混ぜると、ITL 改善 と GPU 利用率改善 の両方が狙えると説明しています。 (vLLM)
#\1. prefill が compute-bound になりやすい理由
#Prefill
長い入力を一気に処理
[token][token][token][token]...
↓
大きな行列演算をまとめて回す
↓
KV cache を作るprefill は、入力列全体をまとめて処理して KV cache を作る前半戦です。NVIDIA は、長いプロンプトほど TTFT が大きくなるのは、attention が入力全体を使って計算し、KV cache を作る必要があるからだと説明しています。vLLM はこの prefill を compute-bound と整理しています。つまり prefill は、「読む量は多いが、まとめて大きな計算として回しやすい」ので、GPU の計算器を比較的しっかり使いやすい段階です。 (NVIDIA Docs)
#感覚的にはこうです。
#Prefill
材料を大量投入
→ GPUが大きな塊で計算
→ まず最初の返答準備を終える
だから効きやすいのは
TTFT と GPU計算効率そのため、vLLM でも max_num_batched_tokens を大きくすると TTFT が良くなりやすい、つまりより多くの prefill トークンを一度にバッチできると説明しています。 (vLLM)
#\2. decode が memory-bound になりやすい理由
#Decode
1トークン出すたびに
[過去のKV cacheを読む]
↓
[今回の1トークンを計算]
↓
[新しいK/Vをcacheへ追加]
↓
次のトークンでは
もっと長いcacheを読むNVIDIA は ITL の説明で、長い出力列では KV cache が成長してメモリコストが増えること、さらに 各新トークンの attention コストは「これまでの入力+出力長」に線形に増えることを明記しています。そのうえで、この計算は 一般に compute-bound ではない と書いています。つまり decode は、FLOPS より KV cache をどれだけ効率よく読み書きできるか が効きやすい段階です。 (NVIDIA Docs)
#図にするとこうです。
#Decodeの各ステップ
step1: 過去 500 を読む → 1 token出す
step2: 過去 501 を読む → 1 token出す
step3: 過去 502 を読む → 1 token出す
step4: 過去 503 を読む → 1 token出すつまり decode は、毎回の計算は小さめなのに、毎回読む履歴は少しずつ増える構造です。だから長文になるほど ITL が悪化しやすく、vLLM も decode を memory-bound と扱っています。NVIDIA も、安定した ITL は efficient memory management・better memory bandwidth・efficient attention computation を示すと説明しています。 (NVIDIA Docs)
#\3. TTFT・ITL・TPS と prefill/decode の対応
#TTFT ← 主に prefill 側の重さが効く
ITL ← 主に decode 側の重さが効く
TPS ← prefill と decode を全部合わせた総合処理量NVIDIA の説明では、TTFT はキュー待ち・prefill・ネットワーク遅延を含み、ITL は decode 部分だけを見る指標です。TPS は同時実行中の全リクエストを合算した総スループットです。vLLM では、decode を優先すると ITL が改善し、prefill を多く積める設定では TTFT や throughput が改善しやすいと説明されています。 (NVIDIA Docs)
#かなり雑にまとめると、こうです。
#TTFTを良くしたい
→ prefillを速くしたい
→ compute-bound側の効率が重要
ITLを良くしたい
→ decodeを滑らかにしたい
→ memory-bound側の効率が重要
TPSを良くしたい
→ 全体の詰まりを減らしたい
→ バッチング・スケジューリング・飽和点管理が重要NVIDIA は、TPS は同時リクエスト数の増加で上がるが、GPU資源の飽和点を越えると低下しうるとしています。vLLM は、max_num_batched_tokens を小さくすると ITL 改善、大きくすると TTFT 改善、さらに十分大きいと throughput 最適化 に向くと説明しています。 (NVIDIA Docs)
#最後に、一枚に重ねるとこうです。
#ユーザー体感と内部処理の対応
リクエスト
↓
[prefill]
- 入力をまとめて読む
- KV cacheを作る
- compute-bound寄り
- 主にTTFTへ効く
↓
[decode]
- 1トークンずつ出す
- KV cacheを毎回読む/足す
- memory-bound寄り
- 主にITLへ効く
↓
[全体同時処理]
- 何本さばけるか
- 主にTPSへ表れる一言でいうと、TTFT は「出だしの速さ」、ITL は「話し始めてからの滑らかさ」、TPS は「サーバ全体の仕事量」です。 そして、prefill は大きな計算をまとめて回しやすいので compute-bound 寄り、decode は増え続ける KV cache を読み続けるので memory-bound 寄り、というのが定番の見方です。 (NVIDIA Docs)
#サムネはNano Banana2
#