EDAについて少しだけ勉強
この資料の日時
元資料の日付と、その本文が公に存在した確認日時は別の記録です。
本文に含まれる語句 HBM DRAM SRAM 帯域・データ移動 先端パッケージング 電力・給電 冷却 歩留まり 基板・材料 チップレット AI推論 AIエージェント
出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.09.23.4
- 記事内容のSHA-256
89e089ce9e52dd46ce976f5b24bd69a97e687b1cb8abc77b272598eabbb53d24- 保存版のSHA-256
0aa1a41c18b2a27627d861836de5d48f28c212cfcff2aeeb0bf8eb2ba1257cb8
外部証明の最終検査結果は詳細を開くと表示します。
EDAとCadence(ケイデンス)、Ansys(アンシス) 、Synopsys、ARM
#Synopsys は 2025年7月17日に Ansys の買収完了を発表しており、いまは「Synopsys と Ansys をどう分けて理解するか」は、元々の役割の違い と 現在の統合後の関係 を分けて見るのがいちばんわかりやすいです。 (Synopsys News Releases)
#EDAとは何か
#EDA は Electronic Design Automation の略で、半導体や電子回路を設計するためのソフト群です。ざっくり言うと、昔は人手でやっていた「回路を書く」「動作確認する」「配線する」「タイミングや消費電力や熱の問題を見つける」「製造できる形に仕上げる」を自動化・高度化するものです。Synopsys、Cadence、Arm の公式説明でも、EDA は設計・モデル化・シミュレーション・検証・解析を通じて、製造前に問題を見つけるための基盤だとされています。 (Synopsys)
#チップ開発の流れを超ざっくり書くと、 仕様を決める → 回路の中身をRTLで書く → 正しく動くか検証する → 論理合成する → 配置配線する → タイミング/電力/熱/ノイズを詰める → テープアウト → ファウンドリで製造 という流れです。EDA はこの一連の工程を支える道具箱です。特に今の SoC は数十億〜数百億トランジスタ級で、人力だけでは設計不可能なので EDA が不可欠です。 (cadence.com)
#まず4社の違いを一言で言うと
#- Synopsys: 半導体設計のための総合EDA大手。検証、合成、実装、サインオフ、IPまで広い。 (Synopsys)
- Cadence: Synopsys と並ぶ総合EDA大手。特にカスタムIC、アナログ/RF、システム設計解析まで強い。 (cadence.com)
- Arm: EDA会社というより、CPUアーキテクチャとCPU IPをライセンスする会社。設計ツールそのものというより、チップの“中身の設計資産”を売る側。 (arm.com)
- Ansys: もともとは EDA 専業というより、物理シミュレーション/解析 の会社。半導体でも、電源、熱、応力、チップ・パッケージ・基板連成などの解析が強い。今は Synopsys 傘下です。 (Ansys)
#
たとえるとわかりやすいです
#家を建てると考えると、
#- EDA(Synopsys / Cadence) = 設計CAD、構造チェック、施工前検証の総合ツール
- Arm = すでに完成度の高い「部屋の設計図」や「骨組みの規格」をライセンスする会社
- Ansys = 地震、熱、風圧、強度、空調まで物理的に本当に耐えられるかを見る解析屋
というイメージです。 つまり Synopsys/Cadence は“設計する道具”、Arm は“設計に組み込む部品・設計資産”、Ansys は“現実世界で壊れないか確かめる解析” に近いです。 (Synopsys)
#Synopsysとは
#Synopsys は、EDA、半導体 IP、検証、サインオフまで広く持つ総合プレイヤーです。公式には EDA ソリューション、シリコンIP、ハードウェア支援検証などを打ち出しており、サインオフ領域では静的タイミング解析、信号/電源完全性、寄生抽出、ECO、トランジスタレベル解析、マルチフィジクスまで扱っています。 (Synopsys)
#強みを一言でいうと、デジタルSoCを大規模に前へ進める力が非常に強い ことです。 「正しく動くか」を見る検証、「回路をゲートに落とす」合成、「配線する」実装、「最後の品質保証」をするサインオフ、さらに USB や PCIe などの Verification IP までそろえており、大規模先端チップの一気通貫の流れを作りやすいです。 (Synopsys)
#さらに現在は Ansys を統合済みなので、Synopsys は従来の EDA に加えて、熱・電源・機械応力など物理世界の解析 も取り込みやすくなっています。ここが最近の大きな変化です。 (Synopsys News Releases)
#Cadenceとは
#Cadence も Synopsys と並ぶ総合EDA大手で、公式には「EDA と Intelligent System Design の提供者」としています。チップだけでなく、パッケージ、ボード、筐体まで含むシステム設計・解析を打ち出しているのが特徴です。 (cadence.com)
#Cadence は特に カスタムIC、アナログ、RF、ミックスドシグナル で存在感が強いです。もちろんデジタル実装や検証も強いのですが、「職人的に詰める必要がある領域」と「システム全体まで見渡す設計」で評価されやすい会社です。公式にも custom IC / analog / RF の統合フローを大きく打ち出しています。 (cadence.com)
#なので、ざっくりした見方をすると、 Synopsys = 先端デジタルSoCの王道総合ツール感 Cadence = それに並ぶ総合力を持ちつつ、アナログ/RFやシステム寄りでも非常に強い という理解で最初は十分です。実際にはかなり領域が重なっています。 (Synopsys)
#Armとは
#Arm はここが一番誤解されやすいですが、Synopsys や Cadence のような“EDAツール会社”ではありません。 Arm は CPU アーキテクチャを定義し、その上で CPU コアや各種IPをライセンスする会社です。公式にも、Arm CPU Architecture は「CPU がソフト実行時に何をすべきかを定義するもの」であり、Arm は多様な CPU コアや physical IP を提供すると説明しています。 (arm.com)
#たとえば半導体メーカーは、 「Arm の命令セット/CPUコアを使ってSoCを作る」 ことがあります。その SoC を実際に設計・検証・配線・サインオフする段階で使うのが Synopsys や Cadence のEDAです。 つまり Arm は 設計対象の中核IPを供給する側 で、EDA会社とは役割が違います。 (arm.com)
#なので関係性でいうと、 ArmのCPU IPを、SynopsysやCadenceのツールでSoCに組み込んで完成させる という理解がいちばん自然です。 (arm.com)
#Ansysとは
#Ansys も誤解されやすいですが、もともとは 機械、流体、電磁界、熱などのCAE/シミュレーション大手 です。半導体分野では、電源完全性、熱、電磁、パッケージ、チップ・パッケージ・システム連成解析など、現実の物理問題 を強く見ます。公式の半導体・電子系ページでも power integrity、thermal simulation、chip-package-system co-analysis などを前面に出しています。 (Ansys)
#先端パッケージや 2.5D/3D-IC では、「論理的に動く」だけでは足りず、熱で性能が落ちないか、電源ノイズで誤動作しないか、応力で壊れないか が非常に重要です。Ansys はそこを詰める役割が強かった会社です。 (Ansys)
#そして今は Synopsys が 2025年7月に買収完了しているので、現在の理解としては、 Ansys = Synopsysグループの中で、物理解析・マルチフィジクスを担う中核 と見るのが自然です。 (Synopsys News Releases)
#4社の違いを一枚でまとめると
#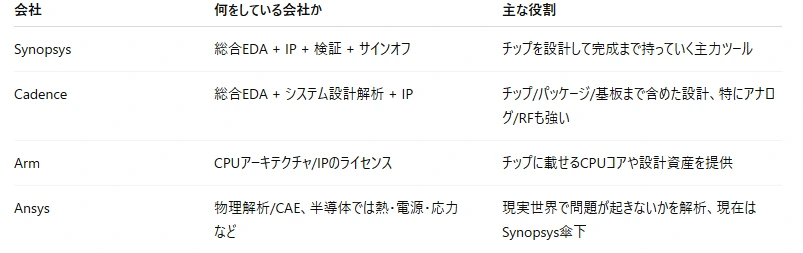
この表の本質は、 Synopsys/Cadenceは“設計ツール” Armは“設計に使うIP” Ansysは“物理解析” という切り分けです。 (Synopsys)
#どこで使われるかを設計フローに沿って見ると
#設計の早い段階で「どんなCPUを載せるか」を決めるときに Arm のIPが候補になります。 その後、RTL設計、検証、合成、配置配線、サインオフでは Synopsys や Cadence のEDAが中心になります。 さらに最後に、熱・電源・パッケージ応力・EMI/EMC のような物理問題を深く詰めるところで Ansys 系の解析が効いてきます。最近は Cadence も system design and analysis を強化しており、Synopsys も Ansys 統合でこの領域を広げています。 (cadence.com)
#初学者向けに超単純化すると
#- EDAとは
半導体を作るための設計ソフト群
- Synopsys / Cadence の違い
どちらも超重要なEDA大手。かなり競合するが、Cadenceはアナログ/RFやシステム寄りでも強く、Synopsysは大規模デジタルSoCの総合力やサインオフ、検証IPまで非常に広い
- Arm の違い
ツール会社ではなく、CPUの設計資産を売る会社
- Ansys の違い
回路そのものより、熱・電源・機械応力など“現実の物理”を強く見る会社。いまはSynopsys傘下
#この4つを混同しないことが、最初の最大のポイントです。 (cadence.com)
##
まず「半導体」「チップ」って何か
#半導体チップは、ものすごく小さな板の上に、非常にたくさんのトランジスタという電子スイッチを並べたものです。
#このスイッチを
#- つなぐ
- 組み合わせる
- 決まった順序で動かす
ことで、計算したり、記憶したり、画像を処理したりします。
#つまりチップは、見た目はただの黒い部品でも、中では
#- 計算する場所
- 記憶する場所
- 外と通信する場所
- 電力を配る場所
などが詰まっています。
#たとえばスマホのSoCなら、1個のチップの中に
#- CPU
- GPU
- AI処理回路
- 画像処理
- メモリ制御
- 通信制御
などが入っています。
##
チップ開発は「家づくり」より「都市設計」に近い
#初心者向けにたとえると、チップ開発は家1軒を建てるより、小さな都市を設計する感じです。
#- どんな街にするか決める
- 道路を引く
- 電気を通す
- 水道みたいに信号を流す
- 混雑しないようにする
- 熱くなりすぎないようにする
- 最後に実際に建てる
という流れです。
#しかも、建てたあとに簡単には直せません。 ソフトならあとで更新できますが、チップは一度工場で作ると修正が高くつくので、作る前の確認がものすごく重要です。
##
チップ開発の流れ
#\1. 何を作るか決める
#最初にやるのは、このチップに何をさせたいのかを決めることです。
#たとえば、
#- スマホ向けなのか
- 自動運転向けなのか
- SSD向けなのか
- AI推論向けなのか
で、求められるものが全然違います。
#ここで考えるのは、
#- どれくらい速くしたいか
- 消費電力をどれくらいにしたいか
- サイズをどれくらいにしたいか
- 価格をどれくらいにしたいか
- 何年後の製品に入れるか
です。
#これは「設計」というより、まず企画と仕様決めです。
##
\2. 大まかな構造を決める
#次に、チップの中身を大きなブロックに分けて考えます。
#たとえば、
#- 計算する部分
- メモリを制御する部分
- 画像を処理する部分
- 外部機器とつなぐ部分
のように分けます。
#これはアーキテクチャ設計と呼ばれます。 建物で言えば、まだ壁紙や配線ではなく、 「この建物は3階建てで、ここがリビングで、ここが階段」 と決める段階です。
#この時点で、全部をゼロから作るとは限りません。 よくあるのは、必要な部品の一部を外から使うことです。
#たとえば、
#- CPUコアは Arm の設計を使う
- 通信部分は既存IPを使う
- USBやPCIeの回路はIPを使う
ということがあります。
#ここでの IP は、知的財産という意味で、 すでに作られている回路ブロックの設計資産 のことです。
##
\3. 回路の中身を書く
#ここからいよいよ「設計」っぽくなります。
#ただし、初心者が思い浮かべるように、設計者が1個1個トランジスタを手書きしているわけではありません。 大規模なデジタルチップでは普通、まずは RTL という形で書きます。
#RTL はかなりざっくり言うと、 この信号が来たら、このデータをこう動かす というルールを、Verilog や VHDL のようなハードウェア記述言語で書くものです。
#ソフトコードに少し似ていますが、実際には 「時間に合わせて同時並行で動く電子回路」 を書くので、普通のプログラムとはだいぶ感覚が違います。
#ここで設計者は、
#- 加算器
- 制御回路
- 状態遷移
- バッファ
- パイプライン
- メモリ制御
などを組み立てます。
##
\4. 正しく動くかひたすら確認する
#RTLを書いたら、すぐ製造はしません。 まず本当に正しいかを延々と確認します。
#これが 検証 です。 実は多くの開発現場で、設計そのもの以上に検証の比重が大きいです。
#確認することはたくさんあります。
#- 計算結果が正しいか
- 想定外の入力でも壊れないか
- データが詰まらないか
- 起動から停止まで問題ないか
- バグがないか
たとえば、交通整理のルールを作ったとしても、 実際に車を流してみたら事故が起きるかもしれません。 それを事前に仮想空間で試す感じです。
#チップはあとから修正が高いので、ここで徹底的に見ます。
##
\5. 「論理」から「実際の回路」に変換する
#RTLはまだ人間がわかりやすい抽象的な記述です。 このままでは工場で作れません。
#そこで 論理合成 をします。
#これは、 RTLで書いた内容を、 実際に作れる論理ゲートの組み合わせに変換する工程です。
#たとえば、
#- AND
- OR
- NOT
- フリップフロップ
みたいな部品の集合に落としていきます。
#ここでようやく、 「どういう回路になるか」がかなり具体的になります。
##
\6. チップの中にどう配置するか決める
#次に、それぞれの回路をチップのどこに置くか決めます。
#これは フロアプラン や 配置配線 の段階です。
#ここで考えることは、
#- 近くに置いた方が速い回路は何か
- 電力を大量に使う部分はどこか
- 熱が集中しないか
- 配線が混みすぎないか
- クロック信号をどう配るか
です。
#都市で言えば、
#- 工場をどこに置くか
- 幹線道路をどう通すか
- 電力網をどう引くか
を決めるようなものです。
#回路そのものが正しくても、配置が悪いと
#- 遅くなる
- 電気を食いすぎる
- 熱くなりすぎる
- ノイズが増える
という問題が起きます。
##
\7. 速度、電力、熱、ノイズを詰める
#ここが初心者には見えにくいですが、非常に重要です。
#チップはただ動けばいいわけではなく、
#- 決まったクロックで動くか
- 消費電力が大きすぎないか
- 発熱がひどくないか
- 信号が乱れないか
- 電圧降下で誤動作しないか
を確認します。
#これを詰める段階が、いわゆるサインオフ前の解析です。
#たとえば、理屈上は動く回路でも、 実際には配線が長すぎて信号到達が遅れ、タイミング違反になることがあります。 あるいは、電流が集中して熱くなりすぎることもあります。
#このため、チップ開発は単なる「回路の正しさ」だけでなく、 物理的に現実世界でちゃんと動くかも確認します。
##
\8. テストしやすい仕組みを入れる
#工場で作ったあと、そのチップが良品か不良品か判定しないといけません。
#でもチップの中身は見えません。 だから開発段階で、テスト用の仕組みを入れておきます。
#これが DFT(Design for Test)です。
#たとえば、
#- スキャンチェーン
- 組み込み自己診断
- テストモード
などを入れます。
#つまり設計段階から、 「あとで検査しやすいようにしておく」 のです。
##
\9. 工場に出すための最終データを作る
#ここまで来て、ようやく製造用の最終データを作ります。 これが テープアウト と呼ばれる段階です。
#昔は本当にテープでデータを渡していた名残の言葉ですが、今でも使います。
#ここでは、 「この設計で製造してよい」 という最終版を工場に渡します。
#チップ開発では、このテープアウトは大きな節目です。 ここまでの修正は比較的しやすいですが、ここを過ぎると修正コストが大きくなります。
##
\10. 半導体工場で作る
#次にファウンドリで製造します。 ここが一般にイメージされる「半導体を作る」工程です。
#シリコンウェハーの上に、
#- 薄膜を作る
- 光で模様を転写する
- 不要部分を削る
- 不純物を入れる
- 層を何度も重ねる
という工程を繰り返して、トランジスタや配線を作ります。
#つまり設計者が作った「超細かい設計図」を、 工場が現実の物質として彫り込んでいく感じです。
#この工程は非常に高価で難しく、 先端ノードでは失敗コストも莫大です。
##
\11. 切り分けて、パッケージして、検査する
#ウェハー上には、同じチップがたくさん並んでいます。 それを1個ずつ切り出して、外の基板に実装しやすい形に包みます。 これが パッケージング です。
#最近はここもすごく重要です。 昔の感覚だと「中身のチップが本体、パッケージはおまけ」っぽく見えますが、今は違います。
#特に AI 向けの高性能チップでは、
#- 複数チップを近くに並べる
- HBM を近接配置する
- 2.5D/3D実装する
など、パッケージ技術自体が性能を左右します。
#その後、ちゃんと動くか1個ずつ検査します。 これで不良品をはじきます。
##
\12. ソフトを動かして本当に使えるか確認する
#チップができても終わりではありません。 今度はそのチップの上でファームウェアやOSやドライバを動かします。
#ここで初めて、
#- 起動できるか
- 発熱は大丈夫か
- 実負荷で安定するか
- 期待した性能が出るか
を確認します。
#つまり、設計上は正しくても、 実機で動かしてみると別の問題が出ることがあります。
#ここを バリデーション や シリコン立ち上げ などと呼ぶことがあります。
##
開発に関わる人たち
#チップ開発は一人でやるものではありません。 かなり分業です。
#たとえば、
#- 仕様を決める人
- アーキテクチャを考える人
- RTLを書く人
- 検証する人
- 配置配線をする人
- アナログ回路を作る人
- テスト回路を入れる人
- パッケージを考える人
- ソフトを立ち上げる人
などがいます。
#つまり「半導体設計者」と一言でいっても、実際はかなり役割が分かれています。
##
EDAはどこで使われるのか
#ここで前の話につながります。
#EDAは、今説明した流れの中で使う設計用ソフトです。
#たとえば、
#- RTLを書いて整理する
- シミュレーションする
- 合成する
- 配置配線する
- タイミングを解析する
- 電力やノイズを確認する
こういう工程で使います。
#つまりEDAは、チップ開発のほとんどの「設計・確認」部分を支える道具です。
##
Synopsys、Cadence、Arm、Ansys をこの流れに当てはめると
#この流れで見ると、4社の違いがかなりわかりやすくなります。
#Synopsys
#チップ開発の設計工程で使う、総合的なEDAツールの大手です。 RTL検証、合成、配置配線、タイミング解析など、設計のかなり広い範囲で関わります。
#Cadence
#これも総合EDAの大手です。 Synopsysとかなり近い領域で競合しています。 つまりこの2社は、チップ設計の「道具箱」の大手同士です。
#Arm
#ArmはEDA会社というより、CPUの設計資産を提供する会社です。 つまり「道具」ではなく、「チップの中に入れるCPU部品の設計図」を提供する側です。
#Ansys
#Ansysは、熱・電力・応力・電磁気など、物理的な解析が強い会社です。 設計した回路が現実にちゃんと耐えるかを確認するイメージです。
#かなり単純化すると、
#- Synopsys / Cadence = 設計ツール
- Arm = 入れる中身の一部
- Ansys = 現実世界での問題を解析
です。
##
初心者向けに「1個のチップができるまで」を超短く言うと
#- 何をするチップか決める
- 中の構造を決める
- 回路を書く
- 正しく動くか何度も確認する
- 実際に作れる回路に変換する
- チップ上に配置して配線する
- 速度・電力・熱・ノイズを詰める
- 製造用データを出す
- 工場で作る
- パッケージして検査する
- ソフトを動かして実機確認する
です。
##
最後に、初心者が最初に持つとよいイメージ
#半導体設計は、
#「目に見えない超小型の機械を、まずは言葉とルールで設計し、それを回路にし、最後に物質として作る仕事」
#です。
#そして重要なのは、最初から最後までずっと 速さ・電力・熱・面積・コスト・信頼性 のバランスを取っていることです。
#ここがソフト開発と大きく違います。 ソフトはあとでアップデートしやすいですが、チップは作り直しが重いので、設計段階の確認がものすごく重要です。
##
NVIDIAのGPUが企画から量産されるまで
#全体像
#企画 → アーキテクチャ設計 → EDAでRTL設計・検証 → EDAで合成・配置配線・サインオフ → EDAでDFT/ATPGを仕込む → TSMCへテープアウト → TSMCでウェハ製造 → CoWoSでGPUダイとHBMを一体化 → ウェハーテスト / パッケージ後テスト / 必要に応じてSLT → サーバーボード/システムへ組み込み → 量産・出荷 (StockLight)
##
\1. まずNVIDIAが「どんなGPUを作るか」を決める
#最初は工場の話ではなく、製品企画です。 たとえば NVIDIA は「次のGPUは、どのAIモデル規模を狙うか」「何ワットまで許すか」「HBMを何スタック載せるか」「NVLinkやPCIeをどうするか」などを決めます。NVIDIAは製造そのものより、製品設計・品質・顧客対応に資源を集中する形を取っているので、ここが価値の出発点です。 (StockLight)
#ここで決まるのは、たとえば
#- 演算器をどれだけ並べるか
- メモリ帯域をどこまで必要とするか
- 消費電力と冷却をどう折り合うか
- パッケージをどれだけ大型化するか
といった大方針です。AI GPUでは、GPU本体だけでなく HBM とパッケージまで含めて製品設計になります。NVIDIA自身もメモリを外部から調達しており、年次報告書では SK hynix、Micron、Samsung からメモリを購入するとしています。 (StockLight)
##
\2. EDAで「頭の中の構想」を論理設計に落とす
#次に、NVIDIAの設計チームが EDAツール を使って、GPUの論理設計を具体化します。 ここでは
#- アーキテクチャ探索
- RTL設計
- 論理シミュレーション
- ハードウェア支援検証
- SoC統合
などを進めます。Synopsys は公式に Verification、Hardware Assisted Verification、SoC Integration、Digital Design などを掲げており、Cadence も Digital Design and Signoff を中核フローとして提供しています。 (synopsys.com)
#ここでの感覚は、まだ「物」を作っているのではなく、GPUの中身をソフトウェア的に設計して仮想的に確かめている段階です。 NVIDIAのような会社では、この前半工程で EDA はほぼ必須で、設計の骨格そのものを作る道具です。EDAは、チップ設計の planning、simulation、testing、manufacturing preparation を自動化するものだと Synopsys も説明しています。 (synopsys.com)
##
\3. EDAで「実際に作れる形」にする
#論理設計が固まると、今度は EDA を使って
#- 論理合成
- フロアプラン
- 配置配線
- クロック設計
- タイミング解析
- 消費電力解析
- 物理検証
- サインオフ
を進めます。Synopsys は Fusion Compiler、PrimeTime、IC Validator、RedHawk-SC などを並べており、Cadence も modern chip design の複雑さに対応する digital design and signoff の流れを打ち出しています。 (synopsys.com)
#この段階では、 「このGPUは理屈上動くか」ではなく、「この巨大回路を本当にシリコン上に置いて、所定クロックで、所定電力内で、熱や電源ノイズも含めて成立させられるか」 を詰めます。 つまり EDA は、NVIDIAにとって 企画の次からテープアウト直前まで、ほぼずっと使う中核道具 です。 (synopsys.com)
##
\4. ここで「あとでテストできるようにする」仕込みも入る
#Advantestのようなテスタは後工程で使われますが、その準備は 設計段階で EDA を使って仕込む 必要があります。 これが DFT(Design for Test) と ATPG です。Synopsys の TestMAX DFT は、boundary scan、scan chains、test points、compression などを実装し、TestMAX ATPG は高カバレッジのテストパターンを生成すると説明しています。Cadence の Modus も、full-chip test logic や ATPG を提供しています。 (synopsys.com)
#ここがかなり重要で、 EDAとAdvantestは別物ですが、完全に切れているわけではありません。 NVIDIAは設計段階で「あとでテスタで測りやすい回路」と「テストパターンの土台」を作り込み、その後に実シリコンを測るとき、初めてテスタの世界に渡ります。 (synopsys.com)
##
\5. テープアウトして、TSMCがウェハを作る
#設計が固まると、NVIDIAは製造データを TSMCのようなファウンドリ に渡します。 NVIDIAの年次報告書でも、同社は TSMC や Samsung を利用して半導体ウェハを生産していると明記しています。 (StockLight)
#ここから先は、EDAの中心フェーズから離れ、実際の製造に入ります。 TSMCがリソグラフィ、成膜、エッチングなどを繰り返して、GPUのロジックダイをウェハ上に作ります。 つまり役割分担は、 NVIDIA = 設計する側 TSMC = 作る側 です。 (StockLight)
##
\6. AI GPUでは、作っただけでは終わらない。CoWoSでHBMと一体化する
#AI GPUで特に重要なのが 先端パッケージ です。 TSMC の CoWoS は、公式には Chip on Wafer on Substrate の先端パッケージ技術で、AI やスーパーコンピューティング向けに、logic chiplets と HBM cubes を高密度インターコネクトで統合できる と説明されています。NVIDIA も年次報告書で CoWoS technology を利用している と明記しています。 (3dfabric.tsmc.com)
#ここが普通の初心者には見えにくいところですが、 いまのAI GPUは 「GPUダイを作って終わり」ではありません。 GPU本体のロジックダイ と HBMメモリ を、シリコンインターポーザやRDLインターポーザを使って近接統合し、巨大な1つの高性能パッケージにします。CoWoS-S は logic chiplets と HBM cubes を統合する構造で、より大型向けには CoWoS-L や CoWoS-R の選択肢もあります。 (3dfabric.tsmc.com)
#つまり AI GPU の流れは、 設計 → 製造 → パッケージ ではなく、 設計 → 製造 → 超重要な先端パッケージ統合 です。 今のAI時代は、パッケージングが製品性能そのものの一部になっています。 (3dfabric.tsmc.com)
##
\7. Advantestがいる場所はここ:ウェハーテスト、ファイナルテスト、SLT
#CoWoSや組立の前後で、チップは徹底的に測定されます。 Advantest は公式に、自社の test systems は主に ウェハ生産工程の終わりの wafer test と、パッケージ後の final inspection process で使われると説明しています。さらに volume production 前の design evaluation / process development evaluation や、最終製品に載せた後の system-level test にも使われるとしています。 (株式会社アドバンテスト)
#なので流れの中で言うと、Advantest はこう入ります。
#- ウェハーテスト
まだウェハ状態のGPUダイを測り、良否や特性を確認する
- ファイナルテスト
CoWoSやパッケージ後の完成品を個別に測る
- 必要に応じてSLT/バーンイン
実使用に近い条件で動かし、品質をさらに確認する (株式会社アドバンテスト)
#ここで大事なのは、Advantest は NVIDIA の設計を作る会社ではなく、できあがったシリコンやパッケージが本当に良品かどうかを測る側だということです。 ただし測定結果は無駄ではなく、Advantest は量産テストで見つかった欠陥原因を設計段階へフィードバックし、歩留まり改善につなげるとも説明しています。 (株式会社アドバンテスト)
##
\8. 組立・システム化して、量産に入る
#NVIDIAは年次報告書で、製造の全フェーズでパートナーを活用し、assembly, testing, packaging にも外部企業を使うとしています。例として Hon Hai(Foxconn)、Wistron、Fabrinet などが挙げられています。別の公式資料では、米国内製造の文脈で TSMC、Foxconn、Wistron、Amkor、SPIL と協業するとしています。 (StockLight)
#つまり、最終的な量産の絵は、 NVIDIAが設計し、TSMCがロジックダイを作り、CoWoSなどの先端パッケージでGPUとHBMを統合し、テスト工程ではAdvantestのようなATE/SLT装置が活躍し、組立・実装パートナーが完成品やシステムへ仕上げる という形です。 (StockLight)
##
1行ずつ対応づけるとこうです
#NVIDIA = 何を作るか決めて、GPUを設計する会社。fablessなので、価値の中心は設計と製品化にある。 (StockLight)
#EDA(Synopsys / Cadence など) = NVIDIAが、GPUを「作る前」に設計・検証・実装・サインオフ・DFTするための道具。 (synopsys.com)
#TSMC = NVIDIAの設計データをもとに、GPUのロジックダイを実際にウェハ上へ作る側。 (StockLight)
#CoWoS / 先端パッケージ = GPUダイとHBMを高密度につなぎ、AI GPUとして成立させる超重要工程。 (3dfabric.tsmc.com)
#Advantest = ウェハーテスト、ファイナルテスト、SLTなどで、できた半導体が本当に良品かを測る側。 (株式会社アドバンテスト)
##
すごく短く言うと
#EDAは「作る前の世界」、 TSMCは「作る世界」、 CoWoSは「GPUとHBMを1つの高性能製品にする世界」、 Advantestは「作られたものを測って品質を保証する世界」 です。 (StockLight)
##
EDAをゲームエンジンやblender、或いはそのプラグイン喩えると
#ただし、そのまま「EDA = ゲームエンジン」ではないです。
#いちばん近い言い方をすると、EDA は
#Blender + ゲームエンジン + コンパイラ + 静的解析ツール + 自動配線ツール + 製造前検査ツール
#を全部まとめたような世界です。
#似ているところ
#\1. 作るための「開発基盤」である
#ゲームエンジンは、ゲームそのものではなく、ゲームを作るための土台です。 EDA も同じで、半導体そのものではなく、半導体を作るための土台です。
#- Unity/Unreal → ゲームを作る
- EDA → チップを作る
この意味ではかなり近いです。
#\2. 部品を組み合わせて大きなものを作る
#ゲーム開発でも、
#- 3Dモデル
- スクリプト
- 物理
- UI
- プラグイン
- アセット
を組み合わせます。
#半導体設計でも、
#- CPUコア
- メモリ
- インターフェースIP
- 配線
- 検証IP
- 物理ライブラリ
を組み合わせます。
#ここはかなり似ています。
#\3. 外部資産を入れて使う
#Blenderのアドオンやゲームエンジンのプラグインみたいに、半導体でも IP という既製部品を使います。
#たとえば、
#- Arm のCPUコア
- PCIe
- USB
- DDRコントローラ
などです。
#この意味では、IPはプラグインや既製アセットにかなり近いです。
##
ゲームエンジンとEDAの違い
#\1. EDAは「見た目を作る」より「成立するかを証明する」寄り
#Blender は視覚的に形を作る感覚が強いです。 でも EDA は、見た目よりも
#- 論理的に正しいか
- タイミングが間に合うか
- 電力が大丈夫か
- 熱で死なないか
- 配線できるか
- 製造ルール違反がないか
を詰める比重がすごく大きいです。
#つまり EDA は、クリエイティブツールというより 工学検証ツールの塊 に近いです。
#\2. 「あとで直せる」が弱い
#ゲームは出したあとにパッチを当てやすいです。 でもチップは、作ってしまうと修正コストが非常に重いです。
#だから EDA は、 出す前に徹底的に潰す ためのツール群です。
#この点はゲームエンジンよりずっと厳しいです。
#\3. 自動化の重みがかなり大きい
#Blenderは人が形を触る感じがありますが、EDA は
#- 合成
- 配置配線
- タイミング最適化
- DRC/LVSチェック
- ATPG
など、自動処理の比重がかなり大きいです。
#人が全部描くというより、 制約を与えてツールに最適化させる 感覚が強いです。
##
たとえ直すならこうです
#一番近い比喩
#EDA = ゲームエンジンというより、「ゲーム開発環境 + コンパイラ + デバッガ + 最適化ツール + コンソール向けビルドシステム + 品質検査」全部入り
#です。
#Blender寄りで言うなら
#- Blenderそのもの、というよりは
Blenderでモデリングする機能
- さらに
エラー検出、物理成立確認、出力先制約への変換
- さらに
工場でそのまま作れる形式へ落とす機能
#まで全部入っている感じです。
##
対応関係をざっくり置くと
#- ゲームエンジン本体
↔ EDA全体の設計基盤
- プラグイン / アセット
↔ ArmなどのIP、各種ライブラリ、PDK
- スクリプトを書く
↔ RTLを書く
- ビルドする
↔ 論理合成
- マップ上にオブジェクト配置
↔ 配置配線
- 負荷や不具合チェック
↔ タイミング解析、電力解析、検証
- 対象ハード向けに最終出力
↔ テープアウト用データ作成
##
かなり本質的な言い方をすると
#EDA は 「チップを作るための統合開発環境」 です。
#なので、あなたの感覚は半分当たりです。 ただし実際には、ゲームエンジンや Blender よりもずっと
#検証、制約、最適化、製造成立性
#の比重が大きいです。
#一言で言うなら、
#“見た目を作るツール”というより、“現実に作れて壊れず動く設計を完成させるツール群”
#です。
##
EDAを使う人の仕事を、ゲーム開発者・3Dモデラー・ビルドエンジニアに対応させて説明
#結論から言うと、半導体開発の現場には、
#ゲーム開発者っぽい人 3Dモデラーっぽい人 ビルド/最適化エンジニアっぽい人 QA/デバッガっぽい人
#がいて、みんな別のEDAを主に使っています。
##
全体の対応イメージ
#まずざっくり対応させるとこうです。
#- ゲームの仕様を考える人
↔ 半導体アーキテクト
- ゲームロジックを書く人
↔ RTL設計者
- 3Dモデルやシーンを組む人
↔ 物理設計者(配置配線)
- ビルドや最適化を詰める人
↔ 合成・タイミング・実装エンジニア
- QAやテスト自動化の人
↔ 検証エンジニア / DFTエンジニア
- 実機で重さや挙動を見る人
↔ シリコン評価・テストエンジニア
#つまりEDAは1個のツールではなく、 ゲーム制作会社で使う開発ツール一式 みたいなものです。
##
\1. 半導体アーキテクト
#ゲームでいうと
#ゲームディレクター / システム設計者
#この人は、 「どんなGPUにするか」 「どれくらい速くするか」 「電力はどこまで許すか」 「メモリ帯域はどれくらい必要か」 を決めます。
#ゲームでいうと、
#- オープンワールドにするのか
- 60fpsを狙うのか
- スマホ向けかPC向けか
- 物理演算をどれくらい入れるか
を決める人に近いです。
#この段階では、まだ細かい回路を書くというより、 作品の設計思想を決める 感じです。
##
\2. RTL設計者
#ゲームでいうと
#ゲームプログラマー
#この人が、チップの動作そのものを書きます。 Verilog や VHDL のような言語で、
#- この信号が来たらこう動く
- この条件ならこのデータを送る
- この状態なら待つ
といった回路の振る舞いを書きます。
#ゲームでいうと、
#- プレイヤー入力を受ける
- 敵AIを動かす
- ダメージ計算する
- 状態遷移を作る
みたいなロジックを書く人です。
#かなり似ています。 ただし違うのは、ゲームコードよりも 並列動作 クロックに合わせた動き 1クロック遅れる/遅れない みたいなハード特有の感覚が強いことです。
#なので RTL設計者は、 ゲームプログラマーにかなり近いが、もっと時間軸と並列性に厳しい人 という感じです。
##
\3. 検証エンジニア
#ゲームでいうと
#QA + テスト自動化 + デバッガ担当
#この人は、「RTL設計者が書いた回路が本当に正しいか」を確かめます。
#たとえば、
#- 想定通りの計算結果になるか
- 特殊な入力で壊れないか
- 詰まりやデッドロックが起きないか
- バグが潜んでいないか
を大量に確認します。
#ゲームでいうと、
#- 壁抜けしないか
- 特定条件でフリーズしないか
- セーブデータが壊れないか
- 自動テストで異常を炙り出す
みたいな仕事です。
#むしろ半導体ではここがすごく重要で、 設計者より検証側の人数や工数が大きい ことも珍しくありません。
#なぜなら、ゲームは後でパッチを当てやすいですが、 チップは作ってから直すのがすごく高いからです。
##
\4. 物理設計者(配置配線)
#ゲームでいうと
#3Dモデラー + レベルデザイナー + シーン構築担当
#この人は、論理設計された回路を 実際にシリコン上へどう置いて、どうつなぐか を詰めます。
#ここはかなり3Dモデラー感があります。 なぜなら、ただ機能が正しいだけではダメで、
#- どこに置くか
- どう線を引くか
- 混みすぎないか
- 熱が偏らないか
- 電力網が持つか
を考えるからです。
#ゲームでいうと、
#- オブジェクト配置
- 当たり判定の整理
- シーンの最適なレイアウト
- カメラや光源の都合
- メモリや描画負荷の制約
を考えながらステージを組む人に近いです。
#ただし半導体では、見た目の美しさではなく 物理的に動くか、遅延が足りるか、ルール違反がないか が評価基準です。
#なので、 3Dモデラーというより“超制約だらけの工業レイアウト設計者” という感じです。
##
\5. 合成・タイミング・実装エンジニア
#ゲームでいうと
#ビルドエンジニア + 最適化エンジニア
#この人たちは、
#- RTLをゲート回路へ変換する
- 面積を減らす
- 電力を減らす
- タイミングを間に合わせる
- クロック周波数目標を満たす
といったことを詰めます。
#ゲームでいうとかなり近いのは、
#- ビルドが通るようにする
- プラットフォーム向けに最適化する
- フレームレートを安定させる
- メモリ消費を削る
- ロード時間を減らす
をやる人です。
#たとえばゲームで 「動くけど重い」 「高スペックPCでは動くけど目標ハードでは60fpsが出ない」 という問題がありますよね。
#半導体でも同じで、 「論理的には正しいけど、目標クロックで動かない」 「消費電力が大きすぎる」 「面積がでかすぎて高すぎる」 という問題が起きます。
#これを詰めるのがこの人たちです。
#かなり本質的に、 半導体版ビルド&最適化職 です。
##
\6. DFTエンジニア
#ゲームでいうと
#テスト自動化基盤を入れる人
#DFTは Design for Test の略で、 「あとで製造後にちゃんと検査できるように、設計段階で仕掛けを入れておく」仕事です。
#ゲームでいうと、
#- デバッグログを仕込む
- テストモードを作る
- 自動テストしやすいフックを入れる
- 隠し診断画面を作る
みたいな役割に近いです。
#普通のユーザーは触らないけれど、 開発や品質管理には絶対必要、という部分です。
#半導体では、
#- スキャンチェーン
- テストポイント
- BIST
- ATPG向けの回路
を入れます。
#つまり DFT エンジニアは、 量産テストのための仕組みを事前に組み込む人 です。
##
\7. シリコン評価・テストエンジニア
#ゲームでいうと
#実機QA + 実機パフォーマンス検証担当
#この人たちは、実際にできたチップを評価します。 ここで初めて、Advantestのようなテスタや各種測定器が本格的に出てきます。
#ゲームでいうと、
#- 実機で落ちないか
- 想定ハードでちゃんと動くか
- 温度上昇で不具合が出ないか
- 長時間動作で安定するか
を確認する人です。
#開発機上では動いたのに、実機だと問題が出ることがありますよね。 半導体も同じで、設計上は問題なくても、 実シリコンでは電圧、熱、ばらつき、ノイズで問題が出ることがあります。
#この人たちは 半導体の実機デバッグ担当 みたいなものです。
##
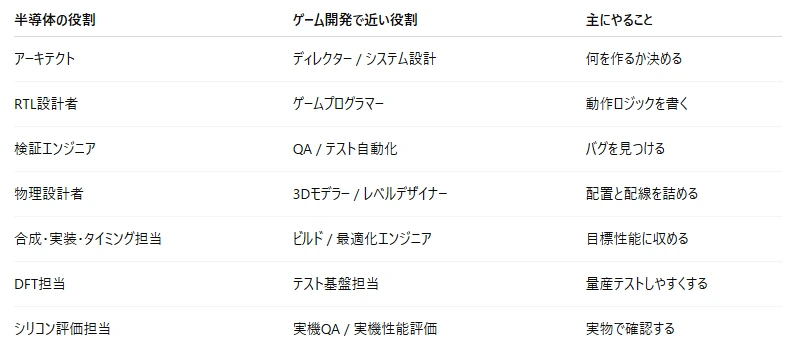
一枚で対応させると
#
#
EDAを使う人は「1種類の職業」ではない
#ここが一番大事です。
#初心者だと 「EDAを使う人 = 半導体設計者」 とひとまとめに見えますが、実際にはかなり違います。
#同じEDAでも、
#- RTLを書く人が使うツール
- 検証する人が使うツール
- 配置配線する人が使うツール
- タイミングを見る人が使うツール
- DFTを入れる人が使うツール
はかなり違います。
#つまり EDA は、 Photoshop 1本で全部やる みたいな世界ではなく、 ゲーム開発会社の全員がそれぞれ違う開発ツールを使っている のに近いです。
##
一番しっくりくるまとめ方
#かなり雑に1文で言うと、
#- RTL設計者 はゲームプログラマー
- 物理設計者 は3Dモデラー兼レベル配置担当
- 合成/タイミング担当 はビルドと最適化担当
- 検証/DFT担当 はQAとテスト自動化担当
- シリコン評価担当 は実機デバッガ
です。
#そして EDAは、その全員が使う“半導体版の総合開発環境群” です。
##
半導体設計の職種ごとに、実際どんな画面を見て何をしているのか
#半導体設計の現場は、外から見ると全員ただPCに向かっているように見えますが、職種ごとに見ている画面も、考えていることもかなり違います。 なのでここでは、「NVIDIAのような会社で大きなGPUを作っているチーム」 をなんとなく想像しながら、作業風景っぽく説明します。
##
まず全体の空気感
#半導体設計者は、机の上で半田ごてを持っているというより、基本は
#- 複数モニター
- Linux端末
- EDAツールのGUI
- ログファイル
- 波形ビューア
- レポート表
- レイアウト画面
を見ながら仕事しています。
#見た目の派手さはあまりなくて、むしろ 「数字」「配線」「波形」「エラー一覧」とずっと戦う仕事 に近いです。
#ゲーム開発なら画面にキャラや背景が出ますが、半導体設計では
#- 線
- 四角
- 波形
- テキスト
- タイミング表
が主役です。
##
\1. アーキテクトの画面
#何を見ているか
#この人は、いきなり細かい回路画面をずっと見ているわけではありません。 どちらかというと、
#- ブロック図
- 性能予測表
- 帯域試算
- 電力予算表
- 面積見積もり
- シミュレーション結果
- プレゼン資料や仕様書
を見ています。
#画面のイメージとしては、 PowerPoint、表計算、社内設計図、性能モデル、簡易シミュレーター が多いです。
#何をしているか
#たとえば AI GPU の場合なら、
#「この世代は演算器をどれくらい増やすか」 「HBM帯域はこれで足りるか」 「NVLinkを何本にするか」 「消費電力上限の中で、どこに予算を振るか」
#みたいなことを考えています。
#作業風景としては、 大きなブロック図を見ながら、
#「このキャッシュ構成だと帯域が足りない」 「演算器を増やしてもメモリ側が詰まる」 「このままだと電力が枠を超える」
#みたいに議論しています。
#この人は、絵を描く人というより “製品の頭脳と骨格を決める人” です。
##
\2. RTL設計者の画面
#何を見ているか
#この人はかなり「コードを書く人」です。 見ているのは主に
#- Verilog / SystemVerilog のソースコード
- エディタ
- コンパイルログ
- 簡易波形
- 仕様書PDF
- Gitの差分
です。
#画面の雰囲気はかなりプログラマーに近いです。 左にコード、右に仕様書、下にログ、別モニターに波形、みたいな感じです。
#コードには例えばこういう世界があります。
#- 状態遷移
- パイプライン制御
- データの受け渡し
- バッファ制御
- エラー条件
- フラグ管理
ただし普通のソフトコードより、 「何クロック目に何が起きるか」 がとても重要です。
#何をしているか
#たとえば、
#「この演算ユニットは入力を受けて3クロック後に結果を返す」 「この条件ではパケットを待たせる」 「この信号が立ったら次のステージへ進める」
#みたいなことを書いています。
#作業風景としては、 コードを修正して保存し、テストを流し、ログを見て、
#「この if の条件で1サイクルずれてる」 「valid と ready の握手が壊れてる」 「リセット直後に不定状態が出る」
#みたいに詰めています。
#見た目は地味ですが、中身はかなり濃いです。 “電子回路の動作を言葉で書くプログラマー” という感じです。
##
\3. 検証エンジニアの画面
#何を見ているか
#この人の画面は、初心者が見るとかなり「それっぽい」です。 よく出てくるのは
#- 波形ビューア
- テストベンチコード
- シミュレーションログ
- アサーションエラー
- カバレッジレポート
- バグ管理票
です。
#特に波形ビューアは印象的で、画面いっぱいに 0 と 1 の信号が時間軸で並んでいます。 何十本、何百本もの信号が横に流れていて、拡大縮小しながら原因を追います。
#何をしているか
#たとえば、
#「この要求信号が来たあと、3クロック以内に応答が返るはず」 「この2つの信号は同時に立ってはいけない」 「このエラー処理のときにFIFOが空になるのはおかしい」
#みたいなことを見ています。
#作業風景としては、 失敗したテストを開いて、波形をスクロールしながら、
#「ここで valid が出てるのに ready が返ってない」 「このフラグが1クロック早く落ちてる」 「仕様ではこの順番のはずなのに、逆転してる」
#と detective みたいに追います。
#この仕事は本当に “電子回路の事件現場を波形で捜査する人” です。
##
\4. 論理合成・実装前担当の画面
#何を見ているか
#この人は、RTLを「実際の回路」に変えていく人です。 画面には
#- 合成スクリプト
- ターミナル
- 合成レポート
- 面積レポート
- 消費電力レポート
- タイミングレポート
が並びます。
#見た目はかなりテキスト寄りです。 ログの量が多く、初心者には呪文に見える感じです。
#例えばレポートには、
#- Area
- Worst Negative Slack
- Total Negative Slack
- Clock frequency
- Cell count
などが並びます。
#何をしているか
#この人は、
#「このRTLをこのライブラリで合成したら面積はいくつか」 「目標クロックに届くか」 「無駄に大きい回路になっていないか」
#を見ています。
#作業風景としては、 スクリプトを回して結果を見て、
#「速いけど面積が増えすぎた」 「電力は減ったがタイミングが悪化した」 「このモジュールだけ異常に重い」
#と調整しています。
#ゲーム開発でいうと、 ビルドしてパフォーマンスを見て、コンパイラ最適化を調整する感じに近いです。
##
\5. 物理設計者(配置配線)の画面
#何を見ているか
#この人の画面は、見た目としてはかなり特徴的です。 GUI上に、チップの平面図みたいなものが出ます。
#- 四角いブロック
- びっしり詰まったセル
- 色分けされた配線層
- 電源網
- 密度ヒートマップ
- congestion map
- timing hot spot
みたいな表示です。
#初心者が見ると、 「都市地図」 とか 「基板アート」 みたいに見えることがあります。
#拡大すると、ものすごく細かいセルが並んでいて、さらに拡大すると配線が何層にも走っています。
#何をしているか
#この人は、
#「このブロックをどこに置くか」 「配線が詰まりすぎていないか」 「クロックを均等に配れるか」 「熱や電力の偏りはないか」
#を見ています。
#作業風景としては、 チップ全体図を見ながら、
#「ここは混みすぎて配線が通らない」 「このメモリの位置が遠くて遅延がきつい」 「このあたりに電源が集中してIR dropが危ない」
#と詰めています。
#この人の仕事は、 “論理的に正しい回路を、現実のシリコンの地面にちゃんと住まわせる仕事” です。
##
\6. タイミング解析担当の画面
#何を見ているか
#この人の画面は、かなり数字とパスの世界です。 よく見るのは
#- Slackレポート
- クリティカルパス一覧
- クロックツリー情報
- 遅延内訳
- setup / hold violation 一覧
です。
#GUIでパスをハイライトすることもありますが、 基本はレポートと数字とパス名を延々追う時間も多いです。
#何をしているか
#たとえば、
#「この信号は次のクロックまでに到達しない」 「この経路が長すぎて目標周波数に届かない」 「ここだけ hold 違反が出ている」
#みたいなことを見ています。
#作業風景としては、
#「このレジスタからこのレジスタへの経路が長すぎる」 「バッファ挿入で直せるか」 「配置を寄せるべきか」 「論理を分割するべきか」
#と考えています。
#ゲームで言えばフレーム落ちの原因を細かく見る人に近いですが、 半導体ではそれがピコ秒、ナノ秒単位です。
##
\7. 電力・熱・電源完全性担当の画面
#何を見ているか
#この人の画面には、ヒートマップや解析結果が多いです。
#- 消費電力分布
- IR drop マップ
- EM解析結果
- 温度分布
- hotspot表示
- パッケージ込みの解析結果
色で赤いところが危ない、青いところは余裕がある、みたいな表示になることがあります。
#かなり「工学解析」っぽい画面です。
#何をしているか
#たとえば、
#「この領域は電流が集中しすぎている」 「ここは温度が上がりすぎる」 「この電源配線では電圧が落ちすぎる」 「長時間動作で信頼性が危ない」
#みたいなことを見ています。
#作業風景としては、 解析結果のヒートマップを見ながら、
#「この演算ブロックが集中しすぎ」 「電源メッシュを太くする必要がある」 「配置を散らさないと熱が逃げない」
#と考えています。
#この人たちは、 “動くか”ではなく“壊れず安全に動き続けるか”を見る人 です。
##
\8. DFTエンジニアの画面
#何を見ているか
#この人は、量産テストの準備をする人です。 画面には
#- スキャンチェーン構成
- テストポイント挿入結果
- ATPGレポート
- fault coverage
- DRC for test
- テストパターン生成ログ
などが出ます。
#やや特殊で、普通の機能設計とは違う世界です。
#何をしているか
#この人は、
#「あとで工場やテスタで不良を見つけやすいようにする」 「スキャンチェーンが正しくつながっているか」 「故障検出率が足りているか」
#を見ています。
#作業風景としては、
#「このブロックは観測しにくい」 「ここにテストポイントを足すべき」 「この故障モデルのカバレッジが足りない」
#と考えています。
#表向きの機能を作る人ではなく、 “量産で困らないよう裏口と診断機能を入れる人” に近いです。
##
\9. シリコン評価・テスト担当の画面
#何を見ているか
#この人は、実物ができてから活躍します。 画面には
#- 測定器の結果
- テスタ出力
- 電圧・電流ログ
- 周波数特性
- 歩留まりデータ
- 良品/不良品の分布
- 実チップの動作ログ
が並びます。
#設計画面というより、評価・測定・統計の画面です。
#何をしているか
#たとえば、
#「このロットだけ異常に歩留まりが悪い」 「この条件だと周波数が伸びない」 「高温時だけ不安定になる」 「このパターンでだけエラーが出る」
#みたいなことを見ます。
#作業風景としては、 実チップを評価ボードに載せ、測定結果を取り込みながら、
#「設計の問題か、製造ばらつきか、パッケージ要因か」 「不良がこのブロック周辺に偏っていないか」 「DFTやATPGの想定どおりに観測できているか」
#を追っています。
#ここで初めて、Advantestのようなテスタの世界と深くつながります。
##
\10. 全員の作業風景を並べるとこうなる
#かなりざっくり言うと、
#- アーキテクト は、表や図を見ながら「何を作るか」を決める
- RTL設計者 は、コードを書きながら「どう動くか」を作る
- 検証担当 は、波形を見ながら「本当に正しいか」を暴く
- 合成担当 は、レポートを見ながら「回路として成立するか」を詰める
- 物理設計担当 は、レイアウト画面を見ながら「シリコン上に住ませる」
- タイミング担当 は、遅延表を見ながら「間に合うか」を削る
- 電力・熱担当 は、ヒートマップを見ながら「無事に動き続けるか」を守る
- DFT担当 は、テスト構成を見ながら「あとで検査できるようにする」
- 評価担当 は、実測データを見ながら「実物で本当に成立したか」を確かめる
です。
##
初心者向けに一番わかりやすいまとめ
#半導体設計の現場は、派手な3D映像をいじる感じではなく、
#コードを書く人 波形を見る人 レイアウト地図を見る人 数字の表とエラーを潰す人 最後に実物を測る人
#の集まりです。
#つまり、みんな同じ「半導体設計者」に見えても、実際には
#- ソフト開発者っぽい人
- デバッガっぽい人
- 都市設計者っぽい人
- 解析屋っぽい人
- 品質保証っぽい人
が同じチップを別の角度から見ている、という感じです。
##
GPU1個の中に、こういう人たちがどの順番で関わるのか時系列でつなげてみてみると
#はい。 では 「GPU1個が企画されてから、実物になって量産されるまで」 を、どの職種の人が、どの順番で関わるか で時系列につなげます。
#大事なのは、これは完全な一直線ではなく、実際は 前に進む → 問題が出て戻る → 直してまた進む を何度も繰り返すことです。 ただ、まずは見通しが立つように、いったん一本の流れとして描きます。
##
\0. まず「次のGPUで何を達成したいか」を決める
#関わる人
#- 事業側
- 製品企画
- 半導体アーキテクト
- ソフトウェア/システム側の上流担当
ここではまだ回路を書きません。 最初に決めるのは、
#- どの市場向けか
- どれくらい速くしたいか
- 消費電力はどこまで許すか
- HBMを何個載せるか
- NVLinkやPCIeをどうするか
- コストやダイサイズをどうするか
です。
#イメージとしては、 「次のGPUは、どんな怪物にするのか」 を決めている段階です。
#ここでの主役は、前に話した対応でいうと ゲームディレクター/システム設計者的な人 です。
##
\1. GPUの中身を大ブロックに分ける
#関わる人
#- アーキテクト
- 一部の上級設計者
- メモリ/インターコネクト担当
- 性能モデリング担当
ここで 「演算器はどれくらい並べるか」 「キャッシュはどう置くか」 「メモリ帯域はどれくらい必要か」 「GPUコア、メモリ制御、I/Oをどうつなぐか」 を決めます。
#まだ細かいRTLではなく、 設計図の骨格 を描く段階です。
#たとえると、 家ではなく都市の設計図で 「工業地帯はここ、幹線道路はここ、発電所はここ」 と決める感じです。
##
\2. 必要なIPや既製部品を選ぶ
#関わる人
#- アーキテクト
- SoC統合担当
- インターフェース担当
- 外部IP評価担当
GPUを全部ゼロから作るとは限りません。 たとえば一部には、
#- PCIe関連
- セキュリティブロック
- メモリPHY
- 各種インターフェース
- CPU管理ブロック
など、既製IPや流用資産を使うことがあります。
#ここでは 「どこを自作し、どこを流用するか」 が決まります。
#ゲームでいうと、 エンジン標準機能や外部ミドルウェアを何にするか決める段階に近いです。
##
\3. RTL設計者が、GPUの各ブロックの動作を書く
#関わる人
#- RTL設計者
- ブロック設計担当
- 制御ロジック担当
- パイプライン担当
ここで初めて、各ブロックが SystemVerilog/Verilog などで具体的に書かれます。
#たとえば、
#- 演算命令をどう流すか
- データを何クロックで渡すか
- キャッシュ制御をどうするか
- メモリ要求をどうさばくか
- エラー処理をどうするか
を実際の回路として記述していきます。
#ここが、前に言った ゲームプログラマーに近い人 の仕事です。
#この段階では、1つの大きなGPUではなく、 まずは 小さいブロックごと に設計していくことが多いです。
##
\4. その横で、検証エンジニアが同時に待ち構えている
#関わる人
#- 検証エンジニア
- テストベンチ開発担当
- フォーマル検証担当
- カバレッジ担当
RTL設計者が書いたものを、検証側がすぐ追いかけます。 つまり時系列では「RTLを書き終わってから検証」ではなく、
#RTLを書くのと並行して、検証環境も作られる
#のが普通です。
#検証側は、
#- 正常系のテスト
- 異常系のテスト
- 境界条件
- ランダムテスト
- アサーション
- カバレッジ確認
を用意して、設計にバグがないかを見ます。
#ここで大量に 「ここ壊れてます」 が返ってきて、RTL設計者が直します。
#つまり流れとしては、
#RTL設計者が書く → 検証が叩く → バグが出る → RTL設計者が直す
#を何度も回します。
##
\5. 小ブロックをつないで、大きなGPUにしていく
#関わる人
#- SoC統合担当
- RTL設計者
- 検証エンジニア
- クロック/リセット担当
各ブロックがある程度できたら、今度はそれをつなぎます。 ここで難しくなるのは、
#- ブロック同士の接続
- クロックの違い
- リセット順序
- データ詰まり
- 帯域競合
- キャッシュ整合性
- 電源管理
です。
#小さいブロック単体では動いても、 つないだ瞬間に一気に難しくなります。
#このあたりから 「GPU1個を本当に1つの生き物として動かす」 フェーズに入ります。
##
\6. 合成担当が「この設計を本当の回路にするとどうなるか」を見る
#関わる人
#- 論理合成担当
- 実装前最適化担当
- 一部RTL設計者
ここでRTLを、実際のゲート回路へ変換します。 このとき見るのは、
#- 面積が大きすぎないか
- 目標クロックに届くか
- 電力が増えすぎないか
- 想定より重いブロックがないか
です。
#ここで問題が出ると、設計者に戻って 「このロジック重すぎます」 「パイプラインを1段増やしてください」 「この経路が長すぎます」 みたいな修正依頼が飛びます。
#つまり時系列としては、
#RTL設計 → 合成 → 性能が出ない → RTLに差し戻し
#が普通に起きます。
##
\7. DFT担当が、量産後に検査できる仕組みを入れる
#関わる人
#- DFTエンジニア
- ATPG担当
- 合成/実装担当
- 検証担当
ここで 「できあがったGPUを、工場やテスタでどう検査するか」 のための仕組みを設計に入れます。
#たとえば、
#- スキャンチェーン
- テストポイント
- BIST
- 圧縮回路
などです。
#つまりこの人たちは、量産後に Advantest などで測れるように、 設計段階で裏側の診断ルートを仕込む 人です。
#流れでいうと、 EDAの世界と、後のテスト工程の世界をつなぐ橋です。
##
\8. 物理設計者が、GPUをシリコン上に置き始める
#関わる人
#- フロアプラン担当
- 物理設計者
- 配置配線担当
- クロック設計担当
ここから、論理的に書かれたGPUを 実際にシリコンの上へ配置していく 段階に入ります。
#まず大きなブロックをどこに置くか決めます。 たとえば、
#- 演算ブロック群
- キャッシュ群
- メモリI/O周辺
- 制御ブロック
- 電源網
をどこに置くか考えます。
#ここはまさに 都市設計 です。
#ここで位置が悪いと、
#- 配線が混みすぎる
- 遅延が増える
- 電源が苦しくなる
- 熱が集中する
ので、後工程全体に響きます。
##
\9. 配置配線が進み、タイミング・電力・熱の専門家が本格参戦する
#関わる人
#- 配置配線担当
- タイミング解析担当
- 電力解析担当
- IR/EM担当
- 熱解析担当
ここからGPUは 机上の論理 ではなく 現実の物理物体 になっていきます。
#ここで見るのは、
#- 目標クロックで本当に動くか
- 配線が長すぎないか
- 電力が集中しすぎていないか
- 電圧降下は大丈夫か
- 発熱が危険でないか
- 配線ルール違反がないか
です。
#この段階で問題が出ると、
#- 配置を変える
- バッファを入れる
- 電源網を強化する
- RTL自体を少し直す
- 一部ブロックを作り直す
こともあります。
#つまりここでも 物理設計 → 解析 → 問題発覚 → 前工程へ戻る が起きます。
##
\10. サインオフに向けて、各分野の担当が最後の詰めをする
#関わる人
#- 物理設計
- タイミング
- 電力/熱
- DFT
- 検証
- 設計責任者
- 品質保証的な上位レビュー担当
ここでは 「このGPU、もう本当に工場へ出していいのか」 を総点検します。
#見るのは、
#- 機能的に正しいか
- テスト可能か
- タイミングが閉じているか
- 消費電力は許容内か
- 物理ルール違反がないか
- 信頼性上の危険がないか
です。
#ここは一種の 出荷判定会議前の総合試験 みたいな空気です。
##
\11. テープアウトして、設計チームの主役が工場側へバトンタッチする
#関わる人
#- 設計責任者
- CAD/フロー担当
- ファウンドリ連携担当
- TSMC側の製造担当
ここで製造用データを TSMC などへ渡します。 ここが テープアウト です。
#この瞬間、主役は少し変わります。 それまで中心だったのは EDA を使う設計者たちでしたが、 ここからは 製造側 の比重が上がります。
#つまり流れとしては、
#EDAの世界のピークがここまで
#です。
##
\12. TSMCがウェハを作る
#関わる人
#- TSMCの製造側
- プロセス担当
- NVIDIA側の製造連携担当
ここでGPUのロジックダイが実際に作られます。 ここは半導体工場の世界で、
#- 成膜
- 露光
- エッチング
- イオン注入
- 多層配線形成
などが進みます。
#この段階では、NVIDIAのRTL設計者が何か画面で直接いじるというより、 ファウンドリと製造条件・歩留まり・進捗を連携して見る側になります。
##
\13. ウェハができたら、まずテスト工程が入る
#関わる人
#- テストエンジニア
- DFT/ATPG担当
- AdvantestなどのATE運用側
- 歩留まり解析担当
ここでまず ウェハーテスト です。 まだウェハ状態の各ダイに針を当てて、
#- 動くか
- どこに不良があるか
- 基本特性がどうか
を測ります。
#ここで初めて、前に設計段階で仕込んだ DFT が本格的に生きます。 つまり、
#設計時のDFT担当の仕事が、ここで現実のテスト工程につながる
#わけです。
#Advantest のようなテスタは、まさにこの辺の重要プレイヤーです。
##
\14. 良品ダイが選別され、CoWoSやパッケージ工程へ進む
#関わる人
#- 先端パッケージ担当
- 組立工程側
- HBM連携側
- 製品化担当
AI GPUではここが極めて重要です。 GPUダイだけでは製品にならず、 HBMと一緒に CoWoS などの先端パッケージ に載せて、巨大な1つの高性能製品にします。
#ここでは、
#- GPUダイ
- HBMスタック
- インターポーザ
- 基板
- パッケージ
が統合されます。
#つまりここで初めて、 「GPUの頭脳」 が 「製品としての体」 を持ちます。
##
\15. パッケージ後に、またテストする
#関わる人
#- テストエンジニア
- パッケージ評価担当
- Advantestなどのテスタ側
- 信頼性評価担当
パッケージ後には ファイナルテスト が入ります。 さらに必要に応じて、
#- 高温動作試験
- 長時間試験
- システムレベルテスト
- バーンイン
も行われます。
#ここで見たいのは、
#- パッケージ後でも正常か
- HBM接続込みで問題ないか
- 高負荷で安定するか
- 初期不良がないか
です。
#つまり 作る前の仮想世界の検証 は終わり、 ここでは 現実の製品の検証 に切り替わっています。
##
\16. 実物GPUを立ち上げ、評価チームが本当に使えるか確認する
#関わる人
#- シリコン評価担当
- ボード設計担当
- BIOS/ファームウェア担当
- ドライバ/ソフト側
- 品質/信頼性担当
ここで実際のGPUを評価ボードやサーバー上で動かします。
#見るのは、
#- 起動するか
- 期待周波数に届くか
- 電力や温度は想定内か
- HBMが正常か
- 長時間動作で落ちないか
- ベンチや実アプリで性能が出るか
です。
#ここは、設計の終点であると同時に、 次世代改善の始点でもあります。
##
\17. 問題が見つかれば、また前の人たちへ戻る
#関わる人
#- 評価担当
- テスト担当
- DFT担当
- 物理設計
- RTL設計
- アーキテクト
ここがとても重要です。 実シリコンで問題が見つかると、
#- テスト条件を見直す
- パッケージを見直す
- 歩留まり改善をする
- 一部マスク修正を検討する
- 次版RTLで修正する
- 次世代設計へ反映する
という形で、前工程にフィードバックされます。
#つまりGPU開発は一本のベルトコンベヤーではなく、 巨大なループ構造 です。
##
1本の流れとして超短くつなぐと
#企画する人 が「次のGPUの方向性」を決める → アーキテクト が骨格を決める → RTL設計者 が各ブロックを書く → 検証エンジニア が壊してバグを出す → SoC統合担当 が全体をつなぐ → 合成担当 が本当の回路に落とす → DFT担当 がテストできる仕組みを入れる → 物理設計担当 がシリコン上に配置する → タイミング/電力/熱担当 が現実に成立させる → 設計責任者 がサインオフしてテープアウト → TSMC がウェハを作る → Advantest系のテスト工程 でウェハーテスト → CoWoS/パッケージ工程 でHBMと統合 → ファイナルテスト/SLT で製品確認 → シリコン評価担当 が実機で立ち上げる → 問題があれば前の工程へ戻る
#です。
##
一番イメージしやすいまとめ
#GPU1個の中には、最初から最後までずっと同じ人が触っているわけではありません。 むしろ、
#- 最初は 構想を作る人
- 次に 動作を書く人
- その次に バグを暴く人
- 次に 現実の回路に変える人
- その次に シリコン上に住まわせる人
- 最後に 実物を測る人
へと、主役が順番に入れ替わっていきます。
#ただし完全にバトンを渡して終わりではなく、 後ろの工程で問題が出るたびに、前の人たちがまた呼び戻されます。 だからGPU開発は、リレー競走というより、何度も前後に行き来する駅伝 に近いです。
##
AIが搭載されていくEDAと半導体設計で起こっている変化
#「AIが設計者の横で手伝う」段階はかなり進んでいる 一方で、 「AIが人の代わりに全部を自律的に決めて最後まで流す」段階は、まだ限定的
#です。現在のEDAのAIは、だいたい次の3層で見るとわかりやすいです。 ① 従来型のAI/ML最適化、② GenAIコパイロット、③ エージェント型自動化 です。Synopsys は AI をシステム設計から製造までの全体で使うと打ち出し、Cadence は verification・design・multiphysics まで含む AI ポートフォリオを示し、Siemens も architectural exploration から manufacturing readiness までの AI orchestration を掲げています。 (Synopsys)
#まず、Verilog / SystemVerilog をAIが書くかですが、これは はい、もう始まっています。 Synopsys は 2025年時点で Copilot の「クリエイティブGenAI機能」に RTLコード生成 や フォーマル・アサーション生成 を含めています。Cadence は 2026年の ChipStack AI Super Agent で、RTL generation、SystemVerilog unit-level tests の生成、SVA生成と自動証明、UVM sequences / checkers / coverage の生成 を公表しています。Siemens も 2026年の Fuse EDA AI Agent で、RTL coding から physical sign-off、manufacturing readiness までをまたぐ multi-tool orchestration を打ち出しています。 (Synopsys)
#ただしここでの重要な注意点は、「AIがコードを書ける」ことと、「AIに丸投げできる」ことは別だという点です。Cadence の説明でも、AIエージェントは specification・design data・EDA tools へのアクセスを使って設計コラテラルやタスクを生成・実行するとされていますが、同時に design correctness と engineering discipline を維持すると書かれており、実務上は人間レビュー前提です。Synopsys 側でも Microsoft の事例は SVA、auxiliary logic、TCL、properties、bind files の生成を示していますが、機能精度は「most properties で 70% functional accuracy」とされており、完全無人より 人のレビューを前提にした加速器 と見るのが正確です。 (Cadence)
#次に、AIとチャットしながら進める使い方は、もうかなり現実化しています。Synopsys は Copilot の中核として Knowledge Assistant と Workflow Assistant を出しており、自然言語で質問し、文書検索、スクリプト生成、ツール操作の guidance を受けられるとしています。Cadence も Verisium / JedAI 系で AI を verification 管理や debug に統合しており、Siemens も Solido や Fuse で natural language interactions を前面に出しています。 (Synopsys)
#あなたが挙げた 「IP選定」 については、答えは 部分的にYes、でもまだ“全面自動化”とまでは言いにくい です。Synopsys の公開説明では Design Exploration や Natural Language Interaction は強く出ていますが、公開情報としては「AIがベンダー横断で最適IPを自動選定して購買判断まで行う」というところまでは強く打ち出していません。いっぽう Cadence は ChipStack AI Super Agent で “Generates SoC fabric RTL and IP with verification collateral based on specification requirements” と明記しており、少なくとも 要求仕様からSoCファブリックやIP構成を生成する方向 には進んでいます。なので現時点では、社内IP再利用や同一ベンダーのIP群の中で候補を絞る支援 は進んでいますが、人間のアーキテクトの代わりに最終選定を丸ごとやる万能エージェント という理解はまだ早いです。これは公開されている機能説明の重心が、より明確に 生成・検証・最適化・デバッグ にあることからの判断です。 (Synopsys)
#検証環境の構築 は、むしろ今いちばん進んでいる領域のひとつです。Synopsys は Microsoft の利用例として、formal testbench の自動作成、SVA / TCL / properties / bind files の生成 を示しています。Cadence は ChipStack で verification plan、SVA、自動prove、UVM sequences / checkers / coverages、unit-level tests を生成するとしており、Verisium では AI-driven test-suite optimization、failure triage、bug root-cause analysis、coverage 向上 を打ち出しています。つまり検証は、テストを書く前からデバッグして原因を絞る後工程まで、かなりAI浸透が進んでいます。 (Synopsys)
#しかもEDAのAIは、単なる「コード補完」だけではありません。 むしろ昔から強かったのは、バックエンドの膨大な探索・最適化 です。Synopsys DSO.ai は reinforcement learning で巨大な設計空間を探索し、PPA を最適化する “autonomous AI application” とされています。Cadence Cerebrus も RTL-to-GDS full-flow optimization を強調しており、ブロック設計者が design goals を指定すると AI が power / performance / area 目標に向けて flow を最適化すると説明しています。つまり、EDAでのAIは 「LLMがコードを書く」より前から、「人間が回しきれない探索空間を自動で回す」ことで大きな価値を出していた ということです。 (Synopsys)
#その流れは サインオフや物理設計 にも広がっています。Synopsys は signoff で AI-driven technologies を前面に出し、PrimeClosure を AI-driven golden signoff ECO closure solution と説明しています。Cadence も Cerebrus や agentic AI を implementation / back-end へ広げており、Siemens も Fuse EDA AI Agent を place-and-route、physical sign-off、manufacturing readiness まで広げるとしています。なのでAIは front-end だけでなく、実装・クロージャ・サインオフ にも深く入っています。 (Synopsys)
#さらに最近は、アナログやカスタム設計 にも入っています。Cadence は Virtuoso Studio を Cadence.AI Generative AI Platform の一部と位置づけ、アナログ / RF / mixed-signal / photonics まで支援するとしています。Synopsys も ASO.ai を analog design, implementation and verification の加速に使うとし、2026年には AI-powered analog layout synthesis を打ち出しています。Siemens も Solido を custom IC design workflows 向けの generative / agentic AI としています。つまりAIは、もはやデジタルRTLだけの話ではありません。 (Cadence)
#Q&A方式でどのような状態か
#SystemVerilog / Verilogを書く → はい。 ただし全面自動ではなく、生成・修正・アップグレード・候補提示・制約付き生成が中心です。 (Synopsys)
#AIとチャットしながら進める → はい。 Knowledge Assistant、natural language interaction、workflow assistant はすでに主流化しつつあります。 (Synopsys)
#IP選定やSoC構成支援 → 一部は始まっている。 特に spec から SoC fabric / IP を組む方向は出てきていますが、最終的なアーキテクチャ判断やベンダー横断選定は、まだ人間主導が強いです。 (Cadence)
#検証環境の構築 → かなり進んでいる。 SVA、formal testbench、UVM sequences、coverage、debug triage、root-cause analysis はすでに公開機能としてかなり具体的です。 (Synopsys)
#あらゆる場面で使われるか → 方向性としてはYes。 実際に major vendors は architecture / RTL / verification / implementation / signoff / analog / multiphysics / manufacturing readiness までAI適用範囲を広げています。ただし 成熟度は工程ごとに差がある ので、今いちばん実用が強いのは verification、debug、tool guidance、scripting、PPA最適化 です。 (Synopsys)
#一言でまとめると、 EDAのAIは、もう「ただのチャットボット」ではありません。 すでに コード生成、検証生成、デバッグ、最適化、フロー実行 に入り始めています。 ただし現時点では、“AIがEDAツールを使う”世界が本格化してきた のであって、“人間なしで完全自律テープアウト”が普通になった わけではありません。公開資料を見ても、各社とも基本は human-in-the-loop の高性能化 として売っています。 (Cadence)
##
AIが今どこまでできて、どこがまだ人間の仕事か
#はい。 かなり雑に一言でまとめると、**今のGPU開発でAIが最も実用に入っているのは「検証・デバッグ・PPA最適化・ツール操作支援」**で、**最後まで人が強く握っているのは「製品要求の定義」「アーキ判断」「最終IP採用判断」「サインオフ責任」**です。Synopsysは Copilot/Knowledge Assistant/Workflow Assistant/RTL生成/DFT最適化を、Cadence は ChipStack/Verisium/Cerebrus を前面に出しており、両社とも「AIがかなり深く入る」が「設計の正しさとエンジニアリング規律は維持する」という立て付けです。 (Synopsys)
#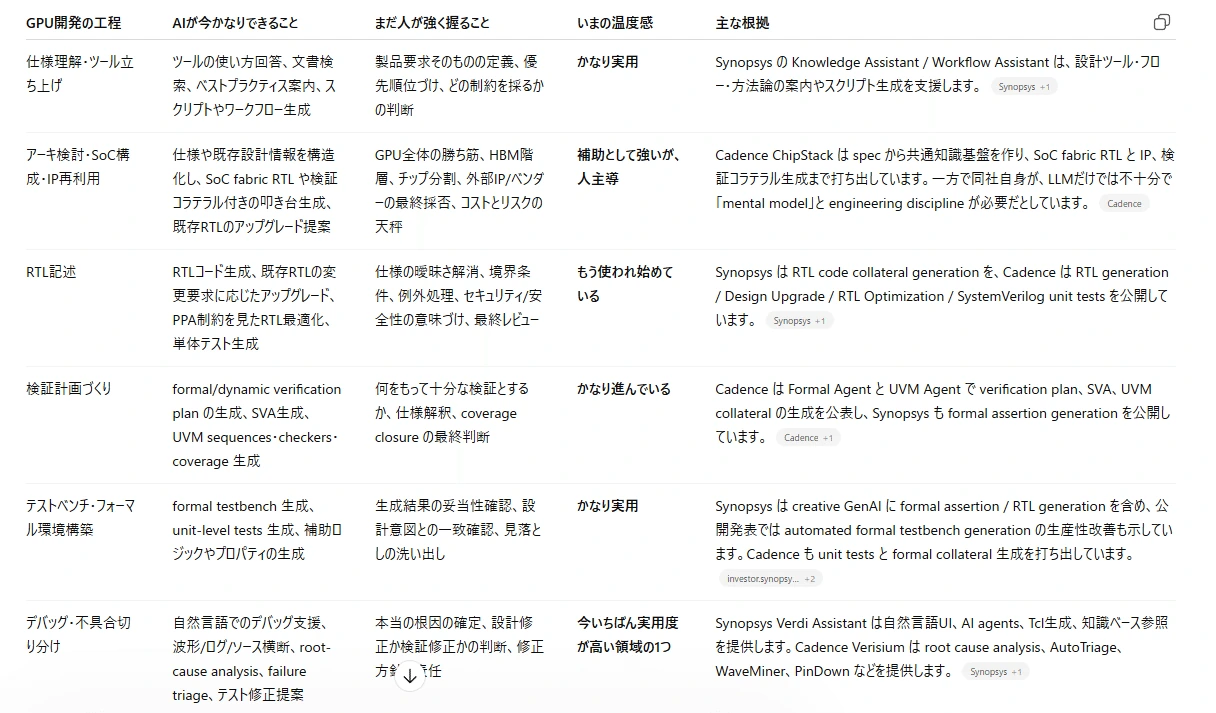
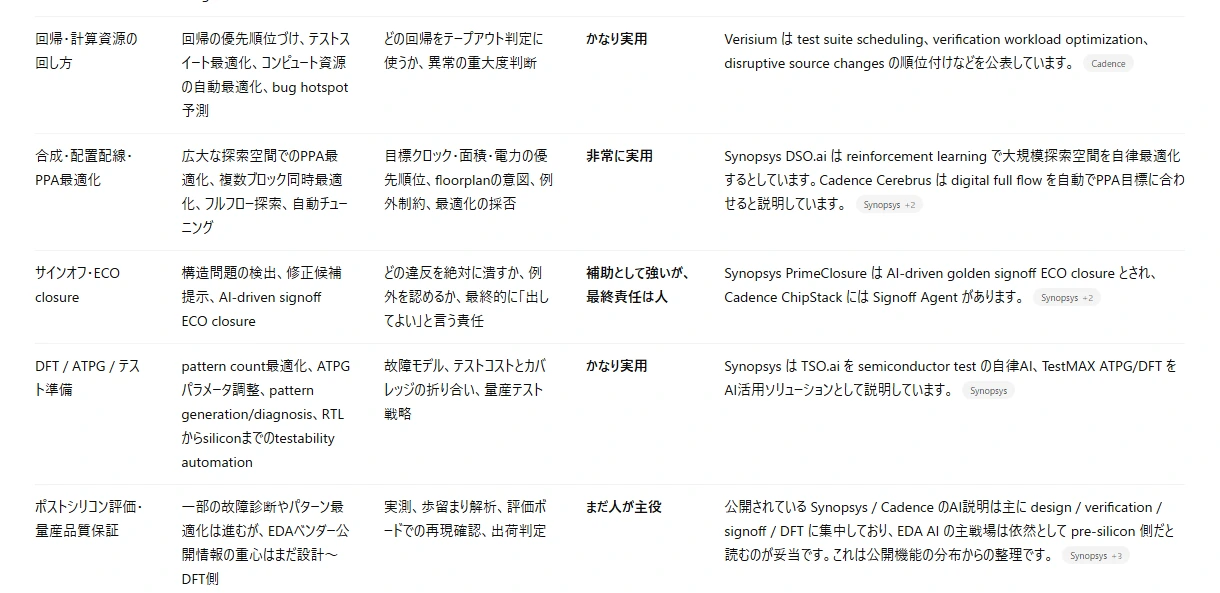
この表をさらに短くすると、今のAI導入の現実はこうです。
#もうかなり強い → ツール質問、スクリプト生成、RTLの叩き台、SVA/UVM生成、デバッグ、回帰最適化、PPA探索、DFT/ATPG最適化。 (Synopsys)
#強いが、人の責任が重い → SoC構成、IP選定、制約の切り方、signoff判断、製品要求の優先順位。Cadence も「LLM alone is not enough」とし、shared mental model と engineering discipline を明示していますし、Synopsys も “Copilot/Assistant” として売っています。 (Cadence)
#つまり現時点のGPU開発では、 AIは“若手を即戦力化する副操縦士”と“膨大な探索を回す自動最適化エンジン”としてはかなり強いです。 でも、GPUという製品の意味を決める人、最後に責任を持って判を押す人までは、まだ人間です。 (Synopsys)
##
AI導入で Synopsys・Cadence・Arm・Ansys の価値がそれぞれどう変わるか投資家目線で整理
#Synopsys と Cadence は「AI時代にチップ設計が難しくなるほど儲かりやすい道具屋」、Arm は「AI時代に作られるチップそのものの中身で取る会社」、Ansys はいま単独株ではなく Synopsys の中で“物理解析の価値”として効く資産、という見方が基本です。なお Ansys は 2025年7月17日に Synopsys が買収を完了しており、現在は単独の上場株としては見ません。 (investor.synopsys.com)
#まず結論だけ先に言うと、私の見立てはこうです。 いちばん“きれいなAI設計ツール銘柄”は Cadence、いちばん“戦略的な上振れ余地”が大きいのは Synopsys、いちばん“AI普及の量に賭ける銘柄”が Arm、Ansys は単独ではなく Synopsys 上乗せ要因です。これは、Cadence が AI・検証・ハードウェア検証を独立で伸ばせる一方、Synopsys は Ansys 統合でシリコンからシステムまで広げられるからです。Arm は AIチップが増えるほど恩恵を受けやすいですが、EDAのような“ほぼ全社に課金する道具屋”とは性質が違います。 (Cadence)
#Synopsys AI導入で一番変わるのは、Synopsys が 「EDA会社」から「silicon-to-systems の工学基盤会社」へ広がった ことです。Synopsys は 2025年9月に Copilot の拡張を発表し、Knowledge Assistant、Workflow Assistant、RTLコード生成、formal assertion 生成などを前面に出しました。さらに DSO.ai は PPA 最適化を自律探索する中核製品で、Synopsys 自身も AI をシリコン設計から製造・検証まで全体に適用する方針を示しています。そこへ 2025年7月の Ansys 買収が重なり、会社側は統合後TAMを 310億ドル、2026年上期に multiphysics を EDA スタックへ融合した最初の統合機能を出す計画だと説明しています。2026年度売上見通しの中間値 96.1億ドルには、Ansys 売上 29億ドル見込みがすでに織り込まれています。 (investor.synopsys.com)
#投資家としての読み方は、Synopsys は「AIで設計難度が上がるほど、EDA + 検証 + IP + 物理解析まで一体で取りにいける会社」になった ということです。特に 2.5D/3D、先端パッケージ、熱・電源・電磁界まで絡む AI システムでは、論理設計だけでなく物理世界の整合が重要になるので、Ansys 統合が効きやすいです。逆にリスクは、統合が大きいぶん実行難度が高い ことです。だから Synopsys の投資判断は「AIそのもの」より、Ansys を飲み込んで本当に platform company になれるか が主論点です。これは私の推論ですが、ソースが示す TAM 拡大と統合ロードマップから見ると、4社の中でいちばん“上振れの幅”が大きいのは Synopsys です。 (investor.synopsys.com)
#Cadence Cadence の強みは、AI導入の恩恵を、いちばん純粋で分かりやすい形で取りやすい ところです。Cadence は 2024年 10-K で、Cerebrus を full-flow IC through signoff の generative AI と位置づけ、Verisium を verification flow 全体の GenAI、Palladium / Protium を AIチップなど巨大設計の検証加速基盤として説明しています。2026年2月には ChipStack AI Super Agent を発表し、仕様や高位記述から設計・検証を自動化し、設計コード・テストベンチ・テスト計画・回帰・デバッグ・自動修正で最大 10倍の生産性向上をうたっています。Cadence はこの agentic AI を NVIDIA の加速計算と組み合わせる発表もしており、AIチップ設計だけでなく system / physical AI 側へも広げています。 (Cadence)
#投資家目線では、Cadence は 「AIで半導体設計が難しくなる」ことを最も素直に業績へ変換しやすい銘柄 です。理由は、フロントエンド設計、検証、PPA最適化、さらに emulation / prototyping hardware まで持っていて、しかも Synopsys のような大型統合案件を抱えていないからです。実際、Cadence は 2025年通期決算で 2026年売上見通し 59億~60億ドル、非GAAP営業利益率 44.75%~45.75%、年初バックログ 78億ドルを示しています。私の見方では、“AI時代のEDA”を最もきれいに買うなら Cadence です。弱点は、すでにかなり高品質企業として評価されやすい 点で、株価面では execution の良さがかなり織り込まれやすいことです。 (investor.cadence.com)
#Arm Arm は EDA ではなく、AIで増えるチップの中身に乗る会社 です。Arm の 2026年2月の投資家資料では、Q3 FYE26 のロイヤルティ売上が前年同期比 27%増の 7.37億ドルで、Armv9 と CSS、そしてデータセンターでの Arm 採用拡大が寄与したと説明しています。Arm はさらに、AI everywhere が高性能かつ電力効率の高い Arm 需要を押し上げるとし、CSS は設計時間・コスト・リスクを減らし、ロイヤルティ単価を大きく引き上げると説明しています。Q3 FYE26 時点で CSS は 21件のライセンス、Arm はそれが将来的に preferred model になりうると示しています。 (Arm Investor Relations)
#投資家としてのポイントは、Arm は AI 導入で “使われるチップの数” と “チップ1個あたりの取り分” の両方を伸ばせる可能性がある ことです。特にクラウド、車載、IoT、カスタムAIアクセラレータ周辺で Arm ベース SoC が増えるほど追い風になります。ですが、Synopsys / Cadence と違って Arm は“設計のたびにほぼ必ず必要な道具”ではありません。だから、投資の性格としては 道具屋の安定成長より、設計勝ち筋・採用シェア・ロイヤルティ単価上昇に賭ける銘柄 です。私の見立てでは、4社の中でいちばん上振れも下振れも大きいのが Arm です。AI時代の勝者になれば大きいですが、収益化のタイミングは設計採用から量産ロイヤルティまで時差があります。 (Arm Investor Relations)
#Ansys Ansys はいま単独の投資対象ではありませんが、AI時代に価値が落ちるどころか、むしろ重要度が上がる資産 です。Synopsys は買収完了時に、AI時代の複雑なシステム開発には electronics と physics のより深い統合が必要だと説明し、Ansys を入れることで silicon design、IP、simulation and analysis を束ねるとしています。Ansys 自身も半導体・3D IC向けに thermal、EMI/EMC、power integrity などの multiphysics を前面に出しており、2024年には TSMC と AI を活用した 3D-IC 設計協業を発表しています。 (investor.synopsys.com)
#投資家視点では、Ansys は 単独で買う会社ではなく、Synopsys の moat を深くする資産 です。AIサーバー、3D-IC、先端パッケージ、電力密度、熱設計が重くなるほど、Ansys の物理解析は「あると便利」ではなく「ないと怖い」に近づきます。つまり Ansys の価値は、今は Synopsys の統合ストーリーの中で評価すべき です。 (investor.synopsys.com)
#株価面でひとことだけ添えると、Synopsys と Cadence はすでにかなり高評価です。 直近の市場データでは、Synopsys の時価総額は約 889.8億ドル、PER は約 80.8倍、Cadence の時価総額は約 957.1億ドル、PER は約 90.2倍です。なので、この2社は「AIで恩恵があるか」だけでなく、その恩恵が今のバリュエーションをさらに上回る速度で利益に落ちるか が重要です。
#私ならこう整理します。 安定性と分かりやすさ重視なら Cadence。 戦略的な化け方まで取りにいくなら Synopsys。 AIコンピュート普及そのものに強く張るなら Arm。 Ansys は単独ではなく Synopsys の統合価値として見る。 この順です。これは企業側の公開資料に基づく私の推論ですが、“AI設計ツールの王道”は Cadence、“AI時代の工学プラットフォーム化”は Synopsys、“AIチップ普及の取り分”は Arm と分けるとかなり見やすいです。 (Cadence)
##
EDAの売り方
#EDAはふつうの個人向けSaaSみたいに「毎日どれだけ触ったか」で単純従量課金されることが多いわけではありません。 中心は今でも 企業向けの期間契約 で、そこに フローティングライセンス、契約枠、クラウド従量課金 が混ざる形です。Synopsys は自社ソフトを主に TSL(Technology Subscription License)という期間契約 で売っていると説明しており、Cadence も自社ソフトを主に time-based licenses でライセンスしていて、期間は通常 2~3年 だと説明しています。 (sec.gov)
#まず、いちばん基本の売り方はこうです。 EDAベンダーは、顧客企業に対して「このツール群を、この期間、この条件で使えます」という形で売ります。Cadence は、契約開始時点で提供される製品群を期間中使え、アップデートも受けられる time-based license を主力にしていると書いています。Synopsys も、TSL は有限期間の time-based license で、契約にはサポート、頻繁なアップデート、複数コピー、顧客環境への適用支援、さらに他ライセンスへの remix rights まで含むと説明しています。つまり、「ソフト本体+保守更新+運用支援」が1つの契約に束ねられている感じです。 (sec.gov)
#なので、感覚としては Adobeを1人で月額契約するというより、 会社全体でEDAツール群を数年契約し、必要な製品や更新やサポート込みで使う に近いです。Cadence は time-based license の支払いは一般に契約期間にわたって行われるとし、Synopsys も支払いは通常、契約期間中にほぼ均等分割で受け取るとしています。 (sec.gov)
#次に、実際の使い方の単位です。 ここは「1人1ライセンス固定」だけではなく、ライセンスサーバー経由で共有する形が多いです。Synopsys は公開のライセンスガイドで、Network (floating)、Counted Nodelocked、Uncounted Nodelocked という形を示しており、ライセンスサーバーがネットワーク上のクライアントにライセンスを配る構成を説明しています。これは要するに、同時に何人・何ジョブが使えるかを契約数で管理する世界です。だから、実務感としては 「触った時間そのもの」より、「何本のライセンス枠を持つか」「同時利用数をどれだけ確保するか」 が重要です。 (Synopsys)
#つまり、あなたの質問にそのまま答えると、 昔ながらの中心モデルでは「使えば使うほど毎秒課金」ではないです。 多くの場合は、
#- 何のツールを使うか
- 何本のライセンス枠を持つか
- 何年契約か
- 更新・保守を含むか
- 追加製品や remix 権があるか
で値段が決まります。Synopsys と Cadence の公開資料はどちらも、主力が時間ベースの契約で、サポートや更新を契約に含む形だと示しています。 (sec.gov)
#ただし、最近はクラウド経由で「使った分だけ」に近いモデルも増えています。 ここが重要な変化です。Synopsys Cloud は FlexEDA というモデルで、EDAライセンスを minute-by-minute で使え、リアルタイムで使った分だけ払うと明記しています。Cadence も cloud EDA の説明で pay-as-you-go や burst capacity を打ち出しており、OnCloud では consumption-based usage model を採ると説明しています。つまり最近は、特にクラウド側で 「普段は通常契約、ピーク時だけ従量」 あるいは 「クラウド上の特定製品は従量課金」 が現実に増えています。 (Synopsys)
#なので、かなり実態に近く言い直すと、EDAの売り方は今こうです。
#\1. 中心は期間契約 EDAの本体は今でもこれが主流です。数年契約で、更新・保守・アップグレード込みで使う形です。 (sec.gov)
#\2. 運用は同時利用数や契約枠で管理 ライセンスサーバーで floating license を配るので、単純な「1人1本」ではなく、企業全体で共有することが多いです。 (Synopsys)
#\3. 大口顧客は“契約枠”で買うこともある Synopsys は FSA(Flexible Spending Account)として、顧客が一定期間に固定金額をコミットし、その範囲で個別注文を引き出す形を説明しています。Cadence も一部顧客について、一定期間の固定金額コミットメントがあるとしています。つまり大企業では、「この部署で年いくら使う」枠契約に近い買い方もあります。 (sec.gov)
#\4. クラウドでは従量課金が増えている Synopsys は分単位課金、Cadence は pay-as-you-go / consumption-based を明示しています。ここは一般的なSaaSやクラウドにかなり近いです。 (Synopsys)
#あと、少し分けて考えた方がいいのが、EDAソフトそのもの と IP と ハードウェア検証機 です。 Synopsys も Cadence も、EDAソフトだけでなく IP や ハードウェア も売っています。IP は Synopsys だと per design basis、つまり設計ごと課金が典型で、場合によっては royalty もあります。Cadence も design IP は 特定設計向けの非独占ライセンスで、場合によっては顧客製品の出荷に応じた royalty を取るとしています。これはEDA本体の「期間契約」とは別の取り方です。 (sec.gov)
#さらに、Cadence はハードウェア製品を sale or lease、つまり販売またはリースすると説明していて、エミュレーションハードウェアはクラウド経由の利用も可能だとしています。つまりEDA会社は、 ソフトは期間契約、 IPは設計単位やロイヤルティ、 ハードは販売・リース、 クラウドは従量もあり という複数の収益モデルを持っています。 (sec.gov)
#一言で整理すると、
#昔からのEDA本体 → 期間契約が中心。使えば使うほど秒単位で増える形ではない。 (sec.gov)
#実務での運用 → フローティングライセンスや契約枠で、同時利用数や使える製品範囲を管理する。 (Synopsys)
#新しいクラウド型EDA → 使った分だけに近い pay-as-you-go / consumption-based が増えている。 (Synopsys)
#「基本は使い放題に近い期間契約だが、契約範囲と同時利用数で縛る。最近はクラウドだけ従量課金が増えている」 がいちばん実態に近いです。 (sec.gov)
##
NVIDIAみたいな大手ファブレスが、Synopsys/Cadenceに実際どんな買い方をしていそうかを、現実的な運用イメージで説明
#ただしこれは NVIDIA の実際の契約書が公開されているわけではない ので、以下は NVIDIA の事業形態 と Synopsys/Cadence の公開されている販売モデル から組み立てた、かなり現実的な運用イメージです。NVIDIA は自社工場を持たない fabless で、製造の全段階を外部パートナーに委ねる形を取っており、TSMC のようなファウンドリ、CoWoS パッケージ、組立・テスト外部委託先を使っています。 (s201.q4cdn.com)
#まず全体像
#NVIDIA 級の大手ファブレスは、Synopsys / Cadence からおそらく次の4つを組み合わせて買っています。
#- 中核EDAソフトの長期契約
- チーム全体で共有するフローティングライセンス枠
- ピーク時だけ膨らませるクラウド利用枠
- 必要に応じて IP とハードウェア検証機の別契約
この「本体は長期契約、山場だけクラウド増強、検証ハードは別建て」という形が、いちばん自然です。Synopsys は主力ソフトを time-based software licenses with support として売っており、Cadence も主力は time-based licenses で、契約期間は一般に 2~3年 だと説明しています。Synopsys はクラウド側で FlexEDA の by-the-minute 課金 も提供しています。 (SEC)
#たぶん一番近い買い方のイメージ
#\1. まず会社として“大口の包括契約”を結ぶ
#NVIDIA のような規模なら、個々の設計者が月額プランを買うのではなく、まず会社全体、または大きな事業部単位で 「今後2~3年、この製品群をこの規模で使う」 という大口契約を結ぶのが自然です。Cadence は time-based license の期間が一般に2~3年で、支払いも通常は期間中の均等または近似均等分割だと説明しています。Synopsys も time-based software license と support を束ねた subscription arrangement を主力にしています。 (SEC)
#投資家的に言い換えると、これは 「毎月の操作量で小さく払う」より、「大きな開発体制を前提に年間予算で押さえる」 モデルです。 大手ファブレスは製品開発を止められないので、まずベースキャパシティを契約で確保するはずです。これは公開資料からの推論ですが、販売モデルと顧客規模を考えるとかなり自然です。 (SEC)
#\2. その契約の中で、チームごとにライセンス枠を使い分ける
#実運用では、GPU 設計は1チームではなく、
#- フロントエンドRTL
- 検証
- 論理合成
- 配置配線
- サインオフ
- DFT
- 物理解析
のように分かれています。なので NVIDIA は、1枚岩のライセンスではなく、製品群ごとのライセンス枠 を持ち、必要なチームがライセンスサーバー経由で同時利用していると考えるのが自然です。Synopsys はネットワーク型のライセンス管理と、クラウド/オンプレ両対応のライセンス管理を案内しています。 (Synopsys)
#感覚としては、 「社員1人に1本ずつ配る」より、「会社に大きなライセンスプールがあって、その時使う人が借りる」 に近いです。 だから NVIDIA のような会社では、費用管理の中心は「誰が何時間触ったか」より、どの製品群の同時利用枠をどれだけ確保するか になりやすいです。これは Synopsys/Cadence の time-based enterprise 寄りモデルからの推論です。 (SEC)
#\3. 通常時はオンプレ中心、山場はクラウドで“バースト”させる
#大手ファブレスは、常時ピーク容量を自前で持つより、普段はベース契約で回し、テープアウト前や大規模回帰の山場だけクラウドで増強 するのが合理的です。Cadence は Cloud EDA で pay-as-you-go and burst capacity を、Synopsys Cloud は pay-per-use access to unlimited licenses by-the-minute を打ち出しています。 (Cadence)
#なので、かなり現実的な運用像はこうです。
#- 普段の設計・日常回帰は社内の通常契約と既存計算基盤で回す
- 大規模な nightly regression、サインオフ詰め、物理実装の探索、締切前の最後の追い込みではクラウドに逃がす
- クラウドは「恒久的な本体」ではなく「納期を守るための伸縮用」
特に AI GPU のような巨大設計では、締切前の検証や PPA 探索が急増しやすいので、この使い方はかなりありそうです。これは公開モデルに基づく推論です。 (Cadence)
#Synopsys と Cadence をどう使い分けていそうか
#Synopsys 側
#NVIDIA 級なら Synopsys からは、
#- デジタル実装・サインオフ系
- DFT / ATPG
- 一部の検証
- 必要に応じてソフトウェア/セキュリティ寄り資産
- クラウド burst capacity
をまとめて買っている可能性が高いです。Synopsys はソフトを subscription と perpetual の両方で提供し、クラウドでは FlexEDA と term-based license の両方を出しています。ハードウェア製品は emulation / prototyping systems で、sold or leased です。 (SEC)
#Cadence 側
#Cadence からは、
#- フロントエンド設計
- 検証
- 実装・サインオフ
- Palladium / Protium のようなハードウェア検証基盤
を大きく押さえている絵が自然です。Cadence も主力は 2~3年の time-based license で、ハードウェア製品は sold or leased、しかも emulation hardware は Cadence-managed cloud arrangement でも利用可能です。 (CloudFront)
#つまり NVIDIA 級だと、 ソフトは長期包括契約、検証ハードは別建て、必要に応じてクラウドで増強 という三層構造になっていそうです。 (CloudFront)
#IP はさらに別の買い方をしていそう
#EDA 本体とは別に、SoC や GPU 周辺では各種 IP も必要になります。 ここは EDA の「使い放題契約」とは別で、設計単位・製品単位・プロジェクト単位 の扱いになりやすいです。Cadence は design IP を specific designs 向けの nonexclusive license として売ると説明しています。Synopsys も IP はソフト契約とは別の収益区分です。 (CloudFront)
#なので NVIDIA のような会社は、たとえば
#- EDA は企業包括契約
- 検証ハードは購入/リース
- IP は個別プロジェクト単位
という形で、契約の箱が分かれているはずです。これは公開されている販売構造からの推論です。 (SEC)
#かなり具体的な“現場の風景”にすると
#たぶん、NVIDIA みたいな会社ではこんな感じです。
#平時 設計者は社内ネットワーク上の既存ライセンスプールを使う。 日常のRTL、検証、合成、配置配線は通常契約の枠内で回す。 (SEC)
#開発が佳境に入ると 大規模回帰、PPA探索、サインオフ、DFT生成が増え、ライセンス需要と計算需要が急増する。 ここでクラウドにジョブを逃がし、分単位または pay-as-you-go で一時的に膨らませる。 (Synopsys)
#巨大検証では Palladium / Protium や ZeBu / HAPS のようなハードウェア支援検証機を、購入またはリースした設備として使う。場合によってはクラウド経由で使う。 (CloudFront)
#経理・購買の目線では 月ごとの細かな従量課金管理より、
#- 2~3年の契約総額
- 部門ごとのライセンス枠
- クラウド burst の追加費用
- ハードウェア検証機の償却またはリース
- IP の個別契約
を別々に管理しているはずです。これは各社の収益構造からの推論です。 (SEC)
#一言でまとめると
#NVIDIA 級の大手ファブレスは、Synopsys / Cadence を 「必要な時に1席ずつ買うソフト」ではなく、「開発工場そのものを動かすための基幹インフラ」 として買っている、と見るのがいちばん近いです。 普段は長期契約で土台を押さえ、締切前だけクラウドで膨らませ、巨大検証は別途ハードで支える。これが最も現実的な像です。 (SEC)
##
長期契約はどれくらいだとだいたいどれくらいの売り上げと利益になるか
#はい。 ただし、個別契約の金額や採算はほぼ非公開 なので、ここで言えるのは 公開財務から逆算した「だいたいこのくらい」 です。 いちばん大事なのは、EDAの長期契約は 契約総額 = その年の売上 ではないことです。Cadence の time-based license は一般に 2~3年 で、支払いは 期間中の equal or near equal installments が多く、売上は 契約期間にわたって認識 されます。Synopsys の TSL も一般に 3年 ですが、2025年の会計方針更新後は time-based license 部分は開始時点寄り、support は期間按分 という形になっており、Cadence より売上認識がやや前倒しになりうる点は押さえておいた方がいいです。 (CloudFront)
#まず、ざっくりした採算の目安です。 Cadence の FY2025 は売上 52.97億ドル、GAAP営業利益率 28.2%、non-GAAP営業利益率 44.6% でした。Cadence の FY2025 の売上総利益率は、売上 52.968億ドル と売上原価 7.223億ドル から逆算すると 約86.4% です。Synopsys の FY2025 は売上 70.54億ドル、売上総利益 54.31億ドル なので、GAAPベースの売上総利益率は 約77.0% です。Synopsys の FY2026ガイダンスは売上 95.6億~96.6億ドル、non-GAAP費用 56.9億~57.5億ドル なので、単純計算の non-GAAP営業利益率は 約39.9%~41.1% です。 (investor.cadence.com)
#なので、EDAの長期契約1本あたりの“ざっくり採算” を見るときは、
#- 売上総利益率 はおおむね 77%~86%くらい
- 営業利益率 はおおむね 28%~45%くらい
と見ておくと、かなり現実に近いです。 もちろん実際には、ソフト中心か、クラウド利用が多いか、サービスをどれだけ付けるか、値引き、ハードウェア検証機やIPが混ざるかで上下します。特に Cadence は 2025年売上の 76% を over-time で認識しており、ハードウェアやIPの比率が上がると利益率や認識タイミングは変わりやすいです。 (CloudFront)
#わかりやすくするため、「ほぼソフト中心の長期契約」 として、単純化した例を出します。 ここではまず 3年契約で年均し のイメージで見ます。Cadence型だとかなりこの見方に近く、Synopsys型だと実際はこれより少し前倒しになる可能性があります。 (CloudFront)
#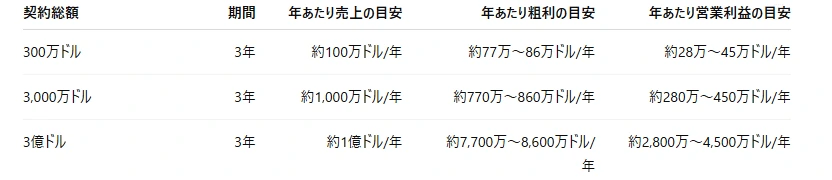
この表は、上の公開財務の 77%~86%粗利、28%~45%営業利益 をそのまま当てはめた概算です。 (investor.cadence.com)
#ただ、NVIDIA級の大手ファブレス向け契約 だと、実際はもう少し複雑です。 なぜなら、1本の契約の中に
#- time-based software
- cloud burst
- services
- hardware emulation / prototyping
- IP
が混ざることがあるからです。Cadence は hardware や IP も売っていて、ハードは sale/lease、IP は別の認識ルールがありますし、Synopsys も subscription software と upfront products が混在します。だから、「契約総額3億ドルだから毎年きれいに1億ドル売上」 とは限りません。特に Synopsys は、time-based software license を arrangement 開始時点寄りに upfront product revenue として認識し、support を期間按分するため、同じ3年契約でも 初年度売上がやや厚く見える 可能性があります。 (SEC)
#投資家目線でいちばん使いやすい考え方は、 「大型EDA契約は、受注した瞬間に全部売上になるのではなく、数年かけて売上化し、利益率はかなり高い」 という理解です。Synopsys は自社の revenue recognized in a particular period generally results from selling efforts in prior periods と述べており、ソフトウェアライセンス売上は通常 約3年の arrangement period にまたがるため、顧客支出の増減が即座に売上へは跳ねにくいと説明しています。これは EDA 企業の売上が比較的安定して見えやすい大きな理由です。 (SEC)
#かなり実務に寄せて言うと、たとえば 3年総額3,000万ドルの純ソフト寄り契約 なら、 Cadence型の見え方では 年間売上はだいたい1,000万ドル前後、会社全体並みの採算を当てるなら 年間営業利益は280万~450万ドル程度 がひとつの目安です。Synopsys型ではこれと同程度の総利益水準でも、売上認識のタイミングはやや前倒し になりえます。 (CloudFront)
#逆に、本当に巨大な顧客向けの包括契約 は、1件で数千万ドルどころか、複数製品群・クラウド・ハード・IPまで含めて 年数千万~億ドル級のランレート になっていても不思議ではありません。これは個別開示はありませんが、Cadence の 2025年売上 52.97億ドル、Synopsys の 2025年売上 70.54億ドル、Cadence backlog 78億ドル、Synopsys backlog の認識期間が複数年にまたがることを見ると、大口顧客契約は相当大きいはずだと推測できます。これは公開財務からの推論です。 (investor.cadence.com)
#一言でまとめると、 3年契約なら、ざっくり「契約総額 ÷ 3」が年間売上の基本線、 粗利はその約8割前後、営業利益は約3~4.5割前後、 と見ておくと投資家目線ではかなり使いやすいです。 ただし Synopsysは会計上やや前倒し、Cadenceはより期間按分寄り という違いはあります。 (CloudFront)
##
「NVIDIAクラスの顧客1社がEDA各社に年間いくら払っていそうか」 を、かなり現実的なレンジで試算
#ただしこれは 公開資料からの推定 で、NVIDIA の実契約金額を示すものではありません。 いちばんブレにくいやり方は、まず 公開資料でわかる上限 を置き、その下に 平常年の現実的レンジ と 山場の年の上振れレンジ を置くことです。Synopsys の 2025年売上は 70.54億ドル、Cadence の 2025年売上は 52.97億ドル で、Cadence は 2025年に単一顧客10%超なし、Synopsys も 2025年は単一顧客10%超なし でしたが、2024年と2023年には単一顧客が12.6%、13.5% を占めた年がありました。Cadence の time-based license は一般に 2~3年、Synopsys のソフト契約も一般に 2~3年 です。 (SEC)
#まず「絶対にあり得る上限」
#公開資料だけから言える、かなり硬い上限はこうです。
#- Synopsys 向け
2025年は単一顧客10%超なしなので、年間 7.05億ドル未満 です。2024年には単一顧客が 12.6% を占めたので、その年のような特殊年なら 約7.7億ドル規模 の超大型顧客も理論上はあり得ます。 (SEC)
- Cadence 向け
2025年は単一顧客10%超なしなので、年間 5.30億ドル未満 です。 (SEC)
#ただ、この水準は かなり外れ値寄り です。 毎年そこまで貼り付くなら開示上かなり目立ちやすいので、“平常運転の NVIDIA 級顧客” を考えると、もう少し下のレンジで見る方が自然です。これは公開されている売上規模と顧客集中度からの推論です。 (SEC)
#私の推定レンジ
#\1. 平常年の「かなり現実的」なレンジ
#これは 大口の包括契約 + 通常のクラウドバースト + 一部IP/サービス を含むが、大型ハードウェア検証機の一時的な大量導入までは強く織り込まない ケースです。
#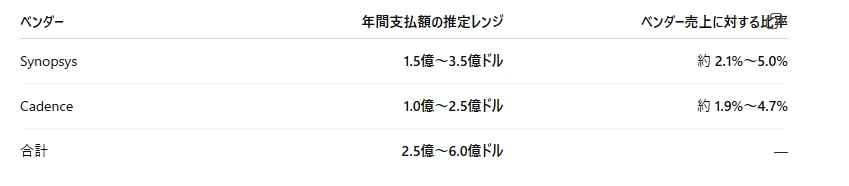
このレンジを中心値で見るなら、 Synopsys 約2.5億ドル、Cadence 約1.8億ドル、合計約4.3億ドル/年 くらいが、私にはいちばんしっくりきます。 理由は、両社とも多数の大口顧客を抱える一方で、NVIDIA 級なら enterprise-wide 契約、回帰、PPA探索、クラウド増強をかなり大きく使っていても不思議ではなく、各社売上の2~5%前後 は十分あり得るからです。これは開示されている売上規模、顧客集中度、2~3年契約中心という事実に基づく私の推定です。 (SEC)
#\2. 山場の年の上振れレンジ
#これは エミュレーション/プロトタイピング機の大型導入、IPの前倒し、クラウド利用の急増、複数プロジェクトの重なり がある年です。
#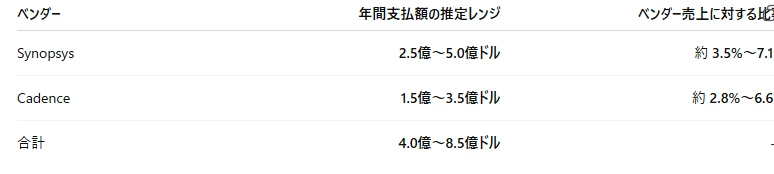
この水準なら、まだ Cadence の「10%未満」 と Synopsys の 2025年「10%未満」 に十分収まりつつ、Synopsys で過去に開示された 12.6%級の超大型顧客年 ほどではない、という位置です。つまり “かなり大きいが、異常値ではない” レベルです。 (SEC)
#なぜこのくらいになりそうか
#理由は3つです。
#1つ目は、契約が短期の席課金ではなく、2~3年の enterprise 契約中心 だからです。Cadence は time-based license が一般に 2~3年 で、支払いは通常 契約期間中の均等または近似均等分割、収益は over time 認識だと説明しています。Synopsys もソフト契約は一般に 2~3年 としています。つまり NVIDIA 級の顧客なら、部署単位ではなく会社・事業部単位でかなり大きな基盤契約を持っていると考えるのが自然です。 (SEC)
#2つ目は、両社とも backlog が非常に大きい ことです。Synopsys の 2025年 backlog は 約114億ドル、Cadence の remaining performance obligations は 約78億ドル で、Cadence はそのうち 53%を次の12か月、43%をその後13~36か月 で認識見込みだとしています。これは、超大口顧客の支払いが「単発の小さなSaaS費用」ではなく、かなり大きな multi-year commitment で回っていることを示しています。 (SEC)
#3つ目は、売上の中にソフトだけでなく、IP、クラウド、ハードウェアが混ざりうる ことです。Cadence はハードウェア製品を sold or leased とし、IP は specific designs 向けのライセンス、場合によりロイヤルティもあると説明しています。Synopsys も 2025年売上の内訳で、time-based products 34.90億ドル、upfront products 20.11億ドル、maintenance/service 15.54億ドル と開示しており、上流ソフトだけでなく upfront の IP/ハード/その他が大きいです。だから NVIDIA 級顧客の年次支出も、純ソフト年 と ハードやIPが重なる年 でかなり振れます。 (SEC)
#かなり短く言うと
#私の推定はこうです。
#- Synopsys: 平常年 1.5億~3.5億ドル、山場の年 2.5億~5.0億ドル。 (SEC)
- Cadence: 平常年 1.0億~2.5億ドル、山場の年 1.5億~3.5億ドル。 (SEC)
- 合計: 平常年 2.5億~6.0億ドル、山場の年 4.0億~8.5億ドル。 (SEC)
私なら、NVIDIAクラスの1社が2社合計で年間4億ドル前後払っていても全く驚かない、という見方をします。 一方で、毎年10億ドル級 を常態と見るのは、現時点の公開情報だけではやや強気すぎます。Synopsys でも Cadence でも、顧客集中度開示との整合が悪くなりやすいからです。 (SEC)
##
HBMやDRAMのようなメモリからnand、トランシーバーやスイッチでの工程
#はい。 超ざっくり先に言うと、主役はこう分かれます。
#HBM/DRAM → メモリアレイ設計 + カスタム/アナログ + 3D/先端パッケージEDA が重いです。 (Synopsys)
#NAND → メモリアレイ/周辺回路のカスタム設計 に加えて、ONFI/Toggleなどのインターフェース検証 が重いです。 (Synopsys)
#トランシーバー(SerDesなど) → アナログ/RF設計 + EM/SI/PI解析 + パッケージ/基板込みのチャネル解析 が主役です。 (Cadence)
#スイッチASIC → 巨大デジタルSoCのRTL検証・エミュレーション・配置配線・サインオフ が主役で、I/O側だけトランシーバー系EDAが乗ります。 (Cadence)
##
まず共通の流れ
#どの製品でも、だいたいは
#仕様/アーキ検討 → 回路/RTL/モデル作成 → 検証 → レイアウト/実装 → 抽出/サインオフ → パッケージ/基板/システム解析
#の順です。 ただし、デジタル比率が高い製品は Cadence の Digital Design and Signoff や Synopsys の verification / HAV / signoff 系が中心になり、アナログ/メモリ/高速I/O比率が高い製品は Virtuoso / Custom Compiler / Spectre / PrimeSim のような custom IC・回路シミュレーション系が中心になります。さらに、パッケージや基板まで効く製品では、Ansys や Cadence Sigrity / Clarity のような SI/PI/熱/EM 解析が後半で強く効きます。 (Synopsys)
##
\1. HBM / DRAM ではどこで何を使うか
#仕様・アーキ段階
#ここでは、容量、帯域、電力、レイテンシ、I/O構成、リフレッシュやトレーニングの成立性を決めます。 HBMになると、ダイ単体ではなく多ダイ/先端パッケージ込みで成立させる必要があるので、普通のDRAMより早い段階から 2.5D/3D の co-design が入ります。Synopsys 3DIC Compiler は、2.5D/3D multi-die 向けに feasibility exploration、partitioning、floorplanning、high-speed die-to-die routing、multiphysics analysis、signoff verification をまとめて扱うと説明しています。 (Synopsys)
#回路設計
#HBM/DRAM本体では、メモリセル、周辺回路、I/O、タイミング回路の比重が大きいので、主役は custom IC / analog / mixed-signal 系です。Synopsys は Custom Compiler + PrimeSim + parasitic extraction + reliability/physical verification を、Cadence は Virtuoso + Spectre を custom IC / analog / RF 設計の中核として出しています。 (Synopsys)
#検証
#ここはデジタルSoCのようにRTL検証だけでは終わりません。 SPICE級の回路シミュレーション、寄生成分込みの確認、custom memory/macros の等価性確認 が重要です。Synopsys ESP は embedded memories や custom macros について、Verilog / RTL / Gate / Switch / SPICE など異なる表現同士の機能等価を確認する用途だとしています。 (Synopsys)
#レイアウト・サインオフ
#メモリは配列が大きく、寄生やばらつきの影響も大きいので、早い段階から寄生抽出・信頼性解析・物理検証 を回します。Synopsys の memory flow でも、block/chip-level simulation、ML-driven optimization、early parasitic analysis、layout reuse、digitized memory design implementation flows を前面に出しています。 (Synopsys)
#HBMだけ追加で重いところ
#HBMでは、TSV/積層/インターポーザ/多ダイ接続/熱/電源 が一気に重くなります。Synopsys 3DIC Compiler は power/signal integrity、thermal、mechanical stress の multiphysics を統合し、Ansys の半導体解析も 3D/2.5D chip-package co-analysis、power integrity、thermal、thermal-mechanical stress を扱います。 (Synopsys)
#要するに HBM/DRAMは、**「デジタルSoCよりも custom memory / analog 寄り」で、HBMだけさらに「先端パッケージEDAが必須」**になります。 (Synopsys)
##
\2. NAND ではどこで何を使うか
#設計の中心
#NANDも、実務感としては メモリアレイ + 周辺回路 + インターフェース + 制御ロジック の組み合わせです。なので、アレイ/周辺回路は custom memory flow、制御やインターフェースはデジタル検証 flow という二層構造になります。Synopsys の memory flow は memory design 全体に対して block/chip simulation、ML optimization、early parasitic analysis を打ち出しており、custom IC family は analog / mixed-signal / layout / physical verification を束ねています。 (Synopsys)
#回路・レイアウト
#NANDでも、回路の主役はカスタム設計側です。つまり、Virtuoso / Custom Compiler のような回路・レイアウト環境、Spectre / PrimeSim のような回路シミュレータ、寄生抽出・物理検証が重く使われます。 (Synopsys)
#インターフェース検証
#NANDは製品メモリなので、ONFI や Toggle NAND などの規格インターフェース検証が重要です。Synopsys は NAND Flash Verification IP を、Cadence は ONFI / Toggle NAND / SPI NAND 向け VIP を提供しており、UVM ベースの IP / SoC / system-level verification に使えるとしています。 (Synopsys)
#もしSoCの中にNANDコントローラを載せるなら
#その場合は NAND本体そのものとは別に、NAND controller IP / PHY / ECC / DMA / firmware周辺 をデジタルSoCとして設計します。Cadence には NAND Flash controller IP と NAND PHY IP があり、主要 NAND 規格への対応を前面に出しています。 (Cadence)
#要するに NANDは、ダイの中は memory/custom flow、外とのやり取りは protocol verification / digital flow が効く、という理解が近いです。 (Synopsys)
##
\3. トランシーバーではどこで何を使うか
#ここが一番「アナログ/RF/SI」色が強い
#SerDesや高速トランシーバーは、送受信アナログ回路、PLL/CDR、等化、ドライバ/レシーバ、パッケージ、基板チャネル が全部つながって性能が決まります。Cadence Virtuoso Studio RF は、schematic と layout の同時設計、RF/system simulation、EM/thermal analysis、optimization を単一環境で扱うと説明しています。 (Cadence)
#回路設計
#ここでは Virtuoso / Custom Compiler と Spectre / PrimeSim のような 回路設計 + SPICE/RFシミュレーション が主役です。RFやmm-waveまで行くと、EMソルバやSパラメータ解析、非線形解析も強く使います。Cadence の RF flow では Spectre RF、EMX、PVS、EM/thermal analysis、S-parameter analysis などが明示されています。 (Cadence)
#チャネル解析
#トランシーバーで決定的に重要なのが、チップの回路だけでなく、パッケージと基板を通ったあとでも波形が開くかです。Cadence Sigrity SystemSI は、serial link analysis で eye diagram、bathtub curve、BER prediction を行うと説明しています。Cadence の high-speed design ページでも、反射、crosstalk、impedance mismatch、PDN noise、EMI を fabrication 前に解析するとしています。 (Cadence)
#パッケージ/基板/システム
#ここは Ansys や Sigrity / Clarity の守備範囲です。Ansys は電子機器向けに PI/SI/EMI/thermal を、Cadence は high-speed PCB / package co-analysis を前面に出しています。 (ansys.com)
#要するに トランシーバーは、4分類の中でいちばん 「アナログ設計EDA + RF/EM解析EDA + SI/PI/基板EDA」 の比率が高いです。 (Cadence)
##
\4. スイッチASICではどこで何を使うか
#仕様・RTL
#ネットワークスイッチASICは、基本的に 巨大デジタルSoC です。 パケット処理、スケジューラ、バッファ管理、テーブル参照、QoS、制御面などは、まず RTL で書いて、機能検証・形式検証を回します。Cadence は functional verification と Digital Design and Signoff を、Synopsys は VC Formal を complex SoC 向けとして打ち出しています。 (Cadence)
#検証
#スイッチASICは規模が非常に大きいので、シミュレーションだけでなくエミュレーション/プロトタイピング が重要です。Cadence Palladium は early hardware/software co-verification and debug、Synopsys ZeBu / HAPS は hardware-assisted verification 用だと説明しています。 (Cadence)
#実装
#ここは典型的なデジタル flow で、論理合成、配置配線、クロック、STA、低消費電力検証、サインオフ が主役です。Cadence Innovus は placement / optimization / routing / clocking を扱い、Digital Design and Signoff 全体は advanced node、3D-IC、mixed-signal、low-power flows に対応すると説明しています。Synopsys 側も verification / DFT / signoff を大きな柱にしています。 (Cadence)
#内蔵メモリ
#スイッチASICの中には大きな SRAM バッファが多いので、そこは embedded memory compiler / foundation IP を使うことが多いです。Synopsys の memory compilers と Cadence Artisan IP は、embedded memories を foundation IP として提供しています。 (Synopsys)
#ただしI/Oだけは別
#スイッチASICの外部ポートは高速SerDesなので、その部分だけは トランシーバー流の SI/PI/チャネル解析 が追加で乗ります。Cadence Sigrity や high-speed design flow は、serial links、DDRx、PDN、EMI、eye diagram、BER まで扱います。 (Cadence)
#要するに スイッチASICは、4分類の中でいちばん 「デジタルSoC EDA」 寄りです。 ただし端のI/Oは完全にトランシーバー設計の世界に足を突っ込みます。 (Cadence)
##
いちばん簡単な覚え方
#HBM/DRAM → メモリそのものを作るので custom memory + 3D/package が主役。 (Synopsys)
#NAND → custom memory + 規格インターフェース検証 が主役。 (Synopsys)
#トランシーバー → analog/RF + EM/SI/PI が主役。 (Cadence)
#スイッチASIC → RTL検証 + エミュレーション + 配置配線 + サインオフ が主役。 (Cadence)
##
この4種類を「どの職種が主役になるか」で、回路屋・検証屋・レイアウト屋・SI/PI屋に分けて図っぽく整理
#「誰が主役になりやすいか」で、かなり雑に図っぽく並べるとこうです。
#凡例 ★5 = かなり主役 ★3 = 重要 ★1 = 関わるが主役ではない
##
4種類を職種ごとに並べると
#\1. HBM / DRAM
#回路屋 ★★★★★ 検証屋 ★★★☆☆ レイアウト屋 ★★★★★ SI/PI屋 DRAM: ★★☆☆☆ / HBM: ★★★★★
#ひとことで言うと 「メモリ専用の回路屋とレイアウト屋が主役。HBMだけはSI/PI屋も主役級」 です。 理由は、DRAM系はメモリアレイ・周辺回路・カスタム設計の比重が非常に高く、Synopsys も memory design を custom design platform、早期寄生・信頼性・digitized memory flow で回すと説明しています。さらに HBM は 2.5D/3D multi-die と先端パッケージが前提になり、Synopsys 3DIC は high-speed die-to-die、multiphysics、signoff を統合し、Ansys も chip-package の PI / thermal / stress を前面に出しています。 (synopsys.com)
#作業風景のイメージ
#- 回路屋: sense amp、I/O、タイミング回路、周辺回路を詰める
- レイアウト屋: メモリアレイの並び、配線、寄生、密度を詰める
- SI/PI屋: HBMではインターポーザ、スタック、電源、熱を詰める
#
\2. NAND
#回路屋 ★★★★★ 検証屋 ★★★☆☆ レイアウト屋 ★★★★☆ SI/PI屋 ★★☆☆☆
#ひとことで言うと 「NANDも基本はメモリ屋の世界。HBMほどパッケージSI/PIは前に出ない」 です。 NANDもメモリアレイと周辺回路の custom / memory flow が中心で、Synopsys は memory solutions として memory development 全体をカバーするとしています。一方で製品としては ONFI / Toggle などのインターフェース検証も重要なので、検証屋の比重は DRAMより少し見えやすくなります。 (synopsys.com)
#作業風景のイメージ
#- 回路屋: セル、周辺回路、読み書きパス、制御回路を詰める
- レイアウト屋: メモリアレイ配置、配線、寄生成分を詰める
- 検証屋: NANDプロトコルやコントローラ側との整合を確認する
#
\3. トランシーバー
#回路屋 ★★★★★ 検証屋 ★★☆☆☆ レイアウト屋 ★★★★☆ SI/PI屋 ★★★★★
#ひとことで言うと 「回路屋とSI/PI屋の二枚看板」 です。 高速トランシーバーは、SerDes、PLL/CDR、等化器、ドライバ/レシーバのようなアナログ/RF回路が主役で、Cadence Virtuoso RF は schematic/layout 同時設計、system/circuit simulation、EM/thermal analysis を統合するとしています。さらに高速度になるほど、チップだけでなく package / PCB まで含めた signal integrity, power integrity, EMI が支配的になり、Cadence Sigrity や Ansys SIwave はまさにそのための道具です。 (Cadence)
#作業風景のイメージ
#- 回路屋: アイ開口、ジッタ、PLL安定性、等化を詰める
- SI/PI屋: package/board込みで反射、クロストーク、PDN、BERを詰める
- レイアウト屋: 敏感なアナログ配線や対称性を守る
#
\4. スイッチASIC
#回路屋 ★★☆☆☆ 検証屋 ★★★★★ レイアウト屋 ★★★★★ SI/PI屋 ★★★☆☆
#ひとことで言うと 「巨大デジタルSoCの世界。検証屋とレイアウト屋が主役」 です。 スイッチASICは、パケット処理・バッファ管理・スケジューリング・テーブル処理などを大量RTLで組む典型的なデジタル設計で、Cadence は digital design and signoff をフルフローで提供しています。規模が巨大なので、Palladium のようなエミュレーションを含む検証の重要度が非常に高く、後半は placement / routing / timing / signoff でレイアウト屋の比重も極めて大きいです。外部I/Oに高速SerDesを持つので、その部分だけ SI/PI屋もかなり関わります。 (Cadence)
#作業風景のイメージ
#- 検証屋: RTL/UVM/フォーマル/エミュでバグを潰す
- レイアウト屋: 巨大ブロックを置いて配線し、タイミングを閉じる
- SI/PI屋: 高速ポート周辺やパッケージ/基板側を詰める
#
一枚で雑にまとめると
#HBM/DRAM → メモリ回路屋 + レイアウト屋 が主役 → HBMだけ SI/PI屋 も主役級 (synopsys.com)
#NAND → メモリ回路屋 が主役 → 次に レイアウト屋、その次に 検証屋 (synopsys.com)
#トランシーバー → 回路屋 + SI/PI屋 が主役 → 次に レイアウト屋 (Cadence)
#スイッチASIC → 検証屋 + レイアウト屋 が主役 → I/Oまわりで SI/PI屋 が入る (Cadence)
##
最短で覚えるなら
#- メモリは回路屋とレイアウト屋
- HBMはそこにSI/PI屋が強く乗る
- トランシーバーは回路屋とSI/PI屋
- スイッチASICは検証屋とレイアウト屋
です。
##
この4種類は Synopsys・Cadence・Ansys のどの製品群に売上が落ちやすいか
#これは 「各製品タイプの設計で、どの作業にお金が乗りやすいか」から逆算した“売上の落ち先マップ” です。 前提として、Ansys は 2025年7月に Synopsys に買収完了しているので、投資家目線では “Ansys単独の売上先” ではなく “Synopsysグループ内でどの製品群に効くか” と見るのが自然です。Synopsys 側は Memory Solutions、Custom Design Platform、3DIC Compiler、Signoff、Verification IP、ZeBu/HAPS などを展開しており、Cadence 側は Custom IC/Analog/RF、Digital Design and Signoff、Verification、Palladium/Protium、IC Package Design and Analysis、Sigrity、Memory & Storage IP を持っています。Ansys 側は Electronics/semiconductor 向けに EM、SI/PI、thermal、electro-mechanical、RedHawk-SC、SIwave などを持っています。 (investor.synopsys.com)
#1枚マップ
#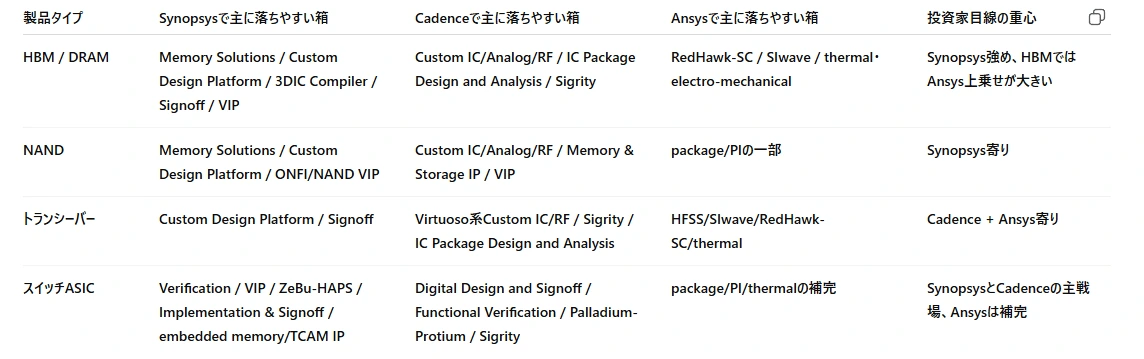
この表は、各社の公式製品群と、HBM/DRAM・NAND・高速I/O・巨大デジタルSoCが要求する設計作業を突き合わせた私の推定地図です。以下で、どこにお金が落ちやすいかを製品ごとに言い換えます。 (synopsys.com)
#\1. HBM / DRAM
#ここは Synopsys に最もお金が落ちやすい領域の1つ です。 理由は、HBM/DRAM が memory 専用フロー と custom/analog と 3D/advanced packaging を同時に必要とするからです。Synopsys は Memory Solutions を前面に出し、Custom Design Platform でカスタム・アナログ設計を、3DIC Compiler で multi-die / 2.5D / 3D の co-design を、Signoff で power/signal integrity や multiphysics を扱っています。HBM 側の protocol/SoC 接続では Verification IP も効きます。Cadence も custom / package / SI/PI 側でしっかり取れますが、“memory開発そのもの”の箱が大きい分、重心はまず Synopsys に置きやすいです。さらに HBM では package、power integrity、thermal、stress が重くなるため、Ansys の価値が最も上乗せされやすい 領域でもあります。 (synopsys.com)
#投資家メモ HBMが増えるほど、Synopsys では Memory + 3DIC + Signoff +(Ansys由来の)PI/thermal が太りやすい、という見方がしやすいです。 (synopsys.com)
#\2. NAND
#NAND は HBMほど package/thermal が前に出ない一方、memory/custom 比率が高い ので、売上の落ち先はかなり素直に Synopsys の Memory Solutions と Custom Design Platform に寄りやすいです。さらに ONFI/NAND 側の検証では Synopsys の ONFI/NAND VIP が効きます。Cadence も custom 設計や Memory & Storage IP、VIP で十分取れますが、NAND全体では “memory flow の太さ” が効く分だけ Synopsys 優位の絵 が描きやすいです。Ansys は package/PI の補完では効くものの、HBMやトランシーバーほど主役ではありません。 (synopsys.com)
#投資家メモ NAND系の案件増加は、4分類の中では Synopsys の“メモリ開発箱”に最も素直に効く と見やすいです。Cadence の取り分はゼロではないですが、主戦場の中心はやや Synopsys 側です。 (synopsys.com)
#\3. トランシーバー
#ここは逆に、Cadence と Ansys が強く見えやすい領域 です。 高速トランシーバーは、回路そのものが analog / RF / mixed-signal であり、さらに package / PCB を通した SI/PI / EM / thermal が性能を左右します。Cadence は Custom IC/Analog/RF、IC Package Design and Analysis、Sigrity を持ち、SystemSI は SerDes を含む serial links の SI 解析を前面に出しています。Ansys は Electronics ポートフォリオとして EM、SI/PI、thermal、electro-mechanical をまとめており、SIwave は IC package / PCB の SI/PI/EMI を扱います。Synopsys も Custom Design Platform と Signoff で取れますが、“高速I/Oの設計とチャネル解析”というテーマでは、Cadence + Ansys の方が売上の落ち先として見えやすい です。 (Cadence)
#投資家メモ トランシーバー強化の波は、Cadence の custom/RF + package/SI と、Ansys の physics に最も追い風です。Synopsys も取りますが、相対的にはここがいちばん Cadence/Ansys 色 が濃いです。 (Cadence)
#\4. スイッチASIC
#ここは Synopsys と Cadence のど真ん中 です。 スイッチASICは巨大デジタルSoCなので、主な支出先は Digital Design and Signoff / Verification / Hardware-assisted verification / memory IP になります。Cadence は Digital Design and Signoff、Functional Verification、Palladium / Protium を持ち、Synopsys は Verification IP、ZeBu / HAPS、Signoff、さらに embedded memory / TCAM IP を持っています。外部ポートが高速SerDesなので、Cadence の Sigrity や package 系、Ansys の SI/PI/thermal も補完的に効きますが、主戦場はあくまで デジタル検証と実装 です。 (Cadence)
#投資家メモ スイッチASIC案件が増える局面は、Synopsys と Cadence の両取りで見るのが自然です。 より細かく分けると、検証ハードと front-end の比重が高いなら Cadence、VIP / signoff / memory IP を含めた広い箱なら Synopsys、という見方がしやすいです。これは公開製品群からの私の推定です。 (Cadence)
#最短の覚え方
#かなり乱暴に一行ずつにすると、
#- HBM/DRAM: Synopsys本丸、ただし HBMはAnsys上乗せ大。 (synopsys.com)
- NAND: Synopsys寄り。 (synopsys.com)
- トランシーバー: Cadence + Ansys寄り。 (Cadence)
- スイッチASIC: Synopsys と Cadence の主戦場、Ansysは補完。 (Cadence)
必要なら次に、この4種類を「Synopsys優位 / Cadence優位 / Ansys上乗せ大」の3色で点数化して横並び比較します。
##
シノプシスとcadence、ARMの製品と商品群
#網羅しすぎない形で、3社の主要な製品群と代表製品を整理します。 なお、Synopsys と Cadence は主にEDA/設計基盤の会社、Arm は主にCPU・GPU・NPUなどのIP/プラットフォームの会社です。 (synopsys.com)
#Synopsys(シノプシス)
#Synopsys の大きな箱は、公式トップでは EDA, Systems, Silicon IP が前面に出ており、加えて Manufacturing, Silicon Lifecycle Management, Software Integrity も主要ポートフォリオです。 (synopsys.com)
#主な製品群
#- EDA(半導体設計自動化)
チップ設計・検証・実装・サインオフ向け。AI-enabled EDA、AI-powered optimization、GenAI copilot もここに含まれます。 (synopsys.com)
- Systems(システム検証/仮想化/HAV)
仮想プロトタイピング、エミュレーション、FPGAプロトタイピング、システムテスト生成など。 (synopsys.com)
- Silicon IP
インターフェースIP、foundation IP、physical IP。 (synopsys.com)
- Manufacturing
TCAD、Mask Synthesis、Manufacturing Analytics、Lithography など。 (synopsys.com)
- Silicon Lifecycle Management (SLM)
in-design から in-field まで、モニタ・解析・自動化でシリコン運用を最適化。 (synopsys.com)
- Software Integrity
アプリケーションセキュリティ、ソフトウェアサプライチェーン、AppSecリスク管理など。 (synopsys.com)
#代表製品の例
#- 検証系: VCS, Verdi, VC SpyGlass, VC Formal, VC VIP, Virtualizer, ZeBu, HAPS。 (synopsys.com)
- メモリ/カスタム/3DIC系: Memory Solutions, Custom Design Platform, 3DIC Compiler。 (synopsys.com)
- 製造系: Sentaurus Process, Taurus TSUPREM-4, Sentaurus Topography 3D, Sentaurus Lithography, S-Litho。 (synopsys.com)
#
Cadence(ケイデンス)
#Cadence の公式な製品カテゴリは、Digital Design and Signoff, Custom IC/Analog/RF Design, Verification, IP, IC Package Design and Analysis, Multiphysics System Analysis, PCB Design and Analysis です。さらに System Design & Analysis の箱として、Allegro, Sigrity, AWR, Reality DC, Fidelity CFD なども並んでいます。 (Cadence)
#主な製品群
#- Digital Design and Signoff
RTL解析、等価性検証、SoC実装、低消費電力検証、合成、電力解析、CDC/制約サインオフ、シリコンサインオフ、テスト自動化。 (Cadence)
- Custom IC / Analog / RF Design
回路設計、回路シミュレーション、レイアウト、レイアウト検証、ライブラリ特性評価、RF/マイクロ波、カスタム電源完全性。 (Cadence)
- Verification
シミュレーション、AI-driven verification、エミュレーション/プロトタイピング、フォーマル/静的検証、Verification IP、デバッグ、Portable Stimulus、System VIP、Virtual/Hybrid Platform、Planning & Management。 (Cadence)
- IP
High-Speed Ethernet、Chiplet and D2D、Denali Memory Interface and Storage IP、Interface IP、PCIe and CXL、Tensilica Processor IP、AI IP Platform。 (Cadence)
- IC Package Design and Analysis
クロスプラットフォーム co-design、ICパッケージ設計、ICパッケージ向け SI/PI 解析。 (Cadence)
- Multiphysics System Analysis
CFD、電磁界解析、RF/マイクロ波設計、Signal/Power Integrity、熱解析、AI-driven system analysis。 (Cadence)
- PCB Design and Analysis
PCB設計、PCB向け SI/PI、RF/マイクロ波、PSpice など。 (Cadence)
#代表製品の例
#- デジタル/実装: Genus, Innovus, Tempus, Voltus, Pegasus, Cerebrus, Joules, Certus, Integrity 3D-IC Platform。 (Cadence)
- カスタム/アナログ: Virtuoso Studio, Virtuoso Layout Suite, Virtuoso ADE Suite, Spectre X, Spectre FX, AWR Microwave Office, Voltus-XFi。 (Cadence)
- 検証: Palladium, Protium, Jasper, Verisium 系。 (Cadence)
- システム/パッケージ/基板: Allegro X, Sigrity X, Clarity 3D Solver, Celsius Thermal Solver, Fidelity CFD, Reality DC。 (Cadence)
#
Arm(アーム)
#Arm は EDA ベンダーというより、CPU/GPU/NPUやシステムIP、サブシステムIP、開発ツールをライセンスする会社です。公式の Products ページでは、Arm AGI CPU, Compute Subsystems, CPUs, Mali GPUs, Ethos NPUs, Security IP, Subsystem IP, System IP, Development Tools が主要カテゴリです。 (arm.com)
#主な製品群
#- Compute Subsystems (CSS)
検証済み・実装済みの compute foundation。クライアント向け CSS など。 (arm.com)
- CPUs
C1, Cortex-A, Cortex-R, Cortex-M, Cortex-X, Neoverse。 (arm.com)
- Mali GPUs
グラフィックス/並列処理向け GPU IP。 (arm.com)
- Ethos NPUs
AI推論向け NPU IP。 (arm.com)
- System IP
CoreLink interconnect、memory controllers、system controllers、CoreSight debug/trace、Socrates など。 (arm.com)
- Security IP
暗号、セキュリティサービス、分離、耐タンパ性など。 (arm.com)
- Subsystem IP
Arm ベースSoC構成要素の再利用・統合向け。 (arm.com)
- Development Tools
Arm Development Studio、Keil MDK、GNU Toolchain など。 (arm.com)
- Physical IP
Artisan Physical IP、embedded memory、interface、logic。なお Arm は Artisan 系について投資方針を見直し、engineering investment を縮小すると案内しています。 (developer.arm.com)
#代表製品/サービスの例
#- IP選定・統合支援: Arm IP Explorer, Socrates IP Tooling。 (arm.com)
- ライセンス商品: Arm Total Access、License Arm Technology。 (arm.com)
#
かなり短く整理すると
#- Synopsys
EDA、システム検証、Silicon IP、製造(TCAD/リソグラフィ)、SLM、Software Integrity。 (synopsys.com)
- Cadence
デジタル実装、カスタム/アナログ/RF、検証、IP、パッケージ、マルチフィジクス、PCB。 (Cadence)
- Arm
CPU/GPU/NPU、Compute Subsystems、System/Security/Subsystem IP、開発ツール、Physical IP。 (arm.com)
##
半導体づくりを高級レストランで一皿を出す流れに置き換えて説明
#まず全体像
#- EDA = 厨房で使う設計ソフト、レシピ管理、試作シミュレーター、動線設計ツール
- 半導体設計 = シェフがメニューを考え、レシピを作り、試作して完成形を決める工程
- TSMC = 実際に大量生産できる超高精度な巨大セントラルキッチン
- CoWoS / パッケージ = 出来上がった料理を、ソースや付け合わせごと最適な一皿に美しく、機能的に盛り付ける工程
EDA はチップ設計を助けるソフト群で、設計、シミュレーション、テスト、製造準備を自動化するものです。CoWoS は TSMC の先端パッケージ技術で、正式には Chip-on-Wafer-on-Substrate の略で、高密度なインターポーザ上にロジックと HBM を近接統合し、AI や HPC 向けに使われます。 (Synopsys)
#\1. 「こんな料理を出したい」を決める
#これは製品企画です。
#レストランなら、 「今日は辛めの魚料理を出したい」 「高級感はあるけど提供は早くしたい」 「原価は抑えたい」 を決めます。
#半導体なら、 「AI向けGPUにする」 「消費電力はここまで」 「性能はこのくらい」 「HBMを何個載せる」 を決めます。
#まだ料理は作っていません。 何を作るか決めている段階です。
#\2. レシピを作る
#これはアーキテクトや設計者の仕事です。
#レストランなら、
#- 肉を先に焼くか
- ソースは何段階で作るか
- 付け合わせは何を置くか
- どの皿を使うか
を決めます。
#半導体なら、
#- 演算器をどれだけ並べるか
- キャッシュをどう置くか
- メモリとどうつなぐか
- 入出力をどうするか
を決めます。
#これはまだ「料理の構造」を決めている段階です。
#\3. EDAは何に当たるか
#EDA は、厨房の超高度な裏方ツール一式です。
#たとえばレストランでいうと、
#- レシピ作成ソフト
- 試作シミュレーター
- 仕込み表の自動生成
- 調理手順の矛盾チェック
- 厨房の動線最適化
- 原価・時間・失敗率の見積もり
- 盛り付け前の最終チェック
を全部まとめたものに近いです。
#半導体では、設計者が Verilog / SystemVerilog などで回路の動作を書き、それを EDA が
#- 正しく動くか
- 遅すぎないか
- 電力を食いすぎないか
- 面積が大きすぎないか
- 製造できる形になっているか
を何度も確認します。EDA は設計と製造準備を自動化する道具群です。 (Synopsys)
#\4. 試作して、味見して、レシピを直す
#これは検証です。
#レストランなら、 実際に試作してみて、 「塩が強い」 「火入れが長い」 「皿に対して量が多すぎる」 を直します。
#半導体も同じで、 「論理は合っているか」 「タイミングは間に合うか」 「熱や電力は大丈夫か」 を直していきます。
#つまり、EDAは試作と味見を何千回も高速で回すための道具です。
#\5. 厨房の動線まで詰める
#ここが半導体らしいところです。
#レストランでは、料理そのものが良くても、
#- 冷蔵庫が遠い
- 焼き場と盛り付け台が離れすぎ
- 皿が取りにくい
- スタッフがぶつかる
と、提供が遅くなります。
#半導体でも同じで、回路の内容が正しくても、
#- 配線が長すぎる
- 電力が一部に集中する
- 熱がこもる
- 信号が遅れる
と、性能が出ません。
#だから EDA は、レシピだけでなく厨房の動線設計まで詰める感じです。
#\6. TSMCは何に当たるか
#TSMC は、世界最高レベルの巨大セントラルキッチンです。
#シェフが考えたレシピを持ち込むと、TSMC が 超高精度で、同じ品質の料理を大量に作る 役です。
#つまり、
#- 設計者 = 料理を考えるシェフ
- EDA = 設計と試作を支える道具
- TSMC = その料理を現実の物として量産する工場
です。
#ここで初めて、頭の中の設計が「物」になります。
#\7. でもAIチップは、料理ができたら終わりではない
#ここが CoWoS / パッケージ に当たります。
#レストランでたとえると、 メイン料理だけ作って終わりではなく、
#- メイン
- ソース
- 付け合わせ
- 温度管理
- 皿の材質
- 盛り付け順
- 食べやすさ
まで最適化して、一皿として完成させる必要があります。
#AIチップも同じで、GPU本体だけ作って終わりではなく、 HBMメモリをすぐ近くに置いて、超短距離でつなぎ、一体の高性能パッケージにすることが重要です。TSMC の CoWoS は、ロジックチップと HBM を高密度インターポーザ上で統合する先端パッケージ技術です。 (3DFabric)
#\8. CoWoSはレストランでいうと何か
#CoWoS は、ただの「皿に乗せる作業」ではありません。
#これはむしろ、 “最高の皿・最高の盛り付け構造・最高の配膳方法まで含めて料理の性能を上げる技術” です。
#たとえば高級レストランで、
#- ソースを別皿にしたら味が落ちる
- 付け合わせが遠いと一体感が消える
- 皿が悪いと温度が逃げる
ということがありますよね。
#AI GPUも同じで、
#- GPUとHBMが遠いと遅い
- 配線が長いと電力が無駄
- まとめ方が悪いと熱も厳しい
となります。
#だから CoWoS は、 「完成した部品をまとめる作業」ではなく、「料理として成立させる最後の重要技術」 です。
#\9. 一連の流れをレストランの一晩でつなぐと
#こうなります。
#メニューを決める → 今日はどんな料理を出すか決める = 半導体の製品企画
#レシピを作る → 材料、火入れ、ソース、順番を決める = アーキ設計
#EDAで試作する → 味見、時間計測、動線確認、失敗ポイントを洗う = 論理設計、検証、配置配線、サインオフ
#TSMCで本番の料理を作る → 超精密な厨房で実物を大量生産する = ウェハ製造
#CoWoS/パッケージで一皿に仕上げる → メインと付け合わせとソースを最適に配置し、一皿として性能を完成させる = GPUとHBMの近接統合、先端パッケージ
#最後に客へ出せる形にする → 見た目、温度、食べやすさまで整える = 完成品として出荷できる状態にする
#いちばん短いまとめ
#一言でいうと、
#EDAは“料理を失敗しないように設計するための道具” TSMCは“その料理を超高精度で実際に作る厨房” CoWoSは“その料理を最高の一皿に仕上げる盛り付け技術”
#です。EDA がないとまともなレシピになりにくく、TSMC がないと実物にならず、CoWoS がないと AI 向けの最高性能の一皿になりにくい、という関係です。 (Synopsys)
##
AIサーバー全体を、レストランのフルコース料理として見る
#まず一言でいうと
#- GPU = メインディッシュ
- HBM = メインのすぐ横にある超重要な濃縮ソース・付け合わせ
- パッケージ/インターポーザ = メインとソースを最適な距離で載せる特注プレート
- 基板(PCB) = その皿を載せるお盆・配膳トレー
- サーバー1台 = 1人前のコースセット
- サーバーラック = 何人前も同時に出す巨大な配膳棚・厨房ライン
つまり、 GPU単体が料理の全部ではなく、HBM・基板・サーバーまで含めて初めて“ちゃんと食べられるフルコース”になる というイメージです。
##
\1. GPUは何に当たるか
#GPUは、フルコースの中心になるメインディッシュです。
#たとえば、
#- 分厚いステーキ
- メインの魚料理
- 一番手間と技術がかかった主役の皿
みたいなものです。
#お客さんが 「この店すごい」 と感じる一番の中心は、たいていメインですよね。 AIサーバーでも同じで、計算の中心はGPUです。
#つまりGPUは、 実際に“仕事をする主役” です。
##
\2. HBMは何に当たるか
#HBMは、メインのすぐ隣に置かれた、超高密度で超重要なソースや付け合わせです。
#ここがすごく大事です。 HBMはただの脇役ではありません。
#高級料理で、
#- ソースが命
- ピューレや付け合わせと一体で味が完成する
- しかもメインのすぐそばにないと成立しない
みたいな料理がありますよね。
#HBMはまさにそれです。
#GPUがどれだけ強くても、HBMが遅かったり遠かったりすると、 料理で言えば
#- メインは立派なのにソースがなかなか来ない
- 一口ごとに味がつながらない
- 全体の完成度が落ちる
状態になります。
#だからHBMは、ただのメモリではなく、 “メインの実力を引き出すために、ぴったり寄り添う高級ソース” みたいな存在です。
##
\3. パッケージ / インターポーザは何に当たるか
#これは、メインとソースを最適な位置関係でまとめる特注プレートです。
#普通の皿ではなく、
#- 熱が逃げにくい
- 見た目も整う
- ソースとメインの距離が絶妙
- 全体が一体として機能する
ように考えられた特別な皿です。
#AIチップでは、GPUとHBMは ただ近くに置けばいい わけではなく、
#- 配線を短くする
- 電力を安定させる
- 熱を逃がす
- 全体として成立させる
必要があります。
#つまりパッケージは、 料理そのものではないが、料理の完成度を決める皿 です。
#高級料理では皿も作品の一部ですが、AIサーバーでもそれに近いです。
##
\4. 基板(PCB)は何に当たるか
#基板は、その皿を載せる大きな配膳トレーです。
#ここにはメインの皿だけでなく、
#- ナイフやフォーク
- ソース入れ
- ワインや水
- 温度管理の小物
- 他の皿との並び
まで全部載ります。
#半導体でいうと基板は、
#- GPUパッケージを載せる
- 電力を配る
- 他の部品とつなぐ
- 信号を通す
- システム全体を物理的に支える
役目です。
#つまり基板は、 主役を活かすための“配膳の土台” です。
#料理でたとえると、皿そのものではなく、 皿を含む一式を安全に運び、正しい順序で機能させるトレー です。
##
\5. サーバー1台は何に当たるか
#サーバー1台は、1人前のフルコースセットです。
#メインの皿だけではなく、
#- 前菜
- スープ
- メイン
- ソース
- 飲み物
- デザート
- カトラリー
- サービス動線
まで揃って、初めて 「1人分の食事」 として成立しますよね。
#AIサーバーでも同じで、GPUだけでは何もできません。
#サーバー1台には、
#- GPU
- HBM
- CPU
- SSD
- NIC
- 電源
- 冷却
- 基板
- シャーシ
などが入っていて、初めて 1台の計算機 として動きます。
#つまりサーバー1台は、 “GPU料理を実際に客へ出せる形にした1セット” です。
##
\6. サーバーラックは何に当たるか
#サーバーラックは、大量のフルコースを同時に回す巨大な配膳棚・厨房ラインです。
#レストランで1皿だけ出すなら簡単ですが、 高級宴会で何十人、何百人分を同時に出すには、
#- 皿の並べ方
- 配膳順
- 温度管理
- 電源や照明
- スタッフ動線
- 一気に出すオペレーション
が重要になります。
#サーバーラックもまさにそれです。
#ラックはただの棚ではなく、
#- 電力を各サーバーへ配る
- 冷却を回す
- ネットワーク接続をまとめる
- 何台ものサーバーを効率よく並べる
- 保守しやすくする
役目です。
#つまりラックは、 1皿を作る場所ではなく、“大量のコース料理を安定して回すための店の運営システム” に近いです。
##
\7. もっとつなげて言うと
#フルコースで見るとこうなります。
#GPU
#メインディッシュ = 一番価値が見えやすい主役
#HBM
#メインに密着した濃縮ソース・付け合わせ = 主役の性能を本当に引き出す存在
#パッケージ
#メインとソースを最適配置する特注皿 = 完成度を左右する
#基板
#皿や周辺をまとめて載せる配膳トレー = 電力・接続・安定性の土台
#サーバー
#1人前のフルコースセット = 実際に提供できる単位
#サーバーラック
#大量のコースを同時提供する厨房ライン・配膳棚 = 店全体の回転率と提供能力を決める
##
\8. 一番大事なポイント
#初心者向けに本質だけ言うと、
#GPUがすごい = うまいメイン料理がある だけでは足りません。
#実際には、
#- HBMが弱いとソース不足
- パッケージが悪いと盛り付け失敗
- 基板が悪いと配膳が不安定
- サーバー設計が悪いと一人前として成立しない
- ラック運用が悪いと店全体が回らない
となります。
#つまりAIサーバーの強さは、 “すごいGPUがあるか”だけでなく、“それをフルコースとして成立させる全体設計”で決まる ということです。
##
超短くまとめると
#GPU = メイン料理 HBM = その味を決める超重要ソース 基板 = 配膳トレー サーバー = 1人前のコース ラック = 宴会を回す店の提供ライン
##
AIデータセンター全体を、巨大な高級レストランにたとえて整理
#今回は、
#- GPU
- CPU
- HBM
- SSD
- NIC
- スイッチ
- サーバー
- ラック
- データセンター全体
を全部つなげて、 「店がどうやって大量の注文をさばいているか」 で見ます。
##
まず全体のたとえ
#AIデータセンターは、 超巨大で、何千人分もの料理を同時に出すレストラン です。
#しかも普通の飲食店ではなく、
#- 注文が大量に来る
- 料理は複雑
- 提供は超高速
- 温度管理も厳しい
- 皿の運び方まで最適化されている
ような店です。
#この店の中で、それぞれの部品はこうなります。
#- GPU = メイン料理を実際に大量に作る主力シェフ
- CPU = 厨房全体を指示し、段取りを組む料理長
- HBM = シェフの手元にある超重要な高級食材・濃縮ソース
- SSD = 大型冷蔵庫・食材倉庫
- NIC = 店の外や他店舗とつながる出入口・配膳窓口
- スイッチ = 店内全体の配膳ルートを仕切る交通整理センター
- サーバー = ひとつの調理台+スタッフ一式
- ラック = 調理台が何列も並んだ厨房の島
- データセンター = 巨大レストラン全体
#
\1. GPUは何か
#GPUは、実際に大量の料理を作る主力シェフ集団です。
#この店の一番の売りは、 大量の注文を一気にさばけることです。
#GPUはまさに、
#- 同じ工程を大量に並列でこなす
- ものすごい量の下ごしらえや調理を一気に進める
- 店の処理能力の中心になる
存在です。
#だから GPU は、 店の看板シェフというより、“厨房の主力そのもの” です。
#AI推論でも学習でも、 実際に重い計算をしているのは主にここです。
##
\2. CPUは何か
#CPUは、料理長・司令塔です。
#CPUはGPUほど大量調理は得意ではありませんが、
#- どの注文をどこへ回すか
- 調理の段取り
- 在庫確認
- 他の機器との連携
- システム全体の制御
を担当します。
#レストランで言えば、
#- 「この注文を先に回して」
- 「この皿を次に出して」
- 「この仕込みを始めて」
- 「他のスタッフに指示を出して」
と采配する人です。
#つまり CPU は、 自分で全部料理する主役ではなく、厨房全体を回す管理者 です。
##
\3. HBMは何か
#HBMは、主力シェフの手元に置かれた超高級で超高速に使える食材置き場・濃縮ソース置き場です。
#普通の倉庫に食材を取りに行っていたら遅いですよね。 一流の厨房では、よく使うものはシェフのすぐ手元にあります。
#HBMはまさにそれです。
#- GPUがすぐ使いたいデータを置く
- 取りに行く時間を最小化する
- 高速に大量供給する
だから HBM は、 厨房の奥の大型倉庫ではなく、シェフの肘のすぐ横にある超高性能な材料棚 です。
#これが遅いと、GPUという主力シェフが待たされます。
##
\4. SSDは何か
#SSDは、大型冷蔵庫・食材倉庫です。
#HBMが手元の材料棚なら、SSDは
#- 仕入れた大量の食材を保存する
- すぐには使わないが必要な時に取り出す
- レシピや仕込み済み素材、在庫を置く
場所です。
#つまり SSD は、
#- モデルデータ
- 学習データ
- 中間保存
- ログや出力
を置いておく大きな保管庫です。
#レストランで言えば、 厨房の横にある超高速冷蔵倉庫 です。
#HBMほど近くはないけれど、店にとって絶対必要です。
##
\5. NICは何か
#NICは、店の出入口・外との受け渡し窓口です。
#たとえば巨大レストランでは、
#- 外部から食材が届く
- 他の厨房と料理を受け渡す
- 注文情報が入ってくる
- 完成品の指示が外へ出る
必要があります。
#NICはまさに、
#- ネットワークからデータを受け取る
- 他サーバーへ渡す
- クラスタ全体で連携する
窓口です。
#レストランでいうと、 注文票の受付口、食材搬入口、他店舗との受け渡し口 が合体したようなものです。
#AIクラスタでは、1台だけで完結しないことが多いので、NICはかなり重要です。
##
\6. スイッチは何か
#スイッチは、店全体の交通整理センターです。
#もし厨房や配膳スタッフが勝手に動いたら、
#- 料理が遅れる
- ぶつかる
- 注文が迷子になる
- 間違ったテーブルへ行く
ことが起きます。
#スイッチは、それを防ぐために
#- どの注文をどこに流すか
- どのサーバー同士をつなぐか
- どの経路を通すか
- 混雑をどう避けるか
を管理します。
#つまりスイッチは、 店内の道路管制室 みたいなものです。
#AIデータセンターでは、GPU同士・サーバー同士で大量のデータをやり取りするので、 スイッチが弱いと、厨房全体が詰まります。
##
\7. サーバーは何か
#サーバー1台は、ひとつの調理台+料理長+主力シェフ+手元食材+倉庫接続をまとめた一単位です。
#つまり、
#- CPU = 料理長
- GPU = 主力シェフ
- HBM = 手元の食材棚
- SSD = 倉庫
- NIC = 出入口
をまとめた、1つの調理ユニットです。
#店全体では何十台、何百台と並びますが、 1台1台が「仕事をする最小単位」に近いです。
##
\8. ラックは何か
#ラックは、調理台が何列も並んだ厨房の島です。
#大型厨房だと、
#- 調理台がずらっと並び
- 電源やガスや水がまとめられ
- 人の動線も整理され
- 冷却や排気も設計されている
はずです。
#ラックも同じで、
#- サーバーを何台も並べる
- 電力供給をまとめる
- 冷却をまとめる
- 配線を整理する
ための単位です。
#だからラックは、 “店の中の一角にある高密度な厨房島” です。
##
\9. データセンター全体は何か
#データセンター全体は、巨大レストランそのものです。
#そこには、
#- 何列もの厨房島(ラック)
- 大量の調理ユニット(サーバー)
- シェフたち(GPU)
- 料理長たち(CPU)
- 食材倉庫(SSD)
- 出入口(NIC)
- 交通整理センター(スイッチ)
- 電力
- 冷却
- 建物全体の管理
がそろっています。
#つまり AIデータセンターとは、 「すごいGPUが何枚かある箱」ではなく、何千・何万の注文を安定してさばくために設計された巨大飲食システム」 です。
##
\10. 学習と推論で少し違う
#これもレストランでたとえると分かりやすいです。
#AI学習
#新メニュー開発+大量試作厨房 に近いです。
#- 大量の材料を使う
- 何度も試す
- 厨房同士の連携が多い
- データのやり取りが多い
ので、GPUだけでなく NIC とスイッチ が特に重要になります。
#AI推論
#完成した人気メニューを大量提供する営業厨房 に近いです。
#- 注文を速く返す
- レイテンシが大事
- 在庫管理も大事
- 効率とコストが大事
ので、サーバー全体のバランスが重要になります。
##
\11. すごく短く1本でつなぐと
#お客さんが注文する → 注文が店に入る = NIC
#どの厨房で作るか決める → 配膳ルートを決める = スイッチ + CPU
#倉庫から材料を出す = SSD
#シェフの手元に必要材料を並べる = HBM
#主力シェフが一気に調理する = GPU
#調理台一式で1人前を作る = サーバー
#それを何十台も並べて大量提供する = ラック
#店全体で何千人分も同時に回す = AIデータセンター
##
最後に本質だけ言うと
#AIデータセンターは、 GPUだけがすごくても回りません。
#- CPUが弱いと段取りが悪い
- SSDが弱いと材料が出てこない
- NICが弱いと外とつながらない
- スイッチが弱いと店内が渋滞する
- ラックや冷却が弱いと厨房が熱で止まる
つまり、 GPUは主役だが、データセンターの強さは“巨大レストラン全体の運営力”で決まる ということです。
##
GPU・HBM・SSD・NIC・スイッチのどこにお金が落ちやすいか
#結論
#1台のAIサーバーで見たお金の落ち先 GPU > HBM > NIC > SSD です。NVIDIAのDGX B200は、1台に 8基のBlackwell GPU、合計 1,440GBのHBM3e、8本のConnectX-7ポート、さらに BlueField-3 DPU と NVMe SSD を搭載しています。構成を見る限り、1台あたりの価値の中心はまずGPU、その次がHBMで、NICは重要だが主役の次、SSDは必要でも相対的には脇役寄りです。これは構成からの推論です。 (NVIDIA)
#ラック/大規模クラスタで見たお金の落ち先 GPU > HBM > スイッチ+NIC > SSD です。理由は、クラスタ化するとGPU同士をつなぐネットワーク費用が一気に膨らむからです。BroadcomはTomahawk 6を AIのscale-up / scale-outネットワーク向け と位置づけており、2025年Q3には AI売上が前年比63%増の52億ドル、その牽引役として custom AI accelerators と networking を挙げています。つまり、クラスタが大きくなるほど スイッチとNICは「付属品」ではなく大きな支出先 になります。 (broadcom.com)
#データセンター全体で見たお金の落ち先 GPU > HBM > ネットワーク(スイッチ/NIC) > SSD/ストレージ が基本です。 ただし、学習中心ならネットワーク比重が上がり、推論・RAG・ベクトルDB中心ならSSD比重が上がります。Micronは、AI推論での KV cache tiering や vector database search/indexing がデータセンターSSD需要を押し上げていると説明しています。 (Micron Technology)
#部品ごとに見ると
#GPU
#いちばん大きなお金が落ちやすい場所です。 理由は、AIサーバーの計算価値の中心そのものだからです。NVIDIA自身も、AIインフラはTSMCのウェハ、HBM、CoWoS、組立・テストを組み合わせて供給しており、最終製品の価値の中心はGPU側にあります。DGX B200でも1台の中心は8基のGPUです。 (NVIDIA)
#HBM
#2番目にお金が落ちやすい場所です。 しかもHBMは、普通のDRAMより 高付加価値・高難度 の製品として売上と利益が乗りやすいです。Micronは、データセンター向け製品は業界でもっとも複雑で高価値な製品群の一部だとし、HBM事業は2025年度Q4に 約20億ドルの四半期売上、年率約80億ドルのランレート に達したと説明しています。NVIDIAもHBM供給元として SK hynix、Micron、Samsung を明示しています。つまり、AIサーバーの支出が増えると、GPUの隣で HBMメーカーにも非常に大きなお金が落ちる 構造です。 (Micron Technology)
#NIC
#1台ではGPU/HBMより小さいが、クラスタ化で効いてくる場所です。 DGX B200は 8本のConnectX-7 VPIポート と BlueField-3 DPU を載せており、1台の時点でネットワーク部材がかなり重いことがわかります。とくに複数ノードを束ねる学習クラスタでは、NICは「ただのLAN口」ではなく、GPUを仕事させるための必需品です。 (NVIDIA)
#スイッチ
#クラスタが大きくなるほど、NIC以上に存在感が増える場所です。 1台のサーバーにはスイッチは載りませんが、ラック間・クラスタ間でGPUを大量接続すると、スイッチASICとその周辺部材が大きな支出先になります。BroadcomはTomahawk 6をAI向け 102.4Tbps 級のスイッチとして出し、AIネットワーキングがAI売上拡大の一部だと説明しています。 なので、1台目線ではNICが先、クラスタ目線ではスイッチが急浮上、と考えるとわかりやすいです。 (broadcom.com)
#SSD
#必要だが、1台あたりの主役にはなりにくい場所です。 DGX B200のローカルストレージは OS用2×1.9TB NVMe と 内部8×3.84TB NVMe で、重要ではあるものの、1台の価値の中心がGPU/HBM/ネットワークであることは構成から見て取れます。 一方で、推論、RAG、ベクトルDB、KV cache offload の世界ではSSD需要が強くなります。Micronはまさにこの用途で データセンターNAND/SSD需要が加速 していると説明しています。つまりSSDは、学習サーバーの中心部材というより、AIデータ基盤が広がるほど効く部材 です。 (Micron Technology)
#いちばん実戦的な見方
#学習クラスターでは GPU → HBM → スイッチ/NIC → SSD の順で見た方が実態に近いです。巨大学習では、GPUの次にHBMが重く、その次にクラスタネットワークが効いてきます。 (NVIDIA)
#推論/RAG/ベクトルDB寄りでは GPU → HBM → ネットワーク → SSD ですが、SSDの比重が学習時より上がります。MicronがAI推論用途でKV cache tieringとvector databaseをSSD需要要因として挙げているのが、そのままこの構図です。 (Micron Technology)
#投資家向けに一行で言うと
#- 一番大きな金額が落ちるのは GPU
- 一番おいしい周辺部材は HBM
- クラスタが巨大になるほど伸びるのは NIC とスイッチ
- 推論/RAGが広がるほど効くのは SSD です。 (Micron Technology)
#
サムネはNano Banana2
#