半導体製造を「層」で見る
この資料の日時
元資料の日付と、その本文が公に存在した確認日時は別の記録です。
本文に含まれる語句 HBM DRAM SRAM 帯域・データ移動 先端パッケージング 光接続 電力・給電 冷却 歩留まり 基板・材料 チップレット AI推論 AIエージェント
出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.09.23.4
- 記事内容のSHA-256
ac7be3148ce86634b7ff79eebf4f7bb03f385b54d960ac565eaed29d0c92330f- 保存版のSHA-256
2c532115587ccdd54488fd5a28741ea96aa31dbe3dcf0af16cb724031dd57115
外部証明の最終検査結果は詳細を開くと表示します。
半導体製造工程をチップの層で捉えて基本から見直してみました
#半導体製造を「層」で見る
#前工程・後工程、材料、装置、見えにくい必須プレーヤーまで
#半導体は、よく「3nm」「2nm」「EUV」「GPU」「HBM」といった単語で語られる。しかし、実際のチップは単なるシリコンの板ではない。現代の半導体、特にAI GPUやサーバーCPU、AI ASICは、トランジスタ層、金属配線層、接合層、インターポーザ層、ABF基板層、電源安定化層、冷却層、テスト層が重なった巨大な工学システムである。
#つまり半導体は、もはや「チップ」ではなく、材料・配線・記憶・電源・熱・検査を統合した計算構造物として見るべき時代に入っている。
##
\1. 前工程と後工程の違い
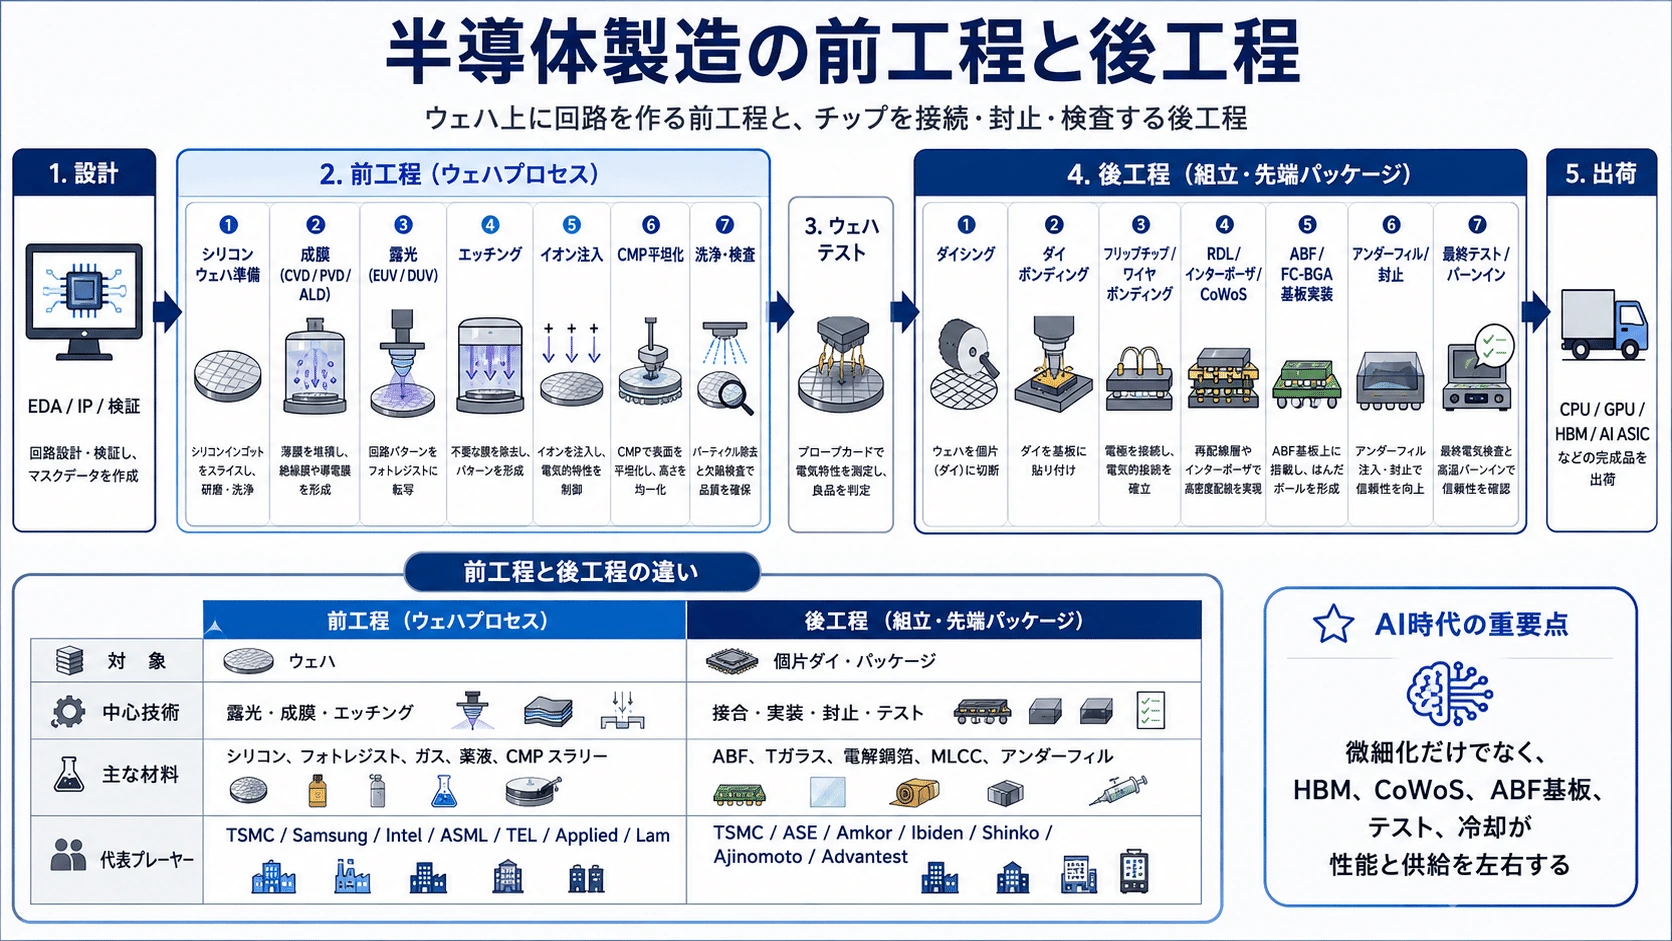
#半導体製造は、大きく 前工程 と 後工程 に分かれる。
#前工程:
シリコンウェハ上にトランジスタと金属配線を作る工程
後工程:
できあがったチップを切り出し、接続し、封止し、
パッケージ化し、検査して使える部品にする工程前工程は、シリコンウェハ上にナノメートル単位で回路を作る世界である。EUV露光、成膜、エッチング、CMP、イオン注入、洗浄などが中心になる。ASMLは、EUV露光がチップ内の最も複雑な層を形成するために使われ、DUVも多くの層で並行して使われ続けると説明している。つまり、前工程は「微細な回路をウェハに刻む工程」である。(ASML)
#一方、後工程は、かつては「チップを包む工程」と見られていた。しかしAI時代には違う。GPUとHBMを結ぶCoWoS、シリコンインターポーザ、RDL、ABF基板、マイクロバンプ、ハイブリッドボンディング、MLCC、テストは、もはや性能そのものを決める。TSMCのCoWoS-Sは大面積シリコンインターポーザ上でロジックチップレットとHBMを統合する技術であり、CoWoS-RやCoWoS-LはRDLインターポーザや局所シリコン接続を使う選択肢として位置づけられている。(3DFabric)
#
#
\2. チップを層で捉える全体図
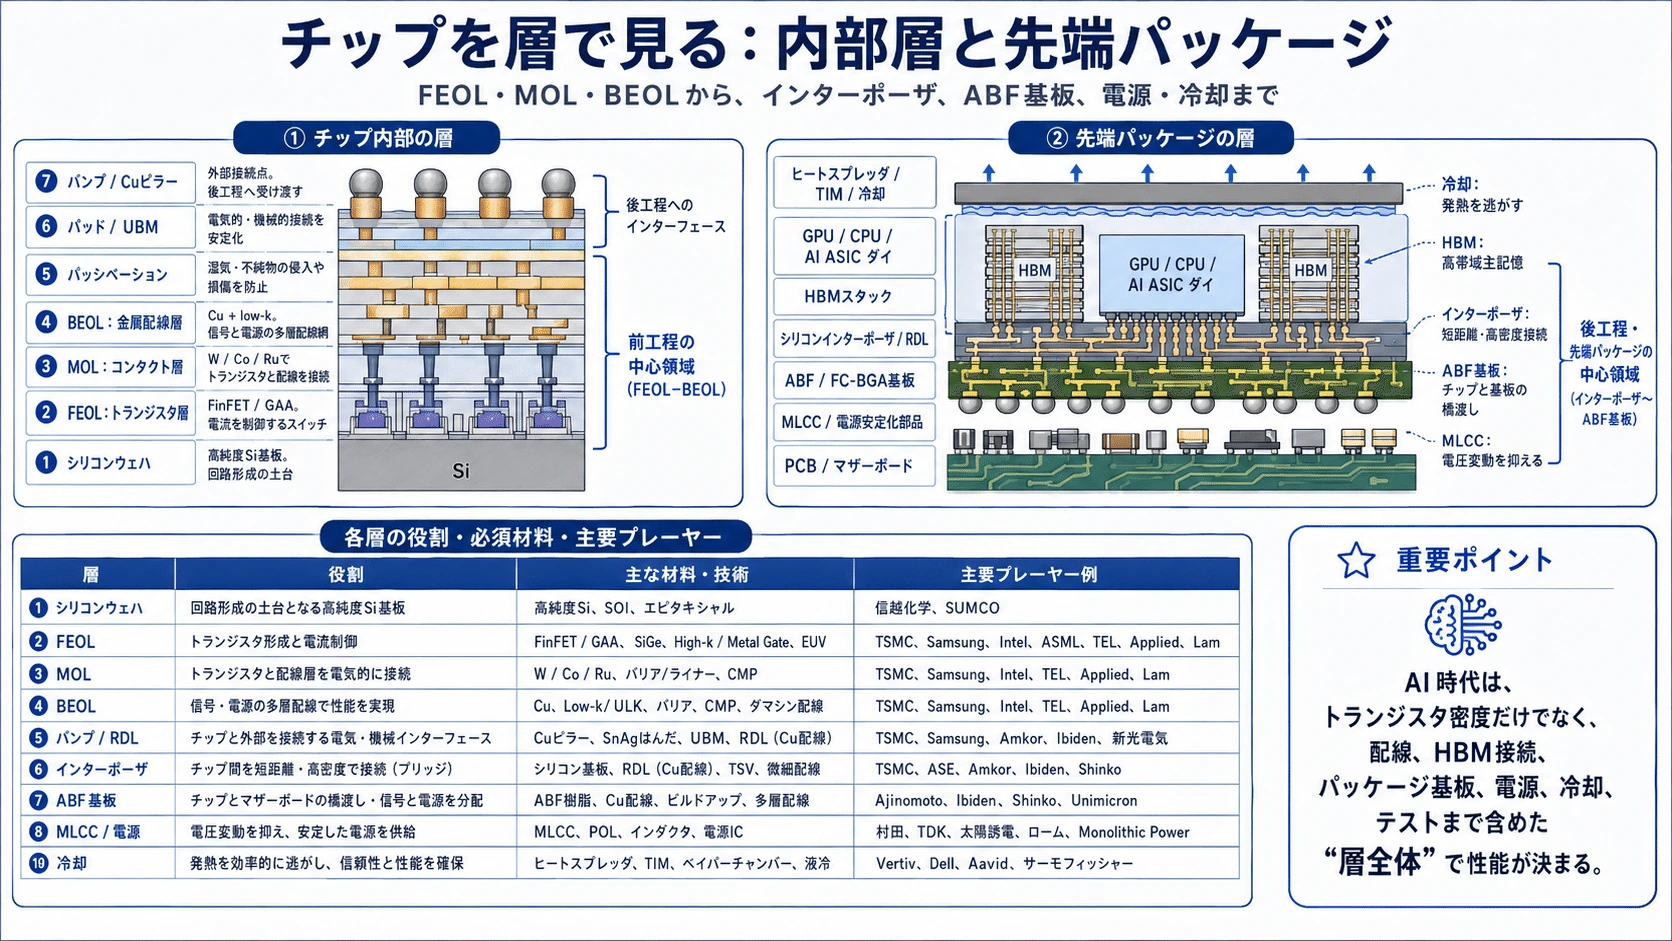
#現代の半導体を断面で見ると、以下のようになる。
#冷却・ヒートスプレッダ・TIM
────────────────────
GPU / CPU / AI ASIC / HBM
────────────────────
マイクロバンプ / ハイブリッドボンディング / RDL
────────────────────
シリコンインターポーザ / RDLインターポーザ / EMIB
────────────────────
ABF / FC-BGAパッケージ基板
────────────────────
MLCC / VRM / 電源安定化部品
────────────────────
マザーボード / 高速PCB
────────────────────
サーバー / ラック / システムさらに、GPUやCPUのダイ内部には、以下のような層がある。
#パッド / バンプ
────────────────
パッシベーション
────────────────
BEOL:金属配線層
────────────────
MOL:コンタクト層
────────────────
FEOL:トランジスタ層
────────────────
シリコンウェハこの構造を見ると、半導体は単に「トランジスタを作る産業」ではないことが分かる。 トランジスタを作り、配線し、メモリとつなぎ、基板に載せ、電源を安定させ、熱を逃がし、最後に検査する。これらすべてが成立して初めて、AI GPUやCPUは動く。
#
#
\3. チップ内部の層
#3-1. シリコンウェハ層:半導体の土地
#最下層は シリコンウェハ である。高純度シリコンの単結晶を成長させ、薄くスライスし、研磨して作る。ここは半導体の「土地」にあたる。
#主要プレーヤーは、信越化学、SUMCO、GlobalWafers、Siltronic、SK Siltron、Soitec などである。市場調査でも、Shin-Etsu Chemical、SUMCO、GlobalWafers、Siltronic、SK Siltronが主要シリコンウェハ企業として挙げられている。(Mordor Intelligence)
#必要な技術は、単結晶成長、スライス、研磨、洗浄、欠陥制御、酸素濃度管理、反り制御である。シリコンウェハはただの丸い板ではなく、後の全工程の歩留まりを左右する超高純度・超平坦な土台である。
##
3-2. FEOL:トランジスタ層
#FEOL:Front End of Line は、シリコンウェハ上にトランジスタを作る層である。
#ここでは、FinFET、GAA、ナノシート、RibbonFETのような構造が作られる。材料としては、シリコン、シリコンゲルマニウム、high-k絶縁膜、HfO₂、金属ゲート、TiN、W、Coなどが使われる。
#必要技術は、EUV/DUV露光、成膜、エッチング、イオン注入、アニール、CMP、検査である。装置プレーヤーは、ASML、Applied Materials、Lam Research、Tokyo Electron、KLA が代表的である。
#ここは「電流をオン/オフするスイッチ」を作る層であり、半導体性能の根幹である。
##
3-3. MOL:コンタクト層
#MOL:Middle of Line は、トランジスタと上の金属配線を接続する層である。
#BEOL金属配線
│
コンタクト / ビア
│
トランジスタ材料としては、W、Co、Ru、TiN、TaN、シリサイド、SiO₂、low-k系絶縁膜などが使われる。 ここがうまく作れないと、トランジスタは存在していても、回路として外へ信号を出せない。
##
3-4. BEOL:金属配線層
#BEOL:Back End of Line は、トランジスタ同士をつなぐ多層金属配線である。
#太い上層配線:電源・クロック・長距離信号
中間配線:ブロック間接続
細い下層配線:セル内・近距離接続
トランジスタ主な材料は、銅、low-k絶縁膜、SiN、Ta/TaN、TiN、Co、Ruなどである。 チップ内部の銅は、基板で使われる「電解銅箔」ではなく、ダマシン配線、めっき、成膜、CMPによって形成される。
#BEOLは、チップ内部の道路網である。どれだけ強いトランジスタを作っても、配線抵抗、遅延、電圧降下、熱、クロストークが悪ければ性能は出ない。AIチップでは、演算器の数だけでなく、配線設計と電源分配網が極めて重要になる。
##
3-5. パッシベーション・パッド・バンプ層
#BEOLの上には、チップを保護するパッシベーション膜と、外部接続用のパッド、UBM、バンプが作られる。
#ここで使われる材料は、SiN、SiO₂、ポリイミド、PBO、Cu、Ni、Au、SnAgはんだ、Ti/TiWなどである。
#高性能CPUやGPUでは、ワイヤボンディングではなく、フリップチップ、Cuピラー、マイクロバンプ、ハイブリッドボンディングへ向かう。ここから先は、前工程と後工程の境界領域である。
##
\4. パッケージ〜システムの層
#4-1. RDL:再配線層
#RDL:Redistribution Layer は、チップの端子配置を使いやすい位置へ引き直す層である。
#チップ上の細かい端子
●●●●●●
│││
RDLで外側へ展開
│ │ │
○ ○ ○RDLは、ファンアウトパッケージ、RDLインターポーザ、CoWoS-R、CoWoS-Lなどで重要になる。 材料は、銅配線、ポリイミド、PBO、エポキシ系絶縁膜、Ti/TiW、Ni、Auなどである。
#RDLは、「小さく密集したチップ端子」を「パッケージや他チップと接続しやすい配置」に変換する配線層である。
##
4-2. シリコンインターポーザ / RDLインターポーザ / EMIB
#AI GPUで特に重要なのが、GPUとHBMを接続するインターポーザ層である。
#HBM GPU / AI ASIC HBM
│ │ │
└──── シリコンインターポーザ ────┘
│
ABF基板HBMは極めて広いバス幅を持つため、GPUとHBMを短距離・高密度で接続する必要がある。そのために、シリコンインターポーザやRDLインターポーザが使われる。
#TSMCのCoWoS-Sはシリコンインターポーザ型、CoWoS-RはRDLインターポーザ型、CoWoS-LはRDLと局所的シリコン接続を組み合わせる方式として理解できる。TSMCはCoWoS-Sについて、最大3.3倍レチクル、約2700mm²級のインターポーザに対応し、それ以上の構成ではCoWoS-LやCoWoS-Rを推奨するとしている。(3DFabric)
#主要プレーヤーは、TSMC、Intel、Samsung、ASE、Amkor、JCET。関連装置では、Besi、EV Group、SUSS、Applied Materials、DISCO、KLAなどが関わる。
##
4-3. HBM層:AIチップの血流
#HBMは、DRAMダイを縦に積み、TSVで接続した高帯域メモリである。
#DRAMダイ
DRAMダイ
DRAMダイ
ベースダイ
インターポーザ主要プレーヤーは、SK hynix、Samsung Electronics、Micron。 HBMは単なるメモリではなく、AI GPUの演算器にデータを供給する血流である。GPUの演算能力がどれだけ高くても、HBM容量・帯域・接続が弱ければ性能は出ない。
#必要技術は、DRAM微細化、TSV、薄化、積層、マイクロバンプ、熱管理、Known Good Dieテストである。
##
4-4. ABF / FC-BGAパッケージ基板層
#シリコンインターポーザやチップレットの下には、ABF/FC-BGAパッケージ基板がある。
#GPU / HBM / インターポーザ
│
ABF / FC-BGAパッケージ基板
│
マザーボードABFは、Ajinomoto Build-up Filmの略で、高性能CPU/GPU向けパッケージ基板のビルドアップ絶縁フィルムである。味の素は、ABFがナノメートル級のCPU回路をミリメートル級の電子部品やシステムへ接続するためのビルドアップ基板形成を支える材料であり、レーザー加工や銅めっきに適した表面を持つと説明している。(Ajinomoto)
#ここで重要な材料は、ABF、銅、Tガラス、ガラスクロス、エポキシ、ソルダーレジスト、はんだボールである。
#主要プレーヤーは、 Ajinomoto / Ajinomoto Fine-Techno、Ibiden、新光電気工業、Unimicron、Nan Ya PCB、AT&S、Samsung Electro-Mechanics、TOPPAN、Kyocera などである。
##
\5. 見えにくいが必須の材料
#5-1. Tガラス:大型基板を反らせない骨格
#Tガラスは、主にABF基板、BT基板、FC-BGA基板、高速PCBで使われる低CTEガラスクロスである。
#ABFビルドアップ層
────────────────
コア材 / プリプレグ
└─ Tガラス / 低CTEガラスクロス
────────────────
ABFビルドアップ層役割は、基板の反りを抑えること。 AI GPUのような巨大パッケージでは、シリコン、樹脂、銅、ガラスの熱膨張差によって反りが起こる。反りが大きいと、バンプ割れ、接続不良、歩留まり低下が起きる。
#主要プレーヤーは、日東紡、Taiwan Glass、AGC、日本電気硝子 などである。
##
5-2. 電解銅箔 / HVLP銅箔:高速信号の道路
#電解銅箔は、主にABF基板、FC-BGA基板、CCL、AIサーバーPCB、スイッチ基板に使われる。
#高速信号では、電流が導体表面を流れるため、銅箔表面が粗いと伝送損失が増える。したがって、AIサーバーや高速ネットワーク基板では、表面が極めて滑らかな HVLP銅箔 が重要になる。
#主要プレーヤーは、三井金属、JX金属、古河電工、Circuit Foil、Co-Tech Development などである。
##
5-3. MLCC:電源の瞬間バッファ
#MLCCは、チップ内部ではなく、パッケージ基板、GPUモジュール基板、マザーボード、VRM周辺で使われる。
#ABF / FC-BGA基板
└─ 裏面MLCC / 埋め込みMLCC
GPUボード
└─ 大量のMLCC
マザーボード / VRM
└─ MLCC + ポリマーコンデンサ + インダクタ役割は、GPUやCPUが一瞬で大電流を要求したとき、電源電圧の揺れを抑えること。Murataは低ESL MLCCを高速動作機器の電源デカップリングに適した部品として説明しており、薄型低ESL品はプロセッサパッケージ裏面に実装して電源ラインのインピーダンス低減に貢献できるとしている。(Murata Manufacturing Co., Ltd.)
#主要プレーヤーは、村田製作所、Samsung Electro-Mechanics、太陽誘電、TDK、Yageo/KEMET、Kyocera AVX。 MLCCの材料では、BaTiO₃系誘電体粉末、ニッケル内部電極、銅・ニッケル・スズ外部電極が重要である。
##
\6. 前工程材料の主要プレーヤー
#6-1. フォトレジスト
#フォトレジストは、露光で回路パターンを転写する感光性樹脂である。
#主要プレーヤーは、JSR、東京応化工業/TOK、信越化学、富士フイルム、住友化学、DuPont、Merck。信越化学は、自社フォトレジストがi線、KrF、ArF、EUVまで対応すると説明している。(信越化学工業) 市場資料でも、TOK、JSR、Shin-Etsu、FUJIFILM、DuPontが主要企業として挙げられている。(Fortune Business Insights)
#フォトレジストは、日本企業の存在感が非常に大きい領域である。
##
6-2. 半導体用ガス
#半導体製造では、窒素、酸素、アルゴン、水素、ヘリウムのようなバルクガスに加え、シラン、アンモニア、NF₃、Cl₂、HBr、BCl₃、フッ素系エッチングガスなどの特殊ガスが使われる。
#主要プレーヤーは、Linde、Air Liquide、Air Products、日本酸素HD/大陽日酸、Merck、Resonac、関東電化、SK Materials などである。Lindeは電子材料向けに100種類以上の特殊ガス・混合ガスを提供していると説明しており、Air Liquideも半導体向け高純度プロセスガス・ケミカルの安定供給を重要な提供価値としている。(Linde Gas)
#ガスは工場の血液のようなもので、供給が止まるとファブ全体が止まる。
##
6-3. 薬液・高純度プロセスケミカル
#薬液は、洗浄、現像、エッチング、剥離、ポストCMP洗浄などで使われる。
#代表例は、硫酸、過酸化水素、アンモニア水、塩酸、フッ酸、TMAH現像液、IPA、NMP系剥離液、ウェットエッチャントである。
#主要プレーヤーは、関東化学、ステラケミファ、三菱ガス化学、トクヤマ、富士フイルム、Entegris、Merck、BASF、Honeywell、Soulbrain。富士フイルムはEntegrisから半導体用高純度プロセスケミカル事業を取得すると発表しており、この領域を強化している。(Fujifilm)
#薬液では、金属不純物、粒子、水分、残渣の管理が極めて重要である。微細化が進むほど、わずかな汚染が歩留まりを破壊する。
##
6-4. CMPスラリー
#CMPスラリーは、ウェハ表面を平坦化する研磨液である。
#研磨粒子
+ 酸化剤
+ pH調整剤
+ 分散剤
+ 防食剤
= CMPスラリー主要プレーヤーは、富士フイルム、Entegris、Merck、Qnity/旧DuPont系、Resonac、JSR、フジミインコーポレーテッド、AGC、Soulbrain、Anji Microelectronics。富士フイルムはCMPスラリーとポストCMPクリーナーを扱い、銅配線向けCMPスラリーで強いポジションを持つと説明している。(Fujifilm Holdings)
#CMPは、削るだけではない。銅は削るが絶縁膜は削りすぎない、酸化膜は削るが窒化膜は残す、といった材料選択性が重要になる。
##
\7. レーザービア、メカニカルドリル、めっき
#後工程・パッケージ基板では、微細な穴を開け、多層配線をつなぐ技術が必要になる。
#ABFビルドアップ層の微細ビアは、主にレーザードリルで開ける。主な装置プレーヤーは、三菱電機、ビアメカニクス、EO Technics、LPKF、Spectronix などである。
#一方、パッケージ基板のコア層や厚いPCBでは、メカニカルドリルも重要である。ここで強いのが ユニオンツール である。ユニオンツールはレーザードリル装置メーカーではないが、PCB・パッケージ基板向けの超精密メカニカルドリル工具で重要な存在である。
#また、穴を開けた後には銅めっきで上下配線を接続する。ここでは、SAP/mSAP、デスミア、無電解銅、電解銅めっき、表面処理薬液が重要である。主要プレーヤーは、MKS/Atotech、JCU、奥野製薬、上村工業、MacDermid Alpha などである。
##
\8. テスト・検査層
#AIチップレット時代に、テストは極めて重要になった。
#なぜなら、1つのパッケージにGPU、HBM、インターポーザ、チップレットを多数載せるため、不良ダイを1つ載せるだけで高価なパッケージ全体が不良になるからである。
#必要になるのは、
#ウェハ検査
プローブテスト
Known Good Die選別
HBMテスト
インターポーザ検査
ABF基板検査
パッケージテスト
バーンイン
システムレベルテスト主要プレーヤーは、Advantest、Teradyne、FormFactor、日本マイクロニクス、Technoprobe、KLA、Onto Innovation、Camtek、DISCO などである。
#AI時代のテストは、最後の確認工程ではなく、歩留まりと利益率を左右する中核工程である。
##
\9. 産業構造としてのまとめ
#昔の半導体産業は、主にこう見られていた。
#良いトランジスタを作れる会社が強いしかしAI時代には、こう変わっている。
#良いトランジスタ
+ 良い配線
+ 良いHBM
+ 良いインターポーザ
+ 良いABF基板
+ 良い電源安定化
+ 良い冷却
+ 良いテスト
を統合できるサプライチェーンが強い特にAI GPUでは、NVIDIAやAMDのような設計企業、TSMCのようなファウンドリ、SK hynix/Samsung/MicronのようなHBMメーカーだけでは足りない。 その背後には、信越化学、SUMCO、JSR、TOK、富士フイルム、関東化学、ステラケミファ、Linde、Air Liquide、Ajinomoto、Ibiden、新光電気、日東紡、三井金属、村田製作所、Advantest、FormFactor、DISCO のような、見えにくいが不可欠な企業群が存在する。
##
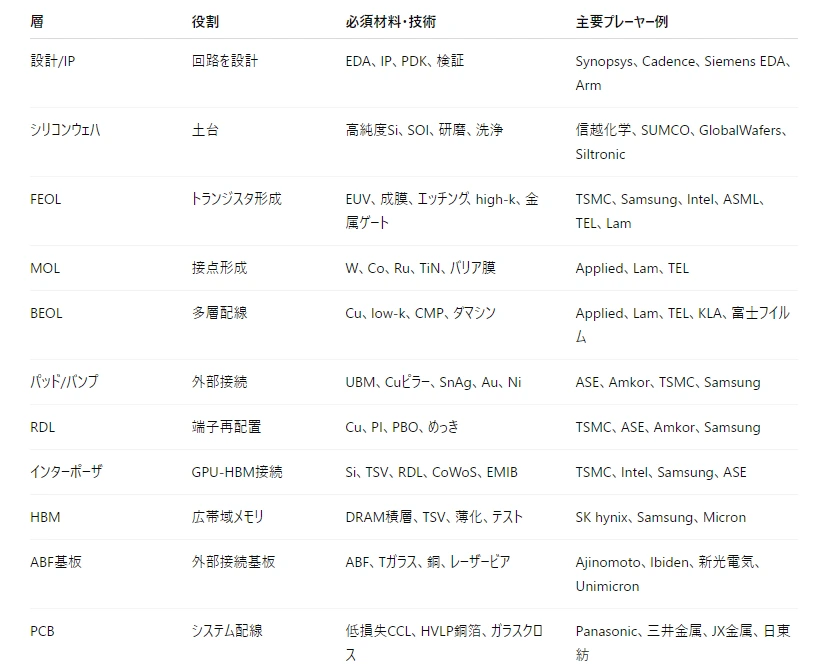
\10. 一枚表で整理する
#
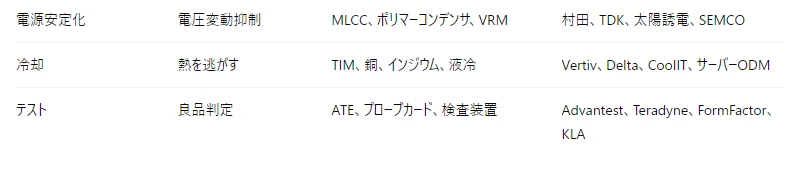
#
結論
#半導体製造を理解するには、前工程と後工程を分けるだけでは足りない。 重要なのは、チップを層構造として見ることである。
#前工程は、シリコンウェハ上にトランジスタと配線を作る。 後工程は、そのチップを切り出し、つなぎ、守り、基板に載せ、電源を安定させ、冷却し、検査する。
#AI時代の半導体は、もはや「トランジスタ微細化だけの競争」ではない。 それは、
#シリコン、銅、ガラス、樹脂、セラミック、薬液、ガス、研磨材、基板、冷却、検査を組み合わせて、巨大な計算システムを作る総合工学#
である。
#GPUやHBMは目立つ。 しかし、その背後には、Tガラス、電解銅箔、ABF、MLCC、CMPスラリー、フォトレジスト、特殊ガス、薬液、レーザービア、プローブカードといった、見えにくいが絶対に必要な層がある。
#この「見えない層」を理解すると、半導体産業の本当のボトルネックと、AIインフラ時代の勝者候補が見えてくる。
##
追記:HBF・XL-FLASH・CPO・COUPE時代の半導体層構造
#NANDが記憶階層を拡張し、光I/Oが接続階層を再設計する
#これまでの半導体理解では、AI GPUの中心は、
#GPU / AI ASIC
+ HBM
+ シリコンインターポーザ
+ ABF基板
+ 電源・冷却・テストだった。
#しかし今後、AI推論、長文コンテキスト、AIエージェント、マルチラックGPUクラスタが拡大すると、これだけでは足りなくなる。
#理由は二つある。
#一つ目は、HBM容量の限界である。 GPUの演算性能は伸びるが、HBMは高価で、容量も物理的・熱的・コスト的に増やしにくい。巨大モデル、長いKVキャッシュ、大量の推論リクエストを扱うには、HBMだけでは足りない。
#二つ目は、電気I/Oの限界である。 GPU同士、スイッチ同士、ラック同士を電気でつなぐと、距離が伸びるほど消費電力、損失、リタイマ、ケーブル重量、信号品質が問題になる。
#そこで出てくるのが、
#HBF / XL-FLASHのような高帯域・高密度NAND
CPO / 光I/O / PIC / EIC
TSMC COUPEである。
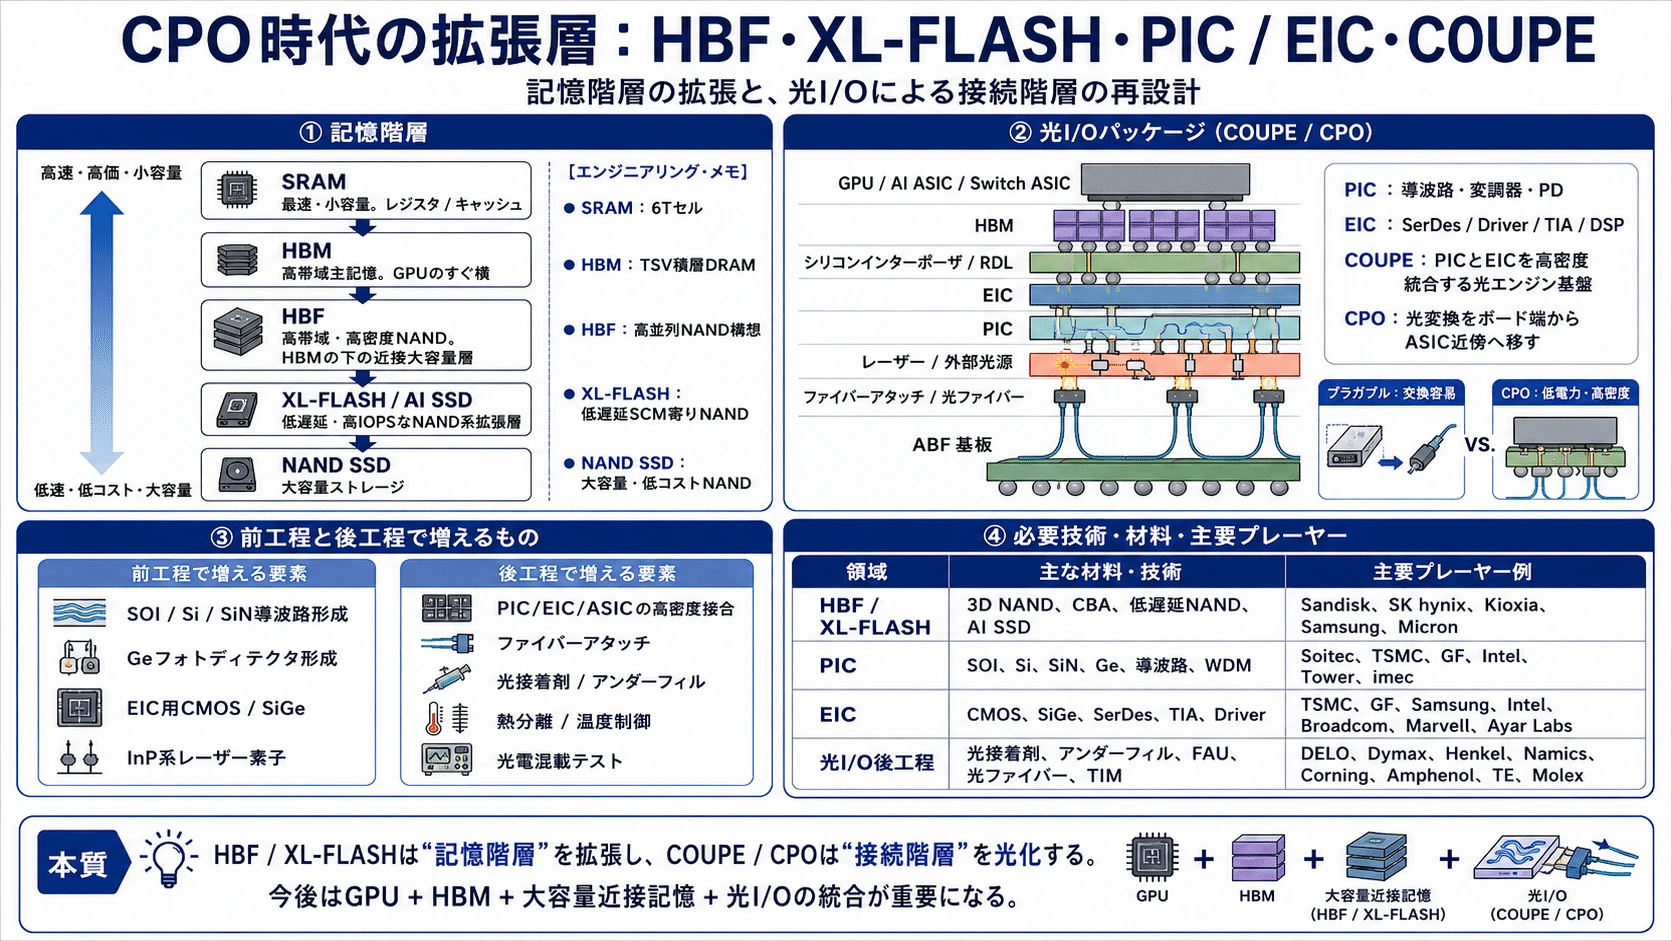
#結論から言うと、HBFやXL-FLASHは、HBMの下に入る大容量近接記憶層である。 CPOやCOUPEは、パッケージ近傍に光I/O層を追加し、チップ間・ラック間の接続を再設計する技術である。
#
#
\1. まずSRAM、DRAM、HBM、NANDの基本
#HBFやXL-FLASHを理解するには、まずメモリ階層を理解する必要がある。
#半導体の記憶は、速いものほど高価で容量が小さく、遅いものほど安価で容量が大きい。
#速い・小容量・高価
────────────────
SRAM:レジスタ / キャッシュ
────────────────
DRAM / HBM:主記憶
────────────────
HBF / XL-FLASH / CXL Memory / AI SSD:近接大容量記憶
────────────────
NAND SSD:ストレージ
────────────────
遅い・大容量・安価SRAMとは何か
#SRAM:Static Random Access Memory は、CPUやGPUの中に入る超高速メモリである。 レジスタ、L1キャッシュ、L2キャッシュ、L3キャッシュ、GPUの共有メモリ、オンチップバッファなどに使われる。
#SRAMの基本セルは、一般的に 6T SRAM と呼ばれる構造で、6個のトランジスタで1ビットを保持する。
#6T SRAMセル
= 6個のトランジスタで1ビットを保持
特徴:
・非常に速い
・リフレッシュ不要
・チップ内に置ける
・ただし面積が大きい
・容量あたりコストが高いSRAMは、データを「電荷」として保持するDRAMとは違い、フリップフロップ的な回路状態で保持する。そのため高速だが、1ビットあたりのトランジスタ数が多く、面積効率が悪い。
#AIチップでSRAMが重要なのは、演算器に近い場所でデータを一時保持できるからである。Tensor Coreや行列演算器にデータを供給するには、外部メモリだけでは遅すぎる。したがってAIチップ内部では、SRAMキャッシュ、レジスタファイル、オンチップネットワークが極めて重要になる。
#ただし、SRAMを大量に積むとダイ面積が爆発する。 そのため、SRAMは「最速だが小容量」の層として位置づけられる。
##
DRAMとHBM
#DRAMは、1トランジスタ+1キャパシタで1ビットを保持するメモリである。SRAMより高密度だが、電荷が漏れるためリフレッシュが必要になる。
#HBMは、このDRAMダイを縦に積み、TSVで接続し、GPUの近くに置く高帯域メモリである。
#HBMスタック
────────────────
DRAMダイ
DRAMダイ
DRAMダイ
DRAMダイ
ベースダイ
────────────────
シリコンインターポーザ
────────────────
GPU / AI ASICと接続HBMは、広いバス幅と短距離接続によって、非常に高い帯域を出す。 AI GPUでは、HBMが事実上の主記憶になっている。
#しかしHBMには弱点もある。
#HBMの弱点:
・高価
・容量を増やしにくい
・パッケージ面積を食う
・熱設計が難しい
・供給が限られるだからこそ、HBMの下に、より大容量で安価な記憶層を置きたくなる。 そこに入ってくるのが、HBFやXL-FLASHである。
##
\2. NANDとは何か
#NAND Flashは、不揮発性メモリである。 電源を切ってもデータを保持できる。
#NANDの基本は、浮遊ゲートやチャージトラップに電荷を閉じ込め、その電荷量によって0/1、あるいは複数ビットを表現する。
#現在の主流は 3D NAND である。 メモリセルを平面ではなく縦方向に何百層も積み上げて容量を増やす。
#3D NAND
────────────────
メモリセル層
メモリセル層
メモリセル層
...
数百層
────────────────
CMOS / 周辺回路NANDはDRAMより遅い。 しかし、容量密度は非常に高く、コスト/bitが安い。
#つまりNANDは本来、
#遅いが大容量
安いが高密度
不揮発というストレージ向けのメモリだった。
#しかしAI時代には、このNANDを「ただのSSD」ではなく、GPUに近い大容量記憶層として使おうとする流れが出ている。
#それが、HBFやXL-FLASHである。
##
\3. HBFとは何か
#HBF:High Bandwidth Flash は、NANDをベースにしながら、HBMのように高帯域・高密度なAI向けメモリ階層を作ろうとする構想である。
#SandiskはHBFについて、同社の低コスト・高密度なCBAベースNAND技術を土台に、シリコン技術、設計技術、3Dスタックパッケージを組み合わせ、高帯域・高耐久・エネルギー効率を狙うAI推論向けメモリとして説明している。(SanDisk Documents)
#ここで重要なのは、HBFは単なるSSDではないという点である。
#HBFは、NANDを以下のように再設計する方向と考えられる。
#HBFの方向性:
・NANDを高並列化する
・積層構造で帯域を増やす
・GPU近傍に配置する
・HBMより大容量にする
・AI推論のKVキャッシュや巨大モデル向けに使うSandiskはHBFを、AIの「メモリウォール」に対応する新しいNAND形態として位置づけ、HBM容量の限界を補う狙いを示している。(Sandisk)
#ただし、HBFは現時点ではHBMの完全な代替ではない。 NANDである以上、DRAM/HBMと比べてレイテンシ、書き換え特性、ランダムアクセス、耐久性などで制約がある。
#したがって、HBFの位置づけはこうである。
#HBM = GPUの作業机
HBF = GPUのすぐ横にある巨大な棚
SSD = 建物の外の倉庫#
\4. HBFはどの層に入るのか
#HBFは、層構造としては HBMの下、SSDの上 に入る。
#GPU / AI ASIC
────────────────
SRAM / キャッシュ
────────────────
HBM
────────────────
HBF
────────────────
XL-FLASH / AI SSD / CXL Memory
────────────────
NVMe SSD / NANDストレージパッケージ実装としては、大きく二つの可能性がある。
#パターンA:HBMの横にHBFスタックを置く
#最も先端的な構成である。
#HBM GPU / AI ASIC HBF
│ │ │
└──── シリコンインターポーザ / RDLインターポーザ ────┘
│
ABF基板この場合、HBFはシリコンインターポーザ、RDLインターポーザ、あるいは類似の高密度パッケージ上に載る。 NANDをHBMに近い形でGPU近傍に置くため、メモリ階層がパッケージ内へ深く入り込む。
#ただし、この方式は熱、パッケージ面積、接続標準、信号品質、NAND耐久性、コントローラ設計が難しい。
#パターンB:GPU近傍の高速モジュールとして置く
#より現実的な初期形態は、HBFやXL-FLASHをGPUボードやサーバー内の高速I/O層に置く形である。
#GPU / HBMパッケージ
────────────────
GPUボード / アクセラレータ基板
────────────────
PCIe / CXL / 専用高速リンク
────────────────
HBFモジュール / XL-FLASH SSD / AI SSDKioxiaのSuper High IOPS SSDのような方向は、この層に近い。KioxiaはNVIDIA Storage-Next向けに、XL-FLASHを使うGP Series SSDを、GPU initiated workloads向けの低遅延メモリ拡張として発表している。(KIOXIA Corporation)
##
\5. XL-FLASHとは何か
#XL-FLASH は、Kioxiaの低遅延・高IOPS型のNAND系メモリである。 通常のTLC NANDのように大容量・低コストを最優先するのではなく、AIや高速ストレージ向けに、低遅延・高IOPS・細かいアクセス粒度を狙う。
#KioxiaのGP Series SSDは、XL-FLASH Storage Class Memoryを使い、NVIDIA Storage-Nextアーキテクチャ向けに、より高いIOPS、512バイト単位の細粒度アクセス、従来TLC SSDより低いI/Oあたり消費電力を狙うと説明されている。(HPCwire)
#XL-FLASHの層構造は、HBFよりも「SSD/SCM寄り」である。
#GPU / HBM
────────────────
PCIe / CXL / NVMe / GPU-direct access
────────────────
XL-FLASH SSD / Super High IOPS SSD
────────────────
通常NAND SSDHBFが「NANDをHBMに近づける」構想だとすれば、XL-FLASHは「SSDをGPUメモリ階層に近づける」構想である。
##
\6. HBFとXL-FLASHの工学的な違い
#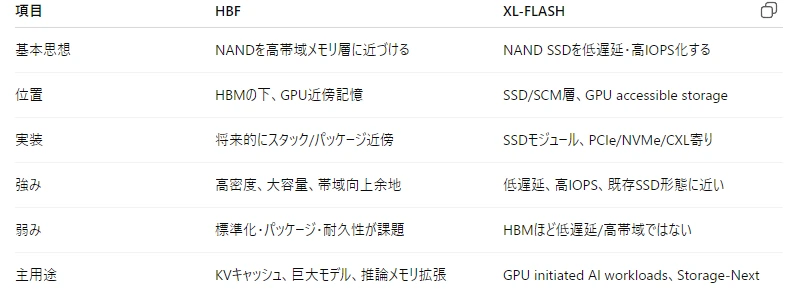
HBFは、より野心的に「NANDをメモリ階層の上へ押し上げる」技術である。 XL-FLASHは、より現実的に「SSDをAIメモリ拡張に近づける」技術である。
##
\7. CPOとは何か
#CPO:Co-Packaged Optics は、光エンジンをスイッチASICや将来のxPUパッケージの近くに置く技術である。
#従来は、電気信号がPCB上を長く走り、ボード端のプラガブル光トランシーバで光に変換されていた。
#従来:
Switch ASIC
↓ 電気配線
PCB
↓
プラガブル光トランシーバ
↓
光ファイバーCPOでは、光変換をASICの近くへ移す。
#CPO:
Switch ASIC
↓ 短い電気接続
EIC / PIC / 光エンジン
↓
光ファイバーNVIDIAは、CPOスイッチについて、プラガブルトランシーバを同一パッケージ上のシリコンフォトニクスに置き換えることで、電力効率や信頼性を改善すると説明している。(Ayar Labs)
#つまりCPOは、単に「銅線を光ファイバーに変える」技術ではない。 本質は、光変換の位置をボード端からパッケージ近傍へ移すことである。
##
\8. プラガブルとは何か
#プラガブル光トランシーバは、スイッチやNICの前面ポートに差し込む交換可能な光モジュールである。
#ASIC
↓
PCB上の電気配線
↓
QSFP / OSFPなどのプラガブル光モジュール
↓
光ファイバープラガブルの利点は、
#交換しやすい
標準化されている
保守しやすい
ベンダー選択肢が広い一方、弱点は、
#ASICから光変換点まで電気配線が長い
消費電力が増える
高帯域化で実装密度が厳しい
DSP/リタイマ負担が重いCPOは、この弱点を解くために出てくる。 ただしCPOには、プラガブルと違って交換性、保守性、熱、歩留まり、光実装の難しさがある。
#したがって、将来は、
#短期:
プラガブル中心
中期:
スイッチASICでCPO併用
長期:
CPO + 光I/Oチップレット + 外部レーザー + 一部プラガブル共存になる可能性が高い。
##
\9. PICとは何か
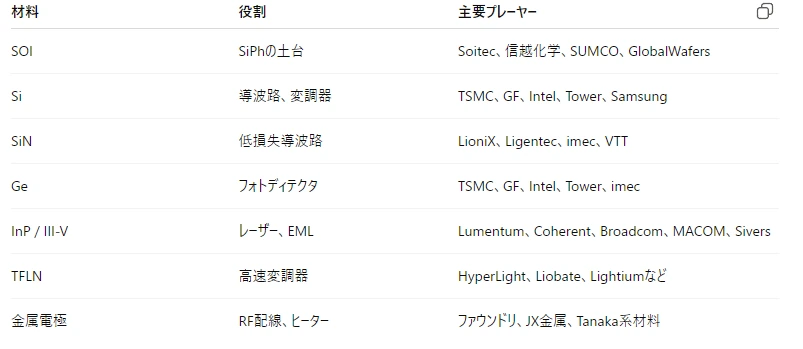
#PIC:Photonic Integrated Circuit は、光をチップ上で扱う集積回路である。 電気ICの銅配線に相当するものが、PICでは導波路である。
#レーザー光
↓
導波路
↓
変調器
↓
カプラ
↓
ファイバーPICに入る基本要素は、
#導波路
変調器
フォトディテクタ
カプラ
WDM合分波器
モニタPD
ヒーター / 温度制御である。
#材料としては、
#SOI
Si
SiN
Ge
InP / III-V
TFLN
金属電極
光接着剤などが使われる。
#SOIは、シリコンフォトニクスPICの土台になる。SoitecはPhotonics-SOIを、AIデータセンター向け統合光接続などに使われる基板プラットフォームとして説明している。(TSMC Research)
##
\10. EICとは何か
#EIC:Electronic Integrated Circuit は、PICを動かす電子チップである。
#PICは光回路だが、GPUやスイッチASICから出てくる信号は電気である。 その電気信号を変調器に入れたり、フォトディテクタから出てくる微弱電流を増幅したりするのがEICである。
#送信:
ASIC
↓
SerDes / Driver / EIC
↓
PIC変調器
↓
光信号
受信:
光信号
↓
PICフォトディテクタ
↓
TIA / CDR / EIC
↓
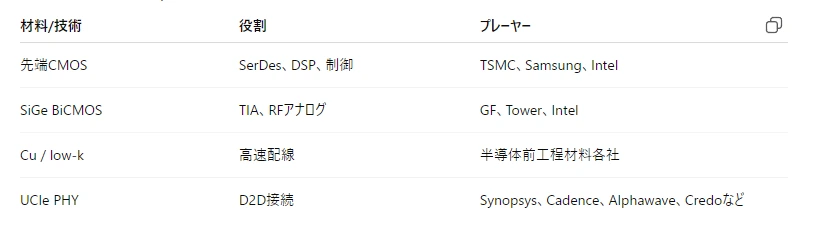
ASICEICに入る回路は、
#SerDes
Driver
TIA
CDR
DSP
PLL
温度制御回路
ADC / DAC
モニタ回路である。
#EICは、光I/Oの消費電力、遅延、信号品質を決める非常に重要な層である。 光I/Oが低pJ/bitを達成できるかどうかは、PICだけでなくEICの設計に大きく依存する。
##
\11. TSMC COUPEとは何か
#COUPE:Compact Universal Photonic Engine は、TSMCが提案する光エンジン統合プラットフォームである。
#TSMCはCOUPEについて、業界のフォトニックエンジン構造、つまりモノリシック、2D、2.5D、3Dの強みと弱みを整理した上で、異なる要求を同一統合プラットフォームへまとめるCompact Universal Photonic Engineとして提案している。また、COUPEはEIC-PIC統合を持ち、EIC-PIC間の電気インターフェースを最適化して結合損失を最小化する設計だと説明している。(TSMC Research)
#簡単に言うと、COUPEは、
#PIC
+ EIC
+ パッケージ統合
+ ファイバー接続
+ ASICとの高密度接続を、AI/HPC向けに使いやすい共通光エンジンとしてまとめる構想である。
##
COUPEの基本構造
#COUPEを層で見ると、概念的にはこうなる。
#AI ASIC / GPU / Switch ASIC
────────────────
UCIe / D2D / 高速電気I/O
────────────────
EIC
Driver / TIA / SerDes / 制御
────────────────
PIC
導波路 / 変調器 / PD / WDM
────────────────
レーザー / 外部光源
────────────────
ファイバーアタッチAlchipとAyar Labsは、TSMC COUPEベースの光接続ソリューションを示し、Ayar LabsのTeraPHYシリコンフォトニクスIC、Alchipの電気インターフェース、着脱式ファイバーコネクタを組み合わせ、AIアクセラレータあたり最大100Tb/s級の帯域を狙うと報じられている。(Tom's Hardware)
#この構成は、単なるCPOスイッチだけでなく、将来的なAI ASIC、GPU、メモリ拡張、XPU-to-XPU接続にも使える可能性がある。
##
\12. COUPEが光I/O層にもたらす役割
#COUPEの役割は、光I/Oを「個別企業の特殊実装」から「標準化・共通化された先端パッケージ部品」に近づけることだと見られる。
#これまでの光I/Oは、以下のように分断されていた。
#PICは光企業
EICは高速SerDes企業
ASICは半導体設計企業
パッケージはOSAT/ファウンドリ
ファイバーは光部品企業COUPEは、これらをTSMCの先端パッケージエコシステムへ引き寄せる可能性がある。
#COUPEの意味:
・PIC/EIC統合を共通化する
・ASIC設計者が光I/Oを使いやすくする
・UCIeなどD2D接続とつなぐ
・CoWoS/SoIC/RDLと組み合わせる
・光I/Oを“チップレット化”するこれが実現すると、光I/OはNVIDIAやBroadcomのような巨大企業だけでなく、ASIC設計企業やクラウド企業のカスタムチップにも広がりやすくなる。
##
\13. COUPEとNANDの将来的な相性
#COUPEとHBF/XL-FLASHは、一見別の技術に見える。
#HBF / XL-FLASH
= 記憶階層を拡張する技術
COUPE / 光I/O
= 接続階層を拡張する技術しかし、将来的には非常に相性がよい。
#理由は、AIシステムでは「巨大な記憶」を「GPUから遠すぎない場所」に置く必要があるからである。
#HBFやXL-FLASHが増えると、次に問題になるのは接続である。
#GPUがHBF/XL-FLASHへアクセスしたい
↓
容量はある
↓
しかし電気配線だと距離・電力・帯域が厳しい
↓
光I/Oでメモリプール/ストレージプールへ接続するつまり、COUPEのような光I/O層は、将来的に
#GPU ↔ GPU
GPU ↔ Switch
GPU ↔ Memory Pool
GPU ↔ HBF / XL-FLASH Poolをつなぐ可能性がある。
#特に長文推論やエージェントでは、KVキャッシュ、検索インデックス、過去文脈、ツール実行ログなどが巨大化する。 これをすべてHBMに置くのは非現実的である。
#したがって将来的には、
#HBM:今すぐ使うKVキャッシュ
HBF:大容量の近接KVキャッシュ
XL-FLASH:GPUアクセス可能な低遅延ストレージ
光I/O:それらをラック/マルチラックでつなぐという階層になる可能性がある。
#COUPEは、この「光でつながるメモリ拡張」のパッケージ側の土台になり得る。
##
\14. CPO時代の前工程と後工程
#CPO時代には、前工程と後工程の境界がより曖昧になる。
#前工程側
#前工程では、従来のCMOSに加えて、PIC製造が重要になる。
#前工程:
・GPU / ASIC / Switch ASICのCMOS製造
・EICのCMOS / SiGe製造
・PICのSiPh製造
・Ge PD形成
・Si / SiN導波路形成
・InPレーザー製造PICの前工程では、
#SOIウェハ
導波路形成
変調器形成
Geフォトディテクタ
金属電極
ヒーター
カプラ
WDM素子が作られる。
#後工程側
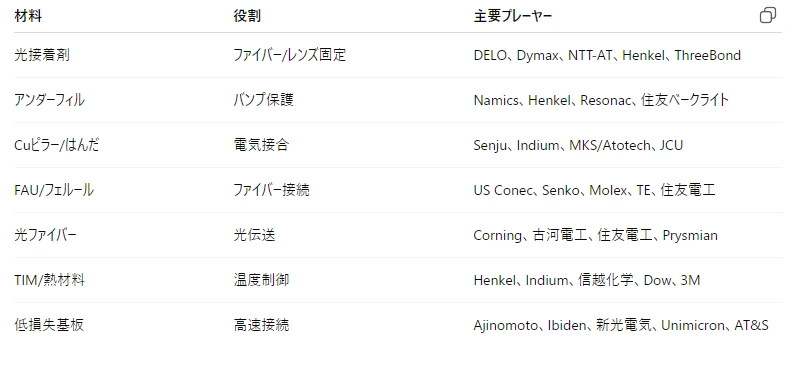
#後工程では、PIC、EIC、ASIC、レーザー、ファイバーを統合する。
#後工程:
・EICとPICの接合
・ASICとのD2D接続
・RDL / インターポーザ接続
・ファイバーアタッチ
・レーザー結合
・光接着剤による固定
・熱分離
・光電混載テストCPO時代の後工程は、従来の半導体実装に精密光学実装が合体する。
##
\15. CPO時代のチップ層構造
#従来のAI GPU層はこうだった。
#GPU / HBM
────────────────
シリコンインターポーザ
────────────────
ABF基板
────────────────
PCB
────────────────
電気配線 / プラガブル光モジュールCPO/光I/O時代にはこうなる。
#GPU / AI ASIC / Switch ASIC
────────────────
HBM
────────────────
HBF / XL-FLASH / CXL Memory / AI SSD
────────────────
シリコンインターポーザ / RDL / CoWoS
────────────────
光I/O層
├─ EIC
├─ PIC
├─ レーザー
└─ ファイバーアタッチ
────────────────
ABF / ガラスコア / 低損失基板
────────────────
PCB / ラック配線
────────────────
CPO Switch / Optical Fabric重要なのは、光I/O層が単独で増えるのではなく、メモリ階層と接続階層を同時に変えることである。
##
\16. 光I/O層で必要な技術
#光I/O層では、以下の技術が必要になる。
#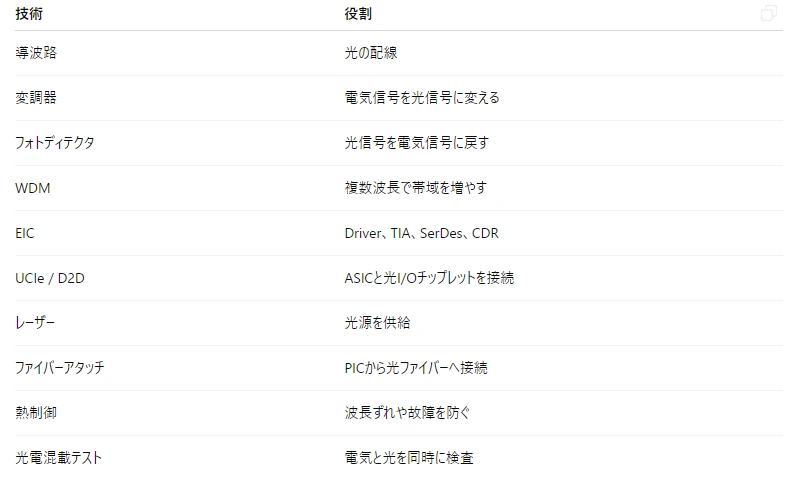
Ayar LabsのTeraPHYは、UCIe対応の光I/Oチップレットとして8Tbps帯域を示しており、AI scale-upアーキテクチャ向けの光I/Oを狙っている。(Ayar Labs)
##
\17. 光I/O層で必要な材料
#PIC側材料
#
EIC側材料
#EICは基本的にCMOS/SiGeチップである。
#
後工程材料
#
#
\18. 主要プレーヤーを層で見る
#HBF / XL-FLASH / NAND側
#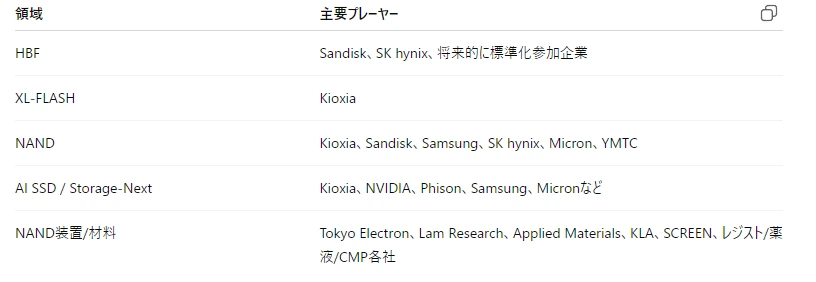
SandiskとSK hynixはHBFの標準化・商用化に向けて協力していると報じられており、HBFはAI GPU向けにHBMを補うNANDベースの高容量メモリとして期待されている。(Tom's Hardware)
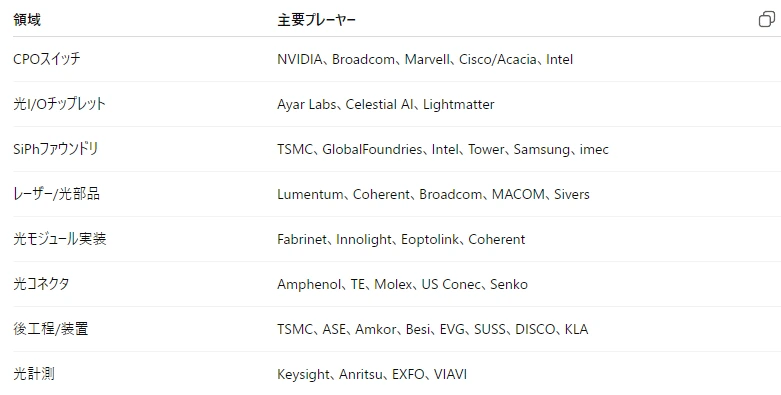
#CPO / 光I/O側
#
#
\19. CPOとHBF/XL-FLASHを同じ地図に置く
#AIインフラの未来層は、こう見ると分かりやすい。
#演算層
GPU / AI ASIC / CPU
────────────────
最速記憶層
SRAM / キャッシュ
────────────────
高帯域主記憶層
HBM
────────────────
近接大容量記憶層
HBF / XL-FLASH / CXL Memory / AI SSD
────────────────
パッケージ統合層
CoWoS / SoIC / RDL / COUPE
────────────────
光I/O層
PIC / EIC / CPO / ファイバー
────────────────
ラック接続層
NVLink / Ethernet / InfiniBand / Optical Fabric
────────────────
データセンター層
Leaf-Spine / Super-Spine / Memory Pool / Storage PoolHBF/XL-FLASHは、縦方向の記憶階層を厚くする。 CPO/COUPEは、横方向の接続階層を光化する。
#つまり、
#HBF / XL-FLASH
= GPUの近くに巨大な記憶を置く
CPO / COUPE
= GPUクラスタと記憶プールを低電力でつなぐという関係である。
##
\20. 本質的なまとめ
#これからのAI半導体は、単にGPUの演算性能を上げるだけでは足りない。
#必要なのは、
#演算を増やす
→ GPU / AI ASIC
演算器の近くに高速記憶を置く
→ SRAM / HBM
HBMの下に大容量記憶を置く
→ HBF / XL-FLASH / AI SSD
ラック全体で記憶と演算をつなぐ
→ CPO / 光I/O / COUPE
これらを低消費電力・低遅延で結ぶ
→ PIC / EIC / UCIe / 光ファイバーである。
#HBFやXL-FLASHは、NANDを単なるストレージから、AI推論の記憶階層へ押し上げる技術である。 CPOやCOUPEは、光I/Oをボード端からパッケージ近傍へ移し、AIクラスタの接続限界を突破しようとする技術である。 SRAMは、依然としてチップ内最速の記憶層として、演算器のすぐ横で働く。 PICは光の配線を作り、EICはそれを電気信号とつなぎ、COUPEはそれらを先端パッケージとして統合する。
#一言で言えば、AI半導体の層構造は今後こう変わる。
#昔:
トランジスタを微細化すれば性能が伸びた
今:
GPU + HBM + CoWoS + ABF + 冷却 + テストで性能が決まる
次:
GPU + HBM + HBF/XL-FLASH + COUPE/CPO + 光I/O + メモリプールで性能が決まるつまり、次の半導体競争は、 トランジスタ密度だけでなく、記憶階層と光接続階層をどう設計するかの競争になる。
#そして、その裏側では、NANDメーカー、SiPhファウンドリ、レーザー企業、光接着剤メーカー、ファイバー企業、パッケージ基板メーカー、光電混載テスト企業まで含めた、巨大な新サプライチェーンが立ち上がっていく。
#特定銘柄の推奨・勧誘・投資助言を目的とするものではありません。投資判断はご自身の責任でお願いいたします。
#サムネはPixAIsunflowerモデルとGPTImage2.0
#