NAND・DRAM・HBMの違いから始める、AI時代のメモリー入門
この資料の日時
元資料の日付と、その本文が公に存在した確認日時は別の記録です。
本文に含まれる語句 HBM DRAM SRAM 帯域・データ移動 先端パッケージング 電力・給電 歩留まり 基板・材料 AI推論 AIエージェント
出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.09.23.4
- 記事内容のSHA-256
fa843b1e87fadf30439c372d02b0d8ab54bcb2902f41373dd7364d58b2abd2fe- 保存版のSHA-256
a8410a63a7f60ed1d89f5716e1a060507aecef8ade98ad361e1c74d613c1fe33
外部証明の最終検査結果は詳細を開くと表示します。
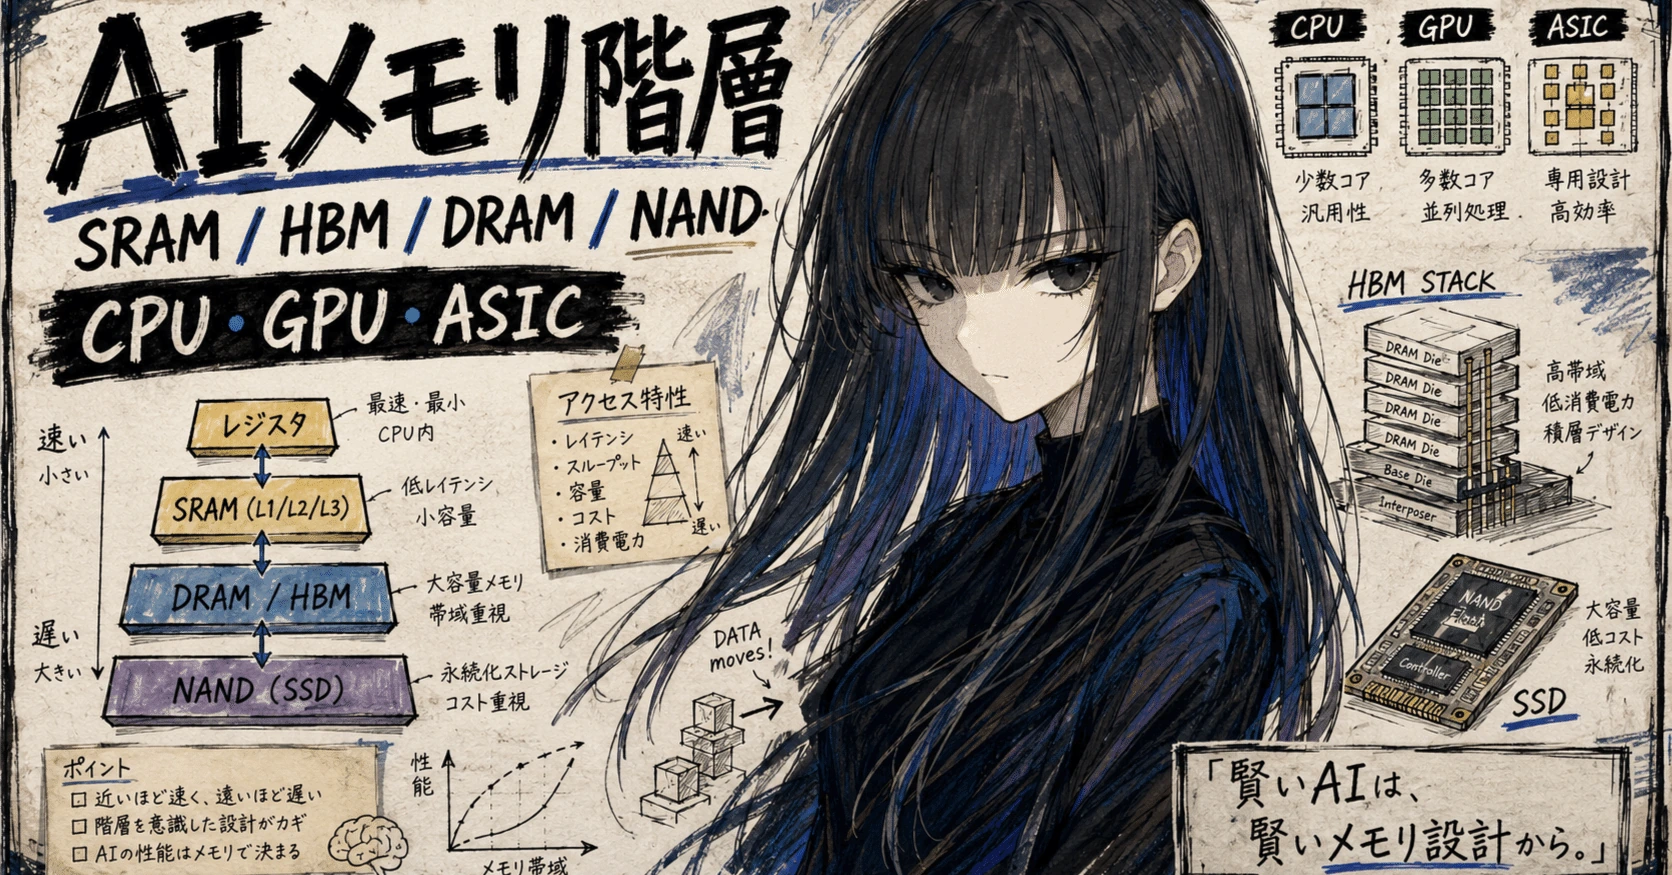
NAND・DRAM・HBMの違いから始める、AI時代のメモリー入門
#メモリーサイクル、供給制約、SRAM・SSD・HDDまでを一つの階層として読む
#AI半導体のニュースを追い始めると、HBM、DRAM、NAND、SRAM、QLC SSD、CXL、HBFといった言葉が一度に出てくる。
#しかし最初に覚えるべきことは、それほど多くない。
#コンピューターは、速いが小さく高価な記憶装置と、遅いが大きく安価な記憶装置を、階層的に組み合わせている。
#この原則を理解すれば、なぜAI向けHBMが不足すると普通のDRAMまで値上がりするのか、なぜNANDメーカーがAIデータセンター向けSSDへ生産を寄せるのか、なぜ最近SRAMの重要性が急に語られ始めたのかが見えてくる。
#
#
1.そもそも「メモリー」と「ストレージ」は何が違うのか
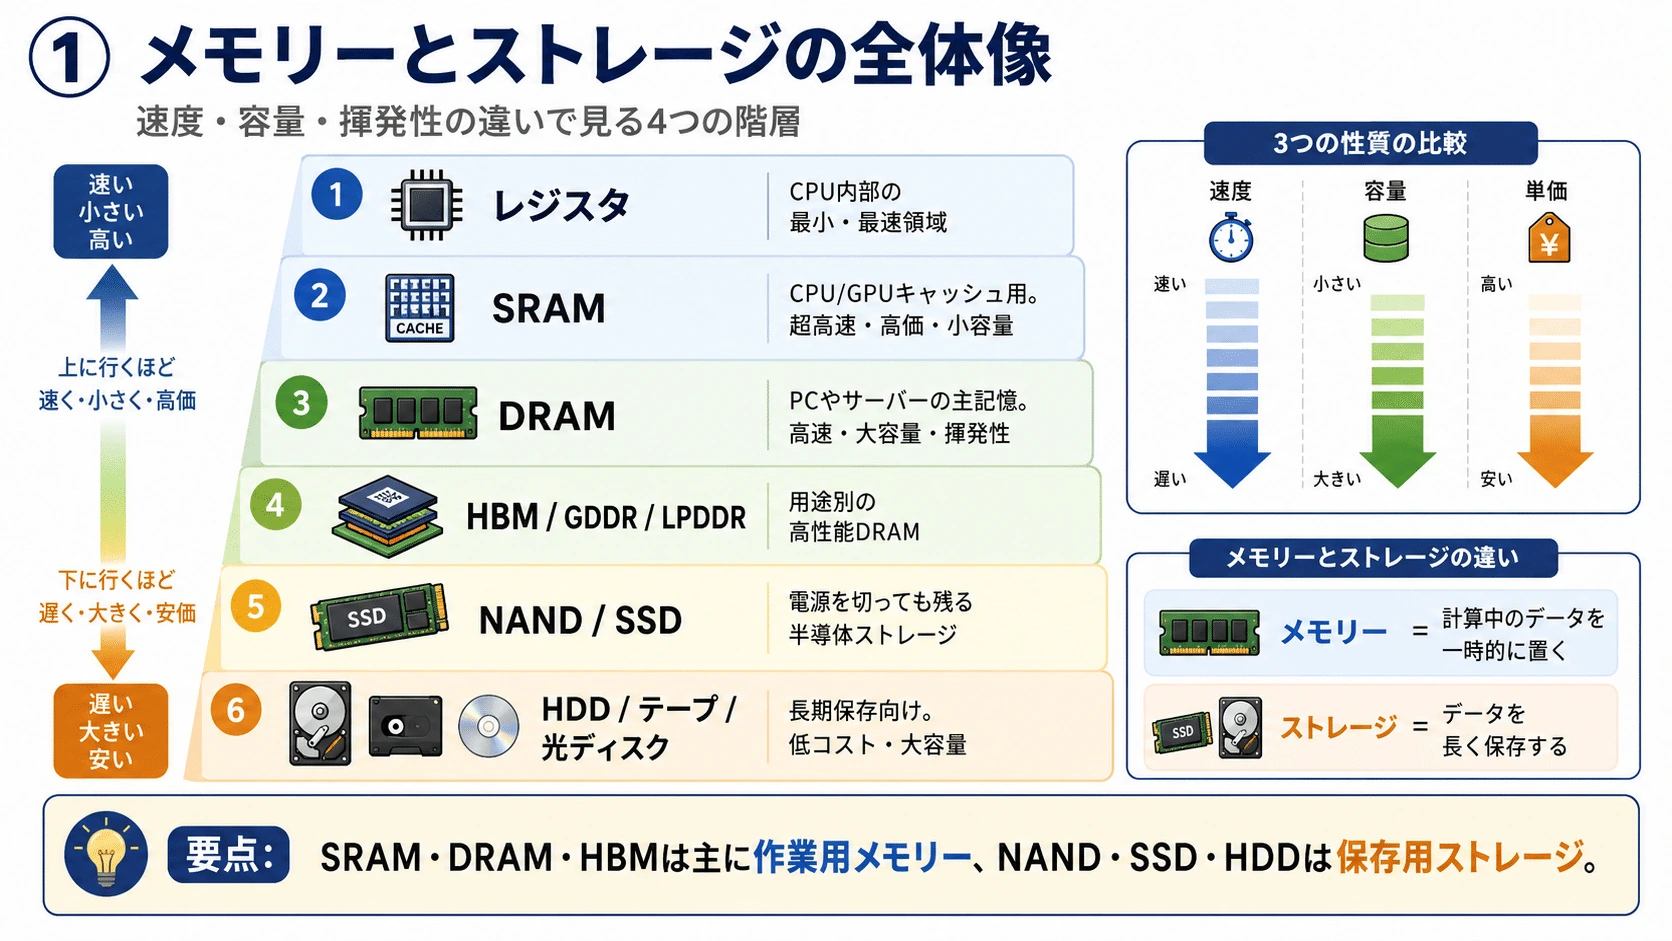
#大まかに言えば、メモリーは計算中に使う場所、ストレージはデータを保存する場所である。
#机の上で作業する場面に例えると分かりやすい。
#| 種類 | 例え | 主な役割 |
| レジスタ | 手に持っている数字 | 演算直前のデータ |
| SRAM | 机の上 | 頻繁に使うデータ |
| HBM・DRAM | 机の引き出し | 作業中のモデルやデータ |
| NAND・SSD | 書類棚 | 後で使うデータ |
| HDD | 倉庫 | 大量の保存データ |
| 磁気テープ | 遠隔地の保管庫 | 長期アーカイブ |上に行くほど高速だが、小容量で高価になる。下へ行くほど遅いが、大容量で安い。
#AIシステムでは、どれか一つだけを使うのではなく、データの使用頻度に応じて各階層を移動させる。
##
2.SRAMとは何か
#SRAMは、CPU、GPU、AI ASICの内部に組み込まれる非常に高速なメモリーである。
#CPUのL1、L2、L3キャッシュや、GPUの共有メモリー、AIチップ内のローカルバッファなどに使われる。
#SRAMの長所は、
#- 非常に低遅延
- 極めて広い帯域
- 演算器のすぐ近くに置ける
- DRAMのようなリフレッシュが不要
という点にある。
#一方で、一般的なSRAMセルは1bitを保存するために複数のトランジスタを必要とする。面積が大きく、容量単価が非常に高いため、数百GBや数TBを安価に積む用途には向かない。
#SemiAnalysisは、SRAMを「非常に高速だが低密度」、DDR DRAMを「高密度で安価だが帯域が小さい」、HBMをその中間でAI向けに適したメモリーと整理している。(SemiAnalysis)
##
SRAMはDRAM不足を解決できるのか
#「DRAMが足りないならSRAMを増やせばよい」という考えは、半分正しく、半分間違っている。
#SRAMでDRAMと同じ容量を置き換えるのは、面積と価格の問題から現実的ではない。
#代わりに行われるのは、
#頻繁に使うデータをSRAMに残し、DRAMやHBMへアクセスする回数を減らす#
という設計である。
#SRAMが増えると、演算器は同じ重みや中間データを何度もHBMから読み直さずに済む。したがって、必要なDRAM容量そのものよりも、必要なDRAM帯域やアクセス回数を減らせる。
#GroqのLPUは、その極端な例である。数百MB規模のオンチップSRAMを単なるキャッシュではなく、主要な重み保存領域として使い、複数のLPUへモデルを分割する。(Groq)
##
なぜSRAMを積層するのか
#通常、SRAMを増やすとAIチップの面積が大きくなる。ダイが大きくなるほど、1枚のウェハーから取れるチップ数が減り、欠陥に当たる確率も上昇する。
#そこで、ロジックダイの横ではなく、上にSRAMダイを積む構想が重要になる。
#TSMCのSoICは、CPU上にSRAMをL3キャッシュとして積層した実用例を持つ。SamsungのX-Cubeも、ロジックダイ上にSRAMを積層し、配線距離の短縮と電力効率向上を狙う技術である。(台灣積體電路製造公司)
#このため「SRAMブーム」は、単体SRAMメーカーの話というより、
#- TSMCやSamsung Foundryの先端工程
- SoICやX-Cubeなどの3D積層
- ハイブリッドボンディング
- SRAM設計IP
- MBISTや半導体テスター
への需要増として現れる。
##
3.DRAMとは何か
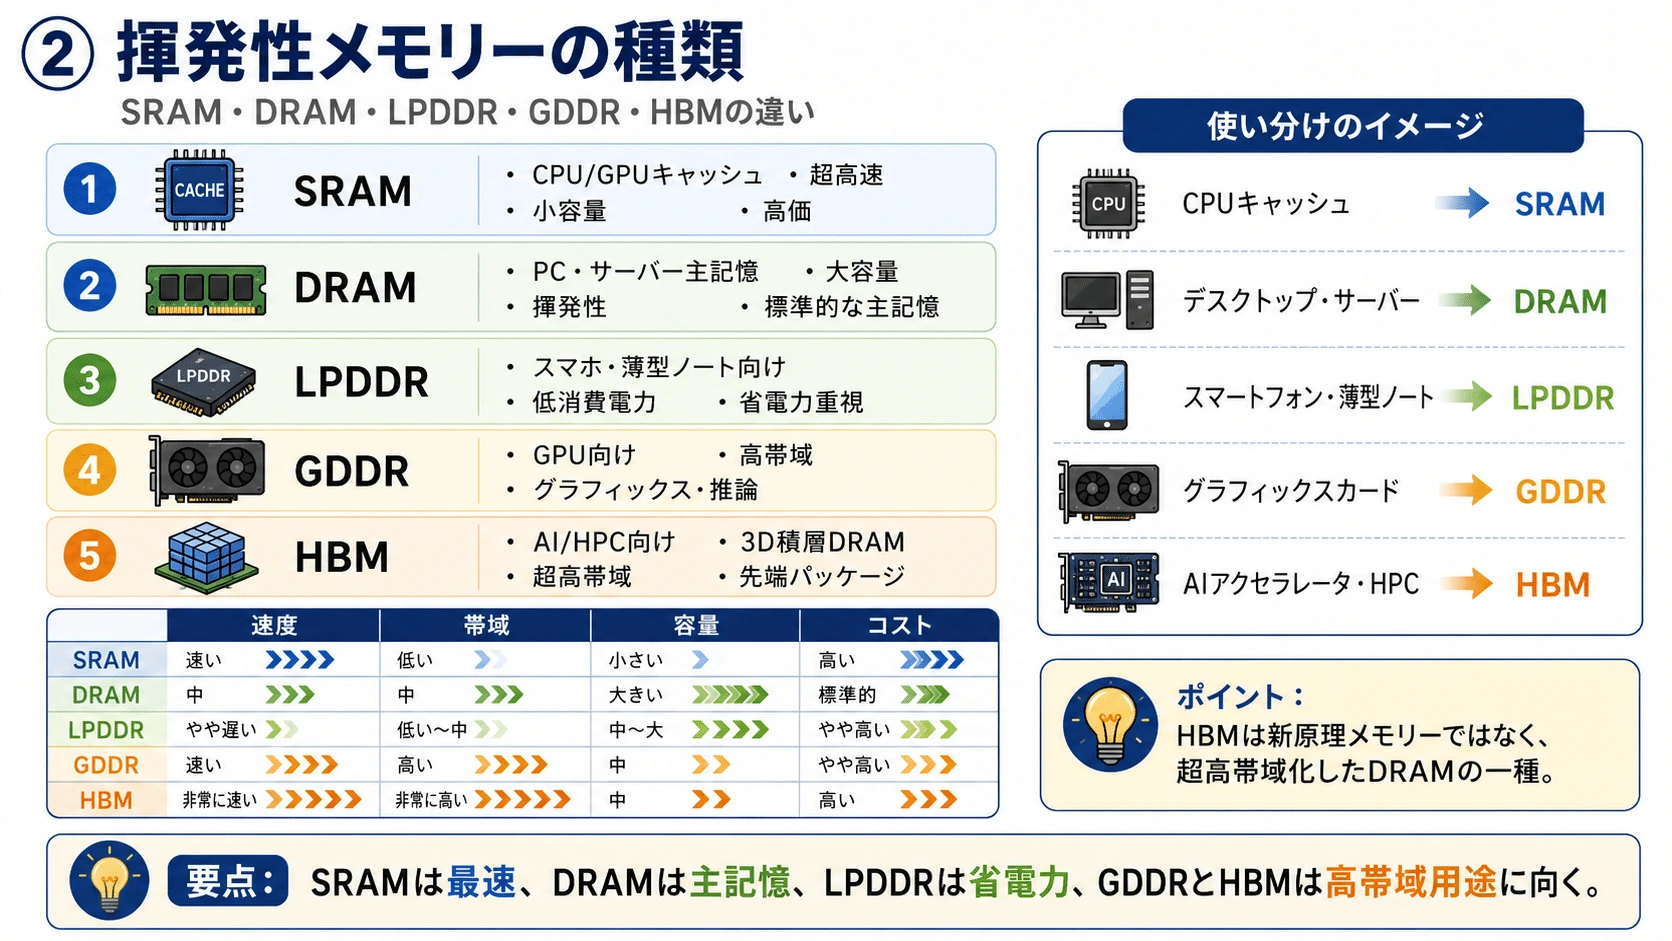
#DRAMは、PC、スマートフォン、サーバーの主記憶として使われるメモリーである。
#電源を切るとデータが消える揮発性メモリーで、SRAMより遅い一方、はるかに高密度で安価に作れる。
#DRAMには用途ごとに複数の種類がある。
#| 種類 | 主な用途 |
| DDR5 | PC、サーバー |
| RDIMM | 大容量サーバーメモリー |
| LPDDR | スマートフォン、ノートPC、AIサーバー |
| GDDR | GPU、グラフィックス |
| HBM | AIアクセラレーター、HPC |重要なのは、HBMもDRAMの一種だということである。
##
4.HBMとは何か
#HBMはHigh Bandwidth Memoryの略で、DRAMダイを縦に積み重ね、GPUやAI ASICの近くに置くメモリーである。
#一般的なDDRは、比較的狭いデータ線を高い速度で動かす。一方HBMは、1000本を超えるような非常に広い配線を使い、一度に大量のデータを運ぶ。
#そのため、
#- AIモデルの重み
- 活性値
- KVキャッシュ
- 学習中の中間データ
をGPUへ高速に供給できる。
#ただしHBMは、DRAMダイを作るだけでは完成しない。
#- 複数のDRAMダイ
- TSVによる垂直接続
- ロジックベースダイ
- 積層・接合工程
- インターポーザー
- CoWoSなどの先端パッケージ
- GPUとの電気的接続
が必要で、通常のDDRより製造難度が高い。
#SemiAnalysisによると、HBM3EではAIアクセラレーターとHBMの間に1000本以上の信号線が必要となり、一般的な基板ではなく、2.5Dパッケージが必要になる。(SemiAnalysis)
##
HBMが普通のDRAMまで不足させる理由
#HBMとDDR5は完全に同じ製品ではないが、上流ではDRAMウェハー、生産設備、人員、材料の一部を共有する。
#しかもHBMは、
#- ダイ面積が大きい
- 積層に使える良品ダイが必要
- 冗長性を持たせる
- 高い歩留まりを要求される
ため、同じウェハー量を使っても、通常DRAMほど多くのビットを出荷できない。
#TrendForceは、主要3社のHBM向けウェハー投入比率が、2026年末にDRAM全体の約22%へ達する一方、得られるHBMビットは全DRAMビットの約9%にとどまると予測している。2027年にはウェハー投入の約30%を使いながら、ビット供給は約13%となる見通しである。(TrendForce)
#つまりHBMは高価格で利益率も高いが、通常DRAMの供給能力を大きく消費する製品でもある。
#その結果、HBMを増やすと、
#- DDR5
- サーバー用RDIMM
- LPDDR
- GDDR
- SSD内部用DRAM
の供給が相対的に減りやすくなる。
#
#
5.NANDとは何か
#NANDは、電源を切ってもデータが残る不揮発性メモリーである。
#スマートフォン、USBメモリー、SDカード、SSDなどの保存領域に使われる。
#DRAMが「作業机」なら、NANDは「書類棚」に近い。
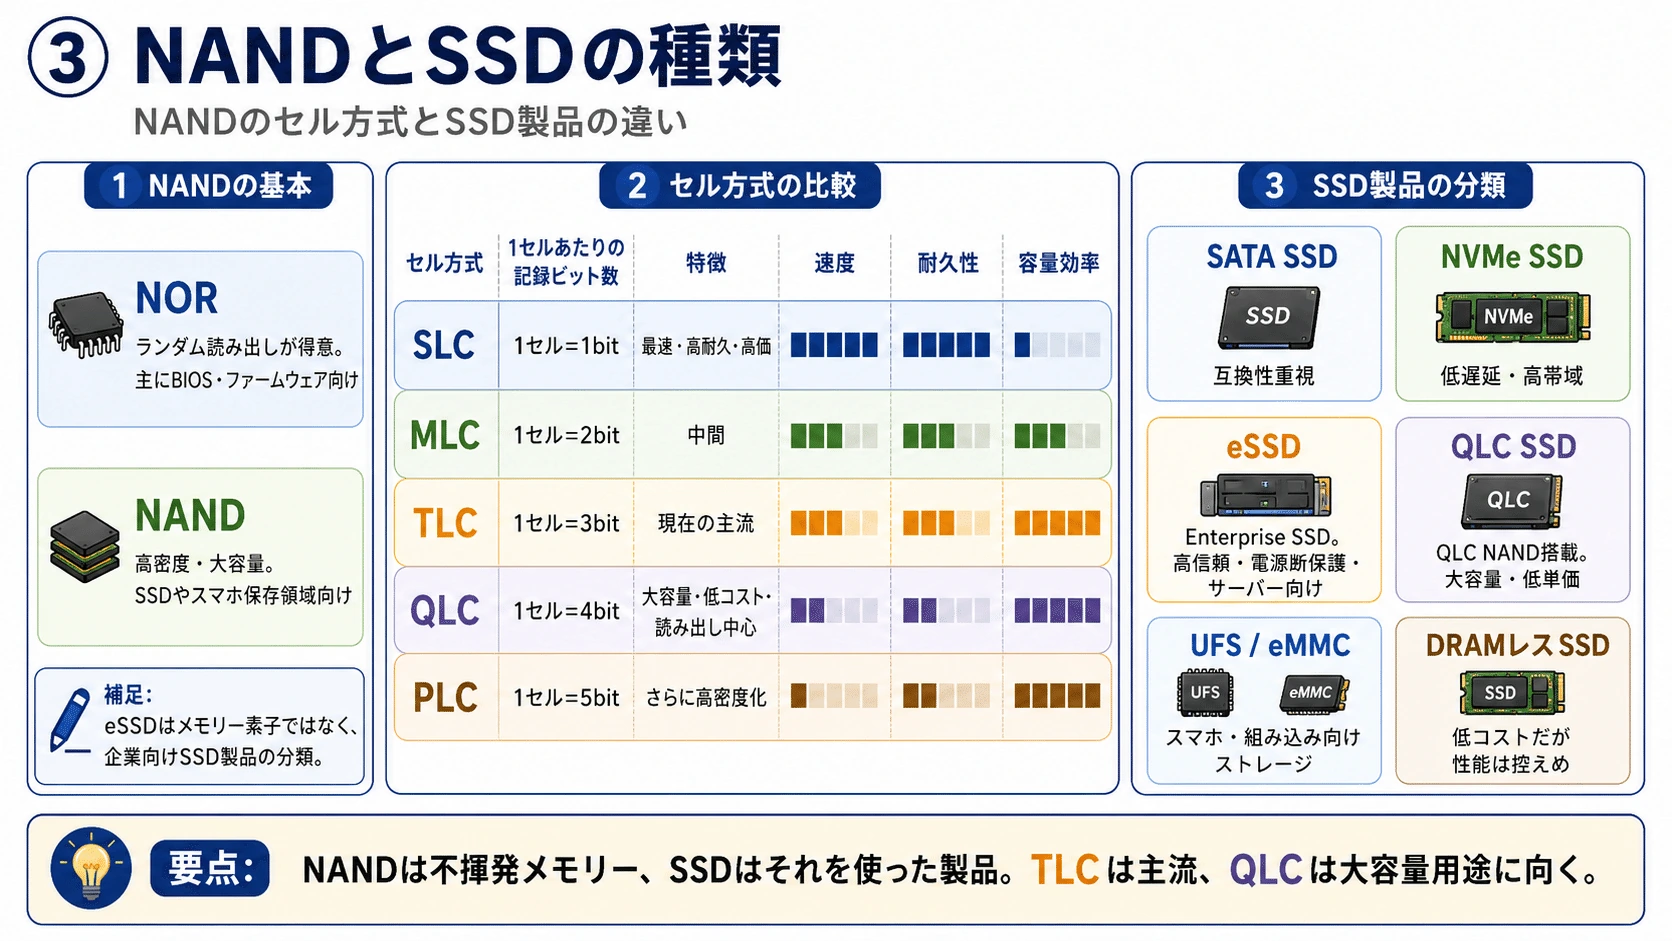
#NANDは1セルに保存するビット数によって分類される。
#| 種類 | 1セルの記録量 | 特徴 |
| SLC | 1bit | 高速・高耐久・高価 |
| MLC | 2bit | SLCとTLCの中間 |
| TLC | 3bit | 性能・耐久・価格のバランス |
| QLC | 4bit | 大容量・低価格 |
| PLC | 5bit | 将来の高密度方式 |ビット数を増やすほど、1セルで多くのデータを保存できる。ただし判別する電圧状態が増え、速度、耐久性、エラー管理の難度が上がる。
##
TLCとQLCは何が違うのか
#TLCは現在の高性能SSDで広く使われる。
#- 比較的高い書き込み耐久性
- 安定したランダム性能
- 高性能サーバーに使いやすい
という特徴がある。
#QLCはTLCより大容量で安価だが、直接書き込み速度や耐久性では不利になる。
#しかしAIデータセンターでは、
#- 学習データ
- RAGの文書
- モデル重み
- 過去のKVキャッシュ
- 画像・動画
- 推論履歴
のような「大量に保存し、読み出しが中心のデータ」が増える。
#そのためQLCは、欠点を抱えながらも、ラック当たり容量とTB当たり電力を改善する技術として重要になっている。
##
6.SSDはNANDそのものではない
#SSDはNANDを利用した完成製品である。
#一般的なエンタープライズSSDは、次の部品で構成される。
#NANDフラッシュ
+ SSDコントローラー
+ DRAM
+ ファームウェア
+ 電源断保護
+ PCIe/NVMeインターフェースSSD内部のDRAMは、単に書き込みデータを一時保存するだけではない。
#最も重要なのは、OSが指定した論理アドレスと、NAND上の物理位置を結び付けるFTL変換表や、メタデータを高速に保持することである。
#NANDはその場で簡単に上書きできず、消去、再配置、ウェアレベリング、不良ブロック管理が必要になる。SSD容量が大きくなるほど、これを管理するDRAMの重要性も増す。
#したがって、高性能なエンタープライズSSDはNANDさえあれば作れるわけではない。DRAM、コントローラー、ファームウェア、電源部品のどれかが不足しても完成品を出荷できない。
#実際、TrendForceは2026年第3四半期のエンタープライズSSDについて、SSD内部に使うDRAM不足が、一部の高性能製品の供給を制約していると指摘している。(TrendForce)
#
#
7.HDDと磁気テープの役割
#NAND SSDより下には、HDDと磁気テープがある。
#HDD
#HDDは回転する磁気ディスクへデータを保存する。
#SSDより遅いが、
#- 容量単価が安い
- ファイルを比較的直接読み出せる
- 大量のオンラインデータを保存できる
ため、データレイク、動画、学習データ、バックアップ、過去のモデルなどに使われる。
#磁気テープ
#磁気テープは、長いテープへ順番にデータを保存する。
#目的の位置まで巻く必要があるため、読み出し開始は遅い。一方で、保管中は電力をほとんど使わず、ネットワークから切り離せる。
#そのため、
#- 数年間使わないデータ
- 災害復旧用コピー
- 法定保存
- 過去の学習データ
- ランサムウェア対策
に向く。
#SSDが増えてもHDDとテープが消えないのは、AIが生成するデータ量があまりに大きく、すべてをSSDへ置くのは高価だからである。
##
8.AI推論でメモリー階層がさらに細かくなる
#従来は、CPUキャッシュ、DRAM、SSD、HDDという比較的単純な階層だった。
#AI推論では、KVキャッシュや長いコンテキストを管理するため、さらに細かい階層が必要になる。
#NVIDIAが示す構造は次のようなものである。
#| 階層 | 保存場所 | データ |
| G1 | GPU HBM | 現在使っているActive KV |
| G2 | システムDRAM | HBMから退避したKV |
| G3 | ローカルSSD | 近いうちに再利用するKV |
| G3.5 | 共有フラッシュ | 複数GPU間で共有するWarm KV |
| G4 | ネットワークストレージ | Cold KV、ログ、長期データ |KVキャッシュとは、LLMが過去の文章を毎回最初から計算し直さないために保存する中間結果である。
#長い会話、AIエージェント、コーディング支援、企業内文書検索が増えると、KVキャッシュは非常に大きくなる。
#すべてをHBMに置けば高速だが、HBMは高価で容量も限られる。すべてを通常ストレージへ置けば、読み戻すまでに時間がかかり、GPUが待機する。
#そこでNVIDIAのCMXは、BlueField DPU、高速ネットワーク、NVMeフラッシュを組み合わせ、G3.5という共有KVキャッシュ階層を作る。これは新しいメモリー素子ではなく、フラッシュをAIメモリーの一部として使うシステムである。(NVIDIA Developer)
##
9.HBFとは何か
#HBFはHigh Bandwidth Flashの略である。
#NANDを高並列に積層し、AIアクセラレーターの近くで大容量メモリーとして使おうとする構想だ。
#HBMほど低遅延・高帯域ではないが、
#- HBMより大容量化しやすい
- NANDなので不揮発
- DRAMより待機電力を抑えやすい
- 重みや使用頻度の低いデータを置ける
という特徴がある。
#想定される用途は、
#- モデル重み
- MoEの使用頻度が低いエキスパート
- 大規模Embedding
- Warm KVキャッシュ
- RAGデータ
などである。
#キオクシアは5TB、64GB/sの広帯域フラッシュモジュールを試作した。SanDiskはHBFについて、2026年後半のサンプル出荷と、2027年初めの推論デバイスの試作を目標としている。したがって、HBFは有望だが、まだHBMやSSDのような量産市場にはなっていない。(KIOXIA Corporation)
##
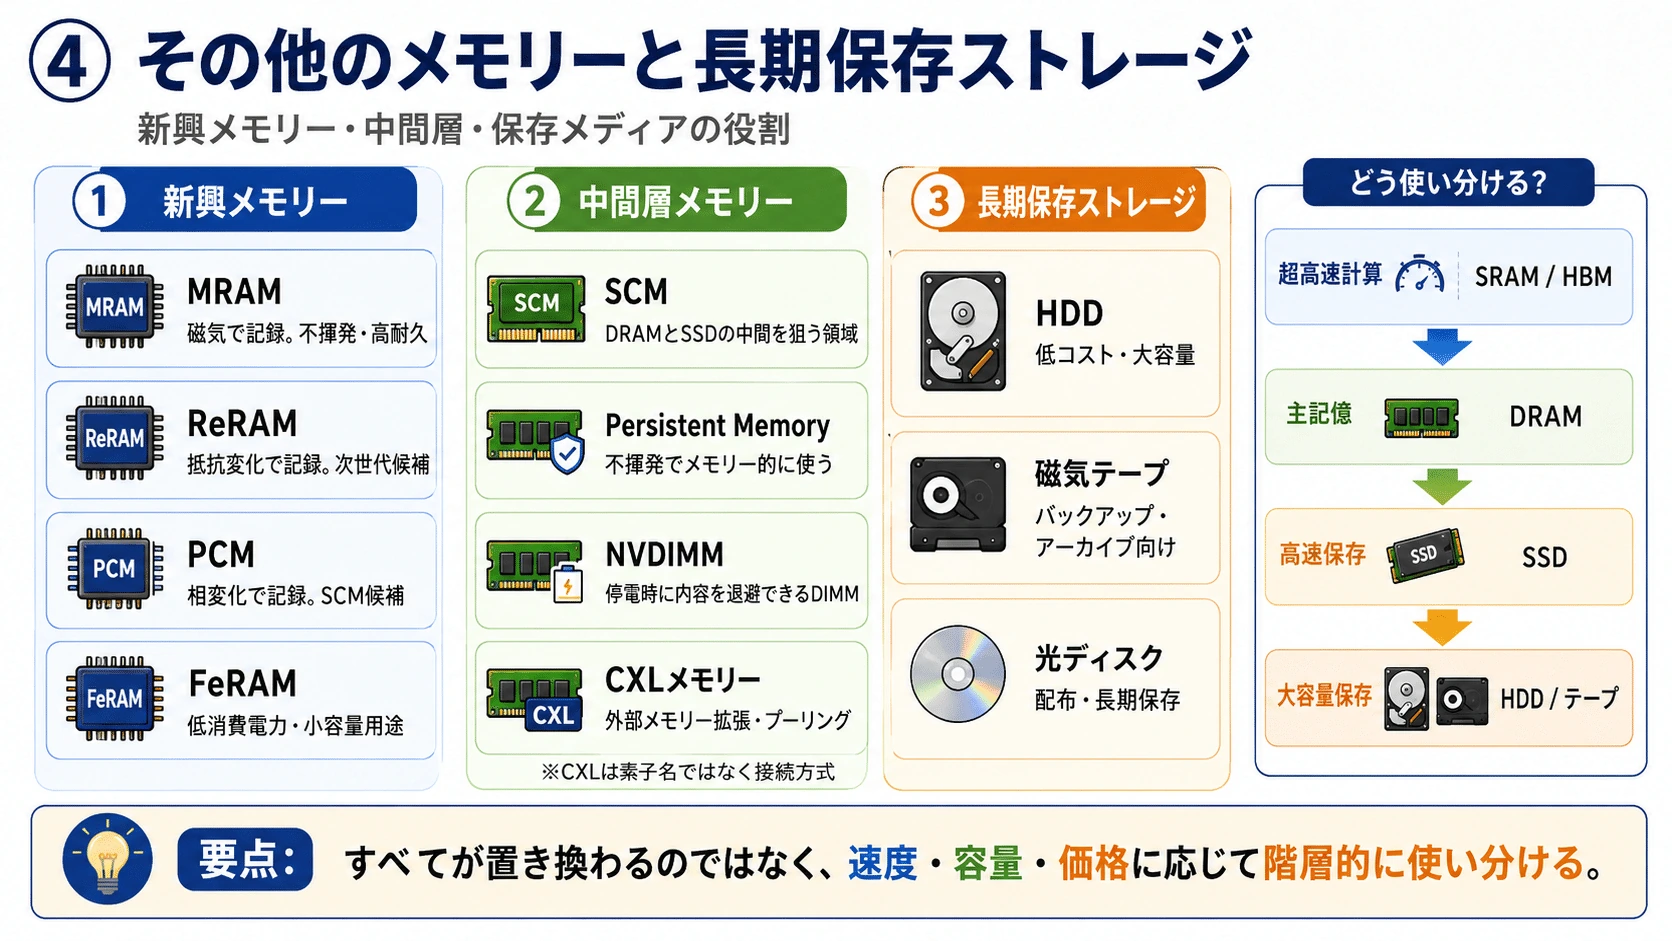
10.XL-FLASHとは何か
#XL-FLASHは、通常のTLCやQLCより低遅延・高耐久を狙ったフラッシュである。
#位置付けとしては、DRAMと一般的なNAND SSDの間に近い。
#キオクシアは、専用SoCとXL-FLASHを組み合わせたGPシリーズで、100M IOPS以上を要求する次世代AIシステムを対象にしている。
#用途は、
#- KVキャッシュ
- データベースのメタデータ
- 高頻度のベクトル検索
- GPUメモリーからの退避
- 小さいデータの大量ランダムアクセス
などである。
#一方、245TB級QLC SSDは、速度よりも大容量保存を担う。つまり同じNANDでも、
#- XL-FLASH:低遅延
- TLC:性能と耐久性
- QLC:容量と低コスト
という使い分けになる。(Kioxia Holdings)
#
#
11.メモリーサイクルとは何か
#DRAMとNANDは、需要が一直線に増える産業ではない。
#価格上昇と供給過剰を繰り返すため、「メモリーサイクル」と呼ばれる。
#基本構造は次の通りである。
#需要増加
↓
在庫減少
↓
価格上昇
↓
メーカー利益増加
↓
設備投資と増産
↓
供給が需要を追い越す
↓
価格下落
↓
減産・投資削減
↓
再び供給不足ただし設備投資を決めても、新工場が出荷へ到達するまで数年かかる。
#そのため需要が急増したときには供給がすぐには追いつかず、逆に需要が弱くなった後も、以前決めた増産設備が稼働し続けて供給過剰になる。
##
メモリーサイクルを読む7つの指標
#1.契約価格
#大手PC、スマートフォン、サーバー企業は、DRAMやNANDを四半期契約などで調達する。
#産業全体を見るなら、日々動くスポット価格よりも契約価格の方が重要である。
#2.ASP
#ASPは平均販売価格である。
#売上は大まかに、
#出荷ビット数 × 1bit当たり価格
#で決まる。
#出荷量が横ばいでもASPが50%上がれば、売上と利益は大幅に増える。
#3.ビット出荷量
#半導体の個数ではなく、合計で何bit出荷したかを見る。
#高容量製品へ移行すれば、製品個数が同じでもビット出荷量は増える。
#4.在庫
#メーカー在庫、顧客在庫、流通在庫が減ると、買い手は値上げを受け入れやすくなる。
#ただし顧客が過剰に買い込んだ後は、実需が続いていても在庫調整が起きる。
#5.ウェハー投入量
#新工場を増やしているのか、既存工場の生産を減らしているのかを見る。
#HBM、DDR、LPDDRのどこへウェハーを配分するかも重要である。
#6.世代移行と歩留まり
#NANDは層数を増やし、DRAMは微細化することで、同じウェハーから得られるビット数を増やせる。
#しかし新工程の立ち上げ時には歩留まりが低く、名目上の生産能力ほど出荷できないことがある。
#7.製品ミックス
#現在のメモリー市場で最も重要な指標である。
#メーカーが利益率の高い、
#- HBM
- サーバーDRAM
- QLC eSSD
- 車載・産業用製品
へ能力を振り向けると、PC、スマートフォン、民生機器向け製品が不足する。
#市場全体のウェハー能力が変わらなくても、製品別には深刻な不足が起こる。
##
12.2026年のメモリー市場では何が起きているか
#現在は、AI需要による強い供給制約が続いている。
#2026年第1四半期には、一般DRAMの契約価格が前四半期比で約93~98%上昇し、DRAM業界売上は81%増の970億ドルに達した。第2四半期も一般DRAM価格は58~63%上昇したとTrendForceは推計している。(TrendForce)
#ただし第3四半期の値上がり予想は、一般DRAMで13~18%、NANDで10~15%へ減速している。
#これは供給が十分になったからではない。価格がすでに非常に高くなり、PCやスマートフォン企業がそれ以上の値上げを製品価格へ転嫁できなくなりつつあるためである。
#サーバーDRAMは依然として供給不足で、メーカーは引き続きAI・サーバー向けを優先している。(TrendForce)
##
eSSD市場の現状
#2026年第1四半期の主要5社のエンタープライズSSD売上は、前四半期比86.1%増の184.6億ドルとなった。供給量が注文増加に追いつかず、eSSD契約価格は同四半期に約80%上昇した。(TrendForce)
#同四半期の売上は、
#| 企業 | eSSD売上 |
| Samsung | 70.5億ドル |
| SK hynix+Solidigm | 46.4億ドル |
| Micron | 30.9億ドル |
| Kioxia | 22.2億ドル |
| SanDisk | 14.7億ドル |となっている。
#SamsungはNAND、DRAM、SSDコントローラーを自社で持つ垂直統合が強い。SK hynixはHBMとサーバーDRAM、Solidigmは大容量QLC SSDに強い。MicronはDRAM、HBM、NAND、SSDを一体で供給できる。KioxiaとSanDiskは、TLC、QLC、XL-FLASH、HBFを使ってAIストレージ階層を拡大しようとしている。(TrendForce)
##
今後どれほどフラッシュが必要になるのか
#キオクシアがTechInsightsの予測を基に示した資料では、データセンター向けフラッシュ需要は、
#- 2025年:295EB
- 2028年:909EB
へ増加する見通しである。
#特に推論AI向けフラッシュは、2025年から2028年まで年平均86%成長するとされている。これはキオクシアの経営計画に用いられた市場予測であり、確定した出荷量ではないが、AIストレージが数年間で大きく拡大する方向性を示している。(Kioxia Holdings)
##
13.現在のサイクルは過去と何が違うのか
#従来のメモリーサイクルは、主にPCとスマートフォンの販売台数に左右された。
#現在は、需要の中心が複数に分かれている。
#- HBM:GPU・AI ASIC
- RDIMM:AIサーバーと一般サーバー
- LPDDR:省電力AIサーバー
- SRAM:AIチップ内部
- TLC SSD:高性能KVキャッシュ
- QLC SSD:大容量AIデータ
- HDD:データレイク
- テープ:長期保存
さらにメーカーは、長期供給契約、前払い、数量保証を顧客へ求め始めている。
#そのため今回のサイクルでは、単に価格が上昇して増産し、すぐに暴落するのではなく、顧客が将来の供給能力を長期契約で囲い込む構造が強まっている。
#一方で、価格が上がりすぎればPC、スマートフォン、民生機器の需要が減る。2026年第3四半期の値上がり鈍化は、この需要破壊が始まりつつあることも示している。(TrendForce)
##
14.投資や産業調査では、各階層を別々に見る
#「AIが伸びるからメモリー企業は全部伸びる」という見方では不十分である。
#見るべき需要は、階層ごとに異なる。
#演算器直近
#対象はSRAM、積層SRAM、先端ロジック、先端パッケージ。
#恩恵を受けるのは、TSMC、Samsung Foundry、EDA、テスト、接合装置などである。
#作業用メモリー
#対象はHBM、DDR5、RDIMM、LPDDR、CXLメモリー。
#中心企業はSamsung、SK hynix、Micronである。
#半導体ストレージ
#対象はTLC、QLC、XL-FLASH、eSSD、HBF。
#中心企業はSamsung、SK hynix・Solidigm、Micron、Kioxia、SanDiskである。
#長期保存
#対象はHDD、磁気テープ、オブジェクトストレージ。
#AIが生成したデータを安価に保持する役割を担う。
##
15.最も重要なのは「どのデータをどこに置くか」
#AI時代のメモリー問題は、単純な容量不足ではない。
#すべてのデータをHBMへ置けば速いが、価格と供給量が追いつかない。すべてをNANDへ置けば大容量だが、演算器が待たされる。
#したがってシステムは、
#最も頻繁に使うデータ
→ SRAM
現在計算しているモデル・KV
→ HBM
一時退避・CPU作業領域
→ DRAM
近いうちに再利用するデータ
→ XL-FLASH・TLC SSD・CMX
大量のモデル、RAG、Warm KV
→ QLC SSD・将来のHBF
使用頻度の低いデータ
→ HDD
長期保存
→ 磁気テープという形へ進む。
##
まとめ
#NAND、DRAM、HBMは競合する一種類のメモリーではない。
#- SRAMは演算器直近の超高速領域
- DRAMはコンピューターの作業用メモリー
- HBMはAI向けに超広帯域化したDRAM
- NANDは電源を切っても残る保存用メモリー
- SSDはNAND、DRAM、コントローラーを組み合わせた製品
- HDDは安価なオンライン大容量保存
- 磁気テープは最終的な長期アーカイブ
である。
#現在起きているSRAMブーム、HBM不足、DRAM高騰、QLC SSD拡大、HDD需要は、別々の現象ではない。
#AIが扱うデータ量が、単一のメモリーだけでは処理できない大きさになり、記憶装置の全階層が同時に増強されている。#
メモリーサイクルを読むときは、単にDRAMやNANDの価格を見るだけでは足りない。
#どの階層の需要が増えているのか、メーカーがどの製品へウェハーを配分しているのか、その結果どの製品が押し出されて不足するのか。
#この流れまで追うことで、AI時代のメモリー市場を立体的に理解できる。
##
追記:CPU・GPU・ASICの中で、演算器とメモリーはどう配置されているのか
#レジスタ、SRAM、HBM、DRAMとNVIDIA Grace Blackwellの関係
#前回の記事では、SRAM、DRAM、HBM、NANDを、演算器からの距離に応じた階層として説明した。
#ここで生じやすい疑問がある。
#演算器とSRAMはCPU側にあり、HBMとDRAMはGPU側にあるのか。#
結論から言えば、この理解は正確ではない。
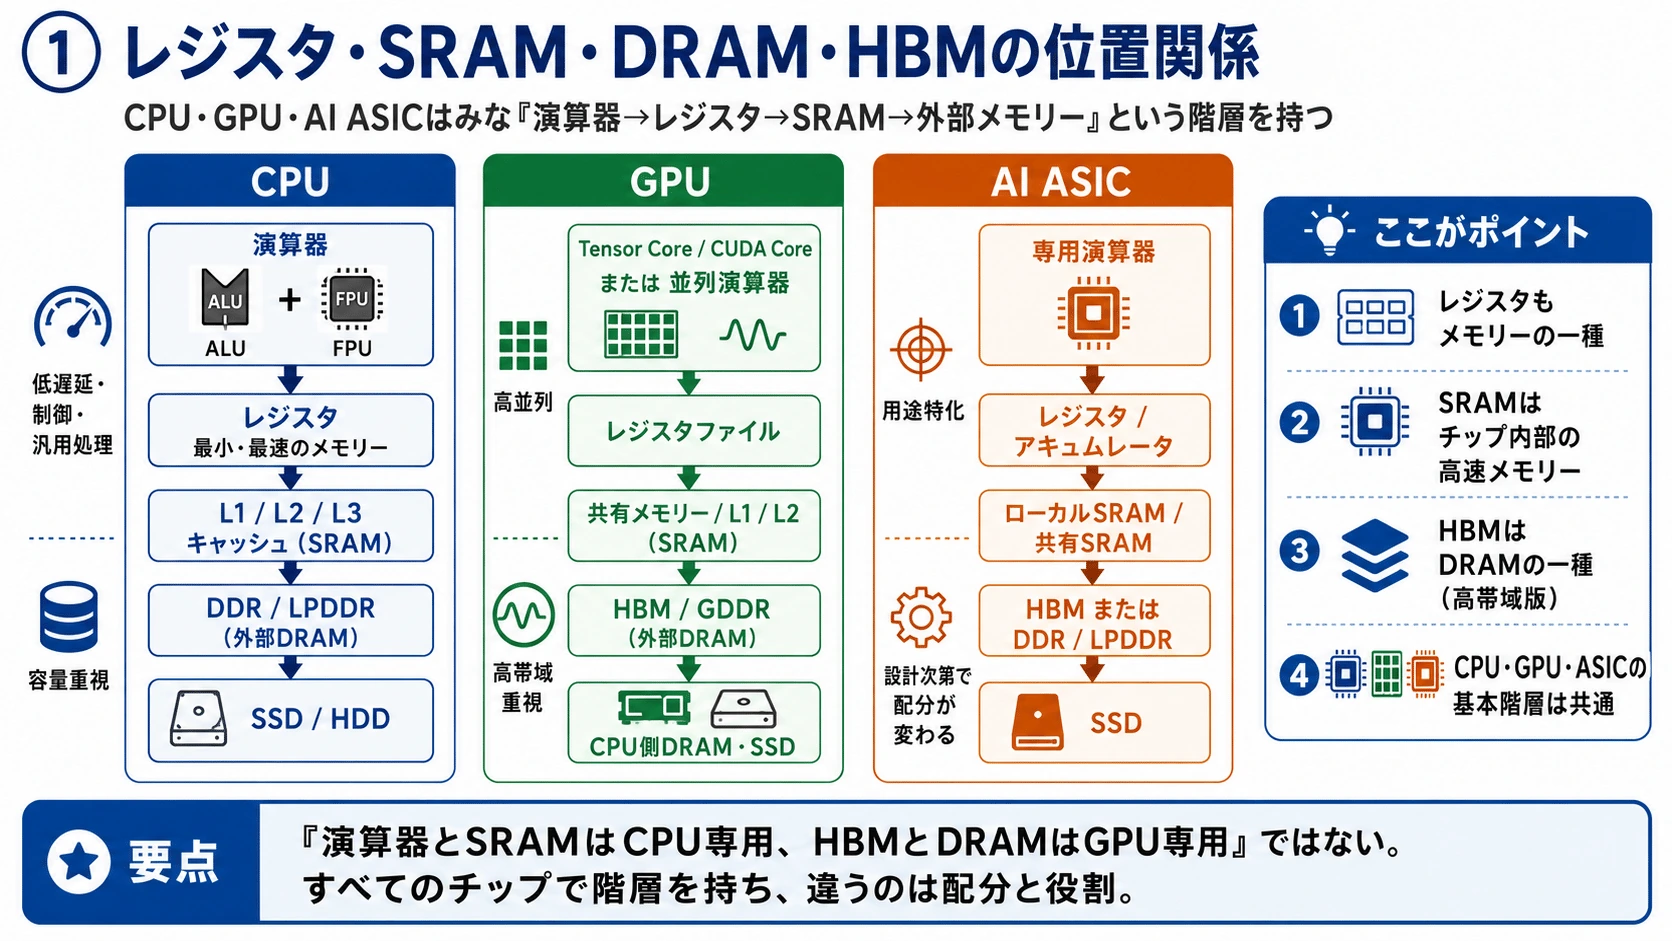
#CPU、GPU、ASICのすべてに演算器、レジスタ、SRAMがある。 そして必要に応じて、そのチップの外側にDDR、LPDDR、GDDR、HBMなどのDRAMを接続する。
#CPUとGPUの違いは、メモリーの種類を分担していることではなく、演算器の構成、並列度、SRAMの使い方、外部DRAMに求める容量と帯域が違うことにある。
#
#
1.レジスタもメモリーなのか
#レジスタも、データを一時的に保持するという意味では明確にメモリーである。
#コンピューターの記憶階層は、演算器に近い順に次のようになる。
#演算器
↑
レジスタ
↑
L1・共有メモリー・L2などのSRAM
↑
HBM・GDDR・DDR・LPDDRなどのDRAM
↑
SSDのNAND
↑
HDD・磁気テープレジスタは、演算器が今まさに使用する値を置く場所である。
#例えば、
#A = 5
B = 7
C = A + Bという計算では、5と7をレジスタへ入れ、加算器が演算し、結果の12もまずレジスタへ置く。
#レジスタには主に、
#- 演算対象の数値
- 計算途中の結果
- メモリーアドレス
- 命令の実行状態
- ベクトルや行列の一部分
- ループ回数や条件判定
などが保存される。
#NVIDIAのGPUでも、各SM、Streaming Multiprocessorの内部にレジスタファイルがあり、スレッドごとのローカル変数を保持する。レジスタと共有メモリーは、どちらもGPUダイ内部にあり、外付けDRAMよりはるかに高速にアクセスできる。(NVIDIA Docs)
##
2.レジスタとSRAMは同じものなのか
#役割は似ているが、厳密には同じとは限らない。
#小さな制御レジスタやパイプラインレジスタは、一般にフリップフロップやラッチのような回路で作られる。
#一方、CPUやGPUの巨大なレジスタファイルは、面積と電力を抑えるため、SRAMに近い専用メモリー回路として設計されることがある。
#| 記憶領域 | 主な実装と用途 |
| パイプラインレジスタ | フリップフロップ、ラッチ |
| CPUの物理レジスタファイル | 専用メモリーセル |
| GPUのレジスタファイル | 高密度な専用記憶回路 |
| L1・L2・L3キャッシュ | SRAM |
| GPUの共有メモリー | オンチップSRAM |
| HBM・DDR | 外付けDRAM |したがって、
#レジスタは最小・最速のメモリーだが、通常のキャッシュSRAMとは管理方法や回路構造が異なる#
と理解すればよい。
##
3.CPUの中にも演算器、レジスタ、SRAMがある
#CPUは次のような構造を持つ。
#CPUコア
├─ 整数演算器
├─ 浮動小数点演算器
├─ ベクトル演算器
├─ レジスタ
├─ L1キャッシュ
└─ L2キャッシュ
↓
複数コアで共有するL3キャッシュ
↓
DDR5・LPDDRなどのシステムDRAM
↓
SSDCPUのL1、L2、L3キャッシュは基本的にSRAMである。
#CPUは、分岐の多いプログラム、OS、データベース、ネットワーク処理、ジョブ管理など、複雑で連続的な処理を得意とする。
#そのため、
#- 1本の処理を速く進める性能
- 大容量キャッシュ
- 低遅延
- 分岐予測
- 幅広い命令への対応
が重視される。
#CPUの外部には、一般にDDR5やLPDDRなどのDRAMが接続される。CPU側DRAMは、HBMほどの帯域はない一方、比較的安価に数百GBから数TBまで増やしやすい。
##
4.GPUにも演算器、レジスタ、SRAMがある
#GPUはHBMだけで動いているわけではない。
#GPU内部にも、
#- CUDA Core
- Tensor Core
- ベクトル・行列演算器
- レジスタファイル
- 共有メモリー
- L1キャッシュ
- L2キャッシュ
が存在する。
#外側にHBMまたはGDDRが接続される。
#GPU内部
Tensor Core・CUDA Core
↑
レジスタ
↑
共有メモリー・L1キャッシュ
↑
L2キャッシュ
↑
外付けHBMまたはGDDRNVIDIAのCUDAモデルでは、各SMにレジスタファイルと共有メモリーがあり、GPU全体では複数のSMがL2キャッシュと外付けDRAMを共有する。CPUにもGPUにも直接接続されたDRAMがあり、GPU側のDRAMはCUDAではグローバルメモリーと呼ばれる。(NVIDIA Docs)
#つまり、
#CPUは演算器とSRAMを持ち、GPUはHBMだけを持つ#
のではない。
#正しくは、
#CPUもGPUも、演算器→レジスタ→SRAM→外部DRAMという同じ基本階層を持つ#
のである。
##
5.CPUとGPUでは何が違うのか
#大きな違いは演算器の数と目的である。
#CPU
#CPUは、少数の高性能コアを持つ。
#- 分岐の多い処理
- OSやアプリの制御
- データベース
- ネットワーク
- ストレージ管理
- GPUへの命令発行
- 逐次処理
に向く。
#GPU
#GPUは、多数の演算器を並列に動かす。
#- 行列積
- ベクトル演算
- AI学習
- AI推論
- 画像処理
- 科学計算
に向く。
#大量の演算器を同時に動かすため、GPUではCPU以上に大きなメモリー帯域が必要になる。そのためGPUの外部には、DDRよりも帯域の広いHBMやGDDRが使われる。
#| 項目 | CPU | GPU |
| 演算器 | 少数・高性能 | 多数・並列 |
| レジスタ | 各コアに搭載 | 各スレッド用に大量搭載 |
| SRAM | L1・L2・L3 | レジスタ、共有メモリー、L1・L2 |
| 外部DRAM | DDR・LPDDR | HBM・GDDR |
| 重視するもの | 低遅延・汎用性 | 帯域・並列処理 |
| 主な役割 | 制御、逐次処理 | 行列、ベクトル処理 |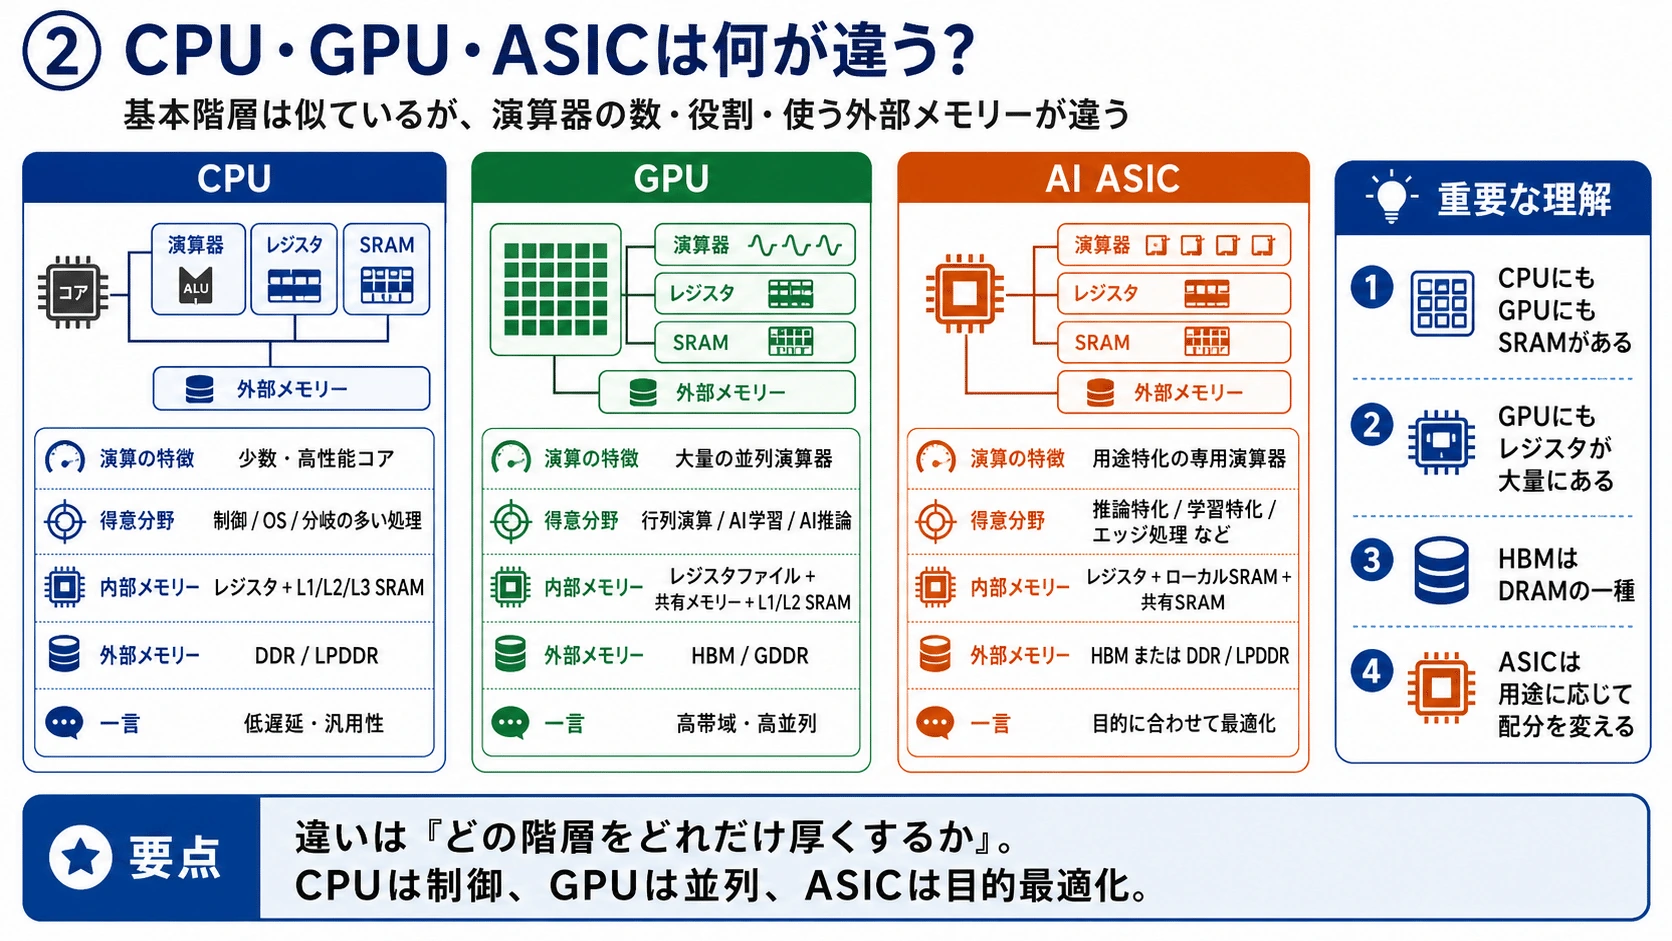
#
6.GPUでレジスタが不足するとどうなるのか
#GPUは、多数のスレッドを同時に実行する。
#各スレッドは、自分の計算途中の値をレジスタへ保持する。したがって一つのプログラムが大量のレジスタを使うと、同時に動かせるスレッド数が減る。
#さらに必要な値をレジスタへ収めきれない場合、データを外部のメモリー側へ退避することがある。これをレジスタスピルという。
#NVIDIAのCUDA資料では、レジスタスピルが起きると、オンチップレジスタにあった値がグローバルメモリー側へ書き出され、必要なときに再び読み込まれると説明されている。(NVIDIA Docs)
#通常
レジスタ
↓
演算器
レジスタ不足
レジスタ
↓ 退避
外部メモリー
↓ 再読込
レジスタ
↓
演算器このため、レジスタは容量が小さくても、GPU性能を左右する非常に重要なメモリーである。
##
7.ASICではどうなるのか
#ASICはApplication-Specific Integrated Circuit、特定用途向け集積回路である。
#GPUは多様な計算へ対応できるが、ASICは用途を限定する代わりに、
#- 不要な演算器を減らす
- 必要な演算器を増やす
- SRAM容量を用途に合わせる
- データの流れを固定する
- 電力効率を高める
ことができる。
#ただしASICでも基本構造は変わらない。
#専用演算器
↑
レジスタ・アキュムレーター
↑
ローカルSRAM
↑
共有SRAM・キャッシュ
↑
HBM・DDR・LPDDR
↑
SSDASICによって、この比率を自由に変えられる。
##
8.HBM中心型ASIC
#大規模モデルの学習や高スループット推論では、大容量のモデルを保持する必要がある。
#その場合は、
#専用行列演算器
↑
ローカルSRAM
↑
大容量HBMという構造になる。
#Google TPUはAI向けASICの一例であり、行列積和演算器を大量に並べたシストリックアレイを持つ。ホストから受け取ったデータやパラメーターをHBMに置き、HBMから行列演算器へ送り込む。行列演算中は、データを演算器間で順番に受け渡すことで、毎回外部メモリーへ戻らないようにしている。(Google Cloud Documentation)
#この構造では、HBMがモデル全体を保持し、SRAMやレジスタが演算中のデータ再利用を担う。
##
9.SRAM中心型ASIC
#低遅延推論を重視するASICでは、SRAMを極端に増やす設計もある。
#専用演算器
↑
大容量オンチップSRAM
↑
複数ASIC間ネットワークSRAM中心型では、頻繁に使うモデル重みや中間データを演算器の近くへ置けるため、HBMやDRAMへのアクセスを減らせる。
#ただしSRAMは面積が大きいため、一つのチップへ保存できるモデル容量には限界がある。大規模モデルは複数チップへ分割し、高速ネットワークで接続する必要がある。
#低遅延には強いが、
#- チップ数
- 製造コスト
- チップ間通信
- 歩留まり
- 消費電力
が課題になる。
##
10.SRAMとHBMを併用するASIC
#実際のAI ASICでは、SRAMかHBMのどちらか一方だけを使うよりも、両方を使う構造が一般的である。
#演算器
↑
レジスタ
↑
小容量・超高速SRAM
↑
大容量・高帯域HBM
↑
ホスト側DRAM
↑
SSD役割は次のように分かれる。
#領域主に置くデータレジスタ今計算している値SRAM再利用する重み、活性値、中間結果HBMモデル全体、大きなKVキャッシュCPU側DRAM退避データ、入力、システム処理SSD長期保存、Warm KV、データセット
#ASICの設計者は、目的に応じてこの配分を変える。
#- 学習重視ならHBMを増やす
- バッチ1推論ならSRAMを増やす
- 大容量推論ならSRAMとHBMを併用する
- 低価格エッジAIならLPDDRを使う
という設計になる。
##
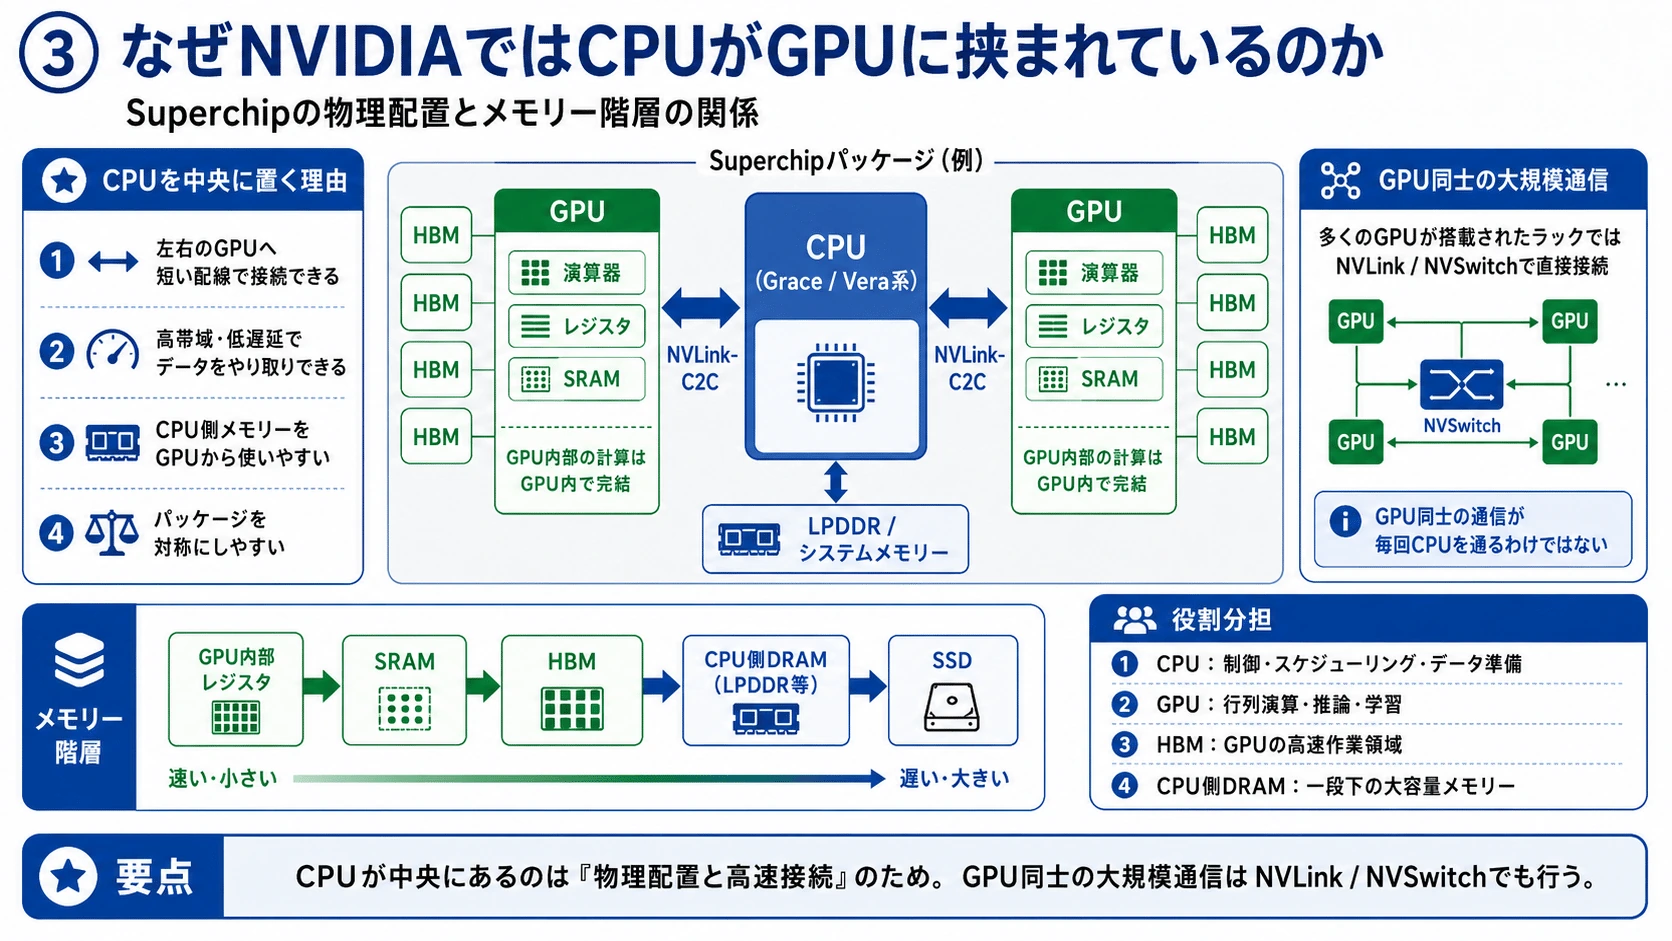
11.NVIDIA GPUでCPUが2基のGPUに挟まれているのは何か
#NVIDIAのすべてのGPUでCPUが挟まれているわけではない。
#この構造は、主にGB200 Grace Blackwell Superchipなどのパッケージで見られる。
#GB200 Superchipは、
#- Grace CPU × 1
- Blackwell GPU × 2
をNVLink-C2Cで接続する。NVIDIAのGB200 NVL72では、この構成を36組使用し、36基のGrace CPUと72基のBlackwell GPUを一つのラックに搭載する。(NVIDIA)
#概念的には次のように見える。
#HBM HBM
↓ ↓
Blackwell GPU ⇄ Grace CPU ⇄ Blackwell GPU
↓
CPU側LPDDRただし、この図を見て、
#左のGPUから右のGPUへデータを送る場合、必ずCPUを経由する#
と考えるのは誤りである。
#ラック内のGPU同士はNVLinkとNVLink Switchによって接続される。GB200 NVL72では、72基のGPUが一つの巨大なNVLinkドメインを構成し、GPU間通信はCPUを逐一中継せずに行える。(NVIDIA)
##
12.なぜCPUをGPUの間に置くのか
#CPUを中央に置く理由は、主に接続距離とパッケージ設計である。
#GPU ── 短い配線 ── CPU ── 短い配線 ── GPUCPUから左右のGPUへ、
#- 配線距離を短くする
- 信号遅延をそろえる
- 消費電力を抑える
- パッケージを対称にする
- 高帯域接続を実現する
ことができる。
#NVLink-C2Cは、CPUとGPUの間で高帯域かつメモリーコヒーレントな通信を行うチップ間接続である。NVIDIAはGB200について、2基のBlackwell GPUと1基のGrace CPUをNVLink-C2Cで接続している。(NVIDIA)
#したがってCPUが中央にあるのは、GPUより上位にあることを表しているのではない。
#CPUと2基のGPUを、短く低電力な配線で結ぶための物理配置である。
#
#
13.CPUはGPUの計算を中継しているのか
#GPUの行列演算自体は、GPU内部で完結する。
#GPU内部
HBM
↓
L2・共有メモリー・レジスタ
↓
Tensor Core
↓
計算結果CPUは主に、
#- OSの実行
- GPUジョブの起動
- データの準備
- ストレージとネットワークの管理
- 複数GPUのスケジューリング
- 分岐や逐次処理
- 例外処理
- GPUに向かない処理
を担当する。
#CPUが一つ一つの行列積を計算したり、HBMとTensor Coreの間に入ったりするわけではない。
#GPUは自分のHBM、SRAM、レジスタを使って計算し、CPUはその外側でシステムを制御する。
##
14.CPU側メモリーとGPU側メモリーは共有できるのか
#従来のCPUとGPUでは、CPU側DRAMからGPU側HBMへデータをコピーする必要があった。
#CPU側DDR
↓ PCIe転送
GPU側HBMGrace HopperやGrace Blackwellでは、NVLink-C2CによってCPUとGPUを密結合する。
#Grace Hopperの例では、Grace CPUのLPDDR5XとHopper GPUのHBM3がメモリーコヒーレントに接続され、CPUとGPUが互いのメモリーへアクセスできる。GPUはHBMに入りきらないデータを、CPU側LPDDRから直接参照できる。(NVIDIA Developer)
#NVIDIAが示したGrace Hopperの例では、
#- GPU側HBM:最大96GB、最大3TB/s
- CPU側LPDDR5X:最大512GB、最大546GB/s
- CPU–GPU間NVLink-C2C:最大900GB/s
という構造だった。(NVIDIA Developer)
#これは二つのメモリーが完全に同じ性能になったという意味ではない。
#高速・小容量
GPU HBM
↓
CPU側LPDDR
低速・大容量頻繁に使うデータはHBMへ置き、容量が大きいが使用頻度の低いデータをCPU側メモリーへ置く。
#つまりCPU側DRAMも、GPUから見れば一段下のメモリー階層として利用できる。
##
15.「メモリーコヒーレント」とは何か
#CPUとGPUが同じデータを見る場合、一方が書き換えた後も、もう一方が古い値を読み続けてはいけない。
#メモリーコヒーレントとは、CPUキャッシュ、GPUキャッシュ、CPU側DRAM、GPU側HBMの間で、データの整合性を保つ仕組みである。
#Grace HopperではNVLink-C2Cによって、CPUとGPUが互いのメモリーへアクセスし、ページ全体を毎回移動させず、必要なデータ単位で利用できる。(NVIDIA Developer)
#ただし、コヒーレントだからといって、CPU側LPDDRへのアクセスがGPU内SRAMやHBMと同じ速さになるわけではない。
#アクセス可能であることと、同じ性能であることは別である。
##
16.CPU・GPU・ASICを一つの図で整理する
#CPU
演算器
↓
レジスタ
↓
L1・L2・L3 SRAM
↓
DDR / LPDDR
↓
SSD
GPU
大量の並列演算器
↓
レジスタ
↓
共有メモリー・L1・L2 SRAM
↓
HBM / GDDR
↓
CPU側DRAM・SSD
AI ASIC
専用演算器
↓
レジスタ
↓
用途別に設計したSRAM
↓
必要に応じてHBM / DDR / LPDDR
↓
SSD3種類とも、基本的なメモリー階層は共通している。
#違うのは、
#- 演算器の種類
- 演算器の個数
- レジスタの量
- SRAMの容量
- 外部DRAMの種類
- データをどの階層で再利用するか
である。
##
まとめ
#レジスタはメモリーであり、演算器に最も近い最小・最速の記憶領域である。
#その外側にSRAM、その外側にHBMやDDRなどのDRAMがある。
#演算器
↓
レジスタ
↓
SRAM
↓
HBM・DDR・LPDDR
↓
NAND SSD
↓
HDD・磁気テープ「演算器とSRAMはCPU、HBMとDRAMはGPU」という分け方ではない。
#- CPUにも演算器、レジスタ、SRAM、DRAMがある
- GPUにも演算器、レジスタ、SRAM、DRAMがある
- ASICにも演算器、レジスタ、SRAMがあり、用途に応じてHBMやDDRを接続する
- HBMはGPU専用の別種メモリーではなく、高帯域化したDRAMである
- NVIDIAのCPUが2基のGPUに挟まれた配置は、高速接続のためのパッケージ構造である
- GPU同士の通信が毎回CPUを通るわけではない
- CPU側DRAMは、GPU側HBMより大容量な下位メモリー階層としても利用できる
最終的に重要なのは、CPUかGPUかではない。
#演算器が必要とするデータを、レジスタ、SRAM、HBM、DRAM、SSDのどこへ置き、どれだけ再利用できるか。#
AIチップの性能は、演算器の数だけでなく、このメモリー階層の設計によって決まる。
##
特定銘柄の推奨・勧誘・投資助言を目的とするものではありません。投資判断はご自身の責任でお願いいたします。
#サムネはPixAIsunflowerモデルとGPTImage2.0
#