Logic Foldingとは何か
この資料の日時
元資料の日付と、その本文が公に存在した確認日時は別の記録です。
本文に含まれる語句 DRAM SRAM 帯域・データ移動 先端パッケージング 電力・給電 歩留まり チップレット AIエージェント
出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.09.23.4
- 記事内容のSHA-256
b8b4ef960fdbce6ec8feab27d7ef65d67d5103c3ff71ae8e0f23c92aa17b9780- 保存版のSHA-256
39e0b387a3fd7d350289b95b1dbd93c93525dd097f89f3ac247ce64f2f392dfd
外部証明の最終検査結果は詳細を開くと表示します。
Logic Foldingとは何か
#ポスト・ムーア時代の半導体は「小さくする」から「近づける」へ向かう
#半導体産業は長いあいだ、トランジスタを小さくすることで性能を上げてきた。いわゆるムーアの法則である。トランジスタが小さくなれば、同じ面積により多くの回路を載せられ、スイッチング速度も上がり、消費電力も下がる。少なくとも過去数十年の大部分では、この単純で強力な法則が半導体の進歩を支えてきた。
#しかし現在、先端ロジックでは別の問題が前面に出ている。トランジスタはまだ微細化できても、配線が思うようにスケールしないのである。回路の中で信号が移動する距離、配線抵抗、配線容量、クロック分配、メモリアクセス、データ移動電力が、チップ性能を大きく制約し始めている。
#この状況で重要になるのが、Logic Foldingという考え方である。
#Logic Foldingを一言で言えば、ロジック回路を3D空間に折りたたみ、長い横方向配線を短い垂直接続に置き換える物理設計手法である。Huaweiは、Tau Scaling Lawという考え方の中で、従来のトランジスタ微細化だけではなく、信号・データ移動の時間を短縮する方向を強く打ち出している。Reutersは、HuaweiがLogicFoldingを用いた新しい設計原理を提示し、米国規制下で先端製造装置へのアクセスが制限される中、トランジスタ縮小以外の性能向上ルートを模索していると報じている。ただし、同時に独立した性能データはまだ限定的であり、主張は慎重に検証する必要がある。(Reuters)
##
\1. まず基本:なぜ「配線」が問題になるのか
#現代チップでは、計算そのものよりも、データをどこからどこへ動かすかが性能と電力を左右する。
#トランジスタが高速でも、演算器にデータが届かなければ処理は進まない。AIアクセラレータでも、GPUでも、DSPでも、演算器を大量に並べるだけでは足りない。SRAM、レジスタファイル、NoC、キャッシュ、メモリ階層を通じて、必要なデータを必要なタイミングで供給し続ける必要がある。
#配線が長くなると、抵抗と容量が増える。配線遅延は概念的には、
#配線遅延 ≒ 配線抵抗 R × 配線容量 Cで考えられる。
#さらに、CMOS回路の動的消費電力は概念的に、
#動的電力 ≒ スイッチング率 × 容量 × 電圧² × 周波数で決まる。つまり、配線容量が大きいほど、信号を1回切り替えるだけでも多くの電力を食う。高周波で大量に切り替わるクロックネットワークでは、この問題が特に深刻になる。
#このため、ポスト・ムーア時代の本質は、単に「トランジスタを小さくする」ことではなく、データと信号が移動する距離を短くすることになりつつある。
##
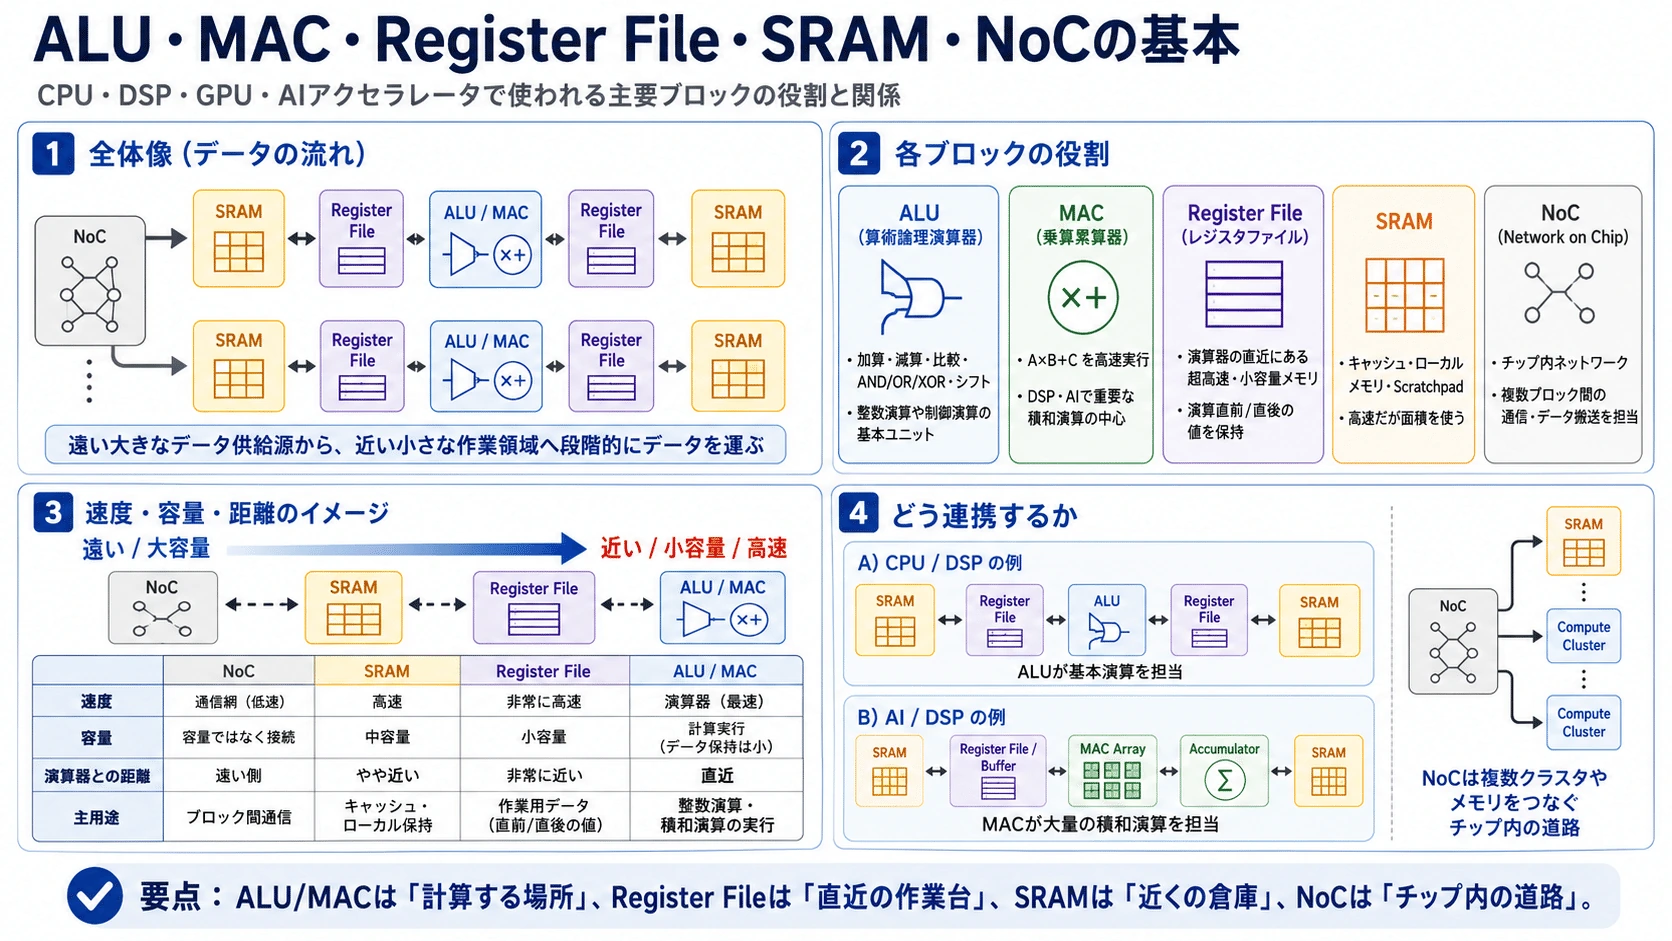
\2. ALU、MAC、Register File、SRAM、NoCの基本
#Logic Foldingを理解するには、まずチップ内部の主要ブロックを理解する必要がある。
#ALU:基本演算を行う場所
#ALUは Arithmetic Logic Unit、日本語では算術論理演算器である。足し算、引き算、比較、AND、OR、XOR、シフトなど、基本的な整数演算や論理演算を担当する。
#CPUでは、ALUはプログラムの基本的な計算を担う。たとえば、a + b、x > 10、ビット演算、アドレス計算などで使われる。
#MAC:AIとDSPの中核になる積和演算器
#MACは Multiply-Accumulate、つまり乗算累算器である。
#A × B + Cを高速に実行する回路である。
#AI、DSP、画像処理、音声処理では、この積和演算が大量に出てくる。ニューラルネットワークの行列演算も、多くの場合は膨大なMACの集合である。
#出力 = 入力1×重み1 + 入力2×重み2 + 入力3×重み3 + ...AIアクセラレータやDSPでは、MACアレイをどれだけ効率よく動かせるかが性能を大きく左右する。
#Register File:演算器の直近にある作業台
#Register Fileは、演算器のすぐ近くにある超高速・小容量の記憶領域である。
#ALUやMACは、毎回遠くのメモリからデータを取るのではなく、まずレジスタファイルから値を読み、演算し、結果をまたレジスタへ戻す。
#イメージとしては、
#SRAM / Cache → Register File → ALU / MAC → Register Fileである。
#Register Fileは容量こそ小さいが、演算器に最も近い「作業台」であり、距離と遅延が非常に重要になる。
#SRAM:チップ内の高速な倉庫
#SRAMは、チップ内で使われる高速メモリである。CPUではL1/L2/L3キャッシュ、AIアクセラレータではローカルバッファやScratchpad Memoryとして使われる。
#SRAMはDRAMより速いが、面積を大きく使う。そのため、どこに置くか、どの演算器に近づけるかが極めて重要になる。
#NoC:チップ内の道路網
#NoCは Network on Chip、つまりチップ内ネットワークである。CPUコア、GPU、DSP、AIアクセラレータ、SRAM、メモリコントローラ、I/Oなどをつなぐ内部通信網である。
#チップが大きくなるほど、すべてのブロックを直接配線でつなぐことは難しくなる。そこでNoCが、チップ内部の道路や物流網として機能する。
#まとめると、
#ALU / MAC = 計算する場所
Register File = 直近の作業台
SRAM = 近くの倉庫
NoC = チップ内の道路である。
#Logic Foldingは、この「計算する場所」「作業台」「倉庫」「道路」の距離関係を、3D空間で再設計する技術だと言える。
#
#
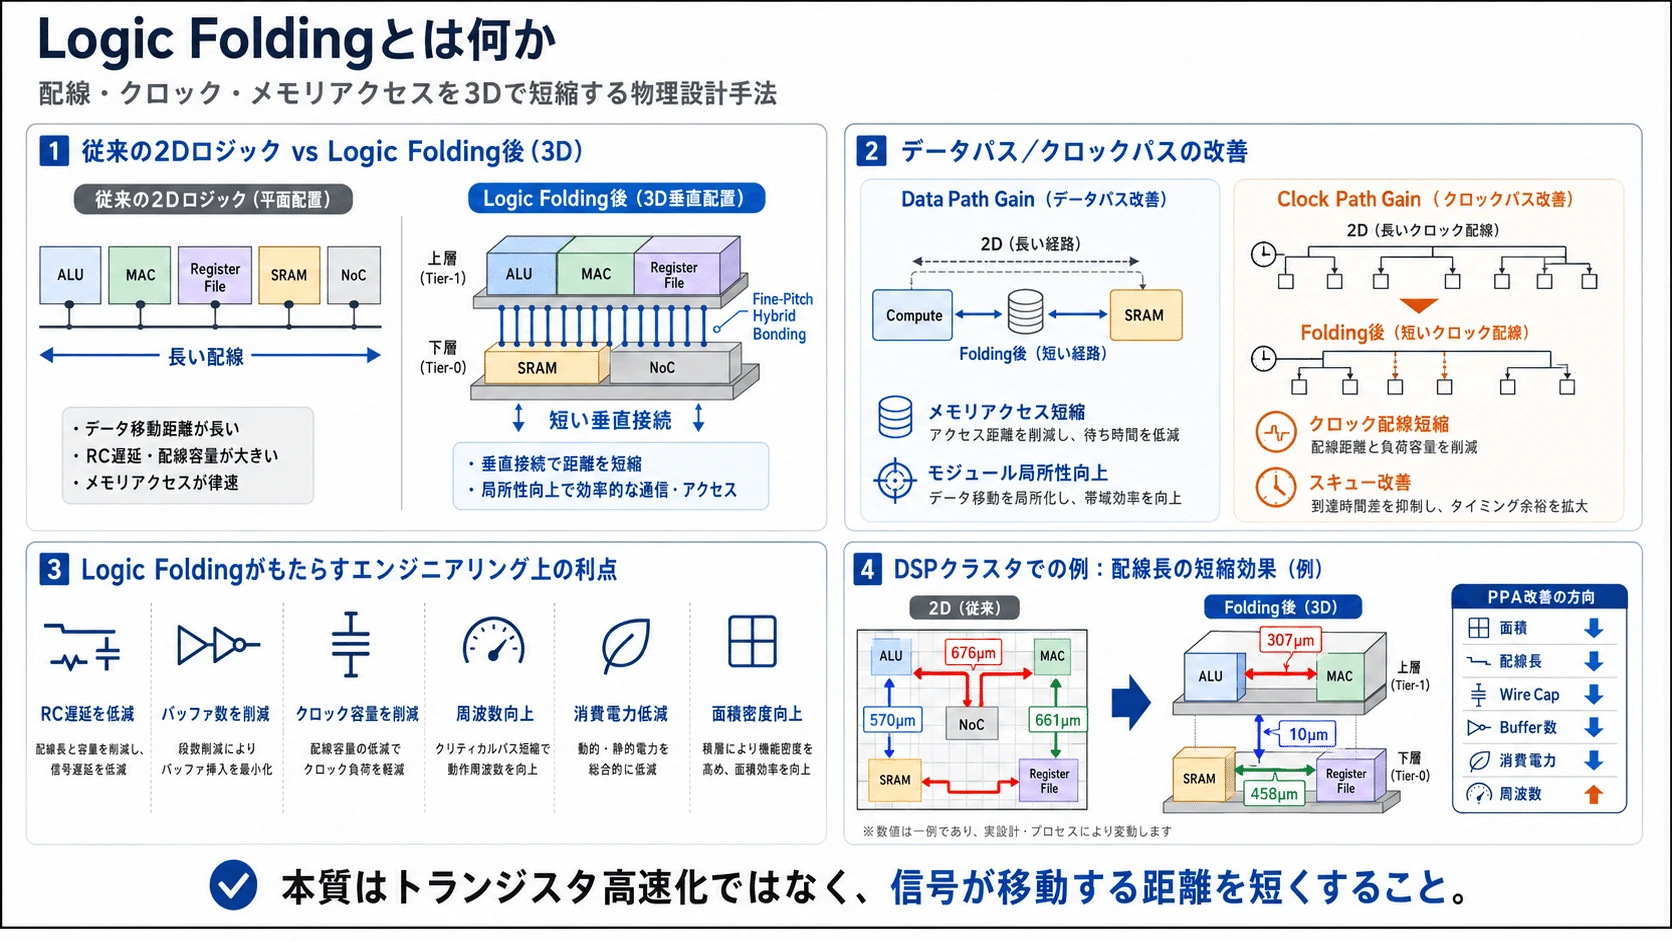
\3. Logic Foldingの基本原理
#従来のロジック設計では、ALU、MAC、Register File、SRAM、NoCなどのブロックは、基本的に1枚の平面上に配置される。
#従来の2D配置
[ALU] ─── [MAC] ─── [Register File] ─── [SRAM] ─── [NoC]この場合、よく通信するブロック同士が遠くなると、長い配線が必要になる。長い配線は、RC遅延、バッファ挿入、クロック分配負荷、消費電力増加を引き起こす。
#Logic Foldingでは、よく通信するブロック同士を上下方向に配置する。
#Logic Folding
上層: [SRAM] [NoC] [一部ロジック]
│ │
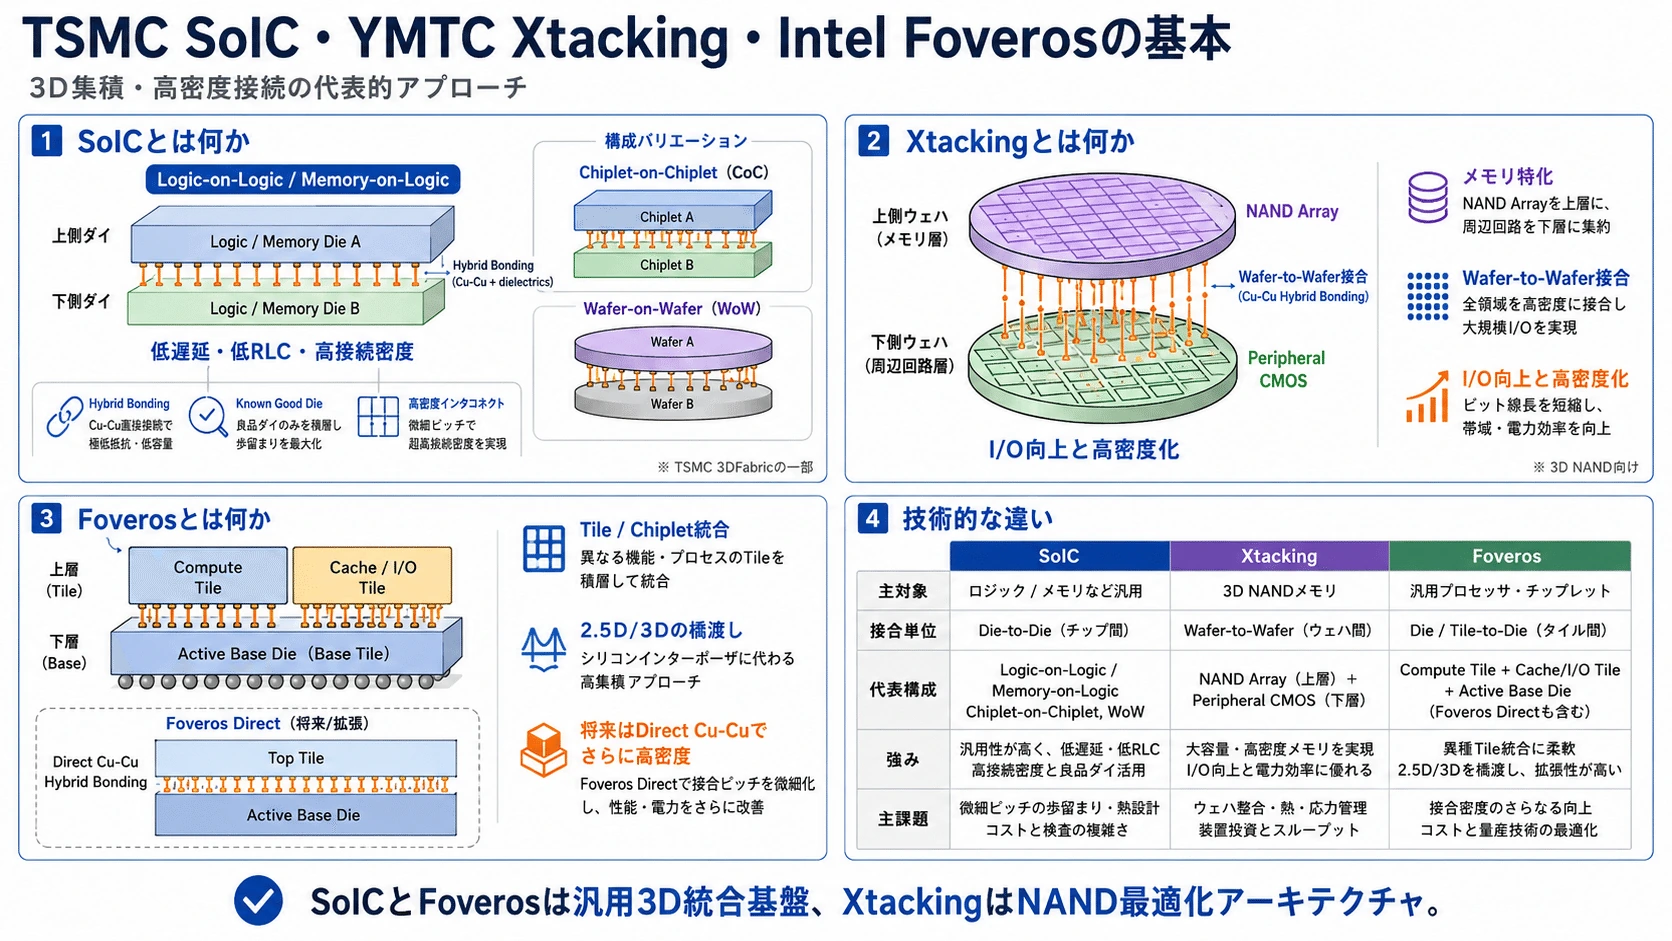
下層: [ALU] [MAC] [Register File]このとき重要なのが、Fine-Pitch Hybrid Bondingである。ハイブリッドボンディングは、銅パッド同士と絶縁膜同士を直接接合する技術であり、従来のマイクロバンプよりも細かいピッチで高密度接続できる。TSMCはSoICを3DFabricの一部として位置づけ、SoIC-Xのchip-on-waferやwafer-on-waferなどを通じて、低RLC・低遅延・高接続密度の3D統合を提供している。(3DFabric)
#Logic Foldingの本質は、単なる「チップを積むこと」ではない。ハイブリッドボンディングによる垂直接続を、パッケージ接続ではなく、ロジック内部の配線資源に近いものとして扱う点にある。
#つまり、長い横配線を短い縦配線に変換する。
#2D:
A ───────────── B
3D:
B
│
Aこの変換によって、
#- データパスが短くなる
- メモリアクセスが短くなる
- クロックツリーが小さくなる
- バッファ数が減る
- 配線容量が減る
- クリティカルパスが短くなる
- 周波数を上げやすくなる
- 消費電力を下げやすくなる
という効果が期待される。
##
\4. なぜクロックネットワークにも効くのか
#クロックネットワークは、チップ全体のフリップフロップやレジスタに「今、このタイミングで値を受け取れ」と伝える同期信号の配布網である。
#クロックは普通のデータ信号と違い、毎サイクル必ず切り替わる。しかも、チップ全体に配る必要がある。そのため、配線容量もバッファ数も大きくなり、消費電力が大きくなりやすい。
#Logic Foldingでフットプリントが縮み、ブロック同士が近づくと、クロック配線も短くなる。クロックツリーの深さが浅くなり、スキューも減る可能性がある。
#スキューとは、クロックが各レジスタに届くタイミングのズレである。スキューが大きいと、設計者は安全のためにクロック周期を長く取る必要がある。つまり、最大周波数を上げにくくなる。
#したがって、Logic Foldingは単にデータパスを短くするだけではない。クロック分配の電力とタイミング余裕にも効く。ここが非常に重要である。
#
#
\5. AMD 3D V-Cacheとの違い
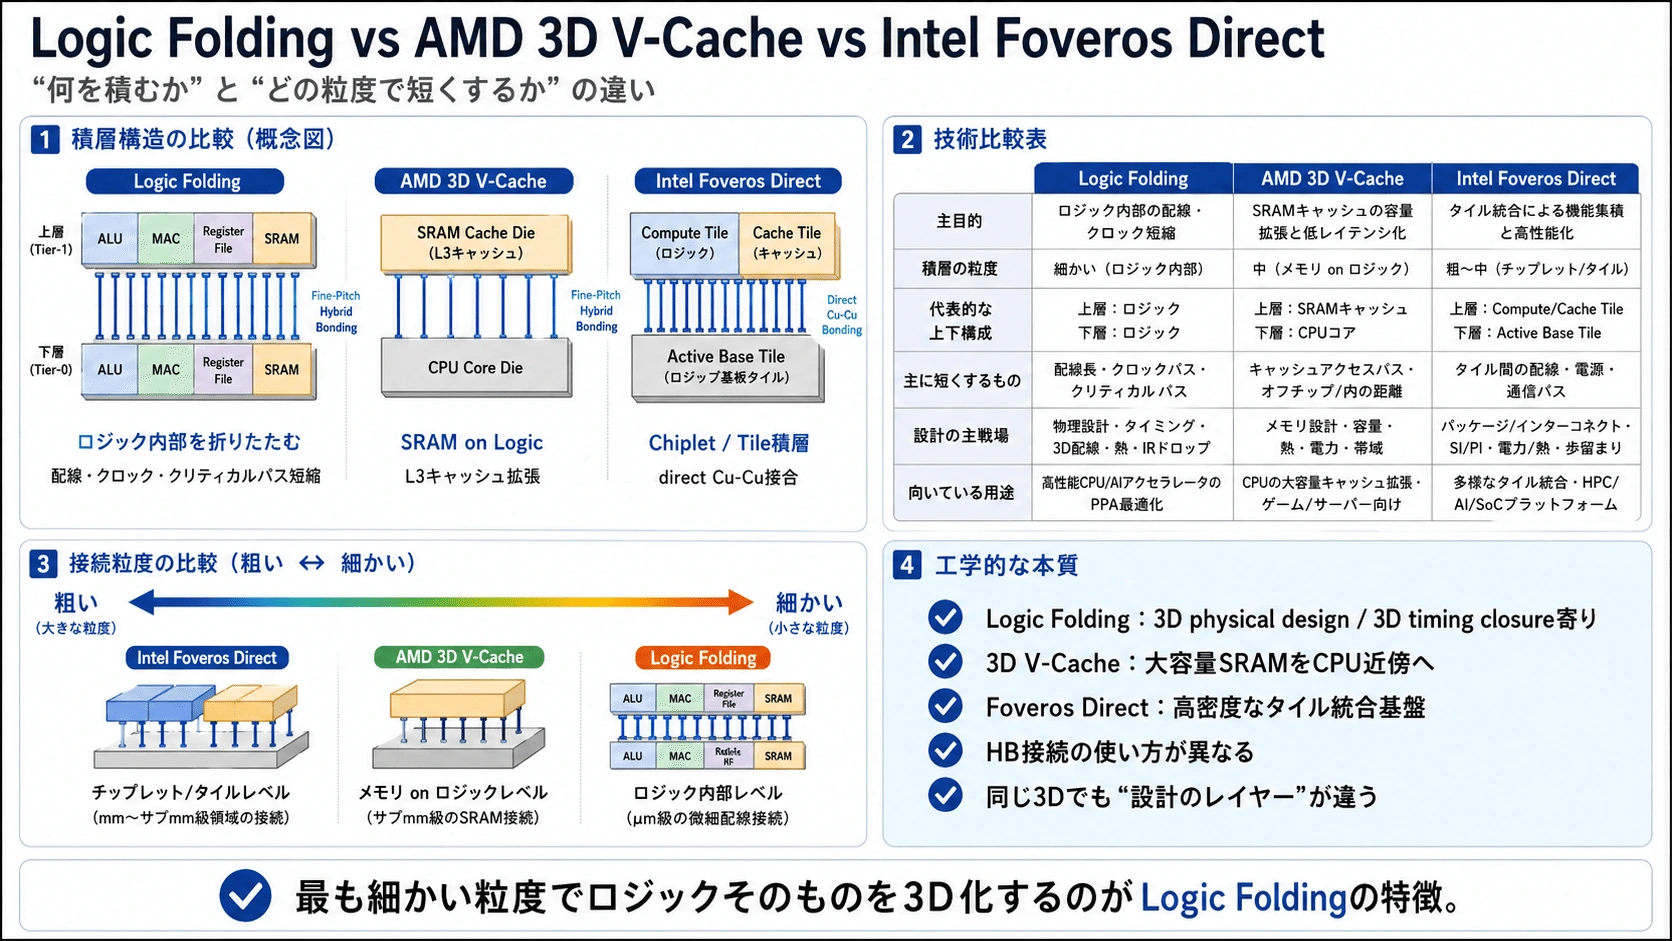
#AMD 3D V-Cacheは、CPUコアダイの上にSRAMキャッシュを積む技術である。AMDは3D V-Cacheを、RyzenやEPYCで使われる3Dスタッキング技術として説明しており、同社ページではオンパッケージ2Dチップレットと比べて200倍超の相互接続密度を示している。(AMD)
#構造としては、かなり単純化するとこうなる。
#AMD 3D V-Cache
上層: SRAM Cache Die
│
下層: CPU Core Die3D V-Cacheの狙いは、CPUコアに大容量L3キャッシュを近づけることである。これにより、メモリアクセスのレイテンシや帯域効率が改善され、特にゲームや一部のサーバーワークロードで性能向上が得られる。
#DARPA関連資料でも、AMDの3D V-CacheはTSMC SoIC-XのCu-to-Cu Hybrid Bondingを使ってSRAMをCPUコアダイ上に積む量産例として紹介されている。(darpa.mil)
#ただし、AMD 3D V-Cacheは、基本的には SRAM on Logic である。 一方、Logic Foldingは Logic on Logic、さらに細かく言えば、ロジック内部のクリティカルパスやデータパスを3D化する発想である。
#比較すると、
#AMD 3D V-Cache
= キャッシュをCPUに近づける
Logic Folding
= ロジック内部の配線・クロック・クリティカルパスを折りたたむという違いがある。
##
\6. TSMC SoICとは何か
#TSMC SoICは、TSMCの3D集積技術である。SoICは System on Integrated Chips の略であり、TSMC 3DFabricの中核的な3D統合技術の一つである。TSMCはSoIC-Xとしてchip-on-waferやwafer-on-waferの構成を示しており、異なるダイやウェハを高密度に接合する技術として位置づけている。(3DFabric)
#SoICの基本は、
#上側ダイ: Logic / Memory Die
│
下側ダイ: Logic / Memory Dieである。
#特徴は、
#- Hybrid Bonding
- 低抵抗・低容量接続
- 高密度インターコネクト
- logic-on-logic
- memory-on-logic
- chiplet-on-chiplet
- wafer-on-wafer
などである。
#SoICは「3D積層を可能にする製造・接合基盤」であり、Logic Foldingは「そのような3D接続を使って、ロジック内部の配置・配線をどう再設計するか」という設計方法論である。
#関係としては、
#SoIC = 積むための製造基盤
Logic Folding = 積んだ空間でロジックをどう折りたたむかに近い。
##
\7. Intel Foveros / Foveros Directとは何か
#Intel Foverosは、Intelの3Dパッケージング技術であり、複数のタイルやチップレットを垂直方向に統合するための基盤である。
#従来のFoverosはマイクロバンプを使った3D積層技術として始まり、Foveros DirectではCu-to-Cu Hybrid Bondingによるより高密度な接続を狙う。IntelのFoveros Direct 3D資料では、直接銅—銅ハイブリッドボンディングによりsub-10µmピッチを実現し、従来のマイクロバンプと比べて接続密度を大きく高めると説明されている。(Intel)
#構造としては、
#上層: Compute Tile / Cache Tile / I/O Tile
│
下層: Active Base Tileというイメージである。
#Intel資料では、Foveros Direct 3Dはactive base tileに1つ以上のchipletを直接接合し、複雑なシステムモジュールを作る技術として説明されている。さらに、face-to-faceやface-to-back構成、異なるファウンドリ由来のチップやウェハの統合にも触れられている。(Intel)
#Foveros Directは、Logic Foldingと同じく3D接続を使うが、主眼はチップレットやタイル統合にある。Logic Foldingはより細かく、ロジック内部の物理設計に踏み込む。
#Foveros Direct
= タイル・チップレット統合基盤
Logic Folding
= ロジック内部の3D物理設計である。
##
\8. YMTC Xtackingとは何か
#YMTC Xtackingは、3D NAND向けのウェハ接合アーキテクチャである。TechInsightsは、Xtackingを、CMOSウェハとメモリセルウェハをウェハボンディングするYMTCの3D NANDアーキテクチャとして説明している。(TechInsights)
#構造は、
#上層ウェハ: NAND Memory Array
│
下層ウェハ: Peripheral CMOSである。
#3D NANDでは、メモリセルアレイと周辺回路をどう配置するかが重要になる。Xtackingでは、メモリアレイと周辺CMOSを別々に最適化し、最後にウェハ同士を接合する。
#メリットは、
#- NANDアレイと周辺CMOSを別プロセスで最適化できる
- I/O性能を高めやすい
- メモリ密度を上げやすい
- 周辺回路を効率よく配置できる
ことである。
#KnowMadeは、YMTCが2018〜2019年にXtackingとしてハイブリッドボンディングを3D NANDに適用し、その後関連特許ポートフォリオを拡大してきたと説明している。(KnowMade)
#ただし、Xtackingは基本的にメモリ専用のアーキテクチャである。Logic Foldingのように、CPUやDSPのロジック内部をクリティカルパス単位で折りたたむものではない。
##
\9. 4つの技術を比較する
#整理すると、以下のようになる。
#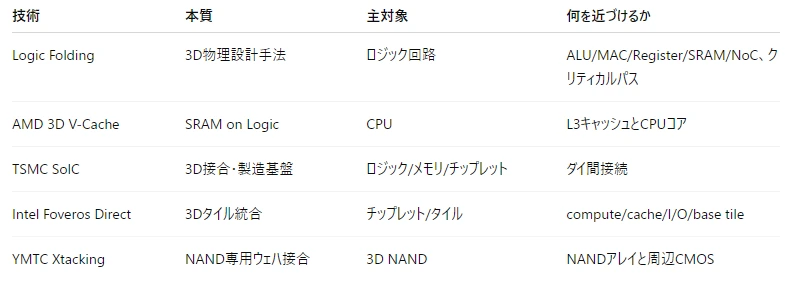
最も重要な違いは、接続の粒度である。
#粗い粒度
チップレット統合
タイル統合
メモリ on ロジック
ロジック on ロジック
ロジック内部のクリティカルパス folding
細かい粒度Logic Foldingは、この中でも特に細かい粒度で、ロジックそのものを3D空間に再配置しようとする。だから、単なるパッケージ技術ではなく、Physical Design Methodology、つまり物理設計方法論に近い。
#
#
\10. Logic Foldingが効きやすい回路
#Logic Foldingはすべての回路に同じように効くわけではない。特に効果が出やすいのは、データ再利用が多く、局所性が高く、クリティカルパスが明確な回路である。
#DSP
#DSPは、ALU、MAC、Register File、SRAMの間で大量のデータを繰り返しやり取りする。フィルタ処理、音声処理、通信処理などでは、同じデータや係数を何度も使う。したがって、SRAMとMAC、Register FileとALU/MACを近づける効果が大きい。
#AIアクセラレータ
#AIアクセラレータでは、MAC Array、SRAM、NoC、レジスタ/バッファの関係が重要になる。MACを大量に並べても、SRAMやNoCからデータが供給されなければ性能は出ない。Logic Foldingにより、重み・入力・部分和の移動距離を縮められれば、性能と電力の両面で効果が出る可能性がある。
#SRAM近傍演算
#SRAMと演算器を近づける設計は、ポスト・ムーア時代の重要テーマである。メモリから演算器へデータを動かすコストが大きいため、演算器をメモリに近づける、あるいはメモリの近くで簡単な処理を行う方向は自然である。
#高局所性クラスタ
#特定のブロック同士が頻繁に通信する場合、それらを1つの3Dクラスタとしてまとめると効果が出やすい。
#たとえば、
#上層: SRAM / Local Buffer / NoC Router
下層: MAC Array / Register File / Accumulatorのような構成である。
##
\11. 3D化で難しくなること
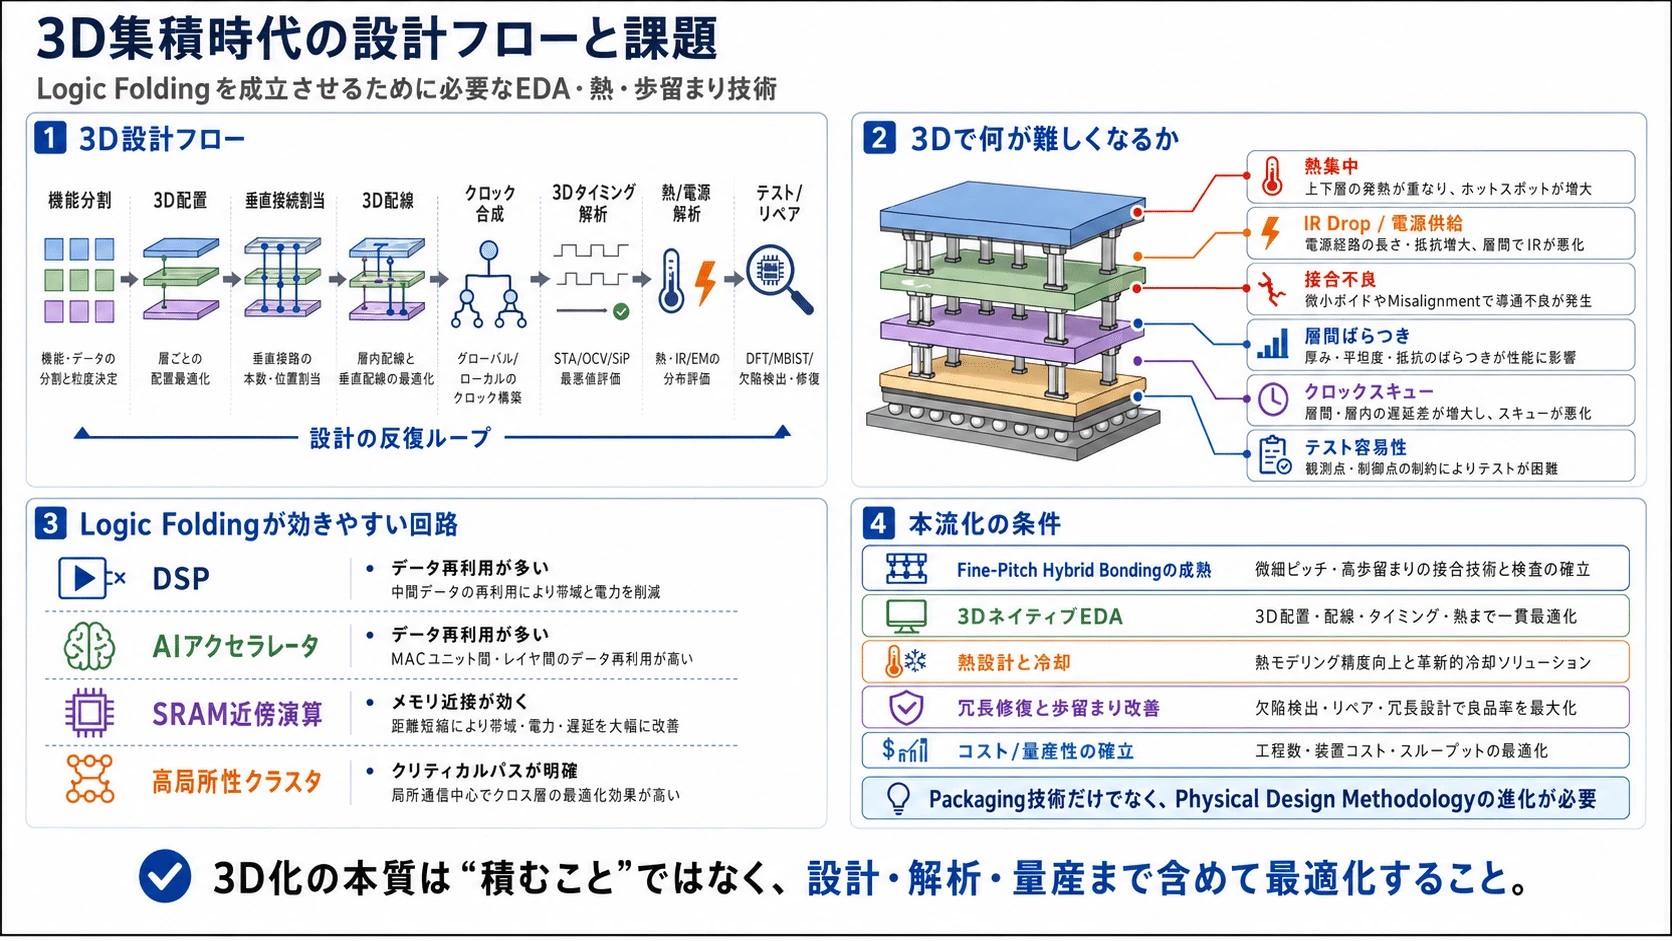
#3D化は万能ではない。むしろ、設計と製造の難易度は大きく上がる。
#熱
#3Dに積むと、発熱源が上下に重なる。下層の熱が上層に伝わり、ホットスポットが増える。ロジック on ロジックでは特に熱が厳しい。SRAMは比較的発熱が小さいが、演算ロジックを重ねると熱密度が問題になりやすい。
#電源供給とIR Drop
#3D構造では、電源を各層に安定して供給する必要がある。電源経路が長くなったり、層間接続が増えたりすると、IR Dropや電源ノイズが悪化する可能性がある。
#接合不良
#ハイブリッドボンディングでは、微小な接合不良、ボイド、ミスアライメント、表面平坦性の問題が歩留まりに影響する。
#テスト
#積んだ後に内部の欠陥をどう見つけるか、どう修復するかが難しい。3D構造では観測点・制御点が制限されるため、DFT、BIST、冗長修復が重要になる。
#EDA
#従来のEDAは2D前提で発展してきた。Logic Foldingでは、3D配置、3D配線、3Dタイミング、3D熱解析、3D電源解析、3Dクロックツリー合成が必要になる。
#
#
\12. 今後のEDAはどう変わるか
#Logic Foldingが本流化するなら、EDAは大きく変わる。
#従来の設計フローは、
#論理設計
↓
2D配置
↓
2D配線
↓
クロックツリー合成
↓
タイミング解析
↓
物理検証が中心だった。
#しかし3D設計では、
#機能分割
↓
層割り当て
↓
3D配置
↓
垂直接続割り当て
↓
3D配線
↓
3Dクロック合成
↓
3Dタイミング解析
↓
熱/電源/IR/EM解析
↓
テスト/リペア設計
↓
歩留まり最適化が必要になる。
#ここで重要になるのは、EDAが単なる自動配置配線ツールではなく、アーキテクチャ探索ツールになるという点である。
#どのブロックを上層に置くのか。 どの信号を垂直に逃がすのか。 どのSRAMをどのMACに近づけるのか。 クロックをどの階層で分配するのか。 熱源をどう分散するのか。 不良接続をどう迂回するのか。
#これらは、人間が手作業で最適化するにはあまりに複雑である。
##
\13. AIとEDAの相乗効果
#ここでAIが重要になる。
#現在のAIは、コード生成、回路設計支援、配置配線探索、検証、ログ解析、設計制約の調整などに応用され始めている。3D集積時代には、設計探索空間が爆発的に広がるため、AIとEDAの相乗効果はさらに大きくなる可能性がある。
#3D配置探索
#AIは、どのブロックをどの層に置くべきかを探索できる。たとえば、
#- 通信頻度
- 配線長
- 熱
- 電源
- タイミング
- 歩留まり
- 面積
- コスト
を同時に見ながら、候補配置を生成する。
#クリティカルパスの自動Folding
#AIは、タイミング解析結果からクリティカルパスを見つけ、そのパスを3Dで短縮する候補を提案できる。
#長い2Dクリティカルパス
↓
AIが候補を抽出
↓
上層/下層へ分割
↓
垂直接続を割り当て
↓
再タイミング解析というループである。
#熱と性能の同時最適化
#3D化では、単に距離を短くすればよいわけではない。近づけすぎると熱が集中する。AIは、性能・電力・熱・歩留まりのトレードオフを学習し、より良い構成を探索できる。
#自動リペア設計
#接合不良や局所欠陥に備えて、冗長接続や迂回ルートを設計する必要がある。AIは、故障パターンを予測し、最小限の冗長性で歩留まりを最大化する設計を提案できる可能性がある。
#EDAログと設計制約の自動調整
#現代のチップ設計では、配置配線、タイミングクロージャ、DRC/LVS、IR Drop、EM解析などで大量のログが出る。AIエージェントは、それらを読み、どの制約を調整すべきか、どのブロックが問題か、どの配線層が混雑しているかを分析できる。
#将来的には、EDAは以下のような方向に進む可能性がある。
#人間が設計方針を与える
↓
AIエージェントが複数の3D配置案を生成
↓
EDAがPPA/熱/歩留まりを評価
↓
AIが結果を読み、次の候補を提案
↓
人間が最終判断これは、従来のEDAが「設計者の手足」だった時代から、EDA+AIが「設計探索の共同研究者」になる変化である。
##
\14. 3D技術は今後どう発展するか
#今後の3D技術は、段階的に進むと考えられる。
#第1段階:メモリ on ロジック
#AMD 3D V-Cacheのように、SRAMをCPUに近づける技術はすでに実用化されている。これは3D化の中でも比較的分かりやすく、効果も明確である。
#第2段階:チップレット/タイル統合
#Intel FoverosやTSMC SoICのように、異なる機能・プロセスノードのダイを高密度に統合する方向が進む。CPU、GPU、I/O、キャッシュ、AIアクセラレータ、アナログ、RF、メモリを、用途ごとに組み合わせる。
#第3段階:ロジック on ロジック
#演算ロジック同士を積む段階である。ここでは熱とEDAの難易度が大きく上がるが、配線短縮効果は大きい。
#第4段階:Logic Folding / 3D Physical Design
#最も踏み込んだ段階が、ロジック内部のブロックやクリティカルパスを3Dで折りたたむ設計である。
#これは単なるパッケージングではなく、
#アーキテクチャ
物理設計
EDA
材料
接合
熱
電源
テスト
歩留まりの全体最適化になる。
##
\15. Huawei Logic Foldingの意味
#HuaweiのLogic Foldingが注目される理由は、単に新しい3D技術だからではない。
#重要なのは、Huaweiが先端EUVや最先端ノードへのアクセス制約を背景に、トランジスタ微細化以外の性能向上ルートを明示的に打ち出したことにある。Reutersは、Huaweiが2031年に1.4nm級のトランジスタ密度相当を目指す設計戦略を示した一方で、中国は依然として先端製造技術でギャップを抱えているとも報じている。(Reuters)
#つまり、Logic Foldingは制裁回避のための迂回路であると同時に、ポスト・ムーア時代に世界全体が向かう方向とも重なっている。
#ただし、Huaweiがこの領域を独占するという意味ではない。TSMC、Intel、AMD、Samsung、imec、各EDA企業、装置メーカー、OSAT、材料メーカーも同じ大きな潮流の中にいる。実際、TSMC SoIC、Intel Foveros Direct、AMD 3D V-Cacheはすでに3D統合の代表的な実用例であり、IntelもFoveros Directでsub-10µm級のCu-to-Cu Hybrid Bondingを前面に出している。(3DFabric)
#Huaweiの特徴は、これを「ロジック内部の物理設計方法論」として強く打ち出している点である。
##
\16. 結論:半導体は縮小と空間再構成の時代へ
#Logic Foldingの本質は、トランジスタを速くすることではない。 信号が移動する距離を短くすることである。
#ALU、MAC、Register File、SRAM、NoCのような基本ブロックは、単体で性能を決めるのではない。それらの間で、どれだけ短く、低電力に、低遅延でデータを動かせるかが重要になる。
#TSMC SoICは3D積層の製造基盤であり、Intel Foveros Directはタイル統合の高密度基盤であり、AMD 3D V-CacheはSRAMをCPUに近づける実用例であり、YMTC XtackingはNANDアレイと周辺CMOSを分離・接合するメモリ特化アーキテクチャである。
#その中でLogic Foldingは、さらに一歩踏み込み、ロジック回路そのものを3D空間に折りたたむという考え方である。
#今後の半導体進化は、単純な微細化だけでは説明できない。 重要になるのは、
#- 3D配置
- ハイブリッドボンディング
- メモリ近接
- クロック最適化
- NoC最適化
- 熱設計
- 電源供給
- 歩留まり修復
- 3D EDA
- AIによる設計探索
である。
#半導体は、もはや「どれだけ小さく作れるか」だけの競争ではない。 これからは、どれだけ小さく作り、どれだけ賢く積み、どれだけ近く置き、どれだけ短く動かし、どれだけAIとEDAで探索できるかの競争になるかも知れない。
##
追記:Hybrid Bondingとは何か
#3D半導体を成立させる縦方向の超微細配線
#Logic FoldingやTSMC SoIC、Intel Foveros Direct、AMD 3D V-Cacheを理解するうえで欠かせない基礎技術が、Hybrid Bondingである。
#Hybrid Bondingとは、複数のダイ、またはウェハ同士を、非常に高密度に直接接合する技術である。従来の3D積層では、マイクロバンプと呼ばれる小さなはんだ接続を使うことが多かった。しかしマイクロバンプはある程度の大きさが必要であり、接続ピッチを細かくするには限界がある。
#それに対してHybrid Bondingでは、銅パッド同士を直接接続し、同時に絶縁膜同士も接合する。つまり、電気的接続と機械的接合を同じ界面で実現する。
#従来のマイクロバンプ接続
上側ダイ
● ● ● ● ← はんだバンプ
下側ダイ
Hybrid Bonding
上側ダイ
Cu | 絶縁膜 | Cu | 絶縁膜
│ │
Cu | 絶縁膜 | Cu | 絶縁膜
下側ダイこの方式では、バンプを介さずに銅同士を直接つなぐため、接続部を薄くでき、抵抗・容量・インダクタンスといった寄生成分を小さくしやすい。その結果、ダイ間の通信をより短距離・低遅延・低消費電力にできる。
##
なぜHybrid Bondingが重要なのか
#現代の半導体では、トランジスタそのものよりも、データを移動させるコストが大きな問題になっている。演算器がいくら高速でも、SRAMやキャッシュ、レジスタ、NoCとの間でデータを運ぶ距離が長ければ、性能も電力効率も悪化する。
#Hybrid Bondingは、この問題に対して「横に長く配線する」のではなく、上下方向に短く接続するという解決策を与える。
#2D配置
[演算器] ───────────── [SRAM]
長い横配線
3D配置
上層: [SRAM]
│
下層: [演算器]
短い垂直接続この短い垂直接続によって、
#- 配線長を短縮できる
- 配線容量を下げられる
- RC遅延を減らせる
- データ移動電力を下げられる
- 帯域密度を上げられる
- チップのフットプリントを小さくできる
という利点が生まれる。
#特にAIチップやHPC向けプロセッサでは、膨大な演算器にデータを供給し続ける必要がある。そのため、1bitをどれだけ低エネルギーで動かせるかが非常に重要になる。Hybrid Bondingは、この「データ移動の電力」を下げるための中核技術になりつつある。
##
AMD 3D V-CacheとHybrid Bonding
#Hybrid Bondingの実用例として分かりやすいのが、AMDの3D V-Cacheである。
#3D V-Cacheでは、CPUコアダイの上にSRAMキャッシュダイを積む。
#上層: SRAM Cache Die
│ Hybrid Bonding
下層: CPU Core Dieこれにより、CPUコアの近くに大容量L3キャッシュを配置できる。 つまり、外部メモリや遠いキャッシュへアクセスする頻度を減らし、より近い場所でデータを保持できる。
#ここでのHybrid Bondingの役割は、SRAMをCPUに極めて近い距離で接続することである。これは「メモリをロジックに近づける」技術の代表例と言える。
##
TSMC SoIC、Intel Foveros Directとの関係
#TSMC SoICやIntel Foveros Directも、Hybrid Bondingを中核にした3D集積技術である。
#TSMC SoICは、ロジックとロジック、メモリとロジック、チップレット同士などを高密度に接合するための3D統合基盤である。AMD 3D V-Cacheのような構造も、このような3D接合技術の上に成立している。
#Intel Foveros Directも、従来のマイクロバンプではなく、より微細なCu-to-Cu接合によって、タイルやチップレットを高密度に積層する方向へ進んでいる。
#つまり、
#TSMC SoIC
= 3D集積を実現する製造・接合基盤
Intel Foveros Direct
= タイル/チップレットを高密度に積む接合基盤
AMD 3D V-Cache
= SRAMをCPUの上に積む実用例
Hybrid Bonding
= それらを支える超高密度接続技術#
Logic Foldingとの関係
#Hybrid Bondingは、あくまで「どう接続するか」という製造・接合技術である。 一方、Logic Foldingは「どのロジックを上下に分け、どの経路を短くするか」という物理設計手法であり、おそらくHybrid Bondingの延長であり、ロジックという粘度をHybrid Bonding的発想で再設計する思想である。
#Hybrid Bonding
= 縦方向に高密度でつなぐ技術
Logic Folding
= その縦方向接続を使って、
ロジック回路の配置・配線・クロック・タイミングを再設計する考え方Logic Foldingは、Hybrid Bondingを単なるダイ間接続ではなく、ロジック内部の3D配線資源として使う設計思想である。
##
Hybrid Bondingの難しさ
#Hybrid Bondingは非常に強力だが、簡単な技術ではない。
#接合面には、極めて高い平坦性と清浄度が求められる。微小な粒子、表面の凹凸、銅パッドの位置ズレ、酸化、ボイドなどがあると、接続不良や歩留まり低下につながる。
#また、接続密度が上がるほど、テストや修復も難しくなる。ロジック内部に近い粒度でHybrid Bondingを使う場合、接続不良をどう検出し、どう迂回するかが重要になる。
#さらに、ロジック同士を積むと熱問題も厳しくなる。SRAMを積む場合よりも、演算ロジックを重ねる方が発熱密度は高くなりやすい。そのため、Hybrid Bondingの発展には、熱設計、電源供給、EDA、歩留まり修復技術が不可欠である。
##
結論
#Hybrid Bondingは、3D半導体時代の基礎インフラである。 従来のマイクロバンプよりも高密度・低RLC・低遅延な接続を可能にし、メモリとロジック、ロジックとロジック、タイルとタイルをより近づける。
#AMD 3D V-Cache、TSMC SoIC、Intel Foveros Directは、その代表的な応用例である。 そしてLogic Foldingは、そのHybrid Bondingをさらに設計内部へ取り込み、長い横配線を短い縦接続へ変換しようとする発想である。
#つまり、今後の半導体進化では、
#Hybrid Bondingが“縦方向の道”を作り、Logic Foldingがその道を使った新しい都市設計を行う
#という関係になる。
#半導体は、単に微細化する事も重要である事に変わりはないが、積み、近づけ、短くつなぎ、3D空間そのものを設計する事も同様に重要である。
##
特定銘柄の推奨・勧誘・投資助言を目的とするものではありません。投資判断はご自身の責任でお願いいたします。
#サムネはPixAIsunflowerモデルとGPTImage2.0
#