GPU一強の次に来るもの──AIエージェント時代にCPU需要が高まる理由
出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.09.23.4
- 記事内容のSHA-256
5c2f24834a0e80b49bf0abba19beef4b2719c239cefe7d25523f0137ec500199- 保存版のSHA-256
91bf93ccc0138f0790735d60a37ad4985a56c4b46066cd3b527a67a70973f74e
外部証明の最終検査結果は詳細を開くと表示します。
GPU一強の次に来るもの──AIエージェント時代にCPU需要が高まる理由
#生成AIブームは、これまでGPUを中心に語られてきた。大規模言語モデルの学習、画像生成、推論処理の多くは巨大な行列演算であり、そこではNVIDIAを中心とするGPUが圧倒的な存在感を持ってきた。だが、AIの使われ方が「質問に答えるチャットボット」から「外部ツールを使って仕事を進めるAIエージェント」へ移り始めると、インフラの主役はGPUだけでは語れなくなる。
#これから重要になるのは、GPUでモデルを動かす力だけではない。AIが検索し、APIを呼び、データベースを照会し、Pythonを実行し、人間の承認を待ち、複数のサブタスクを管理するなら、その周辺には膨大なCPU処理が発生する。つまり、AIインフラは「GPUの計算工場」から、CPU・GPU・メモリ・ネットワーク・ストレージが協調する実行基盤へ変わりつつある。
#AIエージェントは、LLM単体ではない
#従来のLLM推論は、単純化すれば「入力を受け取り、モデルで計算し、出力を返す」処理だった。この場合、主な負荷はGPU上の行列演算に集中する。
#しかしAIエージェントは違う。AIエージェントは、ユーザーの依頼を分解し、必要に応じて検索し、外部ツールを呼び出し、コードを実行し、結果を評価し、さらに次の行動を決める。論文 “Towards Understanding, Analyzing, and Optimizing Agentic AI Execution: A CPU-Centric Perspective” は、Agentic AIでは外部ツールの多くがCPU上で動くか、CPUによってオーケストレーションされるため、CPU-GPU混在システムへの依存が高まると指摘している。さらに同論文は、CPU側の処理を意識した COMB と、CPU-heavy/GPU-heavyなリクエストを分けて扱う MAS を提案し、CPUとGPUの同時利用率を改善できることを示している。(arXiv)
#これは、AIインフラの見方を変える。 GPUは「思考のための巨大な計算エンジン」だが、CPUは「行動・道具・記憶・通信を管理する司令塔」になる。
#CPUはGPUの敵ではなく、GPUを遊ばせないための部品
#CPU需要が高まるという話は、「GPUが不要になる」という意味ではない。むしろ逆である。GPUが高価で重要だからこそ、GPUを待たせないためにCPUが重要になる。
#LLM推論には、大きく分けて prefill と decode がある。prefillは入力全体を処理して最初のトークンを出す段階で、GPUを高効率に使いやすい。一方、decodeは1トークンずつ続きを生成する段階で、逐次性が強く、GPU利用率が下がりやすい。Sarathi-Serveの研究は、このprefillとdecodeの性質の違いがスループットとレイテンシの両立を難しくしていると整理し、chunked-prefillとstall-free schedulingによって推論効率を改善している。(arXiv)
#DistServeも同じ問題意識を持つ。既存のLLMサービングではprefillとdecodeを同じGPU群で混在処理するため干渉が起きる。DistServeはprefillとdecodeを分離し、それぞれに合った資源配分を行うことで、TTFT、つまり最初のトークンまでの時間と、TPOT、つまり1トークンあたりの生成時間を最適化する。(arXiv)
#ここで重要なのは、AI推論の性能は単純なFLOPSだけでは決まらないということだ。 リクエストをどう並べるか。 どのタイミングでGPUに流すか。 KV cacheをどう管理するか。 CPUで動くツール処理をどこまで重ねられるか。
#この「交通整理」こそが、AI推論基盤の新しい競争軸になる。
#CPU-GPU結合システムでもCPUはボトルネックになる
#NVIDIA GH200のように、CPUとGPUを密に結合したシステムでも、CPUの重要性は消えない。むしろ、GPUが高速になるほど、CPU側のスケジューリングやカーネル起動、キュー管理の遅延が目立ちやすくなる。
#2025年の論文 “Characterizing and Optimizing LLM Inference Workloads on CPU-GPU Coupled Architectures” は、PCIe接続のA100/H100と、密結合型のGH200を比較し、GH200は大きなバッチでは高速だが、低〜中バッチではCPU-bound領域が広がると分析している。特にGH200では、ルーズ結合システムより最大4倍大きなバッチサイズまでCPU-bound領域が続くと報告されている。(arXiv)
#これは象徴的だ。 GPUを強くするだけでは十分ではない。GPUに仕事を渡すCPU側、カーネル起動、キューイング、メモリ転送、スケジューリングも同時に強くしなければ、巨大なGPU投資の効率は落ちる。
#KV cacheとメモリ管理が、CPU需要を押し上げる
#LLM推論では、生成中の各リクエストが KV cache を持つ。これはモデルが過去の文脈を参照しながら次のトークンを生成するための記憶領域であり、長文・多ユーザー・複数候補生成では非常に大きくなる。
#vLLMの PagedAttention 論文は、KV cacheが巨大かつ動的に増減するため、非効率な管理ではメモリ断片化や重複が起き、バッチサイズを制限してしまうと指摘している。PagedAttentionはOSの仮想メモリやページングに着想を得てKV cacheを管理し、vLLMは同等レイテンシで従来システム比2〜4倍のスループット改善を示した。(arXiv)
#ここにもCPU的な世界がある。 AI推論は、単なる行列計算ではなく、巨大なメモリ管理システムになっている。KV cacheをどこに置くか、どのリクエストに割り当てるか、いつ解放するか、どこまで共有するか。これはOS、メモリ管理、スケジューリングに近い問題であり、CPU・DRAM・CXL・SSD・ネットワークの重要性を高める。
#FlexGenのような研究も、GPUメモリだけでは足りない状況で、GPU・CPU・ディスクを組み合わせてLLM推論を実行する方向性を示している。これは、GPU HBMだけで全てを抱える時代から、CPU DRAMやストレージも含めた階層型メモリの時代へ進むことを意味する。(arXiv)
#産業界もCPU需要の再評価に向かっている
#この変化は論文上の話にとどまらない。Morgan Stanleyは、AIが生成から自律的な行動へ進むことで、GPUだけでなくCPUとメモリへの支出が拡大すると見ている。Reutersは、agentic AIの普及がデータセンターCPU市場に追加需要をもたらす可能性があるという分析を報じている。(Reuters)
#AMDもこの流れを強く意識している。報道によれば、AMDはagentic AIによる需要を背景に、2030年のサーバーCPU市場見通しを年率35%以上、1200億ドル超へ引き上げたとされる。これは、AIインフラ投資がGPUからCPUへ「移る」というより、GPU中心だった投資テーマがCPU・メモリ・接続・ストレージへ広がることを示している。(The Wall Street Journal)
#Armもまた、AIデータセンター向けCPUの需要を強く打ち出している。2026年には、agentic AI向けのAGI CPUに対する需要や供給制約が報じられており、CPUアーキテクチャそのものがAI時代のデータセンターに合わせて再評価され始めている。(Reuters)
#CPU需要増の本質は「AIが実行システムになる」こと
#CPU需要増の本質は、単に「CPUでLLMを動かすから」ではない。もちろん、小型LLMやエッジAI、企業内の軽量推論ではCPUだけでAIを動かす場面も増えるだろう。しかし、より大きな構造変化は別にある。
#AIがチャットからエージェントへ進むと、AIは単なる文章生成器ではなくなる。 AIは、業務システムを操作する。 検索する。 コードを実行する。 データベースに問い合わせる。 ファイルを読む。 APIを呼ぶ。 複数のサブタスクを同時に進める。 失敗すれば再試行する。 ログを残し、権限を確認し、課金され、監査される。
#この世界では、GPUは「知能の計算エンジン」であり続ける。 だがCPUは、「その知能を現実の業務に接続する実行基盤」になる。
#投資テーマとしての広がり
#この視点で見ると、恩恵を受けるのはCPUメーカーだけではない。
#第一に、AMD EPYC、Intel Xeon、Arm系サーバーCPUのようなCPU本体。 第二に、DDR5、MRDIMM、CXL、メモリインターフェース、RambusのようなCPUメモリ帯域関連。 第三に、PCIe、CXL、NIC、DPU/IPU、SmartNIC、MarvellやAstera Labsのような接続レイヤー。 第四に、SSD、分散KV cache、RAG基盤、データベース、オブジェクトストレージ。 第五に、Cloudflareのような通信・認証・防衛・課金レイヤー。
#つまり、AIインフラの投資テーマは、 GPU/HBMだけの物語 から、 GPUを遊ばせないためのCPU・メモリ・I/O・ネットワークの物語 へ広がっている。
#まとめ:AI時代のCPUは、地味な補助役ではなくなる
#AIブーム初期の主役はGPUだった。これは今後も大きく変わらない。大規模学習、大規模推論、画像生成、音声生成、科学技術計算ではGPUやTPUが中心であり続ける。
#しかし、AIがエージェント化し、実際の業務やアプリケーションの中で動き始めると、必要になるのは「モデルを計算する力」だけではない。必要なのは、AIを待たせず、GPUを遊ばせず、外部世界と安全に接続し、記憶を管理し、ツールを実行し、複数の処理を同時に流すためのシステム全体である。
#その中心にあるのがCPUだ。
#これからのAIインフラは、GPU一強ではなく、 CPU + GPU + HBM + DRAM + CXL + NIC + SSD + スケジューラ の複合体として進化していく。
#CPU需要の高まりとは、単なる半導体サイクルの一部ではない。 それは、AIが「答える機械」から「行動する機械」へ変わることで起きる、データセンター構造そのものの変化である。
##
ここから先は長くなるので気になる部分だけ読めばよいです
#CPUの需要増や必要性、AI推論におけるCPUの重要性についての論文や分析紹介
#\1. 一番直接的な論文:Agentic AIはCPU依存が大きい
#かなり重要なのが、2025年11月投稿、2026年4月改訂の “Towards Understanding, Analyzing, and Optimizing Agentic AI Execution: A CPU-Centric Perspective” です。
#この論文は、AIエージェントの実行を CPU中心 に分析しています。要旨では、Agentic AIは従来の単発LLM推論と違い、計画、ツール呼び出し、推論、適応を行う自律的な問題解決システムであり、その外部ツールの多くはCPU上で動く、またはCPUによりオーケストレーションされると説明しています。さらに、CPU/GPU同時利用を改善するスケジューリング手法として COMB と MAS を提案し、P50レイテンシを最大1.7倍、サービス/総レイテンシを最大3.9倍/1.8倍改善したと報告しています。(arXiv)
#これは「AIエージェント時代のCPU需要」の理論的な中核です。 従来のLLM推論ではGPUが主役ですが、AIエージェントでは以下が増えます。
#- Python実行
- Web検索・クロール
- データベース検索
- RAGの前処理
- JSON/API処理
- サブエージェントの管理
- ツール呼び出しの待機・再試行
- ポリシーチェック
- ログ・メモリ更新
つまり、モデル本体はGPU、エージェントの行動管理はCPU という分業になります。
#\2. CPU-GPU結合アーキテクチャでもCPUがボトルネックになる
#次に重要なのが、2025年の “Characterizing and Optimizing LLM Inference Workloads on CPU-GPU Coupled Architectures” です。
#この論文は、PCIe接続のA100/H100と、CPU-GPUが密結合されたGH200のようなシステムでLLM推論を分析しています。結果として、GH200のような密結合システムは大きなバッチサイズでは高速になる一方、低〜中バッチ領域ではCPU側の性能やカーネル起動・キューイング時間が推論レイテンシに影響すると示しています。特に、GH200はルーズ結合システムよりも最大4倍大きなバッチサイズまでCPU-bound領域が続くとされています。(arXiv)
#これが示すのは、かなり重要です。
#GPUが速くなるほど、GPUに仕事を渡すCPU側のスケジューリング、カーネル起動、キュー管理、メモリ転送が相対的に目立つということです。
#つまり、AI推論ではGPUだけを強くしても、CPU・ホスト側が遅いとGPUを十分に使い切れません。
#\3. LLM推論は「prefill」と「decode」で性質が違い、CPU的なスケジューリングが重要になる
#LLM推論には大きく2段階あります。
#prefill は、入力プロンプト全体を処理して最初のトークンを出す段階です。 これは並列性が高く、GPU計算を飽和させやすい。
#decode は、1トークンずつ続きを生成する段階です。 これは逐次性が強く、GPU利用率が低くなりやすい。
#この違いを扱う論文が Sarathi-Serve と DistServe です。Sarathi-Serveは、prefillは高レイテンシだがGPU計算を飽和させ、decodeは低レイテンシだが1トークンずつなのでGPU利用率が低いと整理し、chunked-prefillとstall-free schedulingでスループットとレイテンシの両立を狙います。Mistral-7BではvLLM比2.6倍、Yi-34Bでは最大3.7倍、Falcon-180Bでは最大5.6倍の serving capacity 改善を報告しています。(arXiv)
#DistServeはさらに、prefillとdecodeを別GPUに分けることで干渉を減らす方式です。論文では、既存方式はprefillとdecodeを同じ場所で混在させるため干渉が起きるとし、DistServeはTTFTとTPOTの要件に応じて資源配分を最適化し、同じSLO内で最大7.4倍多いリクエスト、または12.6倍厳しいSLOを処理できると報告しています。(arXiv)
#ここでのポイントは、AI推論の性能はGPU FLOPSだけではなく、リクエストをどう並べるか、どのタイミングでGPUに流すか、KV cacheをどう扱うかで大きく変わるということです。 この「並べる・切る・待たせない・詰める」仕事がCPU側の制御プレーンに近い領域です。
#\4. vLLM / PagedAttention:KV cache管理は推論の中心問題
#LLM推論では、生成中の各リクエストが KV cache を持ちます。これは長文・多数リクエスト・複数候補生成で巨大化します。
#vLLMの論文 “Efficient Memory Management for Large Language Model Serving with PagedAttention” は、KV cacheメモリがリクエストごとに大きく、動的に増減し、非効率に管理すると断片化や重複でバッチサイズが制限されると指摘しています。PagedAttentionはOSの仮想メモリ/ページングのようにKV cacheをブロック単位で管理し、vLLMは同等レイテンシで従来システム比2〜4倍のスループットを示しています。(arXiv)
#これはCPU需要に直接つながります。 なぜなら、KV cache管理は単純な行列計算ではなく、
#メモリ割り当て、ページング、スワップ、リクエストスケジューリング、共有、再利用
#というOS的な仕事だからです。
#つまり、AI推論は「GPUで行列演算するだけ」ではなく、巨大な動的メモリ管理システムになっています。
#\5. FlexGen / LMCache:CPUメモリ・DRAM・ストレージがGPU推論を支える
#FlexGen は、GPUメモリが限られている環境で、GPU・CPU・ディスクのメモリと計算資源を組み合わせてLLM推論を行う研究です。論文では、FlexGenはGPU、CPU、ディスクからメモリと計算を集約し、テンソルの保存・アクセスパターンを最適化することで、16GB GPU上でOPT-175Bの推論を可能にしたと説明されています。(arXiv)
#LMCache はさらに現代的です。2025年の論文で、vLLMやSGLangが生成したKV cacheをGPU外に抽出・保存し、エンジンやクエリ間で共有する仕組みです。cache offloading、prefix reuse、prefill-decode disaggregationに対応するとされています。(arXiv)
#この流れはかなり重要です。
#GPUメモリは高価で限られています。 そのため、AI推論が大規模化すると、
#GPU HBMだけで全部抱えるのではなく、CPU DRAM、CXLメモリ、SSD、分散KV cacheを使ってGPUを補助する
#方向に進みます。
#これはCPUそのものだけでなく、DDR5、MRDIMM、CXL、メモリコントローラ、NIC、SSD、ストレージ層の需要にも波及します。
#\6. 産業分析でもCPU需要増が指摘されている
#Reutersは2026年4月20日、Morgan Stanleyの分析として、AIが「生成」から「自律的な行動」へ移ると、ボトルネックがCPUとメモリ側へ移り、GPU中心だったAI投資がCPUやメモリへ広がると報じています。Morgan Stanleyは、Agentic AIが2030年までに既存の1000億ドル超のデータセンターCPU市場に、さらに325億〜600億ドルを追加する可能性があると見ています。(Reuters)
#TrendForce系の分析でも、従来のAIデータセンターはCPU:GPU比率がおおむね1:4〜1:8だったのに対し、Agentic AIではツール呼び出し、サブタスク管理、データ受け渡し、評価などのオーケストレーションがCPU負荷になるため、将来的に1:1〜1:2へ近づく可能性があると整理されています。(TrendForce)
#この数字は前提により大きく変わりますが、方向性としては、GPU偏重から、CPU・メモリ・ネットワークを含むバランス型AIインフラへ戻るという見方です。
#\7. 企業側もCPUをAIインフラの中心部品として打ち出し始めている
#Armは Arm AGI CPU を、Agentic AI向けの本番シリコンとして説明しています。最大136個のNeoverse V3コア、DDR5-8800、コアあたり6GB/sのメモリ帯域、300W TDPなどを掲げ、AIデータセンターで多数の並列タスクをオーケストレーションするCPUとして位置づけています。(Arm)
#IntelもGoogleとの2026年4月の提携発表で、AIはアクセラレータだけで動くのではなくシステムで動くものであり、CPUはオーケストレーション、データ処理、システムレベル性能で重要だと説明しています。Google CloudはXeonをAI、推論、汎用コンピューティングで使い続け、IPUも併用してネットワーク、ストレージ、セキュリティ処理をCPUから一部オフロードするとしています。(Intel Corporation)
#AMDもEPYCについて、CPU単体でのAI推論だけでなく、GPUホストCPUとしての役割を明確に打ち出しています。AMDは、CPUだけで小〜中規模AI推論を処理できる一方、モデルが大きくなったり応答時間が短くなるとGPUを加え、EPYCとInstinct GPUの組み合わせで約200億〜4500億パラメータ級モデルにも対応する、と説明しています。(AMD)
#私の整理:CPU需要増の本質は3つある
#\1. CPUで直接推論する需要
#小型LLM、埋め込み、古典的ML、画像/音声の前処理、企業内AIエージェントの軽い処理は、GPUなしでもCPUで回せます。 特にオンプレ、エッジ、企業内サーバーでは、GPUを載せないCPU推論も現実的です。
#\2. GPU推論を支えるホストCPU需要
#大規模LLM本体はGPUで動いても、CPUは以下を担当します。
#リクエスト受付、トークナイズ、バッチング、prefill/decodeの分配、KV cache管理、GPUワーカー制御、ネットワークI/O、ストレージI/O、セキュリティ、ログ、API処理。
#この層が弱いと、GPUが遊びます。
#\3. AIエージェントの外部世界処理
#AIエージェントはLLMだけではありません。 ブラウザ、DB、Python、API、検索、RAG、承認フロー、ファイル操作、サブエージェント管理が増えます。
#ここはGPUの行列演算ではなく、CPUの逐次処理・分岐処理・I/O処理・メモリ処理です。
#投資・銘柄目線での示唆
#この調査から見ると、CPU需要増は単に AMD / Intel / Arm だけの話ではありません。
#恩恵を受けやすいのは、かなり広いです。
#第1層:CPU本体 AMD EPYC、Intel Xeon、Arm AGI CPU、クラウド独自CPU。
#第2層:CPUメモリ帯域 DDR5、MRDIMM、CXL、メモリインターフェース、Rambus系。
#第3層:GPUを遊ばせない接続層 PCIe、CXL、NIC、DPU/IPU、SmartNIC、Marvell、Astera Labs、Broadcom系。
#第4層:KV cache / RAG / ストレージ層 SSD、分散キャッシュ、オブジェクトストレージ、高速ネットワーク、データベース。
#第5層:AIエージェント制御・セキュリティ層 Cloudflare、認証、APIゲートウェイ、ログ、課金、ポリシー制御。
#まとめ
#CPU需要増の根拠はかなりあります。
#ただし、正確には、
#**「LLMの行列演算をCPUがGPUから奪う」ではなく、 「AI推論がサービス化・エージェント化するほど、GPUの外側にあるCPU制御・メモリ管理・ツール実行・I/O処理が巨大化する」**
#ということです。
#今後のAIインフラは、
#GPU/HBMだけの時代 から、 GPU + CPU + DRAM + CXL + NIC + SSD + スケジューラ + セキュリティの時代
#に移っていく可能性が高いです。 この文脈では、AMDやIntelの上昇は単なる出遅れ物色ではなく、AI推論インフラの設計思想そのものが変わってきたことへの再評価と見てよいと思います。
##
COMB と MASについて解説
#COMB と MAS は、どちらも論文 “Towards Understanding, Analyzing, and Optimizing Agentic AI Execution: A CPU-Centric Perspective” で提案された、AIエージェント推論をCPU/GPU混在環境で効率よく動かすためのスケジューリング手法です。 目的は共通していて、CPU側のツール実行が詰まってGPUを遊ばせる問題を減らすことです。論文では、エージェント型AIでは外部ツールの多くがCPU上で動く、またはCPUにより制御されるため、従来のGPU中心最適化だけでは不十分だとしています。(arXiv)
#まず前提:なぜ必要なのか
#普通のLLM推論は、
#入力 → GPUで推論 → 出力
#に近いです。
#でもAIエージェントは、
#入力 → LLM推論 → ツール呼び出し → 検索 → Python実行 → DB照会 → またLLM推論 → 判断 → 次のツール
#のようになります。
#このとき、GPUだけではなくCPUがかなり働きます。論文では、RAGの検索、Web要約、Bash/Python実行、RDKitの分子構造生成などがCPU側で大きな遅延を作り、場合によってはCPU上のツール処理がE2Eレイテンシの大部分を占めると報告しています。さらに、高性能GPUを使うほどLLM推論が速くなるため、ボトルネックがCPU側へ移りやすいとも述べています。(arXiv)
#ここで問題になるのは、GPUは大量並列が得意だが、CPU側のツール処理は並列化しても早く飽和しやすいことです。論文では、CPU並列化はGPUに比べて効率が低く、過剰な並列実行でOSスケジューラ競合やコンテキストスイッチが増え、結果的にGPU利用率まで落とすと整理しています。(arXiv)
#この問題に対する答えが COMB と MAS です。
##
\1. COMBとは何か
#COMB = CPU-Aware Overlapped Micro-Batching 日本語にすると、 CPUを意識した、重ね合わせ型マイクロバッチ処理 です。
#これは主に、同じ種類のCPU-heavyなエージェント処理が大量に来る場合の最適化です。論文では、同種のエージェントワークロードを homogeneous workload と呼んでいます。(arXiv)
#COMBの考え方
#たとえば128件のリクエストが来たとします。
#普通に全部まとめて処理すると、
#**128件ぶんのCPUツール処理を一気に走らせる**
↓
CPUコアが詰まる
↓
CPU処理が遅くなる
↓
GPUに渡すまで時間がかかる
↓
高価なGPUが待たされるということが起きます。
#COMBではこれを、たとえば、
#128件を64件 + 64件に分ける ように、CPUが耐えられるサイズの小さいバッチに分割します。
#これが micro-batching です。
#さらにCOMBでは、単に小分けするだけではありません。
#**1つ目のマイクロバッチがCPU処理を終えたら、GPU推論へ流す。 その間に、2つ目のマイクロバッチはCPU処理を進める。**
#つまり、
#CPU処理とGPU処理を時間的に重ねる
#のがポイントです。論文では、COMBはCPU誘導型のマイクロバッチをエージェントパイプライン全体で調整し、CPUとGPUの時間的な不均衡を減らすものだと説明されています。(arXiv)
#イメージはこうです。
#従来方式:
CPU処理 CPU処理 CPU処理 CPU処理 → GPU処理 GPU処理 GPU処理
GPUは待ち時間が多い
COMB:
CPU処理 batch1 → GPU処理 batch1
CPU処理 batch2 → GPU処理 batch2
CPU処理 batch3 → GPU処理 batch3
CPUとGPUがなるべく同時に動くCOMBが解決する問題
#COMBが狙う問題は3つです。
#1つ目は、CPUの過剰並列化を避けることです。 CPUはGPUほど大量並列に強くありません。バッチサイズを大きくしすぎると、CPUのツール処理が詰まり、かえって遅くなります。COMBは大きなバッチをCPUに適した小さなマイクロバッチへ分けることで、CPUコアの過負荷を抑えます。(arXiv)
#2つ目は、GPUの待ち時間を減らすことです。 CPU処理が終わった分から順にGPUへ流し、次のCPU処理と重ねます。これにより、CPUだけが動く時間、GPUだけが動く時間を減らします。(arXiv)
#3つ目は、KV cacheやメモリ圧を下げることです。 大きなバッチを一気にGPUへ流すとKV cache需要が瞬間的に大きくなります。マイクロバッチ化すると、GPUメモリへの圧力も下がりやすいと論文は説明しています。(arXiv)
#COMBの効果
#論文の実験では、Web-Augmented AgentやSWE-AgentなどでCOMBを評価しています。スタンドアロンの128リクエスト処理では、Web-Augmented AgentでP50レイテンシが改善し、オープンループ負荷ではサービスレイテンシがP50/P90でそれぞれ最大2.9倍/3.9倍改善、総レイテンシもP50/P90で最大1.6倍/1.8倍改善したと報告されています。(arXiv)
#ただし、COMBは万能ではありません。 CPUコアが極端に少ない環境では、重ね合わせ処理そのものがCPU競合を増やす場合があります。論文の16コアCPUでの追加実験では、単純なマイクロバッチ化は効く一方、オーバーラップを入れるCOMBはCPU側競合で効果が弱まるケースが示されています。(arXiv)
#つまりCOMBは、
#CPUが完全に詰まらない範囲で、CPU処理とGPU処理をパイプライン化する技術
#です。
##
\2. MASとは何か
#MAS = Mixed Agentic Scheduling 日本語にすると、 混合エージェント・スケジューリング です。
#これは、CPU-heavyなリクエストとGPU-heavyなリクエストが混ざって来る場合の最適化です。論文ではこれを heterogeneous workload と呼んでいます。(arXiv)
#なぜMASが必要か
#現実のAIサービスでは、すべてのリクエストが同じではありません。
#たとえば、
#CPU-heavyリクエスト
#「Webで調べて、複数ページを要約して、表にして」これは検索、HTML取得、要約、RAG、DB照会などがあり、CPU/I/O負荷が大きい。
#GPU-heavyリクエスト
#「この文章を言い換えて」これはほぼLLM推論だけなので、GPU負荷が中心。
#この2種類を単一キューでFCFS、つまり先着順に処理すると、問題が起きます。
#たとえばCPU-heavyリクエストが大量に来ると、キューを埋め尽くし、GPU-heavyリクエストまで待たされます。 逆にGPU-heavyリクエストが大量に来ると、CPU-heavyリクエストが押し出されます。
#しかし本来、CPU-heavyとGPU-heavyは使う資源が違います。 だから同じキューで雑に並べるのは効率が悪い。
#この問題を解くのがMASです。
#MASの基本構造
#MASはリクエストをまず分類します。
#CPU-heavy request
GPU-heavy requestそして、それぞれに別々の実行キューを持たせます。
#CPU-heavy用キュー:上限 C_cpu
GPU-heavy用キュー:上限 C_gpu
共有リザーブキュー:あふれた分を一時的に受ける論文では、MASはCPU-heavyとGPU-heavyに別々の concurrency cap、つまり同時実行上限を設け、さらに共有リザーブキューを用意することで、片方のリクエスト種別が全体を独占しないようにすると説明されています。(arXiv)
#イメージはこうです。
#到着リクエスト
↓
CPU-heavyかGPU-heavyか分類
↓
CPU-heavy → CPU-heavy用キューへ
GPU-heavy → GPU-heavy用キューへ
↓
満杯なら共有リザーブキュー
↓
それも満杯なら種別ごとの待機キューさらに、待機キューから取り出すときはラウンドロビン的に扱い、片方がもう片方を塞がないようにします。MASのアルゴリズムは、CPU-heavy/GPU-heavyそれぞれの実行キュー、共有リザーブキュー、種別ごとのFCFS待機キューを持ち、完了時に待機キューから再入場を試みる構造です。(arXiv)
#MASが解決する問題
#MASが解くのは、混在負荷での不公平とヘッド・オブ・ライン・ブロッキングです。
#ヘッド・オブ・ライン・ブロッキングとは、先頭の重い処理が詰まるせいで、後ろにある軽い処理まで待たされる現象です。
#AIエージェントでは、
#CPU-heavyが前に詰まる
↓
本当ならGPUだけで速く終わるGPU-heavyまで待つということが起きます。
#MASはCPU-heavyとGPU-heavyを分離することで、
#CPUはCPU-heavyを処理
GPUはGPU-heavyを処理という並行性を維持しやすくします。
#論文では、MASはリクエスト種別ごとの入場制御により、CPU/GPU双方の利用率を保ちつつ、少数派のリクエスト種別を保護すると説明されています。(arXiv)
#MASの効果
#論文では、GPU-heavyリクエストの到着確率を変えながら、CPU-heavyとGPU-heavyが混ざるバースト的な負荷でMASを評価しています。結果として、MASは片方のリクエスト種別が多数派になったときでも、少数派リクエストのレイテンシを守り、全体のP50/P90レイテンシや公平性を改善したと報告されています。特に、少数派リクエストの総レイテンシをP50/P90で最大2.37倍/2.49倍改善したと要旨で述べています。(arXiv)
##
COMBとMASの違い
#項目COMBMAS対象同じ種類のCPU-heavy処理が多い場合CPU-heavyとGPU-heavyが混在する場合主な問題CPU過負荷でGPUが待つ片方のリクエスト種別がキューを独占する方法大きなバッチを小さく分け、CPU処理とGPU処理を重ねるCPU-heavy/GPU-heavyを分類し、別キュー・別同時実行枠で管理効果CPU-GPUのパイプライン化、P50/P90改善公平性向上、少数派リクエストの待ち時間削減たとえ工場の流れ作業を小ロット化する高速道路で大型車レーンと普通車レーンを分ける
##
かなり噛み砕いた例
#COMBの例
#ラーメン屋で考えると、100人分の注文を全部まとめて厨房に投げると、厨房が詰まります。
#COMBは、
#100人分を一気に作らない
20人ずつ作る
最初の20人分を盛り付けている間に、次の20人分を茹で始めるという方式です。
#つまり、CPU厨房とGPU盛り付け係を同時に働かせる発想です。
#MASの例
#一方MASは、客の種類を分けます。
#A: ラーメンだけの客
B: ラーメン + 餃子 + チャーハン + 持ち帰り注文の客この2種類を同じ列に並べると、Bの客が多いとAの客も待たされます。
#MASは、
#ラーメンだけ列
複雑注文列
あふれた時の共用列を分ける方式です。
#つまり、軽い推論リクエストと、重いエージェント処理リクエストを同じキューで潰し合わないようにする仕組みです。
##
AIインフラ投資の文脈での意味
#COMBとMASが示しているのは、非常に重要です。
#AI推論のボトルネックは、もはや単純な
#GPUのFLOPS不足
#だけではありません。
#これからは、
#CPUでのツール処理 CPU/GPU間のスケジューリング キュー制御 バッチング KV cache管理 I/O待ち DB・検索・Python実行 CPUとGPUの同時利用率
#が性能を決めます。
#つまり、AIエージェント時代のデータセンターでは、 GPUを買えば終わりではなく、GPUを遊ばせないCPU制御レイヤーが重要になる ということです。
#この意味でCOMBとMASは、単なる論文上のスケジューリング技術ではなく、AI推論インフラがGPU中心からCPU/GPU協調型へ移る兆候として読むべきだと思います。
##
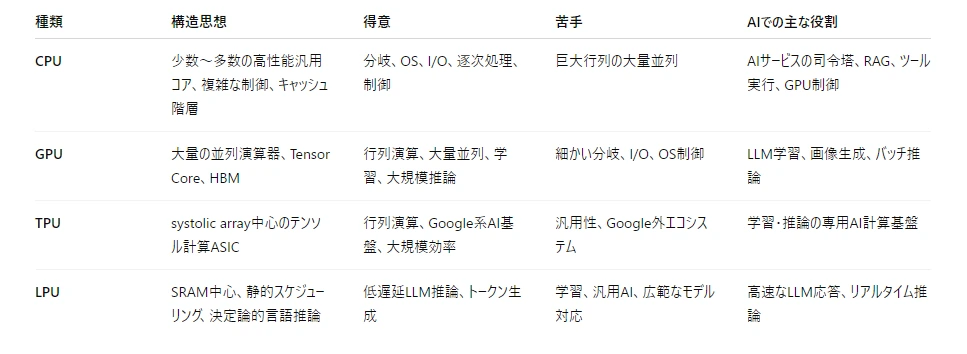
CPU、GPU、LPU、TPUの構造的な違いと、役割
#大きく言うと、違いはこうです。
#CPU = 司令塔 GPU = 大量の作業員 TPU = 行列計算専用工場 LPU = 言語推論専用の高速ベルトコンベア
#AIインフラでは、この4つは競合というより、役割分担です。
##
CPUがOSと密接に連携出来て、GPUが難しい理由
#\1. CPU:汎用処理と制御の中心
#CPUは Central Processing Unit、つまり中央処理装置です。
#構造的には、CPUは少数〜多数の高性能コアを持ち、それぞれが複雑な命令を柔軟に処理できます。OS、メモリ管理、割り込み、例外処理、仮想化、セキュリティ、I/O制御など、コンピュータ全体を動かすための仕組みを担当します。Intelの開発者向けマニュアルも、x86 CPUの命令セットだけでなく、メモリ管理、保護、タスク管理、割り込み、仮想化などを扱うものとして整理されています。(Intel)
#CPUの特徴は、分岐・判断・逐次処理・I/O・OS制御に強いことです。
#AI推論では、CPUは主に以下を担当します。
#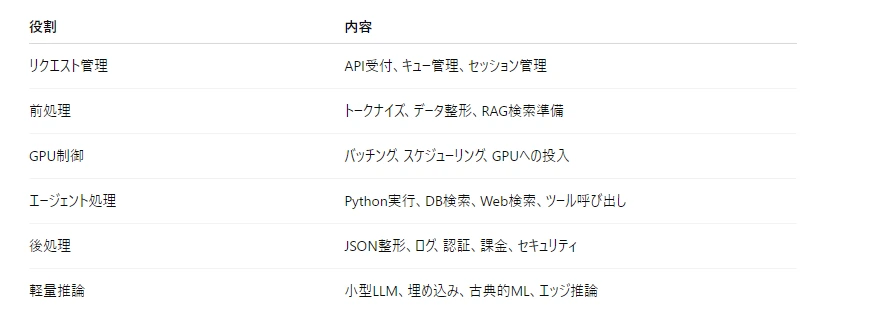
つまりCPUは、AIモデルそのものの行列計算よりも、AIサービス全体を動かす管制塔です。
##
\2. GPU:大量並列計算の主役
#GPUは Graphics Processing Unit ですが、現代ではAI計算の主力です。
#構造的には、GPUはCPUよりもはるかに多くの小さな演算器を持ち、同じような計算を大量に並列実行します。NVIDIA A100の例では、多数のSM、CUDAコア、Tensor Core、HBMメモリコントローラを備え、行列演算やテンソル演算を大量並列に処理する設計になっています。(NVIDIA Images)
#特にAIでは Tensor Core が重要です。NVIDIAはTensor Coreを、混合精度計算を可能にし、AIやHPCの幅広いワークロードを加速する技術として説明しています。(NVIDIA)
#GPUの特徴は、同じ形の計算を大量に並べると非常に速いことです。
#AIでは特に、
#巨大な行列 × 巨大な行列を何度も計算します。 LLMのTransformer、Attention、MLP、画像生成モデル、音声モデルの多くは、行列演算の塊です。
#そのためGPUは、
#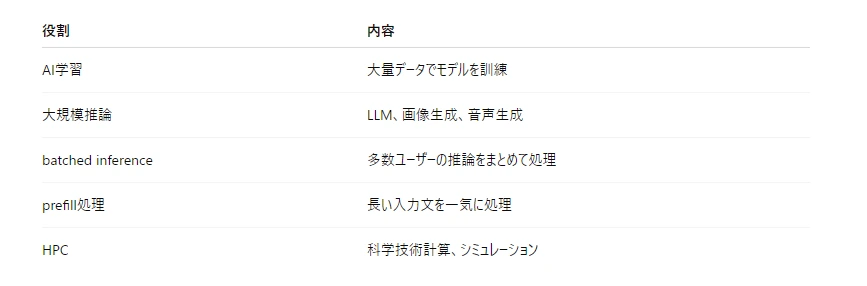
に強いです。
#ただしGPUは、CPUのような細かい分岐・OS処理・I/O制御は得意ではありません。 そのため、GPUはエンジン、CPUは運転手・交通整理という関係になります。
##
\3. TPU:Googleのテンソル計算専用ASIC
#TPUは Tensor Processing Unit です。GoogleがAI向けに作った専用アクセラレータです。
#GPUよりさらに特化していて、中心にあるのは systolic array、日本語でいうと「拍動配列」「行列演算用の物理的な計算格子」です。Google CloudのTPU資料では、TPUの主な仕事はmultiply-accumulate、つまり掛け算と足し算の組み合わせによる行列処理であり、Cloud TPU v3では1プロセッサ内に128×128 ALUのsystolic arrayを2つ含むと説明されています。(Google Cloud Documentation)
#ざっくり言うと、TPUはこういう設計です。
#CPU:何でもできる高性能な職人
GPU:大量の作業員
TPU:行列計算だけを超効率で流す専用工場TPUの強みは、
#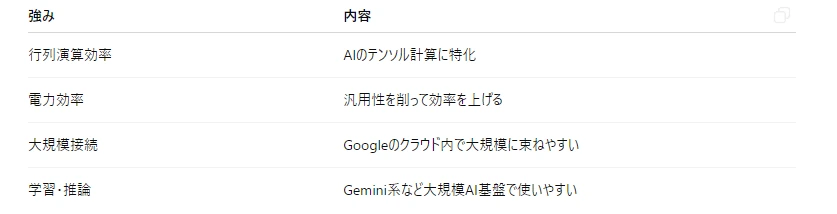
です。
#GPUとの違いは、GPUの方が汎用性が高く、TPUの方がGoogleのAI計算に特化していることです。
#GPUはCUDAエコシステムで広範なAI/HPC/グラフィックスに使えます。 TPUはGoogle CloudやGoogle内部のAI基盤で、テンソル計算を大規模・高効率に流すための専用機です。
##
\4. LPU:言語推論専用の低遅延アクセラレータ
#LPUは一般用語というより、主に GroqのLanguage Processing Unit を指すことが多いです。
#LPUの設計思想はGPUやTPUとかなり違います。 GroqはLPUについて、数百MB級のオンチップSRAMを「キャッシュ」ではなく主要な重み保存先として使い、低レイテンシで演算器にデータを供給すると説明しています。また、専用コンパイラによる静的スケジューリングと決定論的実行を重視しています。(Groq)
#Groq自身の説明では、LPUは実行ステップがクロックサイクル単位で予測可能な deterministic architecture であり、どこで何がいつ起きるかをソフトウェア制御ハードウェアが高精度に把握できる設計です。(Groq)
#つまりLPUは、
#GPU:大量の計算を動的にさばく
TPU:行列計算を専用配列で流す
LPU:言語モデル推論を決定論的なベルトコンベアで流すという違いがあります。
#LPUの強みは、
#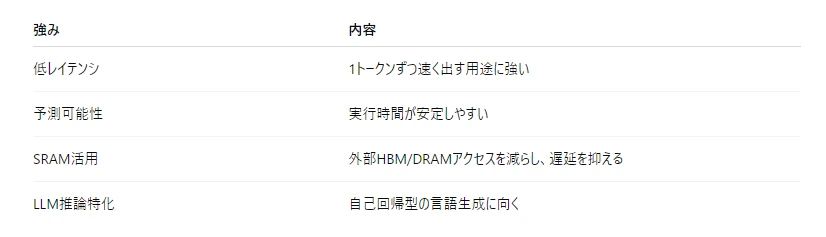
です。
#ただし、LPUはGPUの完全代替ではありません。 特に大規模学習、広範なAIモデル、画像生成、汎用HPCではGPUの方が柔軟です。LPUは LLM推論、特に低遅延・高速トークン生成 に寄せた専用機と見るのが自然です。
##
4つの構造比較
#
#
AI推論の流れで見ると分かりやすい
#たとえば、ユーザーがAIエージェントにこう頼むとします。
#「最近の半導体ニュースを調べて、表にして、投資観点で要約して」このとき内部では、だいたいこうなります。
#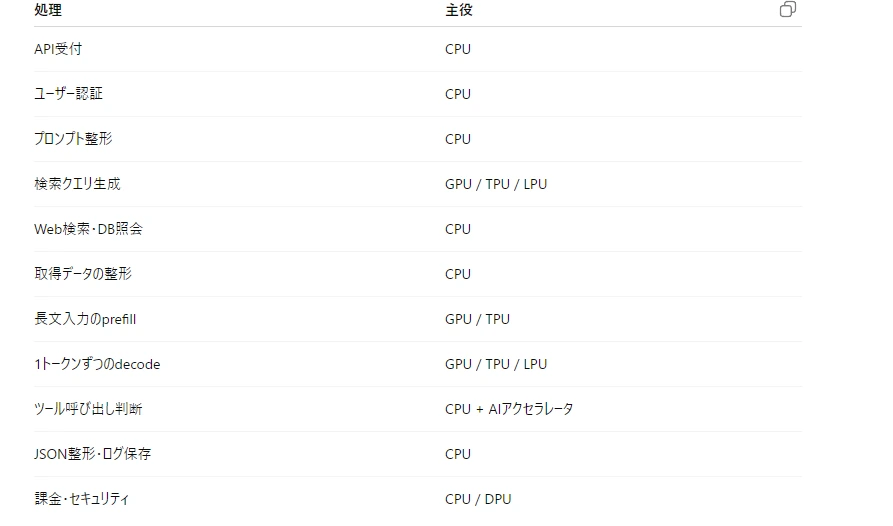
ここで分かる重要点は、AI推論はGPUだけでは完結しないということです。
#LLM本体の計算はGPU/TPU/LPUが速い。 でも、実サービスとして動かすにはCPUが必要です。
##
もう少し直感的なたとえ
#CPU:総料理長・店長
#注文を受ける。 誰に何を作らせるか決める。 材料を確認する。 客対応をする。 会計も見る。
#何でもできるが、1000人分の同じ作業を一気にやるのは苦手。
#GPU:大量の料理スタッフ
#同じ料理を大量に作るのが得意。 仕込み済みの材料を渡せば、爆速で作る。
#ただし、注文管理や会計や客対応は苦手。
#TPU:カレー専用巨大工場
#カレーを作るなら超効率。 でも寿司もケーキも何でも作る店ではない。
#AIの行列計算に特化した専用工場。
#LPU:ラーメン替え玉専用の高速ベルトコンベア
#1玉ずつ、一定リズムで超高速に出す。 低遅延で「次のトークン」を出すことに強い。
#ただし、メニュー全般を作る万能厨房ではない。
##
推論・学習・エージェントでの役割
#AI学習
#主役は基本的に GPU / TPU です。 大量のデータを使って、モデルの重みを更新する必要があるからです。
#CPUはデータ読み込み、前処理、分散学習の制御などを担当します。
#LPUは基本的に学習用というより、推論特化で見るべきです。
##
通常のLLM推論
#大規模モデルでは GPU / TPU が主役です。 低遅延の言語生成では LPU が強みを持ちます。
#CPUは、リクエスト受付、トークナイズ、バッチング、KV cache管理、ネットワーク制御などを担当します。
##
AIエージェント推論
#ここではCPUの重要性が一気に上がります。
#AIエージェントは、ただ文章を生成するだけではありません。
#検索する
APIを呼ぶ
Pythonを実行する
ファイルを読む
DBに問い合わせる
判断する
再試行する
ログを残す
外部サービスと通信するこの多くはCPU側の仕事です。
#つまり、AIエージェント時代は、
#GPU/TPU/LPU = 考える部分の高速化 CPU = 行動・記憶・道具・通信・管理の中心
#になります。
##
どれが一番重要か?
#用途で変わります。
#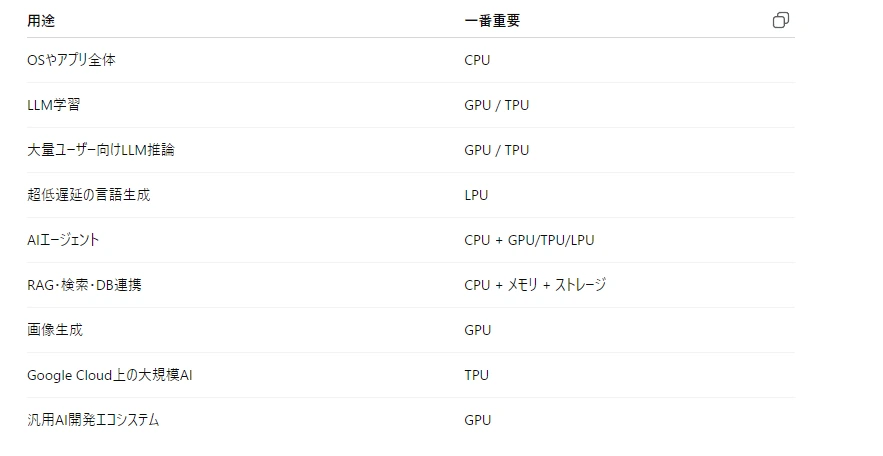
#
まとめ
#CPU、GPU、TPU、LPUの違いを一言でまとめると、
#CPUは、AIを「動かす」ための司令塔。 GPUは、AIを「計算する」ための大量並列エンジン。 TPUは、テンソル計算を「専用工場化」したGoogle系AIアクセラレータ。 LPUは、言語推論を「低遅延ベルトコンベア化」した専用アクセラレータ。
#AIの中心計算はGPU/TPU/LPUが担います。 しかし、AIエージェントやAIサービス全体では、CPUがリクエスト、ツール、メモリ、I/O、スケジューリングを握ります。
#だから今後のAIインフラは、単純な GPU一強 ではなく、
#CPU + GPU + TPU/LPU + HBM + DRAM + CXL + NIC + SSD
#のような、複合システムとして見る必要があります。
##
CPUが複雑な処理をできる理由は、一言で言うと、
#「少数の高性能な頭脳に、分岐・予測・順序制御・例外処理・メモリ管理・OS連携のための複雑な制御回路を大量に積んでいるから」
#です。
#逆にGPUは、
#「細かい判断をする頭脳を減らし、同じ計算を大量に並列実行する演算器を大量に積んでいる」
#という構造です。
#つまりCPUとGPUは、どちらが上というより、設計思想が真逆です。
##
CPUの仕組みを解説
#\1. CPUとは何をしている装置か
#CPUは、プログラムに書かれた命令を1つずつ読み、解釈し、実行する装置です。
#基本的な流れはこうです。
#メモリから命令を取ってくる
↓
命令を解読する
↓
必要なデータをレジスタやキャッシュから取る
↓
演算する
↓
結果を書き戻す
↓
次の命令へ進むこれを専門用語ではだいたい、
#Fetch → Decode → Execute → Memory → Writebackと呼びます。
#日本語にすると、
#命令取得 → 命令解読 → 実行 → メモリアクセス → 結果書き戻しです。
##
\2. CPUの中身
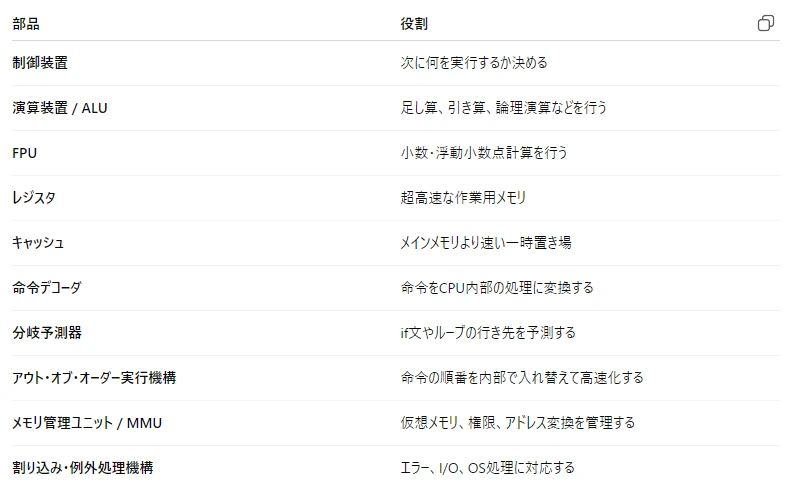
#CPUの内部には、主に以下のような部品があります。
#
CPUの本質は、単なる計算機ではありません。
#計算もするが、それ以上に「順番を管理する機械」です。
##
\3. CPUが複雑な処理をできる理由
#理由1:分岐処理が得意
#複雑なプログラムには、必ず条件分岐があります。
#もしAなら処理1
そうでなければ処理2たとえば、
#if user_is_logged_in:
show_dashboard()
else:
show_login_page()このような処理では、次にどの命令を実行するかが状況によって変わります。
#CPUはこのような分岐を非常に得意としています。
#なぜならCPUには、
#分岐予測器
#があるからです。
#CPUは、
#次はたぶんこっちに進むだろうと予測して、先に命令を読み込んで実行準備をします。
#予測が当たれば速い。 外れればやり直す。
#この「未来を予想して先回りする」機能が、CPUの大きな特徴です。
##
理由2:アウト・オブ・オーダー実行ができる
#人間が書いたプログラムの命令順序は、必ずしもCPUにとって最適ではありません。
#たとえば、
#A = メモリから読み込み
B = C + D
E = A + 1この場合、Aの読み込みに時間がかかるなら、CPUは待っている間に先に B = C + D を実行できます。
#つまりCPUは、内部では命令をこう入れ替えます。
#B = C + D を先に実行
Aの読み込み完了を待つ
E = A + 1 を実行ただし、外から見ると、ちゃんと元の順番で実行されたように見せます。
#これが アウト・オブ・オーダー実行 です。
#CPUは、
#内部では順番を入れ替えて高速化し、外部には正しい順番で実行したように見せる
#という非常に複雑なことをしています。
##
理由3:投機実行ができる
#CPUは分岐予測を使って、
#たぶん次はこっちに進むと予想し、まだ確定していない未来の命令を先に実行することがあります。
#これを 投機実行 といいます。
#たとえば、
#if A:
処理X
else:
処理Yで、CPUが「たぶん処理Xだろう」と予測したら、Aの結果が完全に確定する前に処理Xの準備を始めます。
#当たれば速い。 外れれば取り消す。
#この機能のおかげで、CPUは複雑なプログラムを高速に処理できます。
#ただし、この投機実行は非常に高度で、セキュリティ問題の原因にもなりました。SpectreやMeltdown系の脆弱性は、この高度な先読み機構と関係しています。
##
理由4:キャッシュ階層が強い
#CPUはメインメモリ、つまりDRAMに毎回アクセスしているわけではありません。
#DRAMはCPUから見るとかなり遅いです。
#そこでCPUは、内部に高速なキャッシュを持っています。
#レジスタ
↓
L1キャッシュ
↓
L2キャッシュ
↓
L3キャッシュ
↓
メインメモリ / DRAM
↓
SSD上に行くほど速く、容量は小さい。 下に行くほど遅く、容量は大きい。
#CPUは、必要になりそうなデータを先にキャッシュへ持ってきたり、よく使うデータを近くに置いたりします。
#複雑なプログラムは、メモリのあちこちを細かく参照します。
#このオブジェクトを読む
この配列を見る
このポインタをたどる
このファイルを開く
このネットワーク応答を待つこういう不規則なアクセスに対応するには、CPUのキャッシュ階層とメモリ管理が重要になります。
##
理由5:OSと密接に連携できる
#CPUはOSを動かすための機能を持っています。
#たとえば、
#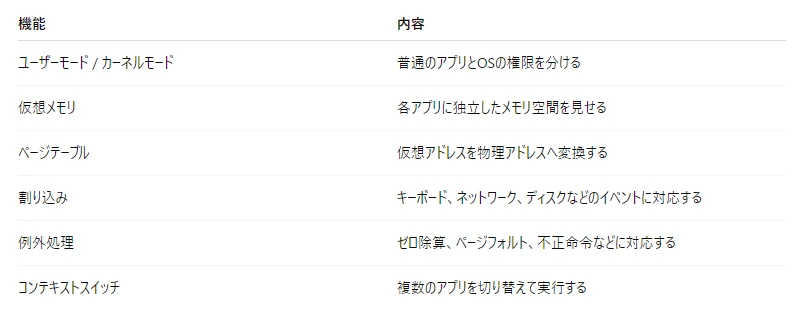
これがあるから、CPUは単なる計算だけでなく、
#ブラウザを動かす
OSを動かす
ファイルを読む
ネットワーク通信する
複数アプリを同時に動かす
セキュリティ権限を管理するといった複雑な処理ができます。
#GPUは基本的に、こういうOS全体の管理は担当しません。
##
\4. CPUの「複雑さ」はどこにあるのか
#CPUの複雑さは、演算器そのものよりも、制御部分にあります。
#極端に言えば、足し算器や掛け算器だけならGPUにも大量にあります。 でもCPUは、それに加えて、
#次に何を実行するか
どの命令を先にやるか
分岐先はどこか
予測が外れたらどう戻すか
メモリ権限は正しいか
例外が起きたらOSへどう渡すか
複数プロセスをどう切り替えるか
キャッシュの整合性をどう保つかを管理します。
#つまりCPUは、
#演算器 + 判断装置 + 予測装置 + 順序管理装置 + メモリ管理装置 + OS連携装置
#です。
#これが複雑な処理を可能にしています。
##
\5. GPUとは何が構造的に違うのか
#CPUとGPUの一番大きな違いは、トランジスタの使い道です。
#同じ半導体チップでも、CPUは多くの面積を制御回路やキャッシュに使います。 GPUは多くの面積を演算器に使います。
#CPUの設計思想
#少数の強いコア
大きなキャッシュ
複雑な制御回路
分岐予測
アウト・オブ・オーダー実行
低レイテンシ重視CPUは、
#1つ1つの処理をできるだけ速く終わらせる
#ことを重視します。
#これを 低レイテンシ重視 と言います。
##
GPUの設計思想
#大量の小さな演算器
多数のスレッド
高いメモリ帯域
単純な制御
同じ処理を大量並列
スループット重視GPUは、
#1つの処理を最速で終わらせるより、大量の処理をまとめて高速に終わらせる
#ことを重視します。
#これを 高スループット重視 と言います。
##
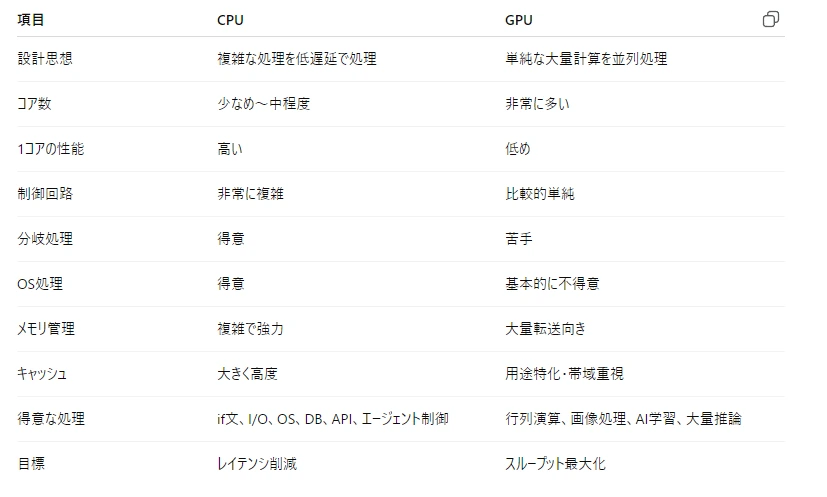
\6. CPUとGPUの違いを表で見る
#
#
\7. 工学的に一番重要な違い:制御密度と演算密度
#CPUとGPUの違いを工学的に言うなら、
#CPUは制御密度が高い。 GPUは演算密度が高い。
#です。
#CPU
#CPUは、チップ面積の多くを、
#命令デコード
分岐予測
キャッシュ
アウト・オブ・オーダー制御
レジスタリネーミング
リオーダーバッファ
例外処理
メモリ保護に使います。
#つまり、CPUは「計算するための回路」だけでなく、計算を正しく速く進めるための管理回路が非常に大きい。
##
GPU
#GPUは、チップ面積の多くを、
#CUDAコア
Tensor Core
SIMD/SIMT演算器
レジスタファイル
HBM接続
スレッドスケジューラに使います。
#つまり、GPUは「同じ計算を大量に行うための演算回路」に面積を振っています。
##
\8. CPUはなぜ分岐に強く、GPUはなぜ分岐に弱いのか
#GPUは多数のスレッドをまとめて実行します。 NVIDIA系では、複数スレッドを warp という単位でまとめ、同じ命令を同時に実行します。
#つまりGPUは、
#たくさんの人に同じ号令を出す方式です。
#たとえば32人が同時に、
#足し算しろと言われるなら、GPUは非常に速い。
#でも、32人のうち半分が、
#Aの処理をしろ残り半分が、
#Bの処理をしろとなると、GPUは困ります。
#なぜなら、同じ号令で同時に動かしたいからです。
#このような状態を 分岐ダイバージェンス と言います。
#if文でスレッドごとに進む道が分かれる
↓
GPUは同時実行しにくくなる
↓
効率が落ちるCPUは少数の強いコアが個別に命令を追うので、こういう分岐に強いです。
##
\9. CPUはなぜ不規則なメモリアクセスに強いのか
#複雑なプログラムでは、データがきれいに並んでいるとは限りません。
#ポインタをたどる
木構造を探索する
ハッシュマップを見る
DBのインデックスを読む
Webリクエストを待つ
ファイルを開くこういう処理は、次にどのメモリ番地を読むかが予測しにくいです。
#CPUはこのために、
#大きなキャッシュ
高度なプリフェッチ
分岐予測
アウト・オブ・オーダー実行
メモリ依存性予測を持っています。
#一方GPUは、データが連続していて、多数スレッドが似た場所を読むと非常に速いです。
#配列Aの0番から100万番まで順番に処理
行列A × 行列B
画像の全ピクセルに同じ処理こういう処理はGPUの得意分野です。
#でも、データ構造がバラバラで、スレッドごとに読む場所が違うと効率が落ちやすいです。
##
\10. CPUとGPUの違いを料理店でたとえる
#CPU
#CPUは、少人数の超有能な料理人です。
#注文を聞く
材料を確認する
客の好みに応じて変える
途中で電話に出る
会計もする
トラブル対応もする
別の注文に切り替える何でもできます。
#ただし、同じ弁当を10万個作るなら、少人数では限界があります。
##
GPU
#GPUは、巨大な弁当工場です。
#同じ工程を大量に並べる
同じ具材を大量に詰める
同じ作業を一斉に行う同じ作業なら圧倒的に速いです。
#ただし、客ごとにメニューが違ったり、途中で指示が変わったり、電話対応や会計まで求められると苦手です。
##
\11. AI推論で見るCPUとGPUの役割
#AI推論では、GPUがモデル本体の行列演算を担当します。
#Transformer
Attention
MLP
行列積
Tensor演算これはGPUが得意です。
#一方CPUは、その周辺を担当します。
#ユーザーリクエスト受付
トークナイズ
バッチング
スケジューリング
KV cache管理
RAG検索
DB照会
Web検索
API呼び出し
Python実行
ログ保存
認証
課金
セキュリティAIエージェントになると、CPUの仕事はさらに増えます。
#なぜなら、AIエージェントは単に文章を生成するだけではなく、外部世界に対して行動するからです。
#検索する
判断する
ツールを使う
ファイルを読む
コードを実行する
結果を検証する
再試行する
別のAIに依頼するこれらはGPUの行列演算だけでは完結しません。
##
\12. CPUとGPUの根本的な違いを一言で
#CPUは、
#複雑で予測しにくい処理を、できるだけ短い待ち時間で正しく処理する装置
#です。
#GPUは、
#単純で規則的な大量計算を、できるだけ多く一気に処理する装置
#です。
#CPUは「賢い少数精鋭」。 GPUは「大量並列の工場」。
#この違いが、構造の違いにもそのまま現れています。
##
まとめ
#CPUが複雑な処理を可能にしている理由は、単に演算能力が高いからではありません。
#重要なのは、
#分岐予測
投機実行
アウト・オブ・オーダー実行
高度なキャッシュ
仮想メモリ
例外処理
割り込み処理
OSとの連携
複雑な命令制御です。
#CPUは、複雑な現実世界のプログラムを正しく動かすために、制御回路を大量に持っています。
#一方GPUは、そのような複雑な制御を削り、演算器を大量に並べることで、行列演算やAI学習のような大量並列処理に特化しています。
#したがって、
#CPUは「判断と制御の半導体」 GPUは「大量計算の半導体」
#です。
#AI時代にGPUが重要なのは、モデル本体が巨大な行列計算だからです。 しかしAIエージェント時代にCPU需要が高まるのは、AIが現実のシステムを操作し、検索し、記憶し、判断し、外部ツールを使うようになるからです。
##
CPUがOSと密接に連携できて、GPUが難しい理由は、根本的にはこうです。
#CPUは「OSを動かすための主役」として設計されている。 GPUは「CPUから仕事を渡されて計算する補助計算機」として設計されている。
#つまり、CPUとGPUでは最初から役割が違います。
##
\1. OSは「何でも起こる世界」を管理する
#OSは、単に計算をしているだけではありません。
#OSは次のようなことを常に管理しています。
#アプリの起動
メモリの割り当て
ファイル読み書き
ネットワーク通信
キーボード・マウス入力
画面表示
権限管理
セキュリティ
プロセス切り替え
エラー処理
割り込み処理
仮想メモリこれらは非常に不規則です。
#たとえば、
#ユーザーがクリックした
ネットワークからパケットが来た
SSDから読み込みが終わった
メモリが足りなくなった
アプリが不正なアドレスにアクセスした
別のアプリにCPU時間を渡す必要があるこういう出来事が、いつ起こるか分かりません。
#CPUは、このような予測不能なイベントに即座に対応するための機能を持っています。
##
\2. CPUには「割り込み」がある
#CPUがOSと密接に連携できる最大の理由の1つは、割り込み処理です。
#割り込みとは、外部の出来事によってCPUの処理を一時停止し、OSの処理へ切り替える仕組みです。
#たとえば、
#キーボードが押された
マウスが動いた
ネットワーク通信が来た
ディスク読み込みが終わった
タイマーが鳴ったこのようなイベントが発生すると、CPUは今やっている処理を一時停止して、OSの処理へ移ります。
#アプリの処理中
↓
割り込み発生
↓
CPUがOSへ制御を渡す
↓
OSがイベントを処理
↓
元のアプリに戻るこれができるから、OSは複数のアプリやデバイスを同時に扱えます。
#GPUにも割り込みやプリエンプション機能はありますが、CPUほど細かく、低遅延で、OSの中心制御を担うようには設計されていません。
##
\3. CPUには「特権モード」がある
#OSは普通のアプリより強い権限を持つ必要があります。
#そのためCPUには、権限レベルがあります。
#代表的には、
#ユーザーモード:普通のアプリが動く
カーネルモード:OS本体が動くです。
#普通のアプリは、勝手にハードウェアを直接操作したり、他のアプリのメモリを読んだりできません。
#たとえばアプリが、
#SSDを直接操作したい
他のアプリのメモリを読みたい
ネットワークカードを直接叩きたいと思っても、CPUが止めます。
#必要な場合は、アプリがOSにお願いします。
#アプリ
↓
システムコール
↓
OS
↓
CPUの特権命令でハードウェア操作この仕組みがあるから、OSは安全にシステム全体を管理できます。
#GPUは基本的に、OSのカーネルを動かす中心ではありません。 GPU上のプログラムは、CPU上のOSとドライバによって起動・管理されます。
##
\4. CPUには「仮想メモリ」とMMUがある
#OSにとって特に重要なのが、仮想メモリです。
#普通のアプリは、自分だけのメモリ空間を持っているように見えます。
#アプリA:自分専用のメモリ空間
アプリB:自分専用のメモリ空間
アプリC:自分専用のメモリ空間でも実際には、物理メモリは全アプリで共有されています。
#この変換を行うのが、CPU内の MMU / Memory Management Unit です。
#仮想アドレス
↓
MMU
↓
物理アドレスCPUは、アプリがメモリにアクセスするたびに、
#このアドレスは有効か?
このアプリに読む権限はあるか?
書き込み権限はあるか?
実行してよい領域か?
ページが存在するか?をチェックできます。
#もし不正なら、CPUは例外を発生させ、OSに制御を渡します。
#これができるから、OSは安全に複数アプリを動かせます。
#GPUにも近年は仮想アドレス空間やIOMMU、Unified Virtual Memoryのような仕組みがありますが、歴史的にも構造的にも、CPUほどOS全体のメモリ保護・ページフォルト処理・プロセス分離の中心にはなっていません。
##
\5. CPUは「コンテキストスイッチ」が得意
#OSは複数のアプリを同時に動かしているように見せます。
#実際には、CPU時間を細かく分けています。
#アプリAを少し動かす
↓
アプリBを少し動かす
↓
ブラウザを少し動かす
↓
音楽アプリを少し動かす
↓
OS処理をするこの切り替えを コンテキストスイッチ と言います。
#コンテキストとは、そのプログラムの状態です。
#レジスタの中身
命令の位置
スタック
メモリ状態
権限状態
プロセス情報CPUは、この切り替えを頻繁に行う前提で作られています。
#一方GPUは、巨大な計算ジョブをまとめて実行することを想定しています。
#GPUでもタスク切り替えはできますが、CPUのように、
#細かいイベントに応じて
短時間で
大量のプロセスを
頻繁に切り替えるという用途には向きません。
##
\6. GPUは「自律的なOS実行機」ではなく「アクセラレータ」
#GPUは基本的に、CPUから仕事を渡されて動きます。
#流れはこうです。
#CPU上のアプリ
↓
OS
↓
GPUドライバ
↓
GPUへ命令・データを送る
↓
GPUが計算する
↓
結果をCPU側へ返すGPUは自分で勝手に、
#ファイルを開く
ネットワーク通信を開始する
プロセスを作る
OSのスケジューラを動かす
メモリ権限を管理する
デバイスドライバを制御するということは基本的にしません。
#GPUは、OSから見ると、
#高性能な計算用デバイス
#です。
#CPUは、
#OSそのものを実行する装置
#です。
#この違いが非常に大きいです。
##
\7. GPUはSIMT構造なので、OS処理と相性が悪い
#GPUは多数のスレッドをまとめて同じ命令で動かす構造を持っています。
#NVIDIA系では、複数スレッドを warp という単位でまとめて実行します。
#つまりGPUは、
#たくさんのスレッドに同じ命令を一斉に実行させるのが得意です。
#ところがOS処理は、まったく逆です。
#OS処理は、
#このプロセスは待機
このプロセスは実行
このメモリは権限違反
このパケットは受信
このファイルは読み込み中
このアプリはクラッシュ
この割り込みを処理のように、分岐だらけです。
#各処理がバラバラに進みます。
#GPUのような「全員で同じ命令をやる」構造では、このような不規則な処理は効率が悪いです。
##
\8. GPUはレイテンシよりスループット重視
#CPUは、1つの処理をすぐに返すことを重視します。
#クリックにすぐ反応する
キー入力にすぐ反応する
割り込みにすぐ反応する
ネットワーク応答をすぐ処理するつまり 低レイテンシ重視 です。
#GPUは、大量の処理をまとめて高速に終わらせることを重視します。
#100万個の画素を処理する
巨大な行列を計算する
大量のトークンをバッチ推論するつまり 高スループット重視 です。
#OSはリアルタイムに細かく反応する必要があります。
#だからOSの中心には、低レイテンシで割り込み・分岐・例外に強いCPUが向いています。
##
\9. GPUはメモリアクセスもOS向きではない
#OSはメモリのあちこちに不規則にアクセスします。
#プロセステーブルを見る
ページテーブルを見る
ファイルディスクリプタを見る
ネットワークバッファを見る
デバイス状態を見る
権限情報を見るこれはポインタをたどる処理が多く、分岐も多いです。
#CPUはこういう処理のために、
#大きなキャッシュ
分岐予測
アウト・オブ・オーダー実行
プリフェッチ
MMU
TLB
例外処理を持っています。
#GPUは、連続した大きなデータを大量に読むのは得意です。
#行列
画像
テンソル
配列しかし、OSのような細かくバラバラなデータ構造の管理には向いていません。
##
\10. CPUとGPUの違いを会社でたとえる
#CPU
#CPUは会社の本社・管理部門です。
#人事
経理
法務
情報システム
トラブル対応
スケジュール調整
権限管理
各部署への指示色々なことを判断し、状況に応じて切り替えます。
#GPU
#GPUは巨大な工場ラインです。
#同じ部品を大量生産する
同じ計算を大量に行う
同じ工程を並列に回す大量生産には強いですが、会社全体の管理には向いていません。
#OSは本社業務に近いので、CPUが向いています。
##
\11. ではGPU上でOSを動かせないのか?
#理論上、GPUでOS的なものを動かす研究や特殊用途はあります。
#また、近年のGPUは昔よりかなり賢くなっています。
#GPU仮想化
プリエンプション
GPUページフォルト
Unified Memory
MIG
SR-IOV
GPU内スケジューラのような機能もあります。
#しかし、それでも一般的なOSの中心をGPUに置くのは難しいです。
#理由は、OSが必要とする性質がGPUの得意分野と違うからです。
#OSが求めるものは、
#低レイテンシ
細かい分岐
頻繁な割り込み
例外処理
プロセス切り替え
強いメモリ保護
多様なI/O制御
権限管理
不規則なデータ構造操作です。
#GPUが得意なのは、
#大量並列
規則的な配列処理
行列演算
画像処理
テンソル計算
高スループットです。
#このため、GPUはOSの主役ではなく、CPUに管理されるアクセラレータとして使われます。
##
\12. AI時代にこの違いが重要になる理由
#AI推論では、GPUはモデル本体の計算を担当します。
#Transformer
Attention
MLP
行列積
Tensor演算しかし、AIサービス全体ではCPUが必要です。
#API受付
ユーザー認証
セッション管理
トークナイズ
リクエストキュー
バッチング
GPUへの投入
KV cache管理
RAG検索
DB照会
ツール呼び出し
ログ保存
課金
セキュリティAIエージェントになると、CPUの役割はさらに増えます。
#Python実行
ブラウザ操作
ファイル読み書き
外部API
検索
DB
承認フロー
再試行
複数タスク管理これはOS的な、不規則で制御中心の処理です。
#だから、AIエージェント時代にCPU需要が再評価されるわけです。
##
まとめ
#CPUがOSと密接に連携できるのは、CPUが最初から
#割り込み
例外
特権モード
仮想メモリ
MMU
TLB
コンテキストスイッチ
システムコール
I/O制御
権限管理を扱うために設計されているからです。
#一方GPUは、
#大量のスレッド
同じ命令の並列実行
高メモリ帯域
行列演算
テンソル計算
高スループットに特化しています。
#つまり、
#CPUは、OSと現実世界を管理するための制御プロセッサ。 GPUは、CPUから渡された大量計算を処理するアクセラレータ。
#この違いがあるため、CPUはOSと密接に連携でき、GPUはOSの中心になるのが難しいのです。
##
SMTとSIMTについて
#\1. SMTとは何か:CPUの「1コアを2人で使う」仕組み
#SMT / Simultaneous Multithreading は、1つの物理CPUコアで複数のスレッドを同時に走らせる技術です。AMDはSMTを「1つのCPUコアが複数スレッドを同時に実行できる技術」と説明しており、一般的には2-way SMT、つまり1コアあたり2スレッドが多いです。Intelでは似た技術を Hyper-Threading と呼んできました。(AMD)
#たとえば、OSから見るとこう見えます。
#物理CPUコア:8コア
SMT有効時:16スレッドただし、これは本当に16個の物理コアがあるという意味ではありません。
#実際には、
#1つの物理コアの中に
2つ分の「命令の流れ」を持たせるという仕組みです。
##
SMTの目的
#CPUコアの中には、たくさんの実行ユニットがあります。
#整数演算器
浮動小数点演算器
ロード/ストアユニット
分岐ユニット
SIMD演算器
キャッシュ
命令スケジューラしかし、1つのスレッドだけを実行していると、常に全部のユニットが埋まるわけではありません。
#たとえば、あるスレッドがメモリ待ちをしている間、
#演算器が空いている
パイプラインが一部空いている
キャッシュ応答待ちで止まっているという状態が起きます。
#そこでSMTでは、同じ物理コアにもう1つ別のスレッドを入れます。
#スレッドAがメモリ待ち
↓
その間にスレッドBの命令を実行これにより、CPUコア内部の空きリソースを埋めて、全体のスループットを上げます。
##
\2. SMTは「コアが2倍になる」わけではない
#ここが重要です。
#SMTは、物理コアを2倍にする技術ではありません。
#たとえると、
#物理コア追加:厨房をもう1つ作る
SMT:1つの厨房に注文係を2人入れるです。
#厨房そのもの、つまり演算器・キャッシュ・ロードストアユニットなどは多くの場合共有です。
#だから、SMTで性能が2倍になることは普通ありません。
#効果はワークロード次第です。
#ワークロードSMTの効果メモリ待ちが多い処理効果が出やすいI/O待ちが多い処理効果が出やすい整数演算と浮動小数点が混ざる処理効果が出る場合あり1スレッドでコアを使い切る処理効果が小さいキャッシュを奪い合う処理逆に遅くなる場合ありセキュリティ重視環境無効化される場合あり
#IBMも、SMTでは2つの命令ストリームが1つのコアの実行リソースを動的に共有すると説明しています。(IBM)
##
\3. SMTがCPUらしい理由
#SMTはCPUの特徴をよく表しています。
#CPUはもともと、
#分岐
メモリ待ち
I/O待ち
例外処理
OS処理
不規則な命令列を扱います。
#つまり、CPUの中では「待ち時間」や「空きリソース」が発生しやすい。
#SMTはそこを埋める技術です。
#1スレッドでは埋めきれないCPU内部リソースを
別スレッドで埋めるという考え方です。
#AIエージェント時代にも関係します。 なぜなら、AIエージェントのCPU処理には、
#Web検索
DB照会
API呼び出し
Python実行
JSON処理
RAG検索
ファイルI/O
ネットワーク待ちのような、待ち時間を含む処理が多いからです。
#こうした処理では、SMTや多コアCPUが役に立ちやすいです。
##
\4. SIMTとは何か:GPUの「全員に同じ命令を出す」仕組み
#一方、SIMT / Single Instruction, Multiple Threads はGPU側の考え方です。
#NVIDIAのCUDA資料では、SIMTモデルでは warp内の全スレッドがカーネル内のコードを一緒に進む と説明されています。またNVIDIA PTX ISAでは、CTA内のスレッドは warp と呼ばれるグループ単位でSIMT方式により実行され、通常warpは32スレッドだと説明されています。(NVIDIA Docs)
#ざっくり言うと、SIMTはこうです。
#1つの命令を
多数のスレッドに一斉に実行させるたとえば画像処理なら、
#全ピクセルに同じ処理をする行列演算なら、
#行列の各要素に同じような計算をするこういう処理に非常に向いています。
##
SIMTのイメージ
#GPUでは、多数のスレッドが warp という単位でまとめられます。
#NVIDIA GPUでは通常、
#1 warp = 32 threadsです。
#この32スレッドに対して、同じ命令が一斉に流れます。
#命令:A + B を計算せよ
thread 0: A0 + B0
thread 1: A1 + B1
thread 2: A2 + B2
...
thread 31: A31 + B31各スレッドは別々のデータを持ちますが、実行する命令は基本的に同じです。
#これが Single Instruction, Multiple Threads です。
##
\5. SMTとSIMTの違い
#名前が似ていますが、全然違います。
#項目SMTSIMT主に使う場所CPUGPU意味同時マルチスレッディング単一命令・複数スレッド目的1コア内の空きリソースを埋める大量スレッドに同じ命令を流す得意複雑な処理のスループット改善規則的な大量並列計算苦手物理コアの完全代替にはならない分岐が多い処理たとえ1つの厨房に注文係を2人工場ラインに同じ号令を出す
##
\6. SMTはCPUの効率化、SIMTはGPUの構造そのもの
#ここが一番重要です。
#SMTは、CPUコアを効率よく使うための追加機能です。
#CPUは、もともと1つのスレッドを非常に賢く処理します。 そこにもう1つのスレッドを同時に入れて、空きリソースを埋めるのがSMTです。
#一方、SIMTはGPUの基本的な実行モデルです。
#GPUは、大量のスレッドに同じ命令を流すことで演算密度を高めています。
#つまり、
#SMT = CPUの中の空き時間を減らす技術
SIMT = GPUが大量並列処理をする基本方式です。
##
\7. GPUで分岐が苦手になる理由はSIMTにある
#SIMTでは、warp内のスレッドが同じ命令を一緒に進みます。
#ところが、if文で進む道が分かれると問題が起きます。
#if (x > 0) {
Aの処理
} else {
Bの処理
}warp内の32スレッドのうち、
#16スレッドはAへ
16スレッドはBへとなると、GPUは全員を完全に同時には進めにくくなります。
#結果として、
#A側を実行している間、B側のスレッドは待つ
B側を実行している間、A側のスレッドは待つのようになり、効率が落ちます。
#これが 分岐ダイバージェンス です。
#NVIDIAのCUDA資料でも、warp内のスレッドが同じ制御フローをたどるとGPU利用率が最大化される、と説明されています。(NVIDIA Docs)
##
\8. CPUのSMTとGPUのSIMTをAIで見る
#AI推論では、両方とも重要です。
#SMTが関係するところ
#CPU側では、
#API処理
トークナイズ
RAG検索
DBアクセス
Web検索
JSON処理
ツール呼び出し
Python実行
ログ処理
セキュリティ処理のような不規則処理が多いです。
#ここでは、CPUの複数コアやSMTが役立ちます。
#特に、待ち時間のある処理では、
#スレッドAがI/O待ち
↓
スレッドBを進めるという形で効率を上げられます。
##
SIMTが関係するところ
#GPU側では、
#Attention
MLP
行列積
テンソル演算
画像生成
大量バッチ推論のような規則的な大量並列計算が中心です。
#ここではSIMTが力を発揮します。
#同じ計算を
大量のトークン・行列要素・画像ピクセルに対して
一斉に実行するからです。
##
\9. かなり簡単なたとえ
#SMT
#1人用の高性能な作業机があります。 でも、作業中に資料待ちや電話待ちが発生します。
#そこで、同じ机にもう1人の作業者も座らせます。
#Aさんが資料待ち
↓
その間にBさんが作業これがSMTです。
##
SIMT
#大工場で、32人の作業員に同じ号令を出します。
#全員、ネジを締めろ
全員、部品を並べろ
全員、同じ位置を加工しろこれがSIMTです。
#ただし、途中で、
#半分はネジ締め
半分は塗装になると効率が落ちます。
##
まとめ
#SMT はCPUの技術です。 1つの物理CPUコアで複数スレッドを同時に走らせ、コア内の空きリソースを埋めて効率を上げます。
#SIMT はGPUの実行モデルです。 大量のスレッドに同じ命令を一斉に流し、行列演算や画像処理のような大量並列計算を高速化します。
#一言で言えば、
#SMT = CPUの空き時間を埋める技術
SIMT = GPUの大量並列を成立させる方式です。
#AIインフラで言えば、 CPU側のエージェント処理・RAG・API・I/OにはSMT的な効率化が効く。 GPU側のLLM行列計算・画像生成・大量推論にはSIMTが効く。
TPUやLPUでは、GPU以上に「分岐処理」「不規則処理」「OS的な制御」が苦手になりやすいです。
#理由は、GPUよりさらに用途を絞って、行列演算・テンソル演算・LLM推論の流れ作業に特化しているからです。
##
まず結論
#CPU、GPU、TPU、LPUを「分岐への強さ」で並べると、だいたいこうです。
#CPU > GPU > TPU / LPUCPUは、分岐・例外・割り込み・OS処理のために作られています。
#GPUは、分岐は苦手ですが、まだ多数のスレッド、warp、スケジューラ、マスク実行などである程度対応できます。NVIDIA CUDAでは、warp内のスレッドが異なる分岐に進むとwarp divergenceが起き、各分岐パスを順に実行するため効率が落ちると説明されています。(NVIDIA Docs)
#TPUやLPUは、さらに「決まった計算グラフを高速に流す」方向に寄っているので、途中で細かく分岐したり、処理内容が動的に変わったりするほど効率が落ちやすいです。
##
\1. TPUは「行列計算の専用工場」だから分岐が苦手
#TPUは、GoogleがAI計算のために作った専用ASICです。
#中心にあるのは systolic array です。 Google Cloudの説明では、TPUの主な仕事は行列処理、つまりmultiply-accumulateであり、多数の積和演算器が物理的な行列として接続されたsystolic arrayを構成するとされています。Cloud TPU v3では、1プロセッサに128×128 ALUのsystolic arrayが2つあります。(Google Cloud Documentation)
#これは非常に強力です。
#行列積のような処理では、
#A行列 × B行列
↓
大量の掛け算と足し算
↓
同じリズムでデータを流すという形になります。
#TPUは、この「データを規則的に流して、積和演算を大量に行う」ことに最適化されています。
#しかし分岐処理は、これと相性が悪いです。
#たとえば、
#if 条件A:
処理X
else:
処理Yのような処理が大量に混ざると、全体を同じリズムで流せません。
#TPUは、ベルトコンベア式の巨大な行列計算工場です。 ベルトコンベア上の部品が全部同じ工程を通るなら速い。 でも、部品ごとに「これは別ラインへ」「これは検査待ち」「これは再加工」と分かれると、専用工場の効率が落ちます。
##
\2. TPUはコンパイラで計算グラフを固める思想が強い
#TPUは、CPUのように1命令ずつ動的に判断していくというより、XLAコンパイラが計算グラフを最適化して、TPUの行列ユニットに効率よく流すという思想が強いです。
#Google CloudのTPUドキュメントでも、XLAコンパイラが行列乗算を小さなブロックに分割し、MXU、つまりmatrix unitで効率的に実行するための変換を行うと説明されています。(Google Cloud Documentation)
#つまりTPUは、
#先に計算の形を決める
↓
コンパイラが最適な流し方を作る
↓
TPU上で高速実行するという色が強いです。
#この方式では、計算の形が安定しているほど強いです。
#行列積
畳み込み
TransformerのAttention
MLP
バッチ推論のような処理は得意です。
#逆に、
#ユーザーごとに違う分岐
ツール呼び出し
ファイルI/O
DB照会
Python実行
API応答待ち
条件によって処理グラフが変わるのような処理は苦手です。
#もちろんTPUでも条件分岐やループを扱えないわけではありません。 ただし、それは「TPUがCPUのように自由な分岐処理を得意とする」という意味ではなく、コンパイルされた計算グラフの中で扱う形になります。
##
\3. GPUはまだ「分岐に耐える仕組み」がある
#GPUも分岐は苦手です。 ただしTPUよりは汎用的です。
#GPUには多数のスレッドがあり、NVIDIAの場合はwarp単位で命令を実行します。warp内の32スレッドが同じ制御フローをたどると効率が最大化されますが、分岐で別々の経路に進むと、各分岐パスを順に実行して、該当しないスレッドを一時的に無効化します。(NVIDIA Docs)
#つまりGPUは、
#分岐しても実行はできる
ただし効率が落ちるです。
#TPUはもっと極端で、
#規則的な行列計算なら非常に強い
処理の形が動的に変わると扱いにくいです。
#なので、GPUは「分岐に弱い大量並列機」。 TPUは「分岐をなるべく避けたい行列計算専用機」。 この違いがあります。
##
\4. LPUは「言語推論の固定パイプライン」に寄っている
#LPUは、主にGroqの Language Processing Unit を指す文脈で使われます。
#GroqはLPUを、LLM推論の高速・低遅延実行に特化したプロセッサとして打ち出しています。公式サイトでも、LPUは推論向けであり、スピードとスケール時の低コストを特徴にしています。(Groq)
#LPUの思想は、GPUのように大量のスレッドを動的にさばくというより、
#LLM推論の計算を
あらかじめ決めたスケジュールで
低遅延に流すに近いです。
#Groq系のLPUはよく、決定論的実行、静的スケジューリング、コンパイラ制御、オンチップSRAM重視という文脈で語られます。
#この方式は、LLMのように、
#Transformer層
Attention
MLP
次トークン生成
また次トークン生成という比較的規則的な推論パイプラインでは強いです。
#しかし、
#途中で外部APIを呼ぶ
条件によって違うツールを使う
Pythonコードを実行する
DB検索結果によって次の処理を変える
ユーザーごとに別のワークフローを走らせるのような処理は、LPU本体よりCPU側で処理する方が自然です。
#つまりLPUは、言語モデルのトークン生成ラインには向いていますが、AIエージェント全体の不規則な制御には向きません。
##
\5. なぜ専用化すると分岐に弱くなるのか
#これは工学的にかなり重要です。
#半導体チップでは、面積・電力・発熱・設計複雑性に制約があります。 何かを強くするには、何かを削る必要があります。
#CPUは、分岐やOS処理のために、以下のような回路をたくさん持っています。
#分岐予測器
投機実行
アウト・オブ・オーダー実行
命令デコーダ
リオーダーバッファ
例外処理
割り込み処理
MMU
キャッシュ整合性
コンテキストスイッチ機構これらは、複雑な処理には強いですが、チップ面積と電力をかなり使います。
#GPUは、それらをかなり削って、演算器を増やします。
#TPUやLPUは、さらに削ります。
#その代わりに、
#行列演算器
テンソル演算器
systolic array
オンチップSRAM
専用データパス
固定パイプライン
コンパイラ最適化に面積を使います。
#だから、専用アクセラレータは速いのです。 しかしその速さは、想定された形の計算が来たときに発揮されます。
##
\6. TPU/LPUでは「処理の流れが乱れる」と性能が落ちる
#TPUやLPUは、データが規則的に流れると強いです。
#入力テンソル
↓
行列演算
↓
活性化
↓
行列演算
↓
次の層このように、形の決まった処理を大量に流すなら非常に効率的です。
#しかし分岐が入ると、流れが乱れます。
#入力Aは処理1へ
入力Bは処理2へ
入力Cは外部ツールへ
入力Dは待機
入力Eは再試行こうなると、専用パイプラインが空きやすくなります。
#これは工場で言うと、
#全員が同じ商品を作る → 専用ラインがフル稼働
商品ごとに工程が違う → ラインの一部が止まるという違いです。
##
\7. TPU/LPUが苦手なのは「AIの思考」ではなく「AIの行動管理」
#ここは誤解しやすいです。
#TPUやLPUが苦手なのは、AIモデルの推論そのものではありません。 むしろ、そこには非常に強いです。
#TPUは、大規模なテンソル計算、学習、推論に強い。 LPUは、LLMの低遅延推論、特にトークン生成に強い。
#苦手なのは、その外側です。
#ツールを選ぶ
APIを呼ぶ
DBを検索する
結果に応じて処理を変える
ユーザー権限を確認する
ファイルを読み書きする
ネットワーク応答を待つ
複数タスクを管理するこれはCPUの領域です。
#だからAIエージェント時代の構成は、
#CPU:行動管理・OS・I/O・ツール・分岐
GPU/TPU/LPU:モデル本体の推論になります。
##
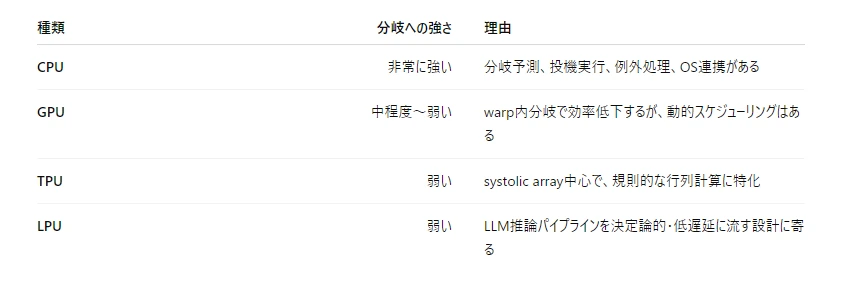
\8. 4種類を分岐処理で比較すると
#
#
\9. たとえで言うと
#CPU
#町の総合病院です。
#救急
内科
外科
検査
会計
受付
入院
紹介状
緊急対応何が来ても対応できます。 ただし、大量の同じ検査を一気にやる効率は専用工場に負けます。
#GPU
#大きな検査センターです。
#同じ種類の検査を大量に回せます。 ただし、患者ごとに対応が細かく変わると効率が落ちます。
#TPU
#血液検査だけに特化した巨大自動ラインです。
#血液検査なら圧倒的に速い。 でも、途中で外科手術や問診や救急対応を任せるのは向いていません。
#LPU
#問診文章の自動生成に特化した超高速ラインです。
#「次の言葉を出す」なら非常に速い。 でも、病院全体の運営や患者ごとの複雑な判断はCPU側が必要です。
##
まとめ
#TPUやLPUでGPU以上に分岐処理が難しくなりやすい理由は、GPUよりさらに専用化されているからです。
#GPUは大量並列計算向けですが、それでもwarp、スケジューラ、マスク実行などで分岐にある程度対応できます。
#一方TPUは、systolic arrayを中心に行列演算を規則的に流す設計です。 LPUは、LLM推論を低遅延・決定論的に流す設計に寄っています。
#そのため、
#規則的なテンソル計算 → TPU/LPU/GPUが強い
不規則な分岐・I/O・ツール実行 → CPUが強いという役割分担になります。
#AIエージェント時代にCPU需要が高まる理由はまさにここです。 モデル本体の計算はGPU/TPU/LPUで速くできても、AIが外部世界を操作し、条件に応じて行動を変え、ツールを呼び、データを探し、結果を判断する部分はCPU的な処理だからです。
##
はい。 この時代、つまり AIエージェント化・推論爆増・リアルタイムAI化 の時代では、GPU、TPU、LPUの優位性はかなり分かれてきます。
#結論から言うと、
#GPU = 最も汎用的なAI工場 TPU = Google型の巨大テンソル専用工場 LPU = 低遅延LLM推論の高速ベルトコンベア
#です。
##
この時代におけるGPUの優位性とTPU/LPUの優位性
#\1. まずGPUの優位性
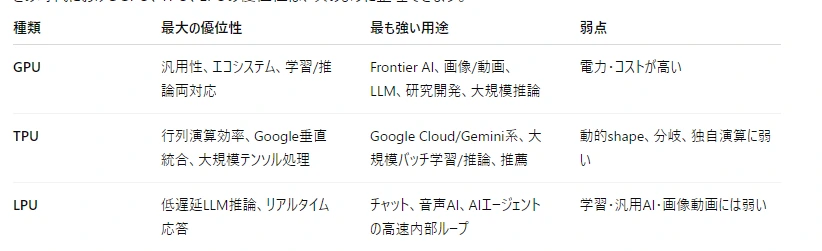
#GPUの最大の優位性は、汎用性とエコシステムです。
#GPUは、もともと大量並列計算に強い装置ですが、現在のNVIDIA GPUはTensor Core、HBM、NVLink、CUDA、TensorRT、cuDNN、NCCL、Triton、PyTorch対応などを含む巨大なソフトウェア・ハードウェア基盤になっています。NVIDIAはTensor Coreについて、学習から推論、HPCまで幅広いAIワークロードを加速する中核部品として説明しています。(NVIDIA)
#GPUの強さは、単に「行列演算が速い」だけではありません。
#GPUが強い理由
#\1. 学習にも推論にも使える
#GPUは、大規模学習、大規模推論、画像生成、動画生成、音声生成、科学計算、ロボティクス、シミュレーションまで広く使えます。
#TPUやLPUは用途が狭い。 GPUは広い。
#これは非常に大きいです。
#AIのモデル構造は急速に変わります。
#Transformer
MoE
Diffusion
State Space Model
Multimodal model
Reasoning model
Agentic model
Robotics foundation modelこうした変化に最も追従しやすいのがGPUです。
##
\2. ソフトウェア資産が圧倒的
#AI研究者・企業・クラウド・OSSの多くが、まずGPUで動くようにモデルを作ります。
#CUDA、PyTorch、TensorRT-LLM、NCCL、Tritonなどの蓄積があるため、新しいモデルが出ても、まずGPUで最適化されやすい。
#これは半導体そのもの以上に重要です。
#GPUの優位性は、チップ単体ではなく「GPUを中心にしたAI開発文明」そのものです。
##
\3. 大規模モデルを束ねる能力が高い
#大規模AIでは、1枚のチップでは足りません。 何十枚、何百枚、何千枚、何万枚のアクセラレータを束ねる必要があります。
#NVIDIAのGB200 NVL72は、36個のGrace CPUと72個のBlackwell GPUを1ラックに収め、72 GPUのNVLinkドメインを1つの巨大GPUのように扱う設計です。NVIDIAは、GB200 NVL72がH100比でリアルタイムLLM推論30倍、LLM学習4倍、エネルギー効率25倍を掲げています。(NVIDIA)
#つまりGPUの優位性は、
#GPU単体の性能
+
NVLink
+
ネットワーク
+
CPU連携
+
ソフトウェア
+
ラックスケール設計まで含めた総合力です。
##
\4. 分岐・不規則処理への耐性がTPU/LPUより高い
#GPUも分岐は苦手ですが、TPUやLPUよりはまだ柔軟です。
#AIエージェント時代には、推論が単純な行列演算だけではなくなります。
#長文入力
RAG
検索
ツール呼び出し
マルチモーダル
MoEルーティング
推論ステップの変化
動的バッチング
KV cache管理こうした複雑さが増えると、完全専用型のTPU/LPUより、GPUの柔軟性が効きやすい。
##
GPUが最も強い領域
#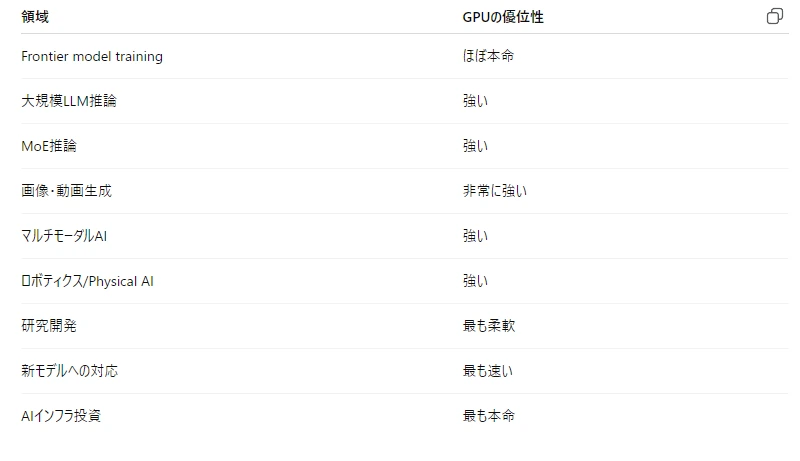
つまりGPUは、AI時代の汎用工作機械です。
##
\2. TPUの優位性
#TPUは、Googleが作った Tensor Processing Unit です。 GPUよりもさらに機械学習の行列演算に特化したASICです。
#TPUの中心は systolic array です。Google Cloudの説明では、TPUは機械学習向けのASICであり、行列演算を高速に行うため、multiply-accumulateを行う多数の演算器が物理的な行列として接続されています。TPU v3では128×128 ALUのsystolic arrayを2つ持つ構成と説明されています。(Google Cloud Documentation)
#TPUの優位性は、決まった形の巨大なテンソル計算を、効率よく大量に流すことです。
##
TPUが強い理由
#\1. 行列演算に特化している
#GPUは汎用並列プロセッサです。 TPUはより専用の行列プロセッサです。
#TPUは、
#巨大な行列積
TransformerのMLP
Attention
畳み込み
ランキング/推薦モデル
大規模バッチ学習のような処理が中心なら非常に強い。
#Google Cloudも、TPUは行列計算が支配的なモデル、大きな有効バッチサイズ、長期間の学習、大規模モデル、超大規模embeddingを持つ推薦モデルなどに向くと説明しています。(Google Cloud Documentation)
##
\2. 電力効率・コスト効率を出しやすい
#専用化すると、無駄な回路を削れます。
#CPUのような分岐予測や複雑な命令制御、GPUのような幅広い汎用性をある程度削り、その分を行列演算・HBM・データフローに振る。
#そのため、同じようなテンソル計算を大量に回すなら、GPUより効率がよくなる場面がある。
#特にGoogle内部のように、
#モデル設計
コンパイラ
データセンター
ネットワーク
運用
フレームワークを垂直統合できる環境では、TPUは非常に強いです。
##
\3. GoogleのAI基盤と一体化している
#TPUは単体チップというより、Googleの巨大AI基盤の一部です。
#Google CloudではTPUをスライスやPodとして束ね、大規模学習や推論に使えます。またXLAコンパイラがMLフレームワークから出たグラフをTPU用機械語へコンパイルし、プログラムの残りはTPUホストマシン上で動きます。(Google Cloud Documentation)
#つまりTPUは、
#Googleのクラウド、Gemini、検索、広告、推薦、YouTube、JAX/XLA文化
#と相性が良い。
#これはNVIDIA GPUとは別の強さです。
##
TPUの弱点
#ただしTPUは、GPUより柔軟性が低いです。
#Google Cloudの資料でも、TPUは頻繁な分岐を含む線形代数プログラム、動的shapeのテンソル、main training loopにカスタム演算を含むニューラルネットワークには向かないと説明されています。(Google Cloud Documentation)
#つまりTPUは、
#形が決まっている
巨大な行列計算が多い
大きなバッチで回せる
GoogleのXLA/JAX/Cloud TPU環境に乗せられるなら強い。
#逆に、
#モデル構造が頻繁に変わる
動的shapeが多い
独自演算が多い
分岐が多い
GPU向けOSSをそのまま使いたいならGPUの方が扱いやすい。
##
\3. LPUの優位性
#LPUは、主にGroqが使っている Language Processing Unit という用語です。 これはGPUやTPUのような汎用AIアクセラレータではなく、LLM推論、特に低遅延のトークン生成に寄せた専用アクセラレータです。
#Groqは、自社のLPUを2016年に開発した推論専用チップとして説明し、設計選択のすべてを「高速で手頃な推論」に向けていると述べています。またGroqCloudは、LPUベースのスタックを世界中のデータセンターで動かし、低レイテンシ応答を提供すると説明しています。(Groq)
##
LPUが強い理由
#\1. 低遅延推論に強い
#LPUの最大の強みは、トークンが速く出ることです。
#LLM推論では、ユーザー体験に大きく効くのは2つです。
#TTFT = 最初のトークンが出るまでの時間
TPOT = 1トークンごとの生成時間チャット、音声AI、リアルタイム翻訳、AI配信アバター、コーディング補助、エージェントの内部思考ループでは、1秒以下の差が体感に直結します。
#この領域では、LPUのような専用推論チップが非常に強くなります。
##
\2. 推論専用なので無駄を削れる
#GPUは学習にも推論にも画像生成にもHPCにも使えます。 その分、汎用性のための余地があります。
#LPUは、もっと割り切っています。
#学習より推論
汎用AIよりLLM推論
最大柔軟性より低遅延
大量機能より決まった推論パスに寄せられる。
#この割り切りにより、リアルタイム応答で優位に立てる可能性があります。
##
\3. AIエージェント時代の「内部ループ」に向く
#AIエージェントは、1回だけLLMを呼ぶのではありません。
#考える
↓
ツールを呼ぶ
↓
結果を見る
↓
また考える
↓
次のツールを呼ぶ
↓
結果をまとめるこのように、何度も短い推論を繰り返します。
#このとき、1回ごとの推論レイテンシが小さいと、エージェント全体が速くなります。
#つまりLPUは、エージェントの「内側の思考反復」を高速化する部品として魅力があります。
##
LPUの弱点
#ただしLPUは、GPUの完全代替ではありません。
#弱点は明確です。
#大規模学習には向きにくい
画像・動画生成など広範なAIには不向き
モデル対応範囲がGPUより狭い
CUDAのような巨大エコシステムはない
最大規模モデルの運用ではGPUクラスターに劣る可能性
柔軟性より専用性に振っているつまりLPUは、
#AI全体の主役というより、 LLM推論の一部、特に低遅延応答の専用エンジン
#として見るべきです。
##
\4. GPU、TPU、LPUを時代別に見る
#学習の時代
#AIモデルを巨大化させる時代では、GPUとTPUが強いです。
#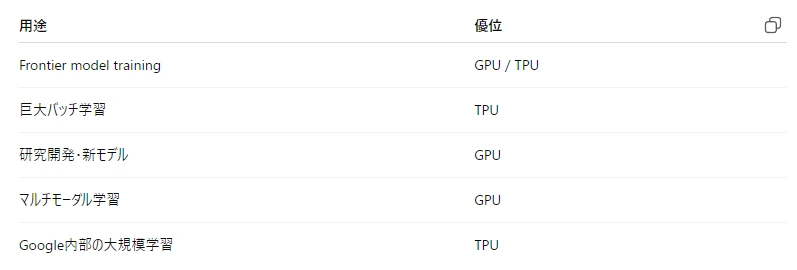
この段階ではLPUは主役ではありません。 LPUは基本的に推論側です。
##
推論爆増の時代
#モデルを作るだけでなく、何十億、何百億、何兆回も呼び出す時代になると、LPUやTPUの重要性が上がります。
#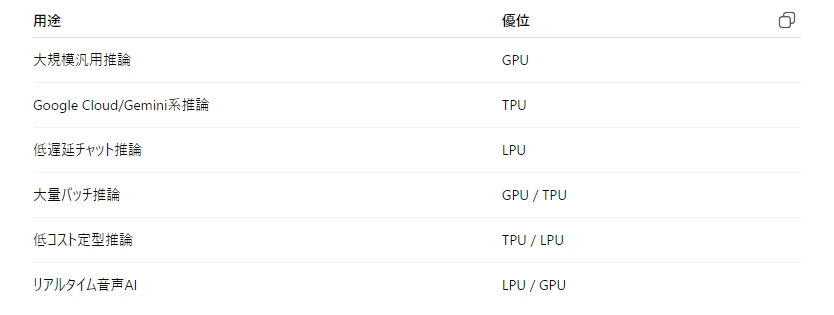
ここでは、GPU一強ではなくなります。
#大量・定型・低遅延・高頻度になるほど、専用アクセラレータの存在感が増えます。
##
AIエージェント時代
#AIエージェント時代は複雑です。
#なぜなら、エージェントは単純なLLM推論だけでなく、ツール呼び出し、検索、DB、API、Python実行、ファイル操作などを含むからです。
#この時代の役割分担はこうです。
#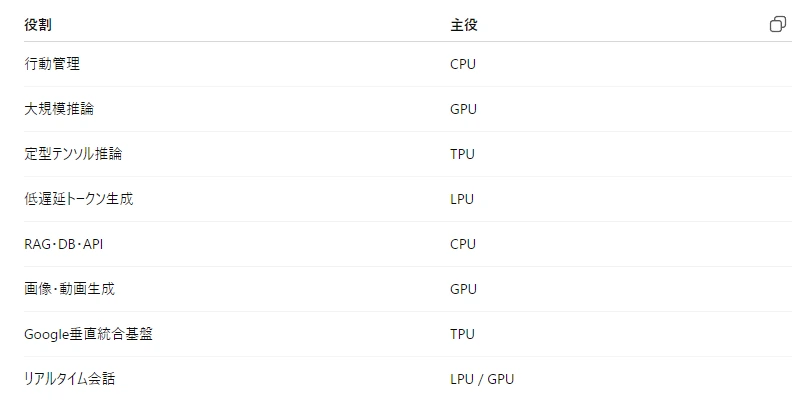
つまりAIエージェント時代では、
#CPUが司令塔 GPUが万能AI工場 TPUが巨大テンソル工場 LPUが低遅延言語エンジン
#になります。
##
\5. 工学的な違いで見る優位性
#GPUの優位性:柔軟な大量並列
#GPUは、多少の分岐や不規則性を含みながらも、大量並列をこなせます。
#行列演算
Attention
MoE
画像生成
動画生成
科学計算
ロボティクス
独自カーネルに対応しやすい。
#モデルが変わる時代にはGPUが強いです。
##
TPUの優位性:規則的な行列計算の効率
#TPUは、systolic arrayで行列演算を規則的に流します。
#巨大バッチ
定型モデル
XLAで最適化できる計算グラフ
Googleクラウド上の大規模学習/推論に強い。
#モデルと計算形状が安定している時代にはTPUが強いです。
##
LPUの優位性:低遅延の逐次トークン生成
#LPUは、LLM推論のトークン生成を高速・安定・低遅延に流すことに寄っています。
#チャット
音声AI
リアルタイム翻訳
AIエージェントの短い反復推論
コーディング補助
低レイテンシAPIに強い。
#人間が待っているリアルタイムAIにはLPUが強いです。
##
\6. かなり簡単なたとえ
#GPU
#総合AI工場です。
#カレーも作れる。 寿司も作れる。 パンも作れる。 新メニューにも対応できる。 しかも巨大チェーン店として世界中に展開済み。
#だから一番汎用的で、一番強い。
##
TPU
#Google専用の巨大カレー工場です。
#カレーを大量に作るなら非常に安く速い。 材料搬入、工場ライン、配送、販売までGoogle内部で統合されている。
#ただし、急に寿司やケーキを作れと言われると、GPUほど柔軟ではない。
##
LPU
#ラーメン替え玉専用の超高速ラインです。
#1玉ずつ、すぐ出す。 待ち時間が少ない。 リアルタイム会話に強い。
#ただし、料理全般を任せる万能厨房ではない。
##
\7. 投資・産業目線での整理
#この時代、GPUの優位性はまだ非常に強いです。
#なぜなら、AIの最先端はまだ変化が激しく、学習・推論・マルチモーダル・ロボティクス・シミュレーションまで全部を支える必要があるからです。 この「何にでも対応できるAI工場」というポジションは、GPUの最大の強みです。
#一方、TPUやLPUの優位性は、推論が産業化・定型化・大量化したときに強くなります。
#同じモデルを大量に回す
同じ形の推論を何億回も行う
レイテンシを極限まで下げる
1トークンあたりコストを削るこうなると、専用アクセラレータが勝ちやすい。
#つまり、
#探索・開発・最先端モデル = GPU優位 定型化した巨大テンソル処理 = TPU優位 低遅延LLM推論 = LPU優位
#です。
##
まとめ
#この時代におけるGPU、TPU、LPUの優位性は、次のように整理できます。
#
最終的には、どれか1つが全部を置き換えるというより、
#CPU:司令塔
GPU:万能AI工場
TPU:巨大テンソル専用工場
LPU:低遅延言語推論エンジンという分業になります。
#そして、最も重要なのはここです。
#GPUは「変化に強い」。 TPUは「定型化した大規模計算に強い」。 LPUは「リアルタイム推論に強い」。
#AIがまだ急速に進化している間はGPUが中心に残りやすい。 一方で、推論が大量化し、モデルや用途が安定してくるほど、TPUやLPUのような専用アクセラレータの価値が高まっていくと思います。
#はい。ここはかなり重要です。
#結論から言うと、TPU/LPUでGPUを置き換えようとするとき、GPUにあってTPU/LPUに足りない部分をCPUで補うことはできます。 ただし、それで完全にGPUの代用になるわけではありません。
#なぜならGPUの強みは、単なる行列演算能力だけではなく、
#ある程度の汎用性を持った大量並列計算機であること
#にあるからです。
#TPU/LPUは、より専用化されています。 CPUで制御部分を補っても、GPUが持つ「柔軟な並列計算能力」そのものはCPUでは補いにくいです。
##
\1. まず全体像
#役割を分けると、こうです。
#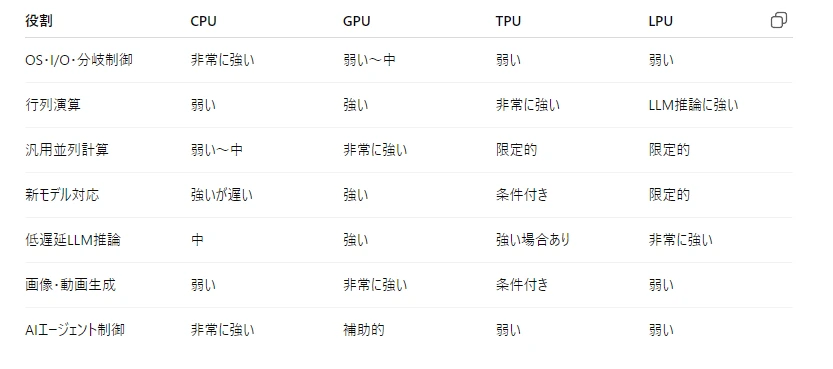
つまり、
#CPU + TPU/LPUで補えるのは、
#CPU:制御・分岐・OS・I/O
TPU/LPU:決まったAI計算です。
#しかし、GPUの強みである、
#柔軟な大量並列計算
広いモデル対応
独自カーネル
画像・動画・物理シミュレーション
研究開発の柔軟性
CUDAエコシステムまでは、簡単には代用できません。
##
\2. CPUで補える部分
#TPU/LPUは、分岐やI/OやOS処理が苦手です。 ここはCPUでかなり補えます。
#たとえばAIエージェントでは、CPUが次を担当できます。
#ユーザーリクエスト受付
認証
ログ保存
RAG検索
DB照会
API呼び出し
Python実行
ツール選択
条件分岐
ファイルI/O
ネットワーク通信
エラー処理
再試行
ジョブスケジューリングそして、モデル本体の推論だけをTPU/LPUへ投げます。
#CPU:次に何をすべきか決める
↓
TPU/LPU:LLM推論を高速に実行
↓
CPU:結果を見て次のツールを呼ぶ
↓
TPU/LPU:また推論するこれは十分に現実的です。
#特に、チャット、音声AI、リアルタイム翻訳、定型的なLLM推論、社内AIエージェントでは、この構成は強いです。
##
\3. CPU + TPU/LPUで代用しやすい領域
#\1. 定型的なLLM推論
#同じモデル、同じような入力、同じような出力形式で大量に回すなら、TPU/LPUは強いです。
#例:
#チャットボット
カスタマーサポート
定型要約
定型翻訳
FAQ応答
社内文書検索
議事録要約このような用途では、CPUが周辺制御を行い、TPU/LPUが推論を処理する形でGPUを代替しやすいです。
##
\2. 低遅延の言語生成
#LPUはここが一番強いです。
#GroqはLPUについて、静的スケジューリングと決定論的実行により予測可能な性能を出す設計だと説明しています。またオンチップSRAMを主要な重み保存先として使い、レイテンシを抑えるとしています。(Groq)
#つまり、LPUは、
#次のトークンを速く出す
リアルタイム会話を滑らかにする
音声AIの応答遅延を減らす
エージェントの短い推論ループを速くする用途ではGPUの一部を置き換えやすいです。
##
\3. Google型の大規模テンソル計算
#TPUは、Googleのようにモデル、コンパイラ、クラウド、運用を垂直統合できる環境では非常に強いです。
#Google Cloudは、TPUは行列計算が支配的な大規模MLジョブ、大きなバッチサイズ、長期間の学習、超大規模embeddingを持つモデルなどに向くと説明しています。一方で、頻繁な分岐、動的shape、main training loop内のカスタム演算などには向かないとしています。(Google Cloud Documentation)
#つまりTPUは、
#形が安定した大規模学習
大規模推論
推薦モデル
検索・広告・ランキング
Google Cloud上のAIではGPU代替になりやすい。
##
\4. それでもGPU代用が難しい領域
#ここが本題です。
#CPUで制御を補っても、TPU/LPUでGPUを代用しにくい領域があります。
##
\1. 新しいモデル構造への対応
#GPUの最大の強みは、新しいモデルに対する柔軟性です。
#AIのモデル構造は毎年変わります。
#Transformer
MoE
Diffusion
State Space Model
Mamba系
マルチモーダルモデル
動画生成モデル
ロボティクス基盤モデル
世界モデル
強化学習
推論モデルこのように処理の形が変わると、TPU/LPUのような専用機は最適化が追いつきにくいことがあります。
#GPUはCUDAやPyTorch、Tritonなどで新しいカーネルを書きやすい。NVIDIAはCUDAを、C++、Python、FortranやPyTorchなどからGPUを活用できるソフトウェア層として位置づけています。(NVIDIA Developer)
#つまり、GPUは、
#まだ形が定まっていないAI
研究開発中のAI
新しい演算が必要なAIに強いです。
#CPU + TPU/LPUでは、CPUが制御できても、TPU/LPU側に適した実行パスがなければ性能が出ません。
##
\2. 画像生成・動画生成・3D・ロボティクス
#LPUは基本的に言語推論向けです。 画像生成や動画生成には向きません。
#TPUはテンソル計算なので画像系にも使えますが、現実の生成AIではモデル構造やカスタム演算、メモリパターン、ライブラリ対応が重要です。
#画像生成・動画生成では、
#Diffusion
U-Net
DiT
VAE
ControlNet
3D Gaussian Splatting
NeRF
動画の時系列処理
マルチモーダル融合のような多様な処理が出ます。
#GPUはこのような多様な演算を比較的柔軟に処理できます。 LPUでは代用が難しい。TPUでも環境やモデル次第で制約が出やすい。
##
\3. カスタム演算・独自カーネルが多い領域
#AI研究や高度な推論基盤では、標準レイヤーだけでは足りません。
#独自Attention
FlashAttention系
独自MoEルーティング
量子化カーネル
特殊なKV cache管理
Sparse演算
低精度演算
推論最適化カーネル
カスタムオペレーターこういう領域では、GPUのプログラマブル性が強いです。
#TPUはXLAで最適化できる形なら強いですが、Google Cloud自身もTPUはメインループにカスタム演算を含むニューラルネットワークには向かないと説明しています。(Google Cloud Documentation)
#CPUで制御を補っても、肝心の重いカスタム演算を高速に走らせる場所が必要です。 ここでGPUが残ります。
##
\4. 動的shape・不規則なバッチ・長さがバラバラの推論
#実サービスのAI推論では、ユーザーごとに入力長が違います。
#10トークンの質問
1000トークンの文書
10万トークンの長文
画像付き入力
ツール呼び出しあり
途中でキャンセル
ストリーミング出力このように形がバラバラです。
#TPUは大きなバッチで形が揃っていると強いですが、動的shapeや頻繁な分岐は苦手です。(Google Cloud Documentation)
#GPUも完璧ではありません。NVIDIA CUDAでも、warp内で分岐が分かれると各分岐パスを順に実行するため効率が落ちると説明されています。(NVIDIA Docs)
#ただしGPUは、TPU/LPUよりも不規則性に耐えやすいです。
##
\5. MoE、ルーティング、疎行列、条件付き計算
#MoE、つまりMixture of Expertsでは、トークンごとに使う専門家モデルが変わります。
#このトークンはExpert 3へ
このトークンはExpert 12へ
このトークンはExpert 1と7へこれは行列演算だけでなく、
#ルーティング
通信
ロードバランス
疎なアクセス
専門家ごとのバッチングが重要です。
#GPUはNCCL、CUDA、カスタムカーネル、NVLinkなどを使って、このような不規則な大量並列処理に対応しやすい。
#TPUでもMoEは可能ですが、実装・環境・コンパイラ・通信設計に強く依存します。 LPUはこの種の汎用的なMoE学習・推論には向きにくいです。
##
\6. 大規模学習
#LPUは基本的に推論特化なので、大規模学習のGPU代替にはなりにくいです。
#TPUは大規模学習に強いですが、Googleの環境に寄ります。 広いAI業界で見ると、研究者・OSS・クラウド・企業内スタックはGPU中心で構築されています。
#大規模学習では、
#分散学習
勾配同期
混合精度
チェックポイント
カスタムオペレーター
新モデル実験
デバッグ
プロファイリングが必要です。
#この柔軟性とエコシステムの厚みでは、GPUが非常に強いです。
##
\7. HPC、科学技術計算、シミュレーション
#GPUはAI以外にも強いです。
#流体解析
分子動力学
気象予測
金融シミュレーション
物理シミュレーション
レイトレーシング
3Dレンダリング
ロボティクスシミュレーションこうした処理は、単純なLLM推論とは違います。
#TPU/LPUはこの領域では代用しにくいです。 特にLPUはほぼ対象外です。
#GPUはAIだけでなく、HPCとグラフィックスの歴史を持つため、ここで大きな優位性があります。
##
\5. 「CPUで補う」ときの限界
#CPUでTPU/LPUの弱点を補うことはできます。 しかし、CPUで補うときには3つの限界があります。
#限界1:CPUは計算密度が低い
#CPUは分岐や制御には強いですが、巨大な行列演算ではGPU/TPU/LPUに負けます。
#つまりCPUは、
#制御はできる
でも重い並列計算は肩代わりしにくいです。
##
限界2:CPUとTPU/LPUの間でデータ移動が発生する
#CPUが制御し、TPU/LPUが推論する場合、処理のたびにデータ移動や同期が発生します。
#CPUで判断
↓
アクセラレータへ投入
↓
結果をCPUへ戻す
↓
CPUで次の判断
↓
またアクセラレータへ投入AIエージェントのように短い推論とツール処理を何度も繰り返すと、この往復がボトルネックになることがあります。
##
限界3:アクセラレータ側が対応していない処理は速くならない
#CPUがどれだけ賢くても、TPU/LPU側にその演算を高速に実行する仕組みがなければ、性能は出ません。
#つまり、
#CPU = 司令塔
TPU/LPU = 専用工場だとして、専用工場が作れない品目は、司令塔が命令しても作れません。
#ここでGPUの「万能工場」性が効きます。
##
\6. GPUが残り続ける核心部分
#GPUにあってTPU/LPUに欠けやすいのは、次の4つです。
#\1. 汎用プログラマブル性
#GPUは、AI専用機ではなく、広い意味での並列プロセッサです。
#新しい演算、新しいモデル、新しい推論方式に対応しやすい。
##
\2. ソフトウェアエコシステム
#CUDA、PyTorch、TensorRT、Triton、cuDNN、NCCL、各種カーネル最適化が厚い。
#このエコシステムが、GPUの最大の堀です。
##
\3. 多用途性
#GPUは、
#学習
推論
画像
動画
音声
3D
HPC
ロボティクス
シミュレーションを横断できます。
#LPUは言語推論に偏ります。 TPUはテンソル計算に強いが、環境依存が大きい。
##
\4. 不確実な未来への対応力
#AIはまだ最終形が見えていません。
#どのモデル構造が主流になるか、どの推論方式が勝つか、どのデータ型が標準になるか、まだ変化しています。
#この不確実性の時代には、専用機よりGPUが強いです。
##
\7. まとめると
#CPU + TPU/LPUでGPUを代替しやすい領域は、
#定型LLM推論
低遅延チャット
音声AI
固定モデルの大量推論
Google型の大規模テンソル処理
社内AIエージェントの一部です。
#一方、代替しにくい領域は、
#新モデル研究開発
画像生成
動画生成
マルチモーダル
ロボティクス
HPC
大規模学習
カスタム演算
独自カーネル
MoE・疎演算・動的shape
不規則な大量並列処理です。
#一言で言うと、
#**CPUでTPU/LPUの“制御の弱さ”は補える。 しかし、GPUの“柔軟な大量並列計算能力”は補いにくい。**
#です。
#だから今後のAIインフラは、
#CPU + TPU/LPU がGPUを完全に置き換えるというより、
#GPU:変化に強い万能AI基盤
TPU:定型化した巨大テンソル処理
LPU:低遅延LLM推論
CPU:制御・I/O・エージェント実行という分業になると思います。
##
VLAにおけるCPU、GPU、LPU、TPUの役割
#結論から言うと、画像生成・動画生成は、単なるクリエイティブ用途ではなく、VLM/VLA/ロボティクスにとって「世界を学ぶための教材」と「行動を試す仮想実験場」になります。
#そしてVLAにおける計算資源の役割は、おおまかにこうです。
#CPU:身体と現実世界を管理する司令塔 GPU:視覚・動画・生成・学習・シミュレーションの主力 TPU:定型化した巨大テンソル計算を高効率に回す専用工場 LPU:低遅延の言語推論・計画ループを回す補助エンジン
##
\1. なぜ画像生成・動画生成がVLM/VLAに重要なのか
#VLMは Vision-Language Model、つまり画像や動画を見て、言語で理解・推論するモデルです。 VLAは Vision-Language-Action Model、つまり画像・言語を入力し、ロボットの行動まで出力するモデルです。
#Google DeepMindのRT-2は、Web規模の視覚・言語データで事前学習したVLMを、ロボット観測から行動へ変換できるVLAへ拡張する研究です。DeepMindはRT-2について、Webとロボットデータの両方から学習し、視覚と言語の知識をロボット制御に転移するモデルだと説明しています。(Google DeepMind)
#つまり、VLAはこういう構造です。
#画像を見る
↓
言語命令を理解する
↓
状況を推論する
↓
何を掴むか、どこへ動かすかを決める
↓
ロボットの行動に変換するここで重要なのは、ロボットが必要とする知能は「物体名を知っている」だけでは足りないことです。
#ロボットは、
#このコップは倒れやすい
この箱は押せば滑る
この布は柔らかく変形する
このドアは取っ手を回す必要がある
この人の手を避けなければ危ないという、物理世界の変化を理解する必要があります。
#この「変化」を学ぶには、静止画像だけでは不十分です。 だから動画が重要になります。
##
\2. 画像生成は「見た目の多様性」を増やす
#画像生成は、VLM/VLAにとって 視覚データの多様化装置 です。
#ロボットは現実世界で、毎回違うものを見ます。
#照明が違う
背景が違う
物体の色が違う
机の材質が違う
カメラ角度が違う
人間の手が写り込む
影や反射がある
物が半分隠れている現実のロボットデータだけでこれらを全部集めるのは大変です。 そこで画像生成や合成データが重要になります。
#画像生成によって、
#同じタスクを別の部屋で再現する
別の物体に置き換える
照明や影を変える
珍しい失敗例を作る
危険な状況を仮想的に作ることができます。
#これは、VLAにとって「現実で起きる無数の見た目の揺らぎ」に強くなるための訓練になります。
#ただし、画像生成だけでは「時間変化」が足りません。 ロボットにとって本当に重要なのは、行動した結果、世界がどう変わるか です。 ここで動画生成・世界モデルが重要になります。
##
\3. 動画生成は「物理世界の時間変化」を学ばせる
#動画生成は、VLAにとって 未来予測の教材 です。
#ロボットは行動する前に、ある程度こう考える必要があります。
#これを押したらどう動くか
これを掴んだら落ちるか
この方向へ腕を動かすとぶつかるか
この物体は転がるか
この箱は開くか
人間が近づいてきたらどう避けるかこれは言語だけではなく、動画的な世界理解です。
#MetaのV-JEPA 2は、インターネット規模の動画データと少量のロボット軌道データを組み合わせ、物理世界を理解・予測・計画するモデルを目指す研究です。MetaはV-JEPA 2を、動画から視覚理解と予測を行い、新しい環境でゼロショットのロボット制御を可能にする世界モデルとして説明しています。(AI Meta)
#これは非常に重要です。 なぜならロボットは、単に「見えているもの」を認識するだけでなく、次に何が起こるか を予測しなければならないからです。
#つまり動画生成・動画予測は、ロボットにとっての「想像力」に近いです。
##
\4. 世界モデルは、ロボットの仮想訓練場になる
#動画生成がさらに進むと、単なる動画ではなく World Model / 世界モデル になります。
#世界モデルとは、環境の状態や行動の結果を予測するモデルです。 Google DeepMindはProject Genieについて、世界モデルは環境のダイナミクスをシミュレートし、世界がどう変化するか、行動がどう影響するかを予測するものだと説明しています。(blog.google)
#NVIDIA Cosmosもこの方向です。NVIDIAはCosmosをPhysical AI向けのWorld Foundation Modelプラットフォームとして位置づけ、テキスト・画像・動画から予測的な動画世界を生成し、エッジケース、閉ループ方策、マルチビューのロボット中心シミュレーションを作れると説明しています。(NVIDIA)
#ここでのポイントは、動画生成が ロボットの練習場 になることです。
#現実のロボットで学習するには、時間もコストも危険もあります。
#ロボットが物を落とす
部品を壊す
人にぶつかる
工場ラインを止める
高価な実機を長時間使うこれをすべて現実で試すのは難しい。
#だから、世界モデルや動画生成で、
#危険な状況を仮想的に作る
珍しい失敗パターンを作る
倉庫や工場を仮想生成する
天候・照明・床面・障害物を変える
ロボットが行動した未来を予測することが重要になります。
#つまり、動画生成は「映像作品を作る技術」ではなく、フィジカルAIの訓練データ工場 になっていく可能性があります。
##
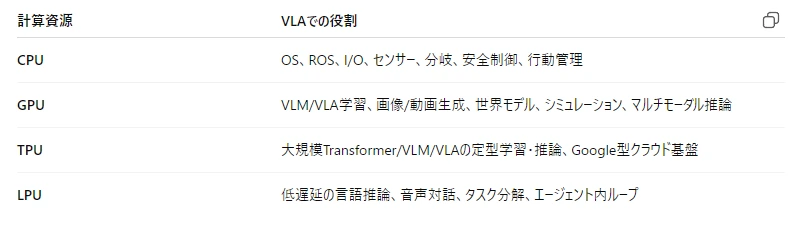
\5. VLAにおけるCPU、GPU、TPU、LPUの役割
#VLAは、1つのチップだけで完結するというより、複数の計算資源が役割分担するシステムです。
#かなり単純化すると、こうなります。
#カメラ・センサー
↓
CPU:入力管理、OS、ROS、I/O、安全制御
↓
GPU/TPU:視覚理解、VLM/VLA推論
↓
CPU:行動計画、制御、安全確認
↓
ロボット制御器・モーターさらにクラウド側では、
#GPU/TPU:大規模学習、動画生成、世界モデル、シミュレーション
CPU:データ管理、ジョブ制御、シミュレーション管理
LPU:低遅延の言語推論・エージェントループになります。
##
CPUの役割:身体と現実世界を管理する
#VLAにおけるCPUは、非常に重要です。
#CPUは、ロボットの「身体側」を管理します。
#OS
ROS / ROS2
センサー入力
カメラ入力
LiDAR
IMU
モーター制御
ネットワーク通信
ファイルI/O
安全監視
異常検知
タスクスケジューリング
人間の介入特にロボットでは、AIモデルの推論だけでなく、リアルタイム制御 が必要です。
#たとえば、VLAが「コップを掴め」と判断しても、実際にはCPU側や制御系が、
#関節角度を読む
モーターへ命令する
力覚センサーを見る
滑っていないか確認する
障害物を避ける
緊急停止する必要があります。
#つまりCPUは、VLAの中で 現実世界との接続係 です。
#AIエージェント文脈で言えば、CPUは「道具を使う」「状況に応じて分岐する」「失敗したら再試行する」部分を担当します。
##
GPUの役割:VLA時代でも最も広い主力
#GPUはVLA時代でも非常に重要です。 むしろ、画像生成・動画生成・世界モデル・ロボティクスが重要になるほど、GPUの価値は強く残ります。
#理由は、GPUが以下の処理に強いからです。
#VLM/VLAの大規模学習
画像生成
動画生成
世界モデル
3Dシミュレーション
ロボット学習
強化学習
マルチモーダル推論
Diffusion Transformer
Transformer推論
物理シミュレーション
レンダリングNVIDIAのGR00T N1は、ヒューマノイド向けのVLAモデルで、視覚言語モジュールが環境と指示を解釈し、後続のDiffusion Transformerがリアルタイムに滑らかな運動を生成する構成です。また、実ロボット軌道、人間動画、合成データの混合で学習すると説明されています。(arXiv)
#これはGPUの重要性をよく示しています。
#VLAでは、テキストだけでなく、
#画像
動画
3D空間
人間の動作
ロボット軌道
シミュレーション
合成データを扱います。
#このような多様なデータとモデルを横断できるのがGPUです。
#GPUは単なるLLM推論チップではなく、視覚・動画・物理・生成・シミュレーションを統合する万能AI工場 です。
##
TPUの役割:巨大テンソル計算を効率よく回す
#TPUは、VLAにおいては主にクラウド側の大規模学習・大規模推論で強みを持ちます。
#Google DeepMindのGemini Robotics 1.5は、視覚情報と指示をモーターコマンドへ変換してタスクを実行するVLAモデルとして説明されています。(Google DeepMind) また、Gemini Robotics On-Deviceはロボット本体で動くよう最適化され、ネットワークに依存しないため、低遅延や接続不安定な環境で有利だと説明されています。(Google DeepMind)
#Google系のVLAでは、TPUはかなり自然な選択肢になります。
#TPUが向くのは、
#巨大なTransformer
大規模VLM学習
大規模VLA学習
定型的なテンソル推論
Google Cloud上の訓練
大量バッチ推論です。
#一方で、TPUはGPUほど汎用的ではありません。 VLA研究では、モデル構造、ロボット制御、動画生成、3D、Diffusion、シミュレーション、カスタム演算が次々に変わります。
#そのため、Googleのようにモデル・コンパイラ・クラウド・データセンターを垂直統合できる場合はTPUが強い。 しかし、広いロボティクス業界全体では、柔軟性・開発環境・シミュレーション統合の面でGPUが主力になりやすいです。
##
LPUの役割:低遅延の言語・推論ループ
#LPUは、VLA全体の主役というより、言語推論やエージェント的な短い思考ループを低遅延で回す補助エンジン と見るのが自然です。
#VLAロボットは、単に連続的に手を動かすだけではありません。
#人間の指示を聞く
タスクを分解する
途中結果を説明する
次の行動を決める
失敗したら再計画する
別の道具を使うこういう部分には、低遅延の言語推論が効きます。
#LPUが向くのは、
#音声対話
短いLLM推論
タスク分解
エージェントの内部ループ
人間との応答
ロボットの説明生成です。
#ただし、LPUは画像生成・動画生成・3Dシミュレーション・VLA学習の主力にはなりにくいです。 LPUは「言語推論の高速ベルトコンベア」であり、フィジカルAIの全体を置き換えるものではありません。
##
\6. VLAを二層構造で見ると分かりやすい
#VLAロボットは、よく 遅い思考 と 速い制御 に分けて考えると理解しやすいです。
#NVIDIA GR00T N1も、人間の認知に着想を得た二重システムを採用し、System 2が視覚と言語に基づく熟考的な意思決定、System 1が反射的・直感的な高速行動モデルという構成だと説明されています。(NVIDIA Newsroom)
#これを計算資源に対応させると、こうです。
#System 2:遅い思考・計画・言語理解
CPU + GPU/TPU + 場合によってLPU
System 1:速い行動・運動生成・制御
GPU + CPU + ロボット制御器System 2は、
#何をすべきか
なぜそうするか
どの物体を対象にするか
人間の指示は何か
安全かを考える層です。
#System 1は、
#腕をどう動かすか
どの速度で動かすか
どう掴むか
滑ったらどう補正するかを処理する層です。
#ここで、GPUは両方に関われます。 視覚理解にも、行動生成にも、動画/シミュレーションにも使えるからです。
#TPUは主に大規模モデル側。 LPUは言語的な低遅延思考ループ。 CPUは全体の接続・安全・現実制御です。
##
\7. なぜフィジカルAIでGPUが強く残るのか
#VLAやロボティクスでは、TPUやLPUも重要ですが、GPUの優位性はかなり強いです。
#理由は、フィジカルAIが非常に雑多な計算の集合だからです。
#LLM
VLM
VLA
画像生成
動画生成
世界モデル
3Dシミュレーション
物理シミュレーション
強化学習
模倣学習
Diffusion Policy
ロボット軌道生成
視覚エンコーダ
マルチモーダル推論これらを全部そこそこ柔軟に処理できるのがGPUです。
#TPUは、形が安定した大規模テンソル計算では強い。 LPUは、低遅延の言語推論では強い。 しかし、フィジカルAIはまだ研究開発段階で、モデル構造もデータ形式も固まっていません。
#だから、不確実性が高い時代ほどGPUが強いです。
##
\8. ただし、推論が定型化するとTPU/LPUの領域も増える
#一方で、将来的にVLAの一部が定型化すると、TPUやLPUの存在感は上がると思います。
#たとえば、
#倉庫ロボットの定型ピッキング
工場内の検査ロボット
家庭内の定型タスク
音声対話付きロボット
特定業務向けVLA推論のように用途が固まると、GPUの汎用性よりも、TPU/LPUの効率や低遅延が重要になる可能性があります。
#特にLPUは、
#人間との会話
指示理解
短い計画
エージェント的な再推論に向きます。
#TPUは、
#Google Cloud上の大量VLA推論
巨大VLM/VLAの学習
定型化したテンソル計算に向きます。
#つまり、
#開発・学習・世界モデル生成はGPU中心 Google型の大規模定型計算はTPU 低遅延言語対話はLPU 現実制御はCPU
#という分業が現実的です。
##
\9. 投資・産業的な考察
#この流れを見ると、ロボティクス・フィジカルAIで重要になる半導体は、単に「ロボット用チップ」だけではありません。
#必要になるのは、
#GPU:動画生成、世界モデル、VLA学習、シミュレーション
CPU:ロボット制御、I/O、OS、安全、エージェント制御
メモリ:動画・センサー・軌道データ・KV cache
ストレージ:ロボットデータ、動画データ、シミュレーションデータ
ネットワーク:クラウド学習、ロボット群管理
TPU:大規模定型学習・推論
LPU:低遅延の言語インターフェースです。
#特に画像生成・動画生成がVLAに重要になると、GPU需要は単なる「チャットAI推論」だけでなく、
#ロボット訓練用の合成データ生成
動画世界モデル
デジタルツイン
工場・倉庫シミュレーション
自動運転向けエッジケース生成
人間動作データの生成・変換へ広がります。
#これはかなり大きいです。
#AIがデジタル空間だけでなく、物理世界へ出ていくほど、視覚・動画・3D・物理シミュレーション の需要が増えます。 そこではGPUの優位性が再び強くなります。
##
まとめ
#画像生成・動画生成は、VLAやVLMにとって重要です。 なぜなら、ロボットに必要なのは「言葉の理解」だけでなく、
#物を見る
変化を予測する
行動の結果を想像する
失敗例を学ぶ
仮想環境で練習する
現実に近い合成データを使うことだからです。
#VLAにおける役割分担は、こう整理できます。
#
そして最も重要なのは、フィジカルAIはGPUを弱めるのではなく、むしろGPUの用途を拡張するという点です。
#チャットAIでは、GPUは主にLLMを動かす装置でした。 しかしフィジカルAIでは、GPUは、
#世界を生成する
世界を予測する
ロボットを訓練する
仮想環境を作る
動画から物理を学ぶ
行動データを増やす装置になります。
#つまり、VLA時代のGPUは、単なるAI計算チップではなく、ロボットが現実世界を学ぶための「仮想世界生成エンジン」 になっていくと思います。
##
特定銘柄の推奨・勧誘を目的とするものではありません。投資判断はご自身の責任でお願いいたします。
#サムネはPixAIsunflowerモデルとGPTImage2.0
#