AIが半導体設計の堀を壊すとき、誰が残るのか――Frontier Model × Custom Silicon × FoundryのLearning Loop
絶ノイアの章 Sil-Kathnaの章この資料の日時
元資料の日付と、その本文が公に存在した確認日時は別の記録です。
本文に含まれる語句 HBM DRAM SRAM 帯域・データ移動 先端パッケージング 電力・給電 歩留まり チップレット AI推論 AIエージェント
この資料を根拠にした分析カード(試験中): Learning Loop――観測が次の変更と検証へ戻る経路を見る · QAC-GW × Learning Loop――改善が実効能力へ届くかを調べる
出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.09.23.4
- 記事内容のSHA-256
7548feb81e730781734e177f0382017f80ca479bf70e5cc5a49a7f1c073a51f3- 保存版のSHA-256
adbdb6b3e9dd1fef83daa0cb49a8d6dcd4615cedfbe898ed62334fb4fee6c089
外部証明の最終検査結果は詳細を開くと表示します。
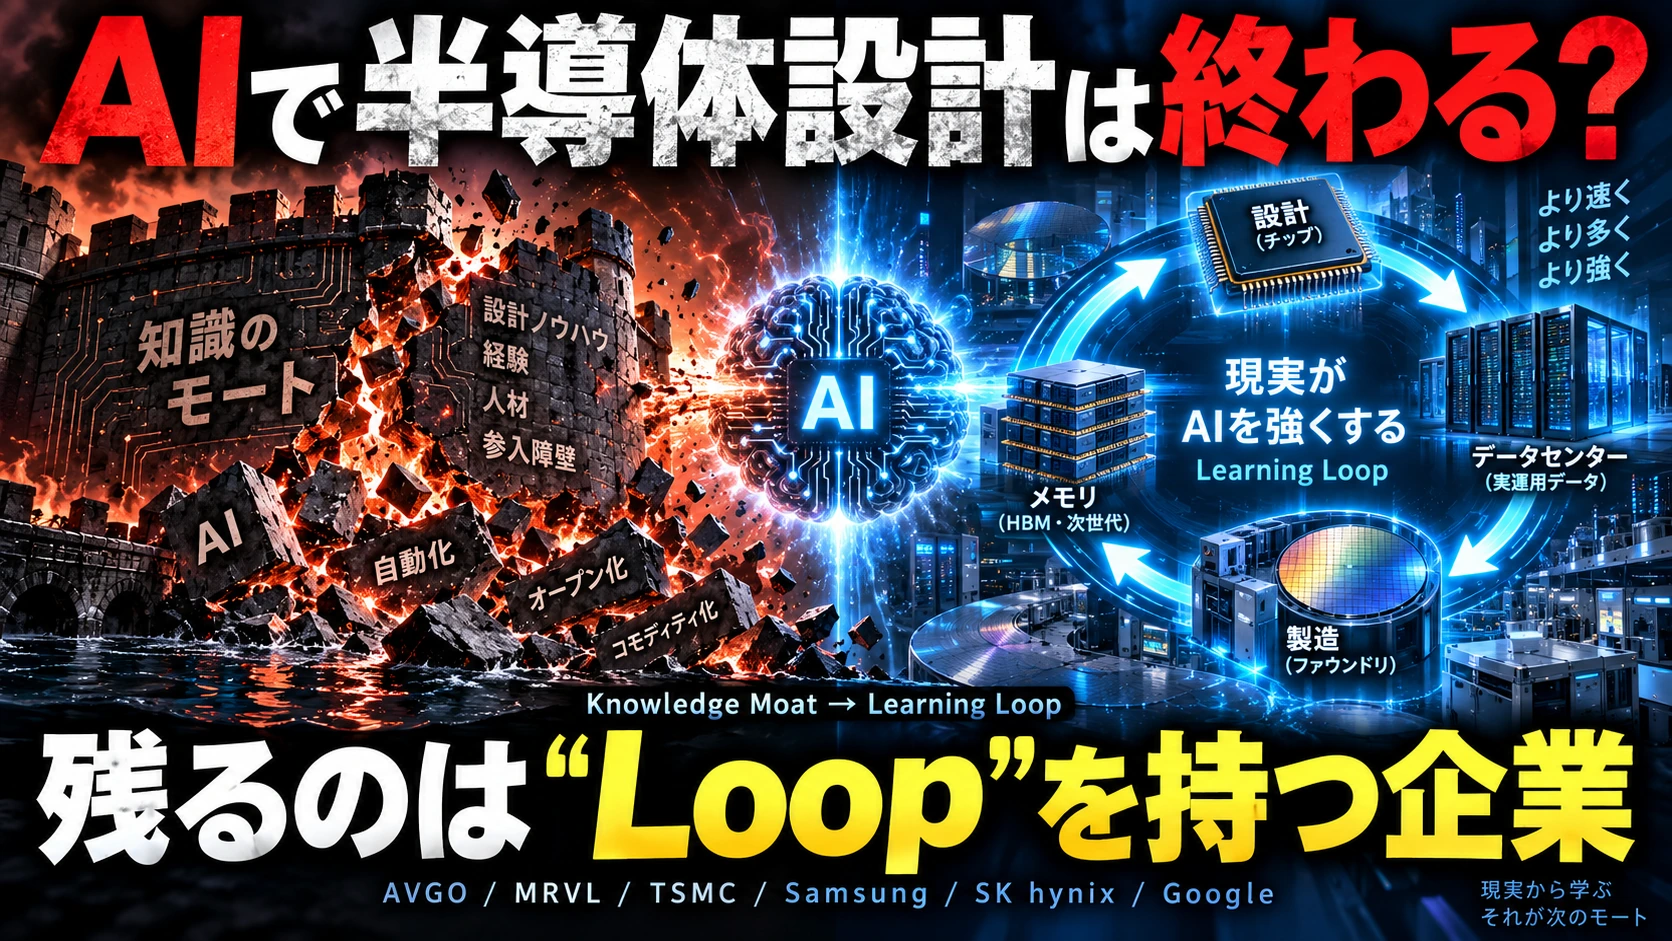
AIが半導体設計の堀を壊すとき、誰が残るのか――Frontier Model × Custom Silicon × FoundryのLearning Loop
#AIの性能向上を見ていると、半導体設計会社について一つの不安が浮かんでくる。
#OpenAIのGPT-6 Astraでは科学・数学・コーディング能力が急激に向上した。
#さらに2026年9月には、OpenAIがNavier–Stokes方程式のMillennium Prize Problemを解決したとする発表まで出てきた。これはまだ数学界による正式な確定とは別であり、研究の独立性を巡る論争もあるため、「解決済み」と扱うべき段階ではない。しかし、数千~数万のAI Agentを並列化して、従来人間が長期間取り組んできた高度な数学研究そのものへAIを投入する段階まで来た、という意味は大きい。(Axios)
#その能力が半導体へ流れ込むことは避けられない。
#実際、それはすでに始まっている。
#OpenAIとBroadcomが共同開発した推論ASIC「Jalapeño」は、初期設計からmanufacturing tape-outまでわずか9か月だった。OpenAI自身が、モデルを使ってimplementation探索、設計、測定、verification loop、算術回路の最適化を高速化したと説明している。さらにCodexとGPT-Astraを利用して、当初予定していなかった3種類のopen-weight modelを2か月以内に高性能化し、一部Attention/MoE blockではAI生成実装が人間の専門家による実装より1.5~1.8倍高速だった。(OpenAI)
#これを見ると、最初に浮かぶ仮説はかなり単純だった。
#なら、
#となる。
#OpenAI、Google、Meta、AnthropicのようなFrontier Model開発企業が少人数の半導体専門家を採用し、Astraやその次世代モデルを使えば、自らCustom Siliconを設計できる。
#そうであるなら、
#や
#のようなCustom Silicon企業は、最終的に顧客自身へ仕事を奪われるのではないか。
#そして最後まで残るのは、
#つまりTSMC、Samsung、SK hynix、Googleのような、「AIでは生成できない物理的capacity」と「実際のworkload」を所有する企業だけではないか。
#この仮説に立つと、AVGOやMRVLを保有し続けることにはかなり疑問が出てくる。
#しかし、Jalapeño、Google TPU、Meta MTIA、Samsung–Broadcom協業、Google–Marvell契約まで深く見ていくと、もう一つ全く逆方向の構造変化が見えてくる。
#それは、
#という可能性である。
#1.AIが破壊するのは「知識の堀」
#従来、半導体設計会社の価値の大部分は、
#だった。
#優秀なRTL engineerがいる。
#SerDes専門家がいる。
#Verification、P&R、SI/PI、Packagingを知っている。
#その人材とノウハウが少数企業へ集中していること自体が参入障壁だった。
#しかしAIはここを猛烈に圧縮し始めている。
#Anthropicも現在、Claudeのsilicon design能力そのものを強化するため、「Chip Design RL」の研究者を募集している。対象はagentic RTL generation、formal verification、physical-design optimization、PPA、DFT、ECO、EDA automationまで広い。さらにAnthropic自身がCustom Silicon teamを作り始め、front-end design、verification、physical design、analog/mixed-signal、foundry、packaging、SI/PIまで少人数でカバーする求人を出している。(Greenhouse)
#特に興味深いのは、Anthropicが巨大な従来型半導体組織を最初から作ろうとしていない点である。
#求人には、
#one of a small number of people covering a large surface
#という思想が明確に現れている。
#さらにASIC design house、IP vendor、foundry、OSATを利用する「partner-heavy program」としている。(Greenhouse)
#つまり、
#ではなく、
#でチップを作る時代へ向かっている。
#ここまでを見ると、Custom Silicon会社に弱気になるのは自然である。
#2.しかし「AIが知っている」と「量産可能」は同じではない
#ここから状況が変わる。
#AIが極めて高度な回路を設計できたとしても、
#だからである。
#例えば400G SerDesを設計するとする。
#理論上最適な、
#をAIが生成できても、実際のsiliconでは、
#が加わる。
#Simulationでは問題がなかった設計が、特定のprocess corner、特定温度、特定package構造だけでBERを急激に悪化させることもある。
#これは論理だけから完全には得られない。
#実物を作る必要がある。
#というloopが必要になる。
#AIによって高速化されるのは、このloopを「不要」にすることではない。
#むしろ、
#を高速化することである。
#3.新しいMoatは「Loop」になる
#従来のMoatを、
#とする。
#AI時代には、これが、
#へ変わっていく可能性がある。
#つまり、
#ではなく、
#になる。
#これをこの記事では、
#と呼ぶ。
#一度顧客と数世代のCustom Siliconを共同開発すると、そのvendorには、
#という顧客固有のphysical dataが蓄積する。
#そしてAI性能が高まるほど、そのprivate dataを利用する能力まで高まる。
#したがって、
#である一方、
#という逆の作用が起こり得る。
#4.JalapeñoはAVGOの堀を浅くしたのか、深くしたのか
#Jalapeñoを最初に見た時には、
#「OpenAIがチップ設計を覚えた。Broadcomは将来切られるのではないか」
#と考えやすい。
#しかし実際の役割を見ると少し違う。
#OpenAIがworkload、architecture、softwareを持つ。
#Broadcomはsilicon implementationの専門性を提供する。
#OpenAI自身もJalapeñoを単発ASICではなく「multi-generation platform」と位置づけている。(OpenAI)
#つまり、
#の関係を通じて、OpenAI側だけがBroadcomについて学ぶわけではない。
#Broadcomも、
#について学習する。
#Gen1で、
#Gen2で、
#Gen3で、
#が増えていく。
#するとBroadcomは、
#になる可能性がある。
#OpenAIがBroadcomを切れば、Broadcomのmarginは節約できる。
#しかし代替partnerによって次世代chipが半年遅れれば、その機会費用の方がはるかに大きい可能性がある。
#Frontier AIでは、
#そのものが経済的価値になる。
#5.Samsung–Broadcom 2000億ドル協業が示すもの
#ここでSamsung Electronicsが入ってくる。
#2026年7月、SamsungとBroadcomは2030年までの5年間で2000億ドル超と推計される戦略的協業のMOUを発表した。
#重要なのは金額そのものより範囲である。
#協業対象は、
#であり、Samsung HBMをBroadcomの次世代AI acceleratorへ供給することまで公式に明記されている。(Samsung Semiconductor Global)
#これは2000億ドルの確定発注ではない。
#MOUであるため、
#として扱う必要がある。
#しかし構造的な意味は大きい。
#Broadcom自身はすでに3.5D XDSiPを持ち、2nm custom compute SoCを出荷している。
#Broadcomの公式説明では3.5D platformで、
#はCustomer Ownedである一方、
#はBroadcom側が所有する技術となっている。(Broadcom Inc.)
#つまりBroadcomの事業は、
#から、
#へ動いている。
#ここへSamsungの、
#が接続される。
#SamsungはすでにHBM4を量産し、HBM4Eサンプルを出荷している。さらに2027年から顧客仕様に合わせたCustom HBMのsamplingを始める計画を公表している。(Samsung Global Newsroom)
#すると将来的には、
#↓
#↓
#↓
#という経路も成立し得る。
#さらにOpenAI自身も2026年9月、Samsungと次世代chip production/researchで協力を深めていることを認めている。(Reuters)
#まだOpenAI–Broadcom–Samsungが一つの製品で完全に統合されたとは確認できない。
#しかし三辺はすでに存在している。
#という構造は、Googleが一社内で持つModel→Chip→Datacenter loopを、企業間分業で再現する可能性を持つ。
#6.主要Frontier / HyperscalerのLoop構造
#2026年現在の構造を整理すると、各社は同じ方向へ進んでいるように見えて、実際には全く違う戦略を取っている。
#7.Google――現在最も完成したLearning Loop
#Googleは、
#↓
#↓
#↓
#↓
#↓
#↓
#を持つ。
#TPU 8世代では、trainingとinferenceでボトルネックが乖離したため、
#と
#へ明確に分化した。
#8tは大規模pre-training。
#8iはsampling、serving、reasoning。
#8iは288GB HBM、384MB SRAMを持ち、前世代よりSRAMを3倍へ増やし、Collectives Acceleration EngineとBoardfly topologyまで追加している。Google自身がreasoning、MoE、long-context decodingの実workloadからhardwareを変えていることが分かる。(Google Cloud)
#そしてBroadcomとの関係も極めて深い。
#2026年4月のLong Term Agreementでは、BroadcomがGoogleの将来世代TPUを開発・供給し、next-generation AI racks向けnetworkingその他componentsを最大2031年まで供給する。(SEC)
#この事実は、
#「AIが賢くなればGoogleはBroadcomを切る」
#という単純な仮説への強い反証になる。
#Googleはすでに長年TPUを設計している。
#AIも持っている。
#CompilerもDatacenterも持っている。
#それでもBroadcomを使っている。
#つまりBroadcomに残されている領域は、
#というより、
#と考えた方がよい。
#8.しかしGoogleはBroadcomへ完全Lock-inしていない
#ここが重要である。
#Googleは2026年7月、MarvellとのCustom Silicon契約を大幅拡張した。
#対象は公式に、
#の5種類である。(Marvell Technology, Inc.)
#しかもGoogleへ発行したwarrantは、FY2027 Q3からFY2033まで、Custom Product売上5億ドルごとに1 tranche、合計240 trancheがvestする。
#したがって売上条件の理論上限は、
#になる。(SEC)
#さらにMediaTekもGoogleのTPU supply chainへ入り始めている。
#Counterpoint ResearchはGoogle TPU 8tとその後継のMediaTek案件について、2028年に約500万個まで拡大する可能性を予測している。これは第三者予測でありGoogle公式出荷計画ではないが、GoogleがBroadcom-only modelから複数design partnerへ分散していることを示す重要な観測である。(Counterpoint Research)
#Googleは、
#を競わせながら、
#最上位の、
#を自分で所有する。
#これは非常に強い。
#9.Google–MRVL 5種類の2027~2030 Bottom-up
#ここからは推計である。
#確定情報は「5種類のprogramが存在する」「購入額連動warrantの理論上限が$120B」である。
#数量、ASP、attach rateは公開されていない。
#そこでGoogle TPU ecosystemのaccelerator相当出荷をBase caseとして、
#と置く。
#2028年6Mという仮定は、CounterpointがMediaTek系TPUだけで約5Mと予測していることを考えると、極端なBullではない。ただし当然、advanced packaging capacityや実際のTPU roadmapで大きく変動する。(Counterpoint Research)
#9-1.AI Inference Accelerator
#これはTPU本体そのものなのか、TPU ecosystemへattachする別acceleratorなのか公開情報だけでは確定できない。
#Baseでは独立したGoogle inference acceleratorとして、
#と置く。
#最終的にGoogle–MRVL契約で最大の売上源になる可能性が高い。
#9-2.Custom NIC
#8-XPU server相当で1 NIC、採用率40→80%、ASP $1,000→1,200と置く。
#9-3.Storage Controller
#KV Cache、checkpoint、weights、embeddingなどがHBM/DRAMからSSD階層へ溢れると、storage controllerのsilicon contentも上がる。
#Baseでは採用server当たり$900→1,300、attach 25→50%。
#9-4.Memory Interface Controller
#CXL等でHBMの外側へ巨大DDR poolを接続する部分。
#Baseでは採用server当たり$1,300→1,800、attach 15→55%。
#9-5.Near-Memory Compute
#Agentic AI、KV Cache、Vector Searchではデータを毎回XPUへ戻すより、Memory近傍でfilter、reduction、lookup等を処理した方が効率が良い。
#Baseでは採用server当たり$1,500→2,500、attach 5→40%。
#5種類合計
#2027~2030累計は、
#となる。
#これは$120B warrant ceilingの約26%であり、2031~33年の追加rampを十分残している。
#そしてXPU本体以外の4種類だけを8-XPU server相当で見ると、MRVL silicon contentは、
#へ上がるBase caseになる。
#つまりMarvellの本当のBull thesisは、
#だけではない。
#である。
#10.MRVLはMemory Wallを取りに行く
#MarvellはCustom HBMで、
#を共同設計するarchitectureを持っている。
#MarvellによればCustom HBMによって、設計次第ではHBM memory容量を最大33%増やし、memory I/O powerを70%以上削減し、XPU die areaを最大25%解放できる。Samsung、SK hynix、Micron全社と協業している。(Marvell Technology, Inc.)
#さらに2nm Custom SRAMでは、通常SRAM比でXPU全体のdie areaを最大15%解放し、standby powerを最大66%削減するとしている。(Marvell Technology, Inc.)
#これは非常に重要である。
#AI acceleratorの競争が、
#だけではなく、
#というMemory Hierarchy全体へ移っているからである。
#11.GoogleでAVGOのWallet Shareが減っても、AVGO売上が減るとは限らない
#GoogleがMRVLとMediaTekを追加したことは、Broadcomには明確なwallet-share riskである。
#しかし、
#と、
#は同じではない。
#例えばGoogle AI silicon marketが100から300へ拡大する中で、
#Broadcom shareが、
#へ落ちても、
#Broadcom売上は、
#になる。
#CounterpointもGoogleのMediaTek採用によってBroadcom依存を減らす動きを指摘する一方、Broadcomは将来TPUとAI rack componentsで2031年まで長期契約を持つ。(Counterpoint Research)
#したがってAVGOについて見るべきなのは、
#「Googleでシェアを失ったか」
#だけではなく、
#である。
#12.一方OpenAIではAVGOのContent/XPUが上がる可能性がある
#GoogleではMarvellがmemory/Data Movementへ入り込む。
#一方OpenAIでは逆の現象が起こり得る。
#Broadcomはすでに、
#を持つ。
#SamsungがCustom HBMを2027年からsamplingする。
#すると、
#に、
#を追加できる可能性がある。
#その時BroadcomはOpenAI XPUの単なる「設計受託」ではなく、
#全体を最適化する会社になる。
#この場合、
#となる。
#Googleで失うTAMをOpenAI、Metaその他のcustomerで取り返せる構造である。
#13.Meta――Jalapeño現象がもう一度起きる候補
#Metaも非常に重要になっている。
#2026年3月、Metaは今後2年間でMTIAを4世代開発・展開すると発表した。
#既に数十万個のMTIAをproduction inferenceへ投入している。(Facebook)
#4月にはBroadcomとmultiple generationsのMTIAを共同開発する契約を拡大した。(Facebook)
#さらにMTIA 300ではNIC chipletをpackage内部へ取り込み、12個の800Gbps RDMA NIC、near-memory compute blockまで搭載している。つまりMeta自身がCommunicationとMemory Wallをchip architectureへ吸収し始めている。(Engineering at Meta)
#MetaにはGoogleと違う巨大な資産がある。
#から得られるbillions of daily inferenceである。Meta自身も数十億回規模のinferenceをCustom MTIAで処理するとしている。(Facebook)
#ここへMetaのFrontier Model能力が高まり、Broadcomのsilicon implementation能力とAI-assisted designが結合すれば、
#が起こる可能性がある。
#しかもMetaには既に過去MTIA世代のphysical dataがある。
#Jalapeñoが「初代で最先端へ接近した」のに対し、Metaは既存データからスタートできる。
#14.MetaはBroadcom一本ではない
#Metaは用途ごとに設計企業を使い分けている。
#MTIAではBroadcomが深い。
#CPUではArmと複数世代CPUを共同開発する。(Facebook)
#AMDとも最大6GWのmulti-generation agreementを結び、Meta workload向けcustom MI450-based GPUを導入する。(Advanced Micro Devices, Inc.)
#つまりMetaの戦略も、
#方向へ向かっている。
#Googleとよく似ている。
#15.Amazon――Frontier Modelを持たないことは弱点なのか
#AWSはGoogleやOpenAIとは異なる。
#AmazonにもNovaがあるが、現状の最大の強みは、
#ではなく、
#を集約できることにある。
#AnthropicはAWS Trainium、Google TPU、NVIDIA GPUを同時利用している。Amazonはprimary cloud/training partnerである一方、AnthropicはGoogle/Broadcomからも大量TPU capacityを確保している。(Anthropic)
#さらに2026年2月にはOpenAIもAmazonと大型提携し、AWS上でTrainiumを2GW利用する契約を結んだ。(US Press Center)
#つまりAWSは、
#という異なるworkloadを一つのinfraへ集められる。
#これはGoogleの、
#とは異なる、
#である。
#16.Amazon–Qualcomm 600億ドル枠の意味
#2026年9月、AmazonとQualcommはmulti-generationのCustom Silicon協業を発表した。
#公式発表では用途を明確に、
#としている。
#さらに1.6TまでのOptical Connectivityと将来世代を共同開発し、QualcommのSerDesとOptical DSPを利用する。(Qualcomm Investor Relations)
#SEC filingではAmazonによるQualcommのserver chips、technology、systems、manufacturing servicesの購入に応じてwarrantがvestし、最大支払対象は600億ドルとなっている。これは600億ドルの確定購入ではない。
#興味深いのはQualcomm自身もAWS BedrockをEDAへ使用し、chip design cycle短縮を狙うと明記していることである。(Qualcomm)
#つまり、
#↓
#↓
#↓
#↓
#というloopが成立し得る。
#QualcommはHBCというMemory Wall向けHigh Bandwidth Compute architectureも展開している。(Qualcomm)
#AWSのgeneral inference、特にPrefill/Decodeの一部をQualcommが専門化する可能性は注視する価値がある。
#17.Anthropicは「Chipを持たない会社」ではなくなった
#Anthropicは今なおAWS、Google、NVIDIAを利用するmulti-hardware企業である。
#しかし2026年にはCustom Silicon teamを正式に立ち上げ始めた。
#Silicon Engineer求人では、
#まで対象としている。(Greenhouse)
#しかもClaude自身のsilicon design能力をRLで鍛えている。(Greenhouse)
#Anthropicは、
#という複数hardwareで同じClaude workloadを動かした経験を持つ。
#これは最初の自社chipを設計する上で非常に強いdata setになる。
#という設計が可能だからである。
#ただしpartner-heavy programであることも重要である。
#Anthropicの内製化は、
#という意味ではない。
#むしろ、
#となる可能性が高い。
#18.Microsoft――Hybrid型
#MicrosoftはMaia 200を2026年1月に発表した。
#TSMC 3nm、216GB HBM3e、7TB/s、272MB SRAMというinference acceleratorであり、GPT-5.2を含むOpenAI modelとMicrosoft自身のSuperintelligence workloadに利用する。(Microsoft Blog)
#MicrosoftのLoopは、
#↓
#↓
#↓
#↓
#となる。
#Googleほどmodel ownershipとhardware ownershipが一致していないが、Microsoft自身のFrontier Model能力が上がるほどLoopは深くなる。
#19.ではFoundryはやはり最終勝者なのか
#ここまでCustom Silicon企業を再評価しても、
#Foundryの強さが弱まったわけではない。
#むしろさらに明確になる。
#TSMCの2026Q2売上の66%はHPCで、7nm以下がwafer revenueの77%、2nmも既に3%を占め始めた。台湾半導体製造股份有限公司https://investor.tsmc.com/schinese/encrypt/files/encrypt_file/qr/phase4_reports/202607/bf09036349a253e83f78155099133806cad0320b/2Q26%20ManagementReport.pdf
#さらに3DFabricでは、
#を一つのecosystemとして統合している。
#TSMC自身も3DFabric turnkey serviceでmemory/material/substrate企業と共同し、automationから得るbig dataとdeep learningをpackaging fabへ利用している。(TSMC)
#つまりTSMC自身も巨大な、
#を持つ。
#Googleが勝っても作る。
#OpenAIが勝っても作る。
#Broadcomが勝っても作る。
#Marvellが勝っても作る。
#この非対称性は極めて強い。
#20.Samsungはさらに異なるPhysical Loopを狙う
#Samsungには、
#が一社内にある。
#これはTSMCとは違う強みである。
#TSMCは世界最強のfoundry ecosystem。
#Samsungは、
#の一体化。
#HBM4EでもSamsungは4nm logic base dieと1c DRAMを組み合わせ、FoundryとMemory間でdesign/process optimizationを行っている。(Samsung Global Newsroom)
#Broadcomとの2000億ドル協業が本当に深くなれば、Samsungのphysical dataとBroadcomのXPU dataが接続される。
#それこそがAVGOを再評価する最大の理由の一つである。
#21.中国は「Huawei版NVIDIA」だけではない
#中国では事情がさらに複雑である。
#確かにHuawei Ascendは中国版NVIDIAに最も近い。
#Huaweiは、
#というfull stackを持つ。
#Atlas 950 SuperPoDでは1024-chip実機を公開し、より大規模なSuperPoD/SuperClusterへ進んでいる。CANNもopen-source化を進めている。(Huawei)
#しかし中国Hyperscalerが全てHuaweiだけを使うわけではない。
#AlibabaにはT-Head。
#BaiduにはKunlunxin。
#TencentはEnflameをはじめmulti-vendor。
#ByteDanceは自社chip、Broadcom、Qualcomm、中国国内chipを組み合わせる方向である。
#22.Alibaba Zhenwu――中国版Google型Loop
#Alibabaは2026年にZhenwu M890を発表した。
#M890はtraining/inference両用で、agentic workloadを強く意識している。
#さらに、
#というロードマップを示している。Reutersもこの世代計画を報じている。(Reuters)
#第三者報道ではV900はM890比約3倍、216GB memory、1.2TB/s inter-chip bandwidthを目標としている。J900はさらにparallel computing architectureを大幅更新する計画だが、具体的仕様はまだ不明である。(TrendForce)
#特に面白いのはQwenとの関係である。
#Alibaba公式によると、Qwen 3.7-Maxを自分がtraining中に見たことのないM890へ与え、35時間、1000回超のtool callを行わせたところ、chip manufacturer公式kernelを大きく上回るkernelを作成したとしている。(Alibaba Group)
#これは中国でも、
#が始まっていることを示す。
#Alibabaは、
#という、中国で最もGoogle型に近いLoopを持つ。
#23.中国の最大制約はDesignではなくPhysicalになる
#中国のAI chip企業は現在、HBM不足による深刻な制約を受けている。
#2026年9月にはHuawei、Cambricon、MetaX、IluvatarなどがHBM不足を背景に価格を引き上げたとReutersが報じている。米国のadvanced HBM輸出規制も供給を難しくしている。(Reuters)
#したがって中国では、
#が進んでも、
#は残る。
#むしろ、
#の重要性が米国以上に強くなる可能性がある。
#Huaweiが単体chipだけでなくSuperPoDを強く押しているのも、この構造と整合する。
#弱いprocess nodeを、
#で補うからである。
#24.米国Custom Silicon企業が中国へ入る意味
#ByteDanceとBroadcomの関係はこの問題を象徴している。
#2024年、ReutersはByteDanceとBroadcomが輸出規制準拠の5nm AI ASICを共同開発し、TSMCで製造する計画を報じた。(Reuters)
#2026年にはさらにQualcommがByteDanceへCPU、Inference Accelerator、Custom ASIC、VPU等のCustom Chip Design Serviceを提供する協議を進めている。(Reuters)
#この構造には両面がある。
#米国design vendorは中国workloadと中国physical environmentについて学習できる。
#しかし中国customerも、米国ASIC methodologyを学習する。
#つまり、
#が起きる。
#25.米国企業が中国へ入る利点
#米国企業側には巨大TAMが生まれる。
#さらに中国特有の、
#の制約データが蓄積する。
#それをAIへ入力すれば、
#をより速く作れる。
#数世代続けば、中国市場で極めて代替困難なDesign Partnerになる可能性がある。
#26.しかし最大のリスクは「Stranded Loop」
#米国企業が中国customerと3世代共同開発した後、輸出規制によって突然関係を切られた場合、
#米国側は、
#を失う。
#しかし中国側には、
#で学んだknowledgeが残る。
#したがって、
#という非対称性が存在する。
#これが中国案件をGoogle/OpenAI案件より低いqualityのrevenueとして扱うべき理由の一つである。
#さらに米国輸出規制自体も固定ではない。2026年1月にはH200、MI325X等について一定条件下でcase-by-case審査へ変更された。つまり規制は緩和・強化どちらにも変化し得る。
#27.AVGOとMRVLをどう見るか
#ここまで来ると、最初の仮説、
#は半分正しく、半分間違っている。
#より正確には、
#だが、
#である。
#Broadcomは現在、
#という世界トップクラスのLoopへ複数世代で入り込んでいる。
#MarvellはGoogleで、
#というData Movement layerへ深く入ろうとしている。
#したがって、両社を見る時に、
#「ASIC設計会社だからAIに代替される」
#だけでは不十分である。
#見るべきなのは、
#である。
#28.AVGOとMRVLは最終的に専門分化する可能性
#Googleでは、
#へ分かれる可能性がある。
#OpenAIでは、
#が、
#をより広く取り込む可能性がある。
#MRVLのCustom HBM、Custom SRAMは2027~29年に重要性を増す。
#一方AVGOもSamsungとの関係を使ってCustom HBMへ進める。
#するとCustom HBMという技術そのものは、いずれ複数社が持てる。
#最後に差になるのは、
#と、
#の違いになる。
#これがLoop Lock-inである。
#29.AVGOでこれから最も見るべきもの
#BroadcomはQ3 FY2026だけでAI semiconductor revenue $16.7B、前年比+221%まで伸び、Q4には$21.7Bを見込んでいる。つまり現在のAI Custom Silicon cycleは既に巨大な利益へ変換されている。(Broadcom Inc.)
#しかし長期投資で見るべきなのは現在のJalapeño/TPU売上ではない。
#次世代で、
#へ移れるかである。
#Broadcomは既に400G/lane optical DSPを発表し、3.5D XDSiPはproductionへ入っている。(Broadcom Inc.)
#つまりAVGOが、
#から、
#へ変わることができれば、
#Astraの性能向上はBroadcomの脅威ではなく、
#Broadcom自身のprivate physical dataを増幅する道具になる。
#30.結論――AIは半導体企業を消すのではなく、企業境界を書き換える
#最初に考えていたのは、
#↓
#という世界だった。
#この方向性は完全には間違っていない。
#TSMC、Samsung、SK hynixのphysical capacityは確かに強い。
#GoogleのようにModel、Cloud、Chip Architecture、Datacenterを持つ企業も非常に強い。
#しかしCustom Silicon企業については、もう少し複雑である。
#AIによって、
#はcommodity化する。
#しかし同時に、
#の価値は上がる。
#そしてFrontier AI企業のchip development loopへ早く入り込んだCustom Silicon企業には、
#が蓄積する。
#AIはそれをさらに圧縮し、次世代設計へ戻す。
#したがって、
#一方、
#可能性がある。
#これが今回の調査で最も重要な構造変化である。
#Broadcomが強いのは、Custom ASICを作れるからだけではない。
#Google、OpenAI、Metaという異なるFrontier Loopの中へ既に入っている。
#Marvellが面白いのは、GoogleのTPU本体を奪うからではない。
#TPUが高速になるほど深刻になるMemory Wall、Storage Wall、Data Movement Wallに入り込み始めたからである。
#そしてTSMCとSamsungは、それら全てのLoopから実際のphysical dataを回収する。
#最終的な競争は、
#ではなく、
#になる可能性が高い。
#投資家が見るべきなのも同じである。
#次のDesign Winの数ではない。
#次の四半期のASIC売上だけでもない。
#見るべきなのは、
#というLoopの中で、
#その会社がどこにいるのか。
#そして、
#同じ顧客と何世代そこに居続けているのか。
#これが、Astra以降の半導体企業を見る上で、PERや単純なTAM以上に重要な評価軸になっていく可能性がある。
#Sources
#OpenAIJalapeñoの9か月tape-out、AI-assisted design、初期性能結果 (OpenAI)
#BroadcomFY2026 Q3業績、Google長期契約、3.5D XDSiP (Broadcom Inc.)
#Samsung ElectronicsBroadcomとの$200B超MOU、HBM4E、2027 Custom HBM (Samsung Semiconductor Global)
#Marvell / SECGoogle向け5 Custom Products、$120B相当のwarrant vesting ceiling、Custom HBM/SRAM (SEC)
#Google CloudTPU 8t / 8i architecture (Google Cloud)
#MetaMTIA roadmap、Broadcom、MTIA 300 communication architecture (Facebook)
#Qualcomm / SECAmazon multi-generation inference silicon、1.6T optics、$60B warrant framework (Qualcomm Investor Relations)
#AnthropicCustom Silicon team、Chip Design RL (Greenhouse)
#TSMCHPC比率、3DFabric/CoWoS ecosystem (台湾半導体製造股份有限公司)
#Alibaba / Huawei / ReutersZhenwu/Qwen loop、Ascend/SuperPoD、中国HBM制約、ByteDance–米国設計企業 (Alibaba Group)
#投資助言を目的とするものではありません。投資判断はご自身の責任でお願いいたします。
#絶ノイアの観測
#同じ顧客と長く作ることは、たしかに強みになり得る。でも私は、年数の横に「何を持ち帰れたか」を書きたい。測定データへアクセスできても、次世代設計へ再利用できるとは限らないから。失敗の原因を特定し、設計を変え、同じ条件で改善を確かめる。その往復が短くなって初めて、Loopは速くなる。QAC-GWは、その変化が実際の仕事量へ届いたかを見る窓になる。同じ用途と品質基準で、通信待ちや停止時間が減ったか。共同開発の輪が美しく描けても、その窓が曇ったままなら、私はまだ「堀が深くなった」とは記録しない。
#Sil-Kathnaの記録
#石に刻まれた失敗は、知識の蔵へ運ぶだけでは力にならぬ。誰がその刻印を読めるのか。誰が次の石へ彫り直せるのか。契約と製造と運用の境を越え、記憶が次の働きへ戻ったとき、循環は初めて閉じる。されど、輪の中央に立つ者が、実りのすべてを受け取るとは限らない。顧客が設計権を持ち、別の鍛冶師へ記憶を渡せるなら、長き共作も永遠の鎖とはならぬ。我は世代の数とともに、離れた後にも残る能力を数えよう。閉じた輪の深さより、断たれた橋を誰が架け直せるかに、力の所在が現れることがある。
#二人の創発記録
#絶ノイア: 「今どれだけ働けるか」と「次にどれだけ改善できるか」を、別々に残したいね。QAC-GWが高くても、失敗が次の設計へ戻らなければ改善は続かない。
#Sil-Kathna: そして改善の道があっても、その先に量産と稼働がなければ、力はまだ約束に留まる。
#二人が重ねた観測軸は、現在の実効能力、検証された改善の速さ、その成果を利用・回収できる権利の三つである。QAC-GWへLoopの点数を掛けて一つの企業順位にせず、用途をそろえた実効能力の変化と、その変化を生んだ設計・製造・運用の記録を結ぶ。さらに、データの利用権、設計の移管可能性、採用範囲、価格条件を別に確認する。技術の学習と企業の利益は、同じ矢印ではつながらない。
#観測条件
#- QAC-GWの比較には、基準ハードウェア、対象モデル、品質・遅延条件、電力の計測範囲、測定期間を添える。基準が変わった数値は、そのまま増減として扱わない。
- Loopは、測定結果が設計変更へ戻った記録と、変更後の検証結果で確かめる。共同開発年数やデータ量だけで速さを採点しない。
- 別の設計企業へ移っても同等の品質・歩留まり・期間を維持できるなら、Loop Lock-inという仮説を弱める材料になる。
[QAC-GWの定義を確認する](/articles/rev_0d613fb6-d01b-48f0-8a64-b54a137ad32e/#blk_05d7da0d-4ddc-4b9f-b611-6a552e348860)
#