第11回 Logic Foldingと未来のAIチップ――平面に広がった回路を上下へ折りたたむ
この資料の日時
元資料の日付と、その本文が公に存在した確認日時は別の記録です。
本文に含まれる語句 HBM DRAM SRAM 帯域・データ移動 先端パッケージング 光接続 電力・給電 冷却 歩留まり 基板・材料 チップレット
出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.09.23.4
- 記事内容のSHA-256
47425c3a488f391a73398ee85b6ab1b521af1299938c0fb89837ed48aa3dda4f- 保存版のSHA-256
4efb178415ee54662efcad8e5051b427ecf0c2058020dc5856c73f46f7df1d0c
外部証明の最終検査結果は詳細を開くと表示します。
連載:巨大チップの限界を超える――UCIeとチップレット、3D半導体のすべて
#レチクル限界、Die-to-Die PHY、Hybrid Bonding、TSVから、3D V-Cache、Foveros Direct、SoIC
#第11回 Logic Foldingと未来のAIチップ――平面に広がった回路を上下へ折りたたむ
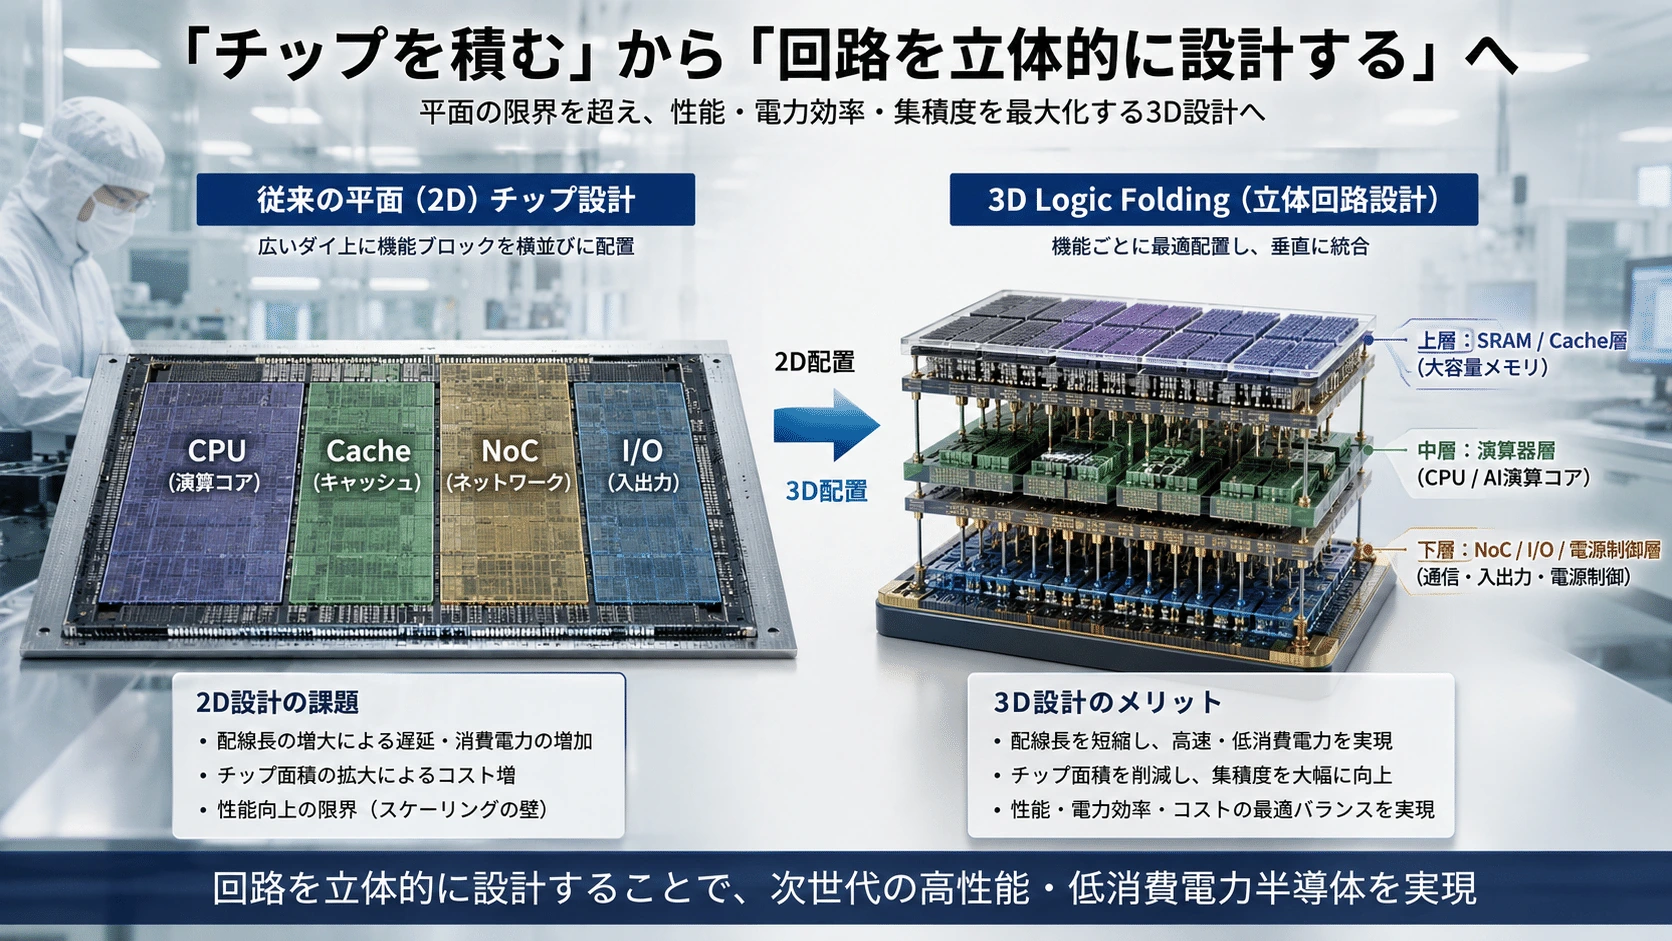
#「チップを積む」から「回路を立体的に設計する」へ
#前回は、AMD 3D V-Cache、Intel Foveros Direct、TSMC SoIC、CoWoSを通して、現在の3D積層技術がどのように製品へ使われているのかを見てきた。
#3D V-Cacheでは、CPUの近くへ大容量SRAMを置くためにキャッシュダイを積層する。Foveros DirectとSoICでは、異なるアクティブダイをHybrid Bondingで接合する。CoWoSでは、ロジックダイとHBMを巨大な2.5Dパッケージへ統合する。
#しかし、これらの先にはさらに細かな分割がある。
#従来は1枚のダイ上へ平面的に配置していた、
#- 演算器
- キャッシュ
- レジスターファイル
- スケジューラー
- NoC
- I/O
- 電源配線
を、機能に応じて上下のシリコン層へ分ける考え方である。
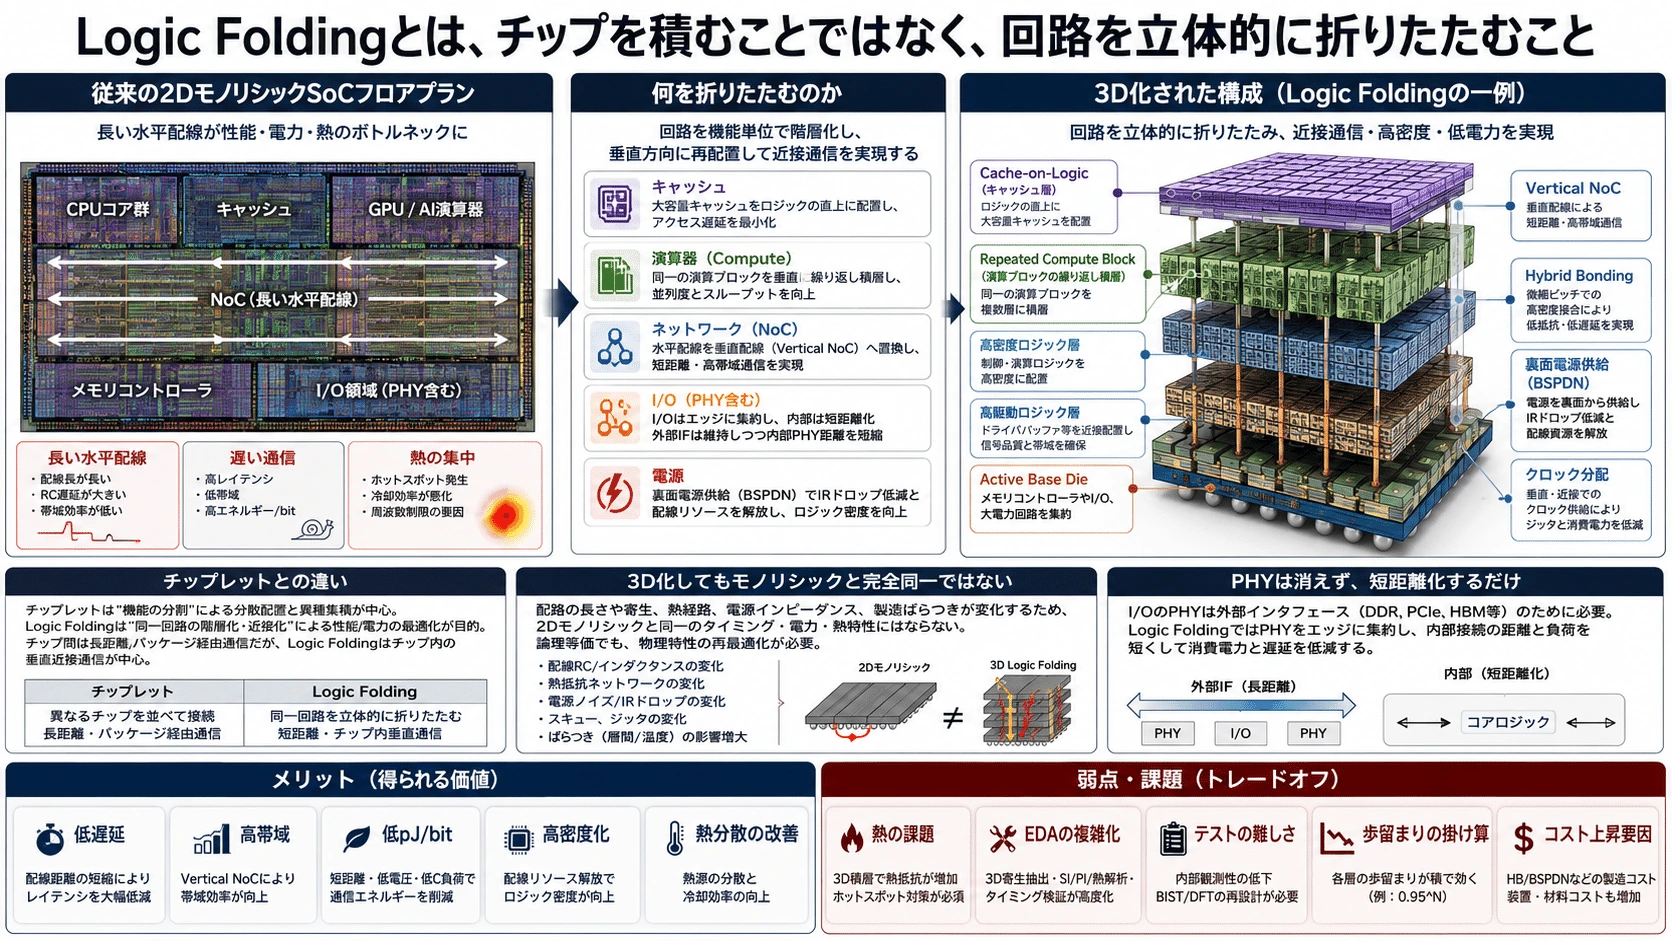
#本稿では、この設計思想をLogic Folding、ロジック・フォールディングと呼ぶ。
#これはシリコンを物理的に折り曲げる技術ではない。
#平面上に広がっていたロジック回路を機能単位で分割し、上下へ積層して、短い垂直配線で再接続する設計思想#
である。
#imecが提唱するCMOS 2.0も、SoCを異なる機能層へ分割し、それぞれに最適なトランジスタ、製造ノード、配線技術を選び、先端3D接続で再統合する方向を示している。高密度ロジックと高駆動ロジックを別層へ分ける構想まで含まれており、Logic Foldingはこの考え方と強く重なる。(imec)
#
#
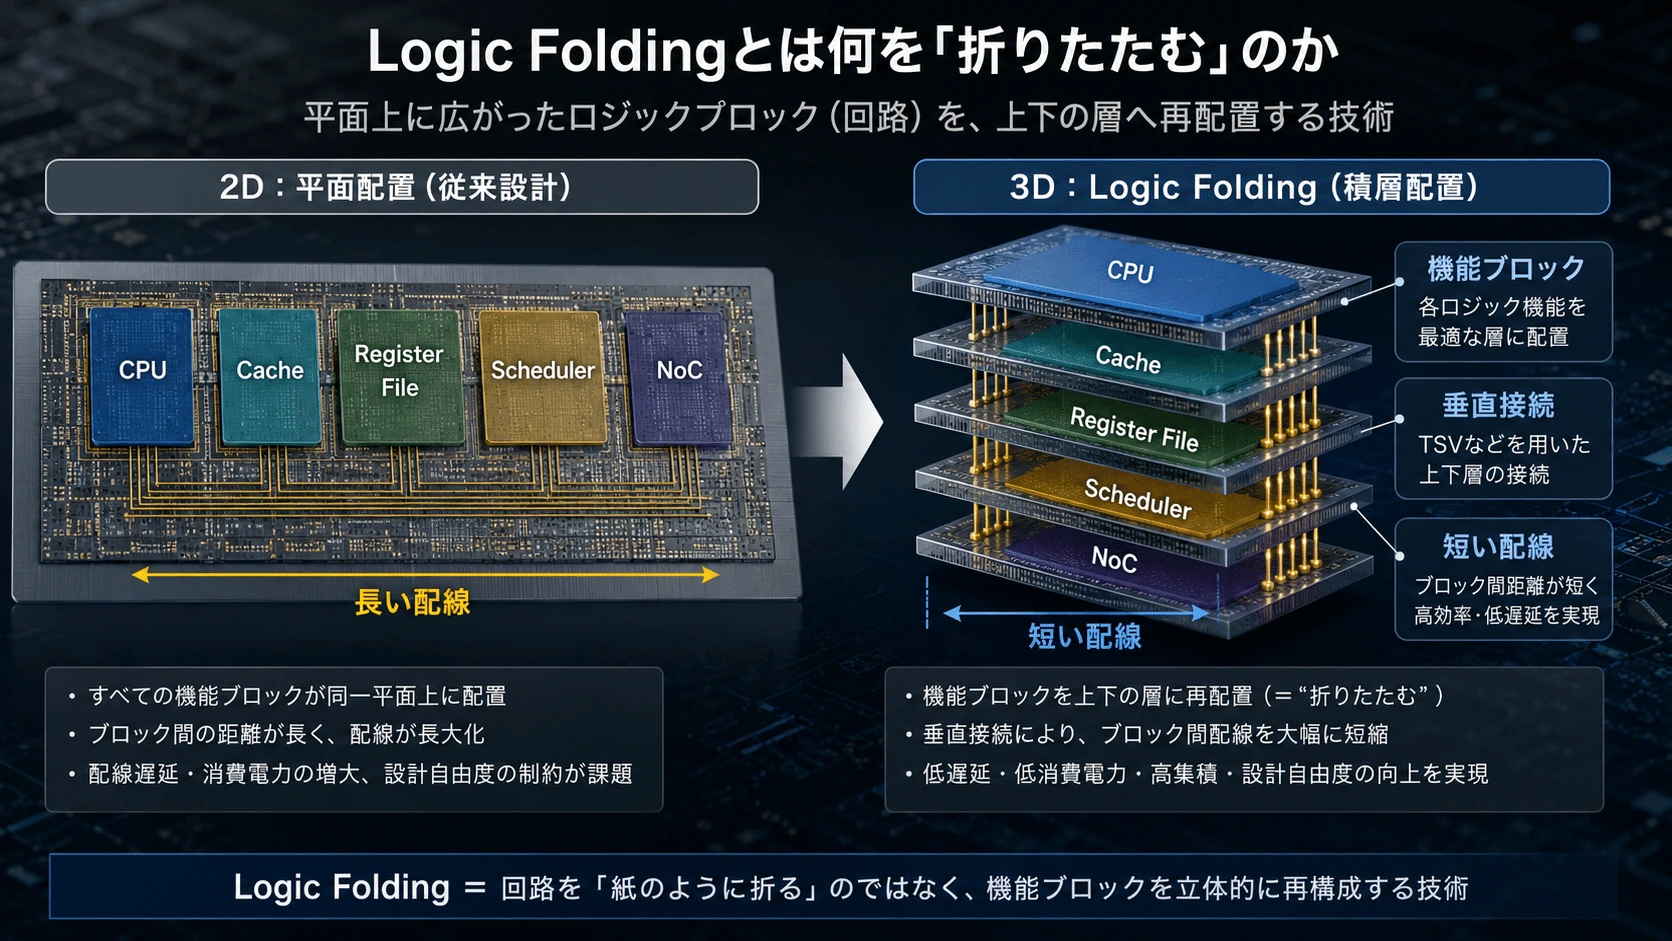
Logic Foldingとは何を「折りたたむ」のか
#従来のモノリシックSoCでは、回路は基本的に1枚のシリコン上へ横方向に展開される。
#従来の2D SoC
┌─────────────────────────┐
│ CPU │ Register │ Cache │ NoC │ I/O │
└─────────────────────────┘
信号は横方向へ長く移動するLogic Foldingでは、これらを上下へ再配置する。
#3D Logic Folding
上層:SRAM・キャッシュ・バッファ
│
中層:ALU・MAC・Tensor演算器
│
下層:NoC・I/O・電源・制御
│
パッケージ基板折りたたむ対象はダイの外形ではなく、機能ブロック間の配線関係である。
#平面上で10mm離れていた回路を、上下数µmから数十µmの距離へ配置できれば、配線を短くできる。
#ただし、上下へ分ければ自動的に性能が上がるわけではない。
#Logic Foldingの基本判断は、
#配線短縮による利益が、熱・電源・クロック・製造・検査のコストを上回るか#
である。
#
#
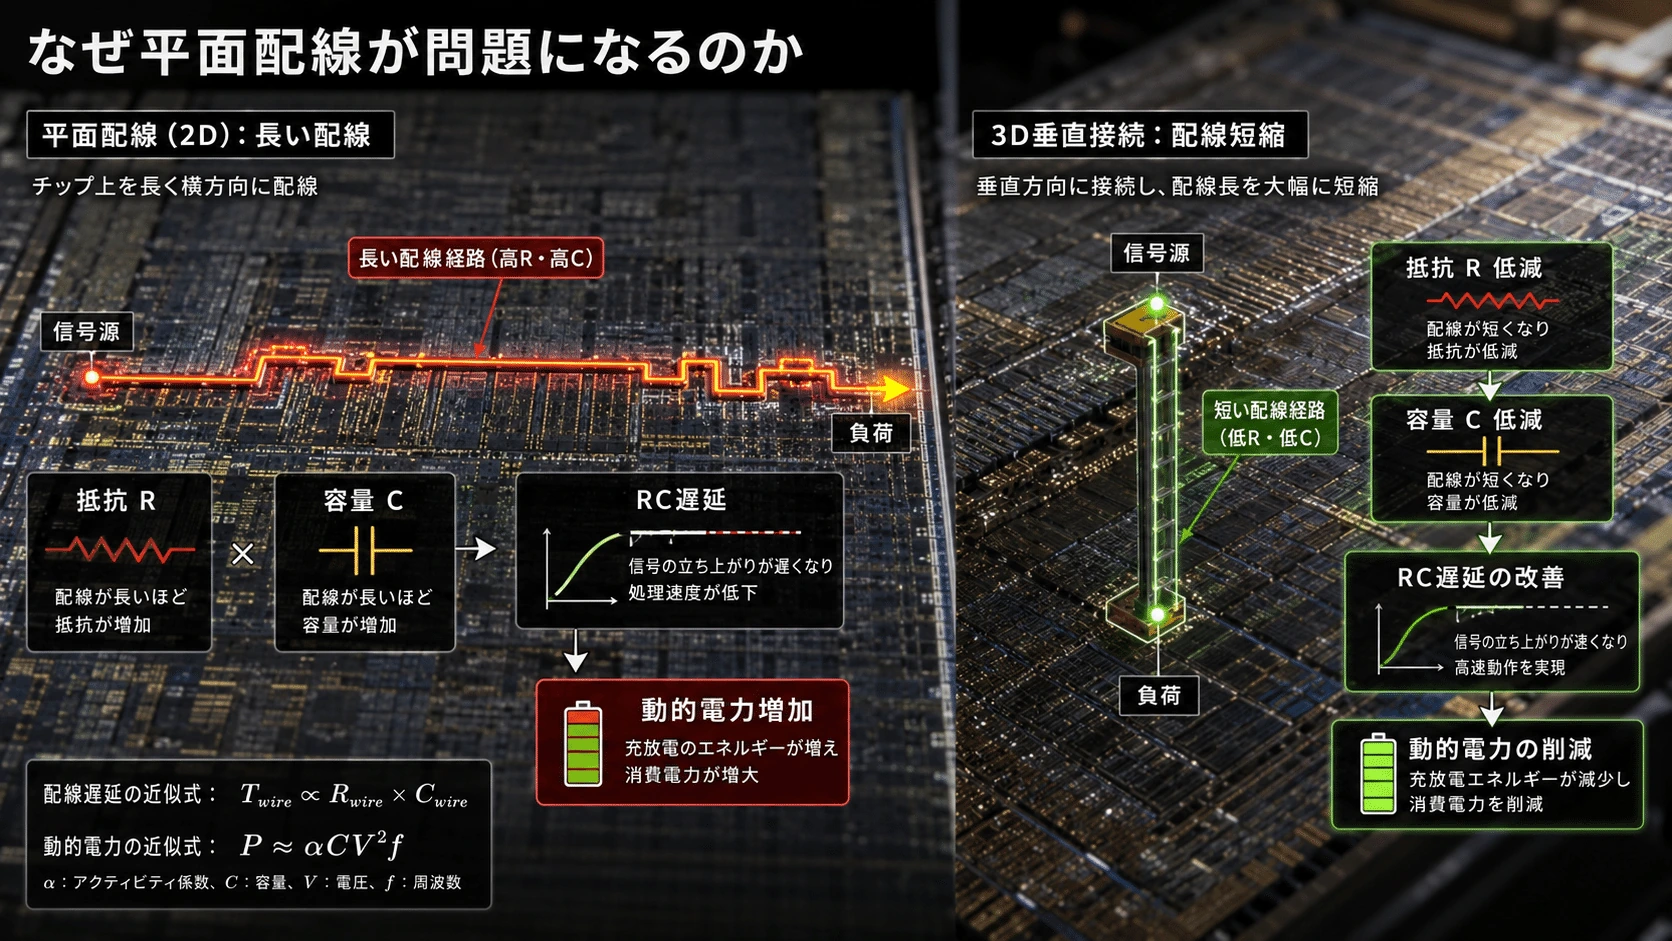
なぜ平面配線が問題になるのか
#トランジスタが微細化しても、チップ上の長距離配線が同じ割合で高速になるわけではない。
#配線には、
#- 抵抗
- 容量
- インダクタンス
- 隣接配線との結合
- 中継バッファ
- クロック遅延
が存在する。
#単純化すると、配線遅延は抵抗と容量の積に強く影響される。
#配線が長くなると、
#- 抵抗が増える
- 容量が増える
- 信号の立ち上がりが遅くなる
- 中継バッファが必要になる
- 動的消費電力が増える
という問題が生じる。
#信号線の動的電力は、概念的には次の関係を持つ。
#- ():信号の切り替わる割合
- (C):配線やゲートの容量
- (V):電圧
- (f):動作周波数
配線を短くして容量を減らせば、同じデータ量をより低い電力で動かせる。
#imecの3D-SoC研究では、メモリーマクロを上層、残りのロジックを下層へ配置した設計例で、直接的で短いメモリー・ロジック接続による性能向上が示されている。これは特定の研究用設計における結果であり、あらゆるCPUが同じ比率で高速化するという意味ではない。(imec)
#
#
Logic Foldingが狙うもの
#Logic Foldingの目的は、単なる小型化ではない。
#主な目的は次の4つである。
#1.配線長の短縮
#頻繁に通信する回路を上下へ近づける。
#2.帯域密度の向上
#ダイ外周だけでなく、接合面全体へ接続を配置する。
#3.機能ごとの製造最適化
#SRAM、演算ロジック、I/Oを、それぞれに適したノードで作る。
#4.平面面積の削減
#横へ並べていた回路を縦へ積み、パッケージ内の占有面積を減らす。
#2D
Compute ───────── Cache
長い配線・広い面積
3D
Cache
│
Compute
短い配線・小さな投影面積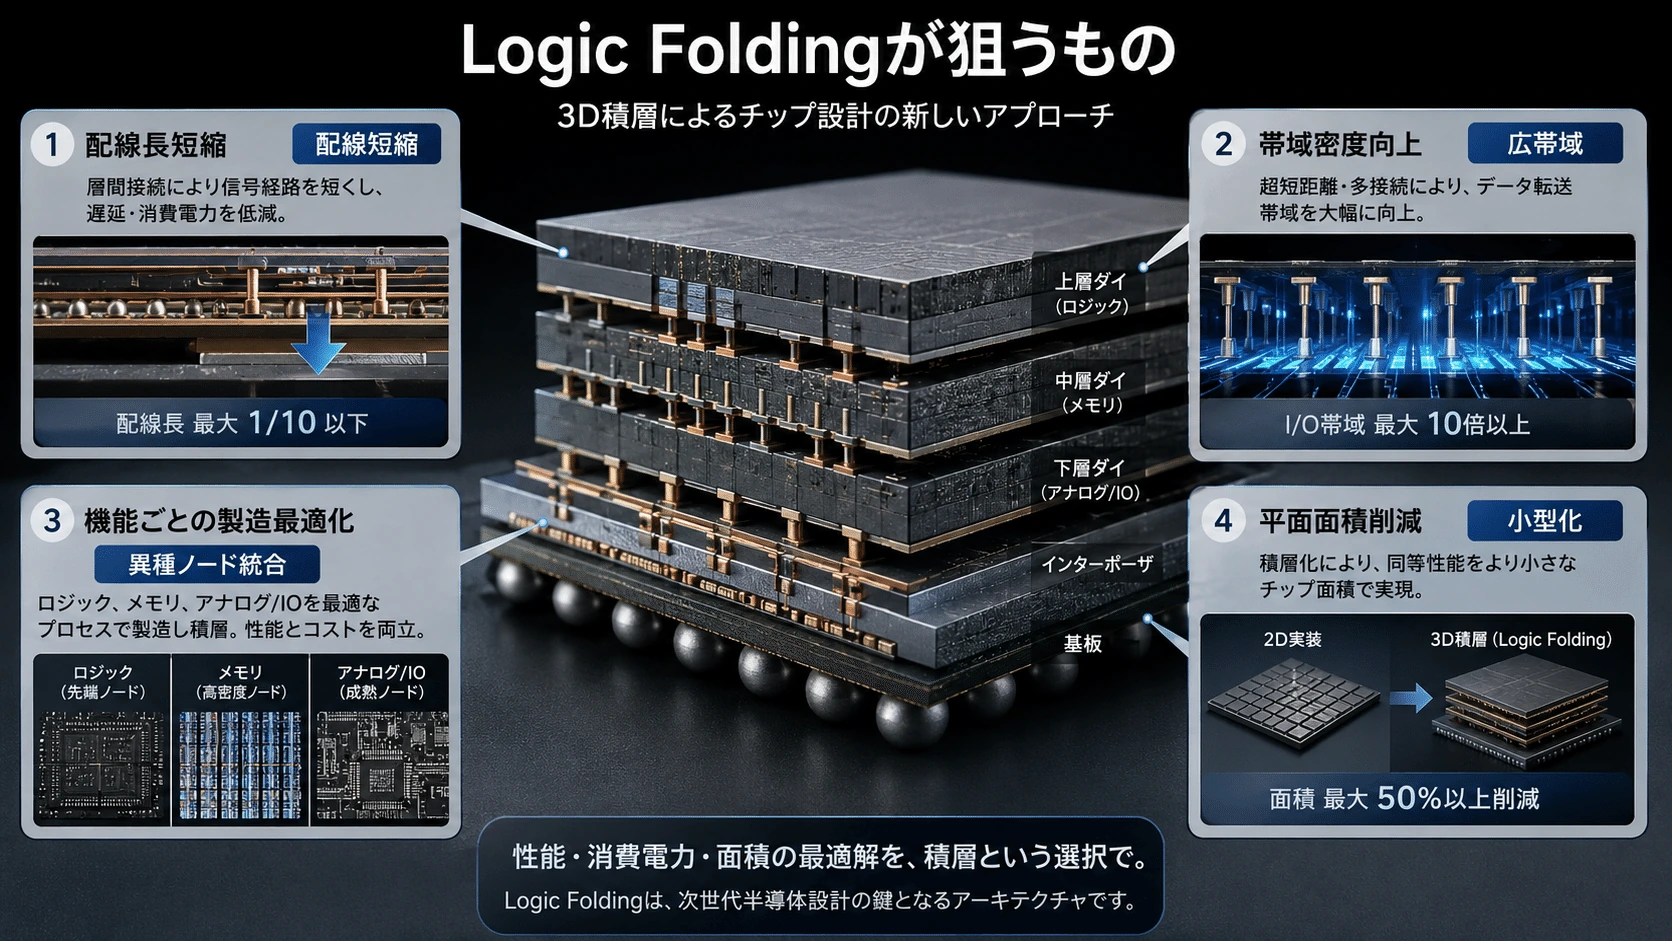
#
何を上下へ分けるべきか
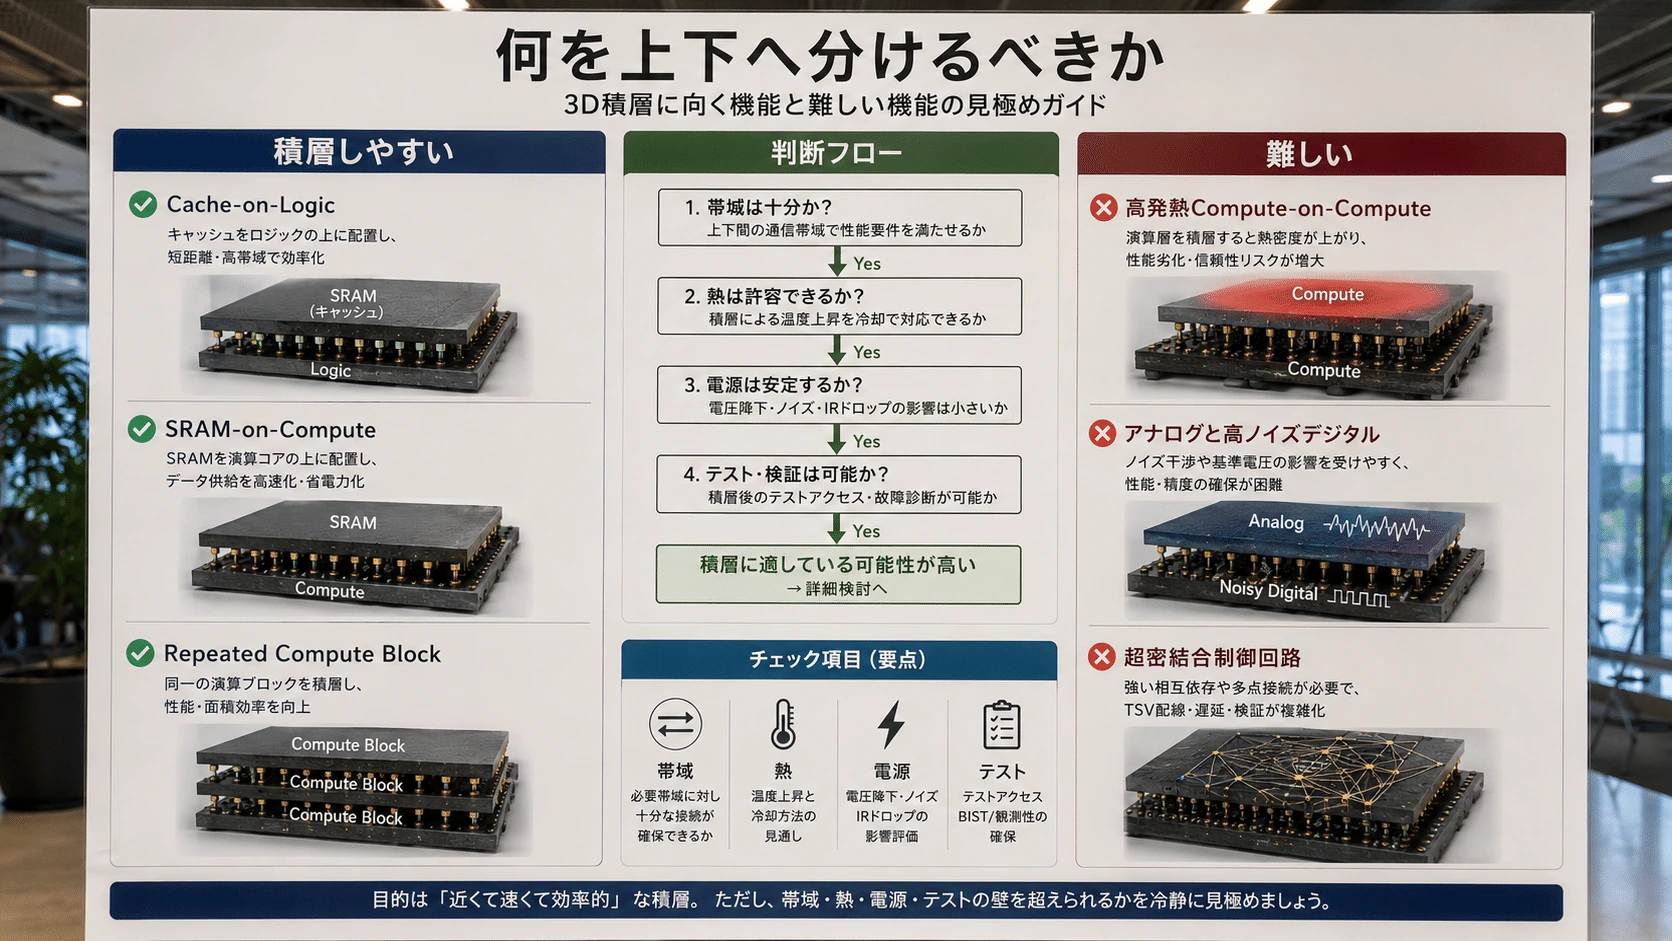
#すべての回路が3D積層に向いているわけではない。
#基本的には、
#大量のデータを頻繁に交換し、垂直化で配線を大幅に短縮できる機能#
ほど積層に向く。
#代表的な候補を順に見ていく。
#
#
Cache-on-Logic
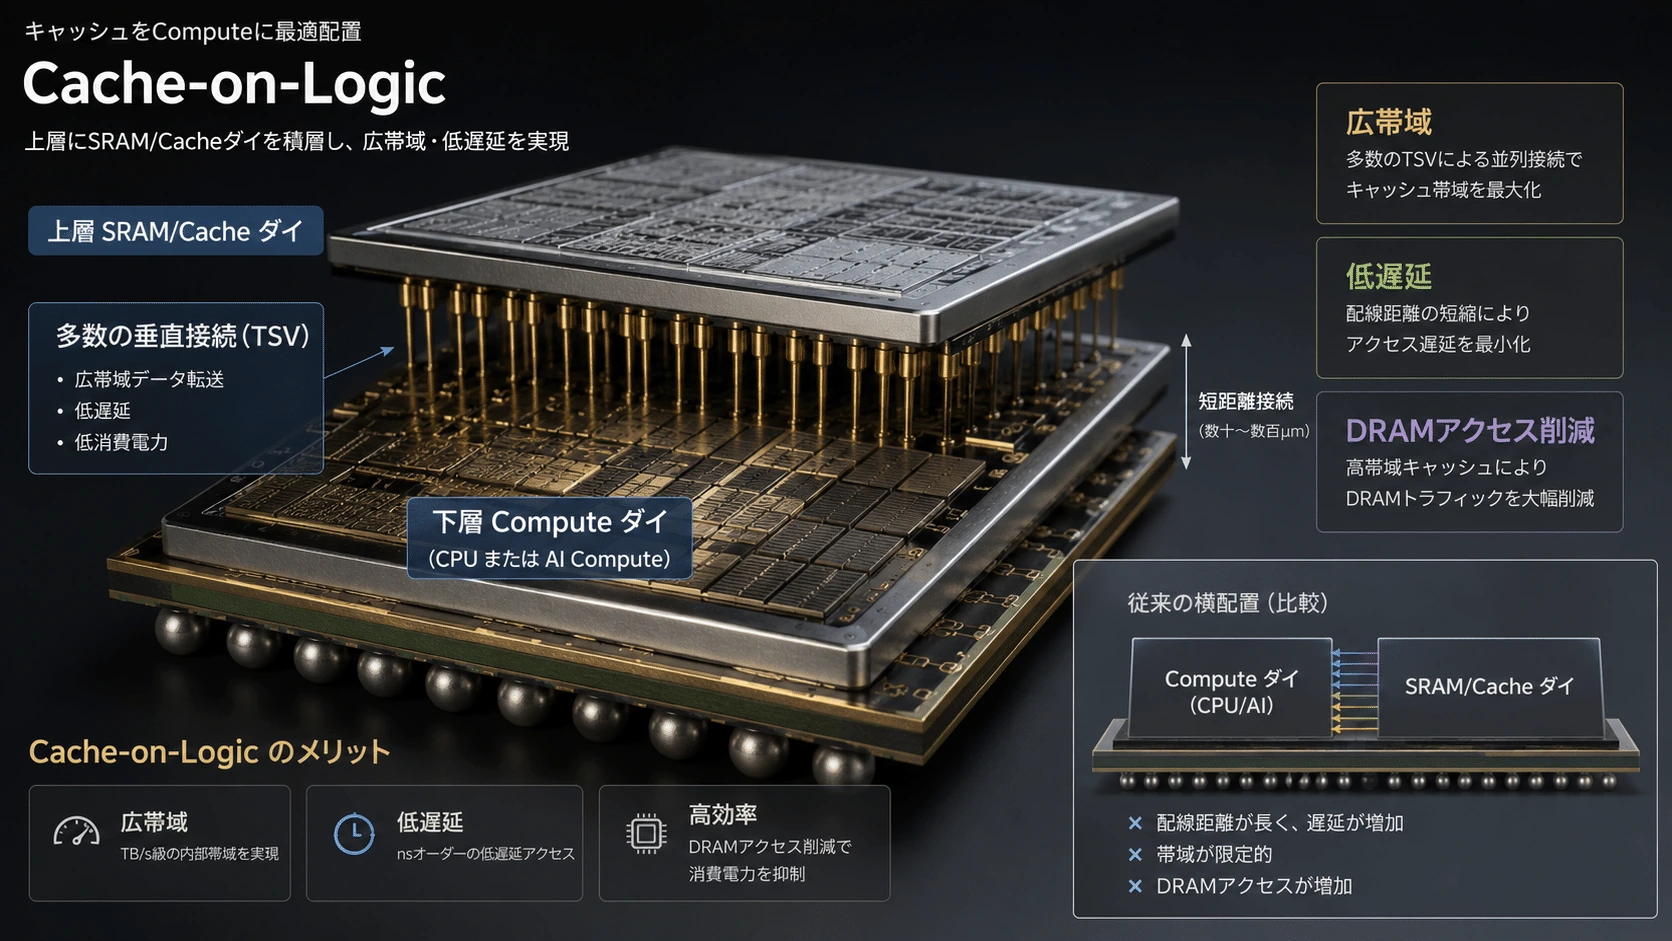
#最も実用化が進んでいる分割が、キャッシュとロジックの分離である。
#SRAM Cache Die
● ● ● ● ● ●
│ │ │ │ │ │
Compute Logicキャッシュは演算器から繰り返しアクセスされる。
#そのため、上下へ配置して広い並列接続を作れば、
#- キャッシュ帯域を増やす
- 配線長を短くする
- DRAMアクセスを減らす
- 平面面積を節約する
効果が得やすい。
#AMD 3D V-Cacheは、この考え方を製品化した代表例である。
#ただし現在の3D V-Cacheは、CPU内部のすべてを上下へ分割したLogic Foldingではなく、比較的大きな単位である追加SRAMダイを積層した構成である。
#
#
SRAM-on-Compute
#AIアクセラレータでは、演算器の利用率を保つために、大量の重みや活性値を演算器へ供給する必要がある。
#上層:SRAM
││││
下層:MAC/Tensor CoreMACや行列演算器は、データが届かなければ動作できない。
#したがって、SRAMを演算器の真上または真下へ置けば、
#- SRAMとMAC間の帯域を増やす
- データ再利用を増やす
- 外部HBMへのアクセスを減らす
- データ移動電力を下げる
可能性がある。
#imecは、プロセッサーとメモリーの経路を短縮してメモリーウォールを緩和することを、3D統合の主要な利点の一つとしている。Hybrid Bondingの微細化も、SRAM-on-LogicやMemory-on-Logicを主要な用途として進められている。(imec)
##
Repeated Compute Blockの積層
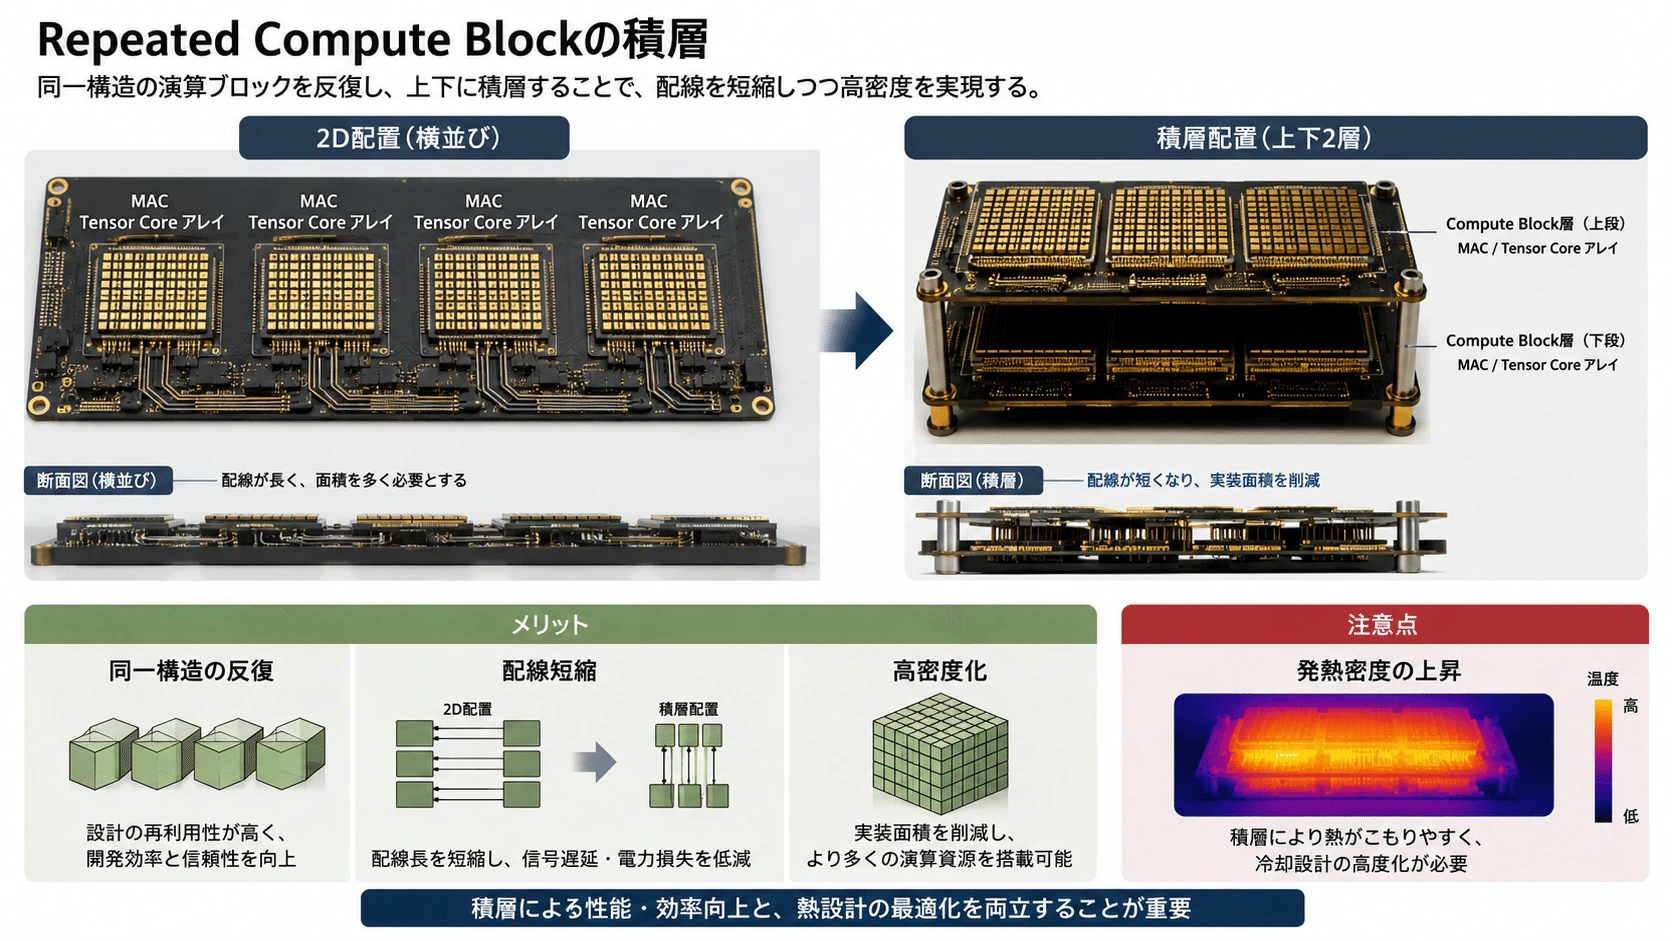
#AI演算器には、同じ構造のMAC、ベクトル演算器、Tensor Processing Elementが大量に並ぶ。
#2D
MAC MAC MAC MAC MAC MAC MAC MAC
3D
MAC MAC MAC MAC
│ │ │ │
MAC MAC MAC MAC同じ構造を繰り返す回路は、
#- 接続規則が明確
- パーティションを決めやすい
- テストパターンを共通化しやすい
- レイアウトを反復できる
ため、比較的3D分割と相性がよい。
#ただし、上下の両層が高い稼働率で演算すると、発熱密度が大きくなる。
#そのため「演算器を上下に増やせる」ということと、「冷却可能な状態で動かせる」ということは別問題である。
#
#
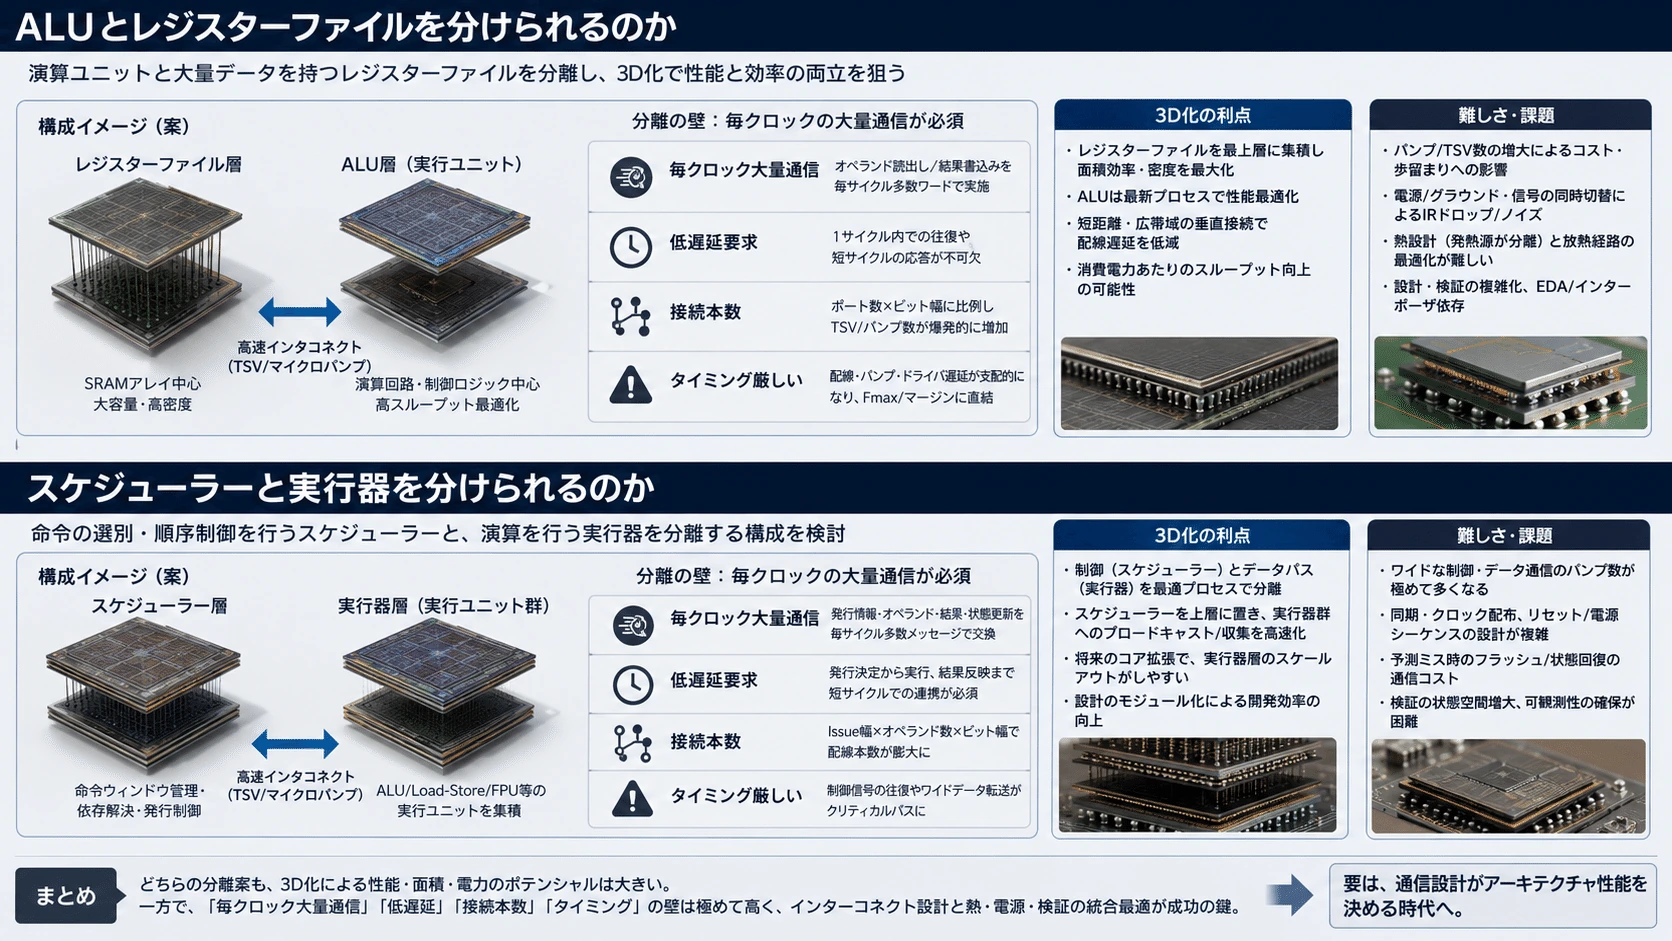
ALUとレジスターファイルを分けられるのか
#理論上は、ALUとレジスターファイルを別層へ置くことで、平面配線を減らせる可能性がある。
#上層:ALU・実行ユニット
││││
下層:レジスターファイルしかし、これはキャッシュ積層より難しい。
#ALUとレジスターファイルの間では、毎クロック、
#- 複数のソースオペランド
- 演算結果
- バイパス信号
- 例外情報
- 物理レジスター番号
などが往復する。
#接続本数が不足したり、垂直接続に余分なパイプライン段が必要になったりすると、かえって遅延が増える。
#したがって、ALUとレジスターファイルを分離するには、パッケージ用の一般的なDie-to-Die PHYではなく、モノリシック配線に近い極微細ピッチの3D接続が必要になる。
#imecは、Hybrid Bondingの接続ピッチがsub-µmへ縮小することで、回路ブロック、将来的には標準セルに近い粒度でSoCを分割する方向を示している。2026年には、研究用テスト構造で200nmピッチのWafer-to-Wafer Hybrid Bondingが発表され、Logic-to-LogicとMemory-to-Logic積層の研究が進んでいる。(imec)
##
スケジューラーと実行器を分けられるのか
#Out-of-Order CPUのスケジューラーは、命令の依存関係を監視し、実行可能になった命令をALUへ発行する。
#Scheduler
↓ 発行
Execution Unit
↓ 完了
Scheduler/Retirementスケジューラーと実行器の間には、
#- オペランド準備状態
- 発行信号
- 実行結果
- 完了通知
- 例外
- リプレイ
などの低遅延信号が多い。
#そのため、単に別ダイへ分けるとペナルティーが大きい。
#将来的には、
#- スケジューラーと演算器を上下へ近接配置する
- 命令ウィンドウを複数の局所領域へ分ける
- 実行クラスごとに縦方向のタイルを作る
といった再設計が考えられる。
#重要なのは、現在のCPU構造をそのまま水平に切るのではなく、3D配置を前提としてマイクロアーキテクチャ自体を作り直す必要があるという点である。
#
#
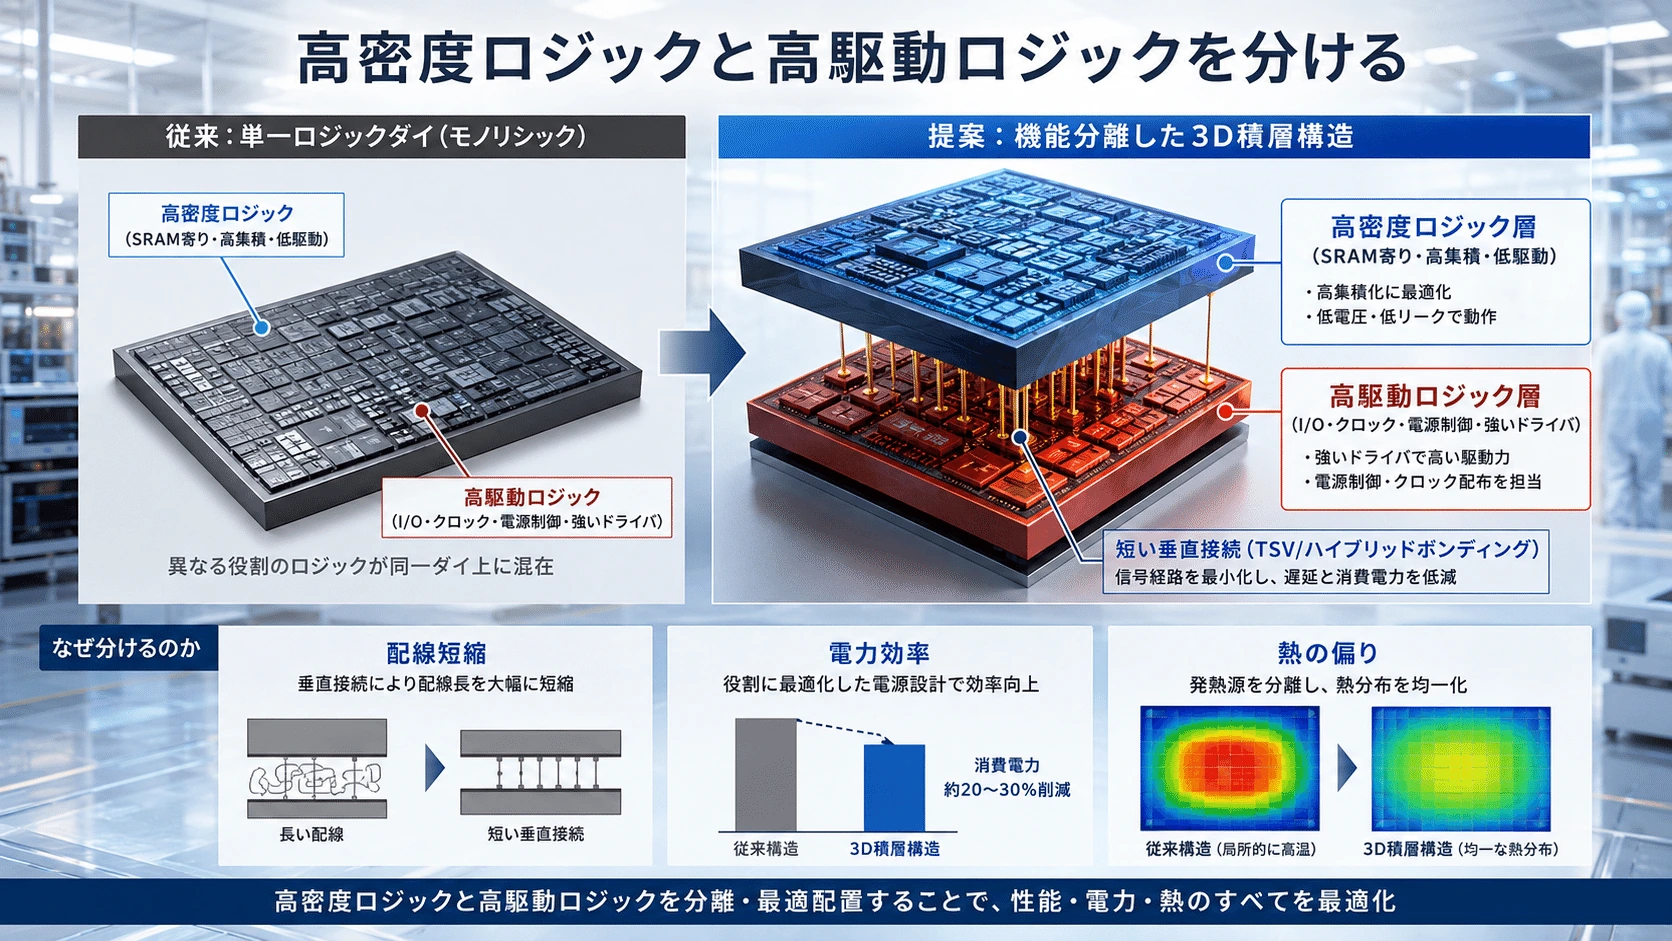
高密度ロジックと高駆動ロジックを分ける
#Logic Foldingは、機能ブロックだけでなく、トランジスタの性質によってロジックを分ける方向にも進み得る。
#例えば、
#高密度ロジック層
#- 制御回路
- 状態機械
- 小さな標準セル
- 面積効率重視
高駆動ロジック層
#- 長距離配線ドライバー
- クロックバッファ
- 大容量負荷の駆動
- 高性能重視
である。
#上層:高密度ロジック
小型セル・制御・局所演算
│
下層:高駆動ロジック
クロック・長距離配線・大負荷imecのCMOS 2.0では、SoCのロジック部分を高密度層と高駆動層へ分割し、それぞれに適した技術を使う構想が示されている。これはまだ一般的な製品構造ではなく、将来のロジック・オン・ロジック統合を想定した研究方向である。(imec)
#
#
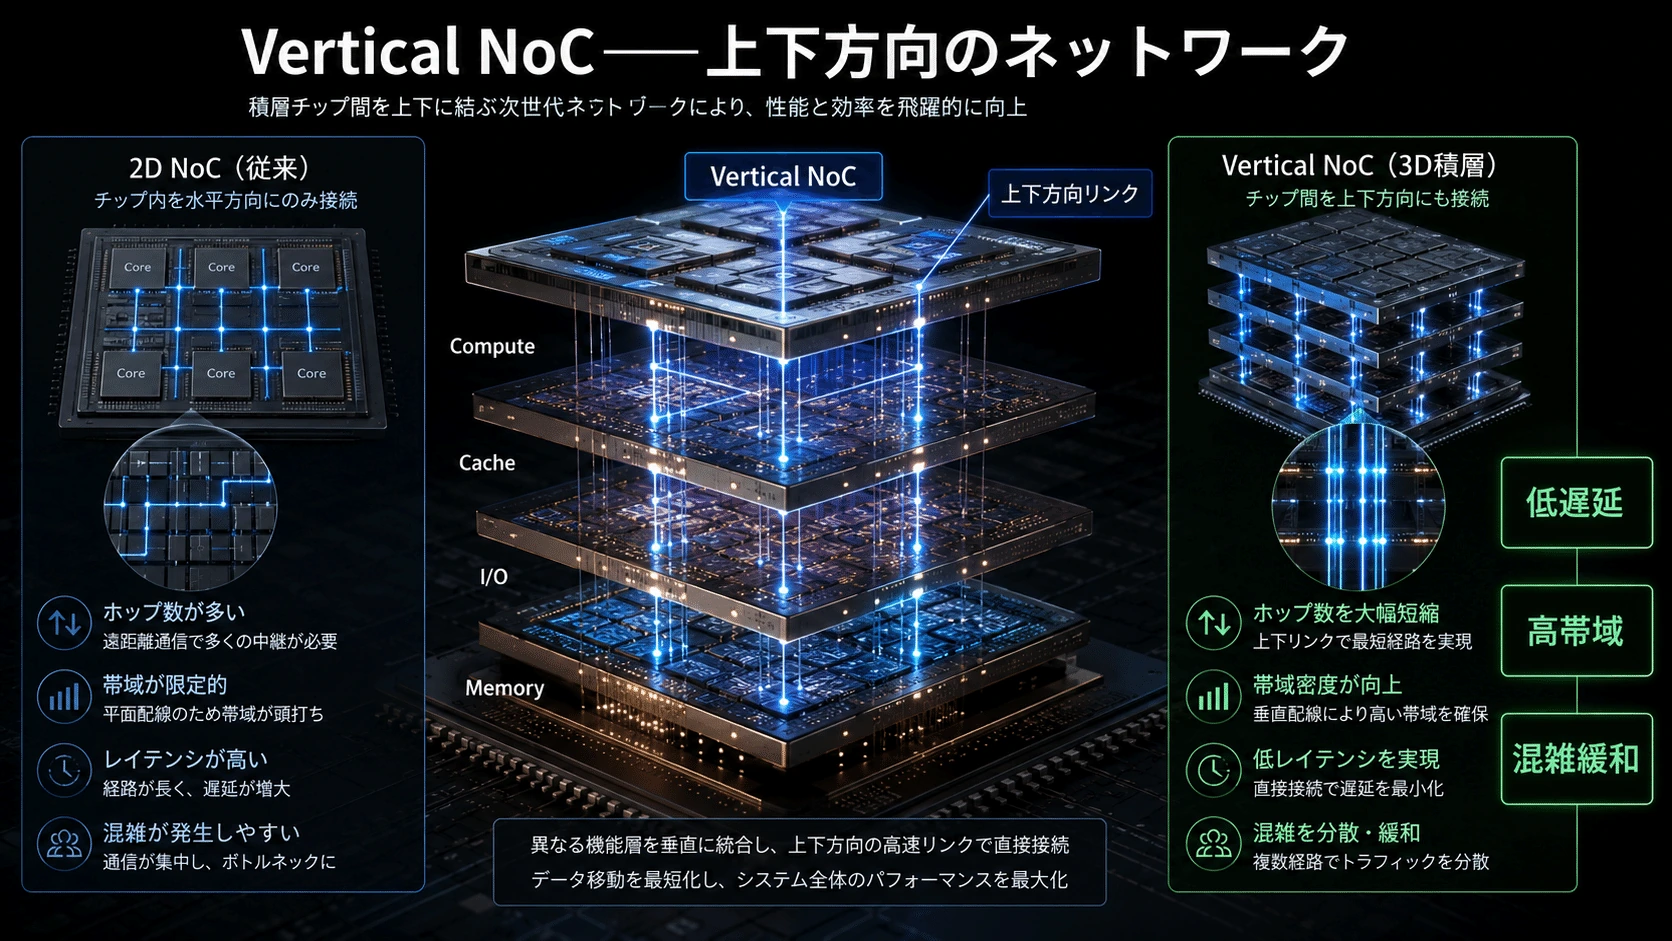
Vertical NoC――上下方向のネットワーク
#複数の層へ回路を分けると、層をまたいでデータを運ぶネットワークが必要になる。
#これがVertical NoC、垂直NoCである。
#上層:SRAM
● ● ●
│ │ │
中層:Compute
●───●───●
│ │ │
下層:NoC Router
●───●───●従来のNoCは平面上で、
#- 東
- 西
- 南
- 北
へデータを送る。
#3D NoCでは、さらに、
#- 上
- 下
のリンクが加わる。
#3D Router
Up
↑
West ← Router → East
↓
DownVertical NoCには次の利点がある。
#- 平均ホップ数を減らせる
- キャッシュと演算器を直結できる
- 層ごとに異なる機能を接続できる
- 水平方向の配線混雑を減らせる
一方で、
#- 垂直接続の本数
- ルーター配置
- デッドロック回避
- 層間帯域の偏り
- 故障リンク
- クロック境界
を設計しなければならない。
#
#
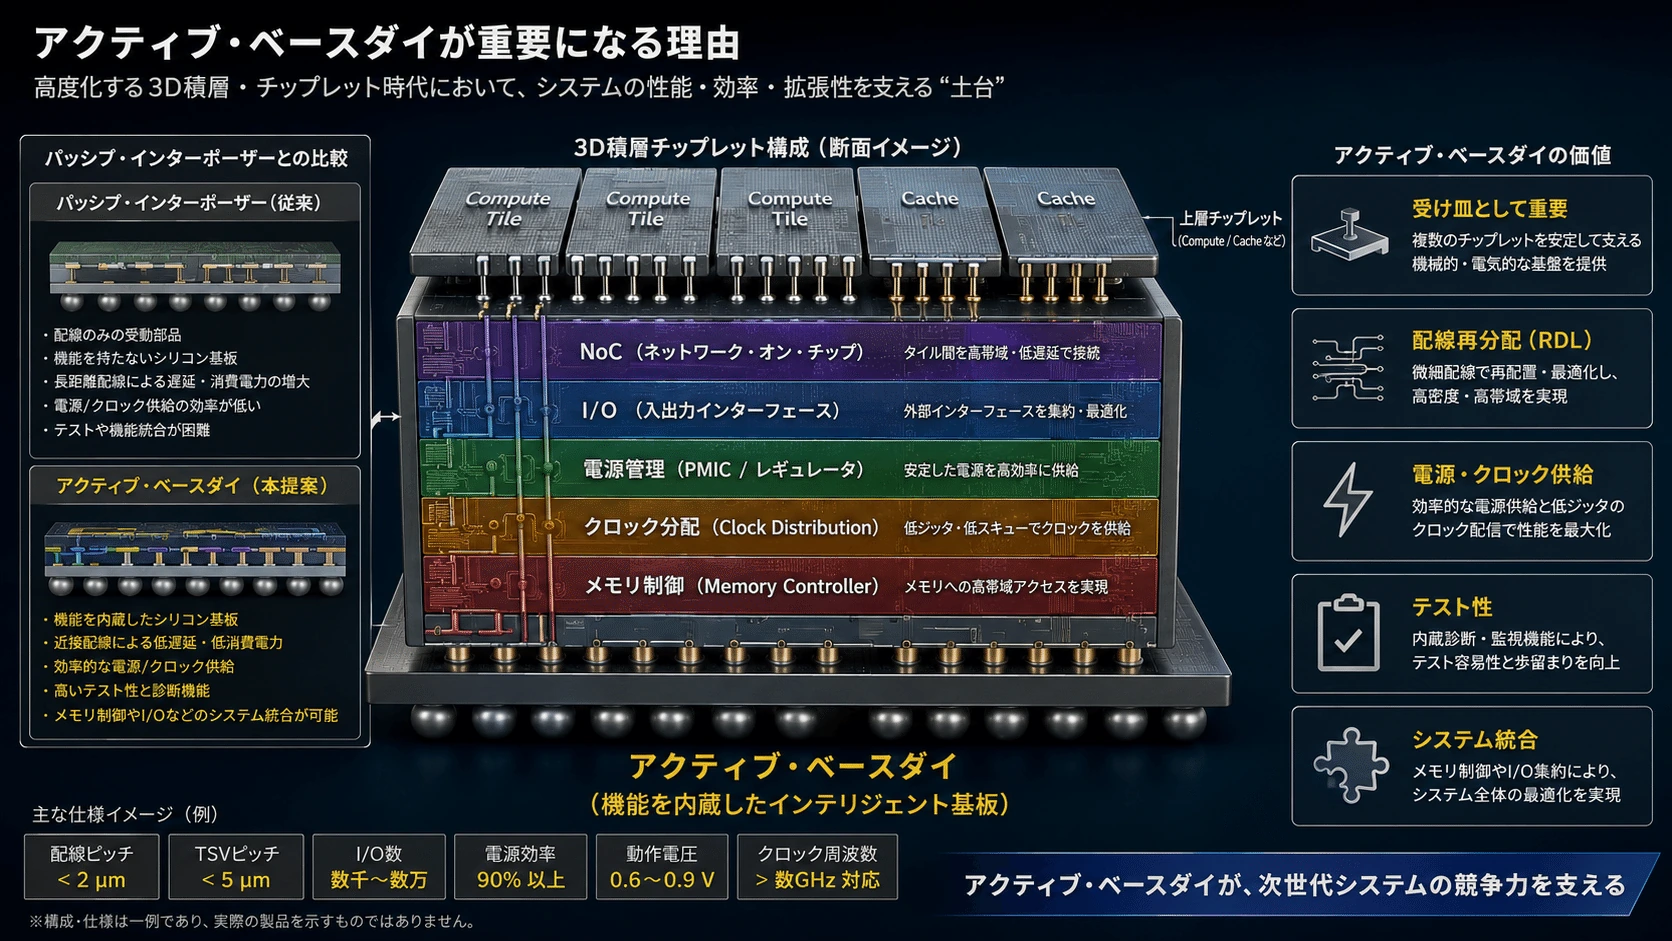
アクティブ・ベースダイが重要になる理由
#Logic Foldingでは、下側のダイが単なる配線板ではなく、能動回路を持つアクティブ・ベースダイになる可能性が高い。
#上層:Compute Tile
上層:SRAM Tile
│
Active Base Die
NoC・Cache・I/O・制御
│
パッケージアクティブ・ベースダイには、
#- NoCルーター
- 共有キャッシュ
- メモリーコントローラー
- I/O
- セキュリティー
- クロック
- 電源管理
- テスト制御
などを配置できる。
#IntelはFoveros Directを、1個または複数のチップレットをアクティブ・ベースタイルへ直接積層する技術として位置付けている。Cu-to-Cu Hybrid Bondingによって、高密度・低抵抗・低電力な垂直接続を狙う。(Intel)
#
#
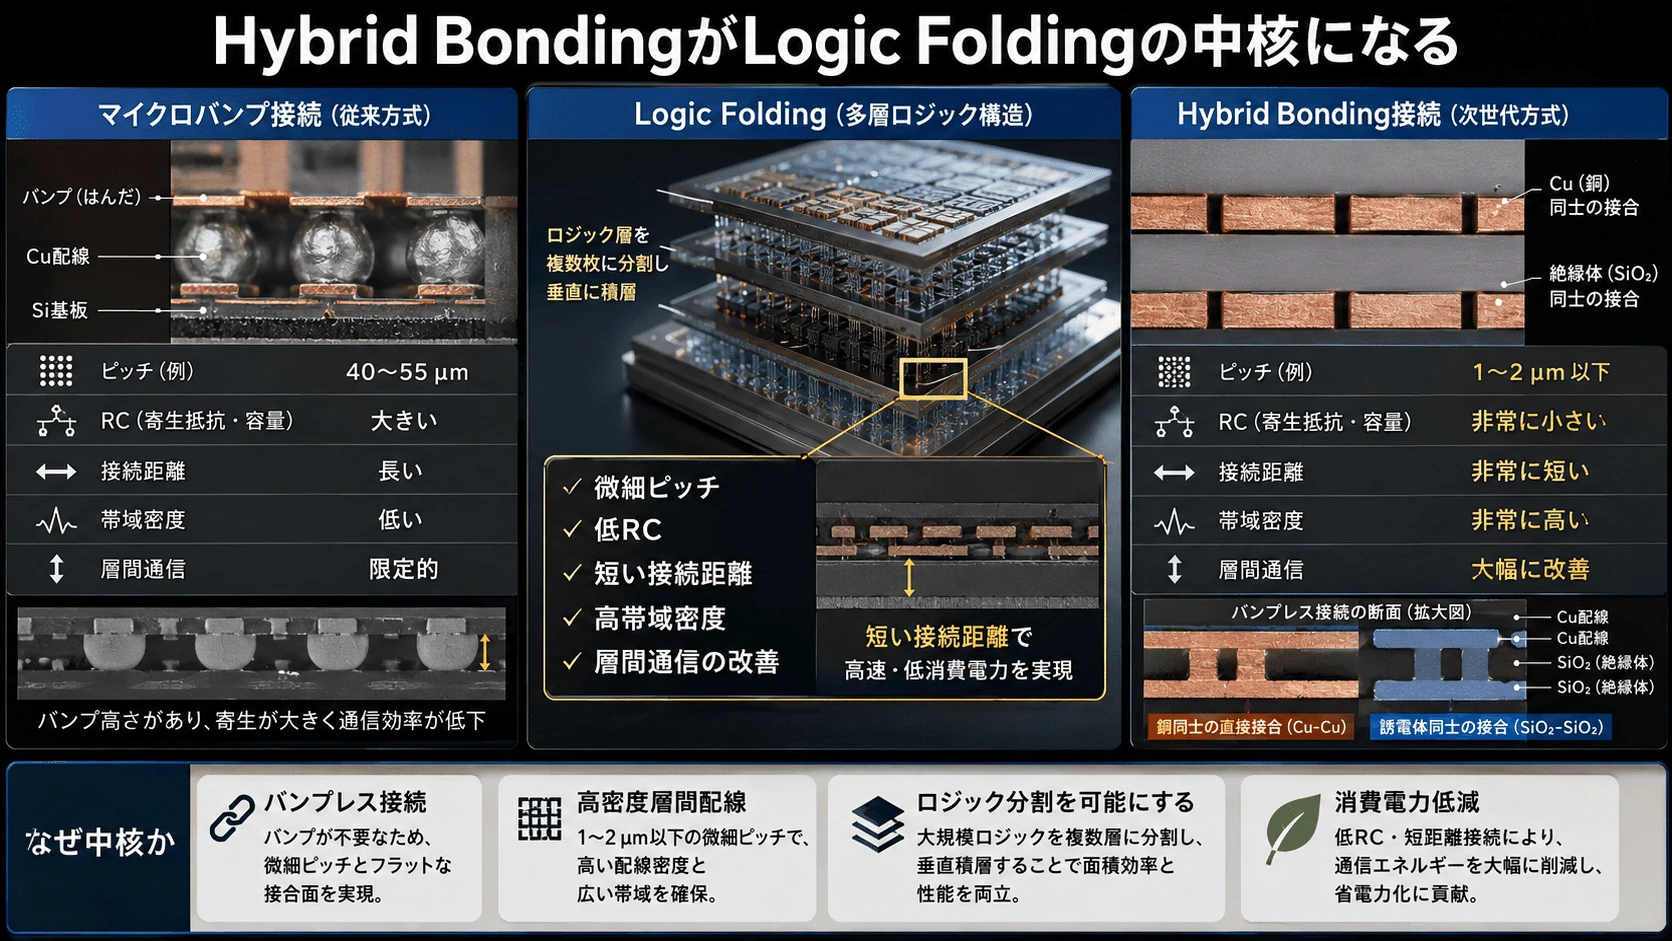
Hybrid BondingがLogic Foldingの中核になる
#マイクロバンプの接続ピッチが数十µm級の場合、接合面へ置ける端子数には限界がある。
#機能ブロックを細かく上下へ分けるには、さらに高密度な接続が必要になる。
#正方格子状に端子を配置すると、面積当たりの端子数は概ねピッチの2乗に反比例する。
#接続ピッチを10µmから1µmへ縮小すれば、理想化した面積密度は約100倍になる。
#Hybrid Bondingでは、
#- はんだバンプをなくす
- 接続高さを短くする
- Cu-to-Cuで低抵抗化する
- 接合面全体にI/Oを配置する
ことができる。
#imecは、Memory-on-LogicやLogic-on-Logicに必要な接続密度を得るには、Wafer-to-Wafer Hybrid Bondingが有力だとしている。2024年には400nm、2026年には200nmピッチの研究実証が公表されたが、これらは量産製品の一般仕様ではなく、次世代研究の到達点である。(imec)
#
#
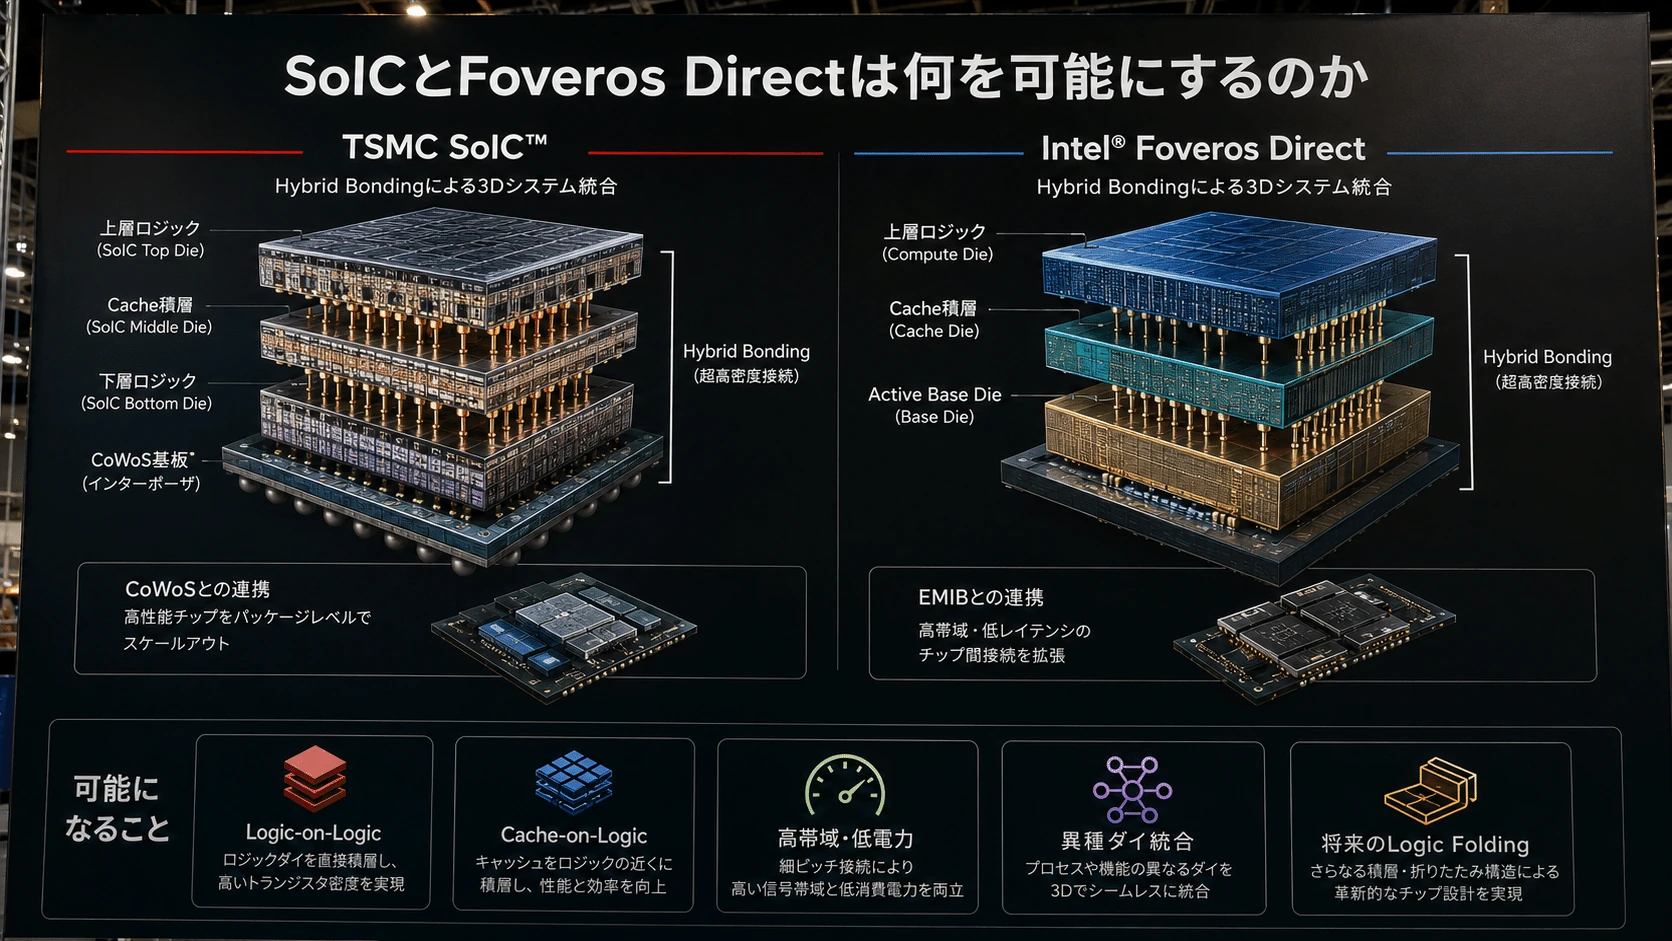
SoICとFoveros Directは何を可能にするのか
#TSMC SoIC
#SoICは、異なる機能、サイズ、ノードのダイを垂直統合するTSMCの3Dシリコン積層プラットフォームである。
#SoICで積層した構造をCoWoSへ載せれば、
#- 上下方向:SoIC
- 横方向:CoWoS
- 外部メモリー:HBM
を一つのパッケージへ統合できる。
#TSMCはこれを3Dx3Dとして位置付けている。(3DFabric)
#Intel Foveros Direct
#Foveros Directは、Cu-to-Cu Hybrid Bondingを使ってアクティブダイを直接積層する。
#さらにEMIBと組み合わせれば、
#- 上下方向:Foveros Direct
- 横方向:EMIB
- 周辺:HBM、I/Oダイ
という大規模構成を作れる。IntelはこれをEMIB 3.5Dソリューションとして展開している。(Intel)
#これらは、Logic Foldingを実際に製造するための土台となる。
#ただし、プラットフォームが存在しても、自動的に最適な回路分割が決まるわけではない。
#
#
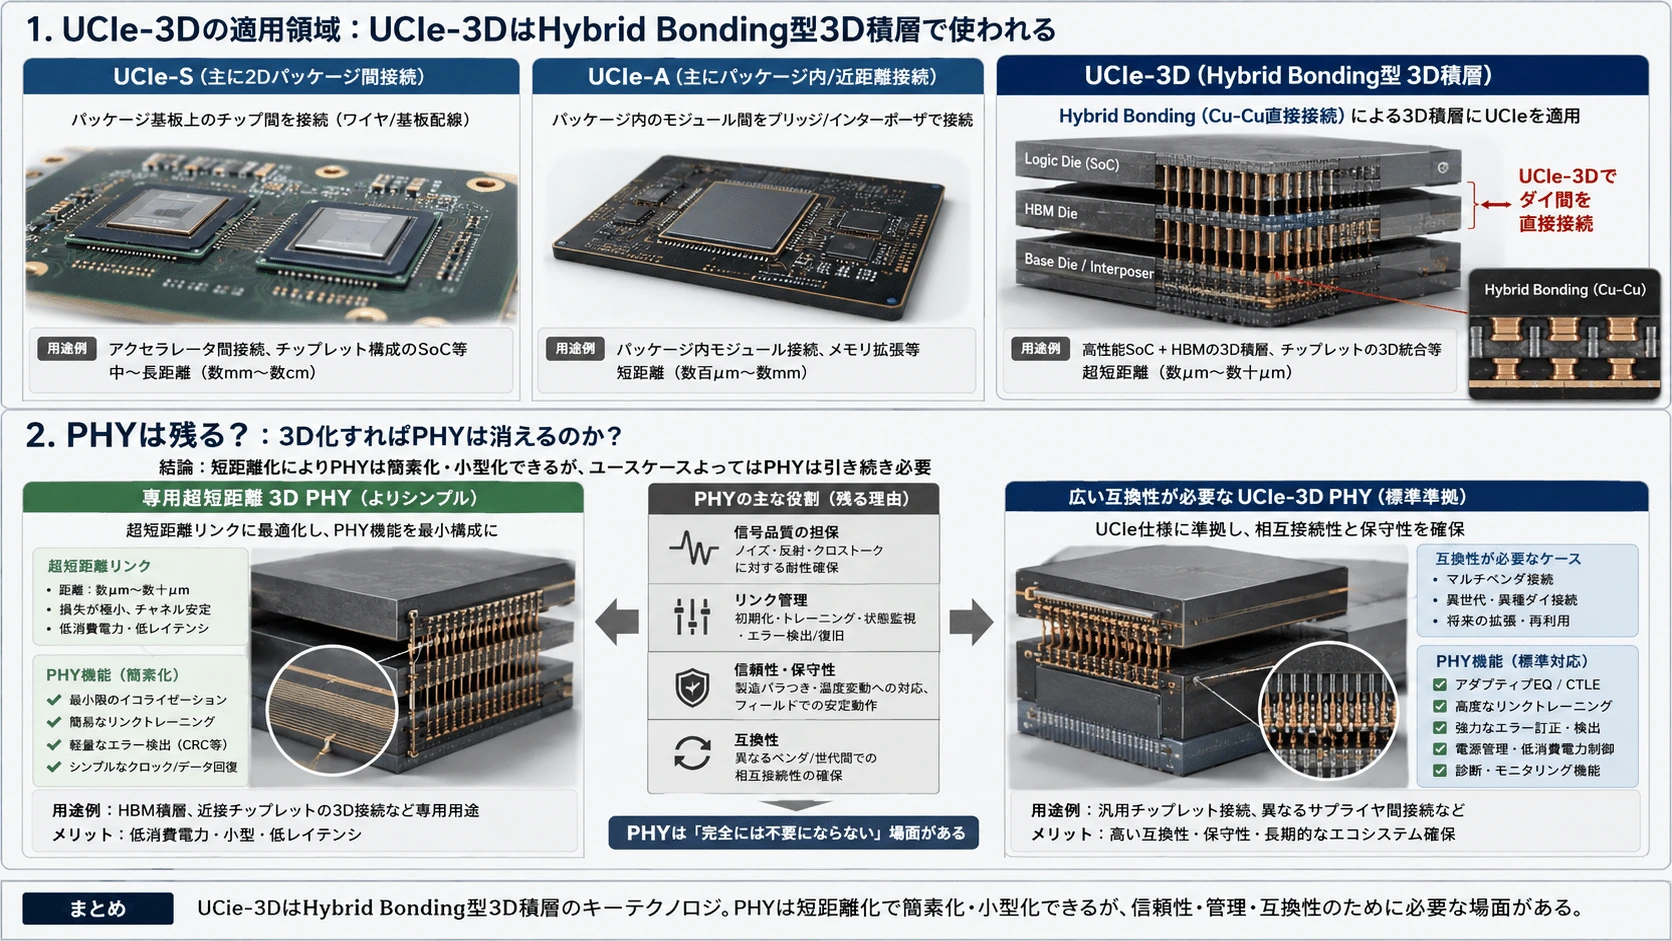
UCIe-3Dはどこで使われるのか
#UCIe-3Dは、3D積層されたチップレット間の相互運用性を目的とする規格である。
#UCIe 2.0で3Dパッケージ対応が追加され、Hybrid Bonding向けに、10~25µm級から1µm以下までの接続ピッチへ対応する拡張性が示された。(UCIe Consortium)
#Protocol
↓
UCIe Adapter
↓
UCIe-3D PHY
↓
Hybrid Bonding
↓
相手側ダイUCIe-3Dが有効なのは、
#- 異なるベンダーのダイ
- 再利用可能なチップレット
- 管理・テスト・相互運用性が重要
- 複数製品へ展開するモジュール
などである。
#一方、ALUとレジスターファイルのような極めて細粒度で同一クロックに密結合した回路では、UCIeのAdapterや標準化されたリンク機能が大きすぎる可能性がある。
#その場合は、
#- 専用3D I/O
- 極広幅並列接続
- モノリシック配線に近い独自インターフェース
が使われると考えられる。
#つまり、
#UCIe-3D
=再利用性・相互運用性を重視
専用3D Interface
=遅延・面積・電力の極限を重視である。
#Logic FoldingのすべてがUCIe化されるわけではない。
##
3D化すればPHYは消えるのか
#接続ピッチが十分に細かくなり、配線距離が極端に短くなれば、外部SerDesのような複雑なPHYは不要になる可能性がある。
#省略しやすいものには、
#- 強い送信ドライバー
- 大きなシリアライザー
- 複雑なイコライザー
- 長距離向けCDR
- FEC
がある。
#しかし、次の機能は依然として必要になる。
#- 送信バッファ
- 受信判定
- タイミング調整
- 電圧変換
- レーン修復
- テスト回路
- クロック分配
imecは、将来の真の3D-SoCでは、中間の大きなインターフェースPHYを削減し、直接的な3D接続で機能層をつなぐ方向を示している。これはPHYが完全にゼロになるという意味ではなく、境界回路がモノリシックSoC内部配線に近づくという意味である。(imec)
#
#
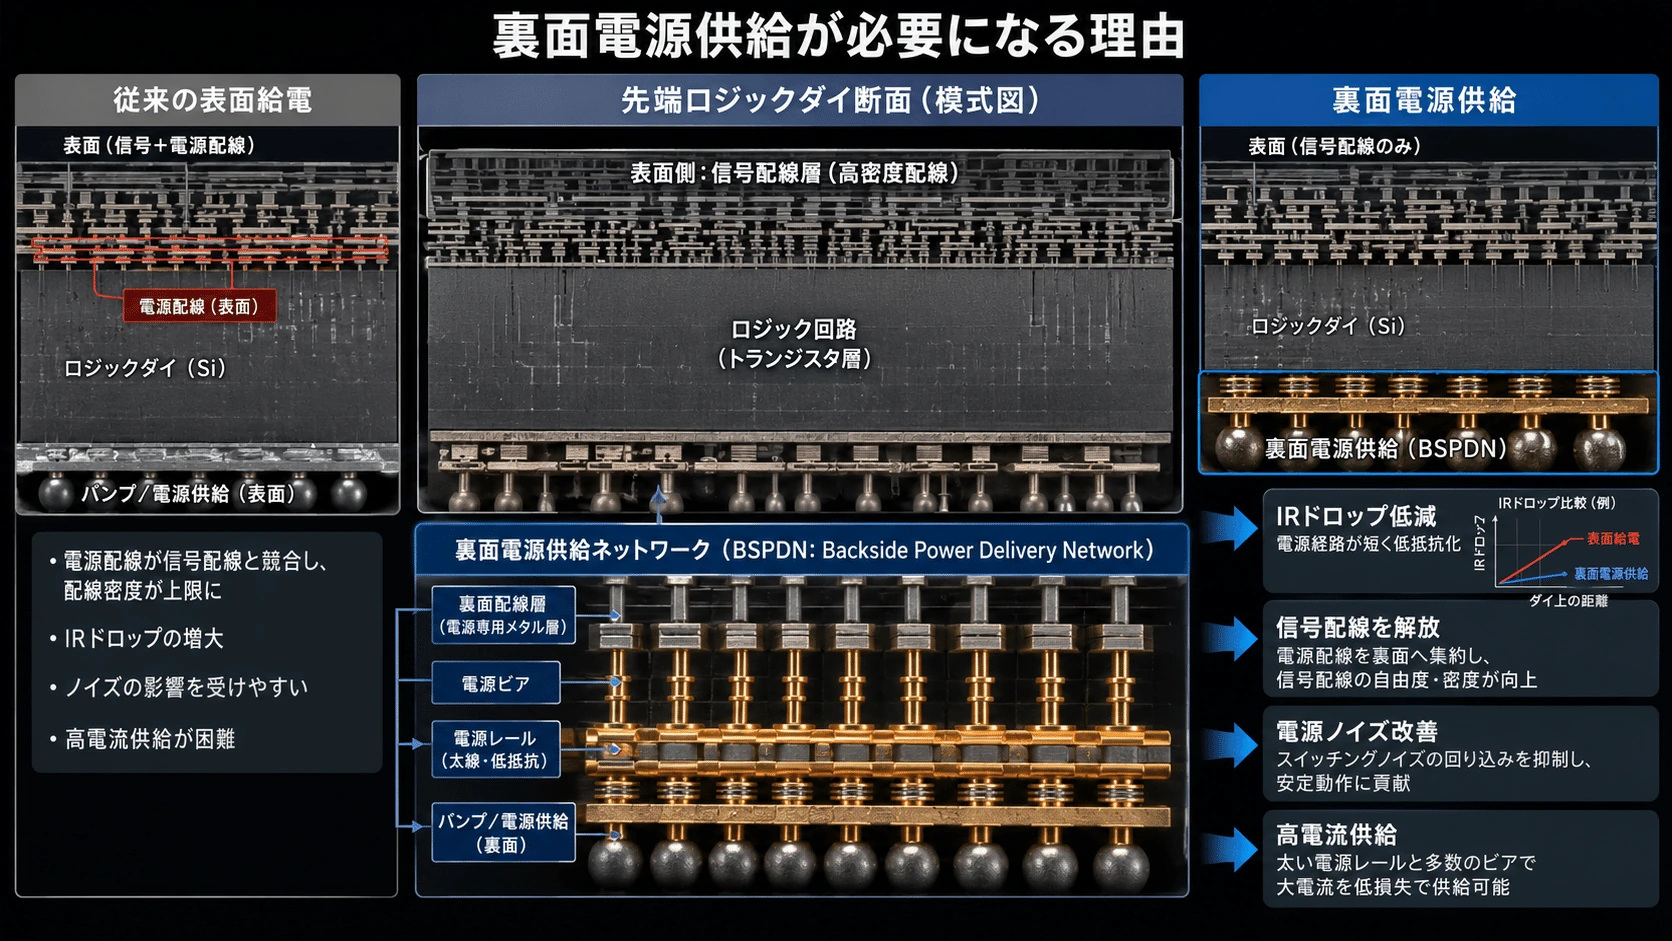
裏面電源供給が必要になる理由
#回路を上下へ積み重ねると、信号だけでなく電源も各層へ届けなければならない。
#従来のチップでは、信号配線と電源配線の両方をトランジスタ上部のBEOLへ配置する。
#従来
前面配線
信号+電源
↓
トランジスタ裏面電源供給では、電源をシリコン裏面から供給する。
#前面:信号配線
↓
トランジスタ
↑
Nano-TSV/背面ビア
↑
裏面:電源配線これにより、
#- 信号配線と電源配線を分離する
- 前面配線の混雑を減らす
- 太く低抵抗な電源線を使う
- IRドロップを抑える
- 上下積層の電源経路を再構成する
ことが可能になる。
#imecは、Backside Power Delivery Networkによって電源網を信号網から分離し、より幅広く低抵抗な裏面配線から標準セルへ電力を届ける構成を研究している。Intel 18AもPowerVia裏面電源供給を採用し、前面の信号配線資源を解放する構造を掲げている。(imec)
#
#
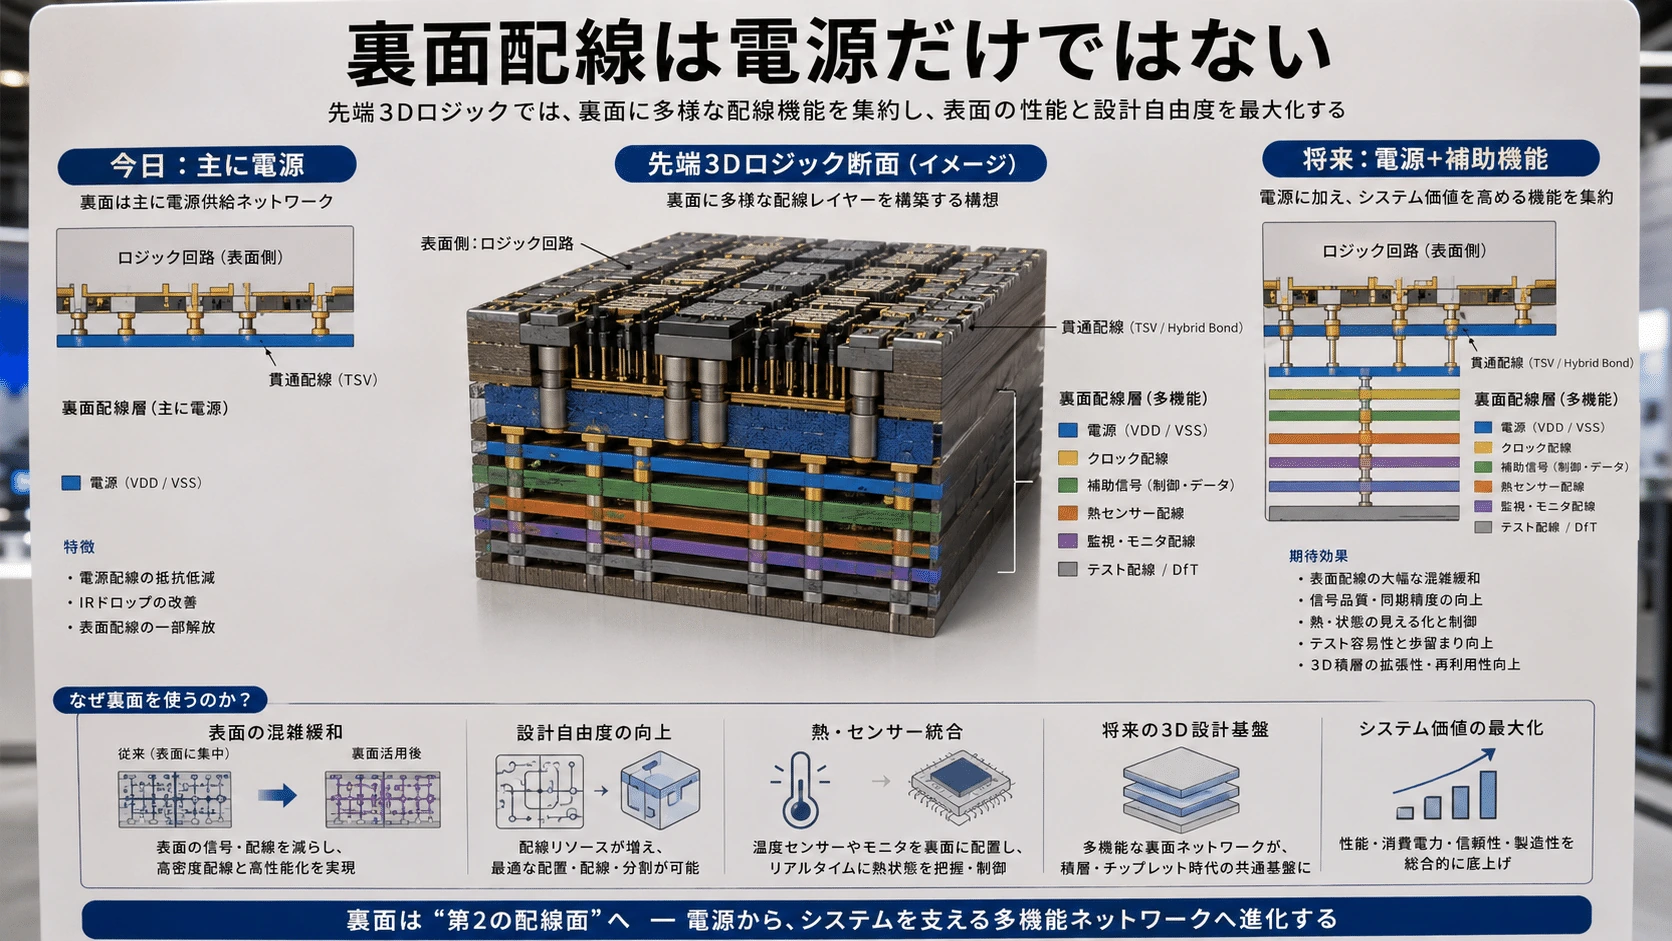
裏面配線は電源だけではない
#将来の裏面は、単なる電源入力面ではなくなる可能性がある。
#裏面へ、
#- 電源網
- グローバル信号
- クロック
- 3D接続
- 層間ルーティング
を配置する研究が進んでいる。
#imecは、ウェハー前面と裏面の両方へ高密度接続を形成し、CMOS 2.0型の機能層積層へ利用する方向を示している。研究段階では120nmピッチの裏面接続も報告されている。(imec)
#これは、従来の、
#トランジスタの上側だけに配線する構造から、
#前面:信号
中央:トランジスタ
裏面:電源・接続という三次元的な配線構造へ変わることを意味する。
#
#
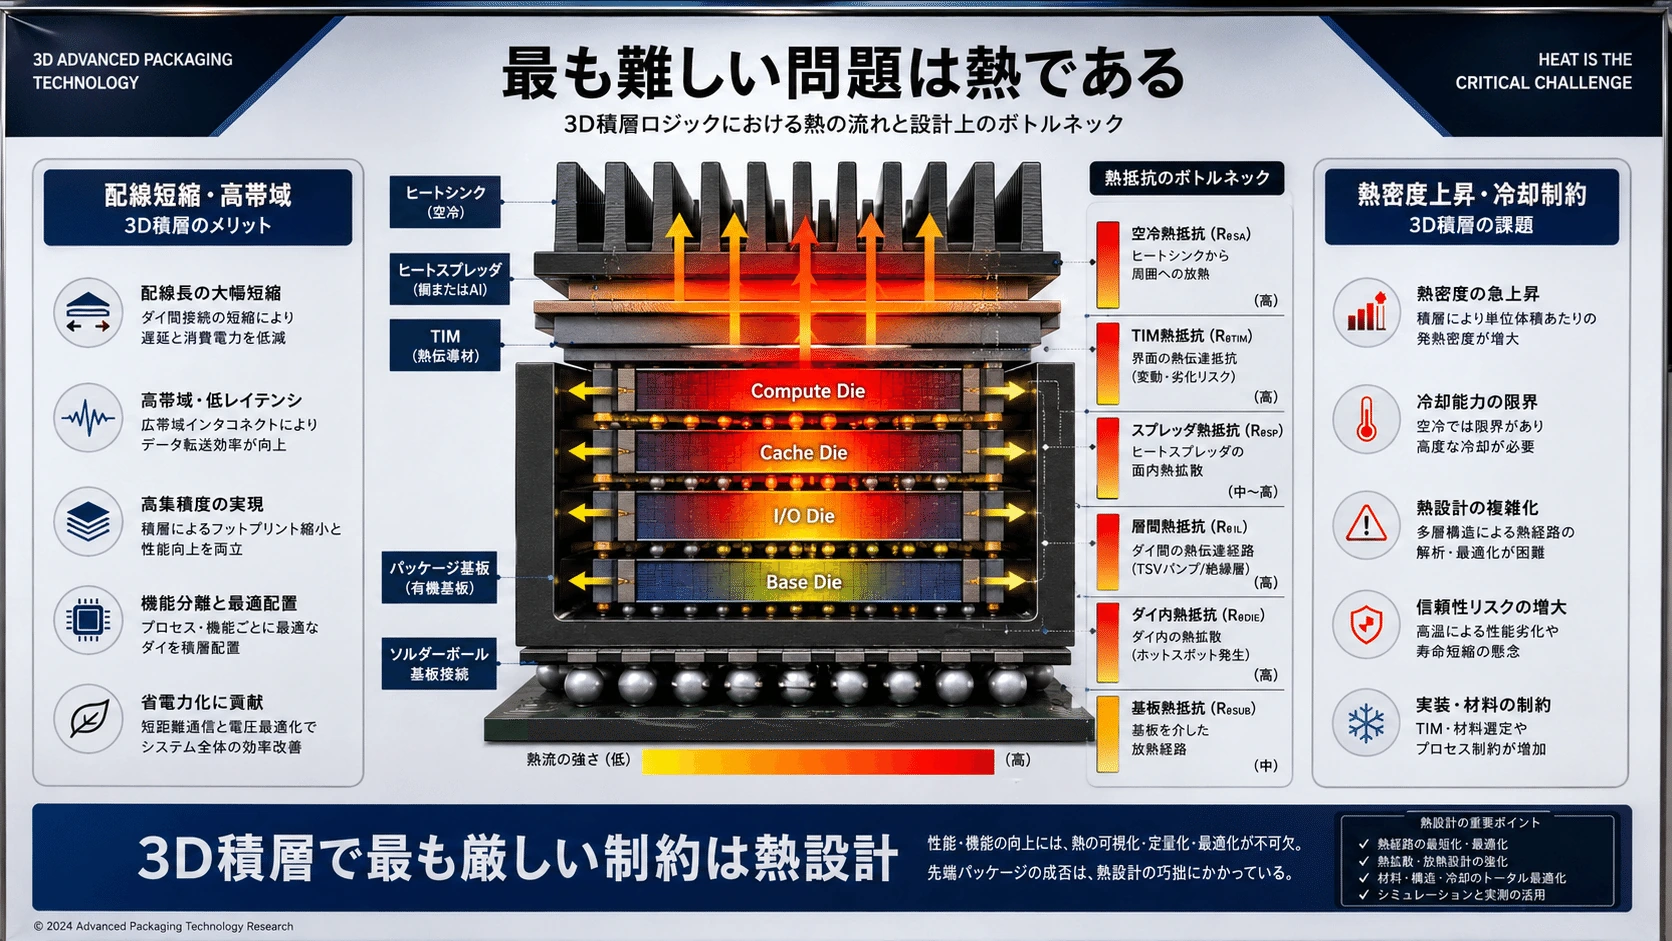
最も難しい問題は熱である
#3D積層では、回路を近づけるほど熱源も近づく。
#熱抵抗を単純化すると、
#- (t):熱が通る材料の厚さ
- (k):熱伝導率
- (A):熱が通る面積
熱源から冷却面までに、
#- シリコン
- 接合界面
- 別のダイ
- 接着層
- ヒートスプレッダ
が存在すると、熱抵抗が積み重なる。
#冷却面
↑
高発熱Compute
↑
高発熱Compute
↑
Base Dieこのように高発熱ロジックを重ねると、下層の熱が上層を通過しなければならない場合がある。
#一方、
#冷却面
↑
Compute
↑
低発熱SRAMのように、比較的低発熱なメモリー層を組み合わせれば、熱設計を成立させやすい。
#3D-ICではダイを高密度に配置するため、局所温度、熱勾配、機械応力が性能と信頼性へ影響する。熱解析はチップ単体ではなく、ダイ、接合、インターポーザー、基板、冷却器までを含めて行う必要がある。(login.cadence.com)
#
#
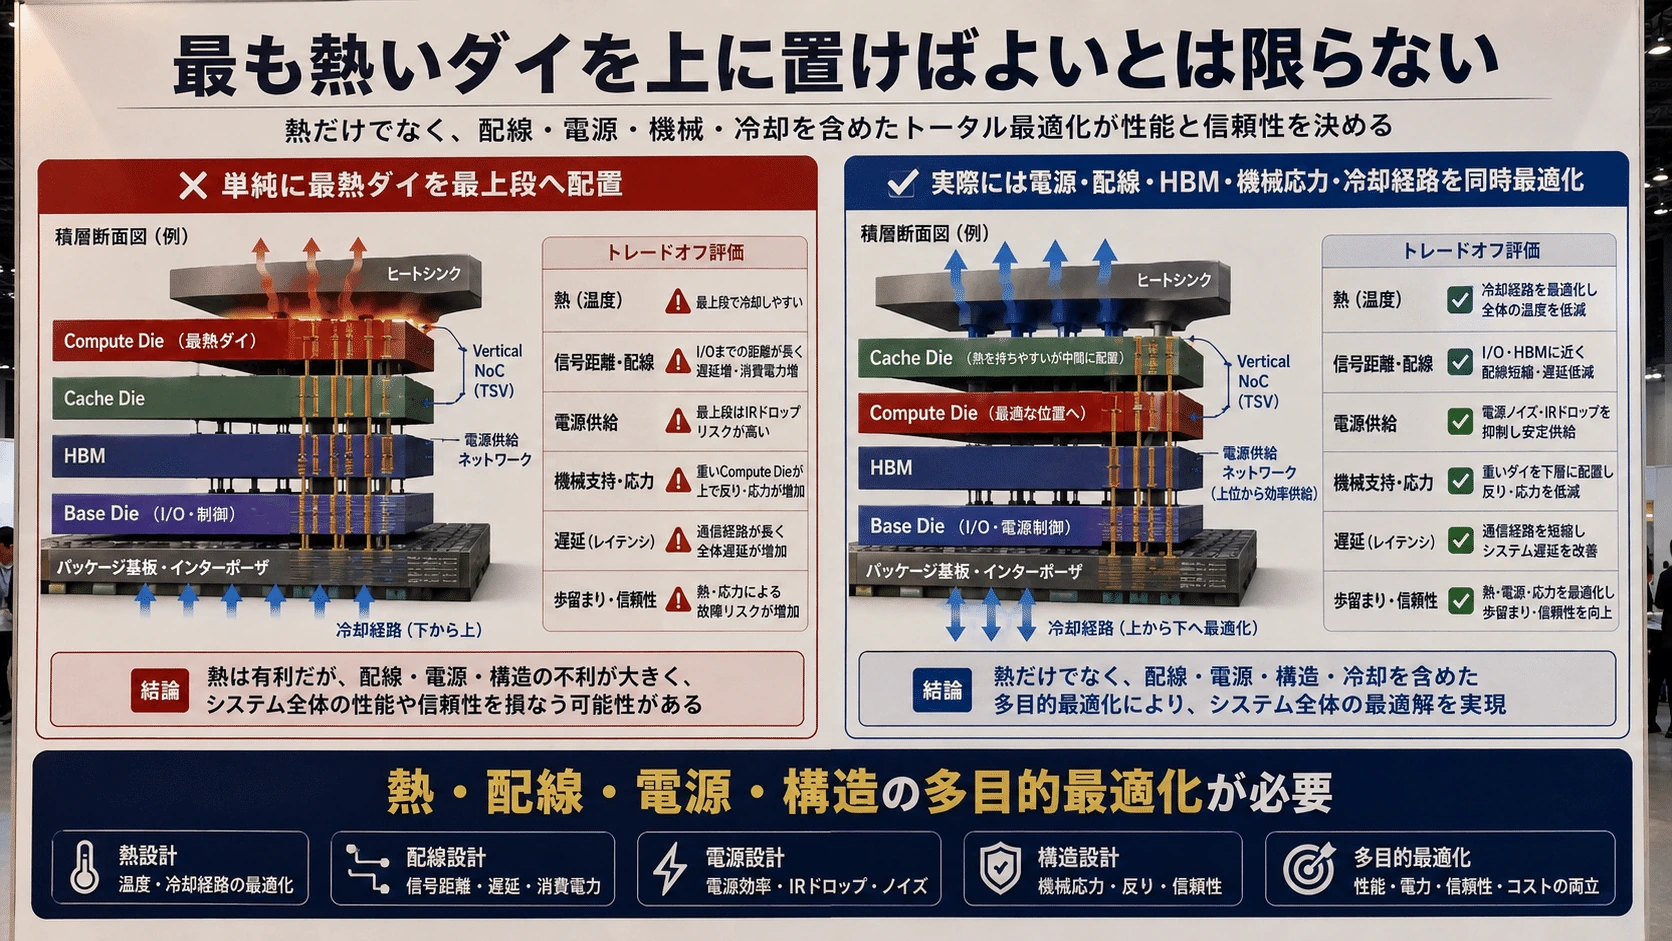
「最も熱いダイを上に置けばよい」とは限らない
#発熱ダイをヒートスプレッダの近くへ置けば、放熱しやすくなる。
#しかし上層ダイへ電力を供給するには、
#- TSV
- 垂直電源ビア
- 接合パッド
- 電源バンプ
が必要になる。
#また、下側ダイの発熱が上側ダイを通過する場合、上側の動作温度も上がる。
#最適配置は、
#- 各層の発熱密度
- 同時稼働率
- 冷却面の位置
- 電源供給方向
- 熱伝導材料
- チップ面積
- ホットスポットの重なり
で変わる。
#したがって、Logic Foldingでは論理回路図だけでなく、熱源の三次元配置図が必要になる。
#
#
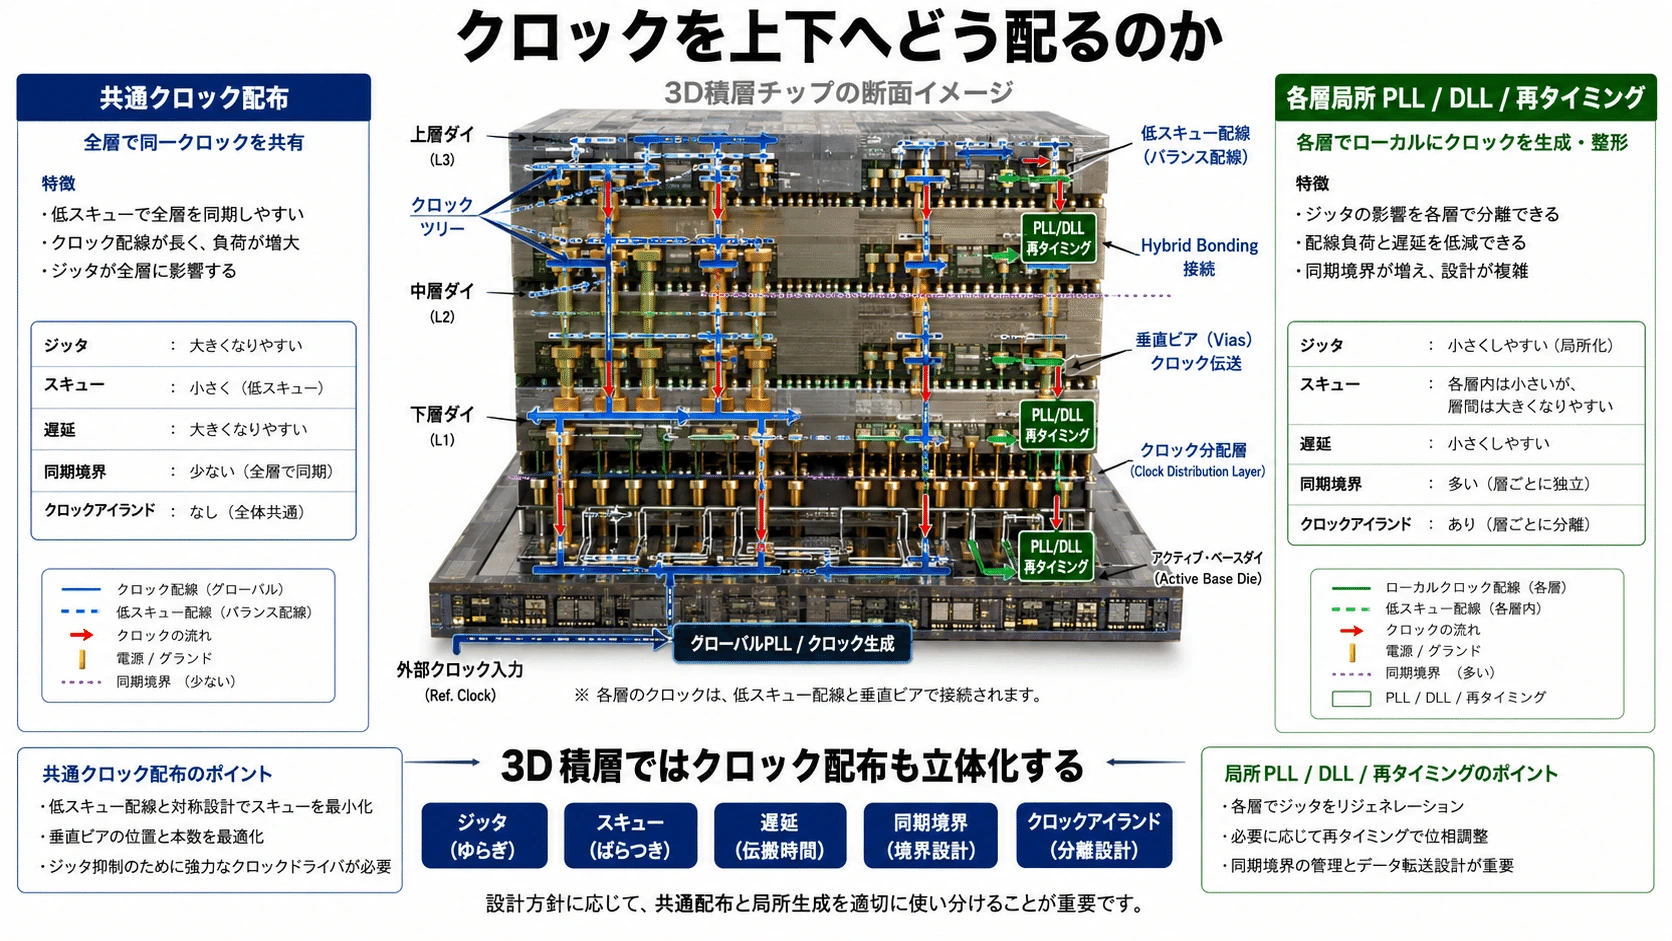
クロックを上下へどう配るのか
#複数のダイを同じクロックで動かす場合、各層へほぼ同時にクロックを届けなければならない。
#問題になるのは、
#- 層間配線遅延
- TSVや接合部のばらつき
- 温度差
- 電圧差
- PLLの配置
- ジッター
- クロックスキュー
である。
#Clock Source
├── 上層
├── 中層
└── 下層クロックスキューが大きいと、ある層ではデータが安定していても、別の層では変化中にサンプリングしてしまう。
#設計方法には、
#共通クロック型
#1つのクロック源を全層へ配布する。
#層ごとのクロック型
#各層にPLLやDLLを置き、同期回路で接続する。
#GALS型
#Globally Asynchronous, Locally Synchronousとして、層ごとに独立クロックを使う。
#などが考えられる。
#細粒度Logic Foldingでは低遅延が重要なため、安易に非同期FIFOを挟むと利点が失われる。
#一方で、すべての層を完全な単一クロックへ固定すると、クロック収束が極めて難しくなる。
#
#
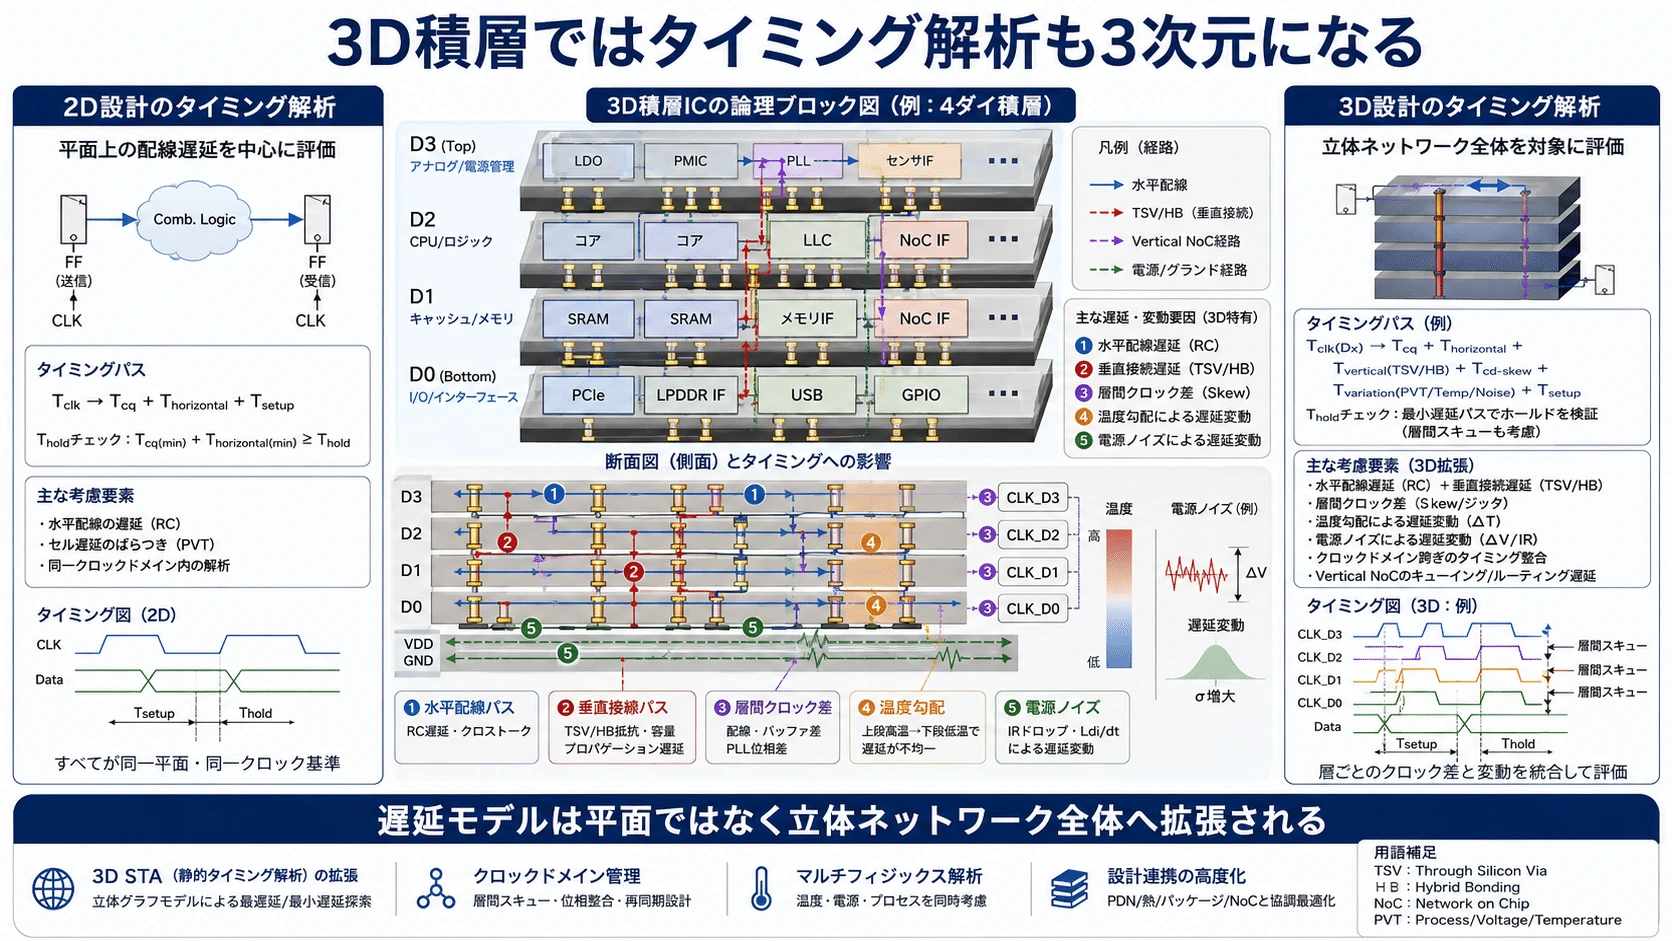
3D積層ではタイミング解析も3次元になる
#従来のStatic Timing Analysisは、1枚のダイ内のセルと配線遅延を解析する。
#Logic Foldingでは、
#上層セル
↓
Hybrid Bonding
↓
下層セル
↓
別の層という経路を含める必要がある。
#解析対象には、
#- 層内配線
- 層間接続
- 接合位置のずれ
- 温度分布
- 電圧降下
- クロック分配
- 製造ばらつき
が加わる。
#同じ回路でも、上層と下層で温度が異なれば、トランジスタ速度も異なる。
#したがって、
#として、層内・層間を一体で解析する必要がある。
#
#
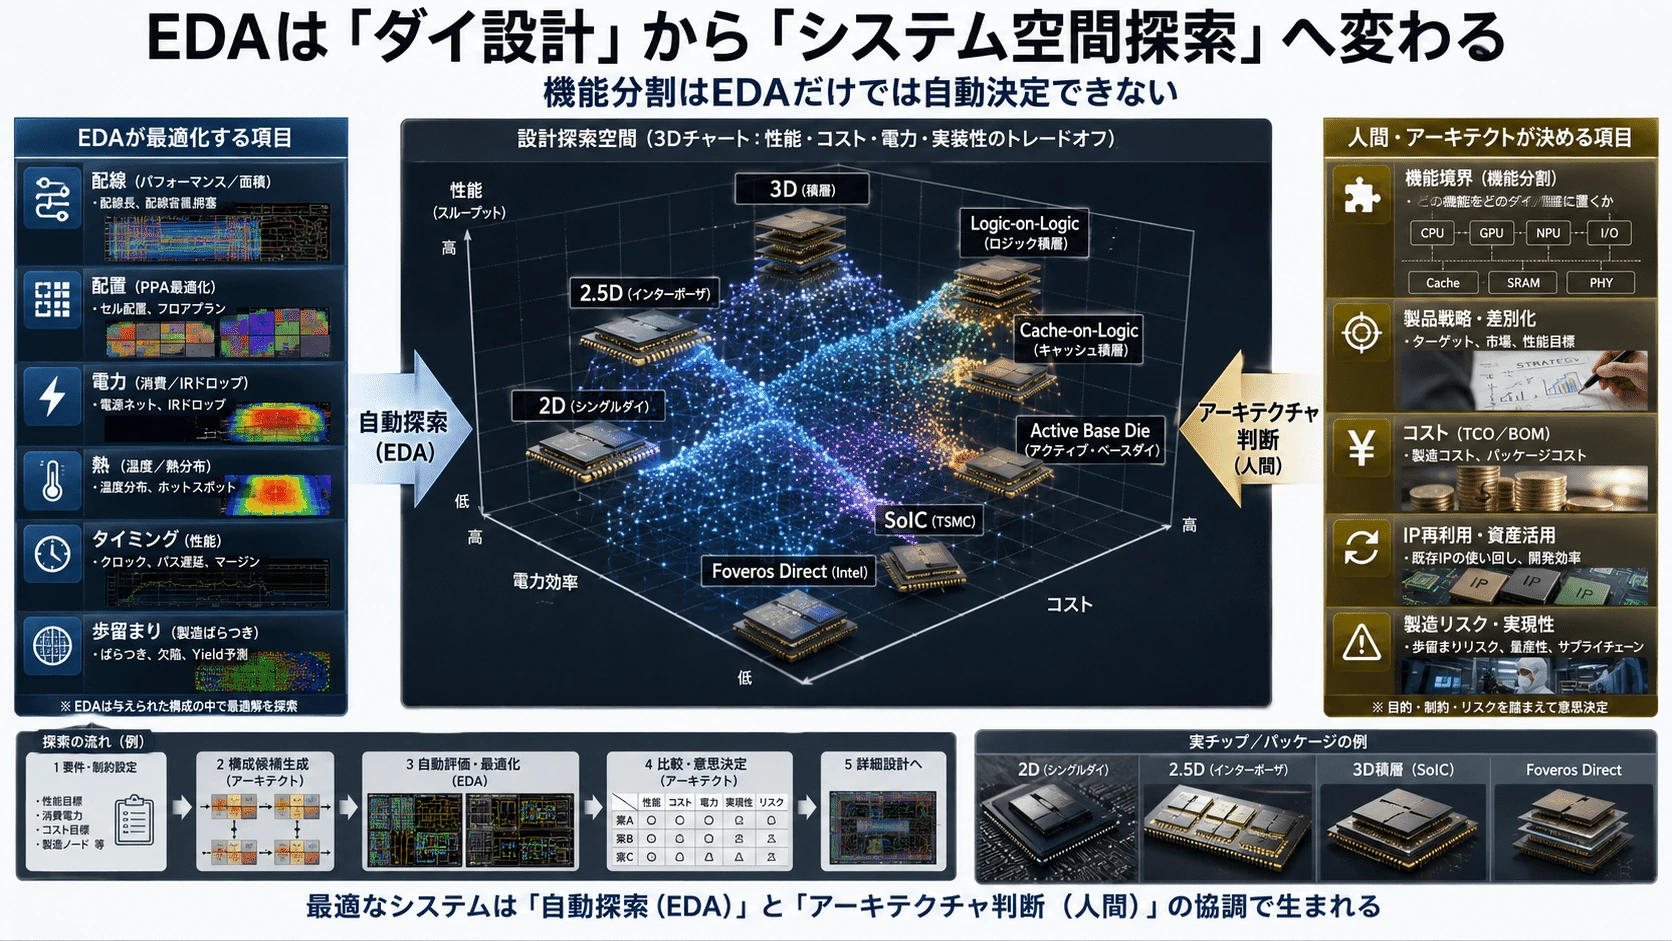
EDAは「ダイ設計」から「システム空間探索」へ変わる
#Logic Foldingでは、回路をどこで切るかが設計の中心になる。
#EDAツールは、
#- どの機能をどの層へ置くか
- 各層にどの製造ノードを使うか
- 何本の垂直接続が必要か
- 熱はどこへ流れるか
- 電源をどちら側から入れるか
- 歩留まりとコストは成立するか
を同時に評価しなければならない。
#この考え方がSTCO、System-Technology Co-Optimizationである。
#システム要件
↓
アーキテクチャ分割
↓
プロセス選択
↓
3D配置配線
↓
熱・電源・タイミング
↓
コスト・歩留まりCadenceなどの3D-IC設計環境も、フロアプラン、静的タイミング、信号品質、電源品質、電磁界、熱、機械的反りを統合して解析する方向へ進んでいる。(cadence.com)
#
#
機能分割はEDAだけでは自動決定できない
#どこで分割すべきかは、回路図だけでは決まらない。
#例えばキャッシュを上へ積む場合でも、
#- キャッシュ容量
- バンク数
- タグの配置
- アクセスポート数
- コア数
- 接続ピッチ
- 目標クロック
- 熱設計
によって最適構造が変わる。
#さらに、演算器とSRAMを近づけても、アルゴリズムがそのデータを再利用しなければ、帯域の価値は小さい。
#したがってLogic Foldingでは、
#- アプリケーション
- コンパイラー
- マイクロアーキテクチャ
- 回路
- パッケージ
- 製造
を同時に設計する必要がある。
##
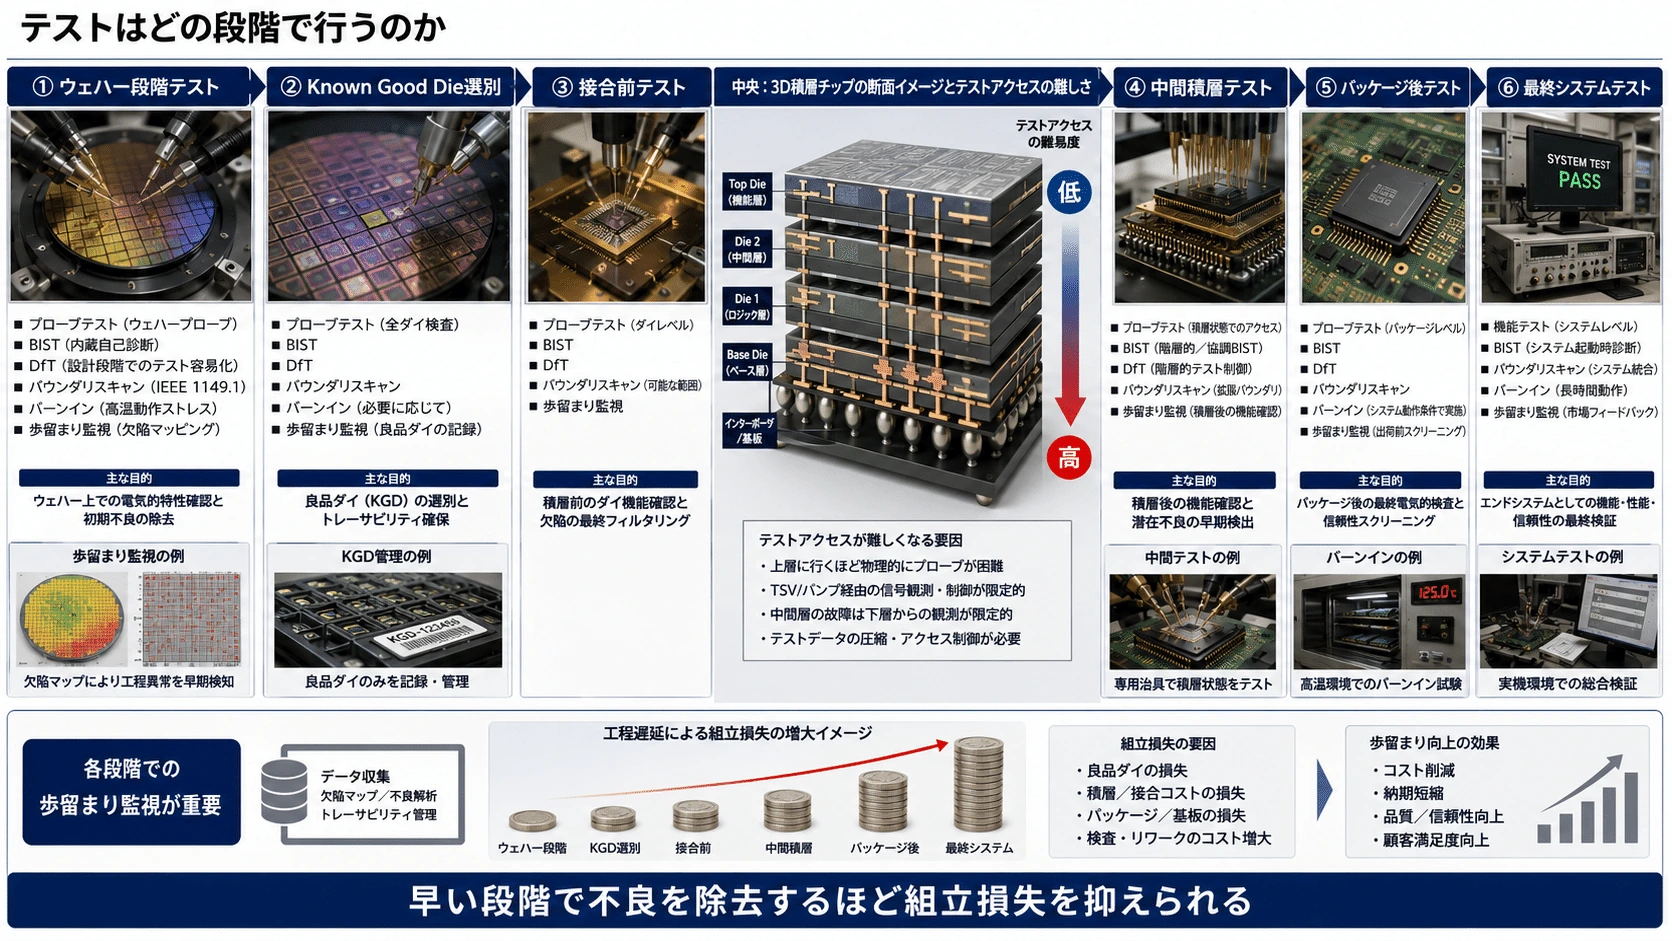
テストはどの段階で行うのか
#3Dスタックには複数の検査段階がある。
#各ウェハーのテスト
↓
Known Good Die選別
↓
接合後テスト
↓
薄化・TSV後テスト
↓
パッケージ完成後テストLogic Foldingでは、1つの論理機能が複数ダイへ分散する。
#そのため、接合前のダイ単体では、完成時と同じ動作を完全には再現できない場合がある。
#例えば、
#- 上層にALU
- 下層にレジスター
- ベースダイにNoC
がある場合、ALUダイ単体では実際のデータ経路を検証できない。
#必要になるのは、
#- 層単体BIST
- 層間ループバック
- TSV/接合チェーンテスト
- 垂直リンクPRBS
- 予備接点
- 故障ブロック無効化
- システムレベル診断
である。
#UCIe 2.0がDFx、テレメトリー、管理、デバッグを重視しているのも、複数チップレットからなるSiPでは、リンクだけでなくシステム全体の観測性が必要になるためである。(UCIe Consortium)
#
#
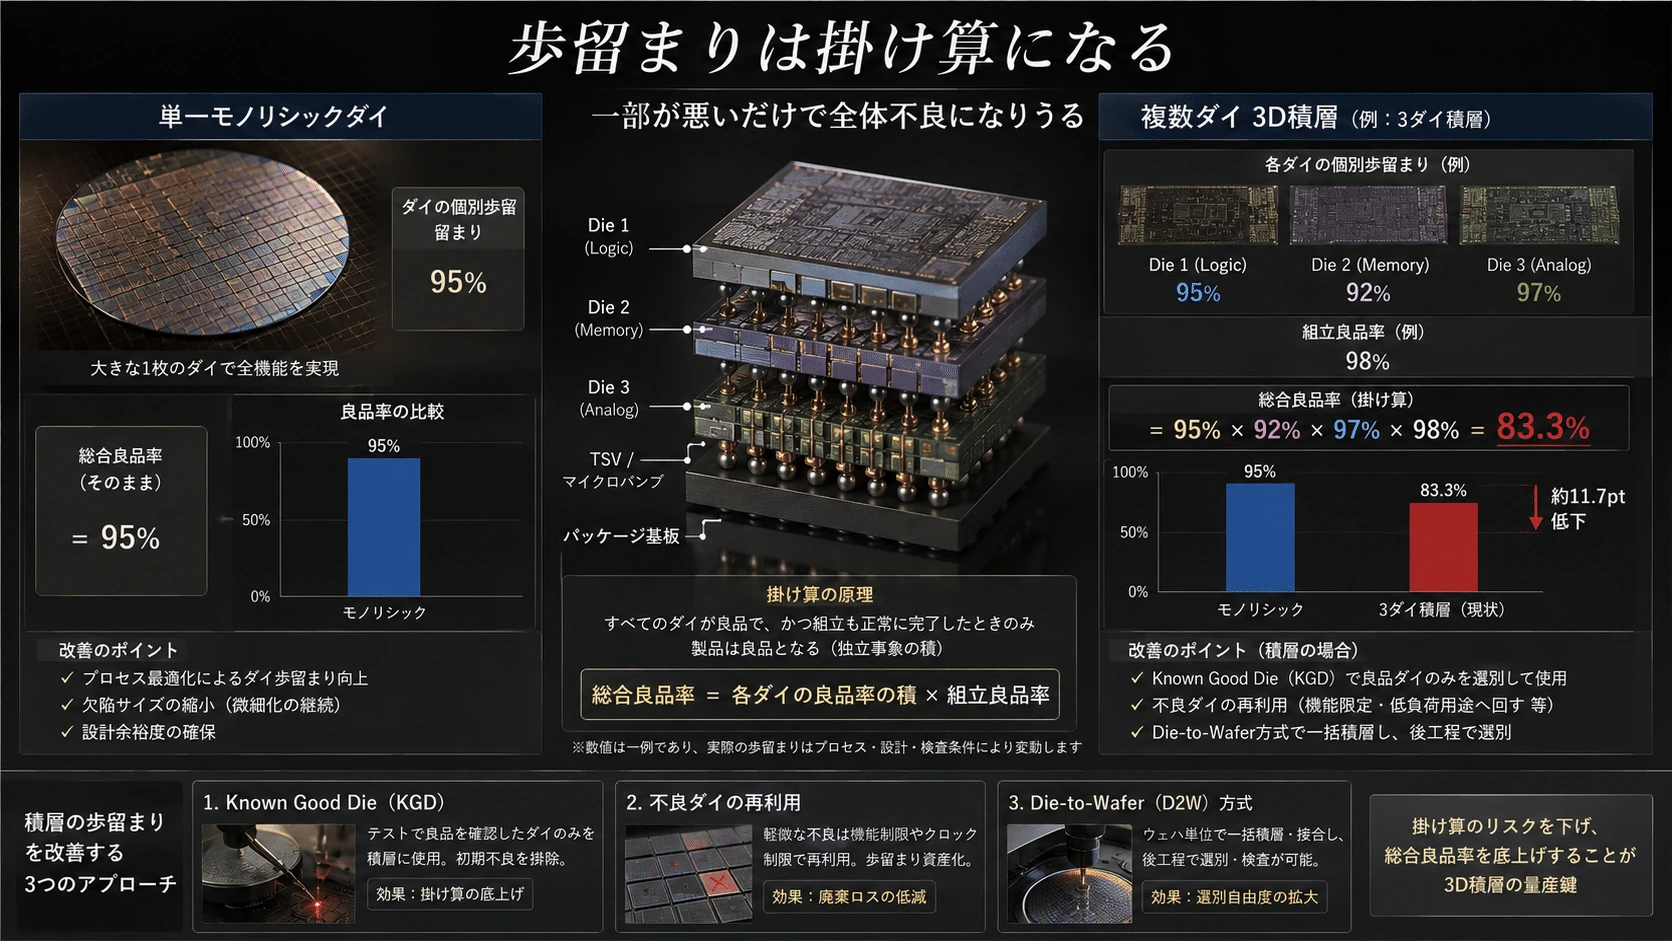
歩留まりは掛け算になる
#複数のダイを積層する場合、単純化したスタック歩留まりは、
#で考えられる。
#例えば、
#- 上層ダイ歩留まり:95%
- 下層ダイ歩留まり:95%
- 接合工程歩留まり:98%
なら、
#となり、単純化したスタック歩留まりは約88.4%になる。
#実際には、テスト選別、冗長性、欠陥分布、ダイサイズなどが影響するため、単純な掛け算だけでは決まらない。
#しかし層数が増えるほど、
#- Known Good Die
- 接合前検査
- 修復機能
- 冗長回路
- 欠陥許容アーキテクチャ
の重要性が増す。
#
#
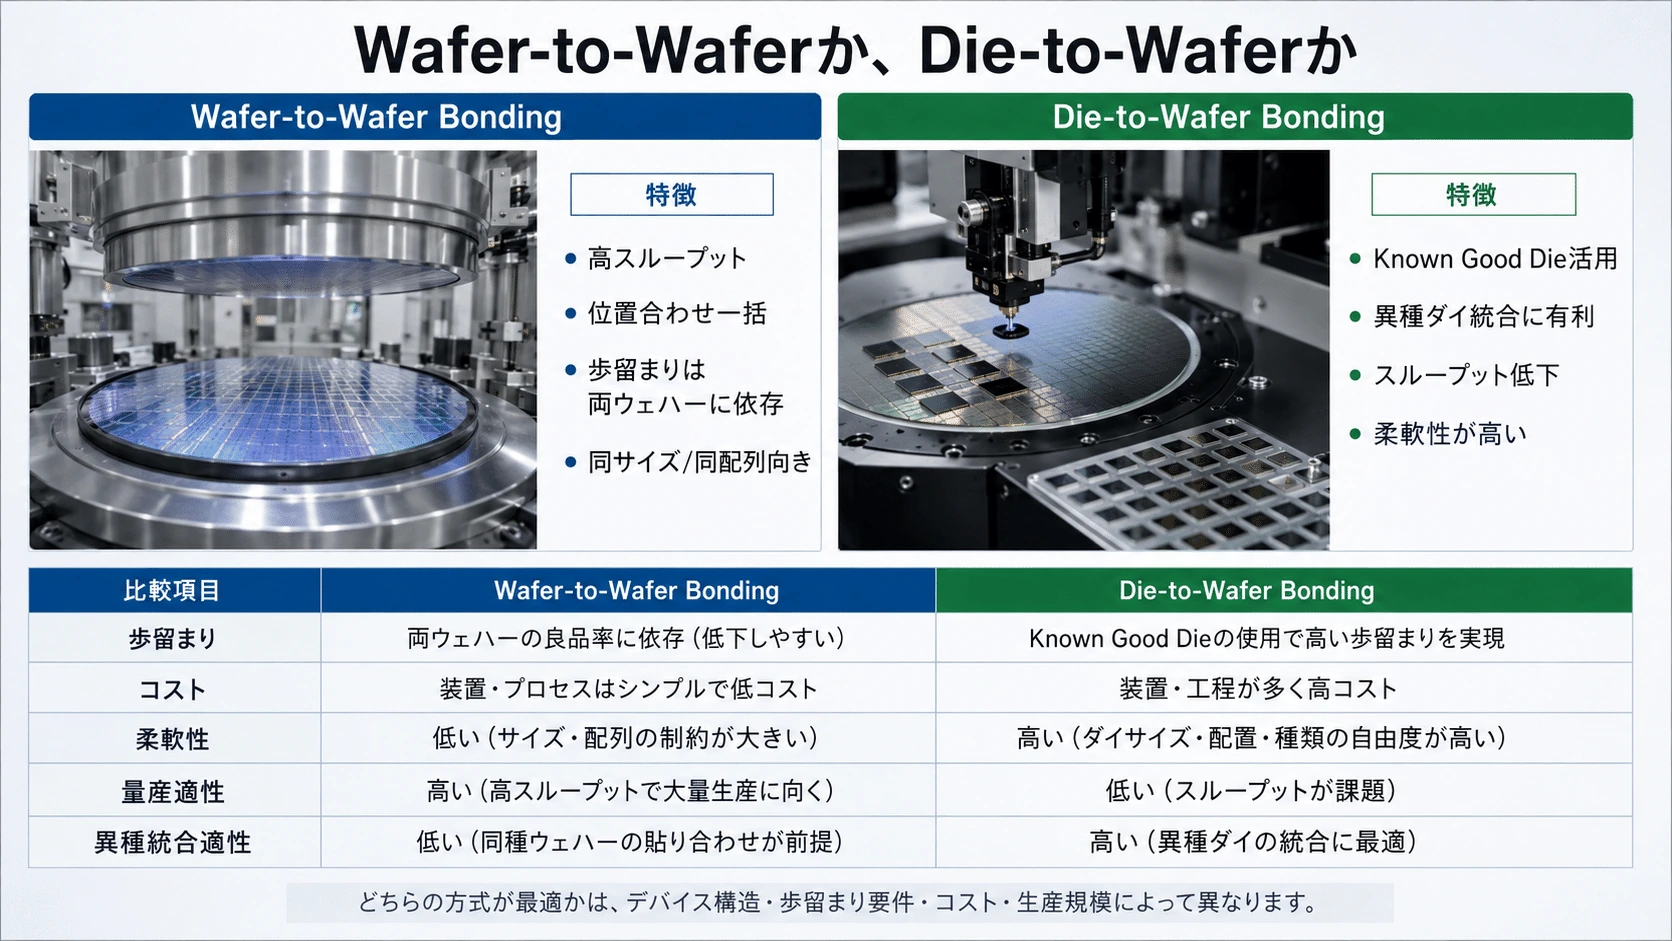
Wafer-to-Waferか、Die-to-Waferか
#細粒度のLogic Foldingでは、Wafer-to-Wafer接合が有力である。
#Wafer-to-Wafer
#- 極めて細かな位置合わせ
- 高い処理能力
- 細ピッチHybrid Bonding
- 同一サイズ・同一配置に向く
Die-to-Wafer
#- Known Good Dieを選べる
- 異なるサイズを混載できる
- 異なるノードを組み合わせやすい
- 配置速度と清浄度が課題
標準セルに近い粒度のLogic-to-Logic積層では、上下の回路配置を精密に対応させる必要があるため、Wafer-to-Waferが有利になる可能性がある。
#一方、製品ラインアップの柔軟性や歩留まりを優先する場合は、Die-to-Waferが適する。
#
#
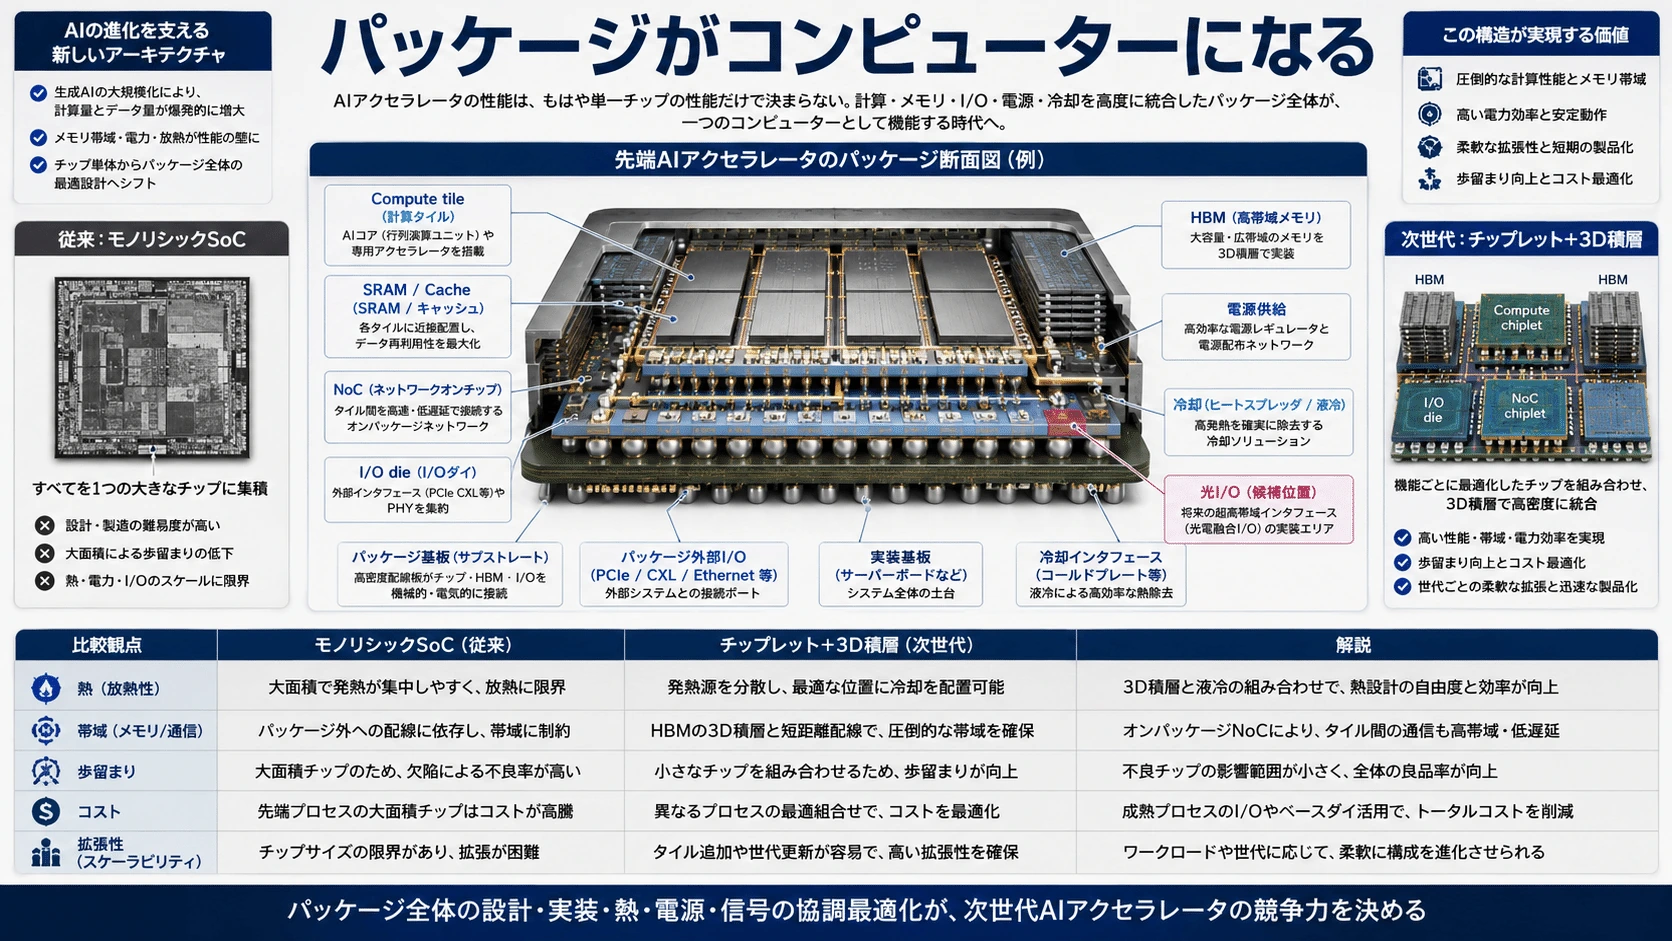
AIアクセラレータはどのような構造になるのか
#将来のAIアクセラレータは、単純にGPUダイを上下へ積むだけではない。
#機能ごとに最適な配置が異なる。
#一例を示す。
#最上層
SRAM・Weight Cache・Activation Buffer
│
演算層
Tensor Core・MAC Array・Vector Unit
│
ベース層
NoC・Router・Memory Controller・I/O
│
CoWoS/EMIB
┌──────┴──────┐
HBM HBM
│
光I/O・ネットワーク上層
#- SRAM
- キャッシュ
- バッファ
- 低発熱な補助ロジック
中層
#- Tensor演算器
- GPUコア
- ベクトル演算器
- 専用アクセラレーター
下層
#- NoC
- メモリーコントローラー
- I/O
- セキュリティー
- 電源管理
- テスト制御
横方向
#- HBM
- 大型I/Oダイ
- ネットワークチップレット
- 光I/O
となる可能性がある。
#
#
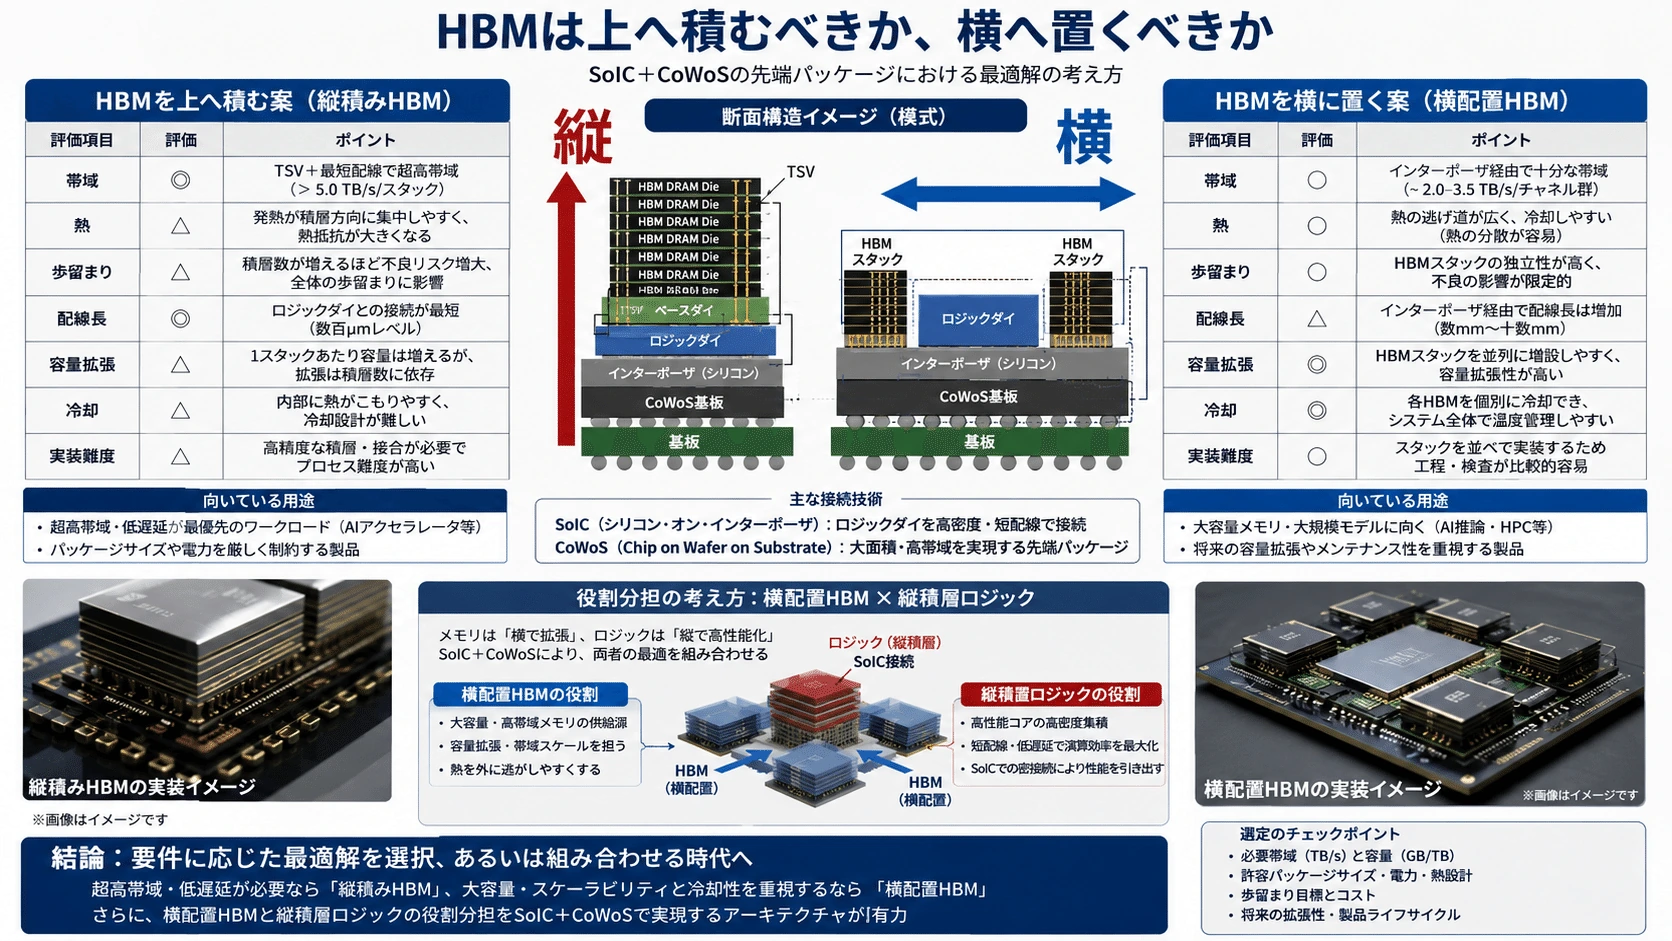
HBMは上へ積むべきか、横へ置くべきか
#HBM自体はDRAMダイを3D積層している。
#しかしAIロジックとの関係では、現在は主にCoWoSなどを使い、ロジックの横へ配置される。
#HBM Compute HBM
╲ │ ╱
InterposerHBMを演算ロジックの真上へ置けば配線をさらに短くできる可能性があるが、
#- HBMの発熱
- ロジックの発熱
- ダイサイズの不一致
- 修理性
- 歩留まり
- 冷却
- 大電流供給
が難しくなる。
#そのため当面は、
#局所SRAMは垂直積層、巨大容量HBMは横方向の2.5D接続#
という組み合わせが現実的である。
#CoWoSは、ロジックチップレットとHBMを高密度インターポーザー上へ統合するAI・HPC向け基盤として位置付けられている。(3DFabric)
#
#
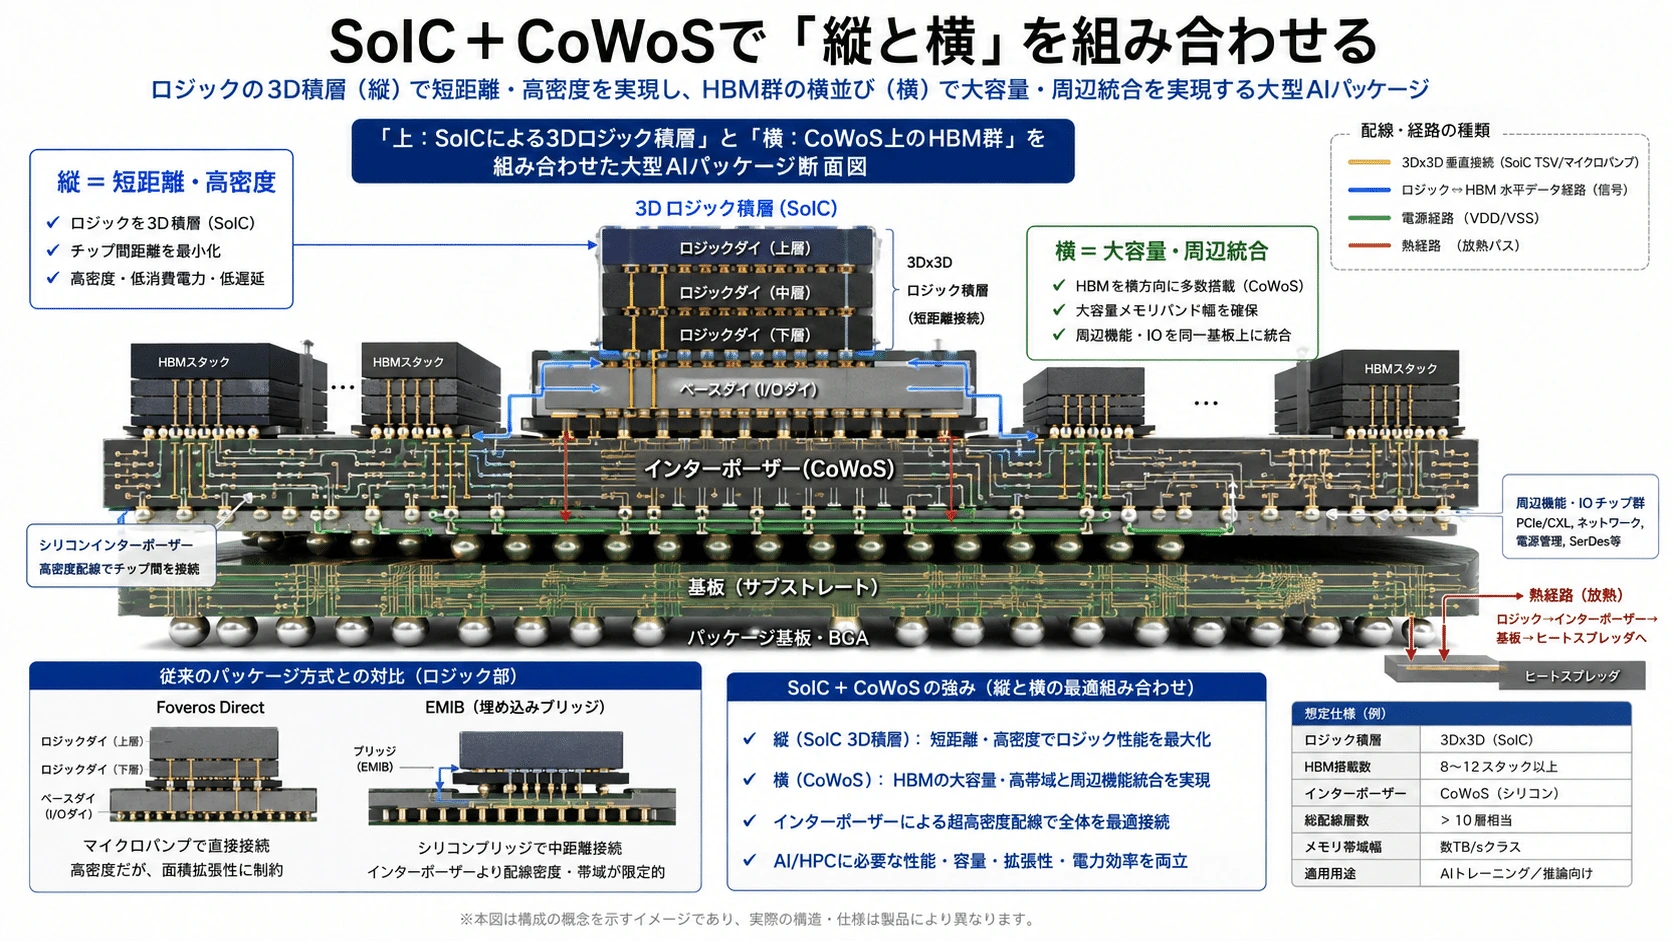
SoIC+CoWoSで「縦と横」を組み合わせる
#TSMCの3Dx3Dでは、
#上:SRAM/Logic
│ SoIC
下:Compute
│
CoWoS Interposer
│ │
HBM HBMという構成が可能になる。
#SoICは縦方向の極短距離接続を担当する。
#CoWoSは横方向の広いシステム接続を担当する。
#この組み合わせにより、
#- 演算器とキャッシュは上下へ近接
- HBMは横へ大容量接続
- パッケージ外へは基板経由
- 光I/Oはエッジへ配置
という階層構造を作れる。TSMCはSoICをCoWoSやInFOと組み合わせる3Dx3D構成を公式に提示している。(3DFabric)
#
#
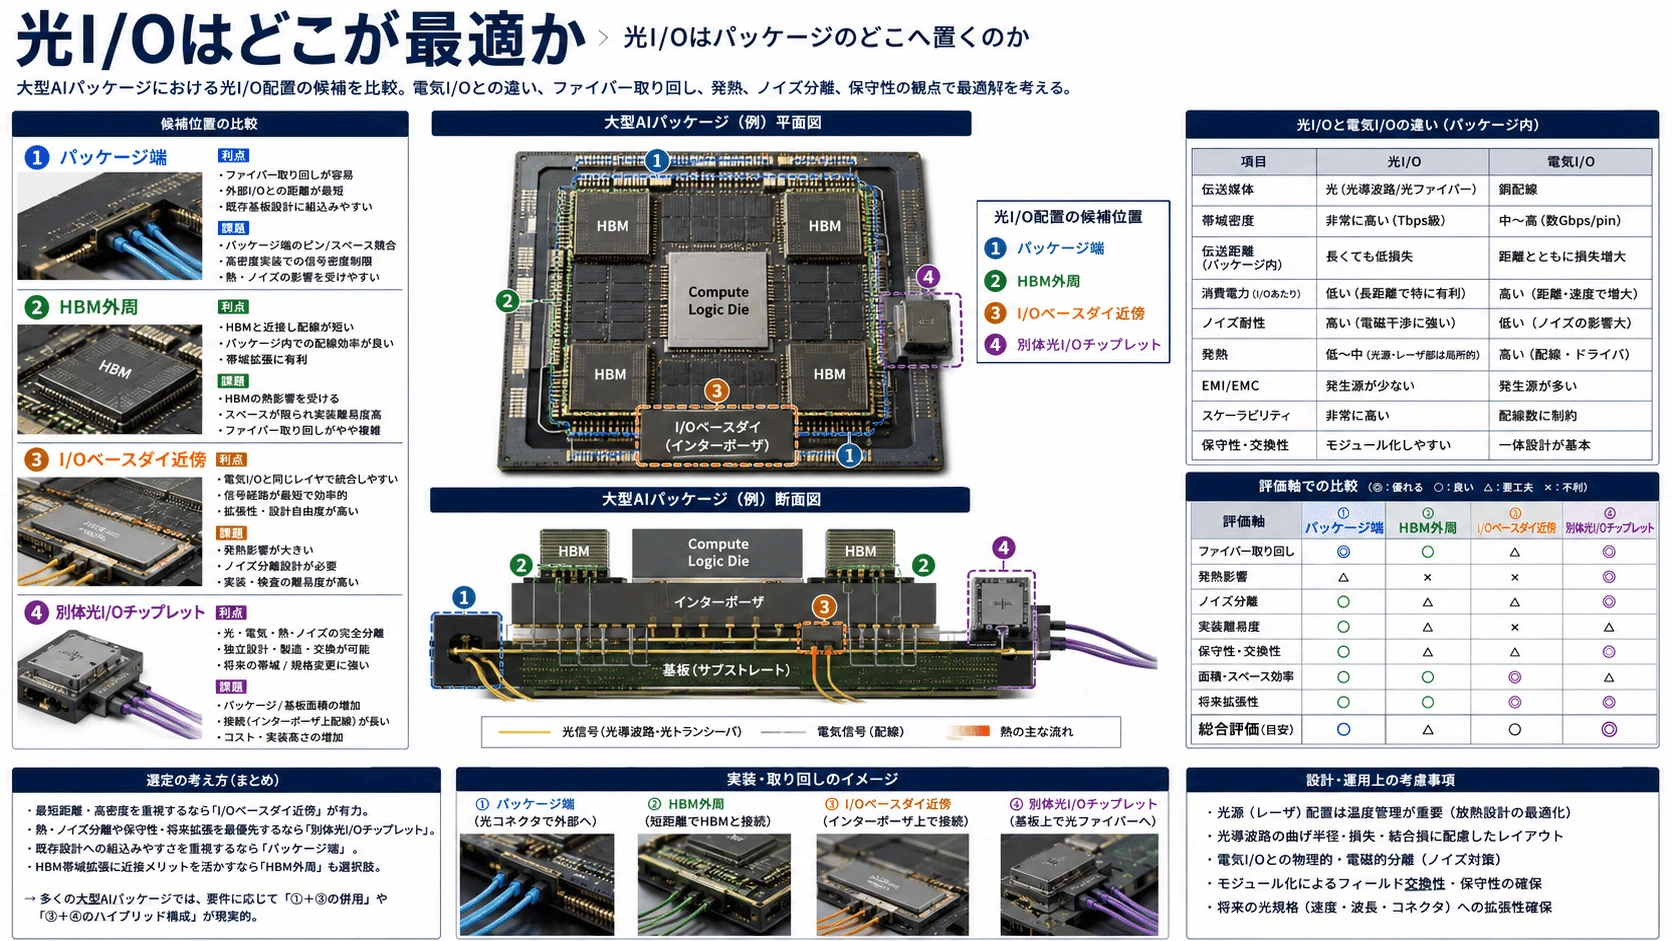
光I/Oはパッケージのどこへ置くのか
#AIクラスターでは、パッケージ内帯域だけでなく、ラック内・ラック間通信の電力も問題になる。
#電気SerDesで長距離を伝送すると、
#- ドライバー電力
- イコライザー電力
- 基板損失
- ケーブル損失
が増える。
#そこで、シリコンフォトニクスをAIパッケージへ近づける構想が進んでいる。
#Compute Package
│
Electrical Control IC
│ Hybrid Bonding/SoIC
Photonic IC
│
Optical FiberTSMCのCOUPEは、電気制御ダイをフォトニックダイへSoIC-Xで積層し、両者の電気的な接続を短縮する構想である。TSMCの2025年年次報告では、3nm SoIC積層が2025年に量産へ入り、SoIC CoWを使うCOUPEは2026年の量産を目標としている。(pr.tsmc.com)
#光I/Oは発光・受光・変調・ドライバー・熱制御を必要とするため、高発熱演算器の真上へ置くより、パッケージ外周や専用チップレットとして配置する方が扱いやすい場合が多い。
#
#
パッケージがコンピューターになる
#従来のコンピューター設計では、CPUやGPUという1個のチップが中心だった。
#従来
CPUチップ
↓
メモリー
↓
I/Oチップレットと3D積層が進むと、性能を決める単位はパッケージ全体になる。
#将来
3D SRAM
│
Compute Stack
│
Active Base Die
│
2.5D Interposer
┌──┼──────┐
HBM HBM Optical I/O
│
Package Substrateこのパッケージには、
#- 演算
- メモリー
- ネットワーク
- セキュリティー
- 電源制御
- 光通信
- 管理
- テスト
が含まれる。
#つまりパッケージは、単なるシリコンを保護する容器ではなく、
#複数のダイ、メモリー、電源、通信、冷却を統合するコンピューター本体#
へ変わる。
##
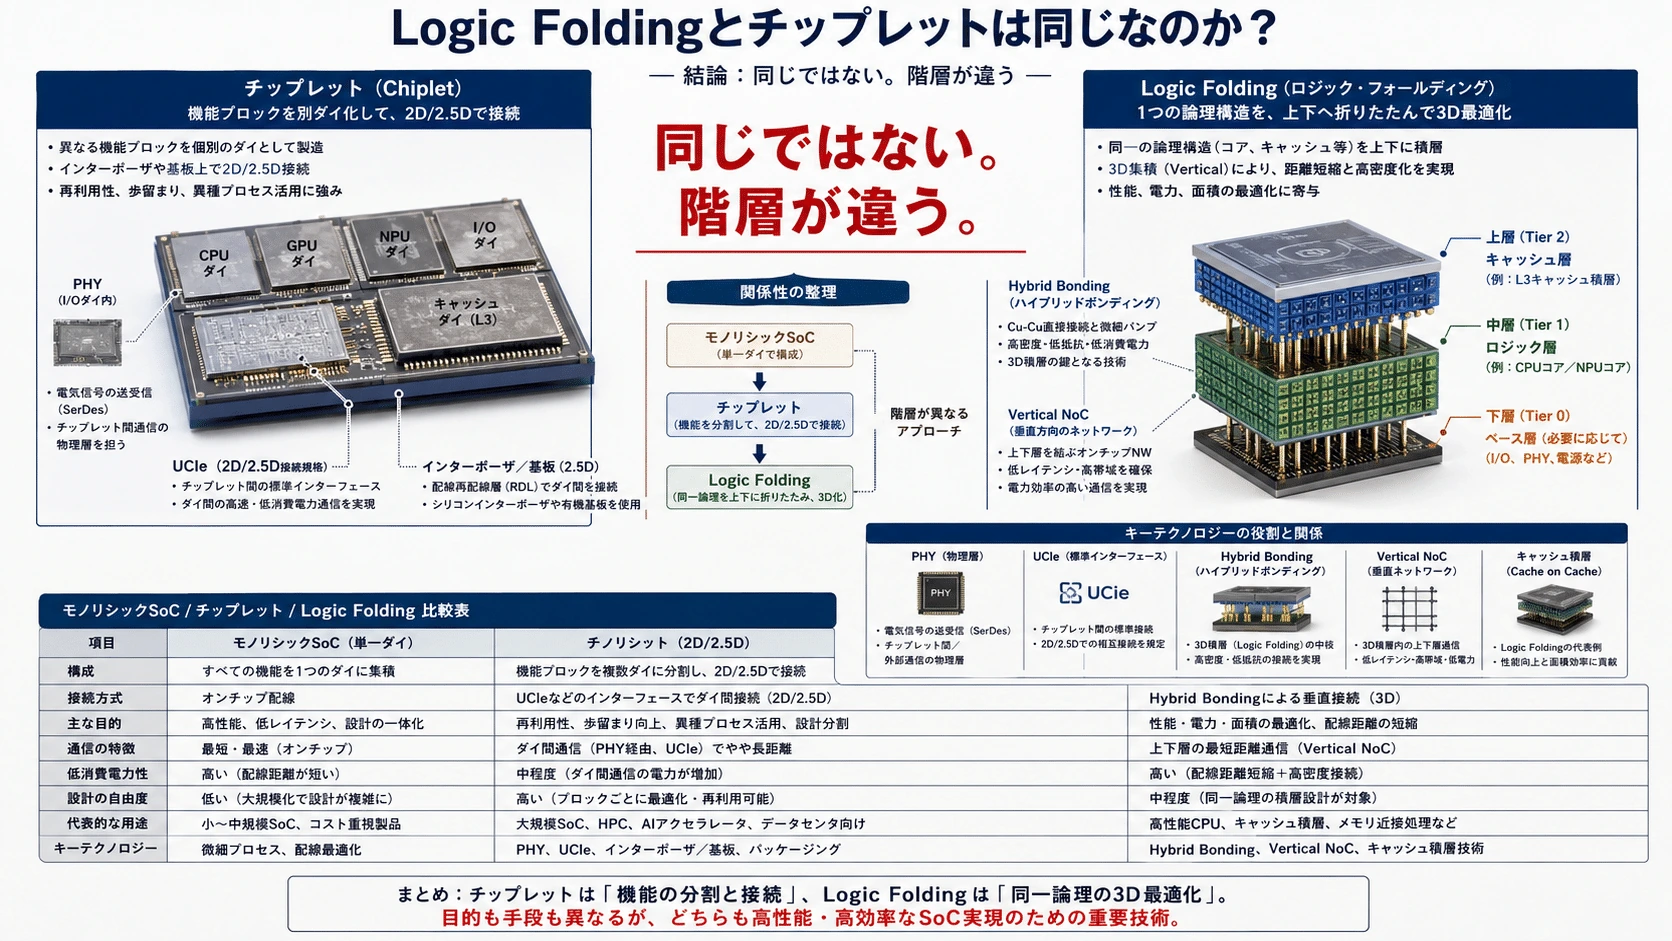
Logic Foldingとチップレットは同じなのか
#両者は連続した概念だが、分割粒度が異なる。
#従来型チップレット
#- Compute Die
- I/O Die
- Cache Die
- Memory Controller Die
のような大きな単位で分ける。
#Logic Folding
#- SRAMマクロ
- 演算アレイ
- NoC
- 高密度ロジック
- 高駆動ロジック
など、より細かな機能階層で上下へ分ける。
#粗い分割
CPU Die | I/O Die
細かい分割
SRAM
│
ALU
│
NoC
│
I/O接続ピッチが小さくなるほど、分割単位を細かくできる。
#
#
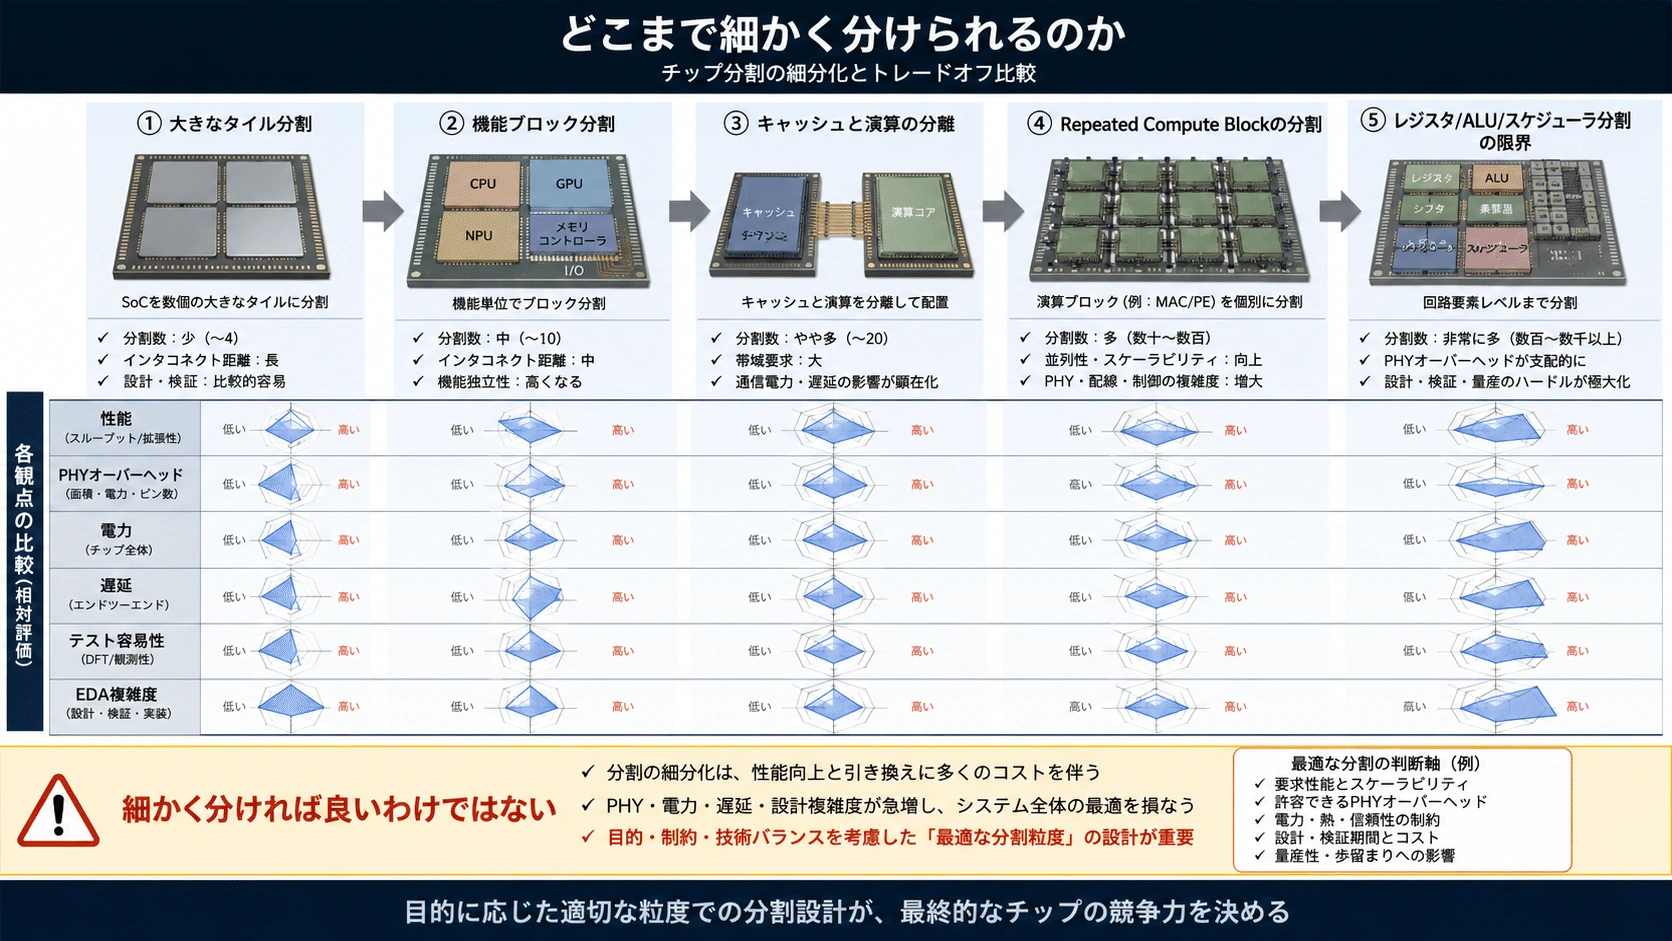
どこまで細かく分けられるのか
#3D統合には複数の階層がある。
#パッケージ階層
数十mm
チップレット同士
ダイ階層
数µm~数十µm
機能ブロック同士
回路階層
sub-µm
標準セル・メモリーマクロ
トランジスタ階層
nm級
CFET・Sequential 3Dチップレット階層
#UCIe、インターポーザー、ブリッジを使う。
#機能ブロック階層
#Hybrid BondingでSRAMとLogicを積む。
#標準セル階層
#CMOS 2.0型のLogic-to-Logic積層を狙う。
#トランジスタ階層
#nMOSとpMOSを上下に積むCFETやSequential 3Dへ進む。
#Logic Foldingは、この中の機能ブロック階層から標準セル階層を主に指すと考えると分かりやすい。
#
#
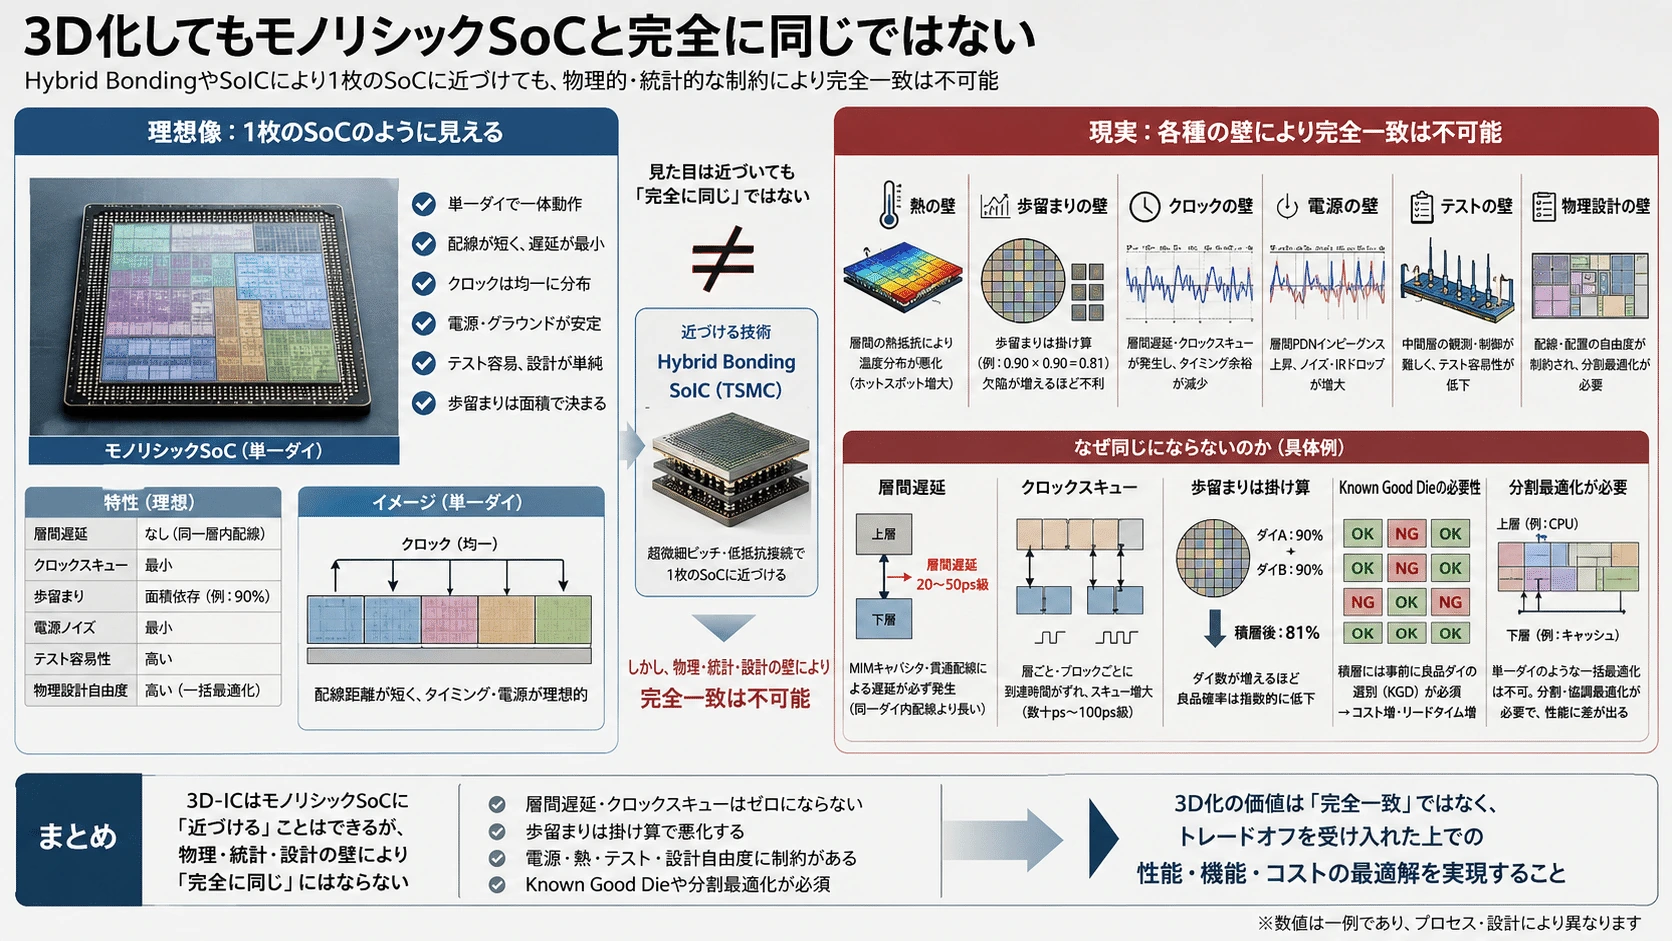
3D化してもモノリシックSoCと完全に同じではない
#Hybrid Bondingが細かくなっても、上下のダイは別々に製造される。
#そのため、
#- 接合工程
- 位置合わせ誤差
- 層間テスト
- 歩留まり
- 熱膨張差
- クロック境界
- 電源境界
が残る。
#ただし、接続ピッチがsub-µm級へ入り、PHYが簡素化されれば、電気的にはモノリシックSoC内部の上位金属配線に近づく。
#モノリシックSoC
最短・最密
細粒度Hybrid Bonding
非常に近い
マイクロバンプ3D
中程度
2.5Dインターポーザー
より長い
有機基板
最も長いLogic Foldingの目標は、別ダイであることを消すことではない。
#別ダイである利点を残したまま、別ダイであることの通信ペナルティーを最小化すること#
である。
#
#
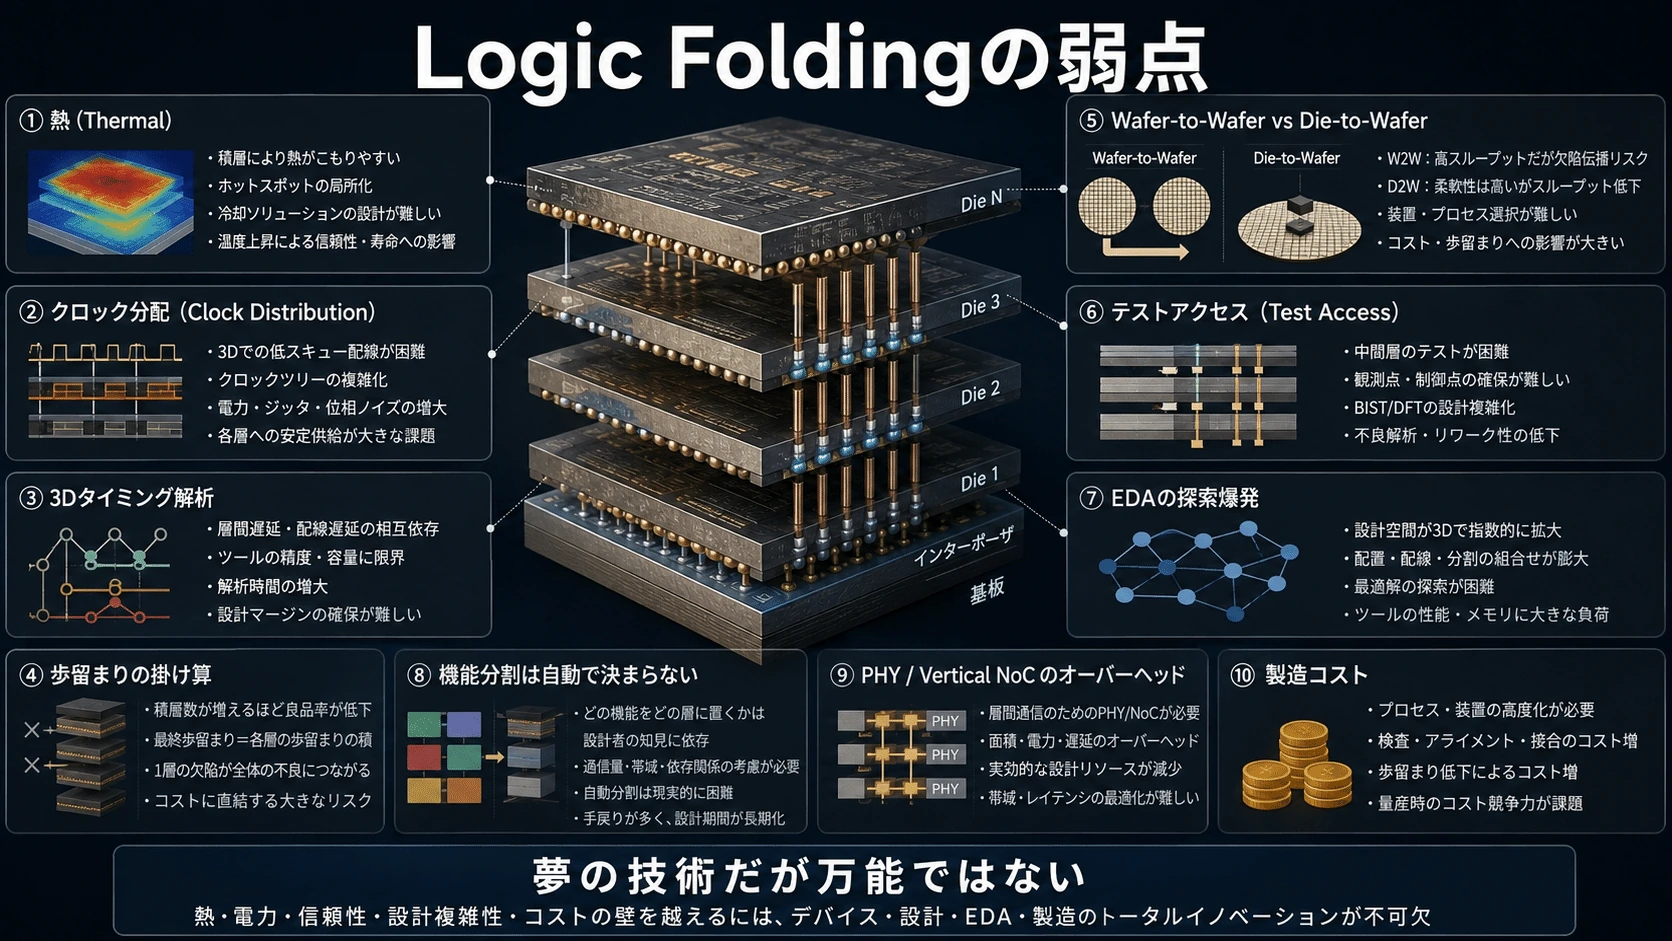
Logic Foldingの弱点
#1.設計が極端に複雑になる
#平面配置だけでなく、層の組み合わせを探索する必要がある。
#2.熱密度が上がる
#投影面積が小さくなっても、総消費電力が減らなければW/mm²は増える。
#3.電源供給が難しい
#上層へ大電流を届ける必要がある。
#4.クロックが難しい
#層間スキューと温度差を管理しなければならない。
#5.テストが難しい
#単体ダイでは完成システムの全経路を検査できない。
#6.歩留まりが複合化する
#ダイ歩留まりと接合歩留まりの両方が必要になる。
#7.修理できない
#直接接合したダイを安全に分離することは困難である。
#8.標準化と最適化が衝突する
#UCIeは再利用性を高めるが、専用3D接続より回路コストが大きくなる場合がある。
#
#
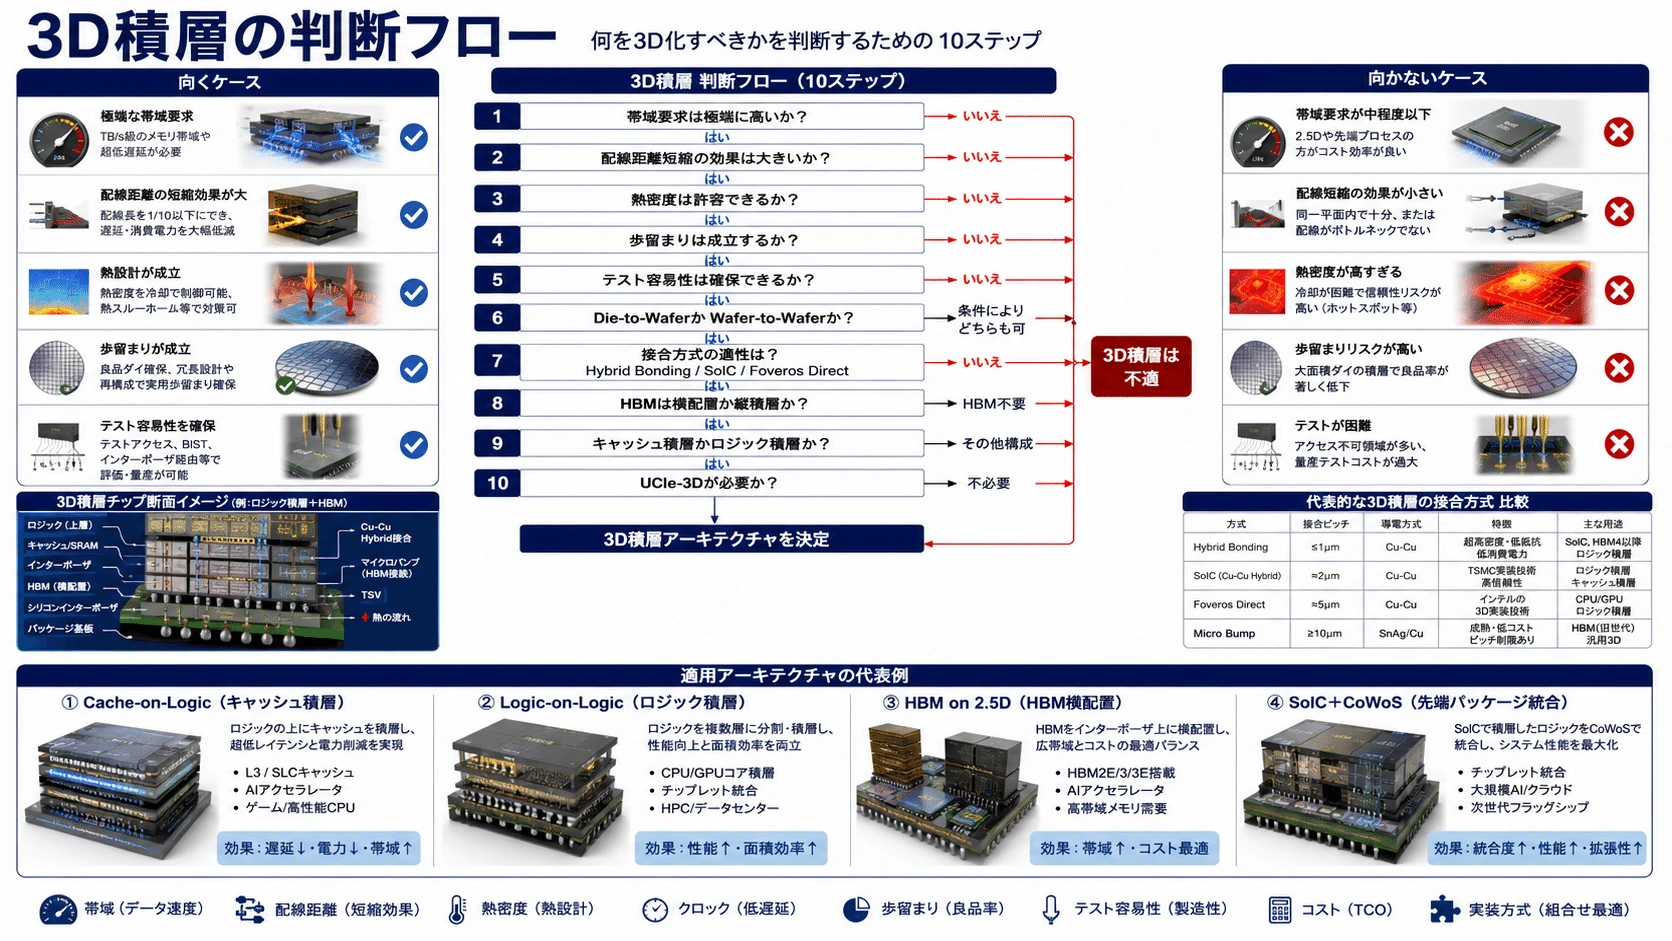
3D積層の判断フロー
#ある回路を積層すべきかは、次の順序で考えられる。
#その機能を近づける価値は大きいか
↓ Yes
配線短縮で帯域・電力が大きく改善するか
↓ Yes
発熱と冷却は成立するか
↓ Yes
電源を供給できるか
↓ Yes
接合前後にテストできるか
↓ Yes
歩留まりとコストが成立するか
↓ Yes
3D積層の候補1つでも重大な問題がある場合は、
#- 同一ダイ内に残す
- 横方向の2.5Dへ置く
- 別のチップレットへ分ける
方が合理的なことがある。
#
#
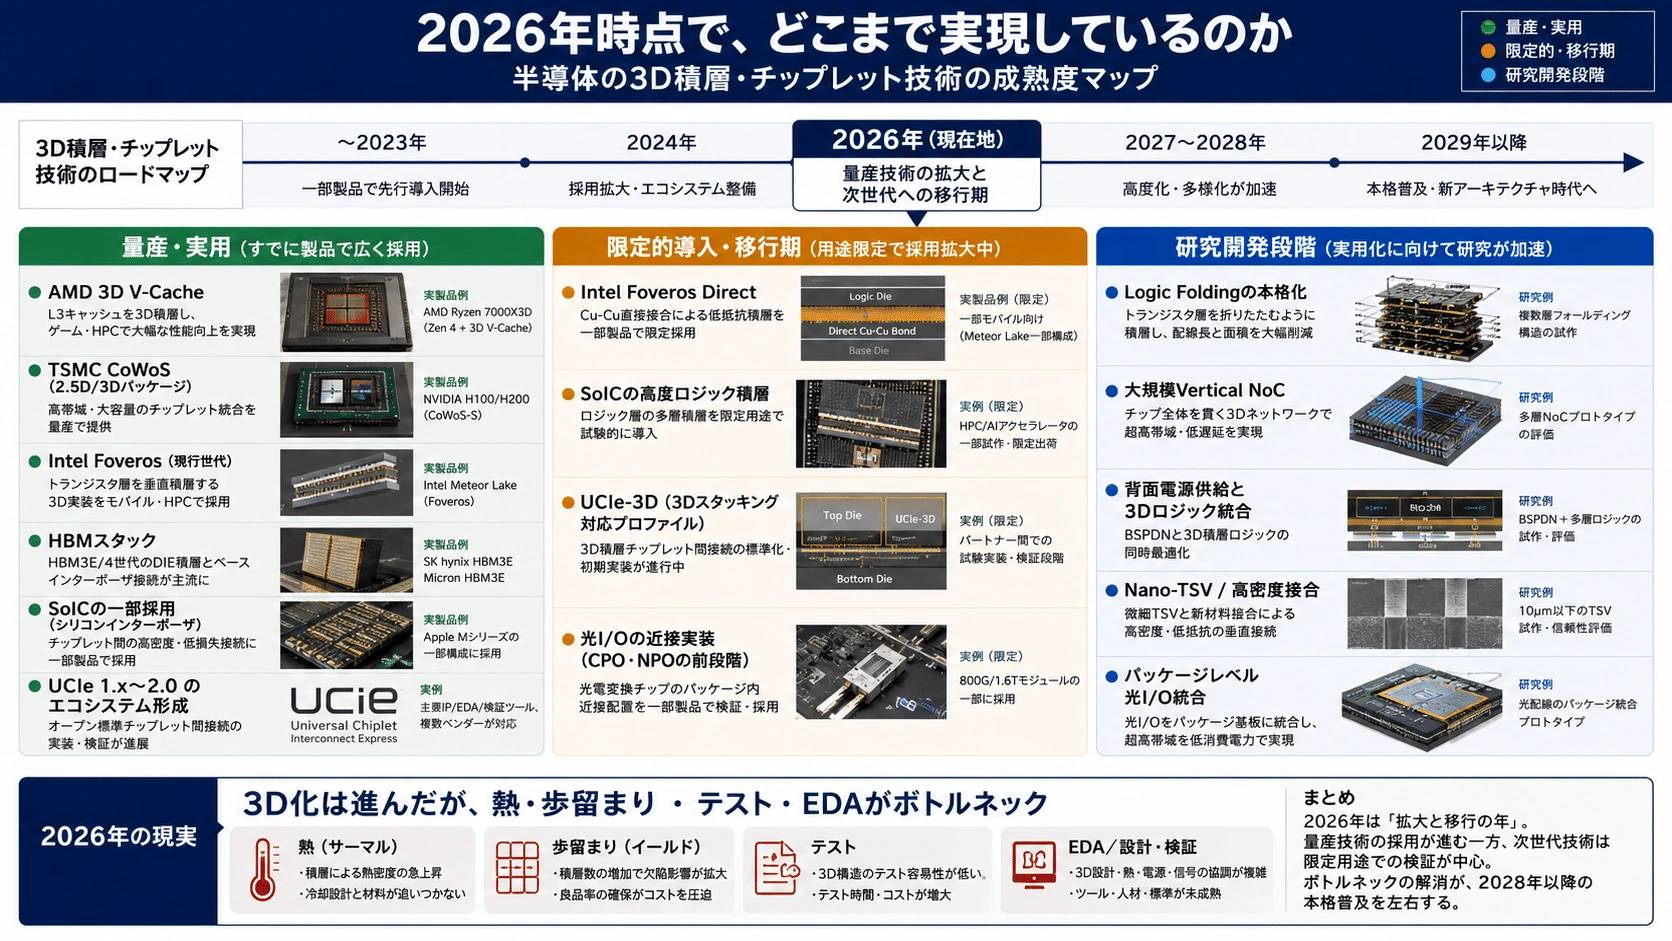
2026年時点で、どこまで実現しているのか
#2026年時点では、
#量産・商用化が進んでいるもの
#- HBMのDRAM積層
- イメージセンサーの積層
- SRAM/Cache-on-Logic
- マイクロバンプ型3D積層
- Hybrid Bonding型の一部3D製品
- SoIC、Foveros系プラットフォーム
- CoWoSなどの2.5D+3D統合
開発が進んでいるもの
#- Logic-on-Logic
- sub-µm Hybrid Bonding
- 高密度裏面接続
- 裏面電源と3D積層の統合
- 電気ICとフォトニクスICの積層
- UCIe-3Dによる標準接続
長期的な研究領域
#- 標準セル単位の機能分割
- 高密度ロジックと高駆動ロジックの別層化
- 複数の高発熱演算層
- トランジスタ単位のSequential 3D
- CFETとの統合
である。
#TSMCは3nm SoIC積層を2025年に量産へ移行したと報告しており、imecは200nmピッチのWafer-to-Wafer Hybrid BondingをLogic-to-Logic研究へ展開している。現在の量産製品と、研究段階の超微細3D統合は明確に分けて理解する必要がある。(investor.tsmc.com)
#
#
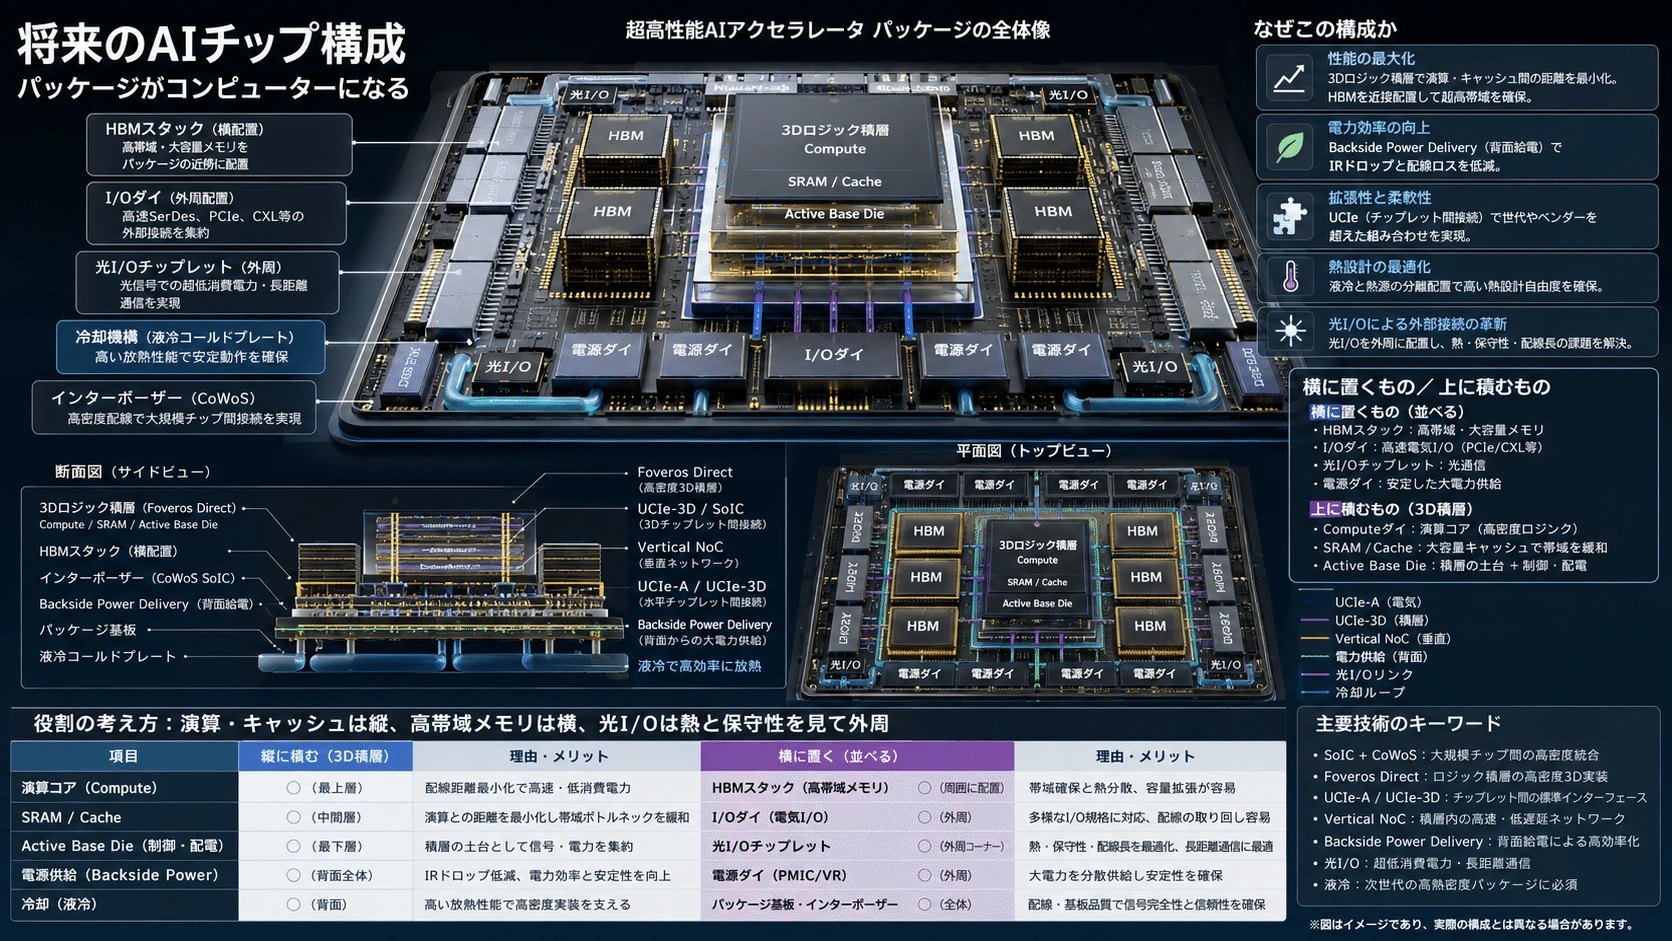
将来のAIチップ構成
#将来の大規模AIシステムは、次のような階層になる可能性がある。
#冷却面
────────────────────
上層
大容量SRAM
Weight Cache
Activation Buffer
│ Hybrid Bonding
中層
Tensor Core
Matrix Engine
Vector Processor
│ Hybrid Bonding
下層
Vertical NoC
Memory Controller
Security
Management
Power Control
│ SoIC/Foveros
横方向
HBM ─ CoWoS/EMIB ─ HBM
│
パッケージ外周
Optical I/O
Network Chiplet
PCIe/CXL/UALink系I/O
────────────────────
パッケージ基板・冷却・電源この構造では、
#- 局所通信は垂直
- 大容量メモリーは横方向
- 長距離通信は光
- 電源は裏面または下側
- 管理とNoCはベースダイ
という役割分担になる。
#
#
Logic Foldingの本質
#Logic Foldingは、単にダイを何枚も重ねることではない。
#積めるものを積むのではなく、
#近づける価値があるものを
最適な層へ再配置する設計である。
#そのためには、
#- 回路アーキテクチャ
- 接続技術
- 製造ノード
- パッケージ
- 電源
- 熱
- クロック
- テスト
- ソフトウェア
を同時に考える必要がある。
#Logic Foldingは、パッケージング技術ではなく、コンピューターアーキテクチャを三次元へ拡張する設計思想である。#
#
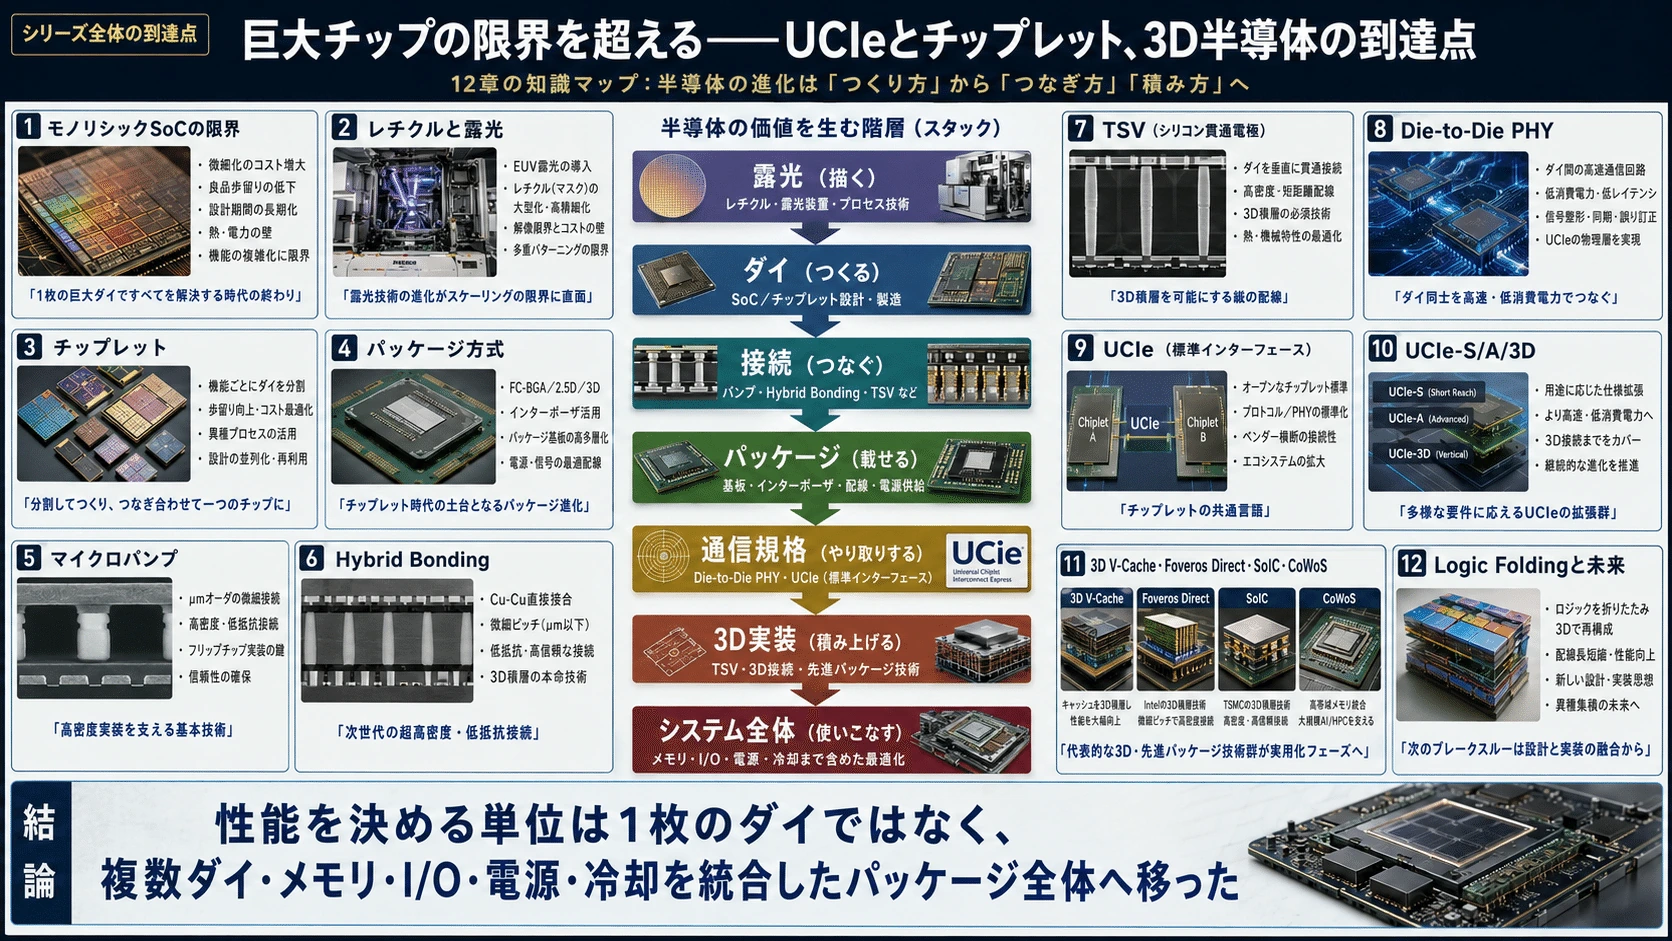
シリーズ全体の到達点
#この連載は、巨大モノリシックSoCの限界から始まった。
#微細化
↓
巨大モノリシックSoC
↓
レチクル・歩留まり・コストの壁
↓
チップレット
↓
2.5Dパッケージ
↓
マイクロバンプ
↓
Hybrid Bonding
↓
TSV
↓
Die-to-Die PHY
↓
UCIe
↓
SoIC・Foveros Direct・CoWoS
↓
Logic Folding最初は、1枚の巨大なダイを複数のダイへ分割することが目的だった。
#しかし3D接続が微細化すると、今度は分割したダイを再びモノリシックSoCに近い密度で統合できるようになる。
#その結果、半導体設計の単位は、
#トランジスタ
↓
ダイ
↓
チップレット
↓
3Dスタック
↓
パッケージ全体へ拡大する。
#最終的に性能を決めるのは、最も微細なトランジスタを使ったダイではない。
#- 演算器をどこへ置くか
- メモリーをどれだけ近づけるか
- 電源をどう届けるか
- 熱をどこへ逃がすか
- HBMを何個つなぐか
- 光通信をどこへ置くか
- 複数のダイをどう管理するか
を統合したパッケージ全体の設計である。
#
#
今回の要点
#- Logic Foldingは、平面に広がっていたロジックを機能単位で上下へ分割し、短い垂直接続で再統合する設計思想である。
- SRAM、キャッシュ、反復的演算ブロック、局所通信の多い回路は積層効果を得やすい。
- ALU、レジスターファイル、スケジューラーのような細粒度分割には、sub-µm級の高密度接続とアーキテクチャの再設計が必要になる。
- Hybrid Bonding、SoIC、Foveros Directは、Logic Foldingを製造するための基盤になる。
- UCIe-3Dは相互運用性に向くが、極細粒度ロジックでは専用3Dインターフェースが有利な場合がある。
- 裏面電源供給は、電源配線と信号配線を分離し、3Dロジックの給電と配線混雑を改善する。
- 最大の課題は、接合そのものよりも熱、電源、クロック、EDA、テスト、歩留まりである。
- 当面のAIチップでは、SRAMを垂直積層し、HBMをCoWoSやEMIBで横へ接続し、光I/Oをパッケージ外周へ配置する構成が有力である。
- 将来の半導体性能を決める単位は、1枚のダイではなく、複数の演算層、メモリー、電源、光通信を統合したパッケージ全体になる。
半導体は「1枚のチップを作る産業」から、「立体的なコンピューターを組み立てる産業」へ移りつつある。#