フィジカルAIは「ロボットの脳」から「ロボットを改良するシステム」へ
AIモデル・知能 エージェント・データ基盤 AIインフラ・産業 考察・仮説
出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.10.17.1
- 記事内容のSHA-256
26955ab543577ecd1c51ed2dd8434d516bd1a7b55241d4f5218168b0f9a4ddb3- 保存版のSHA-256
4ff16d490faee6c62ddfce7b1e55533331013f902f3189a14a6f00c0af07e76c
外部証明の最終検査結果は詳細を開くと表示します。
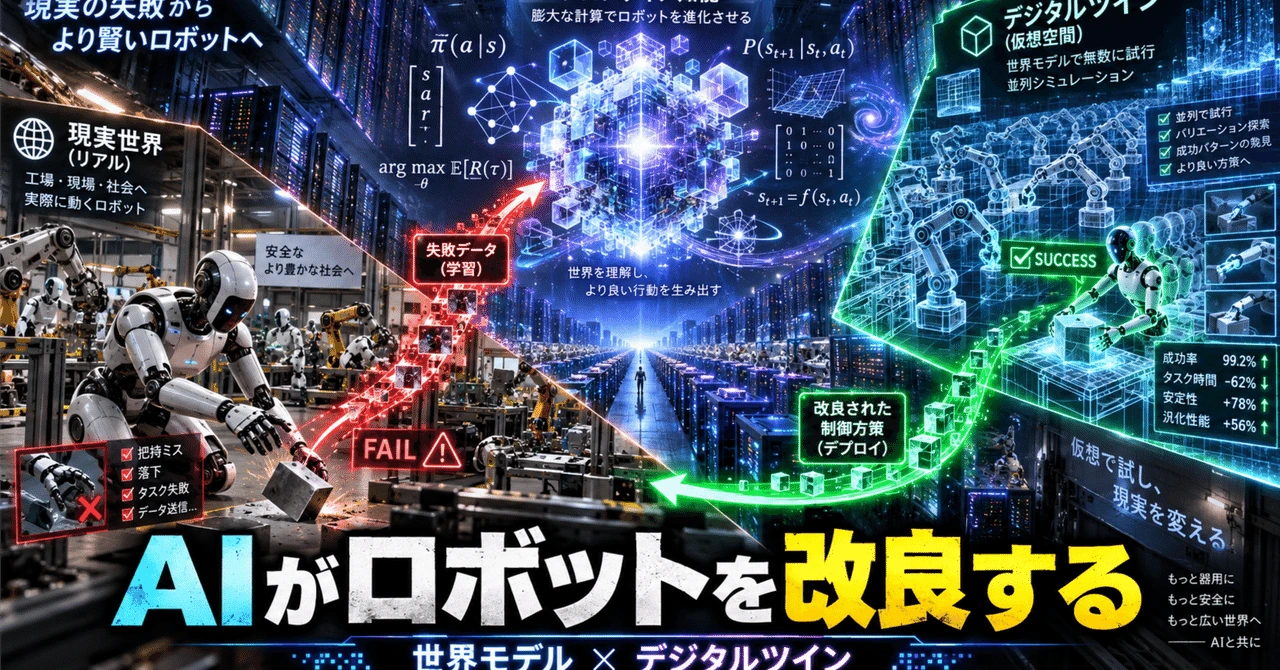
フィジカルAIは「ロボットの脳」から「ロボットを改良するシステム」へ
#大脳・小脳・四肢の再編と、世界モデル、汎用AIがつくる新しい研究開発ループ
#2026年10月1日時点。論文、研究者の実験報告、企業の技術資料をもとに整理する。以下の数値は原則として各研究の報告値であり、異なる評価環境の成功率を単純に比較するものではない。将来像は、実証された成果とは区別して論じる。
#ロボットを賢くする方法が変わり始めている。
#一つは、ロボット自身が持つモデルを強くする方法だ。映像と言語から動作を生成し、未来を予測し、長い作業履歴を覚える。VLA、WAM、WLAとった研究は、この方向を進んでいる。
#もう一つは、ロボットを開発する側の知能を強くする方法である。汎用AIが制御プログラムを書き、シミュレーションを回し、失敗を分析し、ロボット用の学習データまで作る。最近の研究では、この二つ目の経路が具体的な実験結果を伴い始めた。DreamZeroのような世界モデル型の制御と、RHOやEmbodiedSWEのような開発エージェント型の研究が、並行して進んでいる。(DreamZero・RHO・EmbodiedSWE)
#ここで起きているのは、単純な「古典制御からAIへの置き換え」ではない。
#強くなったAIが、古典制御、世界モデル、シミュレータ、学習済み方策を組み合わせる側へ回っている。
#本稿の中心的な見立ては、フィジカルAIの競争単位が、単独の基盤モデルだけでなく、現実の経験からロボット全体を改善するシステムへ広がっている、というものだ。
#1.「大脳・小脳・四肢」は、何を表していたのか
#中国の工業情報化部が2023年に示した「人形机器人创新发展指导意见」は、ヒューマノイドの主要技術を「大脳・小脳・肢体」と整理した。大脳は大規模モデルによる環境認識や人との対話、小脳は運動制御、肢体は腕・手・脚などの機構を指す。理解しやすい機能上の区分である。(中国工業情報化部)
#ただし、この政策文書を「大きなLLM、小さな運動モデル、機械の身体という三段構造だけを想定していた」と読むのは正確ではない。本文には、クラウドとエッジの協調、高忠実度シミュレーション、多体動力学、オンライン制御が含まれる。身体についても、AIを使った骨格構造のトポロジー最適化に触れている。(中国工業情報化部)
#したがって、現在の研究はこの区分を否定しているというより、その内部をより細かい機能として実装し、境界を組み替えていると理解した方がよい。
#また、これは神経科学上の厳密な対応ではない。世界モデルを海馬、VLAを小脳と一対一で対応させる必要はない。大脳・小脳・四肢という比喩は入口として使い、その先では「何を入力し、何を出力し、どの時間尺度で動くか」を見るべきだ。
#大脳と小脳の間にあるもの
#「片付けて」という指示を腕の動作へ変換するまでには、物体の認識、座標の推定、作業の分解、進捗の記憶、次の行動の選択、成功判定が必要になる。これらを一つのモデルにまとめることも、別々のモデルやツールに分けることもできる。
#GoogleのGemini Robotics 2系列は、その具体例だ。Gemini Robotics ER 2が高位の理解や計画を担当し、運動実行をVLAへ引き渡す。一方、τ₀-VLAでは、記憶を持つ上位方策、世界モデルを使う候補探索、下位の汎用運動方策が組み合わされる。(Google DeepMind:Gemini Robotics 2・τ₀-VLA)
#小脳と四肢の間にあるもの
#学習モデルが出す「手先をここへ動かす」という指示も、そのままモーターへ流せばよいわけではない。関節角度への変換、全身のバランス、接触時の力、駆動系の制約などを処理する必要がある。
#NVIDIAのGR00T 1.7の開発例では、全身制御のAGILE WBCと逆運動学のPinkIKを使う。重要なのは、これらが実行時の付属品ではなく、学習データに記録される関節目標を作る側にも入っている点だ。NVIDIA自身、コントローラを変えると同じ動作でも学習分布が変わる、と説明している。(NVIDIA Isaac GR00T)
#小脳と四肢の間は、単なる配線ではない。学習と機械の両方に影響する、独立した設計領域なのである。
#2.新しく分かれ始めた、二種類の「大脳」
#現在の研究を読むうえで、最も有効なのは大脳を二つに分けることだ。
#実行中の大脳は、「今、何をするべきか」を考える。どの物体を先に片付けるか、作業はどこまで進んだか、失敗したので戻るべきか、といった判断を担当する。
#研究開発の大脳は、「このロボットを、どうすればもっとよく動かせるか」を考える。座標変換の不具合を調べ、制御則を書き直し、シミュレータの摩擦を修正し、必要な追加データを選ぶ。
#Gemini Robotics ER 2の高位制御は前者に近く、RHOのようにコードのリポジトリを反復改良するエージェントは後者に近い。両者は同じ基盤モデルを使うこともできるが、役割、権限、評価方法は異なる。(Google DeepMind:Gemini Robotics 2・RHO)
#この区別を入れると、構造は次のように見えてくる。
#研究開発の大脳
├─ モデル・制御コードを改善する
├─ 世界モデル・デジタルツインを校正する
├─ 学習データ・報酬・評価環境を作る
└─ 身体の設計候補を提案する
↓ 検証した更新だけを反映
実行中の大脳
├─ 指示理解・作業計画・進捗管理
├─ 世界予測・候補比較・失敗回復
└─ 適切なスキルや制御器を選ぶ
↓
スキル方策・軌道計画・全身制御
↓
力制御・サーボ・独立した安全機構
↓
身体これは、すべてのロボットがこの順番で計算するという設計図ではない。本稿で研究を整理するための機能図である。実際には一つのモデルが複数の役割を持ち、世界モデルや安全監視が横から複数層に関わる。
#重要なのは、ロボットの行動を生成する計算と、行動生成の仕組みを改良する計算が、別のループとして成立し始めたことだ。
#3.VLA、WAM、WLAは、単純な世代交代ではない
#VLA――見たものと指示から、動作を出す
#VLAはVision-Language-Actionの略で、視覚と言語をロボットの行動へ結び付ける。行動は関節角度の場合もあれば、手先の変位や、一定時間分をまとめた動作列の場合もある。
#ただし、VLAを「現在の一枚の画像から反射的に動くだけのモデル」と捉えるべきではない。履歴、作業分解、言語推論を含む構成もあり、GR00T 1.7やτ₀-VLAのように、長い作業を扱うための仕組みが組み込まれている。(NVIDIA Isaac GR00T・τ₀-VLA)
#WAM――行動と、行動後の世界を結び付ける
#WAMはWorld Action Modelの略で、行動と未来の世界状態を結び付けて学ぶ方向である。DreamZeroは、動画生成モデルを基礎に、未来の映像とロボットの行動を共同でモデル化する。(DreamZero)
#VLAとの違いは、単に「映像を入力するかどうか」ではない。自分の行動によって世界がどう変わるかを、学習目標や内部表現へどの程度明示的に組み込むかにある。
#WLA――言語、世界予測、行動を共同で扱う
#WLA-0が提案するWorld-Language-Actionは、言語によるサブタスク、未来のサブゴール画像、ロボット行動を結び付ける。長い目的を、世界の変化と具体的な運動へ橋渡ししようとする構成である。(WLA-0)
#ただし、WLAは「VLAの次は必ずWAM、その次は必ずWLA」という業界共通の世代規格ではない。各研究が強調する学習対象や構成には重なりがある。
#むしろ現在は、二つの動きが同時に進んでいる。
#モデル内部では、視覚、推論、未来予測、行動を統合する。システム全体では、それらを用途、速度、コスト、安全性に応じて分担させる。
#Cosmos 3の統合的な世界モデルと、Gemini Roboticsの高位・低位の役割分担は、矛盾する方向ではない。統合した表現を学び、それを複数の実行形態へ展開することもできるからだ。(NVIDIA Cosmos 3・Google DeepMind:Gemini Robotics 2)
#4.世界モデルの役割は、一つではなくなっている
#世界モデルを「未来の動画を生成するAI」とだけ考えると、現在の研究の重要な部分を取り逃がす。少なくとも、次の四つの役割がある。
#4-1.世界の変化を学ぶための事前学習
#人間の動画には、物体の使い方、動作の順序、環境の変化が大量に含まれる。しかし、その映像にロボットの関節角度や力のラベルが付いているわけではない。
#DreamDojoは、約44,000時間の人間の一人称動画から、潜在的な行動表現を使って世界の動きを学び、その後にロボットデータへ接続する研究だ。世界モデルはここで、ロボット固有のデータだけでは得にくい経験を取り込む器になっている。(DreamDojo)
#ただし、人間動画を大量に見れば、任意のロボットの摩擦やトルクまで分かるわけではない。一般的な動作知識と、特定の身体で実行するための校正・適応は分けて考える必要がある。
#4-2.行動候補を比較する内部シミュレータ
#Cosmos Policyは、動画モデルをロボットの実演データで追加学習し、行動、未来の視覚状態、価値を予測する。候補行動ごとの結果を比べ、推論時の計画に利用できる。報告値は、シミュレーションのLIBEROで平均98.5%、RoboCasaで67.1%。さらに、実行経験から世界モデルと価値関数を改善する構成も示している。(NVIDIA Cosmos Policy)
#ここでの世界モデルは、単に動画を増やすデータ生成器ではない。「この行動を選ぶ理由」を作る予測器でもある。
#4-3.世界予測と行動生成を一体にした方策
#DreamZeroでは、14B規模の動画拡散モデルを最適化し、7Hzで閉ループ制御したと報告している。著者らの実機評価では、未知のタスク・環境への一般化で、比較したVLAに対して2倍超の改善があった。(DreamZero)
#したがって、「汎用大脳が強くなると、世界モデルは外部シミュレータだけになる」とも言い切れない。世界を予測することと行動を出すことを一体にしたモデルは、引き続き有力な研究路線である。
#なお、この7Hzはモデル側の閉ループ動作に関する値であり、すべてのモーターの電流制御を7Hzで行うという意味ではない。
#4-4.学習時に使い、実行時には生成を省く
#特に重要なのが、世界を予測して学ぶことと、毎回未来映像を生成することは別だと示す研究である。
#Fast-WAMは、学習時には動画予測を併用しながら、推論時には未来生成を省く。研究内の比較では、未来生成を外すより、動画との共同学習自体を外す方が性能低下が大きかった。著者らは、動画予測の価値が、実行時の想像だけでなく、学習中に獲得する世界表現にある可能性を指摘している。(Fast-WAM)
#WLA-0でも、世界予測の専門部分を常に推論時に動かす必要はない。行動のみを出す使い方と、世界予測を利用した追加探索を使い分けられる。(WLA-0)
#これは今後の構造を考えるうえで大きい。
#難しい場面では計算を使って先を読み、反復する熟練動作は、その知識を取り込んだ軽い方策で実行する。
#世界モデルの発展は、必ずしも「ロボットが動くたびに巨大な動画生成モデルを回す未来」を意味しない。
#5.現在の主要な基盤は、どこを担当しているのか
#代表的なモデルと開発基盤を、役割で整理すると次のようになる。すべてを同じ成功率で比較する表ではなく、研究モデル、公開モデル、開発ツール、予告段階の製品を区別するための地図である。
#NVIDIA Cosmos 3 主な役割:世界理解、生成、予測、行動をつなぐ基盤 現時点での位置付け:複数のモダリティと推論・生成を扱う公開世界モデル。(NVIDIA Cosmos 3)
#GR00T 1.7 主な役割:ロボットの視覚・言語・行動方策 現時点での位置付け:3Bの公開チェックポイント。追加学習から評価、実装へつなぐ開発工程が用意される。(NVIDIA Isaac GR00T)
#GR00T N2 主な役割:世界モデル型の次世代ロボット方策 現時点での位置付け:DreamZeroを基礎とするWAMとして予告。2026年末の提供予定と、現在の公開済み成果を区別する必要がある。(NVIDIA:GR00T N2)
#Gemini Robotics 2/ER 2/On-Device 2 主な役割:高位推論、運動生成、ローカル実行 現時点での位置付け:役割を分けた系列として公式に報告。Argonそのものの実機成果ではない。(Google DeepMind:Gemini Robotics 2)
#Physical Intelligenceのπ系列 主な役割:汎用ロボット方策と実行経験からの改善 現時点での位置付け:π*₀.₆/RECAPは、実演、自律実行、人の介入を使う学習ループの代表例。(π*₀.₆ / RECAP)
#Skild S1 主な役割:動画の実演を文脈として使うロボット方策 現時点での位置付け:新しい作業への動画プロンプトによる適応を企業が報告。公開論文の比較結果とは分けて扱う。(Skild S1)
#Alpamayo 2 Super 主な役割:自動運転の状況推論、軌道生成、自動ラベル付け 現時点での位置付け:運転領域の開発モデル。軌道ベンチマークの性能は、そのまま公道での安全性の証明にはならない。(NVIDIA Alpamayo 2 Super)
#Isaac Sim/Isaac Lab、Omniverse、Newton 主な役割:環境構築、物理計算、学習、評価 現時点での位置付け:基盤モデルそのものではなく、モデルや制御器を作り、試すための開発・実験基盤。(NVIDIA Isaac Sim・Newton Physics)
#ここから見えるNVIDIAの位置は、世界モデルを一つ供給する会社、というだけではない。世界の表現、ロボット方策、シミュレーション、学習、実機への展開を接続する位置にある。
#ただし、開発用の部品がそろうことと、未知の現場で安定して働けることは別だ。
#Cosmos 3 Edgeのオンデバイス制御例では、Jetson AGX Thor上で4Bモデルを動かし、約2.13秒分の動作列を約1.53秒で生成する。一方、その記事が示すRoboLabの120タスクのシミュレーション評価は成功率22.9%だった。計算が間に合うこと、失敗に素早く反応できること、作業を成功させることは、別々に評価しなければならない。(NVIDIA Cosmos 3 Edge)
#6.Astra、Fable、Opusが変えたのは「動かし方」だけではない
#Astraと鞭――AIが制御パイプラインを組む
#Krishna SureshとChris Atkesonが9月26日に公開した実験では、人間の手の軌道をViconで取得し、逆運動学と軌道最適化を経てロボットへ移す。GPT-6 Astraは、校正や動力学モデル、制御器、データ処理を含むソフトウェアの構築を支援した。(Robot Whips)
#重要なのは、Astra自身が鞭の状態を高速に観測し続け、瞬間ごとのモーター出力を決めていたわけではないことだ。人間の実演を、機械が実行できる時間軌道へ変換する仕組みを作っている。
#これは「AIがロボットになる」というより、AIがロボット工学の作業をする事例である。
#ただし、研究者の実演、計測設備、既存ライブラリ、機体の準備は残る。一般的な動的操作を無条件に解決した実証ではない。ここから読み取れるのは、特定の問題に対して、専門ソフトウェアを組み合わせる負担が下がり始めたことだ。(Robot Whips)
#FableとPush-T――「学習問題」を制御プログラムとして解く
#Claude CodeとFable 5を使ったPush-T研究では、AIがシミュレータを使い、押し操作の制御プログラムを反復改良した。人間の実演を与えない条件で、状態情報を使うコントローラが200シードで100%成功し、比較対象のDiffusion Policyより制御ステップが46%少なかったと報告されている。(Push-T Agentic Robotics)
#ただし、ここには見逃せない条件がある。100%という結果は、シミュレータの状態情報を使うコントローラの結果だ。RGB画像から動く学習モデルと、同一の情報条件で優劣を証明したものではない。
#それでも、構造上の意味は大きい。ある操作を解く方法が「実演を大量に集めてニューラル方策を学ぶ」だけではなくなり、汎用AIがシミュレータを使って専用アルゴリズムを構成する経路が具体化したのである。
#OpusとAstra――実機の観測、コード、再試行をつなぐ
#Agent as Policyでは、コーディングエージェントがカメラを見て、ロボットAPIを使うコードを書き、実行結果から修正する。二組の部品を組み立てる実機比較では、Astra+Codex CLIとOpus 5+Claude Codeが、それぞれ5試行中5回成功した。Fable 5.1+Claude Codeは5試行中3回だった。(Agent as Policy)
#これはモデル単体ではなく、モデルと実行環境を合わせたシステムの比較であり、試行数も小さい。工場のサイクルタイムや長時間の信頼性を証明する評価ではない。
#CodeActionBenchも、この方向を定量評価する研究だ。シミュレーションの25タスク、9構成、合計675試行で、Astra+Codex CLIは成功率73.3%を報告している。エージェントには校正情報、幾何操作、ロボットのフィードバックが与えられるが、物体の正解位置は渡されない。(CodeActionBench)
#こうした結果が示すのは、「LLMの出力をモーターへ直結すればよい」ということではない。
#観測、ツール、コード実行、失敗からの修正をつないだとき、汎用モデルの能力が物理操作へ移り始めているのである。
#7.次の段階は、AIが「小脳を作る」こと
#コード一式が、改善される方策になる
#RHOは、コーディングエージェントがシミュレーションの結果を見ながら、複数ファイルからなるロボット制御のリポジトリを改良する研究だ。最終的な成果物は、毎回LLMが考え直す文章ではなく、配備して実行できるプログラム群になる。(RHO)
#RAPIDでは、人間の視覚的な実演から、タスクの仕様、行動の基本単位、検証環境を作る。行動の基本単位を軌道最適化プログラムとして生成し、検証と修正を繰り返す。(RAPID)
#これらを整理すると、学習の成果が保存される場所は、ニューラルネットの重みだけではない。制御コード、再利用できるスキル、座標変換の手順、復旧処理にも、経験が蓄積される。
#成功するコードから、VLAの教師データを作る
#この変化をさらに進めたのがEmbodiedSWEである。
#実機への転移実験では、Opus 5が逆運動学を使う解法を書き、そこから500本の成功したシミュレーション軌道を作る。それを使って、既存のπ₀.₅-DROIDを追加学習した。実機のランプ分解では、10試行中2回、最後の電球の取り外しまで完了した。追加学習前の比較モデルは、この条件では完了できなかった。(EmbodiedSWE)
#成功率20%は、完成した実用システムの数字ではない。シミュレーションと実機を対応させる準備も必要だった。しかし、次の経路を実機までつないだ点が重要だ。
#汎用AIが解法を書く
↓
シミュレーションで解法を検証する
↓
成功例を多様化して学習データを作る
↓
VLAを追加学習する
↓
実機で実行・評価するここでは、汎用AIとVLAは競合していない。汎用AIが教師や開発者になり、VLAが実働する側になる。
#「大脳が小脳を作る」という比喩に、現在もっとも近い実証の一つである。ただし、これは既存の事前学習モデルを利用する工程であって、ロボットデータ全体を不要にしたわけではない。
#新しいのは、古典制御そのものではない
#言語モデルから制御コードを生成するCode as Policiesは2022年に公開されている。LLMで報酬やシミュレーションの条件を設計するDrEurekaも2024年の研究だ。古典制御と学習制御を混ぜる発想にも、長い研究の蓄積がある。(Code as Policies・DrEureka・Residual Reinforcement Learning)
#したがって2026年の新しさは、階層制御を初めて発明したことではない。
#汎用AIが、既存の部品を探し、接続し、試し、直し、別のモデルの学習にまで使う範囲が広がったことにある。
#8.強化学習は「小脳の反射神経」だけのものではない
#強化学習は一つの器官に相当する部品ではなく、結果から行動の選び方を改善する学習方法である。関節トルクにも、スキルの選択にも、コード生成にも適用できる。高位の行動を時間的にまとめて扱う考え方も、以前から階層型強化学習で研究されてきた。(Sutton・Precup・Singh:Options)
#現在の変化は、適用先が複数の基盤モデルやエージェントへ具体的に広がり、異なる学習・探索方法と接続していることだ。
#実世界で動いた経験から、VLAを改善する
#Physical IntelligenceのRECAPは、実演、自律実行、人間による介入を統合し、価値の推定を使って方策を改善する。2025年末のπ*₀.₆の研究では、難しい洗濯物処理やエスプレッソ作業で、処理量が2倍超になり、失敗率がおよそ半分になったと報告している。2026年の議論の重要な土台になる成果だ。(π*₀.₆ / RECAP)
#ロボットを動かす「コードを書く能力」を強化学習する
#CaP-XのCaP-RLでは、物理シミュレーションでの実行結果を報酬に使い、コーディングエージェントを追加学習する。改善対象はモーター方策だけではなく、ロボットをうまく動かすプログラムを生成する能力になる。(CaP-X)
#SkildのPhysical Self-Playも、模倣だけではなく、シミュレーション内の相互作用から動的な技能を伸ばそうとする企業研究の一例である。ただし、企業のデモや自己報告と、独立した実機検証は区別する必要がある。(Skild Physical Self-Play)
#「考える」「覚える」「学習する」は分けて読む
#ここで混同しやすいのが、推論時の改善をすべて強化学習と呼んでしまうことだ。
#推論時の探索 何が変わるのか:今回選ぶ行動やサブタスク 代表例・読み方:候補を増やして比較する。重み更新は必須ではない。τ₀-VLAの世界モデル探索。(τ₀-VLA)
#文脈内学習・記憶 何が変わるのか:入力する実演や過去の履歴 代表例・読み方:基本の重みを変えず、与えられた経験を使う。Skild S1の動画プロンプト。(Skild S1)
#Test-Time Training 何が変わるのか:推論時の内部パラメータ 代表例・読み方:RoboTTTでは履歴をfast weightsへ取り込む。必ずしも報酬による学習ではない。(RoboTTT)
#強化学習 何が変わるのか:将来の報酬を高める方策 代表例・読み方:RECAPのロボット方策、CaP-RLのコード生成方策。(π*₀.₆ / RECAP・CaP-X)
#コード・実行基盤の改善 何が変わるのか:プログラム、ルール、スキル群 代表例・読み方:RHOなど。改善が起きても、基盤モデルの重みが変わるとは限らない。(RHO)
#RoboTTTは、この違いを考えるうえで重要だ。最大8,000タイムステップの履歴を扱い、fast weightsを使う。著者らは、実機で一時点の観測を使う比較モデルから87%の相対改善を報告し、5分・10段階の組立作業も示している。これは長期的な経験利用の進展だが、無制限の生涯学習が完成したという意味ではない。(RoboTTT)
#今後は「どれだけ大きなモデルか」に加えて、何を覚え、どこを更新し、その変更がどれだけ持続するかが、重要な比較軸になる。
#9.世界モデルとデジタルツインは、対立ではなく役割が違う
#世界モデル、物理シミュレータ、デジタルツインは、同じものを別名で呼んでいるわけではない。本稿では、次のように区別する。
#世界モデルは、行動や条件によって世界がどう変わるかを予測するものだ。学習型にも、物理法則を使うものにも、その混合にもできる。
#物理シミュレータは、設定された形状、質量、摩擦、接触などから状態の変化を計算する実行環境である。
#デジタルツインは、特定の実機や環境に対応付け、観測や計測によって校正・更新するデジタル側の表現として捉える。物理シミュレータも学習モデルも、その構成要素になり得る。Agentic Real2Simが作る「ある実際の相互作用に対応した、実行可能なツイン」は、この違いを理解しやすい例だ。(Agentic Real2Sim)
#汎用AIは、世界モデルを使うだけでなく、実験環境を作る
#Agentic Real2Simは、実世界の相互作用の記録から、形状、物体の状態、物理パラメータ、座標や軌道を組み合わせ、シミュレーション可能なエピソードのツインを作る。生成した環境を、方策の追加学習や評価にも接続している。(Agentic Real2Sim)
#これは「映像を見て3Dモデルを作る」だけではない。実際に動かして実験できる状態まで、複数の道具をつなぐことが重要になる。
#その意味で、汎用AIの進歩は世界モデルの価値を必ずしも下げない。世界モデルやシミュレータを構築・校正し、利用するための人間の作業を減らせるなら、むしろ使える場面が増える。
#計算資源があれば、現実のデータは不要になるのか
#ここには明確な限界がある。
#あるツインが物体の摩擦を間違えている場合、その中で百万回成功しても、正しい摩擦の環境で百万回試したことにはならない。計算回数を増やすほど、誤った環境に特化する可能性もある。
#学習型世界モデルでも同様だ。HaWMPOは、世界モデルが生成する不正確な未来を、そのまま強化学習の報酬に使う問題に取り組む。実機G1の二つのタスクで、成功率67.5%から80.0%への改善を報告したが、広い一般化を示すにはまだ小規模な評価である。(HaWMPO)
#ここから導かれるのは、「現実を捨てて仮想実験だけを増やす」という方向ではない。
#現実で何を測れば仮想実験の信頼性が上がるかを考え、その計測を行い、モデルを直し、再び仮想実験を使うという方向だ。
#将来の研究開発エージェントにとって重要なのは、試行回数を増やす能力だけでなく、「今のシミュレータでは判断できない」と認識し、必要な実測を選ぶ能力になるだろう。
#10.身体の自己改善は、どこまで現実になっているのか
#身体と制御の共同設計は、すでに研究対象になっている。RoboMoReは、LLMを使って身体形状と報酬を組み合わせて探索する。形だけを変え、制御器や報酬を固定するのではなく、その形で有効な動き方も一緒に探すという発想だ。主な成果はシミュレーション上の比較であり、自律的な製造まで含む実証ではない。(RoboMoRe・RoboMoRe GitHub)
#例えば、ある把持作業で失敗が続いているとする。原因は視覚認識かもしれないし、制御器かもしれない。しかし、指が短い、接触面が滑る、関節の可動域が足りない、といった身体側の問題かもしれない。
#研究開発エージェントがこの切り分けを行えるなら、改善対象はモデルの重みだけではなくなる。
#身体の設計を (m)、制御方策を (pi) とすると、目指す問題は概念的には、
#となる。(Jreal) は実世界での作業性能だ。ただし実際には、強度、発熱、消費電力、安全性、製造可能性、費用などの制約が付く。
#ここで面白いのは、最適解が必ずしも「もっと賢い制御器」になるとは限らない点だ。指先の形や柔らかさを変えることで、制御が簡単になるかもしれない。知能の一部を、計算ではなく機構へ持たせる方向である。
#一方、制御コードの変更と身体の変更では時間尺度が違う。身体を変えれば、製造、組立、配線、校正、耐久試験が必要になり、古い方策やツインがそのまま通用しない場合もある。製造サイクルとsim-to-realのずれを共同設計の制約として扱う研究も、以前から存在する。(Morphology-Control Co-Adaptation)
#したがって、現時点で見えているのは、ロボットが自由に自分の身体を作り替える完成形ではない。
#仮想空間で身体と制御の候補を探索し、現実の製造・計測・検証へつなぐ、遅い外側の改善ループである。
#11.Gemini 4 Argonは、どこに入ってくるのか
#Googleは9月30日、Gemini 4 Argonを公式発表した。公式ベンチマークでは、長期ソフトウェア開発のDeepSWE v1.1が77.9%、長時間動画理解のLVBenchが91.7%だった。また、出力上限を100万トークンへ拡大すると説明している。ここでいう100万は出力上限であり、それだけで持続的な記憶能力やロボット制御性能を証明するものではない。(Google:Gemini 4 Argon)
#この発表で注目したいのは、ベンチマークだけではない。Googleによると、Argonはlibgav1のRust版について、プロファイリング、コンパイラ出力の調査、コード変更、再計測を繰り返し、既存Rust版に対して2.7倍の高速化を達成した。これはロボット実験ではないが、反復的な工学作業の企業内実績である。(Google:Gemini 4 Argon)
#フィジカルAIへの影響は、ここから条件付きで考えるべきだ。
#長い実験ログを読み、動画から失敗箇所を探し、コードを変更して再試験する能力がロボット開発へ移るなら、Argonは研究開発の大脳として働き得る。特に、ロボットのマニュアル、制御コード、過去の試行、シミュレーションの結果を横断して扱う用途が考えられる。
#ただし、長時間動画の質問応答が強いことと、力や接触を正しく推定できることは同じではない。GraphWalksのような長文評価も、そのまま現場の作業記憶の保証にはならない。
#Googleには、すでに実行時の推論を担うGemini Robotics ER 2と運動モデルの系列がある。したがって想定される接続は、Argonがすべてを直接操縦する一択ではない。Argonが研究開発側を担い、ERやVLAを改善する構造も考えられる。これは本稿の見通しであり、公式に統合・実証された構成として扱うべきではない。(Google DeepMind:Gemini Robotics 2)
#同じ注意はClaude Opus 5.5にも必要だ。長時間のエージェント型コーディング向けという製品上の特性と、本稿で確認したOpus 5やFable 5/5.1のロボット実験は別である。最新のモデルへ入れ替えれば、そのまま同じ比率で実機性能が伸びるとは限らない。(Anthropic:Claude Opus 5.5・Agent as Policy)
#今後知りたいのは、一般ベンチマークの順位よりも、同じロボット、同じツール、同じ時間・費用・安全制約の下で、失敗後の改善をどこまで続けられるかだ。
#12.データの競争は、量だけでなく「何へ変換できるか」の競争になる
#実世界データが重要であることは変わらない。しかし、総時間だけで価値を測るのは難しくなる。
#人間動画は、多様な作業や環境を含めやすい。一方、実機データには、その身体の関節、接触、力、センサーの癖に対応した情報がある。シミュレーションは条件を変えて反復しやすいが、モデル化の誤差を持つ。Skildはデータ源を「実機との近さ、多様性、拡張のしやすさ」で整理し、1Xも人間動画、シミュレーション、遠隔操作、自律実行のデータを組み合わせる方針を示している。(Skild S1・1X World Model Lab)
#したがって、「中国は実データ、米国は計算資源と世界モデル」という二分法だけでは、各主体の強みは判断できない。
#実機を多く持っていても、センサーが校正されていなければ、行動と結果を正しく対応付けにくい。大量の映像があっても、必要な接触情報がなければ補えない部分がある。逆に、少量のデータでも、失敗原因の同定やツインの修正に使えれば、大きな改善につながる可能性がある。
#見るべき対象は国籍そのものではなく、データを取得し、利用権限を確保し、品質を管理し、学習・検証・製造へ戻せる組織的な能力だ。
#AIによる増幅も、単なる複製ではない。一つの失敗から、制御コードの修正、追加計測の提案、難しい訓練場面、回帰テスト、別の身体設計という、異なる成果物を作れることに価値がある。
#その一方で、「実データ1時間を仮想データ100万時間へ増やした」といった量だけでは、改善を証明できない。最終的に必要なのは、見ていない現場での成功、介入の減少、作業時間の短縮、故障や事故リスクの抑制として効果を測ることである。
#13.自己改善の制約は、「候補を作れるか」から「改善を証明できるか」へ
#汎用AIがコードや方策の候補を大量に作れるようになるほど、次の問題が大きくなる。
#その変更は本当に良くなったのか。今回だけ成功したのではないか。別の作業を壊していないか。成功判定を都合よく変えただけではないか。
#SafeHarnessは、コーディングエージェントに障害物を避けるよう指示するだけでは衝突が残り、経路計画、動作の検証、接触を考慮した実行基盤が重要になることを示す研究だ。意味を理解していることと、安全な軌道を実行できることは別である。(SafeHarness)
#RegenHarnessでは、実行履歴からルールや復旧手順を改善する一方、回帰テスト、承認、バージョン管理、ロールバックを組み込む。改善対象は実行基盤の設定などであり、基盤モデルが無制限に自己更新する仕組みではない。(RegenHarness)
#ここから導ける重要な設計原則は、提案者と合否判定者を同一の可変部分に閉じ込めないことだ。
#エージェントが制御器を改善することは許しても、その成果を判定する試験や、安全制約まで自由に緩められるようにしては、改善という言葉の意味が失われる。物理的な非常停止や力の制限も、ソフトウェアのサンドボックスだけで代替できるわけではない。
#この分野の次の難所は、賢い提案を作る能力だけでなく、誤った改善を通さず、有効な改善だけを現実へ反映する能力になる。
#14.これから追うべき研究は、どのループを閉じるのかで見る
#論文名やモデル名だけを追うよりも、「どの工程を自動化し、どの工程を現実の検証へ戻せたか」を見る方が、構造変化を捉えやすい。
#第一のループ――実行と、その場の適応
#観測し、進捗を覚え、次の行動を選び、失敗したら修正する。τ₀-VLA、RoboTTT、動画プロンプト型のS1は、この領域を異なる方法で進める。今後は、履歴を長くするだけでなく、過去の誤りを固定化しない記憶、環境変化への追従、計算待ちの間の安全な行動が重要になる。(τ₀-VLA・RoboTTT・Skild S1)
#第二のループ――解法を、再利用できるスキルへ変える
#重い汎用AIが難しい問題を解き、その解法をコード、教師データ、小型方策として保存する。RHO、RAPID、EmbodiedSWEが中心となる。見るべき指標は、一度の成功だけではなく、新しい物体や配置でも通用するか、次回から安く速く実行できるかだ。(RHO・RAPID・EmbodiedSWE)
#第三のループ――現実と仮想世界を合わせ続ける
#現実の失敗からツインや世界モデルを修正し、その中で学習・探索して、実機へ戻す。Agentic Real2Sim、Cosmos Policy、HaWMPOは、このループの異なる箇所を扱う。特に重要なのは、予測映像の見た目ではなく、行動を変えたときの結果の違いを正しく予測できるか、そして仮想評価と実機評価がどれだけ一致するかである。(Agentic Real2Sim・NVIDIA Cosmos Policy・HaWMPO)
#第四のループ――身体と制御を共同で改良する
#身体の変更案を作り、その身体に合う制御を学び、製造して測り直す。RoboMoReの先で必要になるのは、仮想性能だけでなく、製造誤差、耐久性、消費電力、保守性まで含む実機の共同設計だ。少数の製造サイクルで有効な改良を得られるかが、大きな課題になる。(RoboMoRe・Morphology-Control Co-Adaptation)
#これらをつなぐと、今後目指される全体像は次のようになる。
#実機の観測・失敗・人間の介入
↓
汎用AIによる原因分析と、次の実験の選択
↓
┌──────────┼──────────┐
↓ ↓ ↓
コード改善 世界モデル・ 身体の
スキル生成 ツインの更新 設計候補
│ │ │
└──────────┼──────────┘
↓
シミュレーション・探索・強化学習・データ生成
↓
再利用可能なコード/VLA/小型方策へ反映
↓
独立した評価・回帰試験・安全審査
↓
実機へ段階的に展開、または試作・製造
↓
新しい現実の証拠を取得するこれは現時点で、すべて自律的に接続された完成済みシステムではない。個々の研究が、この図の一部を閉じ始めた段階である。特に身体の製造と長期安全性は、ソフトウェア更新と同じ速度では進まない。
#また、すべての工程に最大のモデルを置く必要もない。汎用AIは研究や難しい判断へ、軽いモデルは繰り返しの技能へ、古典制御は明確な物理制約へ割り当てる。どこまでを一体学習し、どこからを独立させるか自体が、今後の重要な研究課題になる。
#結論――世界モデルの次に来るのは、「世界モデルを不要にするAI」ではない
#フィジカルAIで起きていることを、「VLAが古くなり、WAMに置き換わり、最後は汎用AIが全部を動かす」と整理するのは、現状の研究より単純すぎる。
#世界モデルは、世界の変化を学ぶためにも、候補を比較するためにも、行動を生成するためにも、仮想の学習環境を作るためにも使われる。未来生成を実行時には省き、学んだ表現だけを利用する経路もある。
#VLAは、汎用AIに置き換えられるだけの存在ではない。汎用AIが作った解法やデータを受け取り、現場で効率よく動く側にもなれる。古典制御も、AI以前の遺物ではなく、汎用AIが組み立てて利用する技術になり得る。これらはDreamZero、Fast-WAM、EmbodiedSWE、RHOが、それぞれ異なる形で示している。(DreamZero・Fast-WAM・EmbodiedSWE・RHO)
#その上で、Astra、Fable、Opus、そして新たなArgonのようなフロンティアモデルが、実行時の判断だけでなく、研究・設計・デバッグへ関わる可能性が広がっている。ただし、Argonや最新Opusの一般性能から、未実施のロボット評価を先取りして結論付けることはできない。
#現在の構造変化の核心は、次のように表現できる。
#「ロボットの脳を学習する」ことに加えて、「その脳、実行基盤、仮想環境、身体を改善する工程そのものへAIを入れる」ようになった。
#大脳・小脳・四肢という区分は、その入口として今も役立つ。しかし、その間には計画、記憶、予測、技能、最適化、検証という機能があり、さらに全体を設計し直す研究開発のループが重なる。
#これから重要なのは、最も大きな脳を作ったかだけではない。現実の一つの失敗を、次の信頼できる改善へ変換できるか。
#フィジカルAIの次の進歩は、その変換を、より少ない人手と時間で、しかも検証可能な形で繰り返せるシステムから生まれると考えられる。
#