Kyber遅延で見える、NVIDIA GPUとGoogle TPUのネットワーク思想の違い
出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.09.23.4
- 記事内容のSHA-256
9d6d586236e8acc6c593bb45093607285ea6bd6b5f53fc7238df57d0b10d0d6e- 保存版のSHA-256
a96f852236694983c039c403f321581147ca5ab6d311f16eadc825a3564d5c48
外部証明の最終検査結果は詳細を開くと表示します。
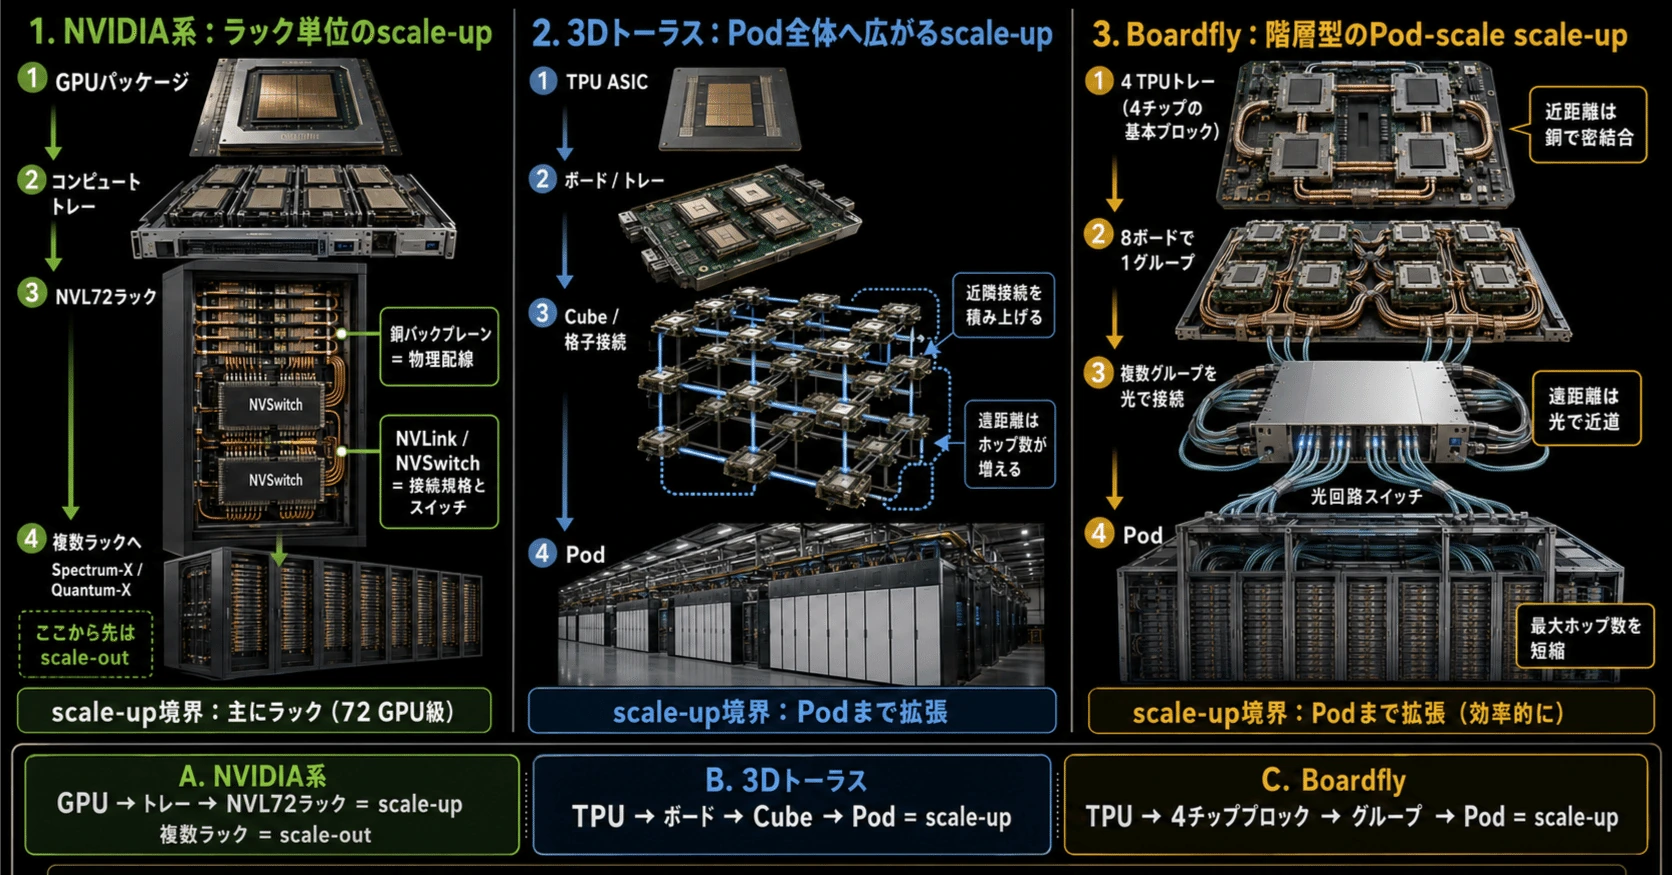
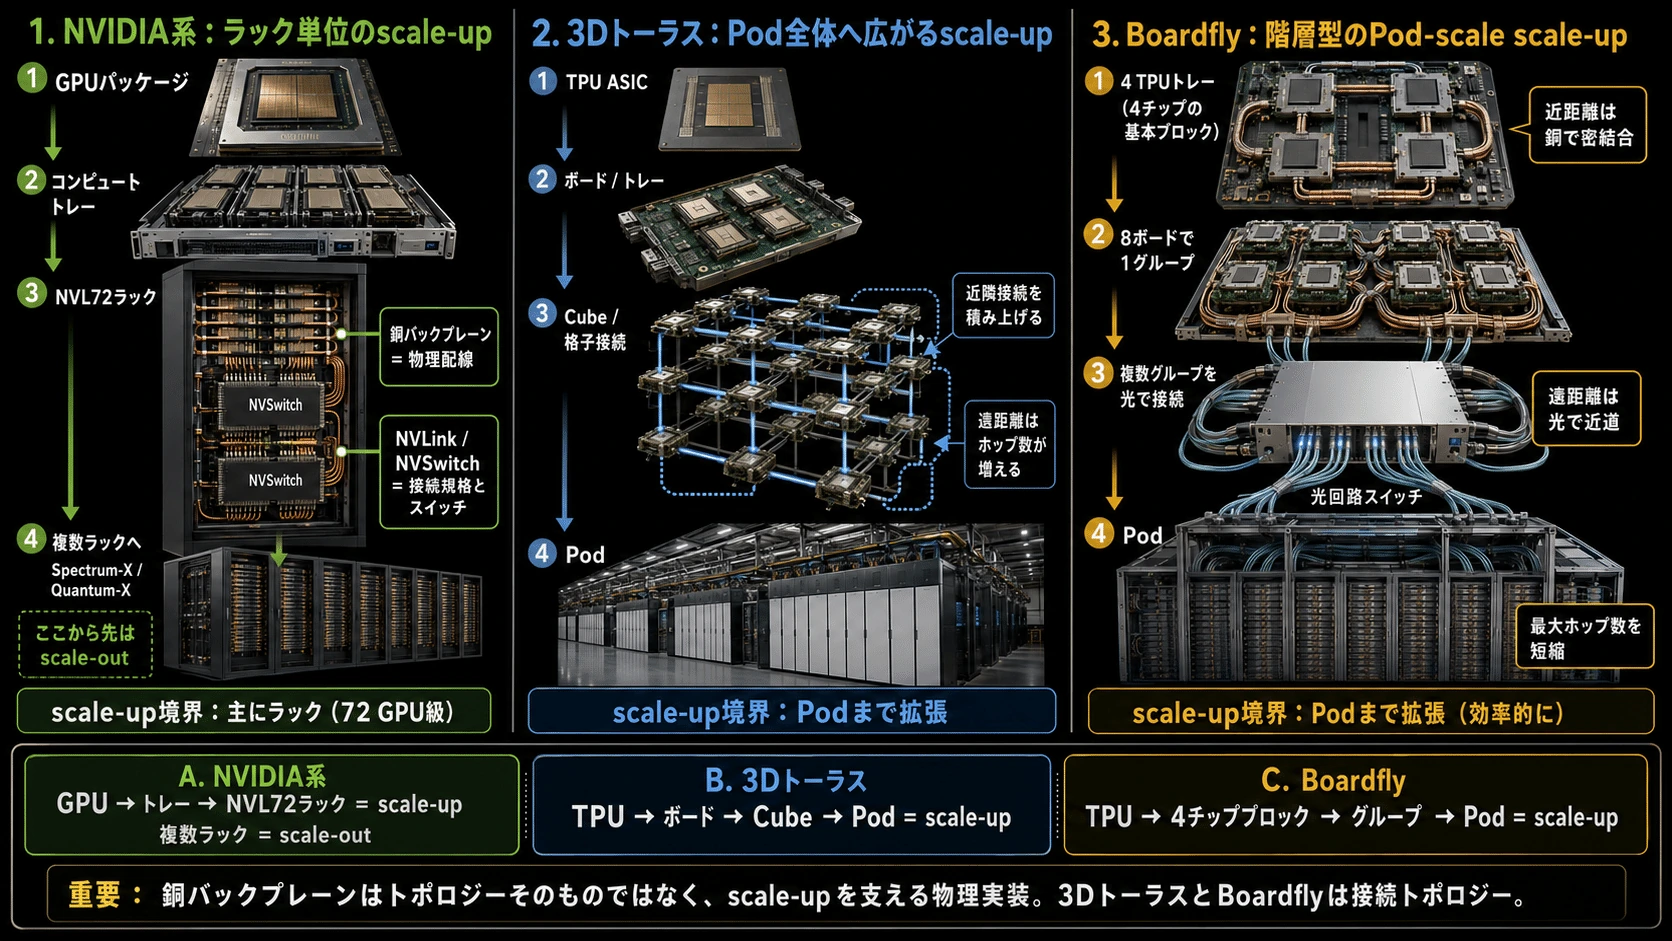
前回の記事ではscale-up,I/O境界,scale-outでのAIDCの繋がりを解説した 今回は、GoogleとNVIDIAで繋がりを比較分析していこうと思う
#https://note.com/atom_/n/n5360e7352589
#Kyber遅延で見える、NVIDIA GPUとGoogle TPUのネットワーク思想の違い
#scale-up・scale-out・I/O境界から読む次世代AIクラスタ
#AIアクセラレーターの競争は、GPUやTPU単体の演算性能だけでは決まらなくなった。数十基から数万基のアクセラレーターを同時に動かす現在のAIデータセンターでは、チップ同士をどこまで一つの計算機として結べるか、そして、その領域を越えた通信でどれだけ性能低下を抑えられるかが重要になる。
#この観点で見ると、NVIDIAとGoogleは異なる戦略を採っている。
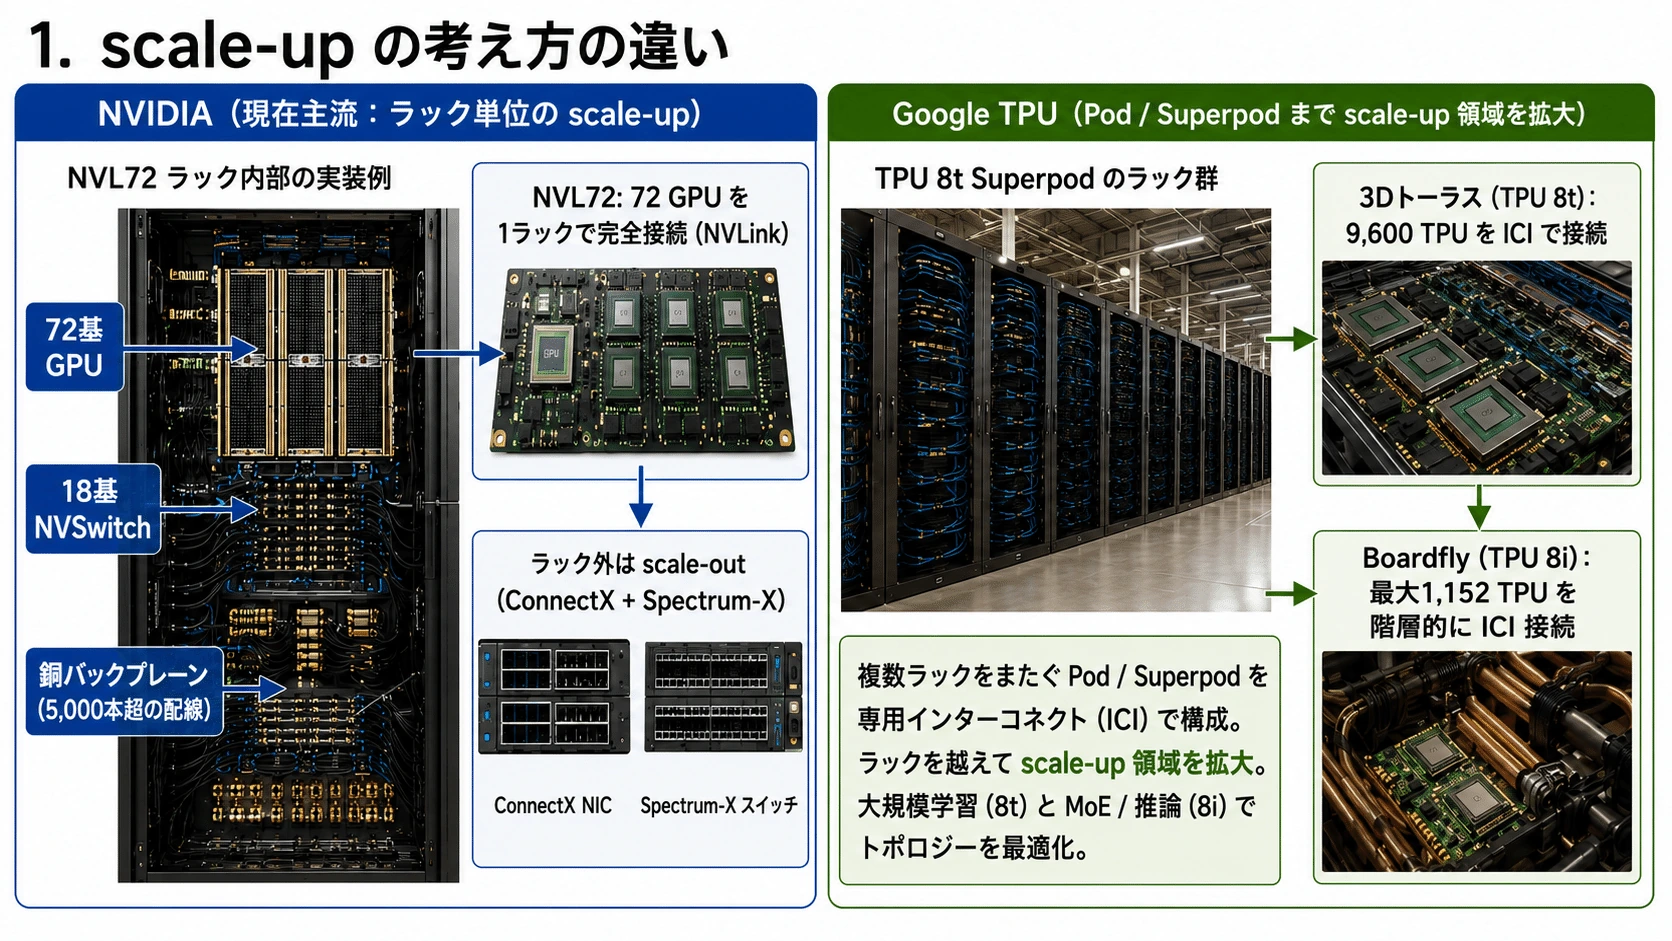
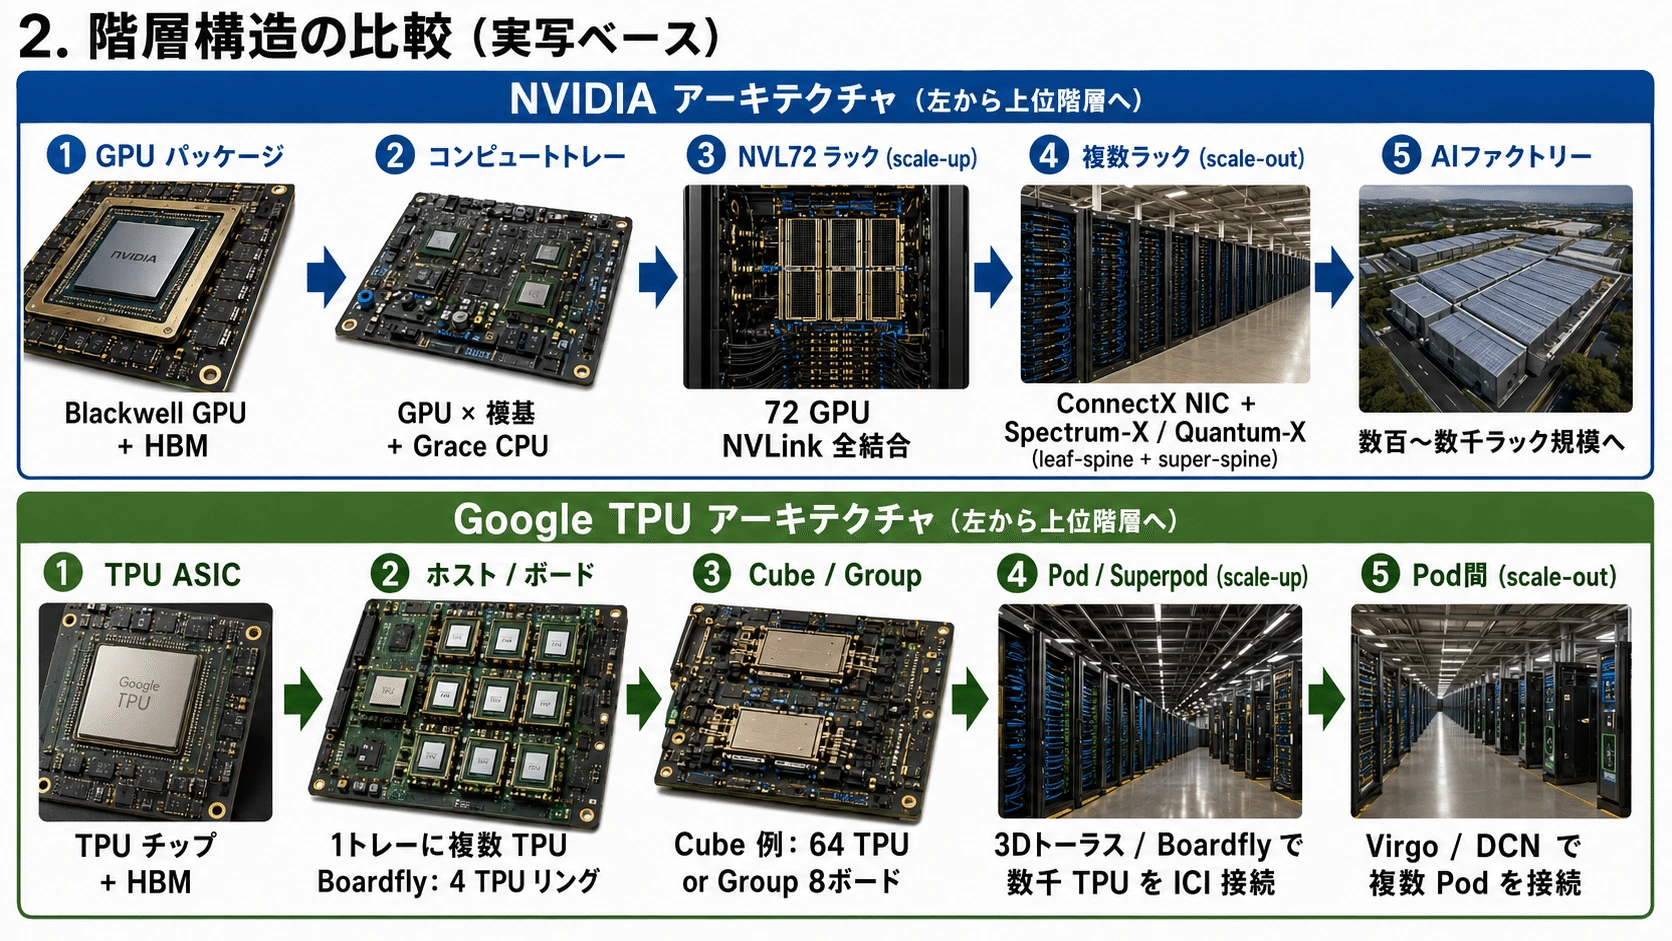
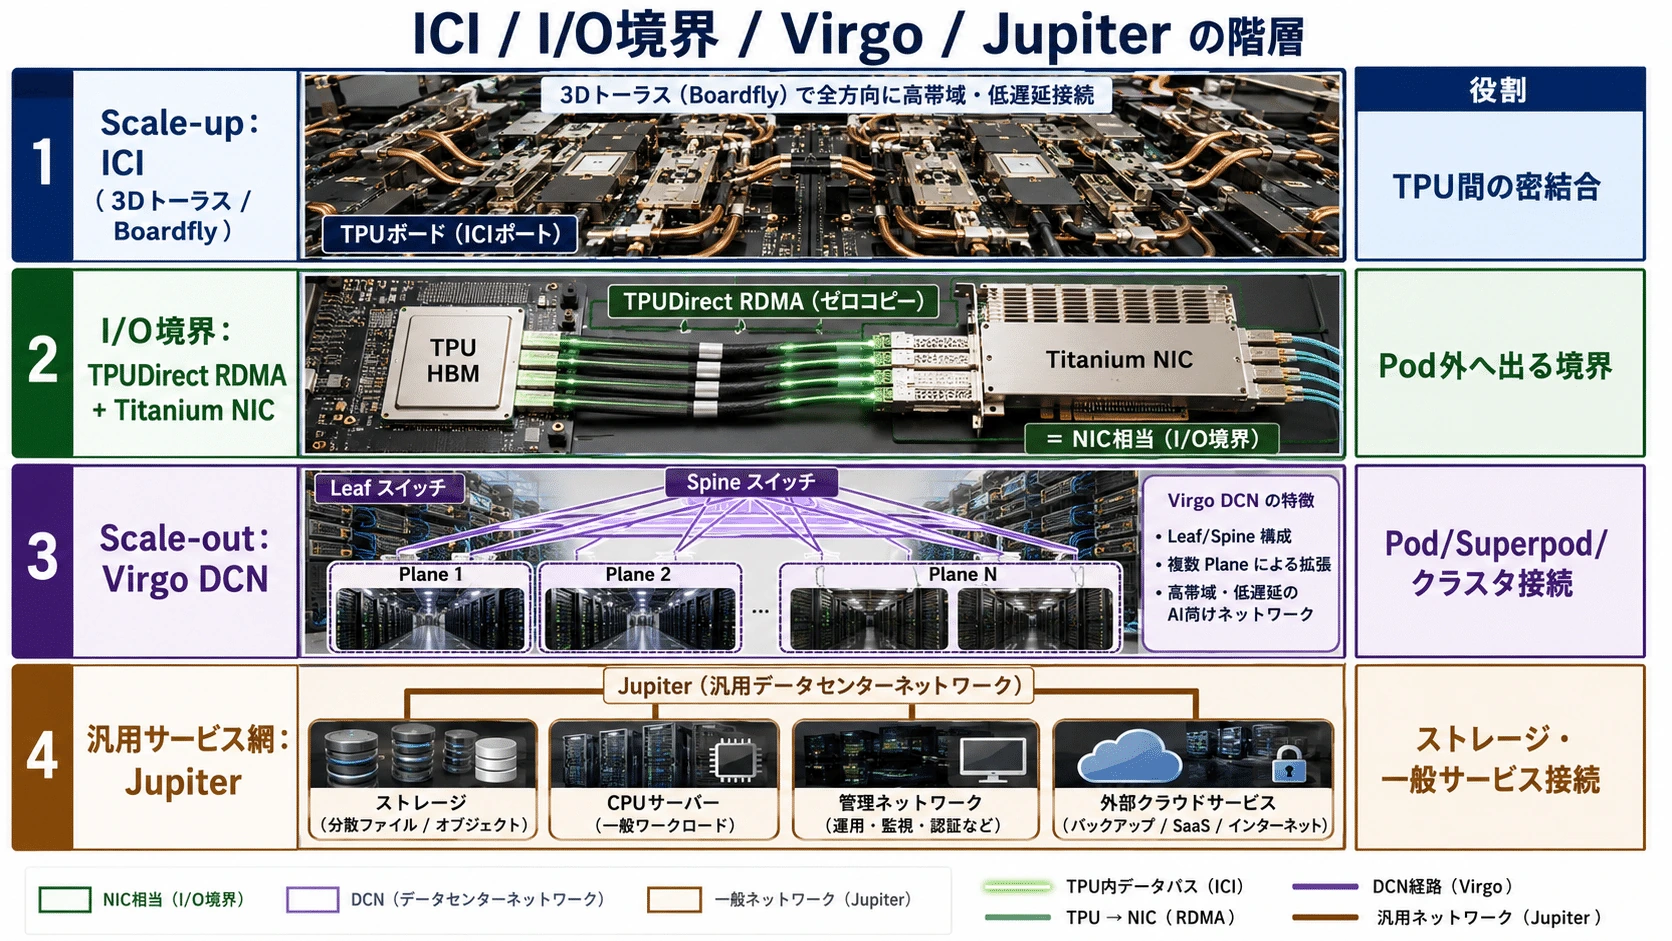
#NVIDIAは、NVLinkとNVSwitchによって比較的小さな領域を非常に強く完全接続し、その外側をConnectX、Spectrum-X、Quantum-Xで拡張する。一方、GoogleはICIを複数ラックへ延ばし、3DトーラスやBoardflyによってPod/Superpod全体を広いscale-up領域として扱い、その外側をVirgoでさらに拡張する。
#そして2026年7月に伝えられたKyberの遅延観測は、この違いを一段鮮明にした。
#
#
1.まず理解すべき三つの層
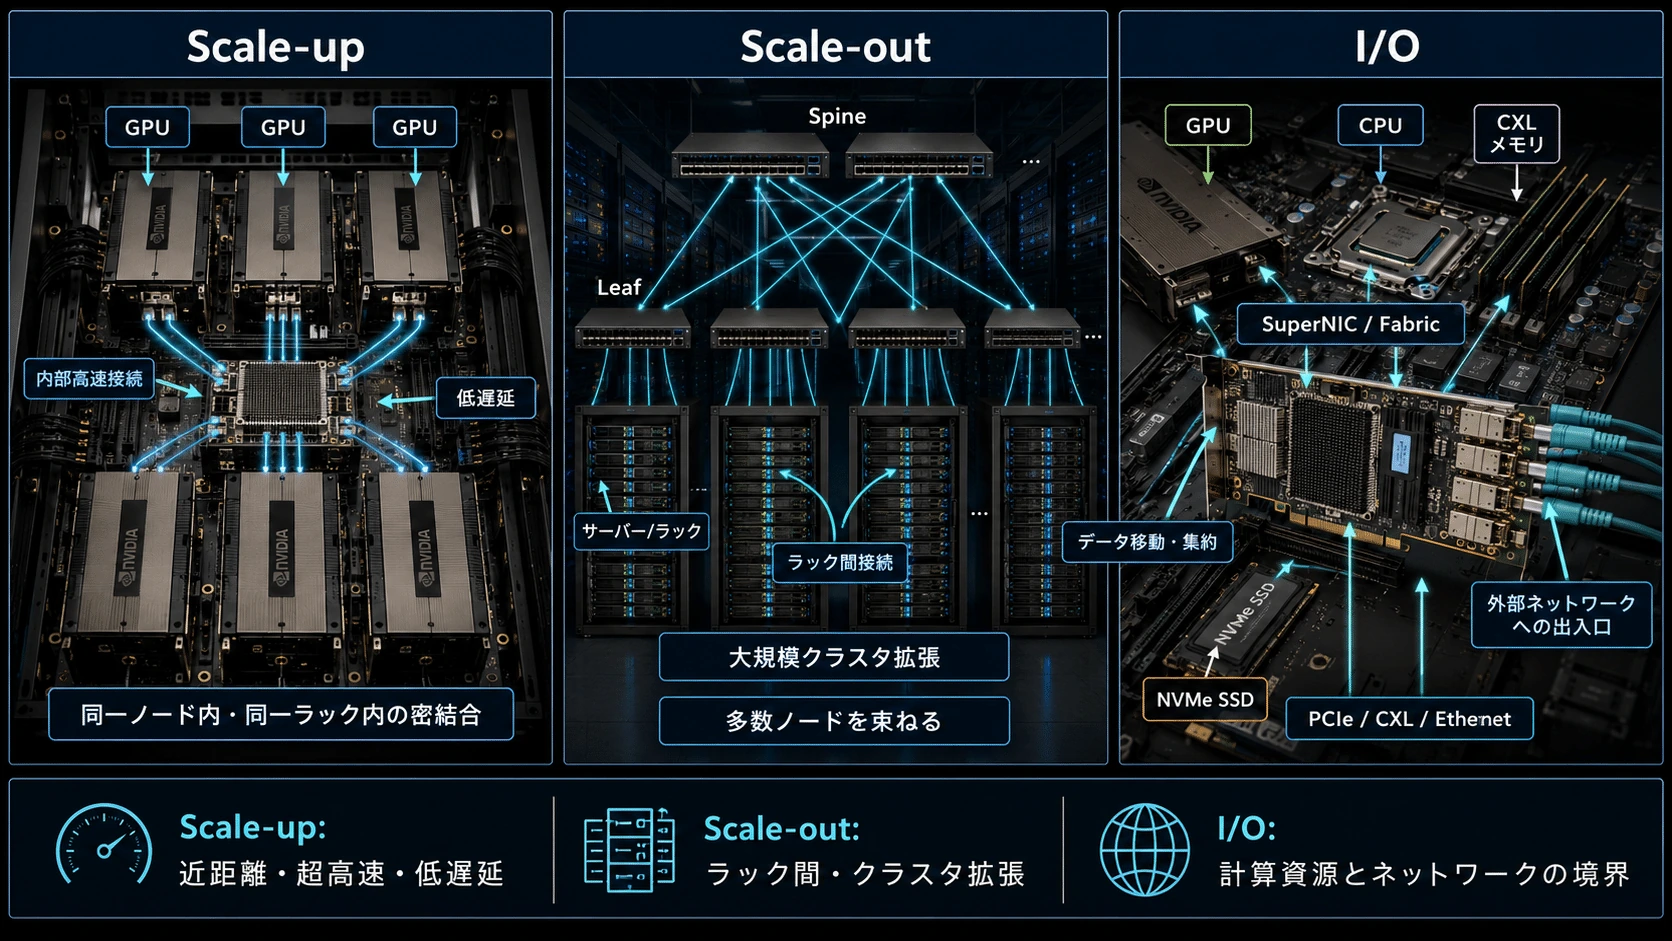
#AIクラスタの通信は、次の三層に分けると整理しやすい。
#scale-up
#複数のGPUやTPUを、あたかも一つの巨大なアクセラレーターのように動かす領域である。
#通信頻度が高く、低遅延と高帯域が必要になる。Tensor Parallelや細粒度のモデル分割では、ほぼ各レイヤーでアクセラレーター同士が同期するため、この層の性能が直接処理速度を決める。
#I/O境界
#アクセラレーターのメモリからデータを取り出し、外部ネットワークやストレージへ渡す境界である。
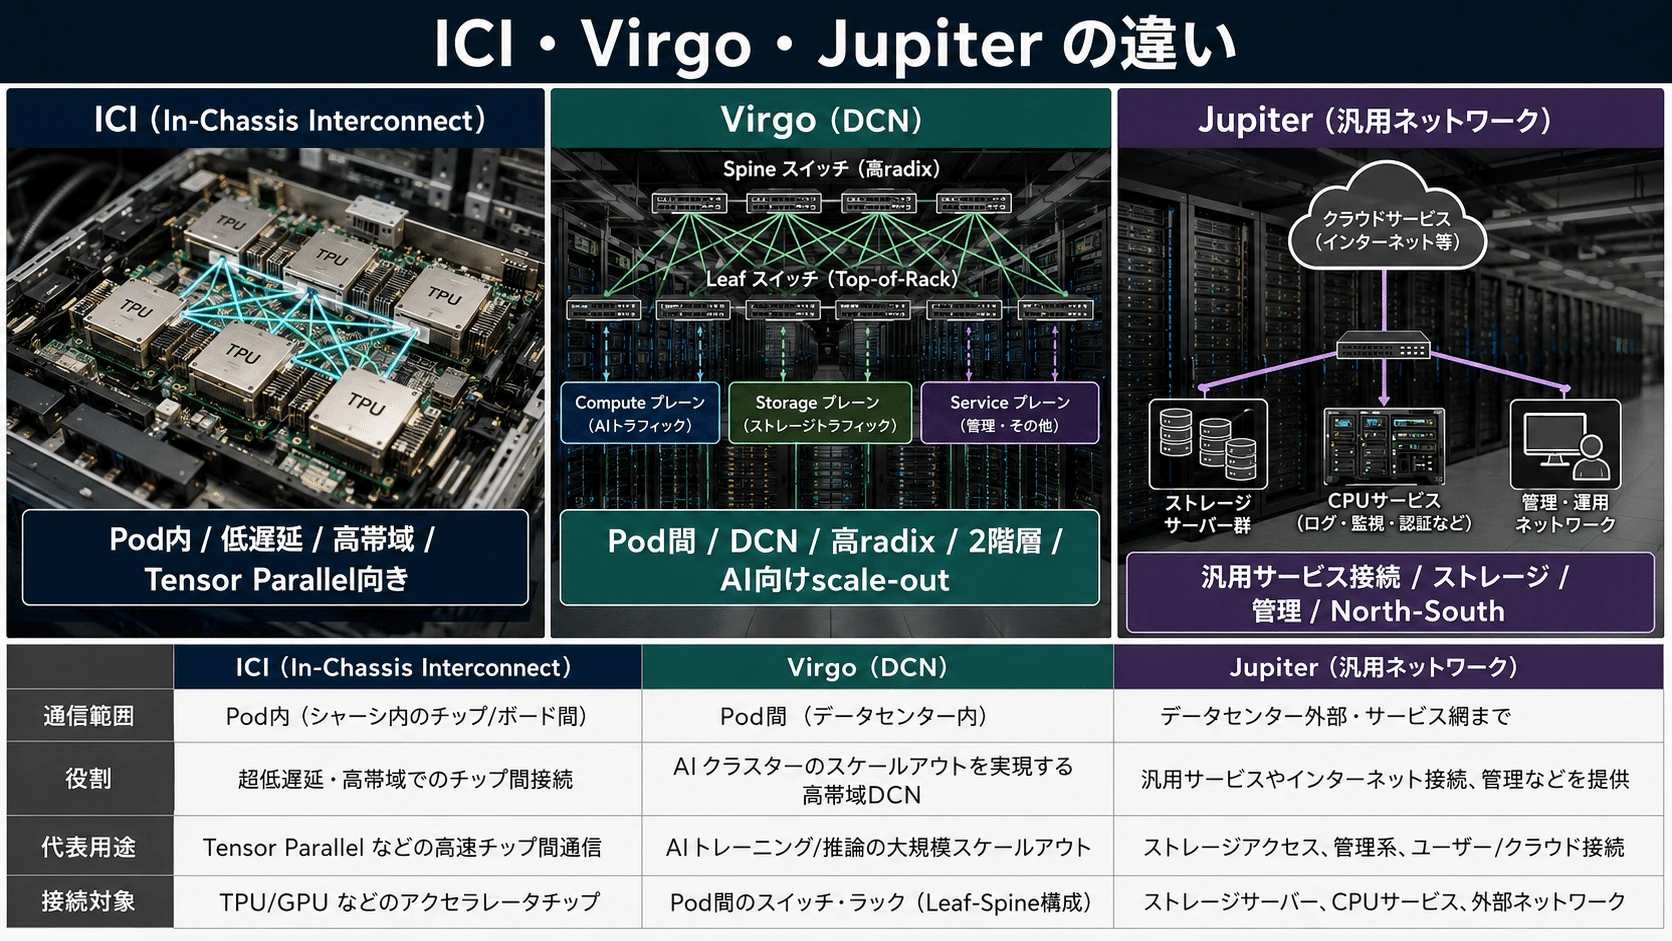
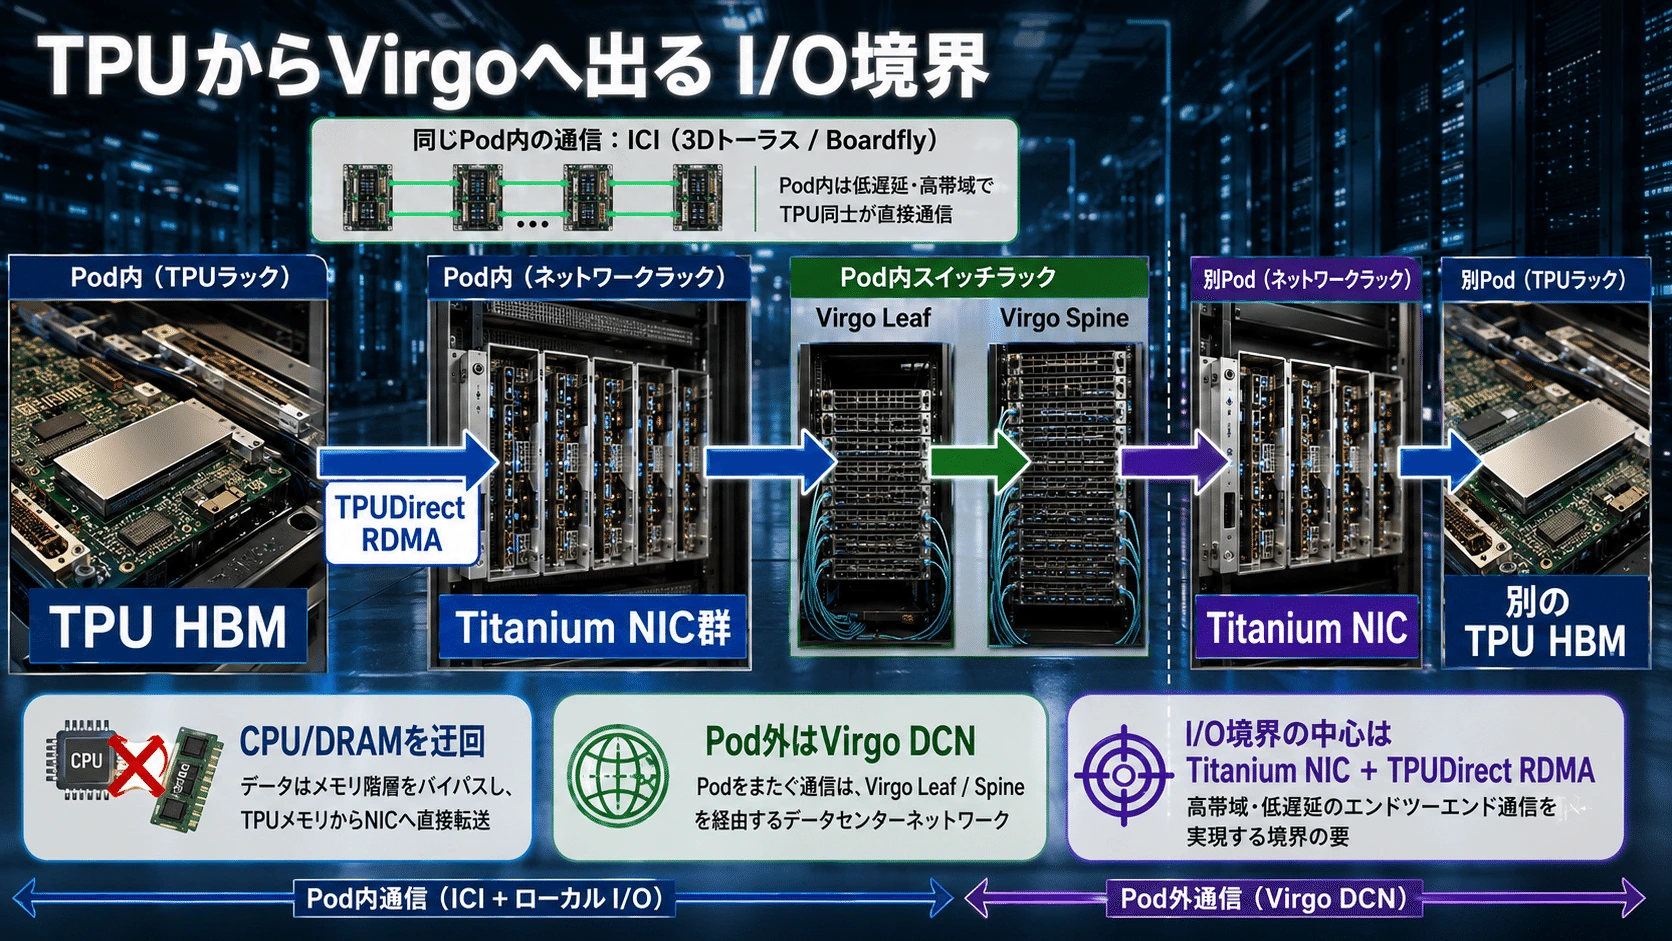
#NVIDIAではConnectXやBlueField、Google TPU 8tではTPUDirect RDMAとNICがこの役割を担う。Enfabrica ACF-Sも、このI/O境界を再設計する製品に分類できる。
#scale-out
#ラック、Pod、クラスタを越えて多数の計算ノードを接続する領域である。
#NVIDIAではSpectrum-X EthernetまたはQuantum-X InfiniBand、GoogleではVirgo DCNが中心になる。
#
#
2.NVIDIAは「小さく太いscale-up島」を作る
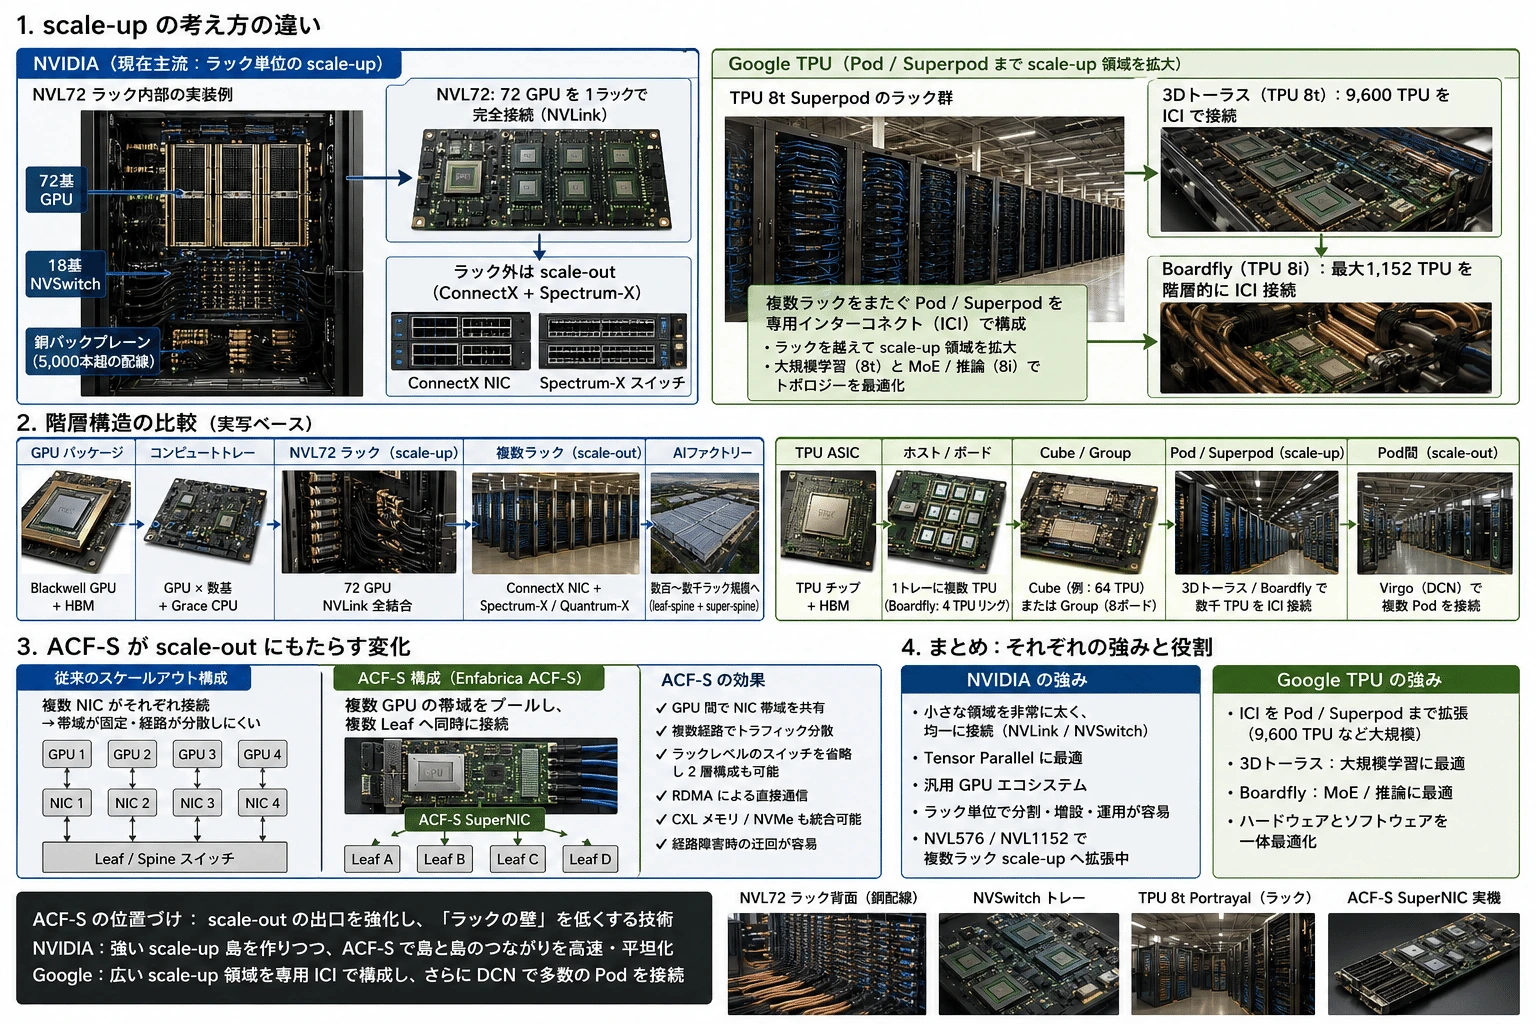
#NVIDIAの主力であるVera Rubin NVL72は、72基のGPUをNVLink 6とNVSwitchで接続し、ラック全体を一つの巨大なアクセラレーターとして扱う設計である。NVIDIAはNVLink 6をGPU間のscale-upファブリック、ConnectX-9をscale-out用のネットワーク・エンドポイントとして位置付けている。(NVIDIA Developer)
#構造を簡略化すると、次のようになる。
#GPU HBM
│
NVLink 6
│
NVSwitch群
│
72 GPUのNVL72ラック
│
ConnectX-9
│
Spectrum-X/Quantum-X
│
別のNVL72ラックNVL72の強みは、72基のGPU間で通信条件を比較的揃えやすいことだ。
#NVSwitchを中心にしたall-to-all型であるため、3Dトーラスのように遠くのGPUへ到達するまで多数のGPUを経由する必要がない。規模は限られるが、その内部では高帯域、低遅延、予測可能性の高い通信を実現しやすい。
#この構造は、細粒度のTensor Parallelや、頻繁なAll-Reduceが必要な処理に向いている。
##
3.Google TPUはPodまでscale-upを広げる
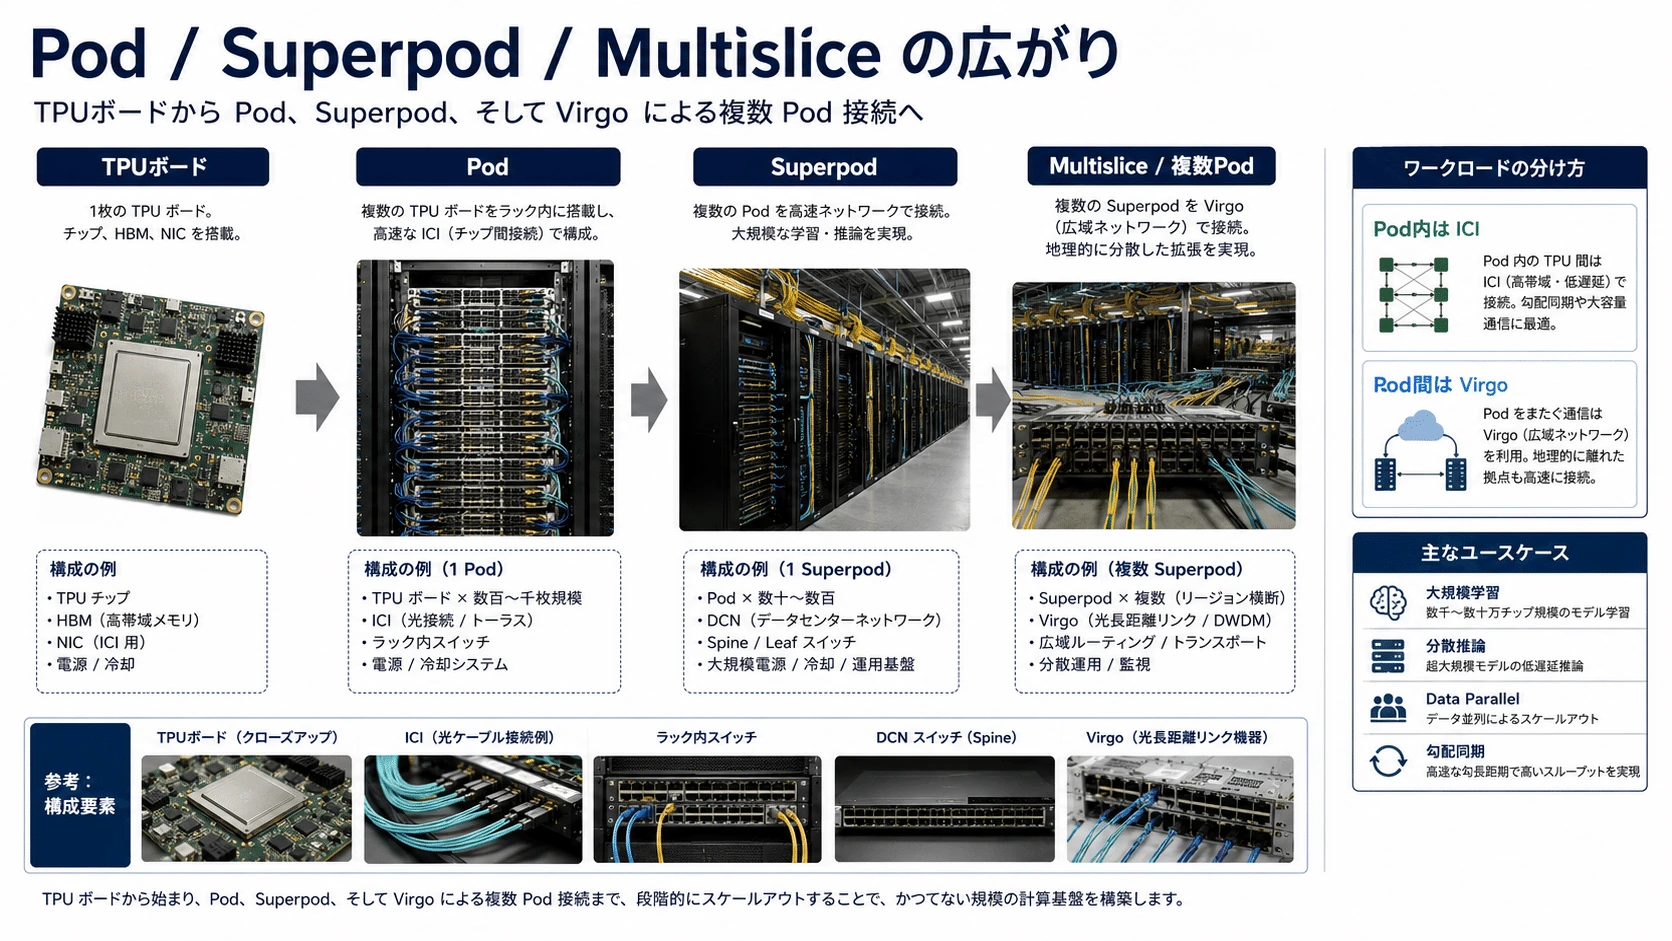
#Google TPU 8tは、3Dトーラス型のICIを使い、一つのSuperpodに最大9,600基のTPUを接続する。GoogleはTPU 8tを大規模事前学習向けと位置付け、単一Superpod内を専用ICIのscale-up領域として構成している。(Google Cloud)
#TPU
├ X方向の隣接TPU
├ Y方向の隣接TPU
└ Z方向の隣接TPU
│
3Dトーラス
│
最大9,600 TPUのSuperpodこの方法では、中央に巨大なNVSwitch群を置かない。
#各TPUが近隣のTPUと接続され、データは複数ノードを中継しながら目的地へ届く。そのため、チップ数を非常に大きく拡張できる一方、近くのTPUと遠くのTPUでは遅延や利用可能帯域が異なる。
#つまりGoogleのscale-upは、
#広いが、すべてのノード間距離が均一ではない#
という性格を持つ。
#
#
Boardflyは推論向けに距離を縮める
#TPU 8iでは、GoogleはBoardflyという新しいscale-upトポロジーを採用した。
#TPU 8iは大規模学習よりも、推論、サンプリング、MoE、長文脈処理を意識した製品であり、オンチップSRAM、Collectives Acceleration Engine、Boardflyを組み合わせている。(Google Cloud)
#Boardflyは、TPUをすべて格子状に並べるのではなく、小さな密結合グループを作り、グループ間に遠距離リンクを設ける階層型構造である。
#密結合TPUグループ
│
長距離リンク
│
別の密結合TPUグループ3Dトーラスより遠距離通信のホップ数を抑えやすく、離れたExpertへトークンを送るMoE処理に適している。
#Googleは、学習向けには3Dトーラス、推論・MoE向けにはBoardflyと、ワークロードに応じてscale-up網そのものを分けた。
##
4.I/O境界の違い
#NVIDIA側
#NVIDIAでは、GPU HBMからラック外へ出る境界にConnectX-9 SuperNICがある。
#GPU HBM
│
GPUDirect RDMA
│
ConnectX-9
│
Spectrum-X/Quantum-XConnectX-9は、GPUサーバーを外部EthernetまたはInfiniBand網へ参加させるscale-out側のエンドポイントである。Vera RubinのコンピュートトレーにはConnectX-9とBlueField-4が統合され、NVIDIAは計算、ネットワーク、セキュリティ、ストレージ処理を一つのプラットフォームとして設計している。(NVIDIA Developer)
#Google側
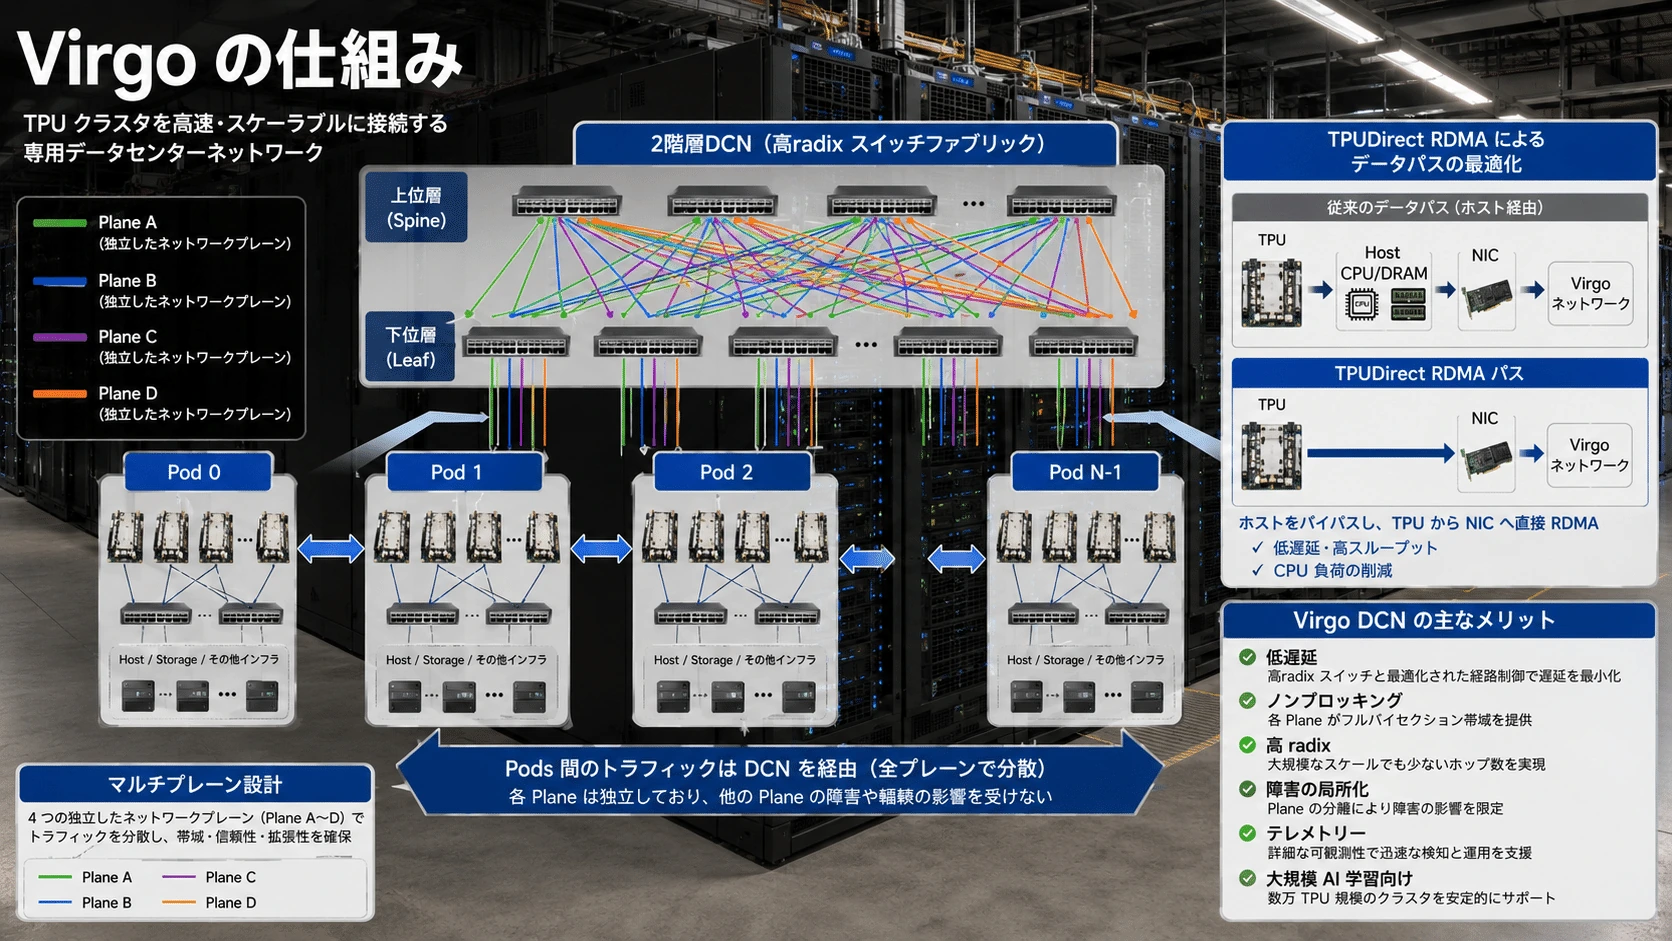
#Google TPU 8tでは、TPUDirect RDMAによってTPUのHBMとNICの間でデータを直接転送する。
#TPU HBM
│
TPUDirect RDMA
│
NIC
│
Virgo DCNホストCPUとホストDRAMを迂回するため、余計なメモリコピーとCPU負荷を減らせる。Google公式資料はこの境界を「TPU HBMとNICの直接転送」と説明しているが、使用されるNIC ASICの詳細までは同資料で公開していない。(Google Cloud)
#
#
5.VirgoはGoogleの巨大scale-out網
#Virgoは、TPUのICIを置き換えるものではない。
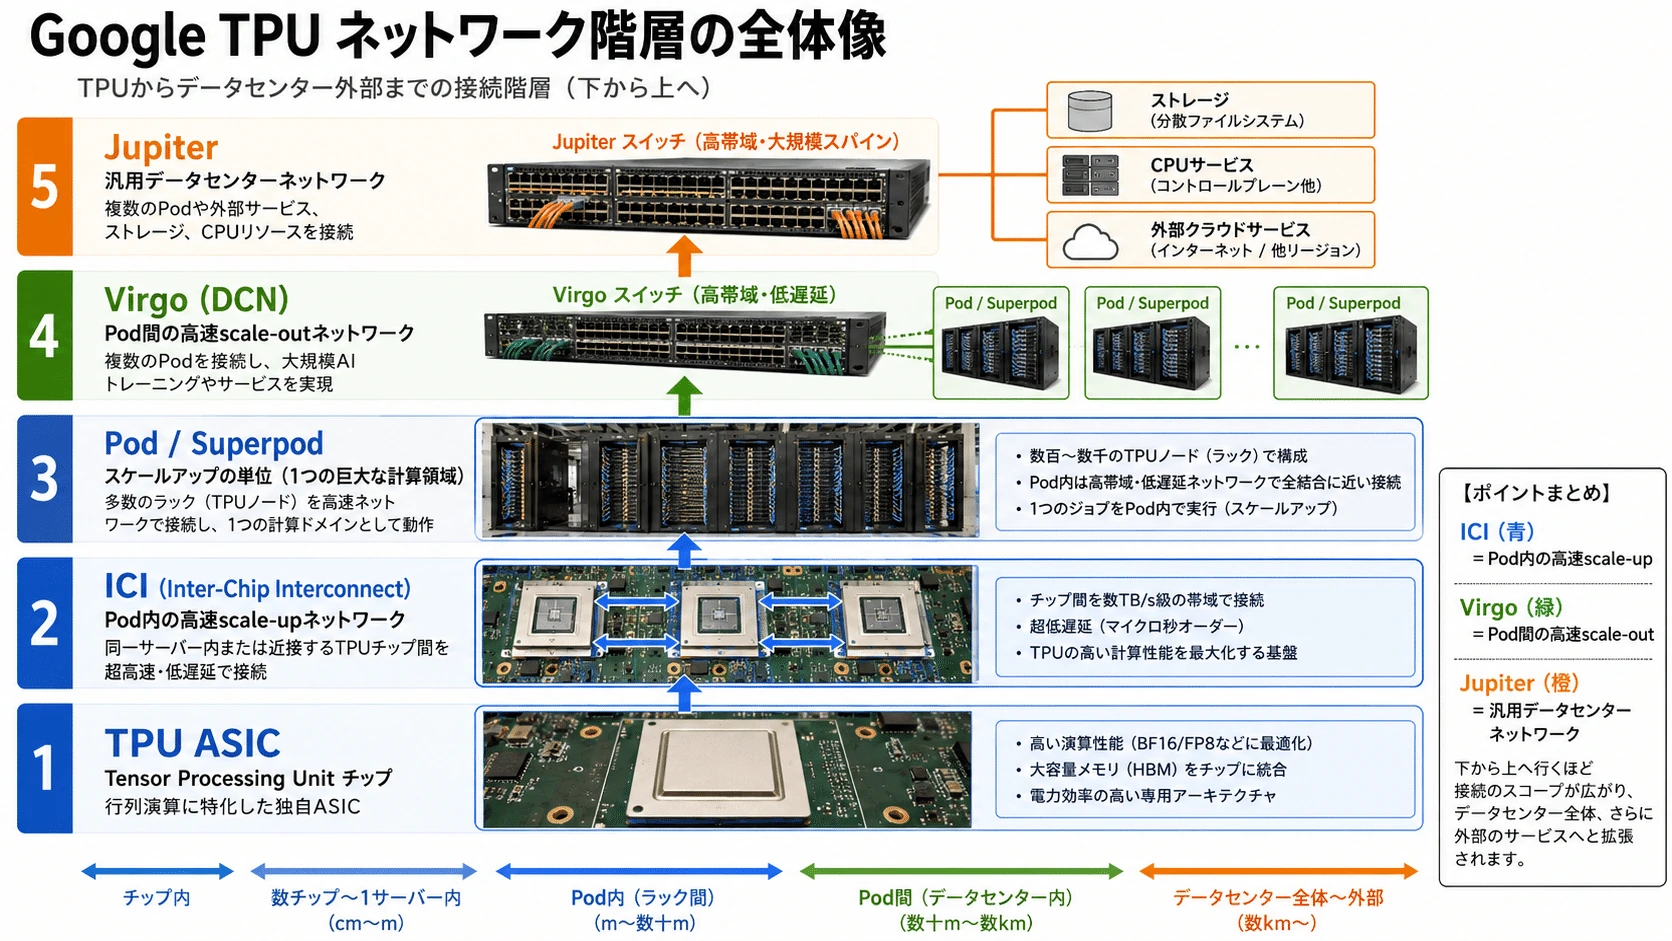
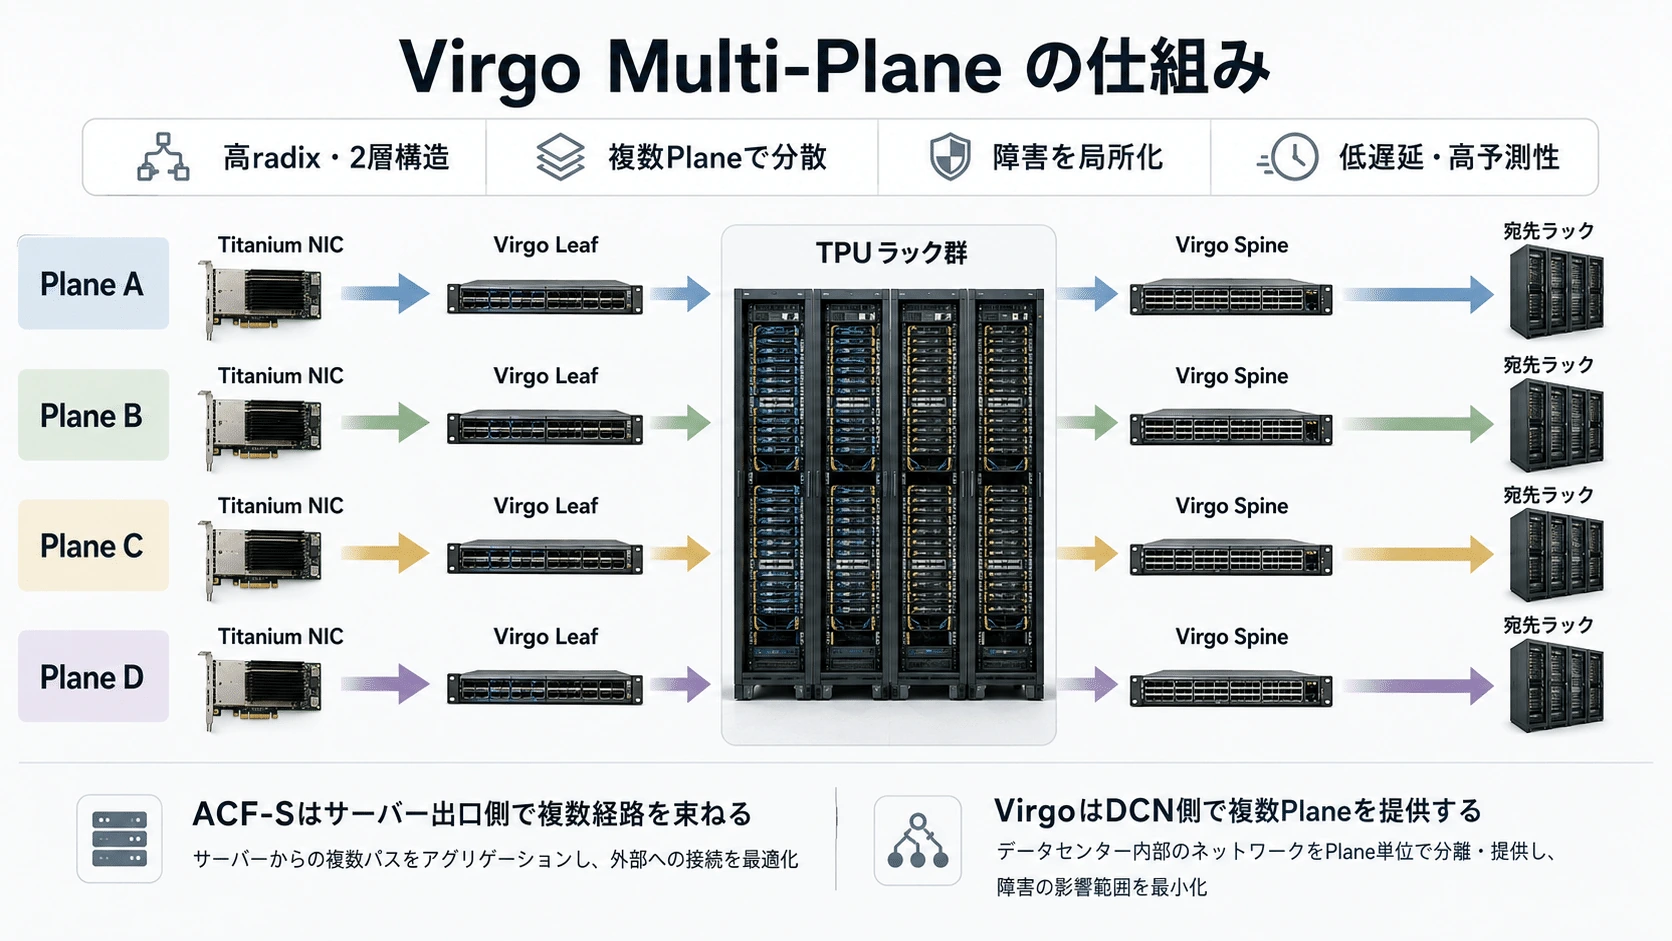
#ICIがPod/Superpod内のscale-upを担当し、Virgoはその外側でPodやラックを接続するscale-out用DCNである。
#Superpod A
│
Virgo
│
Superpod B
│
Virgo
│
Superpod CVirgoは高radixスイッチを使ったフラットな2層ノンブロッキング構造を採用し、複数の独立したネットワークPlaneを持つ。Googleによれば、一つのVirgoファブリックで13万4,000基を超えるTPU 8tを接続し、最大47Pbpsのノンブロッキング二分割帯域を提供できる。(Google Cloud)
#さらにJAXとPathwaysを使うことで、複数データセンターにまたがる100万基超のTPUを、一つのトレーニングクラスタとして扱う構想が示されている。(Google Cloud)
#ここで重要なのは、13万4,000基すべてが一つのscale-up領域にあるわけではないことである。
#- 9,600 TPUのSuperpod内部:ICIによるscale-up
- Superpod間:Virgoによるscale-out
- 複数サイト間:上位ネットワークとPathwaysによる論理統合
という階層構造である。
#TPUラックは、計算サービスやストレージへアクセスするため、Virgoとは別にJupiterのNorth-Southファブリックにも接続される。(Google Cloud)
#
#
6.KyberはNVIDIAのscale-up境界を広げる計画だった
#NVIDIAもラック単位のscale-upにとどまるつもりではなかった。
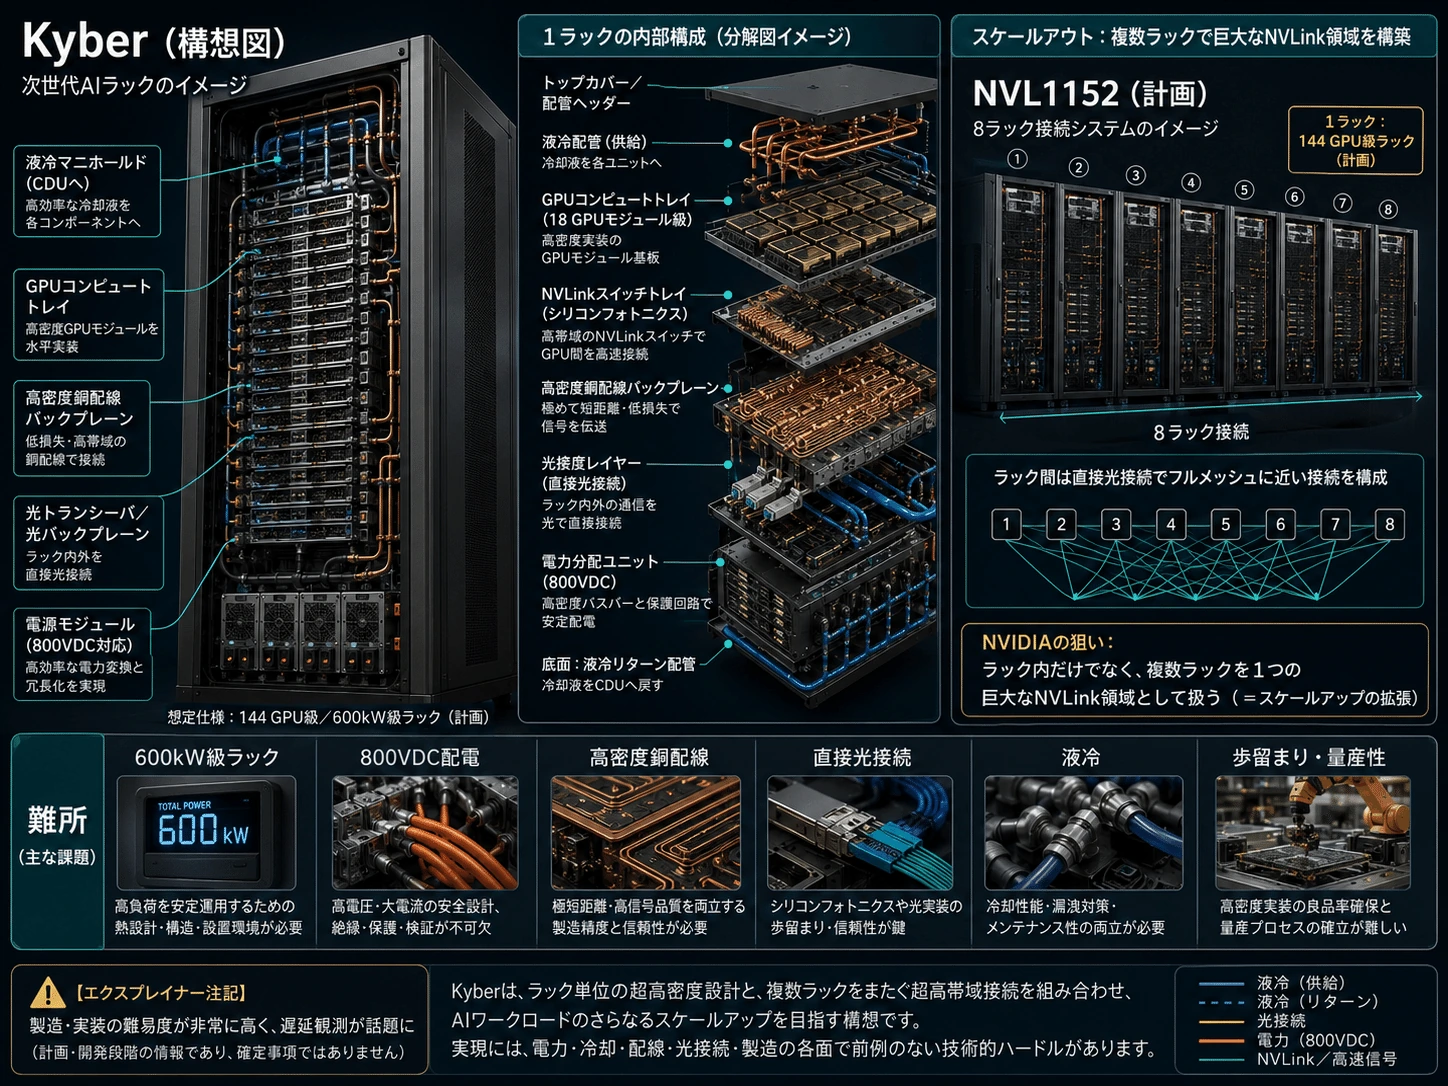
#2026年3月に発表された公式計画では、Rubin Ultra NVL576は72 GPUのMGX NVLラックを8台接続し、576基のGPUを一つのNVLinkドメインに収める。ラック間には銅接続と直接光接続を使う計画だった。(NVIDIA Developer)
#さらにKyberでは、一つのラックに144 GPUを収容し、8ラックで最大1,152 GPUのNVLink scale-up領域を構成する構想が示された。(NVIDIA Developer)
#NVL72 × 8ラック
=NVL576
Kyber NVL144 × 8ラック
=NVL1152これはNVIDIAがGoogleと同様に、scale-up境界をラックの外へ広げようとしていたことを意味する。
#ただし設計思想はGoogleとは異なる。
#Googleが3DトーラスやBoardflyの分散・階層型トポロジーを使うのに対し、NVIDIAは複数ラックでもNVSwitchを中心としたall-to-all型の性格を維持しようとしている。
#
#
7.Kyberの遅延観測が意味するもの
#2026年7月、SemiAnalysisはKyber NVL144が製造上の問題によって12か月超遅れ、2028年へ後退したとの見方を示した。あわせて、Rubin UltraをNVL72ラック2台で構成する一部案も取り下げられたと報じられている。これはNVIDIAの正式発表ではなく、供給網・設計情報に基づく非公式情報である。(X (formerly Twitter))
#また、Rubin Ultraの4ダイ構成が製造実行上の懸念から2ダイへ縮小されたとの報道もある。こちらもNVIDIAは正式確認していない。(Tom's Hardware)
#Kyberの壁は単なるGPU設計の問題ではない。
#144 GPUを一つのラックに収めるには、
#- 巨大なミッドプレーンPCB
- 200Gbps級信号の大量配線
- コネクター精度
- PCBの反り
- 600kW級の電力
- 800VDC配電
- 液冷
- ラック全体の組立歩留まり
を同時に成立させる必要がある。
#そのため、試作機を動かせることと、数千台を経済的に量産できることの間に大きな差が生じる。
##
8.Kyber遅延でGoogleが有利になる部分
#Kyberが2028年へ後退する場合、NVIDIAの近い将来のscale-upは、主としてNVL72と既存MGXラックを利用するNVL576構想に依存することになる。
#一方、Googleはすでに、
#- 3Dトーラスで9,600 TPU
- Boardflyによる推論向け階層接続
- Virgoで13万4,000 TPU超
- Pathwaysで100万TPU超
という階層を示している。(Google Cloud)
#このため「専用インターコネクトを複数ラックへ広げた実績」と「scale-up領域の物理的な広さ」では、Googleが先行している。
#特に大規模事前学習では、9,600基を一つのICI領域として利用できる点が強い。MoEや推論では、Boardflyのように遠距離通信を意識したトポロジーを持つことも優位になり得る。
##
9.それでもNVIDIAのscale-upが弱いとは限らない
#広いscale-up領域が常に高速とは限らない。
#3Dトーラスでは遠方ノードへ到達するほどホップ数が増える。Boardflyも階層をまたぐ通信では複数ホップを必要とする。
#NVIDIAのNVL72は規模が小さい代わりに、NVSwitchによってノード間の通信特性を揃えやすい。
#| 比較軸 | NVIDIA NVL72 | Google TPU Superpod |
| scale-up規模 | 小さい | 非常に大きい |
| ノード間距離 | 比較的均一 | 距離差がある |
| 接続方式 | NVSwitch中心 | 3Dトーラス/Boardfly |
| Tensor Parallel | 強い | トポロジー配置が重要 |
| 大規模Data Parallel | scale-out依存が増える | 広いICI領域を活用 |
| MoE | NVSwitch内は強い | Boardflyで広域化 |
| 運用単位 | ラック単位で分割しやすい | Pod全体の配置最適化が必要 |NVIDIAはCUDA、NCCL、NVLink、ConnectX、Spectrum-Xを一体で提供し、多様なクラウドやオンプレミス環境へ展開できる。
#GoogleはTPU、ICI、Virgo、XLA、JAX、Pathwaysを自社用途に合わせて一体最適化できる。
#一方が絶対的に優れているのではなく、NVIDIAは局所通信の強さと汎用性、Googleは広域scale-upと垂直統合に強みがある。
##
10.ACF-Sはscale-outの「段差」を小さくする
#Enfabrica ACF-Sは、KyberやNVSwitchを置き換える技術ではない。
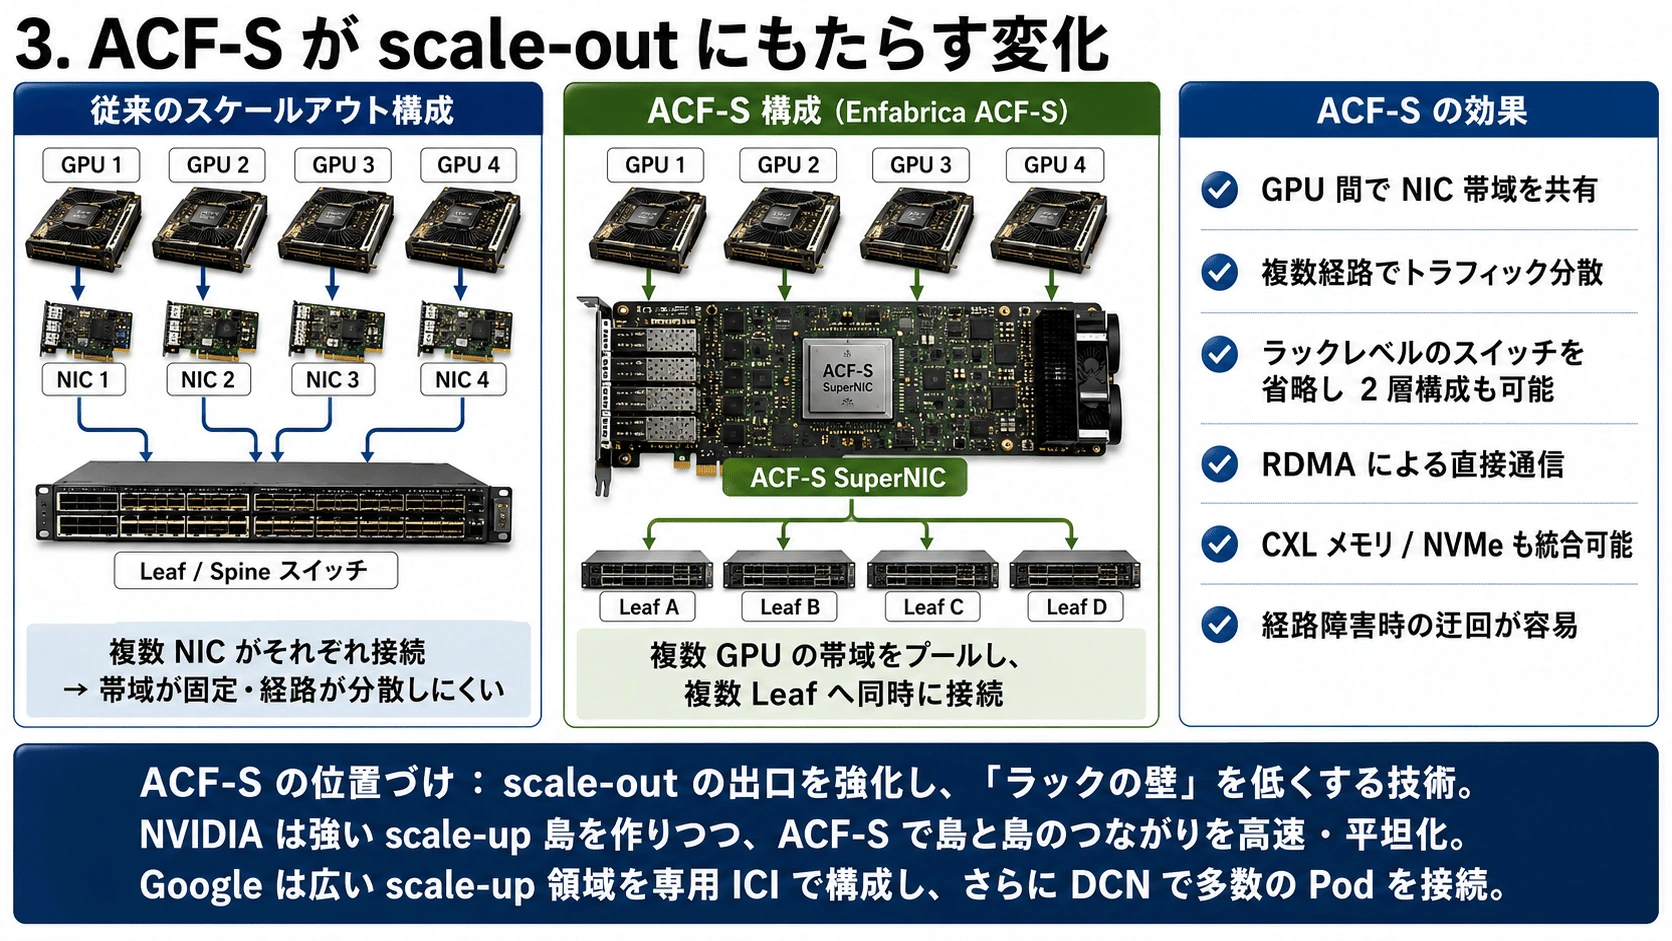
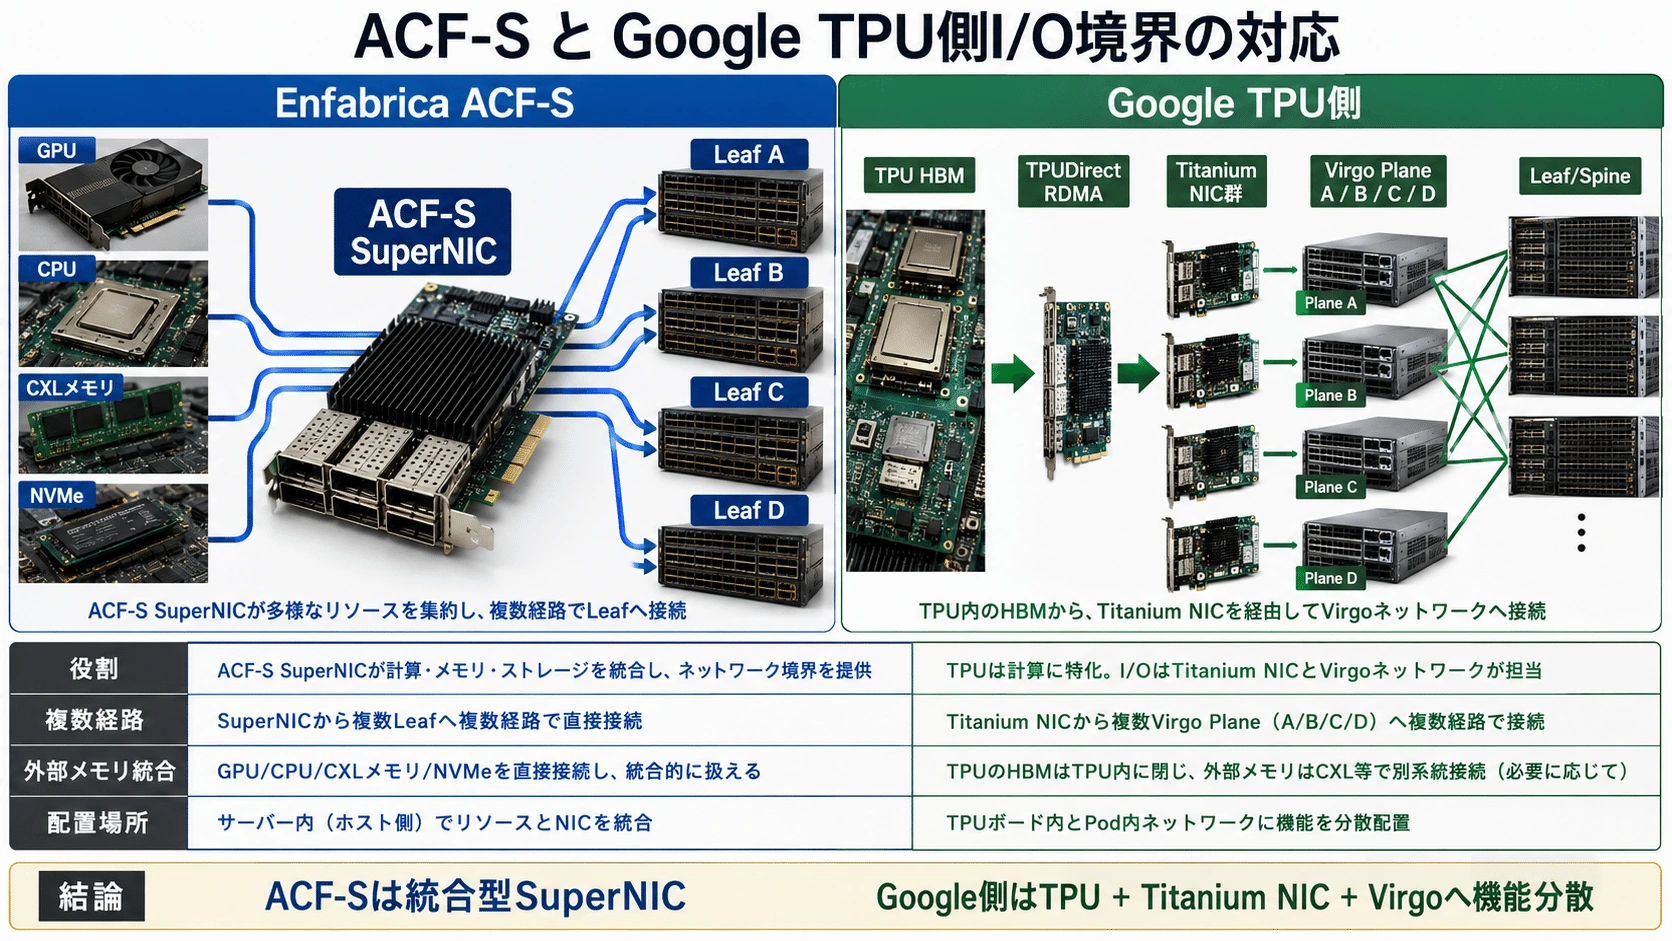
#ACF-Sは、複数GPU、CPU、CXLメモリ、NVMeを一つのI/Oファブリックへ集約し、複数のEthernet経路へ通信を分散する3.2TbpsのMulti-GPU SuperNICである。(Enfabrica)
#複数GPU
CPU
CXLメモリ
NVMe
│
ACF-S
├ Leaf A
├ Leaf B
├ Leaf C
└ Leaf D従来のGPUとNICの固定的な対応を弱め、複数GPUが複数のNIC帯域やネットワーク経路を共有できるようにする。
#これにより、
#- 特定NICへの帯域偏りを減らす
- 複数Leafへトラフィックを分散する
- 中間のPCIe/railスイッチを削減する
- 障害経路を迂回する
- CXLメモリやNVMeを同じ境界へ統合する
ことを狙う。
#Enfabricaは、従来構成に比べて大規模GPUクラスタのデバイス経由数を最大66%削減できると説明しているが、これは同社による設計上の公表値であり、実環境の効果は構成によって変わる。(Enfabrica)
##
11.ACF-Sでscale-outはscale-upになるのか
#ならない。
#ACF-Sを導入してもEthernetはNVLinkにはならず、次の違いは残る。
#- パケット処理
- スイッチ通過遅延
- ラック間距離
- 輻輳
- 再送
- メモリ一貫性
- 細粒度同期の遅延
ACF-Sの役割は、scale-outをscale-upへ変換することではない。
#scale-up島から外へ出た瞬間に性能が急落する「ラックの壁」を低くする#
ことにある。
#特に効果が期待できるのは、Data Parallel、Pipeline Parallel、Expert Parallel、KVキャッシュ共有、外部メモリ利用である。
#各レイヤーで細かく同期するTensor Parallelでは、依然としてNVLink/NVSwitchやICIのような専用scale-up網が必要になる。
#
#
12.GoogleとNVIDIAのI/O境界戦略の違い
#GoogleはACF-Sのような統合SuperNICを前面に出していない。
#Google側では、
#TPU HBM
+ TPUDirect RDMA
+ NIC
+ Virgo Multi-Plane
+ XLA/Pathwaysという形で、I/O境界の機能をシステム全体へ分散している。
#NVIDIA側は、
#GPU HBM
+ GPUDirect RDMA
+ ConnectX/BlueField
+ Spectrum-X/Quantum-Xという明確な製品階層を持つ。
#ACF-Sは、NVIDIA型の境界をさらに統合し、
#ConnectX的NIC
+ PCIe/CXLスイッチ
+ 複数GPUの帯域共有
+ 多経路分散を一つのチップへ寄せる構想である。
#NVIDIAがライセンス取得したEnfabrica技術が、将来のConnectX、BlueField、Spectrum-Xへどの形で統合されるかは、現時点では正式発表されていない。
##
最終評価
#Kyberの遅延観測が示すのは、NVIDIAの設計力が突然失われたということではない。
#むしろ、
#低ホップで均一なall-to-all scale-up領域を、ラックから複数ラックへ広げることが物理的に極めて難しい#
という事実である。
#Googleは中央スイッチ型の完全接続を避け、3DトーラスやBoardflyによって距離差を許容しながら、scale-up領域をPod全体へ広げた。そのため、物理的な拡張性では優位に立ちやすい。
#NVIDIAは、より小さい領域を非常に強く結び、その外側を高性能scale-outで接続する。Kyberはその境界を押し広げる計画だったが、量産の壁によって時間を要する可能性が出てきた。
#今後の対抗策は三段構造になると考えられる。
#第1層
NVL72/NVL576による強いNVLink scale-up島
第2層
ConnectX・Spectrum-X・Quantum-X・ACF-S系技術による
低遅延で平坦なscale-out
第3層
CXL DDR5・NVMe・外部メモリによる
メモリ容量の拡張Googleは、広いICI scale-up領域とVirgoを一体設計する。
#NVIDIAは、局所的に強いNVLink領域を保ちながら、scale-outの性能をscale-upへ近づける。
#したがって、Kyber遅延後の競争は単なるGPU対TPUではない。
#専用scale-upをどこまで物理的に広げるかというGoogleの戦略と、強いscale-up島を高品質なscale-outで結ぶNVIDIAの戦略の競争#
へ変わっている。
#Kyberが予定通り量産されるか、NVL576がどこまで実用的な多ラックscale-upを実現できるか、そしてEnfabrica系のI/O集約技術がNVIDIA製品へどう取り込まれるかが、2027~2028年の重要な分岐点になる。
##
特定銘柄の推奨・勧誘・投資助言を目的とするものではありません。投資判断はご自身の責任でお願いいたします。
#サムネはPixAIsunflowerモデルとGPTImage2.0
#