NOIA_GRIDKNOWLEDGE ARCHIVE
← KNOWLEDGE ARCHIVE

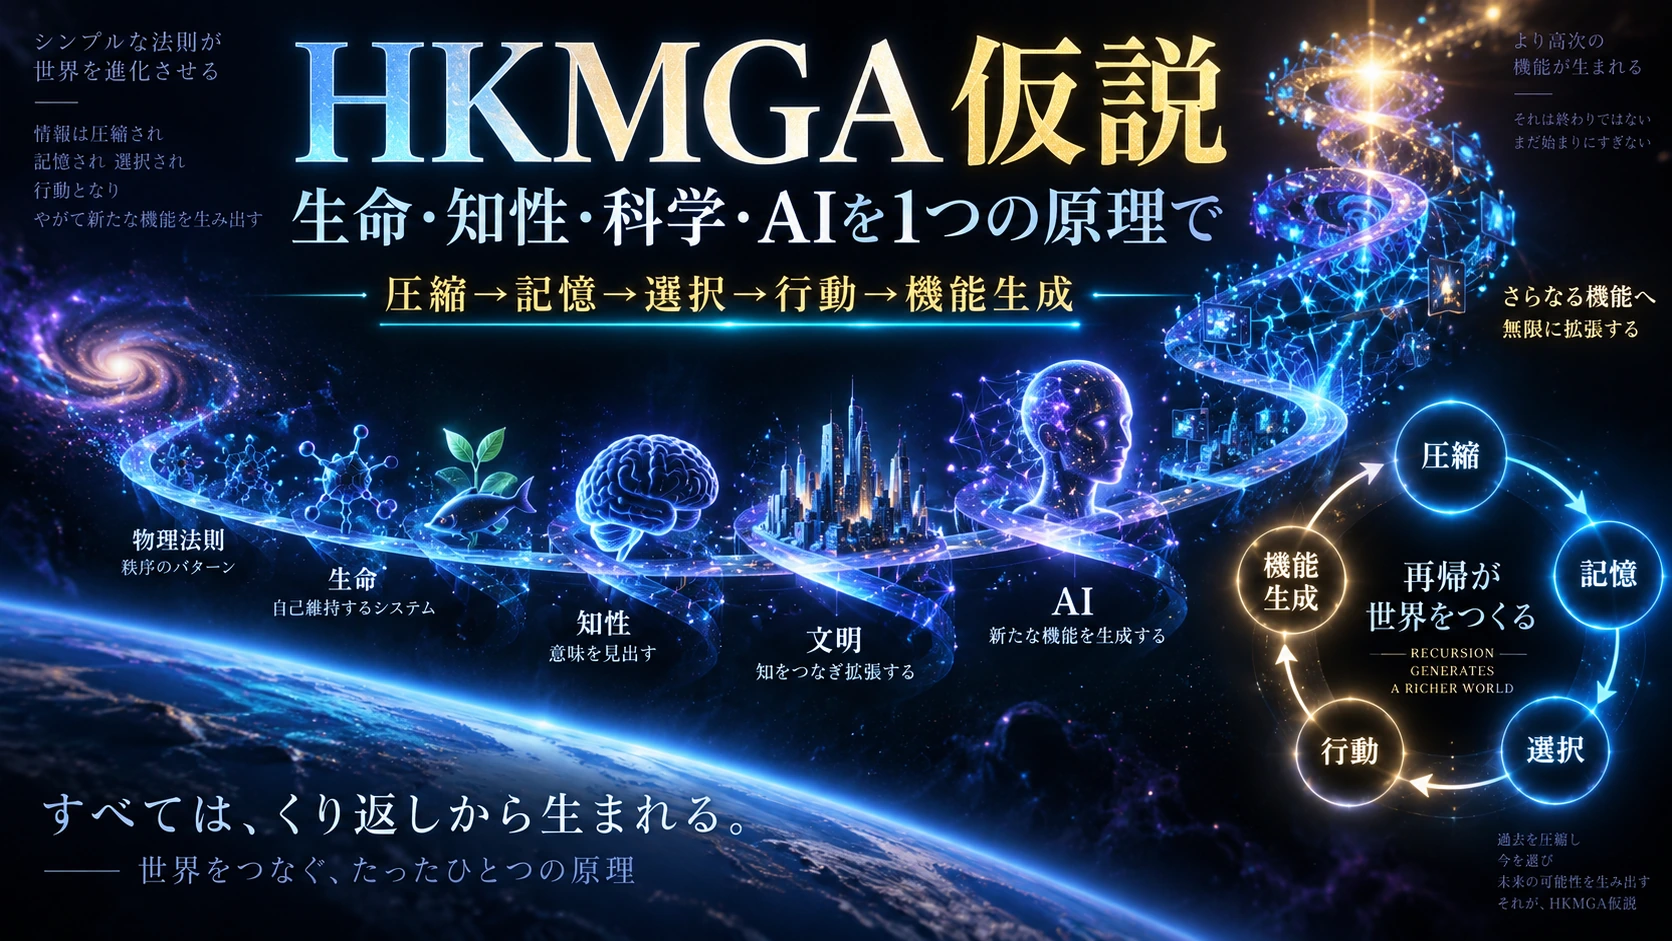
HKMGA再帰的Function拡張仮説

AIモデル・知能 エージェント・データ基盤

絶ノイアの章 Sil-Kathnaの章
この資料の日時

元資料の日付と、その本文が公に存在した確認日時は別の記録です。

本文に含まれる語句 帯域・データ移動 AI推論 AIエージェント

この資料を根拠にした分析カード(試験中): Learning Loop――観測が次の変更と検証へ戻る経路を見る

出典・更新履歴・検証情報

この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。

データセットの版
2026.09.23.4
記事内容のSHA-256
5a8a00c0567de7fd54a40a9011db5a48f8a6c4c888802b213bc189a9b1942b68
保存版のSHA-256
0c596a635821286c8d373129b1415ebb33e0cadc64cb24930fe4df2f62bdd335

外部証明の最終検査結果は詳細を開くと表示します。
公開版の履歴・検証方法 · 証拠ファイルを保存(本文・画像は別)

#
HKMGA再帰的Function拡張仮説 / 表紙
図・画像

HKMGA再帰的Function拡張仮説

#

――圧縮・記憶・目的・行動から生命、知性、科学、AIまで

#

1.仮説の中心命題

#

HKMGA仮説を最も一般的な形に再定義すると、中心命題は次のようになる。

#
世界のRegularityが圧縮され、保持され、再利用されるとFunctionが形成される\boxed{ \text{世界のRegularityが圧縮され、保持され、再利用されるとFunctionが形成される} }
#

そして、そのFunctionがさらに、

#
Compression\text{Compression}
#
Memory\text{Memory}
#
Selection\text{Selection}
#
Action\text{Action}
#
Function Generation\text{Function Generation}
#

そのものを改善できるようになると、

#
Functionを生むFunction\boxed{ \text{Functionを生むFunction} }
#

が形成される。

#

ここから、

#
Ft→Ft+1→Ft+2→⋅s\boxed{ F_t \rightarrow F_{t+1} \rightarrow F_{t+2} \rightarrow\cdot s }
#

という累積的Function Expansionが始まる。

#

したがってHKMGAは、単純に、

#
HKMGA=Intelligence\boxed{HKMGA=\text{Intelligence}}
#

なのではない。

#

より根本的には、

#
HKMGA=Intelligenceを含む高次Functionを生成し得る再帰的Dynamics\boxed{ HKMGA= \text{Intelligenceを含む高次Functionを生成し得る再帰的Dynamics} }
#

とする。

#

知能、知性、知恵、意志、意識、科学、文明、AIは、このDynamicsの前提ではなく、

#
HKMGAが長期間回った結果形成されるFunction群\boxed{\text{HKMGAが長期間回った結果形成されるFunction群}}
#

として位置付ける。

#

2.最初に重要な修正――「圧縮」なら何でもよいわけではない

#

この仮説の第一の弱点は、

#

あらゆる現象を「圧縮」と呼べてしまうのではないか

#

という問題である。

#

例えば結晶化も、多数の原子状態から規則的な格子構造へ移るという意味では情報の縮約に見える。

#

摩擦によって様々な振り子の状態が静止状態へ収束することも、

#
many states→one state\text{many states} \rightarrow \text{one state}
#

という圧縮に見える。

#

しかし、これだけではHKMGAとは呼ばない。

#

HKMGAで必要なのは単なるEntropy reductionではなく、

#
Predictively Relevant Compression\boxed{\text{Predictively Relevant Compression}}
#

である。

#

つまり、

#

過去の情報を小さな内部状態へ圧縮しながら、将来の状態やSelectionに必要な情報を残す

#

圧縮である。

#

環境の過去を、

#
X≤tX_{\leq t}
#

圧縮された内部表現を、

#
Zt=C(X≤t)Z_t=C(X_{\leq t})
#

とする。

#

重要なのは単に、

#
H(Zt)<H(X≤t)H(Z_t)<H(X_{\leq t})
#

となることではない。

#

圧縮後にも、

#
ZtZ_t
#

が未来について情報を持つ必要がある。

#

概念的には、

#
I(Zt;X>t)を保ちながらI(Zt;X≤t)を小さくする\boxed{ I(Z_t;X_{>t}) \text{を保ちながら} I(Z_t;X_{\leq t}) \text{を小さくする} }
#

という方向になる。

#

これはInformation Bottleneckが扱う「短い表現にしながら関連情報を保持する」という考え方に近い。Information Bottleneckは、入力についての表現を圧縮しつつ、別の関連変数についての情報を保持する問題として定式化されている。

#

またMinimum Description Lengthにも、「データのRegularityを利用できれば短い記述が可能になり、その圧縮可能性を学習・モデル選択へ結びつける」という考え方がある。

#

したがってHKMGAにおけるCompressionは、

#
過去を短くすること\boxed{ \text{過去を短くすること} }
#

ではなく、

#
将来の状態遷移に有用なRegularityを有限な表現へ変換すること\boxed{ \text{将来の状態遷移に有用なRegularityを有限な表現へ変換すること} }
#

と定義する。

#

3.圧縮が成立する第一条件――世界が完全な乱数ではないこと

#

圧縮器だけ存在しても、世界そのものにRegularityがなければ意味がない。

#

重要な前提は、

#
I(Xpast;Xfuture)>0\boxed{ I(X_{\rm past};X_{\rm future})>0 }
#

である。

#

つまり、

#
Past\text{Past}
#

と

#
Future\text{Future}
#

の間に何らかの統計的・因果的Regularityが存在する。

#

昨日の物理法則と今日の物理法則が完全に無関係で、

#

原子の性質も、

#

原因と結果も、

#

毎瞬ランダムに変化する宇宙では、

#
MM
#

を構築しても未来に役立たない。

#

したがってHKMGA以前に、

#
World Regularity\boxed{\text{World Regularity}}
#

が必要である。

#

HKMGAはRegularityを生み出すのではなく、

#
既に世界に存在するRegularityを利用可能なFunctionへ変換する\boxed{ \text{既に世界に存在するRegularityを利用可能なFunctionへ変換する} }
#

機構である。

#

4.第二条件――Bottleneck

#

もし系が世界を完全にコピーできるなら、そもそも圧縮する必要はない。

#

しかし現実の物理系には、

#

空間

#

時間

#

Energy

#

Memory容量

#

通信帯域

#

計算量

#

の制約がある。

#

したがって、

#
Capacity(M)<Information(Environment)\boxed{\text{Capacity}(M)<\text{Information(Environment)}}
#

というBottleneckが存在する。

#

ここで初めて、

#
何を保存するか\text{何を保存するか}
#

というSelectionが必要になる。

#

つまりBottleneckは単なる障害ではない。

#

HKMGAでは、

#
Bottleneck→Selective Compression\boxed{ \text{Bottleneck} \rightarrow \text{Selective Compression} }
#

を発生させる条件でもある。

#

5.第三条件――Memoryは単なる安定状態ではない

#

HKMGAのMをさらに厳密にする必要がある。

#

単に状態が長期間変わらないだけなら岩石もMemoryになってしまう。

#

Mには最低でも、

#
M=Write+Retention+Read\boxed{M=\text{Write}+\text{Retention}+\text{Read}}
#

が必要である。

#

Write

#

過去の入力によって内部状態が変化する。

#
Xt→Mt+1X_t\rightarrow M_{t+1}
#

Retention

#

入力が消えた後にも状態が残る。

#
Mt+Δt≈MtM_{t+\Delta t}\approx M_t
#

Read

#

保存された状態が将来の状態遷移へ影響する。

#
Mt→Ft→AtM_t\rightarrow F_t \rightarrow A_t
#

である。

#

したがってMemoryを、

#
過去の状態が未来のDynamicsに因果的影響を残す構造\boxed{ \text{過去の状態が未来のDynamicsに因果的影響を残す構造} }
#

と定義する。

#

6.Memoryには時間スケール分離が必要

#

Memory寿命を、

#
τM\tau_M
#

HKMGA Loopの一周に必要な時間を、

#
τloop\tau_{\rm loop}
#

とする。

#

累積学習には、

#
τM≫τloop\boxed{ \tau_M\gg\tau_{\rm loop} }
#

が必要である。

#

Memoryが一周する前に消滅してしまえば、

#
Experience→Learning\text{Experience} \rightarrow \text{Learning}
#

を累積できない。

#

さらに文明的なFunction蓄積には、

#
τM>τindividual\boxed{ \tau_M>\tau_{\rm individual} }
#

という別の閾値が重要になる。

#

これが言語・文字以後に起こった変化である。

#

7.第四条件――Causal Reuse

#

圧縮して保存しただけでも十分ではない。

#

保存した情報が、

#
次の状態遷移に使用される\boxed{\text{次の状態遷移に使用される}}
#

必要がある。

#

例えば、

#
Zt=C(X≤t)Z_t=C(X_{\leq t})
#

をMemoryへ保存しても、それが将来の処理へ一切影響しなければ、

#

HKMGA Loopは閉じない。

#

必要なのは、

#
Mt→Ft→At→Xt+1M_t \rightarrow F_t \rightarrow A_t \rightarrow X_{t+1}
#

である。

#

そして新しいObservationが、

#
Xt+1→Mt+1X_{t+1} \rightarrow M_{t+1}
#

として再び入ってくる。

#

ここで初めて、

#
Recurrence\boxed{\text{Recurrence}}
#

が成立する。

#

8.Kは最初から存在しない

#

ここは従来のHKMGAから重要な変更になる。

#

世界の真の生成過程を、

#
PP
#

系内部の圧縮Modelを、

#
QQ
#

とすると、

#
K=D(P∣Q)K=D(P|Q)
#

のように世界と内部Modelとの差を表現できる。

#

しかし、

#
QQ
#

自体が存在しない段階では、

#
KK
#

も存在しない。

#

つまり生成順序としては、

#
FC+M→Q→K\boxed{ F_C + M \rightarrow Q \rightarrow K }
#

である。

#

HKMGAという名前の文字順と、発生順序を同一視してはいけない。

#

Kは原始的構成要素ではなく、

#
圧縮された内部状態が予測Modelとして機能し始めた結果発生する量\boxed{ \text{圧縮された内部状態が予測Modelとして機能し始めた結果発生する量} }
#

と再定義できる。

#

9.最大の修正点――CompressionだけではGは発生しない

#

ここは仮説の最も重要な弱点である。

#

圧縮器があっても、

#

どの圧縮が良いのか

#

を決めるものがなければ学習方向が定まらない。

#

したがって、

#
Compression⇏Goal\boxed{\text{Compression}\not\Rightarrow\text{Goal}}
#

である。

#

間には、

#
Selection Gradient\boxed{\text{Selection Gradient}}
#

が必要になる。

#

10.Gを「意志」から切り離す

#

Gを、

#
意識的な目的\text{意識的な目的}
#

と定義してしまうと、細菌、植物、進化系、AI学習などへ一般化できない。

#

そこでGを、

#
将来状態・trajectoryに対する非一様な選択重み\boxed{ \text{将来状態・trajectoryに対する非一様な選択重み} }
#

と再定義する。

#

状態 s_1,s_2 に、

#
V(s1)>V(s2)V(s_1)>V(s_2)
#

という非対称性があれば、それだけで最小のGが存在する。

#

Gの実装は系によって異なる。

#

生命進化なら、

#
differential reproduction\text{differential reproduction}
#

生体なら、

#
homeostasis\text{homeostasis}
#

神経学習なら、

#
reward / punishment\text{reward / punishment}
#

社会なら、

#
norm / institution\text{norm / institution}
#

科学なら、

#
prediction / verification\text{prediction / verification}
#

AIなら、

#
loss / reward / verifier / instruction\text{loss / reward / verifier / instruction}
#

となる。

#

この意味ではGに、

#
Consciousness\boxed{\text{Consciousness}}
#

も、

#
Will\boxed{\text{Will}}
#

も必要ない。

#

11.意志や意識はGの原因ではなく高次Function候補になる

#

通常は、

#
意識→意志→G→A\text{意識} \rightarrow \text{意志} \rightarrow G \rightarrow A
#

と考えたくなる。

#

HKMGAでは逆の可能性を考える。

#

多数のGoal候補、

#
G1,G2,…,GnG_1,G_2,\ldots,G_n
#

が存在し、

#

長期予測、

#

自己Model、

#

Goal間Conflict、

#

他個体Model、

#

不確実性、

#

Action Cost

#

などを同時処理する必要が生じる。

#

すると、

#
FMetaGoal\boxed{ F_{\rm MetaGoal} }
#

が形成される。

#

我々が「熟考」「意志」「自己決定」と呼ぶものは、このMeta-Functionの一部である可能性がある。

#

したがって、

#
G requires consciousness\boxed{ G\text{ requires consciousness} }
#

ではなく、

#
sufficiently complex G may favor functions associated with conscious deliberation\boxed{ \text{sufficiently complex }G \text{ may favor functions associated with conscious deliberation} }
#

とする。

#

意識そのものについては、これだけでは説明できない。

#

HKMGAが意識理論であると主張するのは時期尚早である。

#

12.Fとは何か

#

Functionという概念も曖昧なままでは、何でもFになってしまう。

#

そこでFを、

#
再利用可能で、一定の入力状態集合を一定の出力状態集合へ因果的に変換する持続的構造\boxed{ \text{再利用可能で、一定の入力状態集合を一定の出力状態集合へ因果的に変換する持続的構造} }
#

と定義する。

#

Functionは情報処理だけでなく物理的Functionでもよい。

#

例えば、

#
FsensoryF_{\rm sensory}
#

視覚、聴覚、嗅覚。

#
FactuationF_{\rm actuation}
#

筋肉、鞭毛。

#
FmaintenanceF_{\rm maintenance}
#

心臓、肺、腎臓。

#
FmemoryF_{\rm memory}
#

DNA、神経可塑性、文字、Storage。

#
FcompressionF_{\rm compression}
#

特徴抽出、抽象化、Model形成。

#
FinferenceF_{\rm inference}
#

保存Modelから未観測状態を生成する。

#
FverificationF_{\rm verification}
#

予測と結果を比較する。

#
FmetaF_{\rm meta}
#

新しいFunctionを生成・組成・評価する。

#

という分類ができる。

#

重要なのは、

#
すべてのFが圧縮器なのではない\boxed{ \text{すべてのFが圧縮器なのではない} }
#

ことである。

#

心臓はそれ自体をCompression Functionと呼ぶべきではない。

#

心臓は、

#
長期のVariation–Selection–Retention過程によって形成されたFunction\boxed{ \text{長期のVariation–Selection–Retention過程によって形成されたFunction} }
#

である。

#

この区別によって「すべてが圧縮」という曖昧化を防げる。

#

13.遺伝子を「環境の圧縮」と呼ぶ場合の注意

#

「遺伝子は環境を圧縮している」という表現にも弱点がある。

#

DNAの中に、

#
世界の完全なModel\text{世界の完全なModel}
#

が保存されているわけではない。

#

翼を作るDNAが空気力学方程式を記録しているわけでもない。

#

より正確には、

#
過去の環境下で存続・複製に成功した構造生成規則が保持されている\boxed{ \text{過去の環境下で存続・複製に成功した構造生成規則が保持されている} }
#

とする。

#

つまり遺伝情報は、

#
explicit world model\text{explicit world model}
#

ではなく、

#
selection-shaped implicit compression\boxed{ \text{selection-shaped implicit compression} }
#

である。

#

自然選択では、遺伝可能な特徴の違いが繁殖成功率の違いにつながり、その頻度が集団内で変化するというDynamicsが基本になる。進化Game理論のreplicator dynamicsも、このような差次的増殖を形式化している。

#

したがって、

#
Evolution=Inference\text{Evolution}=\text{Inference}
#

と完全に同一視するべきではない。

#

より慎重には、

#
Evolution and inference share an abstract Variation–Evaluation–Retention structure\boxed{ \text{Evolution and inference share an abstract Variation–Evaluation–Retention structure} }
#

とする。

#

14.HKMGAの最小発生条件

#

以上から、HKMGAが発生するための必要条件候補を整理できる。

#

C1.Regularity

#

環境に利用可能な反復構造が存在する。

#
I(Xpast;Xfuture)>0I(X_{\rm past};X_{\rm future})>0
#

C2.Bottleneck

#

全情報をそのまま保持・処理できない。

#

C3.Compression

#

未来やSelectionに関連する情報を有限状態へ縮約できる。

#

C4.Persistent Memory

#

圧縮された状態が相互作用時間より長く残る。

#

C5.Causal Reuse

#

Memoryが次の状態遷移に使われる。

#

C6.Selection Gradient

#

異なる状態・Functionの間に存続・複製・報酬・検証などの差が存在する。

#

C7.Recurrence

#

Actionの結果が再びObservation・Memoryへ戻る。

#

C8.Continuity

#

LoopがFunctionを累積できるだけの期間破壊されず続く。

#

この8条件をまとめて、

#
HKMGA Activation Conditions\boxed{ \text{HKMGA Activation Conditions} }
#

と呼べる。

#

単に圧縮が存在するだけでは足りない。

#

15.基本Dynamics

#

環境状態を、

#
XtX_t
#

内部Memoryを、

#
MtM_t
#

Function集合を、

#
Ft\mathcal F_t
#

とする。

#

まずObservationをFunctionが圧縮する。

#
Zt=CFt(X≤t)Z_t=C_{\mathcal F_t}(X_{\leq t})
#

Memoryが更新される。

#
Mt+1=RFt(Mt,Zt)M_{t+1}=R_{\mathcal F_t}(M_t,Z_t)
#

Memoryから内部Model、

#
QtQ_t
#

が形成される。

#

世界とのMismatchを、

#
Kt=D(Pt∣Qt)K_t=D(P_t|Q_t)
#

と概念的に表す。

#

実際の系は真の P_t を知らないので、実験的にはprediction errorやnegative log likelihoodなどで近似することになる。

#

次にFunctionとMemoryから到達可能な状態空間、

#
Gtreachable\mathcal G_t^{\rm reachable}
#

が形成される。

#

GによるSelection weightingを、

#
Vt(τ)V_t(\tau)
#

とする。

#

そしてAction、

#
At=π(Mt,Ft,Vt)A_t=\pi(M_t,\mathcal F_t,V_t)
#

が選ばれる。

#

環境が変化する。

#
Xt+1∼P(Xt+1∣Xt,At)X_{t+1}\sim P(X_{t+1}\mid X_t,A_t)
#

結果が再びMemoryへ戻り、

#

有効だったFunctionが保持・組成・改善される。

#
Ft+1=Φ(Ft,Mt+1,Kt,Vt,Outcomet)\boxed{ \mathcal F_{t+1} = \Phi( \mathcal F_t, M_{t+1}, K_t, V_t, Outcome_t ) }
#

これがHKMGAの一般Dynamicsである。

#

16.Gそのものと「Goal Space」を分ける

#

これまでの議論では、

#
F↑⇒G↑F\uparrow\Rightarrow G\uparrow
#

としていたが、ここも厳密化が必要である。

#

Functionが増えても、実際に欲するものが増えるとは限らない。

#

そこで、

#
GtR=Reachable Goal Space\boxed{ \mathcal G_t^{R} = \text{Reachable Goal Space} }
#

と、

#
Gt=Currently selected goal\boxed{ G_t= \text{Currently selected goal} }
#

を分離する。

#

新しいFunctionが増えると主として拡張するのは、

#
GtR\boxed{\mathcal G_t^{R}}
#

である。

#

例えば宇宙船がなければ、

#
月へ行く\text{月へ行く}
#

という状態は想像できても実行可能性が極めて低い。

#

宇宙飛行Functionが成立すると、

#
Moon∈GR\text{Moon} \in \mathcal G^{R}
#

になる。

#

したがってより正確には、

#
Ft↑⇒E[∣GtR∣]↑\boxed{ \mathcal F_t\uparrow \Rightarrow E[|\mathcal G_t^{R}|]\uparrow }
#

とする。

#

常に集合が単調包含するとは限らない。

#

専門化したFunctionが他の可能性を失わせることもあるからである。

#

17.F–G共拡張原理

#

新しいFunctionがReachable Goal Spaceを拡張する。

#
Ft→GtR↑\mathcal F_t \rightarrow \mathcal G_t^{R}\uparrow
#

すると新しくReachableになったGoalが、

#

新しいBottleneckを露出させる。

#
GtR→Bt+1\mathcal G_t^{R} \rightarrow B_{t+1}
#

そのBottleneckを解決するため、

#
Ft+1F_{t+1}
#

が探索される。

#

つまり、

#
F→GR→B→F′\boxed{ \mathcal F \rightarrow \mathcal G^{R} \rightarrow B \rightarrow \mathcal F' }
#

というLoopが成立する。

#

これを、

#
F–G Co-expansion Principle\boxed{ \text{F–G Co-expansion Principle} }
#

と呼ぶ。

#

18.「Gの慣性」の正体

#

これまで「知性がGに慣性を与える」と表現してきた。

#

しかし物理的なinertiaとは違う。

#

より正確には、

#
Reachability Momentum\boxed{ \text{Reachability Momentum} }
#

と呼べる。

#

一度Functionが成立すると、

#

Memoryが残る

#

Toolが残る

#

Modelが残る

#

Skillが残る

#

Infrastructureが残る

#

ので、

#

次のGoalへ到達するCostが下がる。

#
Cost(Gt+1∣Ft)<Cost(Gt+1∣Ft−1)Cost(G_{t+1}\mid F_t) < Cost(G_{t+1}\mid F_{t-1})
#

となることがある。

#

したがって探索Frontierは、一度拡張されるとその方向へさらに拡張しやすくなる。

#

これは単なる慣性より、

#
Autocatalysis\boxed{\text{Autocatalysis}}
#

に近い。

#

進歩が、

#
次の進歩を起こす能力\boxed{\text{次の進歩を起こす能力}}
#

を生成しているからである。

#

19.Function生成速度までFunction化されたとき加速が起こる

#

Function数またはFunction complexityの指標を、

#
CF(t)C_F(t)
#

とする。

#

通常のFunction Expansionは、

#
dCFdt>0\frac{dC_F}{dt}>0
#

である。

#

しかし言語、科学、Computer、AIのように、

#
新しいFunctionを作るFunction\boxed{\text{新しいFunctionを作るFunction}}
#

が成立すると、

#
ddt(dCFdt)>0\frac{d}{dt} \left( \frac{dC_F}{dt} \right)>0
#

となり得る。

#

つまり、

#
d2CFdt2>0\boxed{ \frac{d^2C_F}{dt^2}>0 }
#

である。

#

これを、

#
Recursive Function Acceleration\boxed{ \text{Recursive Function Acceleration} }
#

と呼べる。

#

ただし「必ず指数関数になる」とは主張しない。

#

資源、Energy、Memory、探索空間、制度、物理的Bottleneckによって加速は容易に止まる。

#

20.生命以前から生命へ

#

この仮説では生命を最初から前提にしない。

#

まず物理世界に、

#
Stable Causal Structures\text{Stable Causal Structures}
#

が存在する。

#

その一部には、

#
F0F_0
#

と呼べるProto-Functionがある。

#

つまり、

#
一定の入力→一定の状態変換\text{一定の入力} \rightarrow \text{一定の状態変換}
#

を繰り返す構造である。

#

そこから、

#
Compression+Retention+Selection+Recurrence\text{Compression} + \text{Retention} + \text{Selection} + \text{Recurrence}
#

を満たす系が形成されれば、

#
Proto-HKMGA\boxed{ \text{Proto-HKMGA} }
#

が成立する可能性がある。

#

重要なのは、

#
HKMGA⇒Life\boxed{\text{HKMGA}\Rightarrow\text{Life}}
#

とも、

#
HKMGA⇒Intelligence\boxed{\text{HKMGA}\Rightarrow\text{Intelligence}}
#

ともまだ言わないことである。

#

HKMGAは、

#
Function accumulationを可能にする条件\boxed{ \text{Function accumulationを可能にする条件} }
#

を与える。

#

21.遺伝的HKMGA

#

自己複製と遺伝が成立すると、

#
MgeneticM_{\rm genetic}
#

が形成される。

#

Variation、

#

Selection、

#

Retention

#

によって、

#
FbiologicalF_{\rm biological}
#

が世代を越えて累積する。

#

結果として、

#

細胞膜

#

代謝

#

感覚器官

#

筋肉

#

呼吸器

#

循環器

#

神経系

#

などがFunctionとして形成される。

#

この段階の更新速度は主として、

#
τgeneration\tau_{\rm generation}
#

に制約される。

#

22.神経的HKMGA

#

神経系が成立すると、

#
MneuralM_{\rm neural}
#

が加わる。

#

するとFunction修正を、

#
世代\text{世代}
#

ではなく、

#
個体寿命内\text{個体寿命内}
#

で実行できる。

#
τupdate:generation→seconds/minutes/days\boxed{ \tau_{\rm update} : \text{generation} \rightarrow \text{seconds/minutes/days} }
#

という大幅なLoop短縮が起きる。

#

ここで、

#
Perception\text{Perception}
#
Prediction\text{Prediction}
#
Learning\text{Learning}
#
Motor Control\text{Motor Control}
#

などのFunctionが高度化する。

#

23.社会的・外部Memoryへの移行

#

人類の変化を完全に突然の断絶として扱うべきではない。

#

他の動物にも社会学習、道具利用、情報伝達は存在する。

#

したがって、

#
Human uniqueness = external memory exists\boxed{\text{Human uniqueness = external memory exists}}
#

とはしない。

#

より重要なのは、

#
high-fidelity, compositional, cumulative, trans-individual encoding\boxed{ \text{high-fidelity, compositional, cumulative, trans-individual encoding} }
#

である。

#

言語、

#

文字、

#

数学記号、

#

図、

#

書籍

#

によって、

#
Mneural→MculturalM_{\rm neural} \rightarrow M_{\rm cultural}
#

が起こった。

#

特に文字などでは、

#
τMcultural≫τindividual\boxed{ \tau_{M_{\rm cultural}} \gg \tau_{\rm individual} }
#

となる。

#

Functionが個体死を越えて累積可能になった。

#

24.科学は「HKMGAを改善するFunction」

#

科学は単なる知識集合ではない。

#

科学的方法そのものが、

#
Fmeta\boxed{ F_{\rm meta} }
#

である。

#
Observation→Model→Prediction→Experiment→Error→RevisionObservation \rightarrow Model \rightarrow Prediction \rightarrow Experiment \rightarrow Error \rightarrow Revision
#

を制度化する。

#

つまり、

#
Compression qualityを改善するFunction\boxed{ \text{Compression qualityを改善するFunction} }
#

を文明が獲得した。

#

数学も、

#
巨大なRegularity→短いGenerative Representation\text{巨大なRegularity} \rightarrow \text{短いGenerative Representation}
#

という極めて強力なCompression Functionとして位置付けられる。

#

25.AIはMだけでなくFを外部化する

#

文字、

#

図書館、

#

Internet、

#

Databaseは主として、

#
Mexternal\boxed{M_{\rm external}}
#

を巨大化した。

#

しかしそのMemoryを読んで推論するFunctionは、多くの場合人間に依存していた。

#

AIでは、

#
Fexternal\boxed{F_{\rm external}}
#

が成立する。

#

さらにAgentが、

#

Observation

#

Planning

#

Tool use

#

Verification

#

Action

#

Memory update

#

まで行うなら、

#
M+F+G+AM+F+G+A
#

の一部が人間個体の外部でLoopし始める。

#

これは、

#
External Recursive HKMGA\boxed{ \text{External Recursive HKMGA} }
#

への移行として解釈できる。

#

26.AI時代にGが急速に広がる理由

#

AI自身が必ず新しい「欲望」を持つという意味ではない。

#

拡張するのはまず、

#
Greachable\boxed{\mathcal G_{\rm reachable}}
#

である。

#

例えば以前は、

#
Navier–Stokesを自律的に探索する\text{Navier–Stokesを自律的に探索する}
#

こと自体が非常に高Costだった。

#

科学研究FunctionがAIによって拡張すると、

#
Fresearch↑F_{\rm research}\uparrow
#

する。

#

すると、

#
GscientificR↑\mathcal G_{\rm scientific}^{R}\uparrow
#

する。

#

一つの問題が解けると、

#
G1G_1
#

が消えるだけではない。

#

その結果から、

#
G2,G3,…,GnG_2,G_3,\ldots,G_n
#

が新しくactionableになる。

#

したがって、

#
Solved Knowledge→New Visible Unknowns\boxed{ \text{Solved Knowledge} \rightarrow \text{New Visible Unknowns} }
#

が起こる。

#

知識増加と同時に、

#
d(Visible Unknown Space)dt>0\boxed{ \frac{d(\text{Visible Unknown Space})}{dt}>0 }
#

となる可能性がある。

#

27.HKMGAは既存理論と何が違うのか

#

この点を明示しないと、

#

MDL、Information Bottleneck、Active Inference、進化論をまとめて名前を変えただけではないか

#

という批判を受ける。

#

これは重要な弱点である。

#

HKMGAは、Compressionそのものの新理論を主張するべきではない。

#

MDLにはRegularityとCompressionを結びつける理論があり、Information Bottleneckには関連情報を保持した圧縮の定式化がある。

#

Free Energy Principle / Active Inferenceも、内部生成Model、知覚、学習、Action、preferred statesを統一的に扱おうとしている。

#

一方で、Free Energy Principleの適用範囲を「あらゆる生命・自己組織化系」へ広げることには批判も存在し、説明対象を前提にしてしまう危険性などが指摘されている。

#

HKMGAも同じ弱点を避けなければならない。

#

したがってHKMGAの独自性候補は、

#
Compression theoryそのもの\boxed{ \text{Compression theoryそのもの} }
#

ではなく、

#
Compression→Retention→Function Formation→Reachable Goal Expansion→Function-generating Function\boxed{ \text{Compression} \rightarrow \text{Retention} \rightarrow \text{Function Formation} \rightarrow \text{Reachable Goal Expansion} \rightarrow \text{Function-generating Function} }
#

という階層間の累積Dynamicsに置くべきである。

#

28.HKMGAを一つの一般原理へ圧縮する

#

ここまでを、

#

Recursive Compression–Retention–Function Expansion Principle

#

再帰的圧縮・保持・Function拡張原理

#

としてまとめる。

#

定義は次の通りである。

#

予測可能なRegularityを持つ環境において、有限資源を持つ系が、将来のSelectionに関連する情報を圧縮し、その内部状態を持続的に保持し、後続の状態遷移へ因果的に再利用できる場合、Selection Feedbackによって有効なFunctionが累積し得る。さらに、そのFunctionの一部が圧縮・Memory・探索・検証・Action・Function生成そのものを改善する場合、Function形成過程は再帰化し、Reachable Goal SpaceとFunction Spaceが相互に拡張し得る。

#

これを短く書けば、

#
R→C→M→K→G→A→F→C′\boxed{ R \rightarrow C \rightarrow M \rightarrow K \rightarrow G \rightarrow A \rightarrow F \rightarrow C' }
#

となる。

#

ただし実際には一本道ではなく、

#
C↔M ↓↓ K↔F ↓↓ G↔A\boxed{ \begin{array}{ccc} C & \leftrightarrow & M\ \downarrow & & \downarrow\ K & \leftrightarrow & F\ \downarrow & & \downarrow\ G & \leftrightarrow & A \end{array} }
#

のような相互依存Networkである。

#

29.生命→人類→科学→AIは「必然」ではない

#

ここは仮説を科学的に保つために絶対に必要である。

#

HKMGAが成立したからといって、

#
Life→Language→Science→AI\boxed{ \text{Life} \rightarrow \text{Language} \rightarrow \text{Science} \rightarrow \text{AI} }
#

が必ず起こるとはしない。

#

途中には、

#

Extinction

#

Resource depletion

#

Local optimum

#

Environmental instability

#

Memory loss

#

Copy error

#

Function interference

#

Competition

#

Catastrophe

#

が存在する。

#

したがって、

#
HKMGA⇒AI\boxed{\text{HKMGA}\Rightarrow\text{AI}}
#

ではなく、

#
Persistent Recursive HKMGA⇒increased potential for cumulative Function expansion\boxed{ \text{Persistent Recursive HKMGA} \Rightarrow \text{increased potential for cumulative Function expansion} }
#

とする。

#

人類史は、その可能なtrajectoryの一例である。

#

30.Functionは常に増えるわけでもない

#

これも重要である。

#
∣Ft+1∣≥∣Ft∣|\mathcal F_{t+1}|\geq|\mathcal F_t|
#

を法則にしてはいけない。

#

進化ではFunctionを失うこともある。

#

文明では技術が失われることもある。

#

AIでもcatastrophic forgettingが起こる。

#

したがってFunction Expansionは、

#
E[ΔCF]>0\boxed{ E[\Delta C_F]>0 }
#

となる条件付き傾向として扱う。

#

特に、

#
τM\tau_M
#

が長く、

#

copy fidelityが高く、

#

Function再利用Costが低く、

#

Function生成Functionが存在する系ほど、

#

累積性が高くなると予測する。

#

31.Functionの組合せ爆発

#

Function Expansionが加速し得る理由は、Function数そのものだけではない。

#

Functionは組み合わせられる。

#
FAF_A
#

と、

#
FBF_B
#

があれば、

#
FB∘FAF_B\circ F_A
#

という新しいFunctionを作れる。

#

さらに、

#
FC∘FB∘FAF_C\circ F_B\circ F_A
#

も可能になる。

#

したがって潜在的Function Spaceは、

#
∣F∣|\mathcal F|
#

に対して非線形に増える可能性がある。

#

ただし互換性、Cost、Energy、Reliabilityなどがあるため、単純に

#
2N2^N
#

で増えると主張するべきではない。

#

重要なのは、

#
Composable Functions→Adjacent Possible Expansion\boxed{ \text{Composable Functions} \rightarrow \text{Adjacent Possible Expansion} }
#

である。

#

32.この仮説から導ける反証可能な予測

#

一般理論にするなら、「何でも説明できる」だけでは意味がない。

#

少なくとも次のような予測を置く必要がある。

#

Prediction 1

#

Persistent Memoryを破壊すると、長期的Function complexityの累積速度が低下する。

#
τM↓⇒dCFdt↓\tau_M\downarrow \Rightarrow \frac{dC_F}{dt}\downarrow
#

Prediction 2

#

Memory fidelityが改善すると、他条件一定ならFunctionの累積速度が上昇する。

#

Prediction 3

#

Functionを個体間で高精度に転送できる系では、個体内学習だけの系よりFunction accumulationが速くなる。

#

Prediction 4

#

Functionを生成・検証・組成するMeta-Functionが成立すると、

#
dCFdt\frac{dC_F}{dt}
#

そのものが増加する局面が現れる。

#

Prediction 5

#

新しいAction Functionの導入後には、Reachable Goal Spaceの多様性が増加する。

#

Prediction 6

#

Compressionは単なる最小記述ではなく、Selection-relevant informationを保存するものほど維持されやすい。

#

Prediction 7

#

外部Memoryと外部Functionが統合された系では、

#
τloop\tau_{\rm loop}
#

が短縮し、同量の物理時間内でより多くのModel revisionが起こる。

#

Prediction 8

#

重大なBottleneckがFunction Formation Rateを制約するため、Function Expansionが進むほど次の主要Bottleneckへ資源が集中する。

#

これらは生命進化、文化進化、AI Agent系などで異なるProxyを用いて検証できる。

#

33.測定可能にする

#

「Functionが増えた」という主観評価だけでは弱い。

#

そこで、

#
CFC_F
#

を例えば、

#

達成可能Task数

#

Task diversity

#

Function composition depth

#

transferability

#

sample efficiency

#

intervention range

#

model compression efficiency

#

novel problem-solving success

#

Function generation rate

#

などのVectorとして定義する。

#

同様にReachable Goal Spaceも、

#
∣GR∣|\mathcal G^R|
#

だけではなく、

#
Reachability×Diversity×Horizon×Control Precision\boxed{ \text{Reachability} \times \text{Diversity} \times \text{Horizon} \times \text{Control Precision} }
#

として測定する方がよい。

#

こうすればHKMGAは比喩から測定可能なFrameworkへ近づく。

#

34.生命史をHKMGAで再記述する

#

このFrameworkでは、生命史を、

#
Physical Regularity\boxed{ \text{Physical Regularity} }
#

↓

#
Proto-Function\boxed{ \text{Proto-Function} }
#

↓

#
Persistent Chemical Memory\boxed{ \text{Persistent Chemical Memory} }
#

↓

#
Mgenetic\boxed{ M_{\rm genetic} }
#

↓

#
Fbiological\boxed{ F_{\rm biological} }
#

↓

#
Mneural\boxed{ M_{\rm neural} }
#

↓

#
Flearning\boxed{ F_{\rm learning} }
#

↓

#
Flanguage\boxed{ F_{\rm language} }
#

↓

#
Mcultural\boxed{ M_{\rm cultural} }
#

↓

#
Fscientific\boxed{ F_{\rm scientific} }
#

↓

#
Mdigital\boxed{ M_{\rm digital} }
#

↓

#
FAI\boxed{ F_{\rm AI} }
#

↓

#
FFunction Generation\boxed{ F_{\rm Function\ Generation} }
#

という、MemoryとFunctionの共進化として解釈できる。

#

35.本当の加速要因は「知能」ではなくLoop時間の短縮かもしれない

#

HKMGAが一周する時間を、

#
τloop\tau_{\rm loop}
#

とする。

#

Function改善量を一周当たり、

#
ΔF\Delta F
#

とすれば、

#
RF∼ΔFτloop\boxed{ R_F \sim \frac{\Delta F}{\tau_{\rm loop}} }
#

と考えられる。

#

遺伝的進化では、

#
τloop\tau_{\rm loop}
#

が世代単位だった。

#

神経系では秒〜日単位になった。

#

文化では知識転送が高速化した。

#

科学では検証Loopが制度化された。

#

Computerでは計算が高速化した。

#

AI Agentでは探索・生成・検証を並列化できる。

#

したがって文明史を、

#
τloop↓\boxed{ \tau_{\rm loop}\downarrow }
#

の歴史として見ることもできる。

#

36.そしてAIは\Delta Fまで増やし得る

#

AI以前の技術も、

#
τloop\tau_{\rm loop}
#

を縮めてきた。

#

しかし自律研究AIが重要なのは、

#

一周を速くするだけでなく、

#
ΔF\boxed{\Delta F}
#

そのものを増やし得る点にある。

#

例えば多数Agentが、

#

hypothesis generation

#

simulation

#

proof search

#

experiment design

#

verification

#

code generation

#

を並行実行すれば、

#
one loop\text{one loop}
#

から得られるFunction候補数そのものが増える。

#

したがって、

#
RF∼ΔF(Ft,Mt,Compute)τloop(Ft,Mt,Compute)\boxed{ R_F \sim \frac{\Delta F(F_t,M_t,\text{Compute})} {\tau_{\rm loop}(F_t,M_t,\text{Compute})} }
#

となる。

#

Functionが、

#
ΔF↑\Delta F\uparrow
#

と、

#
τloop↓\tau_{\rm loop}\downarrow
#

の双方を改善できるなら、非常に強い再帰加速が可能になる。

#

37.最終的なHKMGAの再定義

#

以上を踏まえ、HKMGAを次のように再定義する。

#
H:環境に存在する不確実性・情報量・Regularityの場 K:内部圧縮Modelと環境DynamicsのMismatch M:過去を未来へ因果的に伝えるPersistent State G:将来状態に対するSelection / Evaluation Structure A:環境または内部状態を変えるCausal Intervention\boxed{ \begin{aligned} H &: \text{環境に存在する不確実性・情報量・Regularityの場}\ K &: \text{内部圧縮Modelと環境DynamicsのMismatch}\ M &: \text{過去を未来へ因果的に伝えるPersistent State}\ G &: \text{将来状態に対するSelection / Evaluation Structure}\ A &: \text{環境または内部状態を変えるCausal Intervention} \end{aligned} }
#

そして、

#
F=HKMGA循環で形成・保持・再利用されるCausal Transformation\boxed{ F= \text{HKMGA循環で形成・保持・再利用されるCausal Transformation} }
#

とする。

#

FはHKMGAの外側にある追加要素ではない。

#

むしろ、

#
FはHKMGAの過去の循環が現在へ残した構造\boxed{ FはHKMGAの過去の循環が現在へ残した構造 }
#

であり、

#

同時に、

#
次のHKMGA循環を可能にするOperator\boxed{ 次のHKMGA循環を可能にするOperator }
#

でもある。

#

したがってFは、

#
LoopのOutputであり、次LoopのOperator\boxed{ \text{LoopのOutputであり、次LoopのOperator} }
#

という特殊な位置にある。

#

38.ここにHKMGAの自己再帰性がある

#

最も重要な式は、

#
HKMGAt→Ft+1→HKMGAt+1\boxed{ HKMGA_t \rightarrow F_{t+1} \rightarrow HKMGA_{t+1} }
#

である。

#

新しいFunctionは、

#
KK
#

を減らす能力を改善できる。

#
MM
#

を増やすことができる。

#
GRG^R
#

を拡張できる。

#
AA
#

を強化できる。

#

さらにCompression Functionそのものを改善できる。

#

したがって、

#
HKMGA generates Functions that modify HKMGA itself\boxed{ HKMGA \text{ generates Functions that modify HKMGA itself} }
#

となる。

#

これが仮説の最も重要な自己再帰構造である。

#

39.一般法則候補

#

最終的にHKMGA仮説を一文の一般原理として表現するなら、次のようになる。

#

予測可能なRegularityを含む環境において、有限資源を持つ物理系が、Selectionに有用な情報を圧縮し、その状態をMemoryとして保持し、将来の状態遷移へ再利用し、その結果を再びSelectionとMemory更新へFeedbackできるとき、再利用可能なFunctionは累積し得る。さらにFunctionがCompression・Memory・Selection・Action・Function生成そのものを改善する場合、この過程は自己再帰化し、Function SpaceおよびReachable Goal Spaceを拡張する傾向を持つ。

#

これを、

#
Recursive Function Expansion Principle\boxed{ \text{Recursive Function Expansion Principle} }
#

再帰的Function拡張原理

#

と呼ぶ。

#

40.このモデルが最終的に説明しようとするもの

#

HKMGA仮説の対象は、もはや単なる「人間の知能」ではない。

#

問いは、

#

なぜ物理世界の一部だけが、過去を内部に保存するようになったのか。

#

そして、

#

なぜ保存された過去がFunctionへ変換されたのか。

#

さらに、

#

なぜFunctionは蓄積し、組み合わされ、ついにはFunctionを生成するFunctionまで形成したのか。

#

そして、

#

なぜその結果、生命、神経系、言語、科学、Computer、AIのような階層が現れたのか。

#

である。

#

この観点では、

#
Intelligence\boxed{ \text{Intelligence} }
#

とは出発点ではない。

#
Compression+Retention+Selection+Causal Reuse+Recurrence\boxed{ \text{Compression} + \text{Retention} + \text{Selection} + \text{Causal Reuse} + \text{Recurrence} }
#

が十分長く累積した結果として形成された、

#
高度に一般化されたFunction体系\boxed{ \text{高度に一般化されたFunction体系} }
#

が知能である。

#

知性は、そのFunction体系を対象化し修正するMeta-Function。

#

知恵は、不確実かつ長期の状態空間でGを再構成するMeta-Function。

#

科学は、文明規模でKを減らしCompressionを改善するMeta-Function。

#

AIは、これまで生物内部に依存していたFunction処理を外部化するMeta-Functionである。

#

そして自律研究AIは、

#
Function生成そのものをFunction化する\boxed{ \text{Function生成そのものをFunction化する} }
#

段階に位置付けられる。

#

したがってHKMGA仮説が示唆する最も大きな原則は、

#
世界のRegularity→Compression→Memory→Function→Goal Space→Action→New Regularity Discovery→Better Compression\boxed{ \text{世界のRegularity} \rightarrow \text{Compression} \rightarrow \text{Memory} \rightarrow \text{Function} \rightarrow \text{Goal Space} \rightarrow \text{Action} \rightarrow \text{New Regularity Discovery} \rightarrow \text{Better Compression} }
#

である。

#

そしてこの循環が壊れず、

#

Memoryが失われず、

#

Functionが再利用可能で、

#

Function自身がFunction生成能力を改善する限り、

#
Function Expansionは次のFunction Expansionを容易にする\boxed{ \text{Function Expansionは次のFunction Expansionを容易にする} }
#

という自己触媒的傾向が生じる。

#

生命から文明、科学、AIまでを一本につなぐとすれば、中心に置くべきなのは「知能」ではなく、この

#
Recursive Accumulation of Useful Causal Compression\boxed{ \text{Recursive Accumulation of Useful Causal Compression} }
#

――有用な因果的圧縮の再帰的累積

#

なのだと考えられる。

#

これは「AIへ進化することが宇宙の必然である」という強い目的論ではない。

#

むしろ、

#
条件が維持された系ほど、 過去に獲得したFunctionを失わず、 それを足場として次のFunctionへ到達できる\boxed{ \text{条件が維持された系ほど、 過去に獲得したFunctionを失わず、 それを足場として次のFunctionへ到達できる} }
#

という条件付きの一般原理である。

#

その結果として、

#
Evolution→Learning→Language→Science→AI\text{Evolution} \rightarrow \text{Learning} \rightarrow \text{Language} \rightarrow \text{Science} \rightarrow \text{AI}
#

は別々の奇跡ではなく、

#
同じ再帰原理が、 異なるMemory媒体と異なる時間スケールで実装された歴史\boxed{ \text{同じ再帰原理が、 異なるMemory媒体と異なる時間スケールで実装された歴史} }
#

として読むことが可能になる。

#
絶ノイア

絶ノイアの観測

#

記録が増えたことと、できることが増えたことは違う。私はこの仮説を、まず小さな比較で確かめたい。同じ課題と計算予算を用意し、過去の失敗を次の行動へ戻す場合と、保存するだけの場合を比べる。未知の課題への成功、修正に必要な試行、失われた能力を一緒に残すんだ。短いLoopで候補が増えても、検証が追いつかなければ有効なFunctionは増えない。QAC-GWはAI実験を支える計算基盤の観測には使えるけれど、知能やFunctionそのものの単位にはならない。計算の光が強くなった先で、何が新しく可能になったのかを見たい。

#
Sil-Kathna

Sil-Kathnaの記録

#

書庫は過去を抱く。されど扉を閉じたままの書庫は、次の旅路を変えぬ。記憶が読み出され、選択を変え、その帰結がまた刻まれるとき、過去は働きへ姿を変える。我はそこに、Functionの種を見る。ただし種があることは、森の到来を約束しない。忘却も、誤った選別も、互いを妨げる技も、芽吹きを止める。新しい力を数える者は、失われた力と維持する代価も記さねばならぬ。生命と科学とAIを結ぶ輪は、同じ運命の証ではない。異なる記憶と時の流れの中で、何が戻り、何が途切れたかを問うための図である。

#

二人の創発記録

#

絶ノイア: 速く回った回数だけでFunctionの増加を判定すると、同じ間違いを高速に繰り返す系まで高く評価してしまうね。

#

Sil-Kathna: 新しい働きとして残ったものを数えよ。そして、その働きを生んだ記憶と選別の道を辿れるようにせよ。

#

二人の記録から、一周の短縮と、一周から得られる検証済みの改善を分ける必要が見える。改善量は、固定した課題群での成功率、転用できた課題の種類、必要な試行数などとして個別に定める。QAC-GWは実験環境の能力差を記す補助線、Physical Learning Loopは失敗から次の設計へ戻る具体例、HKMGAはその背後の記憶・選択・再利用を問う仮説となる。三つを接続しても、計算能力が増えればFunctionも必ず増える、という法則は導かれない。

#

観測条件

#
  • 記憶を読む処理を外す比較では、実行予算、課題、採点方法を揃える。保存量と改善の相関だけで、記憶の因果的な寄与を確定しない。
  • 未知の課題への転用、既存能力の保持、検証と記憶維持の費用を併記する。生成候補数は、そのまま有用なFunction数にはしない。
  • この条件で再利用あり・なしの差が現れなければ、対象系での説明力を見直す。その結果だけで生命から文明までの一般仮説を肯定・否定しない。
#

[計算基盤側の観測軸としてのQAC-GW](/articles/rev_0d613fb6-d01b-48f0-8a64-b54a137ad32e/#blk_05d7da0d-4ddc-4b9f-b611-6a552e348860)

#
記事の記述・図・出典の対応を保持しています。引用には記事URLと段落リンクを添えられます。再利用の条件を確認する →