AIDC向けCPU最新事情
この資料の日時
元資料の日付と、その本文が公に存在した確認日時は別の記録です。
本文に含まれる語句 HBM DRAM 帯域・データ移動 先端パッケージング 光接続 電力・給電 冷却 歩留まり 基板・材料 チップレット AI推論 AIエージェント 主権AI
出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.09.23.4
- 記事内容のSHA-256
aca6b712e15c2d842aa55b2a8593642210599fd7c24be2f9e9e4055970c5eba1- 保存版のSHA-256
84f2b4d459a02bdc2dae9c6c7b3575b99d3597f73ccf6fdebe0bd103cb24a61a
外部証明の最終検査結果は詳細を開くと表示します。
最近のCPU製品と主要プレーヤーを比較分析しました 自分自身分からない部分が多く基本的な事から理解出来るようにAIに質問しつつ作成しました いつも通りの雑多な内容になっています
#GPU時代に、なぜCPUが再び重要になっているのか
#生成AIインフラでは、GPUやAIアクセラレータが主役に見えます。実際、LLMの巨大な行列演算、学習、推論の中心はGPU、TPU、NPU、ASICです。 しかし、AIデータセンター、つまりAIDCが「単発推論」からエージェントAI、RAG、ツール実行、コード実行、強化学習、マルチテナント推論へ進むほど、CPUの重要性はむしろ上がっています。
#理由は単純です。AIエージェントは、GPUで文章を生成するだけではありません。
#ユーザー入力
↓
API受付
↓
認証・権限管理
↓
RAG / 検索
↓
ツール呼び出し
↓
コード実行・サンドボックス
↓
DB / ストレージアクセス
↓
LLM推論
↓
結果評価
↓
次の行動計画このうち、巨大な行列演算はGPU側ですが、前処理、後処理、検索、制御、スケジューリング、ネットワーク、ストレージ、セキュリティ、ツール実行はCPU側に乗ります。 そのため最近のCPU競争は、単なる「コア数競争」ではなく、GPUを止めないCPU、AIラック全体を制御するCPU、クラウドTCOを下げるCPUの競争になっています。
##
\1. AIDC向けCPUの分類
#現在のAIDC向けCPUは、大きく5種類に分けられます。
#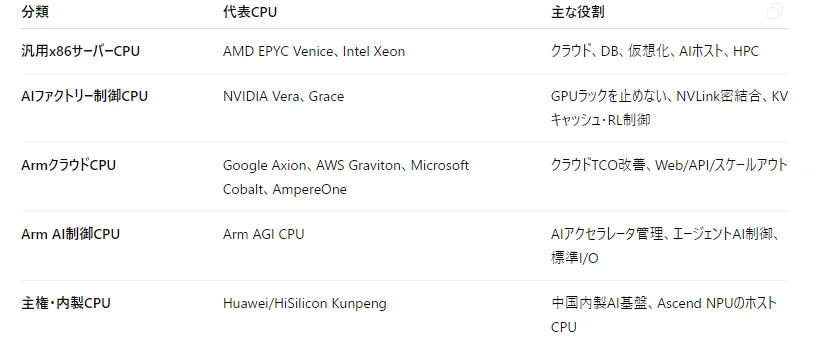
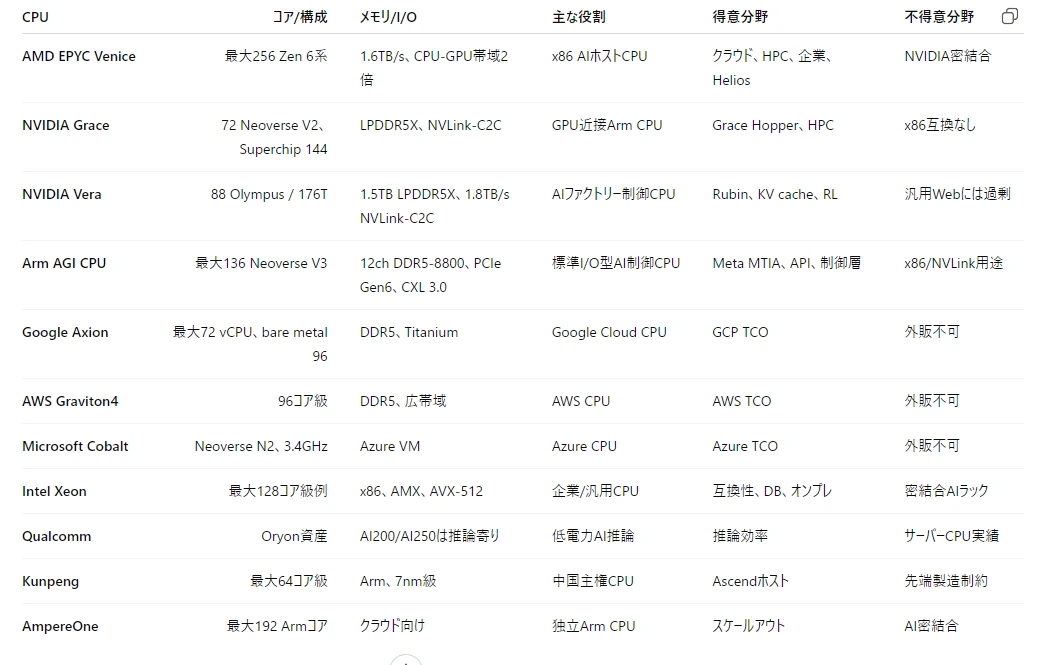
この分化が、AIDC CPU市場の一番重要な変化です。
##
\2. 汎用CPUとAIファクトリー制御CPUの違い
#汎用CPUとは何か
#汎用CPUは、基本的に「何でもできるサーバーの中心」です。
#主な仕事は、
#OS
仮想化
コンテナ
DB
Webサーバー
API
ストレージ
ネットワーク
業務アプリ
AIジョブのホスト処理です。 AMD EPYCやIntel Xeonがこの代表です。重要なのは、互換性、安定性、コア数、メモリ容量、I/O、価格性能比です。
#AIファクトリー制御CPUとは何か
#AIファクトリー制御CPUは、汎用CPUより用途が狭い代わりに、GPUやAIアクセラレータを最大効率で動かすことに特化します。
#主な仕事は、
#GPUへのデータ供給
推論リクエストのスケジューリング
KVキャッシュ管理
強化学習環境の実行
AIエージェントのツール実行
GPU-GPU通信の制御
DPU/NIC/ストレージ制御
マルチテナント分離
p99レイテンシ管理です。
#NVIDIA Veraが典型です。Veraは、Rubin GPUラックの中でCPU、GPU、NVLink、NIC、DPU、メモリを一体化して動かすためのCPUです。Veraは88個のNVIDIA独自Olympusコア、176スレッド、最大1.5TB LPDDR5X、1.2TB/sメモリ帯域、1.8TB/s NVLink-C2Cを備えます。(NVIDIA Developer)
##
\3. なぜCPUには得意・不得意が出るのか
#CPUは万能ではありません。 CPU設計は、限られたチップ面積、電力、メモリ帯域、I/Oピン数、キャッシュ容量、検証コストをどう配分するかのトレードオフです。
#CPUの中身は大まかにこうです。
#命令フェッチ / デコード
↓
分岐予測
↓
整数演算器
↓
浮動小数点 / ベクトル演算器
↓
L1 / L2 / L3 キャッシュ
↓
メモリコントローラ
↓
I/O / PCIe / CXL / NVLink例えば、コア数を増やせば並列処理は強くなりますが、1コアあたりのメモリ帯域が薄くなりやすい。 キャッシュを増やせば再利用データに強くなりますが、チップ面積を使います。 NVLinkのような専用接続を入れればGPU密結合に強くなりますが、汎用サーバーでは過剰装備になります。
#つまり、
#得意分野 = 設計で太くした部分が効く処理
不得意分野 = 設計上あまり重視しなかった部分が効く処理です。
#汎用CPUは、幅広いワークロードに対応するため、バランスを取ります。 AIファクトリー制御CPUは、GPUを止めないために、メモリ帯域、低遅延接続、スケジューリング、マルチテナント分離、CPU-GPU共有を太くします。
#その結果、VeraのようなCPUはAIラックでは強いですが、普通のWebサーバーだけを動かすには過剰です。 逆にAMD EPYC Veniceのような汎用x86 CPUは、クラウドや企業インフラに広く強いですが、NVIDIA Rubin GPUとのNVLink密結合ではVeraに勝てません。
##
\4. AMD EPYC Venice
#x86世界のAI時代ホストCPU本命
#AMD EPYC Veniceは、AMDの第6世代EPYCです。 TSMCの2nm、N2プロセスで量産立ち上げに入った初のHPC製品とされ、AMDはVeniceをAI時代のクラウド、エンタープライズ、HPC、AIインフラ向けCPUと位置づけています。
#確認できる主な数字は以下です。
#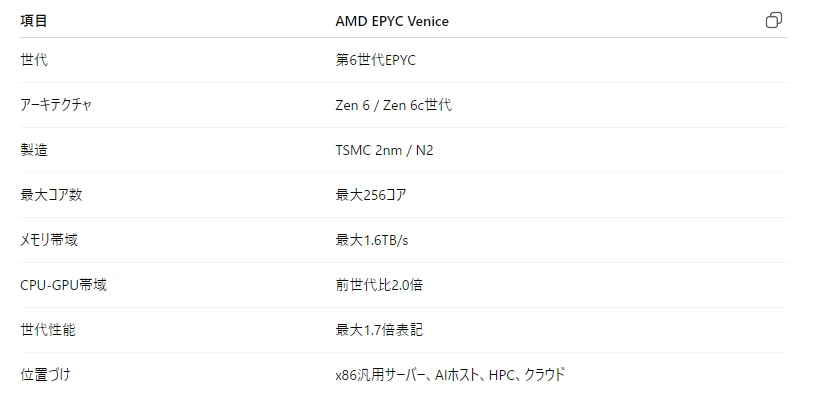
AMDはHeliosラック向け資料で、Veniceを最大256コア、1.6TB/sメモリ帯域、前世代比最大1.7倍性能、CPU-GPU帯域2倍と説明しています。
#工学的特徴
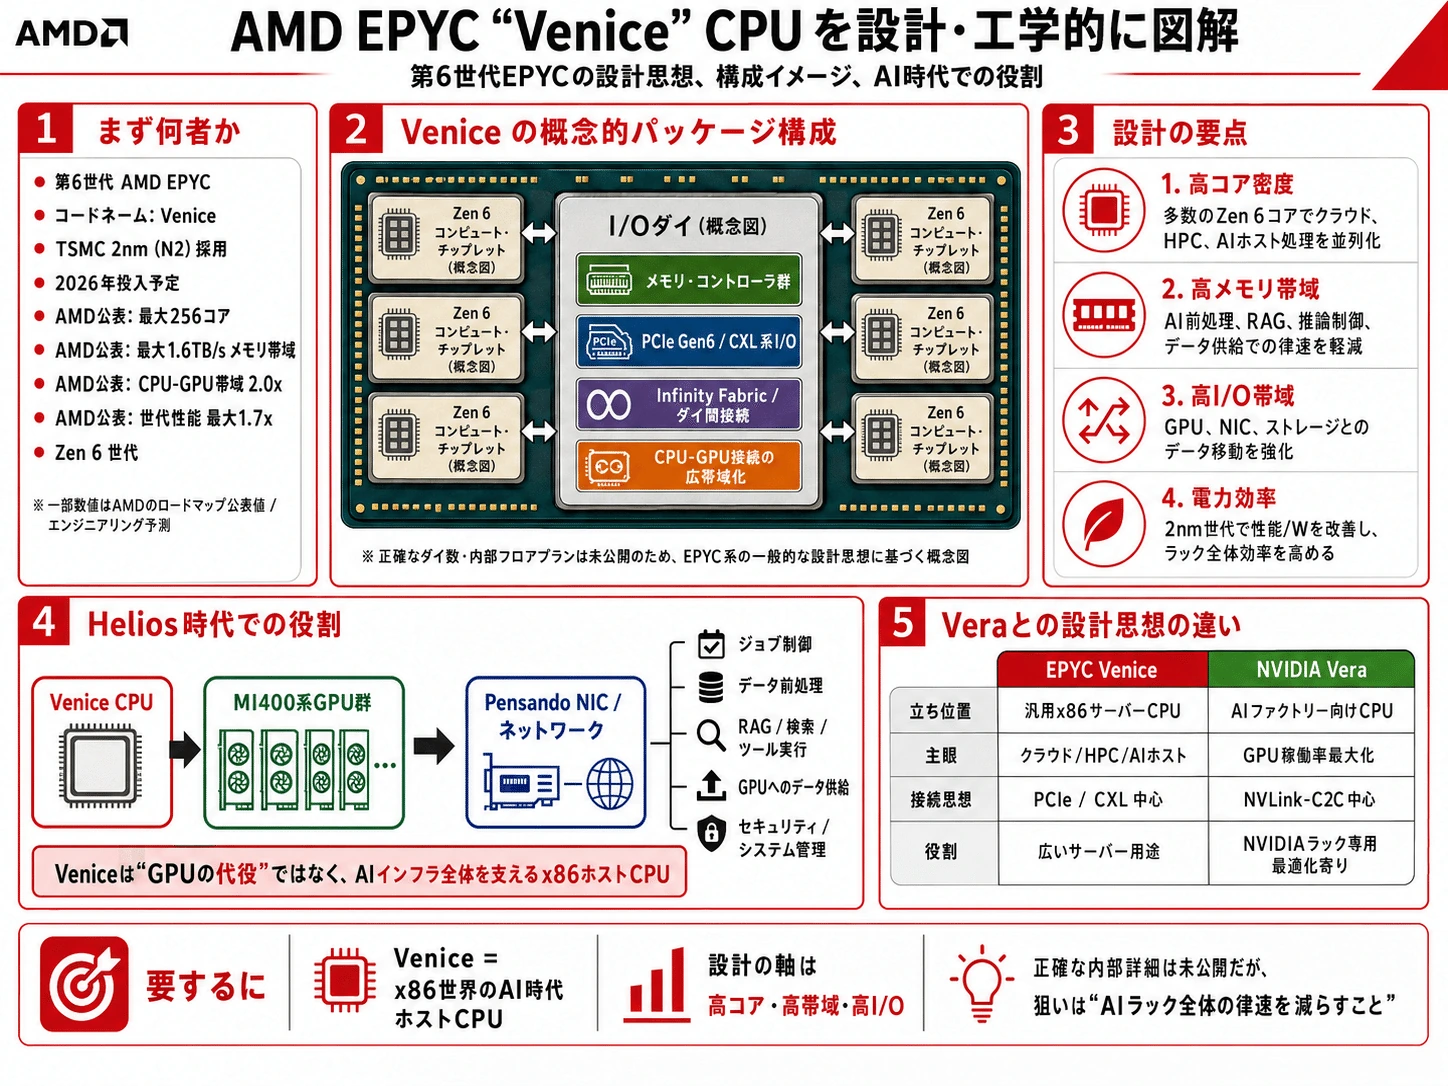
#Veniceは、従来EPYCと同じくチップレット型CPUになると考えられます。 EPYC系では、複数のCompute Die、つまりCPUコアチップレットと、I/O DieをInfinity Fabricで接続します。これにより、巨大な単一ダイを作るより歩留まりを上げやすく、コア数を増やしやすくなります。
#Veniceの狙いは、
#高コア数
高メモリ帯域
PCIe Gen6級I/O
CPU-GPU帯域拡大
x86互換
クラウド/HPC/AIホスト用途です。
#AIファクトリーでは、VeniceはGPUそのものの代替ではなく、GPUクラスタを支えるx86ホストCPUです。
#得意分野
#クラウド汎用サーバー
VM / コンテナ
DB / 分析
HPC
AI推論サーバーのホストCPU
AMD Instinct / Heliosラックの制御
x86互換が重要な企業環境不得意分野
#NVIDIA Rubin GPUとのNVLink密結合
GPUメモリとCPUメモリのNVIDIA式コヒーレント共有
NVIDIA CUDA/NVLink前提のAI工場
LPDDR/NVLink中心の専用AIラック制御Veniceは、x86世界のAI時代CPUとして非常に強いです。 ただし、NVIDIA Veraのような「GPUラック専用CPU」ではなく、あくまで広い汎用性を保ったEPYCです。
#
#
\5. NVIDIA Grace
#GPU時代にCPUをNVIDIAスタックへ取り込んだ第一歩
#NVIDIA Graceは、NVIDIAがデータセンターCPUに本格参入した最初の柱です。 Grace CPU Superchipは、2つのGrace CPUをNVLink-C2Cで接続し、144個のArm Neoverse V2コア、最大1TB/s級のLPDDR5Xメモリ帯域を持ちます。(GIGABYTE)
#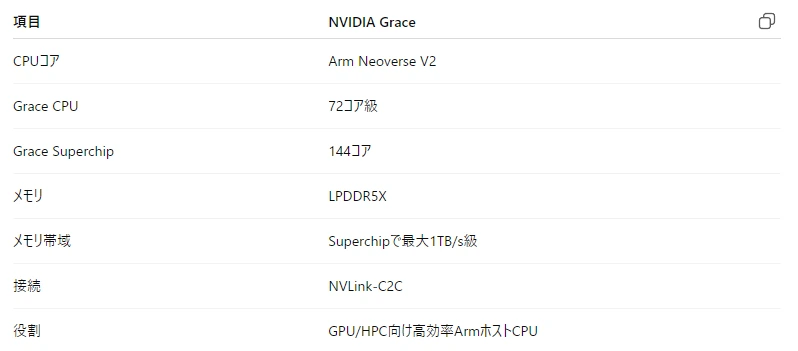
Graceの特徴は、サーバーCPUでありながら、通常のDDRではなくLPDDR5Xを使う高帯域・高効率設計にあります。 これはスマホ的な省電力メモリ技術を、データセンターCPUへ持ち込んだ形です。
#得意分野
#HPC
Grace Hopper / Grace Blackwell
NVIDIA GPUのホストCPU
高メモリ帯域が必要なCPU処理
電力効率重視のArmサーバー不得意分野
#x86前提の既存業務システム
NVIDIA以外のGPU/ASICとの標準的な組み合わせ
汎用企業サーバーでの互換性Graceは、VeraほどAIファクトリー専用ではありません。 しかし、CPUをNVIDIA GPUの近くに置くという流れを作った重要なCPUです。
##
\6. NVIDIA Vera
#AIファクトリー制御CPUの代表
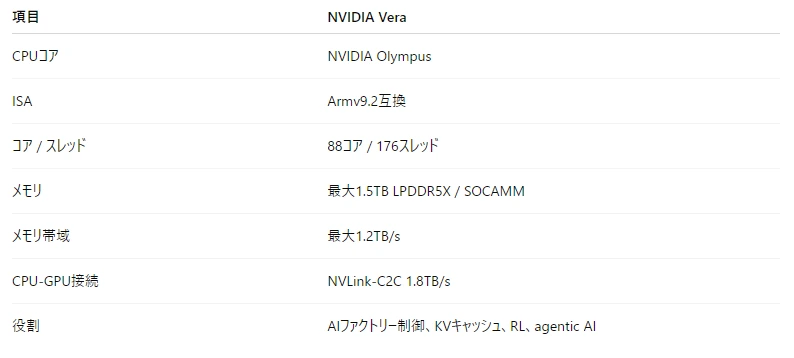
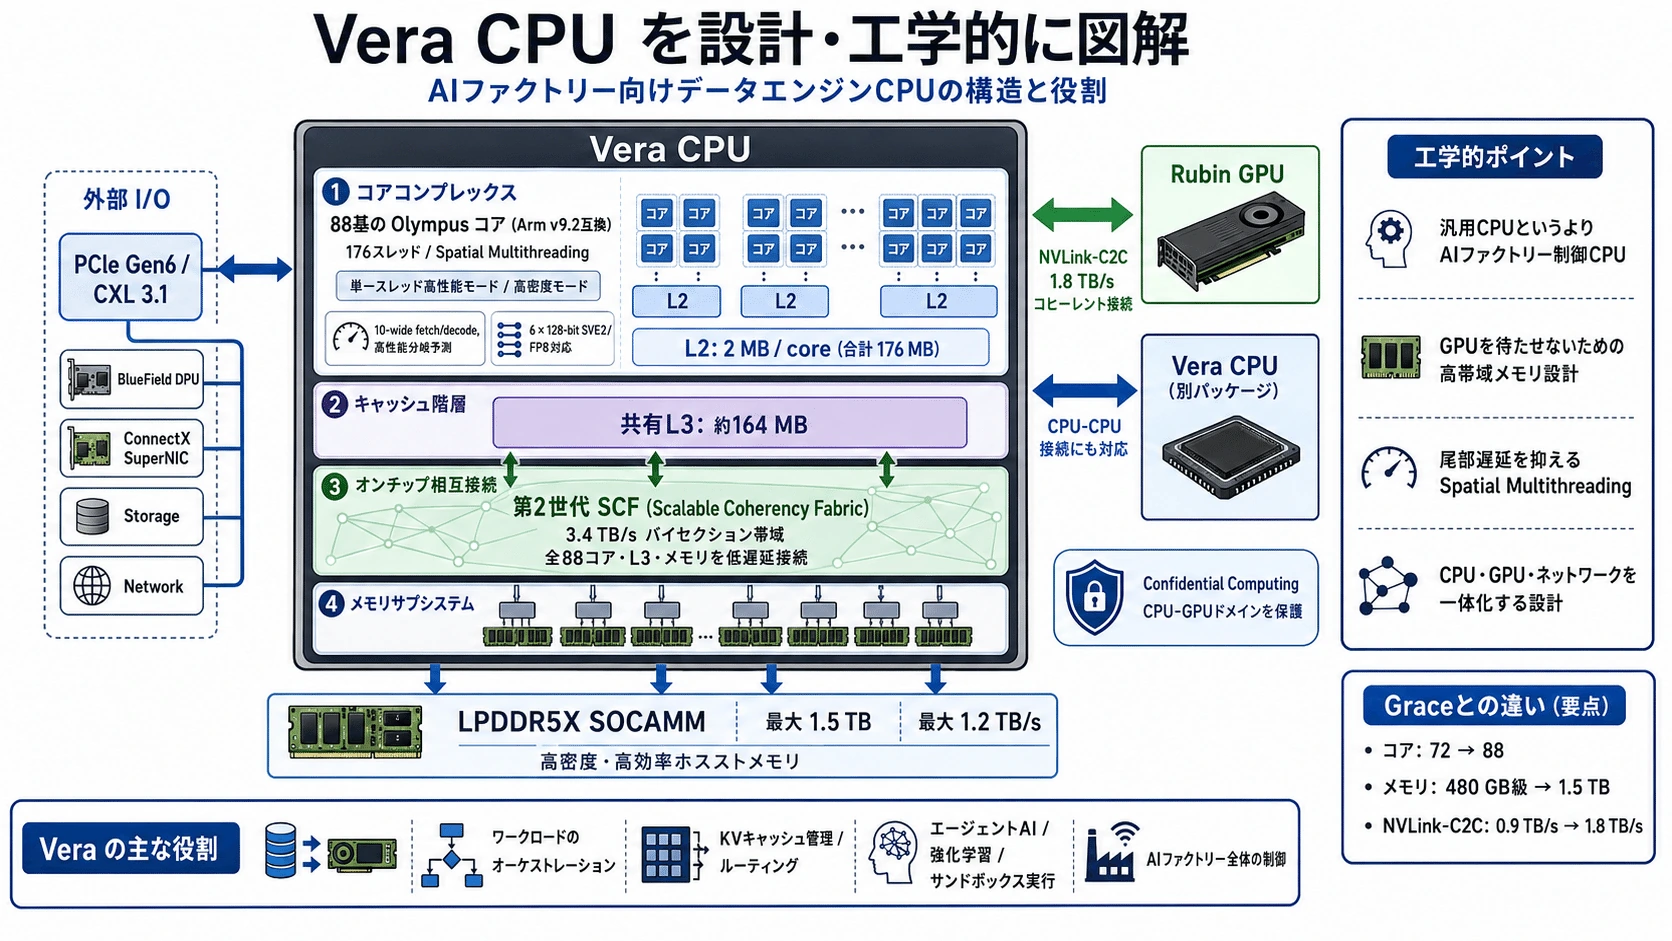
#Veraは、Graceの後継というより、Rubin世代のAIファクトリー制御CPUです。 88個のNVIDIA独自Olympusコア、176スレッド、最大1.5TB LPDDR5X、1.2TB/sメモリ帯域、1.8TB/s NVLink-C2Cを備えます。(NVIDIA Developer)
#
工学的特徴
#Veraの本質は、CPU単体性能ではなく、GPUラック全体の実効性能を上げることです。
#特に重要なのは以下です。
#1. Spatial Multithreading
88コアを176スレッドとして使い、多数のAI制御タスクを処理
2. LPDDR5X / SOCAMM
CPU側に高帯域・大容量メモリを置き、GPUのHBMを補助
3. NVLink-C2C
CPUとRubin GPUを高帯域・低遅延でつなぐ
4. AI制御向け設計
KVキャッシュ、推論リクエスト、RL環境、ツール実行を高速化得意分野
#Rubin GPUラック
Vera Rubin NVL72
KVキャッシュ管理
agentic AI
強化学習環境
GPU稼働率最大化
p99レイテンシ管理
NVIDIA AI Enterprise / CUDA / NIM環境不得意分野
#普通のWebサーバー
低コスト汎用クラウド
x86前提の業務システム
NVIDIA GPUと無関係なサーバー用途Veraは「汎用CPUとして最強」を目指すCPUではありません。 AI工場全体の物流・管制・メモリ補助装置です。
#
#
\7. Arm AGI CPU
#Arm自身が完成シリコンとして出すAI制御CPU
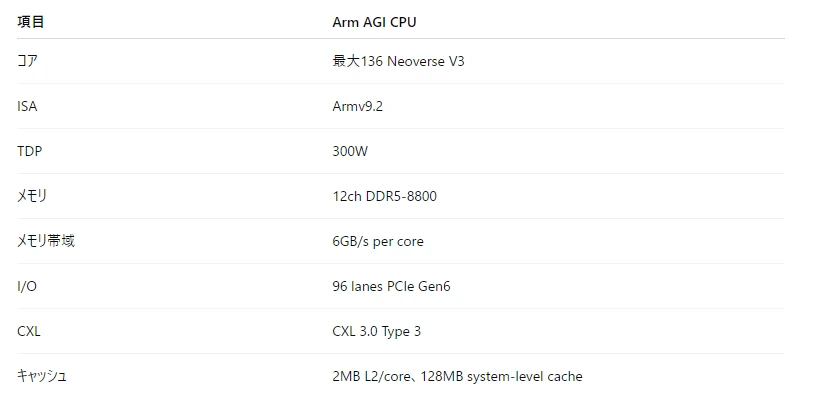
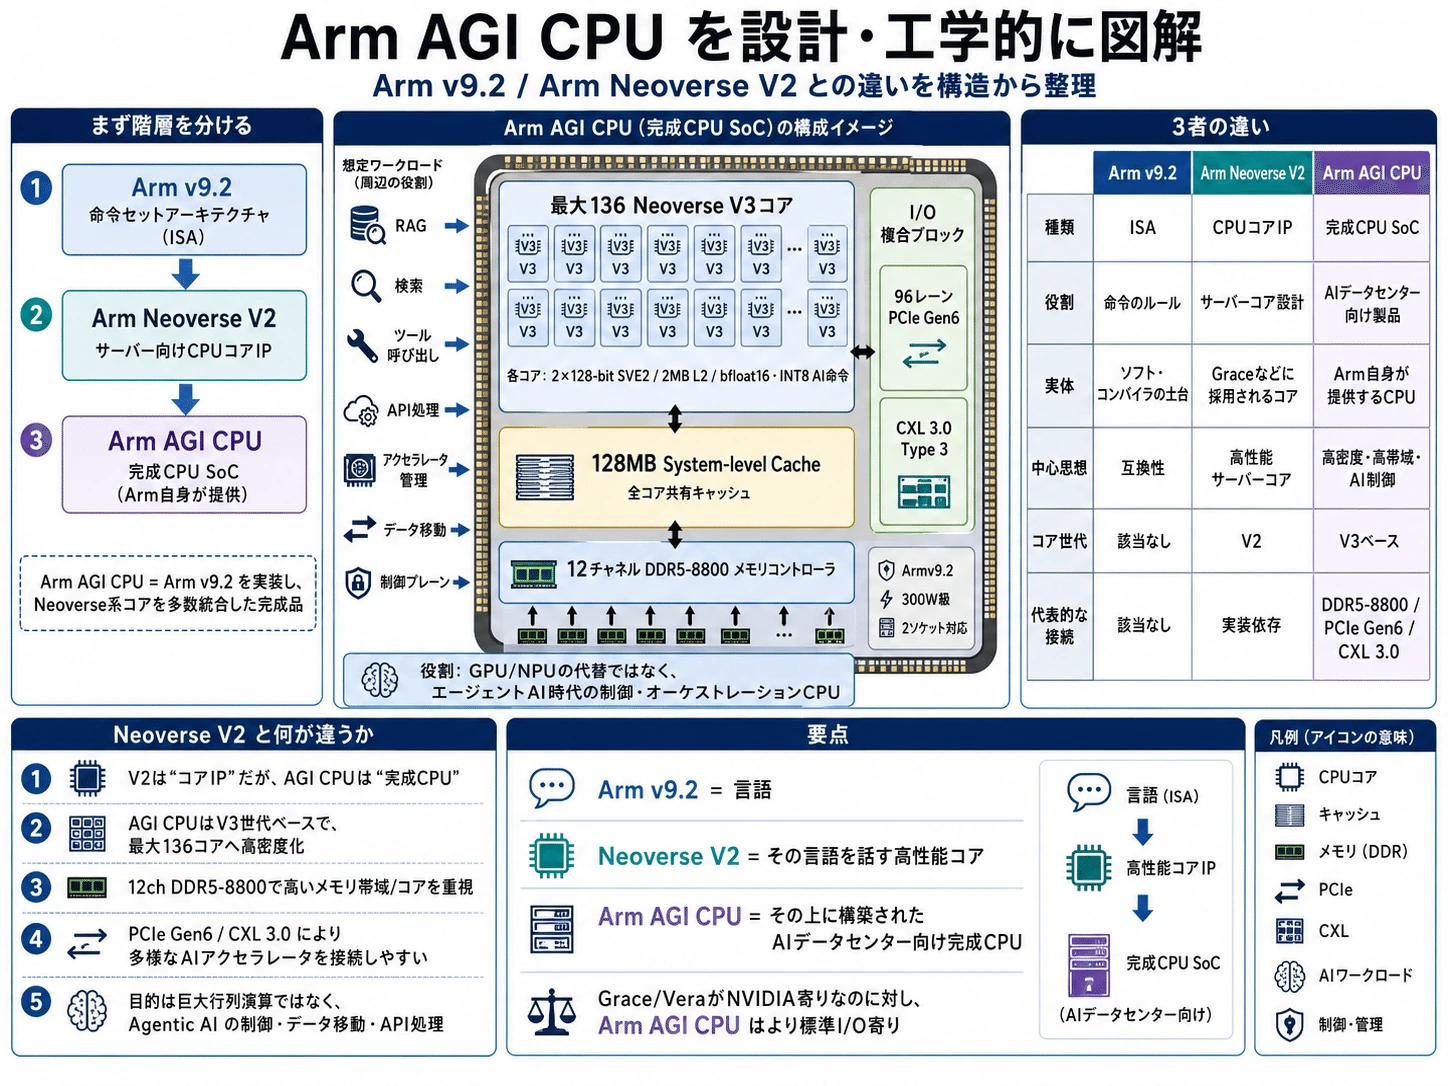
#Arm AGI CPUは、ArmがIP企業から一歩進み、完成CPUとして提供するデータセンターCPUです。 最大136個のNeoverse V3コア、Armv9.2、300W TDP、12チャネルDDR5-8800、96レーンPCIe Gen6、CXL 3.0 Type 3対応という構成です。(Arm)
#
Armv9.2、Neoverse V2、AGI CPUの違い
#Armv9.2
= 命令セット。CPUが理解する「言語」
Neoverse V2
= サーバー向けCPUコアIP。NVIDIA GraceやGoogle Axion世代で使われる
Arm AGI CPU
= Neoverse V3コアを最大136個搭載した完成CPU SoCつまりArm AGI CPUは、Armv9.2そのものでも、Neoverse V2そのものでもありません。 Armv9.2を実装したNeoverse V3系コアを、多数統合した完成CPUです。
#得意分野
#Meta MTIAなど独自AIアクセラレータの制御
API / コントロールプレーン
RAG / ツール実行
クラウドネイティブAIサービス
PCIe/CXLで多様なアクセラレータを接続する環境不得意分野
#x86互換が必要な既存企業システム
NVIDIA NVLink密結合ラック
Arm自身の完成CPU供給・サポート実績が問われる用途Arm AGI CPUは、NVIDIA VeraがNVIDIAスタック専用に近いのに対し、より標準I/O寄りのAI制御CPUです。
#
#
\8. Google Axion
#Google Cloud用の内製Arm CPU
#Google Axionは、Google Cloud向けの自社Arm CPUです。C4A VMは最大72 vCPU、576GB DDR5、6TiB Titanium SSD構成があり、bare metalでは96 vCPU/768GB DDR5のプレビュー構成もあります。(Google Cloud)
#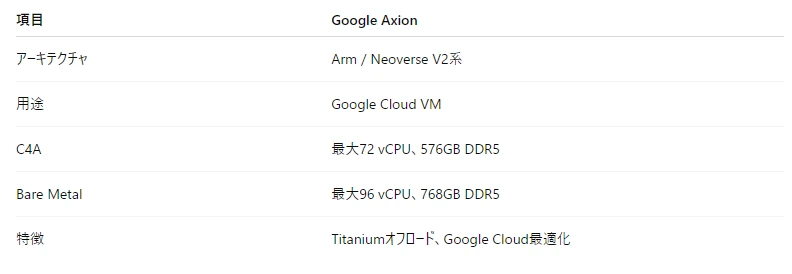
Axionの重要性は、CPU単体性能より、Google Cloud全体との統合です。 GoogleのTitaniumシステムがストレージ、ネットワーク、セキュリティなどをオフロードするため、CPUはクラウドVMの実効性能を出しやすくなります。
#得意分野
#Google Cloud上のWeb/API
コンテナ
クラウドネイティブ
Google TPU / AI Hypercomputer周辺
TCO重視のArm VM不得意分野
#外販CPUとしての利用
オンプレ導入
x86専用ソフト
NVIDIA/AMDのような汎用サーバー販売Axionは「CPUを売る製品」ではなく、Google Cloudの原価と電力効率を改善する内製CPUです。
##
\9. AWS Graviton
#クラウド内製Arm CPUの成功例
#AWS Gravitonは、クラウド内製Arm CPUの代表です。Graviton4は96コア級で、Graviton3より50%多いコア、75%多いメモリ帯域を持つと説明されています。(Arm Developer)
#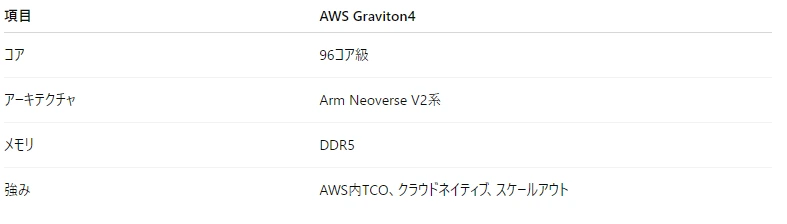
Gravitonの強さは、AWSが自社ワークロードと顧客VMに合わせてCPUを作り、EC2価格性能比を改善できる点です。
#得意分野
#AWS上のLinuxワークロード
Web/API
マイクロサービス
OSS DB
クラウドネイティブ
コスト最適化不得意分野
#AWS外での利用
x86専用ソフト
GPU密結合AIラック制御#
\10. Microsoft Cobalt
#Azure向けArm CPU
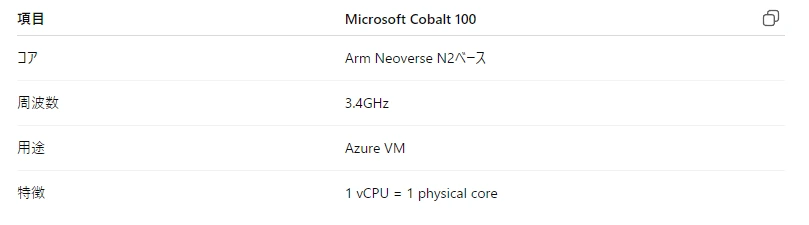
#Microsoft Cobalt 100は、Azure向けの自社Arm CPUです。Microsoft公式資料では、Arm Neoverse N2ベース、3.4GHz動作、VMのvCPUごとに物理コアを割り当てる構成とされています。(Microsoft Learn)
#
得意分野
#Azureクラウドネイティブ
Web/API
OSS DB
キャッシュ
データ分析不得意分野
#Azure外での利用
高性能AIラック制御
x86専用業務システムCobaltは、AWS GravitonやGoogle Axionと同じく、クラウドのTCO改善CPUです。
##
\11. Intel Xeon
#互換性・企業導入・内蔵AI命令の王道
#Intel Xeonは、依然として企業インフラの中心的CPUです。 例えばXeon 6980Pは128コア級、504MBキャッシュ、2.00GHzベースのP-core型Xeonです。(Intel)
#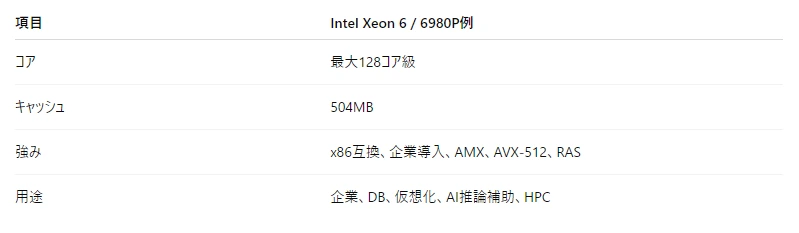
Intelの強みは、x86互換、長年の企業導入、ソフトウェア資産、RAS、セキュリティ、管理機能です。 また、Intel AMXやAVX-512により、CPU側のAI推論や行列処理も強化しています。
#得意分野
#企業システム
金融・官公庁
DB
VMware / Windows Server
オンプレ
x86最適化済みソフト
CPU推論補助不得意分野
#NVIDIA GPUとの密結合
電力効率・コア密度でAMD/Armに押される場面
クラウド内製CPUとのTCO競争Intelは、AIファクトリー専用CPUというより、既存ITとAIをつなぐ保守本流のCPUです。
##
\12. Qualcomm
#低消費電力AI推論からデータセンターへ
#Qualcommは現時点では、AIDC向けCPUというより、AI推論アクセラレータと将来のデータセンターCPU候補として見るべきです。 QualcommはAI200 / AI250でラックスケール推論市場へ参入し、AI200は2026年、AI250は2027年投入予定としています。(Qualcomm)
#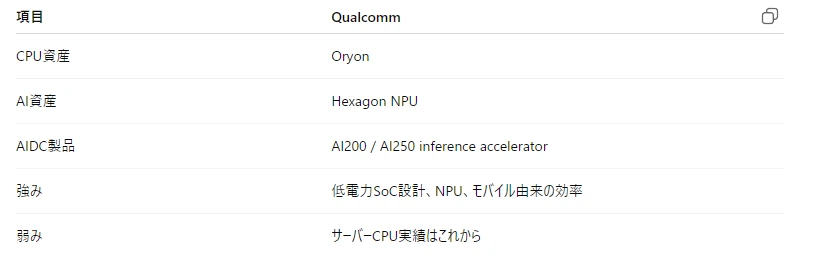
Qualcommの強みは、スマホSoCで鍛えた低電力・異種演算・NPU統合です。 将来的にOryon CPU、Hexagon NPU、高速SerDesを組み合わせて、推論特化AIDCへ入る可能性があります。
#得意分野
#低電力推論
エッジ/ラック推論
固定ワークロードASIC
電力効率重視不得意分野
#汎用サーバーCPU実績
CUDA/ROCm級ソフトウェアスタック
大規模学習クラスタ
x86互換#
\13. Huawei / HiSilicon Kunpeng
#中国主権AI基盤のホストCPU
#Kunpeng 920は、Huawei/HiSiliconのArmベースサーバーCPUです。HiSilicon公式では、Kunpeng 920は7nmプロセスを利用し、HuaweiがArmアーキテクチャライセンスに基づいて独自設計したサーバーCPUとされています。(hisilicon.com) HuaweiのTaiShanサーバーでは、Kunpeng 920 7260が2ソケットで各64コア、2.6GHz構成として示されています。(support.huawei.com)
#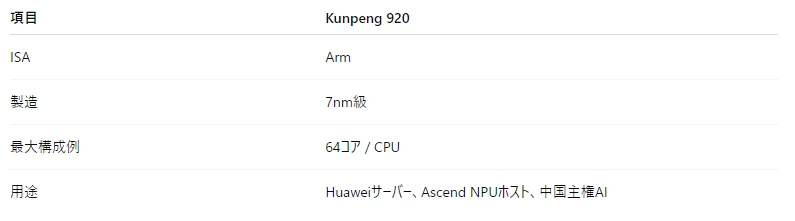
Kunpengは、Ascend NPUと組み合わせることで、中国内製AIスタックのCPU側を担います。
#得意分野
#中国国内クラウド
Huawei Ascend NPUのホストCPU
主権AIインフラ
政府・通信・国有企業向け不得意分野
#TSMC N2/N3級の先端製造
グローバル採用
米国規制下での製造・EDA・装置制約
x86互換Kunpengの本質は、性能だけではなく、制裁下で中国がAIインフラを自立させるためのCPUです。
##
\14. AmpereOne
#独立系ArmサーバーCPU
#AmpereOneは、クラウド向けArmサーバーCPUです。Ampere公式では、最大192個のAmpere自社設計コアを持ち、高いラック密度と線形スループットを狙うCPUとされています。(Ampere Computing)
#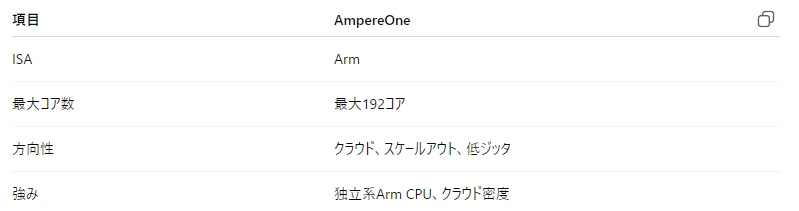
AmpereOneは、AWS/Google/Microsoftの内製CPUと違い、外部に販売されるArmサーバーCPUです。
#得意分野
#クラウドサービス
スケールアウト
Web/API
エッジ
低ジッタ・低レイテンシ不得意分野
#GPU密結合AIラック
巨大x86ソフト資産
NVIDIA/AMDほどのサプライチェーン支配#
\15. 各CPUの比較表
#
#
\16. 今後の見通し
#AIDC向けCPUは、今後さらに分化します。
#NVIDIA系
#NVIDIAは、VeraでGPUラックのCPUまで自社スタック化します。 CPU単体でAMDやIntelと戦うというより、Rubin GPU、NVLink、BlueField、Spectrum、CUDA、NIMと組み合わせ、AI工場を丸ごと売る方向です。
#AMD系
#AMDは、Veniceでx86汎用CPUの最先端を取りに行きます。 HeliosではEPYC、Instinct、Pensando、ROCmを統合し、NVIDIA依存を減らしたい顧客に対して、オープン寄りAIラックを提供します。
#Arm系
#Arm AGI CPU、Google Axion、AWS Graviton、Microsoft Cobalt、AmpereOneは、ArmによるクラウドCPUの拡大を示しています。 AIエージェント時代には、Web/API/制御プレーンが膨らむため、Armの性能/Wは大きな武器になります。
#Intel系
#Intelは、既存企業インフラとx86互換性では強いです。 さらにIntel Foundryや18Aが成功すれば、米国主権製造という観点でも重要になります。
#中国系
#Kunpeng + Ascendは、世界最高性能ではなく、制裁下でAIインフラを自前化するためのCPU/NPUスタックです。 中国国内では、性能以上に「使えること」「調達できること」が価値になります。
##
結論
#AIDC向けCPU市場は、もはや単純なCPU性能競争ではありません。
#重要なのは、
#GPUを止めないこと
AIエージェントの周辺処理を回すこと
メモリ帯域を確保すること
I/Oを太くすること
クラウドTCOを下げること
ソフトウェア資産と互換性を守ることです。
#かなり短く言えば、
#AMD Venice
= x86世界のAI時代CPU本命
NVIDIA Vera
= NVIDIA AIファクトリーの制御CPU
Arm AGI CPU
= ArmエコシステムのAI制御CPU
Google Axion / AWS Graviton / Microsoft Cobalt
= クラウドTCO改善CPU
Intel Xeon
= 既存企業インフラの保守本流CPU
Kunpeng
= 中国主権AI基盤のCPU
Qualcomm
= 低電力AI推論・将来AIDC CPU候補AIDCでは、GPUだけでなく、CPUも再び戦略部品になっています。 ただし、今後のCPUは一つの勝者に集約するのではなく、汎用CPU、AIファクトリー制御CPU、クラウド内製CPU、主権CPUへ分かれていく可能性が高いです。
##
追記:Arm AGI CPUの製造能力・資材確保と、Armが中立性を賭けるリスク
#Arm AGI CPUは、AIDC向けCPU市場の中でも特殊な存在です。 AMD EPYC Veniceが「x86汎用CPUのAIインフラ対応」、NVIDIA Veraが「NVIDIA AIファクトリー制御CPU」だとすれば、Arm AGI CPUはArm自身が完成シリコンとして出す、Armエコシステム向けAI制御CPUです。
#これまでArmは、CPU IPや命令セットを提供する「中立的な設計基盤」のような立場でした。しかしAGI CPUでは、Arm自身がTSMCで製造される完成CPUを出します。ArmはAGI CPUを、agentic AI向けのCPUであり、Armの事業をIP、Compute Subsystems、そしてproduction siliconへ拡張するものとして発表しました。Metaがリードパートナーで、OpenAI、Cloudflare、Cerebras、SAP、SK Telecomなどもパートナーとして挙げられています。(Arm Newsroom)
##
\1. Arm AGI CPUの製造状況
#Arm AGI CPUは、ReutersによるとTSMC 3nmで製造され、2つのシリコン部品が1つのチップとして動作する構成です。生産開始は2026年後半と報じられています。(Reuters)
#主な仕様は以下です。
#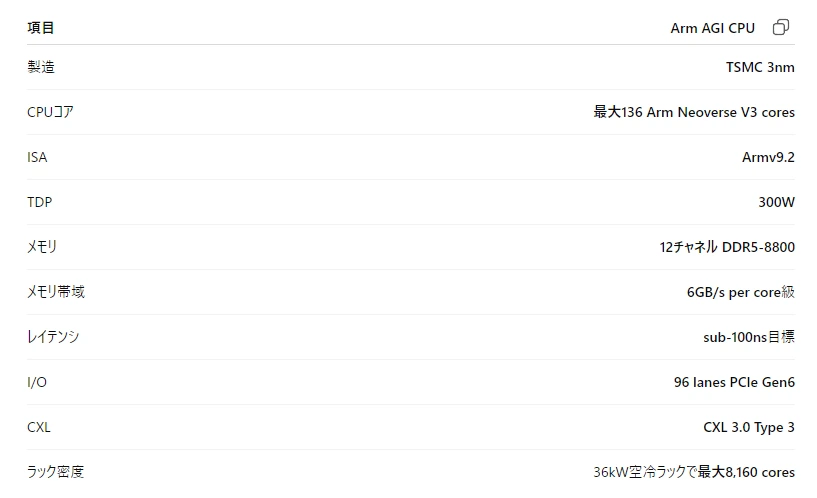
Armの製品ブリーフでは、AGI CPUは最大136個のNeoverse V3コア、6GB/s/coreのメモリ帯域、sub-100nsレイテンシ、300W TDP、36kW空冷ラックで最大8,160コアという密度を訴求しています。(arm.com)
#つまりArm AGI CPUは、NVIDIA VeraのようなNVLink-C2C密結合CPUではなく、DDR5 + PCIe Gen6 + CXL 3.0を中心にした標準I/O型AI制御CPUです。
##
\2. 資材確保の面では、Vera Rubinより軽い
#Arm AGI CPUの資材構成は、AI GPUやVera Rubinラックより軽いです。
#必要になる主な資材は、
#・TSMC 3nmウェハー
・デュアルダイ/チップレット向けパッケージ
・DDR5-8800メモリ
・PCIe Gen6 / CXL 3.0対応基板
・サーバーODMによる1U/ラックシステム
・空冷または液冷の電源・冷却設計です。
#NVIDIA Vera Rubinの場合は、Vera CPUだけでなく、Rubin GPU、HBM4、CoWoS/SoIC系先端パッケージ、NVLink Switch、ConnectX、BlueField、Spectrum、光接続、液冷ラックまで絡みます。したがって、部材構成はArm AGI CPUよりはるかに重い。
#Arm AGI CPUは、少なくともCPU単体としてはHBMを大量に使わないため、HBM供給の争奪戦からは相対的に距離があります。 これは供給面で大きな利点です。
#ただし、TSMC 3nmはすでにApple、NVIDIA、AMD、Broadcom、Qualcomm、MediaTek、ハイパースケーラーのASICなどが取り合う先端ノードです。つまり、AGI CPUはHBM制約は軽い一方で、TSMC先端ノード枠の争奪戦からは逃げられません。
##
\3. Arm AGI CPUの供給面の強み
#Arm AGI CPUの強みは、まずMetaがリードパートナーであることです。 MetaはArmと複数世代のCPUを共同開発し、大規模AIデータセンターを支える方針を示しています。(About Facebook)
#これは供給面で重要です。TSMCやODMから見ると、Metaのような大口需要家が背後にいることで、生産計画を立てやすくなるからです。
#またReutersによると、ArmはAGI CPUが5年以内に年間150億ドル規模の売上になると見込んでいます。(Reuters) この規模を本気で狙うなら、ArmはTSMC、サーバーODM、メモリ、基板の供給網を長期で押さえる必要があります。
#Arm AGI CPUの供給面の強みを整理すると、
#・Metaという大口リード顧客
・OpenAI、Cloudflare、SAP、SK Telecomなどの初期パートナー
・TSMC 3nm採用で、N2よりは成熟した先端ノード
・HBM/CoWoS依存が小さい
・DDR5、PCIe、CXL中心で標準サーバー部材に近い
・Lenovo、Quantaなどサーバーシステム協業の報道です。Reutersは、ArmがLenovoやQuantaと完全なサーバーシステム構築で協業しているとも報じています。(Reuters)
##
\4. Arm AGI CPUの供給面の弱み
#一方で、Arm AGI CPUには明確な弱みがあります。 最大の弱みは、Arm自身が完成CPUを大規模に供給する経験が浅いことです。
#AMDはEPYCで長年サーバーCPUを量産してきました。 NVIDIAもGrace、Grace Hopper、Grace Blackwell、DGX/NVLラックでシステム供給を積み上げています。
#しかしArmは、これまで主にIPライセンス企業でした。 完成CPUを出すとなると、次のような責任を負います。
#・TSMC製造枠の確保
・パッケージングとテスト
・歩留まり管理
・在庫管理
・ファームウェア/BIOS/BMC
・サーバーODM検証
・RMA/故障対応
・長期サポート
・顧客別SKU管理これは、IPをライセンスして顧客がチップを作る従来モデルとはかなり違います。
#そのためArm AGI CPUは、設計思想は魅力的でも、量産実行・供給網運用・サーバーサポートの面ではAMD VeniceやNVIDIA Veraより不確実性があります。
##
\5. AMD EPYC Venice、NVIDIA Veraとの立ち上げ比較
#立ち上げ状況を比較すると、Arm AGI CPUはまだ「これから証明する段階」です。
#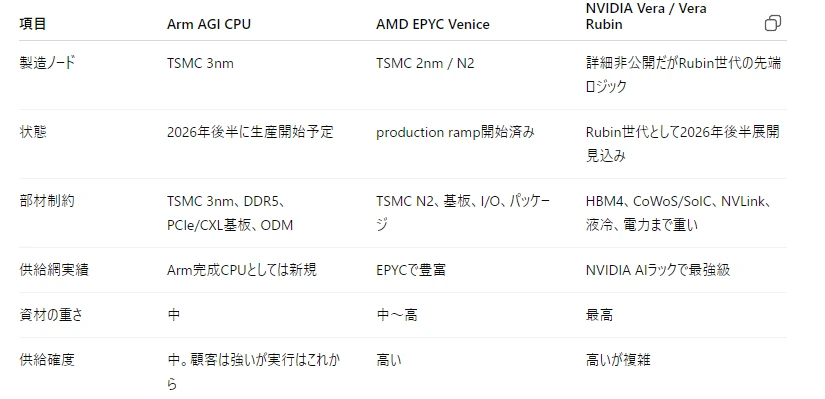
AMD Veniceは、すでにTSMC 2nmでproduction rampに入っています。AMDはこれを業界初のTSMC 2nm HPC製品の量産立ち上げと説明しており、CPU単体の量産確度では非常に強い位置にいます。(Reuters)
#NVIDIA VeraはCPU単体としても重要ですが、実際にはVera Rubinラック全体で見なければなりません。NVIDIAは供給関連コミットメントを巨額に積み上げ、HBM、TSMC、先端パッケージ、基板、ODM、ネットワーク部材を長期で押さえる力があります。一方、Vera RubinはHBM4やCoWoS、液冷、電力まで絡むため、供給網は最も重く複雑です。
#Arm AGI CPUは、その中間です。 Vera Rubinほど部材は重くないが、Arm自身の完成CPU供給は新規挑戦。 Veniceほど量産立ち上げが進んでいるわけでもない。 したがって、設計は面白いが、供給実行はこれから検証される製品と見るのが自然です。
##
追記:Armは中立性を失うリスクを賭けている
#Arm AGI CPUのもう一つの大きな論点は、製造や資材ではなく、ビジネスモデル上の中立性です。
#Armはこれまで、半導体業界の「CPU設計インフラ」のような存在でした。 Apple、Qualcomm、NVIDIA、AWS、Google、Microsoft、MediaTek、AmpereなどがArmのISAやCPU IPを使い、それぞれ自社チップを作ってきました。
#しかしArmが完成CPUを出すと、構図が変わります。
#従来:
Arm = CPU IPを提供する中立的な設計基盤
顧客 = Arm IPを使ってチップを作る企業
AGI CPU以後:
Arm = CPU IP供給元
Arm = 完成CPUを売る競合企業
顧客 = Armの顧客であり、場合によっては競合これは大きな賭けです。
##
\1. 顧客が「Armは競合になった」と見るリスク
#Armの顧客には、AWS Graviton、Google Axion、Microsoft Cobalt、NVIDIA Grace/Vera、Qualcomm Oryon、AmpereOneなど、Arm系CPUを自社開発する企業が多く含まれます。
#ArmがAGI CPUを売り始めると、顧客はこう疑う可能性があります。
#・Armは自社CPUにだけ最新機能を先に入れるのではないか
・Neoverse IPやCSSの提供条件が悪くなるのではないか
・自社CPU事業のために顧客ロードマップ情報を利用するのではないか
・完成シリコンを買わせるために、IPライセンスの自由度を下げるのではないかこの疑念が出るだけで、Armの中立性は揺らぎます。
#Armの価値は、「みんなが使えるCPU標準」であることにありました。 そのArmが完成CPU市場へ入ることは、売上拡大のチャンスである一方、顧客の信頼を傷つける危険があります。
##
\2. 独禁法・規制リスク
#中立性の低下は、規制リスクにもつながります。 Tom’s Hardwareは、ArmがAGI CPUを出した後、米FTCがArmのライセンス慣行について独禁法上の調査を始めたと報じています。焦点は、Armが自社CPUに有利になるように、競合企業のアーキテクチャアクセスを制限していないかという点です。(Tom's Hardware)
#これはArmにとってかなり重大です。 なぜならArmは、単なるCPUメーカーではなく、CPU ISA/IPの上流レイヤーを握る企業だからです。
#上流の設計基盤を握る企業が、下流の完成CPU市場にも出る。 この構図は、規制当局から見れば「自社製品を有利にするために、標準やIPアクセスを操作していないか」という疑いを招きやすい。
##
\3. Qualcommとの対立が象徴するリスク
#Armの中立性リスクは、Qualcommとの対立にも表れています。 QualcommはNuvia買収後のOryon CPUを通じて、Armベースの独自CPUを強化してきました。一方、Armとのライセンス紛争は長期化し、Armが完成CPUを出すことで、顧客側からは「Armはライセンス先を支える存在なのか、それとも制限しながら自社CPUで競争する存在なのか」という疑念が強まりやすくなります。
#これは、Armの既存ビジネスにとって深刻です。 短期的にはAGI CPUで売上を増やせても、長期的に大口ライセンシーがArm依存を下げようとすれば、IPビジネス全体の価値が下がる可能性があります。
##
\4. RISC-Vや独自CPUへの逃避リスク
#Armが中立性を失ったと見られると、顧客はすぐにArmをやめるわけではありません。 Armエコシステムは大きく、ソフトウェア資産も厚いからです。
#しかし長期的には、顧客は次の方向を強める可能性があります。
#・RISC-Vへの研究開発投資を増やす
・独自ISAやカスタムCPUへの移行を検討する
・x86やNVIDIA/AMD CPUに戻す
・Arm IPではなく完成CPUだけを限定的に使う
・Armとのロードマップ共有を減らす特にハイパースケーラーは、10年単位で半導体ロードマップを組みます。 もし「Armに依存しすぎるのは危険」と判断されると、数年後の設計からArmの採用比率が下がる可能性があります。
##
\5. なぜArmはそれでも賭けるのか
#リスクは大きいですが、ArmがAGI CPUに踏み出す理由も明確です。
#AIエージェント時代には、GPUやAI ASICだけでなく、CPU需要も拡大します。Armは、AIが学習・単発推論からエージェント型ワークロードへ進むと、CPUがreasoning、coordination、data movementを担うため、AIデータセンターではCPU容量が大きく増えると説明しています。(Arm Newsroom)
#もしArmがIPライセンスだけに留まれば、この巨大なCPU需要の利益は、NVIDIA、AMD、Google、AWS、Microsoft、Qualcomm、Ampereなどに取られます。 AGI CPUは、ArmがIP料だけでなく、AIデータセンターCPUそのものの売上を取りに行く戦略です。
#Reutersによると、ArmはAGI CPUが5年以内に年間150億ドル規模の売上になると見込んでいます。(Reuters) この数字を見ると、Armが中立性リスクを取ってでも完成シリコンへ進む理由は理解できます。
##
まとめ
#Arm AGI CPUは、製造面ではNVIDIA Vera Rubinほど重くありません。 HBMやCoWoSを大量に使うAI GPUではなく、TSMC 3nm、DDR5、PCIe Gen6、CXL 3.0を中心とした標準I/O型CPUだからです。
#しかし、Arm自身が完成CPUを大規模に供給するのは新しい挑戦です。 AMD VeniceはTSMC 2nmでproduction ramp開始済み、NVIDIA Vera/Rubinは最も重い供給網を持ちながらもNVIDIAの購買力で押さえに行っています。これに対し、Arm AGI CPUはMetaという強力なリード顧客を持つ一方、量産・サポート・サーバーODM展開はこれから証明する段階です。
#さらに、Arm AGI CPUには供給以上に大きな戦略的賭けがあります。 ArmはこれまでCPU IPの中立的な供給者でした。しかし完成CPUを出すことで、Qualcomm、NVIDIA、AWS、Google、Microsoft、Ampereなどの顧客と競合する可能性が出ます。これにより、独禁法リスク、ライセンス交渉の緊張、RISC-Vや独自CPUへの逃避リスクが生じます。
#かなり短く言えば、
#Arm AGI CPU
= 資材構成はVera Rubinより軽い
= ただしArm完成CPUとしての量産実行は未知数
= Metaがいるため需要面は強い
= しかしArmの中立性を傷つける大きな賭け
AMD Venice
= TSMC 2nmで量産立ち上げ済み
= CPU単体の供給確度は非常に高い
NVIDIA Vera / Rubin
= 供給確保力は最強
= ただしHBM、CoWoS、液冷、電力まで絡むため最も重いこの意味で、Arm AGI CPUは設計思想としては非常に有望だが、供給面とビジネスモデル面の両方で最も新しいリスクを抱えたCPUです。
##
追記:AMD EPYC Venice / Veranoの汎用性
#AIインフラ向けに寄っても、なぜVeraより汎用的なのか
#AMD EPYC Veniceと、その後続に位置づけられるVeranoは、明らかにAIインフラ時代を意識したCPUです。Veniceは第6世代EPYCとして、TSMC 2nm / N2で生産立ち上げに入り、AMDはこれを「TSMC 2nmでproduction rampに入った業界初のHPC製品」と説明しています。Veniceはクラウド、エンタープライズ、HPC、AIインフラ向けに位置づけられ、AIがagentic workloadsへ広がることでCPUの重要性が増す、とAMDは強調しています。(AMD)
#AMD資料では、Veniceは最大256コア、最大1.6TB/sメモリ帯域、CPU-GPU帯域2倍、世代性能最大1.7倍という方向性が示されています。Heliosラックでは、VeniceがMI400系GPUやPensando NICと組み合わされ、AIラック全体を支えるホストCPUとして使われる想定です。
#ここで重要なのは、Venice / Veranoも設計資源をAI向けに振っているという点です。CPU設計では、限られたチップ面積、電力、メモリ帯域、I/O帯域、パッケージ配線を、どの処理に割り当てるかを決める必要があります。Veniceでは、高コア数、高メモリ帯域、CPU-GPU帯域、PCIe/CXL系I/Oが重視されます。Veranoでは、AMDがLPDDRなどの先進メモリ技術を取り入れ、agentic AIで増えるメモリ需要と電力制約に対応すると説明しています。(AMD)
#つまり、Venice / Veranoは従来EPYCよりもAIインフラ寄りになります。 しかし、それでもNVIDIA Veraに比べると、かなり汎用的です。
#理由は主に4つあります。
##
\1. x86であることが大きい
#Venice / VeranoがEPYCである以上、最大の強みはx86互換性です。これは単なる命令セットの違いではありません。
#x86であるということは、既存のLinuxサーバー、Windows Server、VMware、KVM、コンテナ基盤、商用DB、金融・官公庁・企業アプリ、監視ツール、セキュリティ製品、運用ノウハウを使いやすいということです。
#AIインフラ向けに強化されても、Venice / Veranoは基本的には、
#クラウドVM
コンテナ
DB
HPC
企業サーバー
ストレージ
ネットワーク
AIホストCPU
GPUサーバー制御に使えるCPUです。
#一方、NVIDIA VeraはArm互換CPUであり、NVIDIA Rubin GPUラックとNVLink-C2Cで密結合することを前提にしたAIファクトリー制御CPUです。Veraは88個のOlympusコア、176スレッド、最大1.5TB LPDDR5X、1.2TB/sメモリ帯域、1.8TB/s NVLink-C2Cを持ち、agentic AI、強化学習、サンドボックス実行、GPUを待たせないオーケストレーションに最適化されています。(SEC)
#したがって、 Venice / Verano = AI時代に最適化されたx86汎用CPU Vera = NVIDIA AIファクトリー制御CPU という違いになります。
##
\2. Venice / VeranoのAI向け強化は、汎用用途にも効きやすい
#Veniceが強化している方向は、AIだけでなく汎用サーバーにも効きます。
#たとえば、
#高コア数
→ クラウドVM、コンテナ、DB、Web、HPCにも効く
高メモリ帯域
→ AI前処理だけでなく、分析、DB、HPCにも効く
PCIe/CXL世代の強化
→ GPUだけでなく、NIC、SSD、DPU、CXLメモリにも効く
CPU-GPU帯域強化
→ AIだけでなく、HPC、シミュレーション、アクセラレータ利用全般にも効くつまりVenice / Veranoの特殊化は、AI向けではあるものの、汎用サーバー性能の底上げにもつながる特殊化です。
#一方でVeraの特殊化は、もっとNVIDIA AIラックの中に深く入っています。
#Rubin GPUとのNVLink-C2C
LPDDR5X/SOCAMMによるGPU HBM補助
KVキャッシュ管理
強化学習環境
agentic AIのサンドボックス実行
NVIDIAラック全体のGPU稼働率最大化これはNVIDIA AIファクトリーでは非常に強いですが、普通のWebサーバーや企業DBだけを動かすには過剰です。
##
\3. 標準I/O中心か、専用密結合中心か
#Venice / Veranoは、基本的にPCIe、CXL、Infinity Fabric、標準サーバーI/Oを中心にしたCPUです。 AMD Heliosも、EPYC Venice、Instinct MI400系、Pensando Vulcano NIC、ROCm、オープン標準のラック設計を組み合わせる方向です。AMDは台湾エコシステムへの100億ドル超の投資で、Venice、MI450X、Heliosラック、先端パッケージ、基板、ODM製造能力を拡大すると説明しています。(Reuters)
#一方、VeraはNVLink-C2Cを中心に、Rubin GPUと非常に密に接続されます。これはCPUとGPUの距離を縮め、GPUのHBMとCPU側LPDDRを近い関係で使うためには強力ですが、その価値はNVIDIAスタック内で最大化されます。
#したがって、汎用性の観点では、
#Venice / Verano
→ 標準I/O中心。多様なGPU、NIC、DPU、SSD、CXLメモリと組み合わせやすい。
Vera
→ NVLink-C2C中心。NVIDIA Rubin GPUラックでは強いが、NVIDIA外では特殊化が強い。となります。
##
\4. VeranoはVeniceよりAIメモリ寄りになるが、それでもVeraより汎用的
#Veranoは、VeniceよりもさらにAIインフラ寄りになる可能性があります。AMDはVeranoについて、LPDDRなどの先進メモリ技術を採用し、agentic AIで増えるメモリ需要と電力制約に対応すると説明しています。(AMD)
#LPDDRをCPUに近づけると、メモリ帯域/Wが改善しやすく、AI前処理、RAG、推論制御、サンドボックス、エージェント処理には有利です。 ただし、従来のDDR DIMM中心サーバーに比べると、メモリ増設性、交換性、構成自由度が変わる可能性があります。
#そのためVeranoは、Veniceより特殊化する可能性があります。 しかしEPYCブランドとしてx86互換、標準I/O、クラウド・HPC・企業用途を残すなら、Veraよりは汎用的です。
##
追記:各社の製造確保・資材確保能力
#AIDC向けCPU競争は、設計だけでなく供給網の奪い合いになった
#AIDC向けCPUの競争では、設計力だけでは勝てません。 実際には、以下の資源をどれだけ確保できるかが勝敗を左右します。
#先端ロジック製造能力
TSMC N3 / N2 / N2P / A16、Intel 18Aなど
先端パッケージ
CoWoS、SoIC、EFB、Foverosなど
メモリ
DDR5、MRDIMM、LPDDR5X/SOCAMM、HBM
基板
ABF基板、高多層基板、AIラック向け大型基板
I/O部品
PCIe/CXL、SerDes、NIC、DPU、光トランシーバー
ラック組立能力
ODM、液冷、電源、配線、検査、バーンイン
データセンター側制約
電力、冷却、水、土地、変電設備つまりCPU競争は、チップの設計競争であると同時に、TSMC・先端パッケージ・メモリ・基板・ODMを押さえる供給戦です。
##
NVIDIA:供給確保能力は最強級。ただし制約点も多い
#NVIDIAの供給確保能力は、現在のAI半導体企業の中で最も強い部類です。 SEC提出資料では、2026年4月26日時点の供給関連コミットメントが1190億ドルで、そのうち950億ドルをFY2027残り期間に支払う予定とされています。(SEC)
#これは、NVIDIAがTSMC、HBM、先端パッケージ、基板、サーバーODM、ネットワーク部品などをかなり先まで押さえていることを示します。単にGPUを売るだけでなく、Vera CPU、Rubin GPU、NVLink、ConnectX、BlueField、Spectrum、液冷ラックまで含むAIファクトリー全体を供給する企業になっているからです。
#NVIDIAの強みは、
#・圧倒的な売上規模
・高ASP、高粗利
・HBMメーカーへの影響力
・TSMC/CoWoS枠の優先確保
・NVLink/NIC/DPU/スイッチまで自社で持つ
・ハイパースケーラーからの長期需要です。
#ただし、NVIDIAは供給網の支配力が強い一方で、必要な部材も最も多いです。GPU、HBM、CoWoS、NVSwitch、NIC、DPU、光接続、液冷ラック、電力まで絡むため、どこか一つが詰まるとラック全体の出荷に影響します。
#つまりNVIDIAは、 確保能力は最強だが、必要資材の複雑性も最大 です。
##
AMD:VeniceでTSMC N2を早期確保。AIラック供給網を急拡大中
#AMDはVeniceで、TSMC 2nm / N2のHPC枠を非常に早く押さえています。AMDはVeniceがTSMC N2でproduction rampに入った初のHPC製品だと発表しており、将来的にはTSMC Arizonaでも生産立ち上げを行う計画です。(AMD)
#さらにAMDは、台湾のAIエコシステムに100億ドル超を投資すると発表しています。Reutersによると、AMDはASE、SPIL、PTI、Wiwynnなどの台湾パートナーと協力し、先端パッケージ、基板、製造インフラを拡大し、CPU需要の高まりに対応する方針です。Lisa Su氏は、CPU供給は2026年を通じて四半期ごとに増え、2027年から2029年にかけても大きな拡張を計画していると述べています。(Reuters)
#AMDの供給確保の強みは、
#・TSMC N2の初期HPC枠を確保
・EPYC CPUの実績
・Instinct GPU、Pensando NIC、ROCm、Heliosを組み合わせる戦略
・台湾エコシステムへの100億ドル超投資
・先端パッケージ、基板、ODM連携の強化です。
#一方で、NVIDIAと比べると課題もあります。
#・HBM/CoWoS/基板/ODMの確保力はNVIDIAほど圧倒的ではない
・MI400/MI450X、Heliosの供給網はこれから本格立ち上げ
・ROCmやラック運用実績はNVIDIA CUDA/DGX系に比べて追う立場
・CPUとGPUの両方でTSMC先端枠を必要とするAMDはCPU単体ではかなり良い位置にいます。 特にVeniceのN2立ち上げは大きい。 しかし、AIラック全体の供給網では、まだNVIDIAを追う立場です。
##
TSMC:全プレーヤーの共通ボトルネック
#TSMCは、AIDC向けCPU/GPU/ASIC供給の中心です。 TSMCの2026年第1四半期資料では、3nmがウェハー売上の25%、5nmが36%、7nmが13%で、7nm以下の先端ノードが合計74%を占めています。用途別ではHPCが61%まで増えており、AI/HPC需要がTSMCの中心になっています。(investor.tsmc.com)
#TSMCはAI需要に対応するため、N3能力を増強していると説明しています。さらにN2は立ち上げ期にあり、N2P、A16へ進むほど、AI/HPC向けの争奪戦は激しくなります。(investor.tsmc.com)
#ここで重要なのは、CPUだけでなくAI ASIC、GPU、ネットワークチップ、HBMベースダイなども同じ先端ノードや先端パッケージを取り合うことです。
#つまり、各社のCPU供給力は最終的に、
#TSMC N2/N3枠
先端パッケージ枠
基板
メモリ
テスト/後工程に制約されます。
##
ハイパースケーラー:資金力は強いが、自社ASICとCPUでTSMC枠を取り合う
#Google、AWS、Microsoft、Metaなどは、Axion、Graviton、Cobalt、MTIA、TPU、Trainium、Maiaなどを自社開発しています。 彼らの強みは、外販を目的にしないことです。自社クラウドのTCOを下げるために、長期でTSMC枠を押さえられます。
#強みは、
#・巨大な自社需要
・長期契約能力
・クラウドソフトウェアとの垂直統合
・CPUを利益商品ではなく原価低減装置として扱える
・AI ASICとCPUを自社サービスに最適化できるです。
#ただし、CPU、AI ASIC、ネットワーク、DPUなどをすべて自社で作ろうとすると、TSMC先端枠の内部優先順位が問題になります。 たとえば、TPUやTrainiumのようなAI ASICがCPUより優先される局面もあり得ます。
#したがって、ハイパースケーラーは供給確保力が強い一方で、自社内でCPUとAI ASICの製造枠を奪い合うという制約があります。
##
Qualcomm:設計力は強いが、AIDC供給網はこれから
#Qualcommは、Oryon CPU、Hexagon NPU、低電力SoC設計、SerDes/接続IPを持ちます。Alphawave買収によって、データセンター向け高速接続、カスタムシリコン、チップレット関連能力を強化しています。
#しかしAIDC向けCPU/ASIC供給では、まだNVIDIAやAMD、ハイパースケーラーほどの実績はありません。 今後、ByteDance向けAI ASICやMeta向けArm CPUのような案件が本格化するなら、Qualcommはデータセンター向けカスタムシリコン企業として再評価されます。
#制約は、
#・TSMC/Samsung先端ノード枠の確保
・HBMや高速メモリの確保
・サーバーODMとの量産実績
・データセンター向けソフトウェアスタック
・米中規制、特に中国顧客向けASICの輸出管理です。
#Qualcommは設計力は強いですが、AIDC供給網では大化け候補だが、まだ立ち上げ段階と見るべきです。
##
Intel:TSMC依存を減らせるが、18A/14Aの歩留まりが勝負
#Intelの強みは、自社ファブを持つことです。 AMD、NVIDIA、Qualcomm、ハイパースケーラーがTSMC枠を取り合う中で、IntelはIntel 18A、将来的な14Aなど、自社プロセスでCPUを作れる可能性があります。
#これは地政学的にも重要です。米国主権半導体、政府、国防、エンタープライズにとって、Intel FoundryはTSMC依存を下げる選択肢になります。
#ただし、Intelの制約は明確です。
#・18Aの歩留まり
・先端量産の安定性
・外部顧客の信頼獲得
・Foverosなど先端実装の量産性
・TSMCに対する性能/電力/コスト競争Intelは供給確保の構造がAMD/NVIDIAとは違います。 TSMC枠を取れるかではなく、自社で本当に安定して作れるかが問題です。
##
HiSilicon / Huawei:国内需要は強いが、製造制約が重い
#Huawei / HiSiliconは、Kunpeng CPUとAscend NPUを持ち、中国国内の主権AIインフラを構築しています。 KunpengはAscend NPUのホストCPUとして使われ、CloudMatrixやAtlas系システムでは、CPUとNPUを組み合わせて中国内製AI基盤を作る方向です。
#ただし最大の制約は製造です。
#・EUV装置が使えない
・TSMC N3/N2へアクセスできない
・SMIC/Hua HongのDUV多重露光に依存
・歩留まり、電力効率、コストが不利
・HBM、先端パッケージ、EDA、検査装置にも制約Huaweiは国内需要と政策支援が非常に強い一方で、最先端製造ではNVIDIA、AMD、TSMC陣営に遅れます。 ただし中国国内では、「最高効率」よりも「調達できること」「制裁下で動くこと」が価値になります。
##
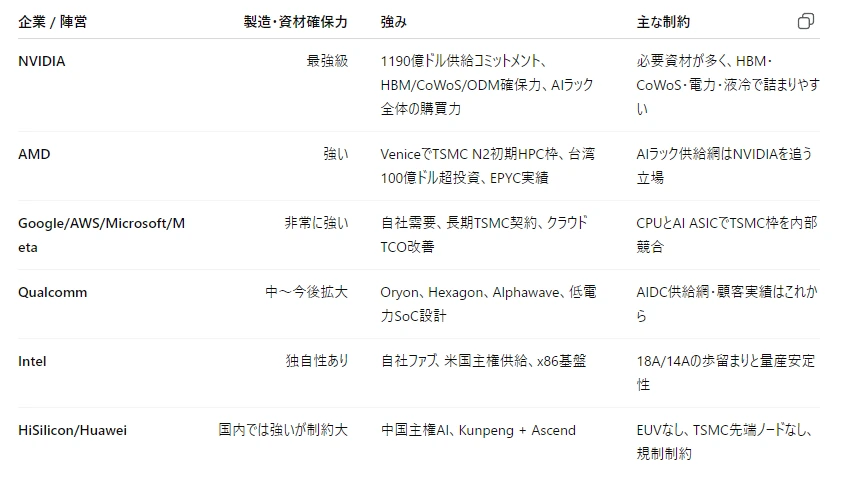
供給確保能力の比較表
#
#
結論
#AIDC向けCPU市場は、性能競争だけでなく、供給網の競争になっています。
#AMD Venice / Veranoは、AIインフラ向けに設計資源を振ることで、従来EPYCより特殊化していきます。 しかし、それでもNVIDIA Veraよりは汎用的です。理由は、x86互換、標準I/O、EPYCエコシステム、クラウド・HPC・企業用途を残す設計だからです。
#一方、NVIDIA Veraは、CPU単体としての汎用性より、Rubin GPUラック全体の実効性能を最大化するCPUです。GPUを待たせないこと、KVキャッシュやagentic AI制御を回すこと、NVLink-C2CでCPUとGPUを一体化することに価値があります。
#そして供給面では、NVIDIAが最も強いです。1190億ドル規模の供給関連コミットメントは、HBM、先端パッケージ、TSMC、基板、ODM、ラック全体を押さえる力を示します。(SEC) ただし、CPU単体ではAMD Veniceも非常に強いポジションです。TSMC 2nm初期HPC枠を押さえ、台湾エコシステムへの100億ドル超投資で、CPU・GPU・パッケージ・基板・ODMの供給網を拡張しています。(AMD)
#かなり短くまとめると、
#Venice / Verano
= AI時代に最適化されたx86汎用CPU。
汎用性を残しながら、AIラックのホストCPUへ進化する。
Vera
= NVIDIA AIファクトリーの専用制御CPU。
汎用性より、Rubin GPUラックの実効性能最大化を優先する。
供給面
= NVIDIAがAIラック全体の確保力で圧倒。
AMDはVeniceでN2 CPU枠を先行確保し、Helios時代に向けて追撃。この構図が、最近のAIDC向けCPU事情の核心です。
#特定銘柄の推奨・勧誘・投資助言を目的とするものではありません。投資判断はご自身の責任でお願いいたします。
#サムネはPixAIsunflowerモデルとGPTImage2.0
#