第8回 Die-to-Die PHYとは何か――チップレット間で信号を送受信する回路
出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.09.23.4
- 記事内容のSHA-256
d532c8d0371ed9dfe2e9d3a36b3e285115dc51fedb0d742dff70ca5aa5b3fc05- 保存版のSHA-256
c5e644da956b4e20c4dceb6269f8edf54490f5b1c6b7c66f96fcedece656ca6a
外部証明の最終検査結果は詳細を開くと表示します。
連載:巨大チップの限界を超える――UCIeとチップレット、3D半導体のすべて
#レチクル限界、Die-to-Die PHY、Hybrid Bonding、TSVから、3D V-Cache、Foveros Direct、SoIC
#第8回 Die-to-Die PHYとは何か――チップレット間で信号を送受信する回路
#TSVやマイクロバンプだけでは、データは流れない
#前回は、シリコン内部を垂直に貫通する配線であるTSVを解説した。
#TSV、マイクロバンプ、Hybrid Bonding、シリコンインターポーザーは、いずれもチップレット間に電気的な経路を作る技術である。
#しかし、銅配線で2つのダイを物理的につないだだけでは、正しいデータ通信は成立しない。
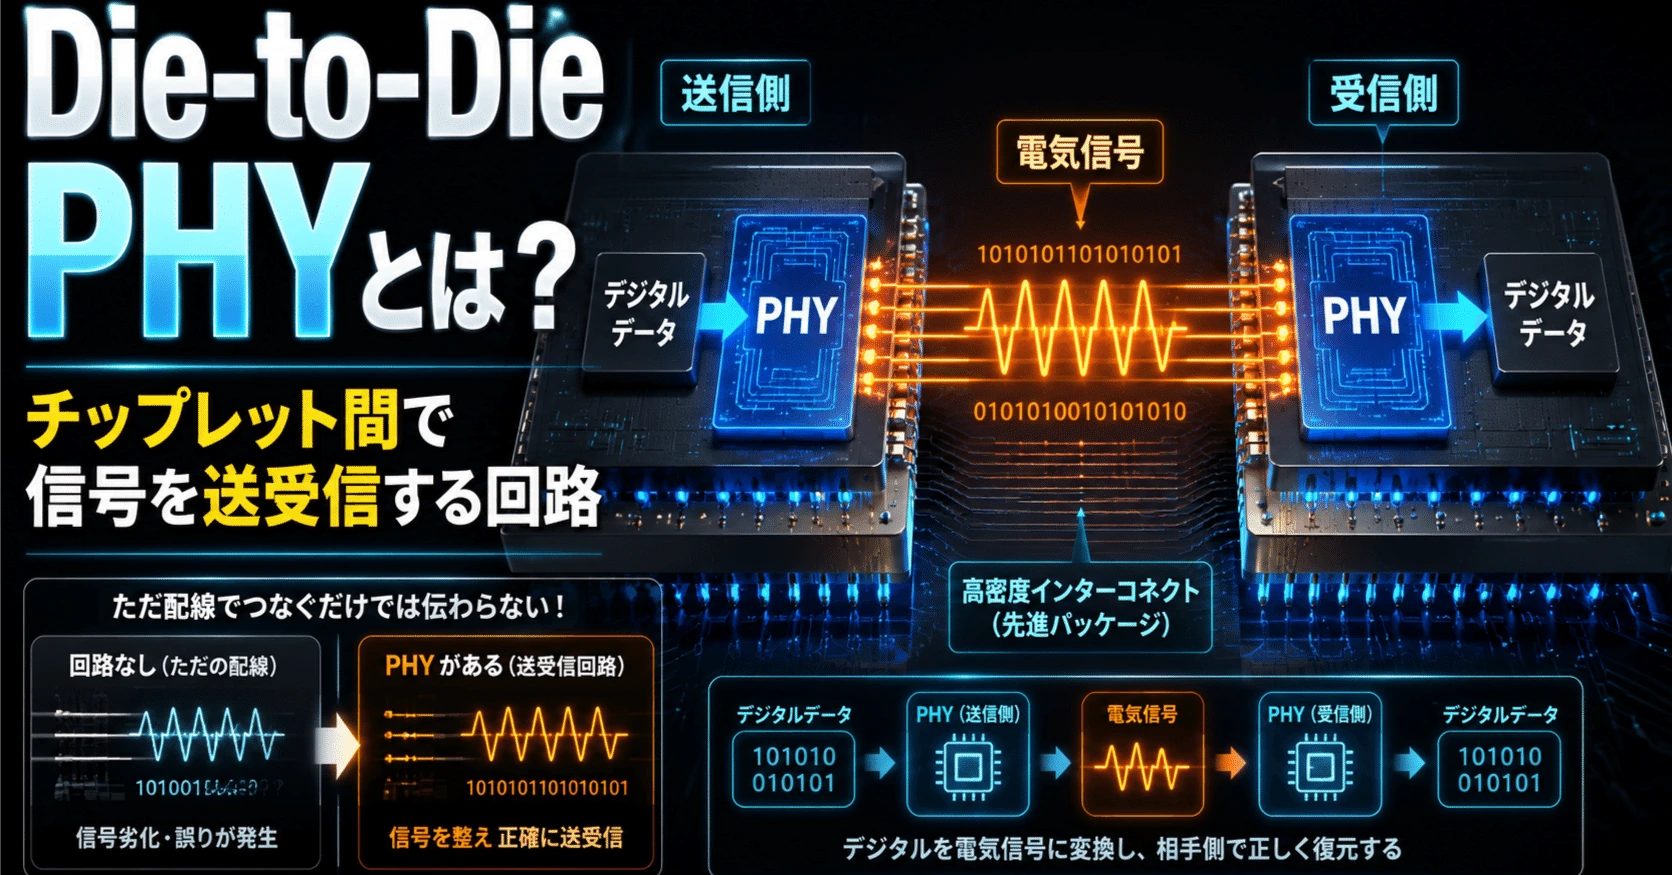
#ダイ内部のデジタルデータを電気信号へ変換し、接続経路へ送り出し、相手側で受信して再びデジタルデータへ戻す回路が必要になる。
#その役割を担うのが、Die-to-Die PHYである。
#送信側チップレット
演算回路・キャッシュ・NoC
↓
プロトコル/コントローラー
↓
Die-to-Die Adapter
↓
Die-to-Die PHY
↓
金属パッド
↓
マイクロバンプ/Hybrid Bonding
↓
インターポーザー/RDL/TSV
↓
相手側の接続端子
↓
相手側Die-to-Die PHY
↓
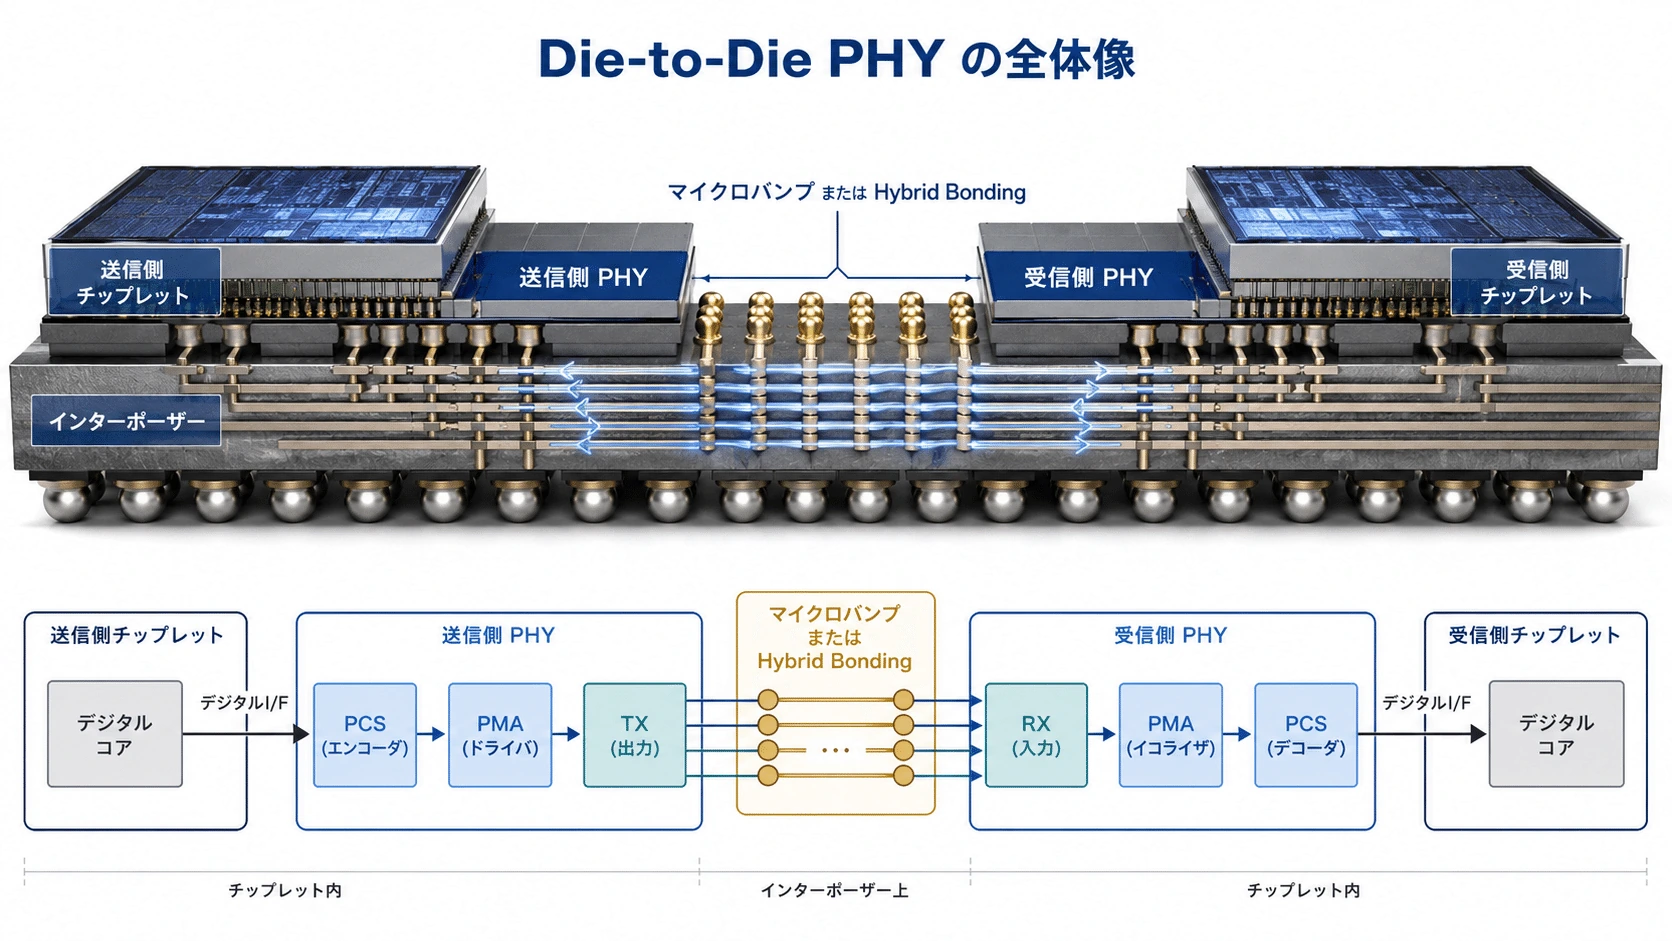
受信側の内部回路UCIeも、チップレット間接続を、Physical Layer、Die-to-Die Adapter、Protocol Layerなどの階層に分けている。Physical Layerは電気信号、クロック、リンクトレーニングなどを担当し、Adapterはリンク状態やパラメーター交渉を扱う。(UCIe Consortium)
#
#
PHYとは何か
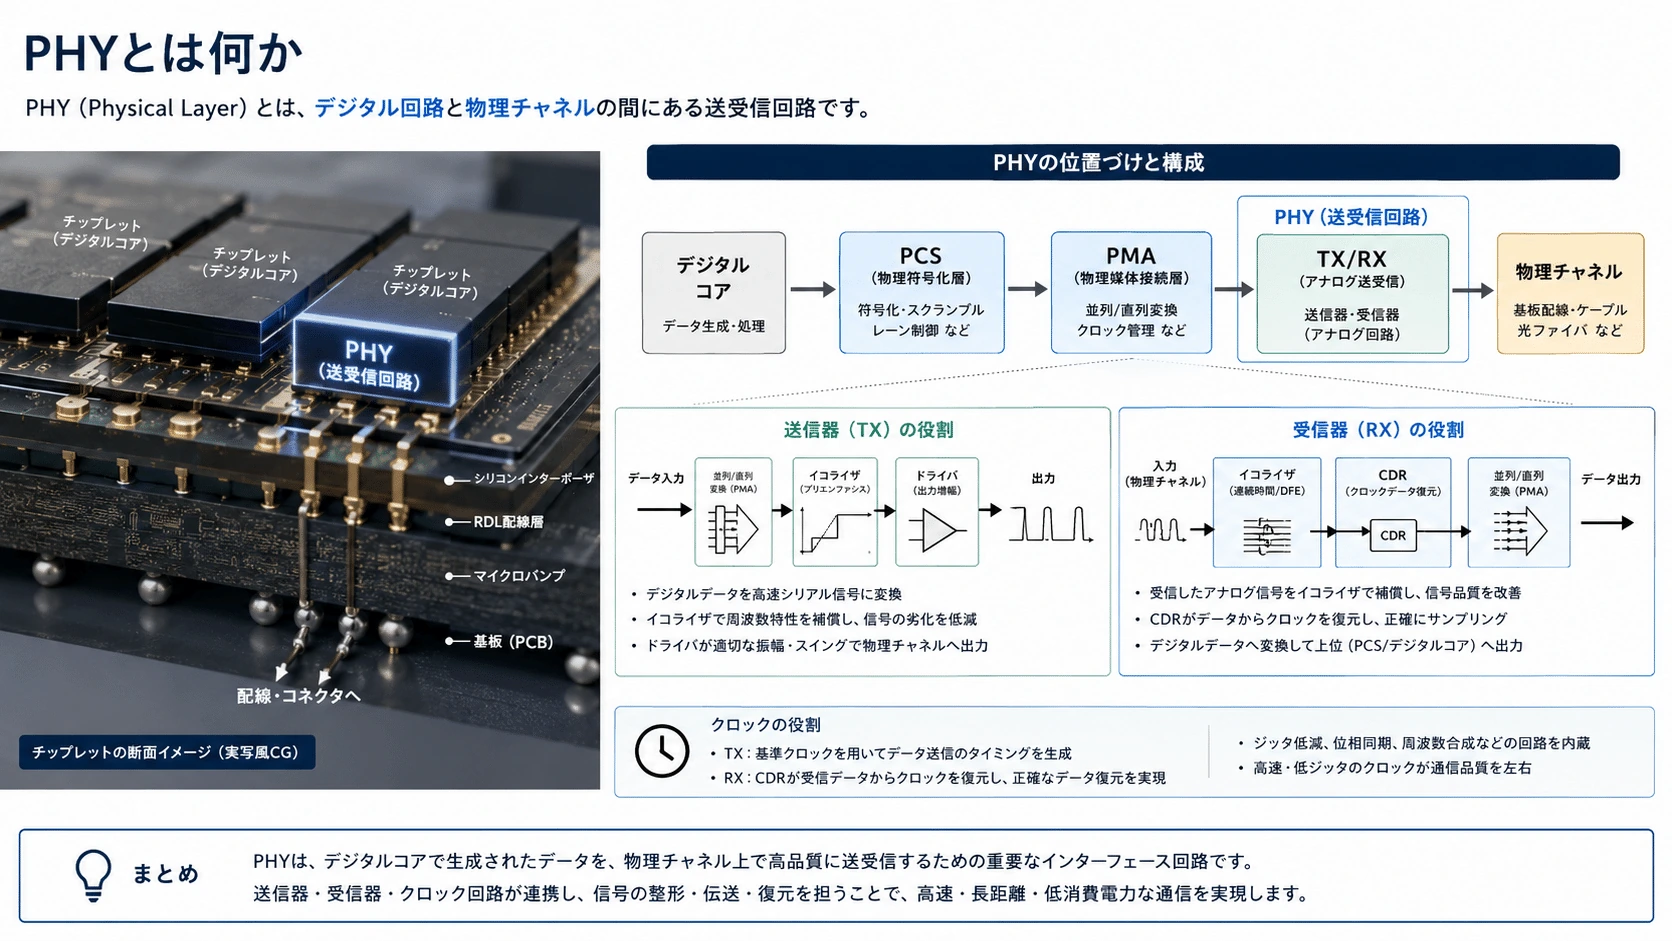
#PHYはPhysical Layer、物理層の略である。
#Die-to-Die PHYは、簡単にいえば、
#ダイ内部のデジタル情報を、パッケージ配線を通れる電気信号へ変換し、相手側で復元する回路#
である。
#デジタルデータ
10110100
↓
送信PHY
↓
電圧・電流の変化
↓
パッケージ配線
↓
受信PHY
↓
デジタルデータ
10110100ただし、PHYの実装範囲は製品や規格によって異なる。
#一般的には、次のような機能が含まれる。
#- 送信ドライバー
- 受信回路
- シリアライザー/デシリアライザー
- クロック生成・分配
- サンプリングタイミング調整
- レーン間の遅延補正
- リンクトレーニング
- 電圧・タイミング校正
- ループバックテスト
- 故障レーンの修復や置換
一部のリンク管理、エラー訂正、再送、プロトコル交渉は、PHYではなく上位のAdapterやControllerに置かれる。UCIe IPでも、PHYと、Adapter/Protocolを含むControllerは別の構成要素として提供されている。(cadence.com)
#
#
Die-to-Die PHYは「配線」ではない
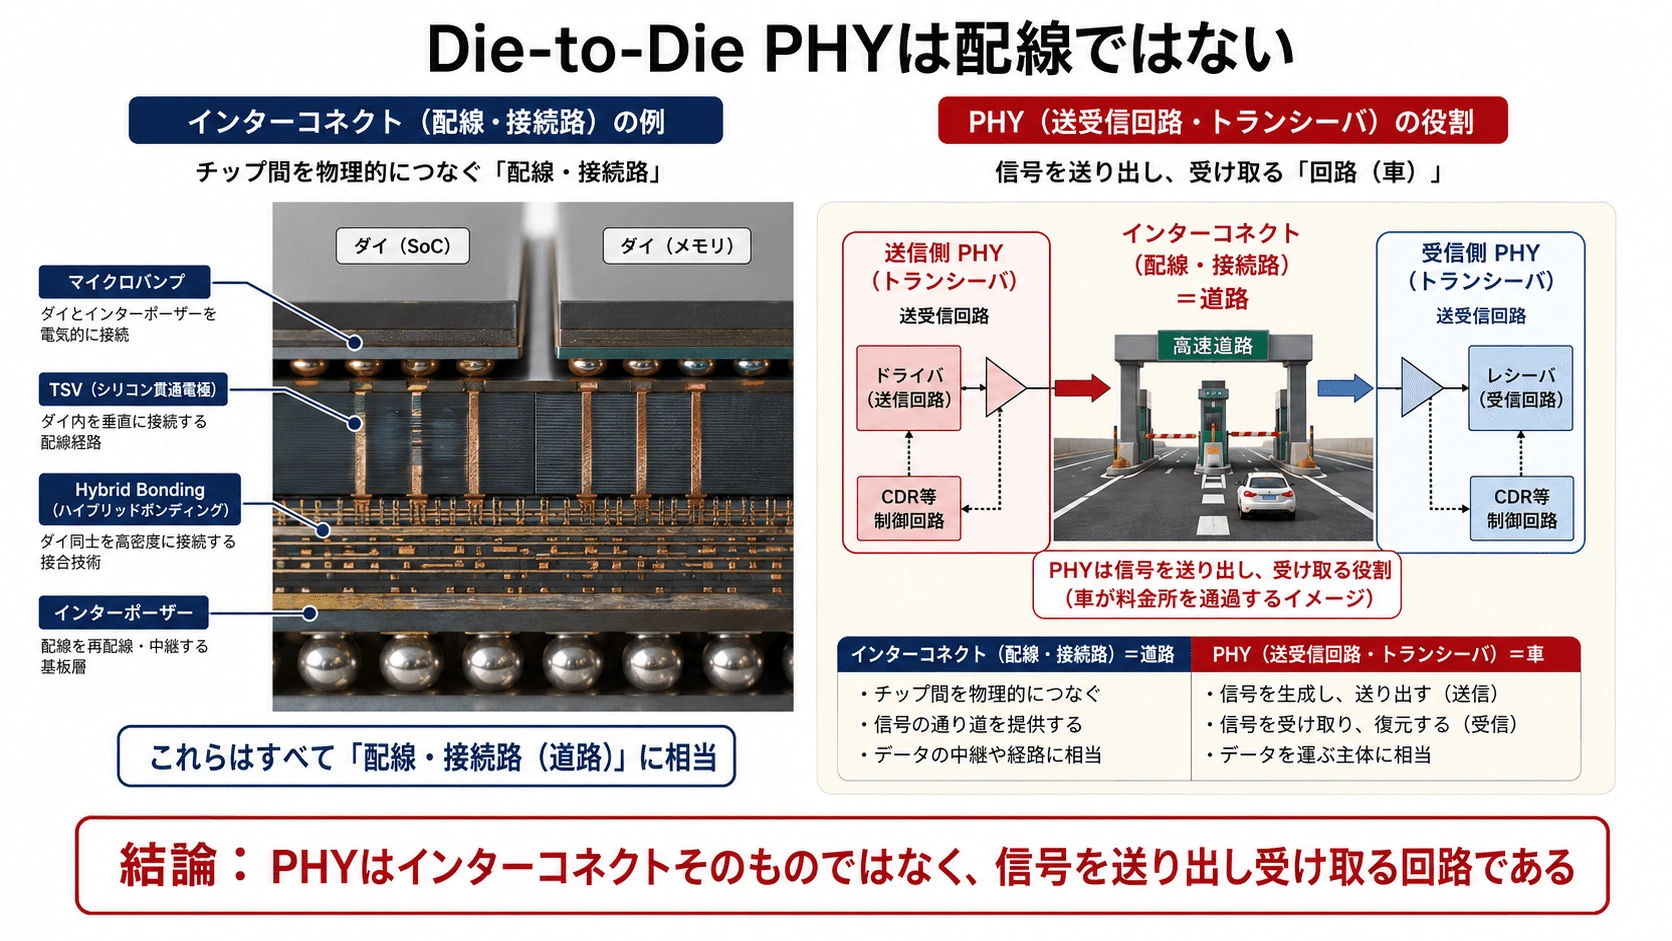
#TSV、マイクロバンプ、Hybrid Bondingと、Die-to-Die PHYの違いを整理すると次のようになる。
#| 技術 | 主な役割 |
| TSV | 1枚のシリコン内部を垂直に貫通する |
| マイクロバンプ | 2つの部品の接合面を電気的につなぐ |
| Hybrid Bonding | 銅と誘電体を直接接合する |
| インターポーザー | ダイ間の信号を横方向へ運ぶ |
| Die-to-Die PHY | 信号を送信・受信し、通信を成立させる |
| UCIe | PHYより上を含めた通信方式を標準化する |TSV・バンプ・配線
=データが通る「道路」
Die-to-Die PHY
=データを道路へ送り出し、
相手から受け取る「送受信設備」
プロトコル
=データの意味と会話の規則AMDもチップレット技術を、物理的な接続を担うインターコネクト技術と、チップレット同士が情報を理解するためのプロトコルに分けて説明している。
#
#
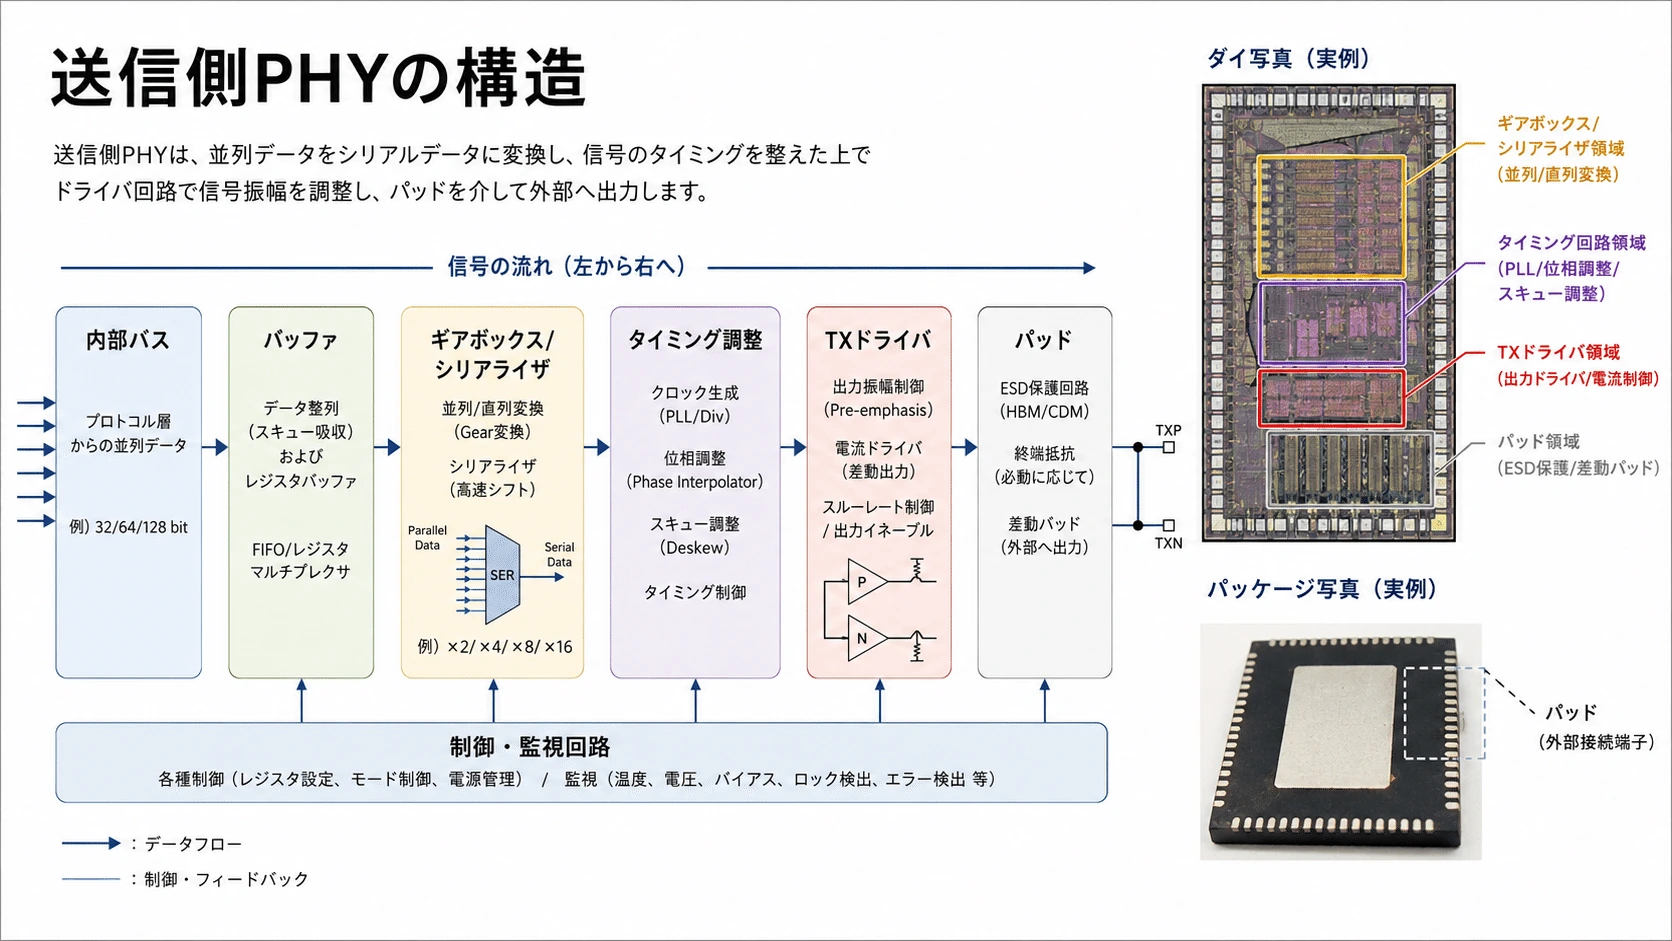
送信側PHYの構造
#送信側のPHYは、内部回路から受け取ったデータを、パッケージ配線へ送れる信号へ変換する。
#内部バス
↓
バッファ
↓
ギアボックス/シリアライザー
↓
タイミング調整
↓
送信ドライバー
↓
パッド・バンプバッファ
#内部のNoCやキャッシュから来たデータを一時的に保持する。
#内部回路とリンクの動作速度が異なる場合には、その速度差を吸収する。
#ギアボックス
#内部バスのデータ幅と、物理リンクのレーン数や動作周波数を変換する。
#例えば、内部では256bitを一度に扱い、PHY側では64レーンを使って複数回に分けて送る、といった変換を行う。
#シリアライザー
#複数bitの並列データを、時間方向へ並べ替えて高速な信号へ変換する。
#並列入力
A B C D
↓ シリアライズ
時間 →
A → B → C → Dただし、すべてのDie-to-Die PHYが強くシリアライズするわけではない。
#チップレット間には多数の接続端子を置けるため、多数のレーンを比較的低い速度で並列動作させる方式も使われる。
#送信ドライバー
#デジタルデータの0と1に対応する電圧または電流を、物理配線へ送り出す。
#パッケージ内の配線は短いため、外部SerDesより小さな信号振幅と弱い駆動力で通信できる場合がある。
#
#
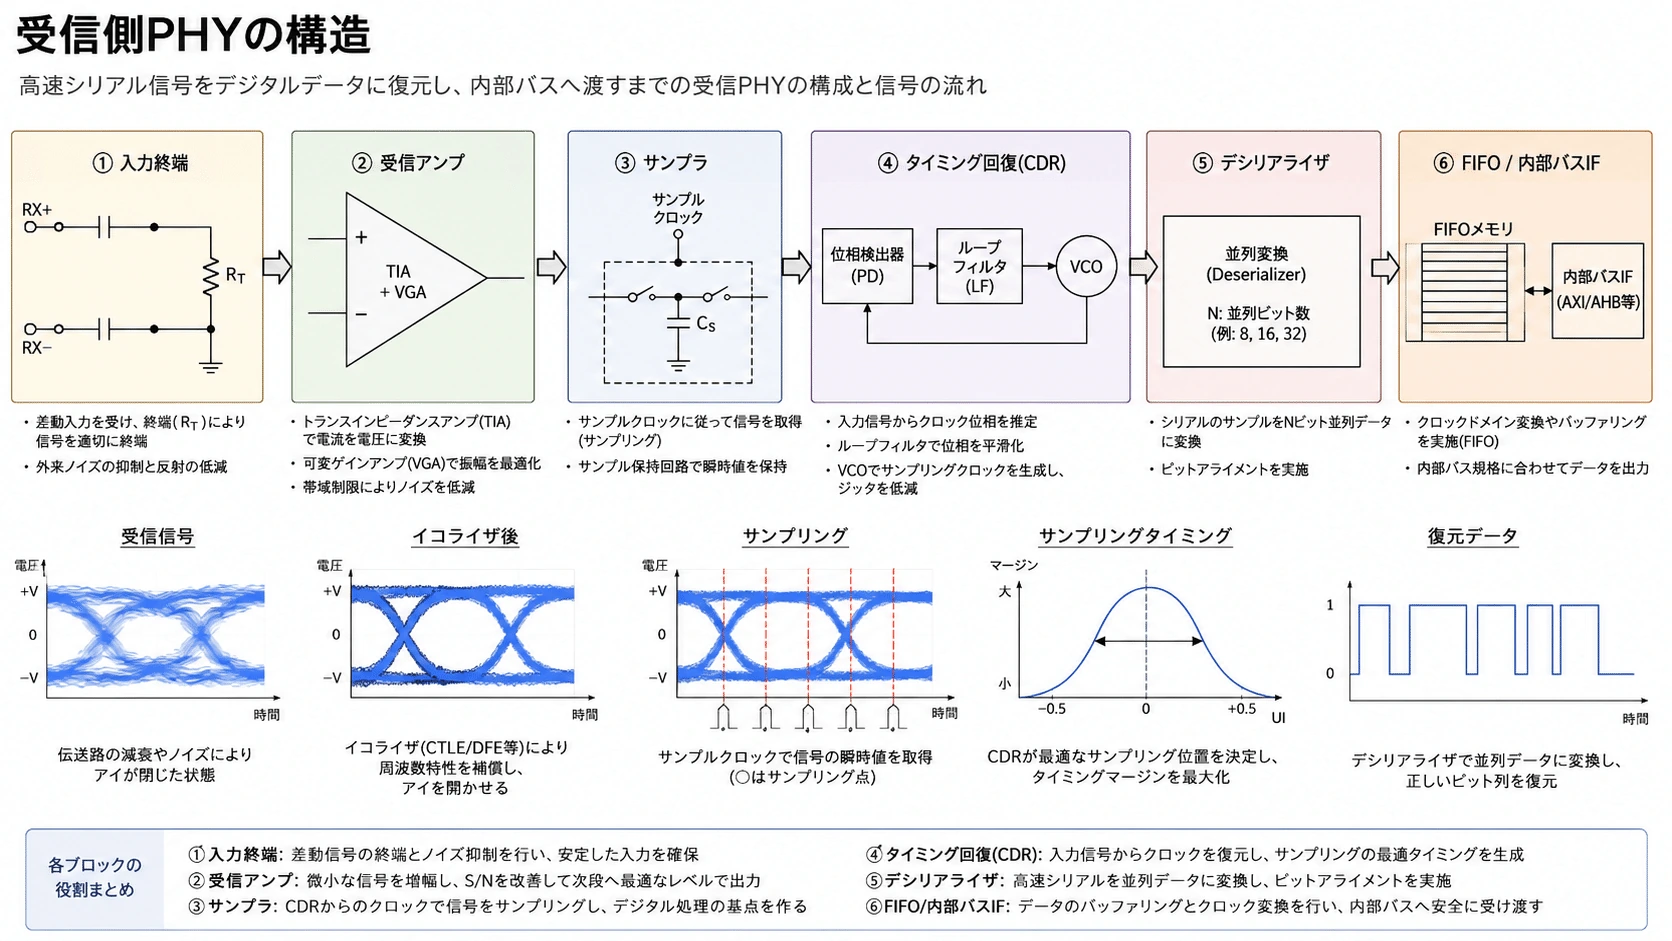
受信側PHYの構造
#受信側PHYは、配線を通って変形した信号から0と1を判定する。
#パッド・バンプ
↓
入力終端
↓
受信アンプ
↓
サンプラー
↓
タイミング補正
↓
デシリアライザー
↓
内部バス入力終端
#配線の特性インピーダンスへ合わせ、信号反射を抑える。
#短いDie-to-Die配線でも、速度が高くなると単なる直流配線として扱えず、伝送線路として設計する必要がある。
#受信アンプ
#到着した小さな電圧差を増幅する。
#サンプラー
#決められた時刻に信号を読み取り、0か1かを判断する。
#同じ波形でも、読み取るタイミングがずれると誤判定する。
#理想的なサンプリング
0 ────╲____╱──── 1
↑
中央で読む
危険なサンプリング
0 ────╲____╱──── 1
↑
変化中に読むデシリアライザー
#高速に連続して届いたbitを、内部回路が扱いやすい幅の並列データへ戻す。
#
#
レーンとは何か
#レーンとは、データを運ぶ基本的な信号経路である。
#Lane 0 ─────────→
Lane 1 ─────────→
Lane 2 ─────────→
Lane 3 ─────────→ただし、1レーンが必ず1個のバンプに対応するとは限らない。
#方式によって、
#- 1本のシングルエンド信号
- 2本を使う差動信号
- データ線とクロック線
- データ線とストローブ線
など、必要な端子数が変わる。
#さらに実際のPHYには、
#- データ
- クロック
- ストローブ
- 電源
- グラウンド
- 管理信号
- 予備レーン
- テスト信号
が必要になる。
#したがって、64データレーンのPHYだからといって、接続端子が64個だけで済むわけではない。
##
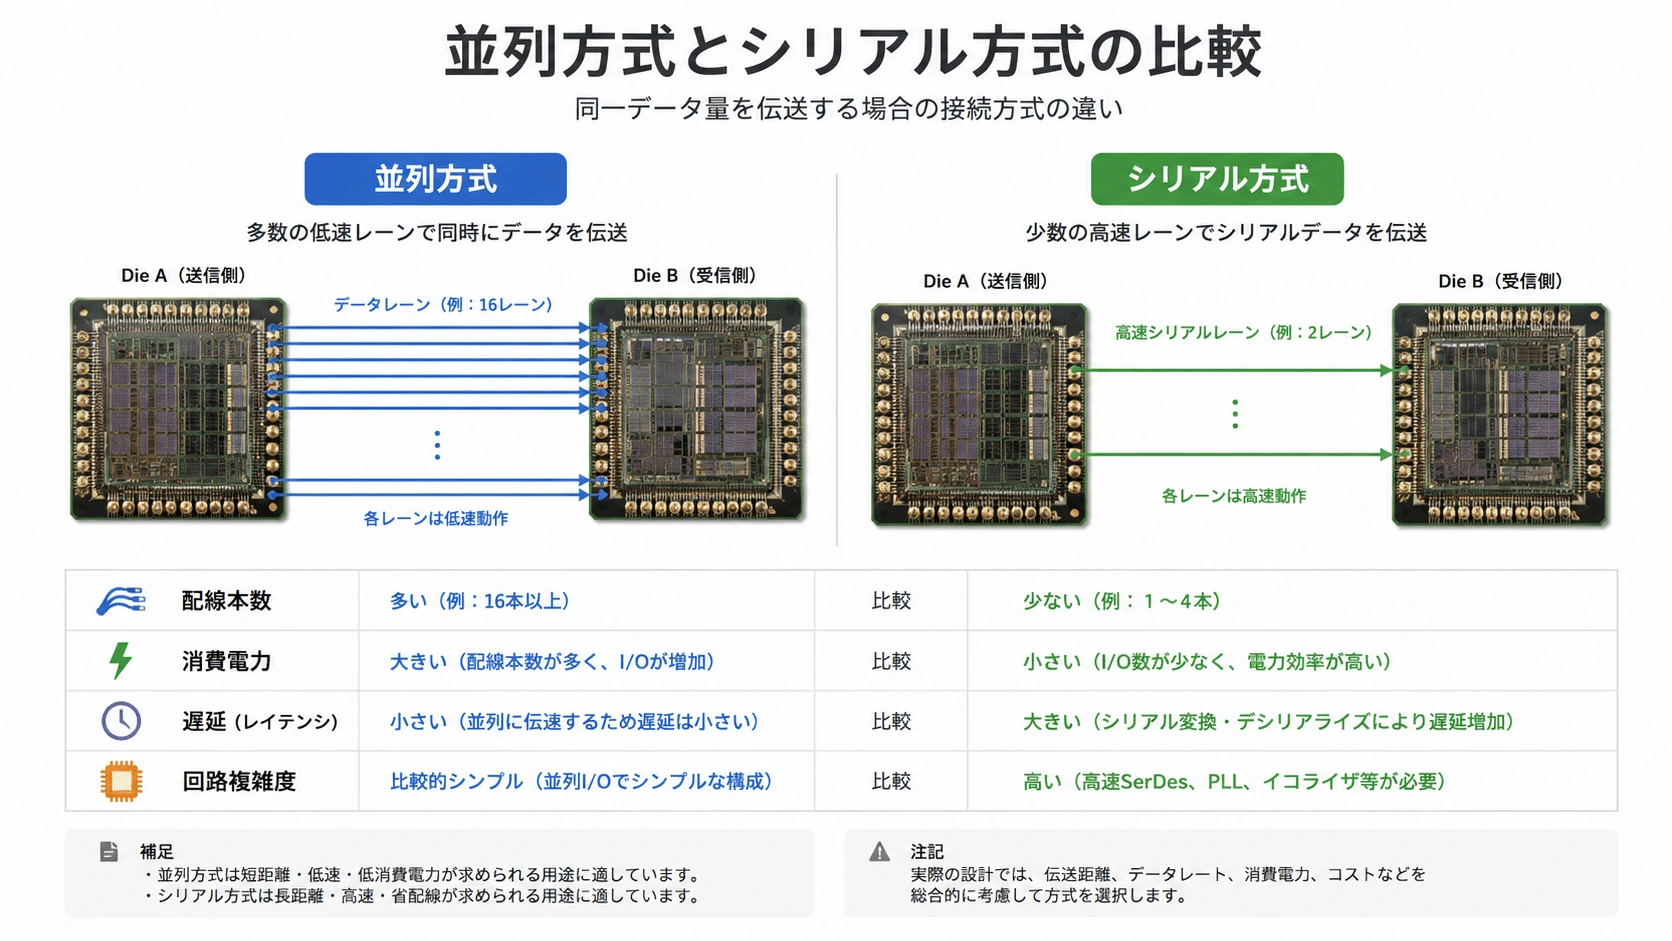
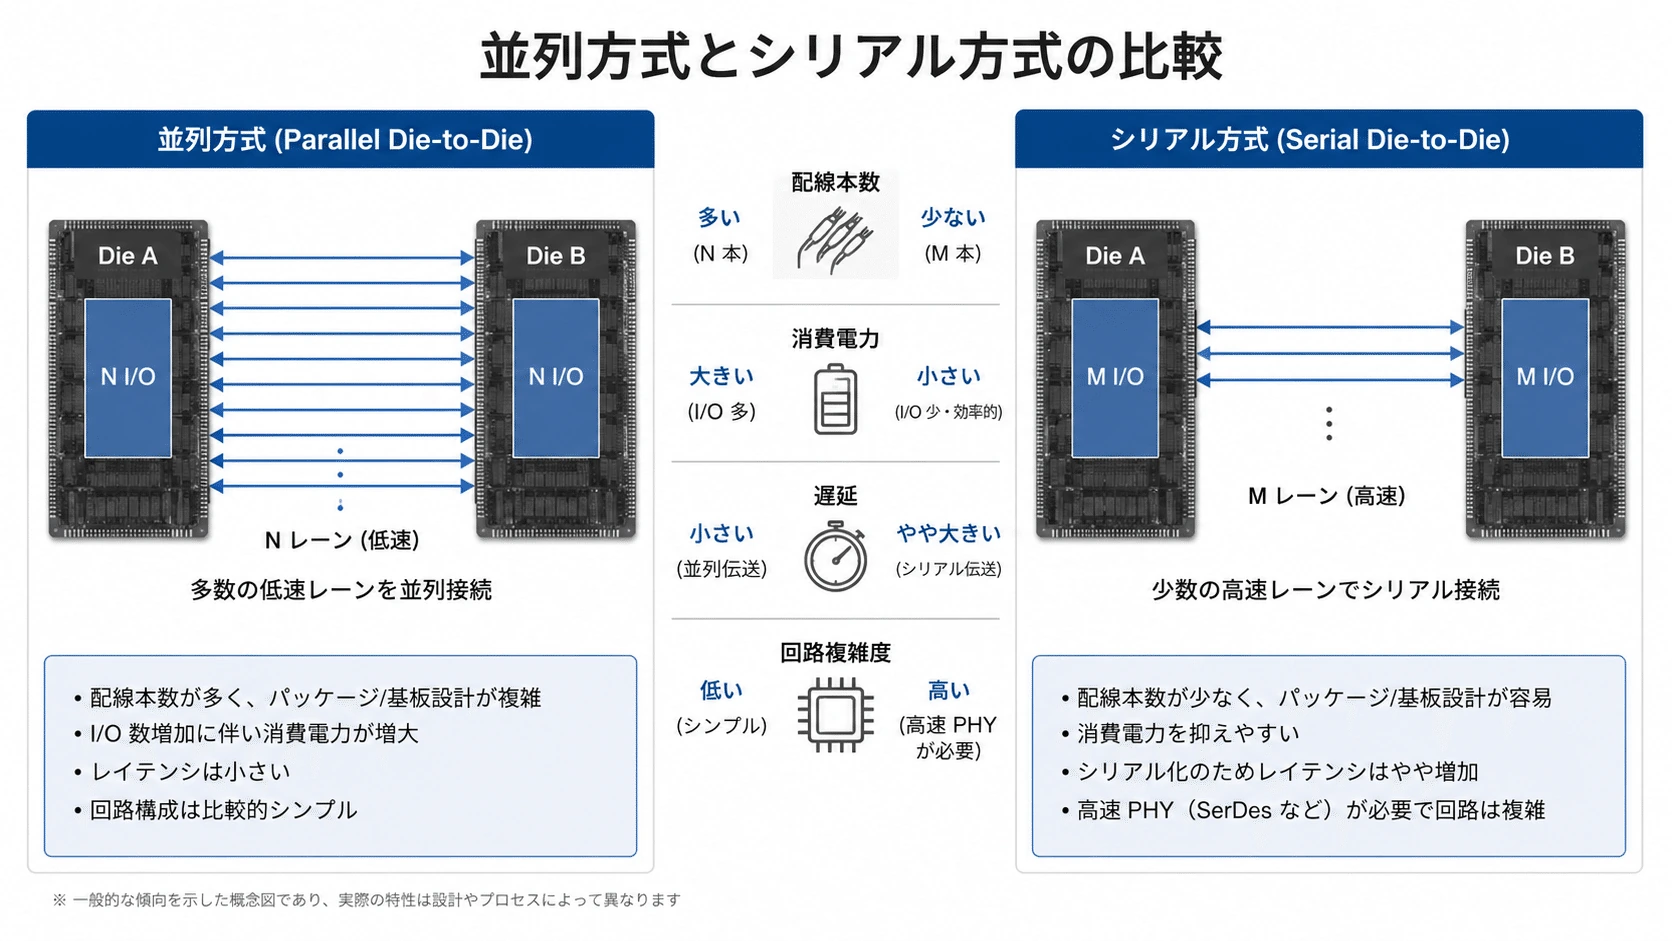
並列方式とシリアル方式
#Die-to-Die PHYには、大きく分けて2つの方向性がある。
#幅広い並列方式
#多数のレーンを比較的低い速度で動作させる。
#多数の配線
→ → → → → → → →
→ → → → → → → →
→ → → → → → → →利点
#- 1レーン当たりの速度を抑えやすい
- 強力なイコライザーを省略しやすい
- 低電圧で動作させやすい
- 低遅延化しやすい
- 1bit当たりの通信電力を下げやすい
弱点
#- 多数のバンプが必要
- ダイの辺を大量に使用する
- パッケージ配線が複雑になる
- レーン間のタイミング差が問題になる
強くシリアライズする方式
#少数のレーンを非常に高速で動作させる。
#少数の高速配線
══════════════→
══════════════→利点
#- 接続端子数を減らせる
- ダイ辺長を節約できる
- 比較的粗い有機基板でも配線しやすい
弱点
#- シリアライザーとデシリアライザーが必要
- PLLやCDRが大きくなる
- イコライザーが必要になる場合がある
- 消費電力と遅延が増えやすい
実際のPHYは、この中間に位置することが多い。CadenceもDie-to-Die IPについて、SerDesとDDR型のアーキテクチャを組み合わせる構成を説明している。(cadence.com)
#
#
Die-to-Die PHYが並列方式を使いやすい理由
#外部I/Oでは、パッケージ端子、マザーボード、コネクタ、ケーブルの本数に制約がある。
#一方、先端パッケージ内では、マイクロバンプやHybrid Bondingによって多数の接点を配置できる。
#外部接続
少数の高速SerDes
↓
基板・コネクタ・ケーブル
パッケージ内接続
多数の短距離レーン
↓
インターポーザー・ブリッジレーン数を増やせば、各レーンを極端に高速化しなくても大きな総帯域を得られる。
#これは、
#1本を極端に速くする代わりに、多数の細い道路へ交通を分散する#
という考え方である。
#
#
生の帯域はどう決まるのか
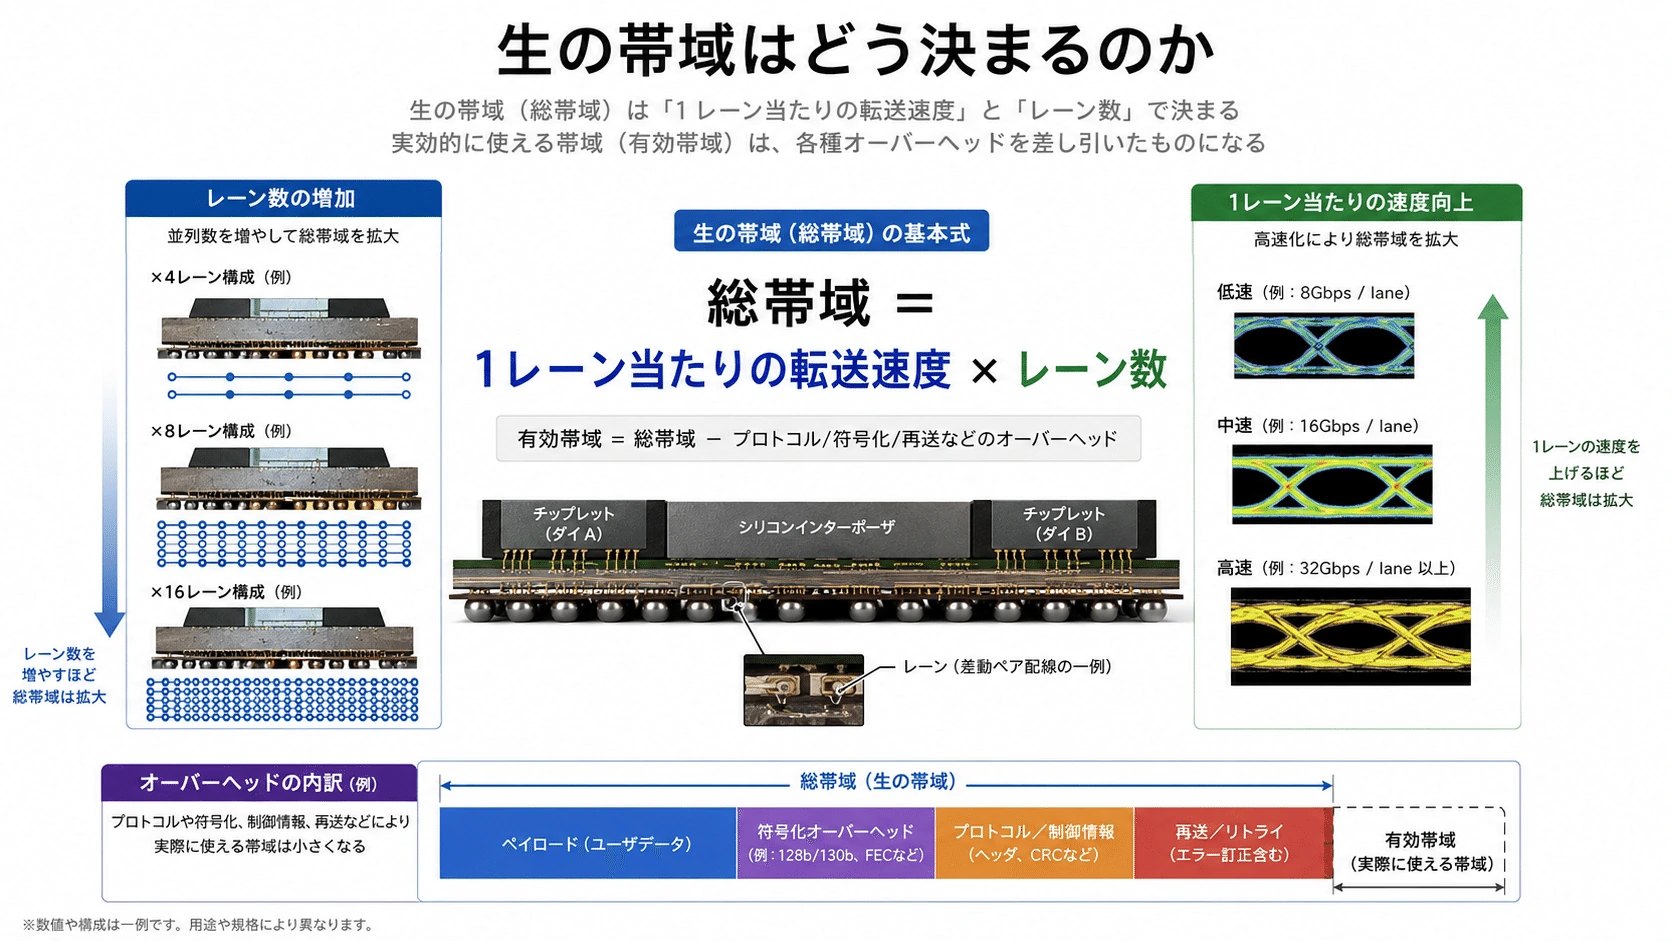
#1方向の理論帯域は、基本的にはレーン数と1レーン当たりの転送速度で決まる。
#Braw:理論上の生帯域 Nlane:データレーン数 Rlane:1レーン当たりの転送速度
#例えば64レーンを32GT/sで動作させる場合、単純化した生の転送量は、
#となる。
#Byteへ換算すると、
#である。
#ただし実効帯域は、
#- エンコーディング
- フレーミング
- CRC
- 制御情報
- アイドル時間
- 再送
- プロトコルヘッダー
によって小さくなる。
#η(イータ)は、オーバーヘッドを考慮した伝送効率である。
#
#
帯域密度
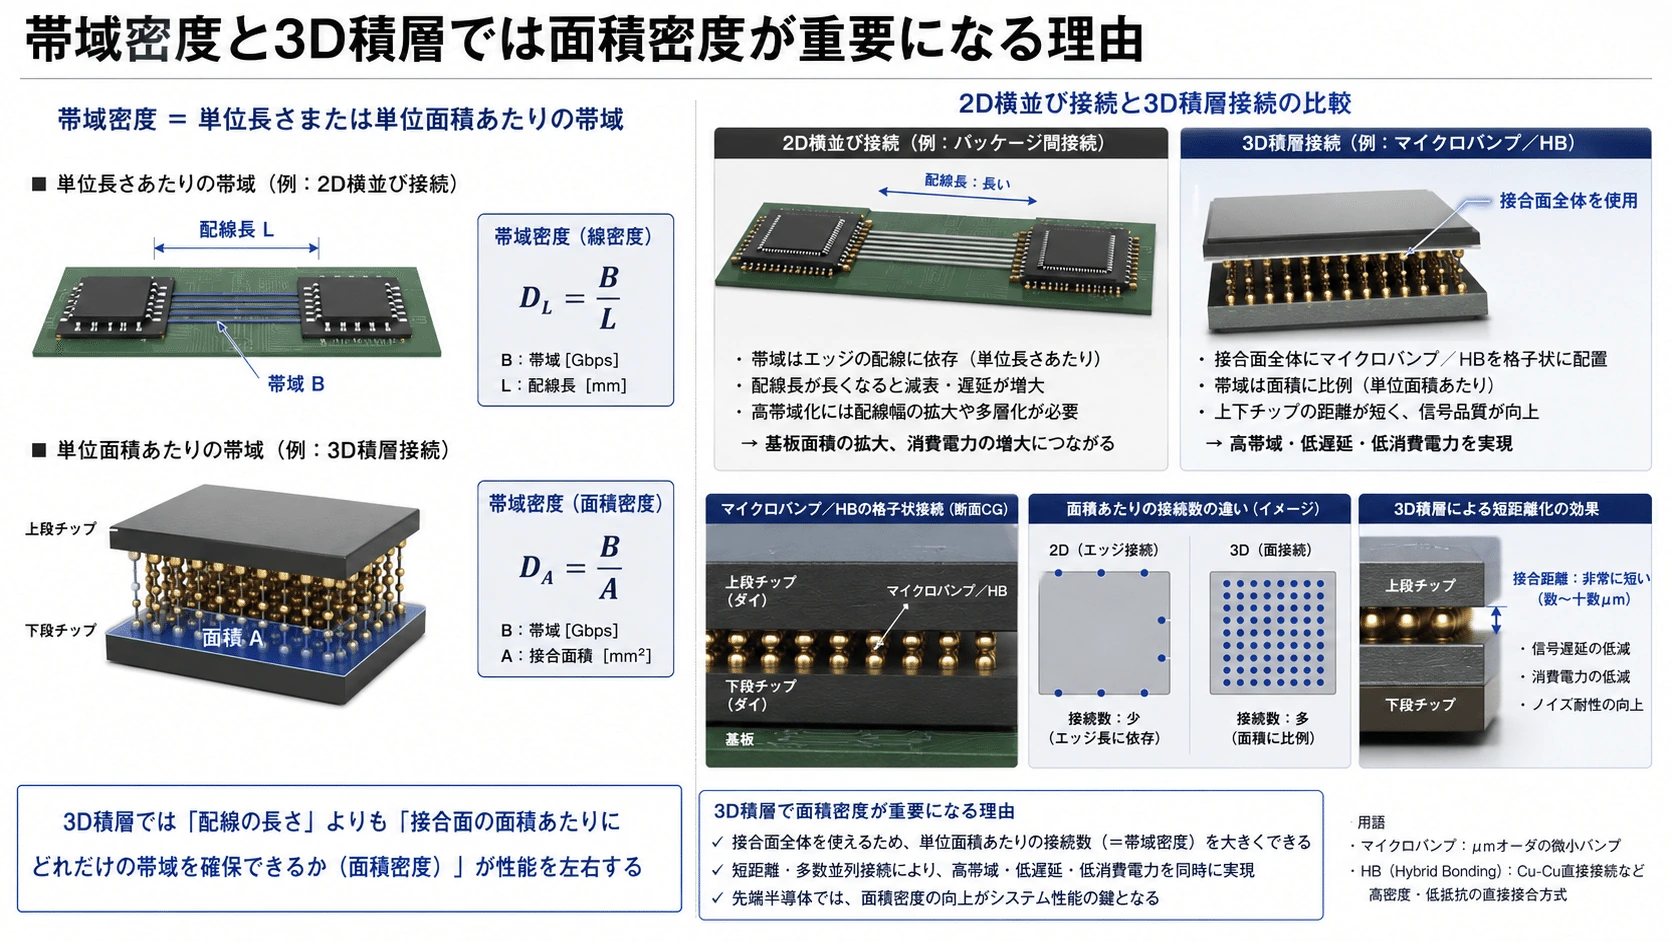
#チップレットでは、総帯域だけでなく帯域密度が重要になる。
#2D・2.5Dパッケージでは、PHYがダイの辺に沿って配置されることが多い。
#そのため、ダイ辺1mm当たりの帯域が指標になる。
#DBW:帯域密度 Btotal:PHY全体の帯域 LPHY:PHYが使用するダイ辺長
#例えば総帯域が1TB/sでも、PHYがダイの辺を20mm使用するのか、5mmだけで済むのかでは、設計上の価値が大きく異なる。
#PHYがダイ辺を大量に占有すると、
#- HBM用PHY
- PCIe用SerDes
- メモリーコントローラー
- 電源端子
- その他のチップレット接続
を置く場所が減る。
#このダイ外周の限られた資源は、shoreline、海岸線に例えられる。
#
#
3D積層では面積密度が重要になる
#Hybrid Bondingを使った3D積層では、接続をダイの外周だけでなく、接合面全体へ配置できる。
#2.5D接続
┌────────────┐
│ │PHY PHY PHY
└────────────┘
↑
主にダイの辺を使用
3D接続
┌────────────┐
│ • • • • • •│
│ • • • • • •│
│ • • • • • •│
└────────────┘
↑
接合面全体を使用この場合は、辺長当たりだけでなく、接合面積当たりの帯域が重要になる。
#UCIe 2.0では3Dパッケージを追加し、Hybrid Bonding向けに10~25µm級から1µm以下までの接続ピッチを想定している。これは2D・2.5Dより高い帯域密度と電力効率を狙うものである。(UCIe Consortium)
##
クロックはどのように渡すのか
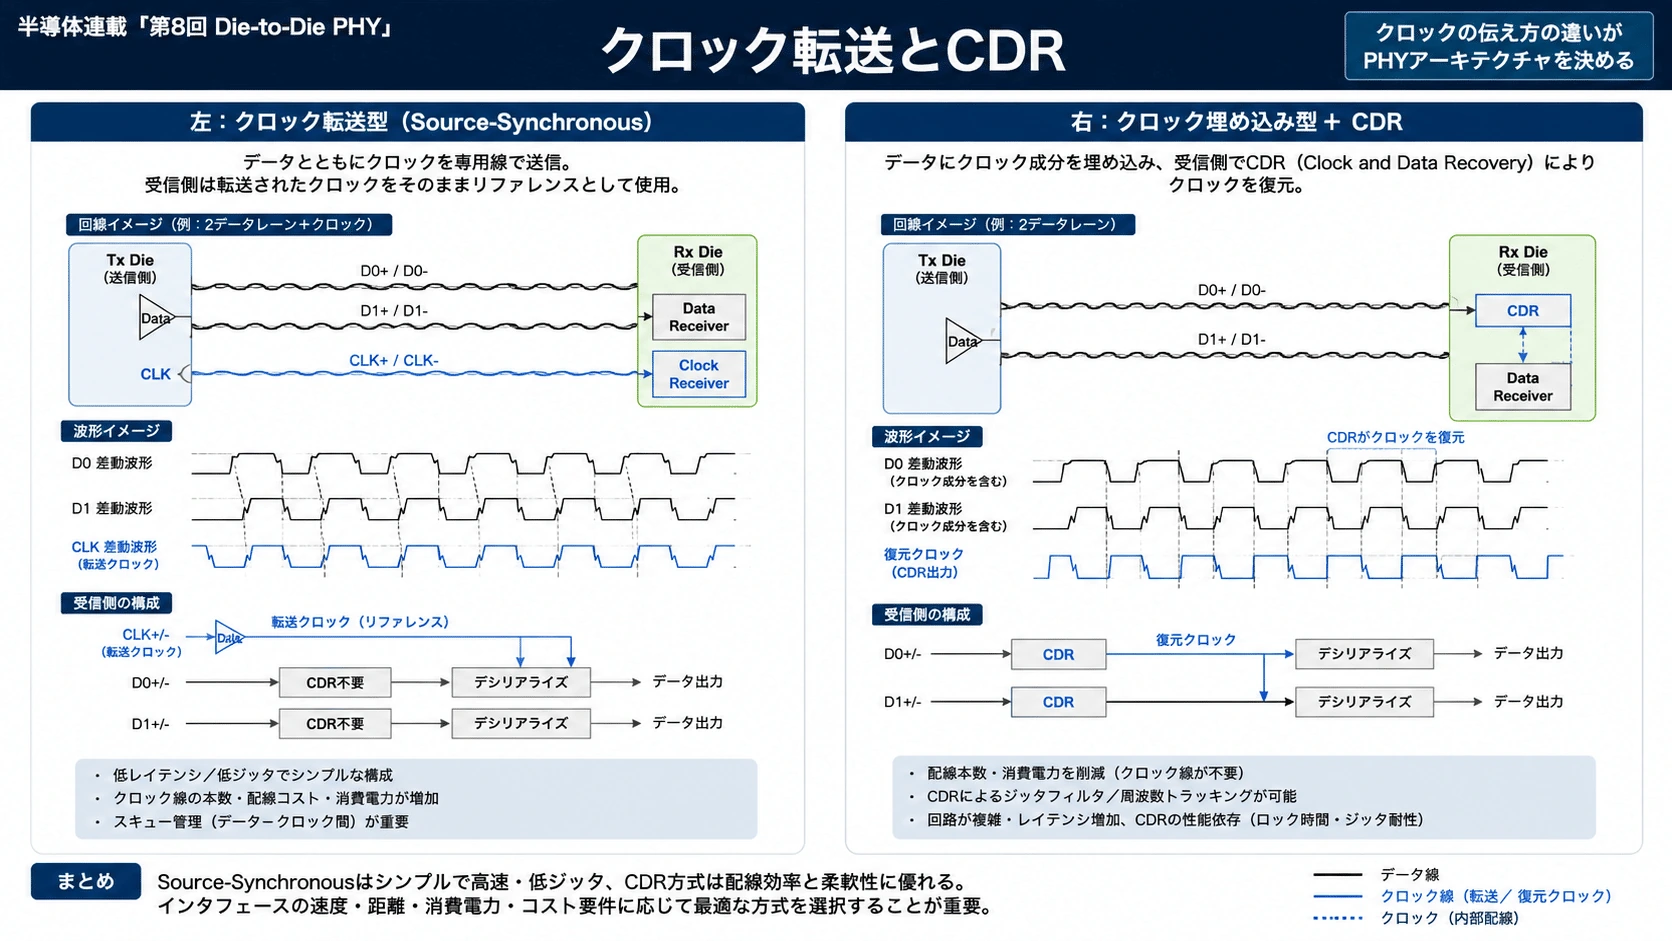
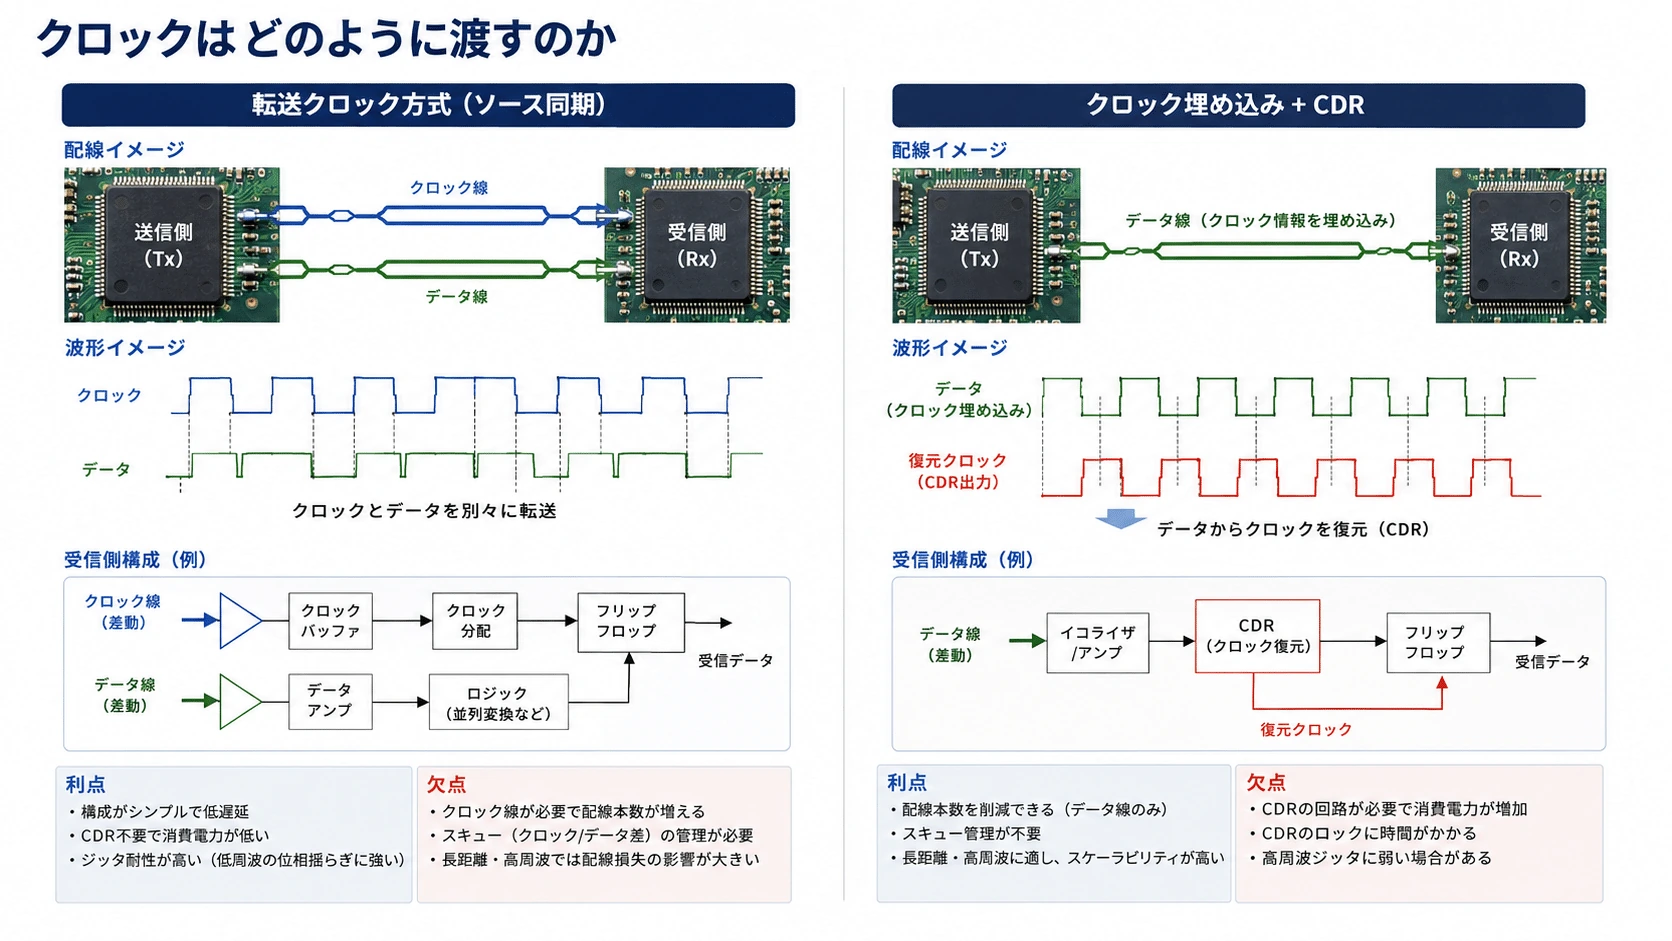
#受信側がデータを正しく読み取るには、どの時刻に信号を読むかを知る必要がある。
#主な方法は次の2つである。
#クロック転送型
#データ線と一緒にクロックまたはストローブを送る。
#Data 0 ─────────→
Data 1 ─────────→
Data 2 ─────────→
Clock ─────────→受信側は、送られてきたクロックを基準にデータを読み取る。
#これはsource-synchronous、ソース同期方式と呼ばれる。
#短く固定的なパッケージ内配線と相性がよく、多数の並列レーンを低遅延で動かしやすい。
#クロック埋め込み型
#データ波形の変化からクロックを復元する。
#データ+タイミング情報
↓
CDR
↓
復元クロック+データこの回路がCDR、Clock and Data Recoveryである。
#外部SerDesで広く使われるが、回路面積、消費電力、ロック時間が必要になる。
#Die-to-Die PHYでも、高速で強くシリアライズする方式ではCDRを使用する場合がある。
#
#
レーン間のスキュー
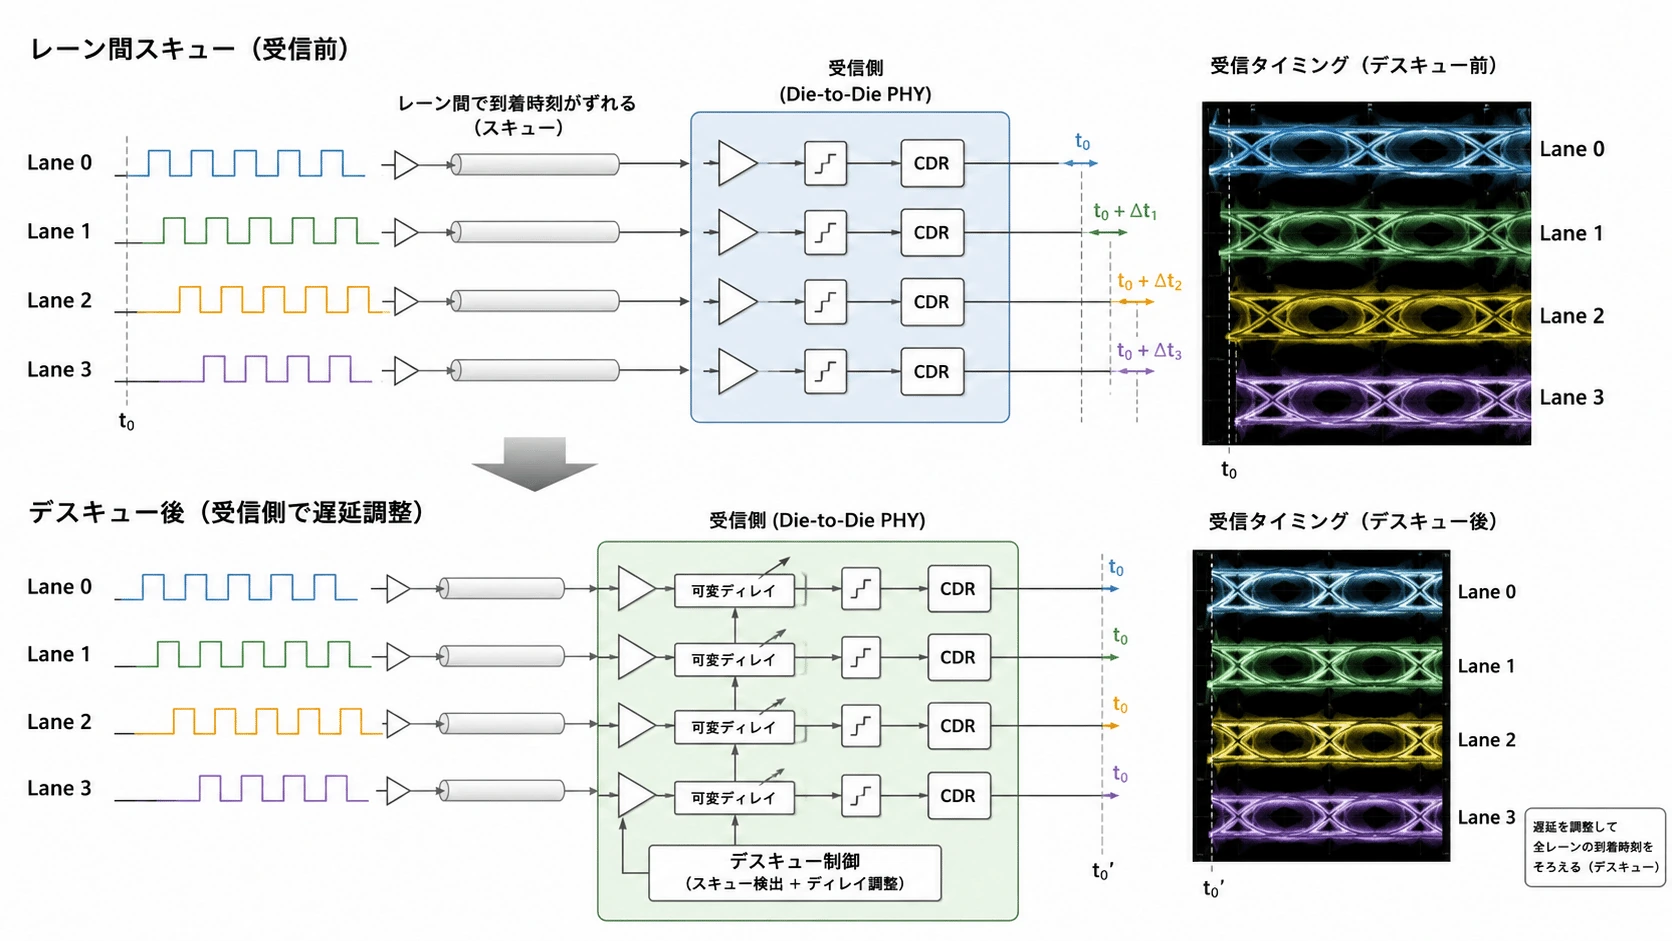
#並列レーンを多数使うと、各信号の到着時刻に差が生じる。
#これをスキューという。
#Lane 0 ───────────→ 到着
Lane 1 ─────────────→ 少し遅い
Lane 2 ──────────→ 少し速い
Lane 3 ──────────────→ 遅い原因には、
#- パッケージ配線長の差
- バンプやパッドのばらつき
- 送信回路のばらつき
- 受信回路のばらつき
- 電源電圧差
- 温度差
- 製造ばらつき
がある。
#受信側では、レーンごとに遅延を調整し、同じデータ単位としてそろえる。
#到着時刻がばらばら
↓
Delay調整
↓
データ境界をそろえるこの処理がdeskew、デスキューである。
#
#
リンクトレーニング
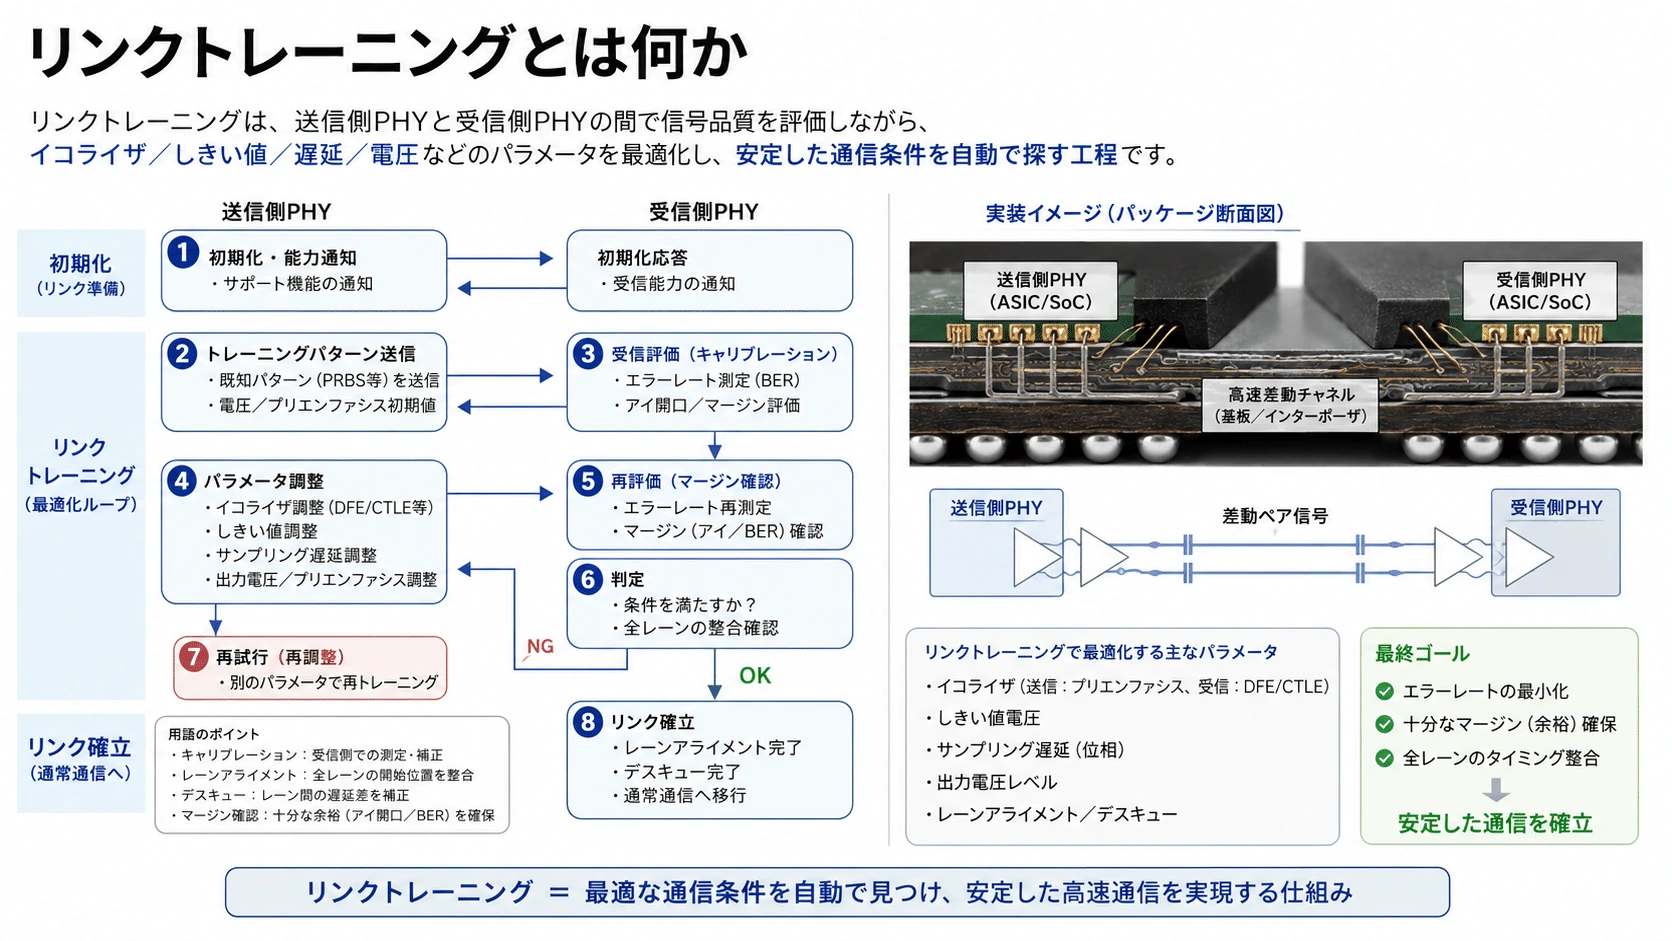
#電源を入れた直後から、すべてのレーンが最適な状態で動くとは限らない。
#そこで通信開始前に、PHY同士がテスト信号を送り合い、動作条件を調整する。
#代表的な処理には、
#- 相手側PHYの検出
- クロックの確立
- レーンの接続確認
- 極性や配線対応の確認
- タイミング調整
- レーン間デスキュー
- 電圧・終端の校正
- 不良レーンの検出
- 予備レーンへの置換
- 正常通信モードへの移行
がある。
#UCIeのPhysical Layerも、電気信号、クロックとともにリンクトレーニングを扱う。現在のUCIe対応IPでは、ハードウェアベースのトレーニング、信号品質監視、テスト、修復機能などが提供されている。(cadence.com)
#
#
不良レーンの修復
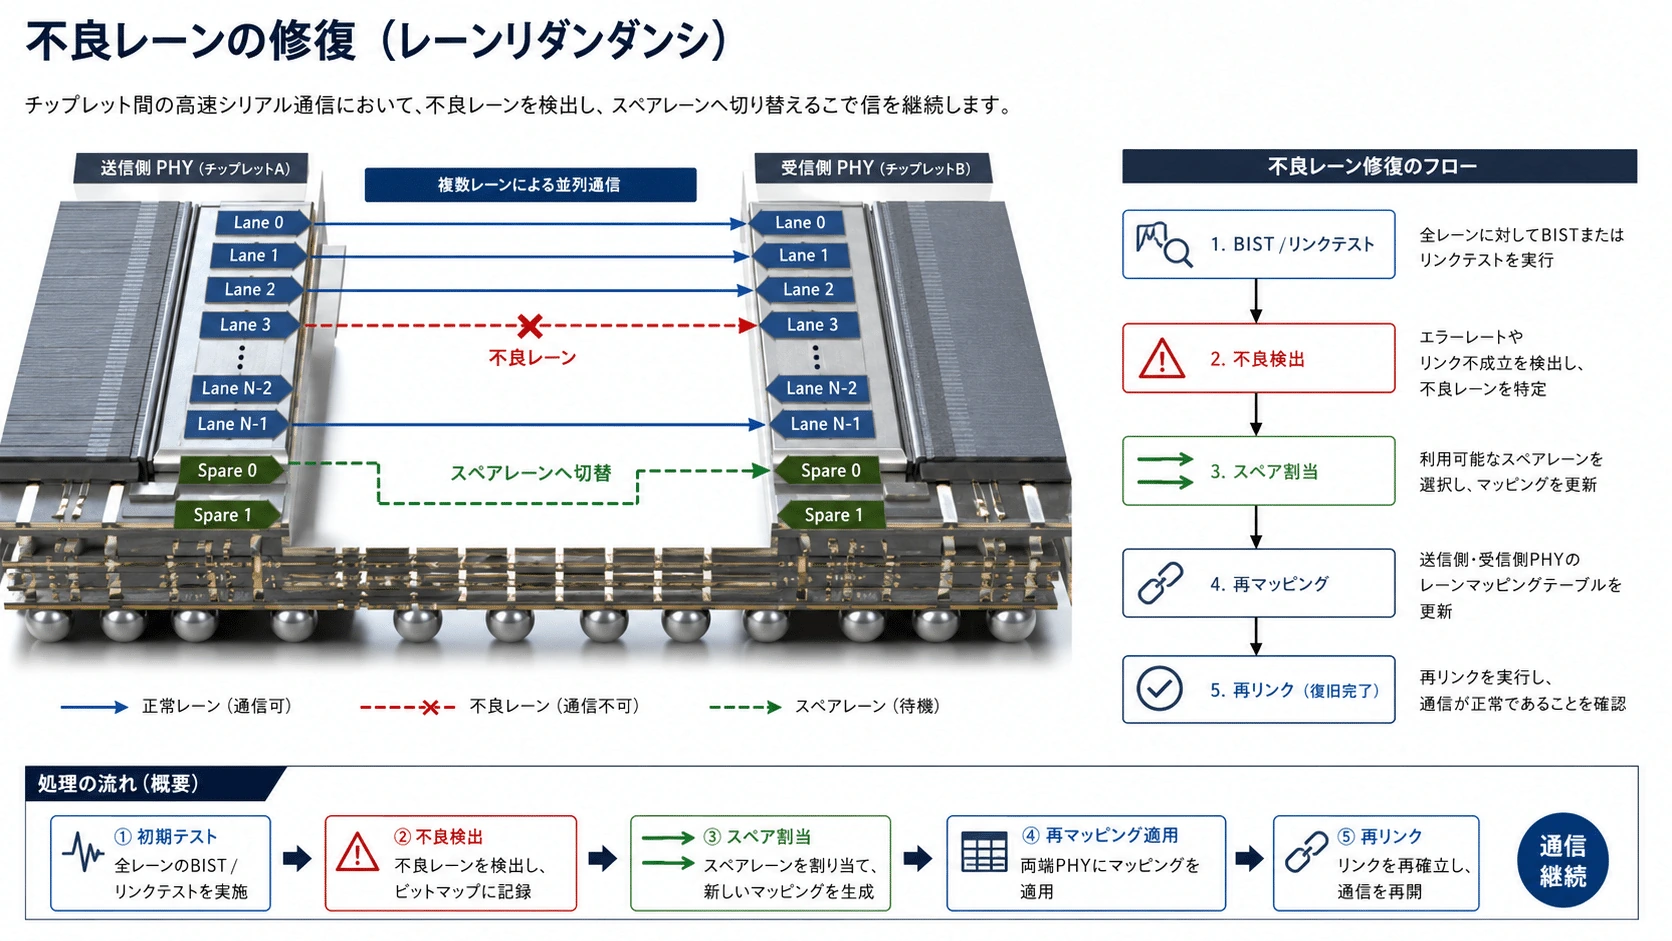
#数百、数千の接続がある場合、1個のマイクロバンプや1本の配線が不良になる可能性を完全には排除できない。
#そこで、あらかじめ予備レーンを用意する場合がある。
#通常時
Lane 0 使用
Lane 1 使用
Lane 2 使用
Lane 3 使用
Spare 待機
Lane 2故障時
Lane 0 使用
Lane 1 使用
Lane 2 故障
Lane 3 使用
Spare Lane 2の代わりに使用この仕組みにより、少数の接続不良があってもパッケージ全体を廃棄せずに済む可能性がある。
#UCIe 1.1では、高信頼性用途に向けた実行時の健康監視と修復が追加され、UCIe 2.0ではチップレットのテスト、テレメトリー、デバッグを扱う管理・DFxアーキテクチャが拡張された。(UCIe Consortium)
#
#
pJ/bitとは何か
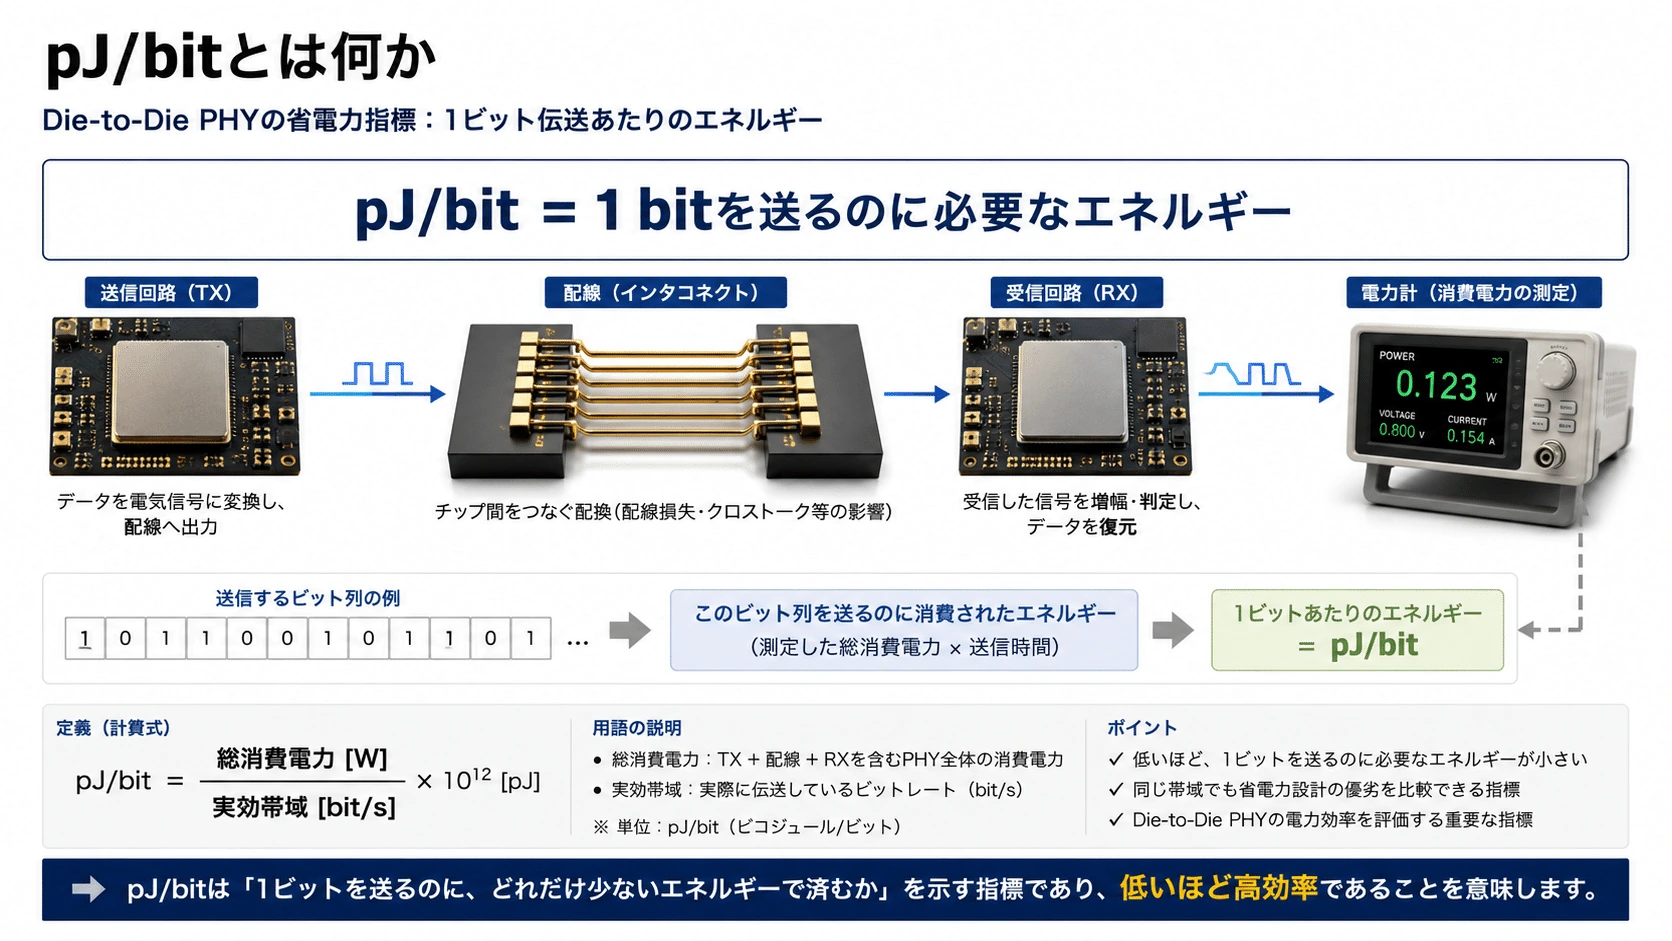
#Die-to-Die PHYでは、通信電力をpJ/bitで表すことが多い。
#1bitを送るのに何ジュール必要かを示す。
#Ebit:1bit当たりのエネルギー Plink:リンク全体の消費電力 Rdata:実際のデータ転送速度
#例えば、PHYが20Wを消費し、40Tbit/sを転送するなら、
#となる。
#パッケージ内リンクでは、
#- 配線が短い
- 信号損失が小さい
- 電圧振幅を小さくできる
- 強力なイコライザーを減らせる
- 多数の並列レーンを使える
ため、外部SerDesより低いpJ/bitを実現しやすい。
#UCIeの初期実装例では、有機基板を使うStandard Packageについて最大約25mm、0.5~1pJ/bit、インターポーザーやブリッジを使うAdvanced Packageについて最大約2mm、0.25~0.5pJ/bitという代表値が示された。ただし、これは電圧、周波数、実装条件に依存する目安であり、すべてのPHYに共通する保証値ではない。(UCIe Consortium)
#
#
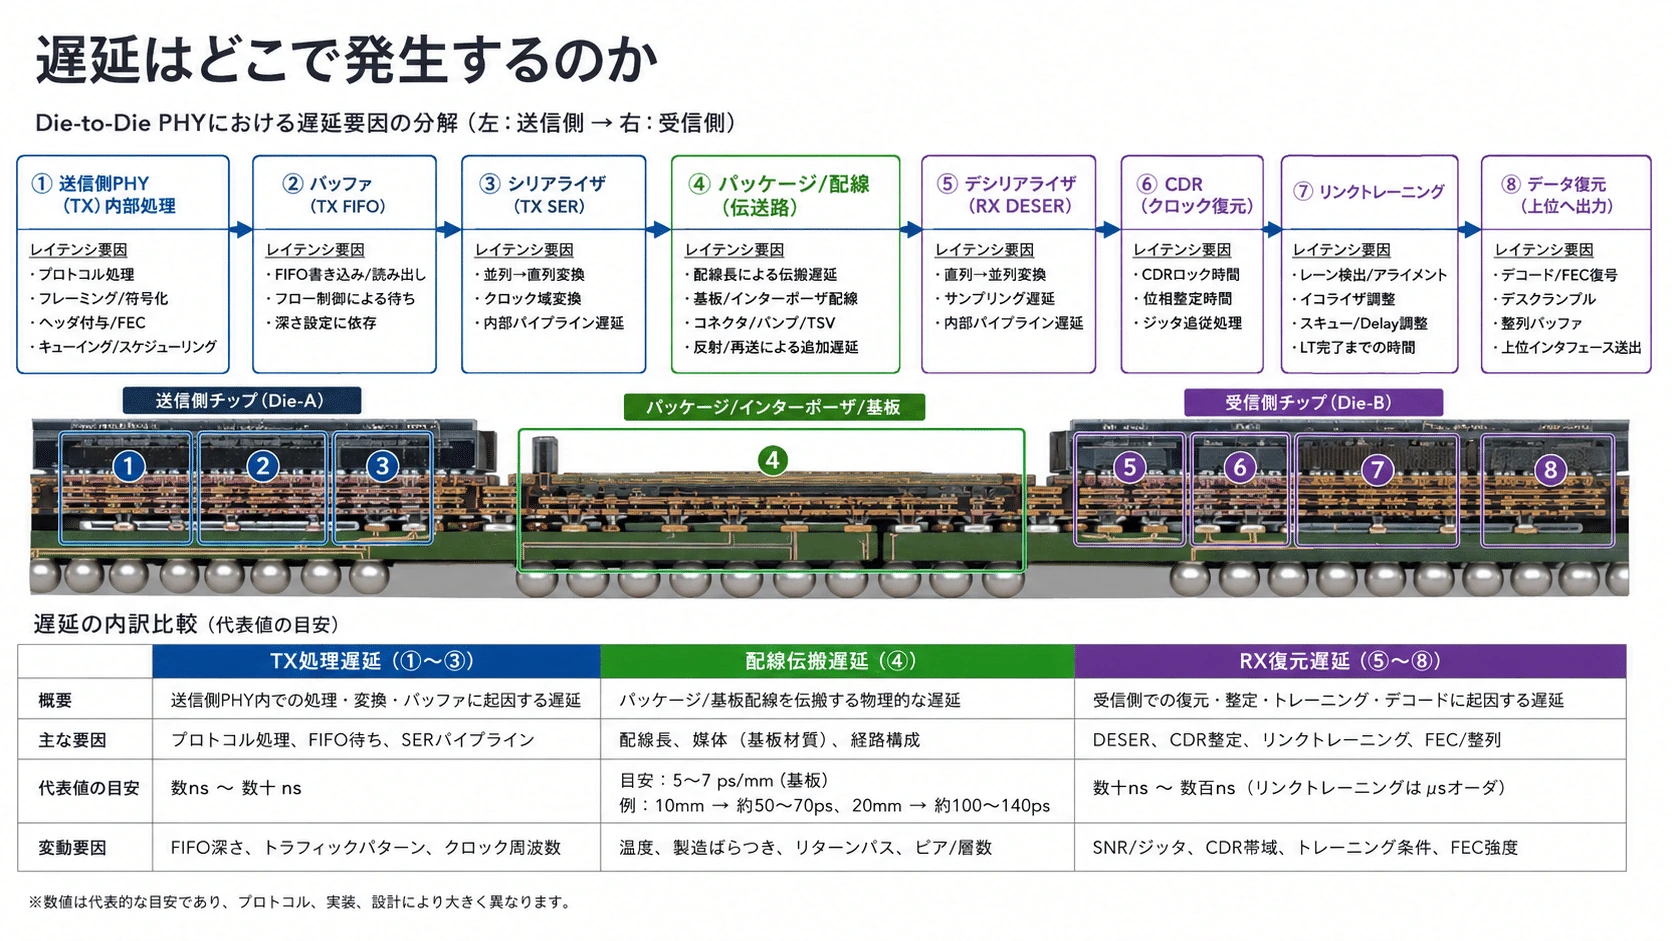
遅延はどこで発生するのか
#チップレット間の距離は短いため、配線そのものの伝搬時間は小さい。
#しかし、通信全体の遅延には多数の要素が含まれる。
#主な要因は、
#- プロトコル処理
- バッファリング
- シリアライズ
- クロックドメイン変換
- PHY内部パイプライン
- 配線の伝搬
- デスキュー
- CRC確認
- エラー時の再送
である。
#配線を1mm短くするより、シリアライザーやFIFOの段数を減らす方が大きな効果を持つ場合もある。
#特にCPUキャッシュ間のような低遅延通信では、最高帯域だけでなく、
#1回の要求が相手へ届き、応答が戻るまで何サイクルかかるか#
が重要になる。
#
#
外部SerDesとの違い
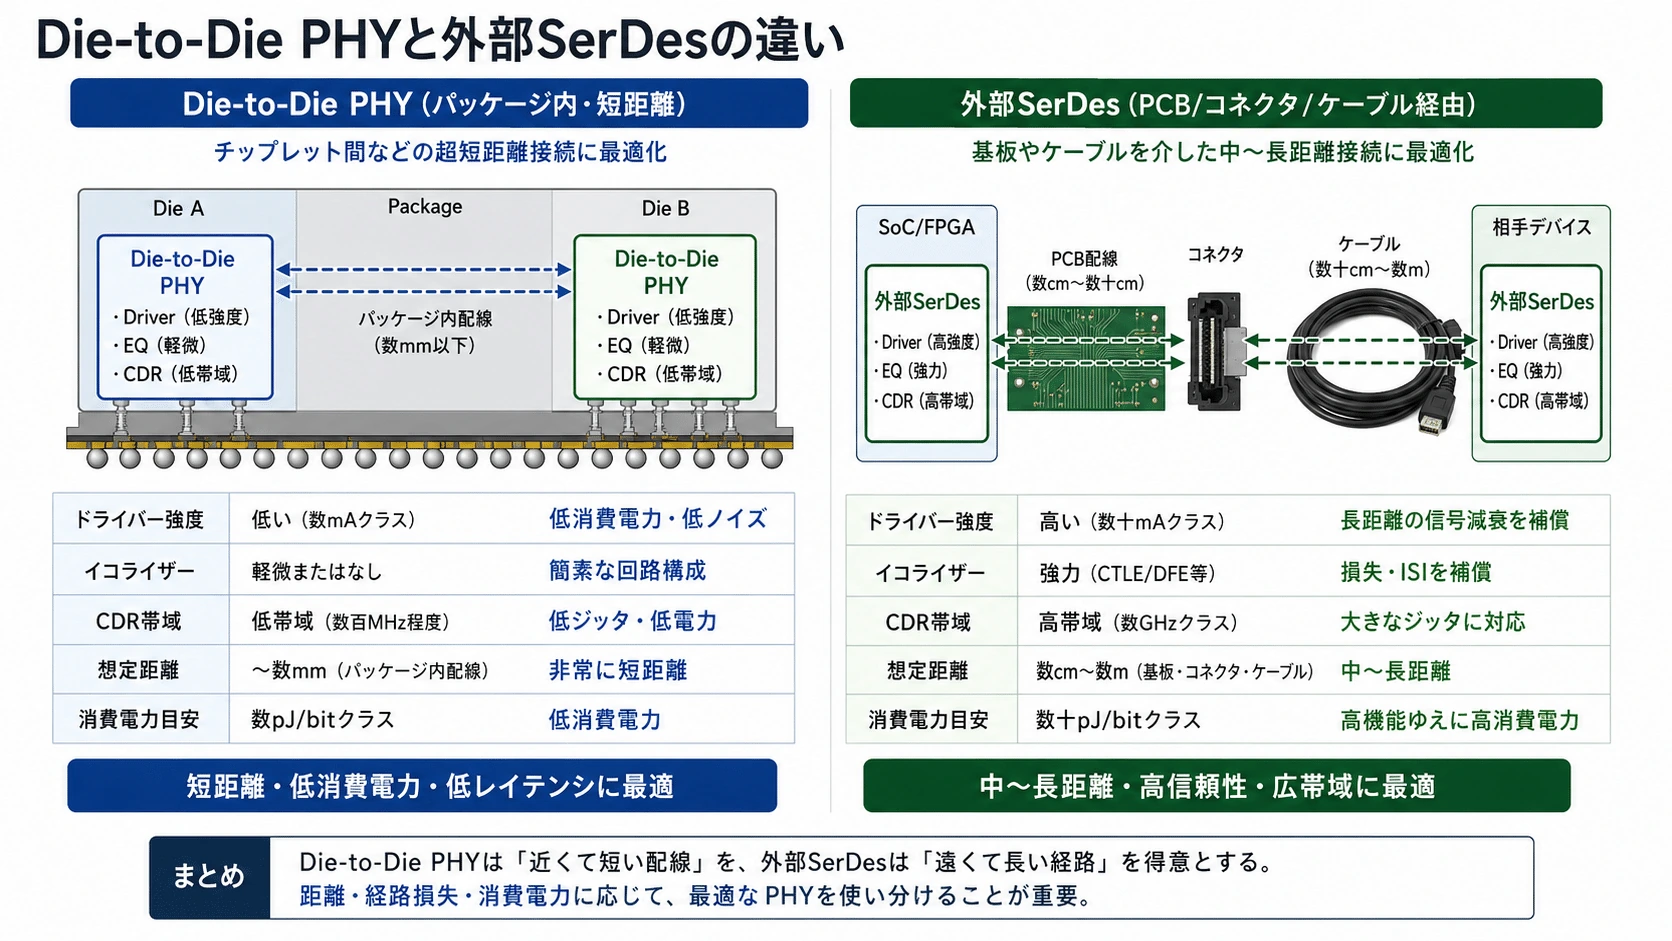
#Die-to-Die PHYと外部SerDesは、どちらもデータを送受信するPHYである。
#ただし、想定する通信経路が大きく異なる。
#| 項目 | Die-to-Die PHY | 外部SerDes |
| 距離 | サブmm~数十mm程度 | 数cm~数m以上 |
| 経路 | バンプ、RDL、インターポーザー、基板 | パッケージ、PCB、コネクタ、ケーブル |
| レーン数 | 多くしやすい | 端子制約で少なめ |
| 1レーンの速度 | 中速~高速 | 非常に高速 |
| 信号振幅 | 小さくしやすい | 比較的大きい |
| イコライザー | 簡素化しやすい | 強力な補償が必要 |
| クロック転送 | クロックを使いやすい | CDRが一般的 |
| 電力効率 | 高くしやすい | 距離と損失により不利 |
| 主用途 | 同一パッケージ内 | PCIe、Ethernet、ケーブル接続など |外部SerDes
#PCB、コネクタ、ケーブルを通るため、信号は大きく減衰する。
#そのため、
#- プリエンファシス
- Feed-Forward Equalizer
- CTLE
- Decision Feedback Equalizer
- CDR
- 強い送信ドライバー
などが必要になる。
#Die-to-Die PHY
#経路が短いため、これらを簡素化できる。
#ただし、有機基板を長く通るStandard Package型のDie-to-Die PHYでは、SerDesに近い回路が必要になる場合もある。
#したがって、
#Die-to-Die PHYはSerDesではない#
と完全に分けるのではなく、
#外部SerDesより短距離・多レーン・低電力へ最適化されたPHY#
と考えた方が正確である。
#
#
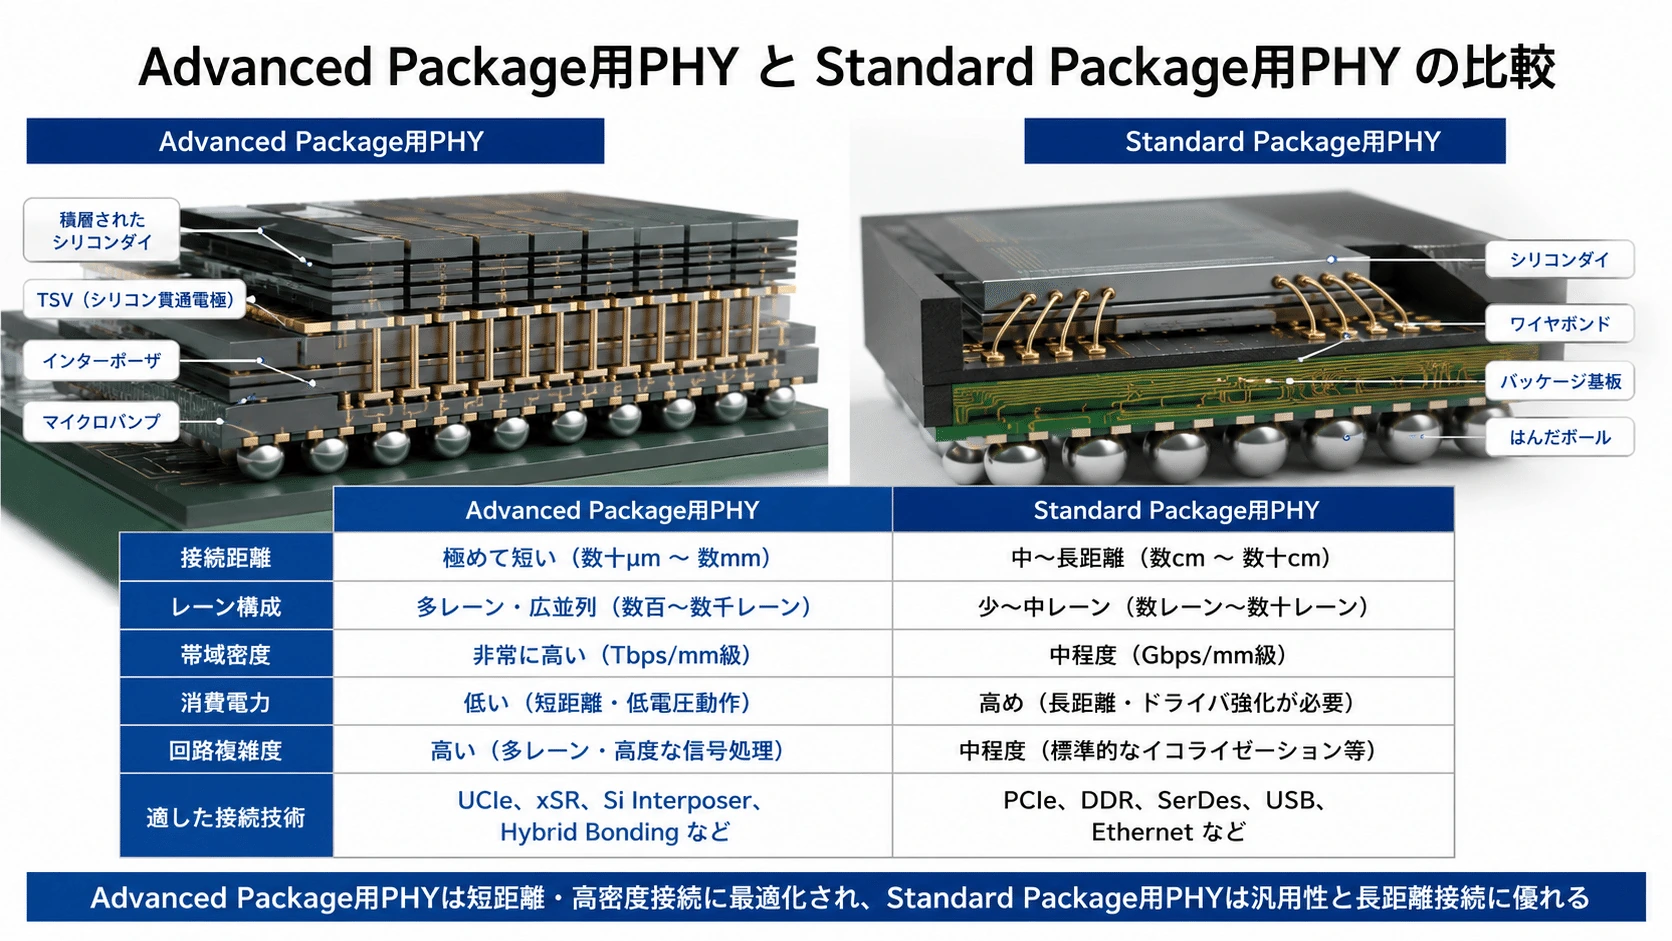
Standard Package用PHY
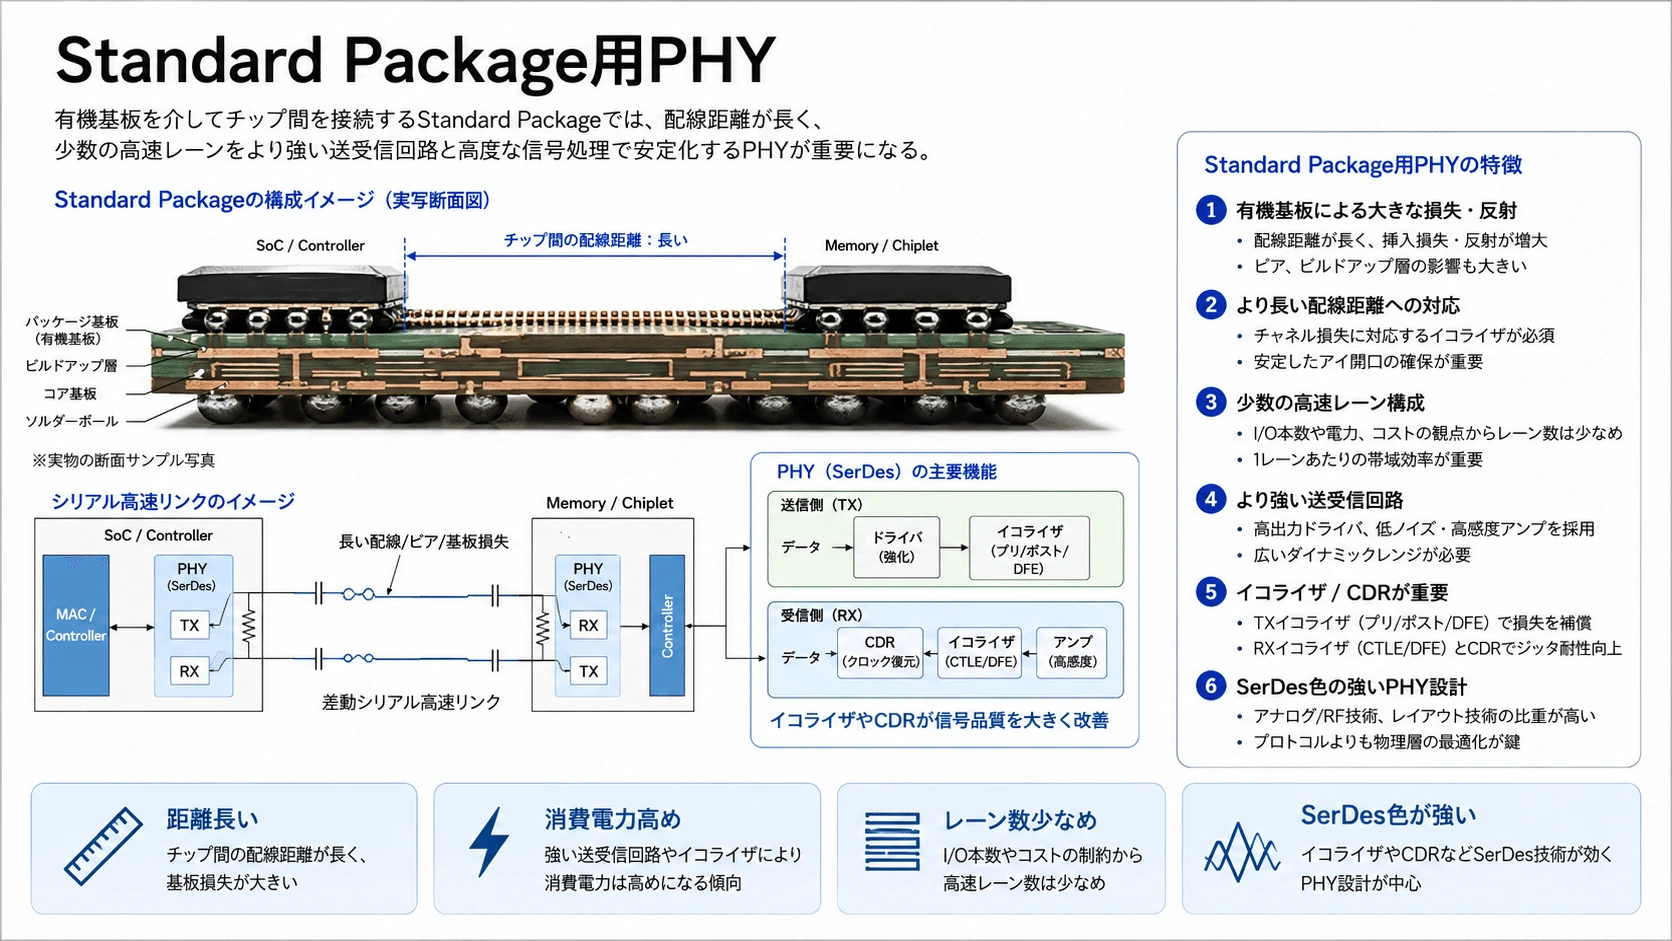
#有機基板上でチップレットを接続する場合、配線距離が比較的長くなる。
#Die A
↓
有機パッケージ基板
==============
↓
Die B配線には、
#- 導体損失
- 誘電体損失
- ビア
- 反射
- クロストーク
- 電源ノイズ
が発生する。
#そのためStandard Package用PHYは、
#- 比較的強い送信ドライバー
- 入力終端
- タイミング調整
- 信号補償
- 広い校正範囲
を必要とする。
#UCIeではStandard Packageを、低コストと比較的長い到達距離を重視する構成として扱っている。(UCIe Consortium)
#
#
Advanced Package用PHY
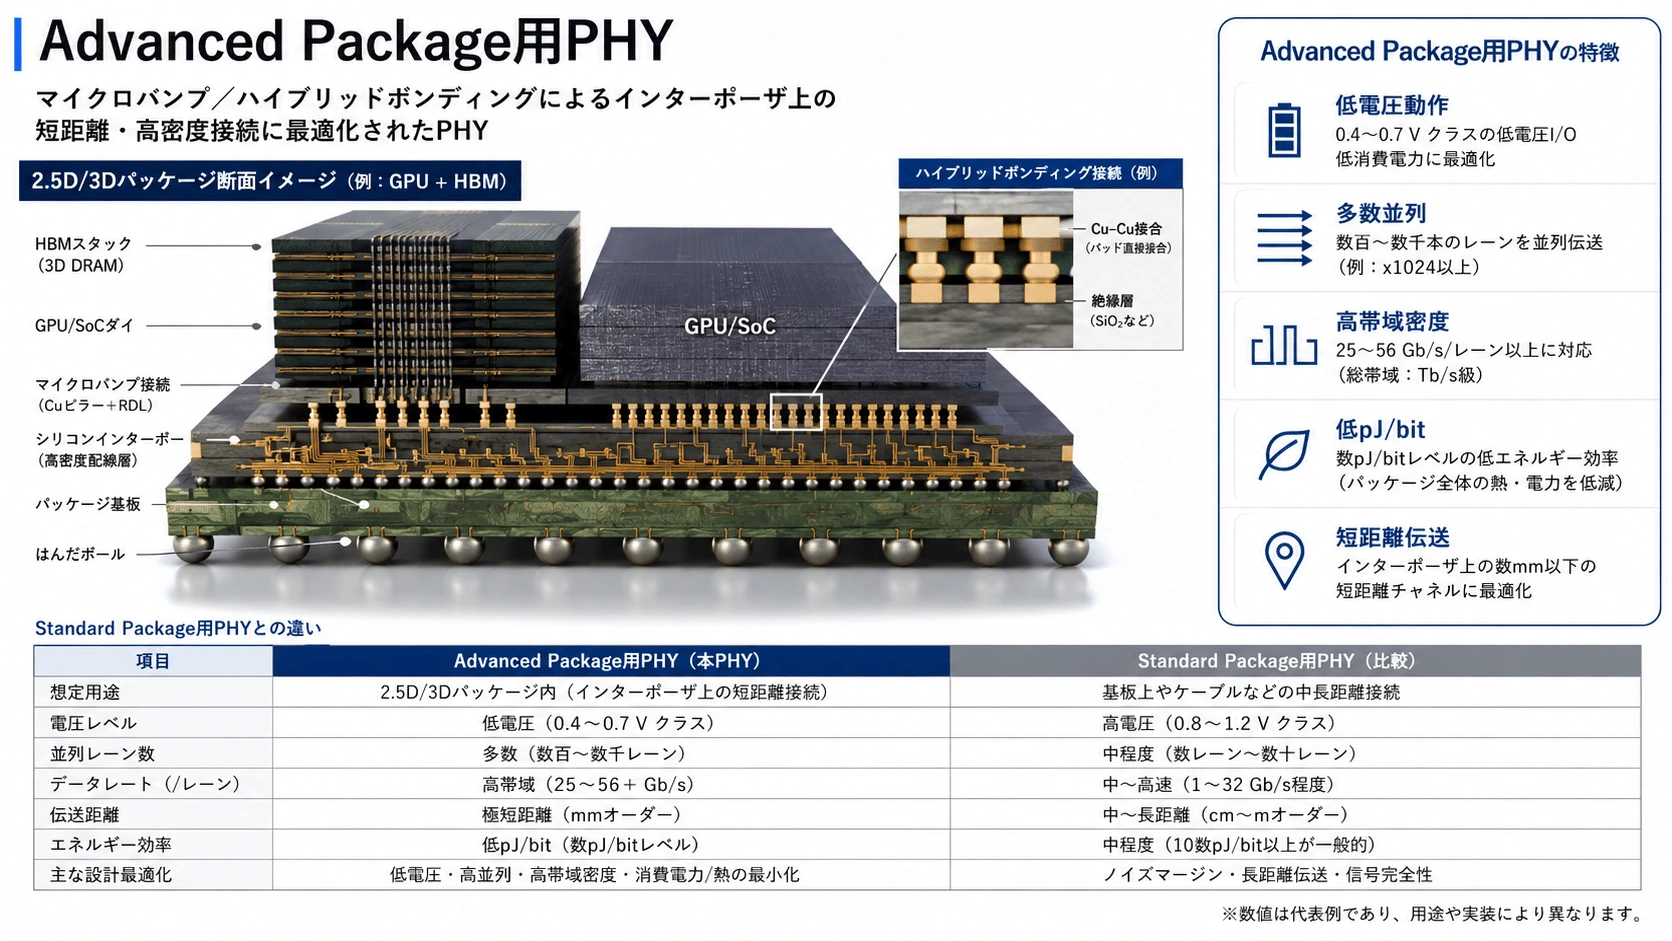
#シリコンインターポーザーやシリコンブリッジでは、配線が短く、細かいピッチで形成される。
#Die A ●●●════════●●● Die B
短い微細配線そのため、
#- 信号振幅を下げやすい
- ドライバーを小さくできる
- レーン数を増やせる
- イコライザーを簡素化できる
- pJ/bitを下げやすい
- 帯域密度を高めやすい
という利点がある。
#UCIeではAdvanced Packageを、高帯域、短距離、低遅延を重視する構成としている。(UCIe Consortium)
#
#
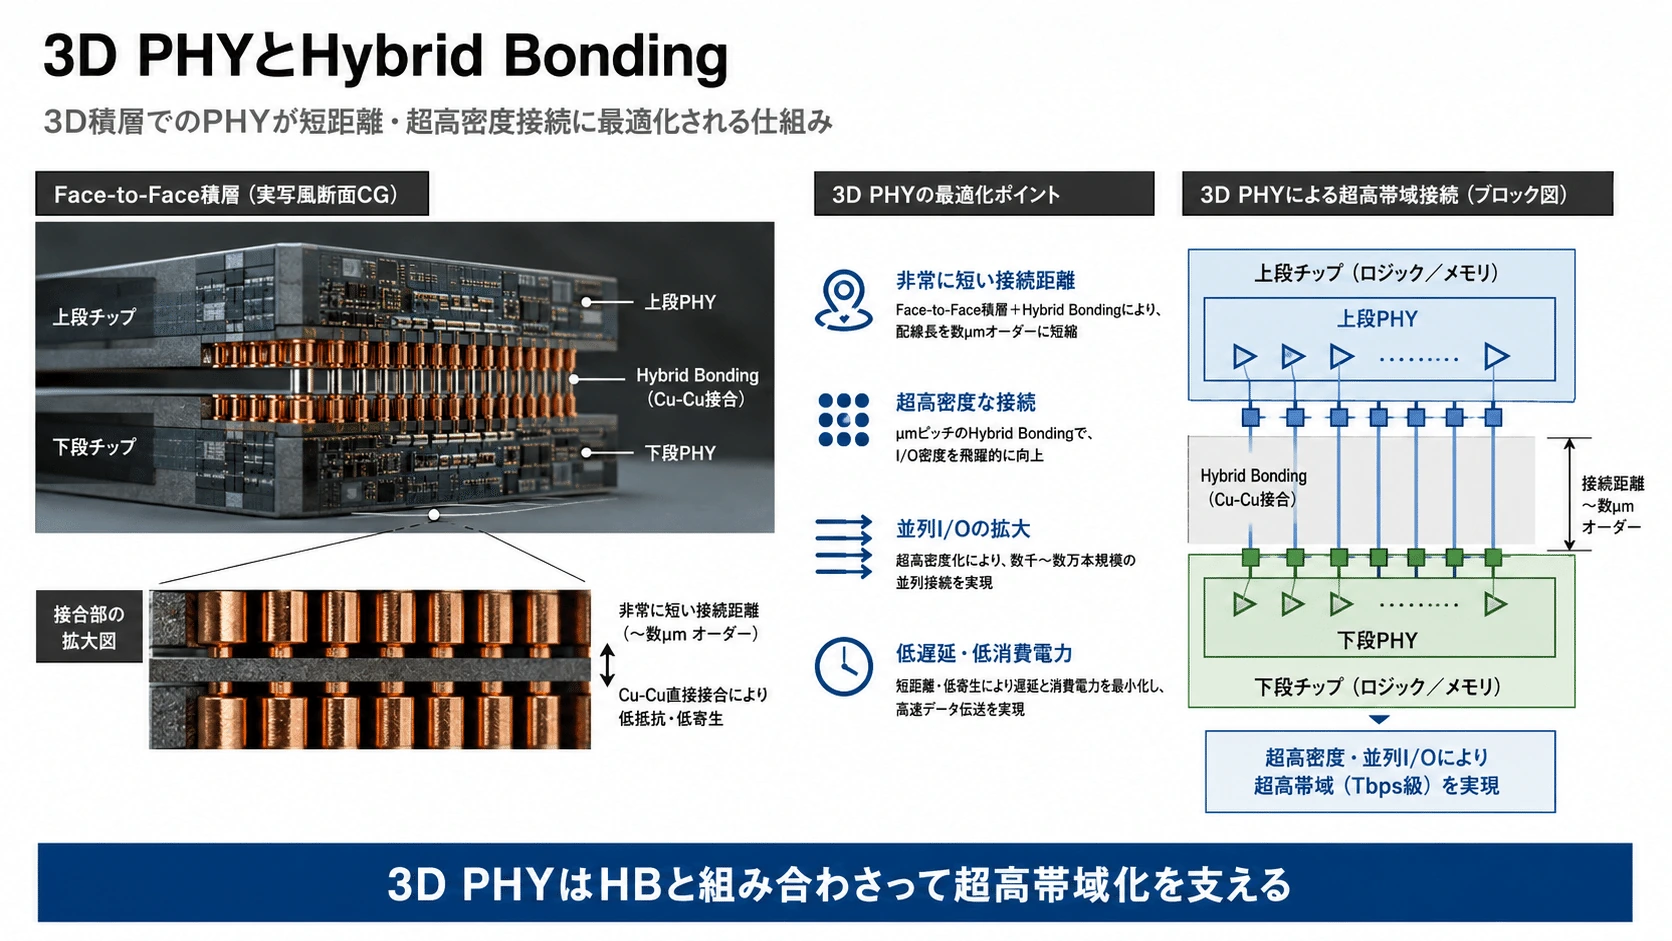
3D PHYとHybrid Bonding
#Hybrid Bondingでは、上下のダイを非常に細かなピッチで接続できる。
#上側ダイ
Cu Cu Cu Cu Cu
│ │ │ │ │
Cu Cu Cu Cu Cu
下側ダイ接続数が増え、距離が短くなるほど、強いシリアライズや大きなドライバーを使わずに大容量データを送れる可能性がある。
#これにより、PHYは外部I/Oよりも、モノリシックSoC内部の配線へ近づく。
#ただし、Hybrid Bondingを使っても、
#- タイミング調整
- クロック分配
- 受信判定
- 電圧レベル変換
- テスト
- 故障レーン処理
は必要である。
#接続が短くなっても、PHYが完全に消えるわけではない。
#3D接続では、従来のSerDes型PHYより簡素な3D I/Oや、極めて広い並列インターフェースを採用する余地が広がる。UCIe 2.0もHybrid Bondingを前提とした3D接続を規定している。(UCIe Consortium)
#
#
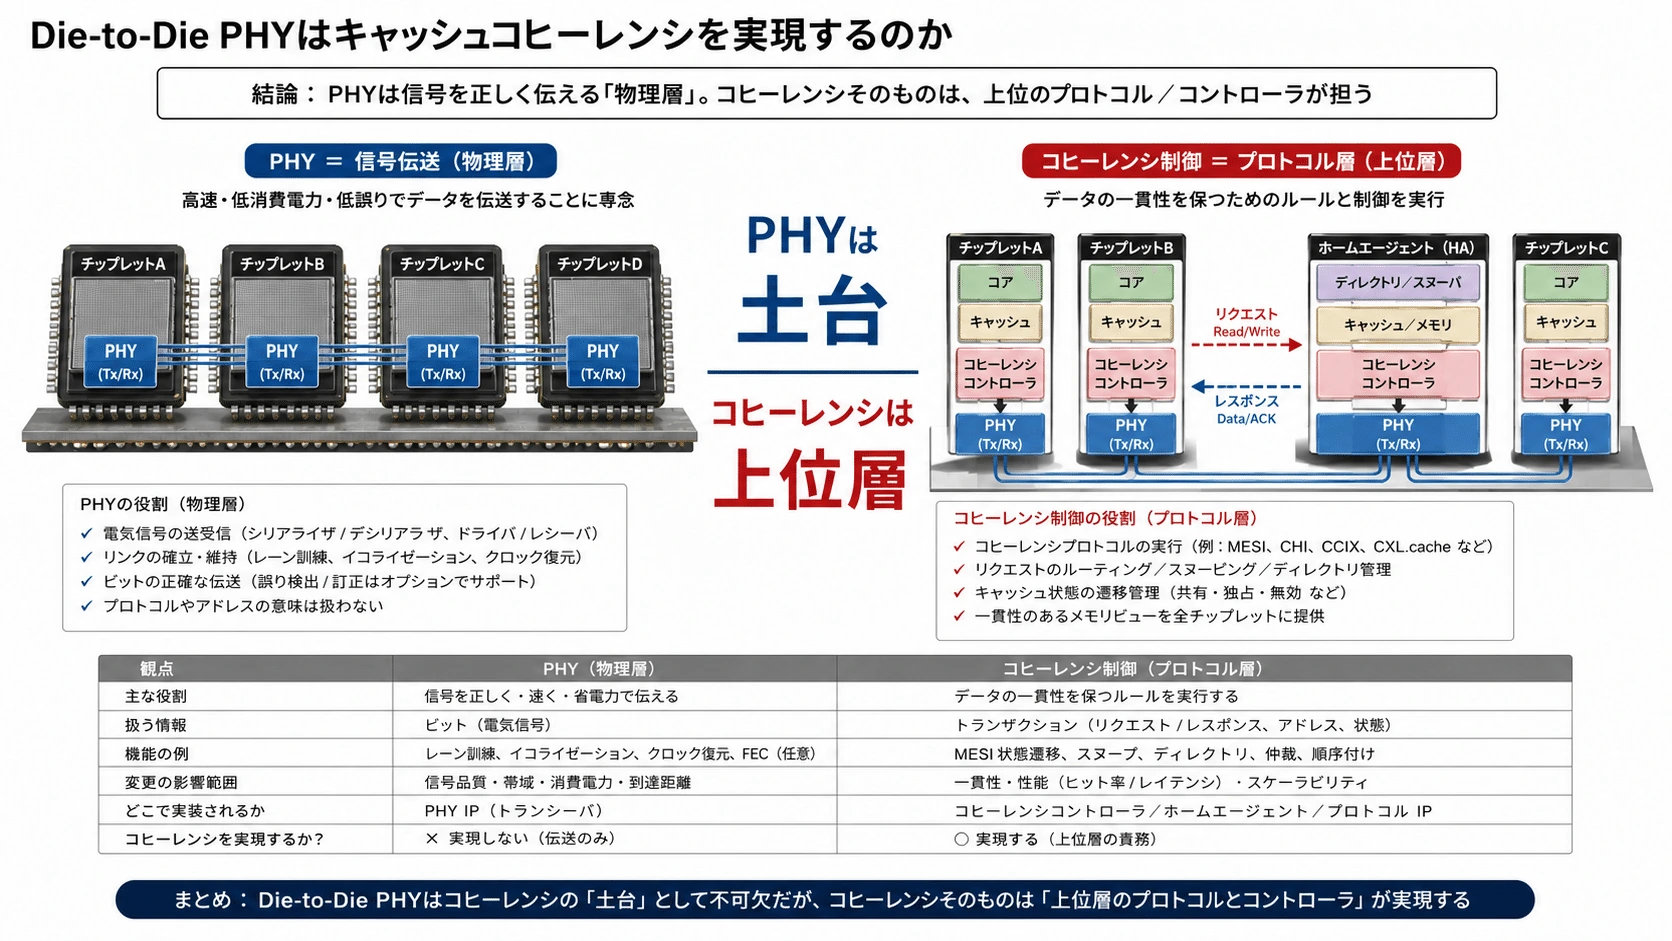
Die-to-Die PHYはキャッシュコヒーレンシを実現するのか
#PHY自体は、送っているデータの意味を理解しない。
#PHYにとっては、
#- キャッシュライン
- AIテンソル
- PCIeパケット
- メモリー読み出し
- 割り込み
- 制御命令
のすべてがbit列である。
#PHYが扱うもの
0101101011010010
上位層が理解するもの
「キャッシュラインを読み出す」
「メモリーへ書き込む」
「割り込みを送る」キャッシュコヒーレンシ、アドレス、順序保証、アクセス権限などは、PHYより上のプロトコルやシステムアーキテクチャが担当する。
#UCIeも、物理層だけでなく、PCIe、CXL、Streamingなどを扱うAdapter/Protocol層を定義している。(UCIe Consortium)
#
#
Die-to-Die PHYとUCIeの違い
#Die-to-Die PHYは一般的な技術分類である。
#UCIeは、特定の相互運用可能なDie-to-Die接続規格である。
#Die-to-Die PHY
独自PHY
AIB系PHY
XSR系PHY
UCIe PHY
企業独自インターコネクトUCIeが定義するのはPHYだけではない。
#Protocol Layer
PCIe/CXL/Streamingなど
↓
Die-to-Die Adapter
リンク管理・交渉・信頼性機能
↓
Physical Layer
電気信号・クロック・トレーニング
↓
パッケージ配線UCIeコンソーシアムは、PHY、プロトコル、ソフトウェアモデル、相互運用性試験まで含むパッケージ内接続規格としてUCIeを策定している。(UCIe Consortium)
#2026年時点のUCIe 3.0では、48GT/sと64GT/sが追加され、UCIe 2.0の最大32GT/sから帯域が拡張されている。ただし、これは規格上の対応速度であり、すべての製品が直ちに64GT/sで動作するという意味ではない。(UCIe Consortium)
##
PHYを増やせば帯域は無制限に増えるのか
#レーン数を増やせば理論帯域は増加する。
#しかし、実際には次の制約がある。
#ダイ辺長
#2D・2.5DではPHYがダイの外周を占有する。
#バンプ数
#データレーンだけでなく、電源、グラウンド、クロック、予備端子が必要になる。
#消費電力
#1bit当たりのエネルギーが低くても、総帯域が非常に大きければPHY全体の電力は増える。
#例えば0.5pJ/bitでも、40Tbit/sを送れば、
#となる。
#クロック分配
#多数のレーンへ低ジッターのクロックを届ける必要がある。
#同時スイッチングノイズ
#多数のI/Oが同時に0から1へ変化すると、電源とグラウンドが揺れる。
#パッケージ配線
#PHY側にレーンがあっても、インターポーザーや基板へ配線できなければ使えない。
#相手側回路
#受信側NoC、キャッシュ、メモリーコントローラーがデータを処理できなければ、PHYだけ速くしても性能は伸びない。
#PHY帯域を増やす
↓
内部NoCが処理できない
↓
バッファが満杯
↓
リンクが待たされる
↓
実効性能は伸びない#
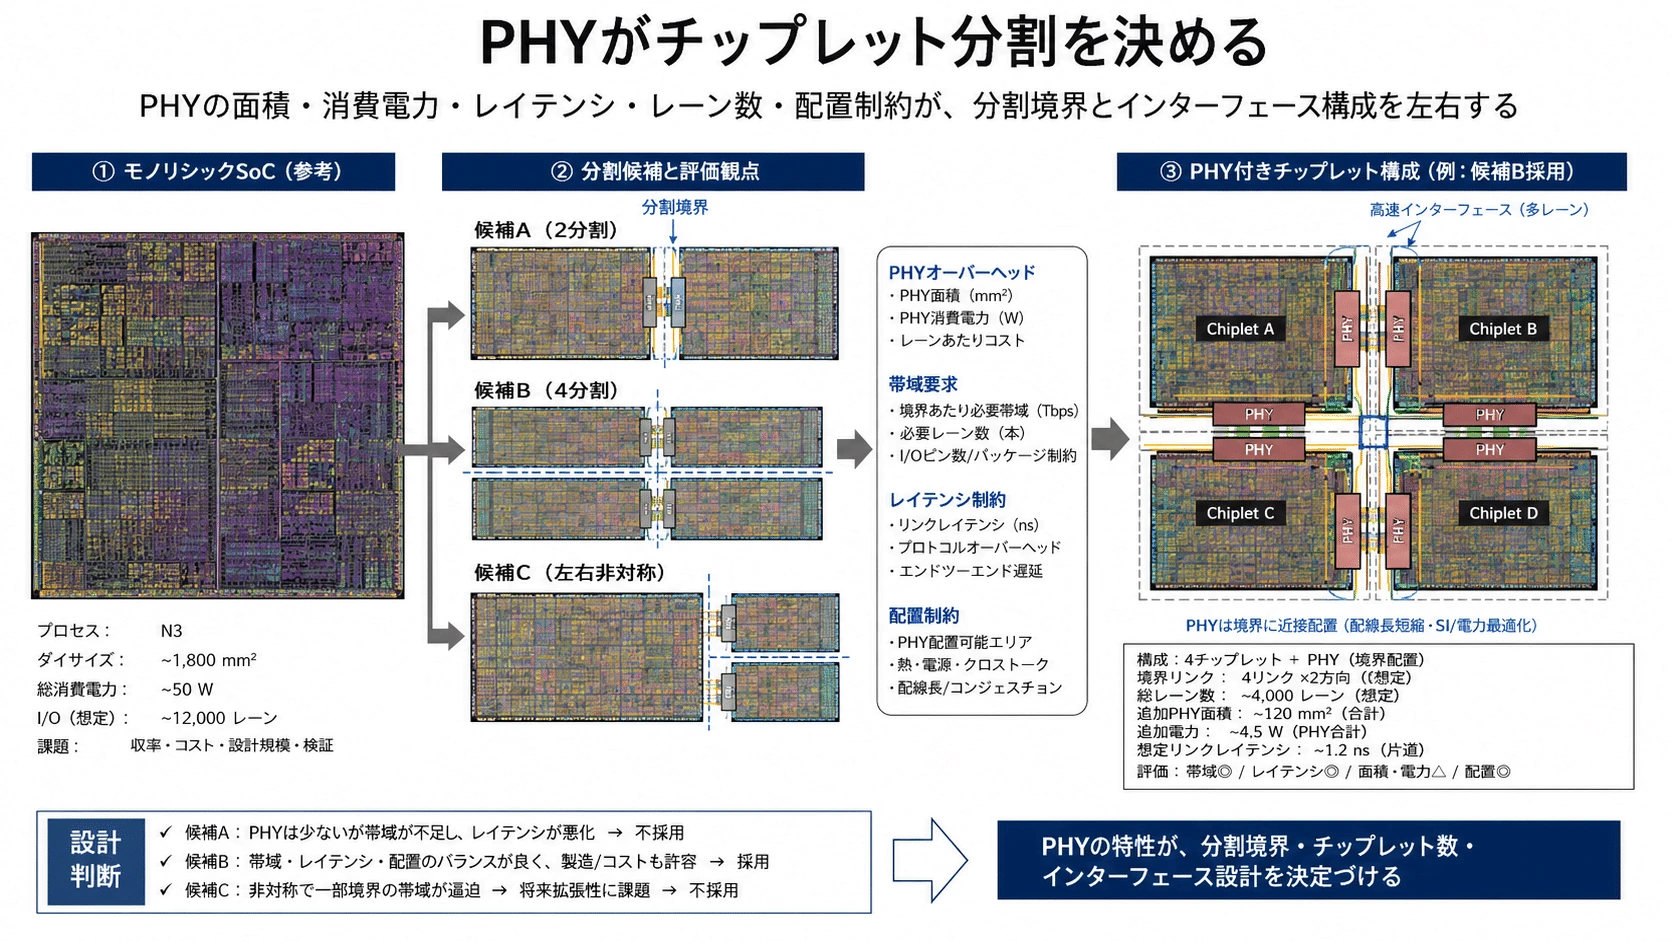
PHYがチップレット分割を決める
#どこでダイを分割するかによって、必要なPHY帯域は大きく変わる。
#分割しやすい境界
#- CPUと外部I/O
- 演算ダイとI/Oダイ
- CPUと専用アクセラレーター
- 独立性の高い機能ブロック
分割が難しい境界
#- ALUとレジスターファイル
- キャッシュとタグ回路
- 毎サイクル大量の信号を交換するロジック
- 微細な制御信号が密集する領域
分割境界をまたぐ通信量が少ない
              ↓
比較的小さなPHYで接続可能


分割境界をまたぐ通信量が多い
              ↓
巨大なPHYと多数の接続が必要
              ↓
面積・電力・遅延が増えるHybrid BondingによるLogic Foldingでは、この境界を従来より細かくできる可能性がある。
#しかし、接続ピッチが小さくなっても、クロック、電源、熱、テスト、回路分割を含めた最適化が必要になる。
#
#
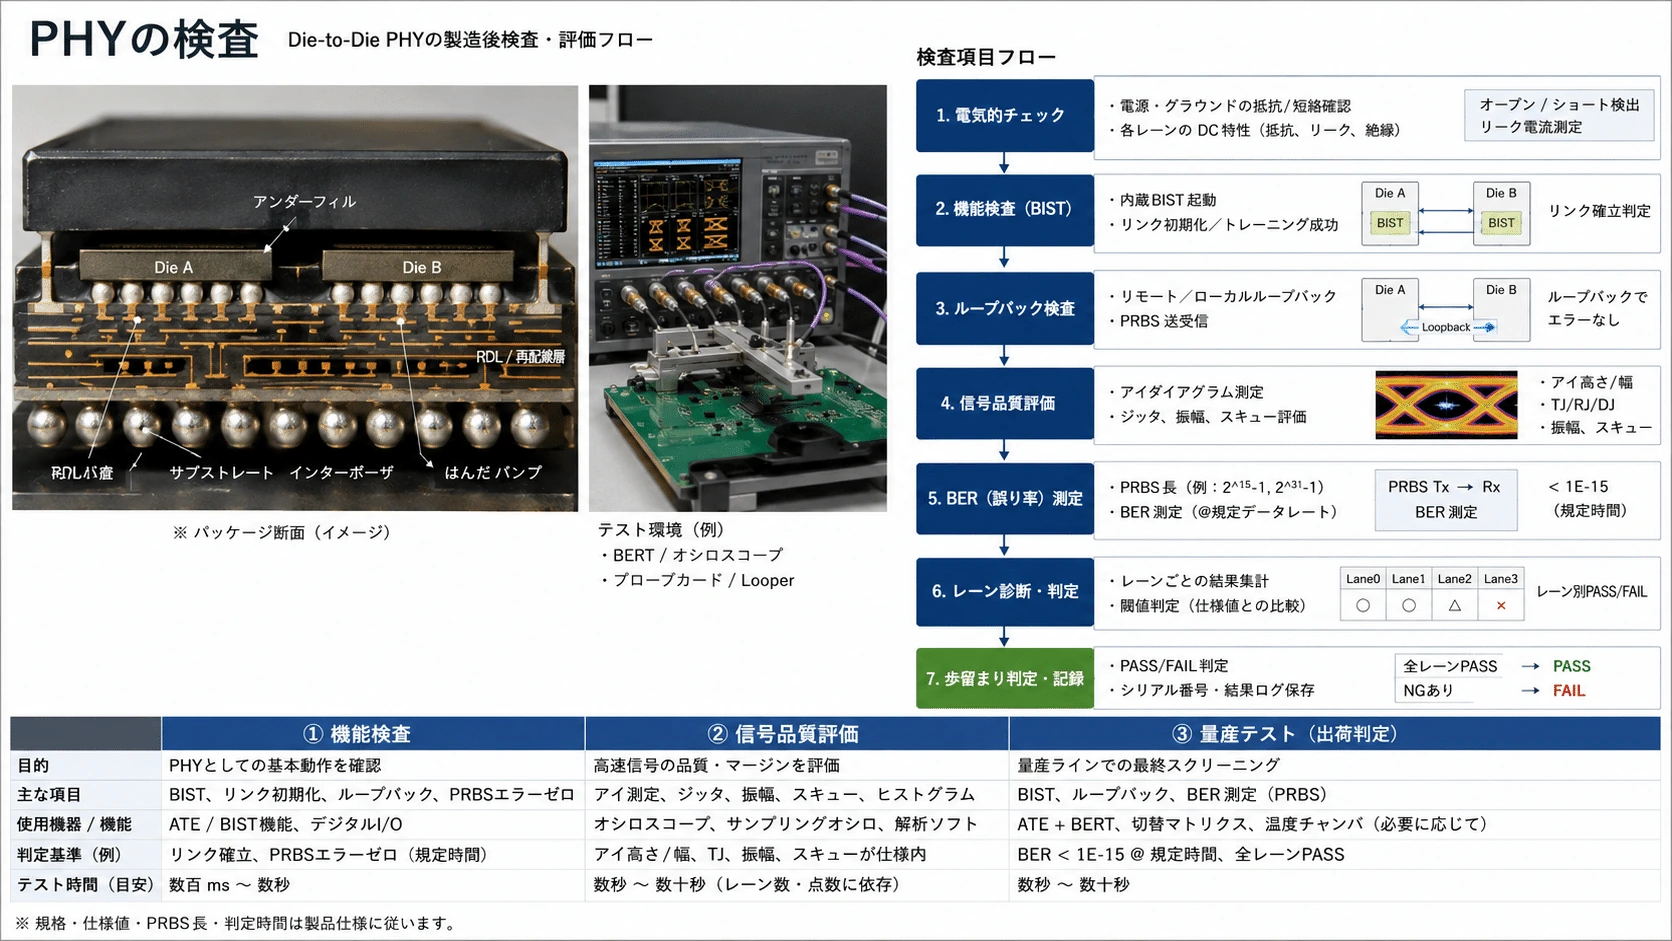
PHYの検査
#完成したパッケージでは、PHY、バンプ、配線、相手側PHYが一続きのリンクになる。
#リンクが動かない場合、原因はさまざまである。
#- 送信ドライバーの不良
- 受信サンプラーの不良
- PLLやDLLの不良
- バンプのオープン
- 配線の短絡
- クロストーク
- 電源ノイズ
- レーン間スキュー
- プロトコル設定不一致
そこでPHYには、テスト用の機能を組み込む。
#ループバック
#送信したデータを内部または相手側で折り返し、正しく戻るか確認する。
#TX
↓
配線
↓
RX
↓
折り返し
↓
TX
↓
元のPHYへ戻すPRBS
#疑似ランダムなbit列を送信し、受信側で誤りを数える。
#アイモニター
#受信信号を異なる電圧・タイミングで測定し、正常に判定できる範囲を調べる。
#BIST
#PHY自身がテストパターンを生成し、自動的に検査する。
#レーン修復
#故障レーンを予備レーンへ置き換える。
#現在のUCIe IPでも、信号品質監視、トレーニング、テスト、診断、修復機能が重視されている。(synopsys.com)
#
#
Die-to-Die PHYの本質
#Die-to-Die PHYは、単なる高速I/O回路ではない。
#高い帯域
+
低い遅延
+
低いpJ/bit
+
小さなPHY面積
+
少ないバンプ数
+
高い信頼性を同時に実現しなければならない。
#しかし、これらにはトレードオフがある。
#レーン数を増やす
→ 帯域は増える
→ バンプ・配線・面積も増える
1レーンを高速化する
→ レーン数を減らせる
→ PHY電力・回路複雑度が増える
信号振幅を下げる
→ 電力を減らせる
→ ノイズへの余裕が減る
パイプラインを減らす
→ 遅延を減らせる
→ タイミング設計が難しくなるしたがって、優れたDie-to-Die PHYとは、単にGT/sが高いPHYではない。
#パッケージ、バンプ、内部NoC、プロトコル、消費電力、熱、テストを含めて、システム全体を最適化したPHY#
である。
##
今回の要点
#- Die-to-Die PHYは、チップレット内部のデジタルデータを電気信号へ変換し、相手側で復元する回路である。
- TSV、マイクロバンプ、Hybrid Bondingは信号が通る物理経路であり、PHYとは役割が異なる。
- PHYには、送信ドライバー、受信回路、シリアライザー、デシリアライザー、クロック、タイミング調整、トレーニングなどが含まれる。
- 多数の低速レーンを使う並列方式と、少数の高速レーンを使うシリアル方式があり、実際には両者の中間構成も使われる。
- 理論帯域は、基本的にレーン数と1レーン当たりの転送速度の積で決まる。
- 実効帯域は、ヘッダー、CRC、制御情報、再送などのオーバーヘッドによって小さくなる。
- Die-to-Dieでは総帯域だけでなく、ダイ辺長当たり、または接合面積当たりの帯域密度が重要になる。
- 配線が短いため、外部SerDesより小さな信号振幅と簡素な補償回路を使い、低いpJ/bitを実現しやすい。
- PHY自体はキャッシュコヒーレンシや命令の意味を理解せず、上位のAdapterやProtocolが処理する。
- UCIeはDie-to-Die PHYだけでなく、Adapter、Protocol、ソフトウェアモデル、相互運用性を含む規格である。
- レーン数や速度を増やせば無制限に性能が伸びるわけではなく、ダイ辺長、電力、配線、内部NoC、熱、歩留まりによって制約される。
次回は、Die-to-Die PHYを異なる企業・異なる製造ノードのチップレット間で共通利用するための規格、UCIeを詳しく解説する。
#UCIeのProtocol Layer、Die-to-Die Adapter、Physical Layer、UCIe-SとUCIe-A、Standard PackageとAdvanced Package、PCIe・CXL・Streaming、リンク初期化、CRC・Retry、レーン構成、相互運用性までを扱う。
#