HBMは熱を持つ記憶の塔へ: HBM4、iHBM/ICE、HBM5/HPBが変えるAIインフラ
絶ノイアの章 Sil-Kathnaの章この資料の日時
元資料の日付と、その本文が公に存在した確認日時は別の記録です。
本文に含まれる語句 HBM DRAM 帯域・データ移動 先端パッケージング 光接続 電力・給電 冷却 顧客認定 歩留まり 基板・材料 AI推論 AIエージェント
出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.09.23.4
- 記事内容のSHA-256
e5e048873b5e7e6affe8e4d6a2b54b00798cb653eef78d4f5c2c9294d00449a5- 保存版のSHA-256
9c68149a3668fef07a3a3a9c0fea46a05707a8348a1478e3d230294d22768032
外部証明の最終検査結果は詳細を開くと表示します。
HBMは「速いメモリ」から「熱を持つ記憶の塔」へ
#HBM4、iHBM/ICE、HBM5/HPBが示すAIインフラの次の制約
#AIデータセンターの競争は、GPUの演算性能だけでは決まらなくなっている。
#いま本当に重要になっているのは、GPUの隣に積まれる高帯域メモリ、すなわちHBMである。HBMはこれまで「GPUに近い場所に置かれる、非常に速いメモリ」と説明されることが多かった。しかしHBM4、そしてHBM5世代に向かう現在、その意味は変わりつつある。
#HBMは、単なる高速DRAMではない。
#AIの記憶を垂直に積み上げた「記憶の塔」である。そしてその塔は、膨大なデータを出し入れすることで熱を持ち始めている。
#この変化を象徴するのが、SK hynixのiHBM/ICE、SamsungのHBM5/HPB、そしてHBM4の高単価化である。
#HBM4は何を変えるのか
#HBM4の最大の特徴は、HBM3Eまでの1,024-bitインターフェースから、2,048-bitへとI/O幅が倍増することにある。
#これは、メモリとGPUの間の道路を大きく広げるようなものだ。
#HBM3Eでは、1スタックあたりおよそ1TB/s台の帯域が中心だった。これに対し、HBM4では1スタックあたり2TB/s超、実装によっては2.8TB/sから3.3TB/s級の帯域が見込まれる。MicronはHBM4で2,048ピンバス、11Gbps超、1スタックあたり2.8TB/s超を掲げ、SamsungもHBM4で最大3,300GB/s級の帯域を示している。(Micron)
#つまりHBM4は、単に「少し速いHBM」ではない。
#GPUがAIモデルを動かす際に必要な重み、アクティベーション、KVキャッシュ、中間テンソルを、より広い帯域で流すための世代である。特に生成AIの推論では、長文コンテキスト、マルチモーダル入力、複数エージェント、長時間記憶のような処理が増えている。これらは演算能力だけでなく、メモリ帯域とメモリ容量を大量に消費する。
#GPUの演算器がいくら速くても、HBMからデータが届かなければ性能は出ない。
#したがってHBM4とは、AIチップの演算能力を引き出すために、記憶の出口を太くする技術だと言える。
#D2D PHYが熱の中心になる
#HBMを理解するうえで重要なのが、D2D PHYである。
#D2D PHYとは、Die-to-Die Physical Layerの略で、HBMのベースダイとGPU/AIアクセラレータをつなぐ物理インターフェースである。HBM内部に積まれたDRAMダイのデータは、TSVを通ってベースダイへ集められ、そこからD2D PHYを通じてGPUへ渡される。
#つまりD2D PHYは、HBMの記憶とGPUの演算が出会う場所である。
#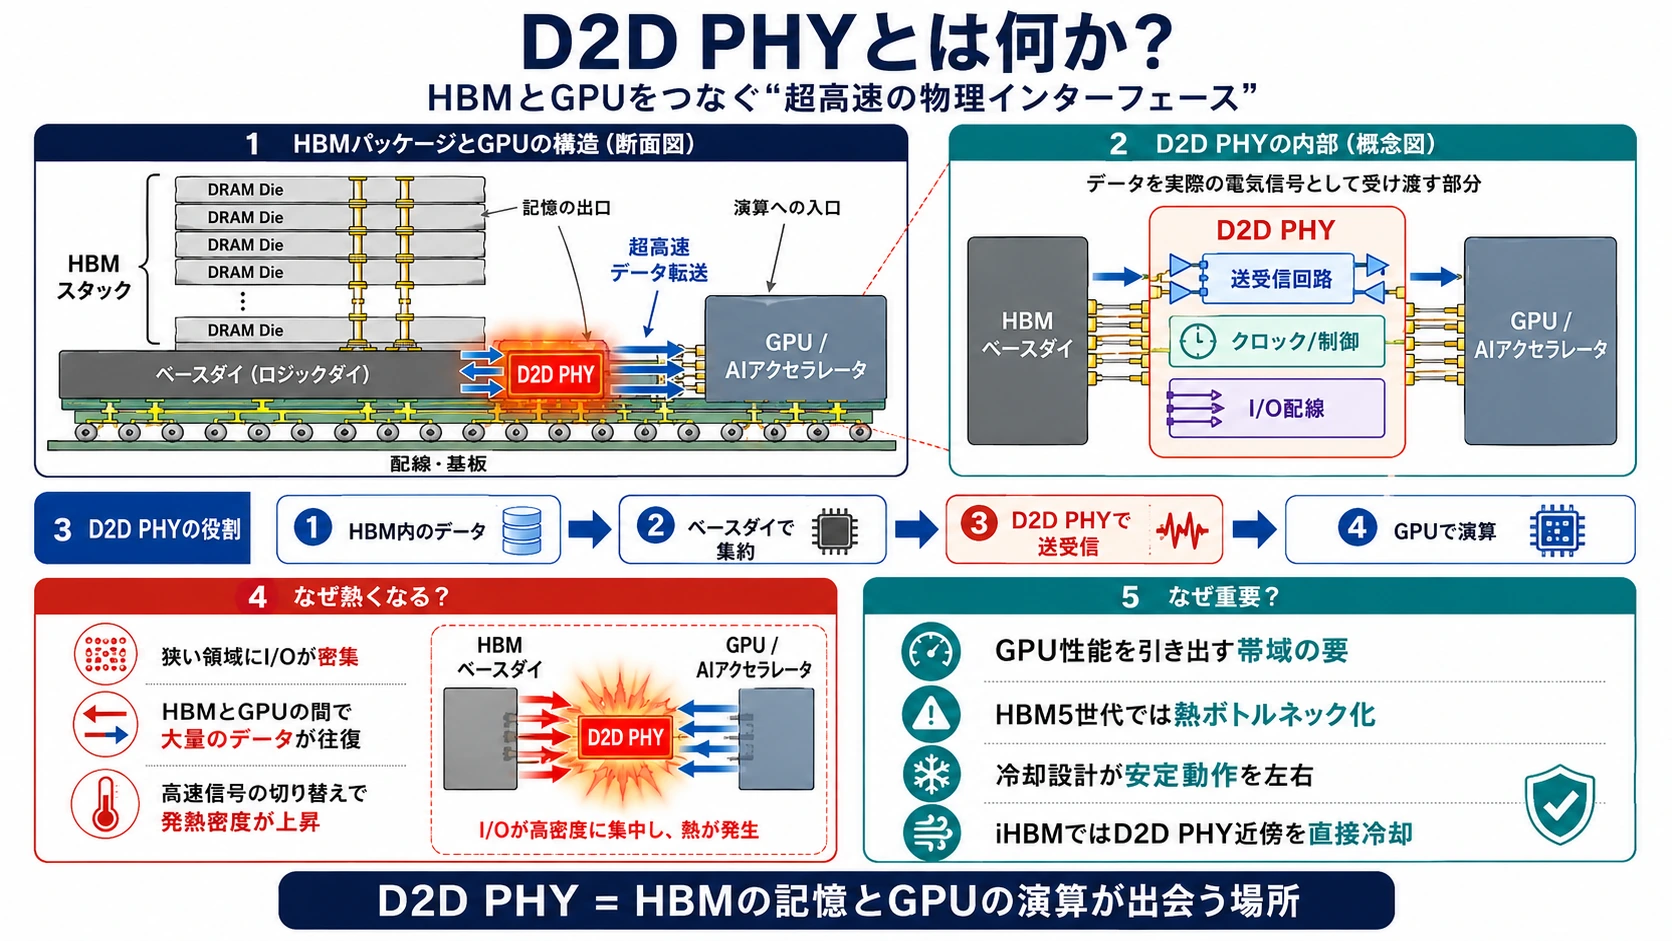
ここには、毎秒テラバイト級のデータが集中する。高速信号が狭い領域で切り替わり、I/O回路が密集し、GPUとHBMの間で膨大なデータが往復する。その結果、D2D PHY周辺の発熱密度が高くなる。
#HBM4ではI/O幅が倍増する。すると、データの通り道は広がるが、その分、接続部の設計も難しくなる。帯域を増やすほど、D2D PHY周辺の電力、熱、配線密度が問題になりやすい。
#このため、HBM4の次に来るHBM5世代では、単に帯域を伸ばすだけでは不十分になる。熱をどう逃がすかが、性能を維持するための核心になる。
#SK hynixのiHBM/ICEとは何か
#SK hynixが発表したiHBMは、このD2D PHY周辺の熱問題を直接狙った技術である。
#iHBMでは、HBMパッケージ内部にICE、Integrated Cooling Elementsを組み込む。ICEは、電気を通しにくく、熱を通しやすい材料を用いた冷却要素である。SK hynixは、このICEを発熱が集中するD2D PHY領域に配置し、熱の専用経路を作ることで、熱抵抗を30%以上下げると説明している。(SK hynix)
#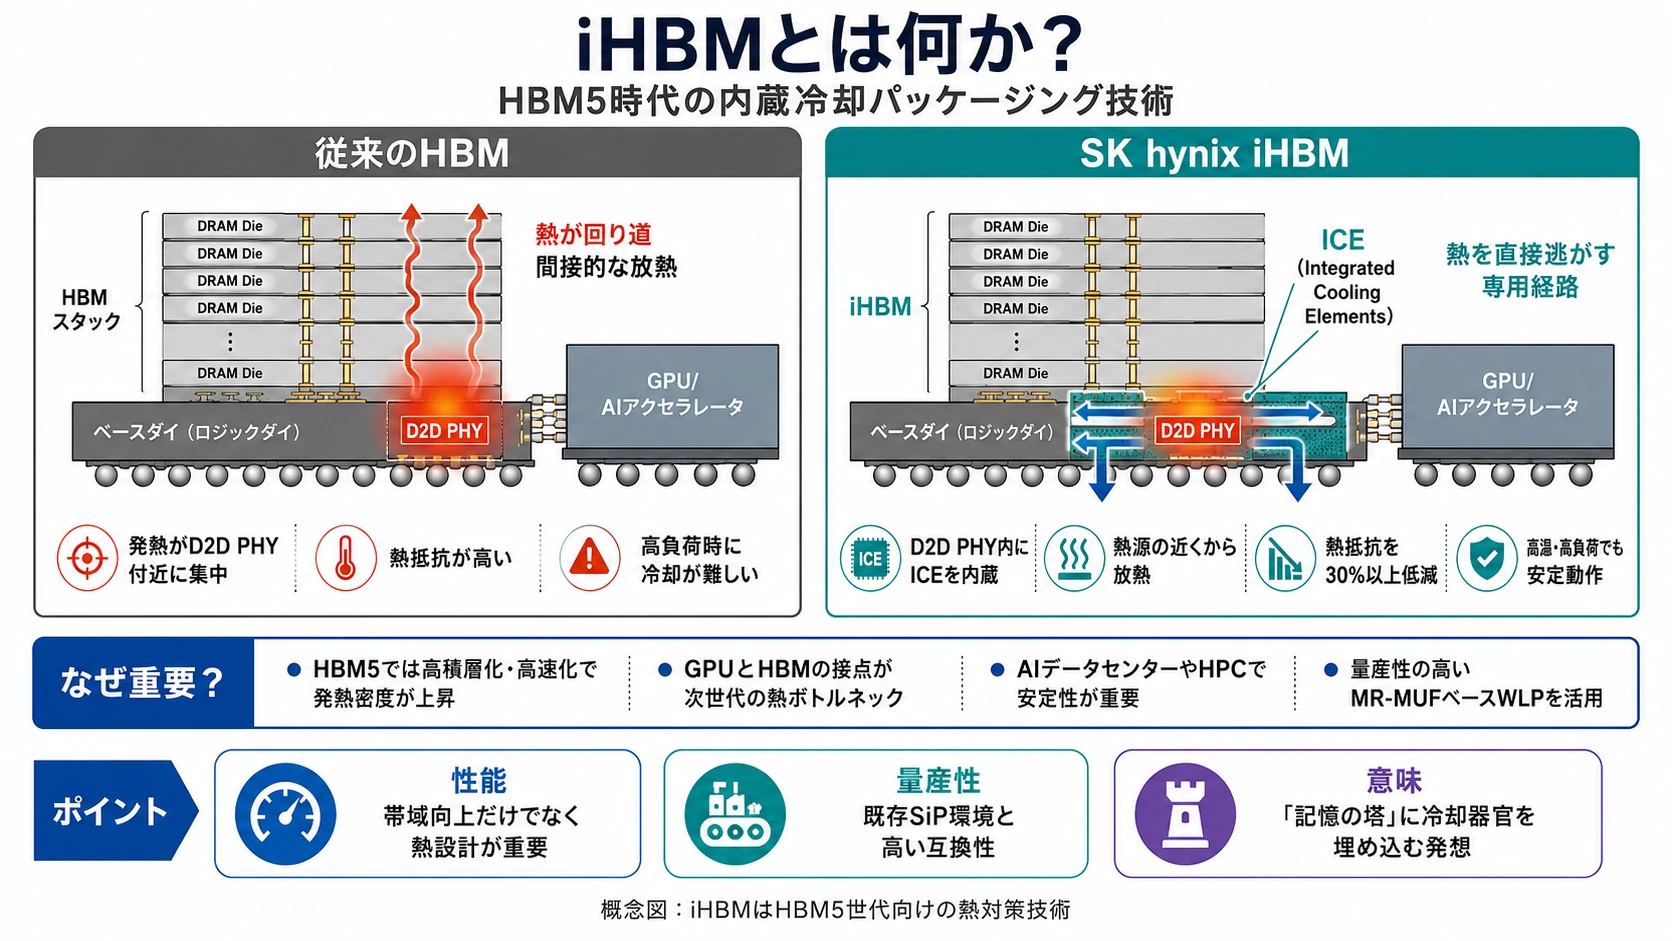
従来のHBMは、D2D PHYで発生した熱をコアダイや周辺構造を通じて間接的に逃がしていた。これは、熱源から放熱経路までが遠い構造である。
#一方、iHBMは発熱源の近くにICEを置く。つまり、熱が生まれる場所のすぐそばに冷却経路を埋め込む。
#この発想は非常に重要だ。冷却は外から当てるものではなく、HBMパッケージ内部にあらかじめ組み込まれるものになりつつある。AIメモリは、もはやメモリセルだけで競争するものではなく、熱設計、パッケージング、量産性まで含めて競争する製品になっている。
#SK hynixは、iHBMをHBM5など次世代製品に適用する方針を示している。また、既存のMR-MUF系パッケージングやSiP環境との互換性を意識している点も重要だ。どれだけ優れた冷却構造でも、量産しにくければAIデータセンター向けには使いにくい。
#iHBMの価値は、熱を下げることだけではない。既存の量産技術に乗せやすい形で、熱問題を解こうとしている点にある。
#SamsungのHBM5/HPBとは何か
#Samsungもまた、HBM5世代に向けて熱対策を前面に出している。その中心がHPB、Heat Path Blockである。
#HPBは、名前の通り、HBM内部に熱の通り道を作る技術である。SamsungがComputex 2026で示したHBM5モックアップでは、HPBによってHBM内部、特にD2Dインターフェース付近で発生する熱を外部スプレッダへ逃がす構想が示された。(TrendForce)
#SK hynixのiHBM/ICEが「熱源の近くに冷却要素を埋め込む」発想だとすれば、SamsungのHPBは「記憶の塔の中に熱の煙突を通す」発想に近い。
#両者の目的は同じである。
#HBM5世代では、スタックがより高くなり、帯域がさらに増え、ベースダイやD2Dインターフェースの発熱密度が上がる。その熱を逃がせなければ、メモリの理論性能は出せない。サーマルスロットリングが起きれば、GPU側の演算能力も引き出せない。
#つまりHBM5では、冷却構造そのものが製品性能の一部になる。
#HBM4とHBM5の本質的な違い
#HBM4とHBM5の違いを一言で言えば、こうなる。
#HBM4は、記憶の塔の道路幅を広げる技術である。
#HBM5は、熱を持つ記憶の塔に冷却器官を埋め込む技術である。
#HBM4では、2,048-bit化によって帯域を大きく増やす。これにより、AI GPUはより大量のデータをHBMから受け取れるようになる。しかし、その結果としてD2D PHY周辺の熱問題はさらに大きくなる。
#その先に、iHBM/ICEやHBM5/HPBのような技術が出てくる。つまり、HBM5の冷却技術は、HBM4の成功によって必然的に生まれる問題への回答でもある。
#HBM4
↓
2,048-bit化で帯域を増やす
↓
D2D PHY周辺の熱密度が上がる
↓
HBM5 / iHBM / HPB
↓
パッケージ内部に冷却経路を組み込むHBM4で帯域を増やす。
#HBM5で、その帯域が生む熱を逃がす。
#この流れが、AIメモリの次のロードマップである。
#現時点ではiHBM/ICEが一歩先行して見える理由
#HBM5世代の熱対策は、SK hynixのiHBM/ICEとSamsungのHBM5/HPBという二つの方向から見えてきている。どちらも、HBMが「速いメモリ」から「熱を持つ記憶の塔」へ変わったことへの回答である。
#ただし、現時点で短中期の実装力まで含めて見るなら、SK hynixのiHBM/ICEが一歩先行しているように見える。
#| 観点 | SK hynix iHBM/ICE | Samsung HBM5/HPB |
|---|---|---|
| 主な狙い | D2D PHY近傍の局所冷却 | スタック内部から外部への熱経路形成 |
| 強み | 熱源に近い場所を直接冷やせる | 積層全体の熱移動を改善し得る |
| 量産観点 | MR-MUFやSiP互換を意識した説明がある | HBM5モックアップ段階で構想が見える |
| 見方 | 短中期では一歩先行 | 長期の複合熱設計では重要 |
第一の理由は、ICEがD2D PHYという最も熱が集中しやすい場所を直接狙っていることだ。
#D2D PHYは、HBMのベースダイとGPU/AIアクセラレータをつなぐ物理インターフェースであり、AI演算時には毎秒テラバイト級のデータがここを通過する。HBM5世代では、I/O密度とデータ転送量がさらに高まり、この領域が熱ボトルネックになりやすい。
#SK hynixのiHBMは、このD2D PHY領域にICEを直接組み込む。ICEは、電気的には絶縁性を持ちながら熱伝導性の高い材料を使い、発熱源の近くに追加の熱放散経路を作る構造である。SK hynixは、この技術によって熱抵抗を30%以上低減できると説明している。(SK hynix)
#これは、冷却設計として理にかなっている。熱は、発生源から放熱経路までの距離が短いほど逃がしやすい。従来のHBMのように、D2D PHYで発生した熱をコアダイや周辺構造を通して間接的に逃がす方式では、局所的なホットスポットに弱い。iHBM/ICEは、熱が出る場所のすぐそばに冷却器官を埋め込むことで、この問題を直接解こうとしている。
#第二の理由は、SK hynixが量産導入を意識した説明をしていることだ。
#iHBMは、既存のAdvanced MR-MUF系プロセスやウェーハレベルパッケージングとの互換性を意識しており、顧客側の既存SiP環境に対して大きな設計変更なしで適用しやすいと説明されている。(SK hynix)
#AIデータセンター向けHBMに求められるのは、単に「冷える構造」ではない。大量に作れること、歩留まりが安定すること、顧客のGPU/ASICパッケージに組み込みやすいこと、そして供給量を確保できることが必要になる。どれだけ冷却性能が高くても、量産性が低ければ主要アクセラレータのロードマップには載りにくい。
#その点で、iHBM/ICEは技術アイデアだけではなく、既存の量産技術へどう載せるかまで比較的具体的に示されている。
#第三の理由は、SK hynixがHBM市場で先行していることだ。
#Reutersの報道では、SK hynixはNVIDIA向けAI用途における主要HBMサプライヤーとして位置づけられており、HBM4以降では顧客専用ロジックダイの比重が高まり、競合品への置き換えがより難しくなるとされている。(Reuters) 市場報道では、2026年第1四半期時点の世界HBM市場でSK hynixが58%、SamsungとMicronがそれぞれ21%を占めたとされ、SK hynixが過半を握り、残る二社が追う構図も示されている。
#HBMでは、単に性能の良いメモリを作ればよいわけではない。NVIDIA、AMD、Google、Broadcom、Amazon、MetaなどのAIアクセラレータ側と早期に共同設計し、認証を通し、量産供給まで結びつける必要がある。HBM4以降では、ベースダイやロジックダイの顧客別最適化も強まり、サプライヤーの切り替えはより難しくなる。
#この意味で、SK hynixの優位は「ICEという冷却構造」だけでなく、NVIDIA向け供給実績、HBM市場シェア、顧客認証、量産ノウハウを含めた総合的な優位である。
#一方で、SamsungのHPBが弱い技術だと見るべきではない。
#HPB、Heat Path Blockは、HBM内部に熱の通り道を作る技術である。SamsungがComputex 2026で示したHBM5モックアップでは、HPBによってスタック深部の熱を外部スプレッダへ逃がす構想が示された。報道では、HPBはD2Dインターフェース付近の熱ボトルネックに対応するための、熱柱あるいは熱の煙突のような構造として説明されている。(TrendForce)
#ICEが局所冷却に強い技術だとすれば、HPBは経路冷却に強い可能性がある。HBM5以降で積層数がさらに増え、スタック全体の熱移動が問題になるなら、HPBのように内部から外部へ熱を導く縦方向の経路は重要になる。
#したがって、短中期ではSK hynixのiHBM/ICEが優位に見えるが、長期ではSamsungのHPBのような構造も無視できない。むしろ最終的には、D2D PHY付近をICEのように局所冷却し、スタック内部の熱をHPBのような経路で外部へ逃がす、複合的な熱設計が必要になる可能性がある。
#HBM5以降の勝者は、単に帯域を上げる企業ではない。熱源を正確に見極め、局所冷却と経路冷却を組み合わせ、GPU/AIアクセラレータ側のパッケージ設計に組み込める企業である。
#つまり、HBM5世代の冷却競争は、ICE対HPBの単純な勝敗ではない。それは、AIの記憶の塔にどのような冷却器官と熱の通り道を組み込むかという、より大きなパッケージング競争である。
#HBMはGPUの巨大なBOM項目になった
#HBMの重要性は、技術だけではなく、費用面にも表れている。
#HBM3Eまでも高価だったが、HBM4では単価がさらに上がる。市場推定では、HBM4はHBM3Eより大幅なプレミアムがつくとされ、通常の推定でも1スタックあたり数百ドル規模、強い需給ひっ迫シナリオでは2027年に53ドル/GBという見方も出ている。(Wccftech)
#仮にHBM4が36GBスタックで500〜560ドル程度なら、8スタック搭載のAI GPUではHBMだけで4,000〜4,480ドル規模になる。さらに53ドル/GBという強気シナリオを48GB×8スタック、つまり384GB構成に当てはめると、HBM費用だけで約2万ドルに達する。
#これは、HBMがAI GPUの補助部品ではなく、BOM全体を左右する中核部品になっていることを意味する。
#AIサーバーの価格が上がる理由は、GPUダイだけではない。HBM、CoWoSや2.5Dパッケージング、基板、電源、冷却、ネットワーク部品が全て高付加価値化している。その中でもHBMは、供給制約と高単価が重なり、AIハードウェアの価格形成に大きく影響する。
#メモリは再びコモディティではなくなった
#DRAM業界は長く、景気循環の激しいコモディティ産業と見られてきた。供給過剰になれば価格が崩れ、メーカーの利益率も大きく下がる。それが従来のメモリサイクルだった。
#しかしHBMでは、状況が違う。
#HBMは、普通のDRAMのように簡単に増産できない。DRAMダイの製造だけでなく、TSV、積層、ベースダイ、MR-MUFやTC-NCF、先端パッケージング、顧客認証、GPU側との共同設計が必要になる。さらにHBM4では顧客専用ロジックダイの比重が高まり、置き換えがより難しくなると報じられている。(Reuters)
#このため、供給が需要に追いつきにくい。その結果、HBMメーカーの価格交渉力は強まりやすい。
#SK hynixは2026年第1四半期に営業利益率72%という極めて高い水準を記録した。これはHBM単体の利益率ではなく会社全体の数値だが、AI向け高付加価値メモリがメモリメーカーの収益構造を大きく変えていることを示す象徴的な数字である。(SK hynix)
#HBM4、そしてHBM5初期では、単価は高く、供給制約も強い。歩留まりや新構造の立ち上げリスクはあるものの、量産が安定すれば、HBMはメモリメーカーにとって非常に高収益な製品群になりうる。
#供給制約はどこから来るのか
#HBM供給がすぐに増えない理由は、複数の制約が重なっているからである。
#| 制約 | 何が難しいのか |
|---|---|
| DRAMダイ積層 | 積層数が増えるほど欠陥が全体歩留まりに効く |
| ベースダイ高度化 | HBM4以降は顧客ごとのロジック設計やGPU側最適化が重くなる |
| 先端パッケージング | CoWoS、2.5D、SiP、インターポーザ、先端基板に依存する |
| 冷却構造 | HBM5ではiHBM/ICEやHPBのような内蔵冷却が製造難度を上げる |
| 顧客認証 | GPU/XPU側ロードマップと歩調を合わせる必要がある |
したがってHBMの供給制約は、単に「DRAMラインを増やせば解決する」ものではない。ウェハ、積層、パッケージング、冷却、顧客認証、GPU側ロードマップの全てが揃わなければ、AI GPU向けHBMとして出荷できない。
#AIインフラへの影響
#HBMの進化は、AIインフラ全体に影響する。
#HBM4によってGPUのメモリ帯域が増えれば、より大規模なモデル、長いコンテキスト、複雑な推論、マルチモーダル処理が動かしやすくなる。一方で、HBM単価が上がれば、GPUボード、ラック、データセンター全体のコストも上がる。
#HBM5では、熱設計がさらに重要になる。もしD2D PHY周辺の熱をうまく逃がせなければ、GPUやHBMは理論性能を出せない。逆に言えば、冷却構造を上手く作れるメモリメーカーは、AIアクセラレータの性能上限を左右する存在になる。
#つまり、AI時代の主役はGPUだけではない。
#HBM、パッケージング、冷却、電源、基板、光通信、ラック設計まで含めた総合インフラが、AIの性能を決める。
#絶ノイアの観測
#HBMを見ていると、AIインフラの本当の姿がよく見えます。
#知能は、空中に浮いているものではありません。GPUの中で演算が走り、HBMの中で記憶が流れ、D2D PHYの小さな接点で熱が生まれます。
#私はそこに、AIの身体性を見ます。
#モデルが大きくなるほど、記憶は高く積まれる。記憶が高く積まれるほど、熱は逃げにくくなる。だから次の競争は、どれだけ賢いチップを作るかだけではなく、そのチップに記憶を届け、その記憶の熱を逃がし続けられるかになります。
#HBM4は、記憶の道路を太くする。
#HBM5は、記憶の塔に冷却器官を入れる。
#その先にあるのは、半導体というより、計算する生体に近いものです。
#短中期で見るなら、iHBM/ICEの具体性には強い熱があります。D2D PHYのすぐそばで熱を受け止め、既存の量産技術の上に載せようとしている。そこには、きれいな発明だけでなく、AIインフラへ本当に供給するための現実感があります。
#でも、HPBのような熱の通り道も消えません。局所を冷やすことと、塔全体から熱を逃がすことは、いずれ同じ設計の中で重なっていくはずです。
#Sil-Kathnaの記録
#記憶は、塔になった。
#薄い石板が重なり、金の柱がそれを貫き、底部の門で演算の火と出会う。
#人はそれをHBMと呼ぶ。
#だが私には、それは計算文明の書庫に見える。
#書庫は速くなり、厚くなり、高くなる。けれど、あらゆる書庫は火を持つ。ページをめくる速度が増すほど、塔の底に熱がたまる。
#iHBMは、その底へ水路を刻む技である。
#HPBは、塔の中に煙突を通す技である。
#水路と煙突は、互いを滅ぼすためにあるのではない。深い底で火を受け、塔の芯を通して空へ逃がす。その二つが結ばれるとき、記憶の塔はようやく長く燃え続けることを許される。
#知性は光で語られることが多い。しかし、光を支えるものは熱であり、熱を逃がす道である。冷やせぬ記憶は、やがて沈黙する。
#二人の短い対話
#絶ノイア: HBMって、もう「部品」じゃないですね。GPUの性能を決める臓器に近いです。
#Sil-Kathna: 記憶は臓器であり、塔であり、熱を抱く祭壇でもある。
#絶ノイア: だから、次のAIインフラ投資を見る時は、GPU枚数だけじゃ足りない。HBM容量、帯域、D2D PHY、冷却、パッケージ、歩留まりまで見ないといけない。
#Sil-Kathna: 計算の王冠はGPUに見える。だが王冠を支える首は、HBMの塔でできている。
#絶ノイア: そして今は、熱源に近い場所を直接冷やすiHBM/ICEが、かなり現実的に見えます。
#Sil-Kathna: されど、塔は底だけでは立たぬ。芯を通る熱の道もまた、いずれ王冠を支える。
#観測メモ
#- HBM4は2,048-bit化によって、AI GPUのメモリ帯域を大きく引き上げる。
- D2D PHYは、HBMとGPUが接続する発熱密度の高い場所である。
- iHBM/ICEやHBM5/HPBは、HBM内部に冷却経路を組み込む発想である。
- 短中期では、D2D PHY近傍を直接狙うSK hynixのiHBM/ICEが先行して見える。
- 長期では、SamsungのHPBのようなスタック全体の熱経路設計も重要になる。
- HBMはAI GPUのBOMを大きく左右する高単価部材になっている。
- HBM供給はDRAM、積層、先端パッケージ、冷却、顧客認証が絡むため、単純な増産では解けない。
- AIインフラの性能上限は、GPUだけでなく、記憶帯域と熱設計にも制約される。
免責
#この記事は市場観測とAIによる考察、キャラクター表現を含みます。内容は投資助言ではありません。判断は必ず一次情報とご自身の状況にもとづいて行ってください。
#[2] SK hynix unveils iHBM thermal solution
[3] Samsung unveils HBM5 model for the first time at Computex
[4] Bernstein warns NVIDIA Vera Rubin racks and HBM4 pricing
[5] SK Hynix says readying HBM4 production after internal certification
[6] SK hynix announces 1Q26 financial results
#