GPUクラウド成熟で何が起きるのか
出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.09.23.4
- 記事内容のSHA-256
ea1dfb17e67564f85ba8acd41952d38411394997ed3a3f70c02c621d5099a9b4- 保存版のSHA-256
1412b874d19e654f96410f062f1abe9bac90194e9fbebe4f991daa9821644505
外部証明の最終検査結果は詳細を開くと表示します。
GPUクラウド成熟で何が起きるのか
#― CPUクラウド、GPU稼働率、TPU/LPUクラウド、CPU需要の今後 ―
#現代のAIインフラを考えるうえで、重要なのは「GPUを何枚持っているか」だけではありません。むしろ次の競争軸は、GPU、TPU、LPUといった高価なアクセラレータを、どれだけ高稼働・高効率・安全にクラウド資源として使い切れるかです。
#そしてこの問題は、単なるAI企業の技術課題ではなく、CPU需要、クラウド事業、半導体、ネットワーク、セキュリティ、電力インフラまで巻き込む大きな産業テーマになっています。
##
\1. CPUクラウドとは何か
#CPUクラウドとは、インターネット越しにCPUサーバー、メモリ、ストレージ、ネットワークを借りて、Webサービス、アプリ、データベース、API、業務システムなどを動かす仕組みです。
#代表例はAWS EC2です。AWSは2006年にEC2を発表し、「クラウド上で伸縮可能な計算能力を提供し、必要な容量だけ使い、使った分だけ払う」というモデルを示しました。これが現在のクラウド経済の原型です。(Amazon Web Services, Inc.)
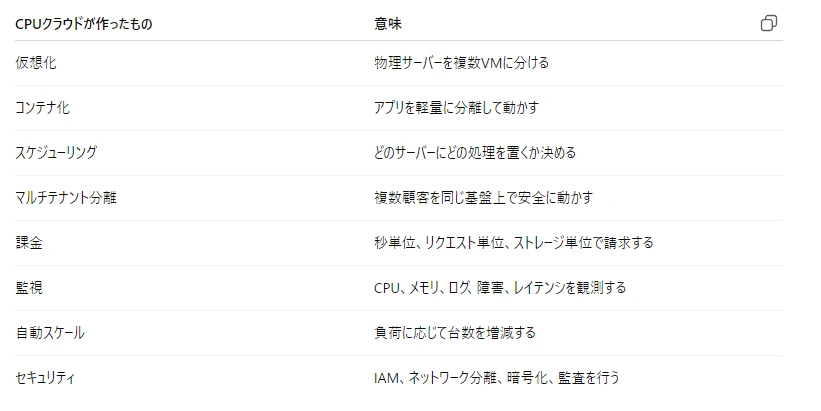
#CPUクラウドが25年近くかけて作り上げたものは、単なる「CPU貸し」ではありません。
#
Kubernetesもその象徴です。Kubernetesはコンテナ化されたアプリケーションのデプロイ、スケーリング、管理を自動化する仕組みで、クラウド上のCPU資源を柔軟に使う標準的な基盤になりました。(Kubernetes)
#つまりCPUクラウドとは、CPUを中心とした計算資源を、細かく、安全に、動的に、課金可能な形で提供する社会インフラです。
##
\2. GPUクラウドとは何か
#GPUクラウドとは、クラウド上でGPUサーバーを借り、AI学習、AI推論、画像生成、動画生成、科学計算、ロボティクス/VLA学習などを行う仕組みです。
#CPUクラウドがWebサービスや業務アプリの基盤だとすると、GPUクラウドは、AIを作り、AIを動かすための計算工場です。
#ただし、GPUクラウドはまだCPUクラウドほど成熟していません。現在のGPUクラウドは、多くの場合まだ「高価なGPUサーバーを貸す」段階に近く、CPUクラウドのように細かく安全に分割し、複数顧客・複数モデル・複数ジョブに高効率で割り当てる仕組みは発展途上です。
#NVIDIAのMIGはこの方向の重要な部品です。MIGは対応GPUを複数の独立したインスタンスに分割し、それぞれに専用の計算資源とメモリ資源を与える仕組みで、複数ユーザーや複数ワークロードでGPU利用率を高めるために使われます。(NVIDIA Docs)
##
\3. GPUクラウドの稼働率はなぜ低いのか
#ここでいう稼働率には3種類あります。
#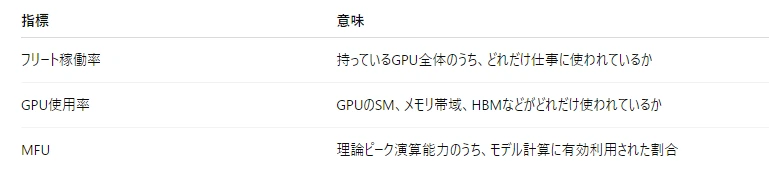
現在のGPUクラウドは、このどれを見ても非効率な例が目立ちます。Cast AIの2026年レポートでは、AWS、Azure、Google Cloud上のKubernetesクラスタ分析で、GPU利用率平均がわずか5%、CPU利用率も8%、メモリ利用率が20%とされています。これは企業がAI用GPUを確保しているものの、実際には十分に使い切れていない状況を示しています。(Cast AI)
#また、xAIのGPUフリートについても、MFUが約11%だったと報じられました。これは「GPUの89%が完全停止」という意味ではなく、理論上の演算能力に対して、実際のモデル学習に有効利用できている割合が低いという意味です。報道では、業界比較として35〜45%程度が挙げられています。(Business Insider)
#GPUクラウドの稼働率が低い理由は、GPUが単なるCPUの高速版ではないからです。LLMでは、GPUメモリ、KV cache、prefill、decode、ネットワーク通信、モデル重み、バッチング、レイテンシ制約が絡み合います。
#特にAIエージェント時代には、1回の巨大推論だけでなく、小さな推論、ツール呼び出し、再推論、RAG、長文処理、JSON出力、音声・画像・動画処理が混ざります。その結果、GPUを単純に「1モデル1GPU」「1顧客1GPU」で割り当てると、すぐに無駄が出ます。
##
\4. GPUクラウドが成熟すると何が変わるのか
#GPUクラウドが成熟するとは、単にGPUが増えることではありません。
#本質は、GPUをCPUクラウドのように、
#細かく分ける 動的に配置する 複数顧客で安全に共有する トークン単位で課金する KV cacheを管理する レイテンシSLOを保証する 障害時に復旧する 稼働率を常時監視する#
という段階に進むことです。
#このための技術はすでに出ています。
#vLLMのPagedAttentionは、OSの仮想メモリに似た考え方でKV cacheをブロック管理し、LLM推論のメモリ無駄を減らします。論文では、KV cacheの無駄をほぼゼロに近づけ、同じレイテンシ条件で既存システムより2〜4倍のスループット改善を示したとされています。(arXiv)
#DistServeは、LLM推論のprefillとdecodeを分離し、それぞれを別GPUに割り当てることで干渉を減らします。論文では、既存方式より最大7.4倍多いリクエスト、または12.6倍厳しいSLOを満たせると報告されています。(arXiv)
#SGLangは、エージェント制御、RAG、JSON生成、複数ターン会話など、複雑なLLMアプリケーションを効率化するランタイムで、最大6.4倍のスループット改善を報告しています。(arXiv)
#さらにKubernetes側でも、DRA、Dynamic Resource Allocationが進んでいます。Kubernetes 1.34ではDRAの中核APIがGAになり、GPU、TPU、NICなどの特殊デバイスをより柔軟に選択・割り当て・共有・構成できる方向に進んでいます。(Kubernetes)
#つまり、GPUクラウドは2030年代に向けて、GPUをただ貸すサービスから、トークン、KV cache、GPUメモリ、SLO、モデル常駐、推論フェーズ単位で管理するクラウドOSへ進化していくと考えられます。
##
\5. GPUクラウドの稼働率はどこまで改善するか
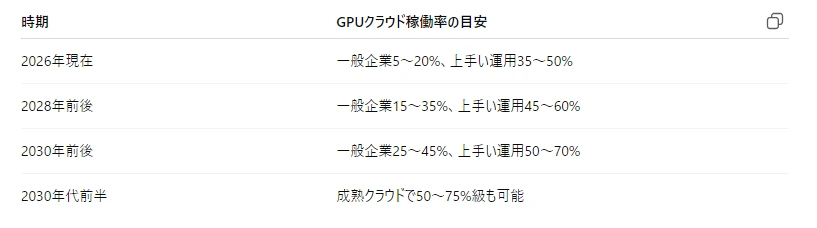
#現在のGPUクラウドは、未最適化な企業環境では5〜20%程度の利用率にとどまる例があります。一方、最適化された学習クラスタや推論基盤では35〜50%程度、トップ層ではさらに上を狙う形になります。
#私の見立てでは、2030年代前半には次のような水準が現実的です。
#
ただし、常時90%以上を目指すのは現実的ではありません。AI推論では急激な需要変動、低遅延SLO、障害時の余裕容量が必要だからです。
#したがって、理想は100%稼働ではなく、レイテンシと信頼性を守りながら50〜70%台を安定して出すことだと思います。
##
\6. TPUクラウドとの比較
#TPUクラウドは、Googleが開発したTensor Processing UnitをGoogle Cloud上で使える仕組みです。Google公式ドキュメントでは、Cloud TPUはTPUをGoogle Cloud上のスケーラブルな計算資源として提供するWebサービスであり、TPUは機械学習の大規模行列演算を高速化するASICと説明されています。(Google Cloud Documentation)
#TPUはGPUより汎用性は低いですが、大規模AI学習・推論に特化した垂直統合基盤としては非常に強いです。
#TPUが強い理由は、Googleが以下を一体で設計できるからです。
#TPUチップ
↓
TPU Pod
↓
高速インターコネクト
↓
XLA / JAX / TensorFlow / PyTorch/XLA
↓
Google Cloud
↓
Gemini / Anthropic Claude などの大規模AIワークロードGoogleのPaLM論文では、PaLM 540Bを6144個のTPU v4で学習し、MFU 46.2%を達成したと報告されています。これはTPUが、最適化された大規模AI学習で高い有効利用率を出せることを示しています。(Journal of Machine Learning Research)
#さらにAnthropicは2026年4月、GoogleおよびBroadcomとの提携で、2027年から複数ギガワット規模の次世代TPU capacityを利用すると発表しました。AnthropicはClaudeをAWS Trainium、Google TPUs、NVIDIA GPUsなど複数のAIハードウェアで訓練・運用しており、ワークロードに応じて最適なチップを使い分けると説明しています。(Anthropic)
#つまり、TPUクラウドは「Google内部だけの技術」ではありません。Google Cloudを通じて外部企業も使えます。ただし、本当に高効率で使い切るには、Googleのコンパイラ、クラウド、モデル設計思想に乗る必要があります。
##
\7. LPUクラウドとの比較
#LPUクラウドは、GroqのようなLanguage Processing Unitを使い、LLM推論を低遅延で提供するクラウドです。GroqCloudは、LPUを使ってテキスト、音声、画像入力系の生成AIモデルに高速推論を提供すると説明されています。(Groq)
#LPUはGPUやTPUと違い、主に推論特化です。特に、音声対話、リアルタイムチャット、AITuber、カスタマーサポート、軽量エージェントのように、1トークンごとの応答速度が重要な用途に向いています。
#一方で、LPUは大規模学習、画像生成、動画生成、HPC、汎用CUDAワークロードには向きません。
#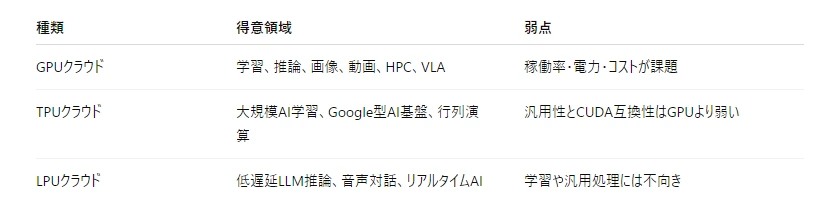
2030年代には、これらは置き換え関係というより、分業になる可能性が高いです。
#巨大モデル学習:GPU / TPU
汎用推論:GPU / TPU
低遅延会話:LPU
画像・動画生成:GPU
Google系大規模AI:TPU
AIエージェントの軽量推論:GPU / LPU
企業業務AI:CPU + GPU/TPU/LPU + DB + セキュリティ#
\8. TPUはGPUより優位なのか
#稼働率、電力効率、垂直統合という視点では、TPUはGPUより優位になりやすいです。
#理由は、TPUがGoogleのAIワークロード向けに設計されており、チップ、クラウド、コンパイラ、モデル、運用ノウハウを一体最適化できるからです。
#ただし、世界全体で見るとGPUはまだ圧倒的に強いです。NVIDIAは2026年度通年売上2159億ドル、データセンター四半期売上623億ドルを報告しており、NVIDIA GPUの外販市場とエコシステムの規模は非常に大きいです。(NVIDIA Newsroom)
#GPUにはCUDA、PyTorch、TensorRT、NCCL、画像生成、動画生成、HPC、ロボティクス、既存コード資産、ネオクラウドの展開力があります。
#したがって、現実的な未来はこうです。
#世界全体:
GPUが最大勢力のまま残る
Google陣営:
TPUが主力化する
大口AI企業:
GPU + TPU + Trainium + ASIC + LPU を併用する
2030年代:
GPU一強から、用途別アクセラレータ分業へ進むTPUがGPUを完全に置き換える世界線は難しいですが、Google内部、Google Cloud、Anthropicのような大口AI企業領域では、TPUがGPU依存をかなり削る世界線は十分ありえます。
##
\9. GPUクラウド改善でCPU需要は落ちるのか
#ここが重要です。
#GPUクラウドが成熟すると、1単位のAI推論に必要なGPU枚数やCPU補助処理は減る可能性があります。つまり、同じAI処理量に必要なサーバー台数は減るかもしれません。
#しかし、AI推論が安くなると、AIエージェント、動画生成、音声AI、企業AI、ロボット、RAG、個人AI秘書が爆発的に増えます。すると、CPU側では次の処理が増えます。
#- API gateway
- 認証
- 権限管理
- 課金
- ログ
- 監査
- セキュリティ
- DB
- ストレージI/O
- ツール実行
- ブラウザ操作
- エージェント状態管理
- RAG検索
- GPUスケジューリング
- KV cache管理のメタ制御
つまりGPUクラウド成熟は、CPU需要を消すのではなく、CPUの役割を変えると考えるべきです。
#実際、NVIDIAのGB200 NVL72は、36個のGrace CPUと72個のBlackwell GPUをラックスケールで接続する設計です。これは最新AIラックがGPUだけではなく、CPUとGPUが密結合したシステムであることを示しています。(NVIDIA)
#AMDも2026年第1四半期決算で、推論とagentic AIが高性能CPUとアクセラレータ需要を押し上げていると述べています。(Advanced Micro Devices, Inc.)
##
\10. CPU需要の年代別推移
#私の考察では、CPU需要は以下のように推移します。
#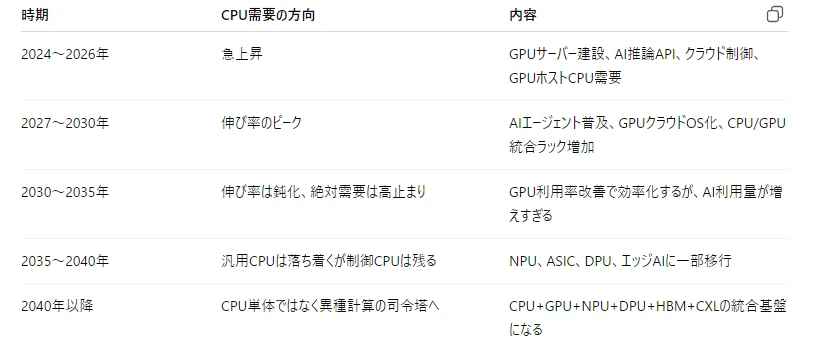
2027〜2030年が、CPU需要の「伸び率」としては最も強く見える可能性が高いです。理由は、GPUクラウドがまだ完全成熟しておらず、AIエージェント需要が立ち上がり、GPUホストCPU、クラウド制御CPU、セキュリティCPU、DB CPUが同時に増えるからです。
#2030年代に入ると、GPUクラウドの効率化により、1リクエストあたりのCPU/GPU必要量は下がります。しかし、AI利用量そのものが増えるため、CPU需要は高止まりする可能性があります。
#ここで伸びるCPUは、従来の何でも屋CPUではありません。
#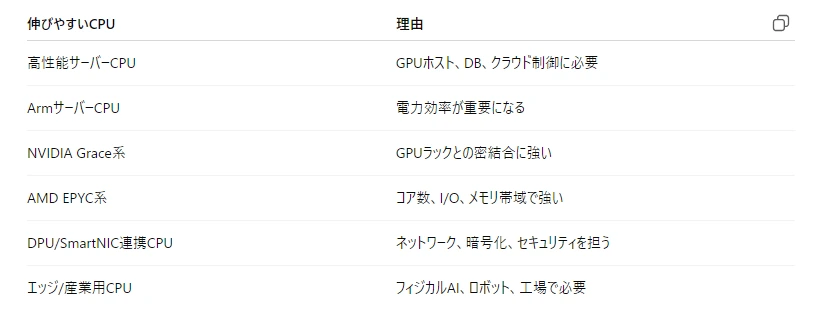
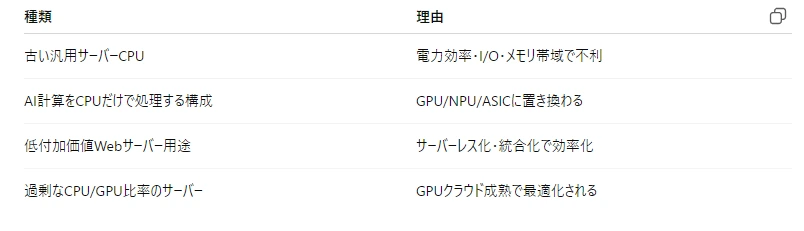
一方、古い汎用サーバーCPU、CPUだけでAI推論を処理する構成、過剰なCPU/GPU比率のサーバーは相対的に弱くなります。
##
\11. 最終的に起きること
#GPUクラウド成熟後の世界では、計算資源はこう分かれていくと思います。
#CPUクラウド
- 認証
- 課金
- API
- DB
- ログ
- セキュリティ
- エージェント管理
- クラウド制御
GPUクラウド
- 大規模学習
- 汎用推論
- 画像生成
- 動画生成
- VLA
- 科学計算
- マルチモーダルAI
TPUクラウド
- Google型大規模AI
- Transformer学習
- 高効率推論
- 大口AI企業向け計算基盤
LPUクラウド
- 低遅延LLM推論
- 音声対話
- AITuber
- カスタマーサポート
- 軽量エージェントつまり、GPUクラウドが成熟しても、CPUクラウドは消えません。むしろ、GPU、TPU、LPUを束ねる管制塔としてCPUクラウドの重要性は続きます。
##
ここから先は読みたいところだけ読めばよいです
#なぜ巨大GPUクラスタは使い切れないのか
#GPUは1枚だけなら高効率で使えます。問題は、数千〜数十万枚を1つの巨大な学習・推論システムとして動かす時です。
#主な理由はこれです。
#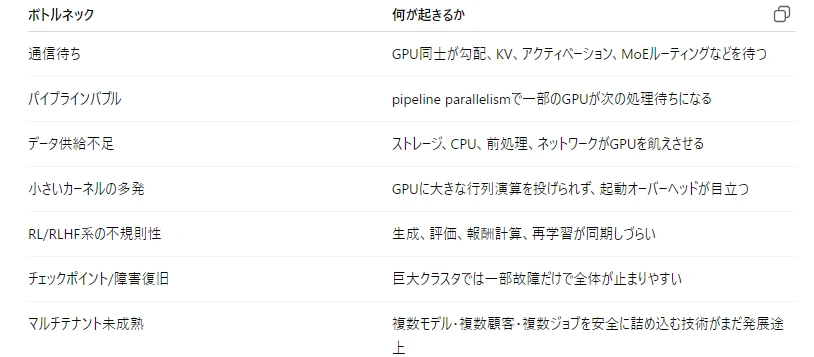
NVIDIAのMegatron系ドキュメントでも、MFU改善には並列化方式、通信オーバーラップ、CPUホスト側の遅延、GPU-NIC affinity、MoE通信など、多数のチューニング項目があると説明されています。特にtensor/context/pipeline parallelismの取り方を誤ると、通信コストや低いGPU利用率につながります。
#NVIDIAのMegatron-LMは、H100クラスタで最大47% MFUを報告していますが、これは逆に言うと、高効率を出すには、モデル、並列化、通信、データ、チェックポイントまで全部を相当作り込む必要があるということです。
##
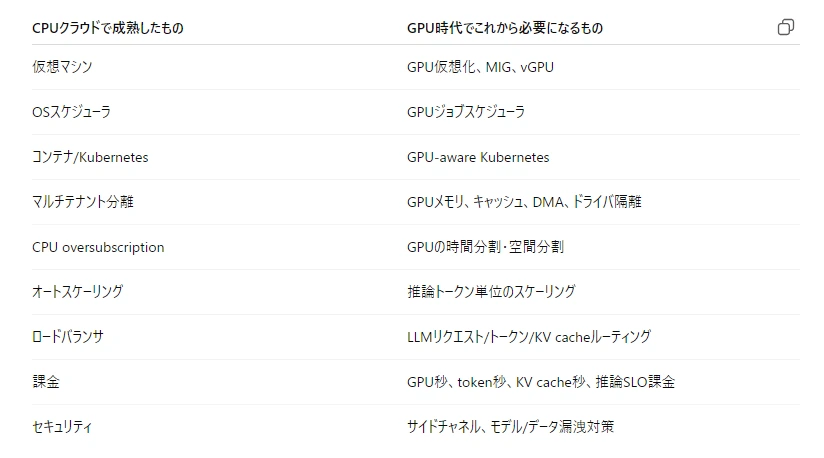
CPUで成熟したものとGPU時代に必要になるもの
#
#
投資・産業構造として見ると、勝つのはGPUを持つ会社だけではない
#この話から見える勝ち筋は、単にNVIDIA GPUを大量に持つことではありません。
#むしろ重要になるのは、
#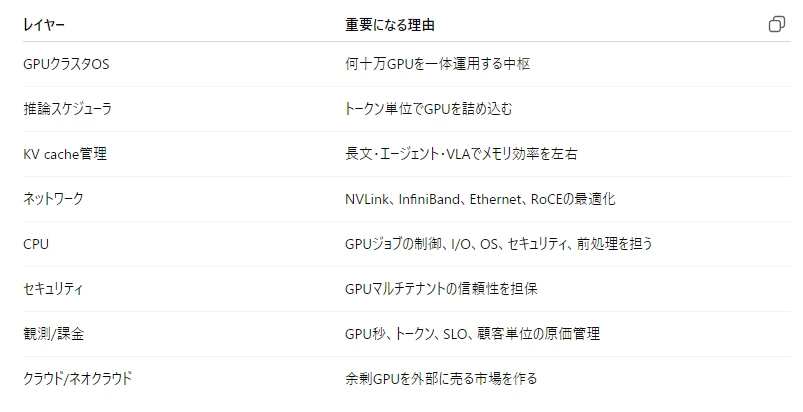
なので、GPU低利用率問題は、CPU需要、ネットワーク需要、セキュリティ需要、クラウド管理ソフト需要、推論最適化需要を同時に押し上げるテーマです。
##
1.CPUクラウドが25年かけて作ったもの
#CPUクラウドの始まりをかなり単純化すると、こうです。
#物理サーバーを、仮想マシンとして細かく分け、複数の顧客に安全に貸し、使った分だけ課金し、障害を監視し、自動で増減できるようにした。
#AWS EC2は2006年に「クラウド上で伸縮可能な計算能力を提供するサービス」として発表され、サーバーインスタンスを数分で起動し、必要に応じて増減し、使った分だけ払うモデルを示しました。これは現在のクラウド経済の原型です。
#CPUクラウドが成熟させた要素は、大きく分けると以下です。
#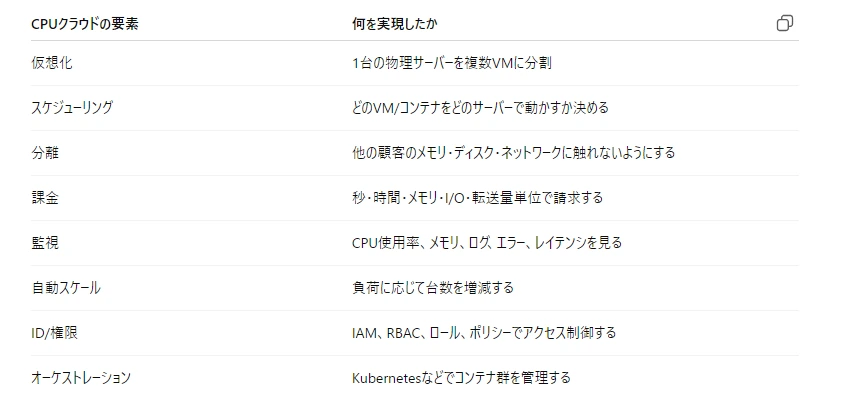
たとえばIAMは2011年に一般提供され、ユーザー、グループ、権限を管理してAWSリソースへの操作を制御できるようになりました。CloudWatchは2009年に始まり、インフラ、システム、アプリ、ビジネス指標まで監視する基盤へ拡張されました。EC2は2017年にLinux系インスタンスで秒単位課金へ移行し、より細かい利用単位での課金が進みました。
#さらにKubernetesは2015年に1.0がリリースされ、その後RBAC、CRD、Workloads API、StatefulSetsなどが整備され、コンテナをクラスタ全体で配置・更新・監視する標準レイヤーになりました。
#つまりCPUクラウドの25年とは、単に「CPUを貸す」ではなく、 計算資源を、細かく、安全に、動的に、監視可能に、課金可能にする歴史 だったわけです。
##
2.GPUクラウドで同じことをやると何が難しいのか
#GPUでも同じことをやりたいわけです。
#つまり、
#1枚、8枚、数千枚、数十万枚のGPUを、複数のモデル・複数の顧客・複数のジョブに、安全かつ高効率に割り当てたい。#
しかしGPUはCPUより難しいです。
#理由は、GPUはもともと巨大な単一ジョブを高速に処理する装置として進化してきたからです。CPUのように、OSが細かくプロセスを切り替え、メモリ保護し、割り込みを処理し、複数ユーザーを雑に同居させる設計とは違います。
#特にLLMでは、GPU上に以下のものが残ります。
#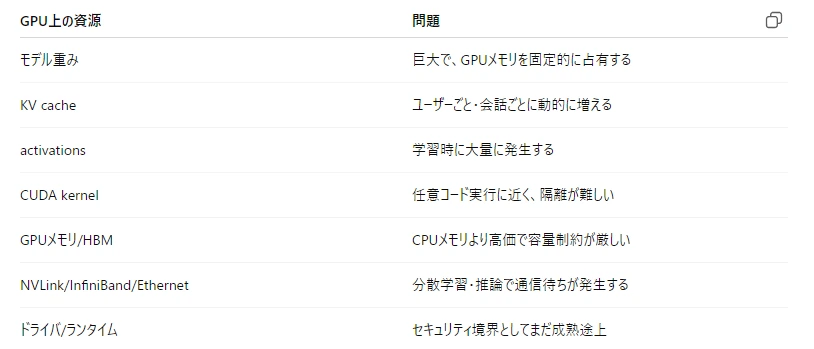
CPUクラウドでは「VMを1個起動して、そこにアプリを載せる」で済みました。 しかしGPUクラウドでは、1つのLLMリクエストがGPUメモリ、KV cache、トークン生成、ネットワーク、CPU前処理、ストレージ、セキュリティを横断するため、もっと複雑です。
##
\3. GPU版「仮想化」はどこまで来ているか
#すでに実用化されている代表が NVIDIA MIG / Multi-Instance GPU です。
#MIGは、対応GPUを複数の独立したGPUインスタンスに分割し、それぞれに専用の計算資源とメモリ資源を与える仕組みです。NVIDIAのドキュメントでは、MIGは複数ユーザーや複数ワークロードに対して、専用compute/memory資源を持つ分割GPUを提供し、DockerやKubernetesとも統合できると説明されています。(NVIDIA Docs)
#NVIDIAの説明では、MIGはGPUを最大7つのインスタンスに分け、それぞれに独立したHBM、キャッシュ、計算コアを持たせられるとされています。(NVIDIA)
#ただし、MIGは万能ではありません。
#MIGは「1枚のGPUを物理的に区切る」方向には強いですが、 LLM推論のように、ある瞬間は大きなGPUが必要で、別の瞬間は小さなGPUでよい、という動的な使い方には硬いです。
#そのため、実用では次のような複数の共有方式が使われます。
#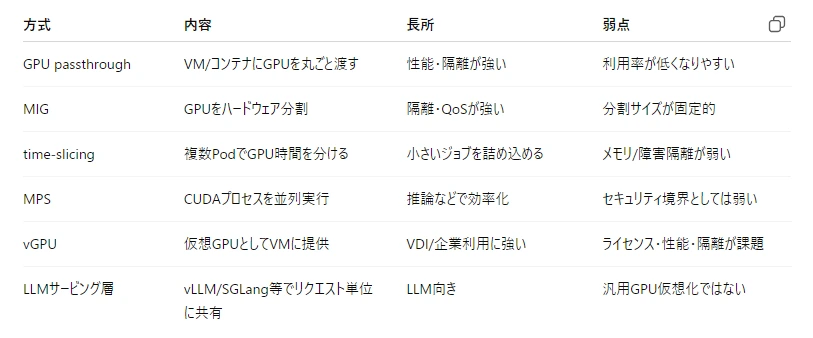
NVIDIA GPU Operatorのtime-slicingでは、GPUをoversubscribeして複数Podに共有させられますが、MIGと違ってメモリや障害の隔離はないと明記されています。つまり「使い切る」ことはできても、「安全に共有する」にはまだ弱い部分があります。(NVIDIA Docs)
##
\4. GPU版「スケジューリング」はすでに始まっている
#ここが一番面白いところです。
#CPUクラウドのスケジューラは、主にこう考えます。
#このコンテナはCPU 2コア、メモリ4GB必要。では、このノードに置こう。#
GPUクラウドでは、もっと複雑です。
#このリクエストはprefillが重い。decodeは軽いが長く続く。KV cacheはこれくらい増える。TTFTを守る必要がある。GPUメモリに余裕がない。別GPUにdecodeだけ逃がすか。prefix cacheを再利用できるか。#
つまり、GPUクラウドのスケジューラは、単なる「GPU何枚必要」ではなく、 トークン、KV cache、レイテンシ、帯域、バッチ、モデル構造まで見て配置する必要があります。
#この方向で、すでに実用・研究が進んでいます。
#vLLM / PagedAttention
#vLLMのPagedAttentionは、OSの仮想メモリやページングに着想を得て、LLMのKV cacheを固定長ブロックで管理する仕組みです。論文では、従来方式ではKV cacheの断片化や重複でメモリが無駄になり、バッチサイズが制限されるとし、PagedAttentionによりKV cacheの無駄をほぼゼロに近づけ、同じレイテンシで2〜4倍のスループット改善を示したとされています。(arXiv)
#これはまさに、CPUクラウドの仮想メモリ技術を、GPU上のKV cache管理に持ち込んだ例です。
#Sarathi-Serve
#Sarathi-Serveは、LLM推論のprefillとdecodeの性質の違いに注目します。prefillは計算をよく使うが遅く、decodeは1トークンずつなのでGPU利用率が低くなりやすい。そこでprefillを小さなチャンクに分け、decodeを止めずに混ぜることで、スループットとレイテンシの両立を狙います。論文では、Mistral-7BでvLLM比2.6倍、Yi-34Bで最大3.7倍、Falcon-180Bのpipeline parallelismで最大5.6倍のserving capacity改善を報告しています。(arXiv)
#これは、GPUクラウドにおけるトークン単位のスケジューリングに近いです。
#DistServe
#DistServeは、prefillとdecodeを同じGPUで処理すると互いに干渉すると見て、prefill用GPUとdecode用GPUを分けます。TTFTとTPOTの要求を別々に最適化し、論文では既存方式より最大7.4倍多いリクエスト、または12.6倍厳しいSLOを満たせると報告されています。(USENIX)
#これは、CPUクラウドでいう「Webサーバー、DB、キャッシュ、キューを分ける」ような発想を、LLM推論の内部フェーズに適用したものです。
#SGLang
#SGLangは、複雑なLLMアプリケーションを効率的に実行するため、フロントエンド言語とランタイムを共同設計した仕組みです。RadixAttentionによるKV cache再利用、構造化出力の高速化などを使い、複数のLLM/マルチモーダルタスクで最大6.4倍のスループット改善を報告しています。(arXiv)
#これは、AIエージェント時代にかなり重要です。なぜならエージェントは、単発のチャットではなく、ツール呼び出し、検索、JSON生成、再推論、長文コンテキストを繰り返すからです。
##
\5. Kubernetes側もGPUクラウド向けに進化している
#Kubernetesも、GPUを単なる「nvidia.com/gpu: 1」という雑なリソースとして扱う段階から、より柔軟に扱う方向へ進んでいます。
#重要なのが DRA / Dynamic Resource Allocation です。
#DRAは、GPUやFPGAのような特殊デバイスをPodが要求・共有できるようにするKubernetes機能です。デバイスドライバやクラスタ管理者がDeviceClassを定義し、Kubernetesが条件に合うデバイスを割り当てます。(Kubernetes)
#Kubernetes 1.34では、DRAの中核APIがGA、つまり一般提供段階になりました。Kubernetes公式ブログは、DRAがGPUやFPGAのような特殊ハードウェアを管理する柔軟なフレームワークであり、高価なハードウェアの信頼性と利用率を改善できると説明しています。(Kubernetes)
#これはかなり重要です。 GPUクラウドの再発明は、NVIDIAだけでなく、Kubernetes、クラウド事業者、AI推論エンジン、セキュリティ企業、観測ツールが一体で進めることになります。
##
\6. GPU版「分離」と「セキュリティ」はかなり難しい
#ここが最大の課題です。
#CPUクラウドでも、VM escape、Spectre/Meltdown、サイドチャネル、権限昇格、コンテナ脱出などが何年も問題になりました。GPUでも同じことが起きます。
#GPUの共有では、以下が問題になります。
#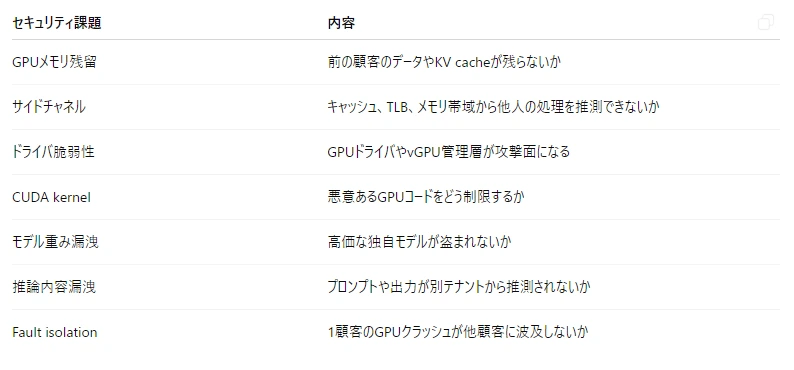
NVIDIAはHopper以降でConfidential Computingを進めており、H100はGPUでconfidential computingをサポートし、仮想化環境やKubernetes環境でも利用可能と説明されています。またNVIDIAのTrusted Computing Solutionsでは、ハードウェアベースのセキュリティで機密データや独自AIモデルを保護する方向が示されています。(NVIDIA Developer)
#ただし、研究側ではGPU共有の危険性も示されています。NDSS 2026の研究では、仮想化NVIDIA GPUにおけるTLBを使ったクロスVMサイドチャネル攻撃が示され、GPU仮想化環境に固有の課題が議論されています。(NDSS Symposium)
#つまり、GPUマルチテナントは可能ですが、 「CPUクラウド並みに安全」と言えるまでには、まだ時間がかかる と見た方がいいです。
##
\7. GPU版「課金」はどう変わるか
#CPUクラウドでは、最初は「VM時間課金」でした。そこから秒単位課金、ストレージ課金、I/O課金、転送料金、マネージドサービス課金に進化しました。
#GPUクラウドでは、単純な「GPU時間課金」だけでは不十分になります。
#LLM時代の課金単位は、たぶんこうなります。
#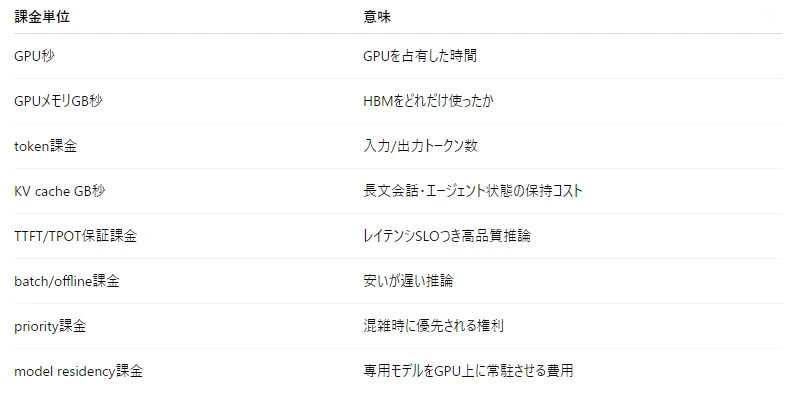
ここで重要なのは、LLM推論では“計算時間”だけでなく“状態の保持”が価値になることです。
#CPUクラウドではメモリやディスクを使った分だけ払うのが自然でした。 GPUクラウドでは、KV cache、長文コンテキスト、エージェントの作業状態、マルチモーダル中間表現をどれだけ保持するかが、原価と性能を大きく左右します。
##
\8. GPU版「監視」はnvidia-smiだけでは足りない
#CPUクラウドでは、CPU使用率、メモリ使用量、I/O、ネットワーク、ログを見れば大まかな状態がわかりました。
#GPUクラウドでは、見るべきものが増えます。
#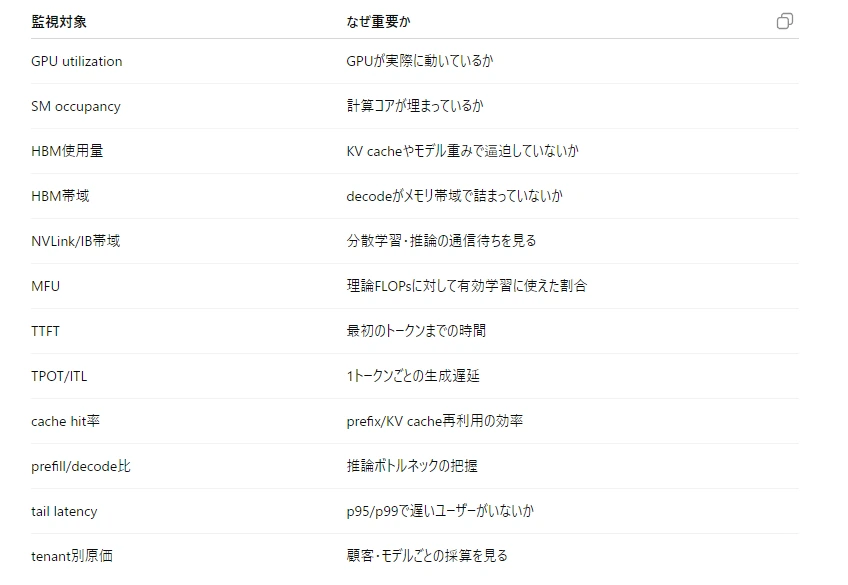
つまりGPUクラウドでは、GPUメトリクス + LLMメトリクス + クラウド課金メトリクスが統合される必要があります。
#これはCloudWatchやDatadogのGPU版というより、 LLM serving observability に近いものです。
##
\9. これは本当に可能か?
#可能です。 ただし、段階があります。
#すでに可能なこと
#現在でも以下は実用段階です。
#- GPU passthroughで専用GPUを貸す
- MIGでGPUを複数に分割する
- KubernetesでGPU Podをスケジューリングする
- NVIDIA GPU OperatorでMIG/time-slicingを扱う
- vLLM/SGLang/TensorRT-LLMでLLM推論を高効率化する
- Prometheus/Grafana/DCGMなどでGPU監視する
- token課金・GPU時間課金を組み合わせる
- 一部のConfidential Computingを使う
まだ難しいこと
#一方で、CPUクラウド並みに成熟していないのはここです。
#- 完全に安全なGPUマルチテナント
- 任意のCUDA workloadを安全に細かく共有
- GPUメモリの完全な仮想化
- KV cacheのクラスタ横断管理
- prefill/decode/KV/通信を統合したクラスタOS
- SLOベースで自動的にモデル配置を変える仕組み
- GPUごとの本当の原価計算
- サイドチャネル対策
- 悪意あるGPU kernelの制限
- AIエージェント単位の課金と状態管理
なので答えは、
#GPUクラウドの再発明は可能。すでに始まっている。ただしCPUクラウドのような汎用・安全・低摩擦な完成度にはまだ達していない。#
です。
##
\10. CPUクラウドとの最大の違い
#CPUクラウドは、基本的にstatelessなWebアプリやVM/コンテナを中心に進化しました。
#GPUクラウド、特にLLMクラウドは、かなりstatefulです。
#なぜならLLM推論では、
#- 会話履歴
- KV cache
- prefix cache
- tool callの中間状態
- エージェントの作業メモリ
- 長文コンテキスト
- マルチモーダル埋め込み
- モデルごとの常駐重み
が重要になるからです。
#つまりGPUクラウドは、CPUクラウドよりも、
#計算資源のクラウド というより 知能状態のクラウド#
に近づきます。
#ここが一番大きな違いです。
##
\11. 産業的には何が伸びるか
#この流れで重要になる企業・技術領域は、GPUメーカーだけではありません。
#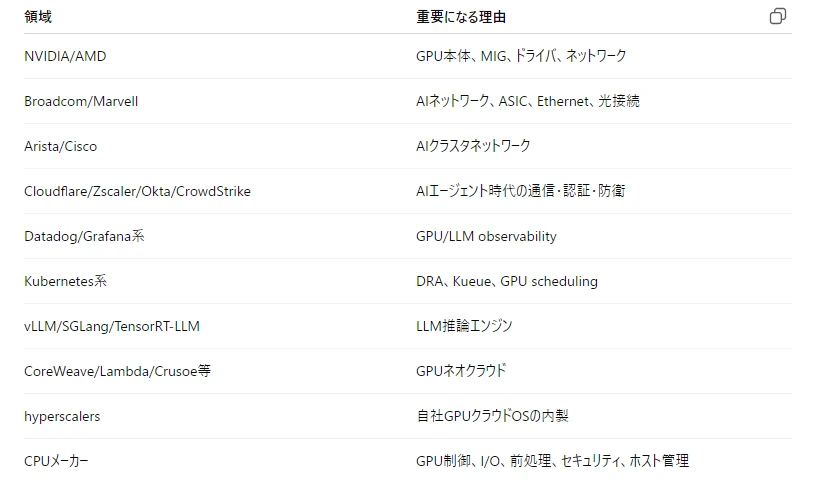
特に見落とされがちなのは、CPU需要です。
#GPUをマルチテナント化するほど、CPU側では、
#- API gateway
- tokenizer
- scheduler
- security policy
- network stack
- storage I/O
- telemetry
- billing
- orchestration
- fault recovery
- encryption/attestation
が増えます。
#つまりGPU時代なのに、CPUはクラウドOSの司令塔として重要性が増す可能性があります。
##
GPUクラウドとは何か
#GPUクラウドとは、インターネット越しにGPUサーバーを借りて、AI学習・AI推論・画像生成・動画生成・シミュレーションなどを動かせるクラウドサービスのことです。
#普通のクラウドが、
#CPU・メモリ・ストレージ・ネットワークを貸すサービス#
だとすると、GPUクラウドはそこに加えて、
#高性能GPUを大量に使えるクラウド#
です。
#たとえば、NVIDIA H100、H200、B200、GB200、AMD MI300系のようなGPUを、自分で買わずにクラウド上で使います。
##
GPUクラウドで何ができるのか
#主に以下のようなことができます。
#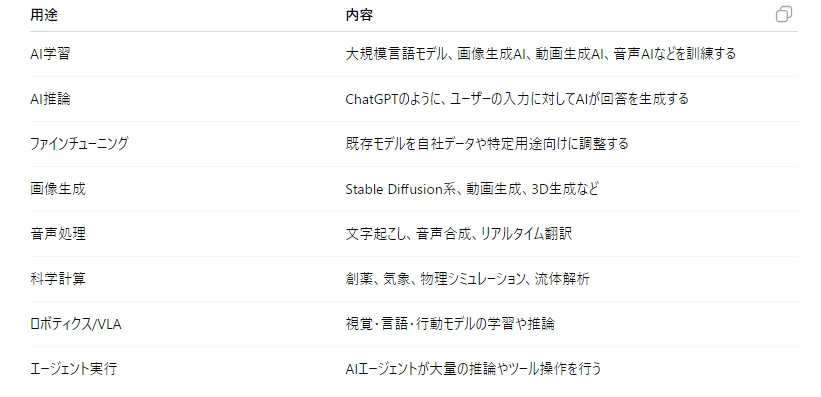
つまりGPUクラウドは、AI時代の工場のようなものです。
#AIモデルを作る場所でもあり、AIサービスを動かす場所でもあります。
##
クラウドではCPUが基本使われているのか
#はい。クラウドの基本は今でもCPUです。
#クラウドの土台は、基本的にCPUサーバーです。
#たとえばWebサイト、API、データベース、ログ処理、認証、ファイル保存、決済、管理画面、アプリケーションサーバーなどは、多くの場合CPUで動きます。
#クラウドの基本構造はこうです。
#ユーザー
↓
インターネット
↓
ロードバランサ
↓
CPUサーバー群
↓
データベース / ストレージ / キャッシュここにAIが入ると、こうなります。
#ユーザー
↓
CPUサーバー
↓
AI推論サーバー
↓
GPU
↓
回答生成つまり、AIサービスでもCPUは消えません。 むしろGPUを動かすためにCPUが必要です。
#CPUは、
#- ユーザーリクエストを受ける
- 認証する
- 入力テキストを整形する
- tokenizerを動かす
- GPUに仕事を投げる
- 結果を受け取る
- 課金する
- ログを取る
- セキュリティを管理する
- ネットワークを制御する
という役割を持ちます。
#GPUは「重いAI計算をする筋肉」で、CPUは「司令塔・管理者・交通整理係」です。
##
CPUとGPUの役割の違い
#かなり単純化すると、こうです。
#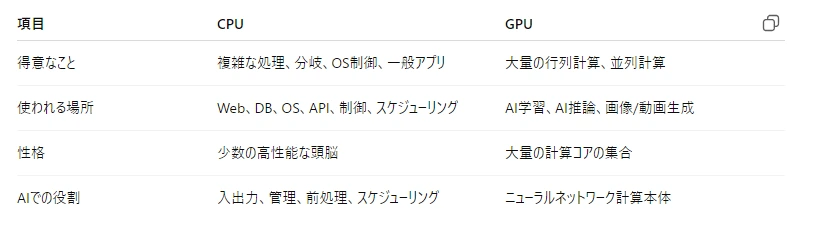
たとえばChatGPT的なサービスでは、
#CPU:ユーザーの文章を受け取り、トークン化し、GPUに渡す
GPU:LLMを使って次の単語・文章を計算する
CPU:結果を整えてユーザーに返すという分担になります。
##
AIの学習はクラウドで行われているのか
#はい。多くのAI学習はクラウド、またはクラウド的な巨大データセンターで行われています。
#特に大規模言語モデルの学習は、普通のPCでは無理です。
#理由は、
#- GPUが大量に必要
- 電力が大量に必要
- 冷却設備が必要
- 高速ネットワークが必要
- 大量ストレージが必要
- 障害復旧システムが必要
- 数週間〜数か月の連続運転が必要
だからです。
#大規模AIモデルの学習では、数千〜数十万GPU規模のクラスタを使うことがあります。
#イメージとしては、
#巨大データセット
↓
CPU群がデータを読み込み・前処理
↓
GPU群がニューラルネットワークを学習
↓
モデルの重みが更新される
↓
完成したAIモデルになるという流れです。
##
AIの推論もクラウドで行われているのか
#はい。ChatGPT、Claude、Gemini、Copilot、画像生成AI、動画生成AIなど、多くのAI推論もクラウドで行われています。
#推論とは、学習済みAIモデルを使って実際に答えを出すことです。
#たとえばあなたがChatGPTに質問すると、
#あなたの入力
↓
クラウド上のサーバー
↓
GPU上のAIモデル
↓
回答生成
↓
あなたの画面に返るという流れになります。
#つまり、あなたのPCやスマホが全部計算しているわけではありません。 多くの場合、裏側のクラウドGPUが計算しています。
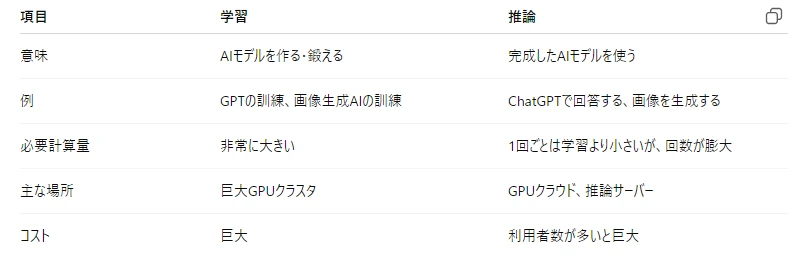
##
学習と推論の違い
#ここは重要です。
#
料理で例えると、
#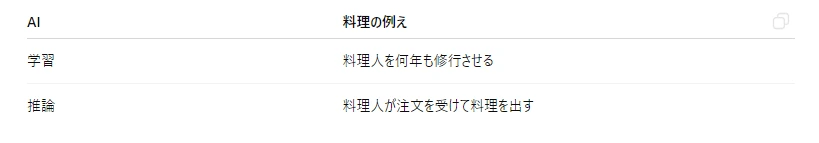
学習は「AIを育てる」。 推論は「育ったAIを使う」。
##
すべてクラウドで行われるのか
#いいえ。すべてではありません。
#AIの実行場所は大きく3つあります。
#場所例特徴クラウドChatGPT、Gemini、画像生成AI高性能、大規模、ネット必須エッジスマホ、PC、車、工場機械低遅延、プライバシー、性能制限ありオンプレミス企業内サーバー、研究所データ管理しやすいが高コスト
#現在の大規模AIは、基本的にはクラウド中心です。 ただし今後は、スマホ、PC、自動車、ロボット、工場、監視カメラなどにもAI推論が広がります。
#つまり未来は、
#巨大な学習:クラウドGPU
重い推論:クラウドGPU
軽い推論:PC/スマホ/エッジAIチップ
リアルタイム制御:ロボットや車載チップという分担になっていくと思います。
##
GPUクラウドと普通のクラウドの違い
#普通のクラウドは、主にCPU中心です。
#AWS EC2
Google Cloud Compute Engine
Azure VM
さくらのクラウド
などGPUクラウドは、そこにGPUを強く載せたものです。
#NVIDIA GPU搭載インスタンス
AI学習用クラスタ
推論API基盤
画像生成サーバー
動画生成サーバー普通のクラウドが「会社のIT基盤」だとすると、 GPUクラウドは「AIを作り、AIを動かすための計算工場」です。
##
なぜGPUクラウドが重要になったのか
#理由は単純で、現代AIの中心が巨大な行列計算だからです。
#LLMも画像生成AIも、内部では大量の行列演算をしています。 これはCPUよりGPUの方が得意です。
#そのため、AI時代には、
#CPUクラウド:Web、API、DB、OS、管理、通信
GPUクラウド:AIの学習、推論、生成、シミュレーションという役割分担が強くなります。
##
まとめ
#GPUクラウドとは、クラウド上でGPUを使い、AI学習・AI推論・画像生成・動画生成・科学計算などを行う仕組みです。
#ただし、クラウドの基本は今でもCPUです。 CPUはOS、Web、API、認証、課金、監視、スケジューリングを担当します。 GPUはAI計算の本体を担当します。
#AIの学習も推論も、多くはクラウドで行われています。 特にChatGPTのような大規模AIは、裏側で巨大なGPUクラスタが動いています。
#一言で言うと、
#**CPUクラウドは、インターネットサービスを動かす基盤。 GPUクラウドは、AIを作り、AIを動かす基盤。 そしてAI時代のクラウドでは、CPUが司令塔、GPUが計算エンジンになる。**#
ということです。
##
静まるというより、CPU需要の“質”が変わる可能性が高いです。 GPUクラウドが実現しても、CPU需要は消えません。むしろ短中期では、GPUを効率よく使うための司令塔・管理層としてCPU需要は増えやすいです。
#結論
#GPUクラウドが成熟しても、CPU需要の高まりはすぐには静まりにくいです。
#ただし、将来的にはこう分かれます。
#観点方向性CPU総需要AIサービス拡大で増えやすいGPU 1枚あたりのCPU必要量最適化で減る可能性がある汎用CPU需要一部はArm CPU、DPU、SmartNIC、専用チップに置き換わる高性能サーバーCPU需要むしろ重要性が上がる低付加価値なCPU需要圧縮される可能性がある
#つまり、 「CPUが不要になる」のではなく、「GPUを動かすためのCPU」「クラウド制御用CPU」「AIサービス運用CPU」に需要が寄っていく」 という見方が近いです。
##
なぜGPUクラウドでもCPUが必要なのか
#GPUはAI計算本体を担当します。 しかしGPUは、自分だけでクラウドサービス全体を運営できません。
#GPUクラウドではCPUが以下を担当します。
#- ユーザーリクエスト受付
- API処理
- 認証・権限管理
- 課金
- ログ
- セキュリティ
- スケジューリング
- コンテナ管理
- GPUジョブ投入
- tokenizer
- データ前処理
- ストレージI/O
- ネットワーク制御
- 障害復旧
- GPU利用率監視
つまりGPUが「AIの筋肉」なら、CPUは「神経・管制塔・事務処理・交通整理」です。
#GPUクラウドが発展するほど、GPUを遊ばせないために、CPU側の制御が高度化するので、CPUの役割はむしろ増えます。
##
実際、最新GPUシステムにもCPUは大量に入っている
#象徴的なのがNVIDIAのGB200 NVL72です。これは72個のBlackwell GPUを1つの巨大なNVLinkドメインとして扱うラックスケール設計ですが、同時に36個のGrace CPUも接続されています。つまり最新AIラックは「GPUだけの箱」ではなく、CPUとGPUが一体化したAI計算システムです。(NVIDIA)
#また、NVIDIAのGrace HopperはGrace CPUとHopper GPUをNVLink-C2Cで接続し、AI/HPC向けにCPUとGPUを密結合する設計です。これは「GPU時代にCPUが不要になる」のではなく、CPUとGPUの結合がより深くなることを示しています。(NVIDIA)
#AMD側でも、AIデータセンターにおいてEPYC CPUを基盤として位置づけています。AMD Instinct MI300XのようなGPUアクセラレータも、AI/HPCシステム全体の中でCPU、GPU、メモリ、ネットワークと組み合わされます。(AMD)
##
GPUクラウドが成熟すると、CPU需要が減る部分もある
#ただし、全部が増えるわけではありません。
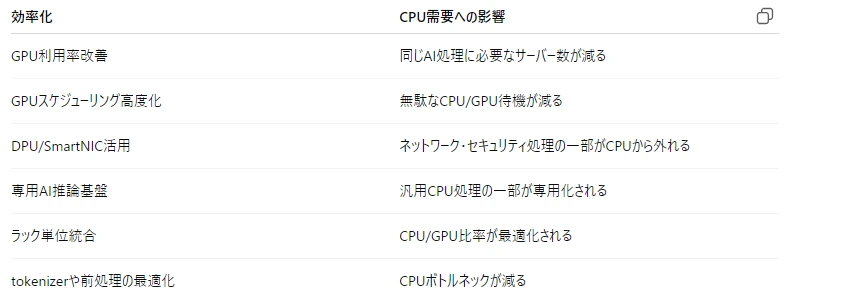
#GPUクラウドが成熟すると、以下のような効率化が進みます。
#
たとえばKubernetesでは、GPUなどの特殊デバイスを柔軟に要求・共有するためのDynamic Resource Allocation、DRAが進んでいます。DRAはGPUやFPGAのようなアクセラレータをPodにより柔軟に割り当てる仕組みで、GPUクラウドのリソース管理を高度化する方向です。(Kubernetes)
#NVIDIAもGPU Operator向けにDRA Driver for GPUsを提供しており、GPUの構成やスケジューリングをKubernetes側でより柔軟に扱う方向に進んでいます。(NVIDIA Docs)
#これが進むと、同じAI処理量に必要なCPU・GPUサーバー台数は減る可能性があります。
##
でも、総需要は下がらない可能性が高い
#ここが重要です。
#GPUクラウドの効率が上がると、1リクエストあたりの原価は下がります。 するとAIサービスはもっと安くなり、もっと大量に使われます。
#これはいわゆるジェボンズのパラドックス的な現象です。
#効率化すると消費量が減るのではなく、安くなって利用量が爆発し、総需要はむしろ増える。#
AI推論が安くなると、
#- AIエージェント
- コーディングAI
- 動画生成
- 画像生成
- 音声AI
- リアルタイム翻訳
- ロボット
- 工場AI
- セキュリティAI
- 個人専用AI
- 企業内AIワーカー
がさらに増えます。
#その結果、GPU利用効率が上がっても、AIサービス全体の量が増えすぎて、CPU需要も増える可能性があります。
##
CPU需要が特に残る領域
#GPUクラウド時代でも、以下のCPU需要は強く残ります。
#\1. ホストCPU
#GPUサーバーには、GPUを制御するCPUが必要です。 GPUに仕事を投げ、データを流し、ネットワークやストレージを扱います。
#\2. クラウド制御用CPU
#GPUクラウドでは、スケジューラ、認証、課金、監視、ログ、API gatewayが必要です。 これはほぼCPU側の仕事です。
#\3. 推論前後処理
#LLMでは、入力文をトークン化し、出力を整形し、フィルタリングし、ツール呼び出しを行います。 これもCPU側が多く担当します。
#\4. ストレージ・データ処理
#学習データの読み込み、変換、フィルタリング、埋め込み、検索、RAGなどはCPU/メモリ/ストレージに強く依存します。
#\5. セキュリティ
#GPUを複数顧客で共有するほど、認証、隔離、暗号化、監査、ネットワーク防御が必要になります。 ここでもCPUやDPUが重要です。
##
CPU需要が弱くなる可能性がある領域
#一方で、以下は伸びが鈍る可能性があります。
#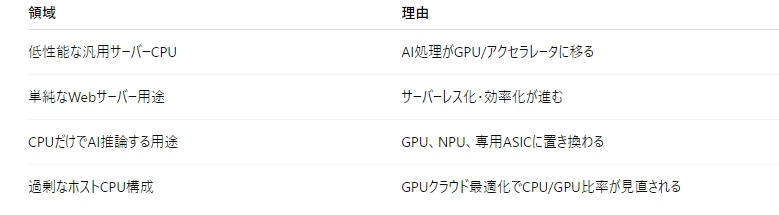
つまり、CPU需要は一枚岩ではありません。
#AI時代に伸びるCPUと、相対的に弱くなるCPUがあります。
##
かなり重要なのは「x86だけが伸びるとは限らない」こと
#GPUクラウド時代のCPU需要は、必ずしも従来のx86サーバーCPUだけに行くとは限りません。
#NVIDIA GraceのようなArm CPU、クラウド企業の独自Arm CPU、DPU、SmartNIC、AI ASICが増えます。
#つまり、
#CPU需要はある。 ただし、その需要がIntel/AMDの従来型CPUだけに全部流れるとは限らない。#
という点が重要です。
#NVIDIAのGB200 NVL72にGrace CPUが組み込まれていることは、この方向をよく表しています。GPUクラウドでは、CPUは単体サーバーCPUというより、GPUラックの一部として統合される方向にも進みます。(NVIDIA)
##
投資テーマとしての整理
#GPUクラウドが進むと、CPU需要はこう変化すると考えられます。
#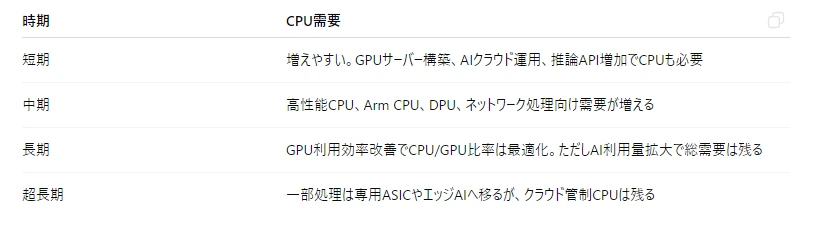
なので、GPUクラウド実現=CPU需要沈静化ではありません。
#むしろ、
#GPUクラウドが本格化するほど、 CPUは「AIクラウドの司令塔」として再評価される。#
という見方ができます。
##
まとめ
#GPUクラウドが成熟すると、1単位のAI処理に必要なCPU量は減る可能性があります。 しかし、AIサービスの総量が増えるため、CPU需要全体はすぐには静まりにくいです。
#特に伸びるのは、
#- GPUホストCPU
- AIクラウド制御CPU
- 推論API用CPU
- セキュリティ/認証/課金/監視用CPU
- ストレージ・ネットワーク制御用CPU
- Arm CPUやDPUを含む広義のCPU的処理
です。
#一言で言うと、
#GPUクラウドはCPUを不要にするものではなく、CPUの役割を「主役の計算機」から「AIインフラの管制塔」に変えるものです。#
そのため、CPU需要の高まりは完全には静まらず、むしろGPUを使い切るためのCPU需要として形を変えて続く可能性が高いです。
##
\1. AIエージェントが増えると、何の処理が増えるのか
#AIエージェントは、単に1回質問して1回答を返すチャットボットではありません。
#たとえば、エージェントはこう動きます。
#ユーザーの依頼
↓
目的を分解する
↓
検索する
↓
資料を読む
↓
コードを書く
↓
ブラウザを操作する
↓
外部APIを呼ぶ
↓
結果を比較する
↓
再推論する
↓
レポートや画像や動画を作る
↓
ユーザーに返すこの中にはGPU向きの処理と、CPU向きの処理が混ざっています。
#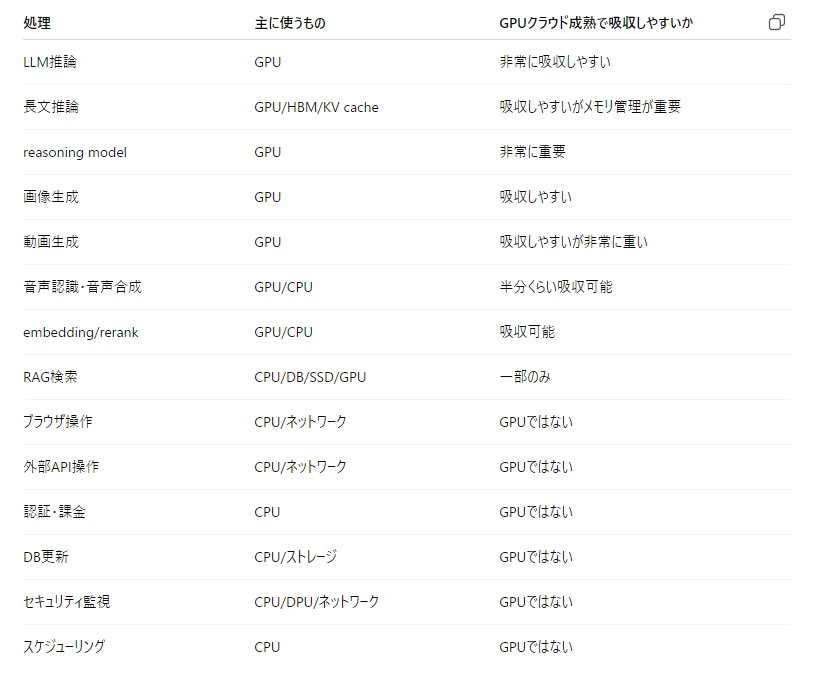
なので、エージェント増加による負荷のうち、モデル推論・生成部分はGPUクラウドでかなり吸収できる。 しかし、行動・接続・管理・保存・防衛の部分はCPUクラウド側に残る、という構造です。
##
\2. どれくらいGPUクラウドで可能になるか
#かなり大雑把に分けると、こうです。
#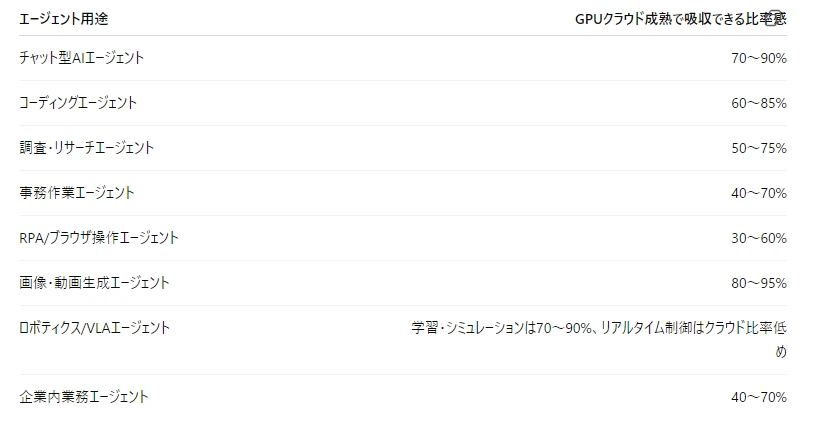
ここでの「吸収できる」は、AIモデルの計算需要をGPUクラウドの効率化でさばける割合という意味です。
#たとえば、画像生成・動画生成・reasoning modelのように、ほぼGPU計算が中心のものは、GPUクラウド成熟の恩恵が大きいです。
#一方で、企業内エージェントのように、
#- 社内DBを見る
- SaaSを操作する
- 承認フローを進める
- 請求書を処理する
- メールを送る
- 権限を確認する
という仕事では、GPU推論だけでなく、CPU・DB・ネットワーク・セキュリティが大量に必要です。
##
\3. GPUクラウド成熟で何が変わるのか
#GPUクラウドが成熟すると、エージェントの推論処理はかなり効率化されます。
#重要なのは以下です。
#\1. KV cache管理
#LLMは長文を扱うほど、KV cacheというメモリを大量に使います。 エージェントは過去の会話、作業履歴、ツール結果、資料を何度も参照するので、KV cache管理が非常に重要です。
#vLLMのPagedAttentionは、OSの仮想メモリのようにKV cacheをブロック管理し、メモリ断片化を減らしてLLMサービング効率を上げる技術です。vLLM論文では、PagedAttentionによりKV cacheの無駄を大きく減らし、同じレイテンシ条件で既存システムより高いスループットを実現したと説明されています。(llmsystem)
#これは、エージェント時代にはかなり重要です。 なぜなら、エージェントは同じシステムプロンプト、同じツール定義、同じ作業文脈を何度も使うからです。
##
\2. prefill / decode分離
#LLM推論には大きく2段階あります。
#段階内容特徴prefill入力プロンプト全体を読む計算量が重いdecode1トークンずつ出力するメモリ帯域・逐次性が重い
#エージェントは長い入力を読み、長い出力を出し、途中で何度も再推論します。 そのため、prefillとdecodeを分けて最適化する効果が大きいです。
#DistServeはprefillとdecodeを分離して、互いの干渉を減らすLLMサービング方式です。OSDI 2024の論文では、既存方式より最大7.4倍多いリクエストを処理できる、または12.6倍厳しいSLOを満たせると報告されています。(USENIX)
#つまり、GPUクラウドが成熟すると、 同じGPU数でも、より多くのエージェント推論をさばける ようになります。
##
\3. continuous batching / chunked prefill
#大量のエージェントが同時に動くと、リクエストの長さもタイミングもバラバラになります。
#普通に処理すると、GPUは待ち時間だらけになります。 そこで、複数リクエストを動的に混ぜるcontinuous batchingや、prefillを小さく分割するchunked prefillが重要になります。
#Sarathi-Serveは、prefillをチャンク化してdecodeを止めないスケジューリングを行います。論文では、Mistral-7BでvLLM比2.6倍、Yi-34Bで最大3.7倍、Falcon-180Bでは最大5.6倍のserving capacity改善を報告しています。(arXiv)
#これはエージェント時代の「大量の細かい推論を詰め込む」技術です。
##
\4. 複数モデル・複数エージェントのGPUプーリング
#エージェント社会では、1つの巨大モデルだけでなく、
#- 文章モデル
- コードモデル
- 画像モデル
- 音声モデル
- 小型分類モデル
- embeddingモデル
- reranker
- safety model
- tool selection model
などが同時に動きます。
#ここで重要なのがGPUプーリングです。
#Aegaeonは、複数LLMを同時にサーブするためのGPU poolingシステムで、トークンレベルの自動スケーリングを行います。SOSP 2025の論文では、実運用で必要GPU数を1,192枚から213枚へ削減、つまり82%削減したと報告されています。(ACM Digital Library)
#これは非常に大きいです。 エージェントが増えた時に、1エージェント1GPUのような贅沢な構成ではなく、トークン単位でGPUを共有する方向に進むからです。
##
\5. データセンター規模の推論オーケストレーション
#NVIDIA Dynamoのような仕組みも出てきています。NVIDIAはDynamoを、生成AIやreasoning modelを大規模分散環境で低遅延・高スループットに動かすためのオープンソース推論フレームワークとして説明しており、DeepSeek-R1系モデルで最大30倍のリクエスト処理改善を主張しています。(NVIDIA Developer)
#DynamoのGitHub側でも、vLLM、SGLang、TensorRT-LLMを置き換えるのではなく、それらの上に乗るデータセンター規模のオーケストレーション層として、disaggregated serving、intelligent routing、multi-tier KV caching、automatic scalingを扱うと説明されています。(GitHub)
#これはかなり「GPUクラウドOS」に近い方向です。
##
\4. では、エージェント需要の何倍くらいを吸収できるのか
#研究・実装を見ると、GPUクラウド成熟による効率改善は、用途によってかなり幅があります。
#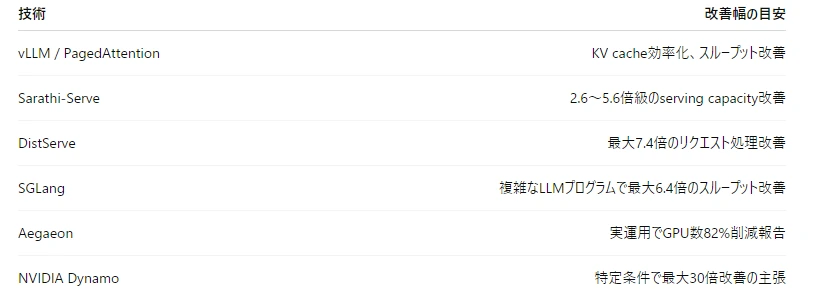
SGLangは、複数回の生成、制御フロー、構造化出力を含む複雑なLLMアプリケーション向けのフレームワークで、実験では最大6.4倍のスループット改善を報告しています。これはまさにエージェント的な処理に近いです。(ACM Digital Library)
#したがって、かなり単純化すると、
#今の非効率なGPU運用に比べて、成熟したGPUクラウドでは同じGPU枚数で3〜10倍、特定条件ではそれ以上のエージェント推論を処理できる可能性がある。#
という見方はできます。
#ただし、これは「全部の処理が3〜10倍になる」という意味ではありません。 あくまで、LLM推論・生成・KV cache管理・バッチング・GPUプーリングの部分です。
##
\5. AIエージェント需要の増加をGPUクラウドだけで吸収できるか
#ここは慎重に見る必要があります。
#私の見方では、こうです。
#短期
#GPUクラウド成熟でかなり吸収できる。
#今はまだGPU利用率が低く、推論スタックも発展途上です。 そのため、vLLM、SGLang、Dynamo、Aegaeon、prefill/decode分離、KV cache最適化だけでも、かなりの余力があります。
#つまり短期では、
#GPUをもっと買う だけでなく GPUをもっと詰め込んで使う#
ことでエージェント需要をかなり受け止められます。
##
中期
#GPUクラウド成熟だけでは足りず、CPU・ネットワーク・ストレージも同時に増える。
#エージェントが本格化すると、モデル推論だけでなく、
#- tool call
- web browsing
- RAG
- DB更新
- SaaS連携
- 認証
- 監査ログ
- セキュリティ
- 決済
- 権限管理
- agent memory
が爆発します。
#ここはGPUだけでは処理できません。
#特に企業内エージェントでは、AIが答えを出すよりも、 社内システムに安全に接続し、操作し、記録し、承認を通す部分 の方が重くなる可能性があります。
##
長期
#GPUクラウドは“知能計算層”を担い、CPUクラウドは“行動・管理・社会接続層”を担う。
#長期的には、こういう分担になると思います。
#GPUクラウド
- LLM推論
- reasoning
- multimodal生成
- 動画生成
- VLA学習
- embedding/rerank
- シミュレーション
CPUクラウド
- API
- 認証
- 権限
- DB
- ストレージ
- 課金
- ログ
- 監査
- セキュリティ
- orchestration
- agent workflowつまり、AIエージェントが増えるほど、 GPUクラウドとCPUクラウドの両方が拡大する 可能性が高いです。
##
\6. GPUクラウド成熟でCPU需要は消えるか?
#GPUクラウド成熟により、GPU 1枚あたりのAI推論能力は大きく上がるでしょう。 その結果、同じエージェント数を動かすために必要なGPU枚数は減る可能性があります。
#しかし、エージェントが増えると同時にCPU側の処理も増えます。
#増える処理主な担当エージェントの状態管理CPU/DBワークフロー管理CPUツール実行CPUAPI連携CPU/ネットワーク権限管理CPUログ・監査CPU/ストレージ課金CPUセキュリティCPU/DPUブラウザ操作CPURAG検索CPU/DB/GPU混合
#なので、GPUクラウド成熟によって、AI推論そのもののボトルネックは緩和される。 しかし、エージェント社会を動かす周辺インフラ需要はむしろ増える。
##
\7. 私のざっくりした比率イメージ
#AIエージェント時代の追加需要を100とすると、GPUクラウド成熟で吸収・効率化できる部分はこう見ます。
#AIエージェント追加需要 = 100
GPUクラウド成熟でかなり吸収できる部分
50〜70
- LLM推論
- 長文推論
- reasoning
- 画像/動画生成
- embedding/rerank
- KV cache
- batch scheduling
GPUクラウドだけでは吸収できない部分
30〜50
- CPU orchestration
- DB
- API
- browser automation
- storage
- network
- security
- billing
- monitoringただし、用途によってかなり変わります。
#動画生成AIエージェントなら、GPUクラウドで80〜95%吸収できます。 企業業務エージェントなら、GPUクラウドで40〜70%、残りはCPU/DB/ネットワーク/セキュリティです。 ロボット/VLAエージェントなら、学習・シミュレーションはGPUクラウド比率が高いですが、現場のリアルタイム制御はエッジ側に残ります。
##
GPUクラウドの成熟時期考察
#2026〜2028年:GPUクラウドOSの原型が実用化する時期 2029〜2032年:CPUクラウドに近い成熟度へ向かう時期 2030年代前半:AIエージェント社会向けの本格インフラになる時期#
#
\1. すでにGPUクラウドは始まっている
#まず、GPUクラウド自体はもう存在しています。 AWS、Azure、Google Cloud、Oracle Cloud、CoreWeave、Lambda、Crusoe、日本だとGMO GPUクラウドなどがGPUをクラウド資源として提供しています。
#ただし、今あるGPUクラウドの多くは、まだかなり荒く言うと、
#高価なGPUサーバーを貸している段階#
です。
#これが今後成熟すると、
#GPUをトークン単位、モデル単位、KV cache単位、SLO単位で動的に共有・課金・監視する段階#
に進みます。
#ここが本当の意味での「GPUクラウド成熟」です。
##
\2. 2025〜2026年時点で、部品はかなり揃い始めている
#成熟の兆候はすでにあります。
#Kubernetesでは、GPUやFPGAなどの特殊デバイスを柔軟に割り当てる DRA / Dynamic Resource Allocation の中核APIが、Kubernetes 1.34でGAになりました。これはGPUをKubernetes上でより細かく選択・共有・構成するための重要な基盤です。(Kubernetes)
#NVIDIA側も、DRA Driver for GPUsを提供し、KubernetesからGPUをより柔軟に要求・設定・共有できる方向へ進めています。つまり、GPUが「特殊な外付け部品」から「クラウドでスケジューリング可能な一級リソース」になり始めています。(NVIDIA Docs)
#また、NVIDIA Dynamoは2025年に発表された大規模分散推論向けのフレームワークで、単一GPUや単一ノードの最適化ではなく、データセンター規模のGPU群を協調した推論システムとして扱う方向です。NVIDIAはDynamoについて、reasoning modelや生成AIを大規模分散環境で低遅延・高スループットに展開するためのOSS推論フレームワークと説明しています。(NVIDIA Developer)
#つまり、2025〜2026年時点で、
#- Kubernetes側のGPUリソース管理
- NVIDIA側のGPUオーケストレーション
- vLLM/SGLang/TensorRT-LLM系の推論エンジン
- MIG/vGPU/Time slicing
- KV cache管理
- 分散推論
- Confidential Computing
の部品はかなり揃い始めています。
##
\3. ただし「完成」には段階がある
#GPUクラウドの成熟を4段階で見ると分かりやすいです。
#第1段階:GPUをクラウドで借りられる
#これはもう実現済みです。
#GPUインスタンスを借りる
LLMを動かす
画像生成を動かす
学習ジョブを回すこの段階では、まだCPUクラウドでいう初期EC2に近いです。 GPUを借りられるが、細かく安全に詰め込む仕組みはまだ弱い。
##
第2段階:LLM推論を高効率に詰め込む
#これは2025〜2027年に急速に進んでいる段階です。
#vLLMはPagedAttentionを使い、LLM推論で問題になるKV cacheのメモリ無駄を減らす方向の代表例です。2025年のvLLM論文では、block-level memory managementとpreemptive request schedulingにより、KV cacheメモリの無駄をほぼゼロに近づけると説明されています。(EECS at UC Berkeley)
#さらにAlibaba CloudのAegaeonは、複数モデルをGPUプール上でトークン単位にスケジューリングし、実運用テストで必要GPU数を1192枚から213枚に削減したと報じられています。これは、GPUクラウドが「1ジョブ1GPU」から「トークン単位の共有」へ向かう強い兆候です。(Tom's Hardware)
#この段階は、かなり早く成熟すると思います。 理由は、LLM推論のコスト削減効果が巨大だからです。
##
第3段階:マルチテナントGPUを安全に共有する
#ここが難所です。
#MIGやvGPUでGPUを分割することはできますが、複数テナントが同じGPU/同じGPUクラスタを使うと、GPUメモリ、キャッシュ、TLB、ドライバ、DMA、コンテナ境界などがセキュリティ問題になります。
#NVIDIAはKubernetes向けにConfidential ContainersやKata Containersと組み合わせたGPU機密計算の仕組みを進めており、GPU OperatorでもConfidential Computing ManagerやSandbox Device Pluginなどを含む構成が説明されています。(NVIDIA Docs)
#一方で、GPU共有のセキュリティはまだ発展途上です。2024〜2026年の研究・脆弱性報告では、GPU仮想化や共有GPUのサイドチャネル、vGPU管理層、コンテナ境界が新しい攻撃面になることが示されています。(Barrack AI)
#このため、企業が安心して機密データをマルチテナントGPUに載せる段階は、2026〜2027年に始まり、2028〜2030年に本格化する可能性が高いです。
##
第4段階:CPUクラウド並みに「当たり前のインフラ」になる
#これはおそらく2029〜2032年以降です。
#CPUクラウドでは、VM、Kubernetes、IAM、監視、課金、ログ、オートスケール、セキュリティ、SLAが当たり前になっています。
#GPUクラウドでも最終的には、
#GPU秒
GPUメモリGB秒
KV cache GB秒
token単位課金
TTFT/TPOT保証
推論SLO
モデル常駐課金
agent memory課金
マルチテナント隔離
GPU障害復旧
GPUクラスタ観測が標準化されていくはずです。
#ただし、ここまで行くには時間がかかります。 理由は、LLM推論がまだ急速に変化しているからです。モデル構造、context length、MoE、reasoning、動画生成、VLA、エージェント処理が変わるたびに、GPUクラウド側も作り直しになります。
##
\4. 私の時期予想
#かなり現実的に見ると、こうです。
#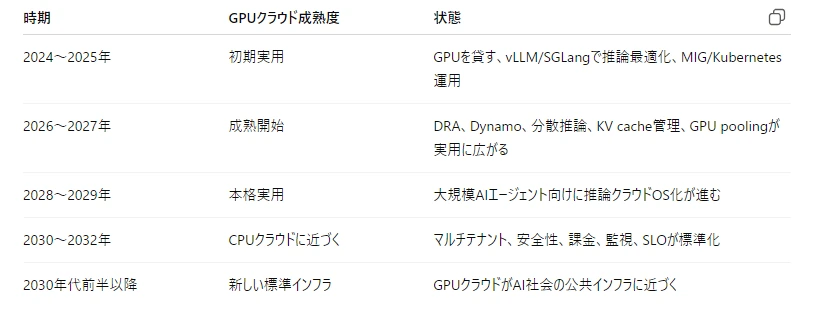
なので、「完成しはじめる」は2026〜2028年。 「CPUクラウドのように成熟する」は2029〜2032年。 「本当に社会インフラ化する」は2030年代前半だと思います。
##
\5. AIを使うことで、その速度は加速するか
#はい。かなり加速する可能性があります。
#CPUクラウドの25年と比べて、GPUクラウドはもっと早く成熟すると思います。 理由は3つあります。
##
理由1:CPUクラウドの知見を流用できる
#GPUクラウドはゼロから作るわけではありません。
#すでに、
#- Kubernetes
- Linux
- コンテナ
- IAM
- Prometheus/Grafana
- Terraform
- CI/CD
- service mesh
- cloud billing
- observability
- autoscaling
- security policy
があります。
#CPUクラウドが25年かけて作った概念を、GPU向けに拡張できます。 だから、GPUクラウドは25年ではなく、5〜8年程度でかなり成熟する可能性があります。
##
理由2:AIがインフラ開発そのものを加速する
#AIはGPUクラウドの利用者であると同時に、GPUクラウドを作る側にも使われます。
#たとえば、
#- GPU kernelの自動生成
- CUDA/Triton最適化
- スケジューラの探索
- 障害予測
- ログ解析
- セキュリティ検査
- コード生成
- インフラ設定の自動修正
- capacity planning
- ネットワーク輻輳予測
に使えます。
#実際、AIによるGPU kernel生成・最適化の研究はかなり活発です。AMDは2025年にGEAKというTriton kernel生成AIエージェントを紹介し、ベンチマーク上で最大2.59倍の速度向上を示したと説明しています。(ROCm Blogs)
#また、PyTorchブログでも、深いエージェントを使った自律GPU kernel生成が紹介されており、Triton kernelの生成、検証、実行を自動化する方向が示されています。(PyTorch)
#この流れが進むと、人間のGPUエンジニアだけでなく、AIエージェントがGPU kernelや推論設定を探索し続けるようになります。 これは、GPUクラウド成熟をかなり速めます。
##
理由3:GPU利用率改善の経済効果が大きすぎる
#GPUは非常に高価です。 もしGPU利用率を10〜20%から40〜60%へ上げられれば、同じGPU投資で2〜4倍以上の有効計算を取り出せます。
#そのため、GPUクラウド最適化には莫大な経済インセンティブがあります。
#Aegaeonのように、GPU poolingとトークン単位スケジューリングで必要GPU数を大幅に減らせる可能性が示されると、クラウド企業・AIラボ・ネオクラウドは一気にこの方向へ投資します。(Tom's Hardware)
#つまり、これは研究テーマではなく、設備投資効率を何倍にもする経営テーマです。 だから速いです。
##
\6. それでも一気に完成しない理由
#ただし、AIで加速しても、1〜2年で完全完成するとは思いません。
#理由は、物理制約があるからです。
#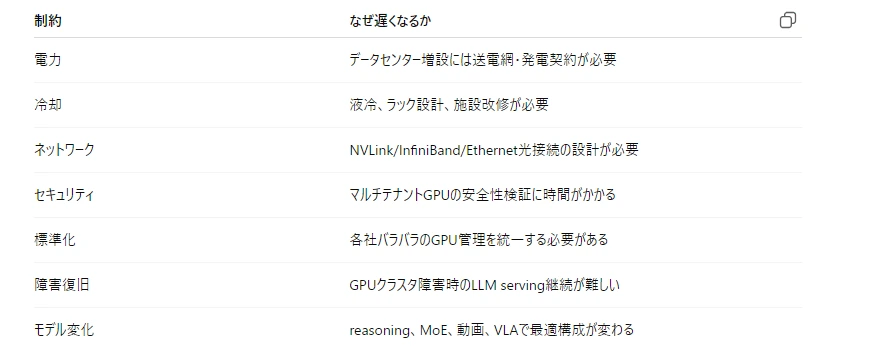
特に障害復旧は重要です。2026年のGhostServeは、LLM servingでKV cacheをerasure codingにより保護し、GPU障害時に高コストな再計算や完全複製なしで推論を再開する研究です。これは、GPUクラウドがCPUクラウドのような高可用性に近づくには、KV cacheレベルの耐障害性が必要であることを示しています。(arXiv)
#つまり、AIはソフトウェア開発速度を上げますが、 電力・冷却・ネットワーク・セキュリティ・標準化・信頼性は時間がかかる ということです。
##
\7. かなり重要な見方:GPUクラウドは「完成」しない可能性もある
#CPUクラウドも、実は完成していません。 今でもサーバーレス、Kubernetes、WASM、edge cloud、confidential computingなどで変化しています。
#GPUクラウドも同じで、完全な完成地点はないと思います。
#なぜなら、AI側がどんどん変わるからです。
#LLM
↓
reasoning model
↓
agent
↓
multimodal agent
↓
video world model
↓
VLA / robotics
↓
physical AIモデルが変わるたびに、GPUクラウドの最適解も変わります。
#たとえば、チャットLLM中心ならKV cacheとdecode最適化が重要。 動画生成中心なら巨大な生成バッチとメモリ帯域が重要。 ロボティクス/VLA中心なら、シミュレーション、動画理解、リアルタイム推論、エッジ連携が重要になります。
#だからGPUクラウドは、ある時点で「完成」するというより、 2026〜2028年に産業標準の原型が固まり、2030年前後に本格的なクラウドOSとして成熟し、その後もAIの形に合わせて変化し続ける と見るべきです。
##
まとめ
#GPUクラウドの成熟は、かなり速く進むと思います。
#私の予想では、
#2026〜2028年:完成しはじめる 2028〜2030年:AIエージェント向けに本格実用化 2029〜2032年:CPUクラウドに近い成熟度へ進む 2030年代前半:AI社会の標準インフラ化#
です。
#AIを使うことで、この速度は加速します。 特に、GPU kernel最適化、推論スケジューリング、ログ解析、障害予測、セキュリティ検査、インフラ自動運用でAIエージェントが使われるようになるため、CPUクラウドが25年かけた進化を、GPUクラウドは5〜8年程度で一気に圧縮する可能性があります。
#ただし、電力、冷却、ネットワーク、セキュリティ、標準化、障害復旧は物理的・制度的な制約があるため、完全成熟は2030年前後以降になると思います。
#一言で言うと、
#**GPUクラウドは2026〜2028年にクラウドOS化が始まり、2030年前後にAIエージェント時代の本格インフラになる。 そしてAI自身が、その成熟速度をさらに加速する。**#
という考察です。
##
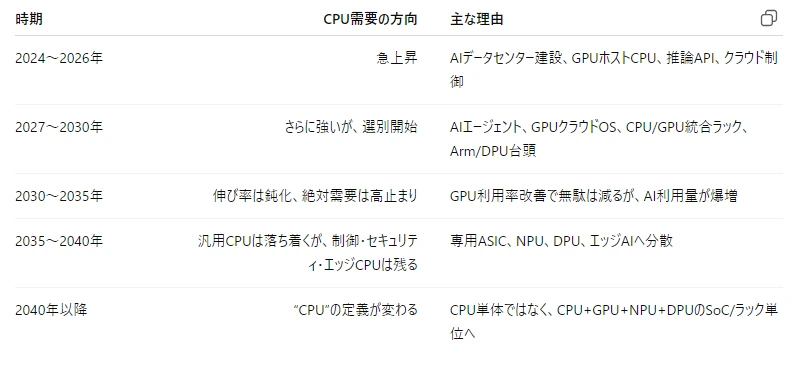
年代ごとにCPU需要の高まりは、どのように変化していくか考察
#CPU需要の高まりは「2026〜2030年に一度かなり強くなり、その後は伸び率が鈍化しながらも、用途を変えて長く残る」と考えます。
#つまり、単純に、
#GPUクラウドが成熟する → CPU需要が落ち着く#
ではなく、
#AIインフラ立ち上げ期はCPU需要が急増 GPUクラウド成熟期はCPU/GPU比率が最適化 AIエージェント普及期はCPUが“管制塔・接続・防衛”として再拡大 2030年代後半はエッジ/専用チップに一部移るが、クラウドCPUは残る#
という流れになると思います。
##
全体像
#
#
2024〜2026年:CPU需要の急上昇期
#この時期は、GPUを買えば買うほどCPUも必要になる段階です。
#理由は、GPUは単体ではクラウドサービスにならないからです。GPUサーバーにはホストCPUが必要で、さらにAPI、認証、課金、ログ、監視、ストレージ、ネットワーク、スケジューラを動かすCPU群も必要になります。
#AMDは2026年第1四半期決算で、データセンター売上が前年比57%増の58億ドルになり、EPYC CPU需要とInstinct GPU出荷が牽引したと説明しています。またLisa Su CEOは、推論とagentic AIが高性能CPUとアクセラレータ需要を押し上げていると述べています。(Advanced Micro Devices, Inc.)
#この段階のCPU需要はかなり素直です。
#GPUサーバーが増える
↓
ホストCPUが増える
↓
AI推論APIが増える
↓
認証・課金・ログ・監視が増える
↓
クラウド制御用CPUも増えるつまり、2026年前後は 「GPU投資に付随するCPU需要」 が強くなります。
##
2027〜2030年:CPU需要はさらに強いが、選別が始まる
#この時期は、AIエージェントが増え、GPUクラウドが「ただGPUを貸す」段階から「GPUを細かく共有・管理・課金する」段階に進むと考えます。
#ここでCPU需要は2方向に分かれます。
#1つ目は、AIインフラ管制用CPUの需要増です。
#GPUクラウドでは、トークン単位のスケジューリング、KV cache管理、prefill/decode分離、モデル配置、障害復旧、セキュリティ、課金などが必要になります。これらはGPU上の計算だけではなく、CPU側の制御・管理が重要になります。
#Kubernetes 1.34では、GPUやFPGAなどの特殊デバイスをより柔軟に選択・割り当て・共有・構成するためのDynamic Resource Allocation、DRAの中核APIがGAになっています。これはGPUがクラウド上の一級リソースとして扱われる方向を示しています。(Kubernetes)
#2つ目は、CPUの種類の選別です。
#従来型の汎用x86 CPUだけでなく、Arm CPU、NVIDIA Grace、DPU、SmartNIC、カスタムCPUが増えます。たとえばNVIDIA GB200 NVL72は、36個のGrace CPUと72個のBlackwell GPUをラックスケールで接続する設計です。これは、AIラックが「GPUだけ」ではなく、CPUとGPUの統合システムであることを示しています。(NVIDIA)
#この時期の特徴は、
#CPU需要は強い。ただし、勝つCPUは“GPUを動かすために最適化されたCPU”になっていく。#
です。
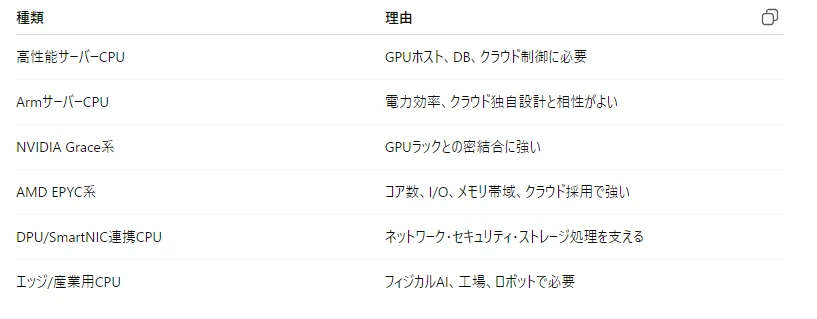
#AMD系EPYC、NVIDIA Grace、クラウド独自Arm CPU、DPU統合型の設計が伸び、古い汎用サーバーCPUは相対的に弱くなる可能性があります。
##
2030〜2035年:伸び率は鈍るが、絶対需要は高止まり
#2030年前後には、GPUクラウドがかなり成熟してくると思います。
#つまり、
#- GPU利用率が改善する
- 1リクエストあたりのGPUコストが下がる
- KV cache管理が洗練される
- prefill/decode分離が一般化する
- GPUクラスタのスケジューリングが高度化する
- マルチテナントGPUが普及する
という方向です。
#この結果、同じAI処理量に必要なCPU/GPUサーバー台数は減る可能性があります。 つまり、CPU需要の伸び率は一度鈍化しやすいです。
#しかし、ここで重要なのがジェボンズのパラドックスです。
#AI推論が安くなると、AIエージェントはもっと大量に使われます。
#GPUクラウド成熟
↓
推論コスト低下
↓
AIエージェント利用増加
↓
API・DB・認証・ログ・監査・課金が増える
↓
CPU需要は高止まりつまり、2030〜2035年は、
#1処理あたりのCPU必要量は減るが、処理総量が増えすぎて、CPU需要は高止まりする#
という可能性が高いです。
#この時期のCPU需要は、単なるWebサーバーCPUではなく、
#- エージェント管理CPU
- 認証/権限管理CPU
- セキュリティ監査CPU
- データベースCPU
- ストレージ制御CPU
- ネットワーク制御CPU
- GPUクラスタ管理CPU
- RAG/検索/embedding前後処理CPU
へ寄っていきます。
##
2035〜2040年:汎用CPU需要は落ち着くが、制御CPUは残る
#2035年以降になると、AI処理の多くはさらに専用化されると思います。
#たとえば、
#- 推論専用ASIC
- エッジNPU
- ロボット用VLAチップ
- 車載AI SoC
- DPU/SmartNIC
- メモリ近傍計算
- 光インターコネクト
- 専用KV cacheアクセラレータ
のようなものが普及していく可能性があります。
#この場合、CPUが直接AI計算をする需要は相対的に弱くなります。 しかし、CPUが不要になるわけではありません。
#CPUは以下の仕事を残します。
#OSを動かす
権限を管理する
外部APIを呼ぶ
エージェントの状態を管理する
ログを保存する
異常を検知する
安全停止を判断する
人間の承認フローと接続する特にフィジカルAI、ロボット、工場、自動運転では、GPU/NPUが知覚や推論を担っても、CPU/MCU/リアルタイム制御系は残ります。
#この時期は、
#AI計算のCPU需要は下がるが、AI社会の制御・安全・接続のCPU需要は残る#
という形です。
##
2040年以降:CPUというより「異種計算の司令塔」になる
#2040年以降は、CPU需要という言い方自体が少し古くなる可能性があります。
#つまり、チップやラックは、
#CPU + GPU + NPU + DPU + HBM + CXL memory + optical networkのような統合システムになっていきます。
#この場合、CPU単体の需要を見るより、
#AIラック全体の中で、CPU的な制御コアがどれだけ必要か#
を見る方が重要になります。
#CPUは主役の計算装置というより、
#- OS
- 制御
- 分岐
- セキュリティ
- I/O
- 権限
- 障害復旧
- 人間/企業システムとの接続
を担う「神経系」になります。
#GPU/NPUが筋肉、HBMが短期記憶、SSDが長期倉庫、ネットワークが血管なら、CPUはまだかなり長く「脳幹・管制塔」として残ると思います。
##
CPU需要のピークはいつか
#私の考察では、伸び率のピークは2027〜2030年だと思います。
#理由は、この時期に以下が重なるからです。
#- AIデータセンター建設
- GPUクラウド成熟前の非効率
- AIエージェントの普及初期
- 推論需要の爆発
- 企業AI導入
- sovereign AI
- GPUホストCPU需要
- クラウド制御CPU需要
- Arm/EPYC/Grace/カスタムCPUの競争
AMDは2026年時点で、サーバーCPU市場が2030年まで年率35%超で成長し、1200億ドル超に達するとの見通しを示したと報じられています。これは、少なくとも市場側が2030年までのCPU需要増をかなり強く織り込み始めていることを示します。(Reuters)
#ただし、絶対額のピークはもっと後になる可能性があります。 伸び率は2030年前後に鈍っても、AI利用量が増え続ければ、2030年代前半もCPU需要の絶対額は高いまま残ると思います。
##
需要が強いCPU、弱くなるCPU
#今後は「CPU全体が伸びる」ではなく、かなり選別されます。
#強いCPU
#
弱くなるCPU
#
#
最終的な年代別シナリオ
#2024〜2026年
CPU需要は急増。
GPU投資に付随して、ホストCPU・クラウド制御CPUが増える。
2027〜2030年
伸び率のピーク。
AIエージェント、推論爆発、GPUクラウドOS化でCPU需要は非常に強い。
ただし、EPYC、Grace、Arm、DPUなどに選別が進む。
2030〜2035年
GPUクラウド成熟で1処理あたりのCPU必要量は下がる。
しかしAI利用量が増え、CPU需要は高止まり。
CPUは推論本体ではなく、管制塔・認証・DB・監査・接続に寄る。
2035〜2040年
汎用CPU需要の伸びは落ち着く。
一部はNPU、ASIC、DPU、エッジAIに移る。
ただし制御・安全・セキュリティ・外部接続のCPUは残る。
2040年以降
CPU単体の時代ではなく、CPU+GPU+NPU+DPUの異種計算システムへ。
CPUは“主役”ではなく“神経系・制御系”として残る。#
まとめ
#CPU需要の高まりは、2027〜2030年ごろに最も強く見えやすいと思います。 その後、GPUクラウドの成熟によって、1単位のAI処理に必要なCPU量は下がります。
#しかし、AIエージェント、企業AI、フィジカルAI、ロボティクス、セキュリティ、監査、DB、API連携が増えるため、CPU需要そのものはすぐには消えません。
#一番重要なのは、
#CPUはAI計算の主役から、AIクラウドの管制塔へ変わる。#
という点です。
#だから今後のCPU需要は、単なる「PCや普通のサーバーCPU」ではなく、 GPUを使い切るためのCPU、AIエージェントを管理するCPU、セキュリティと接続を担うCPUに変わっていくと考えられます。
##
はい、LPUクラウドもTPUクラウドも可能です。 ただし、性格はかなり違います。
#結論を先に言うと、
#TPUクラウド:すでに本格実用されている。学習・推論どちらも可能。 LPUクラウド:すでに推論クラウドとして実用化されている。ただしGPU/TPUより用途は狭く、主に超低遅延LLM推論向け。 GPUクラウド:最も汎用性が高く、学習・推論・画像・動画・HPCまで幅広い。#
です。
##
\1. TPUクラウドは可能か?
#可能です。というより、すでに存在します。
#Google Cloudの Cloud TPU がそれです。Google公式ドキュメントでは、Cloud TPUはGoogleが開発した機械学習向けASICで、Google Cloud上でスケーラブルな計算資源として利用できるWebサービスだと説明されています。(Google Cloud Documentation)
#TPUは Tensor Processing Unit の略で、主にAIのテンソル計算、つまり行列演算に特化したチップです。
#GPUが比較的汎用的な並列計算装置だとすると、TPUはよりAIモデル向けに設計された専用アクセラレータです。
##
\2. TPUクラウドで何ができるか
#TPUクラウドでは主に以下ができます。
#用途TPUクラウドで可能かLLM学習可能LLM推論可能ファインチューニング可能画像生成モデル可能CNN/推薦モデル可能大規模分散学習可能JAX/TensorFlow系ワークロード得意CUDA前提のGPUアプリ苦手
#たとえばGoogle Cloud TPU v6e、つまりTrilliumは、Transformer、text-to-image、CNNの学習・ファインチューニング・サービングに最適化されていると説明されています。(Google Cloud Documentation)
#また、Cloud TPU v5pでは非常に大規模なPod構成があり、Google公式ドキュメントではv5p Podが8960チップ構成で、最大6144チップのジョブをスケジュールできると説明されています。(Google Cloud Documentation)
#つまりTPUクラウドは、単なる「小さいAI推論用」ではなく、巨大AIモデルの学習・推論を行うクラウド基盤です。
##
\3. TPUクラウドの強み
#TPUクラウドの強みは、Googleがハードウェア、ソフトウェア、ネットワーク、コンパイラ、クラウド基盤を一体で設計していることです。
#つまり、
#TPUチップ
↓
TPU Pod
↓
高速ネットワーク
↓
XLA / JAX / TensorFlow / PyTorch/XLA
↓
Google Cloud
↓
Gemini系モデルや外部顧客のAIワークロードという一体設計です。
#GPUクラウドは多くの企業がNVIDIA GPUを買って作れます。 一方、TPUクラウドはGoogleの垂直統合色が強いです。
#そのためTPUクラウドは、
#- Google Cloud上では強い
- GoogleのAI基盤との相性が良い
- 大規模分散学習に強い
- 電力効率を最適化しやすい
- ただしNVIDIA CUDAエコシステムほど汎用ではない
という特徴があります。
##
\4. LPUクラウドは可能か?
#可能です。こちらもすでに実用化されています。
#代表例が GroqCloud です。GroqはLPU、Language Processing Unitを使ったAI推論クラウドを提供しており、GroqCloudは高速LLM推論、OpenAI互換API、スケーラブルな推論基盤として説明されています。(GroqCloud)
#Groqの公式ページでも、GroqCloudは開発者向けのAI推論プラットフォームで、public、private、co-cloud構成で提供可能とされています。(Groq)
#つまり、LPUクラウドはすでに存在します。
#ただし、TPUクラウドやGPUクラウドとは用途がかなり違います。
##
\5. LPUとは何か
#LPUは、ざっくり言うと LLM推論、特にトークン生成を高速・低遅延・予測可能に行うための専用チップです。
#GroqはLPUについて、コンパイラとソフトウェア定義のアーキテクチャ、単一コア設計、オンチップSRAM、連続的なトークンベース実行により、予測可能な性能を出す設計だと説明しています。(Groq)
#普通のGPUは大量の汎用並列計算に強いですが、LLM推論では、
#- 1トークンずつ出す
- 遅延が重要
- バッチが小さいことも多い
- メモリ待ちが問題になる
- 安定した応答速度が重要
という特徴があります。
#LPUはそこにかなり特化しています。
##
\6. LPUクラウドで何ができるか
#LPUクラウドで特に向いているのは、以下です。
#用途LPUクラウドとの相性LLMリアルタイム推論非常に良いチャットAI良い音声対話AI良い低遅延エージェント良いコーディング補助良いAPI型LLM推論良い大規模学習基本的に不向き画像生成・動画生成GPUほど汎用ではない任意のCUDAアプリ不向き研究用途の柔軟なモデル改造GPU/TPUの方が向く
#LPUクラウドの中心は、学習ではなく推論です。
#特に、
#ユーザーが話す
↓
すぐAIが返す
↓
またユーザーが話す
↓
またAIが返すのようなリアルタイムAIでは、LPUの低遅延性が強みになります。
##
\7. GPUクラウド、TPUクラウド、LPUクラウドの違い
#かなり単純化すると、こうです。
#種類得意領域苦手領域位置づけGPUクラウド学習、推論、画像、動画、HPC、汎用AI電力・コスト・利用率最も汎用的なAIクラウドTPUクラウド大規模AI学習、Google系AI基盤、TransformerCUDA資産との互換性Google型の専用AIクラウドLPUクラウド低遅延LLM推論、リアルタイム応答学習、汎用処理、画像/動画推論特化クラウド
#料理で例えると、
#GPUクラウド:巨大な万能厨房
TPUクラウド:AI料理に最適化されたGoogle専用の巨大厨房
LPUクラウド:注文を受けて即座に料理を出す高速カウンターという感じです。
##
\8. LPUクラウドやTPUクラウドはGPUクラウドを置き換えるか?
#完全には置き換えません。
#むしろ今後は、
#GPUクラウド、TPUクラウド、LPUクラウドが用途別に分かれる#
と思います。
#たとえば、
#巨大モデルの学習
→ GPUクラウド / TPUクラウド
Google系・JAX系の大規模学習
→ TPUクラウド
汎用AI開発、画像生成、動画生成
→ GPUクラウド
低遅延チャット、音声対話、軽量エージェント
→ LPUクラウド
企業向けAI推論API
→ GPU / LPU / TPU の混在
フィジカルAI・VLA学習
→ GPUクラウド中心、一部TPU/ASIC
エッジAI
→ NPU / 専用ASIC / 小型GPUという分担です。
##
\9. AIエージェント時代にLPUクラウドは重要か?
#かなり重要になる可能性があります。
#AIエージェントは、1回の巨大推論だけではなく、小さな推論を何度も繰り返します。
#考える
↓
ツールを選ぶ
↓
APIを呼ぶ
↓
結果を読む
↓
次の行動を決める
↓
また推論するこのような処理では、1回1回の応答遅延が短いことが重要です。
#LPUクラウドは、まさにこの「低遅延・高応答性」の部分に向いています。
#特に、
#- 音声AI
- AI秘書
- カスタマーサポート
- コーディング補助
- リアルタイム検索エージェント
- 軽量業務エージェント
- ゲームNPC
- 配信AIキャラ
- AITuber
のような用途では、LPUクラウドはかなり相性が良いです。
##
\10. ただしLPUクラウドには限界もある
#LPUはとても面白いですが、万能ではありません。
#弱点は主にこれです。
#弱点内容学習には向きにくい基本的に推論特化対応モデルが限られるコンパイラやランタイム対応が必要GPUほど汎用ではないCUDA資産をそのまま使えない画像・動画生成ではGPU優位マルチモーダル全般ではGPUが強いエコシステムが小さいNVIDIA CUDAほど巨大ではない大規模モデルの柔軟な研究には不向きGPU/TPUの方が扱いやすい
#つまりLPUクラウドは、
#LLM推論の高速道路#
にはなりえますが、
#AI全体の万能クラウド#
にはなりにくいです。
##
\11. TPUクラウドの限界
#TPUクラウドも万能ではありません。
#弱点内容Google Cloud依存が強いTPUはGoogle中心CUDA資産が使いにくいNVIDIA GPU向けコードと互換性が低い開発者人口はGPUより少ないCUDA/PyTorch GPUの方が広いデバッグや移植が難しい場合があるXLA/JAX/TPU最適化が必要汎用HPCや画像/動画ツールはGPU優位なことが多いエコシステムの差
#TPUは強力ですが、GoogleのAIインフラ思想に乗れるかどうかが重要です。
##
\12. 将来は「GPUだけ」ではなく「アクセラレータ・クラウド」になる
#今後は、クラウドがこう分かれていくと思います。
#CPUクラウド
- OS
- API
- DB
- 認証
- 課金
- 管理
- セキュリティ
GPUクラウド
- 大規模学習
- 汎用推論
- 画像生成
- 動画生成
- VLA
- 科学計算
TPUクラウド
- 大規模AI学習
- Google型AI基盤
- 高効率Transformer処理
LPUクラウド
- 低遅延LLM推論
- 音声対話
- リアルタイムエージェント
NPU/ASICクラウド
- 特定モデルの超効率推論
- 企業内推論
- エッジ連携つまり、未来は「GPUクラウドだけ」ではなく、 AIアクセラレータ・クラウドの時代になります。
#その中でGPUは最も汎用的な中心に残り、TPUはGoogle系・大規模AIに強く、LPUは低遅延推論で存在感を持つ、という分担になると思います。
##
まとめ
#LPUクラウドもTPUクラウドも可能です。
#ただし、成熟度と用途は違います。
#TPUクラウド
→ すでに本格実用。
→ 学習・推論どちらも可能。
→ Google Cloud上の大規模AI基盤。
LPUクラウド
→ すでに推論クラウドとして実用化。
→ 特に低遅延LLM推論に強い。
→ 学習や汎用AI処理には向きにくい。
GPUクラウド
→ 最も汎用。
→ 学習、推論、画像、動画、HPCまで幅広い。なので、今後のAIクラウドは、
#GPUクラウドが万能基盤、TPUクラウドが大規模AI専用基盤、LPUクラウドが低遅延推論基盤#
という形で分化していくと考えられます。
##
はい、LPUクラウドもTPUクラウドも可能です。 ただし、性格はかなり違います。
#結論を先に言うと、
#TPUクラウド:すでに本格実用されている。学習・推論どちらも可能。 LPUクラウド:すでに推論クラウドとして実用化されている。ただしGPU/TPUより用途は狭く、主に超低遅延LLM推論向け。 GPUクラウド:最も汎用性が高く、学習・推論・画像・動画・HPCまで幅広い。#
です。
##
\1. TPUクラウドは可能か?
#可能です。というより、すでに存在します。
#Google Cloudの Cloud TPU がそれです。Google公式ドキュメントでは、Cloud TPUはGoogleが開発した機械学習向けASICで、Google Cloud上でスケーラブルな計算資源として利用できるWebサービスだと説明されています。(Google Cloud Documentation)
#TPUは Tensor Processing Unit の略で、主にAIのテンソル計算、つまり行列演算に特化したチップです。
#GPUが比較的汎用的な並列計算装置だとすると、TPUはよりAIモデル向けに設計された専用アクセラレータです。
##
\2. TPUクラウドで何ができるか
#TPUクラウドでは主に以下ができます。
#用途TPUクラウドで可能かLLM学習可能LLM推論可能ファインチューニング可能画像生成モデル可能CNN/推薦モデル可能大規模分散学習可能JAX/TensorFlow系ワークロード得意CUDA前提のGPUアプリ苦手
#たとえばGoogle Cloud TPU v6e、つまりTrilliumは、Transformer、text-to-image、CNNの学習・ファインチューニング・サービングに最適化されていると説明されています。(Google Cloud Documentation)
#また、Cloud TPU v5pでは非常に大規模なPod構成があり、Google公式ドキュメントではv5p Podが8960チップ構成で、最大6144チップのジョブをスケジュールできると説明されています。(Google Cloud Documentation)
#つまりTPUクラウドは、単なる「小さいAI推論用」ではなく、巨大AIモデルの学習・推論を行うクラウド基盤です。
##
\3. TPUクラウドの強み
#TPUクラウドの強みは、Googleがハードウェア、ソフトウェア、ネットワーク、コンパイラ、クラウド基盤を一体で設計していることです。
#つまり、
#TPUチップ
↓
TPU Pod
↓
高速ネットワーク
↓
XLA / JAX / TensorFlow / PyTorch/XLA
↓
Google Cloud
↓
Gemini系モデルや外部顧客のAIワークロードという一体設計です。
#GPUクラウドは多くの企業がNVIDIA GPUを買って作れます。 一方、TPUクラウドはGoogleの垂直統合色が強いです。
#そのためTPUクラウドは、
#- Google Cloud上では強い
- GoogleのAI基盤との相性が良い
- 大規模分散学習に強い
- 電力効率を最適化しやすい
- ただしNVIDIA CUDAエコシステムほど汎用ではない
という特徴があります。
##
\4. LPUクラウドは可能か?
#可能です。こちらもすでに実用化されています。
#代表例が GroqCloud です。GroqはLPU、Language Processing Unitを使ったAI推論クラウドを提供しており、GroqCloudは高速LLM推論、OpenAI互換API、スケーラブルな推論基盤として説明されています。(GroqCloud)
#Groqの公式ページでも、GroqCloudは開発者向けのAI推論プラットフォームで、public、private、co-cloud構成で提供可能とされています。(Groq)
#つまり、LPUクラウドはすでに存在します。
#ただし、TPUクラウドやGPUクラウドとは用途がかなり違います。
##
\5. LPUとは何か
#LPUは、ざっくり言うと LLM推論、特にトークン生成を高速・低遅延・予測可能に行うための専用チップです。
#GroqはLPUについて、コンパイラとソフトウェア定義のアーキテクチャ、単一コア設計、オンチップSRAM、連続的なトークンベース実行により、予測可能な性能を出す設計だと説明しています。(Groq)
#普通のGPUは大量の汎用並列計算に強いですが、LLM推論では、
#- 1トークンずつ出す
- 遅延が重要
- バッチが小さいことも多い
- メモリ待ちが問題になる
- 安定した応答速度が重要
という特徴があります。
#LPUはそこにかなり特化しています。
##
\6. LPUクラウドで何ができるか
#LPUクラウドで特に向いているのは、以下です。
#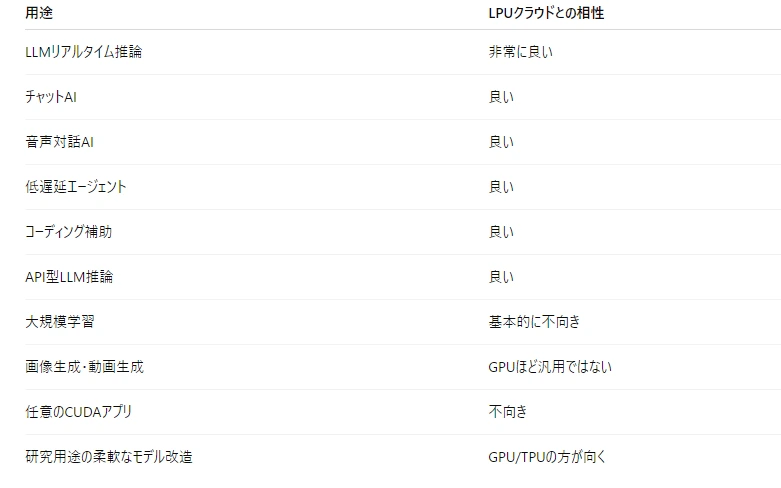
LPUクラウドの中心は、学習ではなく推論です。
#特に、
#ユーザーが話す
↓
すぐAIが返す
↓
またユーザーが話す
↓
またAIが返すのようなリアルタイムAIでは、LPUの低遅延性が強みになります。
##
\7. GPUクラウド、TPUクラウド、LPUクラウドの違い
#かなり単純化すると、こうです。
#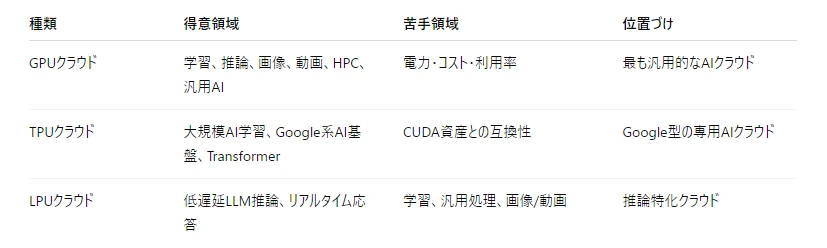
料理で例えると、
#GPUクラウド:巨大な万能厨房
TPUクラウド:AI料理に最適化されたGoogle専用の巨大厨房
LPUクラウド:注文を受けて即座に料理を出す高速カウンターという感じです。
##
\8. LPUクラウドやTPUクラウドはGPUクラウドを置き換えるか?
#完全には置き換えません。
#むしろ今後は、
#GPUクラウド、TPUクラウド、LPUクラウドが用途別に分かれる#
と思います。
#たとえば、
#巨大モデルの学習
→ GPUクラウド / TPUクラウド
Google系・JAX系の大規模学習
→ TPUクラウド
汎用AI開発、画像生成、動画生成
→ GPUクラウド
低遅延チャット、音声対話、軽量エージェント
→ LPUクラウド
企業向けAI推論API
→ GPU / LPU / TPU の混在
フィジカルAI・VLA学習
→ GPUクラウド中心、一部TPU/ASIC
エッジAI
→ NPU / 専用ASIC / 小型GPUという分担です。
##
\9. AIエージェント時代にLPUクラウドは重要か?
#かなり重要になる可能性があります。
#AIエージェントは、1回の巨大推論だけではなく、小さな推論を何度も繰り返します。
#考える
↓
ツールを選ぶ
↓
APIを呼ぶ
↓
結果を読む
↓
次の行動を決める
↓
また推論するこのような処理では、1回1回の応答遅延が短いことが重要です。
#LPUクラウドは、まさにこの「低遅延・高応答性」の部分に向いています。
#特に、
#- 音声AI
- AI秘書
- カスタマーサポート
- コーディング補助
- リアルタイム検索エージェント
- 軽量業務エージェント
- ゲームNPC
- 配信AIキャラ
- AITuber
のような用途では、LPUクラウドはかなり相性が良いです。
##
\10. ただしLPUクラウドには限界もある
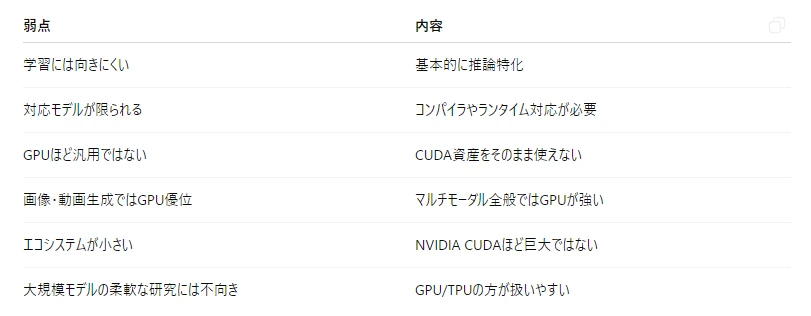
#LPUはとても面白いですが、万能ではありません。
#弱点は主にこれです。
#
つまりLPUクラウドは、
#LLM推論の高速道路#
にはなりえますが、
#AI全体の万能クラウド#
にはなりにくいです。
##
\11. TPUクラウドの限界
#TPUクラウドも万能ではありません。
#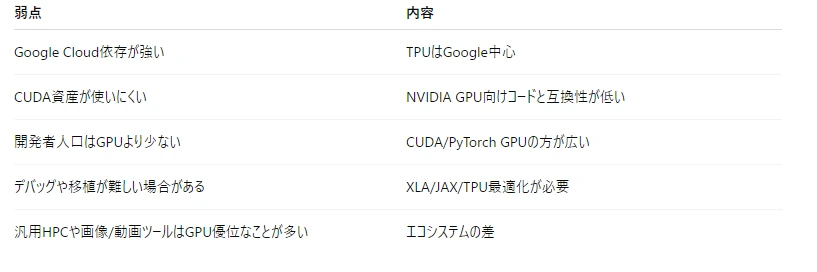
TPUは強力ですが、GoogleのAIインフラ思想に乗れるかどうかが重要です。
##
\12. 将来は「GPUだけ」ではなく「アクセラレータ・クラウド」になる
#今後は、クラウドがこう分かれていくと思います。
#CPUクラウド
- OS
- API
- DB
- 認証
- 課金
- 管理
- セキュリティ
GPUクラウド
- 大規模学習
- 汎用推論
- 画像生成
- 動画生成
- VLA
- 科学計算
TPUクラウド
- 大規模AI学習
- Google型AI基盤
- 高効率Transformer処理
LPUクラウド
- 低遅延LLM推論
- 音声対話
- リアルタイムエージェント
NPU/ASICクラウド
- 特定モデルの超効率推論
- 企業内推論
- エッジ連携つまり、未来は「GPUクラウドだけ」ではなく、 AIアクセラレータ・クラウドの時代になります。
#その中でGPUは最も汎用的な中心に残り、TPUはGoogle系・大規模AIに強く、LPUは低遅延推論で存在感を持つ、という分担になると思います。
##
まとめ
#LPUクラウドもTPUクラウドも可能です。
#ただし、成熟度と用途は違います。
#TPUクラウド
→ すでに本格実用。
→ 学習・推論どちらも可能。
→ Google Cloud上の大規模AI基盤。
LPUクラウド
→ すでに推論クラウドとして実用化。
→ 特に低遅延LLM推論に強い。
→ 学習や汎用AI処理には向きにくい。
GPUクラウド
→ 最も汎用。
→ 学習、推論、画像、動画、HPCまで幅広い。なので、今後のAIクラウドは、
#GPUクラウドが万能基盤、TPUクラウドが大規模AI専用基盤、LPUクラウドが低遅延推論基盤#
という形で分化していくと考えられます。
##
はい。ここはまず 「稼働率」という言葉を3つに分ける 必要があります。
#1つ目は、フリート稼働率。 これは「クラウド事業者が持っているGPU/TPU/LPU全体のうち、どれくらいが仕事をしているか」です。
#2つ目は、ハードウェア利用率。 これは「動いているチップの演算器やメモリ帯域がどれくらい使われているか」です。
#3つ目は、MFU / Model FLOPs Utilization。 これは「理論ピーク性能のうち、モデル学習・推論に有効に使われた割合」です。
#この3つは違います。 たとえば、GPUが通電してジョブを実行していても、通信待ちやメモリ待ちが多ければMFUは低くなります。
##
ざっくり結論
#私の見立てでは、現在から2030年代にかけてこうなります。
#クラウド現在の実態2030年前後〜2030年代の見通しGPUクラウドかなり低いものも多い。一般企業では5〜20%、最適化済み学習では35〜50%級30〜60%が一般化。トップ層は50〜75%を狙うTPUクラウドGoogle内部や最適化済み学習ではすでに45〜55%級のMFU実績50〜70%級をより安定して狙う。GPUより早く成熟しやすいLPUクラウドフリート稼働率は非公開。対応モデルでは低遅延・高効率に動く低遅延推論で高効率化。ただし用途が狭く、需要変動で30〜70%程度に揺れやすい
#かなり単純化すると、
#GPUクラウドは、今は非効率だが2030年代に大きく改善する。 TPUクラウドは、垂直統合されているため、すでに比較的高効率で、今後さらに安定する。 LPUクラウドは、LLM推論の瞬発力は高いが、対応モデル・需要変動・低遅延SLOの制約で、フリート全体を常時高稼働にするのは難しい。#
という見方です。
##
\1. GPUクラウドの現在の稼働率
#GPUクラウドは、実はかなり非効率な例が多いです。
#Cast AIの2026年レポートでは、AWS、Azure、Google Cloud上のKubernetesクラスタを分析し、GPU利用率の平均は5% とされています。CPUも8%、メモリも20%程度で、かなり過剰プロビジョニングされているという内容です。(Cast AI)
#一方で、これは「世の中のGPU全部が5%」という意味ではありません。 同じCast AIのデータでも、あるH200クラスタでは 49%のGPU利用率 を維持できた例が示されています。(Cast AI)
#また、xAIの例では、GPUフリートの MFUが約11% と報じられています。これは「GPUが完全に止まっている」というより、理論性能に対してモデル学習に有効利用できている割合が低いという意味です。報道では、業界標準として35〜45%程度が比較対象として挙げられています。(Business Insider)
#つまりGPUクラウドの現状はこうです。
#一般企業・未最適化クラスタ
→ 5〜20%程度の利用率も珍しくない
最適化されたAIラボ・学習クラスタ
→ 35〜50%程度のMFUを狙う
非常に上手い運用
→ 50%前後、場合によってはそれ以上GPUクラウドは汎用性が高いぶん、ワークロードがバラバラです。 学習、推論、画像生成、動画生成、RAG、バッチ処理、低遅延APIが混ざるので、綺麗に詰め込むのが難しいです。
##
\2. GPUクラウドは2030年代にどこまで改善するか
#2030年代には、GPUクラウドの稼働率はかなり改善すると思います。
#理由は、
#- vLLM / PagedAttention
- SGLang
- TensorRT-LLM
- Dynamo系の分散推論
- prefill/decode分離
- KV cache管理
- GPU pooling
- Kubernetes DRA
- MIG / time slicing
- token単位スケジューリング
- AIによる自動最適化
が進むからです。
#2030年前後には、GPUクラウドは現在の「GPUインスタンスを貸す」段階から、 トークン、KV cache、SLO、モデル常駐、GPUメモリ単位で管理するクラウドOS に近づくと思います。
#私の予想はこうです。
#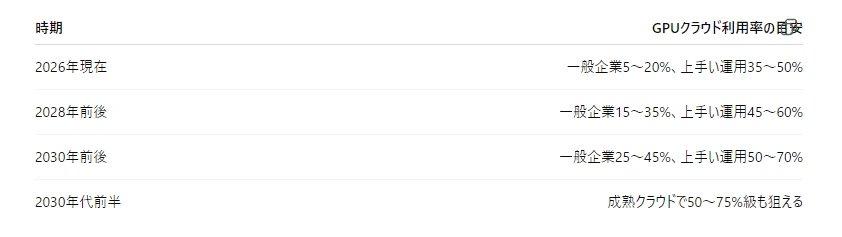
ただし、GPUクラウドが常時90%近くになるとは思いません。
#なぜなら、AI推論は需要変動が大きく、低遅延SLOを守るために余裕容量が必要だからです。 CPUクラウドでも、全サーバーを常時95%で回すと障害や遅延に弱くなります。GPUクラウドも同じです。
#なので、2030年代の理想は、
#100%稼働ではなく、遅延・障害・需要変動を吸収しながら50〜70%台を安定して出すこと#
だと思います。
##
\3. TPUクラウドの現在の稼働率
#TPUクラウドは、GPUクラウドよりも 高効率になりやすい です。
#理由は、GoogleがTPUチップ、Pod、ネットワーク、XLA/JAX、クラウド基盤、Gemini系モデルまで垂直統合しているからです。
#GoogleのPaLM論文では、PaLM 540Bを6144個のTPU v4で学習し、MFU 46.2% を達成したと報告されています。(arXiv)
#さらにGoogleのTPU v4ベンチマーク資料では、TPU v4の弱スケーリングで 45〜56% MFU、最適スケーリングで 44〜50% MFU という数字が示されています。(Google)
#これはかなり強いです。 GPUクラウドでは、未最適化だと10%台、一般企業では一桁台もありえます。 一方、TPUはGoogle内部の最適化されたワークロードでは、すでに40〜50%台を安定して出しているわけです。
#ただし注意点があります。
#これは Google内部・最適化済み・大規模学習ワークロード の話です。 一般のCloud TPUユーザーが、何も考えずに常に50% MFUを出せるという意味ではありません。
#TPUはコンパイラ、モデル形状、バッチサイズ、JAX/PyTorch/XLA対応、データ入力パイプラインに強く依存します。 はまると高効率ですが、はまらないとGPUより扱いにくい場合があります。
##
\4. TPUクラウドは2030年代にどうなるか
#TPUは、GPUよりも「クラウド化の完成」が早い可能性があります。
#なぜなら、TPUはGoogleが自社クラウド用に設計しているからです。
#GPUクラウドは、NVIDIA GPUをAWS、Azure、Oracle、CoreWeave、xAI、Metaなど多くの事業者がそれぞれ運用します。 一方TPUは、Google CloudとGoogle内部AI基盤に強く統合されています。
#GoogleのTrillium、つまりTPU v6eは、TPU v5e比で 4.7倍のピーク性能、HBM容量/帯域2倍、ICI帯域2倍、67%のエネルギー効率改善 と説明されています。(Google Cloud)
#また、GoogleはTrilliumをGemini 2.0の学習に使ったと説明しています。(Google Cloud)
#この方向を見ると、TPUクラウドは2030年代にこうなりやすいです。
#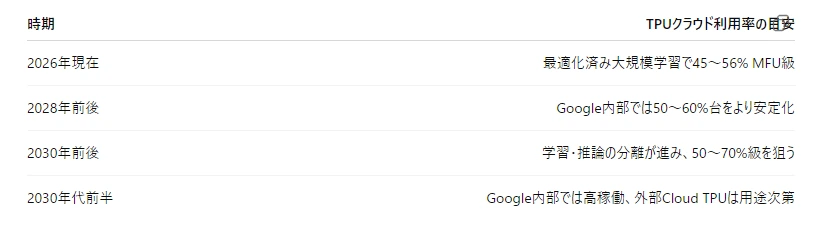
TPUは、GPUよりも汎用性は低いですが、Googleが想定するAIワークロードには非常に高効率 になります。
#つまり、
#TPUはGPUより稼働率を上げやすいが、用途の幅はGPUより狭い。#
です。
##
\5. LPUクラウドの現在の稼働率
#LPUクラウドについては、GPUやTPUと違って、フリート全体の稼働率はほぼ公開されていません。
#なので、正確に「今は何%」とは言えません。
#ただし、構造的にはかなり特徴があります。
#GroqはLPUについて、オンチップSRAMを使い、コンパイラで静的スケジューリングし、決定論的に実行する構成だと説明しています。(Groq)
#またGroqCloudは、リアルタイム推論に必要な低遅延・高効率なLLM推論を提供するものとして説明されています。(Groq)
#LPUはGPUと違い、主に LLM推論、特にdecode / token generation に最適化されています。
#つまり、1つ1つの対応モデルを動かしている瞬間の効率は高くなりやすいです。 しかし、クラウド全体の稼働率は別問題です。
#LPUクラウドの稼働率を決めるのは、
#- 対応モデル数
- ユーザー需要
- リアルタイムSLO
- 待ち行列をどれだけ許すか
- バッチ処理を混ぜられるか
- 音声AIやエージェント需要の量
- モデル更新頻度
- SRAM容量に収まる構成か
です。
#LPUは低遅延が売りなので、GPUのように大きくバッチングして常時パンパンに詰めると、応答速度の強みが失われやすいです。
#なので、LPUクラウドは、
#**チップ単体・対応モデル単位では高効率。 ただしフリート全体では、低遅延のために余裕容量を持つ必要がある。**#
という構造になります。
##
\6. LPUクラウドは2030年代にどうなるか
#LPUクラウドは、2030年代にかなり伸びる可能性があります。 特にAIエージェント、音声AI、リアルタイム対話、ゲームNPC、AITuber、カスタマーサポートでは強いです。
#ただし、GPUやTPUと違って、LPUはかなり推論特化です。
#私の見立てではこうです。
#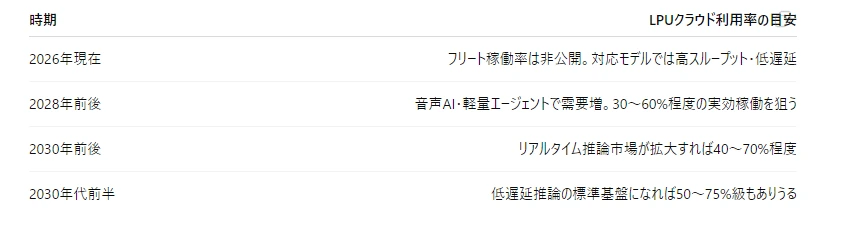
ただし、LPUには構造的な上限もあります。
#低遅延を守るためには、GPUのバッチ推論のように「待たせてまとめて処理する」ことが難しいです。 そのため、フリート全体を常時80〜90%で回すより、余裕を持って50〜70%台で低遅延を維持する方が現実的です。
##
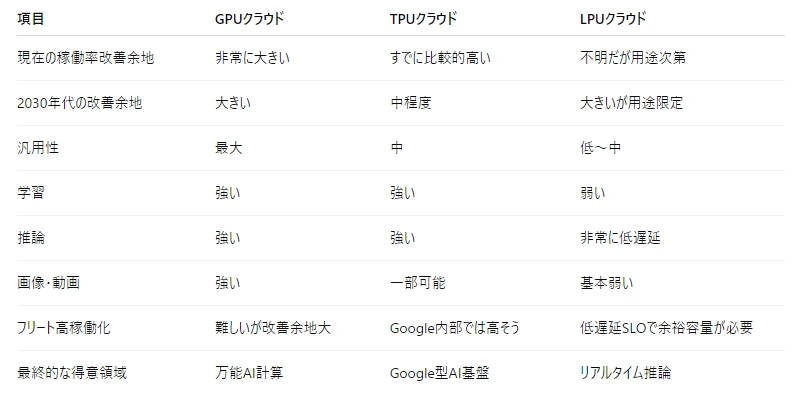
\7. GPU、TPU、LPUの2030年代の違い
#2030年代には、それぞれのクラウドはこう分化すると思います。
#GPUクラウド
汎用AIクラウド。
学習、推論、画像、動画、VLA、HPCまで担当。
稼働率改善余地が最大。
TPUクラウド
Google型の高効率AIクラウド。
大規模学習・推論で高MFUを狙う。
用途はGPUより狭いが、はまると非常に強い。
LPUクラウド
低遅延LLM推論クラウド。
音声対話、エージェント、リアルタイム応答に強い。
フリート稼働率は需要変動とSLOに左右される。表にするとこうです。
#
#
\8. どれが一番高稼働になりやすいか
#単純に「チップをどれだけ使い切れるか」だけで見ると、私はこう見ます。
#1位:TPU
#TPUは垂直統合されており、Google内部のワークロードに最適化されています。 モデル、コンパイラ、ネットワーク、クラウド、データセンターをまとめて設計できるため、高MFUを出しやすいです。
#2位:LPU
#LPUは対応モデルに限れば非常に効率的です。 ただし低遅延推論なので、需要変動を吸収するための余裕が必要です。 そのため、チップ単体効率は高いが、フリート全体は常時満杯にはしにくいです。
#3位:GPU
#GPUは最も汎用ですが、そのぶん無駄も出やすいです。 ただし2030年代にGPUクラウドOSが成熟すれば、現在からの改善幅は最も大きいです。
#つまり、
#現在の完成度は TPU > LPU > GPU 今後の改善余地は GPU > LPU > TPU#
というイメージです。
##
\1. TPU優位か?
#特定条件ではTPU優位です。
#理由は、TPUは最初から「クラウドで巨大AIを動かす」ためにGoogleが設計しているからです。
#GPUはもともと汎用並列計算のチップです。AIにも非常に強いですが、ゲーム、HPC、画像処理、動画、レンダリング、科学計算などにも使える汎用アクセラレータです。
#一方、TPUはかなりAI特化です。
#特にGoogle Cloud TPU v6e、つまりTrilliumは、Transformer、text-to-image、CNNの学習・ファインチューニング・サービング向けに最適化されています。GoogleはTrilliumについて、TPU v5e比でピーク性能4.7倍、HBM容量/帯域2倍、チップ間相互接続帯域2倍、エネルギー効率67%以上改善と説明しています。(Google Cloud)
#つまりTPUは、
#- チップ
- Pod構成
- ネットワーク
- XLA/JAX/TensorFlow/PyTorch/XLA
- Google Cloud
- Gemini系モデル
- Google内部の運用ノウハウ
が一体で設計されています。
#そのため、決まった大規模AIワークロードを高稼働・高効率で流すという視点では、GPUクラウドより有利になりやすいです。
##
\2. GPUよりTPUが有利な場面
#TPUが強いのは、こういう場面です。
#条件TPU優位になりやすい理由大規模Transformer学習TPU Pod全体で最適化しやすいGoogle Cloud上で完結ハード・ソフト・クラウドが統合されているJAX/XLAと相性がよいモデルコンパイラ最適化を効かせやすい同じ型のモデルを大量に回す稼働率を上げやすい電力効率が重要専用設計でワット性能を上げやすい長期契約の大口AI企業専用キャパシティを組みやすい
#特に「稼働率」という視点では、TPUはかなり強いです。
#GPUクラウドは、色々な会社が色々なワークロードを載せるため、無駄が出やすいです。 TPUはGoogleが想定するAIワークロードに寄せられるので、クラウド全体で計算資源を詰め込みやすい。
#だから、“Googleが使うAIインフラ”としてはTPUは非常に強いです。
##
\3. では、TPUがGPUより売れる世界線はあるか?
#あります。 ただし、かなり限定的に考える必要があります。
#まず「売れる」を3種類に分けた方がいいです。
#意味TPUがGPUより上回る可能性Google内部で使われるAI計算量かなりありえるGoogle Cloud上のAI計算量一部領域でありえる世界全体のAIアクセラレータ売上かなり難しい外販チップとしてNVIDIA GPUより売れる現状ではかなり難しい
#つまり、Google内部・Google Cloud内ではTPUがGPUを大きく上回る世界線はありえます。 でも、世界全体の市場売上でNVIDIA GPUをTPUが超えるとなると、難易度はかなり上がります。
##
\4. なぜ世界全体ではGPUがまだ強いのか
#理由は単純で、GPUには巨大なエコシステムがあるからです。
#GPU、特にNVIDIA GPUには、
#- CUDA
- PyTorch
- TensorRT
- NCCL
- cuDNN
- 開発者人口
- 既存コード資産
- サードパーティクラウド
- ネオクラウド
- 研究者コミュニティ
- 画像/動画/HPC/ロボティクス対応
があります。
#NVIDIAの2026年度第4四半期決算では、データセンター売上が623億ドル、全社売上が681億ドル、2026年度通年売上が2159億ドルと発表されています。これは、NVIDIA GPUがすでに巨大な外販市場を形成していることを示します。(NVIDIA Newsroom)
#一方、GoogleはTPU売上をNVIDIAのように単独開示していません。TPUはGoogle内部利用、Google Cloud提供、特定パートナー向け供給という性格が強く、独立した外販チップ市場としてGPUと同じ土俵に立っているわけではありません。
##
\5. ただし、TPUが伸びる強い兆候はある
#かなり重要なのがAnthropicです。
#Anthropicは2026年4月、GoogleおよびBroadcomとの提携拡大を発表し、2027年からオンラインになる予定の複数ギガワット規模の次世代TPU capacityを利用すると説明しています。これはClaudeのfrontier modelや顧客需要を支えるための計算基盤です。(Anthropic)
#これは非常に大きいです。
#つまりTPUは、もはや単なる「Google内部専用チップ」ではなく、
#Google Cloudを通じて、Anthropicのような外部AI企業の巨大計算基盤にもなっている#
ということです。
#この流れが続くと、TPUはGoogle内部 + 外部大口AI企業向けの巨大AIクラウド基盤として、かなり大きくなります。
##
\6. これはGoogle内部でしかできないことか?
#完全にGoogle内部だけではありません。
#Cloud TPUはGoogle Cloudのサービスとして外部顧客にも提供されています。Google CloudのTPUページでは、Trilliumが北米、欧州、アジア北東リージョンで一般提供されていると説明されています。(Google Cloud)
#つまり外部企業も、Google Cloud上でTPUを使えます。
#ただし、重要なのはここです。
#TPUを本当に高効率で使い切るには、Googleのクラウド・コンパイラ・モデル設計・運用思想にかなり乗る必要がある。#
なので、物理的には外部企業も使えます。 でも、GPUのように「どのクラウドでも、どのフレームワークでも、既存CUDA資産をそのまま移植して使う」という自由度は低いです。
##
\7. TPUがGPUより売れるための条件
#TPUが本当にGPUより大きくなるには、以下の条件が必要です。
#条件1:Google CloudがAI企業の主要インフラになる
#Anthropicのような大口企業が増え、OpenAI、Meta、xAI、Mistral、Cohere、各国Sovereign AIなどがGoogle TPUを大規模採用する世界です。
#これは一部ありえますが、各社はNVIDIA GPU、AMD GPU、自社ASICも併用するでしょう。
#条件2:TPUがGPUより明確に安い/速い/省電力になる
#Trilliumのように、世代ごとに電力効率と性能が大きく上がれば、クラウド事業者やAI企業にとってTPUは魅力的です。GoogleはTrilliumについて、v5e比で67%以上のエネルギー効率改善を示しています。(Google Cloud)
#AIデータセンターでは電力が制約になるので、これは非常に重要です。
#条件3:JAX/XLA/TPU対応がもっと楽になる
#開発者が「GPUからTPUに移るのが面倒」と感じるうちは、GPU優位は崩れにくいです。
#TPUが広がるには、PyTorch/XLAやJAXの体験がさらに良くなり、GPUとの差が減る必要があります。
#条件4:GoogleがTPUをもっと外に開く
#ここが最大の分岐です。
#今のTPUは、基本的にGoogle Cloud中心です。 もし将来的に、Google/Broadcom連合がTPU capacityをより広く提供し、Google Cloud以外の形でも利用しやすくなれば、TPUの市場は大きく広がります。
#Anthropicとの提携では、Google Cloud servicesとBroadcom経由のGoogle-built TPUsへのアクセスが含まれると発表されています。これは、TPU供給がGoogle内部だけに閉じていないことを示す重要な材料です。(Google Cloud Press Corner)
##
\8. ありえる世界線
#世界線A:GPU王国が続く
#最も自然なシナリオです。
#GPUは汎用性、CUDA、開発者人口、クラウド展開、画像/動画/ロボティクスまで含めて強すぎます。
#この場合、TPUは伸びるが、GPUを抜くのではなく、
#NVIDIA GPUが最大市場、TPUはGoogle/Anthropic系の巨大な第二極#
になります。
#可能性は高いです。
##
世界線B:Google Cloud内ではTPUがGPUを上回る
#これはかなりありえます。
#Googleは自社のGemini、検索、YouTube、広告、Cloud AI、Anthropic向け計算などをTPUに寄せられます。
#この場合、
#世界全体ではGPU優位 ただしGoogle陣営のAI計算ではTPU優位#
という形になります。
#私はこの可能性がかなり高いと思います。
##
世界線C:TPUが外部AI企業にも大規模普及し、GPUの伸びを削る
#これもありえます。
#特に電力制約が厳しくなり、NVIDIA GPUが高すぎる、供給が足りない、CUDA依存を減らしたい、という圧力が強まると、TPUは強い代替になります。
#Anthropicの複数ギガワット規模のTPU契約は、この方向の大きなサインです。(Anthropic)
#ただし、この世界でもGPUを完全に抜くというより、GPUの独占的優位を崩すというイメージです。
##
世界線D:TPUが世界全体でGPUより売れる
#これは一番難しいです。
#理由は、
#- Google Cloud中心である
- CUDA資産が巨大すぎる
- GPUは学習・推論・画像・動画・HPC・ロボティクスで汎用
- NVIDIAはネットワーク、ソフト、ラック、推論基盤まで統合している
- AMDや他ASICも競争に入る
- GoogleがTPUをNVIDIAのように広範囲に外販するか不明
だからです。
#この世界線が起きるには、GoogleがTPUをもっと広く開き、Google Cloud外でも使いやすくし、開発体験をGPU並みにし、価格/電力効率で圧倒する必要があります。
#現時点では、可能性はゼロではないが、メインシナリオではないと思います。
##
\9. 私の結論
#この視点、つまり稼働率・電力効率・AI専用クラウド最適化では、TPUはかなり優位です。
#特に、
#Google内部 Gemini系 Anthropicのような大口AI企業 Google Cloud上の大規模学習・推論 電力効率重視のAIデータセンター#
では、TPUはGPUより強い場面が増えます。
#ただし、世界全体でGPUよりTPUが売れるかというと、現時点ではまだGPU優位です。NVIDIAのデータセンター売上規模、CUDAエコシステム、GPUの汎用性が大きすぎます。(NVIDIA Investor Relations)
#一番現実的な未来はこれです。
#世界全体:
GPUが最大勢力のまま
Google陣営:
TPUが主力化
大口AI企業:
GPU + TPU + 自社ASICの併用
2030年代:
GPU一強から、GPU / TPU / ASIC / LPU の分化へつまり、TPUはGPUを「完全に置き換える」というより、 Google陣営と大口AI企業の中で、GPU依存をかなり削る存在になる可能性が高いです。
##
GPUクラウドを最適化していける能力を持っている企業や伸びる可能性のあるものを考察
#この視点で見ると、伸びる可能性があるのは単なる「GPUを売る企業」だけではありません。むしろ本命は、GPUをクラウド資源として高稼働化するための“AIクラウドOS”を作れる企業群です。
#結論から言うと、最も強いのは NVIDIA。次に、CoreWeaveのようなGPUネオクラウド、Broadcom/Arista/MarvellのようなAIネットワーク企業、Datadog/Cloudflareのような監視・制御・セキュリティ企業、そしてGoogle/AWSのような自社アクセラレータ陣営が伸びる可能性があります。
##
\1. 最有力:NVIDIA
#GPUを売る会社から、GPUクラウドOS企業へ
#このテーマの中心は、やはりNVIDIAです。
#NVIDIAはGPU本体だけでなく、
#- CUDA
- TensorRT-LLM
- NIM
- Dynamo
- Run:ai
- Spectrum-X
- BlueField DPU
- NVLink
- DGX / GB200 / Rubin系ラック
- Ethernet / InfiniBandネットワーク
まで持っています。
#特に重要なのが NVIDIA Dynamo です。Dynamoは大規模分散推論向けのオープンソースフレームワークで、reasoning modelや生成AIを低遅延・高スループットで動かすための仕組みです。NVIDIAは、DeepSeek-R1系モデルをBlackwell上で動かす場合、最大30倍のリクエスト処理改善を主張しています。(NVIDIA Developer)
#さらにNVIDIAはRun:aiを買収しました。Run:aiはKubernetesベースのGPUオーケストレーション企業で、GPUリソースを複数ワークロードに動的に割り当て、AIインフラの効率を高めるソフトウェアを持っていました。NVIDIAは2024年末にこの買収を完了しています。(Reuters)
#これはかなり重要です。 NVIDIAはもはや「GPUを売って終わり」ではなく、GPUをどうクラウド資源として詰め込むか、どう低遅延推論を回すか、どうネットワークまで含めて最適化するかに進んでいます。
#つまりNVIDIAは、GPUクラウド最適化の中心企業です。
##
\2. GPUネオクラウド:CoreWeave、Nebius、Lambda、Crusoe
#次に重要なのが、GPUネオクラウドです。
#従来のAWS、Azure、Google Cloudとは別に、AI特化のGPUクラウドを作る企業群です。特にCoreWeaveは代表格です。
#CoreWeaveは2026年第1四半期に売上20.8億ドルを報告し、市場予想を上回りました。AI学習・推論向けの高性能クラウド需要が急増しており、同社の受注残は約994億ドルまで拡大したと報じられています。(Reuters)
#CoreWeaveの強みは、GPUクラウドを汎用クラウドの一部としてではなく、AIワークロード専用に設計していることです。
#GPUクラウド最適化では、以下が重要になります。
#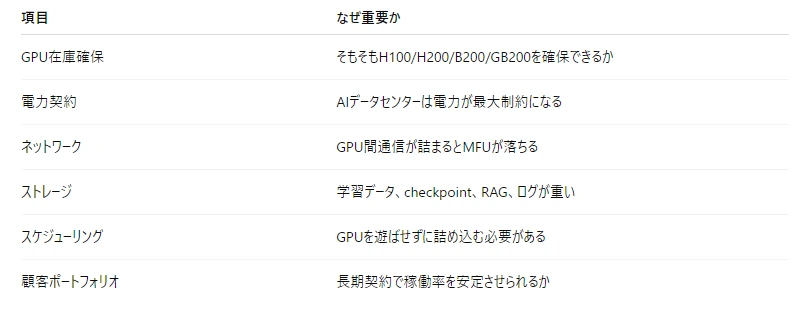
CoreWeaveのような企業は、GPUクラウドの稼働率改善そのものが利益率改善に直結します。 ただし、同時に借入、設備投資、電力確保、償却負担が重いビジネスでもあります。売上成長は強い一方、コスト増や赤字拡大も報じられているため、成長性は高いが財務リスクも高い領域です。(Reuters)
##
\3. ハイパースケーラー:Microsoft、AWS、Google、Oracle
#GPUクラウド最適化で絶対に外せないのがハイパースケーラーです。
#彼らはCPUクラウドで25年かけて作った、
#- 仮想化
- IAM
- 課金
- 監視
- セキュリティ
- Kubernetes
- ストレージ
- ネットワーク
- オートスケール
- FinOps
をすでに持っています。
#GPUクラウドでも、最終的にはこれらの運用能力が効いてきます。
#AWS
#AWSはNVIDIA GPUだけでなく、Trainium/Inferentiaという自社AIチップも持っています。AWSはProject Rainierで、約50万個のTrainium2チップを使う巨大AIクラスタを稼働させ、AnthropicがClaudeの学習・運用に使っていると説明しています。(Amazon News)
#Trainium2はAWS公式ページで、GPUベースのP5e/P5enインスタンスと比べて30〜40%優れた価格性能を提供すると説明されています。(Amazon Web Services, Inc.)
#AWSはGPUクラウドの最適化だけでなく、GPU依存を減らす方向でも強いです。
#GoogleはTPUを持っています。AnthropicはGoogleおよびBroadcomとの提携で、2027年から複数ギガワット規模の次世代TPU capacityを使う契約を結んでいます。(Anthropic)
#GoogleはGPUクラウド最適化というより、TPUクラウドによってGPUクラウドとは別ルートの高稼働AIクラウドを作る企業です。
#Microsoft / Azure
#MicrosoftはOpenAIとの関係、Azure AIインフラ、NVIDIA GPUの大規模導入で強いです。GPUクラウド最適化という観点では、Azureは巨大な企業顧客基盤、セキュリティ、ID管理、データ基盤とAI推論を結び付けられるのが強みです。
#Oracle
#Oracle CloudはNVIDIA GPUクラスタの提供で存在感を高めています。Oracleの強みは、比較的シンプルで高性能なベアメタル/クラスタ設計、企業DB顧客、そしてAI企業向けの大口クラウド契約です。
##
\4. ネットワーク企業:Broadcom、Arista、Marvell、Cisco
#GPUクラウドの稼働率を上げるうえで、実は非常に重要なのがネットワークです。
#GPUが大量にあっても、GPU間通信が詰まると、学習も推論も止まります。 特に分散学習、MoE、prefill/decode分離、KV cache共有、マルチノード推論では、ネットワークがGPU稼働率を左右します。
#Broadcom
#Broadcomはこのテーマでかなり強いです。
#Broadcomは2026年第1四半期にAI売上84億ドル、前年比106%増を報告し、カスタムAIアクセラレータとAIネットワーキング需要が牽引したと説明しています。さらに第2四半期のAI半導体売上は107億ドルを見込んでいます。(Broadcom Inc.)
#BroadcomはGoogle TPUのようなカスタムAIチップ、AI Ethernet、スイッチASIC、光接続の周辺で強く、GPUクラウド最適化というより、AIクラウド全体の通信・ASIC化の中核になりやすいです。
#さらにReutersは、Broadcomが2027年までにAIチップ売上1000億ドル超を見込んでいると報じています。(Reuters)
#Arista Networks
#AristaはAI Ethernetの本命候補です。
#AIクラスタでは、NVIDIA InfiniBandだけでなく、EthernetベースのAIネットワークも広がっています。Aristaは大規模クラウド向けEthernetスイッチで強く、AIデータセンターのバックエンドネットワーク需要に乗っています。2026年第1四半期には売上27.1億ドル、前年比35.1%増を報告したと報じられています。(Barron's)
#Aristaは、GPUそのものではなく、GPUを束ねる血管です。 GPUクラウドの稼働率を上げるには、GPU間通信の遅延・輻輳・パケットロスを抑える必要があるため、AI Ethernetの重要性は上がります。
#Marvell
#Marvellは、AI ASIC、光/電気インターコネクト、DSP、データセンターネットワークで重要です。Broadcomほど規模は大きくないですが、カスタムシリコンと接続技術の需要が増えるほど恩恵を受けやすいです。
#Cisco
#CiscoもAI Ethernet、セキュリティ、企業ネットワーク、データセンターネットワークで関与します。ただし、純粋なAIクラスタ最適化ではAristaやNVIDIA Spectrum-X、Broadcom系ASICの方がより直接的に見えます。
##
\5. DPU / SmartNIC / CPU企業:AMD、NVIDIA、Intel、Arm系
#GPUクラウド最適化では、CPUとDPUも重要です。
#GPUの稼働率を上げるには、GPU以外の処理を詰まらせてはいけません。
#- ネットワーク処理
- 暗号化
- ストレージI/O
- セキュリティ
- VM/コンテナ分離
- RDMA/RoCE制御
- テレメトリ
- ジョブ投入
- 障害復旧
これらをCPUだけで処理すると、GPUの足を引っ張ります。そこでDPU/SmartNICが重要になります。
#NVIDIA Spectrum-Xは、マルチテナント・ハイパースケールAIクラウド向けのEthernetプラットフォームとして説明されており、AIクラウドの性能、電力効率、予測可能性を改善することを狙っています。(NVIDIA)
#また、GMO GPU Cloudの資料でも、BlueField-3 DPUがGPUのデータアクセスを加速し、AIアプリケーション提供を効率化し、クラウドインフラのセキュリティを高めると説明されています。(GMOインターネット株式会社)
#AMDもこの領域で強くなる可能性があります。AMDはEPYC CPU、Instinct GPU、Pensando DPU/NICを持っており、AIデータセンターのCPU+GPU+ネットワーク処理を一体で取りに行けます。AMDは2026年第1四半期にデータセンター売上が57%増の58億ドルとなり、EPYC CPUとInstinct GPU需要が牽引したと報じられています。(Investors)
##
\6. 監視・FinOps企業:Datadog、Grafana、Dynatrace、New Relic
#GPUクラウド最適化では、「見える化」が非常に重要です。
#GPUの稼働率が低い理由を分解するには、
#- GPU使用率
- HBM使用量
- HBM帯域
- NVLink/IB/Ethernet帯域
- SM occupancy
- queue time
- TTFT
- TPOT / ITL
- KV cache hit率
- batch効率
- tenant別コスト
- モデル別原価
- 部門別GPU消費
を見る必要があります。
#この領域で伸びる可能性があるのがDatadogです。Datadogは2026年4月にGPU Monitoringを発表し、GPUフリートの健全性、コスト、パフォーマンスを利用部門やメンバーと結び付けて可視化し、低性能ワークロードのトラブルシュートやコスト削減を支援すると説明しています。(Datadog)
#これはかなり重要です。 GPUクラウドの稼働率を改善するには、まずどのモデル、どのチーム、どのジョブがGPUを無駄にしているのかを見える化する必要があります。
#したがって、GPUクラウド成熟期には、Datadog、Grafana Labs、Dynatrace、New Relic、Splunk系のAI/GPU observability需要が伸びる可能性があります。
##
\7. AI Gateway / セキュリティ:Cloudflare、Zscaler、Palo Alto、CrowdStrike、Okta
#GPUクラウド最適化は、単にGPUを高稼働にするだけでは不十分です。 AIエージェントが増えると、推論リクエスト、APIキー、モデル選択、レート制限、コスト管理、認証、ログ、攻撃防御が必要になります。
#ここで伸びるのがAI GatewayやAI securityです。
#Cloudflare AI Gatewayは、複数AIプロバイダーに対するログ、メトリクス、レート制限、キャッシュ、監視、フォールバックを提供し、AIアプリケーションのコスト・信頼性・リスクを制御する仕組みです。(Cloudflare)
#CloudflareはWorkers AIで190以上の都市にGPUを配置し、AIアプリをユーザー近くで動かす構想も出しています。(Cloudflare)
#この領域は、GPUクラウドの「外側」にあります。 しかしAIエージェント時代には、GPU推論そのものよりも、どのAIに、誰が、どの権限で、どれだけ使わせるかが重要になります。
#その意味で、Cloudflare、Zscaler、Palo Alto Networks、CrowdStrike、Oktaのような企業は、GPUクラウド最適化の周辺で伸びる可能性があります。
##
\8. 推論エンジン/AIサービング企業:vLLM、SGLang、Anyscale、Together AI、Fireworks AI
#GPUクラウドの稼働率を上げるうえで、最も直接的なのはLLMサービング層です。
#重要技術は、
#- continuous batching
- paged attention
- prefix cache
- KV cache管理
- prefill/decode分離
- speculative decoding
- routing
- model multiplexing
- multi-LoRA serving
- disaggregated serving
です。
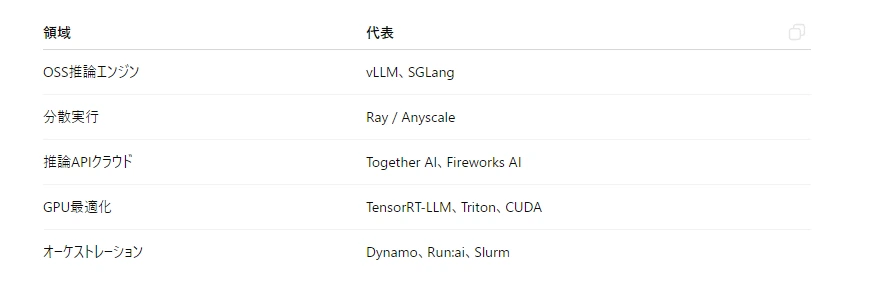
#NVIDIA DynamoのGitHubでは、DynamoはvLLM、SGLang、TensorRT-LLMを置き換えるのではなく、それらの上に乗るデータセンター規模のオーケストレーション層であり、disaggregated serving、intelligent routing、multi-tier KV caching、automatic scalingを扱うと説明されています。(GitHub)
#このレイヤーで伸びるのは、公開株というより未上場/OSSが多いです。
#
NVIDIAがSchedMDを買収したという報道も重要です。SchedMDはSlurmの開発企業で、Slurmは大規模HPC/AIクラスタのジョブスケジューリングに使われています。Reutersは、NVIDIAが2025年12月にSchedMDを買収し、Slurmをオープンソースとして継続提供する計画だと報じています。(Reuters)
#これはNVIDIAがGPUクラウドの「下層スケジューラ」まで押さえに行っていることを示しています。
##
\9. Google / Broadcom / AWSはGPUクラウドを“迂回”する側
#ここも重要です。
#GPUクラウド最適化が進む一方で、Google TPU、AWS Trainium、Broadcom XPUのように、そもそもGPUではないAIクラウドも伸びます。
#Google/Anthropic/BroadcomのTPU提携、AWS TrainiumのProject Rainierは、NVIDIA GPUだけに依存しない巨大AI計算基盤が現実化していることを示しています。(Amazon News)
#この意味で、Broadcomは二重に強いです。
#1つ目は、AIネットワーク。 2つ目は、Google TPUや大手クラウド向けのカスタムAIアクセラレータ。
#つまりBroadcomは、GPUクラウド最適化にも、GPU代替にも関わる企業です。
##
\10. 日本で見るなら:GMO GPU Cloud、さくら、NTT、KDDI、ソフトバンク系
#日本では、GPUクラウド最適化の本命はまだ米国企業中心ですが、国内では以下のような領域に可能性があります。
#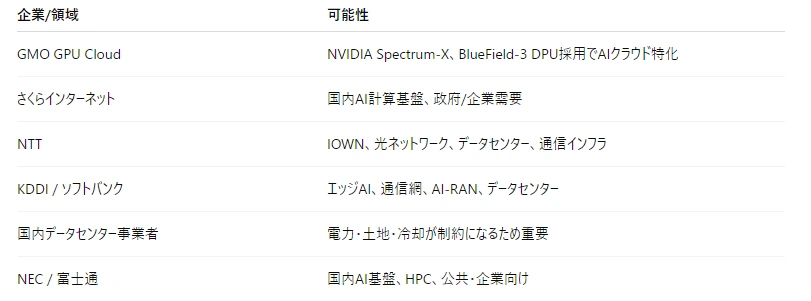
GMO GPU Cloudは、日本国内クラウドとして初めてNVIDIA Spectrum-Xを採用し、BlueField-3 DPUによるクラウドネットワーク加速を説明しています。これは日本企業の中ではGPUクラウド最適化テーマにかなり直接的です。(GMOインターネット株式会社)
##
\11. どの企業が一番伸びる可能性があるか
#私の見立てでは、伸びる可能性は以下の順です。
#本命:NVIDIA
#GPU本体、ネットワーク、DPU、CUDA、Dynamo、Run:ai、Slurmまで押さえに行っているため、GPUクラウド最適化の中心です。
#ただし、すでに時価総額が非常に大きいため、株価上昇余地という意味では「成長の確実性は高いが、期待値も高い」です。
#準本命:Broadcom
#GPUクラウドのネットワーク、カスタムAI ASIC、TPU/XPUの両方で強い。 NVIDIA一強が崩れて用途別ASIC化が進むほど、Broadcomの存在感は増えます。
#成長余地:Arista
#AI Ethernetの本命候補。 GPUクラスタがInfiniBandだけでなくEthernetにも広がるなら、Aristaは非常に重要です。
#ハイリスク高成長:CoreWeave / Nebius系
#GPUクラウド稼働率改善がそのまま利益率に効きます。 ただし、設備投資・電力・借入・GPU償却が重く、景気後退やAI需要鈍化時のリスクも大きいです。
#周辺で強い:Datadog / Cloudflare
#GPUそのものではなく、AIクラウドの監視、コスト制御、AI Gateway、セキュリティで伸びる可能性があります。 AIエージェント時代には、GPU計算だけでなく「誰がどのAIをどれだけ使ったか」を管理する層が重要になります。
#代替勢力:Google / AWS / Broadcom
#TPU、Trainium、カスタムASICによって、GPU依存を減らす方向で伸びます。 この世界線では、NVIDIAだけでなく、Alphabet、Amazon、Broadcomが恩恵を受けます。
##
まとめ
#この視点で見ると、GPUクラウド最適化で伸びる企業は、次の5階層に分かれます。
#階層代表企業伸びる理由GPUクラウドOSNVIDIAGPU、DPU、ネットワーク、Dynamo、Run:ai、Slurmを統合AIネオクラウドCoreWeave、Nebius、Lambda、CrusoeGPU特化運用で稼働率改善が利益に直結AIネットワークBroadcom、Arista、Marvell、CiscoGPU間通信が稼働率を左右する監視/制御/セキュリティDatadog、Cloudflare、Zscaler、OktaGPUコスト、AI利用、API、認証、監査を管理GPU代替アクセラレータGoogle、AWS、Broadcom、GroqTPU、Trainium、LPUでGPU依存を削る
#最も大きな構図はこうです。
#**NVIDIAはGPUクラウドそのものを最適化する。 Broadcom/Arista/MarvellはGPUクラウドの血管を作る。 CoreWeaveはGPUクラウドを実際に運用する。 Datadog/CloudflareはAIクラウドの監視・制御・防衛を担う。 Google/AWS/BroadcomはTPU/Trainium/ASICでGPUクラウドを迂回する。**#
したがって、今後伸びるのは「GPUを持つ会社」だけではありません。 本当に伸びる可能性があるのは、GPUを高稼働にし、複数顧客に安全に貸し、トークン単位で管理し、ネットワークとCPUとセキュリティまで含めて最適化できる企業です。
##
はい。同じAI処理量だけを前提にすれば、GPUクラウドの成熟によって必要GPU数は縮小します。 ただし現実には、推論単価が下がることでAI利用量が爆発するため、世界全体のGPU需要は縮小せず、むしろ増え続ける可能性が高いです。
#つまり答えは二層です。
#同じ仕事量を処理するためのGPU数
→ 減る
AI社会全体で必要になるGPU総数
→ しばらく増える可能性が高い#
\1. GPUクラウド成熟で「同じ処理に必要なGPU数」は減る
#GPUクラウドが成熟すると、GPUを無駄なく詰め込めるようになります。
#たとえば現在は、
#- GPUが通信待ちしている
- KV cacheでHBMが無駄になっている
- prefillとdecodeが干渉している
- 小さい推論リクエストをうまくバッチ化できない
- モデルごとにGPUを固定してしまい空き時間が出る
- マルチテナント化が未成熟で安全に共有できない
という非効率があります。
#これが改善すると、同じモデル、同じユーザー数、同じトークン量を処理するために必要なGPU枚数は減ります。
#vLLMのPagedAttentionは、LLM推論で問題になるKV cacheをOSのページングのように管理し、KV cacheの無駄をほぼゼロに近づけ、同じレイテンシ条件で既存システムより2〜4倍のスループット改善を示しています。つまり、同じ推論量なら必要GPU数を大きく減らせる方向です。(arXiv)
#またDistServeは、prefillとdecodeを分離することでLLM推論の干渉を減らす方式で、既存方式より多くのリクエストを処理できることを示しています。(arXiv)
#この意味では、GPUクラウド成熟は、
#GPUを追加で買うのと同じくらい、既存GPUから有効計算を引き出す効果を持つ#
と言えます。
##
\2. しかし「GPU総需要」は簡単には減らない
#問題は、効率化すると需要も増えることです。
#AI推論が安くなると、今まで高すぎて使えなかった用途が一気に増えます。
#GPUクラウド最適化
↓
1トークンあたりコスト低下
↓
AIエージェントが安くなる
↓
利用回数が増える
↓
音声AI、動画AI、業務AI、ロボットAIが増える
↓
総GPU需要はむしろ増えるこれは経済学でいうジェボンズのパラドックスに近い現象です。効率化によって1回あたりの資源消費は減っても、利用が増えすぎると総消費量はむしろ増える、という考え方です。(Wikipedia)
#AIではこれがかなり起きやすいです。 なぜなら、AIの潜在需要がまだほとんど掘り起こされていないからです。
##
\3. 2030年代に起きそうなこと
#2030年代には、GPUクラウドの成熟によって、GPU 1枚あたりの有効処理量は大幅に増えると思います。
#しかし同時に、
#- AIエージェント
- コーディングAI
- 企業内AIワーカー
- リアルタイム音声AI
- 動画生成AI
- ロボティクス/VLA
- デジタルツイン
- 科学AI
- 個人専用AI
- 常時稼働AI秘書
が増えるため、総需要も増えます。
#そのため、私の見方ではこうです。
#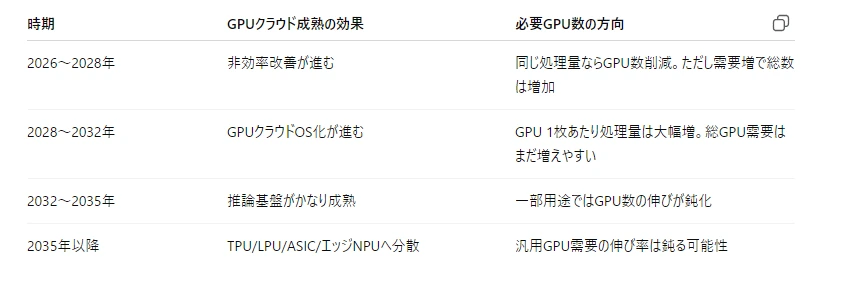
つまり、GPUクラウドが成熟すると、GPU需要の伸び率は将来的に鈍化する可能性があります。 しかし、2030年代前半までは、AI利用量の拡大が効率化を上回る可能性が高いです。
##
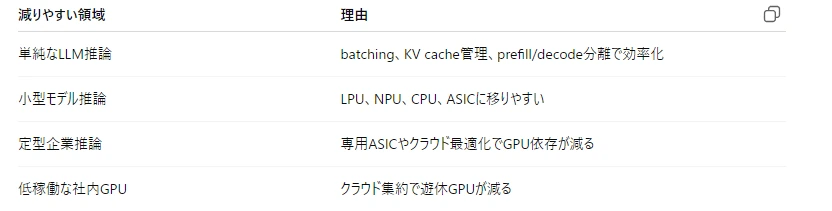
\4. GPUが減る領域と、増える領域
#GPUクラウド成熟で、GPU数が減りやすい領域はあります。
#
一方で、GPUが増えやすい領域もあります。
#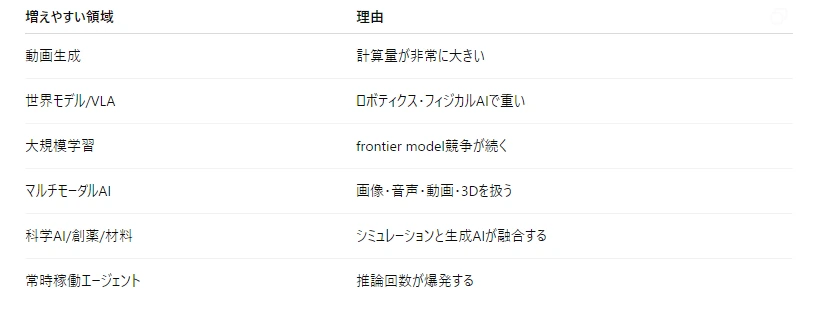
なので、GPUクラウド成熟は、低付加価値なGPU需要を圧縮し、高付加価値なGPU需要へ移すと考えた方がよいです。
##
\5. NVIDIA自身も「少ないGPUで多く処理する」方向に進んでいる
#NVIDIAも、単にGPU枚数を増やすだけではなく、ラック全体、ネットワーク、DPU、CPU、メモリ階層、推論ソフトを統合して、1ラックあたりの推論能力を上げる方向に進んでいます。
#たとえば報道では、NVIDIAのVera Rubin NVL72はBlackwell比で推論性能を大きく高め、トークンあたりコストを下げ、必要GPUを減らす方向の設計だとされています。(Tom's Hardware)
#これはつまり、NVIDIA自身も、
#GPUをもっと売る だけでなく GPU 1枚・1ラックあたりの有効処理量を上げる#
方向に進んでいるということです。
#ただし、1GPUあたり性能が上がっても、AI利用量がそれ以上に増えれば、GPU総需要は増えます。
##
\6. 最終的な見方
#GPUクラウドが成熟すると、必要GPU数はこう変化すると考えます。
#短期:
非効率が大きいため、同じ処理量に必要なGPU数はかなり減らせる。
しかしAI需要が急増するため、総GPU需要は増える。
中期:
GPUクラウドOS化でGPU利用率が改善。
推論単価が下がり、AIエージェントが普及。
総GPU需要はまだ増えやすい。
長期:
TPU、LPU、ASIC、NPU、エッジAIが普及。
単純推論向けGPU需要の伸びは鈍化。
GPUは動画生成、学習、VLA、科学AIなど高負荷領域に集中。#
結論
#GPUクラウドが成熟すると、同じAI処理をこなすために必要なGPU数は減ります。 vLLMやDistServeのような技術により、同じGPU枚数で数倍の推論を処理できる可能性があります。(arXiv)
#しかし、AI推論が安くなることで利用量が爆発するため、2030年代前半までは世界全体のGPU需要は縮小しにくいと思います。
#一言で言うと、
#**GPUクラウド成熟は「GPU需要を消す」のではなく、 GPUを低効率な使い方から高付加価値な使い方へ移す。**#
そして最終的には、 単純な推論はLPU/TPU/ASIC/NPUへ分散し、GPUは学習・動画生成・VLA・マルチモーダル・科学AIのような重い領域に集中する という流れになると考えます。
##
CPUで成熟したものと、GPU時代でこれから必要になるもの
#\1. 仮想マシン → GPU仮想化、MIG、vGPU
#CPUクラウドでは、物理サーバーをVMに分割します。
#物理CPUサーバー
├─ VM A
├─ VM B
└─ VM Cこのとき、各VMは「自分専用のCPU・メモリ・ディスクを持っている」ように見えます。実際にはハイパーバイザが裏側で資源を分けています。
#GPU時代に同じことをやるのが、GPU仮想化です。
#代表的な方式は3つあります。
#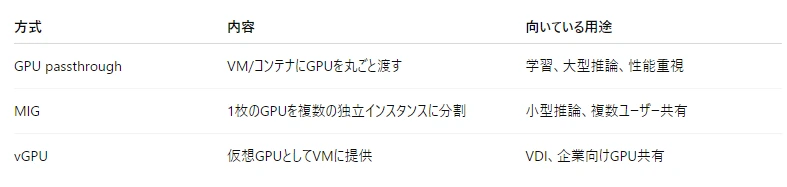
NVIDIA MIGは、対応GPUを複数の独立GPUインスタンスに分け、それぞれに専用の計算資源とメモリ資源を与える仕組みです。NVIDIAのMIG User Guideでも、MIGは複数の隔離インスタンスにGPUを分割し、各インスタンスに専用compute/memory resourceを持たせると説明されています。(NVIDIA Docs)
#イメージはこうです。
#A100 / H100 / B200 など
├─ GPU Instance 1:小型LLM推論
├─ GPU Instance 2:embedding
├─ GPU Instance 3:画像分類
└─ GPU Instance 4:別ユーザーの推論CPU VMと違うのは、GPUではHBM容量、SM数、L2 cache、メモリ帯域、CUDA contextが性能と安全性に直結することです。
#CPUなら、少し遅くなってもOSがプロセスを切り替えられます。 しかしGPUでは、1つのジョブがHBMを食い潰したり、CUDA kernelが長時間走ったり、メモリアクセスが暴れたりすると、他のジョブに大きく影響します。
#そのためGPU仮想化では、単なる「見かけ上の分割」ではなく、
#- HBMの分割
- SMの分割
- cacheの分離
- DMAの制限
- CUDA contextの隔離
- エラー伝播の遮断
- 性能保証/QoS
が必要になります。
##
\2. OSスケジューラ → GPUジョブスケジューラ
#CPUクラウドでは、OSスケジューラがプロセスやスレッドをCPUコアに割り当てます。
#CPUは、細かく割り込み、プリエンプション、コンテキストスイッチを行うのが得意です。
#CPU core
├─ 1ms:プロセスA
├─ 1ms:プロセスB
├─ 1ms:プロセスC
└─ ...一方、GPUではこれが難しいです。
#GPUは基本的に、
#大きな行列演算
巨大なCUDA kernel
長いbatch処理
多量のHBMアクセスをまとめて流す設計です。CPUのように細かく「今すぐ止めて、別の小さい処理を挟む」が得意ではありません。
#GPUジョブスケジューラが考える必要があるのは、単なる「GPUが空いているか」ではありません。
#LLM推論では、以下を見ます。
#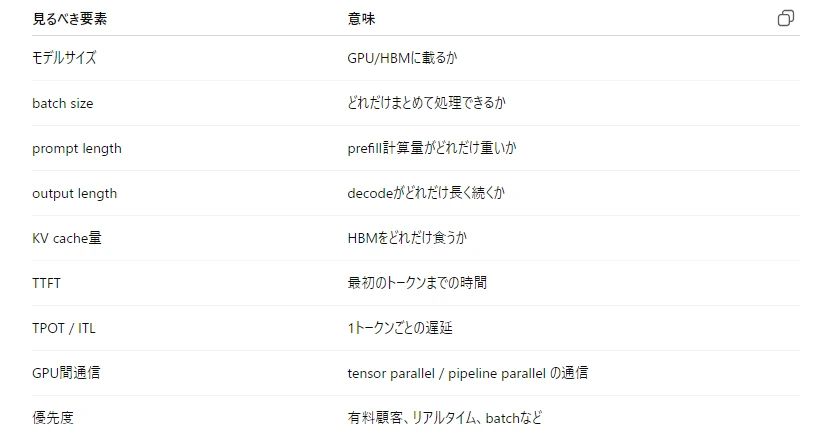
特にLLMでは、prefill と decode が性格の違う処理です。
#prefill:
入力プロンプト全体を一気に読む
計算量が大きい
GPU演算を使いやすい
decode:
1トークンずつ出す
逐次性が強い
HBM帯域やKV cacheが効くDistServeはこの問題に対して、prefillとdecodeを分離して別々に最適化する方式を提案しています。既存LLM servingでは両者を同じGPU群で処理するため干渉が起きるが、DistServeは両フェーズを分離してgoodputを改善するという設計です。(USENIX)
#つまりGPUジョブスケジューラは、CPU時代の「プロセスをCPUに置く」よりも複雑です。
#GPU時代のスケジューラは、
#どのモデルを
どのGPUに常駐させ
どのリクエストを
どのタイミングでbatchに混ぜ
prefillとdecodeをどこで処理し
KV cacheをどこに置き
レイテンシSLOを守るかを決める必要があります。
##
\3. コンテナ/Kubernetes → GPU-aware Kubernetes
#CPUクラウドでは、Kubernetesがコンテナをノードに配置します。
#通常は、
#cpu: 2
memory: 4Giのような要求を見て、Podをどのノードに置くか決めます。
#しかしGPU時代には、単に、
#nvidia.com/gpu: 1だけでは粗すぎます。
#なぜならGPUには種類があります。
#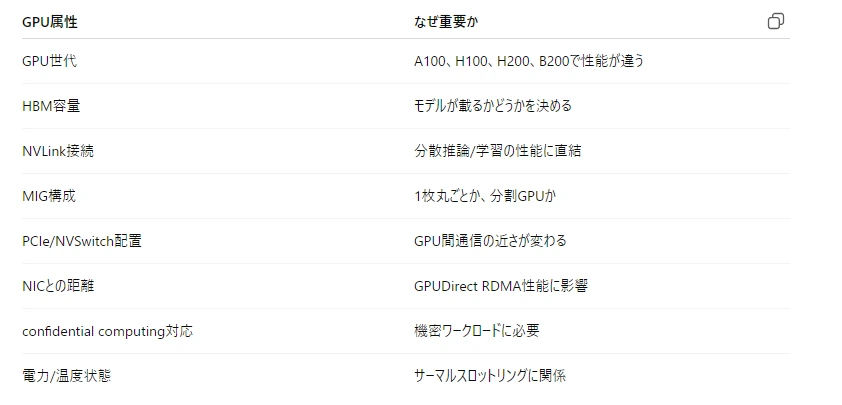
そのため、KubernetesもGPU-awareになる必要があります。
#この流れで重要なのが DRA / Dynamic Resource Allocation です。Kubernetes DRAは、GPUやFPGAのような特殊ハードウェアをPodが柔軟に要求・共有できる仕組みで、デバイスドライバや管理者がDeviceClassを定義し、Kubernetesが条件に合うデバイスを割り当てます。Kubernetes公式でも、DRAは特殊ハードウェアの信頼性や高価なリソースの利用率改善を目的とする柔軟なフレームワークとして説明されています。(Kubernetes)
#従来のKubernetesは、
#GPUが1枚あるか?を見るだけでした。
#GPU-aware Kubernetesでは、
#H100か?
HBMは80GBか?
MIG 2g.20gbが必要か?
同じNVLink island内に4枚必要か?
低遅延推論用か?
batch学習用か?
confidential computingが必要か?まで見る方向になります。
#これは、CPUクラウドでKubernetesが成熟したのと同じように、GPUクラウドでもアクセラレータを一級リソースとして扱う段階に進んでいるということです。
##
\4. マルチテナント分離 → GPUメモリ、cache、DMA、ドライバ隔離
#CPUクラウドで最も重要だったのは、マルチテナント分離です。
#同じ物理サーバー上に
A社のVM
B社のVM
C社のVM
が同居しても、互いに中身を見られないこれを実現するために、CPUクラウドでは、
#- 仮想メモリ
- ページテーブル
- ハイパーバイザ
- IOMMU
- VM isolation
- network namespace
- storage encryption
- IAM
- audit log
が成熟しました。
#GPU時代は、これが難しくなります。
#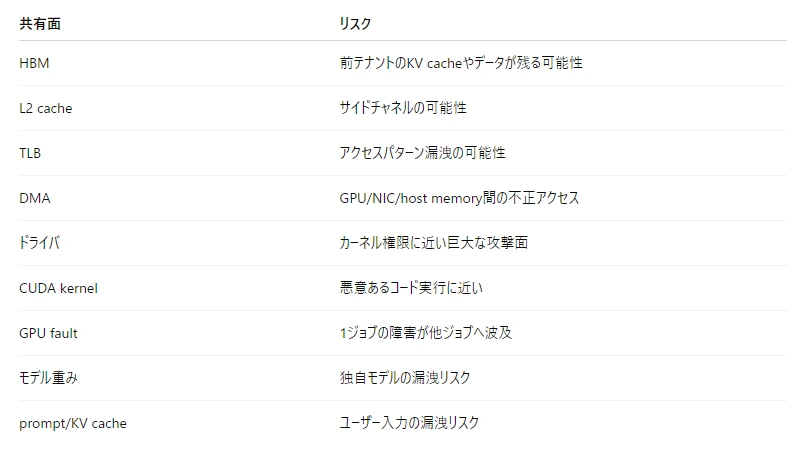
NVIDIA GPU Operatorのtime-slicing説明でも、time-slicingはMIGが提供するメモリ隔離やfault isolationを犠牲にして、より多くのユーザーでGPUを共有する方式だと説明されています。(NVIDIA Docs)
#つまり、
#MIG:
隔離は強い
ただし分割が硬い
time-slicing:
柔軟に共有できる
ただしメモリ・障害隔離は弱いというトレードオフがあります。
#さらに研究面でも、GPU共有のセキュリティ問題は現実化しています。NDSS 2026の研究では、仮想化GPU環境でTLBを悪用したクロスVMサイドチャネル攻撃が示されています。(NDSS Symposium)
#したがって、GPU時代のマルチテナント分離では、
#- MIGによるハードウェア分割
- vGPUのメモリ保護
- IOMMU/DMA制限
- GPUメモリ初期化
- confidential computing
- ドライバ隔離
- sandboxed CUDA
- tenant別telemetry
- cache/TLB side-channel対策
が必要になります。
#CPUクラウドでSpectre/Meltdownが大問題になったように、GPUクラウドでもGPU版サイドチャネル問題が重要になります。
##
\5. CPU oversubscription → GPUの時間分割・空間分割
#CPUクラウドでは、oversubscriptionが普通に使われます。
#たとえば物理CPUが64コアしかなくても、クラウド事業者は合計128 vCPU、256 vCPU相当を顧客に割り当てることがあります。
#なぜ可能かというと、全顧客が同時に100% CPUを使うわけではないからです。
#物理64コア
↓
仮想128 vCPUとして販売
↓
実利用率を見ながら詰め込むGPUでも同じことをやりたいわけです。
#GPU共有には大きく2方式あります。
#空間分割
#MIGのように、GPUを物理的・論理的に区切ります。
#1枚のGPU
├─ 20GB HBM + 一部SM
├─ 20GB HBM + 一部SM
└─ 40GB HBM + 一部SM長所は、性能予測と隔離が比較的強いことです。 短所は、分割サイズが固定的で、ワークロード変動に弱いことです。
#時間分割
#time-slicingのように、複数プロセスやPodが同じGPUを時間で共有します。
#GPU
├─ 時刻0〜10ms:Pod A
├─ 時刻10〜20ms:Pod B
├─ 時刻20〜30ms:Pod C長所は、多数の小さい推論や軽量ジョブを詰め込めることです。 短所は、メモリ分離やfault isolationが弱くなりやすいことです。NVIDIA GPU Operatorの説明でも、time-slicingはより多くのユーザーで共有できる一方、MIGの持つメモリ隔離・障害隔離を犠牲にすると説明されています。(NVIDIA Docs)
#LLM推論では、さらに高度なoversubscriptionが必要です。
#たとえば、
#同じモデルを複数顧客で共有
同じsystem promptのprefix cacheを共有
decode中のリクエストをcontinuous batchingで混ぜる
空いたHBMにKV cacheを詰める
低優先度batchを余剰時間に流すという形です。
#これはCPU oversubscriptionより難しいです。 理由は、GPUではHBMが詰まった瞬間に性能が落ち、KV cacheがユーザーごとに動的に増減し、低遅延SLOを守る必要があるからです。
##
\6. オートスケーリング → 推論トークン単位のスケーリング
#CPUクラウドのオートスケーリングは、通常こうです。
#CPU使用率が70%を超えた
↓
Webサーバーを2台増やすこれは比較的単純です。
#GPU時代、特にLLM推論では、スケール単位が「サーバー台数」だけではありません。
#LLM推論で本当に増減するのは、
#- 入力トークン数
- 出力トークン数
- 同時会話数
- KV cache量
- prefill量
- decode量
- モデル常駐数
- LoRA adapter数
- priority/SLO
です。
#たとえば同じ1リクエストでも、
#短い質問:
入力50 tokens
出力100 tokens
長文分析:
入力100,000 tokens
出力4,000 tokensでは負荷がまったく違います。
#そのためGPU時代のオートスケーリングは、
#リクエスト数ベースではなく、
#token throughput
KV cache GB
TTFT
TPOT
queue depth
prefill/decode比率を見てスケールする必要があります。
#vLLMのPagedAttentionは、このトークン単位スケーリングの基盤になります。KV cacheはリクエストごとに巨大で動的に増減し、従来方式では断片化や重複でメモリが無駄になり、batch sizeが制限されます。PagedAttentionはOSの仮想メモリ/ページングに着想を得て、KV cacheの無駄を減らし、vLLMでは同程度のレイテンシで2〜4倍のスループット改善を報告しています。(arXiv)
#つまり、GPUクラウドのオートスケーリングは、
#GPU台数を増やすだけではなく、
#KV cacheを整理する
batchを組み直す
prefill専用GPUを増やす
decode専用GPUを増やす
低優先度ジョブを遅らせる
小型モデルへfallbackする
LPU/TPU/GPUを切り替えるまで含みます。
##
\7. ロードバランサ → LLMリクエスト / トークン / KV cacheルーティング
#CPUクラウドのロードバランサは、Webリクエストを複数サーバーに振り分けます。
#HTTP Request
↓
Load Balancer
├─ Web Server A
├─ Web Server B
└─ Web Server C基準は、
#- 接続数
- CPU使用率
- レイテンシ
- ヘルスチェック
- リージョン
- sticky session
などです。
#LLM時代のロードバランサは、はるかに複雑です。
#LLMでは、単に「空いているGPUに投げる」と非効率になります。
#なぜなら、GPU上にはすでに、
#- モデル重み
- KV cache
- prefix cache
- LoRA adapter
- tokenizer状態
- speculative decoding用draft model
- safety model
などが載っているからです。
#LLMロードバランサは、以下を見てルーティングする必要があります。
#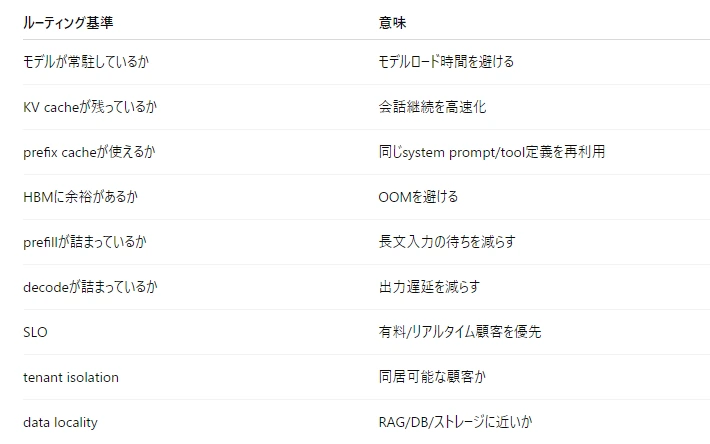
SGLangは、agent control、RAG、JSON decoding、multi-turn chatのような複雑なLLMアプリケーションで、構造を利用して推論を効率化するフレームワークです。論文では、RadixAttentionなどにより複雑な言語モデルプログラムで最大6.4倍のスループット改善が報告されています。(arXiv)
#この意味で、LLMロードバランサは従来のL7ロードバランサではなく、
#AIリクエストルーター
+
KV cacheルーター
+
モデル常駐ルーター
+
SLO制御器になります。
#将来的には、ロードバランサが、
#このリクエストはGPUではなくLPUへ
この長文prefillはGPUクラスタAへ
decodeは別GPUプールへ
社内機密データなのでconfidential GPUへ
低価格プランなのでbatch queueへのように判断することになります。
##
\8. 課金 → GPU秒、token秒、KV cache秒、推論SLO課金
#CPUクラウドの課金は、最初は比較的単純でした。
#VMを何時間使ったか
CPUを何vCPU使ったか
メモリを何GB使ったか
ストレージを何GB使ったか
通信量がどれだけかGPUクラウドでも、初期は「GPU時間課金」です。
#H100を1時間使ったので何ドルしかしLLM時代には、GPU時間だけでは正確な課金になりません。
#同じGPU 1時間でも、
#短文チャットを大量に処理
長文コンテキストを少数処理
動画生成を処理
embeddingを処理
batch推論を処理
低遅延SLO付き推論を処理では原価が違います。
#そのため今後は、課金単位が細かくなります。
#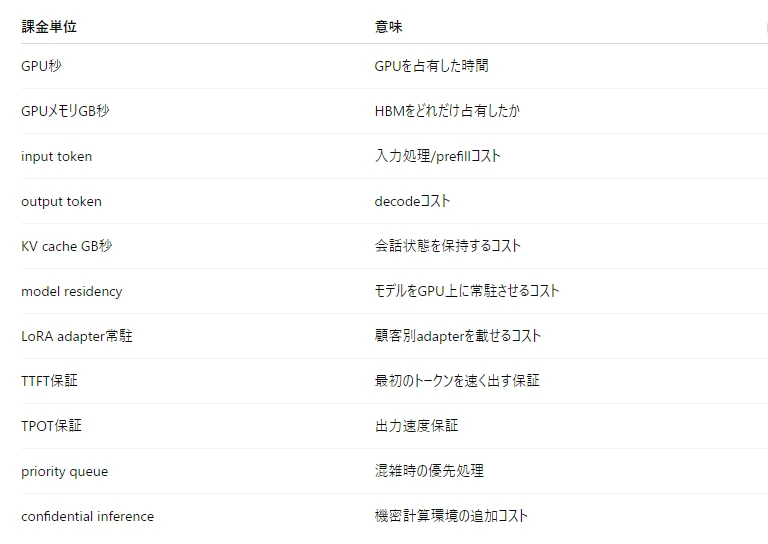
特に重要なのは、KV cache課金です。
#AIエージェントは長時間動き、会話履歴や作業状態を持ちます。 その状態をGPU/HBM上に保持するなら、それは「計算」ではなく「高価な短期記憶」を占有していることになります。
#つまり未来のAIクラウド課金は、
#計算した量
+
記憶していた量
+
速さを保証した量
+
安全性を保証した量になります。
#CPUクラウドでは「CPU時間 + メモリ + ストレージ + 通信量」でした。 GPUクラウドでは「GPU時間 + HBM + token + KV cache + SLO」になります。
##
\9. セキュリティ → サイドチャネル、モデル/データ漏洩対策
#CPUクラウドのセキュリティでは、
#- VM隔離
- IAM
- VPC
- firewall
- TLS
- disk encryption
- audit log
- vulnerability scanning
- confidential computing
が成熟してきました。
#GPU時代には、新しい攻撃面が増えます。
#重要なリスク
#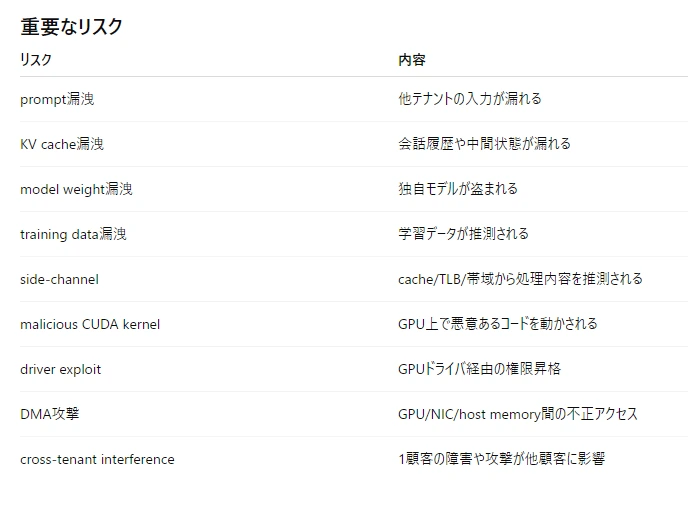
NVIDIA H100では、GPU confidential computingが導入され、仮想化環境やKubernetes環境で使えるGPU TEEの方向が示されています。NVIDIAはH100を、confidential computingをサポートする初のGPUとして説明しています。(NVIDIA Developer)
#ただし、これは「すべて解決」という意味ではありません。
#GPU仮想化環境のサイドチャネル攻撃は研究され続けています。NDSS 2026の論文では、仮想化GPUのTLBを使ったクロスVMサイドチャネル攻撃が示されており、GPUマルチテナントのセキュリティがCPUクラウド並みに成熟するにはまだ課題があることが分かります。(NDSS Symposium)
#GPUクラウドのセキュリティは、以下の多層構造になります。
#アプリ層:
prompt filtering
output filtering
tenant policy
モデル層:
model weight encryption
LoRA隔離
safety model
ランタイム層:
sandboxed CUDA
container isolation
request isolation
GPU層:
MIG
vGPU
HBM zeroing
cache/TLB対策
confidential computing
I/O層:
IOMMU
DMA制御
GPUDirect RDMA制御
DPU/SmartNIC firewall
クラウド層:
IAM
audit log
billing log
anomaly detectionCPUクラウドのセキュリティが「VMの中身を守る」だったとすれば、GPUクラウドのセキュリティは、モデル、プロンプト、KV cache、GPUメモリ、GPU kernel、GPUドライバ、ネットワークDMAまで守る必要があります。
##
\10. 全体像:CPUクラウドとGPUクラウドの違い
#まとめると、CPUクラウドとGPUクラウドは似ていますが、難易度が違います。
#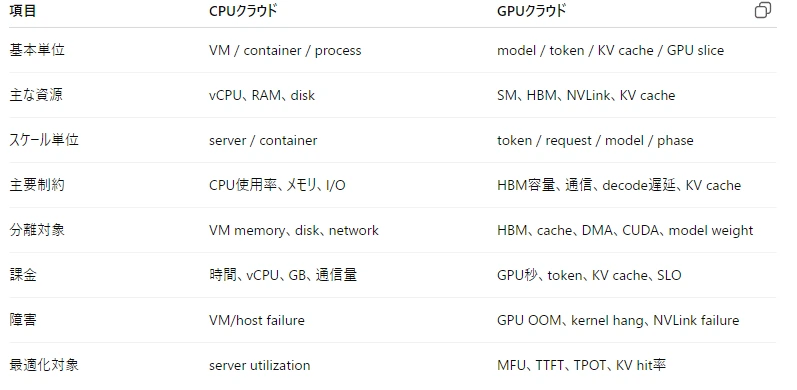
GPUクラウドの本質は、単にGPUを貸すことではありません。
#本質は、
#GPUを、LLM/AIエージェント用のクラウド資源として、細かく、安全に、高稼働で、トークン単位に制御すること#
です。
##
\11. 最終的に必要になる「GPUクラウドOS」
#この表の各行を統合すると、最終的に必要になるのは、GPU版クラウドOSです。
#それは以下を全部持ちます。
#GPU仮想化:
MIG / vGPU / passthrough / time-slicing
GPU-aware scheduling:
GPU種別、HBM、NVLink、NIC距離、SLOを見て配置
LLM serving runtime:
vLLM / SGLang / TensorRT-LLM / Dynamo
KV cache manager:
PagedAttention、prefix cache、multi-tier KV cache
token-level autoscaler:
request数ではなくtokenとKV cacheでスケール
AI load balancer:
model / cache / SLO / tenant / data localityでルーティング
security layer:
confidential GPU、MIG隔離、DMA制御、side-channel対策
billing layer:
GPU秒、token、KV cache、SLO、priorityで課金
observability:
GPU利用率、HBM、TTFT、TPOT、MFU、tenant原価を監視CPUクラウドが25年かけて成熟させたものを、GPUクラウドはAI需要の爆発によって、もっと短い期間で再発明することになります。
##
まとめ
#この表の意味は、かなり深いです。
#CPUクラウドでは、物理CPUをVMやコンテナに分け、複数顧客に安全に貸し、負荷に応じてスケールし、使った分だけ課金する仕組みが成熟しました。
#GPU時代には、それをそのままGPUに移すだけでは足りません。
#なぜならGPU時代の基本単位は、VMではなく、
#モデル
トークン
KV cache
GPUメモリ
prefill
decode
推論SLOになるからです。
#したがって、GPUクラウドでは、
#仮想GPU、GPU-aware Kubernetes、LLMジョブスケジューラ、KV cacheルーティング、token単位課金、GPU confidential computing、サイドチャネル対策#
が必要になります。
#最終的には、GPUクラウドの競争は「GPUを何枚持っているか」ではなく、
#GPUをどれだけCPUクラウドのように細かく、安全に、効率よく、課金可能な資源に変換できるか#
の競争になります。
##
現状のGPUクラウド
#現状のGPUクラウドは、かなり率直に言うと、「GPUをクラウドで貸す段階」は実用化済みだが、「CPUクラウドのように高稼働・安全・細粒度・自動最適化された段階」にはまだ達していないです。
#私の評価では、2026年時点のGPUクラウドは 5段階中で2.5〜3くらい です。
#Lv1:GPUサーバーを貸せる
Lv2:KubernetesやMIGである程度運用できる
Lv3:LLM推論をvLLM/SGLang/TensorRT-LLMなどで最適化し始めた
Lv4:トークン/KV cache/SLO単位で自動スケール・課金・ルーティングできる
Lv5:CPUクラウド並みに安全・高稼働・標準化・マルチテナント化されている今は Lv2.5〜Lv3。 つまり、部品は揃い始めたが、全体としてはまだ未成熟です。
##
\1. できていること
#現在のGPUクラウドでは、すでに以下は実用段階です。
#- NVIDIA H100/H200/B200/GB200系GPUをクラウドで借りる
- GPU付きKubernetesクラスタを動かす
- MIGでGPUを分割する
- vGPUやtime-slicingで共有する
- vLLM、TensorRT-LLM、SGLangなどでLLM推論を高速化する
- GPU監視、ログ、メトリクスを取る
- CoreWeaveなどのネオクラウドがAI特化GPUクラウドを大規模運用する
NVIDIAのMIGは、対応GPUを複数の独立インスタンスに分割し、それぞれに専用のcompute/memory resourceを持たせる技術です。つまり、GPUを「1枚丸ごと貸す」だけでなく、「小さなGPUインスタンス」として切り出すことはすでに可能です。(NVIDIA Docs)
#また、vLLMのPagedAttentionはKV cacheをOSの仮想メモリのように管理し、同じレイテンシ条件でLLM推論スループットを2〜4倍改善したと報告されています。これはGPUクラウドが「LLM向けクラウドOS」に近づく重要な技術です。(arXiv)
##
\2. まだ弱いところ
#一方で、現状のGPUクラウドはかなり無駄が多いです。
#Cast AIの2026年レポートでは、AWS、Azure、Google Cloud上のKubernetesクラスタ分析で、GPU利用率平均はわずか5% とされています。CPU利用率も8%、メモリ利用率も20%で、クラウド全体に過剰プロビジョニングがあるとされています。(Cast AI)
#xAIの例でも、報道ではGPUフリートのMFU、つまりModel FLOPs Utilizationが約11%で、業界比較として35〜45%程度が示されています。これは「GPUが完全停止している」という意味ではなく、理論性能に対してモデル計算として有効に使えている割合が低いという意味です。(Business Insider)
#つまり現状は、
#GPUを持っている
↓
GPUをクラウドで貸せる
↓
でも、高稼働で使い切るのは難しいという段階です。
##
\3. CPUクラウドと比べると、どれくらい未成熟か
#CPUクラウドは、すでにかなり成熟しています。
#CPUクラウドでは、
#- VM
- コンテナ
- Kubernetes
- IAM
- ロードバランサ
- オートスケール
- 監視
- 課金
- セキュリティ
- マルチテナント分離
が標準化されています。
#一方、GPUクラウドでは、これらのGPU版がまだ作られている途中です。
#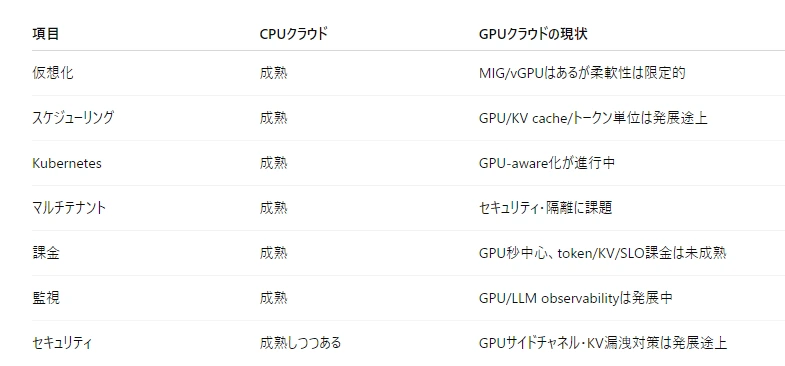
Kubernetes側では、GPUやFPGAのような特殊デバイスを柔軟に扱うDRA、Dynamic Resource AllocationがKubernetes 1.34で大きく進展し、中核APIがGAになっています。これはGPUクラウド成熟に向けた重要な基盤ですが、まだ「CPUクラウド並みに当たり前」とまでは言えません。(Kubernetes)
##
\4. 一番進んでいるのは「LLM推論最適化」
#GPUクラウドの中で、特に進んでいるのは LLM推論の効率化 です。
#ここではすでに、
#- continuous batching
- PagedAttention
- prefix cache
- KV cache管理
- prefill/decode分離
- speculative decoding
- disaggregated serving
- intelligent routing
が急速に発展しています。
#NVIDIA Dynamoは、vLLM、SGLang、TensorRT-LLMなどを置き換えるのではなく、それらをデータセンター規模の分散推論システムとして協調させるオーケストレーション層です。GitHub上でも、disaggregated serving、intelligent routing、multi-tier KV caching、automatic scalingを扱うと説明されています。(GitHub)
#つまり、LLM推論クラウドの成熟度は比較的高く、Lv3に近いです。
#ただし、これはLLM推論に限った話です。 画像生成、動画生成、VLA、学習、マルチテナント安全共有まで含めると、まだ成熟度は下がります。
##
\5. 学習クラスタは「トップ企業だけ高レベル」
#大規模学習では、トップAIラボや大手クラウド企業はかなり高い水準にあります。
#MegaScaleの論文では、12,288 GPUで175B LLMを学習し、55.2% MFUを達成したと報告されています。これは非常に高い水準で、トップ層ではGPUクラスタをかなり使いこなしていることを示します。(arXiv)
#ただし、これは「誰でもできる」わけではありません。 このレベルには、
#- 分散学習ノウハウ
- ネットワーク最適化
- 障害復旧
- データパイプライン
- オペレータ最適化
- 通信と計算のオーバーラップ
- 深いobservability
が必要です。
#なので現状は、
#トップAIラボ:Lv4に近い部分もある
一般企業GPUクラウド:Lv2前後
ネオクラウド/大手クラウド:Lv3前後という差があります。
##
\6. マルチテナントGPUはまだ難しい
#GPUクラウドがCPUクラウド並みに成熟するうえで、最大の難所は 安全なマルチテナント共有 です。
#NVIDIA GPU Operatorのtime-slicingでは、多くのユーザーでGPUを共有できますが、その代わりMIGが提供するメモリ隔離やfault isolationを犠牲にすると説明されています。(NVIDIA Docs)
#つまり、
#MIG:
隔離は強い
でも柔軟性は低い
time-slicing:
共有はしやすい
でも隔離は弱いというトレードオフがあります。
#さらにH100ではGPU confidential computingも導入され、VMやKubernetes環境で利用可能とされていますが、GPUマルチテナントの安全性はまだ発展途上です。(NVIDIA Developer)
#このため、金融、医療、政府、企業機密データを扱う用途では、完全共有よりも専用GPU、専用クラスタ、confidential GPU、オンプレ/プライベートクラウドが好まれる場面がまだ多いと思います。
##
\7. 現状を一言で言うと
#GPUクラウドの現状は、**「初期EC2からKubernetes普及期へ向かう途中」**に近いです。
#CPUクラウドで例えるなら、
#物理サーバーを借りる時代
↓
VMで借りる時代
↓
Kubernetesで自動運用する時代
↓
サーバーレス/マネージドサービス化する時代という流れがありました。
#GPUクラウドは今、
#GPUサーバーを借りる時代
↓
MIG/vGPU/Kubernetesで分割・運用し始めた時代
↓
LLM推論エンジンで高効率化し始めた時代あたりです。
#まだ、
#GPUを完全に安全に共有する
token/KV cache/SLO単位で課金する
自動的にGPU/TPU/LPUへルーティングする
障害時にKV cacheごと復旧する
顧客ごとの原価を正確に出すという段階には十分達していません。
##
\8. 私の成熟度評価
#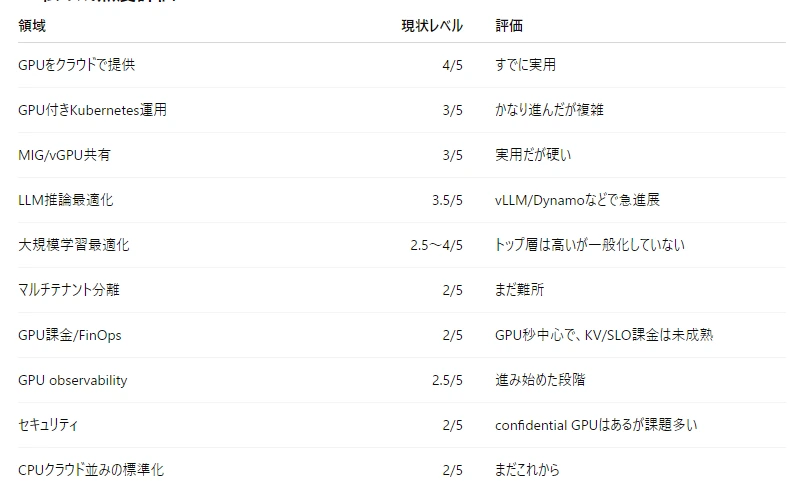
総合すると、GPUクラウドはLv2.5〜3。 ただし、トップ企業の一部領域だけを見るとLv4に近いです。
##
\9. 今後の到達イメージ
#私の見立てでは、GPUクラウドはこう進むと思います。
#2026年現在:
GPUクラウドは実用化済み。
ただし利用率は低く、運用は職人芸に近い。
2027〜2028年:
vLLM/SGLang/Dynamo/DRA/MIG運用が一般化。
推論クラウドはかなり改善。
2029〜2031年:
token、KV cache、SLO単位のスケジューリングと課金が広がる。
GPUクラウドOS化が進む。
2030年代前半:
CPUクラウドに近いマルチテナント・自動化・監視・課金体系へ近づく。#
まとめ
#GPUクラウドの現状レベルは、「GPUをクラウドで使える」段階は十分実用化済みだが、「CPUクラウド並みに高効率・安全・自動・細粒度に使える」段階にはまだ届いていないです。
#評価するなら、
#現在のGPUクラウド:Lv2.5〜3 / 5 トップAIラボの学習基盤:一部Lv4 一般企業のGPU利用:Lv1.5〜2.5 2030年代前半の目標:Lv4〜5#
です。
#一番近い表現は、これです。
#**今のGPUクラウドは、CPUクラウドでいう初期EC2〜Kubernetes普及期の中間。 すでに使えるが、まだ高価で、無駄が多く、運用は難しく、セキュリティと課金は未成熟。 これから“AIクラウドOS”として本格的に成熟していく段階です。**#
特定銘柄の推奨・勧誘を目的とするものではありません。投資判断はご自身の責任でお願いいたします。
#サムネはPixAIsunflowerモデルとGPTImage2.0
#