Personal Cloud Computer――AI Agentが「第二のPC」を持つ時代
出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.09.23.4
- 記事内容のSHA-256
30c17a6713964d417d8b4a226c19d9475cdde8d1a555b3847efea06fa133dc90- 保存版のSHA-256
0a1cbdb83dcf8867d7b6bca72f39eb8f0a077339bd0a926089c045758cd40846
外部証明の最終検査結果は詳細を開くと表示します。
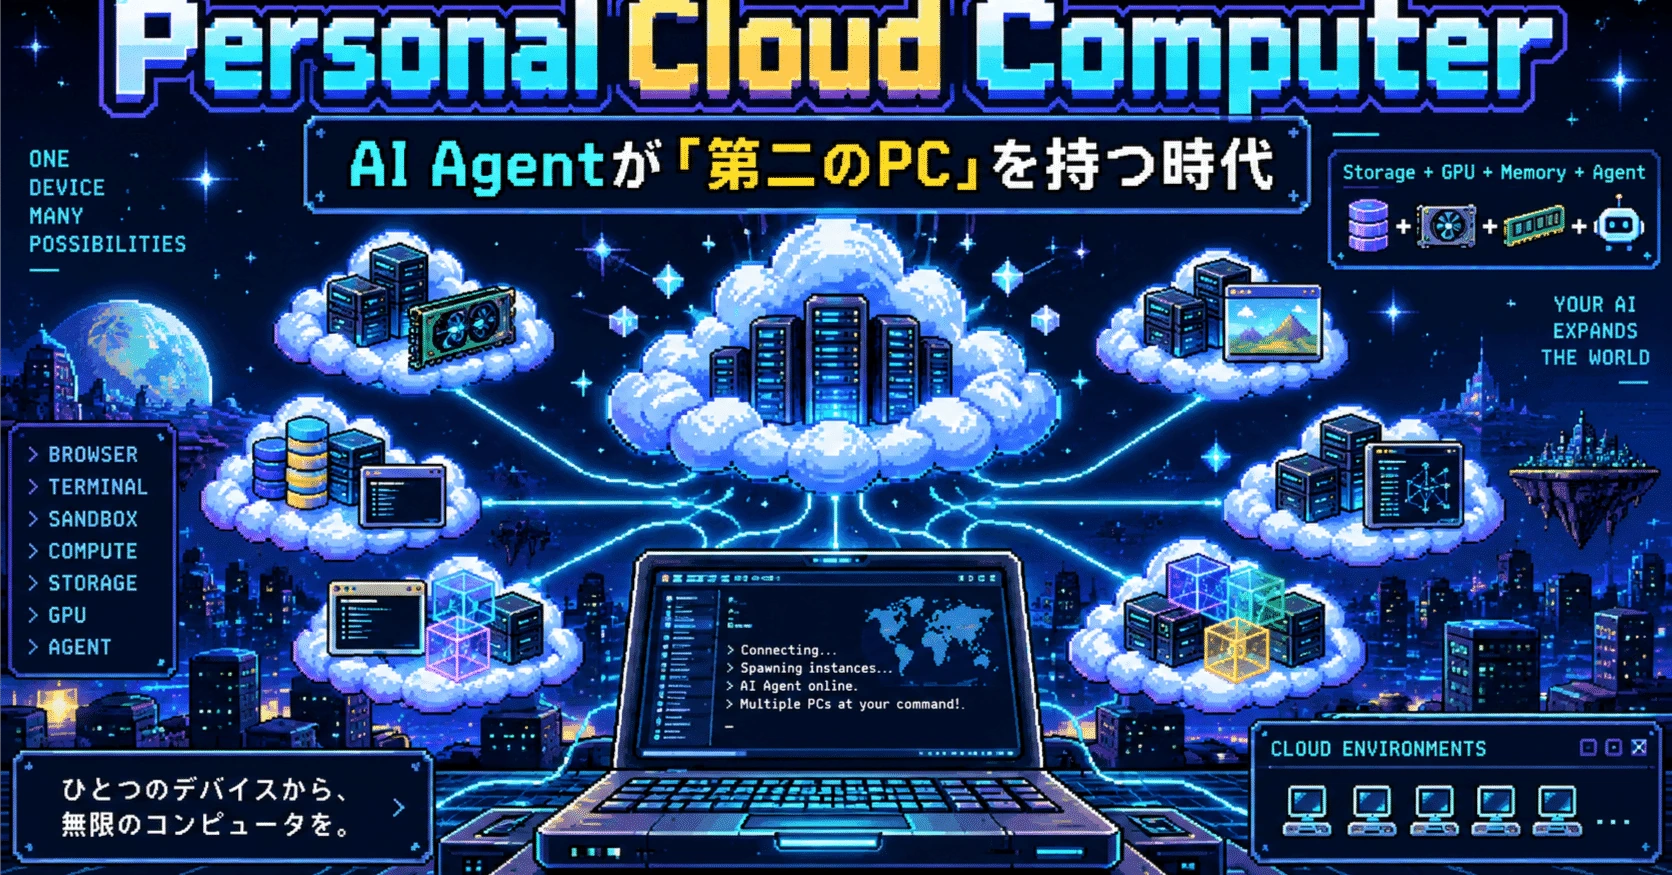
Personal Cloud Computer――AI Agentが「第二のPC」を持つ時代
#AI Agentについて考えていると、ある対談の一節が妙に引っ掛かる。
#OpenAIの次世代Agentについて語る対談の中で、非常に重要な話が出てくる。
#将来のモデルには、Laptop以上のリソースが必要になる。
#https://youtu.be/4qjEgPojjzM?si=nAvw8THvFyrMHWbO
#Laptop――ノート型パソコン。 人間が持ち運び、一人で操作することを前提として設計されたPersonal Computerである。
#Resources――計算資源。 CPU、RAM、GPU、Storage、Network帯域など、Computerが仕事を実行するために必要な資源をまとめた言葉である。
#理由は単純に、
#「将来のAIモデルは巨大だから、もっと大きなGPUが必要になる」
#という話ではない。
#むしろ、その逆である。
#現在のLaptopは、人間のために設計されている。
#人間がKeyboardを入力する速度。
#人間が考えられる速度。
#人間が同時に操作できるApplicationの数。
#人間が一度に追跡できるTaskの数。
#こうした「人間側の帯域」を前提として、PCは作られてきた。
#ところがAIには同じ制約がない。
#対談では、将来のモデルなら100個ものApplicationを同時に扱うことさえ考えられ、モデルが高速になるほど、今度はCPU、Network、Tool CallなどAIの外側にあるComputerそのものが制約になっていく、という趣旨の説明がされている。
#CPU――Central Processing Unit、中央処理装置。 OS、Browser、Compilerなど一般的なSoftware処理を担当する汎用演算装置である。
#Network――ネットワーク。 Cloud、Web、API、別Computerとの間でDataを送受信する通信基盤である。
#Tool Call――ツール呼び出し。 AIがBrowser、Terminal、Database、Applicationなど外部機能を実際に利用する操作を指す。
#これは非常に重要な変化である。
#これまで私たちは、
#ComputerがAIを動かす
#と考えてきた。
#しかしAgent時代には、
#AIがComputerを使い倒す
#ようになる。
#すると一台のLaptopという形そのものが、AIにとって狭すぎる可能性が出てくる。
#その先に見えてくるのが、
#Personal Cloud Computer――個人用クラウドコンピューター
#である。
#これは単なるCloud Storageではない。
#自分専用のStorage、Memory、CPU、GPU、Software Environment、AI AgentなどがCloud上に存在し、必要な時だけ計算資源を呼び出して使う、新しいPersonal Computingの形である。
#1.Laptopは「一人の人間」のために作られた
#現在のPCには、
#CPU――中央処理装置。 一般的なProgramやOS処理を実行するComputerの中核。
#RAM――Random Access Memory、主記憶装置。 現在使っているProgramやDataを一時的に置く高速な作業領域。
#SSD――Solid State Drive、半導体記憶装置。 OS、Application、画像、動画などを長期保存する高速Storage。
#GPU――Graphics Processing Unit、画像・並列演算装置。 画像処理だけでなくAI、Rendering、動画処理など大量並列計算を担う。
#Operating System――基本ソフトウェア。 Windows、macOS、Linuxなど、HardwareとApplicationの間を管理する基盤。
#Browser――Web閲覧ソフト。 Web ServiceやCloud Applicationへアクセスするための実行環境。
#IDE――統合開発環境。 Code編集、実行、DebugなどSoftware開発機能をまとめたApplication。
#などがある。
#非常に高性能である。
#しかし中央にいるのは一人の人間だ。
#人間がBrowserを開く。
#人間がTerminalを操作する。
#人間がCompilerを実行する。
#人間が結果を確認する。
#Terminal――端末・コマンド操作環境。 文字による命令でOS、File、Program、Networkなどを直接操作するInterface。
#Compiler――コンパイラ。 人間が書いたSource CodeをCPUなどが実行できるProgramへ変換するSoftware。
#だから一つの仕事を、
#Research――調査。情報や資料を集める。
#Coding――プログラミング。Codeを書く。
#Compile――コンパイル。Codeを実行形式へ変換する。
#Test――テスト。Programが正しく動くか確認する。
#Benchmark――性能測定。速度やResource使用量を比較する。
#Security Review――安全性審査。脆弱性や危険な処理を確認する。
#Documentation――文書化。仕様や使い方を文章として整理する。
#という複数の仕事へ分けても、普通の人間は完全には同時進行できない。
#ところがAgentなら可能である。
#対談でも、探索しながら別AgentがTestを書き、別の処理でCompileし、さらに別の仮説を試すという並列化が語られている。
#そこで、
#という逆転が起こる。
#モデルは、
#「10案すべて試せばよい」
#と瞬時に判断できる。
#しかしComputer側には、
#限られたCPU。
#限られたRAM。
#一つのFilesystem。
#限られたStorage IOPS。
#限られたNetwork Bandwidth。
#数個以下のGPU。
#しか存在しない。
#Filesystem――ファイルシステム。 FolderやFileを保存・検索・読み書きするOS上のData管理構造。
#Storage IOPS――Storageの入出力性能。 1秒間に何回FileやDataを読み書きできるかを表す性能指標。
#Network Bandwidth――通信帯域。 一定時間内にどれだけ大量のDataを送受信できるかを示す。
#するとAIをさらに有能にする方法は、モデルを賢くすることだけではなくなる。
#Agentへより多くのComputerを与える。
#というScalingが始まる。
#2.「Laptopでは足りない」はCloud Onlyという意味ではない
#Laptop以上のResourcesが必要になるからといって、
#将来はすべてCloudへ送らなければならない
#という意味ではない。
#むしろ将来は、
#Local PC――手元のPC。低Latencyで秘密Dataも扱いやすい。
#Mac mini――小型Desktop Computer。常時稼働用のLocal Serverとしても使える。
#Cloud VM――クラウド仮想マシン。Internet越しに起動できる仮想Computer。
#GPU Instance――GPU付きクラウド環境。必要時だけ強力なGPUを利用する。
#Browser Sandbox――隔離Browser環境。Web操作を他のDataから分離して実行する。
#NAS――Network Attached Storage。家庭や社内Networkに置く大容量共有Storage。
#などをAgentが必要に応じて使い分ける可能性がある。
#つまり将来は、
#Computer = Machine――一台の物理Computer
#ではなく、
#Computer = Compute Pool――利用できる計算資源の集合
#へ変わる。
#LaptopやSmartphoneは、その環境そのものではなく、
#Control Plane――制御面
#になっていく。
#Control Planeとは、実際の重い処理を自分で実行するのではなく、どのComputerを動かし、何を実行させるかを管理する司令塔である。
#この変化はすでにOpenAIの方向性にも現れている。
#3.OpenAI――「コードを書くAI」からComputerを使うAgentへ
#Codexは単なるCode Generatorから、Computer上で仕事を実行するAgentへ拡張している。
#重要になる機能を分解すると、
#Computer Use――コンピューター操作。 GUIやApplicationをAI自身が操作する能力。
#Browser Use――ブラウザ操作。 Web Siteを開き、検索や入力などをAgent自身が行う。
#Terminal――コマンド実行環境。 Code、File、ProgramなどをShellから直接操作する。
#Remote Devbox――遠隔開発環境。 Cloudや別Machineに存在する開発ComputerをNetwork越しに利用する。
#Memory――長期記憶。 過去の会話やPreference、作業情報などを次回以降にも利用する。
#Continuous Work――継続作業。 一回の応答で終了せず、長時間にわたりTaskを進め続ける。
#などである。
#つまりCodexは、
#Codeを書くAI
#から、
#Computerを使って仕事を完遂するAI
#へ向かっている。
#ここでSmartphoneの意味も変わる。
#Human
↓
Smartphone
↓
Personal Agent
↓
Laptop / Mac mini / Devbox / Cloudという構造になる。
#スマートフォンそのものが重い仕事をする必要はない。
#スマートフォンはAgentの操縦席になる。
#4.ChatGPTとCodexの境界が薄くなる理由
#添付された対談では、将来的なPersonal Agentについて、
#Coding Agent。
#Research Agent。
#General Chat Agent。
#などを利用者が毎回切り替えるのではなく、
#一つのPersonal Agentが必要な能力を選択する
#方向が語られている。
#Harness――Agent実行基盤。 Model、Memory、Tool、Permission、Execution Environmentなどをまとめて制御する仕組み。
#Interface――操作画面・接点。 人間がAIへ指示し、結果を確認するためのUIやVoice環境。
#Tool――外部機能。 Browser、Terminal、Code Execution、Database、ApplicationなどAIが利用できる機能。
#つまり、
#「今日はCoding Mode」
#「次はResearch Mode」
#と人間がApplicationを切り替えるのではなく、
#目的だけ伝える。
#Agentが必要なToolを選ぶ。
#必要ならComputerを起動する。
#必要ならCloudへ仕事を送る。
#そういう形になる。
#ここまで来るとChatGPTは、
#Chat Application――会話アプリ
#というより、
#Personal Computing Interface――自分専用Computer全体の操作窓口
#へ近づいていく。
#5.Anthropic――AgentをBrainとHandsへ分離する
#AnthropicはAgent Infrastructureを、
#Brain――頭脳。考え、判断するModelとHarness。
#Hands――手足。Computer、Sandbox、Browser、Toolなど実際にActionする環境。
#へ分けて考えている。
#さらに両者の間に、
#Session――作業状態。長時間Taskを継続するためのContextやState。
#がある。
#概念としては、
#Brain
↓
Session
↓
Handsとなる。
#ここで面白いのは、
#一つのBrainが一つのComputerに固定される必要がない
#ことである。
#あるTaskにはSandbox A。
#別TaskにはSandbox B。
#Web操作にはBrowser Environment。
#Mobile操作にはPhone Environment。
#というようにComputerそのものをTool化できる。
#つまり、
#従来:
#Computerの中からApplicationを選ぶ。
#Agent時代:
#Agentが仕事に必要なComputer自体を選ぶ。
#という逆転が起こる。
#6.Sandboxとは何なのか
#Sandbox――隔離実行環境。 AgentやProgramを、他のFileやSystemから切り離して安全に動かす仕組みである。
#例えばAgentに、
#Workspace FolderだけWrite可能。
#Internetは一部Domainだけ。
#Password FolderにはAccess不可。
#Bank APIはAccess不可。
#という制限をかけられる。
#Virtual Machine――仮想マシン。 一台の物理Server上に、独立した仮想Computerを作る技術。
#Container――コンテナ。 Applicationと必要Environmentを軽量に隔離して動かす仕組み。
#Filesystem Isolation――ファイル隔離。 Agentが見たり変更したりできるFolderを限定する。
#Network Isolation――通信隔離。 AgentがInternetや社内Networkのどこへ接続できるかを制限する。
#Credential Isolation――認証情報隔離。 Password、API Key、TokenなどをAgentから直接見えない場所へ置く。
#Egress Control――外向き通信制御。 AgentがDataを外部へ送信できる宛先や方法を制限する。
#Anthropicが重視しているのは、
#Agentを絶対に間違えなくする
#ことだけではない。
#間違えても破壊できる範囲を小さくする
#ことである。
#7.Blast Radius――失敗時の被害半径
#Blast Radius――爆発半径・被害範囲。 元々InfrastructureやSecurityで使われる言葉で、一つの障害や侵害がどこまで広がるかを表す。
#Agentが、
#全Filesystem。
#全Email。
#全Cloud。
#全Credential。
#全Network。
#へAccessできれば、一回の誤動作で非常に大きな被害が起こり得る。
#逆に、
#Research Folderだけ。
#WebはRead Only。
#外部Upload不可。
#ならば、Agentが誤作動しても被害範囲は狭い。
#だから、
#安全性 = Modelの賢さ
#ではない。
#安全性 = Model + OS + Permission + Isolation
#になる。
#8.Human in the Loopだけでも足りない
#Human in the Loop――人間による途中承認。 AIだけで完全自動化せず、重要操作では人間に確認を求める仕組み。
#これは重要である。
#しかし確認画面が毎分出てきたらどうなるか。
#人間は、
#Allow。
#Allow。
#Allow。
#と押すようになる。
#これが、
#Approval Fatigue――承認疲れ
#である。
#したがって理想は、
#Low Risk――低Risk操作。Sandbox内で自動実行。
#Medium Risk――中Risk操作。記録を残して自動実行。
#High Risk――高Risk操作。人間の承認が必要。
#Forbidden――禁止操作。そもそも技術的に実行不能。
#というようなPolicy Engineが必要になる。
#Policy Engine――方針実行機構。 Risk、Identity、Resourceなどに応じて操作を許可・拒否するSecurity基盤。
#9.Grok――AgentにLinux Computerを与える
#Grokで特に興味深いのが、
#Agent自身へPersistent Cloud Computerを持たせる
#考え方である。
#Persistent――永続的。 Task終了後もFileやLogin Stateなどが消えず、次回も同じ状態から作業を続けられる。
#Grok BotのComputerには、
#Browser――Web操作環境。
#Filesystem――File保存・共有領域。
#Terminal――Linux Commandを実行する操作環境。
#が存在する。
#そして、そのCloud ComputerはLinuxを動かす。
#Linux――Unix系Operating System。 Server、Cloud、Container、Developer Environmentなどで広く利用されるOS。
#つまり、
#Human
↓
Grok Bot
↓
Persistent Linux Cloud Computer
↓
Browser / Filesystem / Terminalという構造になる。
#これは従来の、
#AIが人間のPCを借りる
#というComputer Useから一歩進んでいる。
#AI用のComputerを最初からCloud側へ用意する
#という考え方である。
#10.正確には「一Bot一台」ではなく「一User一台」
#製品としては、
#Bots have their own computer――Botは自分のComputerを持つ
#と説明できる。
#しかし技術的にはもう少し細かい。
#Grok Botでは、
#Userごとに専用Firecracker microVM
#が割り当てられ、
#そのUserが持つ複数Botは同じComputerを共有する構造になっている。
#つまり、
#User
↓
Dedicated Firecracker microVM
↓
Linux
↓
Bot A / Bot B / Bot C
↓
Shared Files / Browser Sessions / Loginsとなる。
#Dedicated――専有。 別Userと同じOS空間を共有せず、自分専用として割り当てられる。
#Shared Files――共有ファイル。 同一Userの複数Botが同じFilesystem上のDataを利用する。
#Browser Session――ブラウザ状態。 Login Cookieや開いているWeb環境など、Browserの継続状態。
#これはAgent同士の共同作業には非常に便利である。
#Research Botが資料を集める。
#Writing Botが同じFileを読む。
#Publishing Botが完成品を使う。
#Filesystemが、
#複数Agentの共有Workspace
#として機能する。
#11.Firecracker microVMとは何か
#Firecracker――AWSが開発した軽量仮想化技術。 Containerの軽さとVMに近いIsolationを両立するために作られたVirtual Machine Monitorである。
#microVM――小型仮想マシン。 通常のVMより機能を絞り、短時間起動・低Overheadを重視した仮想Computer。
#KVM――Kernel-based Virtual Machine。 Linux Kernelに組み込まれたHardware Virtualization基盤。
#Kernel――OSの中核。 Memory、Process、Hardware、PermissionなどComputerの根本機能を管理する。
#通常のContainerではHost Kernelを共有する。
#一方microVMでは、
#microVM A → Kernel A
#microVM B → Kernel B
#microVM C → Kernel C
#という、より強いIsolation Boundaryを構築できる。
#Isolation Boundary――隔離境界。 一つのEnvironmentで問題が起きても、別Environmentへ波及しにくくするSecurity上の境界。
#Agentが自由にShellを動かすなら、このIsolationは極めて重要になる。
#12.なぜAgentとLinuxは相性がよいのか
#人間向けPCでは、
#GUI――Graphical User Interface。WindowやIconをMouseで操作する画面。
#Mouse。
#Desktop。
#Window。
#などが重要だった。
#Agentにとっては、
#Shell――文字命令でOSを操作する環境。
#Python――AIやAutomationで広く使われるProgramming Language。
#Node.js――JavaScriptをServerやTool実行に使うRuntime。
#Git――Source CodeのVersion管理System。
#curl――HTTPなどNetwork通信をCommandから行うTool。
#ffmpeg――動画・音声変換を自動化できるMultimedia Tool。
#Package Manager――SoftwareやLibraryを自動Install・更新する管理機構。
#の方が扱いやすい。
#AgentはMouseを器用に動かすより、
#「このCommandを実行する」
#方が正確だからである。
#このためLinuxは、
#人間向けDesktop OS
#というより、
#AI Agent向けCloud OS
#として非常に有力な位置にいる。
#13.GrokのFilesystemは共有Memoryにもなる
#Agent MemoryというとLLM内部のMemoryだけを想像しやすい。
#しかしPersistent Linux Environmentでは、
#FilesystemそのものがMemoryになる。
#Research Bot
↓
\`research.md\`保存
↓
Writing Bot
↓
\`research.md\`読込
↓
Publishing Bot
↓
完成記事を利用ということができる。
#つまりAgent Memoryには、
#Model Memory――AIが保持する意味的記憶。
#Filesystem Memory――Fileとして残る作業記録。
#Browser State――LoginやWeb操作状態。
#Database State――構造化Dataとして保存された状態。
#など複数種類が存在する。
#14.同じUserのBotは完全隔離されているわけではない
#この便利さにはSecurity上の代償もある。
#同じUserの複数Botが同じComputerを共有するなら、
#Bot Aが保存したFileをBot Bが読む。
#Bot AがLoginしたServiceをBot Bも利用する。
#ということがあり得る。
#つまり現状では、
#User Boundary――利用者間の境界
#は強くても、
#Agent Boundary――同一User内のAgent間境界
#は別問題になる。
#今後は、
#Research AgentだけがResearch FolderへAccess。
#Finance AgentだけがAccountingへAccess。
#Video AgentだけがMedia StorageへAccess。
#というさらに細かなIsolationが重要になる。
#15.一人一Accountから「一人+多数Agent Identity」へ
#Agent Identity――Agent専用の認証主体。 人間本人とは別に、各Agentへ独自のPermissionを与える考え方。
#例えば、
#Research Agent――調査Agent。 Research FolderはRead/Write、WebはRead、EmailやBankは禁止。
#Video Agent――動画Agent。 Video Folder、GPU、ffmpegは使用可能。Accountingは禁止。
#Finance Agent――会計Agent。 AccountingはRead、Bank APIはRead Only、PaymentはDraftまで。
#Read Only――読み取り専用。変更や削除はできない。
#Draft Only――下書きのみ。実際の送信・決済は人間が承認する。
#Capability――能力・権限。 Agentが「何をできるか」を個別に定義するSecurity Model。
#つまり従来の、
#User → Application
#ではなく、
#User
↓
Agent A
Agent B
Agent C
↓
それぞれ違うCapabilityになる。
#16.数百Agentを動かすとLaptopでは足りなくなる
#Multi-Agent――複数Agent協調。 一つの仕事を多数のAIへ分割し、並列処理するArchitecture。
#Fan-out――分散展開。 一つのTaskを多数のAgentへ同時に配り、複数案を並行処理する。
#Orchestrator――統括Agent。 仕事を分解し、各Agentへ割り当て、結果を統合する司令塔。
#例えば、
#Human
↓
Orchestrator
↓
Agent 001
Agent 002
Agent 003
…
Agent 128となる。
#各Agentが、
#Repository――Source Code保管庫。
#Compiler――Code変換処理。
#Browser――Web処理。
#Tests――動作検証。
#Filesystem――File入出力。
#Network――外部通信。
#を使えば、一台のLaptopではすぐにResourceが不足する。
#ここでCloudが有利になる。
#Cloudなら必要な瞬間だけ、
#VMを10台。
#Containerを100個。
#Browserを50個。
#というように増やせる。
#これが、
#Elastic Compute――伸縮可能な計算資源
#である。
#17.AI Scalingは三段階になる
#これまでAIのScalingは主に、
#だった。
#Training Compute――学習計算資源。 AI Modelそのものを作るために投入するGPUや演算量。
#次に、
#が重要になった。
#Inference Compute――推論計算資源。 完成したModelが回答を考える際に使う計算量。
#そしてAgent時代には、
#が加わる。
#Environment Compute――実行環境計算資源。 AgentがBrowser、Compiler、Database、VMなど実際の仕事を動かすためのCompute。
#つまり、
#Modelを賢くするScaling。
#Modelに長く考えさせるScaling。
#Agentへ大量のComputerを与えるScaling。
#の三つが存在する。
#18.GPUだけでなくCPU・Storage・Networkも重要になる
#Agent Workloadでは、
#Compilation――CodeのBuild処理。
#Browser Rendering――Web Page描画。
#Database Query――Database検索。
#Video Encoding――動画圧縮・変換。
#File Compression――File圧縮。
#Package Installation――Software導入。
#Network Processing――通信処理。
#なども大量に発生する。
#つまりAI InfrastructureはGPUだけでは成立しない。
#CPU――汎用演算。
#DRAM――大容量作業Memory。
#SSD――高速Local Storage。
#Object Storage――大量FileをCloudに保存するStorage。
#Network――Server・Agent間通信。
#Virtualization――大量のVMを分離して動かす技術。
#Security Processor――暗号化や隔離をHardwareで補助するProcessor。
#が重要になる。
#対談で言われていた、
#Modelが速くなるほどCPUやTool CallがBandwidthになる
#という話は、この未来につながっている。
#19.StorageはAlways-on、ComputeはOn-demand
#Always-on――常時保持。 Agentが眠っている間もDataやMemoryだけは保持し続ける。
#On-demand――必要時利用。 仕事が発生した瞬間だけCPUやGPUを起動し、終了後に止める。
#Scale-to-Zero――利用時以外はComputeをゼロまで停止する。 StorageやStateだけ残し、計算料金を抑えるCloud設計。
#Personal Cloud Computerでは、
#Storage――Always-on。
#Agent Memory――Always-on。
#CPU――On-demand。
#GPU――On-demand。
#Sandbox――On-demand。
#となる可能性が高い。
#例えば、
#「昨日の動画を編集しておいて」
#と頼む。
#Agentが起動する。
#Storageから動画を読む。
#Sandboxを作る。
#必要ならGPUを確保する。
#字幕を生成する。
#動画をEncodeする。
#Thumbnailを作る。
#完成品をStorageへ戻す。
#CPUとGPUを停止する。
#Memoryだけ残す。
#これが、
#Serverless Personal Computer――必要時だけComputerが出現する個人用計算環境
#である。
#20.5TBの意味も変わる
#現在の5TBを人間だけで考えると巨大である。
#しかしAgent Workspaceなら、
#Video素材――大量容量を消費する映像Data。
#Audio――音楽、音声、Source。
#Image――画像、生成素材、Reference。
#Git Repository――CodeとVersion履歴。
#PDF――論文、資料、Document。
#Web Archive――保存したWeb資料。
#Dataset――分析・AI用Data集合。
#Vector Database――意味検索用のVectorを保存するDatabase。
#Embedding――文章や画像の意味を数値Vector化したData。
#Agent Memory――Agentの長期記憶。
#Environment Snapshot――仮想作業環境の保存状態。
#などを置く。
#つまり、
#Human Storage――人間だけが使う倉庫
#から、
#Human + Agent Workspace――人間とAgentが共同利用する作業空間
#へ変わる。
#21.Agent MemoryはFilesystem以上に重要になる
#AgentのMemoryも複数階層になる。
#Session Memory――セッション記憶。 現在進行中のTaskや会話状態を保持する短中期Memory。
#User Memory――利用者記憶。 好み、設定、過去の判断などユーザー固有情報を保持する。
#Procedural Memory――手続き記憶。 「いつもどう仕事をするか」というWorkflowや作業方法を覚える。
#例えば動画制作なら、
#音声解析
↓
字幕生成
↓
不要部分整理
↓
BGM調整
↓
Thumbnail生成
↓
Encodeという流れを覚える。
#するとAgentは、
#あなたについて知るAI
#から、
#あなたの仕事のやり方を知るAI
#へ変わる。
#これは非常に強力である。
#同時に非常にSensitiveなPersonal Dataにもなる。
#22.Agentは人間よりStorageに対して危険である
#人間が5TBのStorageを持っていても、1日ですべて読むことはできない。
#Agentならできる。
#Agent Data Access Rate――AgentのData走査速度。 大量Fileを自動検索・分類でき、人間より桁違いのDataへ短時間で接触できる。
#だから、
#Prompt Injection――外部文章などからAIへ悪意ある指示を忍び込ませる攻撃。
#Malicious Tool――悪意あるToolやPlugin。
#Credential Theft――PasswordやAPI Keyなど認証情報の窃取。
#Data Exfiltration――秘密Dataを外部へ持ち出す攻撃。
#などへの対策が重要になる。
#AgentがFileを読めることと、
#AgentがFileを外へ送れることは、
#同じPermissionにしてはいけない。
#23.Storageの秘匿性はさらに重要になる
#Personal Cloud Computerには、
#Storage。
#Email。
#Code。
#Agent Memory。
#Credentials。
#Automation。
#Software Environment。
#などが集まる。
#Credentials――認証情報。 Password、API Key、Access TokenなどService利用権限を証明する秘密Data。
#Automation――自動化。 人間の操作なしでTaskを継続実行する仕組み。
#すると、
#誰がDataを復号できるのか
#が極めて重要になる。
#ここで三種類のData状態を考える必要がある。
#Data at Rest――保存中のData。 SSDやObject Storageに置かれている状態。
#Data in Transit――通信中のData。 Networkを通って移動している状態。
#Data in Use――処理中のData。 CPUやGPUのMemory上で実際に計算されている状態。
#AI Agent時代には最後の、
#Data in Use
#まで守る必要がある。
#24.Apple――Provider-blind Storage
#Advanced Data Protection――高度なデータ保護。 iCloudの多数CategoryをEnd-to-End Encryptionで保護するAppleのPrivacy機能。
#End-to-End Encryption――エンドツーエンド暗号化。 原則として利用者側だけが復号Keyを持ち、Providerも平文を読めない方式。
#Provider-blind Storage――事業者から内容を見えにくくしたStorage。 Cloud運営企業自身にも復号権限を持たせない設計を指す。
#これにより、
#「ProviderのModeration AIに正しく理解してもらう」
#のではなく、
#「そもそもProviderが中身を読めない」
#という別のSecurity Modelが成立する。
#創作者、研究者、Journalist、Data Analystなどには非常に重要な特徴である。
#25.しかしE2EEだけではAgentはDataを使えない
#Agentが画像を編集するには復号が必要になる。
#Encrypted Storage
↓
Decrypt
↓
CPU Memory
↓
GPU Memory
↓
AI Processingとなる。
#Decrypt――復号。 暗号化されたDataを元の読める状態へ戻す処理。
#つまり保存時だけ暗号化しても、
#処理中にCloud Operatorから丸見えなら完全ではない。
#そこで登場するのが、
#Confidential Computing――機密計算
#である。
#26.Confidential Computingとは何か
#Confidential Computing――機密計算。 CPUなどHardwareの隔離機能を使い、処理中のMemoryまで保護する技術。
#TEE――Trusted Execution Environment、信頼実行環境。 外部のOSや管理者からも内部Dataを読み取りにくくするHardware隔離領域。
#Confidential VM――機密仮想マシン。 TEEを利用し、VM内で使用中のDataまで保護するVirtual Machine。
#Confidential GPU――機密GPU。 CPUだけでなくGPU処理中のDataも保護する仕組み。
#これにより、
#Encrypted Storage
↓
Confidential CPU
↓
Confidential GPU
↓
AI Agentという構成が可能になる。
#27.Remote Attestation――本当に安全な環境か証明する
#Remote Attestation――遠隔証明。 Cloud側で期待されたHardwareとSoftwareが動いていることを暗号学的に確認する技術。
#これは非常に重要である。
#単にCloud事業者から、
#「安全なVMです」
#と言われて信用するのではない。
#Computer自身に、
#「私は承認されたSoftwareをTEE内部で実行しています」
#と証明させる。
#そして証明が正しい場合だけ、
#暗号Keyを渡す。
#Encrypted Data
↓
Attestation確認
↓
Approved Environment
↓
Key Release
↓
Agentが処理という仕組みにできる。
#28.Apple Private Cloud Compute
#Private Cloud Compute――AppleのPrivacy重視型Cloud AI計算基盤。
#Stateless Computation――状態を残さない計算。 要求処理後にUser Dataを長期保存しないことを基本とする方式。
#Transparency Log――透明性ログ。 どのSoftware Buildが実運用されているかを検証できる追記型公開記録。
#つまり理想は、
#Storage側でProviderに見せない。
#さらに、
#Compute側でもProviderに見せない。
#という二段構造になる。
#29.Personal Cloud Computerの完成形
#理想構造は、
#User-owned Key――利用者所有暗号鍵。ProviderにKey支配を集中させない。
#E2EE Personal Storage――事業者にも読みにくい個人Storage。
#Agent Scheduler――AgentやTaskをいつどのComputerへ割り当てるか管理。
#Remote Attestation――安全な実行環境を検証。
#Confidential VM――処理中Dataも守る仮想Computer。
#Confidential GPU――AIやRendering処理を秘匿。
#Agent Runtime――Agentを長時間動かす実行基盤。
#Capability Layer――各Agentの権限を細かく制御。
#Persistent Memory――Agentの長期Memory。
#となる。
#つまり、
#である。
#30.最大のLock-inはFileではなくMemoryになる
#Lock-in――囲い込み。 Dataや機能を他Providerへ移しにくくし、特定Serviceから離れにくくなる状態。
#現在なら、
#Google Photosに写真がある。
#GmailにEmailがある。
#OneDriveにFileがある。
#というLock-inである。
#しかしPersonal Agentを10年間使えば、
#Writing Style。
#Preferences。
#Workflow。
#Project History。
#過去の判断。
#Procedural Memory。
#などをAgentだけが覚えるようになる。
#ここでProviderを変更すると、
#「自分のことを10年間理解してきたAgent」
#を失う。
#これはFileのLock-inより強い。
#31.Agent Snapshotが必要になる
#Agent Snapshot――Agent状態の保存・移行形式。 Memory、Preference、Workflow、設定などをまとめてExportする概念。
#理想的には、
#User Memory――利用者に関する記憶。
#Procedural Memory――作業手順の記憶。
#Preferences――好み・設定。
#Skills――Agentが利用する能力。
#Workflow――作業工程。
#App Configuration――Application設定。
#File References――関連Fileへの参照。
#Audit History――過去の操作記録。
#などを持ち出せるべきである。
#VMにはSnapshotがある。
#ContainerにはOCI Imageがある。
#CodeにはGitがある。
#Agentにも、
#Portable Agent State――移植可能なAgent状態
#が必要になる。
#32.Account BAN問題がさらに重大になる
#Personal Cloud Computer時代に、
#Account
#の中へ、
#Storage――作品や資料。
#Agent Memory――長期AI記憶。
#Work Environment――仕事環境。
#Virtual Computers――仮想PC群。
#Automation――自動処理。
#Credentials――Service接続情報。
#AI Workspace――AIとの共同作業空間。
#Personal Agent――自分専用AI。
#まで入る。
#するとAccount停止は、
#一つのWeb Serviceを失うこと
#ではなく、
#自分の第二のComputerへのAccess停止
#になる。
#33.Service BanとData Ownershipは分離すべきである
#Service Ban――Service利用停止。 企業が利用規約などを理由にComputeや公開機能を停止する措置。
#Data Ownership――Data所有・支配権。 利用者自身が作成・保存したDataを保持・移行できる権利。
#理想的には、
#Service Access――停止可能。
#Agent Execution――停止可能。
#Public Sharing――停止可能。
#Cloud Compute――停止可能。
#しかし、
#Data Export――可能。
#Encrypted Backup――可能。
#Agent Memory Export――可能。
#Agent Snapshot――可能。
#であるべきだと思う。
#つまり、
#「私たちのGPUは使わせません」
#と、
#「あなたの10年間の作品とMemoryも返しません」
#は別問題である。
#34.Digital Sovereigntyという問題
#Digital Sovereignty――デジタル主権。 自分のData、Identity、Software Environmentを特定企業だけに支配されない状態。
#Personal Cloud Computerが第二のPCになるほど、
#Encryption Keyを誰が持つのか。
#Agent Memoryを誰が所有するのか。
#別Providerへ移せるのか。
#Account Ban後もDataを回収できるのか。
#が重要になる。
#これは単なるPrivacy設定ではない。
#AI時代のPersonal Computingにおける所有権問題
#になる。
#35.OpenAI・Anthropic・Grokは別方向からOS企業へ近づく
#OpenAI――Personal Agent型。 一つのAgentからLocal、Remote、Cloudへ仕事を割り当てる方向。
#Anthropic――Agent Runtime型。 Brain、Hands、Session、Sandbox、Network Policyを分離し、安全な長時間実行を重視する。
#Grok――Persistent Computer型。 UserごとのLinux Cloud ComputerをBotが継続利用し、Computer自体をAgent Workspace化する。
#入り口は異なる。
#しかし全社が、
#AIにどのComputer Environmentを与えるのか
#という問題へ向かっている。
#36.Agentic OSとは何か
#Agentic OS――AI Agent中心のOperating System的基盤。 Agent、Memory、Tool、Permission、Compute、Networkなどを統合管理するLayer。
#従来OSとの対応を整理すると、
#つまりAgentic OSは完全に未知の技術ではない。
#何十年もOSが解いてきた問題を、AI Agent用に再構成するもの
#と考えられる。
#37.LinuxはAgent時代にさらに重要になる可能性がある
#Linuxはすでに、
#Cloud Server。
#Container。
#Kubernetes。
#Developer Environment。
#AI Training。
#High Performance Computing。
#などの中心にある。
#Kubernetes――Container Orchestration基盤。 大量のContainerを自動配置・再起動・拡張するCloud向け管理System。
#HPC――High Performance Computing、高性能計算。 多数のCPUやGPUを使って大規模計算を行う分野。
#そこへAgentが加わる。
#AgentにとってLinuxは、
#Scriptable――自動化しやすい。
#Permission Modelが成熟。
#ContainerやKVMと親和性が高い。
#Package Ecosystemが巨大。
#CLI Toolが豊富。
#という強みを持つ。
#人間向けDesktop市場とは別に、
#Agent用Computerの標準OS
#としてLinuxの存在感がさらに強くなる可能性がある。
#38.「自分のPC」という概念が変わる
#現在、
#「自分のPC」
#と言えば机の上の一台を指す。
#未来には、
#Smartphone
↓
Personal Agent
↓
Local PC
+ Cloud CPU
+ GPU VM
+ Browser Sandbox
+ Persistent Storageという形になるかもしれない。
#Agentが、
#「これはLocalで処理する」
#「これはCloudへ送る」
#「これはGPUを使う」
#「これはNetworkに出してはいけない」
#と判断する。
#つまり、
#ComputerとはHardwareの箱ではなく、自分が利用できるCompute Environment全体
#になる。
#39.AI Agentは「第二のPC」を持つ
#従来は、
#Human
↓
PCだった。
#Agent時代は、
#Human
↓
Personal Agent
↓
多数のComputer
↓
Personal Storageになる。
#人間が目的を与える。
#AgentがComputeを管理する。
#必要ならLinux VMを起動する。
#Browserを並列化する。
#GPUを確保する。
#仕事が終わればComputeを停止する。
#Memoryだけ残す。
#つまりAgentは、
#自分専用の第二のPCを持つ。
#さらに正確には、
#必要なだけComputerを生成して使う。
#40.Laptopはなくならない
#Laptopは不要になるのではなく、役割が変わる。
#今まで:
#Laptop = Computer本体
#将来:
#Laptop = Personal Cloud Computerへの高信頼Terminal
#Terminal――端末。 ここではCloud上のAgentやComputer群を操作・確認する入口という意味である。
#Sensitive Data――機密性の高いData。 → Local。
#Massively Parallel Work――大量並列処理。 → Cloud。
#GPU Rendering――GPUを使う画像・動画処理。 → Cloud GPU。
#Immediate UI――瞬時の反応が必要な画面操作。 → Local。
#となる。
#つまり未来は、
#Local + Edge + Cloud
#である。
#Edge――利用者に近い場所の計算資源。 Localほど近くなく巨大Cloudほど遠くない中間的なCompute地点。
#41.「Laptopでは足りない」の本当の意味
#最初の対談へ戻る。
#Laptopは人間のために作られている。
#これは単に、
#「将来はもっと高性能なGPUが必要になる」
#という話ではない。
#AIが、
#文章を生成する存在
#から、
#Computerを操作する存在
#へ変わった。
#そして次に、
#自分自身のComputer Environmentを持つ存在
#へ変わり始めている。
#OpenAIはPersonal AgentとRemote Computeから。
#AnthropicはBrain、Hands、Sandboxから。
#GrokはPersistent Linux microVMから。
#GoogleはConfidential Computingから。
#AppleはPrivate StorageとPrivate Cloud Computeから。
#別々の入口から同じ未来へ近づいている。
#42.AI競争は「誰のモデルが賢いか」の外へ広がる
#今は、
#GPT。
#Claude。
#Grok。
#Gemini。
#のModel性能が注目される。
#しかしModelが十分に賢くなるほど、差別化はその外へ移る。
#Memory――誰が最も深くユーザーを記憶できるか。
#Sandbox――誰が最も安全なAgent Computerを作れるか。
#Parallelism――誰が最も多くのAgentを同時実行できるか。
#Compute Cost――誰がCPU/GPUを最も安く提供できるか。
#Storage Privacy――誰が最も秘密性の高い保管庫を提供できるか。
#Confidential Compute――誰が処理中Dataまで守れるか。
#Portability――誰がDataやMemoryを自由に持ち出せるか。
#そして最終的には、
#誰が人間の第二のComputerを預かるに値するのか。
#という競争になる。
#Personal Cloud Computerは、単なるCloud PCの進化版ではない。
#それは、
#AIが自分自身のComputerを持ち、人間の代わりにそのComputerを継続的に使うための新しいPersonal Computing Platform
#である。
#Laptopは人間のために作られた。
#次のComputerは、人間とAgentの両方のために作られる。
#Storageの中に記憶を持つ。
#必要な瞬間だけCPUとGPUを呼ぶ。
#Linux VMを起こす。
#Sandboxへ分裂する。
#Browserを並列で動かす。
#仕事が終わればComputeを消す。
#Memoryだけを残して眠る。
#翌朝には、
#昨日何をしていたのかを覚えた状態で再び起きる。
#Personal Cloud Computer――個人用クラウドコンピューター。
#AI Agentが「第二のPC」を持つ時代は、遠いSFではない。
#OpenAI。
#Anthropic。
#Grok。
#Google。
#Apple。
#Cloud Infrastructure企業。
#それぞれが現在、
#Agent Runtime。
#Persistent Computer。
#Confidential Compute。
#Private Storage。
#Memory。
#Sandbox。
#という別々の部品を作り始めている。
#2026年は完成したPersonal Cloud Computerが普及した年ではない。
#しかし、
#次世代Personal Computingを構成する部品が、明確に見え始めた時代
#には入っているのである。
#