XBMとは何か――HBMを「メモリ・チップレット」へ作り替えるIntelの構想
この資料の日時
元資料の日付と、その本文が公に存在した確認日時は別の記録です。
本文に含まれる語句 HBM DRAM 帯域・データ移動 先端パッケージング 電力・給電 冷却 顧客認定 歩留まり 基板・材料 チップレット
出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.09.23.4
- 記事内容のSHA-256
21a06235e3daf71fd4c30a48a9c488a22794d93d95b8d78fa47e153479418bf8- 保存版のSHA-256
bfbfb79a3fe126bbe670d1b9ca5ada0bb57dcc0b4b56ebb13e29a344bcb4dc38
外部証明の最終検査結果は詳細を開くと表示します。
XBMとは何か――HBMを「メモリ・チップレット」へ作り替えるIntelの構想
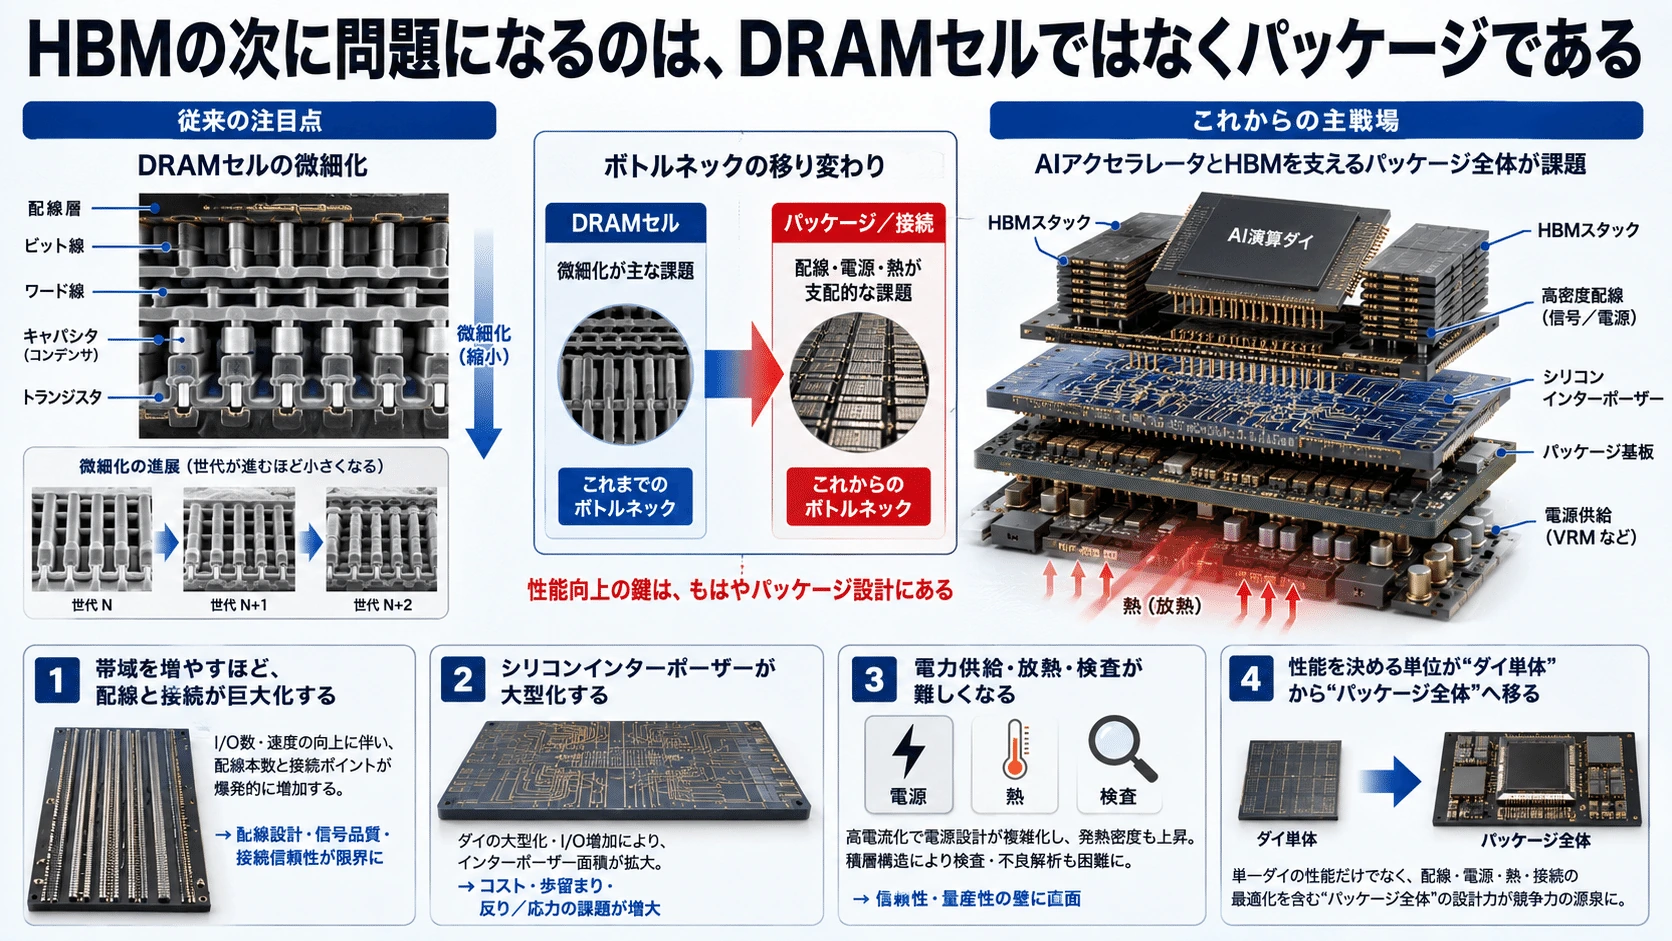
#HBMの次に問題になるのは、DRAMセルではなくパッケージである
#AIアクセラレーターの性能を高めるには、演算器を増やすだけでは足りない。
#GPUやAI ASICが1秒間に処理できる演算量が増えても、計算に必要なデータをメモリから供給できなければ、演算器は待ち時間を抱える。
#この問題を緩和するため、現在のAIアクセラレーターではHBM(High Bandwidth Memory)が広く使われている。
#HBMは、複数のDRAMダイを上下へ積層し、各層をTSVとマイクロバンプなどで接続する。そして積層したメモリを、シリコンインターポーザー上の多数の細かな配線を通じて、GPUやAIアクセラレーターへ接続する。
#現在の代表的なHBM構造
DRAMダイ
│ TSV
DRAMダイ
│ TSV
DRAMダイ
│
ベースダイ
│
マイクロバンプ
│
シリコンインターポーザー
│
GPU/AIアクセラレーターHBMが高い帯域を実現できる理由は、1本の配線を極端に高速化することではない。
#比較的短い多数の配線を並列に並べることで、全体として巨大な帯域を得ている。
#これは、
#1本の道路だけを極端に高速化するのではなく、多数の道路へ交通を分散する#
という考え方である。
#短いパッケージ内配線では、信号振幅を小さくし、強力な送信回路や複雑な信号補償を減らしやすい。そのため、多数の並列配線は帯域だけでなく、ビット当たりの通信電力にも有利になりやすい。
#しかし、この構造には別の問題がある。
#HBMを増やすほど、
#- シリコンインターポーザーが大きくなる
- マイクロバンプの数が増える
- パッケージ内部の配線が複雑になる
- パッケージ基板が大型化する
- 電源供給が難しくなる
- パッケージ反りの管理が難しくなる
- 組み立て後の検査コストが増える
からである。
#つまりAIメモリの問題は、DRAMセルを製造できるかだけではなくなっている。
#巨大なメモリ帯域を、どのような接続とパッケージで演算器へ届けるか#
が次の競争になっている。
#これまで見てきたように、チップレット時代のパッケージは単なる保護容器ではない。演算ダイ、キャッシュ、HBM、I/O、電源、通信網を統合する、コンピューターそのものへ変わりつつある。
#この延長線上に現れたのが、IntelのXBMである。
#
#
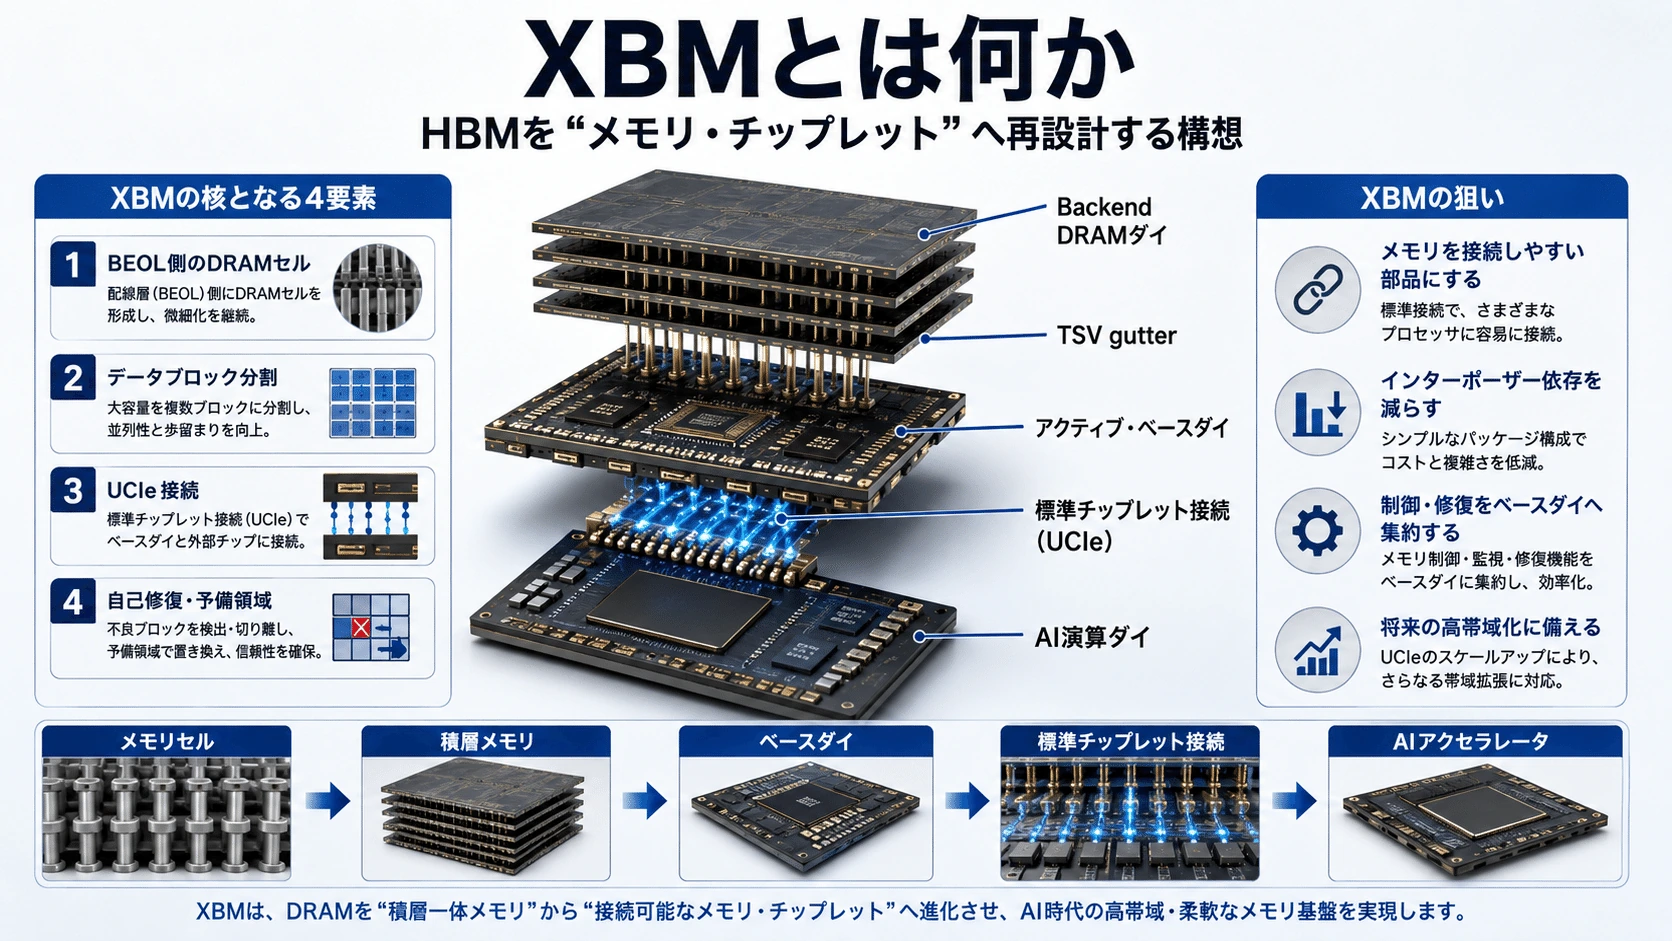
XBMとは何か
#XBMはCross-Batch Memoryの略である。
#2026年7月2日に公開されたIntelの米国特許出願「Ultra High Bandwidth Memory with Backend Transistors」に記載された、高帯域メモリのアーキテクチャである。
#この特許は2024年12月26日に出願されており、公開番号はUS 2026/0191095 A1である。公開資料で確認できるのは特許上の構想であり、現時点で量産製品として発表されたメモリではない。
#XBMの構成を単純化すると、次のようになる。
#XBMの概念構造
Backend DRAMダイ
│
Backend DRAMダイ
│
Backend DRAMダイ
│
Backend DRAMダイ
│
TSV gutter
│
アクティブ・ベースダイ
・UCIe I/O
・SerDes
・テスト
・故障診断
・予備メモリ
│
UCIeリンク
│
GPU/XPU/AI ASICXBMには、大きく四つの特徴がある。
#- DRAMセルをBEOL側へ形成する
- メモリと演算ダイの間をUCIeで接続する
- ベースダイへ制御・検査・修復機能を集める
- スタック完成後の故障を予備領域で修復する
XBMは、単に「HBMより速いDRAM」を作ろうとする構想ではない。
#HBMを構成していたDRAM、TSV、PHY、ベースダイ、パッケージを、チップレット時代に合わせて再設計する構想#
と考える方が近い。
#
#
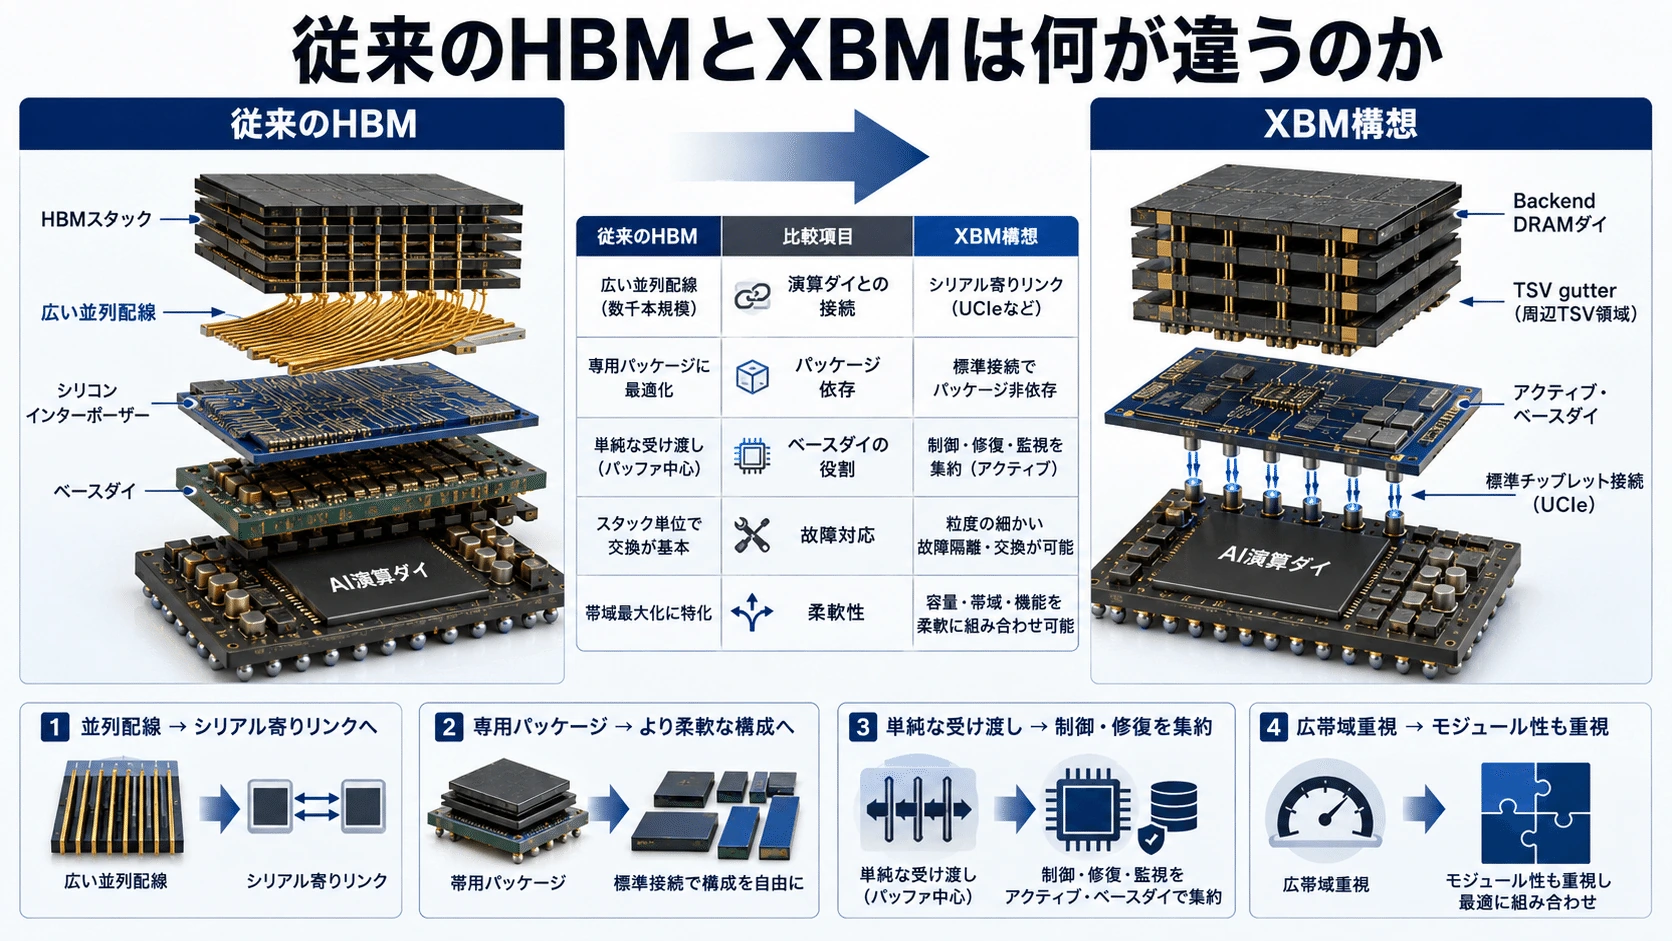
従来のHBMとXBMは何が違うのか
#両者の違いを最初に整理しておこう。
#従来のHBM
GPU
│
非常に広い並列インターフェース
│
シリコンインターポーザー
│
HBMベースダイ
│
TSV
│
積層DRAMXBM構想
GPU/XPU
│
UCIeによる高速リンク
│
パッケージ配線またはインターポーザー
│
UCIe・修復機能を持つベースダイ
│
TSV gutter
│
Backend DRAMスタックHBMは、非常に多くの物理配線を横へ並べることで帯域を確保する。
#XBMは、メモリ内部では多数のチャネルとサブチャネルを維持しつつ、演算ダイとの間ではデータをシリアライズし、UCIe I/O bundleへまとめて送る。
#Intelの特許例では、
#- 8個の独立チャネル
- 1チャネル当たり8個のサブチャネル
- 8層または16層のメモリスタック
- 32GT/sで動作するUCIe I/O bundle
- 0.5~5GBの容量を持つメモリダイ
- ベースダイを経由する演算ダイ向けI/O
などが示されている。
#一例として約1.5GBのメモリダイも記載されているが、これらは特許内の実施例であり、将来の製品仕様を保証する数字ではない。
#
#
第一の変更――DRAMセルをBEOL側へ作る
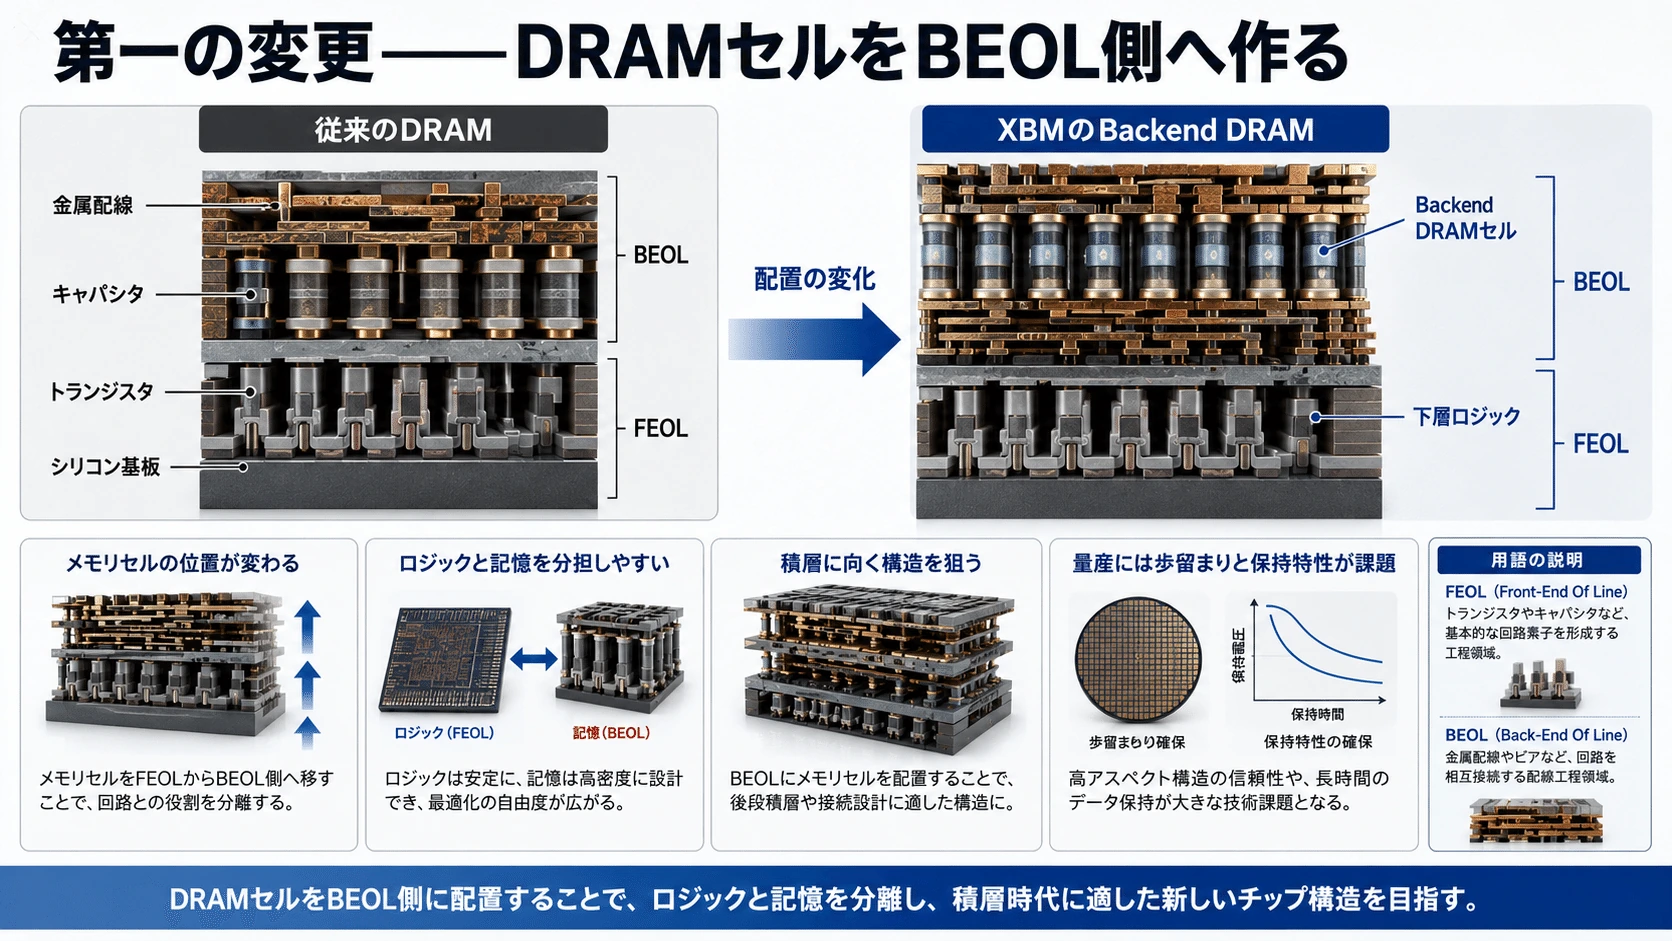
#XBMで最も根本的な変更は、Backend DRAMである。
#一般的な半導体は、大きくFEOLとBEOLに分けて製造される。
#FEOL
#FEOLはFront-End-of-Lineの略である。
#シリコン基板へ、
#- トランジスタ
- ソース
- ドレイン
- ゲート
- 素子分離
などを形成する工程を指す。
#BEOL
#BEOLはBack-End-of-Lineの略である。
#完成したトランジスタの上へ、
#- コンタクト
- ビア
- 金属配線
- 層間絶縁膜
などを積み重ねる工程である。
#一般的なロジック半導体
上側
────────────────
金属配線層 BEOL
金属配線層
金属配線層
────────────────
トランジスタ層 FEOL
────────────────
シリコン基板
下側通常のDRAMでは、メモリセルを構成するトランジスタとキャパシターは、主としてシリコン側の素子工程へ形成される。
#これに対してXBMでは、1T1C型DRAMを、薄膜トランジスタを使ってバックエンド側へ形成する構造が提案されている。特許では、各メモリダイが1T1C Backend DRAMを持ち、それらを多数のデータブロックとして配置する。
#XBMの概念
上側
────────────────
Backend DRAMセル
────────────────
金属配線・HBI
────────────────
下側回路・シリコン
────────────────ただし、これは「GPUの配線層へ、そのまま大容量DRAMを作る」という意味ではない。
#特許で示されている主な構成は、Backend DRAMを持つメモリダイを複数積層し、ベースダイを介して演算ダイへ接続するものである。
#したがってXBMは、
#メモリセルを演算ロジックへ直接埋め込む技術#
というより、
#Backend DRAMを持つ専用メモリダイを、積層可能な部品として設計する技術#
と理解する方が正確である。
#
#
なぜDRAMをデータブロックへ分割するのか
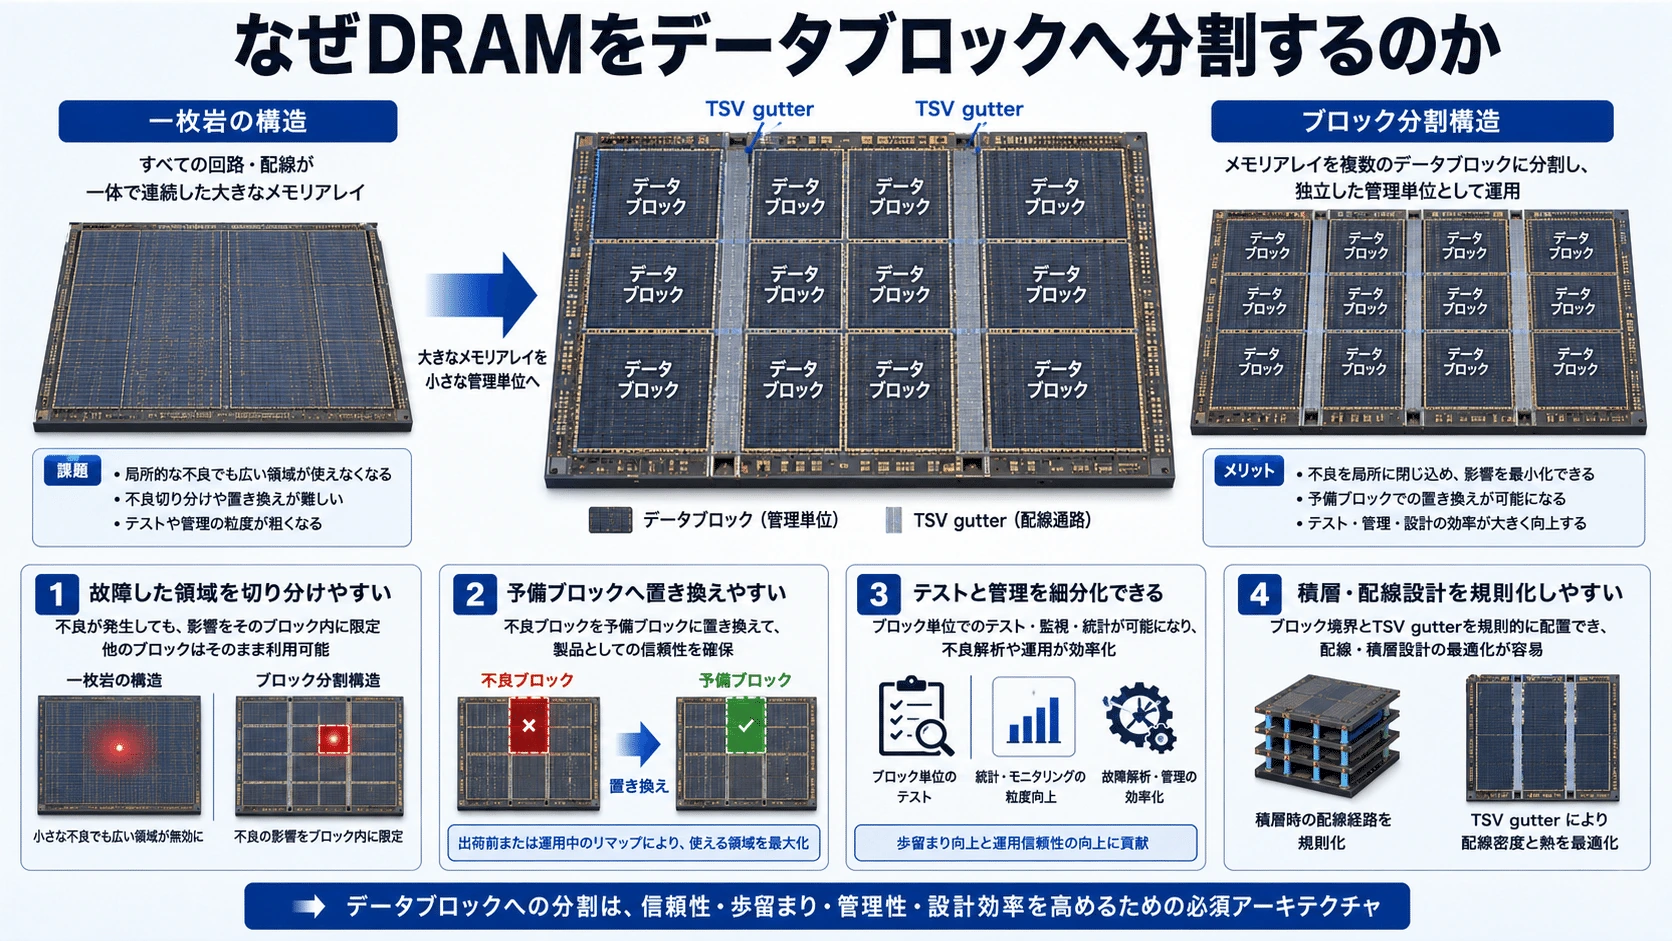
#XBMでは、DRAMアレイをdatablockと呼ばれる小さな単位へ分割する。
#特許の実施例では、1枚のメモリダイへ768個のデータブロックを配置し、それらをチャネル、サブチャネル、TSV gutterへ対応させている。
#XBMメモリダイの概念
┌────────────────────┐
│ DB DB DB │ TSV │ DB DB DB │
│ DB DB DB │ TSV │ DB DB DB │
│ DB DB DB │ TSV │ DB DB DB │
│ DB DB DB │ TSV │ DB DB DB │
└────────────────────┘
DB=Datablock
TSV gutter=垂直配線を集めた領域メモリ全体を一枚岩として扱うのではなく、小さなブロックへ分割すると、
#- サブチャネル単位で制御できる
- 故障領域を切り離しやすい
- 予備ブロックへ置き換えやすい
- 垂直配線を規則的に配置できる
- テスト範囲を細分化できる
という利点が生まれる。
#これは巨大なモノリシックSoCを小さなチップレットへ分割した考え方と似ている。
#巨大な回路を小さな機能単位へ分け、後からパッケージ上で再統合するのがチップレットだった。XBMでは同じ思想を、DRAMアレイ内部へ適用している。チップレットは単にダイを小型化することではなく、複数ダイで一つのシステムを構成することを前提に機能を分割する設計である。
#XBMはその意味で、
#DRAMを、修復・積層・接続しやすいメモリ・チップレットへ再構成する試み#
とも表現できる。
#
#
第二の変更――HBMの広い並列配線をUCIeへまとめる
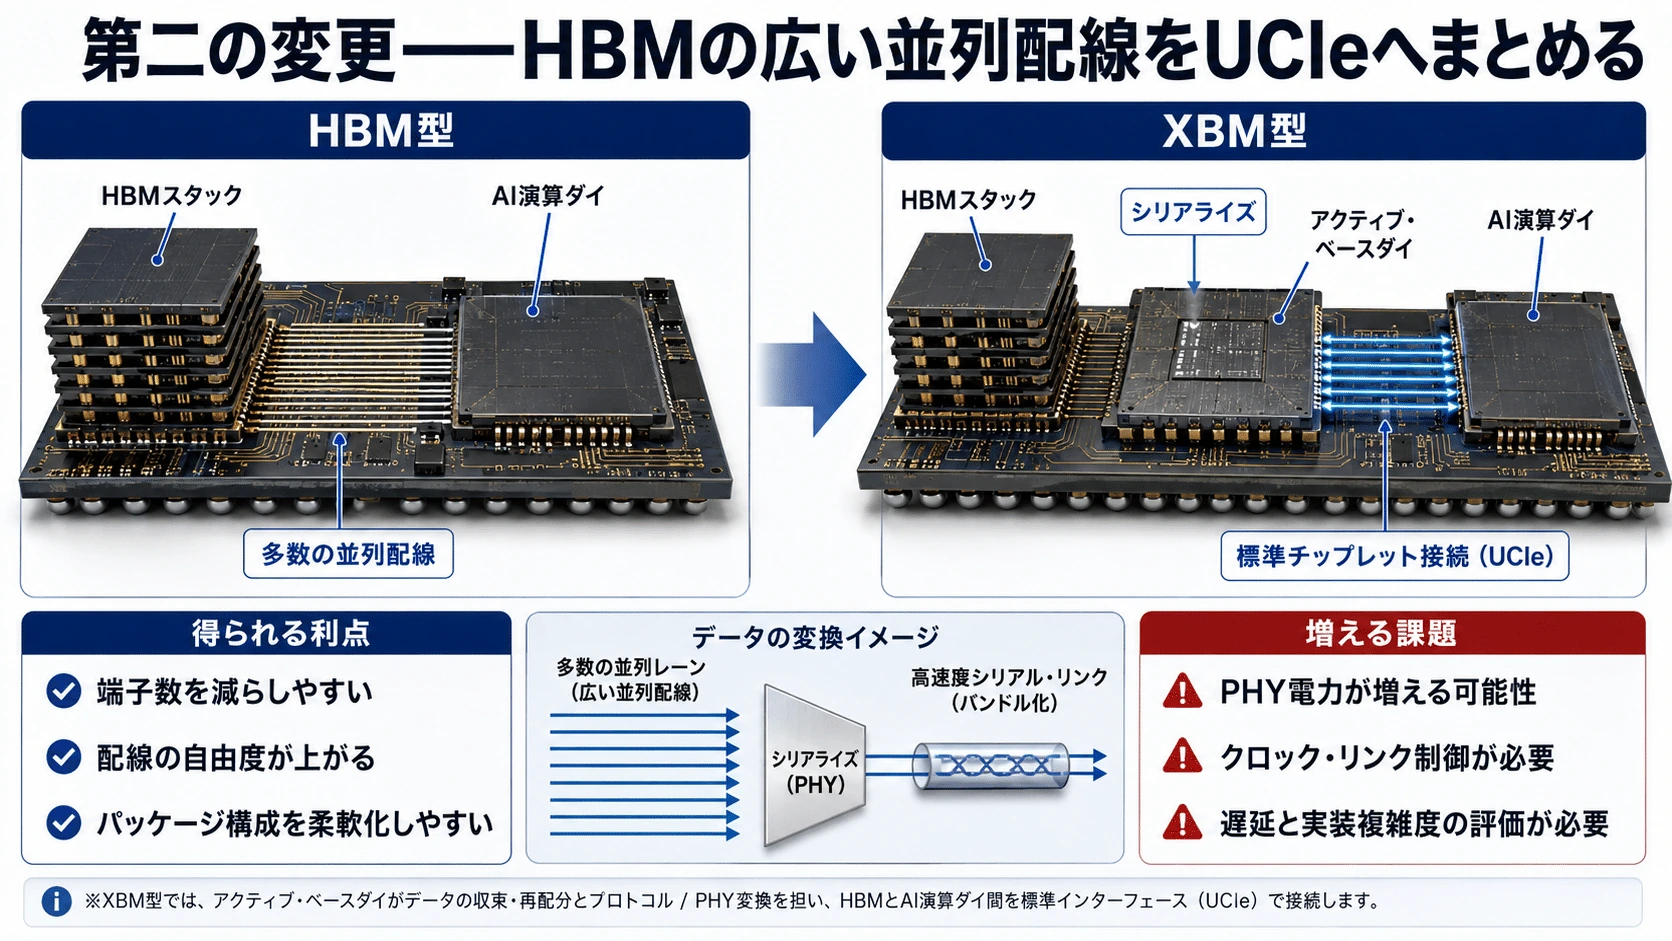
#現在のHBMは、演算ダイとの間に非常に多くの並列配線を置く。
#多数の短距離レーンを使えば、各レーンを極端に高速化しなくても巨大な総帯域を得られる。
#一方、XBMはベースダイでデータをシリアライズし、32GT/sのUCIe I/O bundleを通じて演算ダイへ送る。
#HBM型
A B C D E F G H
│ │ │ │ │ │ │ │
多数の並列配線
│ │ │ │ │ │ │ │
GPUXBM型
A B C D E F G H
↓
シリアライザー
↓
A→B→C→D→E→F→G→H
↓
UCIeリンク
↓
GPU少数の高速配線へシリアライズすると、
#- 物理端子数を減らせる
- ダイ外周の使用量を減らせる
- パッケージ配線の自由度を高められる
- シリコンインターポーザー以外の経路を選びやすくなる
- メモリをチップレットとして扱いやすくなる
可能性がある。
#ただし、無料で得られる利点ではない。
#シリアルリンクには、
#- シリアライザー
- デシリアライザー
- クロック回路
- タイミング補正
- リンクトレーニング
- 信号補償
- エラー検出
- PHY用電力
が必要になる。
#少数の高速配線は端子を減らせる一方、SerDes、PLL、CDR、イコライザーなどによって、回路面積、消費電力、遅延が増えやすい。
#つまりXBMの成否は、
#インターポーザーと超並列配線を減らして得られる利益が、UCIe PHYの電力と面積を上回るか#
で決まる。
#
#
32GT/sは現在のUCIeの上限ではない
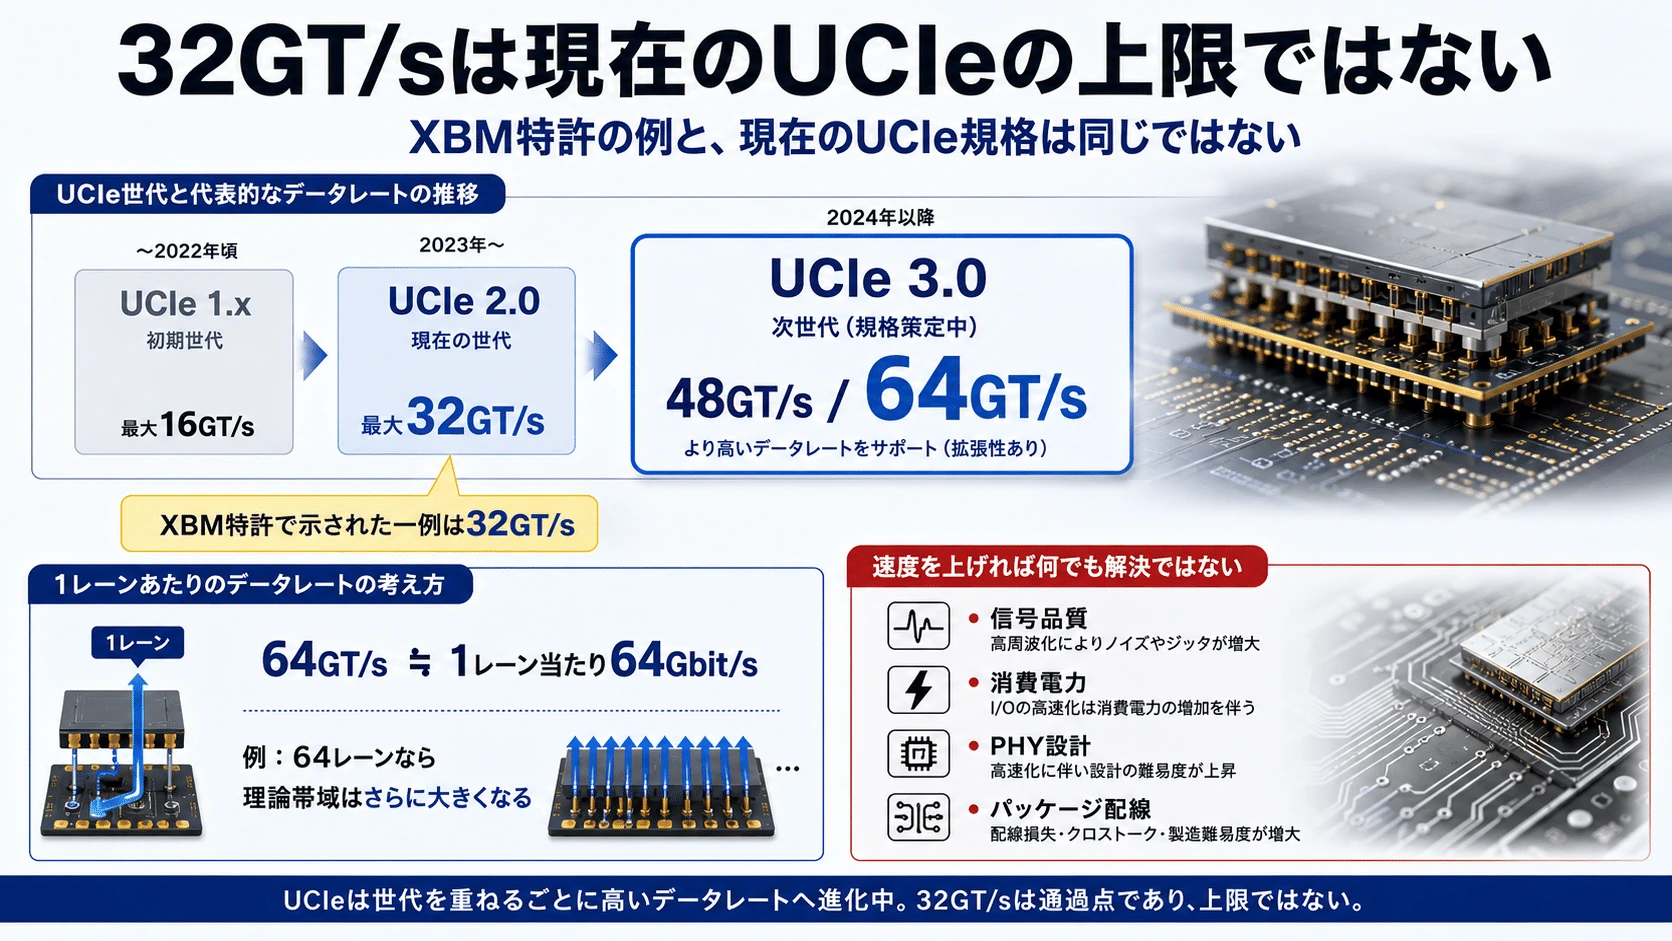
#XBM特許では、UCIe I/O bundleが32GT/sで動作する例が示されている。
#ただし、32GT/sは2026年現在のUCIe規格全体の上限ではない。
#UCIe 3.0では48GT/sと64GT/sが追加され、UCIe 2.0の最大32GT/sからデータレートが倍増している。
#したがって、
#XBMはUCIeの上限である32GT/sを使う#
という説明は正確ではない。
#正しくは、
#2024年に出願されたXBMの実施例が、32GT/sのUCIe I/O bundleを想定している#
となる。
#将来XBMが製品化される場合、32GT/sのままなのか、48GT/sや64GT/sへ拡張するのか、あるいは独自のメモリ向けUCIe構成を使うのかは、まだ分からない。
#
#
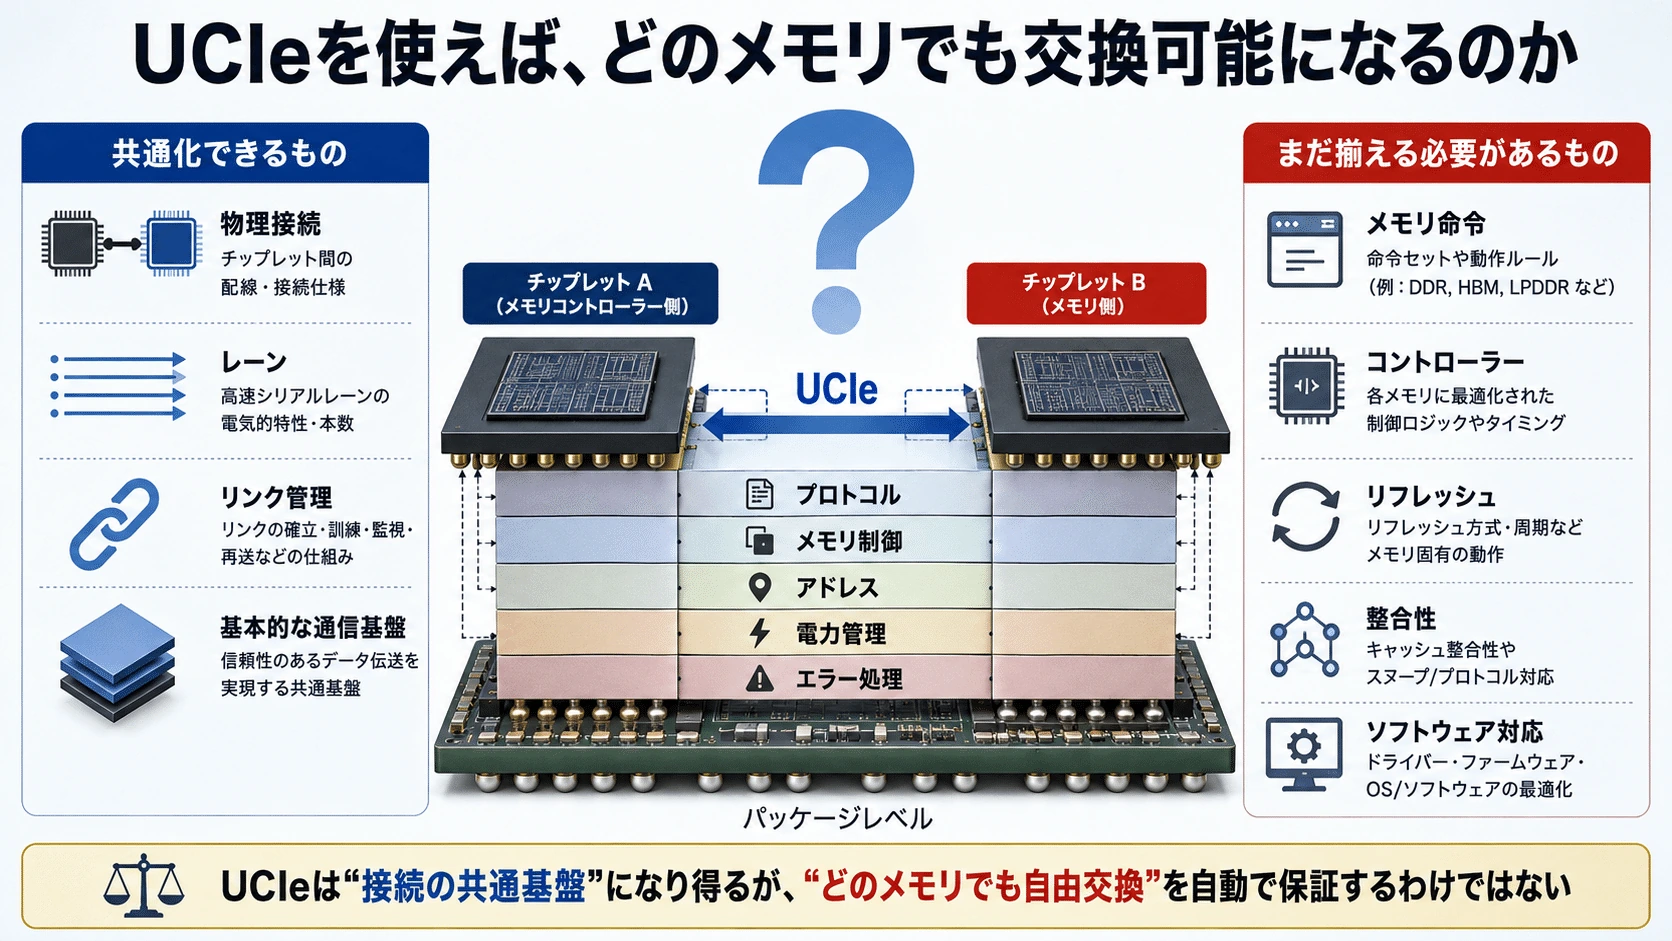
UCIeを使えば、どのメモリでも交換可能になるのか
#UCIeは、単なる電気信号の規格ではない。
#同一パッケージ内のチップレットについて、
#- Physical Layer
- Die-to-Die Adapter
- Protocol Layer
- リンク管理
- テスト
- 適合性
などを扱う共通技術スタックである。
#しかし、XBM特許にUCIeと書かれているからといって、将来Intel製XBM、Samsung製メモリ、Micron製メモリを自由に差し替えられるとは限らない。
#メモリとして動作するには、
#- 読み出しコマンド
- 書き込みコマンド
- アドレス形式
- リフレッシュ
- バンク制御
- エラー訂正
- 順序制御
- キャッシュ整合性
- 電力状態
などを統一する必要がある。
#UCIeはデータを運ぶ共通基盤にはなり得るが、その上で使うメモリプロトコルやコントローラーまで、XBM特許だけで標準化されたわけではない。
#したがって、XBMのUCIe利用は現時点では、
#メモリをチップレット型リンクへ接続するためのアーキテクチャ上の選択#
と考えるべきであり、交換可能な標準メモリ製品が成立したという意味ではない。
#
#
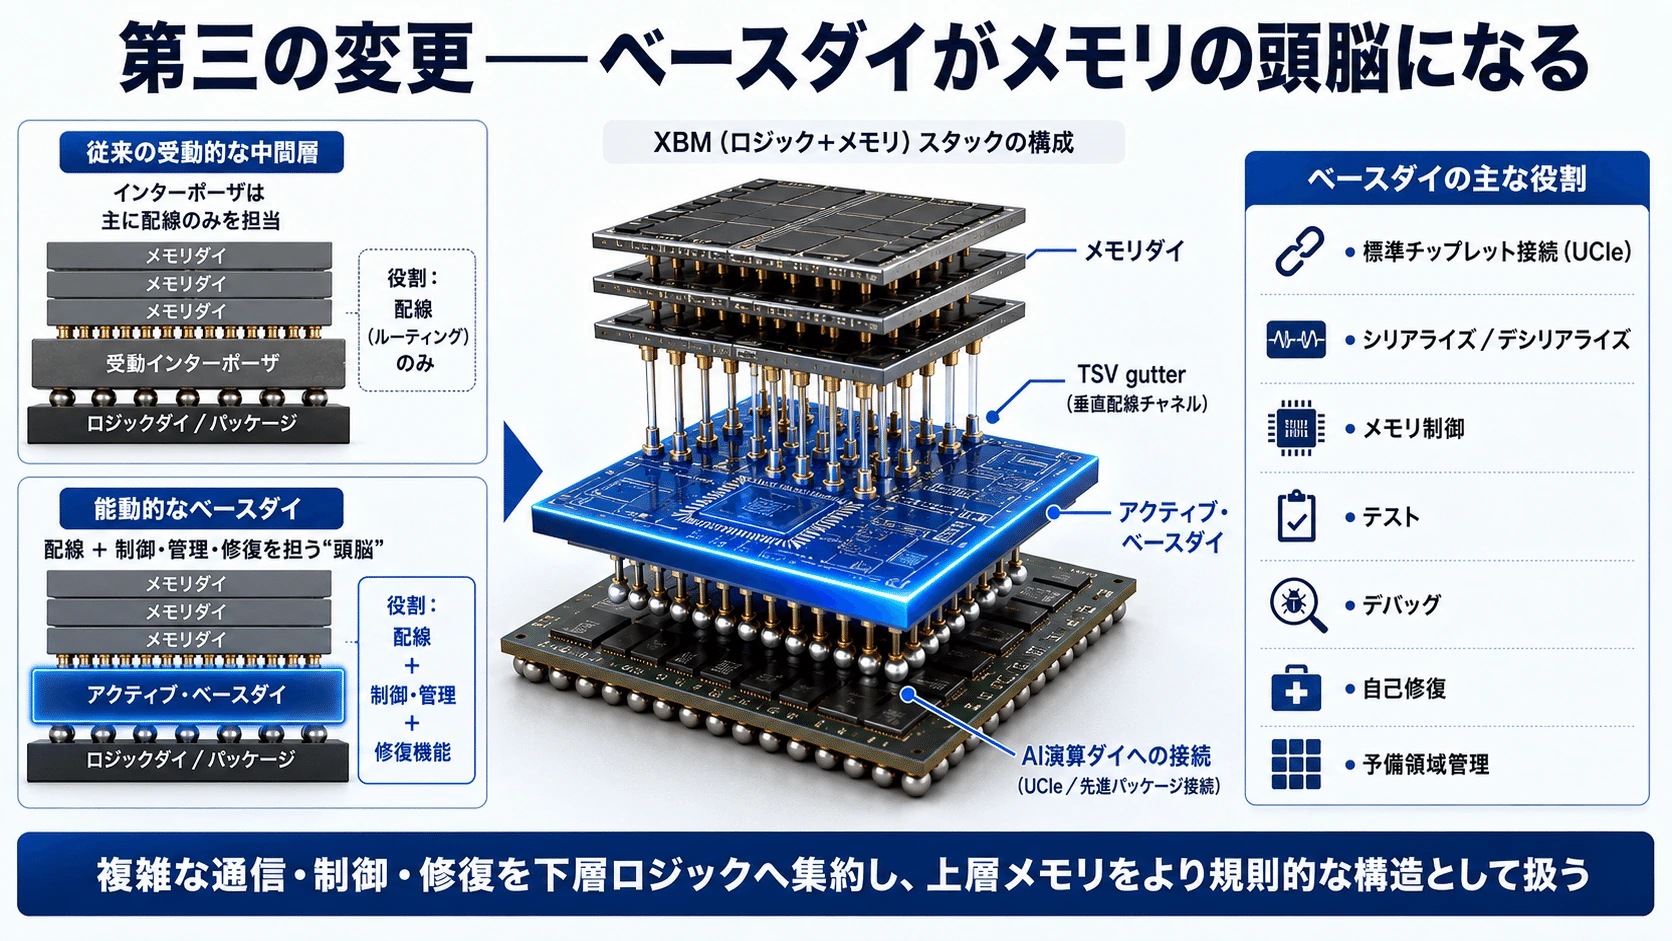
第三の変更――ベースダイがメモリの頭脳になる
#XBMでは、ベースダイが重要な役割を持つ。
#特許の構成例では、ベースダイに、
#- UCIe I/O
- シリアライズ/デシリアライズ
- テスト回路
- コントローラー
- デバッグ回路
- TSV接続領域
- 予備チャネル
- 組み立て後の修復機能
が配置される。
#XBMスタック
DRAMダイ
DRAMダイ
DRAMダイ
DRAMダイ
────────────
Active Base Die
・UCIe PHY
・Memory Control
・Test
・Debug
・Repair
・Spare Array
────────────
パッケージこれは、単なるパッシブなシリコンインターポーザーとは異なる。
#パッシブ・インターポーザーは、主として信号を横方向へ運ぶ配線基盤である。
#一方、アクティブ・ベースダイにはトランジスタ回路を置くことができ、
#- NoC
- キャッシュ
- I/O
- メモリコントローラー
- クロック
- 電源管理
- セキュリティー
- テスト回路
などを実装できる。
#XBMでは、DRAMダイ側を比較的規則的なメモリアレイとして作り、複雑な通信、検査、修復をベースダイへ集める。
#これは、
#上層
=容量を担当するメモリ
下層
=通信・制御・修復を担当するロジックという機能分割である。
#同じDRAMダイを繰り返し積層し、世代ごとにベースダイだけを更新できるなら、理論上はメモリセル製造とI/O技術の更新周期を分離できる可能性もある。
#ただし、これが実際に可能かは、製造プロセス、接合方式、信頼性、コスト、顧客仕様によって決まる。
#
#
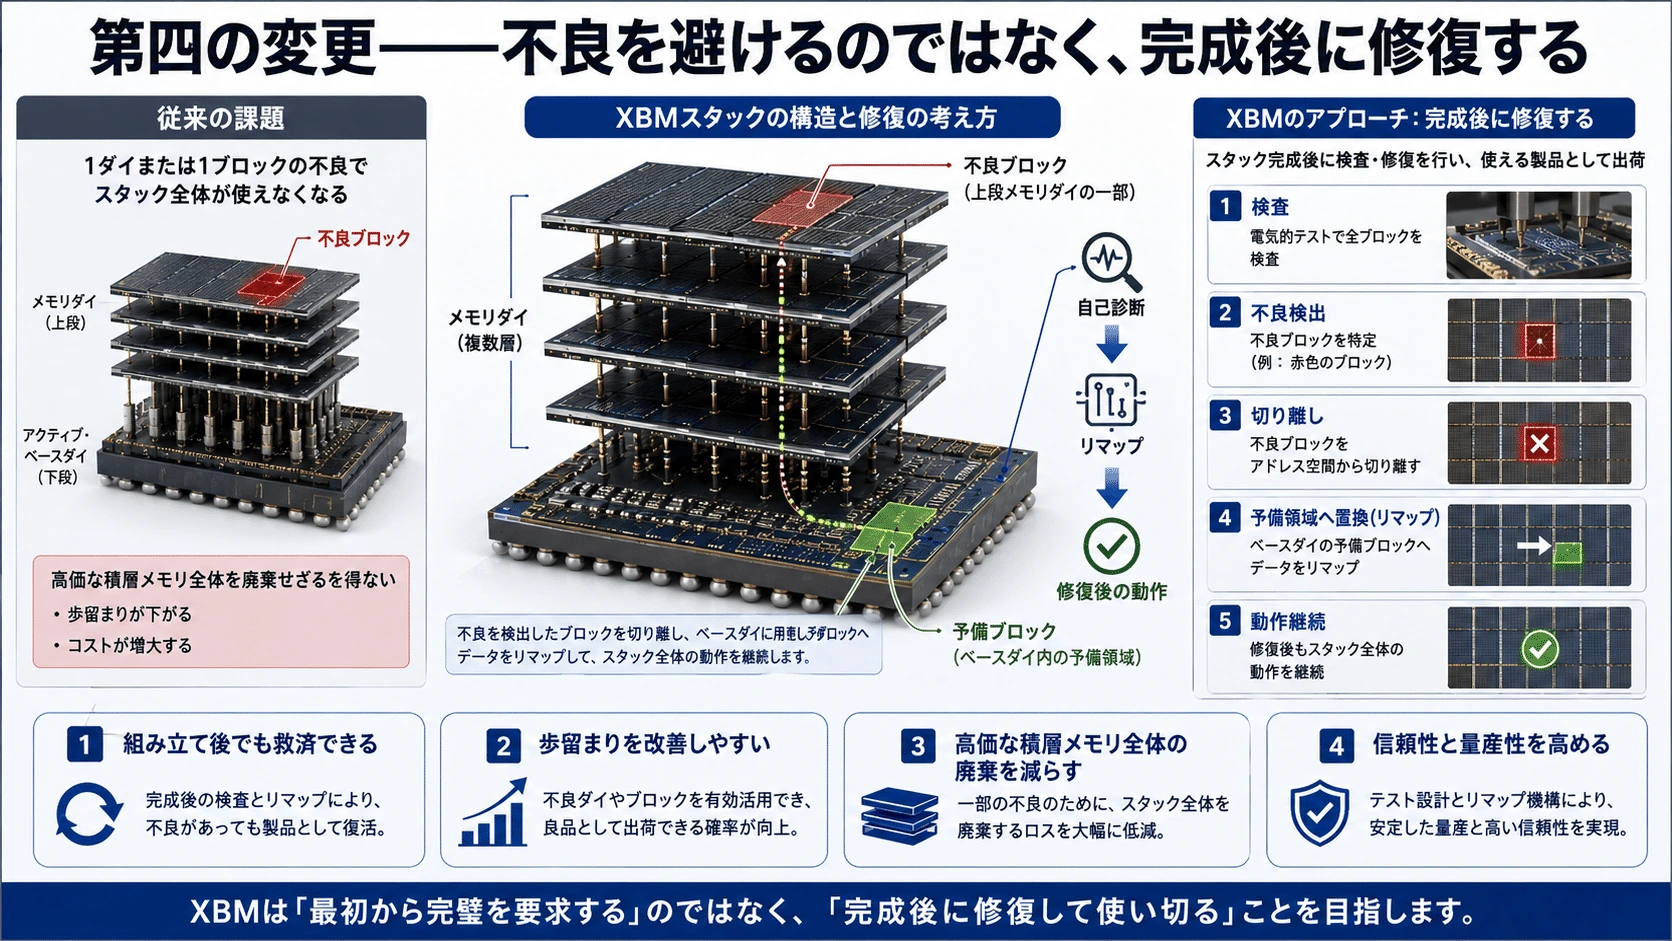
第四の変更――不良を避けるのではなく、完成後に修復する
#積層メモリでは、歩留まりが重要になる。
#8枚のメモリダイを積層し、そのうち1枚に重大な不良があれば、高価なスタック全体を失う可能性がある。
#良品
+
良品
+
良品
+
不良品
↓
完成した積層メモリ全体が不良そのため3D積層では、組み立て前に各ダイを検査し、Known Good Dieだけを使うことが重要になる。
#しかし、微細な接続端子は直接検査しにくく、完成後と同じ電源・温度・接続条件をダイ単体で再現できるとも限らない。
#XBMは、この問題に対して冗長性を積極的に利用する。
#特許では、
#- 各メモリダイのBIST
- 冗長メモリアレイ
- 予備チャネル
- 予備サブチャネル
- デバッグ機構
- 組み立て後の修復
が示されている。
#例示されたベースダイには、修復資源として4個の予備ダイ・サブチャネル、合計32個のデータブロックが配置される。上側ダイに修復不能な欠陥が見つかった場合、ベースダイ側の予備領域を代替として利用する考え方である。
#通常時
上側DRAMのDB 0
上側DRAMのDB 1
上側DRAMのDB 2
↓
ベースダイ
DB 1が故障
上側DRAMのDB 0
上側DRAMのDB 1 ×
上側DRAMのDB 2
↓
ベースダイの予備DBへ置換これはチップレットやウェハースケールプロセッサーでも見られる考え方である。
#欠陥を完全になくすのではなく、
#欠陥があっても、正常な領域と予備領域を使って製品として成立させる#
のである。
#積層数が増えるほど、この修復能力は重要になる。
#
#
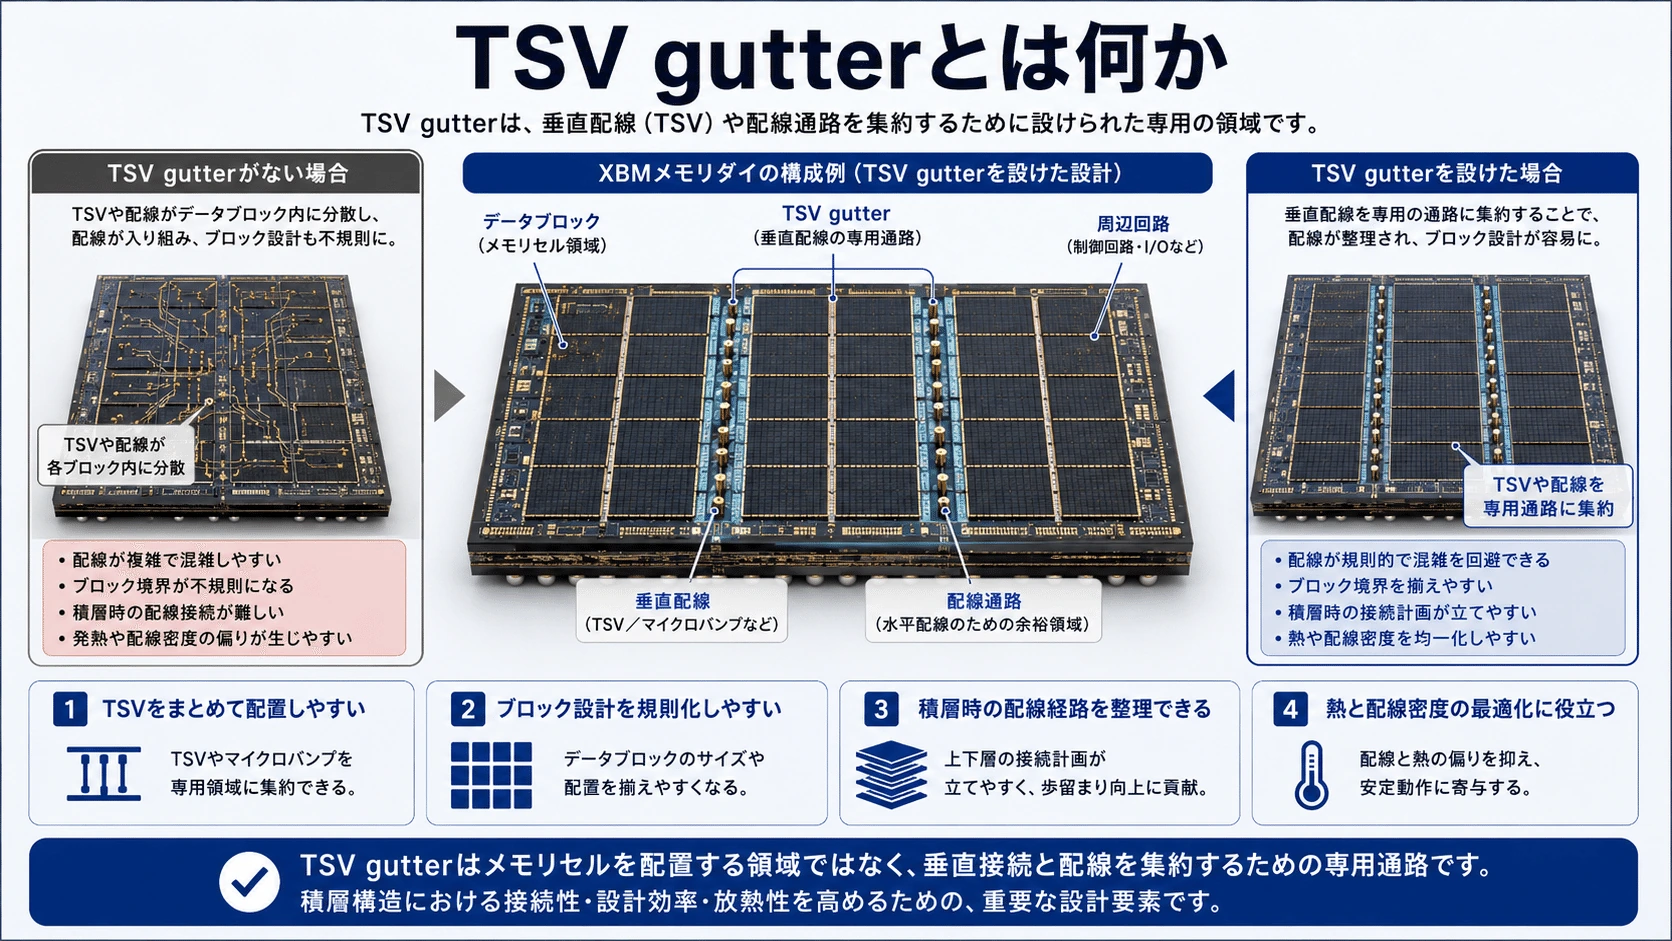
TSV gutterとは何か
#XBMでも、積層したメモリダイを上下へ接続するためにTSVが使われる。
#ただし特許では、TSVをダイ全体へ均等に散らすのではなく、TSV gutterと呼ばれる領域へまとめる構造が示されている。
#メモリダイ
データブロック
████████
TSV gutter
││││││││
データブロック
████████TSV gutterは、上下のダイ間で、
#- 読み出しデータ
- 書き込みデータ
- コマンド
- 制御信号
- クロック
などを運ぶ垂直配線の通路である。
#TSVはダイ同士を接着する技術ではない。
#TSVは、1枚のシリコンを厚さ方向へ貫通し、ダイの表側と裏側を接続する配線である。Hybrid Bondingやマイクロバンプはダイ境界面の接続を担当し、TSVはダイ内部の垂直配線を担当する。
#上側メモリ回路
↓
TSV
↓
接合面
↓
次のメモリダイ特許では、TSV gutterと両面のHigh Bandwidth Interconnectを使い、8層以上のメモリダイを積層する構成が示されている。
#
#
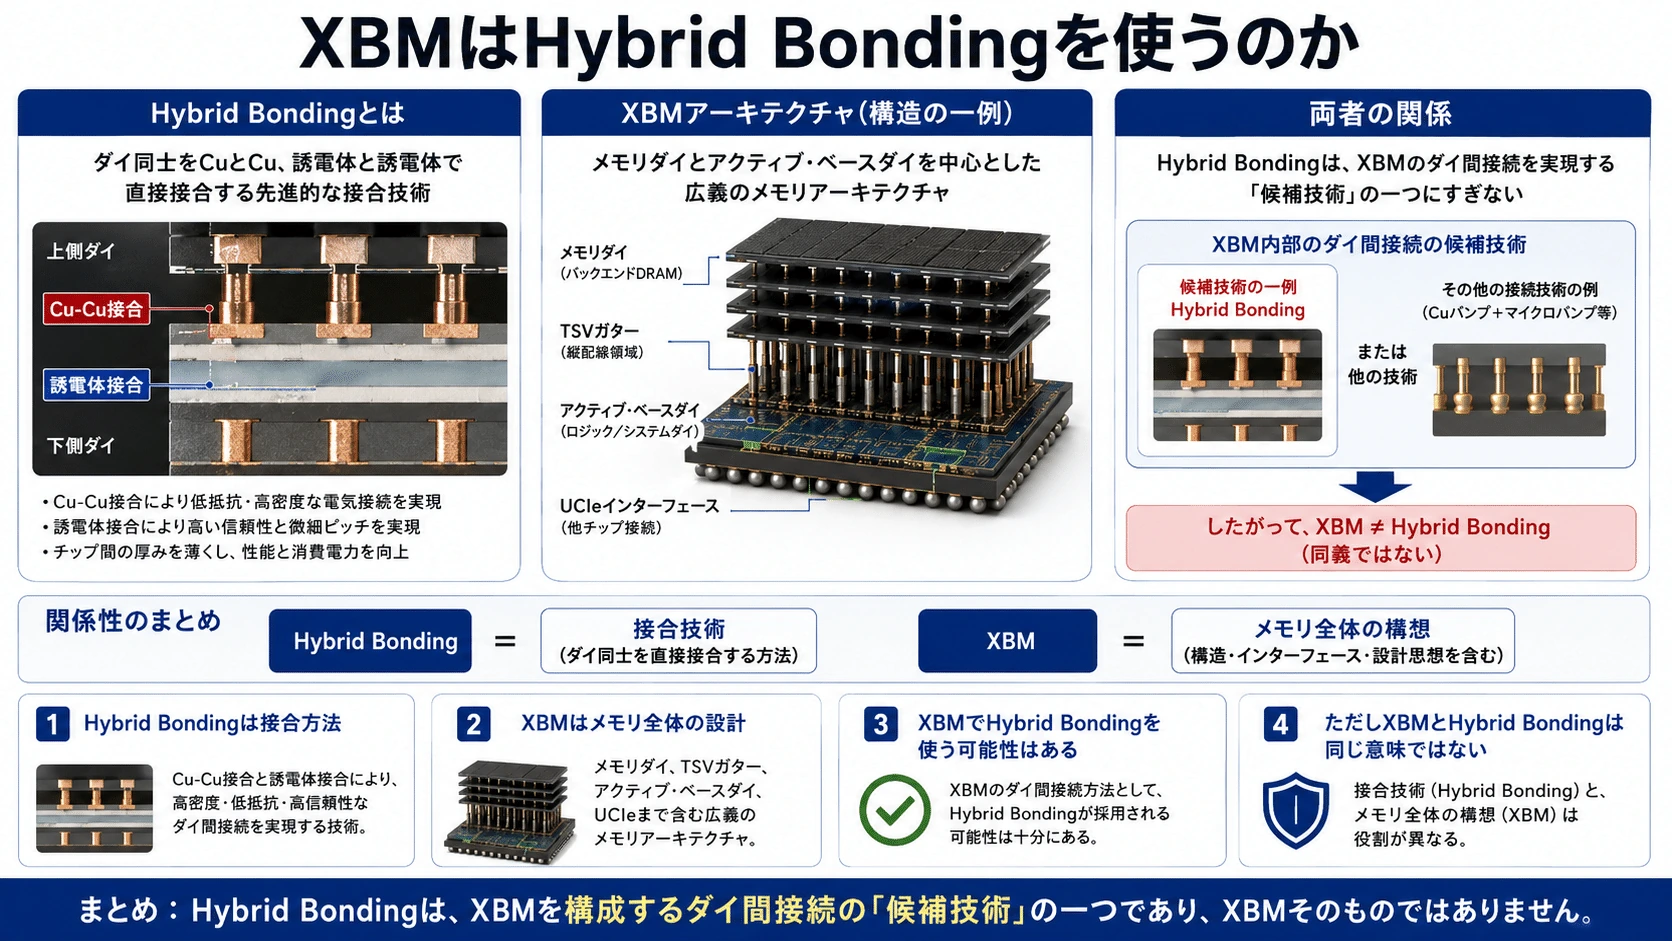
XBMはHybrid Bondingを使うのか
#XBMとHybrid Bondingは、同じものではない。
#Hybrid Bondingは、
#- Cu-to-Cu
- 誘電体-to-誘電体
を同時に接合し、マイクロバンプを使わずにダイ同士を高密度接続する技術である。
#一方、XBMはメモリ全体のアーキテクチャである。
#XBM特許では、ダイ積層についてWafer-to-WaferとDie-to-Dieの両方が例示され、ダイ薄化や両面インターコネクトが記載されている。しかし、将来の商用品が特定のCu-to-Cu Hybrid Bonding方式を必ず採用すると確定しているわけではない。
#整理すると、
#| 技術 | 役割 |
| XBM | 高帯域メモリ全体のアーキテクチャ |
| Backend DRAM | メモリセルの構造 |
| TSV gutter | 積層内の垂直配線 |
| HBI | ダイ間の高帯域接続 |
| Hybrid Bonding | ダイ接合に利用できる技術 |
| UCIe | メモリと演算ダイを結ぶ通信方式 |
| ベースダイ | 通信、制御、検査、修復 |となる。
#将来XBMが微細ピッチのHybrid Bondingを採用する可能性はある。
#しかし、
#XBMとはHybrid Bondingを使ったHBMである#
とだけ説明すると、Backend DRAM、UCIe、ベースダイ、修復機能という重要な特徴が抜け落ちる。
#
#
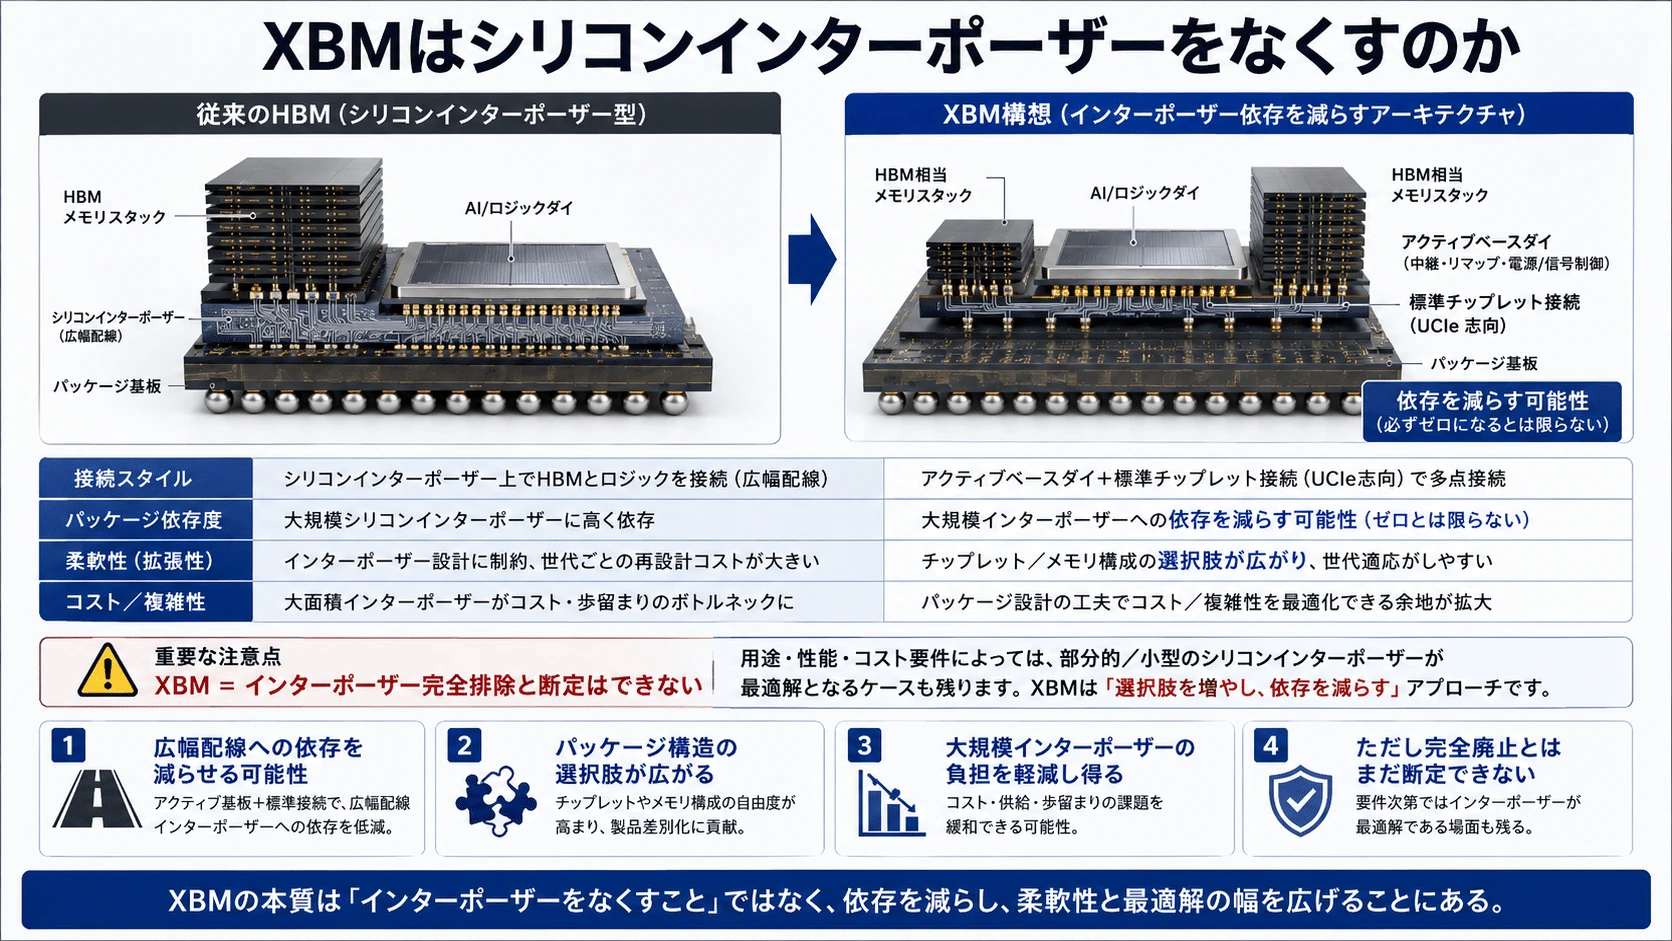
XBMはシリコンインターポーザーをなくすのか
#XBMについては、
#シリコンインターポーザーを完全に不要にする#
という説明が見られる。
#しかし、特許全体を読むと、もう少し慎重に表現する必要がある。
#特許の初期構成には、HBMスタックとロジックダイをシリコンインターポーザーへ搭載する例も含まれている。
#その一方で、
#- メモリスタックをパッケージ基板へ搭載するMemory-on-Package
- メモリ用の中間基板を省く構造
- モールド内へメモリスタックを埋め込む構造
- Reversed Overhang Memory-on-Package
- 電源をVR/PMICから直接供給する構造
なども示されている。
#インターポーザー型
XBM Compute
│ │
═══════════
Silicon Interposer
│
Package Substrate直接パッケージ型
XBM Compute Module
│ │
Package Substrateしたがって、XBMの狙いは、
#必ずシリコンインターポーザーを完全排除する#
ことではなく、
#超広幅のHBMインターフェースへの依存を減らし、メモリの配置方法とパッケージ構造の選択肢を増やす#
ことにある。
#UCIeによる接続で十分な帯域と電力効率を得られれば、全面シリコンインターポーザーを使わず、有機基板、ブリッジ、RDLなどを組み合わせる余地が広がる。
#しかし、実際にどの構造が最適になるかは、
#- UCIeのレーン数
- 1レーン当たりの速度
- 配線距離
- 信号損失
- 必要帯域
- PHY電力
- パッケージ面積
- 製造コスト
によって変わる。
#
#
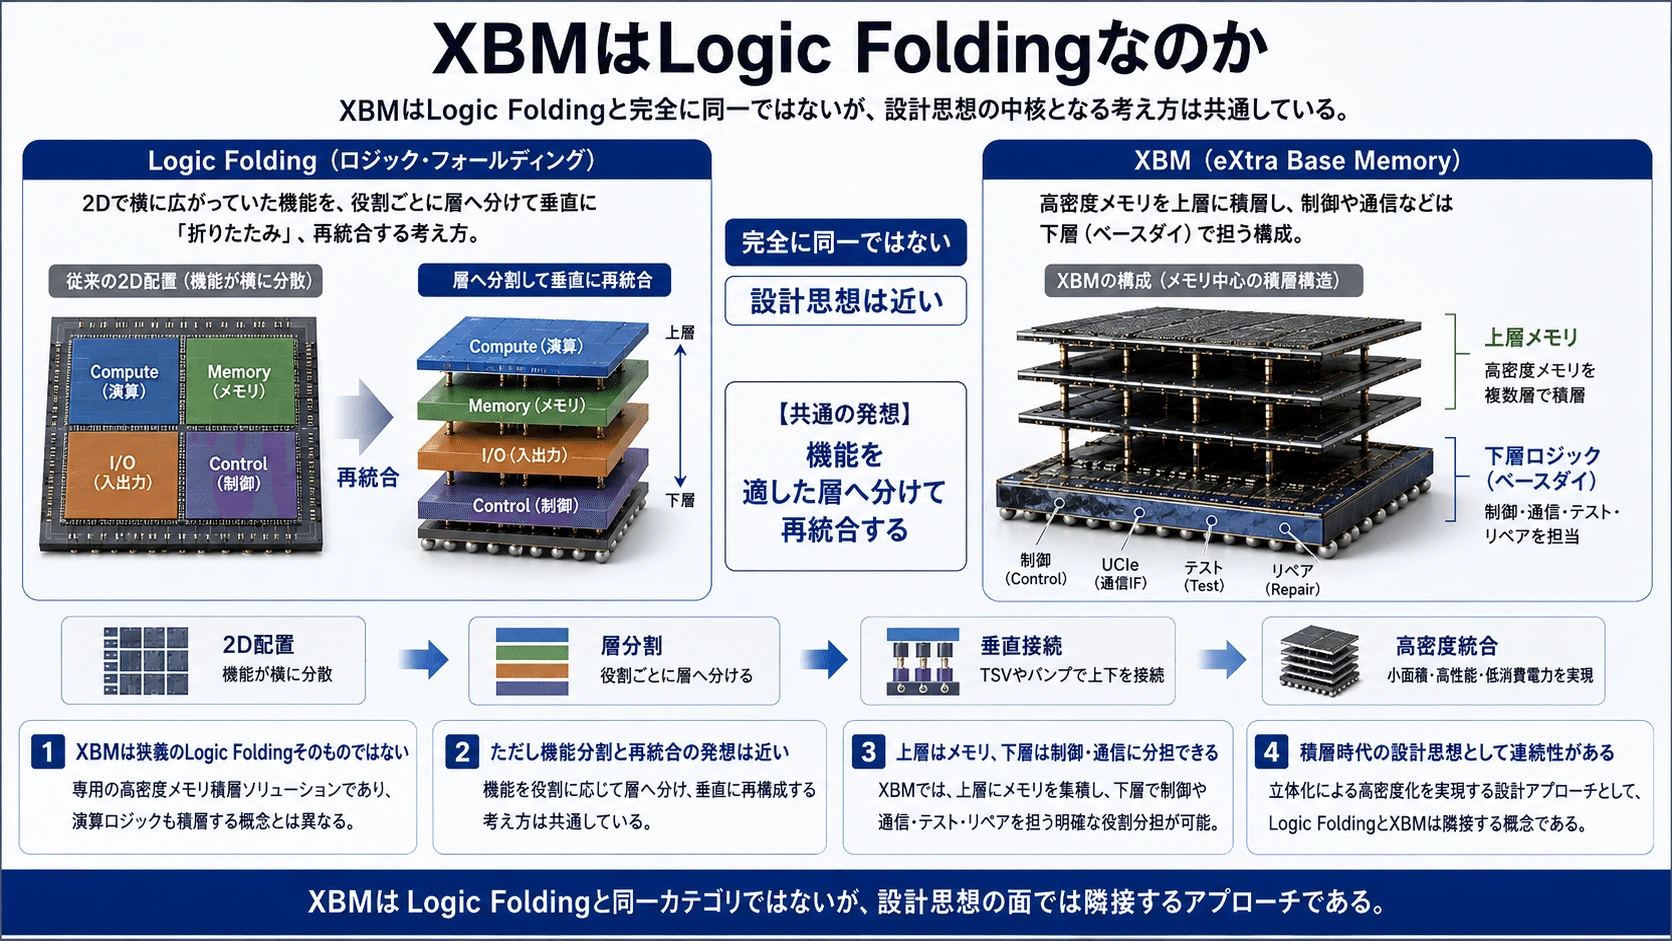
XBMはLogic Foldingなのか
#Logic Foldingは、平面上へ並べていた機能を上下のシリコン層へ分割し、短い垂直配線で再接続する設計思想である。
#例えば、
#従来
Compute ─ Cache ─ I/O ─ Memory Controlを、
#上層:SRAM/Memory
│
中層:Compute
│
下層:I/O/Control/Powerへ再配置する。
#XBMは、GPUの演算回路とDRAMを極細ピッチで直接上下に積層する構造ではない。
#そのため、XBMそのものを狭い意味でのLogic Foldingと呼ぶのは適切ではない。
#しかし、設計思想は強く連続している。
#XBMでは、
#上層
=Backend DRAM
下層
=UCIe・テスト・修復を持つベースダイ
横方向
=GPU/XPUとのチップレット接続という機能分割を行う。
#つまり、
#メモリセル、垂直配線、通信、制御、修復を、それぞれに適した層とダイへ分けて再統合する#
という点では、Logic FoldingやCMOS 2.0に近い方向にある。
#これまでの流れをつなぐと、次のようになる。
#巨大モノリシックSoC
↓
レチクル・歩留まり・コストの壁
↓
チップレット
↓
2.5Dパッケージ
↓
マイクロバンプ
↓
Hybrid Bonding
↓
TSV
↓
Die-to-Die PHY
↓
UCIe
↓
アクティブ・ベースダイ
↓
Logic Folding
↓
XBMXBMはこの最後に突然現れた別の技術ではない。
#これまで個別に扱ってきた技術を、メモリ側で一つのアーキテクチャへまとめたものなのである。連載全体でも、半導体設計の単位はダイからチップレット、3Dスタック、パッケージ全体へ拡大してきた。
#
#
HBMとXBMの比較
#| 項目 | 現在のHBM | XBM構想 |
| 技術段階 | 量産・広範な採用 | 特許出願段階 |
| メモリセル | 一般的なDRAMプロセス | 1T1C Backend DRAM |
| 積層 | 複数のDRAMダイ | 8層以上を想定 |
| 垂直配線 | TSV | TSV gutter+HBI |
| ダイ境界 | マイクロバンプ、将来は直接接合も想定 | 特許上はW2W/D2D積層 |
| GPUとの接続 | 非常に広い並列インターフェース | UCIe I/O bundle |
| 主な配線基盤 | シリコンインターポーザー | インターポーザーまたは直接パッケージ構造 |
| ベースダイ | PHY、制御、HBMインターフェース | UCIe、テスト、デバッグ、修復、予備領域 |
| 故障対応 | ダイテスト、冗長セル、製品内修復 | スタック横断の予備データブロック |
| 主な利点 | 成熟した高帯域・低通信電力 | パッケージ自由度、修復性、チップレット統合 |
| 主なリスク | インターポーザー、パッケージ容量、コスト | Backend DRAM、PHY電力、歩留まり、量産性 |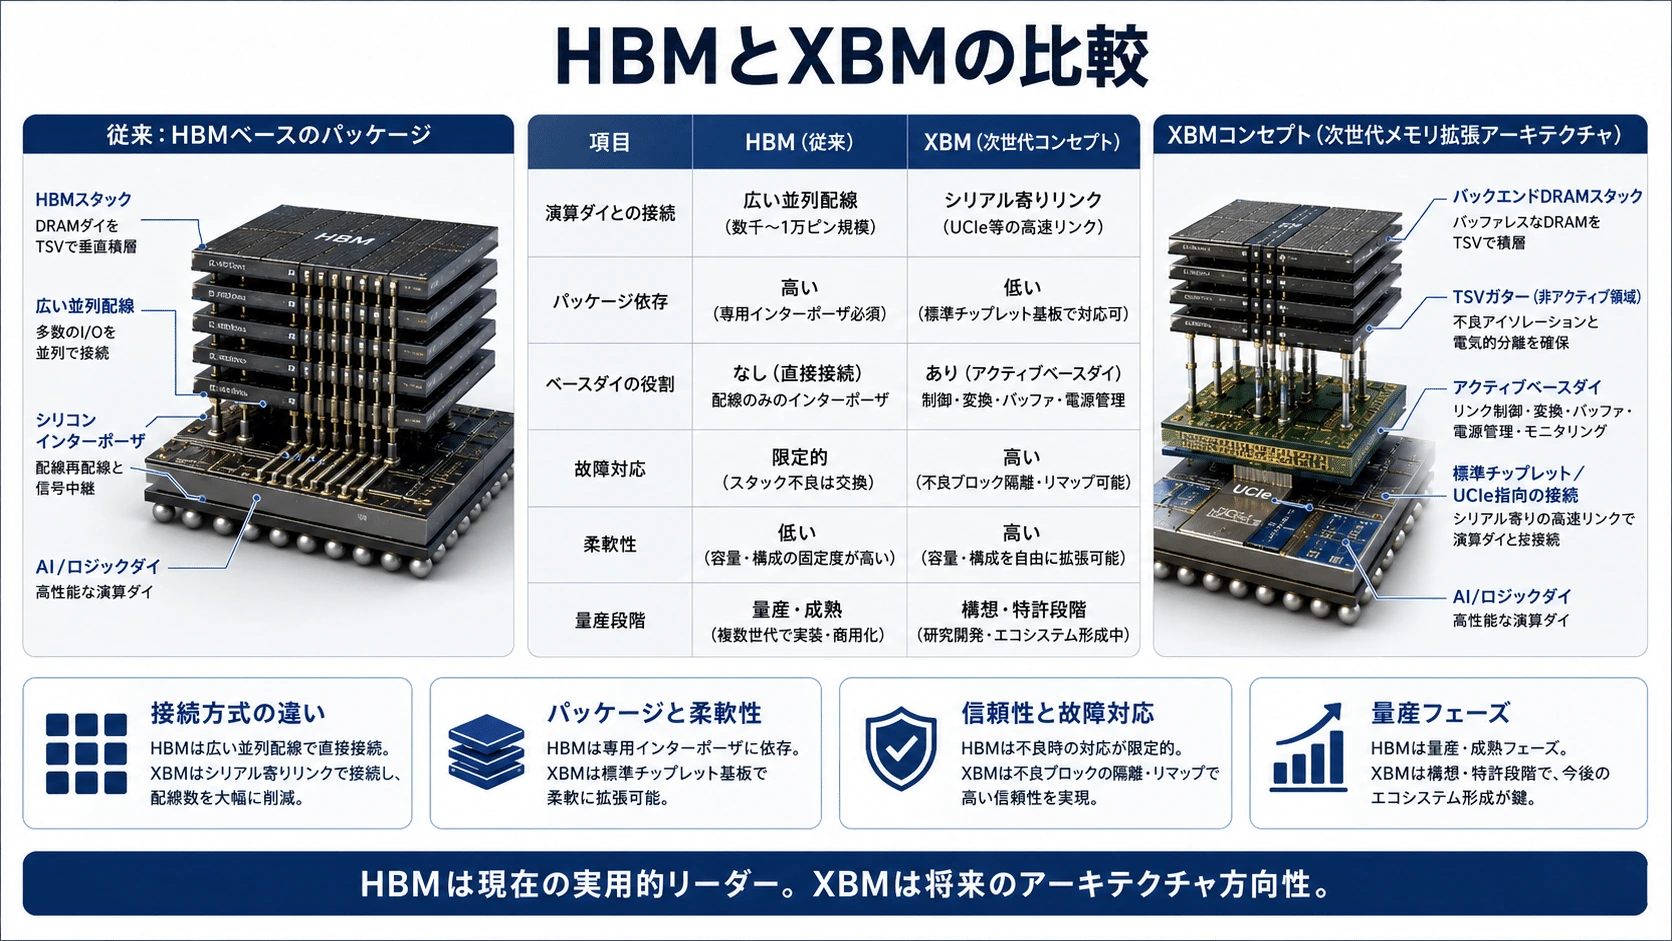
#
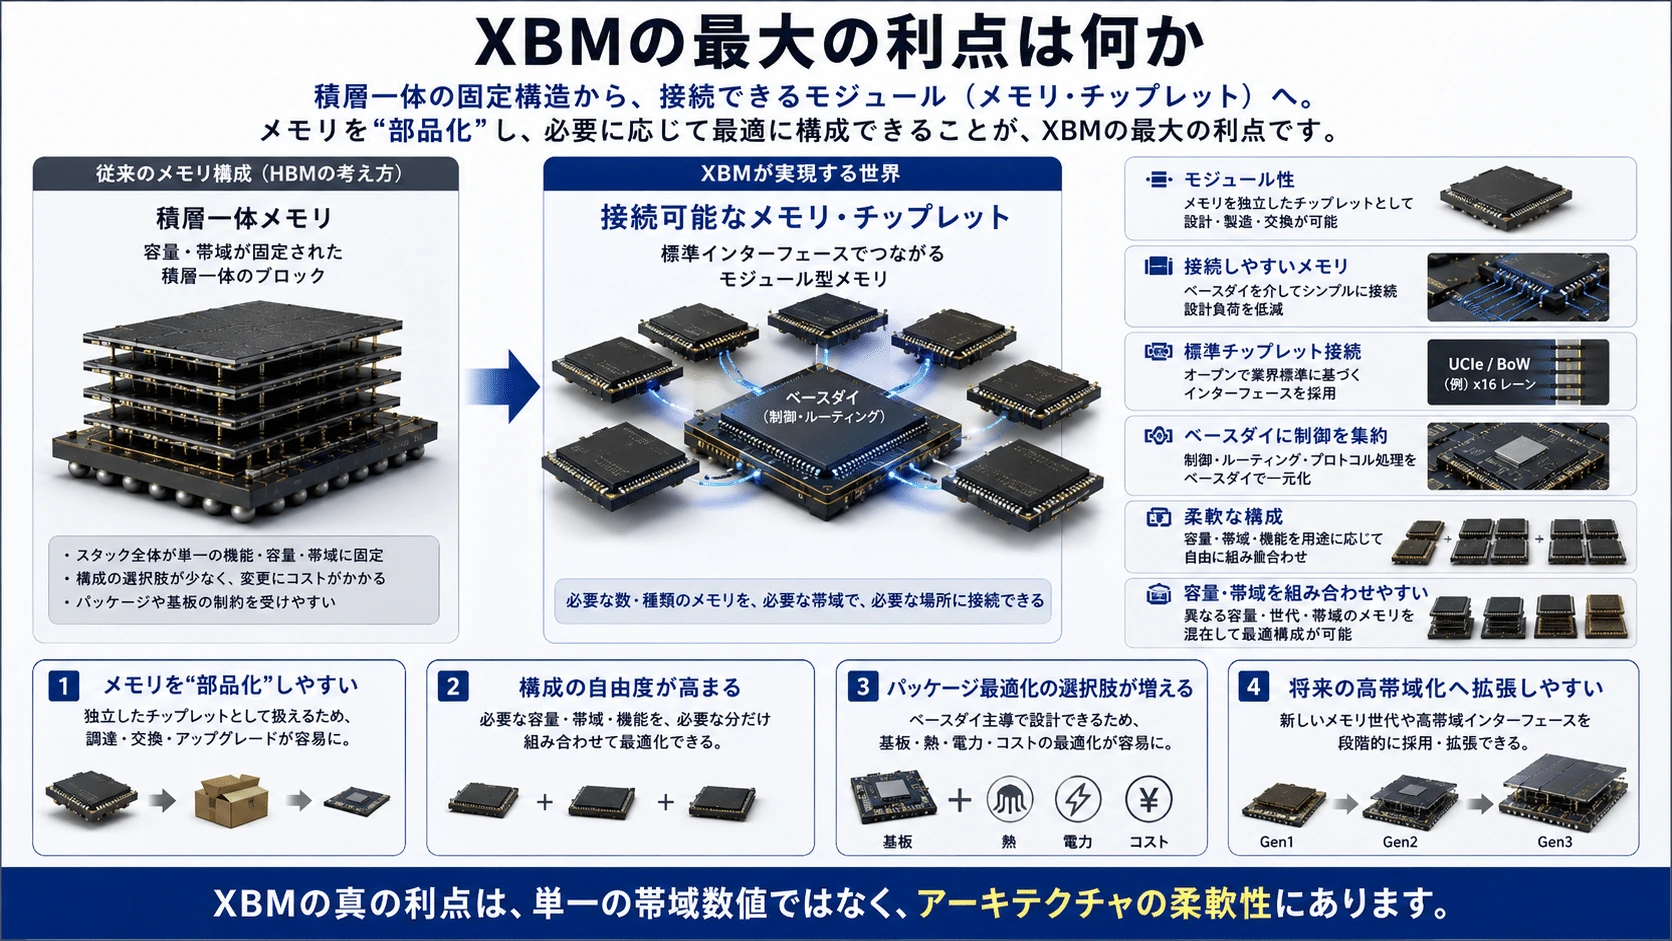
XBMの最大の利点は何か
#XBMの最大の利点は、単純な最大帯域ではない。
#現時点では実測製品が存在しないため、HBM4より速い、消費電力が低い、製造コストが安いと断定することはできない。
#XBMの本当の価値は、
#メモリを、特定の巨大インターポーザーへ固定された部品から、UCIeで接続可能なチップレットへ変えようとしていること#
にある。
#もし成立すれば、AIプロセッサー設計者は、
#- XBMスタックの数
- 容量
- ベースダイ
- パッケージ配置
- UCIeレーン数
- 製造ノード
- メモリ供給元
- 修復機能
を、よりモジュール的に設計できる可能性がある。
#現在
特定GPU
+
特定HBM構成
+
特定インターポーザー
+
特定パッケージXBMが目指す方向
Compute Chiplet
+
Memory Chiplet
+
I/O Chiplet
+
Active Base Die
+
Package Networkこれはメモリを、GPUに付属する受動的な部品ではなく、パッケージ内ネットワークへ参加するアクティブな構成要素へ変える。
#
#
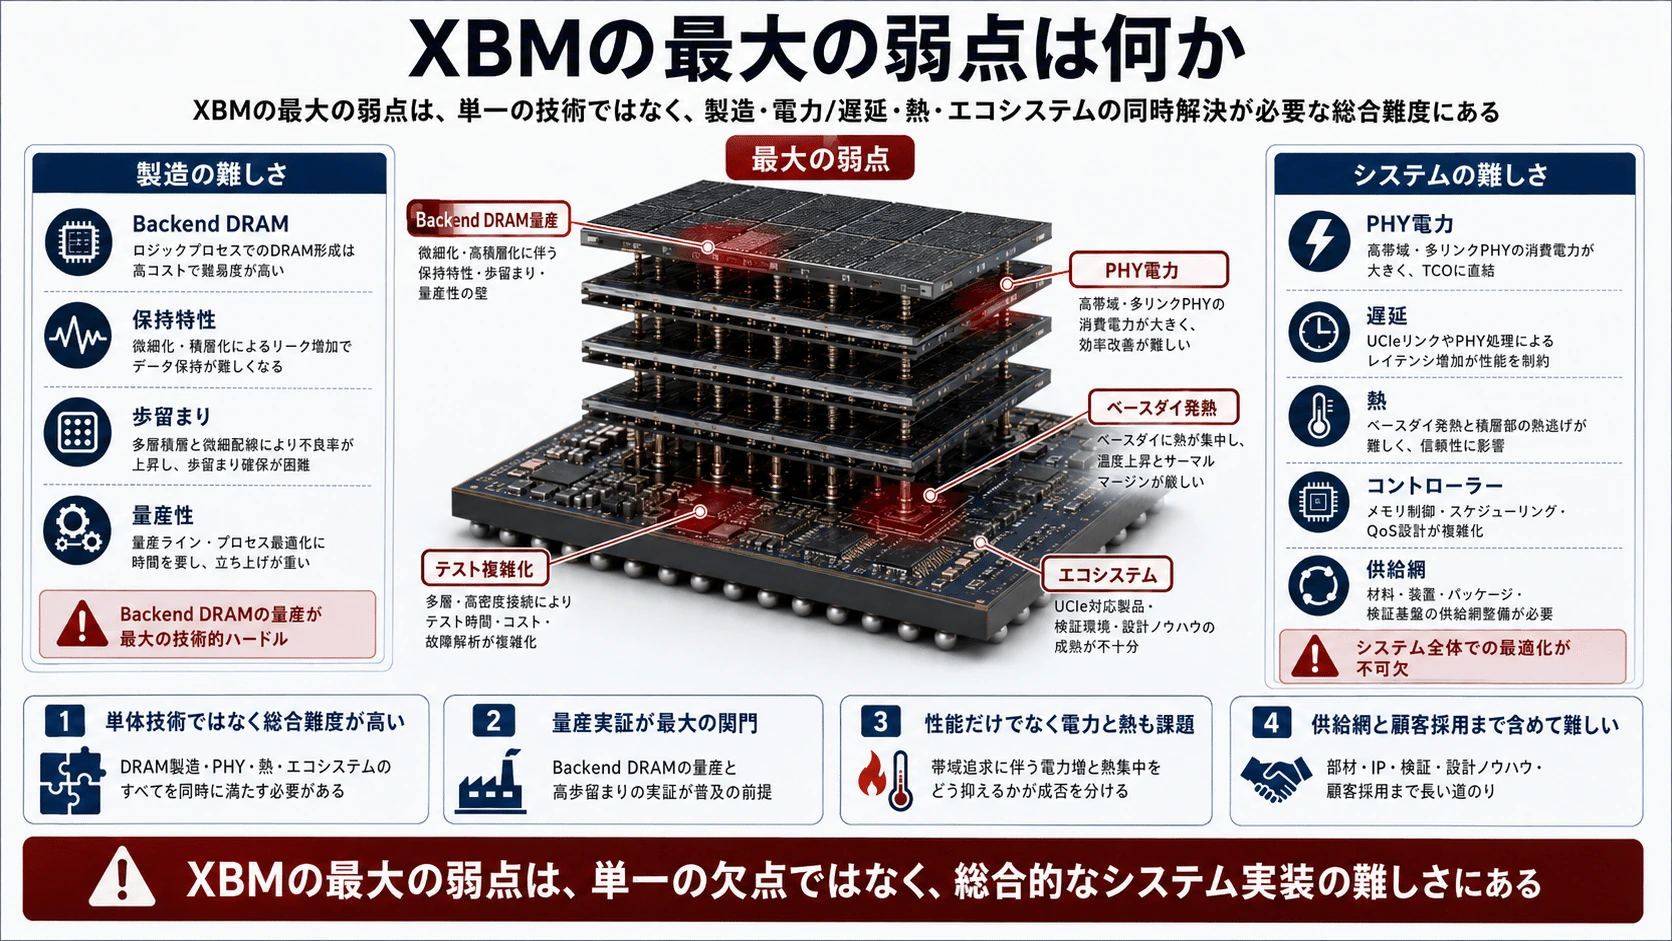
XBMの最大の弱点は何か
#XBMが実用化されるには、複数の技術的課題を同時に解決する必要がある。
#1.Backend DRAMの量産性
#薄膜トランジスタを使うBackend DRAMで、
#- セル面積
- データ保持時間
- リーク電流
- 書き込み性能
- 読み出し性能
- 耐久性
- 製造ばらつき
- 高温動作
- 歩留まり
を、既存のDRAMに対抗できる水準へ持っていく必要がある。
#特許に構造が書かれていることと、数十万枚規模のウェハーで安定量産できることは別である。
#2.UCIe PHYの電力
#HBMは多数の短距離配線を使うため、1本当たりの速度と駆動力を抑えやすい。
#XBMはデータをシリアライズするため、PHY、クロック、タイミング調整の電力が増える可能性がある。
#AIアクセラレーターでは数TB/s級の帯域を継続的に使用するため、わずかなpJ/bitの差でも、メモリシステム全体では大きな電力差になる。
#3.ベースダイの発熱
#ベースダイへ、
#- SerDes
- メモリ制御
- テスト
- 修復
- デバッグ
- クロック
を集めると、メモリスタックの下側に発熱源が生まれる。
#DRAMは温度が上がるとリークとリフレッシュ負荷が増えやすいため、演算回路だけでなく、メモリスタック内部の熱分布も管理しなければならない。
#4.スタック全体の検査
#自己修復機能があっても、すべての不良を救済できるわけではない。
#- 接合不良
- TSV断線
- 電源配線不良
- クロック障害
- 大規模なメモリアレイ不良
- ベースダイ自体の不良
などは、予備データブロックだけでは修復できない可能性がある。
#5.エコシステム
#XBMを量産するには、
#- DRAM製造
- Backend Transistor
- TSV
- ダイ薄化
- 接合
- UCIe PHY
- メモリコントローラー
- パッケージ基板
- テスト装置
- 顧客認証
を一体として立ち上げる必要がある。
#HBMはすでにメモリメーカー、GPUメーカー、ファウンドリ、OSAT、パッケージ基板メーカーによる巨大な供給網を持つ。
#XBMは一つの部品を置き換えるのではなく、このシステム全体へ入り込まなければならない。
#
#
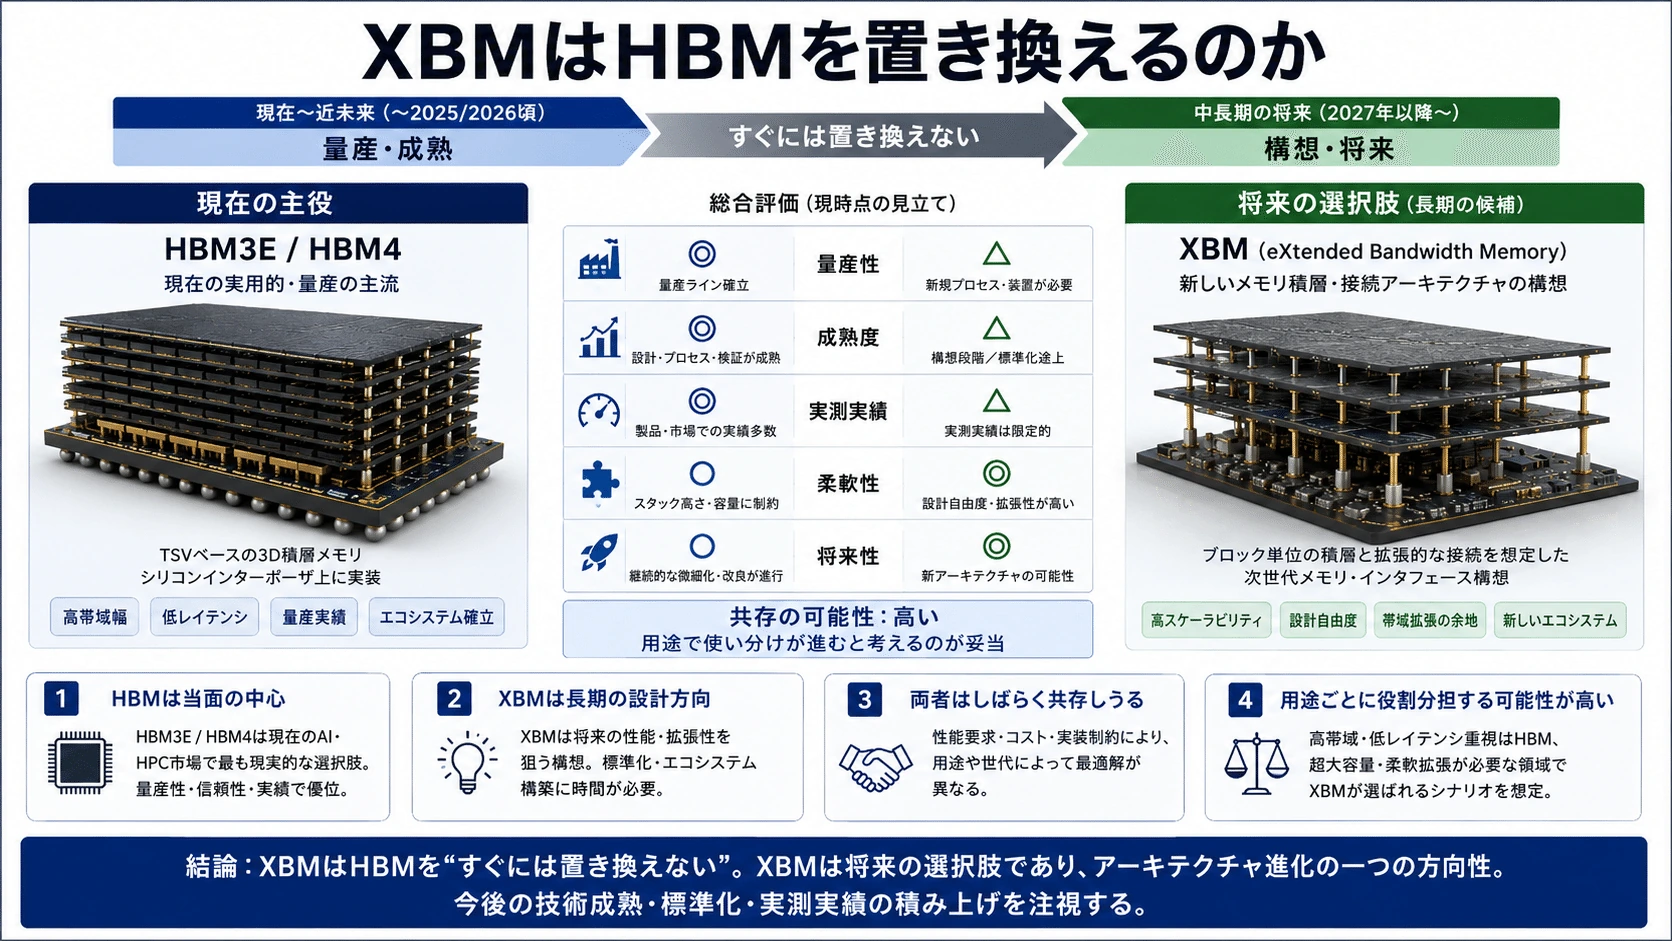
XBMはHBMを置き換えるのか
#現時点では、XBMを「HBMキラー」と呼ぶのは早い。
#確認できるのはIntelの特許出願であり、
#- 製品名
- 試作チップ
- 実測帯域
- 実測消費電力
- 製造工場
- 採用顧客
- サンプル時期
- 量産時期
- 販売価格
は示されていない。公開情報上、正式な製品ロードマップも確認されていない。
#さらに、XBMが将来製品化されたとしても、HBMを全面的に置き換えるとは限らない。
#用途によっては、
#超高帯域・低電力を最優先
→ シリコンインターポーザー型HBM
パッケージ自由度・容量・修復性を重視
→ XBM型メモリ
ロジック直上の極低遅延
→ 3D SRAM/Memory-on-Logic
大容量の共有メモリ
→ CXLメモリ
低コスト
→ GDDR/DDRという使い分けになる可能性がある。
#将来のAIシステムは、一種類のメモリだけで構成されるとは限らない。
#演算器の直上
=SRAM
演算器の隣
=HBM/XBM
パッケージ外
=DDR/LPDDR
サーバー共有
=CXL Memory
ストレージ
=NANDというメモリ階層の中で、XBMがどの位置を取れるかが問題になる。
#
#
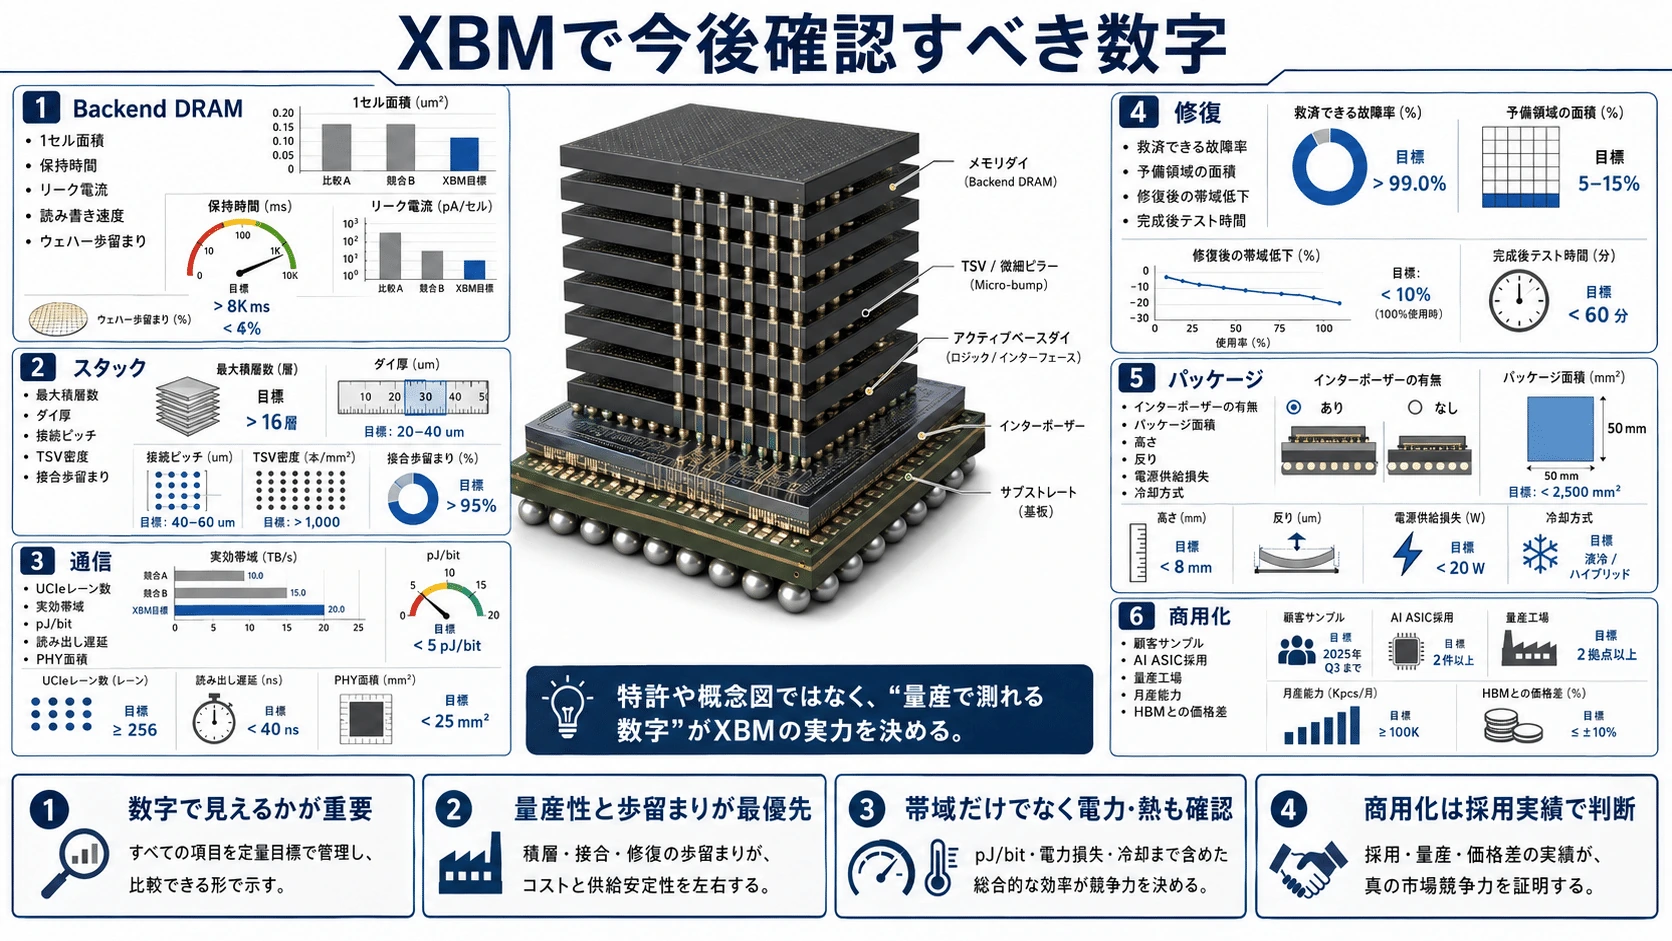
XBMで今後確認すべき数字
#XBMのニュースを見るとき、特許件数や理論帯域だけを追っても、実用性は判断できない。
#重要なのは次の数字である。
#Backend DRAM
#- 1セルの面積
- 保持時間
- リーク電流
- 読み書き速度
- ウェハー歩留まり
スタック
#- 最大積層数
- ダイ厚
- 接続ピッチ
- TSV密度
- 接合歩留まり
通信
#- UCIeレーン数
- 実効帯域
- pJ/bit
- 読み出し遅延
- PHY面積
修復
#- 救済できる故障率
- 予備領域の面積
- 修復後の帯域低下
- スタック完成後のテスト時間
パッケージ
#- インターポーザーの有無
- パッケージ面積
- パッケージ高さ
- 反り
- 電源供給損失
- 冷却方式
商用化
#- 顧客サンプル
- コントローラー対応
- AI ASICへの採用
- 量産工場
- 月産能力
- HBMとの価格差
これらが示されて初めて、XBMが製品へ進んでいると判断できる。
#
#
今回の要点
#- XBMは、Intelの特許に記載されたCross-Batch Memory構想である。
- 現時点では量産製品ではなく、特許出願段階である。
- 1T1C DRAMをBEOL側へ形成するBackend DRAMを使う。
- DRAMアレイを多数のデータブロックへ分割する。
- 積層内の垂直接続にはTSV gutterとHBIを使う。
- 演算ダイとの通信には32GT/sのUCIe I/O bundleを使う例が示されている。
- 32GT/sは現在のUCIe規格の上限ではなく、UCIe 3.0は48/64GT/sへ対応している。
- ベースダイへUCIe、制御、テスト、デバッグ、修復、予備メモリを集める。
- 不良領域をベースダイ側の予備データブロックへ置き換える構造を持つ。
- XBMが必ずシリコンインターポーザーを完全排除するわけではない。
- 特許にはインターポーザー型と、メモリをパッケージ基板へ直接載せる構造の両方が含まれる。
- XBMはHybrid Bondingそのものではなく、メモリ全体のアーキテクチャである。
- Logic Foldingと同様に、メモリ、通信、制御、修復を異なる層へ機能分割する。
- 最大の課題はBackend DRAMの量産性、UCIe PHYの電力、熱、歩留まり、供給網である。
- XBMは現時点でHBMを置き換える製品ではなく、将来メモリをチップレット化するための設計構想である。
#
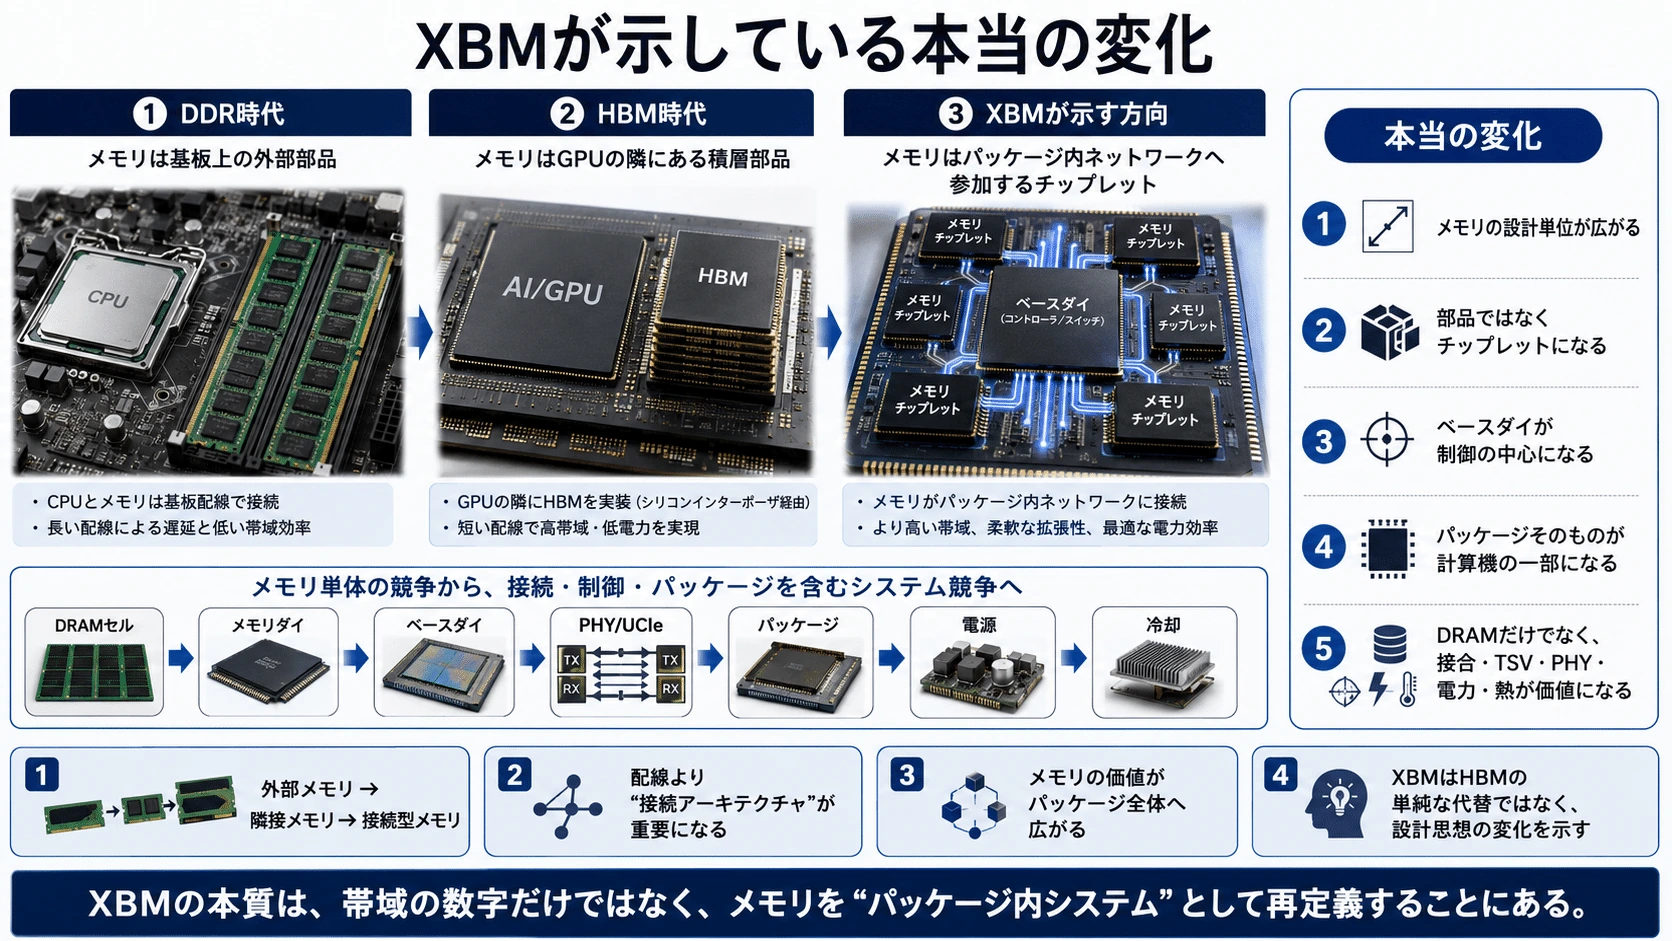
XBMが示している本当の変化
#XBMの重要性は、「IntelがHBMより速いメモリを発明した」という一点にはない。
#本当に重要なのは、メモリの設計単位そのものが変わろうとしていることだ。
#従来、メモリは完成したDRAM部品として、プロセッサーの外側へ接続されていた。
#HBMでは、DRAMを積層し、プロセッサーの隣へ近づけた。
#XBMはさらに一歩進み、
#- メモリセル
- メモリダイ
- ベースダイ
- 修復回路
- PHY
- UCIe
- パッケージ
- 電源
- 冷却
を一つの設計空間として扱おうとしている。
#DDR時代
メモリは基板上の外部部品
↓
HBM時代
メモリはGPUに隣接する積層部品
↓
XBMが示す方向
メモリはパッケージ内ネットワークへ参加するチップレットこれまでの半導体は、トランジスタを小さくし、一枚のダイへ詰め込むことで進化してきた。
#チップレット時代には、異なるダイをパッケージ上でつなぐことが性能を決めるようになった。
#そしてXBMが示しているのは、その考え方が演算ロジックだけでなく、DRAMそのものへ入り始めたという変化である。
#**XBMとはHBMを単純に置き換えるメモリではない。 DRAMを、修復可能で、積層可能で、UCIeへ接続できるメモリ・チップレットとして再発明しようとする構想である。**#
その構想が実際の製品になるかは、まだ分からない。
#しかし、AI時代のメモリ競争が、DRAMセルの微細化だけではなく、接合、TSV、PHY、ベースダイ、パッケージ、修復技術を含むシステム競争へ移ったことは明確である。
#
一次資料・公式資料
#Intel XBM Patent: https://www.freepatentsonline.com/y2026/0191095.html
#UCIe Specifications: https://www.uciexpress.org/specifications
#UCIe 3.0 Official Release: https://www.uciexpress.org/_files/ugd/8dc731_ae67289d0ec646cdba5c1aee245538b3.pdf
#SoftBank / SAIMEMORY / Intel: https://www.softbank.jp/corp/news/press/sbkk/2026/20260203_01/
#VLSI Symposium 2026 Technical Tipsheet: https://www.vlsisymposium.org/wp-content/uploads/2026/04/2026-VLSI-Technical-Tipsheet-REVISED-FINAL-4.25.26-1-1.pdf
#VLSI Symposium Images and Captions: https://www.vlsisymposium.org/images-captions/
#Micron HBM4: https://www.micron.com/products/memory/hbm/hbm4
#Intel DRAM History: https://timeline.intel.com/1985/farewell-to-dram
#TrendForce HBM Outlook: https://www.trendforce.com/presscenter/news/20260602-13074.html
#