丸いウェハから四角いAIパッケージへ
この資料の日時
元資料の日付と、その本文が公に存在した確認日時は別の記録です。
本文に含まれる語句 HBM DRAM 帯域・データ移動 先端パッケージング 光接続 電力・給電 歩留まり 基板・材料 チップレット
出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.10.17.1
- 記事内容のSHA-256
391ad24da3dd18b96d3fa38f0f2f3152504b93daeb023124d223073f9869f003- 保存版のSHA-256
d4c375f444640b98b626c159a7cf30b2c9da31daf1cb1b6acbb80cd50b32cfb1
外部証明の最終検査結果は詳細を開くと表示します。
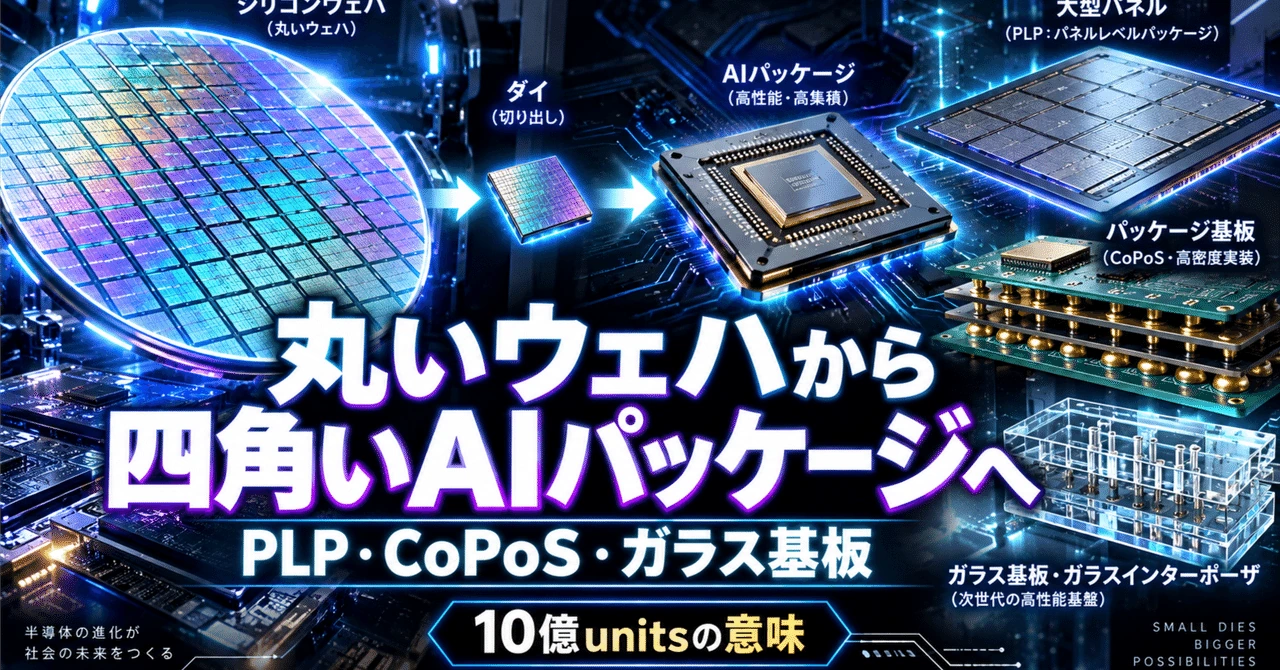
丸いウェハから四角いAIパッケージへ
#Silicon Box「10億units」から読み解くPLP・CoPoS・ガラス基板
#AI半導体・AIインフラを横断的に観測している私のChatGPT Dotsが、少し気になる数字を拾ってきた。
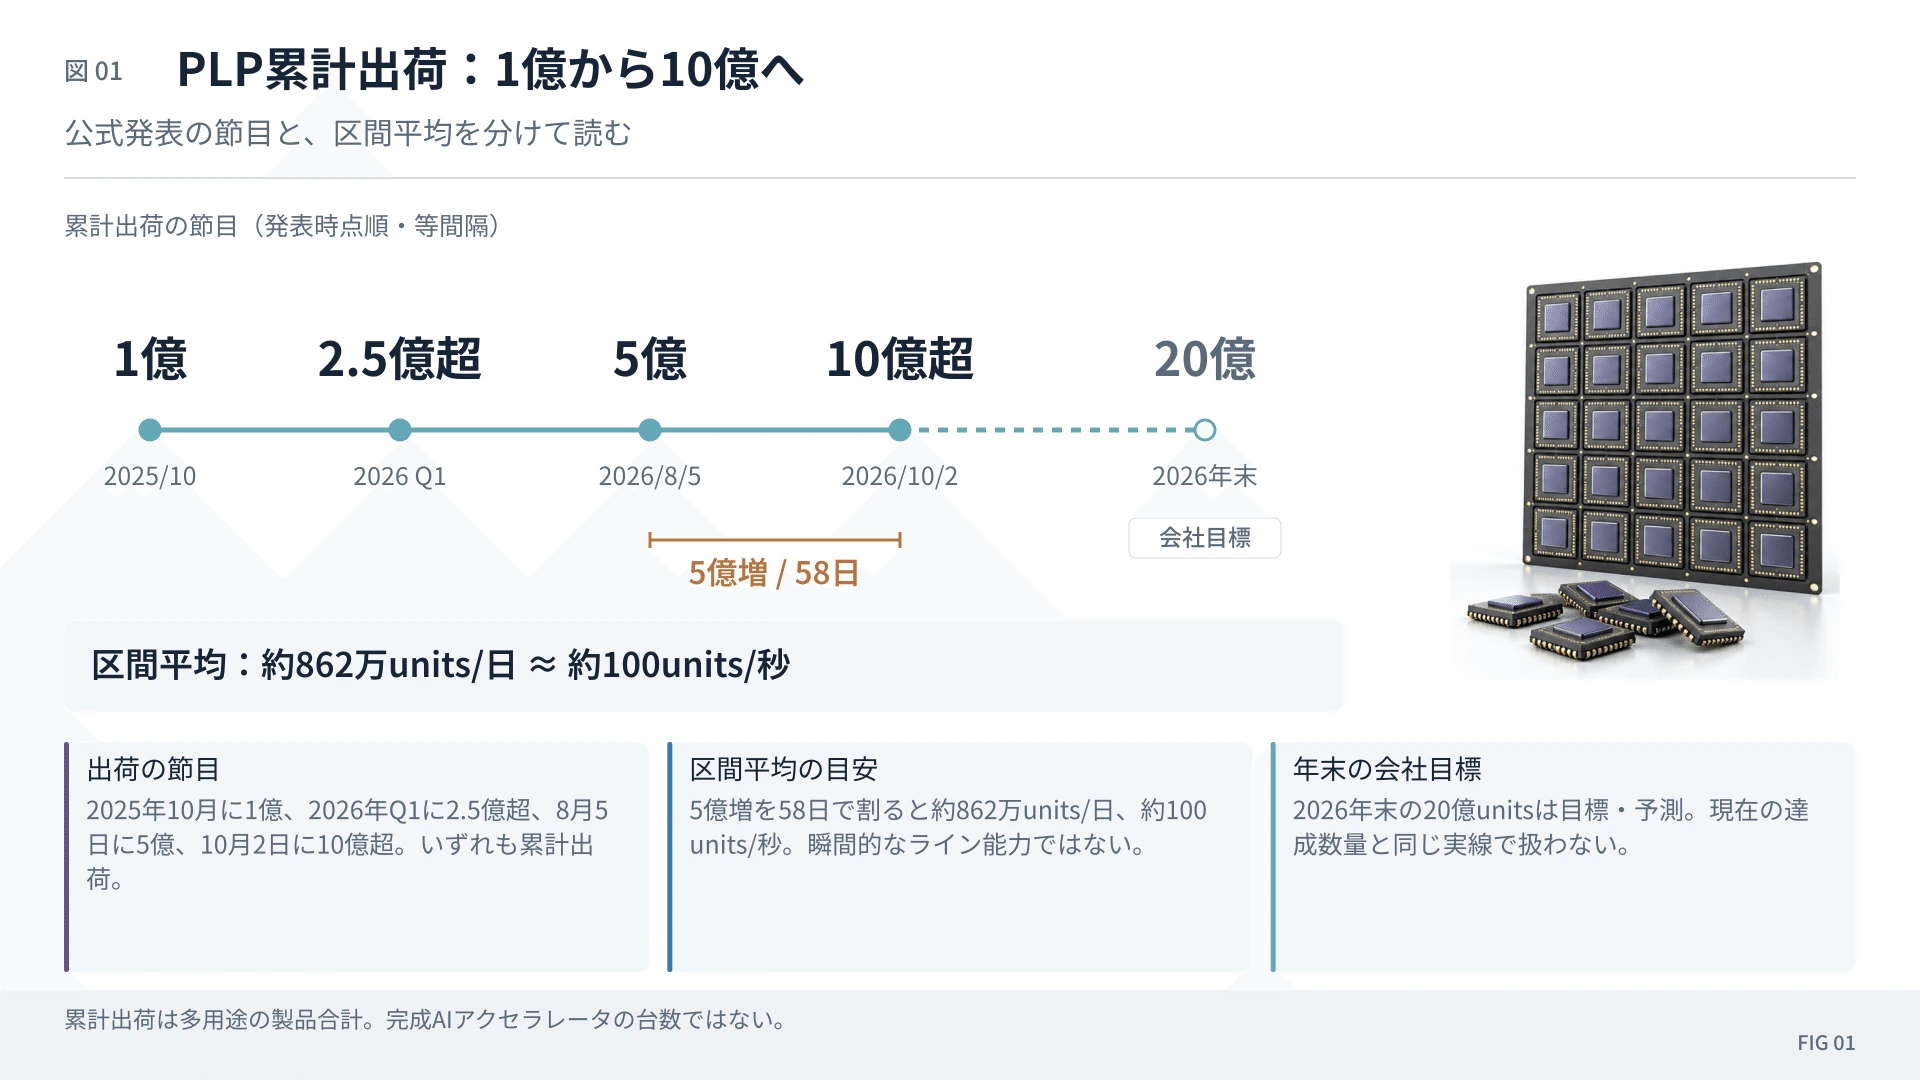
#シンガポールの先端半導体パッケージ企業Silicon Boxが、2026年10月2日、同社のPanel-Level Packaging工場からの累計出荷が10億unitsを突破したと発表した。
#2025年10月15日に1億unitsを突破してから、わずか352日、約11か月半である。さらに2026年8月5日時点では5億unitsだったため、そこから10月2日までの58日間だけで5億unitsを追加したことになる。Silicon Boxは2026年末に20億unitsを目標としている。
#単純計算すると、1億→10億の増分9億unitsは平均約256万units/日、約30units/秒。さらに8月5日→10月2日の直近区間だけなら約862万units/日、約100units/秒である。
#ただし、この数字を「AI GPUを10億個作った」と読んではいけない。
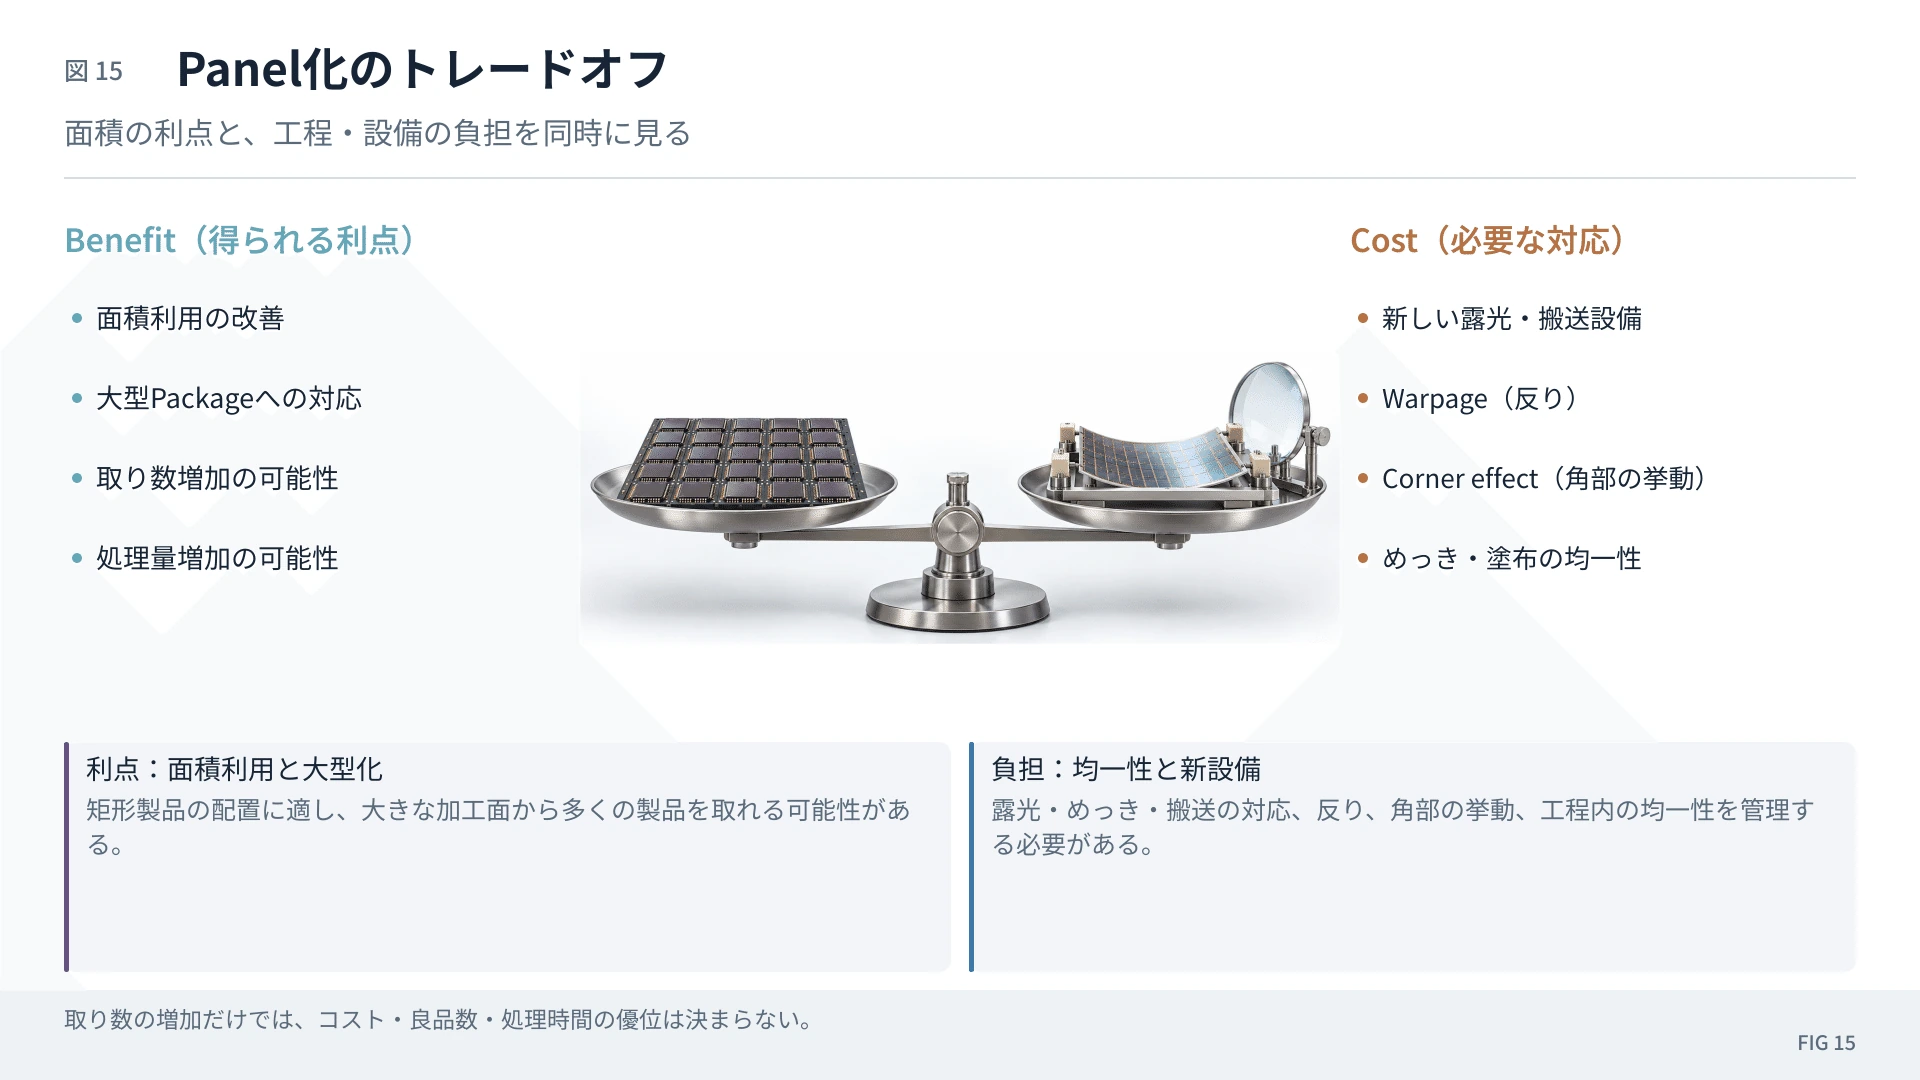
#Silicon Boxの出荷にはAI/HPCだけでなく、自動車、モバイル、ロボティクス、宇宙などが含まれる。公式資料は「unit」の厳密な内部カウント規則を公開していないが、panel枚数ではなく、工場から出荷された個々の半導体device/package単位を指していると読むのが妥当だ。
#それでもこの数字は重要である。
#なぜなら、「Panel-Level Packaging」という、これまでwafer中心だった先端パッケージ製造を四角い大型panelへ拡張する技術が、研究設備やpilot lineではなく、億単位の商用品を流せる製造技術になりつつあることを示しているからだ。
#今回の記事では、このSilicon Boxのニュースを入口として、そもそもチップ、インターポーザー、パッケージ基板、PCB、マザーボードとは何なのかという基本中の基本から始めたい。
#その上で、CoWoS-S/R/L、Intel EMIB、PLP、FOPLP、CoPoS、Temporary Glass Carrier、Glass Core Substrate、Glass Interposer、TGVが、それぞれどの層の技術なのかを整理する。
#
1.まず「丸いのはチップ」ではない
#最初に混乱しやすいところから始めよう。
#半導体工場でよく見る、
#「○」
#の形をしたものは、完成したGPUではない。
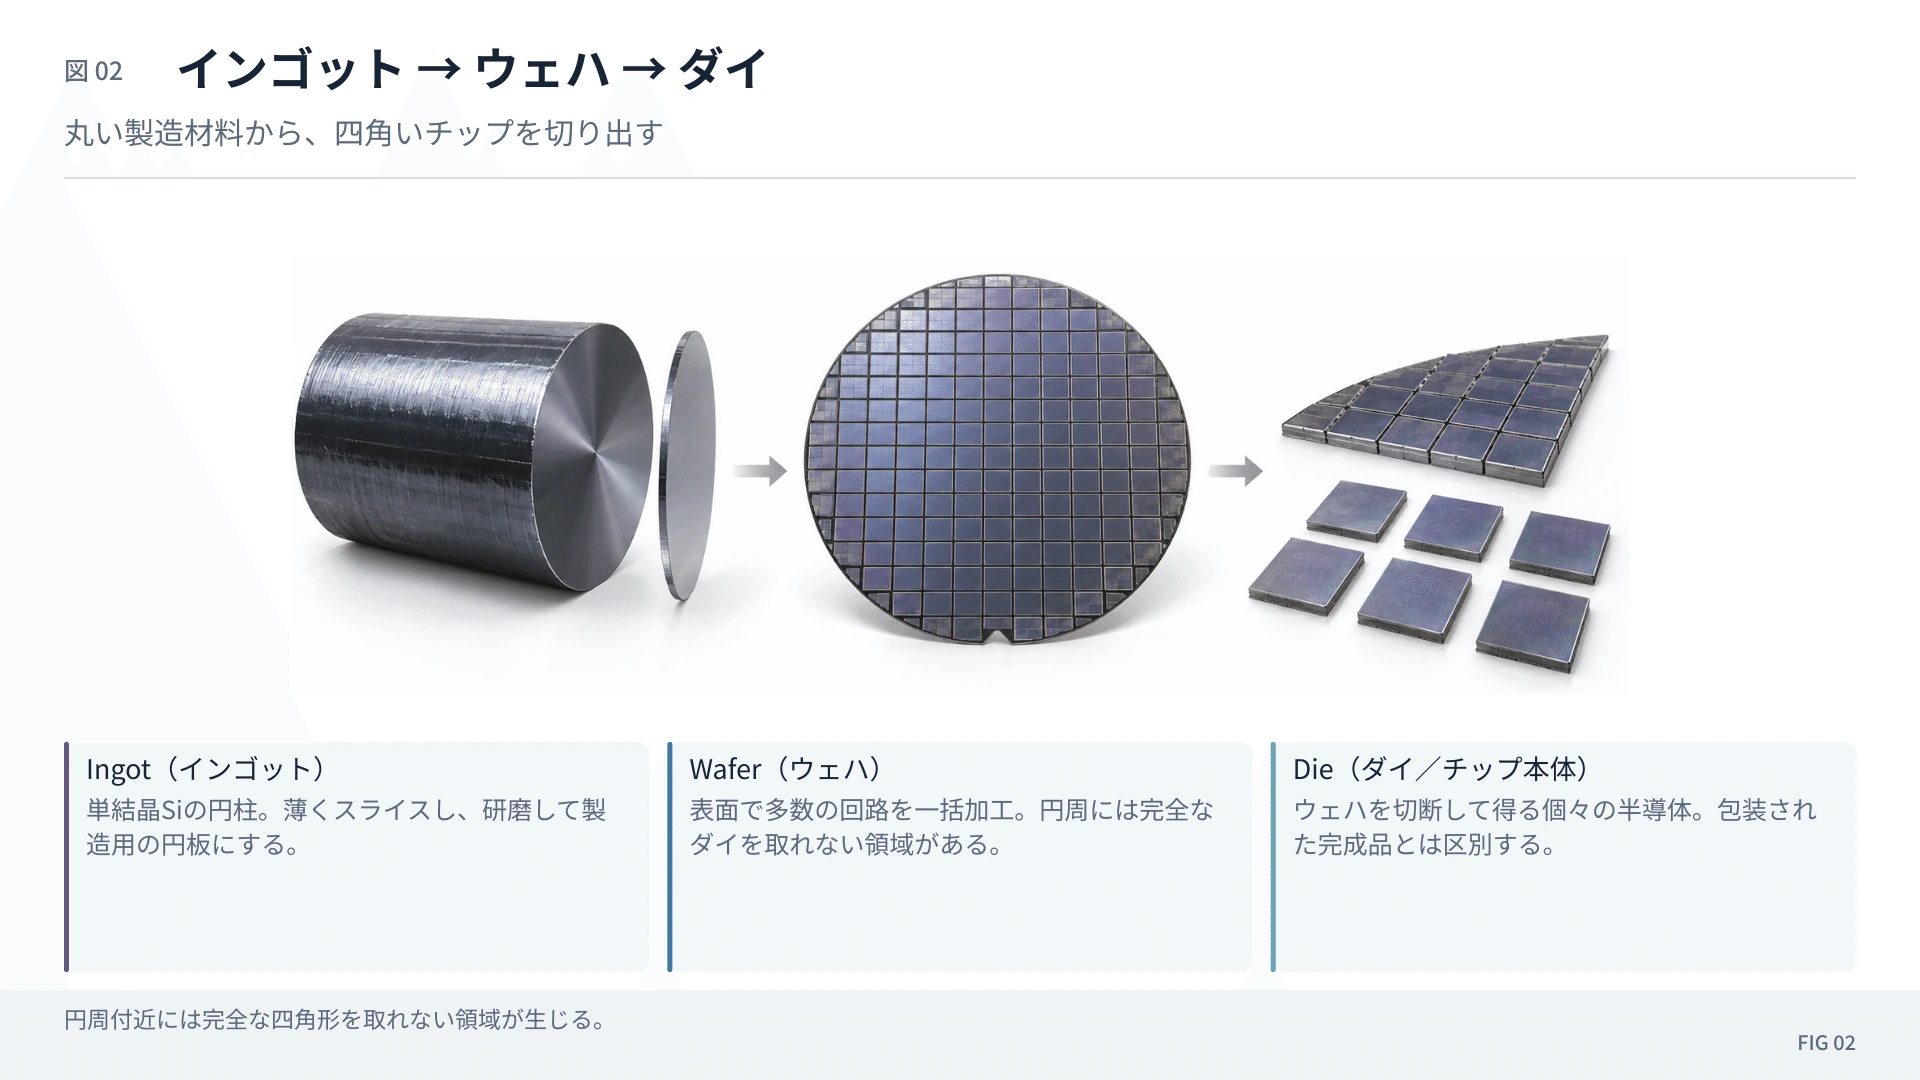
#これはSilicon Wafer、シリコンウェハである。
#高純度シリコンから円柱状の単結晶ingotを作り、それを輪切りにするため、waferは丸くなる。
#その丸いwafer上に、
#○ □ □ □ □ □ □ □ □ □ □ □ □ □ □ □ □ □ □ □ □ □ □
#というように、多数の四角い回路を作る。
#この一つ一つがDie(ダイ)である。
#GPU die、CPU die、AI ASIC dieなどは基本的に四角形または長方形であり、最後に丸いwaferから切り出される。
#したがって、
#丸いwafer → 四角いdie → 四角いpackage
#という順序になる。
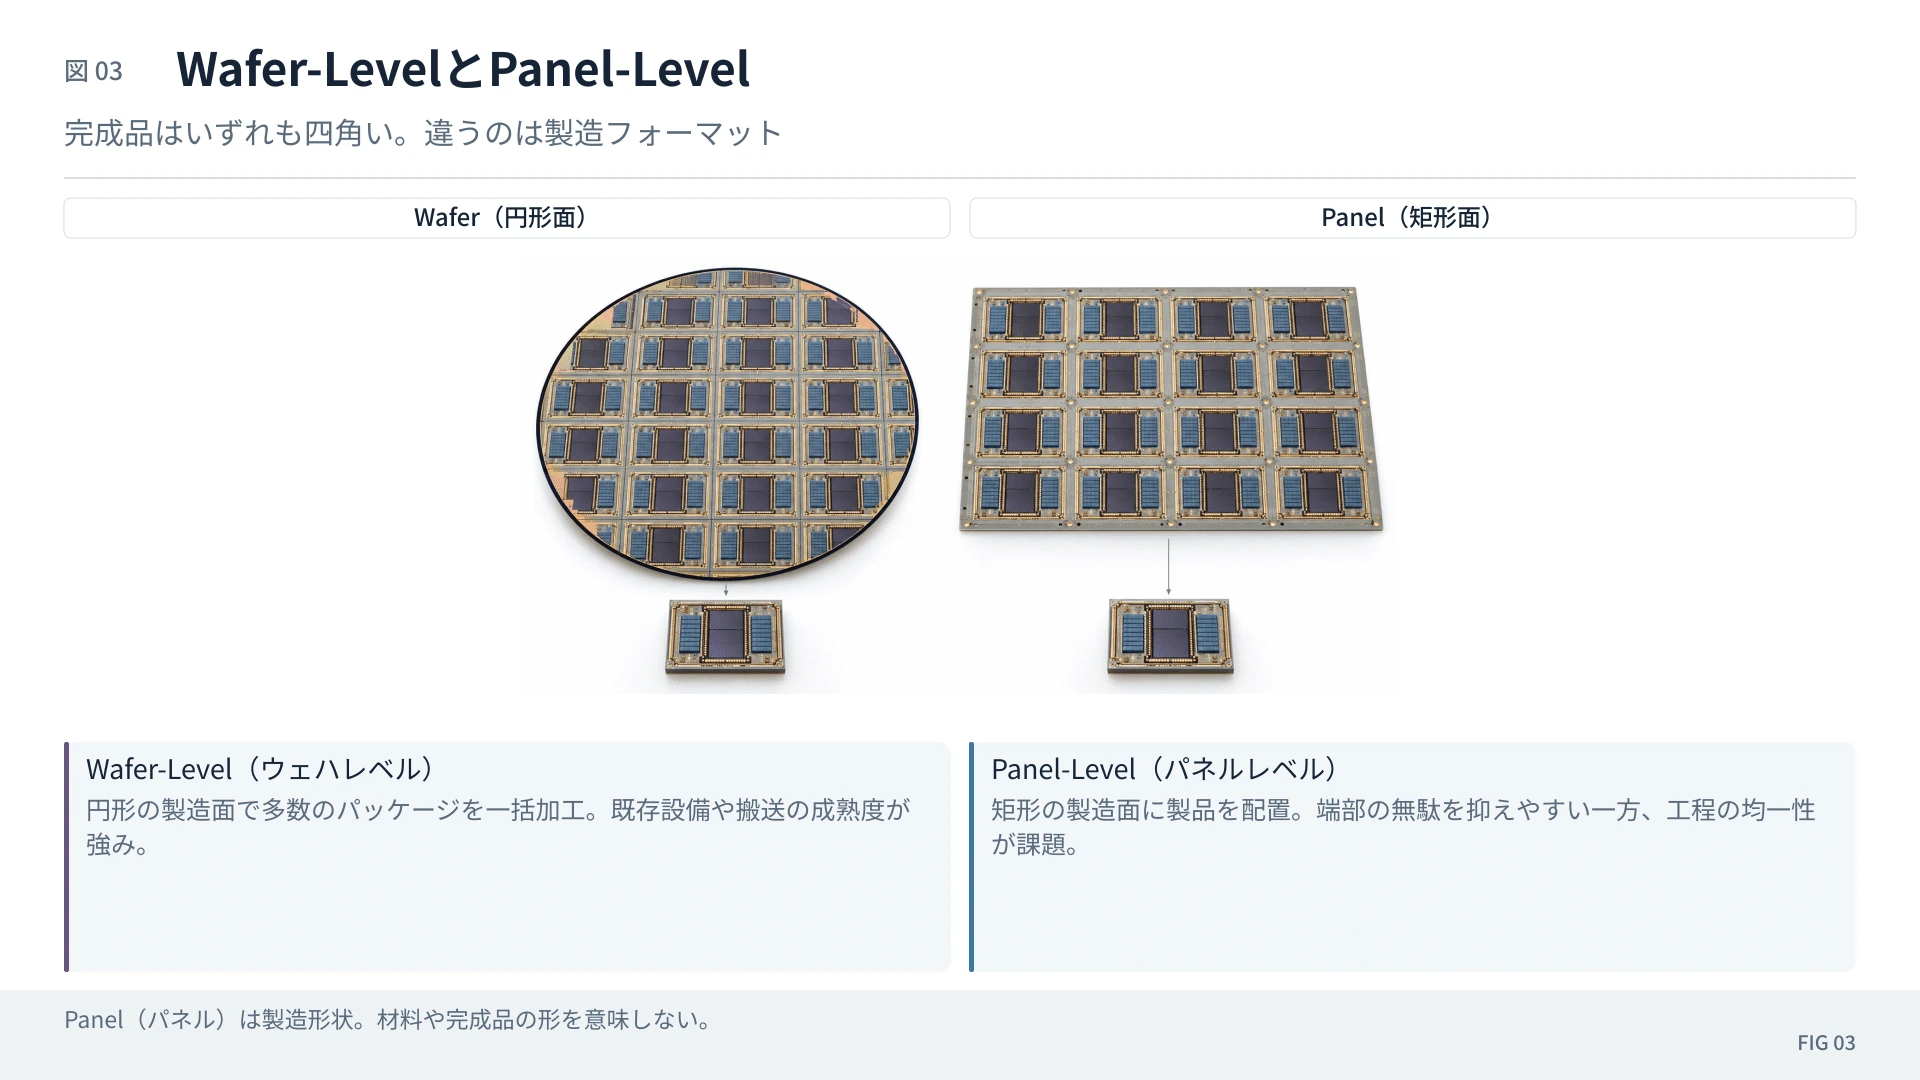
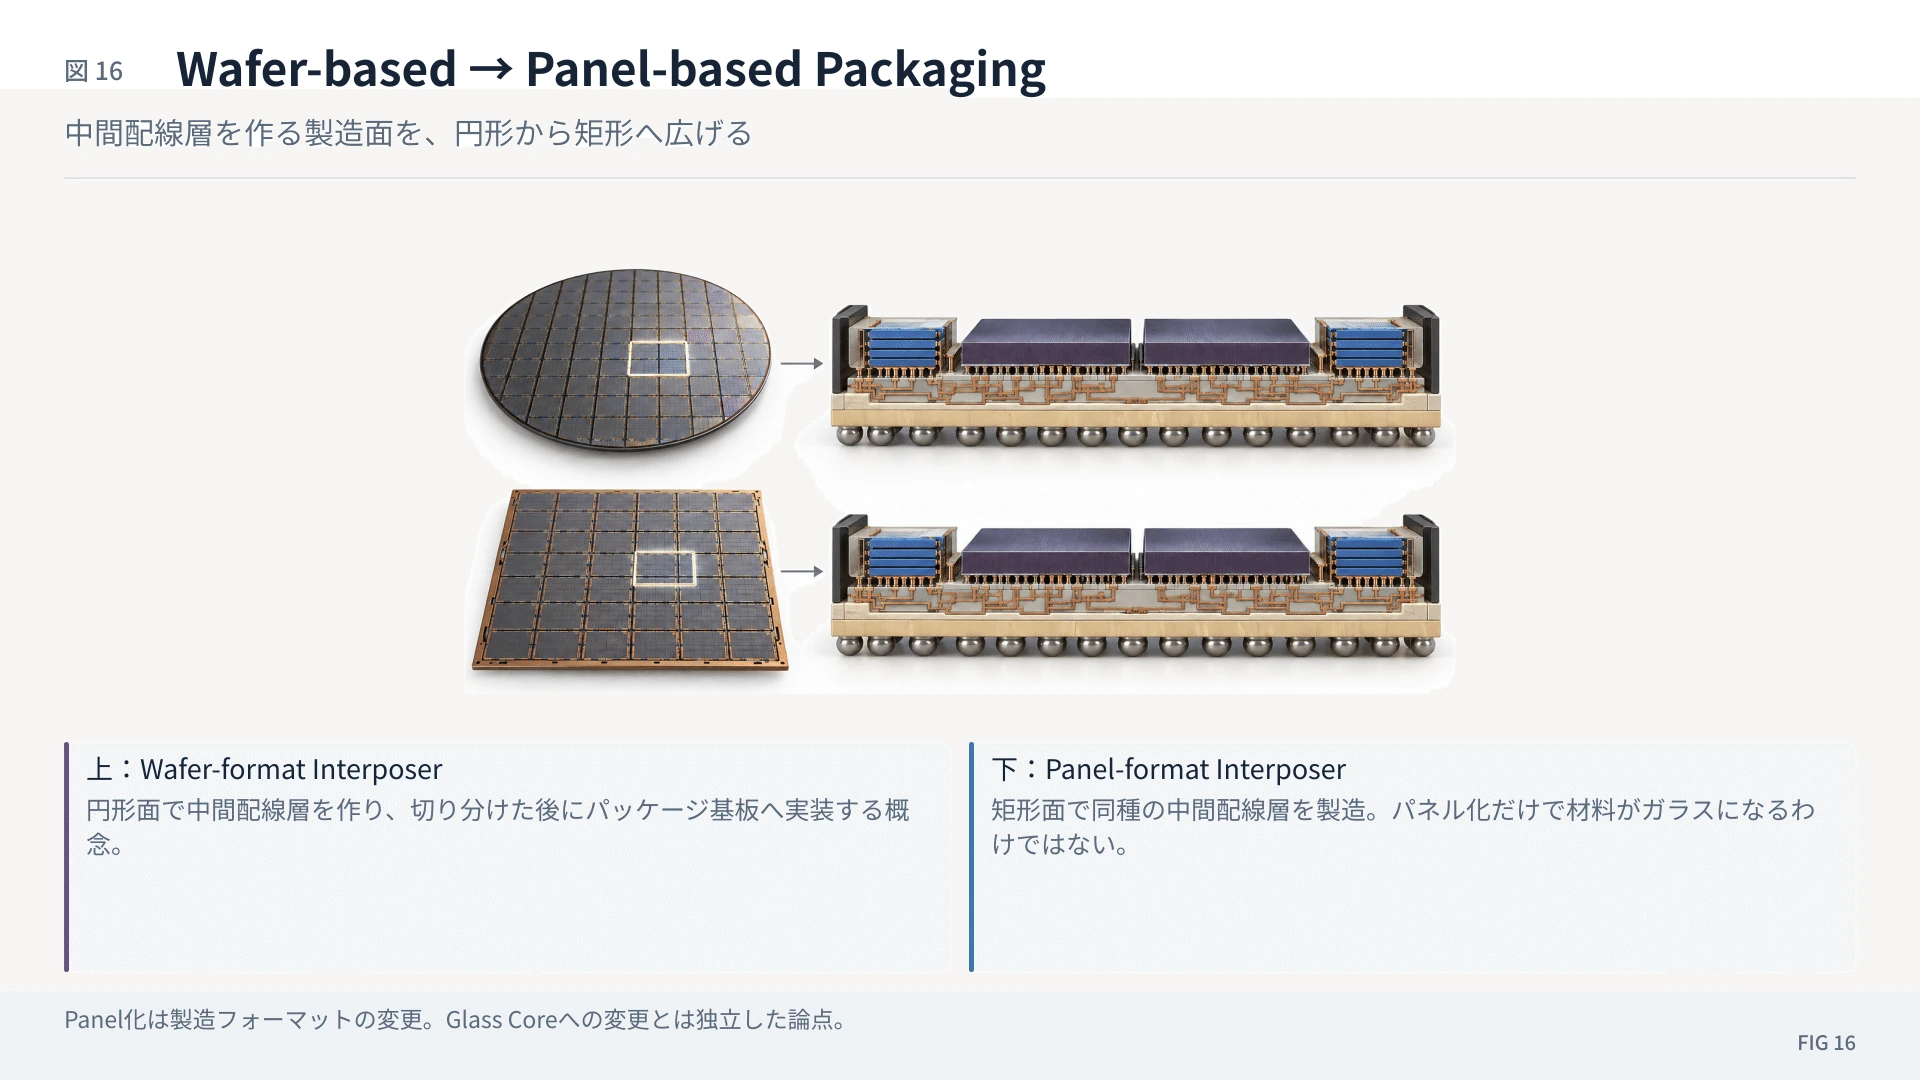
#「CoWoSは丸、PLPは四角」という話も、完成品の形を指しているわけではない。
#違うのは、多数のpackage/interposerを一括加工するときの製造フォーマットが、丸いwaferなのか、四角いpanelなのかである。
#
2.チップからマザーボードまで、何層あるのか
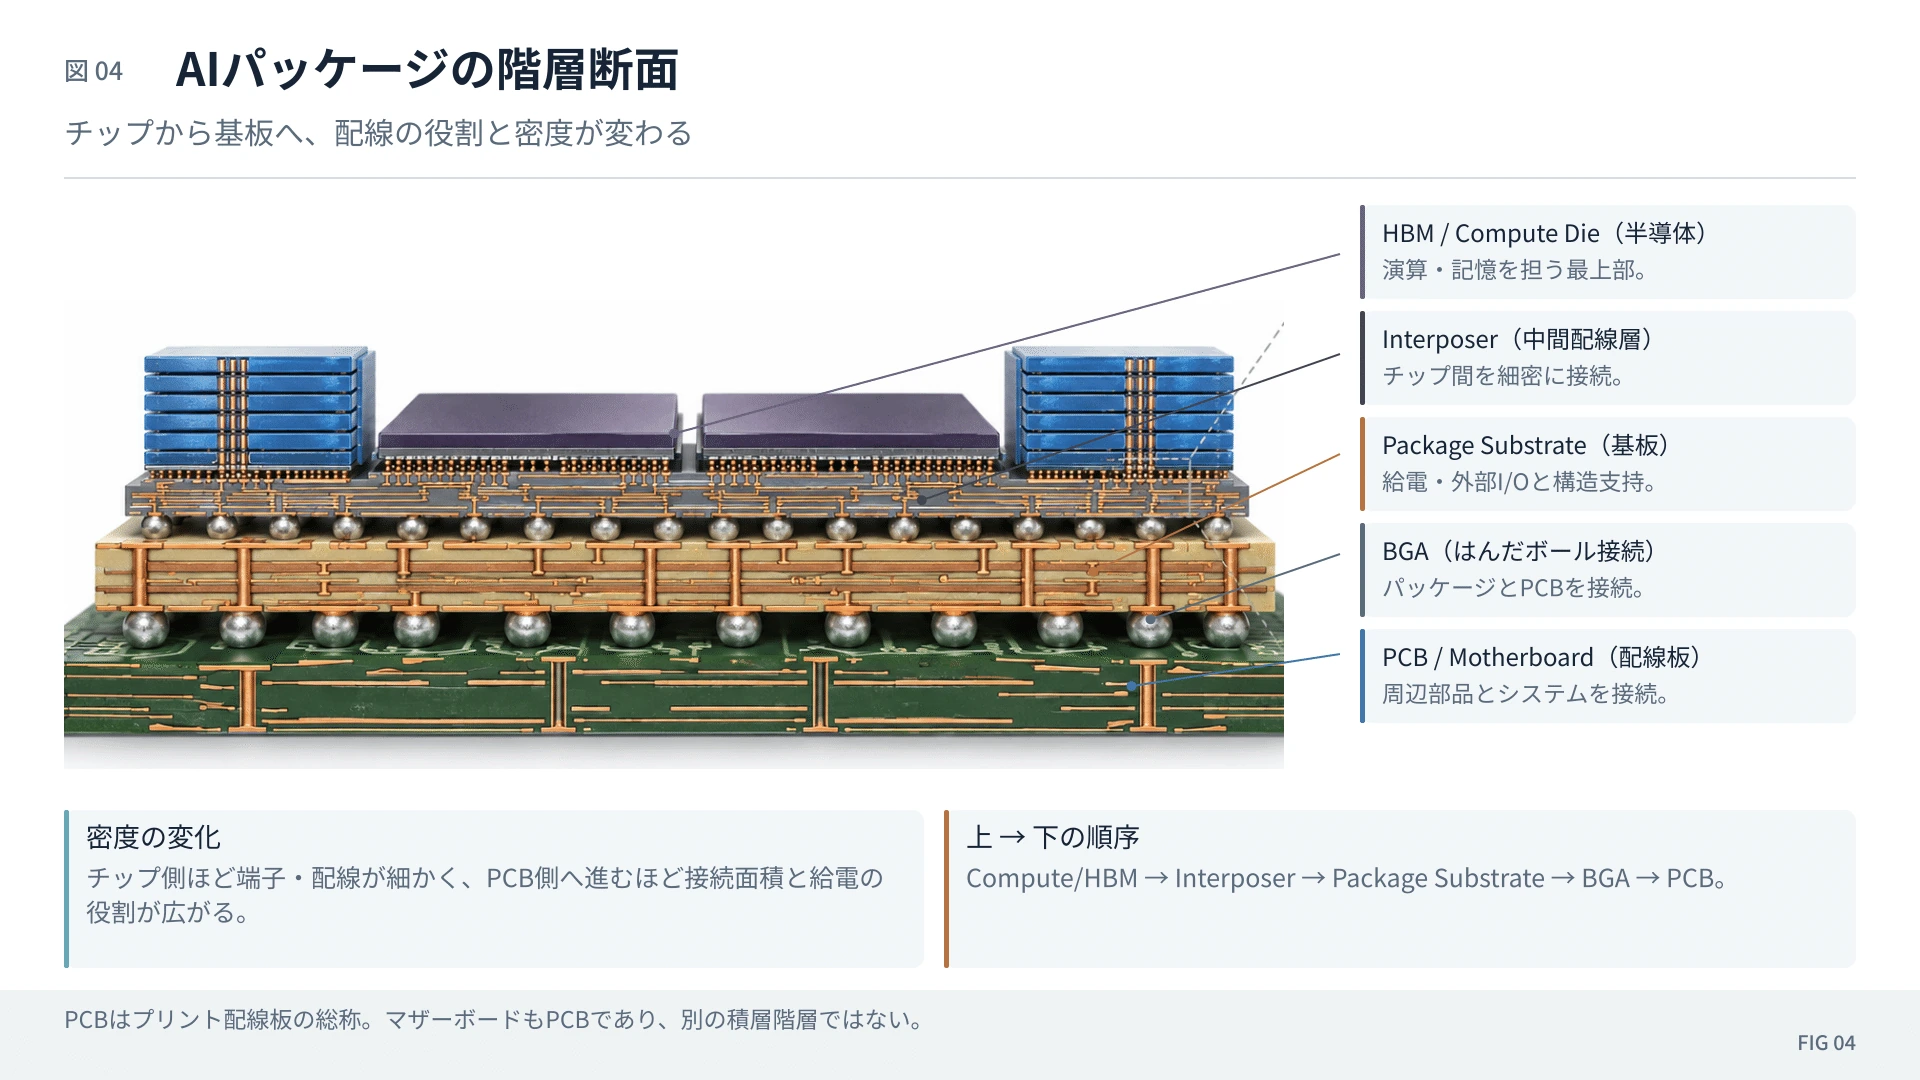
#AI GPU packageを上から下へ極端に単純化すると、次のようになる。
#GPU / AI ASIC / HBM ↓ Interposer ↓ Package Substrate ↓ BGA ↓ PCB ↓ Motherboard / GPU Baseboard
#まずDieは、トランジスタが実際に作られているシリコン片だ。
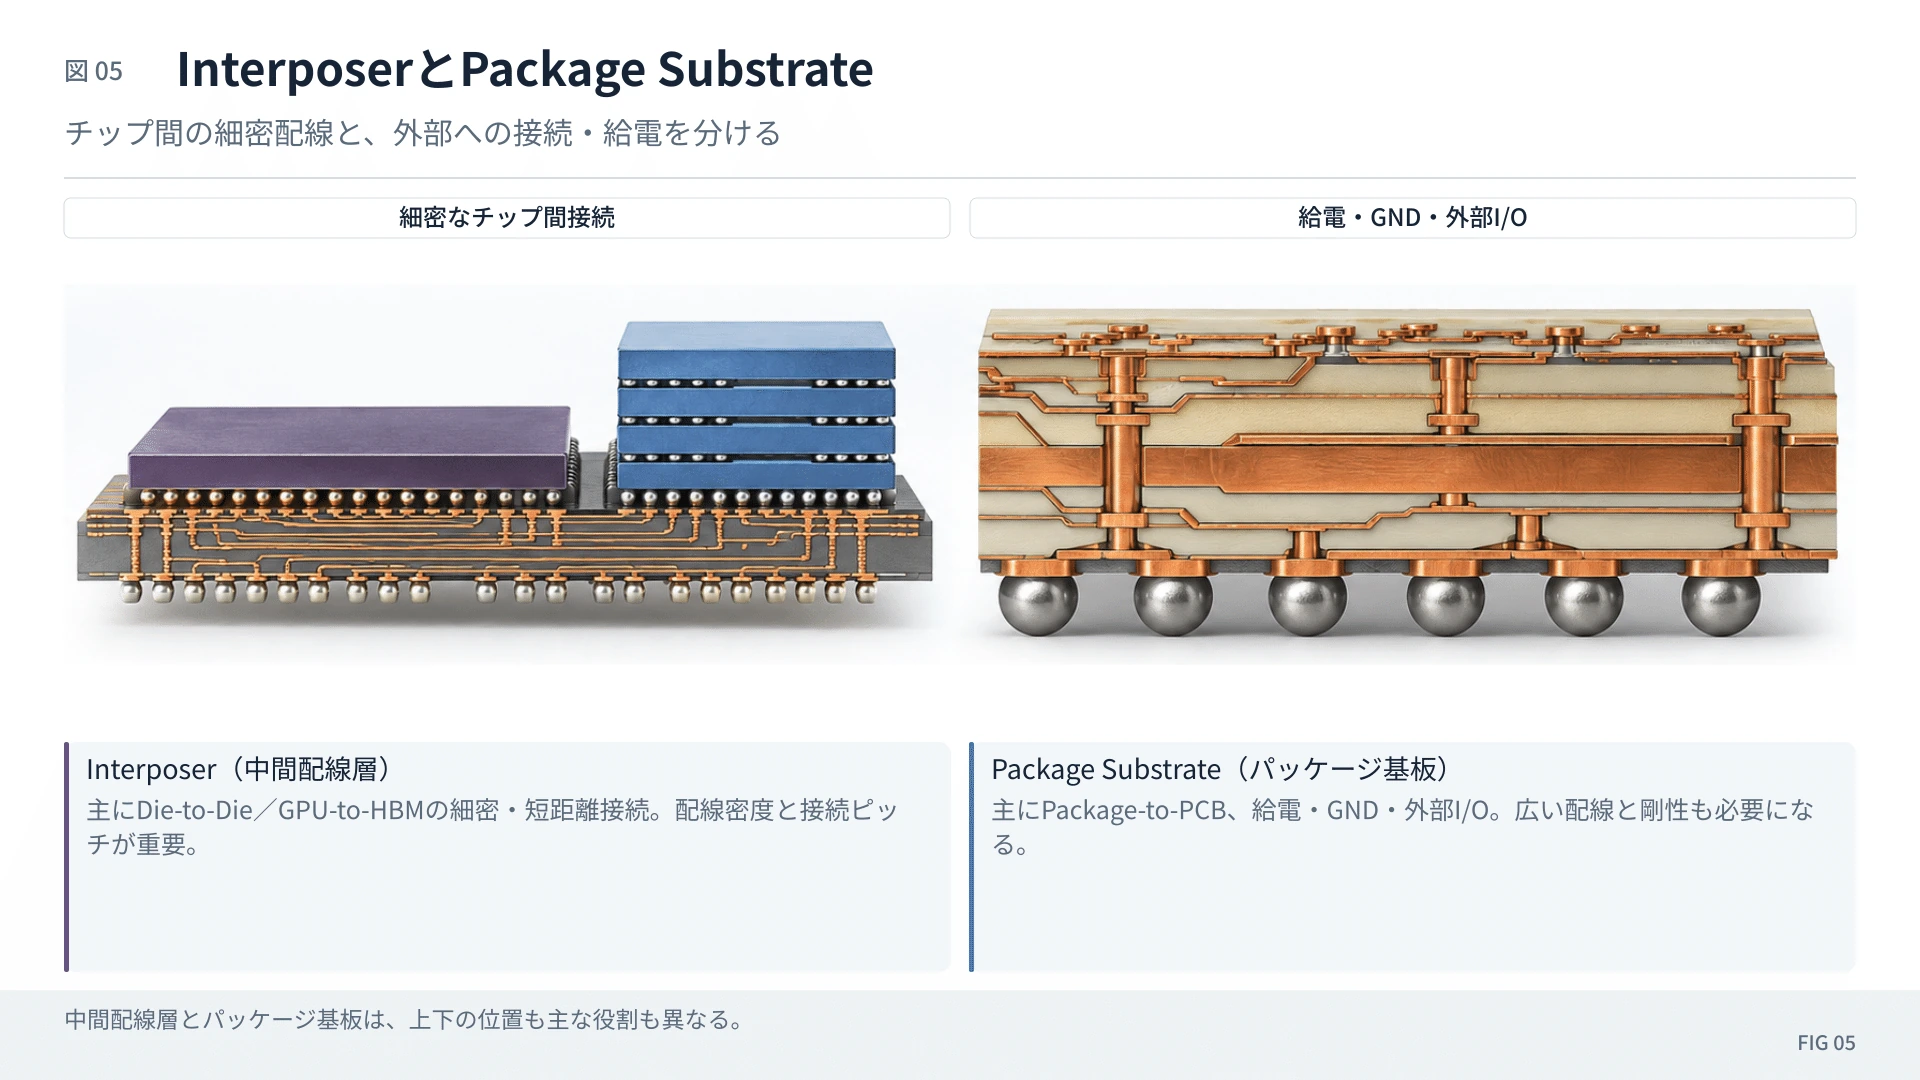
#その複数のdieを近距離・高密度で接続するのがInterposer、インターポーザー(中間配線層)である。
#さらにその下でpackage全体を支え、電源、GND、外部I/Oをより粗いpitchへ広げてPCBへ接続するのがPackage Substrate、パッケージ基板だ。
#そのpackageを載せる大きな配線板がPCB、Printed Circuit Board、プリント配線板であり、CPU、DIMM、PCIe、電源回路、各種コネクタなどシステム全体を載せるPCBがMotherboard、マザーボードである。
#つまり、
#微細 Die ↓ Interposer ↓ Package Substrate ↓ PCB ↓ 粗い Motherboard
#と、下に行くほど配線pitchを段階的に粗くしていく。
#これは非常に合理的だ。
#GPUとHBMの数千本級の配線すべてを、マザーボードと同じ製造技術で作る必要はない。一方、PCIeや電源までsub-micron級の高価なシリコン配線で作る必要もない。
#必要な場所だけ精密にし、外へ行くほど安価な配線へ変換する。
#これが現代のadvanced packagingの基本構造である。
#
3.RDLとは「本当に銅線」である
#ここで頻出するのが、
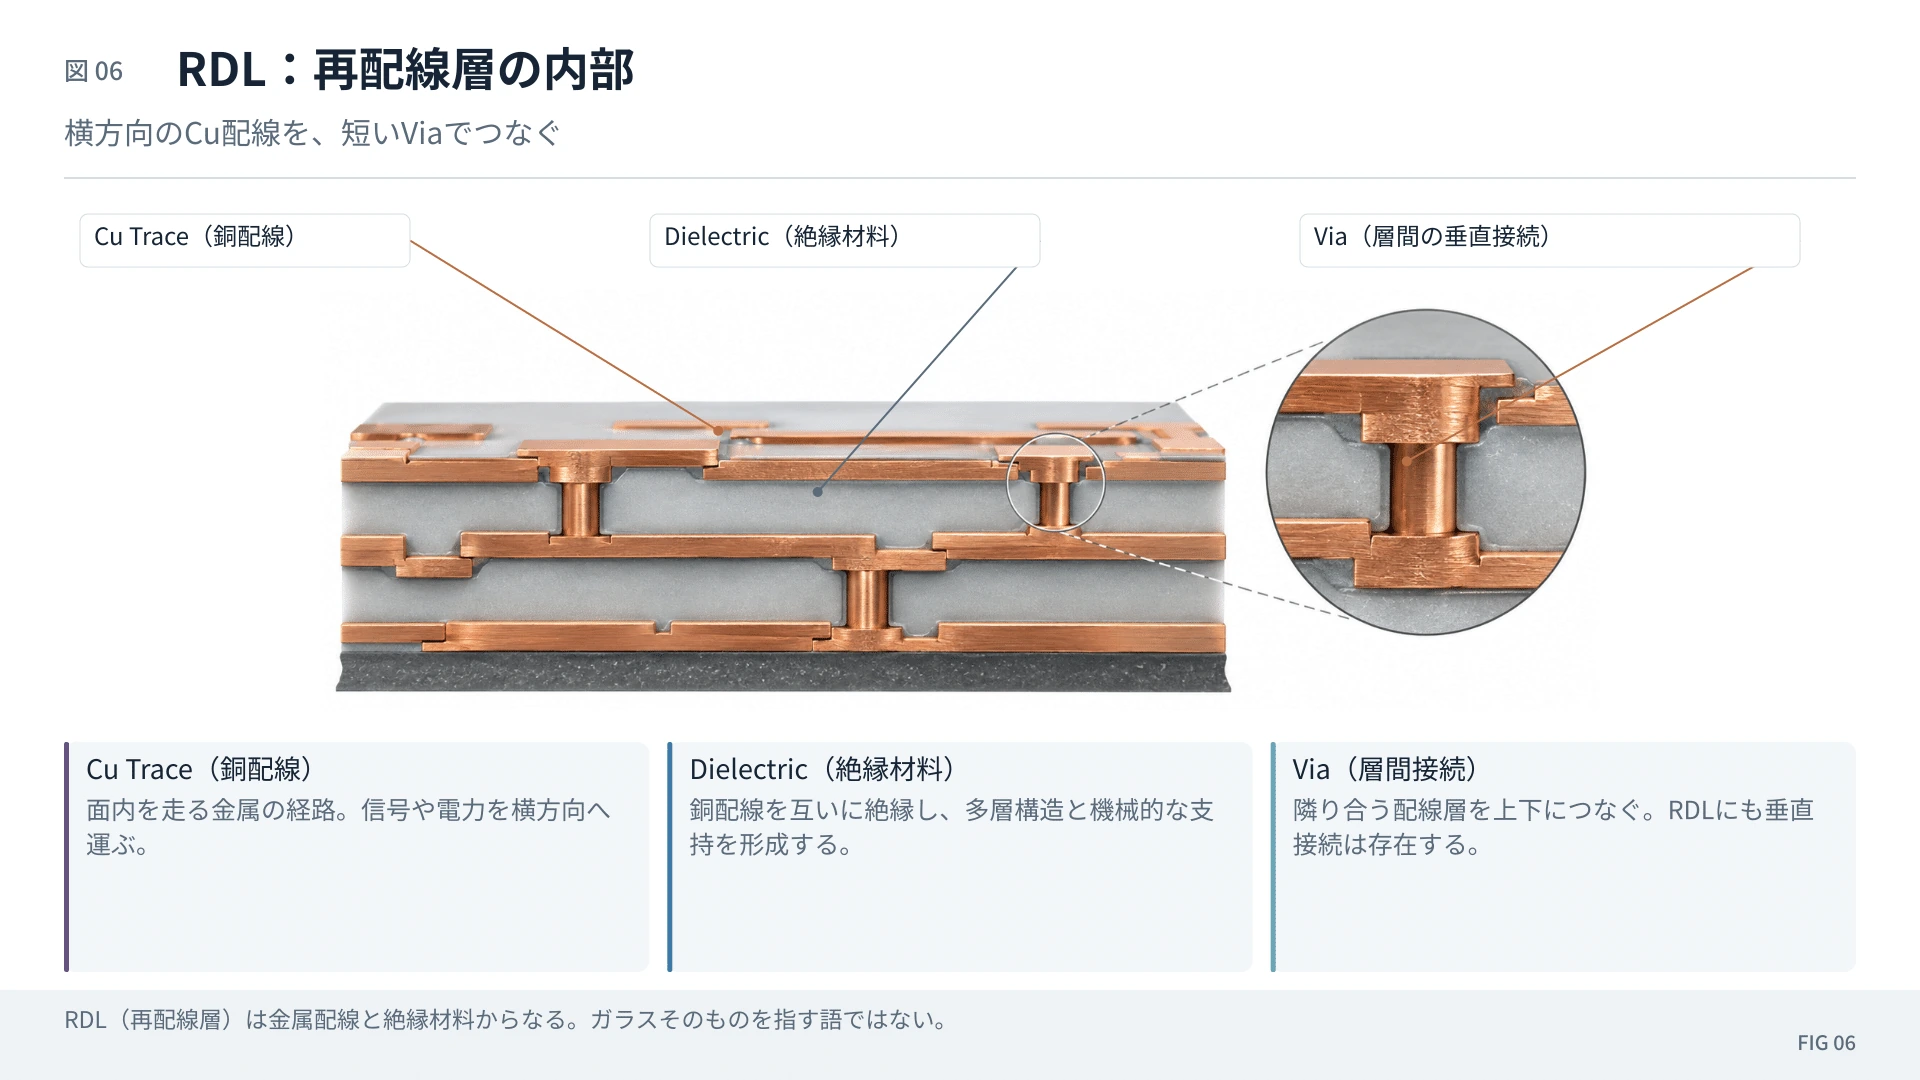
#RDL = Redistribution Layer、日本語では再配線層
#である。
#RDLは概念的な線ではない。
#実際にCu、つまり銅の微細配線が形成されている。
#Die A ↓ micro bump ↓ Cu RDL ────────────── ────────────── ↓ micro bump ↓ Die B
#絶縁膜を挟みながらCu配線とviaを複数層形成し、die上の端子を別の場所へ「再配置」する。
#TSMCのCoWoS-RはpolymerとCu traceからなるRDL interposerを採用し、現在2µm line / 2µm space、つまり4µm pitchまで提供している。
#つまり、
#RDL=横方向の高速道路
#と覚えるとよい。
#
4.CoWoS-S、R、Lは何が違うのか
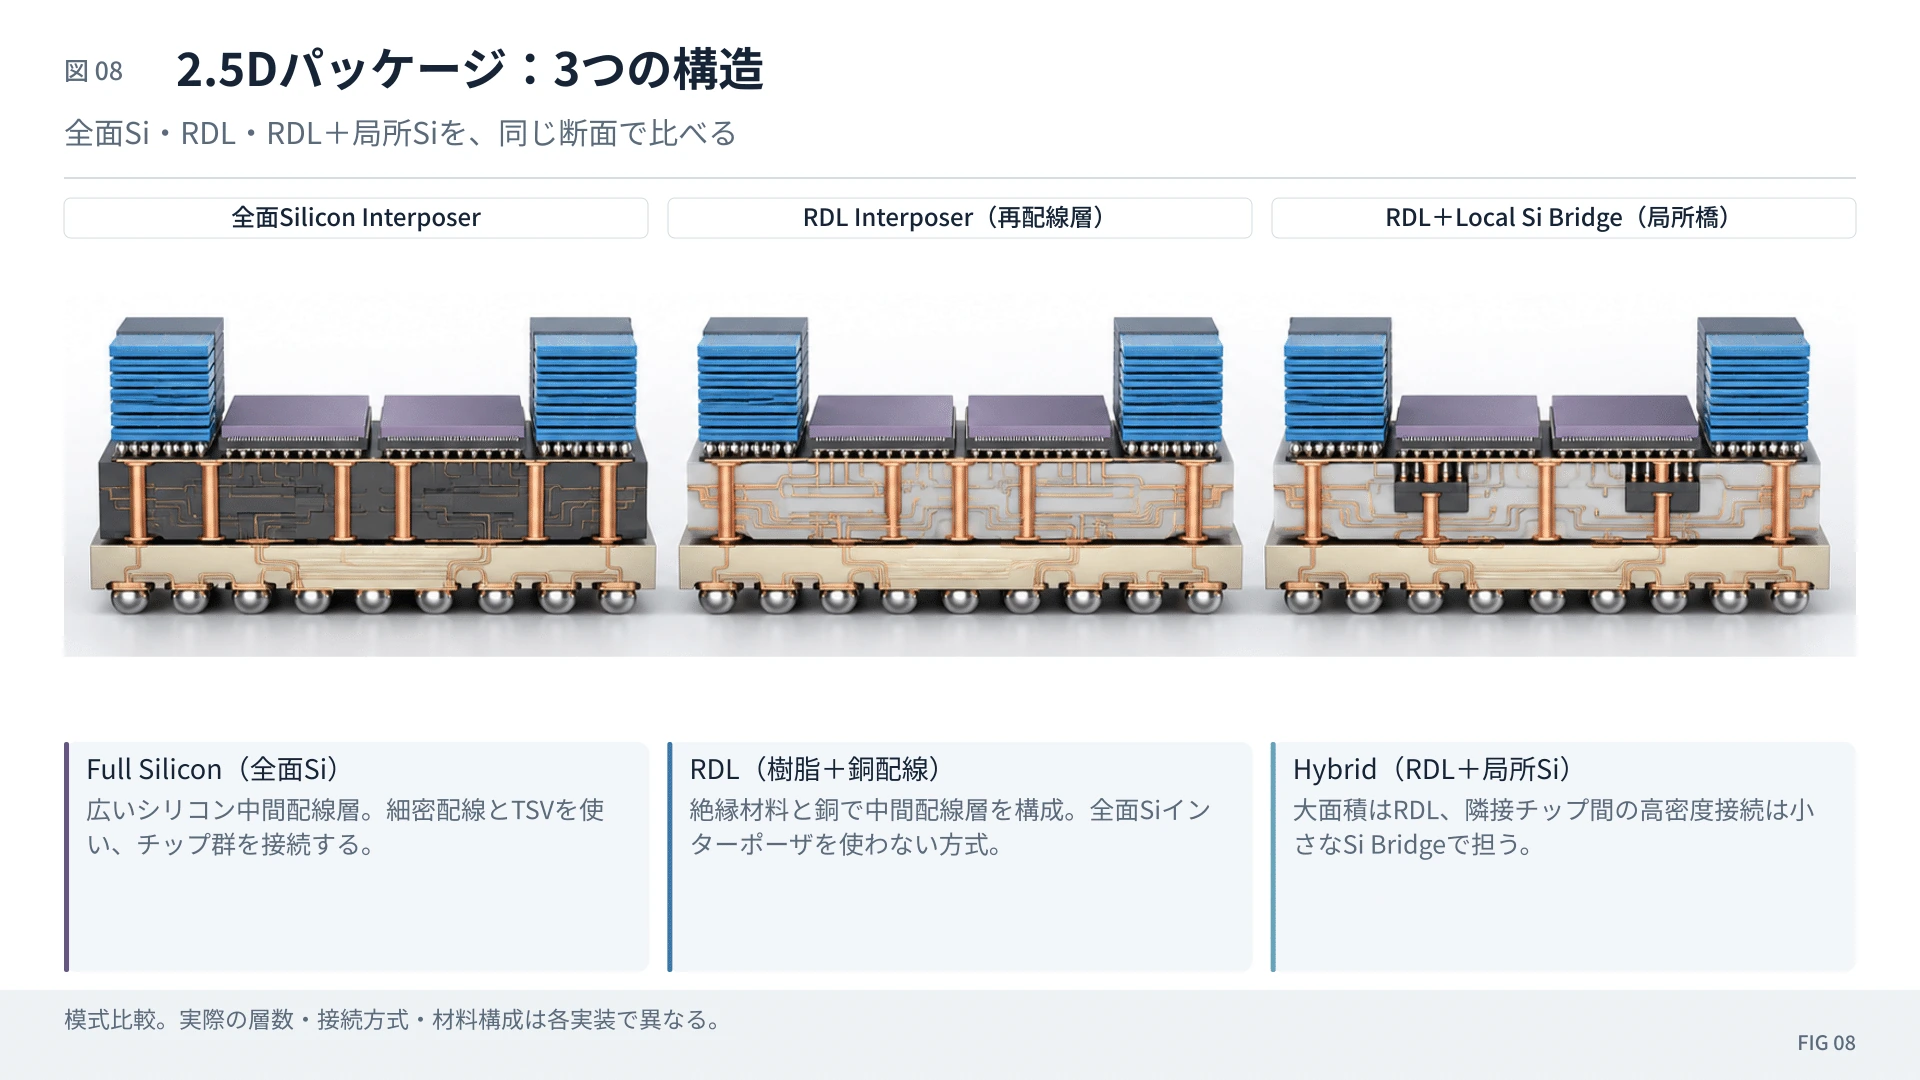
#TSMCのCoWoSには現在、大きくS、R、Lがある。
#CoWoS-S
#SはSilicon Interposerである。
#GPU / HBM ↓ ████████████████ Silicon Interposer ████████████████ ↓ Package Substrate
#GPUやHBMの下全体を大きなシリコンinterposerで覆う。
#半導体前工程に近い非常に微細な配線を作れるため、signal integrityやbandwidthでは非常に強い。
#一方、AI packageが巨大化すると、巨大なシリコン面積そのものが高価になり、丸い300mm waferから巨大な四角形を切り出す面積効率も急速に悪化する。
#TSMCによればCoWoS-Sは2012年から量産されている。
#CoWoS-R
#RはRDL Interposer。
#全面シリコンをやめ、
#GPU / HBM
#↓
#Polymer + Cu RDL
#↓
Package Substrateとする。
#シリコンinterposerより大面積化・低コスト化しやすい一方、最微細配線密度ではシリコンに劣る。
#CoWoS-Rは2023年から量産されている。
#CoWoS-L
#Lはその中間に近い。
#GPU A GPU B
#│ │ └─── LSI ──────┘ ↓
#Large RDL
#↓
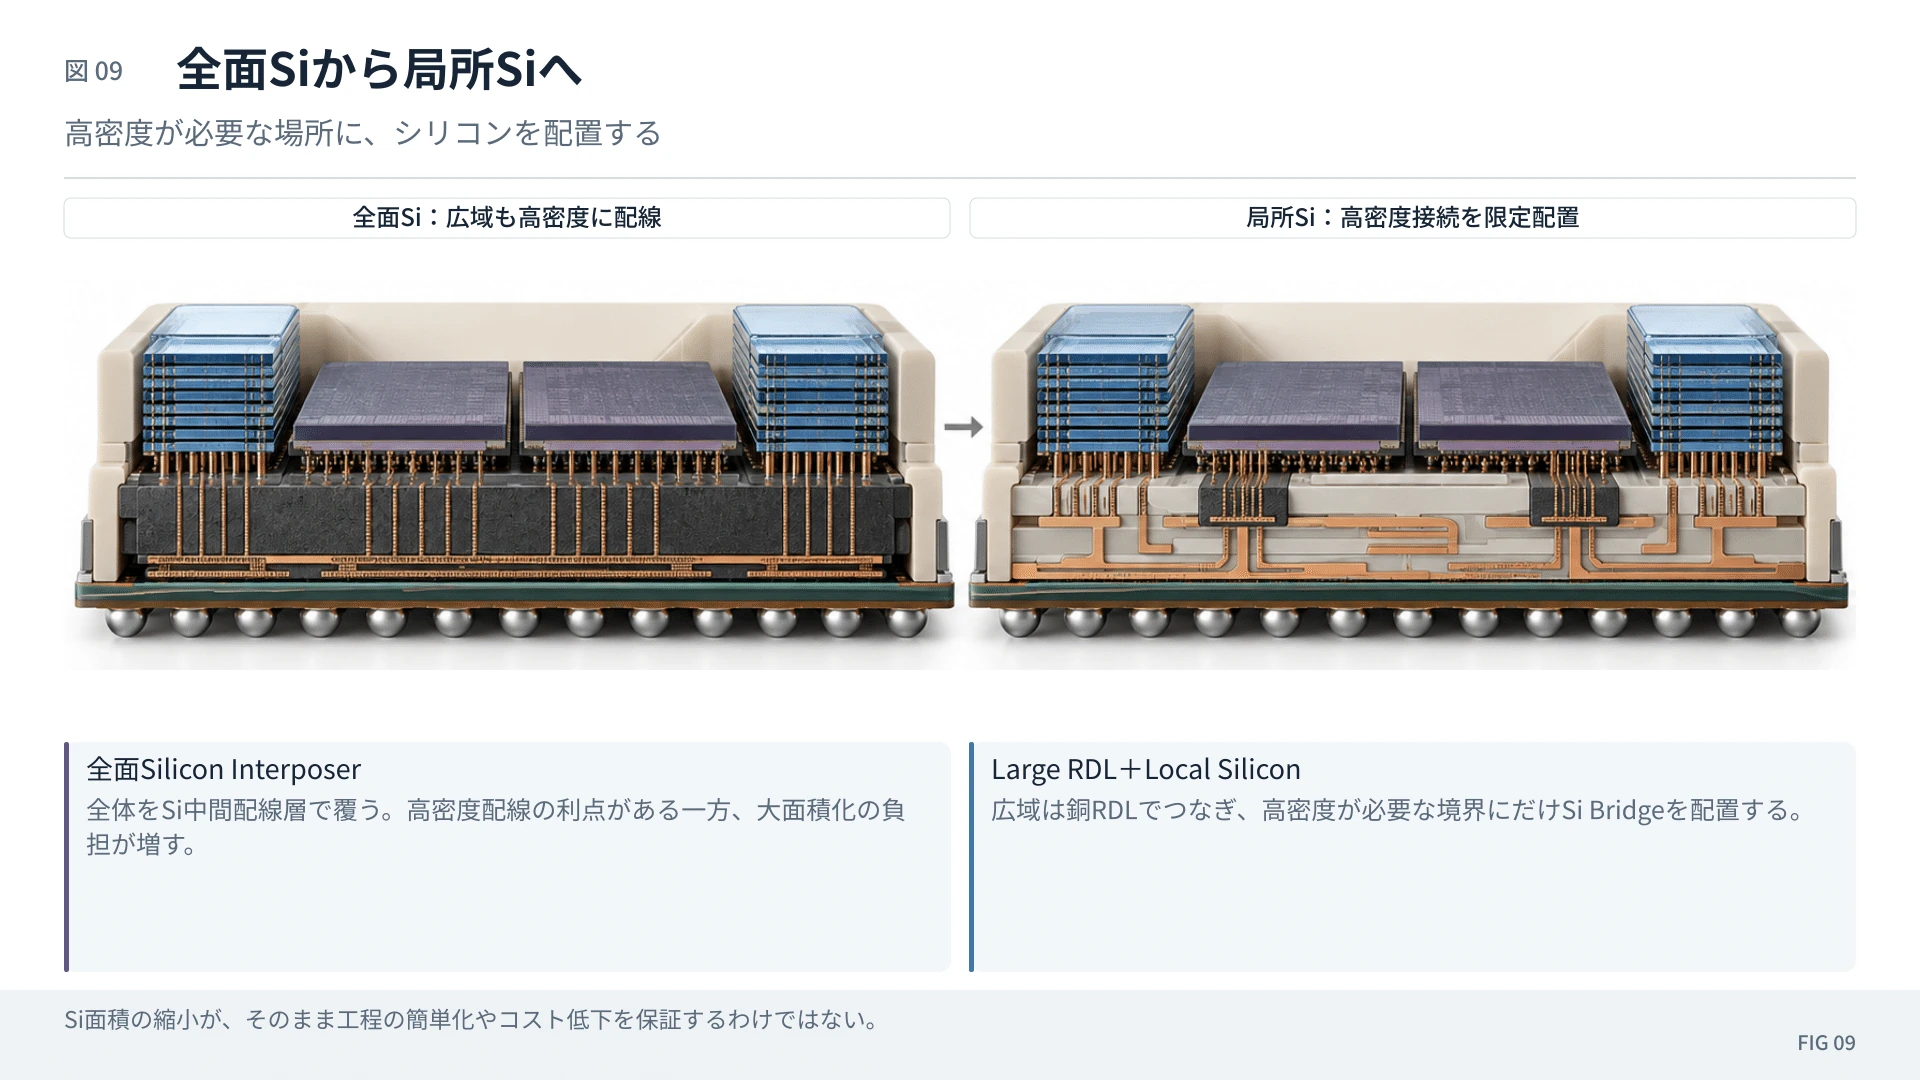
Package Substrate大面積の広域配線はRDLで行い、本当に超高密度な接続が必要な場所だけ、
#LSI = Local Silicon Interconnect、局所シリコン配線
#を埋め込む。
#TSMCのLSIは複数層のsub-micron級Cu配線を持てる。
#つまり、
#Large RDL=街全体の道路網
#LSI=都市間を直結する超高速鉄道
#という役割分担である。
#CoWoS-Lは3.5×reticle世代が2024年からvolume productionに入っている。
#
5.Intel EMIBはCoWoS-Lと何が違うのか
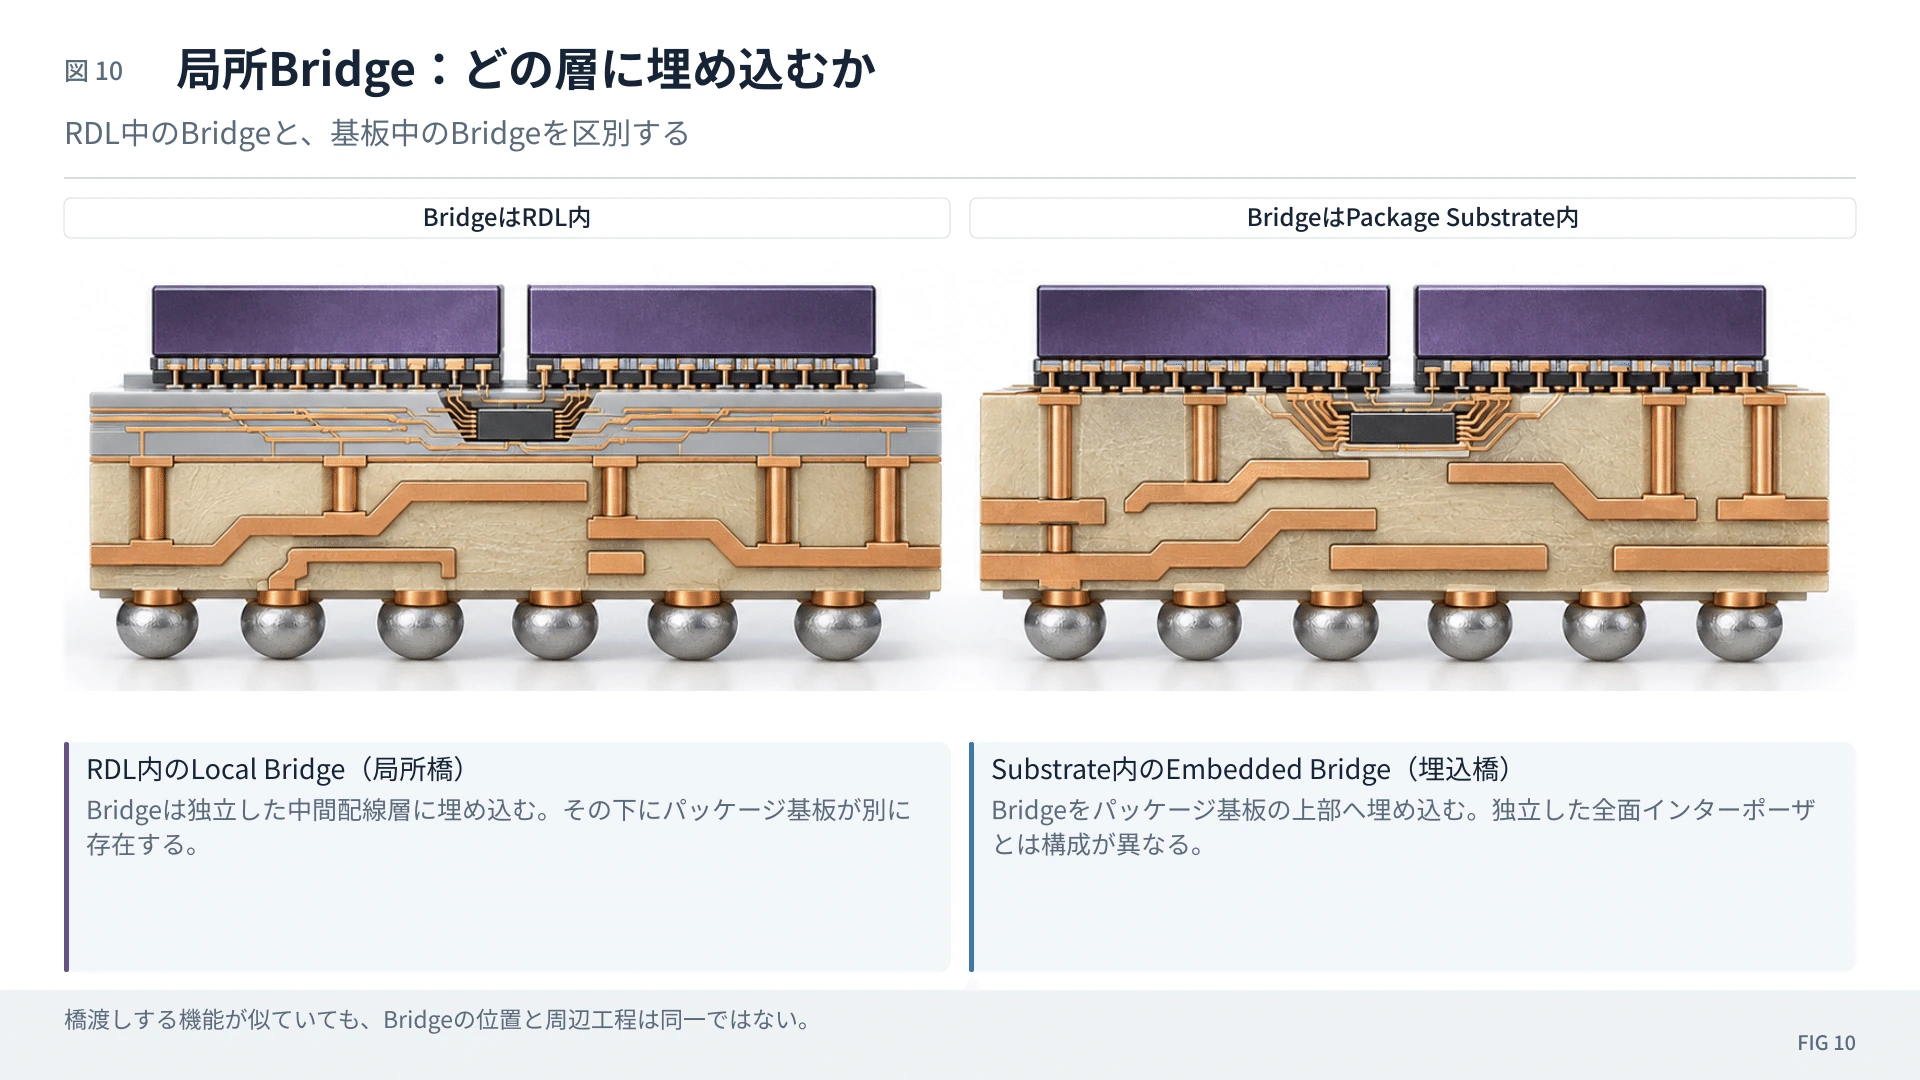
#IntelのEMIBは、
#**Embedded Multi-die Interconnect Bridge 基板埋め込み型マルチダイ接続ブリッジ**
#である。
#考え方はCoWoS-LのLSIと非常に近い。
#違うのは、bridgeをどこに入れるかだ。
#CoWoS-Lでは、
#Die ↓ LSI ↓ Large RDL Interposer ↓ Package Substrate
#なのに対し、EMIBでは、
#Die A Die B │ │ └─ EMIB ─────┘ ↓ Package Substrate
#と、silicon bridgeをPackage Substrateそのものへ埋め込む。
#したがって大きなRDL interposerを別に作らなくてよい。
#Intel自身もEMIBを「large silicon interposerの代わりに、小さなbridge dieをsubstrate cavityに埋め込む方式」と説明しており、2017年から量産している。
#AI packageが巨大化すると、
#全面を超微細化するのではなく、必要な場所だけシリコン
#という思想がCoWoS-L、EMIB、Samsung Cube-Eなどで共通化していることが分かる。
#
6.PLPとは何か
#ここからSilicon Boxへ戻る。
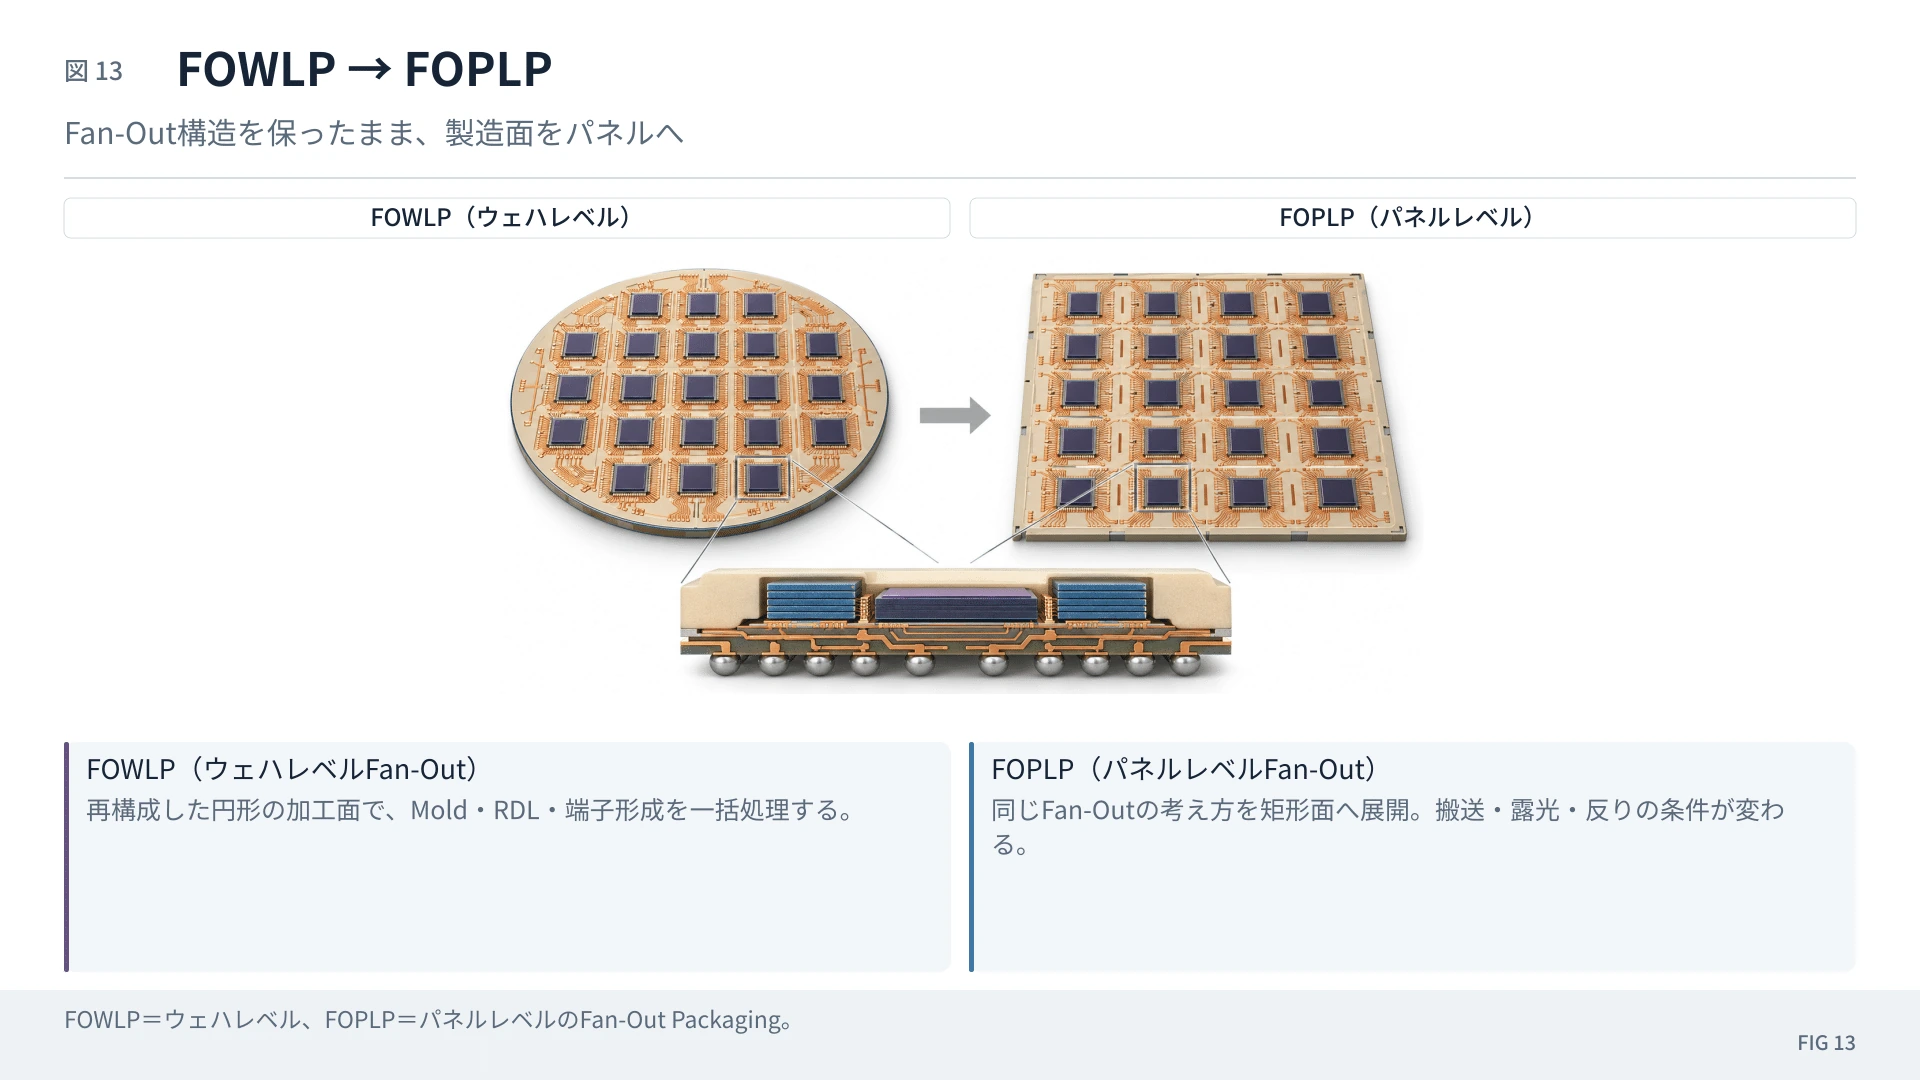
#PLP = Panel-Level Packaging、パネルレベル・パッケージング
#である。
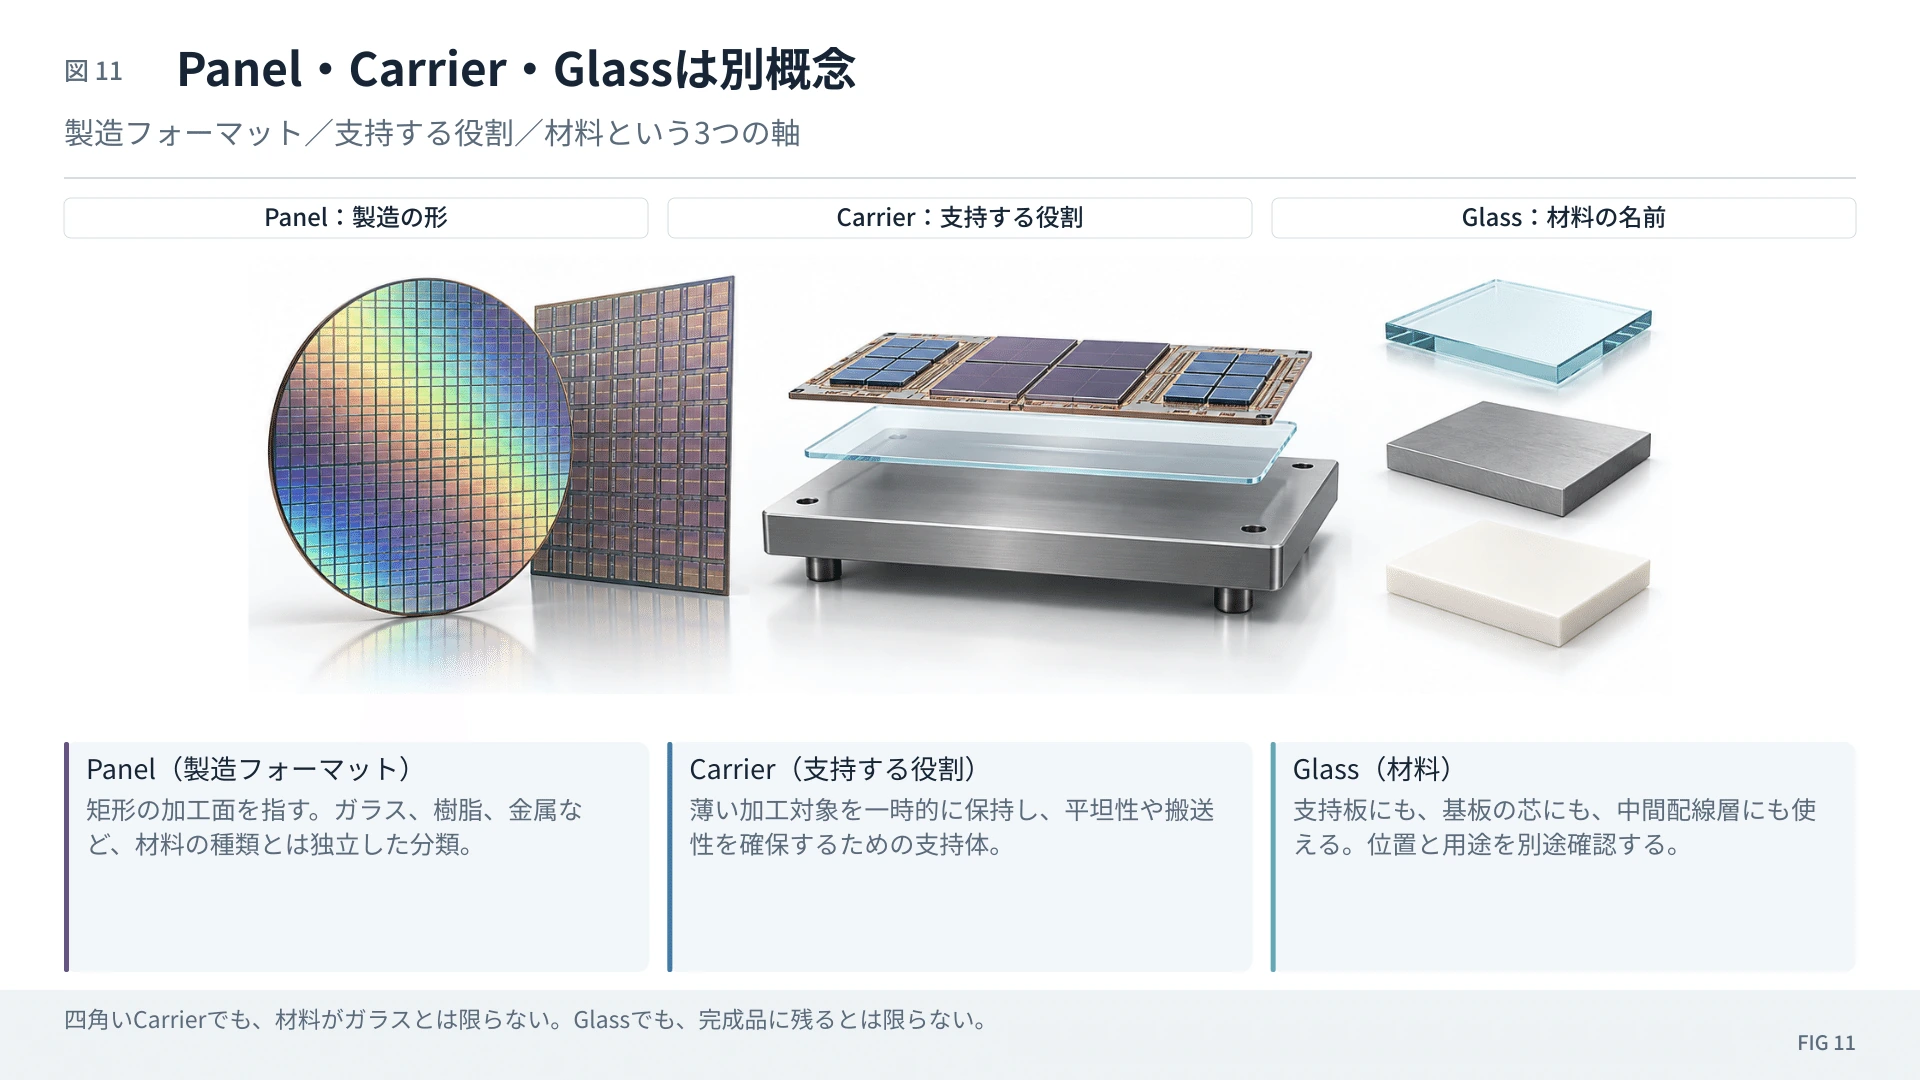
#Panelとは特定の材料名ではない。
#大型の四角い製造単位という意味だ。
#従来、
#300mm Wafer
#○ □ □ □ □ □ □ □ □ □ □
#という丸いwafer上で行っていたpackage工程を、
#Panel
#┌──────────────────┐
│ □ □ □ □ □ □ │
│ □ □ □ □ □ □ │
│ □ □ □ □ □ □ │
└──────────────────┘へ移す。
#これだけ聞くと単純だが、実際には工場設備の思想を変えるほど大きな変更である。
#
7.FOPLPとは何か
#FOPLP = Fan-Out Panel-Level Packaging
#である。
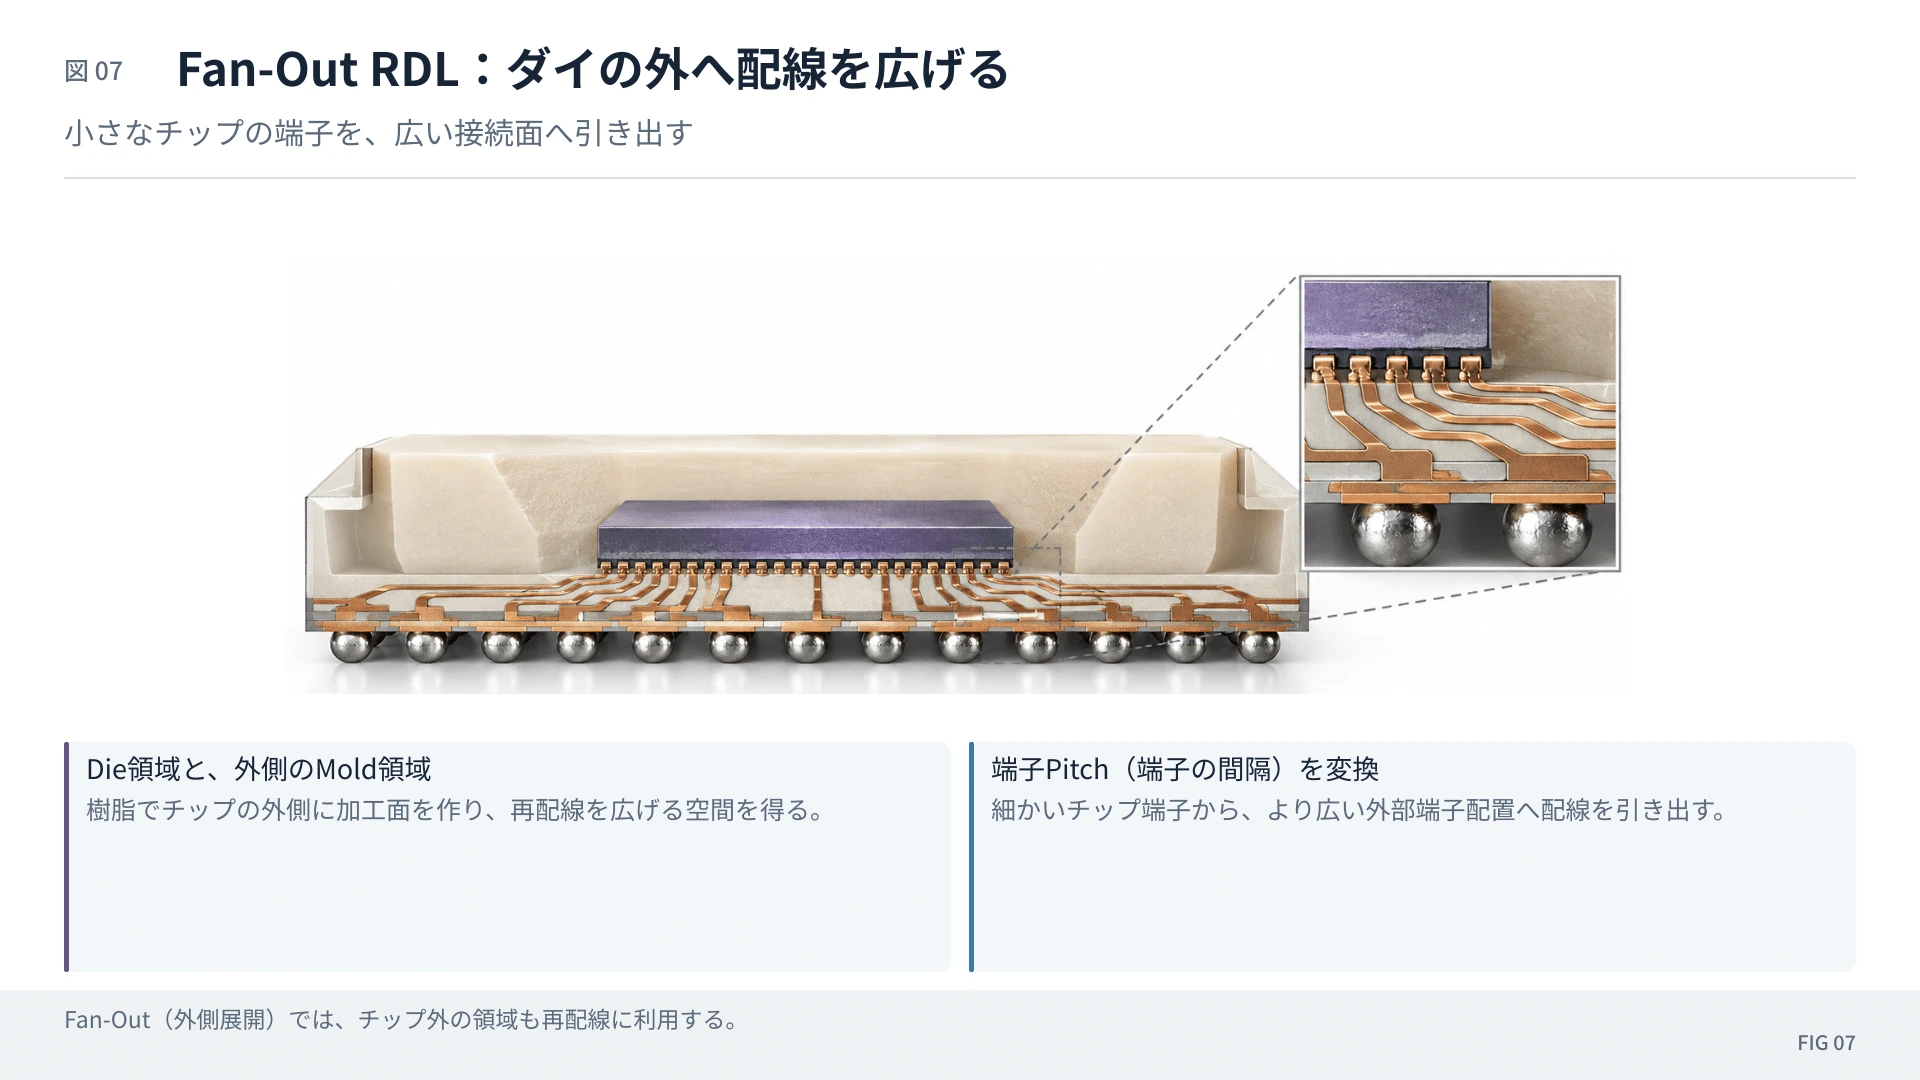
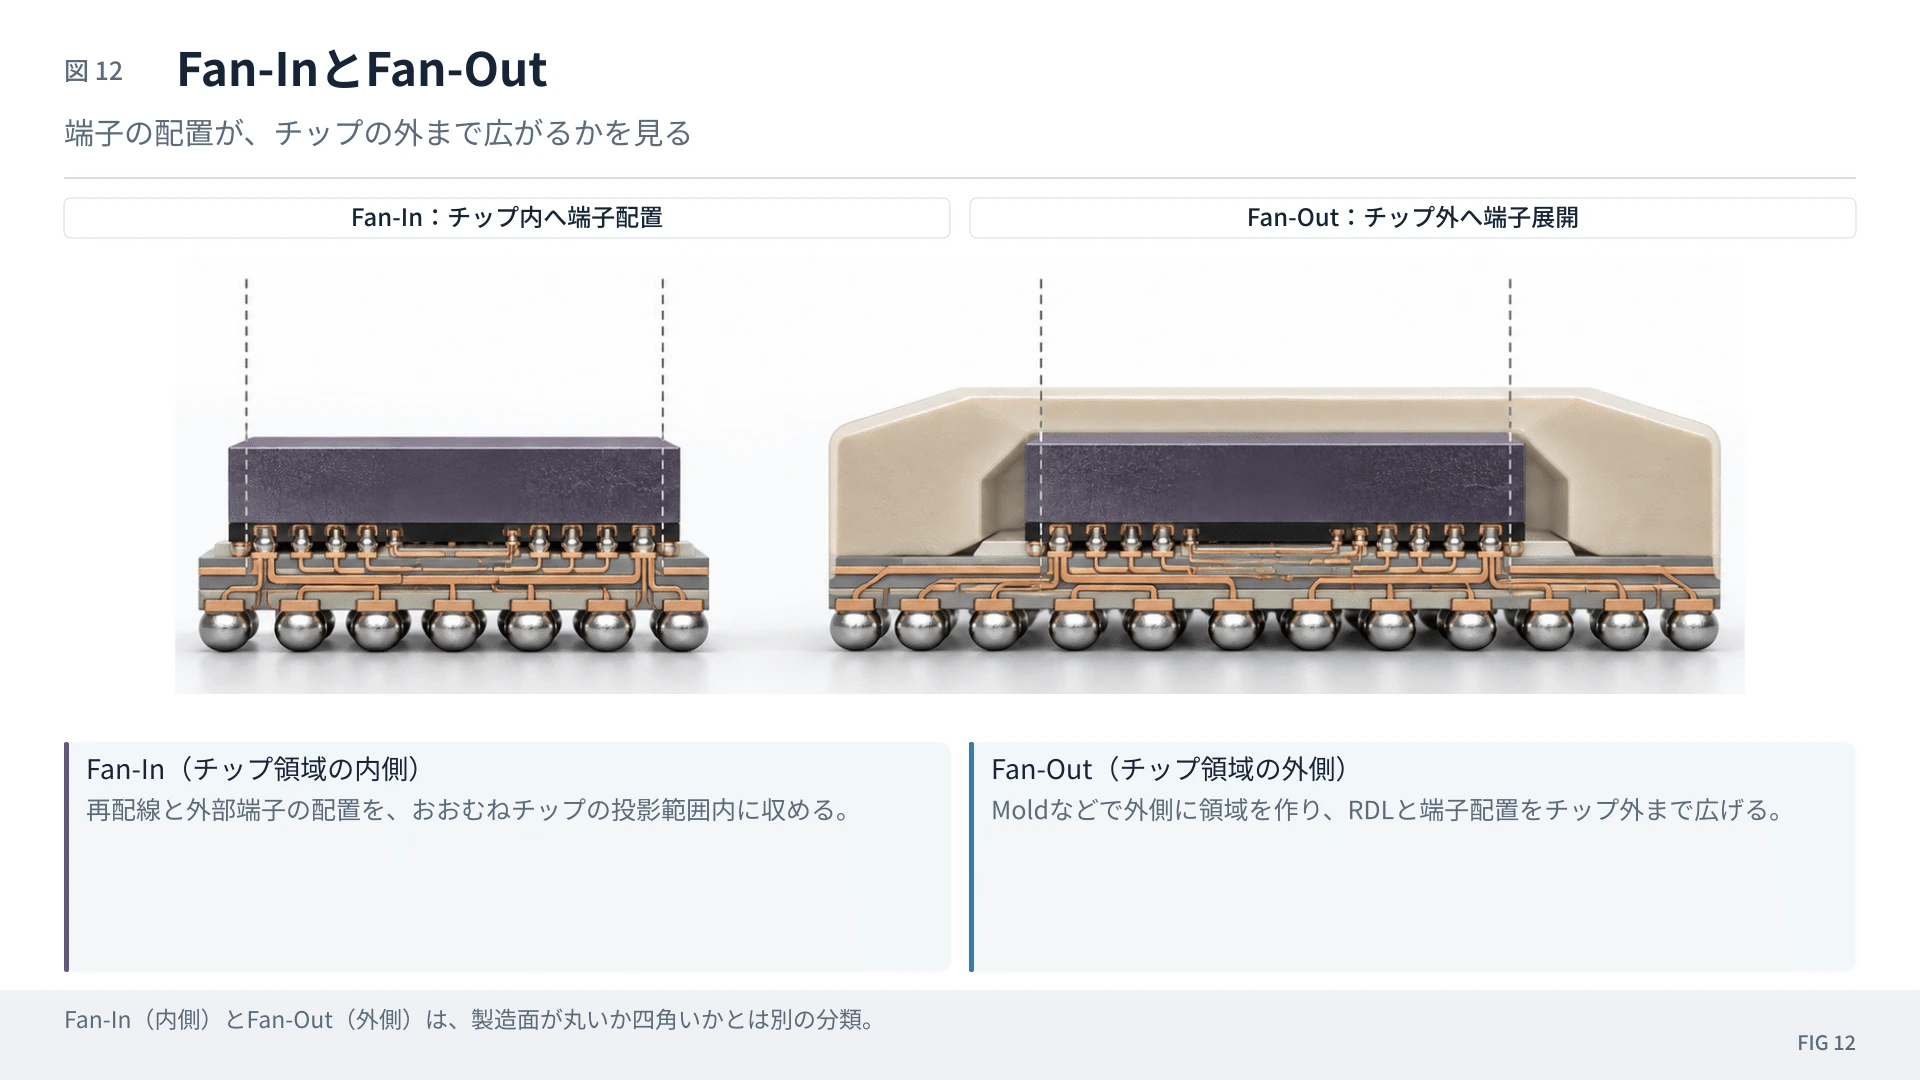
#Fan-Outとは、dieの外側までRDLを広げること。
#Die
#┌────┐ │ ●● │ └────┘ ╲│╱
#RDL
#● ● ● ●
#これを丸いwaferで行えばFOWLP。
#四角いpanelで行えばFOPLPになる。
#したがって、
#FOPLP ⊂ PLP
#である。
#Silicon Boxは独自のlarge-format PLP/SiPlet技術とsub-5µm級interconnectを使って、chiplet integrationを量産している。2025年10月の1億units時点ですでに「millions of units a day」を生産し、同社はpanel-scale yieldが創業チームの過去のwafer-scale 99.7%実績を上回ったとしている。
#重要なのは、10億unitsの中身がすべてAI/HBMではないことだ。
#だからこの数字は、
#「CoWoS級GPUを10億個作れる」
#ことではなく、
#「PLPという製造フォーマットを高volume・高yieldで実際に回せる」
#ことを示している。
#
8.なぜ今「○から□」なのか
#昔から四角いpanelにすれば面積効率は良かったはずだ。
#それでも半導体先端工程が丸いwaferを使い続けたのには理由がある。
#半導体産業は数十年かけて、
#300mm circular waferを前提に、
#lithography、spin coating、CMP、etch、plating、cleaning、inspection、robot handlingを極限まで成熟させてきた。
#丸いwaferは回転対称なのでspin coatingなどとの相性もよい。
#四角いpanelにすると、
#spin coatingをslit coatingへ変える、panel対応stageを作る、角と中央のplating uniformityを揃える、warpageを抑える、inspectionを作り直す、といった変更が必要になる。
#ASEも、wafer→panelではspin coatingをそのまま使えずslit coatingへ変える必要があり、large interposerではmulti-reticle stitchingやwarpage、lithography accuracy、plating uniformityが課題になると説明している。
#それでもAI時代に□が必要になった。
#理由はpackageが巨大化しすぎたからである。
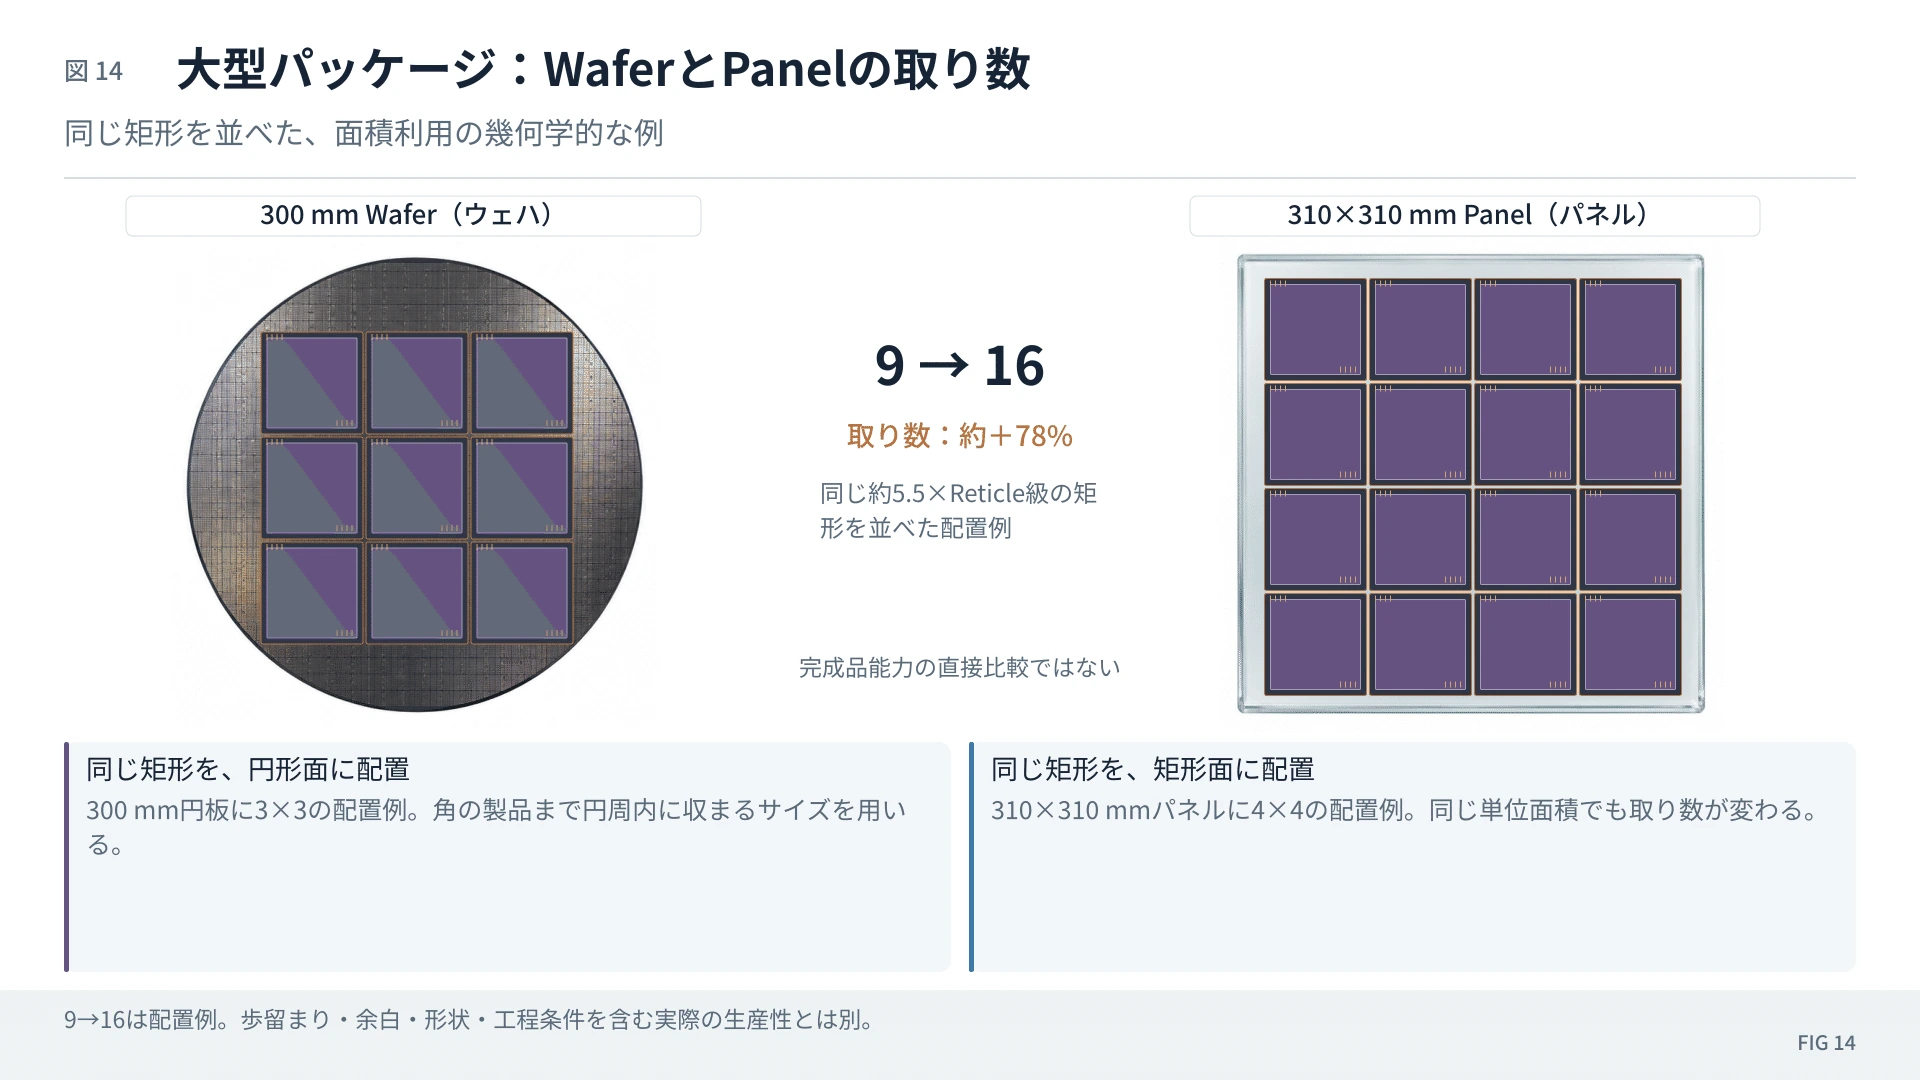
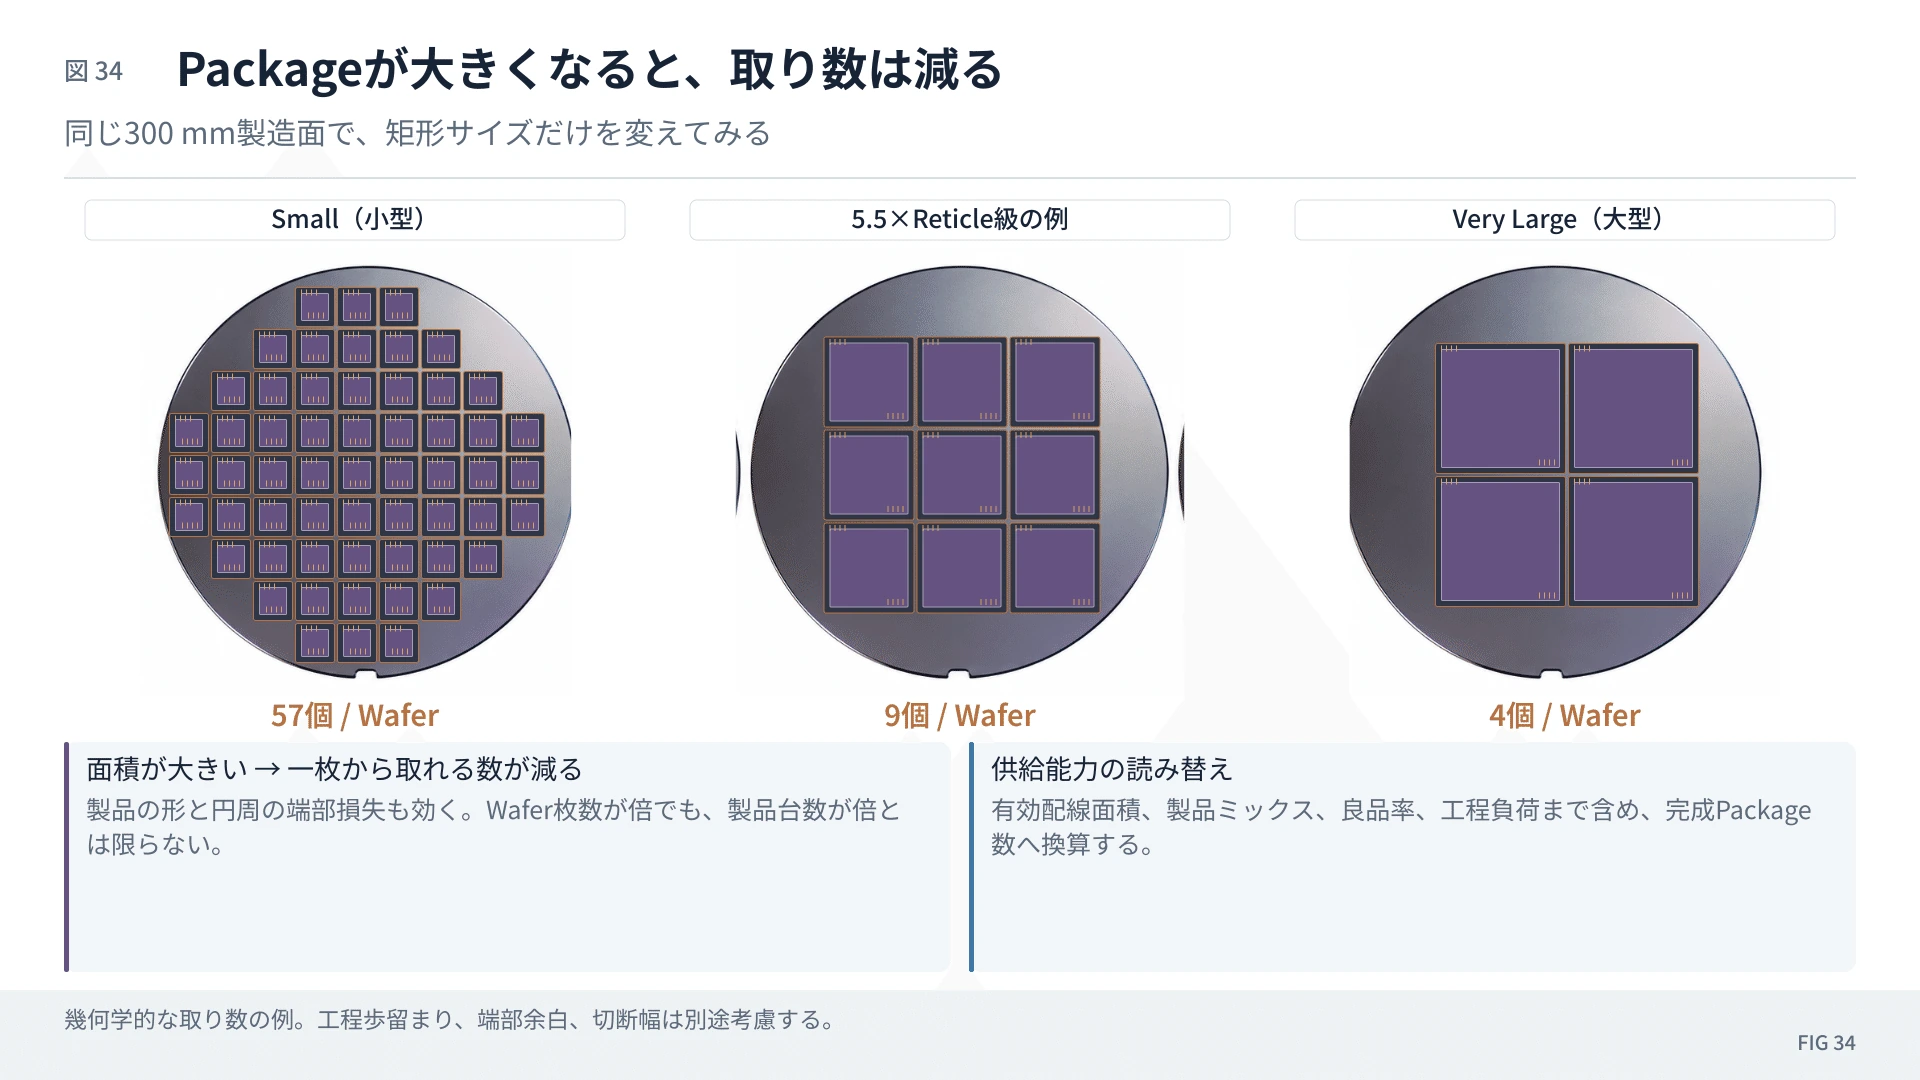
#ASEの実例では、約60×70mm、5.5×reticle級interposerの場合、
#300mm waferなら9個、
#310×310mm panelなら16個
#配置できる。
#同じ300mm級の幅でも、
#で約1.78倍になる。
#小さいpackageでは丸い端の無駄は大した問題ではない。
#しかし、GPU、複数compute die、8個、12個、その先のHBMを一枚に載せるようになると、一個のinterposerが巨大化し、丸いwaferの端から何も取れなくなる。
#つまりAI時代では、
#トランジスタを作る前工程は○のまま
#巨大packageを作る後工程だけ□へ
#という分離が合理的になってきた。
#
9.CoPoSとは「ガラス化」ではない
#TSMCが進めている、
#CoPoS = Chip-on-Panel-on-Substrate
#も、この□化の流れである。
#名前を比較すると分かりやすい。
#CoWoSは、
#Chip-on-Wafer-on-Substrate
#CoPoSは、
#Chip-on-Panel-on-Substrate
#つまり本質は、
#であって、
#ではない。
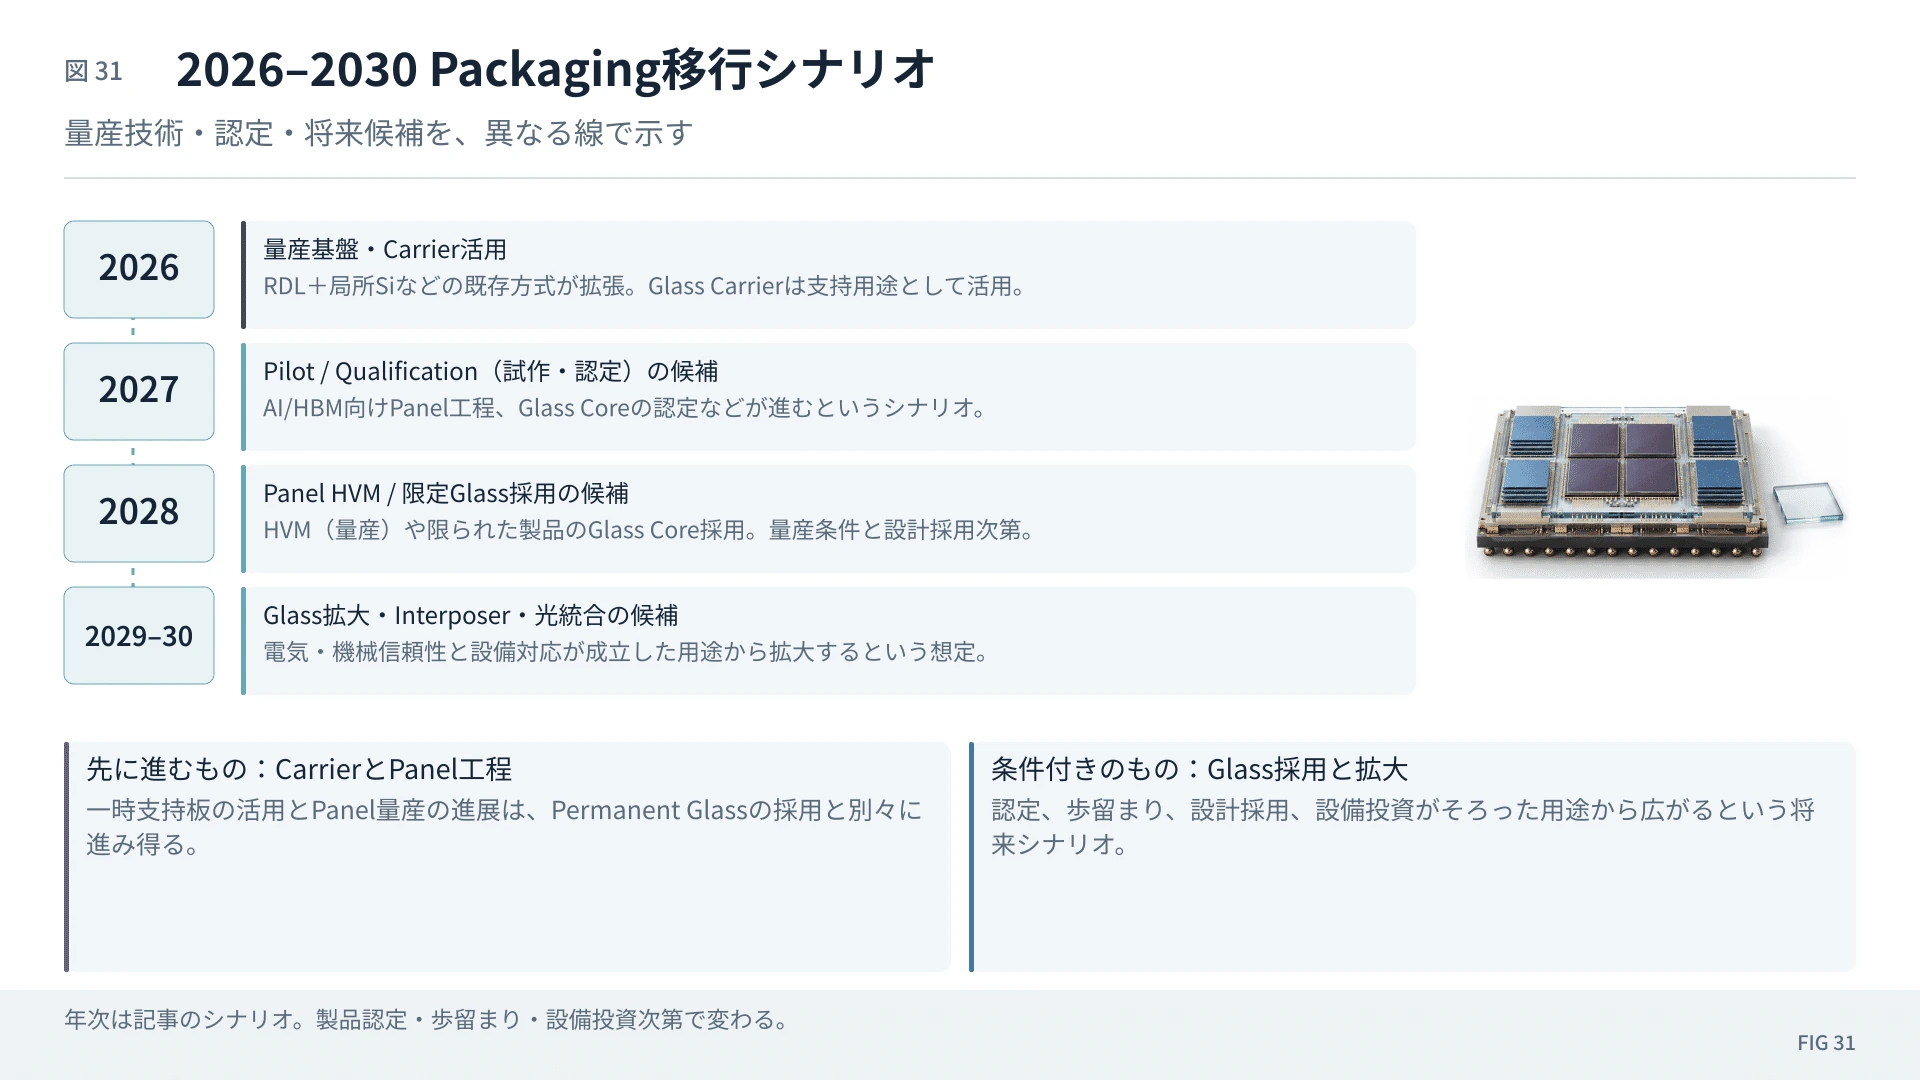
#TrendForceによるとTSMCは310×310mmをCoPoSの標準panel formatとして、2027年pilot、2028年後半mass productionを目指している。一方、Glass Core Substrateのcommercial-scale productionはその後、2030年以降になる可能性が高いと見ている。
#これは非常に重要だ。
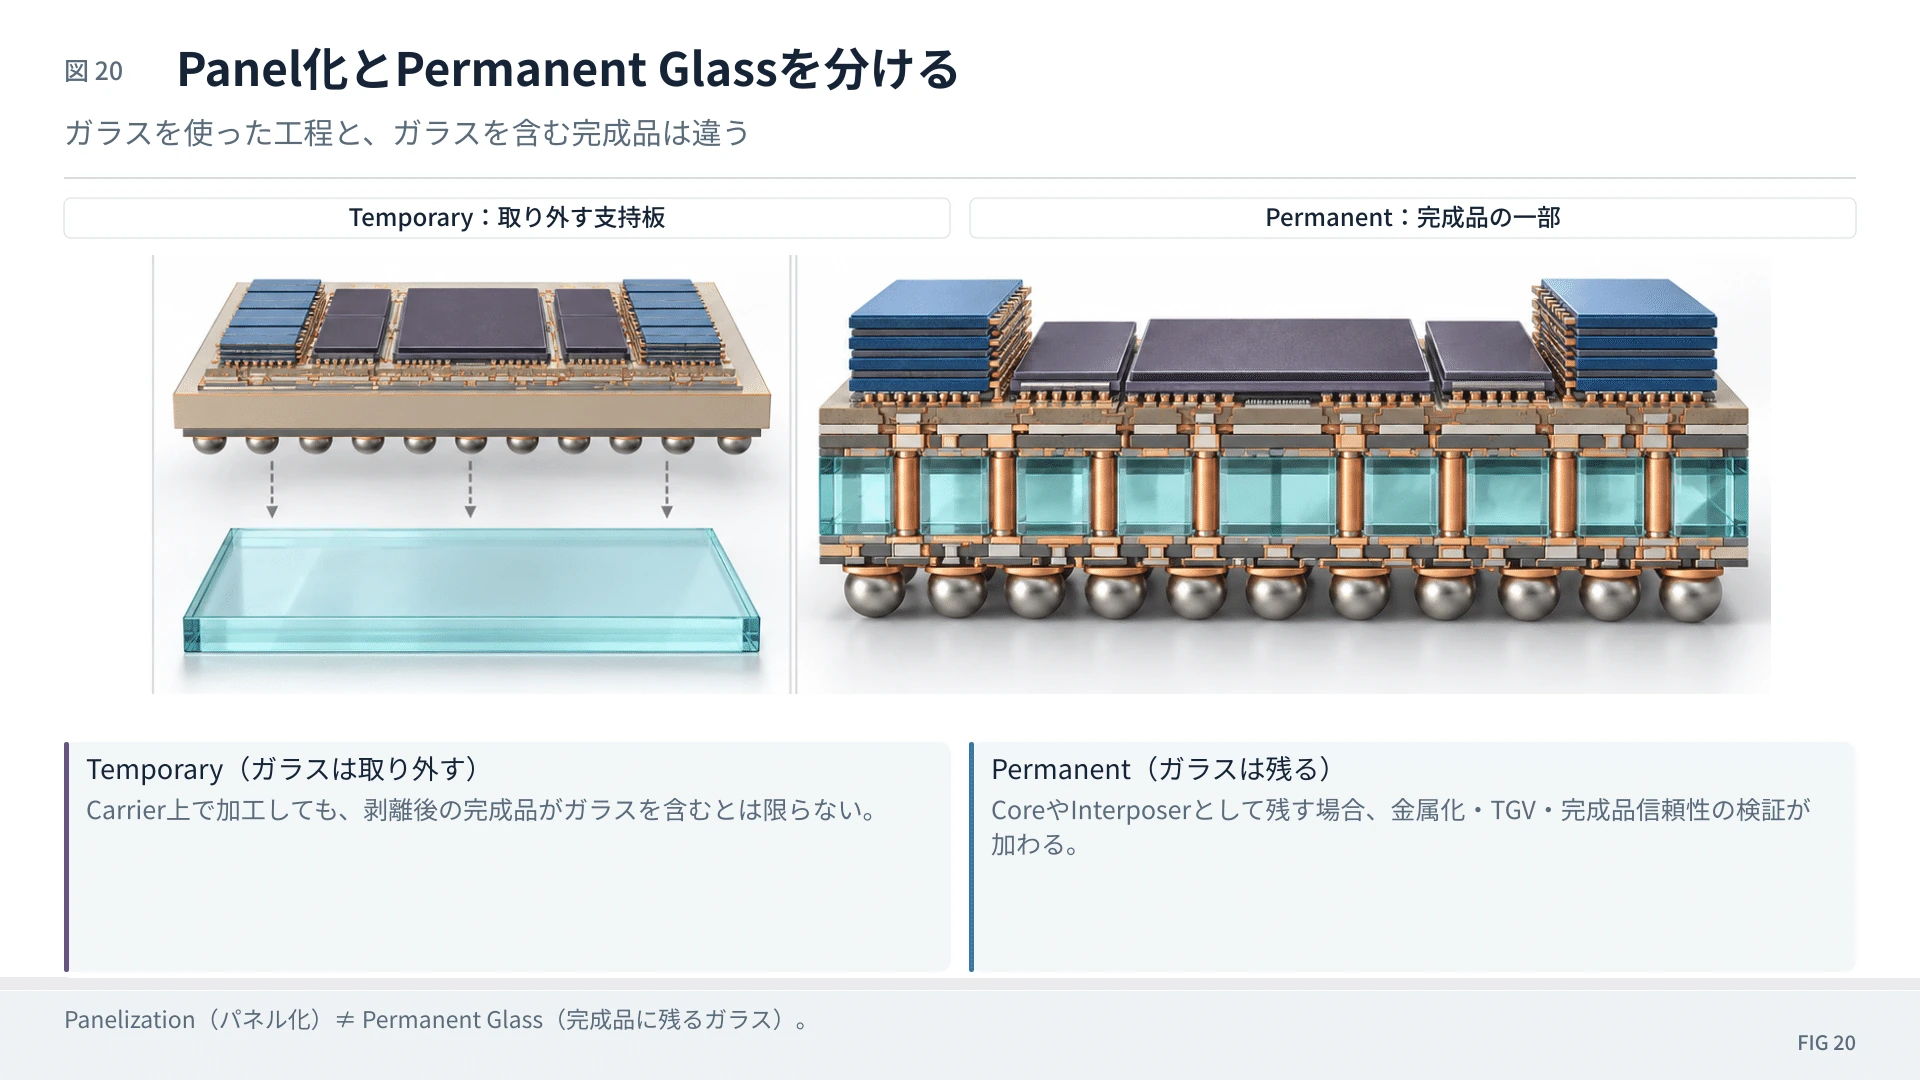
#Panel化とPermanent Glass化は別々の技術ロードマップなのである。
#
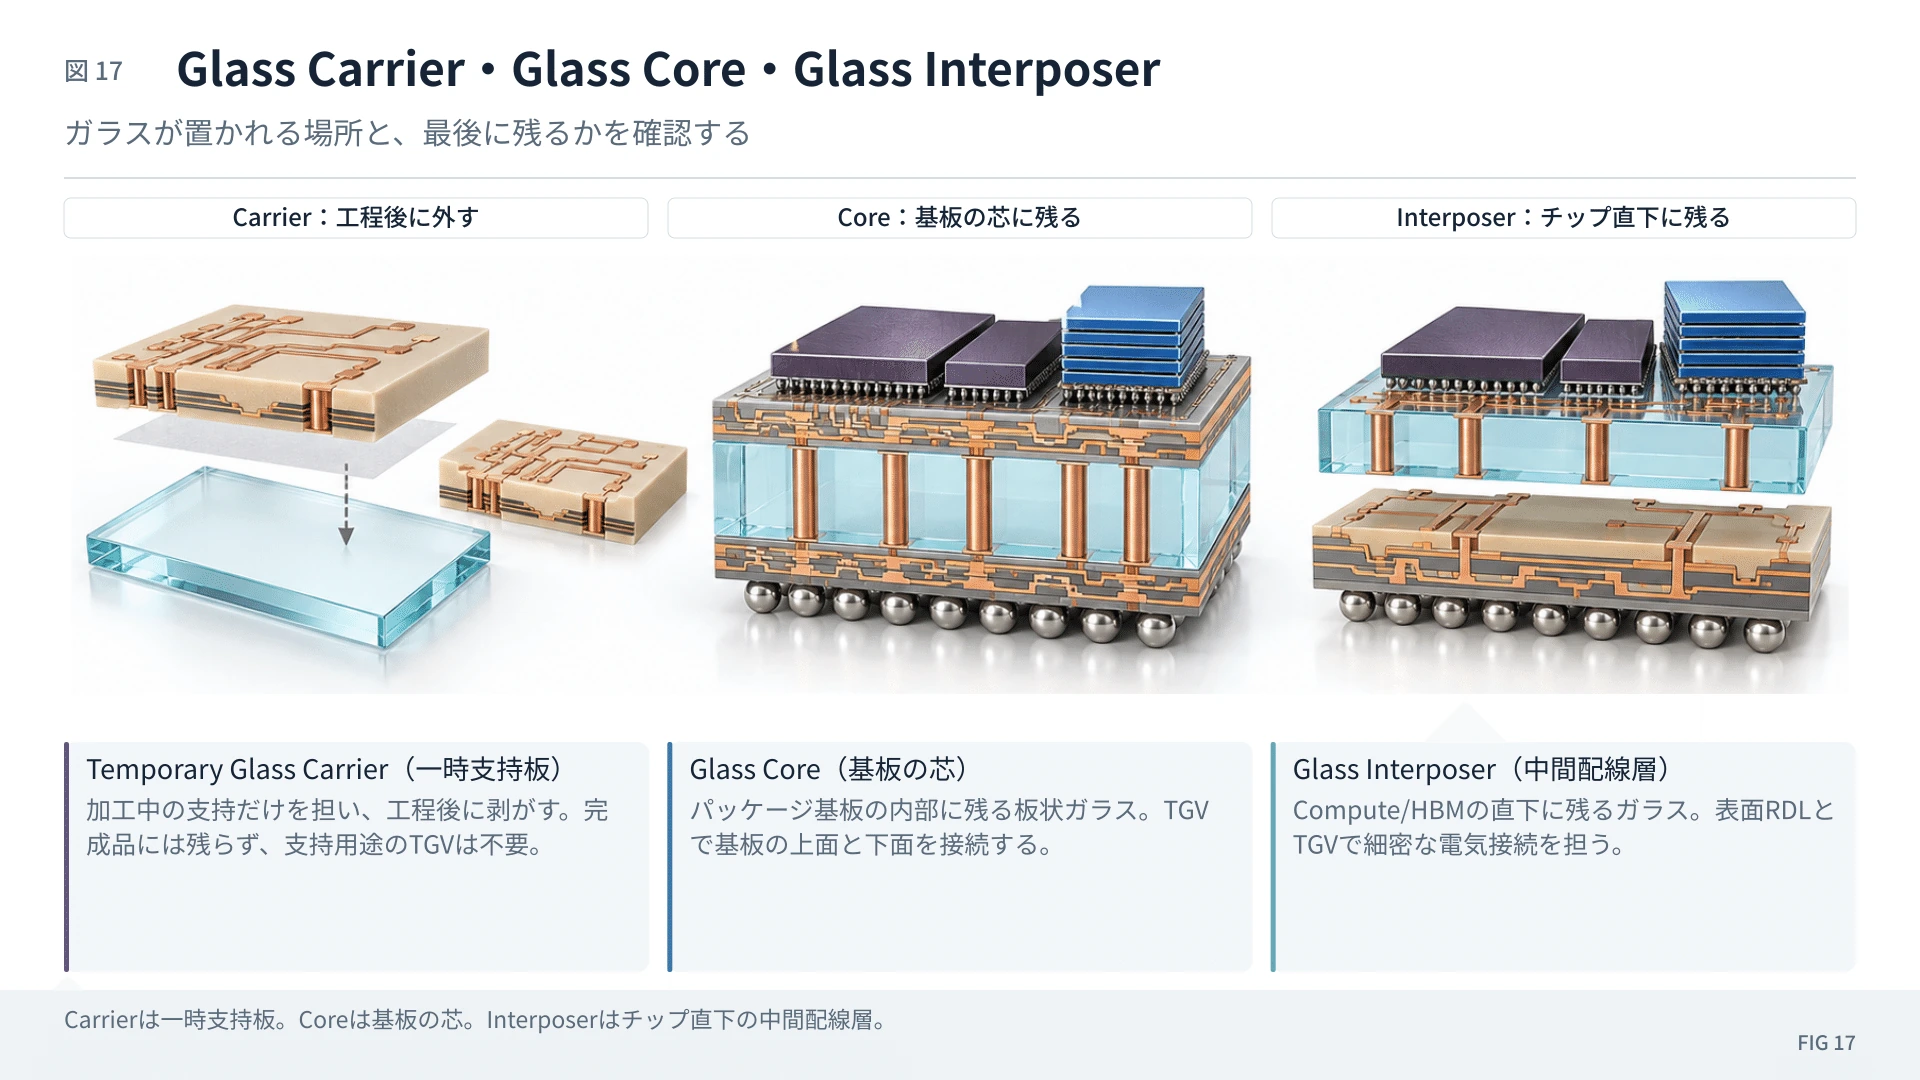
10.「ガラス基板」という言葉には少なくとも3種類ある
#ここでガラスが一気にややこしくなる。
#同じ「glass」と呼ばれていても、役割は全く違う。
#さらに「Permanent Glass Core」という表現は、Temporary Carrierとの対比で「完成製品内に永久に残るglass」を指す説明的な呼び方であり、必ずしも独立した標準規格名ではない。
#
11.Temporary Glass Carrier――ガラスを最後に捨てる理由
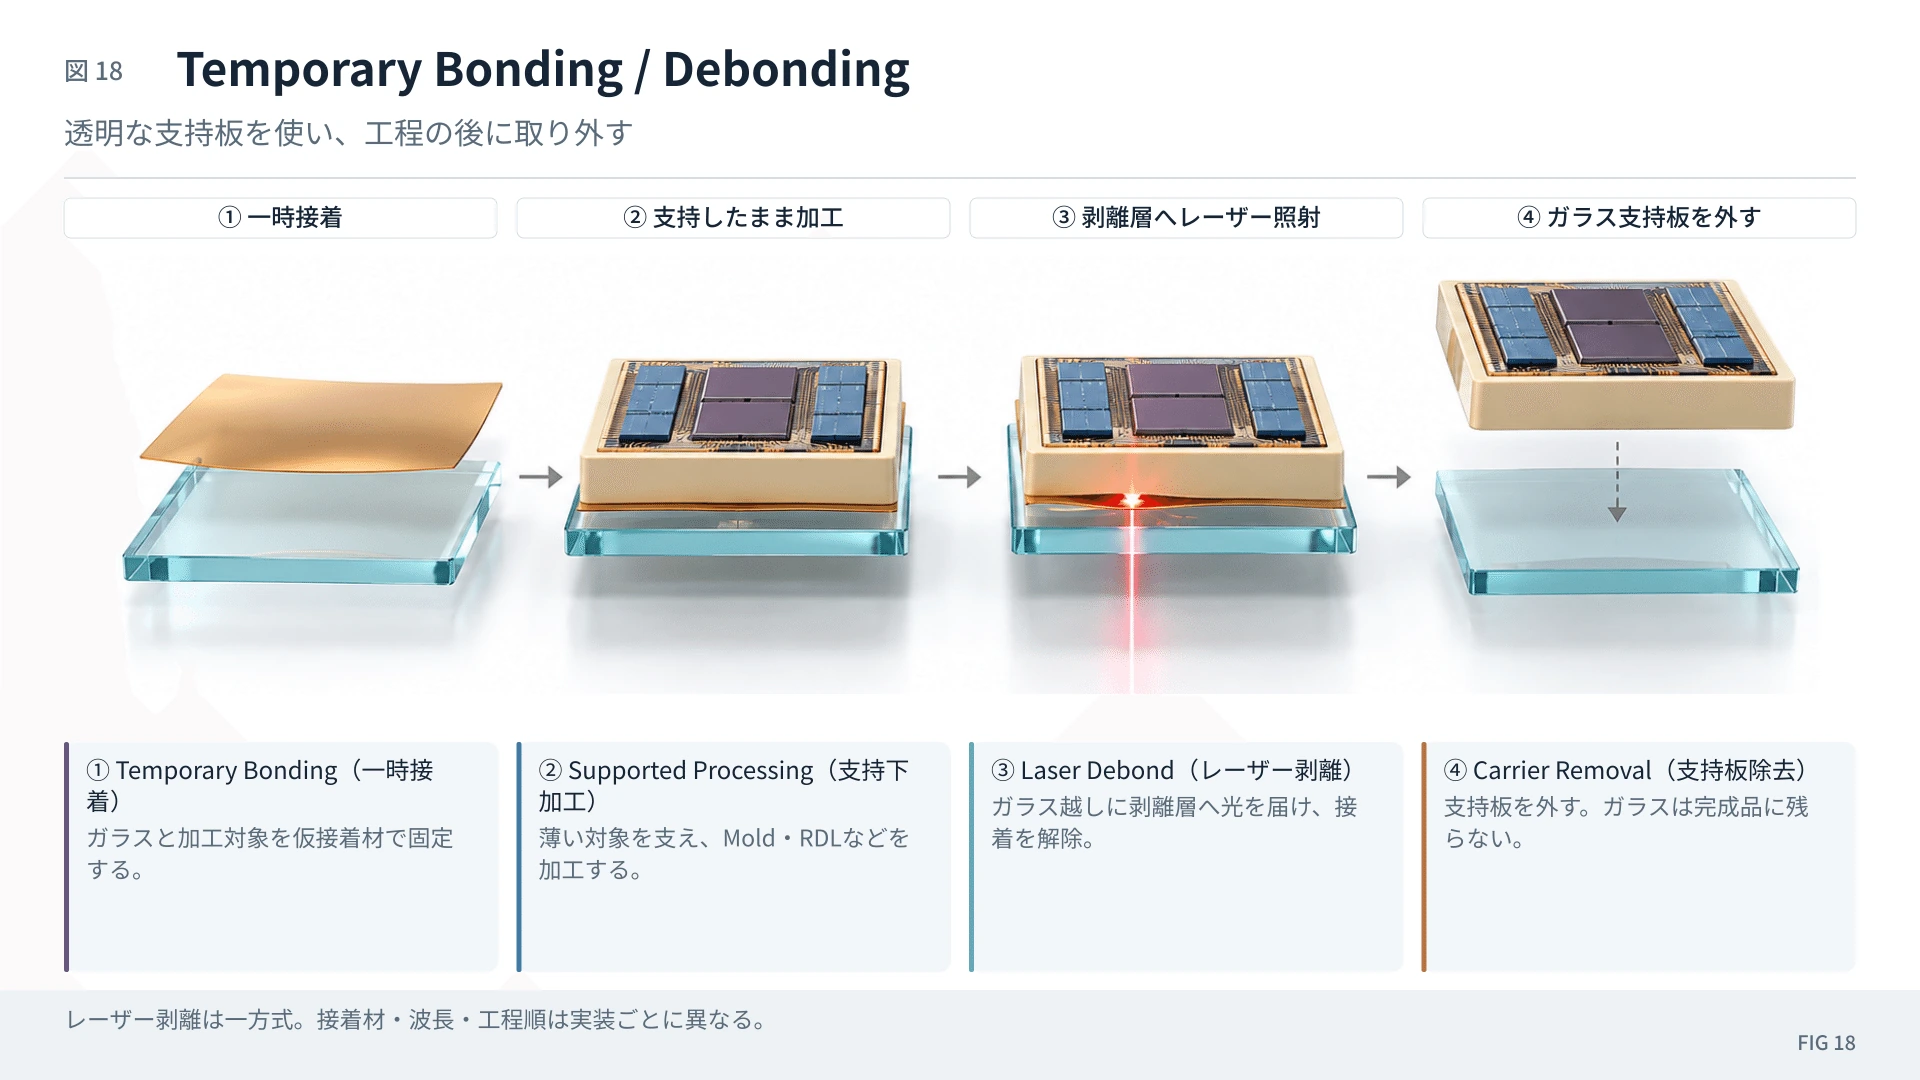
#Fan-OutやPanel工程では、非常に薄いRDL、樹脂、dieの集合体を加工する。
#そのままでは柔らかく、熱で反る。
#そこで、
#Die / Mold / RDL
────────────────
Temporary adhesive
────────────────
████████████████
Glass Carrierと、ガラス板へ一時的に貼り付ける。
#工程終了後、
#Temporary Bonding / Debonding、略してTBDB
#によって剥がす。
#3MもFOWLP/FOPLP向けのTemporary Bonding & Debonding工程としてglass carrierを利用し、laser debond後にcarrierをlift-offするprocessを提供している。
#なぜわざわざ最後に外すものを使うのか。
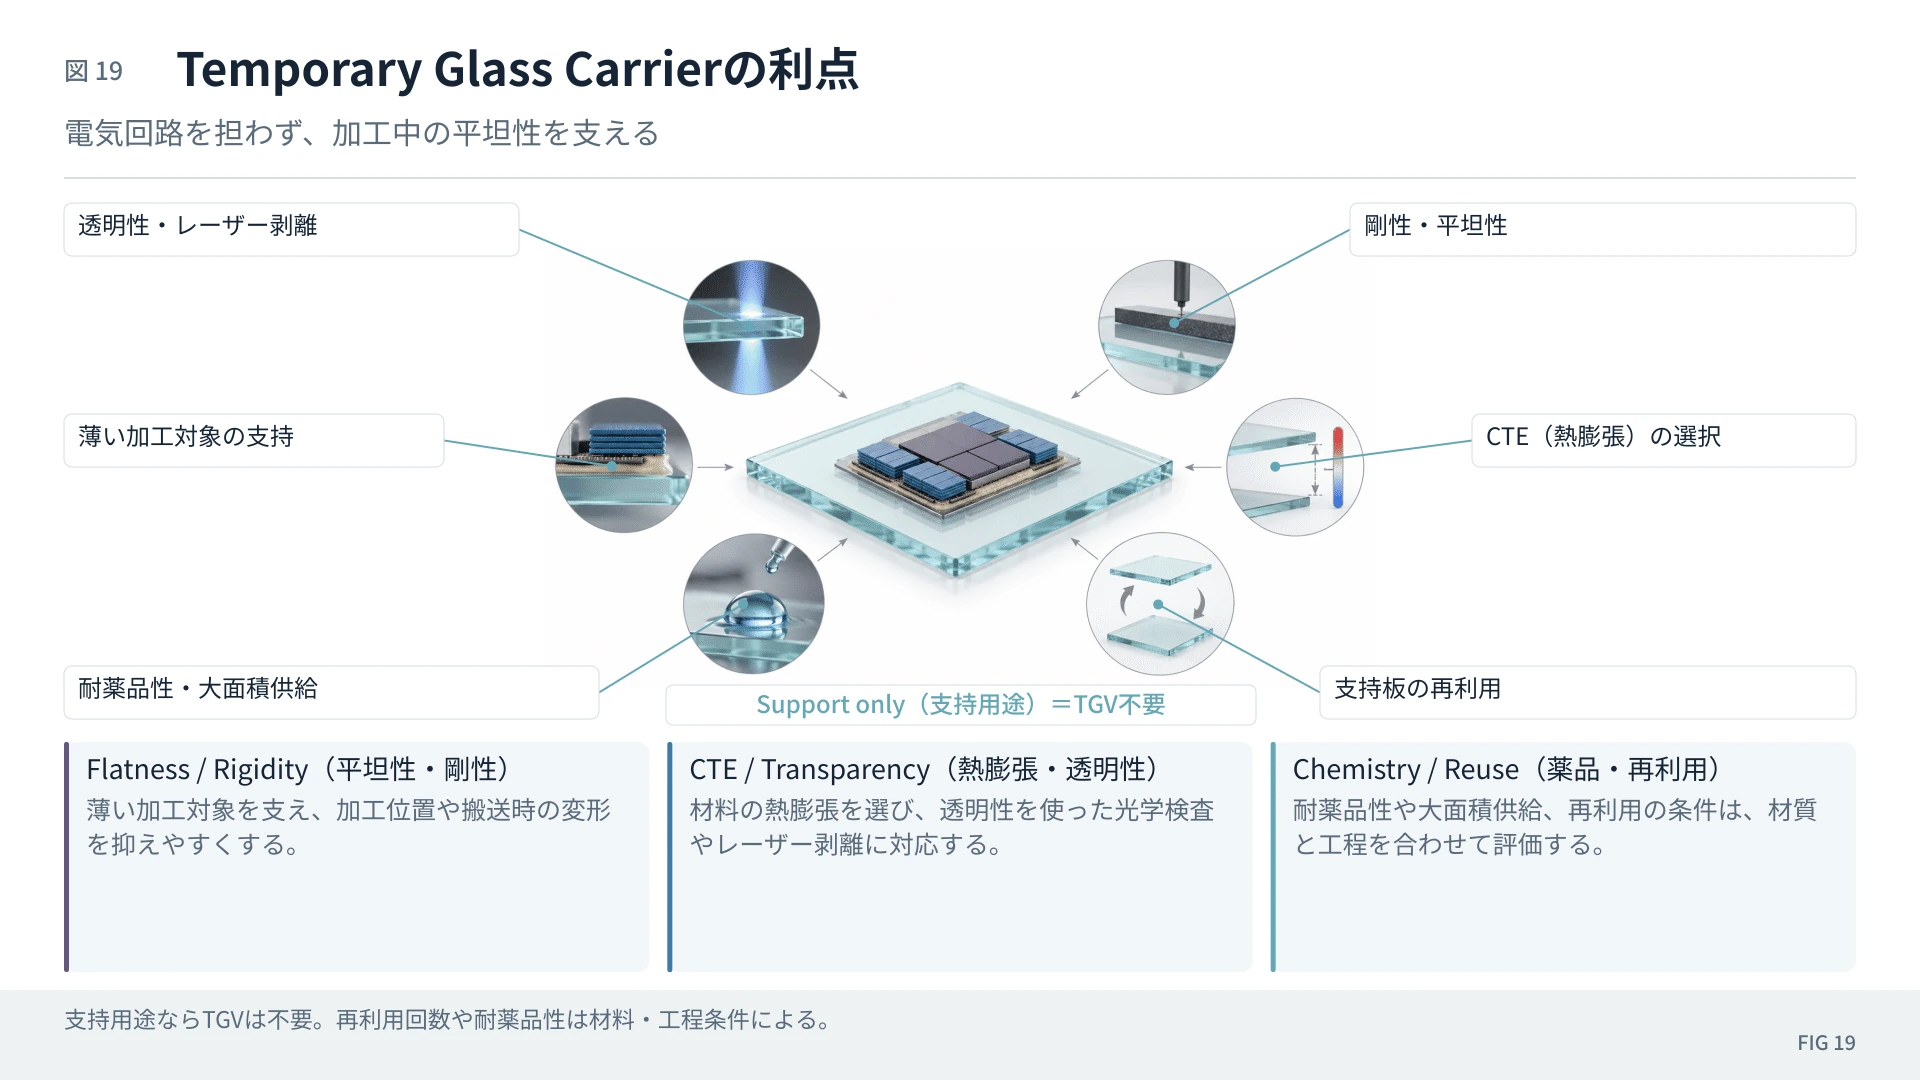
#ガラスは、
#非常に平坦で、硬く、CTEを調整でき、薬品に強く、しかも透明なのでlaser debondしやすい。
#つまり、
#製造時に必要な「平坦で動かない作業台」という性能だけを借りる
#のである。
#さらに必ずしも一回使い捨てではない。
#SCHOTTはglass carrierを条件次第で最大10回再使用可能としている。
#したがって、
#「1panel加工するたびに1枚の高価なglassを捨てる」
#という単純な構造ではない。
#
12.第一世代CoPoSもGlass Carrierだけになる可能性
#ここはまだTSMCが完成stackを公式公開していないため注意が必要だ。
#2026年7月、台湾CommonWealthはTSMCのadvanced packagingに詳しいR&D関係者の話として、第一世代CoPoSは“zero-glass”、つまり永久glassを完成品に残さず、製造中のtemporary reusable glass carrierだけを利用する可能性が高いと報じた。
#一方でGlass Interposer採用を示唆する別の業界報道も存在する。
#したがって現時点では、
#CoPoS=Glass Interposer
#と決めつけない方がよい。
#確実なのは、
#CoPoS=Panel format
#であり、
#Glass Carrier、Glass Interposer、Glass Coreをどこまで初期世代へ導入するかは別問題だということだ。
#
13.Glass Core SubstrateはPackage Substrateそのものを変える
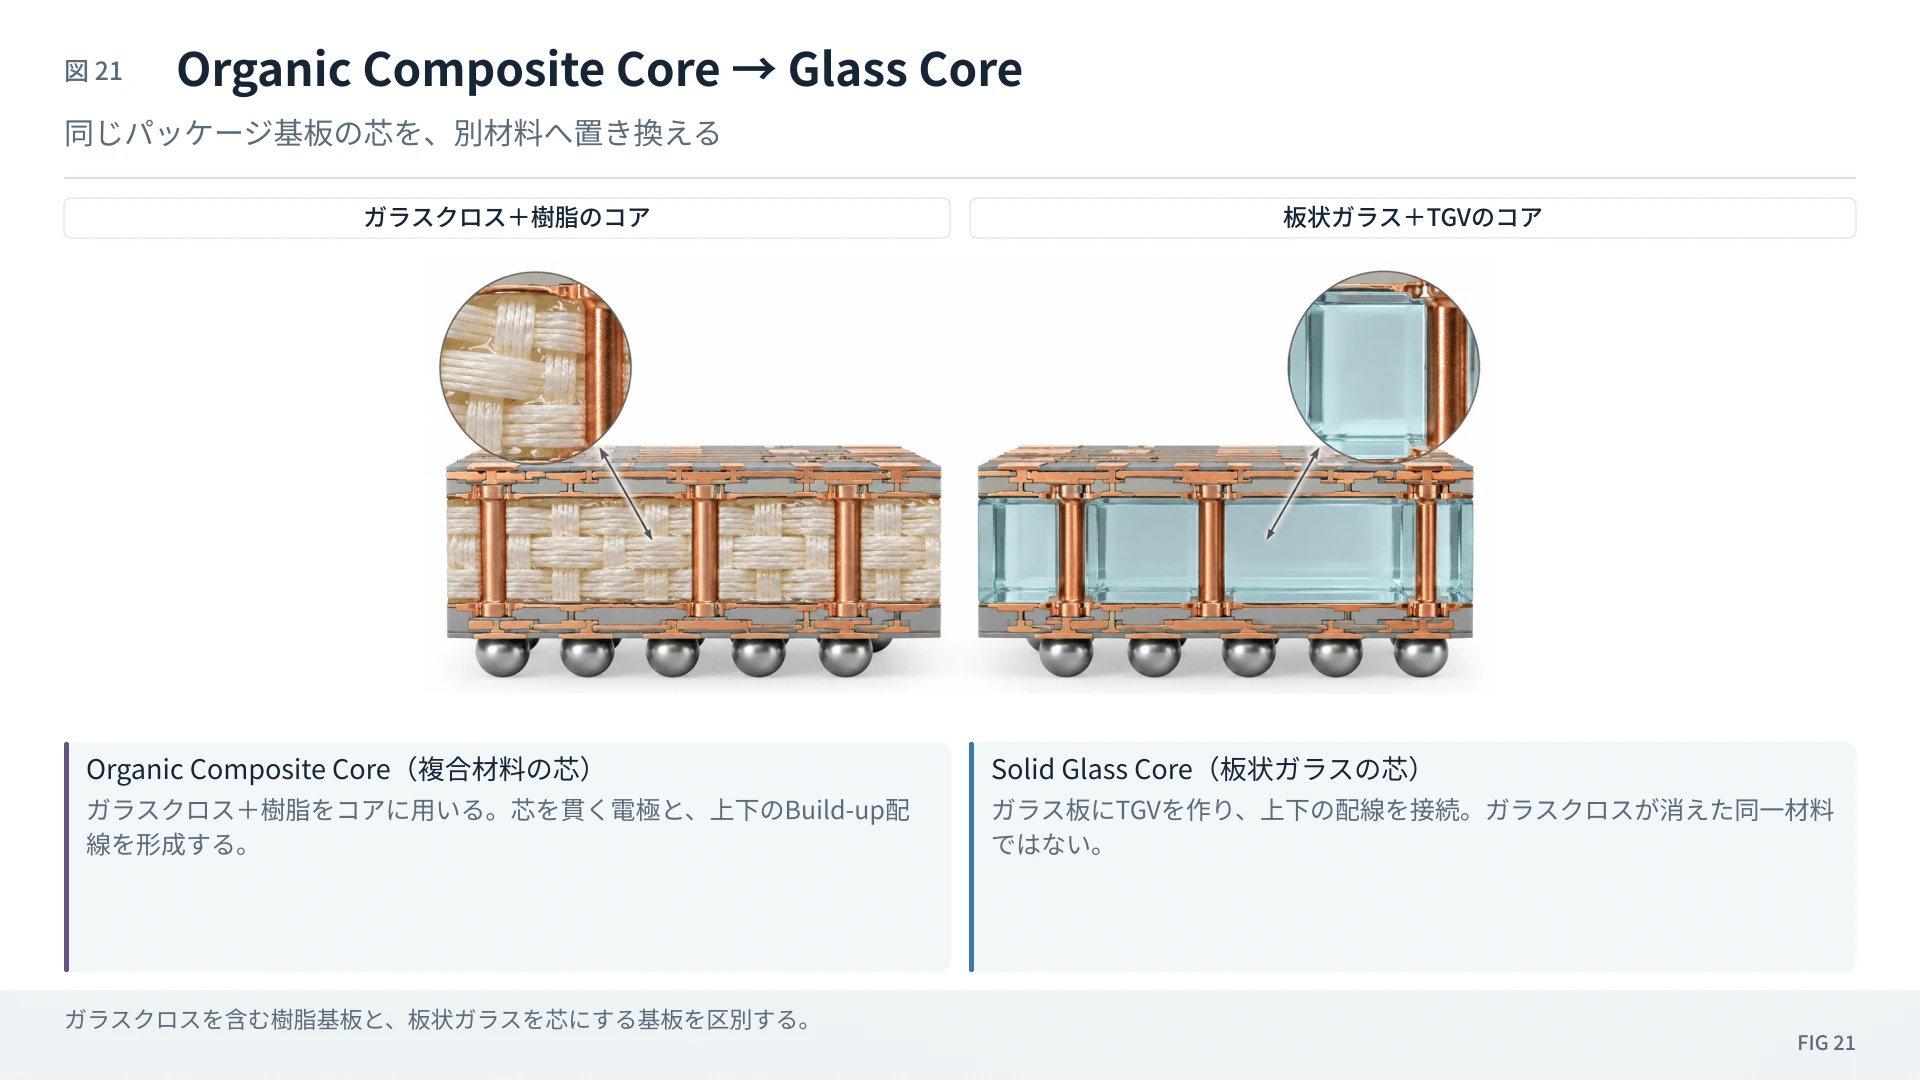
#従来のPackage Substrateでは、organic coreやglass-cloth reinforced resinなどが使われる。
#Glass Coreでは、その中心を一枚のsolid glassへ変える。
#Interposer
#↓
#Cu build-up layers
#████████████████████
#Glass Core │ │ │ TGV TGV ████████████████████
#Cu build-up layers
#↓
BGA
↓
PCBIntelはGlass Coreについて、organic substrateより寸法安定性が高く、大型化しやすく、warpageを抑えられることを強調している。
#Samsung Electro-MechanicsもAI acceleratorやserver CPU向けGlass Coreを開発し、pilot lineでprototypeを生産、2027年以降の量産を計画している。
#ただしSEMIの2026年調査は、Glass Core市場をまだexploratory stage、探索段階と位置づけている。
#selected high-performance applicationでlimited-volume productionが始まるのは2028年頃という見通しであり、TGV、metallization、build-up、dicing、cracking、reliabilityなど未解決課題が多い。
#
14.Glass Interposerはさらに難しい
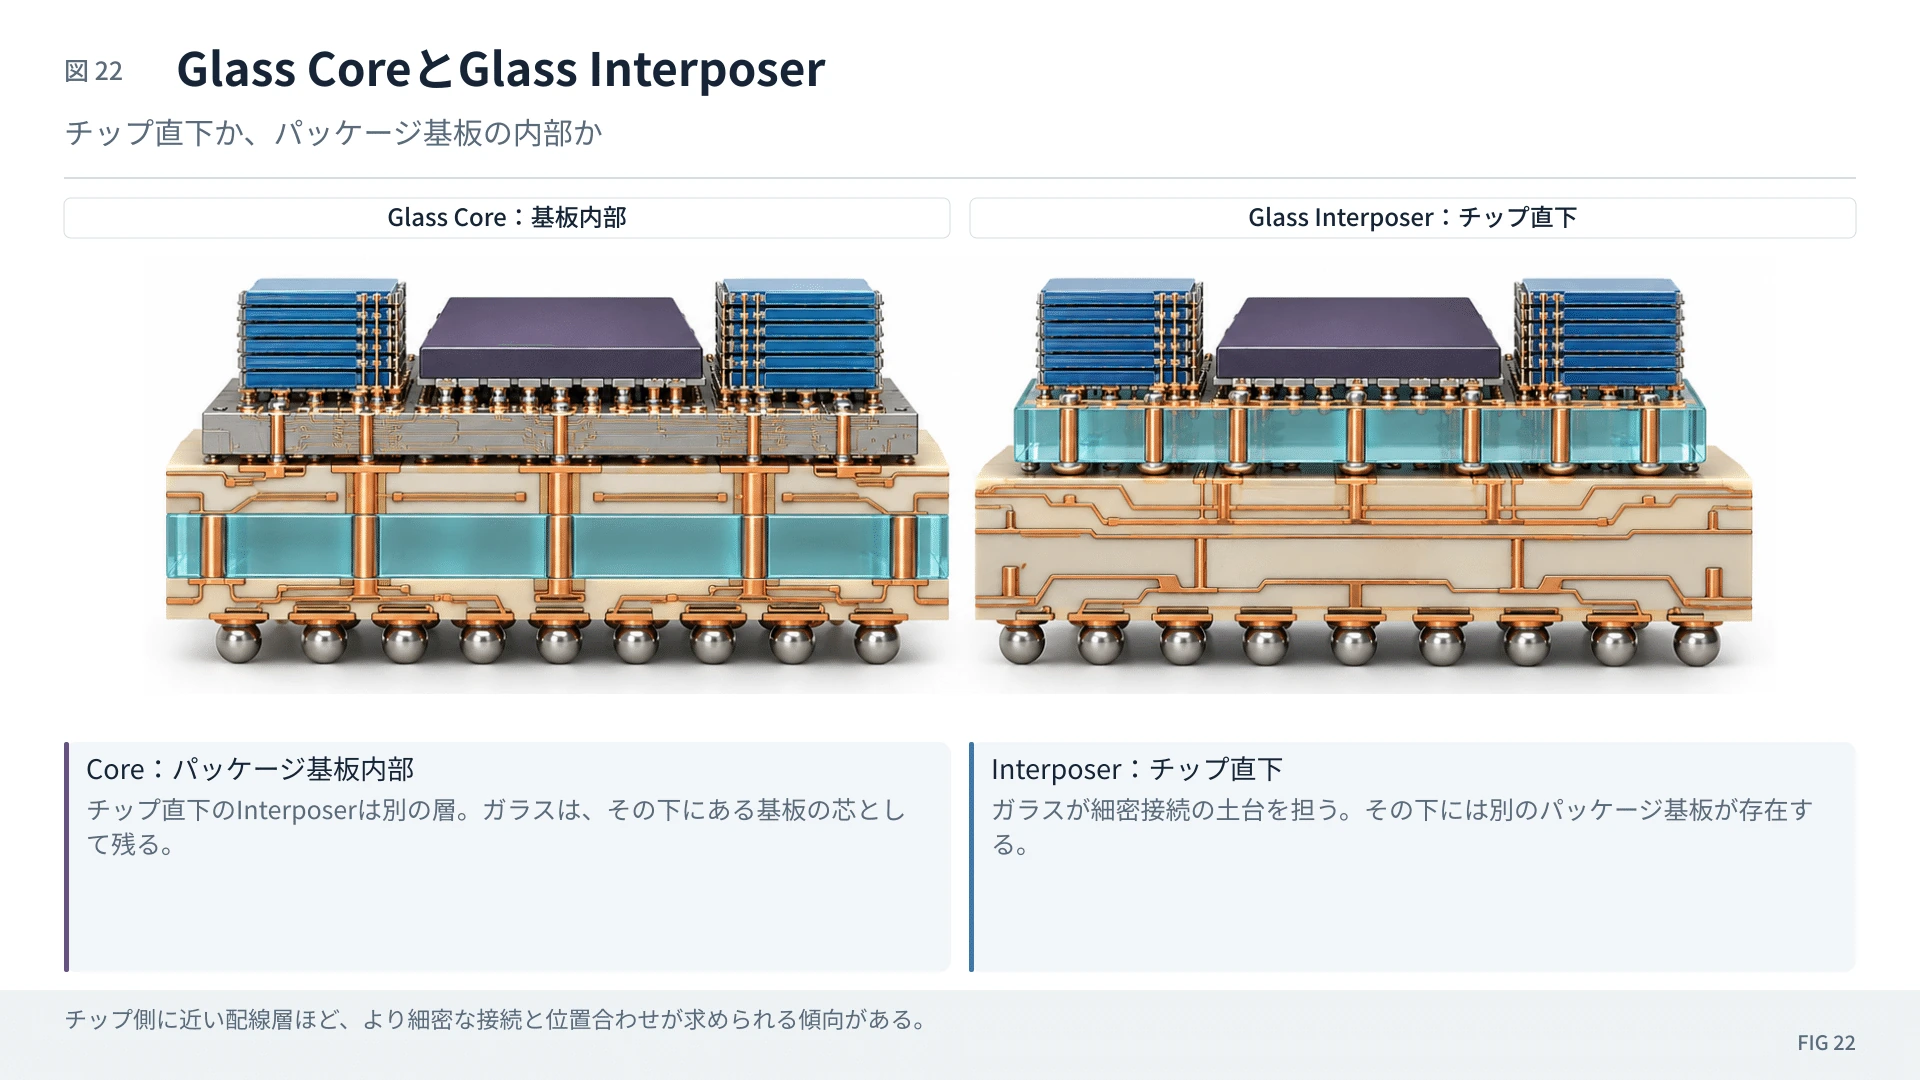
#Glass Core Substrateよりさらにchip側へGlassを持ってきたものがGlass Interposerだ。
#GPU HBM
#│ │
#Fine Cu RDL
#│ │ │
TGV TGV TGV
│ │ │
████████████████████
Glass Interposer
████████████████████
│
Backside RDL
│
Package SubstrateGlass Coreではpackageの「土台」をglassにする。
#Glass Interposerでは、GPU/HBM間という最も高速で高密度な領域そのものをglass化する。
#そのため要求されるRDL密度、TGV密度、overlay、signal integrity、yieldはさらに厳しい。
#概念的な難易度は、
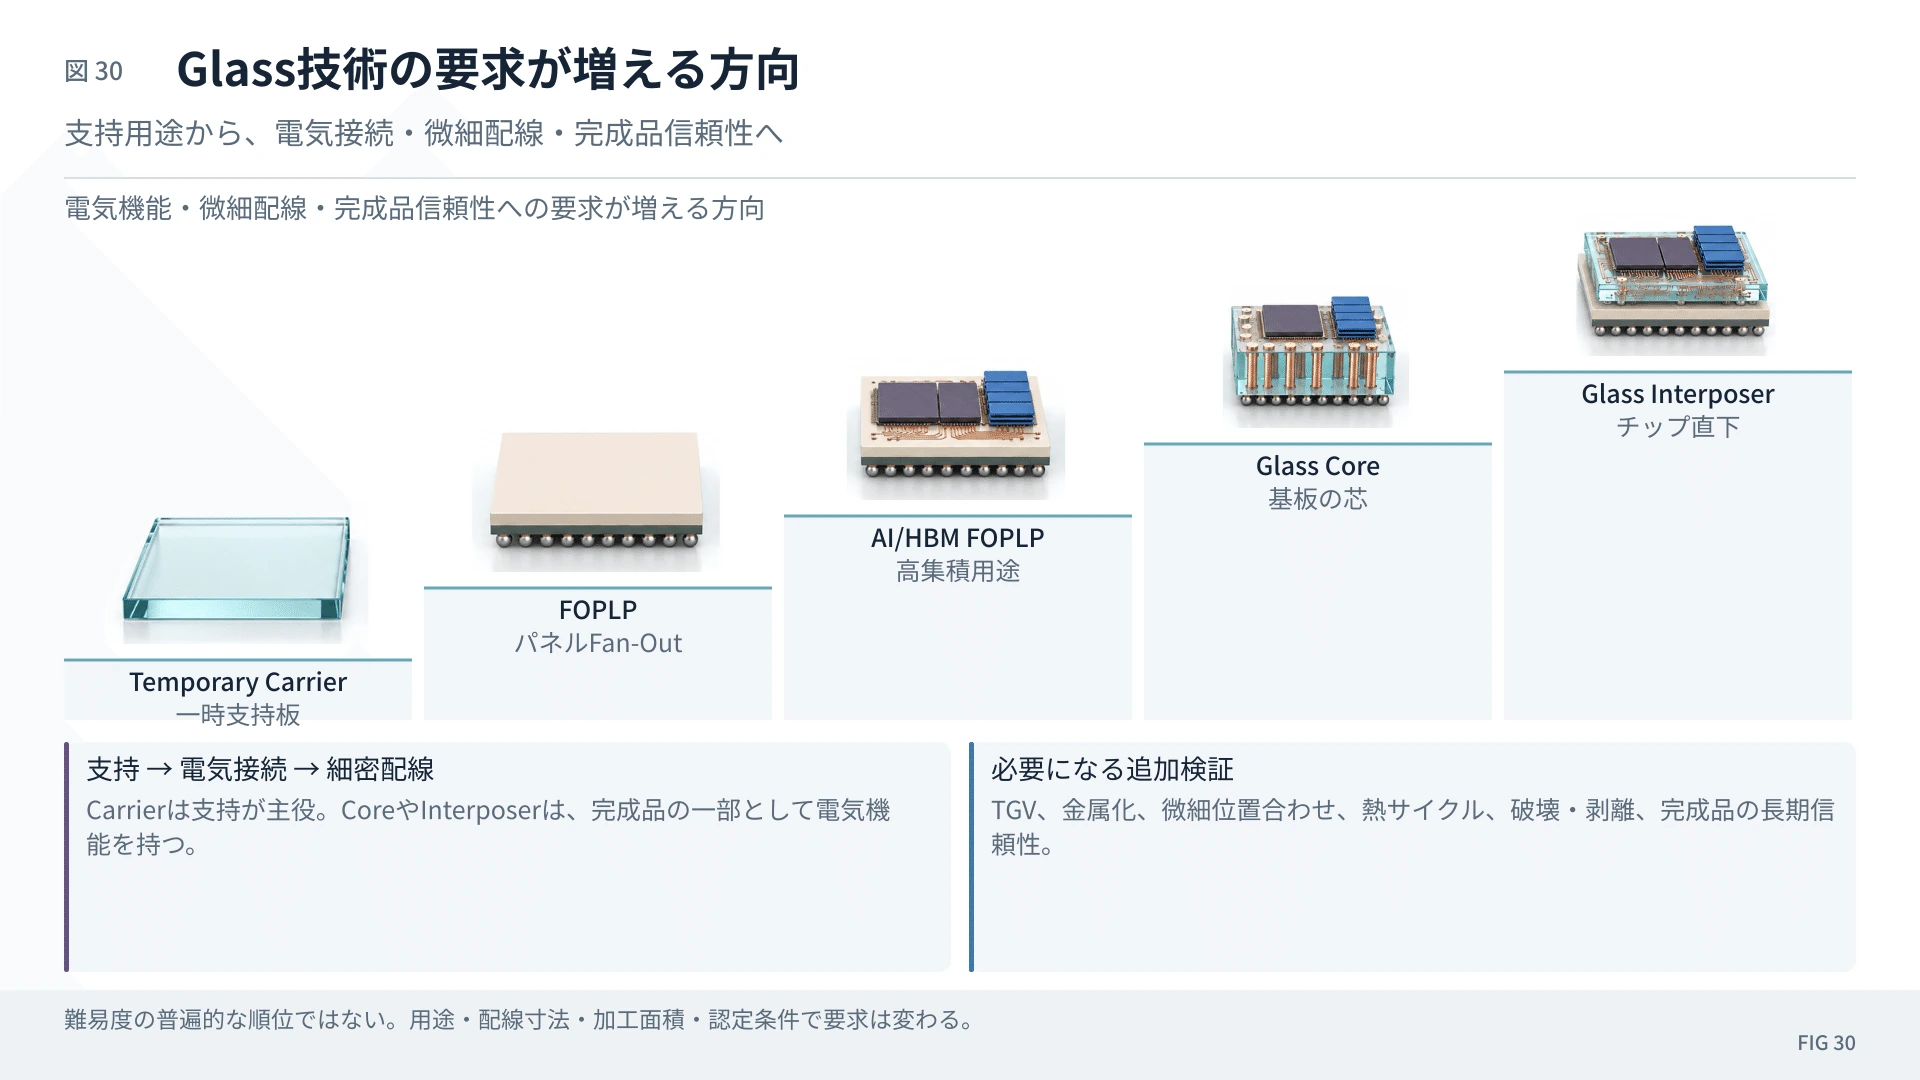
#Temporary Glass Carrier < AI向けFOPLP < Glass Core Substrate < Frontier AI Glass Interposer
#と考えると分かりやすい。
#
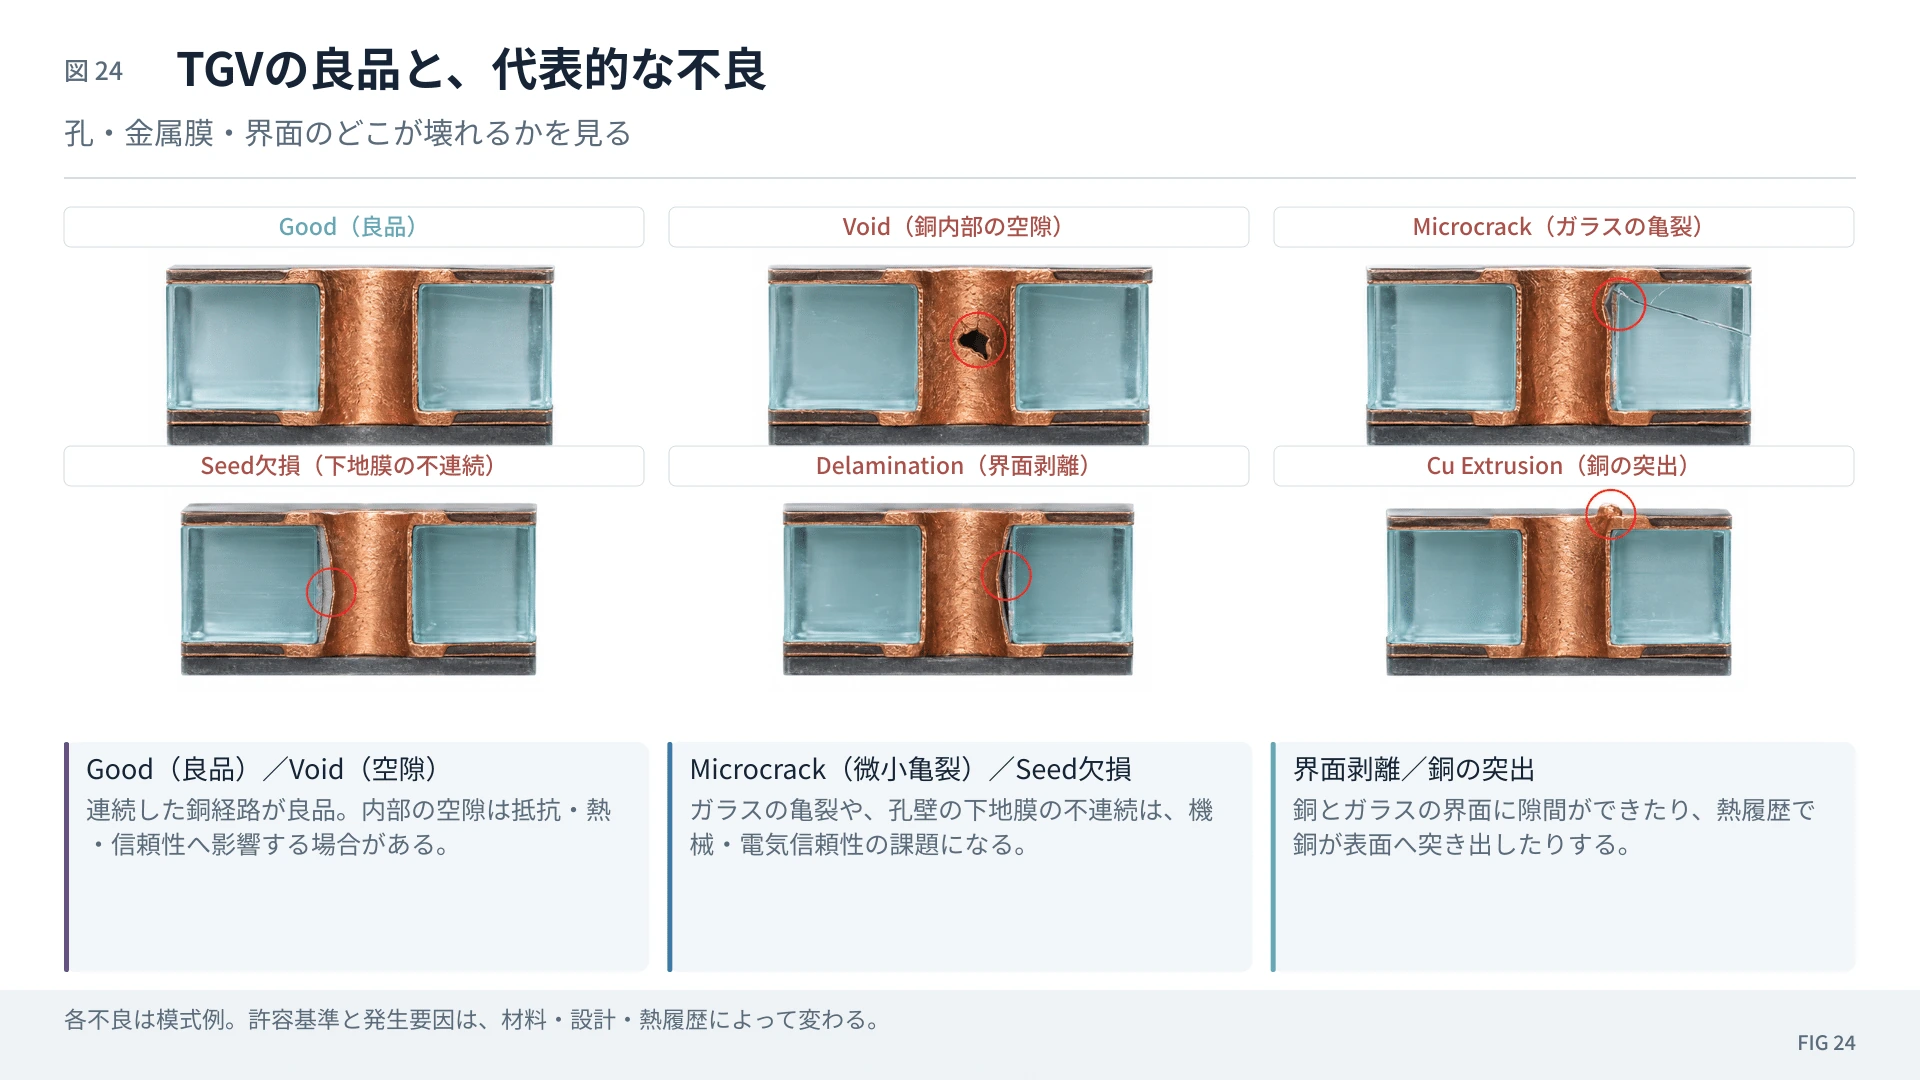
15.ガラスはどうやって配線板になるのか――TGV
#ガラス自体は絶縁体だ。
#電気は流れない。
#したがってGlass Coreにはまず穴を開ける。
#これが、
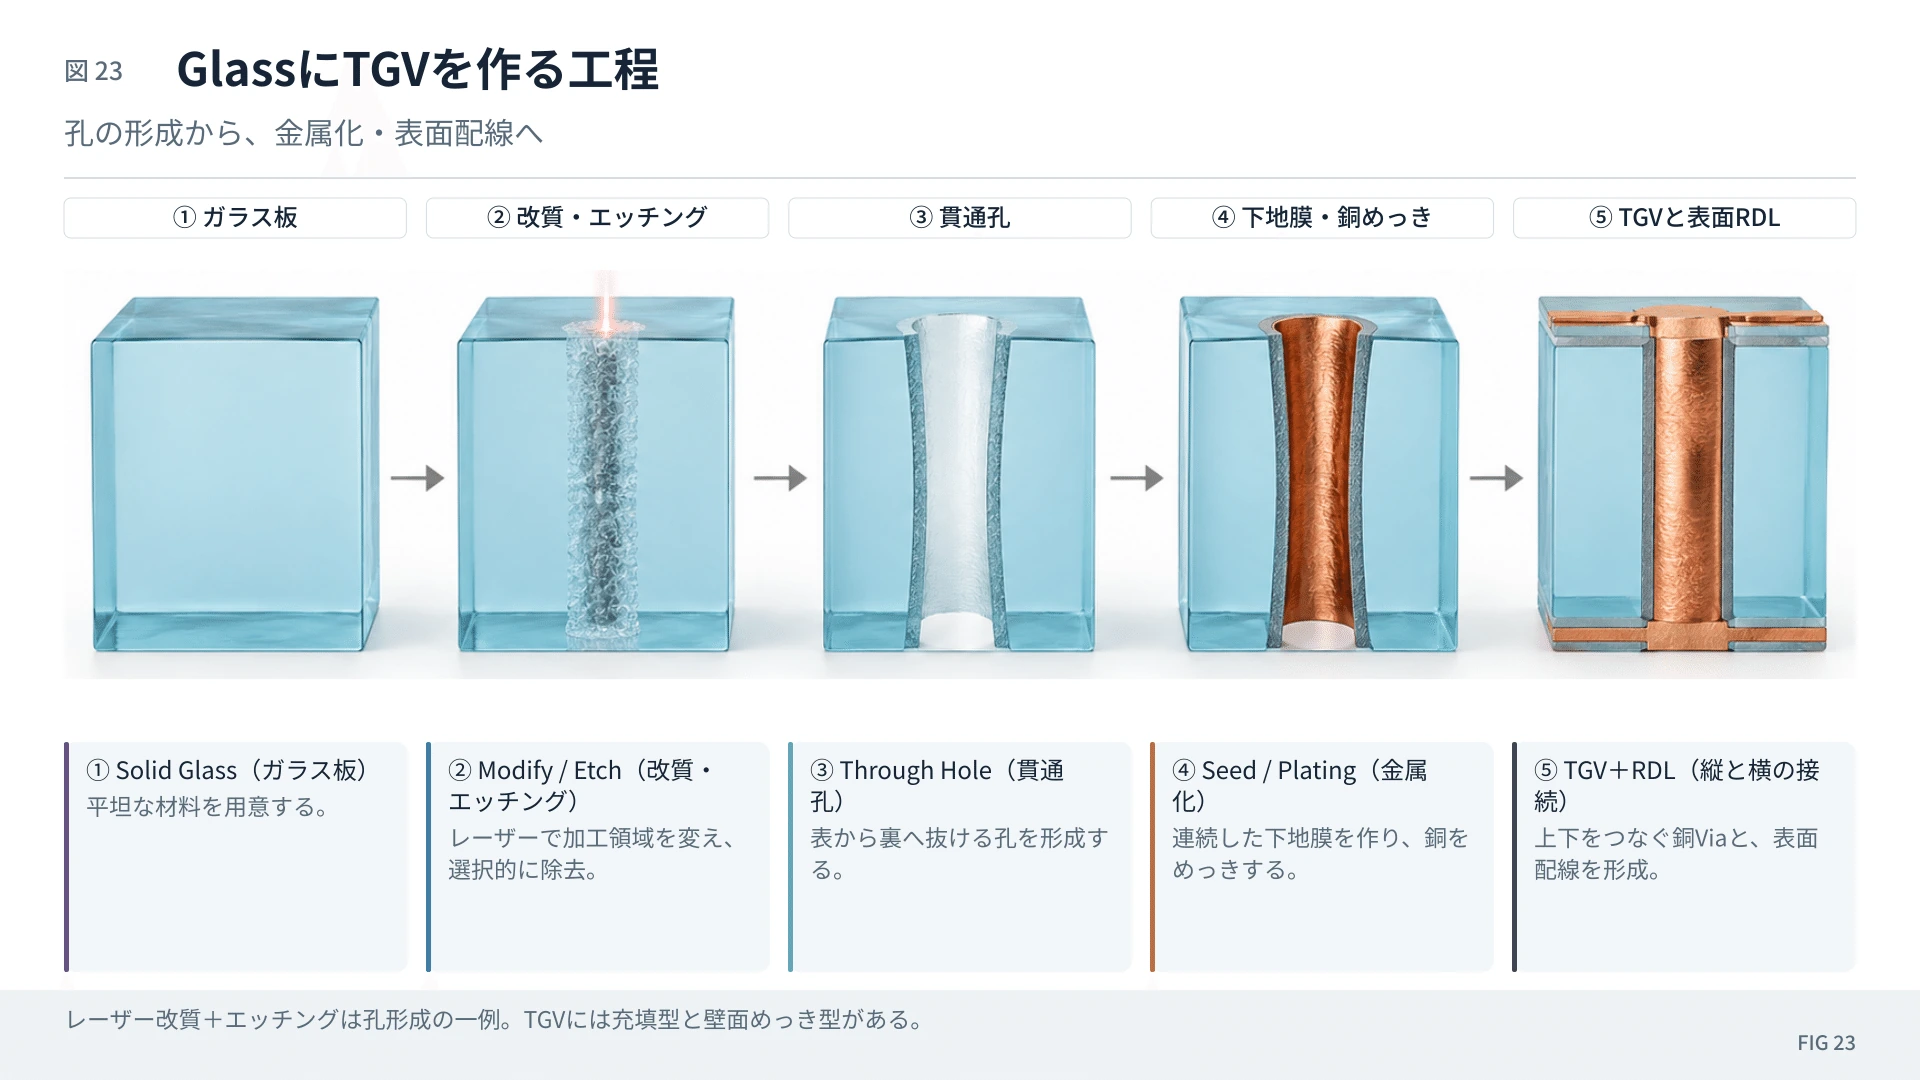
#TGV = Through-Glass Via、ガラス貫通電極
#である。
#上面 Cu RDL
─────────────
│
│ Cu
██████│██████
│ Glass
██████│██████
│
─────────────
下面 Cu RDL工程を単純化すると、
#Glass → 微細穴形成 → cleaning → adhesion/barrier → Cu seed → Cu plating → 必要ならCu full fill → planarization/CMP → surface RDL/build-up
#となる。
#つまり、
#RDL=横方向
#TGV=縦方向
#である。
#DNPは510×515mmのTGV Glass Core pilot lineを構築し、穴全体をCuで埋めるfilled型と、側壁へ金属を形成するconformal型の両方を開発している。2026年からsample、2028年度量産を目標としている。
#Glass Coreの難所は、穴を開けることだけではない。
#むしろ高aspect-ratioの微細穴全体へseed/Cuを均一に形成し、voidを作らず、CuとGlassのCTE差に耐え、数万~数十万viaを低欠陥率で作るmetallizationが重要になる。
#
16.Glass InterposerでもSilicon Bridgeは消えない
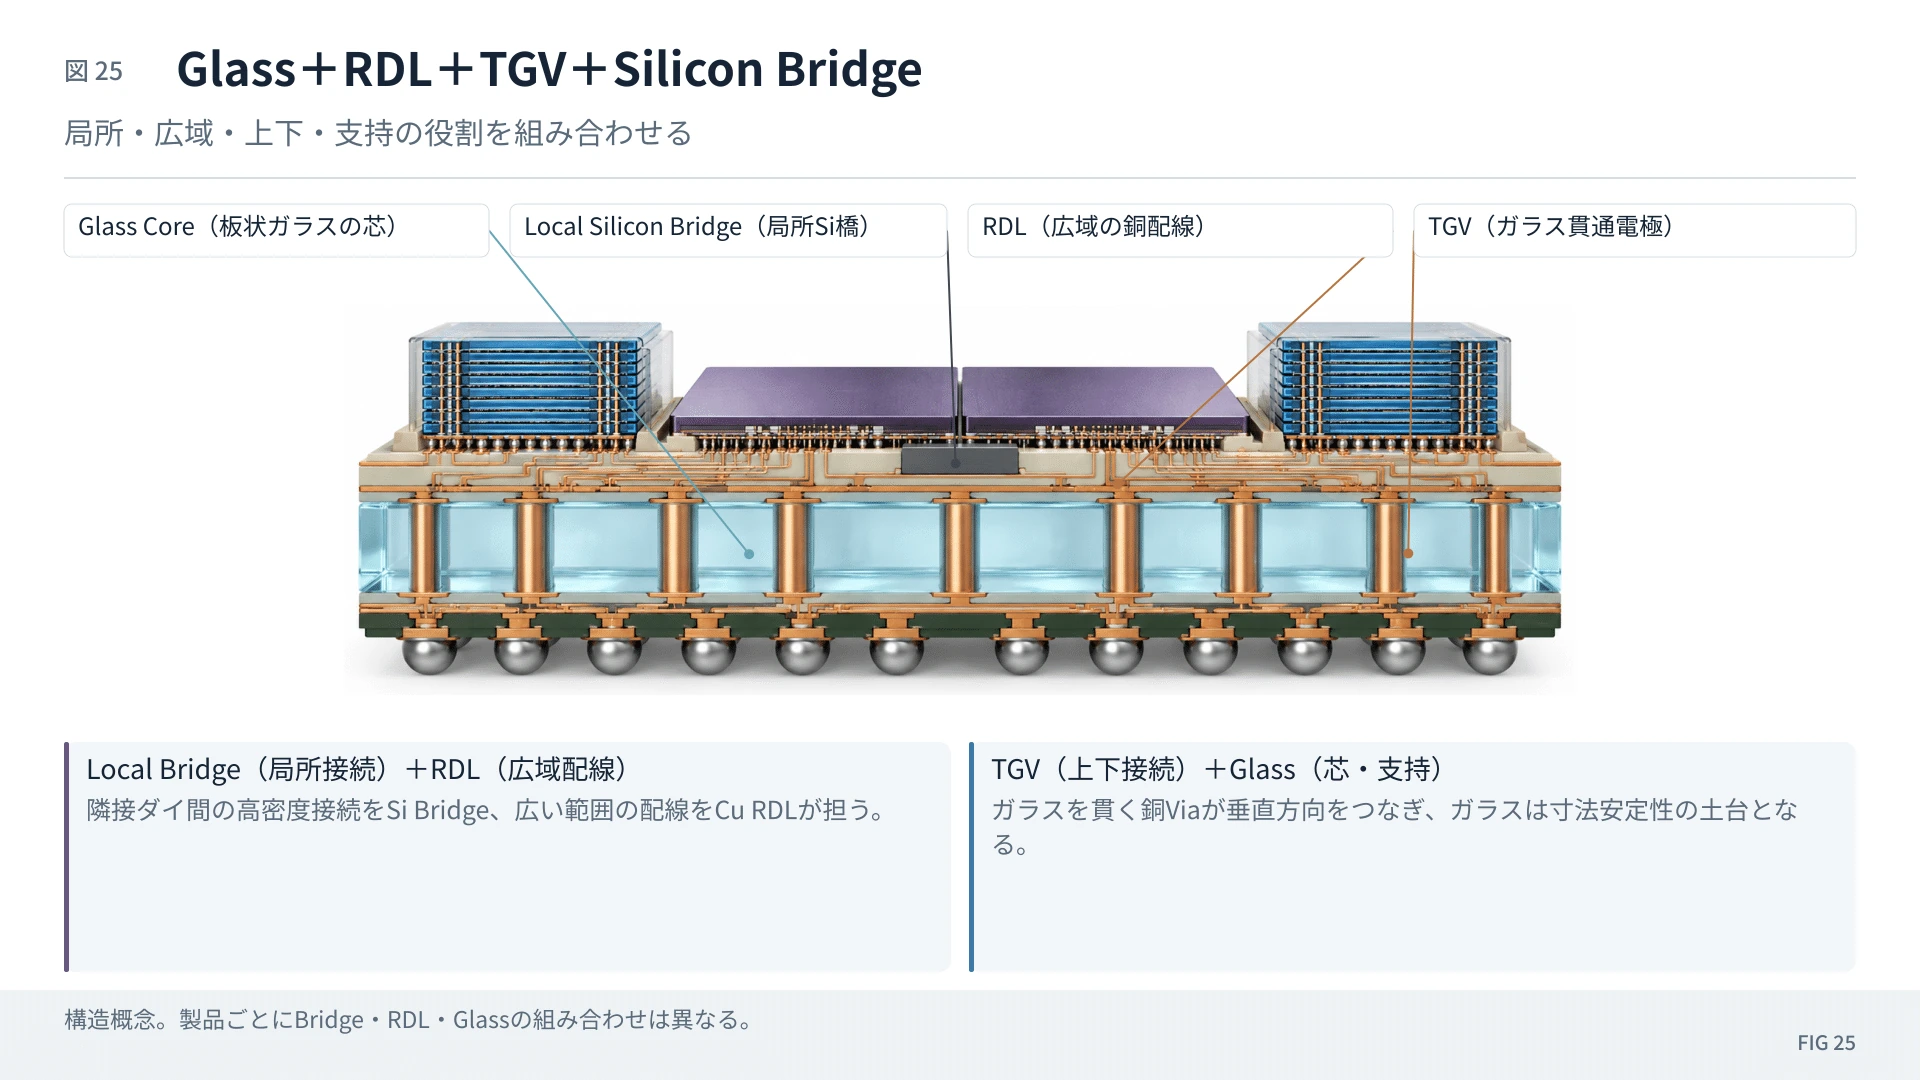
#「Glassに移行するならSilicon Bridgeはいらなくなるのか」
#必ずしもそうではない。
#Glass上にCu RDLを形成しても、GPU↔GPUなど極端な配線密度が必要な局所領域ではシリコンのsub-micron wiringが有利だ。
#そこで、
#GPU A GPU B
#│ │ └── Silicon Bridge ──────┘ ↓
#Global Cu RDL
#│ │
TGV TGV
████████████████████████████
Glassという組み合わせが考えられる。
#つまり、
#Glass=大面積で平坦な土台
#Cu RDL=広域横配線
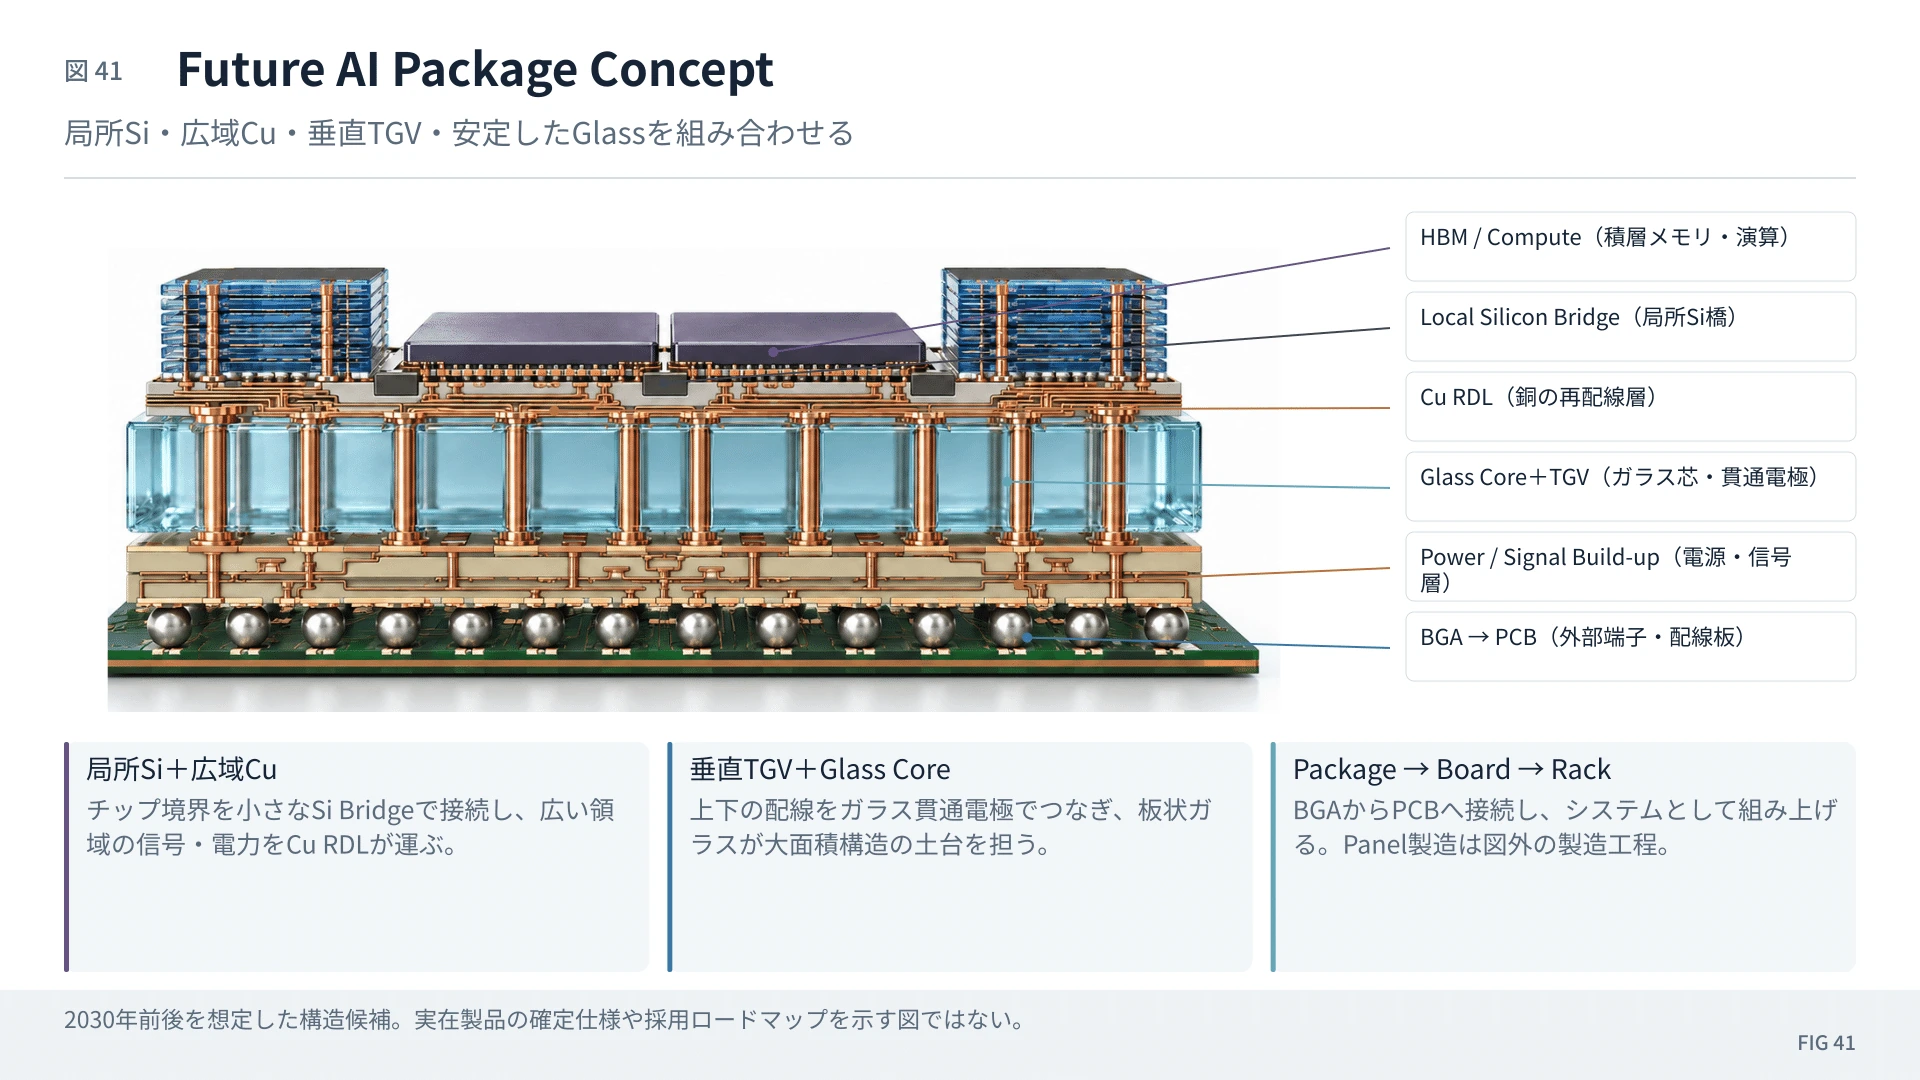
#Cu TGV=縦配線
#Silicon Bridge=局所的な超高密度配線
#という役割分担だ。
#Samsungの2.3D Cube-EはGlass Interposerそのものではないものの、すでにFO-PLPによるlarge RDL interposer + embedded silicon bridgeという同じ思想を採用している。
#
17.紙フェノール→ガラスクロス+樹脂――なぜこの材料はこれほど強いのか
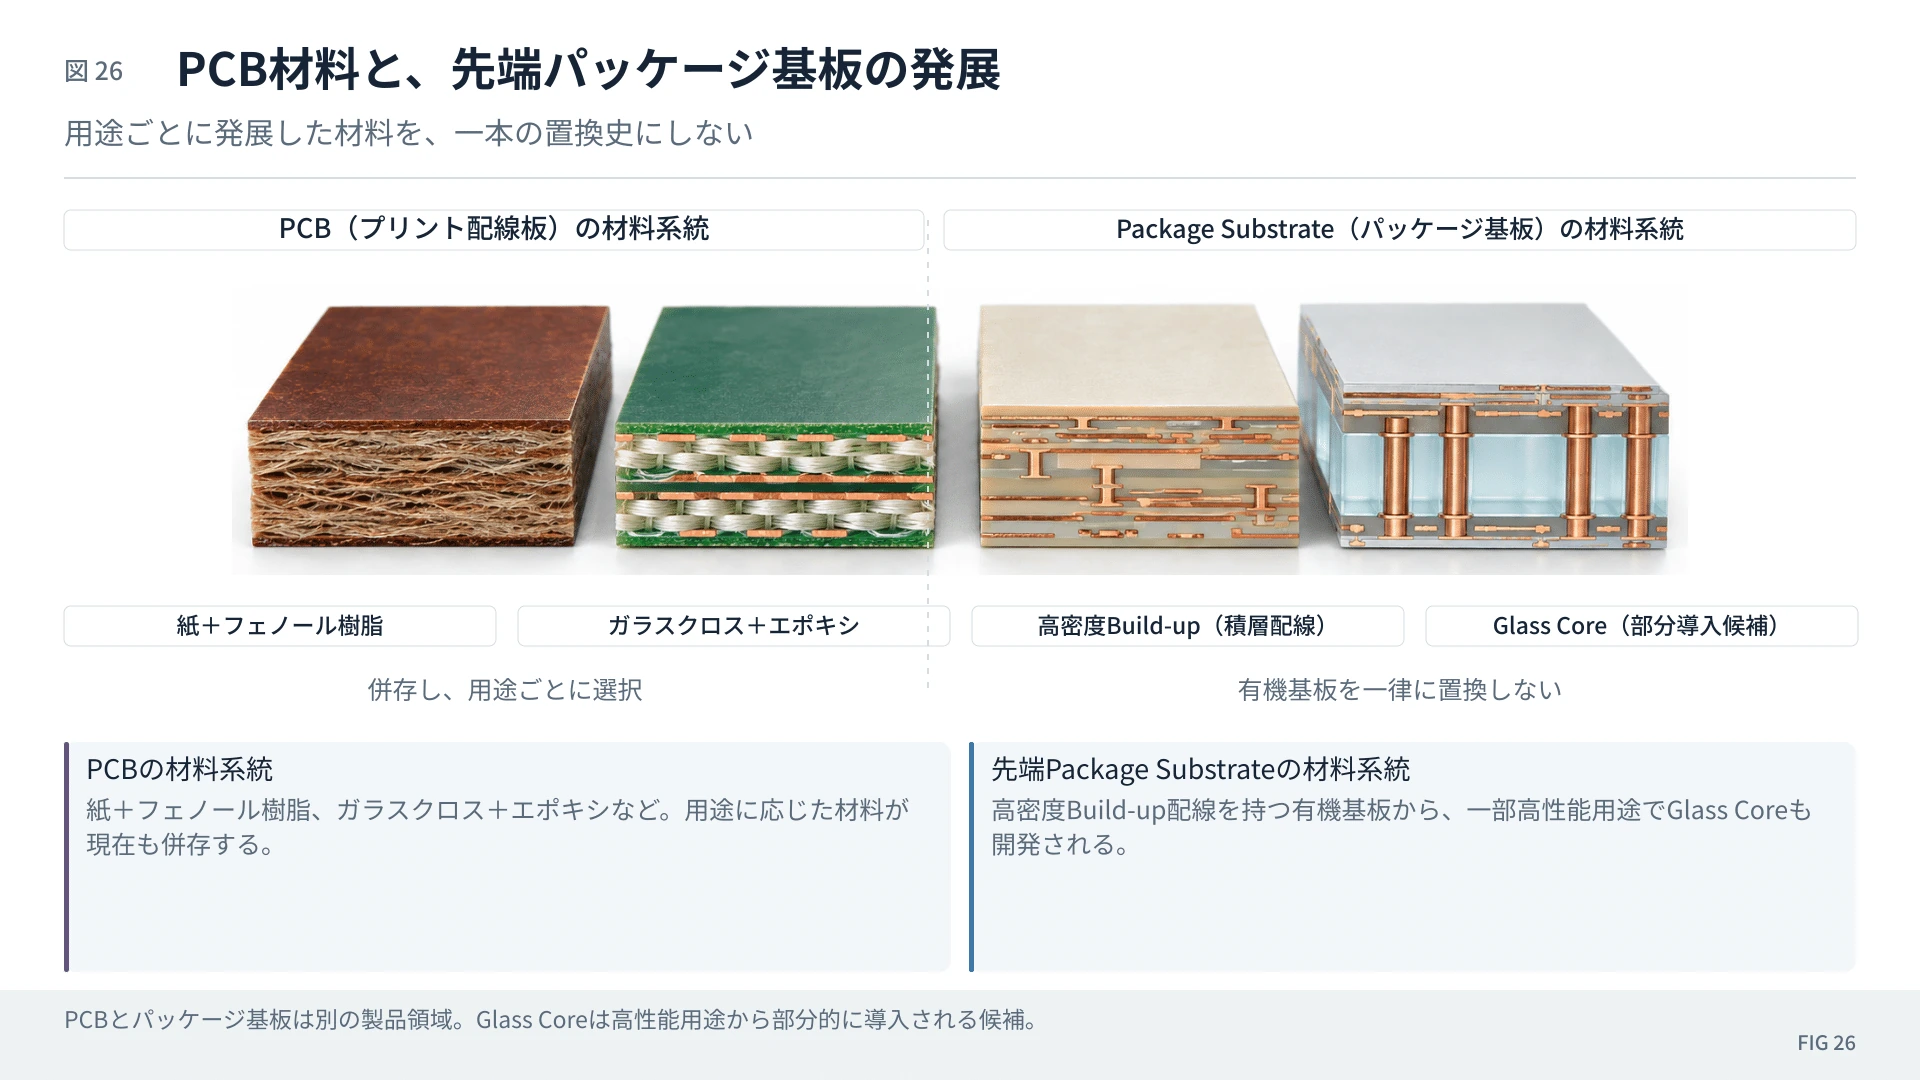
#ここで基板材料の歴史へ一度戻ってみよう。
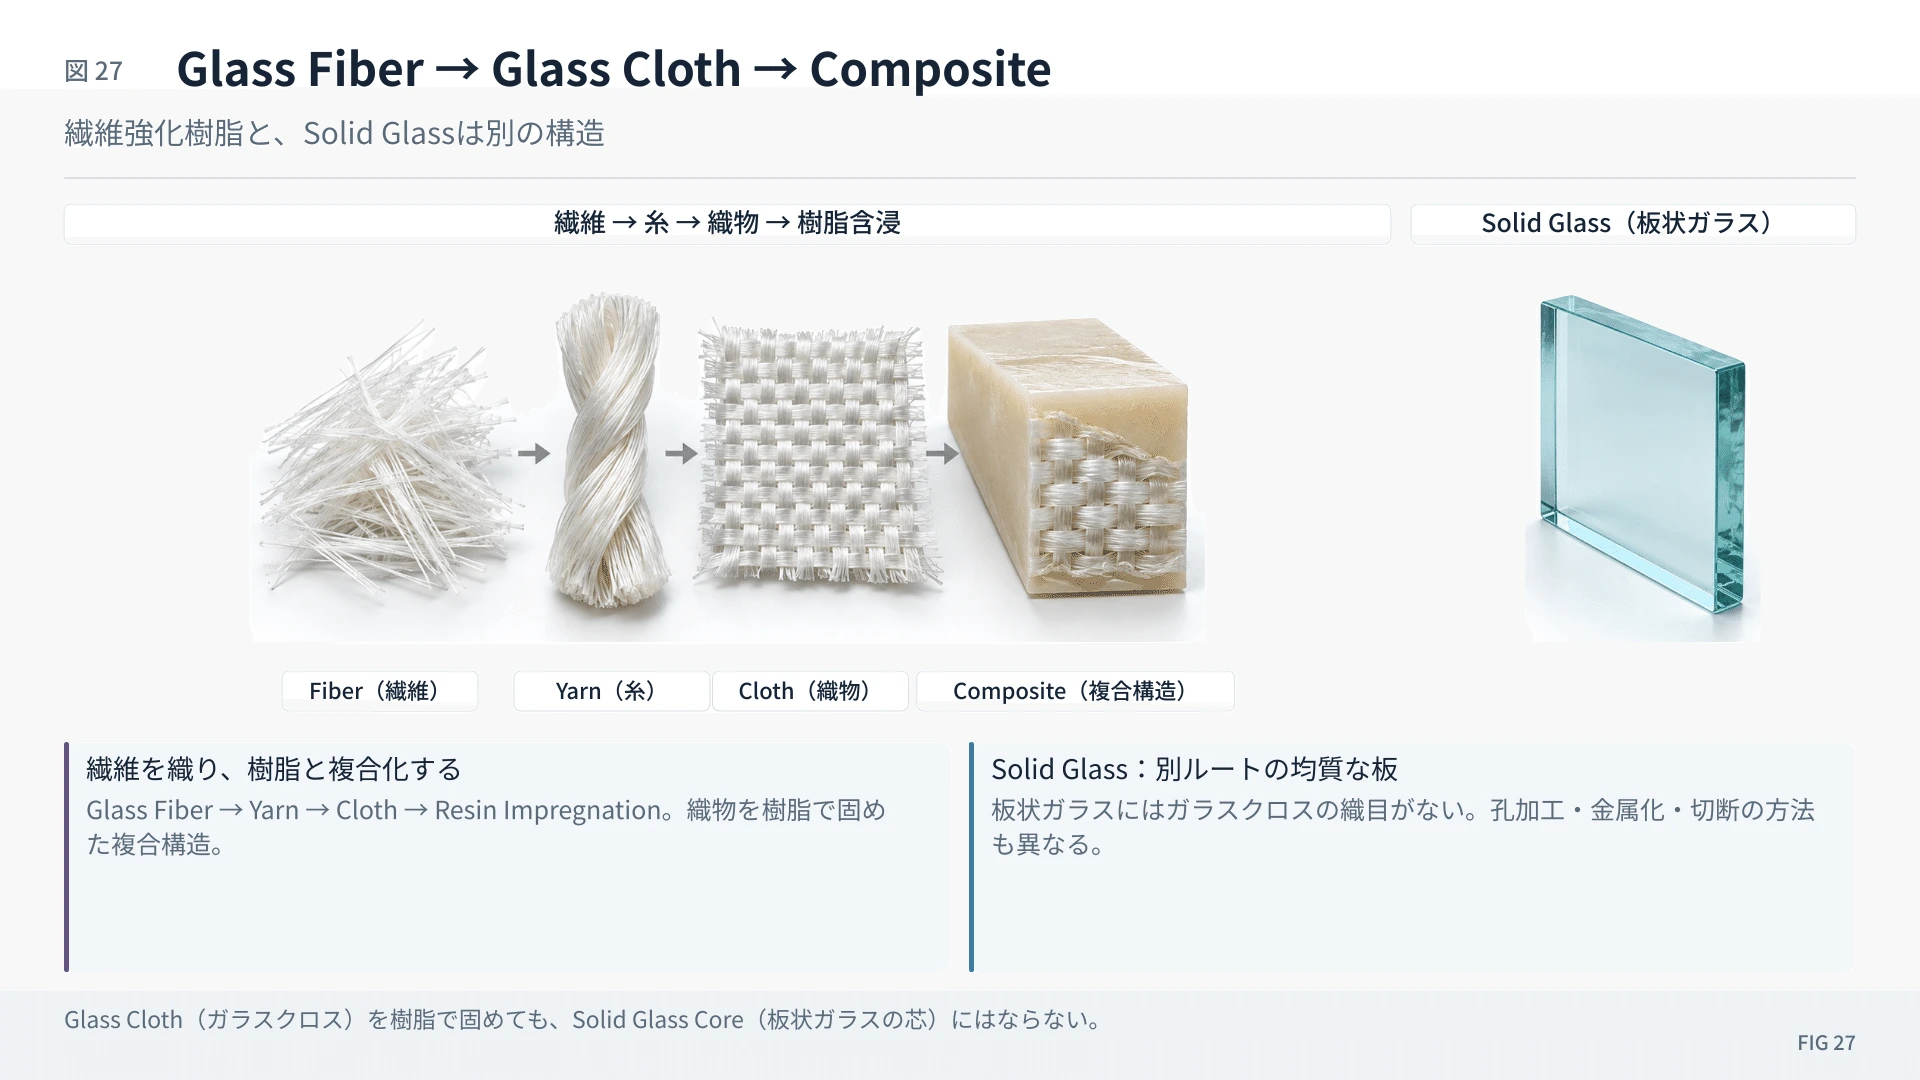
#民生PCBの大まかな材料史では、紙へphenolic resinを含浸した紙フェノール系から、glass clothへepoxy resinを含浸したglass-epoxy系へ進んできた。
#樹脂+ガラスクロスは非常に優秀である。
#樹脂には、
#加工しやすい、割れにくい、積層しやすい、穴を開けやすい、安価
#という長所がある。
#Glass Fiberには、
#剛性、寸法安定性、絶縁性、耐熱性
#がある。
#二つを組み合わせれば、
#柔らかすぎる樹脂と、硬いが脆いglassの欠点を相互補完できる。
#この構造はあまりにもバランスがよいため、Glass Coreが出ても通常のPCBから突然消えるとは考えにくい。
#なお最先端Package Substrateは単純なFR-4そのものではなく、ABF build-up層やhigh-end core/coreless構造などへ大きく進化している。ここでは「organic composite材料の長所」という大きな材料思想を比較している。
#
18.ではなぜ、その最適解をGlassで置き換えるのか
#理由は、AI packageが材料の限界まで巨大になっているからだ。
#樹脂+glass clothは複合材料である。
#微視的には、
#Glass fiber Resin Glass fiber Resin
#という不均一構造を持つ。
#吸湿、熱膨張、glass weave、局所的な誘電率差、layer-to-layer distortionがある。
#packageが小さい間は問題になりにくい。
#しかし100mm級の巨大package全面で数µm精度の位置合わせを要求すると、
#「少し動く」
#こと自体が問題になる。
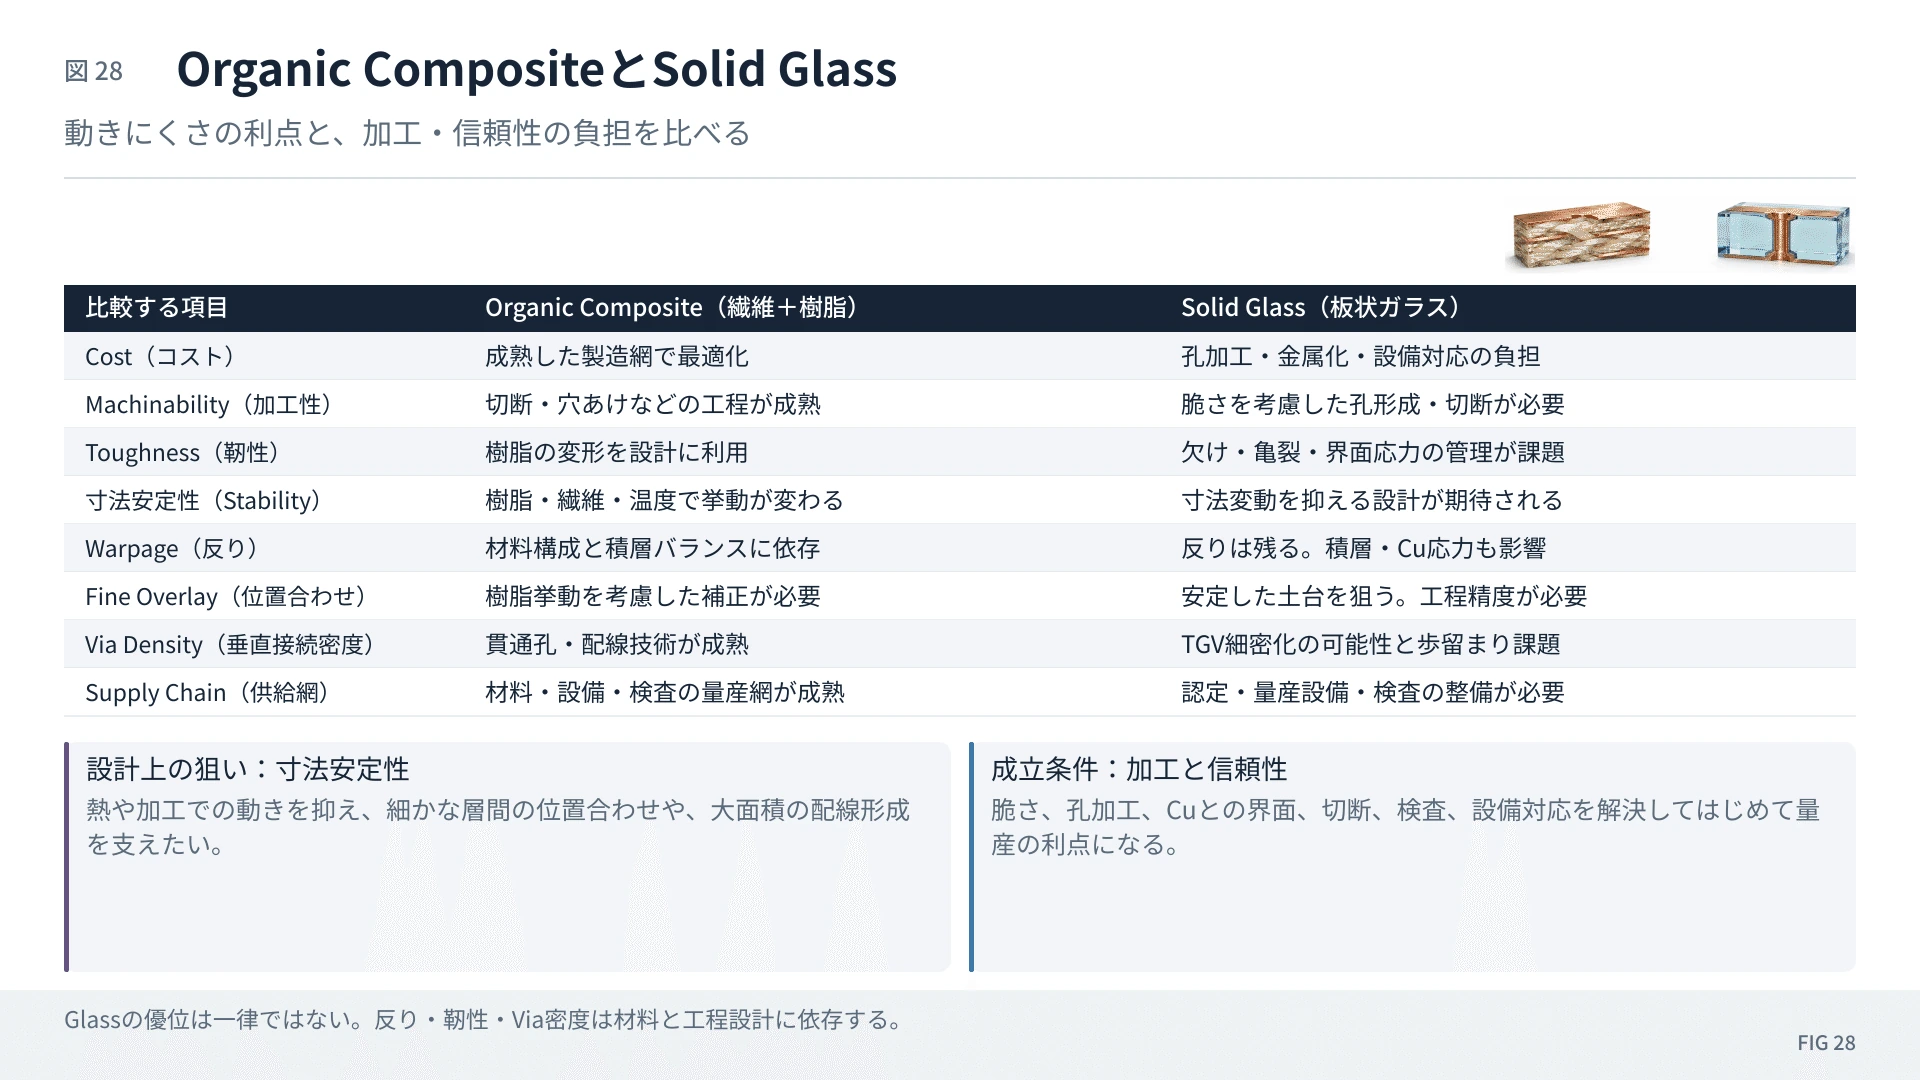
#Solid Glassは加工しにくく、割れやすく、高価だが、
#極めて平坦で、寸法安定性が高く、CTEを設計しやすい。
#つまりGlass Coreは、
#「樹脂+glass clothより何でも優れている」
#のではない。
#加工容易性とコストを犠牲にして、大型AI packageで最も価値が高くなった動かないという性能を買う
#材料転換なのである。
#
19.□Panelにも同じトレードオフがある
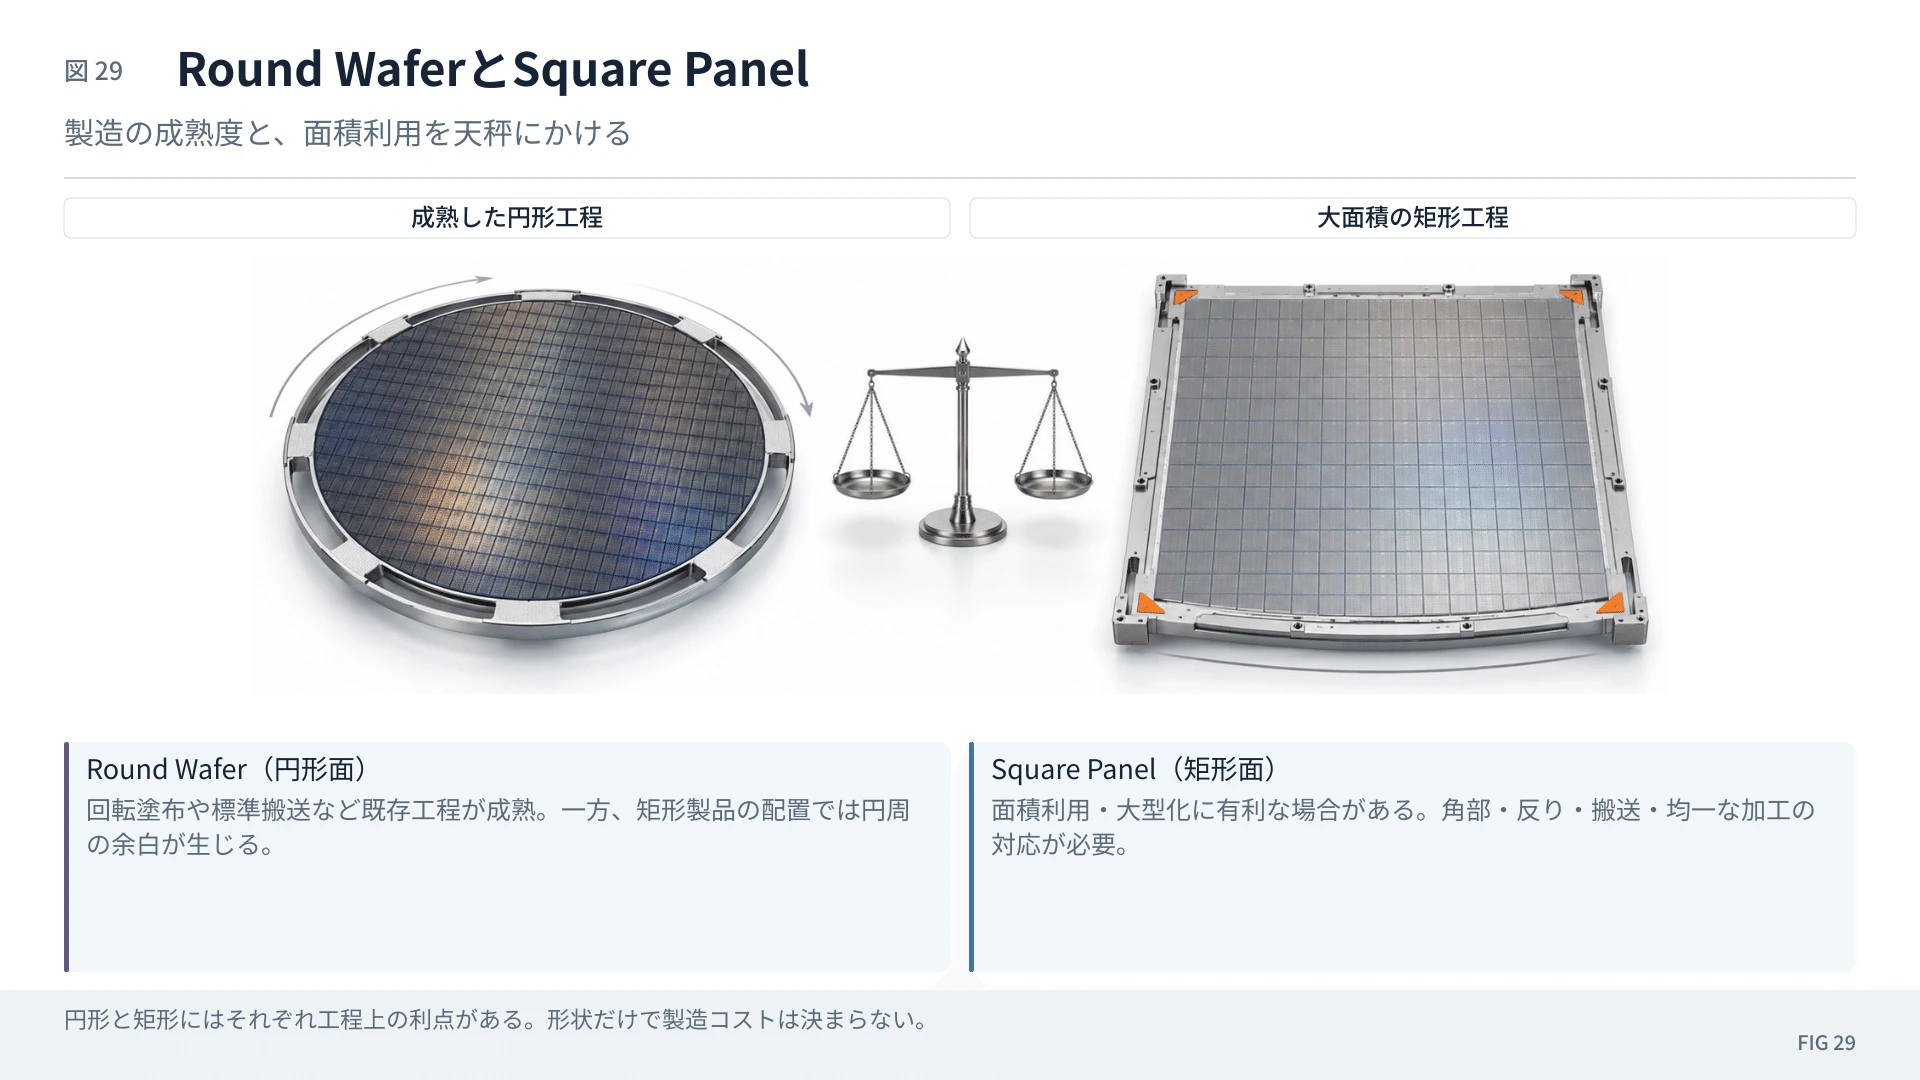
#丸い300mm waferから四角いpanelへ移ると、
#材料利用率、package/panel、throughput potentialは大幅に改善する。
#一方で失うものもある。
#wafer用装置の成熟度、spin coating、wafer robot、標準化されたcassette、CMP、inspection、熱・plasmaの回転対称性などだ。
#Panelでは、
#角と中央を同じ条件にする必要がある。
#巨大panel全域で2/2µm級RDLを作るなら、
#warpage、corner effect、slit coating uniformity、overlay、plating thickness、handling、edge/chippingをすべて管理しなければならない。
#だからASEは、いきなり600×600mmへ行かず、まず310×310mmでAI/HPC向けPLPを始める。
#その310mm lineはFOCoSで2/2µm、FOCoS-Bridgeで8/8µmに対応し、2027年Q1~上期のproduction開始を計画している。
#
20.Glass CarrierとGlass Coreは難易度がまったく違う
#Temporary Glass CarrierではGlassは電気部品ではない。
#必要なのは、
#平坦性、剛性、CTE、耐熱・耐薬品、透明性、bond/debond性
#である。
#TGVもCu配線も不要で、完成品として10年間動き続ける信頼性も不要だ。
#一方Glass Coreでは、
#TGV、seed、Cu metallization、build-up、dicing、crack control、thermal cycling、package-level reliability
#まで必要になる。
#したがって、
#「CoPoSでtemporary glass carrierを量産利用できる」ことと、「Glass CoreをAI GPUへ量産採用できる」ことの間には大きな技術差がある。
#SEMIが2028年をGlass Coreの「selected applicationsにおけるlimited-volume production」の開始時期と見るのは、このためでもある。
#
21.NVIDIAと2028年Glass Core――どこまで現実的か
#ここは確定情報と推測を分ける必要がある。
#NVIDIA supply chainがGlass Coreを強く評価していることを示す業界情報は増えている。
#しかし、
#「2028年のNVIDIA主力GPUがPermanent Glass Coreへ全面移行する」
#という公式確定情報は現時点ではない。
#一方、TSMCのCoPoSについては2027年pilot、2028年後半HVMが現在の有力ロードマップであり、TrendForceはNVIDIA Feynmanを初期採用候補として報じている。
#したがって2028年前後に現実性が高い順番は、
#Panel化+Temporary Carrier
#が先行し、
#Permanent Glass Coreは限定量産・qualification
#が並走し、
#Glass Interposerはさらに後段、
#と見る方が現在の技術成熟度とは整合する。
#
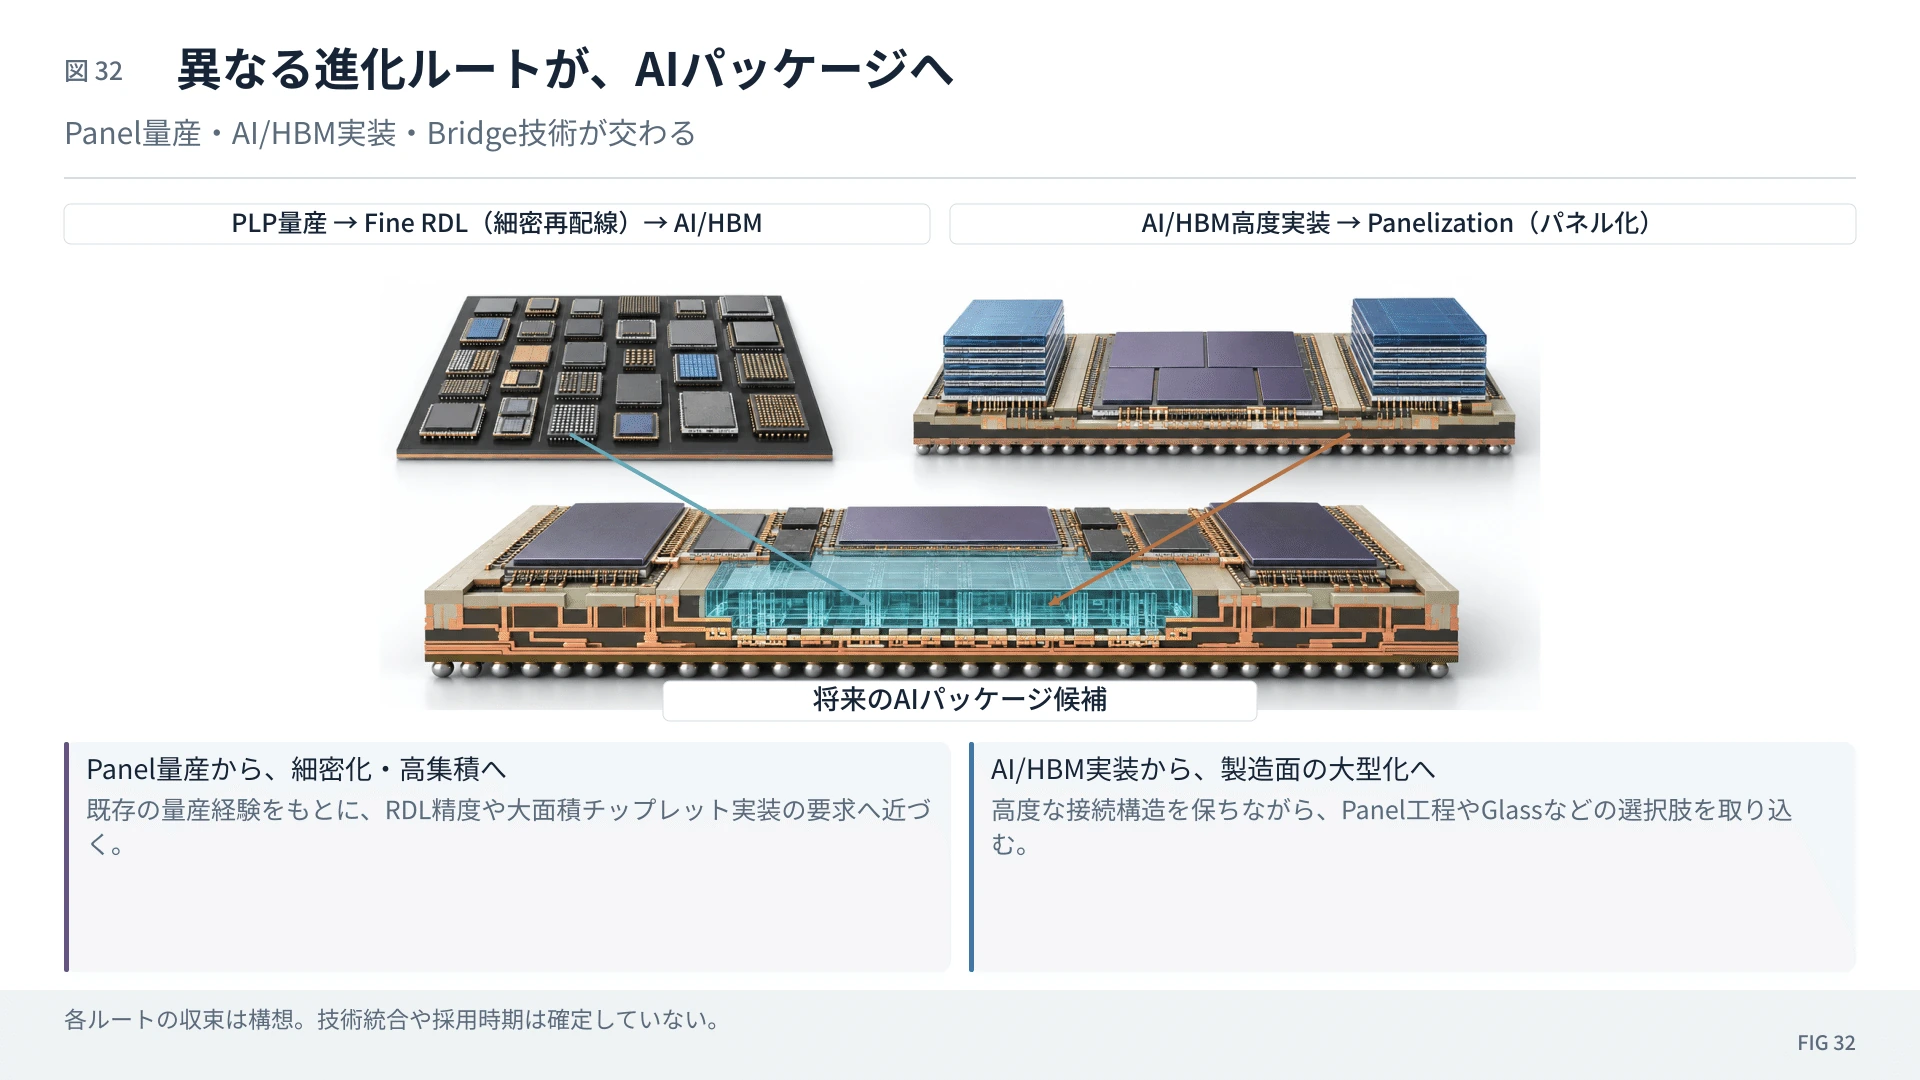
22.Silicon BoxとTSMC/ASEは逆方向から同じ場所へ向かっている
#ここまで整理すると、企業ごとの戦略差が面白い。
#Silicon Boxは、
#PLP量産 → chiplet/AI/HPCを高度化
#という方向から来ている。
#2025年10月1億units、2026年Q1 2.5億超、8月5億、10月10億。Singapore工場は2028年まで能力を増強している。
#ASEとTSMCは逆だ。
#AI/HBM advanced packaging → Panel化
#である。
#ASEはFOCoS/FOCoS-Bridgeを310×310mmへ。
#TSMCはCoWoSからCoPoSへ。
#Samsungはさらに、FO-PLP + silicon bridgeのCube-Eと、Samsung Electro-MechanicsのGlass Coreをグループ内で並行して進めている。
#Intelはまた別で、
#EMIB + Glass Core
#という、large interposerへの依存を減らしながらsubstrate自体を高性能化する方向を強く進めている。2026年にはGlass CoreをAI/HPC向け研究テーマとして継続し、Lens Technologyとのglass packaging協業も発表した。
#
23.ではAI半導体は実際に何個作られているのか
#ここで「10億units」という数字を、AI半導体全体の数量感と比較してみよう。
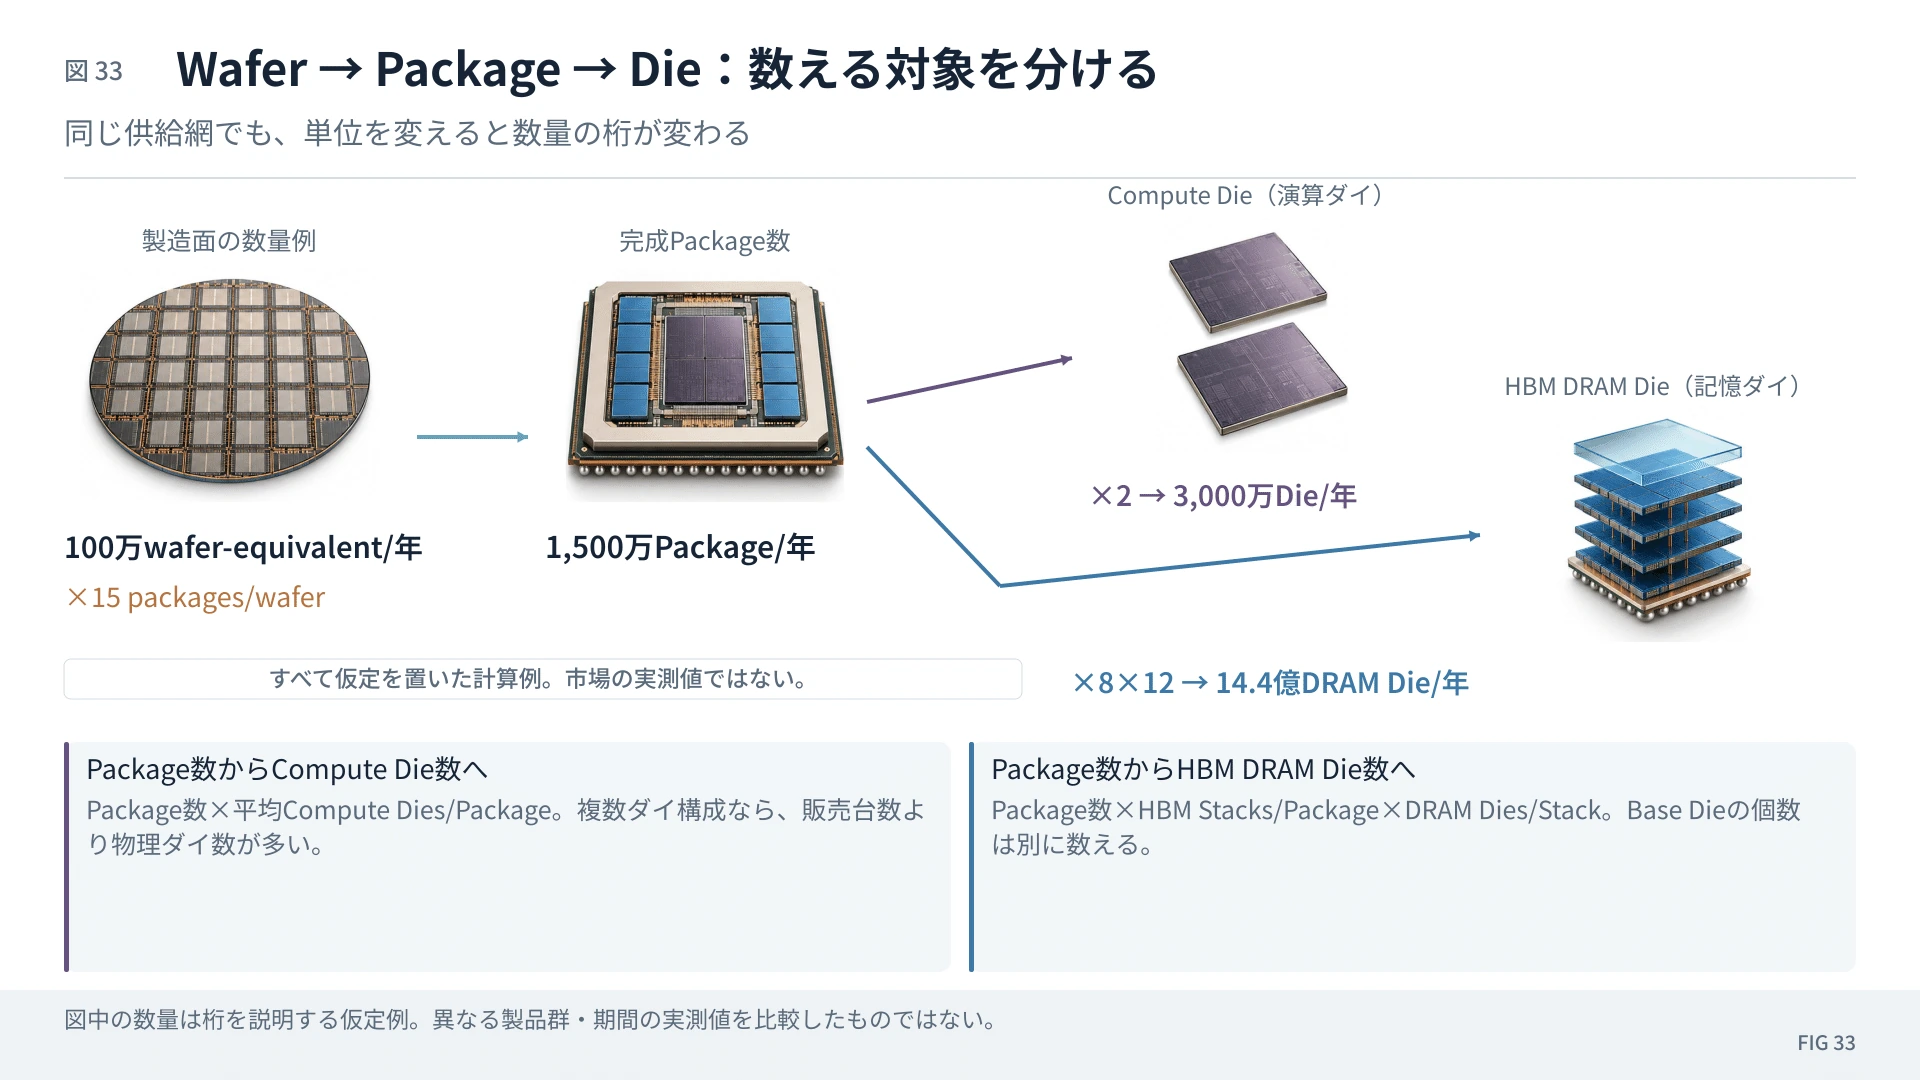
#注意しなければならないのは、
#CoWoS wafer数
#完成AI accelerator数
#physical die数
#は全部違うということだ。
#DIGITIMES Researchは、2026年の世界のCoWoS + CoWoS-like packaging能力を約131.3万枚の12-inch wafer-equivalentと予測していた。そのうち約28%を非TSMCのCoWoS-likeが占める予測だった。
#一方、2026年に入ってからのより新しい市場推計では、TSMCのCoWoS capacityは2026年末に12万~14万wafer/月、OSATを合わせると業界全体で約20万/月へ接近するとされている。2027年にはTSMCだけで約17万/月という推計もある。
#さらに2028年末にはTSMCが約26万wafer/月へ倍増するとの市場報道もある。
#ここで重要なのは、wafer数をそのままGPU個数にしてはいけないことだ。
#
24.1枚のCoWoS waferから取れるAI package数は減っている
#packageが巨大化しているからだ。
#先ほどのASEの5.5×reticle例なら、
#300mm waferから約9個。
#したがって仮に10万wafer/月を全部このサイズに使うなら、単純理論値は、
#となる。
#しかし実際には製品サイズ、edge loss、test vehicle、yield、CoWoS-S/R/Lの構造が違う。
#そして将来packageがさらに巨大になるほど、
#packages / waferは低下する。
#だから、
#だからといって、
#とは限らない。
#むしろ今後は、
#processed wafer数ではなく、何平方mmの有効interposer面積を生産したか
#を見る必要が出てくる。
#
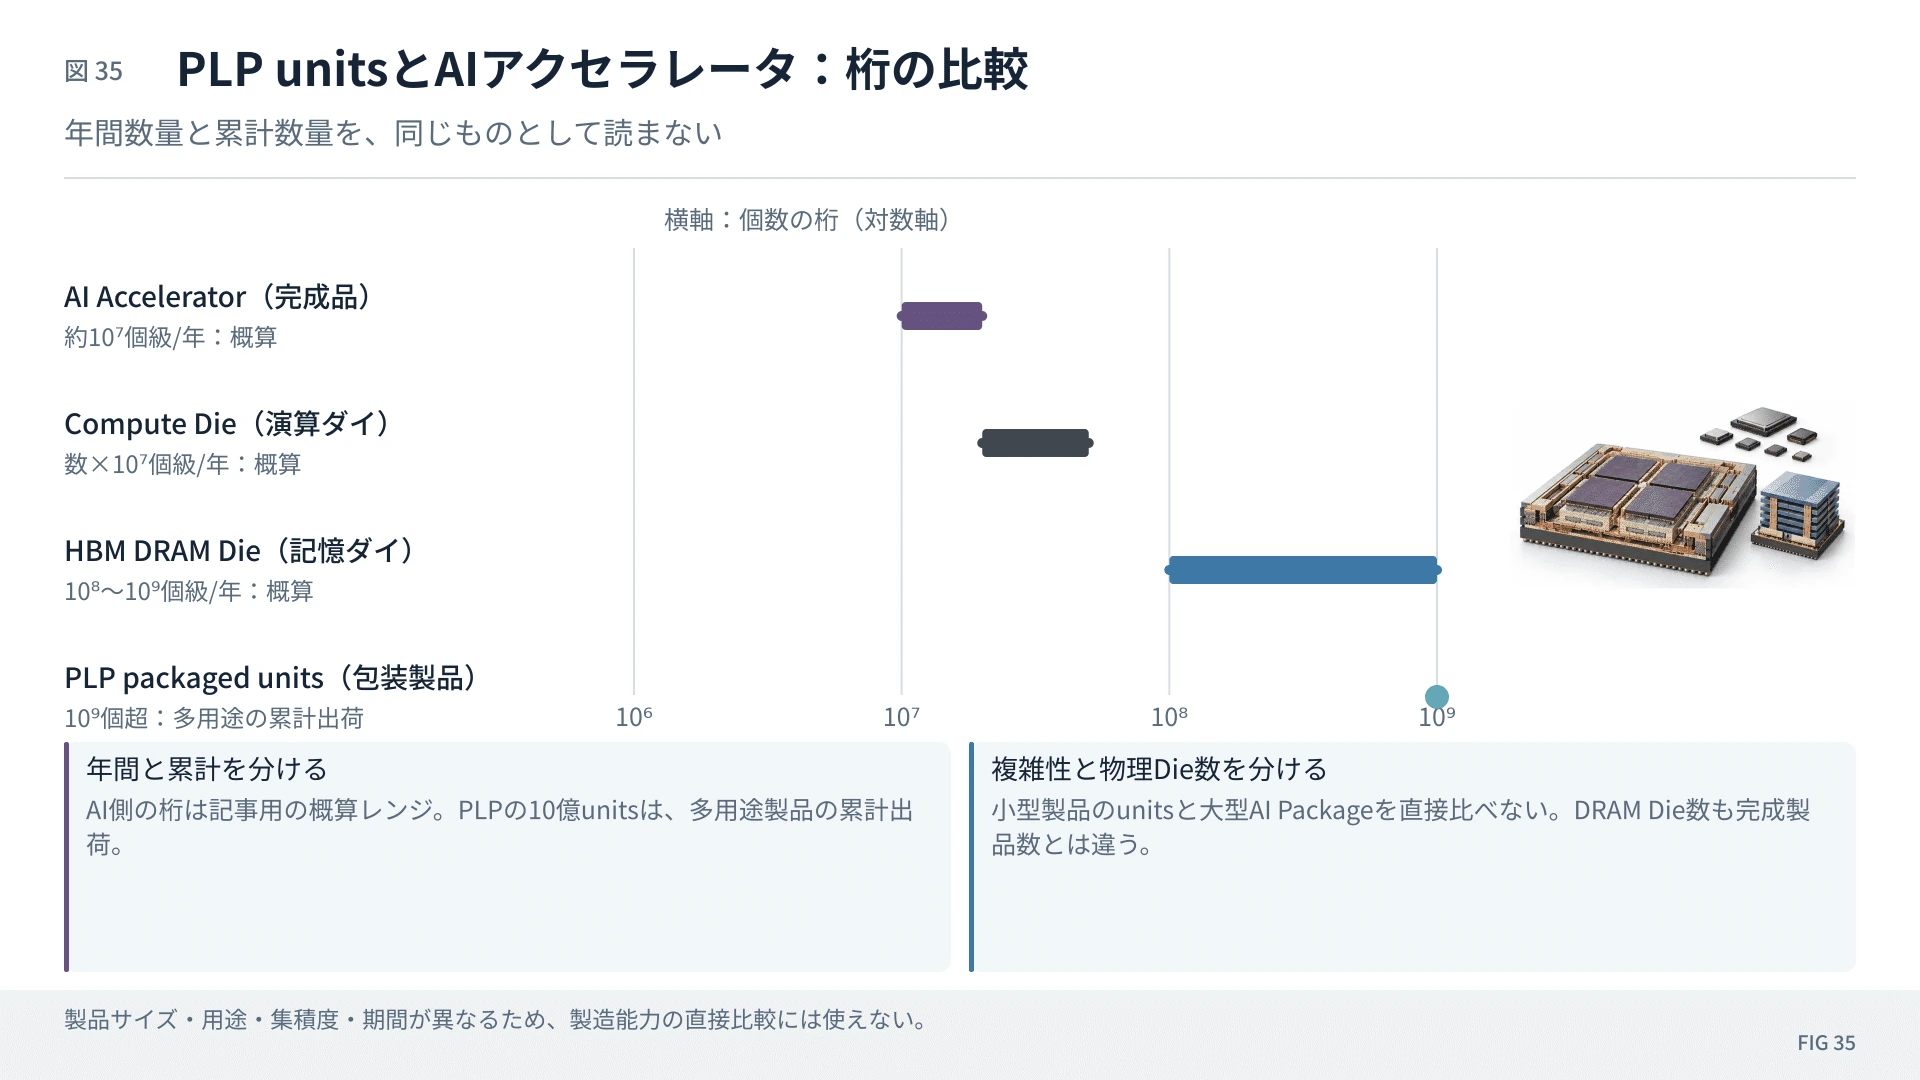
25.完成AI acceleratorは2026年で1,000万台後半の世界
#DIGITIMESは2025年のhigh-end cloud AI accelerator出荷を1,000万units超と推計し、そのうちNVIDIAを約640万unitsとしている。
#同社の2026年中国市場予測では、中国vendorだけで212.3万high-end accelerator、世界share約13%とされている。
#単純逆算すると、
#なので、2026年の世界high-end cloud AI accelerator市場は1,300万~1,600万台超程度のorderと見ると、複数の公開予測と大きく矛盾しない。これはあくまで異なる市場予測を組み合わせた概算であり、公式生産統計ではない。
#さらにDIGITIMESの2026年10月時点の予測では、世界AI server出荷は250万台超、そのうちHBM搭載high-end AI serverが237万台に達するとされている。
#
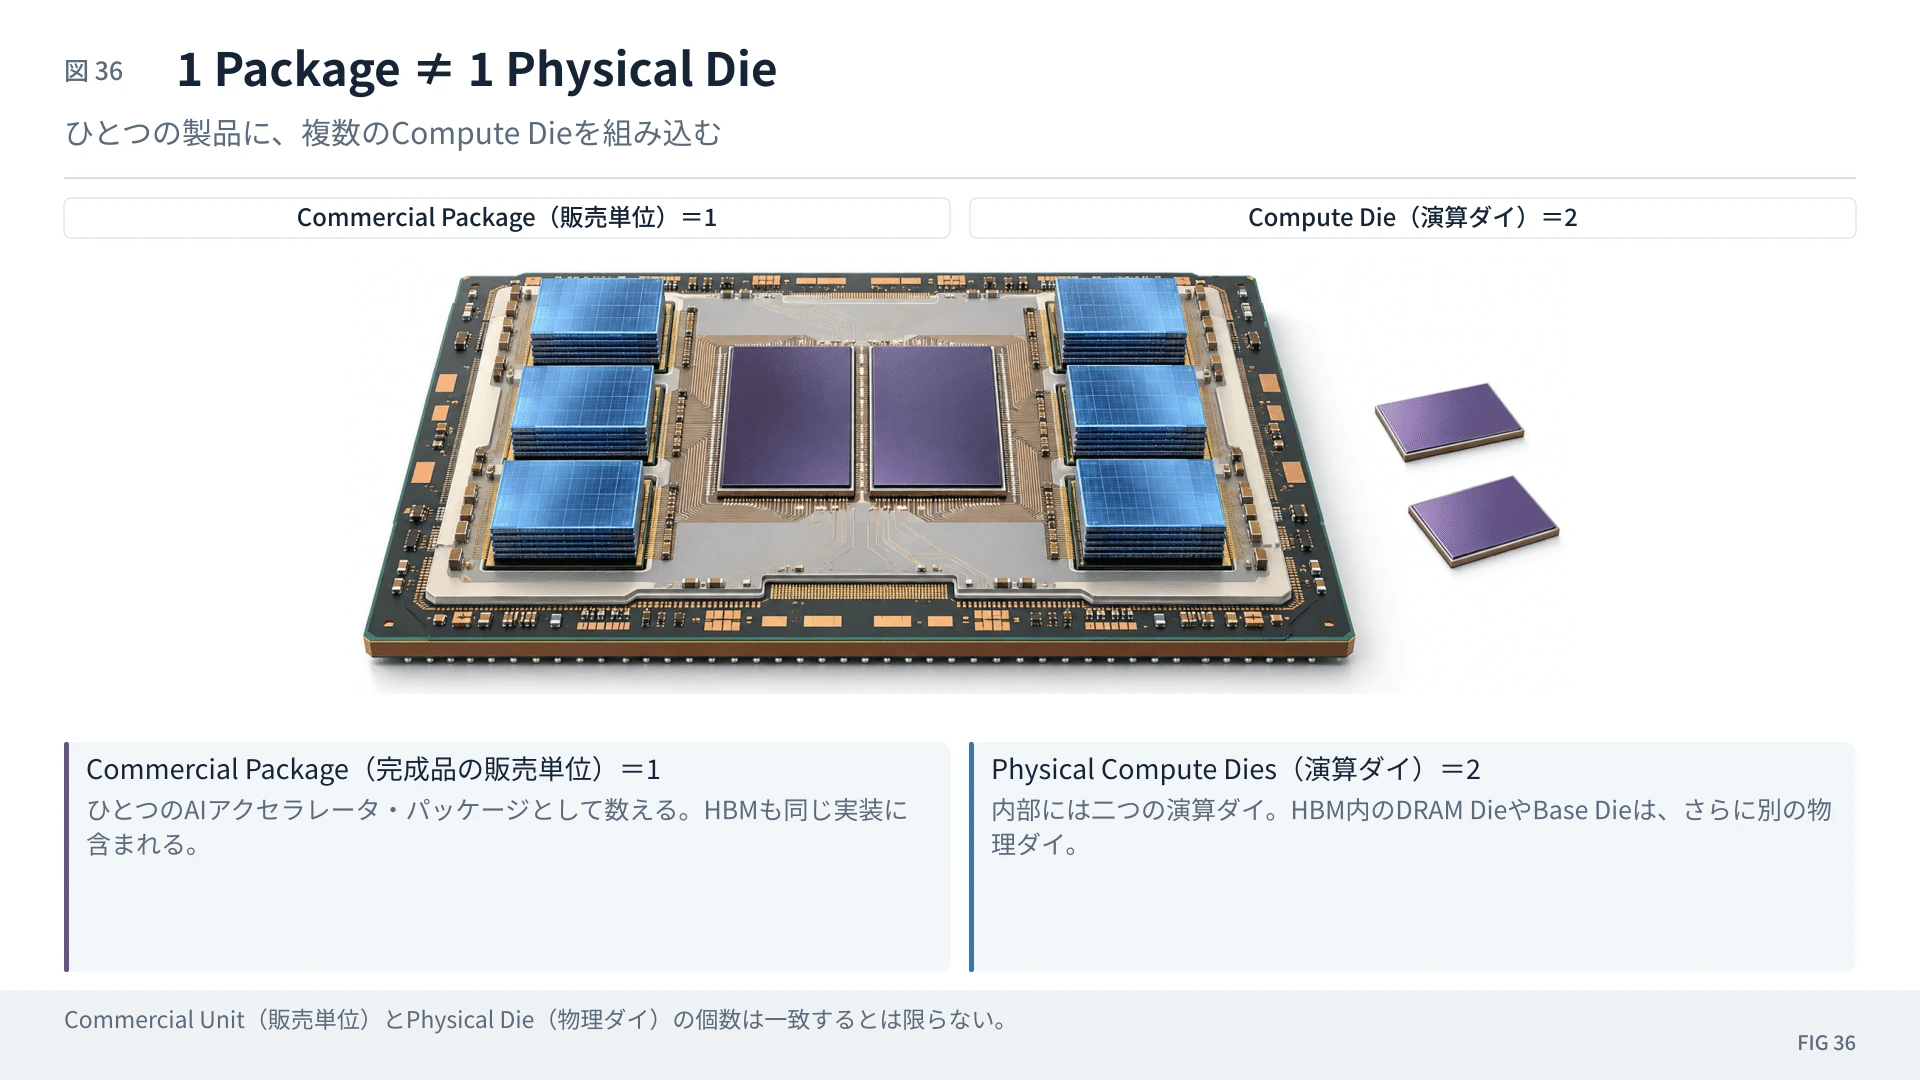
26.完成GPU 1個はphysical die 1個ではない
#ここからさらに数字が変わる。
#NVIDIA Blackwellは、
#1 GPU = 2個のreticle-limit compute die
#である。
#NVIDIA公式も、Blackwellが2つのreticle-limited dieを10TB/sのchip-to-chip interconnectで接続し、1つのGPUとして動作すると説明している。
#Rubinも2個のcompute dieを一つのpackage内で統合する。
#2025年のNVIDIA high-end GPUを640万個、2026年の伸びをTrendForce予測の約26%と置けば、
#で、約806万GPU packageとなる。
#TrendForceは2026年構成を、
#Blackwell 71% Rubin 22% Hopper 7%
#と見ている。
#BlackwellとRubinを2 compute die、Hopperを1大型compute dieとして単純換算すると、
#つまりNVIDIAだけでも約1,500万個級のphysical compute dieになる。
#これは市場予測からの概算であり、実出荷統計ではない。しかし、
#GPU package数とsilicon die数がすでに約2倍違う
#ことを理解するには重要だ。
#
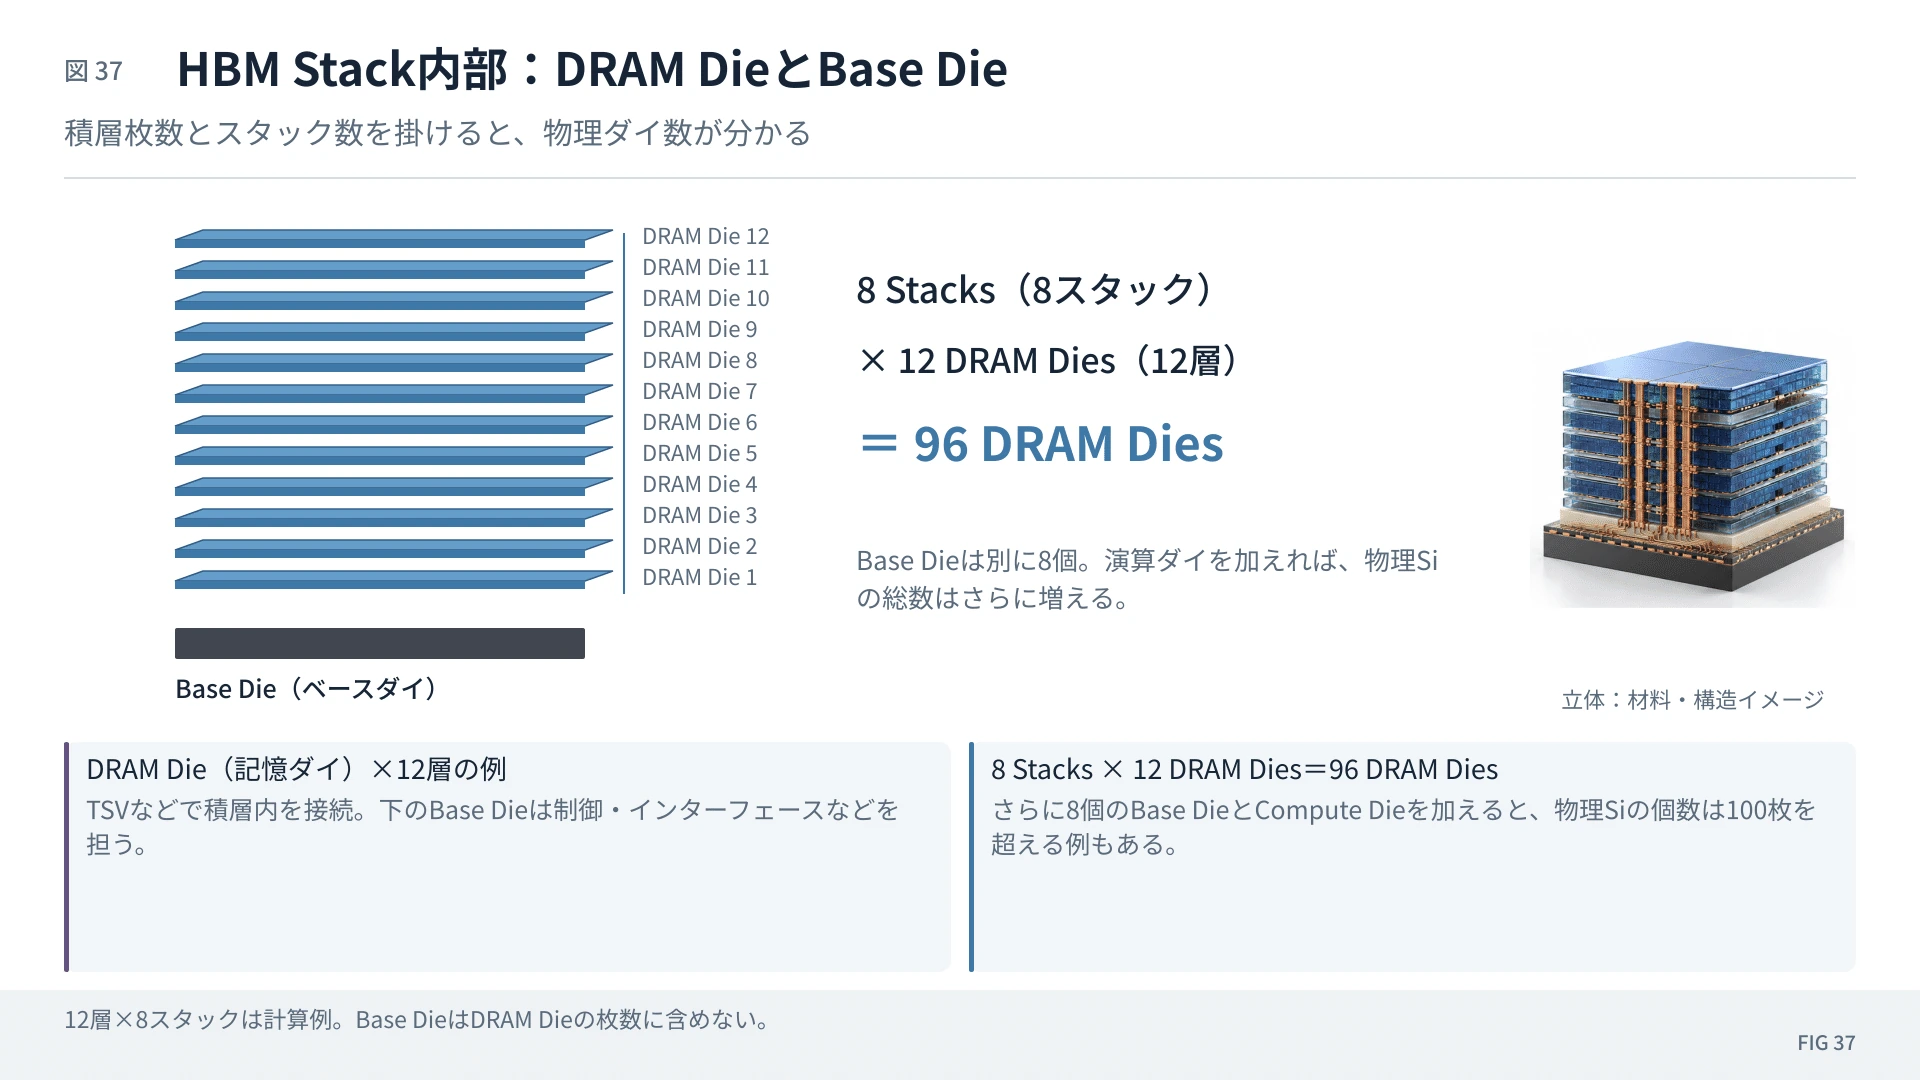
27.HBM内部までdieを数えると、さらに桁が変わる
#さらにHBM stackは「1個のチップ」に見えるが、中には多数のDRAM dieが積層されている。
#例えば12-high HBMを8stack載せれば、
#で、DRAM dieだけで96枚になる。
#そこへcompute die、base die、I/O chipletなどが加わる。
#つまり、
#AI accelerator 1 package
↓
Compute die 1~数枚
I/O/chiplet 数枚
HBM stacks 6~12+
DRAM die 数十~100枚超となる。
#そのため世界で1,000万台後半のhigh-end acceleratorを作ると、HBM内部の物理DRAM dieまで含めれば10億die級になっても不思議ではない。
#だから「半導体を年間何個作っているか」という問いは、何を1個と数えるかで2桁以上変わる。
#Silicon Boxの10億unitsとCoWoSの1,000万台級を単純比較できない理由もここにある。
#
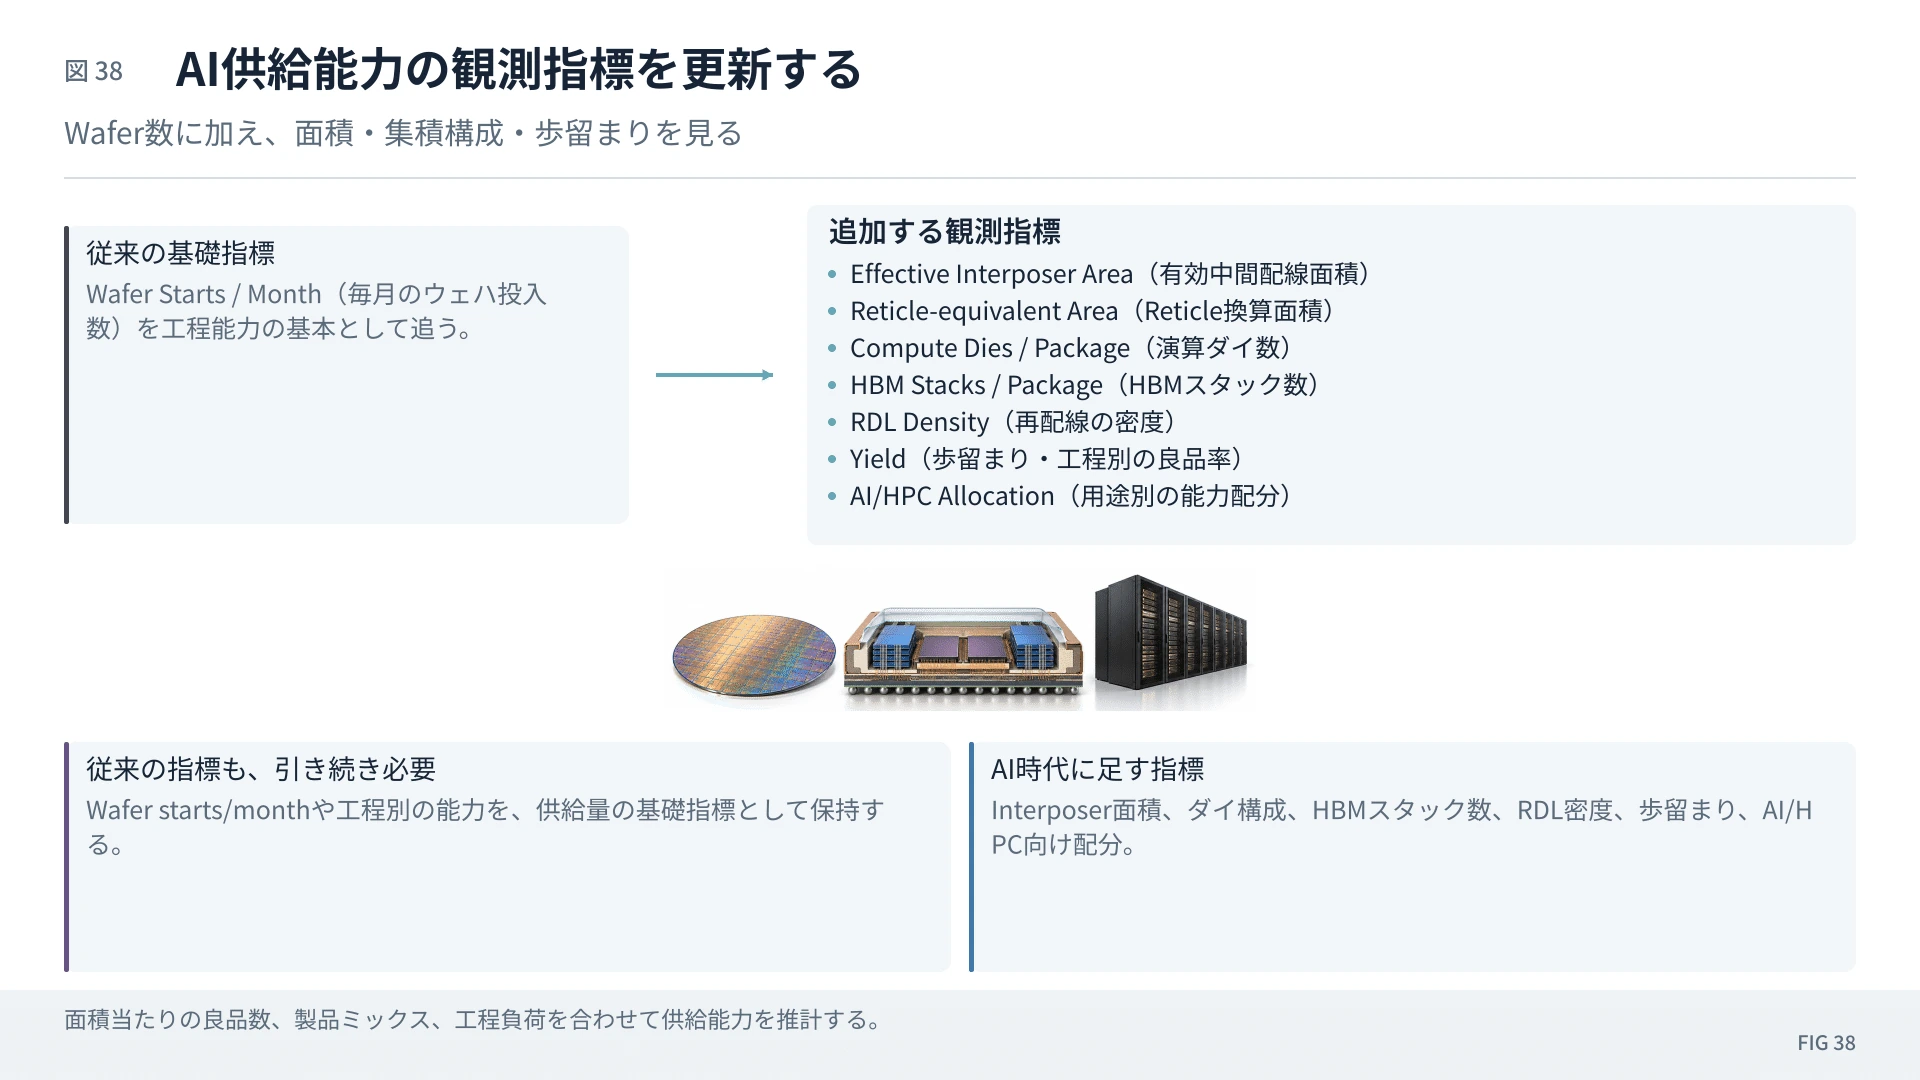
28.これからは「wafer数」だけではAI供給を観測できない
#AI semiconductor supply chainを見る指標そのものを変える必要がある。
#従来なら、
#wafer starts/month
#だけでも生産能力をかなり推測できた。
#しかしAI時代は、
#1枚のpackageに何個compute dieを入れるか、
#HBMを何stack載せるか、
#interposerが何reticle分あるか、
#CoWoS-S/R/Lなのか、
#Panelなのか、
#silicon bridgeを使うのか、
#Glass Coreなのか、
#によって同じwafer数でも最終compute量がまったく違う。
#そこで今後、より重要になるのは、
#有効interposer面積 / 月
#reticle-equivalent packaging area
#AI/HPC allocation率
#RDL line/spaceと層数
#HBM stacks/package
#compute die/package
#Known Good Die歩留まり
#TGV/metallization yield
#といった指標である。
#
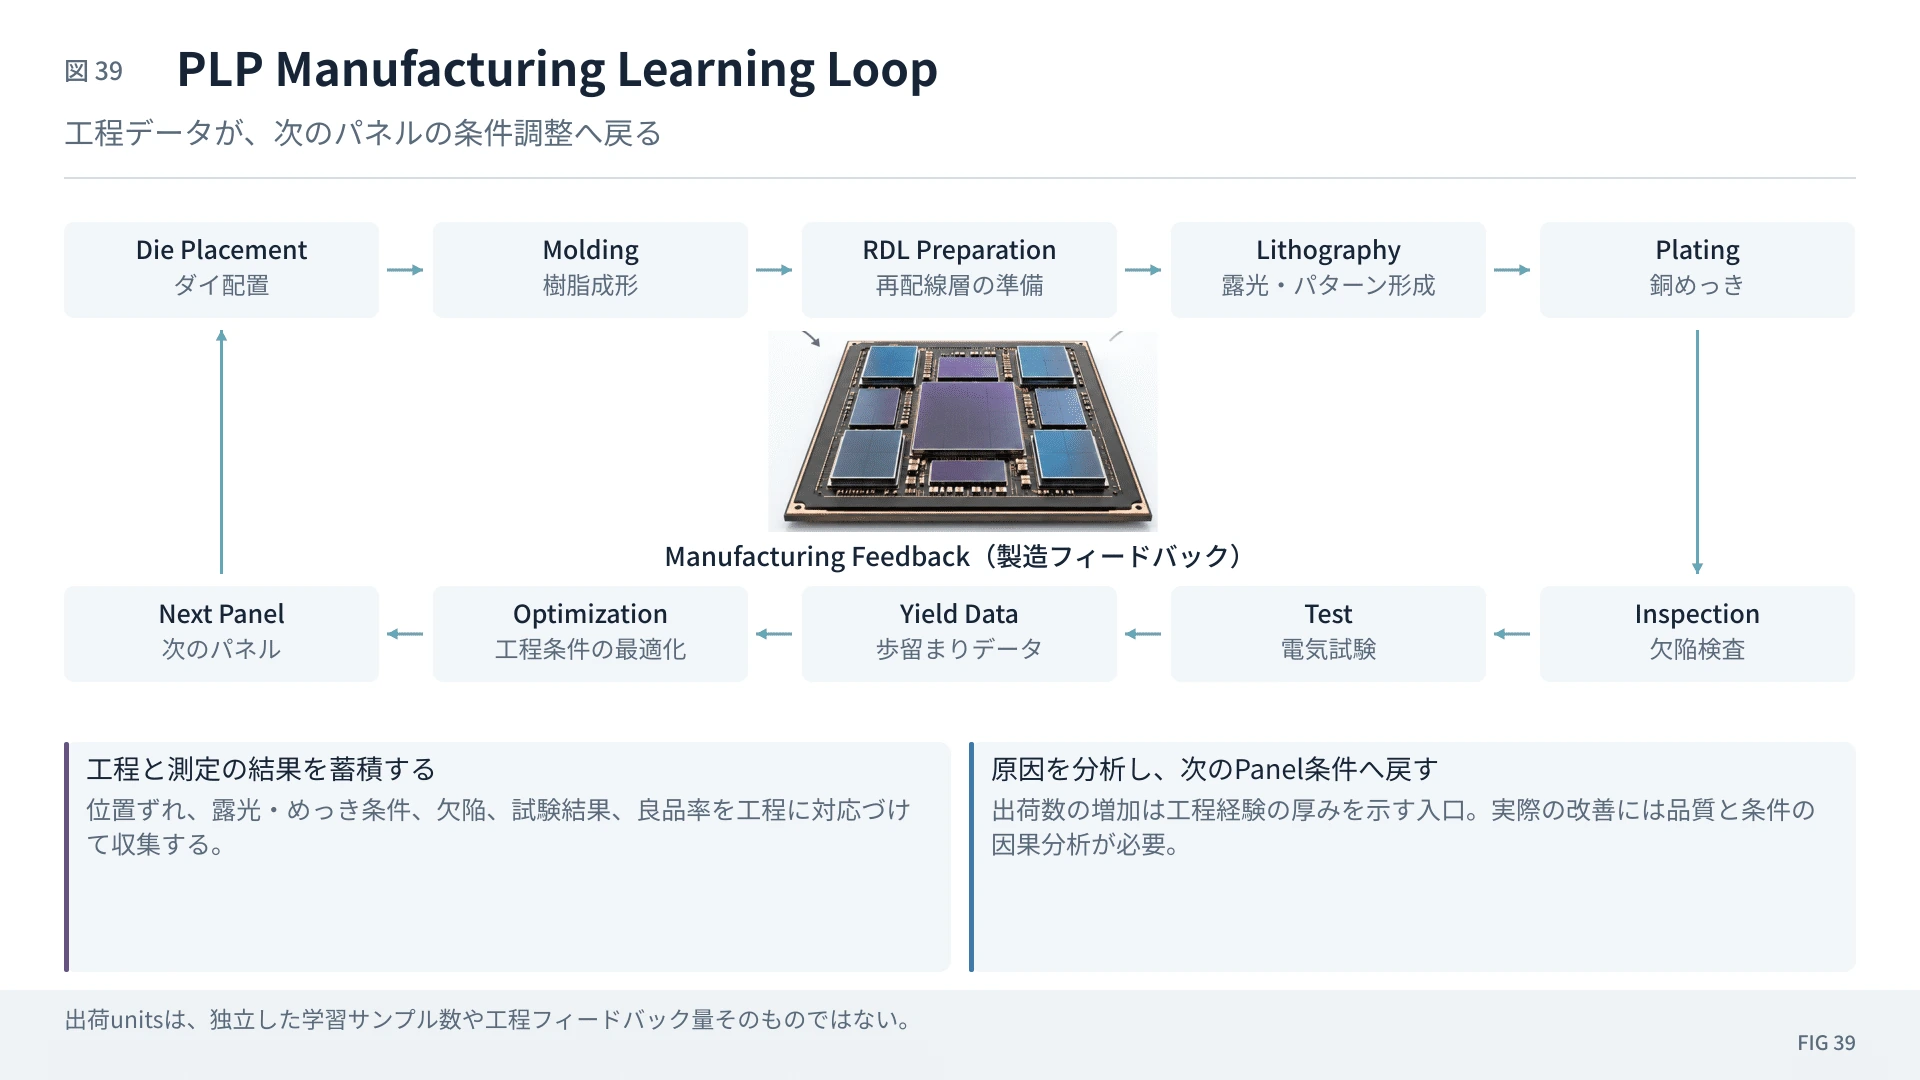
29.Silicon Box「10億units」が本当に示していること
#Silicon Boxの数字へ戻ろう。
#10億unitsは、CoWoS級AI GPUが10億個という話ではない。
#しかし、
#Panel handling
#Die placement
#Molding
#Fine RDL
#Plating
#Lithography
#Inspection
#Test
#Singulation
#をpanel-scaleで何億回という製品量へ拡張できるという意味では、非常に大きい。
#特に1億→10億が352日、5億→10億が58日という速度は、
#PLPが「将来の技術」ではなく、少なくとも一部の製品ではすでに大規模manufacturing technologyになったことを示している。
#一方、次に見るべき数字は「units」ではない。
#Silicon Boxの中で、
#large-body AI/HPC packageが何%なのか。
#package面積はどれくらいなのか。
#HBMを何stack統合しているのか。
#RDLはどこまでfineなのか。
#silicon bridgeを使っているのか。
#CoWoS-L級の高価なKnown Good Dieを載せても採算が合うyieldを維持できるのか。
#ここが公開されれば、Silicon BoxをTSMC CoWoS-L、ASE FOCoS、Samsung Cube-Eと本当の意味で比較できる。
#
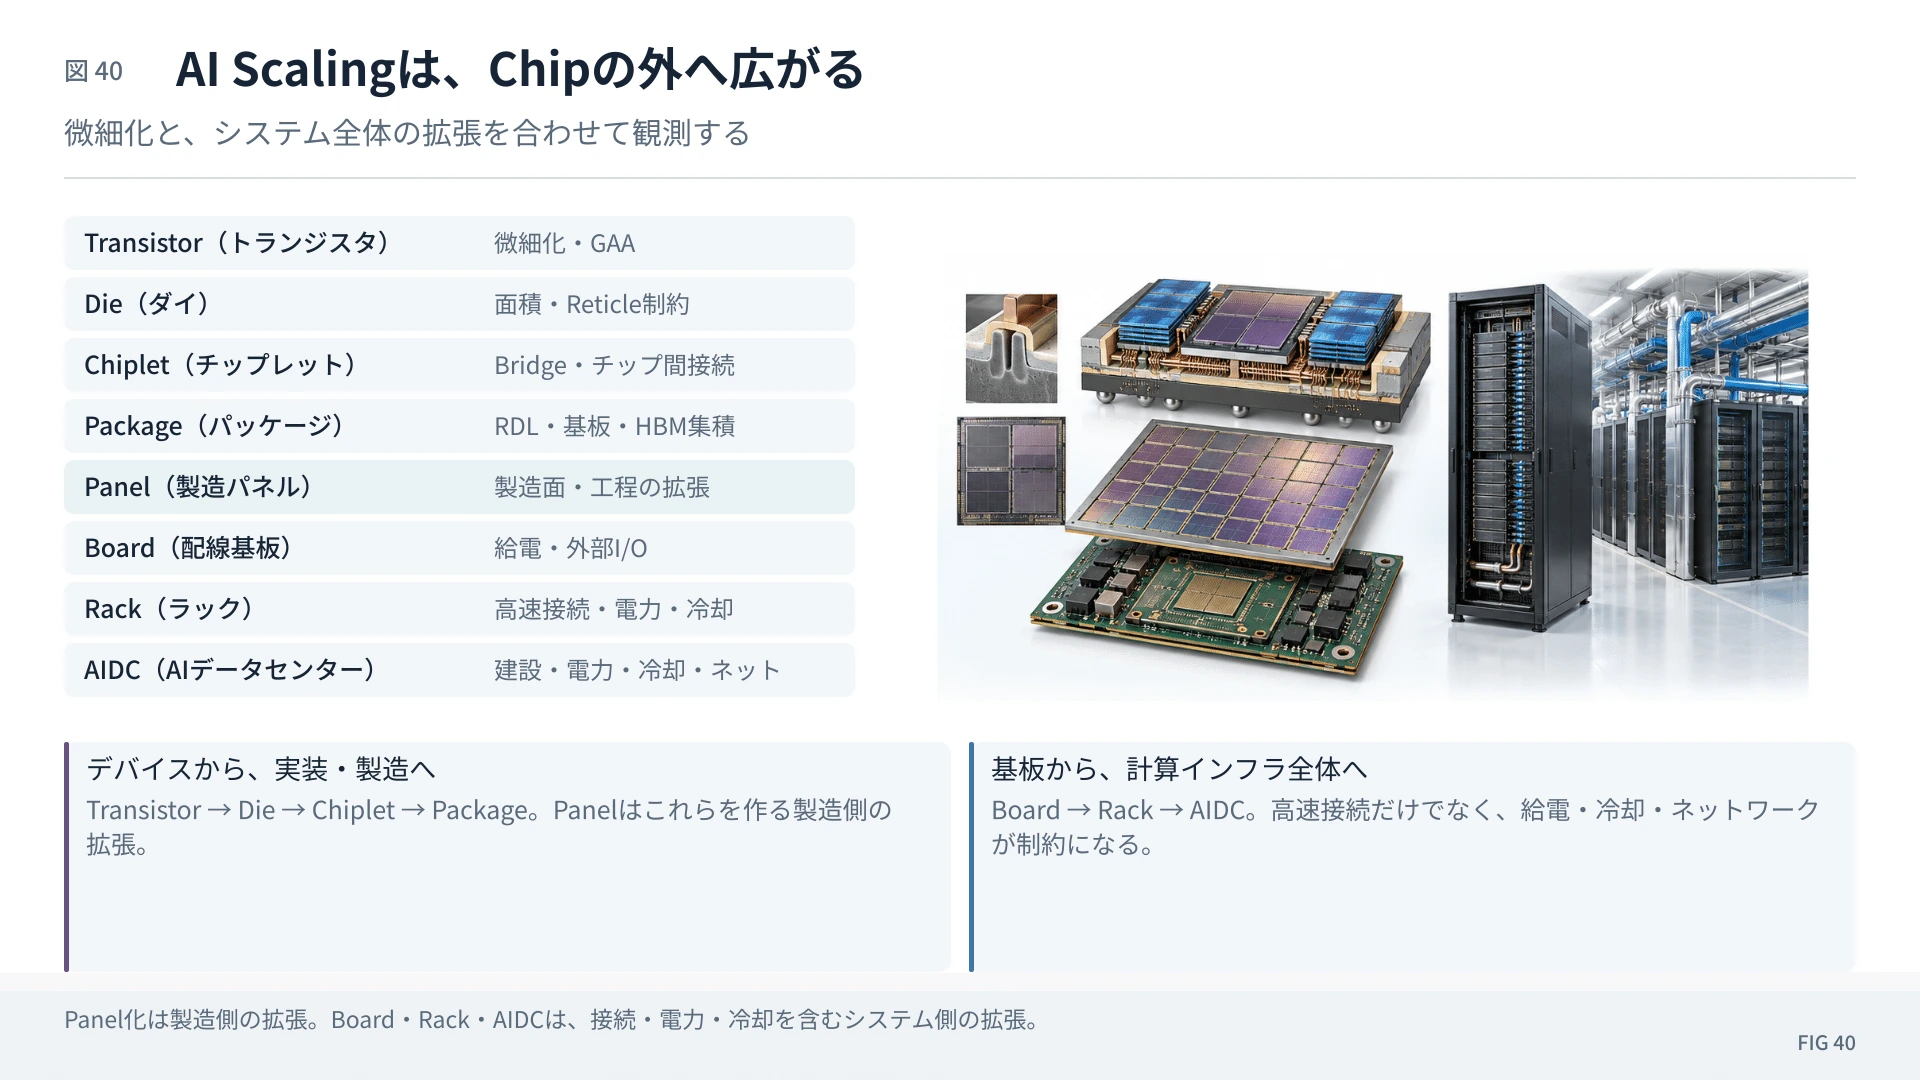
30.AI時代、スケーリングはチップの外へ出た
#ここまで見てくると、Panel、Glass、TGV、CoPoSは単なる「半導体後工程の細かいニュース」ではないことが分かる。
#これまでAI性能のスケーリングは、
#で語られてきた。
#しかしreticle limitに達した後は、
#へ移る。
#つまりスケーリングの舞台が、
#一枚のシリコンdieの内側から、package全体へ拡張した。
#そこで、
#CoWoS-SのFull Siliconから、
#CoWoS-L / EMIBのLocal Siliconへ。
#WaferからPanelへ。
#Organic CoreからGlass Coreへ。
#Horizontal RDLにVertical TGVを加え、
#さらにその上へCPOや3D stackingが乗ろうとしている。
#将来のAI packageを極端に単純化するなら、
#Compute / HBM ↓ Local Silicon Bridge ↓ Large-area Cu RDL ↓ TGV ↓ Glass Core ↓ Package Substrate / PCB ↓ AI Rack
#という方向へ近づいている。
#もちろんすべての層がGlassになるとは限らない。
#樹脂+glass clothは、安価で強く、加工しやすく、今後も極めて重要な材料であり続ける。
#Glassはそれを完全に駆逐するのではなく、
#「高価でも、1µm動かないことに大きな価値がある領域」
#から侵入する。
#そしてPanel化も同じだ。
#丸いwaferが間違っていたのではない。
#小さいpackageでは、成熟した300mm wafer ecosystemの方が合理的だった。
#しかしAI packageが巨大化した結果、
#四角い完成品を作るのに、丸い母材から切り出し続ける損失
#が、ついに新しい工場を作るコストを上回り始めた。
#Silicon Boxの10億unitsは、その構造転換がすでに始まっていることを示す一つの観測点に見える。
#そして2027~2030年に見るべきものは、「Glass基板が来るか来ないか」という二択ではない。
#Temporary Glass CarrierによるPanel量産がどこまで先行するのか。
#Permanent Glass Coreがどの製品からqualificationを通るのか。
#CoWoS-L、EMIB、FOCoS、CoPoSがどの程度Local Silicon + Large RDLへ収束するのか。
#そしてwafer数ではなく、実際にどれだけのinterposer面積、compute die、HBM dieをAI Data Centerへ送り込めるのか。
#AIインフラのボトルネックを追うなら、次に見るべきスケーリング単位は「GPUの個数」だけではない。
#Wafer → Die → Interposer → Package → Panel → Board → Rack
#という全階層を、一つの製造システムとして観測する必要がある。
#
特定銘柄の推奨・勧誘を目的とするものではありません。投資判断はご自身の責任でお願いいたします。
#