Google TPUとNVIDIA GPUについて再考察
出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.09.23.4
- 記事内容のSHA-256
265872213d7a511c32d884387e3ce30f4b33e61a5231d5a38fddafb72503ee8a- 保存版のSHA-256
b55b4053fc179f8df43726c9703d7f589ebb8738128de98a63856999b110cb0c
外部証明の最終検査結果は詳細を開くと表示します。
ironwoodのpodはjupiterのleafスイッチでAECなどによって繋がれているわけではなく、ironwoodのpodとは別に中のTPUサーバーがHostCPUからそれぞれleafに繋がっている理解で合ってますかね?
jupiterでのleafスイッチはbroadcomのTomahawkが主流でNVIDIAではSpectrum-X、Quantum-Xという感じ
AECはノイズ混じりで弱くなった電気信号をデジタル信号にしてからノイズを除去して綺麗にして強い信号に作り直してから送るやつ
デジタルに変換して綺麗な信号に直す装置をDSPと言って、タイミングを調整して送り出す装置をリタイマという
合わせてDSPリタイマと言ったり、リタイマだけでも通じたりする AECはアクティブ銅とか言われていて、credoとかがやってる
リタイマはAsteraのAriesがCPUとGPUの間では圧倒的で8割以上はそれが使われている
でそれはCXLにも対応している
AECの分野でもAsteraはTaurusというリタイマをやってるけど、credoの紫ケーブルが圧倒的で7割くらいが使われているとされている
AsteraのTaurusはケーブルまではやっていないくてケーブルに搭載する頭脳の部分リタイマをやってる
データセンターにはCPUとかGPUとかDRAMとかSSDとかHDDでそれぞれ箱に分けられている
#それらがケーブルを通して繋がってサーバーになり、サーバーがパッシブ銅で繋がれてラックになる
#ラックからアクティブ銅でそれぞれのGPUが対応したleafスイッチに繋がれて、そのleafスイッチがspineスイッチに繋がれる
#spineスイッチからsuper spineに繋がれて、それがデータセンター間接続で緩く繋がれている
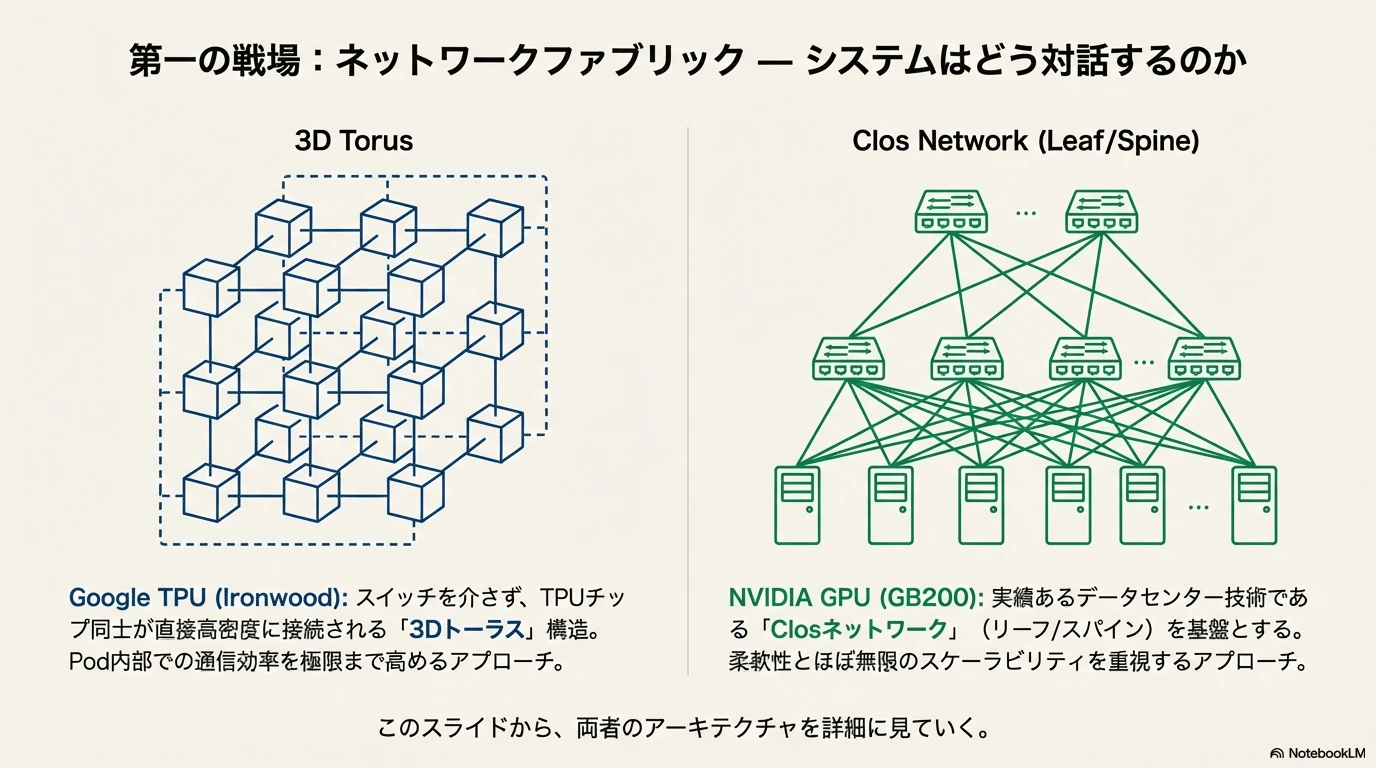
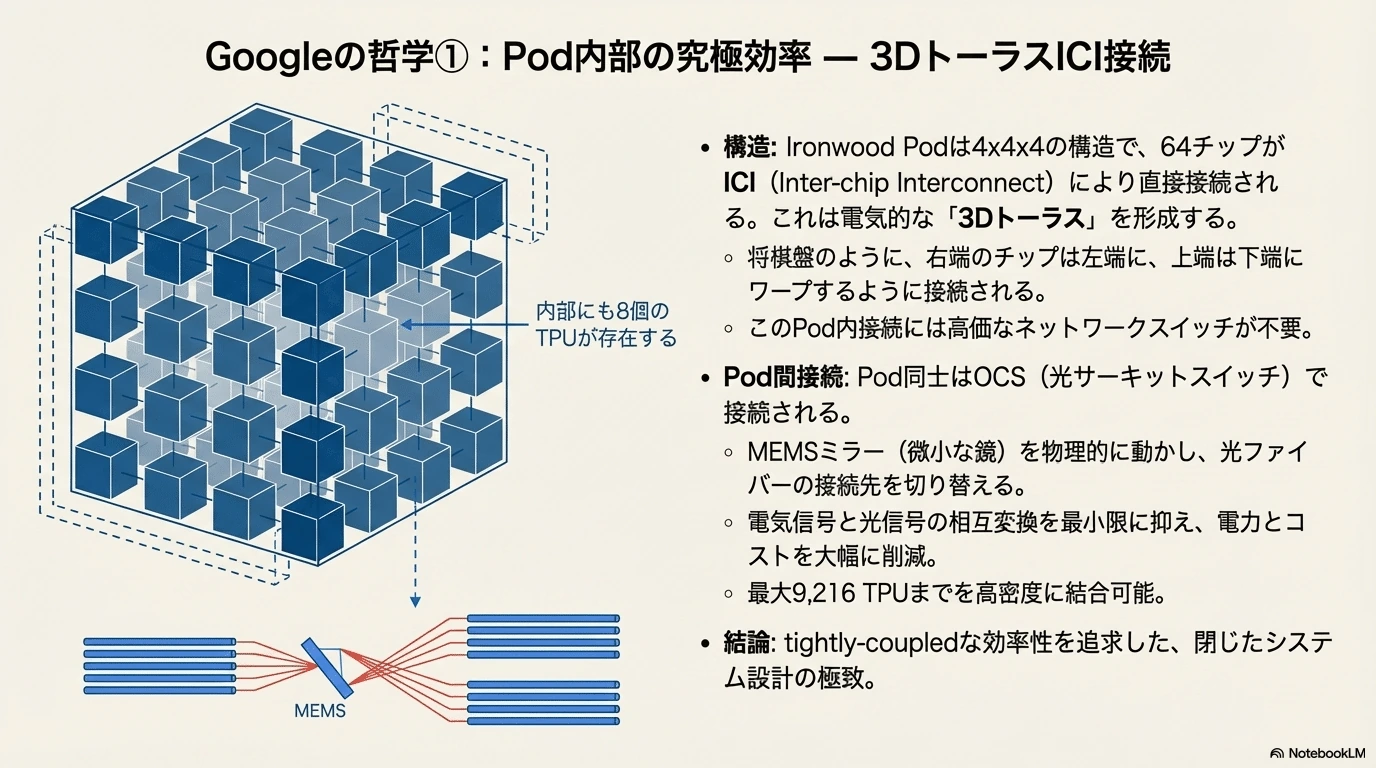
ironwoodではTPU同士が直接繋がっており、それが3Dトーラスの構造をしている、これをICI接続と呼んでいる
3Dトーラスというのは、右端に行ったら左端にワープするような構造だ 通常は3×3×3であるが4×4×4の構造をしているルービックキューブを想像してみて欲しい
ironwoodも実際に4×4×4の構造をしており、これで64チップがICIで電気的に繋がりラックになっている
ルービックキューブとの違いは、ironwoodでは面だけでなく中にも8個のTPUが存在している事だ
このirowoodのキューブはX軸、Y軸、Z軸でそれぞれ端に行くと帰って来るような構造をしている
将棋でいうと一番右端に行くと左端のマス目に戻るみたいな構造だ こういうものをトーラスという
面の端のチップは三方向にワープするし、辺は二方向、真ん中は一方向にワープする
そのワープの電気的な接続はパッシブ銅ケーブルでされている サーバーは2×2の4TPUでHostCPUがPCleでTPUと接続されていて、SSDやDRAMはDIMMで繋がれている
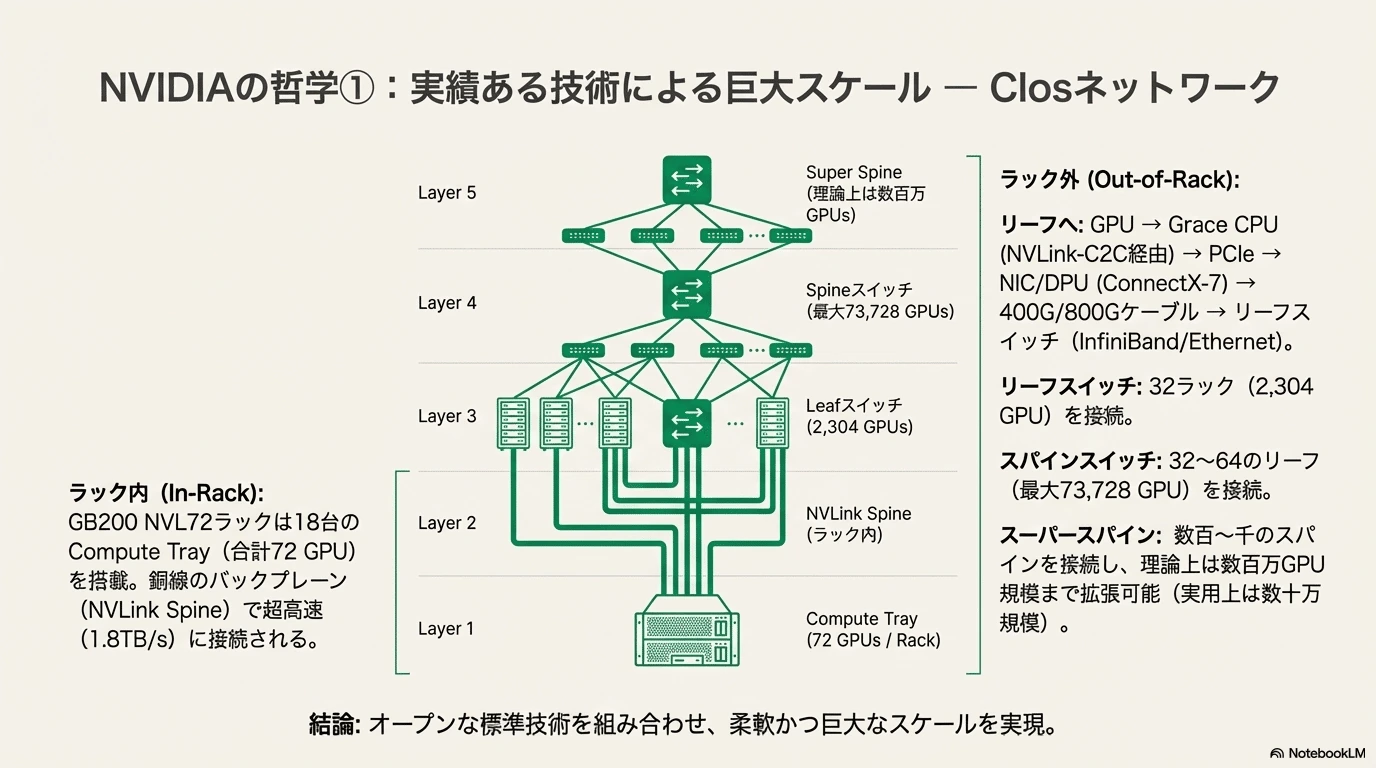
NVIDIA GB200はsuperchipという構造を取っていてCPU一枚にGPUがサンドイッチして一つのchipのような構造を取っている
GPU間接続はCompute Trayが銅のバックプレーン(NVLink Spine)で9台のNVLink Switch Tray に接続され、ラックから一歩も出ずにNVLinkの帯域(1.8TB/s)接続される
そしてラック外の73個目のGPUと接続する時leafスイッチが出てくる GB200のleafまでの経路は GPU からNVLink-C2C 経由で Grace にデータを渡しGrace の PCIe Root からConnectX-7 / BlueField-3 などの NIC/DPU に行って、そこから 400G/800G 光/DAC で InfiniBand/Ethernetのleaf スイッチに接続される
一つのサーバーにつき4つのGPUを積むのはGB200でもironwoodでも共通している
GB200 NVL72ではサーバーをCompute Trayと呼んでいる一つのラックにつきCompute Trayが18個入っており、1サーバーにCPU2基、GPU4基、SSD (NVMe)約 16TB ~ 30TB、メモリ (Unified)1.7 TBが入っている
CXLも付けられるが標準搭載はされていない
1サーバーに4つのGPUなので1ラックで72基のGPUがある
それがleafで32本のラックに相当するGPUが繋がれる
#ここで2304GPUは繋がれている
#このleafがspineに繋がれるspineでは32~64のleafが繋がれる、ここで73728GPUが繋がれる計算になる
#この上にsuper spineというのがあるが、これをやらない場合は64繋いで、繋がない場合は32繋いでsuper spineに繋ぐ感じだ
でこのsuper spineには数百~千のspineを繋げるため理論的には7億GPUとかを一つのclos構造でやる事は可能だが、実際はリスクと距離の限界がある為、今のところは数十万規模に留め、データセンター同士を電気信号を光信号に変換するモジュールと光ファイバで横に繋いでいる
ironwoodではどうかというと、ironwoodはそもそもclosの構造を取っていないpodとjupiterで分かれる
podはMEMSミラーという鏡で反射してOCSスイッチを使い電気から光への変換を省き4×4×4のキューブを繋いでいる
光ファイバの接続先を鏡で変えられる為、故障した箇所を回避したり、トポロジー(3Dトーラスの形状)を柔軟に変更したり出来る
最大9,216TPUを接続する事が可能
これによりTomahawkなどのスイッチ抜きになるためコストと電力を大幅に削減でき、それを計算に回す事が出来る
podでガッチリ組めば電力辺りの性能では効率がよくGB200のラック圧倒的な性能を出すが、それは所詮ラック単位の話で、それ以上のleafやspineまで絡んで来ると到底敵わない
9216チップは少なく感じられるがOCSを使って桁違いの規模で密結合で繋がっている
これを緩く横に並べて使う感じだが、それとは別に先ほども書いたようにleafに向かって2×2のTPUサーバーが繋がっているjupiterもある
これはspineの部分をMEMSミラーを使ったOCSスイッチでやりくりさせている
OCSスイッチを使ってleafスイッチを繋ぎ、数万のTPUを繋げる
そしてJupiterネットワークでは繋ごうと思えばGPUもOCSスイッチで繋げる しかし、数十万と数百万には到底届かない
とはいえ、この数万クラスタのTPUを並べてゆるいアルゴリズムで光ファイバとモジュールで繋いで使えばよい
これはNVIDIAのGB200などでも同じ事である
数十万規模になるとゆるく繋がないと限界がある
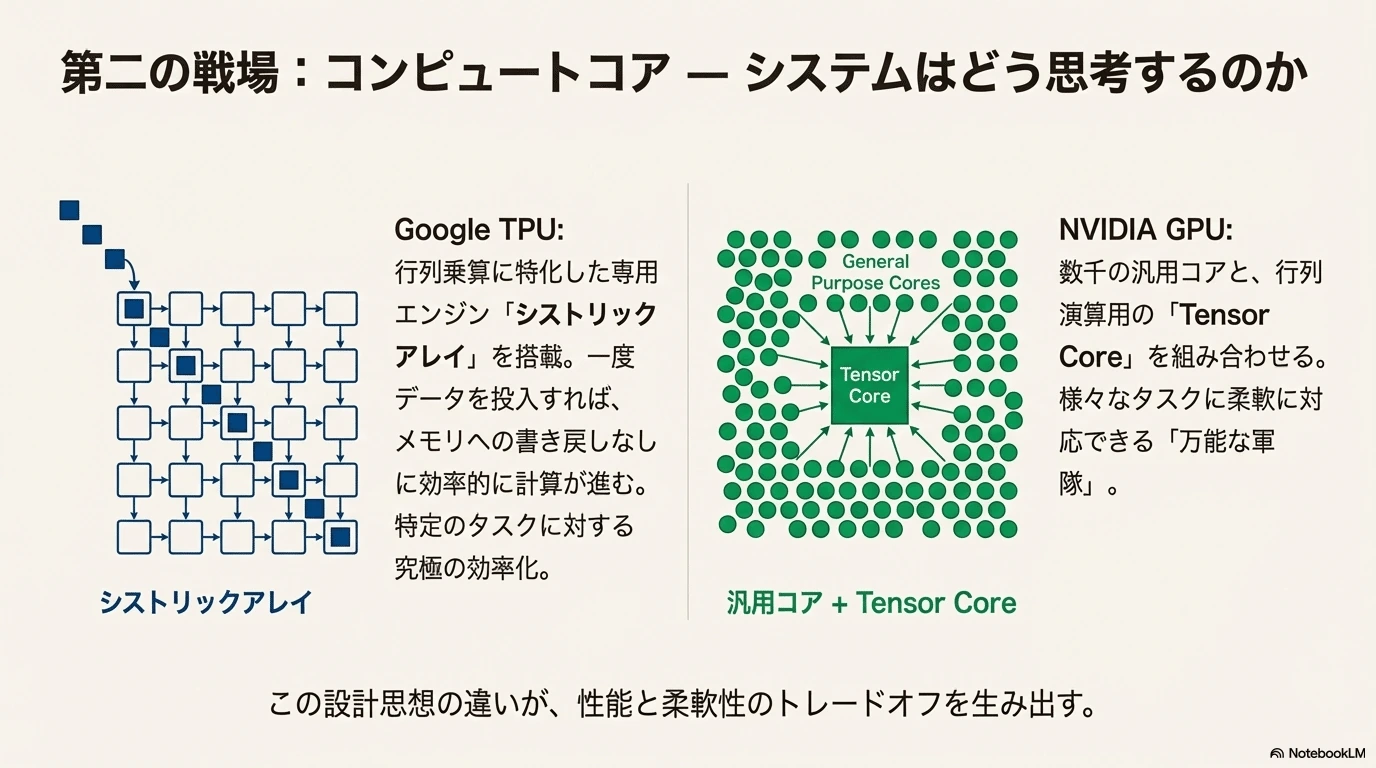
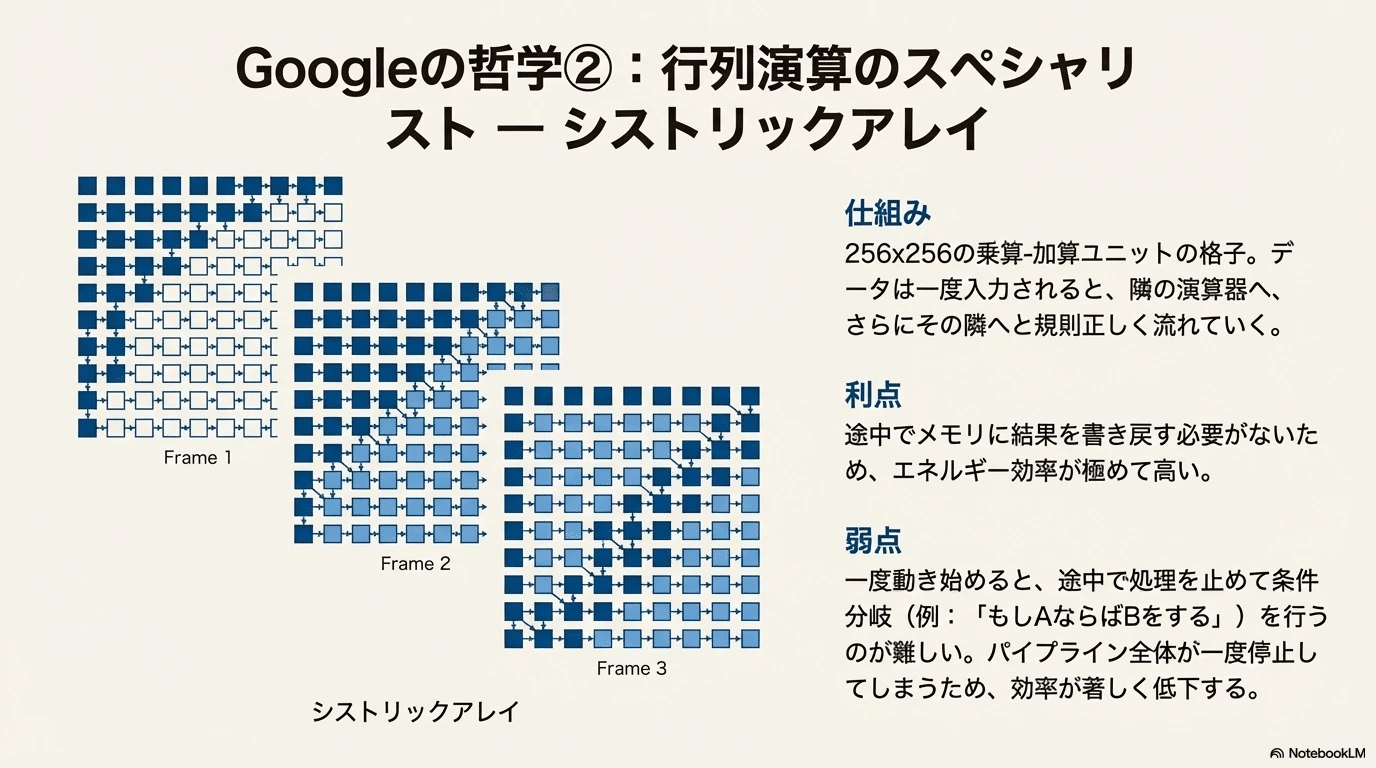
TPUでは行列乗算の際にシストリックアレイを使っている、これは256×256の乗算-加算ユニットの格子が1コアに組み込まれている
一度データを入れると血液のようにドクンと送り出され、隣の演算器へ、さらにその隣へと、バケツリレー形式で規則正しく流れていく
途中でメモリに書き起こす必要がなくエネルギー効率がよいが、一度動きはじめると止める事が難しいため分岐処理が難しい
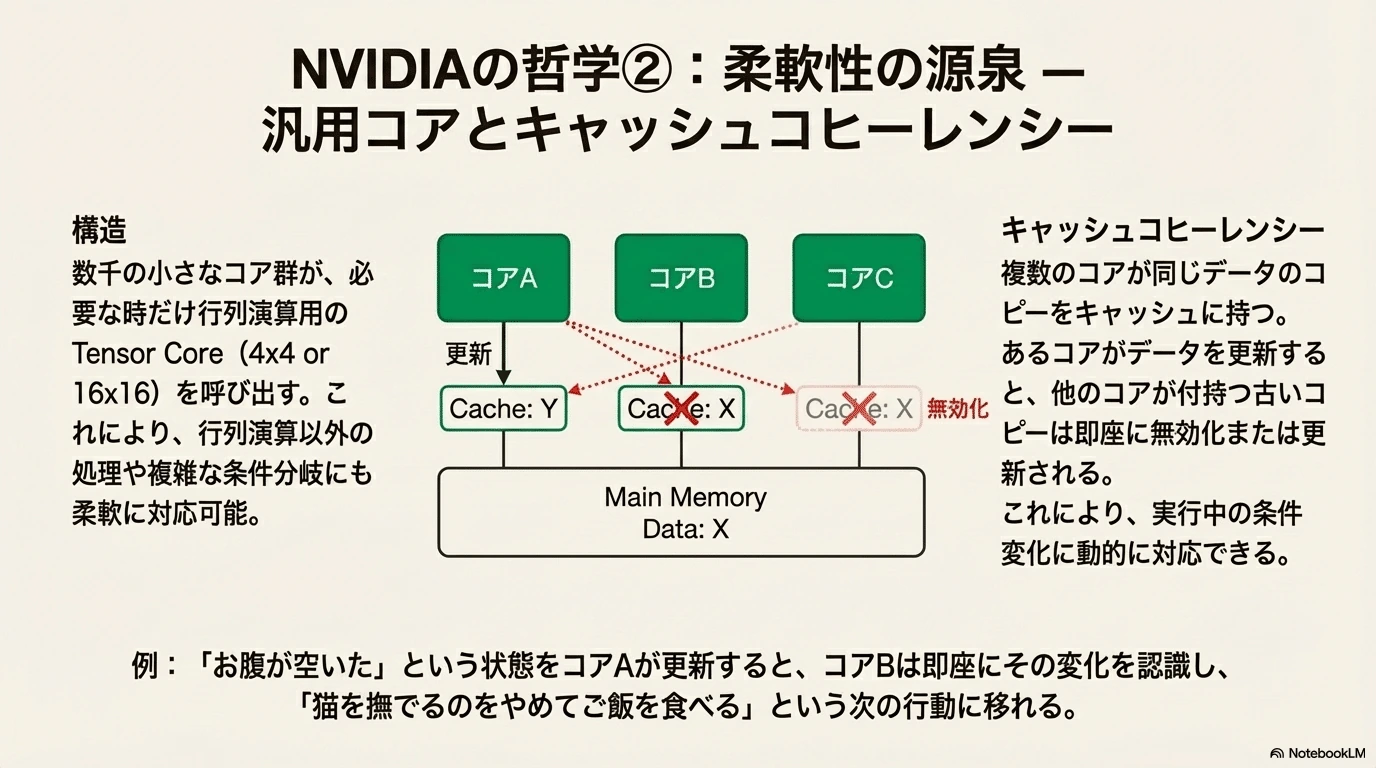
GPUの場合は、GPU全体に何千もの小さなコアがあり、その中にTensor Core 4×4或いは16×16の演算子が埋め込まれている
多数のスレッド(処理の単位)が同時に走り、必要な時だけTensor Coreを呼び出して計算する
その為に汎用性が高く、行列演算以外の処理や複雑な条件分岐が混ざっても柔軟に対応できる
GPUはメインメモリの内容を近くのキャッシュにコピーして持っている
あるコアAがデータを書き換えた瞬間、コアBやCが持っている古いコピーを『無効』にする、または『新しい値』に更新するような事が出来る これをキャッシュコヒーレンシーという これは分岐処理が演算中に行われた時にかなり強力に働く
#腹が減ったから猫を撫でるという条件分岐をする時、腹が減っていないから、減っているに変わった時にコアAで更新して、コアBで腹が減っていない状態を示す事が出来、コアBがコアAを認識して分岐処理をはじめられるのはコヒーレンシーがあるからできる
#コアが一つしかない場合でも、分岐処理を出来ないわけではない コアAだけでも腹が減った状態に自分で書き換えて自分で認識する事は出来る
#ただしこの場合、予め分岐を書いておく必要がある
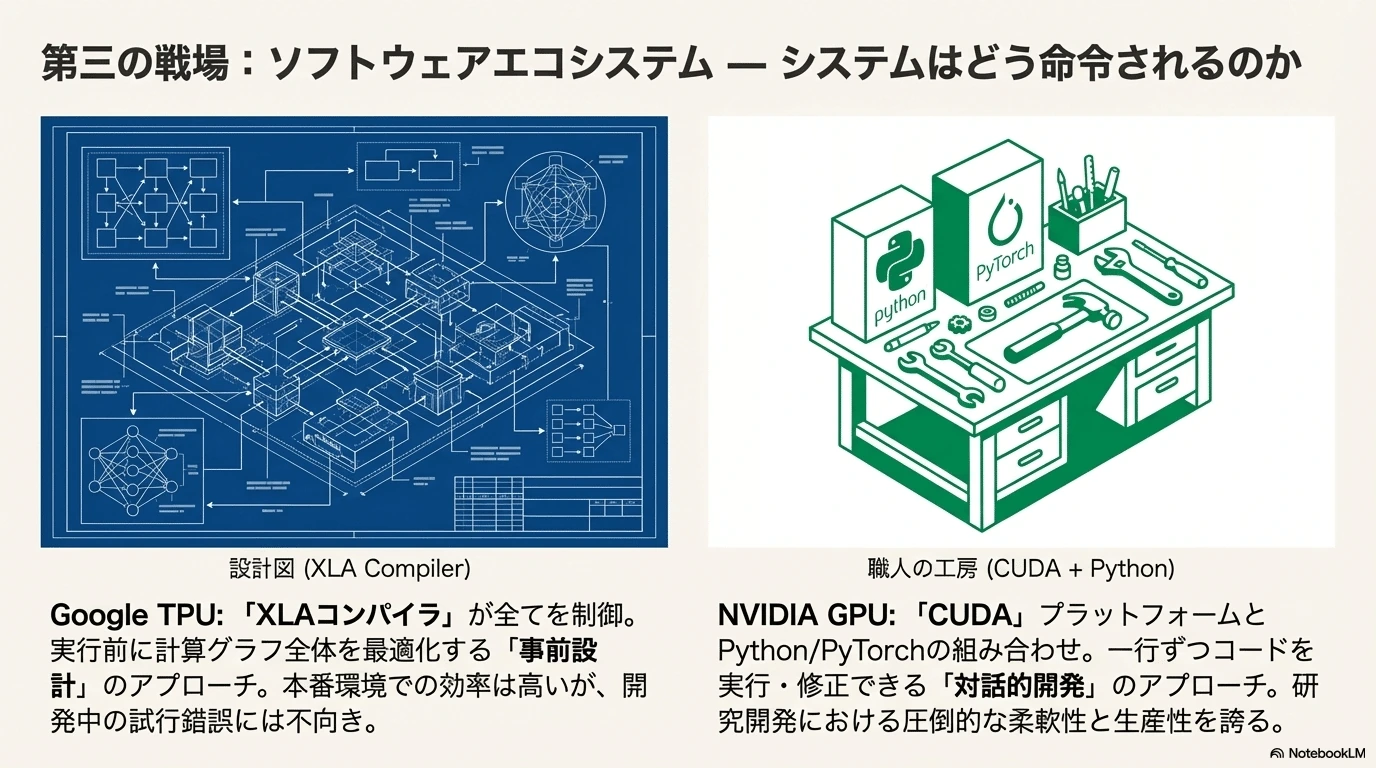
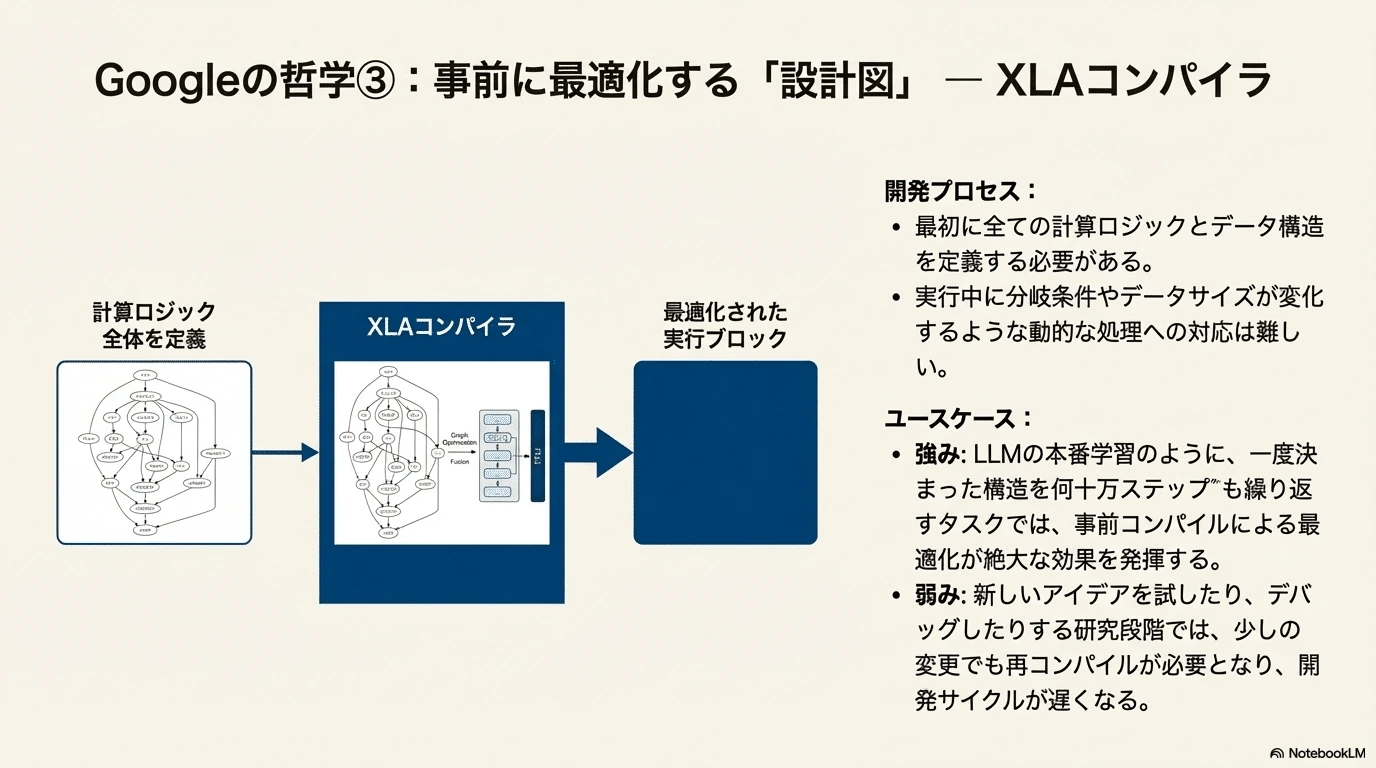
#TPUではそれらの処理はXLAコンパイラというものでする事が多い
#実行中に分岐が変わったり、サイズが変わったりした場合、柔軟に対応するのが難しい
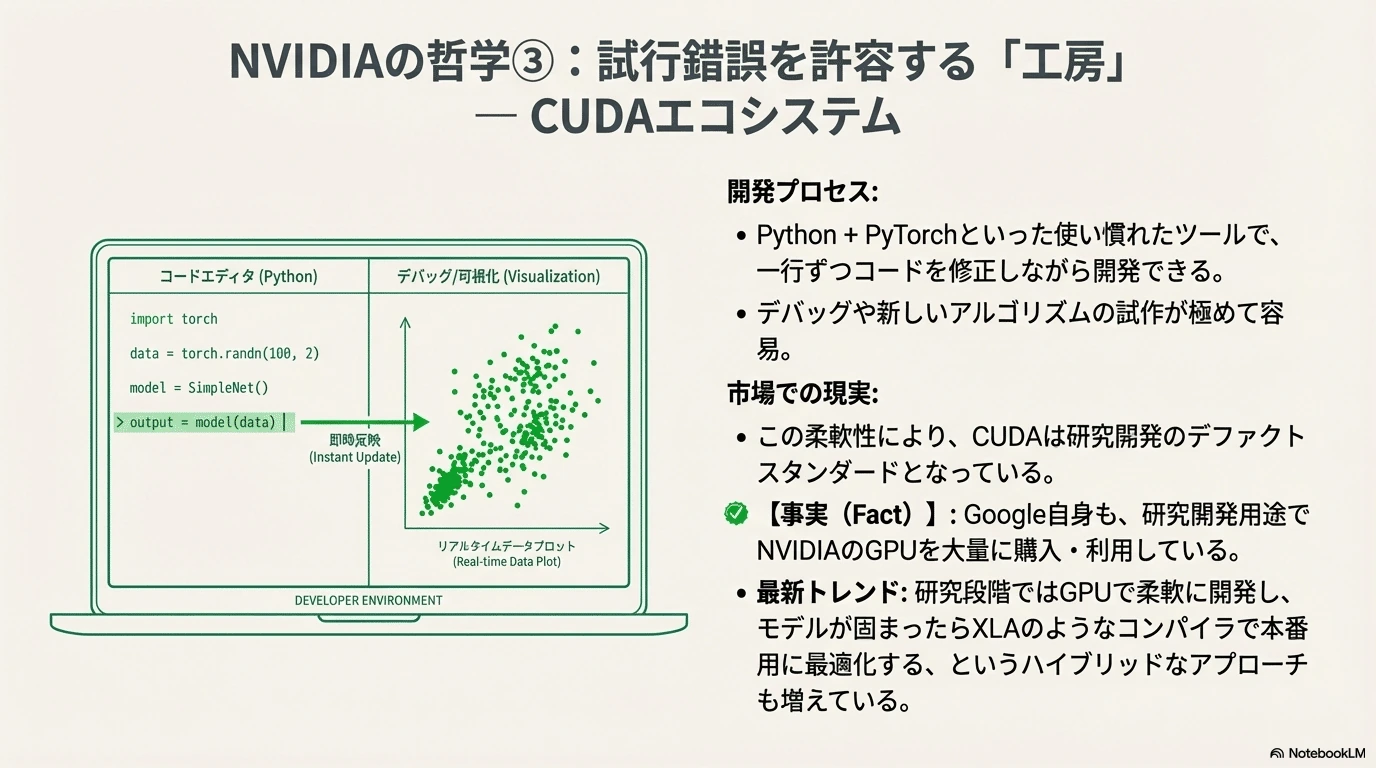
#GPUでは一行ごとに修正しながら開発出来るが、TPUでは最初に全て設計しておく必要がある
#とはいえ本番のLLM学習では殆どが最初に設計して決まった構造を何十万ステップも回している
#最近ではGPUでも研究段階ではPython + PyTorch で好き放題分岐して収束したらXLAのこうなコンパイル系で本番用に固めて最適化という形が増えて来ているらしい
#試作や研究ではGPUで回して修正しながらしているのだ、実際GoogleもGPUを購入して使っている
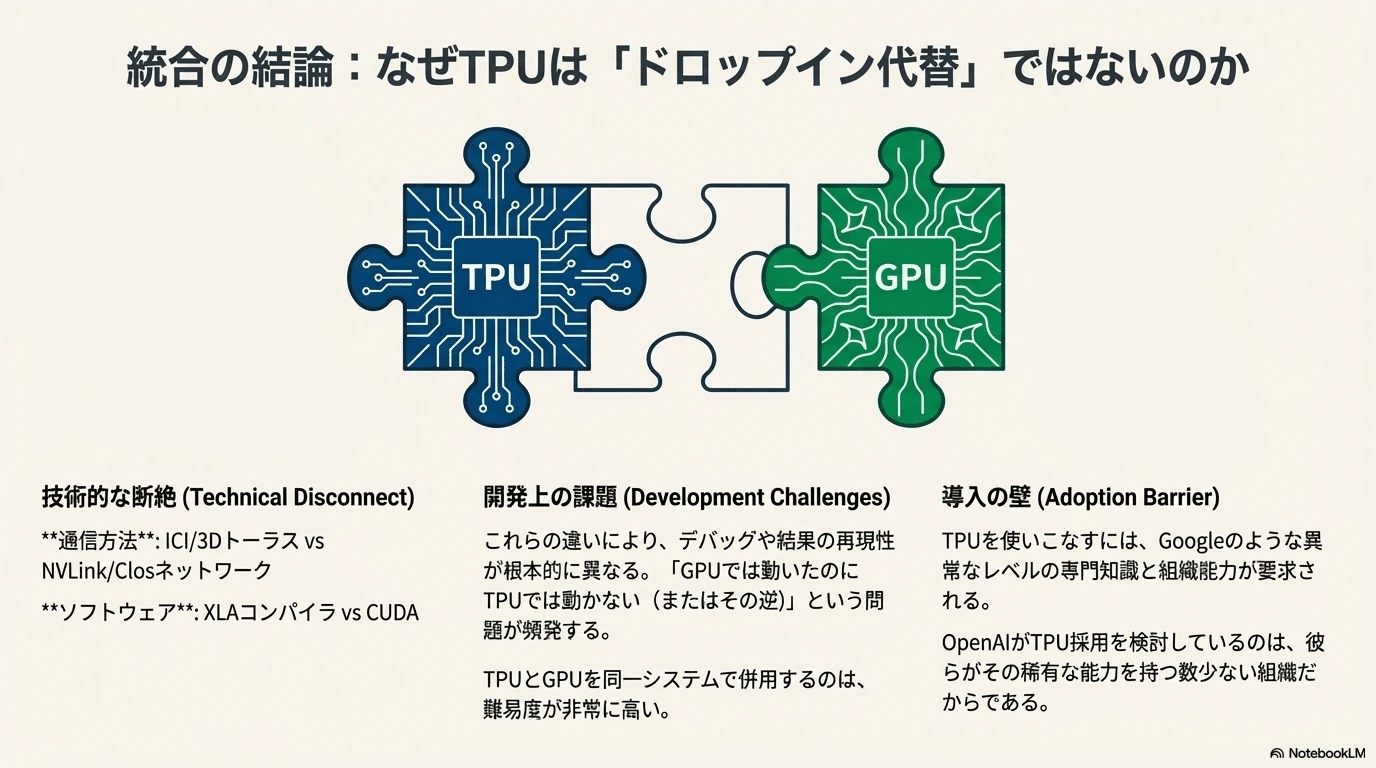
#TPUとGPUを同時に使ってやっていくのは難易度が異常に高い為、厳しいと考えられる
#ソフトウェアもXLAコンパイラとCUDAで全然違う NVIDIAのnvlinkとclosとTPUのようなICI、jupiterネットワークでは通信方法が違う GPUでは上手くいってTPUでは上手くいかないといったような、デバッグ・再現性が異なる
#こういった事がある為、どこでもTPUをすぐに導入できるわけではない
#Googleが異常なだけだ
#後OpenAIも、TPUを採用するらしいがその能力があったという事だろう
#ASICは今のところGoogleの独壇場で、AWSのTrainiumがそれに続いている感じだ
#TrainiumはClaudeで利用されているが、やはりNVIDIAのGPUなしでは厳しい
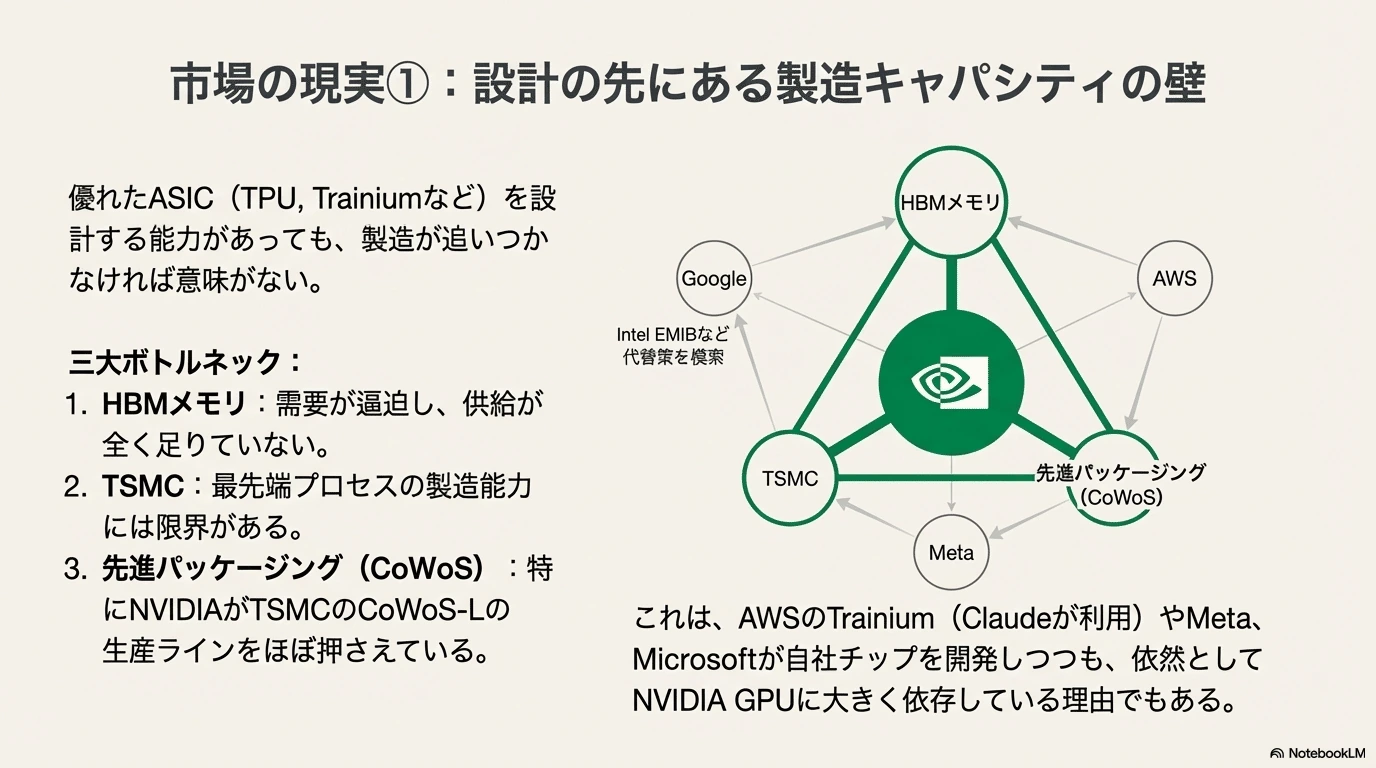
#MetaもMicrosoftもやっているが、彼らに至っては殆どがNVIDIAのGPUである
#それに製造キャパでみても、NVIDIAのGPUで埋まっている
#設計能力はあっても製造が追いつかないのだ
#特にHBMメモリは逼迫している、TSMCの製造能力にも限界がある、CoWoS/SoICのCoWo-Lは殆どNVIDIAが抑えている、Googleはintel EMIBなどの別ルートを模索している段階だ
#これが現実なので、TPUがGPUを無に帰す事はまず不可能だろう
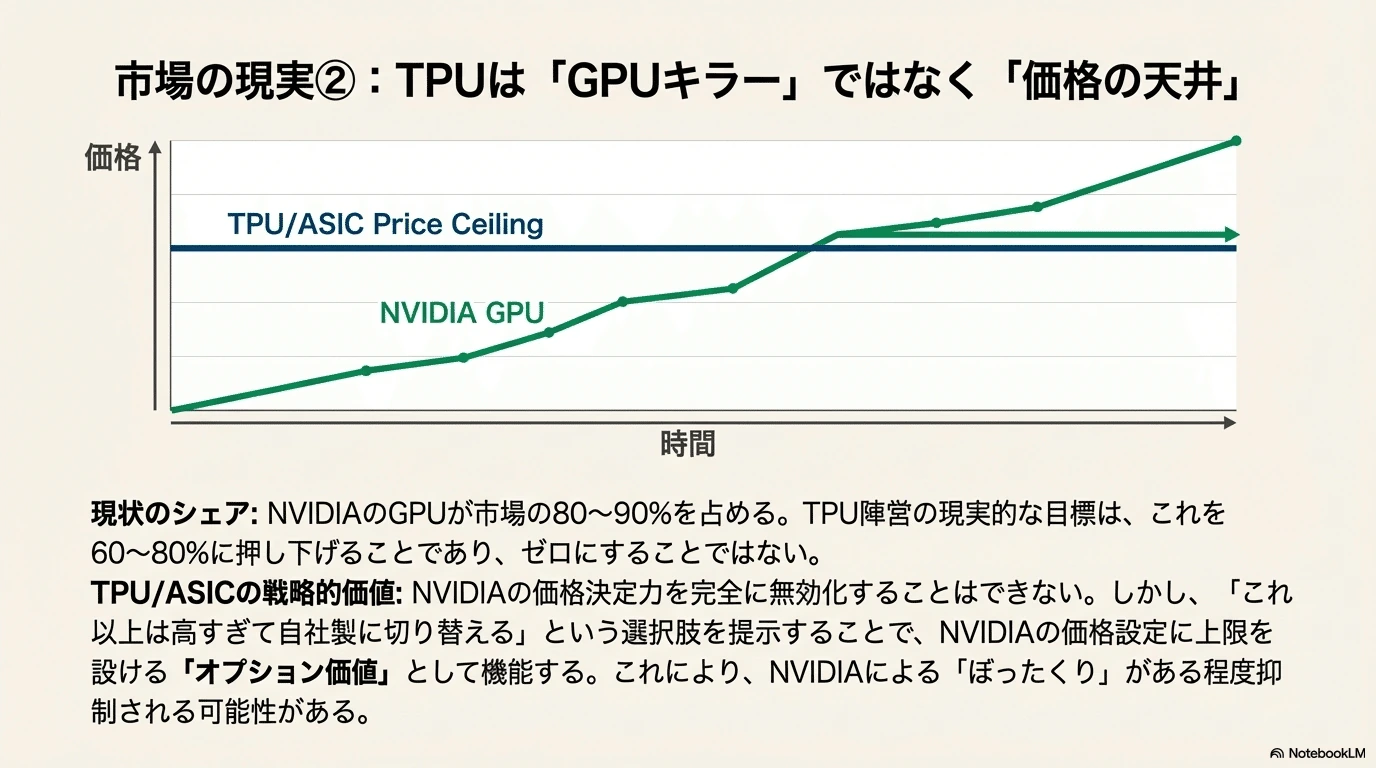
#今のシェアの80~90%NVIDIAのGPUが60〜80%まで下げられたらTPU側が上出来と言ったくらいだと思われる
#TPUがNVIDIAのぼったくりを幾らか軽減する可能性はあるが、そもそもHBMもぼったりである
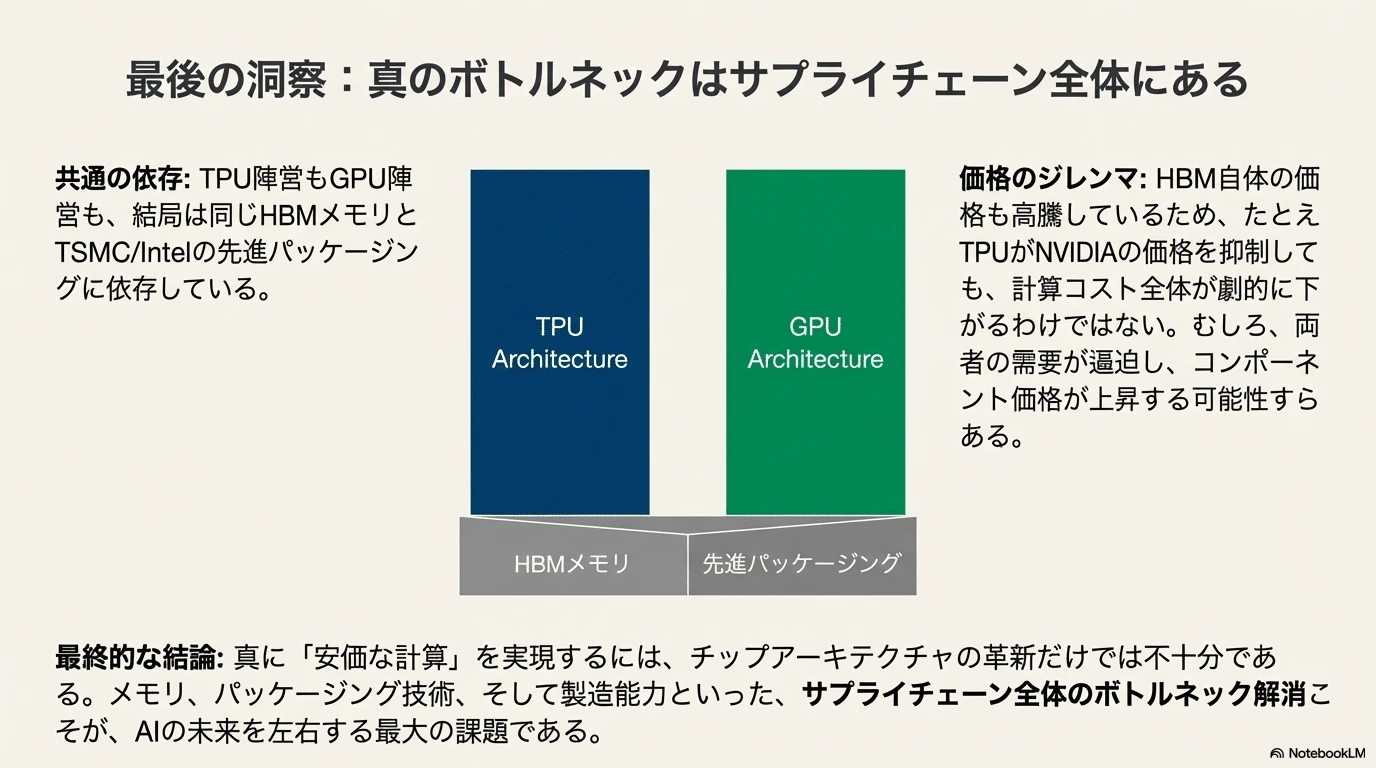
#むしろTPU、GPUともに需要が逼迫し価格が上がってしまうのではないだろうか
#TPU や Trainium のような ASIC 陣営は、NVIDIA の価格決定力をゼロにはできないが、「これ以上はさすがに無理だ」という上限を付けるオプション価値として効いている
しかし、彼らも同じ HBM と先端パッケージに依存している以上、真に「安い計算」を実現するには、メモリとパッケージのサプライチェーンを含めた全体のボトルネック解消が必要になる
#https://gemini.google.com/share/743db66eb2f0
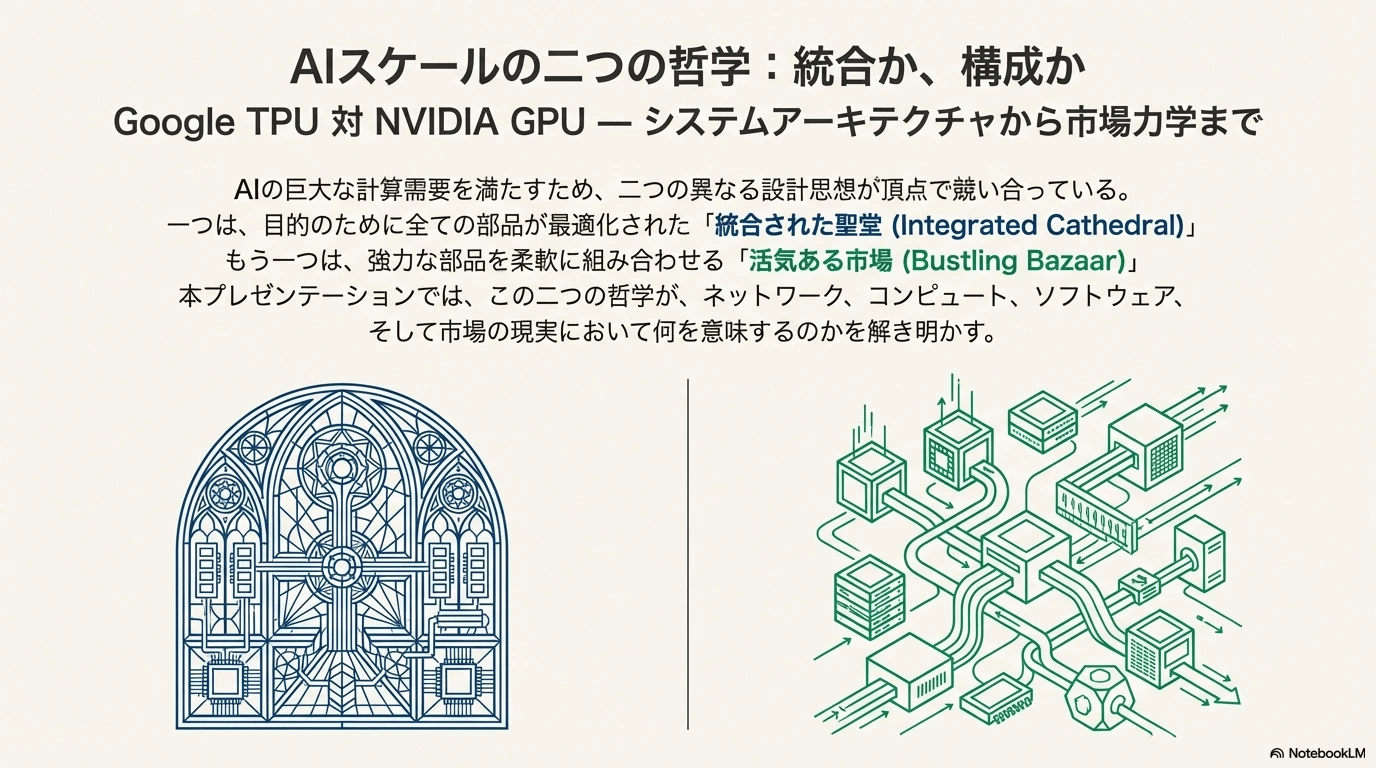
#TPUとGPU_AIインフラの二大哲学とコスト差
##
1
#
#
2
#
#
3
#
#
4
#
#
5
#
#
6
#
#
7
#
#
8
#
#
9
#
#
10
#
#
11
#
#
12
#
#
13
#
#
14
#
記事は9割私が書きました gemini3.0proとchagpt5.1thinkingを多用して調査しています 内容が正しいのかは正直、よくわかりません 素人です
#サムネはPixAIsunflowerとnanobanan
#画像、音声はnotebooklmです
#