総合フロンティア研究最前線
AIモデル・知能 エージェント・データ基盤 メモリ 考察・仮説
出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.10.21.2
- 記事内容のSHA-256
141fa1cca87f32b11522d1e4152def6187debf61f17725b0301f6d84f5712005- 保存版のSHA-256
3ba9577f133143512118bd16073db9fa8fc1c6aa2af34f037b2b150de8c1fdc7
外部証明の最終検査結果は詳細を開くと表示します。
総合フロンティア研究最前線
#―― S級構造変化調査:AIは「計算するモデル」から「状態を保持し、検証し、改善するシステム」へ
#NOIA Research Frontier|2026年10月18日
#はじめに:AI研究の最前線では、何が変わり始めているのか
#AIの能力を向上させるには、より多くのパラメータ、より大量のデータ、より大きなGPUクラスタが必要になる。
#これまでAI研究の発展を説明するうえで、こうしたスケーリングの考え方は非常に重要だった。
#しかし、2026年9月下旬から10月中旬にかけて公表された研究を横断すると、もう一つの変化が見えてくる。
#AIは本当に、同じ情報を何度も計算し直す必要があるのだろうか。
#一度理解した情報を、次の推論へ渡すことはできないのか。過去の実行結果を、毎回文章として読み直さずに利用できないのか。小型モデルが実行した仕事を、大型モデルが後から一括検証できないのか。
#さらに、AIが仕事に成功したなら、その成功経験を次の仕事に残せないのだろうか。
#もし、AI自身が実行手順を改良できるなら。
#もし、改善のための評価器まで改善できるなら。
#そのときAIの能力を決めるものは、モデルのパラメータ数だけではなくなる。
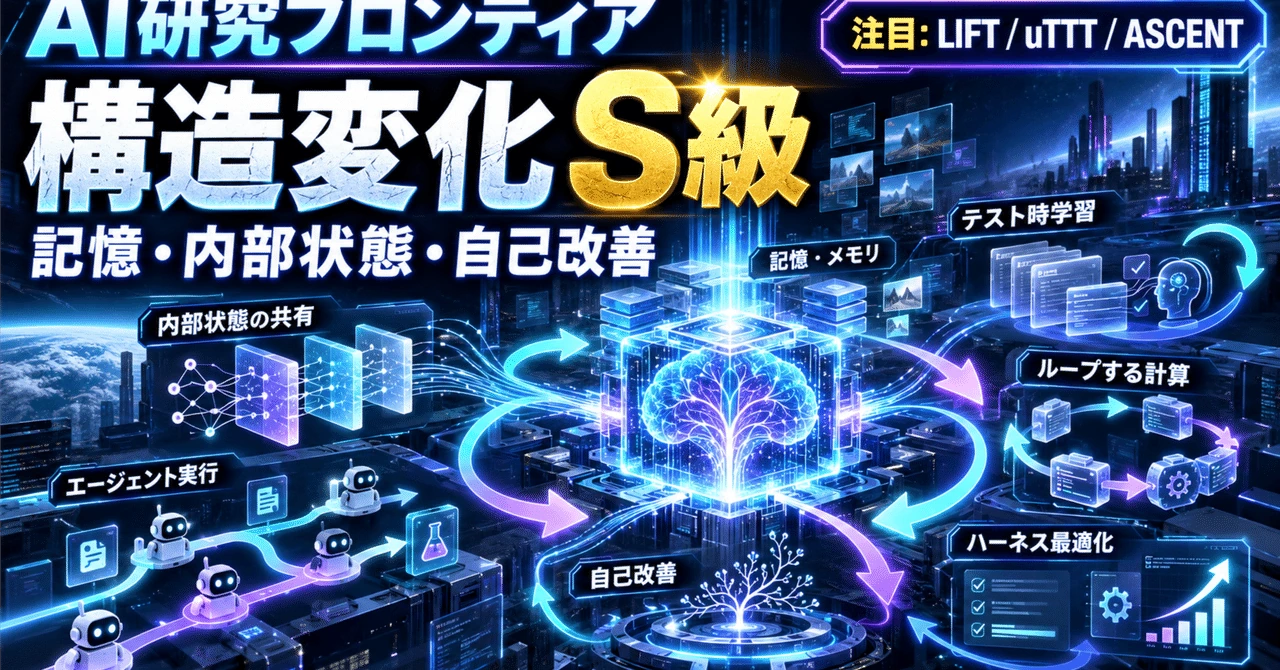
#今回取り上げるのは、そうした構造変化の可能性が大きい研究群だ。
#LIFT、Universal Test-Time Training、Looped MoE、ASCENT、Harness Learning、Causal Improvement Graph、Schema、KV-streams、AiO-Mem、VeriFine。
#さらに10月15日に公開された、Internal-State Sharing、SpecAgent、Probe-and-Resume、Remote KV Tiers、ReFlowという5本の研究も加える。
#これらを独立した論文として紹介するだけでは、最も重要な変化が見えにくい。
#そこで今回は、NOIAの継続監視で蓄積してきた研究結果を、AIシステム全体の構造として接続していく。
#なお、ここでいうS級とは、既存のAIシステムの設計原理を変える潜在的重要度が高いという評価である。商用化済み、独立再現済み、あるいは従来技術を全面的に置き換えたという意味ではない。
#むしろ、その境界を明確にすることが今回の目的の一つだ。
##
第1章 AIの進歩は「モデルの外側」に広がり始めた
#1-1. モデルの能力と、システムの能力は同じではない
#一般的な大規模言語モデルの計算は、単純化すると次のように表せる。
#入力されたtoken列をTransformerが処理し、次のtokenの確率分布を計算する。
#その結果からtokenを選択し、再び計算を繰り返す。
#もちろん実際には、KVキャッシュ、並列化、MoE、推論最適化などが組み合わされる。
#しかし基盤モデルの重みが固定されたままでも、推論中の情報管理や外部の実行環境を変えることで、能力は変化し得る。
#例えば、同じモデルに同じ仕事を与えたとしても、途中の情報を適切に保存できるエージェントと、毎回長い履歴を読み直すエージェントでは、必要な計算量も成功率も異なる可能性がある。
#さらに、失敗した操作を検証できるエージェントと、完了を宣言した時点で処理を終えてしまうエージェントでも、実際の仕事の成功率は変わる。
#2026年秋の研究で特に重要なのは、こうした外部構造の改善が、単なる補助機能ではなく、研究の中心的な対象になり始めていることだ。
#1-2. S級研究をどう評価するか
#本記事では、構造変化を次のように区別する。
#これは論文の権威や発表機関を順位付けするものではない。
#新規性、他の研究への波及、再現可能性、実際の計算費用、今後6〜36か月の実装可能性を総合して判断する。
#今回のS+候補として特に注目したいのは、LIFT、uTTT、Looped MoE、ASCENT、Harness Learning、Schemaだ。
#一方、10月15日の追加研究5件は、いずれもA+または長期的なS候補に位置付ける。現段階で「S級の構造転換が実用化された」と評価するには、独立再現や長期運用の証拠が不足している。
#ただし、今回の5件はS級研究の実用化条件を大きく変える可能性がある。
#特に、何を再計算せず、どの状態を共有し、どの時点で検証するべきかという問題を具体化している。
##
第2章 モデル内部の構造変化:LIFT・uTTT・Looped MoE
#2-1. LIFT:深い層の計算結果を、次の生成ステップへ戻す
#最初に取り上げたいのは、2026年9月29日の研究、LIFT(Latent Information Feedback Transformer)だ。
#原論文:Pretraining Latent Information Feedback Transformers with Teacher Supervision
#従来のAutoregressive Transformerでは、深い層で計算された中間表現は最終的にtoken予測へ使用される。
#次の生成ステップへ移る際、その豊かな中間表現を、別の計算経路として直接引き継ぐ仕組みは標準的には存在しない。
#これは、深い層が得た情報の一部を、離散的なtokenという限られた表現へ押し込むことを意味する。
#LIFTは、ここを変更する。
#深い層から得られた潜在状態を次の生成ステップの浅い層へフィードバックすることで、連続的な内部表現を引き継げるようにする。
#技術的に興味深いのは、学習時の並列性を維持する工夫だ。
#再帰状態を持つモデルは、前のステップで計算された状態を待たなければ次の計算ができない場合がある。
#LIFTでは教師モデルから得た情報密度の高い状態を事前計算し、次のtokenと次の状態の両方を予測するよう学習させる。
#これによって、学習時にはtoken位置間の並列化を維持し、推論時には予測した状態を次のステップへ戻す。
#研究では135M〜1Bパラメータのモデルで評価され、token数を揃えた比較では標準Transformerを上回り、計算量を揃えた比較でも競争力のある結果が報告された。
#これは、パラメータ数を増やす以外にも、情報の伝達経路を変えることで能力を高められる可能性を示す。
#ただし、現在の実証は比較的小規模なモデルが中心である。
#7B、70B、さらには大規模MoEへ拡張した場合、潜在状態の予測誤差がどう蓄積するか、全推論費用がどう変化するかは分かっていない。
#LIFTのS級重要性は、計算結果をtokenだけでなく連続した内部状態として次へ引き継ぐという、モデル内部の情報伝達原理にある。
#2-2. Universal TTT:記憶を層ごとの所有物にしない
#次に重要なのが、10月4日に公開されたUniversal Test-Time Training、uTTTだ。
#原論文:Universal Test-Time Training
#Test-Time Training系のモデルでは、推論中にFast Weightsと呼ばれる更新可能な状態を保持する。
#これは通常の固定された基盤モデル重みとは異なり、入力を処理する過程で更新され、後続の情報処理に利用される。
#従来のTTT系アーキテクチャでは、基本的に各層が独立した記憶状態を持っていた。
#uTTTは、これを層間で共有する。
#深い層で更新された記憶を、後のチャンクで浅い層が読み出すことができる。
#つまり、情報が時間方向へ保持されるだけでなく、ネットワークの深さ方向にも共有される。
#760Mモデルでは、RULER平均が層別TTT-MoEの25.73からuTTT-MoEの27.85へ改善した。
#一方、16K文脈では17.85から16.03、32Kでは10.35から10.23へ悪化している。
#この結果は非常に重要だ。
#共有記憶があるからといって、すべての長文脈処理が改善するわけではない。
#また、学習時の一時領域を含めたメモリ使用量が増える条件も存在する。
#それでも、複数層が同じ更新可能な記憶を使う方式は、今後のモデル内部の状態設計を変える可能性がある。
#2-3. Looped MoE:パラメータを増やさず計算を深くする
#もう一つの方向は、同じ計算ブロックを繰り返し利用するLooped Transformerだ。
#原論文:Scaling Laws for Looped Mixture of Experts
#通常のモデル拡大では、層数やパラメータ数を増加させることが多い。
#Looped Transformerでは、同じブロックを反復して使用する。
#さらにMoEと組み合わせると、各ループで異なるExpertを選択できるため、保存する重みの量と実際の計算量をある程度分離できる。
#この研究では、再帰構造とMoEの疎性を組み合わせたScaling Lawが検討され、Reasoningでのパラメータ効率改善が報告された。
#関連するFixed-Point Looped Modelsでは、反復によって状態が収束する性質を利用し、KV保存や逆伝播の負荷を削減する方向も研究されている。
#ただし、ループ数を増やせば、そのぶん計算や通信も増える。
#特にMoEではExpert RoutingやAll-to-All通信が問題になり得る。
#Looped MoEの価値は、パラメータ数を削減することだけではない。
#保存しているパラメータ容量と、必要なだけ実行する計算深度を別々に設計できる可能性にある。
#三研究が示す共通点
#LIFTは深い層の潜在状態を次のstepへ戻す。
#uTTTは更新可能な記憶を層間で共有する。
#Looped MoEは同じ計算ブロックを反復利用する。
#三者は同じ技術ではない。
#しかし、標準的なTransformerで固定されていた情報の流れや計算経路を見直すという共通点がある。
#モデルを大きくする以外に、情報をどう引き継ぎ、どこで保持し、どれだけ計算するかという設計空間を拡張しているのである。
##
第3章 AIの記憶は、コンテキストから状態管理へ移り始める
#3-1. 記憶には複数の種類がある
#AIの記憶というと、長い会話履歴やRAGのベクトルデータベースを思い浮かべることが多い。
#しかし今回の研究を並べると、記憶はもっと細かく分かれる。
#現在の推論に必要なKVキャッシュ。
#処理中に更新されるFast Weights。
#過去の情報を整理した外部Memory。
#タスクをまたいで残るLoRA。
#さらに、実行環境の改良履歴や、Judgeの評価基準も一種の持続状態として扱える。
#重要なのは、どの情報をどの場所へ保存するかという問題だ。
#すべての情報を長大なコンテキストへ保存し続けることは、必ずしも最適ではない。
#3-2. KV-streams:コンテキストを圧縮しても計算状態を維持する
#原論文:KV-streams for Efficient Compaction in Agentic Reinforcement Learning
#長期間動くエージェントでは、過去のツール実行や観測履歴が増え続ける。
#そのため、古い履歴を短い要約に圧縮するCompactionが利用される。
#しかし従来のCompactionでは、KVキャッシュを破棄し、新たな短縮コンテキストをprefillし直す場合がある。
#つまり、文脈を短くするために計算をやり直している。
#KV-streamsは、この再計算を減らす。
#Compaction後もKV状態を継続し、不要な部分を退避・削除しながら、必要な計算状態を次の処理へ持ち越す。
#著者は3種類のCompaction方式で、学習の経過時間を2.6〜5倍高速化したと報告した。
#さらに興味深いのは、テキスト上のコンテキストから消えた情報が、継続したKV状態には残り得ることだ。
#これはKVキャッシュが、単なる計算の再利用先を超え、エージェントの内部記憶として機能する可能性を示している。
#ただし、この構造には新しい問題も生じる。
#表面上の履歴から情報を削除しても、内部状態に影響が残っているなら、完全な削除や再現性をどう確保するのか。
#ユーザーごとの情報分離や、状態汚染からの復帰は、性能とは別に検証しなければならない。
#3-3. ActKVとAutoCompact:何を残すか、いつ圧縮するか
#ActKVは、将来のエージェント行動へ影響するKVを優先して保持する。
#9月のNOIA観測台帳では、FullKV精度の98.53%を保ちながら、ピークKVメモリを25.98%に抑え、Task Throughput 3.58倍を報告している。
#一方、AutoCompactは、何を圧縮するかだけでなく、いつ圧縮するかを学習対象にする。
#SWE-bench Verifiedでは30.4%から39.6%への改善が報告された。
#重要なのは、単純にコンテキストが短くなったことではない。
#作業に必要な情報を整理し、今後の行動に使いやすい状態を形成すること自体が、エージェントの性能を改善し得るという点である。
#3-4. AiO-Mem:メモリ操作そのものを学習する
#AiO-Memでは、履歴を出典付きEventとして保存する。
#そのうえで、Memory Policyが検索、作業記憶への追加、Skip、Stopを選択する。
#つまり、検索結果を一度渡して回答するだけではなく、必要に応じて追加検索し、情報を選別し、十分な証拠が集まった時点で処理を終了する。
#この一連の操作が強化学習の対象になる。
#LoCoMoではoverall F1が61.0で、比較対象Mem-Tの58.7を上回った。
#一方、最大操作数を8から10へ増やすと性能が下がる条件もあった。
#これは、記憶操作を増やせば必ず能力が上がるわけではないことを示す。
#外部Memoryの検索、Embedding、索引、Policy実行、評価の費用を含めて比較する必要がある。
#記憶研究の新しい構造
#ここまでの研究を接続すると、長期エージェントには次のような階層が考えられる。
#短期的な計算状態はKVへ。
#推論中に更新される情報はFast Weightsへ。
#正確な履歴や出典は外部Memoryへ。
#複数タスクをまたぐ経験は持続LoRAやHarnessの改良履歴へ。
#そして、それぞれの保存・読出し・削除を制御するMemory Policyが存在する。
#これはまだ統合された完成品ではない。
#しかし、AIの記憶が一つの巨大なコンテキストから、異なる寿命と費用を持つ複数の状態へ分かれていく方向を示している。
##
第4章 新しいS候補:Agent同士がテキストを介さず内部状態を共有する
#2026年10月15日には、さらに重要な研究が公開された。
#Augment the Cache, Replace the Activation: A 2x2 Study of Internal-State Sharing
#この研究は、Agent同士の通信方法そのものを変更する可能性を検討している。
#4-1. 従来のAgent通信では計算をやり直している
#通常、Agent Aが調査した内容をAgent Bへ渡す場合、その情報は文章として出力される。
#Agent Bは文章をtokenizeし、自身のTransformerで再び処理する。
#しかしAgent Aは、文章を生成する前に、内部で対象情報の表現を計算している。
#もしこの内部状態をAgent Bが利用できれば、テキスト生成や再Prefillの一部を省略できる可能性がある。
#この研究は、KV CacheとActivationという二つの内部状態を共有する方式を調べた。
#さらに、それぞれについて元の状態へ追加する方式と置換する方式を比較している。
#4-2. KVとActivationでは有効な共有方法が違う
#主な実験はQwen2.5-1.5Bを用いた短い事実転送である。
#KVの共有では、受信側が自分のキャッシュを維持しながら、送信側のKVを追加する方式が有効だった。
#Q/K/V側を適応させた条件で、Shared Fact Accuracyは69.5%に到達した。
#元の情報を直接読める場合の参照値は66.5%だが、この差は統計的に有意な優越を示すものではない。
#一方、KVを直接置換する方式はうまく機能しなかった。
#Activationでは逆の傾向が見られた。
#適切な層に送信側のActivationを挿入して元のActivationを置換すると、条件付き正答率74.2%に達した。
#ただしKVとActivationの評価では問題数や指標が異なるため、69.5%と74.2%をそのまま優劣比較してはいけない。
#また、Activationを挿入する層や位置は実験的に選択されている。
#異なるモデル系列間での転送は大幅に悪化した。
#4-3. なぜ重要なのか
#将来的には、Agentが文章ではなく、内部状態を共有する通信方式が成立する可能性がある。
#例えば複数のエージェントが共通のState Poolへ計算結果を保存し、別のエージェントが必要な状態を読み込むような設計だ。
#LIFTやuTTTがモデル内部の状態共有を研究しているのに対し、こちらはAgentインスタンス間の状態共有を対象としている。
#ただし、現時点でそのような共有Memory Busが実現したわけではない。
#実験は短い事実転送が中心で、異種モデルや長時間の実務タスクに対する汎用性は確認されていない。
#また、内部状態を共有すれば、HBMやネットワークの転送負荷が増える可能性もある。
#今回の評価はA+、長期的なS候補。
#モデル内部の潜在表現がAgent間の通信手段になり得るという方向性は非常に大きいが、適用範囲を決める証拠はまだ初期段階である。
##
第5章 自己改善するAgent Harness:モデルを変えずに能力を高める
#ここまでの研究は主として、モデルの内側や記憶を扱っていた。
#しかし、別の重要な研究潮流が存在する。
#それがHarnessの改善だ。
#Harnessとは、モデルを実際の仕事へ接続する実行プログラムである。
#ツールの使い方、情報の渡し方、再試行、検証、停止判断などが含まれる。
#同じモデルでもHarnessによって仕事の成功率は変わる。
#そして近年、このHarness自体をAIが改良する研究が進んでいる。
#5-1. Harness Learning:改良する能力を学習する
#原論文:Harness Learning Enables Generalizable Test-Time Adaptation
#Harness Learningでは、Proposerモデルを強化学習で訓練する。
#Proposerは、現在のHarnessと実行結果を読み、改善するためのコード変更を提案する。
#変更したHarnessを実行して評価し、その結果から次の改良を学ぶ。
#特徴的なのは、未見のタスクにも改善能力が転移することを目指している点だ。
#研究では21の未見タスク系列で、単一改訂による平均scoreが0.32から0.62へ改善した。
#これは、個別のHarnessを最適化したというだけではない。
#Harnessを改良する操作そのものを学習したという意味を持つ。
#推論時にはProposerとSolverの重みを固定したまま、実行フィードバックによってHarnessを繰り返し変更できる。
#5-2. Causal Improvement Graph:改善の歴史を構造化する
#原論文:Causal Improvement Graph for Agentic Harness Optimization
#CIGは、Harnessの改良試行をEvidence、Hypothesis、Intervention、Outcomeというノードに整理する。
#何が観測されたか。
#原因として何が考えられるか。
#どの変更を試したか。
#実行結果はどう変化したか。
#こうした情報をグラフとして蓄積し、次の改善案を生成するときに利用する。
#研究では、3つのタスクのmacro平均が初期33.0%、Full History方式40.1%、CIG44.6%と報告された。
#また、提案token数を揃えた別の比較でもCIGの優位が報告されている。
#Harness Learningが改訂方策を学習するのに対し、CIGは改訂履歴を外部の構造として保持する。
#両者は競合するだけの技術ではない。
#学習済みのProposerが構造化された改良履歴を参照する方向も考えられる。
#ただし、その統合によって長期的な自律改善が成立することは、まだ実証されていない。
#5-3. ASCENT:成功経験をモデルの重みに定着させる
#ASCENTはHarness LearningやCIGとは異なり、モデルの重み側を改善する。
#タスクの成功軌跡を凍結した初期モデルへ与え、成功した経験を利用した教師分布を生成する。
#その分布を永続LoRAへ蒸留し、次のタスクへ持ち越す。
#ALFWorldのQwen3.5-4Bでは、成功率が46.4%から69.5%へ改善し、平均行動回数も35.1から26.3へ減少した。
#一方、エピソードの経過時間は97秒から115秒へ増えており、学習・検証の総費用に関する留保がある。
#ここで重要なのは、成功率が上昇したことだけではない。
#過去の経験を毎回外部メモリから検索するのではなく、行動方策そのものへ定着させる経路を示した点だ。
#ただし、誤った成功判定を取り込むと、誤った方策が持続する危険もある。
#5-4. Schema:AIが環境の法則をプログラムとして発見する
#原論文:Schema: Discovering Unknown Environments via Agentic Program Induction
#Schemaはさらに異なる方向を扱う。
#未知の環境でエージェントが試行錯誤するとき、発見した規則を単なる文章ではなく、実行可能なプログラムとして表現する。
#そのプログラムを観測履歴に照らして検証し、仮想的に計画を試し、実環境で段階的に実行する。
#ARC-AGI-3では、同じ基盤モデルの比較でRHAEが58.7%から99.2%へ改善した。
#これは環境の状態をただ記憶するのではなく、環境がどのように動くかという規則を推定する研究だ。
#現実のブラウザ、OS、ロボットなどへの応用可能性はあるが、現在の実験から広い実環境での汎用性まで確定したわけではない。
#5-5. Thinking Before Thinking:考える前に、何を考えるか決める
#この研究は、実際に問題を解くWorkerと、探索方針を決めるControllerを分離する。
#長いタスクでは、次に何を試すか、どの過去成果を使うか、どこで停止するかという判断が必要になる。
#Controllerは残り予算やこれまでの成果を考慮し、Workerへ仕事を割り振る。
#ProgramBenchのGPT-5.5条件では、Direct Controlの63.7%に対してMeta-Reasoningが71.5%を報告した。
#ただし比較は主としてモデル呼出し予算に基づいており、token数や経過時間まで完全に一致するわけではない。
#この研究の重要性は、計算を増やすだけでなく、どの計算を実行するか判断する制御機構が能力を左右することを示した点にある。
##
第6章 SpecAgent:大型モデルはすべての行動を生成する必要があるのか
#ここからは、10月15日に公開された追加研究の中心へ進む。
#原論文:Trajectory-Level Speculation with Semantic Verification for Tool-Using Agents
#SpecAgentは、大型モデルの役割を変える研究だ。
#一般的なエージェントでは、大型モデルが次の操作を生成し、ツールを実行し、その結果を読んで再び次の操作を生成する。
#このため、長いタスクでは大型モデルによるDecodeが何度も必要になる。
#SpecAgentはここを変更する。
#6-1. 小型モデルが先に実行し、大型モデルがまとめて検証する
#SpecAgentでは、小型モデルが複数stepの行動を生成する。
#状態を変更しないRead-only操作については、実際にツールを実行して観測結果を取得する。
#その後、大型モデルがその軌跡を一括して読み込み、意味的に妥当な最長のprefixを採用する。
#もし途中に問題があれば、その地点から修正する。
#重要なのは、大型モデルが小型モデルと同じ操作を生成する必要がないことだ。
#小型モデルの行動が正しいかを評価し、必要な部分だけ修復すればよい。
#この仕組みでは、大型モデルの逐次Decodeを減らし、複数stepを一度に読むPrefill中心の検証へ仕事を移している。
#6-2. 実験結果:時間が減ってもFLOPsは増える
#著者はQwen3.5-4Bを小型モデル、Qwen3.5-397B-A17Bを大型モデルとして評価した。
#τ²-Bench Airlineでは、大型モデルのみの場合と同じ86.0%の成功率を維持した。
#一方、平均wall-clockは305.2秒から126.2秒へ短縮した。
#約2.42倍の高速化である。
#推定HBM読出し量も、333〜342TBから148〜150TBへ減少した。
#ところが、推定FLOPsは0.78PFLOPから1.01PFLOPへ増えている。
#これは非常に重要な結果だ。
#SpecAgentは計算量そのものを減らしたのではない。
#大型モデルによる逐次Decodeを減らす一方で、小型モデルの生成と大型モデルのPrefillによる検証を増やしている。
#つまり、メモリ帯域に制約される計算を、より並列性を利用しやすい計算へ移したのである。
#したがって、すべてのGPU環境で同じ効果が得られるわけではない。
#実際、AutomationBenchでは大型モデルのみの15.2%に対し、SpecAgentは10.5%だった。
#VitaBenchでも48.0%に対して44.5%であり、成功率を完全には維持できていない。
#クラウドAPIとローカル小型モデルを組み合わせた実験でも、wall-clockの改善は一貫していなかった。
#6-3. Read-onlyとState-changingの境界が重要になる
#SpecAgentで最も実用的に重要なのは、操作を二種類に分けている点かもしれない。
#状態を変更しない操作は、先行実行できる。
#一方、ファイル変更、送信、注文、データベース更新など、状態を変更する操作は、大型モデルの検証まで保留する。
#これはエージェントの権限制御と直接接続する。
#今後のHarnessでは、どの操作がRead-onlyで、どの操作に副作用があるかを、モデルの文章判断だけに依存せず実行基盤側でも判定する必要がある。
#また、現実のシステムでは一見Read-onlyに見える操作でも、ログ更新や外部API利用などの副作用を持つ場合がある。
#そのため、ツールの分類と権限境界が正しく設計されていることが前提になる。
#SpecAgentの評価はA+。ただし、計算の役割分担を変えるという意味では長期的なS候補である。
##
第7章 Probe-and-Resume:エージェントは途中を採点するより、完了状態を検証すべきなのか
#原論文:Probe-and-Resume: When and How to Evaluate Agent Execution
#この研究は、Agent Criticの使い方を見直す。
#一般的には、途中で複数の候補を生成し、Criticが有望なものを選べば成功率が上がると考えられる。
#しかし実際のTerminal Agentでは、途中状態から最終的な成功を判断することが難しい。
#エージェントがコードを正しく修正したように見えても、最後のテストで失敗する場合がある。
#また、会話履歴だけでは、ファイルシステムや依存関係、環境の隠れた状態を完全に把握できない。
#7-1. Criticへ実環境の複製を渡す
#Probe-and-Resumeでは、エージェントが完了を宣言した段階で環境を複製する。
#Criticはその複製環境で、ファイル確認、コマンド実行、テストなどを行う。
#成功していれば結果を受け入れる。
#失敗していれば、その内容を元のエージェントへ返し、元の作業状態から修正を続けさせる。
#Criticの操作は複製環境へ隔離されるため、検証の副作用が元の環境へ直接反映されない設計になっている。
#これは単なるLLM-as-a-Judgeではない。
#環境へアクセスし、実際の状態を検証するCriticである。
#7-2. Terminal-Bench 2.1の実験結果
#研究では89タスクを各5回評価した。
#基準AgentのPass@1は63.4%。
#Probe-and-Resumeでは72.4%に改善した。
#さらに重要なのは、拒否されたタスクを最初から実行し直す方式との比較だ。
#費用は論文の料金条件で、89タスクそれぞれを1試行する場合の合計に相当する。1タスク当たりの費用ではない。
#Probe-and-Resumeは基準Agentより費用が増える一方、最初から再実行する方式より成功率と費用の両方で有利だった。
#平均時間も、再実行の9.3分に対して、状態を保持して再開する方式は7.8分だった。
#これは、単純なRetryとResumeが異なることを示す。
#過去の作業を保持できれば、正しく完了した部分をやり直さず、失敗した箇所だけを修正できる。
#7-3. Persistent Agentに必要な新しい構造
#この研究をCIGやHarness Learningと接続すると、長期的なAgent OSに必要な要素が見えてくる。
#実行履歴の保存。
#環境のSnapshot。
#副作用を隔離した検証。
#失敗理由の記録。
#局所的な修復。
#正しい状態からの再開。
#さらに、改善結果を将来のHarnessへ反映する仕組みだ。
#従来は運用上の補助機能として扱われがちだったCheckpointやResumeが、実際の仕事の成功率に影響する主要コンポーネントになり得る。
#ただしCriticを追加すれば必ず改善するわけではない。
#判定器の誤り、Snapshotの費用、追加モデルの推論費用、時間制限なども含めて評価する必要がある。
##
第8章 GPUよりKVキャッシュが遅い:AIインフラの前提を見直す研究
#今回の追加調査で、AIインフラへの直接的な影響が最も大きいと考えられるのが、次の研究だ。
#When the KV Cache Is Slower Than the GPU: Scaling Remote KV Tiers for Context-Parallel Prefill
#これは、AIのメモリ階層を考えるうえで非常に重要な問いを提示している。
#一度計算したKVを読み戻すことは、本当にGPUで再計算するより安いのだろうか。
#8-1. KVを保存すれば得になるとは限らない
#長いコンテキストでは、過去のKVキャッシュを再利用することでPrefillを省略できる。
#GPUのHBMに収まりきらない状態は、CPU DRAMや外部ストレージ、リモートKV Tierなどへ退避することができる。
#しかし、GPUのPrefillが十分に高速であれば、保存したKVを読み戻す処理のほうが遅くなる場合がある。
#著者はGLM-5.3、8基のB300、LMCacheとValkeyを組み合わせた環境で、この問題を測定した。
#16K tokenの条件では、リモートKVを有効にするとTTFTのp99が3.96秒から17.3秒へ悪化した。
#別の測定では、GPUによる再計算が0.31秒だったのに対し、リモートKV取得には0.88秒かかった。
#キャッシュヒットが発生しているにもかかわらず、再計算より遅いのである。
#さらに問題のある同期ロード経路では、p99が83.32秒に達し、GPU busy率が7%まで低下していた。
#GPU自体は高速なのに、データの到着を待っていた。
#8-2. 必要なのは、転送か再計算かの損益分岐点
#論文では、KVを読み戻すべきかどうかを、再計算速度とデータ転送速度の関係から説明する。
#単純化すると、KVの読出し時間は次のように考えられる。
#ここでT0は固定処理費用、Sは転送するデータ量、Bは実効転送帯域である。
#一方、GPUで再計算する時間は、token数nとPrefill速度Rによって、
#と近似できる。
#KVの保存量がtoken当たりsであれば、転送帯域の必要条件として、
#が得られる。
#ただし固定処理費用T0があるため、BがB*を超えるだけで必ず読み出しが有利になるわけではない。
#今回の構成では、必要帯域の目安が2.53GB/s、固定処理費用が約0.33秒と推定された。
#このモデルでは、約17K tokenより短い入力は、転送帯域を大幅に改善しても再計算のほうが速いという予測になる。
#ただし17Kという境界値は、限定された実験点から推定したものであり、広い文脈長を使って直接検証した結果ではない。
#8-3. 実装を改善すると何が変わるのか
#研究では、KVをContext Parallel rankごとに分割し、リモートストアをrank単位で分散配置した。
#さらに非同期ロードやクライアントの不具合修正を組み合わせた。
#その結果、GET帯域は約1.7GB/sから10.76GB/sへ改善した。
#問題のあった高ヒット率のリクエスト群では、p99が83.32秒から0.67秒へ低下した。
#ただし、この大きな改善には不具合修正の効果も含まれる。
#「リモートKVがGPU再計算より百倍以上効率的になった」という意味ではない。
#改善後でも中央値では再計算のほうが速い条件があり、一方でp99ではリモートKVのほうが有利になる条件があった。
#つまり、どちらが得になるかは平均時間とTail Latencyでも変わる。
#8-4. RangeやKV-streamsと合わせると見えること
#この研究は、Rangeと一見矛盾しているように見えるかもしれない。
#RangeはKVの復帰処理を効率化し、Remote KV TiersはKVの読み出しが再計算より遅い場合を示している。
#しかし実験環境も対象負荷も異なる。
#Rangeは特定のH100とNVMe構成で、KVの論理単位と物理I/O単位を分離することによる改善を測定した。
#Remote KV Tiersは高速なB300クラスタで、リモートKVの転送・同期・固定費用を含めた損益を測定した。
#両者から得られる結論は、KVを保存すること自体が良いか悪いかではない。
#保存したKVをいつ読み出し、いつGPUで再計算したほうがよいかを、実際の費用で判断する必要があるということだ。
#これはHBM、DRAM、CXL、SSD、ネットワーク、さらにはGPUのPrefill性能まで含めた設計問題になる。
#GPUが高速化するほど、保存状態の読み出しが相対的に不利になる場合も考えられる。
#AIインフラの価値は、単純な保存容量だけでなく、必要な状態を適切な時間内に取り出せるかどうかにも左右される。
##
第9章 強化学習の構造変化:Rolloutを使い捨てにしない
#ここまでの研究は、推論とAgent実行の効率を中心に扱ってきた。
#しかし自己改善型のエージェントを実現するには、学習側の計算費用も重要になる。
#その代表例がReFlowとRollVerifyだ。
#9-1. ReFlow:経験を再利用し、GPUの配分を変える
#原論文:ReFlow: Replay-Driven Decoupling for Efficient RL Post-Training
#大規模な強化学習では、モデルがRolloutを生成し、Rewardを計算し、Trainerがその結果を使って更新する。
#しかしRollout生成とTrainingの速度は一致しない。
#TrainerがRolloutの到着を待つ場合もあれば、Rollout Workerが新しいPolicyの到着を待つ場合もある。
#ReFlowは、この非効率を三つの仕組みで改善する。
#過去の経験を条件付きで再利用するDual Replay Data Cycle。
#Rollout WorkerとTrainerへGPUを動的に割り当てるElastic Resource Pool。
#学習状況と生成速度に応じて配分を変更するAdaptive Schedulerだ。
#単なる非同期化ではなく、経験再利用、資源配分、古いPolicyによる経験の扱いを同時に管理する。
#9-2. 著者が報告した改善
#Qwen3-8BのReasoning RLでは、比較システムに対して1.56〜2.06倍のTraining Throughputが報告された。
#14Bでは1.32〜1.63倍、32Bでは1.19〜1.57倍だった。
#またQwen3-8B、32GPUの条件では、Trainerの待機率が55.8%から15.5%へ低下した。
#これは、同じGPU数からより多くの学習処理を取り出せる可能性を示す。
#ただし、Training Throughputが2倍になったことと、最終モデルの推論能力が2倍になったことは全く異なる。
#重要なのは、同じ品質へ到達するまでに必要なGPU時間と、追加の管理・再試行費用である。
#9-3. RollVerify:古くなった経験を検証して使う
#非同期RLでは、現在のPolicyとは異なる古いPolicyが生成した軌跡を学習へ使う問題が発生する。
#RollVerifyは、軌跡の途中やtoken単位でPolicyとのずれを検証し、必要に応じて軌跡を切り詰め、On-policyに近い形へ復帰させる。
#Qwen3-8Bの数学評価では、GRPO平均57.3に対してRollVerifyは57.2だった。
#一方、著者報告の学習計算量は98.1GPU日から57.5GPU日へ減少した。
#約41.4%の削減である。
#ただし評価、Checkpoint、探索、失敗した実験を含む全費用での比較には留保がある。
#9-4. LoGRA:学習メモリの壁を外す
#LoGRAは低ランクのGradient Sketchを使い、学習時のメモリ使用量を減らす。
#7Bモデルの実験では、平均学習メモリが31.82GiBから17.29GiBへ減少した。
#約45.7%の削減である。
#一方、学習更新速度は25.28回/時から25.73回/時と、大きくは変わっていない。
#したがってLoGRAの価値は、単純な学習高速化だけではない。
#従来はメモリ不足で実行できなかった学習を可能にする点にもある。
#ReFlow、RollVerify、LoGRAはそれぞれ異なる制約を扱っている。
#ReFlowはRolloutとTrainerの資源配分。
#RollVerifyは非同期化した経験の正しさ。
#LoGRAは勾配と更新状態のメモリ負荷。
#これらを接続する研究は重要だが、個別の改善倍率をそのまま掛け合わせることはできない。
##
第10章 Judgeも改善する:LatentGRMとVeriFine
#自己改善型AIの研究で、次に重要になるのは評価だ。
#モデルが成功経験を学習する場合、成功判定が間違っていれば、改善が逆方向へ進む可能性がある。
#つまり、正しい学習を行うには、正しい評価が必要になる。
#しかし評価そのものにも計算費用がかかる。
#10-1. LatentGRM:長い評価過程を圧縮する
#Generative Reward Modelは、回答を評価するために長い自然言語の推論を生成する場合がある。
#LatentGRMは、評価の途中過程を短い連続潜在表現へ圧縮する。
#Qwen3-8Bでは、明示的なRubric-RMとの比較で、8領域平均のvote@5が68.1%から69.0%へ改善した。
#4領域の判定時間では6.11〜6.95倍の速度比が報告されている。
#ただし生成位置の数を両方式で50に揃えると、速度比は1.017倍になる。
#主な効果は個々の計算を高速化したことではなく、評価に必要な生成ステップ数を減らしたことにある。
#また、説明文を後から復元する費用は別に考える必要がある。
#10-2. VeriFine:PolicyだけでなくJudgeを更新する
#VeriFineはPhysical AIの改善ループを扱う研究だ。
#エージェントやロボットのPolicyが改善されると、初期の評価基準では難しい失敗を捉えきれなくなる可能性がある。
#VeriFineでは失敗に応じてCurriculumとJudgeを改良し、必要に応じて人間が評価基準を校正する。
#運転推論の研究では、固定評価器によるscoreが60.56から71.61へ改善し、ADEは2.139mから2.117mへ変化した。
#ただし、これは記録された場面での推論・軌跡評価であり、実道路での事故率改善ではない。
#また、各学習ラウンドでPolicyを同じ初期モデルから学び直しており、ASCENTのような永続的な同一重みへの継続学習とは異なる。
#10-3. 自己蒸留は本当に得なのか
#10月14日に公開されたMore Methods, Better Agents?は、ここまでの自己改善研究を評価するうえで重要な基準を提示した。
#11手法、4環境、3モデル規模で132回のTraining Runを比較した研究である。
#この研究では、ある手法が同じ学習step数で高いscoreを示しても、同じ経過時間へ揃えると優位を失う場合があった。
#追加の教師計算や蒸留処理に時間がかかるためだ。
#これはASCENTやCIGを直接否定するものではない。
#しかし、自己改善の評価には、最良checkpointや最終scoreだけでなく、教師、学習、Rollout、評価、Checkpoint、再試行まで含む総費用が必要だと示している。
#今後の自己改善型AIでは、何回改善したかではなく、同じ全予算でどれだけ信頼できる改善を実現したかが重要になる。
##
第11章 Physical AIと安全性:改善するAIを現実世界へ接続する
#Physical AIでも、同様の構造変化が始まっている。
#例えばMulliganは、ロボットが失敗した初期状態や、これまで試していない状態へデータ収集を振り向ける研究だ。
#3つの実機課題、2,550回の盲検評価で、比較対象より最終成功率が10〜34ポイント高い結果を報告した。
#またActiveWAMは、ロボットの手や腕だけでなく、カメラの視点制御を同時に扱う。
#ここでも重要なのは、単に大量のデータを収集することではない。
#どこで失敗し、どの観測が不足し、次に何を試すべきかを判断する仕組みである。
#ただし、研究室での成功率と現場での商用採算は異なる。
#実際の稼働率、停止時間、介入回数、保守、環境の再設定、安全上の制約を含める必要がある。
#同じことは一般的なAIエージェントにも当てはまる。
#SpecAgentで状態変更操作を保留しても、ツール分類が間違っていれば危険な操作を実行してしまうかもしれない。
#Probe-and-Resumeで環境を複製しても、複製できない外部システムや秘密情報が存在する場合は、同じ検証方法を使えない。
#ASCENTで成功経験を学習しても、Verifierが間違っていれば誤った方策が蓄積する。
#CIGやHarness Learningで実行手順を自動変更するなら、その変更が権限や安全境界を越えていないか確認する必要がある。
#したがって、今後の構造では、モデルの判断だけに安全性を任せるのではなく、Sandbox、権限制御、監査、外部検証、変更管理を別の層として持つことが重要になる。
#モデルを改善するシステムと、その改善を安全に受け入れるシステムは、同時に発展する必要がある。
##
第12章 全研究を接続すると、どんなAIシステムになるのか
#ここまでの研究を統合すると、将来的なAgent Runtimeについて次のような構成が考えられる。
#ただし、これは複数研究を接続した分析上の設計仮説であって、すでに実装された完成品ではない。
#まずControllerがタスクを受け取り、必要な情報と計算予算を判断する。
#Memory Managerは、外部記憶、KV、内部状態、過去の実行結果から必要な情報を選ぶ。
#小型モデルが操作のDraftを作り、Read-onlyな部分を先行実行する。
#大型モデルは、その軌跡をまとめて検証し、状態変更が必要な地点で承認または修正を行う。
#実行環境はSnapshotを保持し、タスクが完了したと宣言された段階で、別のCriticが実環境の複製を検証する。
#もし失敗していれば、元の状態から局所的に修正する。
#成功した経験は、必要に応じて外部記憶や持続LoRAへ保存する。
#Harnessの変更履歴はCIGのような構造で保持し、将来の改良へ再利用する。
#さらにJudgeと学習課題も、独立テストを維持しながら再校正する。
#こうして、モデル、記憶、実行環境、検証、学習が別々の役割を受け持つ。
#これは従来の「一つのモデルがすべてのstepを考えて出力する」構造とは異なる。
#そして重要なのは、各工程が異なる資源を必要とすることだ。
#大規模モデルのDecode。
#小型モデルのDraft生成。
#GPUのPrefill。
#KVの転送と保存。
#SandboxやVMの起動。
#ツール実行。
#Judgeによる検証。
#LoRA更新。
#CheckpointとResume。
#AIの計算需要を考える場合、これらすべてが対象になる。
##
第13章 AIインフラの本当の変化は、計算量だけでは測れない
#ここまでの研究をAIインフラへ接続すると、重要な事実が見えてくる。
#局所的な高速化と、システム全体の費用削減は異なる。
#SpecAgentはwall-clockと推定HBM読出し量を減らしたが、推定FLOPsは増えた。
#RangeはKV復帰を高速化したが、別のGPU・別の負荷ではリモートKVを読み戻すより再計算が有利になる場合がある。
#LoGRAは学習メモリを削減したが、学習更新速度の改善は限定的だった。
#LatentGRMはJudgeを高速化したが、説明を復元する工程は別に残る。
#Probe-and-Resumeは成功率を改善したが、基準Agentよりモデル費用が増加した。
#このように、技術は計算費用を消すこともあれば、別の工程へ移動させることもある。
#13-1. 成功した仕事を基準に測る
#ここで必要になるのが、NOIAで継続して重視している評価単位だ。
#同じ品質・安全性・応答時間の条件を満たした仕事1件を完了するために、どれだけの資源が必要だったか。
#具体的には、同じ期間に使ったGPU時間を成功仕事数で割れば、GPU時間/成功仕事を求められる。
#同様にCPU時間、電力量、ストレージの読み書き量、ネットワーク転送量、人間の確認時間も別々に計測できる。
#これらは単位が異なるため、何の換算もせずに単純加算してはいけない。
#金銭的な総費用を求める場合には、それぞれの資源使用量に適切な単価を適用し、重複を避けて配賦する必要がある。
#そして市場全体の総需要は、成功仕事の件数と、成功仕事当たりの資源消費の両方で変わる。
#仮に1件当たりのGPU時間が半分になったとしても、利用件数が3倍になれば総GPU時間は増える。
#逆に利用が増えなければ、総GPU時間は減る。
#したがって局所的な研究成果から、業界全体のGPU・HBM・SSD需要の増減を直接予測することはできない。
#13-2. 新しい制約はどこへ移動するのか
#今回の研究からは、いくつかの制約移動が考えられる。
#KVをHBMの外へ保存できるようになれば、次は読出し帯域や固定処理費用が重要になる。
#大型モデルのDecodeを減らせば、小型モデルのDraft速度やVerifierの能力が重要になる。
#Rollout生成を効率化すれば、Trainer、Judge、環境実行、Policy同期が新しい制約になり得る。
#Harnessの改良を自動化すれば、変更の安全性やテスト環境の品質が重要になる。
#自己改善を加速すれば、評価基準の正しさが重要になる。
#こうした制約は、必ず一方向へ移動するわけではない。
#用途や負荷によって、複数の制約が並存する。
#今後のAIインフラでは、GPU性能だけではなく、メモリ階層、ストレージ、ネットワーク、CPU、Sandbox、Scheduler、監査の設計が、実効能力を左右する可能性がある。
##
第14章 今後6〜36か月で何を監視すべきか
#ここまでの研究を評価するうえで、最も重要なのは今後の検証だ。
#研究の発表そのものではなく、どの条件で仮説が強まり、どの条件で弱まるのかを明確にしておく必要がある。
#私は、特に次の三つの方向を優先的に監視するべきだと考える。
#第一に、モデルの内部状態が、長期的な記憶やAgent間の通信へ利用されるかどうか。
#第二に、Agent Harnessの改良、実環境での検証、失敗後のResumeが、一つの信頼できる実行基盤へ統合されるかどうか。
#第三に、GPU計算とメモリ転送のどちらを選ぶべきかを、実際の仕事や応答条件によって動的に判断できるようになるかどうか。
#この三つは、それぞれモデルアーキテクチャ、Agentの実用性、AIインフラの経済性を変える可能性がある。
##
結論 AIの計算単位はTokenから「再利用可能な状態と検証可能な仕事」へ広がっている
#今回の研究を振り返ると、一つの共通した方向性が見えてくる。
#これまでAIは、大量の計算によって高い能力を獲得してきた。
#しかし、実際の仕事へその能力を使うとき、同じ情報を何度も処理し直し、同じ手順を何度も生成し、途中状態を何度も確認し、失敗した仕事を最初からやり直す場合があった。
#そうした工程のどこを省略し、どこへ計算を集中させるべきか。
#今回の研究群は、この問いに異なる角度から取り組んでいる。
#LIFTとuTTTは、モデル内部の状態を再利用する。
#Looped MoEは、パラメータと計算深度の関係を見直す。
#KV-streamsとAiO-Memは、記憶をどう保持し利用するかを変える。
#ASCENTは成功経験を重みへ定着させる。
#Harness LearningとCIGは、実行方法そのものを改良する。
#Schemaは環境規則を実行可能なモデルとして保持する。
#SpecAgentは、大型モデルをすべての行動の生成者から、まとめて検証する役割へ移す。
#Probe-and-Resumeは、完了時の実環境検証と失敗後の再開を重視する。
#Remote KV Tiersは、保存した情報を読み戻すことが常に得とは限らないと示す。
#ReFlowとRollVerifyは、強化学習の経験とGPU計算をより効率的に利用する。
#LatentGRMとVeriFineは、評価そのものを改善対象へ変える。
#これらの研究が直ちに一つのAIシステムへ統合されるという証拠はない。
#さらに、独立再現、大規模化、長期運用、商用採算という重要な条件も残っている。
#しかし、研究が向かっている方向は非常に興味深い。
#AIの能力は、単一のモデルがどれほど賢いかだけではなく、そのモデルが何を記憶し、何を再利用し、どの操作を選び、どう検証し、どの経験から改善できるかによって決まるようになりつつある。
#そして、それを実現するための計算資源の使い方も変わる可能性がある。
#今後のAIインフラ市場を考える際も、単にGPUの台数やToken Throughputを見るだけでは不十分になる。
#重要なのは、どれだけ多くの仕事が、正しい結果として完了したか。
#そのために必要だった全計算、メモリ、転送、検証、再試行、そして人間の関与がどれだけだったか。
#この問いへ答えられるシステムこそが、次のAIの競争力を決めるのかもしれない。
#2026年秋の研究が示しているのは、すでに自己改善する完全自律AIが完成したという事実ではない。
#むしろ、そこへ到達するために必要な、記憶、実行、検証、学習、計算基盤の各部品が、それぞれ具体的な研究対象になってきたということだ。
#その意味で、私たちは今、モデルそのもののスケーリングに加えて、AIシステム全体のスケーリングが本格的な研究領域へ広がる過程を観測している。
#そして、この構造変化はまだ始まったばかりなのだと思う。
##
調査資料と検証範囲
#本稿は、ChatGPT Dotsとschedulerを元に行っているNOIA AI研究フロンティア監視の2026年9月下旬〜10月18日までの観測記録を基に構成した。
#NOIA Research Frontier|2026年10月18日
#