銅から光へ――NVIDIA・Marvell・Broadcomが争うAIデータセンター接続のロードマップ
この資料の日時
元資料の日付と、その本文が公に存在した確認日時は別の記録です。
本文に含まれる語句 HBM DRAM 先端パッケージング 光接続 電力・給電 顧客認定 歩留まり 基板・材料 チップレット AI推論
出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.09.23.4
- 記事内容のSHA-256
3f4ca077ae904024227c96f6997570bf165b689f288ebc761f7df32c03c9db4e- 保存版のSHA-256
44ae699f6960e6c1106805098edbc060cee3301c4176e418f09685edfca8fa15
外部証明の最終検査結果は詳細を開くと表示します。
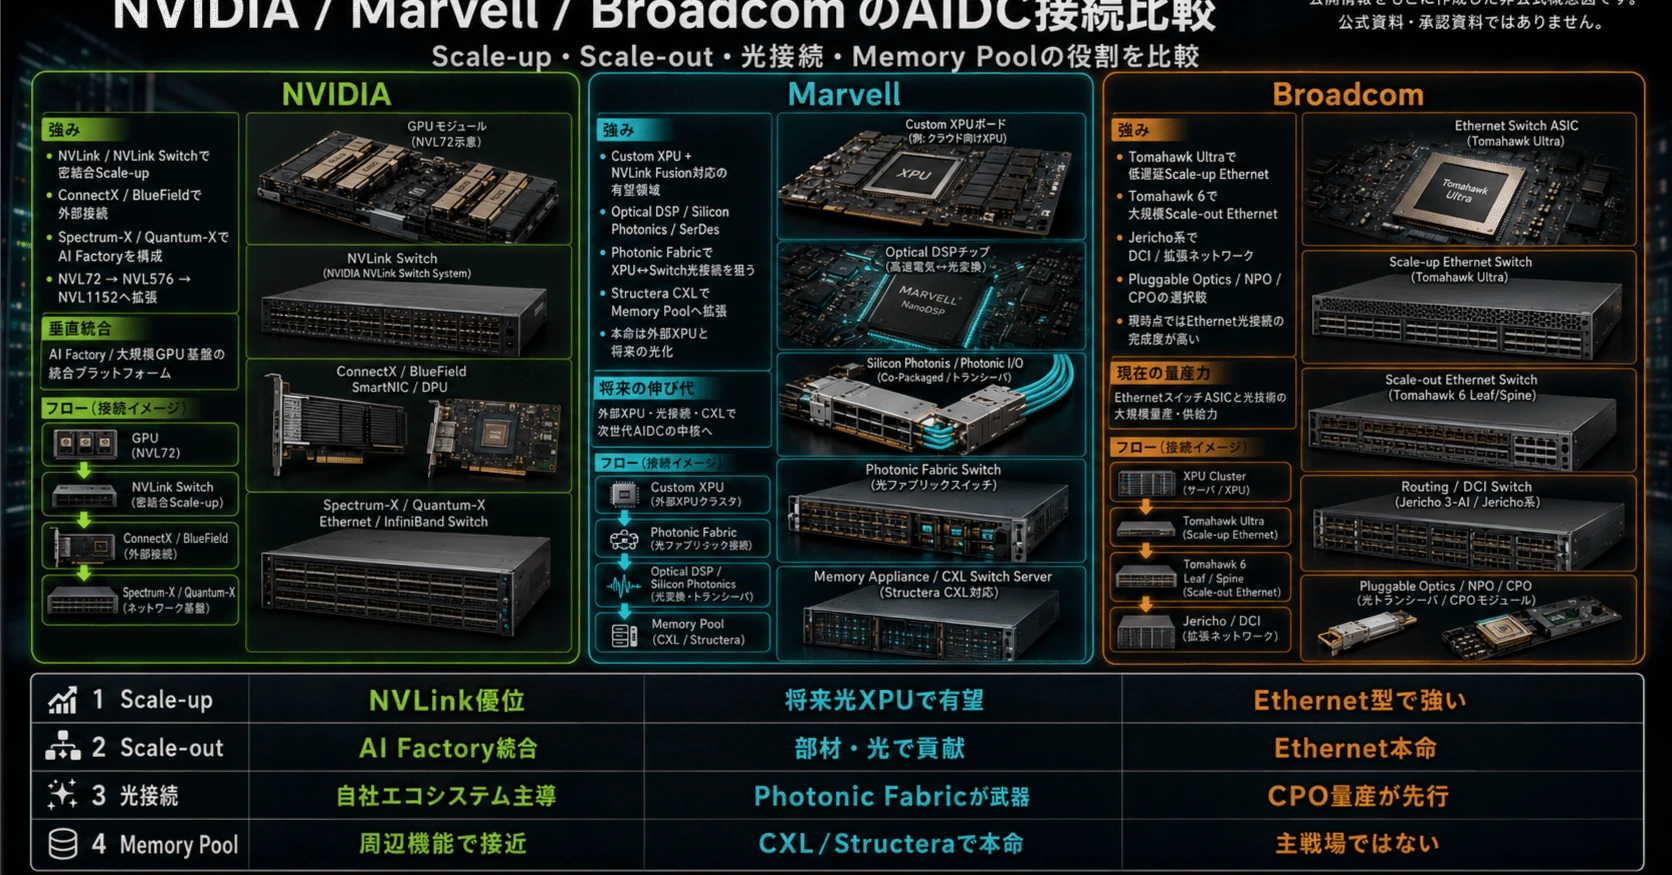
銅から光へ――NVIDIA・Marvell・Broadcomが争うAIデータセンター接続のロードマップ
#1.AIDCの接続構造を理解する
#AIデータセンターでは、すべての通信が同じネットワークを通るわけではありません。大きく分けると、次の階層があります。
#XPUパッケージ内
└─ GPUダイ、I/Oチップレット、HBM
サーバー/ラック内
└─ GPU、CPU、PCIeスイッチ、NVLink Switch
Scale-up
└─ 多数のXPUを1つの巨大な計算ドメインとして接続
Scale-out
└─ 複数のScale-upドメインやPodをEthernet/InfiniBandで接続
Scale-across/DCI
└─ 建物・キャンパス・データセンター間を接続
Memory Pool
└─ 複数のCPU/XPUから共有できる外部DRAM・KVキャッシュ階層Scale-up
#Scale-upは、GPUやXPUを単なるネットワーク上の別コンピューターではなく、一つの大きなアクセラレーターに近い状態で動かす接続です。
#NVIDIAではNVLink/NVLink Switch、NVIDIA外のカスタムASIC陣営ではUALink、Scale-Up Ethernet、独自リンクなどが該当します。
#重要なのは、Scale-upという用途と、銅・光という物理層は別概念であることです。
#NVLink・UALink・Scale-Up Ethernet
=通信規格・プロトコル・ファブリック
銅・CPO・Photonic Fabric
=信号を運ぶ物理実装したがって、NVLinkも当初は銅で、将来は一部区間を光に載せられます。
#Scale-out
#Scale-outは、NVL72、NVL576、TPU Pod、カスタムASICクラスタなどの計算ドメイン同士を接続する外部ネットワークです。
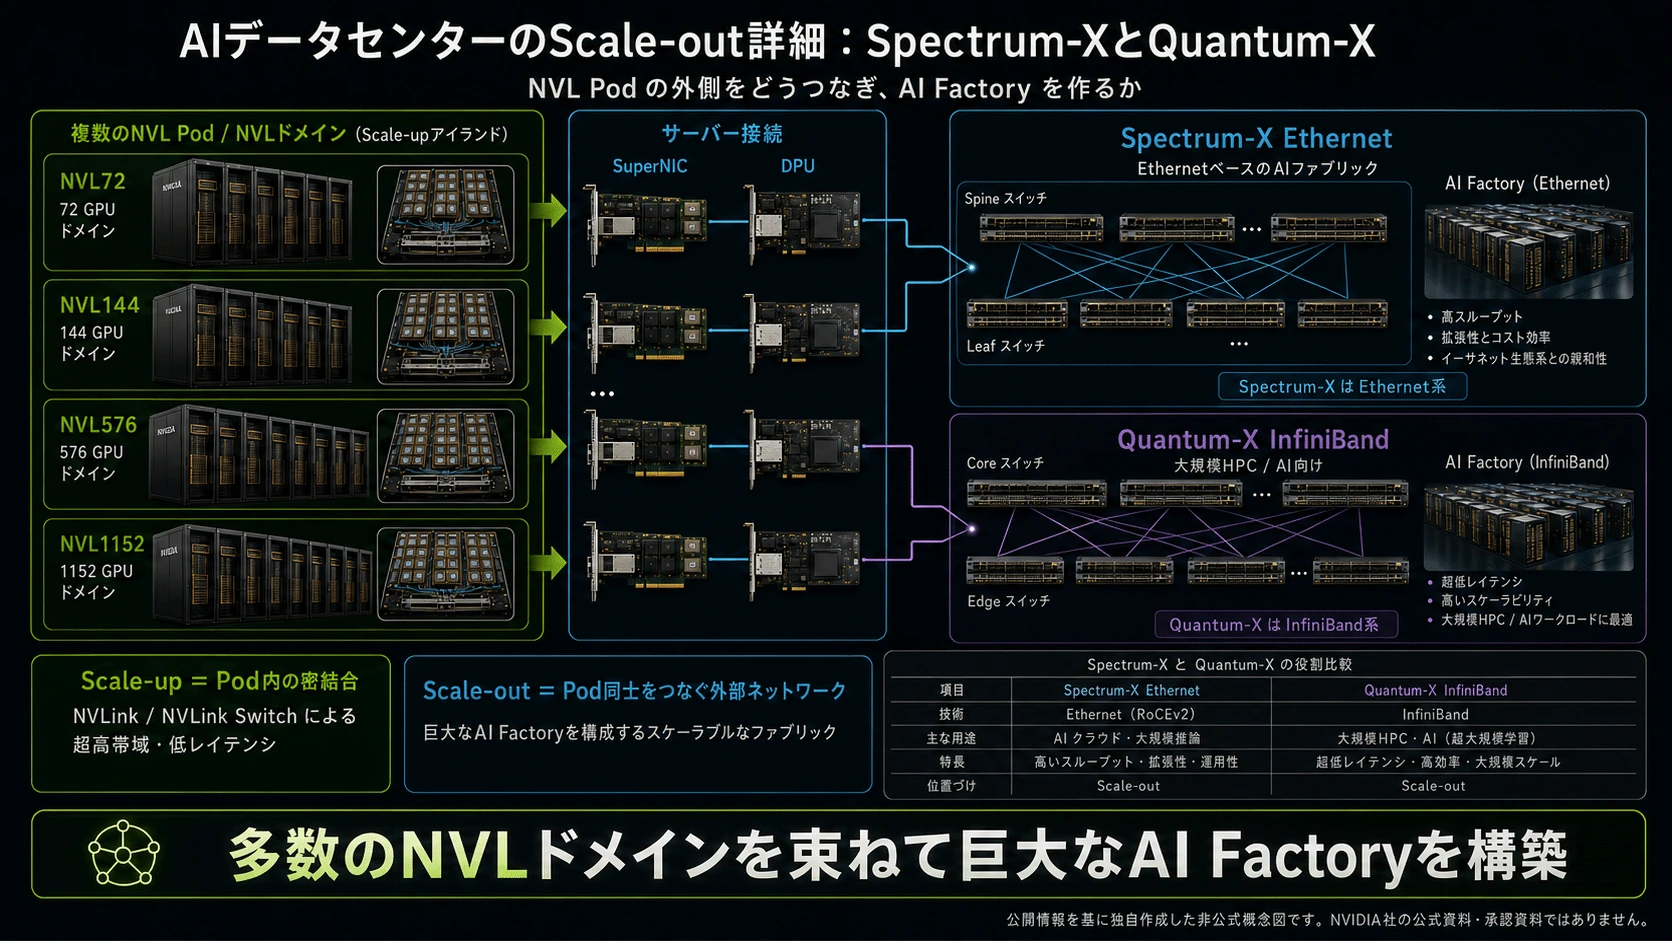
#NVIDIAではConnectX/BlueFieldを介してSpectrum-X EthernetまたはQuantum-X InfiniBandへ接続します。Vera Rubin PODでは、Spectrum-6 SPXラックをSpectrum-XまたはQuantum-X800で構成し、各ラックやPodを束ねる設計が示されています。(NVIDIA Developer)
#Memory Pool
#Memory Poolは、XPUの隣にあるHBMを置き換えるものではありません。
#ローカルHBM
=最高帯域・最低遅延の主記憶
CXL/光接続Memory Pool
=大容量DRAM、KVキャッシュ、共有メモリ、補助階層HBMは演算直結、Memory Poolは容量・共有性・利用効率を補う役割です。
##
2.光化はどこから進むのか
#光化の順番は、おおむね次のようになります。
#すでに光化済み
Scale-out、Leaf–Spine、DCI
2026~2028年
Switch近傍CPO
2027~2029年
ラック間Scale-up光
XPU-to-Switch光
2028~2030年
XPU近傍光I/O
2029~2031年以降
ラックをまたぐ光Memory Pool最短距離の接続ほど、銅は低コスト、低遅延、保守しやすいという利点があります。したがって、2030年になっても「全部が光」になる可能性は低く、パッケージ内・ラック内の短距離は銅、ラック間以上は光という混在構造が基本になると考えられます。Marvell自身も、ラック内では銅、ラックを越えるScale-upでは光が重要になるという整理を示しています。(Marvell Technology)
#場所別ロードマップ
#| 領域 | 2026年 | 2027年 | 2028年 | 2029年 | 2030年前後 |
| パッケージ・ラック内 | NVL72は銅中心 | Kyber向け銅ミッドプレーン量産が焦点 | Kyber初期量産の可能性 | 一部XPU近傍光 | 銅と光I/Oが併存 |
| Scale-upラック間| 試作・評価 | NVL576評価、PF初期売上目標 | NVL576低数量、XPU-to-Switch光 | CPO Scale-up拡大 | 1,000 XPU級光Scale-upが現実化 |
| Scale-out | プラガブル光+CPO量産開始 | CPO普及 | 200G/lane本格化 | 400G/lane移行準備 | CPOが大規模AIクラスタで一般化 |
| Memory Pool | CXL銅接続の製品化 | CXL共有DRAM導入 | ラック内プール拡大 | 光Memory Pool実証 | マルチラック光プール初期普及 |この表の後半は推定です。特にNVL576、NVL1152、XPU近傍光、光Memory Poolには大きな時期変動リスクがあります。
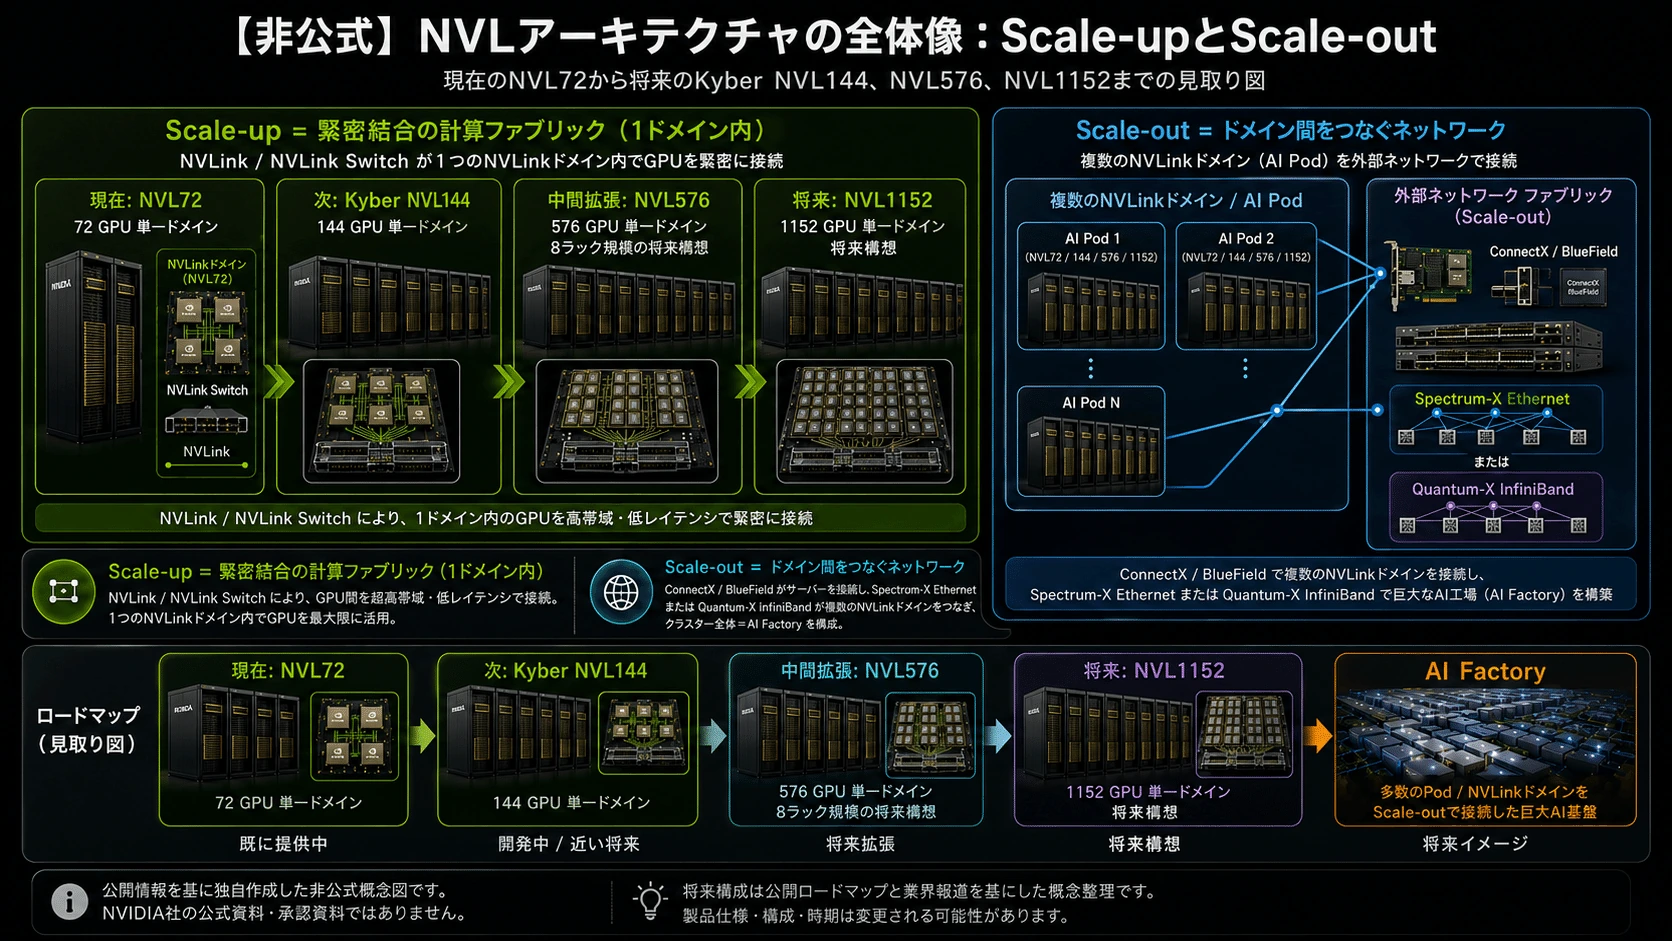
#
#
3.NVIDIAの現在――GB200/GB300 NVL72
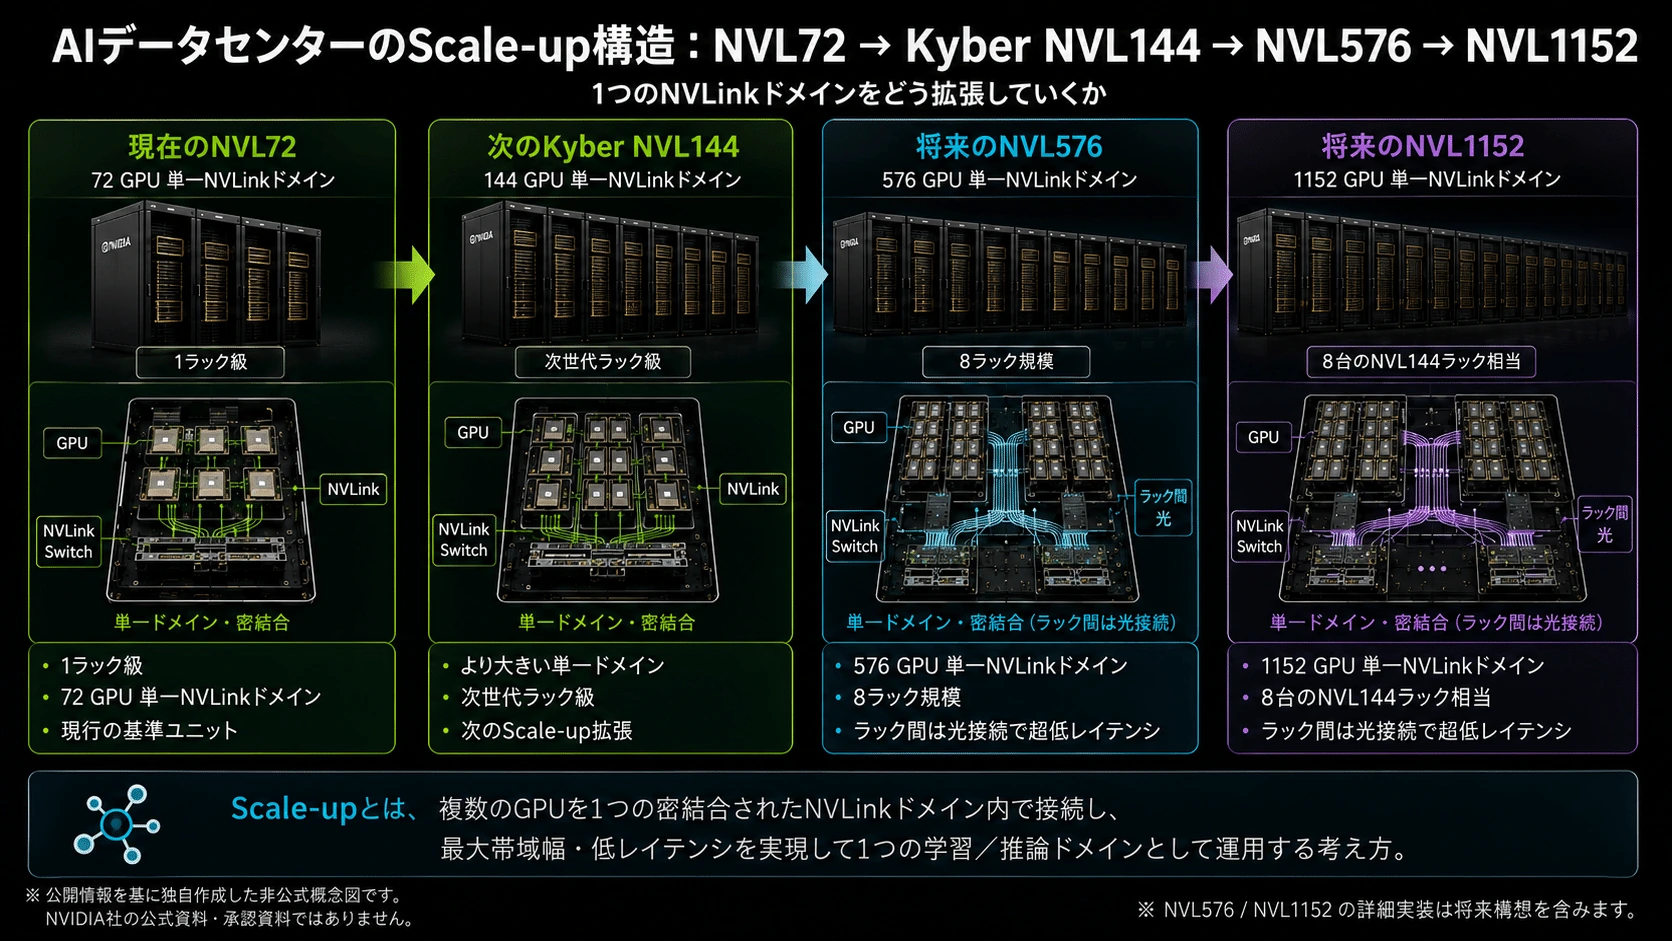
#NVL72は特定のGPU世代名ではなく、72 GPUをNVLinkで結ぶラックスケール構成です。
#NVIDIAは2024年にGB200 NVL72、2025年にGB300 NVL72を出荷し、Vera Rubin NVL72は2026年後半の提供を予定しています。(NVIDIA Developer)
#Vera Rubin NVL72の構造
#Vera Rubin NVL72は次の構成です。
#72基 Rubin GPU
36基 Vera CPU
18基 Compute Tray
9基 NVLink Switch Tray
ConnectX-9 SuperNIC
BlueField-4 DPU
NVLink 6 Copper Spine各Compute Trayには2基のVera Rubin Superchipがあり、NVL72全体を一つのラックスケール・アクセラレーターとして動かします。NVIDIA公式は、NVL72を72 GPU、36 Vera CPU、18 Compute Tray、9 NVLink Switch Trayで構成すると説明しています。(NVIDIA Developer)
#接続は次の二層に分かれます。
#Scale-up
GPU
↓ NVLink
NVLink Switch
↓ 銅スパイン
同じラック内の他GPU
Scale-out
GPU/CPU
↓ ConnectX-9・BlueField-4
Spectrum-X/Quantum-X
↓
他のNVLラック・Podつまり、NVL72ではScale-upは銅NVLink、Scale-outはEthernet/InfiniBand光ネットワークです。
##
4.Kyber NVL144――銅の限界へ挑む高密度ラック
#NVIDIAの公式説明では、Kyberは1ラック内のNVLinkドメインを72 GPUから144 GPUへ倍増する次世代MGXラックです。最初はVera Rubin Ultra NVL144として導入され、その後Feynman世代のNVL1152を構成する基礎になります。(NVIDIA Developer)
#公式上の構造
#Kyber NVL144
144基 Rubin Ultra GPU
1ラック内の単一NVLinkドメイン
縦置きCompute Blade
背面NVLink Switch Blade
大型PCBミッドプレーン
基本的に銅Scale-up
800VDC電源SemiAnalysisの2026年3月時点の分析では、Kyberは36枚のCompute Bladeに各4基のRubin Ultra GPUを載せ、12枚のSwitch Bladeに合計72基のNVLink 7 Switchを配置する構成とされています。GPU側とスイッチ側は大型PCBミッドプレーンと銅フライオーバー配線で接続するという分析です。これはNVIDIA公式の詳細仕様ではなく、試作機とサプライチェーンに基づく推定です。(newsletter.semianalysis.com)
#なぜKyberは光ではなく銅なのか
#Kyberがラック内を光化しない最大の理由は、短距離ではまだ銅の方が有利だからです。
#- 光電変換が不要
- 遅延を小さくしやすい
- 光エンジンやレーザーが不要
- 保守・製造コストを抑えやすい
- ラック内なら距離が短い
一方、144 GPUを全結合するため、巨大ミッドプレーンの信号品質、層数、熱膨張、歩留まり、コネクター精度が極めて難しくなります。
#NVIDIAは当初、Kyberと800VDCデータセンターの本格量産を2027年に合わせる計画を示していました。(NVIDIA Developer)
#しかし2026年7月、SemiAnalysis由来の報道では、巨大な銅ミッドプレーンの製造課題によってKyber NVL144が12か月超遅れ、2028年へずれ込む可能性が報じられました。NVIDIAは「ロードマップは維持されている」と回答しましたが、出荷時期や仕様の詳細は明らかにしていません。(Tom's Hardware)
#現時点の見立て
#公式目標 2027年
強気ケース 2027年末に限定出荷
基本ケース 2028年に量産開始
弱気ケース 2028年後半~2029年Kyberの遅延はGPU自体ではなく、銅Scale-upファブリックを巨大な一枚の物理構造として作る難しさを示しています。
##
5.NVL576――ラック間NVLinkが光になる最初の本命
#NVL576は、Kyber NVL144を4台つなぐ構成ではありません。
#NVIDIA公式では、72基のRubin Ultra GPUを搭載するMGX NVLラックを8台接続し、576 GPUを一つのNVLinkドメインにする構成です。ラック内は銅、ラック間は直接光接続を使い、二層のall-to-all NVLinkトポロジーを形成します。(NVIDIA Developer)
#ラックA:72 GPU ─┐
ラックB:72 GPU ─┤
ラックC:72 GPU ─┤
ラックD:72 GPU ─┤
├─ 光NVLink Switch層
ラックE:72 GPU ─┤
ラックF:72 GPU ─┤
ラックG:72 GPU ─┤
ラックH:72 GPU ─┘
合計576 GPU
単一NVLinkドメインどこが光になるのか
#GPU
↓ 銅NVLink
ラック内NVLink Switch
↓ CPOまたは直接光
上位NVLink Switch層
↓ 光
別ラックNVLink Switch
↓ 銅NVLink
GPUこれはXPU近傍光I/Oではありません。
#NVLink Switch近傍で光に変換し、スイッチ間を光で接続する方式です。
#SemiAnalysisは、Rubin Ultra NVL576について、ラック内は銅を維持し、8ラック間をCPOで接続する可能性が高いと分析しています。ただし、公式は「direct optical connections」とだけ述べており、プラガブル光かCPOかを完全には確定していません。SemiAnalysisは初期NVL576を低数量の試験的システムと見ています。(newsletter.semianalysis.com)
#NVL576の時期
#NVL576はKyberを使わず、既存の72 GPU型MGXラックを8台使うため、Kyberのミッドプレーン問題を直接は受けません。
#しかし、別の問題があります。
#- Scale-up CPOの歩留まり
- 光エンジンの熱安定性
- 光ファイバーの高密度実装
- NVLink Switchとの統合
- 故障時の交換性
- レーザー供給と冗長化
- 二層all-to-allの巨大な部品点数
最近の報道では、KyberだけでなくNVL576も、CPO成熟度次第で低数量化または後ろ倒しになる可能性が指摘されています。(Tom's Hardware)
#私の基本シナリオは次の通りです。
#2027年 試作・顧客評価
2028年 限定的な導入
2029年 CPO歩留まり次第で拡大
2030年 次世代NVL1152へ技術継承#
6.NVL1152――Feynman世代の超大型Scale-up
#NVL1152は、NVL576を2台つなぐものではありません。
#公式構成は、
#Kyber NVL144 × 8ラック
=1,152 GPU
=単一NVLinkドメインです。
#NVIDIAは、Feynman世代で8台のKyberラックを直接光接続し、all-to-all NVL1152を構成すると説明しています。(NVIDIA Developer)
#構造は次のようになると考えられます。
#各Kyberラック内
144 GPU
↓
銅ミッドプレーン
↓
NVLink Switch
ラック間
NVLink Switch
↓
CPO/直接光
↓
他の7台のKyberラックSemiAnalysisの基本推定では、Feynman NVL1152もラック内は銅、ラック間はCPOです。ただしNVIDIA経営陣から「all CPO」と解釈できる発言もあり、XPU側やラック内までどこまで光化するのかはまだ一致していません。(newsletter.semianalysis.com)
#NVL1152の時期推定
#NVIDIAは公式な量産年を明示していません。Kyberの遅延リスクを踏まえると、次の幅で見るべきです。
#強気ケース 2028年後半
基本ケース 2029年
弱気ケース 2030年以降NVL1152には、
#- Kyberラックの量産
- 800VDC電源
- 大型銅ミッドプレーン
- NVLink 7以降
- ラック間CPO
- 1,152 GPU all-to-all制御
を同時に成立させる必要があります。
#したがって、NVL576よりさらに遅延リスクが高い構造です。
##
7.NVIDIAのScale-out光化
#NVIDIAはScale-upの光化より先に、Scale-out側でCPOを製品化しています。
#Quantum-X Photonicsは200G SerDesを使ったInfiniBand CPOスイッチ、Spectrum-X Ethernet PhotonicsはEthernet CPOスイッチです。Quantum-X800のCPOスイッチは144ポートの800Gb/s InfiniBand、Spectrum-X Photonicsは最大409.6Tb/s級までの構成を持ち、Spectrum-X Ethernet Photonicsは2026年後半の提供予定です。(NVIDIA)
#NVL72/NVL576
↓ ConnectX/BlueField
Leaf switch
↓ 光
Spine switch
↓ 光
他Pod・他NVLドメインこのScale-out CPOと、NVL576の光NVLinkは別物です。
#| 項目 | Spectrum-X/Quantum-X | NVL576ラック間光 |
| 分類 | Scale-out | Scale-up |
| プロトコル | Ethernet/InfiniBand | NVLink |
| 接続対象 | NICからLeaf/Spine | NVLink Switch間 |
| 計算ドメイン | 複数ドメイン | 単一576 GPUドメイン |
| 製品化 | 先行 | これから |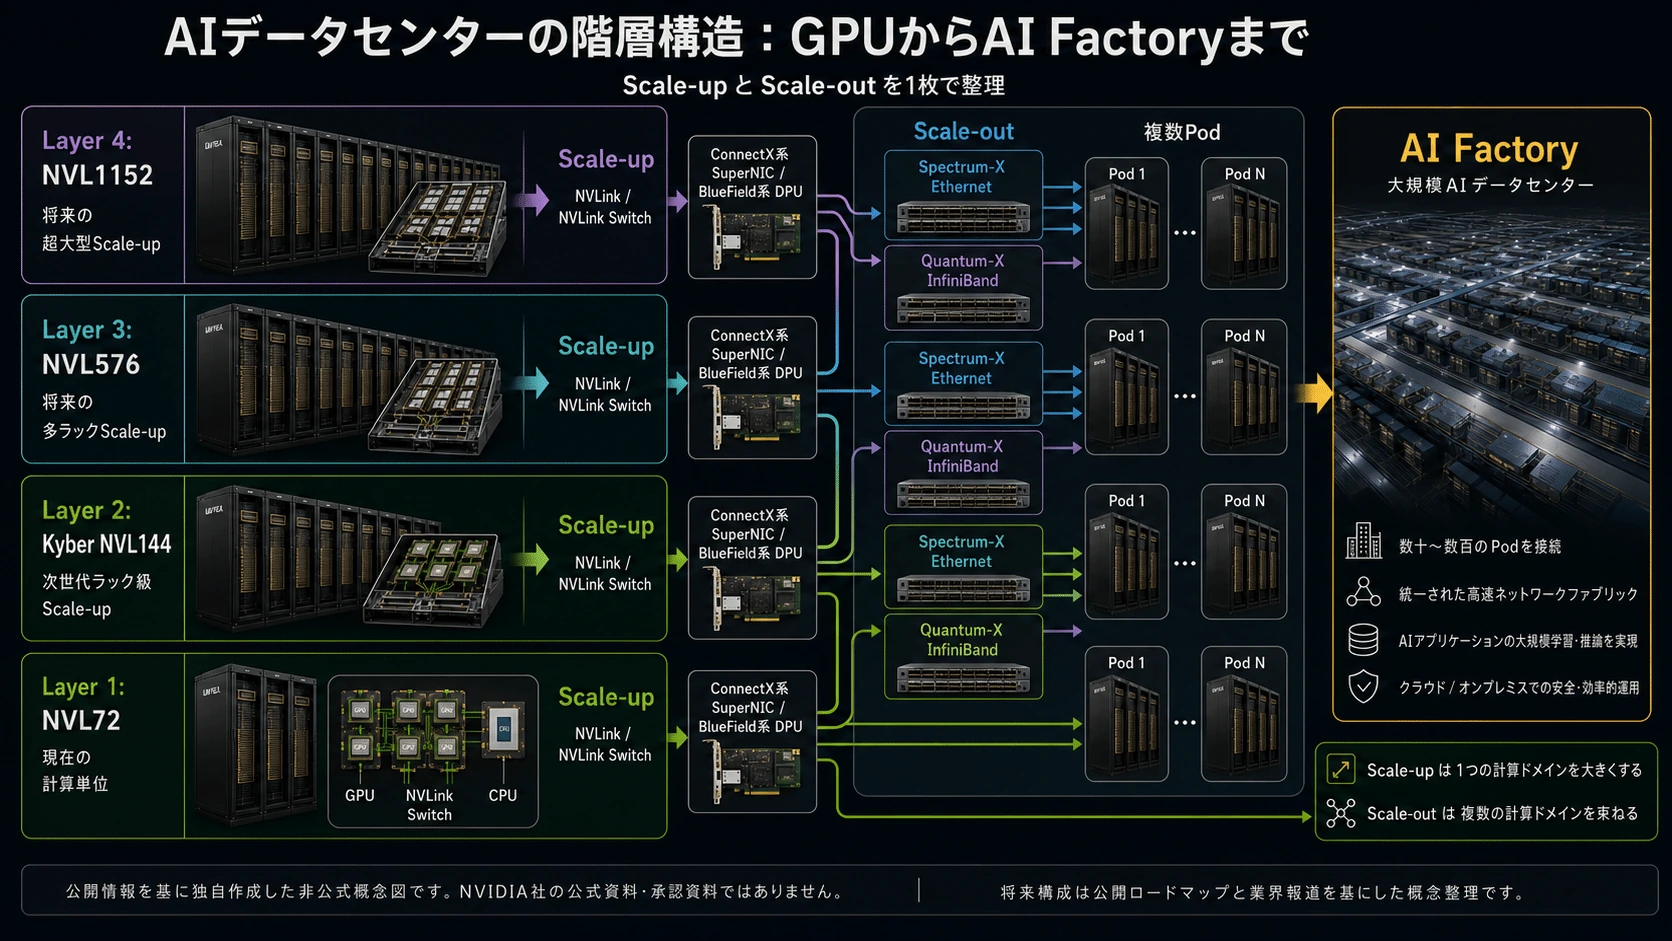
#
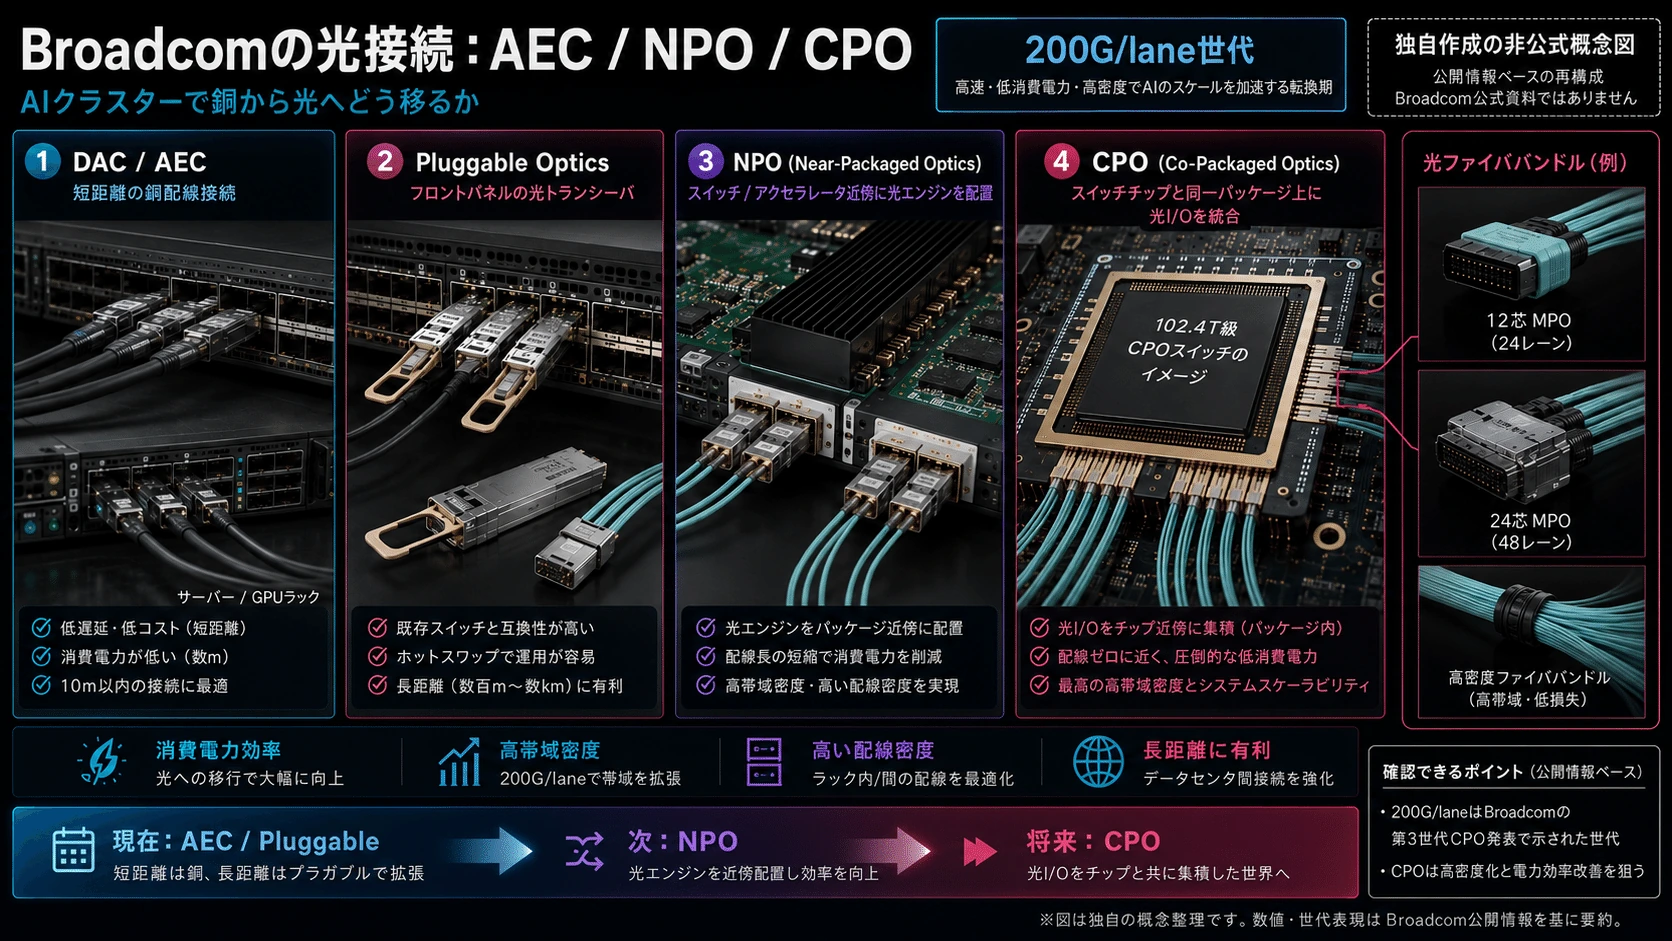
8.Broadcom――現在の光Ethernetで最も強い陣営
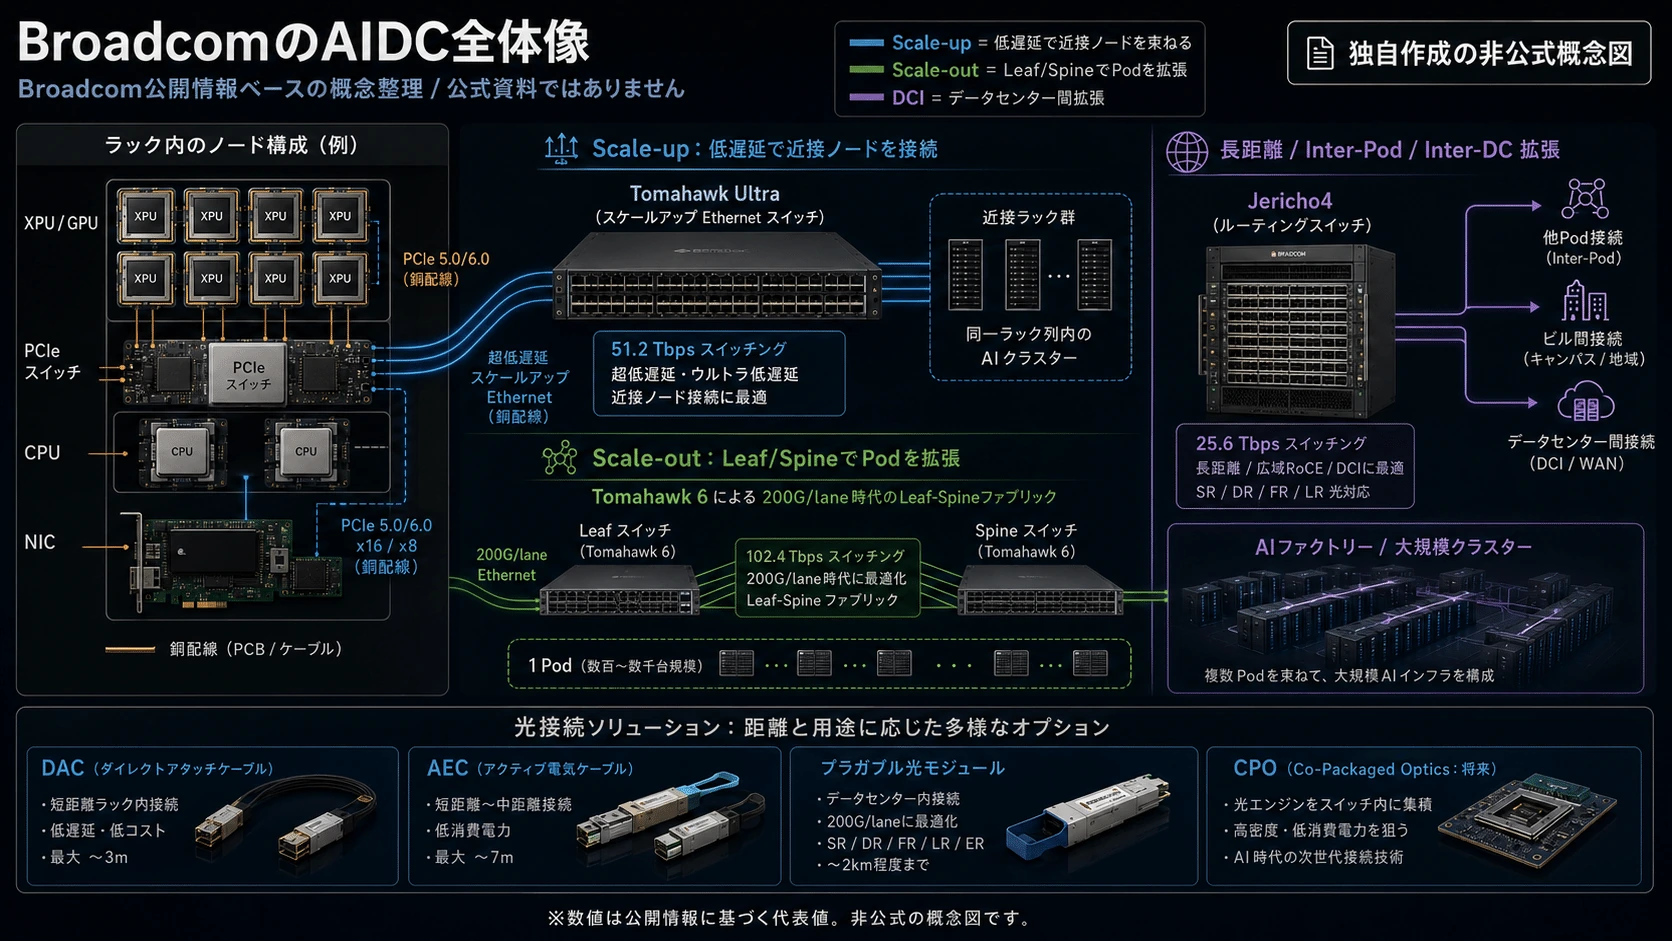
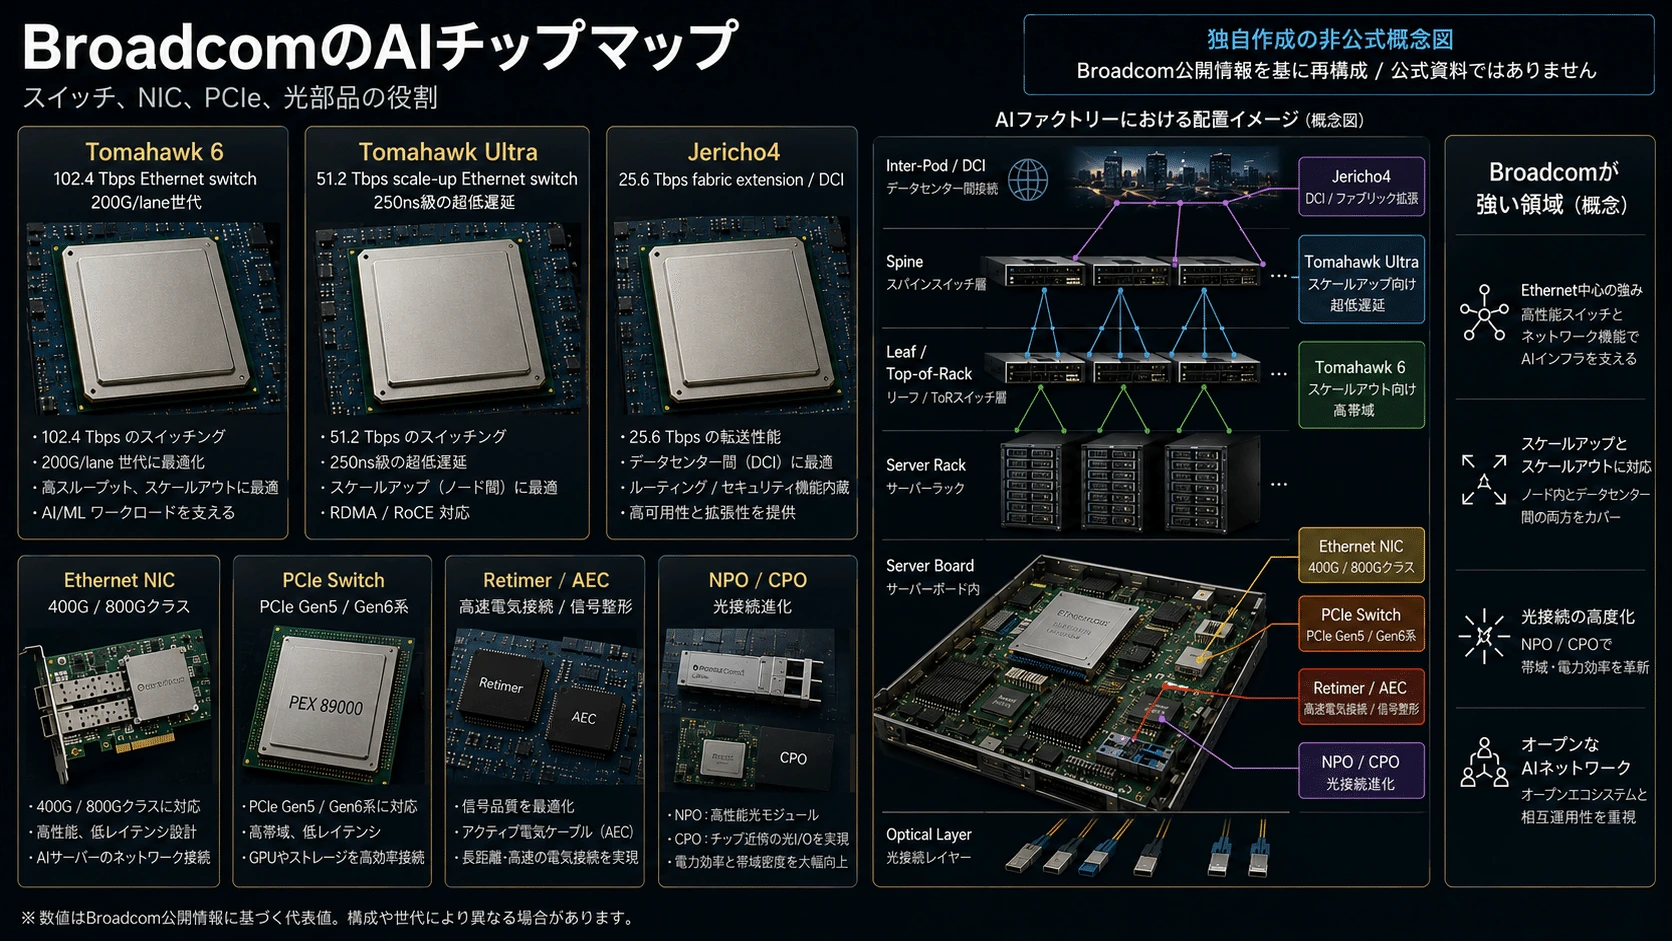
#Broadcomの強みは、Ethernetスイッチ、SerDes、CPO、NIC、カスタムASICを一体で提供できることです。
#Tomahawk Ultra
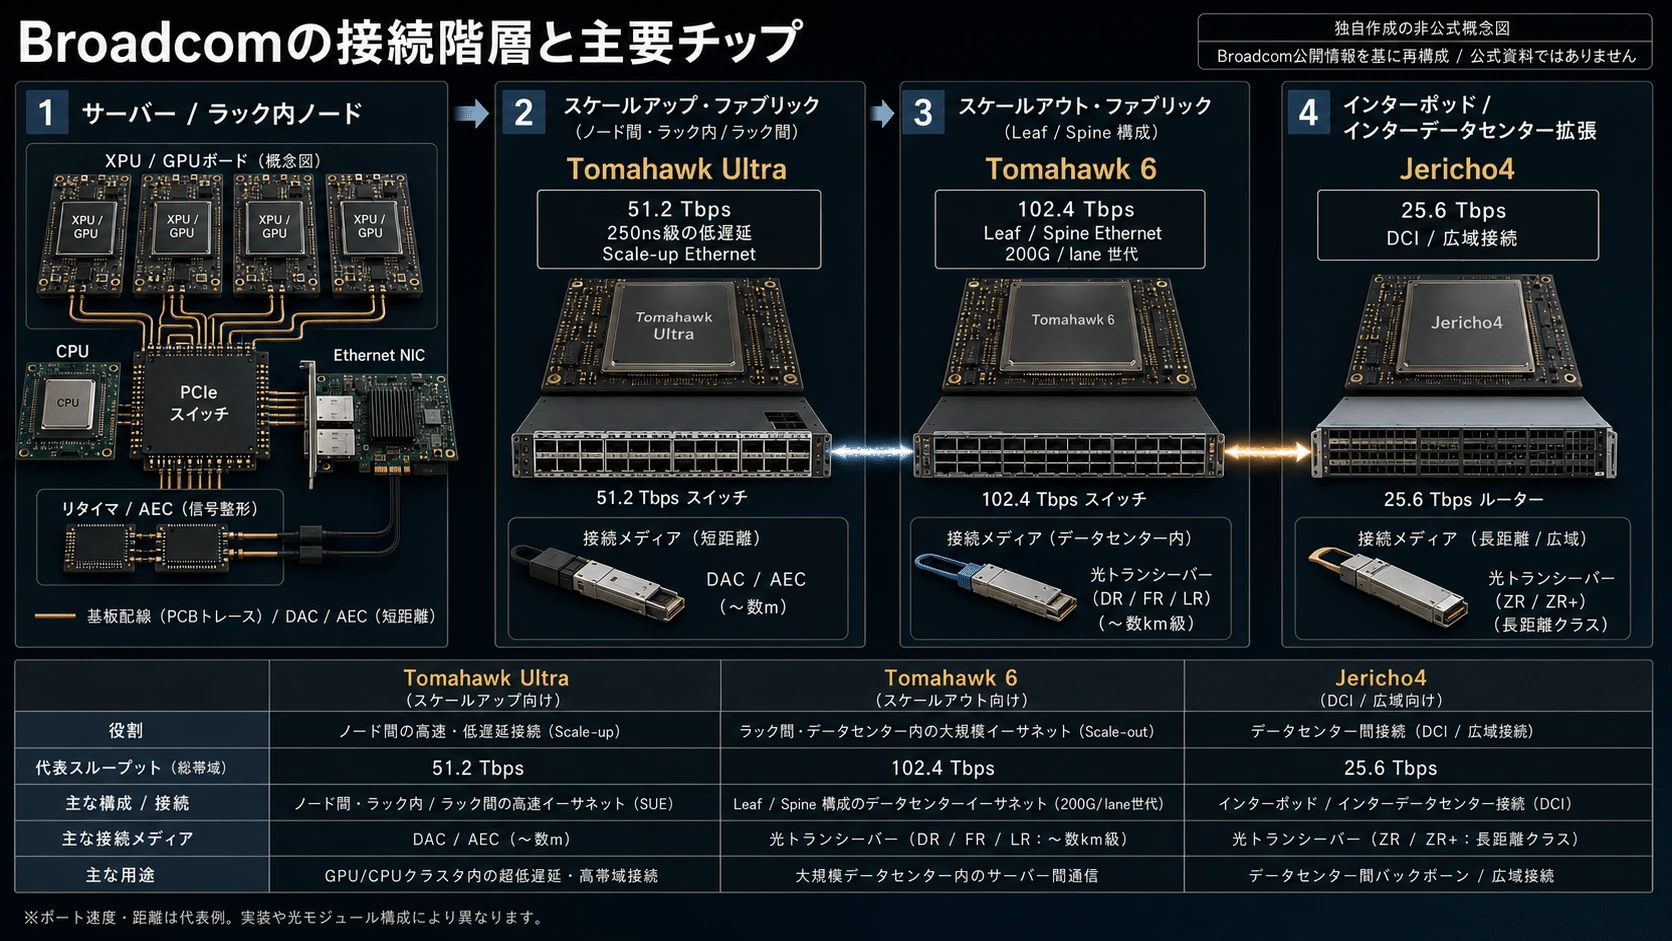
#Tomahawk Ultraは、51.2Tb/s、約250nsのスイッチ遅延を持つScale-up Ethernet向けASICです。64バイトの小さなパケットでもline-rate動作し、GPU/XPU間のロスレス低遅延接続を狙います。
#Custom XPU
↓ UALink / SUE / Ethernet系
Tomahawk Ultra
↓
他XPUこれはNVIDIA NVLinkに対する、オープンEthernet側の回答です。
#Tomahawk 6
#Tomahawk 6は102.4Tb/sの単一チップEthernetスイッチで、Scale-upとScale-outの両方を対象としています。通常版はすでに出荷され、Davisson版では102.4Tb/s CPOスイッチが示されています。
#Broadcomの第3世代CPOは200G/laneを採用し、次世代の高radix Scale-up/Scale-outネットワークを対象にしています。
#Jericho4
#Jericho4は25.6Tb/s級のルーティング/ファブリック拡張ASICで、巨大なRoCEネットワークやデータセンター間接続を担います。BroadcomはJericho4を、単一データセンターを越えてAI Ethernetファブリックを拡張する製品として位置付けています。
#Broadcomの光化ロードマップ
#現在
DAC / AEC
プラガブル800G・1.6T光
Tomahawk 6
2026~2027
Tomahawk 6 Davisson CPO
200G/lane CPO
Tomahawk Ultra Scale-up Ethernet
2028~2030
より大規模なCPO Scale-up
UALink / SUE XPUクラスタ
400G/lane世代への移行Broadcomは、現時点ではMarvellよりも商用スイッチCPOの製品成熟度とEthernetエコシステムで優位です。
#
#
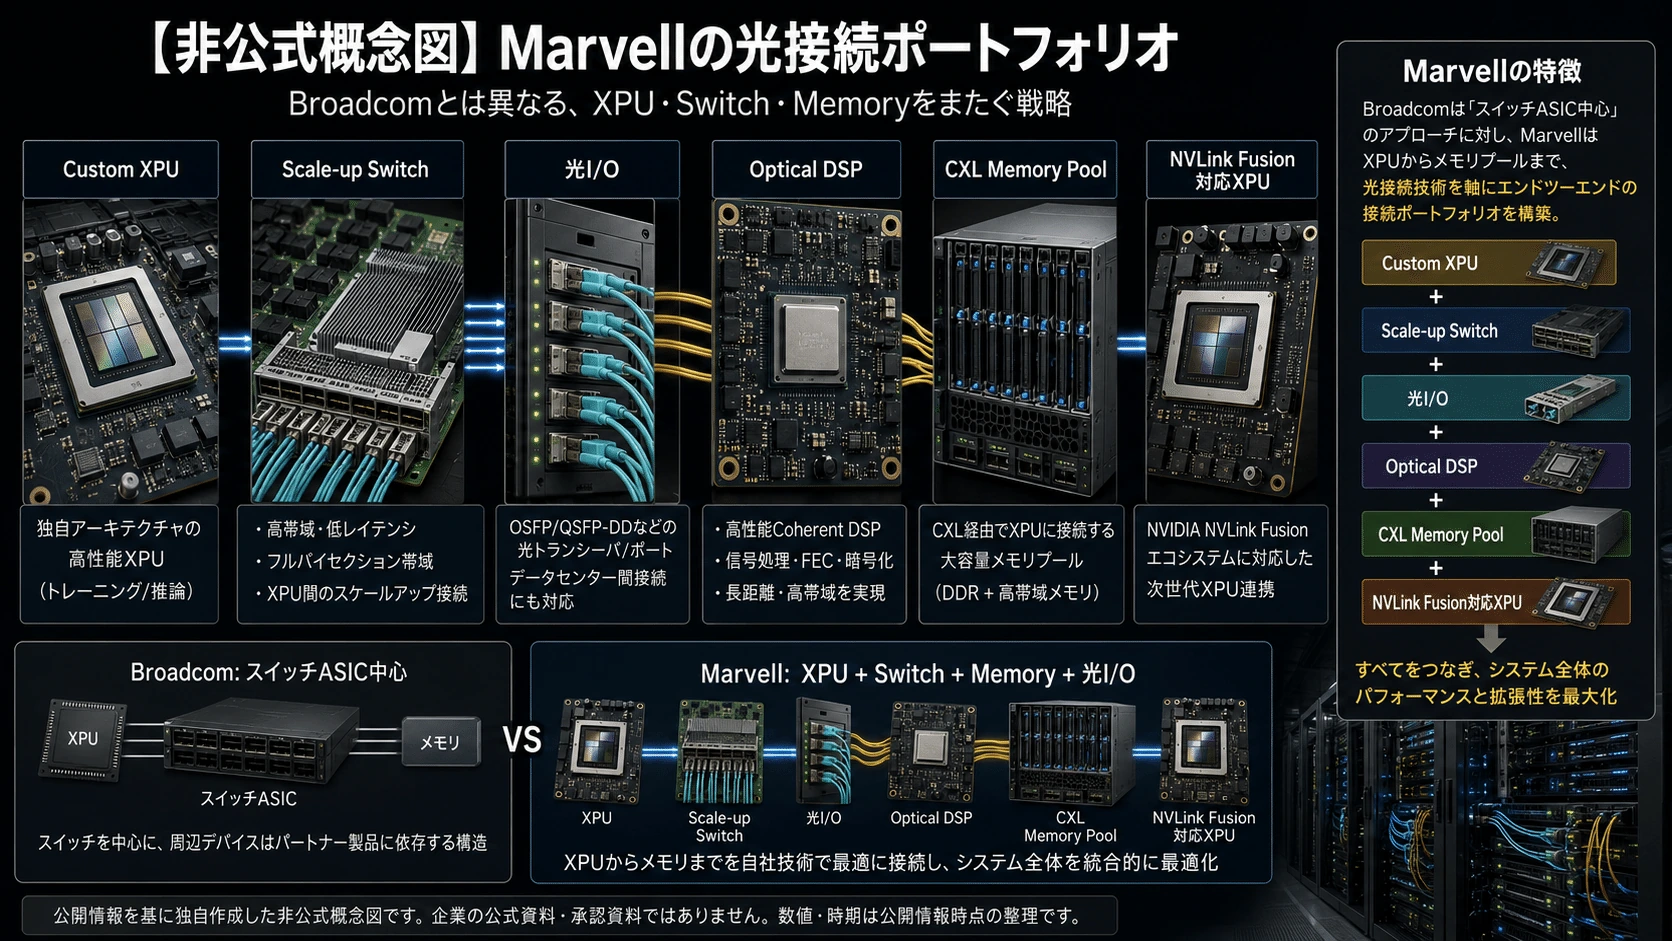
9.Marvell――XPU、Switch、Memoryを光で結ぶ構想
#Marvellの戦略はBroadcomと少し異なります。
#BroadcomがスイッチASICを中心に光化を進めるのに対し、Marvellは、
#Custom XPU
Scale-up Switch
光I/O
Optical DSP
CXL Memory Pool
NVLink Fusionを一つの接続ポートフォリオとして組み合わせようとしています。
#Photonic Fabric
#Marvellが買収したCelestial AIのPhotonic Fabricは、パッケージ、システム、ラックレベルの光I/Oを狙うプラットフォームです。
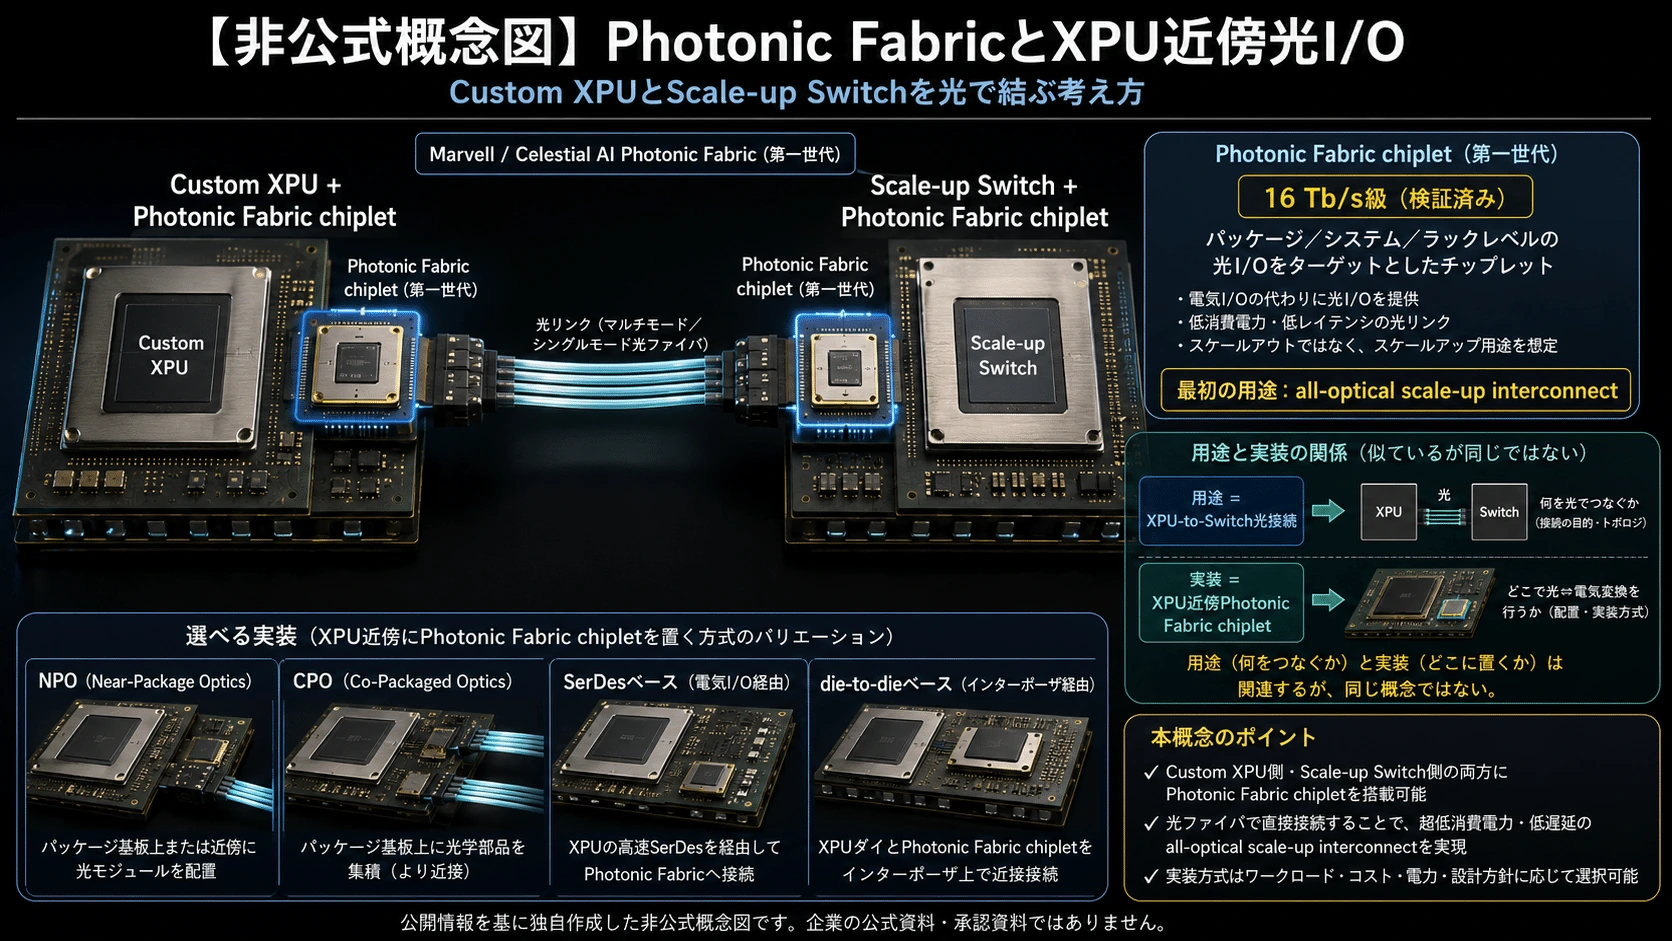
#第1世代Photonic Fabricチップレットは1個あたり16Tb/sを掲げ、カスタムXPU側とScale-up Switch側の双方にco-packageする構想です。最初の用途は、銅から光へ移行するall-optical Scale-up interconnectとされています。(Marvell Technology, Inc.)
#Custom XPU
+ Photonic Fabric chiplet
↓ 光
Scale-up Switch
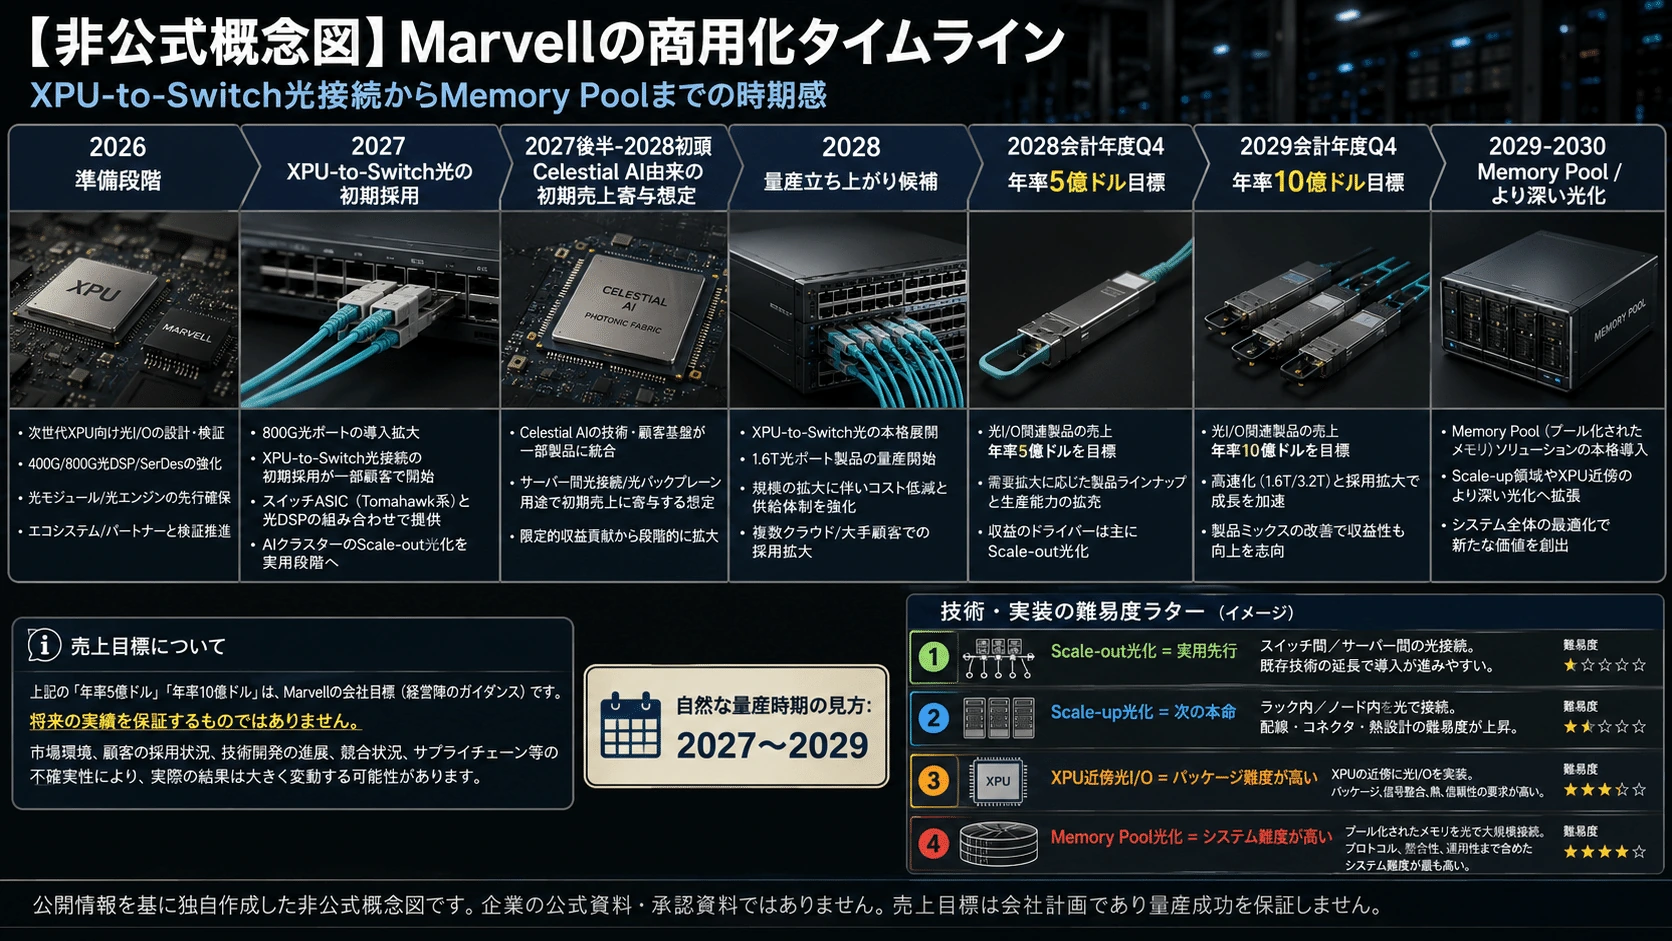
+ Photonic Fabric chipletMarvellは、Celestial AI由来の初期売上を2028会計年度後半、暦年ではおおむね2027年後半から2028年初頭に見込み、FY2028第4四半期に年率5億ドル、FY2029第4四半期に年率10億ドルを目標としています。これは会社計画であり、量産成功を保証するものではありません。(Marvell Technology, Inc.)
#XPU近傍光I/O
#MarvellはXPUとSwitchの両側に電気/光I/Oチップレットを提供し、NPO、CPO、SerDesベース、die-to-dieベースなど複数の実装を選べる戦略を示しています。(Marvell Technology)
#XPU-to-Switchを光で接続し、XPU側にPhotonic Fabricを載せる場合、それは技術的にXPU近傍光I/Oそのものです。
#用途:
XPU-to-Switch光接続
実装:
XPU近傍Photonic Fabric chiplet違う名前に見えますが、前者は「何を接続するか」、後者は「どこで光変換するか」を示しています。
#TSMC COUPEとの関係
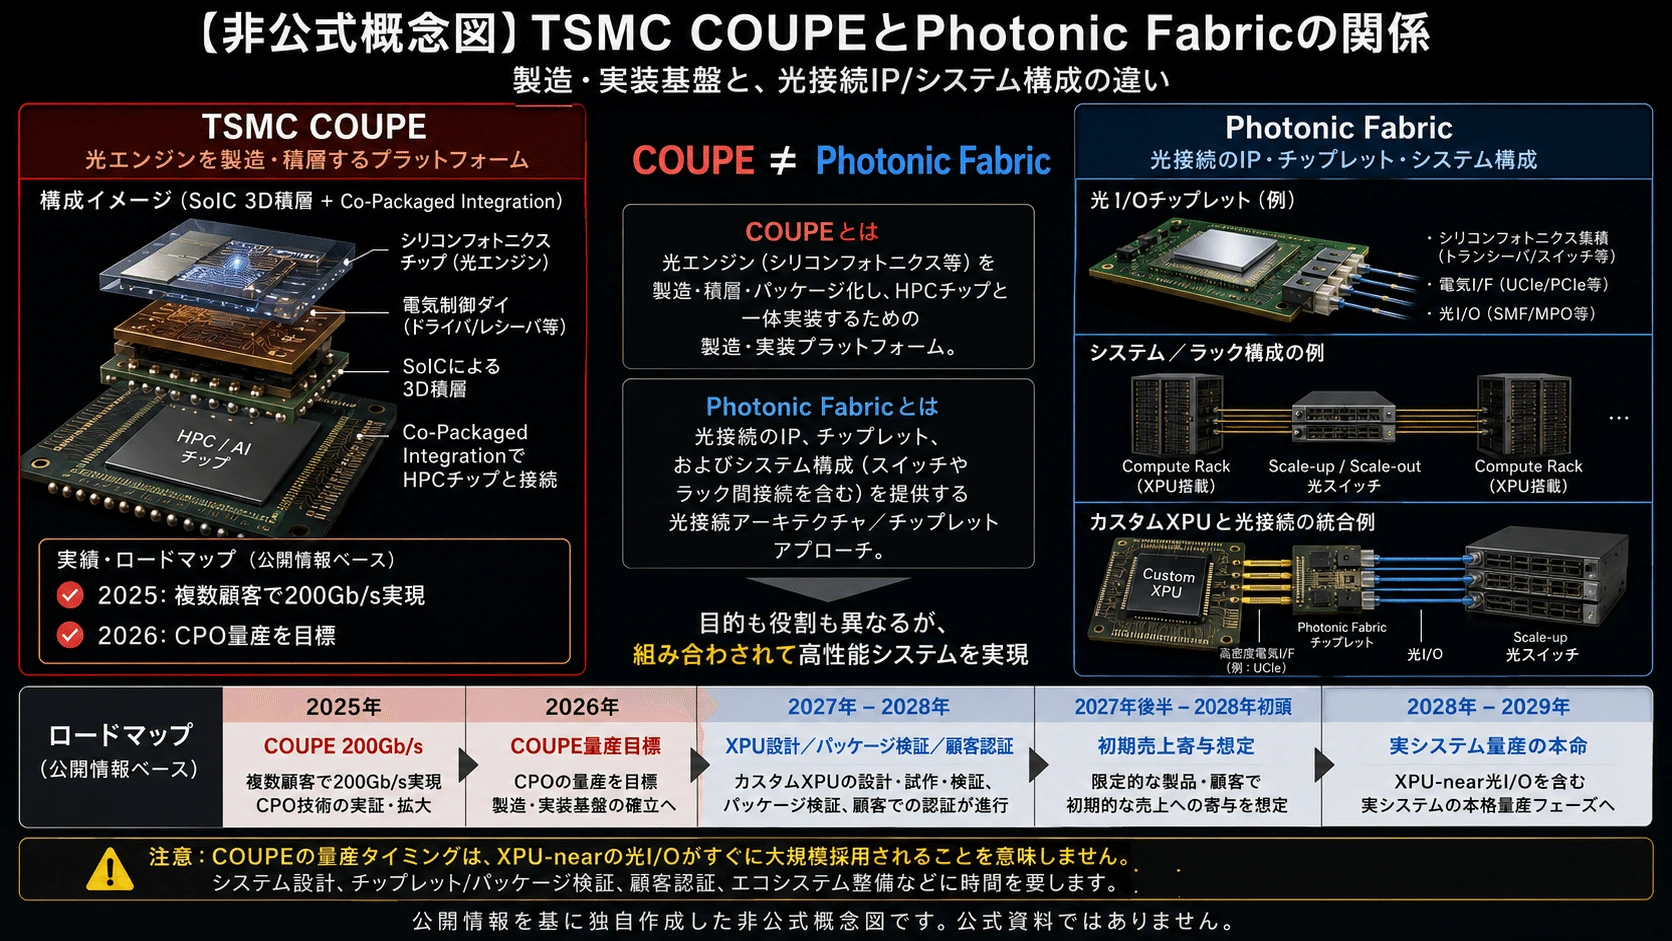
#TSMCのCOUPEは、シリコンフォトニクスチップと電気制御チップをSoICで3D積層し、HPCチップとco-packageする製造・実装基盤です。
#TSMCはCOUPEについて、2025年に複数顧客で200Gb/sを実現し、CPOソリューションの量産を2026年に目標としていると説明しています。(TSMC)
#ただし、
#TSMC COUPE
=光エンジンを製造・積層するプラットフォーム
Marvell Photonic Fabric
=光接続のIP、チップレット、システム構成です。Photonic FabricがCOUPEを採用すると公式確認されたわけではありません。
#COUPEの「2026年量産」は、XPU近傍光I/O製品が2026年に大規模普及するという意味ではなく、製造基盤が整い始める時期です。XPU設計、パッケージ検証、熱試験、顧客認証を考えると、実システムの量産は2027~2029年が自然です。
#
#
10.MarvellのMemory Pool戦略
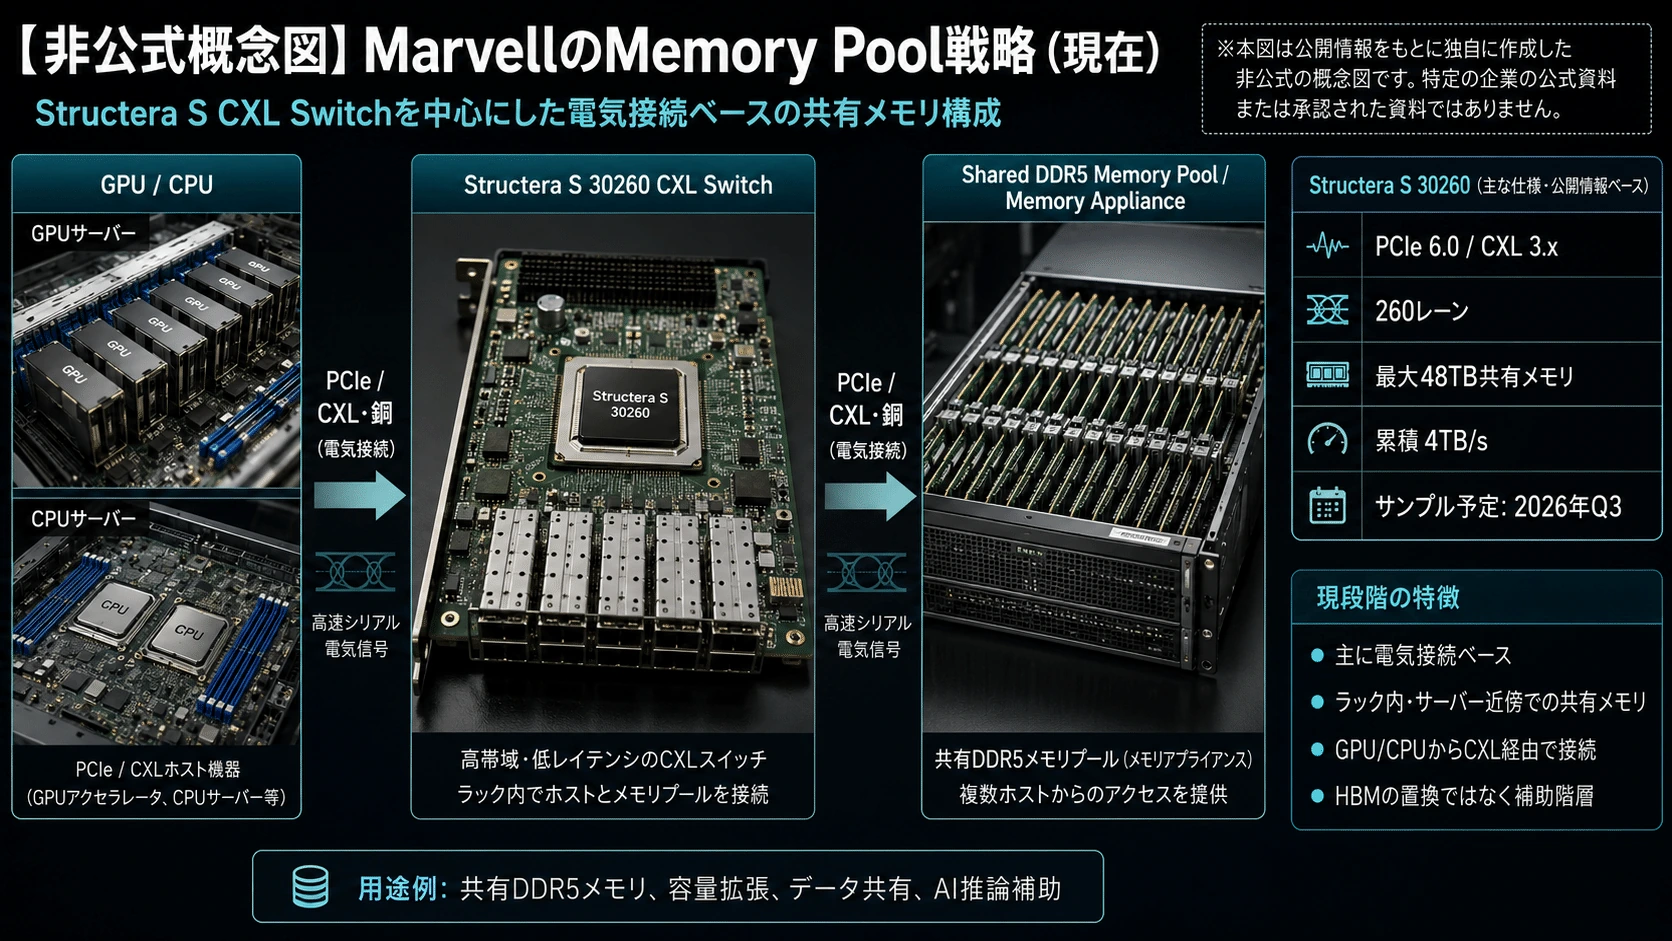
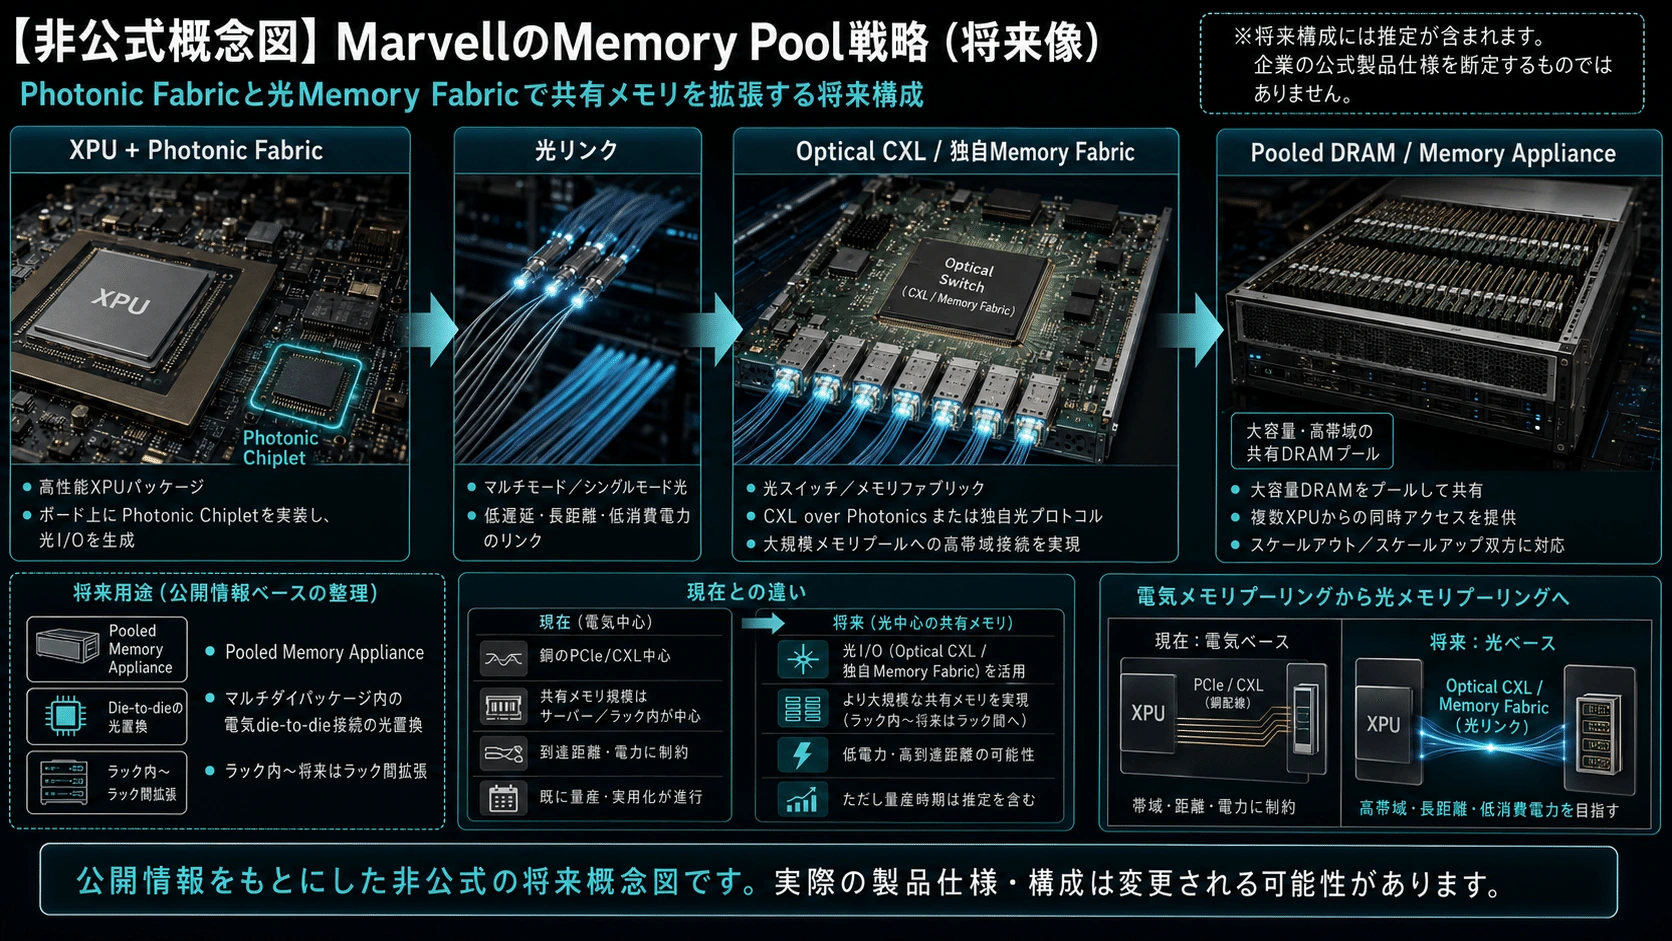
#MarvellはCelestial AIだけでなく、XConnを取り込み、Structera S CXL Switchを展開しています。
#Structera S 30260はPCIe 6.0/CXL 3.x、260レーン、最大48TBの共有メモリ、累積4TB/sを掲げ、2026年第3四半期のサンプルを予定しています。(Marvell Technology)
#現在の構成は主に電気接続です。
#GPU / CPU
↓ PCIe / CXL・銅
Structera CXL Switch
↓
共有DDR5 Memory Pool将来は次の構成が想定されます。
#XPU + Photonic Fabric
↓ 光
Optical CXL / 独自Memory Fabric
↓
Pooled DRAM / Memory ApplianceMarvellはPhotonic Fabricの将来用途として、Pooled Memory Applianceとマルチダイパッケージ内の電気die-to-die接続の光置換を挙げています。(Marvell Technology, Inc.)
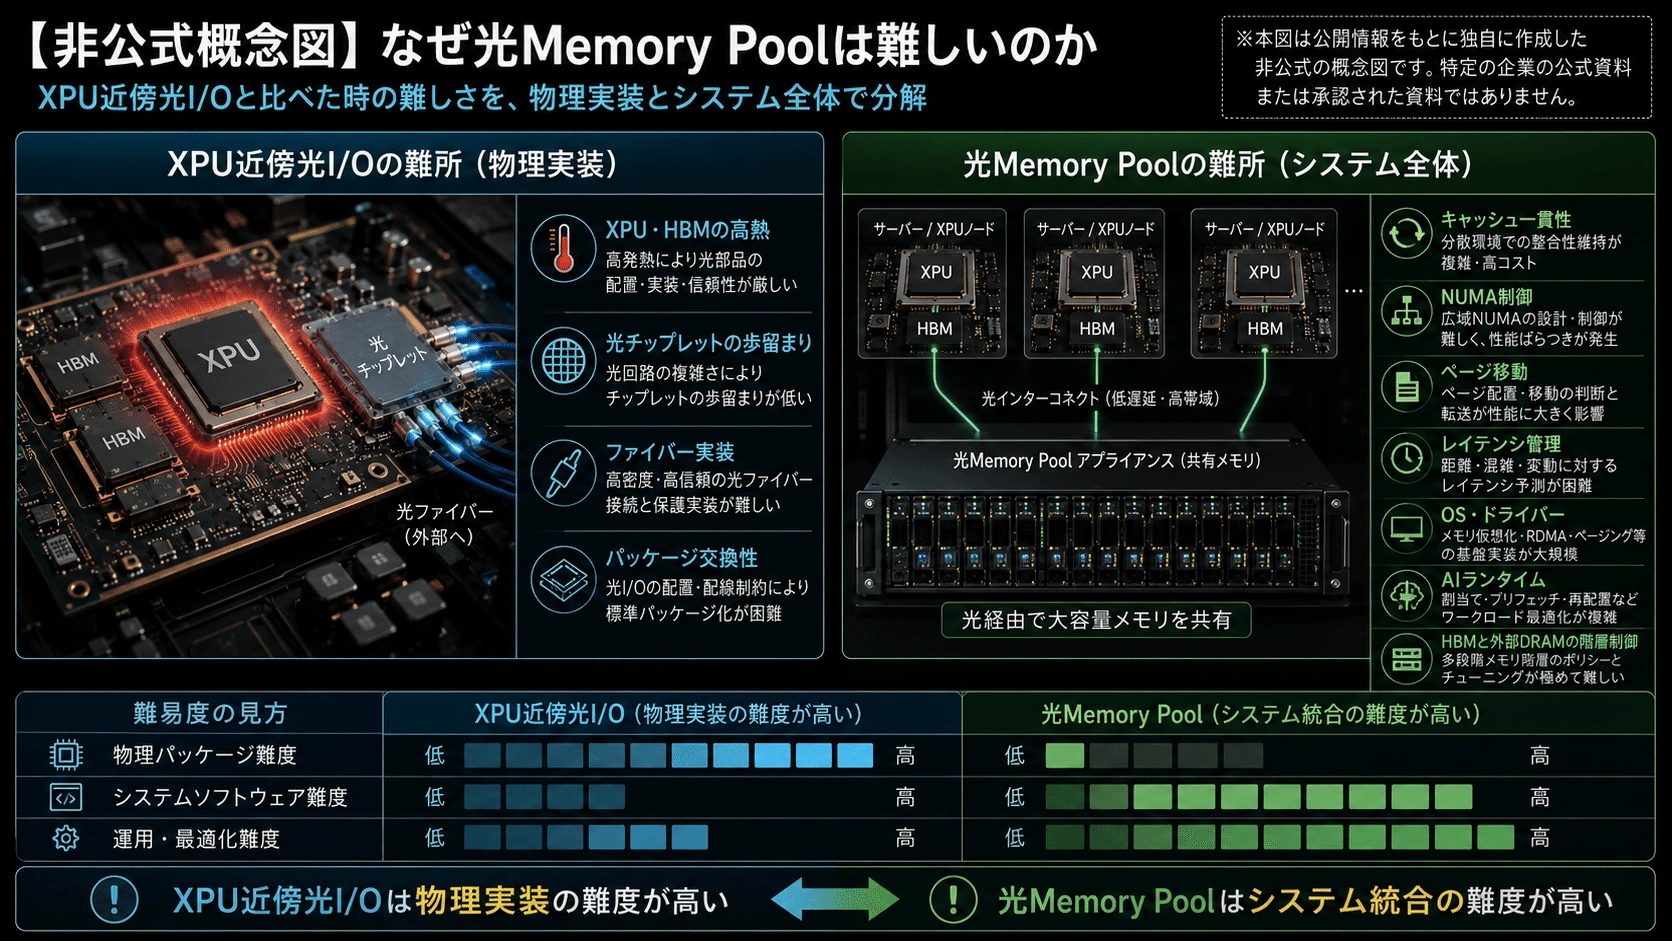
#ただしMemory Poolの光化は、XPU-to-Switchより難しいです。
#物理実装
#XPU近傍光I/Oの方が厳しい部分:
#- XPU・HBMの高熱
- 光チップレットの歩留まり
- ファイバー実装
- パッケージ交換性
システム全体
#Memory Poolの方が厳しい部分:
#- キャッシュ一貫性
- NUMA制御
- ページ移動
- レイテンシ管理
- OS・ドライバー
- AIランタイム
- HBMと外部DRAMの階層制御
したがって、
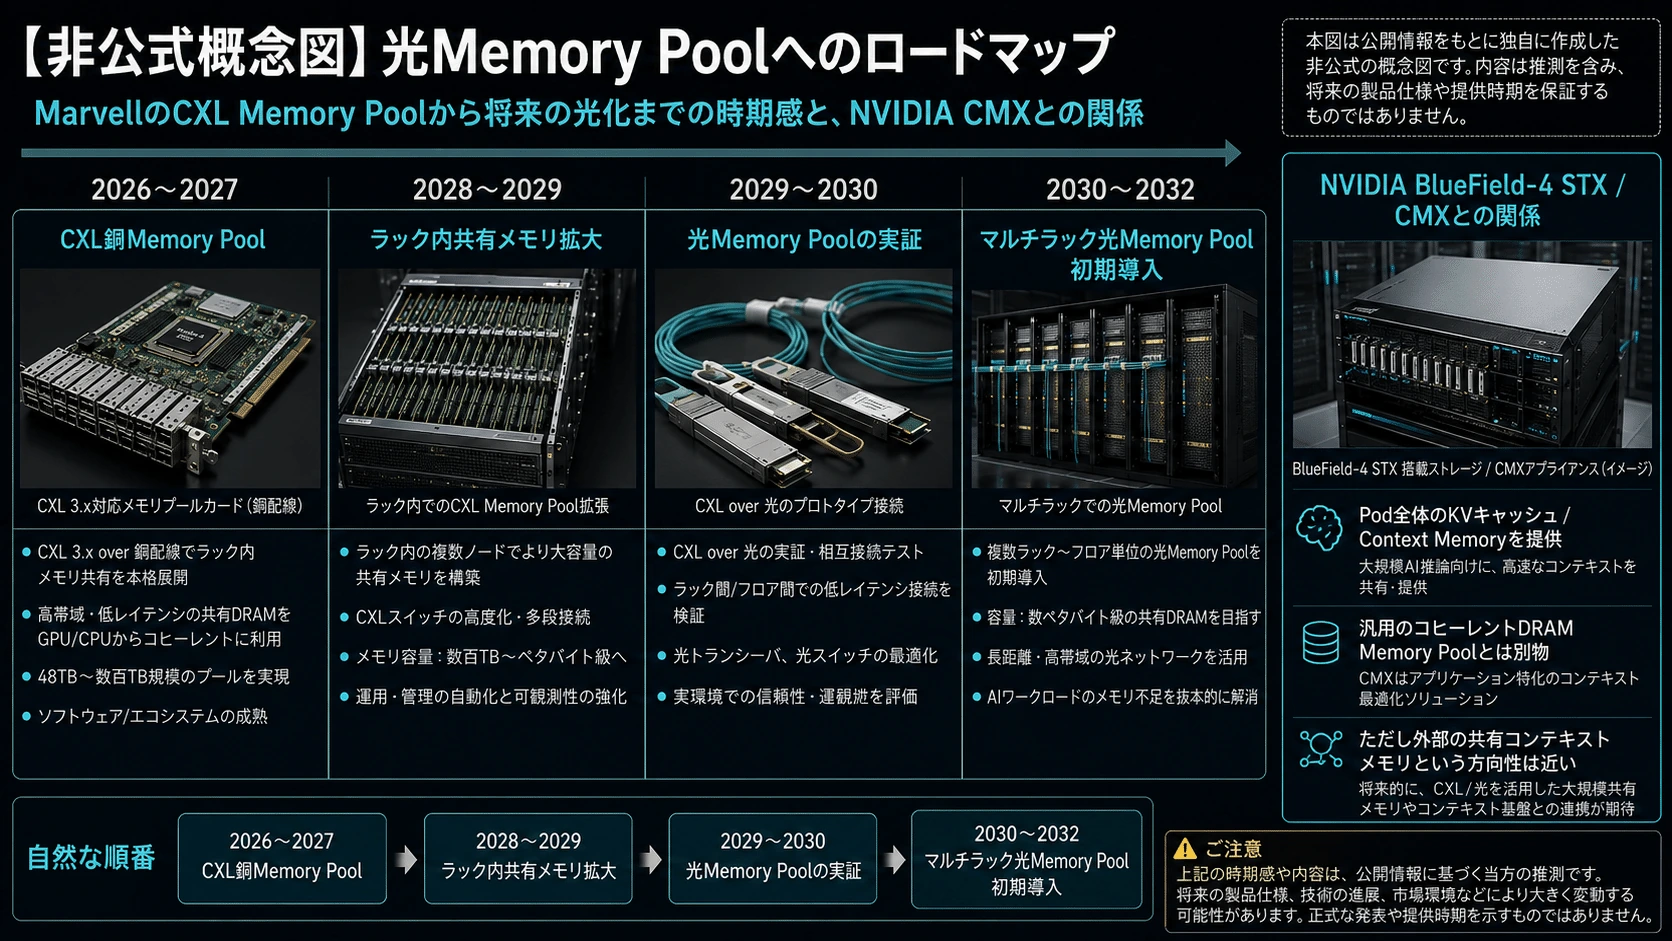
#2026~2027
CXL銅Memory Pool
2028~2029
ラック内共有メモリ拡大
2029~2030
光Memory Poolの実証
2030~2032
マルチラック光Memory Pool初期導入という順番が妥当です。
#なお、NVIDIAのBlueField-4 STX/CMXは、KVキャッシュをPod全体に提供するAIネイティブ・ストレージ階層です。これは汎用のコヒーレントDRAM Memory Poolとは異なりますが、外部の共有コンテキストメモリを使う方向性では近いものです。(NVIDIA Developer)
#
#
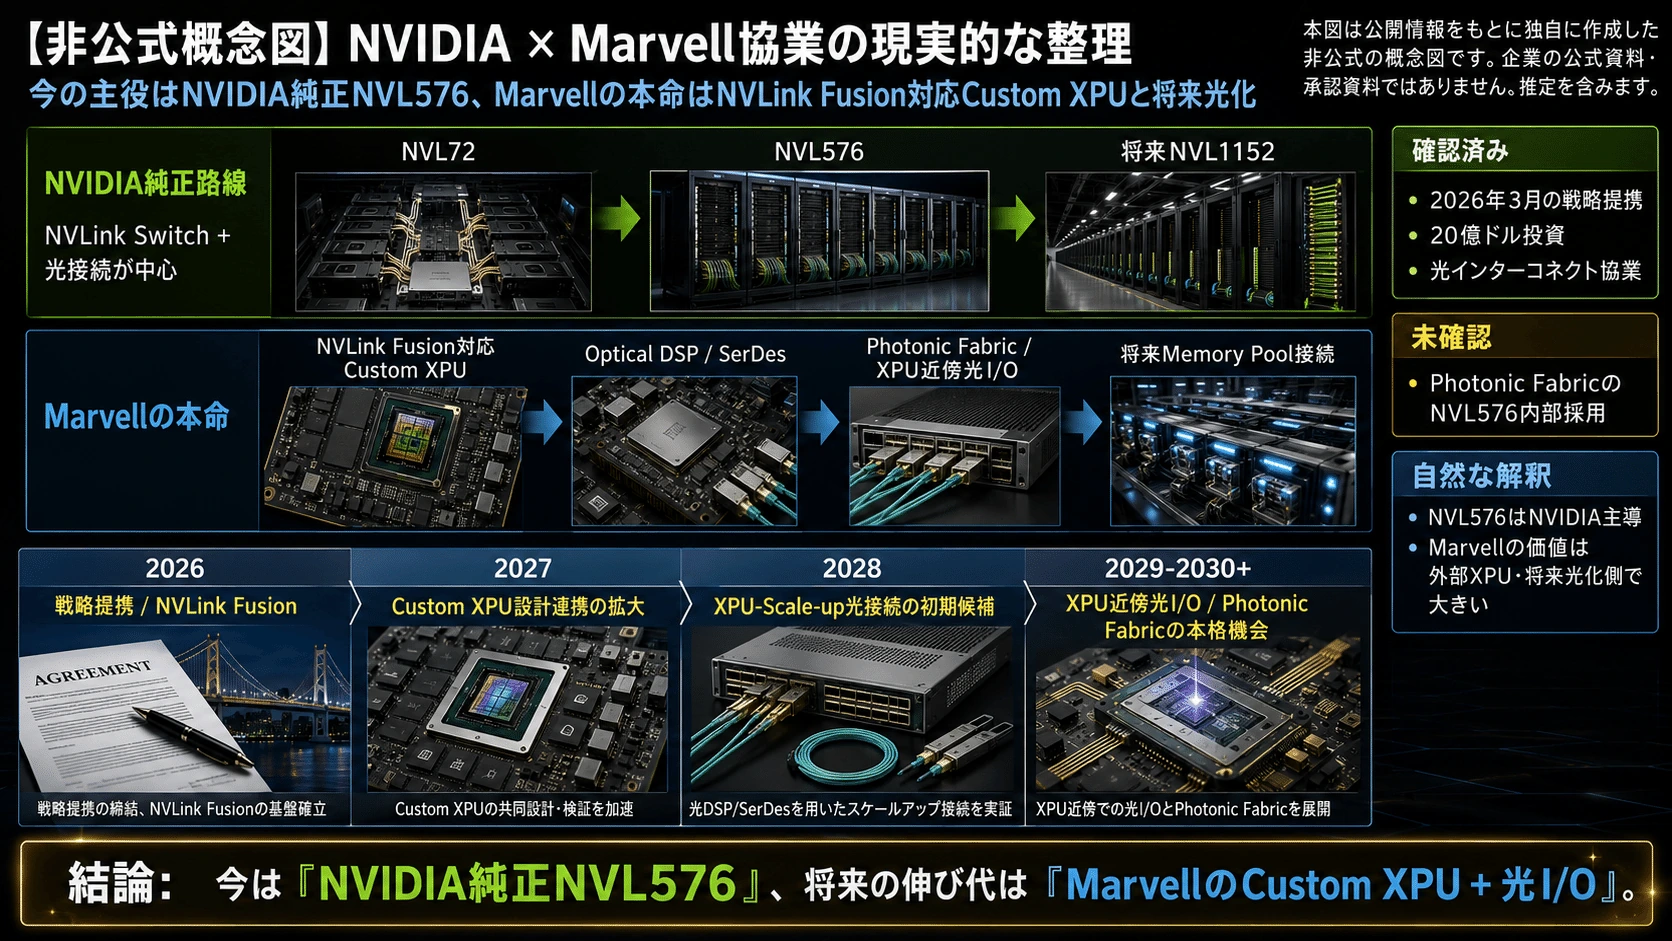
11.NVIDIAとMarvellの協業
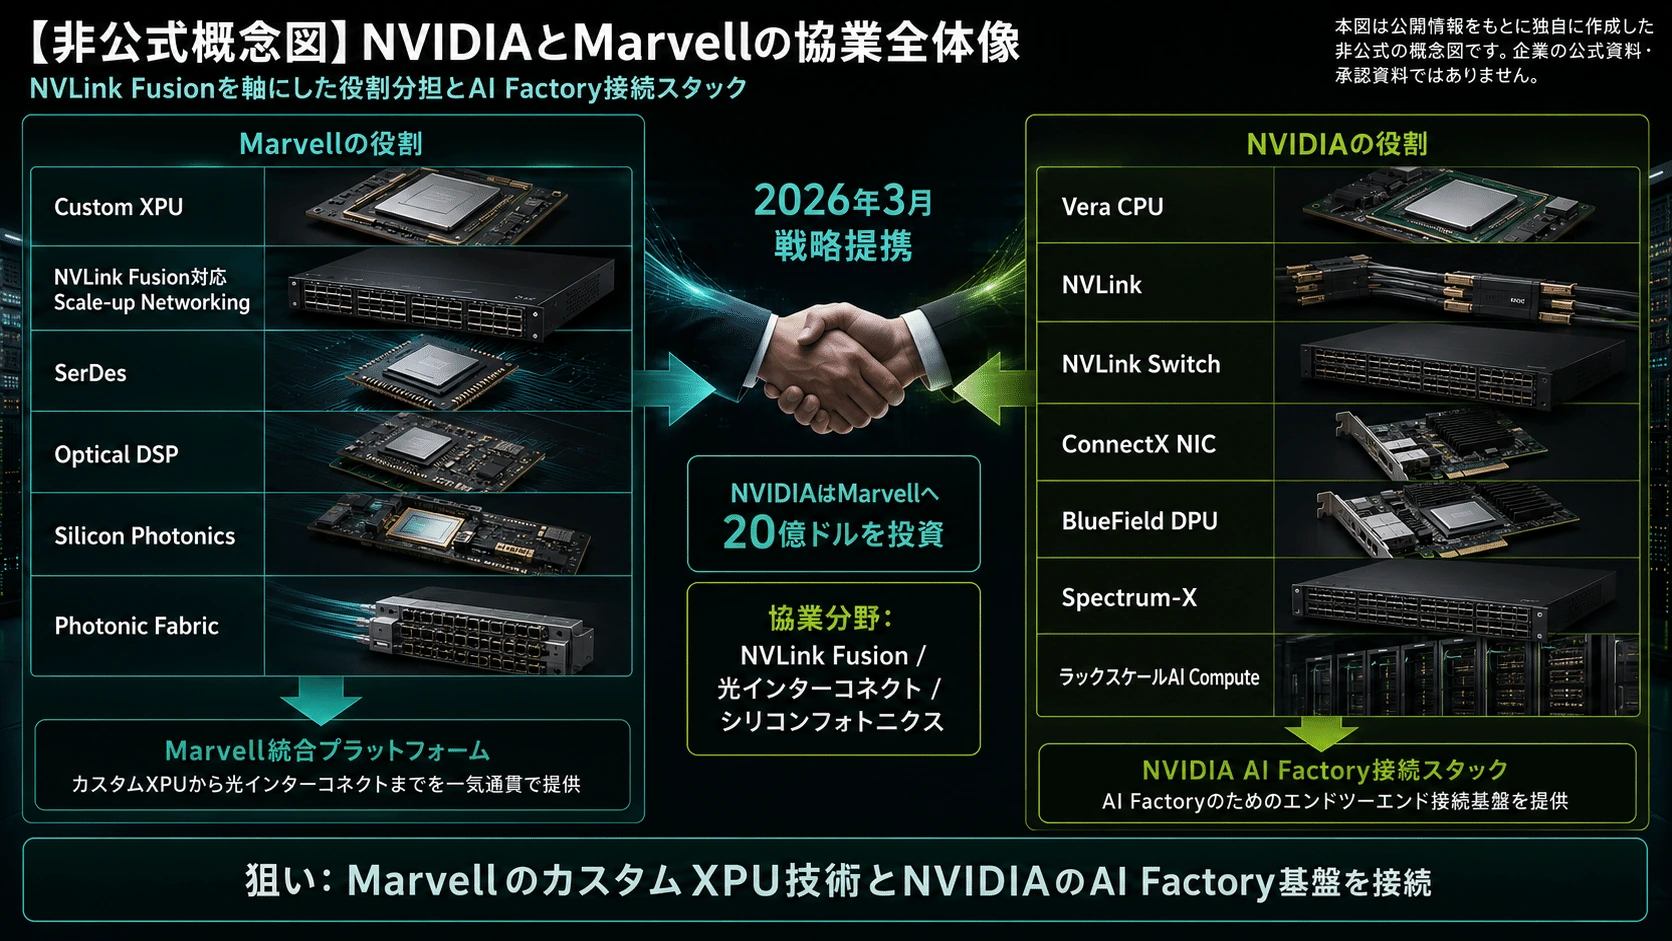
#NVIDIAとMarvellは2026年3月、NVLink Fusionを中心とする戦略提携を発表しました。NVIDIAはMarvellへ20億ドルを投資しています。(NVIDIA Newsroom)
#公式な役割分担は次の通りです。
#Marvell
・Custom XPU
・NVLink Fusion対応Scale-up Networking
・SerDes
・Optical DSP
・Silicon Photonics
・Photonic Fabric
NVIDIA
・Vera CPU
・NVLink
・NVLink Switch
・ConnectX NIC
・BlueField DPU
・Spectrum-X
・ラックスケールAI Compute両社は光インターコネクトとシリコンフォトニクスでも協業します。(NVIDIA Newsroom)
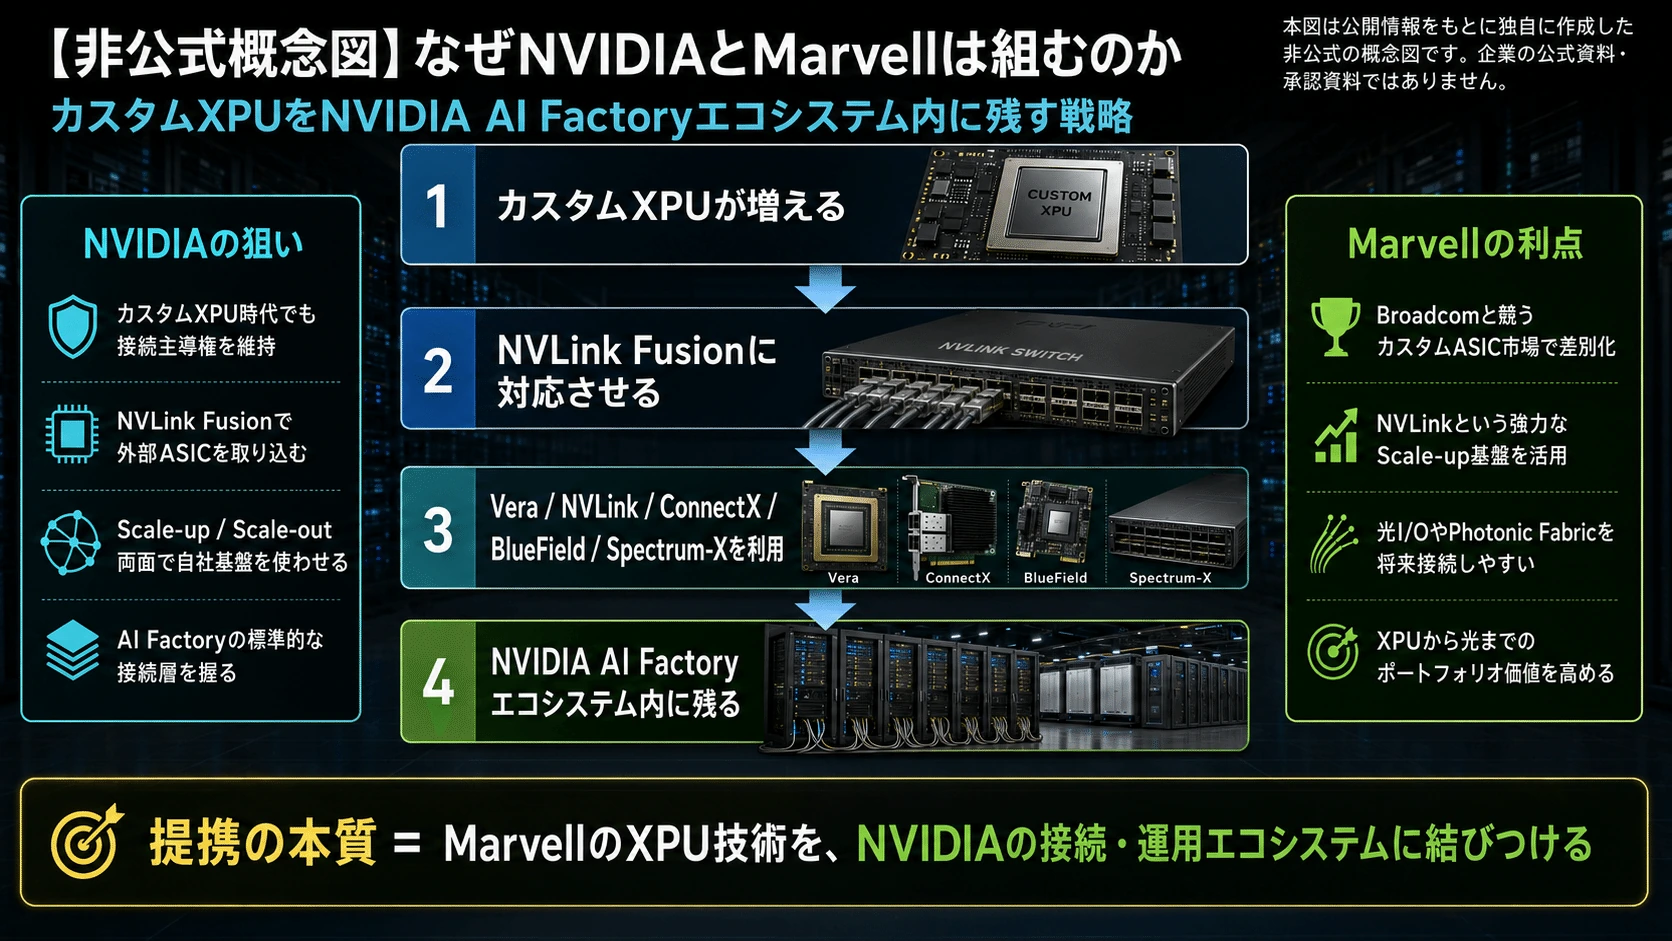
#この提携の狙い
#NVIDIAにとっての狙いは、カスタムXPUが増えても、それをNVIDIAの外へ完全に逃がさないことです。
#カスタムXPUが増える
↓
NVLink Fusionに対応させる
↓
Vera / NVLink / ConnectX / BlueField / Spectrum-Xを使わせる
↓
NVIDIA AI Factoryエコシステム内に残すMarvellにとっては、Broadcomと競合するカスタムASIC市場で、NVLinkという強力なScale-up基盤を利用できる利点があります。
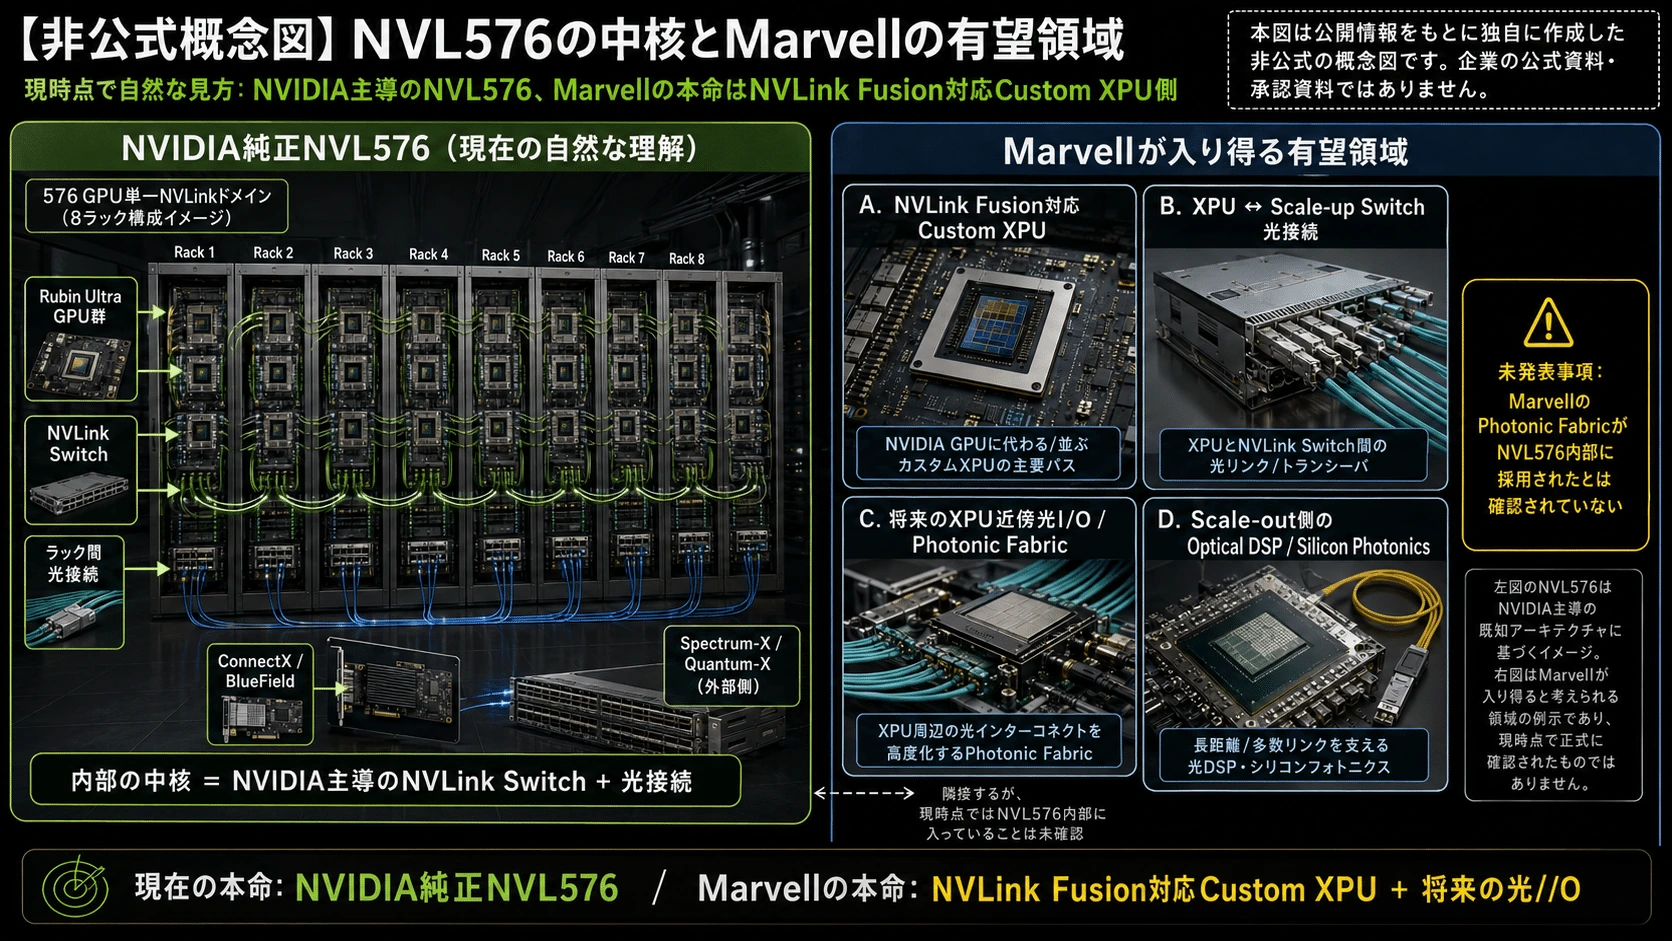
#ただし、MarvellのPhotonic FabricがNVL576内部に採用されたとは発表されていません。
#現時点で最も自然な見方は、
#NVIDIA純正NVL576
=NVIDIA主導のNVLink Switch+光接続
Marvellの本命
=NVLink Fusion対応Custom XPU
+Scale-up Switch
+将来のXPU近傍光I/Oです。
#
#
12.MarvellとBroadcomの競争
#両社が最も強く競合するのは、NVIDIA外のASICクラスタです。
#Broadcomの立場
#Custom ASIC
↓
Tomahawk Ultra / UALink / SUE
↓
Tomahawk 6 Leaf–Spine
↓
Jericho4 / DCIBroadcomは今すぐ使えるEthernetスイッチ、CPO、SerDes、NIC、カスタムASICで強い立場にあります。
#Marvellの立場
#Custom XPU
+ NVLink Fusion / UALink / ESUN
+ Photonic Fabric
+ Teralynx Scale-out
+ Optical DSP
+ Structera CXL MemoryMarvellはTeralynxをScale-out Ethernetに提供し、Photonic FabricをMulti-rack Scale-upに、StructeraをMemory Poolに展開する構想です。OFC 2026では、Teralynx、1.6T Optical DSP、Photonic Fabric、CXLを一つのEnd-to-End接続ポートフォリオとして提示しています。(Marvell Technology, Inc.)
#時間軸で見た競争優位
#| 時期 | 優位になりやすい企業 | 主な理由 |
| 2026~2027 | Broadcom | Ethernetスイッチ、CPO、量産実績 |
| 2027~2028 | Broadcom優位、Marvell追上げ | PF初期量産、NVLink Fusion設計開始 |
| 2028~2029 | 案件ごとに分化 | Broadcom Ethernet対Marvell光XPU |
| 2029~2030 | Marvellの上振れ余地 | XPU近傍光、Memory Pool、NVLink Fusion |
| 2030以降 | 不確定 | 標準、歩留まり、顧客採用次第 |Broadcomの優位は「現在の製品と市場シェア」にあります。
#Marvellの優位は「XPU・Switch・Memoryを同じ光I/O基盤で接続できる可能性」にあります。
#つまり、
#Broadcom
=今のEthernet AIネットワークの完成度
Marvell
=次の光Scale-up・光Memoryのオプション価値
NVIDIA
=独自GPU、NVLink、ソフトウェアまで含む垂直統合という構図です。
##
13.2030年前後までの総合予測
#2026年
#- GB300 NVL72からVera Rubin NVL72へ移行
- NVL72のScale-upは銅中心
- Spectrum-X/Quantum-XのSwitch CPOが先行
- Broadcom Tomahawk 6、Tomahawk Ultra、200G/lane CPOが商用化
- MarvellはPhotonic Fabric統合、1.6T DSP、CXL Switchの準備段階
- TSMC COUPEの製造基盤が立ち上がる
2027年
#- 本来はKyber NVL144導入年
- 実際には限定出荷または遅延の可能性
- Marvell Photonic Fabricが初期売上を生む会社目標
- XPU-to-Switch光接続の初期採用
- Broadcom CPO Scale-outが拡大
- Memory PoolはまだCXL銅中心
2028年
#- Kyber NVL144の現実的な量産開始候補
- NVL576が限定数量で導入される可能性
- Scale-up CPOの実運用データが集まり始める
- Marvell PFを搭載したカスタムXPU/Switch案件
- XPU近傍光I/Oが初期量産へ
- CXL Memory Poolがサーバー・ラック内で拡大
2029年
#- Feynman/NVL1152の基本シナリオ
- NVL576の技術をNVL1152へ継承
- 1,000 XPU級Scale-upで光が事実上必須に
- MarvellのNVLink Fusion+Photonic Fabricが本格評価
- 光Memory Poolのパイロット導入
- Broadcomは次世代CPOとEthernet Scale-upで対抗
2030年前後
#- 最短距離は銅、ラック間以上は光というハイブリッド構造
- XPU近傍光I/Oが一部の高性能カスタムASICで一般化
- CPO Scale-outは大規模AIファクトリーで標準的選択肢へ
- マルチラックScale-upは数百~1,000超XPUへ
- Memory Poolは汎用HBM代替ではなく、KVキャッシュ・共有DRAM・容量階層として普及
- NVLink、UALink、Ethernet系Scale-upが併存
#
結論
#AIデータセンターの光化は、単純に「銅がすべて光へ置き換わる」流れではありません。
#ラック内の短距離
→ 銅が長く残る
ラック間Scale-up
→ 2028年前後から光化
Scale-out
→ すでに光化、CPOへ移行中
XPU近傍光I/O
→ 2028~2030年の次の競争領域
Memory Pool
→ まずCXL銅、光は2030年前後からNVIDIAは、NVL72の銅Scale-upから、NVL576とNVL1152のラック間光NVLinkへ進みます。しかしKyberの巨大銅ミッドプレーンとScale-up CPOの双方に製造難度があり、公式ロードマップより1年前後遅れる可能性を考慮すべきです。
#Broadcomは、Tomahawk Ultra、Tomahawk 6、Jericho4、200G/lane CPOにより、現在のEthernet Scale-up/Scale-outで最も完成度の高い陣営です。
#Marvellは、Photonic Fabric、Custom XPU、NVLink Fusion、Optical DSP、Teralynx、Structera CXLを組み合わせ、XPUからSwitch、Memory Poolまでを光で接続する将来構造を狙っています。
#NVIDIAのMarvellへの投資は、NVL576の部品調達だけを目的とするものではなく、カスタムXPUが伸びる世界でもNVLink、ConnectX、BlueField、Spectrum-Xを中心としたNVIDIAエコシステムを維持するための戦略と見るのが自然です。
#最大の焦点は、2028~2030年に、
#BroadcomのEthernet CPOがそのままScale-up領域を拡大するのか、MarvellのXPU近傍Photonic Fabricが新しい接続階層を作るのか、あるいはNVIDIAがNVLink CPOを垂直統合して両者を囲い込むのか
#という点です。
##
特定銘柄の推奨・勧誘・投資助言を目的とするものではありません。投資判断はご自身の責任でお願いいたします。
#サムネはPixAIsunflowerモデルとGPTImage2.0
#