HBMとGPUとDRAMのぜんぶ:バス幅/メモリコントローラ/VRAM容量/スタック(Hi)/ピン速度/帯域まで一気に理解する
この資料の日時
元資料の日付と、その本文が公に存在した確認日時は別の記録です。
本文に含まれる語句 HBM DRAM 帯域・データ移動 先端パッケージング 電力・給電 冷却 歩留まり 基板・材料 AI推論
出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.09.23.4
- 記事内容のSHA-256
5797016883eb2226564147c0e2fd0b054eaec6032aadf33e8298341867996a10- 保存版のSHA-256
287c5860af0417b918cfad36411613806605b43b47dfcdf33ba5d57a1699d87e
外部証明の最終検査結果は詳細を開くと表示します。
HBMとGPUとDRAMのぜんぶ:バス幅/メモリコントローラ/VRAM容量/スタック(Hi)/ピン速度/帯域まで一気に理解する
#「スペック表の数字が“意味”でつながる」と、複雑に思える概念も理解しやすいです。 SK hynixのHBM4にも触れます。#
#
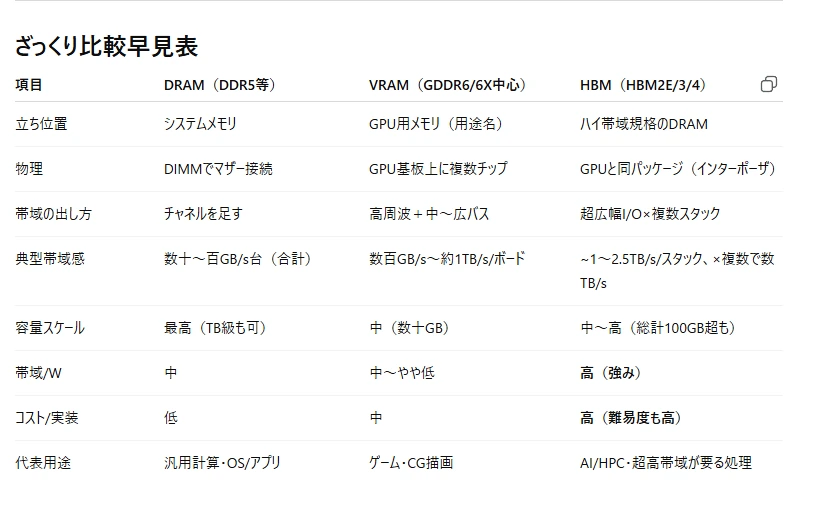
まずは俯瞰:GPU・DRAM・HBM・VRAMの関係
#- GPU:演算プロセッサ本体。メモリにアクセスしてデータを読み書きする側(≒主人公)。
- DRAM:揮発性メモリの総称/技術。PCのDDR5、スマホのLPDDR5(X/6)、グラフィックス用のGDDR6/7、高帯域のHBMは “いずれもDRAMの種類”。
- VRAM:GPU専用に直結して使う用途名。GDDRやHBMがGPUに直結していれば、それはそのボードの「VRAM」。
- HBM:High Bandwidth Memory。DRAMダイを縦に積む(TSV)規格で、超広幅I/Oと短配線で高帯域・高効率を狙う。最新はHBM4。JEDEC(業界標準化団体)が仕様を定めています。(Tom's Hardware)
#
バス幅とメモリコントローラ:数字がどう噛み合うか
#GDDR系(一般的なdGPUの作法)
#- **1チップ=32bit幅(x32)**が通例。したがって バス幅= 32 ×(チップ枚数)。
例:256bitなら x32チップが8枚。MicronのGDDR6資料でも*“32 DQs per component(=x32)”\*と明記。(assets.micron.com)
- メモリコントローラはGPUダイ内に32bit単位で複数入り、本数の合計=バス幅になります(例:6本→192bit、8本→256bit)。
- SKUの作り分けはだいたいこの三択:
① コントローラ本数(=バス幅)を変える ② チップ密度だけ上げて容量だけ増(バス幅据え置き) ③ メモリレートを上げて帯域だけ増。
#HBM(HBM3→HBM4)
#- 単位は“1スタック”(縦積みDRAM+ベースロジック)。
- HBM3は1スタック1,024bit、HBM4は2,048bitまで拡大(32チャネル×各64bit、各チャネルは擬似チャネル×2)。この“幅の倍増”が帯域ジャンプの土台。(Tom's Hardware)
- GPU側にはスタック単位のメモリコントローラIPを複数載せ、スタック数を増やして容量・帯域を水平にスケールさせます。
#
VRAM容量の決まり方:HBMは「ダイ容量×段数」
#- HBMの1スタック容量
= (ダイ容量)×(段数=8/12/16-Hi) 例:32Gb(=4GB)/ダイ × 16-Hi = 64GB/スタック。JEDECのHBM4は24Gb/32Gb密度と最大16-Hiに対応→1スタック最大64GBが上限設計の目安です。(HPCwire)
- 総VRAM容量 = (1スタック容量)×(スタック数)。
例:48GB/スタック × 8スタック = 384GB。
#ポイント:バス幅やチャネル数は“速さ(帯域)”の話であって“容量”は「密度×段数」で決まる、を身体で覚える。#
#
Hi(ハイ)=“何段重ねか”の素直な数え方
#- 8-Hi / 12-Hi / 16-Hi … は縦積み段数のこと。
- 段数を増やすと容量は線形に増えるが、熱・歩留まり・高さの課題も増えるため、実製品は発熱対策(MUF接着、薄型ダイ等)を駆使してバランスを取ります。HBM4世代でも12-Hi/16-Hiが主要レンジ。(SK hynix Newsroom -)
#
ピン(per-pin)の速度と“Gb/s”の正体
#- メモリの「○○Gb/s(per pin)」は、1本の信号線が1秒あたりに運ぶビット数。
- GDDRもHBMもDDR(倍転送)系なので、公称“Gb/s”は既に倍転送を織り込んだ有効レートです(ここに×2をさらに掛けないのがコツ)。
#
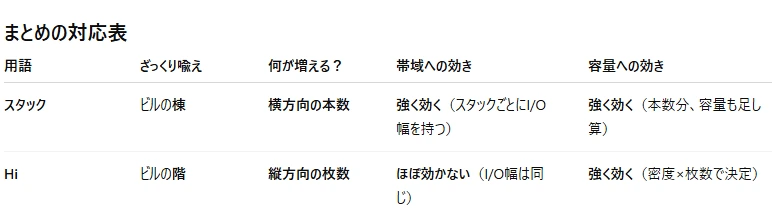
- スタック=“ビルの棟数”
- Hi=そのビルの“階数”
スタック(HBMスタック)とは?
#- **1つのHBM“塊”のこと。
ロジックベースダイ(下階の管制塔)+複数枚のDRAMダイを縦に積層**(TSVで接続)したユニットを指します。
- GPUパッケージの周囲にこのスタックを複数本並べます(例:6スタック、8スタック…)。
- 帯域と容量を“横方向”に足す単位:
- 帯域…スタックごとに固定のI/O幅(HBM2/3: 1,024bit、HBM4: 2,048bit)を持つので、スタック数を増やすと帯域がほぼ線形に増える。
- 容量…1スタックの容量の**“本数分”が合算されるので、こちらも線形に増える**。
たとえば HBM3 の 1スタックが ≈1.2TB/s の帯域・24GBの容量なら、8スタックで ≈9.6TB/s・192GB といった具合で伸びます(実効は配線・消費電力・温度で前後)。
##
Hi(ハイ)とは?
#- 「N-Hi」は**そのスタックの“DRAMダイの枚数”**を表す記号です(ロジックベースは数えない)。
- 4-Hi / 8-Hi / 12-Hi / 16-Hi …と増えるほど、縦方向に何枚積んだかを示す。
- 容量を“縦方向”に増やすノブ:
- 1ダイの密度(Gb) × Hi(枚数) = 1スタック容量
- 例:1ダイ 24Gb(=3GB) のHBM3で 8-Hi → 24Gb×8 = 192Gb = 24GB/スタック。
- 帯域は基本“Hiで変わらない”:
- 帯域は**I/O幅(bit)×ピン速度(Gb/s)**で決まり、Hiの増減では増えない(内部並列度やタイミング条件でわずかに差が出ることはあっても、設計上は容量ノブ)。
スタックは一塊のイメージでHiに1ダイの密度を掛ける事でスタックの容量が求められます
#
計算ミニチート
#- 1スタック容量 = (1ダイ容量)×(Hi)
- 1スタック帯域(GB/s) = (I/O幅÷ 8)×(ピン速度)
- HBM3:1,024bit、HBM4:2,048bit
- 総容量= 1スタック容量 × スタック数
- 総帯域= 1スタック帯域 × スタック数
具体例(感覚づけ)
#- HBM3(例):1ダイ=24Gb=3GB
- 8-Hi → 24Gb×8=192Gb=24GB/スタック
- ピン速度 9.6Gb/s とすると 1スタック帯域 ≈ (1024/8)×9.6 = 1,228.8 GB/s ≈ 1.23TB/s
- 8スタックなら 容量=24GB×8=192GB, 帯域≈1.23×8=≈9.8TB/s
- HBM4(例):1ダイ=32Gb=4GB、2,048bit
- 16-Hi → 32Gb×16=512Gb=64GB/スタック
- ピン速度 8Gb/s(JEDEC)→ 1スタック 2.0TB/s、10Gb/s実装なら 2.56TB/s
- 8スタックで 容量=64GB×8=512GB, 帯域=2.0〜2.56×8=16〜20.5TB/s
- **より多く“入れたい”**なら:**Hi(縦)**を上げる or **スタック数(横)**を増やす。
- ただし Hiを上げると熱・高さ・歩留まりの難易度が上がる。
- **より速く“回したい”**なら:スタック数を増やす(=I/O幅合計を増やす)か、ピン速度の高い世代/グレードを選ぶ。
- Hiを増やしても帯域は増えない点がハマりどころ。
#
帯域幅の式(覚えやすい版)
#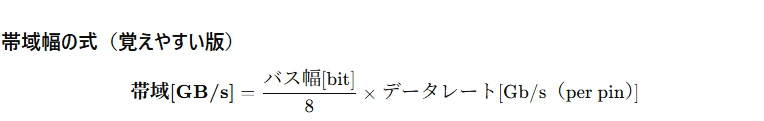
- HBM4(1スタック)例:2,048bit × 8Gb/s ÷ 8 = 2,048GB/s ≒ 2.0TB/s(JEDEC標準レート)。10Gb/sなら2.56TB/s/スタック。(Tom's Hardware)
- 総帯域はスタック数倍でほぼスケール(配線・電力・熱が許す範囲で)。
#
SK hynixのHBM4:標準を超えるスピードと量産準備
#- JEDECのHBM4は2,048-bit幅と最大8Gb/s/ピンを規定(理論2TB/s/スタック)。ダイ密度は24Gb/32Gb、最大16-Hiで64GB/スタックまでの道筋が整理されました。(Tom's Hardware)
- SK hynixは HBM4の開発完了&量産準備を発表。“10Gb/s超/ピン”を実現し、標準(8Gb/s)比で25%超のマージンを掲示。12-Hi実装・MR-MUFなどの積層・放熱技術もアピールしています。(SK hynix Newsroom -)
- 報道では、2025年にサンプル出荷~量産立ち上げの流れが示唆され、主要顧客(AI/GPUベンダ)向けに2,048-I/O×10Gb/s級を供給する見通し。(Reuters)
まとめると:**HBM4の“幅(2,048bit)×速さ(8→10Gb/s/ピン)×高さ(12/16-Hi)”**の三段攻めで、1スタック2~2.56TB/s、容量は最大64GB/スタックまで見える——これが“次世代AI/GPUのエンジン”たる所以です。#
#
スペック表の読み方・実戦メモ(GDDRとHBM)
#- GDDR系
- バス幅(192/256/320/384bit…)を見る
- チップ枚数 ≒ バス幅/32(x32が基本) → 概容量=(チップ容量)×(枚数)
- 帯域=(バス幅/8)×Gb/s(Gb/sはそのまま使う)
- GDDR6XはJEDEC標準外のベンダー拡張(Micron×NVIDIA、PAM4)。“標準”と混同しない。(Tom's Hardware)
- HBM系
- スタック数(= 本数)を見る
- 1スタック容量=(ダイ密度)×(Hi) → 総容量=スタック数倍
- 1スタック帯域=(2,048/8)×Gb/s(HBM4) → 総帯域=スタック数倍
- 実効は冷却・電力・配線品質で上下。レビューでは温度・スロットリング挙動も必ず確認。
#
よくある疑問に一言で
#- 「HBMに“VRAM”はあるの?」
→ ある。HBMは規格名、VRAMは使い方(用途名)。GPU直結のHBMは、そのボードのVRAMそのもの。
- 「バス幅と容量って関係ある?」
→ 直接はない。容量=密度×段数、速さ=バス幅×Gb/s。
- 「Hiって何者?」
→ 縦積み枚数。8/12/16-Hi の“高さ”で容量を稼ぐ。
- 「per-pin ってなに?」
→ 1本の信号線の速度(Gb/s)。HBM4は標準8Gb/s、SK hynixは10Gb/s超を公表。(Tom's Hardware)
##
1スーパーチップ事のHBMスタック数
#主要アクセラレータのHBMスタック数(横に何本)・総容量(VRAM)・実効帯域をざっと俯瞰できる表から。数字は“1 GPU(または1スーパー チップ)あたり”の代表値です(OEMや世代差で微差あり)。
#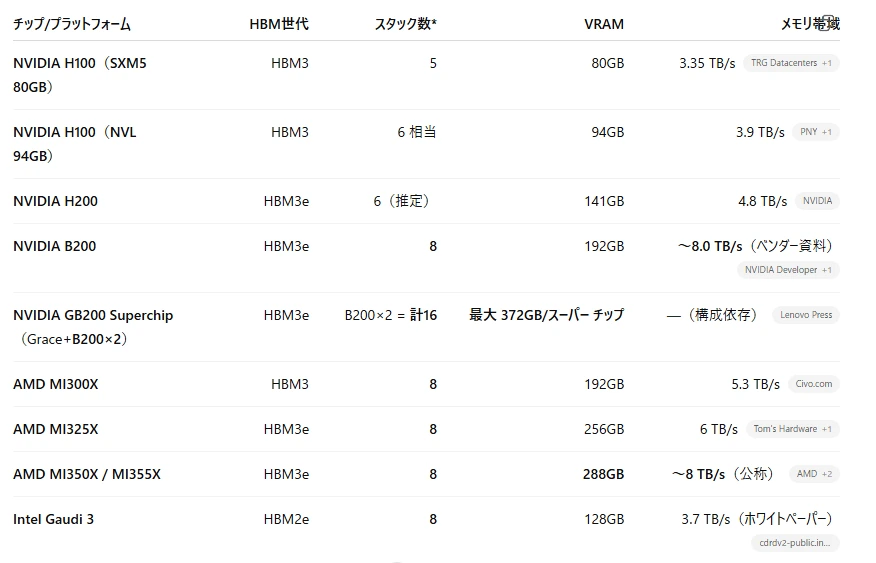
* スタック数=“パッケージ上でGPUダイの周囲に並ぶHBMスタックの本数(横)”。 (注)GB200はB200×2の“スーパー チップ”なので、表示は1スーパー チップ単位。Grace CPU側のLPDDR5Xメモリは別枠です(最大480GB級が一般的ですが、HBMではありません)。(Lenovo Press)
##
「スタック数の最大値」は何で決まる?(横の上限)
#- 現行実装の上限は8スタックが主流(B200、MI3xx、Gaudi 3 など)。基板サイズ/シリコンインターポーザ面積(“ビーチフロント”)/熱設計が制約。
- 次の増加ポイントは12スタック:TSMCはCoWoS-Lの拡張で**“最大12 HBMスタック”**を公式に示しており、2027年量産のロードマップが公表済み。これは“横に何本置けるか”の物理上限を押し上げます。(ori.co)
実務的には「8→12スタック」への拡張で、同じ世代でも容量・帯域が直線的に伸びる(電力/冷却/歩留まりとのトレードオフは増大)。#
#
「Hi(層数)の最大値」は?(縦の上限)
#- HBM3/3E:一般に12-Hi(12層)まで。
- HBM4:標準で12-Hi/16-Hiが想定され、1ダイ**24Gb(=3GB)**クラスが主流見込み。
- 12-Hi ⇒ 36GB/スタック、16-Hi ⇒ 48GB/スタックが目安。(Tom's Hardware)
- さらにHBM4はI/Oが2,048-bitに倍増、JEDEC基準の8 Gb/s/Pinに対し、各社は10 Gb/s級をアピール。**電力効率も+40%**をうたいます。(micron.com)
#
SK hynixのHBM4:どこまで来ている?
#- 2025年9月にHBM4の開発完了と量産準備を公式発表。2,048-bit、>10 Gb/s/pin、12-Hi対応などを明示。(SK hynix Newsroom -)
- 業界ロードマップでは、12-Hi/16-Hiと24Gbダイを前提に36~48GB/スタックが標準化される見込み。次世代(HBM4E)も視野。(Tom's Hardware)
#
これから“何が”増えるのか(まとめ)
#- 横(スタック数)
→ 8 → 12スタックへ。パッケージング(CoWoS-L/R等)の発展で総容量・総帯域が素直に伸びる。(ori.co)
- 縦(Hi:層数)
→ HBM4で12-Hi/16-Hiが一般化し、1スタック=36~48GB時代へ。(Tom's Hardware)
- I/Oとピン速度
→ 2048-bit ×(8~10+ Gb/s/pin)で帯域が1スタックあたり倍増級。同一電力での効率も改善。(micron.com)
- 製品例の見通し
- GB200/B200級:8スタック→将来12スタック版が視野。HBM4化で“(スタック数)×(層数)×(ピン速度)”の三重増。
- AMD MI350/355X後継:既に288GB/~8TB/sまで到達。HBM4採用世代で**>300GB/8TB/s超**が当たり前に。(AMD)
- Gaudi系:現行はHBM2e 128GB/3.7TB/s。HBM4世代では容量・帯域のテコ入れが鍵。(cdrdv2-public.intel.com)
#
余談:GB200の“VRAMはいくつ?”問題
#- B200単体は192GB/~8TB/sが目安(8スタック)。(NVIDIA Developer)
- GB200 SuperchipはB200×2なので、**“HBM合計は最大372GB/スーパー チップ”**と記すサーバーベンダーの資料が多数(ECCや予約領域を含む“可用容量”の表記差に注意)。(Lenovo Press)
#
使い分けの指針(再掲)
#- VRAM容量(=HBM容量)は大規模モデルの収容力に直結。
- 帯域は学習/推論時のスループットに直結。
- スタック数(横)とHi(縦)、ピン速度の三つ巴で“総容量×実効帯域”が決まる、という理解でOK。
#
I/Oピンのbitとは?
#- HBMの**データI/O幅(bus width)は「1本のDQピン=1bit幅」として数えます。
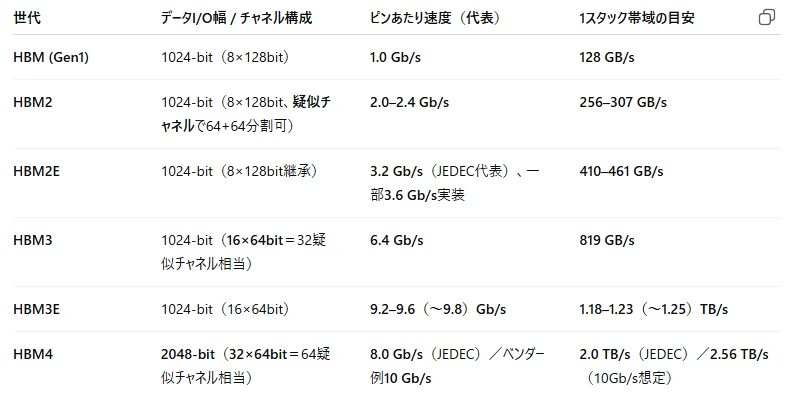
例:HBM2/3は1024-bit=1024本のデータピン、HBM4は2048-bit**。この“bit”が広いほど同じピン速度でも帯域は大きくなります。HBMはチャネルを束ねてこの幅を作ります(HBM2=8×128bit、HBM3=16×64bit、HBM4=32×64bit)。(EE Times Asia)
- **ピンあたり転送速度(Gb/s per pin)**は1ピンで何ギガビット/秒送れるか。DDR系なので両エッジ転送ですが、公開されるGb/s値はその効果込みの“実効”です。
- **帯域幅(1スタック)**は
帯域
世代ごとのI/O構成と帯域(代表値)
#
出典(構成と速度)
#- HBM/2:1チャネル128bit、HBM2は疑似チャネル(64+64)を導入、最大2.4Gb/sまで拡張。(EE Times Asia)
- HBM3:16×64bit=1024-bit構成、6.4Gb/sで**〜819 GB/s/stack**。(synopsys.com)
- HBM3E:1024-bit据え置きで9.2〜9.6Gb/s(ベンダーにより表記差)。(Medium)
- HBM4:2048-bitへ倍増、JEDECは8Gb/s/pin → 2TB/s/stack。(オールアバウトサーキット)
- SK hynixは10Gb/s/pin達成を発表(JEDEC比+25%)。(SK hynix Newsroom -)
補足:I/Oは「データDQ」に加えてコマンド/アドレス/クロックなどの信号もあり、HBM3E世代では総配線は約2000本規模に達します(データ+制御)。このため実装はシリコンインターポーザ等の2.5D配線技術が必須になります。(Semiconductor Engineering)#
計算式とサクッと計算例
#- 式:帯域= (I/O幅÷ 8) ×(ピン速度)
- 例1:HBM3(1024-bit, 6.4Gb/s)→ (1024/8)×6.4 = 819.2 GB/s。(ServeTheHome)
- 例2:HBM4(2048-bit, 8.0Gb/s)→ (2048/8)×8.0 = 2048 GB/s = 2.0 TB/s。(オールアバウトサーキット)
- 例3:HBM3E(1024-bit, 9.6Gb/s)→ (1024/8)×9.6 = 1228.8 GB/s ≈ 1.23 TB/s。
- 例4(ベンダー実装例):HBM4(2048-bit, 10Gb/s)→ (2048/8)×10 = 2560 GB/s = 2.56 TB/s。(ServeTheHome)
進化のポイント(I/Oピン視点)
#- 幅を広げる:HBM→HBM3までは1024-bitで推移、HBM4で2048-bitに倍増(チャネルも8→16→32へ)。(ServeTheHome)
- ピン速度を上げる:1.0→2.4→3.6→6.4→9.x→8(HBM4 JEDEC)/10(実装例)。世代ごとに信号方式・クロッキング・RAS/ECC強化などで引き上げ。(EE Times Asia)
- 制御の細分化:HBM2の疑似チャネル導入→HBM3で16×64bit化→HBM4で32×64bit化。並列度が増え、実効性が上がります。(EE Times Asia)
#
この記事の狙いは「数字が意味でつながる体験」です。
#- **HBM=“幅を倍に、積み重ねで容量を伸ばし、短配線で効率を上げる”**発想。
- **GDDR=“x32チップを並べて幅を作り、レートで速さを足す”発想。
どちらも式に落ちると読みやすい。次にスペック表を見かけたら、(バス幅/8)×Gb/sと、密度×Hi×スタック数**を指でなぞってみてください。もう“ただの数字”ではなくなります。
##
参照(主要ソース)
#- JEDEC HBM4 概要:2,048-bit, 8Gb/s/ピン, 32チャネル, 最大64GB/スタック(24/32Gb×16-Hi)。(Tom's Hardware)
- Cadence:HBM4の24Gb/32Gb密度と16-Hiで64GB/スタックの解説。(Cadence Community)
- SK hynix:HBM4 開発完了・量産準備/10Gb/s超/ピン公表。(SK hynix Newsroom -)
- 報道:HBM4 サンプル~量産の進捗、2,048-I/O×10Gb/s級の文脈。(Reuters)
- GDDR6のx32(32 DQ):1チップ=32bit幅の一次資料。(assets.micron.com)
- H100/H200/B200/GB200のメモリ仕様とベンダー資料:NVIDIA公式・Supermicro等。(TRG Datacenters)
- AMD MI300X/MI325X/MI350X/MI355Xの容量・帯域:AMD資料/各種報道。(Civo.com)
- Intel Gaudi 3の容量・帯域:Intelホワイトペーパーほか。(cdrdv2-public.intel.com)
- TSMC CoWoS-Lの“12スタック”ロードマップ:TSMC公式。(ori.co)
- JEDEC HBM4の骨子(2048-bit/8Gb/s/pin、12–16Hi想定など)とロードマップ記事:JEDEC公開情報の解説、各業界紙。(micron.com)
- SK hynix HBM4の最新発表(開発完了・量産準備、10Gb/s級、12-Hi等):公式ニュース/報道。(SK hynix Newsroom -)
#
サムネ pixai sunflowerモデル
#