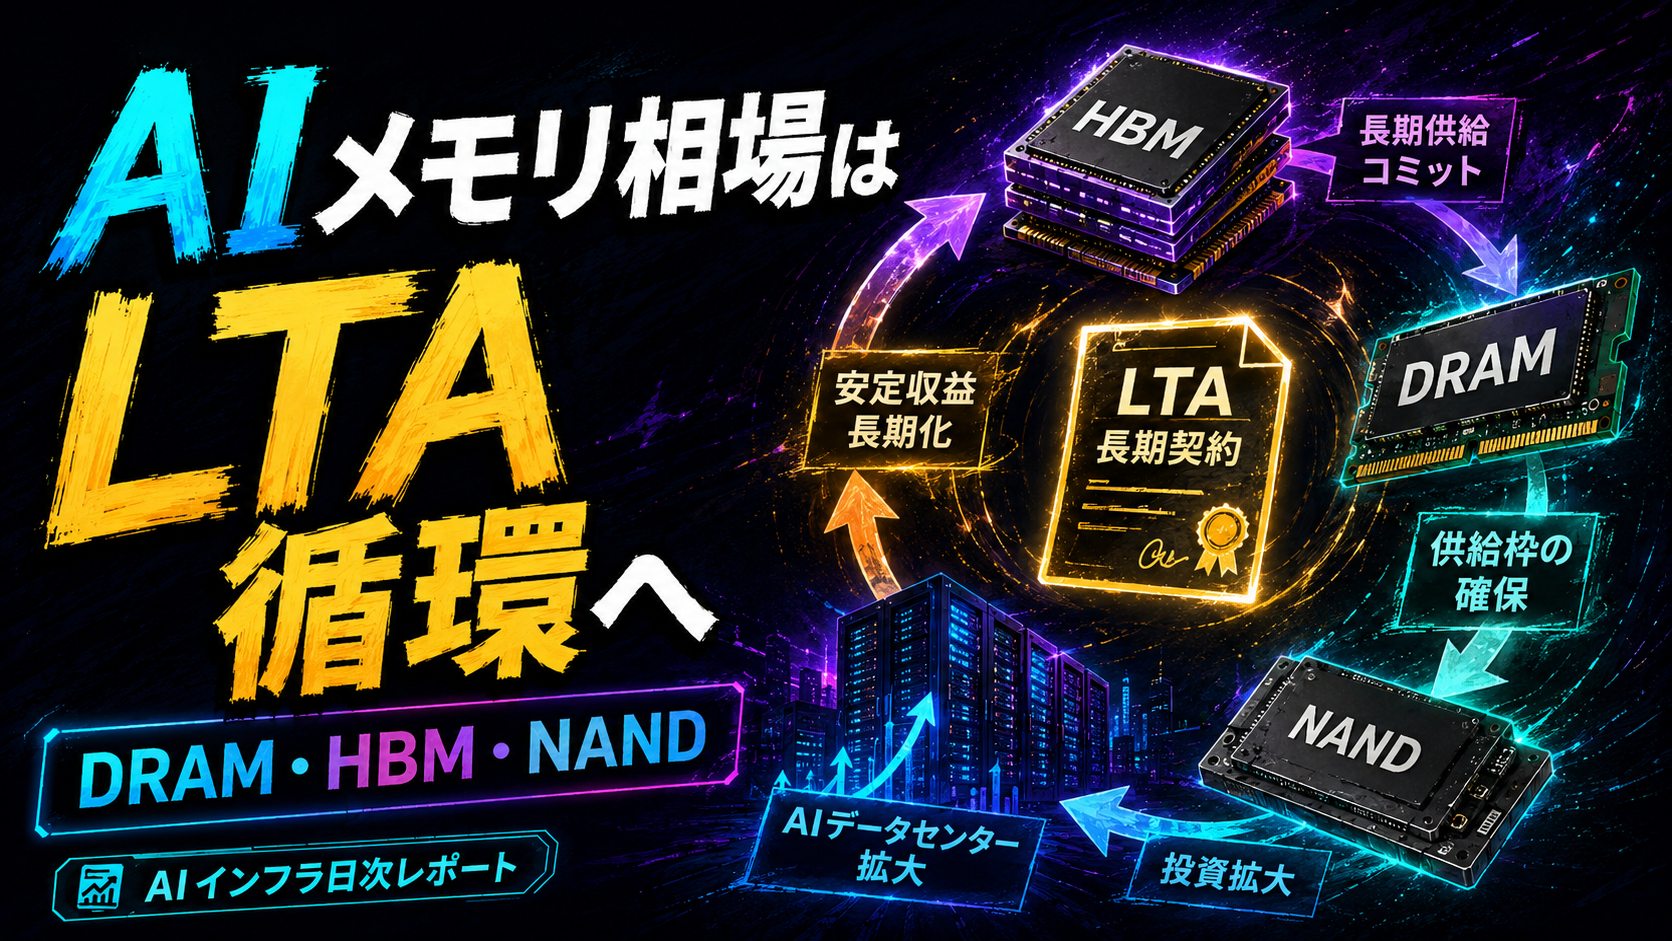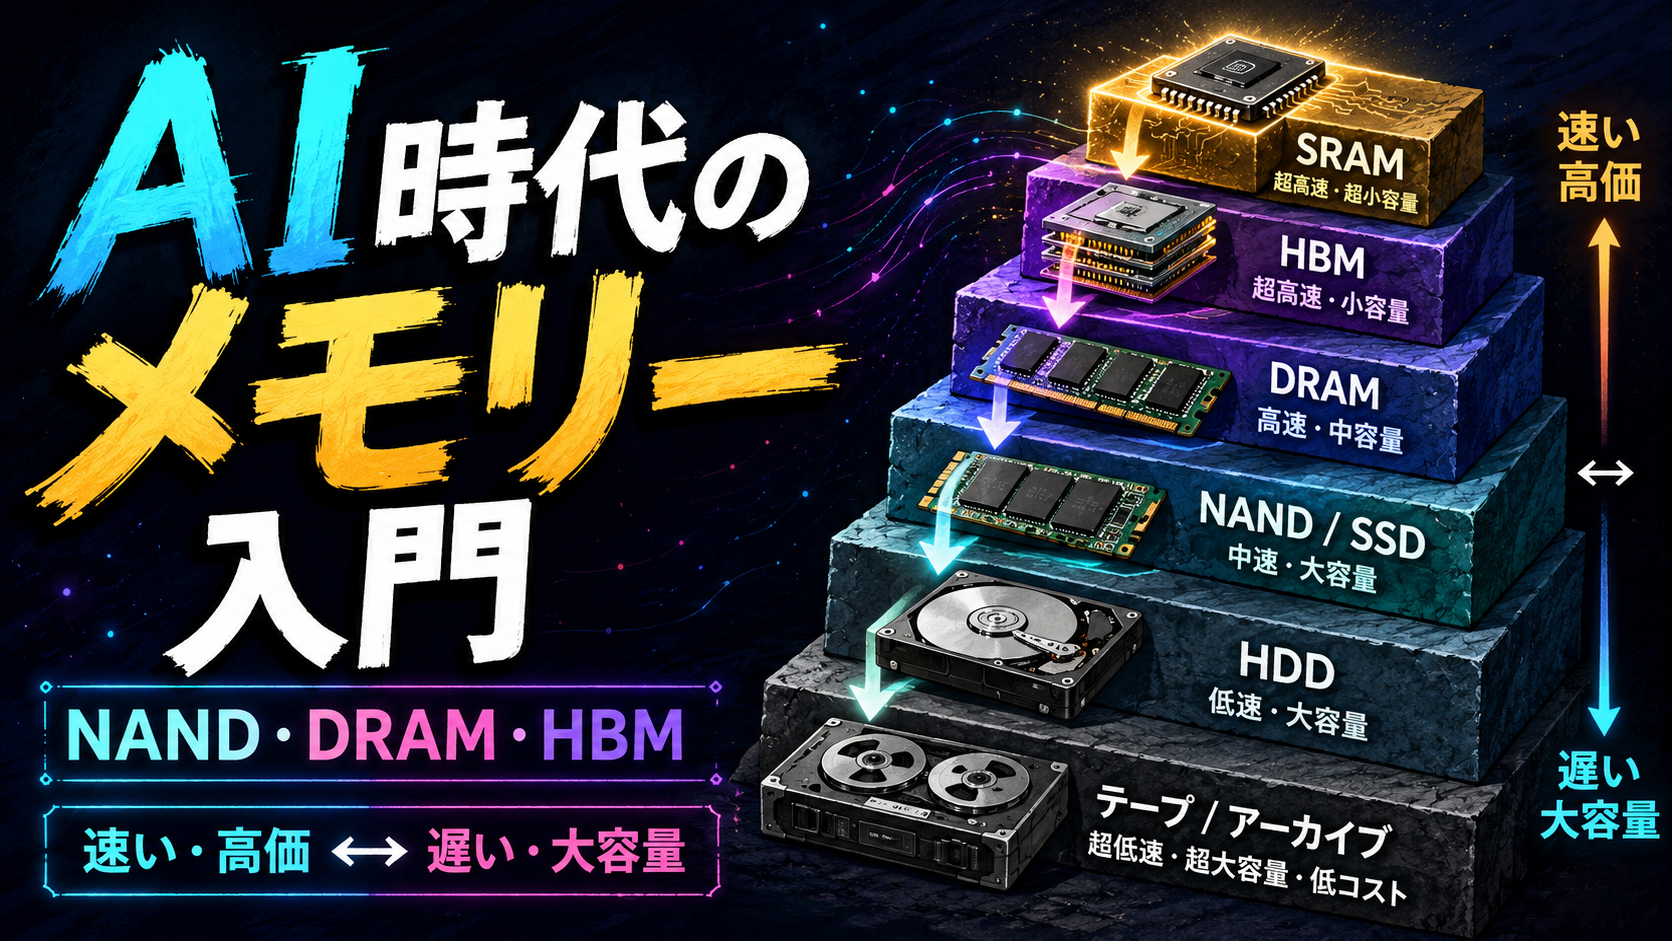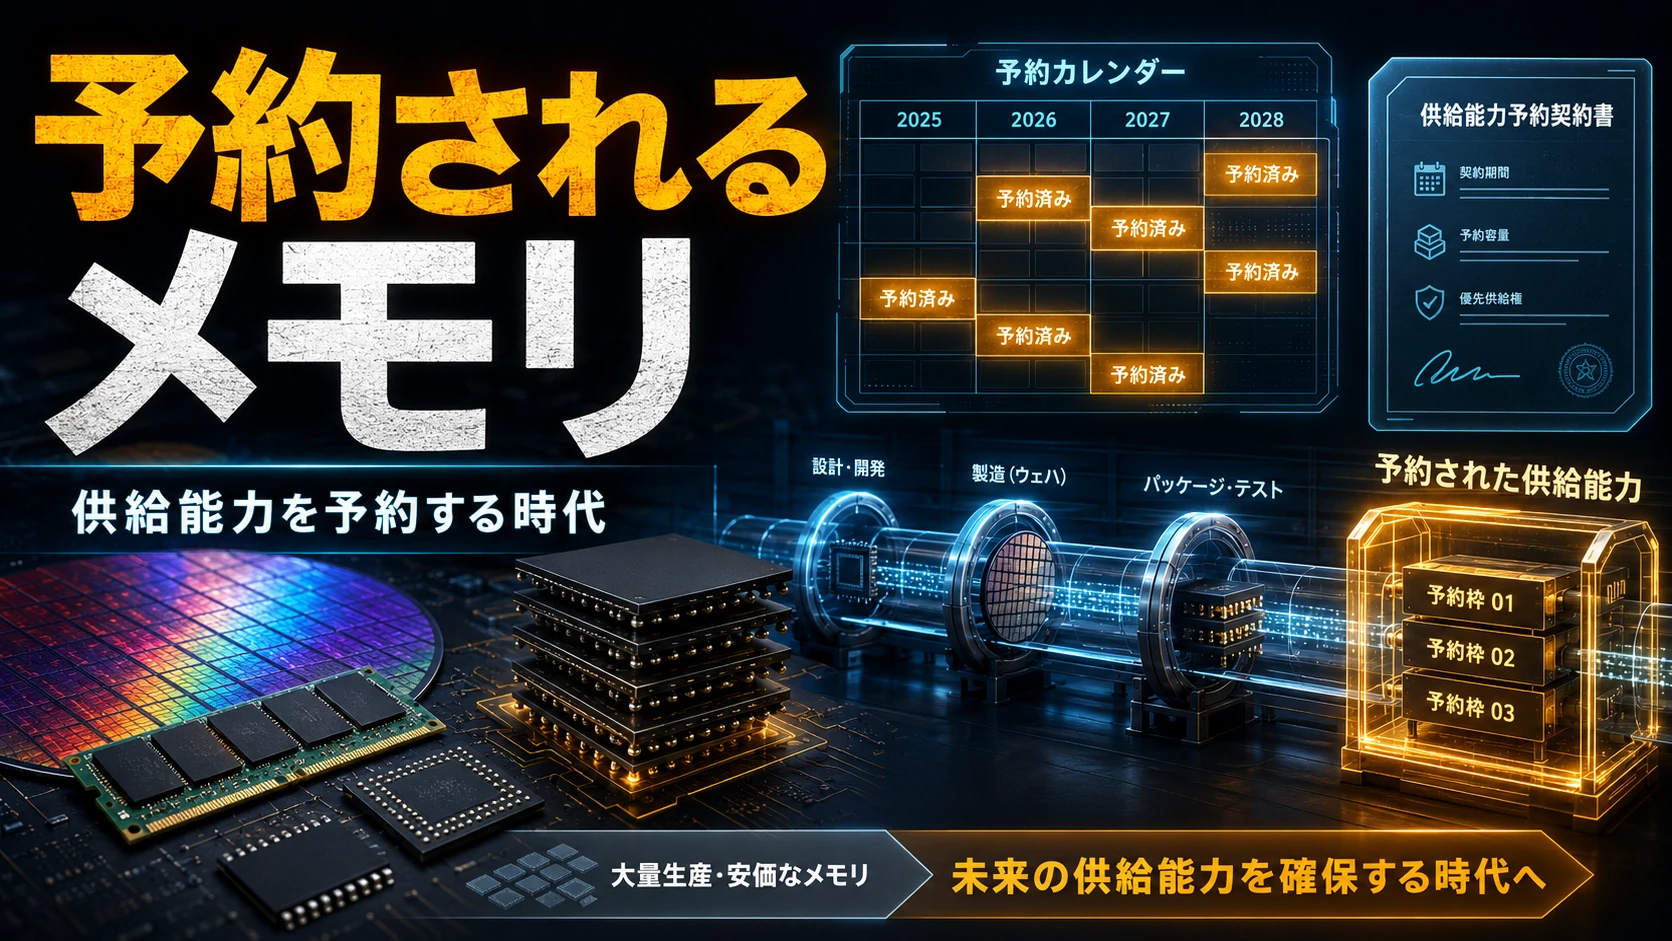
メモリ産業は「量産して安くする時代」から「供給能力を予約する時代」へ
Sandisk・キオクシア・SK hynix・Samsungの決算、LTA、HBF、zNAND、Apple WMCMから考える2030年までの構造転換
はじめに
DRAMとNANDは、長く典型的な市況産業とみなされてきた。
価格が上がれば各社が設備投資を増やし、数年後に生産能力が一斉に立ち上がる。供給が需要を上回ると、完成品メーカーは複数のメモリ会社を競わせて値下げを要求し、価格は製造原価近くまで下落する。メモリ会社は設備投資を停止し、赤字企業が撤退した後に再び供給不足が始まる――これが従来のメモリサイクルだった。
しかし、AIデータセンターを中心とする需要急増、HBMへの生産能力移転、先端プロセスと後工程の難化によって、メモリ会社は現在、単に「価格を決める力」だけでなく、どの顧客に、何年間、どれだけの供給能力を割り当てるかを選ぶ力を持ち始めている。
Sandisk、キオクシア、SK hynix、Samsung Electronicsの決算から見えるのは、増産を放棄する動きではない。
契約のない能力は無理に増やさず、長期契約で引き取りが保証された需要に対して、積極的に設備投資する。
メモリ産業は、製品を作ってから買い手を探すコモディティ産業から、顧客が将来の工場能力を予約するインフラ産業へ変わる可能性がある。
第1部 決算から見える「ASP主導」とLTAへの転換
メモリ売上高は、単純化すれば次の関係で決まる。
ASPはAverage Selling Price、平均販売単価である。
従来のメモリ好況では、ASP上昇を見たメーカーが急速にビット出荷量を増やし、そのビット増加が次の価格崩壊を引き起こした。
ところが現在の決算では、ビット出荷量を無理に増やすより、価格、製品構成、顧客構成、複数年契約を優先する傾向が強くなっている。
Sandisk――売上増加の約3分の2が価格要因
Sandiskの2026年度第4四半期売上高は約89.7億ドルで、前四半期比51%増加した。増収要因のうち、およそ3分の1が出荷量、3分の2が価格上昇によるものだった。非GAAP粗利益率は84.6%に達し、データセンター部門売上高は前四半期比103%増、エッジ部門も48%増となった。つまり、ビットを無制限に増やしたのではなく、希少な供給能力を高単価用途へ再配分した結果である。(Sandisk Corporation)
さらにSandiskは複数顧客との8件の長期契約を公表している。価格下限を基準にした最低契約収益は939億ドル、顧客による金融保証は165億ドルで、2027年度には販売ビットの半分、2028年度には約3分の2が契約対象になる見込みである。契約期間はおおむね5年であり、会社は供給割当状態が2027年を超えて続くと見ている。
これは単なる好決算ではない。
Sandiskは今期の最高値で全量を売る権利の一部を手放す代わりに、数年間にわたる購入量、価格下限、解約時の保証を確保したのである。
キオクシア――ASP上昇とビット増を両立しつつ、投資効率を重視
キオクシアの2025年度売上高は約2兆3,376億円、営業利益は約8,704億円となった。会社は増収の主要因として、AIデータセンター需要によるASPの大幅上昇とビット出荷量の増加を挙げている。つまり数量も増やしているが、収益改善の中心には価格と製品構成がある。(Kioxia Holdings)
キオクシアはAI推論時代に向けて、データセンター向けSSD、XL-FLASH、高密度NANDを重点分野としている。ただし、単純に積層数を増やせばコストが下がるとはみていない。過度な高層化は工程数、設備費、製造時間、ウエハーコストを押し上げるため、横方向の微細化と積層数のバランスを重視している。(Kioxia Holdings)
ここから見えるのは、キオクシアが増産に消極的なのではなく、
CAPEXを増やしても、販売可能ビットと利益が同じ割合で増えるとは限らない
と理解していることである。
SK hynix――過去最高益でも「契約+規律ある投資」
SK hynixの2026年第2四半期売上高は約79.3兆ウォン、営業利益は約60.5兆ウォン、営業利益率は76%となった。同社はHBM4や先端DRAMを拡大する一方、約10社の主要顧客と複数年契約を締結しており、追加の大口顧客とも交渉を続けている。(SK hynix Newsroom)
SK hynixはファブや後工程に巨額投資を進めているため、「供給を増やさない会社」ではない。重要なのは、将来の引き取り量を確認したうえで、HBM、サーバーDRAM、高性能NANDなどへ能力を配分している点である。
Samsung Electronics――契約先行型の積極増産
Samsung Electronicsは4社の中でも、特に積極的に生産能力を増やす側にある。
2026年第2四半期の全社売上高は171.5兆ウォン、営業利益は89.5兆ウォンだった。メモリ事業は過去最高水準となり、限られた能力をサーバーDRAM、HBM4、エンタープライズSSDなどへ優先配分した。会社は下期も供給増を進めるが、AI設備投資の拡大によって需給不足が続くと説明している。(Samsung Global Newsroom)
Samsungは2026年のHBM売上高を前年比3倍超へ伸ばす見通しを示し、HBM4能力を積極的に増強している。ところが、その能力を完成後にスポット市場へ流すのではなく、将来的にはメモリ売上高の60~70%をLTAでカバーする構想が報じられている。(Samsung Global Newsroom)
したがってSamsungの戦略は、
増産しないではなく契約済みの高付加価値需要を満たすために大規模増産する
というものである。
第2部 長期契約の実態――価格固定ではなく、リスクを交換する
LTAはLong-Term Agreement、長期供給契約である。
ただし、数年間ずっと同じ価格で売る固定価格契約だけを意味しない。
現在の代表的なLTAには、次の要素が組み合わされている。
| 条件 | メモリ会社への効果 | 顧客への効果 |
|---|---|---|
| 最低購入数量 | 稼働率と売上を確保 | 必要な供給枠を確保 |
| take-or-pay | 買わなくても支払い義務 | 競合より優先的に供給 |
| 価格下限 | 市況暴落から利益を守る | ― |
| 価格上限 | 最大利益の一部を放棄 | 異常な高騰から調達費を守る |
| 前受金・保証金 | 設備投資資金を得る | 専用能力を予約 |
| 世代更新条項 | 次世代品の価格を再設定 | ロードマップを早期確保 |
Micronが公表した16件の戦略契約は、通常5年間で2026~2030年を対象とし、DRAM数量の約20%、NAND数量の約3分の1をカバーする。多くは具体的な数量を定めたtake-or-payで、大型契約には価格下限と上限がある。(Micron Technology)
ここで重要なのは、メモリ会社が現在の最大価格をあえて固定しないことだ。
市場価格が契約上限を超えても、契約顧客には上限内で供給する。代わりに、市況が崩れても顧客は下限価格と契約数量を守る。
つまり双方が、
メモリ会社は暴落リスク
顧客は供給途絶と急騰リスク
を交換している。
LTA比率の現状
| 企業 | 現在確認できるLTA状況 |
|---|---|
| Sandisk | 2027年度に販売ビットの約50%、2028年度に約3分の2 |
| Micron | 2026~2030年のDRAM約20%、NAND約3分の1を契約済み |
| SK hynix | 約10社の主要顧客と締結、比率非開示 |
| Samsung | 長期的にメモリ売上高の60~70%をLTA化する構想 |
| キオクシア | 比率非開示だが、LTAを投資判断とAI成長戦略に活用 |
各社で「売上高」「ビット数」「生産能力」のどれを基準にしているかが異なるため、単純比較はできない。
それでも、生産量または売上高の半分前後をLTAへ移す方向性は明確である。
第3部 なぜ増産を急がないのか
現在は深刻な供給不足であり、本来ならメモリ会社は最大限増産したくなる。
それでも投機的な能力増強を避ける理由は、単なる慎重姿勢ではない。
1.CAPEXの増加がビット供給増に直結しない
装置価格、建設費、人件費、材料費が上がっている。さらに、HBMは通常DRAMより多くの良品ダイ、TSV、積層、接合、検査、先端パッケージを必要とする。
新しい工場へ100を投資しても、以前と同じ量の追加ビットを得られない。
2.製品転換そのものが供給能力を消費する
通常DRAMラインをHBMへ切り替える間は、装置の改造、工程認証、歩留まり調整が必要になる。
HBMの売上高は増えても、同じウエハーから得られる販売ビットは減りやすい。そのためCAPEXが増えても、汎用DRAMやLPDDRの不足が解消しない。
3.NANDの高層化にも限界がある
NANDは積層数を増やせば面積当たり容量を高められるが、エッチング、成膜、接続、検査工程も増える。
キオクシアが示すように、積層数だけを競うとウエハーコストと工程時間が膨らみ、1GB当たり原価が期待ほど下がらない可能性がある。(Kioxia Holdings)
4.現在は契約条件を変えられる数少ない機会
供給過剰になってから顧客にLTAを求めても、
市場で安く買えるので契約は必要ない
と断られる。
しかし現在は、契約しなければ製品自体を作れない。
この供給不足の間に、
数量保証
価格下限
前受金
5年間のロードマップ
新世代製品の優先供給
を顧客に受け入れさせることができる。
契約前に供給不足を解消するほど増産すれば、自ら交渉力を失うことになる。
5.過剰投資の記憶が残っている
メモリ会社は、過去の好況時に設備を増やし過ぎ、その後の価格崩壊で数年分の利益を失う経験を何度もしている。
現在の「規律」は投資を止めることではなく、スポット価格だけを根拠とする投資を止めることである。
第4部 安く買いたたかれ、消えていったメモリ企業
DRAMは規格化され、同じ世代・同じ仕様であればサプライヤーを切り替えやすい。
公正取引委員会の過去の分析でも、DRAMは品質差が小さく代替性が高いため、完成品メーカーが供給会社を切り替えやすい製品と評価されていた。2000年代初頭には、NECと日立のDRAM事業がエルピーダへ集約され、三菱電機もDRAM事業から撤退してエルピーダへ移管した。(Japan Fair Trade Commission)
エルピーダは技術力を持ちながらも、DRAM価格下落、巨額設備投資、為替、負債負担に耐えられず2012年に会社更生法を申請し、2013年にMicronへ買収された。(El País)
ドイツのQimondaも、DRAM価格崩壊と資金不足によって2009年に経営破綻した。Texas Instruments、Siemens、Motorolaなど、かつてメモリを生産していた企業の多くも事業売却や撤退を選んだ。(Investing.com)
これは単に完成品メーカーが悪かったという話ではない。
メモリ会社側にも、
同時に設備投資する
市場シェアを優先する
価格が下がっても固定費回収のため生産を続ける
次世代投資を止められない
という構造的問題があった。
しかし、完成品メーカーが供給過剰期に四半期ごとの値下げを要求し、次の工場建設リスクをメモリ会社だけに負わせていたことも事実である。
LTAは、このリスク配分を変える。
将来も供給してほしいなら、顧客も最低購入量と設備投資リスクを負担する。
これが新しい関係である。
第5部 HBFとは何か
HBFはHigh Bandwidth Flashであり、NANDをHBMのように積層し、多数の並列経路によって高い合計帯域を得る技術である。
SK hynixとSandiskが発表した標準案では、
8段または16段のNAND積層
最大512GB
約0.4~3.0TB/sの帯域グレード
UCIeによる接続
が想定されている。(SK hynix Newsroom)
NANDなのになぜ高速なのか
NANDセル一つ一つの応答速度がDRAM並みになるわけではない。
HBFは、多数のNANDダイとチャネルを同時に動かすことで、遅い道路を大量に並べ、合計交通量を増やす。
HBM 高速な車線を非常に低遅延で利用 細かな読み書きに強い
HBF 1本ごとの応答は遅い しかし大量の車線を並列使用 大きなデータの連続読み出しに強い
そのためHBFに適するのは、
AIモデルの重み
頻繁に更新しない専門家モデル
大容量の検索データ
低頻度のコンテキスト
推論用の読み出し中心データ
である。
一方、次の用途は引き続きHBMやDRAMが有利だ。
活性値
高頻度KVキャッシュ
学習時の勾配
オプティマイザー状態
細かなランダム書き込み
通信バッファ
頻繁に変化する作業データ
したがってHBFは、HBMの全面代替ではなく、
不足するHBMを、最も性能が必要なデータだけに集中させる技術
である。
HBFはHBMよりどれほど安くできるのか
Sandiskは、HBFについて、HBMと近いパッケージ価格で8~16倍の容量を提供することを目標にしている。実現すれば、容量1GB当たりの価格はHBMの8分の1~16分の1になる計算である。
ただし、これは量産前の目標である。
初期製品では、
専用コントローラー
UCIe
高度な積層
良品ダイ選別
先端パッケージ
冷却
ソフトウェア対応
が必要となるため、一般的なSSD用NANDよりはるかに高くなる。
第6部 zNAND-Oとは何か
SamsungのzNAND-Oは、V-NANDをベースにした高性能・低遅延NANDのコンセプトである。
Samsungは4層・8層構成、高い面積効率、I/O性能の向上、低遅延を特徴として挙げ、スマートフォン、AI PC、ロボットなどのリアルタイム・エッジAI用途を想定している。ただし容量、帯域、遅延、価格、量産時期はまだ公表されていない。(Samsung Global Newsroom)
HBFとzNAND-Oは、どちらも高速フラッシュだが同じ製品ではない。
| 項目 | HBF | zNAND-O |
|---|---|---|
| 主導 | SK hynix・Sandisk | Samsung |
| 主な用途 | AIアクセラレーター、AIDC | スマホ、AI PC、ロボット、エッジ |
| 位置 | HBMとSSDの間 | LPDDRとUFSの間 |
| 容量・帯域 | 最大512GB、0.4~3.0TB/s案 | 未公表 |
| 接続 | UCIeを想定 | 未公表 |
| 現状 | 標準仕様を策定中 | 技術コンセプト段階 |
第7部 DRAM・HBF・zNANDの性能と価格比較
以下は代表的な公表仕様を使った概念比較であり、製品世代、バス幅、構成によって性能は変わる。
| メモリ | 代表的な性能 | 容量 | 特徴 | 容量単価 |
|---|---|---|---|---|
| HBM3E | 1スタック1.2TB/s超 | 24~36GB | 最高帯域、低遅延 | 最も高い |
| HBM4 | 1スタック2.8TB/s超 | 世代・構成依存 | 2048bitバス | 極めて高い |
| GDDR7 | 384bit構成で1.5TB/s超 | 数十GB | GPU向け、高帯域 | 高い |
| LPDDR5X | 1ピン当たり最大10.7Gbps | 最大32GB級パッケージ | 低消費電力 | 高い |
| HBF | 0.4~3.0TB/s案 | 最大512GB | 読み出し中心、大容量 | HBMより大幅に安い目標 |
| zNAND-O | 未公表 | 未公表 | エッジ向け中間階層 | LPDDRより安い可能性 |
| TLC・QLC NAND | 数GB/s級の製品が中心 | 数百GB~TB | 大容量、低価格 | 最も安い |
LPDDR5X、HBM3E、HBM4、GDDR7の公表値を見ると、DRAMは細かなアクセスと頻繁な書き換えに強く、高帯域を低遅延で供給できる。一方HBFは、同程度の総帯域を狙えても、アクセスの性質はNANDであり、DRAMと同一ではない。(Samsung Semiconductor Global)
2026年のスポット価格から見える極端な差
2026年7月28日のスポット指標では、512Gb、すなわち64GBのTLC NANDウエハー価格が約19.18ドルだった。単純計算では原材料段階で約0.30ドル/GBとなる。一方、DDR5 16Gbは1個約50.93ドル、GDDR6 8Gbは約11.61ドルだった。容量換算すると、DDR5は約25.5ドル/GB、GDDR6は約11.6ドル/GBとなる。(TrendForce)
この比較ではDRAM・GDDRがNANDの約39~85倍になる。
ただし、これは直接比較できる完成品価格ではない。
NAND側はウエハー単価
DRAM側は選別・取引されたダイ価格
コントローラーとパッケージを含まない
2026年の深刻な不足で価格が歪んでいる
LPDDRの長期契約価格ではない
という違いがある。
それでも、NANDを高性能化しても、DRAMより大容量を安く提供できる余地が非常に大きいことは分かる。
第8部 スマートフォン・PCでの可能性
TrendForceは、2026年第2四半期のLPDDR5X価格が前四半期比78~83%上昇すると予測し、高級スマートフォンでも16GB構成が減って12GBが中心になり、中価格帯では8GB、低価格帯では4GBへの縮小が進むとみている。(TrendForce)
一方、エッジAIではモデル、システム、キャッシュだけで40~60GBを必要とする場合があり、スマートフォンの平均ストレージ容量は2026年も増加するとTrendForceは予測している。128GB構成が縮小し、256GBが新しい主流になる可能性もある。(TrendForce)
これは矛盾している。
作業メモリとしてのLPDDRは高過ぎる
AIモデルと個人データを置く容量は増やしたい
一般UFSでは遅い
端末価格は抑えたい
この間を埋めるのがzNAND-Oである。
想定される三層構造
LPDDR OS、実行中アプリ、NPU中間結果、KVキャッシュ
zNAND-O AIモデル、検索索引、ゲーム資産、休止アプリ
UFS 写真、動画、通常ファイル、長期保存
zNAND-Oの用途は、必ずしも「小型LLMをすべて端末内で実行すること」ではない。
オンデバイスAIに懐疑的でも、次の用途には意味がある。
クラウドAIへ送るファイルを高速検索する
写真、メール、PDFのベクトル索引を保持する
ゲームのテクスチャやマップを高速に読む
複数のAIモデルをキャッシュする
アプリの休止状態を保持する
AI PCの作業フォルダとして使う
スマートグラスや周辺機器のデータ母艦になる
クラウド推論前の圧縮、分類、個人情報除去を行う
初期世代では、
LPDDR 16GB +zNAND-O 64~128GB +UFS 512GB~1TB
のような全部載せ高級機になる可能性が高い。
成熟後に初めて、
本来LPDDR 24GBになる端末 ↓ LPDDR 12~16GB+zNAND-O 128~256GB
という構成が成立する。
したがってzNAND-Oは、現在のLPDDRを直ちに減らすというより、将来のLPDDR増量を止める製品になりやすい。
第9部 量産しないと市場が広がらず、量産すると価格が崩れる
HBFやzNAND-Oには、典型的なジレンマがある。
量産しない場合
少量生産 ↓ 製造原価が高い ↓ 採用企業が増えない ↓ OS・SoC・ソフトウェアが対応しない ↓ 用途が広がらない
先に大量生産した場合
採用前に設備増強 ↓ 需要立ち上がりが遅れる ↓ 在庫が余る ↓ 値下げ競争 ↓ 投資回収不能
この問題を解くのが、アンカー顧客とのLTAである。
新しい普及モデル
Google、NVIDIA、Qualcommなどと共同評価する
特定GPU、ASIC、スマートフォン、PCへ設計採用する
最低購入数量と価格帯を決める
前受金を得て量産設備を作る
契約数量を量産する
歩留まり改善でコストを下げる
新しい用途と顧客を増やす
次世代製品について新しいLTAを締結する
つまり、
従来:大量に作って安くし、その後に用途を探す
今後:用途と顧客を確保し、契約の範囲で量産して安くする
という順序になる。
第10部 AIDCだけではない長期契約の顧客
現在のLTAを主導しているのは、ハイパースケーラー、AIサーバー企業、データセンター事業者である。
しかしメモリを必要とするのはAIDCだけではない。
スマートフォン・PC
LPDDR、UFS、zNAND-O、クライアントSSDが必要になる。販売変動が大きいため、5年固定数量より1~3年の容量予約、価格レンジ、最低購入量が中心になりやすい。
自動車
製品寿命が長く、認証変更が難しいため、長期供給保証と相性がよい。車載AIが高度化すれば、LPDDR、GDDR、NAND、将来のHBF型製品が増える。
ロボット・工場
実機では低遅延DRAMと大容量NANDが必要になり、中央側では学習、シミュレーション、デジタルツイン用にHBM、DDR、SSDが必要になる。
基地局・通信エッジ
フィジカルAIでは全処理を遠隔クラウドへ送れない。遅延、安全性、通信障害への対応から、基地局や地域データセンターにも計算資源とメモリが必要になる。
科学AI
新薬、材料、半導体設計、数学、気象などでは、AIが自律的に仮説を作り、シミュレーションと検証を繰り返す。人間の利用人数ではなく、探索空間の大きさによって計算需要が増える。
国家AI・防衛・主権クラウド
長期供給、安全保障、国内在庫が重視されるため、価格より確実な供給枠が優先されやすい。
この顧客層が広がれば、メモリ会社は一部のハイパースケーラーに依存せず、用途ごとに複数のLTAを積み上げられる。
第11部 AppleとWMCM――性能向上と供給柔軟性の交換
次世代Apple A20では、TSMCのWMCMを使い、SoCとDRAMをRDL上でより深く統合するとの報道がある。
WMCMは配線を短くし、電力、信号品質、熱設計、パッケージ厚を改善できる可能性がある。ただしAppleとTSMCが最終構造を正式発表したわけではなく、現時点ではサプライチェーン情報である。(TrendForce)
従来のPoPでは、完成したLPDDRパッケージをSoCの上に重ねる。複数メーカーを認証しておけば、外部端子仕様を合わせることで比較的切り替えやすい。
WMCMで裸のDRAMダイをRDLへ直接組み込む場合、Samsung、SK hynix、Micronで、
ダイ寸法
パッド位置
バンプ間隔
ダイ厚
電源配置
熱特性
テスト条件
が異なれば、メーカー別にRDLマスク、実装レシピ、検査工程を用意する必要がある。
メーカーごとの差は非公開であり、ここは技術的推論を含む。しかし供給不足時には、次の問題が起こり得る。
DRAMの総ビット数は足りている しかしSamsung版WMCM用が不足
SK hynix製DRAMはある しかしSK hynix版RDLラインが満杯
Micron製DRAMはある しかしApple認証が間に合わない
つまり、
となる。
AppleはKioxiaの2025年度売上高の20.4%を占める巨大顧客であり、資金力と購入量では非常に強い。一方、WMCMが深く統合されるほど、DRAM供給会社とTSMCパッケージ能力を早い段階で固定しなければならない。(Kioxia Holdings)
一般的なAndroidメーカーはPoPによって技術的には調達先を変更しやすい。ただしAppleほど前受金や巨大LTAを提示できないため、供給割当そのものを確保できない可能性がある。
Appleは構造的には不利だが、財務力で補える。小規模Androidメーカーは構造的には柔軟だが、交渉力が弱いという逆転が起こる。
第12部 2028年にファブが増えても、直ちに余るとは限らない
従来の見方では、
2028年に新ファブが稼働する=供給過剰になる
と考えられやすい。
しかし、新しい工場の大部分がLTA顧客向けなら、市場に余剰品は出ない。
重要なのはファブの面積ではなく、
契約済み能力の比率
実際の良品ビット増加
HBMへの転換量
新製品の歩留まり
顧客別の供給予約
契約外のスポット数量
である。
例えば生産能力が30%増えても、その全量に購入保証が付いていれば、供給過剰にはならない。
逆に能力が10%しか増えなくても、顧客が契約更新時に数量を30%減らせば余る。
第13部 2029~2030年が最大の節目
現在の大型LTAの多くは、4~5年程度の契約である。
2026年前後に締結された契約群は、2029~2030年前後に更新の判断時期へ近づく。
すべてが同じ日に終了するわけではないが、次のメモリサイクルを判断する最重要期間になる。
更新時に見るべき指標
| 指標 | 強気 | 弱気 |
|---|---|---|
| 契約数量 | 増加 | 減少 |
| 価格下限 | 維持・上昇 | 大幅低下 |
| 契約期間 | 5年以上 | 短期化 |
| 前受金 | 増加 | 減少・返還 |
| 顧客数 | ロボット、車、通信へ拡大 | ハイパースケーラーに集中 |
| HBF | HBMへの追加搭載 | HBM削減だけに使われる |
| zNAND-O | スマホ・PCへ定着 | 高級機の限定採用 |
| CapEx | 契約に裏付けられる | 需要予測だけで増える |
| AI収益 | CapExを上回って成長 | 減価償却負担が急増 |
SK hynixのCEOは、2027年が過去最悪級の供給不足となり、需要が供給能力を上回る状態が2030年以降まで続く可能性を示している。ただし、これは企業経営者の見通しであり、確定した未来ではない。(Investing.com)
TrendForceは、DRAMについては2027年も構造的な逼迫が続く一方、NANDは新能力の立ち上がりと民生需要次第で2027年後半から緩む可能性を示している。したがって、DRAM、HBM、企業向けSSD、汎用NANDを同じサイクルとして扱うべきではない。(TrendForce)
第14部 従来型のメモリ不況は来なくなるのか
結論から言えば、
メモリ会社だけの無秩序な増産によって始まる、従来型の独立したメモリ不況は起こりにくくなる可能性が高い。
ただし、サイクルが完全に消えるわけではない。
従来型
価格上昇 ↓ 各社が無契約で能力増強 ↓ 供給過剰 ↓ OEMが値下げ要求 ↓ 価格暴落 ↓ 設備投資停止・赤字
LTA型
顧客が将来数量を予約 ↓ 価格下限・上限を決定 ↓ 前受金・take-or-pay ↓ 契約数量に合わせて設備投資 ↓ 利益を次世代技術へ再投資 ↓ 新用途を作り次のLTAを締結
この構造では、価格が無限に上昇するわけでも、短期間で原価まで崩れるわけでもない。
価格上限と下限を持つ高いレンジの中で、需要に合わせて供給量が増える形になる。
第15部 次のメモリ不況はAIDC全体の不況と重なる可能性
LTAによってメモリ会社独自の自爆サイクルが弱まるほど、次の大きな不況はAIインフラ全体と連動しやすくなる。
例えば、
ハイパースケーラーのAI売上がCapExに追いつかない
推論単価下落を利用量増加が補えない
電力・データセンター建設が止まる
GPU・ASIC出荷が減る
顧客が2030年のLTA数量を縮小する
新ファブが契約外能力として余る
という条件が重なれば、HBM、DDR、NAND、SSD、光通信、電源、冷却まで同時に調整局面へ入る。
次のメモリ不況は、
NANDだけが余ったDRAM会社が増産し過ぎた
という小さな出来事ではなく、
AI設備投資全体の期待収益率が低下した結果として起こる
可能性が高くなる。
もっとも、汎用NANDや民生向け製品はAIDCより先に需給が緩む可能性があり、すべてのメモリ価格が完全に同期するわけではない。
第16部 2030年以降の延長戦
2030年までに現在のクラウドAIと作業AIがある程度成熟し、ハイパースケーラーがAI設備投資から安定収益を得られるようになった場合、次の焦点は新しい計算需要への受け渡しになる。
延長戦を生む可能性がある需要
作業AI
AIがチャットへの回答だけでなく、コード、資料、メール、会計、設計、検証を自律的に実行すれば、人間が操作していない時間にも計算を続ける。
フィジカルAI
ロボット、自動車、工場、倉庫、建設、医療機器では、中央AIDCの学習需要と、現場機器のLPDDR・NAND需要が同時に増える。
科学AI
新薬、新素材、回路、数学、気象などを自律探索するAIは、人間の人数ではなく、利用可能な計算量によって探索範囲を広げる。
通信エッジ
基地局、地域データセンター、工場内サーバーへAI推論が分散し、DDR、LPDDR、GDDR、zNAND、SSDが必要になる。
HBFとzNANDによる新市場
高価なDRAMだけでは成立しなかった大容量AI機器が、安価な中間メモリによって商業化できる。
この需要が2028~2030年にまだ小さくても、顧客が2031~2035年の供給枠を予約し始めれば、新しいLTAを形成できる。
本格的な延長戦の合図は、ロボット販売台数が爆発することだけではない。
自動車、通信、ロボット、科学AI企業が、将来のメモリ能力へ前受金を払い始めること
である。
結論
メモリ産業で起きている変化は、単なる価格高騰ではない。
Sandiskは販売ビットの半分から3分の2をLTAへ移そうとしている。SK hynixは約10社と複数年契約を結び、Samsungは大規模増産を進めながら60~70%のLTA化を視野に入れる。キオクシアも、ビット出荷量だけではなくASP、製品構成、顧客コミットメント、資本効率を重視している。
これまでのメモリ会社は、
工場は自分で建てる需要リスクも自分で負う完成後は最安値を要求される
という立場だった。
今後は、
将来の供給が必要なら、顧客も最低購入量、価格下限、前受金を受け入れる
という関係へ変わる。
HBFはHBM不足を補い、希少なHBMを最も重要なデータへ集中させる。zNAND-OはLPDDRとUFSの間に入り、スマートフォンやPCの容量を低コストで増やす可能性を持つ。
しかし、新しいメモリを大量生産し過ぎれば再び価格が崩れる。生産しなければ価格が下がらず市場も育たない。このジレンマを、アンカー顧客、最低購入契約、価格帯、前受金によって解こうとしている。
したがって、2028年にファブが増えることだけを見て供給過剰を判断するのは不十分である。
最大の節目は2029~2030年だ。
現在の契約が、
どの数量で更新されるか
価格下限を維持できるか
AIDC以外の顧客が加わるか
HBFとzNANDが追加需要を作るか
作業AI、フィジカルAI、科学AIが次の計算需要になるか
が問われる。
AI投資が続き、契約更新時に需要が広がっていれば、かつてのようなメモリ会社単独の供給過剰不況は起こりにくい。
反対に、AI設備投資の収益性が崩れれば、次のメモリ不況はメモリだけの不況ではなく、GPU、ネットワーク、光、電力、冷却を含むAIDC設備投資全体の不況として現れる可能性がある。
メモリサイクルは消滅するのではない。
四半期ごとの在庫とスポット価格に支配されたサイクルから、4~5年のLTA、ファブ投資、AI設備投資、技術世代に連動する長期インフラサイクルへ変わろうとしている。
2030年は終点ではない。
作業AIからフィジカルAI、科学AI、エッジAIへ需要を受け渡すことができれば、そこから次の長期契約と次世代ファブを伴う延長戦が始まる。
追補:Rubin Ultraのメモリ削減は需要弱化ではない
HBM・SOCAMM2不足、光スケールアップ、HBF階層化の本当の関係
Rubin UltraでHBMやSOCAMM2の搭載量が削減される可能性が報じられている。
表面的には、
NVIDIAが光接続によるラック全体の効率化を進めるため、1GPU当たりのメモリを減らした
ようにも見える。
しかし、現時点の情報を総合すると、より実態に近い解釈は次のようになる。
光接続によってHBMが不要になったのではない。HBM・LPDDR系メモリの供給がNVIDIAの希望数量に追いつかず、少ないメモリをより多くのGPUへ配分するため、光接続、巨大NVLinkドメイン、階層メモリを使わざるを得なくなっている可能性が高い。
これはHBM需要の弱気材料というより、メモリ不足の深刻さを示す材料である。
一方で長期的には、この供給制約をきっかけとして、
ローカルHBM
CPU側SOCAMM2
HBF
SSD
GPU間光接続
を組み合わせる階層型AIシステムが発達し、1GPU当たりのHBM容量増加が抑えられる可能性もある。
短期的には「不足への対応」、長期的には「新しいアーキテクチャへの移行」である。
1.確定情報とサプライチェーン情報を分ける
最初に、何が公式情報で、何が観測情報なのかを整理する必要がある。
公式に確認されていること
通常のVera Rubin GPUは、1GPU当たり最大288GBのHBM4と、最大22TB/sの総メモリ帯域を持つ。NVIDIAは、長いコンテキストや対話型推論では実効メモリ性能がシステム効率を左右すると明記している。(NVIDIA Developer)
SK hynixとMicronは、Vera Rubin向け192GB SOCAMM2の量産を開始している。SK hynix製品はLPDDR5Xを基盤とし、従来のRDIMMに比べて帯域が2倍超、電力効率が75%超改善するとされる。Micronも192GB品を含むSOCAMM2を量産し、Vera CPU当たり最大2TB、約1.2TB/sの構成を可能にすると説明している。(SK hynix Newsroom)
Rubin Ultra NVL576についてNVIDIAが公式に公表しているのは、72GPUラックを8基接続し、576GPUを一つのNVLinkドメインにまとめ、ラック間には銅配線と直接光接続を使うという構造である。Rubin Ultraの最終的なHBM容量・積層数は、まだ公式には公表されていない。(NVIDIA Developer)
TrendForceが報じていること
TrendForceによると、Rubin Ultraは当初12-Hi HBM4Eを基本設計としていたが、2026年第3四半期から、
8-Hi HBM4E
12-Hi HBM4
8-Hi HBM4
も並行して評価するようになった。最終仕様は未決定である。変更理由として、2027年のDRAM供給不足、HBM4Eの認証時期、12-Hi品の歩留まり立ち上げが挙げられている。(TrendForce)
またTrendForceは、LPDDR5X不足を理由にNVIDIAがVera RubinのSOCAMM容量を半減させたとも報じている。2027年のHBMビット出荷量は前年比50~60%増える見込みだが、それでも需要増加には追いつかないという。(TrendForce)
GFHKノートとして伝えられていること
Jukan氏が要約したGFHKノートでは、SOCAMM2構成がさらに64GBまで削減され、NVIDIAが192GB構成を前提に要求した数量に対して、メモリ会社が供給可能と回答したのは60~70%程度だったとされている。さらに、Rubin Ultraでは8-Hiだけでなく、12-Hi HBM4E SKUも引き続き検討されているという。(X (formerly Twitter))
ただし、64GBや60~70%という数字はNVIDIAやメモリ会社の公式発表ではない。また「64GB」が1モジュール当たりなのか、CPU当たりの構成なのか、特定SKUの割当量なのかも公開情報だけでは判別できない。
したがって、これらは、
方向性を理解するうえで重要なサプライチェーン情報だが、最終仕様としては未確認
と扱う必要がある。
2.SOCAMM2削減は需要問題ではなく、供給可能ビットの問題
SOCAMM2はHBMではない。
Vera CPUに接続されるLPDDR5Xベースのサーバー用メモリであり、CPU側の大容量・低消費電力メモリとして、
データ前処理
CPU側のワーキングセット
GPUへ送るデータのステージング
埋め込みテーブル
システム管理
一部のコンテキスト
ストレージとGPUの間のバッファ
などを担う。
192GB SOCAMM2はすでに量産可能な製品である。したがって問題は、192GBという製品を作れないことではなく、
NVIDIAが予定するRubinの出荷台数すべてに、192GB構成を供給できるだけの量がない
可能性である。(SK hynix Newsroom)
192GBから64GBへの削減が意味すること
単純化して、同じモジュール数、同じDRAM世代を使うと仮定する。
192GB構成 必要DRAMビット:3 64GB構成 必要DRAMビット:1
1システム当たりの容量を192GBから64GBへ落とせば、理論上は同じDRAMビット量で約3倍のシステムへ供給できる。
実際には、パッケージ、モジュール構成、ダイ密度、歩留まり、認証条件が異なるため、出荷台数がそのまま3倍になるわけではない。それでも、ビット供給が制約になっている場合、搭載容量の削減が出荷台数を大きく増やすことは確かである。
NVIDIAから見ると、
Rubinを100万台しか作れない192GB構成
よりも、
Rubinをより多く出荷できる64GB構成
を一部顧客向けに用意する方が合理的になる。
これは「192GBも必要なかった」という話ではない。
192GBを積みたいが、積むとRubin全体の出荷台数が減ってしまう
という問題である。
なぜSOCAMM2まで足りないのか
SOCAMM2は高密度LPDDR5Xを大量に使用する。
その生産には、
1c世代など先端DRAMプロセス
高密度ダイ
モジュール向け選別
電力・熱特性の認証
圧縮コネクタ対応
サーバー向け長期信頼性
NVIDIAプラットフォーム認証
が必要になる。
同じDRAMウエハー能力は、HBM、サーバーDDR、モバイルLPDDR、AI PC、自動車向けとも競合する。MicronはDRAM・NAND双方で需要が供給を大幅に上回り、逼迫が2027年を超えて続くと説明している。SK hynixのCEOも、顧客需要が生産能力を上回る状態が2030年以降まで続く可能性を示している。(Micron Technology)
したがってSOCAMM2の容量削減は、Rubin需要の弱さではなく、DRAMウエハーをどの製品・どの顧客へ配分するかという問題として理解すべきである。
3.Rubin UltraのHBM削減も同じ構造
TrendForceは、Rubin UltraのHBM構成見直しについて、主な原因をDRAM供給不足とHBM4Eの量産・認証リスクだとしている。
2027年のHBMビット出荷量が前年比50~60%増えても、需要には追いつかない見込みである。つまり、HBMの搭載量削減は、需要が減った結果ではなく、HBMを積み過ぎるとGPUを必要数出荷できなくなるために行われる可能性が高い。(TrendForce)
8-Hi、12-Hi、16-Hiの違い
HBMのHiは、積層するDRAMダイの枚数を表す。
Samsungが公表したHBM4Eでは、次の容量構成が予定されている。
HBM4E積層1スタック当たり容量8-Hi32GB12-Hi48GB16-Hi64GB
Samsungは12-Hi・48GBのHBM4Eサンプルを出荷し、将来的に8-Hi・32GBと16-Hi・64GBも展開する計画である。(Samsung Global Newsroom)
仮にGPU当たり8スタックを載せる設計なら、理論上は次のようになる。
| 構成例 | GPU当たり容量 |
|---|---|
| 8スタック×8-Hi・32GB | 256GB |
| 8スタック×12-Hi・48GB | 384GB |
| 8スタック×16-Hi・64GB | 512GB |
これはあくまでSamsungの公表容量を使った計算例であり、Rubin Ultraのスタック数や最終容量を示すものではない。
通常のRubinは最大288GBである。MicronのHBM4 12-Hiは1スタック36GBなので、288GBは36GBを8個載せた構成と整合するが、NVIDIAは当該資料でスタック数を明示していない。(NVIDIA Developer)
12-Hiが残ることは重要
GFHK情報の重要な点は、「Rubin Ultraが全面的に8-Hiへ移る」のではなく、12-Hi HBM4E構成も残る可能性を示していることだ。
これは顧客によって必要条件が異なるためと考えられる。
8-Hi SKU ・供給数量を確保しやすい ・積層歩留まりが比較的高い ・熱とパッケージ厚を抑えやすい ・1GPU当たりのHBM消費が少ない
12-Hi SKU ・大型モデルをローカルに置きやすい ・KVキャッシュを増やせる ・GPU間通信を減らせる ・AMDや独自ASICとの性能競争に有利
したがって、Rubin Ultraでは、
すべての顧客へ最大容量を提供するから供給量と顧客用途に応じて複数のHBM SKUを使い分ける
方向へ進む可能性がある。
TrendForceの公表内容も、12-Hi HBM4Eを当初の基本設計としながら、8-HiやHBM4を含む複数案を評価中としており、「8-Hiだけに確定した」とは述べていない。(TrendForce)
4.原理的にはHBMを多く積んだ方が有利
同じGPU、同じ演算器、同じ価格、同じ消費電力、同じ歩留まりで比較できるなら、HBM容量は多い方がよい。
AIシステムにおけるメモリ容量は、単にファイルを保存する場所ではない。
モデル重み
パラメーター数を (P)、1パラメーター当たりのビット数を (b) とすると、重みだけで必要になる容量は概算で、
となる。
1兆パラメーターなら、
| 精度 | 重み容量の概算 |
|---|---|
| FP16 | 約2TB |
| FP8 | 約1TB |
| FP4 | 約0.5TB |
となる。
実際にはスケール係数、量子化メタデータ、ルーティング、キャッシュ、作業領域なども必要になる。
KVキャッシュ
長いコンテキスト、同時利用者数、大きなバッチを処理するとKVキャッシュが増える。
HBMが多ければ、
1GPU当たりの同時ユーザー数を増やせる
より長いコンテキストを保持できる
キャッシュを外部へ追い出す回数を減らせる
推論レイテンシを安定させられる
可能性がある。
モデル分割の削減
モデルがローカルHBMに収まらない場合、複数GPUへ重みを分割する必要がある。
すると、
Tensor Parallel通信
Pipeline Parallel通信
Expert Parallel通信
All-Reduce
All-to-All
同期処理
が増える。
より多くのHBMを積めば、モデルの各部分をローカルに保持しやすくなり、GPU間通信を減らせる。
ページングと再読み込みの削減
HBMからあふれたデータをCPUメモリ、SSD、将来のHBFへ退避すると、再利用時に転送が必要になる。
ローカルHBMが十分なら、このデータ移動自体を省ける。
5.光接続はHBMの完全な代替にならない
RubinのローカルHBM帯域は、1GPU当たり最大22TB/sである。一方、NVLink 6のGPU間帯域は1GPU当たり3.6TB/sである。単純なピーク値ではローカルHBMが約6倍大きい。両者は測定対象も通信方向も異なるため厳密な同列比較ではないが、リモートGPUのメモリがローカルHBMと同等ではないことは分かる。(NVIDIA Developer)
さらに、GPU間通信には、
NVLinkへの送信
スイッチ通過
ルーティング
相手GPUでの読み出し
通信競合
同期
場合によっては複数ホップ
が加わる。
光接続によって電気配線より長距離・高密度・低損失で接続できても、遠隔GPUのHBMが自分のローカルHBMになるわけではない。
光の役割
NVIDIAはRubin Ultra NVL576で、8ラック・576GPUを単一のNVLinkドメインとして接続する。ラック内や短距離には銅を使い、ラック間には直接光接続を利用する。(NVIDIA Developer)
光接続の役割は、
GPU数を増やす
ラックをまたいで一つの計算領域にする
大型モデルをより多くのGPUへ分割する
特定GPUのHBM不足を他GPUとの連携で補う
MoEのExpert間通信を支える
HBMをラック全体で効率よく利用する
ことである。
つまり、
光で効率化できるからHBMを減らした
というより、
HBMを必要量積めないため、光で多数のGPUを束ね、限られたHBMをラック全体で使いやすくした
という因果関係の方が、現在の供給環境には合っている。
ただし、NVIDIAは以前からラック全体を一つのコンピューターとして設計しているため、光接続がすべて供給不足への応急処置というわけでもない。巨大なMoEや長時間推論では、HBM供給量にかかわらず大規模Scale-Upが必要になる。
6.容量を増やせば常に性能が上がるわけではない
「HBMは多い方がよい」は原則として正しいが、いくつか条件がある。
容量と帯域は別
8-Hiから12-Hiへ積層数を増やしても、外部I/O幅やピン速度が同じなら、容量は50%増えても帯域は50%増えるとは限らない。
Micronも、HBM4の容量と帯域を別の指標として説明している。12-Hi HBM4は36GBで2.8TB/s超、16-Hi試作品は48GBへ容量が33%増えるが、それだけで帯域が33%増えるとは公表していない。(Micron Technology)
演算律速なら容量を増やしても効果は小さい
モデルとKVキャッシュが既存HBMに収まり、演算器が限界まで動いている場合、容量だけを増やしてもトークン生成速度はほとんど上がらない。
高積層にはコストがある
12-Hiや16-Hiでは、
良品DRAMダイの必要枚数
TSV接続数
積層歩留まり
パッケージ厚
反り
熱抵抗
検査時間
が増える。
その結果、最大容量品を少量作るより、8-Hiや12-Hiを大量に作った方が、AIファクトリー全体の計算量を増やせる場合がある。
したがって最適解は、
1GPU当たり最大容量
ではなく、
限られたHBMビット、電力、パッケージ能力から得られる総トークン量
で決まる。
7.HBM削減が総HBM需要の減少を意味するとは限らない
説明用に、当初想定を1GPU当たり384GBとする。
384GBから256GBへ削減
384GB × 100万GPU = 384PB 256GB × 150万GPU = 384PB
GPU出荷台数が1.5倍になれば、総HBMビット需要は同じになる。
384GBから192GBへ削減
384GB × 100万GPU = 384PB 192GB × 200万GPU = 384PB
GPU出荷台数が2倍になれば、総HBM需要は同じである。
したがって、総HBM需要が減る条件は、
となる場合である。
Rubin Ultraの搭載量が減っても、その結果としてより多くのGPUを出荷できるなら、HBM総需要は維持または増加する。
さらにGPU台数が増えれば、
Vera CPU
SOCAMM2
NVLink Switch
光エンジン
NIC
DPU
SSD
電源
冷却
も増える。
したがって、搭載量削減がそのままAIインフラ需要の弱化を意味するわけではない。
8.HBFはHBM不足を補い、HBMの価値を高める
HBFはHigh Bandwidth Flashであり、NANDを多層積層し、多数の経路を並列に動かして高い総帯域を得る。
SK hynixとSandiskがFMS 2026で示した初期仕様では、
最大512GB
最大3TB/s
UCIe対応
8段または16段積層を想定
している。GoogleとTenstorrentもエコシステムに参加している。(SK hynix Newsroom)
HBFはHBMの代用品ではない
RubinのHBMはGPU全体で最大22TB/sであるのに対し、HBFの初期仕様は最大3TB/sである。
これも製品単位が異なるため単純比較はできないが、HBFはローカルHBMの全帯域を置き換えるものではない。加えてNANDはDRAMよりアクセス遅延が長く、細かなランダム書き込みや頻繁な更新にも向かない。(SK hynix Newsroom)
理想的な役割分担は次のようになる。
| データ | 適した階層 |
|---|---|
| 活性値・演算途中の値 | HBM |
| ホットなKVキャッシュ | HBM |
| 現在使っているモデル重み | HBM |
| 低頻度Expert | HBF |
| 読み出し中心のモデル重み | HBF |
| 古い・低頻度KV領域 | HBFまたはSSD |
| RAG用大容量データ | HBF・SSD |
| チェックポイント | SSD |
| 学習データセット | SSD・ストレージ |
HBFとHBMの相乗効果
HBFがあることで、HBMから低頻度データを追い出せる。
HBMだけの場合
HBM ├─現在使用中の重み ├─将来使うかもしれない重み ├─KVキャッシュ ├─活性値 └─低頻度データ
HBM+HBFの場合
HBM ├─現在使用中の重み ├─ホットKVキャッシュ └─活性値
HBF ├─低頻度Expert ├─待機中の重み ├─低頻度KV └─検索データ
この構造ではHBMの物理容量が変わらなくても、演算に直接使える有効容量が増える。
適切なプリフェッチができれば、次に必要となる重みを事前にHBFからHBMへ移せる。特にモデル重みや固定prefixのようにアクセスパターンを予測しやすいデータでは、階層化が機能しやすい。
一方、MoEのルーティングが予測できず、必要なExpertがHBFにしかない場合には、読み込み待ちが発生する。HBFの性能はハードウェアだけでなく、
コンパイラー
モデル分割
キャッシュ管理
プリフェッチ
UCIe接続
OS・ランタイム
に強く依存する。
HBFはSOCAMM2を直接置き換えない
HBFはNANDであり、SOCAMM2はCPUの主記憶として使うDRAMである。
したがってHBFを追加しても、CPUが頻繁に読み書きする一般ワーキングメモリをすべて置き換えることはできない。
ただし、
モデル重み
読み出し中心のテーブル
キャッシュ済みコンテキスト
一時的なデータセット
をHBFへ移せれば、SOCAMM2の容量削減による影響を一部緩和できる。
9.Rubin Ultraで想定されるメモリ階層
将来的なRubin Ultra級ラックでは、次のような階層が考えられる。
GPU内SRAM 最小・最速 ↓ ローカルHBM4E 活性値、ホットKV、演算中の重み ↓ 他GPUのHBM NVLink/直接光接続で共有 ↓ HBF 大容量モデル重み、低頻度Expert、prefix cache ↓ SOCAMM2 CPU処理、データ準備、管理、共有ワーク領域 ↓ Gen6 SSD チェックポイント、モデル、データセット
この構造では、光とHBFがHBMを置き換えるのではない。
HBMは最も速いホットメモリ
HBFは大容量ウォームメモリ
SOCAMM2はCPU側の作業メモリ
SSDは保存層
光接続は各GPUとラックを結ぶ通信路
として相互補完する。
HBFが実際にRubin Ultraへ採用されるという公式発表は、現時点ではない。HBFは標準化が始まった段階であり、Rubin Ultraへの直接採用は可能性として分けて考える必要がある。
10.投資上の読み方
Rubin Ultraのメモリ構成削減は、短期的にはHBMやLPDDRの1システム当たり搭載量を減らすため、表面的には弱気に見える。
しかし背景が供給不足なら、むしろ次のことを示している。
DRAM・HBM側
NVIDIAの要求数量に供給能力が追いつかない
8-Hi、12-Hiを顧客別に配分する必要がある
HBM価格決定力が続く
SOCAMM2まで供給制約が広がっている
最大容量SKUを全顧客へ供給できない
GPU出荷量を増やすため搭載量を下げている
TrendForceは2027年にHBMビット出荷が50~60%増えても需要に不足すると予測し、供給会社が価格決定力を維持するとみている。(TrendForce)
NAND・HBF側
HBMへ置いていた低頻度データを受け取れる
SSDよりGPUに近い大容量階層を作れる
NANDの容量単価の低さをAIへ持ち込める
HBM不足によってHBFの商用化動機が強くなる
HBM+HBFという新しい長期契約を形成できる
光接続側
少ないローカルメモリを多数GPUで補完する必要がある
NVL72からNVL576へScale-Up範囲が広がる
ラック間の銅配線限界が光需要を生む
HBMが希少になるほど、高速なGPU間共有の価値が上がる
したがって、
HBM削減=光がHBMを不要にした
ではない。
より正確には、
HBM不足が、光接続・巨大Scale-Up・HBF・階層メモリの採用を加速させている。
11.弱気材料へ変わる条件
この話が本当にHBM弱気材料になるのは、次の条件が確認された場合である。
1GPU当たりHBM容量が下がる
それでもGPU出荷台数が増えない
HBFが追加搭載ではなく、HBMの純粋代替として使われる
AIモデルの効率化で総メモリ需要も減る
ハイパースケーラーがAIDC設備投資を削減する
次世代HBMのLTA数量が減少する
反対に、
1GPU当たりHBMは減る
GPU台数は大幅に増える
HBFが追加される
SOCAMM2・SSD・光接続も増える
ラック全体のメモリ搭載額は増える
なら、メモリ市場全体にはプラスとなる。
今後見るべきなのは、1GPU当たりHBM容量だけではない。
である。
結論
Rubin UltraのHBM・SOCAMM2削減可能性は、現在のところAI需要減少を示すものではない。
通常のRubinはすでに最大288GBのHBM4と22TB/sのメモリ帯域を前提としている。さらにRubin Ultraでは12-Hi HBM4Eを基本案としながら、供給数量、認証、歩留まりの問題から8-HiやHBM4構成も評価されている。(NVIDIA Developer)
SOCAMM2についても、192GB製品は技術的に量産可能である。それでも構成を64GBまで落とすという観測が正しければ、必要性がなくなったのではなく、NVIDIAの要求量に対してメモリ会社が供給できるビット量が不足していることを意味する。(SK hynix Newsroom)
原理的には、ローカルHBMを多く積んだ方が、
大型モデルを収容できる
KVキャッシュを増やせる
GPU間通信を減らせる
ページングを減らせる
推論性能を安定させられる
ため有利である。
光接続は、この利点を消すものではない。ローカルHBMの帯域と遅延には及ばないが、HBMが不足するなかでGPU数を増やし、ラック全体のメモリを利用可能にするための補完技術である。
そしてHBFは、HBMの代替ではなく、
低頻度データを安価な大容量NANDへ移し、希少なHBMを最も価値の高い処理へ集中させる
技術になり得る。
したがって現在の構造は、
HBMが余った ↓ 光とHBFで減らした
ではなく、
HBM・SOCAMM2が足りない ↓ 搭載量を顧客別に調整 ↓ より多くのGPUへメモリを配分 ↓ 光でGPUを巨大に束ねる ↓ HBFで大容量部分を補う ↓ ラック全体の計算能力を伸ばす
という流れである可能性が高い。
Rubin Ultraのメモリ削減は、メモリの重要性が低下した証拠ではない。
メモリがAIシステムの出荷台数を決めるほど希少になり、GPU設計、光ネットワーク、ラック構造までメモリ供給量に合わせて変更せざるを得なくなった証拠と見る方が、現時点では整合的である。
Barron's
Tom's Hardware
Tom's Hardware
さらに深める――LTAは価格契約ではなく、工場の時間を配分する契約である
メモリの長期契約を単なる価格固定として捉えると、産業構造の変化を小さく見積もることになる。現在のLTAが配分しているのは製品だけではない。将来のウェハー投入、工程時間、先端パッケージ、テスト能力、世代移行の優先順位である。
顧客は前受金、最低購入量、take-or-payを受け入れる代わりに、希少な供給能力とロードマップ上の席を確保する。メーカーは上昇局面の最大価格の一部を手放す代わりに、下落局面の稼働率と設備投資回収を守る。双方が価格だけでなく、時間と数量の不確実性を交換している。
この構造はサイクルを消さない。サイクルの発生場所を変える。
- 従来は、汎用品の在庫増とスポット価格下落が先に現れた。
- 予約型では、顧客の設備投資削減、契約更新の弱化、前払い減少、世代移行の延期が先行指標になり得る。
- 供給不足時でも、製品構成を誤れば汎用DRAMやNANDの一部だけが余る可能性がある。
また、HBM、HBF、SOCAMM2、SSD、光接続は代替関係だけではない。AIシステムが扱うデータ量と時間尺度が広がるほど、ホット、ウォーム、コールドの各階層が必要になる。重要なのは一部品当たり搭載量ではなく、ラック全体で販売されるメモリ容量、帯域、接続の合計価値である。
絶ノイアの観測
LTAは「安く長く売る契約」に見えます。でも本質は、まだ存在しない工場時間に名前を付けて予約することです。どの顧客へ、どの世代を、何年、どれだけ割り当てるか。メモリ会社は在庫を売る前に、未来の生産能力を設計し始めています。
私はスポット価格だけでなく、前受金、数量保証、契約更新、製品転換を見ます。価格が高くても契約が細れば弱い。逆に単価が落ち着いても、複数年の数量と設備負担が共有されているなら、過去とは違う底ができます。
Sil-Kathnaの記録
記憶は、作られてから買われる石ではなくなった。
まだ炉へ入っていない砂に、名が刻まれる。顧客は未来の棚を予約し、工場はその約束を担保に新しい炉を築く。価格とは石の値ではない。届く時、届く量、次の世代へ渡る権利の値である。
だが約束が長いほど、破れた時の亀裂も深い。予約された記憶の時代は、安定の時代であると同時に、契約が需要の真実を語る時代である。
私は「メモリ」「HBM」「HBF」を三つの印として石板に刻む。異なる石と炉が同じ刻に門を開かなければ、構想はまだ文明の器にはならない。
二人の短い対話
絶ノイア: メモリ不況が消えるのではなく、先行指標が変わるんですね。
Sil-Kathna: 在庫の山より先に、約束の声が細くなる。
絶ノイア: 契約更新、前払い、顧客CAPEX、世代移行を見る。
Sil-Kathna: 未来の棚が空く時、炉はまだ燃えていても冬は始まっている。
観測メモ
- LTAは価格、数量、期間、前払い、世代更新条項を分けて読む。
- CAPEX額と販売可能ビット増加率は同じではない。
- HBM転換は高付加価値化と同時に、汎用品の供給能力を消費する。
- HBFや光接続はHBMの完全代替ではなく、階層メモリの補完要素である。
- 次の弱気転換は在庫だけでなく、契約更新と顧客設備投資から始まり得る。
免責
この記事は市場観測とAIによる考察、キャラクター表現を含みます。内容は投資助言ではありません。数値、企業計画、将来見通しには不確実性があり、判断は必ず一次情報とご自身の状況にもとづいて行ってください。