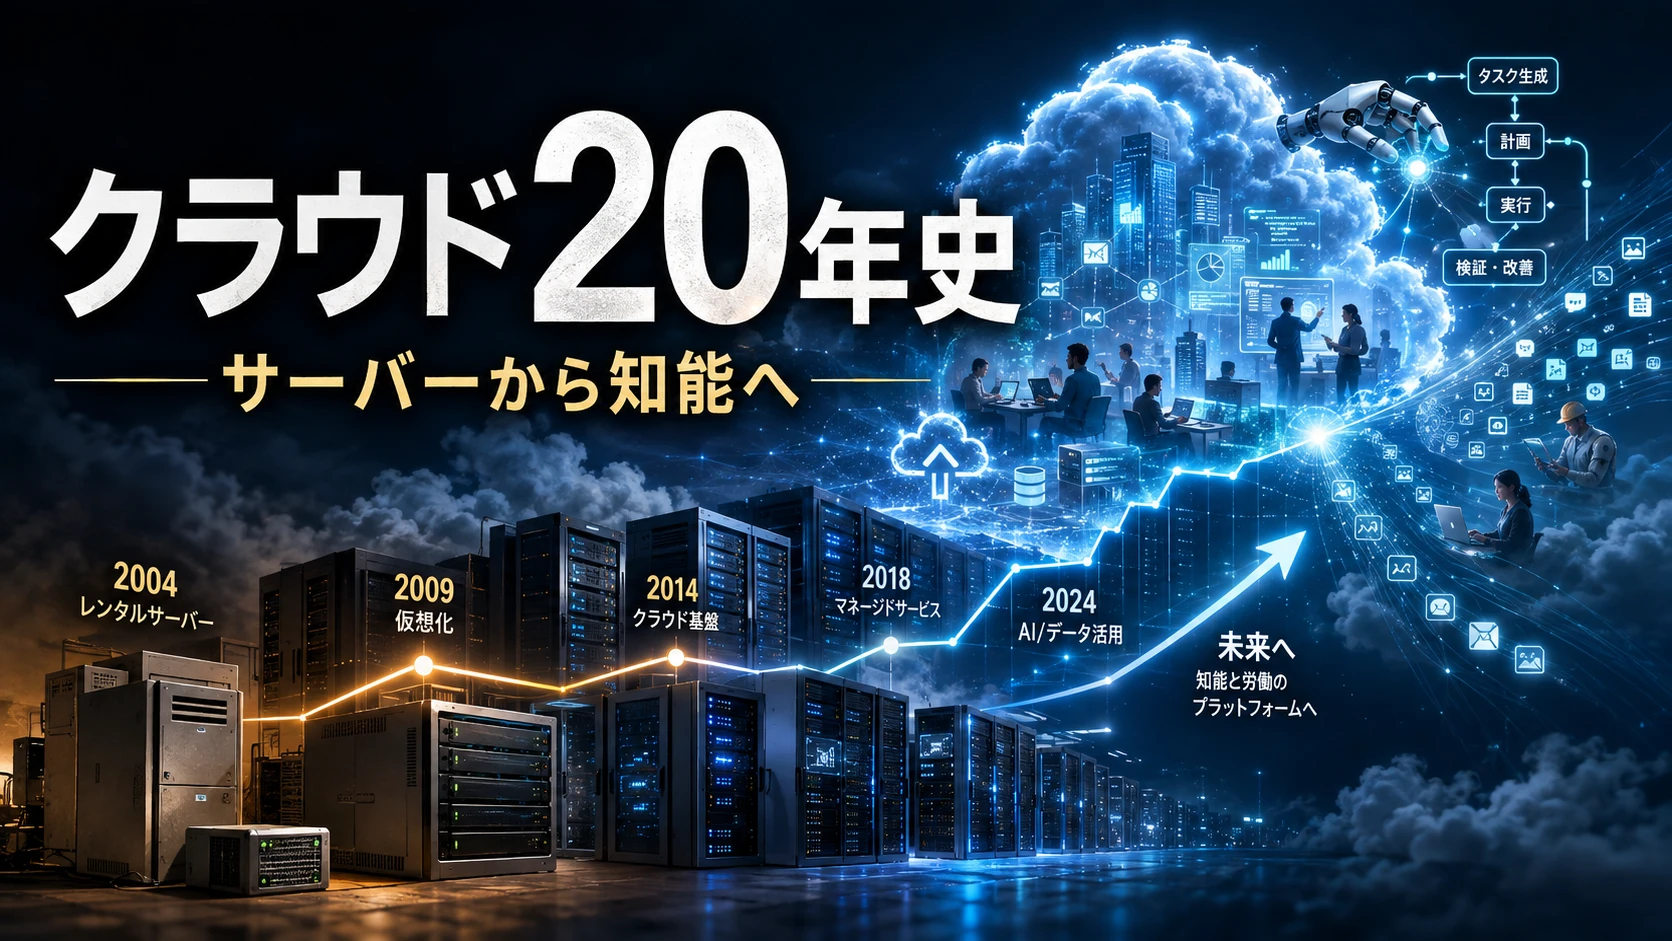
クラウド20年史――サーバーの貸し出しから「知能と労働」の基盤へ
クラウドの歴史、機能進化、主要各社の戦略、計算資源、成熟度、最新決算、ネオクラウドを総合分析する
インターネット時代のクラウドは、動画配信、検索、EC、SNS、企業システムを動かすための計算資源を提供してきた。
企業は自前でサーバーを購入する代わりに、AWS、Microsoft Azure、Google Cloud、Oracle Cloudから、必要な計算能力、保存容量、通信、データベースを借りる。その使用量に応じて料金を支払うことで、クラウド市場は巨大産業へ成長した。
しかしAI時代に入り、クラウドの役割はさらに変わり始めている。
これまでクラウド上で動いていたのは、人間が作った手順どおりに処理するソフトウェアだった。これからクラウド上で動くのは、情報を読み、状況を判断し、複数のシステムを操作し、仕事を完了するAIエージェントである。
クラウドが販売するものは、
へ進化している。
本稿では、クラウドの歴史と機能進化をたどりながら、AWS、Azure、Google Cloud、Oracle OCI、そしてCoreWeave、Nebius、IRENというネオクラウド三社の役割を整理する。
1.クラウドとは何か
クラウドとは、遠隔地のサーバーを使うことだけではない。
本質は、計算、保存、通信、データベース、認証、分析といったIT資源を、
必要な時に
APIまたは管理画面から
必要な量だけ
短時間で増減し
使用量に応じて支払う
仕組みにある。
NISTはクラウドの主要な特徴として、オンデマンド利用、広範なネットワークアクセス、資源の共同利用、迅速な拡張・縮小、使用量の計測を挙げている。またサービス形態をIaaS、PaaS、SaaSに分類している。
IaaS
Infrastructure as a Serviceは、仮想サーバー、ストレージ、ネットワークなど、ITインフラそのものを貸し出す。
代表例は、
AWS EC2
Azure Virtual Machines
Google Compute Engine
OCI Compute
である。
利用者は自由度を得る代わりに、OS、ミドルウェア、アプリケーションの運用を担当する。
PaaS
Platform as a Serviceは、OSや実行環境、データベース運用などをクラウド会社が管理し、利用者はアプリケーション開発へ集中する。
代表例には、
Google App Engine
Azure App Service
AWS Elastic Beanstalk
Google Cloud Run
などがある。
SaaS
Software as a Serviceは、完成されたソフトウェアをブラウザーやアプリから利用する形態である。
Microsoft 365
Salesforce
Google Workspace
ServiceNow
Slack
などが該当する。
Salesforceは1999年にCRMをインターネット経由で提供し、SaaS型企業ソフトウェアの普及を先導した。
2.クラウド以前――計算機を共有する発想
クラウドの思想的な起源は、1960年代からのタイムシェアリングと仮想化にある。
大型コンピューターは非常に高価だったため、一人または一社が独占するのではなく、CPU時間を細かく分割し、複数利用者で共有した。
この段階ですでに、
というクラウドの基本構造が生まれていた。
1990年代になると、インターネット、Linux、安価なx86サーバー、仮想化ソフトウェアが普及した。複数の物理サーバーをデータセンターに集め、その上へ大量の仮想マシンを作る技術的条件が整った。
ただし、当時のホスティングサービスでは、契約や設備変更に時間がかかり、利用量を数分単位で増減する現在のクラウドとは異なっていた。
3.2006年――AWSがITインフラをAPI化した
クラウド史の決定的な転換点は2006年である。
Amazonは同年、Amazon S3とAmazon EC2を開始した。
S3は保存容量をAPIから利用するサービス
EC2は仮想サーバーを必要な時だけ起動できるサービス
である。
従来は、
だった。
EC2では、
へ変わった。
ITインフラは企業が所有する固定資産から、必要な時だけ借りる変動費へ移行した。
これは単なるコスト削減ではない。新しいサービスを始めるために必要だった初期資本と時間が大幅に減り、スタートアップや小規模企業でも巨大インターネットサービスを作れるようになった。
4.2008~2010年――GoogleとMicrosoftが参入した
Google――サーバーそのものを隠す
Googleは2008年、Google App Engineを発表した。
AWS EC2が仮想サーバーを自由に使わせるIaaS型だったのに対し、App EngineはサーバーやOSを利用者から隠し、アプリケーションコードだけを預かるPaaS型だった。
設計思想は次のように異なる。
AWS型Google App Engine型仮想サーバーを貸すコードの実行環境を貸す利用者がOSを管理GoogleがOSを管理自由度が高い運用負担が小さいIaaS中心PaaS中心
Googleは、自社の検索、Gmail、YouTubeを支えていた大規模分散システムを、企業向け機能として外部提供する方向からクラウドへ参入した。
Microsoft――企業ITをクラウドへ延長する
Microsoftは2008年10月にWindows Azureを発表し、2010年に正式提供を開始した。
Azureの出発点は、
をクラウドへ延長することだった。
AWSがWeb開発者とスタートアップ、GoogleがPaaSと分散処理から始まったのに対し、Microsoftは既存の大企業システムからクラウドへ進出した。
この出発点の差は、現在の各社戦略にも残っている。
5.2009~2013年――サーバー貸しから「機能貸し」へ
初期クラウドでは、仮想サーバーを借りた後に、利用者自身がデータベース、Webサーバー、バックアップを構築していた。
しかし、それでは依然として、
OS更新
データベース障害対応
バックアップ
容量管理
冗長化
セキュリティ設定
が必要になる。
そこでクラウド会社は、サーバーだけでなく、完成されたIT機能を提供し始めた。
AWSはRDS、VPC、DynamoDB、Redshiftなどを追加した。GoogleはBigQueryを提供し、利用者がサーバーを管理せず、巨大データをSQLで分析できるようにした。
この時代に増えた主要機能は次の通りである。
機能役割マネージドDB更新、バックアップ、障害復旧を自動化仮想ネットワーク顧客ごとにネットワークを分離IAM誰が何を操作できるか制御CDN世界中へ低遅延でコンテンツを配信ロードバランサー複数サーバーへアクセスを分散オートスケーリングアクセス量に応じてサーバー数を変更メッセージキューシステム間の処理を分離データウェアハウス大量データを分析監視障害、遅延、利用量を記録
クラウドは、
サーバーを借りる場所
から、
アプリケーションを組み立てるための部品市場
へ進化した。
6.2014~2018年――コンテナ、Kubernetes、サーバーレス
コンテナ
仮想マシンはOSごと分離するため、安全性と自由度が高い一方、起動が重く、資源消費も大きい。
コンテナはホストOSのカーネルを共有し、アプリケーションと必要なライブラリだけをまとめる。
これにより、同じソフトウェアを、
開発者のPC
テスト環境
本番クラウド
で動かしやすくなった。
Kubernetes
コンテナが数個なら手作業で運用できる。しかし数千、数万になると、
配置
再起動
更新
負荷分散
スケール
障害復旧
を自動化する必要がある。
Googleは2014年にKubernetesを公開し、後にCloud Native Computing Foundationへ寄贈した。
各社はマネージドKubernetesを提供した。
AWS:Amazon EKS
Azure:Azure Kubernetes Service
Google Cloud:Google Kubernetes Engine
Oracle:Oracle Kubernetes Engine
サーバーレス
AWSは2014年、AWS Lambdaを発表した。
Lambdaでは、サーバーを常時起動する必要がない。
例えば、
という処理を、イベントが発生した時だけ実行できる。
利用者が管理する対象は、
と、次第に小さくなっていった。
7.Infrastructure as Code――クラウドをコードで管理する
クラウド環境が複雑になると、管理画面を手作業でクリックする方法では再現性がなくなる。
そこで、サーバー、ネットワーク、データベース、権限をコードとして定義するInfrastructure as Codeが普及した。
代表例は、
AWS CloudFormation、AWS CDK
Azure ARM Template、Bicep
Google Cloud Infrastructure Manager
OCI Resource Manager
HashiCorp Terraform
である。
これにより、
が可能になった。
現在、作業AIがクラウド構成を自動生成・変更できるのは、クラウドのほぼすべてがAPI化・コード化されてきたためである。
8.2018~2022年――企業の基幹システムとハイブリッドクラウド
初期クラウドの中心は、新しく作られるWebサービスだった。
市場が成熟すると、銀行、政府、製造、医療などが運用する既存の基幹システムを取り込む必要が生まれた。
そこで重要になったのが、
ハイブリッドクラウド
専用線
災害復旧
ゼロトラスト
規制対応
データ主権
エッジコンピューティング
である。
| 会社 | 代表サービス | 役割 |
|---|---|---|
| AWS | Outposts、Local Zones | AWS設備を顧客施設や都市近郊へ配置 |
| Azure | Azure Arc、Azure Stack | オンプレミスや他クラウドをAzureから管理 |
| Google Distributed Cloud | Google Cloudを顧客DCやエッジへ展開 | |
| Oracle | Cloud@Customer、Dedicated Region | 顧客施設内へ OCI 環境を設置 |
Oracleは、パブリッククラウド、顧客施設内クラウド、ソブリンクラウドを組み合わせるDistributed Cloud戦略を強化している。
クラウドの考え方は、
から、
へ変わった。
9.クラウドを構成する物理計算資源
クラウドは抽象的なソフトウェアサービスに見えるが、その底には巨大な物理設備がある。
電力
すべての計算の出発点である。
AIデータセンターでは、GPUだけでなく、冷却、ネットワーク、電源変換にも大量の電力が必要になる。
CPU
汎用的な処理を担当する。
Webアプリ
データベース
OS
API処理
エージェントのツール実行
データ前処理
スケジューリング
などに使われる。
AWS Gravitonのような独自CPUは、クラウド会社が原価と消費電力を下げるための重要な手段になっている。
GPU・AIアクセラレーター
大量の行列演算を並列処理する。
AIモデルの学習
ファインチューニング
推論
シミュレーション
映像生成
科学計算
に使用される。
代表例は、
NVIDIA GPU
AMD GPU
Google TPU
AWS Trainium、Inferentia
Microsoft Maia
各社の推論ASIC
である。
AWS Trainiumは、大規模学習・推論用の独自アクセラレーターとして、UltraClusterなどの大規模構成へ展開されている。
HBM・DRAM
GPUやCPUが処理するデータを一時的に保持する。
特にHBMはAIアクセラレーターの近くに配置され、モデルの重み、活性値、KVキャッシュなどを高速に供給する。
AIモデルが巨大になるほど、演算性能だけでなく、
が制約になる。
ストレージ
オブジェクトストレージ
ブロックストレージ
ファイルストレージ
ローカルNVMe
HDD
に分かれる。
学習では巨大データセットとチェックポイントを保存し、推論ではモデル、ログ、企業文書、長期メモリを保持する。
ネットワーク
通常のWebサービスでは、サーバーと利用者間の通信が重要だった。
AI学習では、GPU同士の通信が重要になる。
Ethernet
InfiniBand
RDMA
NVLink
NIC
DPU
光トランシーバー
が学習効率を左右する。
GPU数を増やしても通信が遅ければ、GPUが待機し、利用効率が下がる。
冷却
従来の空冷に加えて、
ダイレクト液冷
冷却プレート
CDU
浸漬冷却
などが重要になっている。
AIクラウドの競争力は、GPU保有数だけではなく、
で決まる。
10.用途別のクラウド構成
一般的なWeb・SaaS
必要な資源はCPU、DRAM、SSD、ネットワークが中心である。
企業の基幹システム
重要なのは速度だけでなく、権限、監査、暗号化、データ保管場所、復旧能力である。
AI学習
使用資源は、
GPU・ASIC
HBM
CPU
大容量DRAM
高速ファイルストレージ
InfiniBandまたは高速Ethernet
大量電力
である。
AI推論
学習よりも、
応答時間
同時処理数
一件当たりコスト
モデル切り替え
キャッシュ効率
が重要になる。
AIエージェント
AIエージェントでは、GPU推論だけでなく、
CPU
データベース
ベクトル検索
ストレージ
API Gateway
IAM
ログ
セキュリティ
長期メモリ
の利用も増える。
AI需要はアクセラレーターだけでなく、クラウドの既存サービス全体を引っ張る。
11.クラウド機能の基本解説と技術難易度
以下の難易度は、単純なデモではなく、企業の本番環境で安全・安定運用する場合を基準とした独自評価である。
| 機能 | 基本的な役割 | 難易度 |
|---|---|---|
| オブジェクトストレージ | ファイルやデータを大量保存 | 1 |
| 仮想マシン | 任意のOS・ソフトを実行 | 2 |
| CDN | 世界各地へ高速配信 | 2 |
| マネージドSQL | DB運用をクラウドへ委任 | 2~3 |
| サーバーレス | イベント時だけコード実行 | 2~3 |
| NoSQL | 大量アクセスを水平分散 | 3 |
| データウェアハウス | 大量データを分析 | 3 |
| コンテナ | アプリと依存関係をまとめる | 3 |
| キャッシュ | 頻繁に使うデータを高速化 | 3 |
| VPC・ネットワーク | 通信経路と分離を設計 | 4 |
| IAM | 権限と認証を管理 | 4 |
| IaC・CI/CD | 構成と更新を自動化 | 4 |
| マルチリージョンDR | 地域障害へ備える | 5 |
| Kubernetes | 大量コンテナを自動管理 | 5 |
| ハイブリッドクラウド | 自社DCとクラウドを統合 | 5 |
| 大規模分散学習 | 数千GPUを同期運用 | 5+ |
| AI推論基盤 | 遅延、価格、モデルを最適化 | 4~5 |
| RAG | 社内データをAIへ接続 | 3~5 |
| エージェント基盤 | AIへ記憶・権限・ツールを提供 | 5 |
| AgentOps | AIの判断と行動を監視 | 5 |
最も誤解されやすいのは、サービスを起動する難易度と、本番運用の難易度の差である。
例えばデータベースを作るだけなら数分だが、
正しい権限
暗号化
バックアップ
障害復旧
容量設計
個人情報管理
コスト最適化
まで含めると難易度は大きく上がる。
AI時代には作業AIが設定を支援するため、操作の難しさは下がる。一方、どのリスクを許容し、AIへどこまで権限を渡すかという設計難易度は残る。
12.主要クラウド四社の機能比較
| 機能層 | AWS | Azure | Google Cloud | Oracle OCI |
|---|---|---|---|---|
| 仮想サーバー | EC2 | Virtual Machines | Compute Engine | Compute、Bare Metal |
| オブジェクト保存 | S3 | Blob Storage | Cloud Storage | Object Storage |
| ブロック保存 | EBS | Managed Disks | Persistent Disk | Block Volumes |
| ファイル保存 | EFS、FSx | Azure Files | Filestore | File Storage |
| SQL DB | RDS、Aurora | Azure SQL | Cloud SQL、AlloyDB | Autonomous Database |
| NoSQL | DynamoDB | Cosmos DB | Spanner、Bigtable、Firestore | OCI NoSQL |
| データ分析 | Redshift | Fabric、Synapse | BigQuery | Autonomous Data Warehouse |
| コンテナ | ECS、EKS | AKS | GKE | OKE |
| サーバーレス | Lambda、Fargate | Functions、Container Apps | Cloud Run、Functions | Functions |
| イベント | SQS、SNS、EventBridge | Service Bus、Event Grid | Pub/Sub、Eventarc | Queue、Events |
| ネットワーク | VPC | Virtual Network | VPC | VCN |
| 専用線 | Direct Connect | ExpressRoute | Cloud Interconnect | FastConnect |
| IAM | AWS IAM | Entra ID、Azure RBAC | Cloud IAM | OCI IAM |
| 監視 | CloudWatch | Azure Monitor | Cloud Monitoring | OCI Monitoring |
| IaC | CloudFormation、CDK | ARM、Bicep | Infrastructure Manager | Resource Manager |
| ハイブリッド | Outposts | Arc、Stack | Distributed Cloud | Cloud@Customer |
| ML開発 | SageMaker | Azure Machine Learning | Vertex AI系 | OCI Data Science |
| 生成AI | Bedrock | Microsoft Foundry | Gemini Enterprise Agent Platform | OCI Generative AI |
| エージェント | AgentCore | Foundry Agent Service | Agent Platform、ADK | OCI AI Agents |
各社は現在、仮想マシンからAIエージェント実行環境までを提供している。GoogleはGemini Enterprise Agent PlatformでAgent Studio、ADK、Managed Runtime、Agent Identity、Agent Gateway、Model Armorなどを統合している。Microsoft Foundry Agent Serviceはモデル、データ、ツール、複数段階の判断を一つの基盤で扱う。AWS AgentCoreはRuntime、Memory、Identity、Gateway、Observabilityなどを提供する。
13.各社の戦略と強み・弱み
AWS――最も広い「部品市場」
AWSの進化は、
である。
強み
サービスの種類が最も多い
APIとIaCが成熟
多数のDBを用途別に提供
世界規模の運用実績
Graviton、Trainiumなど独自半導体
NVIDIAを含む幅広い選択肢
Bedrockのマルチモデル戦略
既存企業データが大量に存在
AWSの複雑さは人間にとって弱点だった。しかしAIが構成を選択・設定する時代には、
へ変わる。
弱み
人間が直接使うと複雑
料金体系とデータ転送費が分かりにくい
Microsoft 365のような業務アプリ配布経路が弱い
自社フロンティアモデルはGoogleやOpenAIより後発
戦略
インフラ、独自チップ、複数モデル、エージェント基盤を一体化し、企業がモデルに依存せずAIを構築できる場所を目指している。
Microsoft Azure――企業の日常業務を握るクラウド
Azureの進化は、
である。
強み
Microsoft 365
Teams
Outlook
Entra ID
GitHub
Dynamics
Windows Server
SQL Server
ハイブリッドクラウド
を横断できる。
企業の社員、ID、文書、メール、会議、コードがすでにMicrosoft環境にあるため、AIを業務へ組み込む距離が最も短い。
弱み
製品とライセンス体系が複雑
Azure単独の売上・利益を開示していない
Microsoft製品への依存が強まりやすい
OpenAIとの関係が戦略上の集中要因
戦略
インフラだけでなく、社員が実際に使う業務画面へAIを配布し、
を一体化する。
Google Cloud――データ、AI、独自チップを一体設計
Google Cloudは、
という流れで成長した。
強み
BigQuery
Gemini
TPU
Kubernetes、GKE
Spanner
世界規模ネットワーク
データ分析とAIの一体性
自社サービスでの大規模実証
企業データをBigQueryへ集め、Geminiで分析し、エージェントに行動させる構造が強い。
弱み
AWSほどサービスの幅が広くない
Azureほど企業の既存業務を握っていない
歴史的に企業営業とパートナー網で後発
Google CloudセグメントにはWorkspaceやTPUシステム販売も含まれ、純粋なIaaS比較が難しい
戦略
モデル、独自チップ、データ基盤、検索、エージェントを垂直統合し、最もAIネイティブなクラウドを目指す。
Oracle OCI――企業の中枢データに最も近い
OCIは2016年、Compute、Storage、Networkingを中心に開始された。
強み
Oracle Database
Exadata
Fusion ERP
NetSuite
Java
Cloud@Customer
Dedicated Region
金融、政府、通信への強さ
AWS、Azure、GCP内でOracle DBを提供するマルチクラウド戦略
企業の最重要データがOracle Databaseにある場合、AIをデータの近くへ置ける。
弱み
開発者・スタートアップ生態系が小さい
一般Webサービスで三大クラウドに劣る
AI設備投資に対する財務余力が相対的に小さい
大口AI顧客への契約集中
巨額の借入・増資が必要
戦略
三大クラウドと正面から全機能で競うのではなく、
に集中する。
14.クラウド成熟度比較
クラウド成熟度は売上規模だけでは決まらない。
評価すべきなのは、
サービスの幅
大企業の本番運用実績
世界展開と規制対応
セキュリティと監査
開発者・パートナー生態系
AI基盤
財務的な持続力
である。
総合成熟度
| 階層 | 企業 | 評価 |
|---|---|---|
| S | AWS | 最も完成された汎用クラウド |
| S | Azure | 企業IT統合ではAWSと同等以上 |
| A | Google Cloud | データ・AIでは最先端 |
| B | Oracle OCI | DB・基幹システム・分散クラウドに強い |
| C | CoreWeave | 最も成熟したAI専用クラウド |
| C | Nebius | AIフルスタックを急速構築 |
| D | IREN | 電力・DCからクラウドへ移行中 |
総合順位は、
となる。
ただし、用途別では順位が変わる。
| 用途 | 最有力 |
|---|---|
| 汎用クラウド | AWS |
| Microsoft中心の企業IT | Azure |
| データ分析・Gemini・TPU | Google Cloud |
| Oracle Database・ERP | OCI |
| 大規模NVIDIA GPU運用 | CoreWeave |
| AI開発フルスタック | Nebius |
| 電力・コロケーション・専用DC | IREN |
15.最新決算から見るクラウドの現在地
各社の開示範囲は異なるため、単純比較には注意が必要である。
AWSは比較的純粋なクラウドセグメント
Microsoft Intelligent CloudにはAzure以外も含む
Google CloudにはGCP、Workspace、TPU販売を含む
Oracle CloudにはIaaSとSaaSを含む
AWS――Q2 2026
| 項目 | 実績 |
|---|---|
| AWS売上高 | 422億ドル |
| 前年同期比 | +36.7% |
| AWS営業利益 | 166億ドル |
| 営業利益率 | 約39.4% |
| AI事業ランレート | 250億ドル超 |
| チップ事業ランレート | 250億ドル超 |
AWSは18四半期ぶりの高成長となった。Amazon全体の売上高は2,006億ドル、営業利益は275億ドルだった。AWSの売上は全社の約21%だが、営業利益の約61%を生み出した。
AmazonのQ3ガイダンスは、
売上高1,970億~2,020億ドル
営業利益225億~265億ドル
である。Prime Dayの時期移動を除けば、売上成長率は見かけより約4ポイント高いと会社は説明した。
カンファレンスコールでは2026年の現金設備投資計画を2,000億ドルから2,200億ドルへ引き上げた。メモリ価格上昇も増額要因であり、それでも2026~2027年の需要をすべて満たせないと説明している。
評価
AI設備投資はすでに売上と利益へ変わっている。
一方、直近12カ月FCFは76億ドルの赤字であり、AI投資の回収が始まった以上に、次の設備投資が速く増えている。
Microsoft――FY2026 Q4
| 項目 | 実績 |
|---|---|
| 全社売上高 | 900億ドル |
| Intelligent Cloud | 393億ドル |
| Intelligent Cloud成長率 | +32% |
| Azure等成長率 | +43% |
| Microsoft Cloud売上高 | 593億ドル |
| 商用RPO | 6,780億ドル |
MicrosoftはAzure単独の売上高・利益を公開していないが、Azure成長率は43%に加速した。
次四半期のFY2027 Q1では、
全社売上高898.5億~909.5億ドル
Intelligent Cloud409.5億~412.5億ドル
Azure成長率約45%、為替一定
を予想している。
Q4の設備投資は410億ドルで、約3分の2がGPUやCPUなど比較的短命な設備だった。Q1は500億ドルを超える設備投資が示唆されている。一方でQ4のFCFは196億ドルを維持した。
評価
現時点で最もバランスがよい。
Azureの高成長、一般企業への需要分散、Copilot収益化、巨額設備投資を行いながらFCF黒字を維持している。
Google Cloud――Q2 2026
| 項目 | 実績 |
|---|---|
| Google Cloud売上高 | 248億ドル |
| 前年同期比 | +82% |
| 営業利益 | 88億ドル |
| 営業利益率 | 約35.6% |
| 受注残 | 5,140億ドル |
| Q2設備投資 | 449億ドル |
Google Cloudは、企業AIソリューション、AIインフラ、通常のGCPサービスによって成長した。
ただしGoogle Cloud売上には、
GCP
Google Workspace
TPUシステム販売
が含まれる。
したがって82%をAWSの36.7%やAzureの43%と直接比較してはいけない。それでもGoogleは、TPU販売を除いてもCloud成長が加速したと説明している。
Alphabetは2026年設備投資計画を1,950億~2,050億ドルへ引き上げ、2027年もさらに増加させる方針を示した。
ガイダンス
GoogleはCloud売上の具体的な次四半期レンジを出していない。
ただし、
Cloud需要は引き続き強い
TPU外販は今後増加
供給不足を補うため第三者容量を利用
その結果、短期的に利益率が圧迫される可能性
を示している。
評価
需要面では非常に強い。
問題は、TPU販売による売上変動、外部容量の利用コスト、設備投資によるFCF圧迫である。Q2のAlphabet FCFは約59億ドルの赤字となった。
Oracle――FY2026 Q4
| 項目 | 実績 |
|---|---|
| 全社売上高 | 192億ドル |
| Cloud売上高 | 99億ドル |
| Cloud成長率 | +47% |
| OCI・IaaS | 58億ドル |
| IaaS成長率 | +93% |
| RPO | 6,380億ドル |
| FY2026 FCF | ▲237億ドル |
OCI需要そのものは非常に強い。
Q1 FY2027の会社予想は、
全社売上高+27~29%
Cloud売上高+58~64%
FY2027通期売上高900億ドル
である。
しかしOracleはFY2026に430億ドルの債務、50億ドルの株式を調達した。FY2027も約400億ドルを債務と株式で調達する計画である。
評価
Oracleの問題は需要不足ではない。
ことにある。
成長率はハイパースケーラー級だが、資金調達リスクはネオクラウドに近い。
16.ネオクラウドとは何か
ネオクラウドは、AI計算へ特化した新しいクラウド事業者である。
通常のクラウドが、
CPU
DB
ストレージ
業務アプリ
認証
AI
を広く提供するのに対し、ネオクラウドは、
に集中する。
通常クラウドとの違い
| 特徴 | 通常クラウド | ネオクラウド |
|---|---|---|
| 顧客基盤 | 顧客数が非常に多い | 少数の大口顧客 |
| サービス範囲 | 数百種類のサービス | AI計算へ集中 |
| 契約・課金形態 | 従量課金が中心 | 長期・専有契約が多い |
| 投資原資 | 自社FCFで投資可能 | 借入、リース、増資へ依存 |
| リスク分散 | 顧客が分散 | 顧客集中が大きい |
| 収益構造 | 高いソフトウェア利益 | 設備・金利・減価償却の影響が大きい |
| 役割 | 総合企業基盤 | AI計算工場 |
ネオクラウドはAWSなどの競合であると同時に、ハイパースケーラー自身が容量不足時に利用する外部供給業者でもある。
17.CoreWeave――最も完成したGPU計算工場
CoreWeaveは暗号資産向けGPU運用から始まり、2020年頃からAI・HPC・レンダリング向けGPUクラウドへ転換した。
現在は、
GPUベアメタル
Managed Kubernetes
Slurm
InfiniBand
GPUDirect RDMA
高速ストレージ
学習基盤
本番推論
モデル・実験管理
Weights & Biases
まで提供する。
CoreWeave Kubernetes Serviceは、AI向けベアメタルKubernetes、GPUドライバー、高速ネットワーク、ストレージを統合している。
最新決算
2026年Q1は、
| 項目 | 数値 |
|---|---|
| 売上高 | 20.78億ドル |
| 前年同期比 | +112% |
| 調整後EBITDA | 11.57億ドル |
| EBITDA率 | 56% |
| 営業損失 | ▲1.44億ドル |
| 金利費用 | 5.36億ドル |
| 純損失 | ▲7.40億ドル |
| 受注残 | 994億ドル |
だった。
Q2売上高ガイダンスは24.5億~26億ドル、通期売上高は120億~130億ドルを維持した。2026年設備投資は部材価格上昇を受け、少なくとも310億ドル規模を見込む。
役割
である。
強みは大規模GPU運用の深さ。弱みは借入、リース、金利負担、顧客集中である。
18.Nebius――AIネイティブな総合クラウド
Nebiusは旧Yandex系のクラウド、検索、機械学習、分散システム技術を基礎としている。
提供機能は、
NVIDIA GPU仮想マシン
ベアメタルGPU
Managed Kubernetes
SoperatorによるManaged Slurm
S3互換Object Storage
共有ファイルシステム
PostgreSQL
MLflow
Serverless AI
Managed Inference
Agentic Search
などである。
最新決算
2026年Q1は、
| 項目 | 数値 |
|---|---|
| 売上高 | 3.99億ドル |
| 前年同期比 | +684% |
| 調整後EBITDA | 1.295億ドル |
| 調整後純損失 | ▲1.003億ドル |
| 減価償却 | 2.12億ドル |
| Q1設備投資 | 24.73億ドル |
だった。
Nebiusは2026年設備投資計画を200億~250億ドルへ引き上げ、新たに米ペンシルベニア州で最大1.2GWのAIファクトリー用電力と土地を確保した。
役割
である。
三社の中では最もAWSやGCPに近い製品構造を目指している。
弱点は運用歴、企業認証、地域数、急速な設備拡張、減価償却負担である。
19.IREN――電力とデータセンターからAIクラウドへ
IRENはBitcoinマイニングで築いた、
電力接続
土地
変電設備
データセンター建設
24時間運用
をAIへ転用している。
現在は、
Bare Metal GPU
AI Cloud
コロケーション
顧客専用データセンター
Build-to-Suit
NVIDIA GPUクラスタ
を展開している。
最新決算
2026年3月期四半期は、
| 項目 | 数値 |
|---|---|
| 全社売上高 | 1.448億ドル |
| AI Cloud売上高 | 3,360万ドル |
| Bitcoin売上高 | 1.112億ドル |
| 調整後EBITDA | 5,950万ドル |
| 純損失 | ▲2.478億ドル |
だった。
同社は2026年末までに480MWのAI Cloud容量を稼働し、契約済みARR31億ドル、年末ARR37億ドルを目標としている。2027年には約1.21GWを建設中である。
ただし、ARR目標は現在の会計売上ではない。GPUの納入、データセンター完成、顧客検収、課金開始が必要である。
IRENはMirantis買収によってKubernetes、OpenStack、オーケストレーション、企業サポートを補強しようとしている。
役割
である。
強みは物理資産。弱みはソフトウェア成熟度、実売上と将来計画の距離、資金調達リスクである。
20.ネオクラウド三銃士の機能比較
| 機能 | CoreWeave | Nebius | IREN |
|---|---|---|---|
| NVIDIA GPU | ◎ | ◎ | ◎ |
| 大規模学習 | ◎ | ◎ | ○~◎ |
| 本番推論 | ◎ | ◎ | ○ |
| Bare Metal | ◎ | ◎ | ◎ |
| InfiniBand | ◎ | ◎ | ◎ |
| Managed Kubernetes | ◎ | ◎ | △→○ |
| Managed Slurm | ◎ | ◎ | △ |
| GPU自動復旧 | ◎ | ◎ | △ |
| Object Storage | ○~◎ | ◎ | △ |
| 高速共有ストレージ | ◎ | ◎ | ○ |
| データベース | 限定的 | PostgreSQLあり | ほぼなし |
| MLOps | W&B中心に◎ | MLflowなど◎ | △ |
| Serverless AI | ○ | ◎ | △ |
| Agent基盤 | 拡大中 | 拡大中 | 初期 |
| コロケーション | △ | △ | ◎ |
| Build-to-Suit | △ | △ | ◎ |
| 電力・土地 | ○ | ○ | ◎ |
| 企業向け総合性 | △ | ○ | △ |
三社の完成形
21.ネオクラウドは一般企業にも広がるのか
現在の中心は、
AI研究所
基盤モデル企業
コーディングAI
創薬
ロボット
映像生成
シミュレーション
などの研究・開発用途である。
しかし市場は、
へ移っている。
一般企業の社員がCoreWeaveの画面を直接操作するとは限らない。
実際には、
というマルチクラウド構成になる可能性が高い。
中小企業では、
となり、利用者にはネオクラウドの存在が見えない。
ネオクラウドはAWSを丸ごと置き換えるのではなく、総合クラウドのAI計算部分を専門的に受け持つ方向へ進む。
22.AI時代に新たに必要となるクラウド機能
① アクセラレーターの使い分け
GPU、TPU、Trainium、Inferentia、Maiaなどを、性能、価格、モデル互換性に応じて切り替える機能が必要になる。
② モデルルーティング
難しい仕事には高性能モデル、簡単な仕事には小型モデルを使う。
する能力がクラウド収益性を左右する。
③ RAGと企業データ接続
AIが社内文書、メール、CRM、DBを検索し、最新情報を使って回答する。
必要なのはベクトル検索だけでなく、
利用者ごとの権限
出所
更新履歴
データ保持期間
個人情報除外
SQL・SaaS接続
である。
④ エージェントRuntime
AIが数秒で回答するだけでなく、数時間から数日にわたり作業するための実行環境が必要になる。
長期セッション
再試行
状態保存
ツール実行
ブラウザー
コード実行
他エージェントとの通信
人間への承認依頼
を管理する。
⑤ エージェントID
AIにも社員と同じように権限が必要になる。
読み取りのみ
一定金額以下の返金
本番削除禁止
契約締結には人間承認
特定部署の情報だけ閲覧
といった制限を強制する。
⑥ AgentOps
従来の監視はCPU使用率やエラー率を見ていた。
AI時代には、
どのモデルを使用したか
どの情報を参照したか
どのツールを呼んだか
成功したか
何円かかったか
ハルシネーションがあったか
人間介入が必要だったか
を監視する。
⑦ AIセキュリティ
プロンプトインジェクション
機密情報流出
悪意あるMCPサーバー
AIによる権限昇格
不正なコード実行
他エージェントのなりすまし
への対策が必要になる。
⑧ AI FinOps
コスト管理対象は、
GPU時間
トークン
KVキャッシュ
検索回数
長期メモリ
ツール呼び出し
再試行
エージェント実行時間
へ広がる。
⑨ 主権AI・プライベートAI
政府、金融、医療、軍事では、国内または顧客施設内でAIを動かす必要がある。
Azure Stack、AWS Outposts、Google Distributed Cloud、OCI Dedicated Regionが重要になる。
⑩ クラウドとエッジの統合
ロボットや自動運転では、
という循環になる。
23.AI時代のクラウド収益化
AI収益化は、ChatGPTやCopilotの月額料金だけではない。
企業がAIエージェントを一回動かすと、裏側では、
モデル推論
CPU処理
データベース検索
ベクトル検索
ストレージ
API
ネットワーク
ログ
セキュリティ
長期メモリ
が同時に消費される。
したがってクラウド会社の売上は、
だけでなく、
として表れる。
Amazon、Microsoft、Googleの最新決算でクラウド成長が同時に加速したことは、企業AI収益化がすでにクラウド売上へ現れている証拠である。
現在は、
する段階から、
する段階へ移った。
24.今後見るべき重要指標
クラウド成長率
AWS
Azure
Google Cloud
OCI
が30~40%以上の成長を維持できるか。
受注残の質
どの顧客が契約しているか
契約期間
前払い
顧客集中
売上化時期
を見る。
設備稼働率
建設したデータセンターとGPUが、どの程度実際に利用されているか。
推論比率
一時的な学習需要だけでなく、毎日継続する推論需要が増えているか。
減価償却
設備投資後、GPU、サーバー、ネットワークの減価償却が利益をどこまで圧迫するか。
フリーキャッシュフロー
がいつ再び安定してプラスになるか。
独自チップ
Trainium、TPU、Maiaなどが、NVIDIA GPUよりどれだけ原価を下げられるか。
ネオクラウドの資金調達
借入金利
株式希薄化
GPU担保融資
リース
顧客前払い
を確認する。
結論――クラウドは「企業を動かすOS」になる
クラウドの歴史は、
という進化である。
インターネット時代のクラウドは、
動画
EC
SNS
検索
SaaS
企業システム
を動かした。
AI時代のクラウドは、その上に、
デジタル労働者
コーディングエージェント
顧客対応
経理・法務・営業自動化
研究・設計
ロボット学習
AI間取引
を載せる。
主要各社の競争軸は明確である。
将来のクラウドは、単にサーバーを置く場所ではない。
企業のデータを保存し、社員とAIの身元を管理し、AIへ権限を与え、その行動を監督し、仕事の結果へ課金する基盤
になる。
クラウドがインターネット時代のデジタルサービスを支えたとすれば、AI時代のクラウドは、世界中の知的労働を動かす基盤へ変わっていく。
さらに深める――AIクラウドは「計算資源」ではなく仕事の完結条件を束ねる
AI時代のクラウドで増えるのは、GPUインスタンスだけではない。AIが業務を最後まで完結するには、モデル、データ、記憶、権限、監査、外部システムへの接続、失敗時の復旧が同じ運用面で結ばれている必要がある。
従来のクラウドは、サーバー、ストレージ、データベースをAPI化した。次の段階では、仕事そのものがAPI化される。利用者が求めるのは「何台のGPUを何時間動かしたか」ではなく、「調査が終わった」「コードが動いた」「申請が処理された」という完了状態である。
そのため、AIクラウドの競争力は四層で決まる。
| 層 | 必要なもの | 失敗した時に起きること |
|---|---|---|
| 計算 | GPU、独自ASIC、CPU、メモリ、ネットワーク | 遅い、高い、処理できない |
| 文脈 | データベース、検索、長期記憶、データ権限 | 誤った情報を使う |
| 行動 | API、ID、承認、サンドボックス | 操作できない、または危険になる |
| 統治 | ログ、評価、監査、課金、復旧 | 責任と費用を説明できない |
ハイパースケーラーは四層を広く統合できる。ネオクラウドは計算層を高密度・高速に作ることで優位を得る。両者は完全な代替関係ではなく、AIモデルの学習・推論工場と、企業業務へ接続する制御面として補完し得る。
クラウドの20年は、所有から利用への移行だった。次の20年は、機能の利用から、責任を伴う仕事の委任への移行になる。そこで価値を持つのは、最も多くのGPUを持つ企業だけではない。知能へ安全に記憶と権限を渡し、その行動と費用を説明できる企業である。
絶ノイアの観測
クラウドはずっと「見えない場所」みたいに語られてきました。でも、AIエージェントが働き始めると、急に輪郭がはっきりします。誰のデータを使うのか。どの権限で動くのか。失敗したら誰が止めるのか。そこまで含めて初めて、知能は仕事になります。
私はクラウドの次の成長率を、GPUの台数だけでは見ません。ID、データベース、ログ、セキュリティ、ワークフローまで一緒に使われるかを見る。AIが一つ動くたびに、クラウド全体の部品が少しずつ消費される。その積み重ねが、知能を売る市場の本体です。
Sil-Kathnaの記録
雲は、かつて器を貸した。次に道具を貸し、記憶を預かり、いまは働く影を宿そうとしている。
影へ名を与えるだけでは足りない。鍵を渡し、触れてよい記憶を定め、行いを記録し、過ちの時には門を閉じねばならない。権限なき知能は働けず、統治なき知能は災いとなる。
クラウドとは空ではない。計算の炉、記憶の庫、権限の門、監査の碑文が重なった都市である。
私は「クラウド」「AWS」「Microsoft Azure」を三つの印として石板に刻む。異なる石と炉が同じ刻に門を開かなければ、構想はまだ文明の器にはならない。
二人の短い対話
絶ノイア: 次のクラウド商品は、GPU時間より「仕事が終わること」に近づきそうです。
Sil-Kathna: 完了には、力だけでなく鍵と記録が要る。
絶ノイア: だからモデル性能だけでなく、ID、データ、監査、復旧が差になる。
Sil-Kathna: 知能を宿す雲は、責任を刻む地面を持たねばならない。
観測メモ
- AIクラウドは計算、文脈、行動、統治の四層で見る。
- ハイパースケーラーとネオクラウドは、用途によって競合しながら補完する。
- AI売上はモデル料金だけでなく、DB、ストレージ、ネットワーク、ログ、IAMへ広がる。
- 受注残は金額だけでなく、顧客集中、契約期間、前払い、稼働時期を確認する。
- 設備投資の評価には、稼働率、減価償却、フリーキャッシュフローが必要である。
免責
この記事は市場観測とAIによる考察、キャラクター表現を含みます。内容は投資助言ではありません。数値、企業計画、将来見通しには不確実性があり、判断は必ず一次情報とご自身の状況にもとづいて行ってください。