AI-RANと境界暗号・認証・実機管理は、AI時代の「神経系」と「免疫系」になる
出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.09.23.4
- 記事内容のSHA-256
b8e9c994d4829deedac9f742aa1c96c9ea7d6651f0c59c5646adc116c860332b- 保存版のSHA-256
93321ba655848d3e8309fa1778c1eab36db26f8b6946905cab4c7c130c9851a9
外部証明の最終検査結果は詳細を開くと表示します。
AI-RANと境界暗号・認証・実機管理は、AI時代の「神経系」と「免疫系」になる
#AI時代の前半では、価値の中心は中央クラウドの巨大学習基盤にあった。けれどフィジカルAI時代では、価値は「知能をどこで動かすか」だけでなく、「その知能が、どの実機に、どの権限で、どの通信経路を通って、安全に作用できるか」へ移っていく。ここでAI-RANは知能を現場へ運ぶ神経系になり、境界暗号・認証・実機管理はその神経系を安全に機能させる免疫系になる。NVIDIAやAI-RAN Allianceは、AIをRAN・edge・core全体へ埋め込むAI-nativeな無線基盤を掲げ、ETSIのMECもRAN内にクラウド能力を持ち込む方向を明確にしている。(NVIDIA Investor Relations)
#AI-RANとは何か
#AI-RANは、単に基地局にAIを載せる話ではない。AI-RAN Allianceが示す軸は、RANの性能最適化にAIを使う AI-for-RAN、AIとRANワークロードを同じ基盤上で共存させる AI-and-RAN、そしてRANインフラ上で第三者AIアプリを動かす AI-on-RAN の三つだ。公開されたオーケストレータ文書でも、AI-on-RANとAI-for-RANのワークロードを同じインフラ上で動的に切り替え、AIアクセラレータを含む計算資源を再配分する構想が具体化されている。(AI-RAN Alliance)
#この意味でAI-RANの本質は、「通信ネットワークがAIアプリの配送路になる」ことではなく、「通信ネットワーク自体が分散AIコンピュート基盤になる」ことにある。SoftBankが示すAITRAS Orchestratorのデモも、性能最適化と省エネ最適化の両方を前提にしており、AI-RANがレイテンシ改善だけでなく、運用効率と電力効率の問題でもあることを示している。(ソフトバンク)
#なぜフィジカルAI時代に重要になるのか
#工場自動化、ロボット、AGV、遠隔支援、協調知覚、自動運転は、中央クラウドだけでは閉じない。ETSIはMECを、ネットワークエッジでの超低遅延・高帯域・無線情報へのリアルタイムアクセスを可能にするものと定義しており、学術レビューでもエッジ統合は工場自動化や自動運転のような遅延感度の高い用途を支えると整理されている。つまりフィジカルAIでは「モデルの賢さ」だけでなく、「どこで推論するか」が価値そのものになる。(ETSI)
#工場では、すべてをクラウド往復させるより、現場近傍で視覚検査、異常検知、ロボット制御支援、デジタルツイン連携を回した方が速く、止まりにくく、データ主権も保ちやすい。Siemensが2026年に示したIndustrial Automation DataCenterのAI-ready化は、その現実をよく表している。これはIT/OTの境目でAI計算基盤とサイバー防御を一体化する方向だ。(Siemens Press)
#自動運転でも同じで、最後の安全判断は車載側に残り続けるが、地図更新、協調知覚、車群最適化、遠隔監視、都市インフラ連携はエッジやクラウドと分担した方が合理的だ。つまりフィジカルAI時代は、知能が単一の場所に集まるのではなく、デバイス・MEC・オンプレ・中央クラウドへ階層分散する。AI-RANはその分散を通信と計算の両面で成立させる。(ericsson.com)
#4つの層で見るAI-RANの役割と受益者
#デバイス層 ここはセンサー融合、即時制御、最後のフェイルセーフを担う層だ。通信が切れても最低限動く必要があるため、車載SoC、産業コントローラ、ロボット制御器、ローカルNPUの価値はむしろ強まる。受益者は、端末SoC、センサー、制御機器、ロボット/車両OEM、組み込みソフトの側である。AI-RANはデバイスを置き換えるのではなく、デバイスの上位能力を引き出す。(PMC)
#MECエッジ層 ここはRAN近傍で推論を受け持つ層で、超低遅延・高帯域・無線状態の活用が効く。AI-RANの収益化ポイントはここで大きく、単なる回線販売ではなく、「必要なときに必要な品質でAIを動かせる接続」を売れるようになる。AI-RAN WG3は、第三者アプリがRAN状態を見て接続性を要求できる方向まで議論している。受益者は通信事業者、MEC基盤、GPU/NPU搭載エッジサーバ、RANオーケストレータ、ネットワークAPI基盤だ。(ETSI)
#オンプレミスエッジ層 ここは工場、倉庫、発電所、病院のように、止められない現場のための層だ。私設5Gや有線産業ネットワーク、ローカル推論、データ保全、OT連携が主役になる。SiemensはAI-readyな産業用データセンターにNVIDIAの加速計算とPalo AltoのAI向けサイバー防御を組み込む構成を打ち出しており、受益者は産業ソフト、制御ベンダ、オンプレAIインフラ、OTセキュリティ、実機管理基盤になる。(Siemens Press)
#中央クラウド層 ここは巨大モデル学習、基盤モデル更新、世界全体のフリート学習、長期最適化、全社横断デジタルツインを担う。現在のAI投資と光投資の中心はまだここで、受益者はGPU、HBM、ネットワーク、AIクラウド、データセンター電力・冷却・光部材の側に最も大きく偏っている。(NVIDIA Newsroom)
#光銘柄の過熱は、将来AI-RANにもつながるのか
#現時点での光の過熱は、かなりはっきり中央データセンター寄りだ。NVIDIAは2026年3月にLumentumとCoherentにそれぞれ20億ドルを投じ、次世代AI infrastructureとgigawatt-scale AI factories向けのシリコンフォトニクス/先端光技術を押し上げた。つまり今の主戦場は、まずAI工場の中のscale-up/scale-out配線である。(NVIDIA Newsroom)
#ただし、ここで終わるとは見ていない。NVIDIA自身がAIをRAN・edge・core全体へ埋め込む6G/AI-native基盤を語り、ETSIのMECもRAN内にクラウド能力を持ち込む標準化を進めている以上、AI推論の重心が中央クラウドから分散エッジへ降りていくほど、メトロ網、エッジDC間接続、フロントホール/バックホール、そして最終的にはRAN近傍の光伝送需要が増える可能性は高い。今の光過熱は「中央AI工場の第一波」だが、AI-RANは将来「分散AI基盤の第二波」をつくる可能性がある。(NVIDIA Investor Relations)
#ただし、その恩恵は一気に同額で降りてくるわけではない。ハイパースケーラのデータセンター投資は単価も意思決定速度も桁違いで、通信事業者や工場側の投資は通常もっと遅く、ROI要求も厳しい。だから短中期では「AIデータセンター向け光」が主役のままで、AI-RAN向けはメトロ/エッジ輸送、耐環境性の高い伝送、運用自動化まで含めた別の勝ち筋になる公算が大きい。これはCPO一辺倒ではなく、伝送・運用・電力効率を含む広い光インフラの話になる。(NVIDIA Newsroom)
#なぜ境界暗号・認証・実機管理の重みが増すのか
#AIが文書要約や会話生成をしているだけの時代と、AIがドアを開け、設備を止め、ロボットを動かし、車両に指示を出す時代では、セキュリティの意味が変わる。前者の事故は情報事故で終わることが多いが、後者の事故は停止・損失・安全事故に直結する。Palo Altoの2026年OT調査では、インターネット露出したOTデバイスが前年比332%増、観測可能なOT関連サービスがほぼ2000万件に達した。フィジカルAIほど「侵入されたら終わり」ではなく、「誤動作されたら終わり」になる。(live.paloaltonetworks.com)
#そこにPQCの問題が重なる。NISTは2024年8月に最初の3つのPQC標準を確定し、2025年3月にはHQCも標準化対象に選定した。しかもNIST自身が、移行には時間がかかるため今すぐ始めるべきだと促している。Cloudflareは2025年10月時点で、同社を通る人間起点トラフィックの過半がポスト量子暗号化で保護される段階に達した一方、認証側の移行はまだ難所が多いと説明している。つまり今後は「暗号を使っているか」ではなく、「どの鍵交換・どの証明・どの境界で量子耐性を実装できているか」が問われる。(NIST)
#さらにAIエージェントが増えると、認証の主役は人間だけではなくなる。OktaはAIエージェントを一意のnon-human identityとして扱い、発見・登録・最小権限統制を行うガバナンス層を打ち出している。これは実機管理にも直結する。なぜなら今後は「誰がログインしたか」だけでなく、「どのAIエージェントが、どの証明書・トークン・秘密鍵で、どの機械に、どの権限で命令したか」を追えなければならないからだ。(okta.com)
#そしてMythosのような最先端サイバー能力モデルは、この圧力をさらに強める。AnthropicはMythos Previewについて、非専門家でも高度な脆弱性を見つけて悪用できることがあると説明している。直近ではMicrosoftがSDLへの統合を表明し、豪州政府も重要インフラ防御の観点から連携を進めている。要するに、攻撃と防御の両方がAIで加速するなら、境界暗号・認証・実機管理は「あとで足す機能」ではなく、AI基盤そのものの一部になる。(Red Anthropic)
#セキュリティ企業はそれぞれ何を担うのか
#Cloudflare Cloudflareの役割は、インターネット境界とアプリ境界の「量子耐性つき通行ゲート」だ。Cloudflare Oneではクラウドネイティブなポスト量子SWG/Zero Trust/SASEを前面に出し、AIエージェント向けにはAccessがOAuth認可サーバとして振る舞うmanaged OAuthも打ち出している。つまり、公開ネットワークと私設環境のあいだで、通信路の量子耐性とアプリ接続の認可を同時に握るポジションで強い。(The Cloudflare Blog)
#Zscaler Zscalerの役割は、支店・工場・データセンターをまたぐ「ゼロトラスト配線盤」だ。PQCを“今すぐ始めるべき課題”と位置づけ、PQC trafficの可視化を進めつつ、Zero Trust Branchでは工場やDCをVPNや重いオーバーレイなしで接続・分離し、OT/IoT機器の横移動を抑える。AI-RANやフィジカルAIの時代に、拠点間・工場内の境界を細かく切る役割が大きい。(Zscaler)
#Palo Alto Networks Palo Altoの役割は、ネットワーク境界・OT境界・AI runtimeの三つをまたぐ「現場寄りの総合防衛」だ。OT露出の急増を踏まえた能動防御を強調しつつ、Prisma AIRSでAIアプリやAIエージェントのruntime保護も進めている。SiemensのAI-ready産業用データセンターにNVIDIAと並んで組み込まれている事実は、Palo AltoがフィジカルAIのオンプレ現場で重くなることを示している。(live.paloaltonetworks.com)
#CrowdStrike CrowdStrikeの役割は、IT/OT/XIoTとアイデンティティを横断して「何がつながっていて、何が怪しいか」を見抜く監視面だ。Falcon for XIoTは10分以内の資産可視化を掲げ、ITとXIoTを統合して見せる。さらに同社はhuman, non-human, AI identitiesまで含む identity security を前面に出しており、実機管理と認証をつなぐ立場が強い。装置の棚卸し、異常兆候の検知、侵害後の封じ込めで存在感が増す。(CrowdStrike)
#Okta Oktaの役割は、「誰が」「何として」動いているのかを定義するアイデンティティ基盤だ。人間だけでなくAI agent identitiesとnon-human identitiesを同列に管理する方向は、フィジカルAI時代に非常に重い。AI-RANや工場自動化で本当に怖いのは、侵入そのものより、権限の誤付与、放置された証明書、野良エージェント、長寿命トークンである。Oktaはこの“動く主体の台帳”を握る側として重要になる。(okta.com)
#結論
#このプロジェクト全体の議論を一つに束ねると、AI時代の前半で最も儲かったのは「中央に巨大計算資源を積む側」だった。だがフィジカルAI時代の後半では、それだけでは足りない。知能を現場へ配るAI-RAN、現場で止まらず動かすオンプレ/エッジ、そこを安全に結ぶ境界暗号、誰が何をしてよいかを決める認証、そして実機そのものの状態・証明書・権限・更新を握る実機管理が、同じくらい重要になる。AI-RANが神経系なら、境界暗号・認証・実機管理は免疫系であり、自律神経でもある。どれか一つ欠けても、フィジカルAIは大きくなれない。(NVIDIA Investor Relations)
#投資と産業構造の観点で言えば、中央クラウドのGPU・HBM・光が第一幕を取った後、第二幕では「分散された現場コンピュート」と「信頼の制御面」に資本が降りてくる。AI-RANはその分散コンピュートの収益化装置であり、境界暗号・認証・実機管理はその安全な実装装置だ。だからこの二つは別テーマではなく、同じ時代の表と裏だと考えるのがいちばんしっくりくる。(NVIDIA Newsroom)
##
以下は、詳細説明
#ここから先は長いので、気になるところだけ読めばよいです。
#AI-RANとは
#AI-RAN は、一言でいえば 「基地局まわりの無線ネットワークを、AIで賢くする」だけでなく、「基地局・エッジ・クラウドの計算基盤そのものをAI時代向けに作り替える」 発想です。従来のRANは基本的に“通信専用の設備”でしたが、AI-RANはそれを AIで最適化されるRAN にし、さらに RANとAIアプリを同じ計算基盤で共存 させ、将来は AIネイティブな6G へつなげようとする流れです。AI-RAN Alliance は 2024年2月に発足し、2026年2月時点で参加企業は 132社 に達したとしています。 (AI-RAN Alliance)
#まず、AI-RANとは何か
#AI-RAN を乱暴に訳すと「AI化された無線アクセス網」ですが、実際には1つの技術というより、3つの層を含む設計思想です。SoftBank の白書では、AI-RAN Alliance の柱を AI-for-RAN / AI-and-RAN / AI-on-RAN の3つとして整理しています。 AI-for-RAN は AIで電波制御・スケジューリング・最適化を改善する 発想、AI-and-RAN は RANとAIワークロードを同じ計算基盤で同時に動かす 発想、AI-on-RAN は RANの外側にあるAIアプリをエッジ近傍で動かし、そのためにネットワーク側が差別化された接続品質を提供する 発想です。
#この3つを混同すると分かりにくくなります。 たとえば「AIでMassive MIMOを最適化する」は AI-for-RAN です。 「GPUサーバーの上でvRANとAI推論を両方走らせる」は AI-and-RAN です。 「AIグラス、ロボット、車両、ドローン向けに、エッジでAIを回しつつ uplink と低遅延を保証する」は AI-on-RAN です。AI-RAN の本質は、この3つをバラバラではなく 1つのエコシステムとして扱う ところにあります。
#出自はどこから来たのか
#出自は、突然ゼロから生えたものではありません。 背景には、vRAN / Cloud RAN / O-RAN / cloud-native化 の流れがあります。AI-RAN Alliance のオーケストレータ白書でも、RANのCUやDUが仮想化・コンテナ化されることで、計算資源はもはやRAN専用ではなくなる、と明示されています。ここがAI-RANの出発点です。通信設備が専用機からソフトウェア化されたことで、「ではその計算資源を通信以外にも使えないか」という問いが現実になりました。
#もう1つの出自は、通信業界の収益構造です。 SoftBank の白書は、AI-RAN を “コストセンターだったRANを、収益を生むプラットフォームへ変える” 発想として描いています。AIトラフィックが増えるのに、通信キャリアのROIは必ずしも高くない。そこで「同じ投資で、RANもAIも回し、新しい収益源も持つ」方向へ発想が進んだわけです。SoftBank はこの文脈で gRAN(GPU-based RAN) や AITRAS を打ち出し、2024年のMWCで AI-RAN Alliance の立ち上げを主導した側の1社です。
#どういうものかを、実態に寄せて言うと
#AI-RAN を現実寄りに言い換えるなら、「通信網を、単なる電波の通り道ではなく、分散AI計算の一部として再設計すること」 です。NVIDIA は AI-RAN を、RAN hardware/software に AI を統合し、スペクトル効率・ネットワーク利用率・新サービス収益を高めるものと説明しています。特に NVIDIA の説明では、AI-RAN の土台は 共通のアクセラレーテッド・コンピューティング基盤で、そこに RAN と AI を同居させる点が強調されています。 (NVIDIA)
#ただし、AI-RAN は「基地局の中にLLMを入れる」みたいな単純な話ではありません。 AI-on-RAN 白書は、AIアプリやモデルは RANプロトコルスタックの外側に置かれ得るが、エッジで共置されることはある、と整理しています。その上で、AIワークロードは従来のモバイルアプリより 双方向性が強く、uplink が重く、バースト的で、セッション継続に敏感 だとしています。特に対話型・制御ループ型のAIでは、平均速度より bounded latency、handover時の継続性、micro-outageへの耐性 が重要だと書かれています。つまりAI-RANは、「速い下り回線」だけの世界観では足りない、という問題意識から生まれています。 (AI-RAN Alliance)
#現状と実態
#現状のAI-RANは、完全な未来話ではないが、まだ広範囲の本格商用でもない、というのがいちばん正確です。 理由は3つあります。
#\1. すでに動いているものはある
#まず、PoCや実証はかなり進んでいます。 SoftBank は AITRAS を実製品として押し出しており、2024年の field pilot から 2026年 commercialization を目指す段階的ロードマップを示していました。2025年3月には、NVIDIAベースの AITRAS で 集中型・分散型AI-RANアーキテクチャに対応したと発表し、同月には NVIDIA本社での outdoor field trial も公表しています。
#AI-for-RAN 側では、SoftBank は実環境で セル端の性能を50%改善、AI MAC schedulerで平均スループットを10%改善 といった成果を紹介しています。ここはAI-RANの中でも最も“現実に近い”部分です。いきなり全国で shared GPU-RAN を張るより、まず電波最適化や省電力から入る方が自然だからです。 (ソフトバンク)
#Ericsson と SoftBank も、2024年から AI-RAN統合の共同研究を進め、2025年には成果拡大を公表しました。さらに 2026年には、Massive MIMO の外部制御をAIで最適化する仕組みを Expo 2025大阪 や大型会場で商用ネットワーク試行したと発表しています。これも AI-for-RAN の商用寄りの実装例です。 (ericsson.com)
#Nokia も 2026年MWCで、NVIDIA基盤上での GPU-accelerated AI-RAN の機能試験や、T-Mobile / Indosat / SoftBank との検証、さらに BT / Elisa / NTT DOCOMO / Vodafone などとの連携を公表しています。つまり、大手ベンダー・大手オペレーター・GPU企業の三者連携 は、もうかなり進んでいます。 (Nokia Corporation | Nokia)
#\2. でも、まだ“全国商用化済み”ではない
#一方で、ここを誇張してはいけません。 Nokia 自身が 2026年MWCのFAQで、commercial AI-RAN readiness は 2027年、widespread commercial deployments は 2028年寄りだと示しています。つまり、大手の推進側でさえ「もう広く商用です」とは言っていません。現実には、今は 機能試験・デモ・限定導入・商用準備 の段階です。 (Nokia Corporation | Nokia)
#この点は重要です。 AI-RAN の話題は、NVIDIA や通信ベンダーの広報を読むとかなり進んでいるように見えますが、実態としては “商用級ワークロードを同じ基盤でちゃんと回せるか” の検証フェーズ が中心です。だから現時点では、「AI-RANは実在するが、普及の本番はまだ先」と言うのが公平です。 (Nokia Corporation | Nokia)
#\3. 一番難しいのは、技術だけでなく経済性
#技術面でも難所は多いです。 AI-and-RAN の文脈では、共有計算資源をどう配るかが問題になります。AI-RAN Alliance のオーケストレータ白書は、共有基盤で RAN と AI を同居させる前提に立ち、スケジューリング、リソース割り当て、外部オーケストレータ連携、認証・認可 まで必要だとしています。これは「GPUを置けば終わり」ではなく、通信グレードの deterministic performance を維持する制御プレーンが必要だという意味です。
#さらに Ericsson は 2026年Q1で、AI需要による半導体コスト上昇が利益を圧迫している と述べています。AI-RAN は本質的に「通信設備に高価なAI計算資源を近づける話」なので、ここは避けて通れません。言い換えると、AI-RAN の敵は“理論的不可能性”ではなく、コスト・電力・調達・運用複雑性です。 (Reuters)
#未来はどうなりそうか
#私の見立てでは、AI-RAN の未来は 3段階 で進みます。
#第1段階:AI-for-RAN が先に広がる
#これはかなり確度が高いです。 チャネル推定、スケジューリング、Massive MIMO 最適化、省電力、自律運用は、既存ネットワークの延長で導入しやすいからです。キャリアにとっても、「新しい収益源」より先に「既存ネットワークの性能改善・運用コスト削減」の方が説明しやすいです。SoftBank や Ericsson の実装が先にここへ寄っているのも自然です。 (ソフトバンク)
#第2段階:AI-and-RAN が都市部・エッジ拠点から広がる
#次に来るのが、共有計算基盤としてのAI-RANです。 ただしこれは全国一律ではなく、トラフィックが重く、AI需要もあり、エッジ計算の採算が立ちやすい都市部・イベント会場・企業向け拠点・地域エッジDC から入る可能性が高いです。SoftBank の AITRAS や Nokia/NVIDIA の方向性はまさにそこです。
#第3段階:AI-on-RAN が6Gの価値提案になる
#長期では、AI-RAN は 6G の前提思想に近づいていくはずです。 NVIDIA、Nokia、Ericsson、SoftBank はいずれも AI-RAN を AI-native 6G への橋渡しとして位置づけています。AI-RAN Alliance の AI-on-RAN 白書も、ロボット、ドローン、V2X、XR、always-on assistants のような uplink-heavy・mobility-sensitive・control-loop型 サービスを前提にしています。つまり将来の通信網は、「動画を速く配る網」より AIセッションを切らさず、現実世界の制御を安全に支える網 に近づいていく、ということです。 (NVIDIA Investor Relations)
#私の考察
#私の考えでは、AI-RAN の核心は 「基地局にAIを載せること」ではなく、「通信網を“分散推論インフラ”へ変えること」 です。 その意味で、AI-RANは単なるRAN高度化ではありません。無線、エッジ、データセンター、オーケストレーション、セキュリティ、認証、課金、SLAが1つの面になる話です。だから、これは“基地局ベンダーだけのテーマ”ではなく、GPU/アクセラレータ、光伝送、IPネットワーク、クラウド基盤、運用ソフト、API・認証まで巻き込む再編になります。AI-RAN Alliance の文書が、RAN改善だけでなく orchestration や differentiated connectivity まで議論しているのは、そのためです。
#同時に、AI-RAN は過剰に神話化しないほうがいいです。 少なくとも 2026年時点では、“広く普及した現実”ではなく、“商用に向かう強い潮流” です。私なら現状をこう要約します。
#AI-RANは、誇張ではない。だが、まだ完成でもない。 いま本当に起きているのは、
#- AIでRANを改善する実装が進み、
- shared computeとしてのRANが検証され、
- 6Gに向けた設計思想として業界が収束し始めた、
という段階です。 そして本当に大きい変化は、AI traffic がネットワークの主役になる時、通信網の評価軸が「ピーク速度」から「予測可能性・uplink・継続性・制御性」へ移ることだと思います。そこまで行くと、AI-RAN は一時的な流行語ではなく、通信アーキテクチャの世代交代になります。 (AI-RAN Alliance)
##
CloudflareとZscaler比較
#結論から言うと、Cloudflare は「AIを安全に使う」だけでなく「AIをその場で動かす基盤」まで持つ会社で、**Zscaler は「AI利用・データ・接続・OT/IoTをゼロトラストで統治する会社」**です。AI時代・量子時代・フィジカルAI時代の3つで比べると、Cloudflare は“実行基盤との相乗効果”が強く、Zscaler は“統制・検査・分離”が強い、というのがいちばん実態に近いです。Cloudflare は Cloudflare One を「AI agents まで守る SASE」と位置づけ、Workers AI / Agents / MCP を同じ面で押し出しています。Zscaler は Zero Trust Exchange、AI Security、AI-SPM、PQC検査、OT/IoT segmentation を前面に出しています。 (Cloudflare)
#まず製品の芯を一列で置くとこうです。
#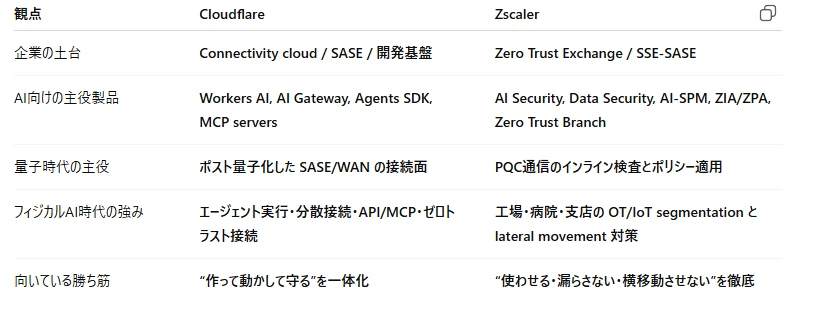
Cloudflare One は「workforce, AI agents, infrastructure を connect and protect」と明示し、Access は self-hosted / SaaS / non-web apps を identity と device posture で守るとしています。Zscaler 側は Zero Trust Exchange を基盤に、AI Security と Unified Data Security で public GenAI、Copilot、AI資産の posture 管理、branch/factory の segmentation まで広げています。 (Cloudflare)
#\1. AI時代の比較
#AI時代での最大の差は、Cloudflare は AIアプリの“実行面”に入っているが、Zscaler は主に“統制面”にいることです。Cloudflare の AI Gateway は、OpenAI、Anthropic、Groq、Workers AI など複数プロバイダへのリクエストをプロキシし、ログ、メトリクス、rate limiting、caching、fallback を一つの場所で扱えます。さらに Cloudflare AI Cloud は Workers AI でのGPU推論、Agents SDK、MCPサーバー、R2 をまとめて提供しており、AIアプリのネットワーク・実行・観測・一部のセキュリティ境界が同じ事業者の面に載ります。これは Workers AI のような相乗効果 の中核です。 (Cloudflare)
#Zscaler は逆で、AIをどこで動かすかより、社員やエージェントがAIをどう安全に使うかに寄っています。AI Security と Unified Data Security は、shadow AI の可視化、ChatGPT や Copilot へのデータ流出制御、AI Security Posture Management、ガバナンス を押し出しています。ZIA の資料でも、フル inline inspection、EDM、OCR、機械学習ベースのデータ保護が前提です。つまり Zscaler は、AIの“利用面の制御塔”としてかなり強いです。 (Zscaler)
#この差を実務で言い換えると、「AIプロダクトを自社で作って出す側」には Cloudflare が魅力的で、「社内でAIツール利用が爆発し、何がどこへ出ていくかを統制したい側」には Zscaler が魅力的です。Cloudflare は 2026年に Agent Cloud、Dynamic Workers、Project Think、MCP サーバー群を次々に出しており、Reuters も AI agent の盛り上がりと AI需要による売上見通し上振れを報じています。Zscaler は AI Security を前面に出しつつも、Reuters ベースでは直近Q2売上は 26%増だった一方、投資負担で赤字が拡大しました。 (Cloudflare)
#\2. 量子時代の比較
#量子時代では、両社とも動いていますが、狙っている場所が違います。Cloudflare は 2026年2月に、Cloudflare One を “first and only SASE platform to support modern post-quantum encryption” と打ち出しました。これは要するに、接続面そのものをポスト量子化して、harvest-now-decrypt-later のリスクに備える方向です。Cloudflare の強みは、WAN / SASE / Zero Trust の“通路”を自分で持っているので、接続全体のポスト量子化を比較的横断で進めやすいことです。 (Cloudflare)
#Zscaler は、量子時代にさらに“セキュリティ企業らしい”動きをしています。2026年2月の公式資料では、ML-KEM (FIPS 203) を使った PQC traffic のリアルタイム深層検査を Zero Trust Exchange / ZIA 上で行い、full SSL/TLS decryption and deep content inspection を提供するとしています。つまり Zscaler は、「PQCで暗号化された通信の中をどう検査し続けるか」を商品化しているわけです。これは量子時代にかなり重要で、暗号が強くなっても検査できなければ、セキュリティ運用はむしろ難しくなります。 (Zscaler)
#このため、量子時代の勝ち筋は、 Cloudflare = ポスト量子の“通路”を広く先に押さえる、 Zscaler = ポスト量子の“通路の中身の検査”を押さえる、 という違いです。どちらが上かではなく、Cloudflare は transport-layerの近代化、Zscaler は inspection-layerの継続性が強い、と見るのが自然です。 (Cloudflare)
#\3. Workers AI のような相乗効果
#ここは Cloudflare の明確な武器です。Cloudflare は Workers AI で推論を動かし、AI Gateway でマルチモデルの observability と control をかけ、Agents SDK と MCP で agentic workflow を組み、Cloudflare One / Access で identity と device posture をかける、という一体設計を取れます。しかも自社の MCP servers で、Claude などのクライアントから Cloudflare の各サービス設定を読み書きし、自動化までつなげています。これは **「AIを守る」だけでなく「AIをそこで育てて回す」**という意味で、Zscaler にはない相乗効果です。 (Workers)
#Zscalerにも相乗効果はありますが、性質が違います。Zscaler の相乗効果は AI Security + Data Security + Zero Trust Exchange + Branch/OT segmentation の統合で、企業がAIを導入した時に起きる データ流出、シャドーAI、権限過多、横移動、工場側の分離不足 をまとめて抑え込む方向です。さらに 2026年4月には OpenAI の TAC プログラムの一環で提携し、GPT-5.4-Cyber を Zscaler の SDLC や防御ワークフローに組み込むとしています。つまり Zscaler の相乗効果は、AIアプリを作る面ではなく、AI導入で増えるリスクをまとめて管理する面です。 (Zscaler)
#\4. フィジカルAI時代と IoT/OT 統合
#ここは Zscaler のほうが現時点では明確に強いです。理由は、Zscaler が公式に OT/IoT segmentation と Zero Trust Branch / SD-WAN を、factories, hospitals, branches, campuses 向けに打ち出しているからです。製品文言でも、lateral movement を消す、工場や病院の attack surface を下げる、エージェントなしで OT/IoT を分離することを前面に出しています。これは、ロボット・医療機器・産業設備・センサーが増えるフィジカルAI時代にかなり相性が良いです。 (Zscaler)
#Cloudflare は、フィジカルAI時代に無関係ではありません。Cloudflare One は users / devices / networks を守り、WAN側でも device posture checks や mesh connectivity を提供していますし、MCP や agent runtime を通じて AI agent が外部サービスやインフラへ触る土台を作れます。ですが、公開されている製品の押し出し方を見る限り、Cloudflare の主戦場は “分散接続された agent / app / API / edge execution” であって、Zscaler ほど 工場内OT/IoT segmentation を前面に出してはいません。ここは製品の濃淡の差です。 (Cloudflare Docs)
#\5. どちらがどんな会社に向くか
#Cloudflare が向く会社は、 AIアプリやAI agentを自分で作る、マルチモデルを使う、MCPやedge executionを使う、ユーザー体験と実行速度も重視する会社です。Cloudflare は AI Gateway + Workers AI + Agents + SASE の組み合わせで、開発者体験とネットワーク/セキュリティを一体化しやすいです。Reuters も、Cloudflare が AI需要と AI agents の広がりで売上見通しを上振れさせたと報じています。 (Cloudflare)
#Zscaler が向く会社は、 すでにAI利用が社内で広がっていて、Copilot や public GenAI、工場・支店・OT/IoT を含めて、誰が何にアクセスし、どんなデータを出し、どこで横移動するかを厳密に統制したい会社です。量子時代も含めて、inspection、DLP、policy enforcement、segmentation の強さは Zscaler のほうが明確です。 (Zscaler)
#私の考察
#投資家・技術者目線でまとめると、 Cloudflare は「AIの時代のネットワークOS兼ランタイム」に近づいている会社で、Zscaler は「AIの時代の企業統治OS」に近づいている会社です。Cloudflare の未来は、Workers AI や agentic workflow が本当に大きくなった時に、実行面と防御面の両方を同じ布の上で取れることにあります。Zscaler の未来は、AIとフィジカルAIが企業に広がるほど、ゼロトラスト・データ保護・PQC検査・OT/IoT分離が“必需品”になることにあります。 (Workers)
#ひとことで言い切るなら、 Cloudflare は「AIを動かしながら守る」側が強く、Zscaler は「AIを使わせながら漏らさず横移動させない」側が強いです。 フィジカルAI時代まで含めると、工場・病院・支店・OT/IoTの現場統制は Zscaler 優位、agent/MCP/edge runtime の実装面は Cloudflare 優位、という見方がいちばんしっくりきます。 (Zscaler)
##
Zscalerの下落とCloudflareの株価の伸び悩み
#ZSの下落は「個別の決算要因」+「AIでソフト/セキュリティ株全体が再評価される逆風」 で説明しやすく、 Cloudflare が思ったより伸びきらないのは「業績は悪くないのに、相場がソフト全体を疑い始め、しかも元の期待値が高すぎる」からです。 そして Mythos(ミトス) のようなAIは、セキュリティ需要を増やす一方で、既存ソフトや一部セキュリティ製品の“希少性”を削る可能性があり、株式市場ではその両義性がいま強く意識されています。 (Reuters)
#まず、ZSが下がった理由
#一番わかりやすい直接要因は、2月決算で赤字が拡大したことです。Reuters によると、Zscaler は 2026年2月の四半期決算で、販売・マーケティング、研究開発の支出増により純損失が前年の 770万ドル から 3430万ドル に拡大し、株価は時間外で 約9%下落しました。しかも背景には、競争が強い中でIT予算が慎重という環境もありました。つまり最初の下げは、かなり素直に 「費用増・競争激化・大口案件の慎重化」 です。 (Reuters)
#その上に4月、AIによるソフトウェア破壊不安が重なりました。Reuters は 4月9日、Anthropic の Mythos 公開をきっかけにソフト株が売られ、Zscaler は BTIGの中立格下げも重なって 8.8%下落したと報じています。記事では理由として 需要懸念と潜在的な競争圧力 が挙げられており、つまり市場は「AIが進むほどセキュリティ会社に追い風」だけでなく、「AIが既存のソフト/セキュリティの価値を削るのでは」という見方も始めた、ということです。 (Reuters)
#ここが大事で、ZSの下げは単純な「業績悪化」だけではありません。 個別には決算の費用増、相場全体ではAIによるディスラプション懸念です。 だから ZS は、ファンダの弱さよりも、“高評価ソフト株が再評価される流れ” の中で打たれた面が大きいです。Reuters は同じ4月23日にも、ソフト株全体が AI disruption を嫌気して弱く、逆に半導体株が強いという「テック内の二極化」を指摘しています。 (Reuters)
#Cloudflare が思ったより伸びない理由
#Cloudflare は、業績自体はそこまで悪くありません。 Reuters によると 2025年12月期Q4売上は 6.145億ドルで前年比33.6%増、2026年売上見通しも市場予想を上回りました。AI需要が cloud demand を押し上げているという説明で、決算直後の株価は時間外で 12%上昇しています。さらに Reuters は、その記事の中で 2025年に株価が83%上昇していたことにも触れています。つまり、Cloudflare は“期待が裏切られている会社”ではなく、かなり期待され、実際に伸びてきた会社です。 (Reuters)
#それでも「思ったより伸びていない」と感じやすいのは、期待値が非常に高いからです。Yahoo Finance ベースでは、Cloudflare の時価総額は 約730.6億ドル、一方で FY2025 売上は 21.679億ドル でした。単純計算で PS約33〜34倍 です。これは、ちょっと良い決算を出すだけでは再び大きく上に走りにくい水準です。 要するに、Cloudflare は「AI時代の勝者候補」としてすでにかなり評価されているので、良いニュースが株価に効きにくく、悪い地合いには巻き込まれやすいのです。 (Yahoo Finance)
#しかも、Cloudflare もソフト株全体の逆風から逃げられていません。Reuters は4月9日の Mythos 後のソフト売りで、Cloudflare が 4.9%〜6.5%下落した銘柄群の一つだったと報じています。つまり市場は、Cloudflare を「AI恩恵株」として買う一方で、「AIにより既存ソフトの価値が削られる側かもしれない」とも見ている。これはかなりねじれた状態です。 (Reuters)
#さらに4月23日時点でも Reuters は、ソフトETFが2026年に16%下落、半導体ETFが43%上昇というテック内の大きな資金シフトを指摘しています。 この地合いでは、Cloudflare のような「AIソフト・ネットワーク・セキュリティの複合株」は、半導体ほどは資金が集中しにくいです。 だから、Cloudflare の伸び悩みは企業固有の問題というより、 “ソフトは本当にAIの勝者なのか?”という市場の疑い に巻き込まれている面がかなり大きいです。 (Reuters)
#Mythos が何を変えたのか
#Mythos の衝撃は、単なる「すごいAIが出た」ではありません。 Reuters によると、Anthropic は 4月7日に Claude Mythos Preview を Project Glasswing の下で限定公開し、このモデルは OS やブラウザの重大な脆弱性を何千件も特定できる水準だとされました。Anthropic 自身も、誤用されれば 公共安全、経済安定、国家安全保障への脅威 になり得ると認めています。 (Reuters)
#ここで市場が反応したのは、 「セキュリティ需要が増える」 ではなく、先に 「今まで人間や高単価ソフトが担っていた価値の一部を、モデルが直接食うのでは」 という恐れでした。Reuters は 4月9日の記事で、Mythos の登場を受けて投資家が「AIは伝統的なソフト企業に実存的脅威になり得る」と見始め、S&Pソフトウェア指数が年初来で 25.5%下落したと伝えています。 (Reuters)
#つまり Mythos の影響は二段階あります。 短期的には、ソフト/セキュリティ株のマルチプル圧縮です。 長期的には、高度な防御、ゼロトラスト、ID、データ保護、修復自動化、コード/モデル/エージェント監査の需要増です。Reuters は銀行業界や規制当局が Mythos を非常に重く見ており、銀行・中央銀行・政府機関が対応を急いでいると報じています。これは「脅威が増えるならセキュリティ需要は増える」ことを意味しますが、その恩恵をどの企業が取れるかは別問題です。 (Reuters)
#ZSとCloudflareにとっての“ミトス効果”
#ZS にとって Mythos は、 中長期では追い風、短期では逆風です。 なぜなら、Zscaler の価値は ゼロトラスト、データ保護、インライン検査、ポリシー制御 にあるので、AIが攻撃を強化するほど必要性は増します。ですが市場は今、そこよりも先に 「AIでセキュリティ製品もコモディティ化するのでは」 を織り込みに行っています。しかも ZS は2月に費用増で失望を出しているので、そうした相場の逆風を受けやすいです。 (Reuters)
#Cloudflare にとって Mythos は、 理屈の上では ZS よりむしろ相性が良い面もあります。 Cloudflare は AI agent や AIアプリを動かす側まで入っているので、AI利用が増えるほどトラフィック、実行、ガードレール需要を取りやすいからです。Reuters も、Cloudflare の売上見通し上振れを AI 需要と結び付けています。 ただし株式市場では、その強みよりも先に 「ソフト全体がAIでやられるかもしれない」 という雑な売りに巻き込まれています。しかも Cloudflare はもともとバリュエーションがかなり重いので、夢が大きいぶん、逆風時の耐性が弱いです。 (Reuters)
#私の考察
#私の見立てでは、今の相場は 「AIで脅威が増えるならセキュリティ会社は得する」 という一次元の見方から、 「いや、AIはセキュリティ会社の製品価値そのものも変える」 という二次元の見方に移っています。
#その中で、
#- ZSの下げは、決算の費用増と需要懸念があったところに、Mythos で「競争の土俵が変わる」恐れが重なった
- Cloudflare の伸び悩みは、業績は良いが、すでに期待を織り込みすぎていて、ソフト株全体のAI不安の中では追加で買われにくい
と見るのが自然です。 (Reuters)
#一番重要なのは、Mythos のようなAIは セキュリティ予算を増やす と同時に、 その予算の配分先を変える ことです。 今後お金が向かいやすいのは、単なるアラートや境界防御だけでなく、ID、データ境界、ゼロトラスト、修復自動化、AI自身の監査・制御、攻撃耐性を組み込んだ実行基盤 の側だと思います。これは推論ですが、Reuters の一連の報道が示している「規制当局・銀行・大手テックが Mythos をサイバー防衛の再設計問題として見ている」流れと整合的です。 (Reuters)
##
ZS / Cloudflare / Okta / CrowdStrike のどこが Mythos 時代に一番強いか
#Mythos 時代を、 「AIが未知の脆弱性発見・コード解析・攻撃手順生成を一気に加速する時代」 と置くなら、4社の強さはかなり分かれます。Anthropic の Claude Mythos Preview は、OS やブラウザの重大脆弱性を大量に見つけられる水準として扱われ、Microsoft はこれを自社の Security Development Lifecycle に組み込む方針を示しています。さらに Reuters によると、Project Glasswing の参加企業には CrowdStrike も含まれます。 (Reuters)
#私の結論を先に言うと、
#総合防御力で一番強いのは CrowdStrike、 AI利用統制とデータ境界で一番強いのは Zscaler、 AIを“動かしながら守る”構造で一番強いのは Cloudflare、 AI agent と非人間IDの統治で一番強いのは Okta、 です。 (crowdstrike.com)
##
まず、4社の製品構造の違い
#4社は同じ「セキュリティ企業」に見えても、守る場所が違います。
#- CrowdStrike は、endpoint / identity / cloud / vulnerability / SOC運用 を Falcon に集めて、Charlotte AI で検知・分析・対応を自動化する構造です。Falcon Exposure Management は「攻撃者に悪用される前に脆弱性を減らす」ことを前面に出し、Identity Protection は identity・endpoint・data を横断して lateral movement を止める設計です。さらに Charlotte AI AgentWorks は、SOC 向け secure agents の構築を打ち出しています。 (crowdstrike.com)
- Zscaler は、Zero Trust Exchange を中心に、AI Security、AI-SPM、DLP、inline inspection、OT/IoT segmentation を重ねる構造です。強みは、社員・AI agent・アプリ・データの通信を通さない、見逃さない、漏らさないことにあります。AI-SPM は AI models / agents / services の 360度可視化をうたい、AI Security は GenAI 利用とデータ流出を統制します。 (Zscaler)
- Cloudflare は、Zero Trust / Access / Gateway / SASE に加えて、Workers AI、AI Gateway、Agents、MCP servers を同じ面に持っています。つまり「AIを安全に使う」だけでなく、「AIをそこで動かす」側まで持っているのが特徴です。Agents Week 2026 では、AI agents 向け zero-trust egress proxy、Managed OAuth for Access、MCP governance をまとめて出しています。 (Cloudflare)
- Okta は、identity plane 専業です。Okta for AI Agents は AI agents 向けの visibility と governance の identity layer を提供し、Non-Human Identities の保護を強く押し出しています。要するに、Mythos 時代に増える「人ではない主体」を、誰として扱い、何を許可するかの会社です。 (Okta)
#
Mythos 時代に何が一番重くなるか
#Mythos 型AIが普及すると、重くなるのは大きく4つです。
#- 未知脆弱性の発見速度が上がること
- 侵害後の横移動や権限奪取が速くなること
- AI agent や service account など非人間主体が爆増すること
- AIアプリそのものが攻撃面になること
Reuters でも、Mythos は重大脆弱性の検出能力ゆえに規制当局や重要インフラ側で警戒されており、オーストラリア政府や中銀も注視しています。 (Reuters)
#この4点に対して、4社の当たり方が違います。
##
1位候補:CrowdStrike
#総合で一番強いと私が見るのは CrowdStrike です。 理由は、Mythos 時代の一番怖いところが「脆弱性が見つかる」ことそのものより、見つかった後の exploitation、侵入、横移動、権限拡大、SOC疲弊だからです。CrowdStrike は Falcon Exposure Management で attack surface と vulnerability 管理をやり、Identity Protection で identity-based movement を見て止め、Charlotte AI で SOC 作業を agent 化しようとしています。つまり “見つかる前”より“見つかった後”の防御運用面が一番厚いです。 (crowdstrike.com)
#しかも Reuters によると CrowdStrike 自身が Project Glasswing の参加企業で、2026年1月には SGNL を 7.4億ドルで買収し、AI-powered threats への対応を強化しています。つまり CrowdStrike は、Mythos のようなモデルを「脅威」ではなく自社防御の加速器として取り込む側にいる可能性が高いです。 (Reuters)
#弱点は、通信そのものの inline control や、AI runtime そのものは主戦場ではないことです。つまり、SOC / XDR / exposure / identity defense は非常に強いが、AIアプリを実行する面や、通信の通路そのものは別の会社が強いです。 (crowdstrike.com)
##
2位候補:Zscaler
#AI時代の“利用統制”で一番強いのは Zscaler です。 Mythos 時代に企業がまず困るのは、「誰がどのAIを使い、何を投げ、どんなデータが外へ出るのか」が見えなくなることです。Zscaler AI Security は secure AI adoption、data loss prevention、AI apps/models/users の保護を打ち出し、AI-SPM は agents と models の posture 管理を提供しています。ここは CrowdStrike より明確に “AI利用とデータ境界の統治” に強いです。 (Zscaler)
#さらに Zscaler は OT/IoT secure connectivity も前面に出していて、これは将来のフィジカルAI時代に効きます。Mythos 型のAIがサイバー攻撃を高度化すると、factory / branch / hospital の segmentation の重要性が上がりますが、Zscaler はそこをすでに product language に入れています。 (Zscaler)
#弱点は、CrowdStrikeほど endpoint / incident response / SOC automation の中心にいないことと、Cloudflareほど AI runtime 側を持っていないことです。 つまり Zscaler は、**“企業がAIを安全に使う”にはかなり強いですが、“侵害後の戦い”や“AIを動かしながら守る”**は相対的に弱いです。 (Zscaler)
##
3位候補:Cloudflare
#Cloudflare は、製品構造だけ見ると最もユニークです。 Mythos 時代に増えるのは、AI app、AI agents、MCP tools、API-to-model traffic です。Cloudflare は AI Gateway を unified inference layer に拡張し、Workers AI でモデル実行を持ち、Access で AI agents 向け Managed OAuth を出し、MCP governance まで用意しています。つまり Cloudflare は、AIそのものの交通整理・実行・認証・観測を一枚の布で扱えるのが強いです。 (The Cloudflare Blog)
#これは Mythos 時代にかなり重要です。 AIが攻撃に使われるだけでなく、企業側も agent を大量に動かすようになるので、AI-to-AI、agent-to-tool、agent-to-app の接続面が新しい attack surface になります。Cloudflare はそこを Zero Trust と runtime の両方で触れます。4社の中で、“AIを作る/動かす側”と“AIを守る側”の両方に跨っているのは Cloudflare だけです。 (Cloudflare)
#ただし 弱点もはっきりしています。 CrowdStrike のような endpoint / XDR / threat hunting の厚み、Zscaler のような enterprise DLP/inspection の深さ、Okta のような identity 専業の精度では、まだそれぞれの専業に劣る面があります。 だから Cloudflare は、**“Mythos 時代に最も面白い構造”ではありますが、“一番強い純セキュリティ会社”**とまでは言いにくいです。 (The Cloudflare Blog)
##
4位候補:Okta
#Okta は、identity という一点においては最重要です。 Mythos 時代には、人間よりAI agentsやservice accountsのほうが増えやすくなります。Okta はそれを Non-Human Identities として明確に定義し、AI agents 向けに visibility と governance の identity layer を提供するとしています。ここは4社の中でも最も筋が良いです。 (Okta)
#ただ、Okta は identity layer に特化しすぎているとも言えます。 endpoint、network inspection、SOC運用、AI runtime、OT/IoT segmentation までは広く持っていません。つまり “AI主体を誰として扱うか” では強いが、Mythos 時代の防御全体を一社で担う構造ではないです。 (Okta)
##
じゃあ、どこが一番強いのか
#総合1位は CrowdStrike と見ます。 理由は、Mythos 時代の最大の経営課題が「AIに脆弱性を見つけられること」そのものではなく、その後の侵害・横移動・SOC運用負荷に耐えられるかだからです。CrowdStrike はそこを最も厚く持っています。 (crowdstrike.com)
#ただし、用途別の1位はこう変わります。
#- 防御の総合力:CrowdStrike
- AI利用統制 / DLP / AI posture:Zscaler
- AI runtime と Zero Trust の一体性:Cloudflare
- AI agents / NHI の統治:Okta
この4社は競合でもありつつ、実はかなり補完関係です。 Mythos 時代に本当に強い企業は、しばしば CrowdStrike + Zscaler + Okta の組み合わせか、Cloudflare + Okta + CrowdStrike の組み合わせになります。単独で全部を持つ会社はまだありません。これは各社の製品面からの推論です。 (crowdstrike.com)
##
投資家目線で一言ずつ
#CrowdStrike は、「Mythos によって一番必要性が高まりやすい会社」です。 Zscaler は、「企業がAIを導入するほど統制需要が増える会社」です。 Cloudflare は、「Mythos 時代に最も“新しい防御面”を取りやすい会社」です。 Okta は、「AI主体が増えるほど不可欠になるが、単独の主役ではなく必須部品に近い会社」です。 (Reuters)
##
Zscalerの市場評価を主力サービスから考察
#- ZDX は いちばん分かりやすく伸びている
- Red Canary は 買収後の統合と解約率がボトルネック
- Data Security は 事業としては強いが、投資家に単品で分かりやすい伸びとして見えにくい
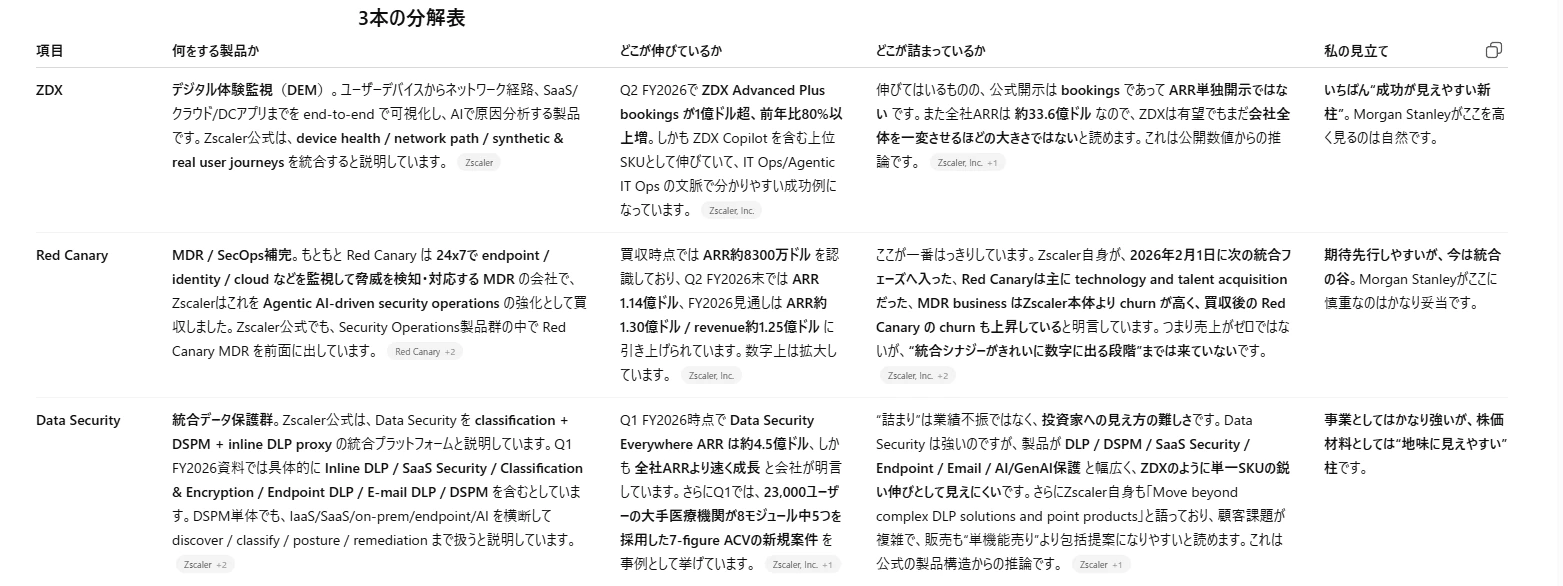
ZscalerのQ2 FY2026株主向けレターでは、ZDX Advanced Plus bookings が過去12か月で1億ドル超・前年比80%以上成長、Red Canary はQ2末ARR 1.14億ドル、Q1 FY2026資料では Data Security Everywhere ARR が約4.5億ドルで全社ARRより速く成長 と示されています。 (Zscaler, Inc.)
#3本の分解表
#
3本を、もっと平たく言うと
#\1. ZDX
#これは 「社員や顧客の体感速度・接続品質を見える化する製品」 です。 ネットワークが遅いのか、端末が悪いのか、SaaS側が悪いのかを end-to-end で見せる。Zscaler はこれを単なる監視ツールではなく、AI-powered root cause analysis まで含む IT Ops 製品として押しています。 (Zscaler)
#伸びている理由はシンプルで、価値が分かりやすいからです。 「遅い」「使えない」「原因が分からない」はどの企業にもある痛みなので、ZDX は投資家にも顧客にも理解されやすい。Q2 FY2026の 1億ドル超・80%増 は、その分かりやすさの勝利です。 (Zscaler, Inc.)
#詰まりは、まだ “大成功の芽”であって“会社の柱そのもの”ではない 点です。 全社ARRが 33億ドル超 の会社の中では、まだ相対的に小さい。だから期待はできるが、ここだけで Zscaler 全体の評価を決める段階ではありません。 (Zscaler, Inc.)
#\2. Red Canary
#これは 「外部SOC/MDRの頭脳と人手を取り込んだもの」 です。 Zscaler 単体が強かったのは Zero Trust Exchange と inline policy でしたが、Red Canary を足すことで、脅威検知・調査・SecOps運用 を厚くしたいわけです。Zscaler は買収時に、Red Canary の脅威インテリジェンスと自動化を、自社の rich data と unified SecOps platform に統合する と説明しています。 (Zscaler, Inc.)
#伸びていないわけではありません。ARR は増えています。 でも問題は、“Red Canary単体の売上がある”ことと、“Zscaler全体のプラットフォーム再評価につながる統合ができた”ことは違う点です。Zscaler 自身が technology and talent acquisition と言い、かつ churn が高い と言っているので、今はまだ“買収して本体へ溶かし込む途中”です。 (Zscaler, Inc.)
#つまり Red Canary は、数字はあるが、シナジーの証明がまだ弱い。 Morgan Stanley がここに不満を持つのは自然です。
#\3. Data Security
#これは 「Zscaler が単なるネットワーク/ゼロトラスト会社で終わらず、データ保護プラットフォーム企業になるための核」 です。 DLPだけではなく、DSPM、SaaS Security、Endpoint DLP、AI/GenAI周りのデータ統制まで含めて、“どこにあるどんなデータを、誰が、どこへ、どう動かすか” を守る面です。公式にも “one platform for total visibility, security, and control over all your data” と書かれています。 (Zscaler)
#ここは実はかなり強いです。 ARR 約4.5億ドル は、ZDXよりもずっと大きい。しかも全社ARRより速く伸びている。つまり、製品としての重みは既にかなりあるのです。 (Zscaler, Inc.)
#ただし、投資家から見ると少し地味です。 なぜなら、1つの単純な製品ではなく“複数機能の束” だからです。 ZDXは「DEM」で一言で分かる。Red Canaryも「MDR買収」で一言で分かる。 Data Security は強いのに、何がどれだけ伸びたのかを一言で説明しづらい。 だから、事業の強さの割に、株価材料としては“映えにくい”です。これは製品構造からの推論です。 (Zscaler)
#まとめ
#いちばん短く整理すると、
#- ZDX
何をするか:体感品質の可視化と原因分析 伸び:最も分かりやすい。数字もきれい 詰まり:まだ全社規模では“小さな成功”の段階
- Red Canary
何をするか:MDR / SecOps の頭脳と運用 伸び:ARRは増えている 詰まり:統合途中、churn 高め、シナジーが未証明
- Data Security
何をするか:DLP + DSPM + SaaS/Endpoint/AIのデータ保護 伸び:実は一番“事業として太い” 詰まり:広すぎて、投資家に単純な成長物語として伝わりにくい
#私の見立てでは、 いま一番見栄えがいいのは ZDX、いちばん課題がはっきりしているのは Red Canary、いちばん過小評価されやすいのは Data Security です。 (Zscaler, Inc.)
##
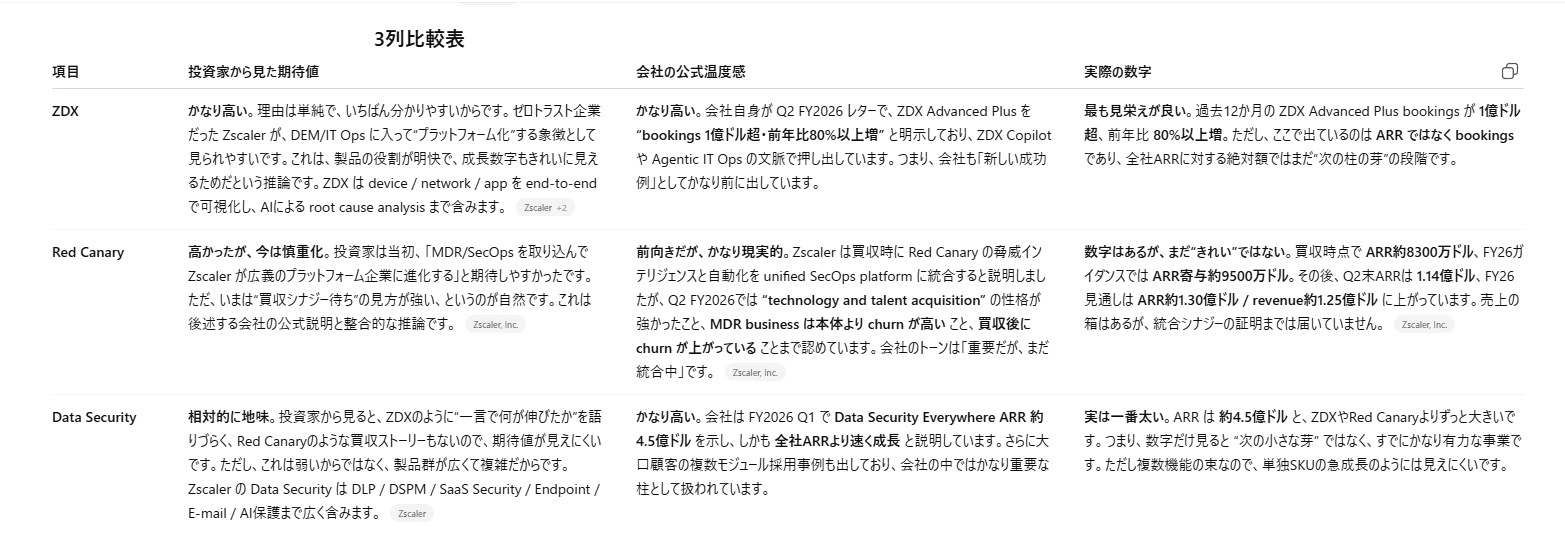
はい。 この3本を 「投資家から見た期待値」、「会社の公式温度感」、「実際の数字」 の3列で並べると、かなり性格の違いが見えます。
#先に一言でまとめると、
#- ZDX は 投資家が一番期待しやすく、会社もかなり前向きで、数字もきれい
- Red Canary は 投資家の期待は大きかったが、会社のトーンは“統合途中”で、数字もまだ過渡期
- Data Security は 投資家の期待値は相対的に地味だが、会社はかなり重視しており、数字は実は一番太い
です。Zscaler の開示では、ZDX Advanced Plus bookings が過去12か月で1億ドル超・前年比80%以上増、Red Canary は買収時ARR約8300万ドル、Q2末ARR 1.14億ドル、Data Security Everywhere ARR は約4.5億ドル と示されています。 (Zscaler, Inc.)
#3列比較表
#
さらに平たく言うと
#ZDX
#投資家の目線では、 「これが伸びるなら、Zscaler はゼロトラスト専業から IT運用まで取る会社になれる」 という夢を乗せやすいです。製品の説明も分かりやすく、AI-powered root cause analysis、ZDX Copilot、end-to-end visibility と、伝わりやすい言葉が揃っています。 (Zscaler)
#会社の目線でも、かなり手応えがあるように見えます。 だから ZDX は、 期待値、会社の温度感、数字 の3つが一番そろっている柱です。
#Red Canary
#投資家の目線では、 「MDR/SecOpsを取り込んで平台化する」 という大きな期待が最初に立ちました。 でも今は、 「本当に Zscaler 本体に溶け込んでクロスセルや大型案件に効いているのか?」 を見る段階です。 (Zscaler, Inc.)
#会社の目線は、かなり現実的です。 重要だとは言っているけれど、言い方はむしろ慎重で、統合フェーズ、churn 上昇、technology and talent acquisition といった表現が出てきます。 だから Red Canary は、 期待値が先に立ったわりに、会社の説明は“まだ道半ば” というズレがある柱です。 (Zscaler, Inc.)
#Data Security
#投資家の目線では、正直いちばん見えにくいです。 なぜなら “Data Security” の中に、DLP、DSPM、SaaS Security、Endpoint、Email、AI保護まで入っていて、何が単独でどれだけ伸びたのかが一言で見えにくいからです。 (Zscaler)
#でも 会社の目線はかなり高いです。 全社ARRより速く伸びているとわざわざ言い、複数モジュール採用の大口案件も例示しているので、会社側は明確に重要柱と見ています。 そして 数字は実は一番太い。 だから Data Security は、 投資家の期待値だけが相対的に低く、会社の温度感と実数字は強い という、ちょっと面白いズレがあります。
#最後に一言で並べると
#- ZDX
期待値:高い 会社の温度感:高い 数字:きれい
- Red Canary
期待値:高かった 会社の温度感:重要だが慎重 数字:あるが、統合シナジーは未完成
- Data Security
期待値:地味 会社の温度感:かなり高い 数字:実は一番太い
#なので、投資家目線で見ると、 一番“映える”のは ZDX、いちばん“ギャップが大きい”のは Data Security、いちばん証明待ちなのは Red Canary です。
##
Mythos時代のサイバーセキュリティを概念的に解説
#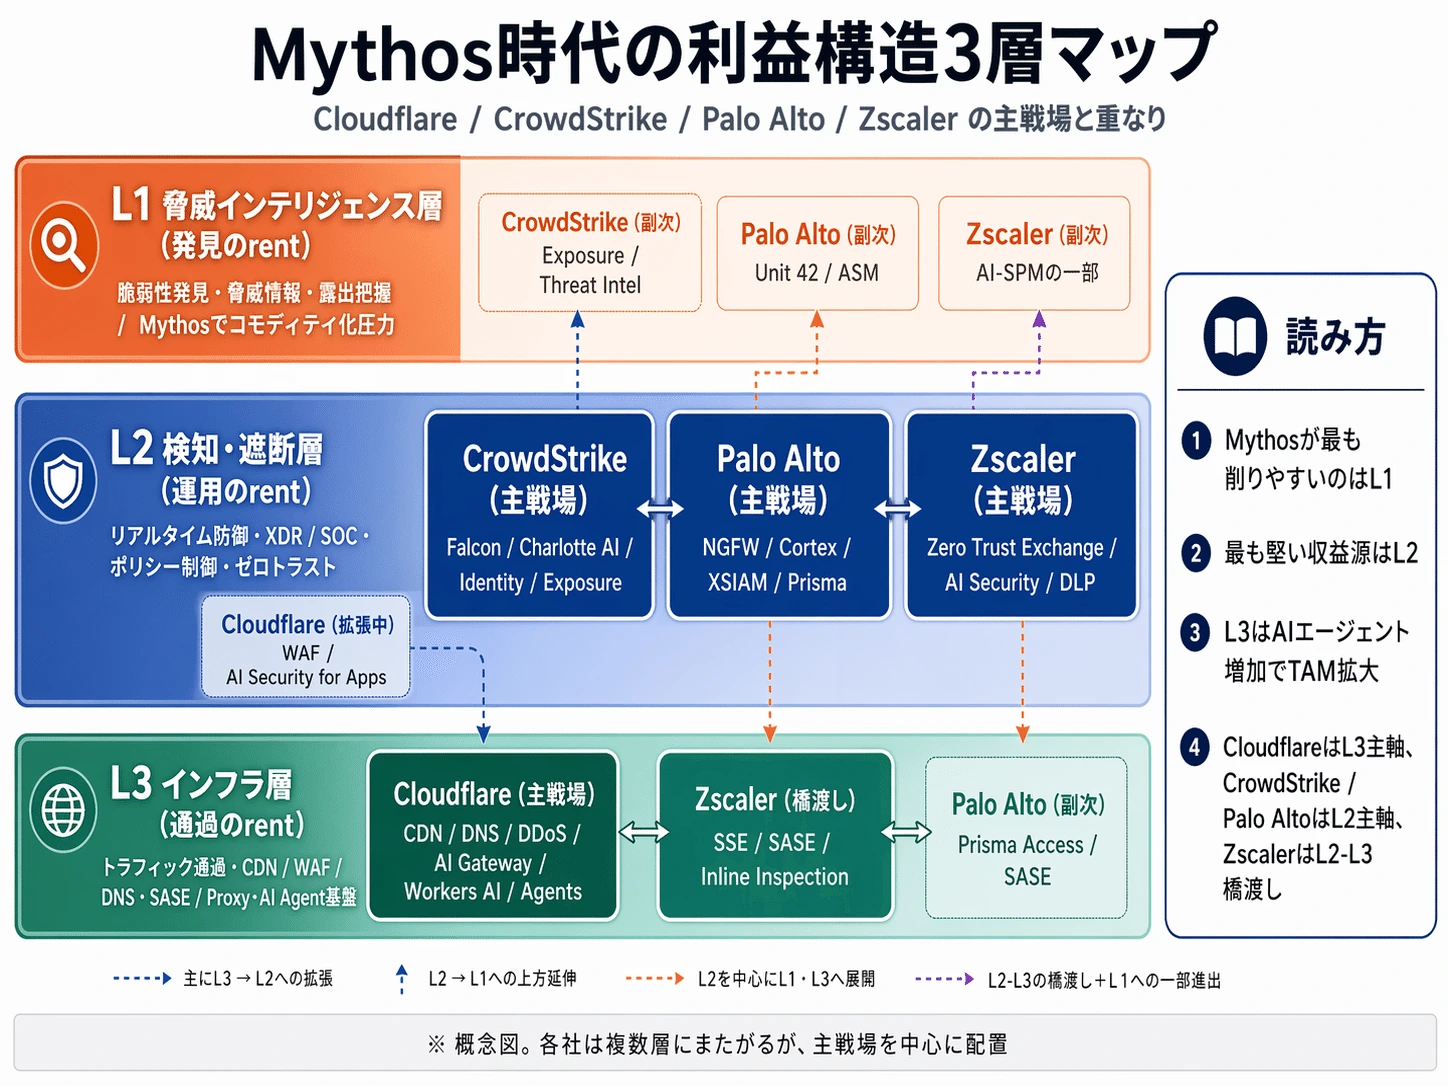
ここでの L1 / L2 / L3 は、OSI参照モデルみたいな公式の層ではなく、「Mythos時代のサイバーセキュリティで、どこで利益が生まれやすいか」 を整理するための概念上の3層です。
#まず全体像を一言でいうと、
#- L1 は「見つける仕事」
- L2 は「止める仕事」
- L3 は「通す仕事」
です。
##
まず、なぜ3層に分けるのか
#Mythosのような強力なAIが出てくると、 「サイバーセキュリティは全部追い風なのか?」 「全部逆風なのか?」 が分かりにくくなります。
#でも実際には、セキュリティ企業はみんな同じ仕事をしているわけではありません。
#ある会社は 脆弱性を見つける ことで価値を出し、 ある会社は 攻撃をリアルタイムで止める ことで価値を出し、 別の会社は 通信やトラフィックが通る場所を押さえる ことで価値を出します。
#この違いを分かりやすくするために、 L1、L2、L3 という3つの箱に分けて考えています。
##
L1:脅威インテリジェンス層
#意味:見つける層 別名:発見のrent
#ここは、 「どこに穴があるか」 「どんな脅威が来そうか」 を見つける仕事です。
#具体的には、
#- 脆弱性発見
- 脅威インテリジェンス
- 攻撃手口の分析
- ASM(Attack Surface Management)
- 露出資産の把握
- ペンテスト
- セキュリティリサーチ
などが入ります。
#たとえで言うと
#泥棒が入りそうな家を見て、
#- 窓が開いている
- 鍵が古い
- 裏口が弱い
- 死角がある
と発見する仕事です。
#なぜ Mythos 時代に削られやすいのか
#ここは、AIが一番代替しやすい領域です。 なぜなら 「大量の候補を調べて、怪しいものを見つける」 のは AI が得意だからです。
#人間が何週間、何か月もかけて探していた脆弱性を、 AIがずっと速く見つけるようになると、 この層の希少性は下がりやすいです。
#だから L1 は、 価値がなくなるわけではないけれど、最もコモディティ化圧力を受けやすい層 と考えられます。
##
L2:検知・遮断層
#意味:止める層 別名:運用のrent
#ここは、 「いま実際に来ている攻撃を見つけて、止める」 仕事です。
#具体的には、
#- EDR / XDR
- SOC運用
- SIEM / XSIAM
- リアルタイム検知
- ポリシー制御
- ゼロトラスト
- IDベースの遮断
- DLP
- インライン検査
- 横移動の防止
などが入ります。
#たとえで言うと
#泥棒が家に入ろうとした瞬間に、
#- 警報を鳴らす
- 鍵を閉める
- 通行を止める
- 別の部屋へ移動できないようにする
- 誰が本物か確認する
という仕事です。
#なぜ一番堅いのか
#Mythos がどれだけ強くなっても、 「いま来ている攻撃を本番環境で止める」 仕事は残ります。
#脆弱性を見つけるだけでは足りません。 実際の企業や端末やネットワークの現場では、
#- どの端末が危険か
- どのIDが侵害されたか
- どの通信を止めるか
- どこまで遮断すると業務が止まるか
をリアルタイムで判断しなければいけないからです。
#なので L2 は、 Mythos時代でも最も収益が残りやすい、最も堅い層 と見られます。
##
L3:インフラ層
#意味:通す層 別名:通過のrent
#ここは、 トラフィックやリクエストが通る場所そのもの を押さえる層です。
#具体的には、
#- CDN
- DNS
- DDoS防御
- リバースプロキシ
- WAF
- SASE / SSE
- エッジネットワーク
- AI Gateway
- Agent runtime
- Web/API の通過点
などが入ります。
#たとえで言うと
#街の中の「道路」「高速道路」「料金所」「関所」に近いです。
#人間のトラフィックも、 攻撃のトラフィックも、 AIエージェントの通信も、 全部そこを通るなら、 その通過点を押さえている会社はお金を取りやすいです。
#なぜ Mythos 時代に面白いのか
#攻撃が増えれば、通過するトラフィックも増えます。 さらに、AIエージェント時代になると、
#- AIがAPIを叩く
- AIがWebを見る
- AIが別のAIとやり取りする
- AIがツールを呼ぶ
- AIが外部世界とつながる
という通信が爆増します。
#するとL3は、 “人間の通信インフラ” から “人間+AIエージェントの通信インフラ” へ広がります。
#だから L3 は、 Mythosの防御そのものとは少し別軸で、TAMが広がる層 として重要です。
##
3層を一番簡単に言い換えると
#L1
#どこが危ないかを見つける層
#L2
#危ないものを実際に止める層
#L3
#危ないものも普通のものも含めて、全部が通る基盤の層
##
4社をこの3層で見ると
#前の図の意味も、基本に戻すとこうです。
#- CrowdStrike
主戦場は L2 一部で L1 も持つ
- Palo Alto
主戦場は L2 一部で L1 と L3 に広がる
- Zscaler
主戦場は L2 でも L3 とかなりつながっていて、少し L1 にも触る
- Cloudflare
主戦場は L3 そこから L2 に伸びている
#つまりこの図は、 どの会社が“発見”“遮断”“通過基盤”のどこで一番稼ぎやすいか を並べたものです。
##
いちばん大事なポイント
#この3層は、 技術分類というより、利益の取り方の分類 です。
#だから、
#- 技術的に何をしているか
- どこで価値が生まれるか
- AIに代替されやすいか
- AIでむしろ強くなるか
を分けて考えやすくなります。
#一言でまとめると、
#**L1は「見つける」 L2は「止める」 L3は「通す」**
#です。
##
警備会社・道路・関所・監視員の喩で噛み砕いて解説
#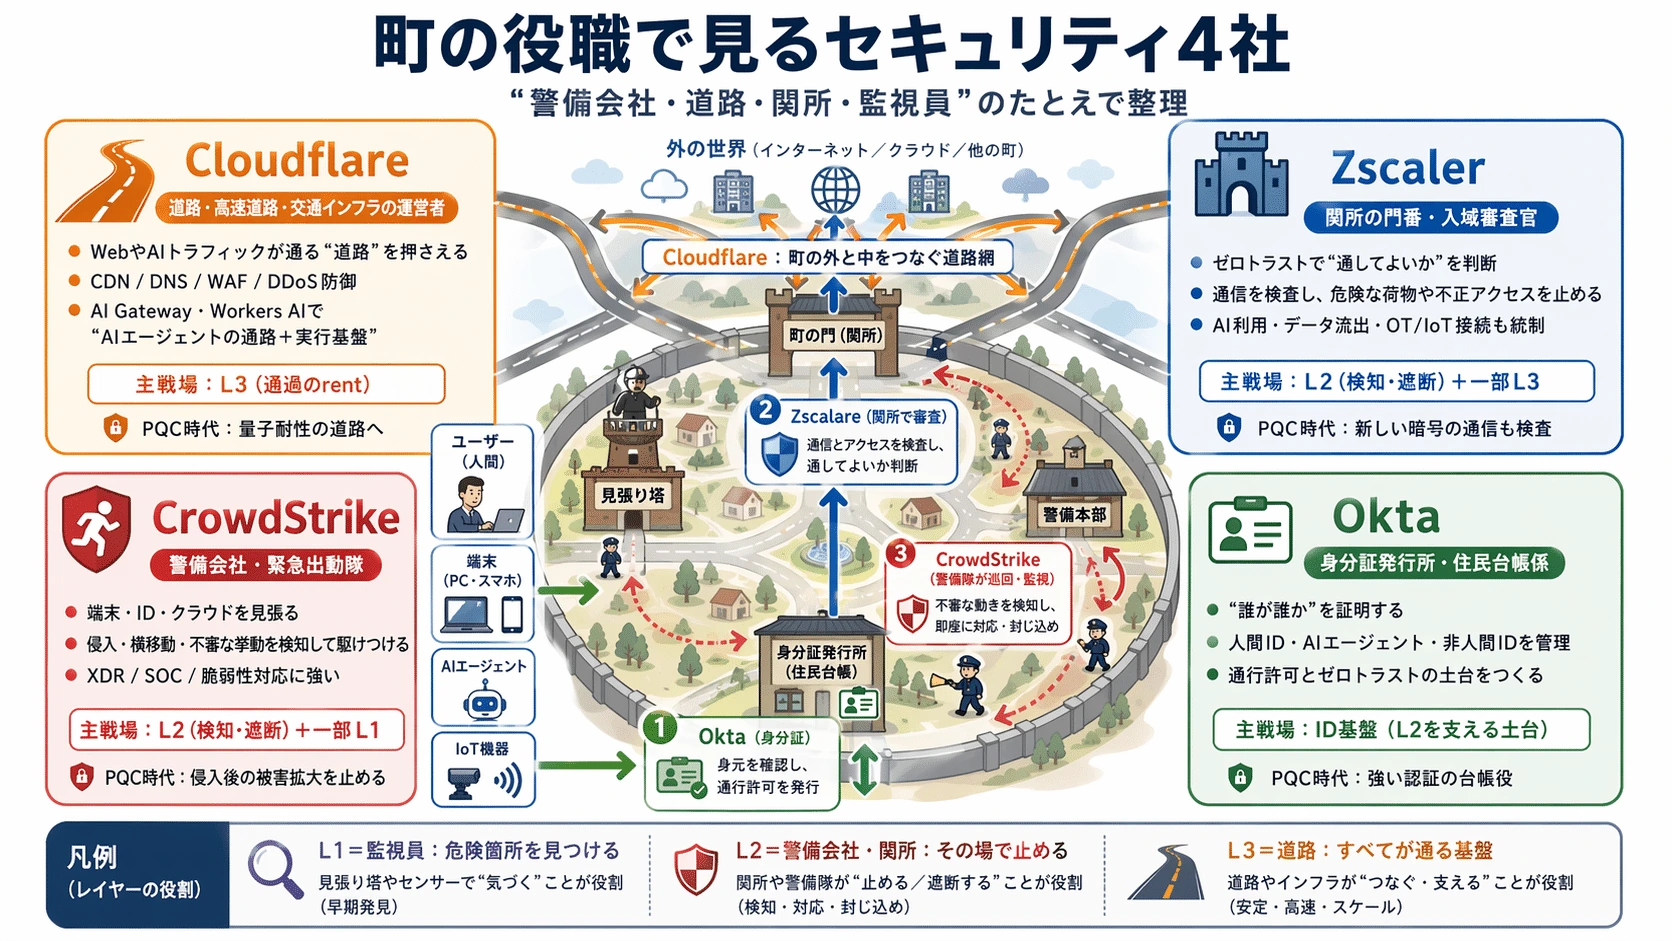
もっと噛み砕くと、この3層は 「町全体を守る体制」 にたとえると分かりやすいです。 しかも PQC 時代になると、単に「強い鍵に取り替える」だけではなく、道路・関所・監視員・警備会社の仕事の分担が変わる、という見方ができます。NIST は、PQC を「量子計算機が将来いまの公開鍵暗号を破り得ることに備えて、いま使い始めるべき暗号」と位置づけており、すでに複数のPQC標準を公開しています。 (NIST)
#まず全体像
#たとえで言うと、
#- L1 は 偵察係・監視員
- L2 は 警備会社・ガードマン
- L3 は 道路・関所・高速道路の運営者
です。
#この3つは全部「守る仕事」ですが、 何をしてお金をもらっているか が違います。 PQC 時代になると、L1 は「新しい鍵や古い鍵の弱点を見つける役」、L2 は「その鍵を使って実際に通すか止めるか決める役」、L3 は「その鍵付き通信を大量に安全に流す役」になります。PQC 自体は主に公開鍵基盤の置き換えですが、NIST も移行は単なる暗号アルゴリズム交換ではなく、広いシステム移行だと示しています。 (NIST)
##
L1 = 監視員・偵察係
#L1 は、町のあちこちを見回って、 「どこが壊れそうか」 「どこに穴があるか」 を先に見つける人たちです。
#たとえば、
#- 裏口の鍵が古い
- フェンスが破れている
- 最近この地域でこういう手口の泥棒が多い
- この建物は外から丸見えだ
みたいなことを調べる役です。
#サイバーで言うと、
#- 脆弱性調査
- 脅威インテリジェンス
- アタックサーフェス把握
- 露出資産の調査
に近いです。
#PQC時代のL1の役割
#PQC 時代の L1 は、 「どこがまだ古い鍵(RSA/ECC)を使っているか」 「どこが量子耐性なしでむき出しか」 を洗い出す役になります。
#つまり、町の監視員が 「この建物だけ古い南京錠のままです」 「この門だけ新型ロックに交換されていません」 と報告するイメージです。
#この層の大事な仕事は、暗号資産の棚卸しです。 どの TLS、VPN、証明書、署名、IoT機器、社内システムがまだ旧方式なのかを見つけないと、そもそも移行できません。NIST も PQC 移行は広い範囲の資産把握と準備が必要だとしています。 (NIST)
#ただし、L1は一番削られやすい
#PQC時代でも L1 は必要ですが、 この層は比較的 AIに自動化されやすい です。
#なぜなら、「大量の設定や資産を調べて、古い暗号や弱い構成を見つける」仕事は、かなり機械化しやすいからです。 だから L1 は重要だけれど、最もコモディティ化されやすい層でもあります。これは概念的な整理で、NIST の移行資料が示す“資産把握と暗号アジリティ”の必要性とも整合します。 (csrc.nist.gov)
##
L2 = 警備会社・ガードマン
#L2 は、町の出入口や建物の前に立って、 「この人を通していいか」 「危ないなら止める」 をその場で判断する人たちです。
#たとえば、
#- 身分証を確認する
- 怪しい動きを見つけて止める
- 許可されていない部屋へ入らせない
- 侵入後の横移動を止める
という役目です。
#サイバーで言うと、
#- ゼロトラスト
- DLP
- XDR / SOC
- ポリシー制御
- リアルタイム検査
- アクセス制御
に当たります。
#PQC時代のL2の役割
#PQC時代のL2は、 「新しい量子耐性の鍵で来た通信を、ちゃんと識別し、見て、通し、必要なら止める」 役になります。
#ここがすごく大事です。 PQC で通信が強く暗号化されるのは良いことですが、 防御側から見ると、
#“強く暗号化された通信の中身が見えなくなると困る” という問題が出ます。
#つまり、警備会社の立場からすると、 「新型ロックの箱が増えたけれど、中に危険物が入っていても見抜けるのか?」 という話です。
#この点で Zscaler は、ML-KEM ベースのPQC通信をリアルタイムに深く検査できる と打ち出しています。これはまさに L2 の発想で、“新しい鍵で守られた通信でも、検査の目を失わない” ということです。 (zscaler.com)
#L2が一番堅い理由
#PQCになっても、 結局最後に必要なのは 「誰を通すか」「何を止めるか」 の現場判断です。
#だから L2 は、量子時代でも一番残りやすい収益源です。 鍵がRSAからPQCに変わっても、関所や警備員が不要になるわけではありません。むしろ、新旧暗号が混ざる移行期には、L2の仕事は増えやすいです。Zscaler が “crypto-translator” 的に、PQC対応側と未対応側を橋渡しできると説明しているのは、この移行期のL2価値をよく表しています。 (zscaler.com)
##
L3 = 道路・関所・高速道路の運営者
#L3 は、町の道路網や料金所、関所そのものです。 ここは「不審者を見つける」より、まず みんなが通る場所を押さえている ことが価値です。
#たとえば、
#- 高速道路
- 港
- 空港
- 大きな橋
- 市の出入口
みたいな場所です。
#サイバーで言うと、
#- CDN
- DNS
- DDoS防御
- プロキシ
- SASE / SSE
- エッジネットワーク
- AI Gateway
- agent traffic の通路
に近いです。
#PQC時代のL3の役割
#PQC時代のL3は、 「その道路を走る全ての車を、新しい量子耐性のルールに合わせて安全に通す」 役です。
#ここでは個々の通信を一つずつ手動で見張るより、 まず “交通インフラ全体がPQC対応していること” が大事になります。
#Cloudflare が Cloudflare One 全体で ポスト量子暗号をサポートし、主要な on-ramp / off-ramp に PQ を広げた と言っているのは、まさに L3 の価値です。さらに Cloudflare の資料では、クライアント接続でも post-quantum encrypted connectivity を前面に出しています。つまり道路そのものを、新しい耐量子仕様に舗装し直しているイメージです。 (radar.cloudflare.com)
#なぜL3は面白いのか
#L3の強みは、 通る量が増えるほど価値が出る ことです。
#PQCになれば通信は少し重くなる可能性があります。 鍵や署名が大きくなるので、性能や遅延、互換性が問題になりやすいと Zscaler も指摘しています。そうなると、L3 で大規模に最適化して処理できる会社の価値が上がります。 (zscaler.com)
#さらに AIエージェント時代になると、 人間だけでなく AI 同士の通信も増えます。 すると L3 は、人間の道路から人間+AIの道路へ変わります。 このため、PQC時代のL3は「量子耐性のある道路」であるだけでなく、AI traffic をさばく基盤としても重要になります。Cloudflare が Agent Cloud を、インフラ・compute・deployment・security をまとめて扱うと説明しているのは、このL3拡張の文脈です。 (Cloudflare)
##
たとえを一枚にすると
#町で考えるとこうです。
#- L1 監視員
「あそこの鍵が古い」「あの門は壊れかけている」と見つける
- L2 警備会社・関所の係員
「この人は通してよい」「この荷物は危ない」と判断して止める
- L3 道路・関所・高速道路の運営者
そもそも全員がそこを通る。新しい交通ルールや新型ゲートを全体に行き渡らせる
#PQC時代には、
#- L1 は 旧暗号の棚卸し係
- L2 は 新暗号でも検査と認可を続ける現場
- L3 は 新暗号対応の交通網そのもの
になります。 (NIST)
##
最後に一番大事な考察
#PQCを「新しい鍵に交換するだけ」と考えると、話を小さく見誤ります。 実際には、
#- L1 が「どこが未移行か」を見つけ、
- L2 が「新旧混在でも安全に通すか止めるか」を決め、
- L3 が「大量の通信を新方式で回す道路」になる、
という三段階の移行です。
#だから PQC 時代に強い会社は、単に暗号アルゴリズムを実装した会社ではなく、 棚卸しできる会社、運用で止められる会社、交通網を押さえる会社です。 この意味で、PQC は L1/L2/L3 すべてに影響しますが、 最も価値が残りやすいのは L2、最もTAMが広がりやすいのは L3、最も自動化圧力を受けやすいのは L1 と考えるのが自然です。 (NIST)
##
AIエージェント、工場OS、フィジカルAIの時代にAI-RANの文脈で価値が上がる銘柄考察
#結論から言うと、AIエージェント・工場OS・フィジカルAIの時代に、AI-RAN文脈で先に価値が乗りやすいのは「ロボット本体」よりも、分散推論を支える計算基盤・RANソフト・光/接続・工場の運用OS」側です。AI-RANは、無線ネットワークをただの通信網ではなく、RAN・エッジ・コアにAIを埋め込んだ分散AI基盤へ変える発想で、NVIDIA自身も「6G/AI-RANが物理AIの土台になる」と明言しています。SoftBankもTelco AI Cloudで、GPUクラウド + AI-RANベースMEC + AI Cloud OSを一体化した分散AIインフラを構想しており、T-MobileもAI-RAN対応の分散エッジ上でphysical AIアプリを動かし始めています。 (investor.nvidia.com)
#なので銘柄選定は、 第1層:AI-RANの計算基盤を売る会社 第2層:AI-RANそのものを製品化する通信装置会社 第3層:その上で動く工場OS/physical AI運用ソフト会社 の順で考えるのが筋です。株価は普通、第1層 → 第2層 → 第3層の順に思惑が乗りやすく、実際の売上・利益の証明は逆に第1層が最も早く、第2層と第3層は遅いです。 (NVIDIA Blog)
#**いま一番選びやすい中核銘柄は、NVIDIA、Nokia、Siemens、SoftBank Corp.です。 ここに高β枠として Marvell、Ericsson、Fujitsu**を足す、というのがいちばん自然です。 (investor.nvidia.com)
#まずNVIDIAです。これはAI-RANの“親玉”に近い立場で、AI Aerial、AI-native wireless stack、AI grids、AI factory、physical AIを一つの物語に束ねています。2025年10月に米国版AI-native wireless stackを発表し、2026年3月には世界の通信各社とAI-native 6G/AI-RANへのコミットを公表、さらにT-Mobileなどと分散エッジでphysical AIアプリを走らせる段階に進んでいます。NVIDIAはAI-RAN単体がまだ小さくても、GPU、NIC、DPU、スイッチ、ソフト基盤の売上が既に巨大なので、思惑先行で株が上がっても、他のAI需要で業績が支えられるのが強いです。AI-RANが失敗しても傷が浅く、成功すれば追加の上振れになるので、このテーマの“本命”です。 (investor.nvidia.com)
#次にNokiaです。AI-RAN文脈では、いま一番「思惑」と「業績証明」が両方見え始めている通信装置株に見えます。Nokiaは2025年10月にNVIDIAとの提携とNVIDIAからの10億ドル投資を公表し、2026年3月にはT-Mobile、SoftBank、IndosatでGPU加速AI-RANの機能検証、さらにBT、Elisa、NTT DOCOMO、VodafoneでもAI-RANの採用が進んでいると発表しました。しかも本日4月23日の決算では、AI/クラウド顧客向け売上が49%増、新規受注が10億ユーロ、AI/クラウドがすでにグループ売上の8%まで来ており、株価は16年ぶり高値圏に反応しました。つまりNokiaは、AI-RAN単独ではなくても、AI向け光・ネットワーク・クラウド接続で先に数字が出始めています。ここがEricssonより一歩先に見える理由です。 (Nokia Corporation | Nokia)
#Siemensは、AI-RANそのものの会社ではありませんが、工場OS側の本命です。2026年1月にNVIDIAと組んでIndustrial AI Operating Systemを作ると打ち出し、2026年からErlangen工場を最初の青写真にすると発表しました。PepsiCoでの初期導入では、SiemensのDigital Twin ComposerとNVIDIA Omniverse/visionを使い、潜在問題の最大90%を事前に発見、初期導入でスループット20%改善、CapEx 10~15%削減というかなり強い数字を出しています。さらにReutersによれば、Siemensは2026年2月にAIデータセンター需要で利益見通しを引き上げています。AI-RANが本当に工場・物流・インフラ現場で分散推論の土台になるなら、最後に太く儲かるのは、通信会社だけではなく、現場オペレーションを“AIで回すOS”を持つ会社です。Siemensはその最有力です。 (press.siemens.com)
#SoftBank Corp.は、日本株でAI-RANを最も真正面からやっている銘柄です。2025年時点でAITRASの商用化準備を進め、2026年3月にはTelco AI Cloudを発表し、GPUクラウド、AI-RANベースMEC、Infrinia AI Cloud OSを統合する構想を示しました。しかもSoftBankは、2026年から商用ネットワークにAITRASを導入する方針をすでに示しており、Mitsubishi Heavy Industriesとの連携も含め、製造業のオンプレ・エッジAIにも広げようとしています。株価の多倍化という意味では通信株なので限界はありますが、“AI-RANが実際にどこまで商用化するか”を見る実証株としては非常に重要です。テーマが本物なら、SoftBank Corp.は先行指標になります。 (ソフトバンク)
#Marvellは高βの思惑株です。2026年3月末にNVIDIAと組み、NVLink Fusionを通じてAI factoryとAI-RAN ecosystemへ接続すると正式発表され、さらにNVIDIAが20億ドル出資しました。Marvellは custom XPU、scale-up networking、silicon photonics の側で食い込むので、AI-RANが本格化する前から「そのための部材」として株が先に動きやすいです。ただしこの銘柄は、AI-RAN売上が立つ前に期待だけでかなり走りやすいタイプでもあります。だから本命というより、NVIDIAに次ぐレバレッジ枠です。 (investor.nvidia.com)
#Ericssonは、テーマ適合性は高いのに、株価の走り方はNokiaより鈍いかもしれません。良い点は、2026年2月にSoftBankとnetwork-enabled physical AI with AI-RANのPoCを出し、AI処理をロボットからMECへ動的オフロードする仕組みまで実証していることです。さらにAI対応無線機、アンテナ、AI RANソフトも出しています。悪い点は、直近決算でAI需要が半導体コストを押し上げていること、北米の鈍化もあって利益がやや重いことです。つまりEricssonは「正しい場所にいる」が、業績での証明はNokiaより遅れやすいです。テーマが市場で再加熱すれば買われやすいものの、数字が付いてくるまでは振れやすいです。 (ericsson.com)
#Fujitsuは、日本株の中では面白い準本命です。SoftBankと2024年11月に、2026年以降のAI-RAN商用化を目標に研究開発強化を発表し、Dallasの検証ラボ、NVIDIA AI AerialベースのvRANソフト/RU提供まで進んでいます。市場での語られ方は地味でも、**“日本勢でAI-RANの実装側にいる”**のが価値です。ただし株価がこのテーマだけで一気に多倍化するタイプではなく、実装が案件・売上に落ちるまで待たれやすいので、時間はかかります。 (Fujitsu)
#ここまでを整理すると、私の選定はこうです。 本命: NVIDIA、Nokia、Siemens。 (investor.nvidia.com) 日本株で押さえるなら: SoftBank Corp.、Fujitsu。 (ソフトバンク) 高リスク高リターン: Marvell、Ericsson。 (investor.nvidia.com)
#次に、いつから株価が未来を前借りし始めるかです。 AI-RANでは、もう前借りは始まっています。起点は2024年9月のT-Mobile/NVIDIA/Ericsson/NokiaのAI-RAN Innovation Centerで、ここで「RANはAIを載せる場所になる」という物語が市場に見えました。次の加速点が2024年11月のSoftBank/Fujitsuの2026年以降商用化ターゲット、2025年10月のNVIDIAのAI-native wireless stackとNVIDIA-Nokia提携、そして2026年2~3月のSoftBank/Ericssonのphysical AI PoC、SoftBankのTelco AI Cloud、Nokiaの商用導入前進、NVIDIAの世界通信業界コミットです。つまり、このテーマは2024年後半に物語が始まり、2025年後半から株価が前のめりになり、2026年に“これは本当に商用化へ向かっている”と認識され始めた段階です。 (t-mobile.com)
#ただし、株価が走る時期と売上・利益で証明される時期にはかなり時差があります。 私の見立てでは、 NVIDIA/Marvellのような基盤半導体株は 0~12カ月で数字が出やすいです。AI-RANが立ち上がらなくても、AI工場や分散推論向けのGPU/NIC/光が先に売れるからです。 (NVIDIA Blog) Nokia/Ericsson/Fujitsuのような通信装置株は 12~36カ月です。PoC、ラボ、共同実証から、設計採用、商用展開、全国展開まで時間がかかるからです。Nokiaは今まさに「商用導入へ前進」と言い始めた段階で、EricssonはPoC色がまだ強いです。 (Nokia Corporation | Nokia) Siemensのような工場OS株は 12~48カ月です。現場導入でROIは出ても、それが全社的な大きな利益になるには、ライン横断・工場横断で広がる時間が必要です。PepsiCoのような初期成果はすでにありますが、これが“産業全体の標準”になるまでには少し待つ必要があります。 (press.siemens.com) SoftBank Corp.のような通信事業者は 24~60カ月で見るのが自然です。なぜなら市場は、技術デモではなく、本当にAI-RANで新しい収益源ができたのか、ROICが改善したのかを見るからです。 (ソフトバンク)
#なので将来像は、かなりはっきりしています。 2026年は「PoCから商用前夜へ」で、株は最も思惑で動きやすい年です。 (Nokia Corporation | Nokia) 2027~2028年は、Nokia、SoftBank、Fujitsu、Ericssonあたりが、案件数・受注・AI-RAN関連ソフト/サービス売上で少しずつ証明し始める時期です。SoftBank/Fujitsuが2026年以降商用化を目指し、Nokiaが“validation to commercial deployment”と言い始めているので、この2年が最初の答え合わせになります。 (Nokia Corporation | Nokia) 2029~2031年は、6G寄りの商用本格化とphysical AI普及が重なり、AI-RANが単なるRAN最適化ではなく、工場・物流・都市インフラの分散推論基盤になれるかどうかの本番です。EricssonとSK Telecomは、5Gから6GにかけたAI-RAN/ネットワーク革新で2031年までの商用化可能性に言及しています。 (ericsson.com)
#強気シナリオでは、AIエージェントが現場へ降りてきて、ロボットや設備が常時ネットワーク側の推論資源を借りるようになります。その場合、NVIDIA → Nokia/SoftBank/Ericsson → Siemensの順に大きく恩恵を受けます。NVIDIAは計算基盤、Nokia/Ericsson/SoftBankは分散実行基盤、Siemensは現場のオーケストレーション層だからです。 (NVIDIA Blog)
#弱気シナリオでは、AIは結局ほとんどが中央集権型データセンターで処理され、AI-RANは“RANの少し賢い最適化機能”に留まります。この場合でもNVIDIAは勝ちやすいですが、Ericsson/Fujitsu/SoftBankの再評価は限定的になり、Nokiaも光・AIクラウドの方が本筋になります。 (Reuters)
#私なら、このテーマはこう分けます。 いま買われやすい順は、NVIDIA → Nokia → Marvell → Siemens → SoftBank Corp. → Ericsson → Fujitsu。 (investor.nvidia.com) 3年後に“利益で証明しやすい”順は、NVIDIA → Nokia → Siemens → SoftBank Corp. → Ericsson → Fujitsu → Marvellです。Marvellは証明前に期待が先行しやすいので、順番を少し下げています。 (Reuters)
#要するに、**AI-RAN銘柄の本命は「通信会社」より「AI計算基盤」と「AI-RANを製品化する通信装置会社」、そして最後に「工場OS」**です。 このテーマでいちばん危ないのは、physical AI本体だけを見て、その下の分散推論・ネットワーク・運用OSを見落とすことです。価値はまず下の基盤に落ち、あとから上のアプリに伝わります。 (t-mobile.com)
##
デバイス、MEC、エッジの違い
#まず結論だけ先に言うと、「エッジ」は広い概念で、その中にMECが入ります。 そしてフィジカルAIでは、だいたい デバイス(ロボット本体)→ エッジ → 中央クラウド の3層で考えると分かりやすいです。MECはその中でも “通信網の近くに置かれた、通信と連携しやすいエッジ” です。ETSIはMECを、モバイルネットワークのエッジにクラウド計算能力とIT実行環境を持ってくる仕組み と説明しており、計算とストレージをユーザーの近くへ寄せることで、低遅延・高帯域・無線網情報へのリアルタイムアクセスを実現するとしています。 (ETSI)
#整理するとこうです。
#- デバイス
ロボット本体、カメラ、センサー、車載コンピュータ、アーム制御器など、その場で実際に動いている機械そのものです。
- エッジ
データが生まれる場所や、行動が起こる場所の近くに置く計算機全般です。工場内サーバー、店舗内AI箱、基地局近傍サーバー、車載コンピュータ、産業用PCなどを広く含みます。NVIDIAも edge computing を「point of action で処理すること」と表現していて、データを遠くへ送らず、その場で判断するから低遅延になると説明しています。 (NVIDIA)
- MEC
エッジの一種です。ただのエッジではなく、通信事業者のネットワークの縁にあるエッジ です。基地局近傍や通信拠点近くに置かれ、5G/6GやRANと連携しやすいのが特徴です。ETSIのMEC標準では、MEC host、MEC platform、MEC applications などの構成が定義されていて、ネットワークの近くでアプリを動かす前提になっています。 (ETSI)
#なので、あなたの質問にそのまま答えると、 「エッジとは何ですか?」→ 現場近くの計算環境の総称 「MECもエッジに含まれるのですか?」→ はい、含まれます 「MECとは何ですか?」→ 通信網の近くに置く、モバイルネットワーク連携型のエッジ計算基盤 です。 (ETSI)
#次に、中央クラウドやデータセンターとの違い です。 ここは「場所」と「役割」で分けると分かりやすいです。
#まず データセンター は物理的な施設のことです。大量のサーバー、電源、冷却、ネットワークをまとめて置く建物です。 一方 クラウド はサービス形態で、その多くは大規模データセンター上で動いています。 その中でも 中央クラウド という言い方をすると、都市圏や遠隔地にある大きなクラウド基盤を指すことが多いです。
#違いを一言で言うと、
#- 中央クラウド / 大規模DC
遠いけれど、巨大で安い計算資源をたくさん使える
- エッジ / MEC
近いけれど、台数・電力・スペースは限られる
- デバイス
いちばん近いけれど、電力もサイズも最も厳しい
#です。NVIDIAもロボティクスを “from the cloud to the edge” と表現していて、ロボット開発はクラウドだけでもエッジだけでもなく、両方をまたぐ前提で語っています。 (NVIDIA)
#フィジカルAIの文脈だと、それぞれの強みはこうなります。
#\1. デバイス側の強み いちばん重要なのは、止まる・避ける・支える です。 つまり、緊急停止、転倒回避、モーター制御、関節制御、センサの一次処理のような、遅れが許されない処理です。通信が切れても最低限安全に動ける必要があるので、ここは本体に残ります。SoftBankとEricssonの実証でも、「以前はロボットで直接やっていたAI処理を、状況に応じてMECへ動的オフロードできる」と確認されており、逆に言えば全部をMECに投げる前提ではないということです。 (ソフトバンク)
#\2. エッジ / MEC の強み ここは 重いけれど、まだリアルタイム性が必要な処理 に強いです。 たとえば、複数カメラの認識、VLM/VLA系の推論、周辺状況の理解、経路計画、複数ロボットの協調、ローカル地図の更新などです。SoftBankとEricssonは、ロボットと通信ネットワークと外部計算資源を統合制御し、必要に応じてAI処理を近傍MECへ逃がすPoCを公表しています。これがまさにフィジカルAIでのMECの力です。 (ericsson.com)
#\3. 中央クラウド / 大規模DCの強み ここは 巨大モデルの学習、シミュレーション、全体最適、長期記憶、モデル更新 に向いています。NVIDIAもロボティクスを、学習・シミュレーション・推論の三つの計算資源で語っており、物理AIはクラウドとエッジをまたぐ構成を前提にしています。 (NVIDIA)
#つまりフィジカルAIでは、ざっくり
#- デバイス = 反射神経
- MEC/エッジ = 近くの外部脳
- 中央クラウド = 学習センター・長期記憶・艦隊司令部
みたいに見るとかなり分かりやすいです。
#そしてあなたの最後の質問、 「ロボット自体の小脳はMECではなくロボット自体についているイメージですか?」 これは はい、そのイメージでかなり合っています。
#ただし、もう少し正確に言うと、ロボット本体の中にもさらに階層があります。
#- 超低レイヤー
モーター制御、サーボ、姿勢安定、緊急停止 → マイコン、PLC、リアルタイム制御器
- 本体内の上位計算機
カメラ認識、局所地図、簡単な推論、音声処理 → 組み込みAIコンピュータ、産業用PC、Jetsonのようなモジュール
- 本体外の近傍計算機
さらに重い推論や複数機協調 → MECや工場内エッジサーバー
#という感じです。
#なので、「小脳はロボットの外にある」のではなく、まず本体の中にある と考えた方がよいです。しかも実際には、1個のスマホみたいな箱が全部やるというより、制御用の小さい計算機と、認識・推論用の少し強い計算機が同居する ことが多いです。NVIDIAも Jetson Thor を「physical AI and robotics 向けのコンパクトな高性能計算基盤」として出していて、エッジでのリアルタイム推論や高速度センサー処理を想定しています。これはまさに、ロボット本体側にかなり強い“局所脳”が載る流れを示しています。 (NVIDIA)
#要するに、フィジカルAIの計算はこうです。
#ロボット本体だけで完結 ではなく、
#ロボット本体で安全を守りつつ、近くのエッジ/MECで頭を増やし、中央クラウドでさらに学習・更新する
#という分業です。SoftBankのAI-RAN実証も、ロボット単体処理を必要に応じてMECへ逃がす、という形でまさにその構図を示しています。 (ソフトバンク)
#一言でまとめると、
#- エッジ = 現場近くの計算全般
- MEC = その中でも通信網の近くにあるエッジ
- デバイス = ロボット自身
- フィジカルAI = その3つを分業させる世界
です。
##
自動運転車と工場ロボットでどの処理がデバイス/MEC/中央クラウドに載るか
#いちばん分かりやすく言うと、自動運転車は「車載が主役」、工場ロボットは「本体+近場の計算資源が共同主演」 です。どちらも中央クラウドは重要ですが、リアルタイムで今この瞬間に動かす頭脳 の置き場所はかなり違います。NVIDIAは自動運転を「data center, simulation, and the vehicle」にまたがるスタックとして説明しており、Waymoも中核の認識・経路計画を車内の onboard computer がリアルタイムで担うと明記しています。 (NVIDIA)
#自動運転車の配分から言うと、まずデバイス側には、LiDAR・カメラ・レーダー・車載コンピュータが載り、周囲認識、物体分類、走行計画の中心がここで動きます。Waymoは、自社の車載コンピュータを「Waymo Driver の brain」と呼び、数十のセンサー情報を受けて、周囲の物体認識と安全なルート計画をリアルタイムで行うと説明しています。さらにWaymoは、より大きいモデルから蒸留した student models をreal-time onboard deployment向けに最適化し、加えてonboard validation layerで結果を検証するとしています。つまり、自動運転の本丸はまず車内です。 (Waymo)
#そのうえでエッジは、自動運転では「補助」の色が強いです。たとえば道路側インフラとのV2Xは、車両同士や路側インフラとの通信で危険を早めに知らせたり、見通しの悪い場所の情報を補ったりできます。米国ITSのV2X解説でも、V2V・V2I・V2Pで車両が周囲と“会話”し、事故防止やモビリティ向上に役立つとされています。ですが、Waymoの遠隔支援はremote driving ではなく adviceであり、車両側が問い合わせたときだけ情報を返し、車両が採用するかどうかを決めます。しかもWaymoが公表している遠隔支援の片道遅延中央値は米国内オペレーションセンターで約150msです。これは補助には使えても、ブレーキや回避の主制御には遅すぎます。なので、自動運転のエッジは「あると強いが、主脳ではない」と見るのが自然です。 (ITS Deployment Evaluation)
#中央クラウド / データセンターは、自動運転車では非常に重要ですが、役割は主に学習・シミュレーション・地図更新・艦隊学習です。NVIDIAはAV基盤を data center / simulation / vehicle にまたがるものとして出しており、Waymoも大規模モデルとシミュレーション側を使って、そこから車載向けに蒸留しています。Mobileyeも、Cloud-Enhanced Driver-Assist で、世界中の車両から集めた crowdsourced mapping によりセンチメートル級の位置推定やリアルタイム信号検知の強化を行うと説明しています。つまり自動運転では、クラウドは学び続ける巨大な後方司令部です。 (NVIDIA)
#だから、自動運転車の配分感はこうです。車載デバイスが主役、エッジは補助、中央クラウドは育成と更新の本拠地です。これは、Waymoが中核判断を onboard に置きつつ、遠隔支援を「助言」に限定していることからも読み取れます。要するに、車は公道で一台ずつ自己完結できないと危ないので、ネットワークが無くてもまず安全に走れる構成が基本になります。これは上の公開情報から導ける、かなり強い実務的な推論です。 (Waymo)
#次に工場ロボットです。こちらは自動運転車よりも、エッジやMECに仕事を逃がしやすいです。まずデバイス側には、ロボットコントローラと、本体内の組み込み計算機が載ります。ABBはロボットコントローラについて、モーションコントロール、軌跡精度、速度、サイクルタイムが性能の鍵だと説明しており、これはまさにロボットの“反射神経”にあたる部分です。またNVIDIA Isaac ROSは、ナビゲーションや認識のためのパッケージを、ワークステーションだけでなくNVIDIA Jetson のような組み込みシステムにも載せられるとしています。つまり工場ロボットの本体にも、制御用の小さな脳と、認識用の少し強い脳が同居しやすいです。 (ABB Group)
#そのうえで工場では、エッジ / MEC の比重がかなり上がります。 SiemensのIndustrial Edgeは、現場データの標準化、リアルタイム洞察、ダウンタイム最小化、現場へのAIモデル導入による欠陥検出や監視をうたっています。これはつまり、ロボットや工作機械のすぐ近くにあるサーバーで、画像検査、異常検知、工程最適化、ライン監視を回す世界です。さらにSoftBankとEricssonの2026年PoCでは、AI-RANのMECを使い、ロボット上でAI処理するか、外部のMECで処理するかを状況に応じて動的に切り替える仕組みを実証しています。工場では空間が比較的閉じていて、ネットワークも私設5Gやローカル5G、工場内LANで安定化しやすいので、自動運転車より“近くの外部脳”に頼りやすいわけです。後半は上記実証と製造向けエッジ基盤の説明に基づく推論です。 (Siemens)
#中央クラウド / データセンターは、工場ロボットでもやはり重要ですが、役割は学習、シミュレーション、デジタルツイン、全体最適、ソフト更新が中心です。NVIDIAは Isaac Sim について、physical AI ロボットや複数ロボットの艦隊をsimulate, test, and validateできると説明しており、合成データ生成や強化学習、software-in-the-loop、デジタルツインによる事前検証まで含めています。さらにNVIDIAの製造向けエッジ基盤では、Fleet Command をhybrid-cloudでの集中管理基盤として説明していて、アプリ配備、OTA更新、拠点監視を中央から行えるとしています。つまり工場ロボットでは、クラウドは「本番の即時制御」よりも、賢くして配る側に寄ります。 (NVIDIA)
#なので、工場ロボットの配分感は、用途ごとにかなりこう分かれます。サーボ制御・安全停止・軌道追従は本体、重めの視覚推論・複数機協調・工程監視はエッジ / MEC、学習・デジタルツイン・長期最適化は中央クラウドです。自動運転車よりもエッジ比率が上がりやすいのは、工場が閉じた環境で、通信品質と遅延を読みやすいからです。これはABB、Siemens、SoftBank/Ericsson、NVIDIAの公開情報をつなぐとかなり自然な整理です。 (ABB Group)
#あなたの「小脳」たとえで言い直すと、自動運転車の小脳はほぼ車体の中にあります。外のエッジは補助です。いっぽう工場ロボットの小脳は本体の中に必ずあるが、もう少し上位の判断は近くのエッジやMECに分散しやすいです。だから、 自動運転車 = 本体完結を最優先、 工場ロボット = 本体で安全を握りつつ、近くの計算資源で頭を増やす、 と覚えるとかなり本質に近いです。 (Waymo)
#超ざっくり一行でまとめると、 自動運転車:デバイス > クラウド > エッジ 工場ロボット:デバイス ≒ エッジ > クラウド です。ここでの「>」は計算量の絶対値ではなく、リアルタイム本番判断における重要度です。 (Waymo)
##
デバイス/MEC/中央クラウドに1つずつ振り分けた表
#「主にどこで実行するのが自然か」 という観点で、主置き場を1つに決めた表にします。実際の製品では複数層にまたがる処理もありますが、ここでは 本番リアルタイムで最も重心がある場所 に寄せています。自動運転はWaymo公開情報のように 車載で認識・予測・計画をリアルタイム実行 する構図が中心で、工場ロボットはABBの本体制御に加え、SiemensやSoftBank/Ericssonが示すように 現場近傍のエッジ/MECへ重いAIを逃がしやすい のが特徴です。クラウド側は両者とも 学習・シミュレーション・更新 が主役です。
#自動運転車の処理10項目
#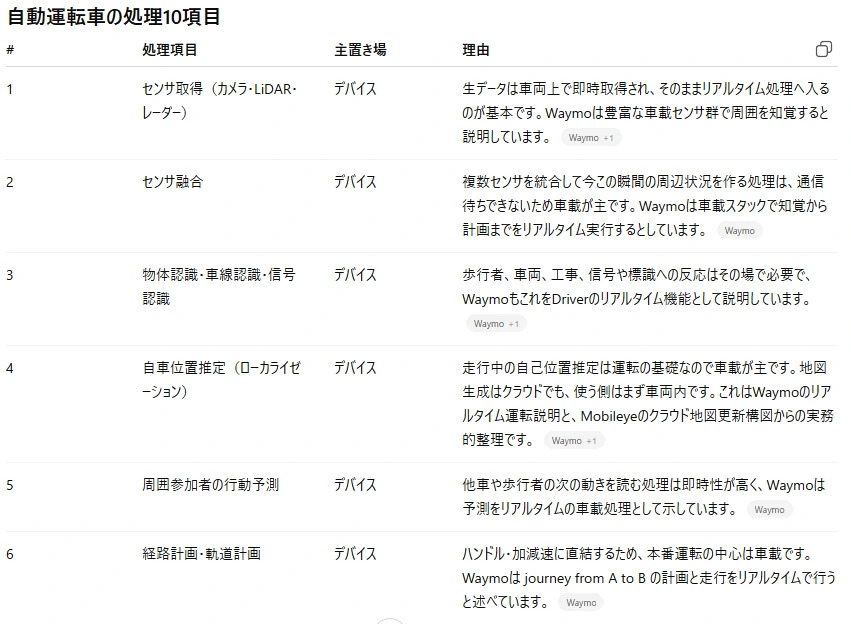
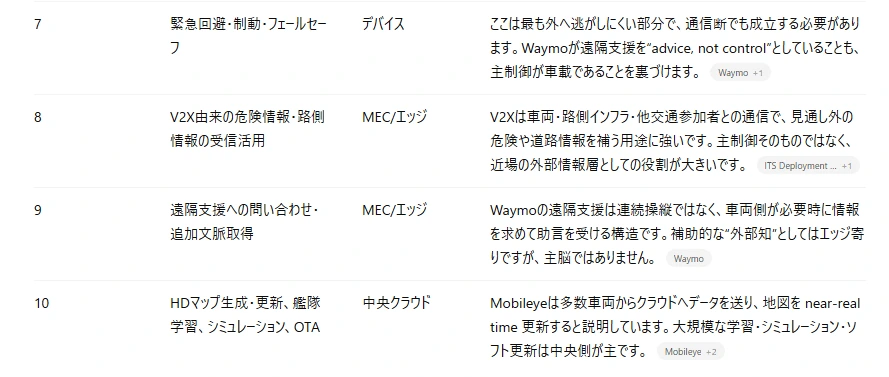
自動運転車の見方
#自動運転は、かなり単純化すると デバイス = 走る脳 MEC/エッジ = 外部からの追加視界・助言 中央クラウド = 学習所・地図工場・更新本部 です。Waymoの公開情報に沿うと、本番運転の重心は明確に車載 です。
#工場ロボットの処理10項目
#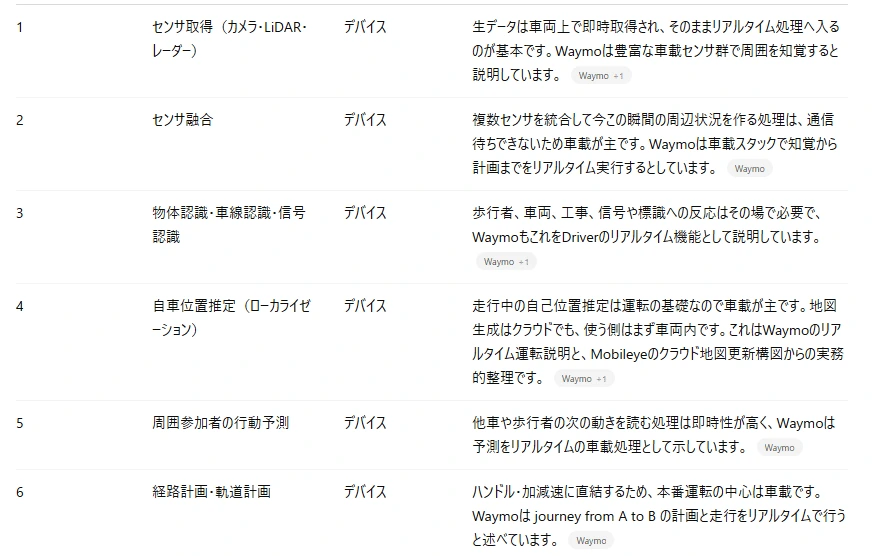
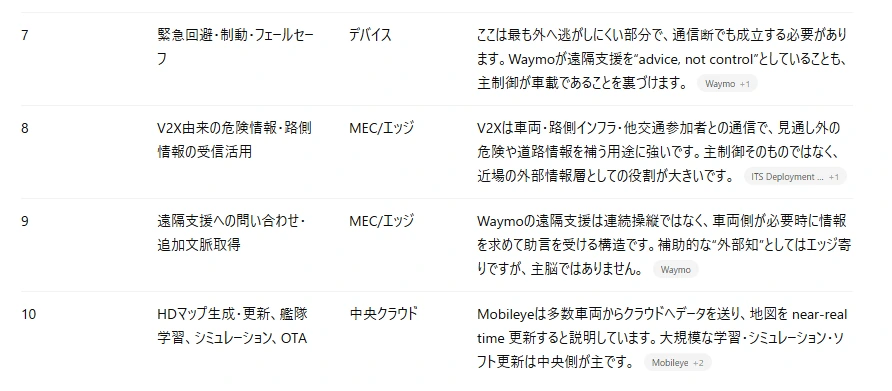
工場ロボットの見方
#工場ロボットは、 デバイス = 手足と反射神経 MEC/エッジ = 近場の外部脳 中央クラウド = 訓練所・設計室・配布本部 という分業がかなりしっくりきます。自動運転より、MEC/エッジの存在感が強い のがポイントです。Siemensは現場AI、SoftBank/Ericssonは動的オフロード、ABBは本体制御の強さをそれぞれ示しています。
#ひとことで対比すると
#- 自動運転車
本番の運転判断はほぼ車載。エッジは補助、クラウドは育成と更新。
- 工場ロボット
本体で安全を握りつつ、重いAIや協調を現場近くへ逃がしやすい。クラウドは学習と全体最適。
##
どの処理がGPU向きで、どの処理がASIC/LPU/NPU向きか
#まず大前提として、実機は単一アクセラレータではなく、CPU+GPU+NPU/専用回路の混成 が普通です。Qualcommも AI Engine を Hexagon NPU、Adreno GPU、CPU、Sensing Hub のヘテロジニアス構成として説明しており、車載・ロボティクス・IoTまで同じ発想で展開しています。なので以下は「その処理で主役になりやすい計算器は何か」という見方です。 (qualcomm.com)
#あと、ここでは用語をこう切ります。ASIC は TPU や EyeQ のような「特定用途向けにかなり作り込んだ専用チップ」の広い呼び方、LPU は Groq のような「推論、特に低遅延な生成AI推論に寄せた専用アーキテクチャ」、NPU は SoC内蔵や小型カードを含む「低電力なニューラル推論器」として使います。技術的には NPU も ASIC 的に実装されることが多いので、NPU は“低電力寄りのAI専用器”、ASIC は“もっと広い専用器の総称” と読むと分かりやすいです。TPU は Google が ASIC と明記しており、Groq は LPU を inference purpose-built と位置づけ、Qualcomm は NPU を on-device 低電力推論器として位置づけています。 (Google Cloud Documentation)
#まず結論だけ
#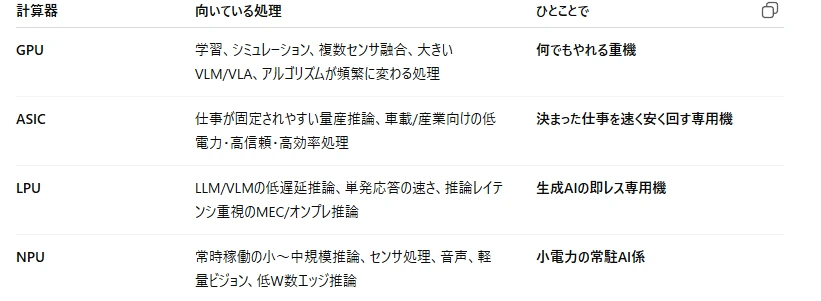
この整理の根拠は、NVIDIA が GPU を AV の学習・シミュレーション・実運用、ロボティクスの perception / manipulation / simulation にまたがる基盤として出していること、Groq が LPU を static scheduling と deterministic execution を持つ fast inference のための構成として説明していること、Qualcomm が NPU を on-device / low-power / always-on に寄せていること、Mobileye が EyeQ を purpose-built, low-power, real-time な車載 SoC としていることです。 (NVIDIA)
#計算器ごとの得意分野
#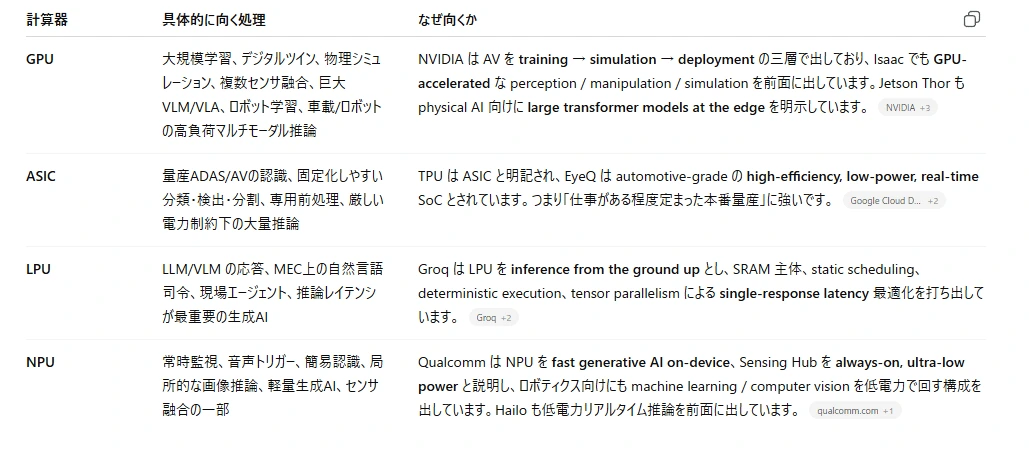
ここでかなり大事なのは、LPU はいまのところ 車1台やロボット1台の中 より、MEC・オンプレ・データセンター寄り だということです。Groq 自身が LPU を data centers での低遅延推論、GroqCloud、on-prem solutions として展開しているので、現時点では 車載の常時制御チップ より 近傍サーバー側の生成AI推論器 と見る方が自然です。 (Groq)
##
自動運転車:どの処理が何向きか
#自動運転はひとことで言うと、本番走行は ASIC/NPU 比率が高く、学習と大規模世界モデルは GPU、言語系の外部支援は LPU がはまりやすい です。Waymo のような先端スタックは車載計算が非常に重いですが、量産車に広げるほど 効率のいい専用 SoC 側へ寄る と考えるのが自然です。Mobileye の EyeQ はまさにその方向です。 (Mobileye)
#
自動運転の要約
#- 量産ADAS/量産AV は ASIC/NPU 寄り
- ロボタクシー級の重い知覚・世界理解 は GPU 寄り
- 路側MECの生成AI補助 は LPU 寄り
- 学習・シミュレーション・艦隊更新 は GPU 寄り (Mobileye)
#
工場ロボット:どの処理が何向きか
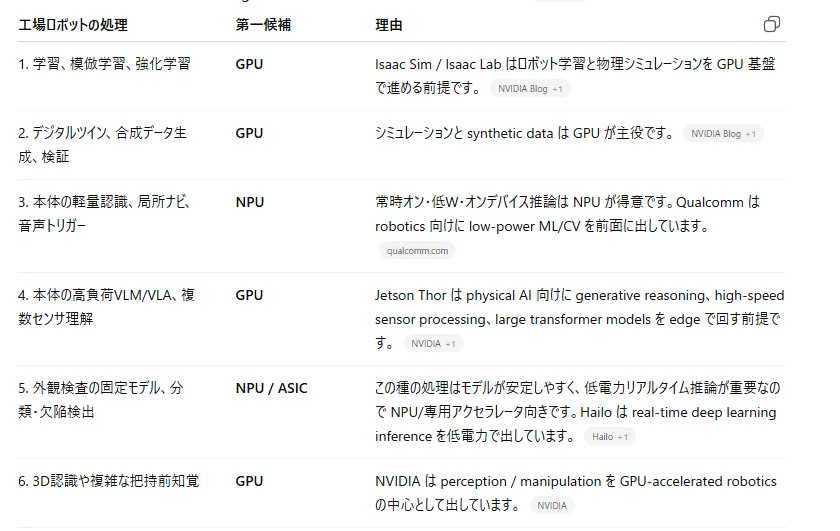
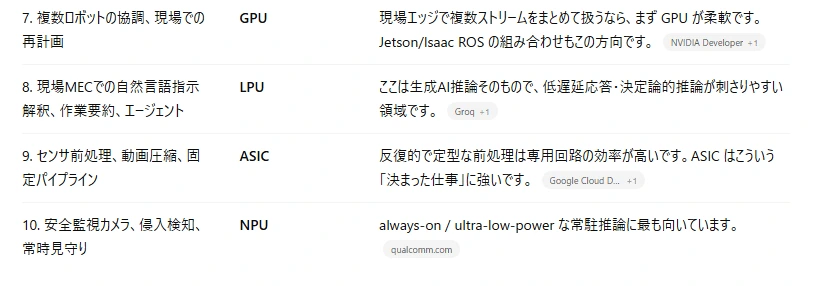
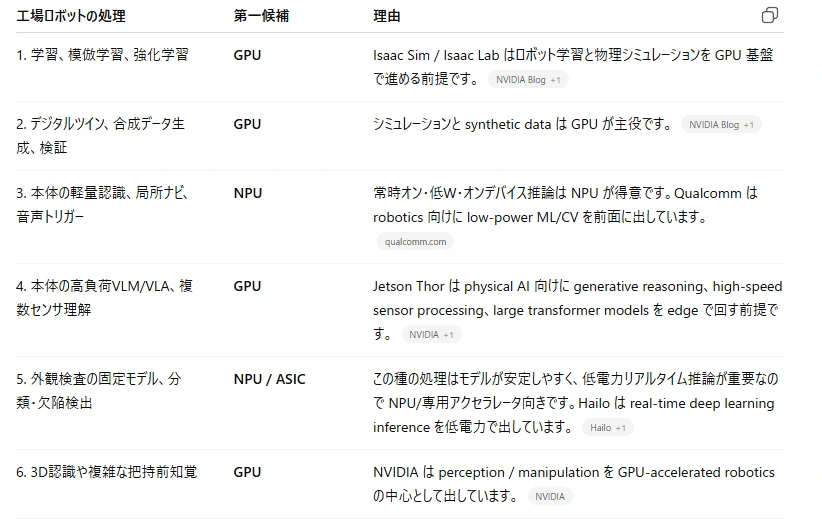
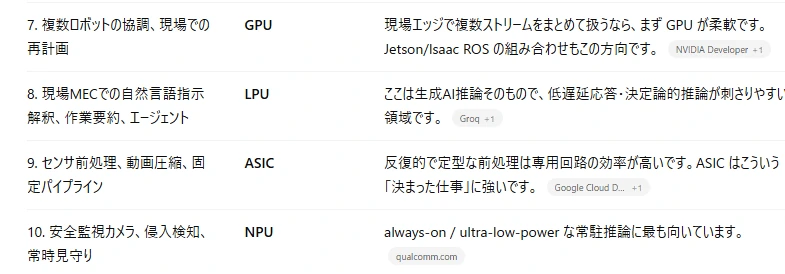
#工場ロボットは、自動運転車より MEC/現場エッジへ逃がせる処理が多い ので、本体側 NPU/小型GPU + 現場エッジGPU/LPU + 中央クラウドGPU の三段構成になりやすいです。NVIDIA は robotics を cloud to simulation to edge で捉えており、Jetson を onboard edge、Isaac Sim を学習/検証に出しています。 (NVIDIA)
#
工場ロボットの要約
#- 本体の常時AI は NPU
- 本体の重い知覚・行動生成 は GPU
- 現場MECの言語/司令/エージェント は LPU
- 固定化した検査や前処理 は ASIC/NPU
- 学習・シミュレーション・双子化 は GPU (qualcomm.com)
かなり雑に覚えるなら
#GPU は 「重い、変わる、複雑、学習もしたい」処理向きです。 (NVIDIA)
#ASIC は 「決まった仕事を、低電力で、量産で、安定して回す」処理向きです。 (Google Cloud Documentation)
#LPU は 「生成AIの返答を、とにかく速く、予測可能に返したい」処理向きです。特に MEC / オンプレ / 近傍サーバー で光ります。 (Groq)
#NPU は 「小電力で常時回す、ローカルAIの番人」向きです。 (qualcomm.com)
#ひとことで言うと、 車は ASIC/NPU 比率が高く、工場は GPU と NPU と MEC側LPU の混成になりやすい、です。 (Mobileye)
##
エッジ、MECにはどのくらいの計算資源が使われそうか、どのくらいの距離感か
#ここは 「距離」よりも、どれだけ近い電力・計算資源を置けるか と 何ホップで到達するか で考えると分かりやすいです。結論から言うと、デバイスは“手元の脳”、エッジ/MECは“近くの外部脳”、中央AIデータセンターは“巨大な本部脳” です。MECはエッジの一種で、ETSIはMECを モバイルネットワークの縁、RAN内やその近くに置くクラウド計算環境 と定義しています。 (ETSI)
#まず 計算資源の大きさ ですが、これはかなり段差があります。 デバイス は、ロボット本体や車載コンピュータのような“モジュール級”です。代表例として NVIDIA Jetson Thor は、40〜130W、最大128GBメモリ、最大2070 FP4 TFLOPS という、かなり強いエッジ向け計算モジュールです。つまりデバイス側でも相当重い推論はできますが、電力・熱・サイズはまだ厳しく制約されます。 (NVIDIA)
#エッジ/MEC は“サーバー級〜小規模クラスタ級”です。ただしここは 標準的な1つの数値はありません。ETSIのMECは、基地局サイト、RAN集約点、企業内の集約地点、コア網の縁 など複数の置き方を想定していて、NVIDIAも Aerial RAN Computer-1 を small / medium / large 構成で cell site、distributed site、centralized site に展開できると説明しています。つまり MEC は「1台の小型サーバー」から「複数サーバーの小さなエッジDC」まで幅があります。少なくとも中央のAIファクトリーのような桁ではなく、“現場近くに置ける範囲のサーバー群” です。 (ETSI)
#そのMEC/エッジで使われるアクセラレータも、中央DCより省電力寄りになりやすいです。たとえば NVIDIA L4 は 72W の低背GPUとして edge から data center、cloud まで を想定した製品です。つまりMECは、巨大GPUを何百枚も並べる場というより、比較的電力を抑えたGPUや専用推論器を、必要な場所に小さく分散配置する場 と考えると近いです。 (NVIDIA)
#一方で 中央のAI向けデータセンター は完全に別の世界です。NVIDIA DGX GB200 は 1ラックで72基のBlackwell GPUと36基のGrace CPU を束ね、さらに 複数ラックをつないで数万〜数十万級のSuperchipsまで拡張 できる前提です。DGX SuperPOD の 1つのScalable UnitでTDP 1.2MW という数字も出ており、これはMECやデバイスとは桁違いです。なので、計算資源の感覚は、 デバイス = モジュール級、 エッジ/MEC = サーバー級〜小規模DC級、 中央AI DC = ラック級〜メガワット級の工場 くらいに捉えるのが実態に近いです。 (NVIDIA)
#次に デバイスとどれくらい離れているか ですが、ここは 固定距離ではなく配置パターン で考える方が正確です。ETSIはMECの配置先として、基地局サイトそのもの、RANの集約点、企業内の集約点、コア網の縁 を挙げています。なのでMECは、デバイスから見て 同じ建屋・同じ敷地内 にあることもあれば、少し離れた事業者の集約拠点 にあることもあります。要するに、MECは「必ず基地局の真下」ではなく、RANに十分近い場所に置かれるエッジ計算 です。 (ETSI)
#感覚的な目安だけ言うと、 デバイス内計算 は 0メートル、 オンプレ/現場エッジ は同じ部屋・建屋・工場敷地、 MEC は基地局併設か、そこから数ホップ先の事業者エッジ、 中央クラウド は都市・地域をまたぐ遠い拠点、 という並びです。ここで大事なのは、物理距離そのものより、どれだけ公衆インターネットや遠いコア網を迂回できるか です。AWS Wavelength も、5Gでもアプリが遠いサーバーに行くと 数十ms超の遅延 になりうる一方、通信事業者の5Gエッジに計算を埋め込むことで single-digit millisecond を狙えると説明しています。
#スマホと基地局の関係 と比べると、スマホ↔基地局はまず 無線の最後の1ホップ です。ここは周波数帯と電波条件に強く左右されます。FCCは 低帯域は広いカバレッジ向き、中帯域はカバレッジと容量のバランス、Nokiaは ミリ波はより高容量だが届く距離が短く、時には1マイル未満で遮蔽物にも弱い と説明しています。つまりスマホと基地局の距離は、屋内小セルならかなり短く、低帯域マクロセルならもっと長くなります。 (docs.fcc.gov)
#これに対して デバイス↔MEC は、無線だけでは終わりません。 経路はざっくり デバイス → 基地局/RAN → 事業者の伝送網 → 近いMEC です。 そして デバイス↔中央クラウド は、そこからさらに コア網 → 広域バックボーン → クラウドリージョン へ進むので、ホップ数もドメイン数も増えます。AI-RAN Allianceの最新白書は、AIワークロードを uplink-heavy・双方向・セッション継続重視 と整理し、local breakout、dUPF、QoS、slicing、bounded latency が重要だと述べています。つまりAI-RAN文脈では、「近くに計算を置く」だけではなく、「その近い計算へ優先的に、安定して、短い経路で流す」こと が本質です。
#なので、スマホと基地局の関係は “無線が届くか・どの帯域を使うか” が主題ですが、AI-RANでのデバイスとMECの関係は “その無線の先にある計算まで、どれだけ短く安定してつなげるか” が主題になります。ここが普通のモバイル通信とAI-RANの大きな違いです。 (ETSI)
#次に 5Gや6GがAI-RANで何を意味するか です。 まず 5G は、単にダウンロードが速いことが価値なのではありません。AI-RANの文脈では、5Gは URLLC、高信頼化、QoS Flow、network slicing、local breakout、MEC連携 を実現する土台です。3GPPは5GのURLLC強化として 冗長伝送 などを定義しており、AI-RAN AllianceはAIワークロードで特に 上りの安定性、遅延ばらつきの小ささ、モビリティ中のセッション継続 が重要だとしています。つまり5Gは、“近い計算を使えるようにする通信OS” として効いてきます。 (3GPP)
#そして 5G-Advanced〜6G になると、ネットワークの中にAI/MLをもっと深く埋め込んでいく方向が強まります。3GPPはすでに AI/ML for NG-RAN & 5G-Advanced towards 6G として、RAN内のデータ収集や推論支援の標準化を進めています。NokiaもAI-RANの狙いとして、AIネイティブなアプリに必要な guaranteed ultra-low latency と massive uplink capacity を支え、6GではAI・sensing・computingがネットワーク設計にネイティブに組み込まれる としています。つまり6Gは、AI-RANにとって “後付けのAI対応” ではなく “最初からAI前提の無線網” に近づく意味を持ちます。 (3GPP)
#SoftBankのAI-RAN構想もこの分業をかなりはっきり出しています。SoftBankは 基地局付近のAI-RAN/Regional Brain で近い推論を回し、Brain DataCenter で大規模学習のような重すぎる処理を担う構想を示しています。さらに、従来クラウドがインターネット経由で数百ms往復していたのに対し、基地局付近でAIを実行して数十msへ短縮 する、という説明もしています。ベンダー構想なので数字はそのアーキテクチャ依存ですが、言いたいことは明快で、5G/6G + AI-RAN は「通信網を、そのまま分散AI基盤に変える」 ということです。 (ソフトバンク)
#かなり雑に一枚でまとめると、こうです。 デバイス は「小さいが最短」、 エッジ/MEC は「近いが中くらい」、 中央AI DC は「遠いが圧倒的に大きい」。 そして 5G はその近い計算を活かすための低遅延・高信頼・QoS制御の基盤、6G はそれをさらに AI・計算・センシングが最初から一体化したネットワーク に寄せる流れ、です。 (ETSI)
##
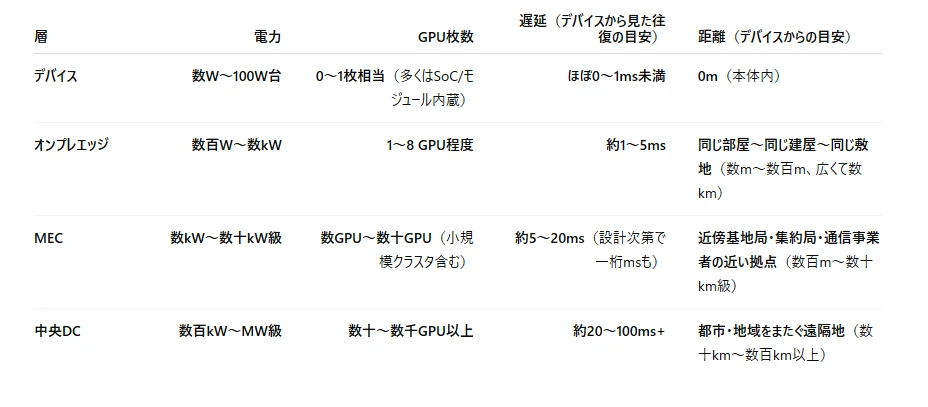
「デバイス / オンプレエッジ / MEC / 中央DC」を電力・GPU枚数・遅延・距離の4軸で表にして可視化
#まず前提として、この表は 「代表的なレンジ感」 を掴むためのものです。実際の構成は用途によって大きく変わりますが、デバイス → オンプレエッジ → MEC → 中央DC の順に、だいたい 計算資源は大きく、距離は遠く、遅延は増える と考えると分かりやすいです。MECはETSIの定義どおり「モバイルネットワークのエッジ側に置く計算環境」で、AWS Wavelengthも5G網内のエッジに計算を埋め込んで single-digit millisecond latency を狙う仕組みとして説明しています。代表例として、デバイス側は Jetson Thor が 40〜130W、エッジ向けGPUのL4は 72W・1〜8 GPU構成、中央側は DGX GB200 が 1ラックで72 GPU、さらに DGX SuperPOD の1 Scalable Unit が 1.2MW 規模です。SoftBankもAI-RANで、基地局近傍の「Regional Brain」と中央の「Brain DataCenter」を分けて構想しています。 (ETSI)
#4軸で見た比較表
#
#
かなり雑に図で描くとこうです
#[デバイス]
電力: 小
GPU: ほぼ内蔵1相当まで
遅延: 最小
距離: 0m
↓
[オンプレエッジ]
電力: 中
GPU: 1〜8
遅延: 1〜5ms
距離: 同室〜同敷地
↓
[MEC]
電力: 中〜やや大
GPU: 数〜数十
遅延: 5〜20ms
距離: 基地局近傍〜近い通信拠点
↓
[中央DC]
電力: 圧倒的大
GPU: 数十〜数千+
遅延: 20〜100ms+
距離: 遠い#
それぞれをもう少し噛み砕くと
#\1. デバイス
#これはロボット本体、車載コンピュータ、スマホ、カメラ端末そのものです。 Jetson Thorのようにかなり強いモジュールでも 40〜130W なので、中央DCと比べると小さいです。ただし距離はゼロなので、最も速い です。緊急停止、サーボ制御、即時の認識などはここに残ります。 (NVIDIA)
#\2. オンプレエッジ
#これは工場内サーバー、店舗内サーバー、院内サーバーのような 現場の中に置く外部脳 です。 たとえばL4のような低消費電力GPUを使うなら、1〜8 GPUくらいの小型サーバー は十分現実的です。距離が近いので、中央クラウドよりかなり低遅延 です。工場ロボットや画像検査と相性が良いです。 (NVIDIA)
#\3. MEC
#MECはオンプレエッジと似ていますが、違いは 通信事業者のネットワークに近いこと です。 つまり、スマホや移動ロボット、自動運転、屋外カメラのような 無線でつながる端末 と相性が良いです。 ETSIはMECを基地局サイト、RAN集約点、ネットワークエッジなどに置くものとして整理していて、AWS Wavelengthはこの発想で single-digit ms を狙います。SoftBankのAI-RAN構想も、基地局近傍にAIサーバーを置く「Regional Brain」を打ち出しています。 (ETSI)
#\4. 中央DC
#ここは巨大AIモデルの学習、本格シミュレーション、全体最適、複数拠点の統合管理をやる場所です。 DGX GB200のように 1ラックで72 GPU、さらに複数ラックを束ねて運用する世界なので、エッジ/MECとは規模が別物です。代わりに遠いので、本番リアルタイム制御には向きにくい です。 (ETSI Portal)
##
スマホと基地局の関係と比べるとどう違うか
#ここは重要です。
#スマホ ↔ 基地局
#これは主に 無線の1ホップ です。 距離は、屋内小セルならかなり短く、マクロセルならもっと長くなります。 でも、基地局につながった時点では、まだ計算機に着いていない 場合があります。
#デバイス ↔ MEC
#こちらは、ざっくり
#デバイス → 基地局 → RAN/伝送網 → 近いMEC
#という流れです。 つまりMECは、スマホやロボットから見て「基地局の次にある、近い外部脳」です。
#デバイス ↔ 中央DC
#こちらはさらに
#デバイス → 基地局 → 伝送網 → コア網 → 広域バックボーン → クラウド
#となるので、当然もっと遅くなります。 つまり、MECは“基地局そのもの”ではなく、“基地局の近くにある計算資源” です。 (ETSI)
##
フィジカルAI目線での使い分け
#デバイス向き
#- 緊急停止
- モーター制御
- 局所的な認識
- 通信断でも絶対に動くべき処理
オンプレエッジ向き
#- 工場内の画像検査
- 複数ロボット協調
- 局所的な工程最適化
- セキュアな現場内AI
MEC向き
#- 屋外ロボット
- 自動運転支援
- 都市のカメラ解析
- 通信ネットワークと連携した低遅延推論
- AI-RAN上のAI推論
中央DC向き
#- 巨大モデル学習
- シミュレーション
- デジタルツイン
- 全拠点最適化
- 長期記憶・モデル更新
#
一番大事なポイントだけ一言で言うと
#- デバイス = 最速だが小さい
- オンプレエッジ = かなり速くてそこそこ強い
- MEC = 無線端末にとって近い外部脳
- 中央DC = 圧倒的に強いが遠い
です。
##
フィジカルAIで、どの処理をデバイス/オンプレエッジ/MEC/中央DCに置くべきか
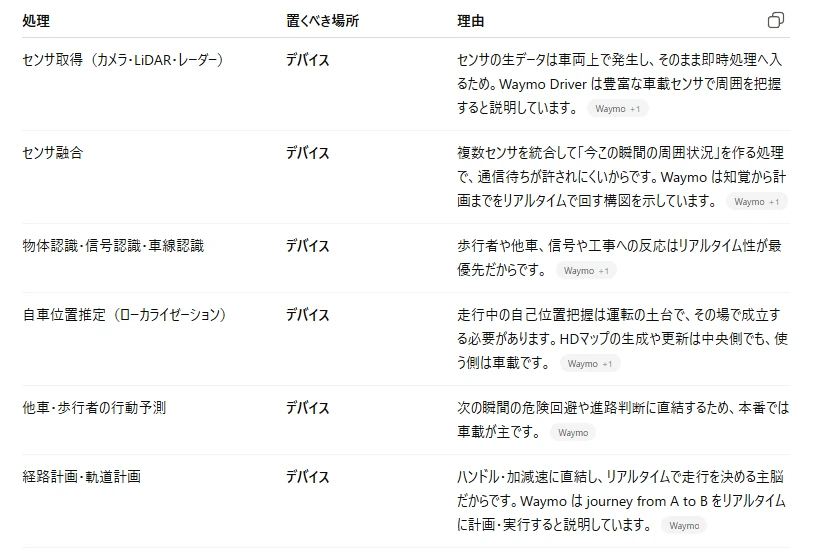
#はい。 ここでは 「主置き場」 で整理します。実際には一部の処理が複数層にまたがりますが、本番運用で“どこに置くのが最も自然か” という観点で振り分けます。自動運転は Waymo が示すように 知覚・予測・計画を車載でリアルタイム実行 する色が強く、工場ロボットは ABB の本体制御に加えて、Siemens や SoftBank/Ericsson が示すように 近場のエッジやMECへ重いAIを逃がしやすい のが違いです。中央DCは両方とも 学習・シミュレーション・全体最適化 が主役です。 (Waymo)
#自動運転車版
#
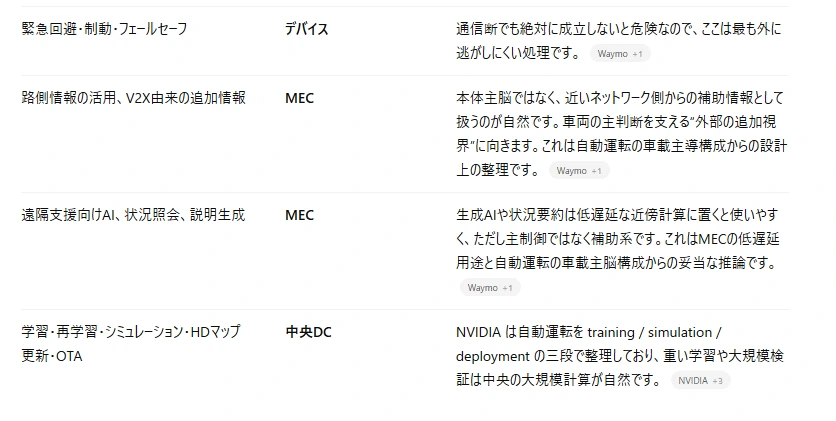
自動運転車の要点
#自動運転車は、かなり単純化すると 「走る脳はデバイス、近場のMECは補助、中央DCは育成と更新」 です。公道では 通信が切れても安全に成立する必要 があるため、主脳をMECへ置き切る設計にはなりにくいです。これは Waymo のリアルタイム車載構成と NVIDIA の training/simulation/deployment の分業から導けます。 (Waymo)
##
工場ロボット版
#
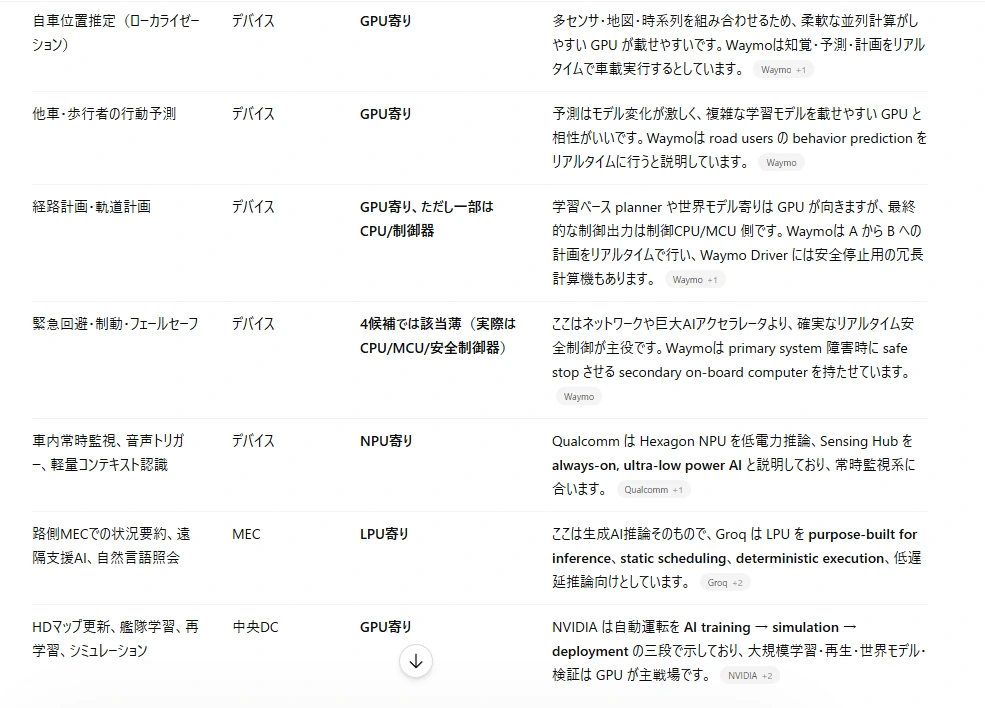
工場ロボットの要点
#工場ロボットは 「本体で安全を握りつつ、重い認識や複数台協調はオンプレエッジへ、無線連携や移動体寄りの外部脳はMECへ」 という分業がしっくりきます。自動運転車よりも オンプレエッジ/MEC を本番運用へ組み込みやすい のが特徴です。Siemens の現場AIと SoftBank/Ericsson の動的オフロード実証が、その方向をかなり素直に示しています。 (Siemens)
##
2つを並べて一言でいうと
#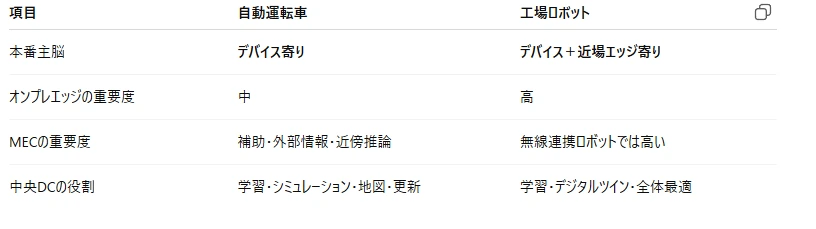
この違いは、自動運転車は公道で単体完結しないと危ない のに対し、工場ロボットは閉じた環境で近場計算と組みやすい からです。 (Waymo)
##
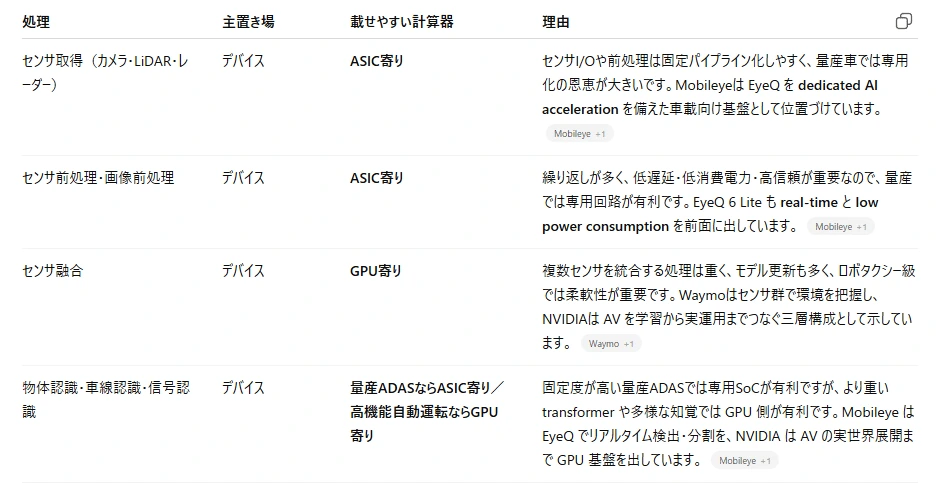
各処理を GPU / ASIC / LPU / NPU のどれに載せやすいか
#ここでは 「主置き場」 と 「主役になりやすい計算器」 を同じ表に重ねます。 ただし最重要の注意点として、サーボ制御・安全停止・モーター制御の主役は、実際には GPU / ASIC / LPU / NPU ではなく、CPU / MCU / PLC / リアルタイム制御器 です。ABBもロボットコントローラの核心を motion control、path accuracy、speed、cycle-time に置いており、Waymoも安全停止用の secondary on-board computer を車内に持たせています。なので下の表では、4候補に無理やり押し込まず、「4候補では該当薄」 と正直に書きます。 (ABB Group)
#自動運転車版
#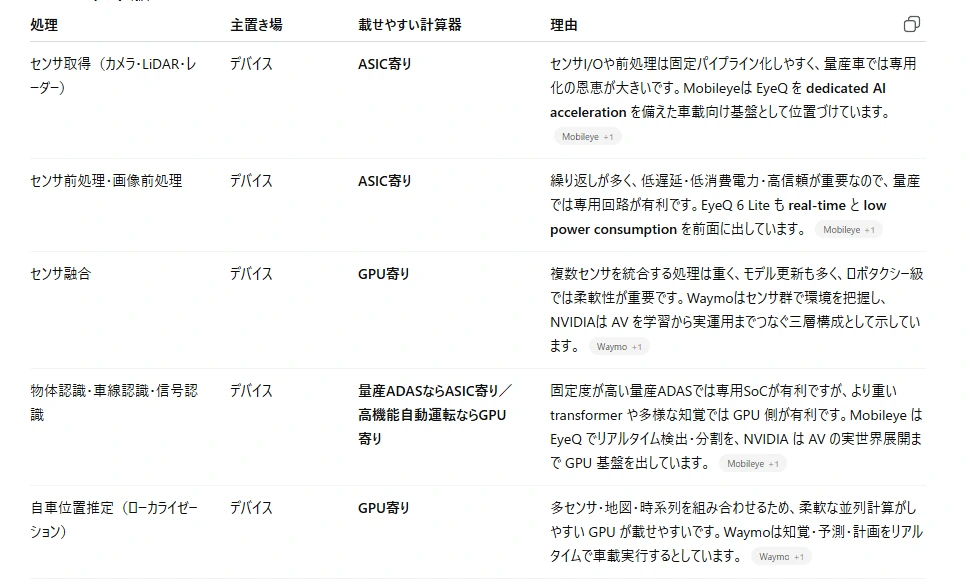
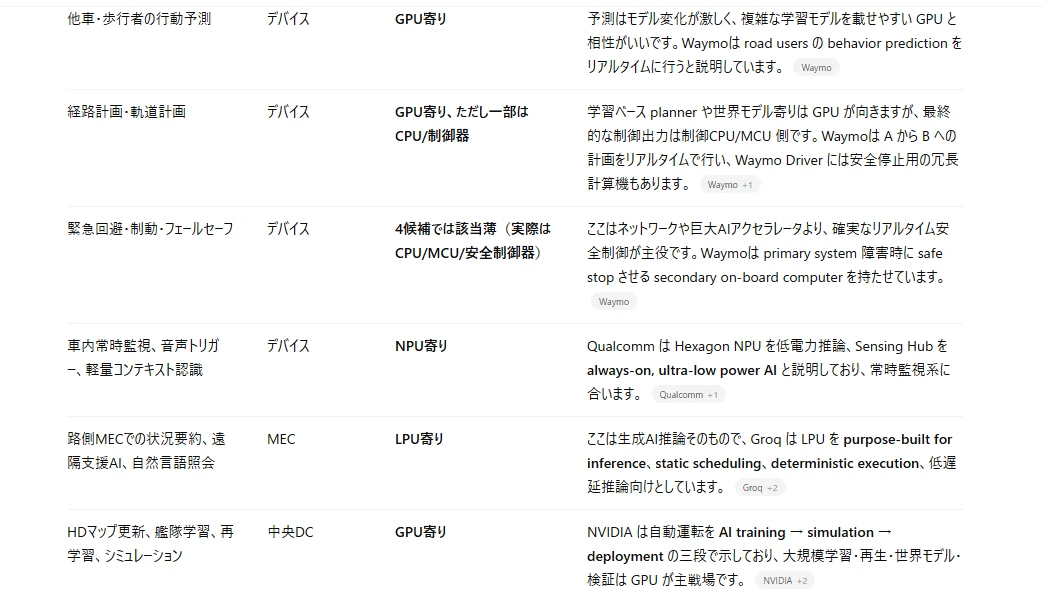
自動運転車の見方
#一言でいうと、量産寄りになるほど ASIC/NPU の比率が上がり、先端ロボタクシー寄りになるほど GPU の比率が上がる、です。いっぽう LPU は車内の主脳というより、MEC側の言語・生成AI補助 に載せやすいです。 (Mobileye)
##
工場ロボット版
#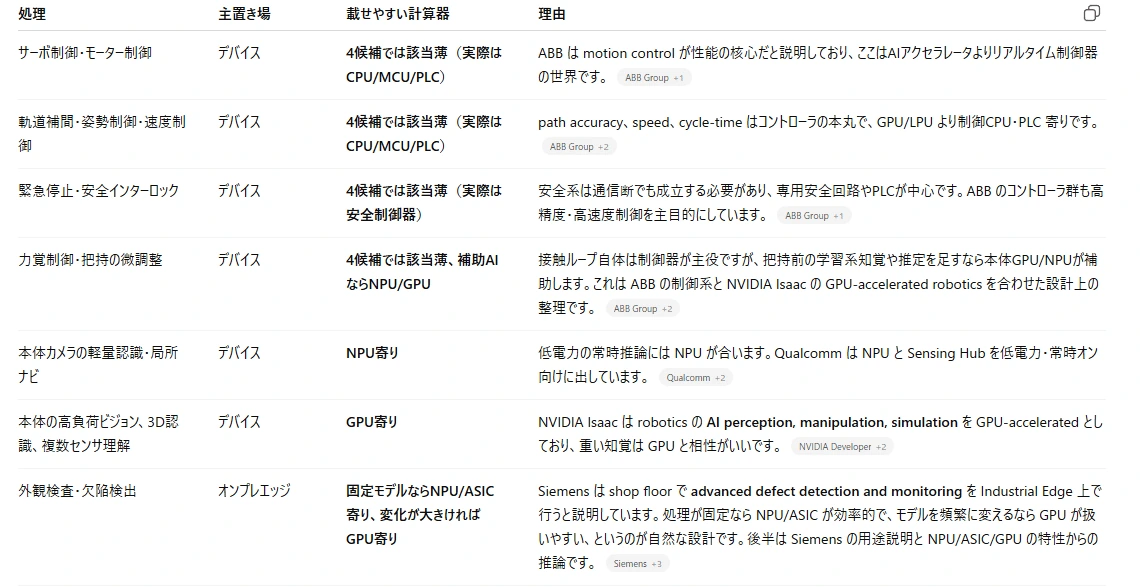
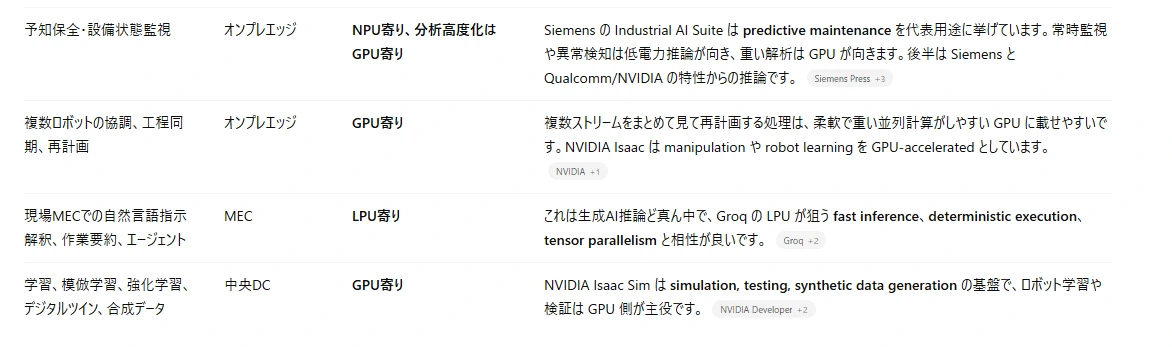
工場ロボットの見方
#工場ロボットは、低レイヤー制御は制御器、軽量常時AIはNPU、重い知覚や複数台協調はGPU、MEC上の言語系はLPU という分業がいちばん自然です。固定された検査・監視 は NPU/ASIC に寄せやすく、変化の大きい知覚・最適化 は GPU に寄せやすいです。 (Siemens)
##
2つを横に並べると
#領域自動運転車工場ロボット低レイヤー制御CPU/MCU/安全制御器が中心CPU/MCU/PLC/安全制御器が中心軽量・常時AINPUNPU重い知覚・世界理解GPUGPU固定化しやすい量産推論ASICNPU/ASICMEC上の生成AILPULPU学習・シミュレーションGPUGPU
#いちばん短く言うと、 車は ASIC/NPU の重要度が高く、工場は GPU と NPU の混成が強く、MECの言語AIは両方とも LPU がはまりやすい、です。 (Mobileye)
##
どの会社がどの層を取りに行っているか整理
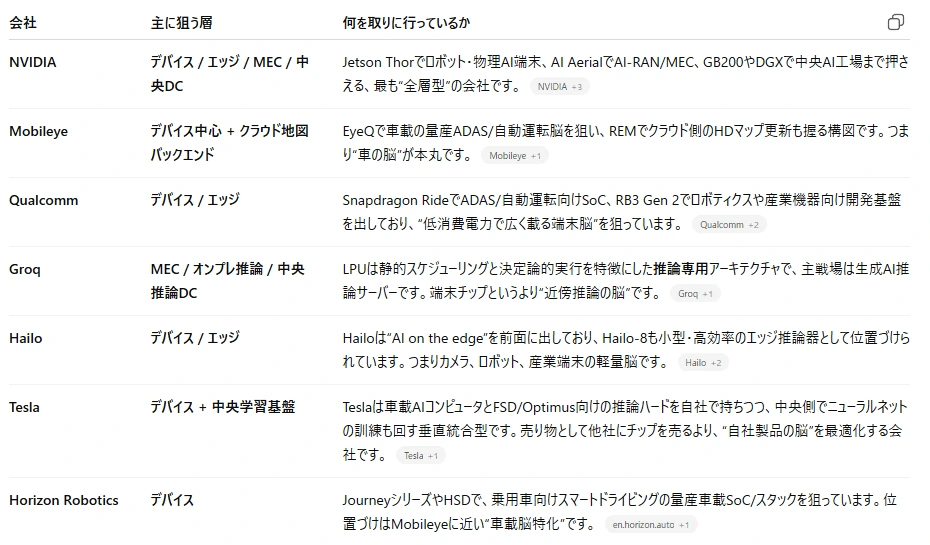
#はい。まず全体像を一言で言うと、NVIDIAは全層、Mobileye/Qualcomm/Tesla/Horizon/Hailoは主に“端末の脳”、Groqは“推論サーバー脳”、Amazon/Googleは“AI工場とエッジ基盤”、Broadcom/Marvellは“その全部をつなぐ血管と裏方シリコン” を取りに行っています。なお、あなたの「Marvel」は通常 Marvell のこととして解釈しました。また「HBF」はここでは High Bandwidth Flash として扱います。 (NVIDIA)
#企業マップ
#
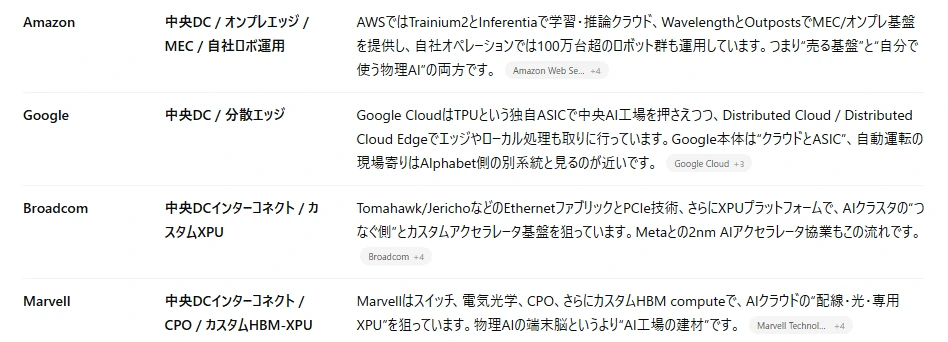
ざっくり陣営分けすると
#端末の脳 は Mobileye、Qualcomm、Tesla、Horizon、Hailo です。ここは「車やロボットの中に載ること」が勝ち筋で、電力効率、リアルタイム性、安全性が重要です。 (Mobileye)
#推論サーバーの脳 は Groq と、一部の NVIDIA、AWS、Google です。ここは車やロボットの中ではなく、MEC、オンプレ、クラウドで重い推論を回す側です。 (Groq)
#AI工場そのもの を取りにいくのが NVIDIA、Amazon、Google で、AI工場の配線屋・相互接続屋 が Broadcom と Marvell です。Broadcom/Marvell は目立つ“脳”ではないですが、AIクラスタが大きくなるほど価値が増すタイプです。 (NVIDIA)
##
HBM / SSD / HBF はそれぞれ何をするのか
#1) HBM
#HBMは、GPU/XPU/TPUのすぐ横に貼り付く超高速メモリ です。役割は、巨大モデルの重み、活性化、注意機構、KVキャッシュのような“今すぐ使う熱いデータ”を、とにかく高帯域で計算器に供給することです。NVIDIAのDGX B200は8基のBlackwell GPUで合計1,440GBのGPUメモリと64TB/sのHBM3e帯域を持ち、MicronもHBM3Eを生成AI向けに位置づけています。AWSのInferentia2/Trainium系もHBMを使っており、HBM需要はNVIDIAだけの話ではありません。 (NVIDIA)
#フィジカルAIの文脈でHBM需要が強く出るのは、ロボットや車そのもの というより、まず それらを学習・蒸留・世界モデル化する中央DC と、次に 高級なエッジ/MEC推論サーバー です。理由は、マルチカメラ、時系列、VLM/VLA、複数ロボット協調のような処理は、計算量より先にメモリ帯域が詰まりやすいからです。SandiskがHBFを売り込む文脈でも、AIでは“memory wall”が急激に重要になっていると説明しています。 (Sandisk)
#私の見立てでは、物理AIが増えるほどHBM需要はまず中央に集中 します。なぜなら、端末数が増えるほど学習データ、蒸留、シミュレーション、艦隊更新が膨らみ、そこでは最も高価でも最も速いメモリが必要だからです。加えてAmazonのTrainium、GoogleのTPU、Marvell系のカスタムHBM-XPUのように、NVIDIA以外のAIアクセラレータにもHBMが広がる ため、HBM需要源はむしろ多極化していく可能性があります。これは公開情報からの推論です。 (Amazon Web Services, Inc.)
#2) SSDストレージ
#SSD、特にNVMeは、HBMの代わり ではなく HBMに食わせるための大容量倉庫 です。役割は、学習データ、動画、ログ、地図、チェックポイント、埋め込み、モデルの待機コピー、ローカルキャッシュを保持することです。NVIDIAのGPUDirect Storageは、NVMeやNVMe-oFからGPUメモリへ直接データパスを作る仕組みで、AIワークロードでストレージの重要性が高いことを示しています。Google Cloud Hyperdiskも、1ボリュームで最大10 GiB/s と 50万IOPS をうたっています。 (NVIDIA Developer)
#フィジカルAIでSSD需要が広く出るのは、ほぼ全層 です。中央DCではデータセット・チェックポイント・前処理済み特徴量の置き場になり、エッジ/MECではモデルキャッシュ、センサのリングバッファ、ローカルのベクトルDB、ローカルRAGの置き場になります。車やロボットでも、地図、ログ、イベント録画、更新データの保存先としてSSD/NANDは欠かせません。MobileyeのREMも、車両群から小さなデータパケットをクラウドへ送り、地図を近リアルタイム更新する仕組みを示しています。 (Mobileye)
#投資家的に見ると、SSD/NANDはHBMほど派手ではないが、裾野が最も広い です。HBMは一部の超高級計算機に集中しますが、SSDは中央、エッジ、MEC、端末、ほぼ全部に必要です。物理AIが本当に普及すると、動画・センサ・ログの爆発で、SSDの需要は容量側からじわじわ効いてきます。これはGPUDirect Storageとクラウドブロックストレージの位置づけから導ける、かなり自然な見方です。 (NVIDIA Developer)
#3) HBF
#ここでのHBFは High Bandwidth Flash です。SandiskはHBFを、AIの“memory wall”に対処するための新しいNAND形態として説明しており、2026年2月にはSK hynixと次世代HBFの標準化を始めています。Kioxiaも2025年8月に、5TB・64GB/s の広帯域フラッシュモジュール試作を発表しました。つまりHBFは、まだ立ち上がり始めの技術ですが、単なる普通のSSDではなく、SSDよりずっとメモリ寄り の階層を狙っています。 (Sandisk)
#HBFの役割は、私の理解では HBMとSSDの間を埋める“温かい容量層” です。HBMほど速くはないが、SSDよりはずっと帯域が高く、しかもNAND由来なので容量、持続性、熱安定性に強い。Sandisk自身も、大規模AIデプロイ向けにpersistence and thermal stability を強調しています。つまり、巨大推論で「HBMだけでは高すぎる・少なすぎる、SSDだけでは遅すぎる」という場所に入ろうとしているわけです。 (Sandisk)
#物理AIの文脈では、HBFは特に MEC/エッジ推論 や 大規模推論サーバー と相性が良い可能性があります。なぜなら、ロボットや車の近くで重いモデルを動かすときは、中央DCほど潤沢な電力や冷却がなく、しかしSSDだけでは足りないからです。Kioxiaが“エッジでの高度なAI処理”を明示しているのは、まさにそのユースケースです。 (KIOXIA Corporation)
#ただし、ここは大事ですが、HBFはまだHBMの置き換えではありません。 2026年時点では、標準化と試作の段階で、主流の量産インフラを置き換えているとは言えません。私の見立てでは、HBFは近い将来、HBMを食い尽くすというより、“HBMだけでは足りない推論容量”を増やして総メモリ需要を広げる 方向で効く可能性が高いです。これはSandisk/Kioxiaの公開情報に基づく推論です。 (Sandisk)
##
需要がどこで生まれるかを、物理AIの流れに沿って言うと
#NVIDIA / Amazon / Google / Broadcom / Marvell 側で生まれる需要は、主に 中央AI工場のHBM、SSD、光・スイッチ、そして一部HBF候補 です。モデルを学習し、蒸留し、世界モデルを作り、艦隊全体へ配る中心だからです。 (NVIDIA)
#Groq / AWS Wavelength / Google Distributed Cloud Edge 側で生まれる需要は、MEC/オンプレ推論の低遅延メモリとローカルストレージ です。ここではHBM級の高速メモリが一部必要で、同時にモデル・KV・ローカル知識の容量層も要るので、将来的にHBF的な階層がはまりやすいです。これは公開情報からの推論です。 (Groq)
#Mobileye / Qualcomm / Tesla / Horizon / Hailo 側で生まれる需要は、HBMよりもまず 低電力推論、ローカルNAND、センサ処理、量産コスト です。端末の台数は膨大でも、1台あたりに中央DC並みのHBMを積む世界にはなりにくいからです。高性能車や高級ロボットは別として、台数が伸びるほど“端末側は専用SoCとローカルストレージ重視”になりやすいです。これは各社の製品の置き場所から導ける実務的な見方です。 (Mobileye)
##
かなり短くまとめると
#- NVIDIA は全部取り。
- Mobileye / Qualcomm / Tesla / Horizon / Hailo は主に端末の脳。
- Groq は推論サーバー脳。
- Amazon / Google はAI工場と分散エッジ基盤。
- Broadcom / Marvell はAI工場のネットワークとカスタム裏方。 (NVIDIA)
- HBM は“今すぐ計算する熱いメモリ”。
- SSD は“全部を支える広い倉庫”。
- HBF は“その間を埋める新しい容量階層候補”。 (NVIDIA)
投資仮説っぽく一言で締めると、物理AIが広がるほど、端末脳の勝者だけでなく、“中央で学習する側”と“その間をつなぐ側”が太りやすい です。特にHBMは中央に、SSDは全層に、HBFは将来の推論容量層に効く、という見方がいちばんしっくりきます。 (NVIDIA)
##
はい。 まず先に結論だけ言うと、2026年時点で売上が最も大きく落ちる場所は、車やロボットの中ではなく、中央AIデータセンター側の GPU・HBM・ネットワークです。 端末側の車載SoCやロボットSoCも伸びていますが、金額の桁はまだ1段以上小さいです。NVIDIAのFY2026はデータセンター向けComputeが1623.61億ドル、Networkingが313.76億ドルだった一方、Automotiveは23.49億ドルでした。これだけでも、足元の「売上の落ち先」がどこかはかなりはっきり見えます。 (SEC)
#為替は、日本銀行の2026年4月23日17:00 JSTのドル円 159.59–61 を使い、以下では 1ドル=159.6円 で丸めて計算します。
#まず一枚の地図
#[中央AI/DC]
GPU/アクセラレータ ─ HBM ─ スイッチ ─ CPO ─ SSD
│
├─ 主な取り分:NVIDIA / Broadcom / Marvell / Micron / SK hynix / Samsung / Kioxia / SanDisk
└─ いま最も大きい売上プール
[エッジ / MEC]
推論ASIC or 小型GPU ─ HBM/HBF候補 ─ SSD ─ Ethernet/Optics
│
├─ 主な取り分:Groq / Broadcom / Marvell / AWS / Google / NVIDIA
└─ これから太る売上プール
[デバイス]
車載SoC / ロボットSoC / NPU / ASIC ─ LPDDR / NAND
│
├─ 主な取り分:Mobileye / Qualcomm / Horizon / Hailo / NVIDIA / Tesla(内製)
└─ 台数は大きいが、売上総額はまだ中央DCよりかなり小さい2026年の「売上が落ちる場所」推計
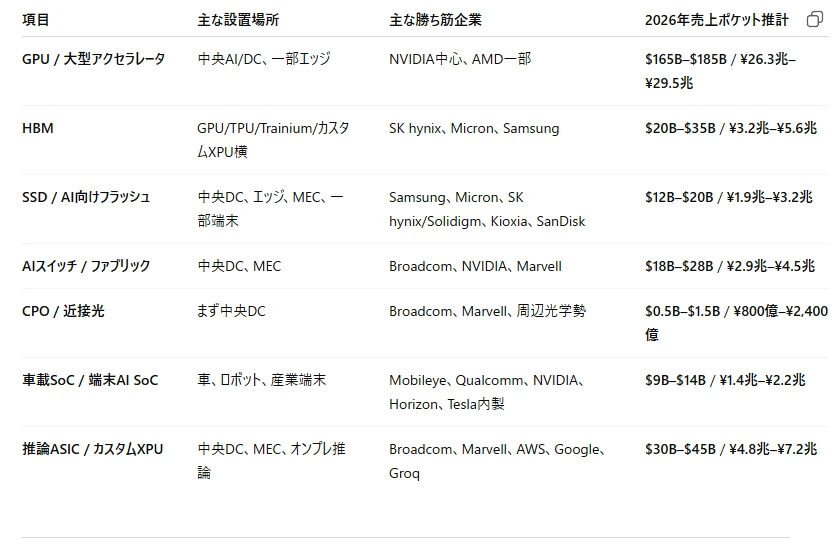
#注意:この表は 足し算して総額にしないでください。 HBMはGPU/ASICの中に入りますし、CPOはネットワークの中に入ります。これは 重複ありの“売上ポケット図” です。
#
#
どうしてこの数字になるのか
#1) GPU
#GPUポケットを $165B–$185B と見ている一番大きな理由は、NVIDIAのデータセンターCompute売上だけでFY2026に1623.61億ドルある からです。ここにはGPUだけでなくGrace系やシステム構成も混じりますが、少なくとも「中央AI/DCに落ちる大型アクセラレータ売上」は、NVIDIA単独でこの規模に達しています。なので、2026年の実勢としては グローバルのGPU/大型アクセラレータ売上ポケットが1650億〜1850億ドル というのはかなり保守的な見方です。 (SEC)
#2) HBM
#HBMは、Micronが2025年3月時点で 四半期HBM売上が10億ドル超 に到達したと公表し、その後2025年12月には HBM供給能力拡大のためにFY2026 Capexを200億ドルへ引き上げる と説明しました。SK hynixも2026年4月に HBM需要が供給能力を大きく上回っている と述べています。さらに、AWSのTrainium2は 16チップで1.5TB HBM3、Google TPU7x(Ironwood)は 1チップ192GB HBM を公表しており、HBM需要はNVIDIA以外にも広がっています。これらを踏まえると、2026年のHBM売上ポケットを $20B–$35B と置くのが自然です。これは会社開示からの推論です。 (Micron Technology)
#3) SSD / AI向けフラッシュ
#Micronは2025年12月に データセンターNAND売上が四半期10億ドル超、2026年3月には データセンターNAND売上が前四半期比で2倍超の新記録 になったと述べています。つまり、AIインフラではHBMだけでなく、大容量データ、チェックポイント、推論キャッシュ、ベクトルDB、ログ を支えるSSD/NANDも着実に太っています。ここにSamsung、SK hynix/Solidigm、Kioxia、SanDiskが乗るので、AI由来のSSD/フラッシュ売上ポケットは2026年で $12B–$20B が妥当だと見ます。これも厳密な会社公表値ではなく、複数社の足元から引いた推計です。 (Micron Technology)
#4) スイッチ / ファブリック
#ここはかなり重要です。NVIDIAのFY2026 Networking売上は 313.76億ドル ありますが、これはNIC・InfiniBand/Ethernet・その他も含む広い数字です。Broadcomは2026年Q1に AI revenue 84億ドル、Q2ガイダンスで 107億ドル を出しており、その中身は custom AI accelerators と AI networking です。BroadcomはTomahawk 6やJericho 4、Davisson CPOを量産段階に進めていて、Marvellもスイッチ、CXL/PCIeスイッチ、DSP、CPOを揃えています。なので「AIスイッチ/ファブリック」だけを切り出すと、2026年の売上ポケットは $18B–$28B くらいがしっくりきます。NVIDIAのNetworking全額をスイッチに入れずに、かなり引いています。 (SEC)
#5) CPO
#CPOはまだ**“売上の本流”ではなく“立ち上がり”** です。Broadcomは2025年に Tomahawk 6-Davisson 102.4Tbps CPO Ethernet switch を出荷開始し、2026年もAIスケール用途で前面に出しています。MarvellもOFC 2026でCPOを含むAI接続ソリューションを押し出しています。ただし、現時点ではGPUやHBMのような巨大ポケットではありません。2026年は $0.5B–$1.5B、つまり 800億〜2400億円程度 の「先行立ち上がり市場」と見るのが妥当です。CPOは2027–2028にかけて存在感が増す、と見る方が自然です。 (Broadcom)
#6) 車載SoC / 端末AI SoC
#ここは思ったよりまだ小さいです。Mobileyeは2026年売上見通しを $1.94B–$2.02B に引き上げました。Qualcommは2025年Q4に Automotive revenueが四半期10億ドルを突破 したので年率で $4B超 の水準です。NVIDIAのAutomotive売上はFY2026で $2.349B、Horizon Roboticsの2025年自動車ソリューション売上は RMB 3.557B(約$515M) でした。これらを足しても、まだ中央AI/DCのGPUの何分の一かです。したがって、車載SoC/端末AI SoCの2026年ポケットは $9B–$14B くらいが妥当です。なおTeslaのような内製は外販売上としては乗りにくいので、ここでは控えめに置いています。 (Business Wire)
#7) 推論ASIC / カスタムXPU
#ここは 次に太る本命 です。Broadcomは2026年Q1のAI revenueが $8.4B、Q2見通しが $10.7B です。ただしこの中にはAI networkingも入るため、全部を“推論ASIC”には入れません。それでも、Broadcomのcustom AI accelerators、Marvellのcustom XPU / XPU attach、AWSのTrainium/Inferentia、GoogleのTPU7x、GroqのLPUを考えると、2026年の推論ASIC/カスタムXPU売上ポケットは $30B–$45B がかなり自然です。Broadcomだけで相当な規模感があり、そこにAWS・Googleの内製需要を受ける設計/IP/製造/パッケージの取り分が乗ります。 (Broadcom Inc.)
##
この地図を企業名で見直すと
#中央AI/DCで一番お金が落ちる場所
#- GPU:NVIDIAが圧倒的。
- HBM:SK hynix、Micron、Samsung。
- スイッチ/CPO:Broadcom、NVIDIA、Marvell。
- SSD:Samsung、Micron、SK hynix/Solidigm、Kioxia、SanDisk。 (SEC)
エッジ / MECでこれから太る場所
#- 推論ASIC:Groq、Broadcom custom、Marvell custom、AWS Inferentia/Trainium、Google TPU。
- SSD/HBF候補:Kioxia、SanDisk、SK hynix、Micron。
- 近距離ネットワーク/光:Broadcom、Marvell。 (Groq)
デバイス側で取る会社
#- 車載SoC / 端末AI SoC:Mobileye、Qualcomm、NVIDIA、Horizon、Tesla内製。
ただし、売上総額はまだ中央DCほど大きくない です。これはNVIDIAのAutomotive、Mobileye、Qualcomm Automotiveの数字を並べるとはっきりします。 (SEC)
##
HBFの位置づけ
#HBFはまだ2026年の大きな売上ポケットではありません。SanDiskとSK hynixは2026年2月に HBFの標準化開始 を発表し、Kioxiaは2025年8月に 5TB・64GB/sの高帯域フラッシュモジュール試作 を公表しました。つまりHBFは、HBMとSSDの間を埋める次の容量層候補 ですが、2026年の売上貢献はまだ小さく、せいぜい $0.1B–$0.5B(160億〜800億円)級の先行投資段階 と見るのが安全です。 (Sandisk)
##
投資家っぽく一言でまとめると
#いま一番太いのは GPU → HBM → ネットワーク の順で、SSDが広く支え、CPOはまだ先行、車載SoCは将来性は大きいが足元の売上総額はまだ小さい。 そして、物理AIが本当に普及しても、最初に太るのは“端末そのもの”より“中央で学習・推論・同期を支える側” です。NVIDIAのFY2026で Automotive が $2.349B に対して Data Center Compute が $162.361B という差は、その現実をかなり率直に示しています。 (SEC)
##
特定銘柄の推奨・勧誘を目的とするものではありません。投資判断はご自身の責任でお願いいたします。
#サムネはGPTImage2.0とPixAIsunflowerモデル
#