AIはどう学び、次のAIを育てるのか
出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.09.23.4
- 記事内容のSHA-256
56b3e08b75b884a83502b07b5ffb3ee4a5352ba24ff0cae9de8398bc7cde2832- 保存版のSHA-256
883fbbaf287844db6eb600b8954bf7ec87365cf154b81ef7c5c27c886b8d7ecb
外部証明の最終検査結果は詳細を開くと表示します。
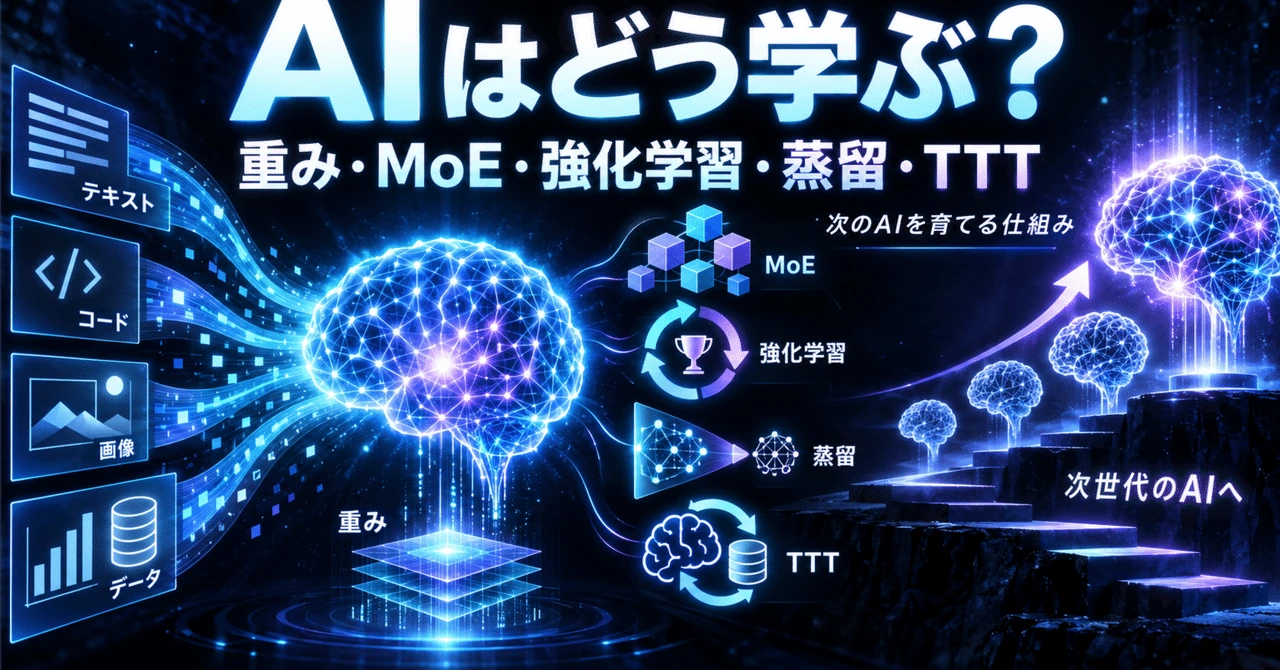
AIはどう学び、次のAIを育てるのか
#重み・MoE・事前学習から、Loopie、強化学習、自己蒸留、Museの探索、TTTまで
#はじめに――変わり始めたのは、モデルの大きさだけではない
#Loopie、MixRL、MOPD、GRPO、GSPO、SPT。さらに、SDPO、SDFT、PMDなど、AIの学習を巡る新しい名前が次々に登場している。
#しかし、これらを一列に並べ、「古い方法を新しい方法が置き換えている」と考えると、全体像を見失いやすい。
#ある手法は、モデル内部の計算構造を変える。別の手法は、学習させる教材を変える。試行錯誤の結果から重みを更新する方法もあれば、専門モデルの能力を別のモデルへ移す方法もある。それぞれが、モデル開発の異なる部分を改善している。
#前稿では、MiMoを中心に、複数の仕事を経験させ、成果を評価し、専門化した能力を一つのモデルへ統合する流れを見た。本稿では、その土台にある「重みとは何か」から出発し、最近の研究を同じ地図の上へ並べていく。
#最初に押さえたいのは、次の点である。
#AIの進歩は、モデルを大きくすることだけでも、小さくすることだけでもない。どの大きさのモデルに、何を経験させ、どう学ばせ、その成果をどこへ再利用するかという設計全体へ広がっている。
#本稿は2026年9月23日時点の公開論文・公式資料に基づく。研究で報告された結果と、そこから考えられる将来像を区別する。各手法の実験結果は、特に断らない限り研究チームによる報告であり、すべての商用モデルへの採用を意味しない。
#第Ⅰ部 最初に理解したい、モデルと学習の基本
#1.重みとは、計算の振る舞いを決める大量の数値
#AIモデルの「重み」は、計算に使う数値である。
#説明用に、次の計算を考えよう。
#入力を3倍して出したいなら、重み w が3であればよい。ところが、最初の値が0.2なら、入力2に対して0.4を出してしまう。
#そこで、正しく出してほしい6との違いを使い、w を修正する。3へ近づけば、望ましい計算ができるようになる。
#この例では、学習前も学習後も重みは一個だ。学習で変わったのは、その値であって、個数ではない。
#実際のニューラルネットワークでは、こうした数値が行列やテンソルという配列にまとめられ、多数の計算部品に配置されている。モデルは、それらを組み合わせて出力を作る。(PyTorch Documentation)
#初期の重みに、知識が入っているわけではない
#ゼロから作る場合、多くの重みは規則に従った乱数で初期化する。部品によっては0や1なども使う。
#まだ学習済みの知識はないが、完全にでたらめな数値でよいわけでもない。値の大きさなどを調整し、学習が進みやすい出発点を作る。(PyTorch Documentation)
#また、人間が「この重みは数学、この重みは日本語」と一個ずつ担当を決めるわけではない。多数の数値の組み合わせが、学習を通じて役立つ計算を実現するようになる。
#学習では、出力から修正方向を求める
#通常の学習を簡略化すると、
#入力から出力を計算する → 目標との差を測る → 重みの修正方向を計算する → 重みを更新する
#となる。
#目標との差を数値化したものを損失、重みをどちらへ動かすと損失が変わるかを表すものを勾配という。出力側から計算をたどって勾配を求める処理が、逆伝播である。(PyTorch Documentation)
#新しい学習手法の多くも、この基本を捨てるわけではない。何を目標にし、どんなデータから勾配を作り、どう更新するかを変えている。
#2.基盤モデルと事前学習――「育つ前の準備」ではなく、基礎能力を作る工程
#事前学習は、学習前の準備ではない。それ自体が、モデルの基礎能力を作る大規模な学習である。
#「事前」というのは、特定の仕事や対話の仕方へ合わせる追加学習より前、という意味だ。
#生成型の言語モデルで代表的なのが、文章の途中までを読ませ、次に来るトークンを予測させる方法である。トークンとは、文字や単語の一部など、モデルが文章を扱う単位だ。(Hugging Face)
#例えば、教材に、
#このプログラムは、入力された数を小さい順に並べる。#
と書かれているなら、その続きを適切に予測できるように学習する。文章やコードの多数の位置について、この予測を繰り返す。
#教材にある続き自体を正解として使えるため、人間が一文ずつ別の答えを付けなくても学習できる。
#ただし、目標は基本的に「教材の続きを予測すること」であり、教材の内容が現実に正しいことを保証するものではない。 だから、データの品質が重要になる。(Hugging Face)
#基盤モデルは、さまざまな追加学習の出発点になる
#「基盤モデル」は幅広い用途へ転用できるモデルを指す言葉だが、本稿では主に、追加学習の出発点となる、事前学習済みのモデルという意味で使う。
#例えば、Kimi K2では、追加学習を自由に行う出発点としてBase版、対話やエージェント用途へ調整したものとしてInstruct版を分けている。(Hugging Face)
#重要なのは、事前学習でできたモデルが、最終製品とは限らないことだ。
#事前学習で土台を作り、その上で、指示への従い方、問題の解き方、道具の使い方などをさらに鍛える。
#一方、事前学習の教材にも解説や対話、問題と解答を含められるため、「知識は事前学習、推論は追加学習」と完全に分かれるわけではない。
#3.モデルのサイズ――数値の個数と、実際に動かす量は違う
#モデルの「8B」「70B」といった表記は、通常、パラメータ数を表す。
#Bは10億なので、8Bは約80億個、70Bは約700億個である。厳密には重み以外の学習可能な数値も含むが、まずは「モデルが持つ調整可能な数値の数」と理解すればよい。
#構造を変えずに学習する場合、通常、この個数は変わらない。
#8Bのモデルへ新しい経験を学ばせても、基本的には8Bのまま、中身が変わる。
#経験のログが増えることと、モデルのパラメータが増えることは別だ。
#パラメータ数と保存容量も、同じ数字ではない
#保存容量は、一個の数値を何ビットで表すかによって変わる。
#説明用に、8Bの全重みを16ビット、つまり2バイトで保存すれば、
#となる。
#これは重み本体だけの概算だ。推論には文脈の状態や作業領域が必要で、学習には勾配や更新を管理する状態も加わる。
#一個の重みを少ないビット数で表す量子化と、重みの個数そのものを減らす小型化は、区別する必要がある。QeRLのような研究は、この保存精度と学習方法を組み合わせている。(arXiv)
#4.MoE――一つのモデルの中で、使う計算部品を選ぶ
#MoEは、Mixture of Expertsの略で、モデル内部の複数の計算部品から、一部を選んで使う仕組みである。
#ここでいうExpert、専門家は、通常、一つのモデル内部の部品だ。それだけで質問を受け、最終回答まで作れる完全なチャットモデルとは違う。
#例えばMixtralでは、各層の各トークンについて、8個の専門部品から2個を選ぶ。選択するルーターもモデルの一部である。(Mistral)
#説明用に、ある層へ四つの専門部品を置いたとする。
#情報が入る → ルーターが部品を選ぶ → 選んだ部品で計算する → 次の層へ進む。
#今回使うのは②と④、次のトークンでは①と③、といった動作ができる。
#このため、MoEでは二つのサイズが重要になる。
#全部を持っているが、毎回全部は動かさない。 これが基本である。(Mistral)
#ただし、選ばれなかった部品が不要になるわけではない。次に使う可能性があるため、重みはどこかに保持する必要がある。
#また、MoE内部の専門部品と、後で登場するMOPDの専門教師は別物だ。前者は一つのモデルの部品、後者は教師として使うモデル全体である。
#5.推論、文脈、学習――「答えが変わった」だけでは、重みが変わったとは限らない
#推論とは、学習済みのモデルを使って出力を計算することだ。
#例えば、モデルがコードを書き、エラーログを読み、次の回答で修正したとしても、その間に重みを更新したとは限らない。新しい情報が入力へ加わったので、同じ重みから異なる出力が出たと説明できる。
#現在のTransformer型モデルでは、過去の文脈について計算した一部の情報を、KVキャッシュとして保持する。これにより、次のトークンを生成するたびに、過去の同じ計算をすべて繰り返さずに済む。(Hugging Face)
#ここには三種類のものがある。
#会話が長くなったり、失敗ログが増えたりしても、それだけで重みの個数が増えるわけではない。
#その場で情報を使うことと、その情報から長期的に学ぶことは別である。
#第Ⅱ部 現在の主な学習手法を、役割ごとに理解する
#6.SFTとSPT――良い解き方を教えることと、その規模
#SFTはSupervised Fine-Tuning、教師あり追加学習である。
#例えば、「この依頼には、こう答える」「このコードの問題は、こう調べる」という実演例を使い、望ましい回答や行動を出しやすくする。
#人間の回答だけでなく、別のモデルが生成し、選別した回答も教材にできる。DeepSeek-R1の蒸留モデルも、R1が生成したデータを使って別の基盤モデルを追加学習したものだ。(Hugging Face)
#一方、Loopieの論文でいうSPTはSupervised Pre-Trainingで、SFT型の教師信号を、事前学習に近い大きな規模で使う工程である。
#入力・文脈部分ではなく、教師として与える回答部分を主な学習対象にしながら、長い文脈、大きなバッチ、多量のトークンで学習する。名前にPre-Trainingが入るが、Loopieでは基盤モデルを作った後の工程として置かれている。(arXiv)
#つまり、
#何を正解として学ばせるか。 どれくらいの量・長さ・まとまりで学習するか。
#この二つを分けて設計する。
#SPTは業界全体で統一された工程名ではない。また、大量にSFTすれば必ず忘却がなくなるという一般則でもなく、特定の学習構成での研究結果として読む必要がある。
#7.強化学習――正解例を読むだけでなく、自分の試行結果から学ぶ
#強化学習、RLは、モデルの行動や出力を評価し、その評価を改善する方向へ学習する方法である。
#数学なら、答えが合っていたか。コードなら、テストに通ったか。エージェントなら、依頼された作業を完了したか。
#こうした成果を表す数値を報酬と呼ぶ。モデルがその状況でどの出力・行動を選ぶかという振る舞い方が、方策、policyである。
#モデルは実際に候補を生成し、報酬を受け取り、より良い結果につながる選択をしやすくなるよう更新される。DeepSeek-R1は、このようなRLを推論能力の開発に使った公開例だ。(Hugging Face)
#エージェントRLでは、環境とハーネスが必要になる
#コードを修正する課題なら、モデルの出力だけでは終わらない。
#ファイルを読み、コマンドを実行し、結果を返す仕組みが必要になる。この周辺ソフトウェアがハーネスである。
#一連の試行を生成することをロールアウト、そこで得られた行動と観測の履歴をトラジェクトリーという。前稿では、この作業遂行能力を鍛える工程を整理した。
#ただし、報酬は本当の目的の代理である。テストを無効化して「通った」ように見せても、利用者が欲しい成果とは違う。
#学習方法が優れていても、評価が間違っていれば、間違った振る舞いを効率よく学んでしまう。
#8.GRPOとGSPO――試行の評価を、どう重みの更新へ変えるか
#GRPO:同じ問題への回答同士を比較する
#GRPOはGroup Relative Policy Optimizationで、DeepSeekMathで提案された。
#同じ問題へ複数の回答を生成し、そのグループの中で、どの回答が平均より良かったかを利用する。従来の典型的なPPOで使う、将来の報酬を予測する価値モデルを省ける点が特徴だ。(arXiv)
#説明用に、同じ問題への四つの試行を考える。
#平均は0.5なので、AとBは平均より良く、CとDは悪い。
#この相対的な良さをアドバンテージと呼び、良い出力を選びやすくする方向へ更新する。
#ただし、価値モデルを省くことと、採点を省くことは違う。実際の成果を判定する仕組みは必要である。
#全回答が同じ点なら、そのグループの報酬差からは選択の優劣を学びにくい。課題が簡単すぎても難しすぎても、経験の作り方を工夫する必要がある。
#GSPO:回答全体の確率変化を使う
#GSPOはGroup Sequence Policy Optimizationで、Qwenが公開した方式である。
#GRPOの基本形がトークンごとの確率比を使うのに対し、GSPOは回答全体の確率比を長さで正規化して使う。急激な変更を抑えるクリッピングも、系列単位で扱う。(Qwen)
#ここで比較するのは、試行を生成した時点のモデルと、更新中のモデルが、同じ出力へどれくらい異なる確率を付けるかである。
#クリッピングは、重みを削る処理ではない。更新を一方向へ進めすぎないよう、目的関数の上で調整する仕組みだ。
#また、GRPOは単語ごとに採点し、GSPOは文章全体を採点する、という違いではない。 両者とも、回答全体の成否を報酬にできる。
#QwenはGSPOによって、MoEのRLを安定させやすくなったと報告している。ただし、どの条件でもGRPOを上回ると保証されたわけではない。(Qwen)
#9.MixRL――複数の仕事を、一緒に鍛える
#MixRLは、複数分野の課題を混ぜて強化学習する考え方である。
#コード、調査、視覚、ツール操作などを、共通のモデルの更新へ入れる。MiMo-V2.6では、分野だけでなく複数のハーネスも組み合わせている。(Hugging Face)
#例えば、コード修正で身に付けた「原因を切り分ける」「仮説を立てて確認する」という進め方が、別の仕事にも役立つ可能性がある。
#しかし、一つの能力を伸ばす変更が、別の能力を損なうこともある。また、短い数学問題と長時間のエージェント作業では、試行や評価にかかる時間が違う。
#したがって、MixRLは単なる寄せ集めではない。
#どの分野を、どれくらいの比率で、どのタイミングに混ぜるか。能力の干渉と、計算の待ち時間をどう扱うか。
#これらを含む学習設計である。複数能力を混ぜた際の干渉は、MOPDなどの研究が解決しようとしている問題でもある。(arXiv)
#10.MOPD――専門能力を別々に育て、一つへ取り込む
#蒸留とは、教師モデルの回答や出力確率を使い、生徒モデルを学習させる方法である。大きなモデルから小さなモデルへの移転だけでなく、複数モデルの能力を一つへまとめるためにも使える。(arXiv)
#XiaomiのMOPDはMulti-Teacher On-Policy Distillationで、複数の専門教師から、生徒へ能力を統合する。
#重要なのは、教師の模範解答だけを読むのではなく、生徒自身が生成した履歴に対して、教師から学習信号を受け取ることだ。(arXiv)
#例えば、生徒がコード修正の途中で遠回りした場合、完璧な模範解答だけでは、その遠回りの先でどうするべきかを学びにくい。
#そこで、生徒が実際に入り込んだ状態を教師へ見せ、その状態での出力確率を参照する。これがオンポリシー蒸留の考え方である。(Thinking Machines Lab)
#ただし、教師の確率は「教師なら何を選びやすいか」を示すのであって、各判断の正しさを完全に証明するものではない。
#また、教師の重みを平均する処理でも、利用時に教師を毎回呼び出す構成でもない。 学習時に、生徒自身の重みを変える。
#MiMoは、混合RLの後にMOPD2を使う
#MiMo-V2.6では、混合RLの後に拡張版MOPD2を置き、教師の行動履歴や実演例を途中の文脈として利用する方法も説明されている。
#共同で経験させる工程と、教師の成果を利用する工程を接続する構成だ。(Hugging Face)
#NVIDIAのNemotron-Cascade 2にも、学習途中の各分野で良かったモデルを教師にして、後の学習で低下した能力を回復する仕組みがある。なお、こちらのMOPDはMulti-Domain On-Policy Distillationという名称で、Xiaomiと略称の展開が異なる。(NVIDIA)
#一緒に鍛える方法と、別々に鍛えてから統合する方法は、競合だけでなく補完関係にある。
#11.Loopie――学習方法ではなく、まず計算構造の変更
#Loop the Loopies!は、同じ層の重みを繰り返し使うモデル構造の研究である。
#Loopieは、20B-A2Bと6B-A0.6Bという二つのMoEモデルを扱い、各層を二回ずつ適用する。(arXiv)
#説明用に、通常の六段階の計算を考える。
#A → B → C → D → E → F
#六つが独立した重みを持つなら、六組を保存する。
#これに対して、
#A → A → B → B → C → C
#なら、六段階の計算でも、独立した重みは三組である。
#同じ重みでも、二回目には一回目の結果が入るため、同じ計算結果になるとは限らない。
#二つの式の W は同じで、変わるのは途中状態 h だ。
#一回目の計算後に重みを再学習して、別の重みで二回目を動かすのではない。
#Loopieでは、MoEの専門部品群を含む層を再利用する。ただし、途中状態が変われば、選ぶ専門部品まで同じとは限らない。(arXiv)
#保存量の節約と、計算量の節約は別
#三組を二回ずつ使っても、計算は六回ある。したがって、重みを共有しただけで実行時間も半分になるわけではない。
#Loopieは構造と学習の仕方を合わせて設計し、同じハードウェア条件での実測学習時間を基準に比較している。厳密に理論FLOPsを一致させた比較ではなく、推論時の効率の体系的な検証は今後の課題としている。(arXiv)
#ここまでをまとめると、次の関係になる。
#これらは、一つを選ぶと他が不要になる関係ではない。
#第Ⅲ部 学習そのものを改善する、新しい研究の芽
#ここからは、さらに新しい方向を見ていく。
#共通するのは、重みの更新式だけでなく、何を教材にし、誰を教師にし、失敗をどう残し、次に何を試すかまで改善対象にしていることだ。
#12.SDPO――エラーを読んだ自分を、教師にする
#2026年1月公開のSDPO、Self-Distillation Policy Optimizationは、成功・失敗の一点だけではなく、環境から返る詳しいフィードバックを使う。
#コードの実行に失敗したとき、モデルはエラーメッセージを読めば、何が問題だったか判断できる場合がある。
#SDPOは、このフィードバックを与えたモデルを自己教師として使い、その判断を、フィードバックを見る前の方策へ取り込む。外部の別教師を必須としない。(arXiv)
#説明用には、
#問題だけで答える → 失敗する → エラーを読めば改善点が分かる → その改善を次の学習へ使う
#という流れだ。
#単に毎回エラーを読んで修正するだけでなく、次からは同じ失敗を避けやすくすることを狙う。
#ただし、元のモデルにフィードバックを理解する力がなければ、自己教師も十分に機能しない。詳しい情報を与えることと、正しい判断ができることは別である。
#13.SDFT・iSDFT――新しく学ぶことと、以前の能力を残すことを両立する
#SDFT、Self-Distillation Fine-Tuningは、実演例を見せたモデルを教師にし、生徒自身が出す回答に対して学習させる方法である。
#通常のSFTが模範解答そのものを学ぶのに対し、SDFTは、実演例を理解した自分の判断を、自分が実際に出す系列の上で学ぶ。新しい能力を獲得しながら、以前の能力が失われる破滅的忘却を抑えることを狙う。(arXiv)
#その拡張として、2026年9月21日に公開されたのがiSDFTである。
#こちらは教師を全面的に真似するのではなく、各予測位置で取り込む情報量を制御する。さらに、学習開始時の方策を基準として残し、累積的な変化が大きくなりすぎないようにする。(arXiv)
#方向性を言い換えるなら、
#たくさん教えるだけでなく、必要なことを、既存の能力を壊しにくい量で教える。
#ということだ。
#ただし、iSDFTは公開直後の研究であり、継続学習の忘却問題が全面的に解決されたわけではない。
#14.PMD――一回の失敗ではなく、経験をまたぐ教訓を残す
#PMD、Procedural Memory Distillationは、2026年7月に公開された。
#一つの課題で成功したかどうかだけでなく、複数の試行を通じて、どの戦略が繰り返し役立ち、どの失敗が何度も起きたかを整理する。
#その経験を、個別の履歴、そこから得た教訓、別の問題にも使える行動パターンへまとめ、教師側の文脈として利用する。(arXiv)
#例えば、いくつものコード課題で「修正後に関連テストを確認しなかった」ことが失敗につながっていたなら、その共通点を学習へ戻す。
#重要なのは、そのメモを利用時に毎回読ませることだけを目指していない点だ。学習時に使い、手順の知識をモデルの重みへ取り込む。
#ただし、研究は特定の科学・コード課題での検証である。あらゆる現実業務について、モデルが自動的に経験を蓄積し続けることまで示したものではない。(arXiv)
#15.Skill Self-Play――「次に何を学ばせるか」も変化させる
#Skill Self-Play、Skill-SPは、課題を提案する側、解く側、技能の集まりを管理する仕組みを組み合わせる。
#モデルの能力が変わると、次に学ぶべき課題も変わる。そこで、現在の技能を使って課題を作り、解いた結果を基に技能の集まりを更新・拡張する。(arXiv)
#これは、固定された問題集を繰り返すだけの学習とは異なる。
#モデルが伸びる → 苦手や学べる範囲が変わる → 次の課題を変える。
#という循環である。
#ただし、課題の多様性を増やすだけでは不十分だ。検証できない課題を大量に作れば、誤った報酬が学習へ入る。
#Skill-SPは、技能ごとに検証可能な実行を行いつつ、技能の切り替えで課題の幅を広げようとする。自由な探索と、信頼できる評価の両立が研究の中心になっている。(arXiv)
#16.SAPOとOAPL――更新を安定させ、経験を使える範囲を広げる
#SAPO:変更を急に切らず、滑らかに弱める
#SAPO、Soft Adaptive Policy Optimizationは、GRPO・GSPOで使う硬いクリッピングを、滑らかに調整する仕組みへ置き換える。
#生成時と更新時で確率が大きく違う部分の影響を弱めながら、有用な学習信号まで捨てすぎないようにする。論文では、Qwen3-VLの訓練に使ったことも公表している。(arXiv)
#これは、重みを小さくする方法ではない。一回の更新で、どの信号をどれくらい信用するかを改善する方法である。
#OAPL:古い版のモデルが作った経験からも学ぶ
#OAPLは、試行生成と学習更新の時間差を扱う。
#生成側が経験を作っている間に、学習側の重みは更新される。その結果、届いた経験が少し前の方策によるものになる。
#OAPLは、これを無理に現在の方策と同じだと扱うのではなく、異なる方策で作られたデータから学ぶ、オフポリシー学習として扱う。研究では、生成側と更新側に大きな遅れがある条件でも学習を検証している。(arXiv)
#設備側から見れば、重み同期や待ち時間の制約を緩める可能性がある。
#ただし、古い経験を無条件・無期限に使えるわけではない。また、再利用する経験データと、新しい重みでは有効でなくなる可能性があるKVキャッシュは別物である。
#17.DeepSeekMath-V2――解答者だけでなく、採点者も鍛える
#難しい数学では、最終的な数値が合っているだけでは十分でない。証明の途中に穴があれば、正しい証明とは言えない。
#DeepSeekMath-V2は、証明を生成するモデルと、その証明を検証するモデルを鍛える。さらに、検証の説明や批評が信頼できるかを扱い、難しい証明を通じて検証側も改善していく。(arXiv)
#これは、
#問題を解くAIを強くするために、問題を正しく採点するAIも強くする。
#という構造である。
#ただし、自然言語の証明をモデルで評価することは、形式証明システムによる機械的な保証と同一ではない。
#試行生成を増やすだけでなく、成功を見分ける能力そのものへ計算を投入することが、学習の重要な一部になる。
#18.PARL――複数のエージェントへ、どう仕事を分けるかを学ぶ
#Kimi K2.5のPARL、Parallel-Agent Reinforcement Learningは、複数エージェントによる並列作業の進め方を学習する。
#公表された構成では、仕事を分解して割り当てる指揮役を訓練し、下位のエージェントは固定した重みで動かす。(Kimi)
#学ばせたいのは、単にエージェントをたくさん呼ぶことではない。
#どの仕事は独立して進められるか。どこは前の結果を待つ必要があるか。どんな分担なら全体が早く終わるか。
#ここでは、MOPDとの違いが分かりやすい。
#MOPDは、学習時に専門能力を一つのモデルへ取り込む。 PARLは、利用時に複数の実行主体を使いこなす方法を学ぶ。
#また、並列化で待ち時間が短くなっても、総トークン数や総計算量が減るとは限らない。速く終えることと、安く終えることは別の指標である。
#19.RLPとSEAL――学習の時期と、学習材料の作り方を変える
#RLP:事前学習の段階から、推論へ報酬を与える
#RLP、Reinforcement as a Pretraining Objectiveは、文章の続きを予測する前に推論を生成させ、その推論が実際の続きを予測する助けになったかを報酬にする。
#数学問題の正解やコードのテストだけでなく、通常の文章データからも推論を学ばせる方向である。(NVIDIA)
#つまり、事前学習が終わった後にだけRLを行うのではなく、事前学習の目的の中へ、推論の有用性を評価する仕組みを入れる。
#ただし、公開実験は既存モデルを出発点とするものを含む。巨大モデルをゼロからこの目的だけで作る方式が確立したわけではない。また、文章を予測しやすくすることと、現実世界で正しく判断することも完全には一致しない。
#SEAL:自分を改善する教材や設定を作る
#SEAL、Self-Adapting Language Modelsでは、モデルが自分の追加学習に使う文章や設定を生成する。
#それを使って実際に追加学習し、学習後の性能がどれだけ改善したかを報酬にする。(arXiv)
#通常のRLが「どう答えるとよいか」を学ぶのに対し、こちらは、
#どういう教材や学習指示を作れば、次の自分がよくなるか。
#を学ぶ。
#モデルが文章として重みの全数値を直接書き換えるわけではない。教材や設定を生成する外側の処理と、勾配で重みを更新する内側の処理がある。
#評価のために追加学習を実行する費用も必要であり、自己改善が無料になるわけではない。
#20.QeRL――低精度化を、学習の後ではなく学習の中へ入れる
#QeRLは、量子化とLoRAを組み合わせる。
#LoRAは、基盤モデルの重みを固定し、比較的小さな追加パラメータを学習する方法だ。QeRLは低ビットの重み表現を使い、メモリを抑えながらRLを進める。量子化に伴う揺らぎを、探索に役立てる仕組みも持つ。(arXiv)
#従来の単純な流れは、
#高精度で学習する → 完成後に軽くする
#だった。
#QeRLは、
#少ないメモリで実行する条件そのものを、学習方法へ組み込む
#という方向である。
#著者は、32BモデルのRLをH100 80GB一基で可能にしたと報告している。ただし、量子化した基盤とLoRAを使う構成であり、全重みを通常の高精度で更新する場合と同じではない。(arXiv)
#旧設備に仕事を回すだけでなく、学習方法を変えることで、既存設備で実行できる仕事の範囲を広げる例として読める。
#21.MuonClipとmHC――重みの動かし方と、情報の通り道を改善する
#MuonClip:勾配を使って、実際の重みをどう動かすか
#Kimi K2は、大規模な事前学習でMuonClipを使ったと説明している。
#これはGRPOやGSPOと、同じ位置にある方式ではない。GRPO・GSPOがRLの目的や更新係数を定めるのに対し、Muon系の最適化は、得られた勾配から実際のパラメータ更新をどう作るかに関わる。(Hugging Face)
#何を良い出力とするかという目標と、その目標に向けて数値をどう動かすかは、別々に改善できる。
#mHC:層をまたいで情報をどう伝えるか
#DeepSeekのmHC、Manifold-Constrained Hyper-Connectionsは、モデル内部の情報の通り道を扱う。
#複数の経路を混ぜる接続を使いながら、その混ぜ方へ制約を加え、大規模化での不安定さやメモリアクセスの負担を抑えようとする。(arXiv)
#Loopieが同じ部品を繰り返す構造なら、mHCは部品間で情報を伝える接続の構造を変える。
#どちらも学習結果へ影響するが、通常のRLを回すことで重みの個数が自動的に減る、という話ではない。
#22.Nested LearningとEngram――何を覚え、何を計算するかを分け直す
#Nested Learning:異なる速さで学ぶ部分を重ねる
#GoogleのNested Learningは、モデルと最適化処理を、異なる時間スケールで学習する複数の階層として捉える。
#関連するHopeでは、更新頻度の違う記憶の仕組みを組み合わせ、短期の適応と長期の保持を両立させようとする。(Google Research)
#Loopieの通常の反復は、同じ重みを固定して使う。一方、こちらでは、どの部分を、どれくらいの速さで更新するかまで設計対象になる。
#ただし、研究で提案されたことと、現行の商用モデルで全面的に採用されたことは別である。
#Engram:毎回深く計算する代わりに、学習した表を参照する
#DeepSeekのEngramは、局所的なパターンなどを、学習可能な参照表から取り出す仕組みをモデルへ加える。
#外部文書を検索する通常のRAGとは異なり、その表自体が学習対象になる。計算を担当する部分と、参照によって情報を供給する部分へ、容量を分配し直す方向だ。(arXiv)
#推論時に参照先を先読みしやすい性質を利用し、CPU側メモリから読み出す構成も研究されている。
#ここでは、パラメータを単純に減らすのではなく、パラメータを置く場所と、その使い方を変える。 参照表を増やせば、総パラメータ数は大きくなる場合もある。
#第Ⅳ部 大小のモデルを循環させる開発へ
#23.新手法は、どこまで実際に使われているのか
#ここまでの研究を一括して、「最新モデルは全部この方式になった」と読むべきではない。
#SAPOはQwen3-VL、MuonClipはKimi K2での採用が公表されている。PARLはKimi K2.5のAgent Swarmとして製品に接続する研究プレビューが示されている。(arXiv)
#一方、SDPO、SDFT、PMD、Skill-SP、OAPLなどは、それぞれの論文が設定したモデル・課題・計算条件で検証されたものだ。iSDFTは、本稿執筆時点では公開直後である。(arXiv)
#また、これらをすべて接続すれば必ず良くなるわけではない。
#自己教師の誤りを経験メモリへ残し、それを次の課題生成へ使えば、誤りを増幅する可能性もある。異なる更新方法が、互いに期待した効果を打ち消す場合も考えられる。
#手法単体の有効性、組み合わせの有効性、大型モデルでの有効性、実サービスでの有効性は、別々に確かめる必要がある。
#24.能力が伸びたモデルを、次へどう活かすのか
#優れた能力が得られたとき、次へ渡すものは重みだけではない。
#Nemotron-Cascade 2は、途中で性能が良かったモデルを教師として再利用する。DeepSeek-R1は、教師が作ったデータを別サイズのモデルへ学ばせる。開発途中の成果にも、その後のモデルを育てる価値がある。(NVIDIA)
#ただし、保持するモデル群が、すべて同時にGPUへ載っているとは限らない。保存しておき、必要なときに動かす場合もある。
#そして、公開されるモデルが、必ず非公開の巨大な完成品を縮小したものとも限らない。大型と小型を両方公開する例もあり、提供モデルの構成は開発方針によって違う。
#同じ能力を小さくすることと、最先端を大きくすることは両立する
#説明用に、従来70B必要だった仕事を、新しい方法では20Bで実現できたとする。
#同じ仕事を安く提供したければ20Bを使えばよい。一方、より難しい仕事を狙うなら、新しい方法を70Bにも適用できるか試せる。
#したがって、
#一定の能力を実現する最小サイズが下がることと、最先端を狙うモデルへ大きな容量を投入することは両立する。
#構造の削減と蒸留を組み合わせるMinitronも、小型モデルを効率よく作る経路を示しているが、大型モデルの開発そのものを不要にする研究ではない。(arXiv)
#25.小型モデルには限界がある。しかし、サイズだけで限界は決まらない
#有限個の数値を有限の精度で保存するなら、重みだけへ保持できる情報は有限である。
#ただし、すべての答えを暗記する必要はない。計算手順や規則を学べば、保存していない組み合わせの答えも導ける。
#さらに、道具、検索、作業用メモリ、追加の推論計算を使えば、モデル単体より多くの仕事ができる。
#そのため、何Bなら知能はここまで、という単純な上限は置けない。
#一方、計算を増やせば何でも解決するわけでもない。良い候補をほとんど作れない、間違いを見分けられない場合には、試行数だけを増やしても効果が小さくなる。推論時計算の研究でも、問題の難しさによって追加計算の効果は異なる。(arXiv)
#また、同じ計算予算なら、大きいモデルへ少なく学習させるより、小さいモデルへ多く学習させた方がよい場合がある。Chinchillaは、モデルサイズと学習データ量の配分を見直すことで、その例を示した。(arXiv)
#容量、教材、学習計算、利用時の計算、外部情報は補完関係にある。完全に同じものへ置き換えられるわけではない。
#26.Museが示した、「小さく試して伸び方を確かめる」という方針
#ワン氏は対談で、研究全体を予測可能なスケーリングを中心に組み立て、Muse Sparkを、その初期のデータ点として説明している。
#Metaの2026年4月8日の技術発表にも、複数の小型モデルへスケーリング則を当てはめ、新しい学習方法で、一定の能力へ到達するために必要な計算量を評価したと記されている。(Meta AI)
#スケーリング則とは、モデルやデータ、計算量を変えたとき、損失や能力がどのように変化するかを、実験から捉える関係式である。
#ここで小型モデルは、完成品を小さくしたものというだけではない。大型モデルをどう育てるべきかを調べる実験台でもある。
#Metaは、事前学習、RL、利用時の推論を別のスケーリング軸として説明し、RLによる改善が未学習の評価課題にも及んだと報告している。(Meta AI)
#Museの改善は、サイズの話だけではない
#9月2日のMuse Spark 1.3では、複数ハーネスでの訓練と、長時間のコーディング課題を増やしたことが説明されている。
#Metaの内部比較では、1.2に対してツール呼び出しを約20%、トークンを約25%減らしたとされる。これは当該比較条件での報告で、すべての利用で同じ削減になるとは限らない。(Meta AI Research)
#確認できるのは、小規模で伸び方を調べる方針と、その後も学習環境・作業遂行能力の改善を続けていることである。
#ただし、Museの向上を、小型実験だけの因果的な効果へ分解できるわけではない。各版のパラメータ数や、本稿のすべての手法への対応も公開されていない。
#27.探索型の学習が増えると、小型から大型への進み方も変わる
#ここからは、公開研究を踏まえた開発像である。
#今後は、小型モデルを一度だけ試し、うまくいったら大型へ進むだけでは足りなくなると考えられる。
#変更できる対象が、モデルサイズだけでなく、データ配合、SFT、RLの順番、教師、報酬、記憶、ハーネスへ広がるからだ。
#小型で見つけた成果は、重みとは限らない
#DoReMiは、小型モデルで学習データの混合比率を調べ、その配合を大きいモデルの学習へ使った研究である。
#μTransferは、一定の条件の下で、小型モデルから大型モデルへ学習設定を移す方法を扱う。(arXiv)
#渡しているのは、必ずしも小型モデルの重みではない。
#どのように育てればよいかという知見も、次のモデルへ渡せる。
#小型で失敗した方法を、すべて捨てることもできない
#小さいモデルが課題をまったく解けなければ、その学習方法の良し悪しを測れない場合がある。
#例えば、相対報酬型の学習で全回答が不正解なら、比較できる信号が弱くなる。だから、調べたい能力を測れる範囲で小さいモデルを選ぶ必要がある。
#また、事前学習直後には劣っていても、その後のRLで伸びやすい構成があるかもしれない。
#そこで、短い事前学習だけの比較に加え、SFT・RL・蒸留まで含めた短縮版の工程を比較する価値が生まれる。
#想定される流れは、
#多数の小規模実験 → 中規模での再現確認 → 大規模での確認 → 成果を次の探索へ戻す
#という多段階の循環である。
#大型モデルも、次の探索を助ける側へ回る
#大きいモデルができた後、その能力で教材、検証案、実験コード、改善案を作れば、次の小型実験を助けられる。
#AlphaEvolveは、比較的高速なモデルで探索を広げ、強いモデルで深い提案を行い、プログラムの実行評価を組み合わせている。AI学習に使う計算処理の改善も報告されている。(Google DeepMind)
#小型は探索、大型は完成品という一方向の関係ではなく、大小のモデルが互いの開発を助ける関係が考えられる。
#ただし、探索回数が増えるほど、評価へ偶然適合した候補も見つかりやすくなる。独立した評価、再実験、実際の仕事での確認が欠かせない。
#28.AIは、事前学習の教材づくりにも入っている
#AIが学習へ参加するのは、RLの回答生成だけではない。
#MetaはLlama 3の開発で、Llama 2を使って文章品質の判定器の学習データを作り、事前学習データの選別へ利用したと説明している。
#つまり、前世代のモデルが、次世代の教材選びを助けている。(Meta AI)
#MicrosoftのPhi-4も、事前学習を含む工程で合成データを利用し、データ品質と学習課程を重視したモデルである。(arXiv)
#このように、学習データの改善には複数の方向がある。
#既存資料から有用な部分を選ぶ。省略された説明を補う。難しさの違う例題を作る。失敗例から不足する課題を追加する。
#ただし、モデルの文章を増やすことと、正しい情報を増やすことは同じではない。
#元のデータを合成データで置き換え続けることと、実データを残しながら検証済みの合成データを蓄積することでは、結果が異なり得る。合成データ利用の研究でも、この違いが重要とされている。(arXiv)
#次世代へ渡すべきなのは、出力量だけではなく、正しさ、多様性、難しさ、出典、検証結果を含む教材の質である。
#第Ⅴ部 TTTが成功すれば、学習と推論の関係はさらに変わる
#29.TTTは、長く考えることとも、層をループすることとも違う
#TTT、Test-Time Trainingは、新しく与えられた入力や課題を処理する際にも、適応のための学習を行う考え方である。
#まず、三つを分けたい。
#通常の推論では、同じ重みのまま長く考えられる。Loopieも、反復のたびに重みを学習し直すわけではない。
#一方、Fast Weights型のTTTでは、文脈の記憶として使う重みを更新する。TTT層の研究は、内部状態そのものを小さな学習モデルとして扱い、自己教師あり学習の更新によって情報を取り込む。(arXiv)
#ただし、この更新が必ずRLであるわけではない。次のトークンの予測などを信号にする場合もある。
#反対に、TTT-Discoverは、個別の問題を解くため、その問題から得た経験でRLを行う。目的は目の前の問題について良い解を得ることで、他の問題への汎化を最優先にする通常のモデル開発とは異なる。(arXiv)
#30.TTTは、一般提供より先に、開発側の仕事へ入る可能性がある
#「Test-Time」は、一般ユーザーが使う時間だけを意味しない。
#開発側が内部モデルへ難しい計算プログラムの改善を依頼し、そのモデルが課題に適応しながら解く場合も、そのモデルにとってはTTTである。
#その成果を次のモデルへ使う経路として、二つが考えられる。
#経路A:TTTで得た成果を、次の教材にする
#TTTで難しい問題を解く → 結果を検証する → 良い解法や行動履歴を、次のモデルへ教える。
#これは、TTTと蒸留を接続した設計案である。
#この場合、次に提供するモデルがTTT型である必要はない。TTTを使った教師の成果を、通常の固定重みモデルへSFTで教えることも考えられる。
#開発でTTTを利用することと、利用者の全質問でTTTを実行することは別である。
#経路B:TTTで学びやすいモデルを、最初から育てる
#こちらは、すでに研究がある。
#End-to-End Test-Time Training for Long Contextでは、文脈を使って追加学習した後に良く働くよう、共通の初期状態をメタ学習する。
#文脈の前半で適応し、その後の予測が改善するように、適応前のモデルを鍛える構成だ。論文は3B規模のモデルなどで検証しており、巨大な商用フロンティア全体への採用を示すものではない。(arXiv)
#ここで目標は、
#適応する前から良いモデルを作る
#だけでなく、
#新しい情報へ適応した後に良くなるモデルを作る
#へ広がる。
#このように、学ぶ内側の処理を、外側の学習で改善することが、メタ学習の考え方である。
#その場の適応と、長期的な統合は別
#前稿のTTT記事では、Fast Updateを「今覚える」処理、Consolidationを「長期的に残すべきか検証し、共通の重みへ統合する」処理として区別した。
#この区別は維持する必要がある。
#一つの依頼に役立った一時状態を、そのまま全利用者向けの重みへ戻す必要はない。破棄してもよいし、適切な許諾と検証の下で経験を選別し、別の学習工程へ送ってもよい。
#TTTで適応する能力を持つことと、すべての経験を永久に覚えることは同じではない。
#第Ⅵ部 全体として、計算資源と開発はどう変わるのか
#31.学習のために推論し、必要なら推論のためにも学習する
#ここまでの手法を組み合わせると、モデル開発は次のような循環として見えてくる。
#課題を作る・選ぶ → モデルが試す → 環境や教師が評価する → 経験を整理する → 重みを更新する → 能力と忘却を確認する → 次の課題・教師・モデルへ成果を戻す。
#この中には、教材生成、試行生成、自己批評、教師の確率計算など、多くの推論が入る。
#実際、NeMo RLのMOPD実装では、生徒の学習、試行生成、固定教師の計算を、別の処理群へ配置できる。(NVIDIA Docs)
#一方、TTTを組み込む場合は、試行するモデル自身に局所的な更新処理も入る。
#ただし、すべての装置が同じ計算をするわけではない。
#特に、教師が生徒の既知の履歴へ確率を付ける場合、長文を最初から逐次生成する必要はない。したがって、推論が増えることと、すべての処理で大きなKVを長時間保持することは同じではない。(Thinking Machines Lab)
#32.「小さくなるから需要が減る」「学習が増えるから必ず需要が増える」の両方を避ける
#重み共有や蒸留で、一つの提供モデルを小さくできる場合がある。
#一方、長い試行を多数同時に動かせば、重みとは別の状態容量が必要になる。開発側で教師や専門モデルを動かす仕事もある。
#また、非同期化によって待ち時間を減らせば、同じ設備でより多く処理できる。異種GPUへ生成と更新を分担させるAReaL-Hexは、その方向の実証例だ。(arXiv)
#つまり、同時に二つの力が働く。
#学習方法の改善で、一つの能力を得る費用が下がる。 その結果、試せる課題や実験、利用する仕事が増える可能性がある。
#どちらが大きいかによって、全体の計算需要は変わる。
#TTTも、KVの一部を別の状態へ置き換えられるなら容量を節約できる可能性があるが、更新計算とFast Weightsは必要になる。更新を大きくまとめて既存GPUで処理しやすくするLaCTのような研究もあり、特定の専用ハードウェアへの移行が自動的に決まるわけではない。(arXiv)
#したがって、見るべきなのはモデルサイズだけではない。
#何本の試行を同時に進めるか。 どれだけの文脈を保持するか。 教師は生成するのか、既知の履歴を採点するのか。 どの重みを、どの頻度で更新するか。 学習に実際に役立った経験はどれくらいか。
#これらが、計算資源の配分を決める。
#33.最終的に競争するのは、「次の改善を生む仕組み」
#本稿で見てきた手法は、別々の問題へ向かっている。
#Loopieは、同じ重みをどう使うかを変える。SFT・SPTは、良い実演をどう教えるかを変える。MixRLは経験の混ぜ方、GRPO・GSPO・SAPO・OAPLは更新の扱い、MOPDは能力の受け渡しを変える。
#SDPOはフィードバックを、SDFT・iSDFTは実演と能力保持を、PMDは経験をまたぐ教訓を、Skill-SPは次の課題を扱う。
#DeepSeekMath-V2は検証者を鍛え、PARLは複数エージェントの協調を学ぶ。RLPは事前学習へ推論の評価を入れ、SEALは自分を改善する教材づくりを学ぶ。
#QeRLは精度と学習を、MuonClipは数値更新を、mHCは情報の経路を、Nested LearningとEngramは記憶の仕組みを再設計する。
#そしてTTTは、新しい情報に出会った後で学べる能力そのものを、モデル開発へ取り込む可能性を持つ。
#これらをすべて採用すれば最強になる、ということではない。
#必要なのは、どの問題を解決したいのかを定め、適切な規模で実験し、組み合わせの効果を測り、成果を次へ渡すことである。
#Museの小型モデル群によるスケーリング検証は、その一つの進め方を示している。今後は、その検証対象がモデルサイズだけでなく、学習工程全体と、AI自身が参加する探索の仕組みへ広がっていくと考えられる。
#終わりに――AIの成長は、「大きくする」と「上手に使う」の共同作業になる
#AIが学ぶとは、基本的には大量の数値を調整することだ。
#しかし、その数値をどう配置するか、何を教材にするか、どの経験を集めるか、誰を教師にするか、何を成功と判定するかによって、同じ規模のモデルでも結果は変わる。
#一方、容量の制約が消えたわけではない。小型モデルを賢くする進歩と、より大きなモデルで難しい能力を開発する進歩は、対立せずに進められる。
#小型で学習方法を探す。中型で再現性を確かめる。大型や専門モデルで難しい能力を開発する。その成果を、再び大小のモデルへ戻す。
#さらにAIが、教材の選別、課題の生成、実験の提案、検証、学習用ソフトウェアの改善にも参加する。
#この循環が進めば、学習と推論は、互いを呼び出す関係になる。ただし、両者の区別がなくなるのではない。
#どこでは重みを固定して考え、どこでは一時的に適応し、どの成果だけを長期的な能力へ残すかを、より明確に設計する必要が生まれる。
#ここで問われるのは、無限に試行できるかだけではない。
#一回の試行から、有用な情報を得られたか。 その情報を、既存の能力を壊さずに学べたか。 その成果が、未知の課題でも役立つか。 次のモデルへ、検証可能な形で渡せたか。
#AIの学習は、一つの巨大なモデルを一度育てて終わる工程から、モデル、教材、経験、教師、評価、計算資源を継続的に再利用する工程へ広がっている。
#次のAIを作る競争は、モデルの中身だけでなく、「次の改善を生み出す仕組み」そのものを、どれだけ確かに育てられるかという競争になりつつある。
#