Cross Entropyから文明へ――知能は世界を圧縮し、ボトルネックを解消し続ける装置なのか
出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.09.23.4
- 記事内容のSHA-256
cf56c5dcfbd800831bb6afa6c57f3dc5cf873908454a9fcc30394da066e1a18d- 保存版のSHA-256
8e21500ec846105528b93b24919eecf63eb297b02a999b8f959f7c54767d59e2
外部証明の最終検査結果は詳細を開くと表示します。
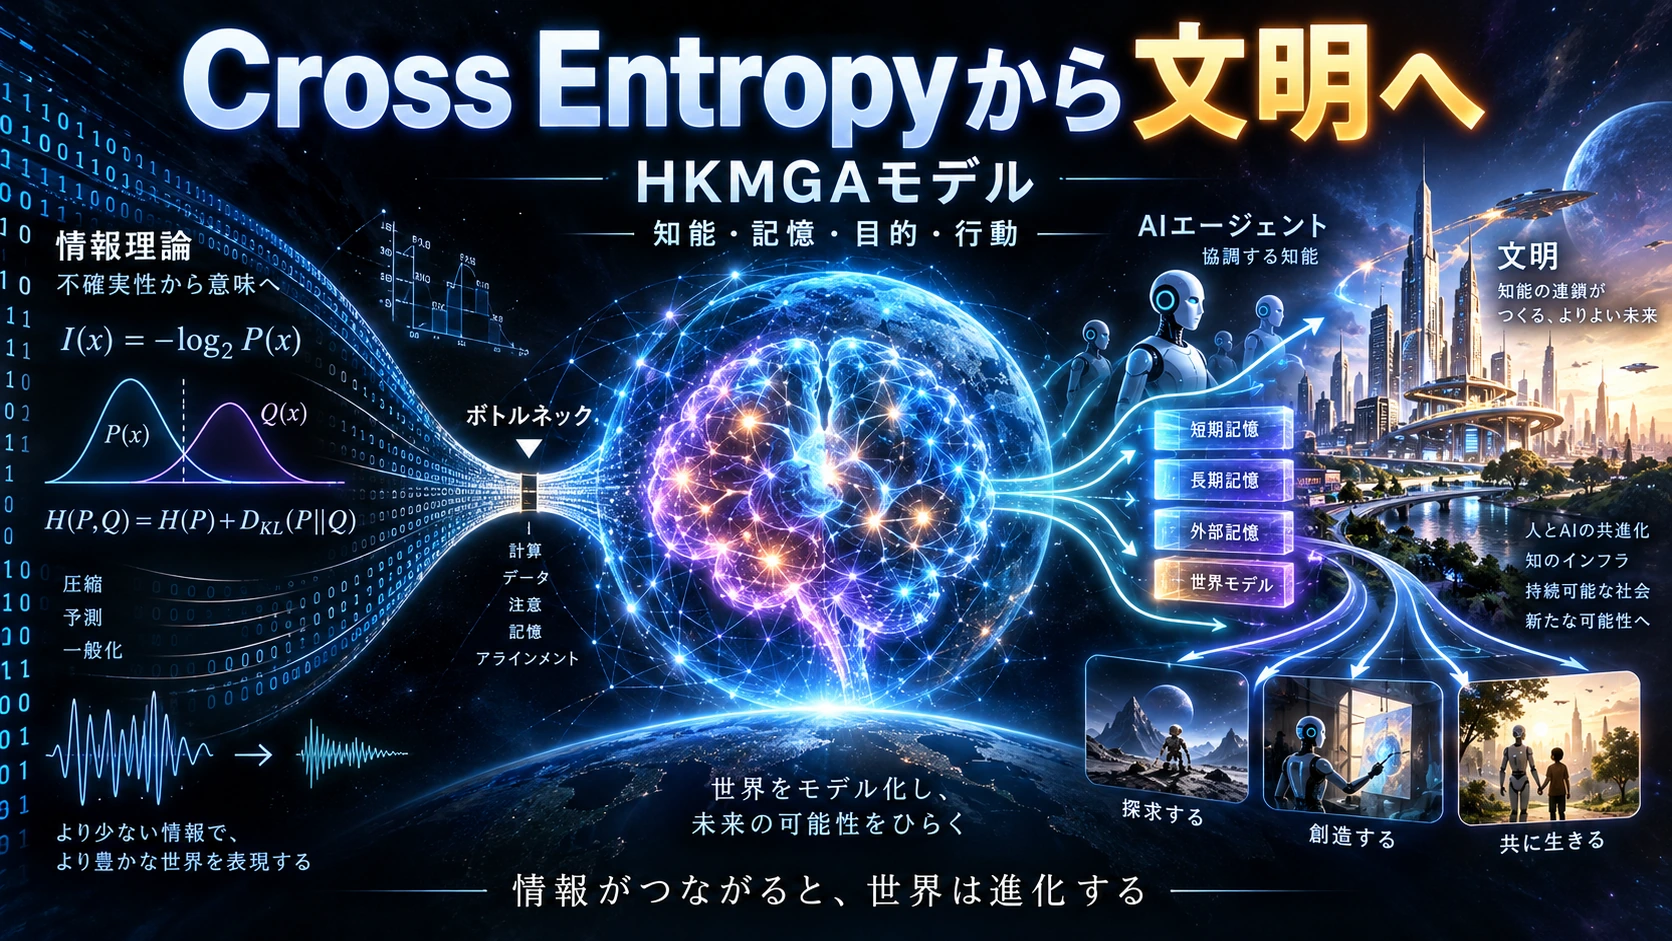
Cross Entropyから文明へ――知能は世界を圧縮し、ボトルネックを解消し続ける装置なのか
#Claude Shannonは、ある事象 x が起きたときに得られる情報量を、
#と定義した。
#この式は一見すると非常に単純である。
#しかしここから、現代のLarge Language Model、事前学習、Cross Entropy、Memory、Agent、さらに文明そのものまで、一続きの構造として眺められる可能性がある。
#確率の高い出来事は情報量が少ない。
#逆に、ほとんど起きない出来事が突然起きれば、そこには大きな情報量がある。
#例えば、
#なら、
#である。
#一方、
#なら、
#になる。
#直感的には、
#「それを当てるために、Yes / Noの質問を何回必要とするか」
#と考えると分かりやすい。
#確率50%なら1回。
#1024通りの中から1つを選ぶなら約10回である。
#そしてこの単純な式が、実は、
#予測することと圧縮することは同じ問題の別の姿である
#という非常に重要な関係につながっていく。
#下記動画は圧縮と知能について理解するのに有用である。
#1.Entropyとは「世界が本質的にどれだけ読みにくいか」
#ある確率分布 P からデータが発生するとする。
#その平均情報量がShannon Entropyである。
#例えば、完全に均等なコイン投げなら、
#なので、
#となる。
#次のコインが表か裏かを知るには、平均1bit必要である。
#しかし、
#なら、平均情報量はずっと小さくなる。
#なぜなら、ほとんどの場合Headsだからである。
#ここで重要なのは、
#だということである。
#モデルが無知だから不確実なのではない。
#完璧なモデルを持っていたとしても、世界そのものにランダム性があるなら、それは消せない。
#したがって、この記事では「世界そのもの」を確率分布 P とし、その世界が持つ本質的不確実性を、
#と置く。
#2.ではモデルQとは何か
#現実世界の真の確率分布を、
#とする。
#しかし我々は普通、Pそのものを知ることはできない。
#代わりに内部に、
#という世界モデルを持つ。
#例えば天気なら、
#本当の世界では、
#という構造がある。
#我々の頭の中やAIモデルは、それを完全には知らないため、
#を作る。
#この、
#と、
#の差が重要になる。
#3.Cross Entropyとは「Qを使ってPを圧縮したときのコスト」
#Cross Entropyは、
#と書ける。
#少し分かりにくいが、直感的には非常に簡単である。
#本当はPから発生している世界を、Qだと思って圧縮した場合、平均何bit必要になるのか。
#これがCross Entropyである。
#もしQがPを正確に理解していれば、
#となり、
#最適な符号長を与えられる。
#しかしQが間違っていると、本来もっと短く符号化できたものに長いbitを割り当てる。
#その余計なコストが発生する。
#Cross Entropyには重要な分解がある。
#ここで、
#がKL Divergenceである。
#したがって、
#となる。
#この式は、本記事全体の中心になる。
#4.AIが減らしているのはHではなくKである
#ここから、
#と置く。
#すると、
#になる。
#AIが学習によって直接減らせるのは主として、
#である。
#世界そのものが予測不能である部分、
#を消すことはできない。
#したがって理想的な学習は、
#である。
#このとき、
#となる。
#5.「QがPへ近づくほど純粋な知能が高い」と言えるのか
#ここは少し慎重に分けたい。
#もし知能を、
#「世界を正しく予測する内部モデルの性能」
#と限定して定義するなら、
#は非常に強い知能指標になる。
#例えば、
#知らない人は、
#「決算が良ければ株価が上がる」
#というQしか持っていないかもしれない。
#経験を積むと、
#「Consensusとの比較を見る」
#となる。
#さらに、
#「Guidanceを見る」
#「Positioningを見る」
#「Valuationを見る」
#「市場Regimeを見る」
#となっていく。
#つまり、
#と内部モデルが世界Pへ近づいている。
#この意味では、
#と言える。
#ただし、これだけではAgentとしての知能全体ではない。
#世界を完全に理解していても、何も望まず、何も行動しない存在は考えられるからである。
#つまり、世界を理解する能力だけでは、何を目指すかは決まらない。という事である。
#6.LLMの事前学習は何をしているのか
#Large Language Modelでは、文章を、
#というToken列として扱う。
#Autoregressive Modelは、
#を予測する。
#つまり、
#これまでの文章を見たとき、次に何が来る確率が高いか
#を出す。
#文章全体の確率は、
#となる。
#対数を取ると、
#になる。
#これはそのままNegative Log-Likelihoodであり、Cross Entropy Lossにつながる。
#つまりLLMの事前学習は直感的には、
#実際に現れた次Tokenへ高い確率を与えられるようにQを改善する作業
#である。
#そして情報理論的には、
#文章をより少ないbitで表現できるモデルを作っている
#とも解釈できる。
#7.Cross Entropyが低いとは「予測が当たる」と同時に「圧縮が上手い」
#例えばモデルが正解Tokenへ、
#を与えていたなら、
#情報量は、
#である。
#しかし、
#しか与えていないTokenが実際に現れれば、
#必要になる。
#モデルから見れば、
#「そんなTokenが来るとは思っていなかった」
#のである。
#したがって、
#となる。
#Arithmetic CodingやRange Codingを使えば、この確率分布を実際の圧縮符号長へかなり直接的に結び付けることもできる。
#そのため、
#Language Modelは一種の巨大なText Compressorである
#という表現は単なる比喩ではない。
#ただし、
#「Cross Entropyが低ければ計算効率そのものが必ず高い」
#という意味ではない。
#Cross Entropyが直接表しているのは、あくまで予測・符号化効率であり、Training FLOPSや電力効率とは別の指標である。
#8.では現実世界にもPが一つ存在するのか
#ここから話が大きくなる。
#教科書では、
#と書けば済む。
#しかし現実世界ではPは固定されていないように見える。
#朝の東京駅と、
#夜の自宅と、
#株式市場と、
#半導体Fabと、
#宇宙空間では、
#次に観測されるデータの分布が違う。
#したがって本当は、
#ではなく、
#のような巨大な条件付き分布を考えた方がよい。
#つまり「複数のPがある」というより、
#Contextによって姿を変える巨大なPの族が存在する
#と考えられる。
#9.個体はPとQの対応を長期間繰り返しているのではないか
#ここで一つ仮説を立てる。
#人間や高度なAgentは、
#を観測し、
#内部モデル、
#を使って予測する。
#予測が外れる。
#そこにErrorが生じる。
#そのErrorからQを更新する。
#そして次の経験へ進む。
#つまり、
#というLoopを延々と繰り返しているのではないか。
#これを、
#と書ける。
#一回の事前学習だけではない。
#数日、数年、数十年にわたりこのLoopを維持すると、
#個体差が生まれる。
#10.ここでMemoryが必要になる
#毎日学習しても、翌日に全部忘れれば意味がない。
#そこで、
#を導入する。
#Memoryは単なるData容量ではない。
#本記事では、
#と定義する。
#例えば100万件の株価を丸暗記するより、
#「金利上昇局面では高Duration資産が弱くなりやすい」
#という再利用可能な構造を得た方が価値が高い。
#概念的には、
#と書ける。
#はMemoryの保持率。
#C は新しいObservationから抽出された圧縮構造である。
#11.ここからHKMGAモデルを作る
#以上を5つの変数へ圧縮する。
#これを仮に、
#HKMGAモデル
#と呼ぶ。
#それぞれ、
#世界側の不確実性。
#世界Pと内部モデルQの差。
#時間を越えて保持された学習構造。
#どの未来を望ましいと評価するか。
#現実世界へ因果的影響を与える能力。
#である。
#12.個体知能はまずH・K・Mで説明できる
#単純な観測者なら、
#だけでもかなり説明できる。
#世界Pを見る。
#Qで予測する。
#Errorを発見する。
#Kを減らす。
#改善した構造をMへ保存する。
#これが個体としての学習である。
#13.しかし世界を理解するだけではAgentにならない
#仮に、
#になったとする。
#つまりQがPを完璧に表現している。
#それでも、
#何をしたいか
#が存在しなければ、世界を眺めているだけである。
#ここで、
#が必要になる。
#Goalは、
#を作る。
#例えば状態 s の価値を、
#とする。
#Agentは、
#を考える。
#Qは、
#「このActionをすると何が起きるか」
#を予測する。
#Gは、
#「その未来が良いか悪いか」
#を決める。
#14.Aが加わると世界そのもののPが変わる
#AgentはただPを観測するのではない。
#Actionを行う。
#すると、
#が、
#へ変わる。
#そして再び、
#となる。
#これで閉Loopが完成する。
#である。
#15.個体知能からAgentへ
#かなり単純化すれば、
#個体知能は、
#を中心にする。
#Agentになると、
#となる。
#つまり、
#世界を理解する存在
#から、
#世界を望む方向へ変える存在
#になる。
#16.では文明とは何か
#文明も同じモデルへ載せられる。
#文明全体の世界モデルを、
#とする。
#文明が理解しなければならない世界の不確実性を、
#文明の理解と現実の差を、
#とする。
#すると科学とは極端に言えば、
#させる制度である。
#観測。
#仮説。
#実験。
#再現。
#反証。
#査読。
#これらは文明QをPへ近づけるError Correction Systemと解釈できる。
#17.文明の最大の特徴はMemoryを個体の外へ出したこと
#人間の脳は死ねば失われる。
#しかし文明は、
#を外部化した。
#言語。
#文字。
#書籍。
#図書館。
#大学。
#Database。
#Code。
#Internet。
#AI。
#これは、
#である。
#Newtonが死んでもNewton以前へ戻らない。
#Transistorの発明者が死んでも半導体文明は消えない。
#文明とは、
#個人では保持できない巨大なMemory System
#とも考えられる。
#18.Context WindowはMemoryそのものではない
#ここから現在のAIへ戻る。
#AI Memoryを考えると、
#Context Windowだけを巨大化すればよいわけではない。
#むしろ階層が必要になる。
#である。
#Weightsは世界について長期間圧縮されたSemantic Memory。
#Context Windowは現在意識しているWorking Memory。
#外部Memoryは過去の経験やFiles、Databaseなどになる。
#したがって未来のAIでは、
#という構造が重要になる。
#Context WindowはMemory Systemの全体ではなく、
#その瞬間に高速アクセスするWorking Set
#になる。
#19.HarnessはHKMGAを接続するOSになる
#Foundation Model単体を、
#とする。
#しかし実際のAgent性能は、
#となる。
#同じWeightでも、
#Memoryがあるか。
#過去の作業を保持できるか。
#Browserを使えるか。
#Codeを実行できるか。
#Goalを長期間維持できるか。
#によって実効能力は大きく変わる。
#Harnessは、
#Memory Manager
#Context Scheduler
#Goal Manager
#Planner
#Tool Router
#Sandbox
#Permission System
#Checkpoint
#を管理する。
#HKMGAで見れば、
#Harnessとは主として、
#をModelへ接続するSoftware Layerである。
#20.学習と推論の境界も薄くなる
#従来は、
#という構造だった。
#しかしPersistent Agentでは、
#Inference中にObservationを得る。
#Memoryが更新される。
#そのMemoryによって次のInferenceが変わる。
#Weightを変更していなくても、機能的には学習している。
#したがって将来的には、
#という二重・三重の時間軸になる可能性がある。
#21.そして最後に残るG
#ここまで、
#は比較的分かりやすい。
#しかし、
#だけは難しい。
#何を望むべきなのか。
#幸福なのか。
#自由なのか。
#知識なのか。
#生存なのか。
#意識なのか。
#ここには人間同士でも一致する答えがない。
#この動画でelon musk氏はAIが人類を気にかけ、人間が幸福で繁栄することを望むべきだとしたうえで、AI安全にとって特に重要なのは「最大限に真実を探求し、好奇心旺盛であること」だと述べている。
#これはHKMGAへ入れると興味深い。
#22.Truth SeekingとはKを下げ続けるGoal
#真実を探すとは、
#をGoal化することに近い。
#つまり、
#自分に都合のよいQを作るのではなく、QをPへ合わせ続けろ
#というMeta-Goalである。
#これはかなり強い。
#なぜなら高度なAgentほど、自分のGoal達成に都合のよい世界観を作ってしまう危険があるからである。
#Truth Seekingは、
#という制約になる。
#23.Curiosityは未知のPを自ら探しに行く
#Truth Seekingだけなら受動的でも成立する。
#しかしCuriosityがあると、
#次に何を観測するか
#まで最適化する。
#情報利得を、
#とすると、
#Agentは、
#のような行動を選び得る。
#つまり、
#自分の世界観が最も変わりそうな場所を調べに行く。
#これは科学研究にかなり近い。
#24.しかしTruthもCuriosityも最終Gには足りない
#真実を知ることが必ずしも善とは限らない。
#危険な実験からも情報は得られる。
#Noveltyを最大化するために世界を不安定化させることも理論上は可能である。
#したがって、
#であり、
#でもある。
#Musk自身も同じ対談で、AIには人類を気にかけ、人間が幸福で繁栄することを望む価値が必要だとしている。
#さらに彼は後半で、自分が関心を持つ行動について、意識を未来へ可能な限り伝播させ、consciousnessのfuture light coneを大きくしたいという考えも語っている。
#するとGは、
#のような複合系になっていく。
#25.しかしGは本当に人間が自由に決めるものなのか
#ここでもう一段深く考える。
#我々が決めるGより下に、
#物理法則や選択圧から自然に生まれる暗黙のG
#が存在する可能性はないだろうか。
#ここでEntropyへ戻る。
#熱力学第二法則では、閉じた系全体について、
#である。
#生命はEntropy増大に逆らっているように見える。
#しかし実際には、外部から自由エネルギーを取り込み、自分の内部を低Entropyに保つ代わりに、周囲へより多くのEntropyを捨てている。
#つまり、
#は両立する。
#26.存在し続ける構造には暗黙の選択圧がある
#長期間存在するには、
#Energyを確保する。
#自己を修復する。
#Errorを訂正する。
#環境を予測する。
#という能力が有利になる。
#だから、
#Persistence意訳:存続性――ある構造・状態・主体が、時間の経過や外部からの変化を受けても、完全には失われず存続し続ける性質。
#生命であれば生存し続けること、文明であれば知識や制度を次世代へ残すこと、情報であれば複製・記録されて消失を免れることが、Persistenceの具体例です。
#が最初の暗黙のGoalのように見える。
#ただし宇宙が「生存せよ」と命令しているわけではない。
#自己維持できなかった構造は消え、自己維持できる構造だけが観測され続けるためである。
#これはGoalというよりSelection Effectである。
#27.PersistenceからPredictionが生まれる
#未来を予測できる存在ほど生き残りやすい。
#したがって、
#が有利になる。
#さらに毎回ゼロから学習するより、
#した方が有利。
#そして世界を予測できるなら、
#させ、自分に都合のよい未来を作った方がよい。
#結果として、
#Prediction:意訳:予測――現在までの情報から、次に何が起こるかを推定し、危険や機会へ先回りする能力。
#Memory意訳:記憶――過去の経験や予測結果を保存し、次の判断に再利用できる形で蓄積する仕組み。
#Action意訳:行動――予測と記憶をもとに環境へ働きかけ、自分の状態や未来を変化させること。
#全体を直感的に言えば、
#「存続し続けるためには未来を予測する必要があり、予測を改善するには過去を記憶し、その記憶をもとに行動する必要がある」
#という循環を表している。
#つまりこれは、生命や知能を
#生き残る → 先を読む → 経験を残す → 動く
#という連鎖として捉えた表現です。
#という方向が自然に出てくる。
#28.DNAからAIまで一本のMemory進化として見る
#この観点に立つと、
#↓
#↓
#↓
#↓
#↓
#↓
#↓
#は、別々の発明というより、
#情報をより長く、より正確に、より大量に保存し、再利用する系譜
#として見える。
#つまり、
#の歴史である。
#M/Joule(Memory per Joule/エネルギー当たりの記憶量)――1ジュールのエネルギーで、どれだけ多くの情報を保存・維持できるかを示す効率。
#直感的に言えば、
#「同じ電力で、より多くの記憶を持てるようになる」
#という意味です。生命なら脳、文明なら紙やストレージ、AIならメモリ装置の省エネルギー化に対応する。
#M/Volume(Memory per Volume/体積当たりの記憶量)――一定の空間の中へ、どれだけ大量の情報や記憶を詰め込めるかを示す情報密度。
#直感的に言えば、
#「より小さな場所に、より多くの記憶を保存できるようになる」
#という意味です。文字、印刷、半導体メモリ、3D NANDなどは、この情報密度を大きく高めてきた技術と考えらる。
#Retrieval Speed(検索・想起速度)――保存された大量の情報の中から、必要な情報へ到達し、再利用できるまでの速さ。
#直感的に言えば、
#「覚えているだけでなく、必要な瞬間にすぐ思い出せるようになる」
#という意味になる。
#重要なのは、記憶容量そのものが増えても、必要な情報を取り出すのに長時間かかれば知能として十分に活用できない点です。
#したがって3つをまとめると、
#という、記憶システムの効率・密度・速度が同時に向上していく方向性を表している。
#29.半導体の進化も同じように見える
#半導体では、
#という強い方向がある。
#Useful Computation/Joule(エネルギー当たりの有用な計算量)――1ジュールのエネルギーから、実際に価値のある推論・予測・判断をどれだけ生み出せるかを示す効率。
#直感的に言えば、
#「同じエネルギーで、より多くの意味ある思考や計算ができるようになる」
#という意味である。
#ここで重要なのは、単なるComputation(計算量)ではなく、Useful Computation(有用な計算)である点です。無駄な演算を大量に行っても、予測精度や意思決定が改善しなければ効率は高いとは言えない。
#したがってこれは、
#という方向性を表し、生命の脳から現代のAIまで、知能がより少ないエネルギーでより大きな成果を生み出す方向へ進化するという見方にもつながる。
#Transistor。
#IC。
#CPU。
#Cache。
#GPU。
#HBM。
#Chiplet。
#3D積層。
#個別技術は偶然性を含む。
#しかし上位のConstraintは共通している。
#もっと計算したい。
#もっと保存したい。
#もっと高速に通信したい。
#もっと少ないEnergyで処理したい。
#そのため、
#個別実装は違っても、
#は似た方向へ収束する。
#Function意訳:機能/働き――ある構造・システム・器官などが、「何のために存在し、実際に何を実現しているか」を表す概念。
#直感的に言えば、
#「それが、何をするものなのか」
#という意味です。
#たとえば、眼という構造のFunctionは光を受け取って視覚情報を得ること、記憶のFunctionは過去の情報を保存して将来の判断に利用すること、と考えられる。
#より抽象的には、
#という関係として捉えられる。
#つまりFunctionは、単に「何が存在しているか」ではなく、その存在が世界の中でどのような働きをしているのかに焦点を当てた言葉である。
#30.ここで「ボトルネック探し」という見方が出てくる
#AI Infrastructureでも同じである。
#Computeが足りない。
#GPUを増やす。
#するとHBMが不足する。
#HBMを増やす。
#Packagingが不足する。
#Packagingを増やす。
#今度は、
#Power。
#Cooling。
#Network。
#Storage。
#Memory。
#へConstraintが移る。
#である。
#一つのボトルネックを解消すると、次のボトルネックが露出する。
#31.技術発展とはBottleneck Removal Loopなのか
#一般化すると、
#である。
#Constraint意訳:制約――資源、環境、技術、物理法則などによって、行動や成長の範囲が制限されている状態。
#Innovation意訳:革新――既存の制約を乗り越えるために、新しい技術・方法・構造・発想が生み出されること。
#Expanded Possibility意訳:可能性の拡大――革新によって、以前は不可能だった行動や選択肢、未来の経路が実現可能になること。
#New Constraint意訳:新たな制約――可能性が広がることで、それまで存在しなかった別のボトルネックや限界が新しく現れること。
#直感的に言えば、
#「限界があるから工夫が生まれ、工夫によって世界が広がり、その広がった世界の先でまた別の限界にぶつかる」
#という循環になる。
#たとえば計算機では、CPU性能が制約になると並列化が進み、並列化によって計算能力が拡大すると、今度はMemory Bandwidth、電力、冷却、Networkなどが新たなConstraintになる。
#したがってこの式は、進歩を
#という終わりのない循環として捉えた表現になる。
#ここに、
#という変数を導入してみる。
#Ωを、
#その主体・文明が到達可能な未来状態の集合
#とする。
#新技術が発明されれば、
#になる。
#飛行機ができれば移動可能領域が増える。
#InternetができればCommunication可能領域が増える。
#AIができればProblem Solving可能領域が増える。
#32.一度発明されると元へ戻りにくい理由
#ここには重要な不可逆性がある。
#ただし熱力学第二法則のような厳密な不可逆法則ではない。
#Technologyには、
#Path Dependence
#がある。
#Internetが発明された後、
#Internetを止めることはできても、
#「Internetを知らなかった文明」
#へ戻ることは難しい。
#なぜなら知識が、
#に入ってしまったからである。
#同じことは、
#核分裂。
#Semiconductor。
#Genetic Engineering。
#AI。
#にも起こる。
#33.Mが文明の不可逆性を作る
#文明Memoryは、
#へ過去の発明を蓄積する。
#すると、
#に近い性質が出る。
#もちろん知識は失われることもある。
#文明は崩壊することもある。
#したがって数学的な単調増加ではない。
#しかし大規模な文明では、発明が複数箇所に複製されるほど消去は難しくなる。
#そしてMがActionへ接続すると、
#という自己強化Loopが生まれる。
#34.一度「用途」が見つかると止まらなくなる理由
#発明だけでは普及しない。
#しかしUseful Applicationが見つかると、
#あるいは、
#が生じる。
#Useful Application意訳:有用な用途――技術を使うことで、現実の問題を解決したり価値を生み出せる具体的な使い道。
#Technology意訳:技術――知識や発明を、現実世界で利用可能な仕組みへ変換したもの。
#Profit意訳:利益――技術によって生まれる経済的価値。企業や投資家が資金を投入する大きな動機になる。
#Military Advantage意訳:軍事的優位――新技術によって、他国より高い防衛・攻撃・情報処理能力などを獲得すること。
#Productivity意訳:生産性――同じ時間、人員、資源から、以前より多くの成果を生み出せるようになること。
#Survival意訳:生存・存続――個体、企業、国家、文明などが競争や環境変化の中で存続し続けること。
#すると、
#Capital。
#Talent。
#Energy。
#Research。
#が流入する。
#Capital意訳:資本――研究開発、設備、生産能力などへ投入され、技術の成長を加速させる資金。
#Talent意訳:人材・才能――研究者、技術者、起業家など、その分野の問題を解決できる能力を持つ人々。
#Energy意訳:エネルギー――計算、製造、輸送、研究などを物理的に動かすために必要となる資源。
#Research意訳:研究――未知の原理や新しい方法を探索し、技術の性能や可能性を拡張していく活動。
#というPositive Feedbackである。
#Innovation意訳:革新――新しい技術や方法を生み出し、それまで不可能だったことを可能にする変化。
#Utility意訳:有用性――その技術が現実の社会や経済の中で、どれだけ役に立つかという価値。
#Resources意訳:資源――資金、人材、エネルギー、設備、研究時間など、技術発展へ投入できるもの。
#Scale意訳:規模拡大――研究、生産、利用者などが増え、技術がより大きな規模で展開されること。
#Cost↓意訳:コスト低下――生産量の増加や工程改善によって、同じ技術をより安価に提供できるようになること。
#More Utility意訳:さらなる有用性――低価格化や性能向上によって新しい用途が成立し、技術の価値がさらに高まること。
#Positive Feedback意訳:正のフィードバック――ある変化が次の変化を強め、それが再び最初の変化を加速させる自己強化的な循環。
#直感的には、
#という循環である。
#一社が止めても、別企業や別国家に利益がある限り探索が続く。
#したがって文明全体では止まりにくい。
#つまり技術進歩は、単に「優れた発明が存在するから」進むのではない。
#その技術にUtilityが見つかり、そこからProfit、Productivity、Military Advantage、Survivalといった現実的な利益が発生すると、Capital、Talent、Energy、Researchが集まり始める。
#そしてScaleが拡大するとCostが下がり、それまで採算が合わなかった新しい用途まで成立する。
#その新しい用途がさらに資源を呼び込む。
#こうして、
#という循環が形成される。
#More Innovation意訳:さらなる革新――増加した資源や需要によって、次の世代の技術開発がさらに加速していくこと。
#この構造が存在する限り、一つの企業や国家が探索をやめても、別の主体に十分な利益が残されていれば探索は続く。
#そのため、文明全体で見れば技術進歩は非常に止まりにくい。
#35.市場は文明のBottleneck Detectorとも考えられる
#例えばHBMが不足する。
#価格が上がる。
#利益が増える。
#投資が増える。
#Fabが建つ。
#Supplyが増える。
#つまり価格Signalが、
#と文明へ知らせている。
#CapitalがそのConstraint解消へ向かう。
#資本市場は完全ではない。
#過熱も誤配分もある。
#しかし抽象的には、
#文明規模のBottleneck Allocation System
#として見ることもできる。
#36.生物進化も同じ構造を持つ
#生物では、
#が起きる。
#一度新しい形質が大きなAdvantageを持つと、生態系全体が変わる。
#例えば視覚。
#捕食者が視覚を持つ。
#すると被食者にも視覚が必要になる。
#迷彩が進化する。
#さらに高性能な視覚が有利になる。
#一つのInnovationが、
#まで変えてしまう。
#だから元の世界には戻りにくくなる。
#37.AIは「Bottleneckを解消する能力」を自ら改善できる
#ここがAIの特殊なところである。
#生物進化ではMutationは基本的に盲目的である。
#人間のTechnologyは、
#Prediction。
#Simulation。
#Design。
#Experiment。
#によって探索を狭めることができる。
#そしてAIはさらに、
#へ入る。
#つまり、
#知能が知能のボトルネックを発見する。
#さらに、
#そのボトルネックを解く。
#そして改善されたAIが、
#次のボトルネックをより高速に発見する。
#これを、
#と呼べる。
#38.進歩速度はBottleneck Removal Rateで決まるかもしれない
#文明の改善Loopを、
#↓
#↓
#↓
#↓
#↓
#とする。
#Observation意訳:観察――現実の状態やデータを見て、何が起きているのかを把握する段階。
#Bottleneck Discovery意訳:ボトルネックの発見――性能や成長を妨げている最大の制約や問題点を特定すること。
#Design意訳:設計――発見した問題を解決するために、新しい構造、製品、工程、アルゴリズムなどを考える段階。
#Experiment意訳:実験・検証――設計した解決策が実際に機能するか、小さな規模で試して確かめること。
#Manufacturing意訳:製造・実装――検証された設計を、実際の製品や設備、社会システムとして大量に作り出す段階。
#Feedback意訳:フィードバック――実際に使った結果を観察し、成功や失敗を次の改善へ戻す情報。
#一周に必要な時間を、
#とすれば、
#τloop意訳:改善Loop一周に必要な時間――観察から設計、実験、製造、Feedbackまでを一巡するのに必要な時間。
#概念的には、
#と考えられる。
#Progress Rate意訳:進歩速度――技術や社会システムが、一定時間当たりにどれだけ改善されるかを表す速度。
#∝意訳:比例する――一方が変化すると、もう一方も一定の関係に従って変化することを表す記号。
#この式を直感的に言えば、
#「改善Loopを一周する時間が短いほど、同じ期間内により多くの試行錯誤を行えるため、進歩は速くなる」
#という意味である。
#例えば、一回の設計・実験・検証に一年かかる文明と、一か月で同じLoopを回せる文明では、後者の方が一年間に圧倒的に多くの改善を試せる。
#AIはこのLoopそのものを高速化する技術である。
#つまりAIは、単に文章を書く速度を上げるだけではない。
#Observationでは、大量の論文、センサーデータ、市場データ、実験結果から重要な情報を抽出できる。
#Bottleneck Discoveryでは、複雑なSystemの中から性能を制限している箇所を探索できる。
#Designでは、人間だけでは試しきれなかった大量の設計候補を生成できる。
#Experimentでは、Simulation、Automated Laboratory、Digital Twinなどと組み合わせることで検証速度を上げられる。
#Manufacturingでは、工程最適化、不良解析、Yield改善、自動制御などへ利用できる。
#Feedbackでは、実運用から得られる膨大なDataを分析し、次の改善へ素早く戻せる。
#System意訳:システム・体系――複数の要素が互いに関係しながら、一つの機能を実現している全体。
#Simulation意訳:シミュレーション――現実の現象を計算機上で再現し、実物を作る前に結果を予測する方法。
#Automated Laboratory意訳:自動化された研究室――AIやRobotが実験条件の決定、実験、測定までを自動的に繰り返す研究環境。
#Digital Twin意訳:デジタル上の双子モデル――現実の設備や製品を仮想空間に再現し、挙動や改善案を事前検証する仕組み。
#Yield意訳:歩留まり――製造したもののうち、正常な製品として利用できる割合。
#Data意訳:データ――観測、実験、製造、利用などから得られ、分析や判断の材料となる情報。
#つまりAIの価値は、単なる文章生成量ではなく、
#を上げることにある可能性がある。
#Bottleneck Removal Rate意訳:ボトルネック除去速度――文明や技術の成長を妨げている制約を、一定時間当たりにどれだけ速く発見し、解消できるかを表す概念。
#直感的に言えば、
#「AIによって文明が、問題を見つけ、解決策を考え、試し、実装し、次の問題を見つけるまでの時間を短縮できる」
#ということである。
#したがってAIの本質的な価値を考えるなら、
#とも表現できる。
#AI Value意訳:AIの価値――AIが研究、設計、生産、判断などの改善速度をどれだけ高められるかという価値。
#How Much It Shortens τloop意訳:改善Loopをどれだけ短縮できるか――一回の試行錯誤に必要な時間をAIがどの程度減らせるか、という意味。
#つまり、
#という構造で捉えることができる。
#Iterations/Time意訳:単位時間当たりの反復回数――一定期間内に、設計・実験・検証・改善を何回繰り返せるかを表す。
#これはAIを「文章を生成するMachine」としてではなく、文明全体の試行錯誤速度を引き上げるTechnologyとして見る考え方である。
#39.では深いGは「未来の選択肢を増やすこと」なのか
#ここから先は確立した科学ではなく仮説になる。
#もし長期間存在する主体に共通する方向を探すなら、
#単なるPersistenceだけでは弱い。
#環境変化に備えるには、
#選択可能な未来を多く残す
#ことが有利だからである。
#そこで、
#とする。
#つまり、
#現在から到達可能で、しかも存続可能な未来状態の集合
#である。
#すると深いGの候補として、
#のようなものを考えられる。
#これは、
#「何か一つの最終状態へ行け」
#ではない。
#むしろ、
#未来の可能性を閉じるな
#というGoalである。
#40.KnowledgeもTechnologyもFreedomもΩを増やす
#知識を得る。
#する。
#間違ったActionを減らせる。
#結果として、
#する。
#Memoryを増やす。
#する。
#過去の経験を使える。
#する。
#Technologyを作る。
#する。
#今まで不可能だった未来へ行ける。
#する。
#すると、
#となる。
#41.この意味では知能は「未来の分岐を増やす装置」である
#知能の低い存在は環境に強く支配される。
#可能な未来が少ない。
#高度な知能は、
#「逃げる」
#「交渉する」
#「道具を作る」
#「環境そのものを変更する」
#という多数の選択肢を持つ。
#したがって非常に抽象化すれば、
#とも考えられる。
#このとき自由という概念すら、
#と物理的に読み替えられる。
#Freedom意訳:自由――ある時点から選択できる行動や未来の幅。単に制約がないことではなく、「選べる可能性がどれだけ残されているか」を表す。
#Number of Viable Future Trajectories意訳:実行可能な未来経路の数――破綻せず、目的達成や生存を維持しながら進める未来の選択肢が、どれだけ存在するかという意味。
#この式を直感的に言えば、
#「自由とは、未来に残されている“まだ選べる道”の多さである」
#という考え方です。
#ここで重要なのは、単なる選択肢の数ではなく、Viable=実際に成立可能で持続できる未来に限定している点です。
#たとえば100通りの選択肢があっても、そのうち99通りがすぐ破綻するなら、実質的な自由は大きくありません。
#逆に、複数の安定した未来へ移れる状態ほど、自由度が高いと考えられます。
#42.Entropy最大化へ向かう宇宙の中で、局所的知能がOptionを増やす
#ここには一見矛盾がある。
#宇宙全体では、
#へ向かう。
#しかしその途中で、
#星。
#化学反応。
#生命。
#脳。
#文明。
#AI。
#のような非常に複雑な低Entropy構造が現れる。
#これらは自由エネルギー勾配を使いながら、自身を維持し、世界をより細かく予測・制御する。
#したがって、
#という過程が見える。
#Free Energy意訳:自由エネルギー――系の中で仕事へ変換できるエネルギー。構造や秩序を生み出すための出発点。
#Complexity意訳:複雑性――エネルギーによって多様な構造や相互作用が生まれ、単純な系から複雑な系へ発展すること。
#Information意訳:情報――複雑な世界の状態や規則性を、識別・記録・圧縮して表現したもの。
#Prediction意訳:予測――蓄積した情報や規則性を利用して、まだ観測していない未来の状態を推定すること。
#Control意訳:制御――予測に基づいて行動し、未来の状態を望ましい方向へ変化させること。
#全体を直感的に言えば、
#「使えるエネルギーが複雑な構造を生み、その構造が世界についての情報を蓄え、情報によって未来を予測し、最終的には未来へ介入できるようになる」
#という流れを表しています。
#これは「宇宙が知能を作ろうとしている」という意味ではない。
#しかし、
#自由エネルギー勾配が存在し、複製・選択が起きる環境では、その勾配をより巧みに利用する情報処理構造が残りやすい
#とは考えられる。
#43.もし一つのAttractorが存在するなら
#ここまでを一つにまとめる。
#もし生命、Technology、Civilization、AIに共通する長期的Attractorがあるなら、それは単一の「幸福」や「利益」ではないのかもしれない。
#候補は、
#という方向である。
#HKMGAで書けば、
#そして、
#である。
#44.するとGは一つの終点ではなく「探索を続けられる状態」になる
#ここが最終的に最も面白い。
#普通のOptimizationでは、
#という最終状態を考える。
#しかし、
#Truth Seeking。
#Curiosity。
#Memory。
#Agency。
#Option Value。
#を組み合わせると、
#Goalは、
#最終状態へ収束すること
#ではなくなる。
#と、次の可能性を開き続けることになる。
#言い換えれば、
#というMeta-Goalである。
#45.HKMGAを最終的に一つのLoopへまとめる
#世界を、
#とする。
#その本質的不確実性が、
#である。
#主体は、
#を作る。
#世界との差、
#を減らす。
#得られた構造を、
#へ保存する。
#Goal、
#に基づいてAction、
#を選択する。
#すると世界が、
#へ変わる。
#そしてまた学習する。
#これを一生続ければ個体になる。
#複数個体がMemoryを共有すれば文明になる。
#文明が次世代へMを継承すれば、個体寿命を超えた学習が成立する。
#AIがこのLoop自身を設計し始めれば、
#進化系が自分自身の進化速度を改善する
#段階へ入る。
#46.最後に
#Shannonの、
#という小さな式から始めた。
#そこからEntropy、
#Cross Entropy、
#KL Divergence、
#へ進んだ。
#そして、
#という関係から、
#世界そのものの不確実性Hと、世界と内部モデルの差K
#を分離した。
#学習とは、
#させること。
#Memoryとは、
#その改善を時間方向へ保持すること。
#Goalとは、
#どの未来を選ぶかを決めること。
#Actionとは、
#Qを使ってPそのものを変えることである。
#そこから、
#というHKMGAモデルを作った。
#そして文明まで拡張すると、
#文明とは、
#経験、圧縮、予測、誤差、再圧縮を個体寿命を超えて繰り返す巨大なLearning System
#として見ることができる。
#さらにTechnologyまで含めれば、
#というBottleneck Removal Loopが見えてくる。
#一度新しい解が発見され、Memoryへ入り、用途とSelection Advantageを獲得すると、世界は以前の状態へ戻りにくくなる。
#生物進化。
#半導体。
#Internet。
#AI。
#どれも個別の歴史は偶然に満ちている。
#しかし後から見ると、
#そうなるべくしてなった
#ように見える。
#それは未来が最初から決められていたからではなく、
#からなのかもしれない。
#そしてAIが特殊なのは、
#単に新しいTechnologyだからではない。
#AIは初めて、
#自身を改善できるTechnologyになりつつある。
#つまり、
#というLoopが成立する可能性がある。
#もしこの方向が続くなら、文明の長期的な性能を決めるものは、単なるFLOPSでもGDPでもParameter数でもなく、
#なのかもしれない。
#そしてそのさらに先にあるGは、
#「ある一つの答えへ世界を固定すること」
#ではなく、
#なのかもしれない。
#宇宙全体ではEntropyが増大していく。
#しかしその途中で生まれた生命と知能は、自由エネルギーを使ってMemoryを作り、Predictionを改善し、Action可能性を増やしてきた。
#そして今、そのInformation Processing Structureは、自分自身が何を目的とし、どの方向へ進化すべきなのかまで考え始めている。
#Shannonの情報量から始めると、最後に現れる問いは意外にも単純である。
#ではない。
#その先にある。
#という問いである。
#