Mac Studio 256GBは本当にOpenAIとAnthropicに買い占められているのか
出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.09.23.4
- 記事内容のSHA-256
ba766a302b7c78940007ec576a9a51a37e91398117a4811edafbabb390a07a5e- 保存版のSHA-256
a2e241b6ce1ecaea3059c564fd2e0cae29b5b3a75f5325241c90935fb8de1362
外部証明の最終検査結果は詳細を開くと表示します。
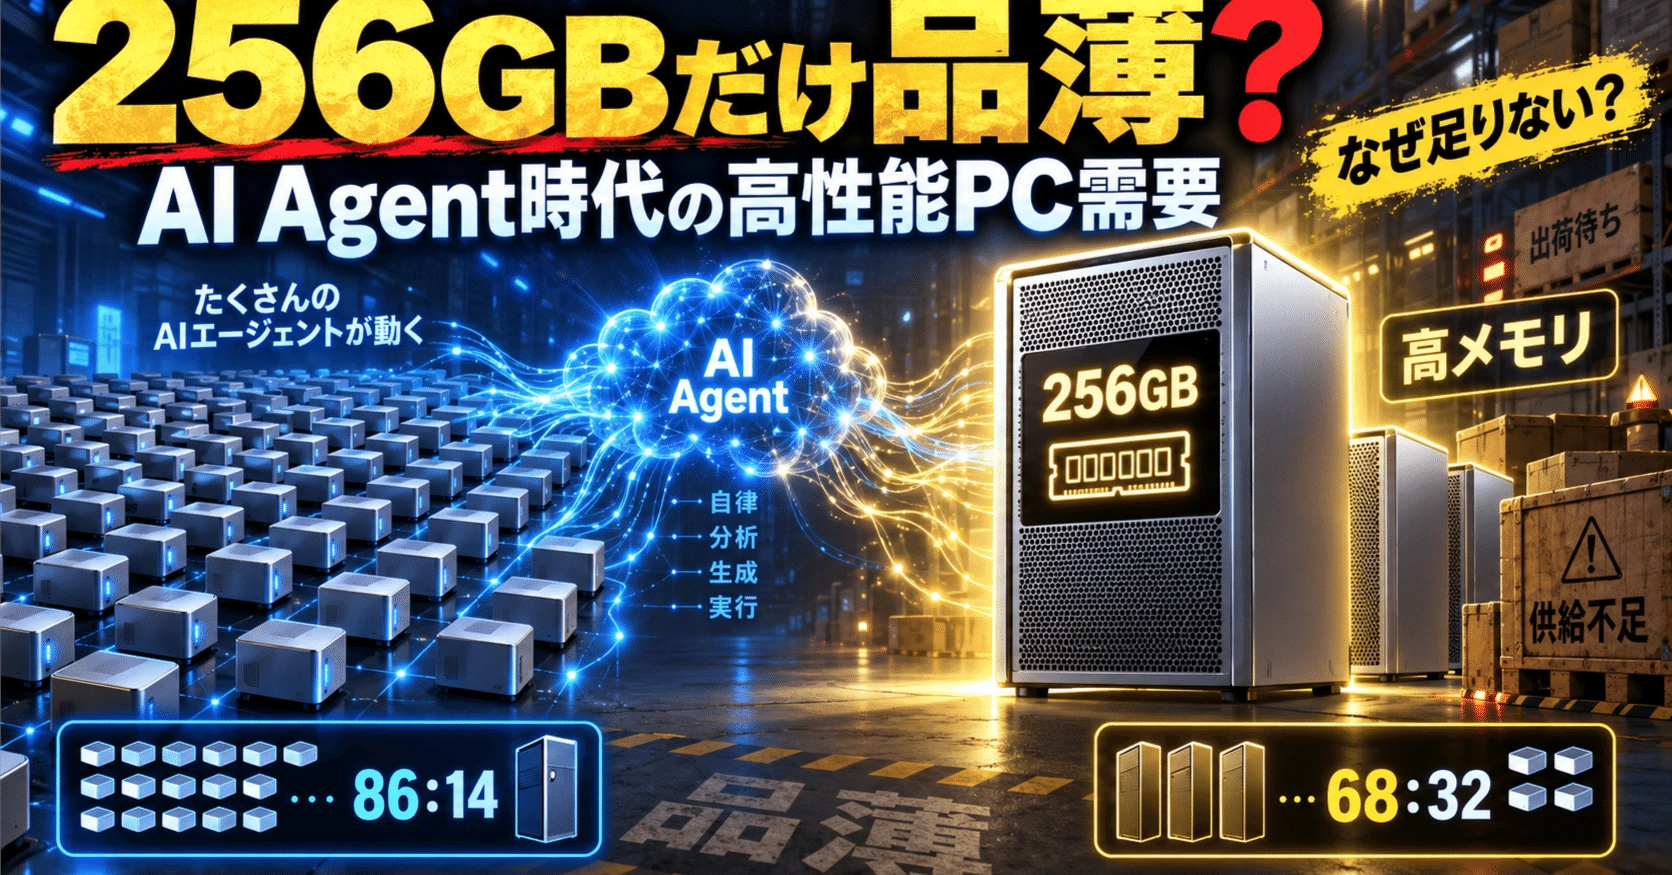
Mac Studio 256GBは本当にOpenAIとAnthropicに買い占められているのか――Agency Cloudから計算するAI時代のMac需要
#2026年8月末から、興味深い噂が広がっている。
#OpenAIがMac miniとMac Studioを数万台規模で購入している。
#さらに、
#AnthropicもMacを大量に確保している。
#そして2026年9月現在、M5 Ultra Mac Studio、とりわけ256GB Unified Memory構成では、注文から到着まで数か月を要する例が報告されている。
#ここから、
#「OpenAIやAnthropicがMac Studioを買い占めたため、256GBモデルが品薄になっているのではないか」
#という話がXなどで出てきた。
#この話は完全なデマではない。
#The Informationは、OpenAIがMac miniとMac Studioを数万台購入し、Reinforcement LearningやComputer-Use Agentの訓練へ利用していると報じている。
#ただしOpenAIやAppleが台数を公式確認したわけではない。
#Anthropicについて報じられているのも、Mac Studioを直接大量購入しているという話ではなく、AWS経由でMac miniを利用しているという内容である。
#したがって、
#OpenAIとAnthropicが256GB Mac Studioを買い占めている
#というところまで確認されたわけではない。
#さらに重要なのは、
#- Mac miniを何台買ったのか
- Mac Studioを何台買ったのか
- Studioは96GBなのか256GBなのか
- 256GBを何千台購入したのか
という構成別データが公開されていないことである。
#それでも256GB Mac Studioの品薄は興味深い。
#なぜなら、Agent Infrastructureとして考えた場合、
#本当に256GB Studioを大量に必要とするのか
#という疑問が生じるからである。
#ここを数量的に考えていく。
#過去記事ではMacOSのVM化制約を元に分析しました
#https://note.com/atom_/n/n029ebadf776b
#今回は、Mac Studioを大量に購入するとするとどういった理由がありそうかをAgency Cloud/Node最適化の観点から分析してみます。
#1.AI Infrastructureを4層に分ける
#Agent時代のAI Infrastructureは、次の4つに分けると理解しやすい。
#Brain AIDC
#AI推論・学習を行う頭脳基盤である。
#NVIDIA GPU、TPU、Trainium、HBMなどを使い、Frontier Model、大規模Inference、Training、Reward Modelなどを処理する。
#人間に例えれば、
#考える脳
#である。
#Agency Cloud
#Agentが実際の仕事を行うComputeである。
#Browserを開く。
#Operating Systemを操作する。
#CodeをBuildする。
#Spreadsheetを編集する。
#3DCG Softwareを使う。
#CADを操作する。
#Game Engineを動かす。
#こちらは人間に例えるなら、
#手、目、机、作業場
#である。
#Persistent State
#User Memory、Agent Memory、Files、DB、Credentials、Artifacts、Project Stateなどを長期保存する場所である。
#Agency Nodeを再起動しても失ってはいけない情報なので、
#長期記憶と書庫
#に近い。
#Local / Edge
#Userに近い場所で処理するComputeである。
#Personal PC、Mac、Smartphone、Office内Serverなどが含まれる。
#つまりAgent Infrastructureを、
#脳
#仕事場
#長期記憶
#ユーザーの近く
#という4つに分ける。
#今回注目するのは、このうちの仕事場=Agency Cloudである。
#2.なぜBrain AIDCとは別にAgency Cloudが必要なのか
#従来の生成AIでは、
#「強いGPUがあればよい」
#と考えやすかった。
#しかしAgentでは事情が変わる。
#AgentSysBenchでは、10種類のAgent Applicationのうち5つで、LLM以外の部分が主要Latency要因になった。
#Sandbox Working Setは最大28GB。
#さらに、
#Task-aware Serving――Latency 29~40%改善
#Communication-aware Placement――最大4.5倍
#State Offloading――Memory使用量4.6倍削減
#という結果が出ている。
#つまり、
#である。
#直感的には、
#頭の回転だけ2倍になっても、手が遅い、机が狭い、必要な書類を毎回倉庫から取りに行くのであれば、仕事全体は2倍速くならない
#という話である。
#そこでAgent全体を、
#として見る必要がある。
#つまりAgentは「AIモデル」ではなく、
#AIモデル+コンピューター+OS+Software+State
#を合わせたSystemになってきている。
#3.Windows/Linuxでは既にAgency Cloudが形になり始めている
#MicrosoftのWindows 365 for Agentsでは、Windows VMをCloud PC Poolとして保持する。
#Agentが仕事を始めるとCloud PCを借りる。
#仕事が終わると返却する。
#したがって、
#である。
#直感的には、
#社員1万人に1人1台の専用会議室を永久に割り当てるのではなく、必要な時だけ共有会議室を予約する
#ような仕組みである。
#Google GKE Agent Sandboxも同様で、Idle AgentをSnapshotして停止し、必要になればWarm Poolから復帰させる。
#つまりAgent数そのものより、
#同時に本当に作業しているAgent数
#の方がHardware需要を決める。
#この考え方が、後の計算で重要になる。
#4.Mac miniとStudioは何が違うのか
#まず物理仕様を見る。
#M5 Pro Mac miniを、
#とする。
#M5 Ultra Mac Studioは、
#である。
#MiniからStudio 256GBへ移ると、
#CPUは、
#つまり2倍。
#Memoryは、
#4倍。
#GPUも、
#4倍。
#Memory Bandwidthも、
#ほぼ4倍である。
#つまり、
#となる。
#これを言葉で言うと、
#Studioは単純に「Miniを2倍速くしたMac」ではない。
#CPUは2倍しか増えていないのに、
#メモリ、GPU、メモリ帯域だけ約4倍に増えている。
#つまりStudioは、
#計算する人数を増やすより、一人あたりに広い机、大量の資料、高性能な作業道具を与える方向
#へ振ったHardwareなのである。
#5.RAM / CPU比を見るとさらに分かりやすい
#Mini 64GBでは、
#Studio 256GBでは、
#Studio 512GBでは、
#になる。
#この数字は、
#CPU 1 Coreあたり、どれだけRAMを持たせられるか
#という意味である。
#直感的には、
#Miniは、
#作業員18人に64GB分の机を与える
#Machine。
#Studio 256GBは、
#作業員36人に256GB分の巨大な机を与える
#Machine。
#Studio 512GBは、
#作業員数は36人のまま、机だけ512GBへさらに巨大化
#したMachineである。
#だから、
#と考えると分かりやすい。
#512GBは「さらに速いStudio」というより、
#同じ作業員数で、異常に巨大な資料を机の上へ広げられるStudio
#なのである。
#6.1万Agentで仮想モデルを作る
#ここからはOpenAI内部の実測値ではない。
#公開研究とMacの仕様を組み合わせたScenario Modelである。
#Agentが、
#存在するとする。
#ただし1万Agent全部が常時仕事をしているわけではない。
#そこでActive率を、
#と置く。
#すると、
#となる。
#直感的には、
#1万人の社員アカウントが存在していても、ある瞬間にPCへ張り付いて仕事をしているのは3,000人
#と考える。
#残り7,000 Agentは、
#待機、
#Toolの返答待ち、
#人間の承認待ち、
#次の仕事待ち、
#などである。
#7.3,000 Active Agentを3種類へ分ける
#今回は、
#Thin――60%
#Medium――30%
#Heavy――10%
#と仮定する。
#すると、
#Thinは、
#Mediumは、
#Heavyは、
#となる。
#直感的には、
#3,000人の作業者のうち、1,800人はBrowserや軽いToolしか使わない。
#900人はCodingや複数Applicationを使う。
#300人だけが巨大Workspaceや重いSandboxを必要とする。
#という会社を想定している。
#この60:30:10はOpenAIの実測値ではない。
#あくまでRemote Brain型の一般的なKnowledge Workを考えるための仮定である。
#8.Thin / Medium / Heavyの重さを決める
#Thin Agentを、
#Mediumを、
#Heavyを、
#とする。
#Heavyの28GBはAgentSysBenchで観測された最大Sandbox Working Setを参考にする。
#これも言葉で考えると分かりやすい。
#Thinは、
#Browserを開いて調べ物をしているAgent。
#Mediumは、
#Browser+Editor+Terminalなどを同時利用しているAgent。
#Heavyは、
#巨大Repository、Build、複数Processなどを抱えて仕事をしているAgent。
#というイメージである。
#Thin Agency Node――軽量な日常作業を大量にさばく実行層
#Thin Agency Nodeは、Browser操作、Web検索、Form入力、簡単なOffice作業、API呼び出し、軽量なShell操作など、比較的少ないCPU・RAMで処理できるAgent Workloadを担当する。
#重要なのは、一つのAgentを極端に高性能なMachineで動かすことではなく、安価なNodeへ多数の軽量Agentを高密度に収容することである。
#Brainとなる大規模ModelはAIDC側に置き、Thin Node側ではOS、Browser、Tool、Temporary Workspaceなどの実行環境を提供する構成が基本となる。
#Mac環境なら64GB級Mac mini、LinuxならContainerやmicroVM、Windowsなら共有Cloud PC Poolなどがこの層に近い。
#Agency Cloud全体では最も台数が多くなりやすく、Cost / Agentを下げるための基礎層となる。
#Medium Agency Node――複数Toolと大きめの作業状態を扱う中間層
#Medium Agency Nodeは、単純なBrowser Agentより重い一方、3DCGや大規模Simulationほどではない仕事を担当する。
#例えばCoding AgentがRepositoryを展開し、Editor、Terminal、Browser、Test Environmentを同時に利用したり、SpreadsheetやDocumentを複数開きながら長時間作業したりする場合が該当する。
#Thin Nodeより多くのCPU、RAM、SSD I/O、Hot Stateを必要とするが、必ずしも大容量GPUや256GB級Memoryまでは必要としない。
#この層はThinとHeavyの境界であり、Workloadによっては高性能Mac mini、128GB級Workstation、あるいは複数Containerを収容するServerへ割り当てられる。
#Astra級でSubagentやTool並列実行が増えるほど、このMedium層からHeavy層へ移行するWorkloadが増える可能性がある。
#Heavy Agency Node――大容量Memory・GPU・巨大Workspaceを必要とする専門作業層
#Heavy Agency Nodeは、Agentが大きな作業状態や複数の専門Softwareを同時に保持する必要があるWorkloadを担当する。
#巨大RepositoryのBuild、複数ContainerによるSoftware開発、3DCG、Game Engine、CAD、CAE、EDA、Local Vision Model、複数Subagentの並列実行などが代表例である。
#この層では単純なCPU性能だけでなく、Hot RAM、Memory Bandwidth、GPU性能、高速SSD、長時間維持されるWorkspaceが重要になる。Mac環境では256GB級Mac Studioが候補となり、Windows/LinuxではGPU Workstationや高RAM Serverが対応する。
#Agency Cloud全体では台数は少なくても、一台あたりの価格と消費電力が大きいため、Heavy Workloadを正確に判定して必要なTaskだけをこの層へRoutingすることがTCO最適化の重要点となる。
#9.Hardwareを100%まで使わない
#実際のData Centerでは、MemoryやCPUを100%まで詰めることは危険である。
#OS自身もResourceを使う。
#突然負荷が増えることもある。
#故障したNodeの仕事を別Nodeへ逃がす必要もある。
#そこで80%だけ使う。
#Miniなら、
#CPU equivalent。
#Memoryは、
#である。
#Studio 256GBなら、
#CPU equivalent。
#Memoryは、
#になる。
#直感的には、
#100席あるRestaurantで常に100席を予約で埋めず、20席程度を急な客やトラブルのために空けておく
#のと同じである。
#10.Thin AgentはMiniに何個入るか
#Thin AgentはCPUを1、Memoryを1GB使う。
#Mini側はCPUが14.4、Memoryが51.2GB使える。
#したがって、
#となる。
#小さい方がLimitなので、
#Agent程度となる。
#なぜ14なのか。
#Memoryだけなら51 Agent入る。
#しかしCPUは14 Agent程度でいっぱいになる。
#つまり、
#巨大な64GB Memoryを持っていても、Thin Agent用途ではMemoryの大半が余る。
#MiniはMemory不足ではなくCPU不足で先に詰まるのである。
#Thin Agentは1,800いるため、
#切り上げて、
#必要になる。
#11.Medium AgentもMiniで十分
#Medium AgentはCPUを2、Memoryを4GB使う。
#そこで、
#となる。
#つまり約7 Agent。
#Memoryだけ見れば12 Agent入る。
#しかしCPUが7 Agent程度で詰まる。
#したがってMedium Agent 900個には、
#なので、
#必要になる。
#ThinとMediumを合わせると、
#Miniである。
#直感的には、
#普通のAgent仕事の大半は、大きなRAMより大量の安いCPU Nodeを並べた方が効率がよい
#という結果である。
#12.Heavy AgentではStudio 256GBが綺麗にはまる
#Heavy AgentはCPU 4、Memory 28GBを使う。
#Studio 256GBでは、
#CPU側は、
#Memory側は、
#となる。
#驚くほど近い。
#つまり、
#を1台に載せると、
#CPUもRAMもほぼ同時にいっぱいになる。
#これはHardwareとしてかなり綺麗なBalanceである。
#直感的には、
#Miniでは「CPUはいっぱいなのにRAMが余る」という状態だった。
#Studio 256GBでは、
#CPUとRAMをほぼ同じ割合で使い切れる。
#だからHeavy AgentにはStudio 256GBが非常に効率的なのである。
#300 Heavy Agentなら、
#なので、
#となる。
#13.86:14という比率はこうして出てくる
#Miniは258台。
#Studioは43台。
#合計は、
#台。
#Mini比率は、
#Studio比率は、
#したがって、
#となる。
#これを直感的に言えば、
#100台Macを購入するなら、86台程度は安いMiniでよく、本当に大きな作業机が必要なHeavy Agentだけ14台程度Studioにする
#という構成である。
#だから、
#単純なRemote Brain型Agency Cloudなら、StudioがFleetの半分を占めるような構成にはなりにくい
#というのがこの計算から得られる一番重要な示唆である。
#ただし繰り返すが、
#86:14はOpenAIの実構成ではない。
#仮定から作ったScenario Modelである。
#14.では512GB StudioならHeavy Agentをもっと載せられるのか
#512GB版では使えるMemoryが、
#になる。
#Heavy Agentを載せると、
#CPU側は、
#Memory側は、
#となる。
#つまりMemoryだけなら14 Agent載る。
#しかしCPUは7 Agentしか処理できない。
#したがって、
#程度で止まる。
#256GB版でも7。
#512GB版でも7。
#直感的には、
#机だけ2倍広くしたのに、作業員数を増やしていない
#からである。
#7人しか働けないのに、14人分の机を用意しても仕事量は2倍にならない。
#これが、
#Remote Brain型Agency Cloudでは512GBは過剰
#と考える理由である。
#15.512GBが必要になるのはどんな時か
#Agent一つについて、
#CPU需要を、
#Memory需要を、
#とする。
#256GB StudioではCPU 1単位に対して利用可能Memoryが、
#ある。
#したがって、
#になるとMemoryが先に足りなくなり始める。
#512GB Studioでは、
#なので、
#というWorkloadなら512GB化に意味が出る。
#数字だけでは分かりにくいので、こう考える。
#256GB Studioは、
#作業員1人につき約7GB分の机
#を持つ。
#もし仕事が、
#作業員1人につき10GB、12GBという巨大な資料を常に広げなければならない
#タイプなら256GBでは机が足りない。
#そこで512GBが効く。
#つまり512GBが本当に必要なのは、
#計算量よりMemory量が異常に大きい仕事
#である。
#例えば、
#- 巨大Local LLM
- 巨大KV Cache
- 多数VM
- Large CAE / EDA State
- 巨大3D Scene
- 大量Subagent Hot State
などである。
#16.だから256GBと512GBでは品薄の意味が違う
#256GBが必要になる用途は広い。
#Large Workspace。
#3DCG。
#Game Engine。
#Local Vision。
#複数Application。
#Medium Local Model。
#Heavy Agency Node。
#一方512GBは、
#とにかくMemoryを大量に必要とする特殊用途
#に偏る。
#そのため、
#256GBの品薄は原因を判断しにくい。
#Local LLMでも売れる。
#Agency Cloudでも売れる。
#VFXでも売れる。
#企業Researchでも売れる。
#一方512GBが大量に売れる場合は、
#巨大Local ModelやExtreme Memory Workloadが本当に増えている
#というSignalとして、256GBより解釈しやすい可能性がある。
#17.ここへAstraが登場する
#GPT-6 AstraではComputer Use能力がさらに伸びた。
#OSWorld 2.0では、
#GPT-5.6 Solが65.7%。
#Astraが72.6%。
#さらにTask時間は、
#へ短縮された。
#時間だけ比べると、
#つまりAstraは、
#同じ仕事を約53%の時間で終える
#計算になる。
#逆に言えば、
#約47%の時間を削減
#した。
#直感的には、
#これまで1台のStudioを75分占有していたAgentが、40分で仕事を終えて次のAgentへMachineを渡せる。
#だから、
#同じ種類、同じ量の仕事だけを続けるなら、AstraによってAgency Hardware需要は減る
#方向に働く。
#18.成功率も含めると約48%になる
#Task成功率まで単純に含めて、
#「成功した仕事1件を作るまで平均何分必要か」
#と考える。
#GPT-5.6では、
#Astraでは、
#比率は、
#である。
#つまりこのBenchmarkをそのままInfrastructureへ当てはめるという強い仮定を置けば、
#となる。
#分かりやすく言えば、
#以前100台必要だった仕事量なら、Astraでは約48台相当のMachine時間で処理できるかもしれない
#ということである。
#もちろん実際のProductionではここまで単純ではない。
#しかし方向を見るSensitivity Factorとしては使える。
#19.それならStudio需要は半分になるのか
#ここで重要なのがJevons Effectである。
#AstraによってHeavy Workload自体が増える可能性がある。
#従来Heavy比率を、
#とした。
#Astraによって3DCG、Game、CADなどへ用途が広がり、
#になったとする。
#つまりHeavy仕事は2倍。
#しかし1仕事あたりのMachine時間は、
#倍。
#したがって、
#となる。
#つまり、
#Heavy仕事が2倍になったのに、必要なStudio時間はほぼ以前と同じ
#になる。
#これはかなり直感的に重要である。
#Astraは仕事を約2倍効率化する。
#だからHeavy仕事が2倍増える程度なら、その増加を効率化がほぼ打ち消してしまう。
#20.Studio需要が本当に増える分岐点は約21%
#元々Heavy比率は10%。
#Astra効率Factorを、
#とする。
#Studio需要が旧世代を超える条件は、
#である。
#整理すると、
#となる。
#つまり、
#と、Astra自身の効率改善を上回り始める。
#言葉で言えば、
#Astraが仕事を約2倍効率化するなら、Heavy仕事の割合も約2倍以上にならないとHardware需要は増えない。
#元が10%なので、
#約20~21%。
#これが分岐点になる。
#21.Heavy比率別に見るとさらに分かりやすい
#旧世代では43台Studioが必要だった。
#Astraなら、
#Heavy 10%:
#Heavy 20%:
#Heavy 30%:
#Heavy 40%:
#となる。
#つまり、
#Heavy比率10%のままならStudioは約半分。
#20%ならほぼ元通り。
#30%なら以前より約50%多い。
#40%なら約2倍。
#という関係になる。
#Astraの登場だけを見て、
#「高性能化したからHardware需要が減る」
#と考えるのも、
#「用途が増えるからHardware需要が増える」
#と考えるのも片手落ちである。
#重要なのは、
#効率改善より仕事量の増加が大きいか
#である。
#22.Active率が上がるとさらに需要は増える
#もう一つ重要なのがActive率である。
#従来Agentが、
#5分作業。
#人間確認待ち。
#30分停止。
#という動きだったとする。
#Astra級になると、
#Research。
#Coding。
#Browser操作。
#Test。
#修正。
#再Test。
#Documentation。
#まで自律的に進められる可能性がある。
#するとAgent一体が、
#以前より長い時間、本当にComputerを使い続ける
#ようになる。
#Active率が、
#になれば、単純に同時稼働Agentは約1.33倍。
#だからである。
#50%なら、
#倍。
#つまりAstraによって一つ一つの仕事が速くなっても、
#AIが人間へ仕事を返さず次の工程まで進むことで、Machineの稼働率そのものは上がる
#可能性がある。
#23.Astra級では仕事そのものも重くなる可能性がある
#さらに、
#という変数を置く。
#これは、
#Astra級になったことで1 TaskあたりのAgency側Resourceがどれだけ重くなるか
#である。
#従来Coding Agentを1とする。
#3DCG、Game Engine、CADなどへ広がって平均1.5倍重くなるなら、
#である。
#Studio需要は、
#と考えられる。
#難しく見えるが、意味は単純である。
#Studio需要は、
#どれだけ長く働いているか
#×
#Heavy仕事がどれだけ多いか
#×
#1仕事をどれだけ速く処理できるか
#×
#1仕事そのものがどれだけ重いか
#で決まる。
#ここでAstraは、
#つまり仕事を速くする。
#しかし、
#になる可能性がある。
#だから最終的にどちらが勝つのかは、まだ分からない。
#24.例えばAstra+3DCG/CADが本格化するとどうなるか
#Heavy Workloadを30%。
#従来より1 Heavy Taskが1.5倍重いとする。
#すると計算上、Studio比率は約32%まで上昇し得る。
#つまり、
#程度になる。
#直感的には、
#従来は100台中、
#86台Mini
#14台Studio
#だった。
#しかしAstraによってGame、3DCG、CADなどの仕事までAgentへ流れ込むと、
#68台Mini
#32台Studio
#くらいまでHeavy Machineの割合が増えても不思議ではない。
#つまりStudio比率が2倍以上になるScenarioである。
#25.3つの世界を考えると分かりやすい
#Scenario A――Remote Brain
#AIDCが全部考える。
#MacはBrowserやOSを動かすだけ。
#この場合、
#程度。
#Studio 512GBはほぼ不要。
#これは、
#頭脳はData Center、Macは手足だけ
#という世界である。
#Scenario B――Astra Hybrid
#AIDCにFrontier Brainを残すが、
#Local Vision、
#Large Workspace、
#Multiple Apps、
#Subagent、
#Game Engine、
#CAD、
#などをAgency Node側で処理する。
#この場合、
#程度までStudio比率が上昇し得る。
#つまり、
#Macは手足だけではなく、小さな脳と巨大な机も持つ
#ようになる。
#Scenario C――Creative / Engineering Heavy
#Agentが、
#3DCG。
#Game Development。
#CAD。
#CAE。
#EDA。
#などへ本格的に進出する。
#この場合Studio相当Heavy Nodeが30~40%以上になっても不思議ではない。
#ただしこの世界ではMacだけではなく、
#Windows GPU Workstation、
#Linux Server、
#Threadripper、
#EPYC、
#GPU Server、
#などもAgency Cloudへ入ってくる。
#つまり最終形はMac Cloudではなく、
#異種ComputerからなるAgency Compute Fabric
#になる可能性が高い。
#26.では256GB Studio品薄をどう読むべきか
#ここまで考えると256GBの難しさが分かる。
#256GB Studioは、
#Local LLMにも合理的。
#3DCGにも合理的。
#Creative Workにも合理的。
#Heavy Agentにも合理的。
#企業Researchにも合理的。
#つまり需要は、
#のように重なっている。
#そのため、
#256GBが売れている=OpenAIが買っている
#とは言えない。
#さらにNVIDIA DGX Sparkなどでも高メモリLocal AI Machineの需要とMemory供給制約が見られている。
#したがって、
#が同時に発生している可能性が高い。
#直感的には、
#買いたい人が増えているのに、材料であるMemoryも不足している。
#だからLead Timeが急激に伸びても不思議ではない。
#27.「OpenAI買い占め説」はどこまで本当なのか
#現在確認できる範囲を整理する。
#OpenAIがMac mini / Mac Studioを数万台購入した
#有力報道はある。
#ただし公式確認はない。
#Computer-Use AgentやRL用途
#これも報道内容に含まれる。
#AnthropicがMac Studioを大量購入
#これは確認できない。
#報道されているのはAWS経由でMac miniを利用しているという内容である。
#OpenAIが256GB Studioを大量購入
#不明。
#256GB品薄の主因がOpenAI
#不明。
#したがって、
#買い占め説を否定する証拠もないが、買い占め説を証明するデータもない
#というのが正確である。
#28.今後どの数字が出れば判断できるのか
#今後Astra級Agent Infrastructure研究で最も重要なのは、単なるBenchmark Scoreではない。
#CPU Core Seconds / Successful Task
#Agentが1件の仕事を成功させるために、Agency NodeのCPUをどのくらい使うか。
#Peak Hot RAM
#平均ではなく、
#P50。
#P95。
#P99。
#を見る。
#特にP95/P99が大きければStudioの価値が増す。
#例えば平均20GBでも、10%のAgentが120GB必要なら、Heavy Node Poolが必要になるからである。
#Local GPU Seconds
#3DCG、Rendering、Vision、Local PolicyなどをAgency Node側でどれだけ処理するか。
#これが増えるほどStudioやGPU Workstationが有利になる。
#Active Duty Cycle
#Agentが生きている時間のうち、本当にComputerを使っている割合。
#Heavy Workload比率
#Browserや軽量Codingではなく、CAD、3D、巨大Buildなどへどの程度移るか。
#Local Resource Inflation
#Astra級Agentが従来Agentより、Agency側で何倍のResourceを使うか。
#Subagent Fan-out
#1 Agentが同時に何個のBrowser、Container、Tool Environmentを起動するか。
#29.最重要式を言葉で読む
#今後の研究を見る時には、
#を覚えておくとよい。
#難しい式ではない。
#は、
#Agentがどれだけ長く働き続けるか。
#は、
#その仕事のうち何割がHeavyなのか。
#は、
#モデルが賢くなったことで1仕事がどれだけ速くなったか。
#は、
#その仕事自体がどれだけ重くなったか。
#である。
#つまり、
#Astraが高速になればeが下がり、Hardware需要は減る。
#しかし、
#Astraが人間の代わりに長時間働けばaが上がる。
#CADや3DまでやればHが上がる。
#巨大Workspaceを持てばκが上がる。
#この綱引きでStudio需要が決まる。
#30.今のところ最適比率は分からない
#Remote Brain型なら、
#というScenarioがかなり自然である。
#しかしAstra級で、
#Heavy Workloadが30%。
#Heavy Taskが1.5倍重くなる。
#という世界なら、
#程度まで動き得る。
#この2つの数字の違いは非常に大きい。
#100台購入すると考えれば、
#Remote Brainなら、
#Mini 86台、Studio 14台。
#Astra Hybridなら、
#Mini 68台、Studio 32台。
#Studio需要は2倍以上になる。
#だから今重要なのは、
#正しい比率を今すぐ当てることではない。
#31.重要なのは「86:14を何が68:32へ動かすのか」
#それは、
#Hot RAM
#Local GPU
#Active率
#Heavy Workload比率
#Subagent並列度
#である。
#もし今後Astra級Agentの実測値が、
#「1 AgentあたりRAMは依然10~20GB程度」
#「Local GPUはほとんど使わない」
#「BrainはほぼAIDC」
#という結果なら、
#Mini中心のRemote Brain型が正しかった可能性が高い。
#この場合、現在の256GB Studio品薄をAgency Cloudだけでは説明しにくい。
#Local LLM、Creative用途、企業需要、Memory不足の比重を高く見るべきになる。
#反対に、
#「P95 Hot RAMが100GBを超える」
#「CAD/3D/GPU処理が増える」
#「1 Agentが複数ApplicationやSubagentを常時並列実行する」
#という結果なら、
#Studio 256GBを大量に置く構成が一気に合理的になる。
#32.結論――Mac Studio品薄は、Agent時代のCompute構造を見る観測窓かもしれない
#現在、
#OpenAIがMacを大量調達しているという有力報道
#は存在する。
#しかし、
#その大部分が256GB Mac Studioである
#ことは確認されていない。
#したがって、
#256GB Studioが品薄なのはOpenAIとAnthropicが買い占めたからだ
#と断定することはできない。
#しかし別の意味で、この品薄は非常に興味深い。
#LinuxではAgent Sandbox。
#WindowsではCloud PC Pool。
#AWSではThin RuntimeとHeavy Instance。
#NVIDIAではDGX Spark。
#AppleではMac miniとMac Studio。
#つまりBrain AIDCとは別に、
#Agentが現実のComputer Workを行うAgency Compute Layer
#が形成され始めている。
#Remote Brain型を仮定すれば、今回の計算では、
#となった。
#つまり単純Computer Useだけなら、Studioは少数でよい。
#ところがAstra級でComputer Useが、
#Browser。
#Coding。
#Game Development。
#3DCG。
#CAD。
#Engineering。
#へ広がり、
#Heavy Workloadが増え、1 AgentあたりのHot RAMやLocal GPU需要が増えるなら、
#程度まで動くScenarioも考えられる。
#つまり、現在分からないのは、
#Agentが賢くなることで、Computerが軽くなるのか。
#それとも、
#Agentが賢くなったからこそ、より巨大なComputer Workを任せるようになるのか。
#という部分である。
#Astraは一つの仕事をより速く終わらせる。
#これはHardware需要を減らす。
#しかしAstraによって、これまでAIには任せられなかった3DCG、CAD、Game、EngineeringなどがAgent Workloadへ流入する。
#これはHardware需要を増やす。
#さらにAgentが人間へ途中で仕事を返さなくなれば、Active率も上がる。
#だから将来のAgency Compute需要は、
#単純なModel Benchmarkだけからは読めない。
#今後本当に重要になるのは、
#CPU
#Hot RAM
#Local GPU
#Active Duty Cycle
#Heavy Workload比率
#Subagent Fan-out
#というSystems Levelの実測値である。
#これらが公開されれば、今Scenarioとして置いている数値を実測値へ差し替えられる。
#その時初めて、
#Mac miniとMac Studio 256GBの本当の最適比率
#が見えてくる。
#そして、もし将来のAstra級Production Traceが、
#大量のHot RAM
#Local GPU
#複数Application
#大量Subagent
#を必要としていたと判明するなら、
#2026年のMac Studio 256GB品薄は、単なるLocal LLMブームではなく、
#Heavy Agency Computeという新市場が立ち上がり始めた初期Signal
#だった可能性が出てくる。
#逆に、Astra級でもAgency Nodeは軽量なままだったなら、
#現在の品薄はLocal LLM、Creative需要、企業需要、Memory供給制約によるものだったと評価を修正すべきである。
#今はまだ答えは出ていない。
#しかし、
#「OpenAIが買い占めたらしい」
#という一つの噂から、
#Agent時代にはBrain AIDCとは別に、どれほど巨大なAgency Computeが必要になるのか
#という問題まで掘り下げていくと、Mac Studio 256GBの品薄は単なるApple製品の在庫問題とは違って見えてくる。
#今後Astra級Agent Infrastructureの研究が出てきた時に見るべきなのは、Benchmark Scoreだけではない。
#そのAgentが、どれほど大きな机を必要としていたのか。
#そこが、次のComputer需要を決める数字になる。
#