OpenAIのB2B出遅れの実態と巻き返し戦略を考察
出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.09.23.4
- 記事内容のSHA-256
03935c8576fb248045f0a97e1e17b01abc406017b520c4f3f200c303bef9f8ac- 保存版のSHA-256
96d7a7348e8bc00a3f460fc31b3c360d56a7e34ad50eadd2f05f58d9ac45c385
外部証明の最終検査結果は詳細を開くと表示します。
OpenAIのB2B出遅れの実態と巻き返し戦略
#エグゼクティブサマリー
#本レポートの結論は、「OpenAIのB2Bの出遅れは、モデル性能そのものよりも、①計算資源(供給制約)、②プロダクト焦点の拡散と整理(ロードマップの揺れ)、③エンタープライズ要件(統治・監査・ソブリン/オンプレ)への対応速度、④開発者体験(エージェント標準・運用観測性・安全設計)の総合戦」として表面化している、という点にある。根拠として、OpenAIが動画生成アプリSoraを終了し、より収益性が高いと見られる“コーディング/企業向け”へ軸足を移したこと、同時に「ロボティクス」を含む研究領域への再配分を示唆したこと、さらにコンサル大手と企業導入を加速する連合を組成したことが挙げられる。
#
この局面で最も強い競争圧力は、①Anthropic社の「Claude/Claude Code」による開発現場のOS化(ターミナルやIDEで自律的に作業を進めるエージェント型コーディング)、②Google(Alphabet)のクラウド統合(Vertex AI・Gemini)+ソブリン/オンプレ(GDC air-gapped)、③Meta社のオープンウェイト(Llama)+デバイス(スマートグラス等)による配布力、④xAI社の検索・X連携+低価格帯モデル**の分配である。
#OpenAIが巻き返すための「勝ち筋」は、(A)コーディング/業務エージェント領域での“運用可能性”を武器にする(SDK、トレーシング、移行手当、SLA/監査ログ、ガバナンスAPI)、(B)ソブリン/オンプレッシング層の穴をパートナーで埋める(地域内GPU推論、政府・医療向けの強化、クラウド/ハード事業者との“準オンプレ”パッケージ)、(C)物理AI時代に向けた「学習(クラウド)↔推論(エッジ)」の往復を前提に、NVIDIA/AMDを含むハード依存を戦略的に多重化する、の三本柱になる。
#以降、Sora終了、Spud(次世代モデルのコードネーム報道)、ChatGPTの次期系(ユーザーが「ChatGPT-5.5」と呼ぶものを含む)を“シグナル”として扱い、競合比較(製品・収益・戦略)と、物理AI(ロボティクス/エッジ)への含意を整理する。
#主要シグナルの整理
#OpenAIの近時の意思決定は、B2B戦略を読む上で「強いシグナル」になっている。特に(i)Sora終了、(ii)次世代モデル(Spud)関連の観測、(iii)エージェントAPI/SDKの再編は、同社が“消費者向けの拡大”と“企業向けの運用要求”を、計算資源制約の中で統合し直していることを示す。
#Sora終了が示すもの
#OpenAIはSoraについて、Web/アプリ体験を2026年4月26日に終了、APIを2026年9月24日に終了すると告知している。 報道では、Sora運用が「大きな計算資源を必要とし、他チームの火力を削る」ことが議論され、結果としてOpenAIがより収益性が高いと見られるコーディングツール/企業顧客へ重心移動したとされる。
#この意思決定は、単なる製品終了ではなく、B2B観点では次を意味する。
#- 供給制約(計算資源)がプロダクト優先順位を直接支配しうること(=企業顧客は「継続性リスク」を織り込む必要がある)。
- OpenAIが動画(高コスト)→コーディング/業務(高ARPU・継続課金・導入支援)へ資源移動し、B2Bで勝つ意思を明確化したこと。
- 同時に「ロボティクス」等の研究領域も言及されており、物理AI”を次の大市場と見ている可能性が高い(後述)。
Spudと「ChatGPT-5.5」の扱い
#ユーザーが挙げた「Spud」と「ChatGPT-5.5」は、現時点で公式にChatGPT-5.5という製品名・版番号として確定している一次情報は確認できないため、本レポートでは次のように扱う。
#- Spud:次世代旗艦モデル(あるいはその訓練ラン)の内部コードネームとして報じられているもの。
- ChatGPT-5.5:ユーザー側が想定する「次の中間アップデート」を指す呼称として、Spudが最終的にどのブランド名で出るかは未確定と明示する。
背景として、OpenAIの内部事情に近いとされる報道では、OpenAIの年次換算売上が急拡大する一方で、インフラ投資負担と競争激化により「焦点の再設定」が迫られていると指摘される。 また、ChatGPT側ではモデルの入れ替えが継続しており、ChatGPTから一部モデルが退役し、API提供は継続というチャネル差も明文化されている。 この状況は、「次世代モデルが出るなら、まずどのチャネル(ChatGPT / API / 企業専用)へ、どんな価格体系で出るか」がB2Bの実務上の論点になることを示す。
#エージェントAPI/SDK再編が示す「B2B運用意識」
#OpenAIは開発者向けに、**Responses APIを“エージェント的アプリの統一インターフェース”として位置づけ、Web検索・ファイル検索・コンピュータ操作・リモートMCP等の組み込みツールを掲げている。 さらに**Agents SDKを提供し、ツール利用、ハンドオフ、トレーシング等を含むエージェント開発を容易化している。 加えて、Assistants APIを非推奨とし、2026年8月26日に停止するとし、移行ガイドを提示している。
#これはB2B視点では、「(i)統合APIへ収束(運用/監査/コスト制御を一箇所に集約)、(ii)“エージェントの本番運用”を前提にした設計(ツール実行・観測性・移行期限の明記)」という“エンタープライズ・ソフトウェア化”の意思表示と解釈できる。
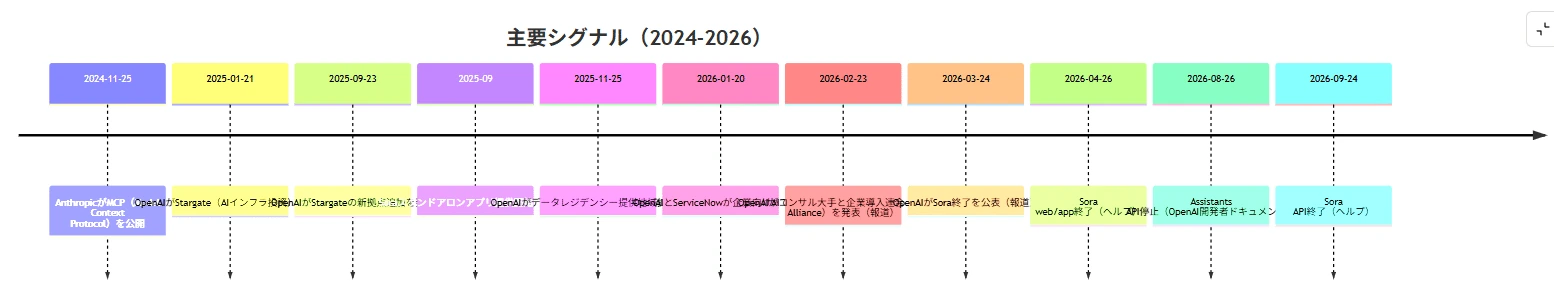
#timeline
title 主要シグナル(2024-2026)
2024-11-25 : AnthropicがMCP(Model Context Protocol)を公開
2025-01-21 : OpenAIがStargate(AIインフラ投資)を発表
2025-09-23 : OpenAIがStargateの新拠点追加を発表
2025-09 : Soraスタンドアロンアプリ提供開始(報道)
2025-11-25 : OpenAIがデータレジデンシー提供地域拡大を告知
2026-01-20 : OpenAIとServiceNowが企業向けAIで提携
2026-02-23 : OpenAIがコンサル大手と企業導入連合(Frontier Alliance)を発表(報道)
2026-03-24 : OpenAIがSora終了を公表(報道)
2026-04-26 : Sora web/app終了(ヘルプ)
2026-08-26 : Assistants API停止(OpenAI開発者ドキュメント)
2026-09-24 : Sora API終了(ヘルプ)(各項目の根拠:Sora開始/終了、データレジデンシー、ServiceNow提携、企業導入連合Assistants API停止。)
#B2B競争環境の比較
#ここでは、B2Bで意思決定を左右する「機能」「ターゲット」「課金」「統合」「導入経路」「オンプレ/オフライン」「規制・コンプライアンス」「開発者エコシステム」を軸に、OpenAIと主要競合を比較する。重要なのは、企業は“最強モデル”だけでは選ばず、運用・統治・コスト予見性・供給安定性で選ぶ、という点である(Sora終了はこの現実を強く示した)。
#製品・機能・提供形態の比較表
#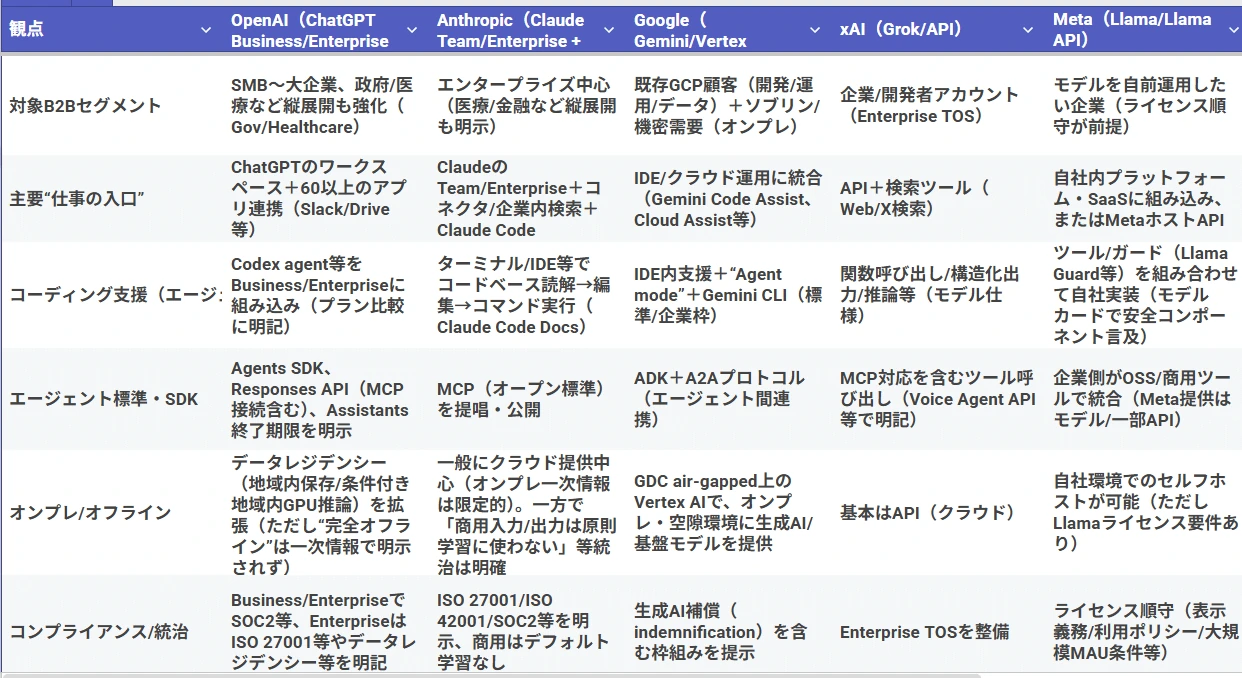
上表から、OpenAIのB2B上の出遅れは「モデル」よりも、次の3点で説明できる。
#- 開発現場の主戦場が“チャットからエージェント型コーディング/運用へ移った
AnthropicのClaude Codeは、コードベース理解→ファイル編集→コマンド実行を前提に設計され、ターミナル/IDE等へ広く展開している。 OpenAIもCodex agent等をプランに組み込み、Responses API/Agents SDKで追撃しているが、Sora終了の報道では「Claude Codeが開発者/企業AI市場でOpenAIに優位を与えている」と明示的に比較され、OpenAIがより儲かる領域(コーディング/企業顧客)へ舵を切ったとされる。
- オンプレ/ソブリン要求への“提供形態”競争
GoogleはGDC air-gapped上でVertex AIと生成AIモデルを提供し、「インターネットやパブリッククラウド非接続でも利用可能」と明記している。 OpenAIはデータレジデンシー(地域内保存)と、条件付きの地域内GPU推論オプション拡張を示しているが、Googleの“空隙オンプレ”は調達要件が厳しい領域(防衛・重要インフラ等)で差別化になりやすい。
- 供給制約(計算・電力・チップ)がB2Bの約束(SLA/継続性)を揺らす
Sora運用の計算資源負担が他チームに影響したという説明、さらにCFOが計算資源不足で事業機会を見送っているとする報道は、「能力があっても供給不足で売れない」局面が現実化していることを示す。
#OpenClawが示した「エージェント経済」の難しさ
#ユーザー要件に含まれる「OpenClaw」は、Google製ではなく、**個人/業務のタスクを“実行する”AIアシスタント(メール・予定・フライト等)を謳う独立プラットフォームである。 注目すべきは、Anthropicが**Claudeのサブスクリプション枠でOpenClaw等の第三者ツール利用をカバーしない方針へ切り替え、利用者にAPIキー/従量課金(pay-as-you-go)を促した点だ。
#この事例は、B2B戦略に直結する示唆を持つ。
#- 常時稼働・自律実行エージェントは、チャットより計算資源を食い、サブスクの想定利用を破壊しやすい(=収益モデルが従量へ引き戻される)。
- セキュリティ面でも、常時稼働エージェントは「間接プロンプトインジェクション」「資格情報(トークン)」「実行権限」「永続化」などの攻撃面を増やすと整理されている。
- したがってB2Bで勝つには、エージェントを売るだけではなく、「権限・監査・隔離・確認フロー」を含む“運用設計込みのプロダクト”**が必要になる(OpenAIがResponses APIでツール/トレーシングを統合し始めたのは、この方向性と整合する)。
参考として、Google側でもエージェント基盤(Vertex AI Agent Engine)に関して、過剰権限のサービスアカウント等がリスクになり得ることが研究報告として示され、Googleドキュメント側でもアクセス管理(サービスアカウント/権限)を明示している。 企業は「モデル選定」より先に、「エージェントの権限境界」と「運用観測性」を設計しないと、導入が止まる段階に入ったと言える。
#収益・利益比較
#為替レートと換算方法
#本レポートの円換算は、日本銀行公表の2026年4月7日(火)17:00時点のスポットUSD/JPY 159.86円/ドル(レンジ表記のうち先頭値を採用)を用いた。 換算:JPY = USD × 159.86。
#上場企業の実績(売上・純利益)
#上場企業は財務諸表/開示から、年度ズレを注記して比較する(単位:十億USD、兆JPY)。
#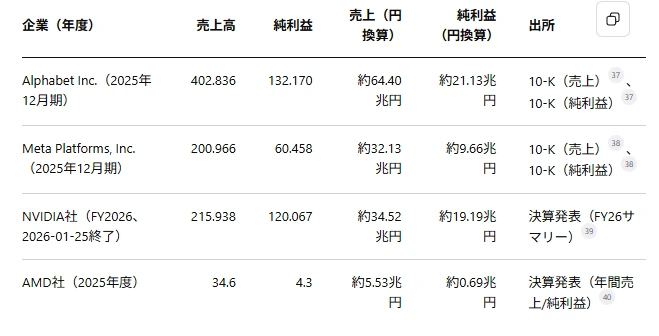
ここで重要なのは、NVIDIAの利益規模(純利益約19.2兆円相当)が、生成AI競争の“物理的供給側(GPU/ネットワーク/ソフト)”に著しく偏っていることだ。 OpenAIを含むモデル企業は、需要が伸びるほど計算資源費用が増え、“供給側”ほど利益率が出ない構造を抱えやすい(少なくとも短期的には)。
#非上場企業の推定値(注:非監査・run-rate中心)
#非上場のOpenAI/Anthropic/xAIは、監査済みの通期財務が原則公開されないため、報道ベースの年次換算(annualized/run-rate)を「参考値」として扱う。run-rateは課金体系や無料枠変更で大きく振れ得る点が指摘されているため、過信は禁物である。
#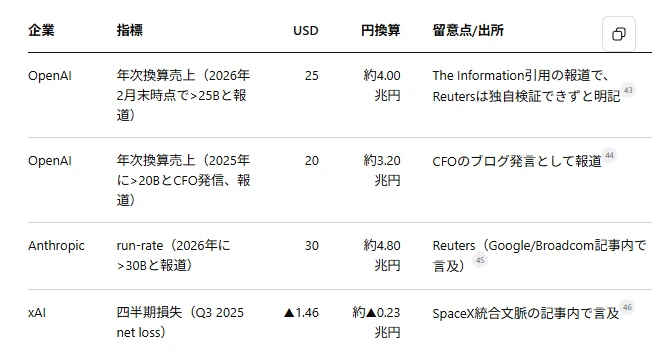
このレンジから読み取れるのは、「モデル会社の売上規模は急拡大し得るが、利益の帰着先は“供給側(GPU/電力/データセンター/専用チップ)”へ寄りやすい」という構造である。Googleが専用AIチップ開発を長期契約で強化し、同じくAnthropic向けにGoogleチップ由来の計算資源供給が報じられているのは、その“構造転換(NVIDIA一強→自社/共同設計へ)を示す。
#物理AI時代の含意
#物理AI(ロボティクス/エッジデバイス)は、生成AIの次の主戦場として急速に立ち上がりつつある。特徴は、(1)現実世界のセンサー入力、(2)リアルタイム性、(3)安全性、(4)クラウド学習とエッジ推論の分業が必須で、B2B導入は「工場・物流・医療・公共」など“規制と安全”が中心になりやすい点だ。
#プラットフォーム戦の構図
#- NVIDIA社は、ロボット開発基盤としてIsaac(ライブラリ/フレームワーク/モデル/参照ワークフロー)を提示し、AMR・マニピュレータ・ヒューマノイドまで射程に入れている。
さらにIsaac Sim(Omniverse上のロボティクスシミュレーション/合成データ生成)を“開発→検証→学習”の中心に置き、ROS互換の加速スタック(Isaac ROS)で実機側へ落とし込む。 エッジ側にはJetson Orinなどを用意し、キット価格まで含めて“開発者入口”を作っている。
- AMD社は、エッジAI向けにRyzen AI Embeddedを拡張し、TOPS(推論性能)やROCm対応などを打ち出している(量産時期も明記)。
これは「クラウドGPUの争奪」だけでなく、工場・現場での推論(低遅延/データ主権)へ計算資源が分散することを前提にした動きだ。
- Skild AIはPhysical AI should be omni-bodied(身体非依存)を掲げ、ロボット基盤モデルを志向している。
NVIDIAのケーススタディでは、Skild AIがNVIDIAの加速計算基盤を使い、異なるロボット身体への適応(ゼロ/最小の追加学習)を狙う訓練手法を述べている。
- Google DeepMindは、視覚言語行動(VLA)としてGemini Robotics 1.5を提示し、視覚情報+指示からモーターコマンドへ変換するモデル、さらに空間理解/計画に強いGemini Robotics-ER 1.5を掲げている。
産業側との連携も進み、Agile RobotsとGemini Robotics基盤モデルを組み合わせる提携を公表している。
- OpenAIは、Sora終了の報道において「ロボティクスを含む研究領域に注力」と言及され、B2B/開発者向けへ統合する“super-app”構想の文脈で、ロボティクスが並列に置かれている。
ただし現時点でOpenAIが物理AI向けに、GoogleのGemini RoboticsのようなVLAモデルを製品として公表している一次情報は限定的で、ここは“伸びしろである。
#物理AIの参照アーキテクチャ
#物理AIでは「クラウドで学習→シミュレーションで検証→エッジで推論→ログを戻して改善」という閉ループが重要になる。NVIDIAはこの閉ループをIsaac/Omniverse/Jetsonで縦に統合し、Googleはロボット基盤モデル+オンプレ(GDC)という形で、機密領域の配備形態も含めて取りに来ている。
#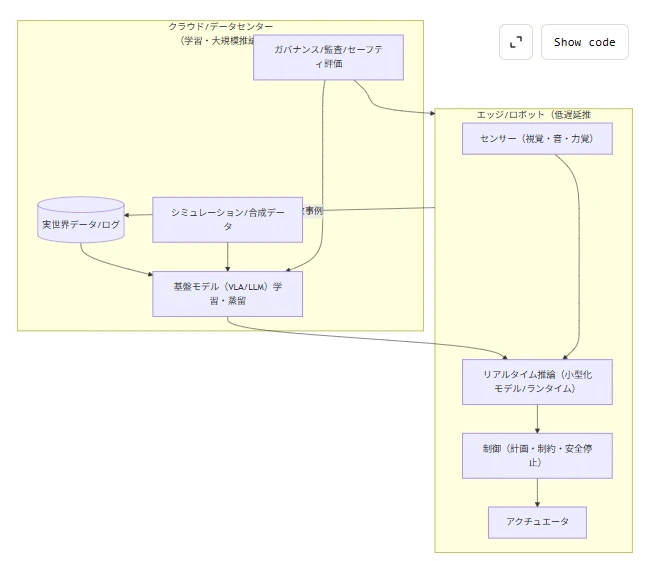
物理AIがB2Bに与える追加要件は、(i)オンプレ/空隙環境(防衛・重要インフラ)、(ii)安全認証/事故責任、(iii)サプライチェーン(チップ/電力/部材)依存であり、ここでOpenAIはNVIDIA/Google/Metaのような“縦統合や配布チャネル”が相対的に弱い。 一方でOpenAIはStargateを掲げてAIインフラ投資を進める姿勢を示しており、供給制約を緩和できれば“モデル側の優位”を物理AIへ延伸する余地はある。
#OpenAIへの戦略提言
#以下は、一次情報で確認できるOpenAIの方向性(企業向け集中、提携拡大、API/SDK再編、データレジデンシー強化、Sora終了による資源再配分)を前提に、「B2Bでの巻き返し」と「物理AI時代への布石」を同時に満たすための提言である。
#B2B巻き返しの中核戦略
#提言は“モデル性能”ではなく、“企業が本番運用できること”を製品の中心価値に据えることに尽きる。
#第一に、ロードマップの継続性を“契約可能な形”にする。 Sora終了は、企業側に「突然の終了リスク」を強く印象付けた。 OpenAIはAssistants APIの停止期限を明記するなど前進しているため、これを企業向け全機能(モデル、ツール、コネクタ、エージェント)に拡張し、「LTS(長期サポート)モデル」「非互換変更の移行ウィンドウ」「顧客側監査のための変更履歴」を標準化すべきである。
#第二に、エージェントの経済”に合わせて課金を再設計する。 OpenClaw事例が示した通り、常時稼働エージェントはサブスク想定を壊し、従量課金へ戻る圧力が強い。 OpenAIはBusinessで月額席課金(例:$25/月、年契約で$20/月)を明示しつつ、柔軟クレジット(deep research等)も併用している。 この“ハイブリッド”を企業導入の中心に据え、(a) 役割別(開発/非開発/運用)シート、(b) エージェント稼働分のコミット枠、(c) 高リスク操作(金融送金・基盤操作)の二段階承認をセットにした「エージェント運用パッケージ」として販売するのが合理的である(単なるトークン課金では調達が通りにくい)。
#第三に、導入経路を“業務システム側”へ寄せ、共同販売(co-sell)を拡張する。 OpenAIはコンサル大手との企業導入連合(Frontier Alliance)を組成し、業務プロセスにAIエージェントを組み込む支援を進めると報じられている。 さらにServiceNowとの複数年提携では、顧客が“個別開発なし”でフロンティアモデル機能にアクセスできることを狙っている。 この方向性を、ERP/CRM/ITSM/データ基盤へ横展開し、OpenAI単体売りから「既存業務の中に埋め込む売り方」へ完全に切り替えるべきだ。
#第四に、ソブリン/オンプレの空白を、製品ではなく「配備形態の選択肢」で埋める。 GoogleはGDC air-gapped上で生成AI/Vertex AIを提供し、オフライン環境の需要を取りに来ている。 OpenAIはデータレジデンシーと地域内GPU推論オプションを拡張しているが、競争上は「完全に切断された環境」への対応が残る。 ここでOpenAIが現実的に取れるのは、(i)既存クラウドのソブリン/専有環境(例:Azure Local等)との連携強化、(ii)政府・医療向け(Gov/Healthcare)の専用運用形態を増やす、(iii)モデルの一部をセルフホスト可能な形で提供(ライセンス/監査付き)する、のいずれかである。Gov/Healthcareの縦展開自体は既に一次情報があるため、残るのは「配備形態」をどこまで広げるかが差別化点になる。
#物理AI文脈での勝ち筋
#物理AIでは、OpenAIは“モデル会社”としての強みだけでは不十分で、ロボット開発の閉ループ(シミュレーション→実機→ログ→改善)を誰のプラットフォーム上で回すかが支配変数になる。
#提言は次の通り。
#- NVIDIA主導のロボット開発スタック(Isaac/ROS/Jetson)との正面連携:OpenAIがロボット向けモデル/エージェントを提供する場合、実機側の標準(ROS等)と検証基盤(シミュレーション)を避けて通れない。NVIDIAはその“開発面”を既に製品化しているため、OpenAIは競合するより公式対応で取り込む方が早い。
- GoogleのVLA(Gemini Robotics)に対抗するなら、公開ベンチではなく「産業タスクの安全・保証」で差別化:GoogleはVLAモデルと産業ロボ企業の提携を明確に進めている。
OpenAIは、ChatGPT/エージェントの運用知見(権限・監査・承認・トレーシング)を“物理タスク”へ移植し、事故責任(ログ・説明可能性)を製品価値に変えるべきである。
- ハード依存の多重化(NVIDIA一辺倒からの戦略的分散):Googleが専用チップを長期で強化し、Anthropic向けにもGoogleチップ計算資源が報じられる状況は、モデル企業が“計算資源の調達力”で差が付くことを示す。
OpenAIはStargateで大規模インフラを掲げるが、実装・資金・電力の制約がある以上、「GPU/専用チップ/エッジNPU」を横断する最適配置(学習・蒸留・推論)を前提にした製品設計が必要になる。
#最後に、OpenAIのフォーカス回帰は、B2Bにとっては好材料である。Sora終了は痛みを伴うが、逆に言えば「企業が買える形(コーディング・業務エージェント・統治)」に資源を寄せたということだ。 今後の勝敗は、Spud(次世代モデル)がどれほど強いかよりも、その能力を「安全に・監査可能に・継続的に」業務へ埋め込めるか、そして物理AIに向けてクラウドとエッジの閉ループを誰のプラットフォーム上で回すかにかかっている。
#サムネはNano Banana2
#