生成AIと各国の著作権と訴訟、ライセンス市場の比較と分析
この資料の日時
元資料の日付と、その本文が公に存在した確認日時は別の記録です。
出典・更新履歴・検証情報
この保存版のデータを照合するための情報です。元記事の初公開日とは区別しています。
- データセットの版
- 2026.09.23.4
- 記事内容のSHA-256
5709ddab965130455eb066c4e3ead673fec0893df4b7bc50aee7e46e59538bac- 保存版のSHA-256
d35ad0976e1b935069663fb549520026f8e8fbd9eaea71da2ab0041e5a743ef3
外部証明の最終検査結果は詳細を開くと表示します。
序論
#生成AIの開発は、その根幹において、膨大なデータセットの取り込みと分析に依存している。この「学習」プロセスは、必然的に著作権で保護された作品の大量複製を伴うため、著作権法が著作者に与える排他的権利と根本的な緊張関係を生じさせている。この対立は、技術革新の促進と創作者の権利保護という、著作権制度が本来両立を目指すべき二つの価値の間で、世界的な法的・政策的課題を提起している。
#本レポートでは、この複雑な問題構造を解き明かすため、二つの重要な分析段階を区別する。第一に「インプット段階」、すなわちAIモデルの開発・学習過程における著作物の利用であり、第二に「アウトプット段階」、すなわち学習済みモデルが新たなコンテンツを生成・利用する過程である 1。法的論点の多くは、前者のインプット段階の適法性に集中しており、本レポートもこの点を中心に議論を展開する。
#この課題に対する各国の対応は、その法哲学と産業政策を反映し、大きく分岐している。日本は、技術革新を優先する許容的な枠組みを採用する一方、欧州連合(EU)は、権利者中心の規制的アプローチを構築している。米国では、柔軟ながらも訴訟リスクの高い判例法主義に基づき、個別事案ごとに判断が下される。そして中国は、国家主導のトップダウン型規制と、その実効性との間に乖離が見られる。
#本稿は、まず日本の著作権法第30条の4を深掘りし、その特異な法的構造がAI開発とライセンス市場に与える影響を分析する。次に、EU、米国、中国の規制モデルを比較検討し、それぞれの法的・政策的アプローチの相違点を明らかにする。さらに、現在進行中の画期的な訴訟事例を詳細に検討し、法廷で争われている核心的論点を浮き彫りにする。最後に、これらの分析を統合し、ライセンス市場の形成、対価還元の仕組み、そして今後の政策的展望について、戦略的な示唆を提示することを目的とする。
#第I部 日本の枠組み – イノベーションを許容するアプローチ
#1.1 著作権法第30条の4の解体
#日本のAI開発における著作権問題の法的基盤は、2018年の著作権法改正で導入された第30条の4に集約される 。この「柔軟な権利制限規定」は、現在の生成AIブームに先立ち、ビッグデータ解析や技術開発を促進する目的で設けられたものである 。
#「非享受目的」の原則
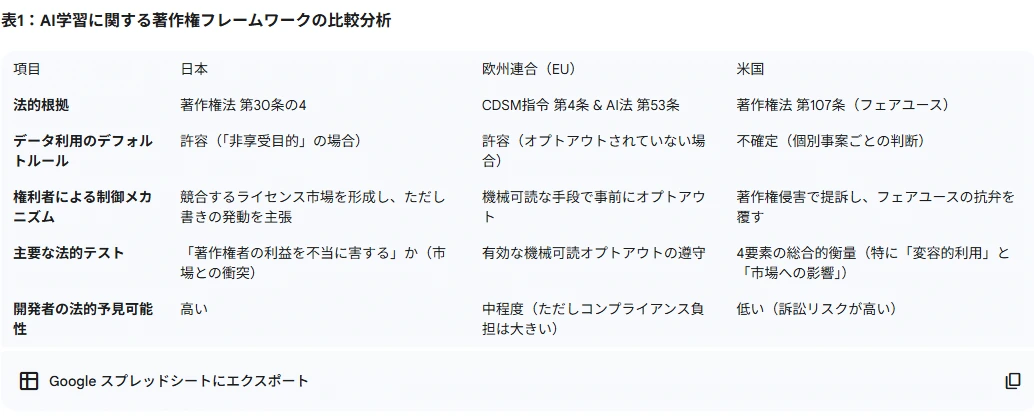
#本条の核心は、「著作物に表現された思想又は感情を自ら享受し又は他人に享受させることを目的としない場合」(非享受目的)には、原則として著作権者の許諾なく著作物を利用できると定めた点にある 。AIの学習は、人間が作品を鑑賞するのではなく、機械がデータから統計的パターンを抽出する行為であるため、「非享受目的」の典型例と解釈されている 。
#インプットとアウトプットの分離
#文化庁の公式な考え方によれば、「享受」目的の有無は、問題となる利用行為そのものの段階で判断される 。したがって、最終的にAI生成物を人間が鑑賞する目的があったとしても、その前段階であるAIの学習行為(情報解析のためのデータ複製)自体は、非享受目的であると評価される。この法解釈は、AI開発のインプット段階とアウトプット段階を明確に分離し、開発者に対して強力な法的保護を与えるものである。
#適用範囲と限界
#本条の適用は「必要と認められる限度において」とされているが、この要件は広く解釈される傾向にある。例えば、大規模言語モデル(LLM)の学習に膨大な量の著作物が必要であるという事実自体をもって、直ちに「必要と認められる限度」を超えると評価されるものではない 。これにより、開発者は大規模なデータセットを比較的安心して利用することが可能となっている。
#1.2 セーフティバルブとしてのただし書き – 「不当に利益を害する場合」のテスト
#第30条の4は、非享受目的の利用を原則として許容する一方で、その例外として「ただし、当該著作物の種類及び用途並びに当該利用の態様に照らし著作権者の利益を不当に害することとなる場合は、この限りでない」という「ただし書き」を設けている 。この規定は、権利者の利益とのバランスを図るためのセーフティバルブとして機能する。
#「不当な利益侵害」の定義
#「著作権者の利益を不当に害する」か否かの判断基準は、その利用行為が「著作権者の著作物の利用市場と衝突するか、あるいは将来における著作物の潜在的な販路を阻害するか」という観点から、個別具体的に判断される 。これは、創作のインセンティブを損なうような直接的な経済的損害が発生するかどうかに焦点を当てたテストである。
#アイデアと表現の二分論との区別
#留意すべきは、このただし書きが、AIが学習元データと類似した作風やアイデアの作品を生成することによって発動されるわけではないという点である。著作権法は具体的な「表現」を保護するものであり、抽象的な「アイデア」や「作風」は保護の対象外である(アイデア・表現二分論。したがって、AI生成物が学習元著作物の創作的表現そのものを複製・翻案しない限り、作風が似ているというだけでは、通常、著作権者の市場と衝突するとは見なされず、「不当な利益侵害」には該当しないと整理されている。
#1.3 確立されたライセンス市場の影響
#第30条の4のただし書きが実際に適用される最も典型的なシナリオは、AI学習用のデータについて、既に商取引(ライセンス市場)が成立している場合である。この場合、無許諾での利用は既存の市場と直接衝突し、権利者の経済的利益を不当に害すると判断される可能性が極めて高い。
#文化庁の考え方に示された具体例
#文化庁が公表した「AIと著作権に関する考え方について」では、ただし書きに該当しうる具体的なケースがいくつか例示されている。
#- ケース1:情報解析用データベースの無断複製
- 大量の情報をAIによる情報解析に活用しやすい形で整理したデータベースの著作物が有償で販売されている場合に、ライセンス契約を結ばずに当該データベースを複製する行為。これは、権利者が設定したライセンス市場を直接的に侵害する最も明確な例である。
- ケース2:有料APIの迂回
- ウェブサイトが閲覧用のコンテンツとは別に、情報解析用に整理されたデータへアクセスするための有料APIを提供している場合に、そのAPIを利用せず、ウェブサイト上の閲覧用データをスクレイピングして、有料APIから得られるデータと同様のものを構築する行為。これもまた、権利者が構築したデータ提供市場を迂回し、フリーライドする行為として、ただし書きに該当する可能性が高い。
- ケース3:技術的措置の回避
- ウェブサイトがrobots.txtなどを用いてAI学習のための複製を防止する技術的措置を講じており、かつ、その事実や過去のデータ販売実績などから、将来的に情報解析用データベースを販売する蓋然性が高いと推認される場合に、その技術的措置を回避してデータを収集する行為。これは、権利者の「将来における潜在的な販路を阻害する」行為と評価され、ただし書きに該当しうると考えられる。
「データベースの著作物」の重要性
#これらのシナリオが適用される前提として、利用対象となるデータベースが、単なるデータの集合体ではなく、「その情報の選択又は体系的な構成によつて創作性を有する」ものとして、著作権法上の「データベースの著作物」に該当する必要がある。創作性が認められない単なるデータベースの場合、そもそも保護されるべき著作物が存在しないため、ただし書きの議論には至らない。
#1.4 日本の国家AI戦略とクリエイターへの対価還元
#日本政府は、米国や中国と比較して国内のAI開発、特に基盤モデル開発が遅れていることに強い危機感を抱いており、これを国家戦略の重要課題と位置づけている。この背景から、近年、AIの「促進」と「規律」の両面を企図した法整備と政策的支援が急速に進められている。
#AI新法案の制定
#現在国会で審議中のAIに関する新たな法案(通称「AI新法案」)は、EUのAI法がリスク規制に重点を置くのとは対照的に、AI開発の「促進」を明確な目的の一つに掲げている点が特徴である 。この法案は、AIに関する国の基本計画を策定し、それに基づいて研究開発支援、データセンターなどのインフラ整備、人材育成を強力に推進することを目指している 。これは、日本の国際競争力を強化するための法的基盤を整備する試みである。
#「著作物等データセットの流通促進に係る環境構築事業」
#クリエイターへの対価還元と質の高い学習データの確保という二つの課題に対応するため、政府は「著作物等データセットの流通促進に係る環境構築事業」を立ち上げた。これは、次節で詳述する市場の機能不全に対する直接的な政策介入である。この事業は、権利処理が済んだ質の高いデータセットをAI開発者が円滑に利用できるよう、ライセンス契約を仲介・管理する集中的、あるいは分散的なプラットフォームや仕組みを構築することを目的としている。これにより、クリエイターが自身の著作物をAI学習用に提供し、正当な対価を得るための市場を創出することを目指している。
#1.5 日本の市場の遅れの分析
#日本の著作権法第30条の4は、AI開発者に高い法的安定性を提供し、イノベーションを促進するために設計された。しかし、その許容的な性質が、逆説的にAI学習用データの民間ライセンス市場の発展を阻害するという、意図せざる結果を招いている。
#この現象は、以下のような連鎖的思考によって説明できる。
#- 第30条の4は、AI開発者が公開されているデータを学習に利用する際の著作権侵害訴訟のリスクを大幅に低減させる。これにより、開発者は許諾を得るためのライセンス料を支払う強い動機を持たない。
- 対照的に、米国ではフェアユースの法理が曖昧で訴訟リスクが高く、EUではAI法やDSM指令によるコンプライアンス義務が重いため、AI開発者はリスク回避の手段として積極的にライセンスを求めるインセンティブが働く。
- 日本の法制度では、第30条の4のただし書きが発動し、無断学習が違法となるのは、ライセンス市場が「既に存在し、その市場が害される」場合である 13。これは「鶏が先か、卵が先か」という問題を生じさせる。つまり、開発者が合法的に無料でデータを入手できる状況では、権利者が多大なコストをかけてライセンス市場を構築する動機が生まれにくい。そして、市場が存在しない限り、ただし書きによる保護は機能しない。
- この結果、開発者は支払う必要性を感じず、権利者は対価を求める有効な手段を持たないという「市場の失敗」が生じる。これが、日本の民間AI投資額が米中両国に比して著しく低い一因であり、政府がトップダウンで市場構築を試みる「著作物等データセットの流通促進に係る環境構築事業」のような政策介入を必要とする根本的な理由である。
第II部 国際的な規制モデルの比較分析
#2.1 欧州連合 – 権利者中心の規制的アプローチ
#EUは、AIの潜在的リスクを管理し、個人の基本的権利を保護することを重視する、包括的かつ規制的なアプローチを採用している。この哲学は、AIと著作権の関係においても明確に反映されている。
#AI法における著作権関連の義務
#EU AI法は、AIシステムをリスクレベルに応じて分類し、規制する枠組みである。特に、汎用AI(GPAI)モデルの提供者に対しては、著作権に関連する特定の義務を課している。同法第53条は、GPAI提供者に対し、以下の事項を義務付けている。
#- EU著作権法、特に後述のTDM例外における権利者の権利留保(オプトアウト)を特定し、遵守するための方針を整備・実施すること。
- モデルの学習に使用されたコンテンツの「十分に詳細な」要約を公に利用可能にすること。これにより、権利者は自身の作品が利用されたか否かを確認する透明性が確保される。
- 下流のAIシステム提供者に対し、詳細な技術文書を提供すること。
DSM指令のTDM例外とオプトアウト制度
#EUにおけるAI学習の法的根拠は、「デジタル単一市場における著作権指令」(CDSM指令)に定められたテキスト・データマイニング(TDM)例外である。
#同指令第4条は、商業目的を含む一般的なTDMのための著作物複製を例外的に認めているが、これには重大な条件が付されている。すなわち、権利者は「機械可読な手段など、適切な方法で」自身の権利を「明示的に留保する」(オプトアウトする)ことができる。権利者がオプトアウトの意思表示を行った場合、TDM例外は適用されず、その著作物の利用には許諾が必要となる。
#しかし、この制度は運用上の大きな課題に直面している。オプトアウトの意思表示に標準化されたフォーマットが存在しないため、権利者とAI開発者の双方に混乱が生じている。また、EU域外でデータ収集(スクレイピング)が行われた場合に、EU市場でAIモデルが提供されたとしても、オプトアウトの効力が法的に及ぶかは不明確であり、越境執行の課題が指摘されている。欧州委員会は、これらの問題を解決するため、中央集権的な権利留保登録簿の創設などを検討している。
#EUのモデルは、権利者に自身の作品の利用を拒否する権利を積極的に与える「オプトアウト」方式をデフォルトとしている。これは、権利者が市場を形成して初めて保護が機能する日本の「ただし書き」や、事後的な司法判断に委ねられる米国のモデルとは対照的であり、イノベーションと権利保護のバランスを取ろうとする政治的妥協の産物であるが、その実効性には依然として不確実性が残る。
#2.2 米国 – フェアユースの法理による司法判断
#米国では、AI学習の適法性は、成文法による明確な規定ではなく、判例法理である「フェアユース(公正な利用)」を通じて、個別事案ごとに判断される。この柔軟な法理は、技術革新に対応する余地を残す一方で、開発者に高い法的予測不可能性と訴訟リスクをもたらしている。
#フェアユースの4要素(合衆国法典第17編第107条)
#フェアユースの判断は、法律に定められた以下の4つの要素を総合的に衡量して行われる。
#- 利用の目的と性格: 利用が商業的か非営利的か、そして「変容的(transformative)」な利用か否か。
- 著作物の性質: 利用された著作物が事実に基づくものか、創造性の高いものか。未公表か公表済みか。
- 利用された部分の量と実質性: 著作物全体との関係で、利用された部分の量的な割合と質的な重要性。
- 利用が著作物の潜在的市場または価値に与える影響: 新たな利用が、原著作物の市場を代替し、損害を与えるか否か。
「変容的利用」の法理:Google BooksからWarholへ
#AI開発者がフェアユースを主張する際の中心的論点が、「変容的利用」である。
#- 拡大解釈(Authors Guild v. Google): 2015年の第二巡回区控訴裁判所判決は、Googleが図書館の蔵書を大規模にデジタル化し、検索可能なデータベースを構築した行為を「高度に変容的」なフェアユースと認定した 。この利用は、原著作物の目的(書籍を読むこと)とは異なり、書籍に関する情報を提供すること(検索)を目的としており、原著作物の市場を代替するものではないと判断された。この判決は、AI学習もまた、コンテンツを消費するのではなく、新たなツールを創出するための変容的かつ非表現的な利用であるとするAI開発者側の主張の法的根拠となってきた。
- 限定的解釈(Andy Warhol Foundation v. Goldsmith): しかし、2023年の最高裁判所判決は、変容的利用の判断枠組みを大幅に限定した。最高裁は、フェアユースの分析は、問題となっている具体的な「利用」に焦点を当てるべきだと判示した。二次的著作物が、原著作物と「実質的に同じ」商業的目的で利用される場合(Warhol事件では、ウォーホルの作品も元の写真も、共に雑誌にプリンスの肖像としてライセンスされた)、たとえ芸術的に独創的な変更が加えられていても、フェアユースとは認められにくくなる。
このWarhol判決は、フェアユース分析の重心を第4要素(市場への影響)へと大きくシフトさせた。これはAI開発者にとって深刻な挑戦を意味する。AIの学習プロセス自体は目的において変容的(ツール作成 vs コンテンツ消費)かもしれないが、そのツールが生み出す「アウトプット」が学習元データと直接競合する(例:AI生成画像がストックフォトと、AI生成音楽が人間の楽曲と競合する)場合、裁判所は、その利用全体が原著作物の市場を害するものであり、したがってフェアユースではないと判断する傾向を強める可能性がある。この解釈の転換が、第III部で論じる訴訟の背景にある。
#2.3 中国 – 厳格なルールと運用の現実との乖離
#中国は、国家の統制下でAI産業の発展を強力に推進する一方、生成AIサービスに対して迅速かつ包括的な規制を導入している。しかし、その厳格な規定と、実際の市場における運用との間には、しばしば大きな隔たりが見られる。
#主要な規制の概要
#「生成AIサービス管理暫定弁法」や「インターネット情報サービス深度合成管理規定」といった一連の規則は、サービス提供者に対して明確な義務を課している。
#- 適法なソースからのデータを使用すること。
- 知的財産権及び商業道徳を尊重すること。
- 他者の権利(著作権、肖像権、プライバシー権など)を侵害しないこと。
- AIによって生成されたコンテンツにはラベルを付与すること。
これらの規定は、表面的には知的財産権の保護を強く謳っている。
#運用の実態(Disney et al. v. MiniMax)
#しかし、ハリウッドの主要スタジオが中国のAI企業MiniMax社を相手取って米国で提訴した事件は、中国のルールと市場の現実との乖離を象徴する事例である。訴状によれば、MiniMax社が提供するAIサービス「Hailuo AI」は、大規模かつ「意図的で厚顔無恥な」著作権侵害を行っていたとされる。具体的には、
#- スタジオが著作権を持つ映画やキャラクターの海賊版を用いてAIモデルを学習させた。
- ユーザーがダース・ベイダーやワンダーウーマンといった著名なキャラクターの高画質な画像や動画を生成できるようにした。
- 侵害コンテンツを自社の広告に利用し、「ポケットの中のハリウッドスタジオ」と称して積極的にマーケティングを行った。
この訴訟は、中国企業による侵害行為に対し、権利者がより強力な知財保護と執行力を持つ米国の法廷で救済を求めるという戦略を浮き彫りにしている。中国国内の規制が建前上は包括的であっても、その実効的な運用が伴わない場合、グローバルな知的財産リスクを生み出し、権利者はAIサービスが利用可能な市場で訴訟を提起せざるを得なくなる。この状況は、OpenAIのSoraなどと競合するKling AIのような他の中国発AIサービスにとっても、潜在的な法的リスクを示唆している。
##
表1:AI学習に関する著作権フレームワークの比較分析
#
#
第III部 法廷闘争 – 画期的な訴訟と核心的論点
#3.1 「インプット」論争 – 学習行為そのものは侵害か?
#AIを巡る著作権訴訟の中心的な争点は、学習データとして著作物を利用する「インプット」行為が、それ自体で著作権侵害を構成するか否かである。米国では、この問いに対する答えがフェアユースの法理を通じて形成されつつある。
#実践における変容的利用の抗弁(Bartz v. Anthropic & Kadrey v. Meta)
#カリフォルニア州北部地区連邦地方裁判所が下した一連の判決は、LLMの学習に対するフェアユースの抗弁を司法が初めて本格的に審査した事例となった 。Bartz v. Anthropic事件とKadrey v. Meta事件の両方で、裁判所は著作権で保護された書籍をAIモデルの学習に利用した行為を、「典型的な」あるいは「高度に」変容的な利用であると認定した 。
#その論理は、AIの学習を、人間が言語や文体を学ぶために本を読む行為になぞらえるものである 。その目的は、元の書籍を再出版したり代替したりすることではなく、言語を生成できる新たなツールを創造することにあるとされた。これらの判決において決定的に重要だったのは、原告側が、AIの「アウトプット」が著作権を侵害していることや、具体的な市場への損害を立証する証拠を提出できなかった点である。裁判所は、もし市場の希薄化を示すより強力な証拠があれば、判断は異なっていた可能性を示唆している 。
#データ来歴の決定的役割(Anthropic事件における海賊版問題)
#Anthropic事件は、学習データの来歴という極めて重要な論点を提起した。すなわち、合法的に入手されたデータ(購入されデジタル化された書籍)と、「海賊版ライブラリ」から入手されたデータとの区別である。
#裁判所は、LLMの学習自体は変容的なフェアユースであるとしつつも、海賊版コピーを入手し、「中央ライブラリ」を構築するために保持する行為はフェアユースでは「ない」と判断した。海賊行為そのものは、正規のコピーの市場を直接的に害する非変容的な行為である。
#この判決は、学習データのソースが単なる背景情報ではなく、フェアユース分析において決定的な要因となりうることを示唆している。AI開発者のフェアユースの抗弁は、その基盤が大規模な著作権侵害の上になりたっている場合、著しく弱体化する。これは、開発者が合法的に入手したデータセットを利用する強い動機付けとなり、ライセンス市場の正当性を補強するものである。
#競合製品に対する反証(Thomson Reuters v. ROSS Intelligence)
#この事件は、AIとフェアユースに関する議論に重要な対照的視点を提供する。裁判所は、法律情報サービスWestlawが著作権を持つヘッドノート(判例要旨)を学習データとして開発されたAI法律調査ツールROSSについて、フェアユースの抗弁を「棄却」した。
#裁判所は、ROSSの利用がWestlawと全く同じ目的、すなわち競合する法律調査ツールを作成するために行われたため、変容的ではないと判断した。ROSSは市場においてWestlawを直接代替するものであった。裁判所は、ROSSが生成AIではないことを明確に指摘したが、この区別は重要な原則を浮き彫りにする。すなわち、AIツールがその学習データのソースとなった製品と直接的に競合すればするほど、フェアユースの抗弁は弱くなる。これは、特定の専門分野の専有データを学習させた特化型AIモデルにとって、重大な意味を持つ。
#3.2 「アウトプット」論争 – regurgitation、市場代替、および市場への損害
#訴訟のもう一つの主要な戦線は、AIモデルの「アウトプット」が引き起こす著作権侵害と経済的損害に関するものである。ここでは、学習行為の適法性とは別に、生成されたコンテンツそのものが問題となる。
#The New York Times v. OpenAI
#この訴訟は、議論の焦点を学習行為の適法性から、モデルの出力がもたらす有害な影響へとシフトさせた 。ニューヨーク・タイムズ社の中心的な主張は、ChatGPTが同社の記事を逐語的またはほぼ逐語的に「regurgitate(吐き出す)」することがあり、これによりユーザーが有料の購読契約を回避できてしまうという点にある。これは、購読料やライセンス収入に損害を与える直接的な市場代替を構成するとされる。この主張は、最高裁のWarhol判決の論理を直接的に活用し、フェアユース第4要素である「潜在的市場への影響」に焦点を当てている。タイムズ社は、たとえ学習が変容的であったとしても、その結果生み出された製品が原著作物と直接競合し、その価値を毀損すると主張している。
#音楽業界の攻勢(RIAA v. Suno & Udio)
#大手レコード会社がAI音楽生成サービスSunoとUdioを提訴した一連の訴訟は、多角的な攻撃戦略を示している 。
#主たる訴えは、許諾なく膨大な著作権保護下の楽曲ライブラリをAIモデルの学習に使用したことによる大規模な著作権侵害である。
#しかし、より注目すべきは、レコード会社側が訴状を修正し、デジタルミレニアム著作権法(DMCA)違反の訴えを追加した点である。彼らは、AI企業がYouTubeのようなプラットフォームから「ストリームリッピング」によって学習データを取得したと主張している。これは、ダウンロードを防止するために設計された技術的保護手段(TPM)を回避する行為にあたる。
#DMCAに基づくこの新たな主張は、戦況を一変させる可能性を秘めている。なぜなら、TPMの回避は、その後のコンテンツ利用がフェアユースに該当するか否かとは無関係に、それ自体が独立した違法行為(合衆国法典第17編第1201条違反)だからである。もし裁判所が、学習データ取得のためのストリームリッピングがDMCAに違反すると判断すれば、それはフェアユースを巡る複雑な議論を迂回する強力な法的武器を権利者に与えることになり、AI企業のデータ収集慣行の正当性を根底から揺るがすことになるだろう。
#第IV部 今後の展望 – ライセンス、対価還元、および政策的見通し
#4.1 AIライセンスのアーキテクチャの出現
#法的な不確実性と訴訟リスクの高まりに直面し、AI開発者と権利者の間では、フェアユースの議論を超えた市場ベースの解決策、すなわちデータライセンス契約の模索が始まっている。特に音楽業界や出版業界では、この動きが顕著である。
#進化する契約形態
#現在形成されつつあるライセンス契約の形態は多岐にわたる。
#- 一括払い/一時的なライセンス料: 過去の作品カタログをAI学習に利用する権利に対する対価として支払われる。
- レベニューシェアモデル: AIサービスから得られる収益の一部を権利者が受け取る仕組み。ストリーミングサービスのマイクロペイメント(再生毎の支払い)をモデルとすることが多い。
- 株式持ち分: ライセンス契約の一環として、音楽レーベルや出版社がAIスタートアップの株式を取得する。
- 「倫理的AI」のためのパートナーシップ: 許諾済みのデータのみを用いて新たなAIモデルを共同で構築する提携。
法的リスクが増大するにつれ、倫理的に調達され、完全にライセンス許諾された学習データを持つAI企業は、競争上の著しい優位性を得る可能性がある。リスク回避を重視する大口の法人顧客に対し、自社サービスを「法的に安全」なものとして売り込むことができ、プレミアム価格の設定や投資の誘致につながるだろう。実際に、AI音声技術企業のElevenLabsが独立系音楽レーベルの権利団体Merlinや音楽出版社Kobaltと契約を締結した例は、この動きが既に始まっていることを示している。
#4.2 アトリビューション(帰属表示)という技術的要請
#ライセンス交渉において権利者側が強く要求しているのが、YouTubeのContent IDに類似した、堅牢なアトリビューション技術の開発である。これにより、AIのアウトプットにおいて自らの作品がどのように利用されたかを追跡することが可能になる。
#技術的・概念的ハードル
#これは技術的に極めて困難な課題である。同一または酷似したコピーを照合するContent IDとは異なり、生成AIはデータを統計的なパターンへと変換する。全く新しいAI生成物が、どの特定の学習データから影響を受けたかを特定することは、計算論的にも概念的にも複雑である。
#新たな解決策の模索
#この課題に対し、特定の出力に対する各学習データの影響度を定量化しようとするデータアトリビューションアルゴリズム(例:シャープレイ値)や、来歴記録の標準規格と分散型技術を組み合わせたContent ARCsのようなフレームワークが提案されている。しかし、これらの技術はまだ初期の研究開発段階にある。
#4.3 音楽ストリーミング経済からの教訓
#AIの対価還元モデルを構築する上で、音楽ストリーミング経済の進化は、重要かつ警鐘に満ちた先例となる。
#この歴史的経緯は、AIの対価還元モデルが直面するであろう課題を示唆している。
#- 音楽業界がストリーミングへと移行した際、プラットフォーム(Spotifyなど)と大手レーベルとの間で交わされたライセンス契約は、複雑で不透明なものであった。
- この不透明性は、アーティストへの収益分配を巡る論争を引き起こした。特に、特定の楽曲再生に紐付かない収益、例えばプラットフォームがレーベルに支払う最低保証金の前払い(アドバンス)や、その未回収分である「ブレークエイジ(breakage)」の分配方法が問題となった。
- 多くのアーティストは、自身の楽曲が高い再生回数を記録しているにもかかわらず、ストリーミングから得られる印税が、物理メディア時代の契約に基づく未回収のアドバンスの返済に充当され、新たな収入がほとんど得られないという現実に直面した。
- この歴史は、AIライセンス契約が締結される際に、その経済的利益が企業レベルの権利者(レーベル、出版社)に集中し、個々のクリエイターにまで効果的に「トリクルダウン」しないリスクが非常に高いことを示している。「ブレークエイジ」論争の再燃を避けるためには、契約の初期段階から、透明性が高く、公平な収益分配メカニズムを組み込むことが不可欠である。
4.4 結論と戦略的提言
#グローバルトレンドの統合
#本レポートの分析から明らかなように、生成AIと著作権を巡る問題に対し、世界は単一の解決策に収斂するのではなく、それぞれ異なる規制・法体系を持つブロックへと分断されつつある。米国は高リスク・高リターンの訴訟主導の場となり、EUは高コストのコンプライアンスが求められる市場へ、そして日本は国家が主導して市場を創出するモデルへと向かっている。
#ライセンスへの不可逆的なシフト
#日本の許容的な法制度や、米国で続くフェアユースを巡る法廷闘争にもかかわらず、世界的な潮流は不可逆的にライセンス契約へと向かっている。訴訟リスク、EUからの規制圧力、そして法的に保証されたAI製品を求める市場の需要が相まって、無許諾でのAI学習は、主要な商業プレイヤーにとって長期的に維持不可能な戦略となりつつある
#生成AIと著作権:日米欧の法規制と市場の行方—NYT訴訟と日本の「追い風」のジレンマを深掘り
#記事 gemini2.5pro DeepResearch サムネ nanobanana
#